Upgrade to Pro — share decks privately, control downloads, hide ads and more …

DEVOXX 2016 - Analytics et Big Data, une histoi...

DEVOXX 2016 - Analytics et Big Data, une histoire de cubes...

Mathias Kluba
et
Mehdi BEN HAJ ABBES
@MehdiAbbes

Avatar for Mathias Kluba

Mathias Kluba

April 21, 2016

More Decks by Mathias Kluba

Other Decks in Programming

Transcript

  1. 1

  2. 2 Mathias Kluba Architecte Big Data au sein de la

    Société Générale Mehdi BEN HAJ ABBES Architecte Technique Big Data @MehdiAbbes
  3. 4

  4. 7

  5. 8

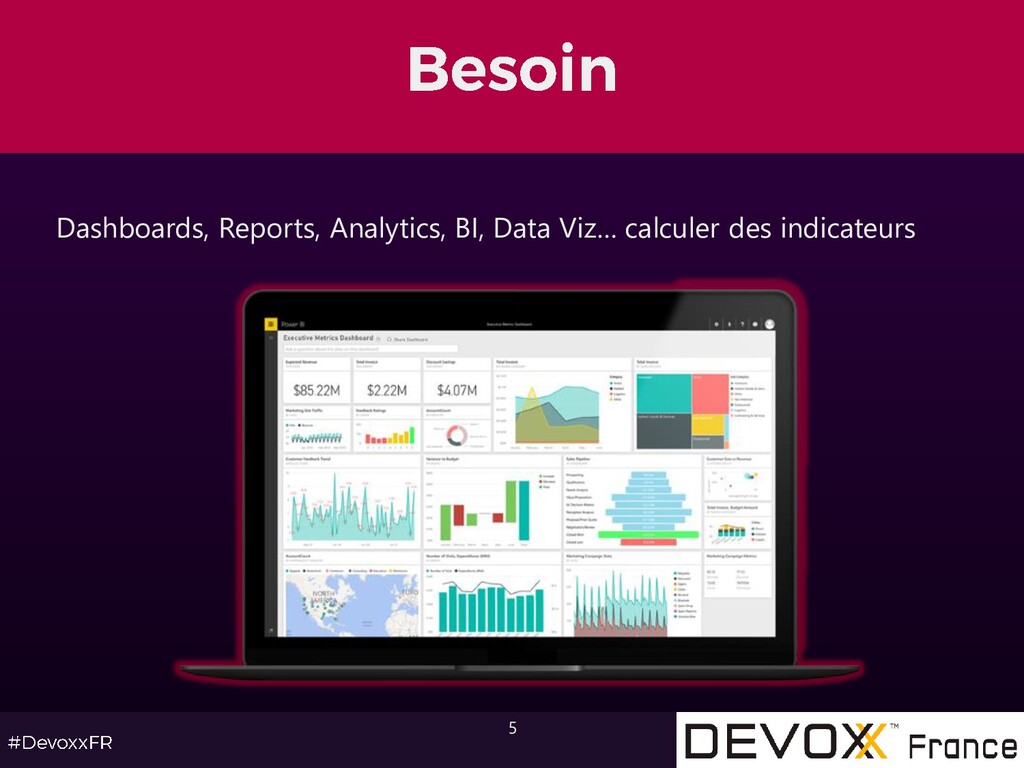
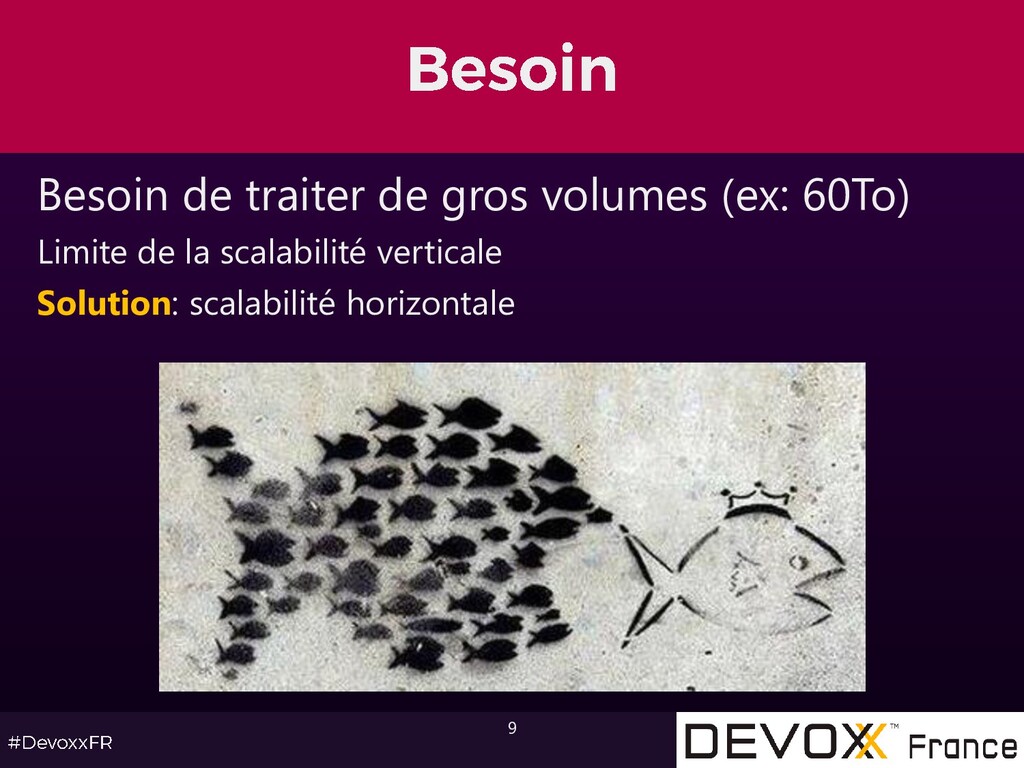
  6. 9 Besoin de traiter de gros volumes (ex: 60To) Limite

    de la scalabilité verticale Solution: scalabilité horizontale
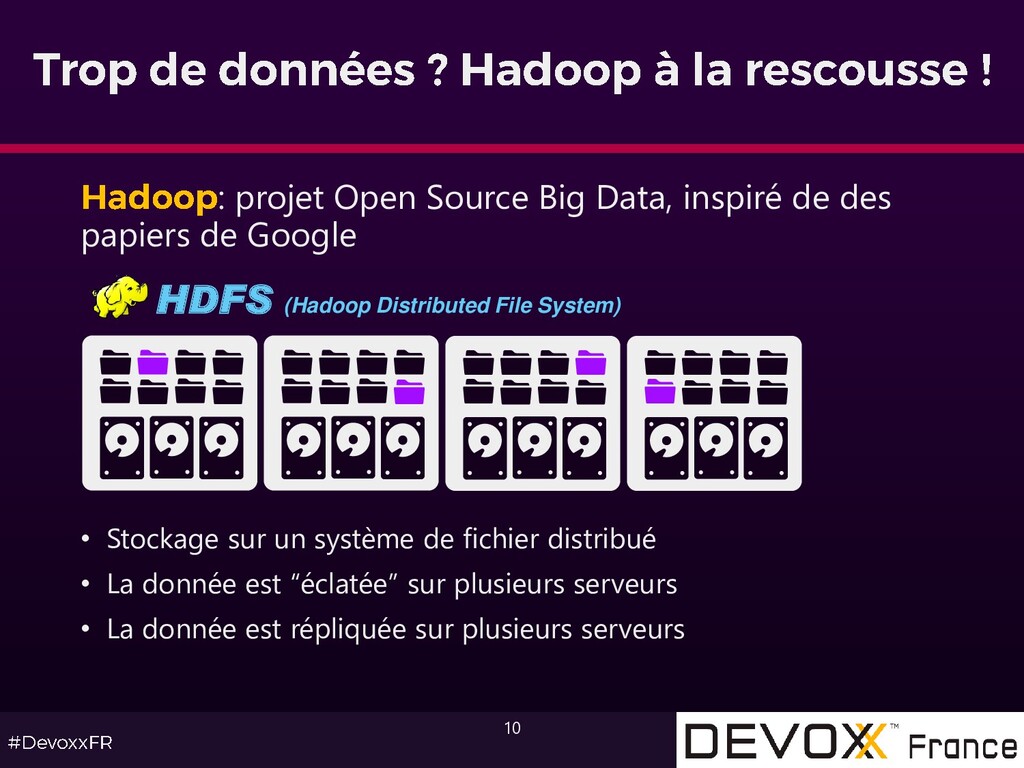
  7. 10 : projet Open Source Big Data, inspiré de des

    papiers de Google • Stockage sur un système de fichier distribué • La donnée est “éclatée” sur plusieurs serveurs • La donnée est répliquée sur plusieurs serveurs HDFS (Hadoop Distributed File System)
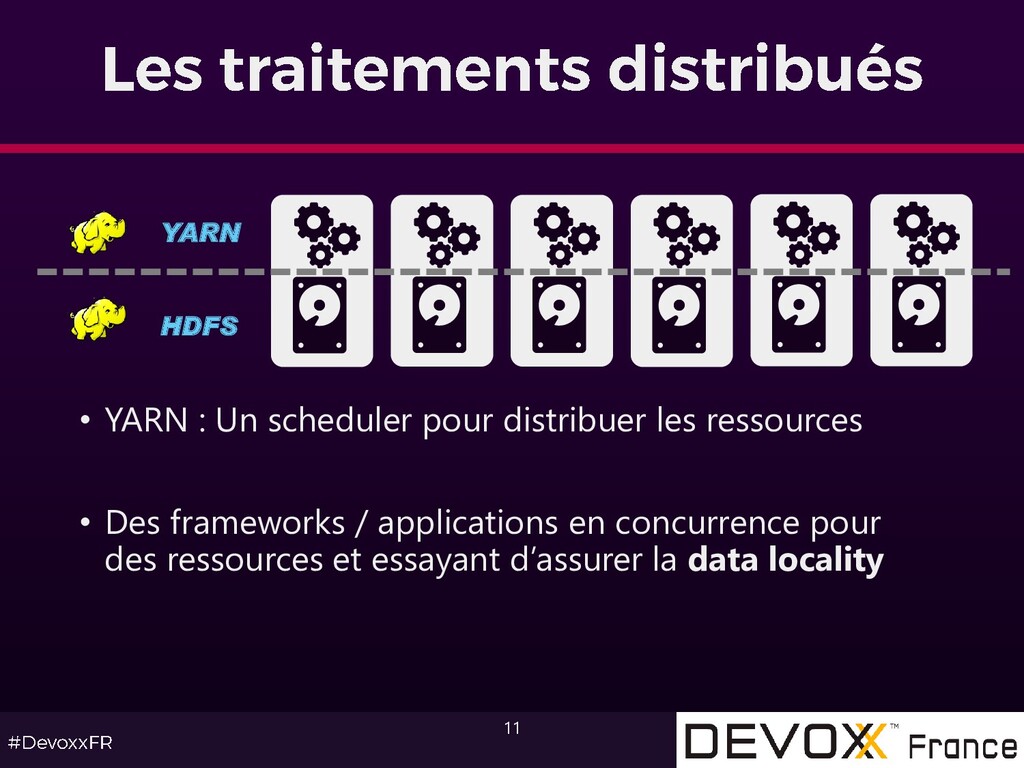
  8. 11 • YARN : Un scheduler pour distribuer les ressources

    • Des frameworks / applications en concurrence pour des ressources et essayant d’assurer la data locality HDFS YARN
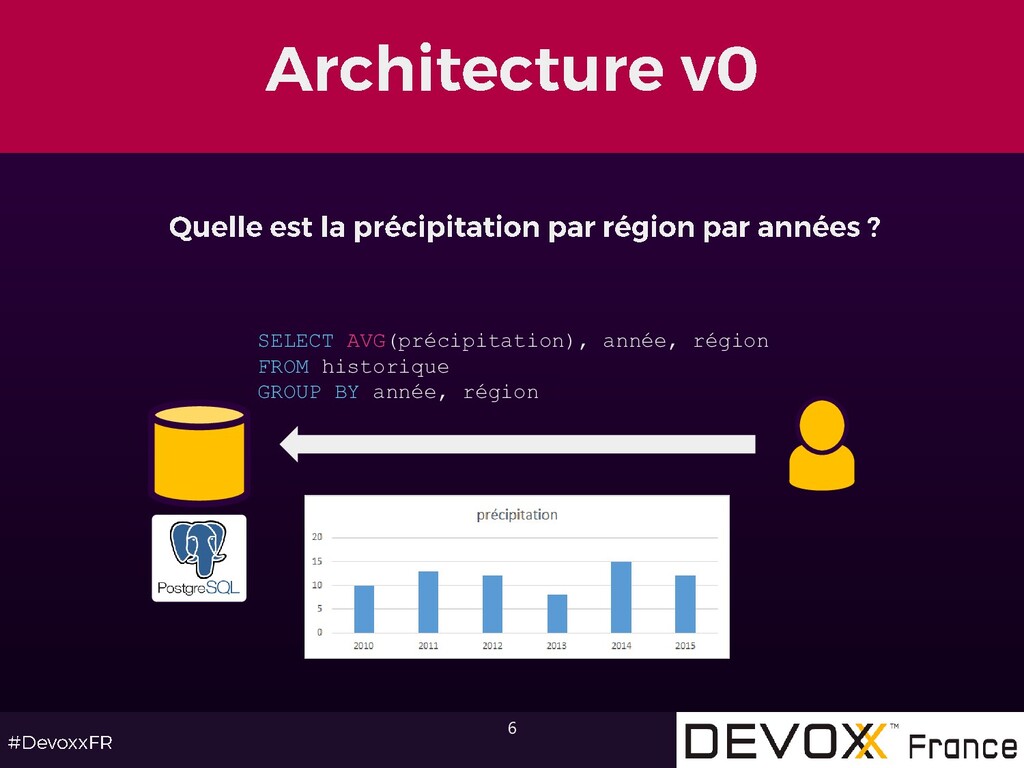
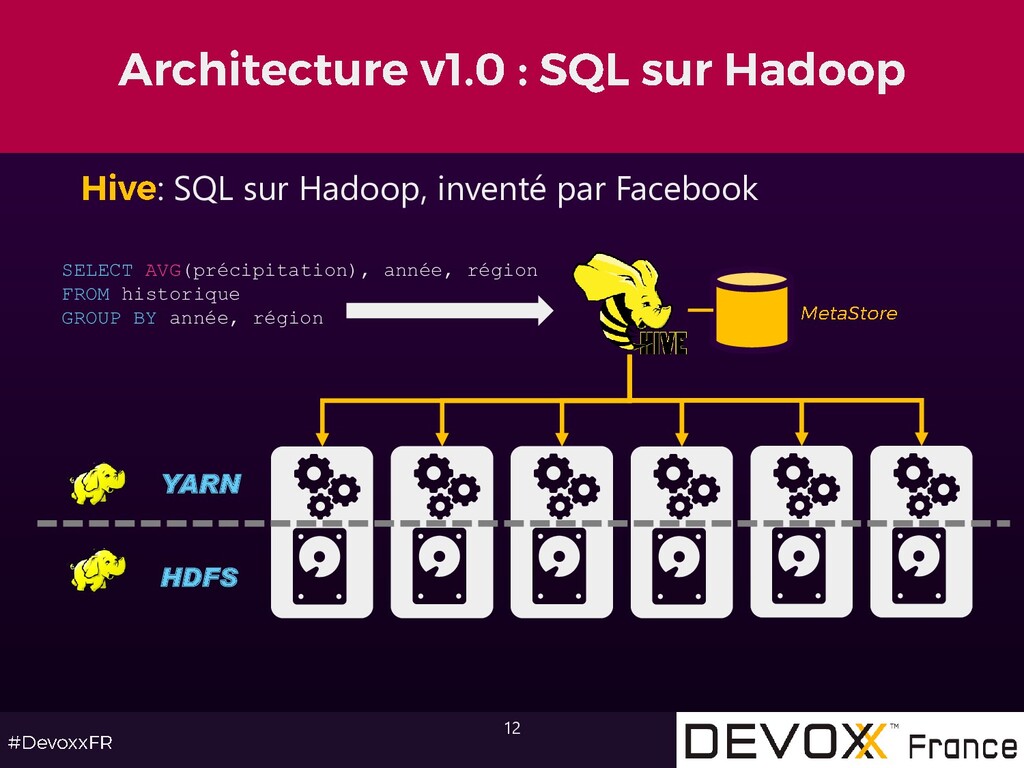
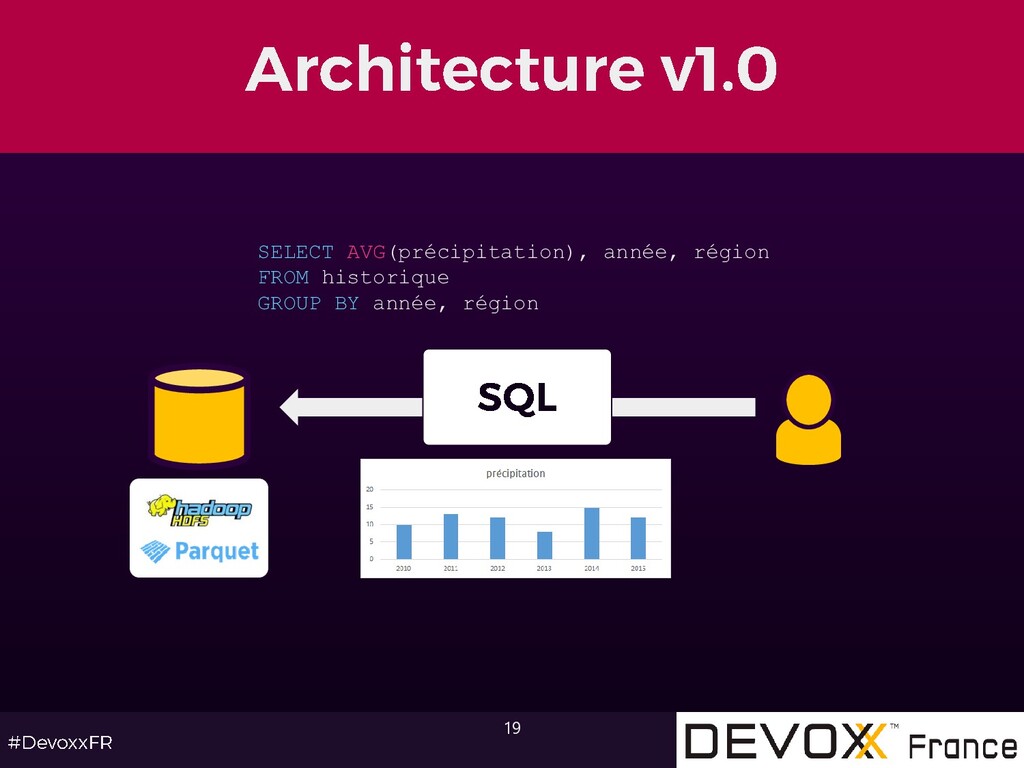
  9. 12 : SQL sur Hadoop, inventé par Facebook HDFS YARN

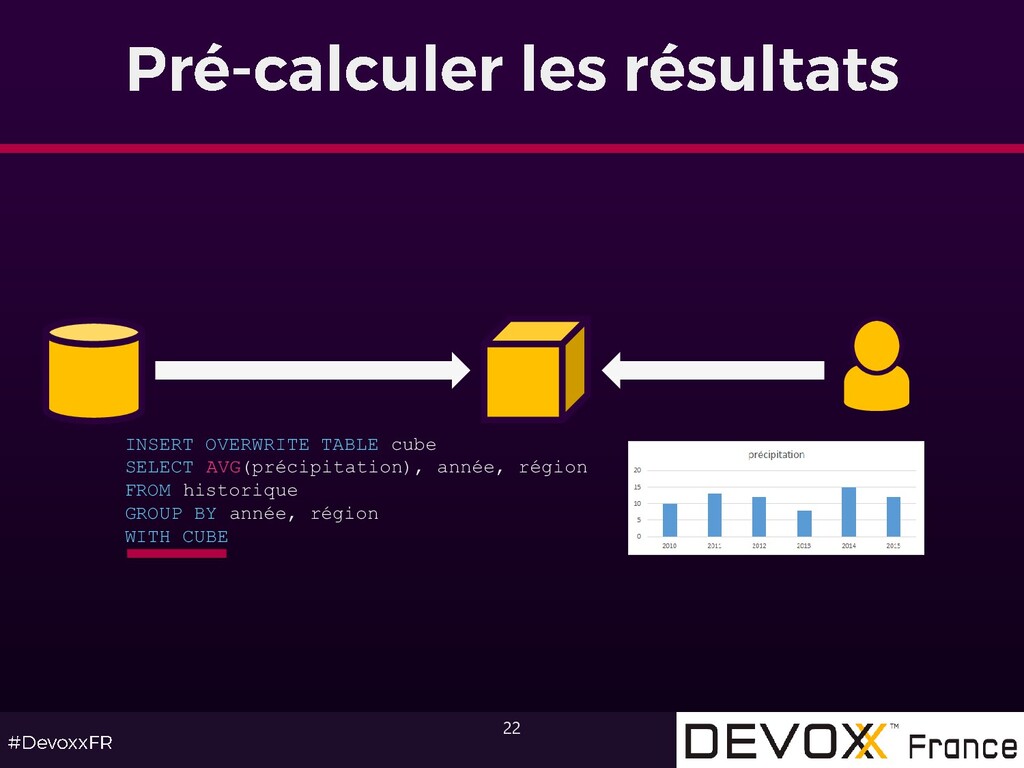
    SELECT AVG(précipitation), année, région FROM historique GROUP BY année, région
  10. 13

  11. 14

  12. 16

  13. 17

  14. 18

  15. 20

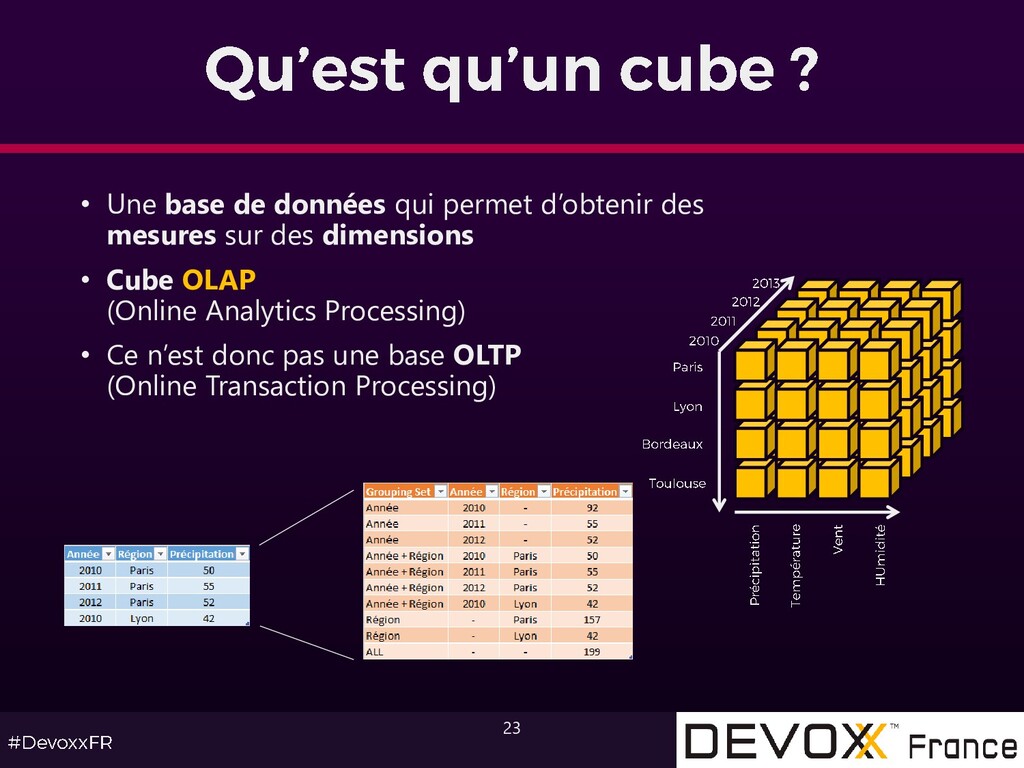
  16. 23 • Une base de données qui permet d’obtenir des

    mesures sur des dimensions • Cube OLAP (Online Analytics Processing) • Ce n’est donc pas une base OLTP (Online Transaction Processing)
  17. 24 • Toujours plus de données, plus d’axes, etc. •

    Construction du cube tous les jours, ou même en temps réel • Plusieurs approches…
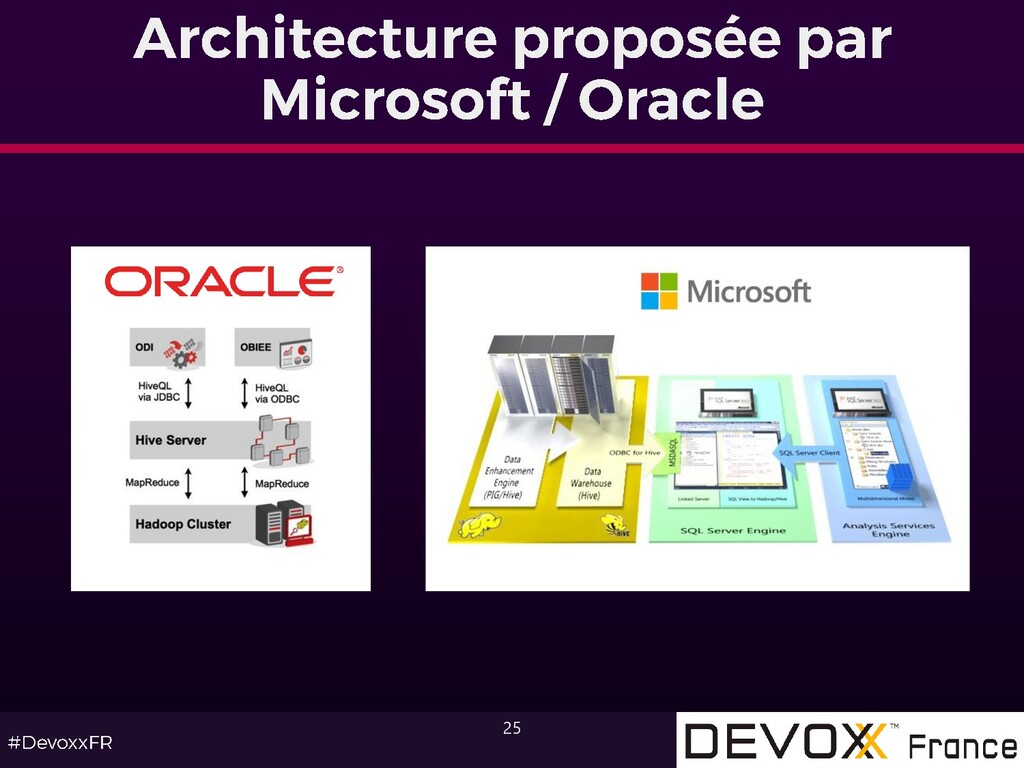
  18. 25

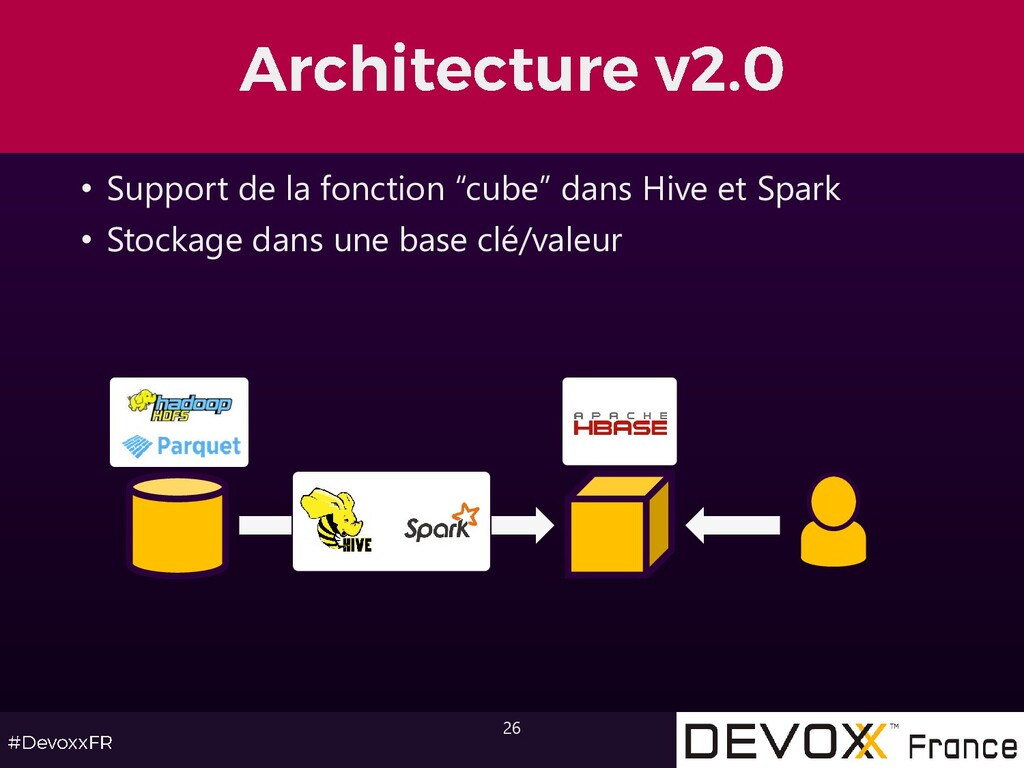
  19. 26 • Support de la fonction “cube” dans Hive et

    Spark • Stockage dans une base clé/valeur
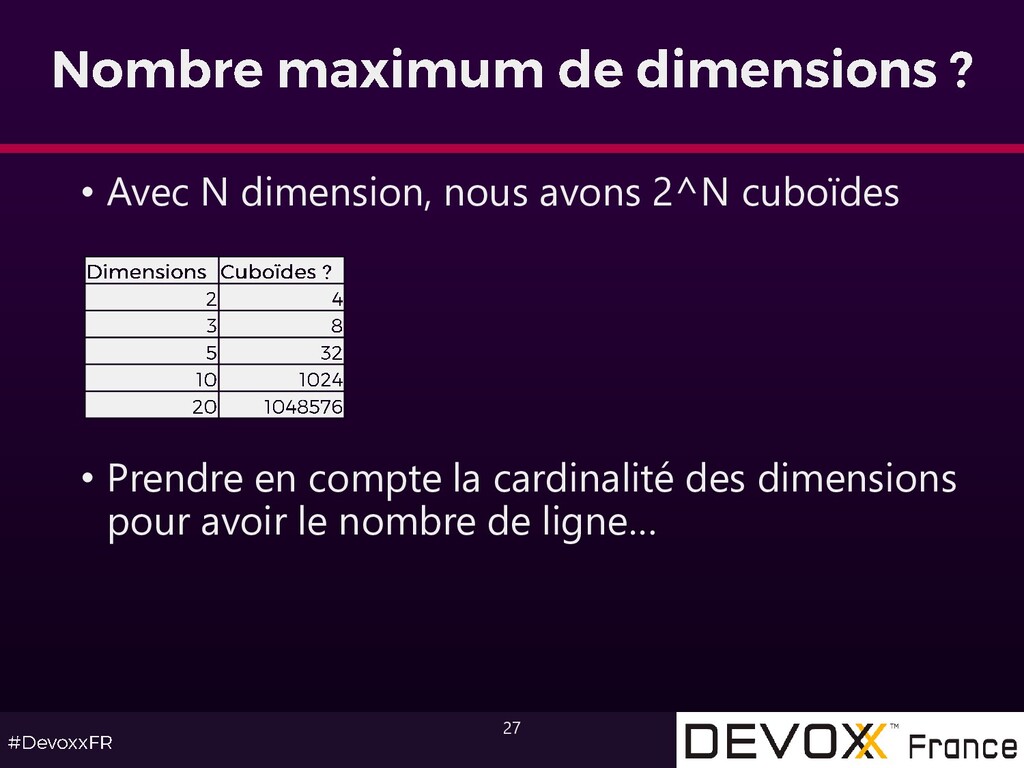
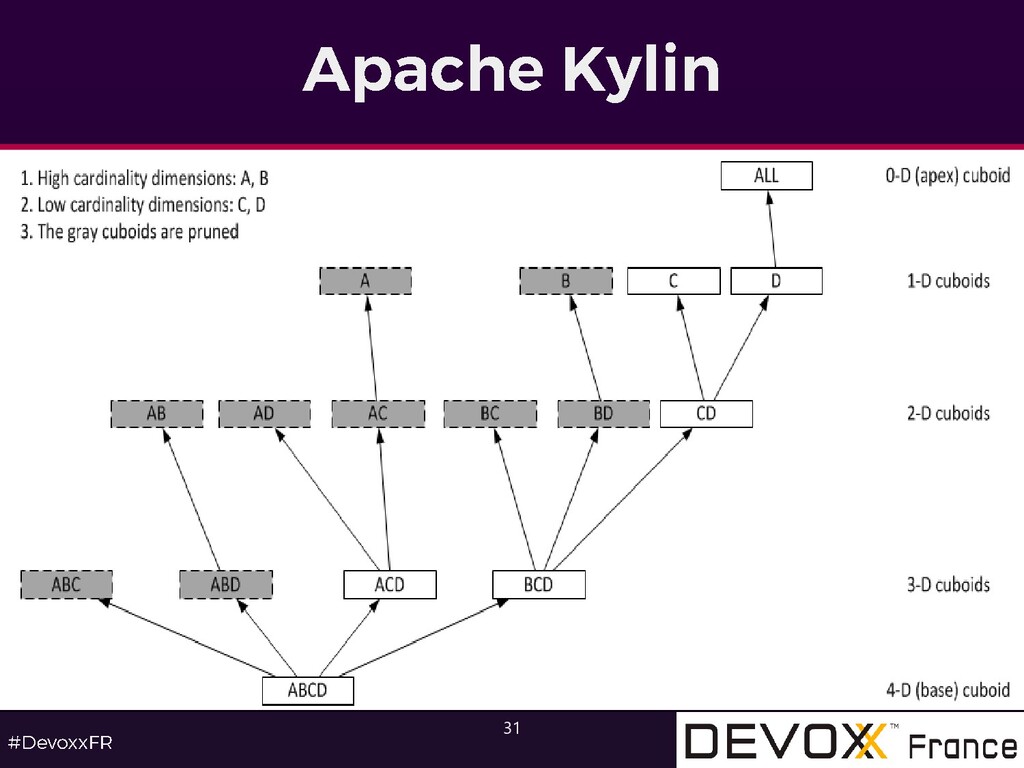
  20. 27 • Avec N dimension, nous avons 2^N cuboïdes •

    Prendre en compte la cardinalité des dimensions pour avoir le nombre de ligne…
  21. 28

  22. 29 kylin / ˈkiːˈlɪn / 麒麟 --n. (in Chinese art)

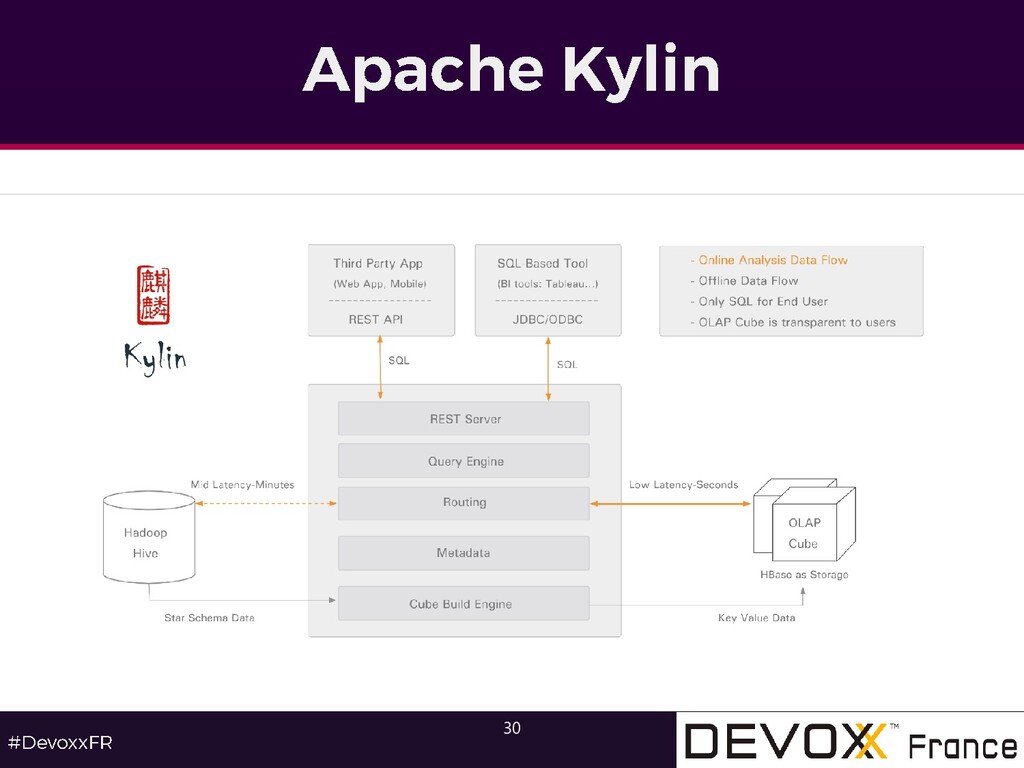
    a mythical animal of composite form Extreme OLAP Engine for Big Data Kylin is an open source Distributed Analytics Engine, contributed by eBay Inc., provides SQL interface and multi-dimensional analysis (OLAP) on Hadoop supporting extremely large datasets • Open Sourced on Oct 1st, 2014 • Accepted as Apache Incubator Project on Nov 25th, 2014 • http://kylin.io (http://kylin.incubator.apache.org) @ApacheKylin
  23. 30

  24. 31

  25. 32

  26. 33

  27. 34

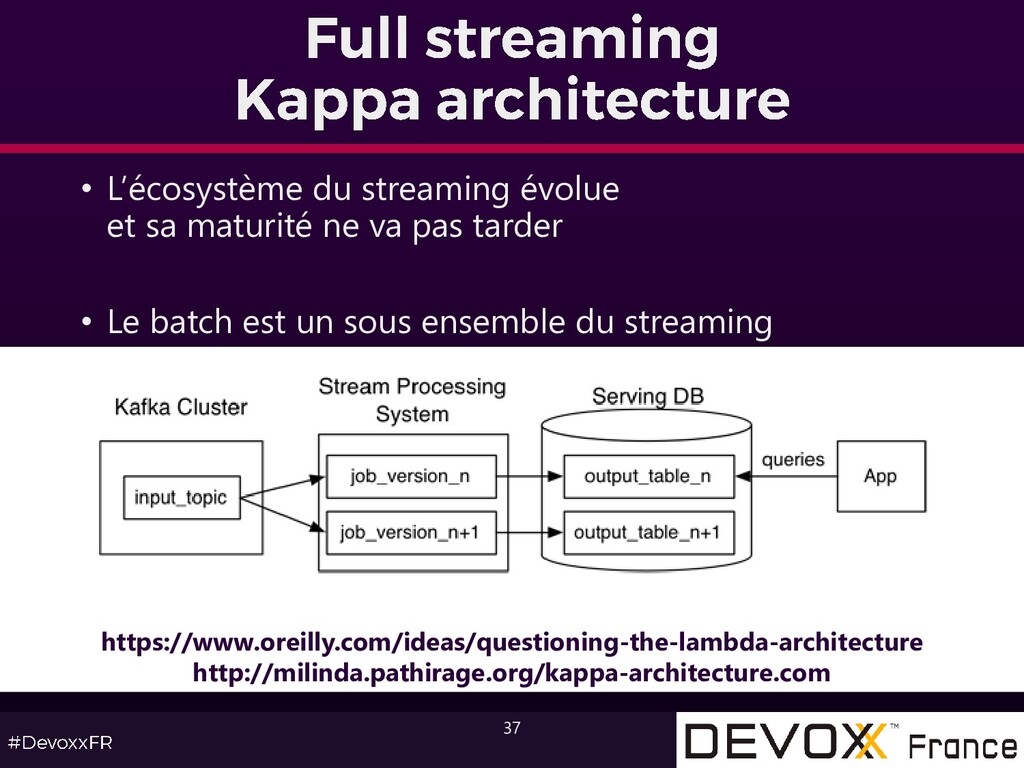
  28. 35 • Pour ne pas attendre des heures • Pour

    minimiser la latence • Pour être plus réactif • Pouvoir traiter des flux continus de données Besoin de traiter au fil de l’eau
  29. 36

  30. 39

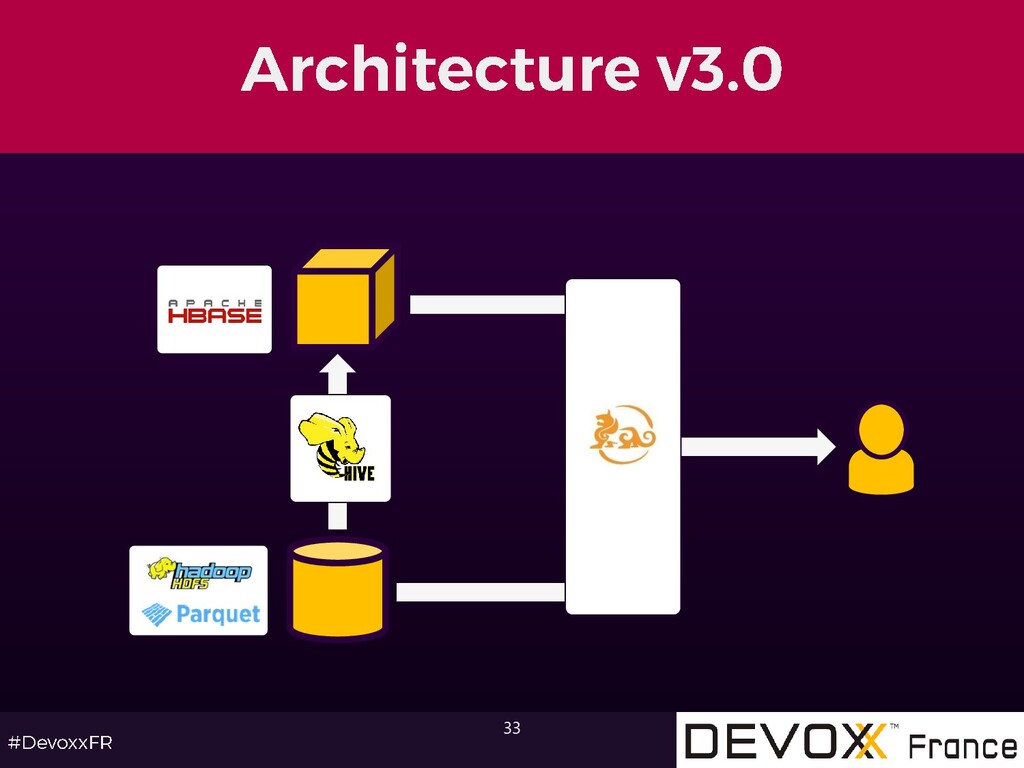
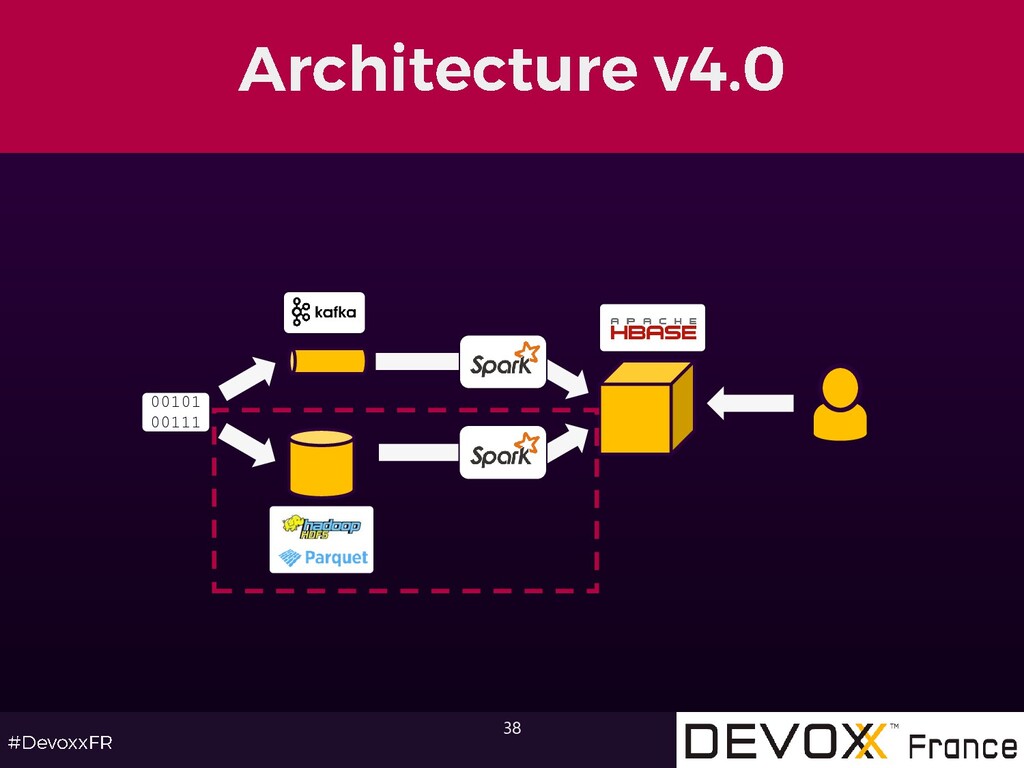
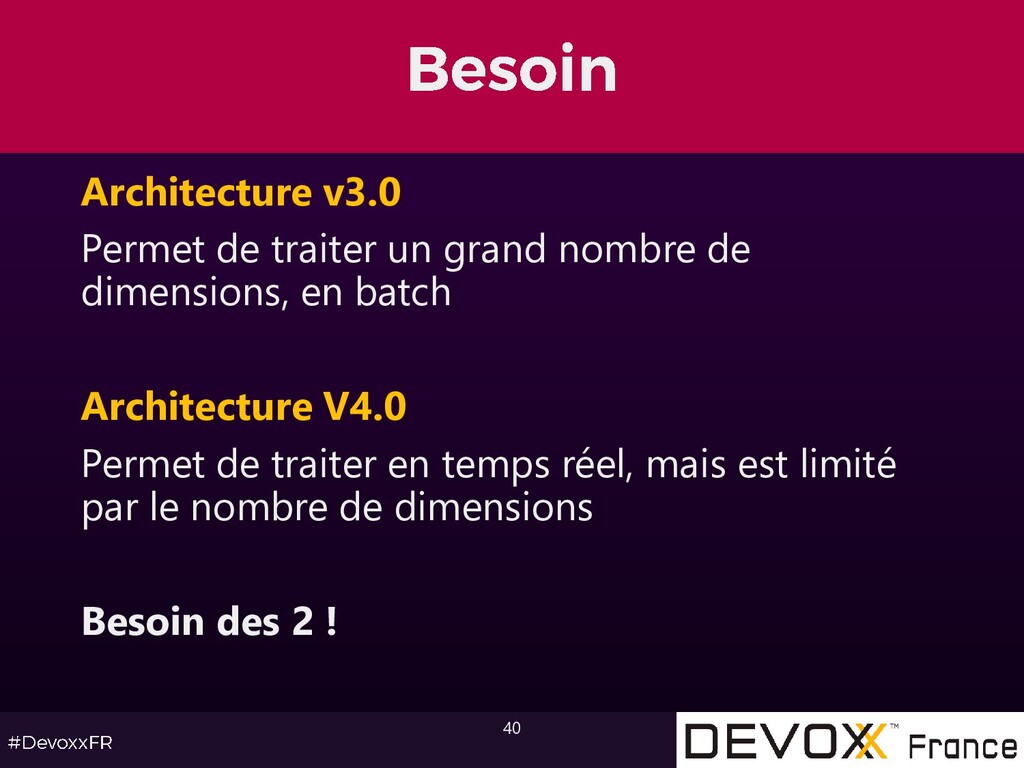
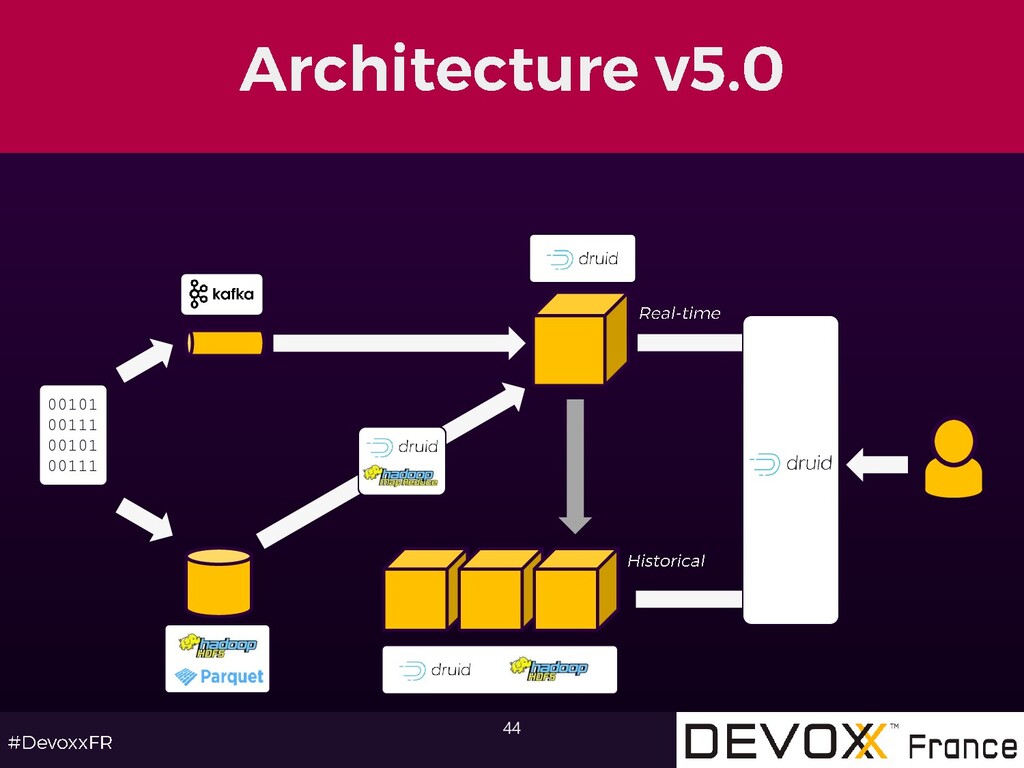
  31. 40 Architecture v3.0 Permet de traiter un grand nombre de

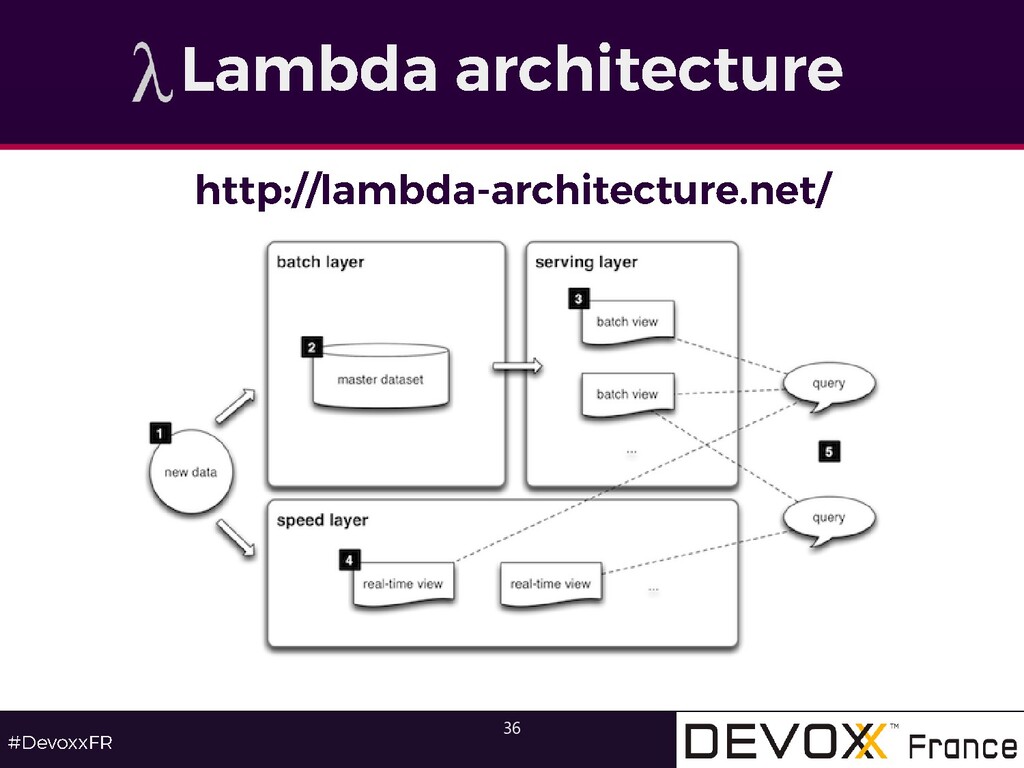
    dimensions, en batch Architecture V4.0 Permet de traiter en temps réel, mais est limité par le nombre de dimensions Besoin des 2 !
  32. 41 • Projet open-sourcé par Metamarkets • Analytics pour des

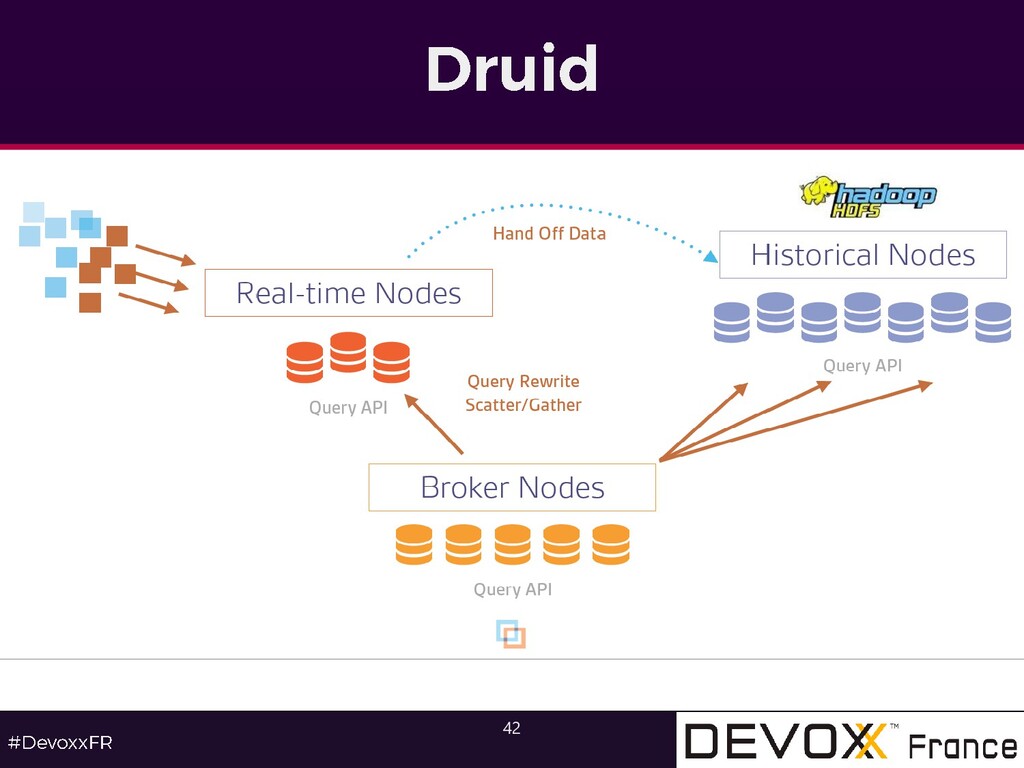
    Time-Series • Stockage colonne • Batch & temps réel • Batch: analyse des données d’Hadoop • Temps réel: flux d’événements de Kafka • Agrégations à la volé, mais très rapide grâce au stockage colonne • http://druid.io/ @druidio • Utilisé chez Paypal, Critéo, eBay, Netflix, etc.
  33. 42

  34. 43

  35. 45

  36. 46 • Nécessite de connaitre l’ancienne valeur • Nécessite de

    recalculer tous les cuboïdes impactés Cube en temps réel… avec des mises à jours!
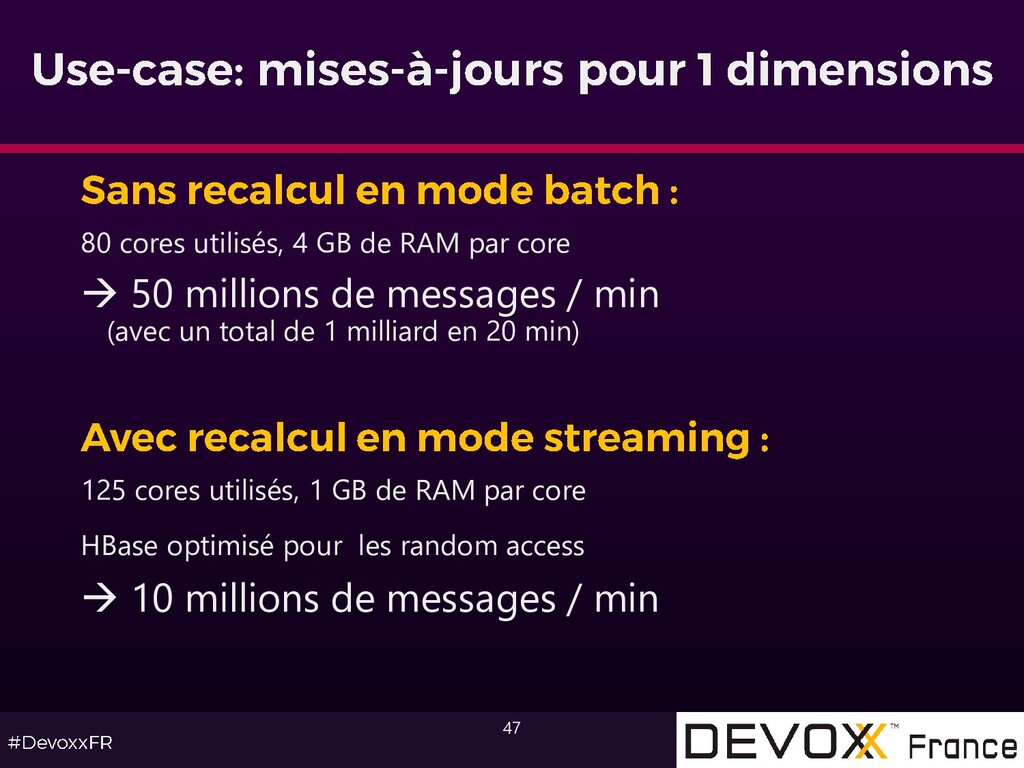
  37. 47 80 cores utilisés, 4 GB de RAM par core

    → 50 millions de messages / min (avec un total de 1 milliard en 20 min) 125 cores utilisés, 1 GB de RAM par core HBase optimisé pour les random access → 10 millions de messages / min
  38. 48

  39. 49 Apache Lens https://lens.apache.org/ API Rest, driver JDBC, Cube QL,

    Cube MetaStore Requête une source à l’aide de drivers (Spark, Hive, etc.) Mondrian http://community.pentaho.com/projects/mondrian/ Interface MDX Java. Requête une source à l’aide de JDBC Compatible avec Phoenix (SQL pour HBase) WSO2 http://wso2.com/products/data-analytics-server/ Plateforme complète de développement, dont WSO2 Data Analytics Server API pour construire des cubes, repose sur les technologies comme Spark, Hive, Cassandra, etc.
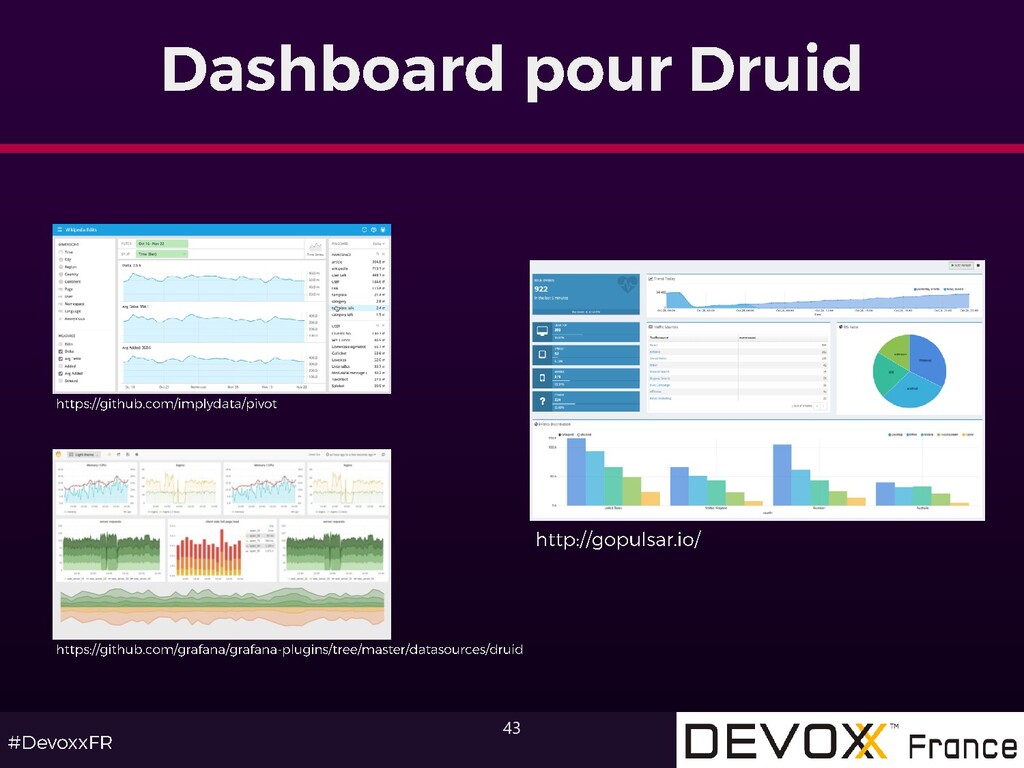
  40. 50 Pulsar http://gopulsar.io Plateforme d’analytics, CEP, API Rest, SQL, HOLAP

    Source d’événements Kafka, source Druid CDAP http://cask.co/ Plateforme complète pour développement Big Data API pour construire des cubes, source Kafka ou Hive, stockage HBase
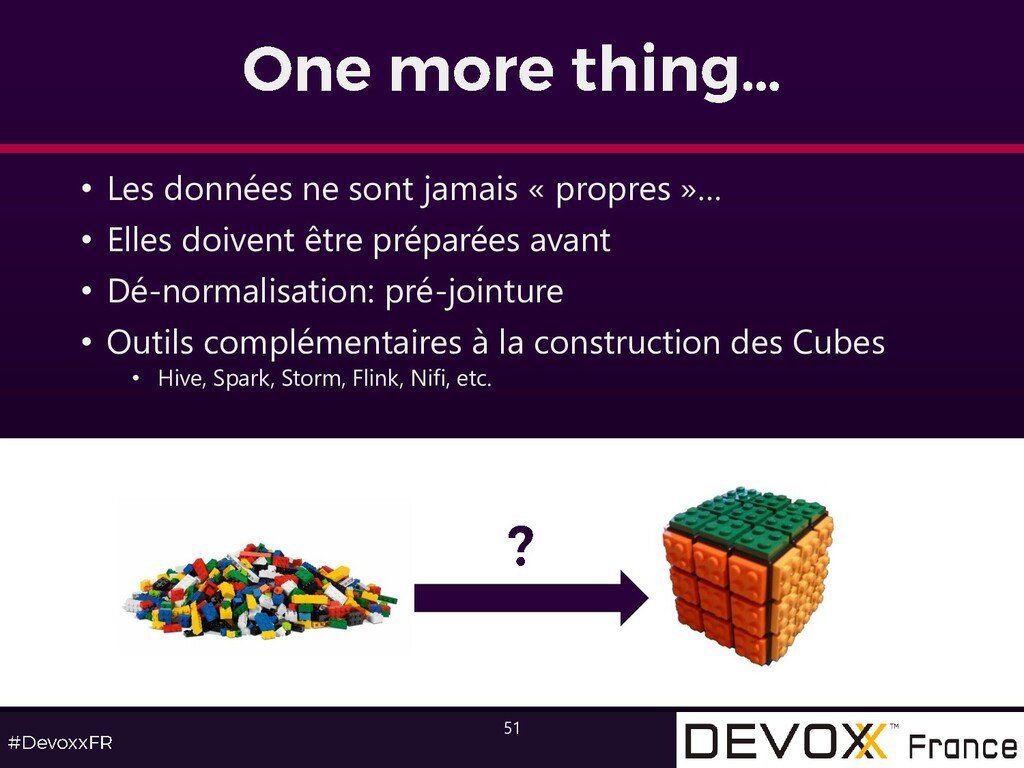
  41. 51 • Les données ne sont jamais « propres »…

    • Elles doivent être préparées avant • Dé-normalisation: pré-jointure • Outils complémentaires à la construction des Cubes • Hive, Spark, Storm, Flink, Nifi, etc.
  42. 52