Share
Embed
ECCV2024論文紹介:SAM
hinako0123
December 23, 2024
Transcript
28 slides
-
自己紹介 光岡日菜子 - 名城大学 堀田研究室所属 - 名古屋CV・PRML勉強会幹事(2024/4~) 趣味:カフェ・飲み屋巡り/MT車/SNS運営 研究:I2I Translation/Segmentation
2 @ramentabetai__1 @nagoyacv conpass lab -
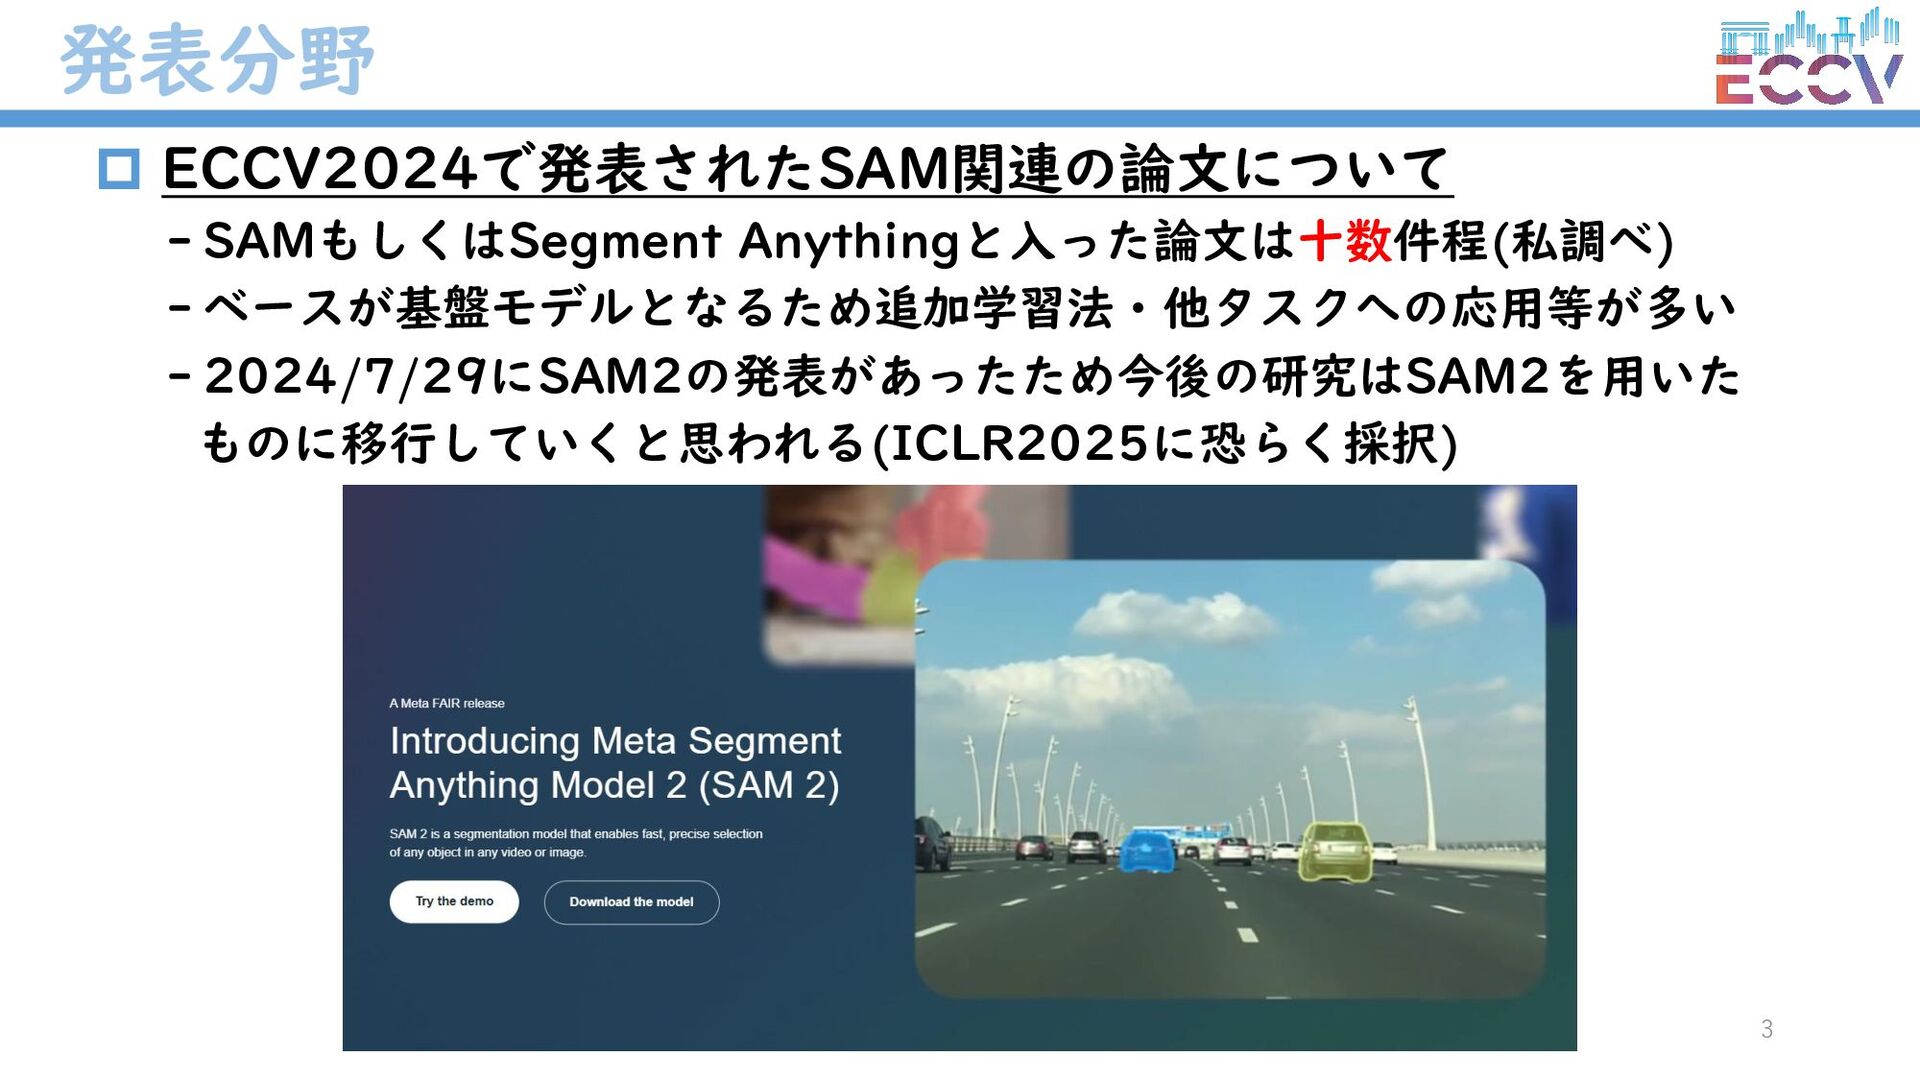
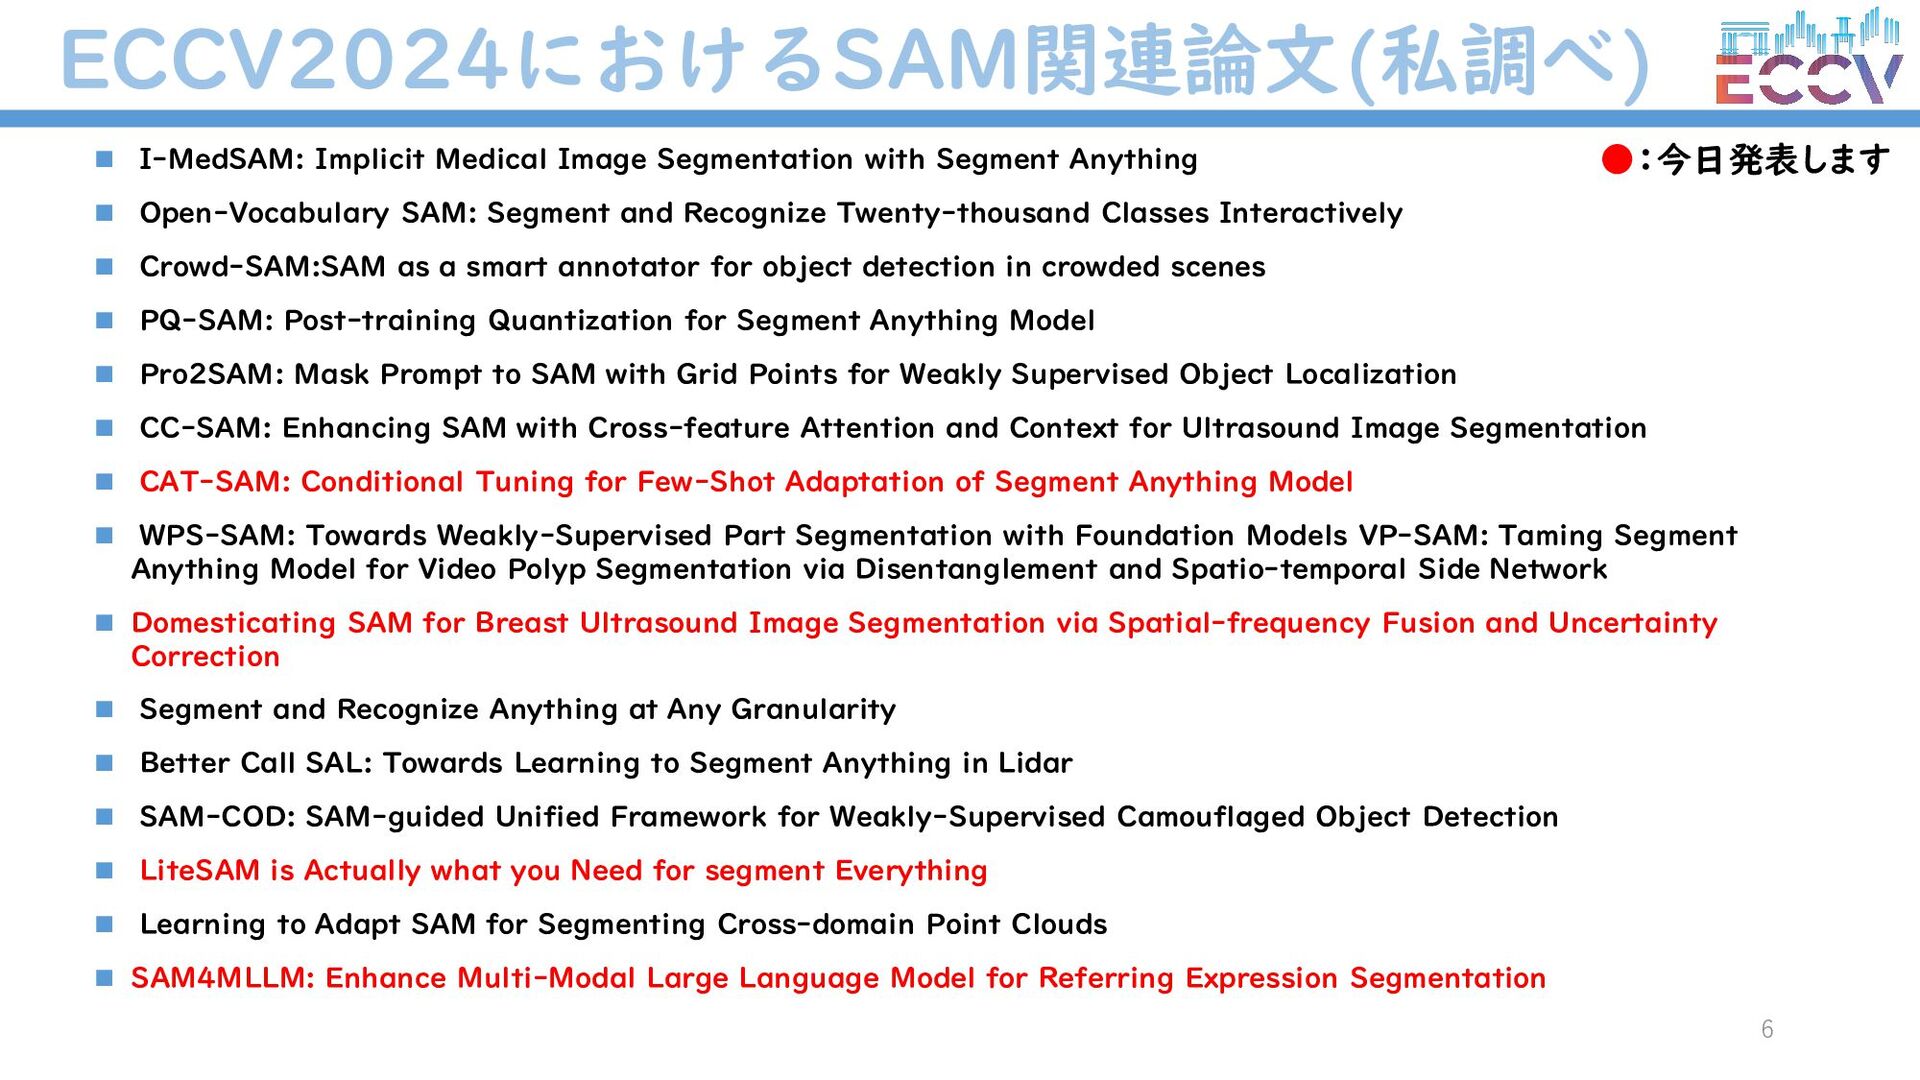
発表分野 3 ECCV2024で発表されたSAM関連の論文について - SAMもしくはSegment Anythingと入った論文は十数件程(私調べ) - ベースが基盤モデルとなるため追加学習法・他タスクへの応用等が多い -
2024/7/29にSAM2の発表があったため今後の研究はSAM2を用いた ものに移行していくと思われる(ICLR2025に恐らく採択) -
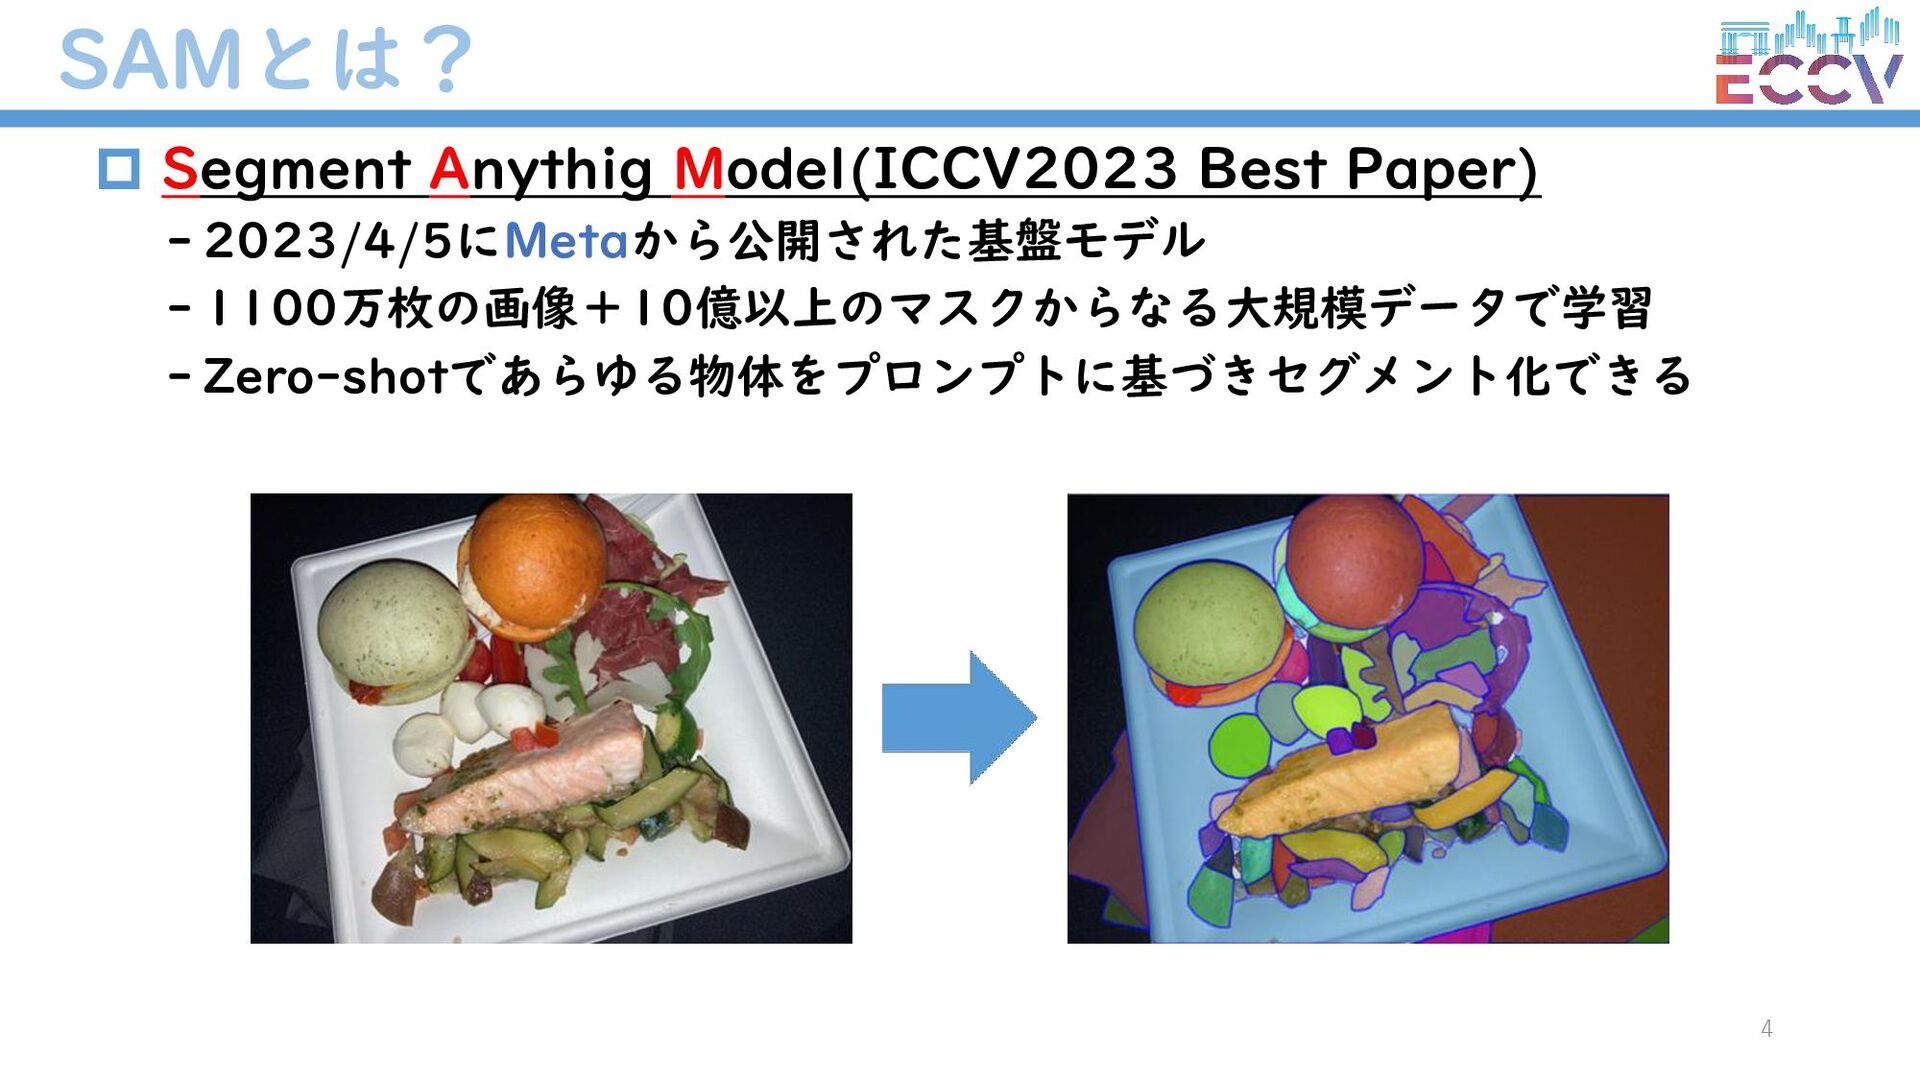
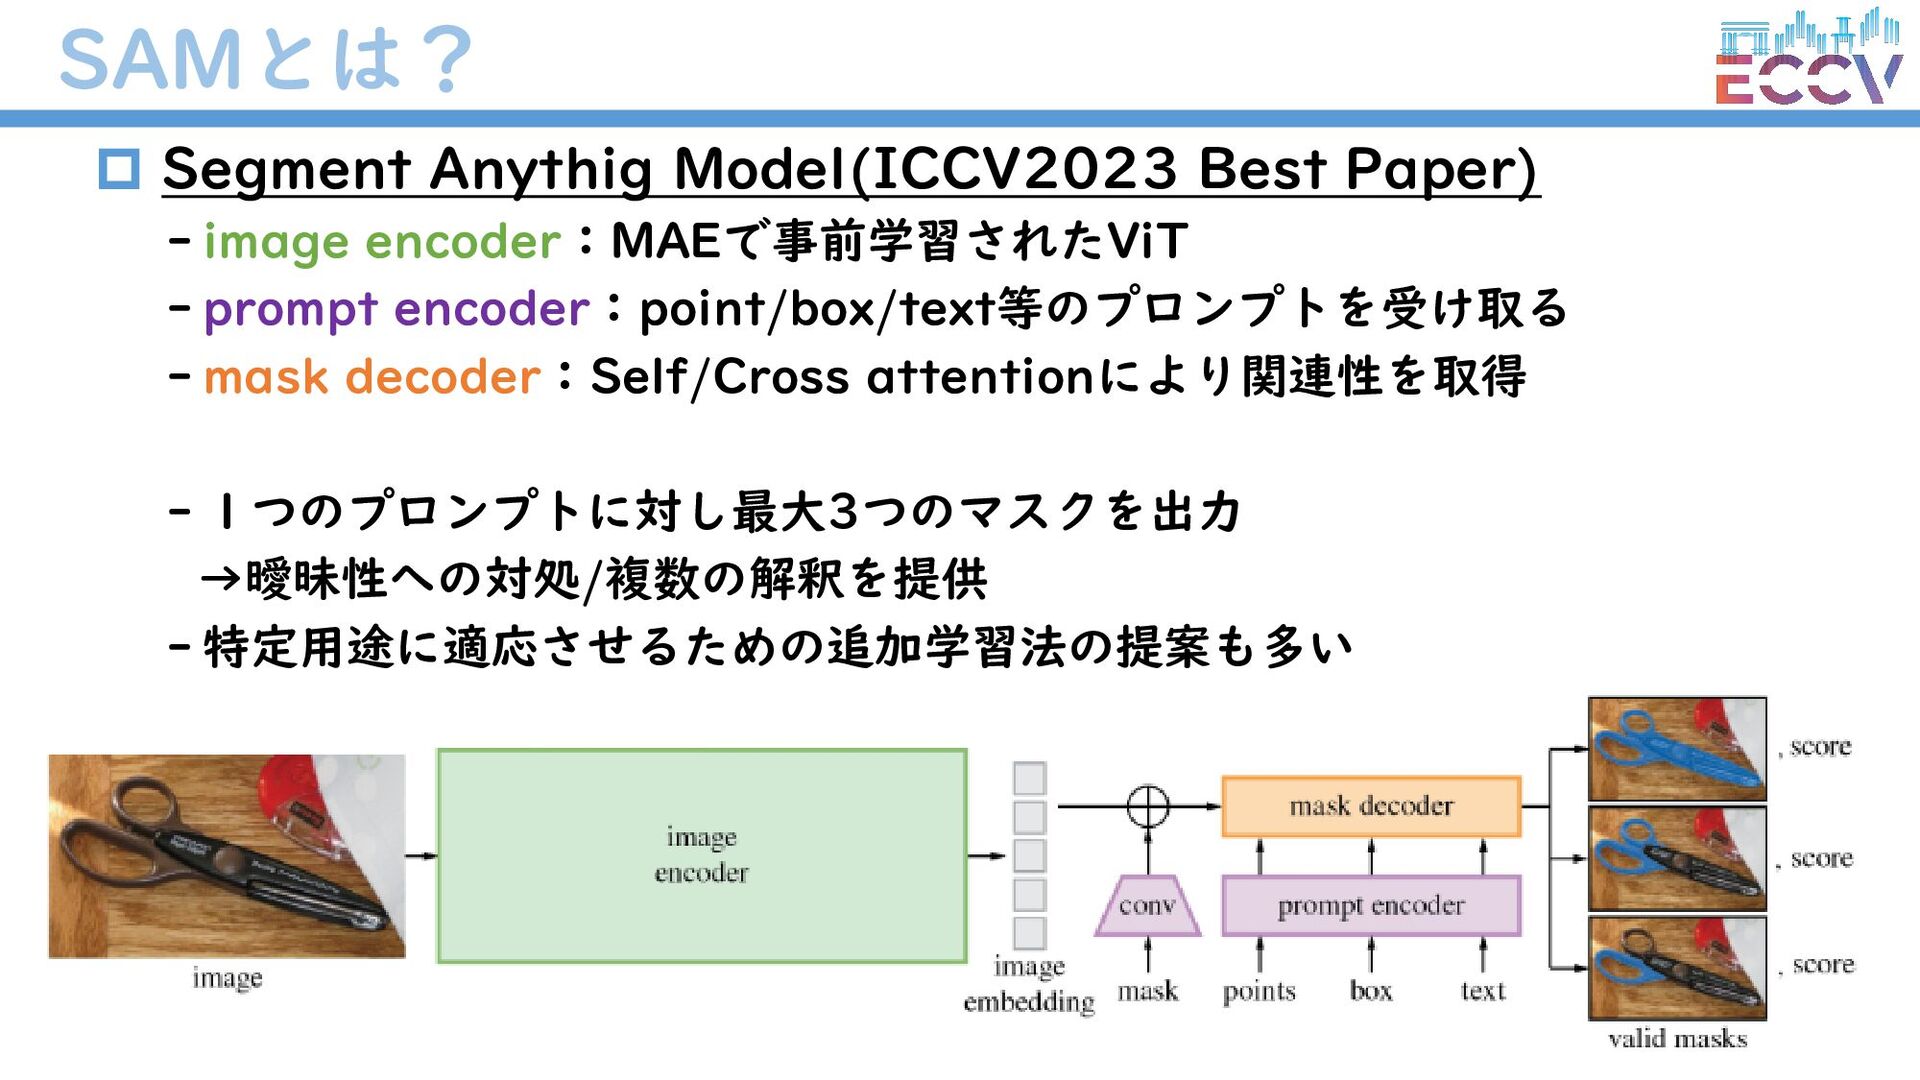
SAMとは? 4 Segment Anythig Model(ICCV2023 Best Paper) - 2023/4/5にMetaから公開された基盤モデル
- 1100万枚の画像+10億以上のマスクからなる大規模データで学習 - Zero-shotであらゆる物体をプロンプトに基づきセグメント化できる -
SAMとは? 5 Segment Anythig Model(ICCV2023 Best Paper) - image
encoder:MAEで事前学習されたViT - prompt encoder:point/box/text等のプロンプトを受け取る - mask decoder:Self/Cross attentionにより関連性を取得 - 1つのプロンプトに対し最大3つのマスクを出力 →曖昧性への対処/複数の解釈を提供 - 特定用途に適応させるための追加学習法の提案も多い -
ECCV2024におけるSAM関連論文(私調べ) 6 ◼ I-MedSAM: Implicit Medical Image Segmentation with Segment
Anything ◼ Open-Vocabulary SAM: Segment and Recognize Twenty-thousand Classes Interactively ◼ Crowd-SAM:SAM as a smart annotator for object detection in crowded scenes ◼ PQ-SAM: Post-training Quantization for Segment Anything Model ◼ Pro2SAM: Mask Prompt to SAM with Grid Points for Weakly Supervised Object Localization ◼ CC-SAM: Enhancing SAM with Cross-feature Attention and Context for Ultrasound Image Segmentation ◼ CAT-SAM: Conditional Tuning for Few-Shot Adaptation of Segment Anything Model ◼ WPS-SAM: Towards Weakly-Supervised Part Segmentation with Foundation Models VP-SAM: Taming Segment Anything Model for Video Polyp Segmentation via Disentanglement and Spatio-temporal Side Network ◼ Domesticating SAM for Breast Ultrasound Image Segmentation via Spatial-frequency Fusion and Uncertainty Correction ◼ Segment and Recognize Anything at Any Granularity ◼ Better Call SAL: Towards Learning to Segment Anything in Lidar ◼ SAM-COD: SAM-guided Unified Framework for Weakly-Supervised Camouflaged Object Detection ◼ LiteSAM is Actually what you Need for segment Everything ◼ Learning to Adapt SAM for Segmenting Cross-domain Point Clouds ◼ SAM4MLLM: Enhance Multi-Modal Large Language Model for Referring Expression Segmentation •:今日発表します -
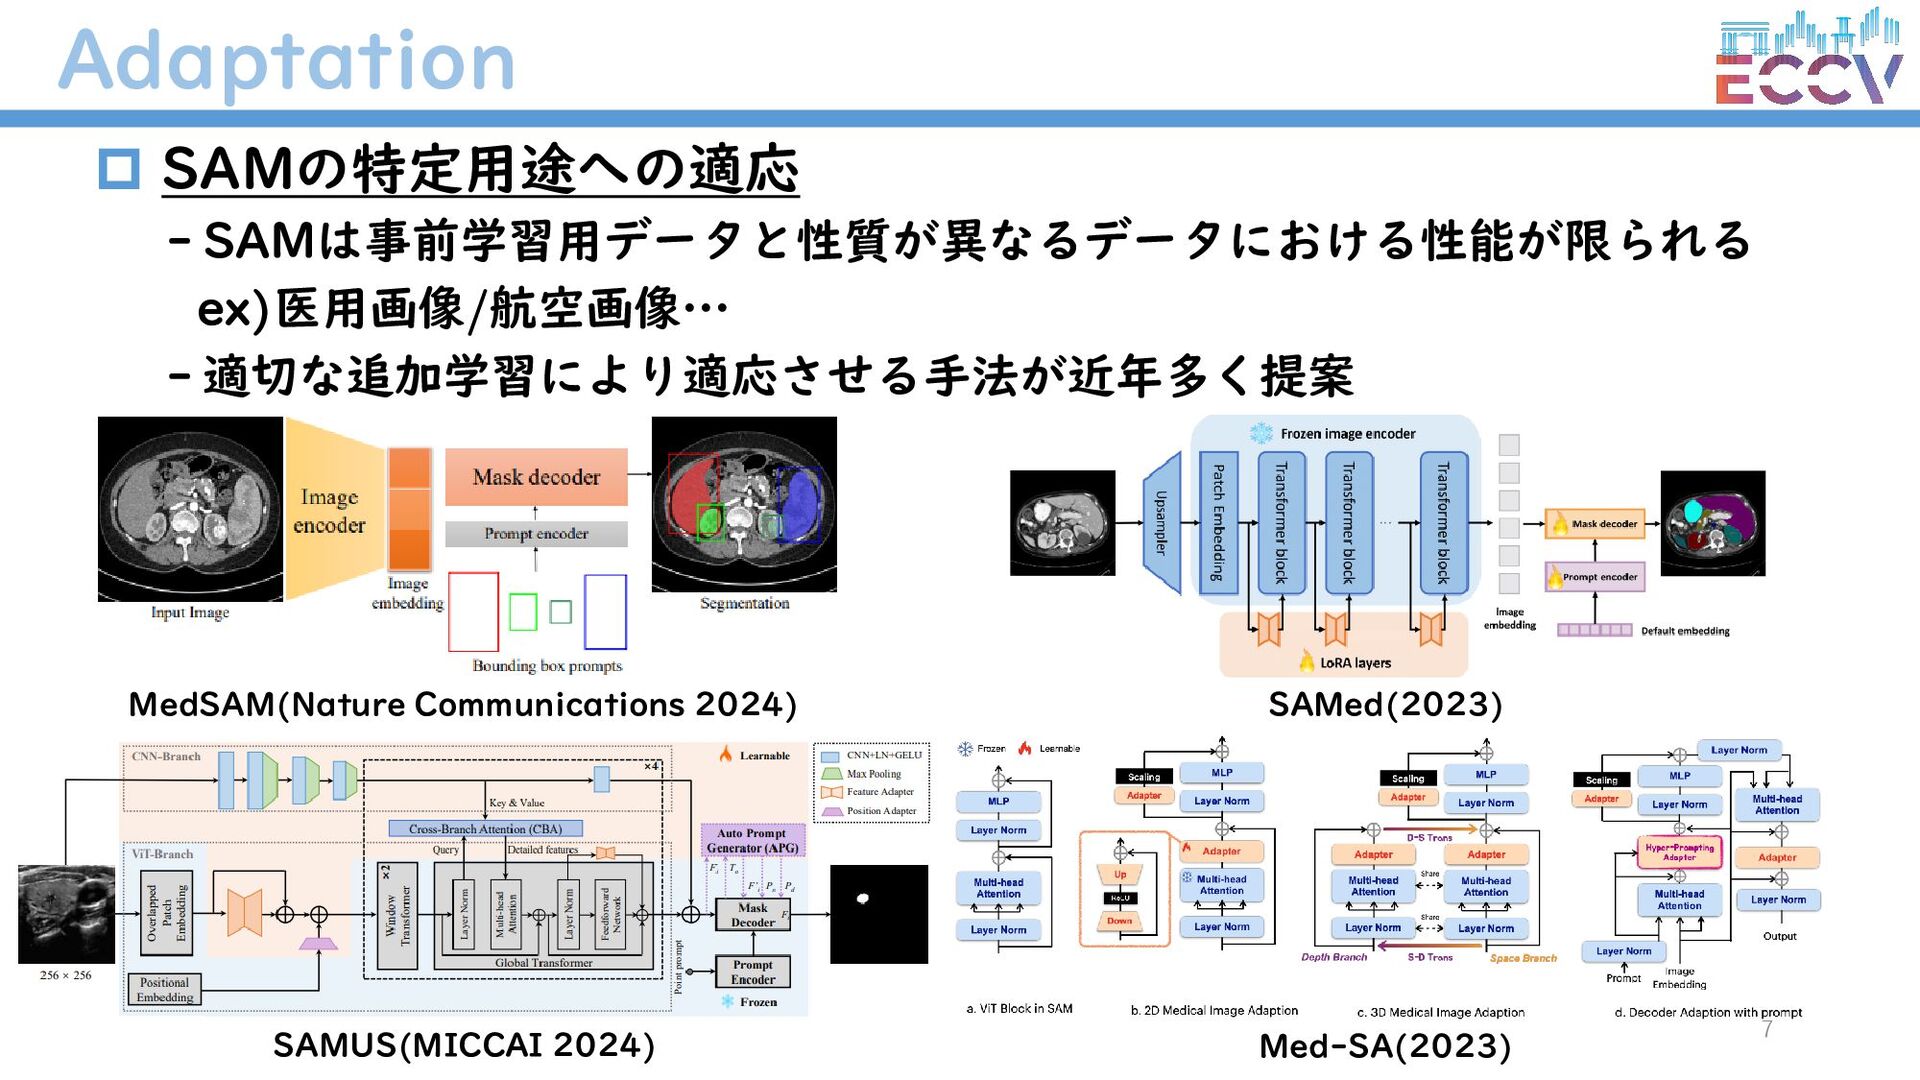
Adaptation 7 SAMの特定用途への適応 - SAMは事前学習用データと性質が異なるデータにおける性能が限られる ex)医用画像/航空画像… - 適切な追加学習により適応させる手法が近年多く提案 MedSAM(Nature
Communications 2024) SAMUS(MICCAI 2024) SAMed(2023) Med-SA(2023) -
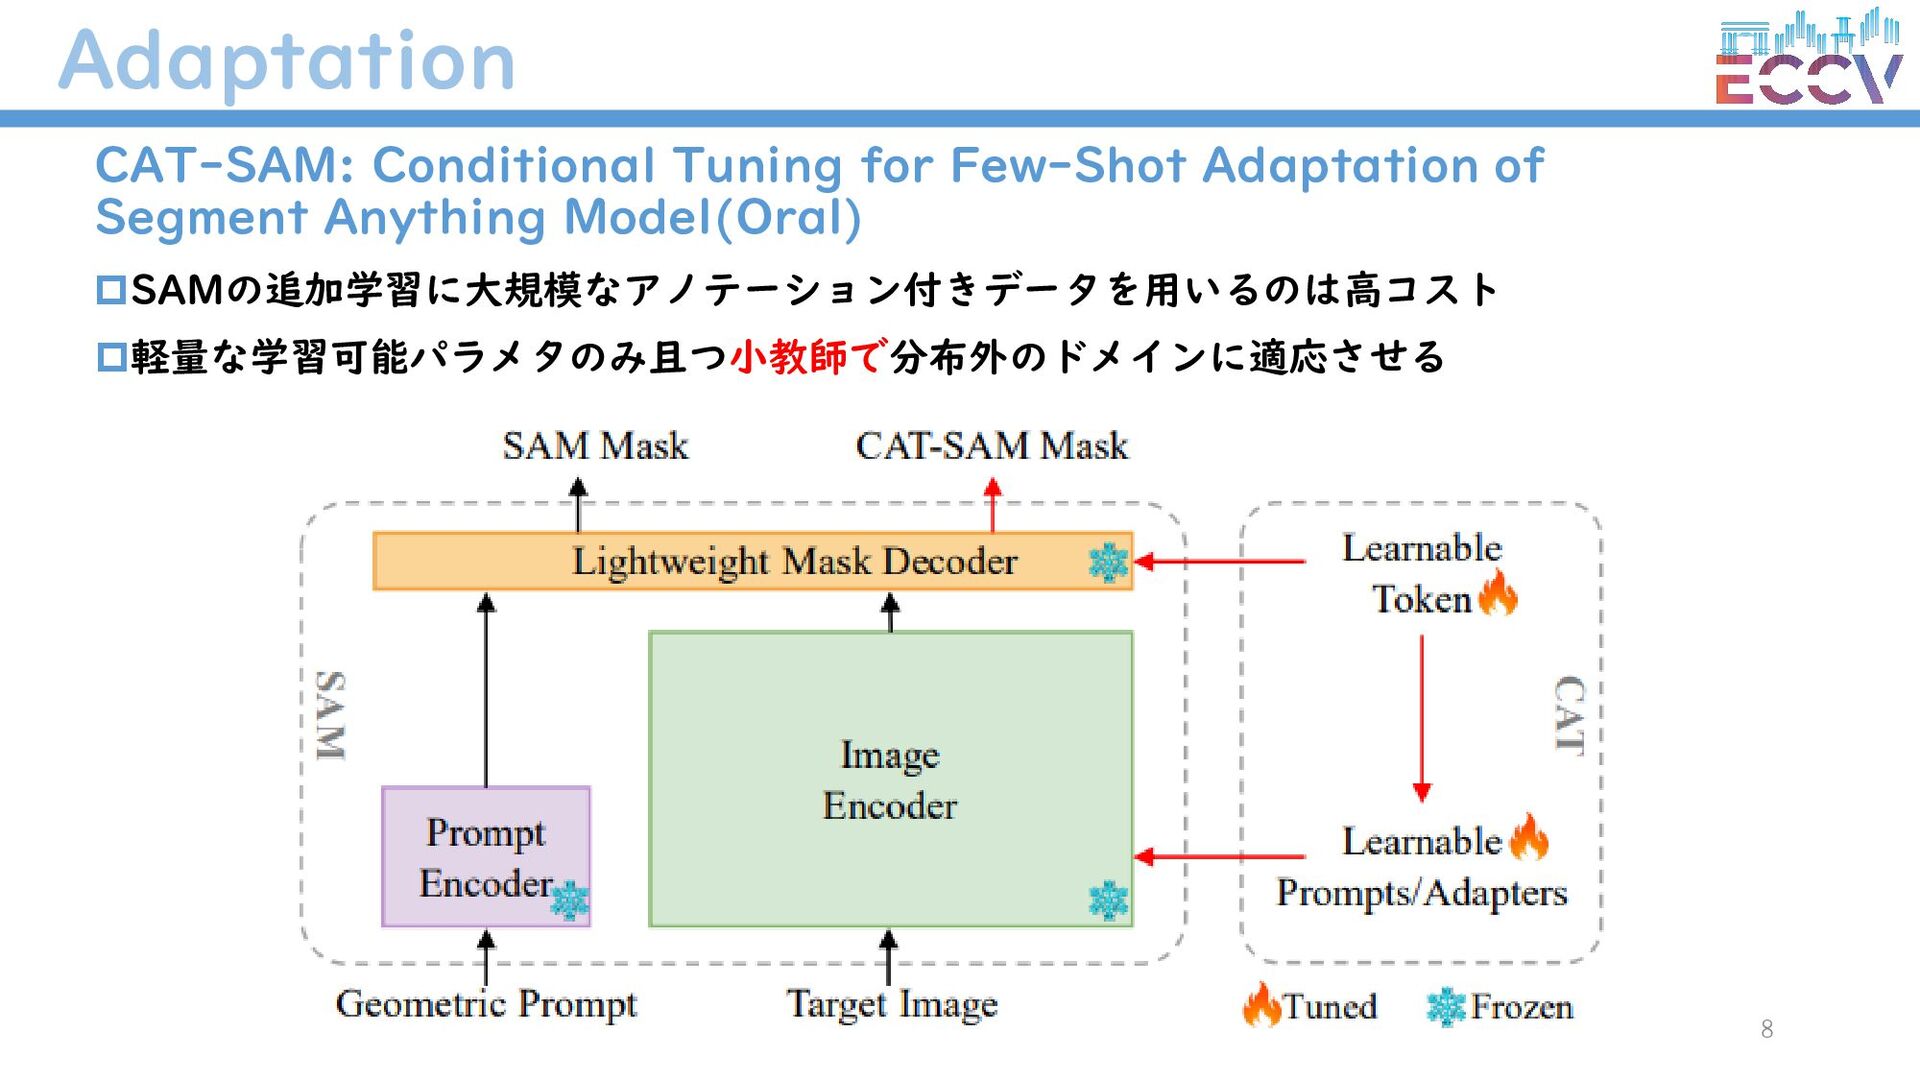
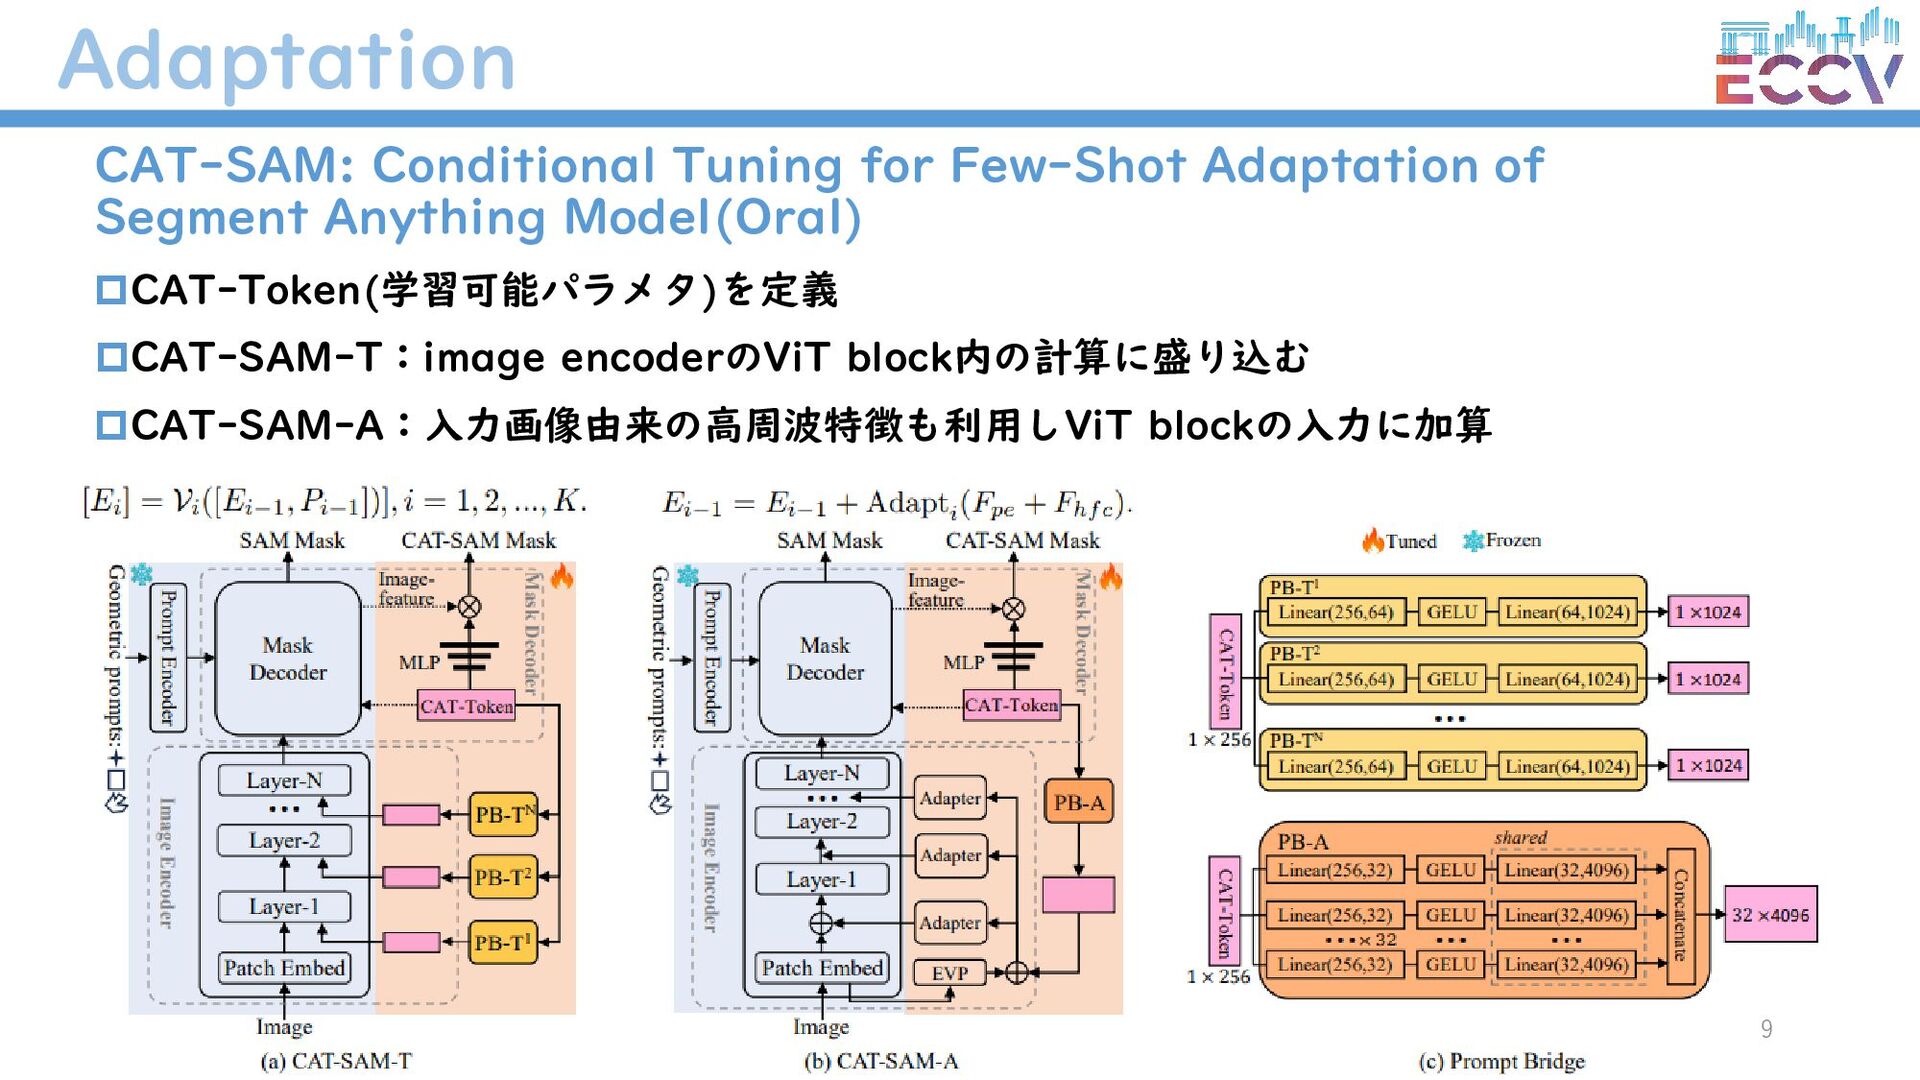
Adaptation 8 CAT-SAM: Conditional Tuning for Few-Shot Adaptation of Segment
Anything Model(Oral) SAMの追加学習に大規模なアノテーション付きデータを用いるのは高コスト 軽量な学習可能パラメタのみ且つ小教師で分布外のドメインに適応させる -
Adaptation 9 CAT-SAM: Conditional Tuning for Few-Shot Adaptation of Segment
Anything Model(Oral) CAT-Token(学習可能パラメタ)を定義 CAT-SAM-T:image encoderのViT block内の計算に盛り込む CAT-SAM-A:入力画像由来の高周波特徴も利用しViT blockの入力に加算 -
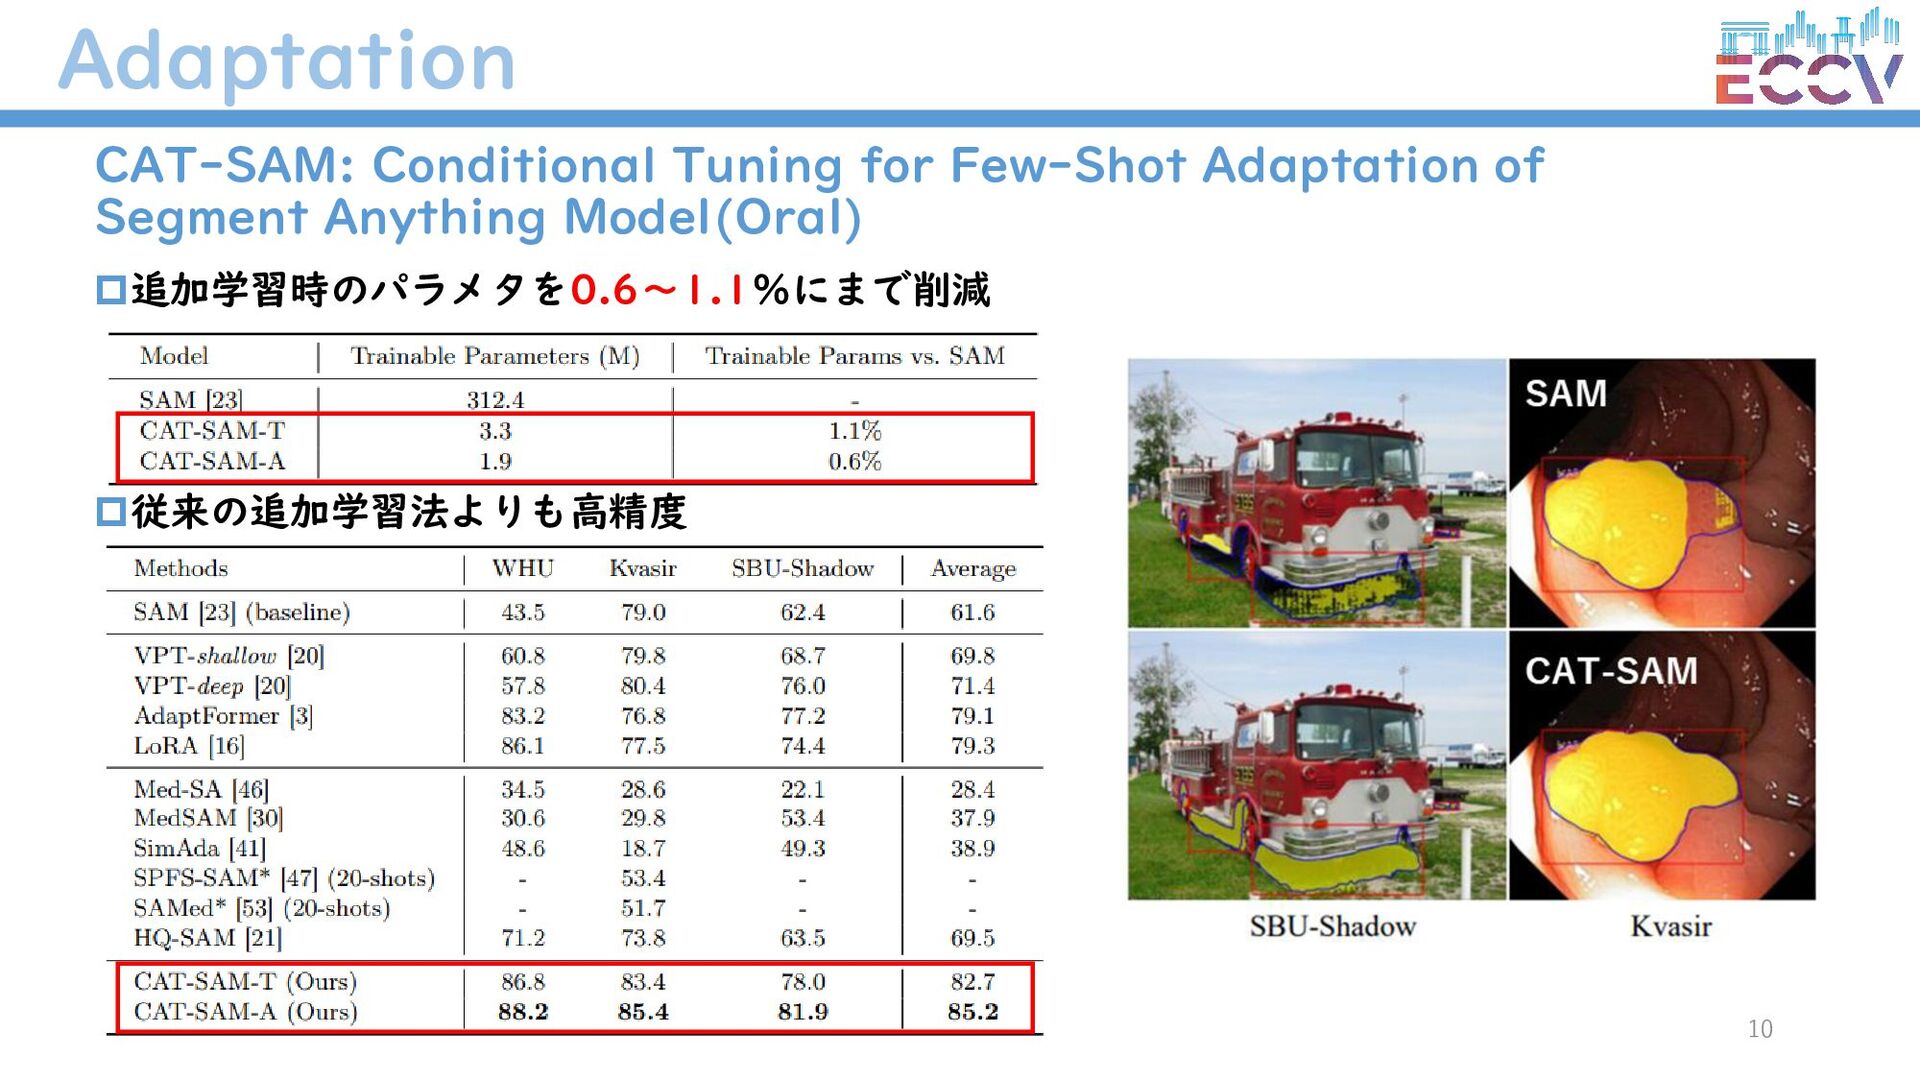
Adaptation 10 CAT-SAM: Conditional Tuning for Few-Shot Adaptation of Segment
Anything Model(Oral) 追加学習時のパラメタを0.6~1.1%にまで削減 従来の追加学習法よりも高精度 -
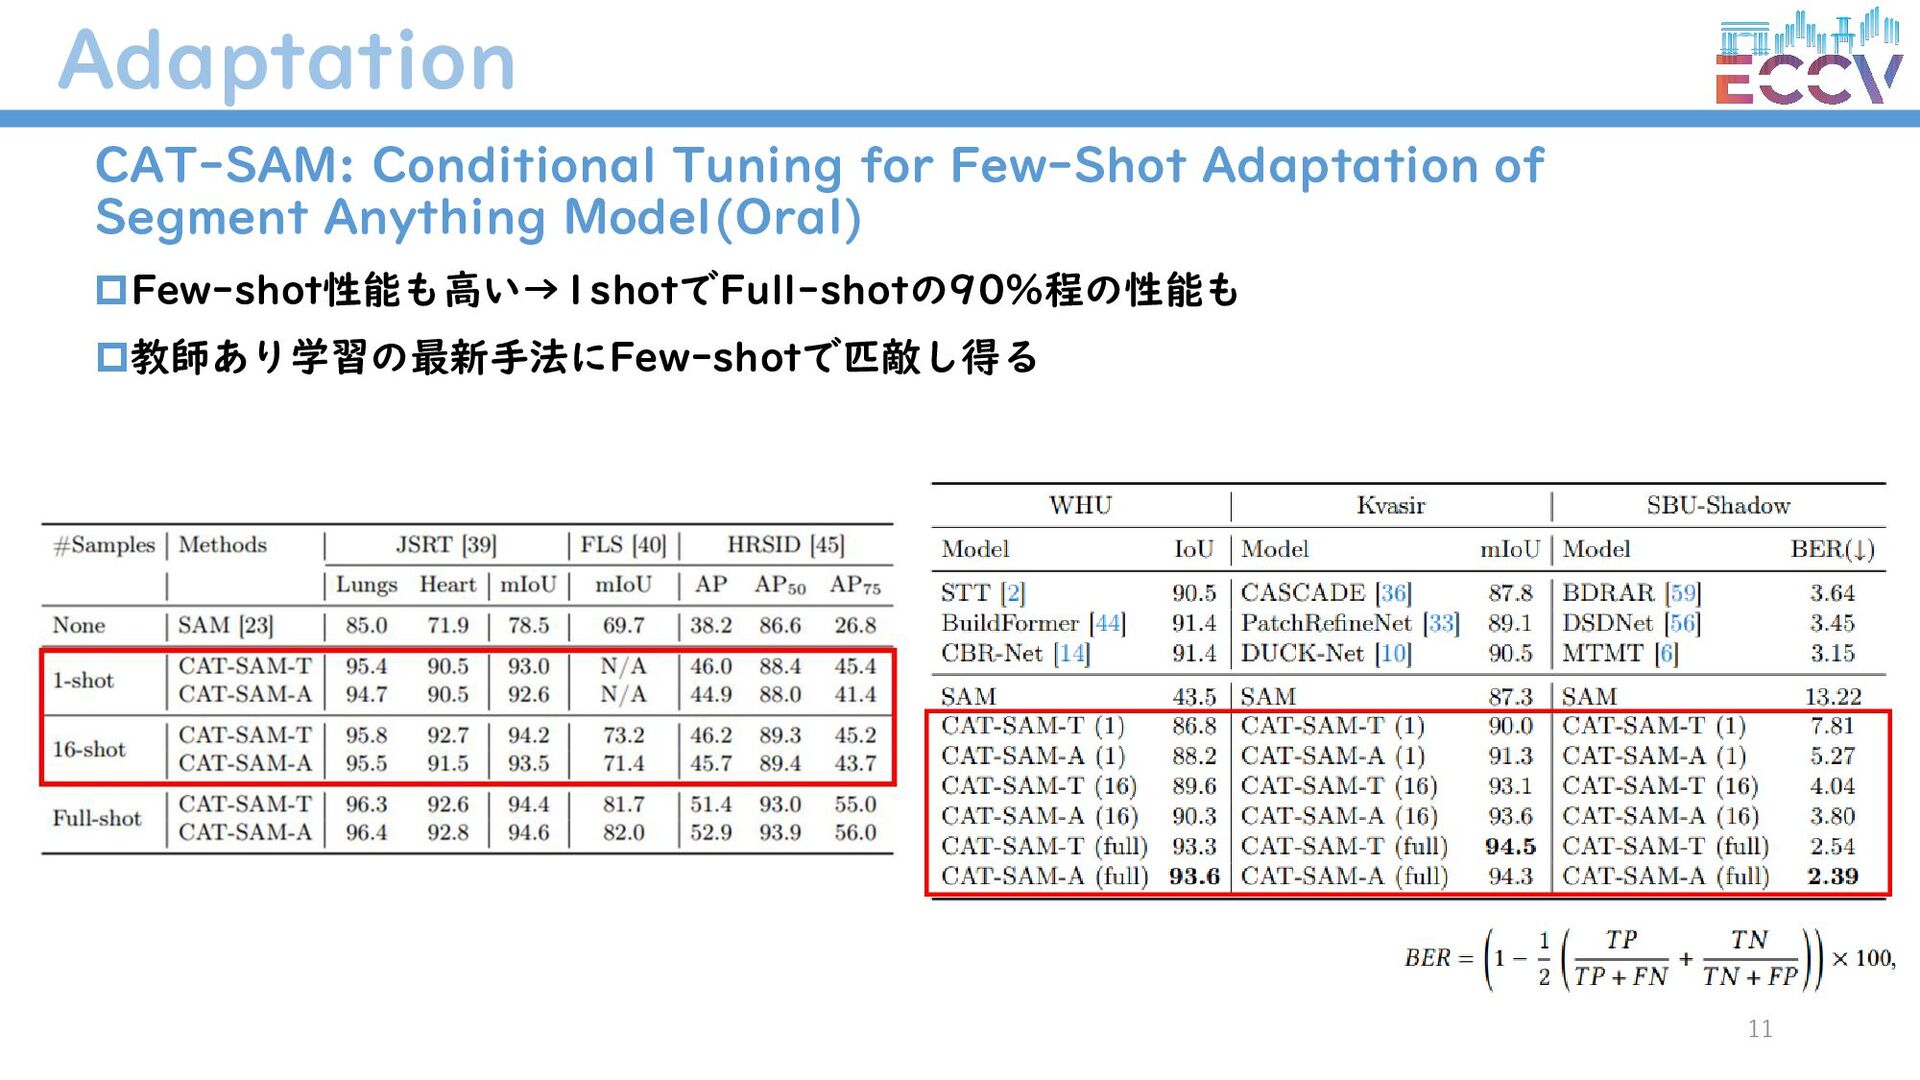
Adaptation 11 CAT-SAM: Conditional Tuning for Few-Shot Adaptation of Segment
Anything Model(Oral) Few-shot性能も高い→1shotでFull-shotの90%程の性能も 教師あり学習の最新手法にFew-shotで匹敵し得る SAM -
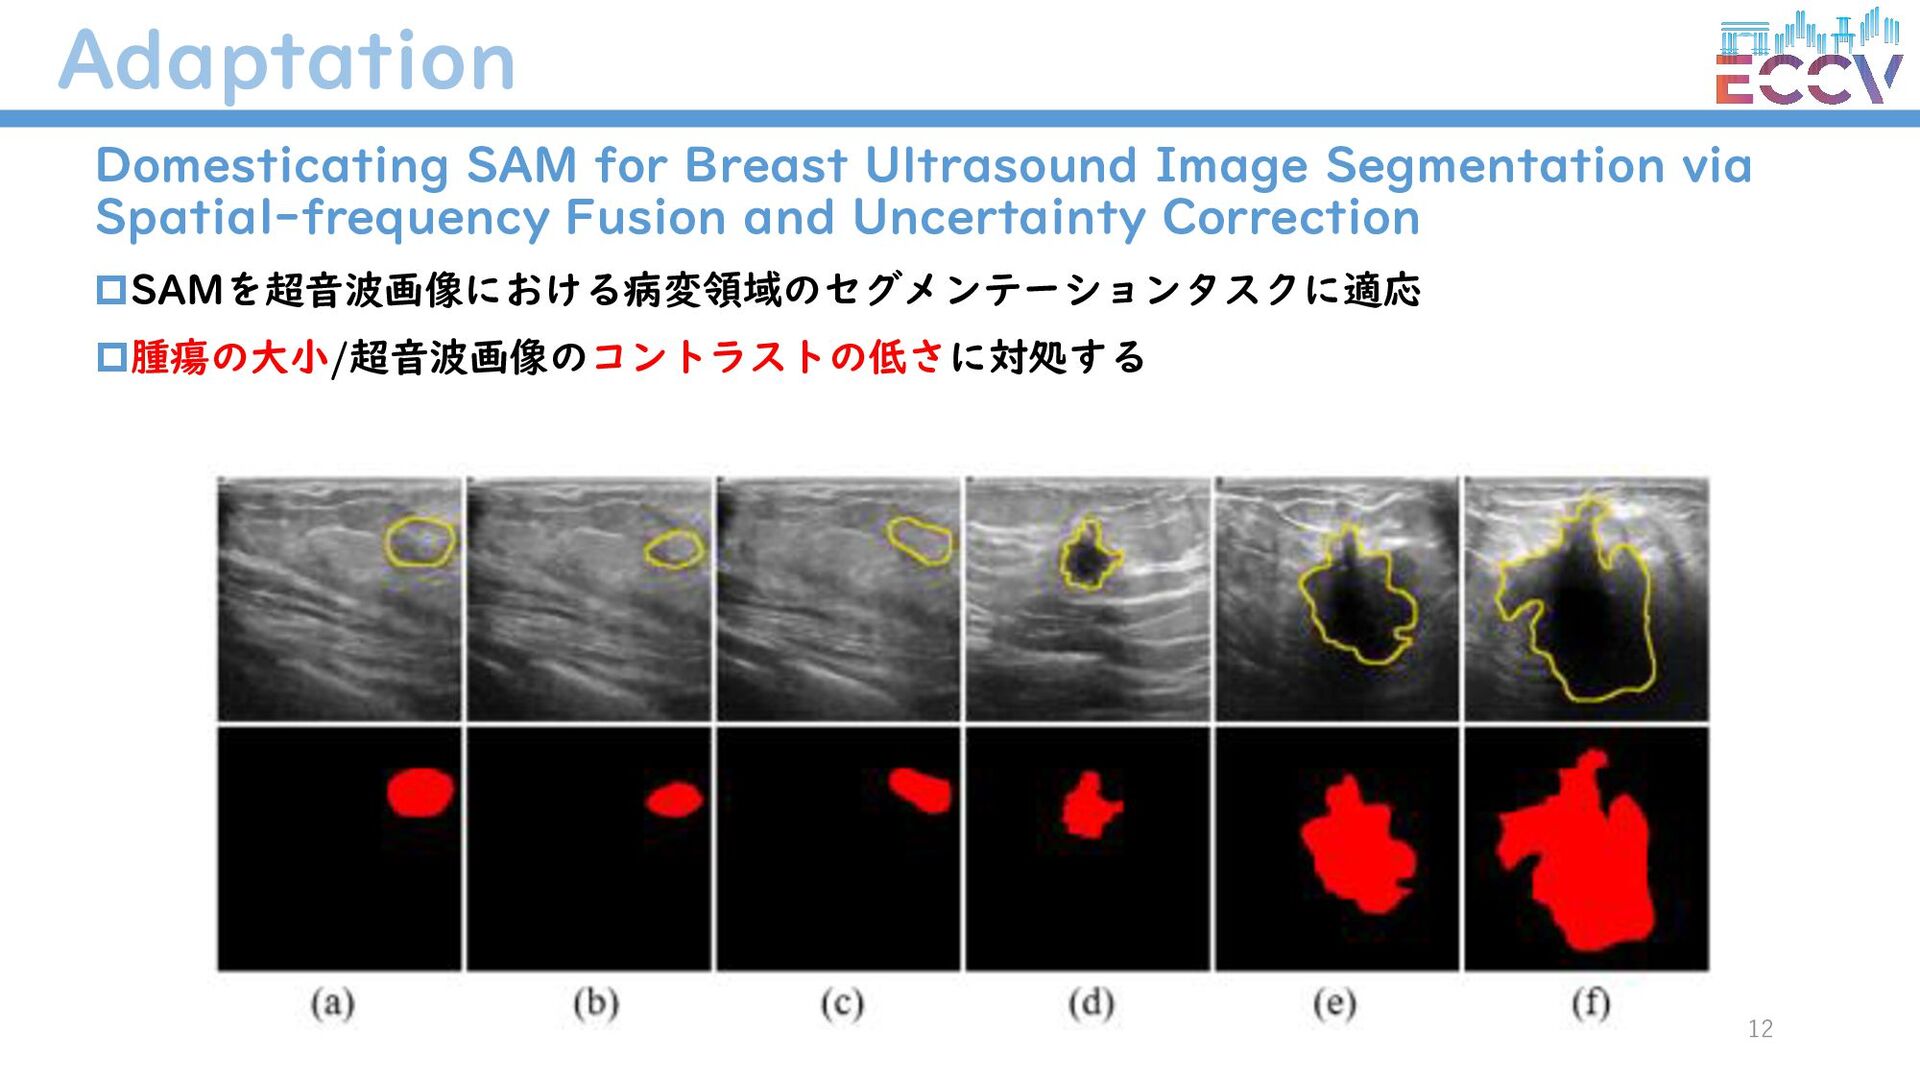
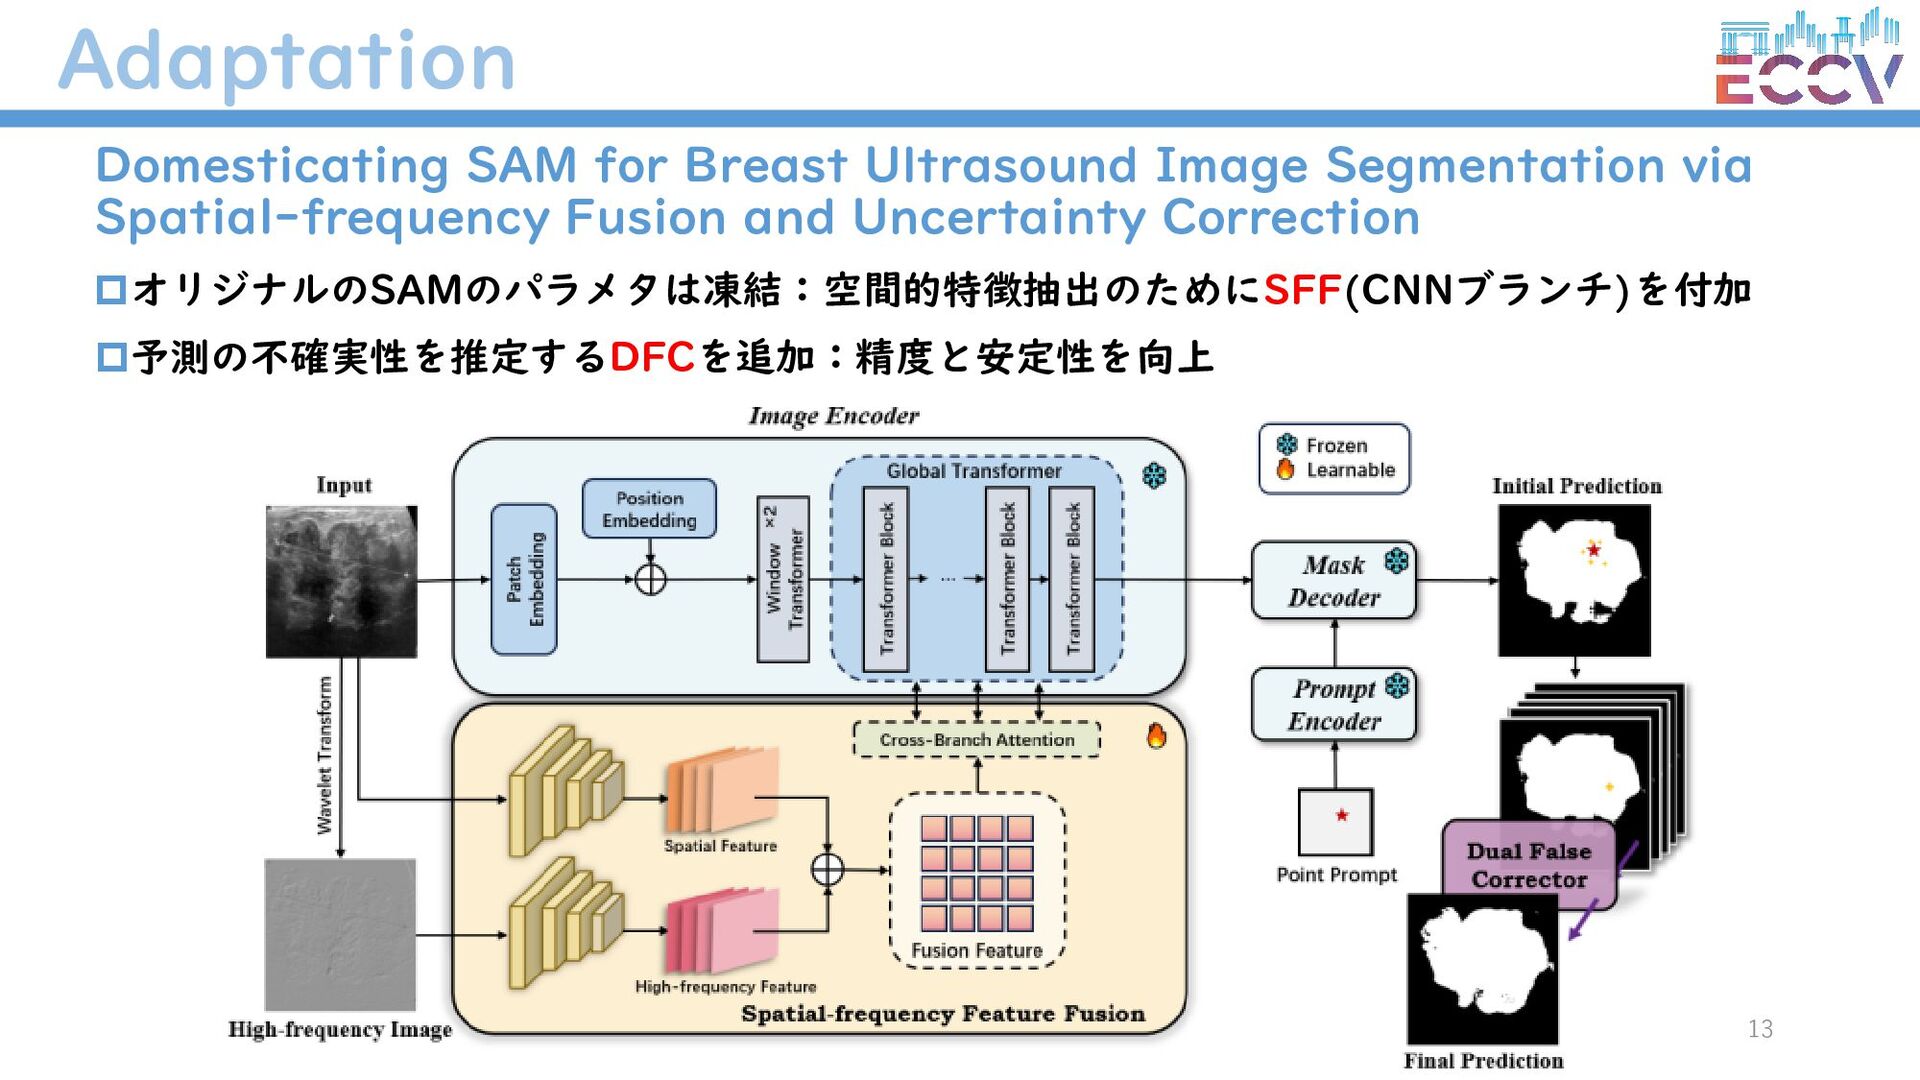
Adaptation 12 Domesticating SAM for Breast Ultrasound Image Segmentation via
Spatial-frequency Fusion and Uncertainty Correction SAMを超音波画像における病変領域のセグメンテーションタスクに適応 腫瘍の大小/超音波画像のコントラストの低さに対処する -
Adaptation 13 Domesticating SAM for Breast Ultrasound Image Segmentation via
Spatial-frequency Fusion and Uncertainty Correction オリジナルのSAMのパラメタは凍結:空間的特徴抽出のためにSFF(CNNブランチ)を付加 予測の不確実性を推定するDFCを追加:精度と安定性を向上 -
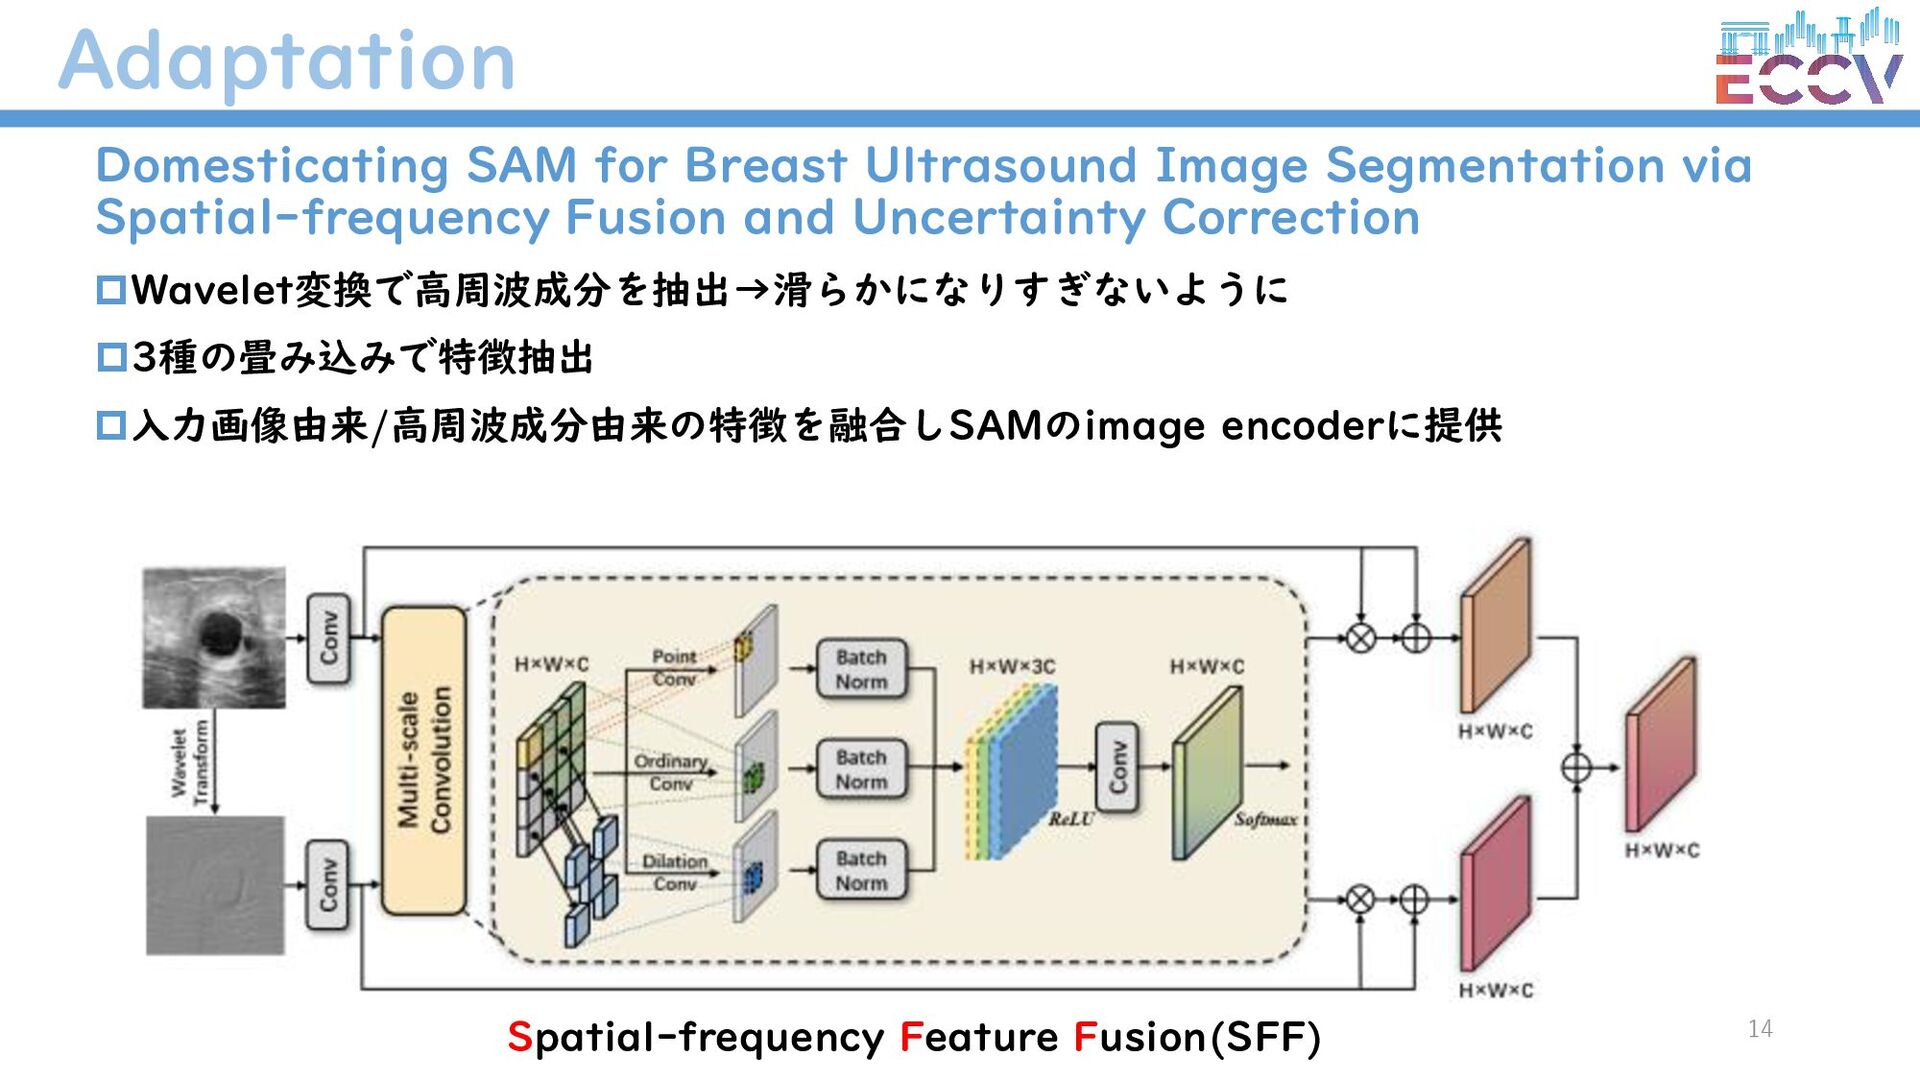
Adaptation 14 Domesticating SAM for Breast Ultrasound Image Segmentation via
Spatial-frequency Fusion and Uncertainty Correction Wavelet変換で高周波成分を抽出→滑らかになりすぎないように 3種の畳み込みで特徴抽出 入力画像由来/高周波成分由来の特徴を融合しSAMのimage encoderに提供 Spatial-frequency Feature Fusion(SFF) -
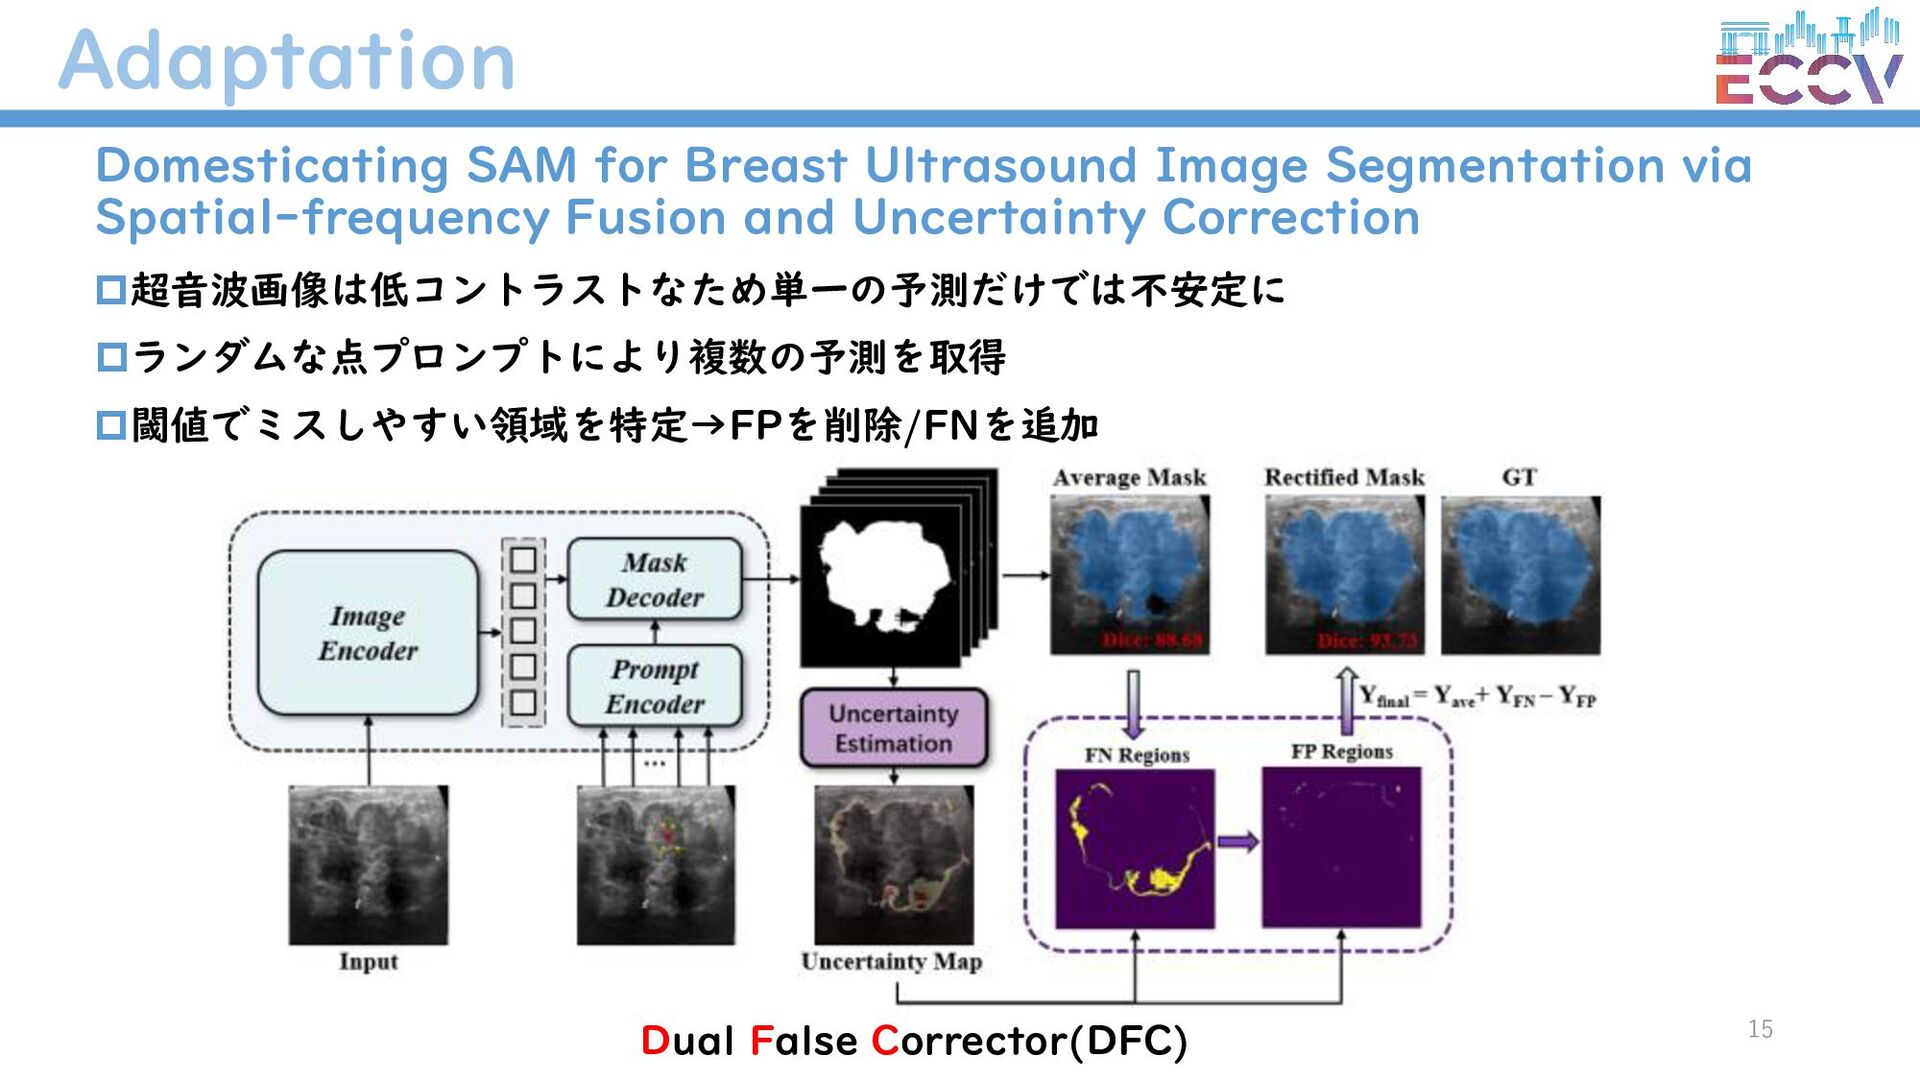
Adaptation 15 Domesticating SAM for Breast Ultrasound Image Segmentation via
Spatial-frequency Fusion and Uncertainty Correction 超音波画像は低コントラストなため単一の予測だけでは不安定に ランダムな点プロンプトにより複数の予測を取得 閾値でミスしやすい領域を特定→FPを削除/FNを追加 Dual False Corrector(DFC) -
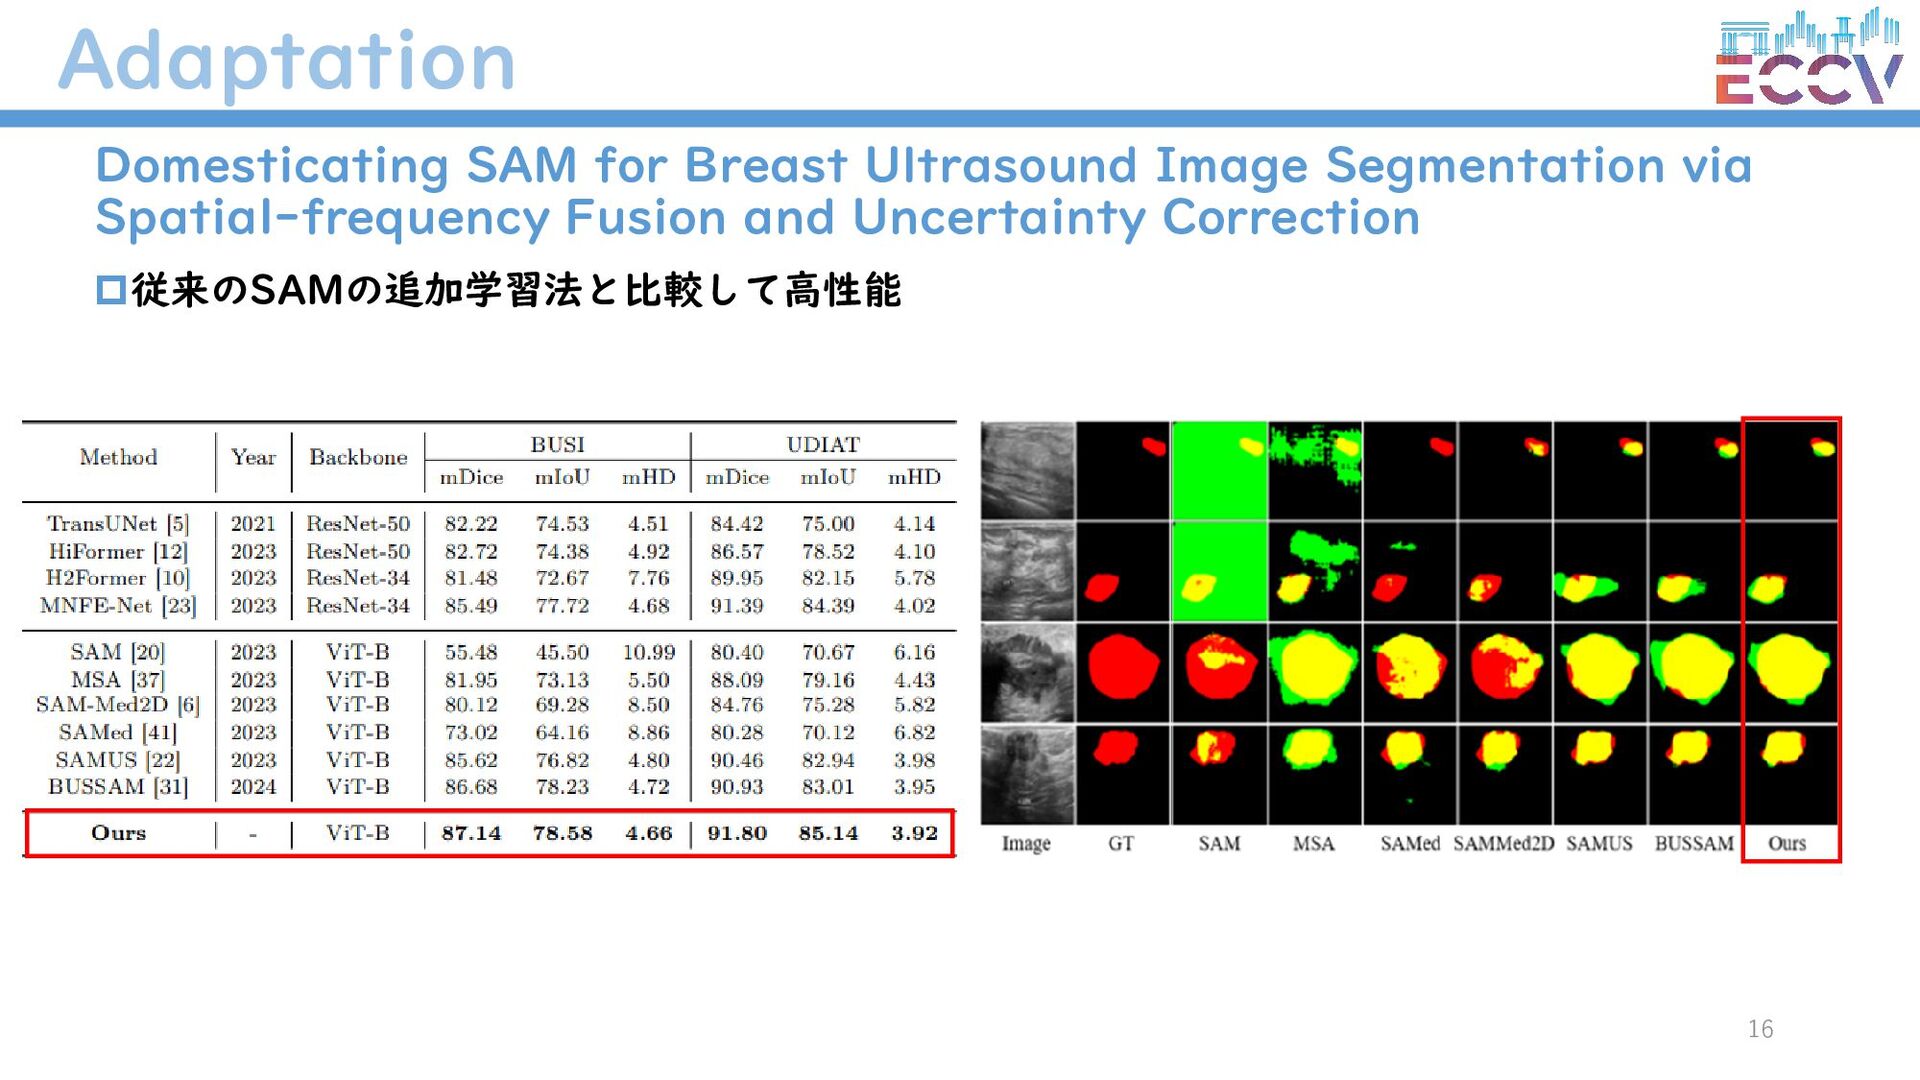
Adaptation 16 Domesticating SAM for Breast Ultrasound Image Segmentation via
Spatial-frequency Fusion and Uncertainty Correction 従来のSAMの追加学習法と比較して高性能 -
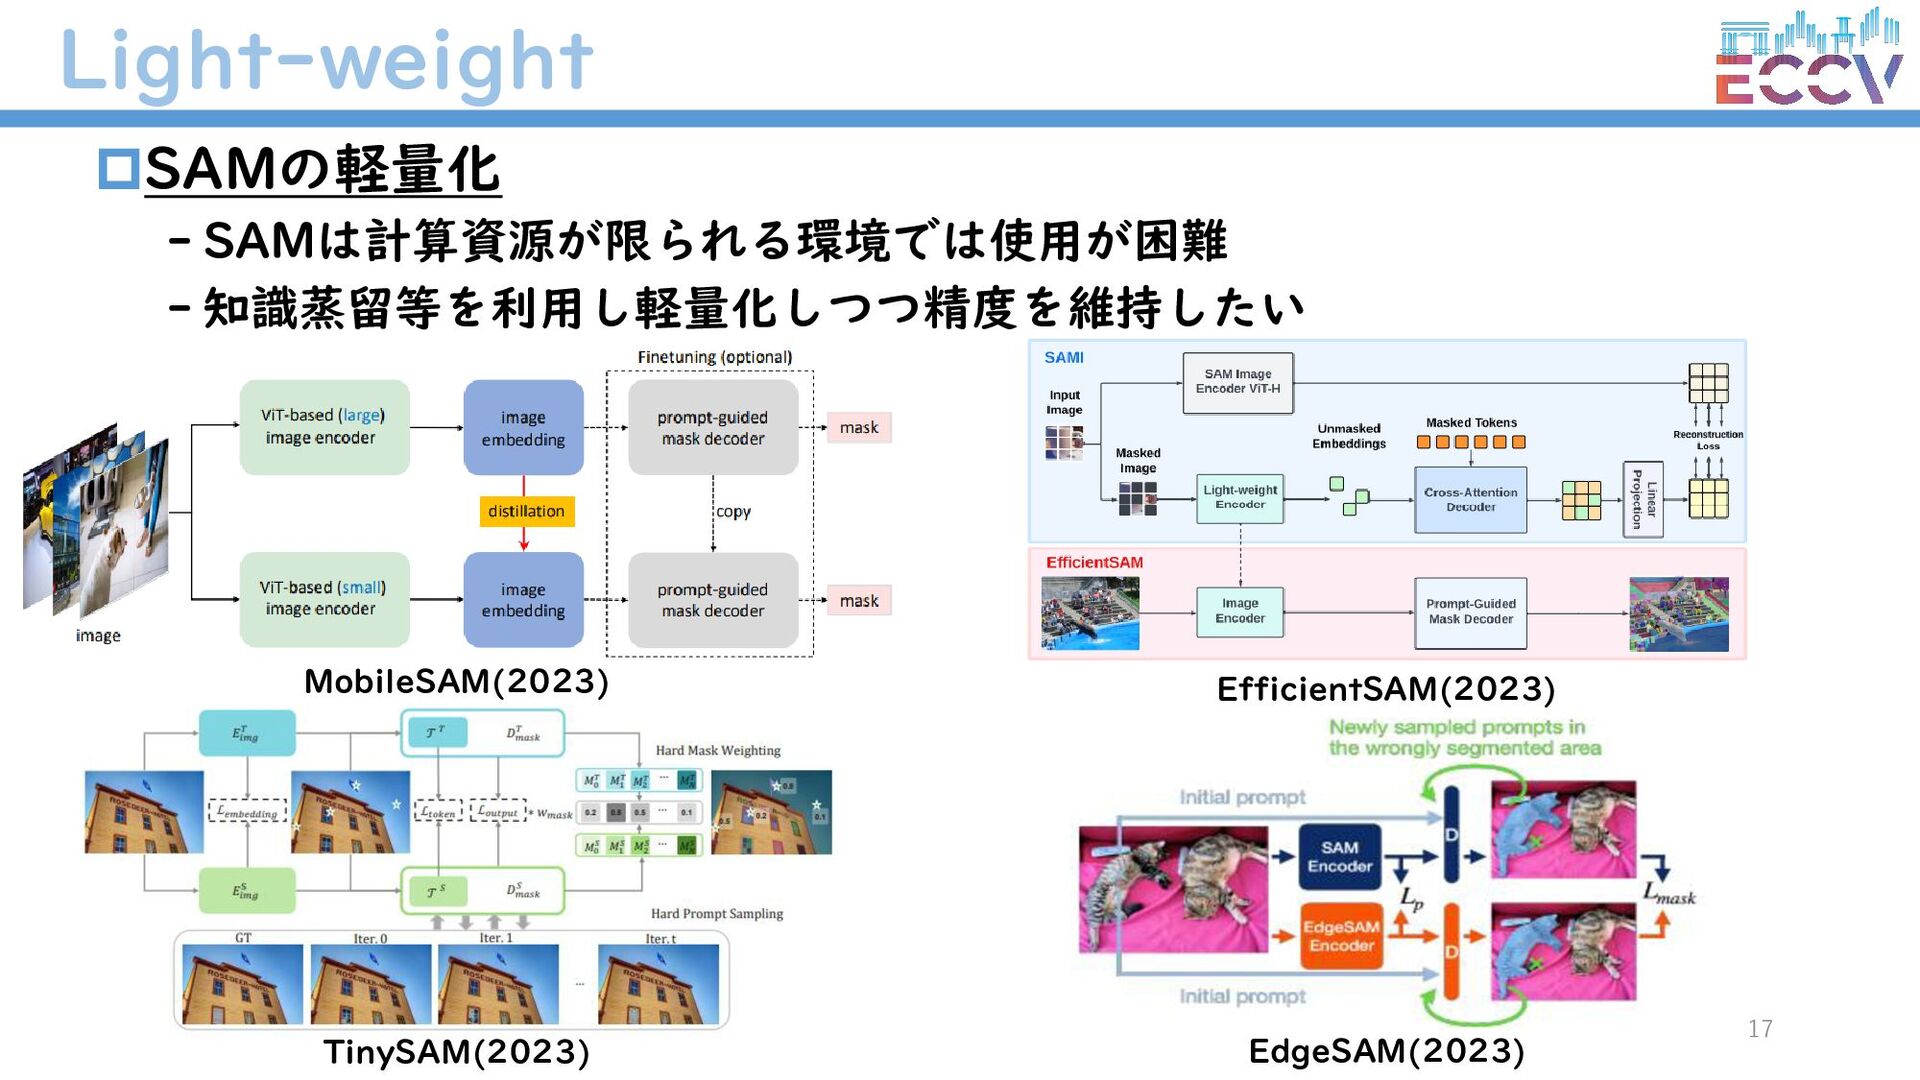
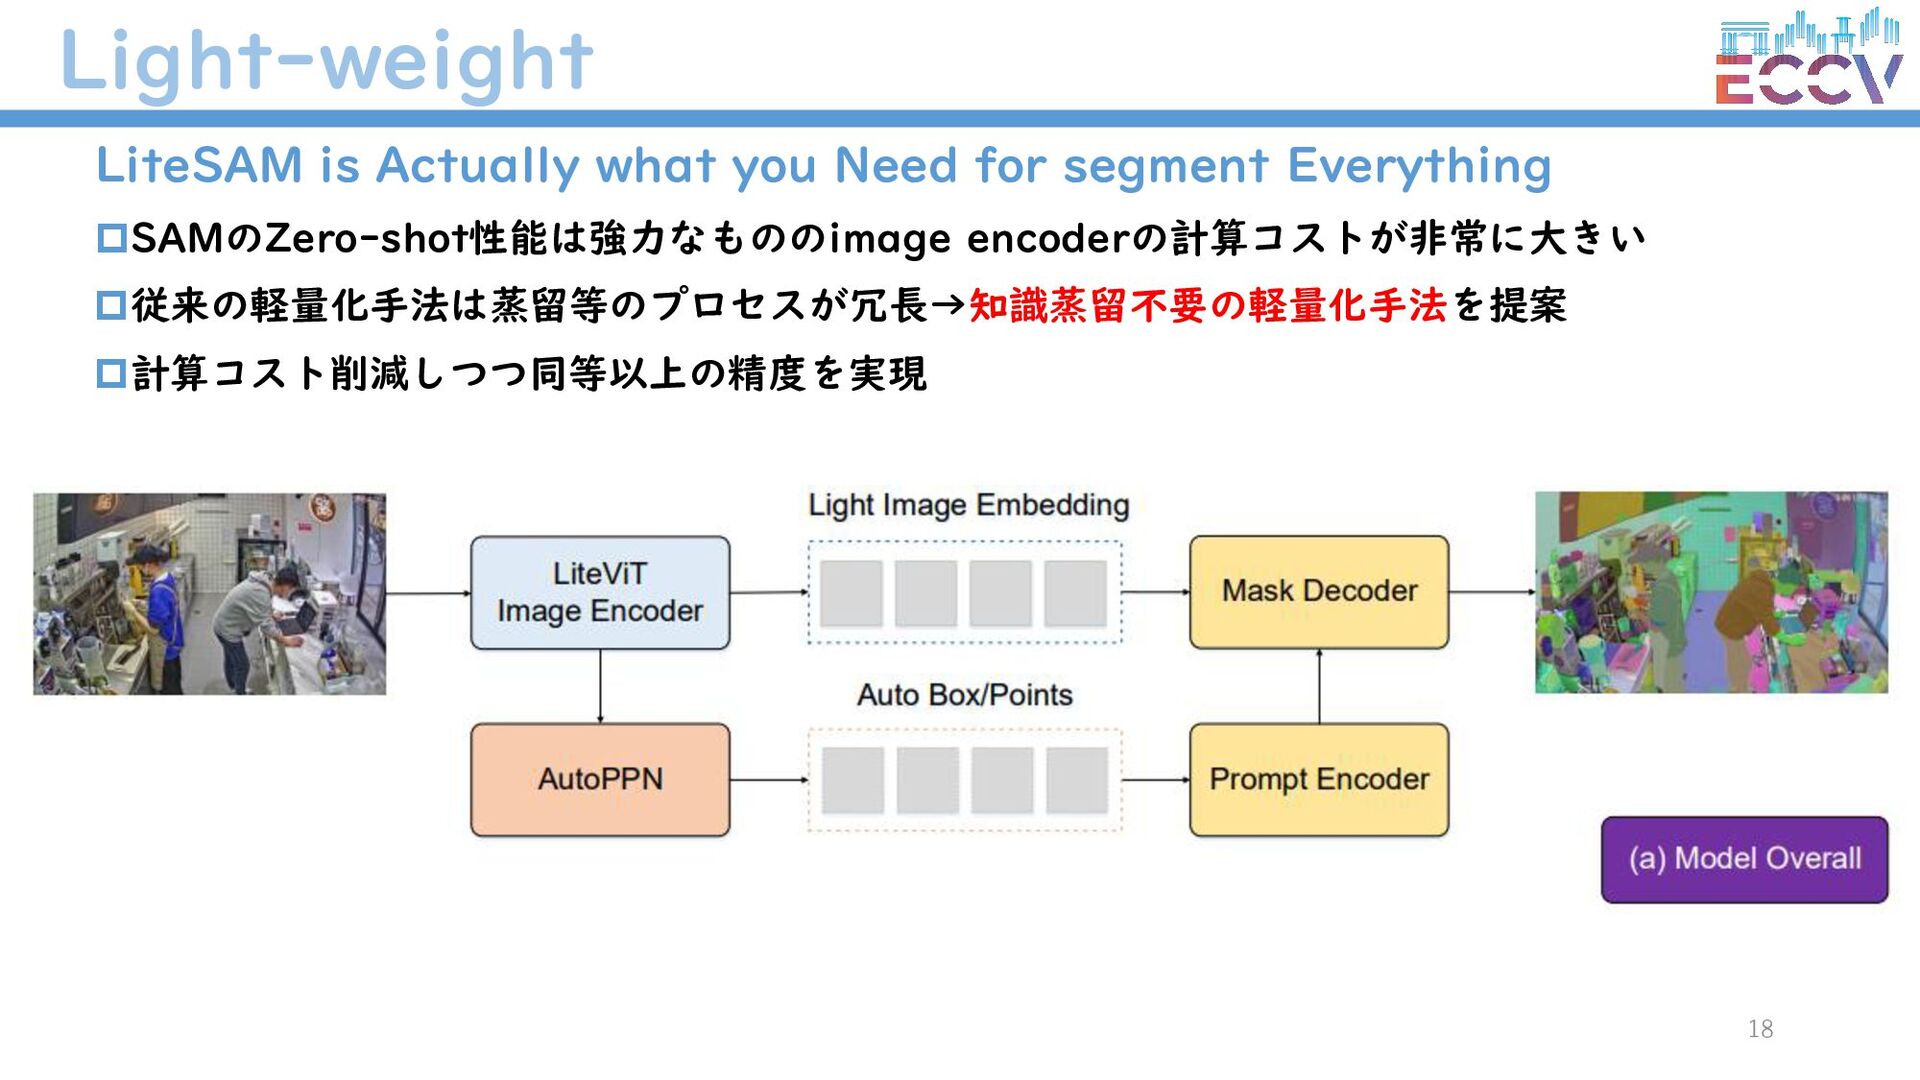
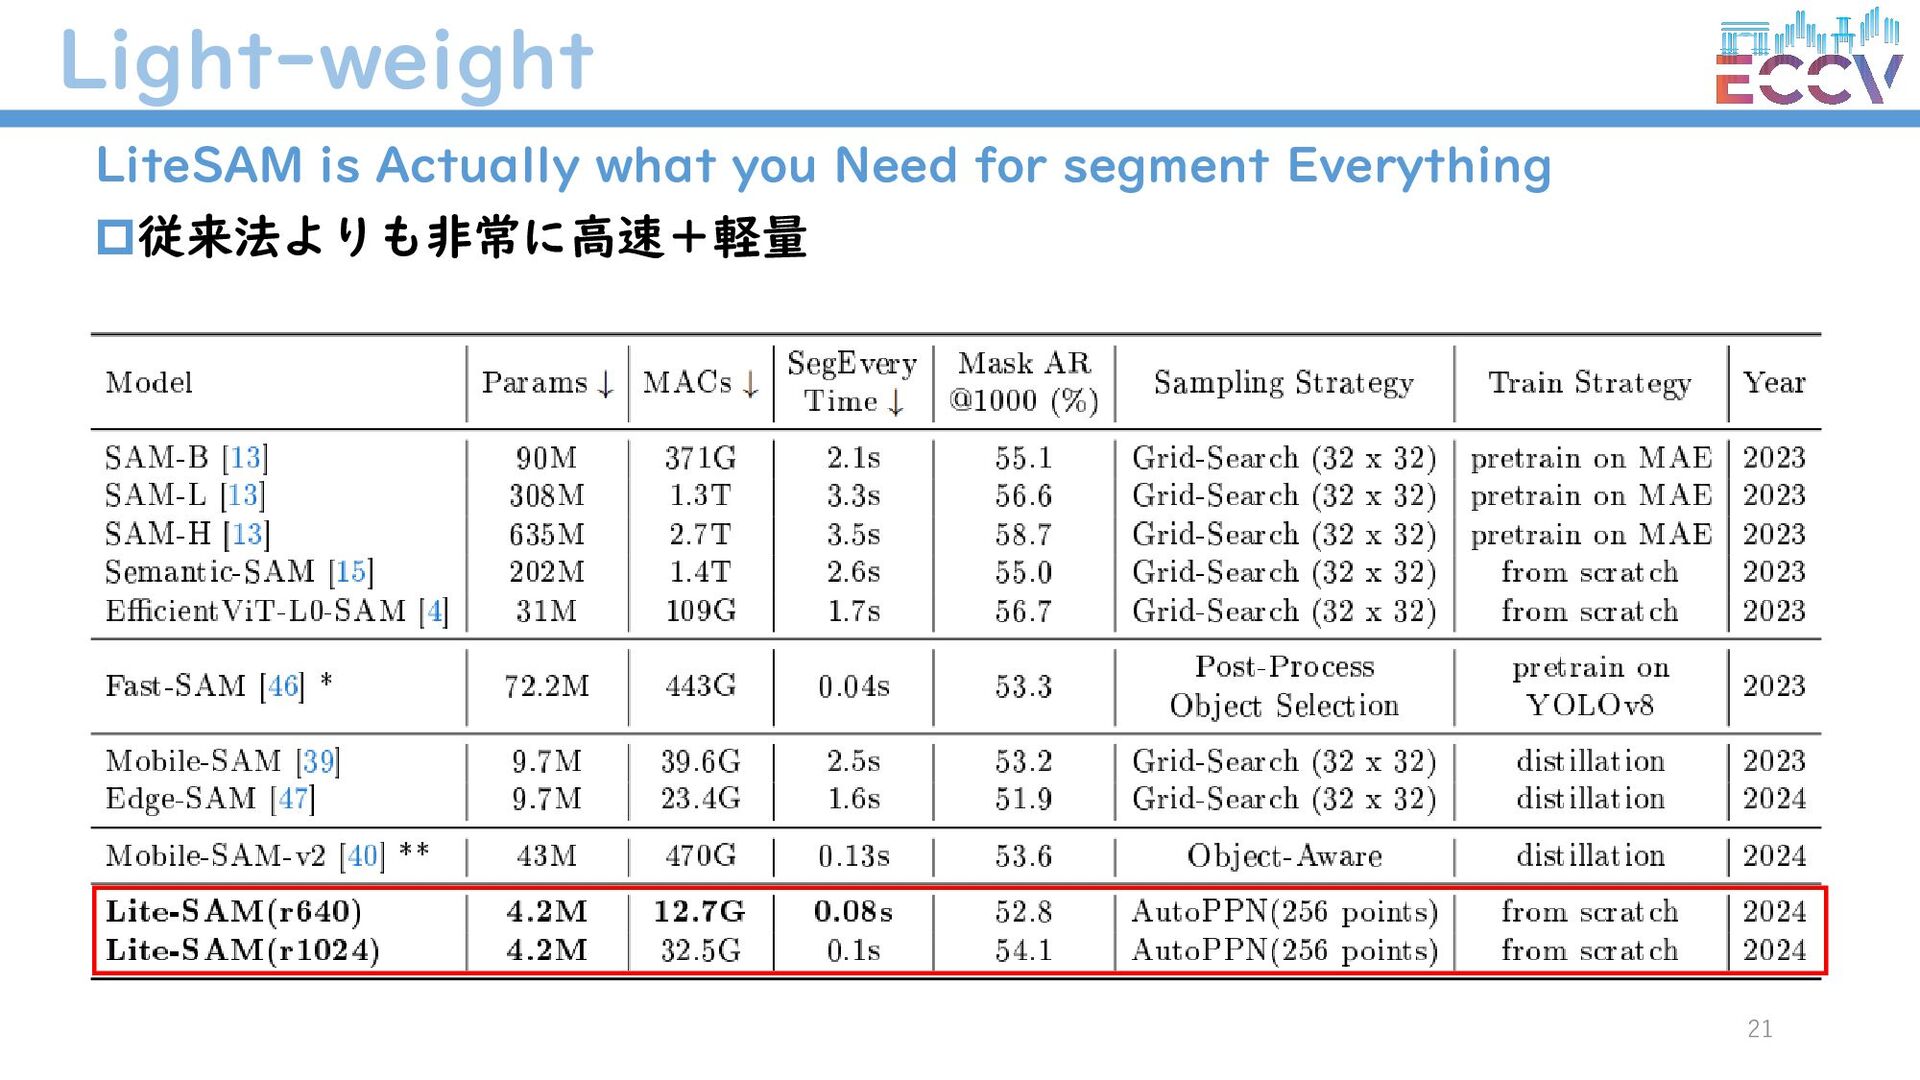
Light-weight 18 LiteSAM is Actually what you Need for segment
Everything SAMのZero-shot性能は強力なもののimage encoderの計算コストが非常に大きい 従来の軽量化手法は蒸留等のプロセスが冗長→知識蒸留不要の軽量化手法を提案 計算コスト削減しつつ同等以上の精度を実現 -
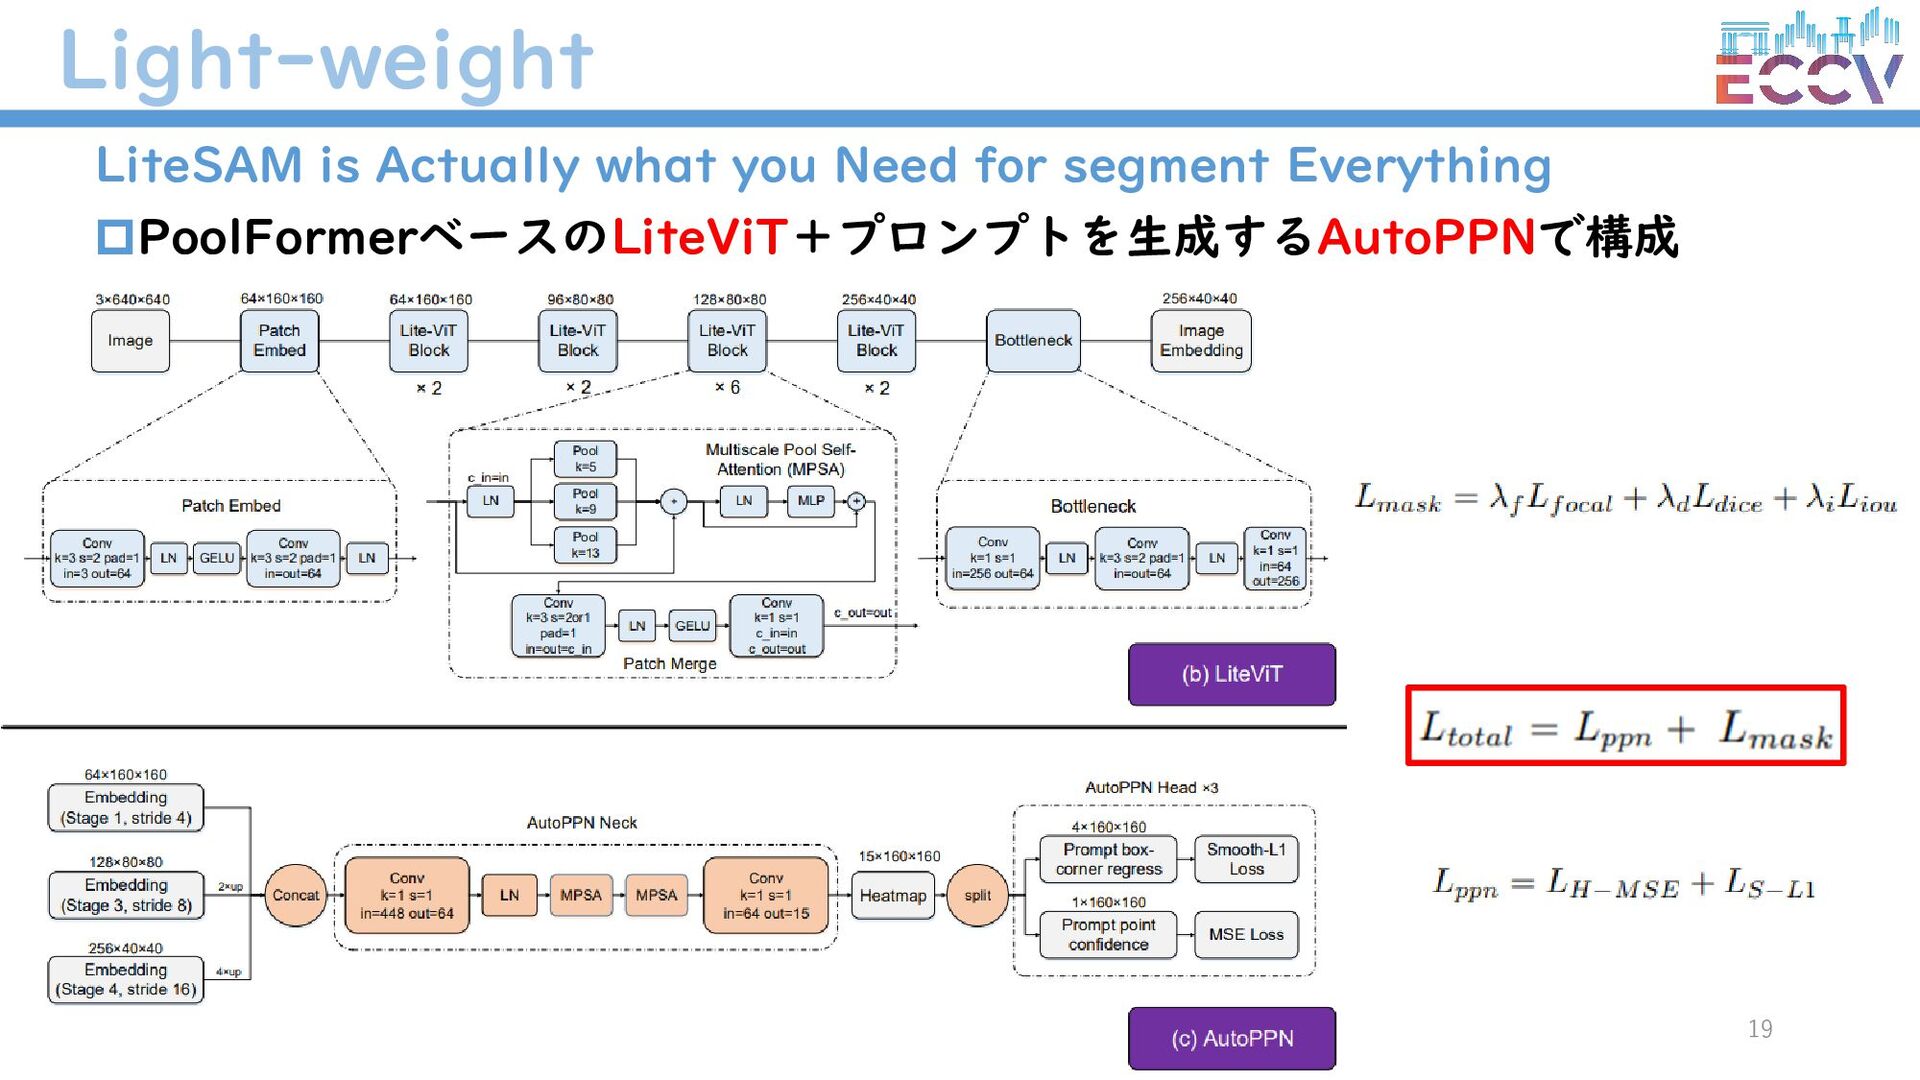
Light-weight 19 LiteSAM is Actually what you Need for segment
Everything PoolFormerベースのLiteViT+プロンプトを生成するAutoPPNで構成 -
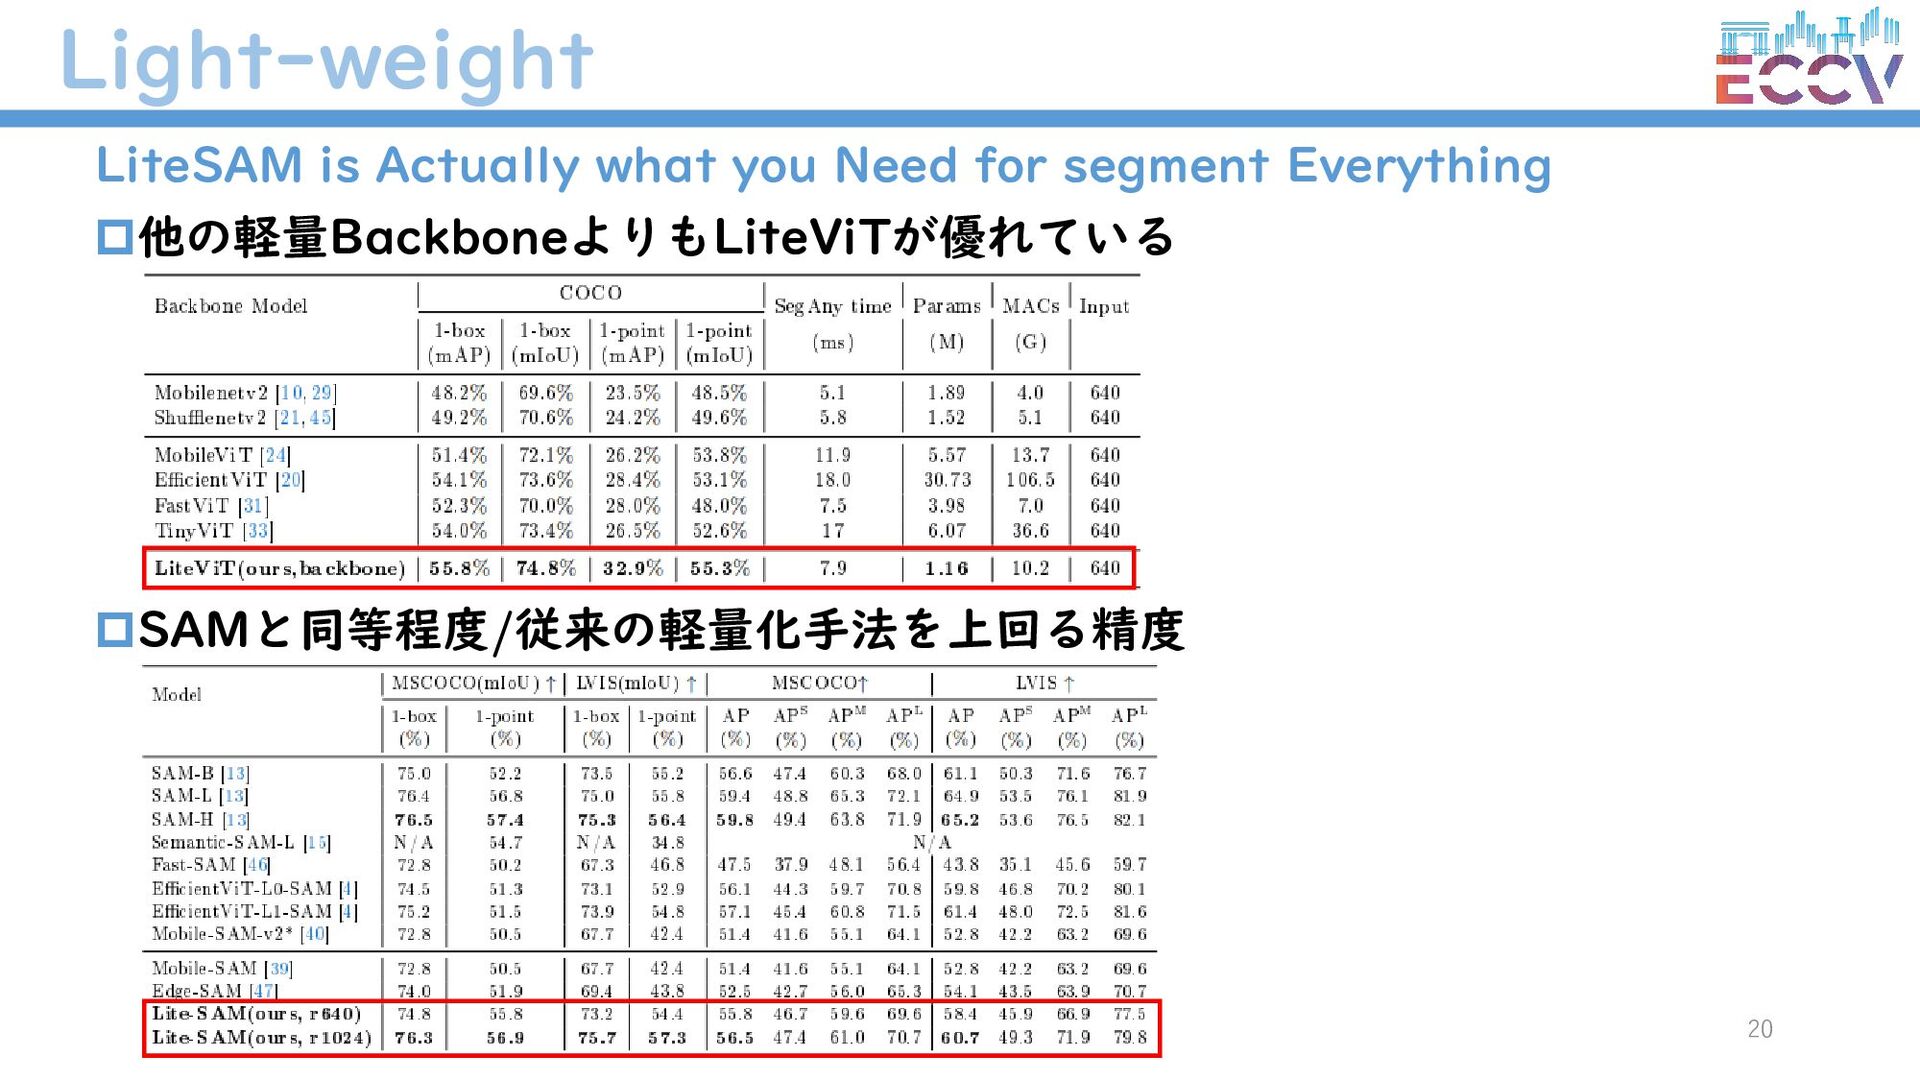
Light-weight 20 LiteSAM is Actually what you Need for segment
Everything 他の軽量BackboneよりもLiteViTが優れている SAMと同等程度/従来の軽量化手法を上回る精度 -
Light-weight 21 LiteSAM is Actually what you Need for segment
Everything 従来法よりも非常に高速+軽量 -
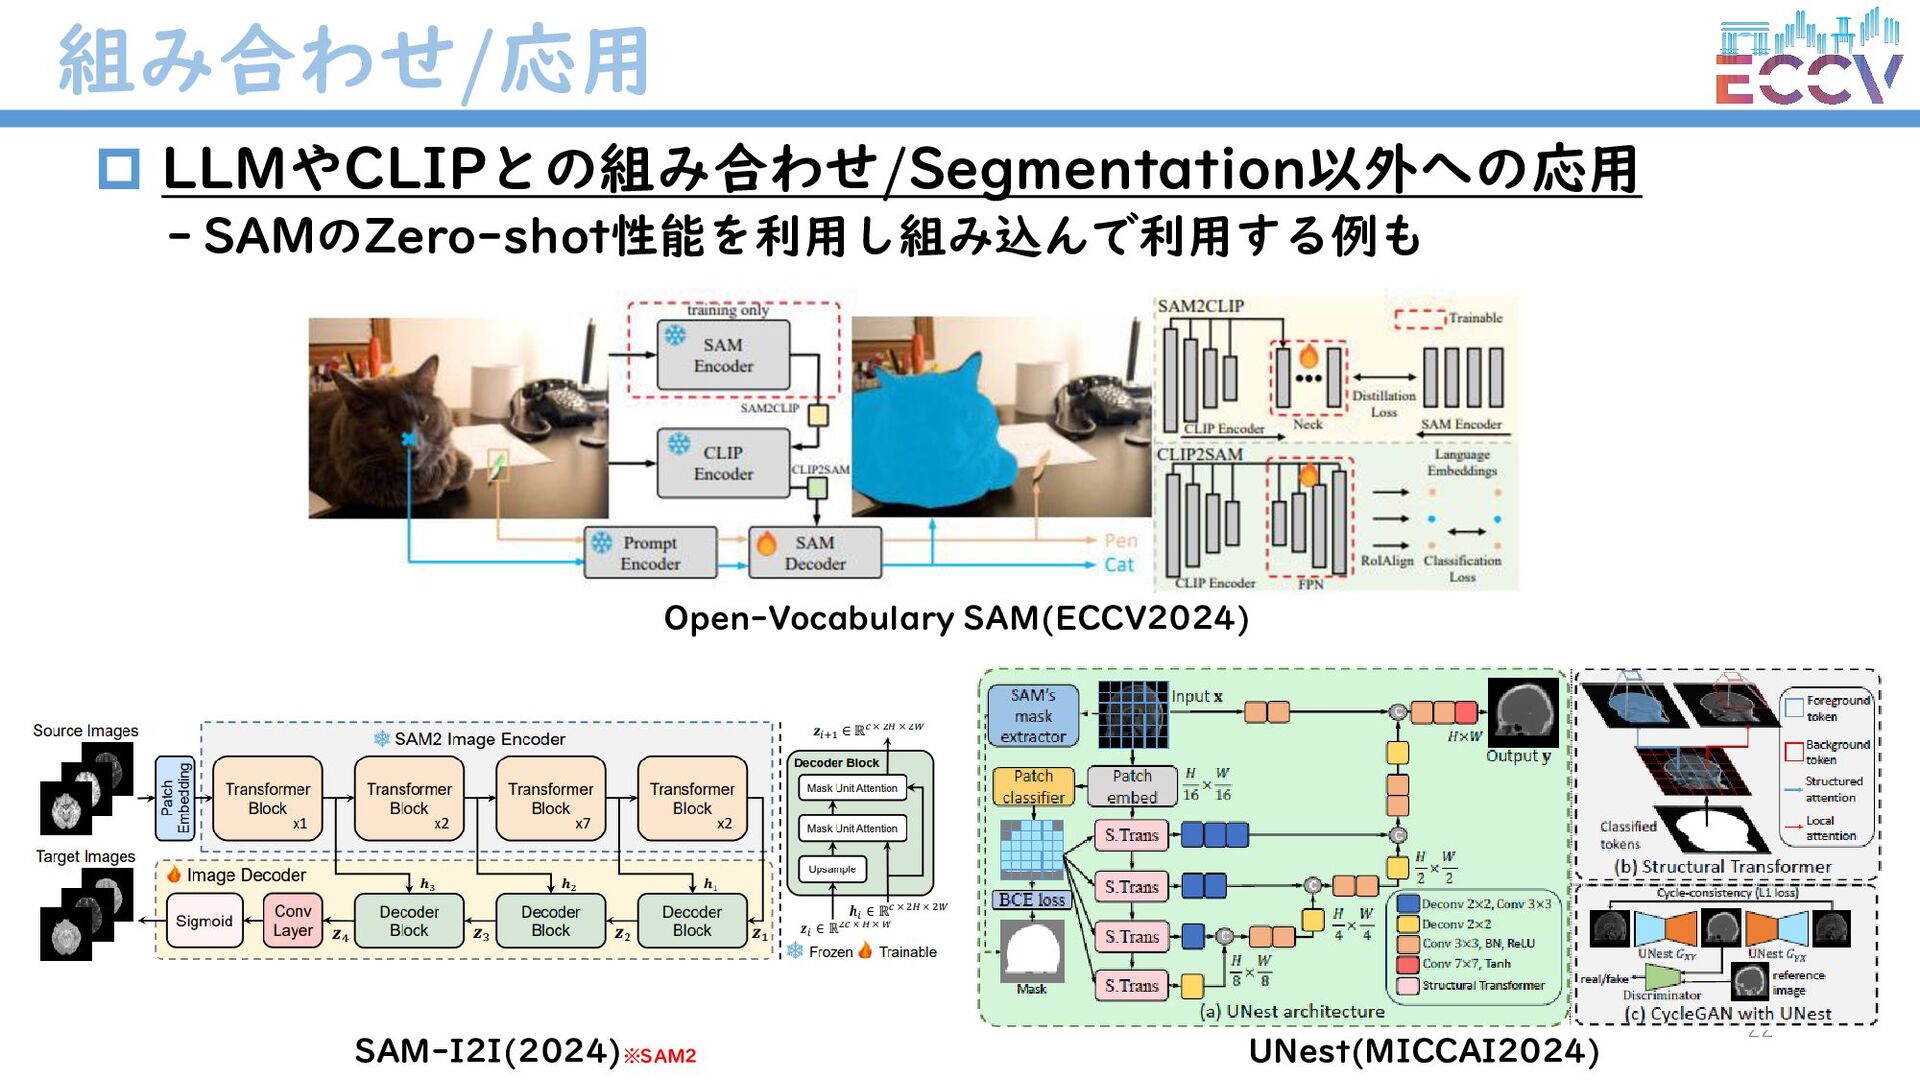
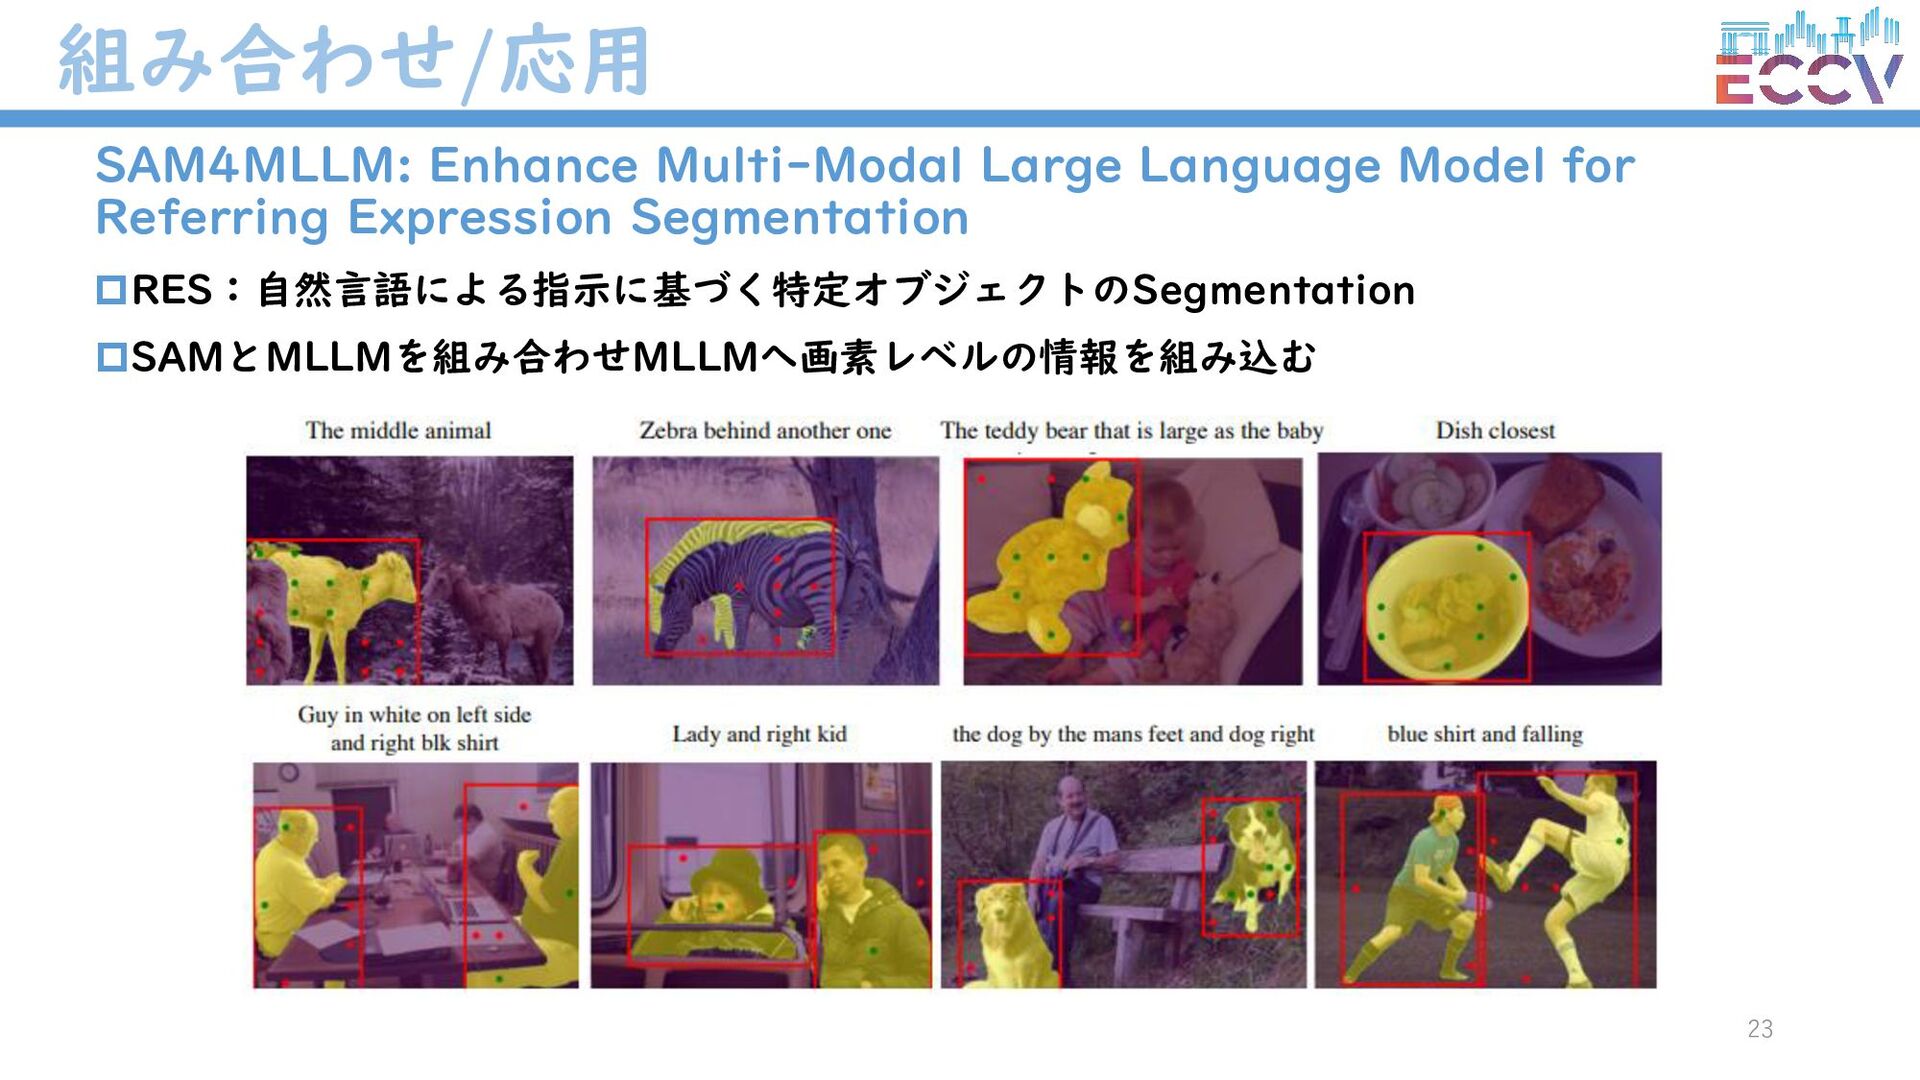
組み合わせ/応用 23 SAM4MLLM: Enhance Multi-Modal Large Language Model for Referring
Expression Segmentation RES:自然言語による指示に基づく特定オブジェクトのSegmentation SAMとMLLMを組み合わせMLLMへ画素レベルの情報を組み込む -
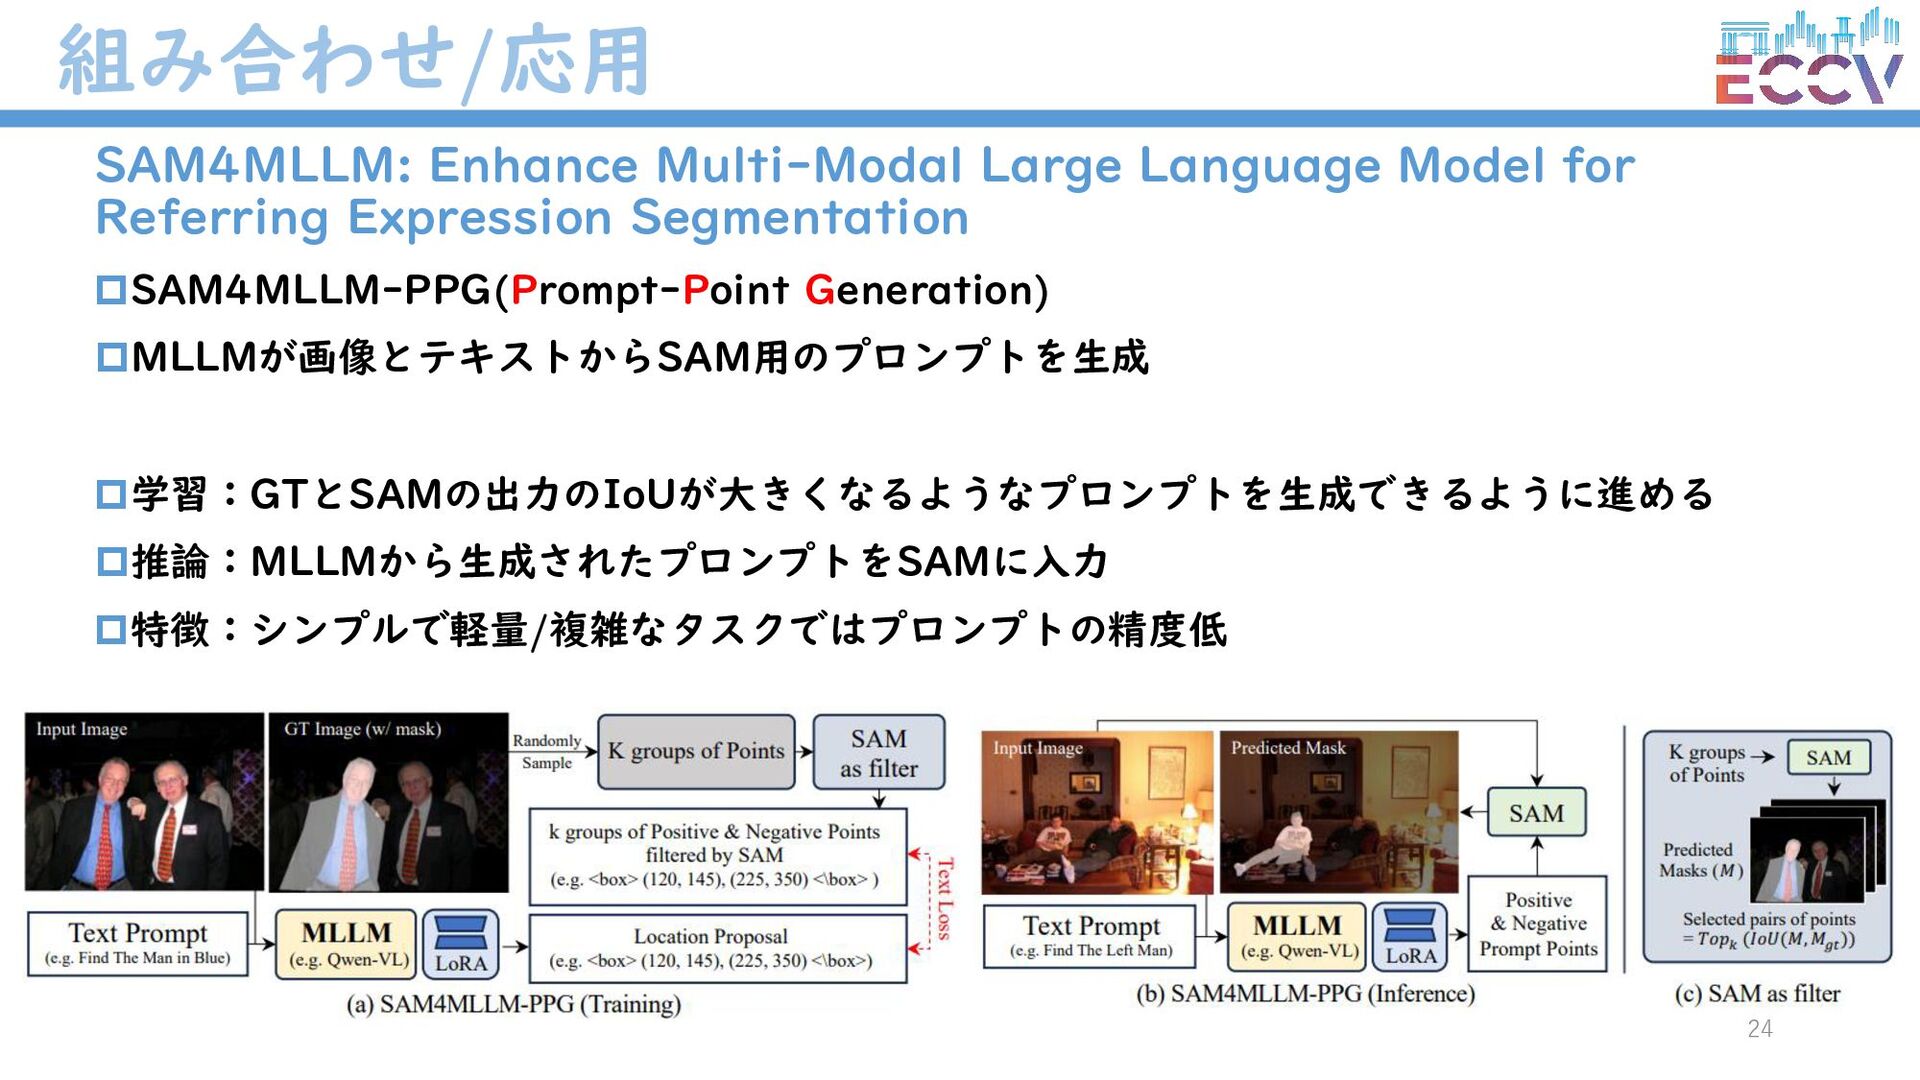
組み合わせ/応用 24 SAM4MLLM: Enhance Multi-Modal Large Language Model for Referring
Expression Segmentation SAM4MLLM-PPG(Prompt-Point Generation) MLLMが画像とテキストからSAM用のプロンプトを生成 学習:GTとSAMの出力のIoUが大きくなるようなプロンプトを生成できるように進める 推論:MLLMから生成されたプロンプトをSAMに入力 特徴:シンプルで軽量/複雑なタスクではプロンプトの精度低 -
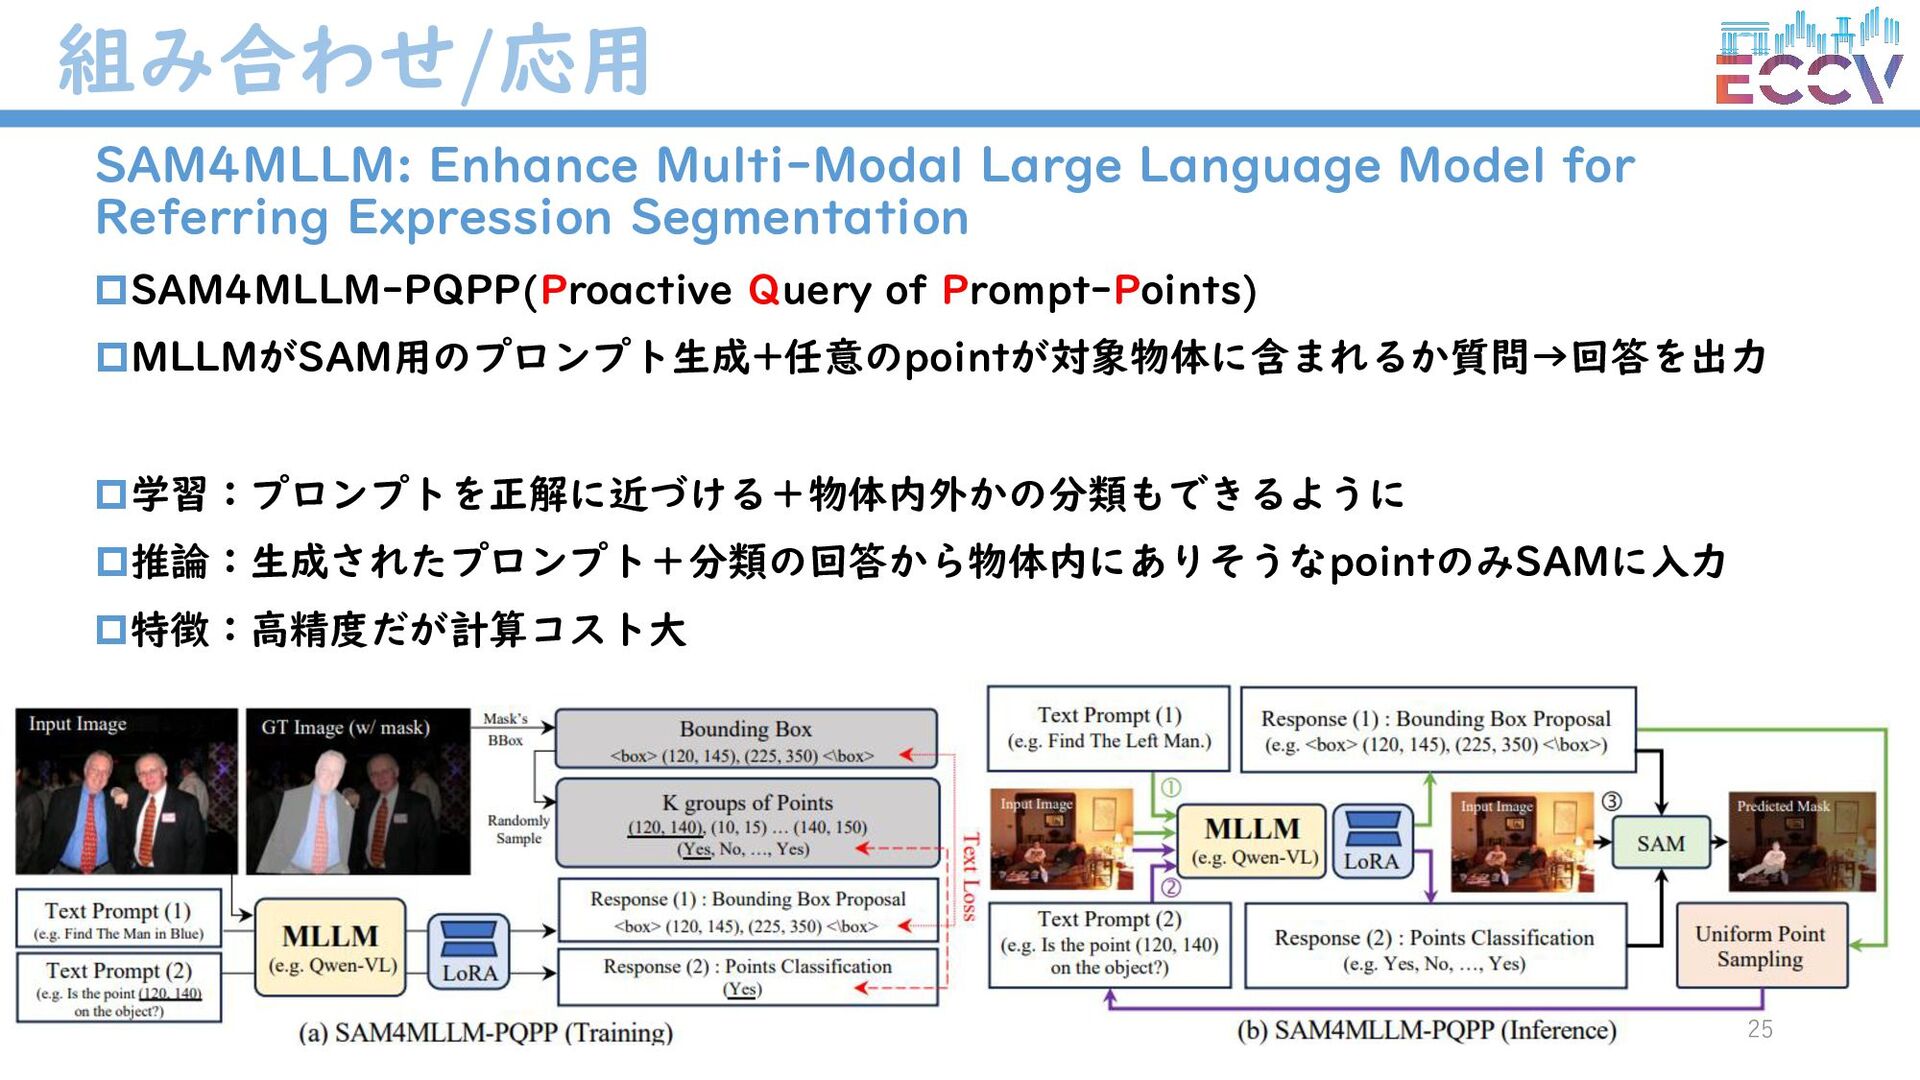
組み合わせ/応用 25 SAM4MLLM: Enhance Multi-Modal Large Language Model for Referring
Expression Segmentation SAM4MLLM-PQPP(Proactive Query of Prompt-Points) MLLMがSAM用のプロンプト生成+任意のpointが対象物体に含まれるか質問→回答を出力 学習:プロンプトを正解に近づける+物体内外かの分類もできるように 推論:生成されたプロンプト+分類の回答から物体内にありそうなpointのみSAMに入力 特徴:高精度だが計算コスト大 -
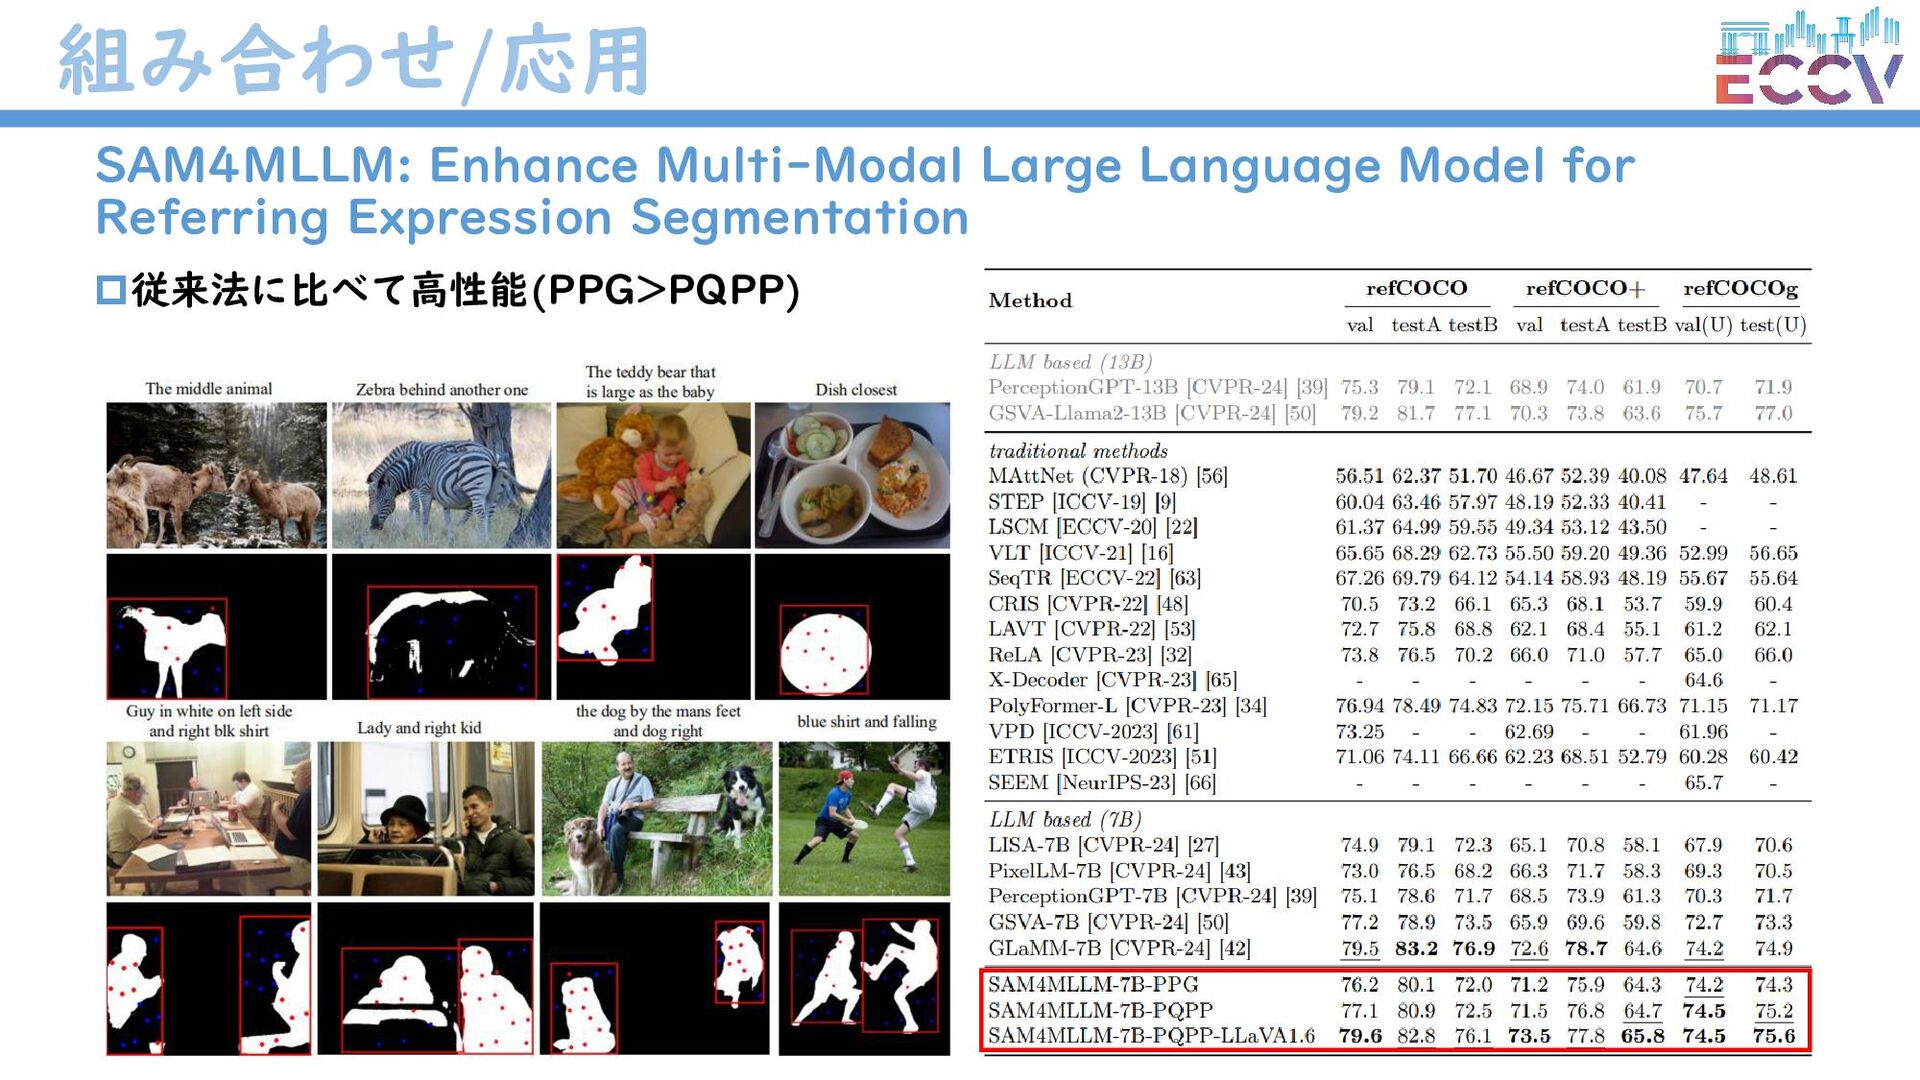
組み合わせ/応用 26 SAM4MLLM: Enhance Multi-Modal Large Language Model for Referring
Expression Segmentation 従来法に比べて高性能(PPG>PQPP) -
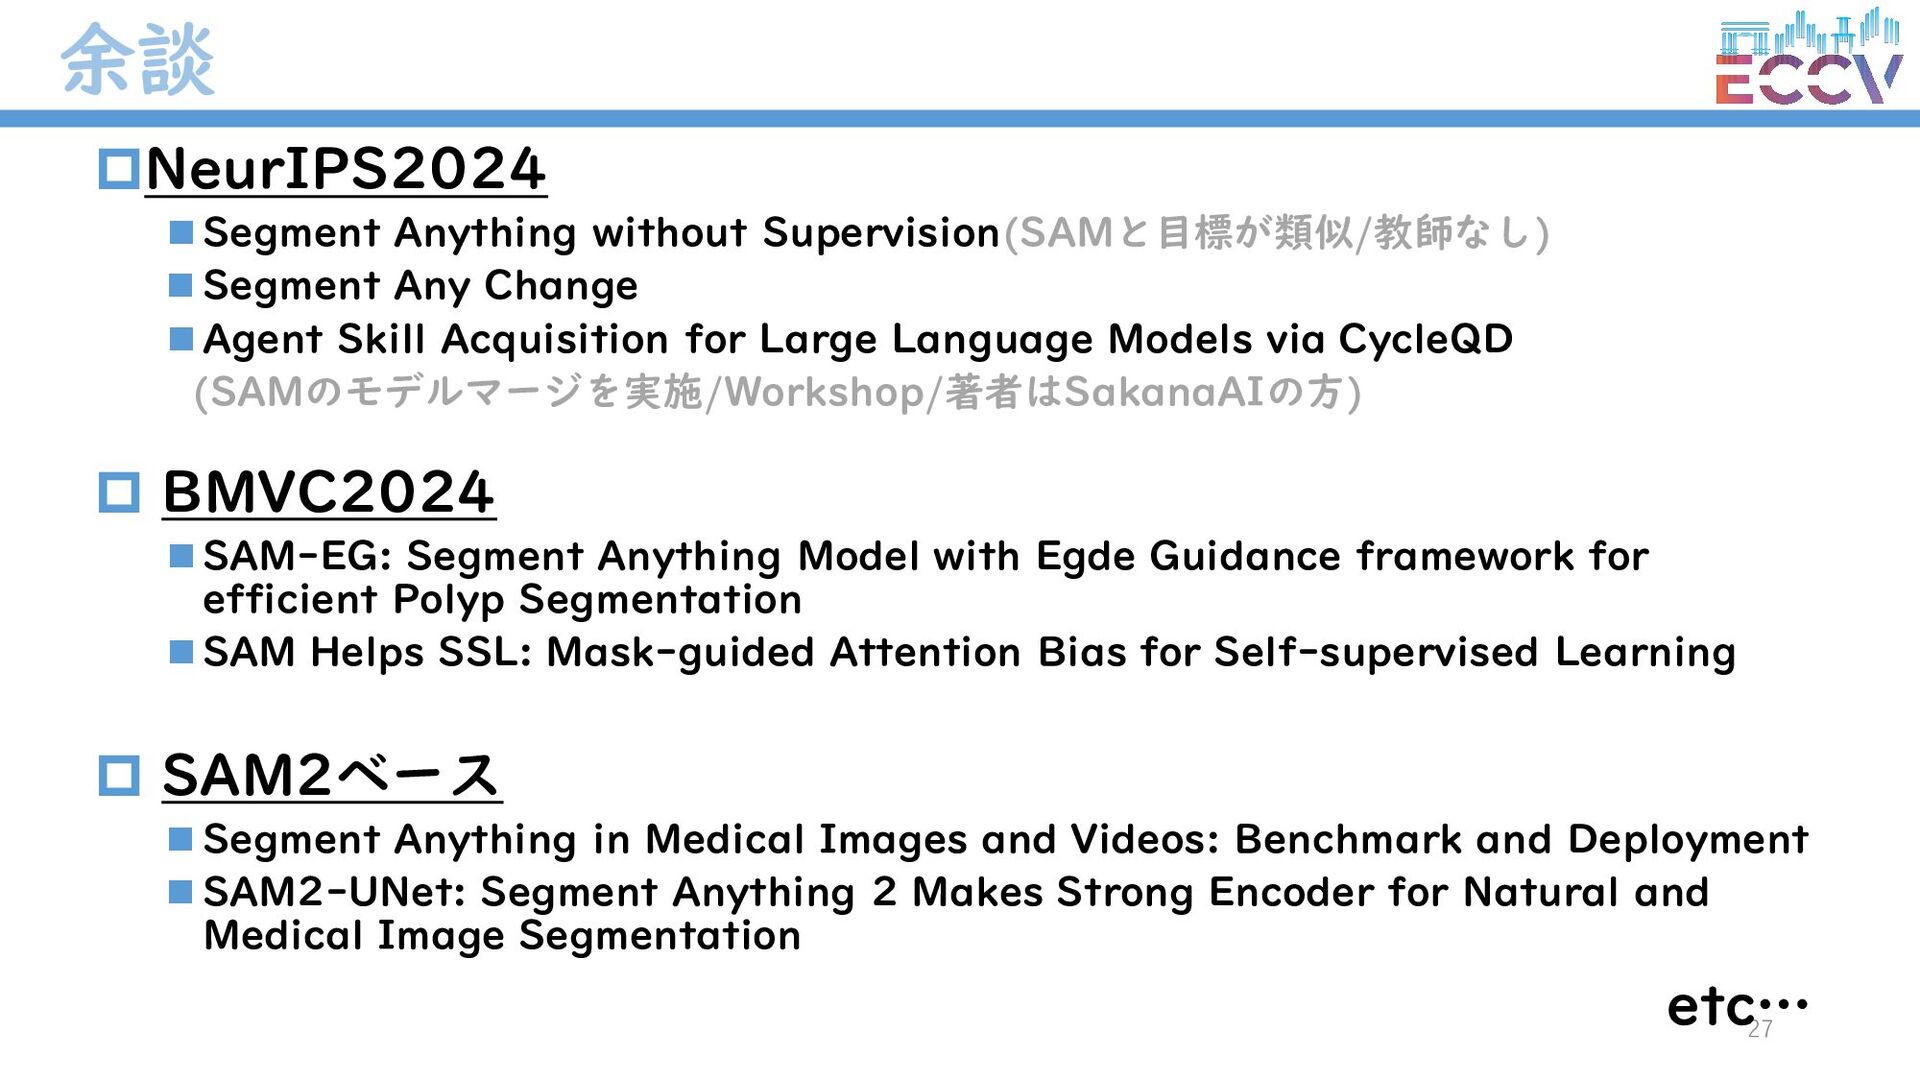
余談 27 NeurIPS2024 ◼ Segment Anything without Supervision(SAMと目標が類似/教師なし) ◼ Segment
Any Change ◼ Agent Skill Acquisition for Large Language Models via CycleQD (SAMのモデルマージを実施/Workshop/著者はSakanaAIの方) BMVC2024 ◼ SAM-EG: Segment Anything Model with Egde Guidance framework for efficient Polyp Segmentation ◼ SAM Helps SSL: Mask-guided Attention Bias for Self-supervised Learning SAM2ベース ◼ Segment Anything in Medical Images and Videos: Benchmark and Deployment ◼ SAM2-UNet: Segment Anything 2 Makes Strong Encoder for Natural and Medical Image Segmentation etc… -
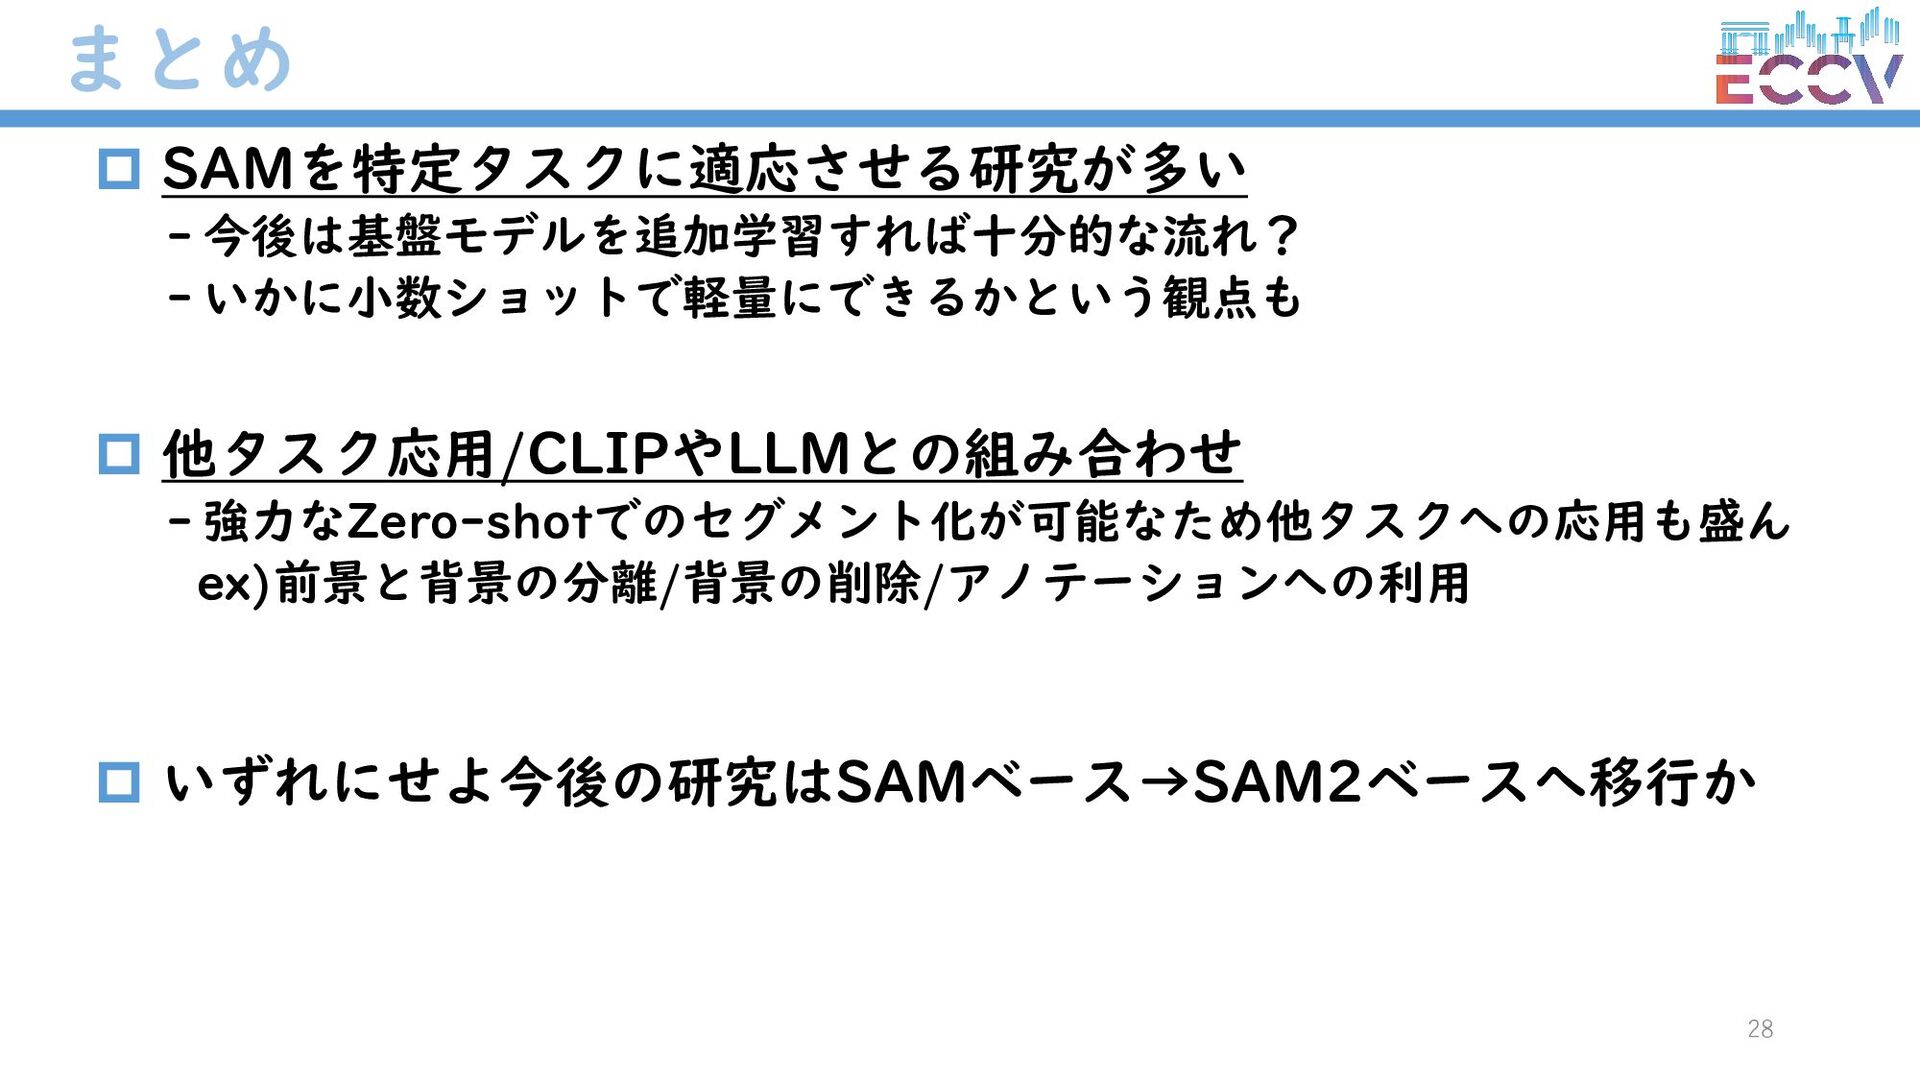
まとめ 28 SAMを特定タスクに適応させる研究が多い - 今後は基盤モデルを追加学習すれば十分的な流れ? - いかに小数ショットで軽量にできるかという観点も 他タスク応用/CLIPやLLMとの組み合わせ
- 強力なZero-shotでのセグメント化が可能なため他タスクへの応用も盛ん ex)前景と背景の分離/背景の削除/アノテーションへの利用 いずれにせよ今後の研究はSAMベース→SAM2ベースへ移行か