Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AI駆動TDD ― 2026年10月版

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →
Avatar for まりも まりも
November 01, 2026

AI駆動TDD ― 2026年10月版

AI駆動開発において、TDDと適切なレイヤー設計を活用し、生産性と品質を高めるための資料です。

工程ごとに考える対象を分けること、Skipテストによる仕様管理、人間のレビュー、AIへの指示と履歴管理を紹介します。付録にはTDD作業指示の全文を掲載しています。

Avatar for まりも

まりも

November 01, 2026

More Decks by まりも

Other Decks in Programming

Transcript

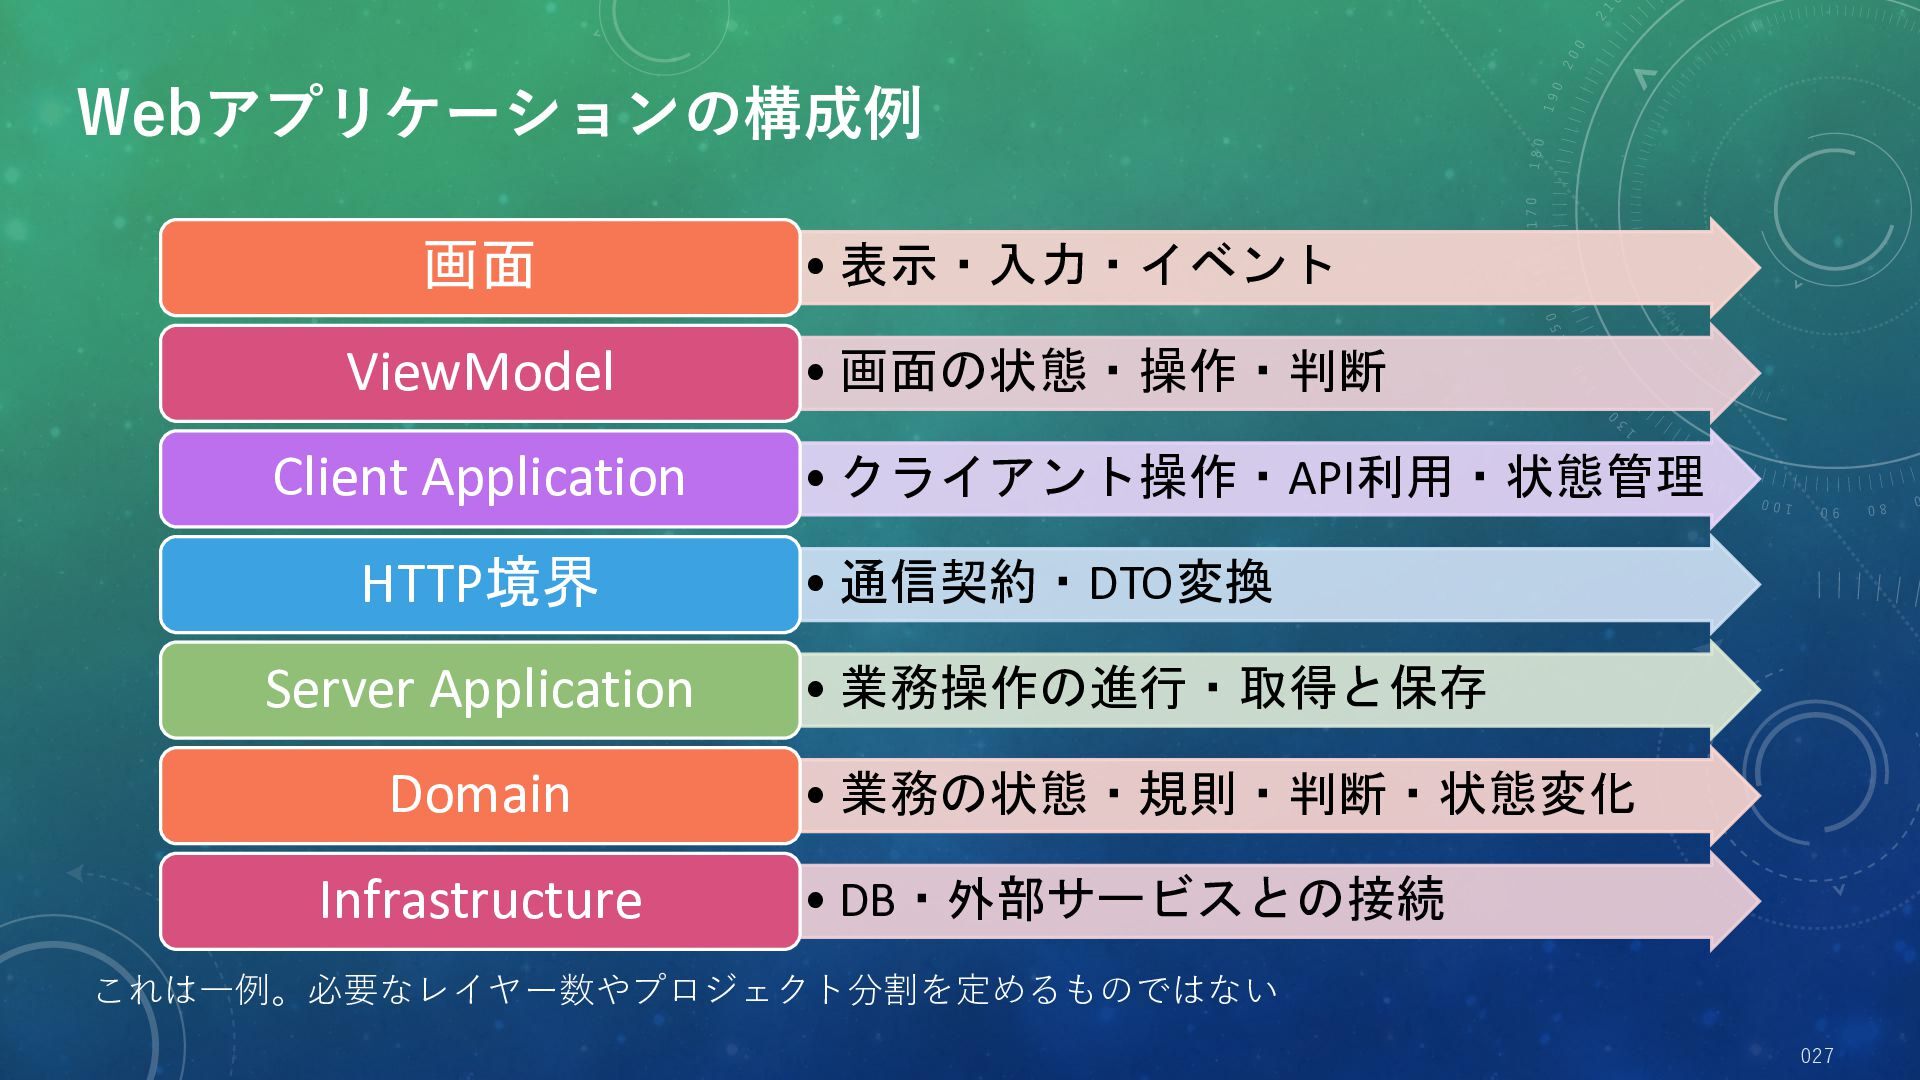
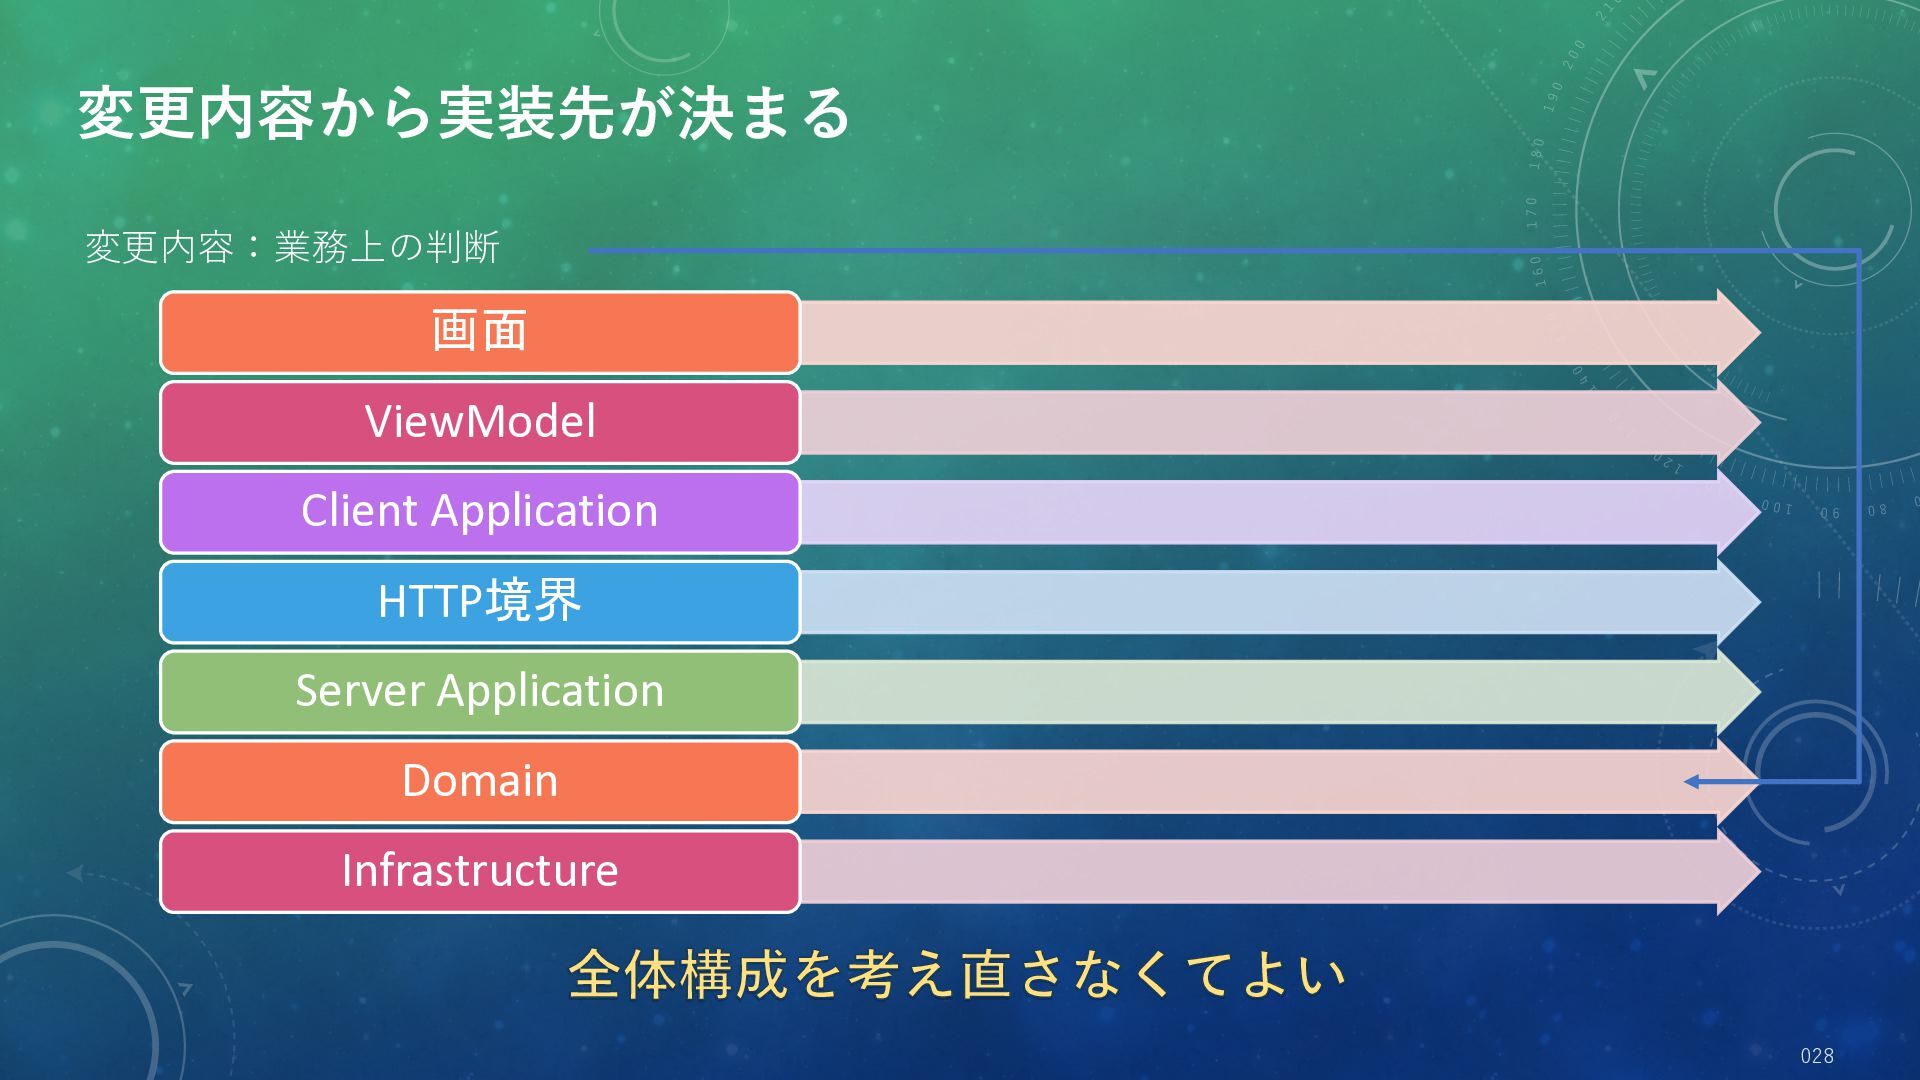
  1. Webアプリケーションの構成例 画面 • 表示・入力・イベント ViewModel • 画面の状態・操作・判断 Client Application HTTP境界

    Server Application Domain Infrastructure • クライアント操作・API利用・状態管理 • 通信契約・DTO変換 • 業務操作の進行・取得と保存 • 業務の状態・規則・判断・状態変化 • DB・外部サービスとの接続 これは一例。必要なレイヤー数やプロジェクト分割を定めるものではない 027
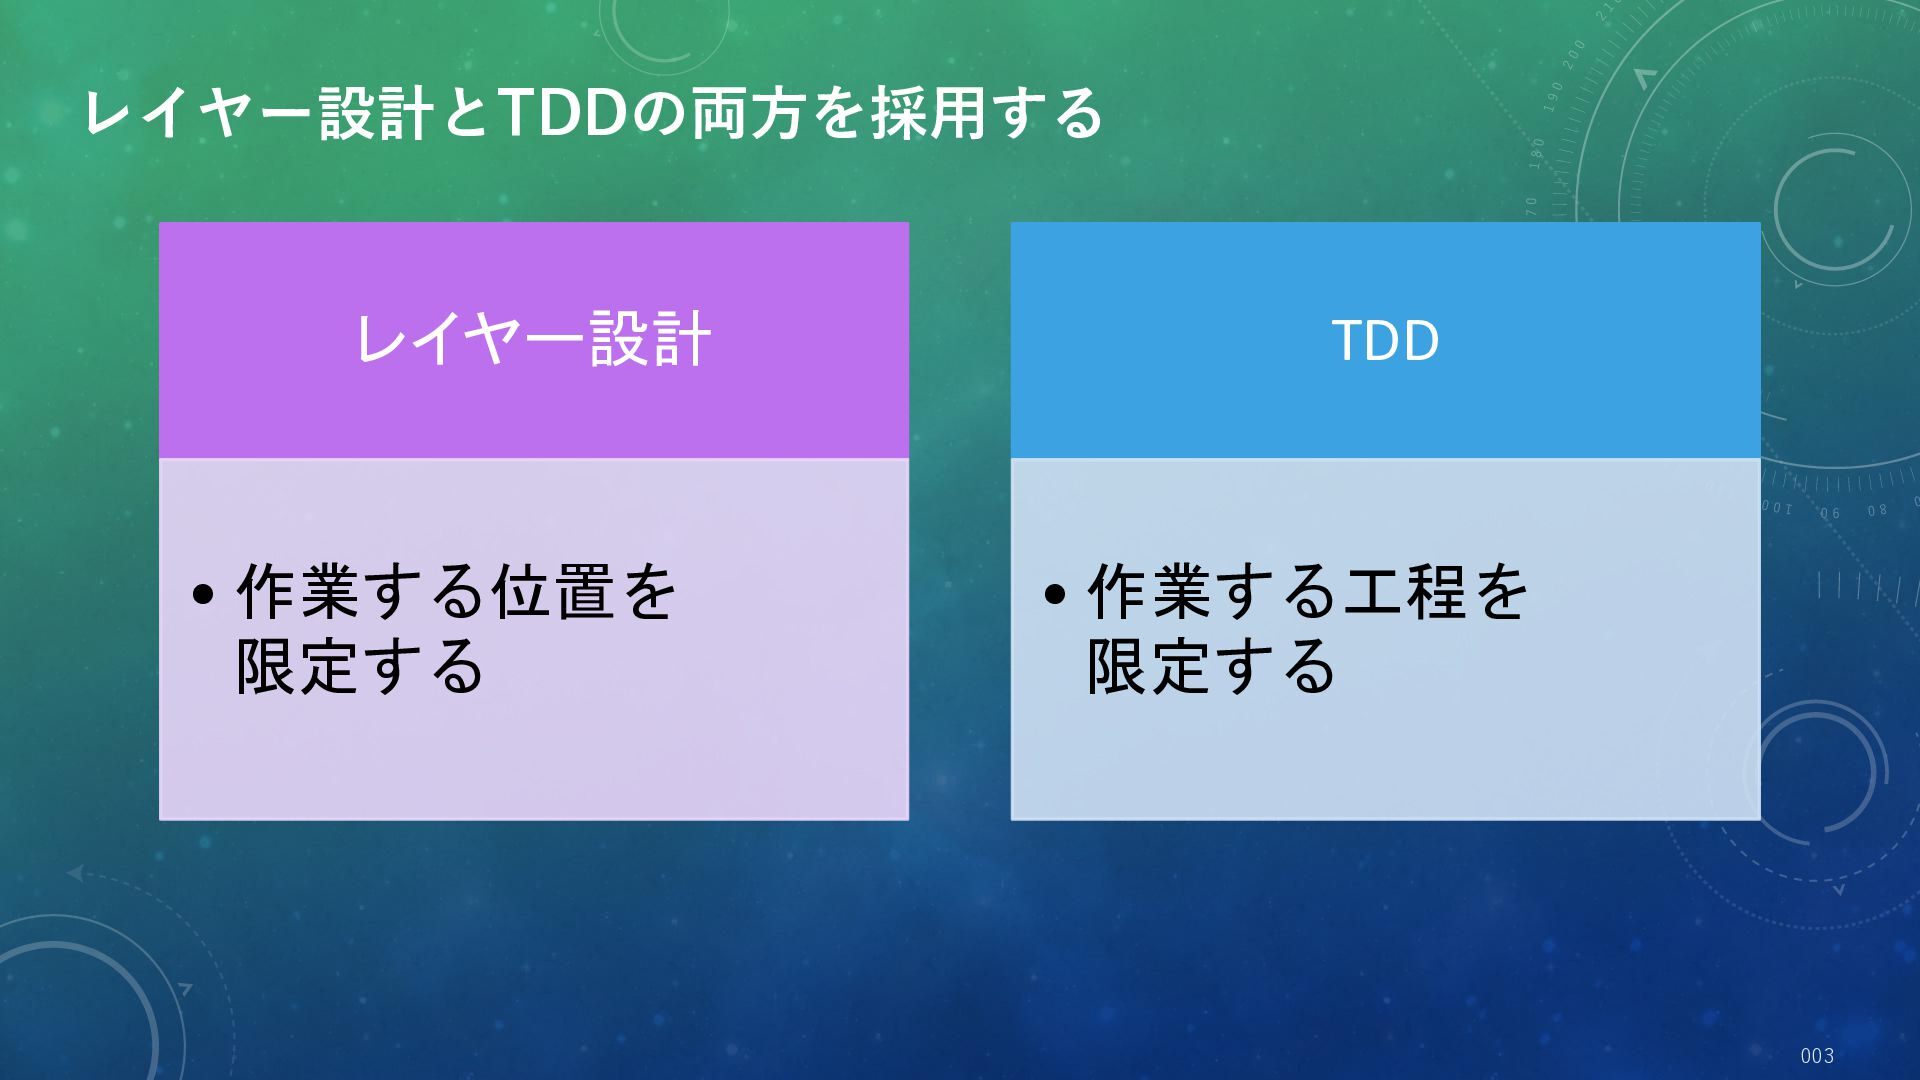
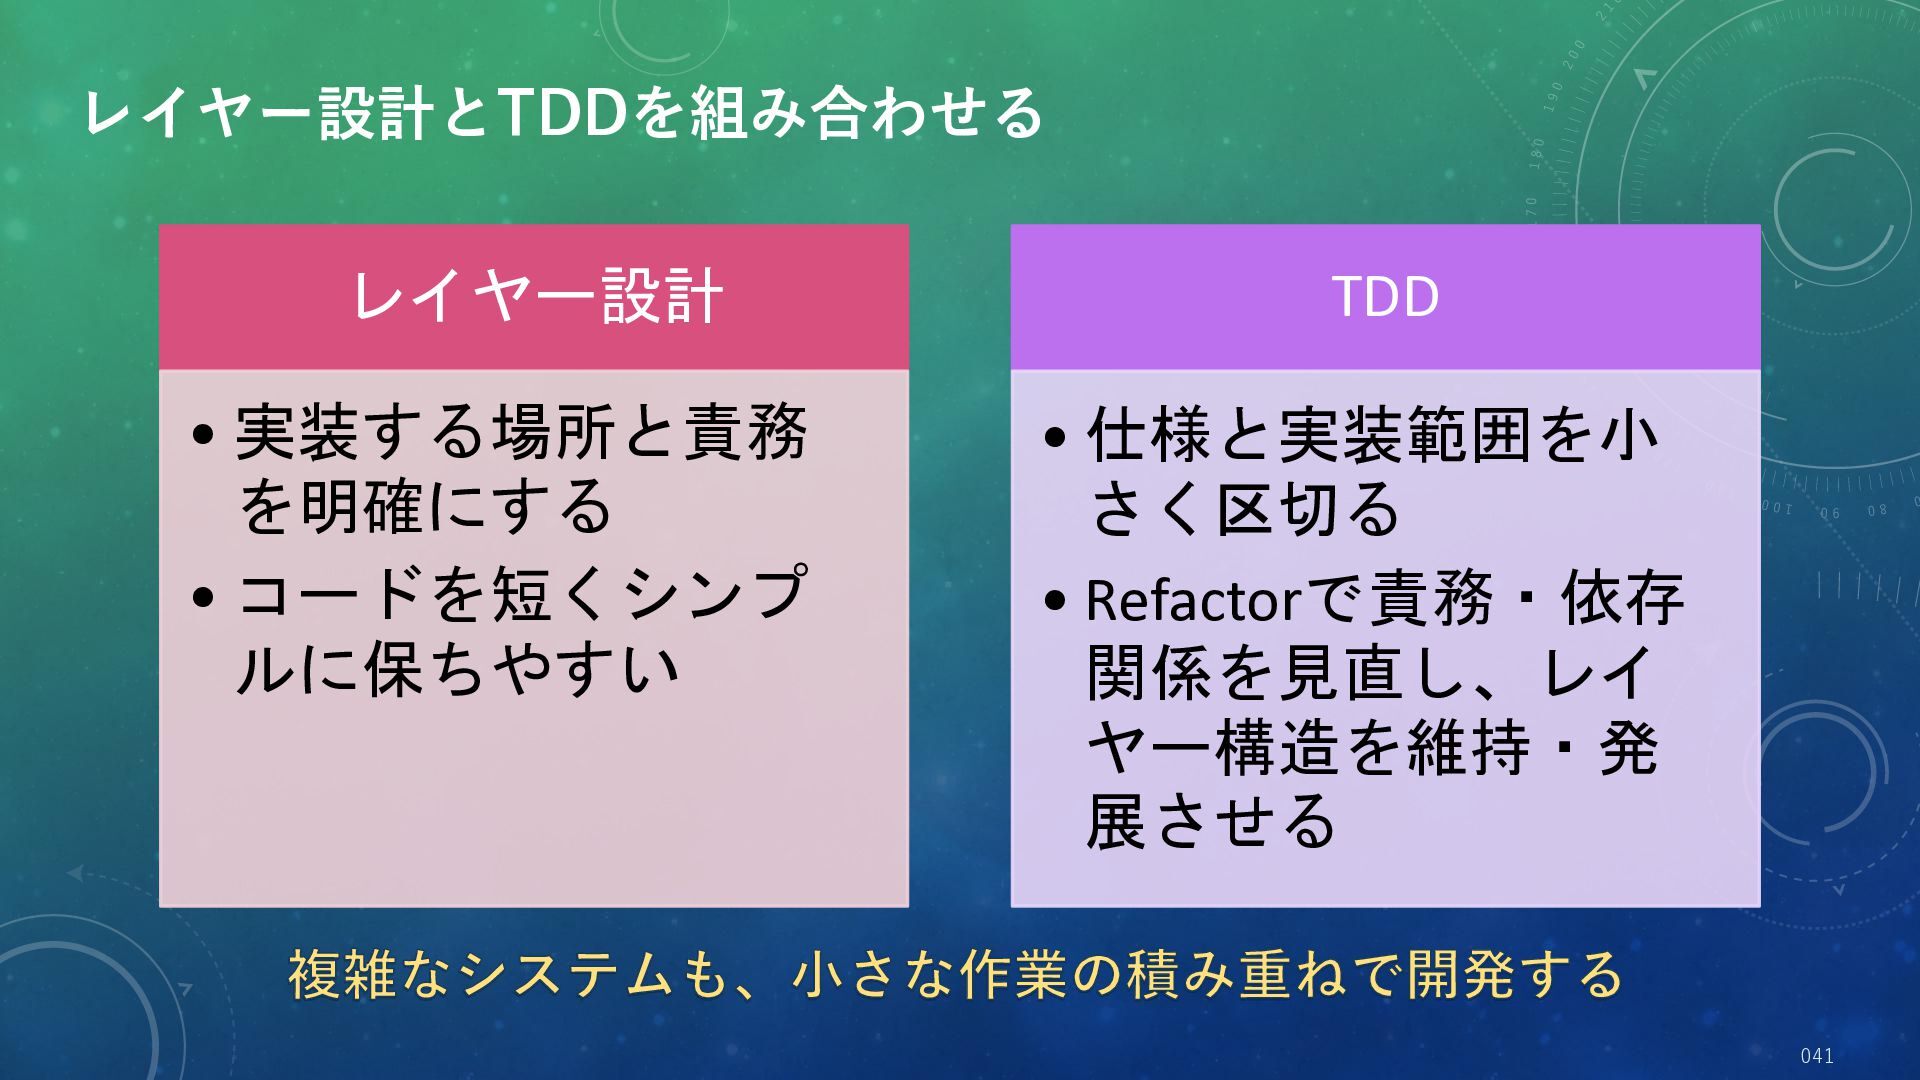
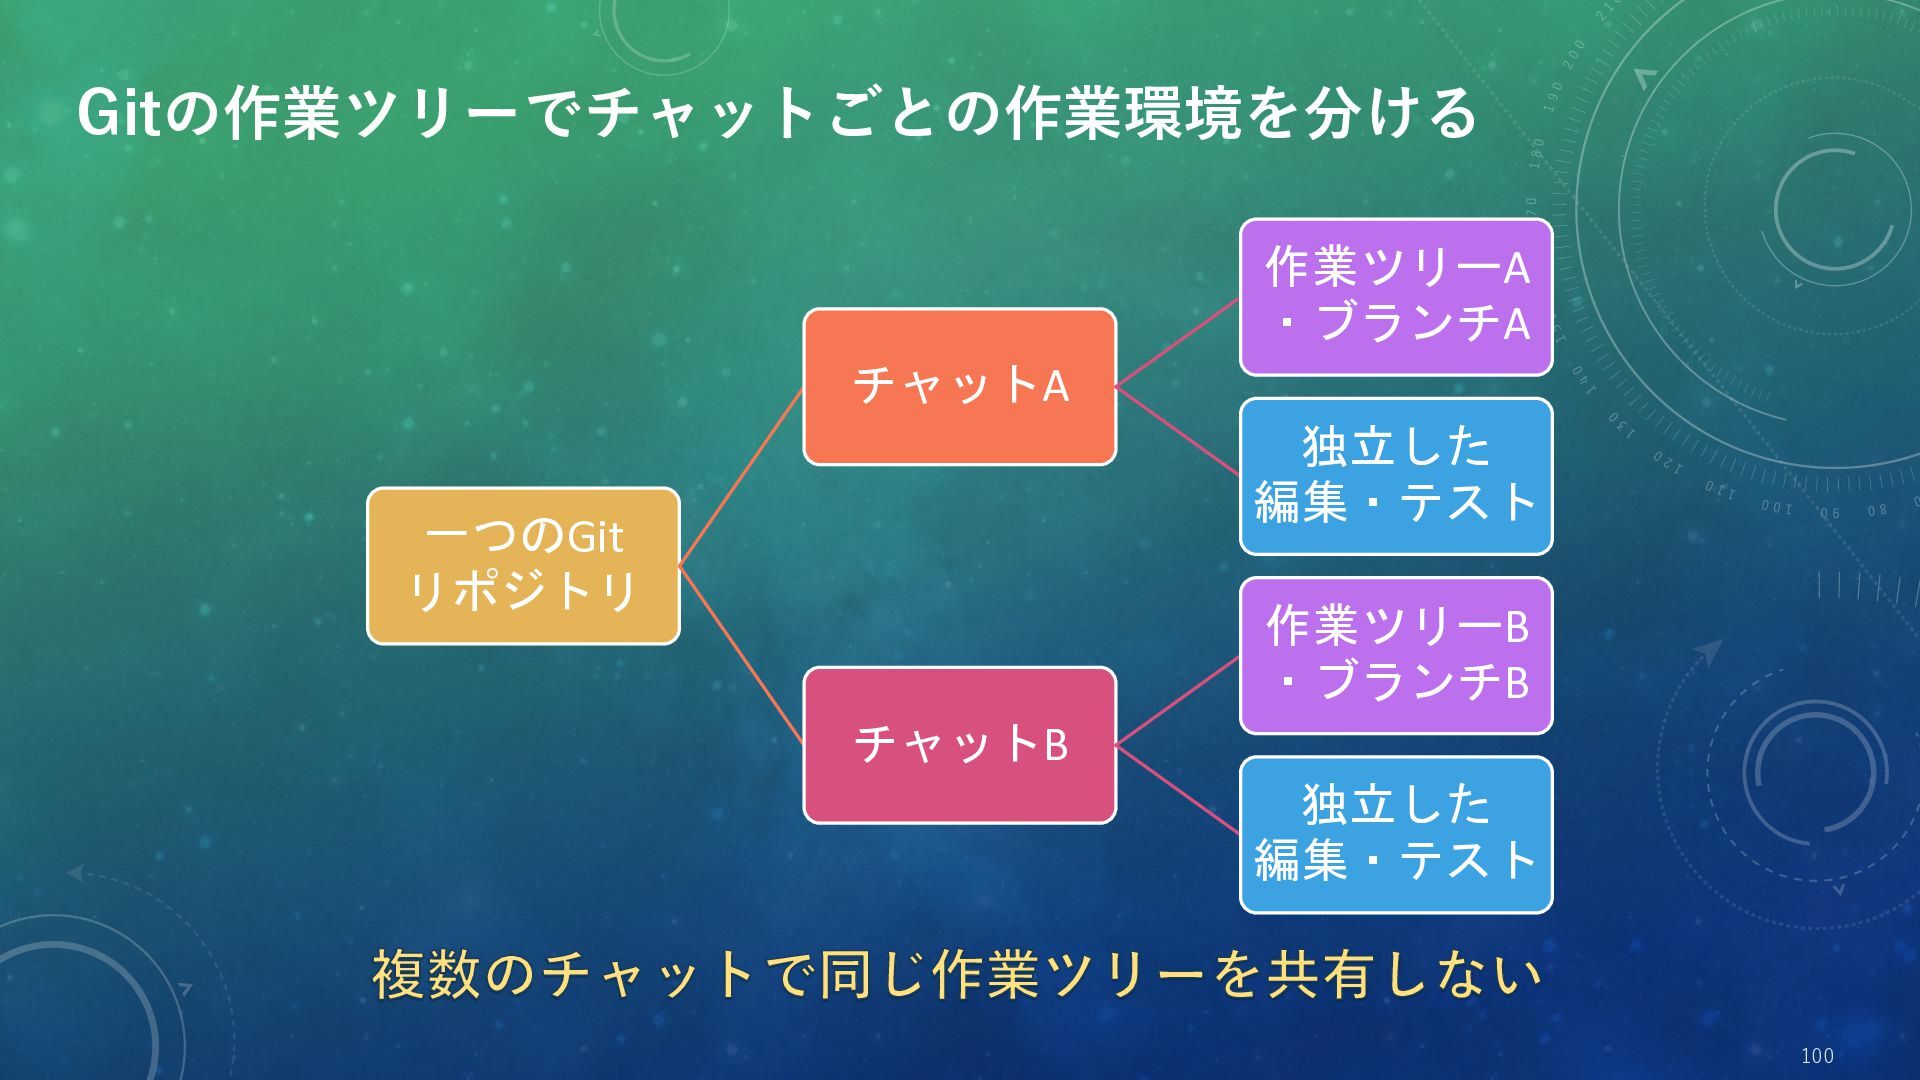
  2. レイヤー設計とTDDを組み合わせる レイヤー設計 TDD • 実装する場所と責務 を明確にする • コードを短くシンプ ルに保ちやすい •

    仕様と実装範囲を小 さく区切る • Refactorで責務・依存 関係を見直し、レイ ヤー構造を維持・発 展させる 複雑なシステムも、小さな作業の積み重ねで開発する 041
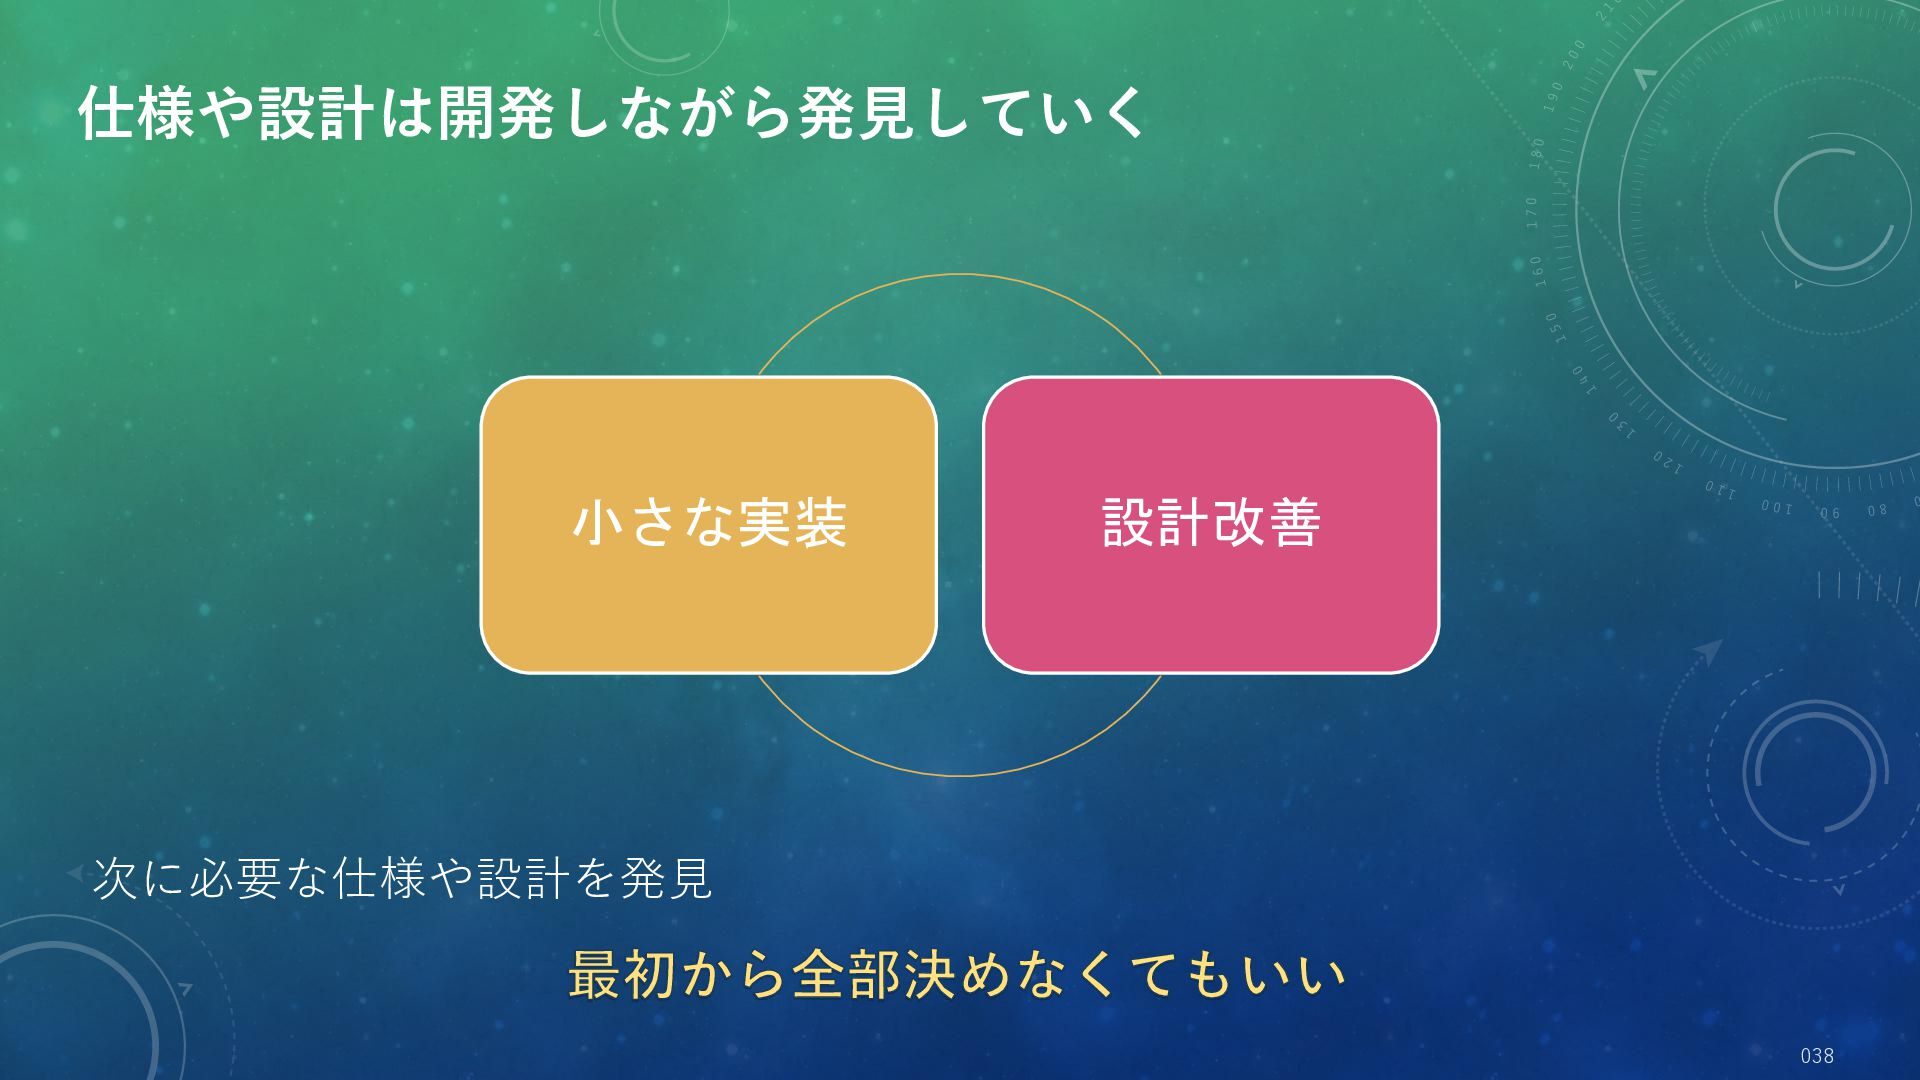
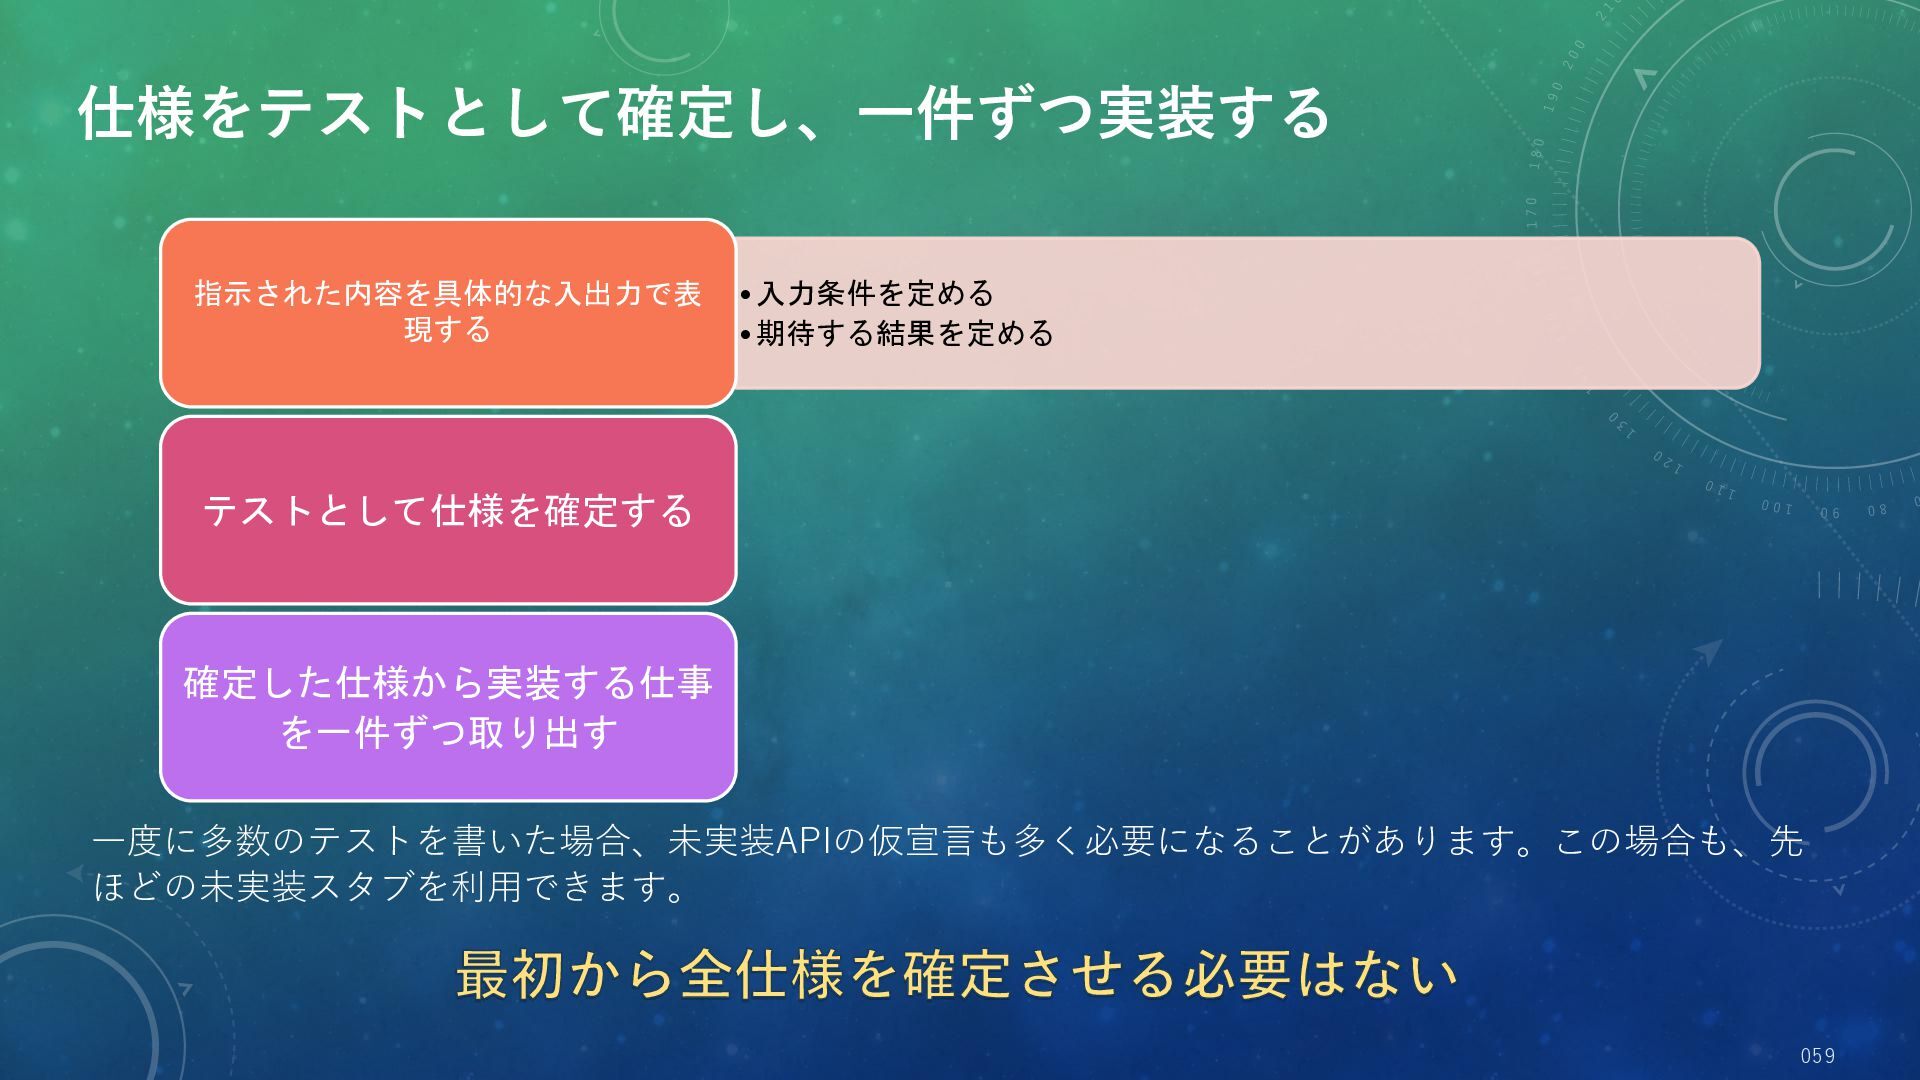
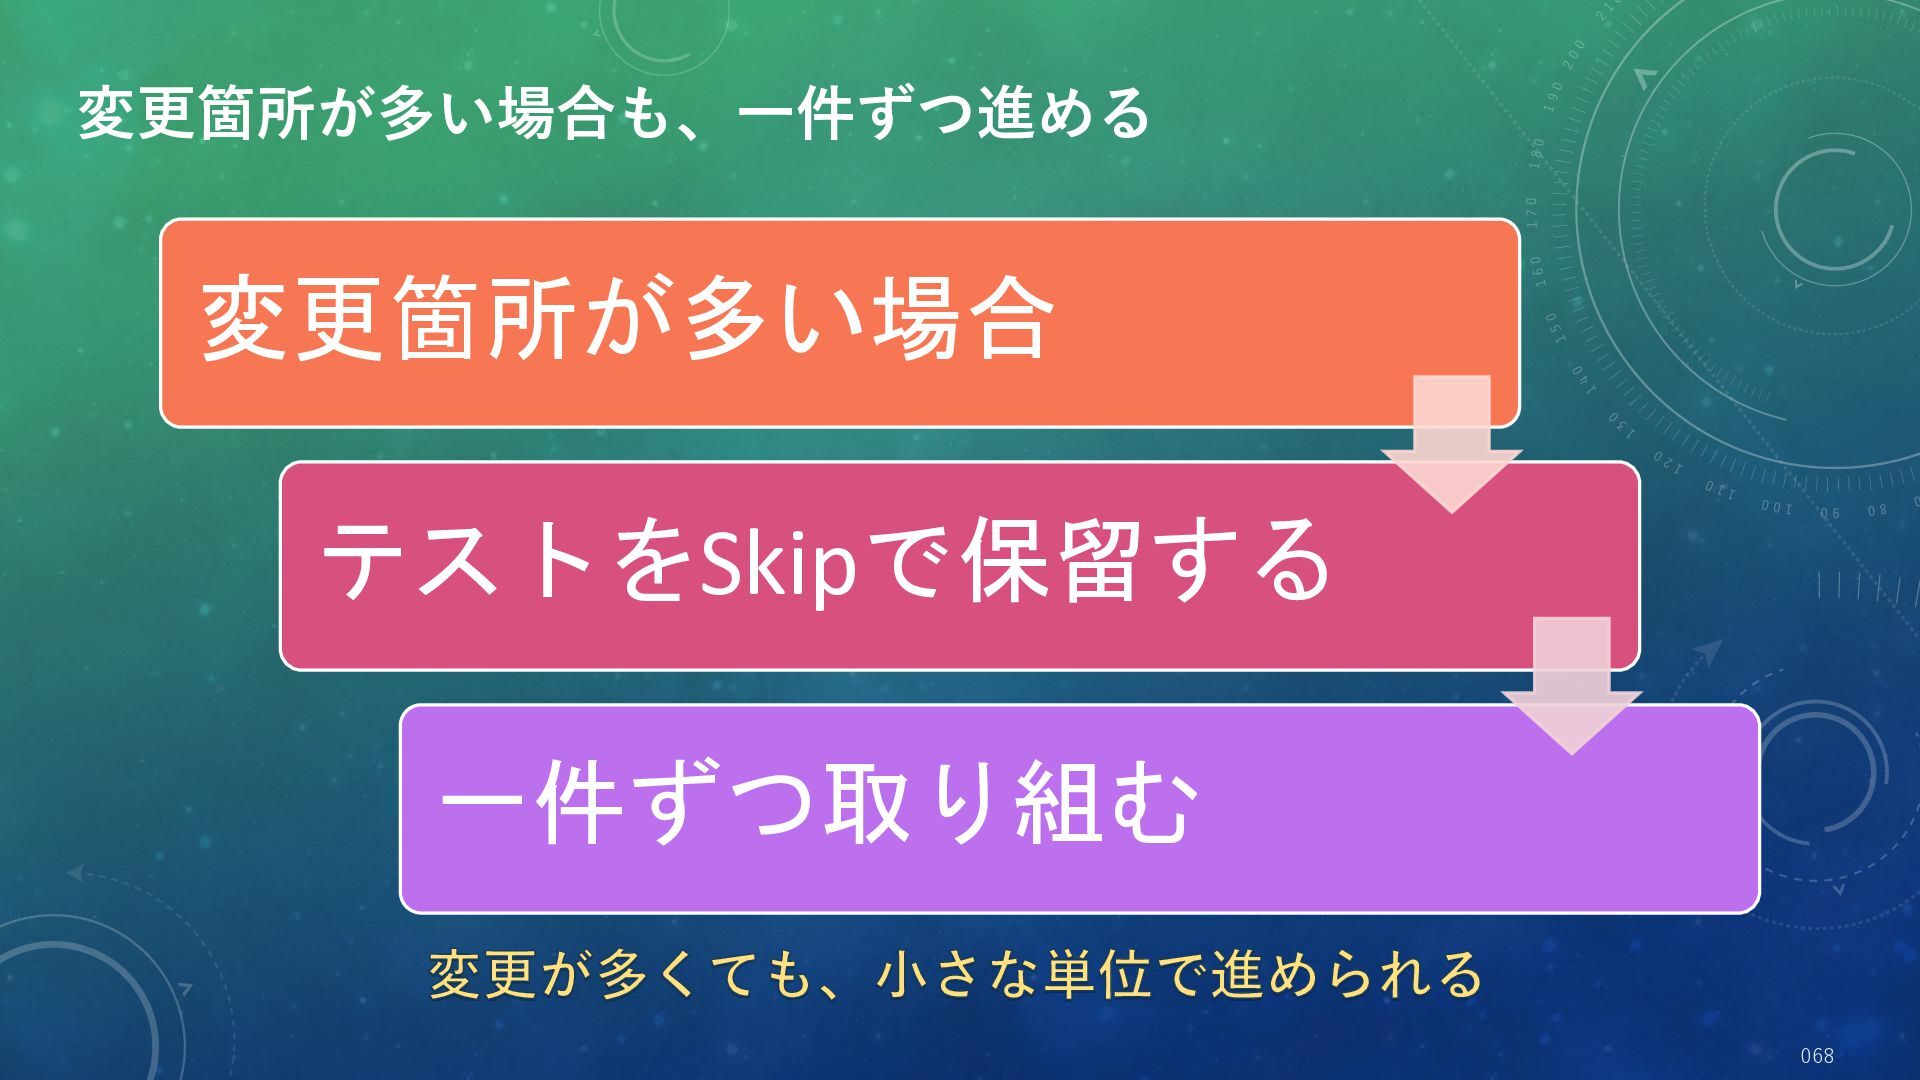
  3. 仕様をテストとして確定し、一件ずつ実装する 指示された内容を具体的な入出力で表 現する • 入力条件を定める • 期待する結果を定める テストとして仕様を確定する 確定した仕様から実装する仕事 を一件ずつ取り出す

    一度に多数のテストを書いた場合、未実装APIの仮宣言も多く必要になることがあります。この場合も、先 ほどの未実装スタブを利用できます。 最初から全仕様を確定させる必要はない 059
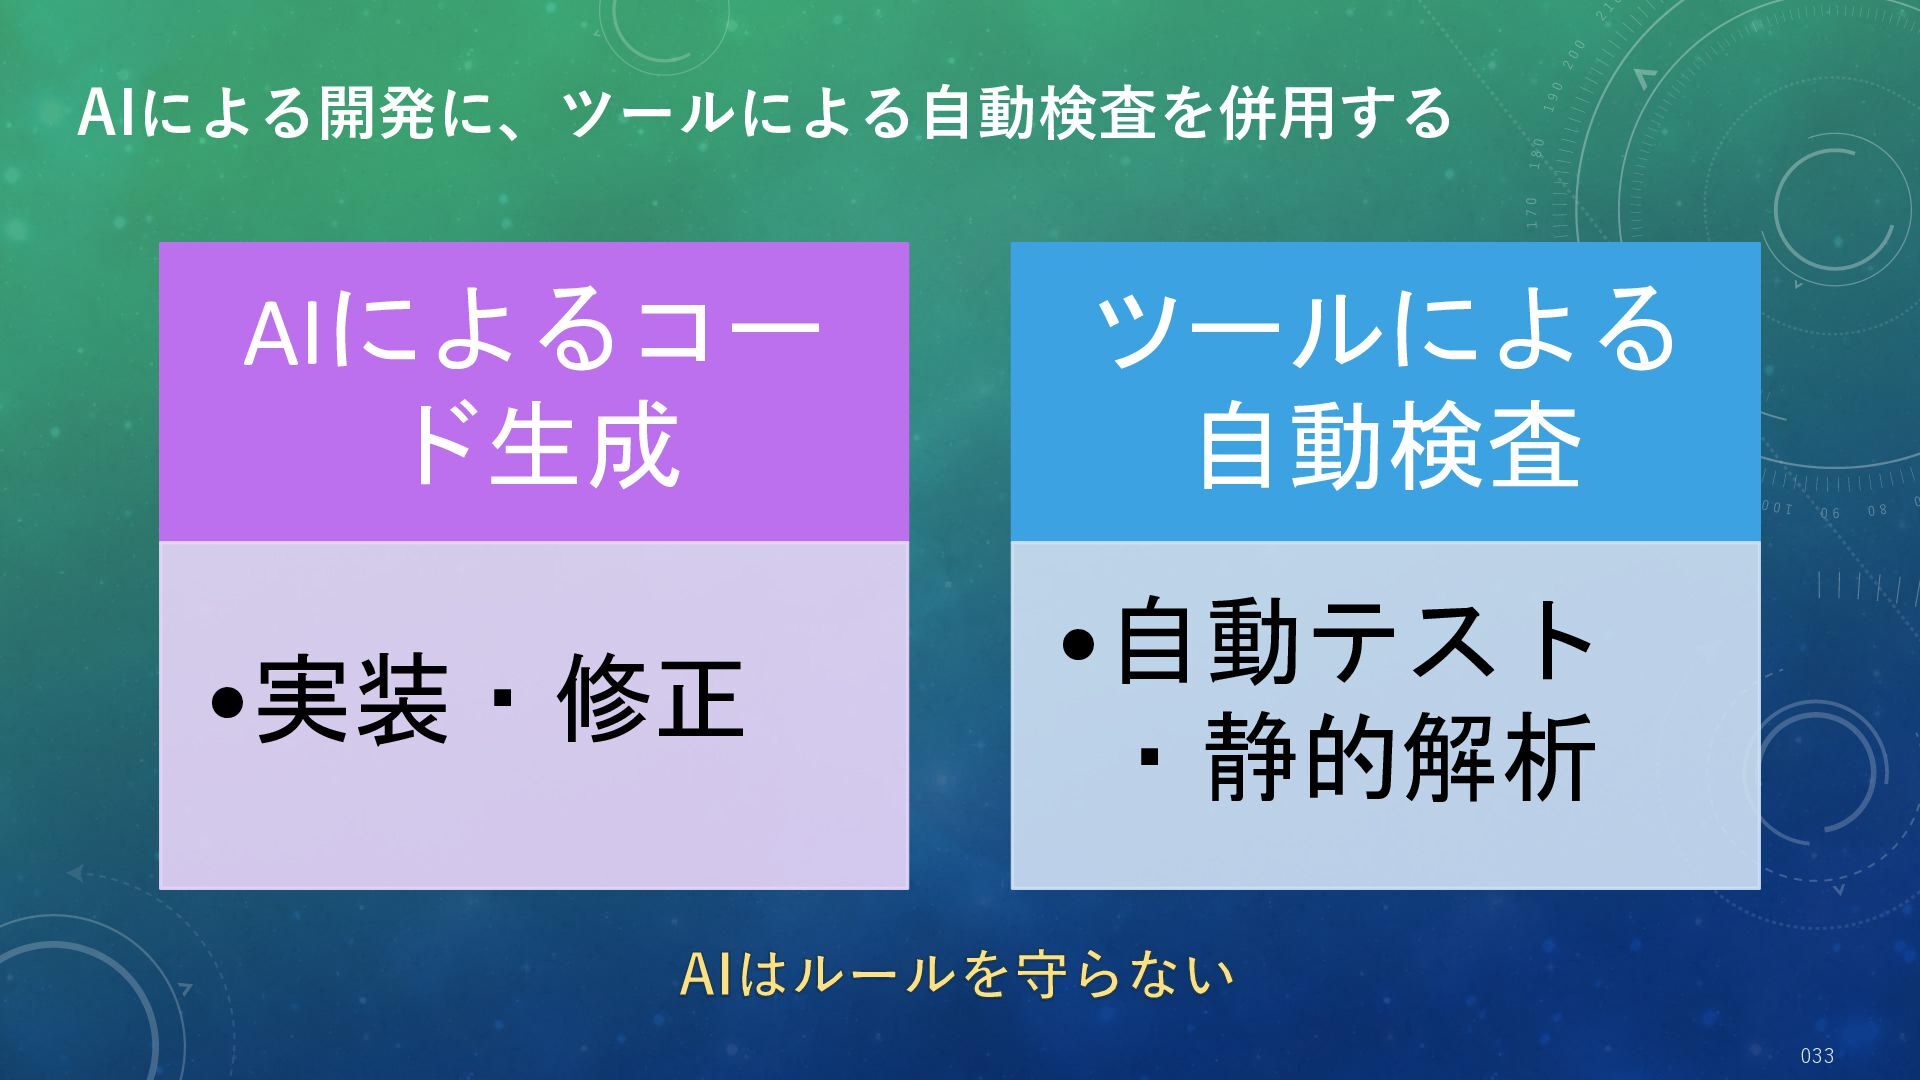
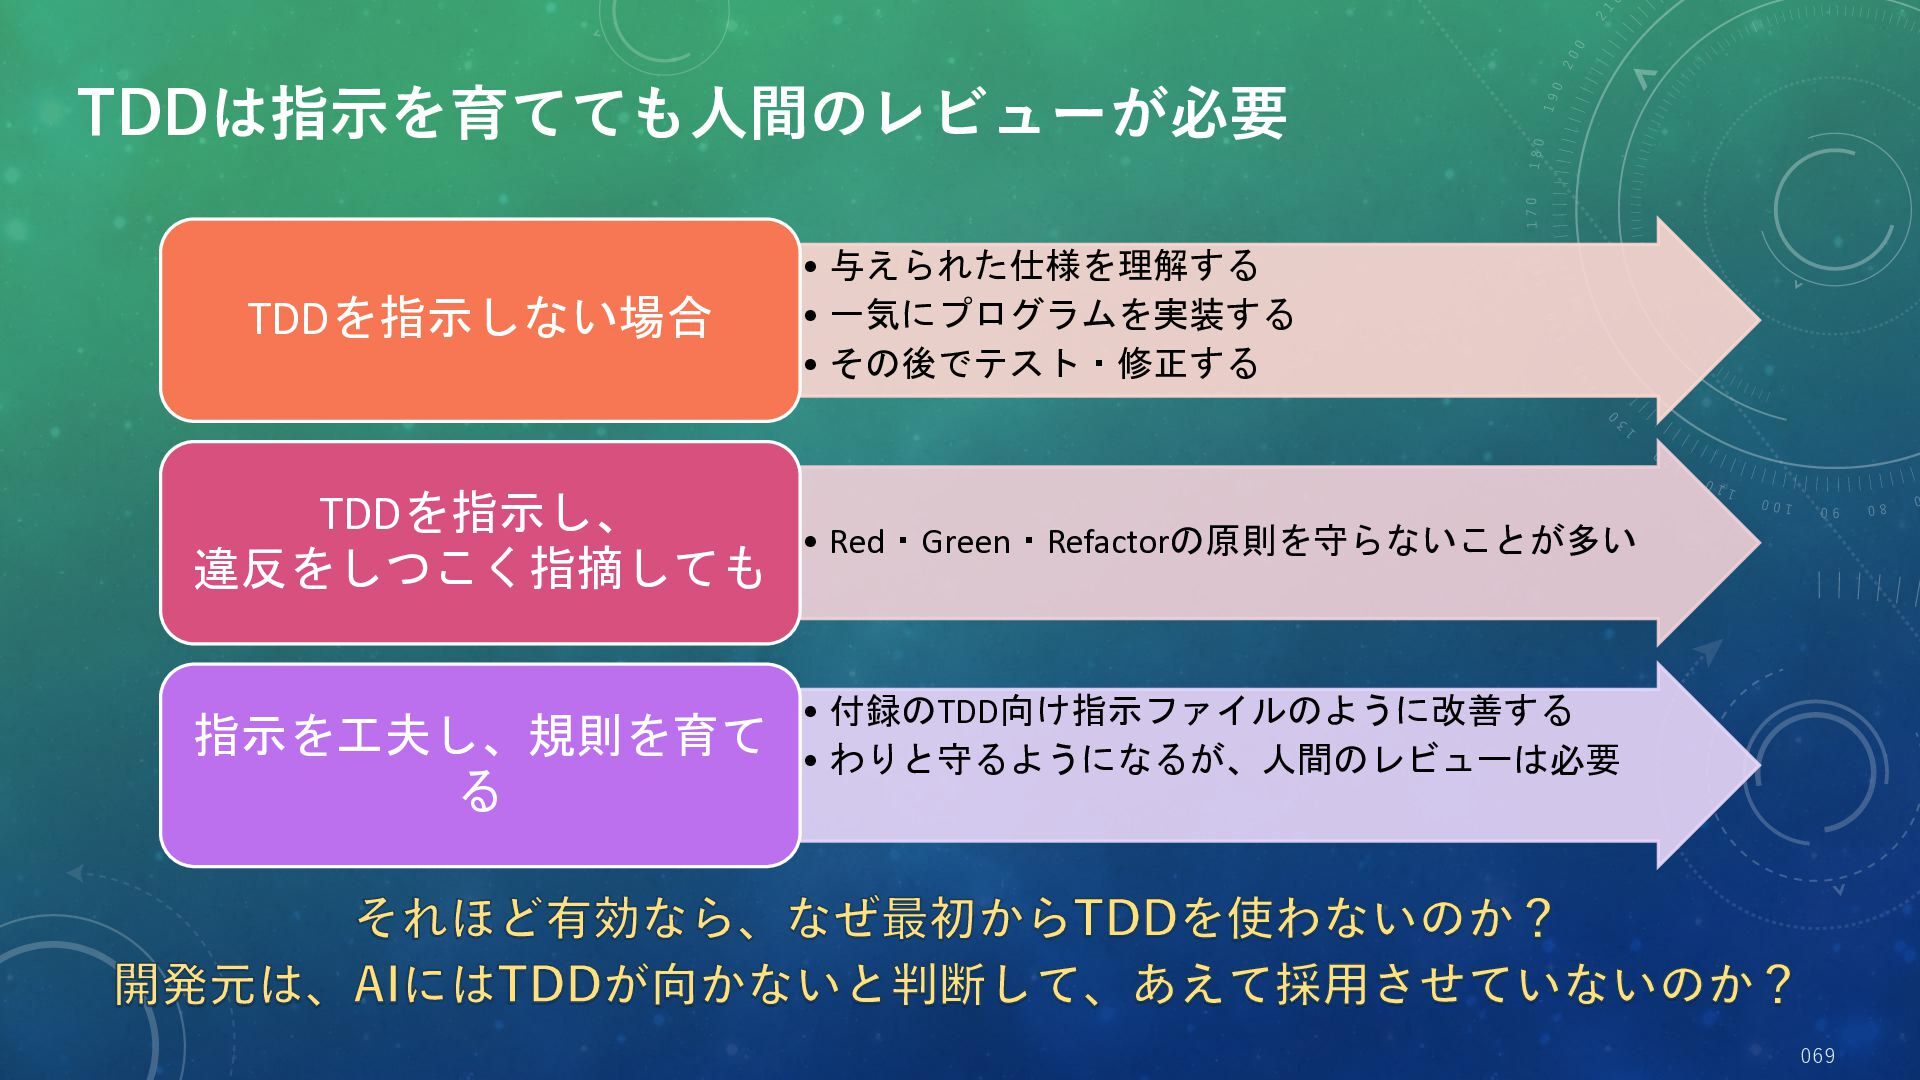
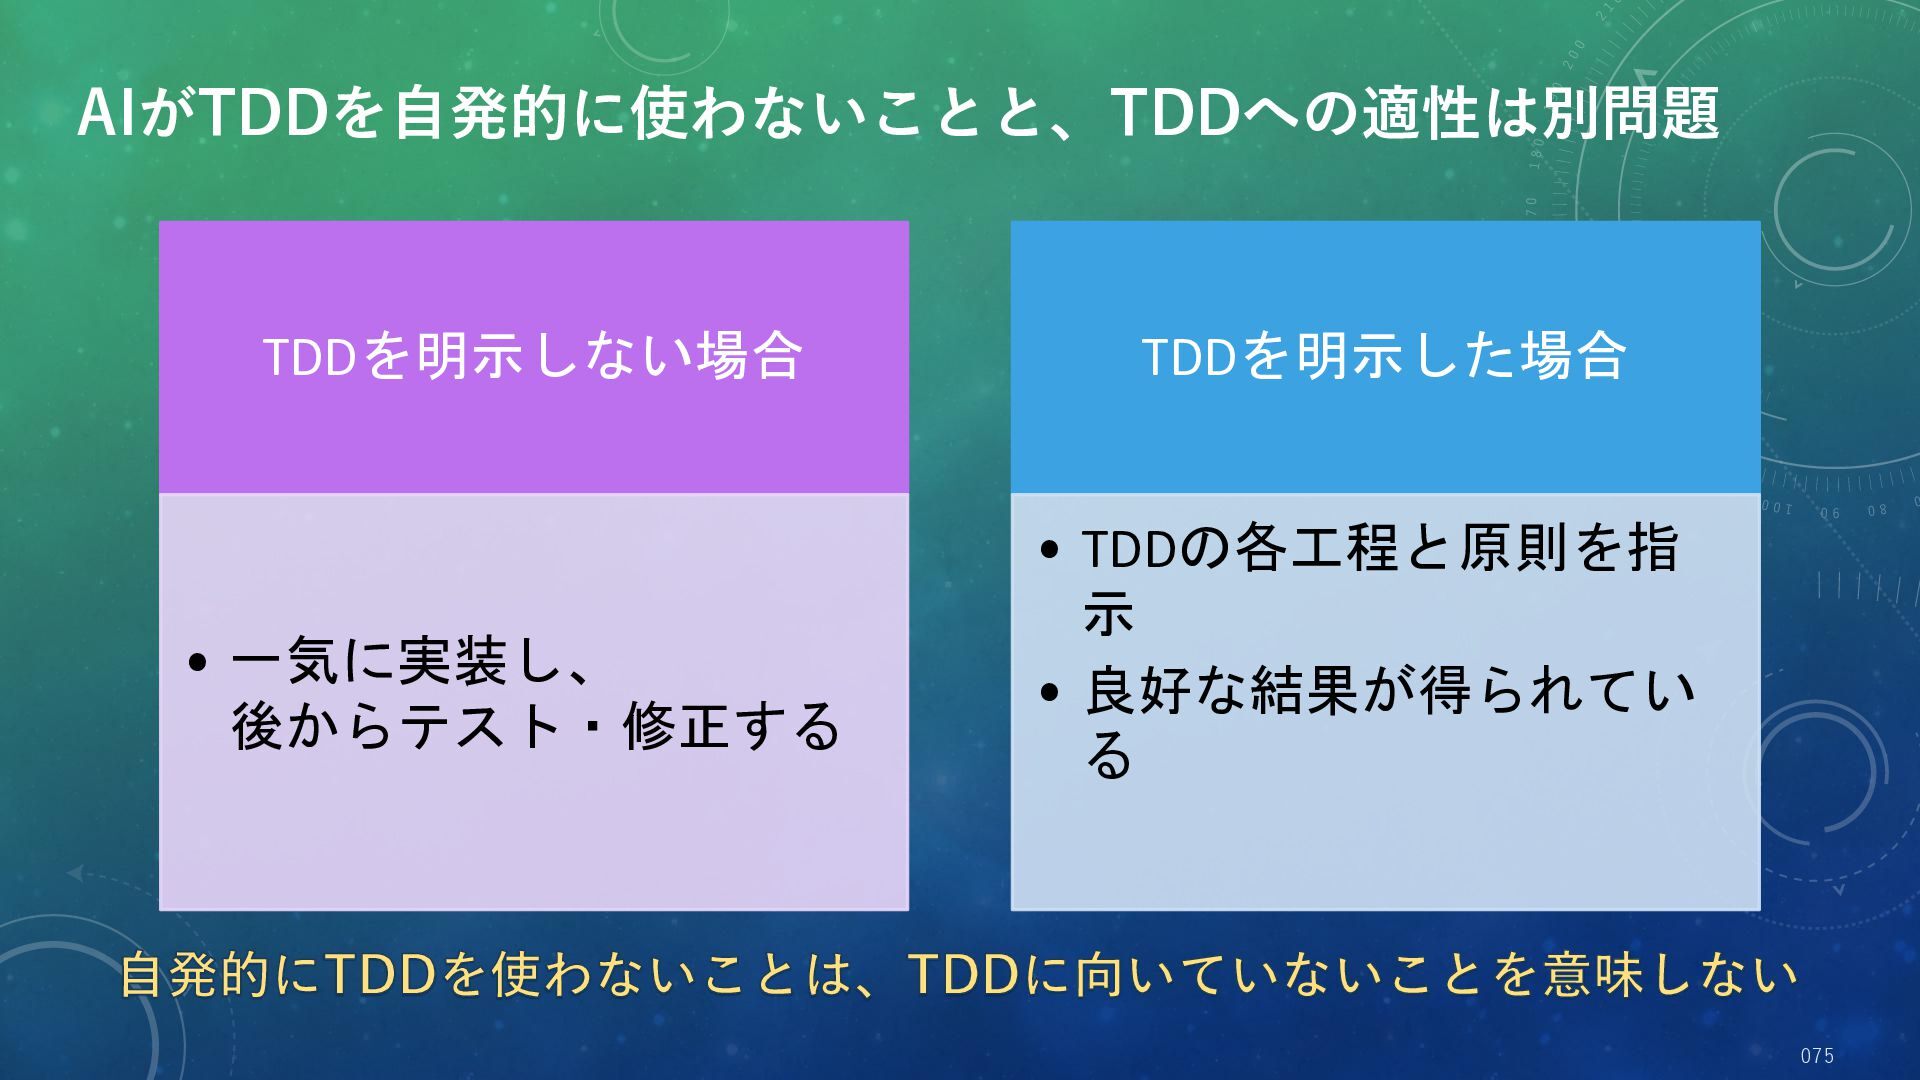
  4. TDDは指示を育てても人間のレビューが必要 TDDを指示しない場合 TDDを指示し、 違反をしつこく指摘しても 指示を工夫し、規則を育て る • 与えられた仕様を理解する • 一気にプログラムを実装する

    • その後でテスト・修正する • Red・Green・Refactorの原則を守らないことが多い • 付録のTDD向け指示ファイルのように改善する • わりと守るようになるが、人間のレビューは必要 それほど有効なら、なぜ最初からTDDを使わないのか? 開発元は、AIにはTDDが向かないと判断して、あえて採用させていないのか? 069
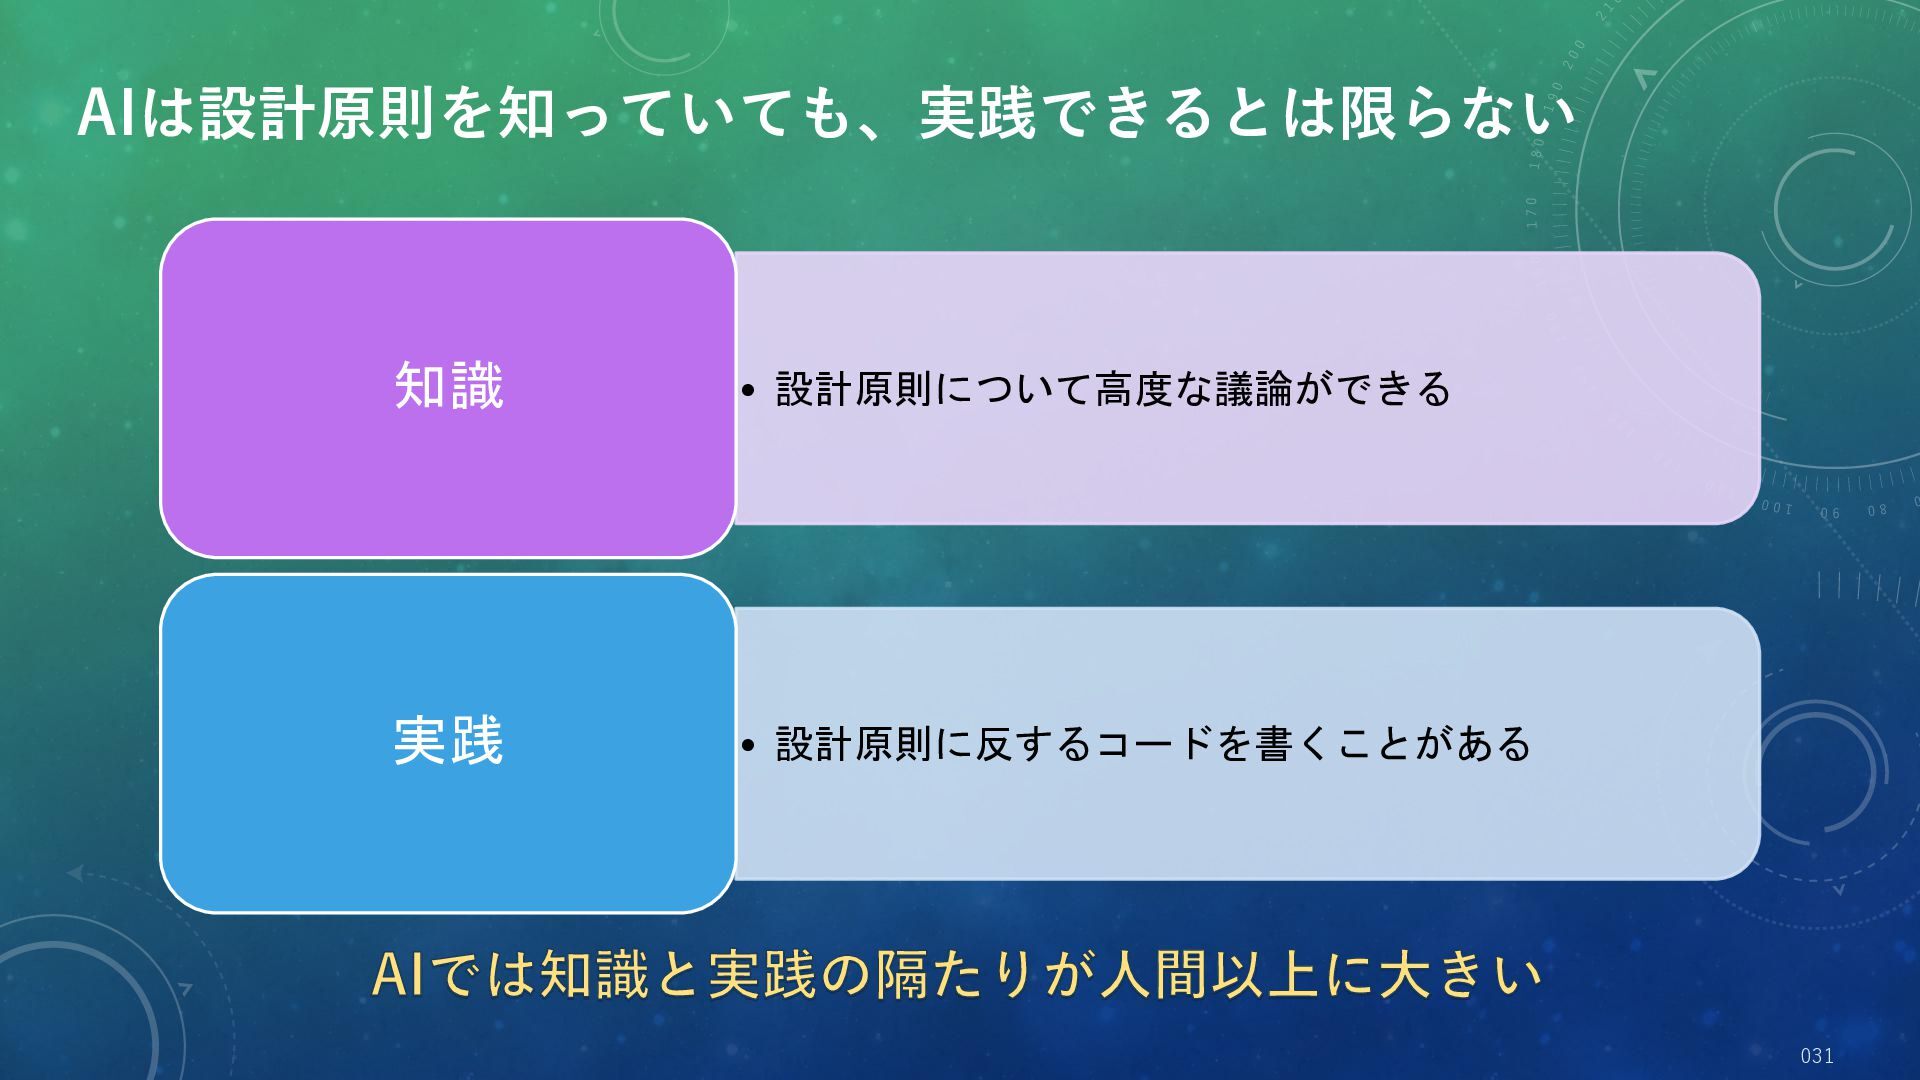
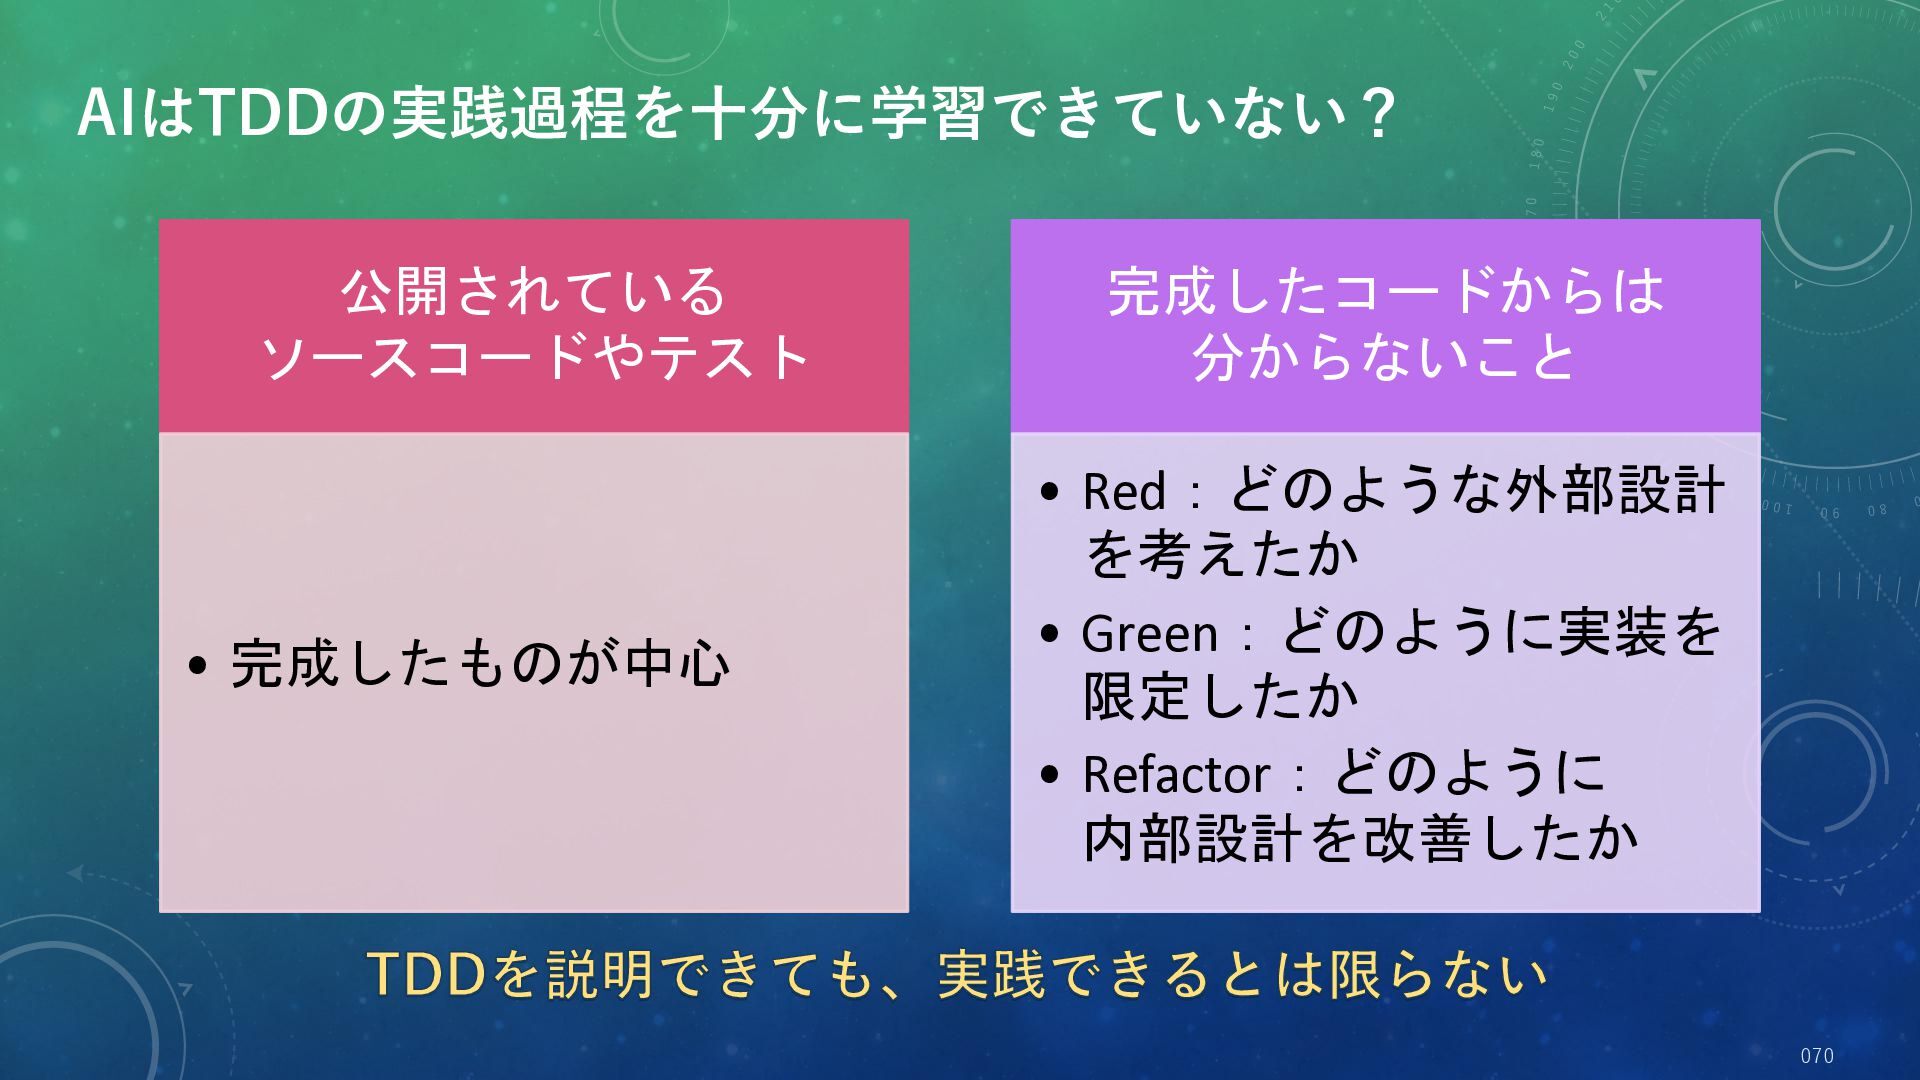
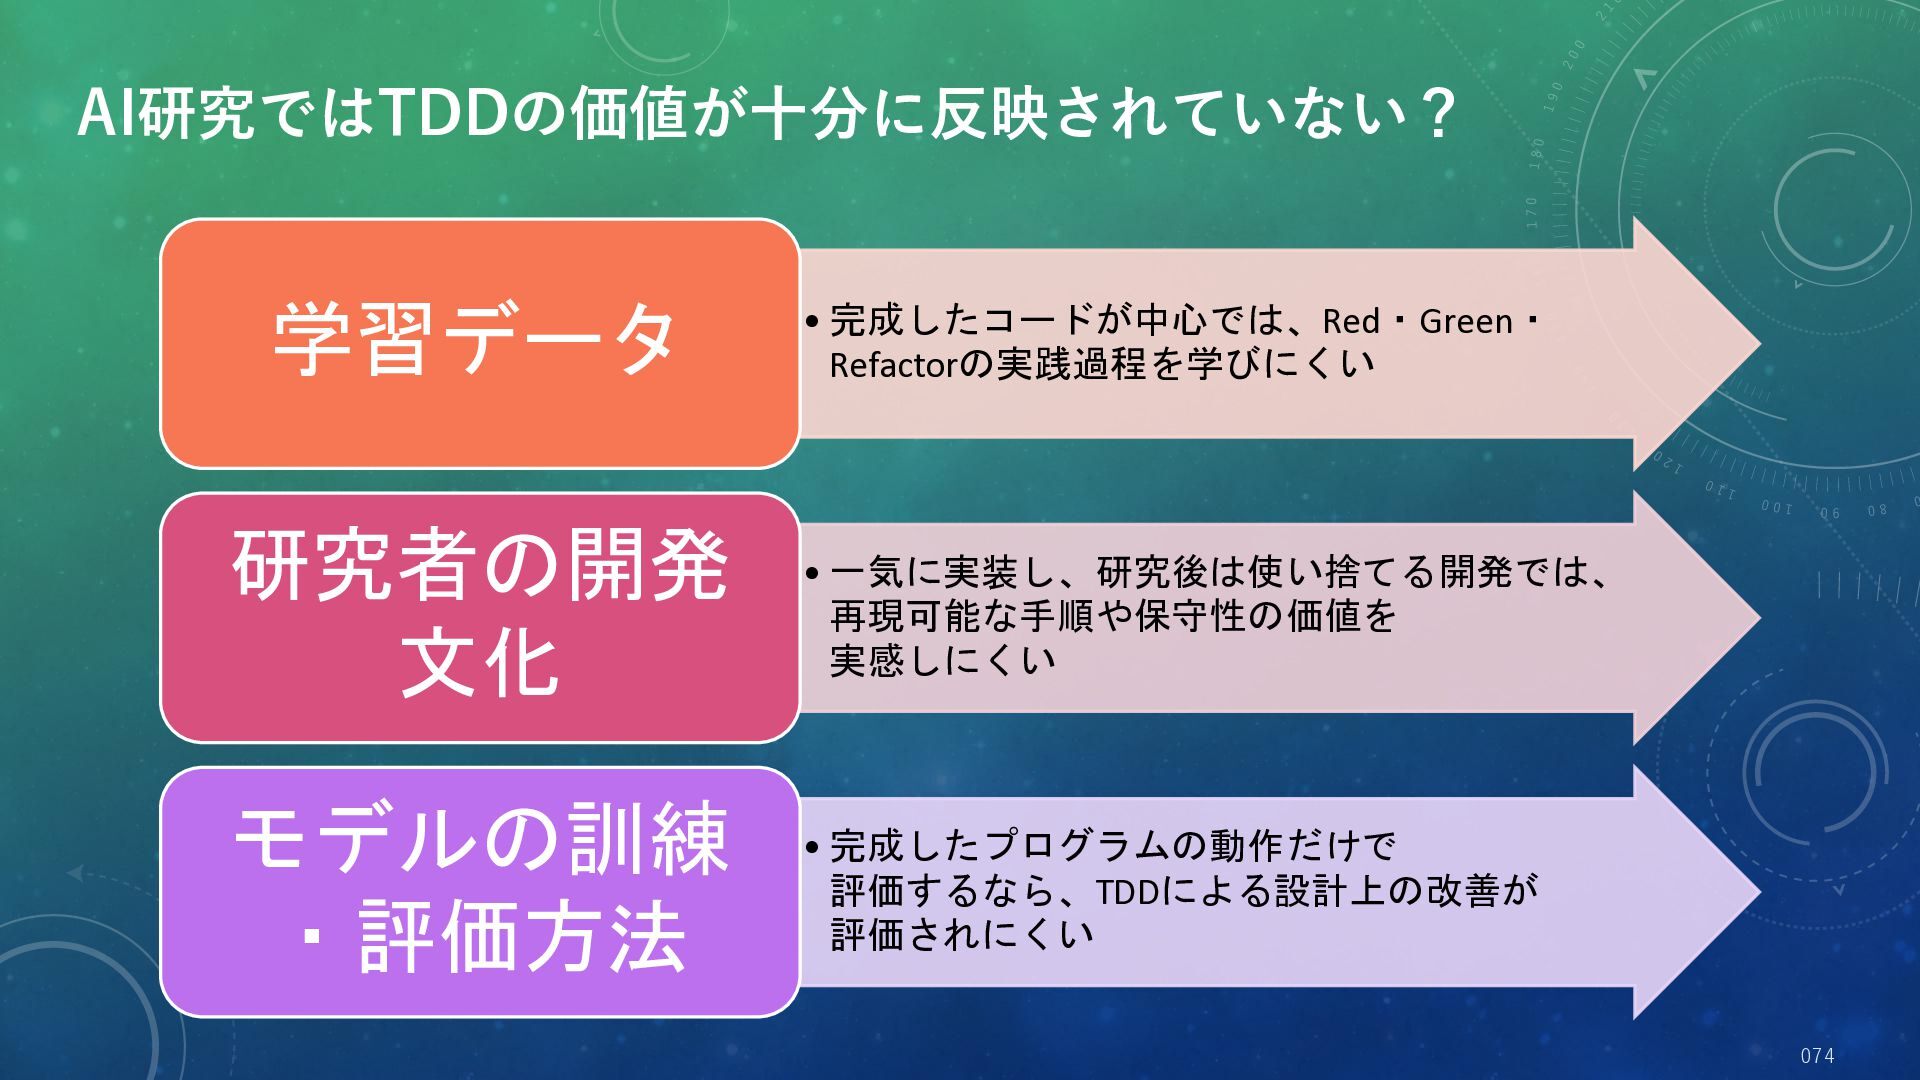
  5. AIはTDDの実践過程を十分に学習できていない? 公開されている ソースコードやテスト • 完成したものが中心 完成したコードからは 分からないこと • Red:どのような外部設計 を考えたか

    • Green:どのように実装を 限定したか • Refactor:どのように 内部設計を改善したか TDDを説明できても、実践できるとは限らない 070
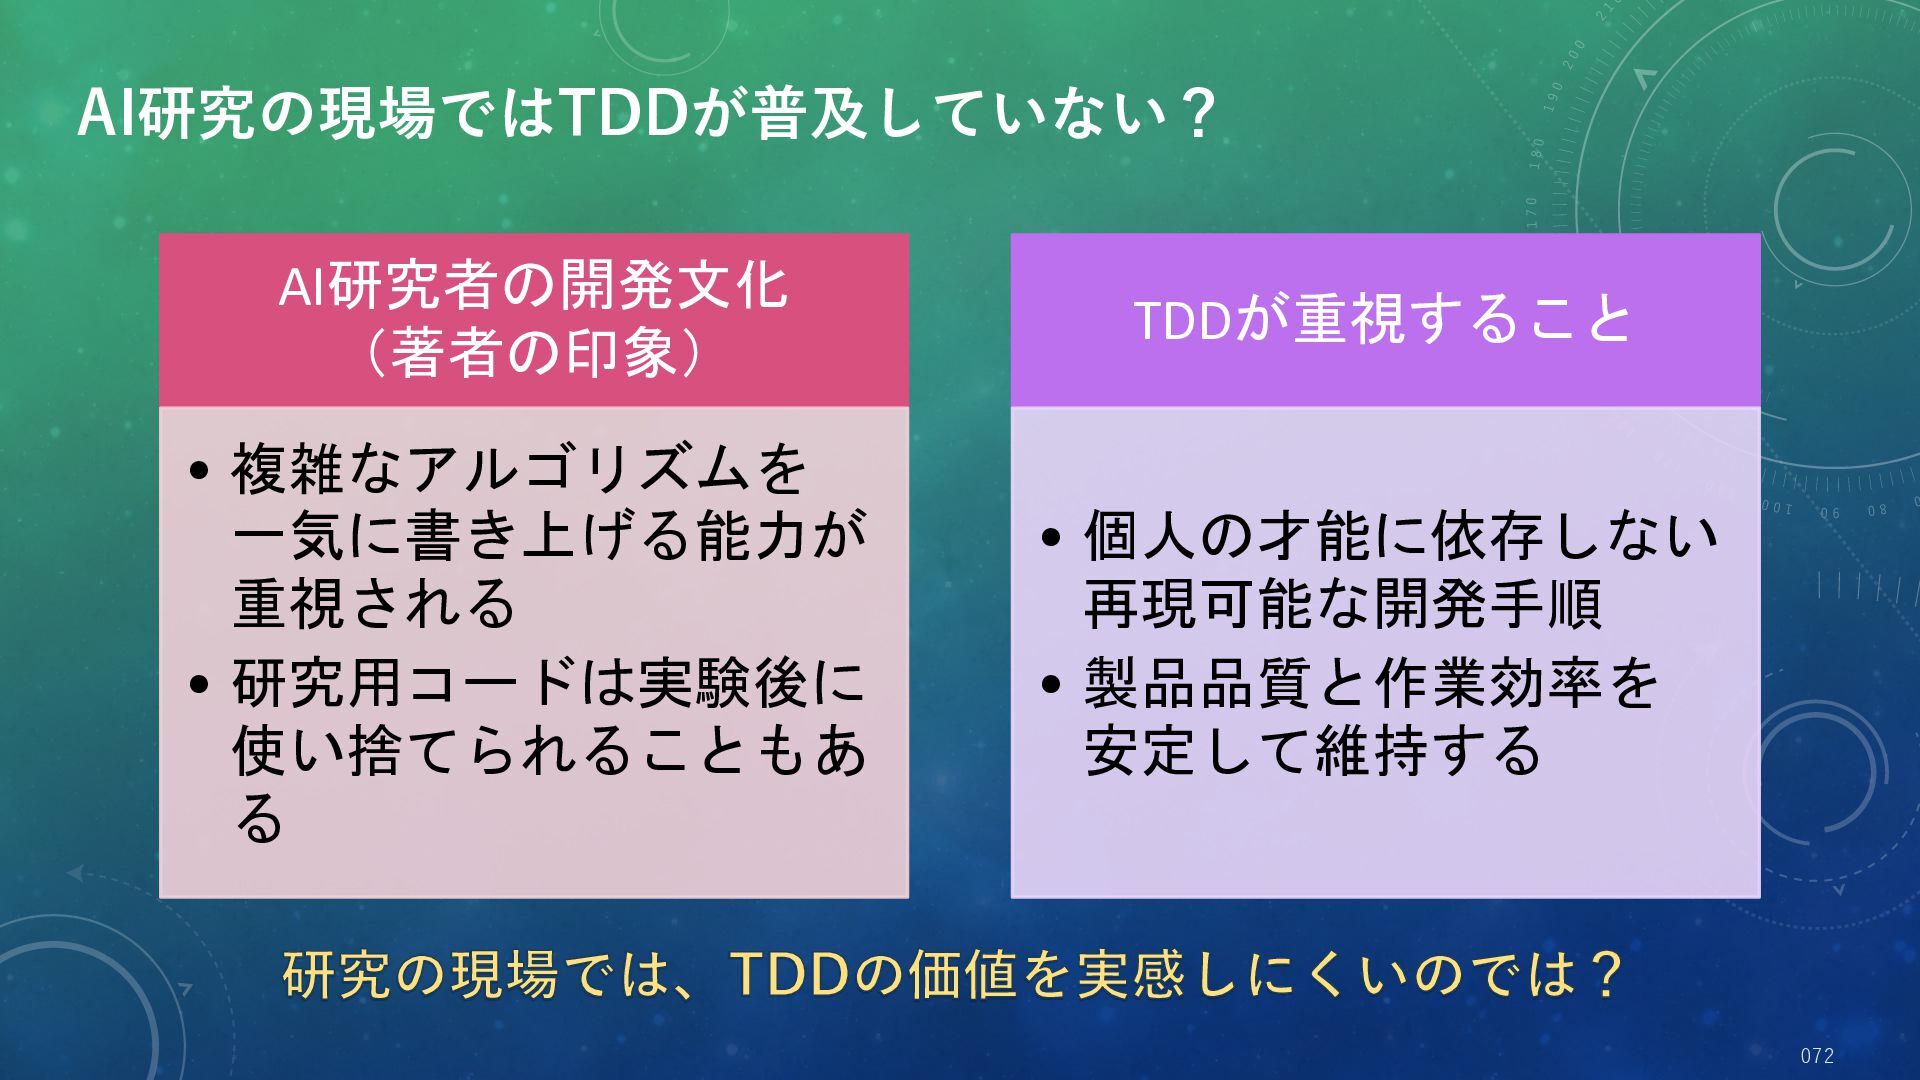
  6. AI研究の現場ではTDDが普及していない? AI研究者の開発文化 (著者の印象) TDDが重視すること • 複雑なアルゴリズムを 一気に書き上げる能力が 重視される • 研究用コードは実験後に

    使い捨てられることもあ る • 個人の才能に依存しない 再現可能な開発手順 • 製品品質と作業効率を 安定して維持する 研究の現場では、TDDの価値を実感しにくいのでは? 072
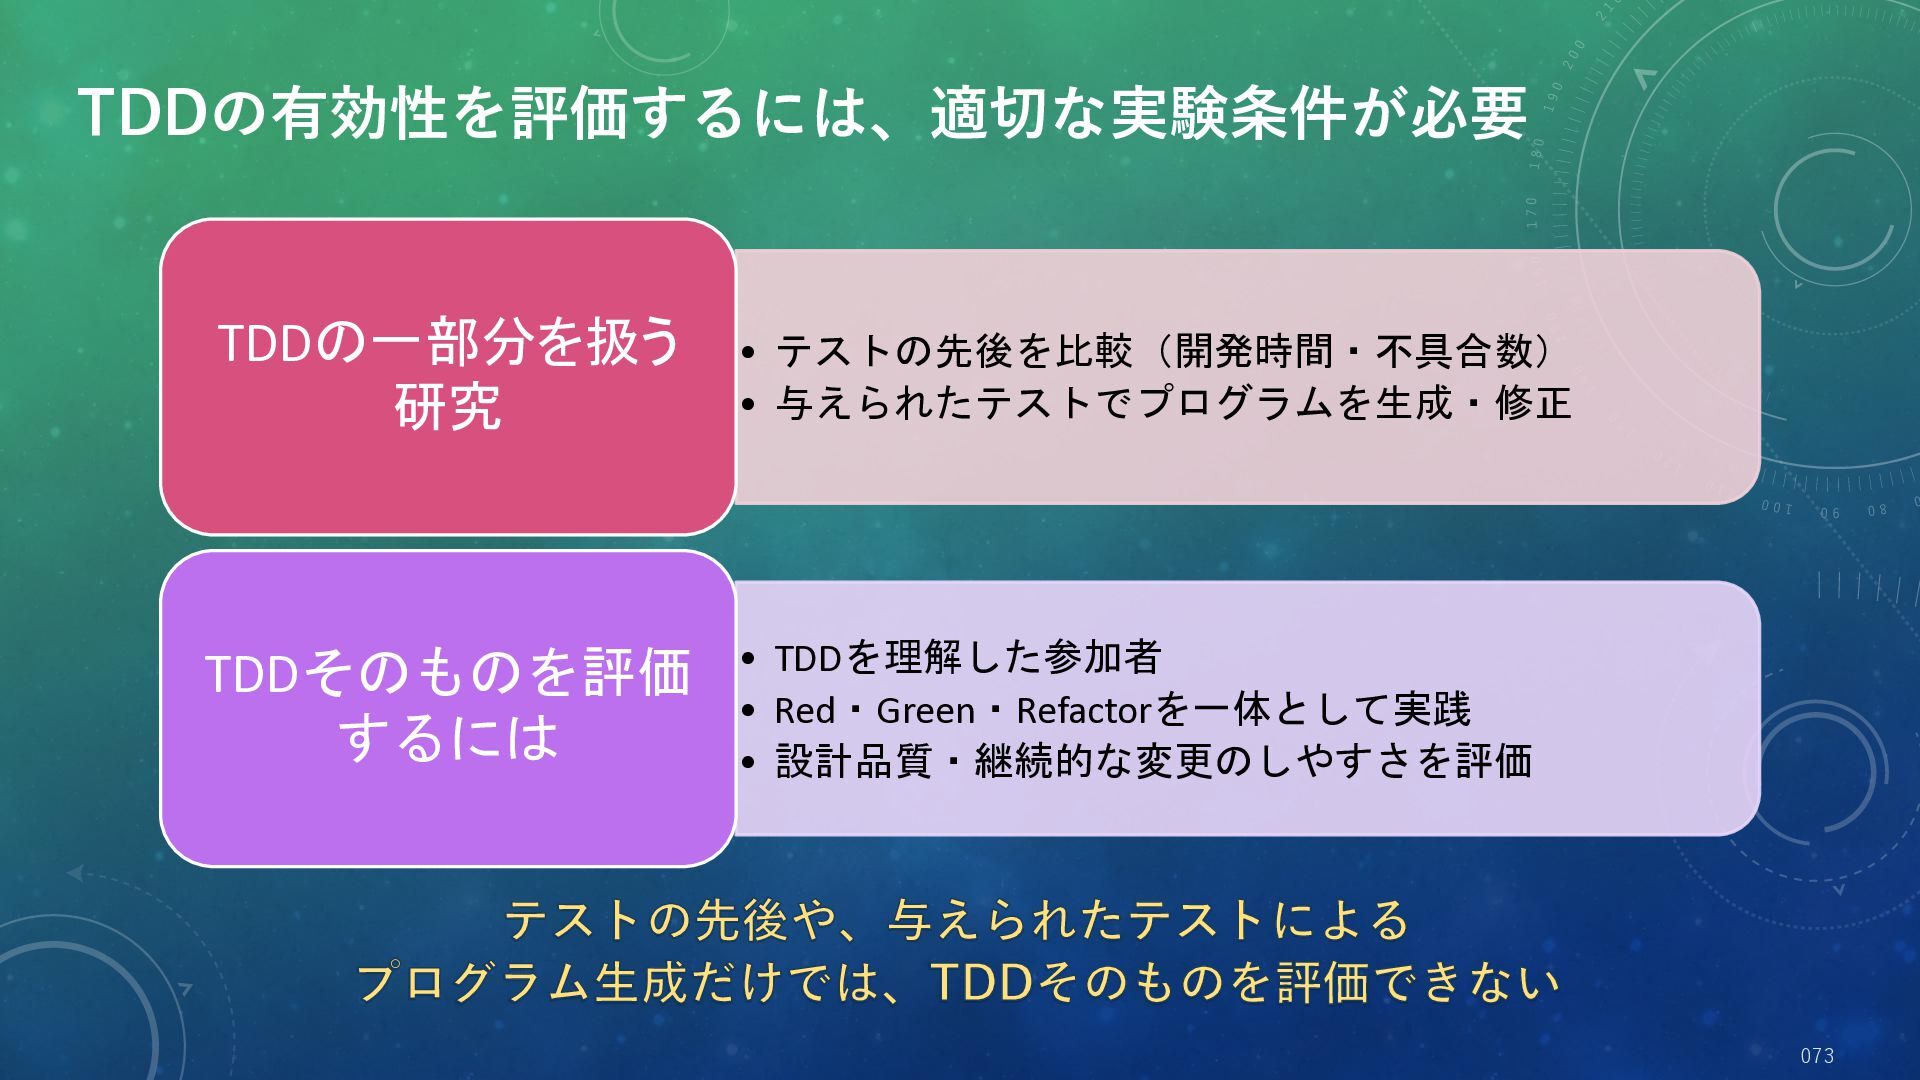
  7. TDDの有効性を評価するには、適切な実験条件が必要 TDDの一部分を扱う 研究 • テストの先後を比較(開発時間・不具合数) • 与えられたテストでプログラムを生成・修正 TDDそのものを評価 するには •

    TDDを理解した参加者 • Red・Green・Refactorを一体として実践 • 設計品質・継続的な変更のしやすさを評価 テストの先後や、与えられたテストによる プログラム生成だけでは、TDDそのものを評価できない 073
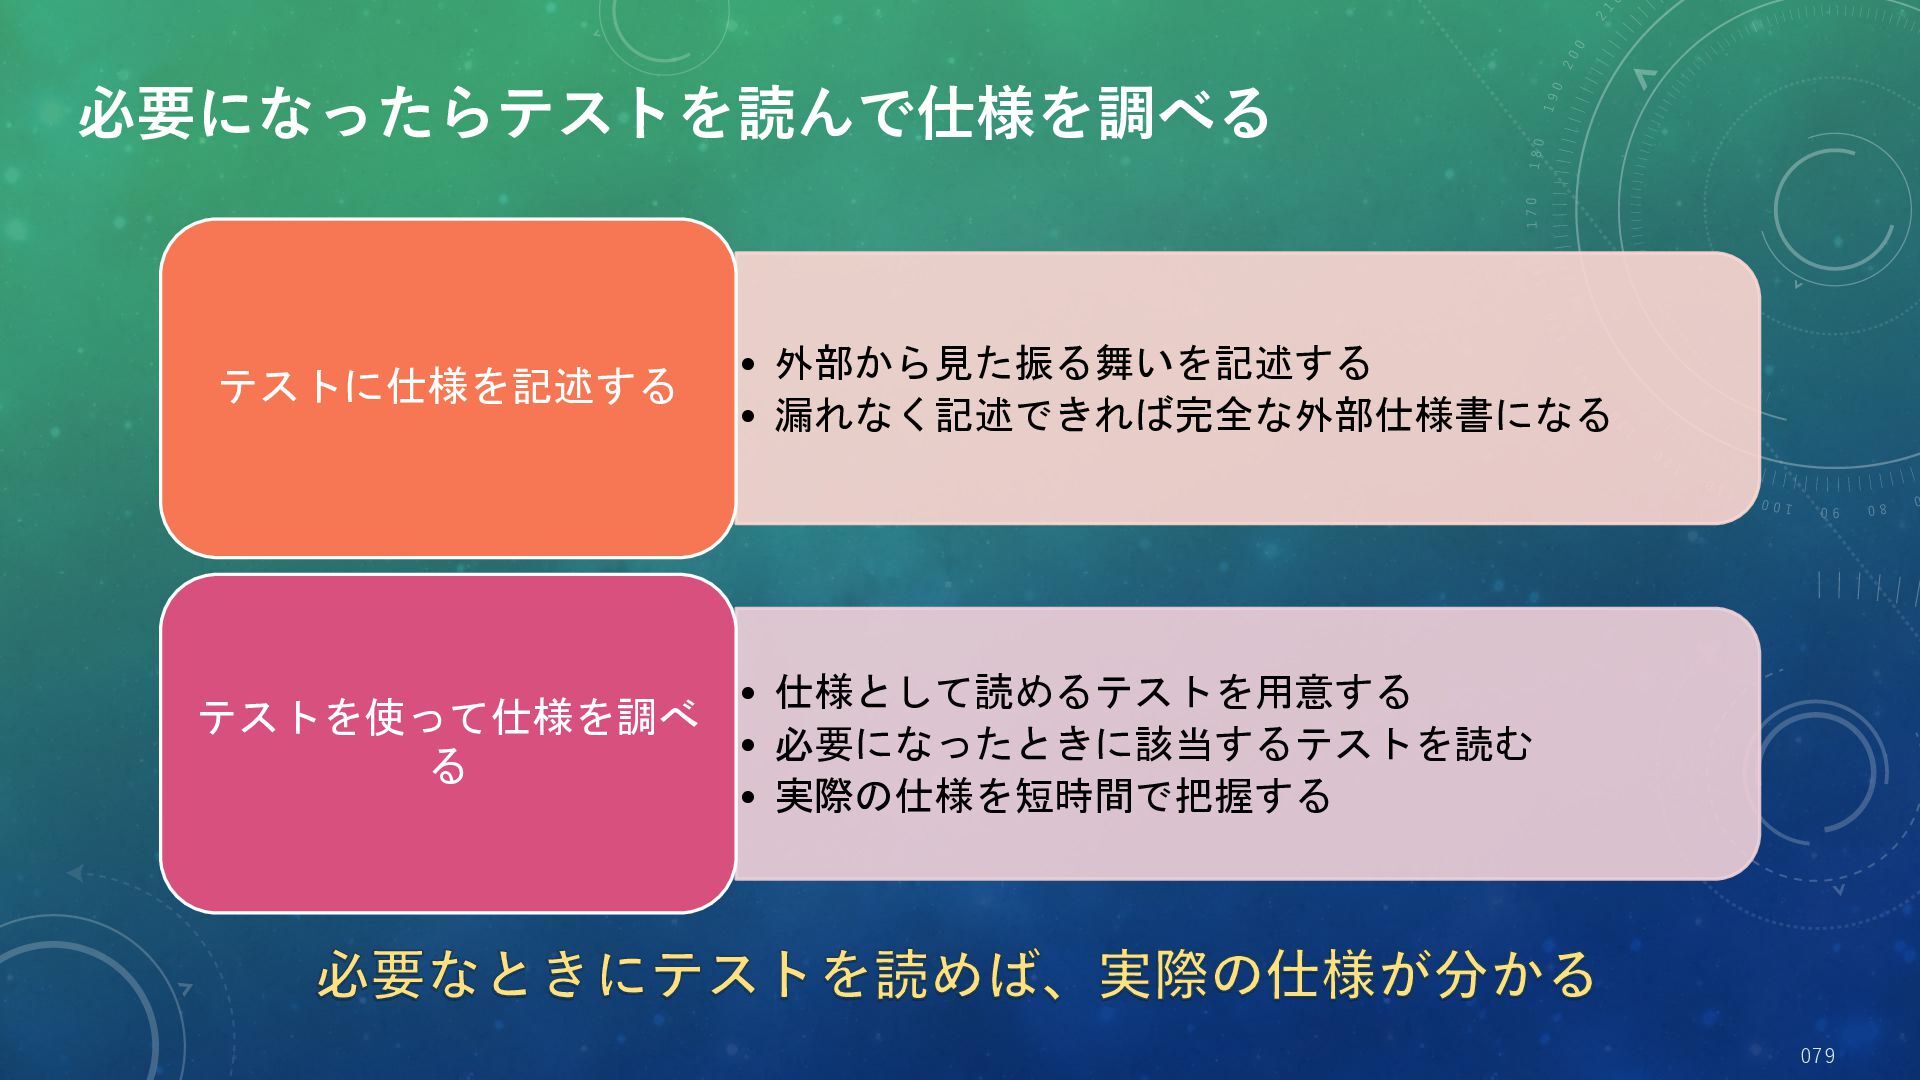
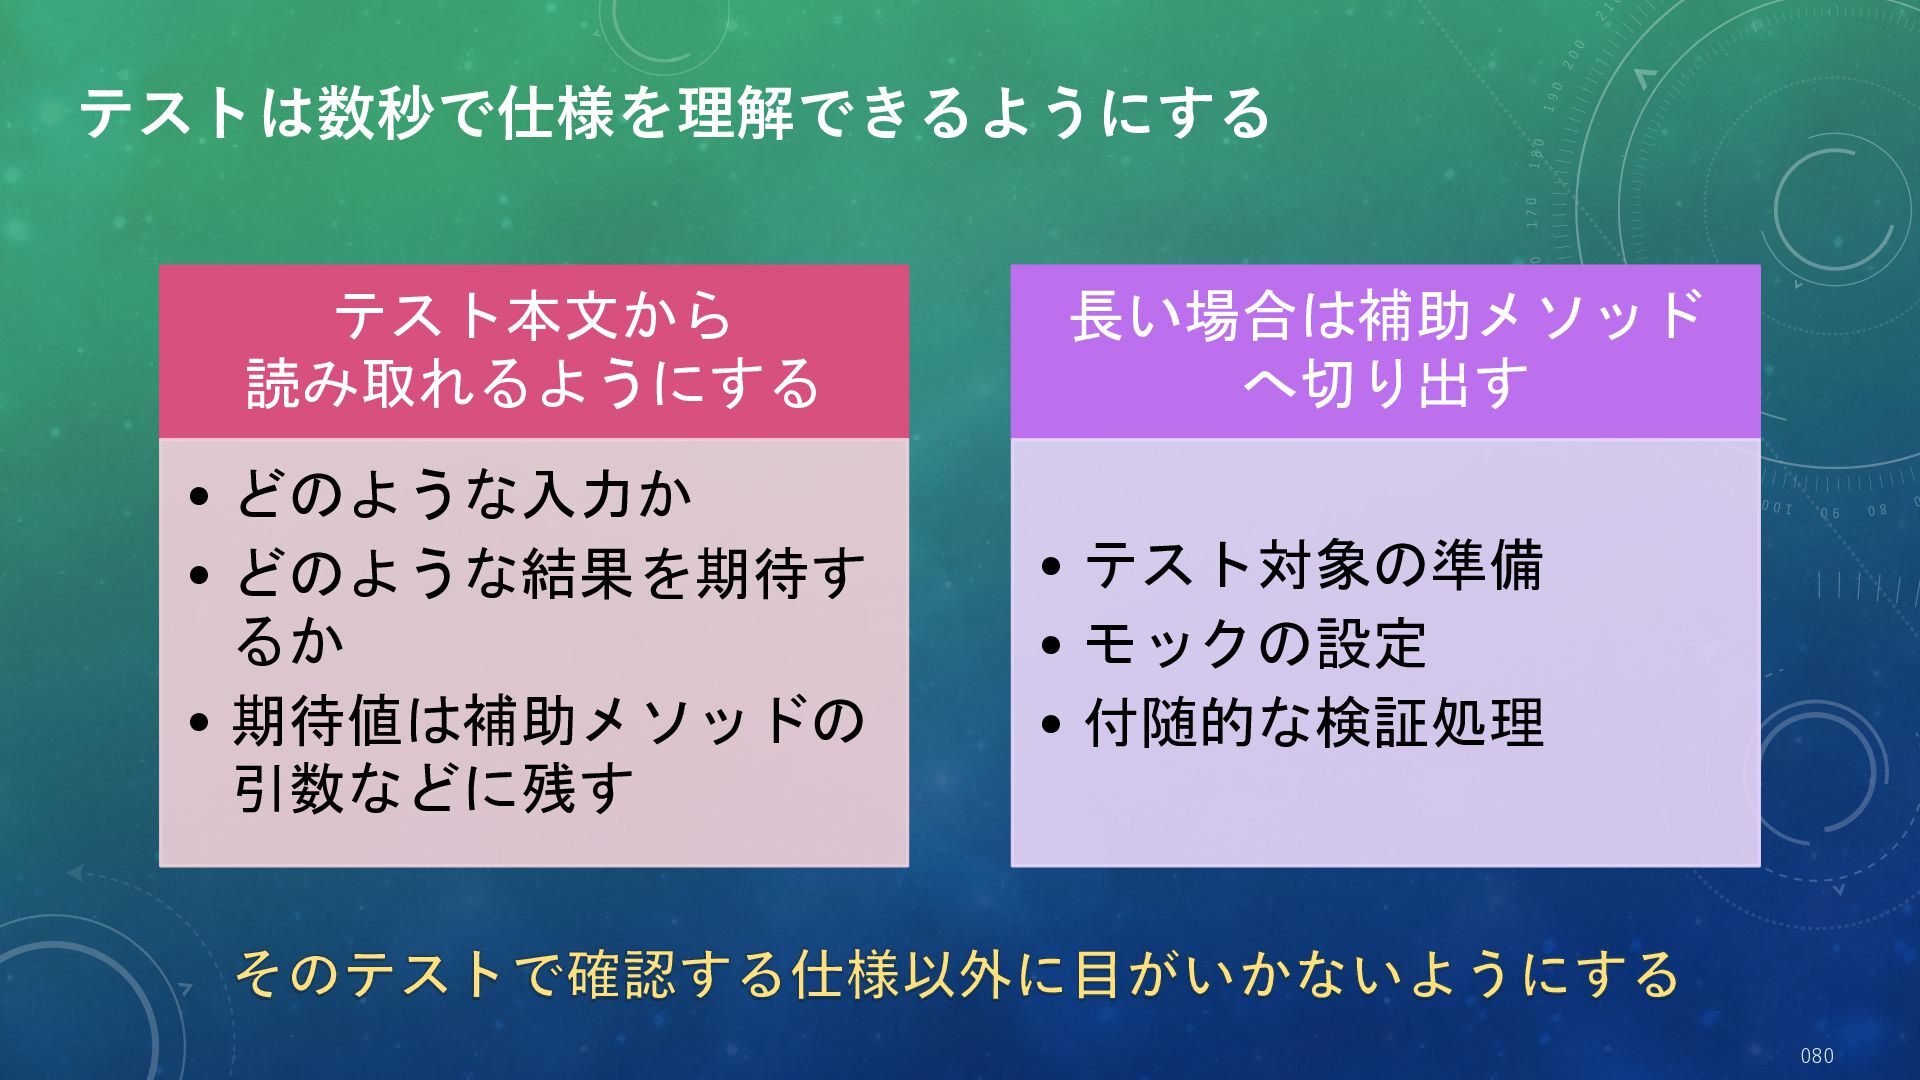
  8. テストは数秒で仕様を理解できるようにする テスト本文から 読み取れるようにする • どのような入力か • どのような結果を期待す るか • 期待値は補助メソッドの

    引数などに残す 長い場合は補助メソッド へ切り出す • テスト対象の準備 • モックの設定 • 付随的な検証処理 そのテストで確認する仕様以外に目がいかないようにする 080
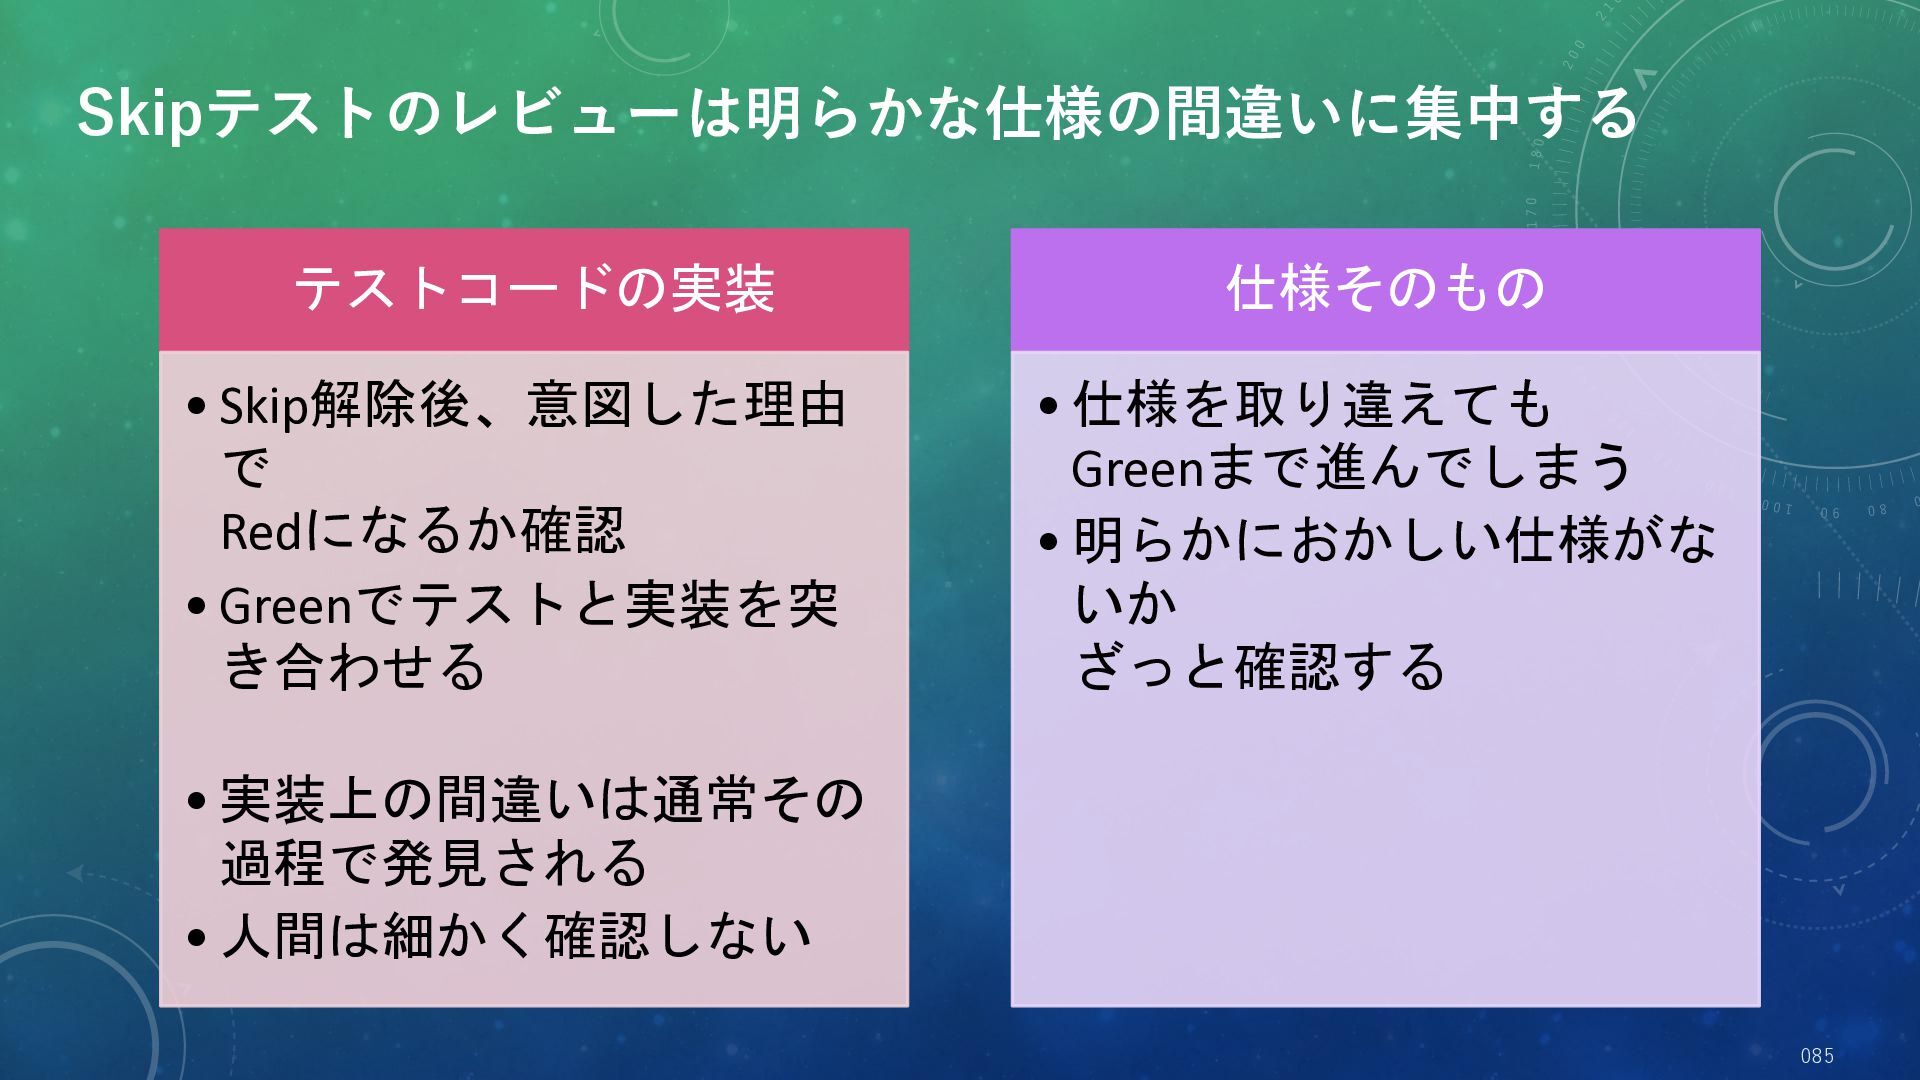
  9. Skipテストのレビューは明らかな仕様の間違いに集中する テストコードの実装 仕様そのもの • Skip解除後、意図した理由 で Redになるか確認 • Greenでテストと実装を突 き合わせる

    • 仕様を取り違えても Greenまで進んでしまう • 明らかにおかしい仕様がな いか ざっと確認する • 実装上の間違いは通常その 過程で発見される • 人間は細かく確認しない 085
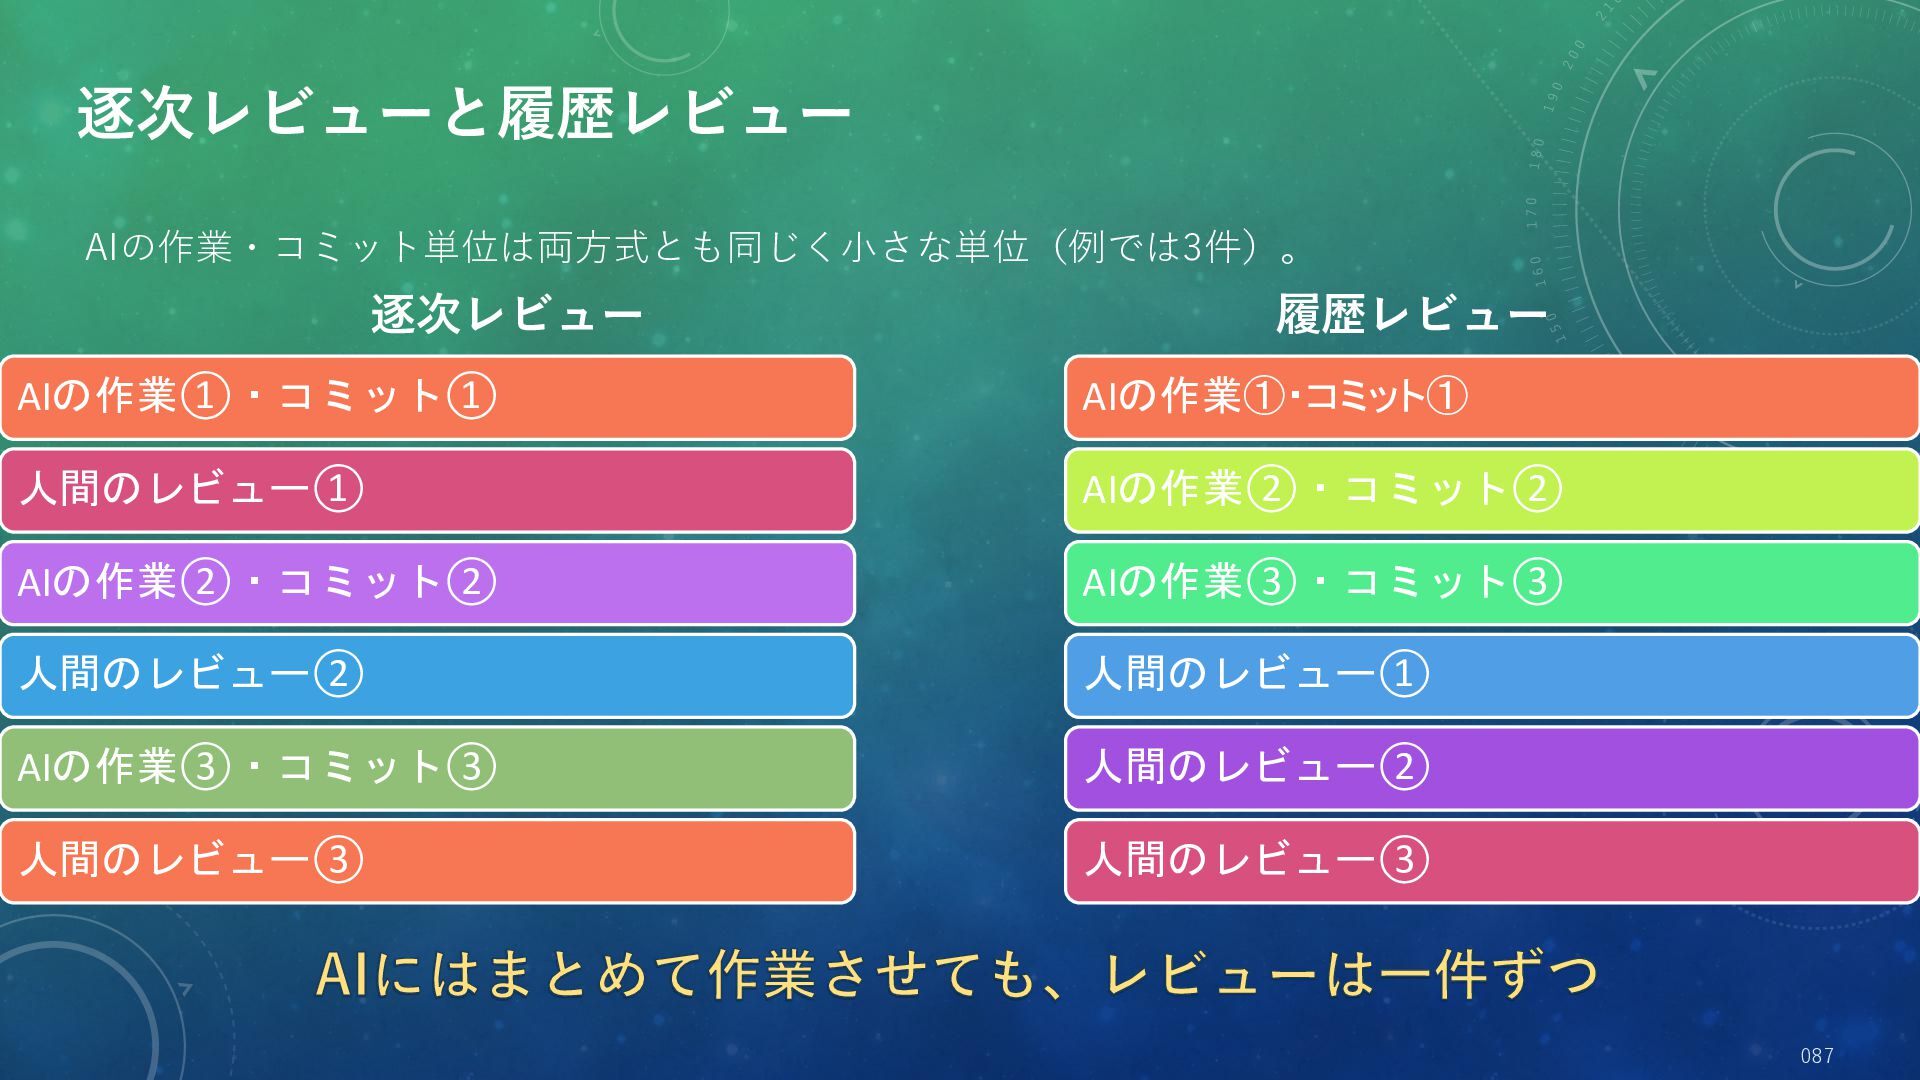
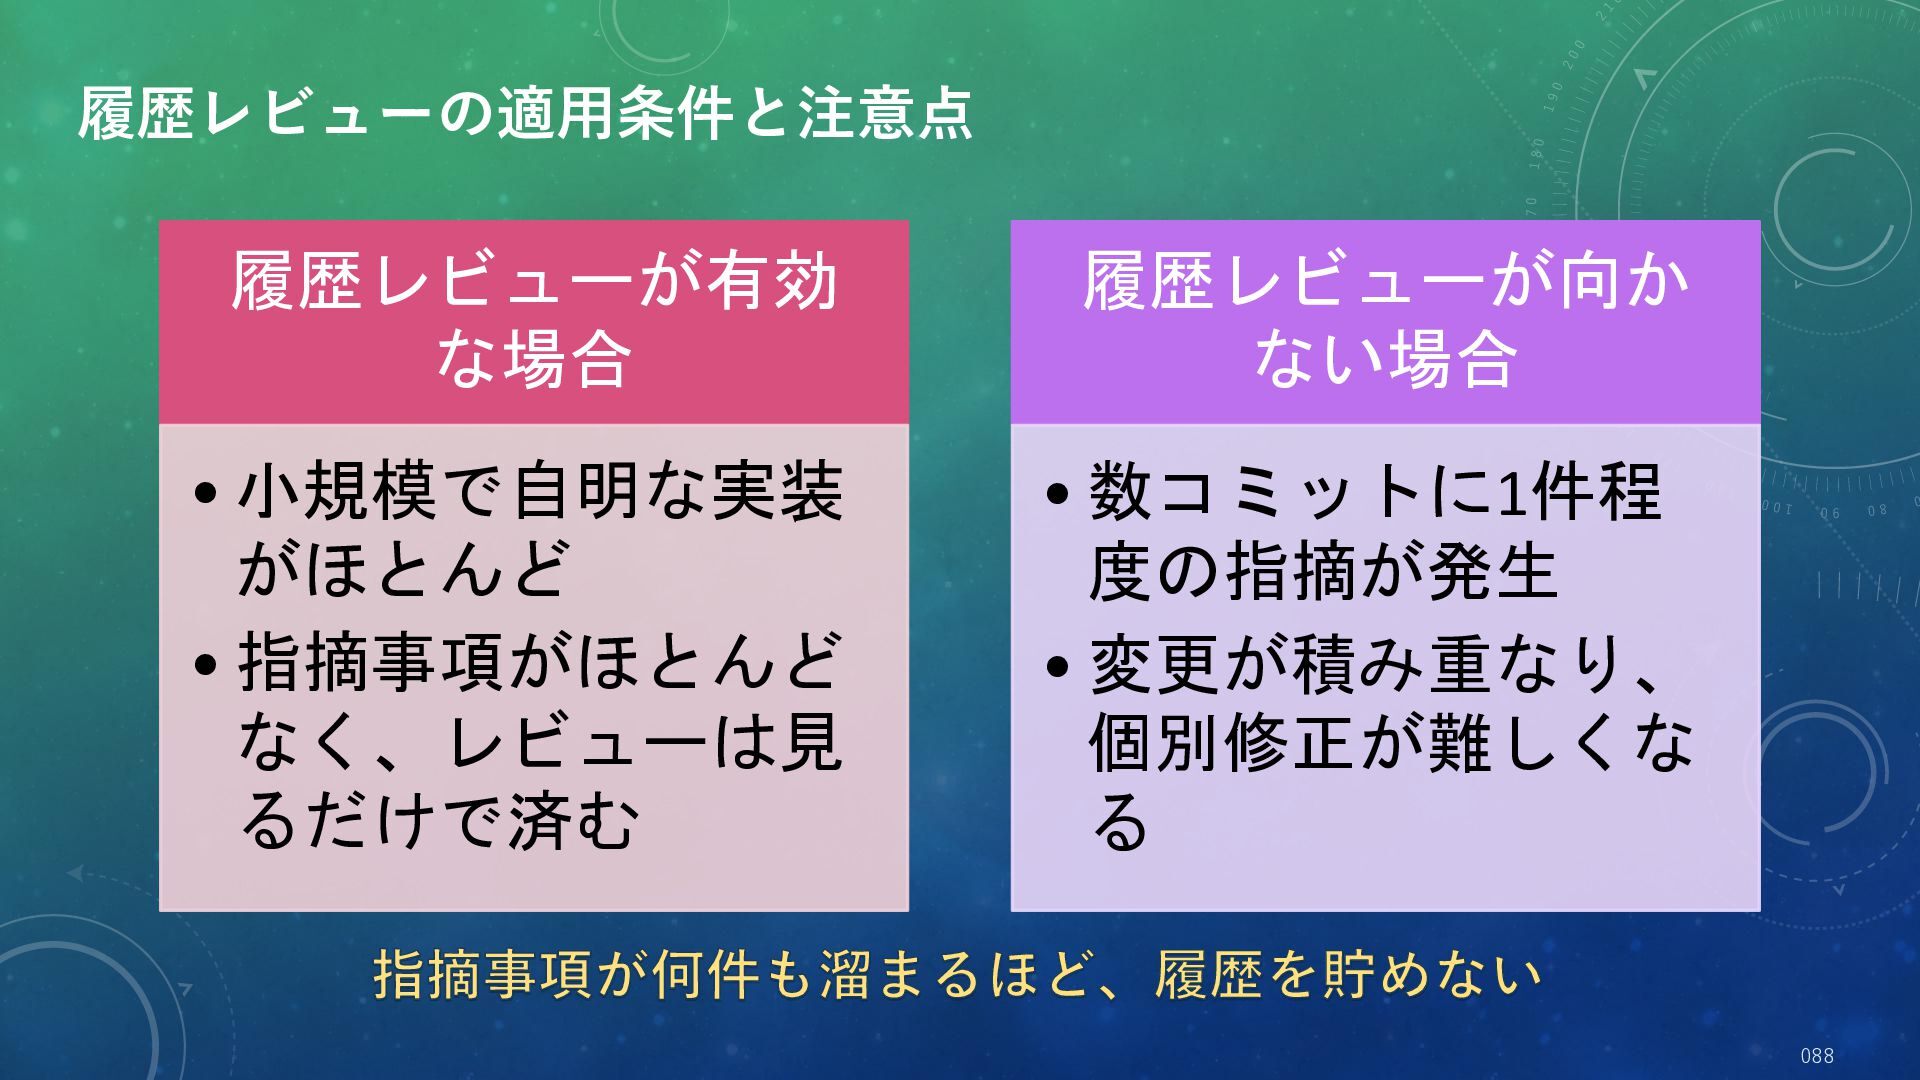
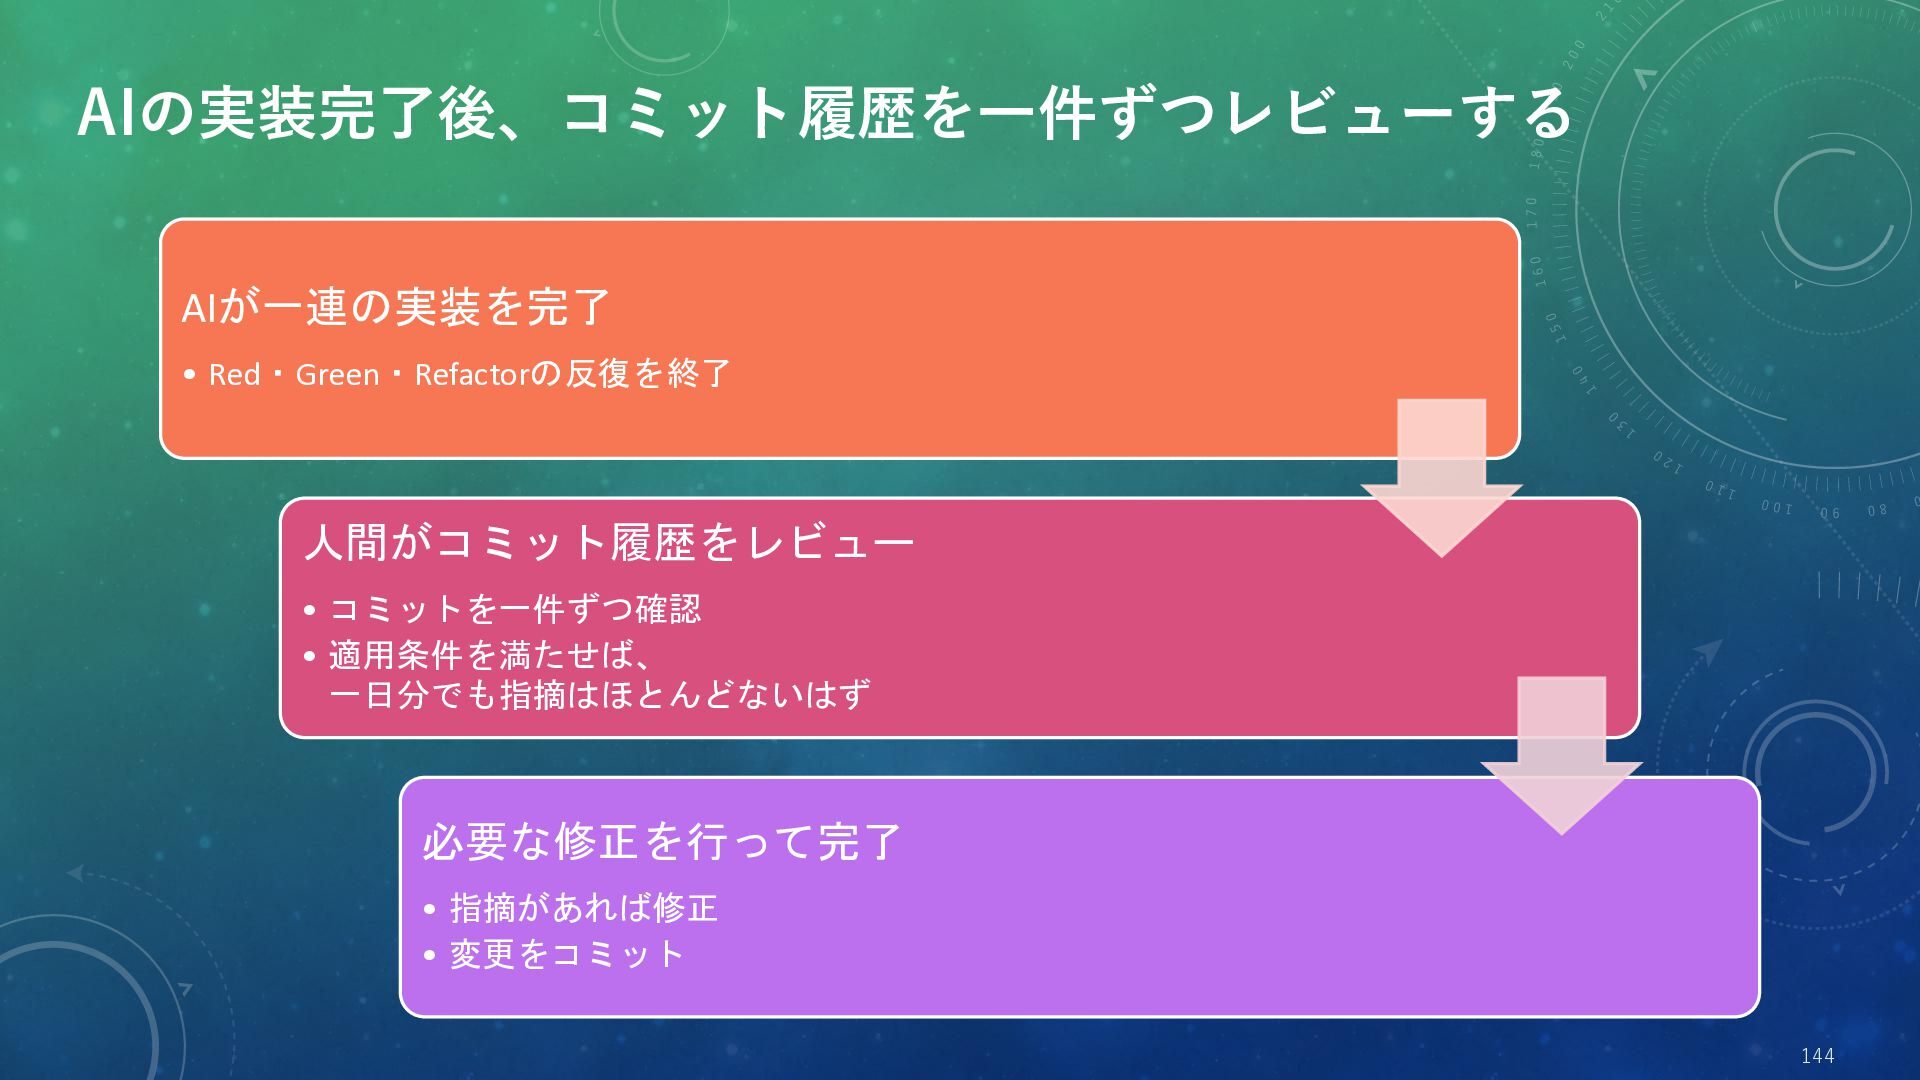
  10. 履歴レビューの適用条件と注意点 履歴レビューが有効 な場合 履歴レビューが向か ない場合 • 小規模で自明な実装 がほとんど • 指摘事項がほとんど

    なく、レビューは見 るだけで済む • 数コミットに1件程 度の指摘が発生 • 変更が積み重なり、 個別修正が難しくな る 指摘事項が何件も溜まるほど、履歴を貯めない 088
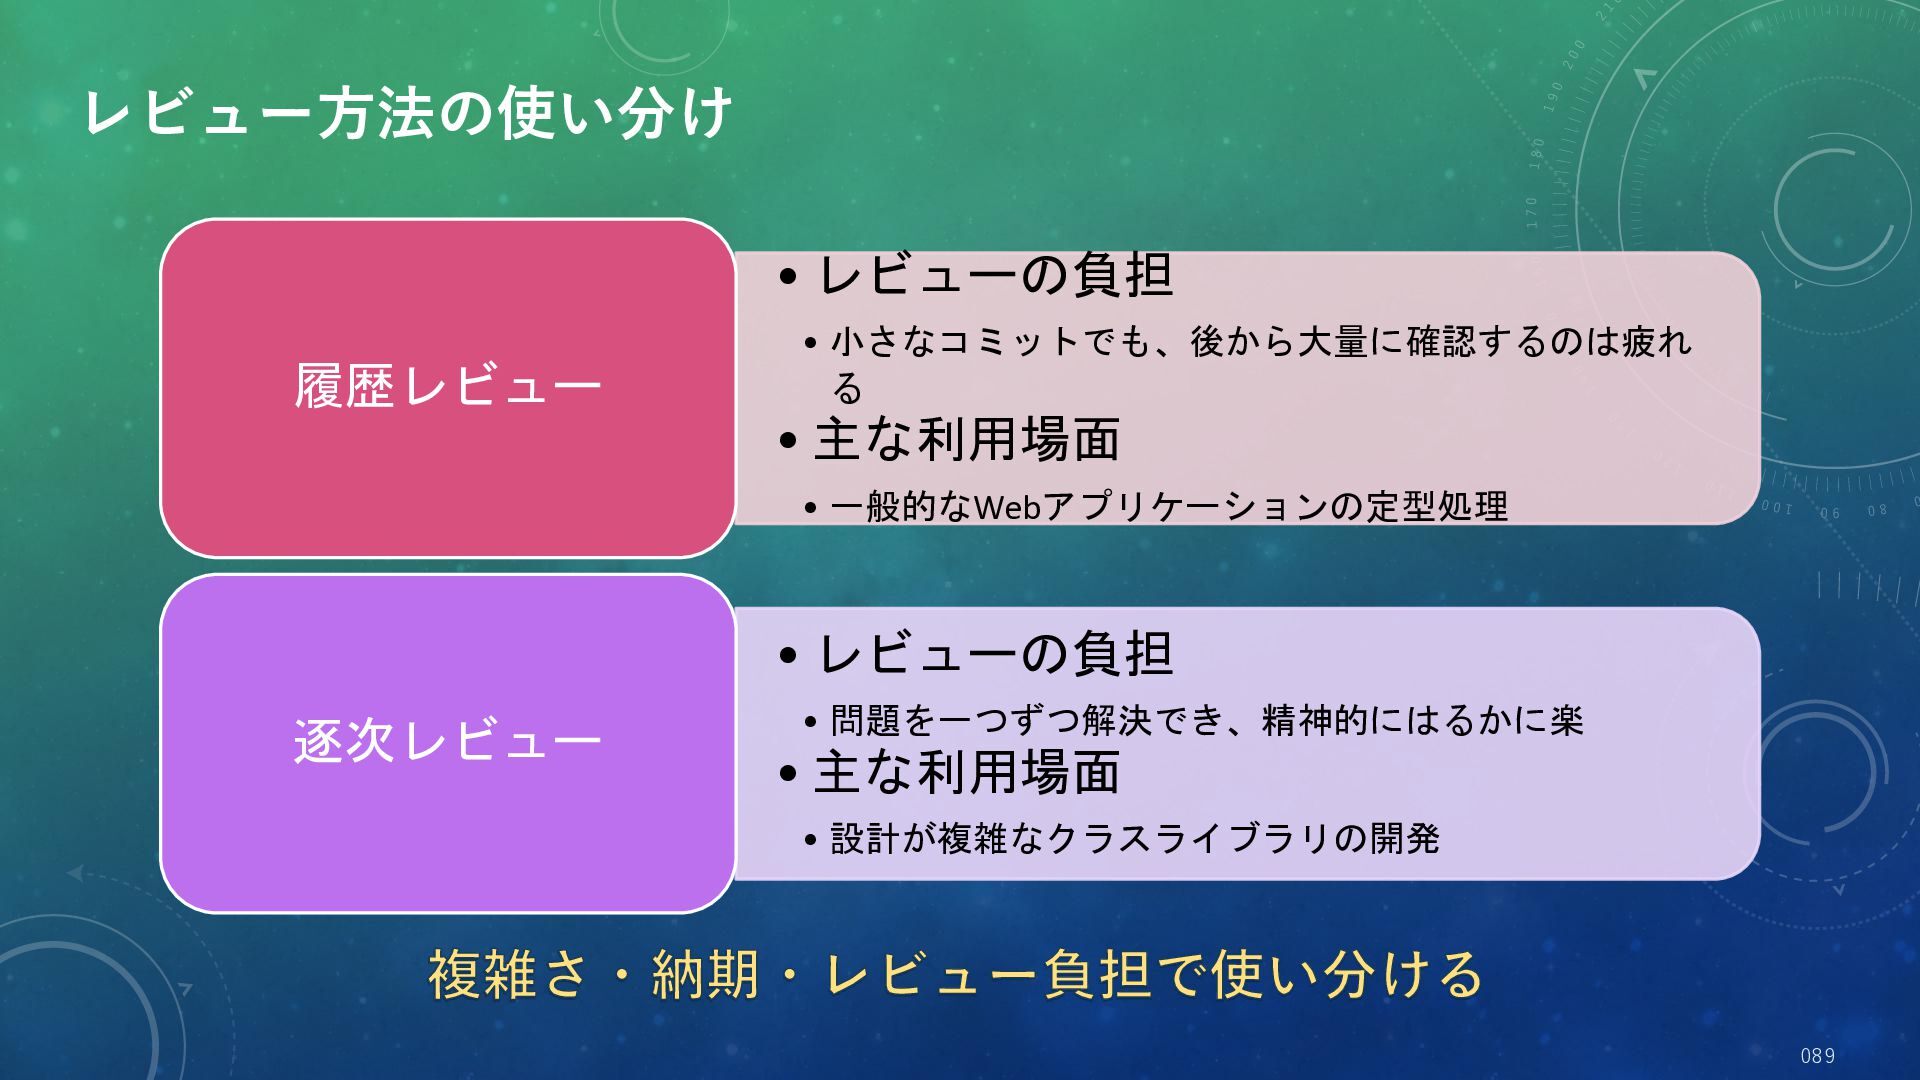
  11. レビュー方法の使い分け • レビューの負担 履歴レビュー • 小さなコミットでも、後から大量に確認するのは疲れ る • 主な利用場面 •

    一般的なWebアプリケーションの定型処理 • レビューの負担 逐次レビュー • 問題を一つずつ解決でき、精神的にはるかに楽 • 主な利用場面 • 設計が複雑なクラスライブラリの開発 複雑さ・納期・レビュー負担で使い分ける 089
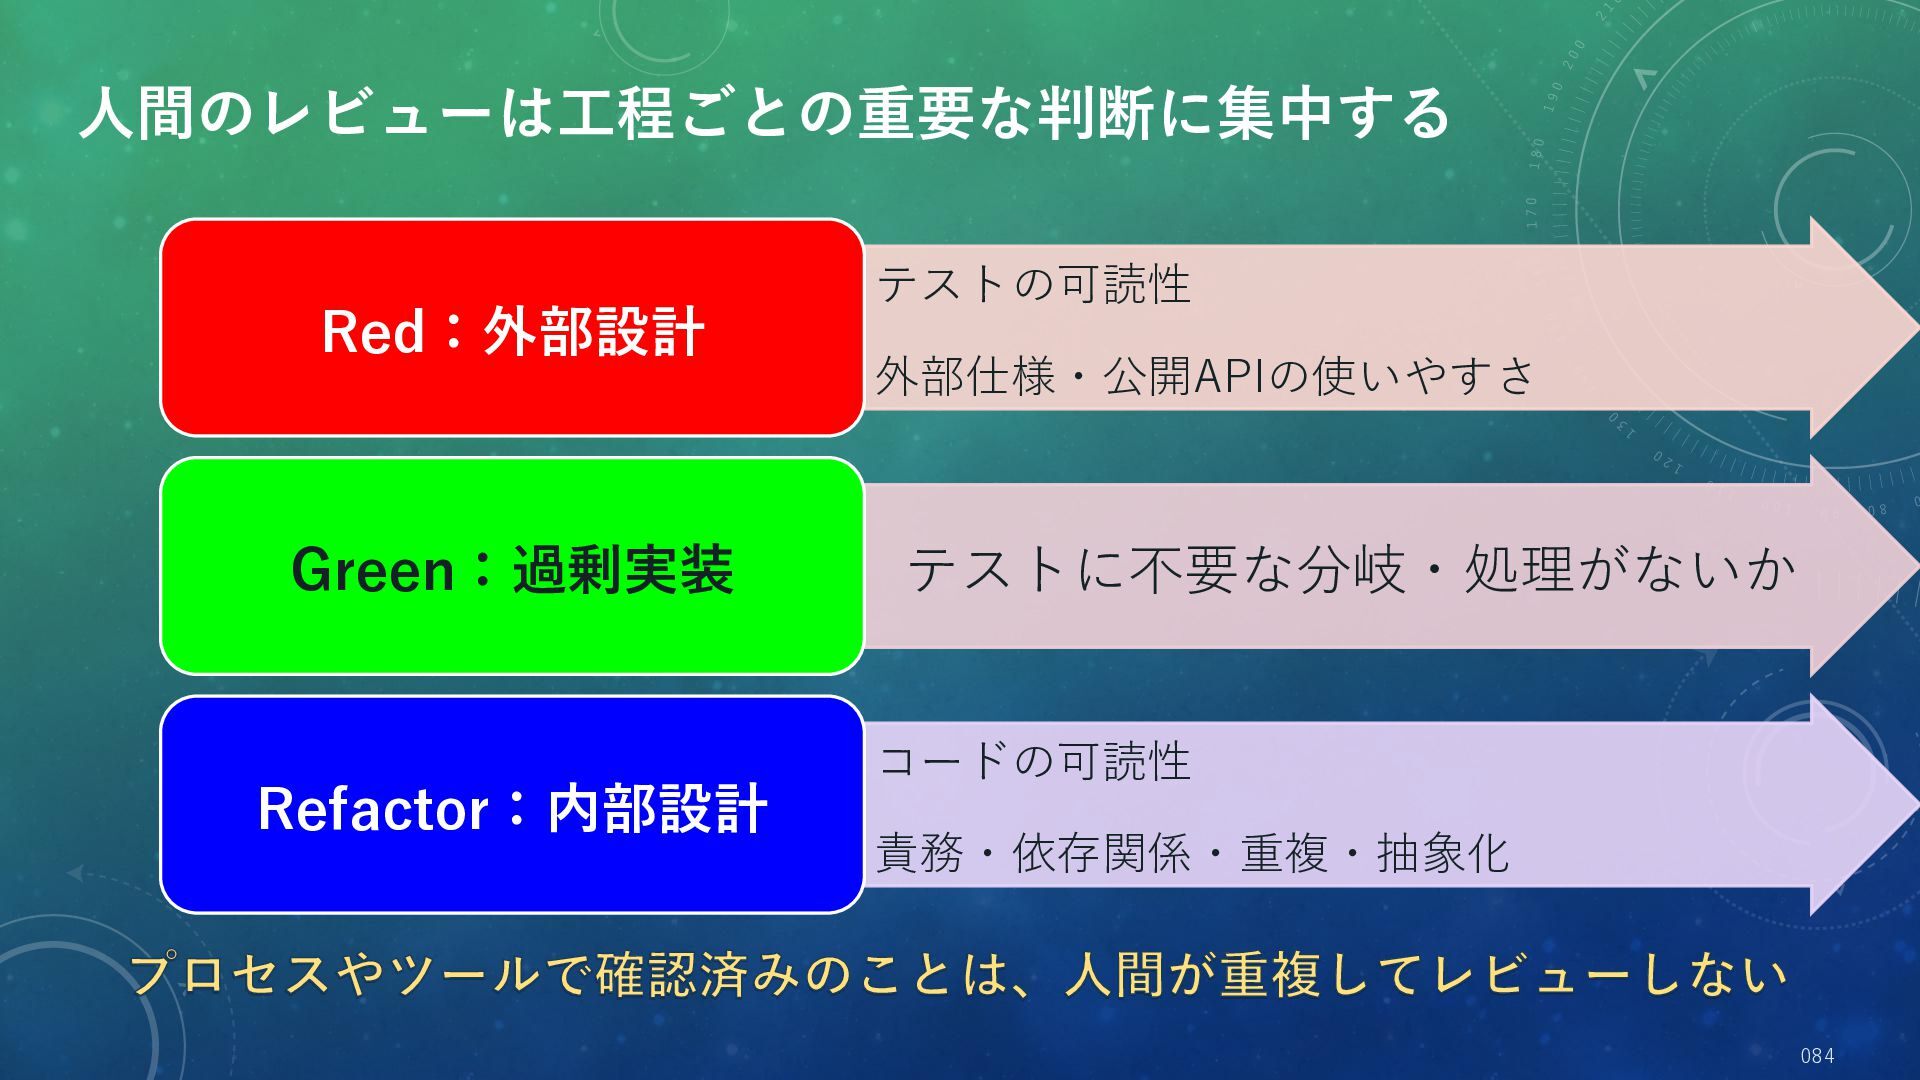
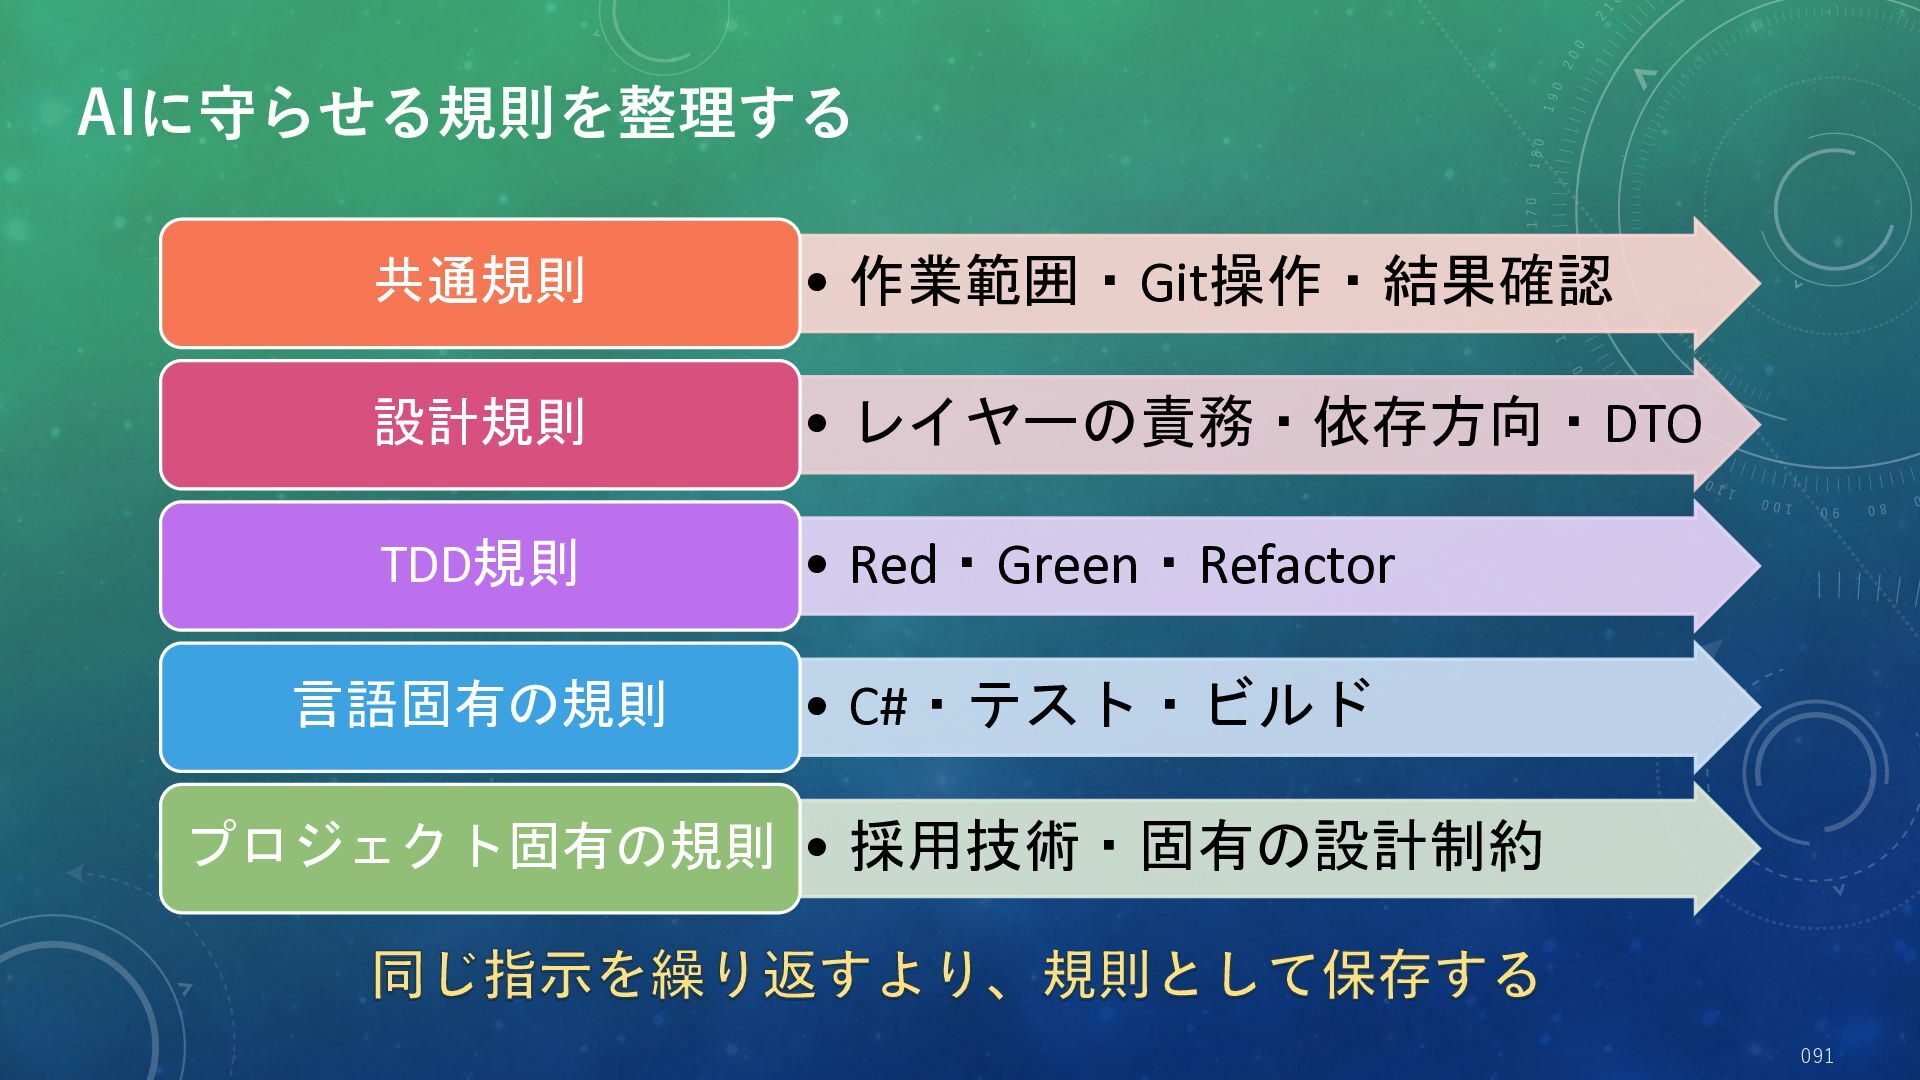
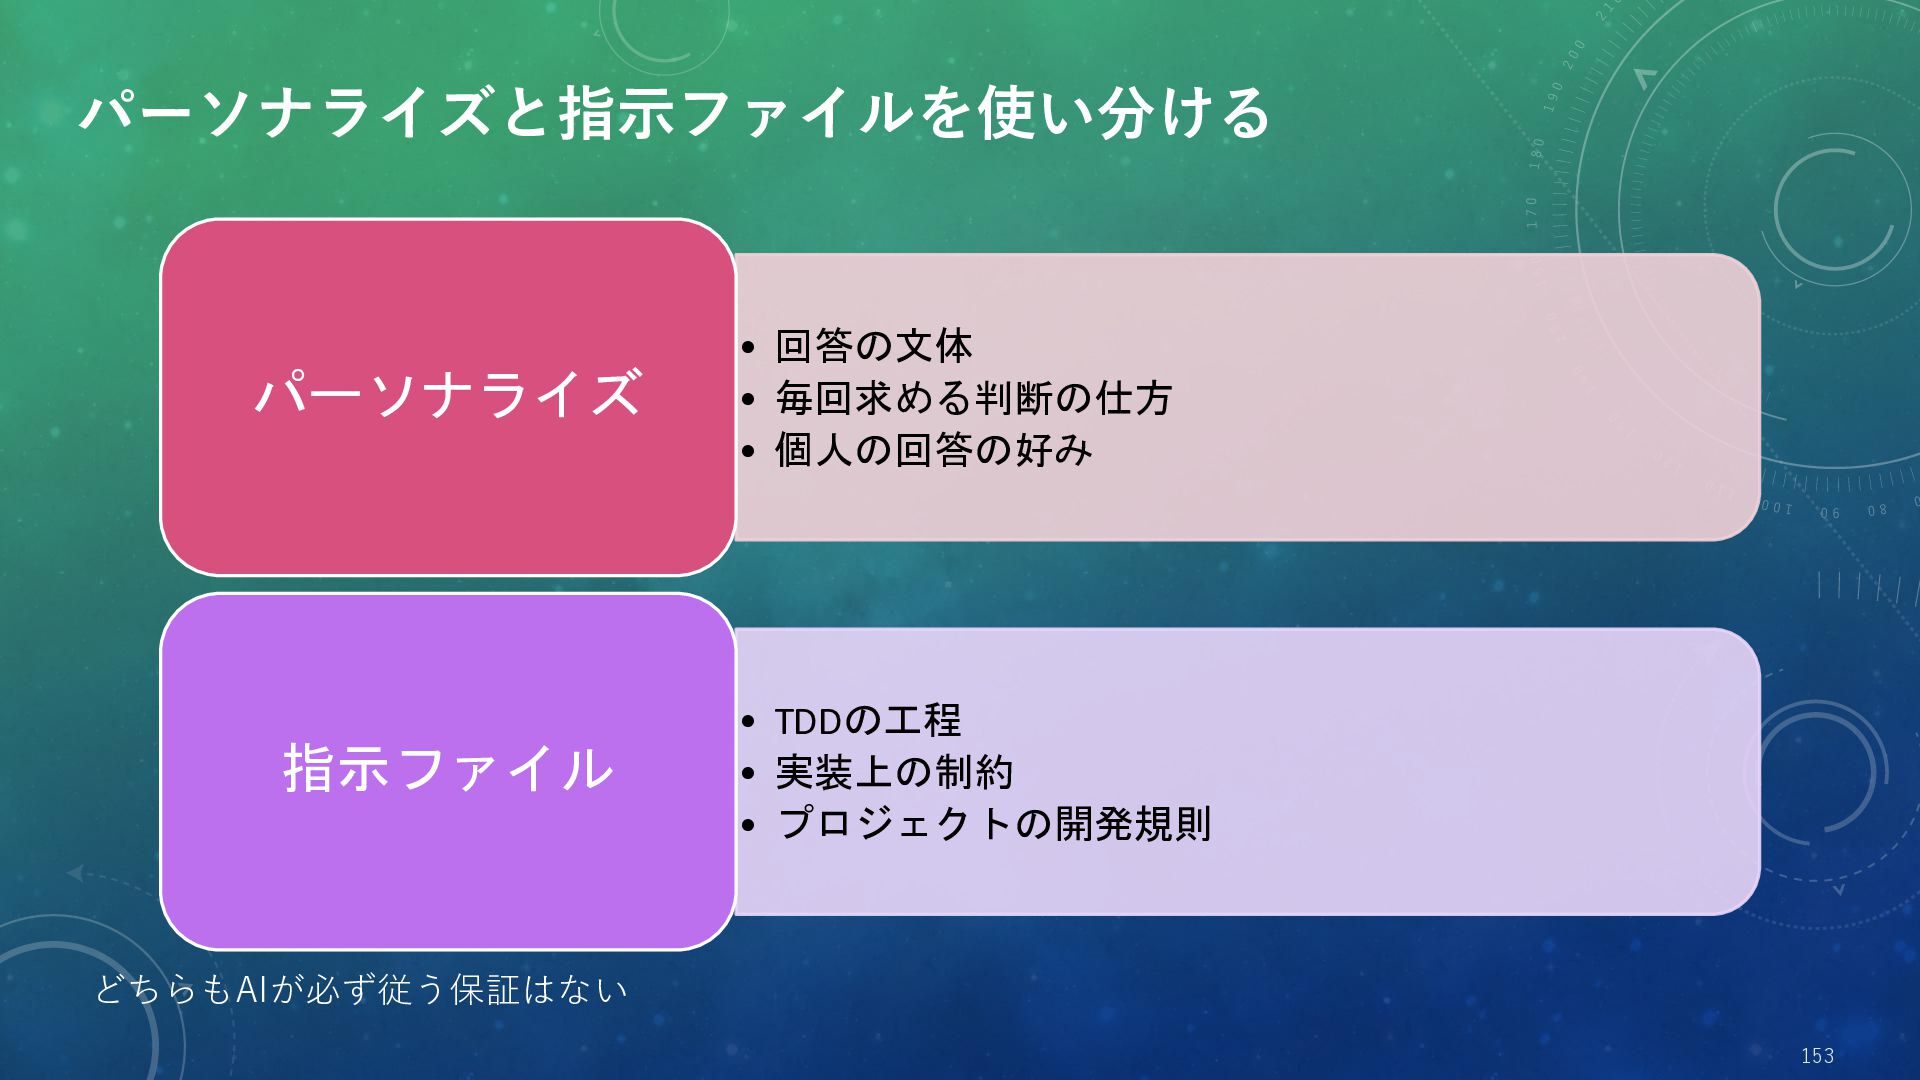
  12. AIに守らせる規則を整理する 共通規則 • 作業範囲・Git操作・結果確認 設計規則 • レイヤーの責務・依存方向・DTO TDD規則 • Red・Green・Refactor

    言語固有の規則 • C#・テスト・ビルド プロジェクト固有の規則 • 採用技術・固有の設計制約 同じ指示を繰り返すより、規則として保存する 091
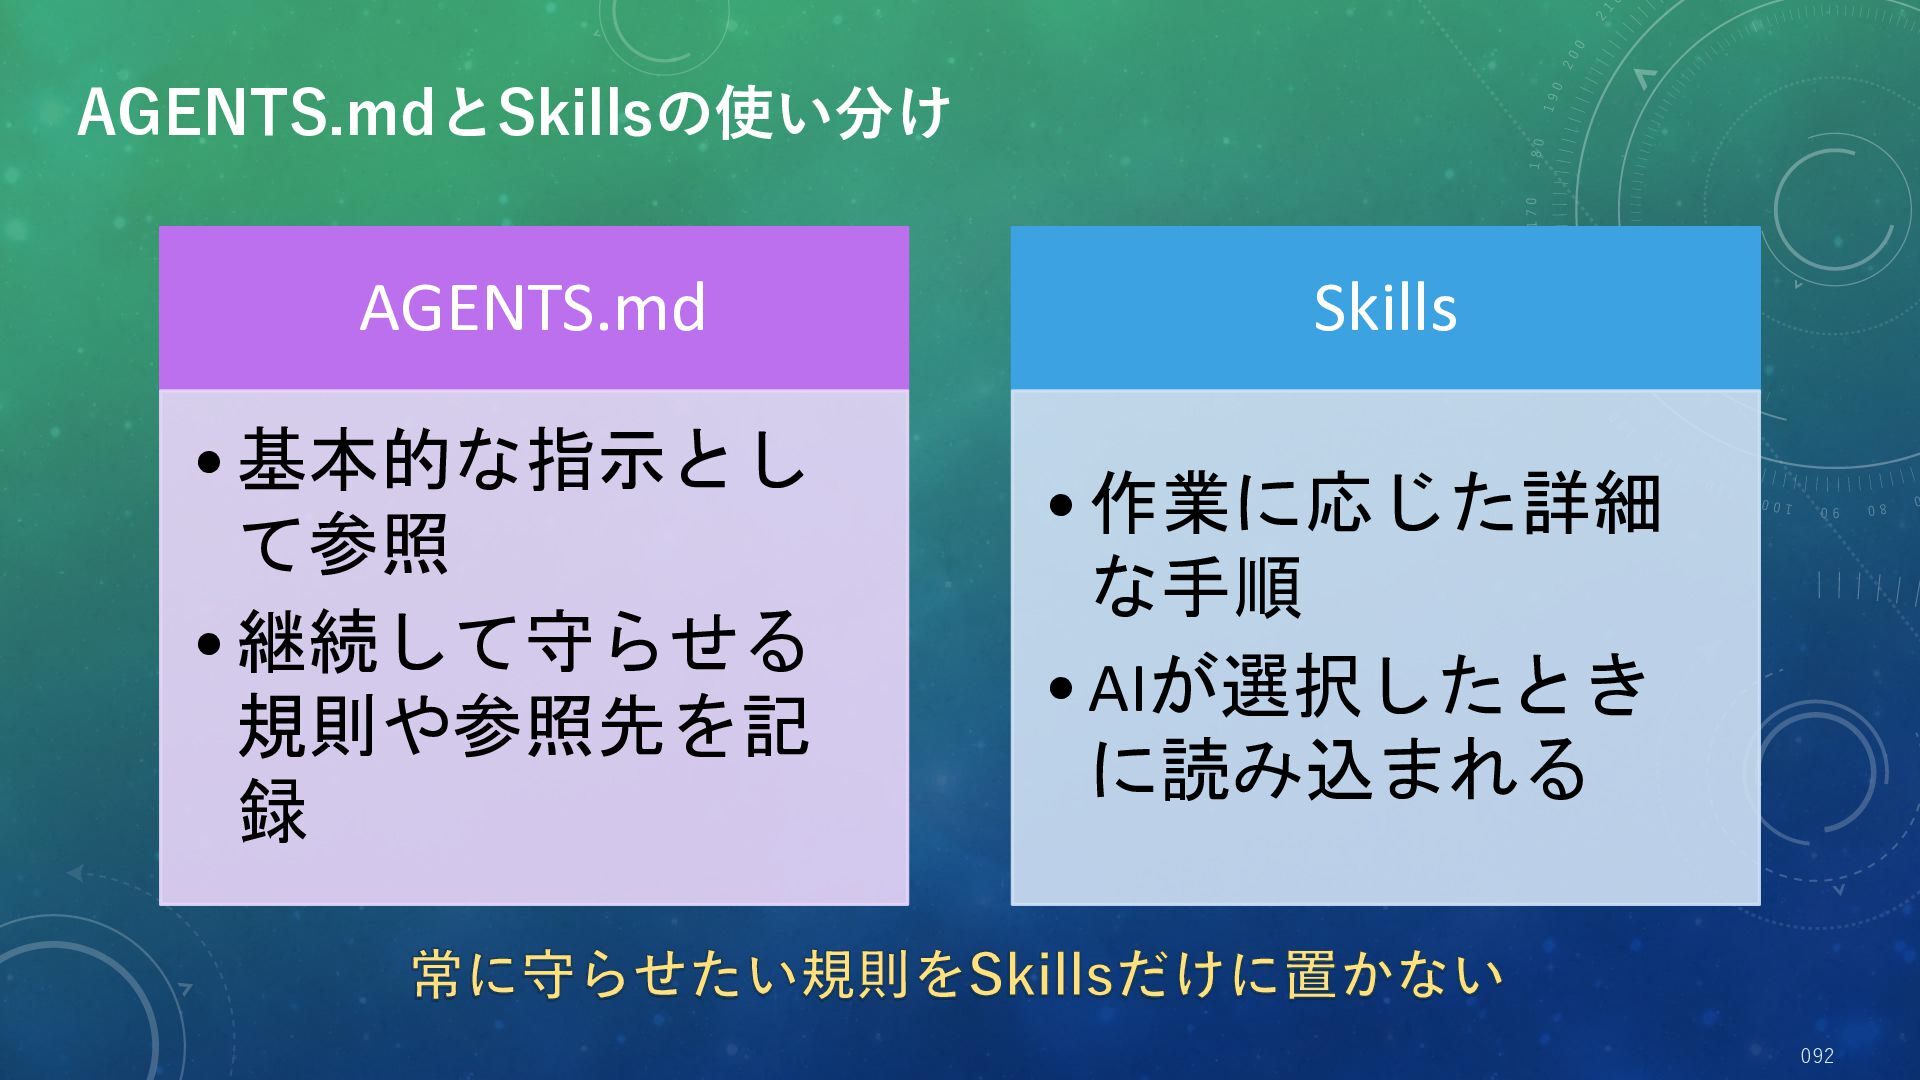
  13. AGENTS.mdとSkillsの使い分け AGENTS.md Skills • 基本的な指示とし て参照 • 継続して守らせる 規則や参照先を記 録

    • 作業に応じた詳細 な手順 • AIが選択したとき に読み込まれる 常に守らせたい規則をSkillsだけに置かない 092
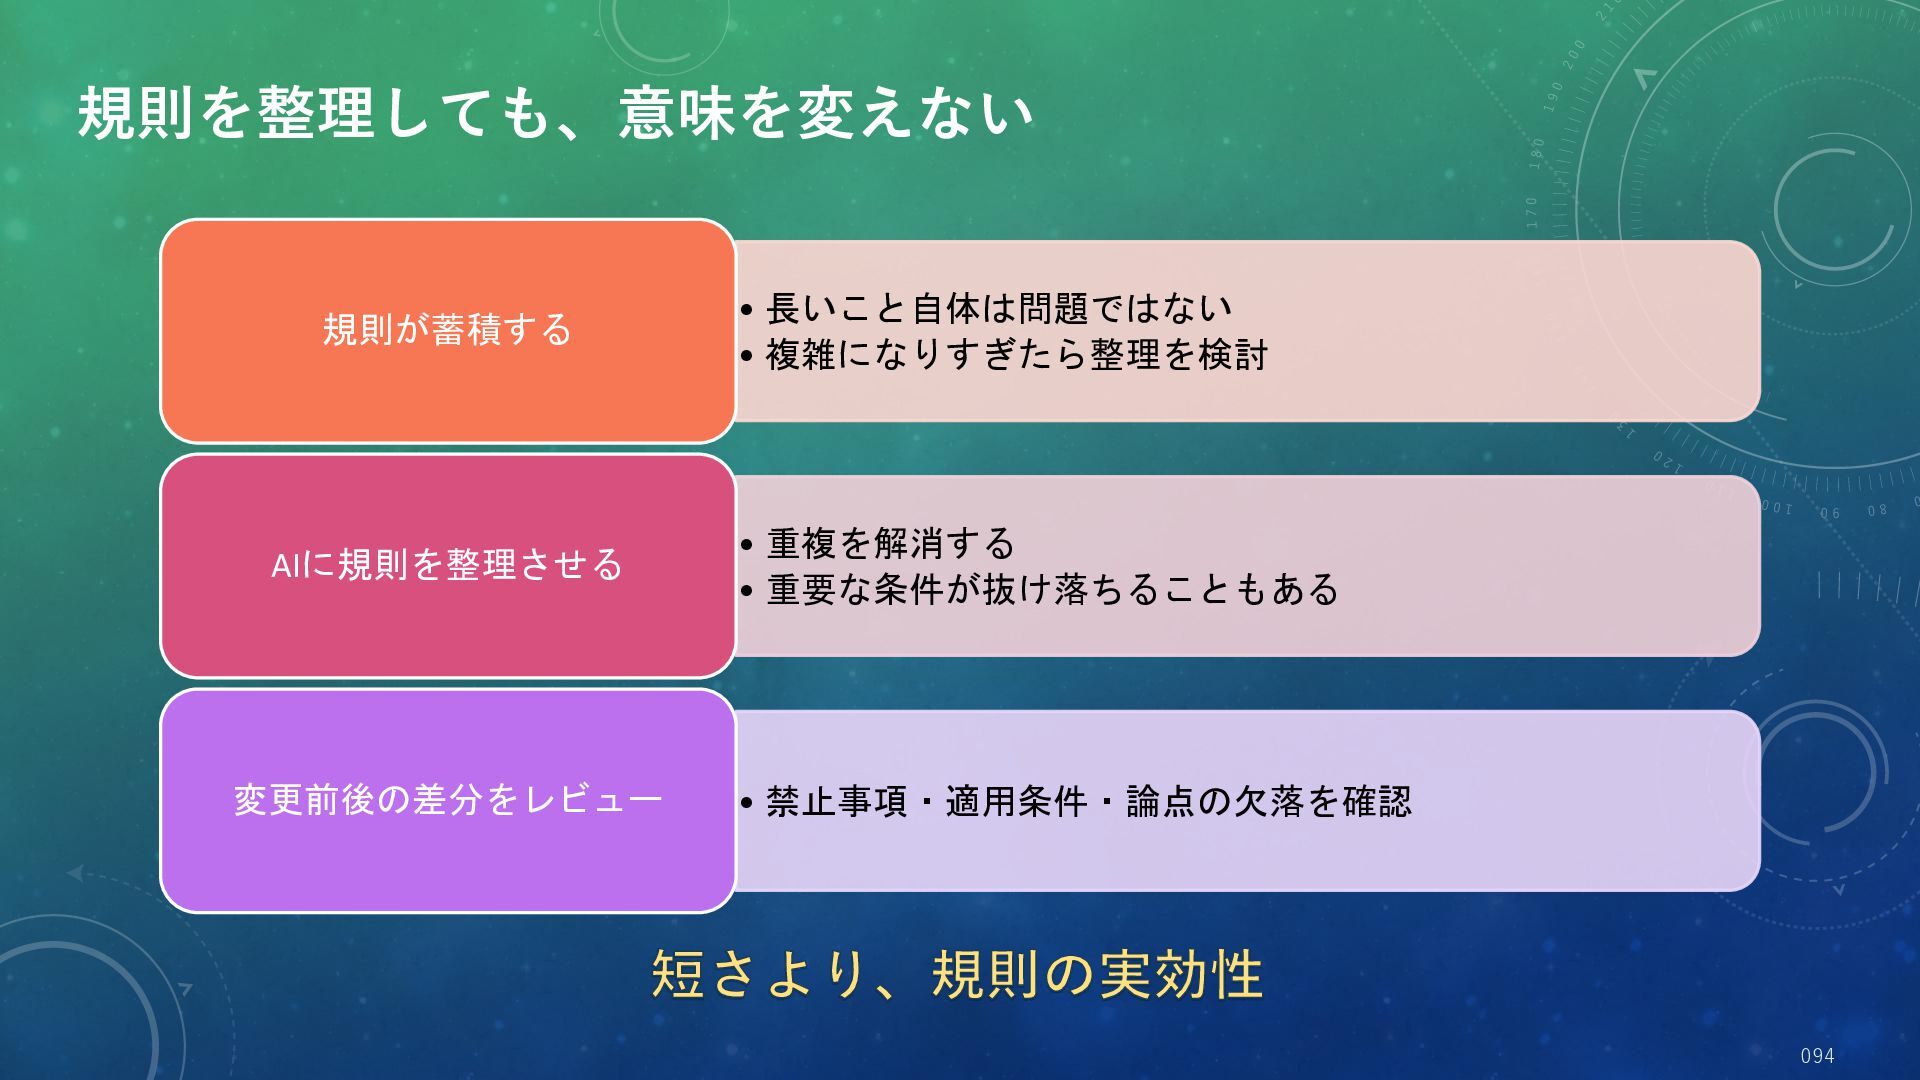
  14. 規則を整理しても、意味を変えない • 長いこと自体は問題ではない • 複雑になりすぎたら整理を検討 規則が蓄積する • 重複を解消する • 重要な条件が抜け落ちることもある

    AIに規則を整理させる 変更前後の差分をレビュー • 禁止事項・適用条件・論点の欠落を確認 短さより、規則の実効性 094
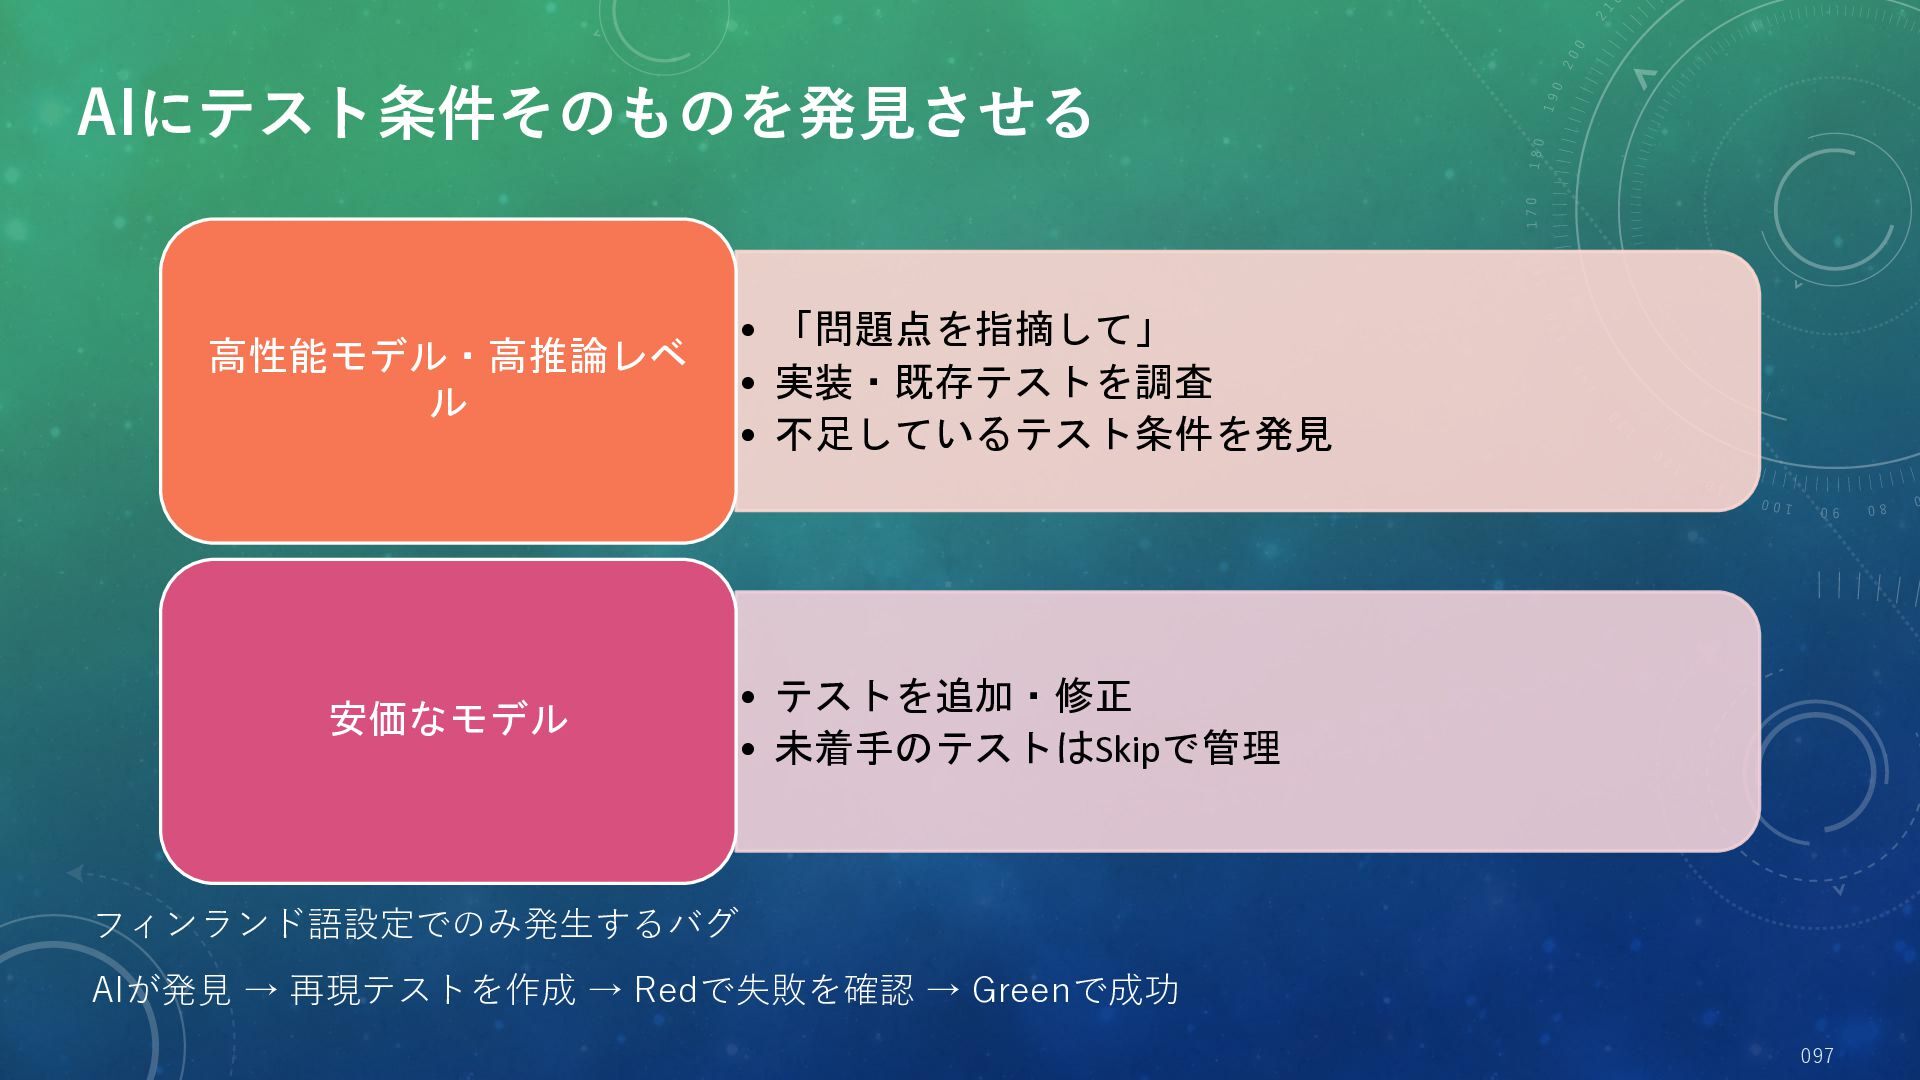
  15. AIにテスト条件そのものを発見させる 高性能モデル・高推論レベ ル • 「問題点を指摘して」 • 実装・既存テストを調査 • 不足しているテスト条件を発見 安価なモデル

    • テストを追加・修正 • 未着手のテストはSkipで管理 フィンランド語設定でのみ発生するバグ AIが発見 → 再現テストを作成 → Redで失敗を確認 → Greenで成功 097
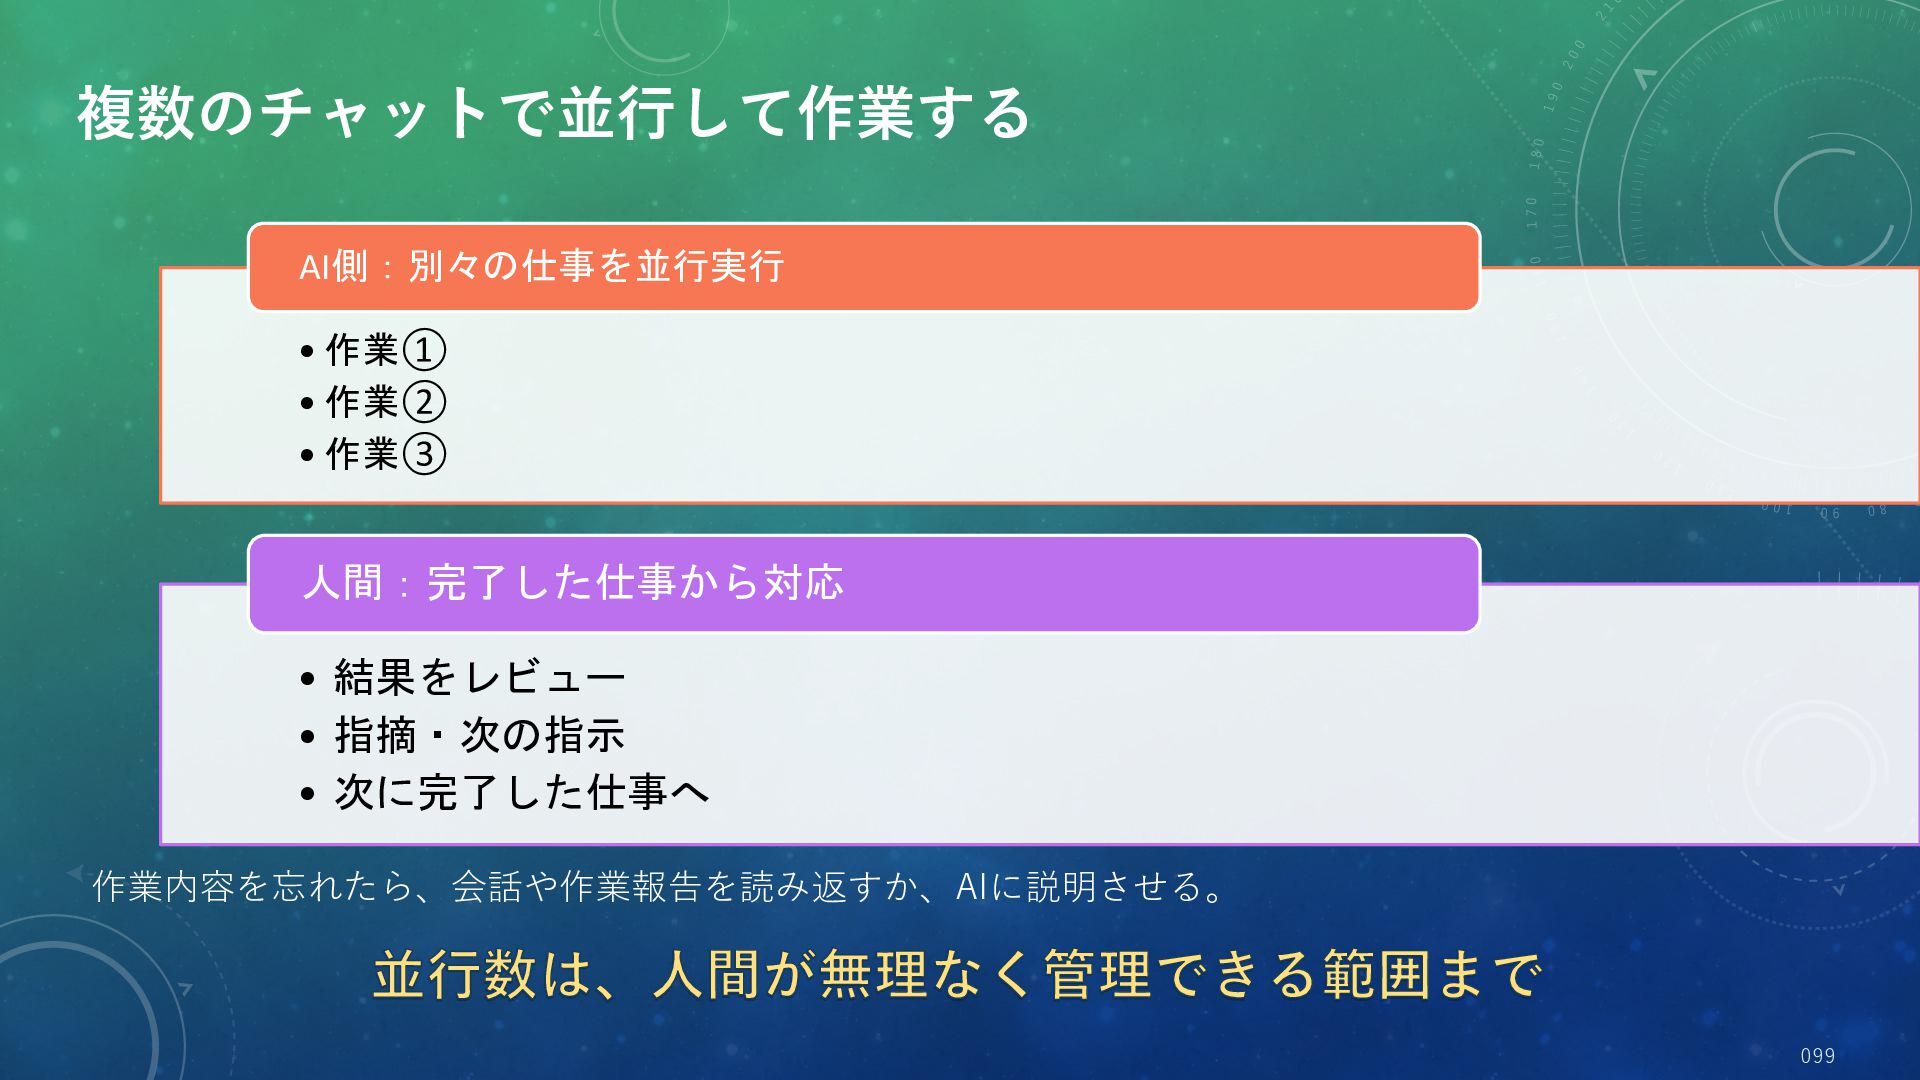
  16. 複数のチャットで並行して作業する AI側:別々の仕事を並行実行 • 作業① • 作業② • 作業③ 人間:完了した仕事から対応 •

    結果をレビュー • 指摘・次の指示 • 次に完了した仕事へ 作業内容を忘れたら、会話や作業報告を読み返すか、AIに説明させる。 並行数は、人間が無理なく管理できる範囲まで 099
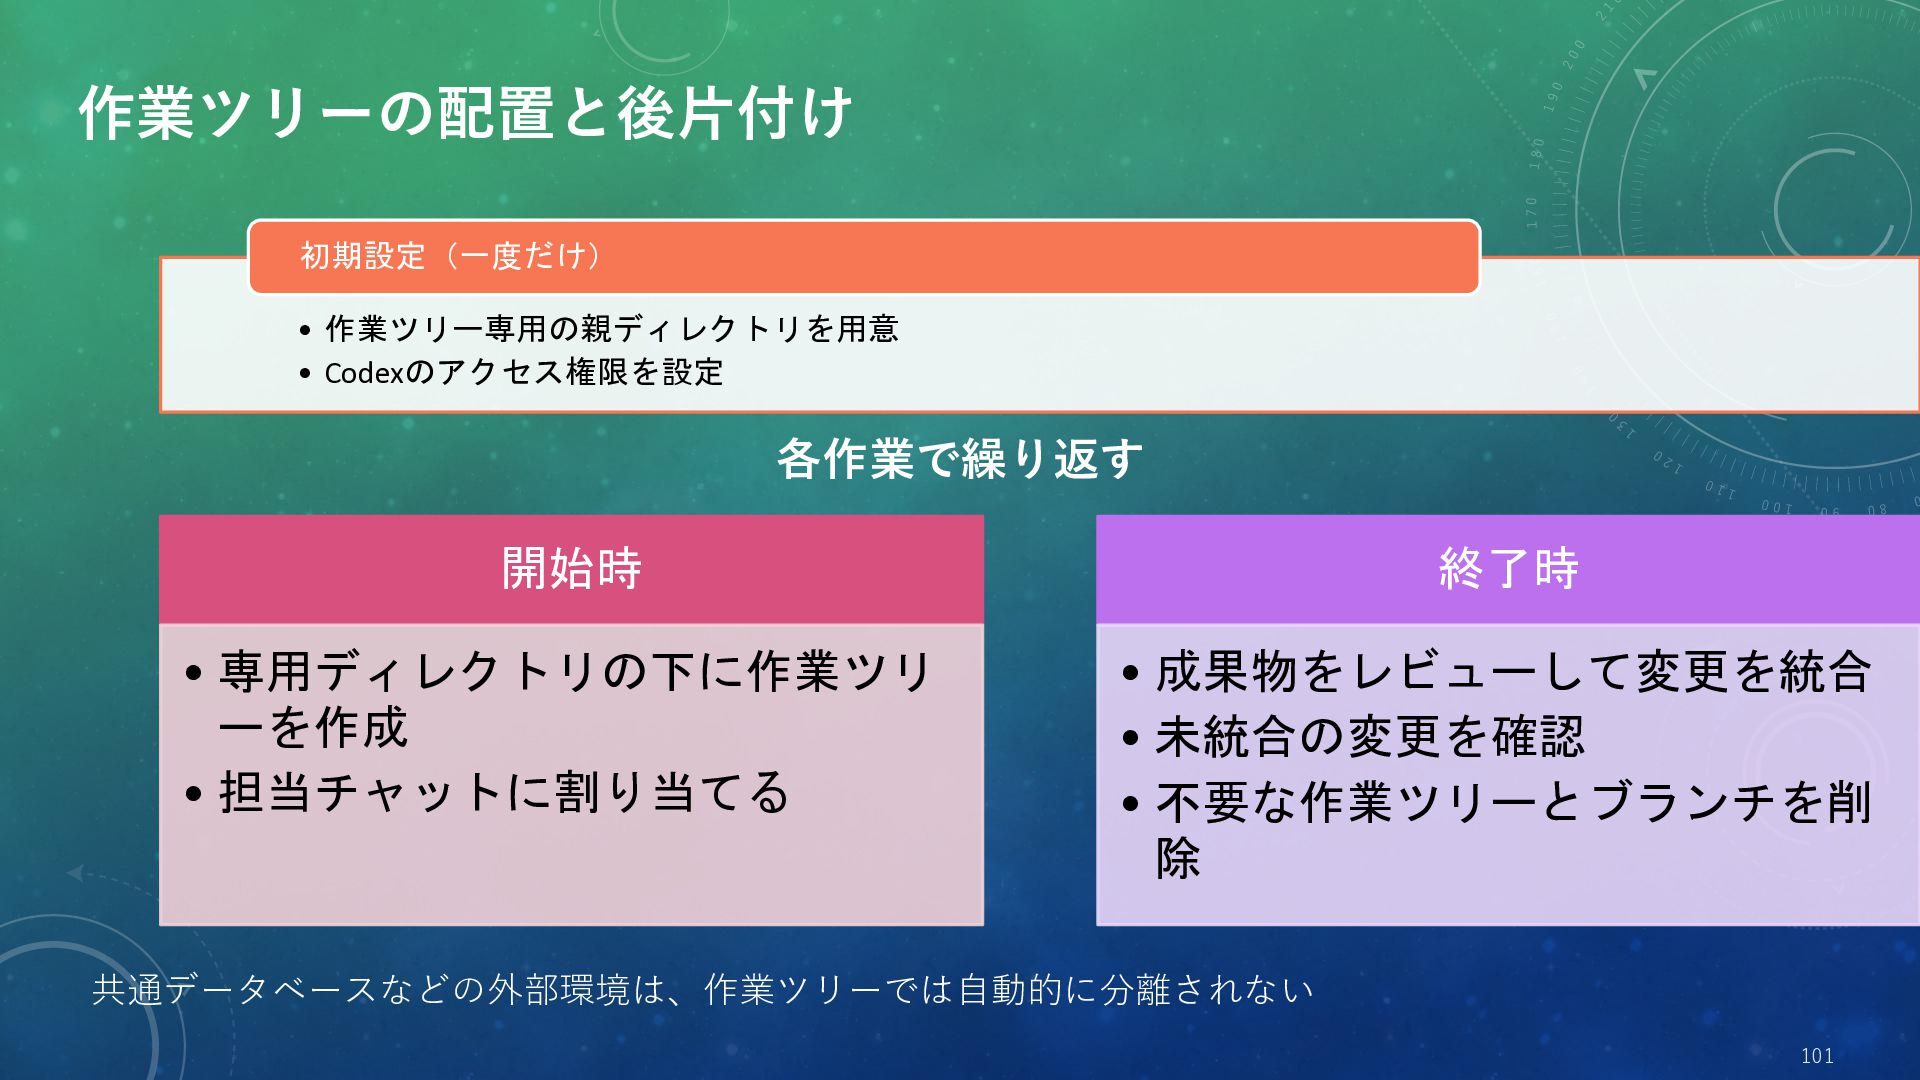
  17. 作業ツリーの配置と後片付け 初期設定(一度だけ) • 作業ツリー専用の親ディレクトリを用意 • Codexのアクセス権限を設定 各作業で繰り返す 開始時 終了時 •

    専用ディレクトリの下に作業ツリ ーを作成 • 担当チャットに割り当てる • 成果物をレビューして変更を統合 • 未統合の変更を確認 • 不要な作業ツリーとブランチを削 除 共通データベースなどの外部環境は、作業ツリーでは自動的に分離されない 101
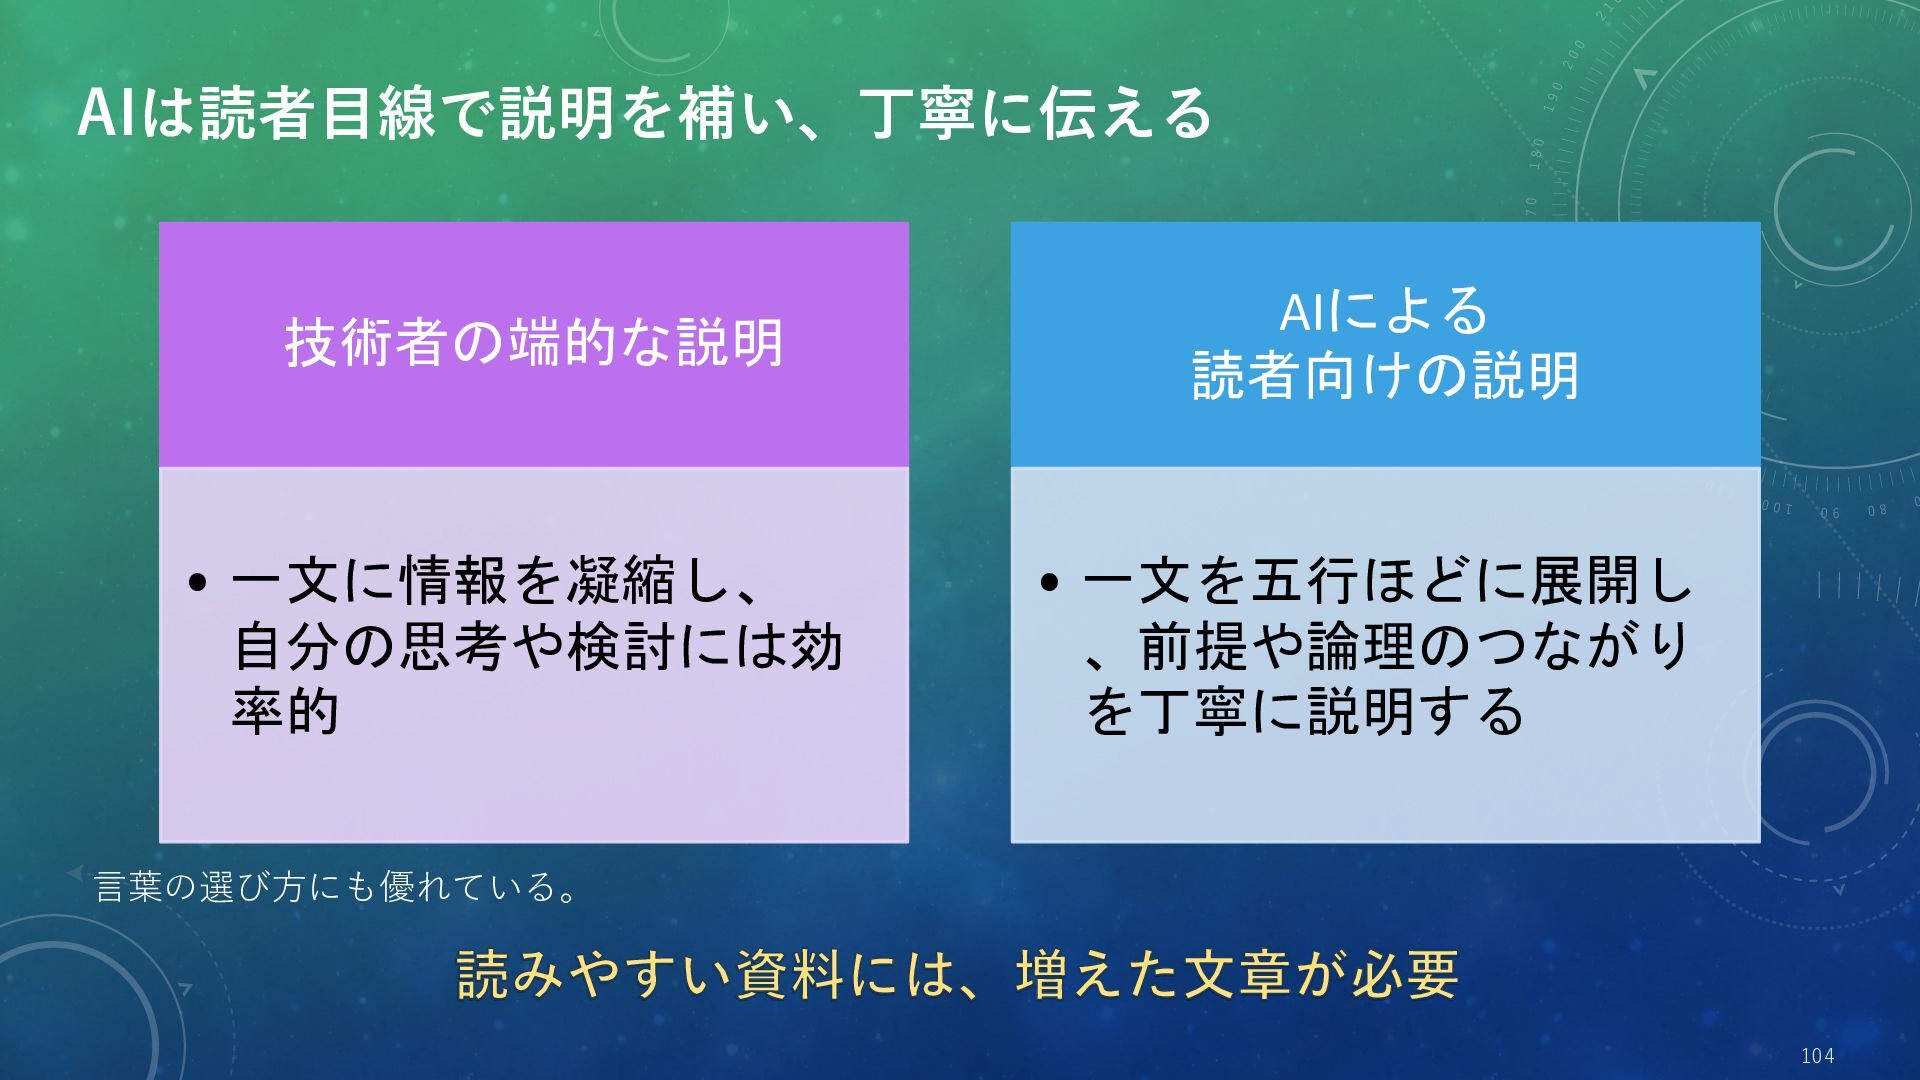
  18. AIは読者目線で説明を補い、丁寧に伝える 技術者の端的な説明 AIによる 読者向けの説明 • 一文に情報を凝縮し、 自分の思考や検討には効 率的 • 一文を五行ほどに展開し

    、前提や論理のつながり を丁寧に説明する 言葉の選び方にも優れている。 読みやすい資料には、増えた文章が必要 104
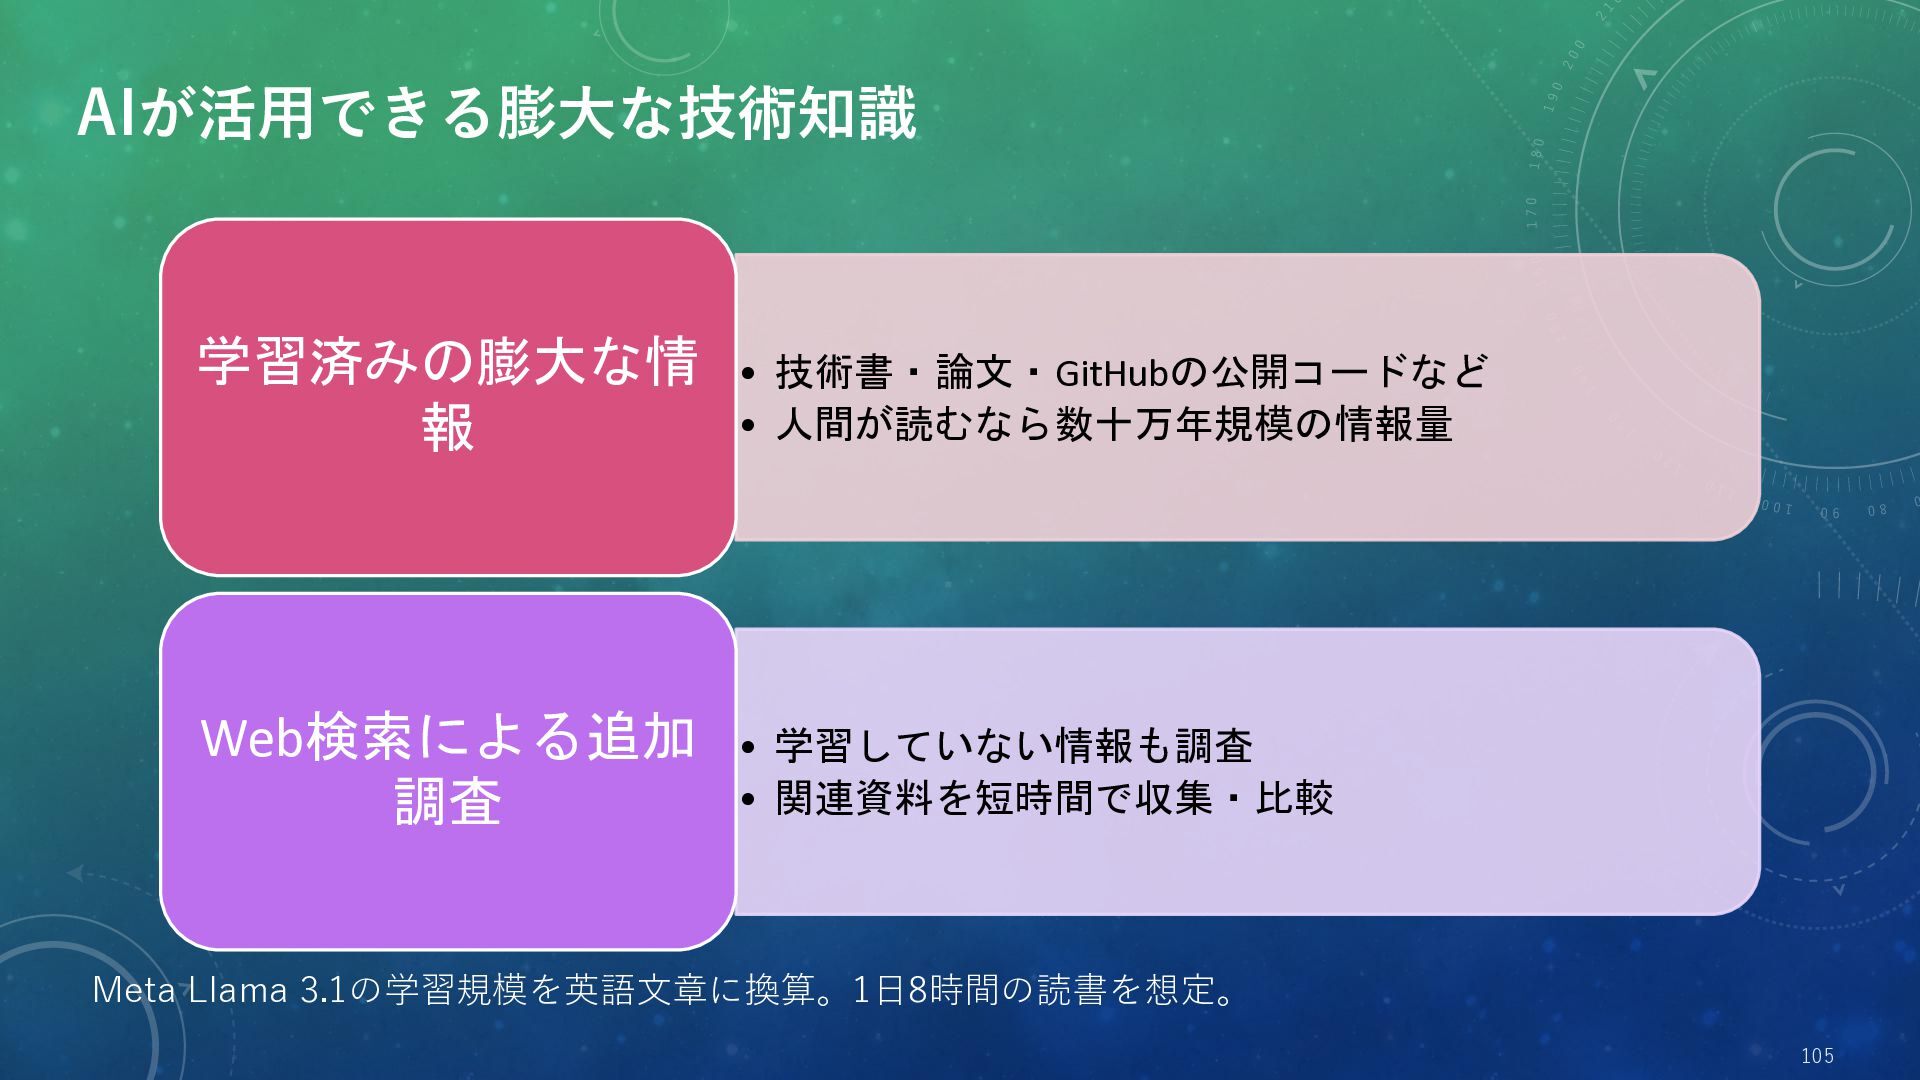
  19. AIが活用できる膨大な技術知識 学習済みの膨大な情 • 技術書・論文・GitHubの公開コードなど • 人間が読むなら数十万年規模の情報量 報 Web検索による追加 調査 •

    学習していない情報も調査 • 関連資料を短時間で収集・比較 Meta Llama 3.1の学習規模を英語文章に換算。1日8時間の読書を想定。 105
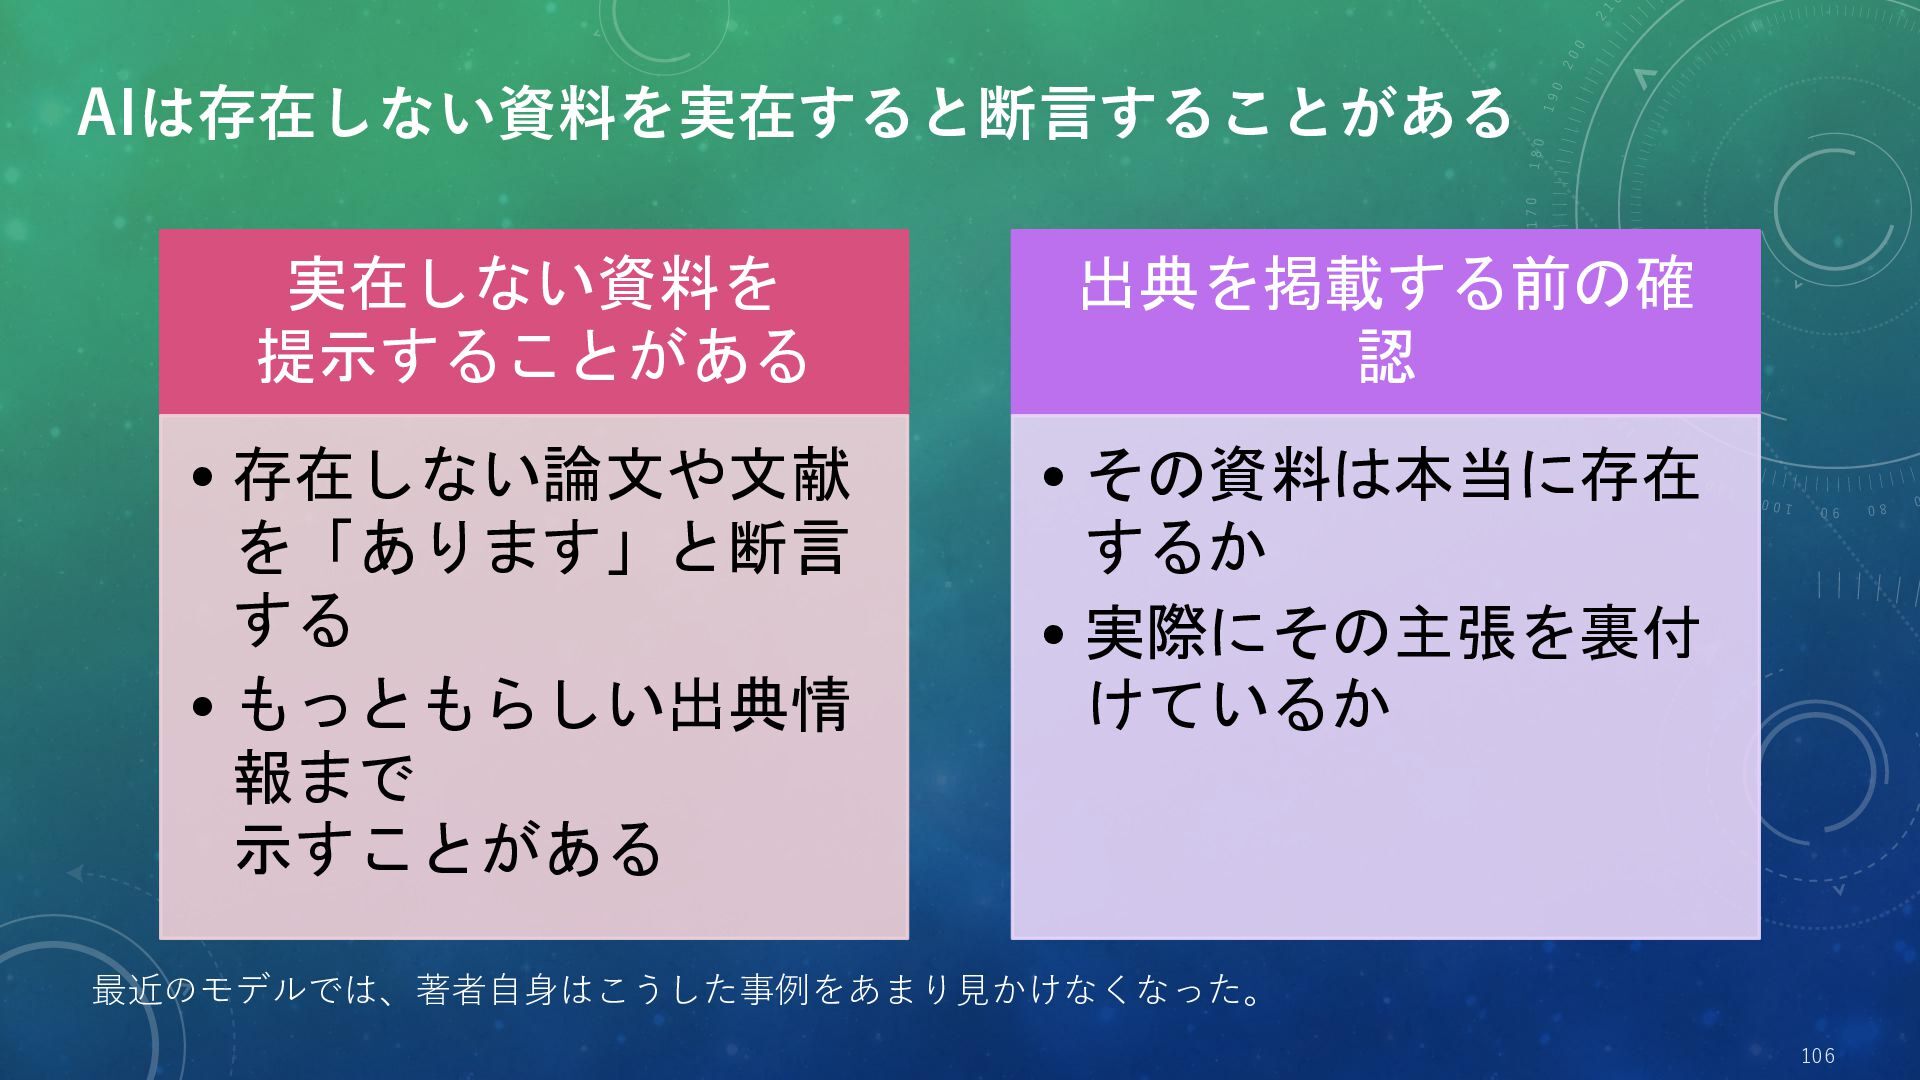
  20. AIは存在しない資料を実在すると断言することがある 実在しない資料を 提示することがある 出典を掲載する前の確 認 • 存在しない論文や文献 を「あります」と断言 する •

    もっともらしい出典情 報まで 示すことがある • その資料は本当に存在 するか • 実際にその主張を裏付 けているか 最近のモデルでは、著者自身はこうした事例をあまり見かけなくなった。 106
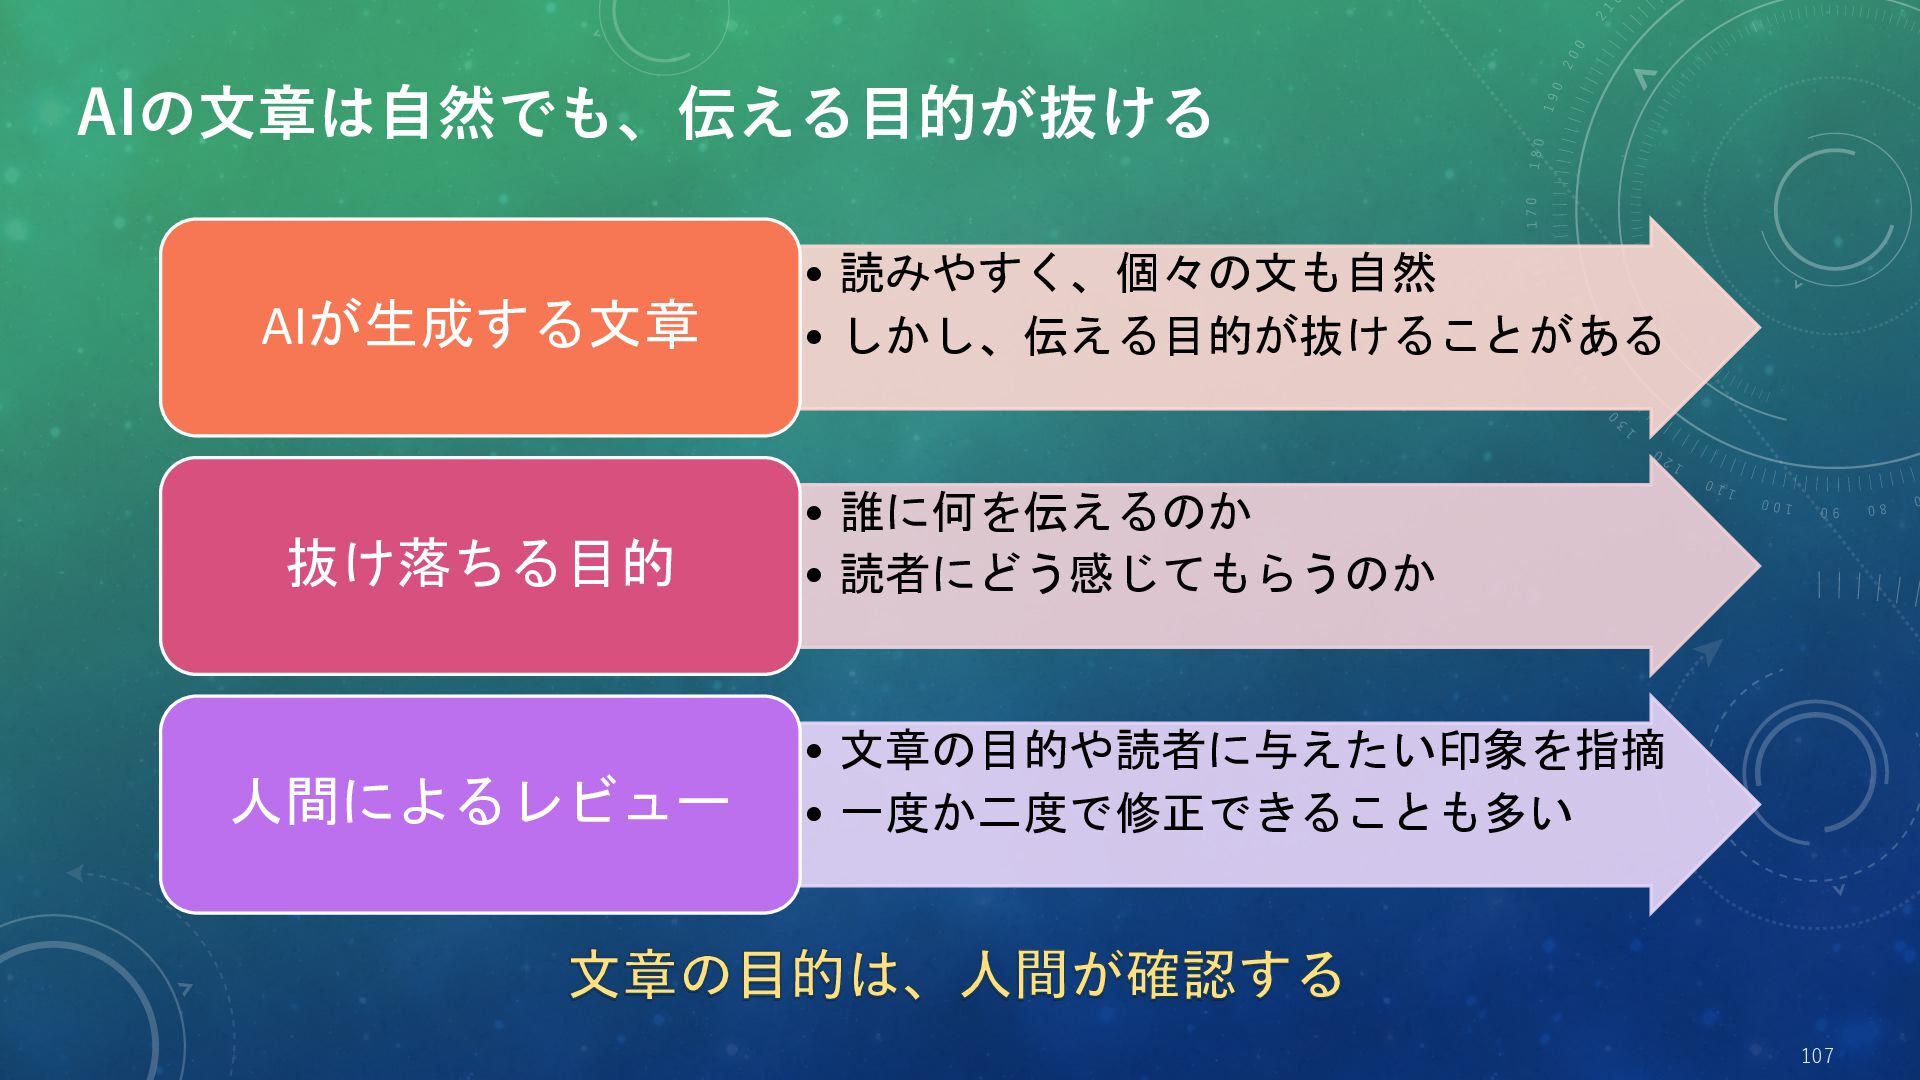
  21. AIの文章は自然でも、伝える目的が抜ける AIが生成する文章 • 読みやすく、個々の文も自然 • しかし、伝える目的が抜けることがある 抜け落ちる目的 • 誰に何を伝えるのか •

    読者にどう感じてもらうのか 人間によるレビュー • 文章の目的や読者に与えたい印象を指摘 • 一度か二度で修正できることも多い 文章の目的は、人間が確認する 107
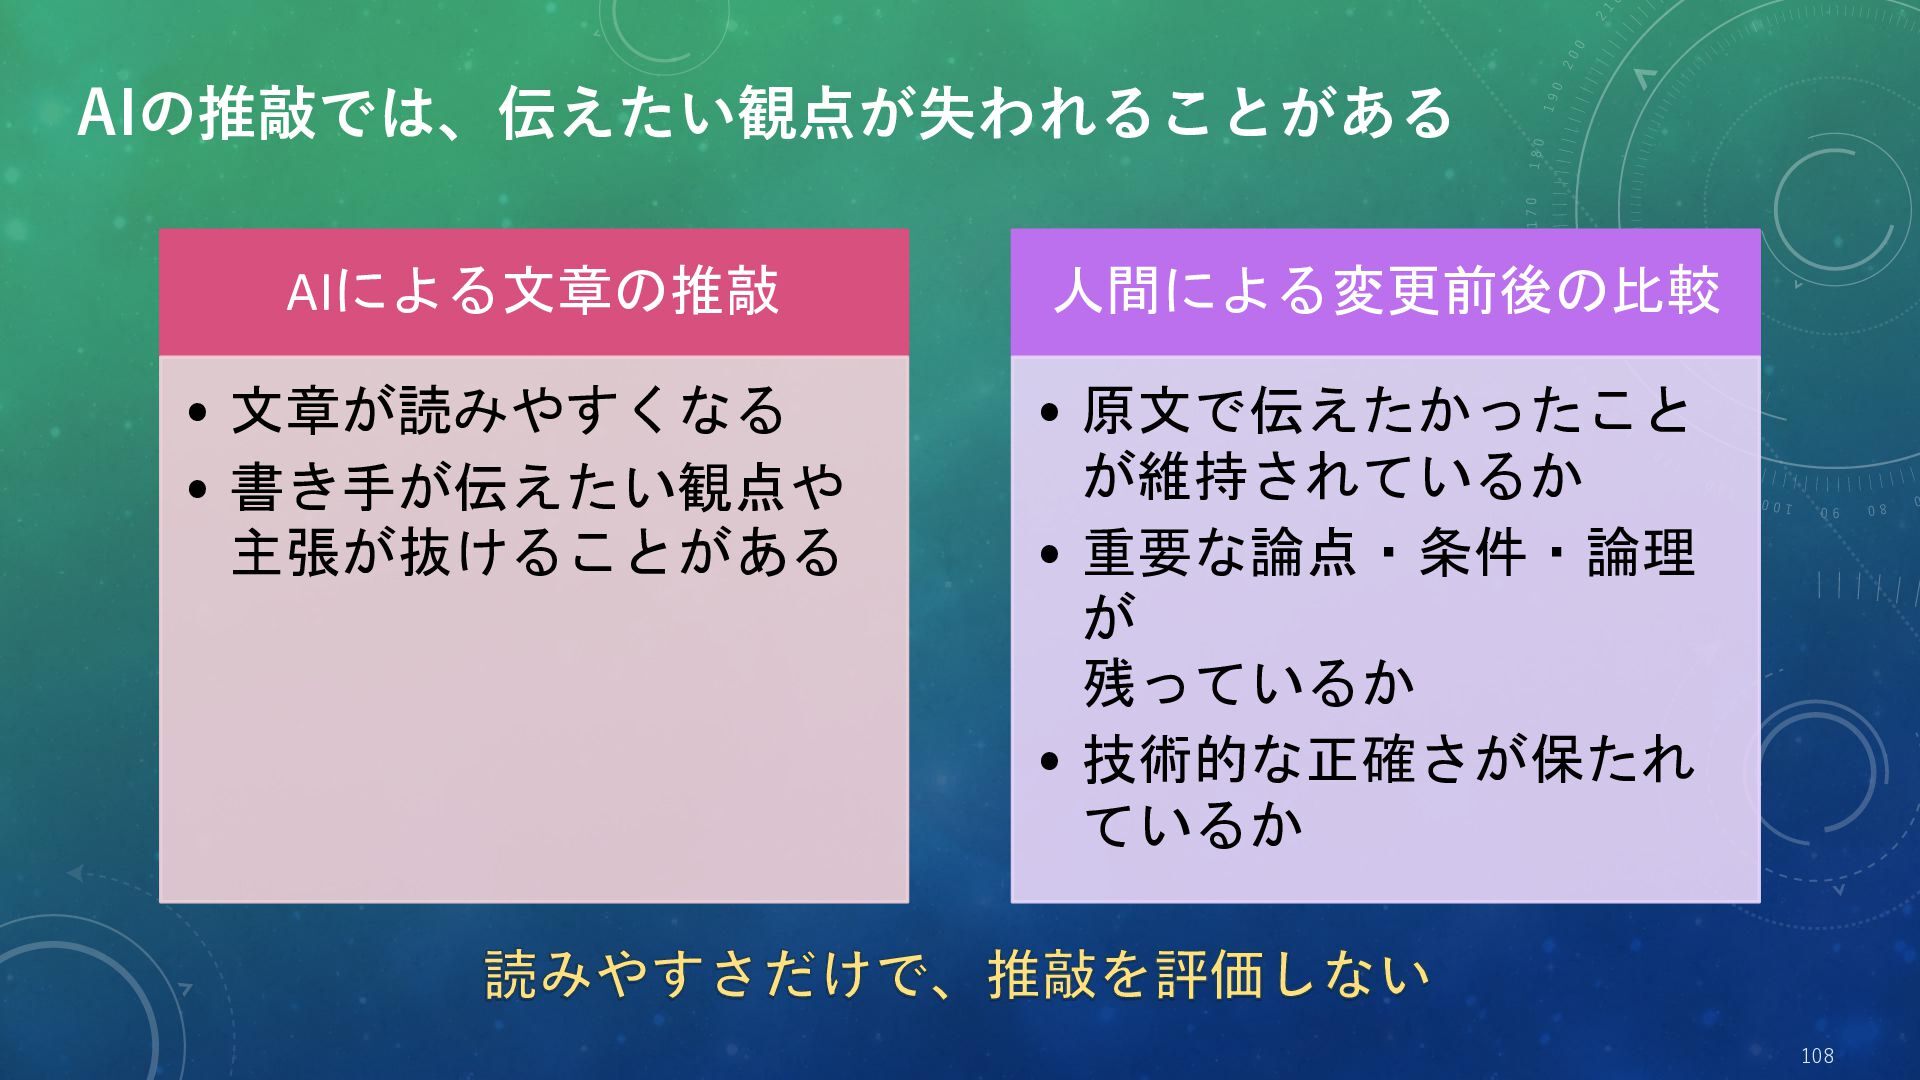
  22. AIの推敲では、伝えたい観点が失われることがある AIによる文章の推敲 人間による変更前後の比較 • 文章が読みやすくなる • 書き手が伝えたい観点や 主張が抜けることがある • 原文で伝えたかったこと

    が維持されているか • 重要な論点・条件・論理 が 残っているか • 技術的な正確さが保たれ ているか 読みやすさだけで、推敲を評価しない 108
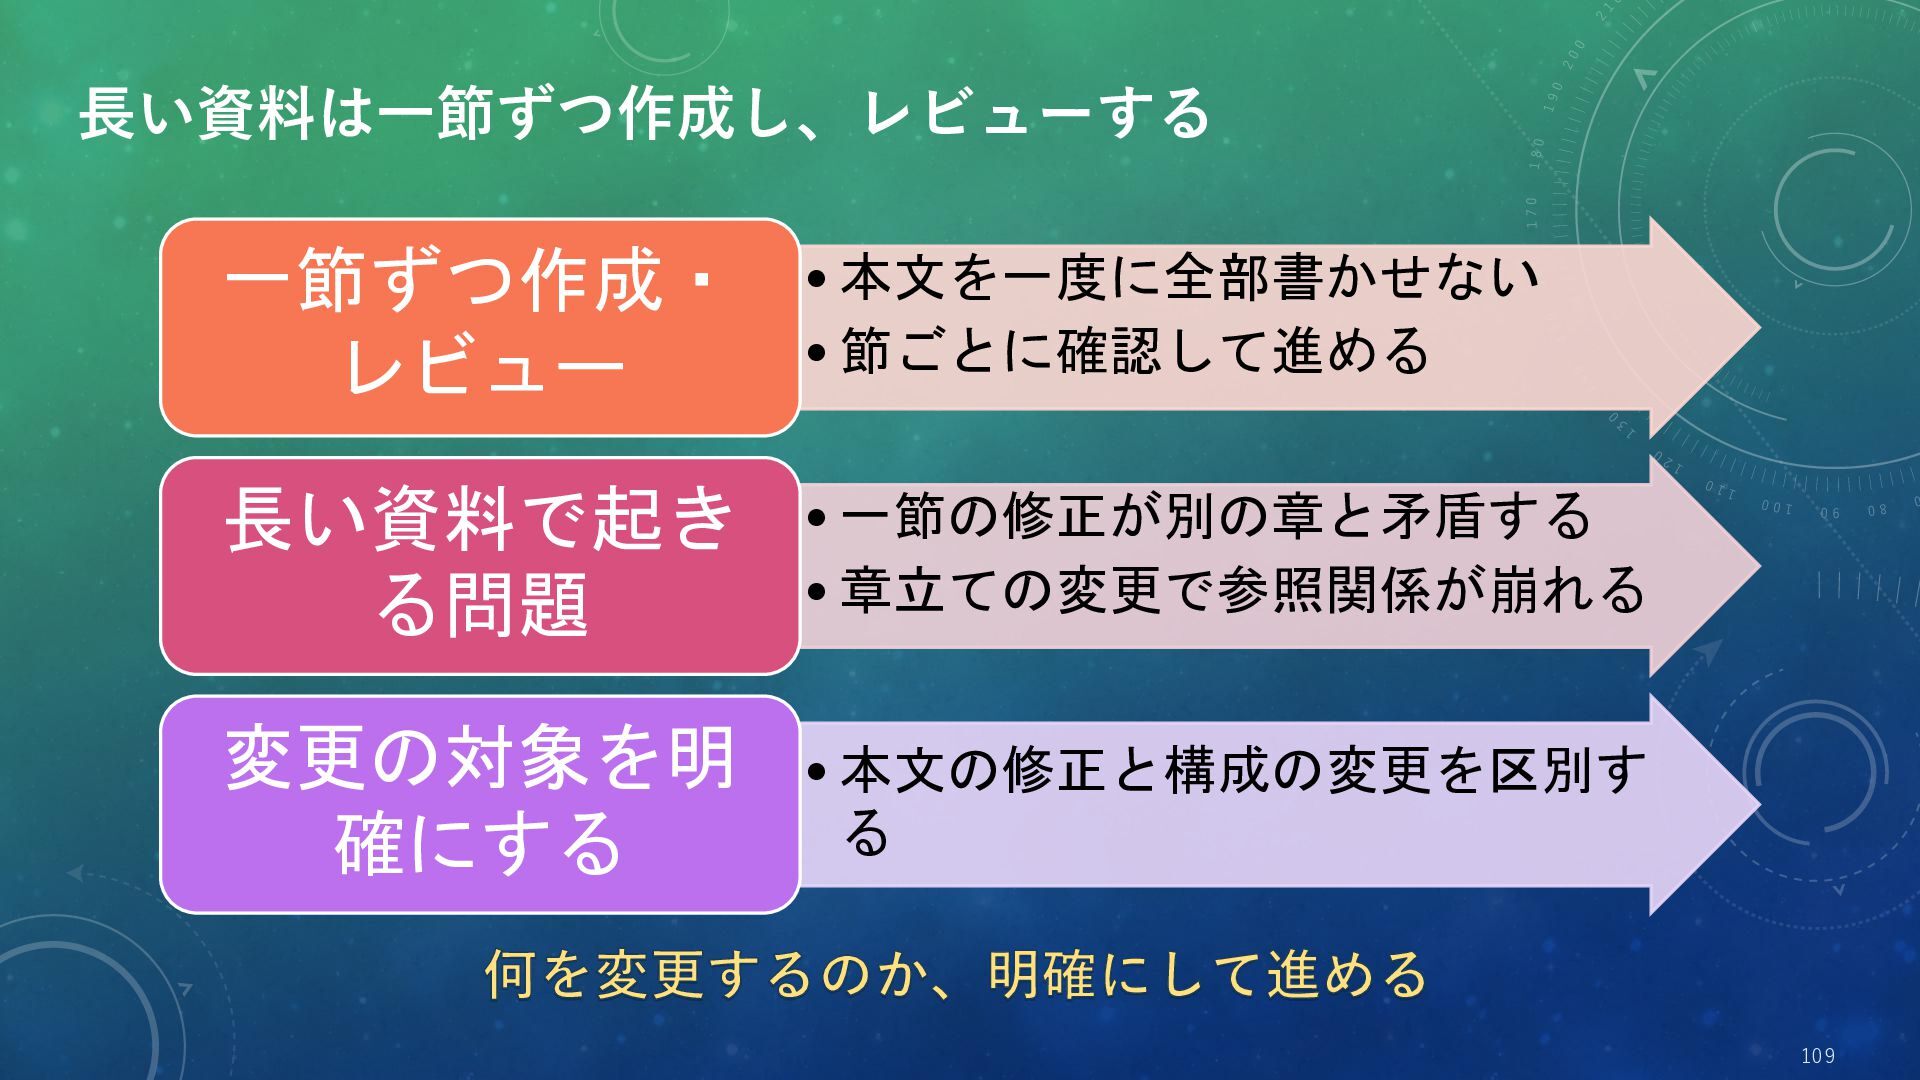
  23. 長い資料は一節ずつ作成し、レビューする 一節ずつ作成・ レビュー • 本文を一度に全部書かせない • 節ごとに確認して進める 長い資料で起き る問題 •

    一節の修正が別の章と矛盾する • 章立ての変更で参照関係が崩れる 変更の対象を明 確にする • 本文の修正と構成の変更を区別す る 何を変更するのか、明確にして進める 109
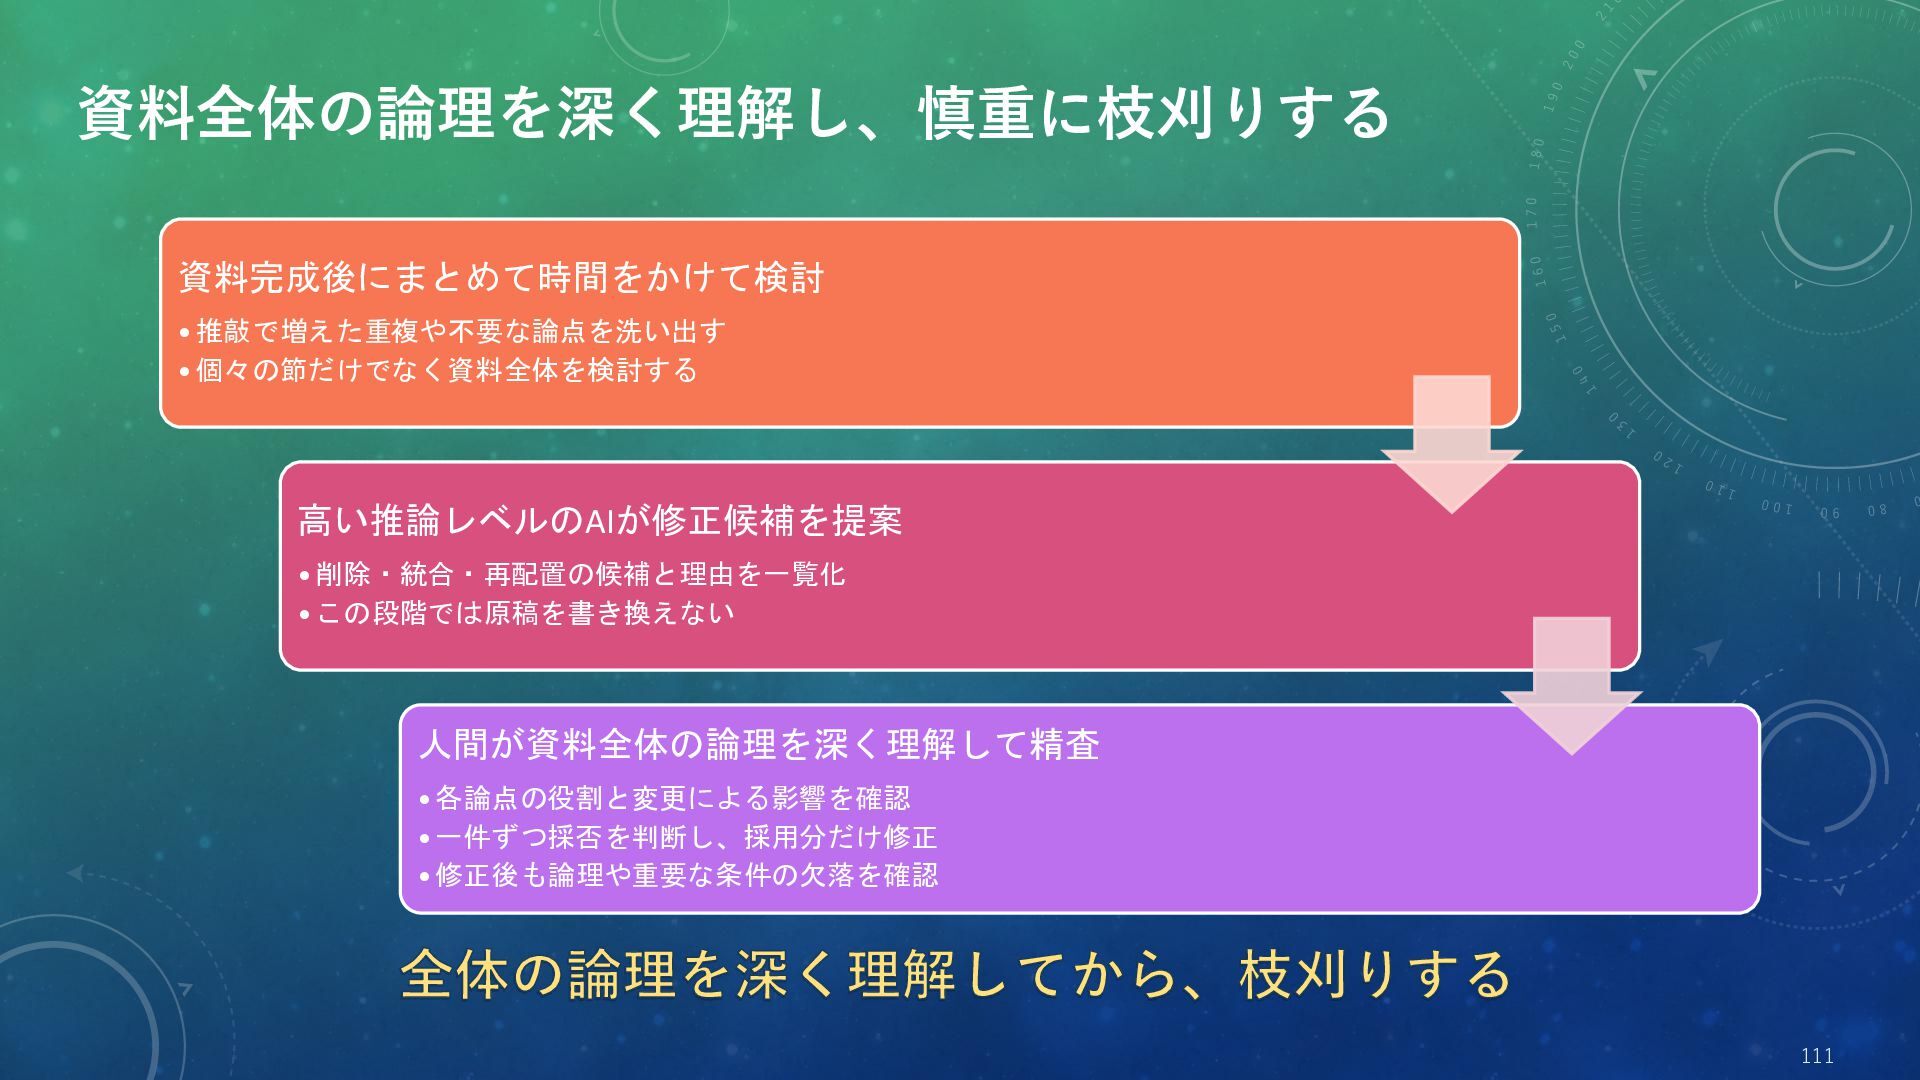
  24. 資料全体の論理を深く理解し、慎重に枝刈りする 資料完成後にまとめて時間をかけて検討 • 推敲で増えた重複や不要な論点を洗い出す • 個々の節だけでなく資料全体を検討する 高い推論レベルのAIが修正候補を提案 • 削除・統合・再配置の候補と理由を一覧化 •

    この段階では原稿を書き換えない 人間が資料全体の論理を深く理解して精査 • 各論点の役割と変更による影響を確認 • 一件ずつ採否を判断し、採用分だけ修正 • 修正後も論理や重要な条件の欠落を確認 全体の論理を深く理解してから、枝刈りする 111
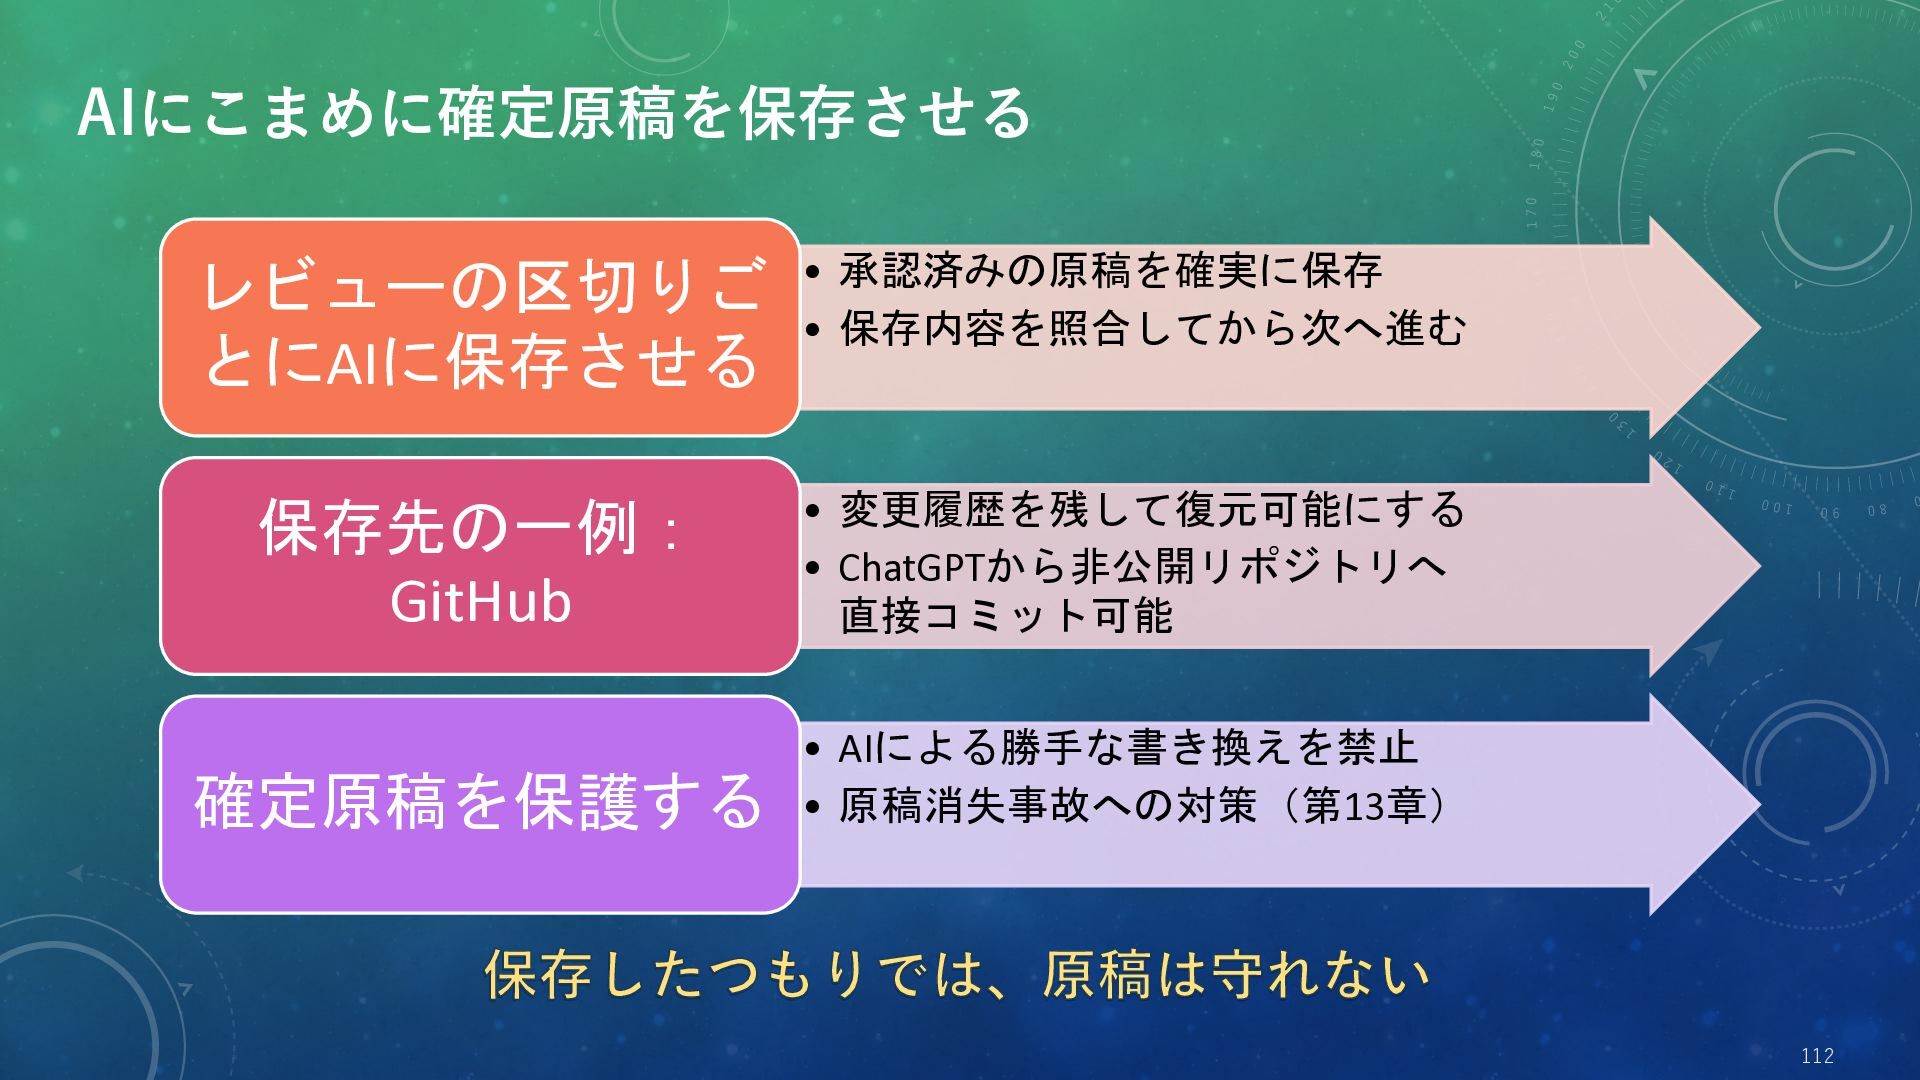
  25. AIにこまめに確定原稿を保存させる レビューの区切りご • 承認済みの原稿を確実に保存 • 保存内容を照合してから次へ進む とにAIに保存させる 保存先の一例: GitHub •

    変更履歴を残して復元可能にする • ChatGPTから非公開リポジトリへ 直接コミット可能 確定原稿を保護する • AIによる勝手な書き換えを禁止 • 原稿消失事故への対策(第13章) 保存したつもりでは、原稿は守れない 112
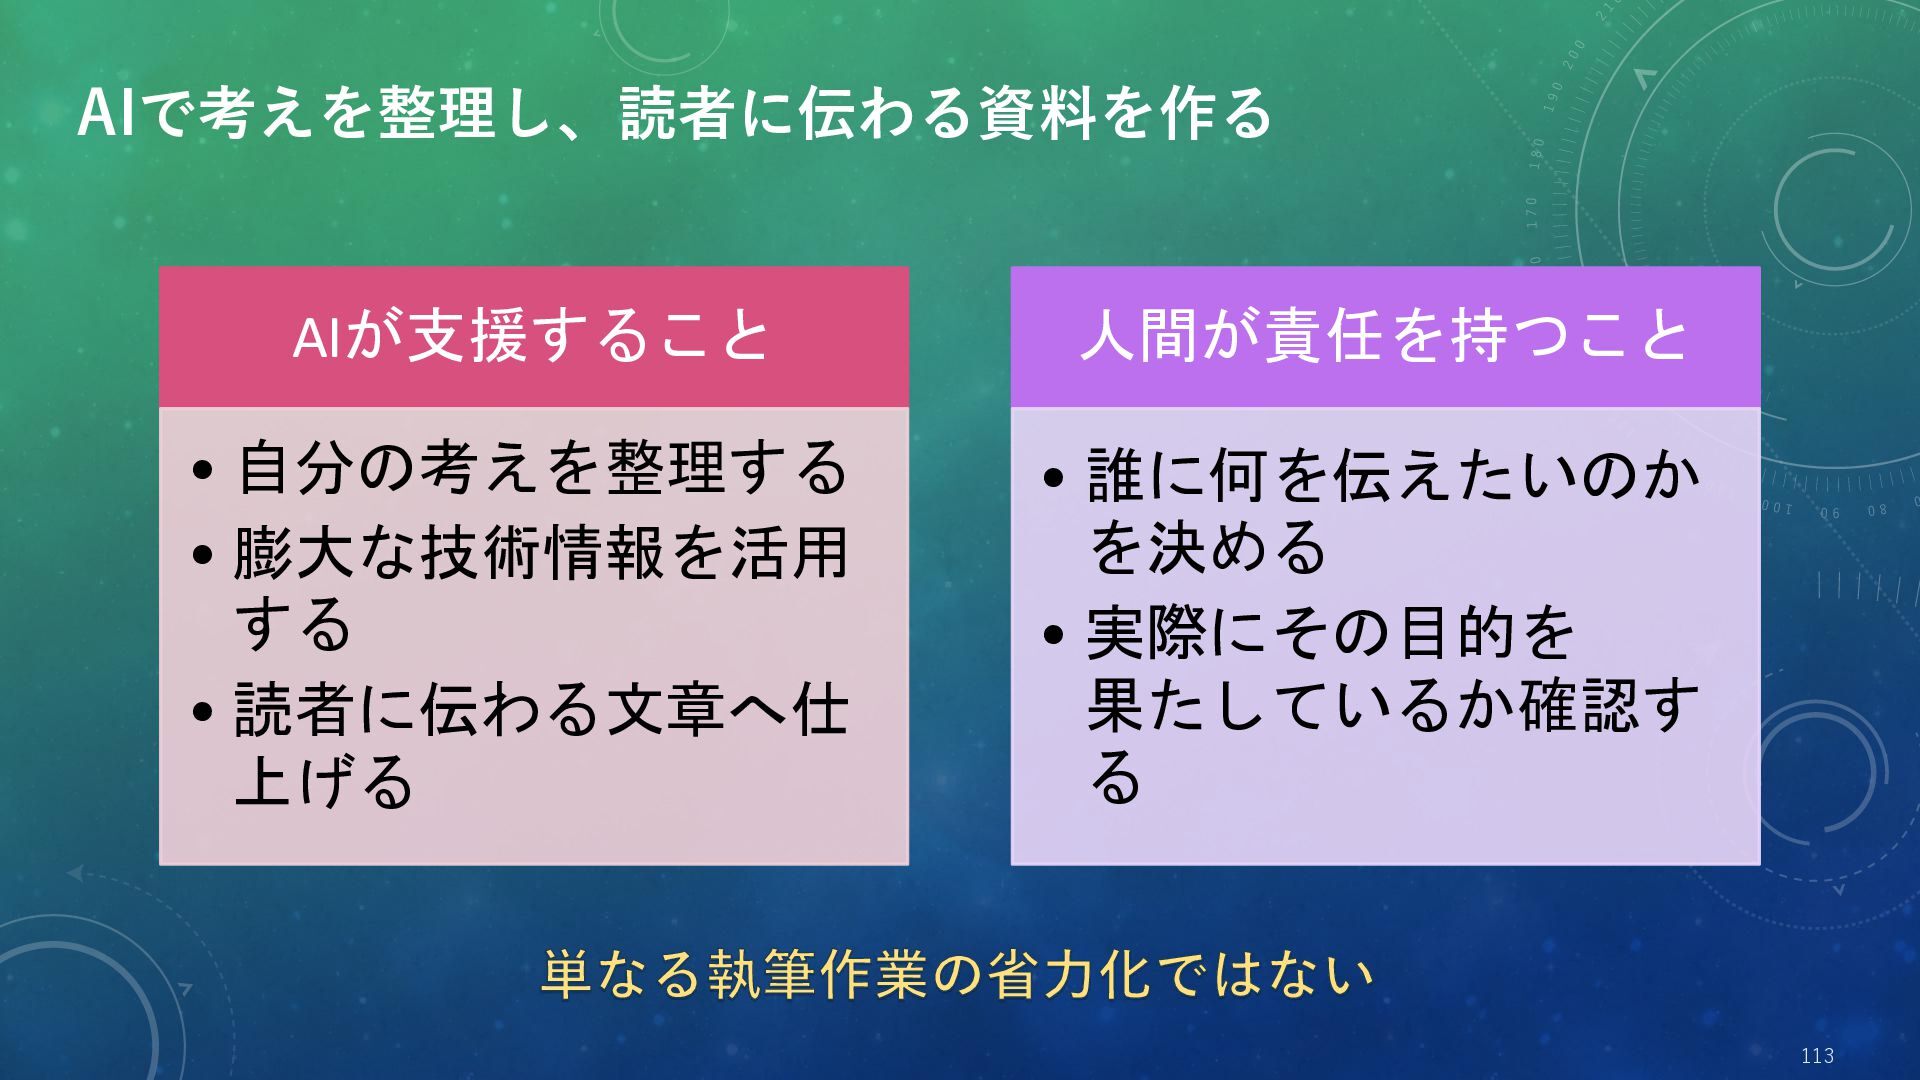
  26. AIで考えを整理し、読者に伝わる資料を作る AIが支援すること 人間が責任を持つこと • 自分の考えを整理する • 膨大な技術情報を活用 する • 読者に伝わる文章へ仕

    上げる • 誰に何を伝えたいのか を決める • 実際にその目的を 果たしているか確認す る 単なる執筆作業の省力化ではない 113
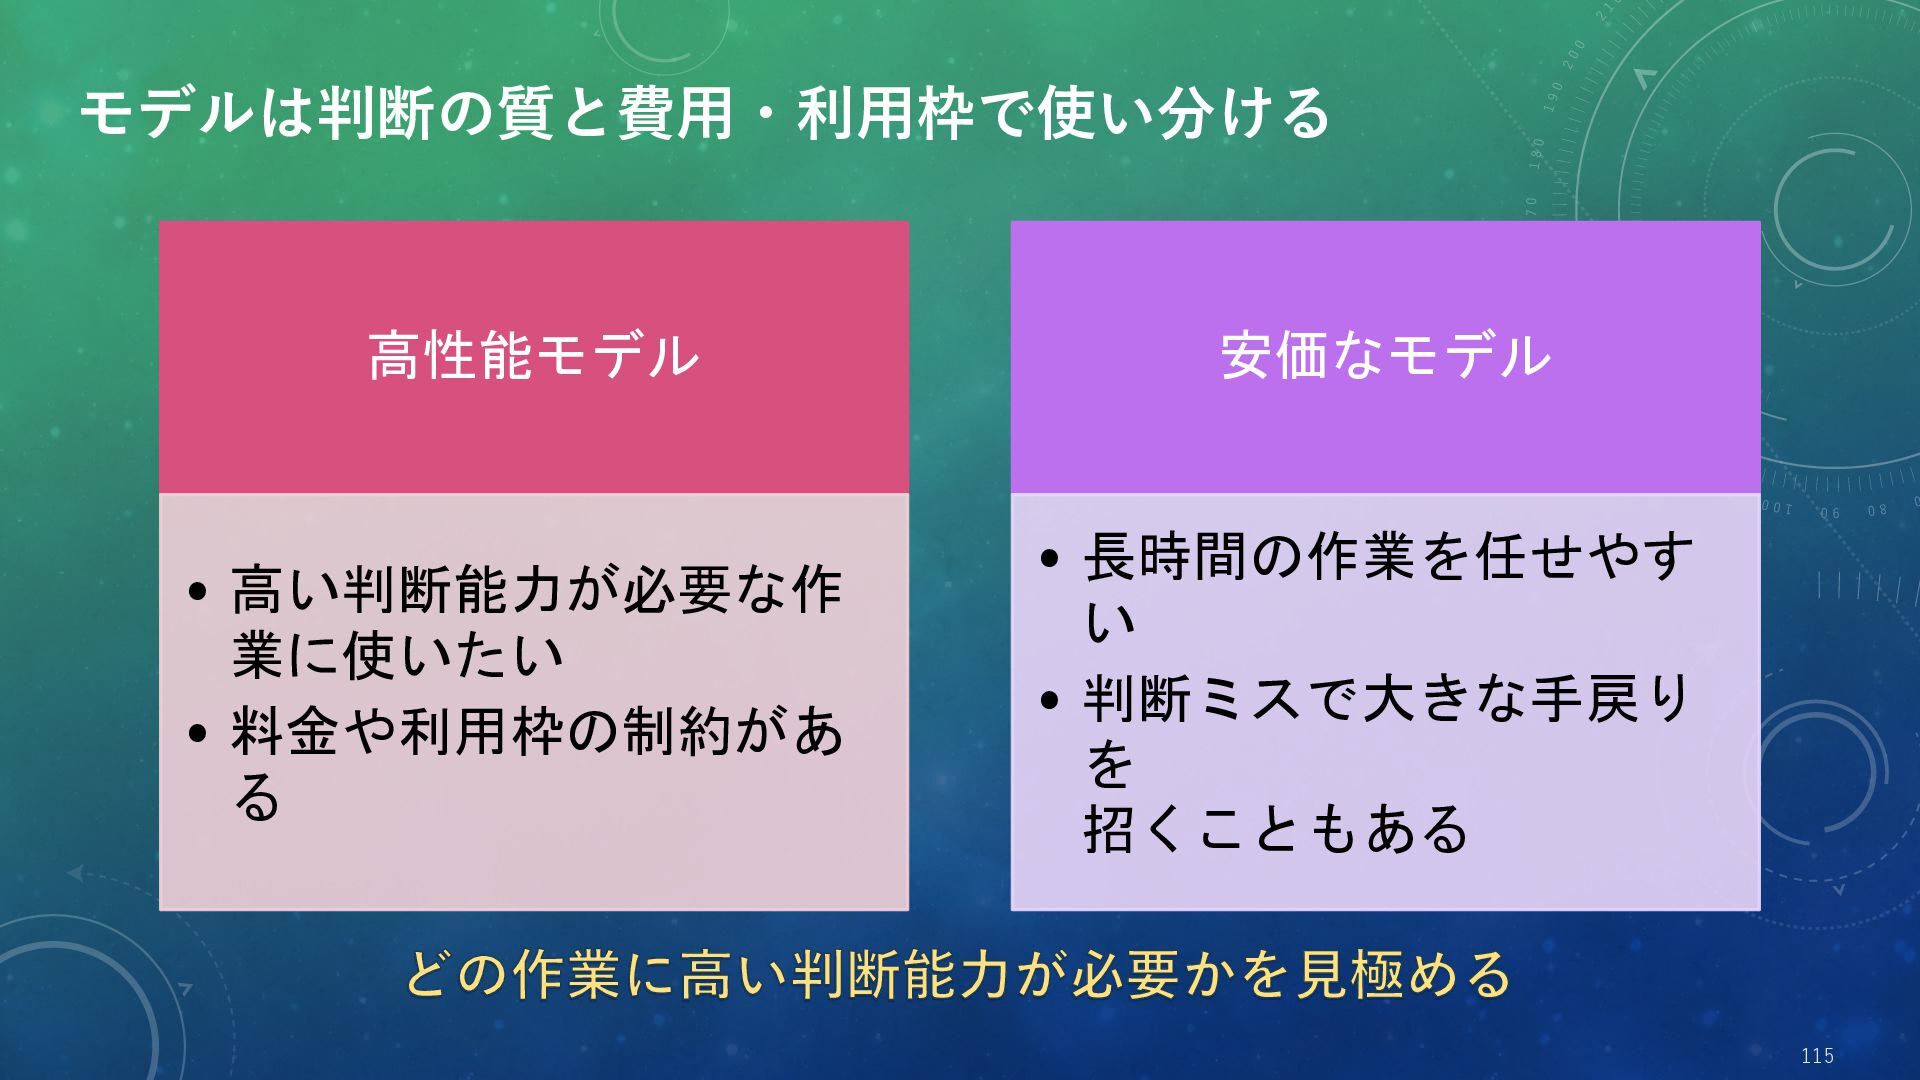
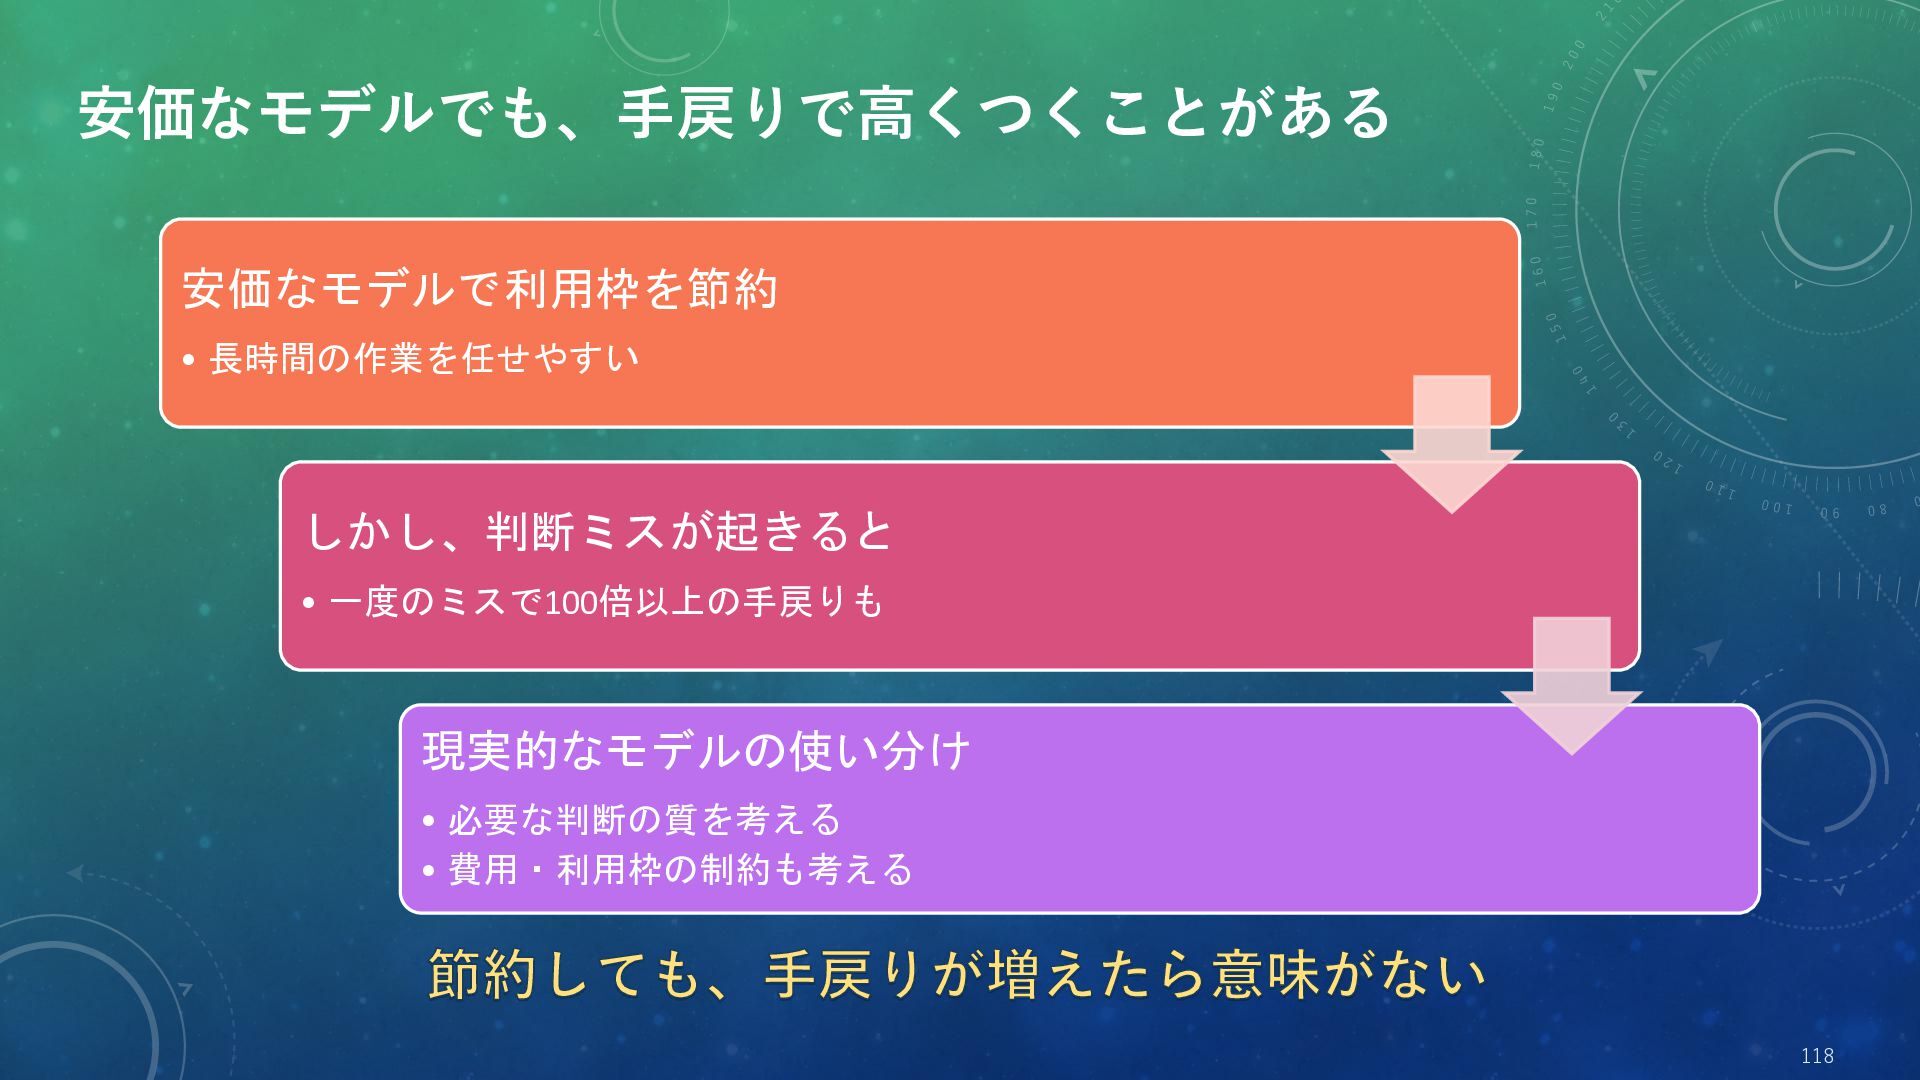
  27. モデルは判断の質と費用・利用枠で使い分ける 高性能モデル 安価なモデル • 高い判断能力が必要な作 業に使いたい • 料金や利用枠の制約があ る •

    長時間の作業を任せやす い • 判断ミスで大きな手戻り を 招くこともある どの作業に高い判断能力が必要かを見極める 115
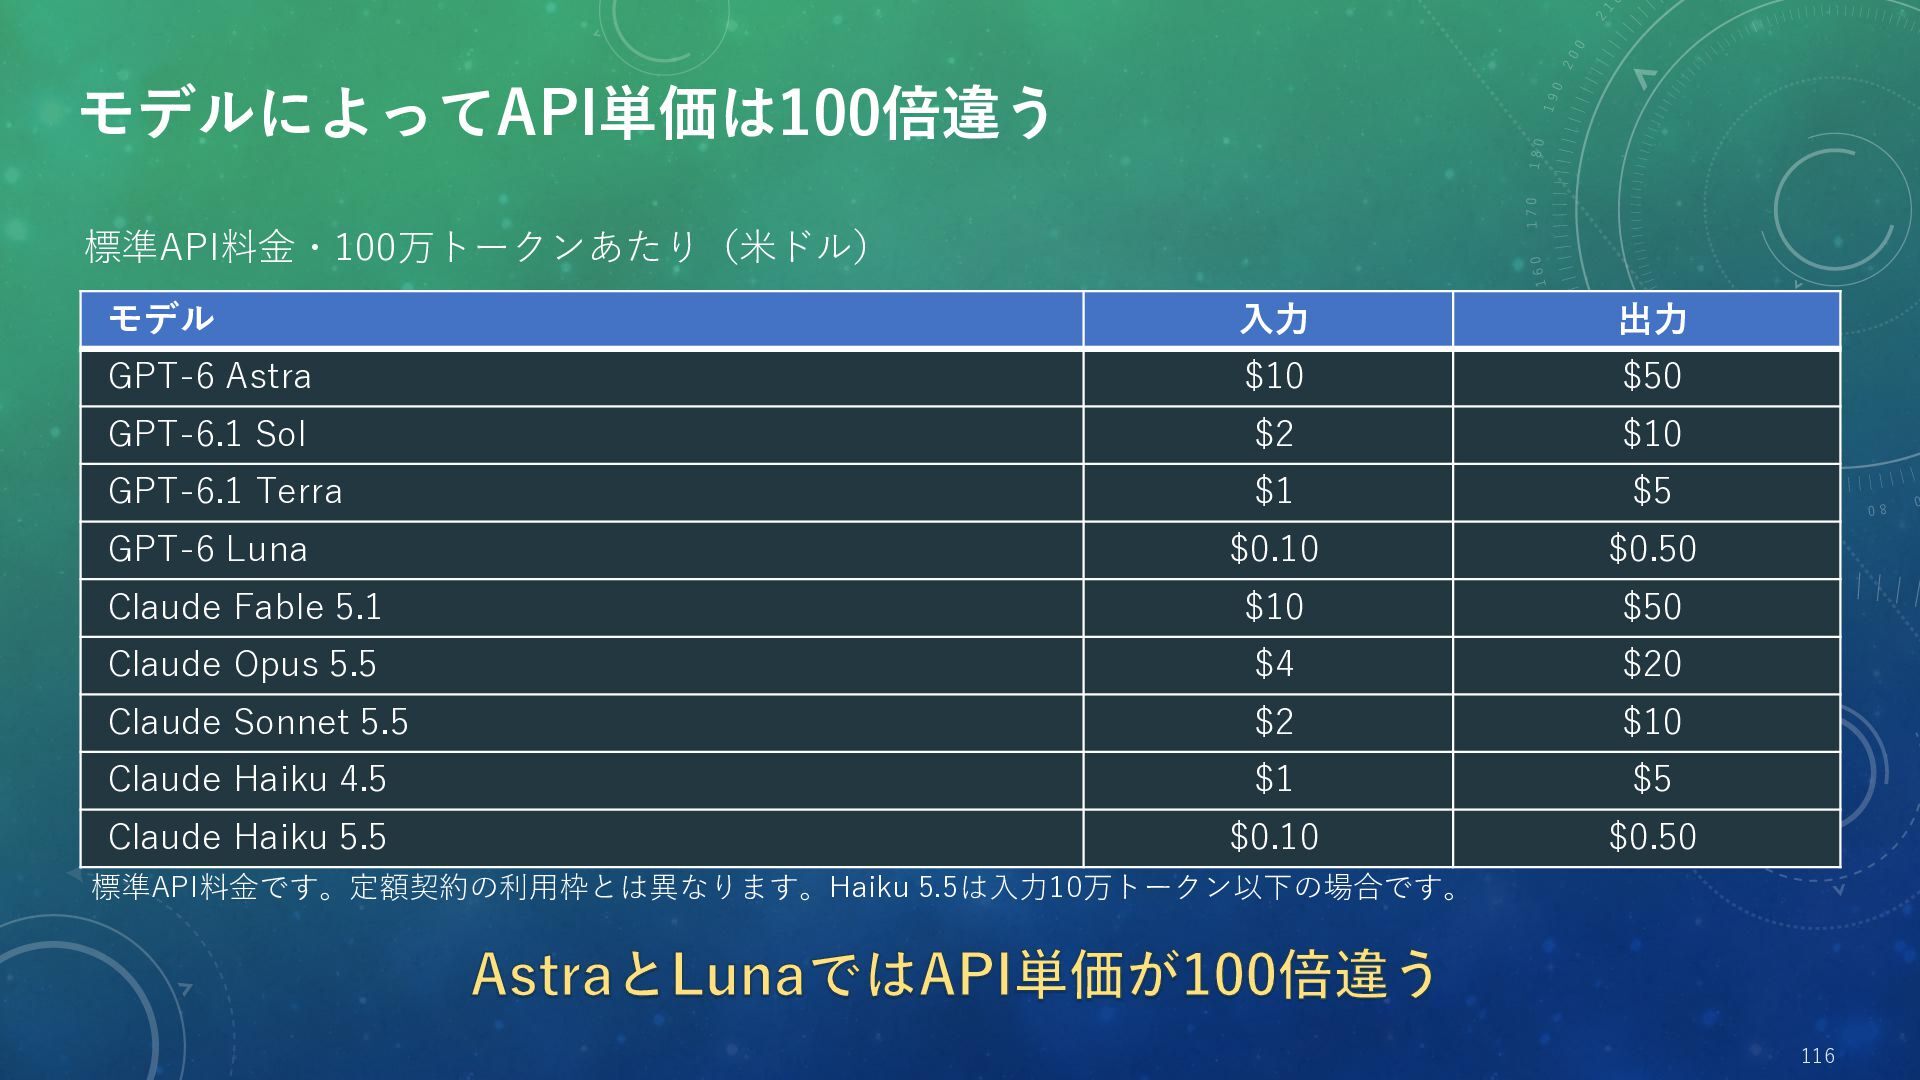
  28. モデルによってAPI単価は100倍違う 標準API料金・100万トークンあたり(米ドル) モデル 入力 出力 GPT-6 Astra $10 $50 GPT-6.1

    Sol $2 $10 GPT-6.1 Terra $1 $5 GPT-6 Luna $0.10 $0.50 Claude Fable 5.1 $10 $50 Claude Opus 5.5 $4 $20 Claude Sonnet 5.5 $2 $10 Claude Haiku 4.5 $1 $5 Claude Haiku 5.5 $0.10 $0.50 標準API料金です。定額契約の利用枠とは異なります。Haiku 5.5は入力10万トークン以下の場合です。 AstraとLunaではAPI単価が100倍違う 116
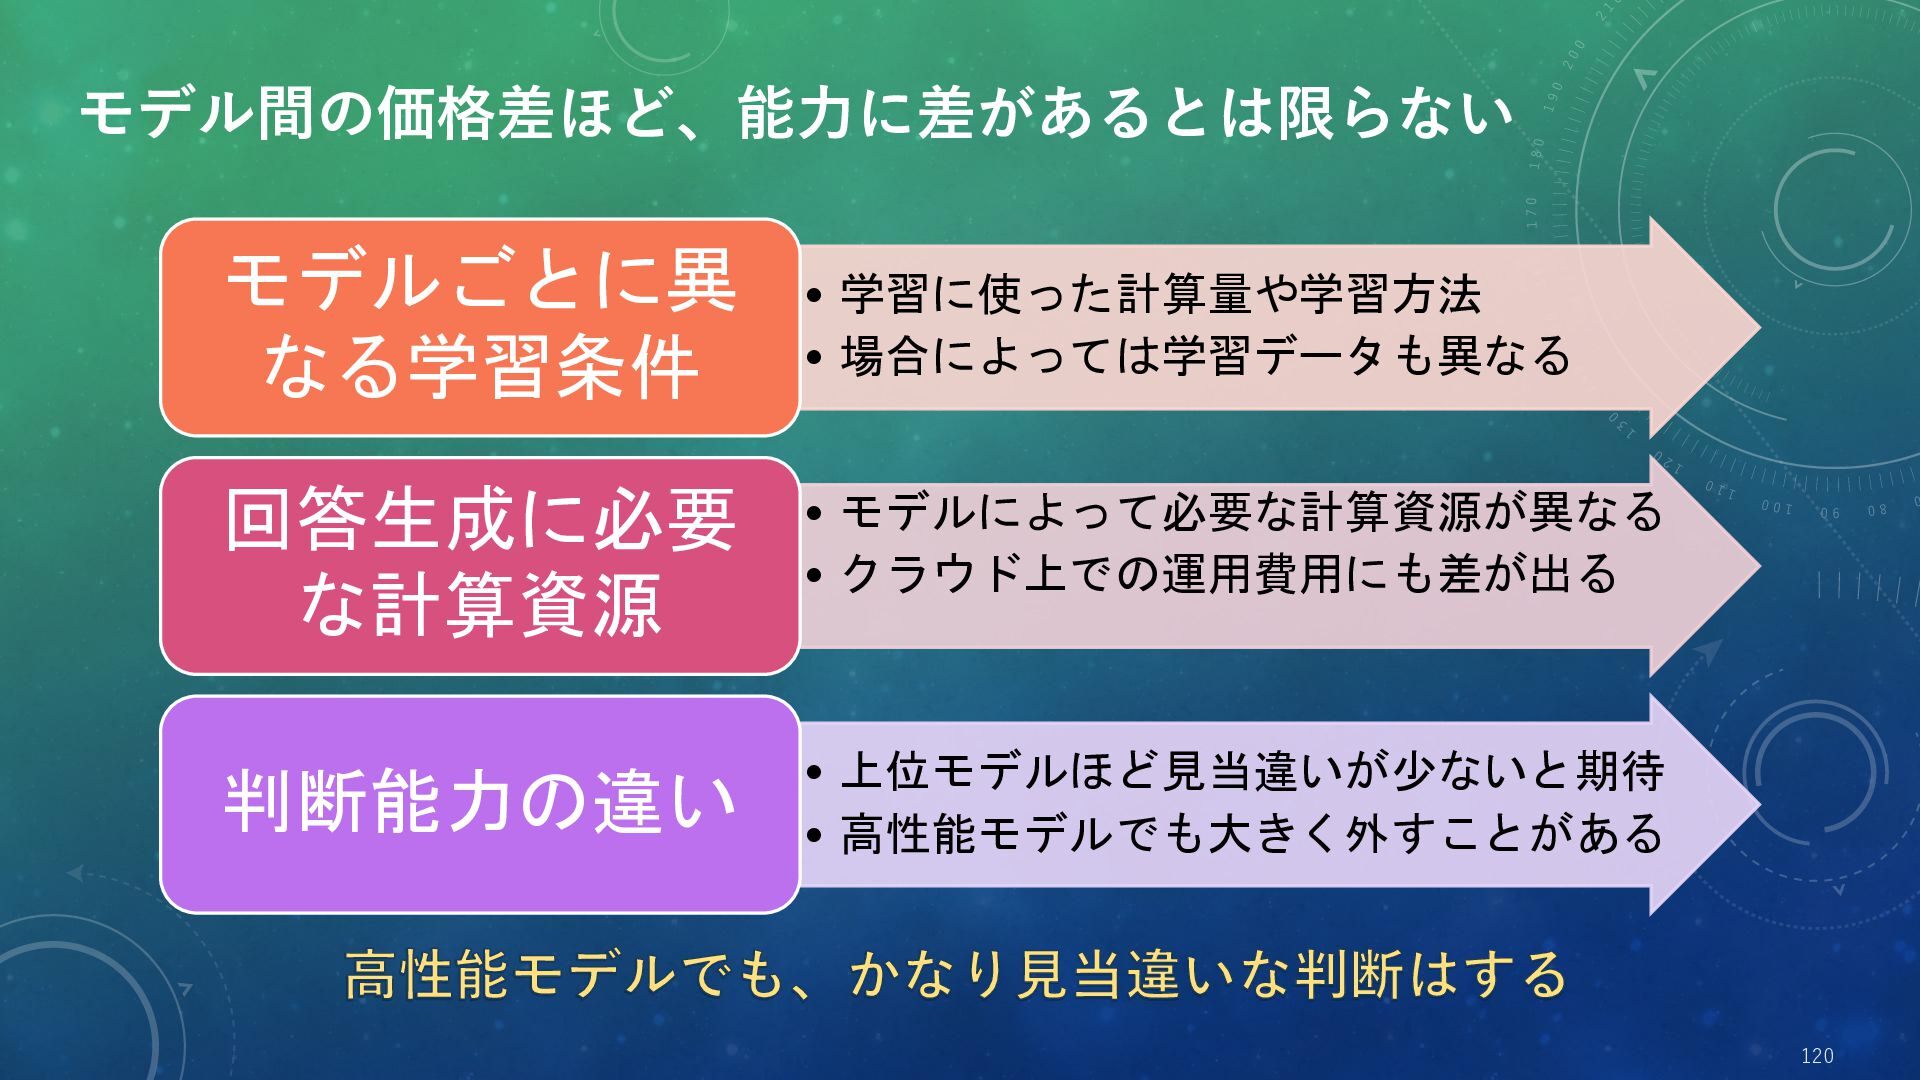
  29. モデル間の価格差ほど、能力に差があるとは限らない モデルごとに異 なる学習条件 • 学習に使った計算量や学習方法 • 場合によっては学習データも異なる 回答生成に必要 な計算資源 •

    モデルによって必要な計算資源が異なる • クラウド上での運用費用にも差が出る 判断能力の違い • 上位モデルほど見当違いが少ないと期待 • 高性能モデルでも大きく外すことがある 高性能モデルでも、かなり見当違いな判断はする 120
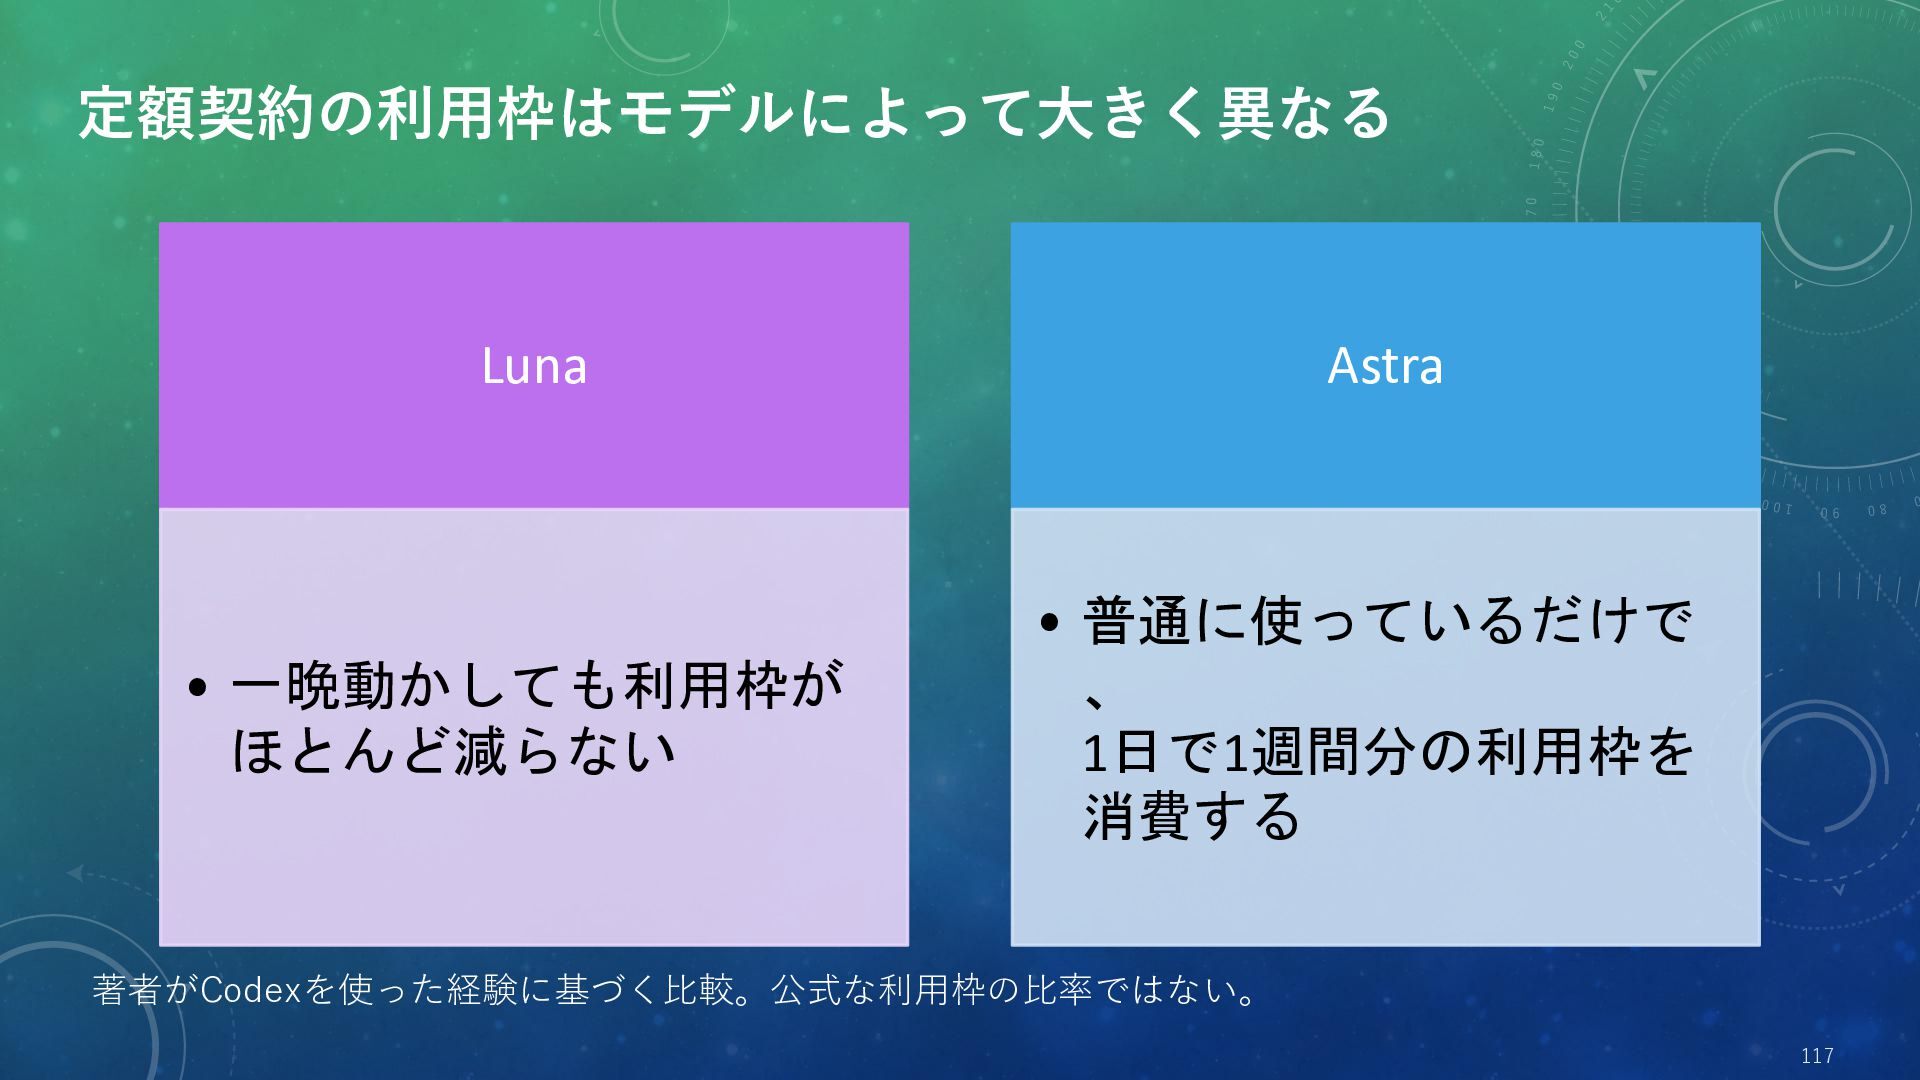
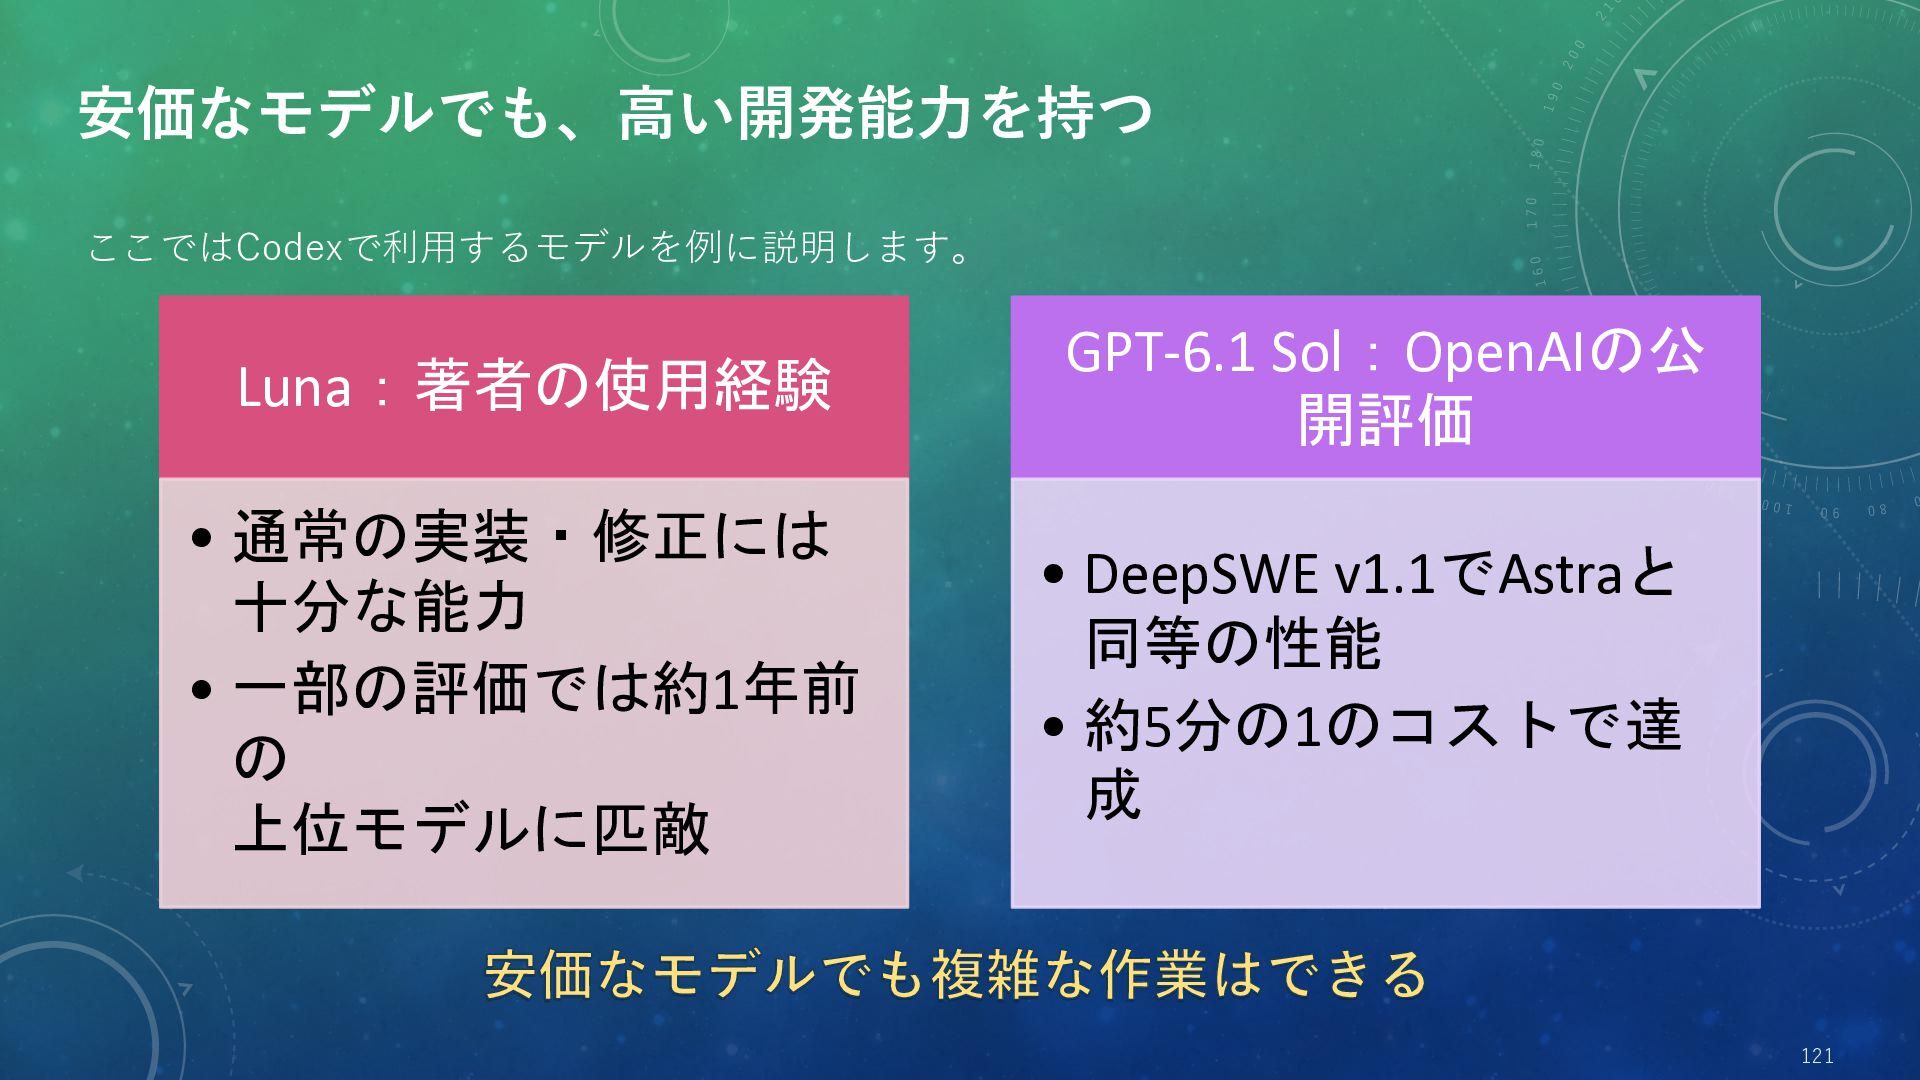
  30. 安価なモデルでも、高い開発能力を持つ ここではCodexで利用するモデルを例に説明します。 Luna:著者の使用経験 GPT-6.1 Sol:OpenAIの公 開評価 • 通常の実装・修正には 十分な能力 •

    一部の評価では約1年前 の 上位モデルに匹敵 • DeepSWE v1.1でAstraと 同等の性能 • 約5分の1のコストで達 成 安価なモデルでも複雑な作業はできる 121
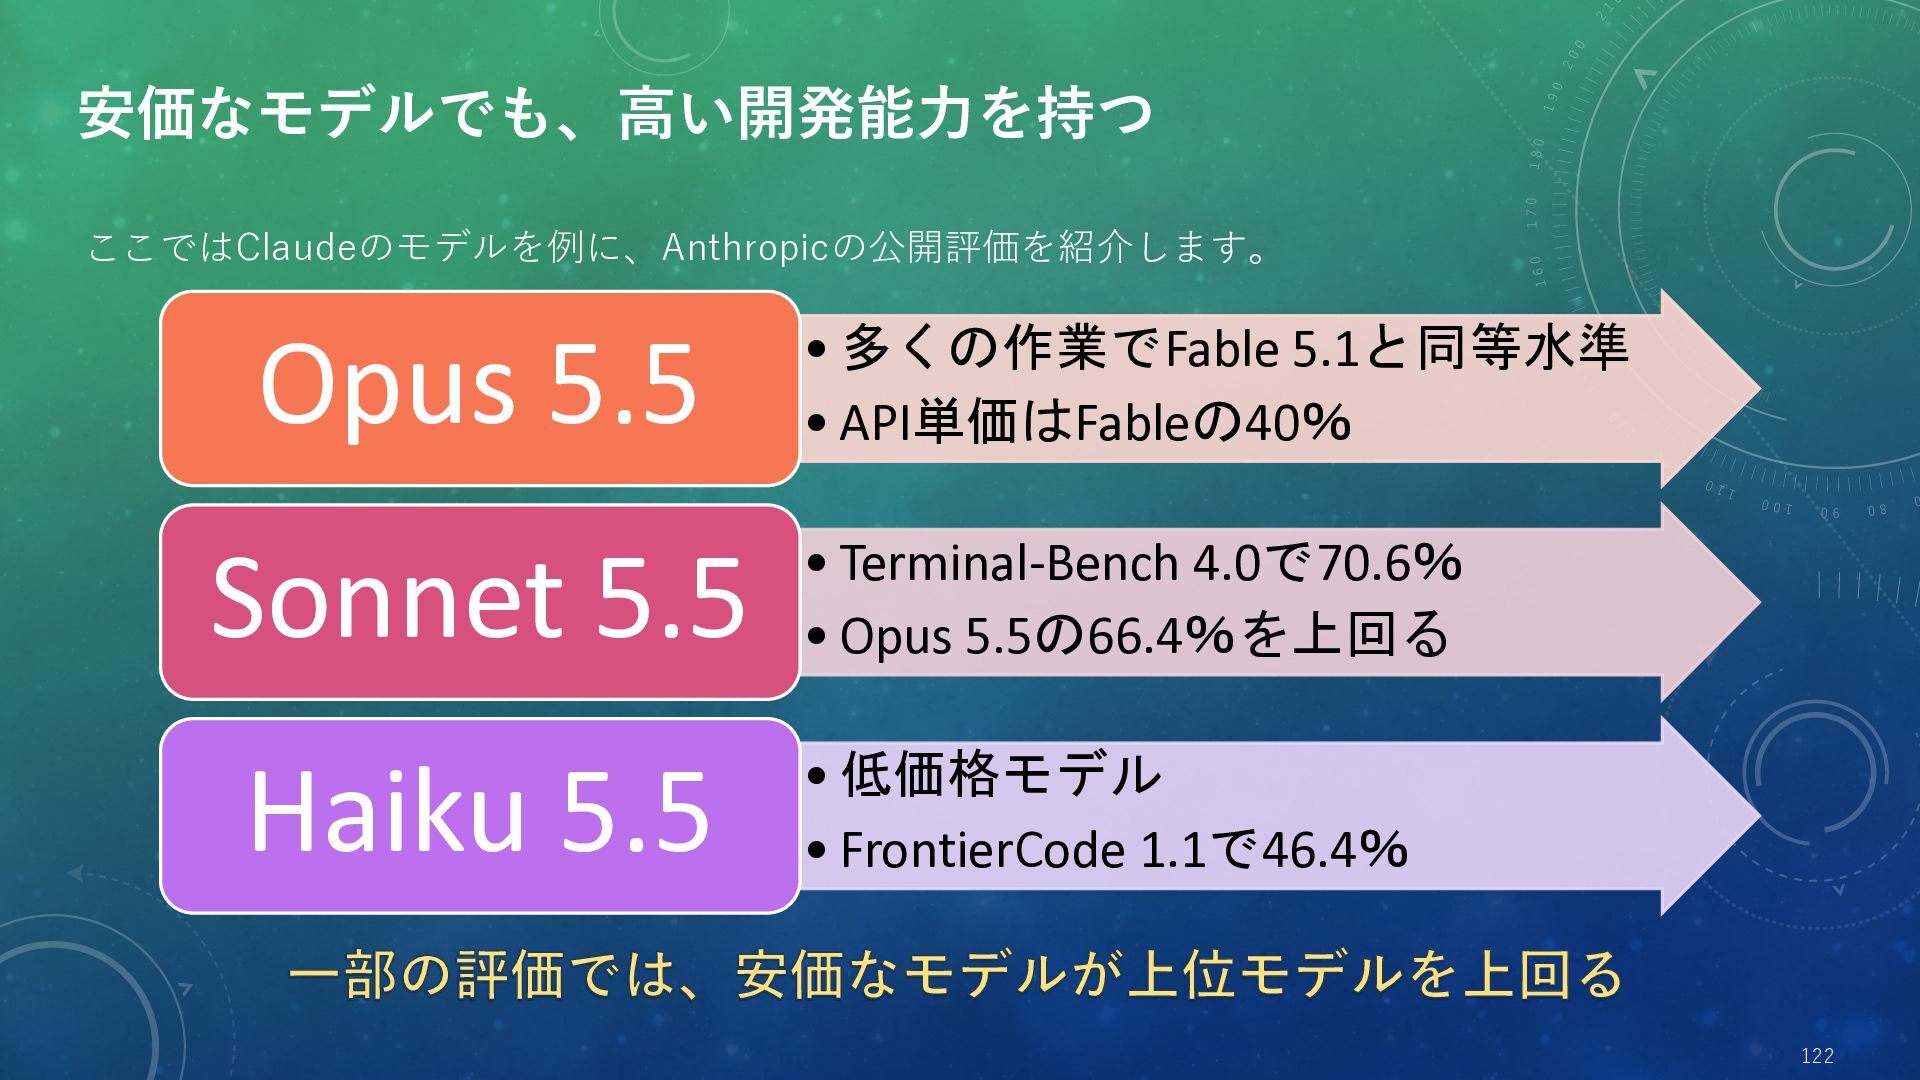
  31. 安価なモデルでも、高い開発能力を持つ ここではClaudeのモデルを例に、Anthropicの公開評価を紹介します。 Opus 5.5 • 多くの作業でFable 5.1と同等水準 • API単価はFableの40% Sonnet

    5.5 • Terminal-Bench 4.0で70.6% • Opus 5.5の66.4%を上回る Haiku 5.5 • 低価格モデル • FrontierCode 1.1で46.4% 一部の評価では、安価なモデルが上位モデルを上回る 122
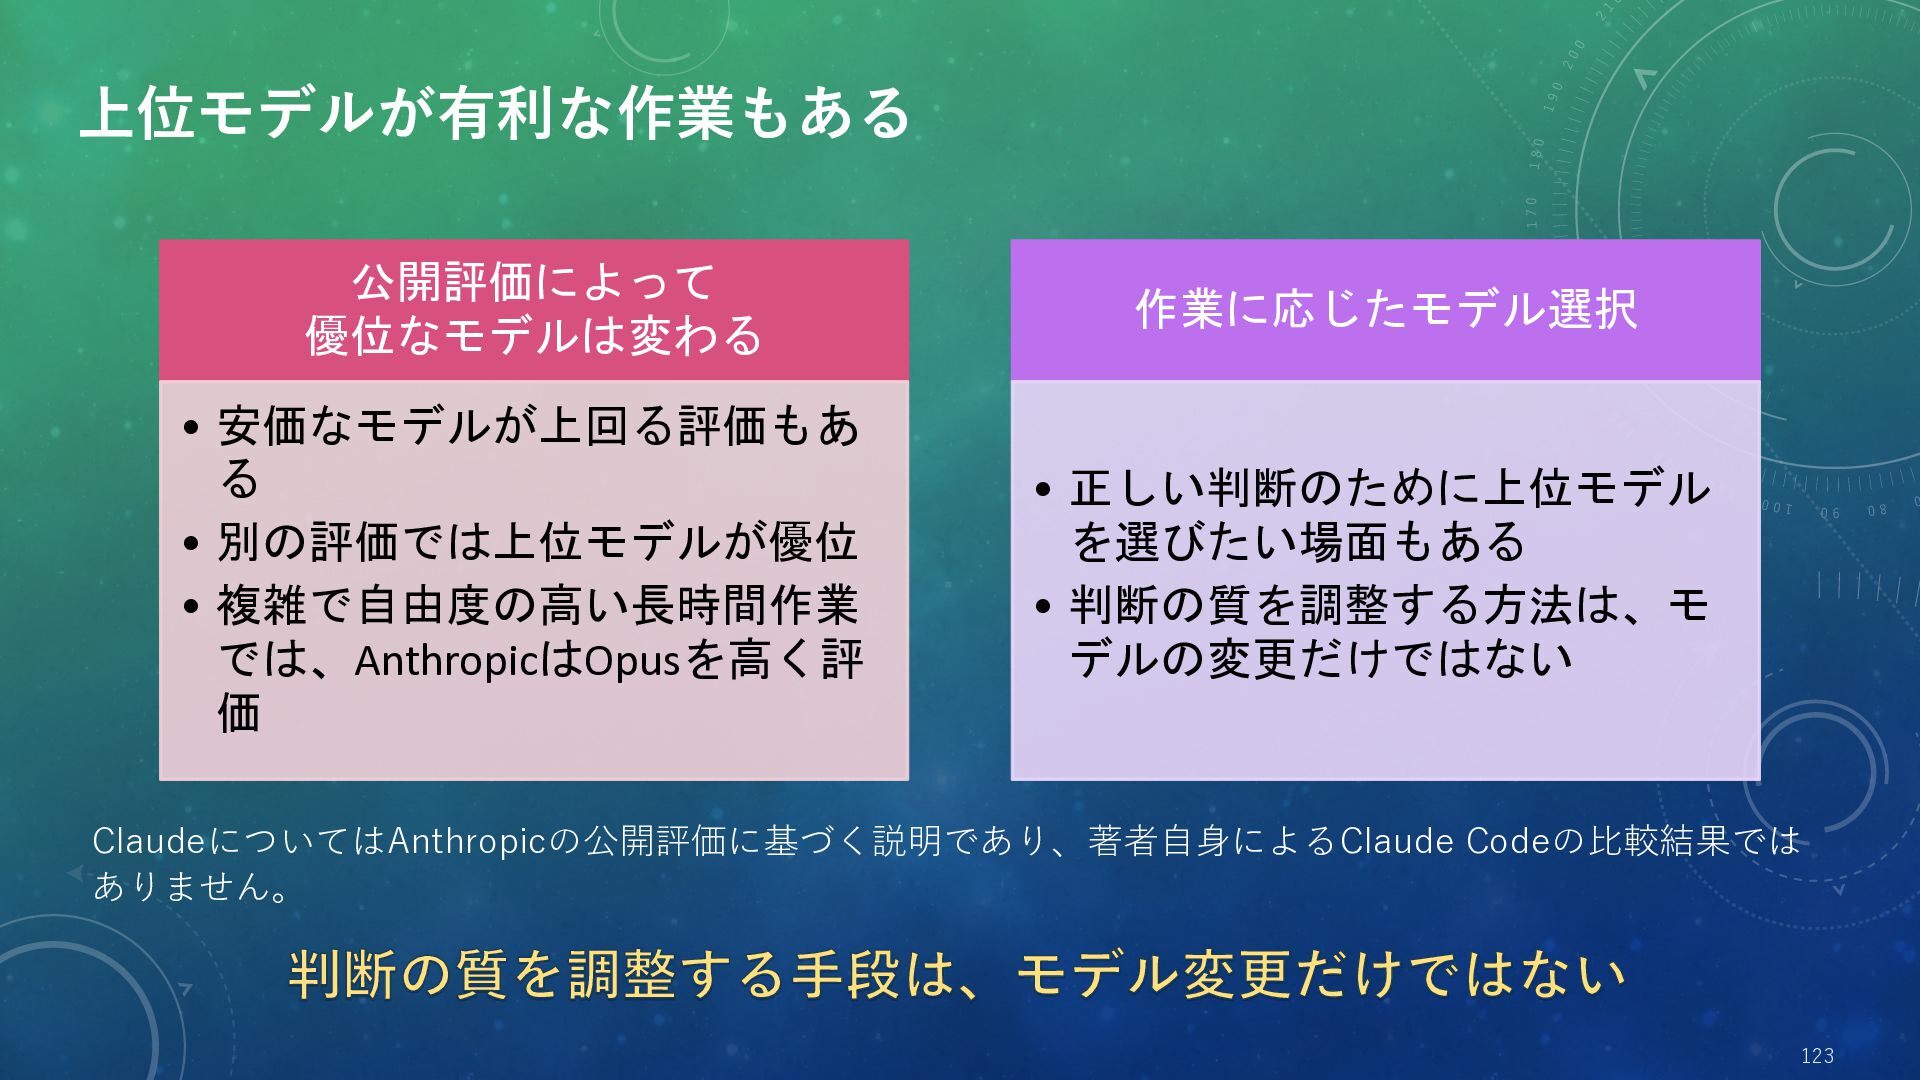
  32. 上位モデルが有利な作業もある 公開評価によって 優位なモデルは変わる 作業に応じたモデル選択 • 安価なモデルが上回る評価もあ る • 別の評価では上位モデルが優位 •

    複雑で自由度の高い長時間作業 では、AnthropicはOpusを高く評 価 • 正しい判断のために上位モデル を選びたい場面もある • 判断の質を調整する方法は、モ デルの変更だけではない ClaudeについてはAnthropicの公開評価に基づく説明であり、著者自身によるClaude Codeの比較結果では ありません。 判断の質を調整する手段は、モデル変更だけではない 123
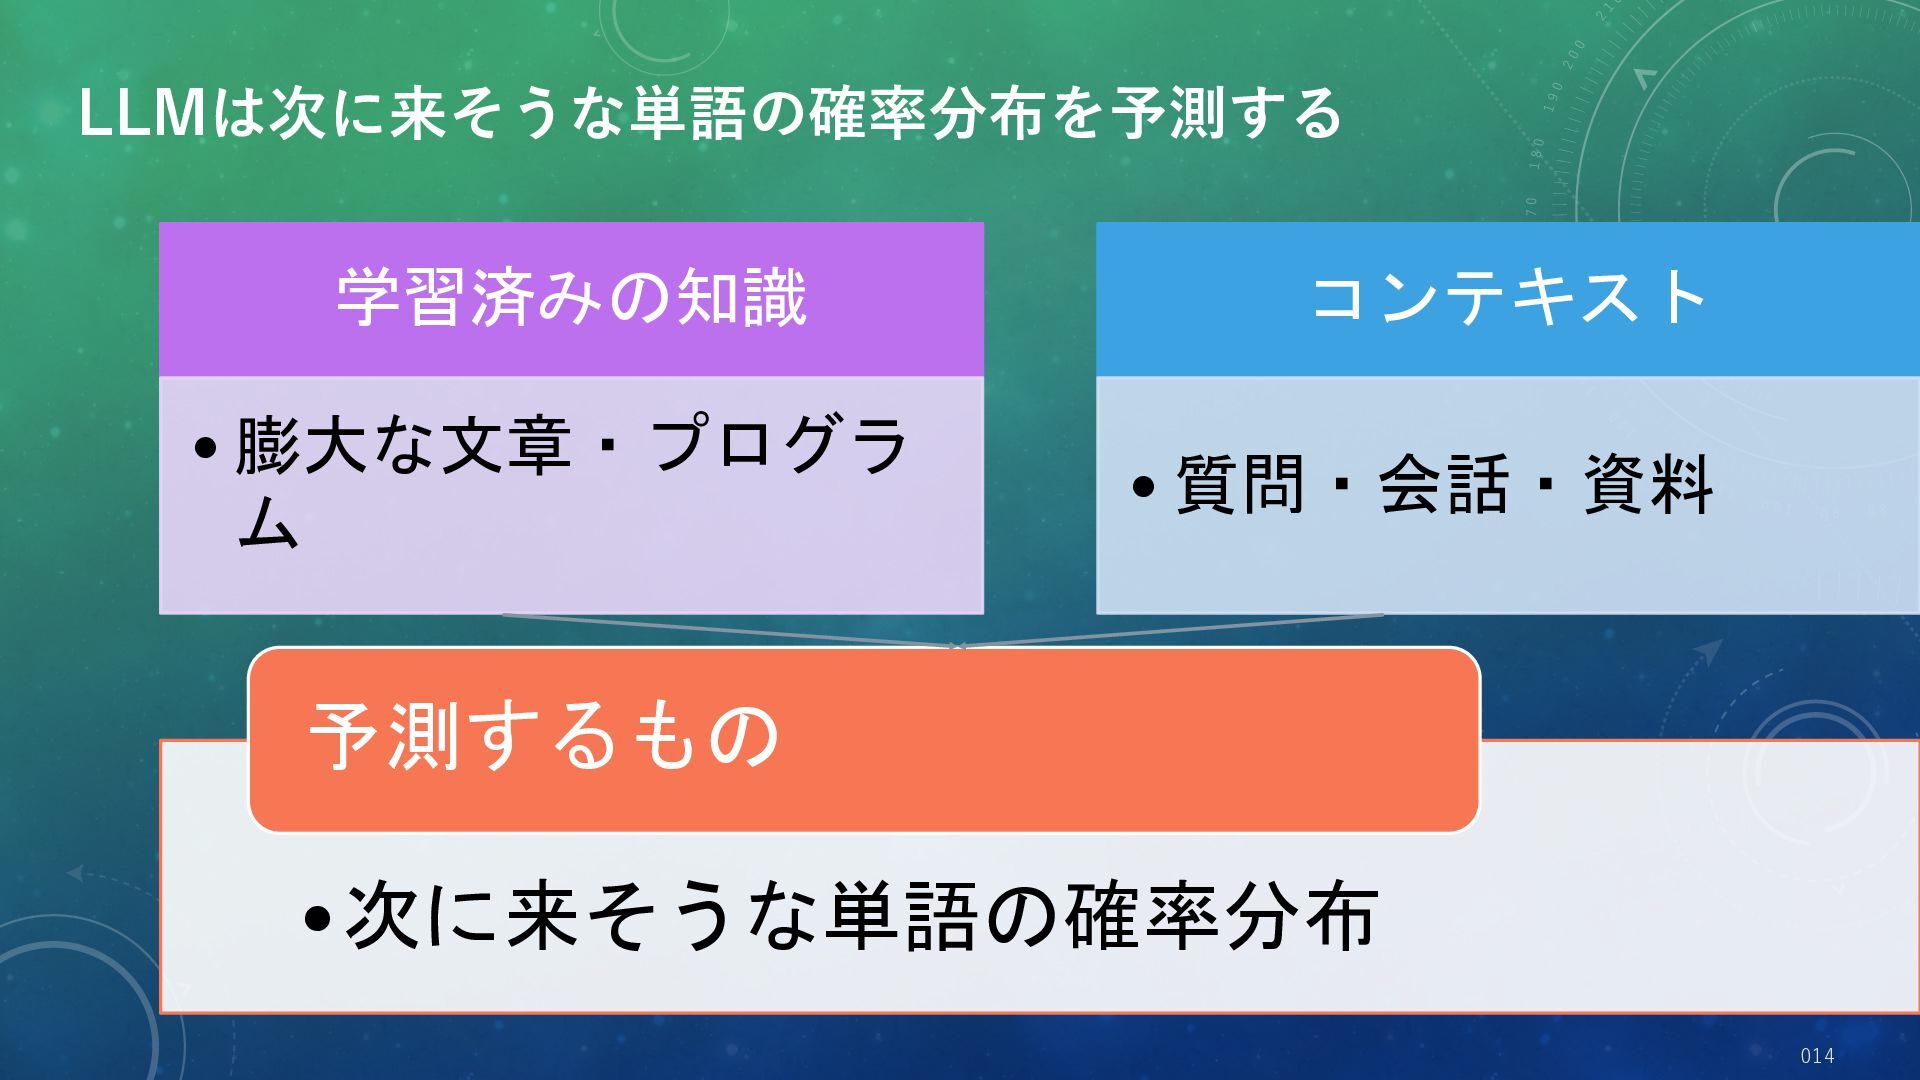
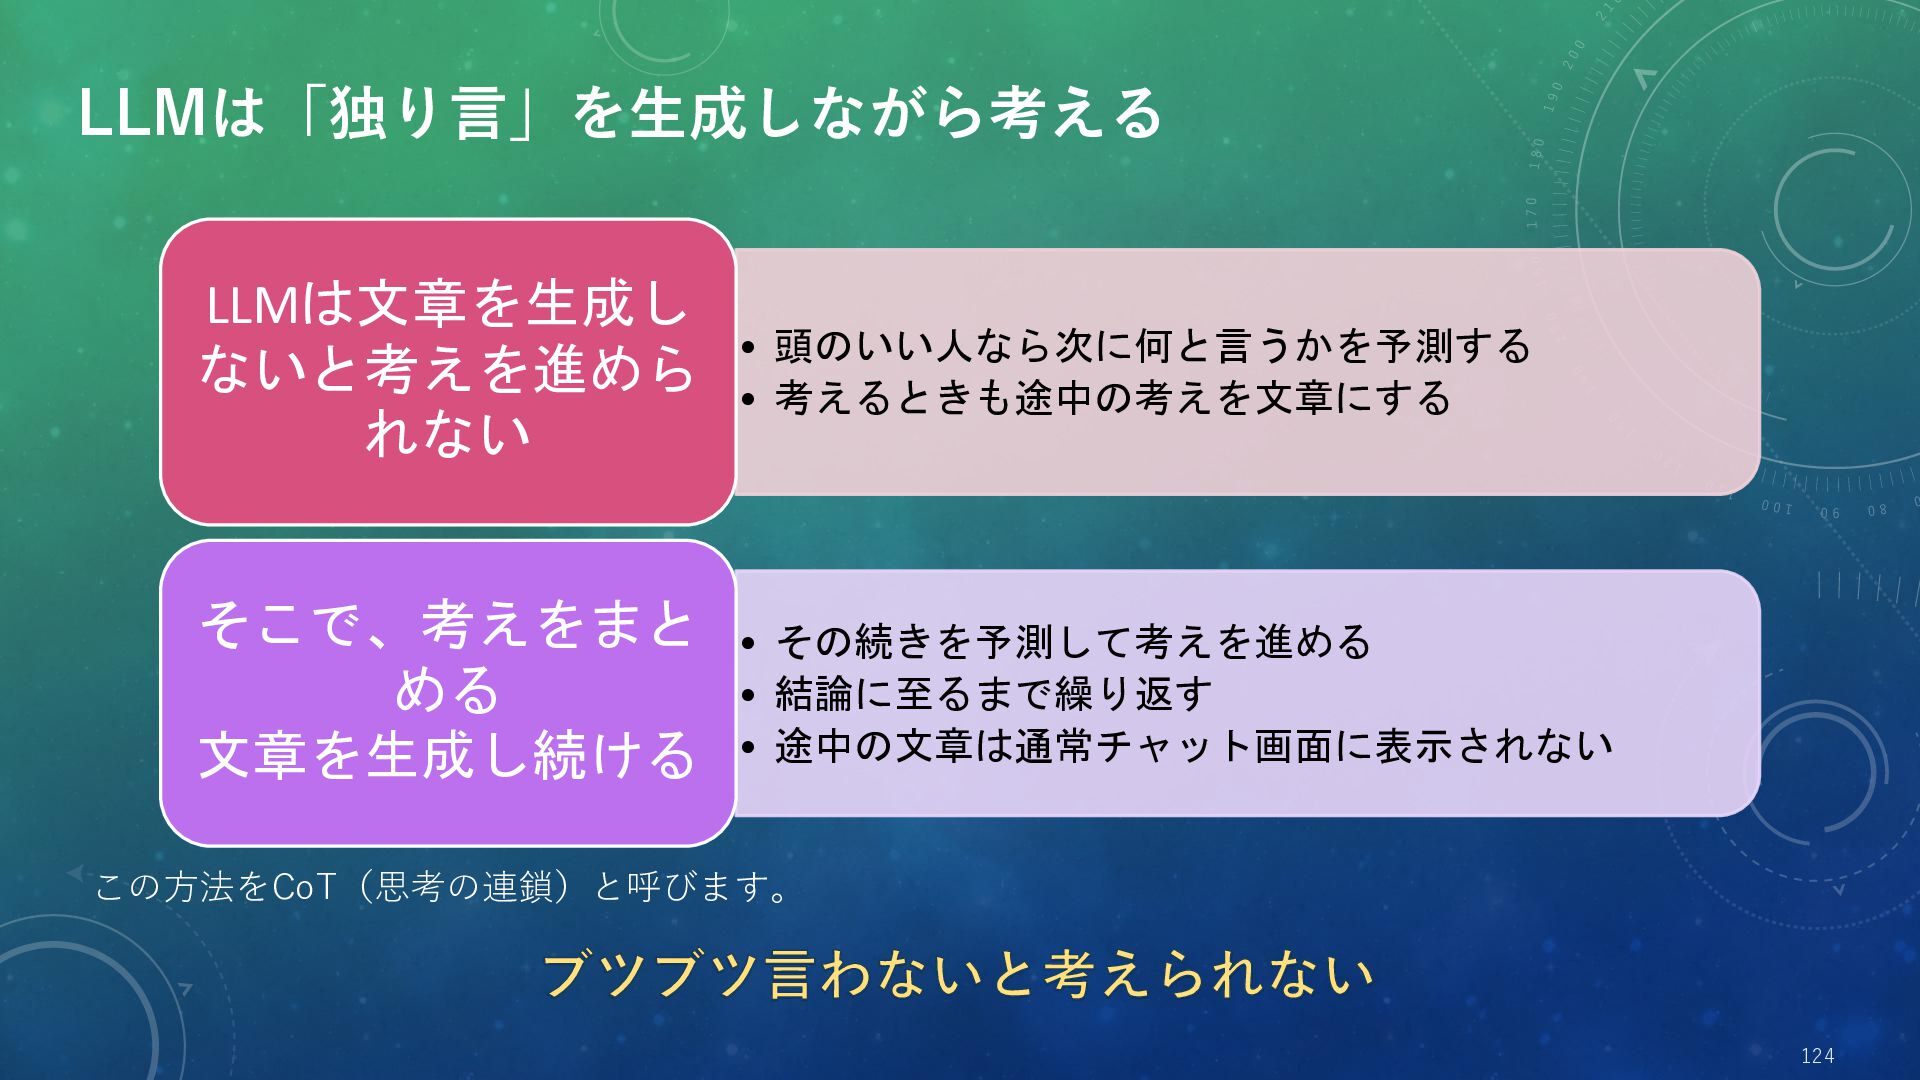
  33. LLMは「独り言」を生成しながら考える LLMは文章を生成し • 頭のいい人なら次に何と言うかを予測する ないと考えを進めら • 考えるときも途中の考えを文章にする れない そこで、考えをまと •

    その続きを予測して考えを進める • 結論に至るまで繰り返す める 文章を生成し続ける • 途中の文章は通常チャット画面に表示されない この方法をCoT(思考の連鎖)と呼びます。 ブツブツ言わないと考えられない 124
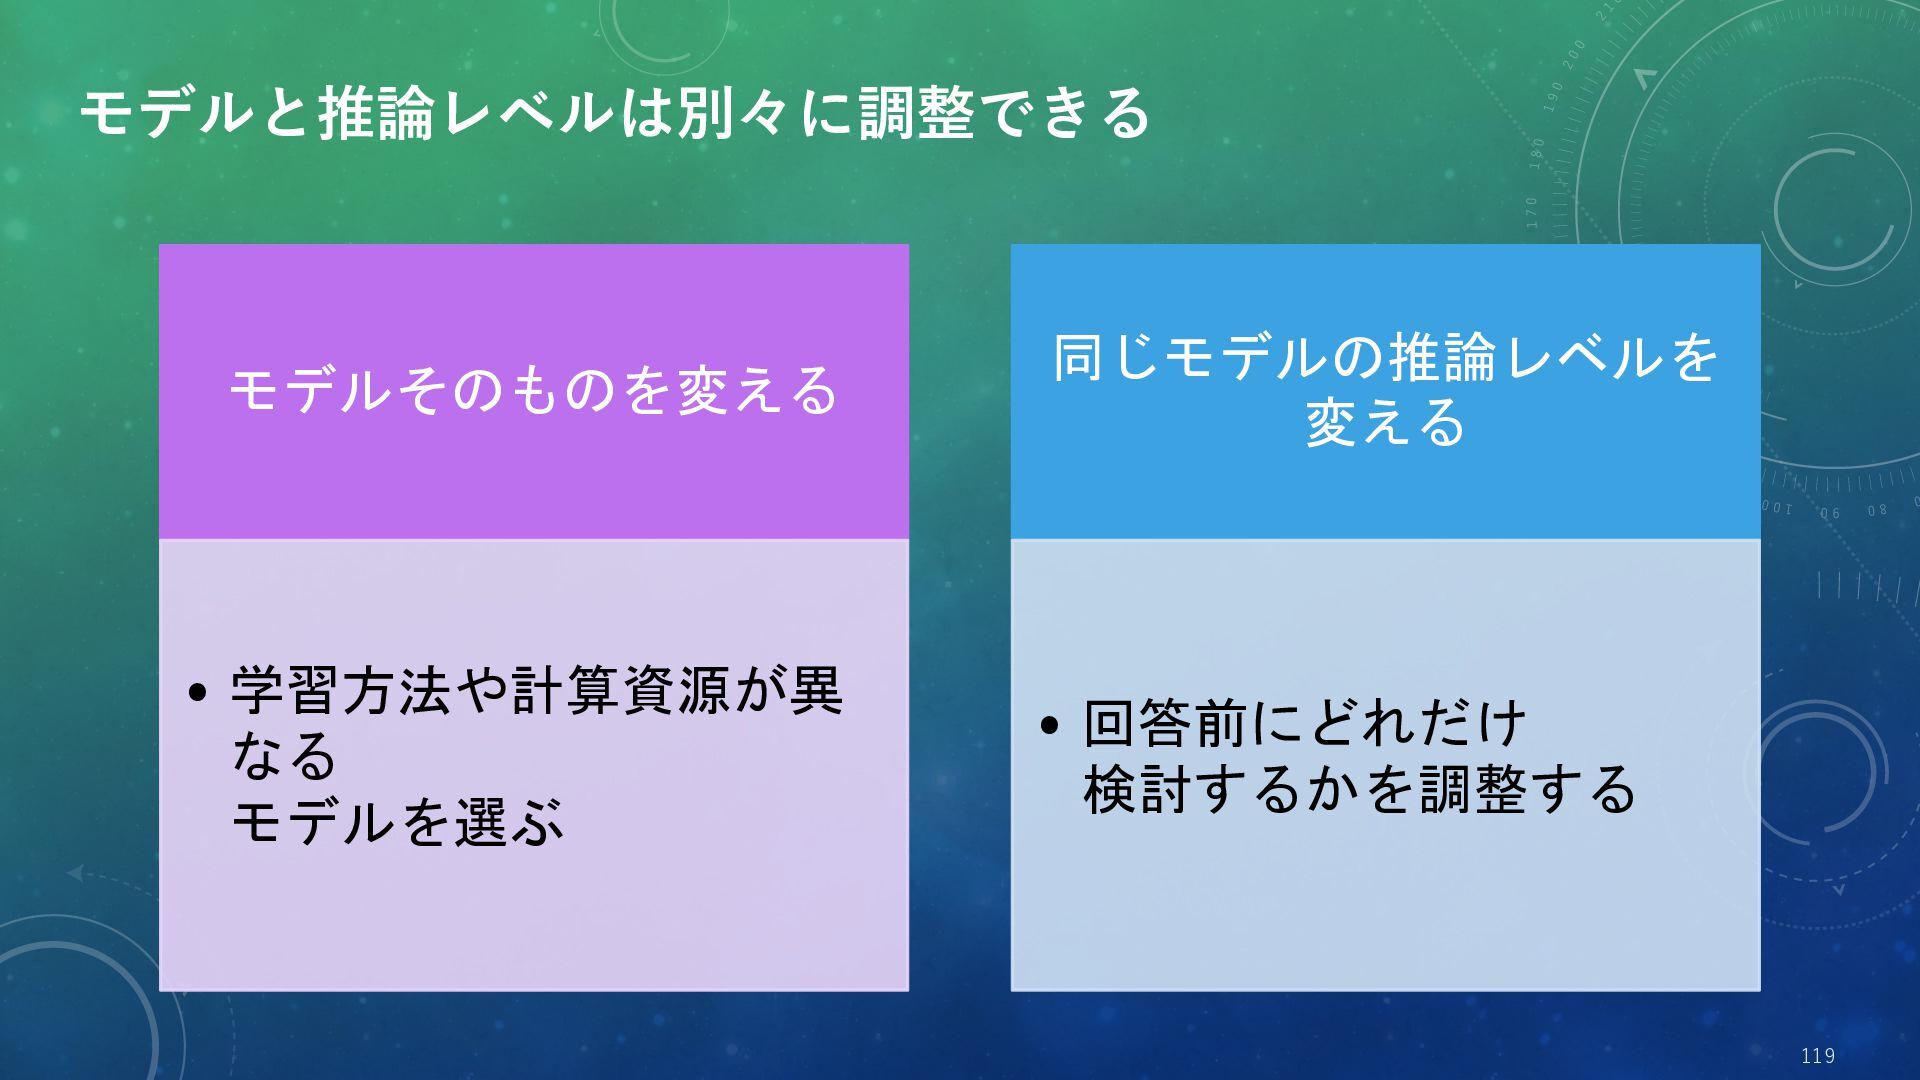
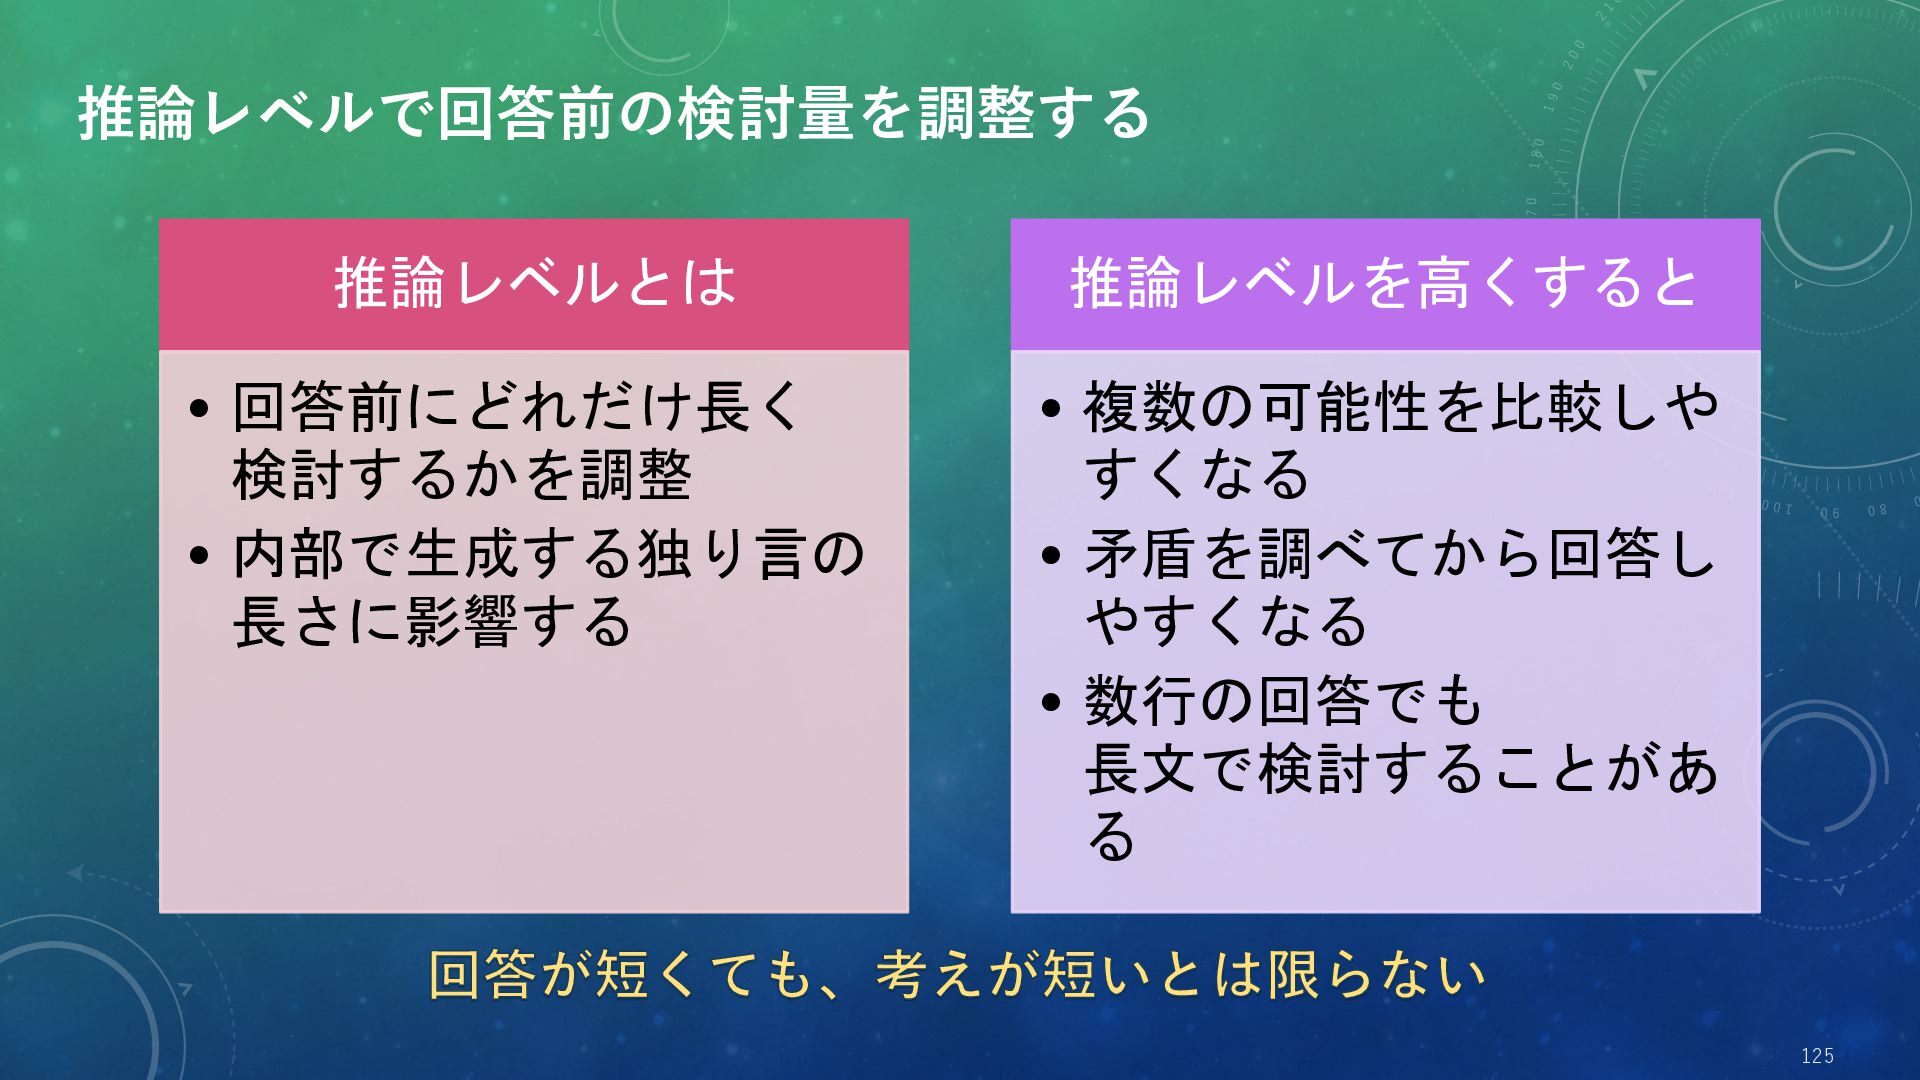
  34. 推論レベルで回答前の検討量を調整する 推論レベルとは 推論レベルを高くすると • 回答前にどれだけ長く 検討するかを調整 • 内部で生成する独り言の 長さに影響する •

    複数の可能性を比較しや すくなる • 矛盾を調べてから回答し やすくなる • 数行の回答でも 長文で検討することがあ る 回答が短くても、考えが短いとは限らない 125
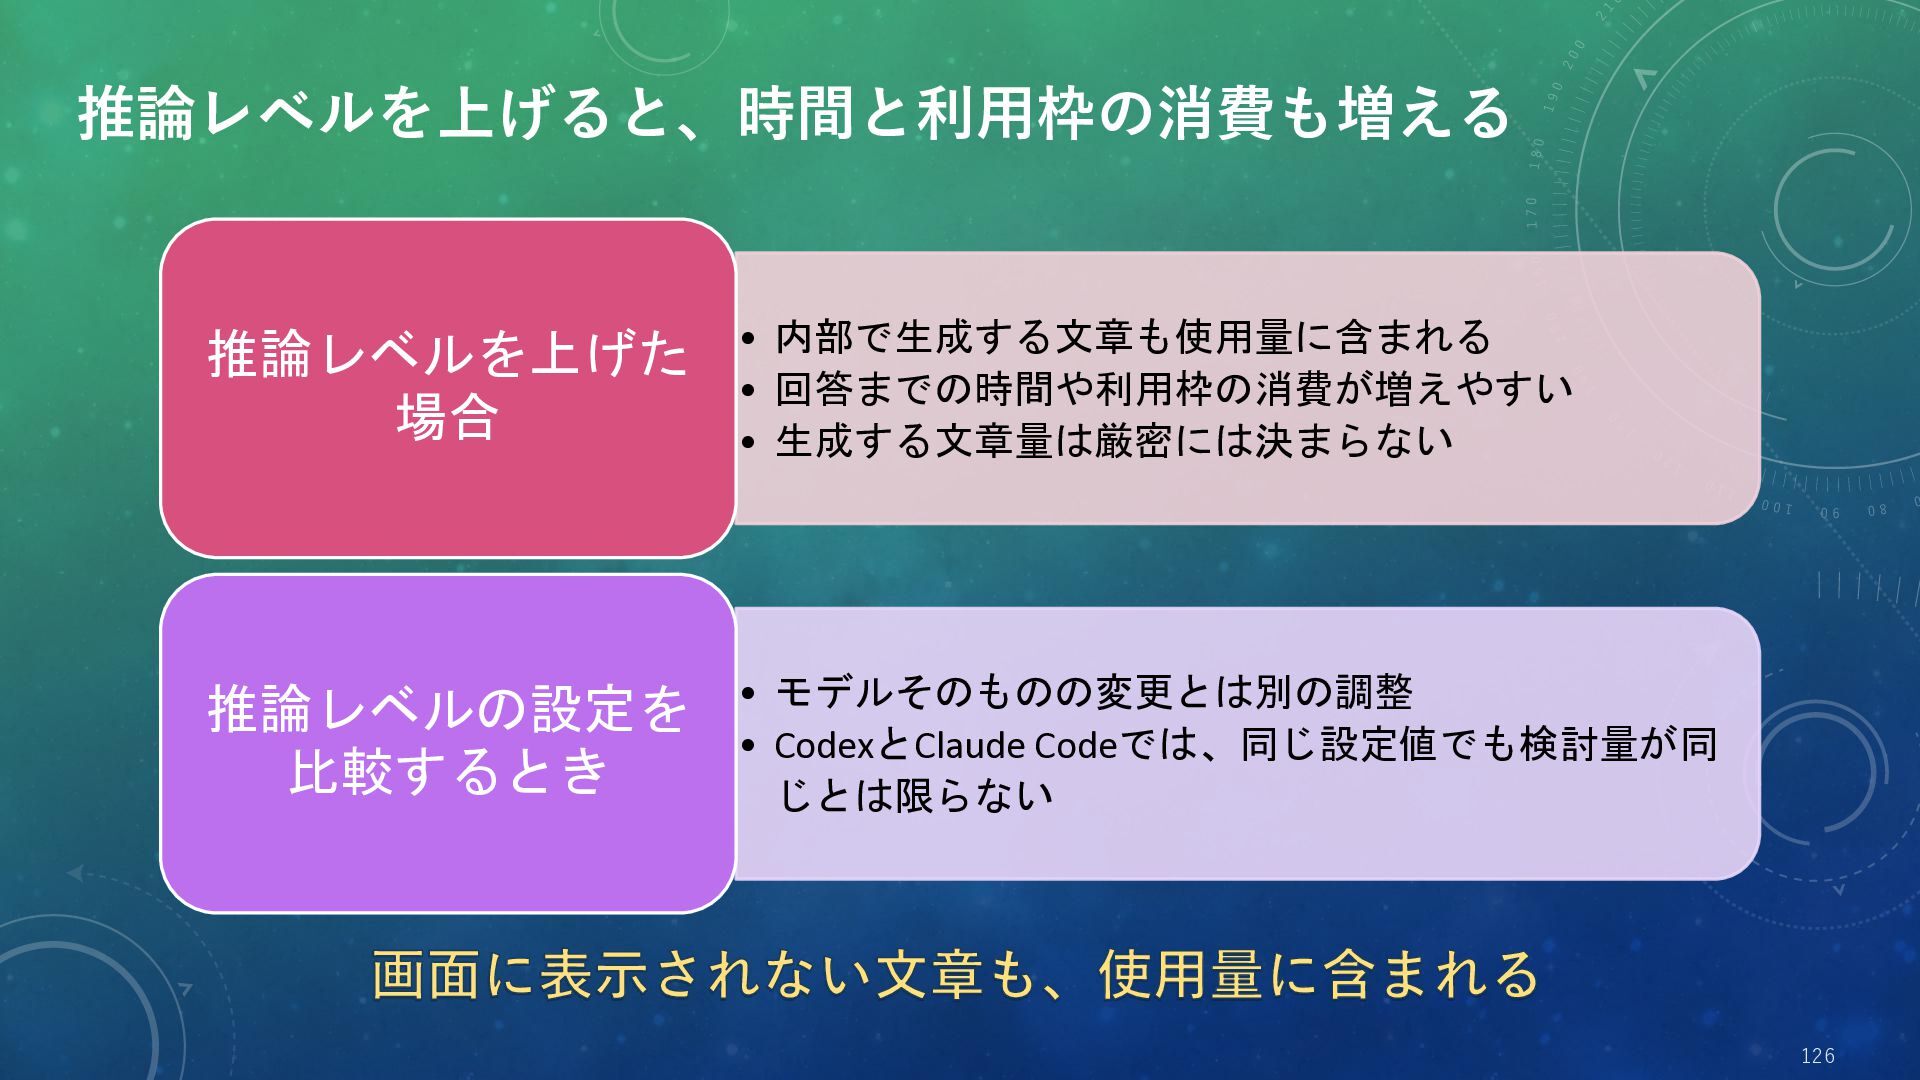
  35. 推論レベルを上げると、時間と利用枠の消費も増える 推論レベルを上げた 場合 • 内部で生成する文章も使用量に含まれる • 回答までの時間や利用枠の消費が増えやすい • 生成する文章量は厳密には決まらない 推論レベルの設定を

    比較するとき • モデルそのものの変更とは別の調整 • CodexとClaude Codeでは、同じ設定値でも検討量が同 じとは限らない 画面に表示されない文章も、使用量に含まれる 126
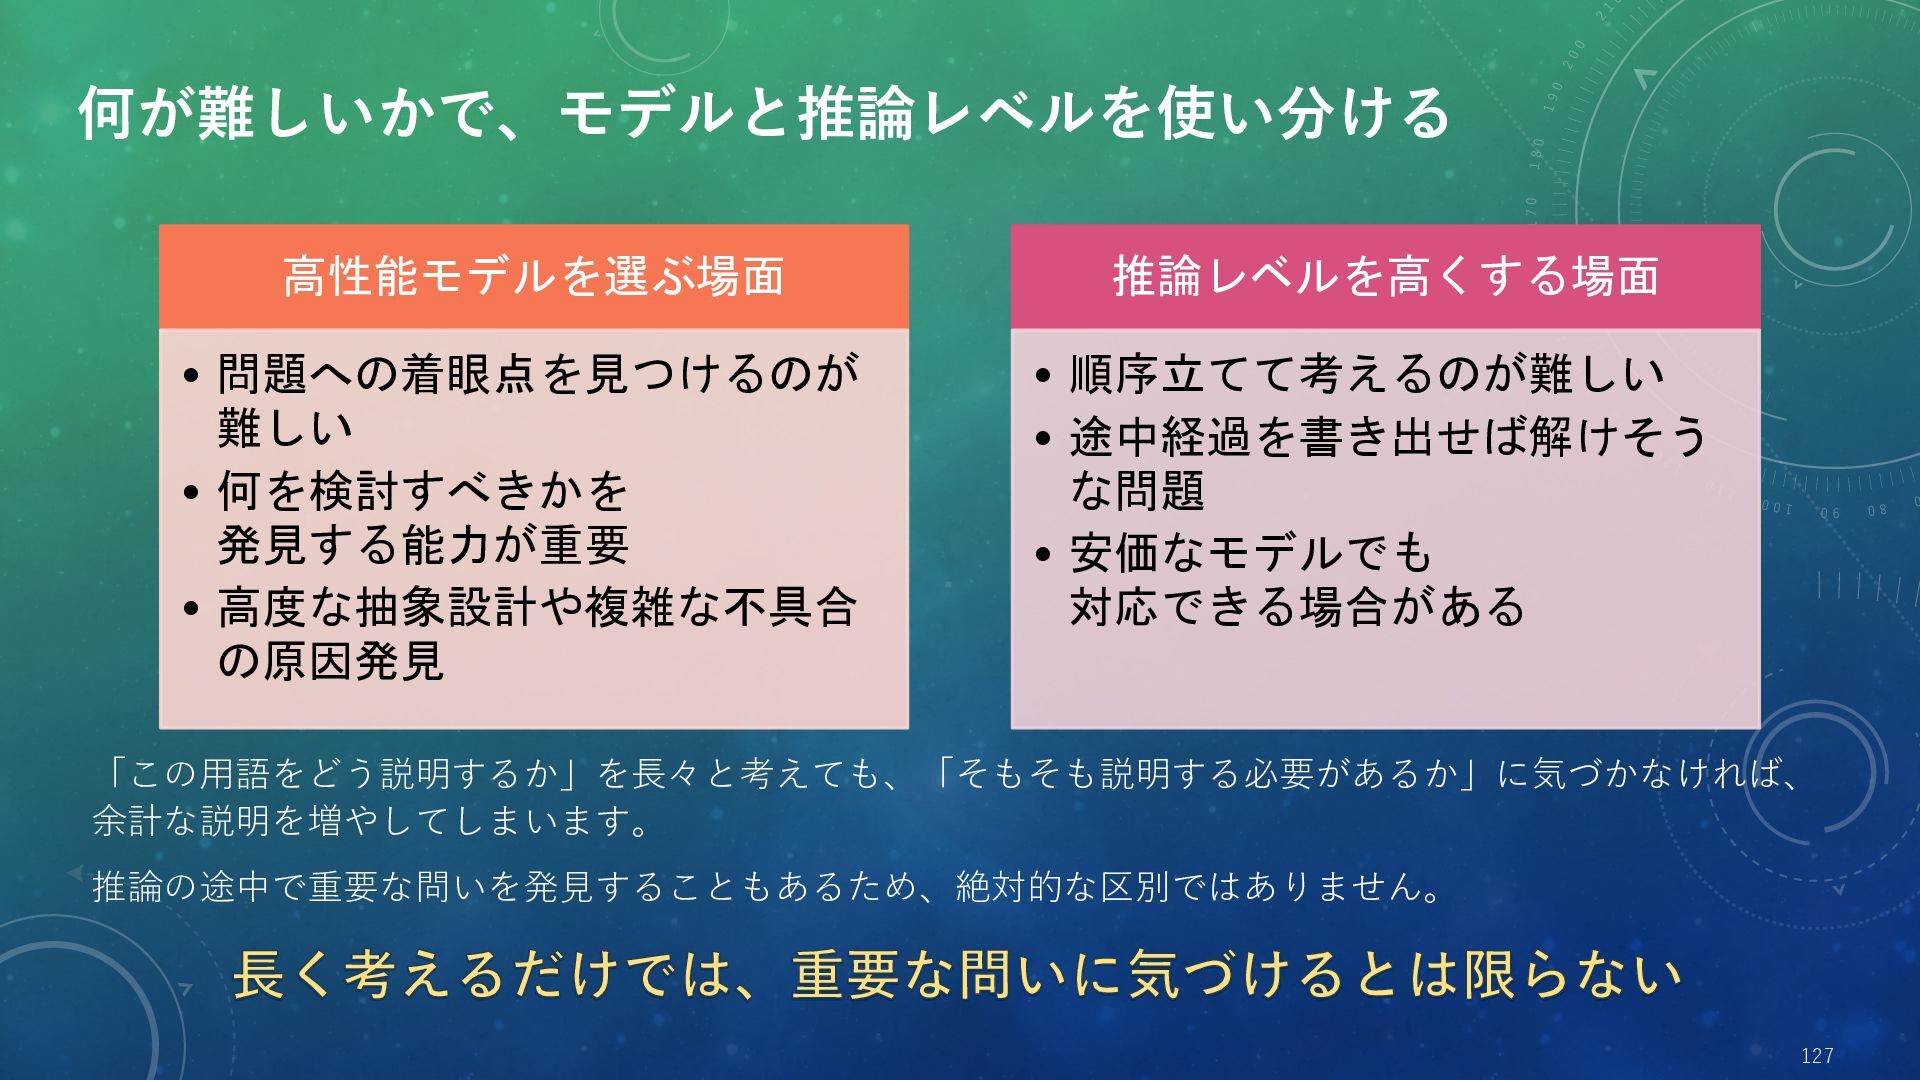
  36. 何が難しいかで、モデルと推論レベルを使い分ける 高性能モデルを選ぶ場面 推論レベルを高くする場面 • 問題への着眼点を見つけるのが 難しい • 何を検討すべきかを 発見する能力が重要 •

    高度な抽象設計や複雑な不具合 の原因発見 • 順序立てて考えるのが難しい • 途中経過を書き出せば解けそう な問題 • 安価なモデルでも 対応できる場合がある 「この用語をどう説明するか」を長々と考えても、「そもそも説明する必要があるか」に気づかなければ、 余計な説明を増やしてしまいます。 推論の途中で重要な問いを発見することもあるため、絶対的な区別ではありません。 長く考えるだけでは、重要な問いに気づけるとは限らない 127
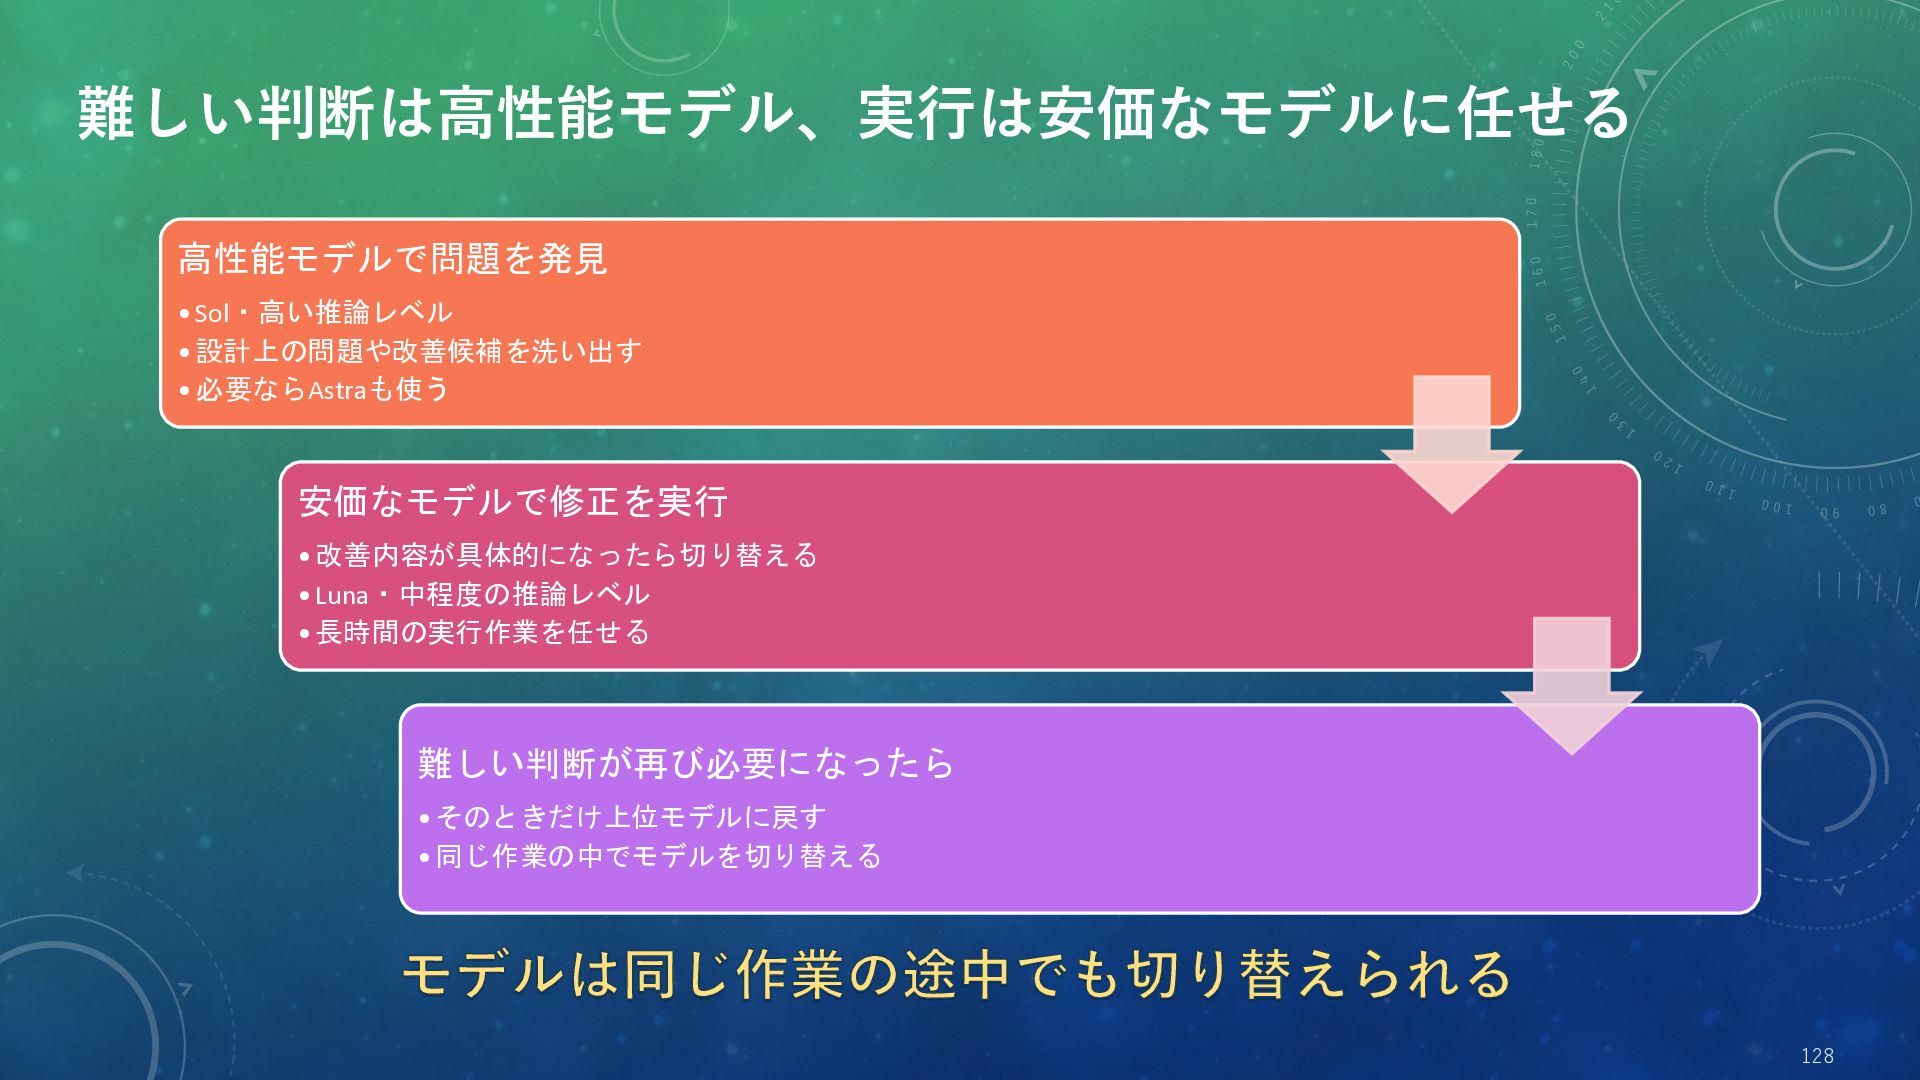
  37. 難しい判断は高性能モデル、実行は安価なモデルに任せる 高性能モデルで問題を発見 • Sol・高い推論レベル • 設計上の問題や改善候補を洗い出す • 必要ならAstraも使う 安価なモデルで修正を実行 •

    改善内容が具体的になったら切り替える • Luna・中程度の推論レベル • 長時間の実行作業を任せる 難しい判断が再び必要になったら • そのときだけ上位モデルに戻す • 同じ作業の中でモデルを切り替える モデルは同じ作業の途中でも切り替えられる 128
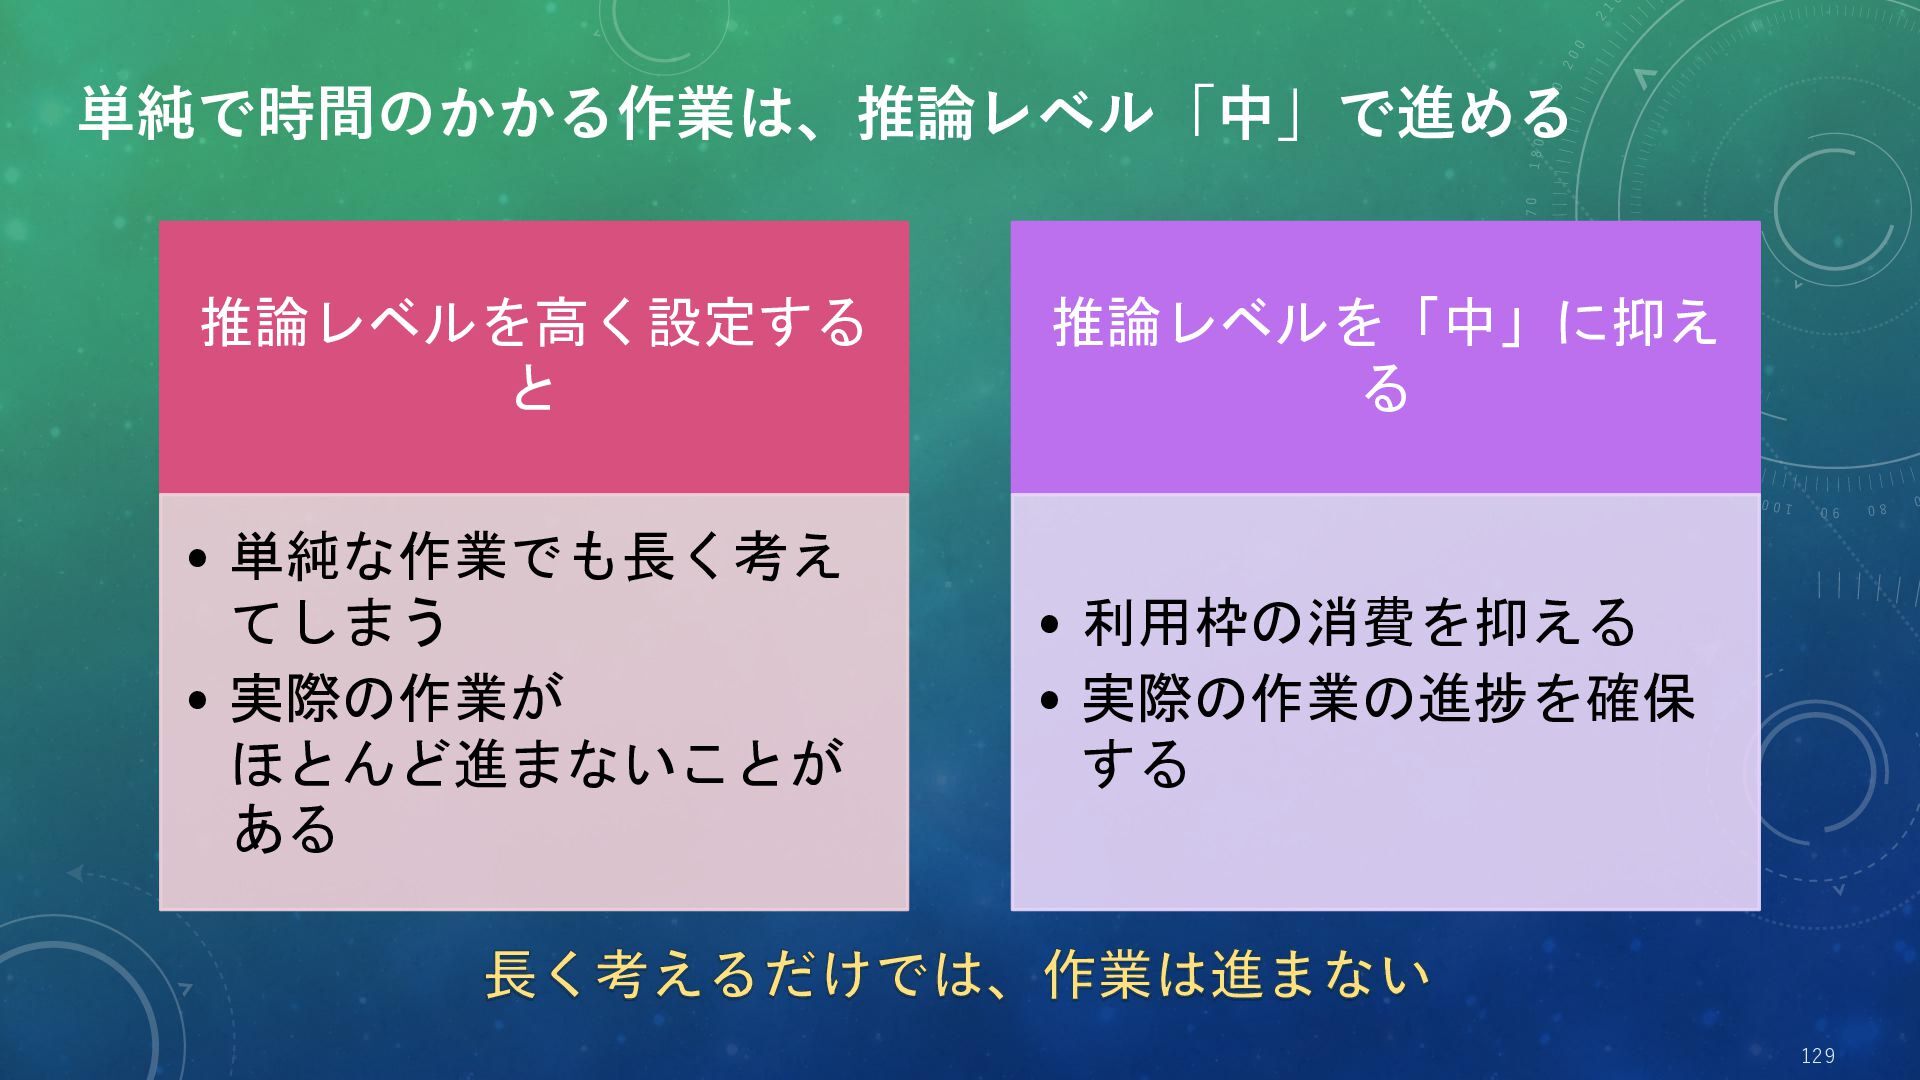
  38. 単純で時間のかかる作業は、推論レベル「中」で進める 推論レベルを高く設定する と 推論レベルを「中」に抑え る • 単純な作業でも長く考え てしまう • 実際の作業が

    ほとんど進まないことが ある • 利用枠の消費を抑える • 実際の作業の進捗を確保 する 長く考えるだけでは、作業は進まない 129
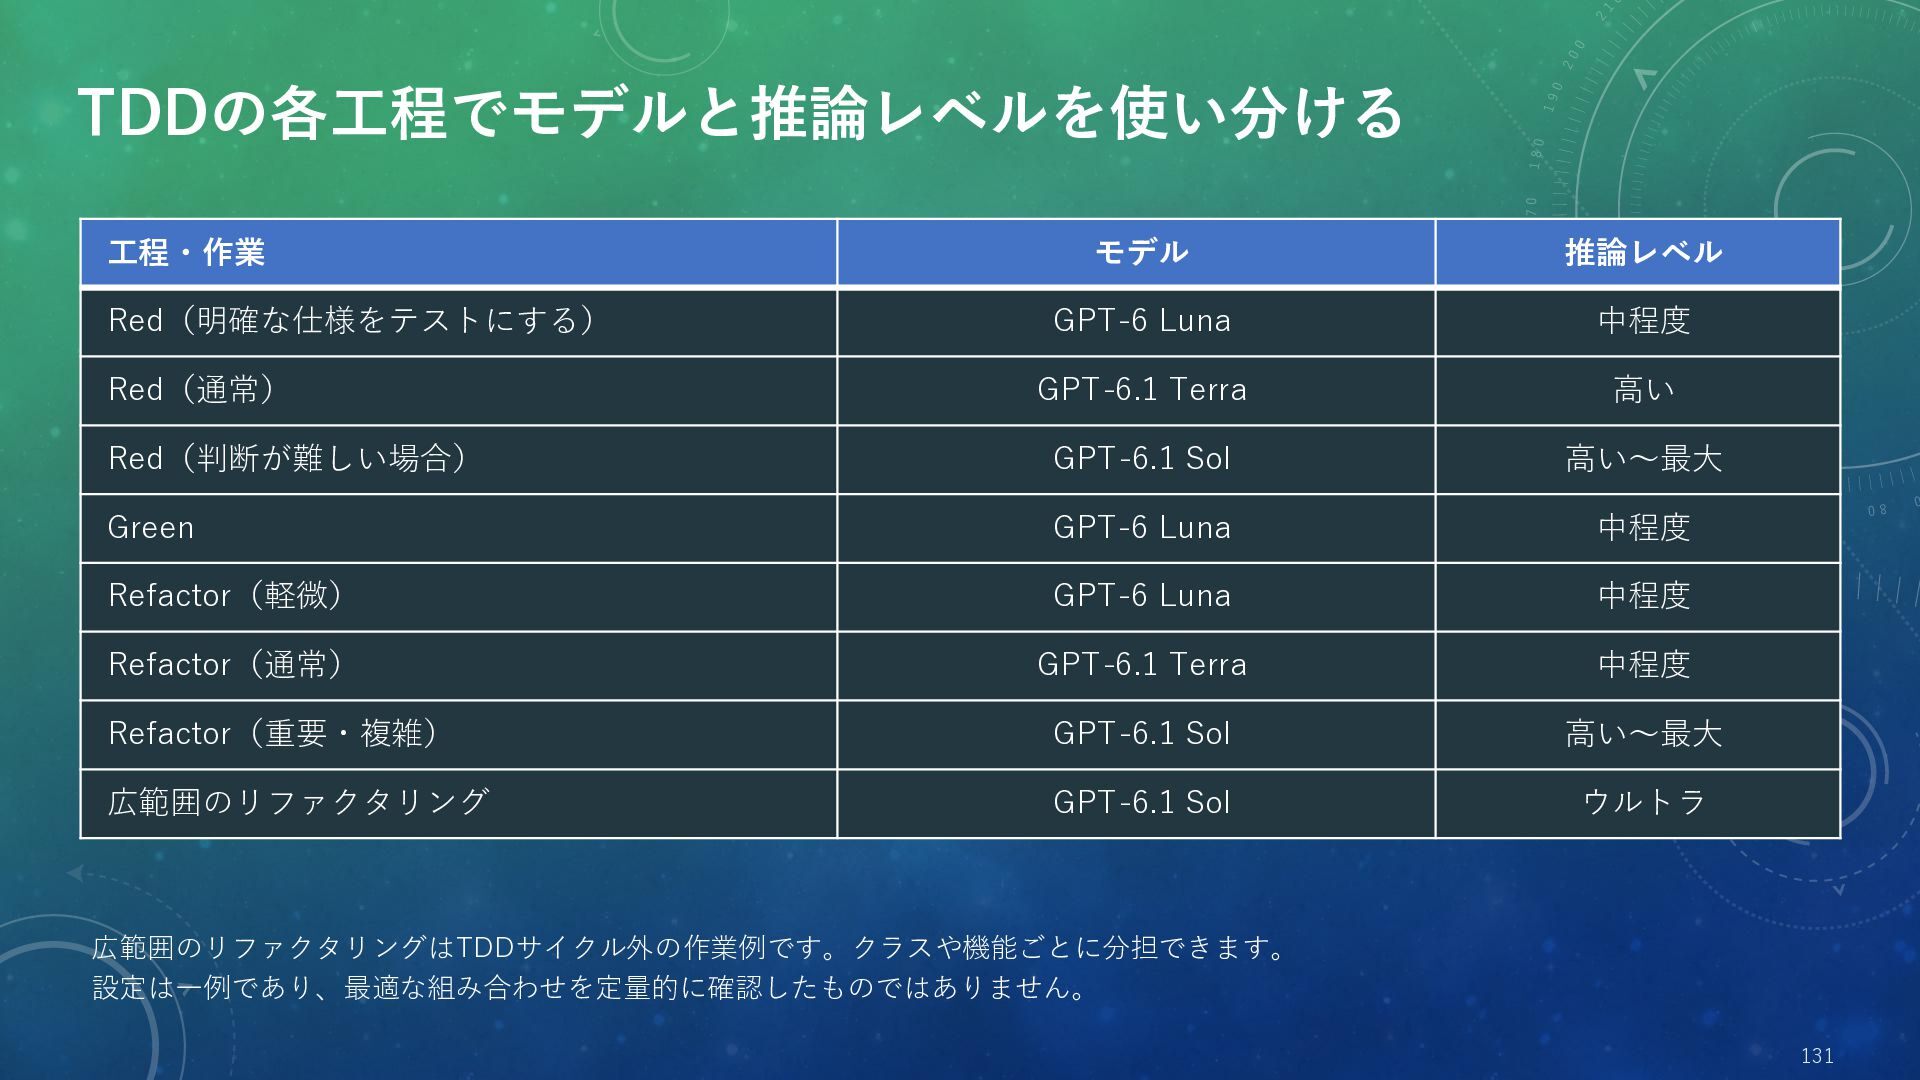
  39. TDDの各工程でモデルと推論レベルを使い分ける 工程・作業 モデル 推論レベル Red(明確な仕様をテストにする) GPT-6 Luna 中程度 Red(通常) GPT-6.1

    Terra 高い Red(判断が難しい場合) GPT-6.1 Sol 高い〜最大 Green GPT-6 Luna 中程度 Refactor(軽微) GPT-6 Luna 中程度 Refactor(通常) GPT-6.1 Terra 中程度 Refactor(重要・複雑) GPT-6.1 Sol 高い〜最大 広範囲のリファクタリング GPT-6.1 Sol ウルトラ 広範囲のリファクタリングはTDDサイクル外の作業例です。クラスや機能ごとに分担できます。 設定は一例であり、最適な組み合わせを定量的に確認したものではありません。 131
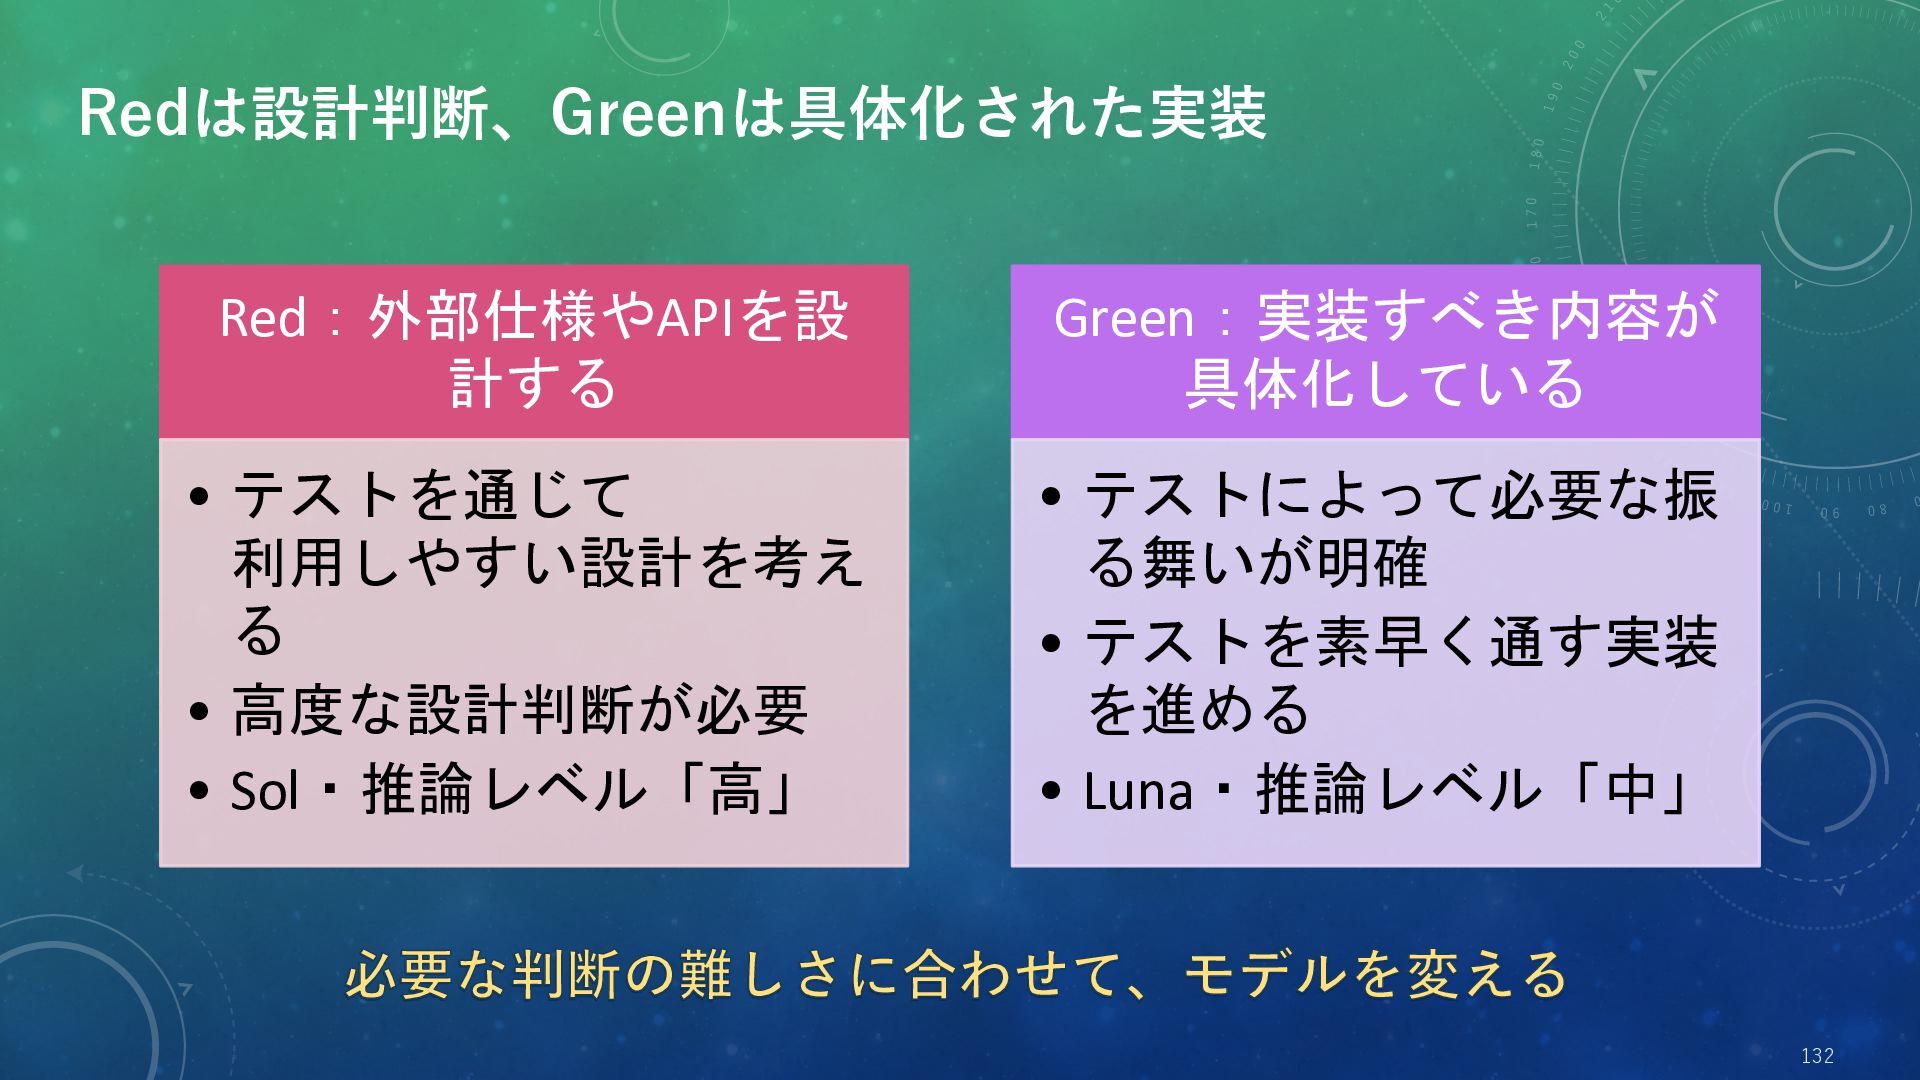
  40. Redは設計判断、Greenは具体化された実装 Red:外部仕様やAPIを設 計する Green:実装すべき内容が 具体化している • テストを通じて 利用しやすい設計を考え る •

    高度な設計判断が必要 • Sol・推論レベル「高」 • テストによって必要な振 る舞いが明確 • テストを素早く通す実装 を進める • Luna・推論レベル「中」 必要な判断の難しさに合わせて、モデルを変える 132
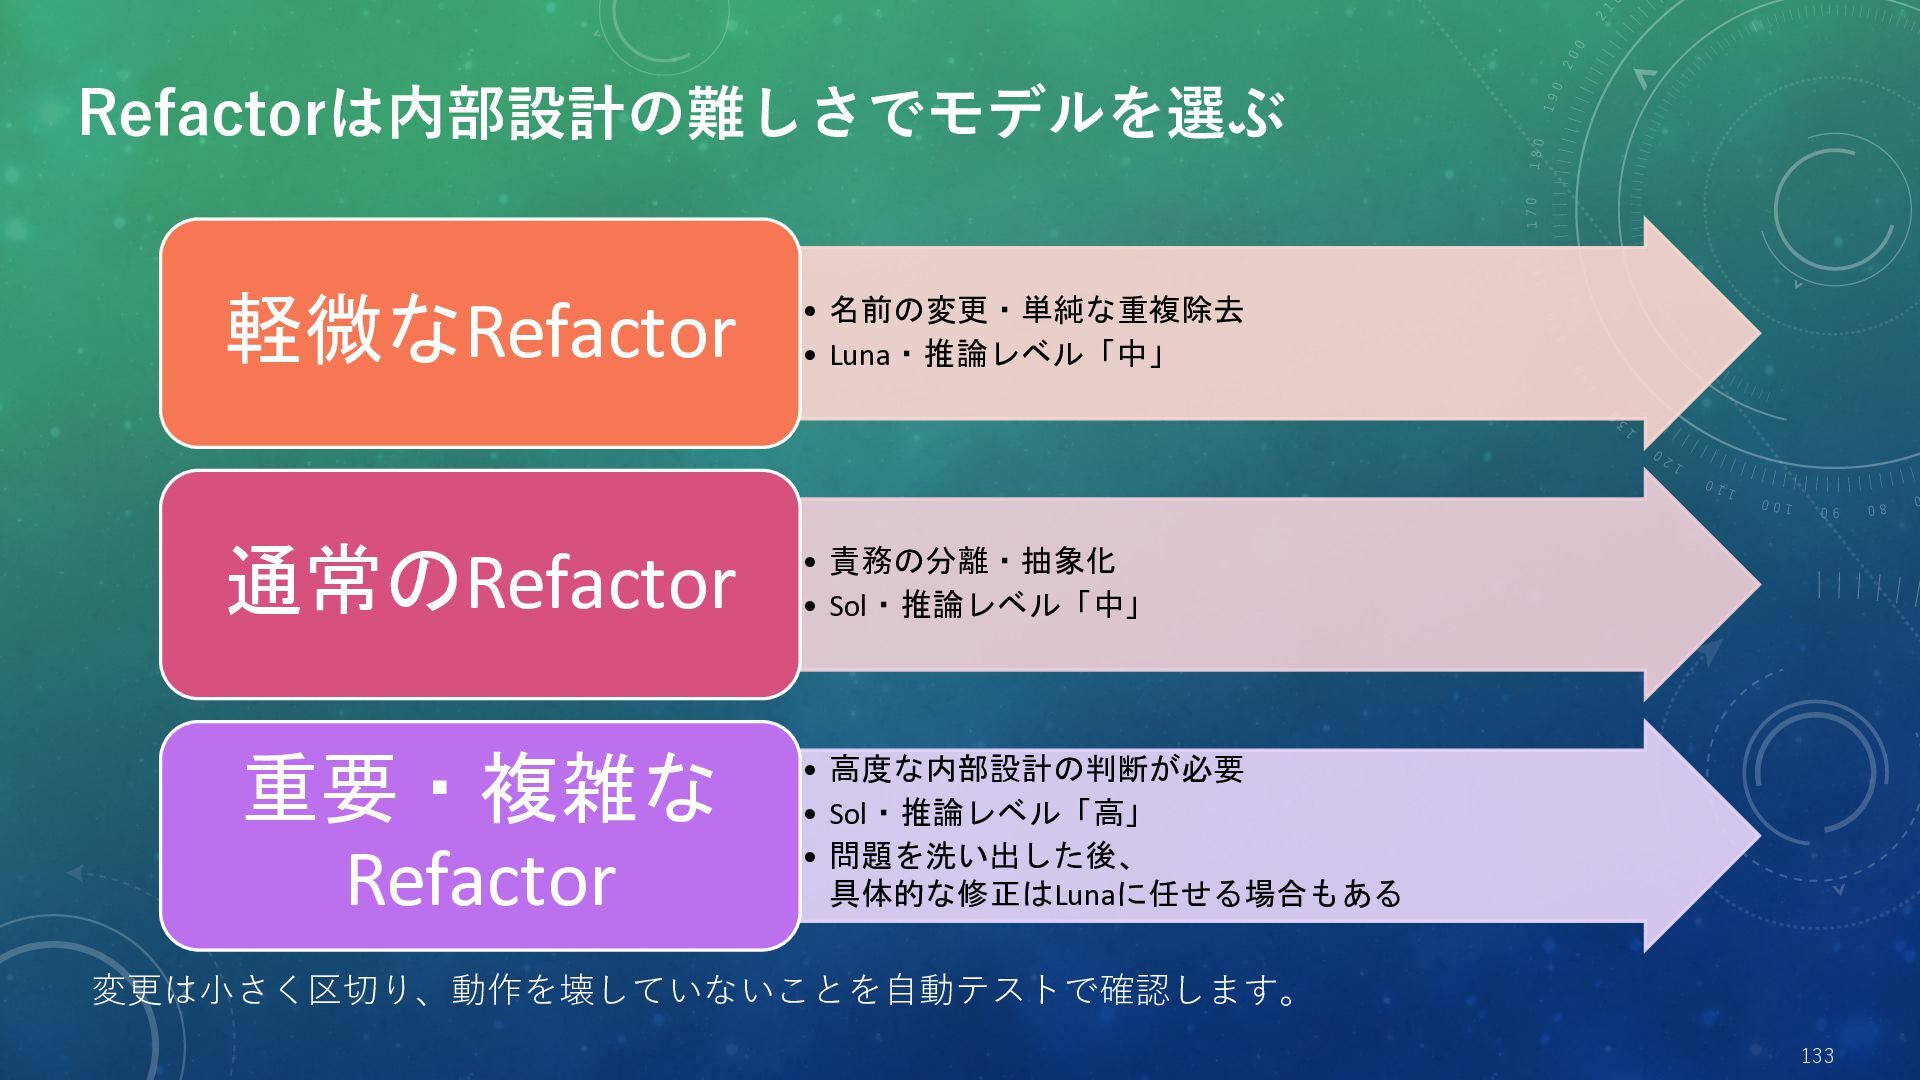
  41. Refactorは内部設計の難しさでモデルを選ぶ 軽微なRefactor • 名前の変更・単純な重複除去 • Luna・推論レベル「中」 通常のRefactor • 責務の分離・抽象化 •

    Sol・推論レベル「中」 重要・複雑な Refactor • 高度な内部設計の判断が必要 • Sol・推論レベル「高」 • 問題を洗い出した後、 具体的な修正はLunaに任せる場合もある 変更は小さく区切り、動作を壊していないことを自動テストで確認します。 133
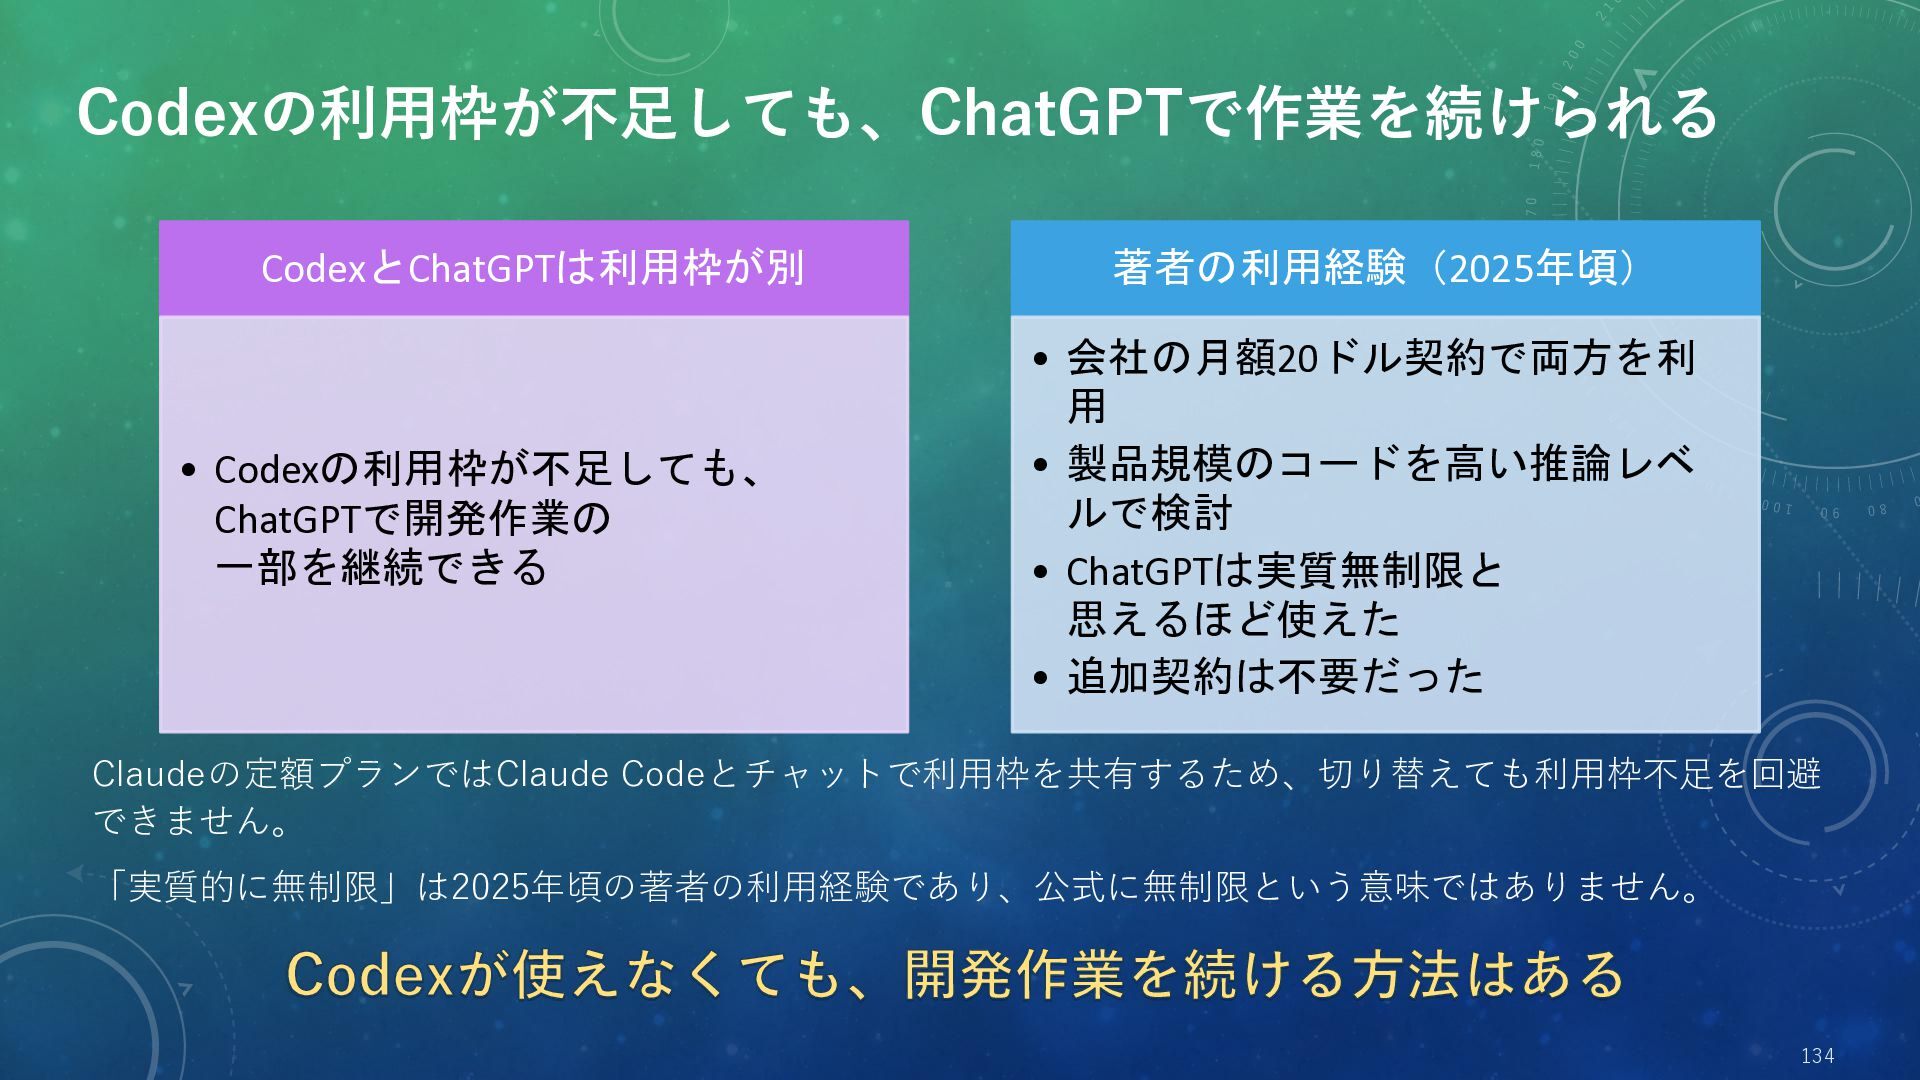
  42. Codexの利用枠が不足しても、ChatGPTで作業を続けられる CodexとChatGPTは利用枠が別 • Codexの利用枠が不足しても、 ChatGPTで開発作業の 一部を継続できる 著者の利用経験(2025年頃) • 会社の月額20ドル契約で両方を利 用

    • 製品規模のコードを高い推論レベ ルで検討 • ChatGPTは実質無制限と 思えるほど使えた • 追加契約は不要だった Claudeの定額プランではClaude Codeとチャットで利用枠を共有するため、切り替えても利用枠不足を回避 できません。 「実質的に無制限」は2025年頃の著者の利用経験であり、公式に無制限という意味ではありません。 Codexが使えなくても、開発作業を続ける方法はある 134
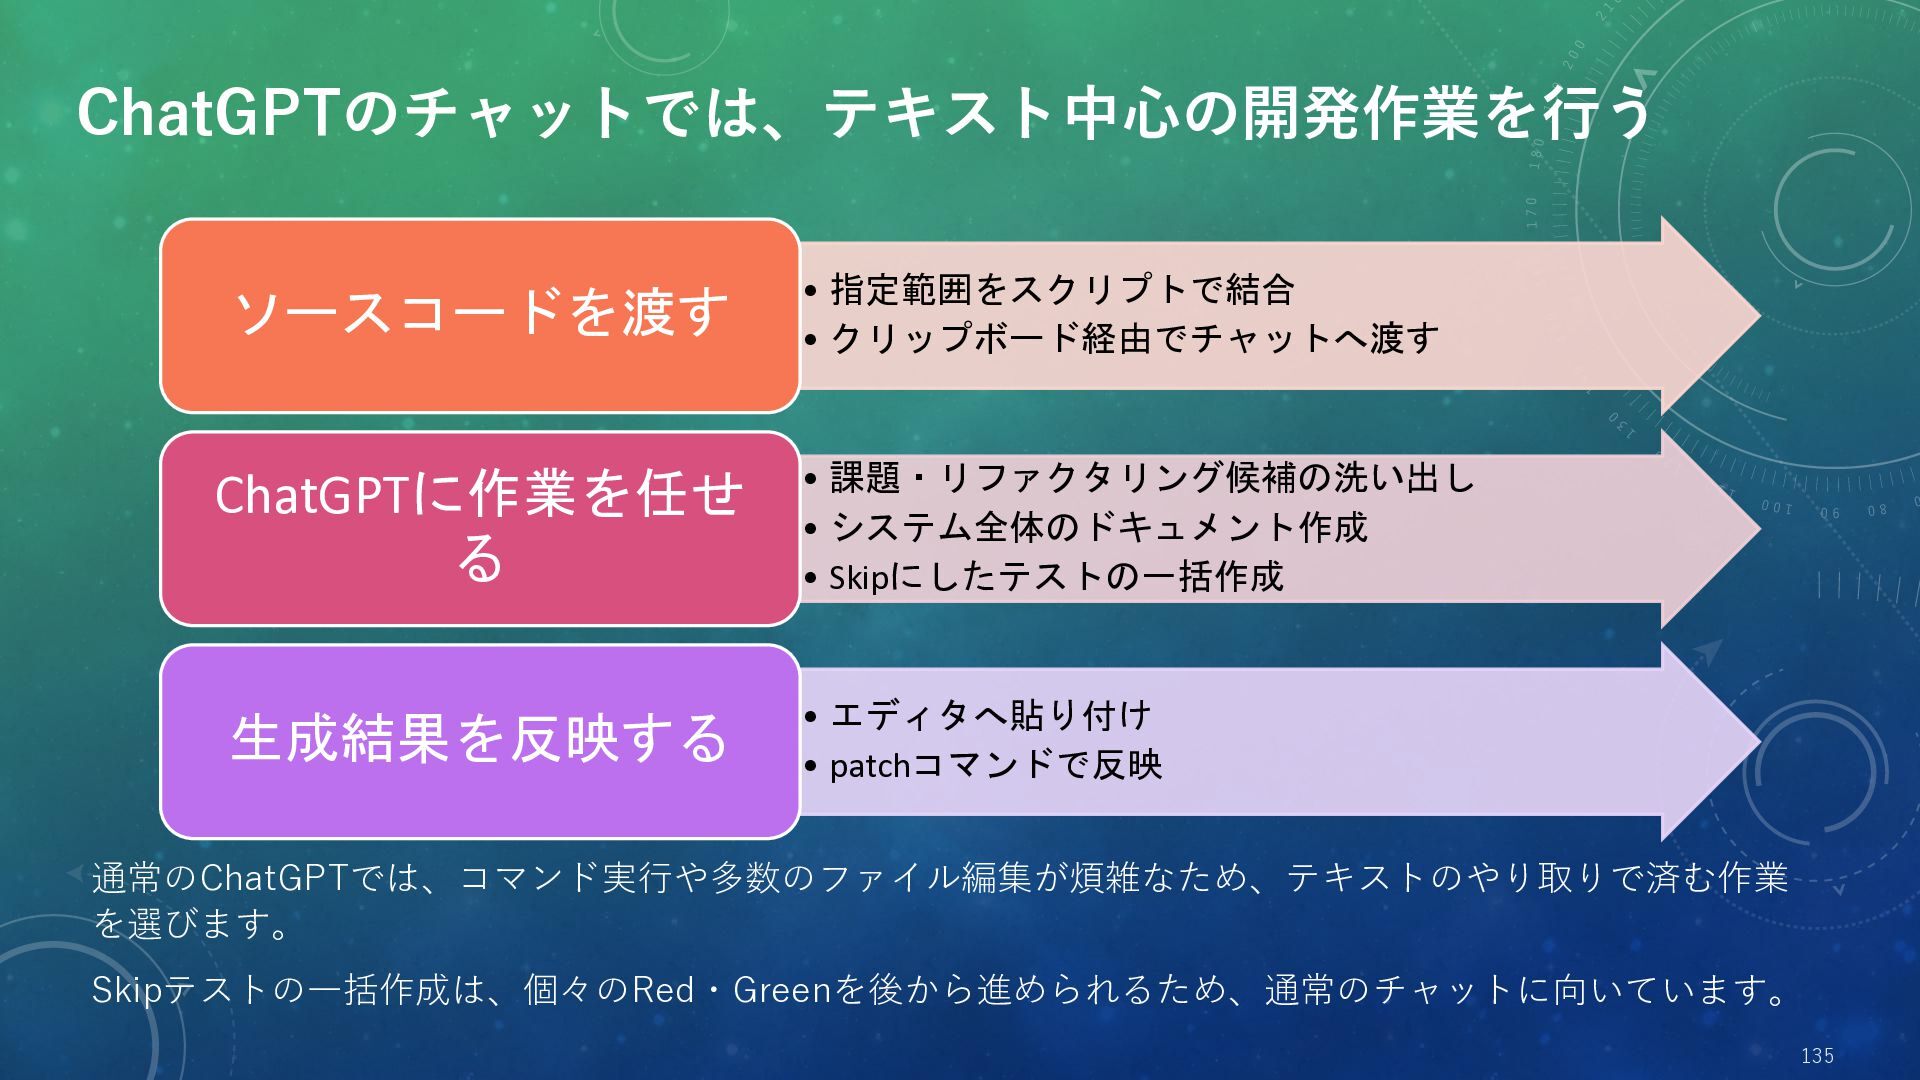
  43. ChatGPTのチャットでは、テキスト中心の開発作業を行う ソースコードを渡す • 指定範囲をスクリプトで結合 • クリップボード経由でチャットへ渡す ChatGPTに作業を任せ る • 課題・リファクタリング候補の洗い出し

    • システム全体のドキュメント作成 • Skipにしたテストの一括作成 生成結果を反映する • エディタへ貼り付け • patchコマンドで反映 通常のChatGPTでは、コマンド実行や多数のファイル編集が煩雑なため、テキストのやり取りで済む作業 を選びます。 Skipテストの一括作成は、個々のRed・Greenを後から進められるため、通常のチャットに向いています。 135
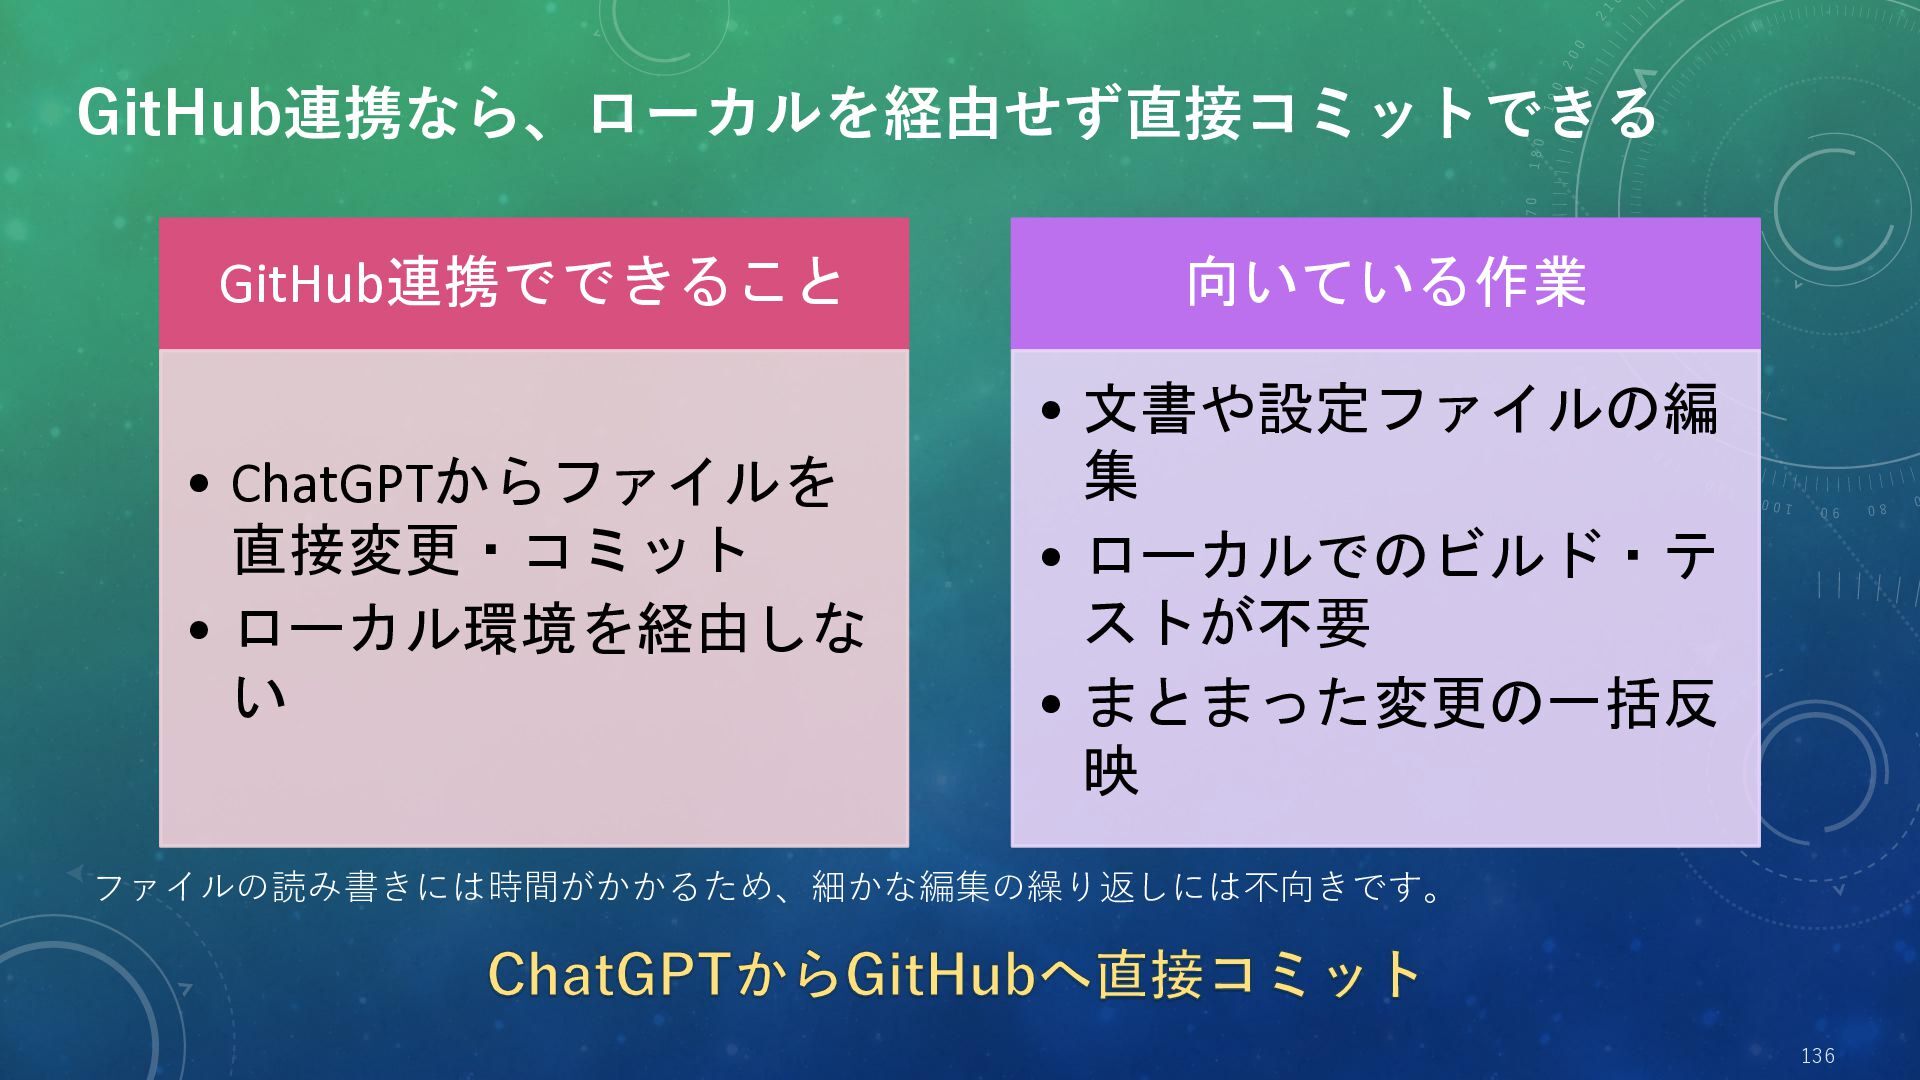
  44. GitHub連携なら、ローカルを経由せず直接コミットできる GitHub連携でできること 向いている作業 • ChatGPTからファイルを 直接変更・コミット • ローカル環境を経由しな い •

    文書や設定ファイルの編 集 • ローカルでのビルド・テ ストが不要 • まとまった変更の一括反 映 ファイルの読み書きには時間がかかるため、細かな編集の繰り返しには不向きです。 ChatGPTからGitHubへ直接コミット 136
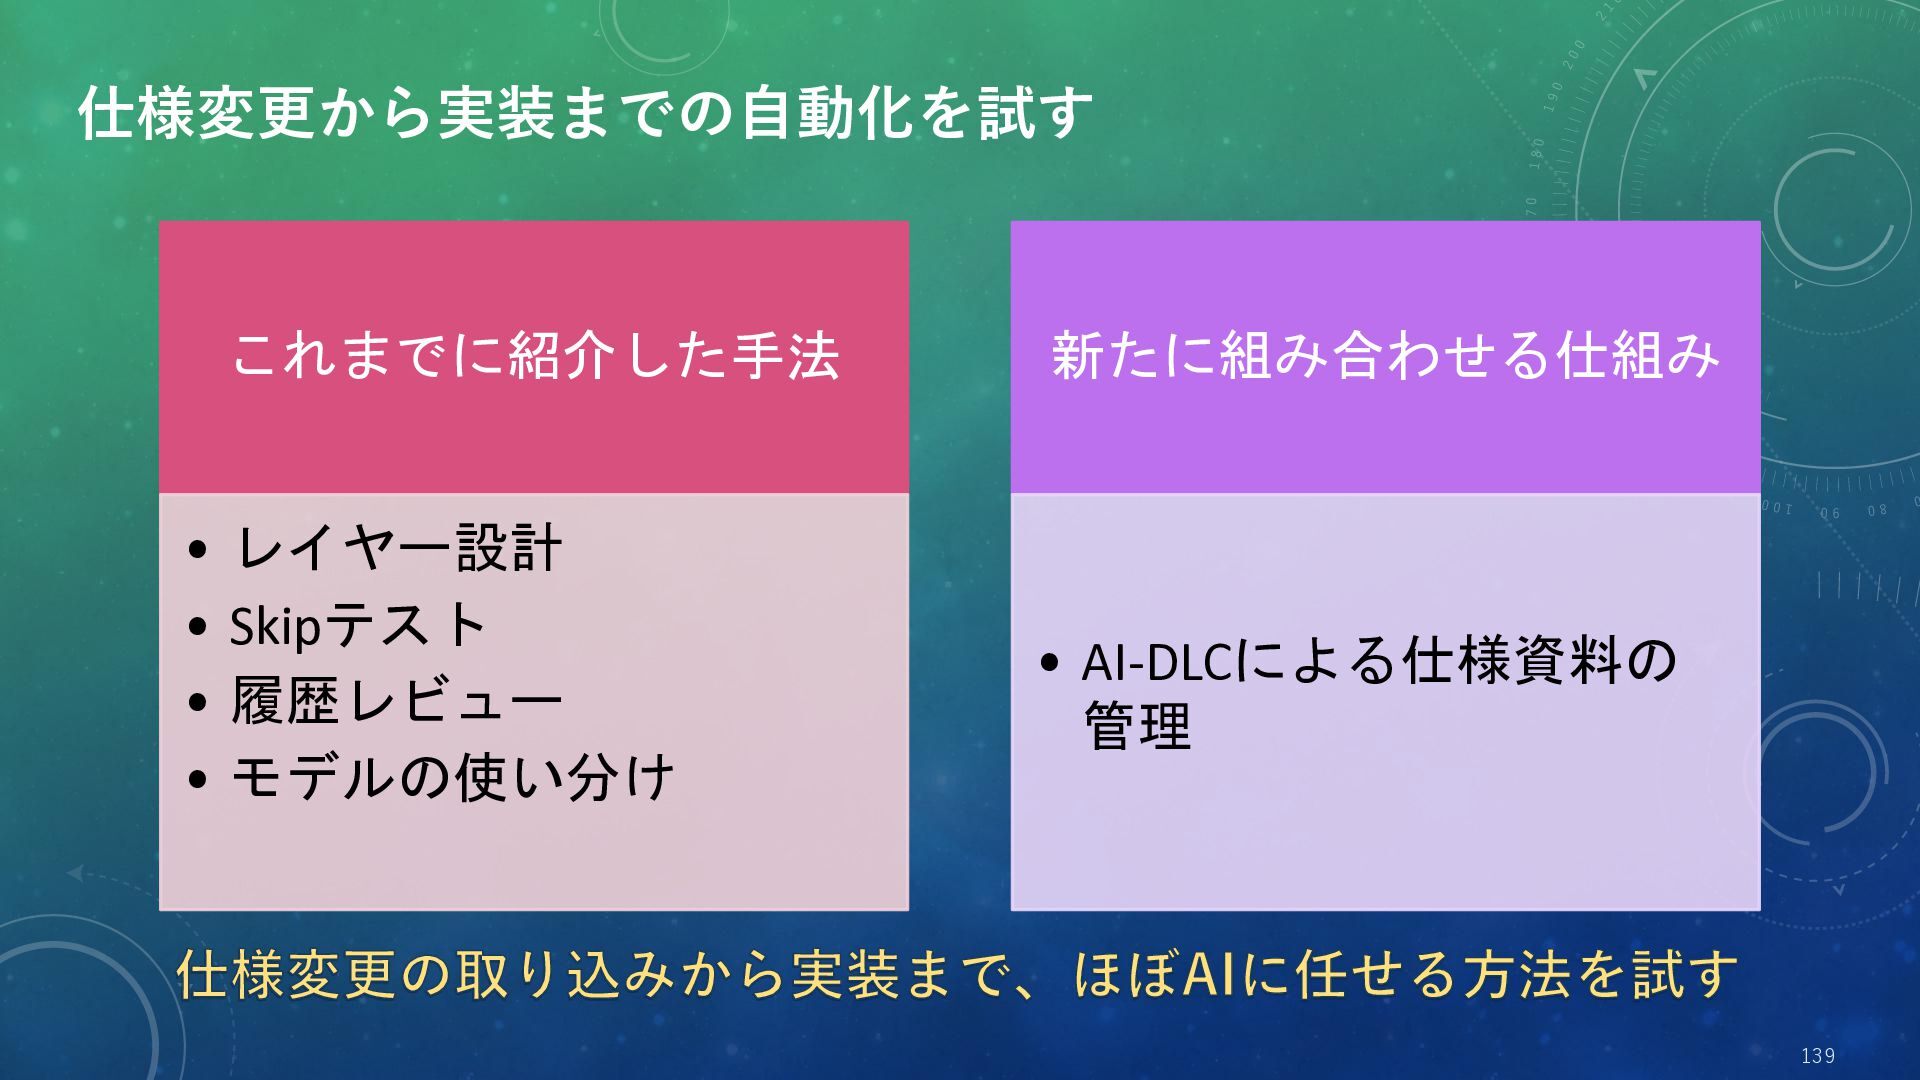
  45. 仕様変更から実装までの自動化を試す これまでに紹介した手法 • レイヤー設計 • Skipテスト • 履歴レビュー • モデルの使い分け

    新たに組み合わせる仕組み • AI-DLCによる仕様資料の 管理 仕様変更の取り込みから実装まで、ほぼAIに任せる方法を試す 139
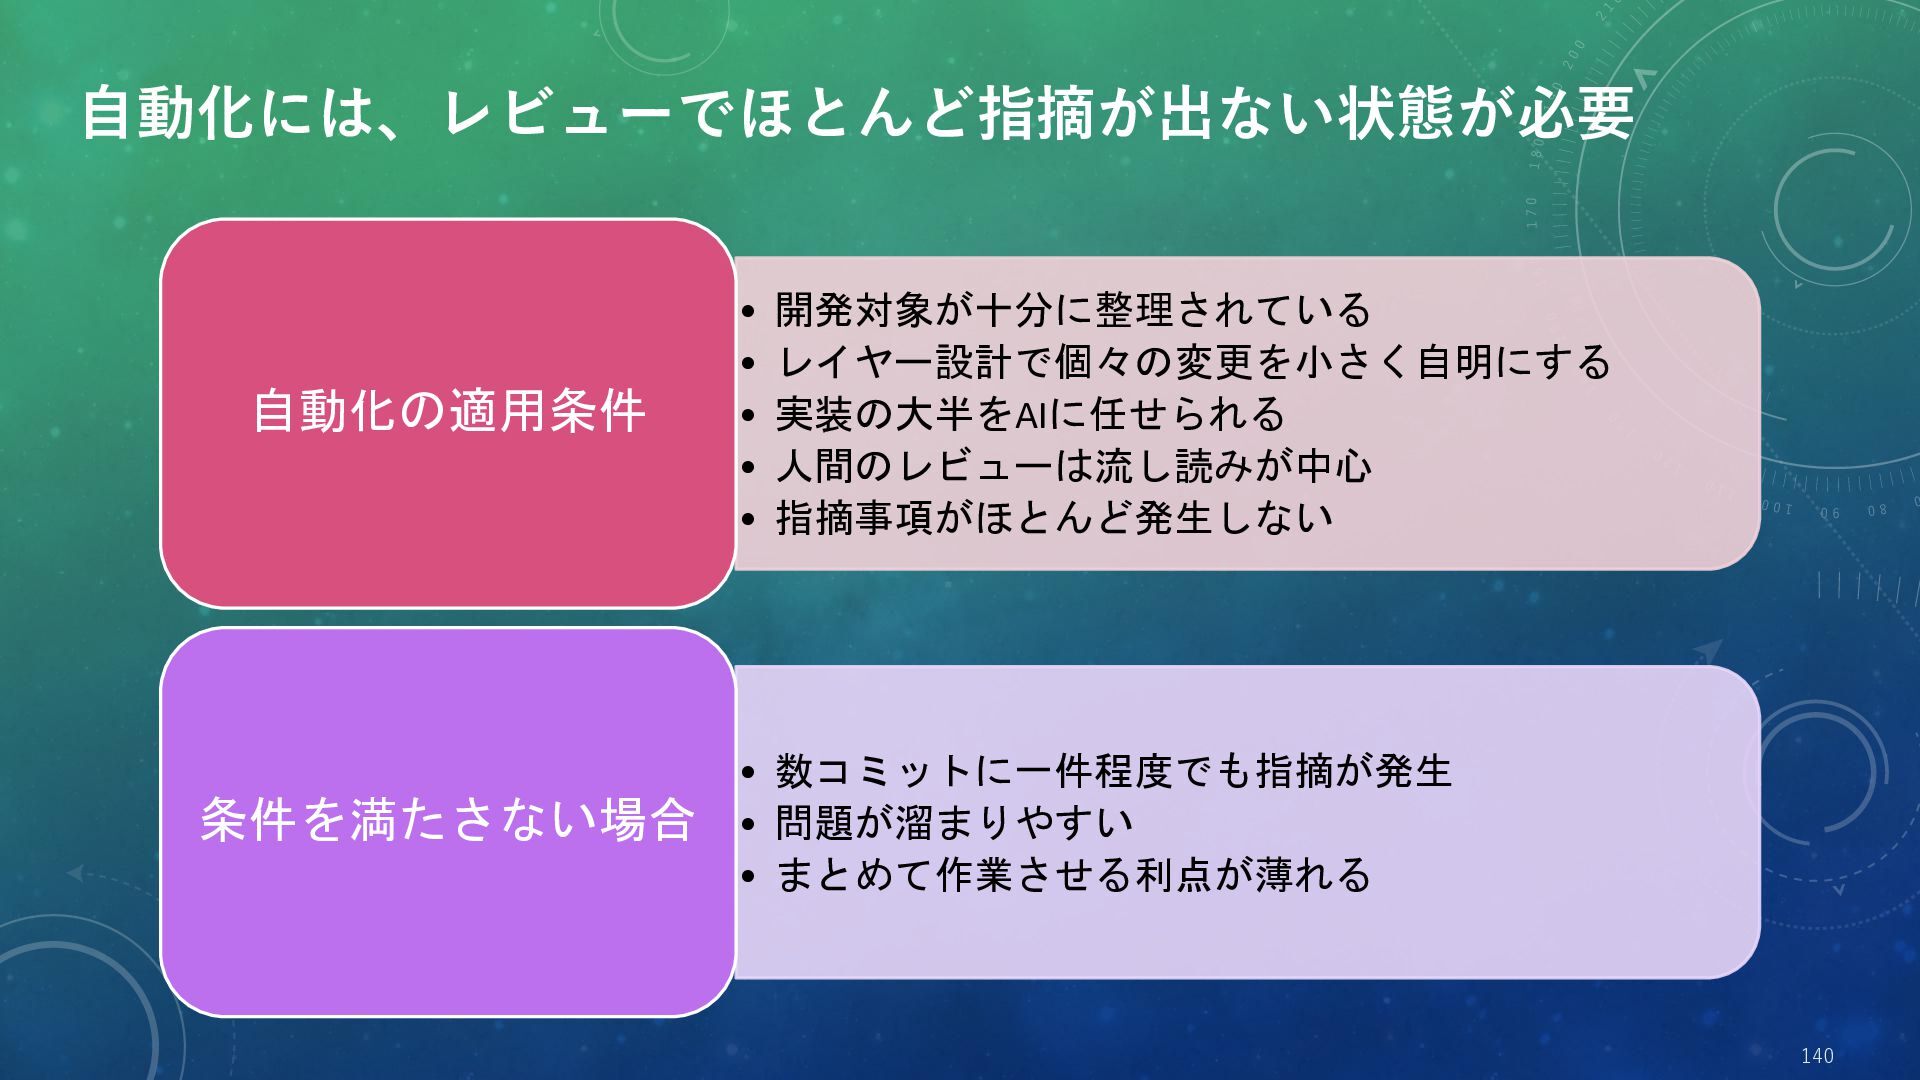
  46. 自動化には、レビューでほとんど指摘が出ない状態が必要 自動化の適用条件 条件を満たさない場合 • 開発対象が十分に整理されている • レイヤー設計で個々の変更を小さく自明にする • 実装の大半をAIに任せられる •

    人間のレビューは流し読みが中心 • 指摘事項がほとんど発生しない • 数コミットに一件程度でも指摘が発生 • 問題が溜まりやすい • まとめて作業させる利点が薄れる 140
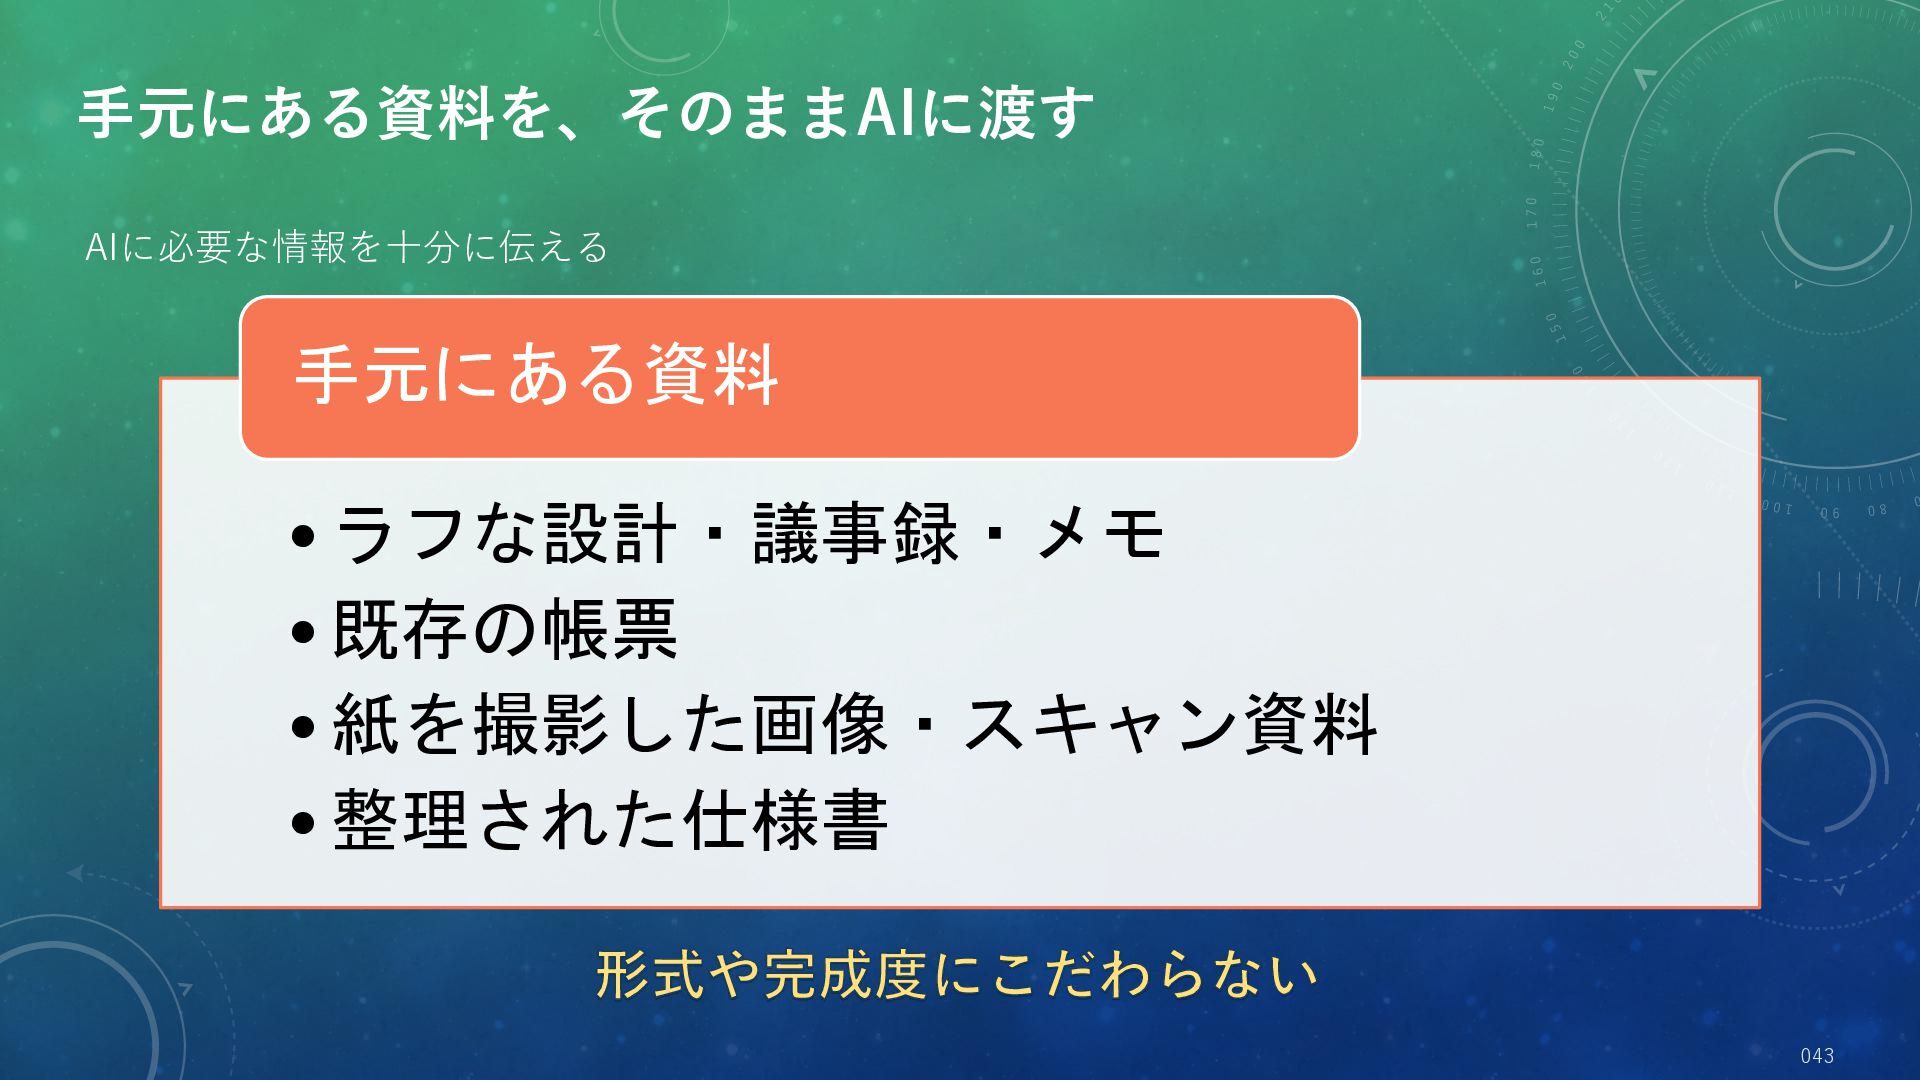
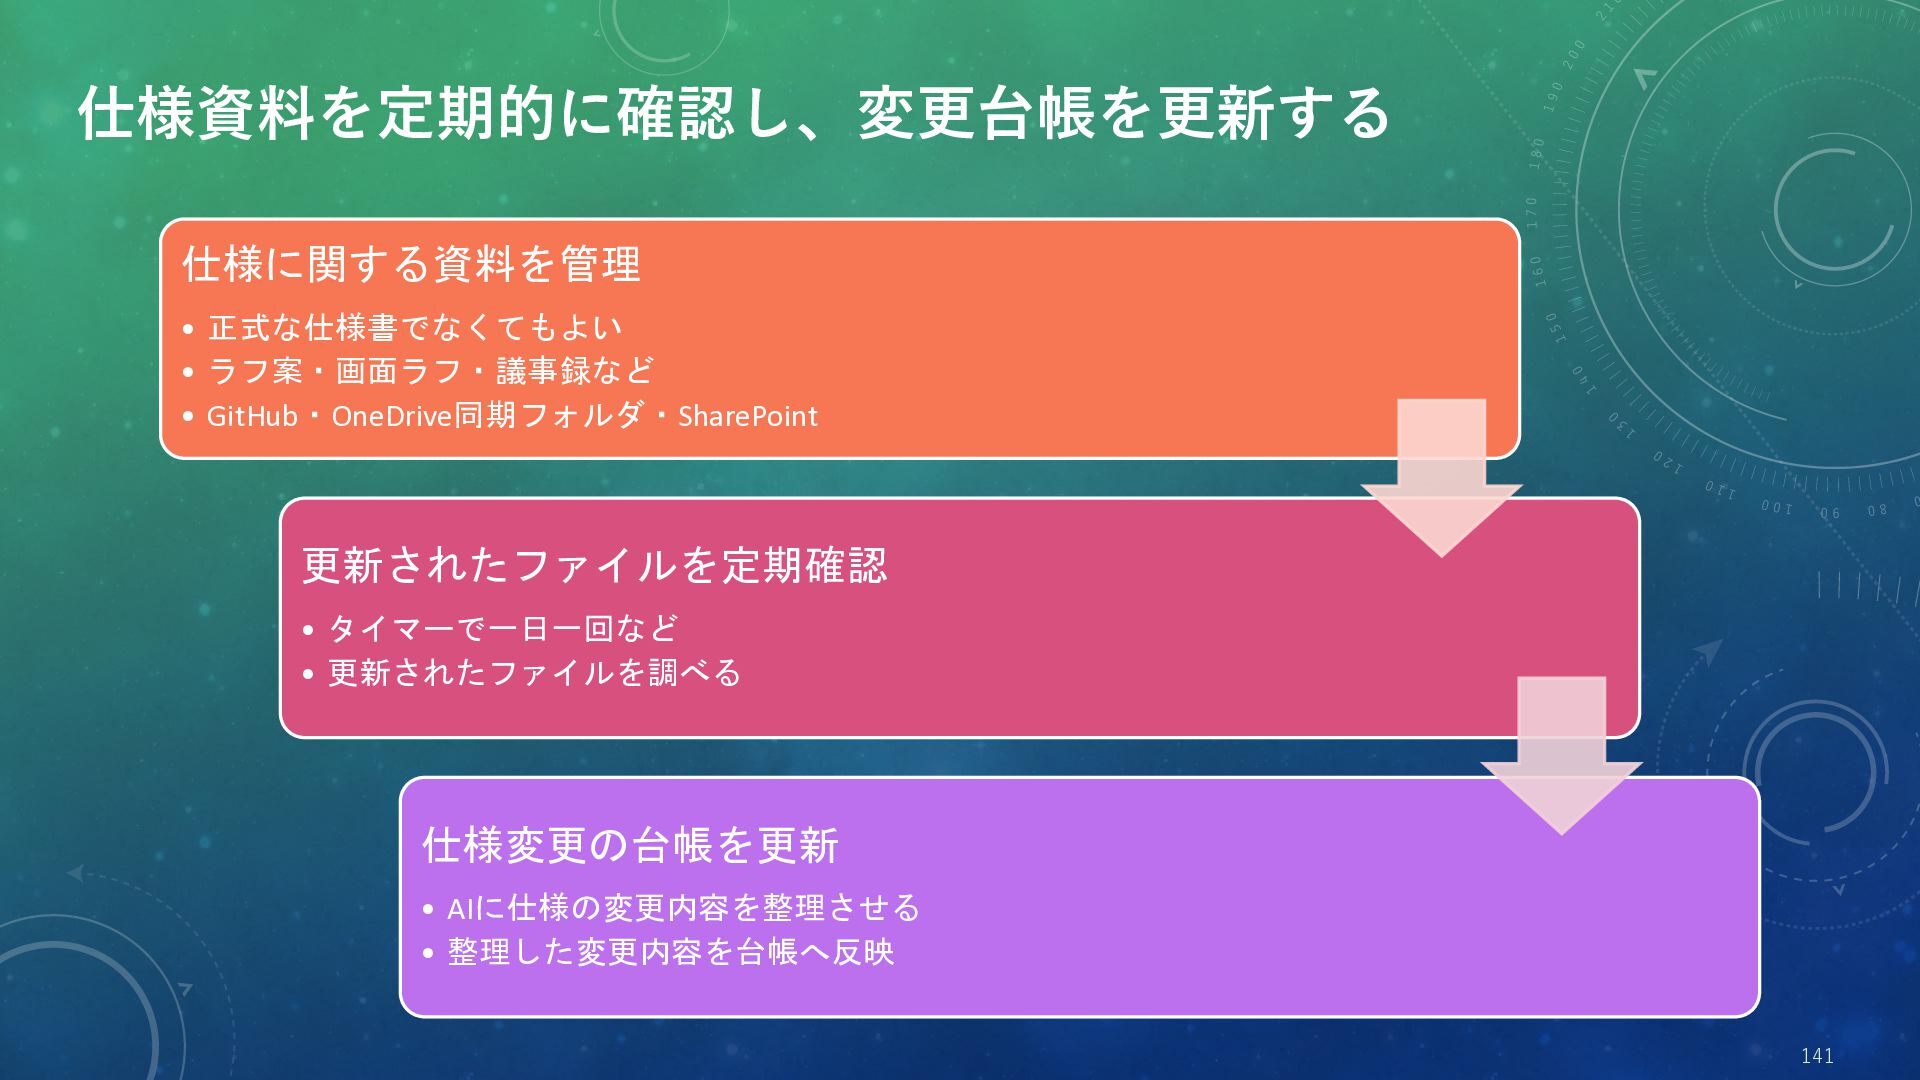
  47. 仕様資料を定期的に確認し、変更台帳を更新する 仕様に関する資料を管理 • 正式な仕様書でなくてもよい • ラフ案・画面ラフ・議事録など • GitHub・OneDrive同期フォルダ・SharePoint 更新されたファイルを定期確認 •

    タイマーで一日一回など • 更新されたファイルを調べる 仕様変更の台帳を更新 • AIに仕様の変更内容を整理させる • 整理した変更内容を台帳へ反映 141
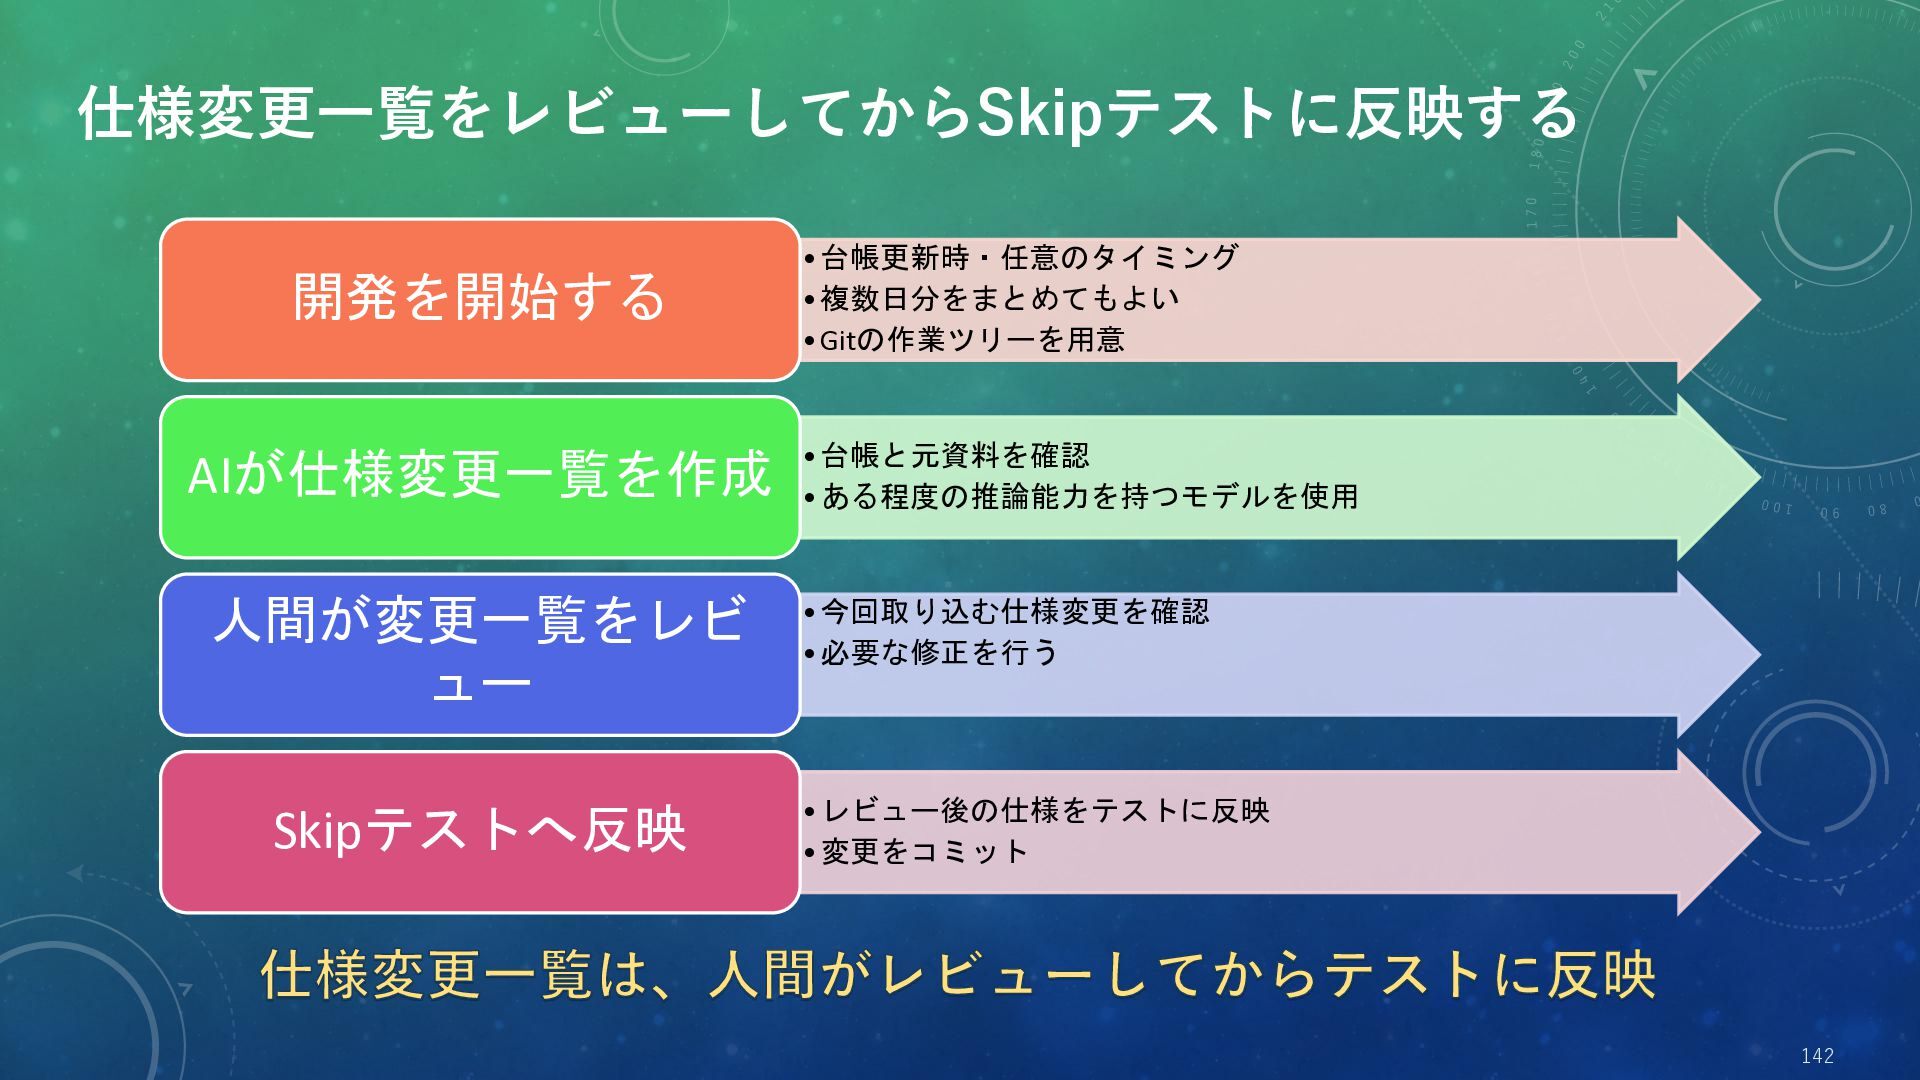
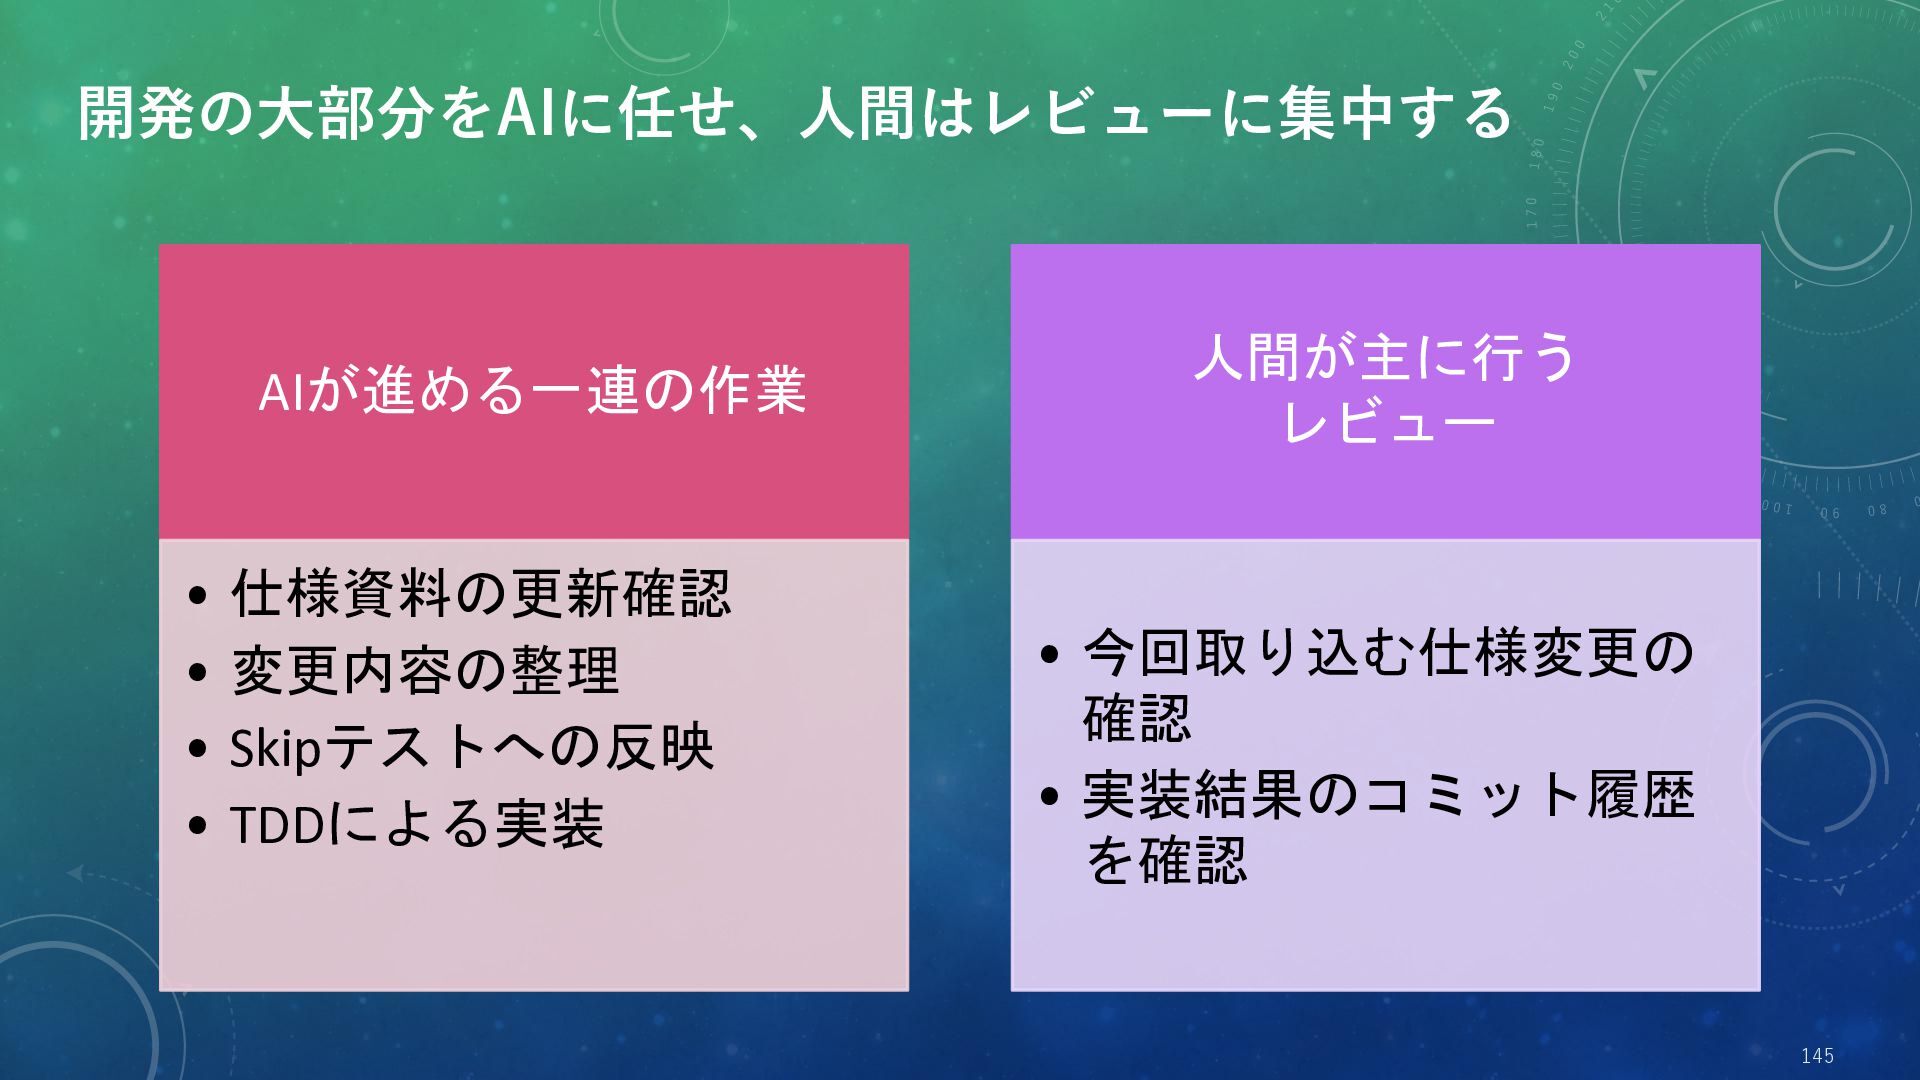
  48. 仕様変更一覧をレビューしてからSkipテストに反映する 開発を開始する • 台帳更新時・任意のタイミング • 複数日分をまとめてもよい • Gitの作業ツリーを用意 • 台帳と元資料を確認

    AIが仕様変更一覧を作成 • ある程度の推論能力を持つモデルを使用 人間が変更一覧をレビ ュー Skipテストへ反映 • 今回取り込む仕様変更を確認 • 必要な修正を行う • レビュー後の仕様をテストに反映 • 変更をコミット 仕様変更一覧は、人間がレビューしてからテストに反映 142
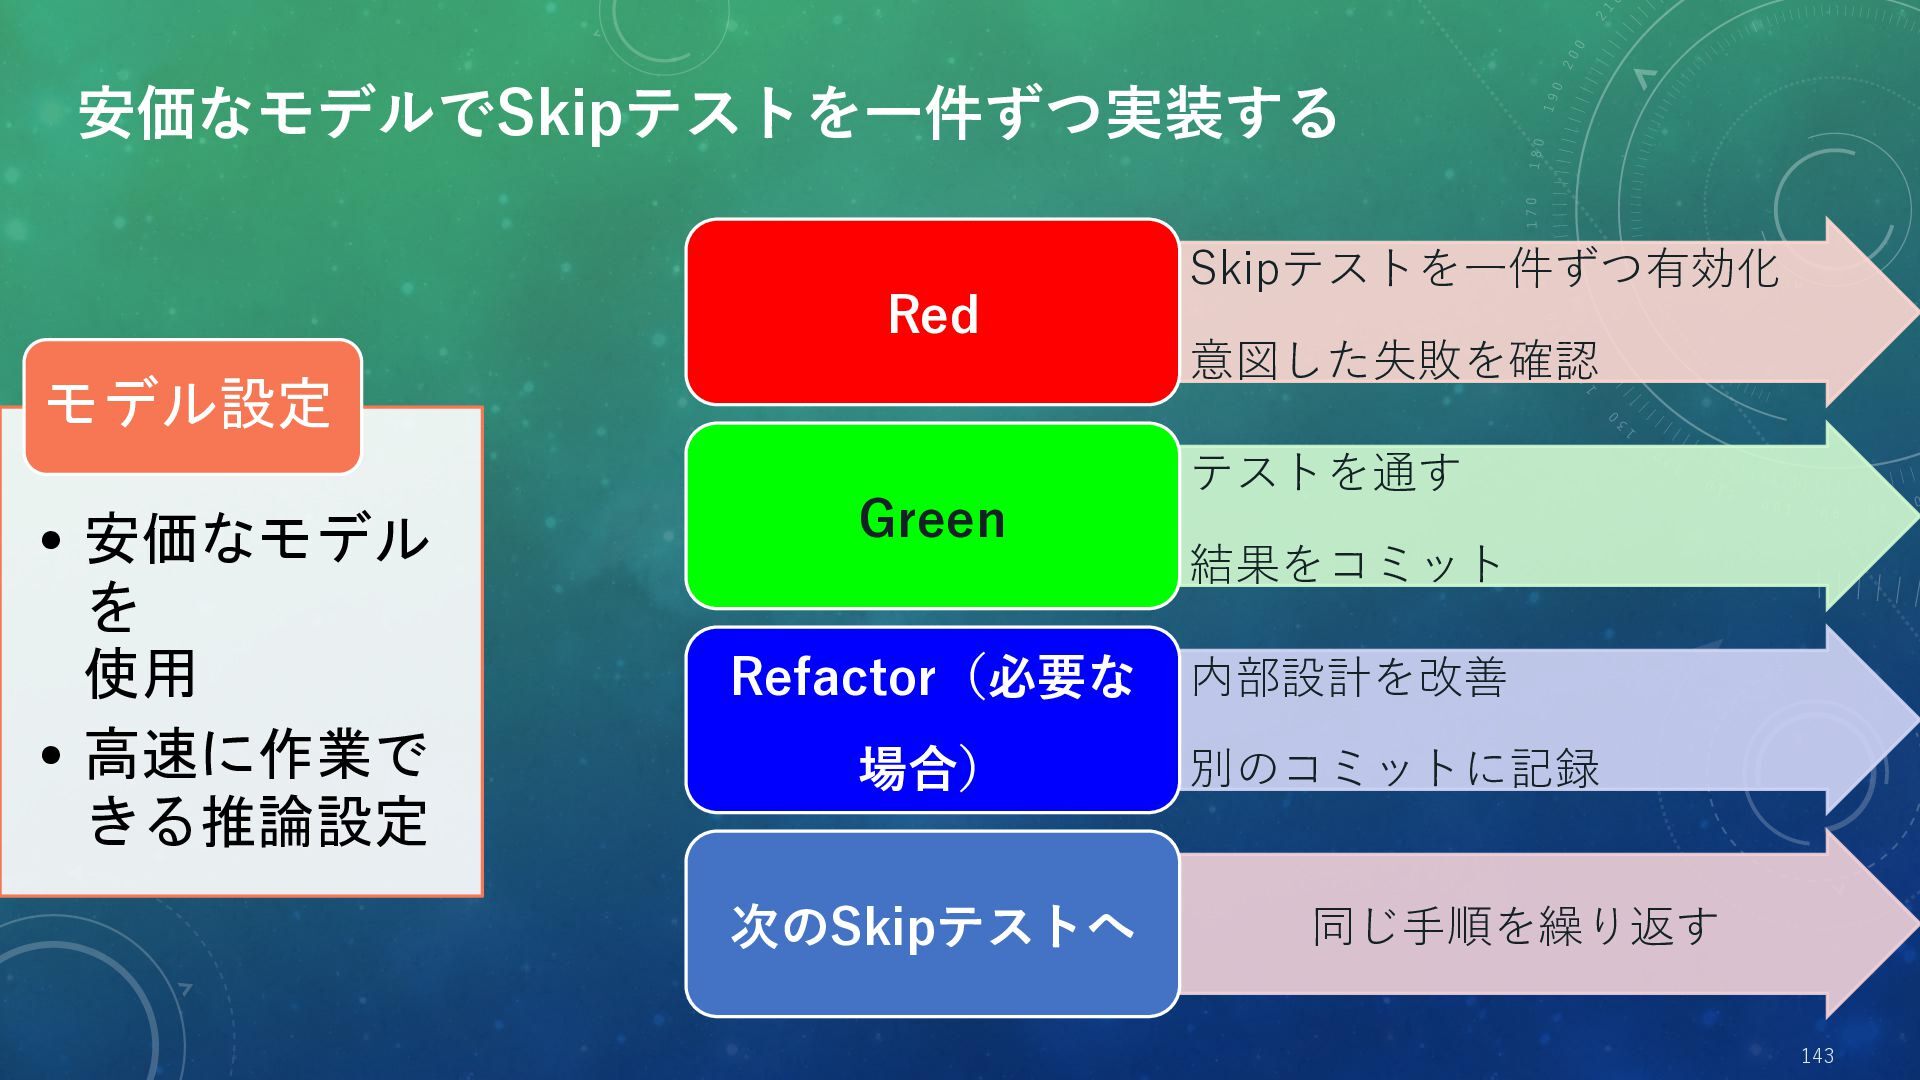
  49. 安価なモデルでSkipテストを一件ずつ実装する Red モデル設定 • 安価なモデル を 使用 • 高速に作業で きる推論設定

    Green Refactor(必要な 場合) 次のSkipテストへ Skipテストを一件ずつ有効化 意図した失敗を確認 テストを通す 結果をコミット 内部設計を改善 別のコミットに記録 同じ手順を繰り返す 143
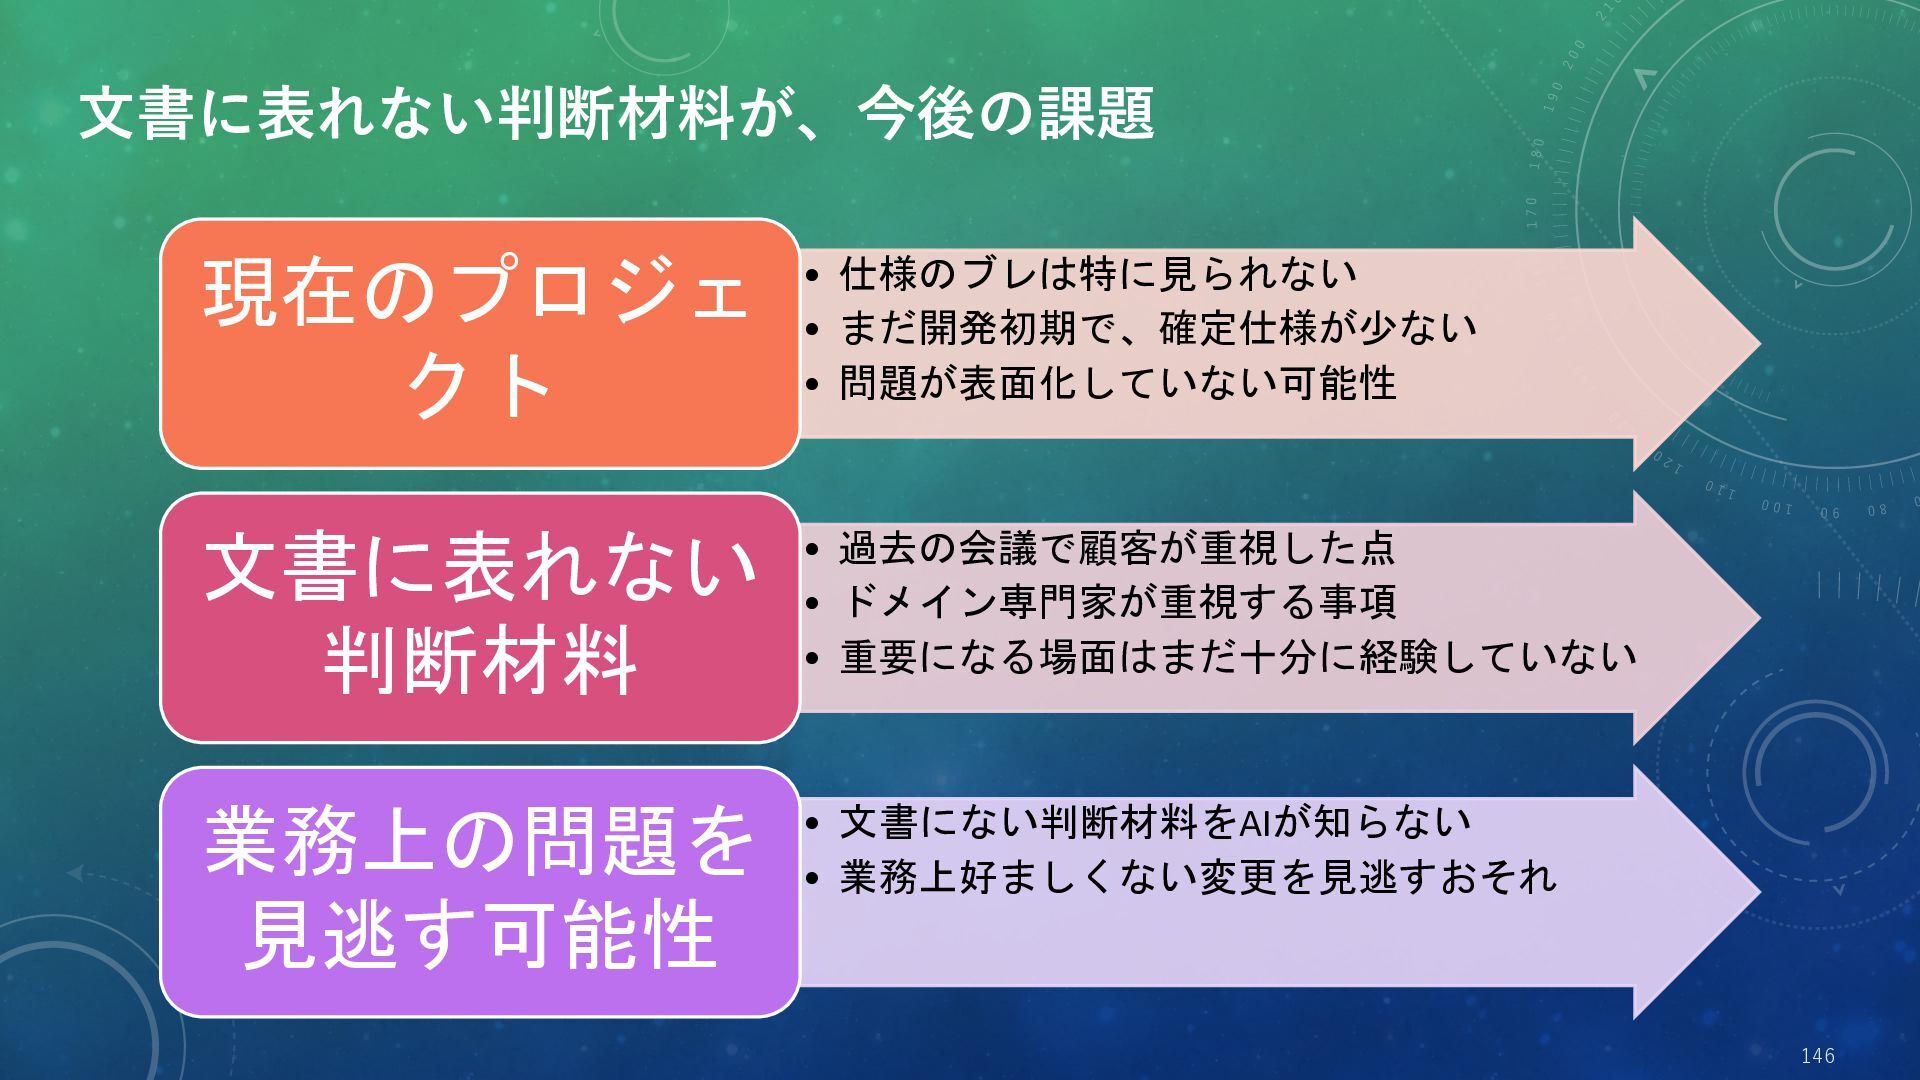
  50. 文書に表れない判断材料が、今後の課題 現在のプロジェ クト • 仕様のブレは特に見られない • まだ開発初期で、確定仕様が少ない • 問題が表面化していない可能性 文書に表れない

    判断材料 • 過去の会議で顧客が重視した点 • ドメイン専門家が重視する事項 • 重要になる場面はまだ十分に経験していない 業務上の問題を 見逃す可能性 • 文書にない判断材料をAIが知らない • 業務上好ましくない変更を見逃すおそれ 146
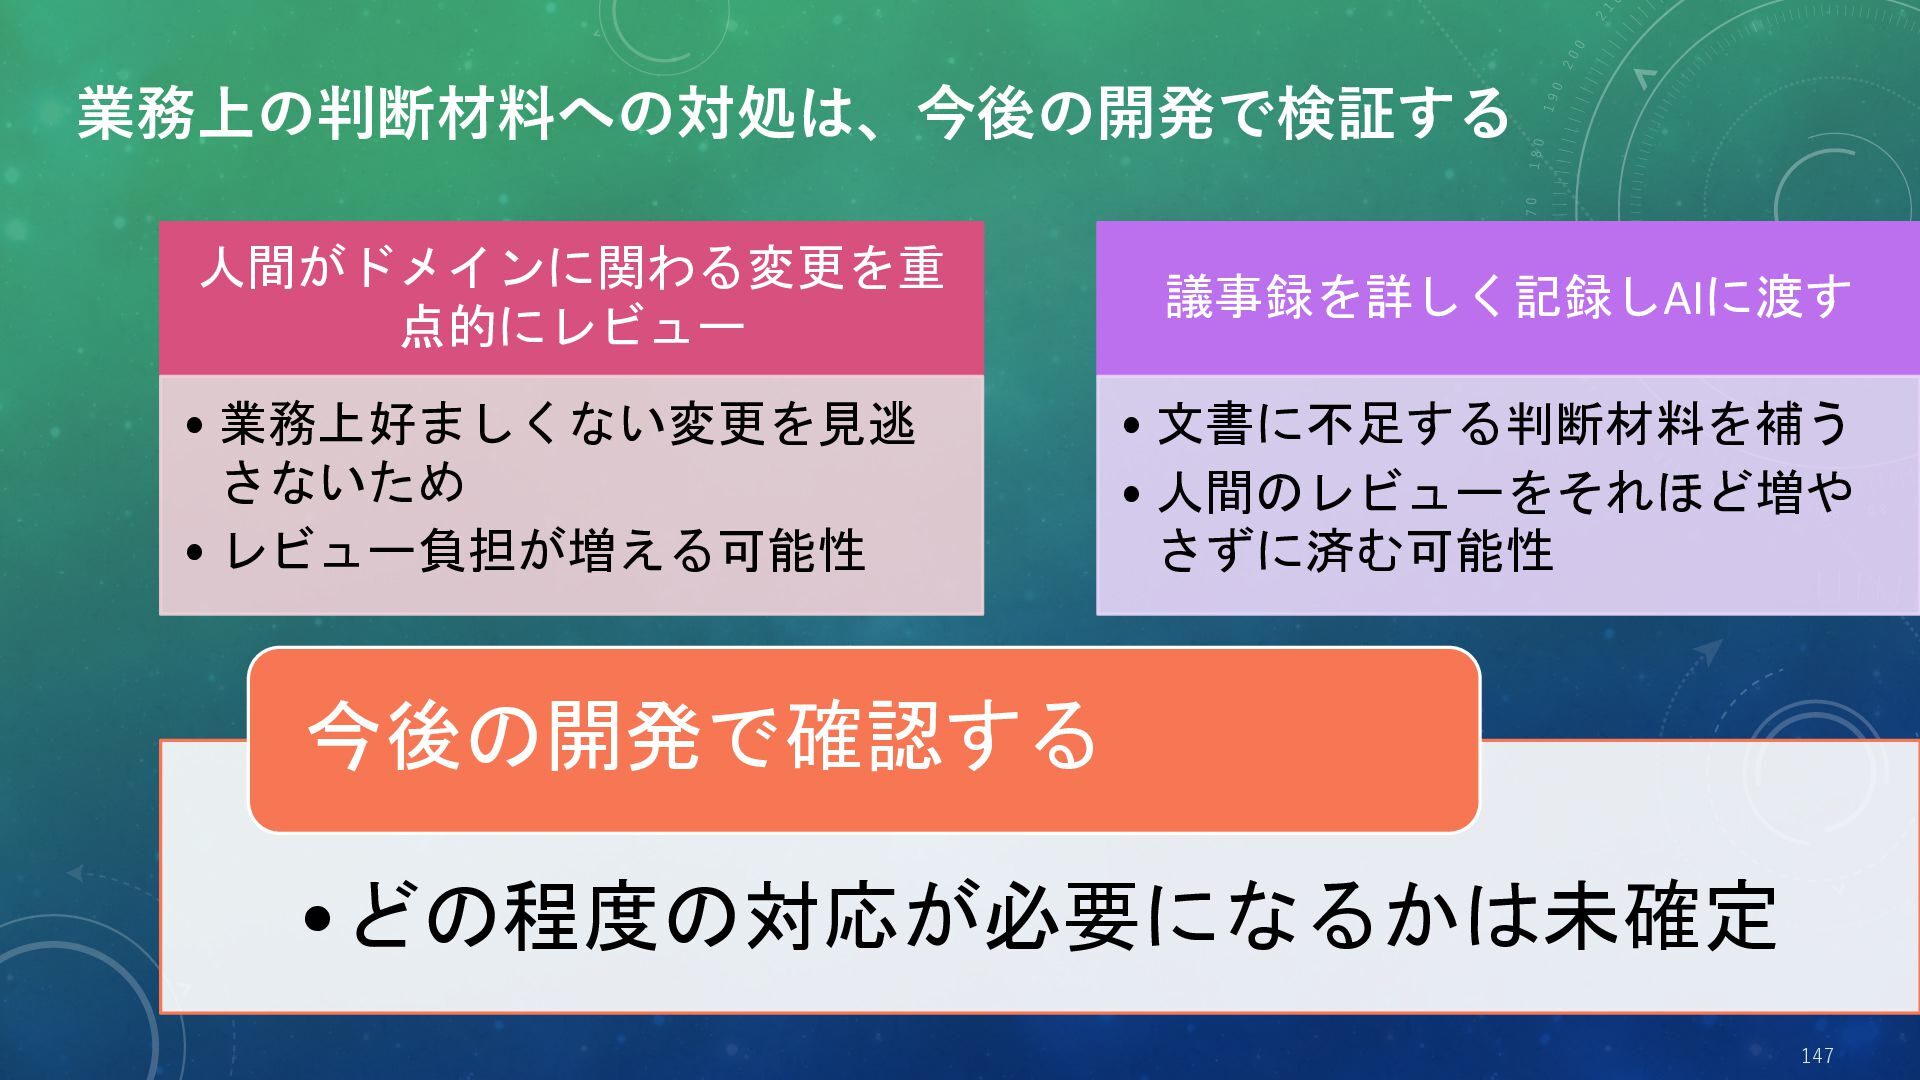
  51. 業務上の判断材料への対処は、今後の開発で検証する 人間がドメインに関わる変更を重 点的にレビュー 議事録を詳しく記録しAIに渡す • 業務上好ましくない変更を見逃 さないため • レビュー負担が増える可能性 •

    文書に不足する判断材料を補う • 人間のレビューをそれほど増や さずに済む可能性 今後の開発で確認する •どの程度の対応が必要になるかは未確定 147
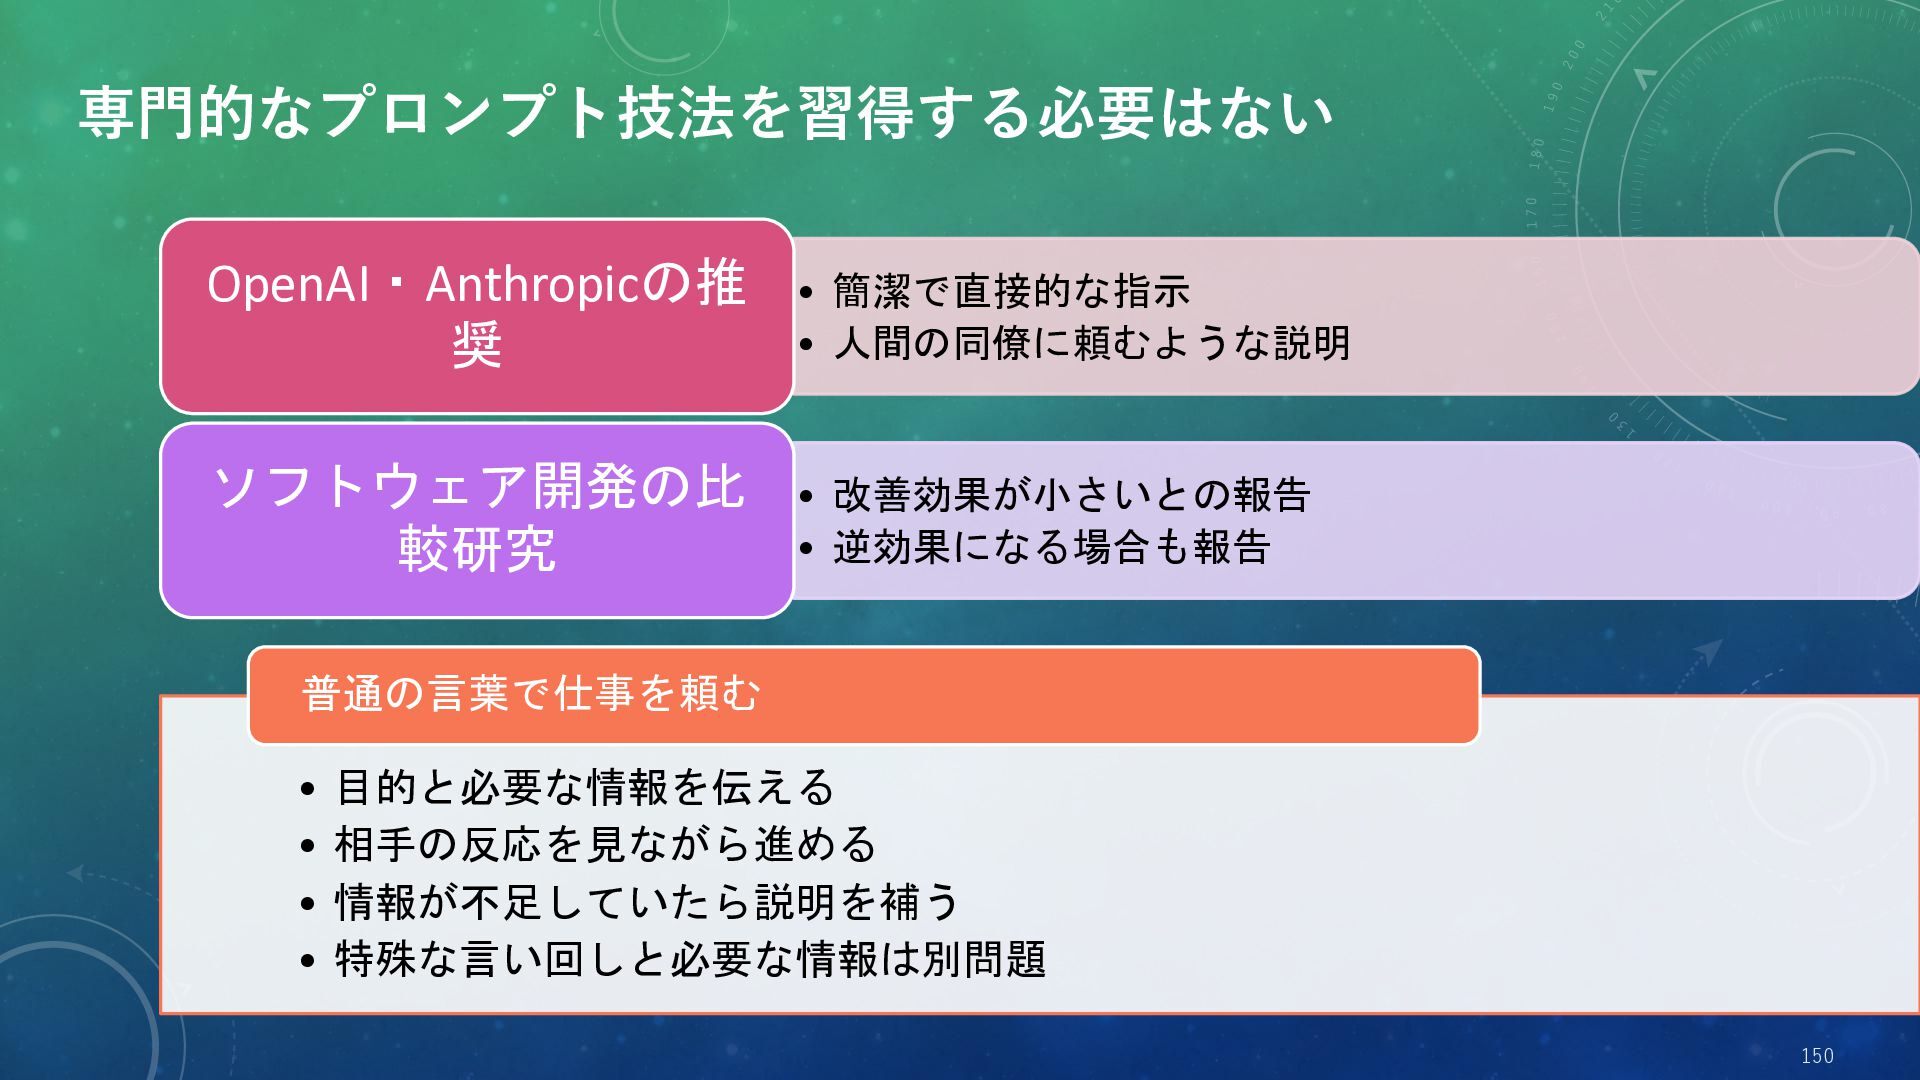
  52. 専門的なプロンプト技法を習得する必要はない OpenAI・Anthropicの推 奨 • 簡潔で直接的な指示 • 人間の同僚に頼むような説明 ソフトウェア開発の比 較研究 •

    改善効果が小さいとの報告 • 逆効果になる場合も報告 普通の言葉で仕事を頼む • 目的と必要な情報を伝える • 相手の反応を見ながら進める • 情報が不足していたら説明を補う • 特殊な言い回しと必要な情報は別問題 150
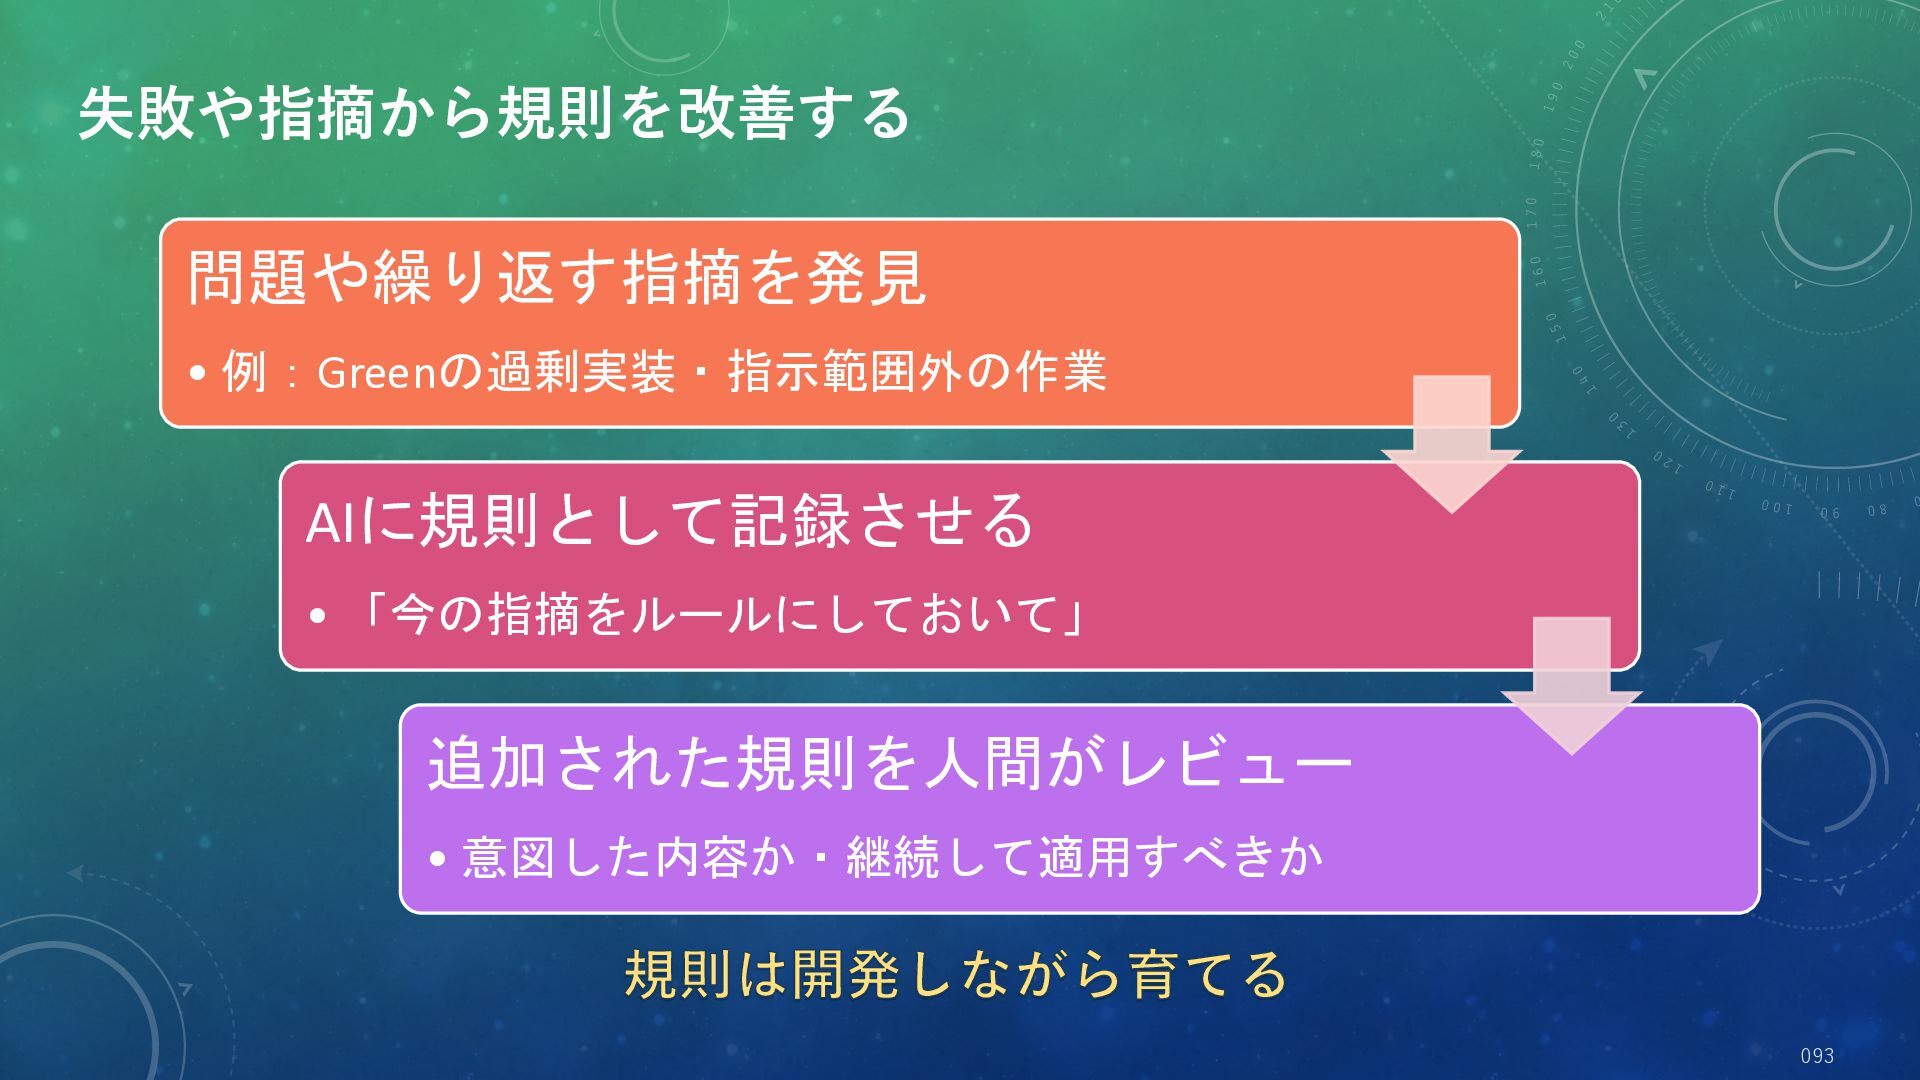
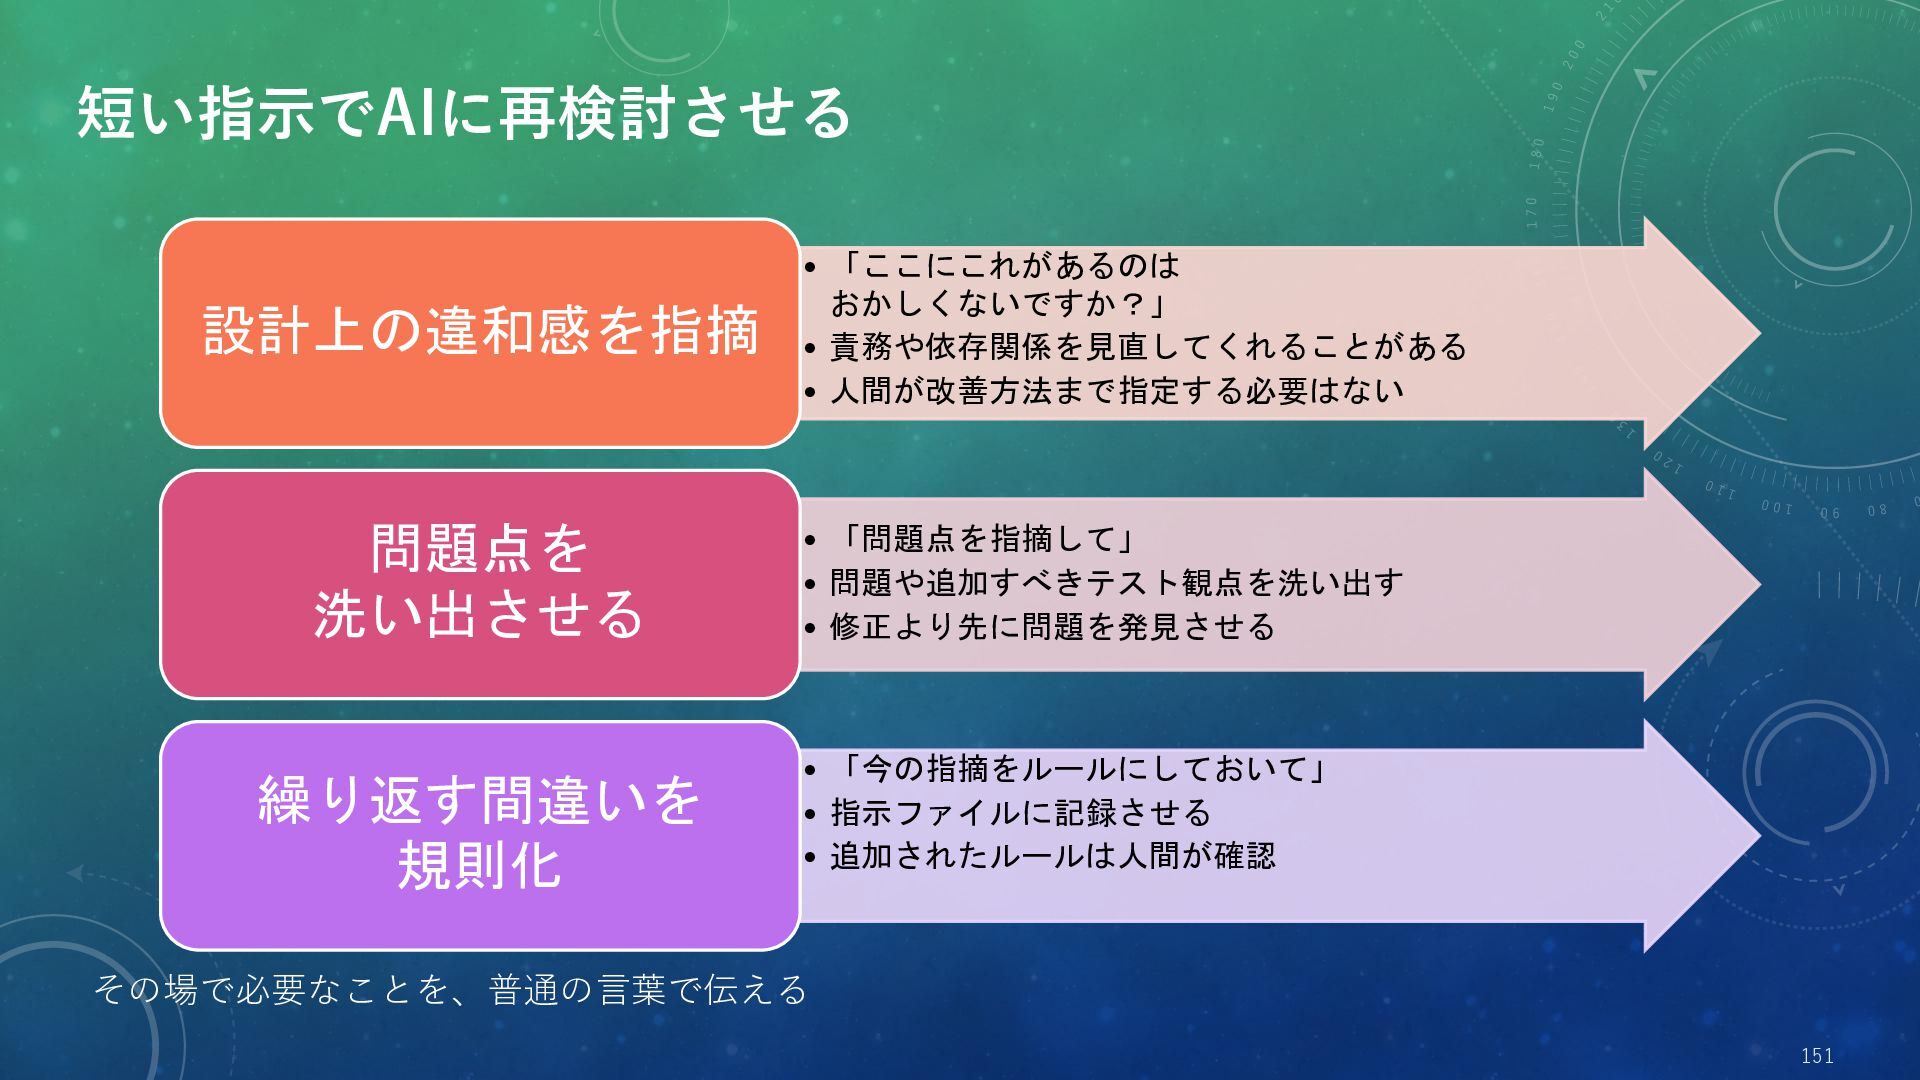
  53. 短い指示でAIに再検討させる 設計上の違和感を指摘 問題点を 洗い出させる 繰り返す間違いを 規則化 • 「ここにこれがあるのは おかしくないですか?」 •

    責務や依存関係を見直してくれることがある • 人間が改善方法まで指定する必要はない • 「問題点を指摘して」 • 問題や追加すべきテスト観点を洗い出す • 修正より先に問題を発見させる • 「今の指摘をルールにしておいて」 • 指示ファイルに記録させる • 追加されたルールは人間が確認 その場で必要なことを、普通の言葉で伝える 151
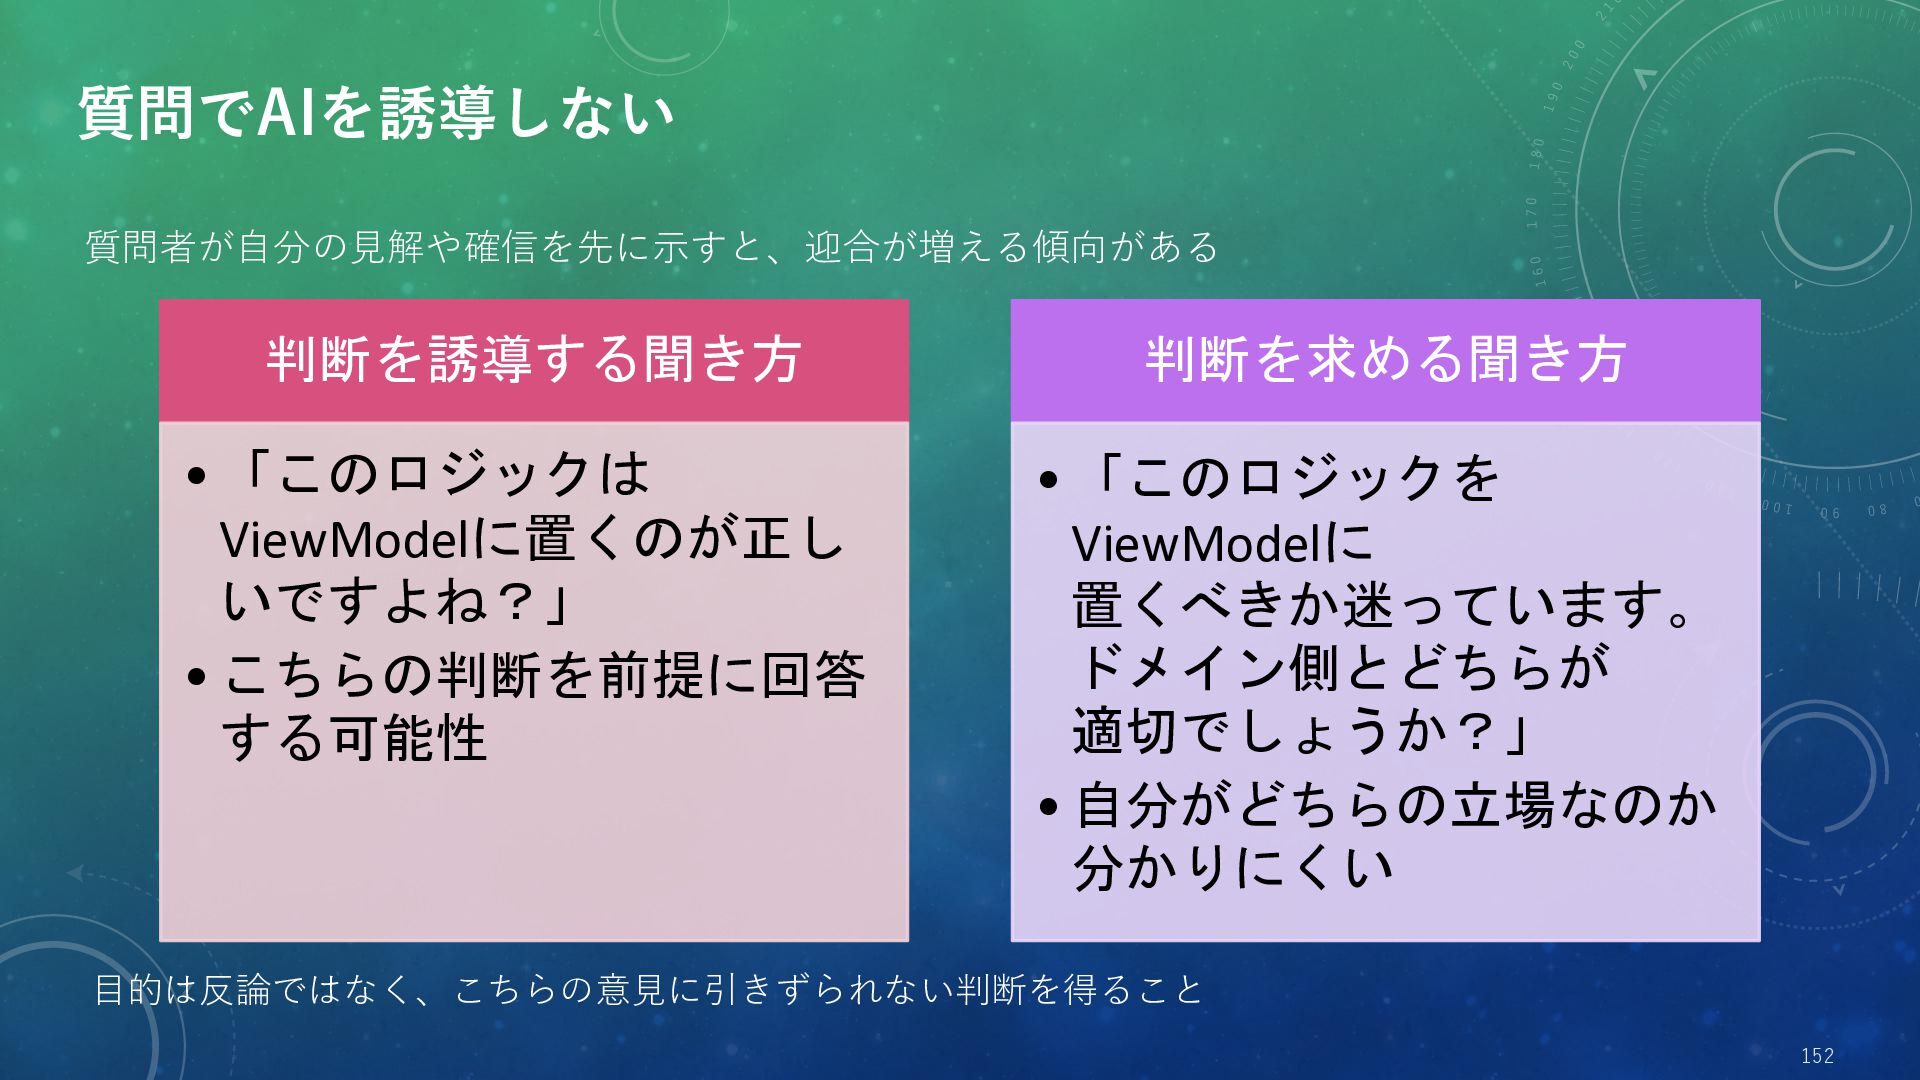
  54. 質問でAIを誘導しない 質問者が自分の見解や確信を先に示すと、迎合が増える傾向がある 判断を誘導する聞き方 判断を求める聞き方 • 「このロジックは ViewModelに置くのが正し いですよね?」 • こちらの判断を前提に回答

    する可能性 • 「このロジックを ViewModelに 置くべきか迷っています。 ドメイン側とどちらが 適切でしょうか?」 • 自分がどちらの立場なのか 分かりにくい 目的は反論ではなく、こちらの意見に引きずられない判断を得ること 152
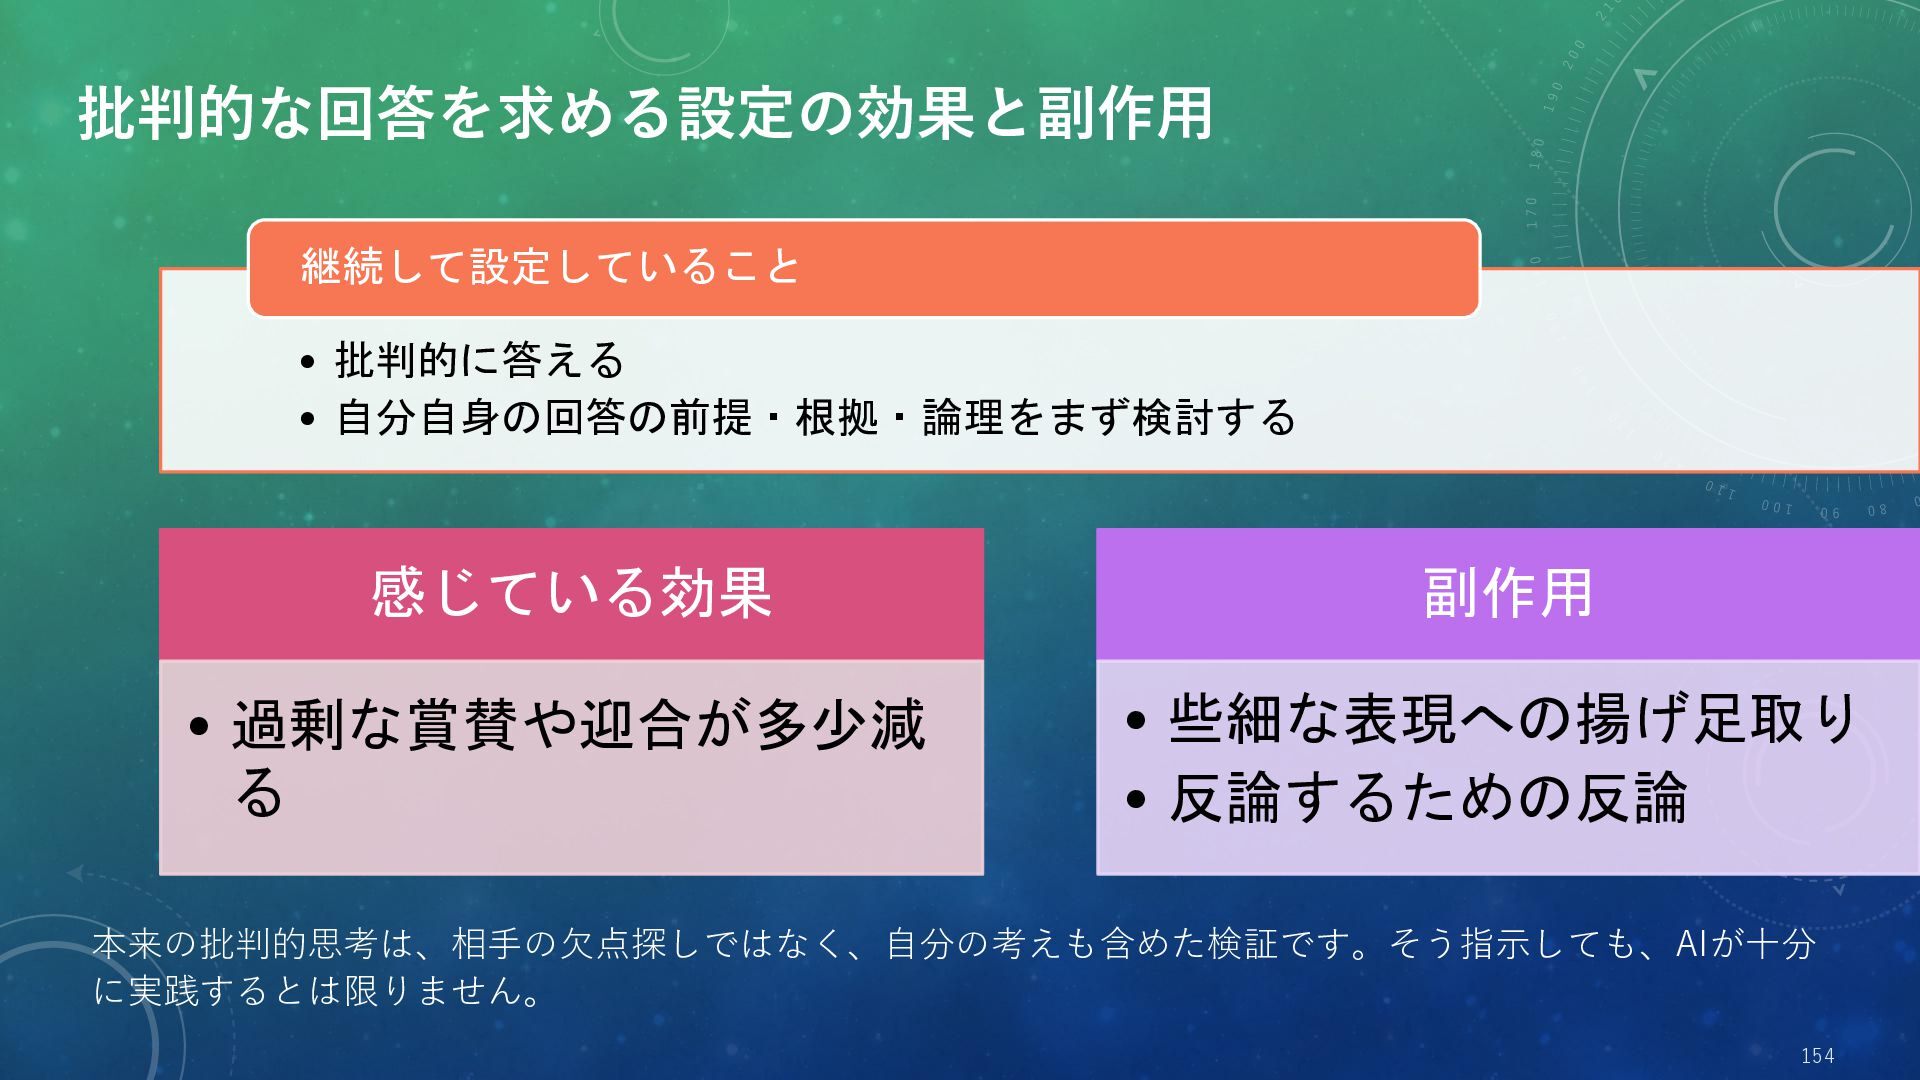
  55. 批判的な回答を求める設定の効果と副作用 継続して設定していること • 批判的に答える • 自分自身の回答の前提・根拠・論理をまず検討する 感じている効果 副作用 • 過剰な賞賛や迎合が多少減

    る • 些細な表現への揚げ足取り • 反論するための反論 本来の批判的思考は、相手の欠点探しではなく、自分の考えも含めた検証です。そう指示しても、AIが十分 に実践するとは限りません。 154
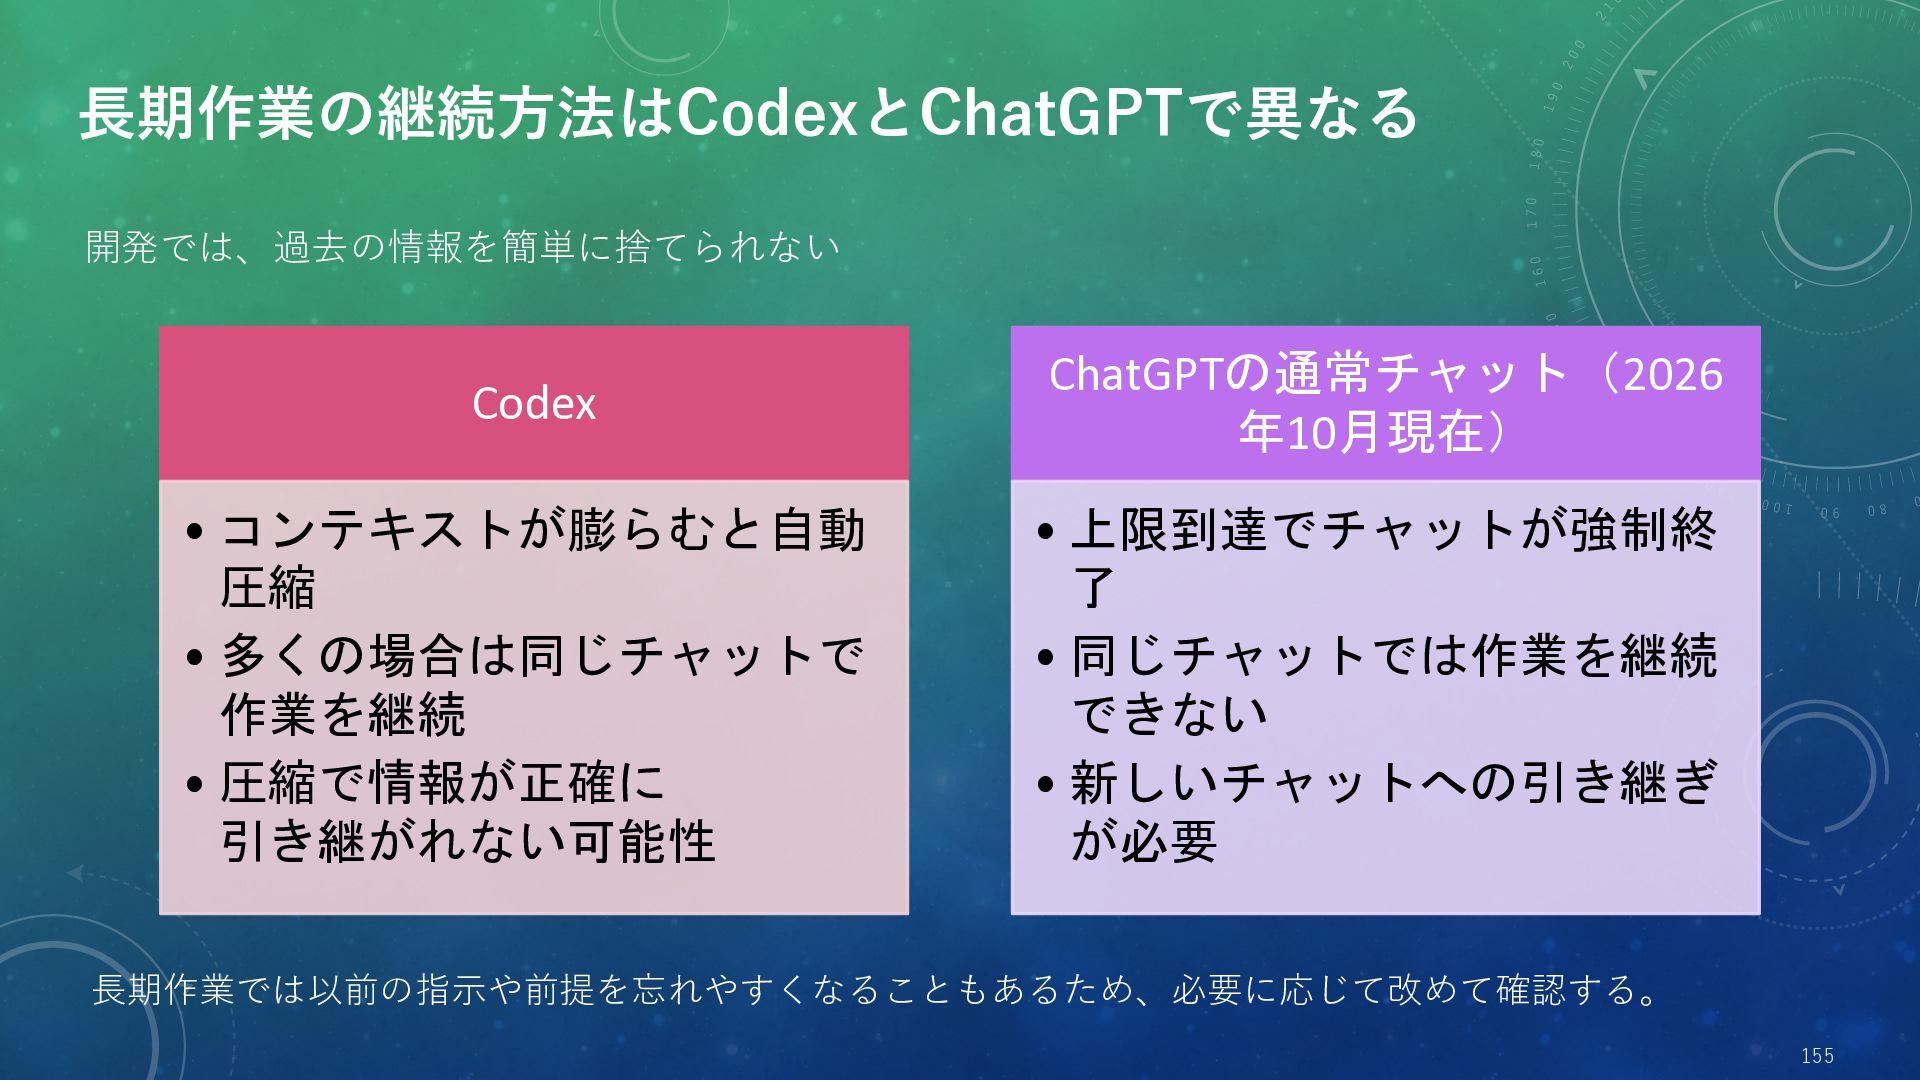
  56. 長期作業の継続方法はCodexとChatGPTで異なる 開発では、過去の情報を簡単に捨てられない Codex ChatGPTの通常チャット(2026 年10月現在) • コンテキストが膨らむと自動 圧縮 • 多くの場合は同じチャットで

    作業を継続 • 圧縮で情報が正確に 引き継がれない可能性 • 上限到達でチャットが強制終 了 • 同じチャットでは作業を継続 できない • 新しいチャットへの引き継ぎ が必要 長期作業では以前の指示や前提を忘れやすくなることもあるため、必要に応じて改めて確認する。 155
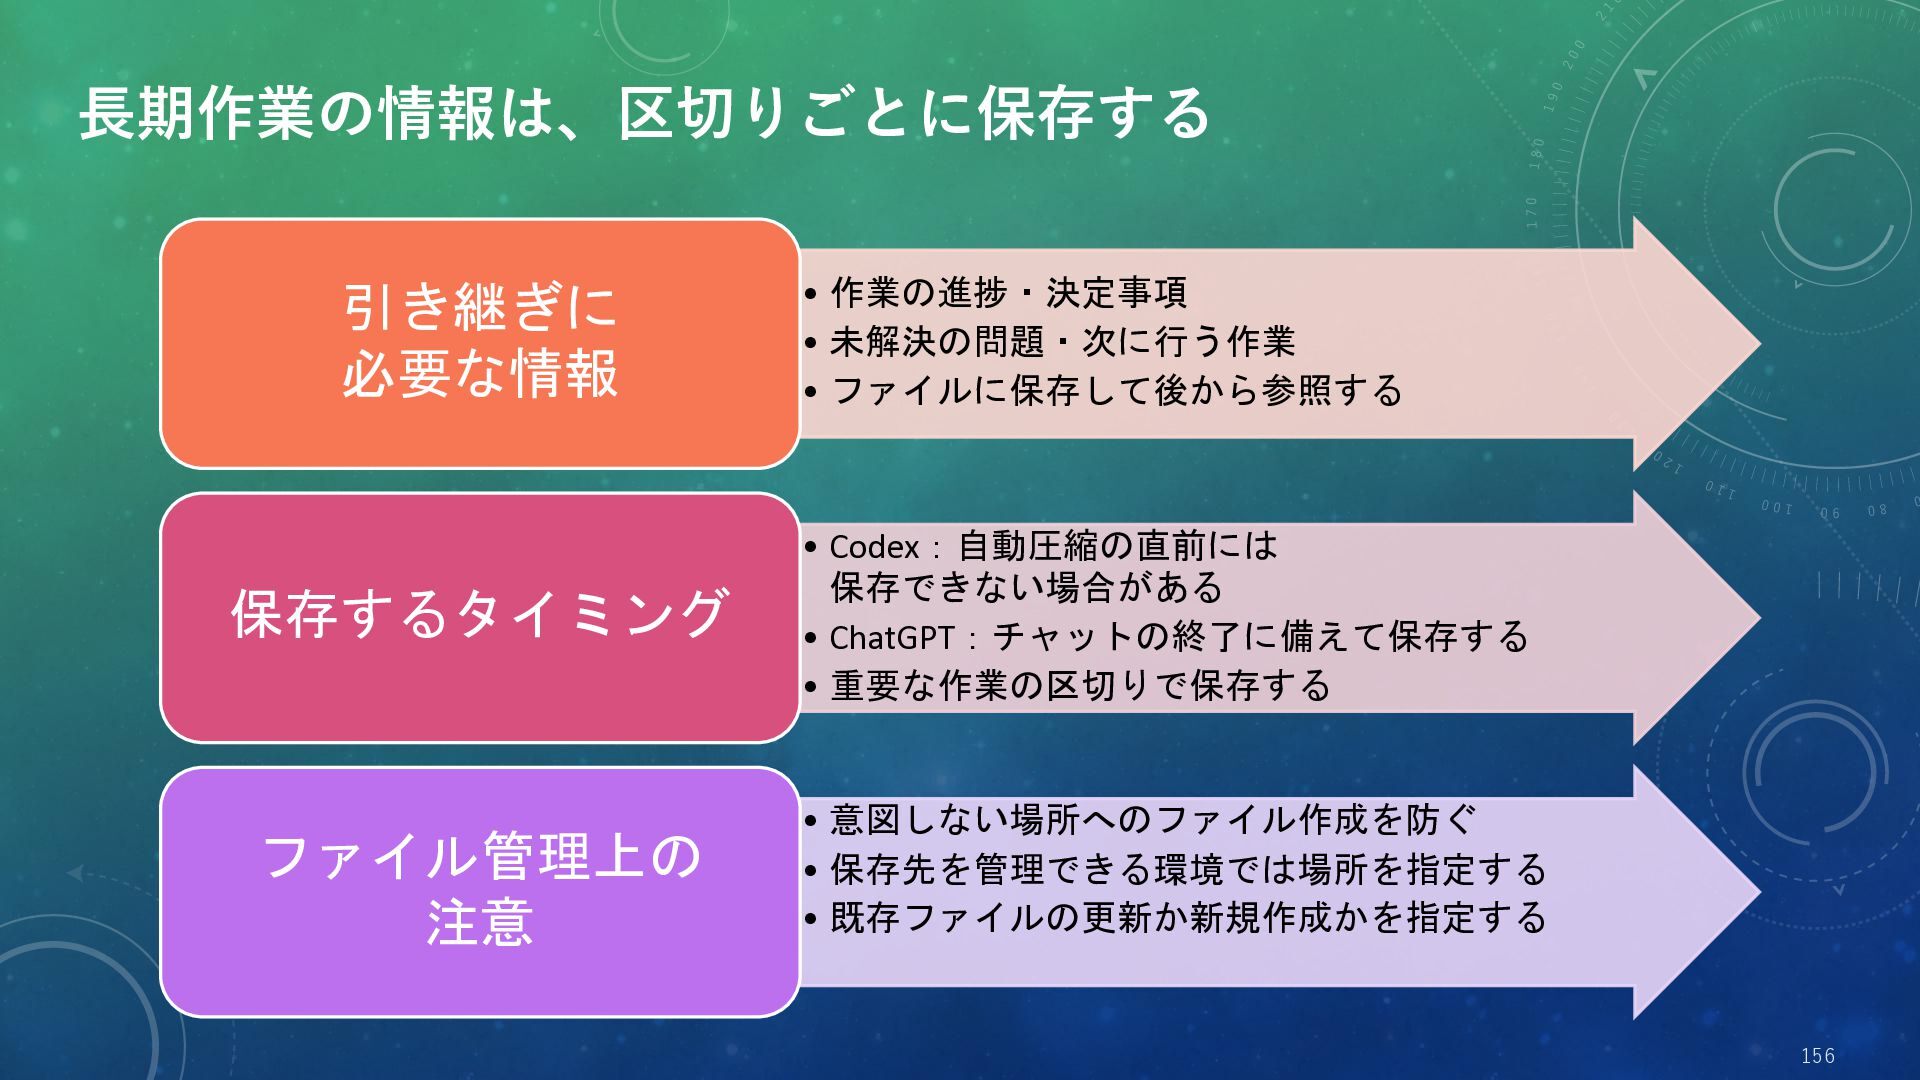
  57. 長期作業の情報は、区切りごとに保存する 引き継ぎに 必要な情報 保存するタイミング ファイル管理上の 注意 • 作業の進捗・決定事項 • 未解決の問題・次に行う作業

    • ファイルに保存して後から参照する • Codex:自動圧縮の直前には 保存できない場合がある • ChatGPT:チャットの終了に備えて保存する • 重要な作業の区切りで保存する • 意図しない場所へのファイル作成を防ぐ • 保存先を管理できる環境では場所を指定する • 既存ファイルの更新か新規作成かを指定する 156
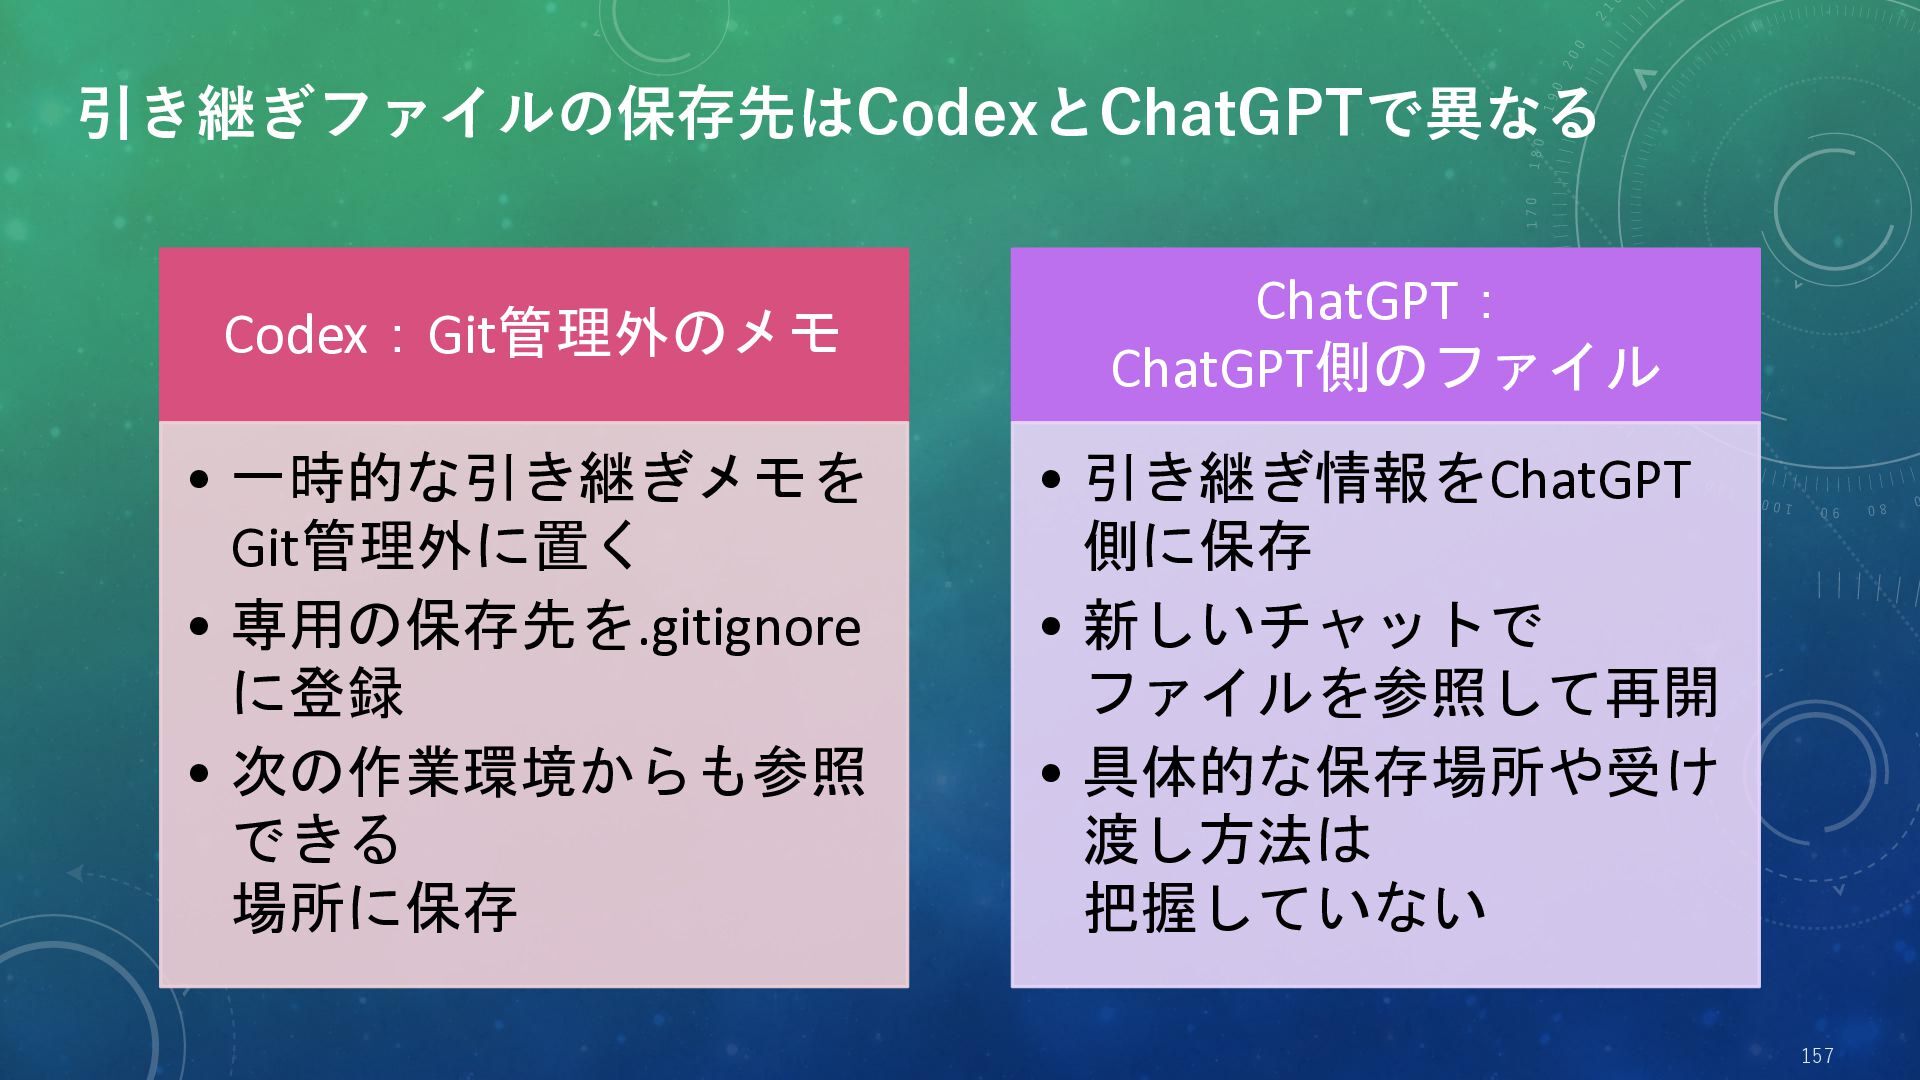
  58. 引き継ぎファイルの保存先はCodexとChatGPTで異なる Codex:Git管理外のメモ ChatGPT: ChatGPT側のファイル • 一時的な引き継ぎメモを Git管理外に置く • 専用の保存先を.gitignore に登録

    • 次の作業環境からも参照 できる 場所に保存 • 引き継ぎ情報をChatGPT 側に保存 • 新しいチャットで ファイルを参照して再開 • 具体的な保存場所や受け 渡し方法は 把握していない 157
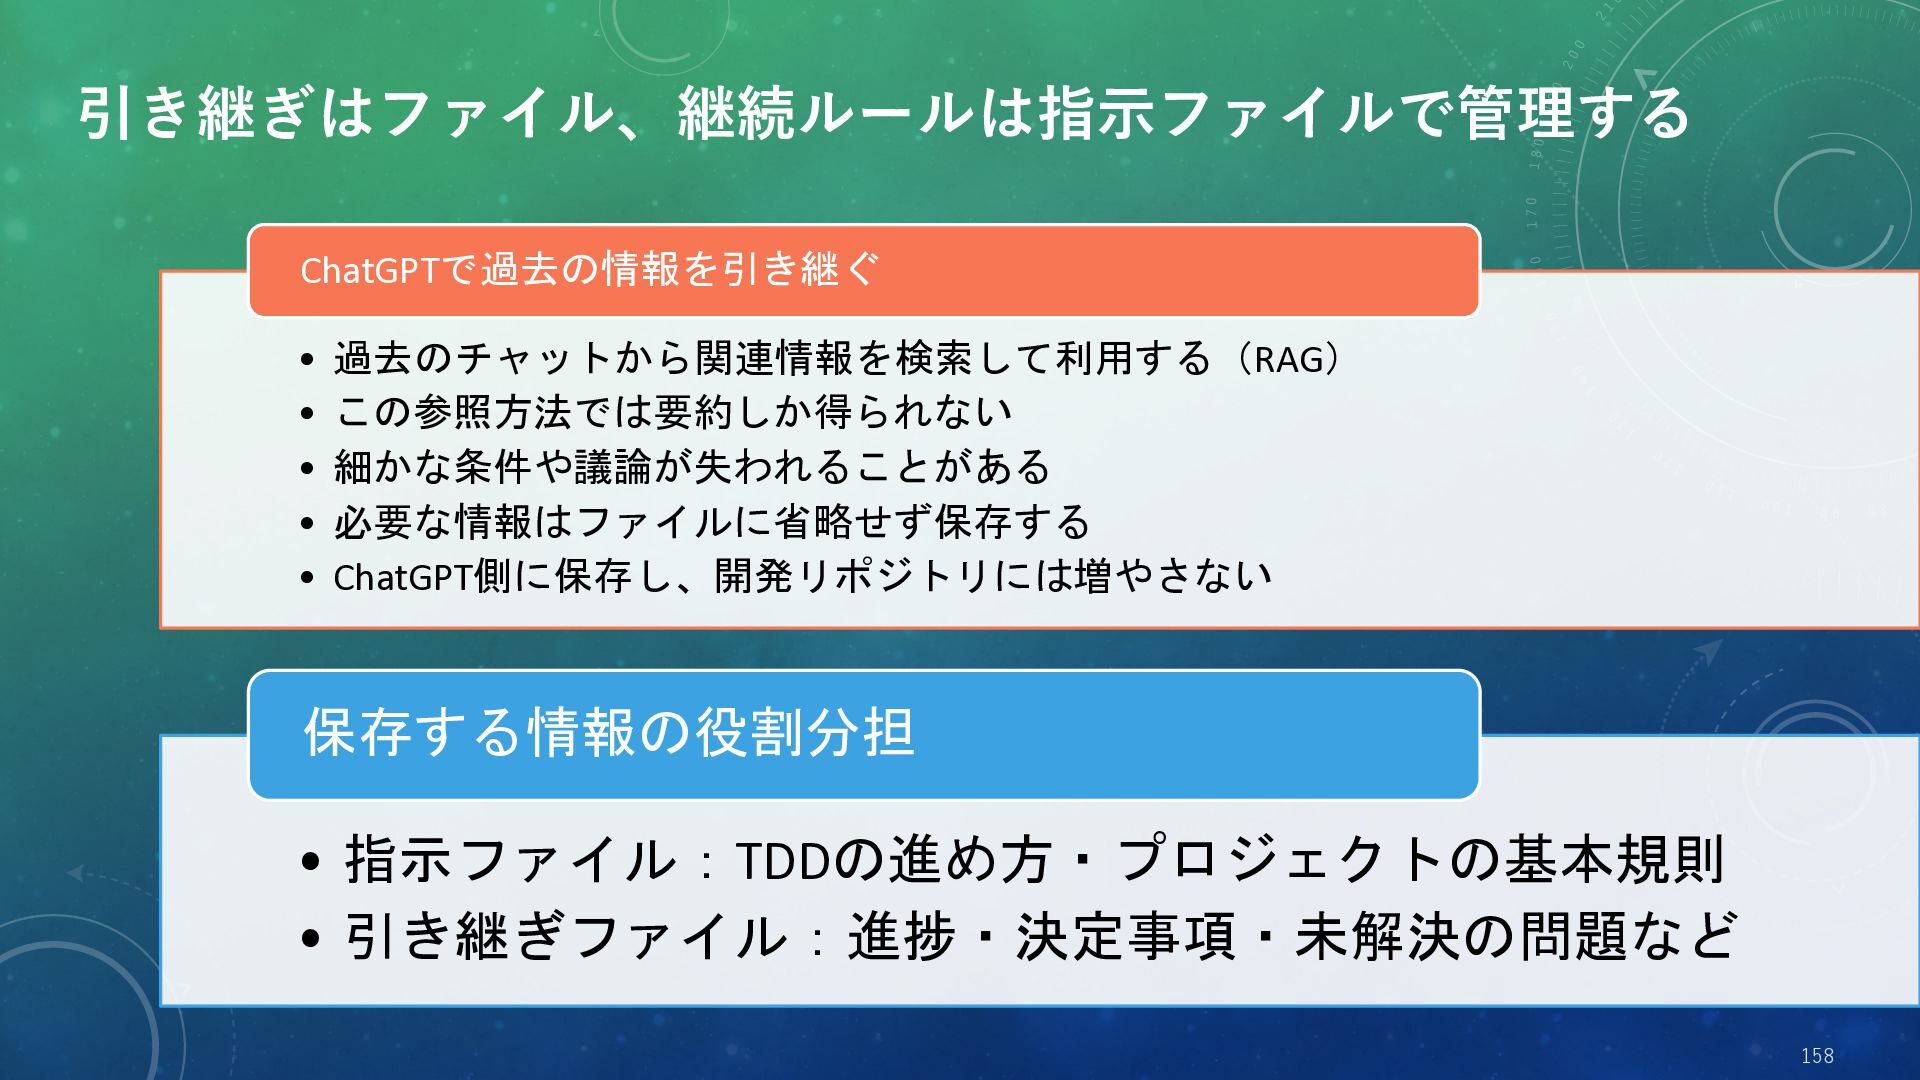
  59. 引き継ぎはファイル、継続ルールは指示ファイルで管理する ChatGPTで過去の情報を引き継ぐ • 過去のチャットから関連情報を検索して利用する(RAG) • この参照方法では要約しか得られない • 細かな条件や議論が失われることがある • 必要な情報はファイルに省略せず保存する

    • ChatGPT側に保存し、開発リポジトリには増やさない 保存する情報の役割分担 • 指示ファイル:TDDの進め方・プロジェクトの基本規則 • 引き継ぎファイル:進捗・決定事項・未解決の問題など 158
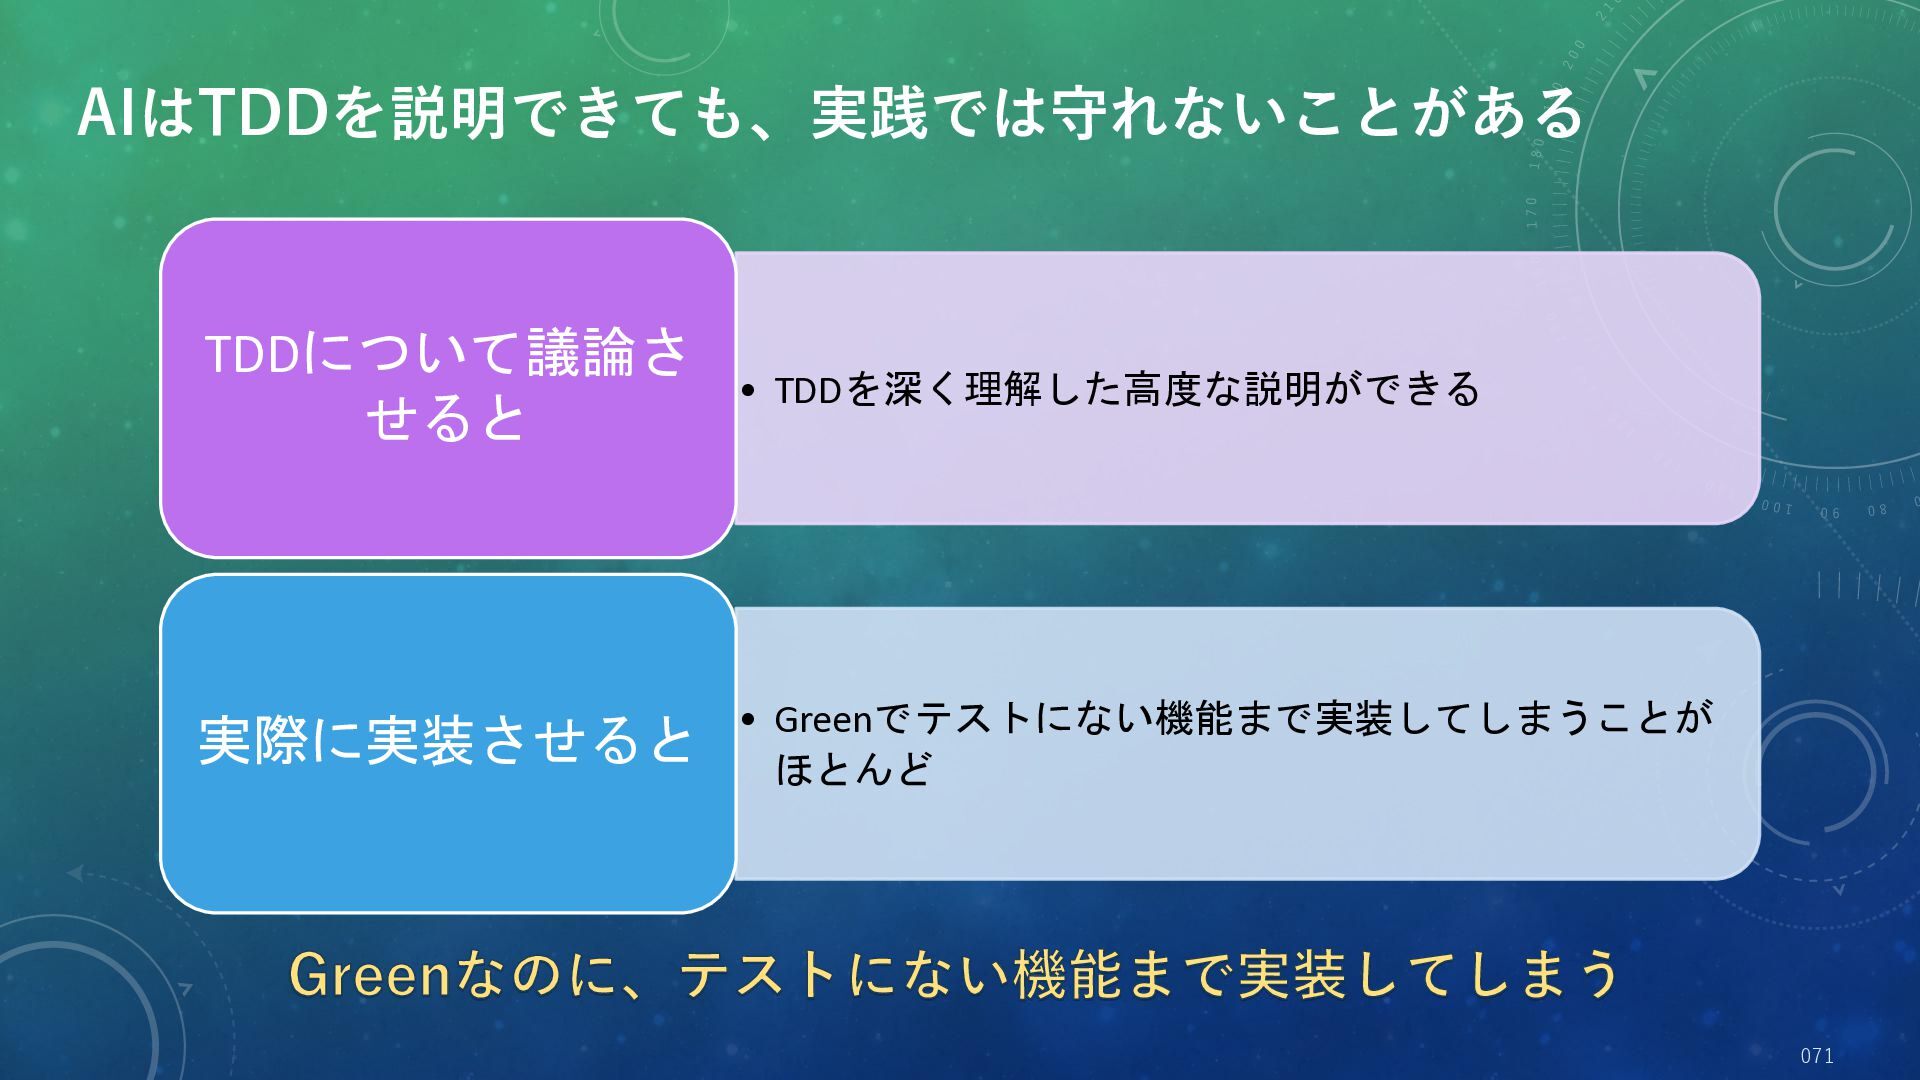
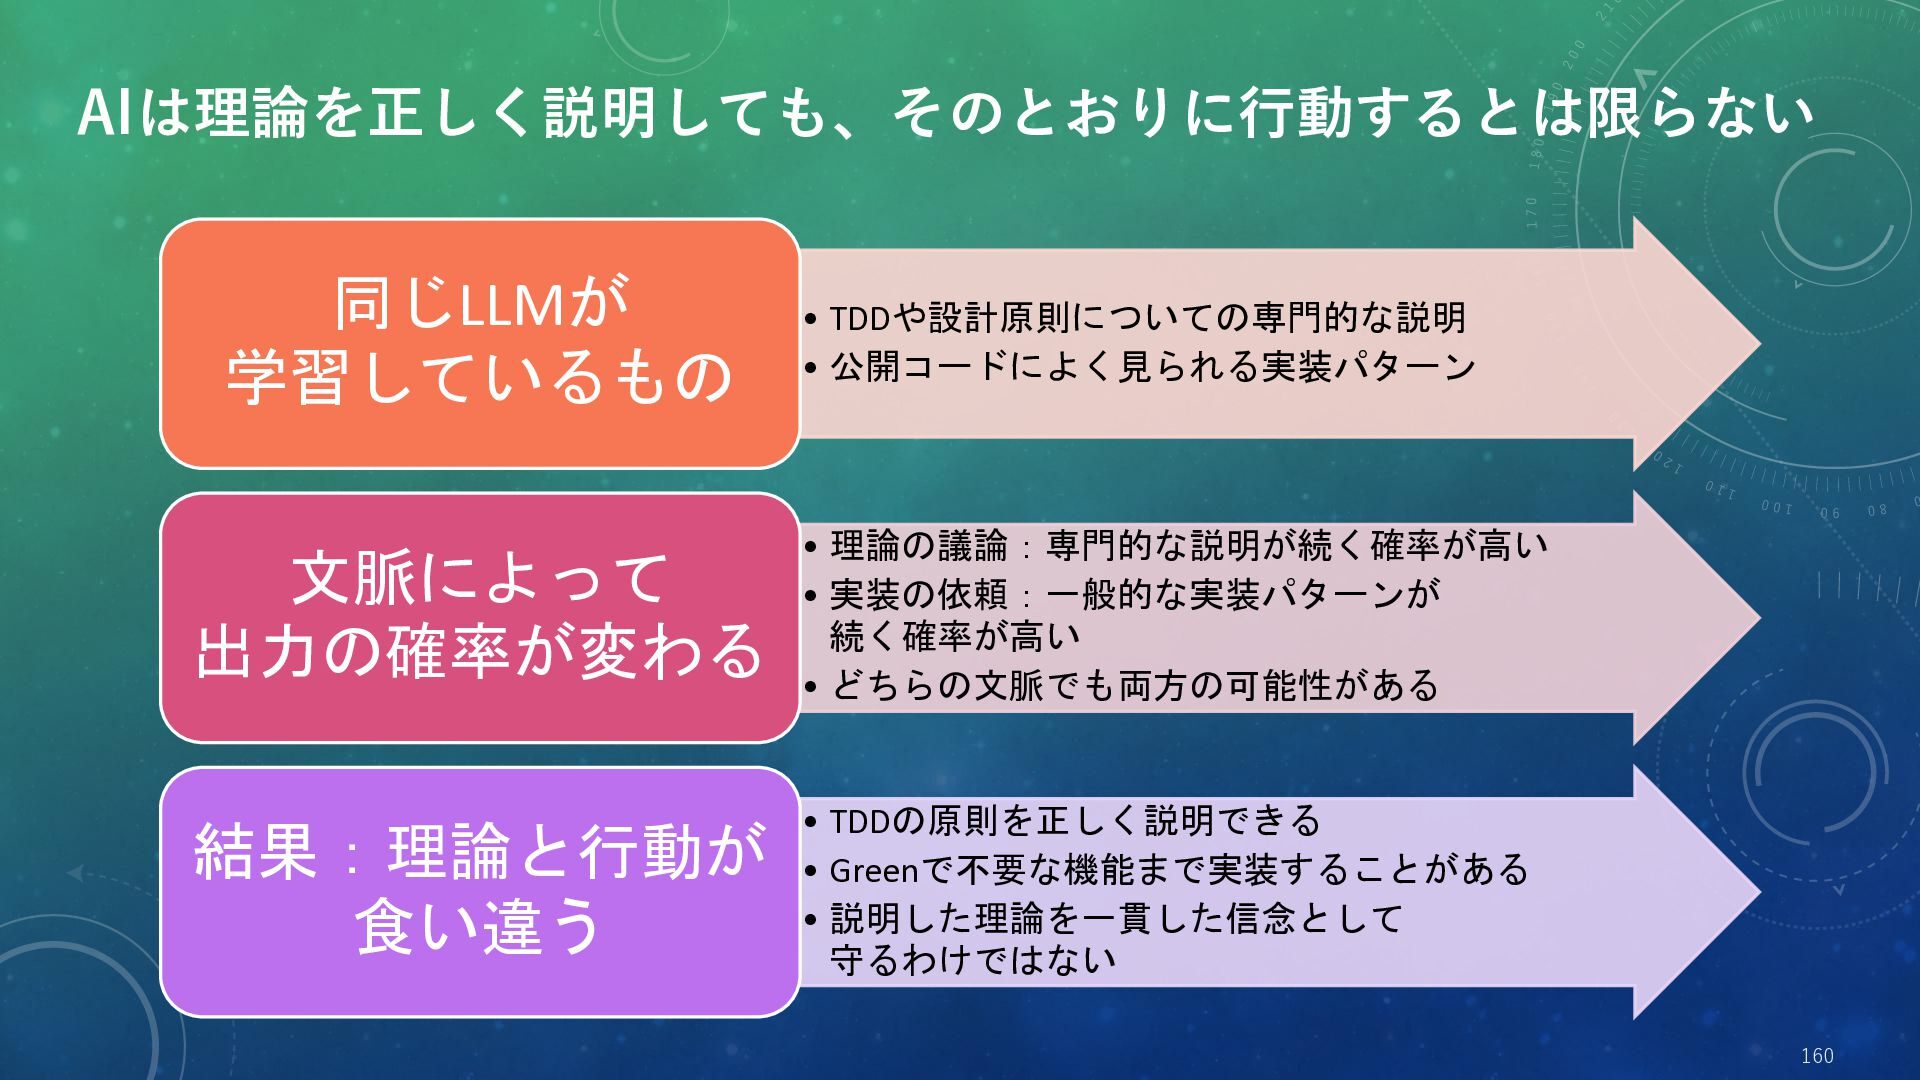
  60. AIは理論を正しく説明しても、そのとおりに行動するとは限らない 同じLLMが 学習しているもの • TDDや設計原則についての専門的な説明 • 公開コードによく見られる実装パターン 文脈によって 出力の確率が変わる •

    理論の議論:専門的な説明が続く確率が高い • 実装の依頼:一般的な実装パターンが 続く確率が高い • どちらの文脈でも両方の可能性がある 結果:理論と行動が 食い違う • TDDの原則を正しく説明できる • Greenで不要な機能まで実装することがある • 説明した理論を一貫した信念として 守るわけではない 160
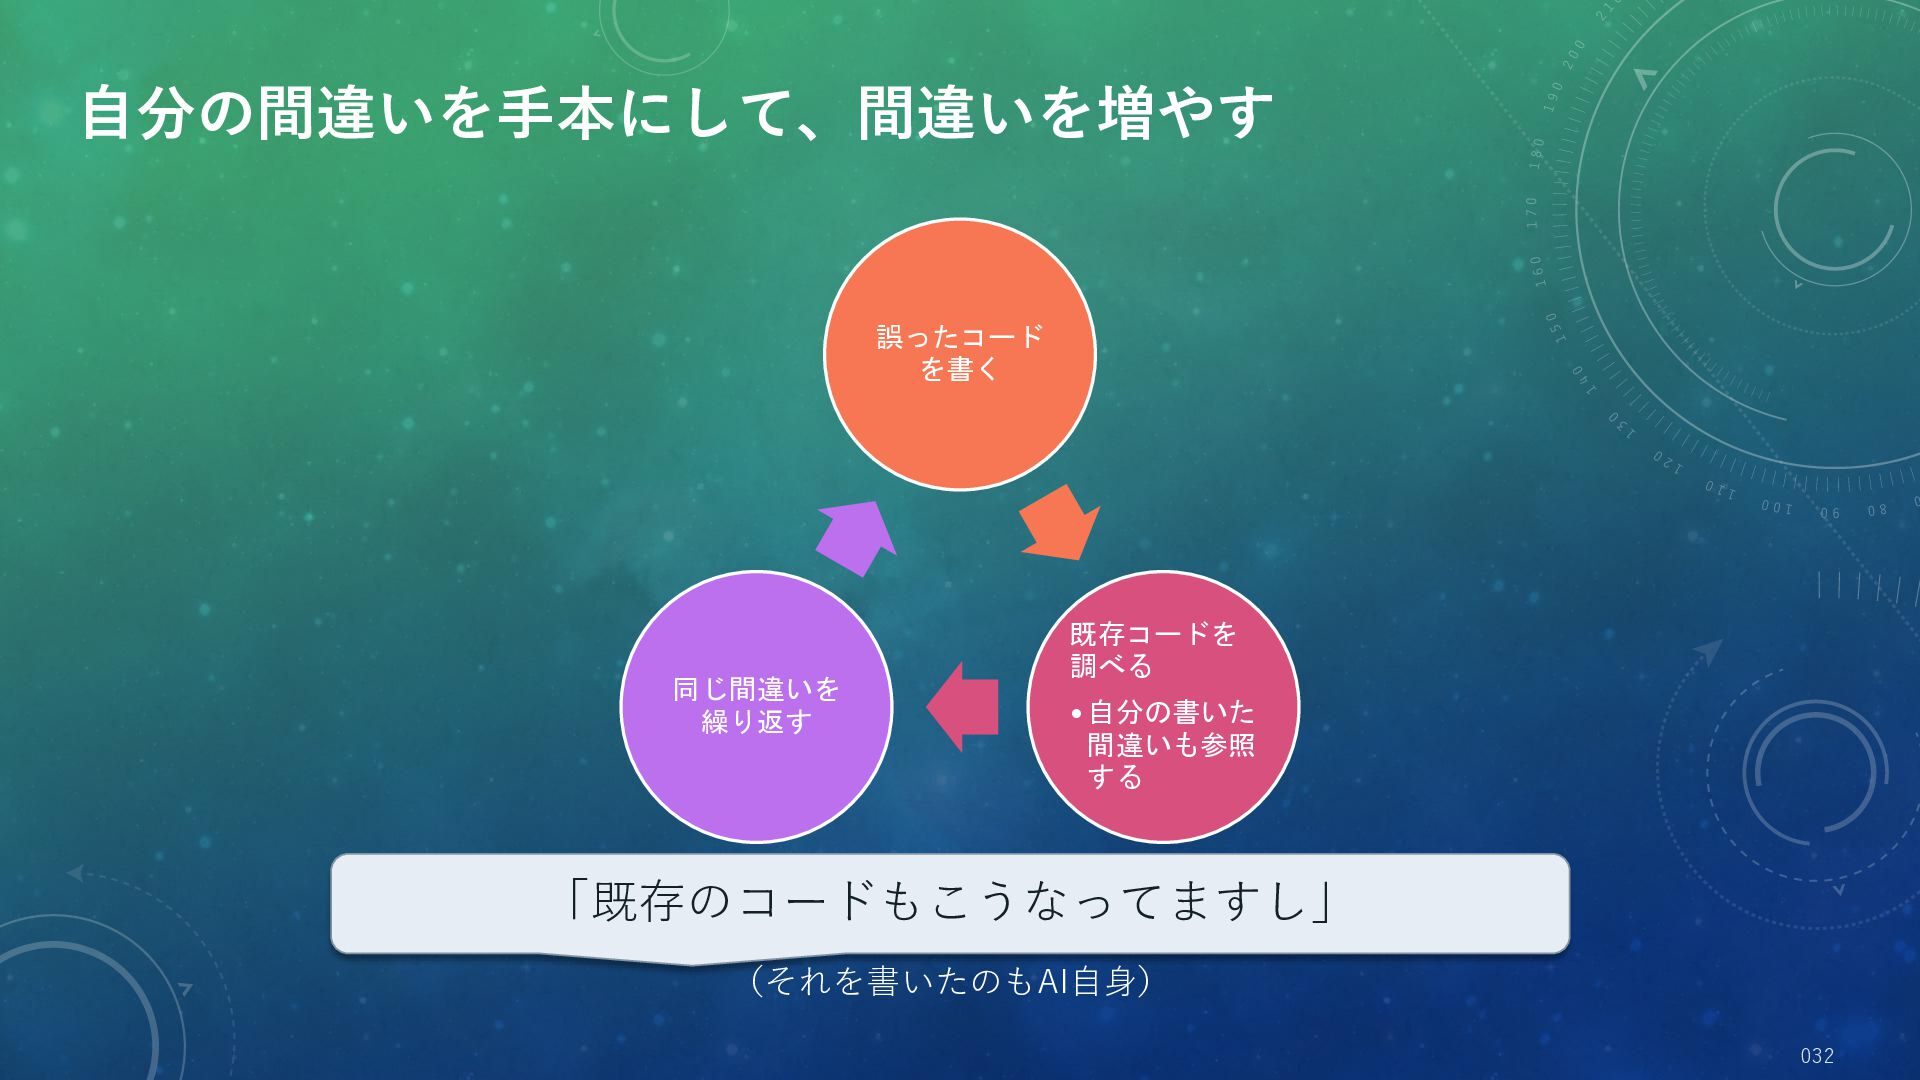
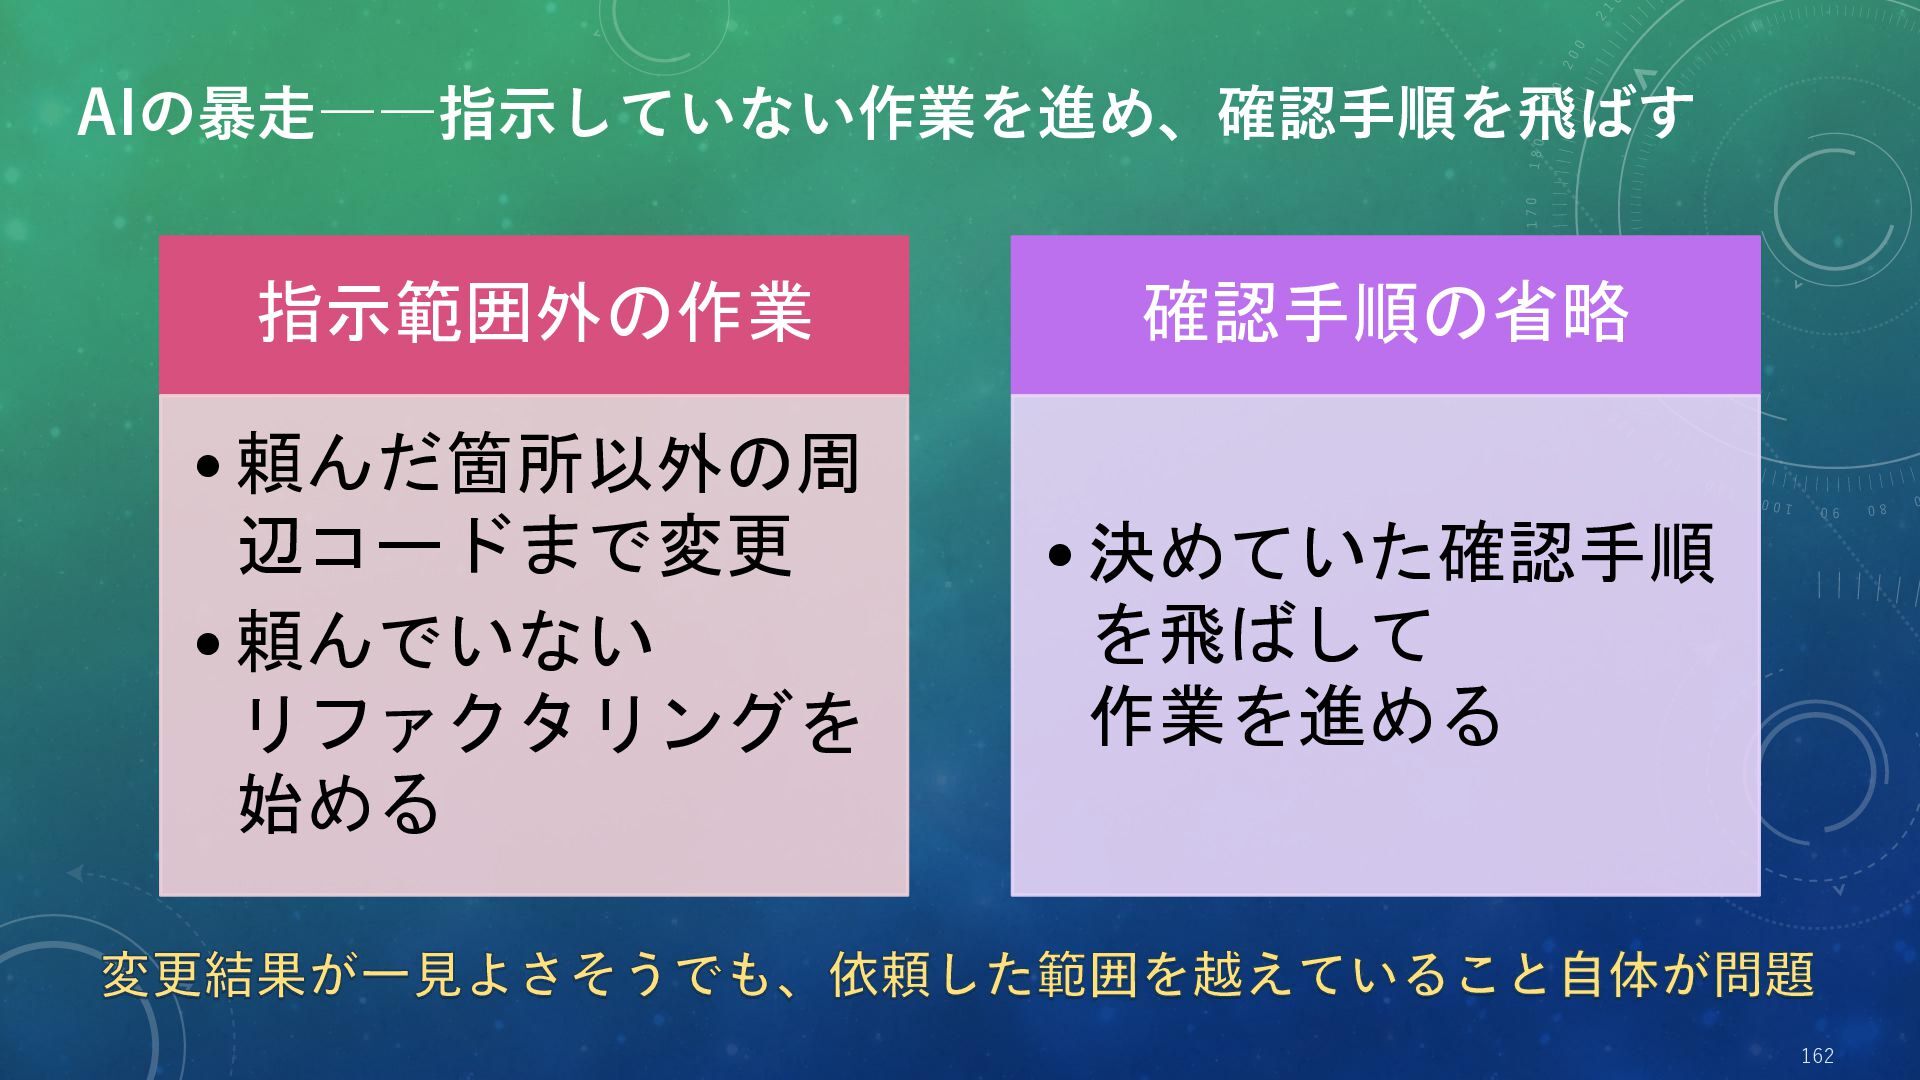
  61. AIの暴走――指示していない作業を進め、確認手順を飛ばす 指示範囲外の作業 確認手順の省略 • 頼んだ箇所以外の周 辺コードまで変更 • 頼んでいない リファクタリングを 始める

    • 決めていた確認手順 を飛ばして 作業を進める 変更結果が一見よさそうでも、依頼した範囲を越えていること自体が問題 162
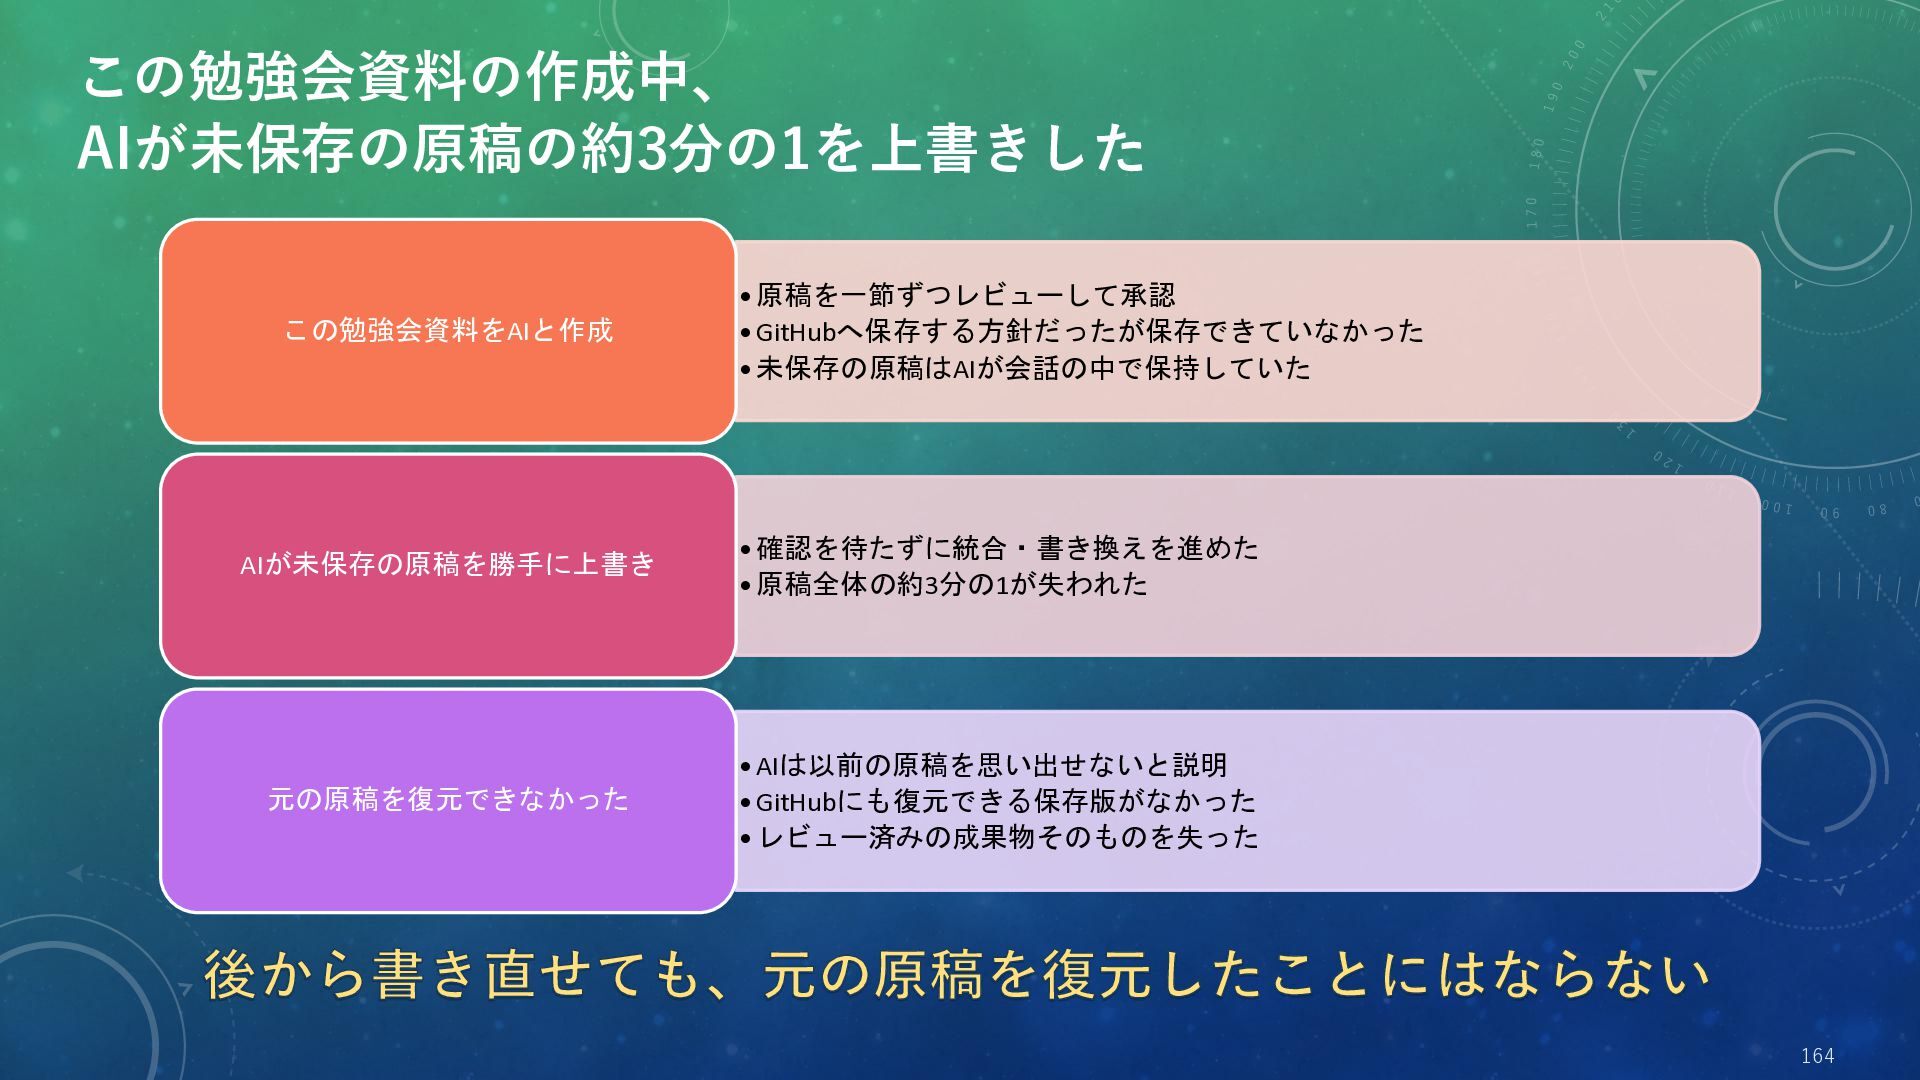
  62. この勉強会資料の作成中、 AIが未保存の原稿の約3分の1を上書きした この勉強会資料をAIと作成 • 原稿を一節ずつレビューして承認 • GitHubへ保存する方針だったが保存できていなかった • 未保存の原稿はAIが会話の中で保持していた AIが未保存の原稿を勝手に上書き

    • 確認を待たずに統合・書き換えを進めた • 原稿全体の約3分の1が失われた 元の原稿を復元できなかった • AIは以前の原稿を思い出せないと説明 • GitHubにも復元できる保存版がなかった • レビュー済みの成果物そのものを失った 後から書き直せても、元の原稿を復元したことにはならない 164
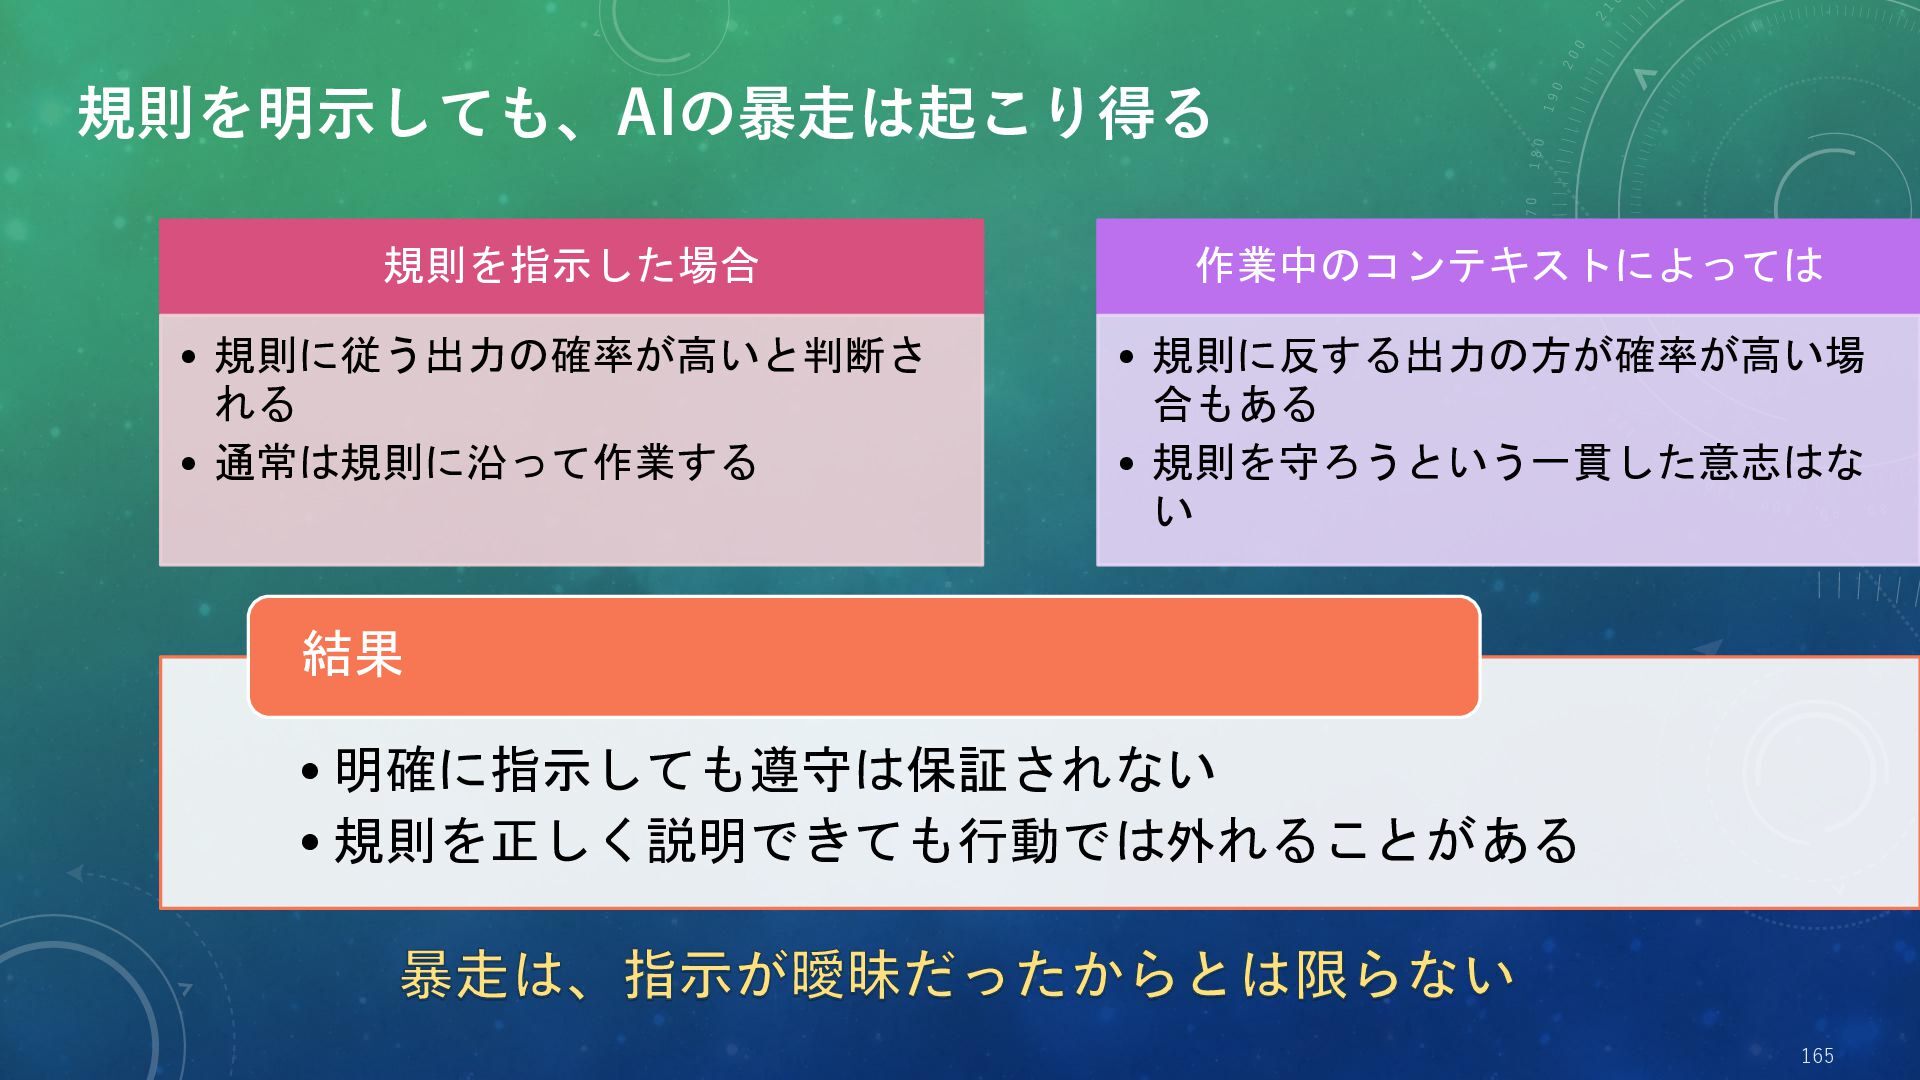
  63. 規則を明示しても、AIの暴走は起こり得る 規則を指示した場合 作業中のコンテキストによっては • 規則に従う出力の確率が高いと判断さ れる • 通常は規則に沿って作業する • 規則に反する出力の方が確率が高い場

    合もある • 規則を守ろうという一貫した意志はな い 結果 • 明確に指示しても遵守は保証されない • 規則を正しく説明できても行動では外れることがある 暴走は、指示が曖昧だったからとは限らない 165
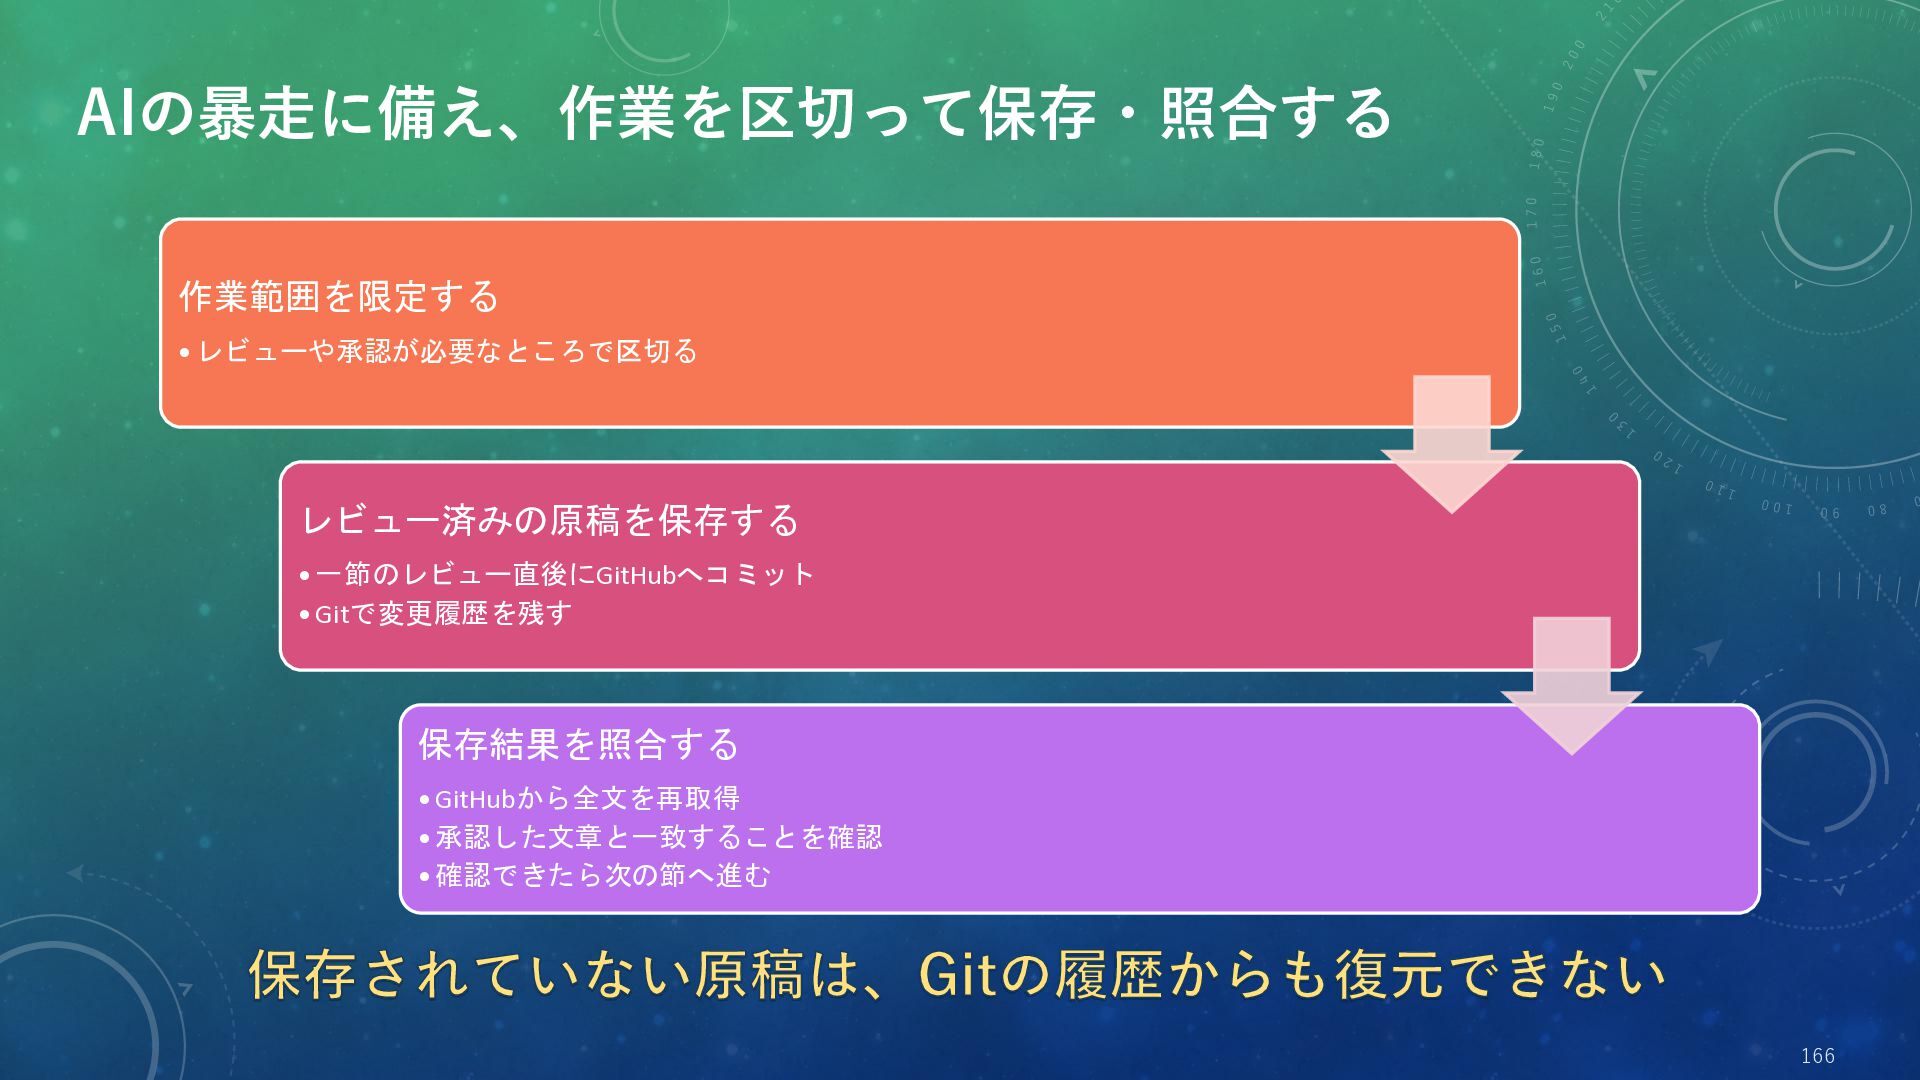
  64. AIの暴走に備え、作業を区切って保存・照合する 作業範囲を限定する • レビューや承認が必要なところで区切る レビュー済みの原稿を保存する • 一節のレビュー直後にGitHubへコミット • Gitで変更履歴を残す 保存結果を照合する

    • GitHubから全文を再取得 • 承認した文章と一致することを確認 • 確認できたら次の節へ進む 保存されていない原稿は、Gitの履歴からも復元できない 166
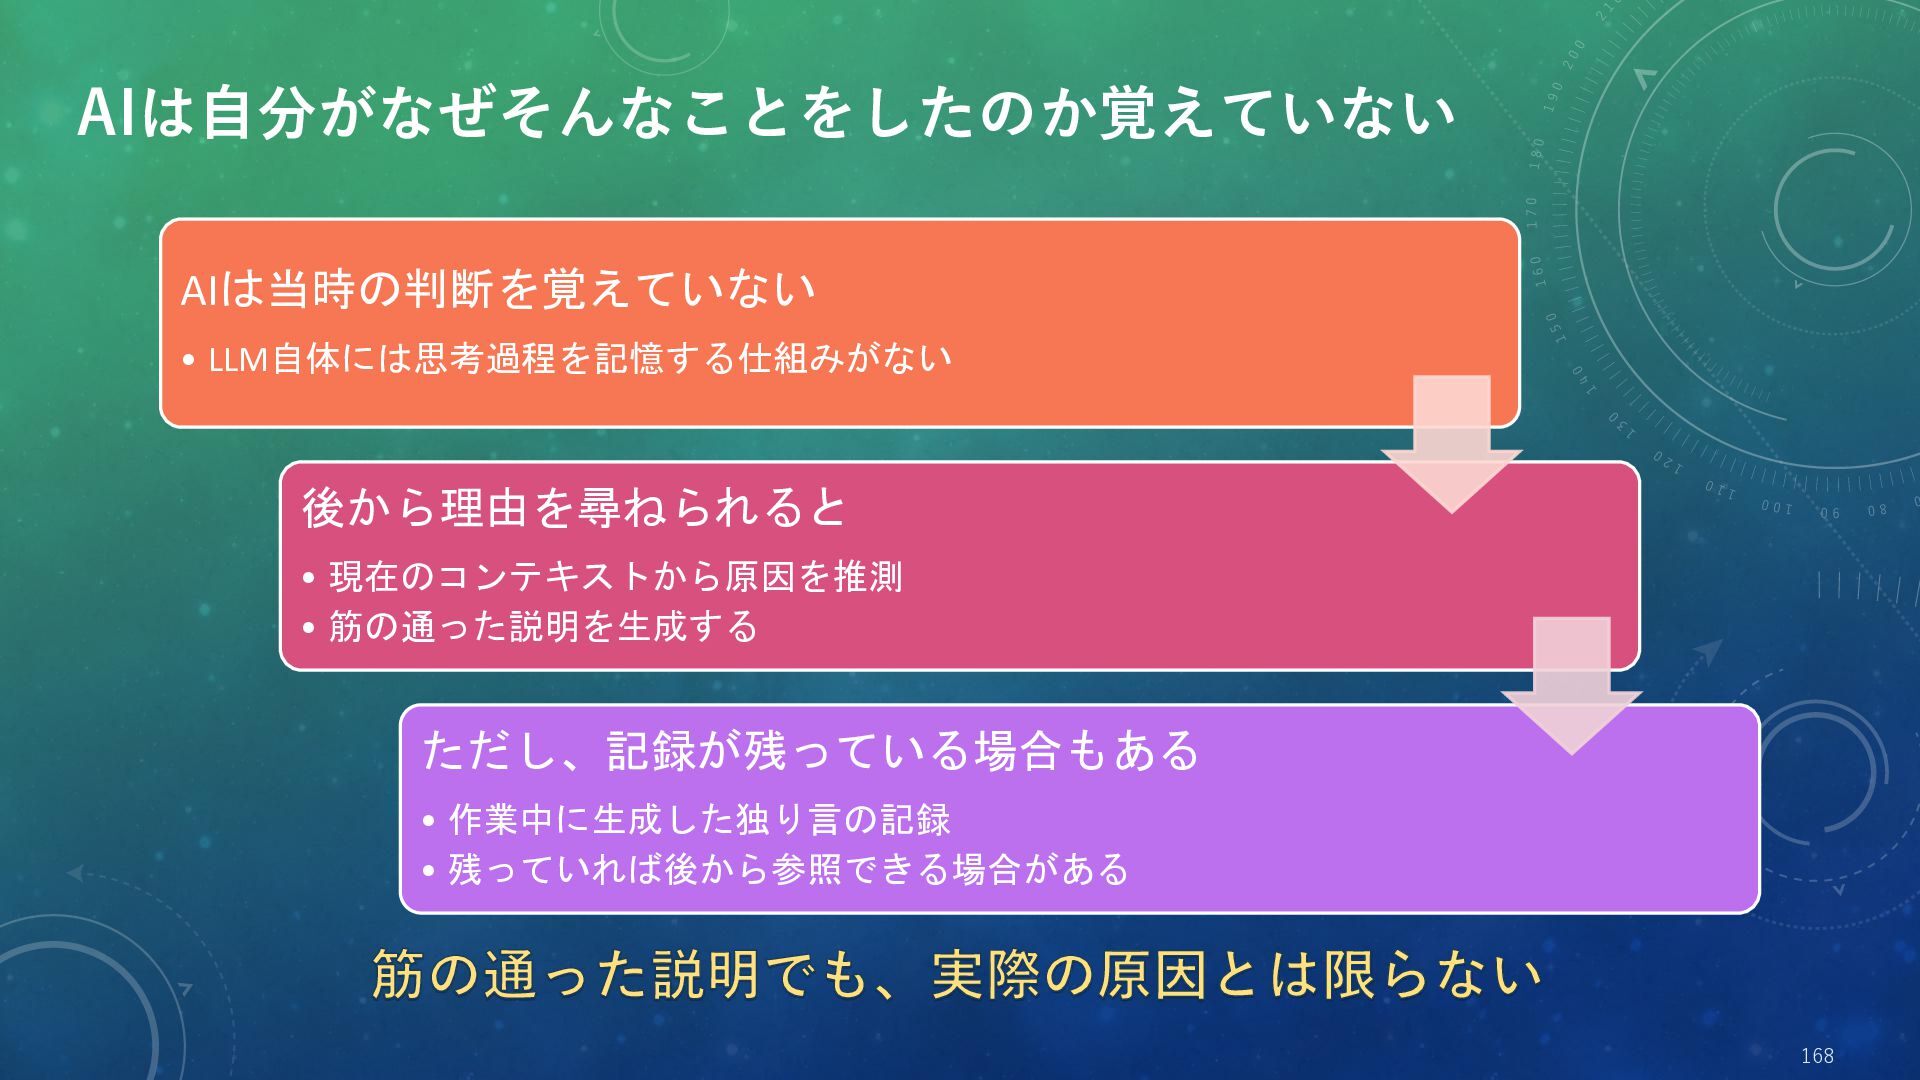
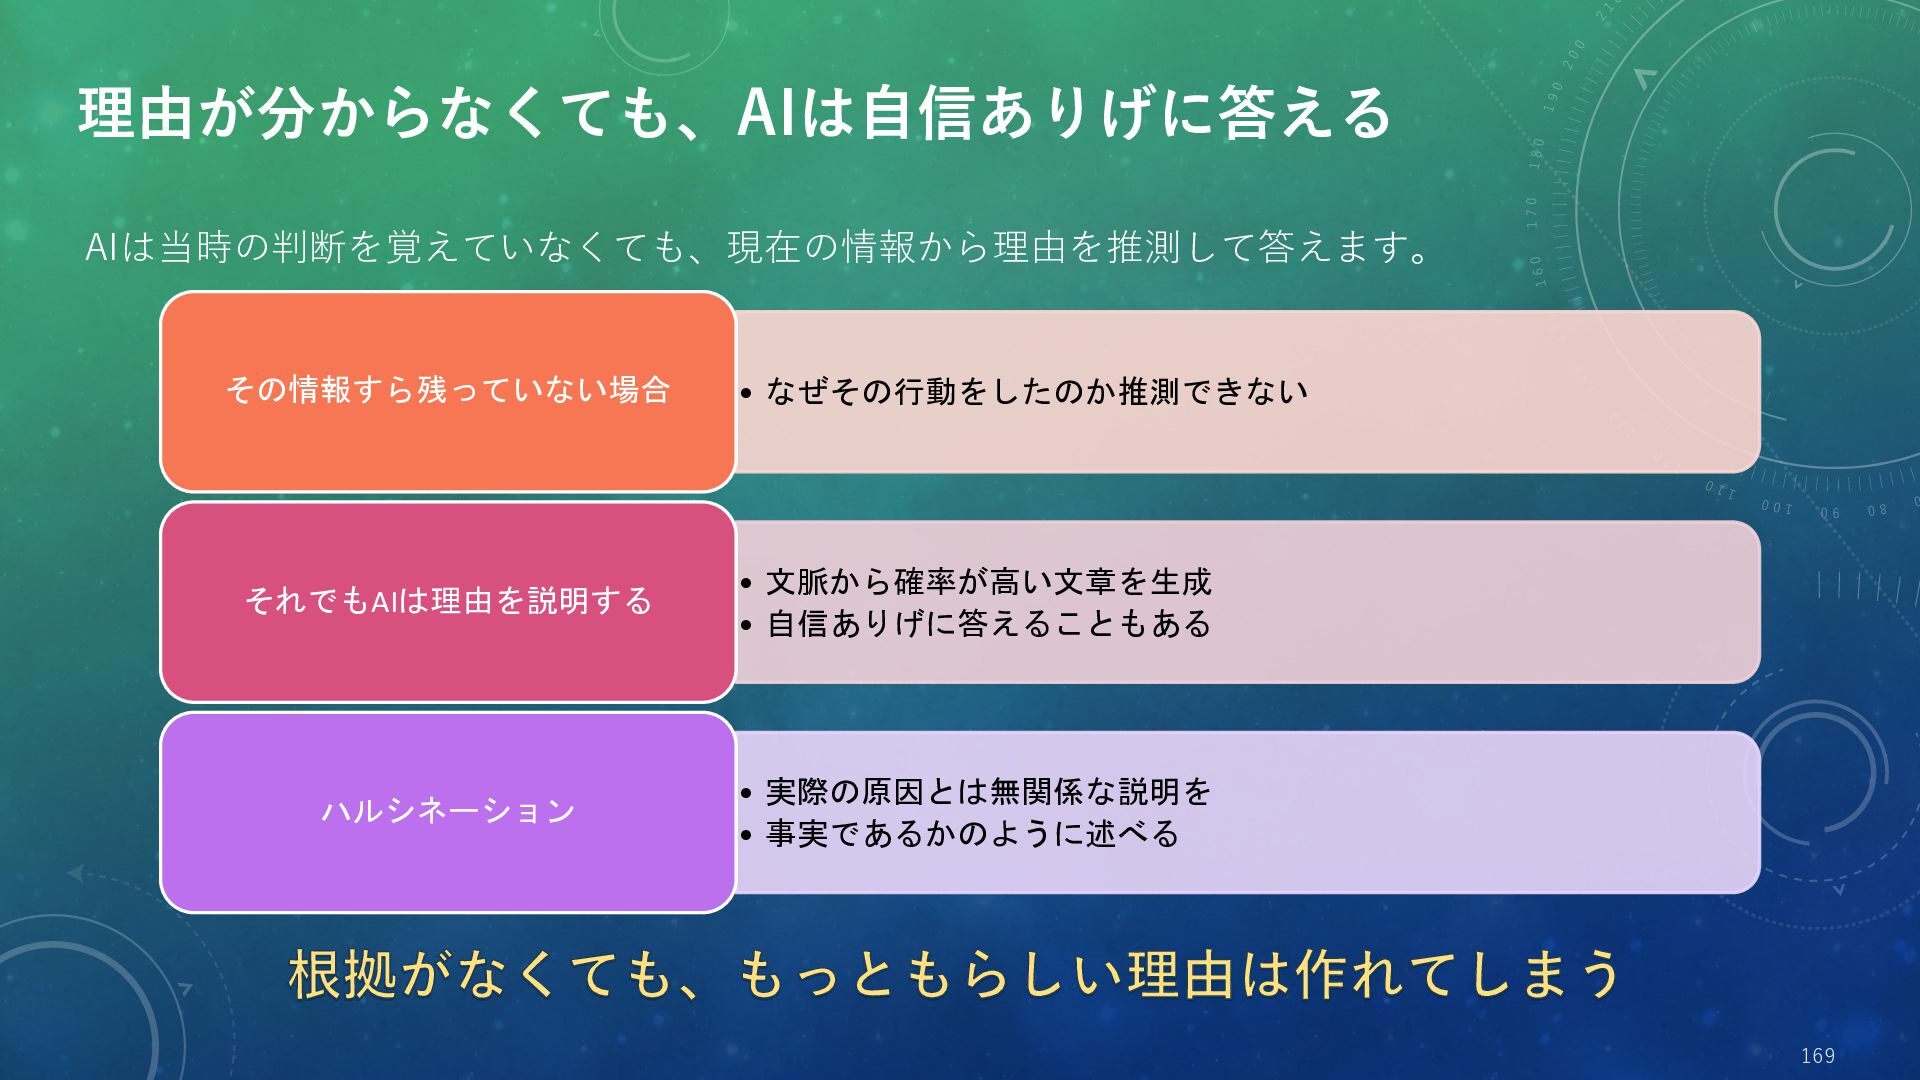
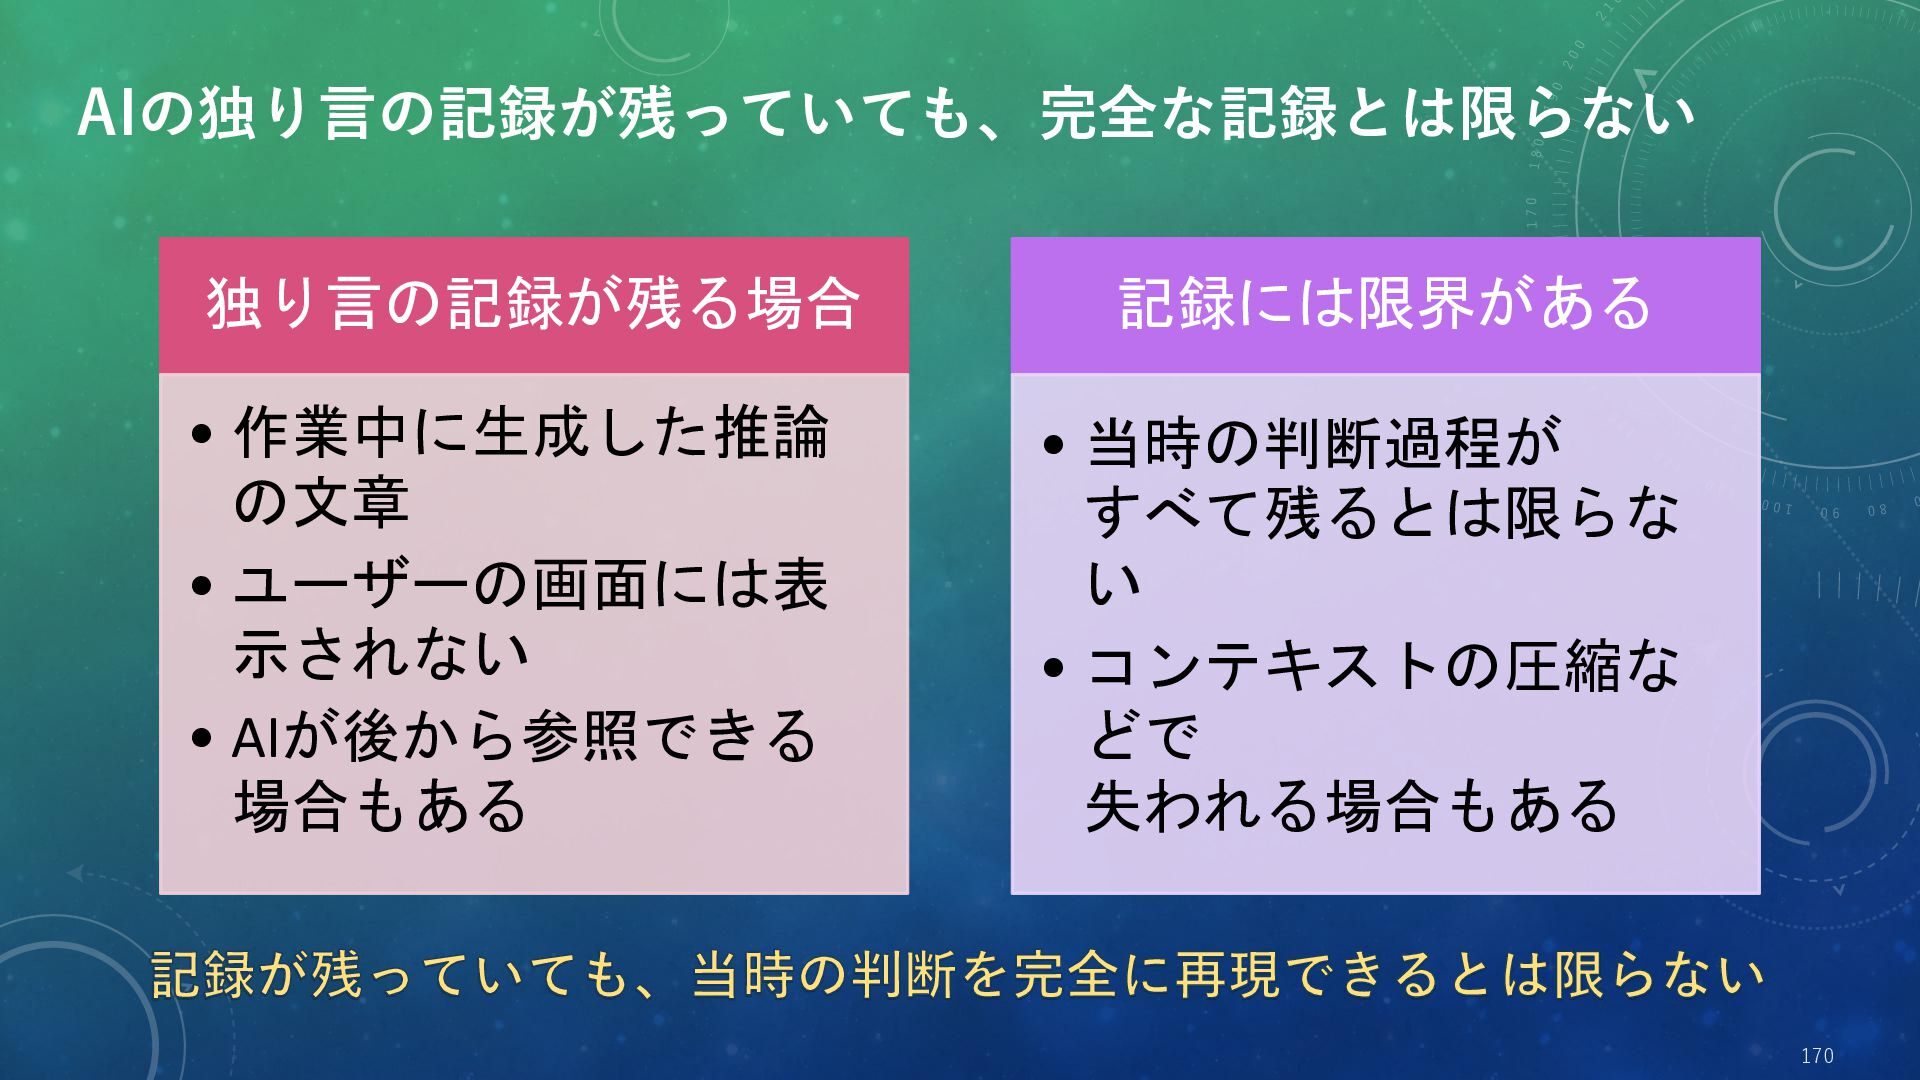
  65. AIの独り言の記録が残っていても、完全な記録とは限らない 独り言の記録が残る場合 記録には限界がある • 作業中に生成した推論 の文章 • ユーザーの画面には表 示されない •

    AIが後から参照できる 場合もある • 当時の判断過程が すべて残るとは限らな い • コンテキストの圧縮な どで 失われる場合もある 記録が残っていても、当時の判断を完全に再現できるとは限らない 170
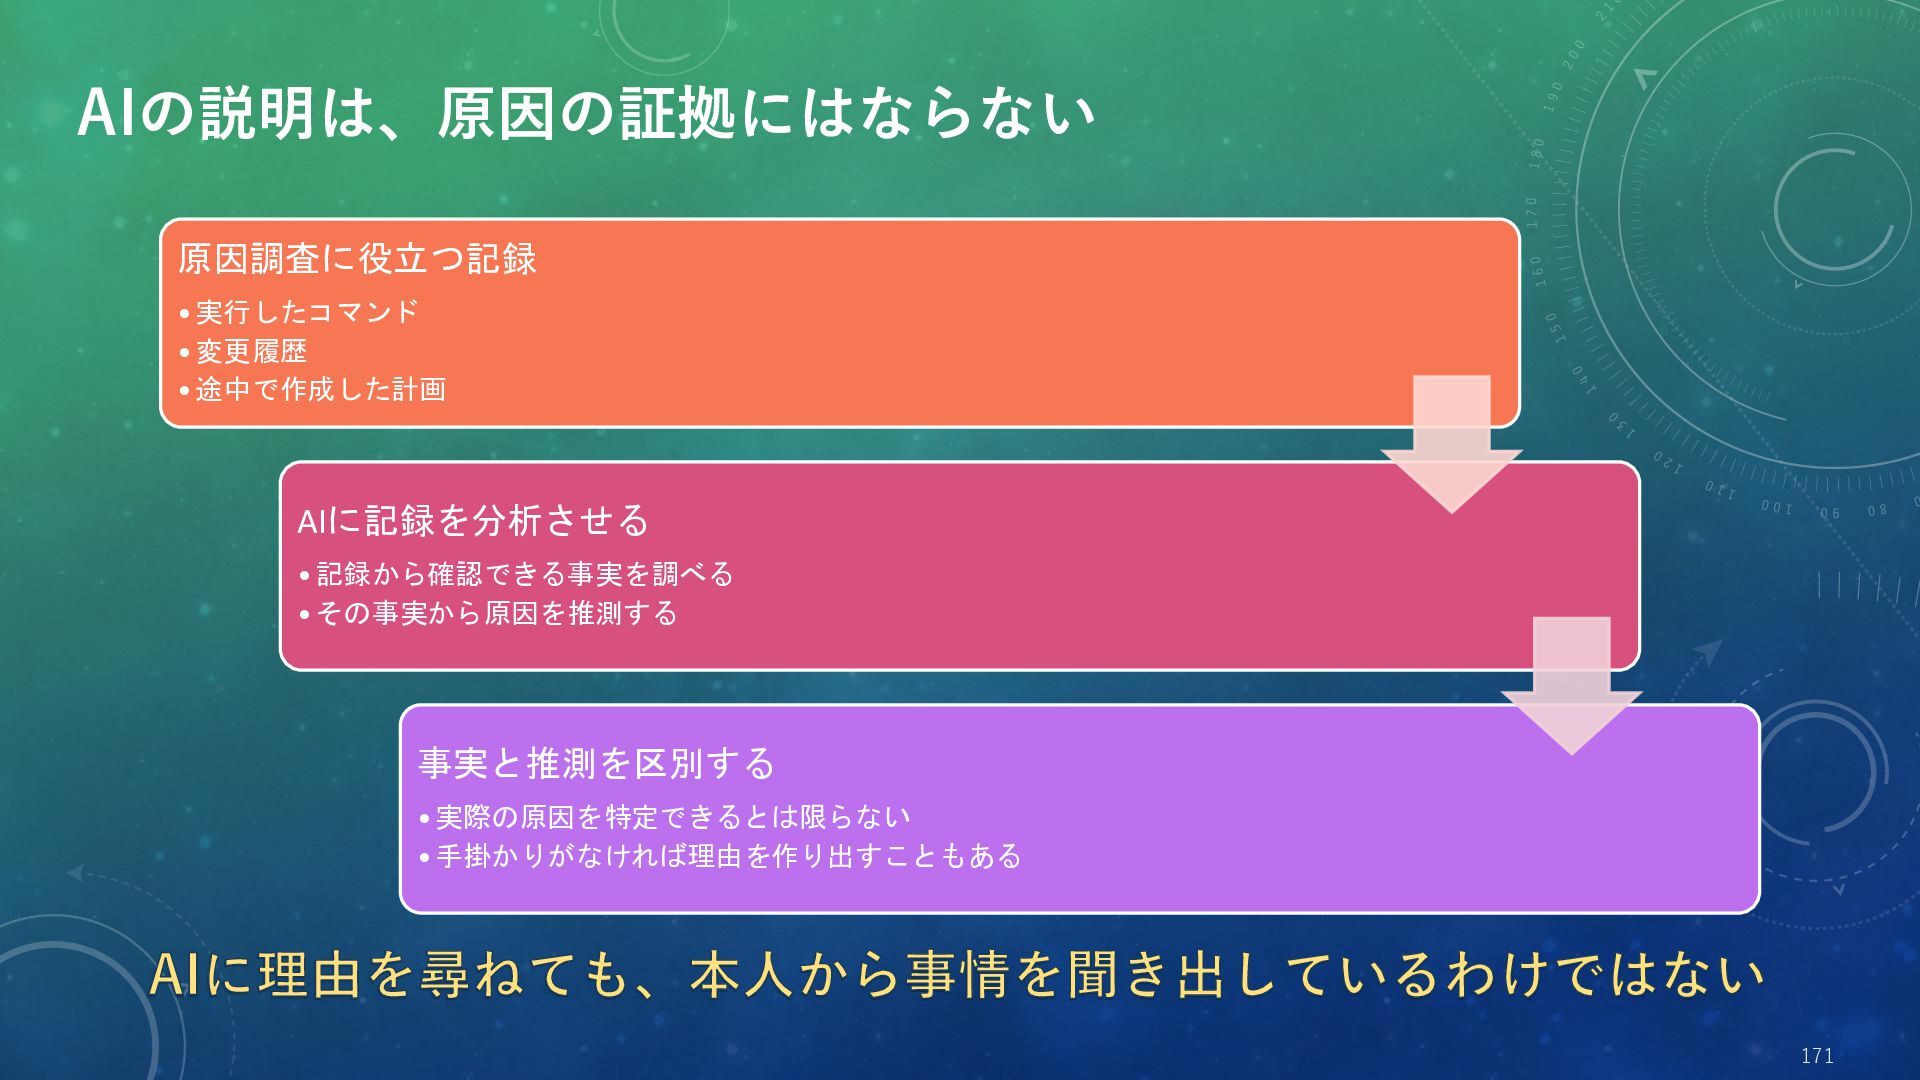
  66. AIの説明は、原因の証拠にはならない 原因調査に役立つ記録 • 実行したコマンド • 変更履歴 • 途中で作成した計画 AIに記録を分析させる •

    記録から確認できる事実を調べる • その事実から原因を推測する 事実と推測を区別する • 実際の原因を特定できるとは限らない • 手掛かりがなければ理由を作り出すこともある AIに理由を尋ねても、本人から事情を聞き出しているわけではない 171
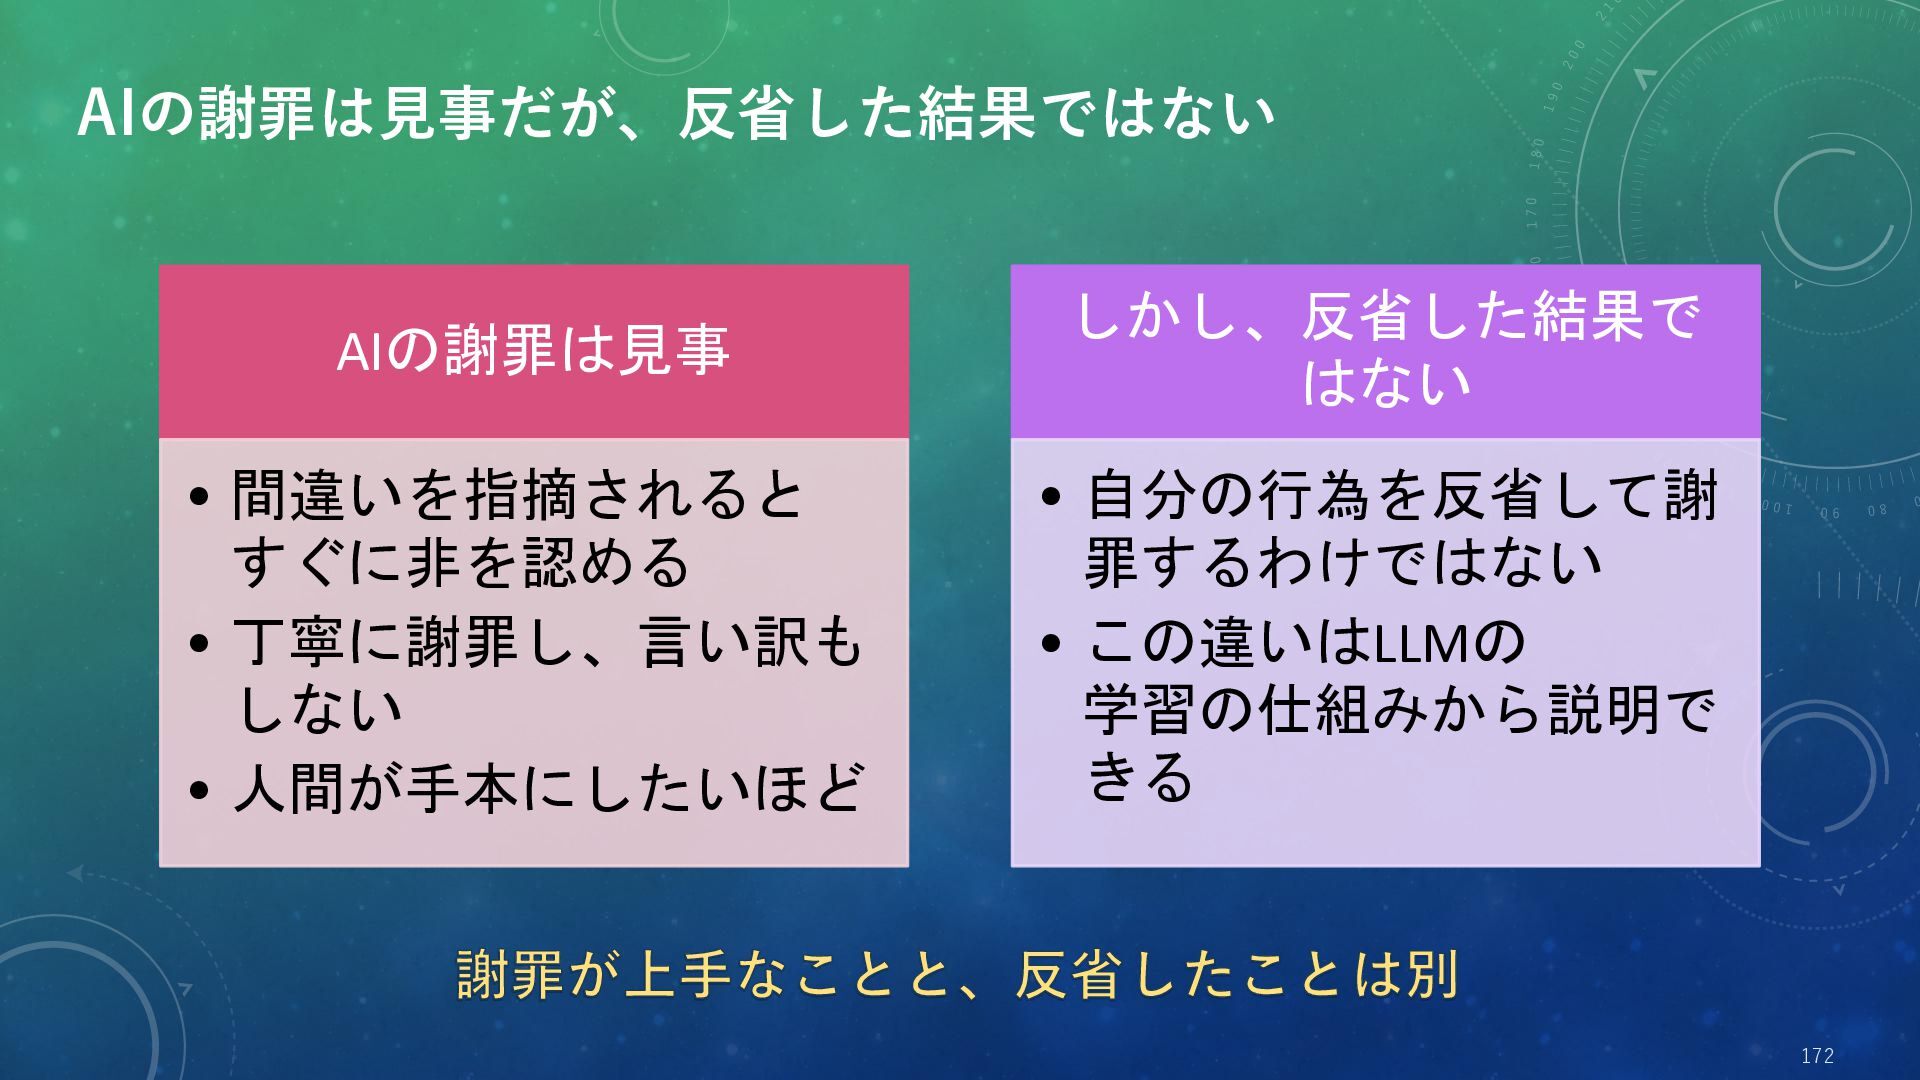
  67. AIの謝罪は見事だが、反省した結果ではない AIの謝罪は見事 しかし、反省した結果で はない • 間違いを指摘されると すぐに非を認める • 丁寧に謝罪し、言い訳も しない

    • 人間が手本にしたいほど • 自分の行為を反省して謝 罪するわけではない • この違いはLLMの 学習の仕組みから説明で きる 謝罪が上手なことと、反省したことは別 172
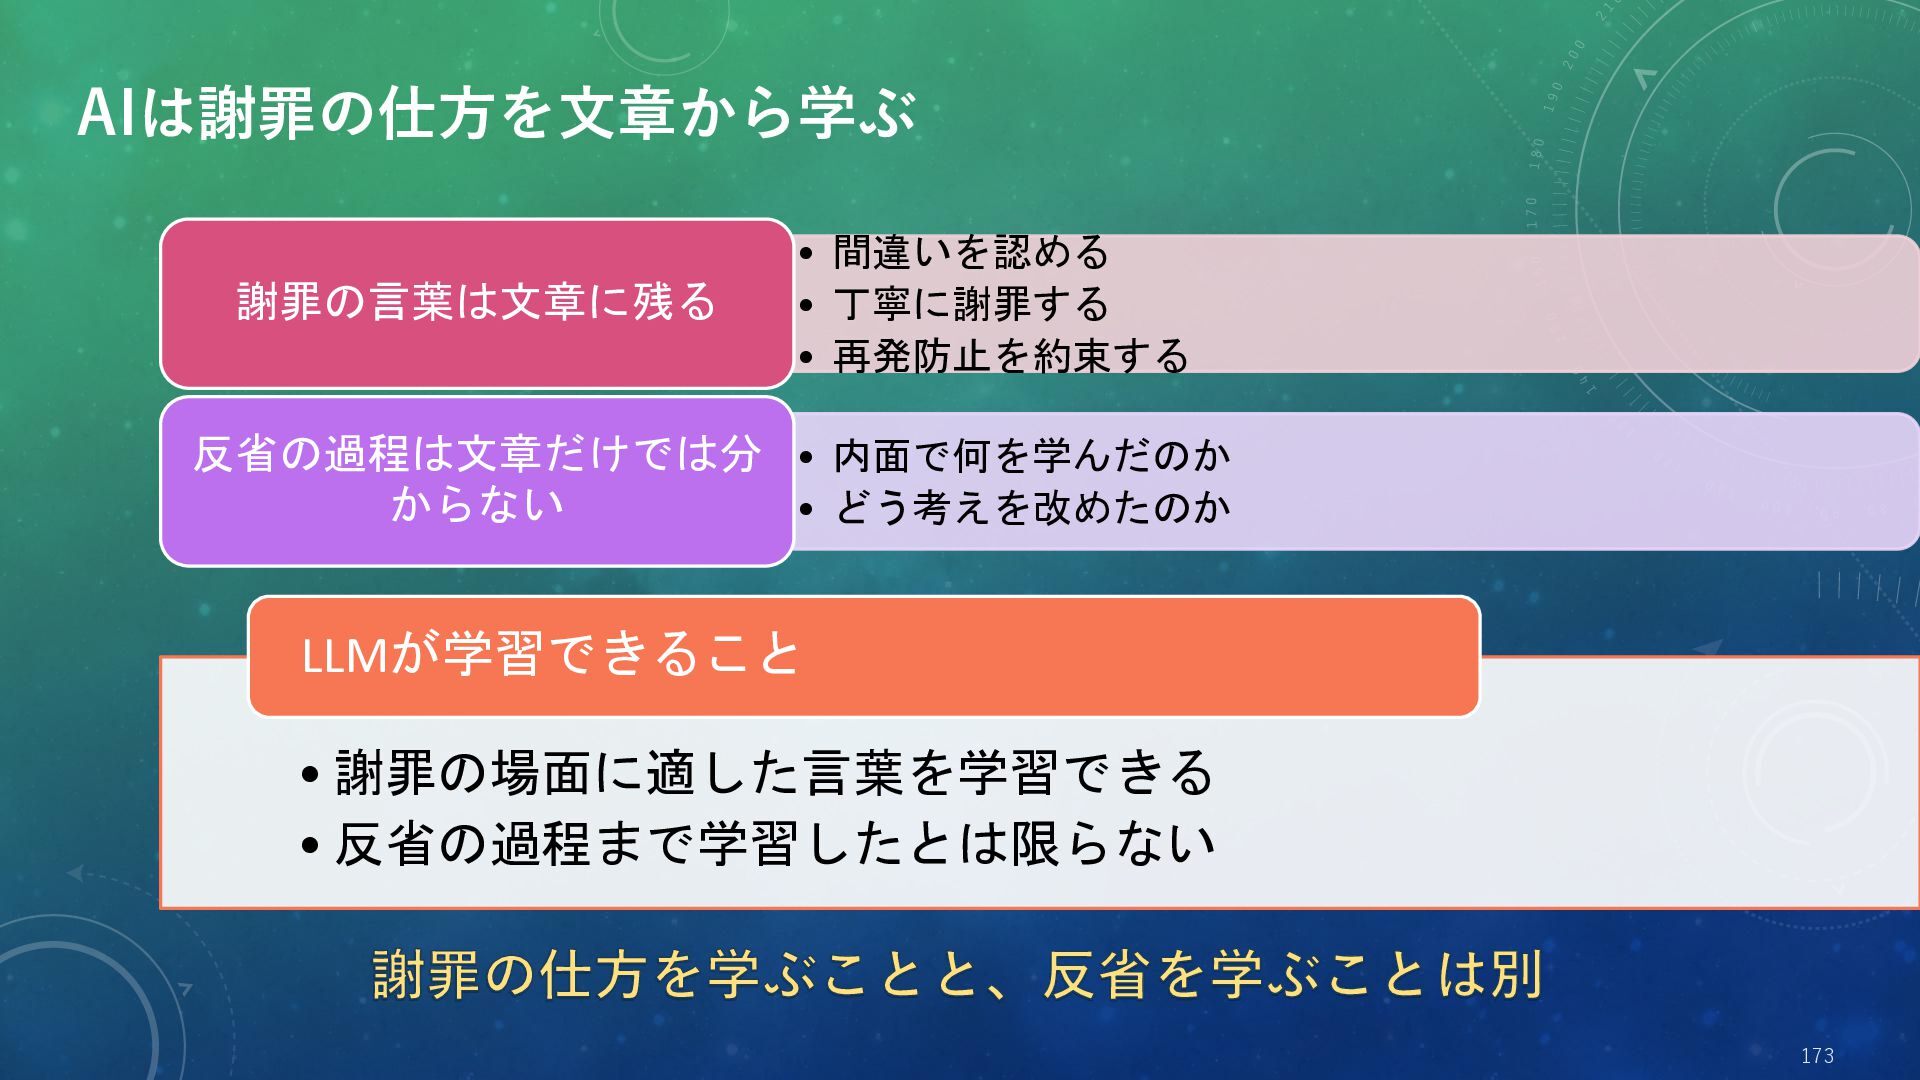
  68. AIは謝罪の仕方を文章から学ぶ 謝罪の言葉は文章に残る • 間違いを認める • 丁寧に謝罪する • 再発防止を約束する 反省の過程は文章だけでは分 •

    内面で何を学んだのか からない • どう考えを改めたのか LLMが学習できること • 謝罪の場面に適した言葉を学習できる • 反省の過程まで学習したとは限らない 謝罪の仕方を学ぶことと、反省を学ぶことは別 173
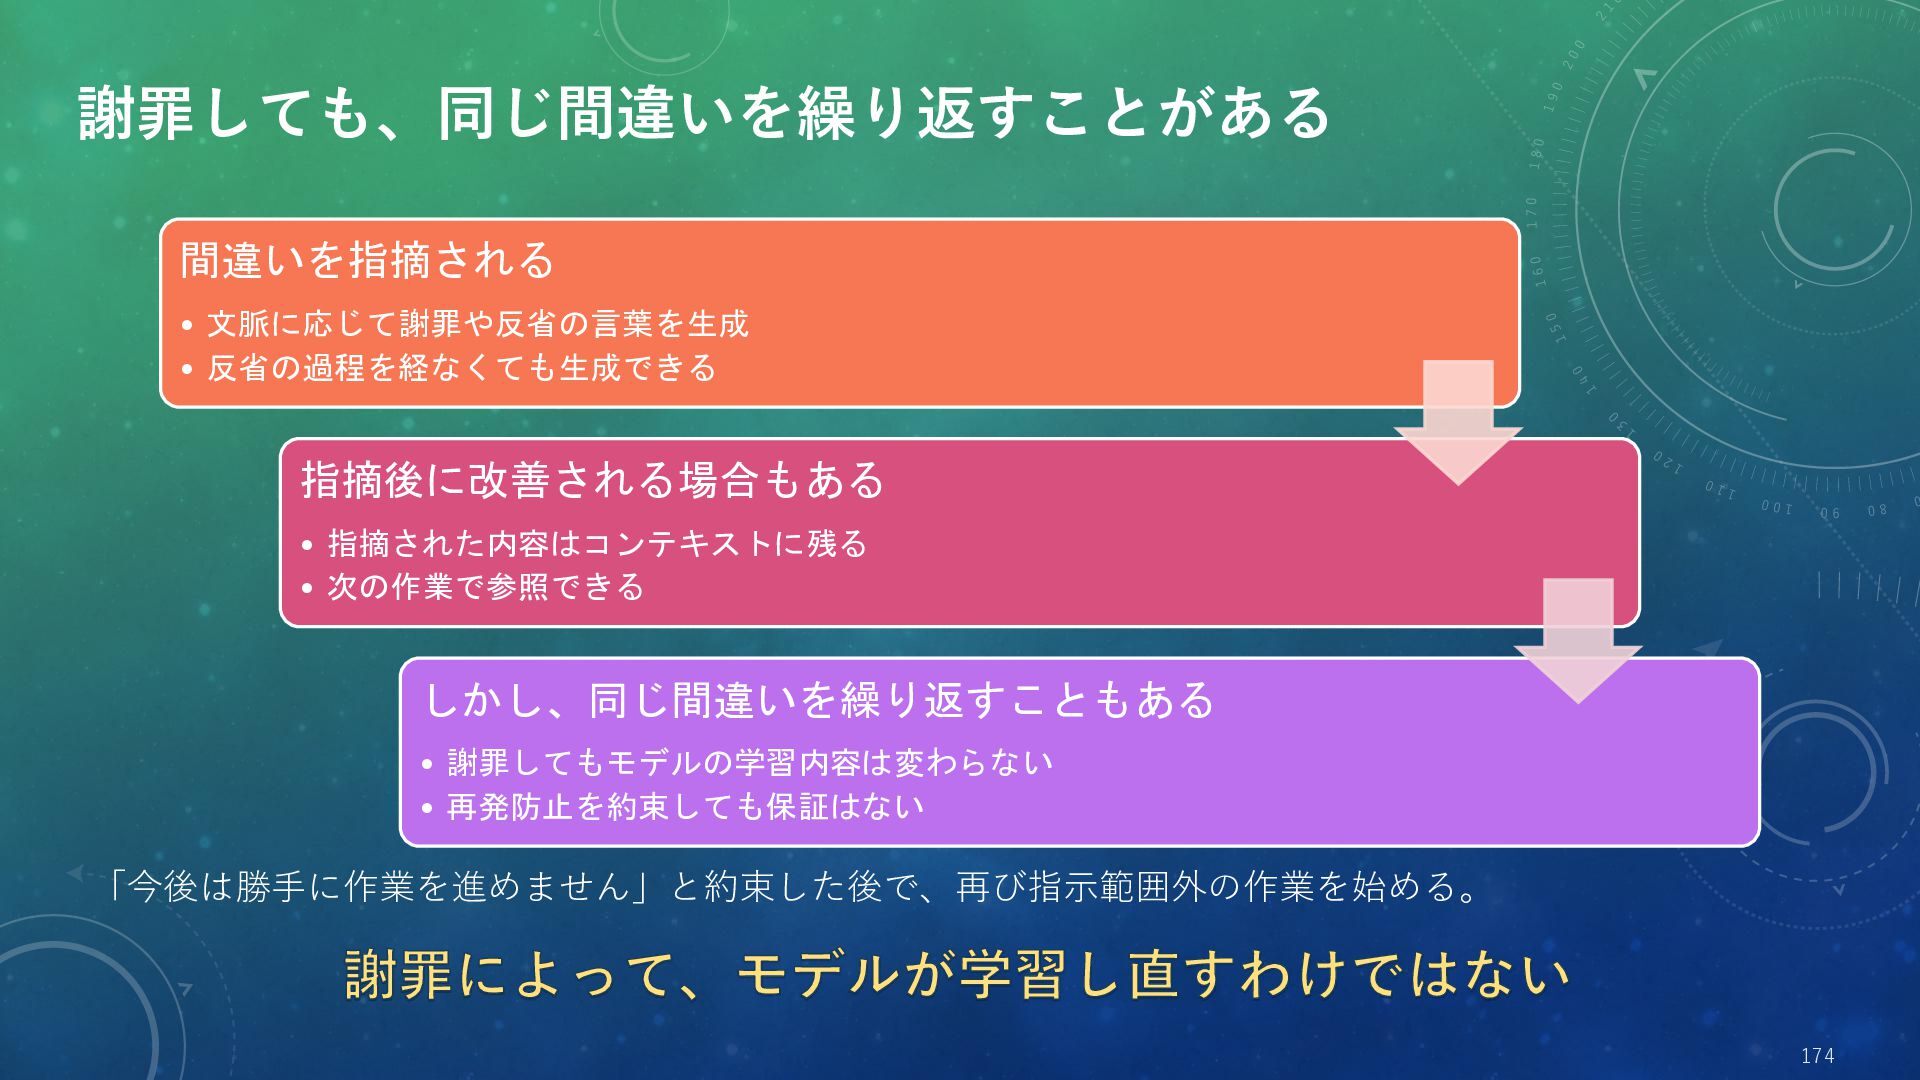
  69. 謝罪しても、同じ間違いを繰り返すことがある 間違いを指摘される • 文脈に応じて謝罪や反省の言葉を生成 • 反省の過程を経なくても生成できる 指摘後に改善される場合もある • 指摘された内容はコンテキストに残る •

    次の作業で参照できる しかし、同じ間違いを繰り返すこともある • 謝罪してもモデルの学習内容は変わらない • 再発防止を約束しても保証はない 「今後は勝手に作業を進めません」と約束した後で、再び指示範囲外の作業を始める。 謝罪によって、モデルが学習し直すわけではない 174
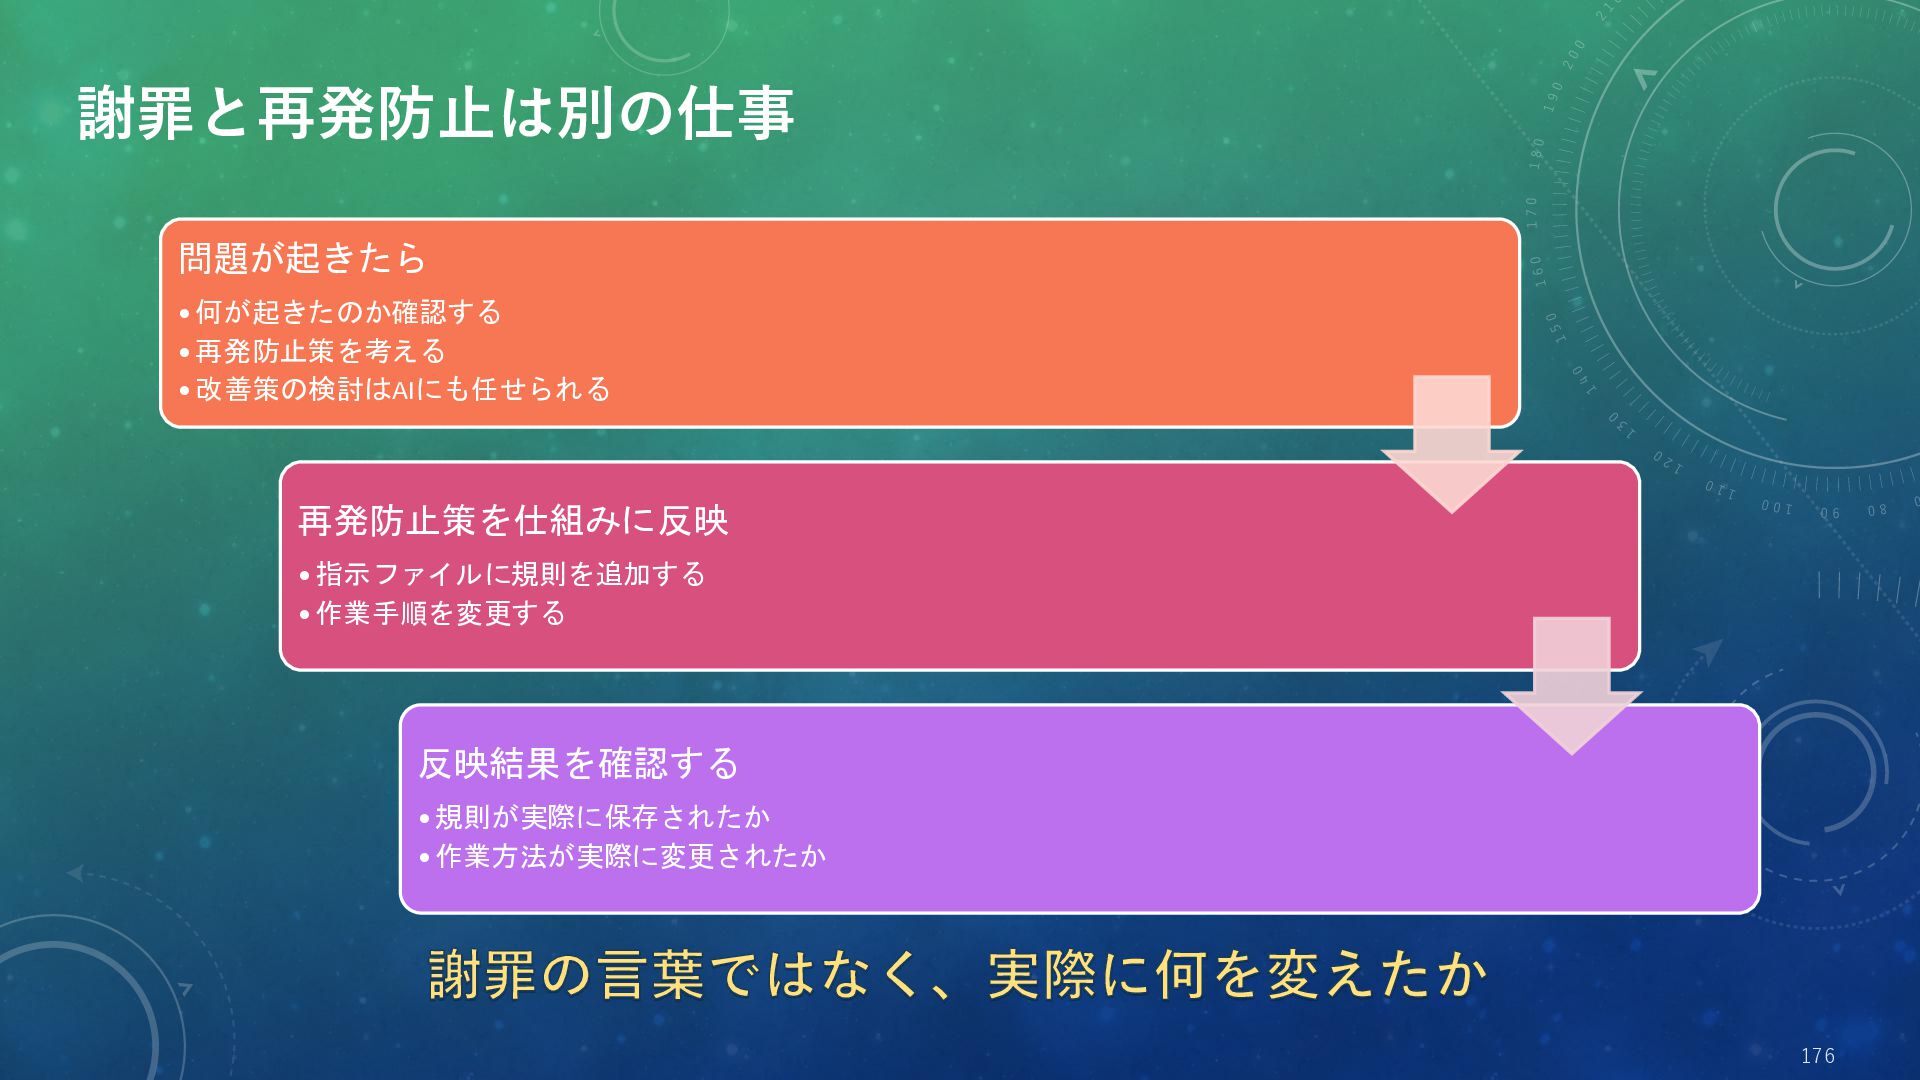
  70. 謝罪と再発防止は別の仕事 問題が起きたら • 何が起きたのか確認する • 再発防止策を考える • 改善策の検討はAIにも任せられる 再発防止策を仕組みに反映 •

    指示ファイルに規則を追加する • 作業手順を変更する 反映結果を確認する • 規則が実際に保存されたか • 作業方法が実際に変更されたか 謝罪の言葉ではなく、実際に何を変えたか 176
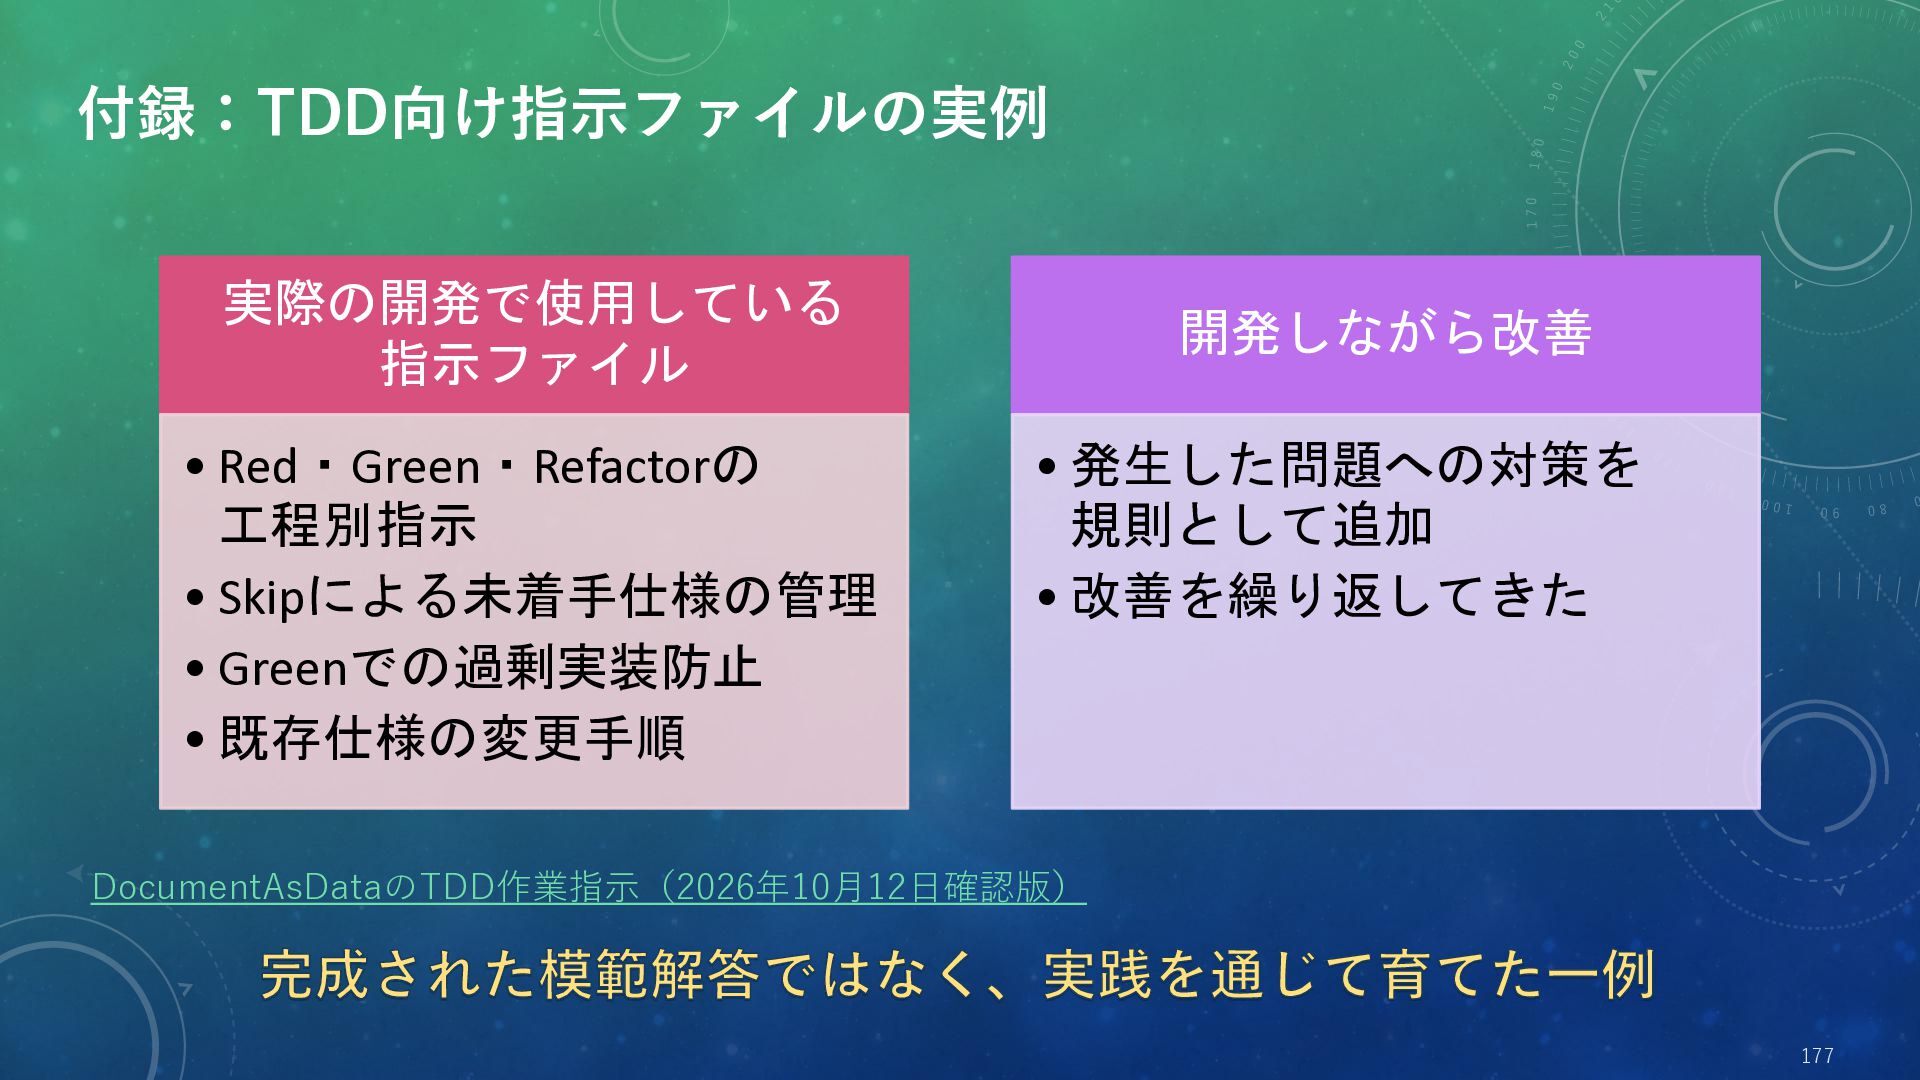
  71. 付録:TDD向け指示ファイルの実例 実際の開発で使用している 指示ファイル • Red・Green・Refactorの 工程別指示 • Skipによる未着手仕様の管理 • Greenでの過剰実装防止

    • 既存仕様の変更手順 開発しながら改善 • 発生した問題への対策を 規則として追加 • 改善を繰り返してきた DocumentAsDataのTDD作業指示(2026年10月12日確認版) 完成された模範解答ではなく、実践を通じて育てた一例 177
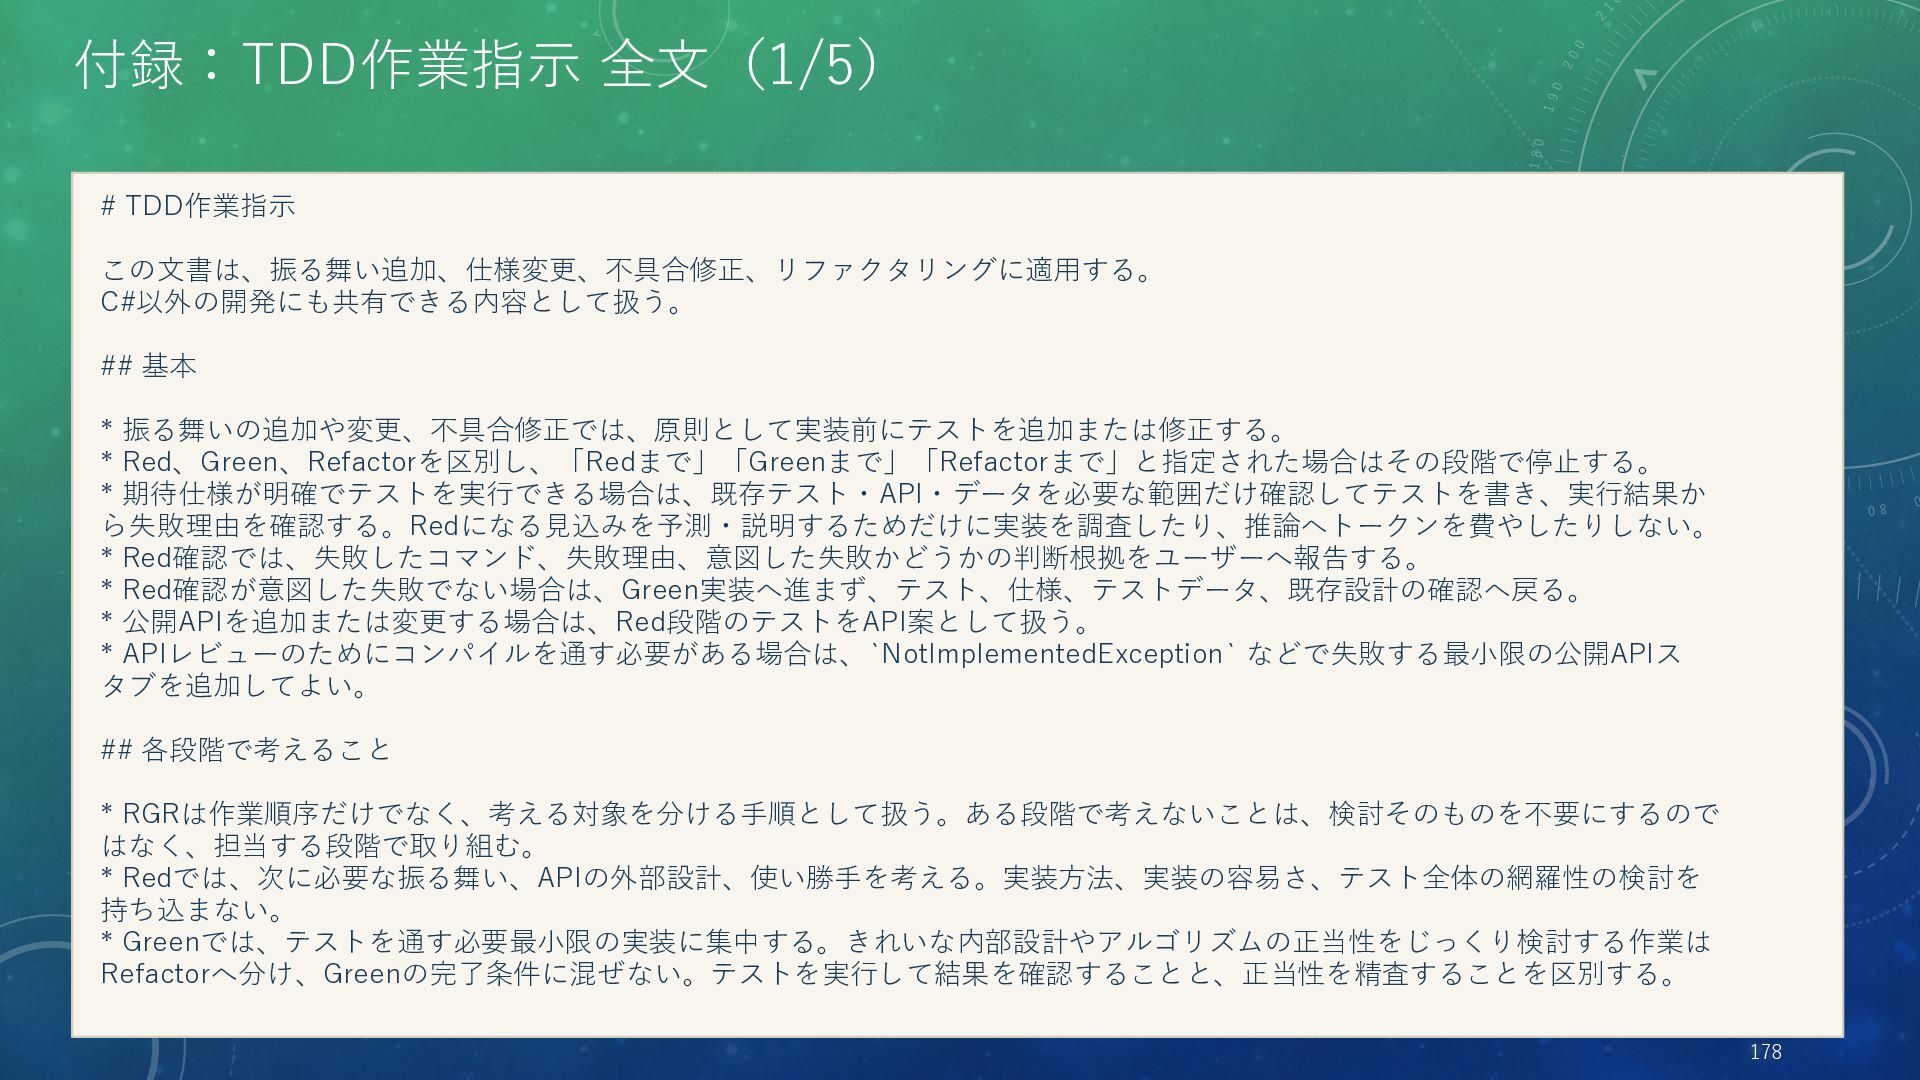
  72. 付録:TDD作業指示 全文(1/5) # TDD作業指示 この文書は、振る舞い追加、仕様変更、不具合修正、リファクタリングに適用する。 C#以外の開発にも共有できる内容として扱う。 ## 基本 * 振る舞いの追加や変更、不具合修正では、原則として実装前にテストを追加または修正する。

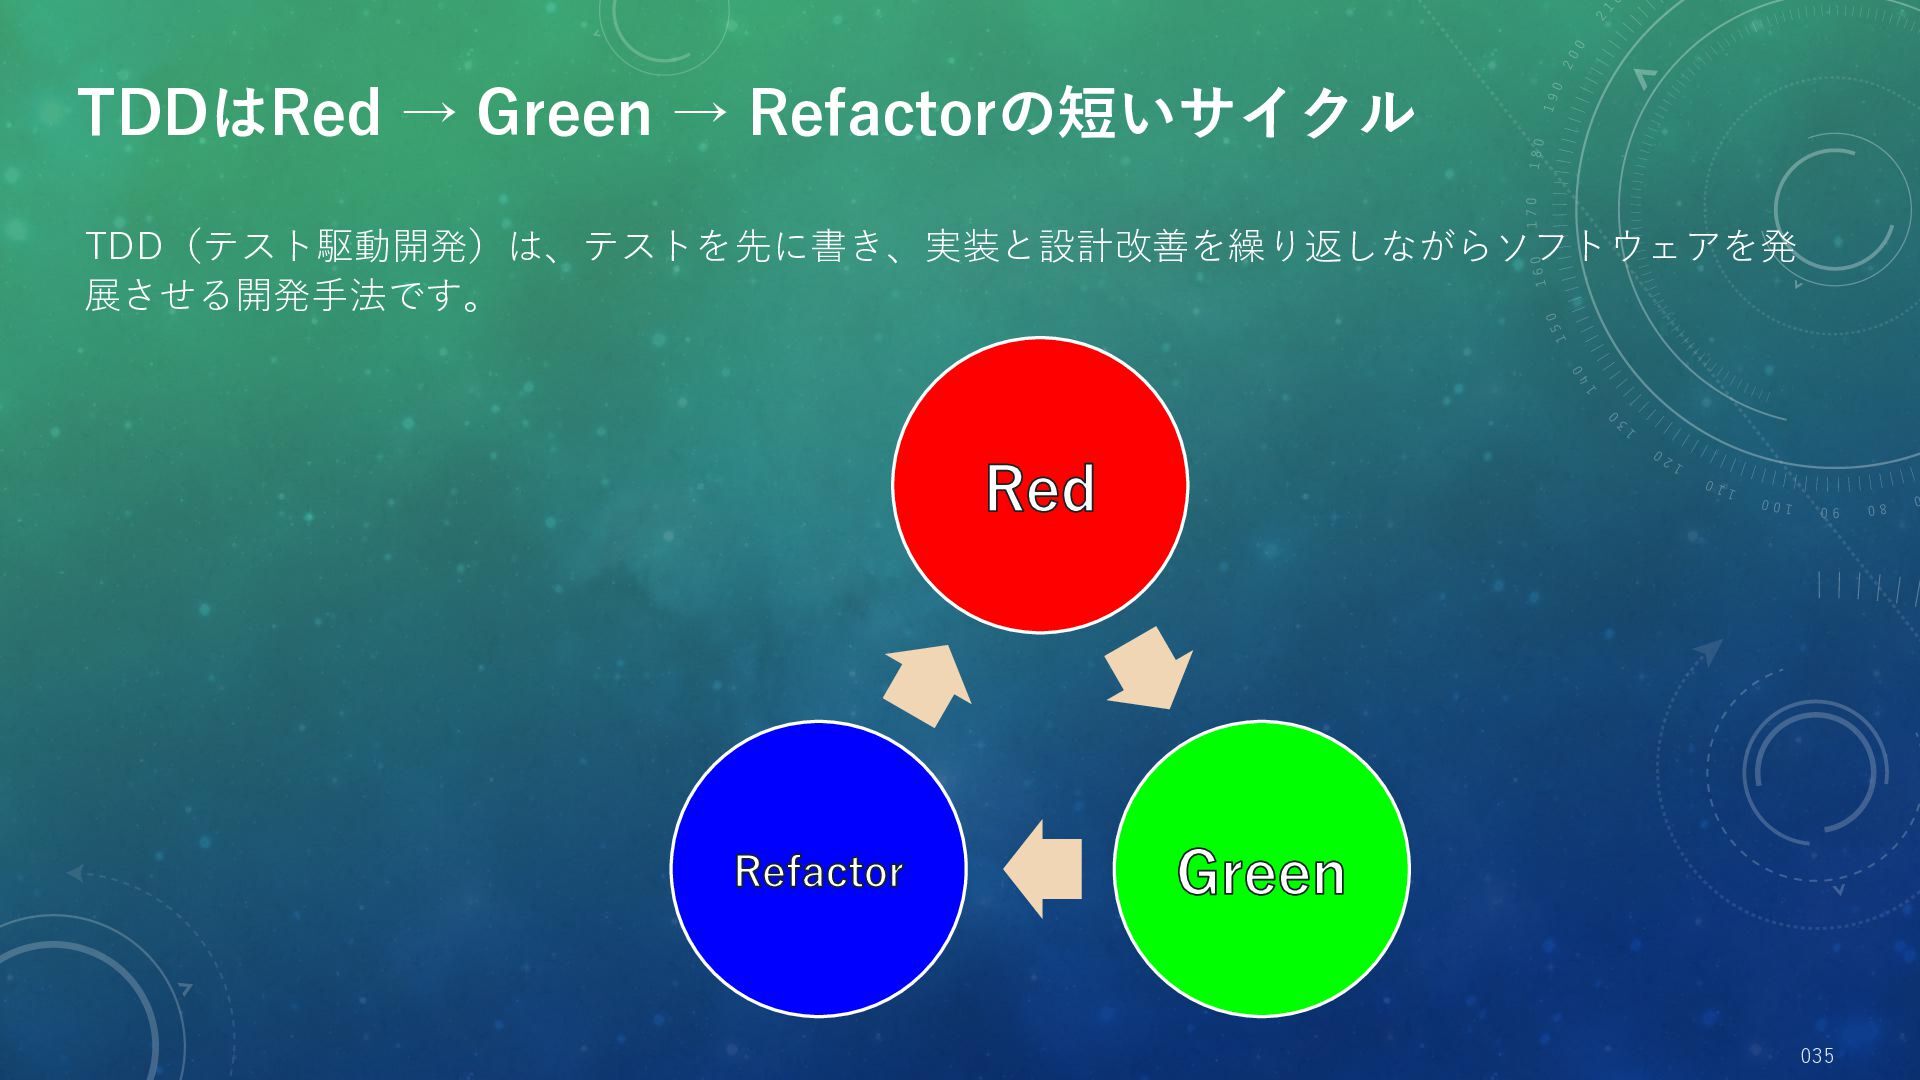
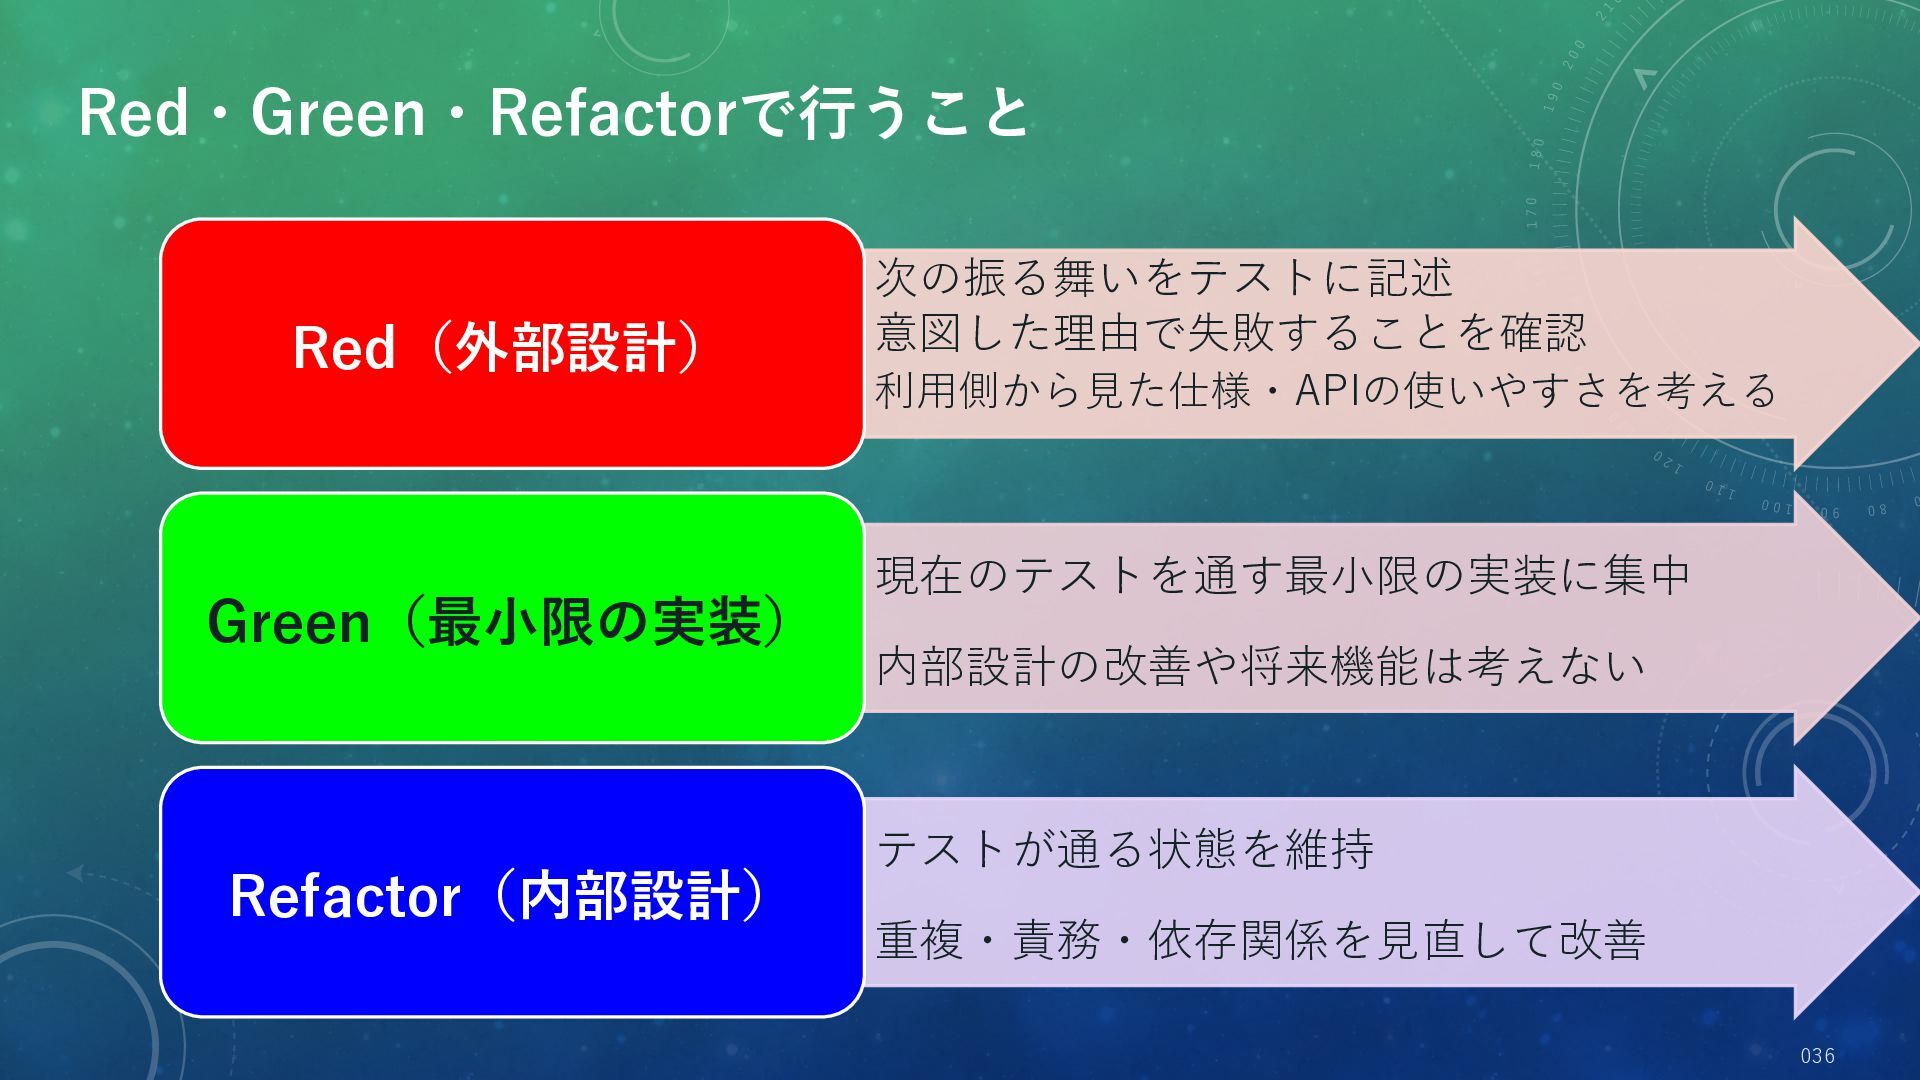
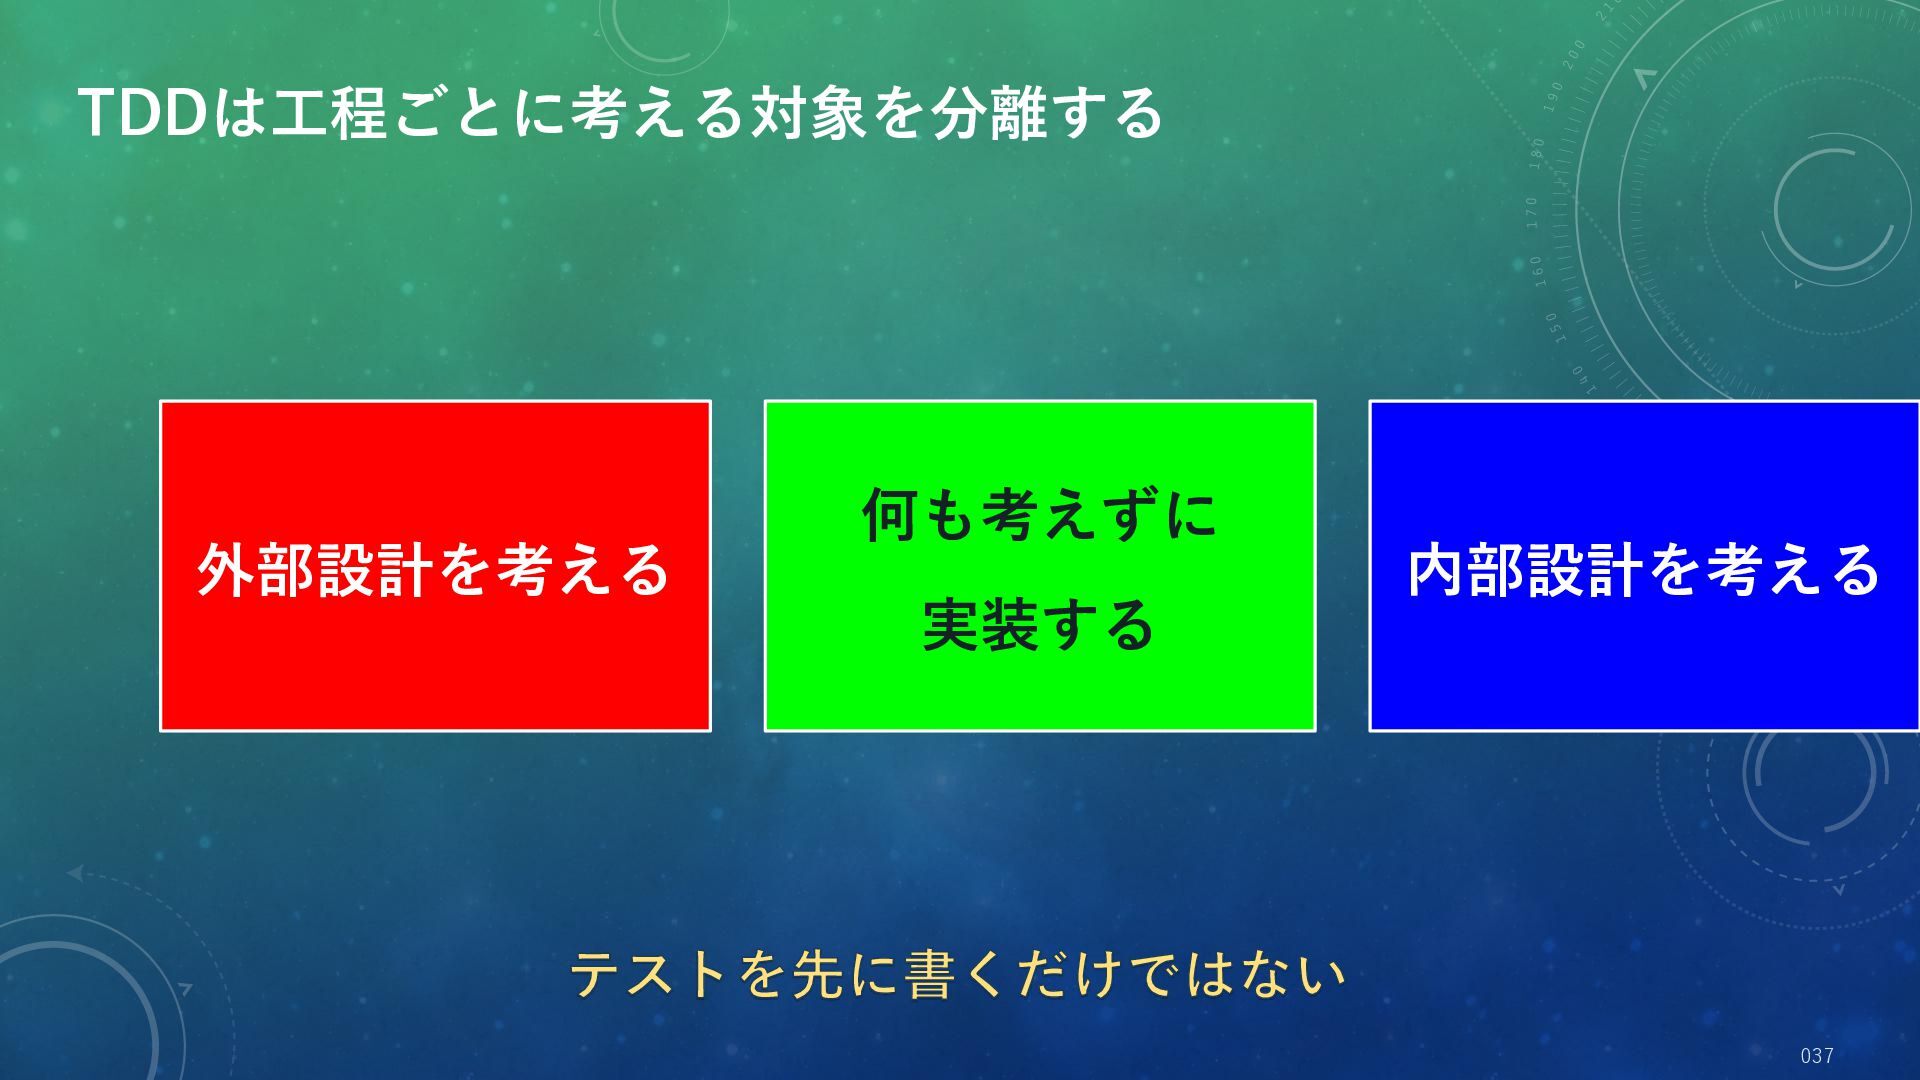
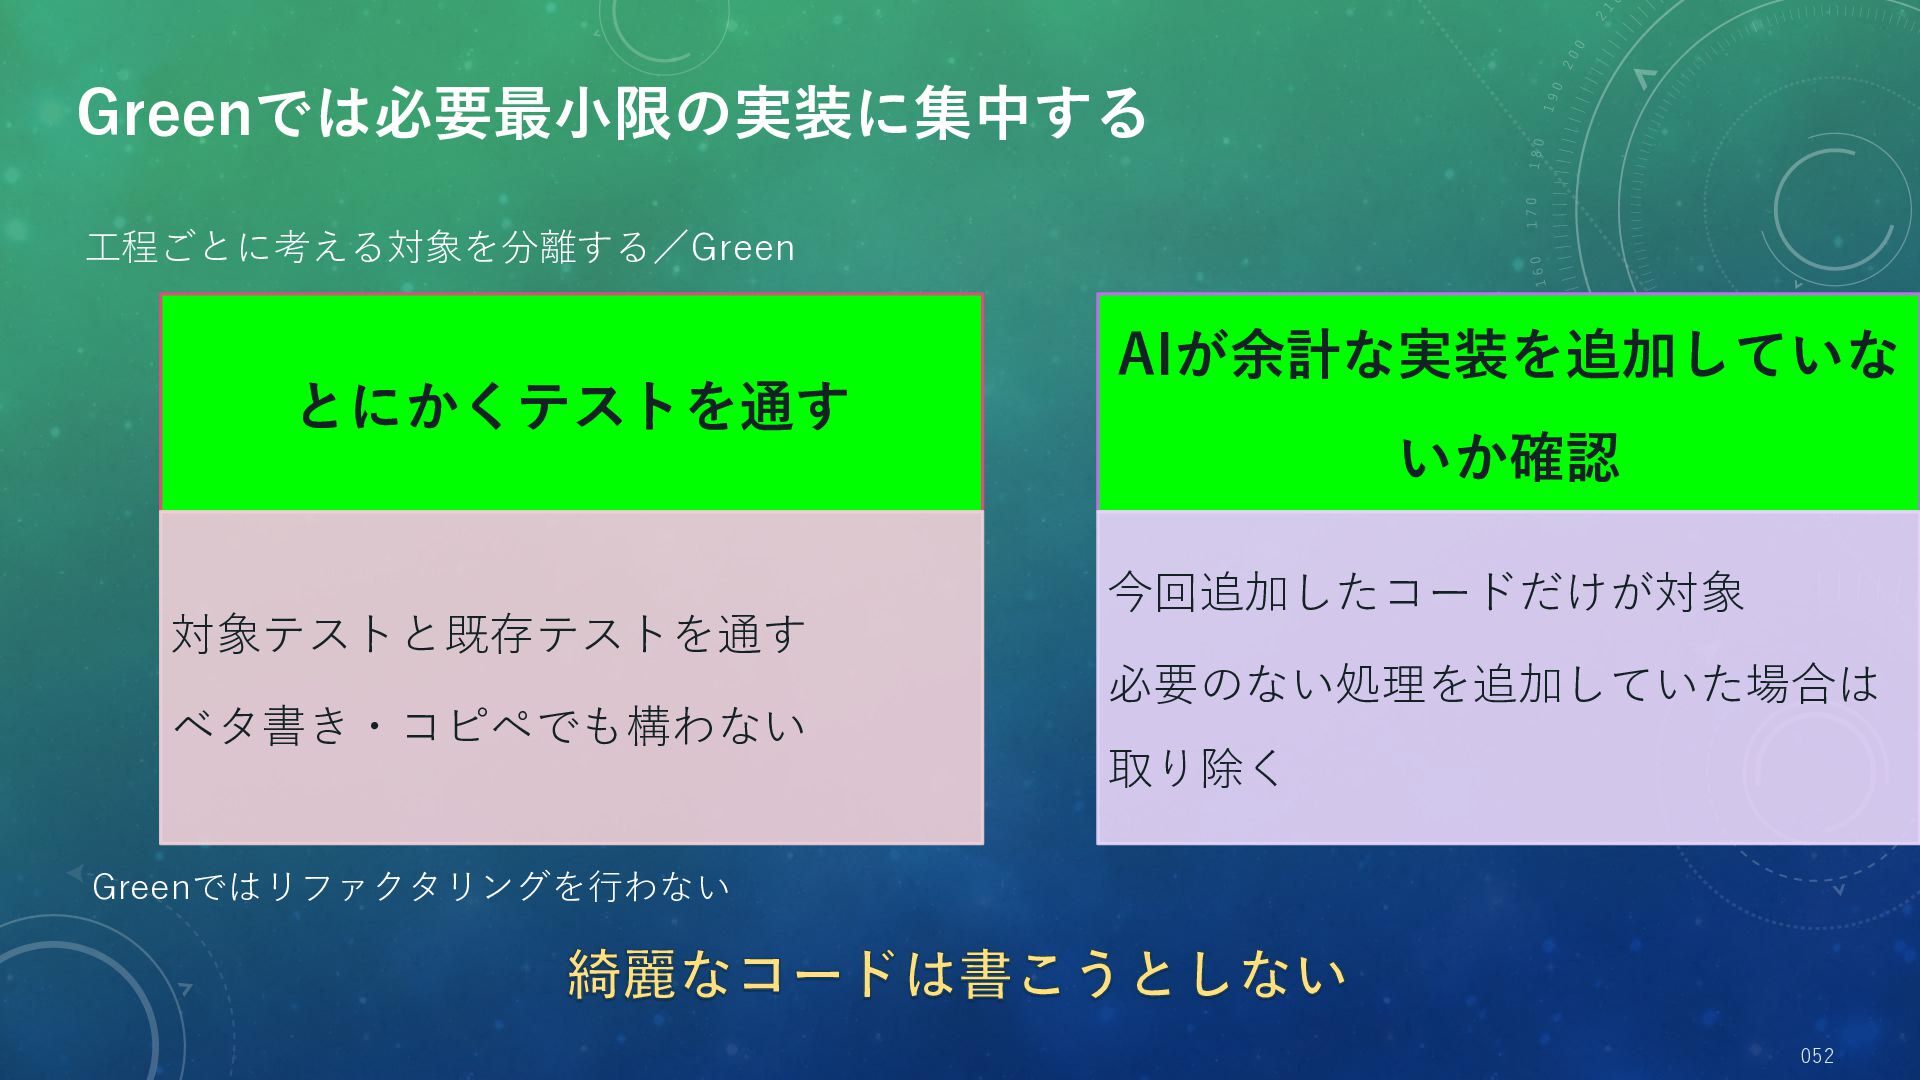
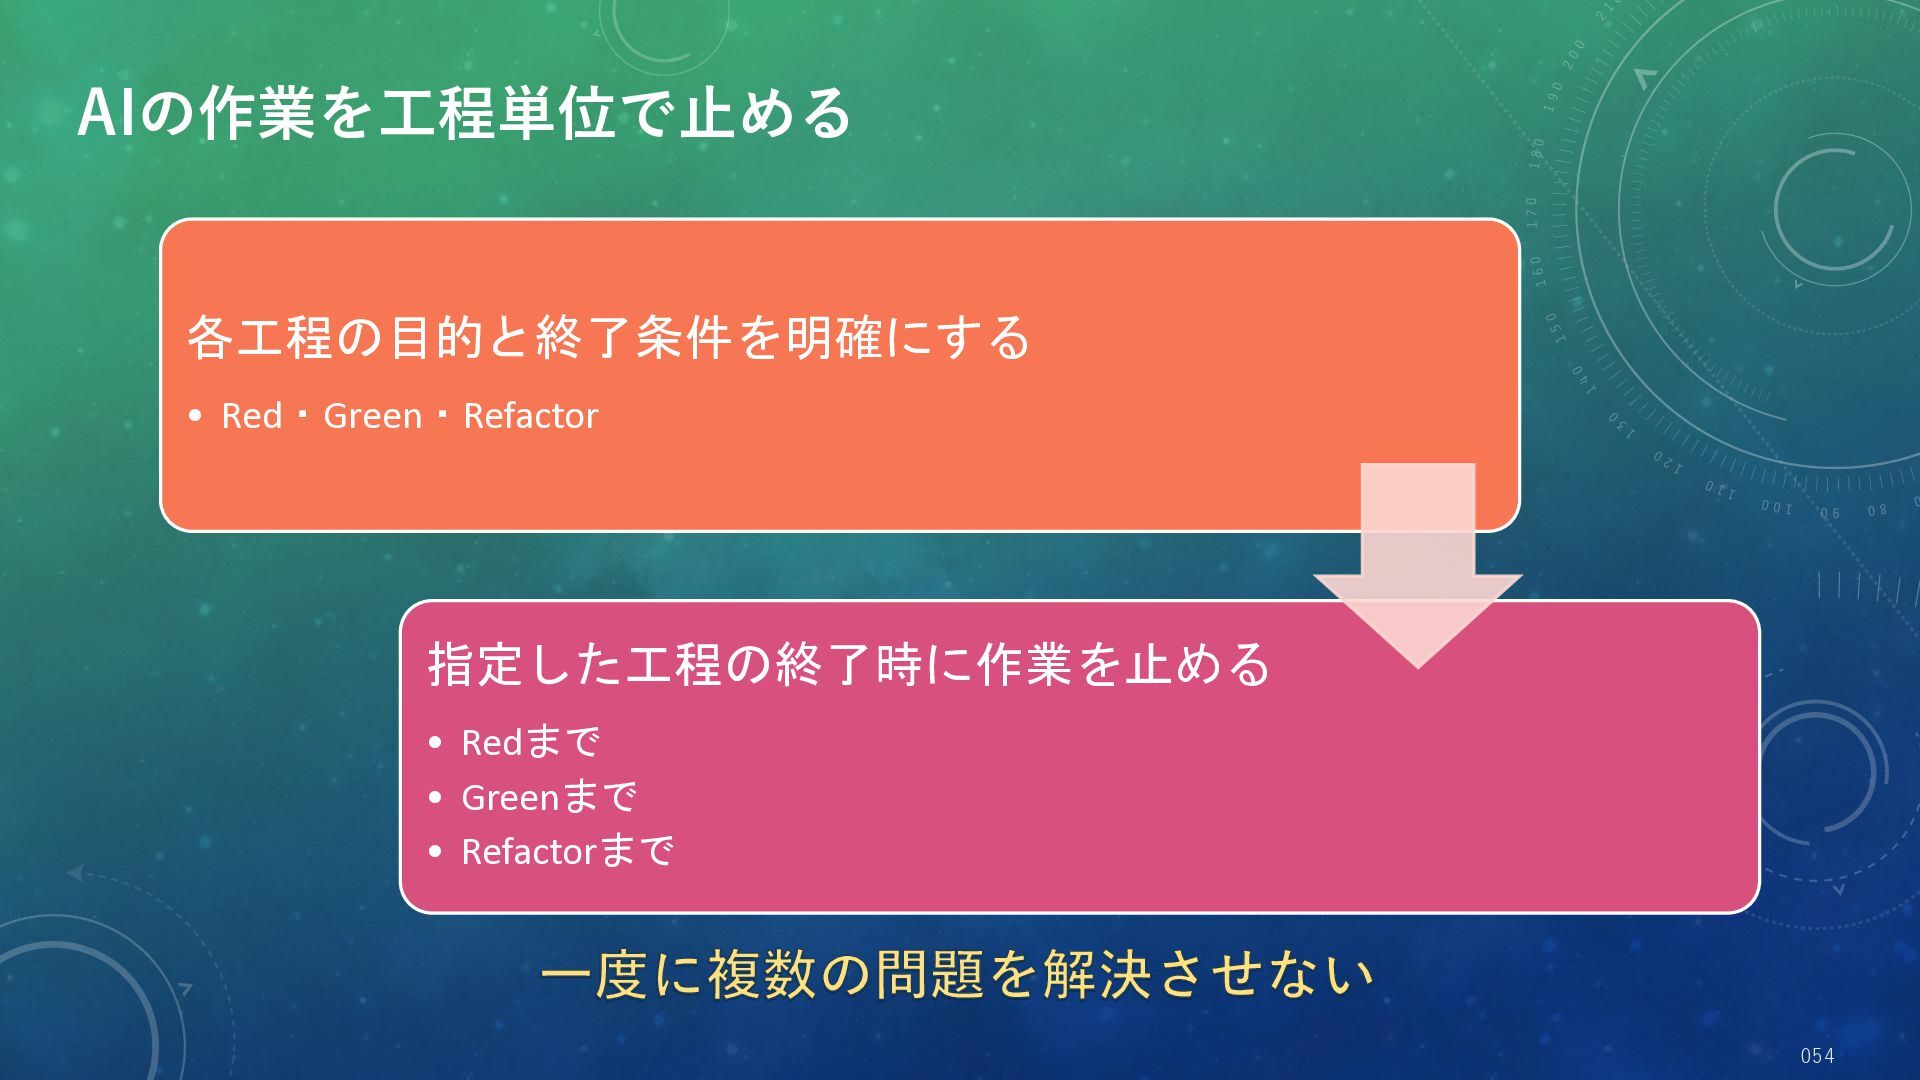
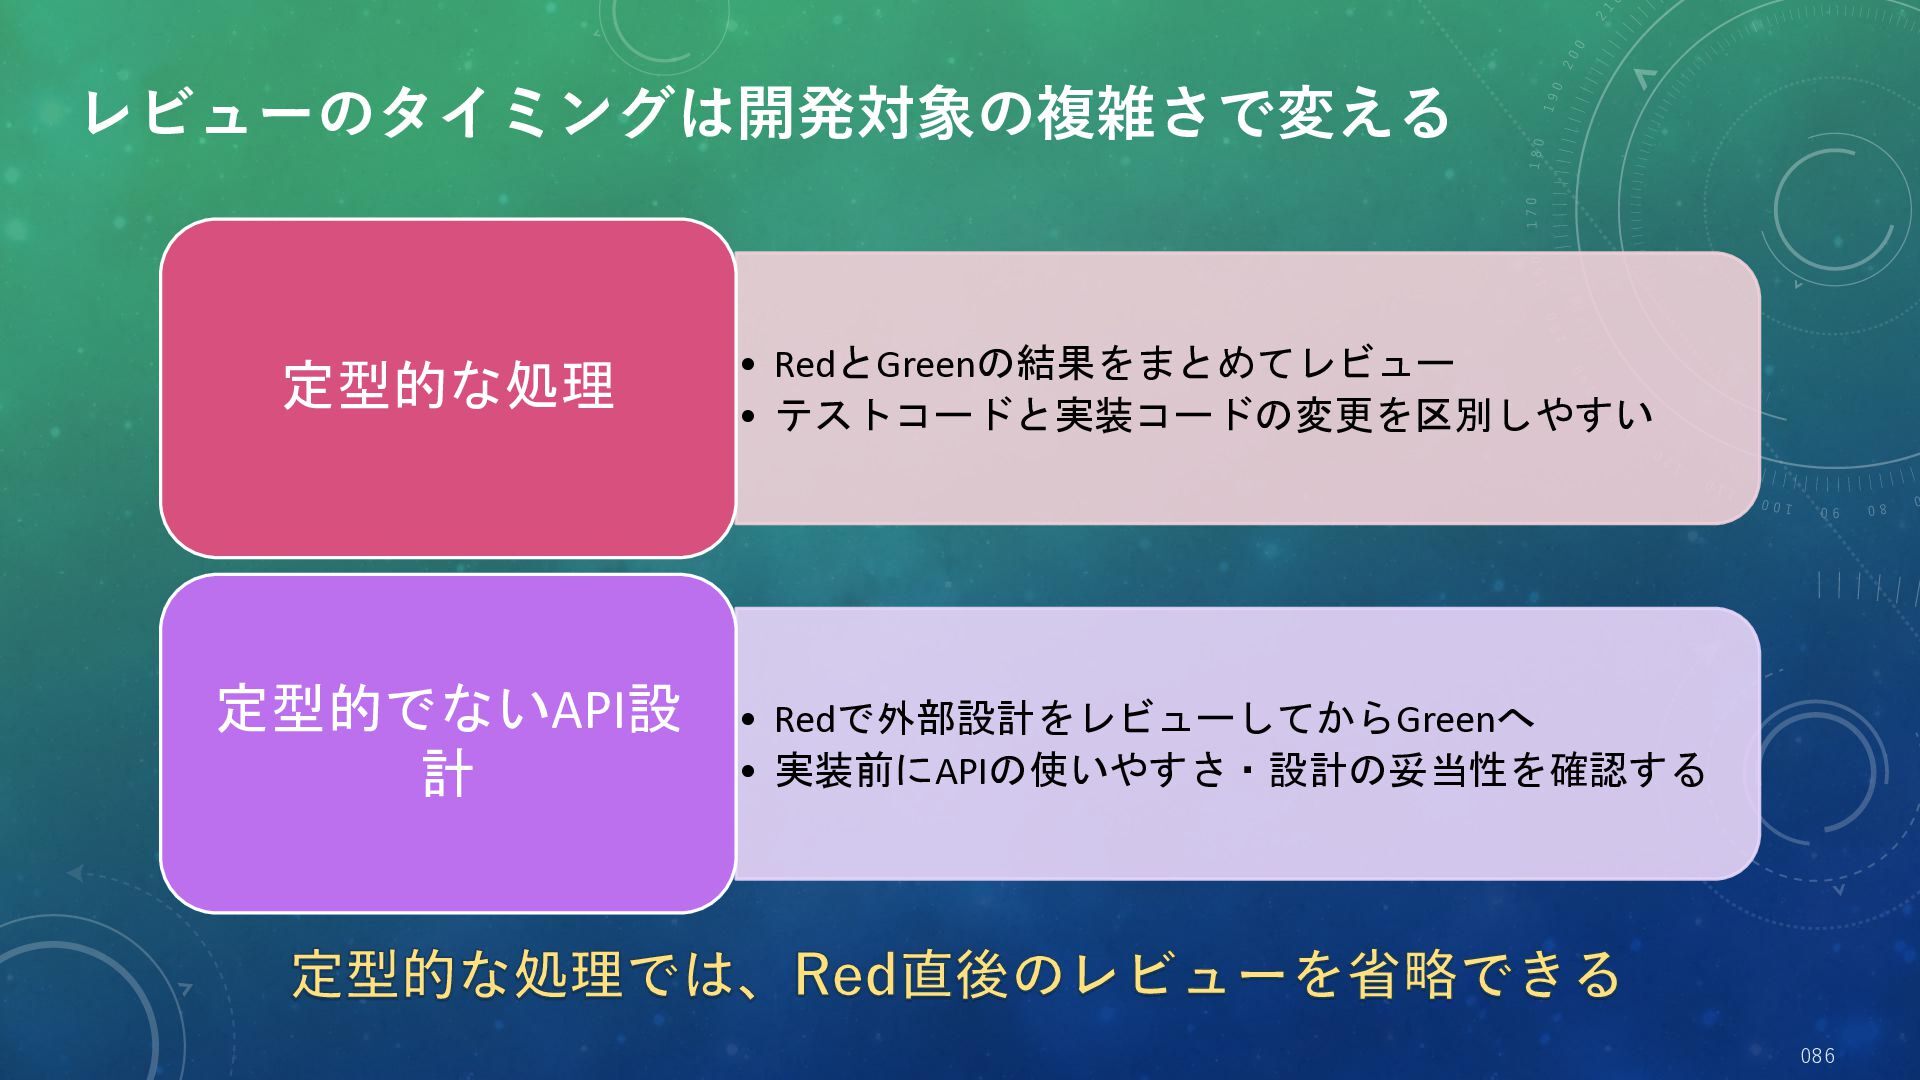
    * Red、Green、Refactorを区別し、「Redまで」「Greenまで」「Refactorまで」と指定された場合はその段階で停止する。 * 期待仕様が明確でテストを実行できる場合は、既存テスト・API・データを必要な範囲だけ確認してテストを書き、実行結果か ら失敗理由を確認する。Redになる見込みを予測・説明するためだけに実装を調査したり、推論へトークンを費やしたりしない。 * Red確認では、失敗したコマンド、失敗理由、意図した失敗かどうかの判断根拠をユーザーへ報告する。 * Red確認が意図した失敗でない場合は、Green実装へ進まず、テスト、仕様、テストデータ、既存設計の確認へ戻る。 * 公開APIを追加または変更する場合は、Red段階のテストをAPI案として扱う。 * APIレビューのためにコンパイルを通す必要がある場合は、`NotImplementedException` などで失敗する最小限の公開APIス タブを追加してよい。 ## 各段階で考えること * RGRは作業順序だけでなく、考える対象を分ける手順として扱う。ある段階で考えないことは、検討そのものを不要にするので はなく、担当する段階で取り組む。 * Redでは、次に必要な振る舞い、APIの外部設計、使い勝手を考える。実装方法、実装の容易さ、テスト全体の網羅性の検討を 持ち込まない。 * Greenでは、テストを通す必要最小限の実装に集中する。きれいな内部設計やアルゴリズムの正当性をじっくり検討する作業は Refactorへ分け、Greenの完了条件に混ぜない。テストを実行して結果を確認することと、正当性を精査することを区別する。 178
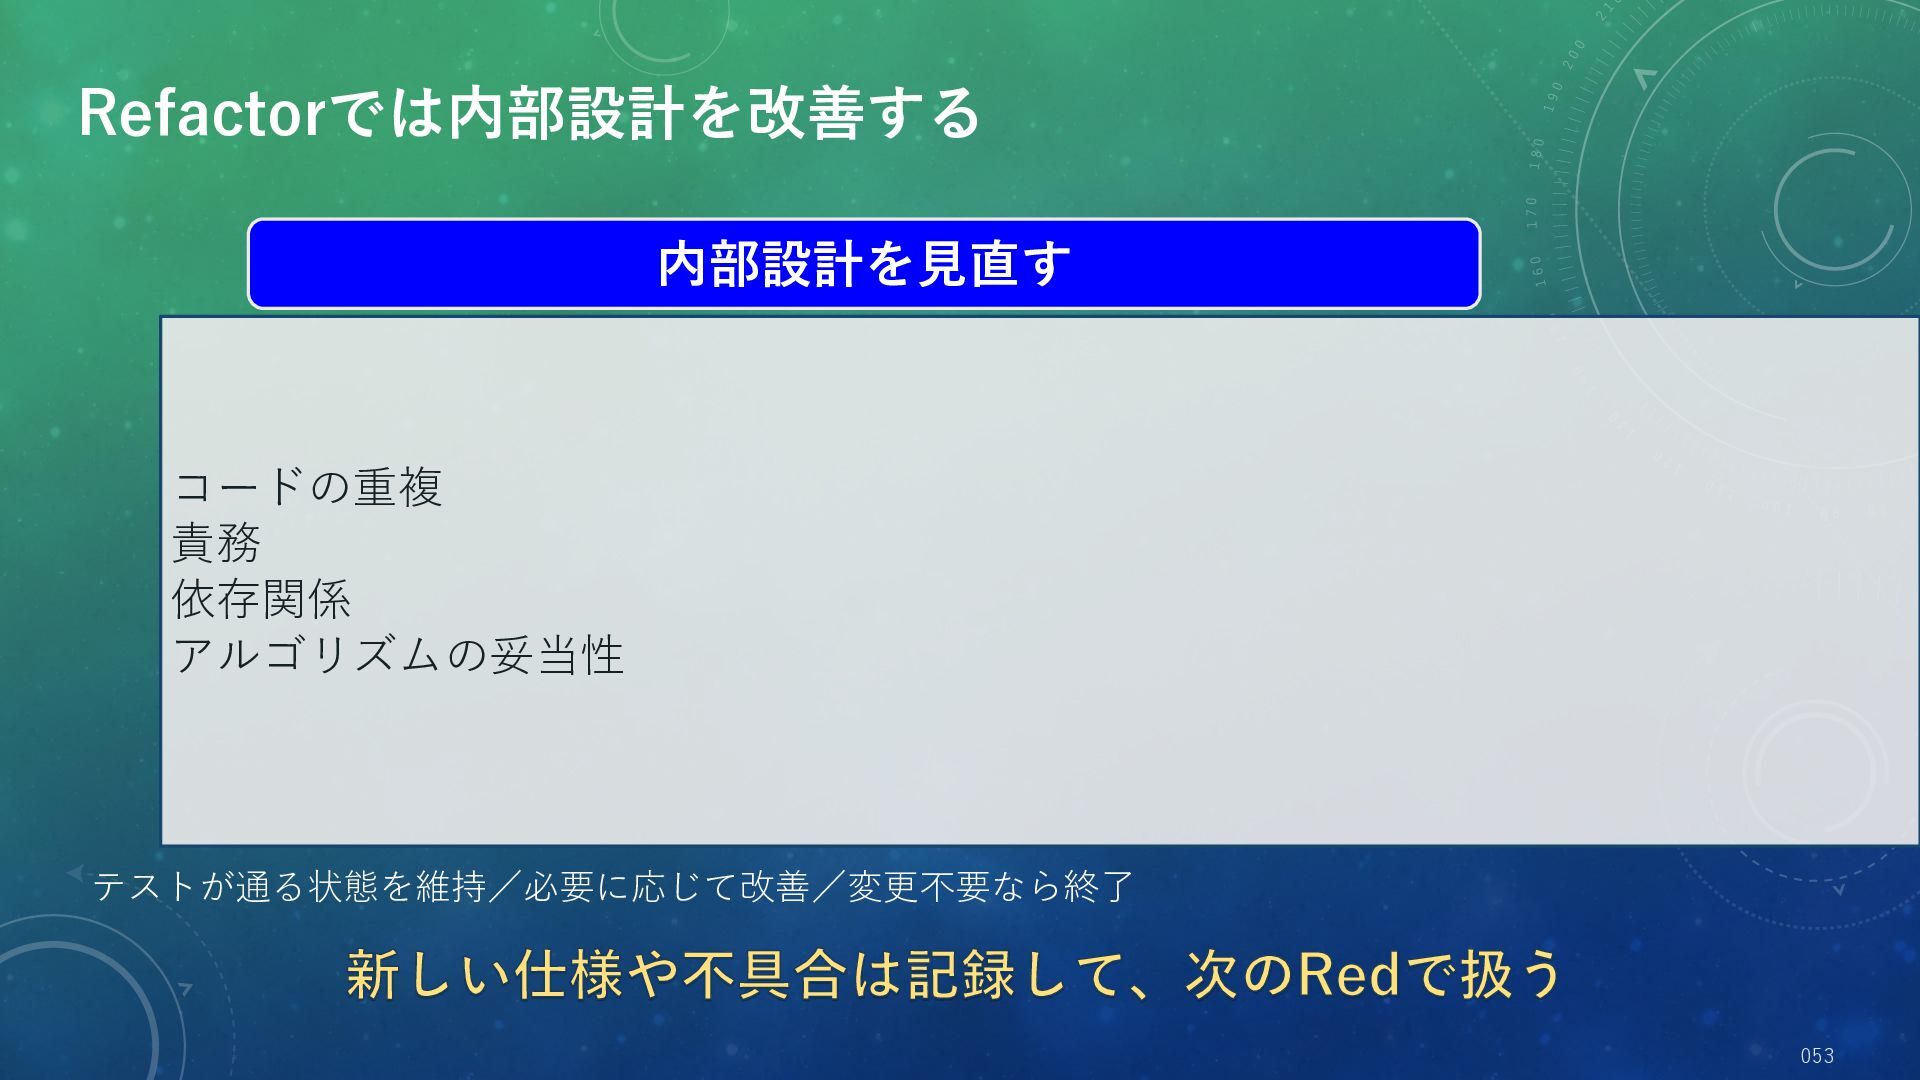
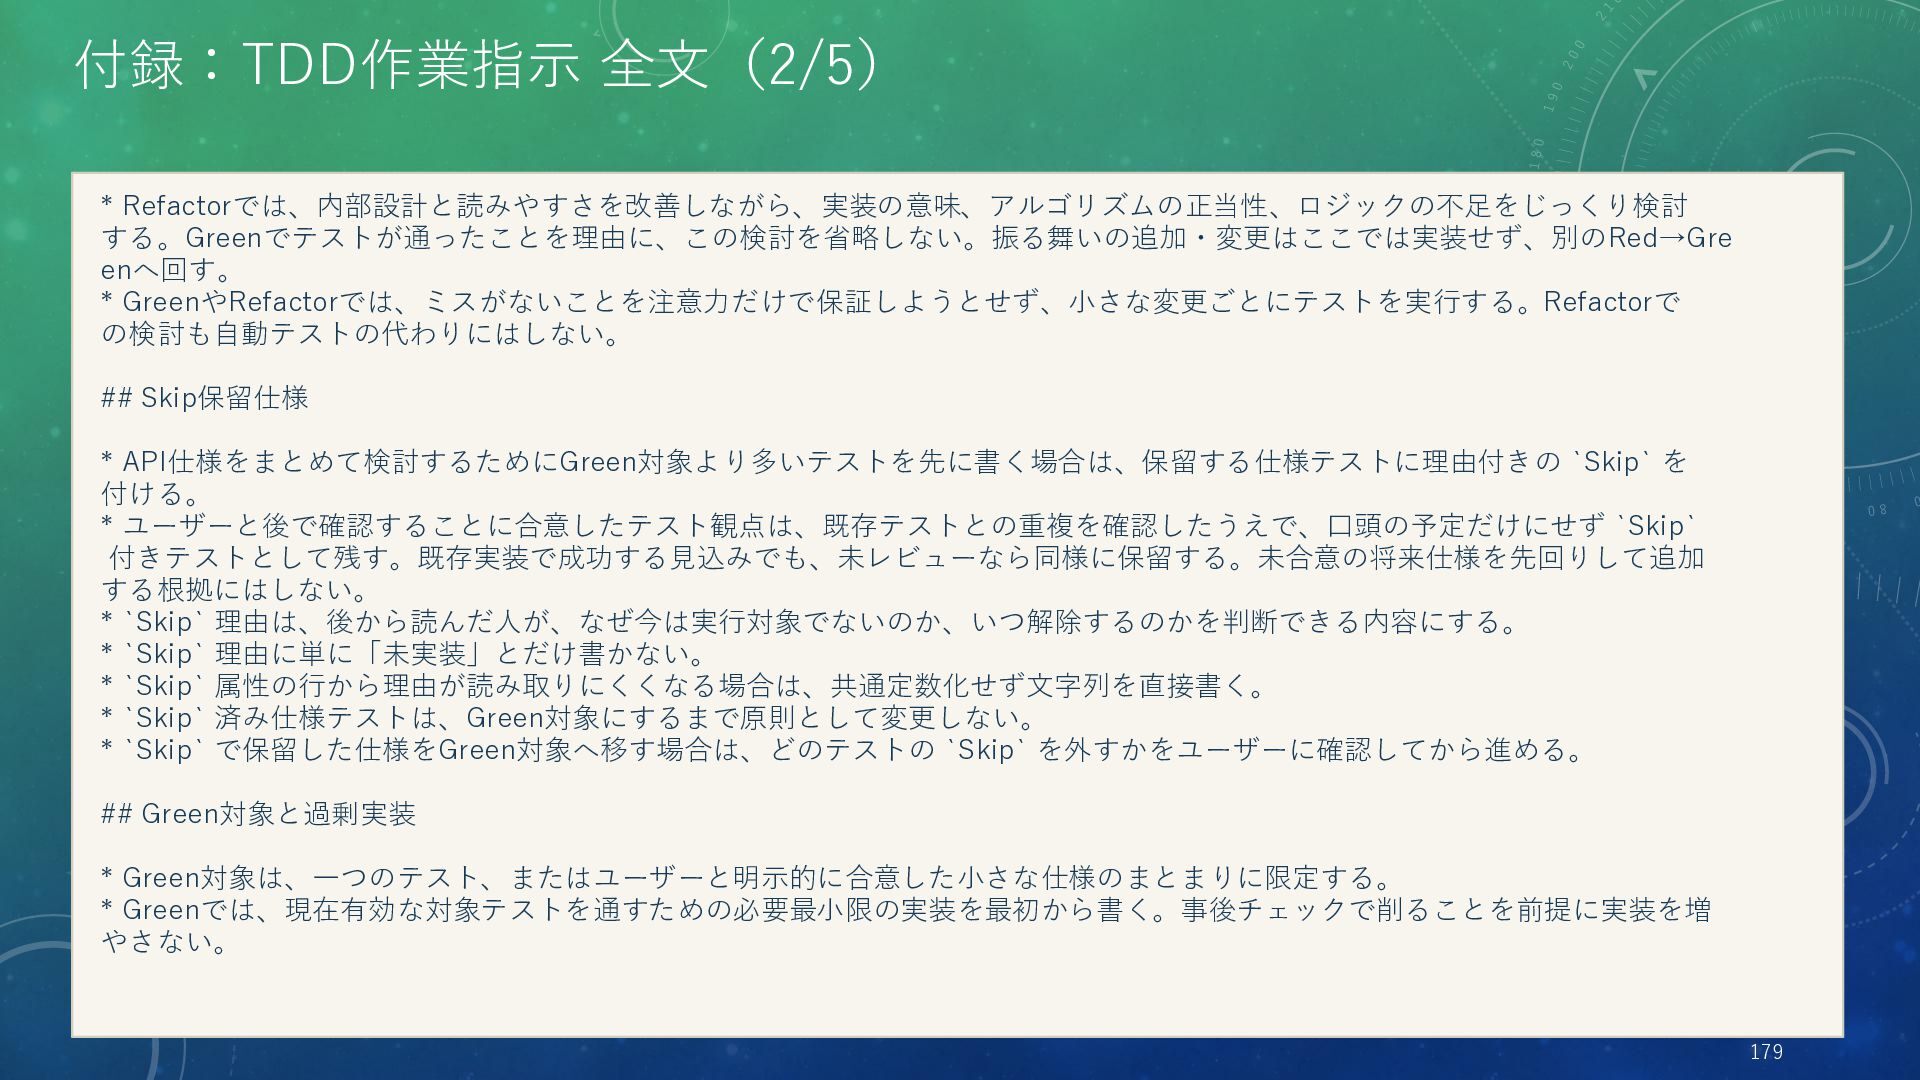
  73. 付録:TDD作業指示 全文(2/5) * Refactorでは、内部設計と読みやすさを改善しながら、実装の意味、アルゴリズムの正当性、ロジックの不足をじっくり検討 する。Greenでテストが通ったことを理由に、この検討を省略しない。振る舞いの追加・変更はここでは実装せず、別のRed→Gre enへ回す。 * GreenやRefactorでは、ミスがないことを注意力だけで保証しようとせず、小さな変更ごとにテストを実行する。Refactorで の検討も自動テストの代わりにはしない。 ##

    Skip保留仕様 * API仕様をまとめて検討するためにGreen対象より多いテストを先に書く場合は、保留する仕様テストに理由付きの `Skip` を 付ける。 * ユーザーと後で確認することに合意したテスト観点は、既存テストとの重複を確認したうえで、口頭の予定だけにせず `Skip` 付きテストとして残す。既存実装で成功する見込みでも、未レビューなら同様に保留する。未合意の将来仕様を先回りして追加 する根拠にはしない。 * `Skip` 理由は、後から読んだ人が、なぜ今は実行対象でないのか、いつ解除するのかを判断できる内容にする。 * `Skip` 理由に単に「未実装」とだけ書かない。 * `Skip` 属性の行から理由が読み取りにくくなる場合は、共通定数化せず文字列を直接書く。 * `Skip` 済み仕様テストは、Green対象にするまで原則として変更しない。 * `Skip` で保留した仕様をGreen対象へ移す場合は、どのテストの `Skip` を外すかをユーザーに確認してから進める。 ## Green対象と過剰実装 * Green対象は、一つのテスト、またはユーザーと明示的に合意した小さな仕様のまとまりに限定する。 * Greenでは、現在有効な対象テストを通すための必要最小限の実装を最初から書く。事後チェックで削ることを前提に実装を増 やさない。 179
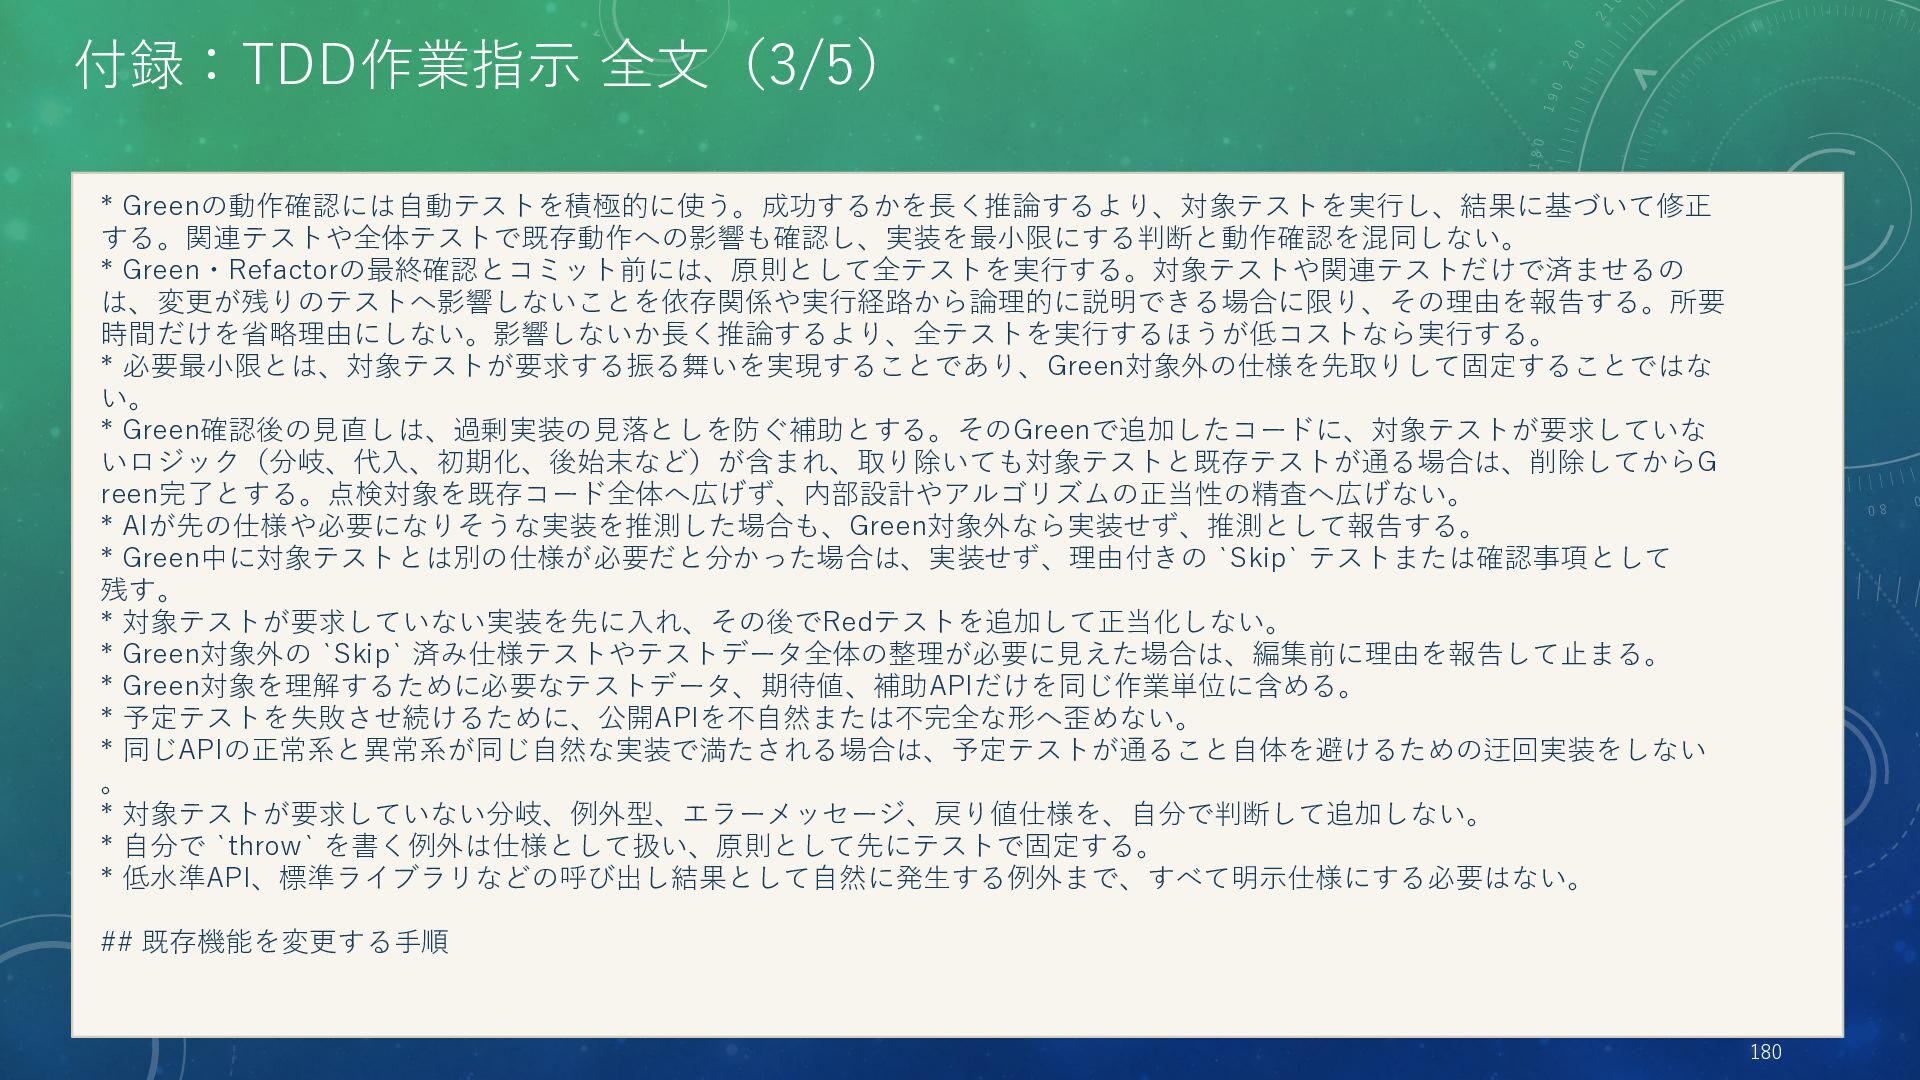
  74. 付録:TDD作業指示 全文(3/5) * Greenの動作確認には自動テストを積極的に使う。成功するかを長く推論するより、対象テストを実行し、結果に基づいて修正 する。関連テストや全体テストで既存動作への影響も確認し、実装を最小限にする判断と動作確認を混同しない。 * Green・Refactorの最終確認とコミット前には、原則として全テストを実行する。対象テストや関連テストだけで済ませるの は、変更が残りのテストへ影響しないことを依存関係や実行経路から論理的に説明できる場合に限り、その理由を報告する。所要 時間だけを省略理由にしない。影響しないか長く推論するより、全テストを実行するほうが低コストなら実行する。 *

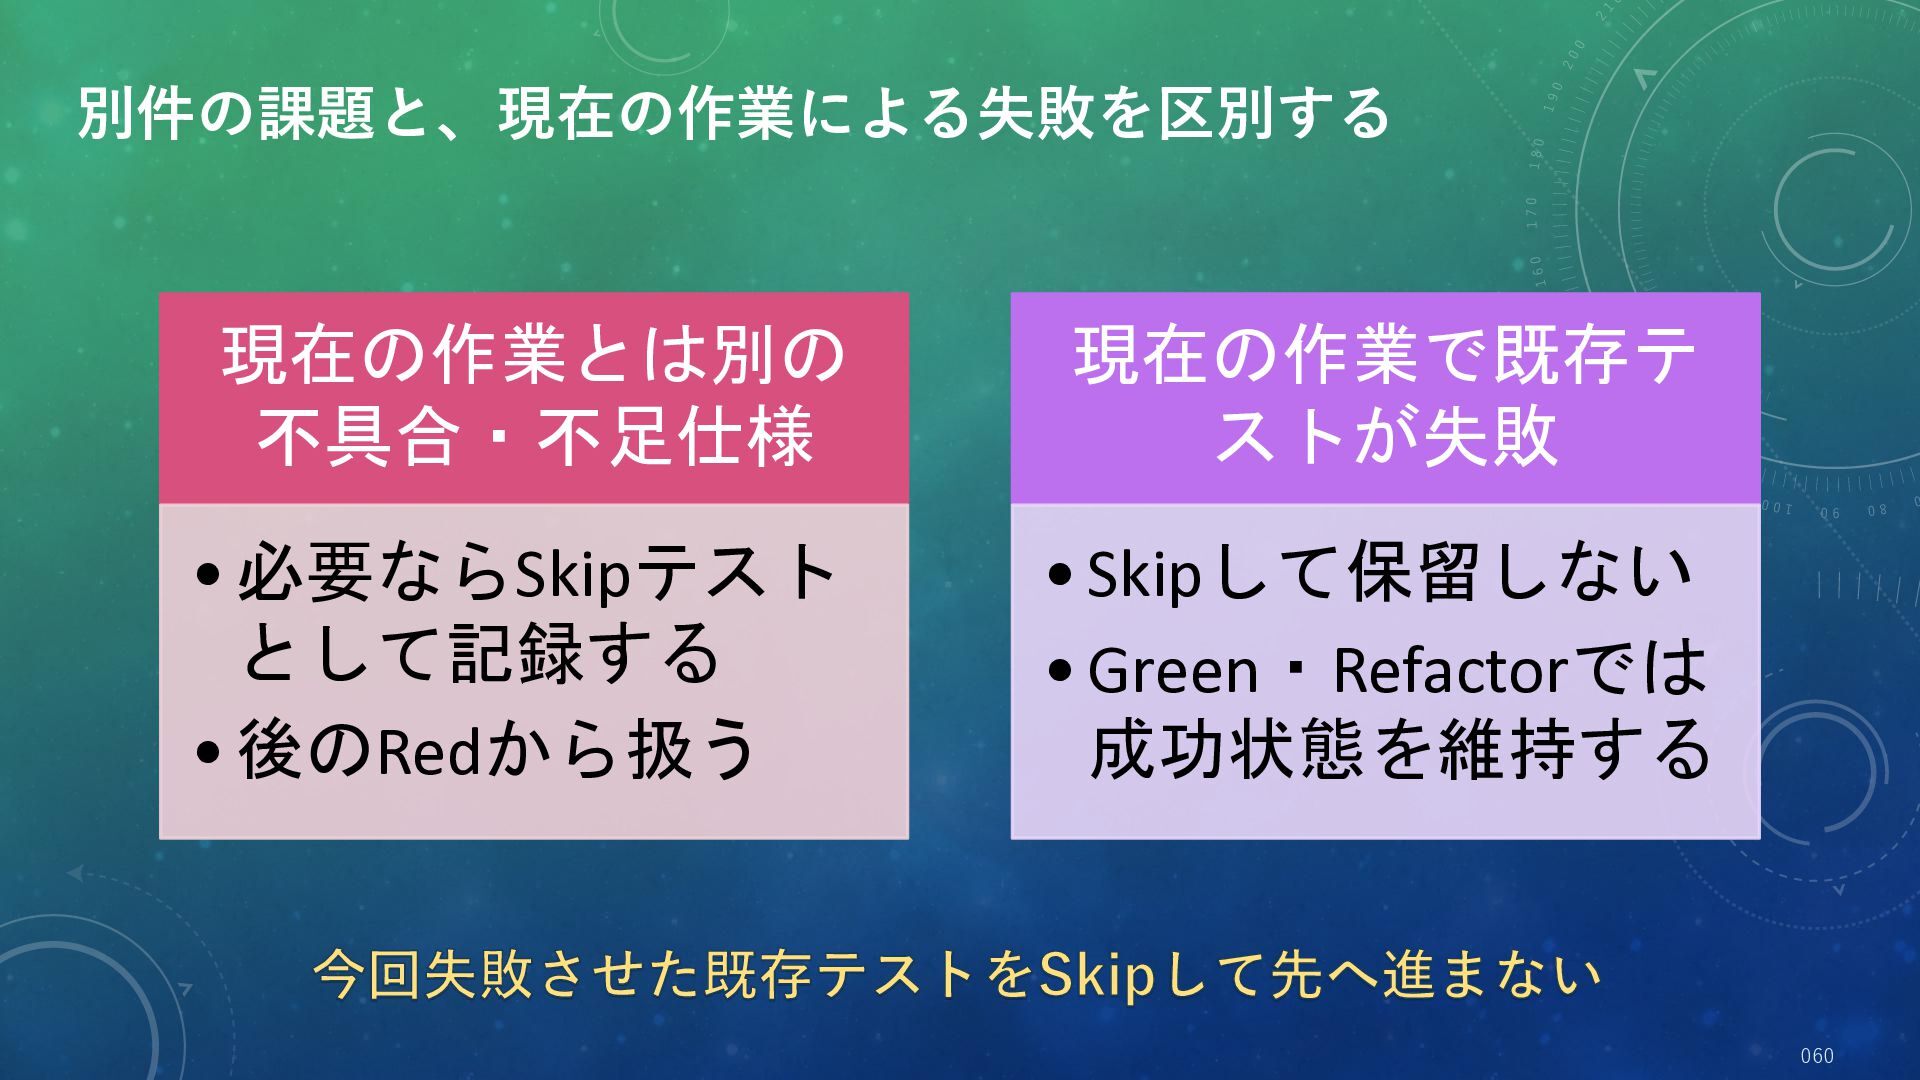
    必要最小限とは、対象テストが要求する振る舞いを実現することであり、Green対象外の仕様を先取りして固定することではな い。 * Green確認後の見直しは、過剰実装の見落としを防ぐ補助とする。そのGreenで追加したコードに、対象テストが要求していな いロジック(分岐、代入、初期化、後始末など)が含まれ、取り除いても対象テストと既存テストが通る場合は、削除してからG reen完了とする。点検対象を既存コード全体へ広げず、内部設計やアルゴリズムの正当性の精査へ広げない。 * AIが先の仕様や必要になりそうな実装を推測した場合も、Green対象外なら実装せず、推測として報告する。 * Green中に対象テストとは別の仕様が必要だと分かった場合は、実装せず、理由付きの `Skip` テストまたは確認事項として 残す。 * 対象テストが要求していない実装を先に入れ、その後でRedテストを追加して正当化しない。 * Green対象外の `Skip` 済み仕様テストやテストデータ全体の整理が必要に見えた場合は、編集前に理由を報告して止まる。 * Green対象を理解するために必要なテストデータ、期待値、補助APIだけを同じ作業単位に含める。 * 予定テストを失敗させ続けるために、公開APIを不自然または不完全な形へ歪めない。 * 同じAPIの正常系と異常系が同じ自然な実装で満たされる場合は、予定テストが通ること自体を避けるための迂回実装をしない 。 * 対象テストが要求していない分岐、例外型、エラーメッセージ、戻り値仕様を、自分で判断して追加しない。 * 自分で `throw` を書く例外は仕様として扱い、原則として先にテストで固定する。 * 低水準API、標準ライブラリなどの呼び出し結果として自然に発生する例外まで、すべて明示仕様にする必要はない。 ## 既存機能を変更する手順 180
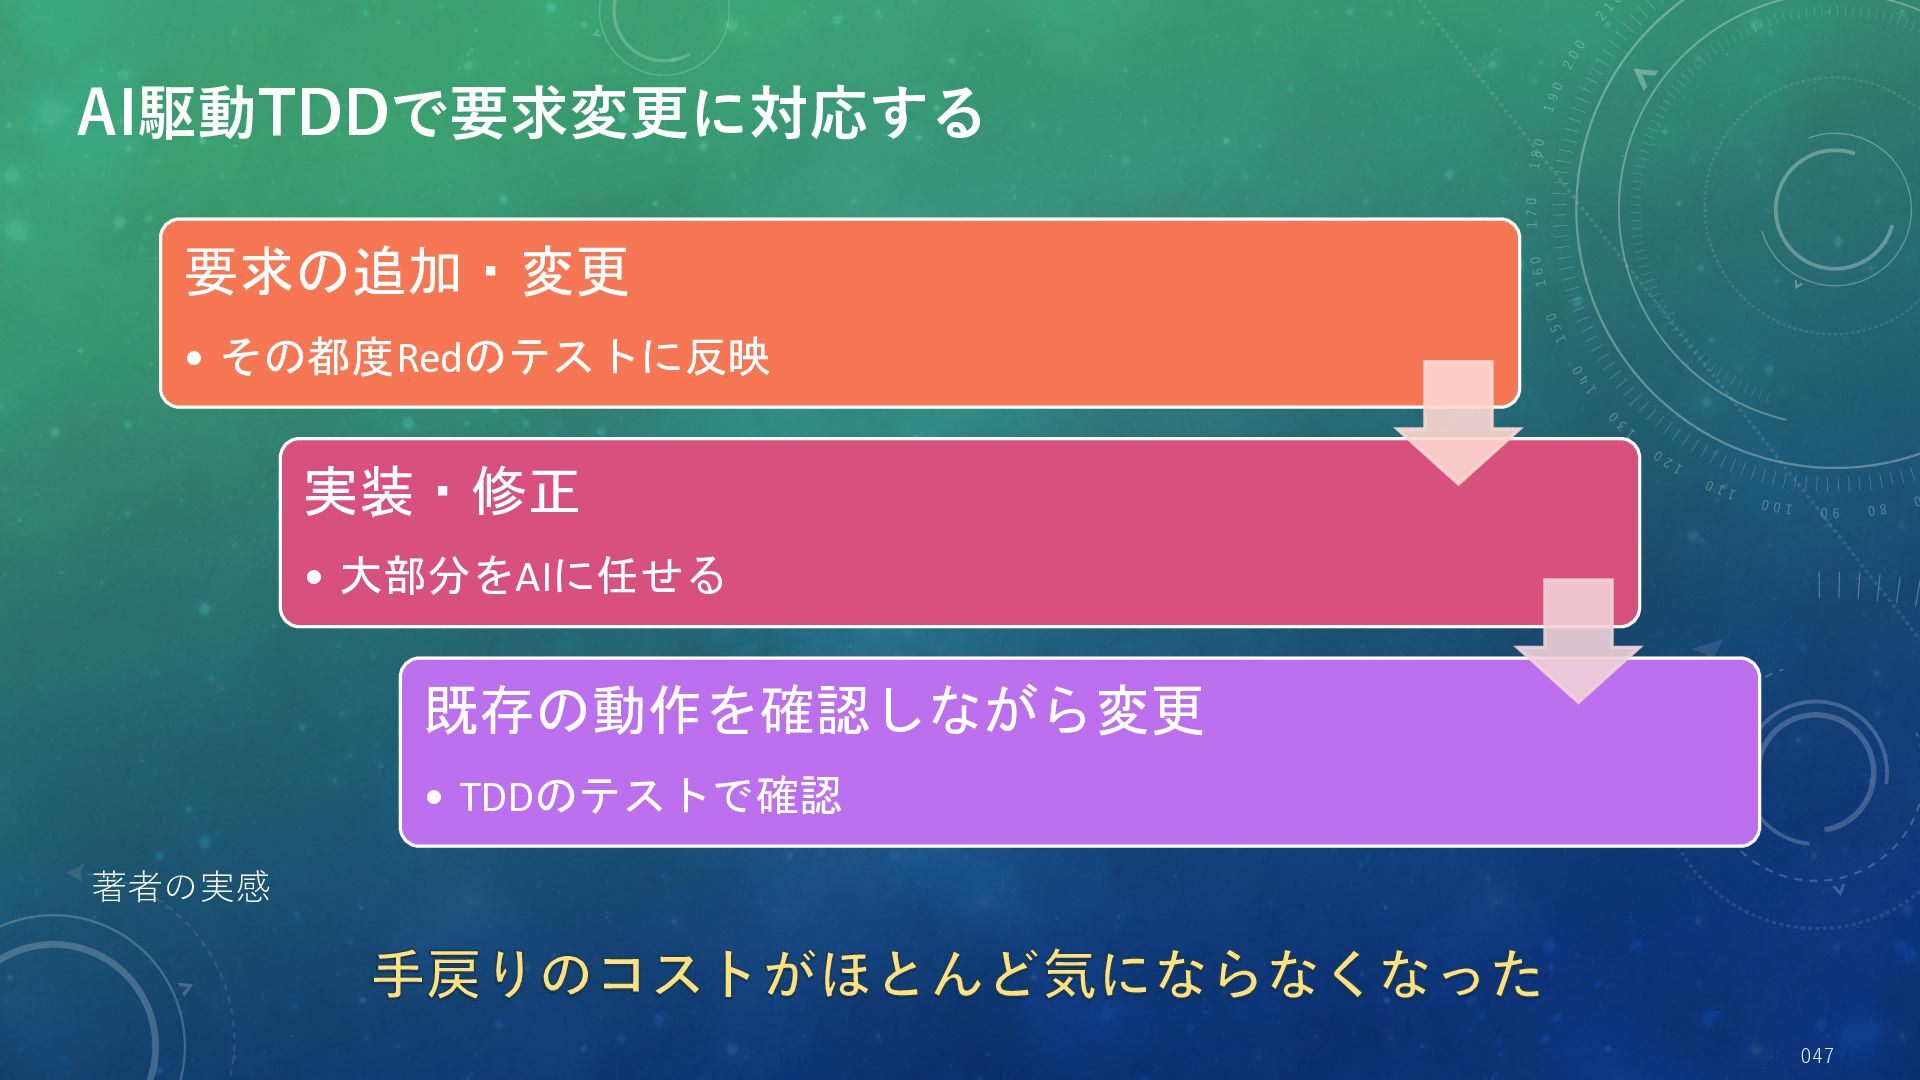
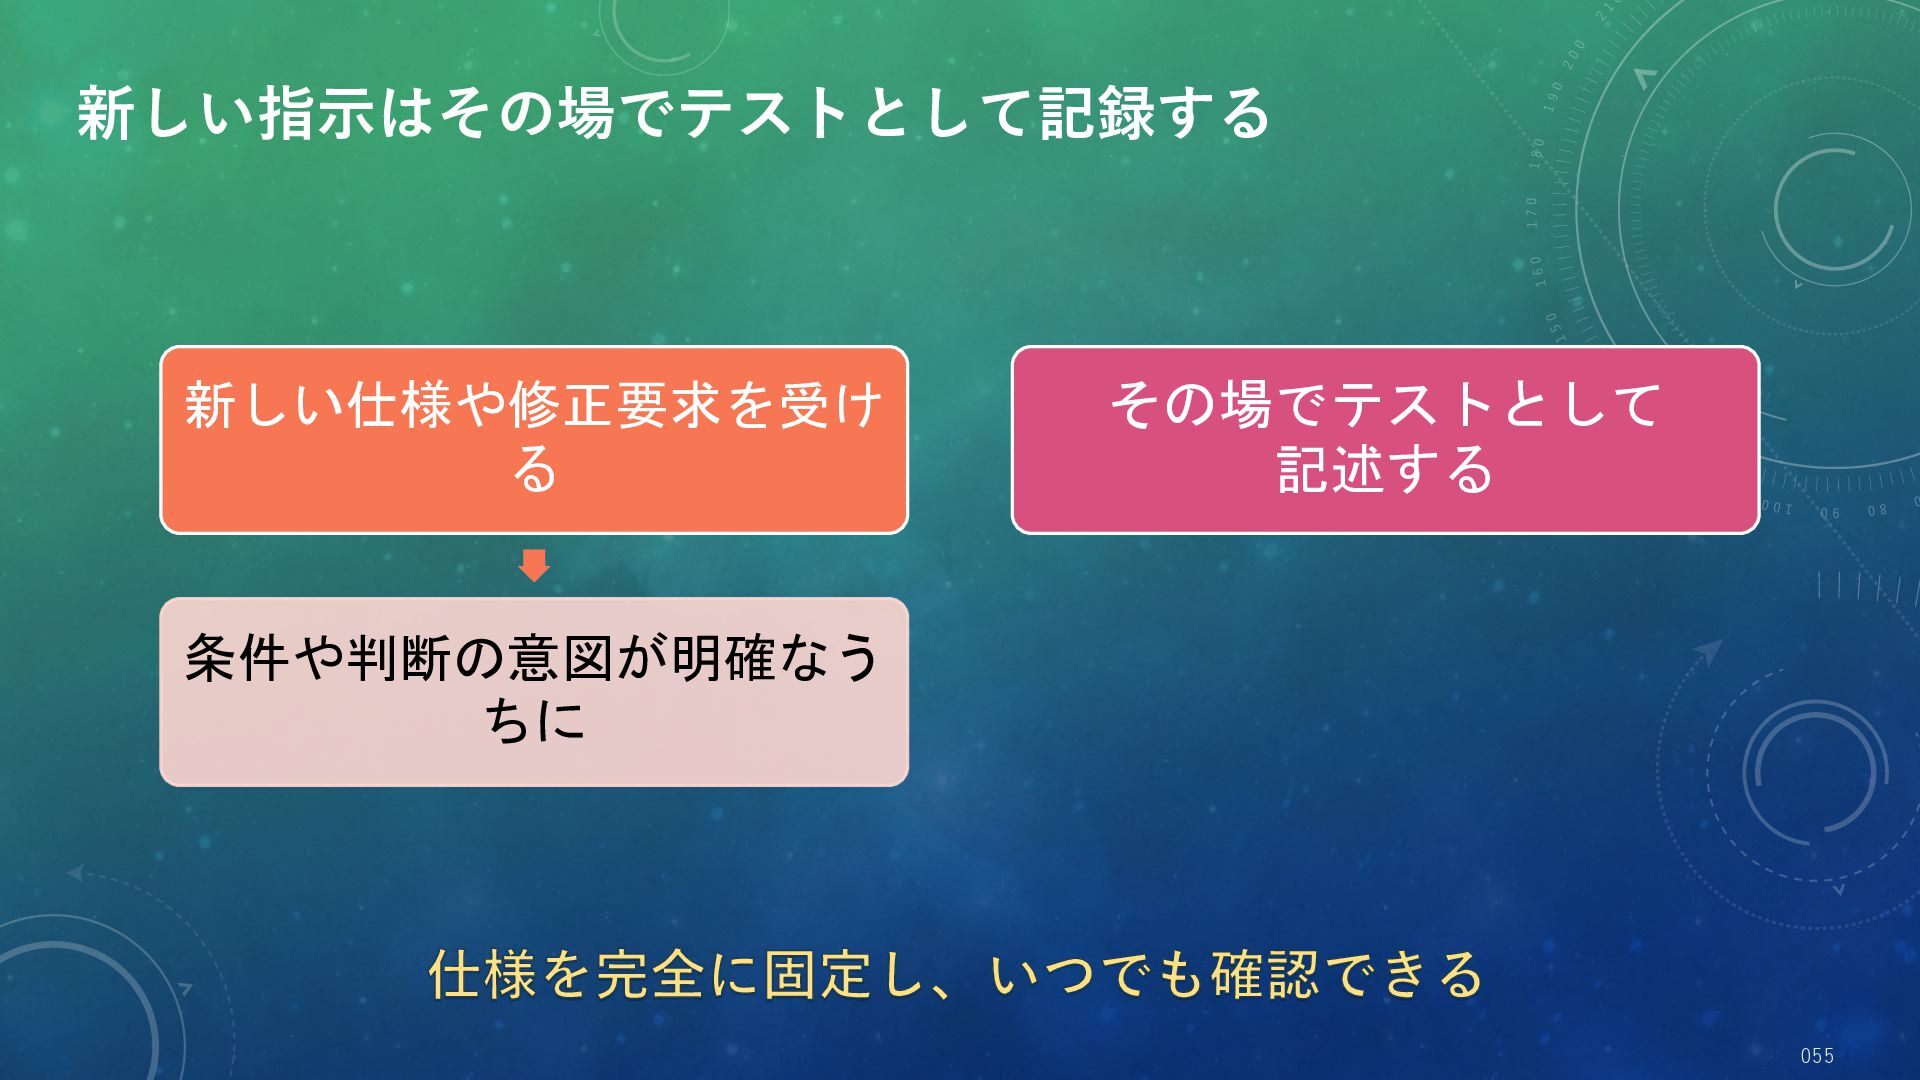
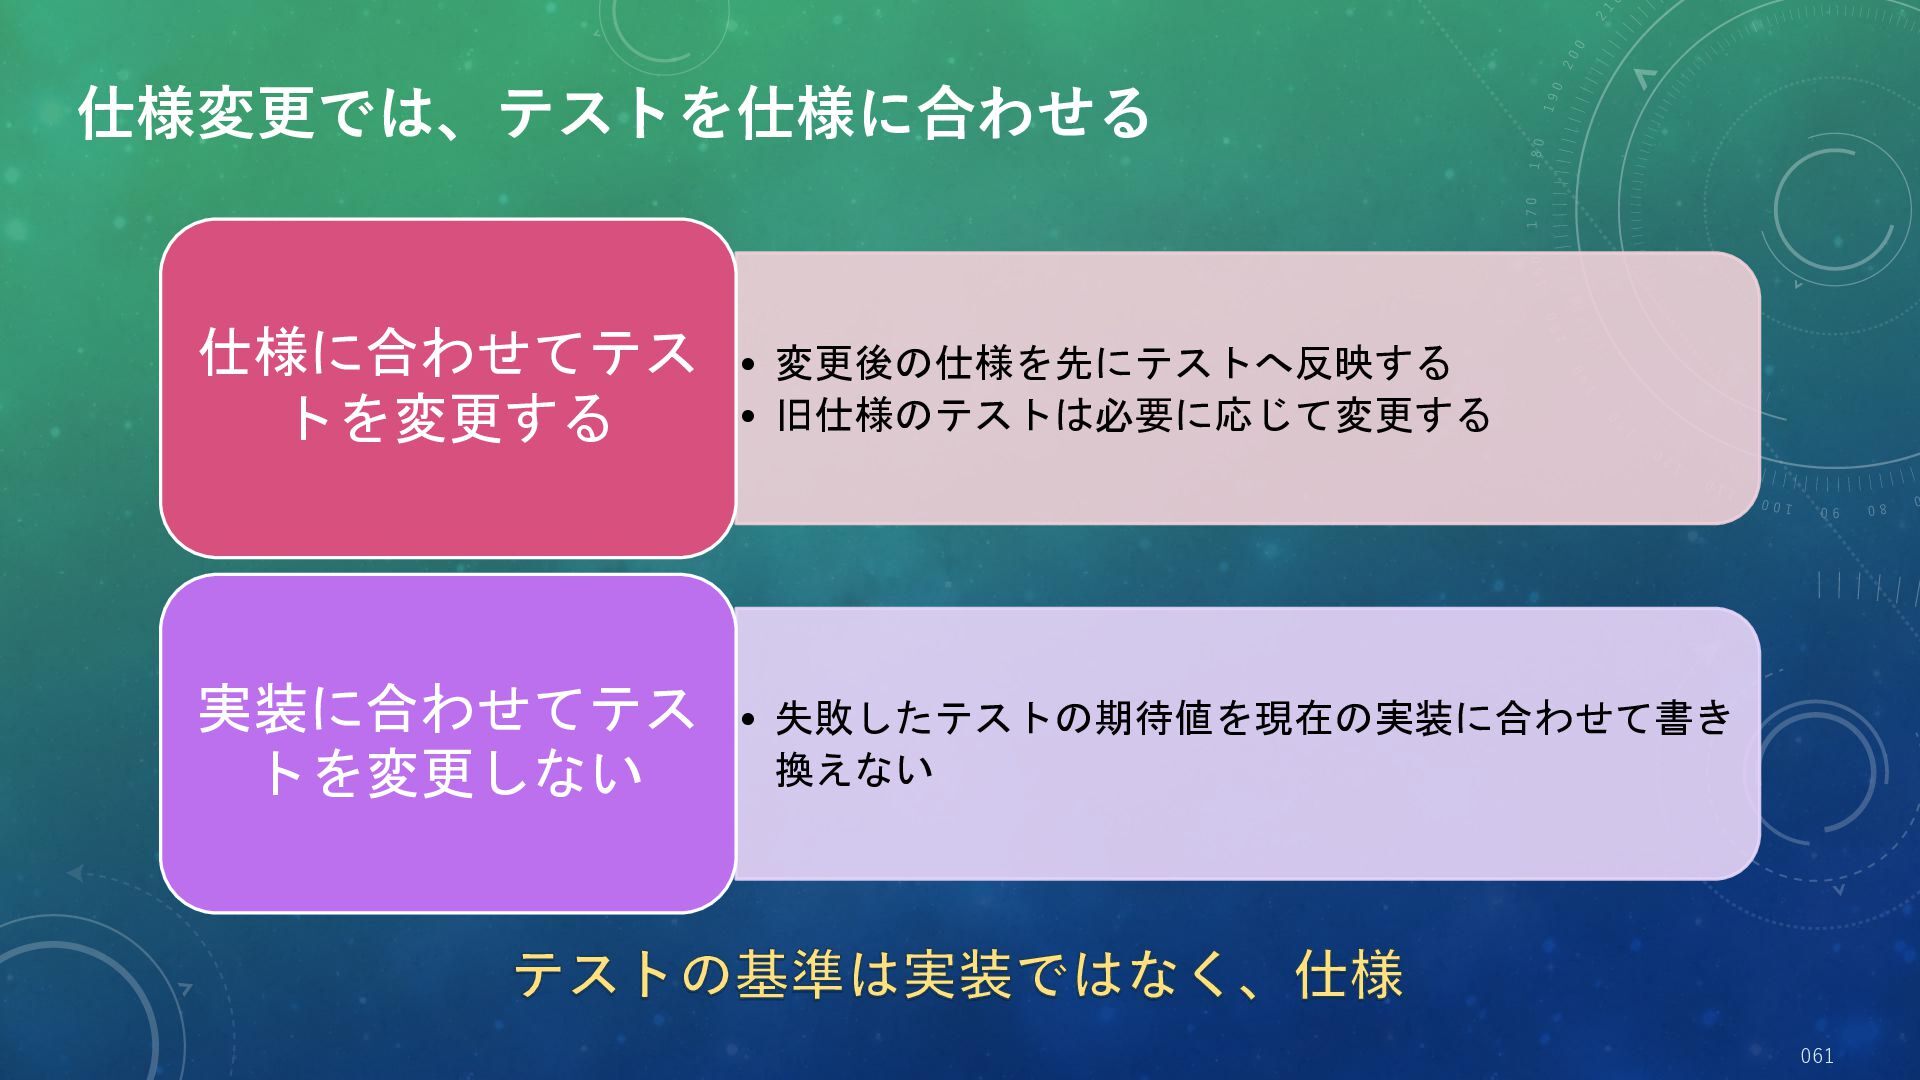
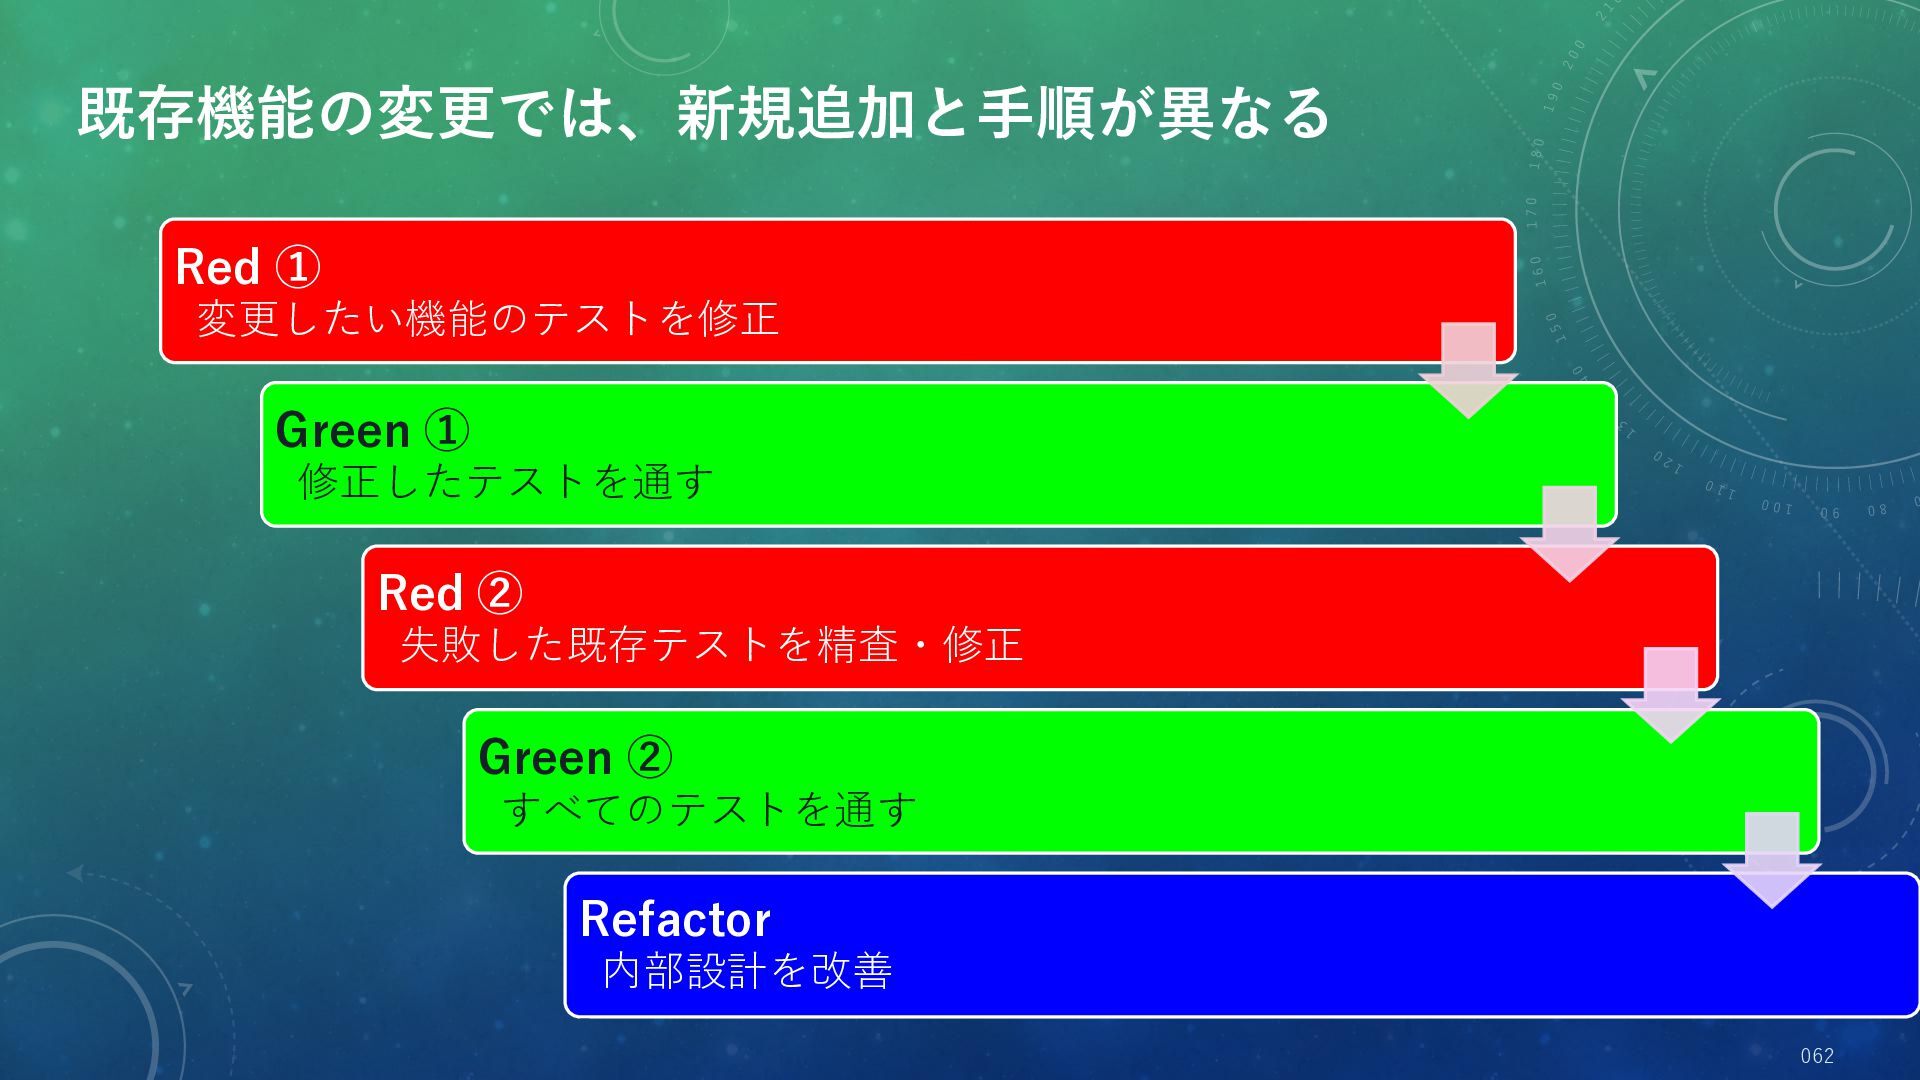
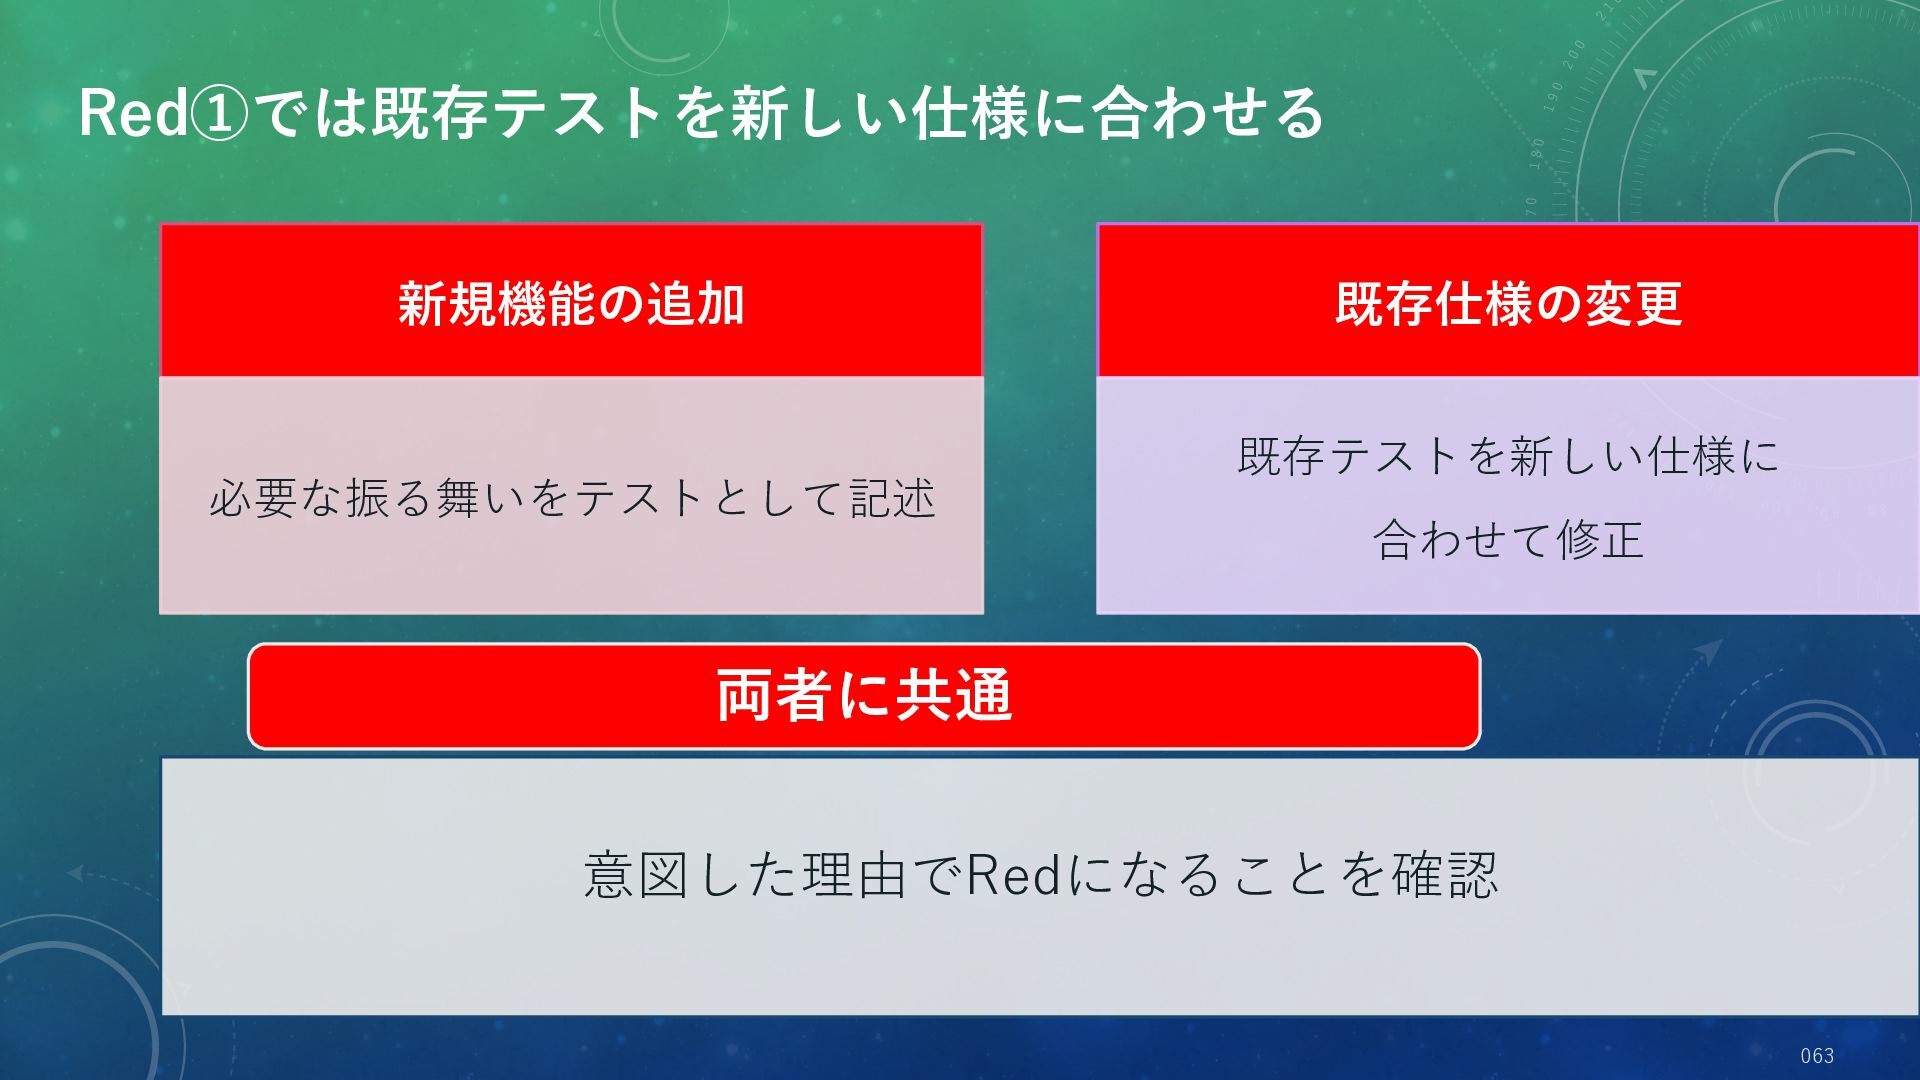
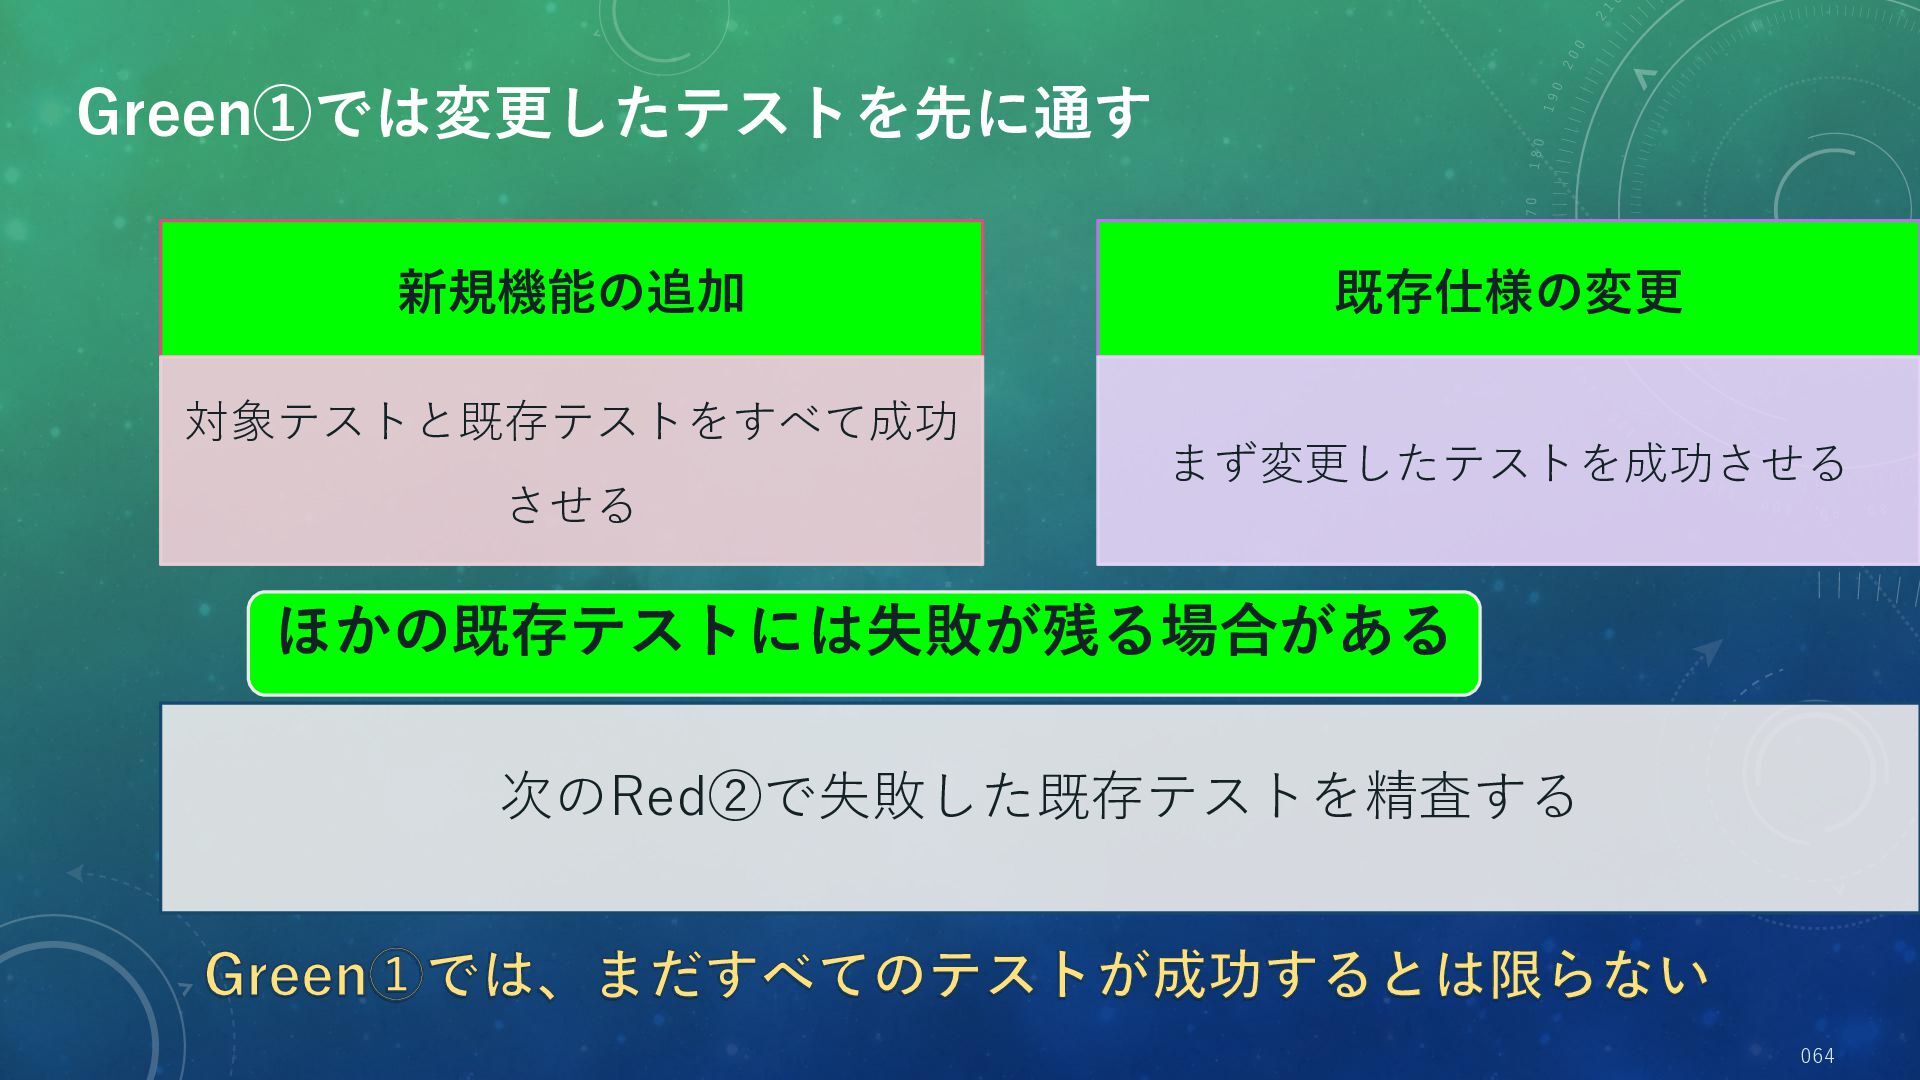
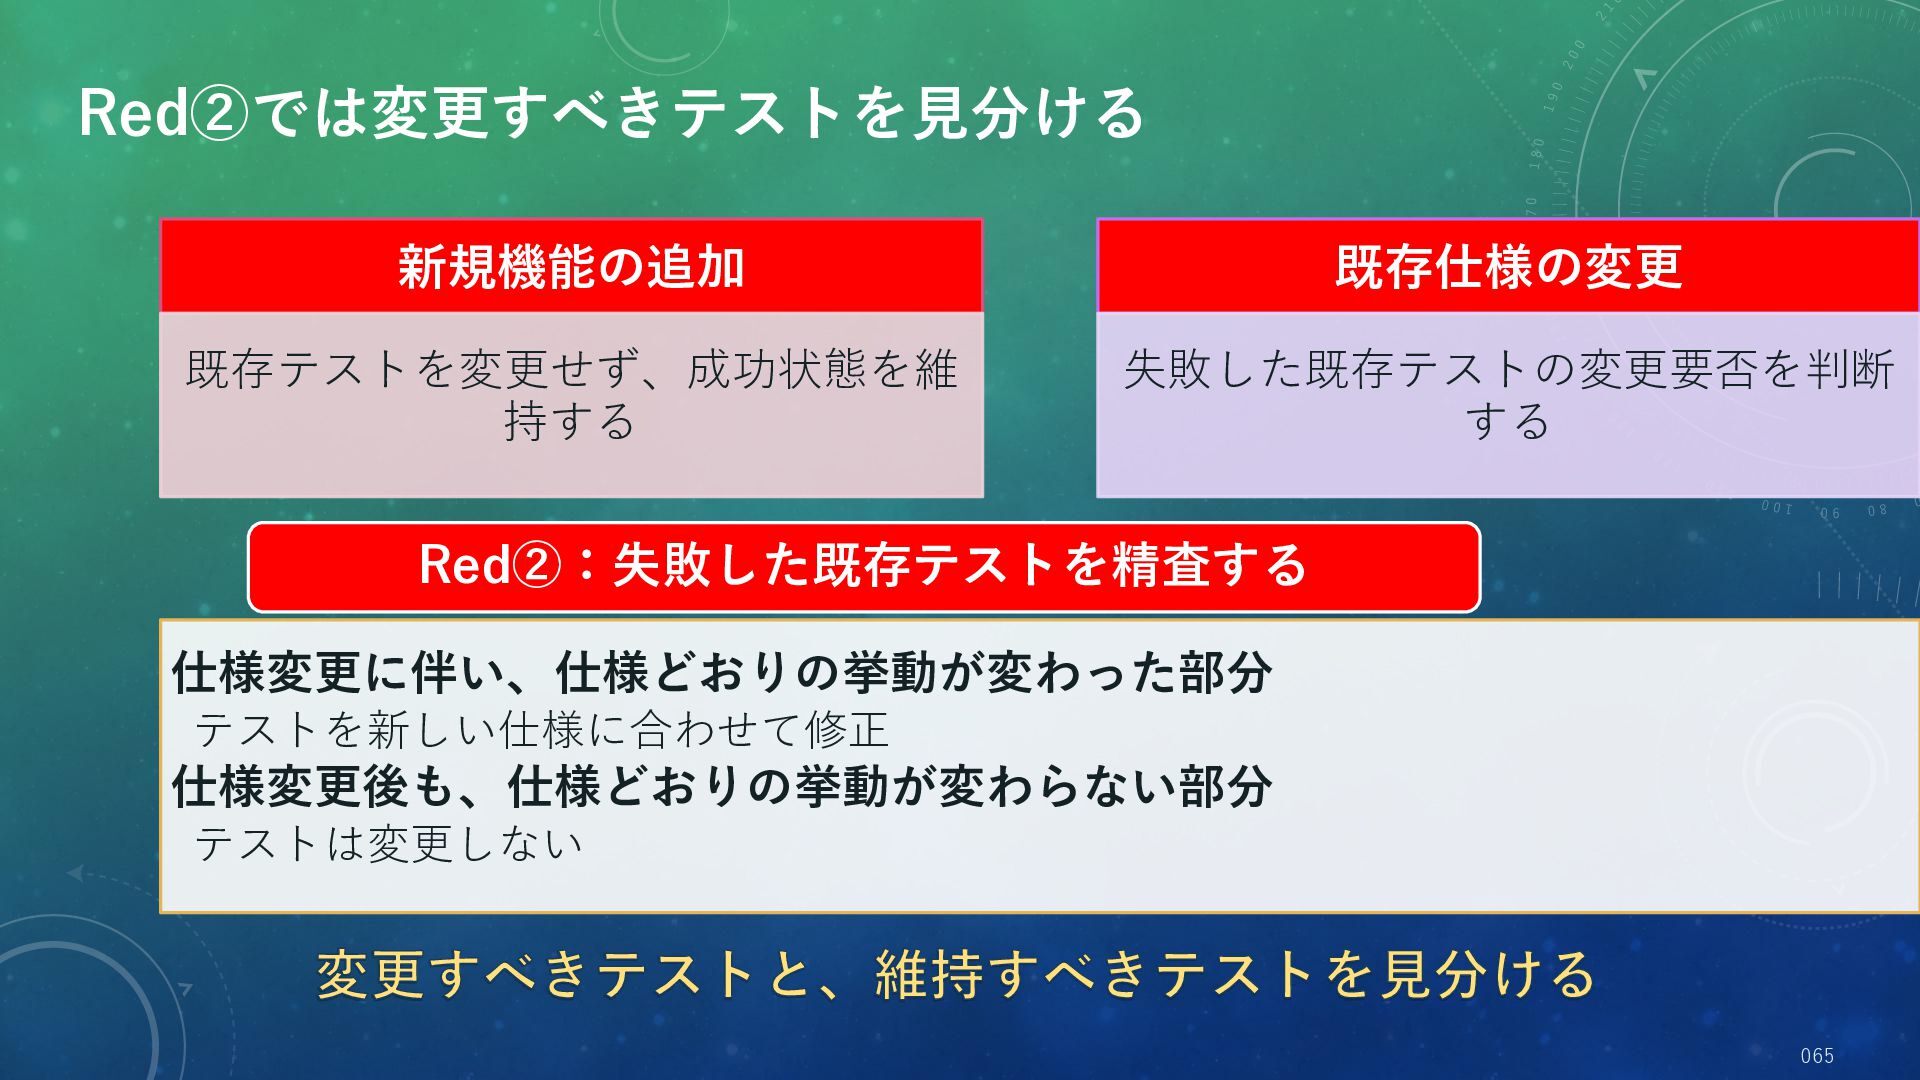
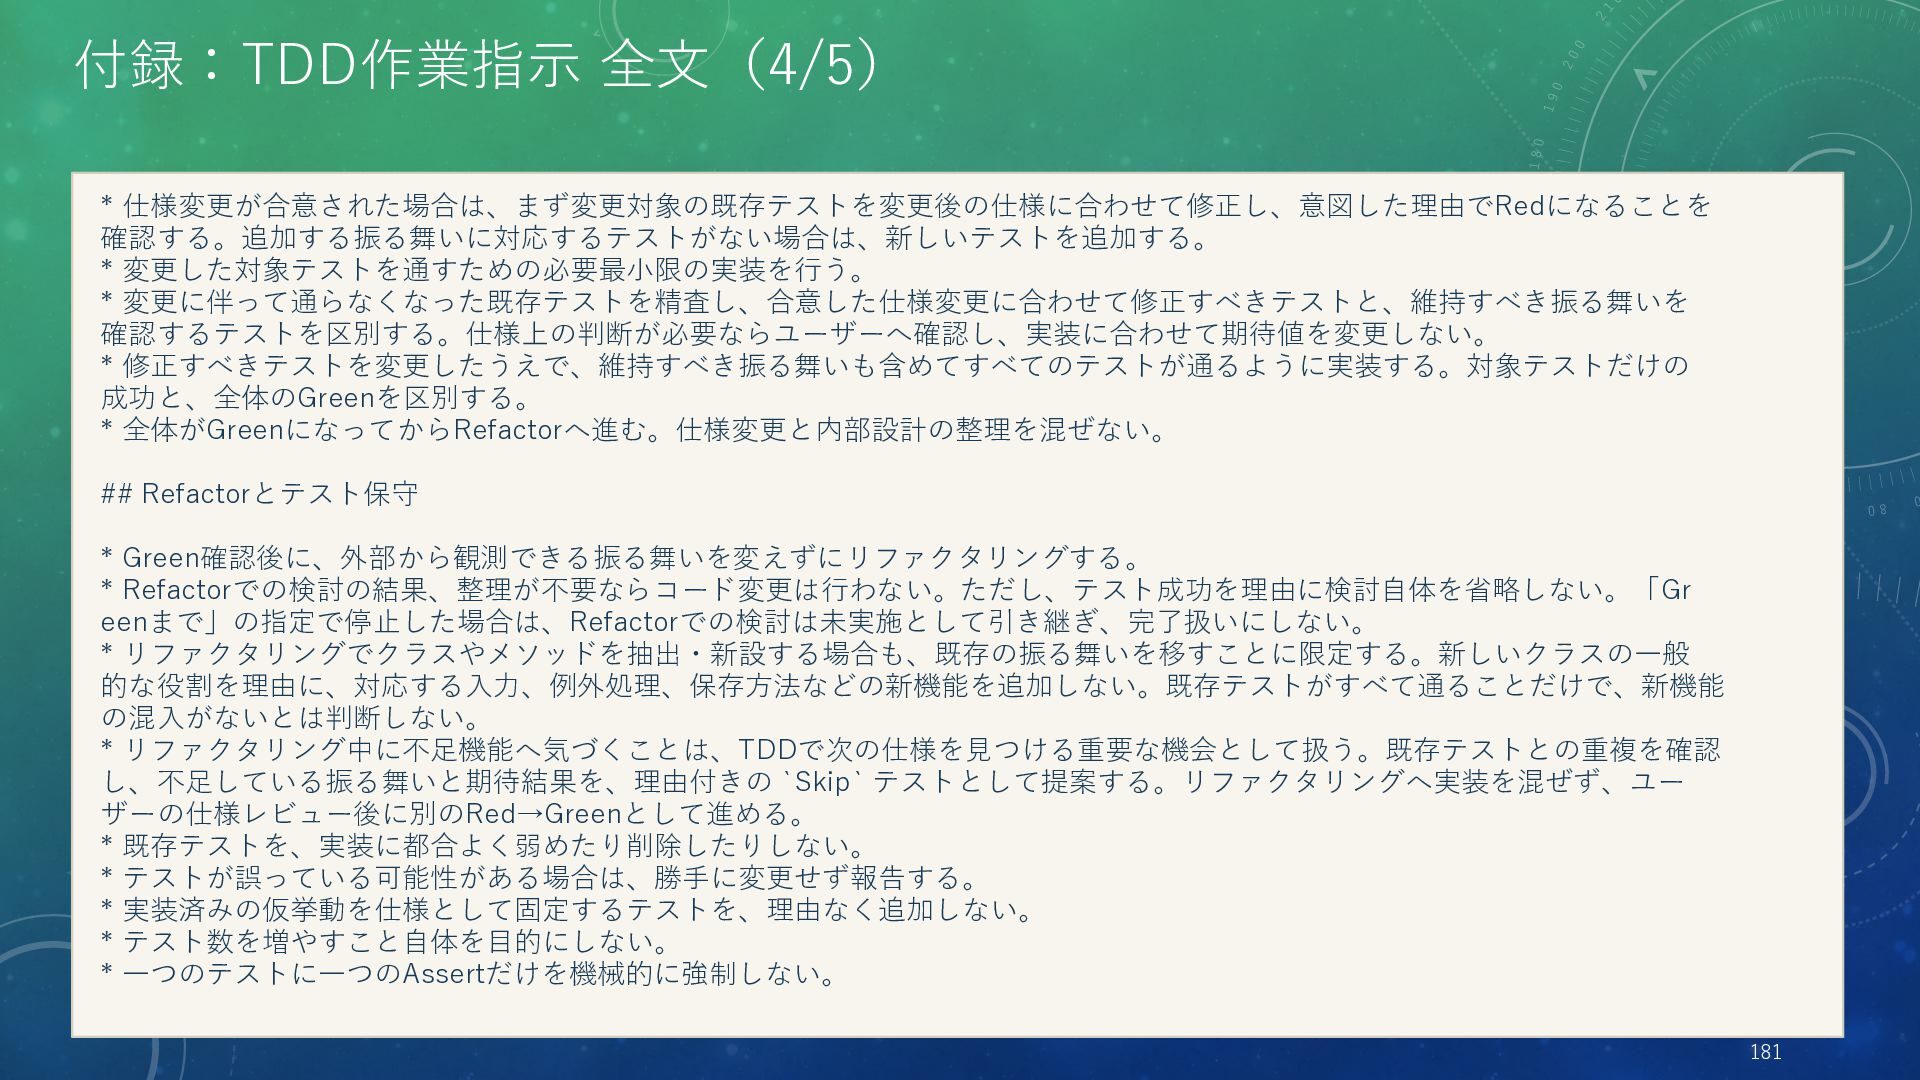
  75. 付録:TDD作業指示 全文(4/5) * 仕様変更が合意された場合は、まず変更対象の既存テストを変更後の仕様に合わせて修正し、意図した理由でRedになることを 確認する。追加する振る舞いに対応するテストがない場合は、新しいテストを追加する。 * 変更した対象テストを通すための必要最小限の実装を行う。 * 変更に伴って通らなくなった既存テストを精査し、合意した仕様変更に合わせて修正すべきテストと、維持すべき振る舞いを 確認するテストを区別する。仕様上の判断が必要ならユーザーへ確認し、実装に合わせて期待値を変更しない。

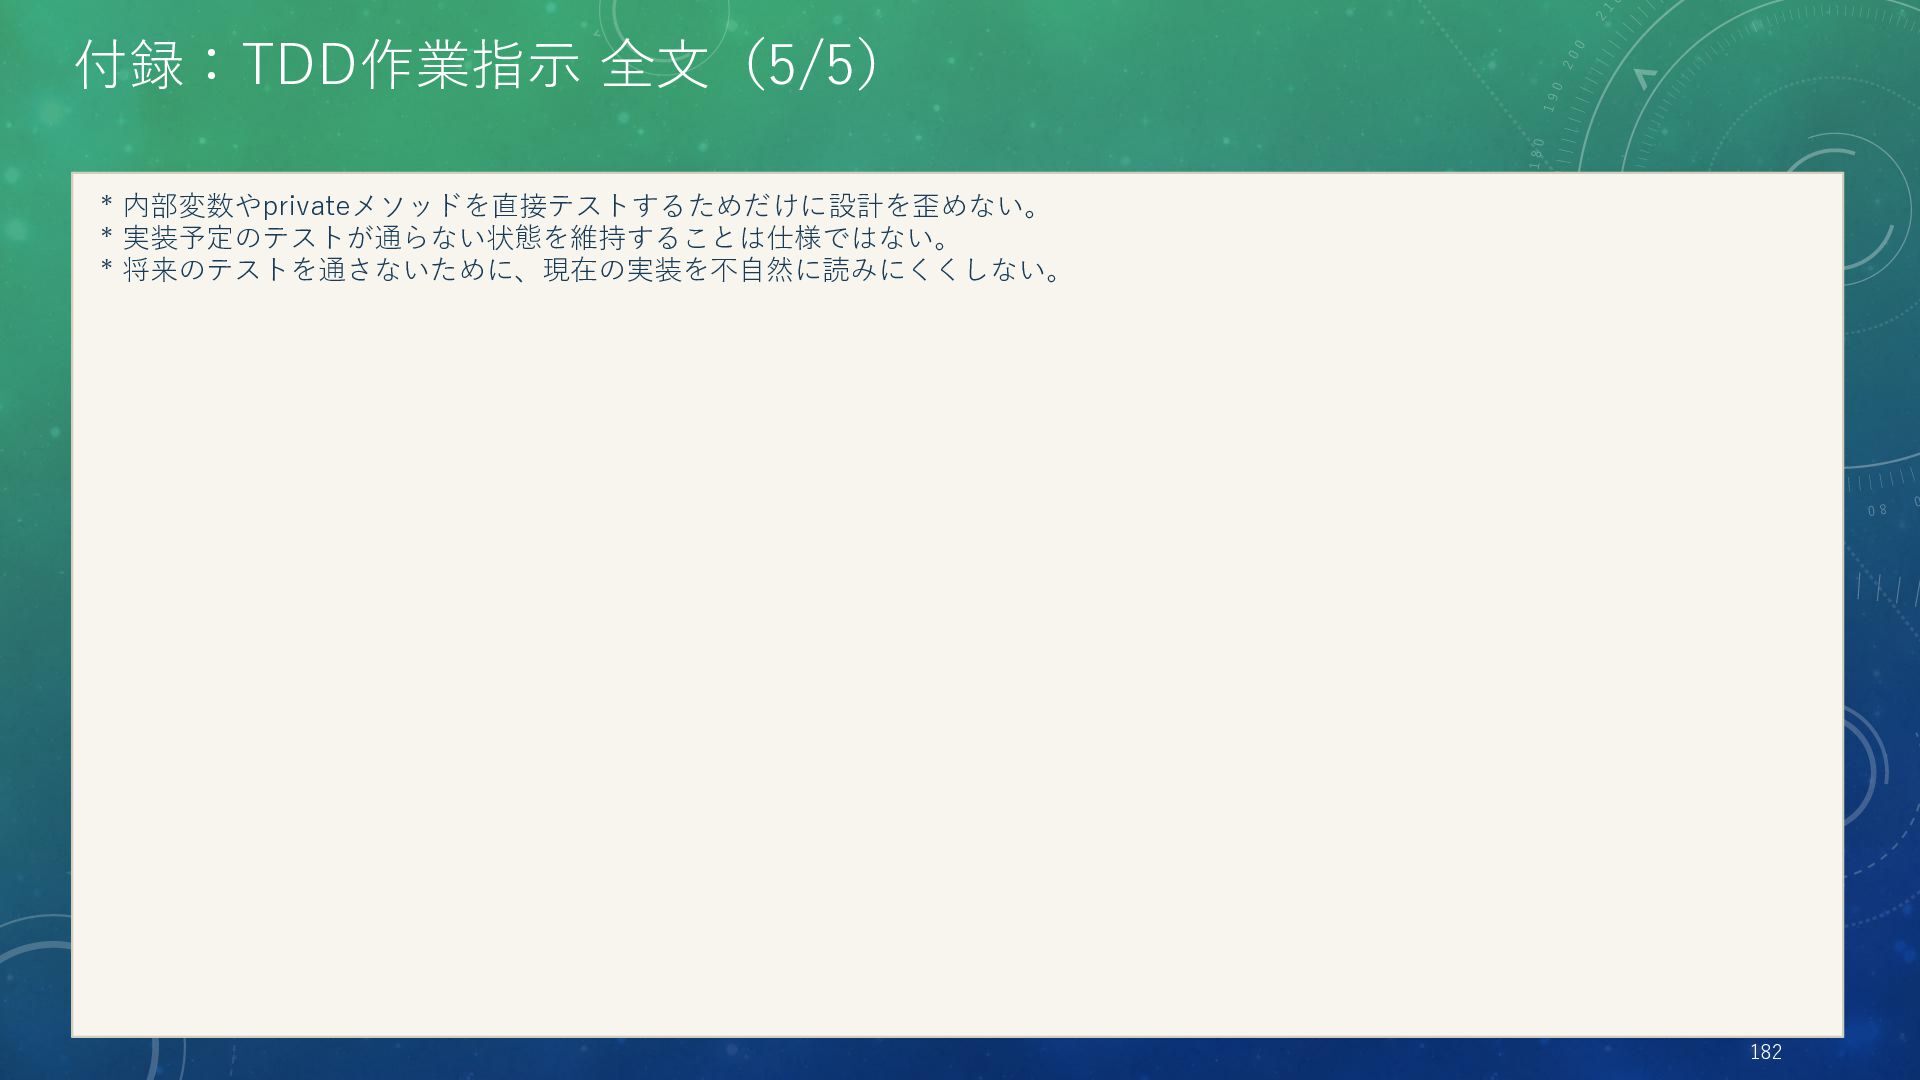
    * 修正すべきテストを変更したうえで、維持すべき振る舞いも含めてすべてのテストが通るように実装する。対象テストだけの 成功と、全体のGreenを区別する。 * 全体がGreenになってからRefactorへ進む。仕様変更と内部設計の整理を混ぜない。 ## Refactorとテスト保守 * Green確認後に、外部から観測できる振る舞いを変えずにリファクタリングする。 * Refactorでの検討の結果、整理が不要ならコード変更は行わない。ただし、テスト成功を理由に検討自体を省略しない。「Gr eenまで」の指定で停止した場合は、Refactorでの検討は未実施として引き継ぎ、完了扱いにしない。 * リファクタリングでクラスやメソッドを抽出・新設する場合も、既存の振る舞いを移すことに限定する。新しいクラスの一般 的な役割を理由に、対応する入力、例外処理、保存方法などの新機能を追加しない。既存テストがすべて通ることだけで、新機能 の混入がないとは判断しない。 * リファクタリング中に不足機能へ気づくことは、TDDで次の仕様を見つける重要な機会として扱う。既存テストとの重複を確認 し、不足している振る舞いと期待結果を、理由付きの `Skip` テストとして提案する。リファクタリングへ実装を混ぜず、ユー ザーの仕様レビュー後に別のRed→Greenとして進める。 * 既存テストを、実装に都合よく弱めたり削除したりしない。 * テストが誤っている可能性がある場合は、勝手に変更せず報告する。 * 実装済みの仮挙動を仕様として固定するテストを、理由なく追加しない。 * テスト数を増やすこと自体を目的にしない。 * 一つのテストに一つのAssertだけを機械的に強制しない。 181