Share
Embed
経験の浅いチームでアラート対応の 改善からチームに SRE を根付かせる
https://codmon.connpass.com/event/410368/
アラート対応どうしてますか? 〜設計・自動化・マインドなどの知見共有会〜
発表資料です
i2tsuki
November 19, 2026
Transcript
17 slides
-
経験の浅いチームでアラート対応の 改善からチームに SRE を根付かせる 株式会社MIXI ソーシャルベッティング事業本部 TIPSTAR事業部 ⼤野⼀樹 アラート対応どうしてますか? 〜設計‧⾃動化‧マインドなどの知⾒共有会〜
#alertmeetup 2026/11/19 ©MIXI -
⾃⼰紹介 ⼤野⼀樹 株式会社MIXI ソーシャルベッティング事業本部 TIPSTAR事業部 サーバーグループ エンジニア - インフラエンジニアからキャリアをスタートした SRE
- 2017 年くらいから SRE - ⼊社してから「家族アルバム みてね」以外のほとんど のサービスに SRE としてコミット - 好きな分野は O11y, システムパフォーマンス - ©MIXI - ⽗ - i2tsuki (@i2tsuki) on Speaker Deck 22 -
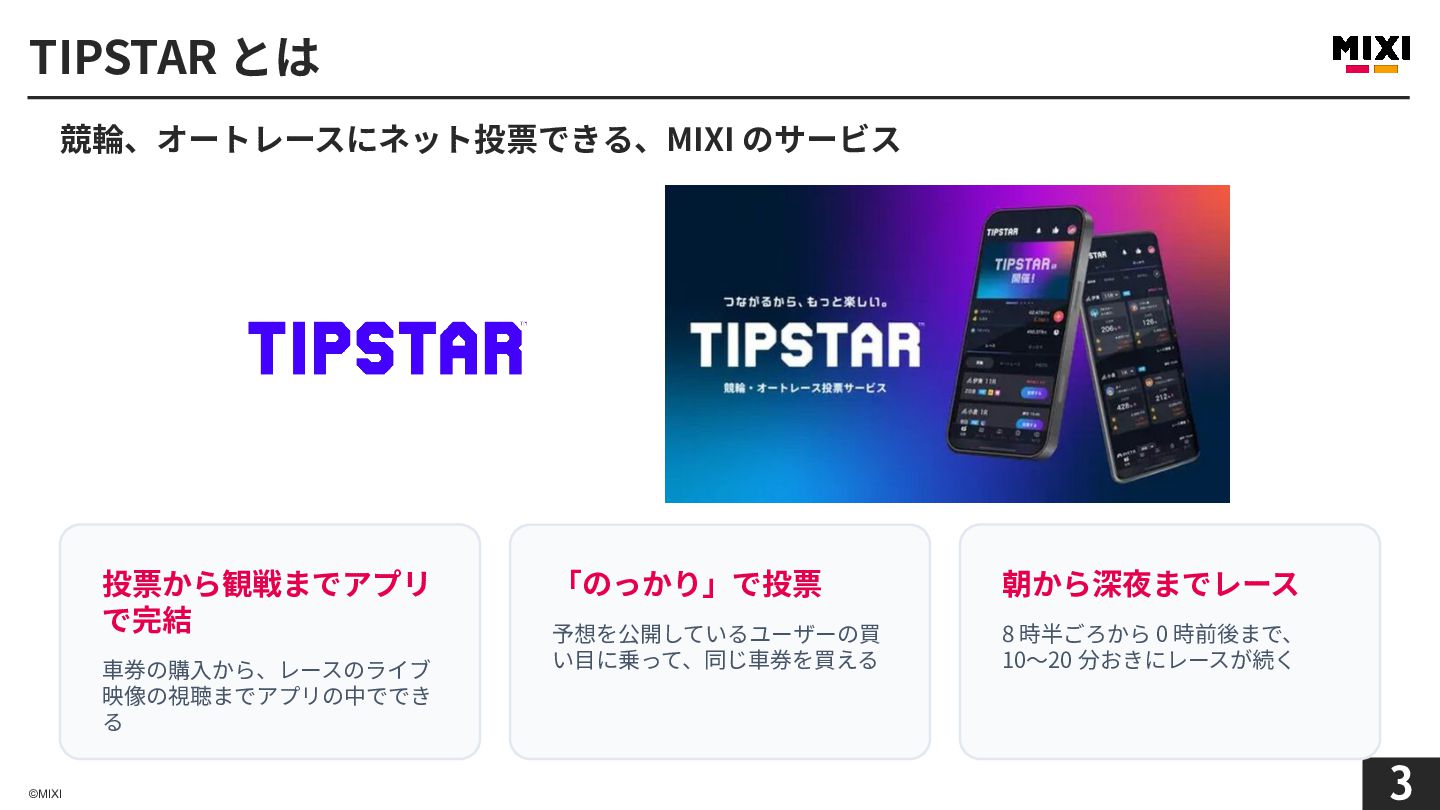
TIPSTAR とは 競輪、オートレースにネット投票できる、MIXI のサービス 投票から観戦までアプリ で完結 ⾞券の購⼊から、レースのライブ 映像の視聴までアプリの中ででき る ©MIXI
「のっかり」で投票 朝から深夜までレース 予想を公開しているユーザーの買 い⽬に乗って、同じ⾞券を買える 8 時半ごろから 0 時前後まで、 10〜20 分おきにレースが続く 33 -
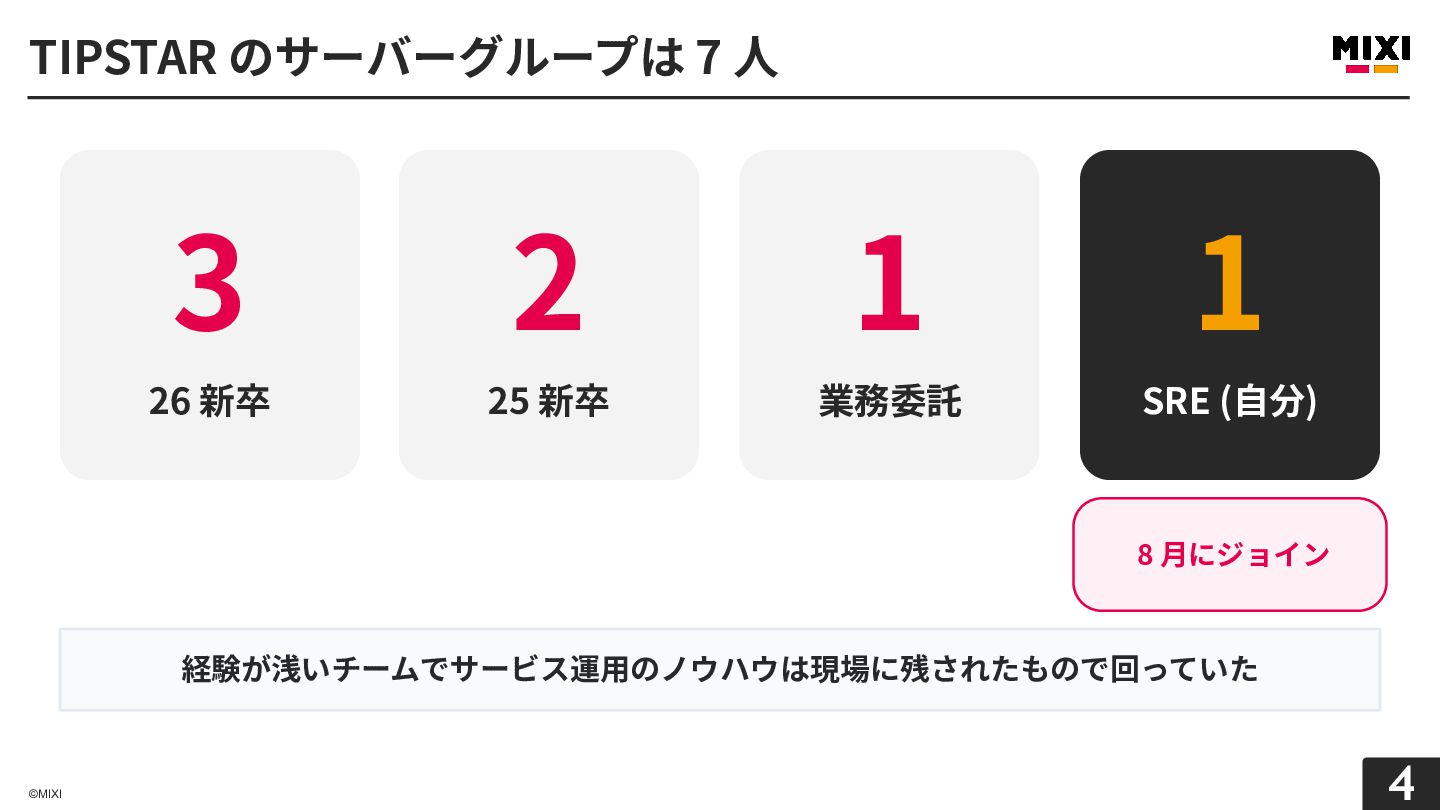
TIPSTAR のサーバーグループは 7 ⼈ 3 2 1 1 26 新卒
25 新卒 業務委託 SRE (⾃分) 8 ⽉にジョイン 経験が浅いチームでサービス運⽤のノウハウは現場に残されたもので回っていた ©MIXI 44 -
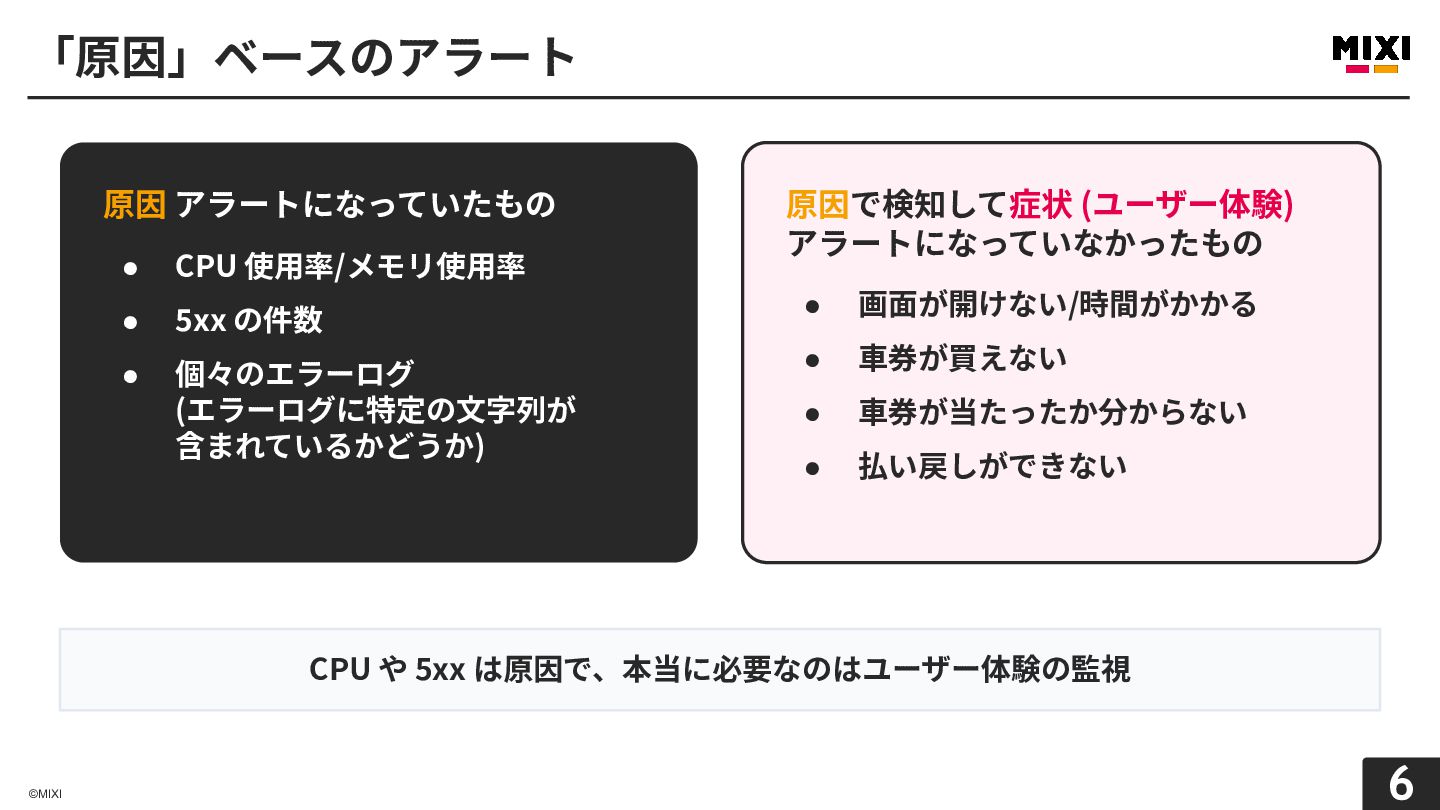
「原因」ベースのアラート 原因 アラートになっていたもの 原因で検知して症状 (ユーザー体験) アラートになっていなかったもの • CPU 使⽤率/メモリ使⽤率 •
5xx の件数 • 画⾯が開けない/時間がかかる • 個々のエラーログ (エラーログに特定の⽂字列が 含まれているかどうか) • ⾞券が買えない • ⾞券が当たったか分からない • 払い戻しができない CPU や 5xx は原因で、本当に必要なのはユーザー体験の監視 ©MIXI 66 -
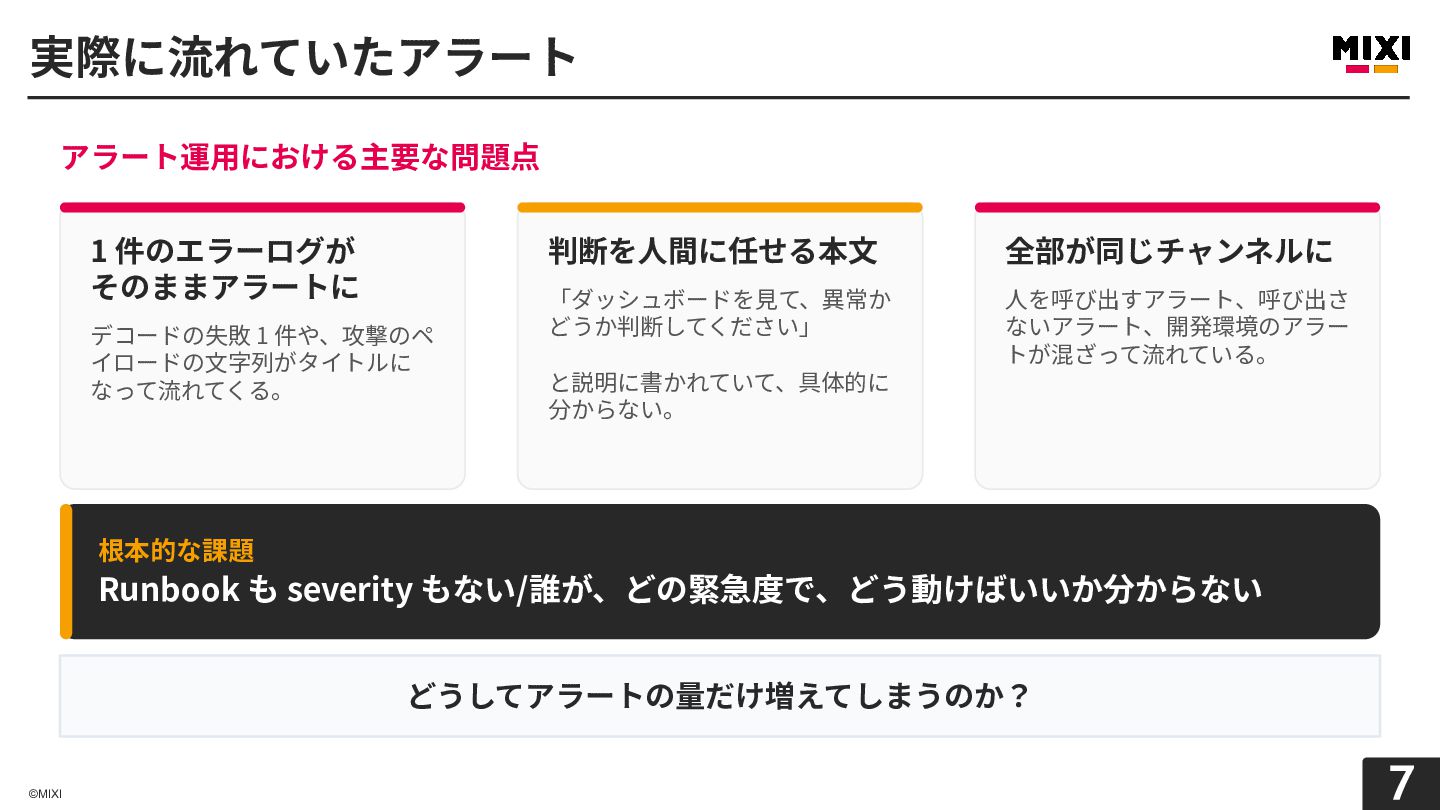
実際に流れていたアラート アラート運⽤における主要な問題点 1 件のエラーログが そのままアラートに デコードの失敗 1 件や、攻撃のペ イロードの⽂字列がタイトルに なって流れてくる。
判断を⼈間に任せる本⽂ 全部が同じチャンネルに 「ダッシュボードを⾒て、異常か どうか判断してください」 ⼈を呼び出すアラート、呼び出さ ないアラート、開発環境のアラー トが混ざって流れている。 と説明に書かれていて、具体的に 分からない。 根本的な課題 Runbook も severity もない/誰が、どの緊急度で、どう動けばいいか分からない どうしてアラートの量だけ増えてしまうのか? ©MIXI 77 -
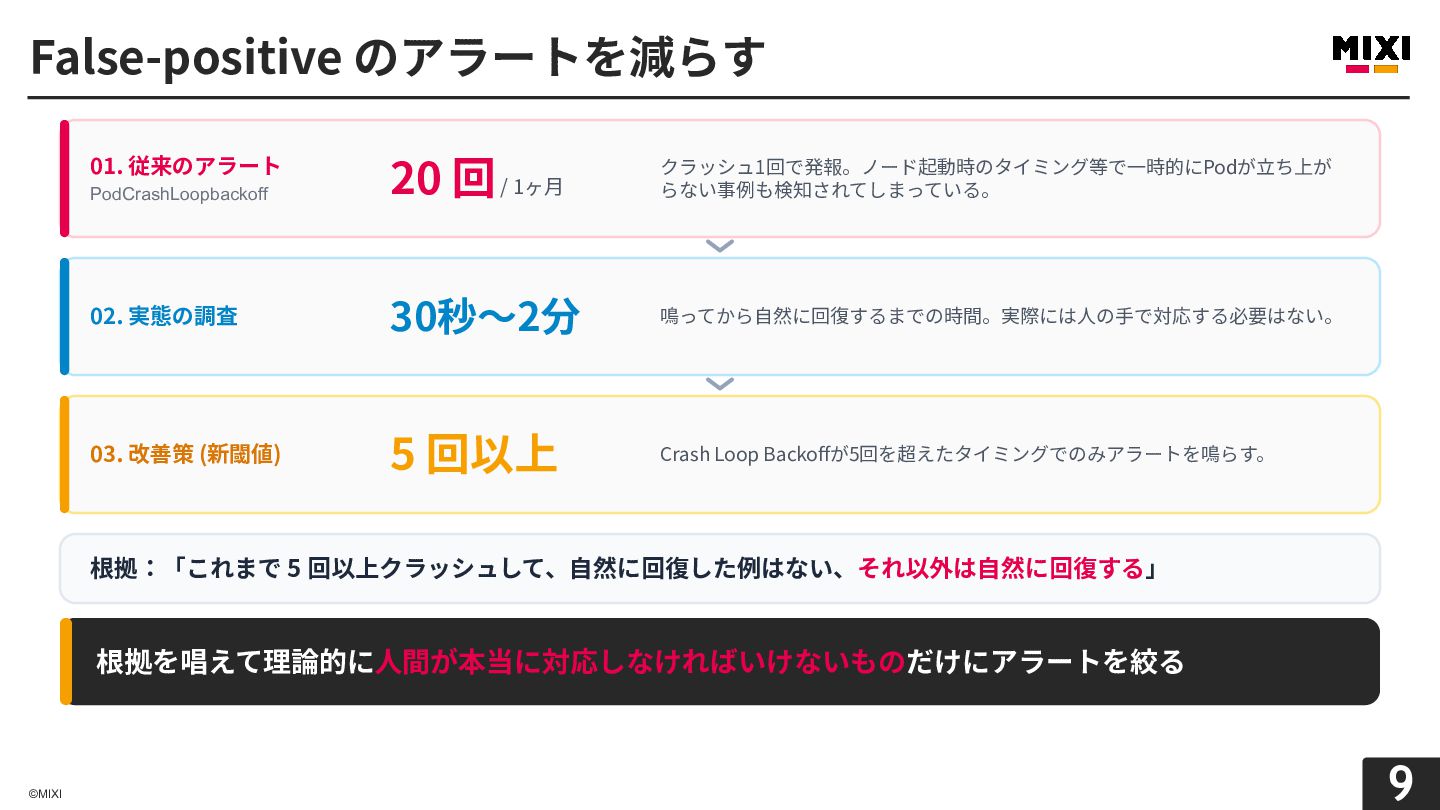
False-positive のアラートを減らす 01. 従来のアラート PodCrashLoopbackoff 20 回 / 1ヶ⽉ クラッシュ1回で発報。ノード起動時のタイミング等で⼀時的にPodが⽴ち上が
らない事例も検知されてしまっている。 02. 実態の調査 30秒〜2分 鳴ってから⾃然に回復するまでの時間。実際には⼈の⼿で対応する必要はない。 03. 改善策 (新閾値) 5 回以上 Crash Loop Backoffが5回を超えたタイミングでのみアラートを鳴らす。 根拠:「これまで 5 回以上クラッシュして、⾃然に回復した例はない、それ以外は⾃然に回復する」 根拠を唱えて理論的に⼈間が本当に対応しなければいけないものだけにアラートを絞る ©MIXI 99 -
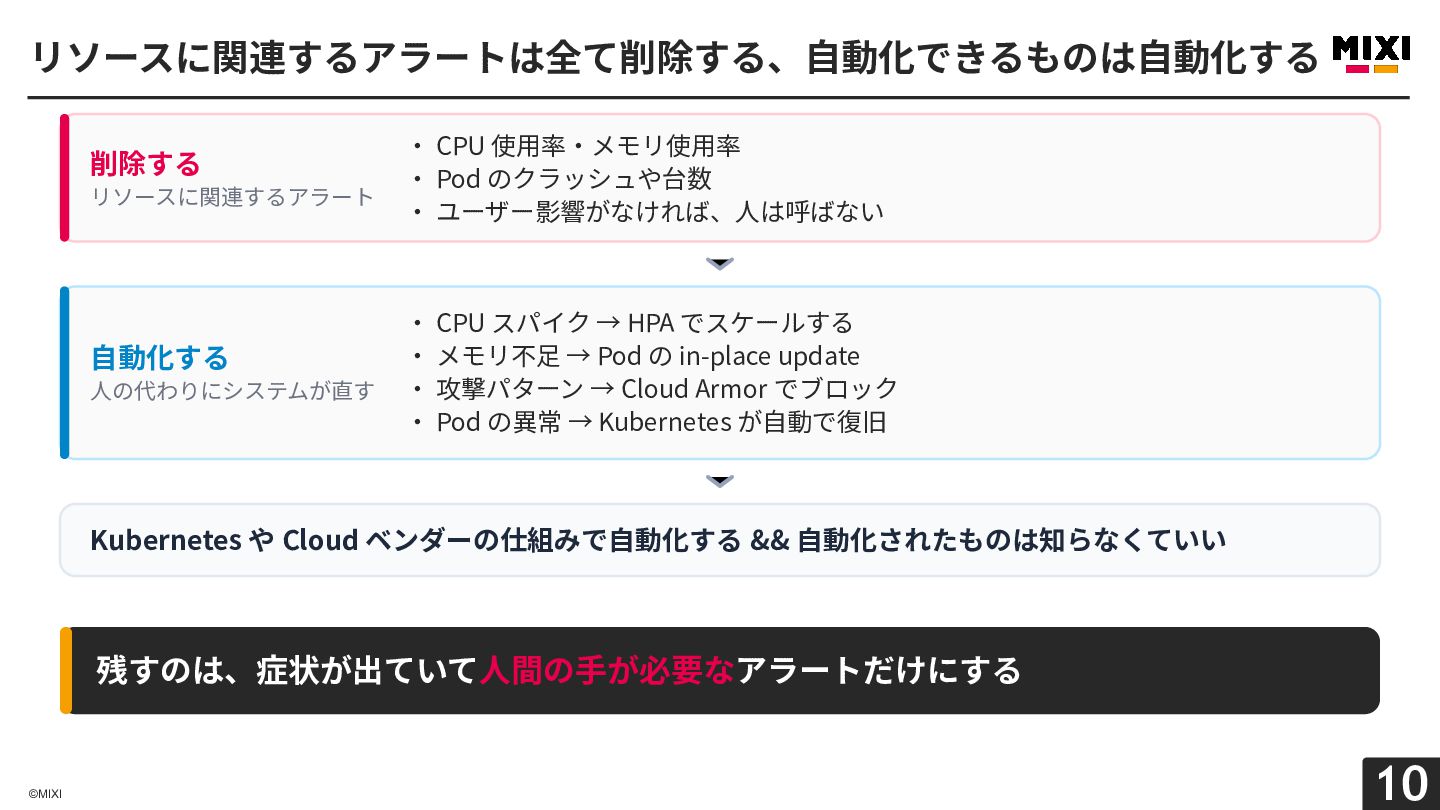
リソースに関連するアラートは全て削除する、⾃動化できるものは⾃動化する 削除する リソースに関連するアラート ⾃動化する ⼈の代わりにシステムが直す ‧ CPU 使⽤率‧メモリ使⽤率 ‧ Pod
のクラッシュや台数 ‧ ユーザー影響がなければ、⼈は呼ばない ‧ CPU スパイク → HPA でスケールする ‧ メモリ不⾜ → Pod の in-place update ‧ 攻撃パターン → Cloud Armor でブロック ‧ Pod の異常 → Kubernetes が⾃動で復旧 Kubernetes や Cloud ベンダーの仕組みで⾃動化する && ⾃動化されたものは知らなくていい 残すのは、症状が出ていて⼈間の⼿が必要なアラートだけにする ©MIXI 10 10 -
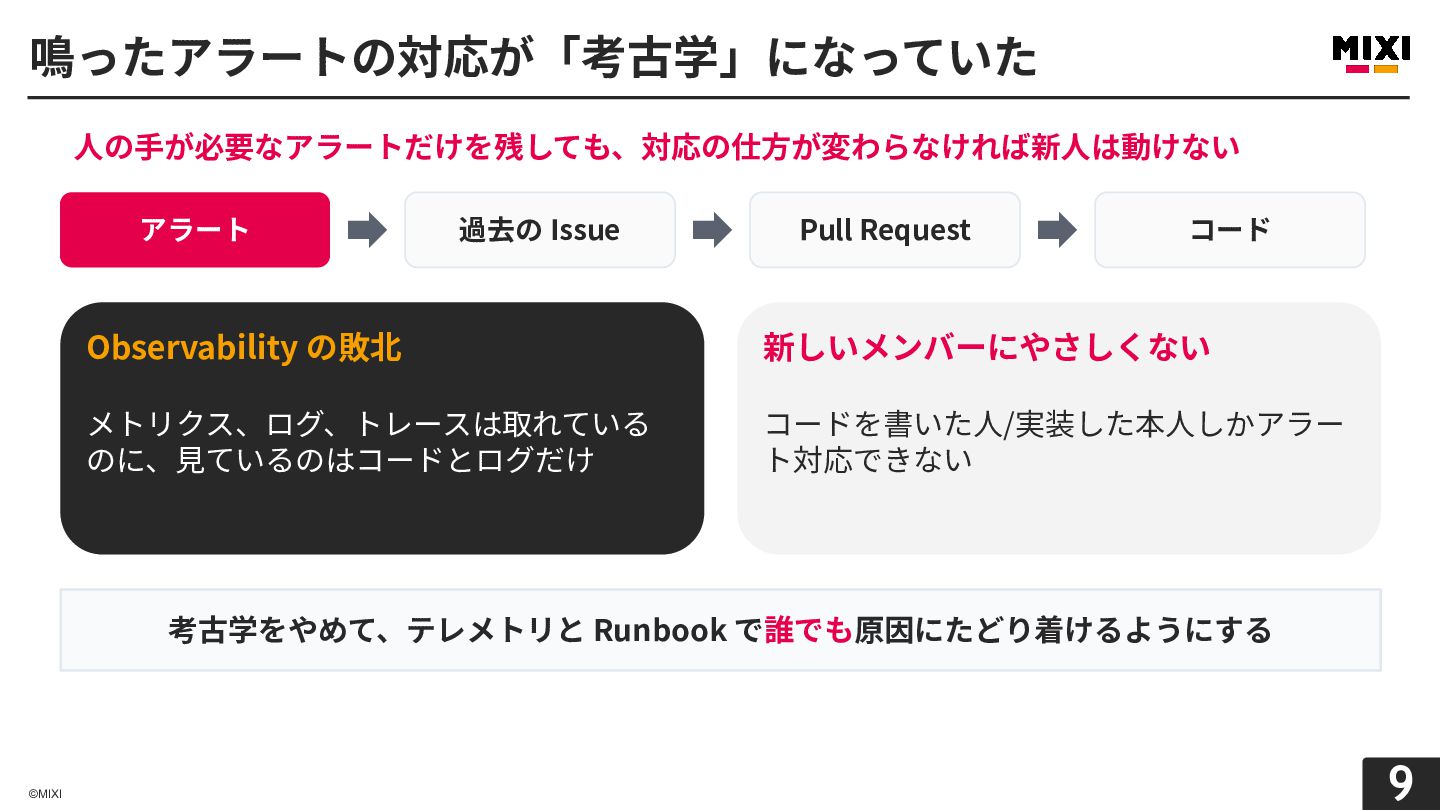
鳴ったアラートの対応が「考古学」になっていた ⼈の⼿が必要なアラートだけを残しても、対応の仕⽅が変わらなければ新⼈は動けない アラート 過去の Issue Pull Request コード Observability の敗北
新しいメンバーにやさしくない メトリクス、ログ、トレースは取れている のに、⾒ているのはコードとログだけ コードを書いた⼈/実装した本⼈しかアラー ト対応できない 考古学をやめて、テレメトリと Runbook で誰でも原因にたどり着けるようにする ©MIXI 119 -
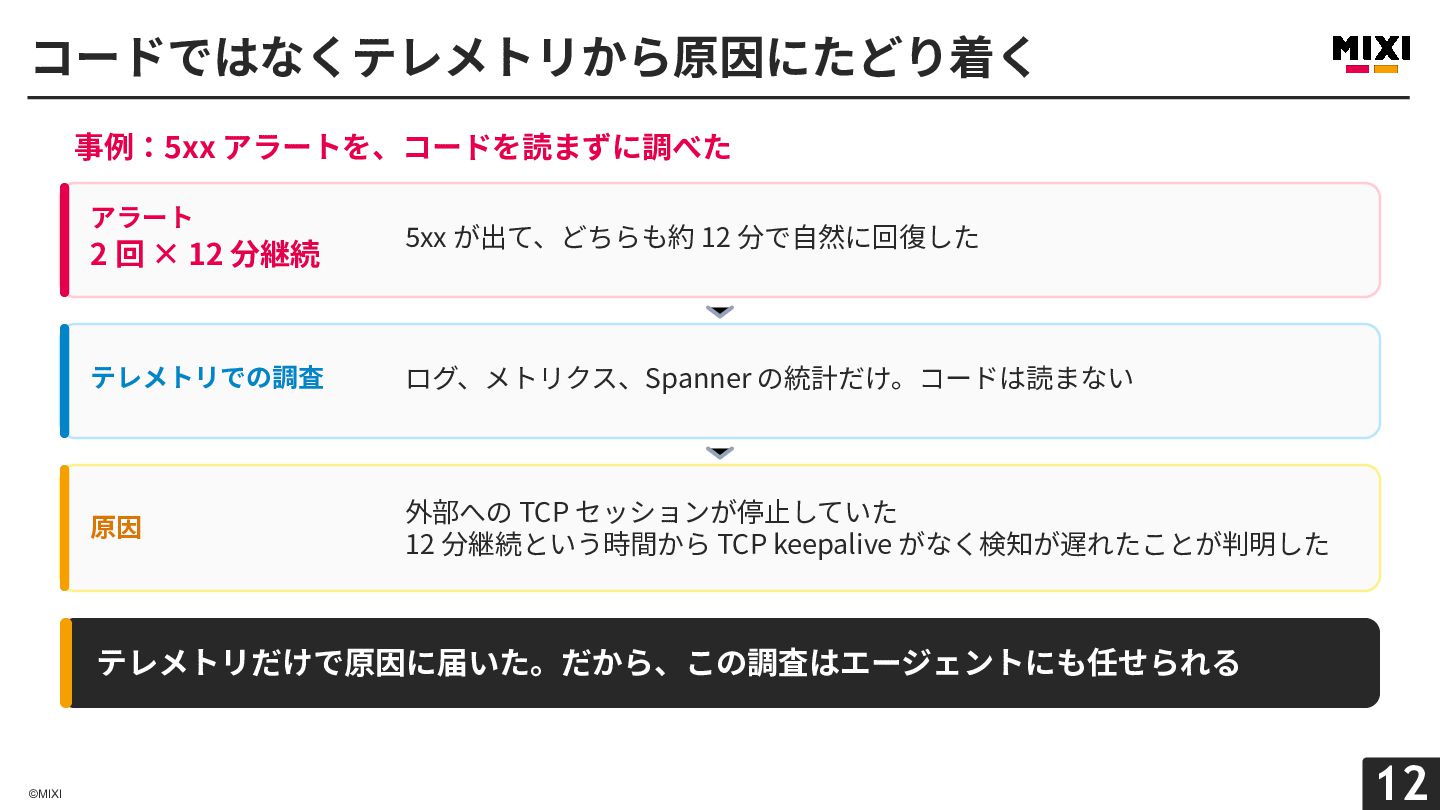
コードではなくテレメトリから原因にたどり着く 事例:5xx アラートを、コードを読まずに調べた アラート 2 回 × 12 分継続 5xx
が出て、どちらも約 12 分で⾃然に回復した テレメトリでの調査 ログ、メトリクス、Spanner の統計だけ。コードは読まない 原因 外部への TCP セッションが停⽌していた 12 分継続という時間から TCP keepalive がなく検知が遅れたことが判明した テレメトリだけで原因に届いた。だから、この調査はエージェントにも任せられる ©MIXI 12 12 -
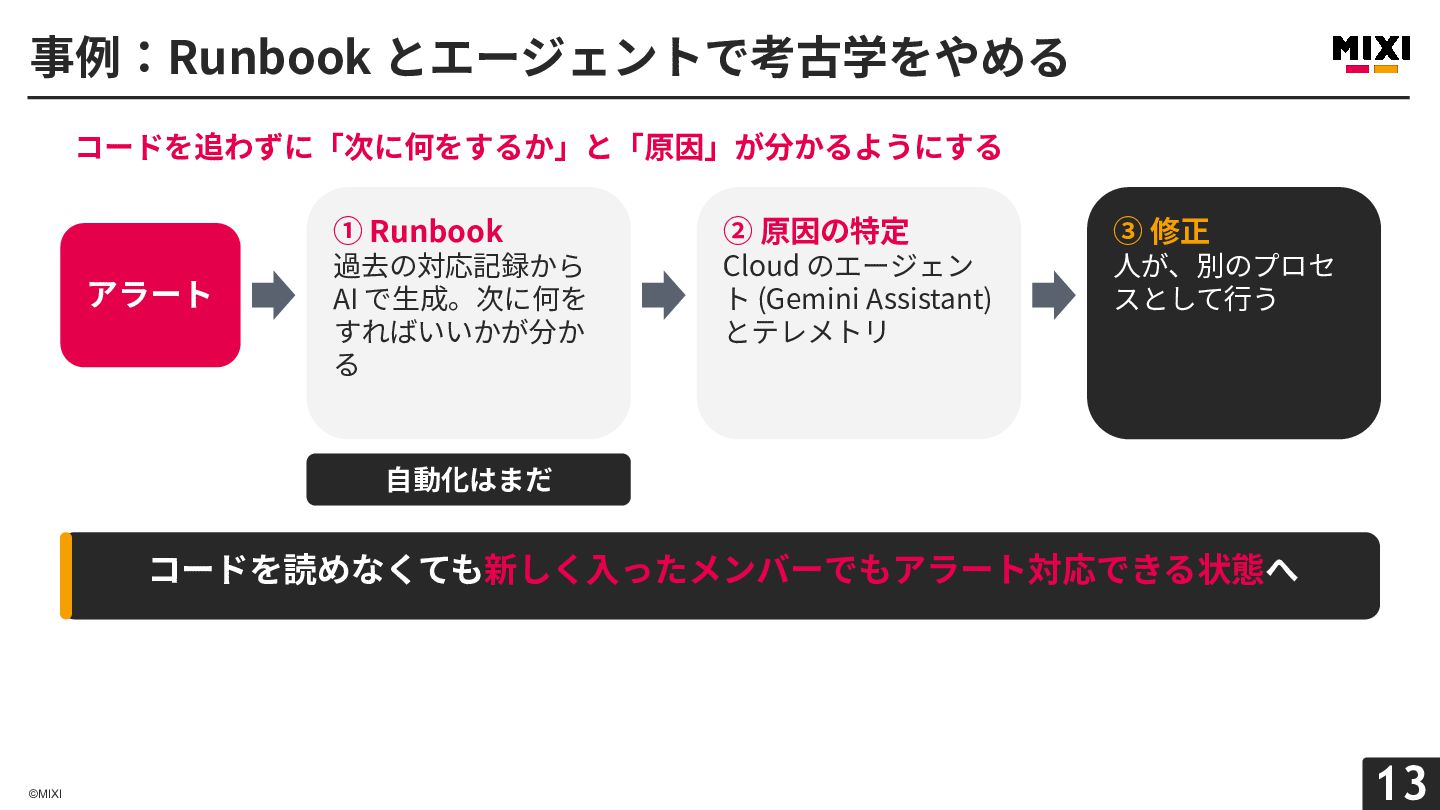
事例:Runbook とエージェントで考古学をやめる コードを追わずに「次に何をするか」と「原因」が分かるようにする アラート ① Runbook ② 原因の特定 ③ 修正
過去の対応記録から AI で⽣成。次に何を すればいいかが分か る Cloud のエージェン ト (Gemini Assistant) とテレメトリ ⼈が、別のプロセ スとして⾏う ⾃動化はまだ コードを読めなくても新しく⼊ったメンバーでもアラート対応できる状態へ ©MIXI 13 13 -
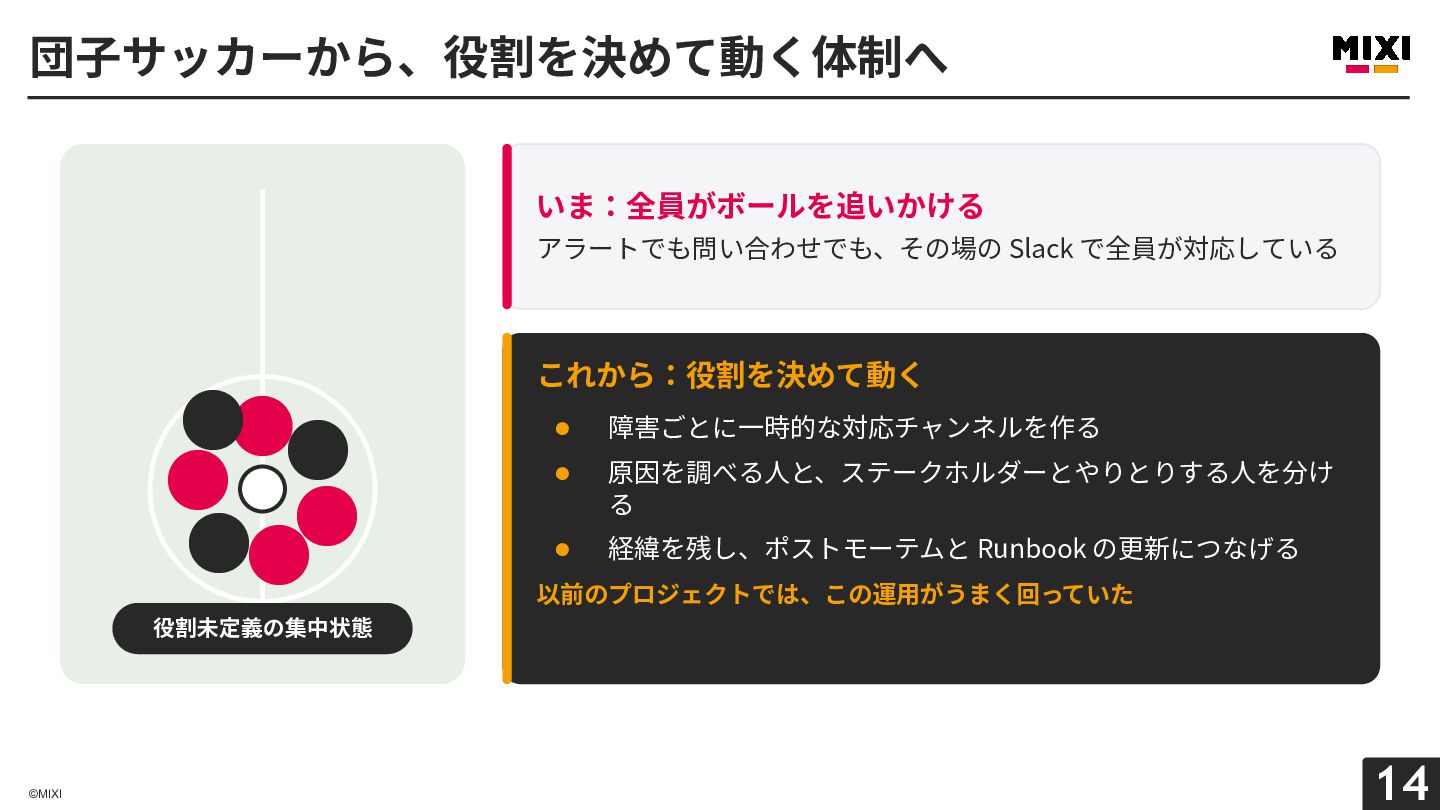
団⼦サッカーから、役割を決めて動く体制へ いま:全員がボールを追いかける アラートでも問い合わせでも、その場の Slack で全員が対応している これから:役割を決めて動く • 障害ごとに⼀時的な対応チャンネルを作る • 原因を調べる⼈と、ステークホルダーとやりとりする⼈を分け
る • 経緯を残し、ポストモーテムと Runbook の更新につなげる 以前のプロジェクトでは、この運⽤がうまく回っていた 役割未定義の集中状態 ©MIXI 14 14 -
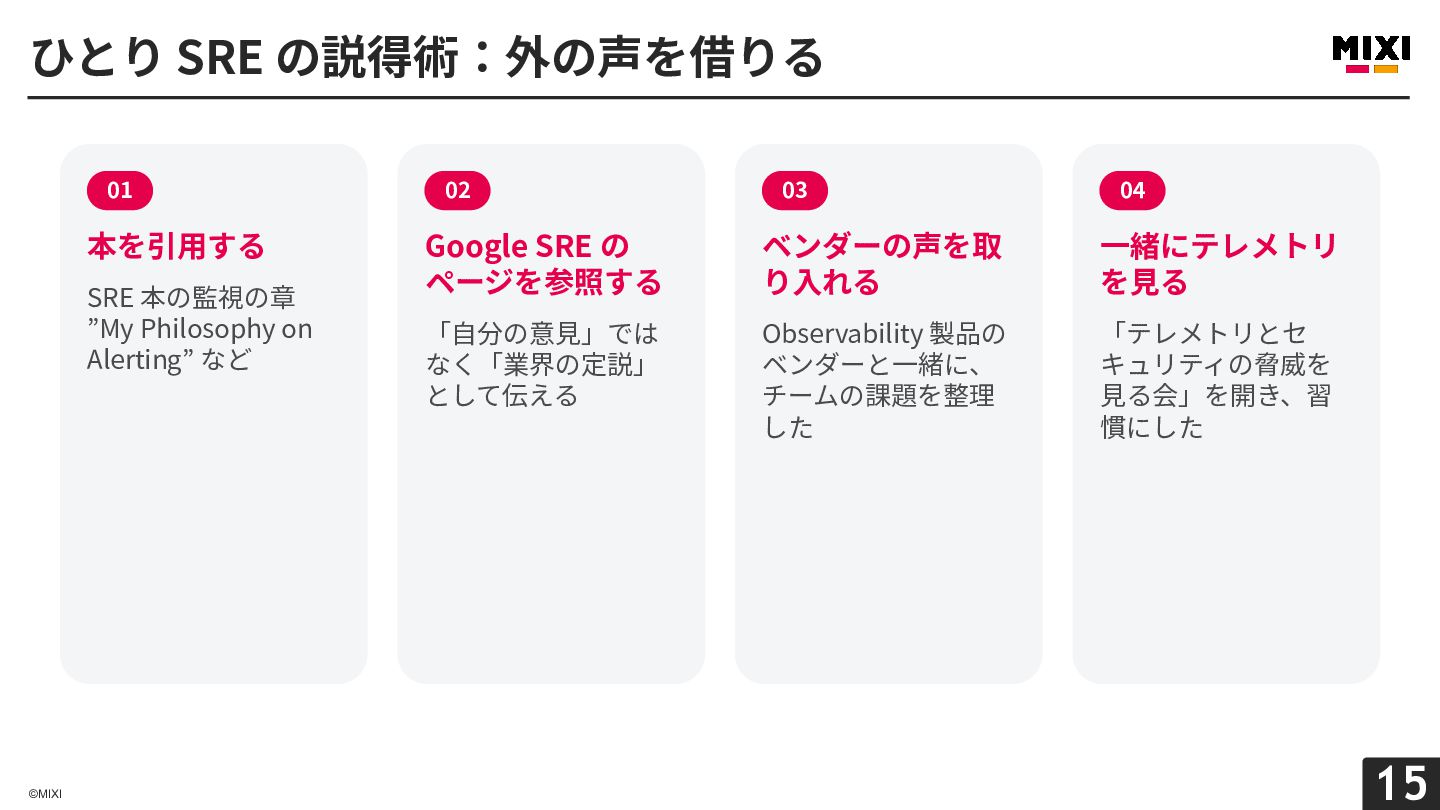
ひとり SRE の説得術:外の声を借りる 01 本を引⽤する SRE 本の監視の章 ”My Philosophy on
Alerting” など ©MIXI 02 03 04 Google SRE の ページを参照する ベンダーの声を取 り⼊れる ⼀緒にテレメトリ を⾒る 「⾃分の意⾒」では なく「業界の定説」 として伝える Observability 製品の ベンダーと⼀緒に、 チームの課題を整理 した 「テレメトリとセ キュリティの脅威を ⾒る会」を開き、習 慣にした 15 15 -
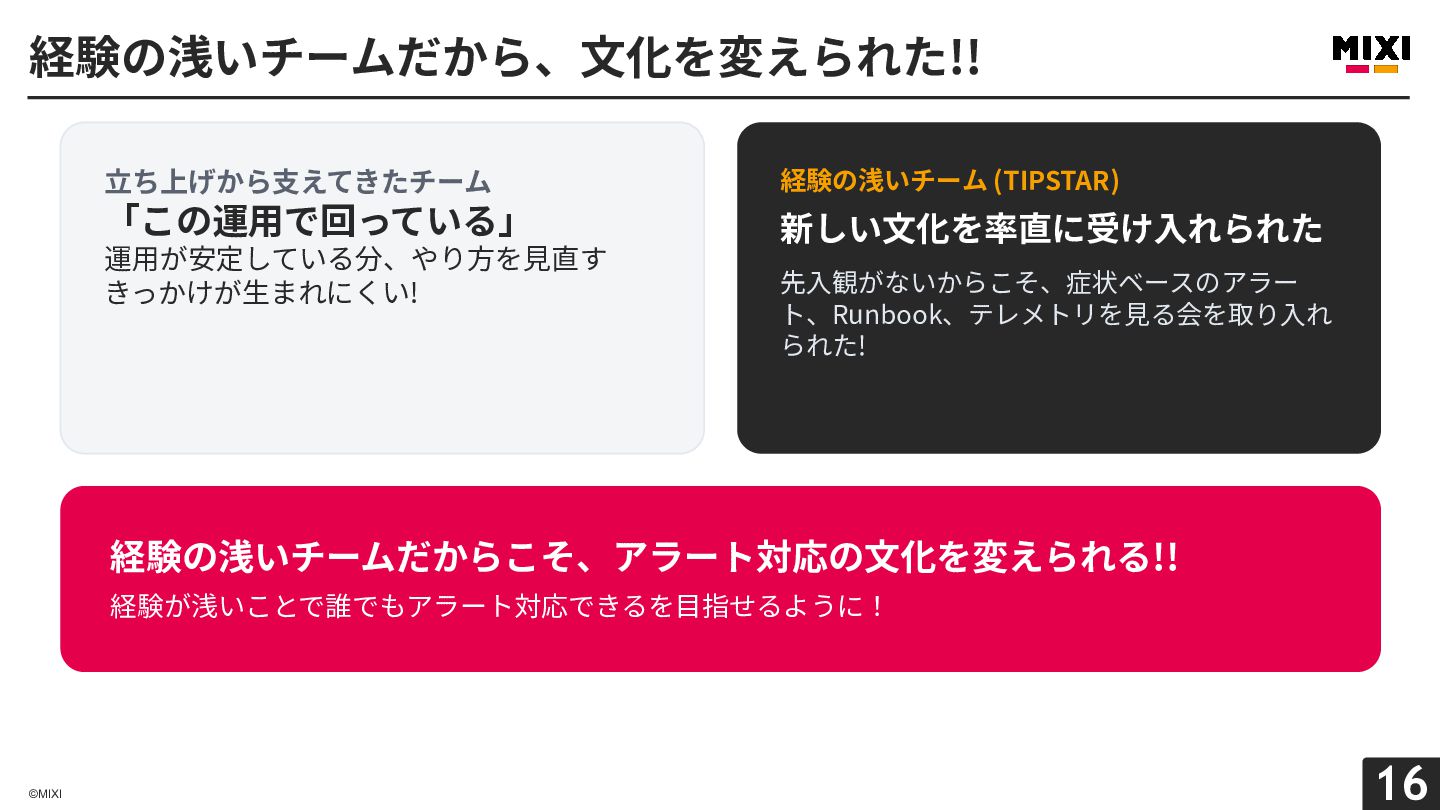
経験の浅いチームだから、⽂化を変えられた!! ⽴ち上げから⽀えてきたチーム 経験の浅いチーム (TIPSTAR) 「この運⽤で回っている」 新しい⽂化を率直に受け⼊れられた 運⽤が安定している分、やり⽅を⾒直す きっかけが⽣まれにくい! 先⼊観がないからこそ、症状ベースのアラー ト、Runbook、テレメトリを⾒る会を取り⼊れ
られた! 経験の浅いチームだからこそ、アラート対応の⽂化を変えられる!! 経験が浅いことで誰でもアラート対応できるを⽬指せるように! ©MIXI 16 16 -
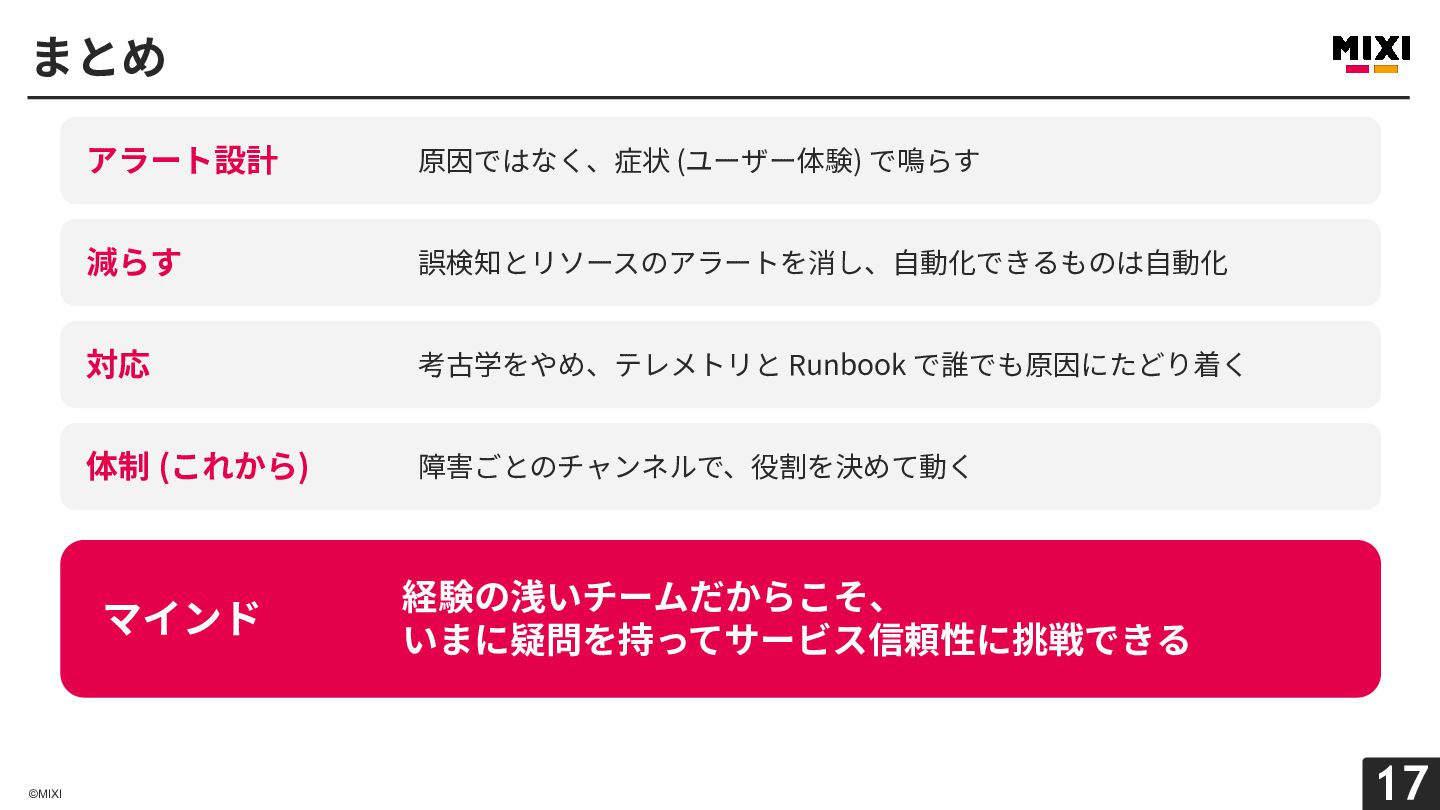
まとめ ©MIXI アラート設計 原因ではなく、症状 (ユーザー体験) で鳴らす 減らす 誤検知とリソースのアラートを消し、⾃動化できるものは⾃動化 対応 考古学をやめ、テレメトリと
Runbook で誰でも原因にたどり着く 体制 (これから) 障害ごとのチャンネルで、役割を決めて動く マインド 経験の浅いチームだからこそ、 いまに疑問を持ってサービス信頼性に挑戦できる 17 17