Share
Embed
機械学習を用いた3次元データ認識について
Asako Kanezaki
September 26, 2019
Transcript
75 slides
-
機械学習を用いた 3次元データ認識について 産業技術総合研究所 人工知能研究センター 金崎 朝子 2019/09/26 13:25-14:25 情報処理学会連続セミナー2019 第3回:
AIと歩む未来(2):画像・映像処理の最前線 https://www.ipsj.or.jp/event/seminar/2019/program03.html -
お品書き 1. Deep Learningの基礎知識 2. 3D物体認識 – 3D点群からの物体認識 – マルチビュー画像からの物体認識
3. 3Dデータ生成 – 微分可能レンダラー – マルチビュー画像生成 4. 3D再構成 – Self-Supervised Learning – 微分可能レイヤー -
Deep Learningによる画像識別 • Convolutional Neural Networks (CNN)が主流 例) AlexNet [Krizhevsky+,
2012] 入力 出力 ⇒猫 (1000クラスのカテゴリの尤度) 微分可能な処理(例:畳み込み)⇒重みを誤差逆伝播法で学習 = 誤差を = ()とすると、 = chain rule -
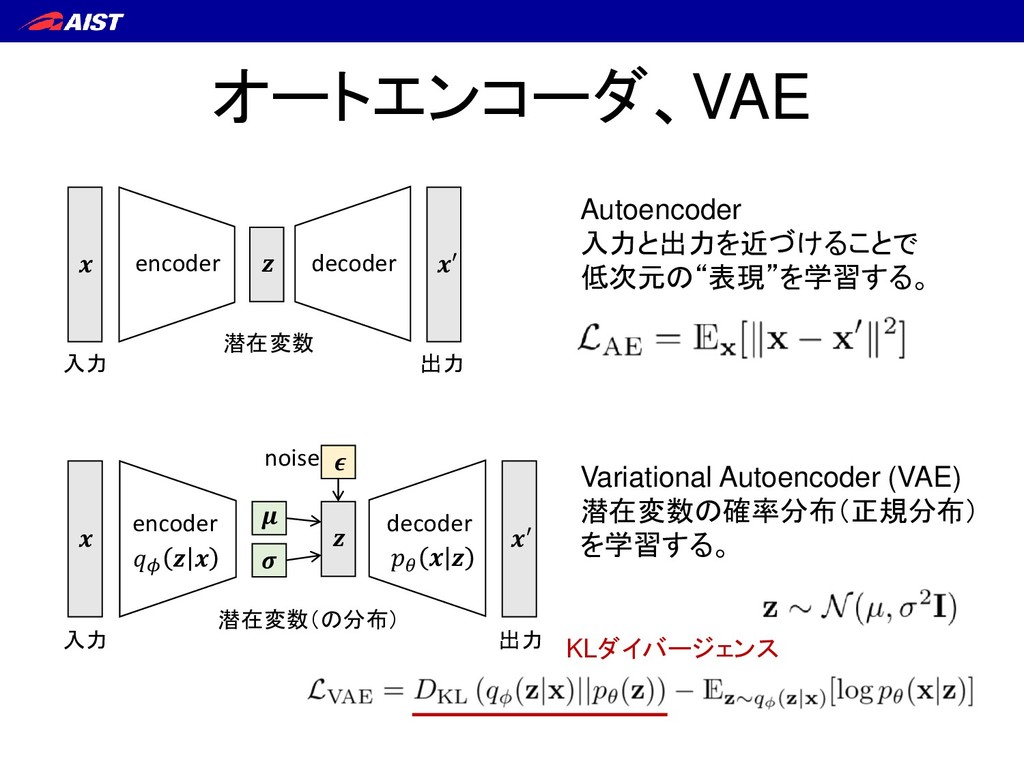
オートエンコーダ、VAE ′ encoder decoder ′ encoder decoder noise Autoencoder 入力と出力を近づけることで
低次元の“表現”を学習する。 Variational Autoencoder (VAE) 潜在変数の確率分布(正規分布) を学習する。 入力 出力 潜在変数 入力 出力 潜在変数(の分布) KLダイバージェンス -
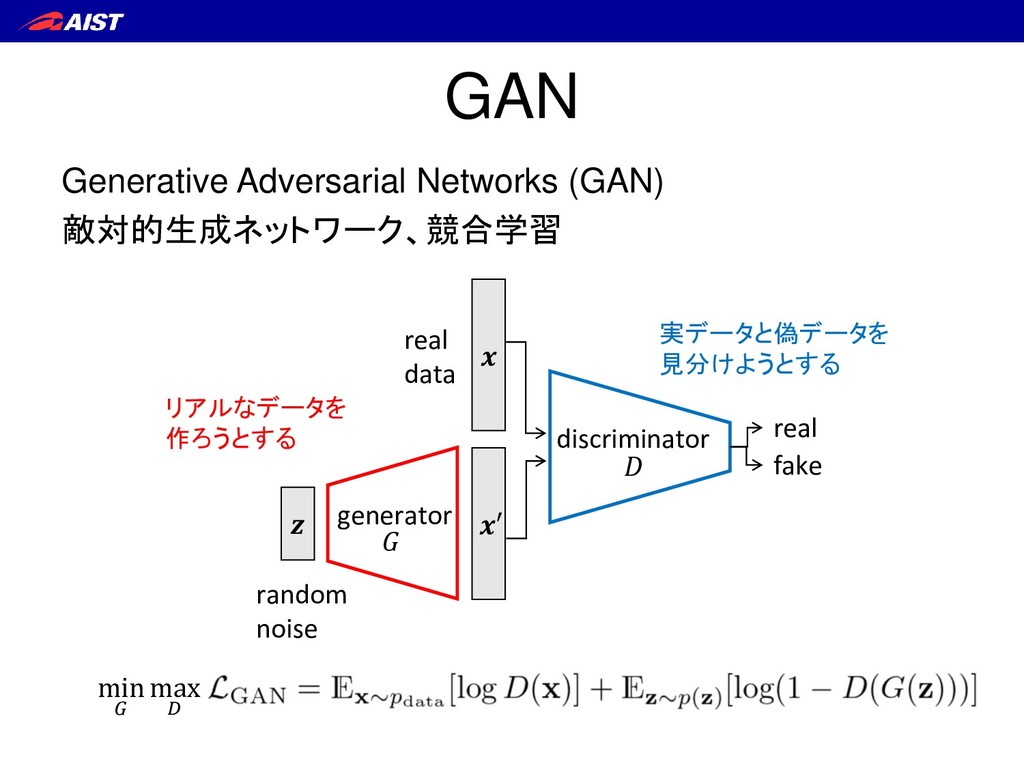
GAN Generative Adversarial Networks (GAN) 敵対的生成ネットワーク、競合学習 ′ discriminator generator random
noise real data real fake リアルなデータを 作ろうとする 実データと偽データを 見分けようとする min max -
Deep Learningをするには • 方法1: 操作を微分可能にする – 既知の解法を微分可能レイヤーで近似する • 方法2: GANを使う
– 識別器を学習することでブラックボックスな生成器を学習 • 方法3: 強化学習を使う – 報酬を定義することでブラックボックスなポリシーを学習 入 微 出 微 微 微 入 出 生成 識別 Yes/No 入 出 ポリシー 報酬 ・・・ -
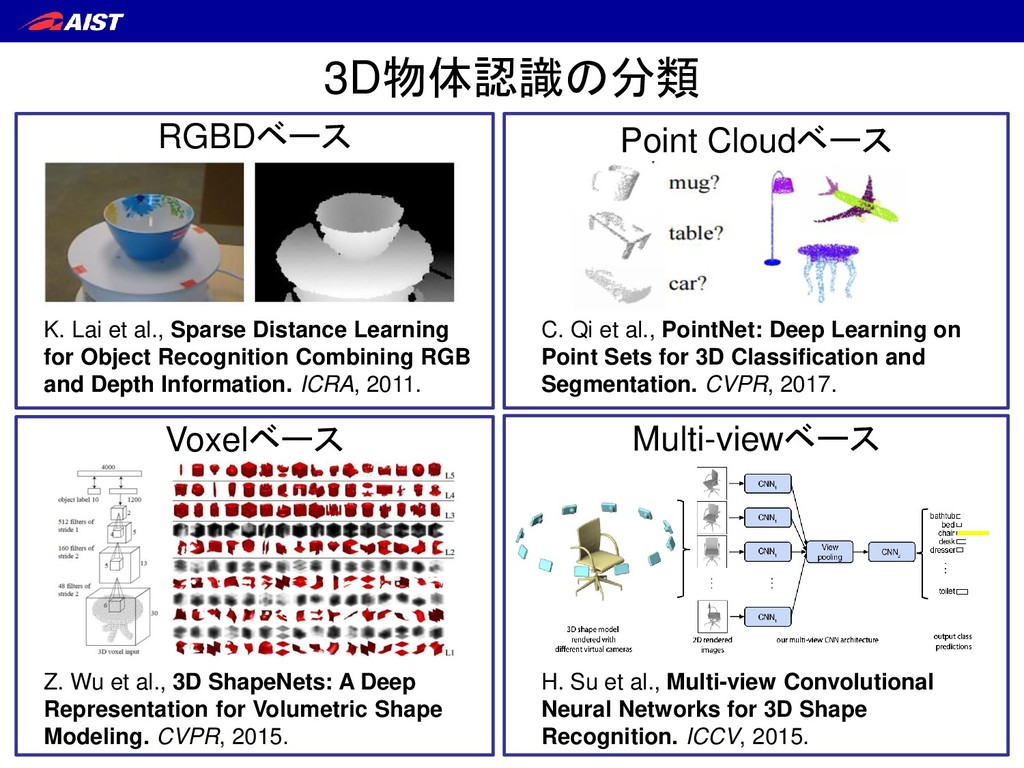
3D物体認識の分類 Point Cloudベース RGBDベース Multi-viewベース Voxelベース K. Lai et al.,
Sparse Distance Learning for Object Recognition Combining RGB and Depth Information. ICRA, 2011. C. Qi et al., PointNet: Deep Learning on Point Sets for 3D Classification and Segmentation. CVPR, 2017. Z. Wu et al., 3D ShapeNets: A Deep Representation for Volumetric Shape Modeling. CVPR, 2015. H. Su et al., Multi-view Convolutional Neural Networks for 3D Shape Recognition. ICCV, 2015. -
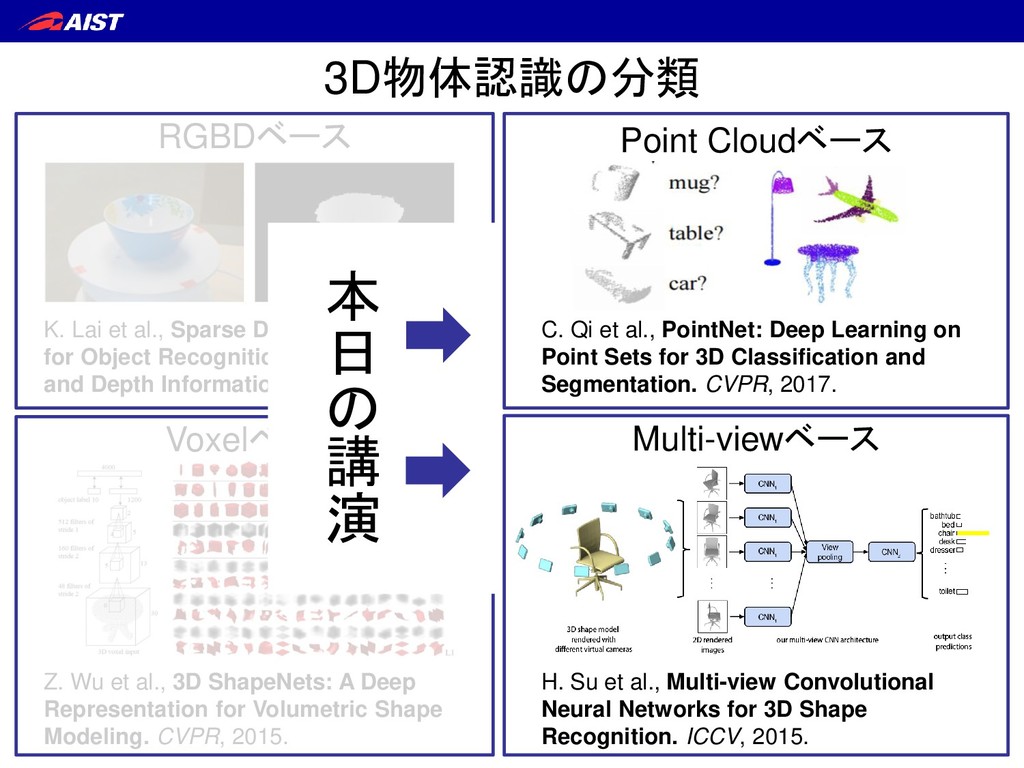
3D物体認識の分類 Point Cloudベース RGBDベース Multi-viewベース Voxelベース K. Lai et al.,
Sparse Distance Learning for Object Recognition Combining RGB and Depth Information. ICRA, 2011. C. Qi et al., PointNet: Deep Learning on Point Sets for 3D Classification and Segmentation. CVPR, 2017. Z. Wu et al., 3D ShapeNets: A Deep Representation for Volumetric Shape Modeling. CVPR, 2015. H. Su et al., Multi-view Convolutional Neural Networks for 3D Shape Recognition. ICCV, 2015. 本 日 の 講 演 -
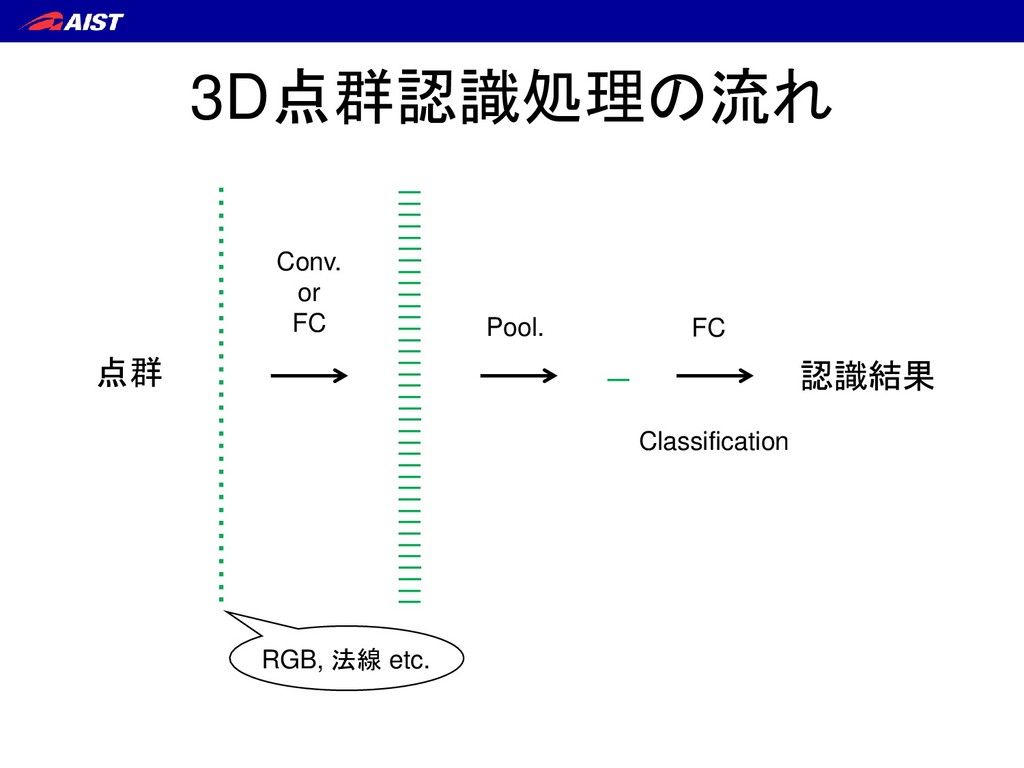
3D点群認識処理の流れ 認識結果 点群 ・ ・ ・ ・ ・ ・ ・
・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ ・ Conv. or FC ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー ー Pool. ー FC Classification RGB, 法線 etc. -
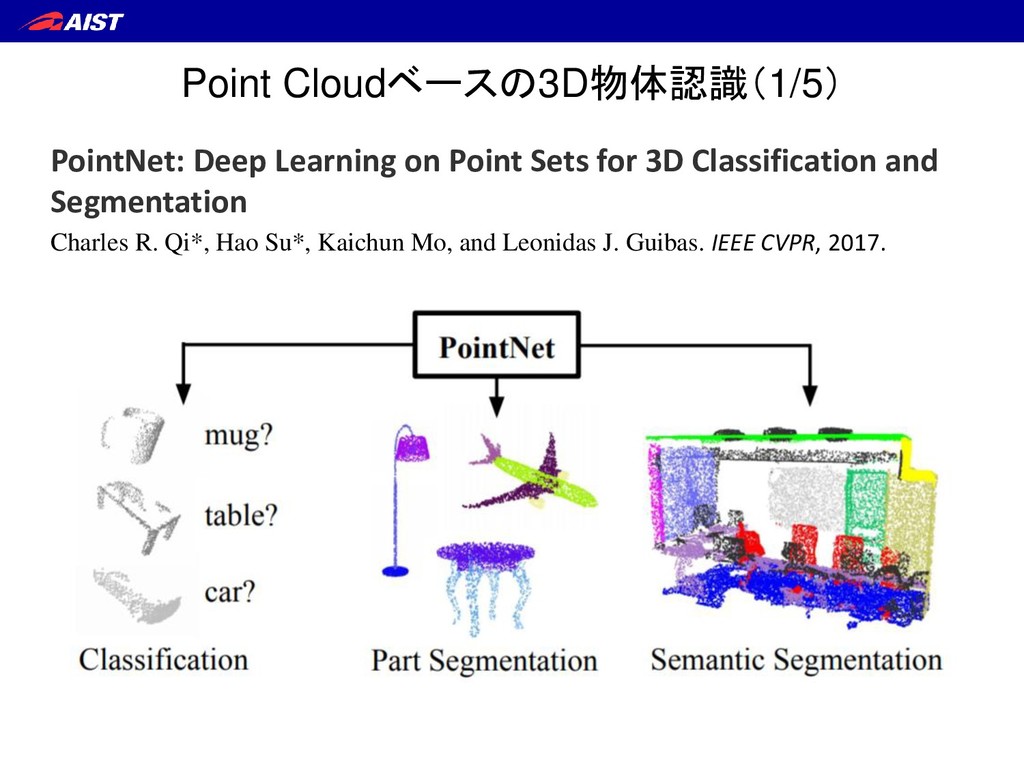
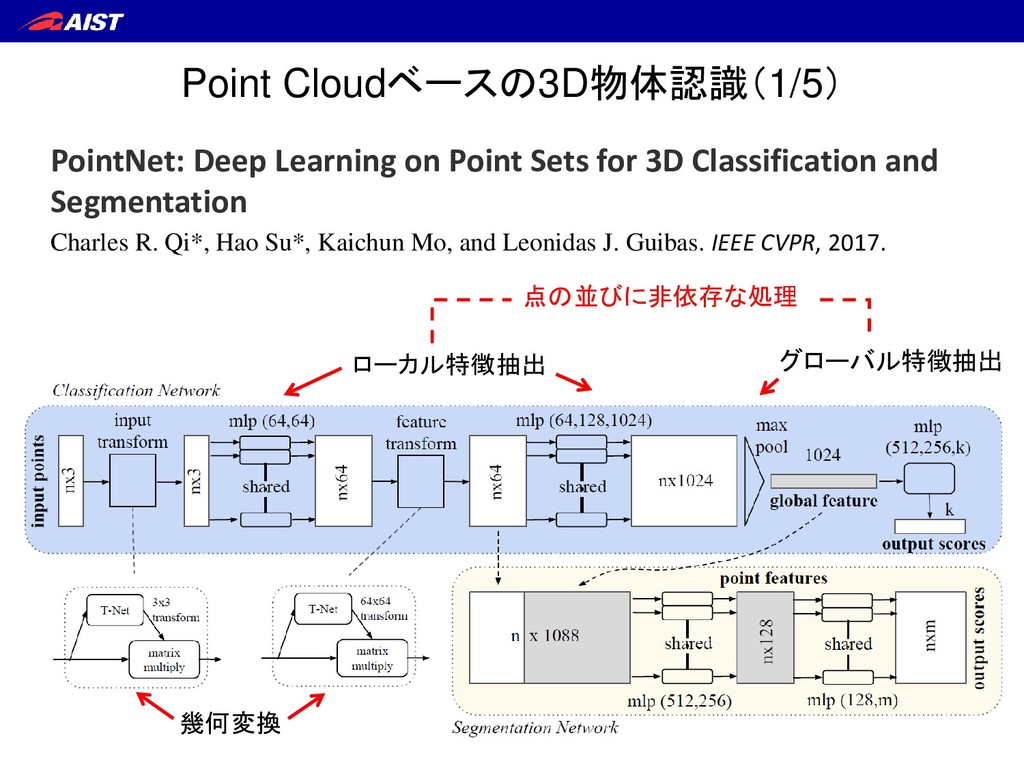
Point Cloudベースの3D物体認識(1/5) PointNet: Deep Learning on Point Sets for 3D
Classification and Segmentation Charles R. Qi*, Hao Su*, Kaichun Mo, and Leonidas J. Guibas. IEEE CVPR, 2017. -
Point Cloudベースの3D物体認識(1/5) 幾何変換 ローカル特徴抽出 グローバル特徴抽出 PointNet: Deep Learning on Point
Sets for 3D Classification and Segmentation Charles R. Qi*, Hao Su*, Kaichun Mo, and Leonidas J. Guibas. IEEE CVPR, 2017. 点の並びに非依存な処理 -
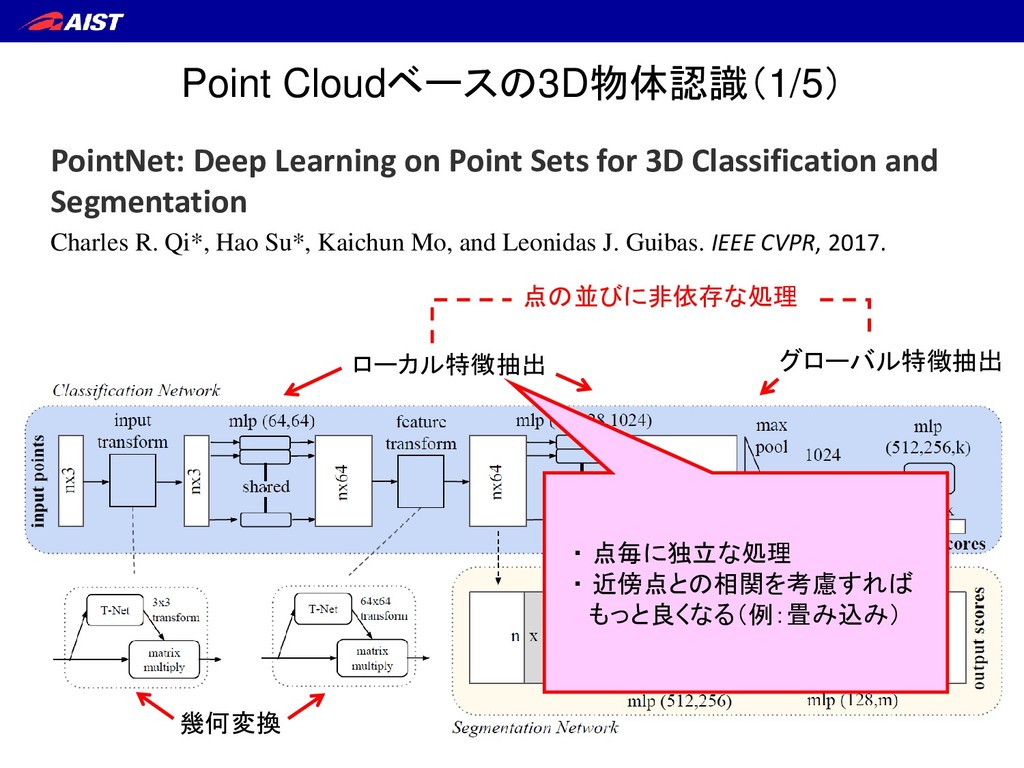
Point Cloudベースの3D物体認識(1/5) 幾何変換 ローカル特徴抽出 グローバル特徴抽出 PointNet: Deep Learning on Point
Sets for 3D Classification and Segmentation Charles R. Qi*, Hao Su*, Kaichun Mo, and Leonidas J. Guibas. IEEE CVPR, 2017. 点の並びに非依存な処理 ・ 点毎に独立な処理 ・ 近傍点との相関を考慮すれば もっと良くなる(例:畳み込み) -
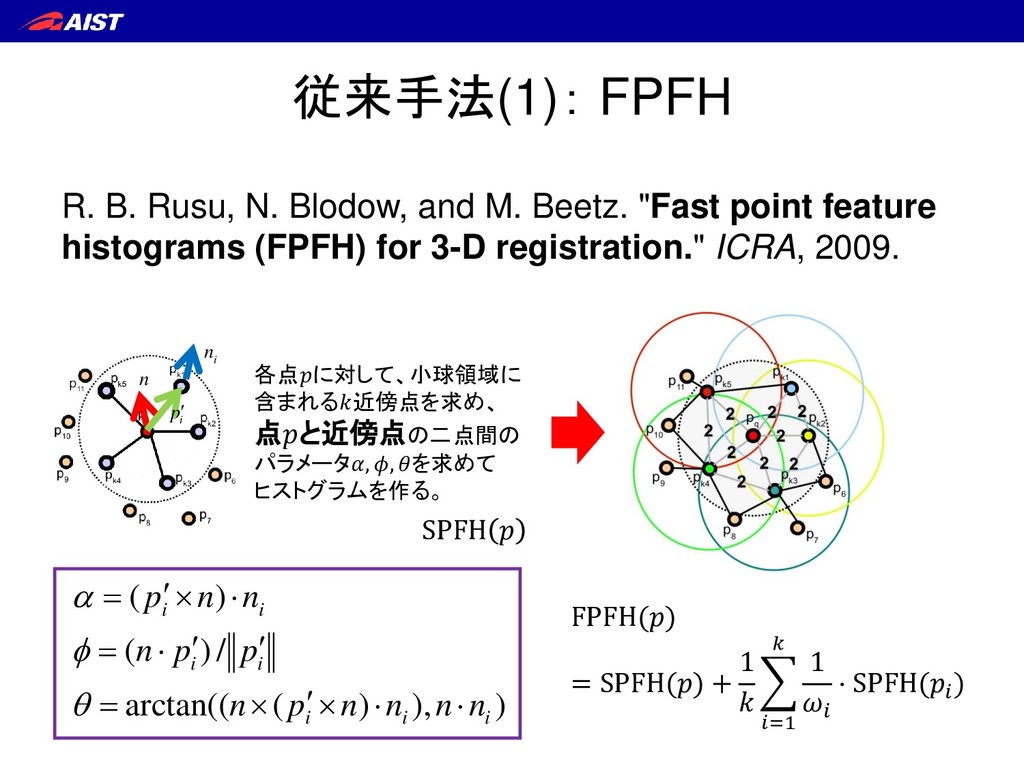
従来手法(1): FPFH R. B. Rusu, N. Blodow, and M. Beetz.
"Fast point feature histograms (FPFH) for 3-D registration." ICRA, 2009. i p n i n SPFH 各点に対して、小球領域に 含まれる近傍点を求め、 点と近傍点の二点間の パラメータ, , を求めて ヒストグラムを作る。 FPFH() = SPFH() + 1 =1 1 ⋅ SPFH( ) ) ), ) ( arctan(( / ) ( ) ( i i i i i i i n n n n p n p p n n n p = = = -
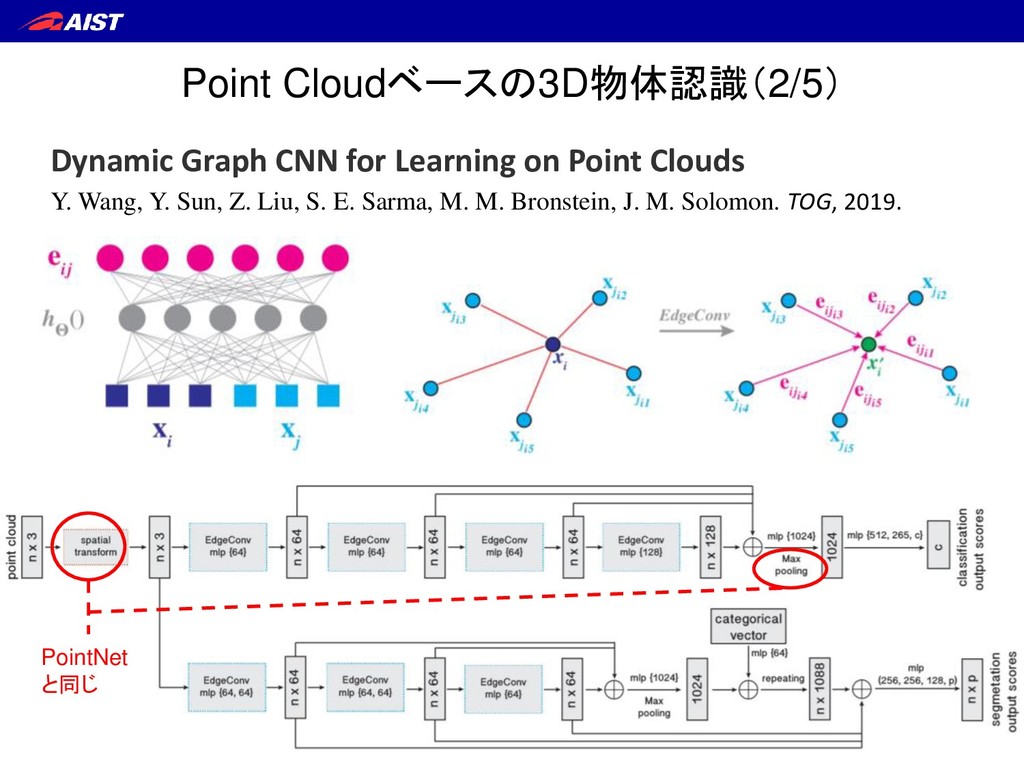
Point Cloudベースの3D物体認識(2/5) Dynamic Graph CNN for Learning on Point Clouds
Y. Wang, Y. Sun, Z. Liu, S. E. Sarma, M. M. Bronstein, J. M. Solomon. TOG, 2019. PointNet と同じ -
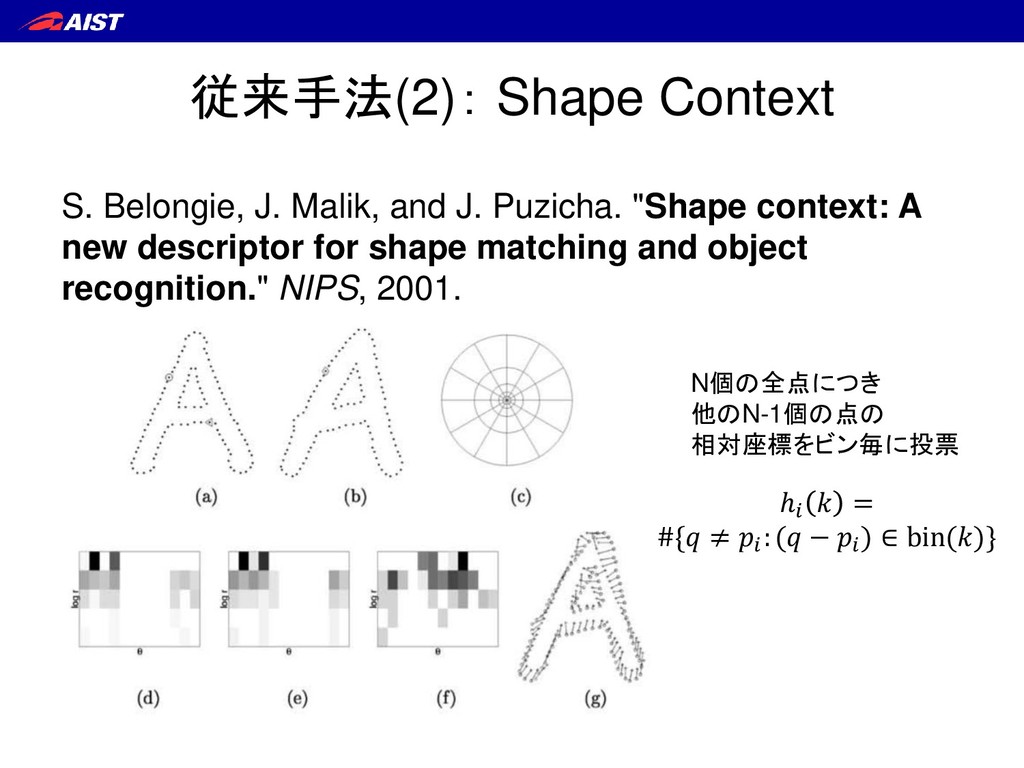
従来手法(2): Shape Context S. Belongie, J. Malik, and J. Puzicha.
"Shape context: A new descriptor for shape matching and object recognition." NIPS, 2001. N個の全点につき 他のN-1個の点の 相対座標をビン毎に投票 ℎ = #{ ≠ : ( − ) ∈ bin()} -
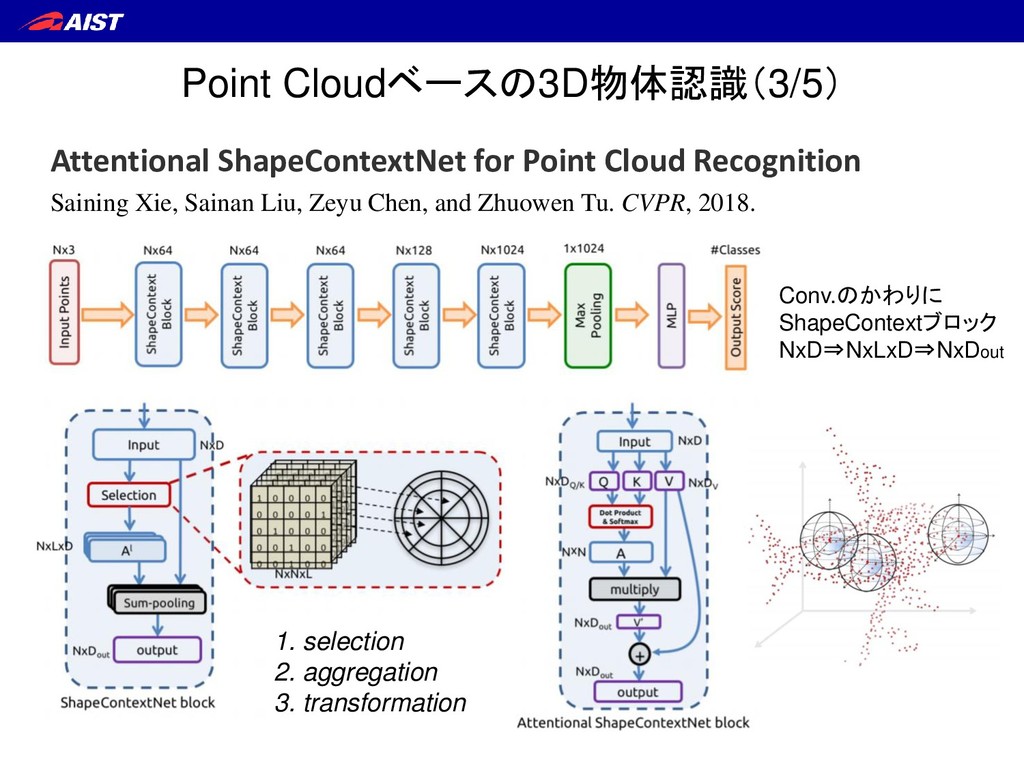
Point Cloudベースの3D物体認識(3/5) Attentional ShapeContextNet for Point Cloud Recognition Saining Xie,
Sainan Liu, Zeyu Chen, and Zhuowen Tu. CVPR, 2018. 1. selection 2. aggregation 3. transformation Conv.のかわりに ShapeContextブロック NxD⇒NxLxD⇒NxDout -
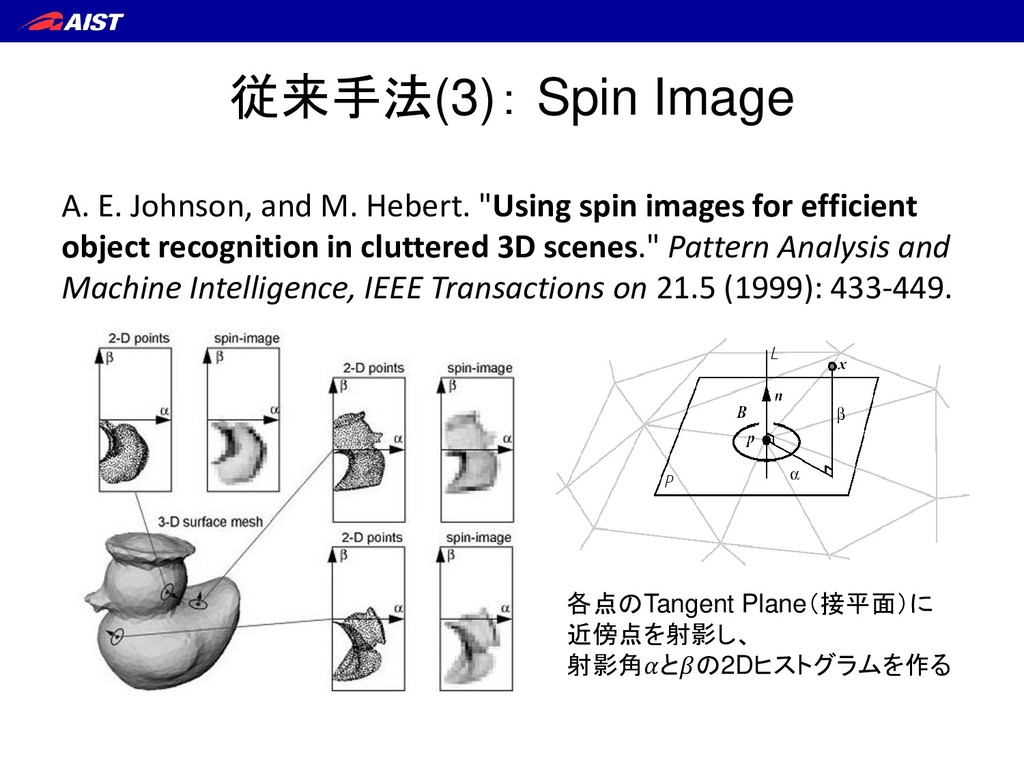
従来手法(3): Spin Image A. E. Johnson, and M. Hebert. "Using
spin images for efficient object recognition in cluttered 3D scenes." Pattern Analysis and Machine Intelligence, IEEE Transactions on 21.5 (1999): 433-449. 各点のTangent Plane(接平面)に 近傍点を射影し、 射影角との2Dヒストグラムを作る -
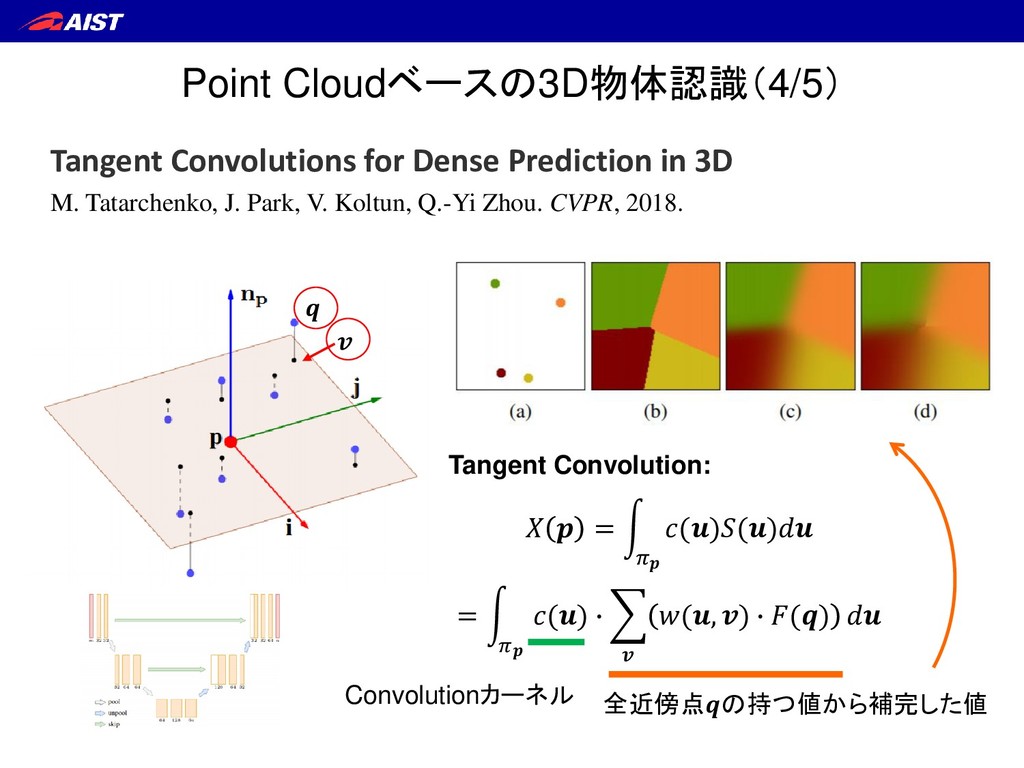
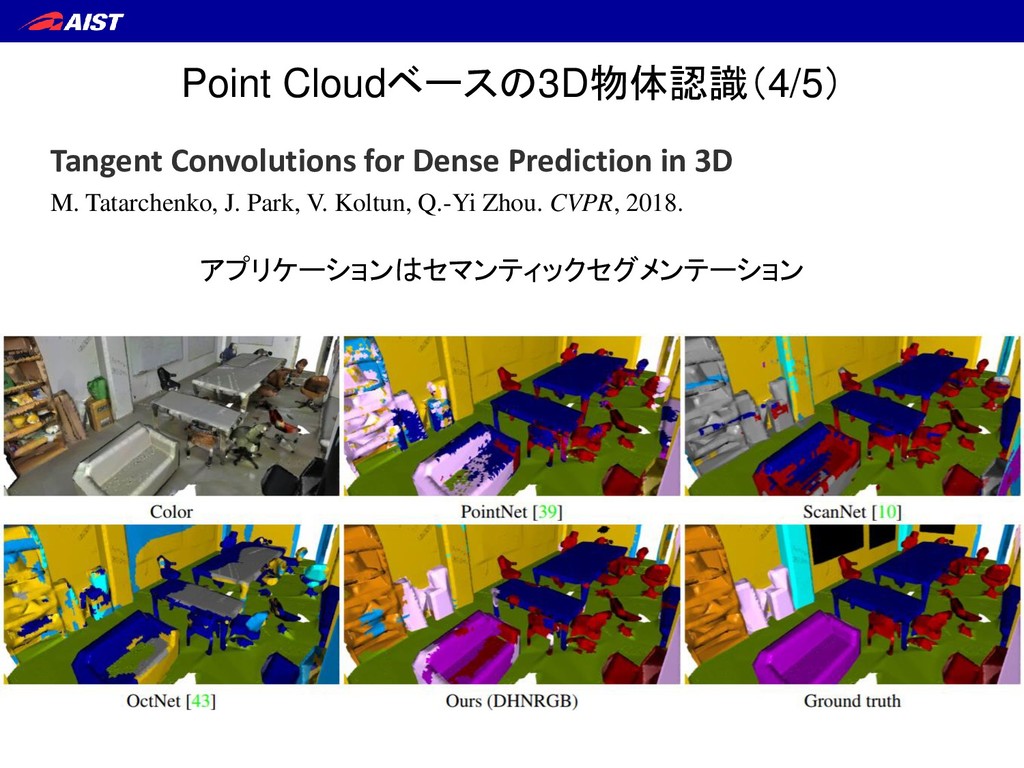
Point Cloudベースの3D物体認識(4/5) Tangent Convolutions for Dense Prediction in 3D M.
Tatarchenko, J. Park, V. Koltun, Q.-Yi Zhou. CVPR, 2018. Tangent Convolution: = න ()() = න () ∙ (, ) ∙ () Convolutionカーネル 全近傍点の持つ値から補完した値 -
Point Cloudベースの3D物体認識(4/5) Tangent Convolutions for Dense Prediction in 3D M.
Tatarchenko, J. Park, V. Koltun, Q.-Yi Zhou. CVPR, 2018. アプリケーションはセマンティックセグメンテーション -
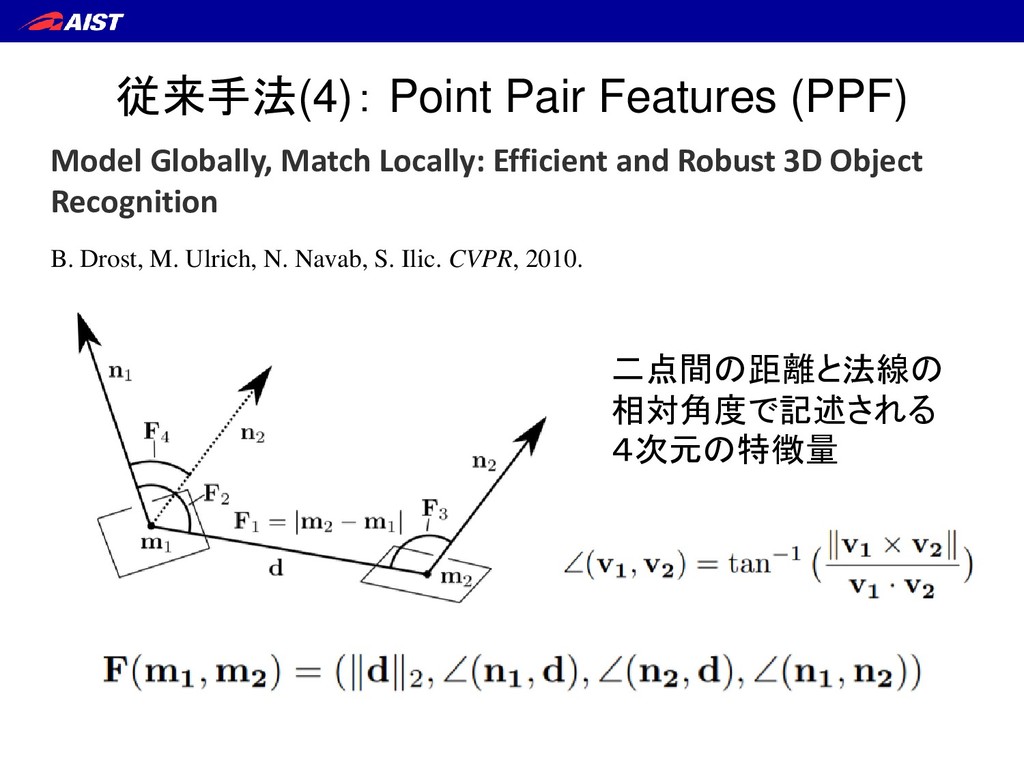
二点間の距離と法線の 相対角度で記述される 4次元の特徴量 従来手法(4): Point Pair Features (PPF) Model Globally,
Match Locally: Efficient and Robust 3D Object Recognition B. Drost, M. Ulrich, N. Navab, S. Ilic. CVPR, 2010. -
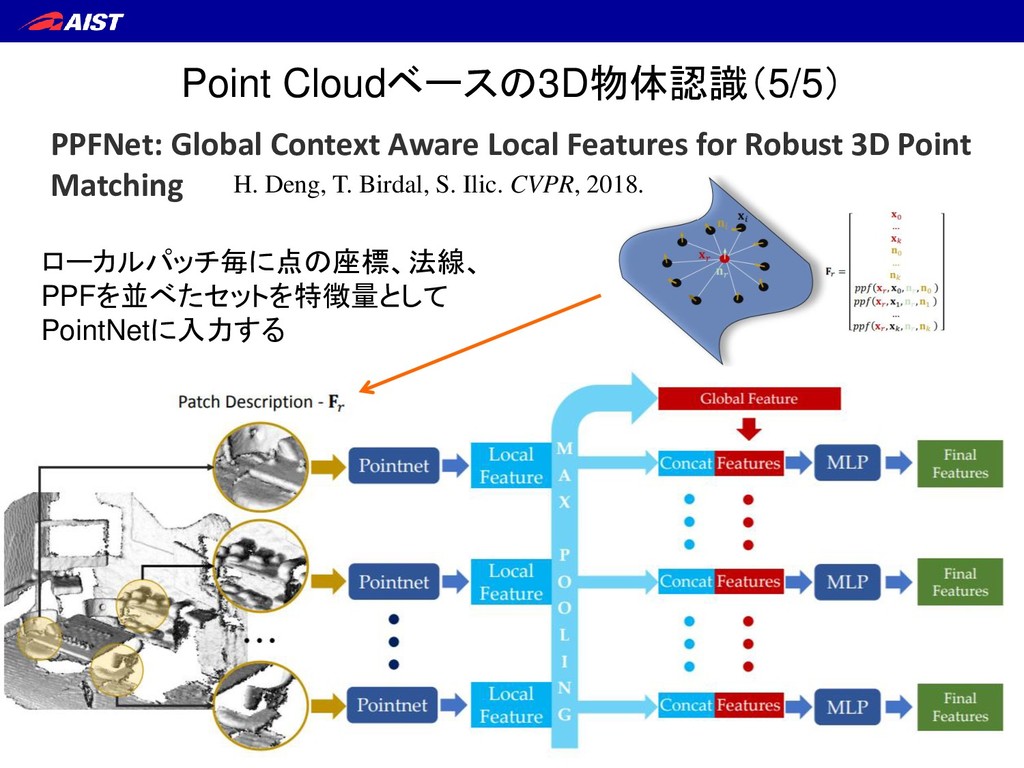
Point Cloudベースの3D物体認識(5/5) PPFNet: Global Context Aware Local Features for Robust
3D Point Matching H. Deng, T. Birdal, S. Ilic. CVPR, 2018. ローカルパッチ毎に点の座標、法線、 PPFを並べたセットを特徴量として PointNetに入力する -
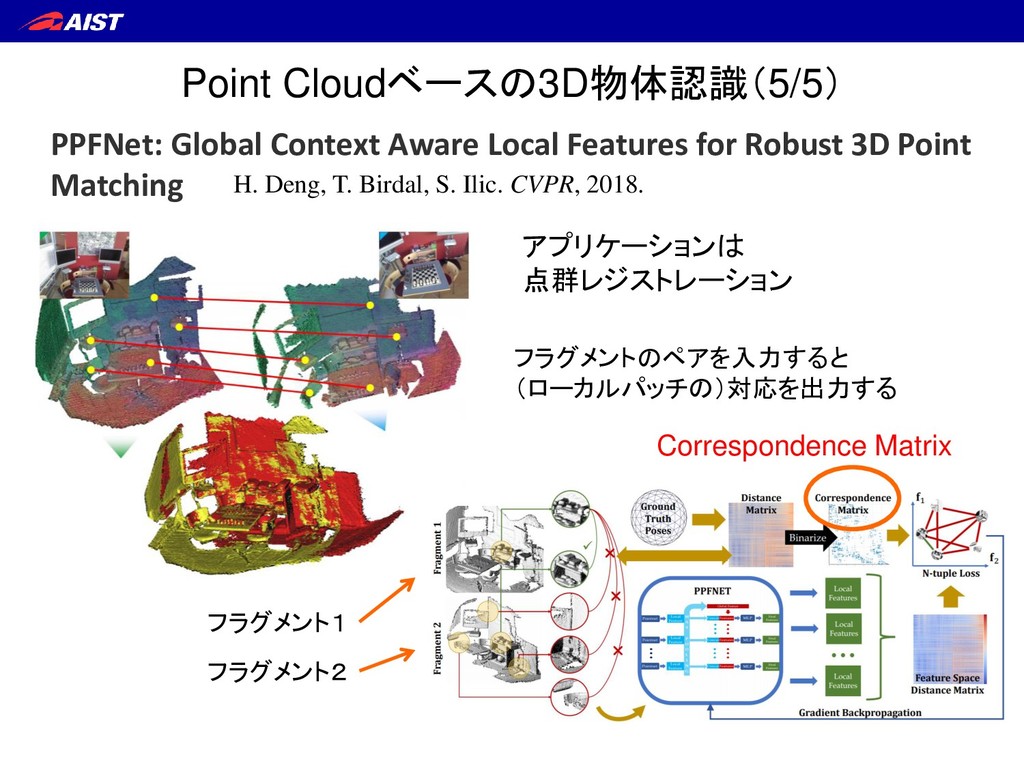
Point Cloudベースの3D物体認識(5/5) PPFNet: Global Context Aware Local Features for Robust
3D Point Matching H. Deng, T. Birdal, S. Ilic. CVPR, 2018. アプリケーションは 点群レジストレーション フラグメントのペアを入力すると (ローカルパッチの)対応を出力する Correspondence Matrix フラグメント1 フラグメント2 -
参考資料@SlideShare • “CVPR2018のPointCloudのCNN論文と SPLATNet” – by Takuya Minagawa https://www.slideshare.net/takmin/cvpr2018p ointcloudcnnsplatnet
• “三次元点群を取り扱うニューラルネットワー クのサーベイ” – by Naoya Chiba https://www.slideshare.net/naoyachiba18/ss- 120302579 -
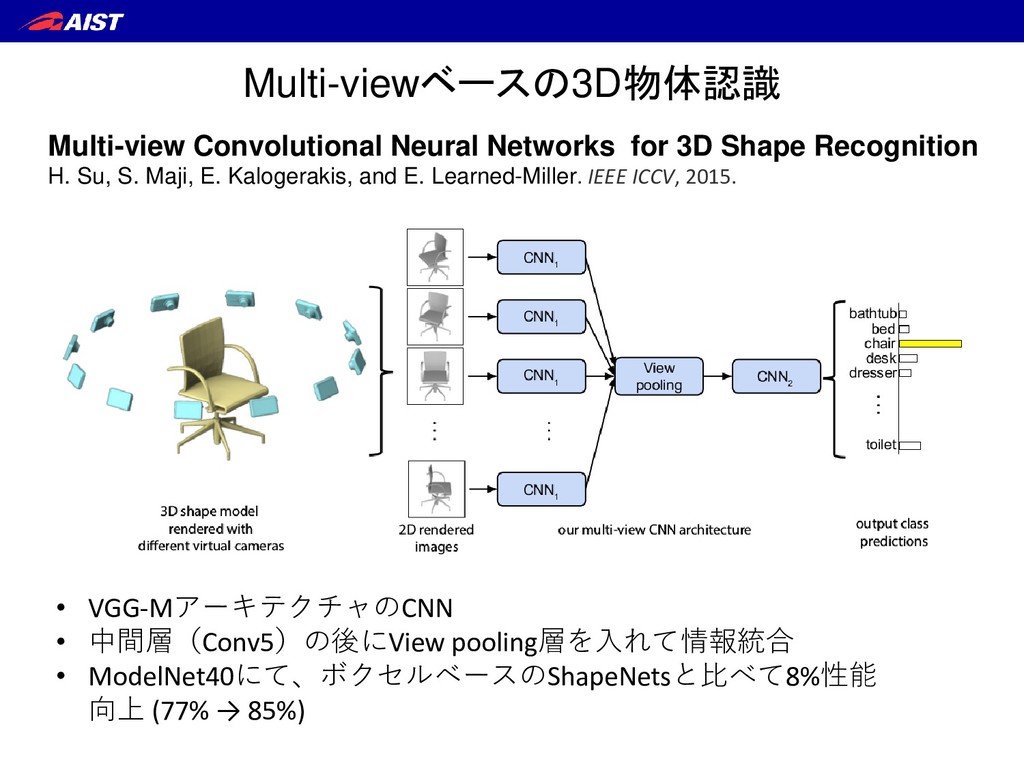
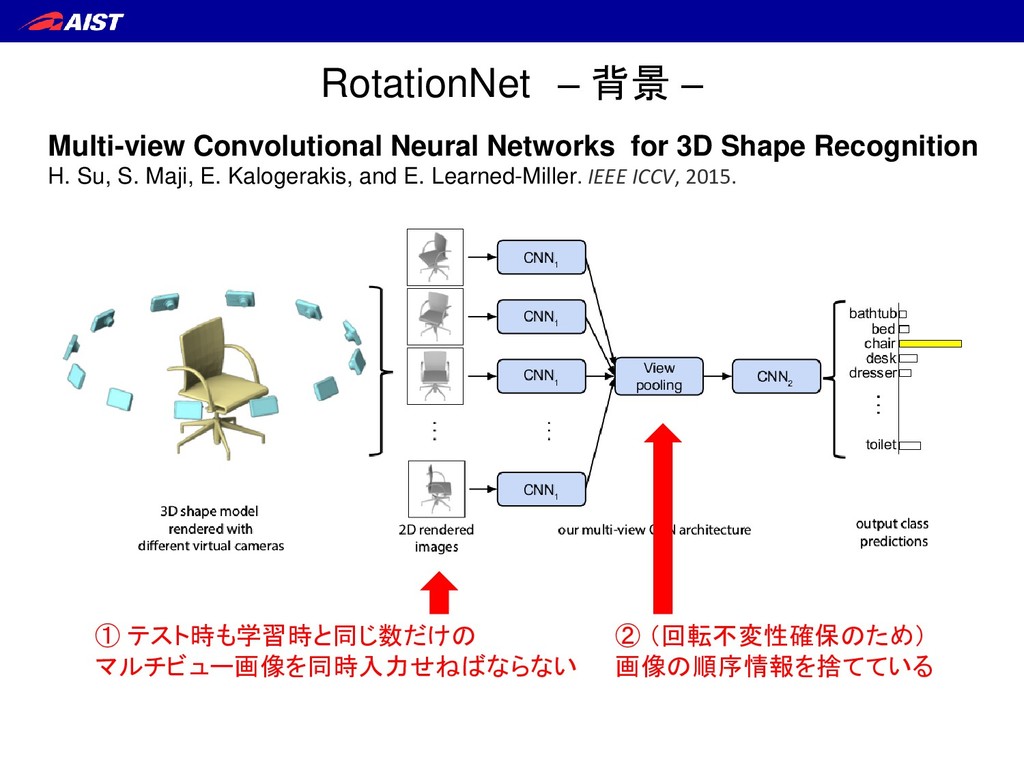
Multi-view Convolutional Neural Networks for 3D Shape Recognition H. Su,
S. Maji, E. Kalogerakis, and E. Learned-Miller. IEEE ICCV, 2015. Multi-viewベースの3D物体認識 • VGG-MアーキテクチャのCNN • 中間層(Conv5)の後にView pooling層を入れて情報統合 • ModelNet40にて、ボクセルベースのShapeNetsと比べて8%性能 向上 (77% → 85%) -
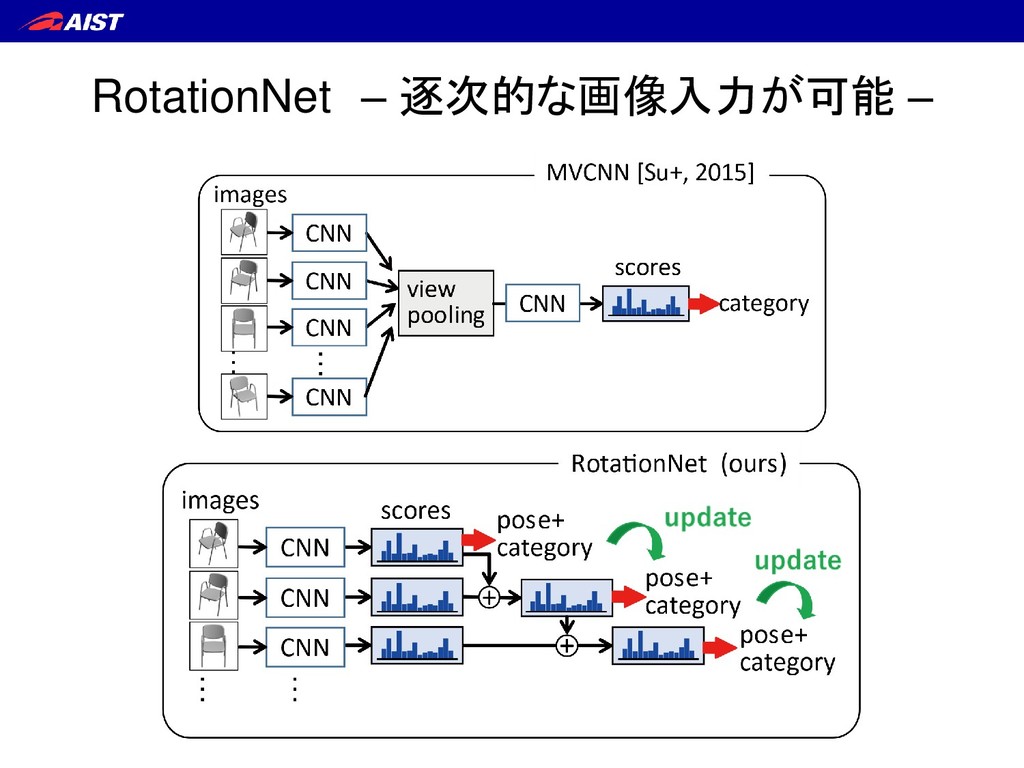
RotationNet: Joint Object Categorization and Pose Estimation Using Multiviews from
Unsupervised Viewpoints Asako Kanezaki, Yasuyuki Matsushita, and Yoshifumi Nishida. IEEE CVPR, 2018. Multi-viewベースの3D物体認識 • 物体のカテゴリと姿勢(各画像の対応する視点)を同時に推定する。 • ModelNet10, 40でSOTA • SHREC’17のトラック1とトラック3で優勝。 IEEE TPAMI, 2019. ←New! -
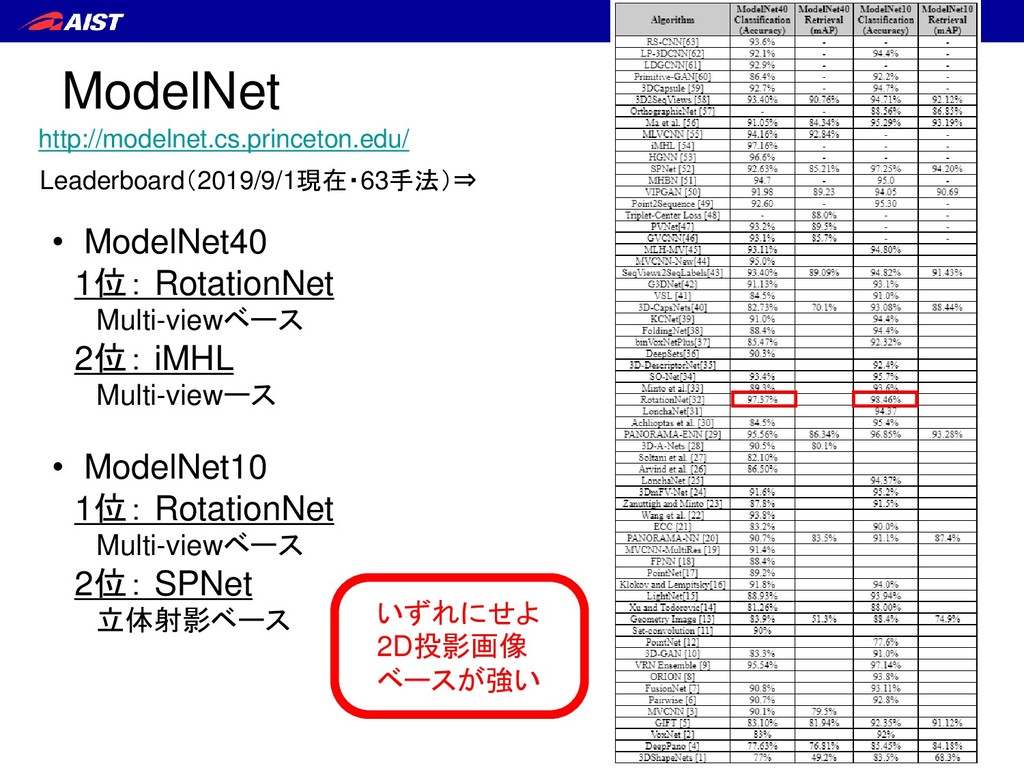
ModelNet http://modelnet.cs.princeton.edu/ Leaderboard(2019/9/1現在・63手法)⇒ • ModelNet40 1位: RotationNet Multi-viewベース 2位: iMHL
Multi-viewース • ModelNet10 1位: RotationNet Multi-viewベース 2位: SPNet 立体射影ベース いずれにせよ 2D投影画像 ベースが強い -
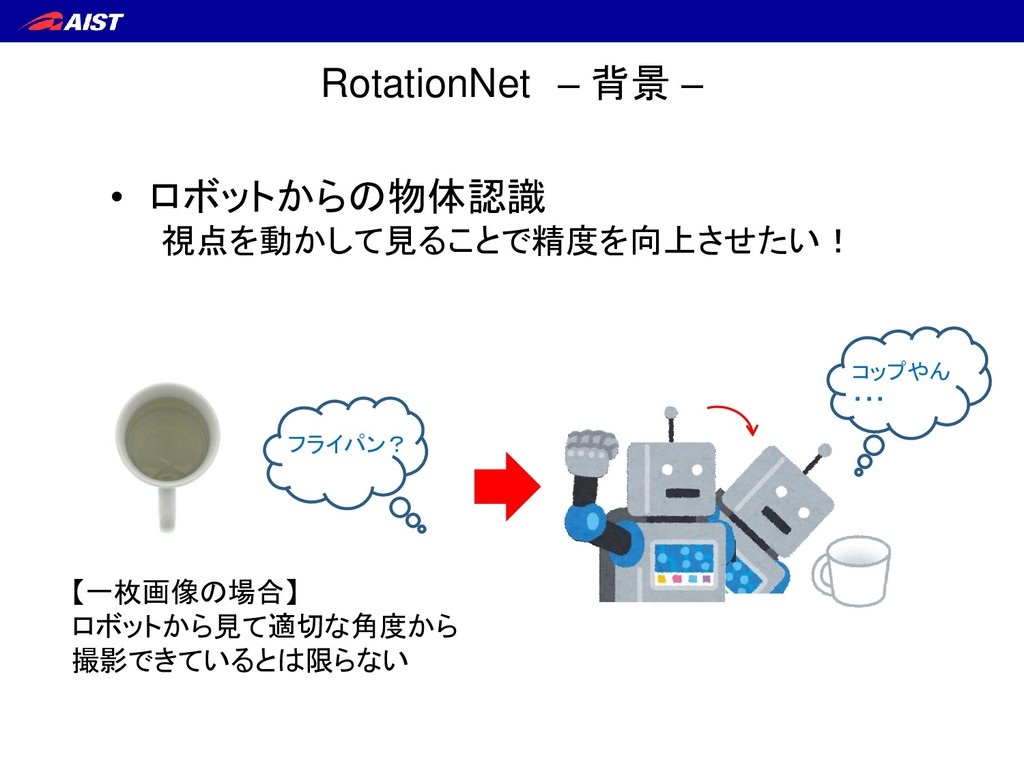
RotationNet – 背景 – 【一枚画像の場合】 ロボットから見て適切な角度から 撮影できているとは限らない フライパン? コップやん ・・・
• ロボットからの物体認識 視点を動かして見ることで精度を向上させたい! -
Multi-view Convolutional Neural Networks for 3D Shape Recognition H. Su,
S. Maji, E. Kalogerakis, and E. Learned-Miller. IEEE ICCV, 2015. ① テスト時も学習時と同じ数だけの マルチビュー画像を同時入力せねばならない ② (回転不変性確保のため) 画像の順序情報を捨てている RotationNet – 背景 – -
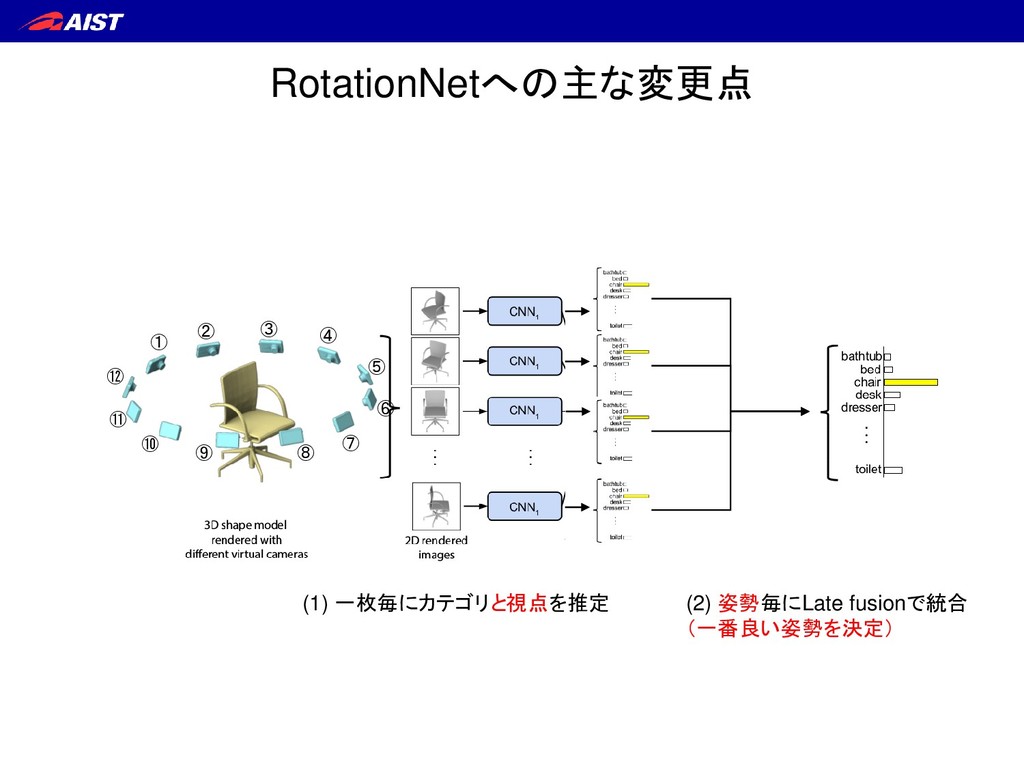
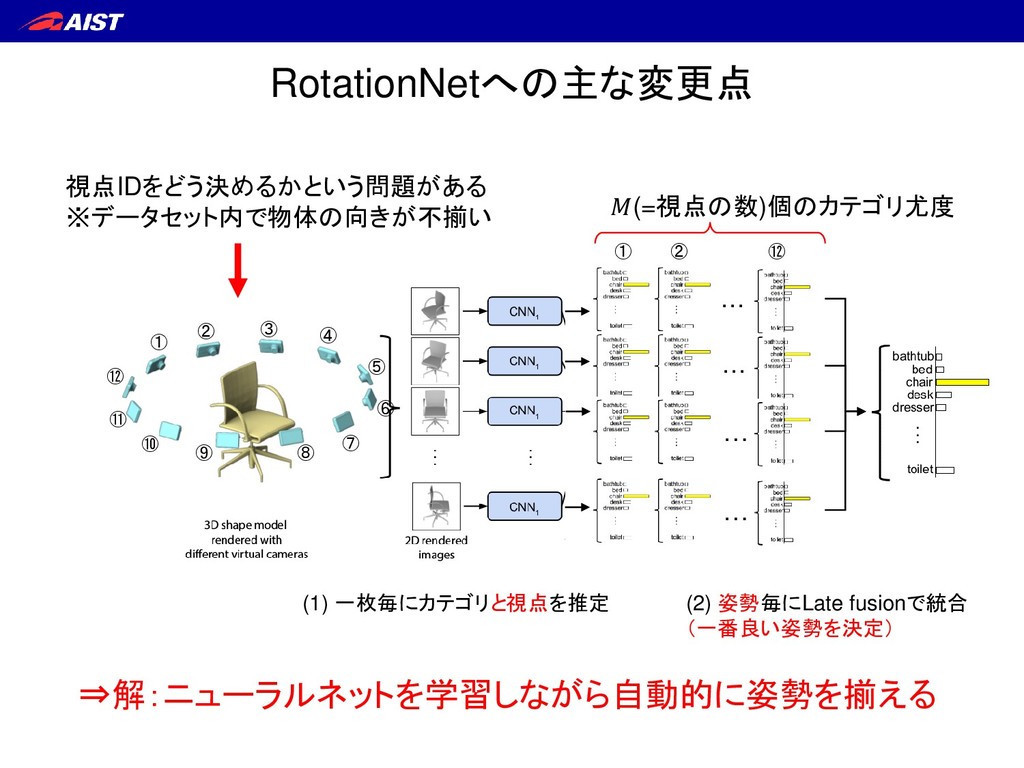
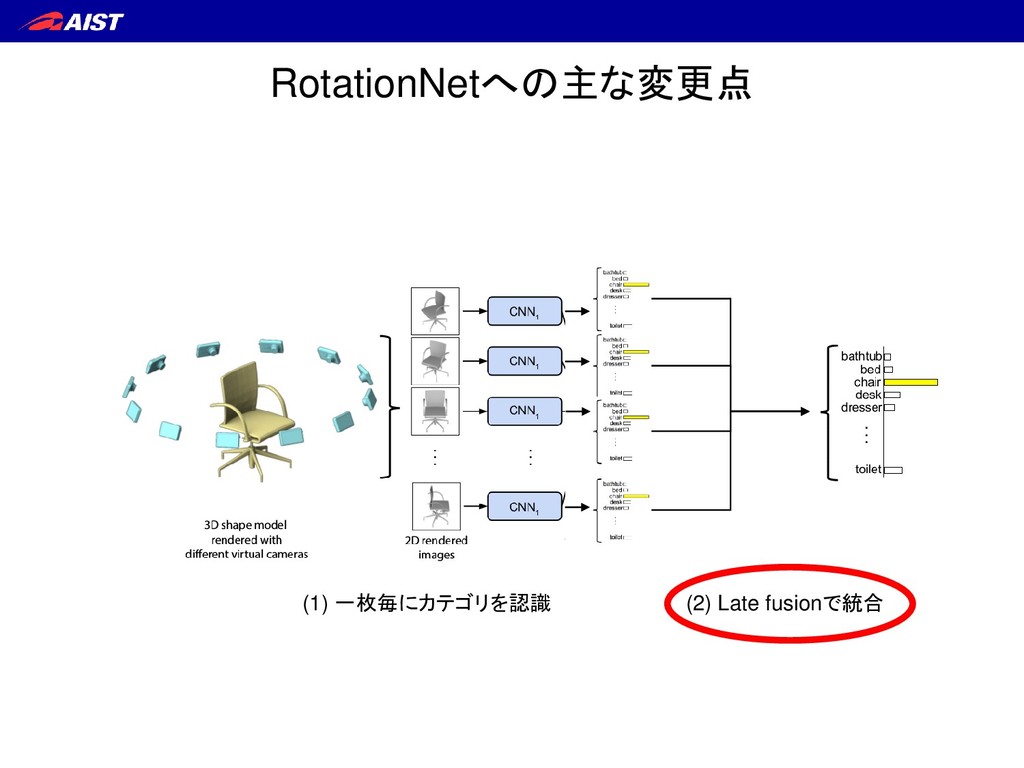
RotationNetへの主な変更点 (1) 一枚毎にカテゴリと視点を推定 (2) 姿勢毎にLate fusionで統合 (一番良い姿勢を決定) … … …
… (=視点の数)個のカテゴリ尤度 ① ② ③ ④ ⑤ ⑩ ⑨ ⑧ ⑦ ⑥ ⑪ ⑫ ① ② ⑫ 視点IDをどう決めるかという問題がある ※データセット内で物体の向きが不揃い ⇒解:ニューラルネットを学習しながら自動的に姿勢を揃える -
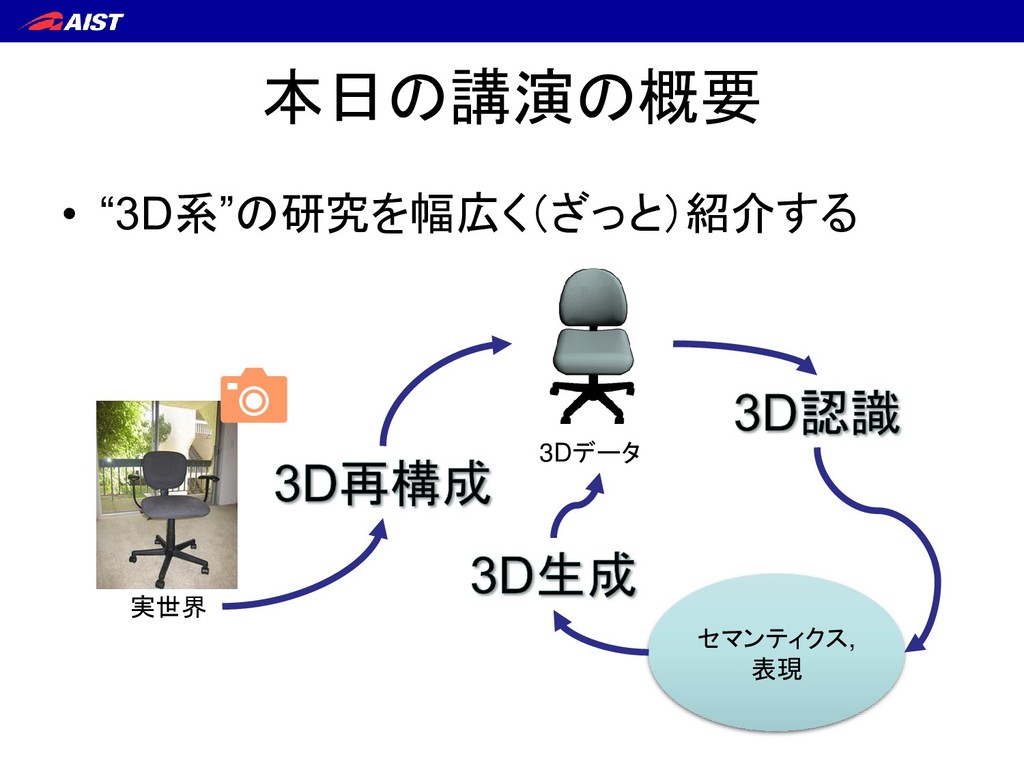
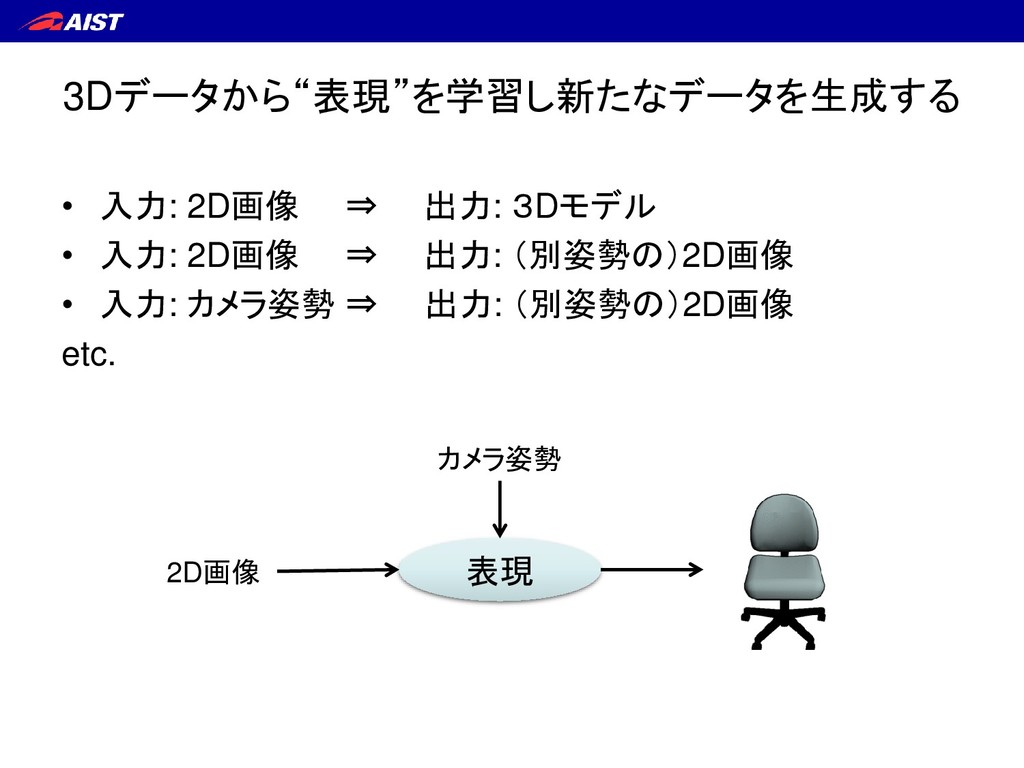
3Dデータから“表現”を学習し新たなデータを生成する • 入力: 2D画像 ⇒ 出力: 3Dモデル • 入力: 2D画像
⇒ 出力: (別姿勢の)2D画像 • 入力: カメラ姿勢 ⇒ 出力: (別姿勢の)2D画像 etc. 2D画像 カメラ姿勢 表現 -
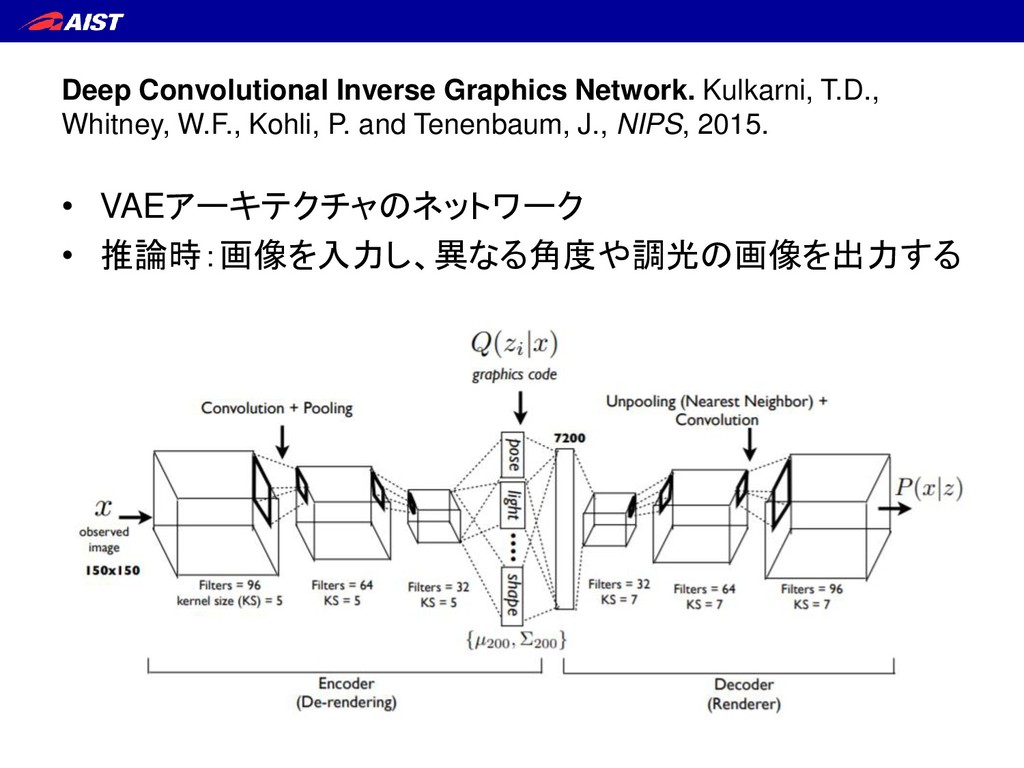
Deep Convolutional Inverse Graphics Network. Kulkarni, T.D., Whitney, W.F., Kohli,
P. and Tenenbaum, J., NIPS, 2015. • VAEアーキテクチャのネットワーク • 推論時:画像を入力し、異なる角度や調光の画像を出力する -
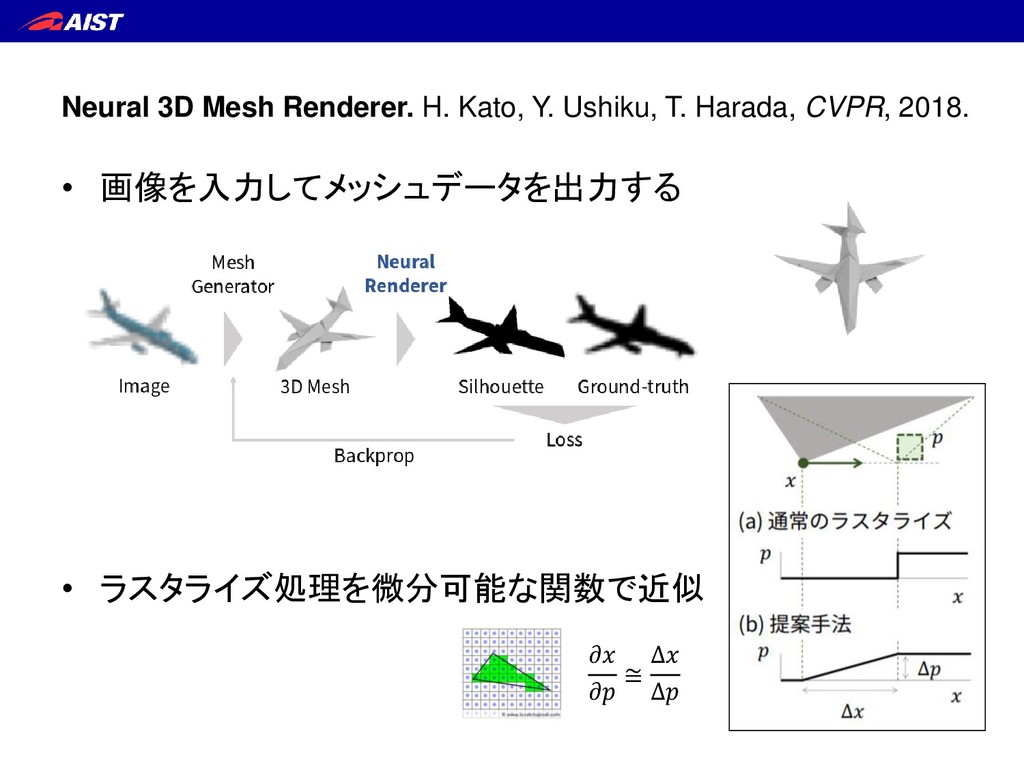
Neural 3D Mesh Renderer. H. Kato, Y. Ushiku, T. Harada,
CVPR, 2018. • 画像を入力してメッシュデータを出力する • ラスタライズ処理を微分可能な関数で近似 ≅ Δ Δ -
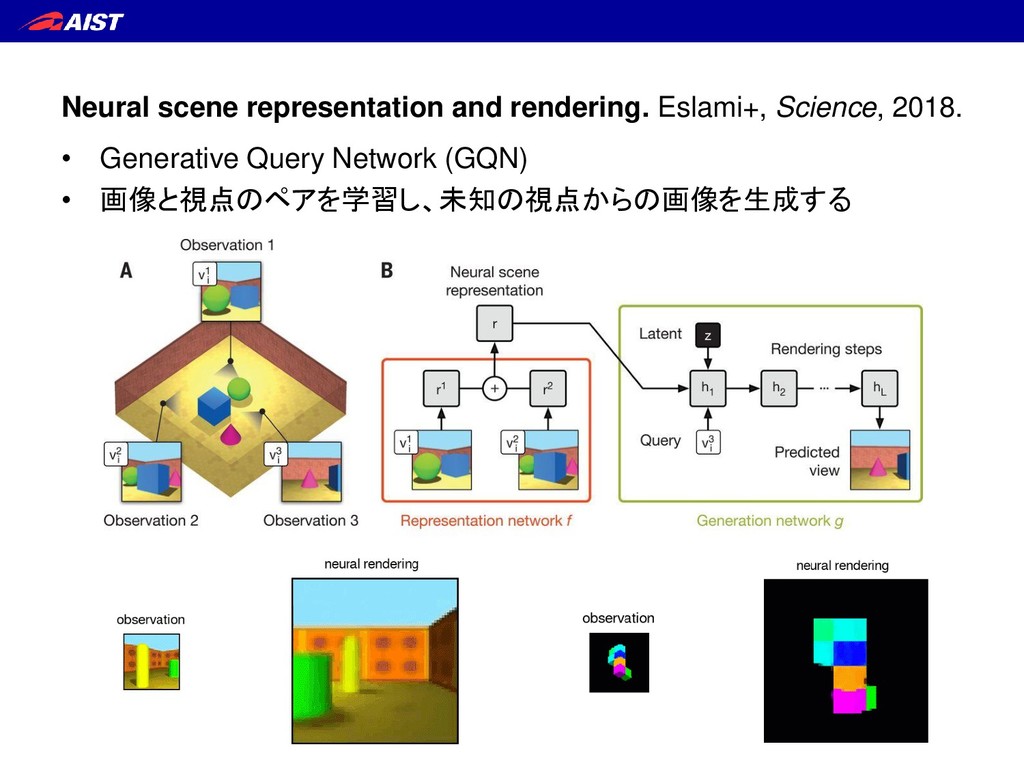
Neural scene representation and rendering. Eslami+, Science, 2018. • Generative
Query Network (GQN) • 画像と視点のペアを学習し、未知の視点からの画像を生成する -
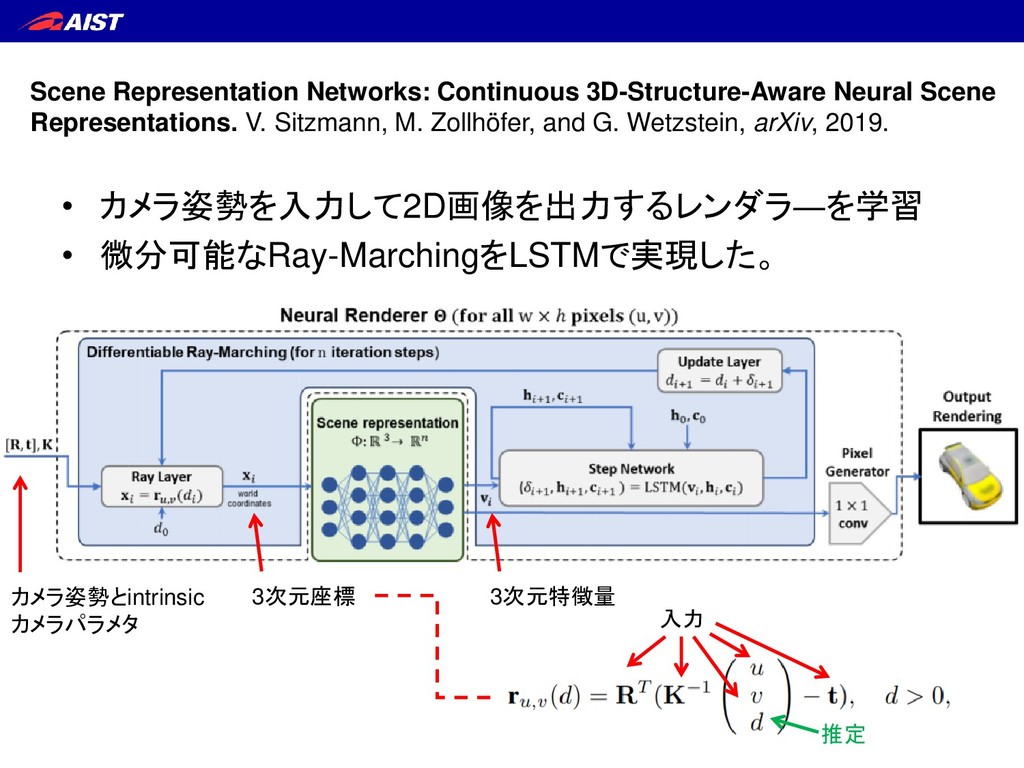
Scene Representation Networks: Continuous 3D-Structure-Aware Neural Scene Representations. V. Sitzmann,
M. Zollhöfer, and G. Wetzstein, arXiv, 2019. • カメラ姿勢を入力して2D画像を出力するレンダラ―を学習 • 微分可能なRay-MarchingをLSTMで実現した。 カメラ姿勢とintrinsic カメラパラメタ 3次元座標 3次元特徴量 入力 推定 -
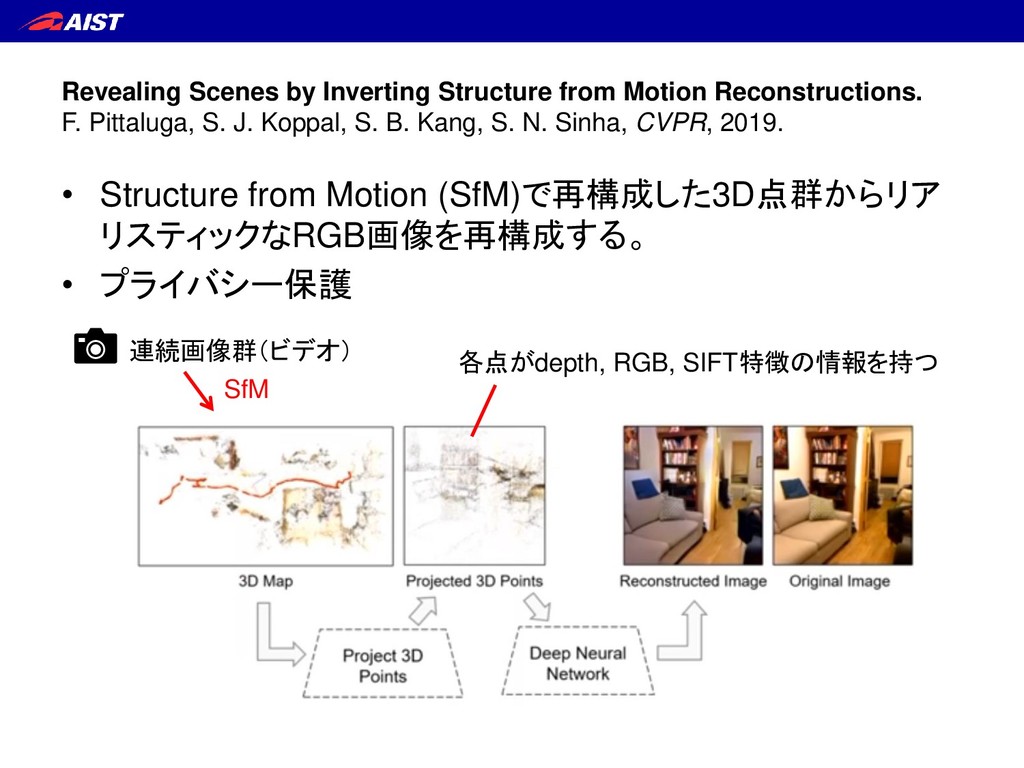
Revealing Scenes by Inverting Structure from Motion Reconstructions. F. Pittaluga,
S. J. Koppal, S. B. Kang, S. N. Sinha, CVPR, 2019. • Structure from Motion (SfM)で再構成した3D点群からリア リスティックなRGB画像を再構成する。 • プライバシー保護 連続画像群(ビデオ) SfM 各点がdepth, RGB, SIFT特徴の情報を持つ -
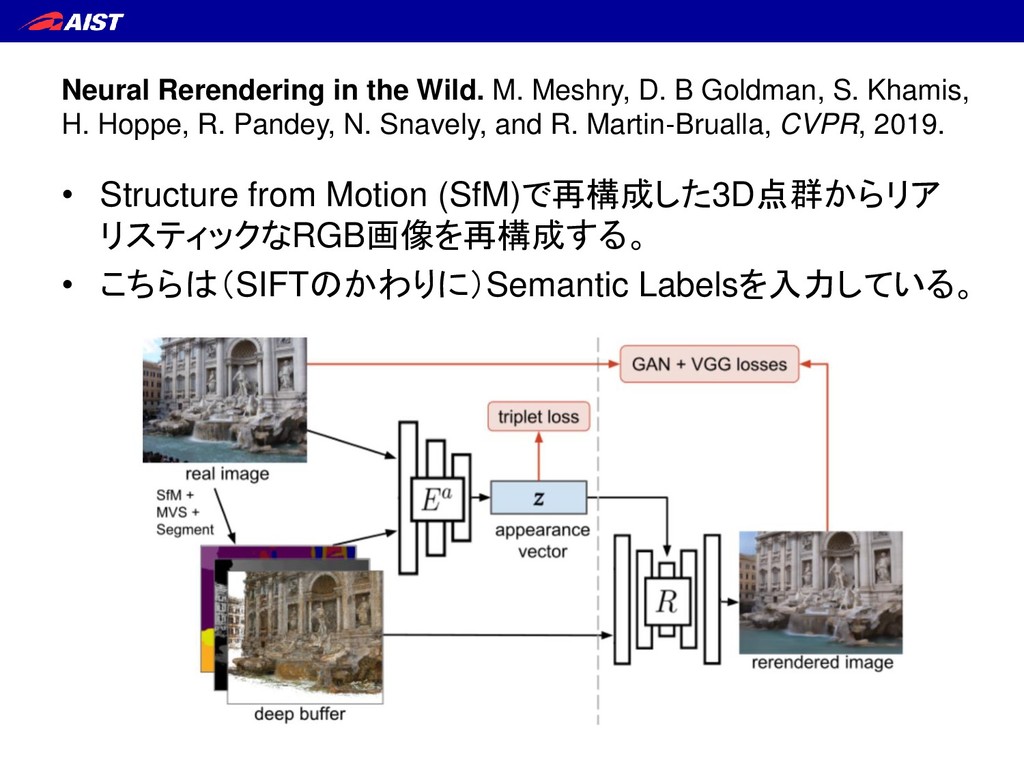
Neural Rerendering in the Wild. M. Meshry, D. B Goldman,
S. Khamis, H. Hoppe, R. Pandey, N. Snavely, and R. Martin-Brualla, CVPR, 2019. • Structure from Motion (SfM)で再構成した3D点群からリア リスティックなRGB画像を再構成する。 • こちらは(SIFTのかわりに)Semantic Labelsを入力している。 -
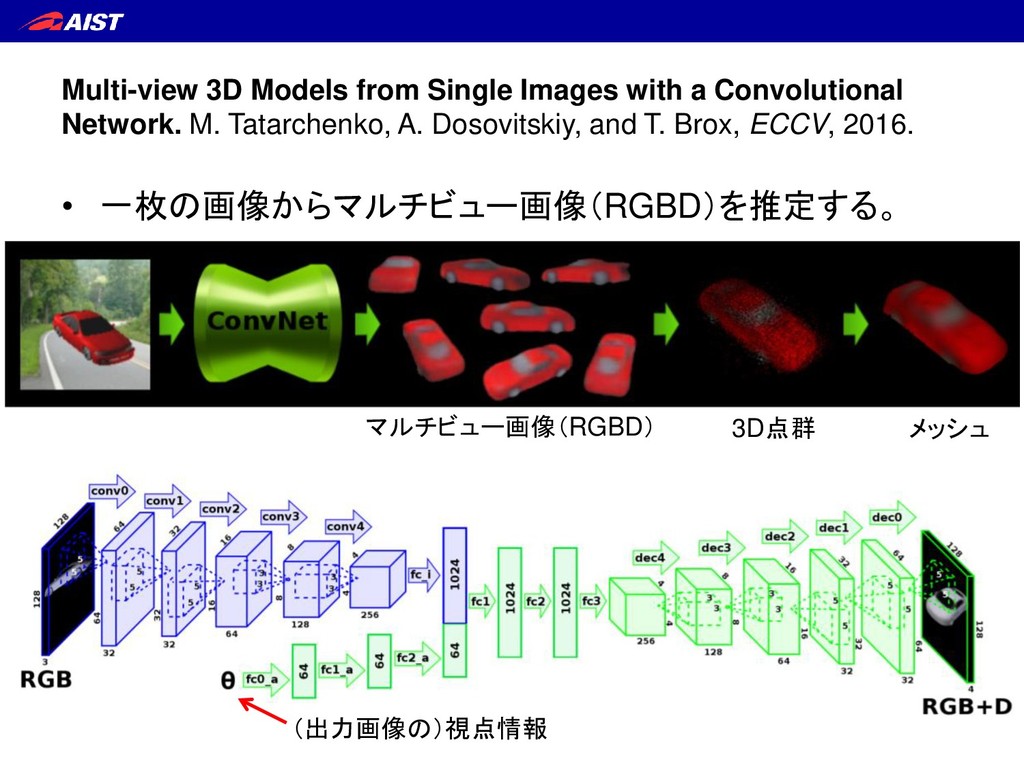
Multi-view 3D Models from Single Images with a Convolutional Network.
M. Tatarchenko, A. Dosovitskiy, and T. Brox, ECCV, 2016. • 一枚の画像からマルチビュー画像(RGBD)を推定する。 マルチビュー画像(RGBD) 3D点群 メッシュ (出力画像の)視点情報 -
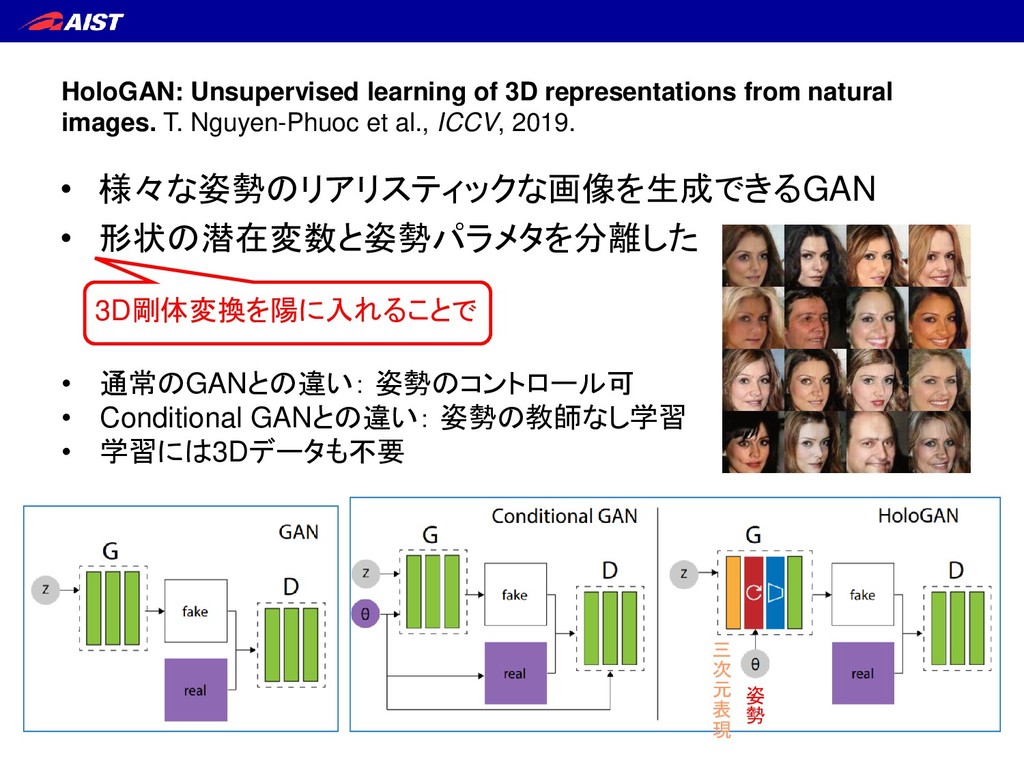
HoloGAN: Unsupervised learning of 3D representations from natural images. T.
Nguyen-Phuoc et al., ICCV, 2019. • 様々な姿勢のリアリスティックな画像を生成できるGAN • 形状の潜在変数と姿勢パラメタを分離した • 通常のGANとの違い: 姿勢のコントロール可 • Conditional GANとの違い: 姿勢の教師なし学習 • 学習には3Dデータも不要 3D剛体変換を陽に入れることで 三 次 元 表 現 姿 勢 -
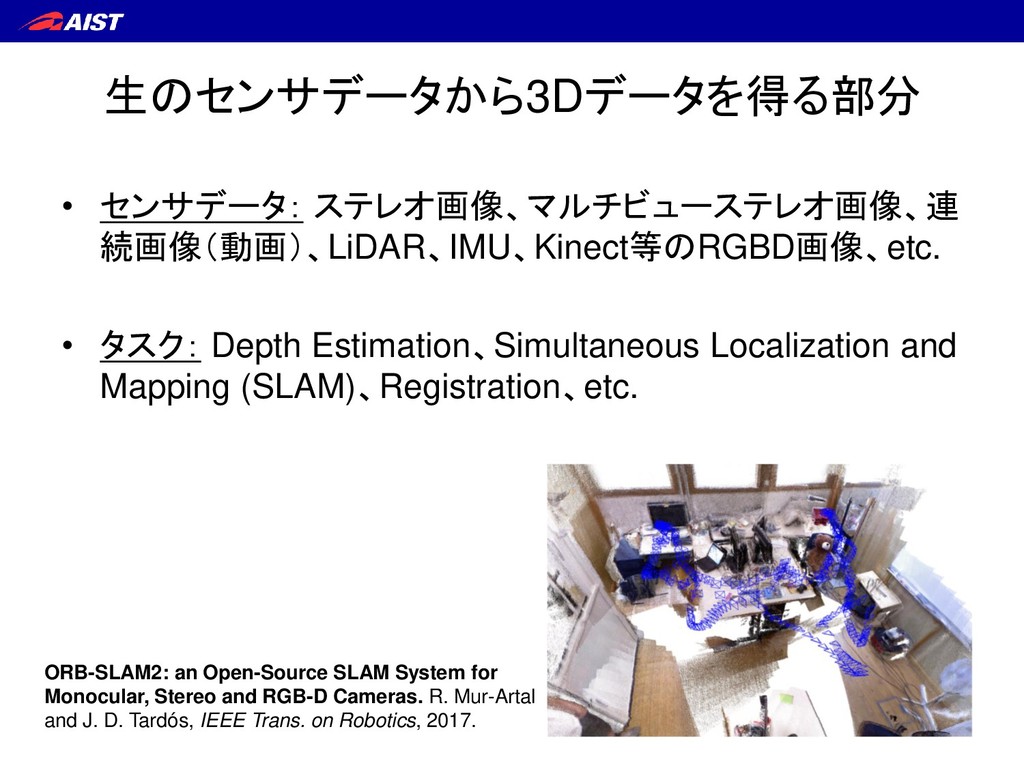
生のセンサデータから3Dデータを得る部分 • センサデータ: ステレオ画像、マルチビューステレオ画像、連 続画像(動画)、LiDAR、IMU、Kinect等のRGBD画像、etc. • タスク: Depth Estimation、Simultaneous Localization
and Mapping (SLAM)、Registration、etc. ORB-SLAM2: an Open-Source SLAM System for Monocular, Stereo and RGB-D Cameras. R. Mur-Artal and J. D. Tardós, IEEE Trans. on Robotics, 2017. -
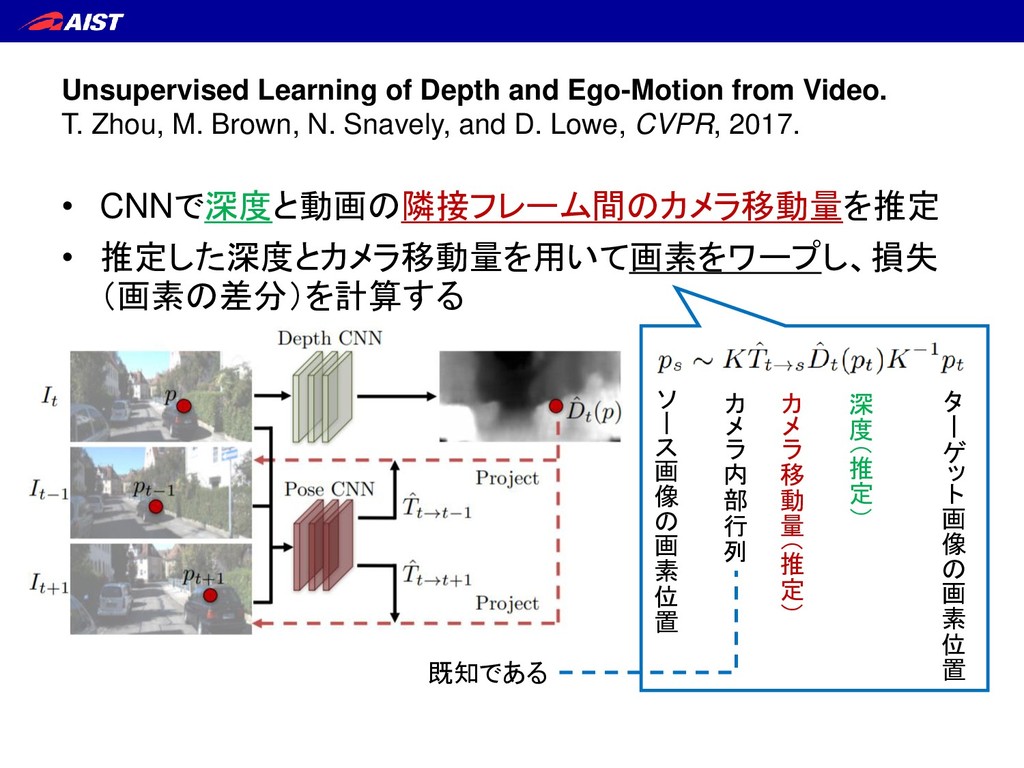
Unsupervised Learning of Depth and Ego-Motion from Video. T. Zhou,
M. Brown, N. Snavely, and D. Lowe, CVPR, 2017. • CNNで深度と動画の隣接フレーム間のカメラ移動量を推定 • 推定した深度とカメラ移動量を用いて画素をワープし、損失 (画素の差分)を計算する ソ ー ス 画 像 の 画 素 位 置 タ ー ゲ ッ ト 画 像 の 画 素 位 置 カ メ ラ 内 部 行 列 カ メ ラ 移 動 量 ( 推 定 ) 深 度 ( 推 定 ) 既知である -
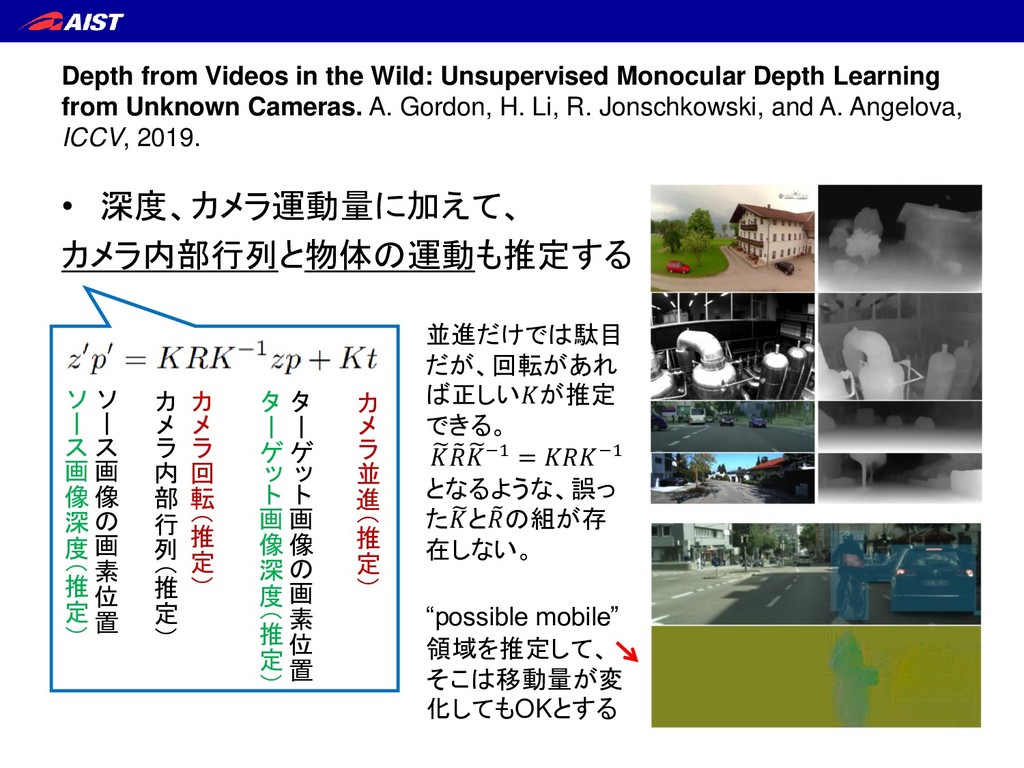
Depth from Videos in the Wild: Unsupervised Monocular Depth Learning
from Unknown Cameras. A. Gordon, H. Li, R. Jonschkowski, and A. Angelova, ICCV, 2019. • 深度、カメラ運動量に加えて、 カメラ内部行列と物体の運動も推定する ソ ー ス 画 像 深 度 ( 推 定 ) タ ー ゲ ッ ト 画 像 の 画 素 位 置 カ メ ラ 内 部 行 列 ( 推 定 ) カ メ ラ 回 転 ( 推 定 ) タ ー ゲ ッ ト 画 像 深 度 ( 推 定 ) ソ ー ス 画 像 の 画 素 位 置 カ メ ラ 並 進 ( 推 定 ) 並進だけでは駄目 だが、回転があれ ば正しいが推定 できる。 ෩ ෨ ෩ −1 = −1 となるような、誤っ た෩ と ෨ の組が存 在しない。 “possible mobile” 領域を推定して、 そこは移動量が変 化してもOKとする -
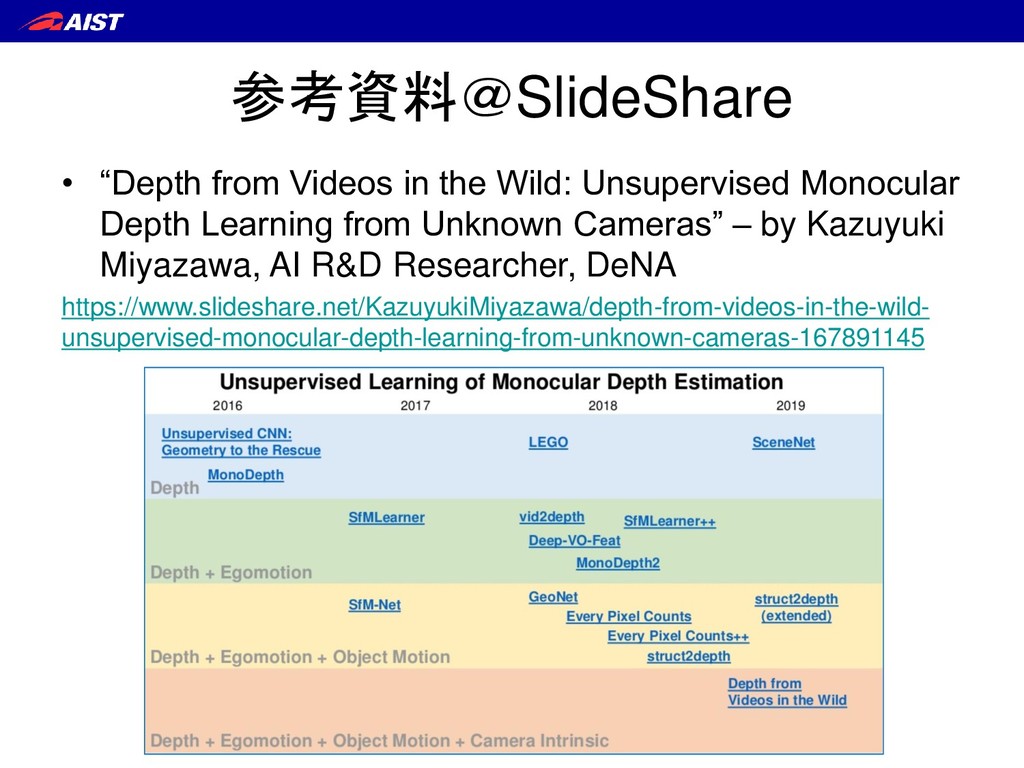
参考資料@SlideShare • “Depth from Videos in the Wild: Unsupervised Monocular
Depth Learning from Unknown Cameras” – by Kazuyuki Miyazawa, AI R&D Researcher, DeNA https://www.slideshare.net/KazuyukiMiyazawa/depth-from-videos-in-the-wild- unsupervised-monocular-depth-learning-from-unknown-cameras-167891145 -
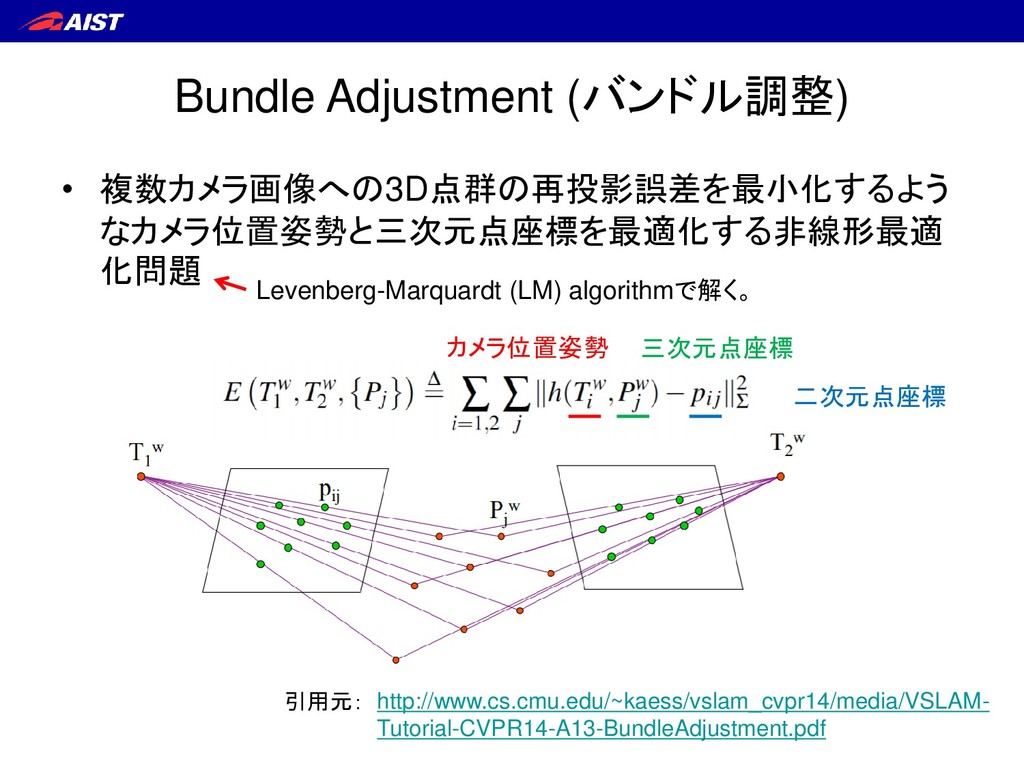
Bundle Adjustment (バンドル調整) • 複数カメラ画像への3D点群の再投影誤差を最小化するよう なカメラ位置姿勢と三次元点座標を最適化する非線形最適 化問題 http://www.cs.cmu.edu/~kaess/vslam_cvpr14/media/VSLAM- Tutorial-CVPR14-A13-BundleAdjustment.pdf 引用元:
Levenberg-Marquardt (LM) algorithmで解く。 カメラ位置姿勢 三次元点座標 二次元点座標 -
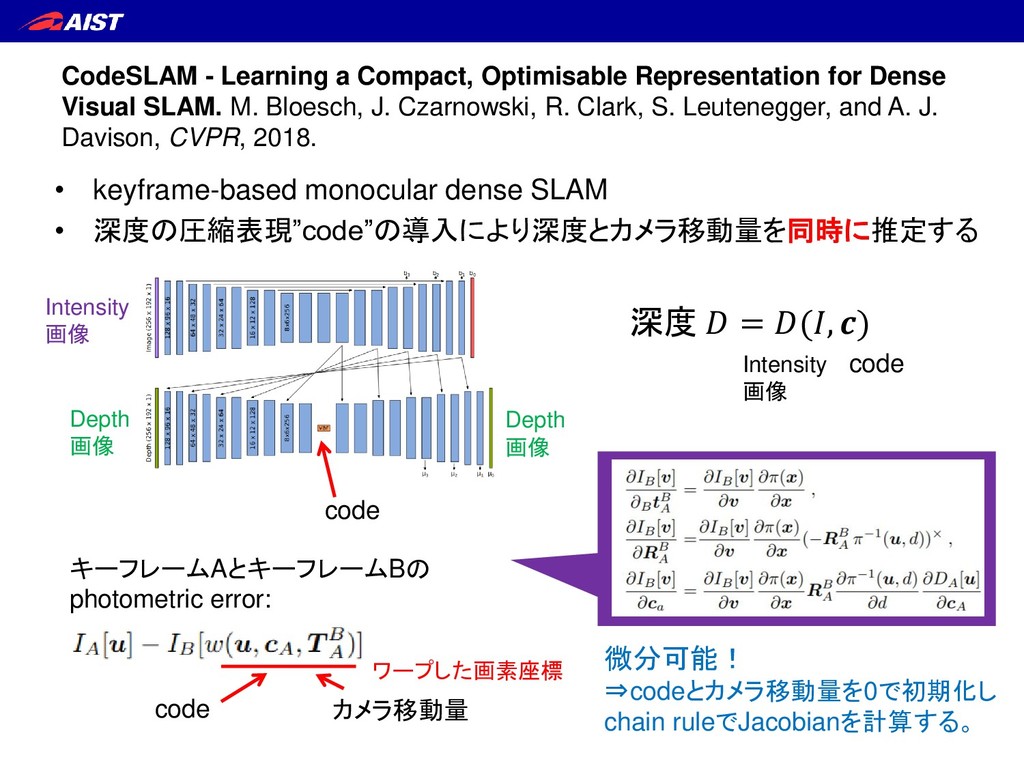
• keyframe-based monocular dense SLAM • 深度の圧縮表現”code”の導入により深度とカメラ移動量を同時に推定する CodeSLAM - Learning
a Compact, Optimisable Representation for Dense Visual SLAM. M. Bloesch, J. Czarnowski, R. Clark, S. Leutenegger, and A. J. Davison, CVPR, 2018. Intensity 画像 Depth 画像 Depth 画像 code 深度 = (, ) code Intensity 画像 キーフレームAとキーフレームBの photometric error: ワープした画素座標 code カメラ移動量 微分可能! ⇒codeとカメラ移動量を0で初期化し chain ruleでJacobianを計算する。 -
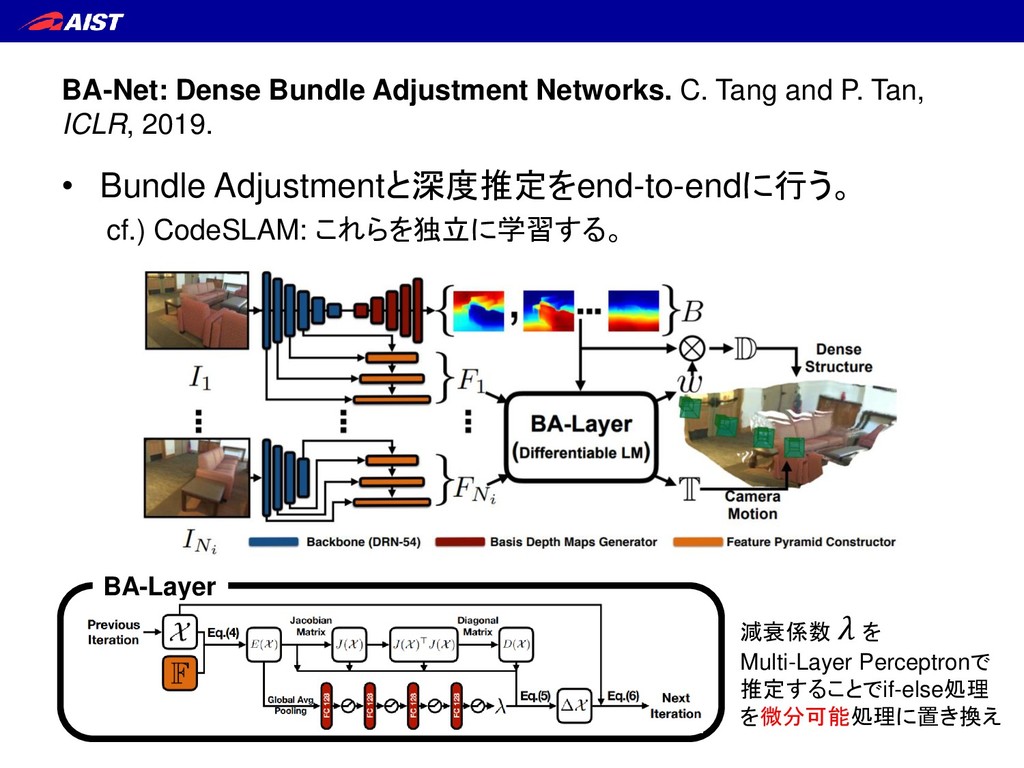
BA-Net: Dense Bundle Adjustment Networks. C. Tang and P. Tan,
ICLR, 2019. • Bundle Adjustmentと深度推定をend-to-endに行う。 cf.) CodeSLAM: これらを独立に学習する。 BA-Layer 減衰係数 を Multi-Layer Perceptronで 推定することでif-else処理 を微分可能処理に置き換え -
参考資料@SlideShare • “CodeSLAM: Learning a Compact, Optimisable Representation for Dense
Visual SLAM (3D勉強会@関 東)” – by Mai Nishimura, Research Engineer at OMRON SINIC X https://www.slideshare.net/MaiNishimura2/banet-dense-bundle-adjustment- network-3d • “BA-Net: Dense Bundle Adjustment Network (3D勉強会 @関東)” – by Mai Nishimura, Research Engineer at OMRON SINIC X https://www.slideshare.net/MaiNishimura2/codeslam-learning-a-compact- optimisable-representation-for-dense-visual-slam-3d -
Camera (Re)Localization • 既知のマップがあり、現在の入力がマップのどこに 位置するかを出力する。 • RANSAC: 外れ値を含む観測値に最もよくフィットするモデ ル(パラメータ)を繰り返し計算で推定する。 RelocNet:
Continuous Metric Learning Relocalisation Using Neural Nets. Balntas+, ECCV, 2018. RANSACによる剛体変換の推定 -
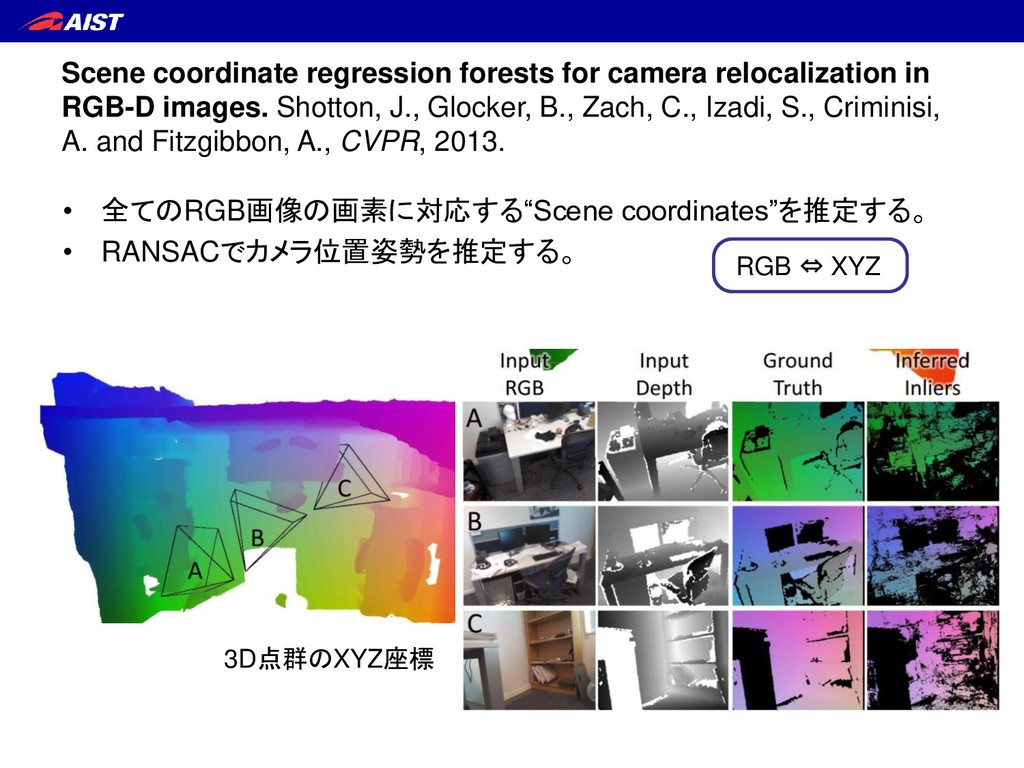
Scene coordinate regression forests for camera relocalization in RGB-D images.
Shotton, J., Glocker, B., Zach, C., Izadi, S., Criminisi, A. and Fitzgibbon, A., CVPR, 2013. • 全てのRGB画像の画素に対応する“Scene coordinates”を推定する。 • RANSACでカメラ位置姿勢を推定する。 RGB ⇔ XYZ 3D点群のXYZ座標 -
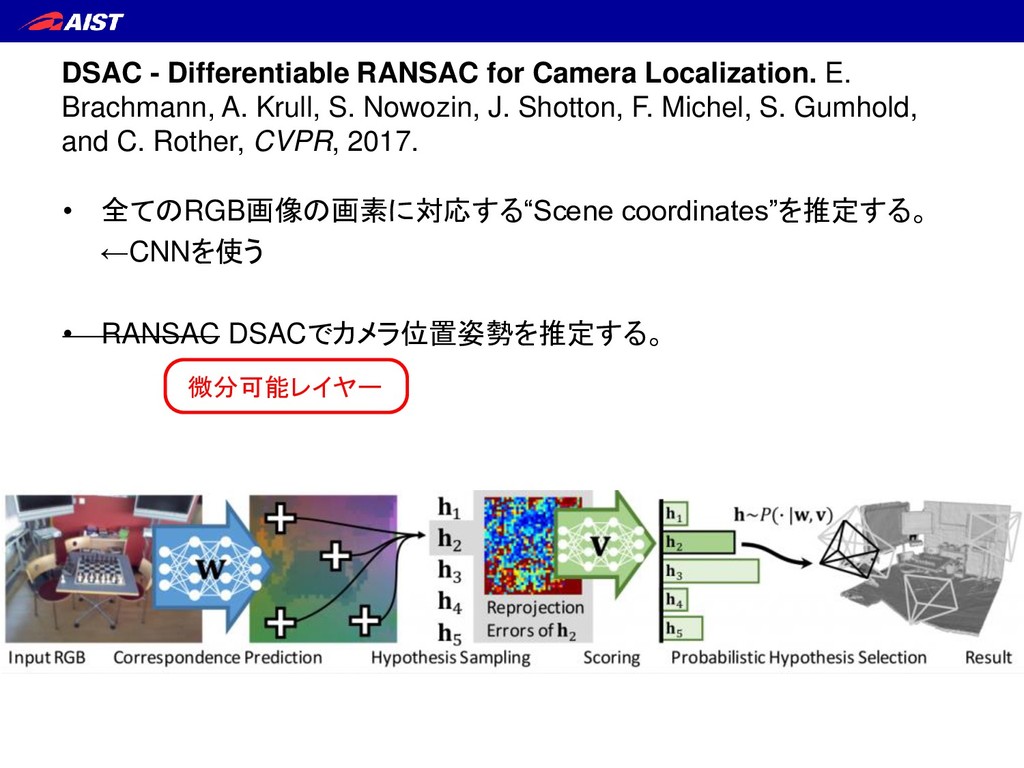
DSAC - Differentiable RANSAC for Camera Localization. E. Brachmann, A.
Krull, S. Nowozin, J. Shotton, F. Michel, S. Gumhold, and C. Rother, CVPR, 2017. • 全てのRGB画像の画素に対応する“Scene coordinates”を推定する。 ←CNNを使う • RANSAC DSACでカメラ位置姿勢を推定する。 微分可能レイヤー -
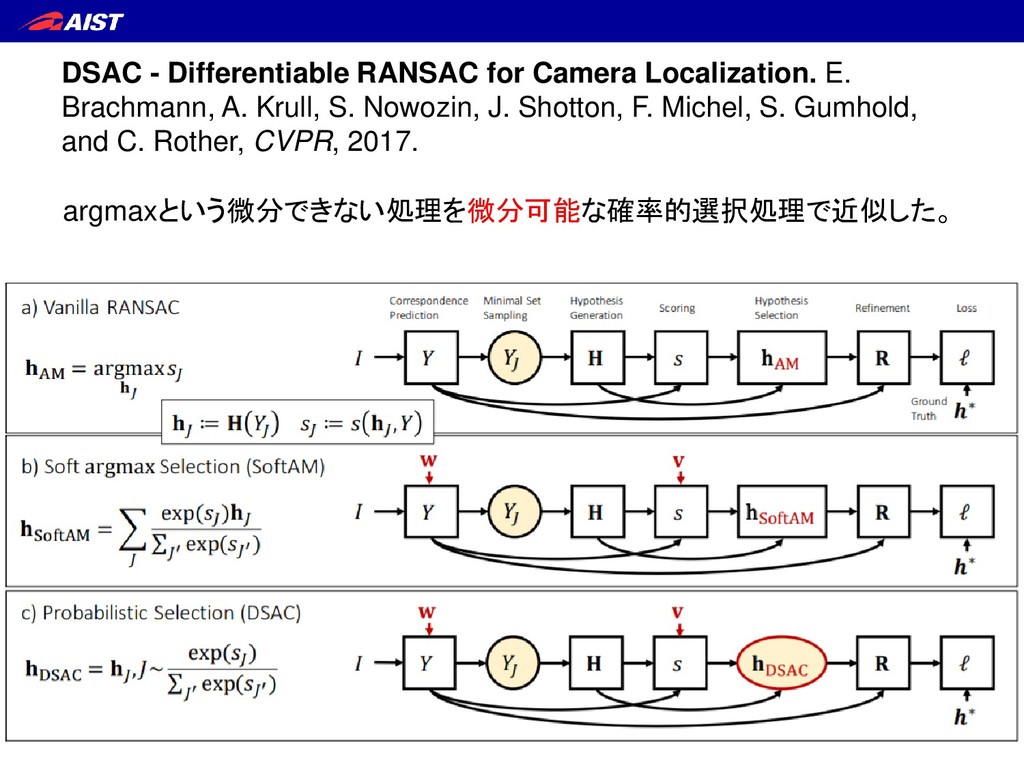
DSAC - Differentiable RANSAC for Camera Localization. E. Brachmann, A.
Krull, S. Nowozin, J. Shotton, F. Michel, S. Gumhold, and C. Rother, CVPR, 2017. argmaxという微分できない処理を微分可能な確率的選択処理で近似した。 -
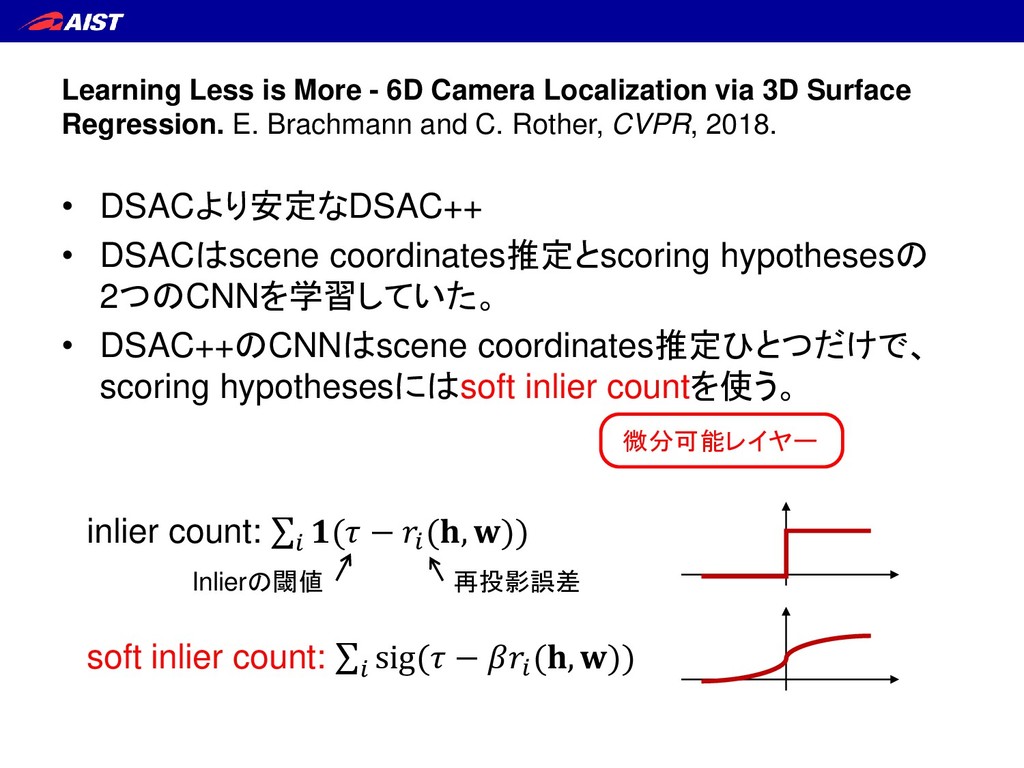
Learning Less is More - 6D Camera Localization via 3D
Surface Regression. E. Brachmann and C. Rother, CVPR, 2018. • DSACより安定なDSAC++ • DSACはscene coordinates推定とscoring hypothesesの 2つのCNNを学習していた。 • DSAC++のCNNはscene coordinates推定ひとつだけで、 scoring hypothesesにはsoft inlier countを使う。 微分可能レイヤー inlier count: σ ( − (, )) soft inlier count: σ sig( − (, )) Inlierの閾値 再投影誤差