Upgrade to Pro — share decks privately, control downloads, hide ads and more …

論文紹介: A convolutional encoder model for neural ...

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest. →

論文紹介: A convolutional encoder model for neural machine translation

首都大 小町研 ACL 2017 読み会

Satoru Katsumata

December 10, 2023

Transcript

18 slides
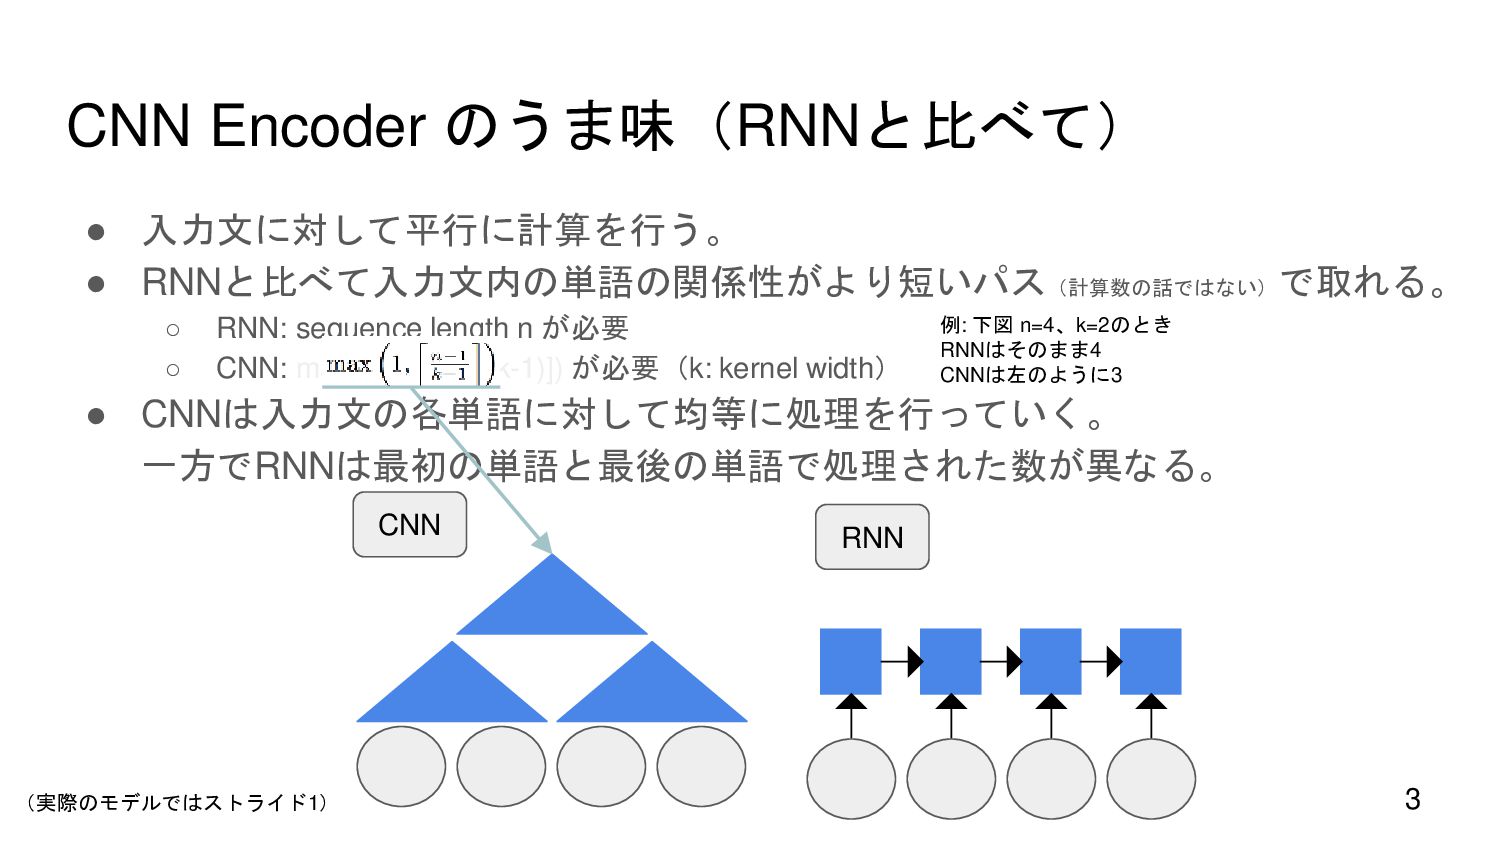
  1. CNN Encoder のうま味(RNNと比べて) • 入力文に対して平行に計算を行う。 • RNNと比べて入力文内の単語の関係性がより短いパス(計算数の話ではない) で取れる。 ◦ RNN:

    sequence length n が必要 ◦ CNN: max(1, [(n-1) / (k-1)]) が必要(k: kernel width) • CNNは入力文の各単語に対して均等に処理を行っていく。 一方でRNNは最初の単語と最後の単語で処理された数が異なる。 CNN RNN 例: 下図 n=4、k=2のとき RNNはそのまま4 CNNは左のように3 3 (実際のモデルではストライド1)
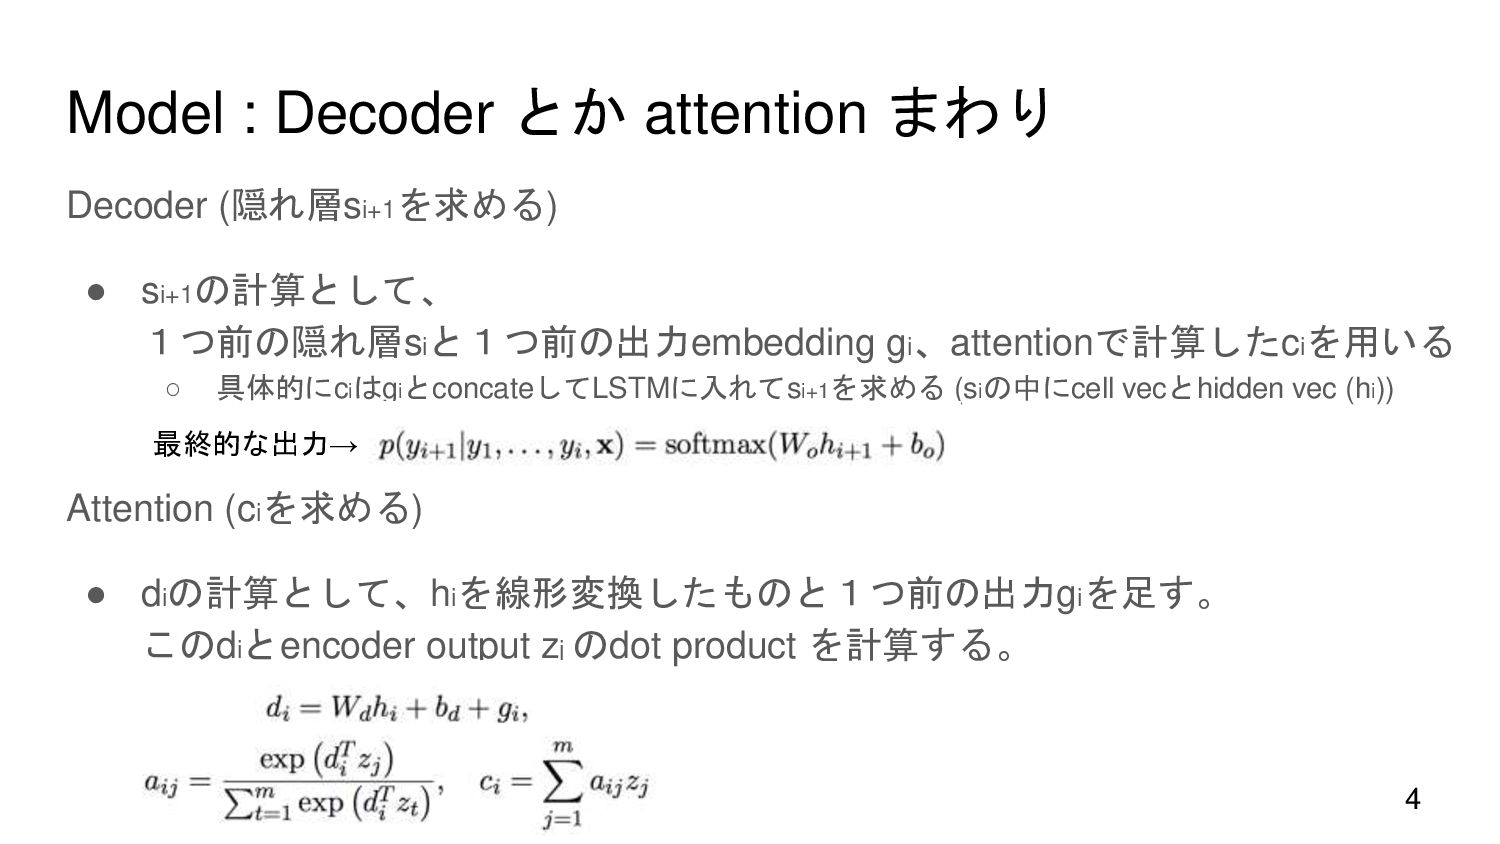
  2. Model : Decoder とか attention まわり Decoder (隠れ層si+1 を求める) •

    si+1 の計算として、 1つ前の隠れ層si と1つ前の出力embedding gi 、attentionで計算したci を用いる ◦ 具体的にciはgiとconcateしてLSTMに入れてsi+1を求める (siの中にcell vecとhidden vec (hi)) Attention (ci を求める) • di の計算として、hi を線形変換したものと1つ前の出力gi を足す。 このdi とencoder output zj のdot product を計算する。 最終的な出力→ 4
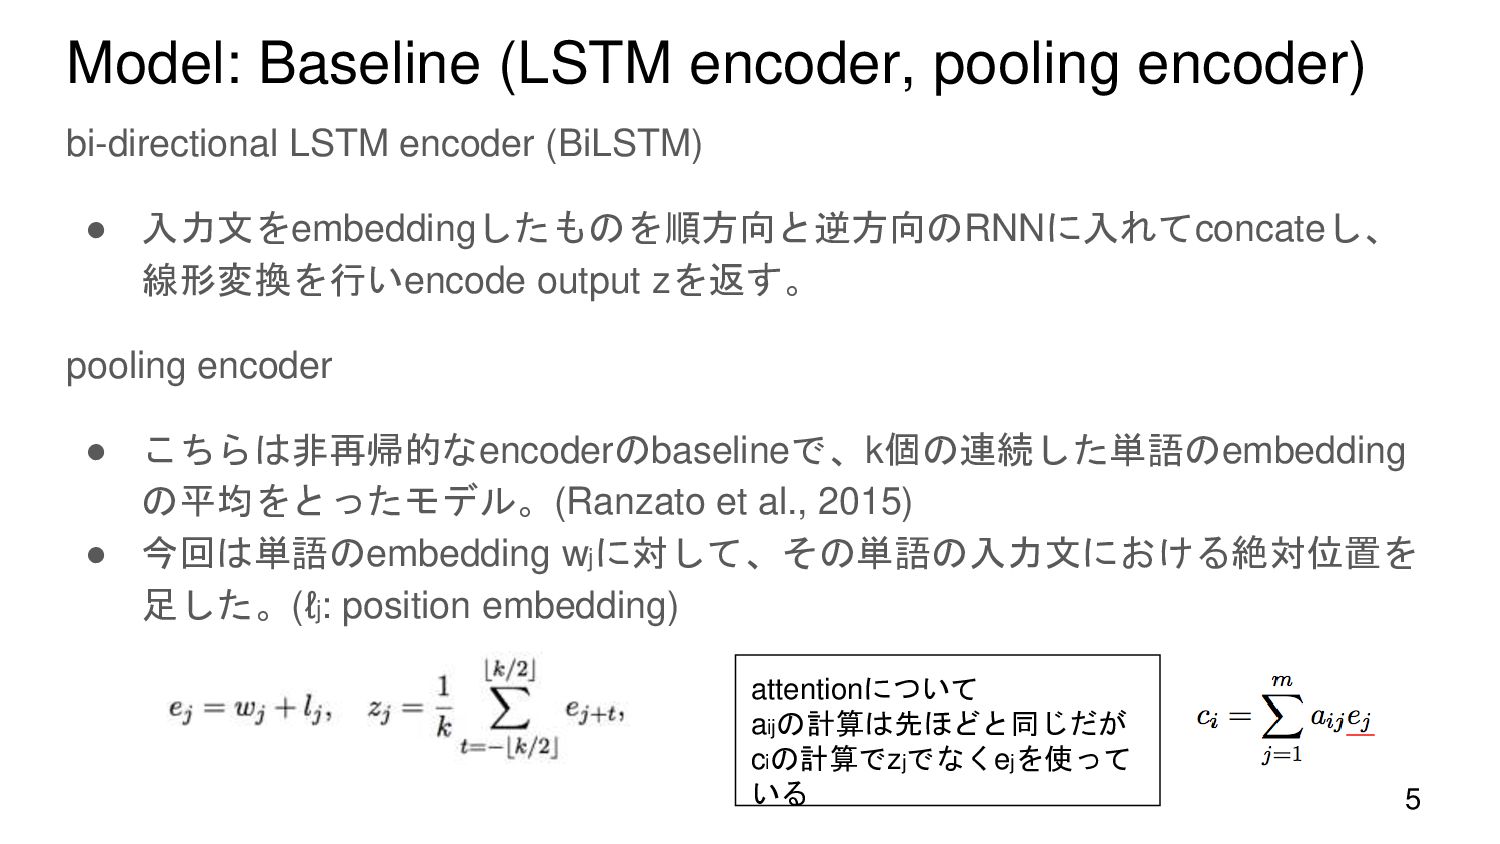
  3. Model: Baseline (LSTM encoder, pooling encoder) bi-directional LSTM encoder (BiLSTM)

    • 入力文をembeddingしたものを順方向と逆方向のRNNに入れてconcateし、 線形変換を行いencode output zを返す。 pooling encoder • こちらは非再帰的なencoderのbaselineで、k個の連続した単語のembedding の平均をとったモデル。(Ranzato et al., 2015) • 今回は単語のembedding wj に対して、その単語の入力文における絶対位置を 足した。(ℓj: position embedding) attentionについて aijの計算は先ほどと同じだが ciの計算でzjでなくejを使って いる 5
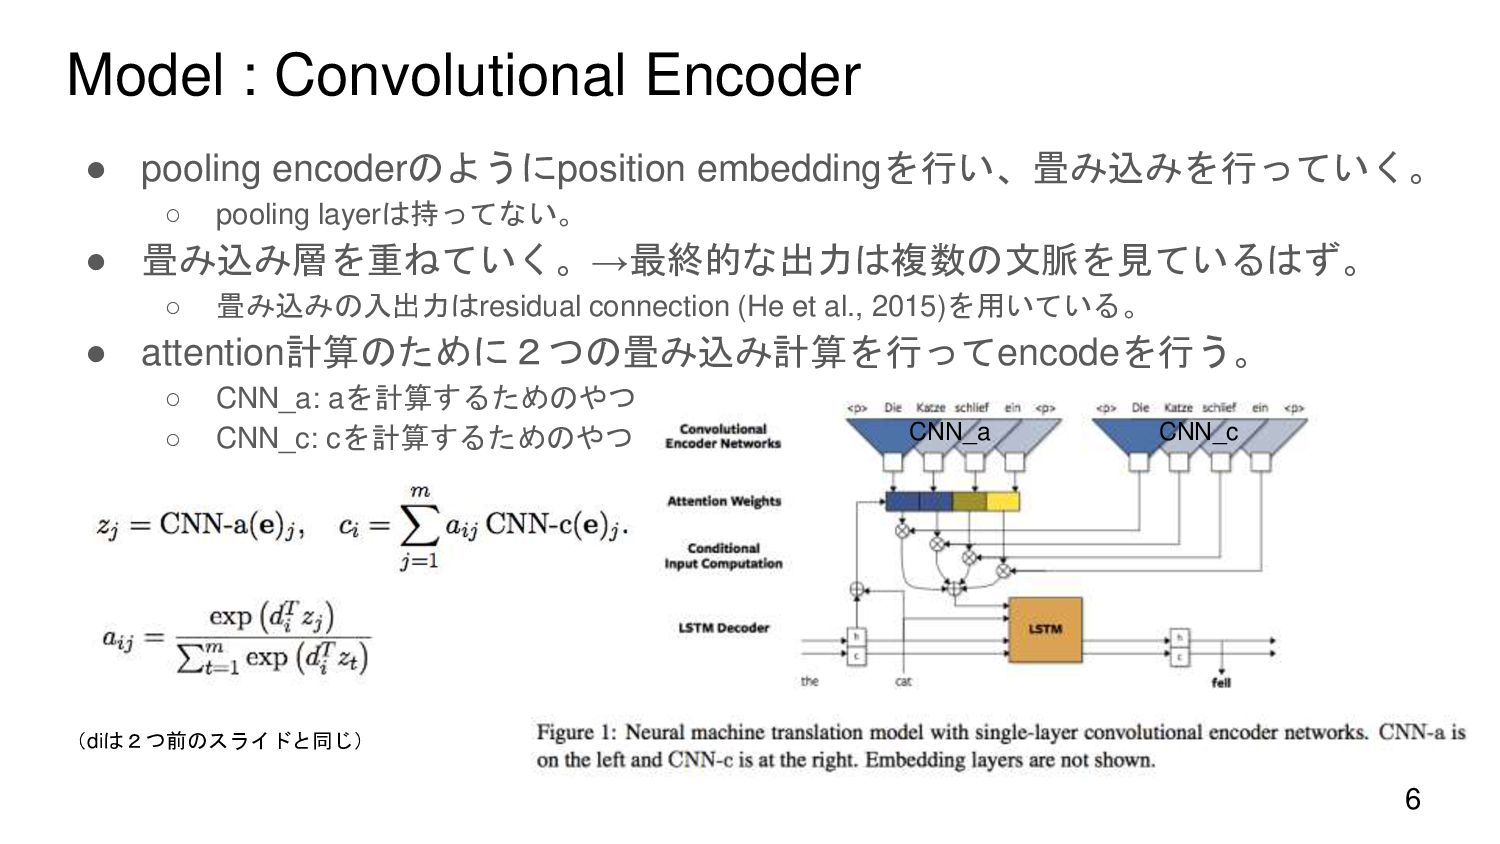
  4. Model : Convolutional Encoder • pooling encoderのようにposition embeddingを行い、畳み込みを行っていく。 ◦ pooling

    layerは持ってない。 • 畳み込み層を重ねていく。→最終的な出力は複数の文脈を見ているはず。 ◦ 畳み込みの入出力はresidual connection (He et al., 2015)を用いている。 • attention計算のために2つの畳み込み計算を行ってencodeを行う。 ◦ CNN_a: aを計算するためのやつ ◦ CNN_c: cを計算するためのやつ 6 CNN_a CNN_c (diは2つ前のスライドと同じ)
  5. 他のCNN Encoder と比べて何が嬉しいのか • これまでのCNN encoderでは既存のRNN encoderより性能が低かった。 → 今回、既存のRNN encoderに匹敵する性能が出た!

    • (Kalchbrenner and Blunsom, 2013) → 文に対して畳み込みencodeを用いた。 ◦ sentenceやn-gramに対してCNN encodeを行い、decoderへの入力トークンを生成する。 ◦ SMT出力のn-best rescoring で使われた。 • (Cho et al., 2014) → 固定長の表現が得られるまで繰り返しCNNを用いた。 ◦ recurrent encoder の方が高い精度を達成した。 • (Kalchbrenner et al., 2016) → 畳み込みで翻訳を行うモデル (ByteNet) を提案。 ◦ このモデルはattention機構が無く、SOTAに届かなかった。 • (Lamb and Xie, 2016) → encodeに多層のCNNを用いた。 ◦ 量的評価がされていなかった。 • (Meng et al., 2015) → PBSMTのphrase対のスコア計算に用いた。 • (Tu et al., 2015) → Dependency-basedSMTのphrase対のスコア計算に用いた。 7
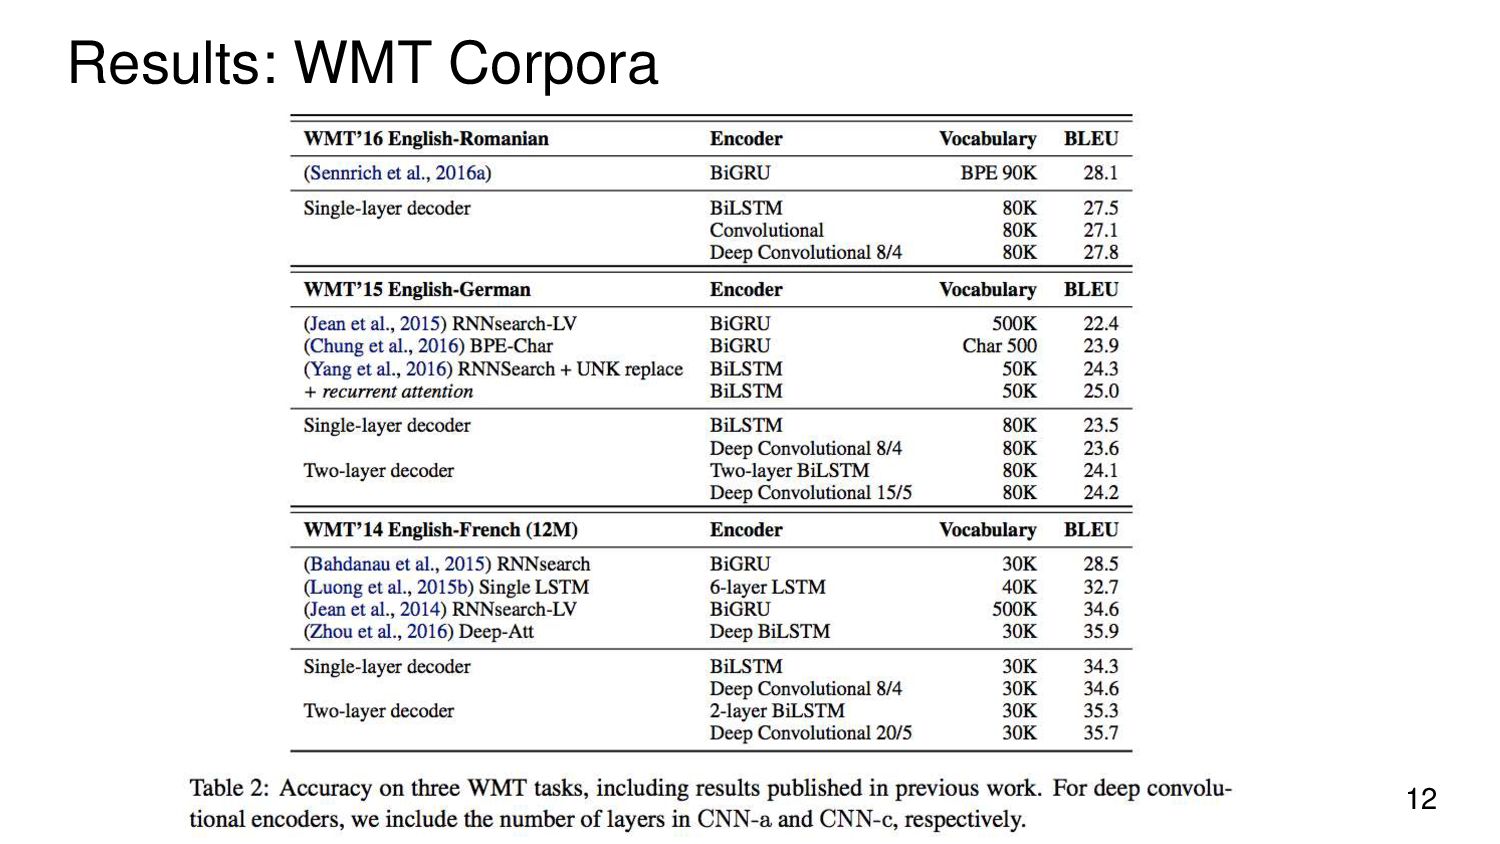
  6. 実験: Dataset • IWSLT’14 German-English (異なるencoderの評価) ◦ train: TEDとTEDxの字幕データ、頻度3回以下の単語を<unk>化 (En:

    24158 words, Ge: 35882 words) ◦ (特に記載無ければ)入力文長制限: 175words ← position embeddingの適切な学習を保証している。 ◦ trainの文数: 167K, test: 6948 sents (tst2010, tst2011, tst2012, tst2013, dev2010) • WMT’16 English-Romanian ◦ (Sennrich et al., 2016)と同じデータを用いている。→ 学習は2.8M sents用いた。 (En: 200K words, Ro: 80K words) ◦ test: newstest2016 ◦ BPEは使っておらず、word baseで行っている。 • WMT’15 English-German ◦ train: Europarl v7, Common Crawl, News Commentary v10を用いて、3.9M sentsを使用した。 (En: 200K words, Ge: 80K words) ◦ test: newstest2015 • WMT’14 English-French ◦ train: 一般的に用いられる(Schwenk 2014)12M setnsに対して文長制限150wordsを行い、 10.7M sents用いた。(En: 200K, Fr: 30K) ◦ test: ntst14 8 validation setについて IWSLT’14: trainの5% WMT: trainの1%
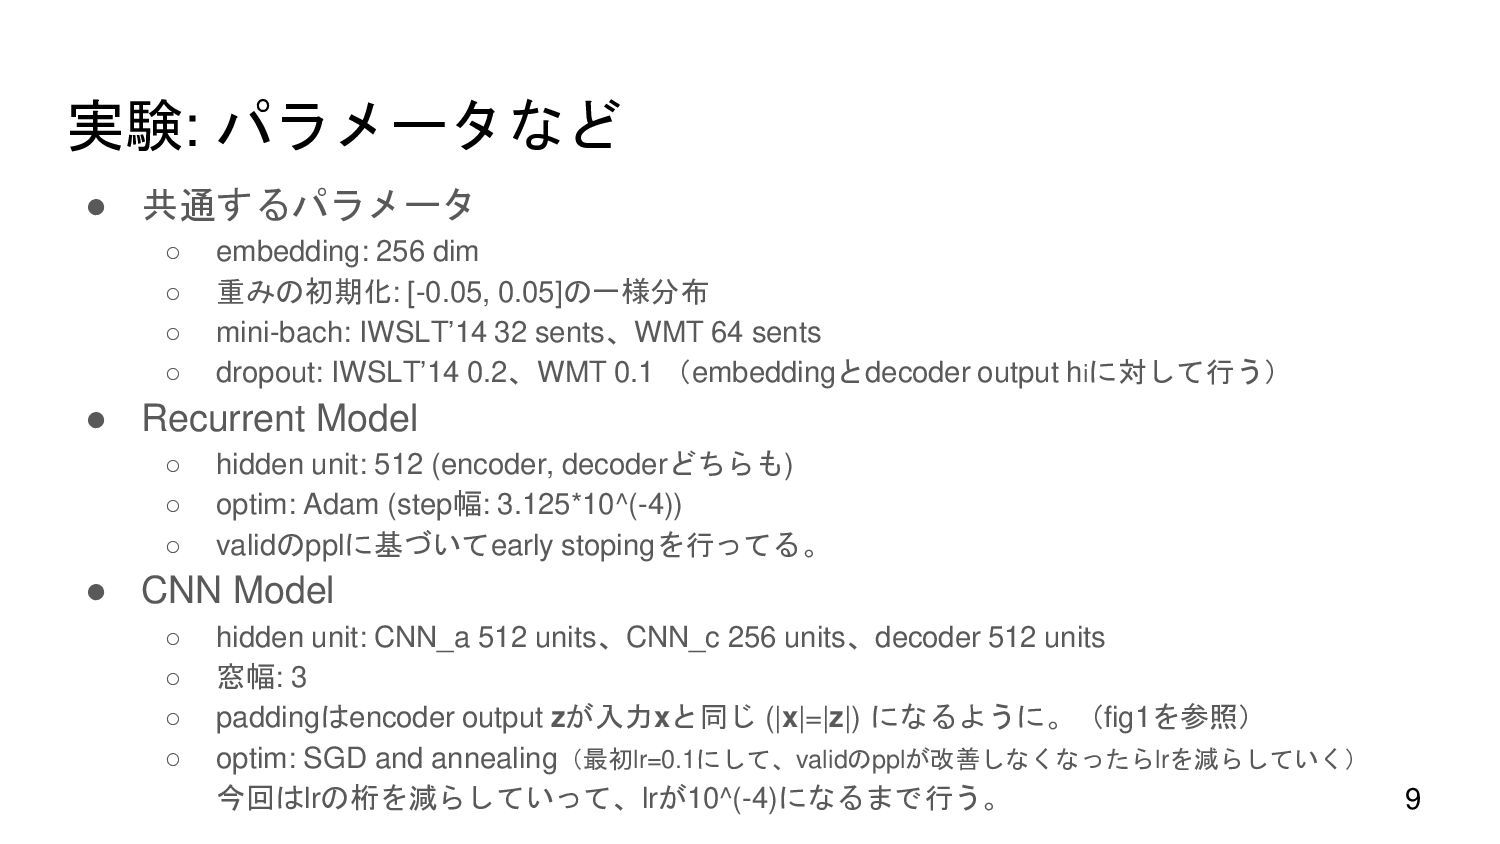
  7. 実験: パラメータなど • 共通するパラメータ ◦ embedding: 256 dim ◦ 重みの初期化:

    [-0.05, 0.05]の一様分布 ◦ mini-bach: IWSLT’14 32 sents、WMT 64 sents ◦ dropout: IWSLT’14 0.2、WMT 0.1 (embeddingとdecoder output hiに対して行う) • Recurrent Model ◦ hidden unit: 512 (encoder, decoderどちらも) ◦ optim: Adam (step幅: 3.125*10^(-4)) ◦ validのpplに基づいてearly stopingを行ってる。 • CNN Model ◦ hidden unit: CNN_a 512 units、CNN_c 256 units、decoder 512 units ◦ 窓幅: 3 ◦ paddingはencoder output zが入力xと同じ (|x|=|z|) になるように。(fig1を参照) ◦ optim: SGD and annealing(最初lr=0.1にして、validのpplが改善しなくなったらlrを減らしていく) 今回はlrの桁を減らしていって、lrが10^(-4)になるまで行う。 9
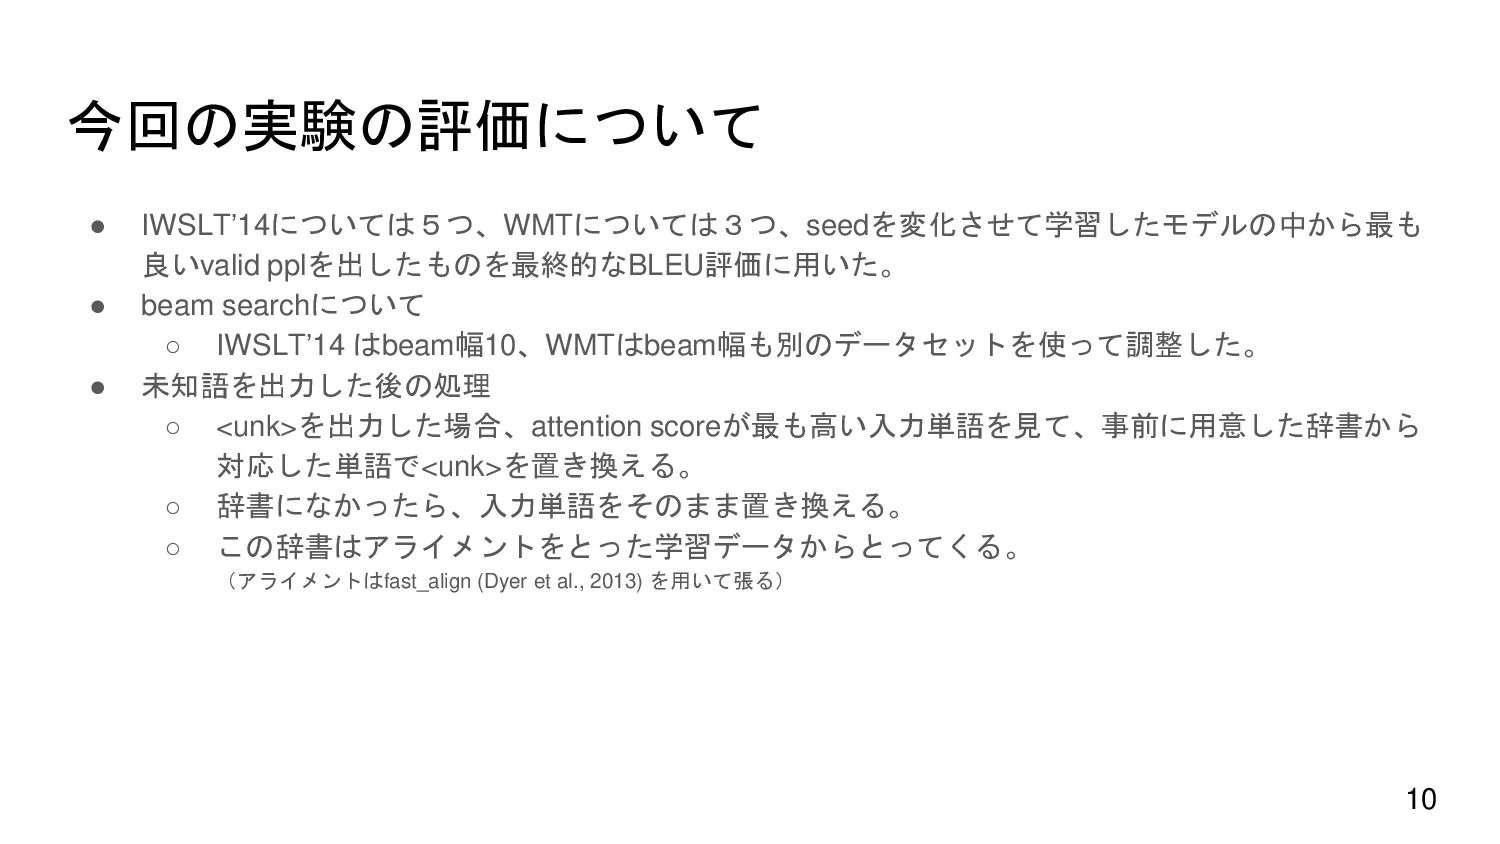
  8. 今回の実験の評価について • IWSLT’14については5つ、WMTについては3つ、seedを変化させて学習したモデルの中から最も 良いvalid pplを出したものを最終的なBLEU評価に用いた。 • beam searchについて ◦ IWSLT’14

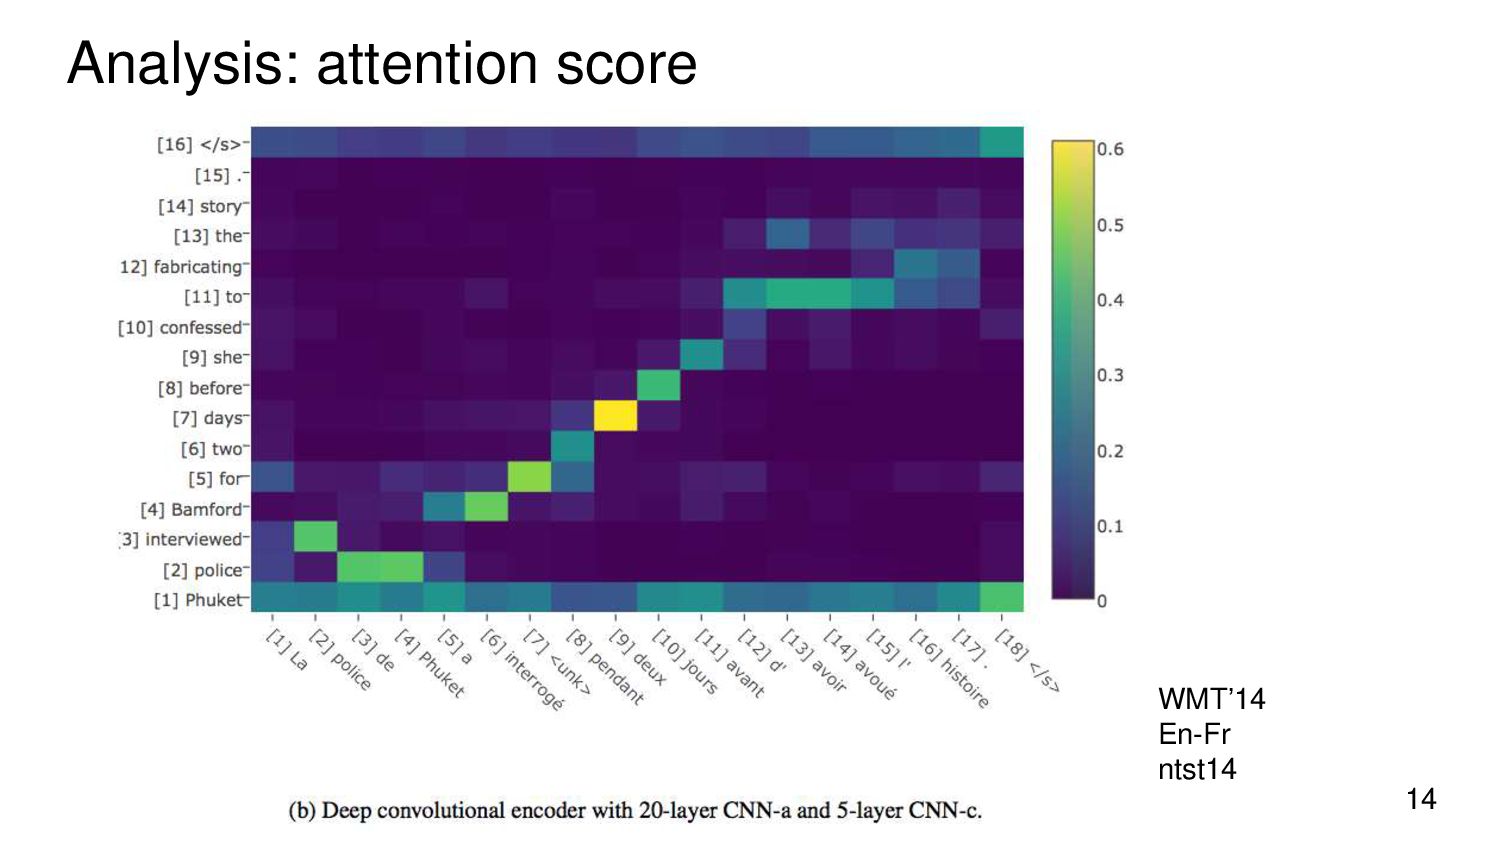
    はbeam幅10、WMTはbeam幅も別のデータセットを使って調整した。 • 未知語を出力した後の処理 ◦ <unk>を出力した場合、attention scoreが最も高い入力単語を見て、事前に用意した辞書から 対応した単語で<unk>を置き換える。 ◦ 辞書になかったら、入力単語をそのまま置き換える。 ◦ この辞書はアライメントをとった学習データからとってくる。 (アライメントはfast_align (Dyer et al., 2013) を用いて張る) 10
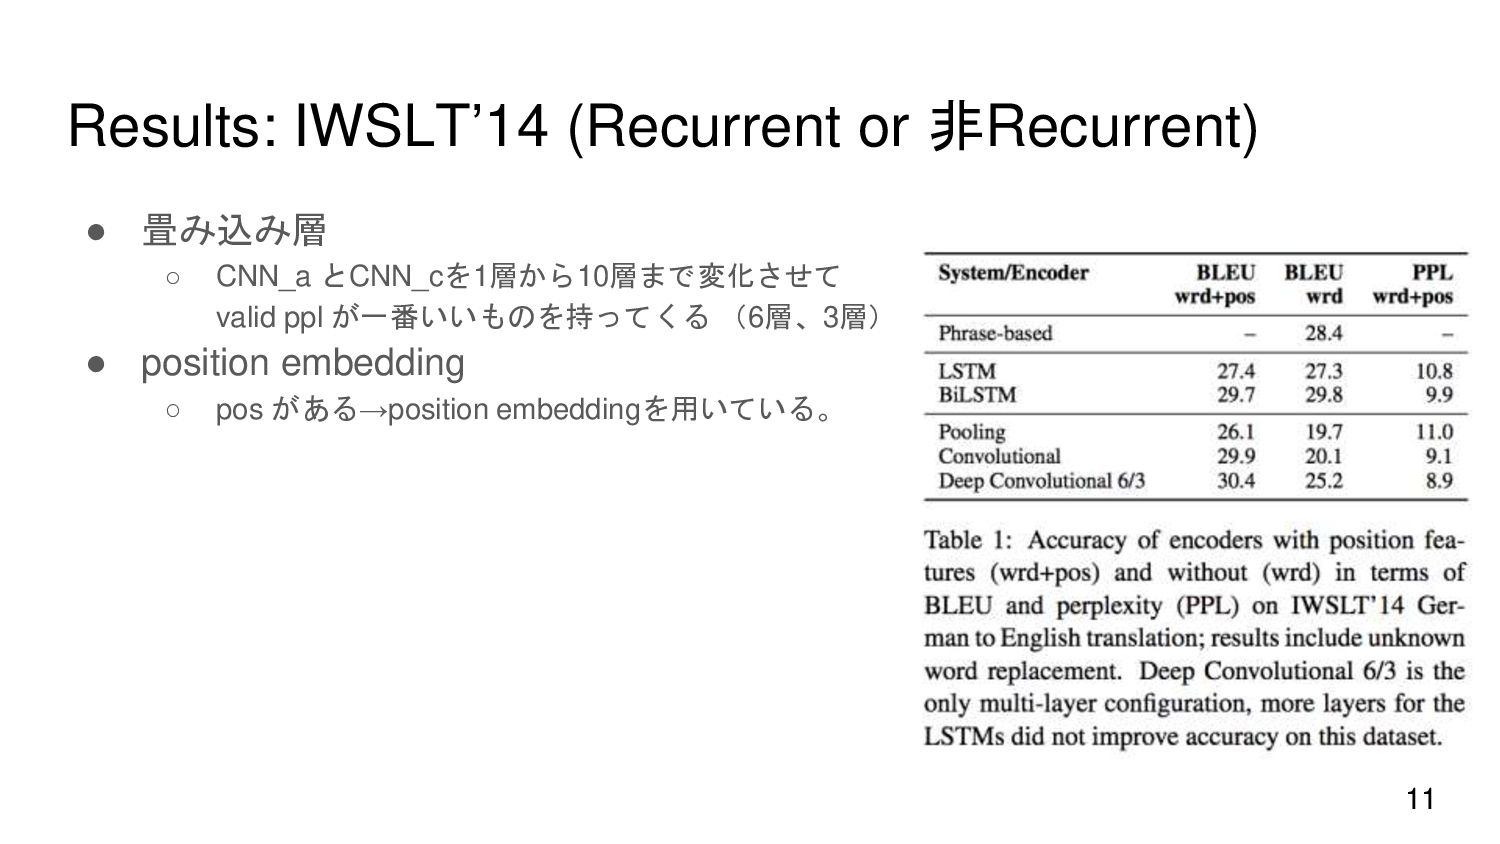
  9. Results: IWSLT’14 (Recurrent or 非Recurrent) • 畳み込み層 ◦ CNN_a とCNN_cを1層から10層まで変化させて

    valid ppl が一番いいものを持ってくる (6層、3層) • position embedding ◦ pos がある→position embeddingを用いている。 11
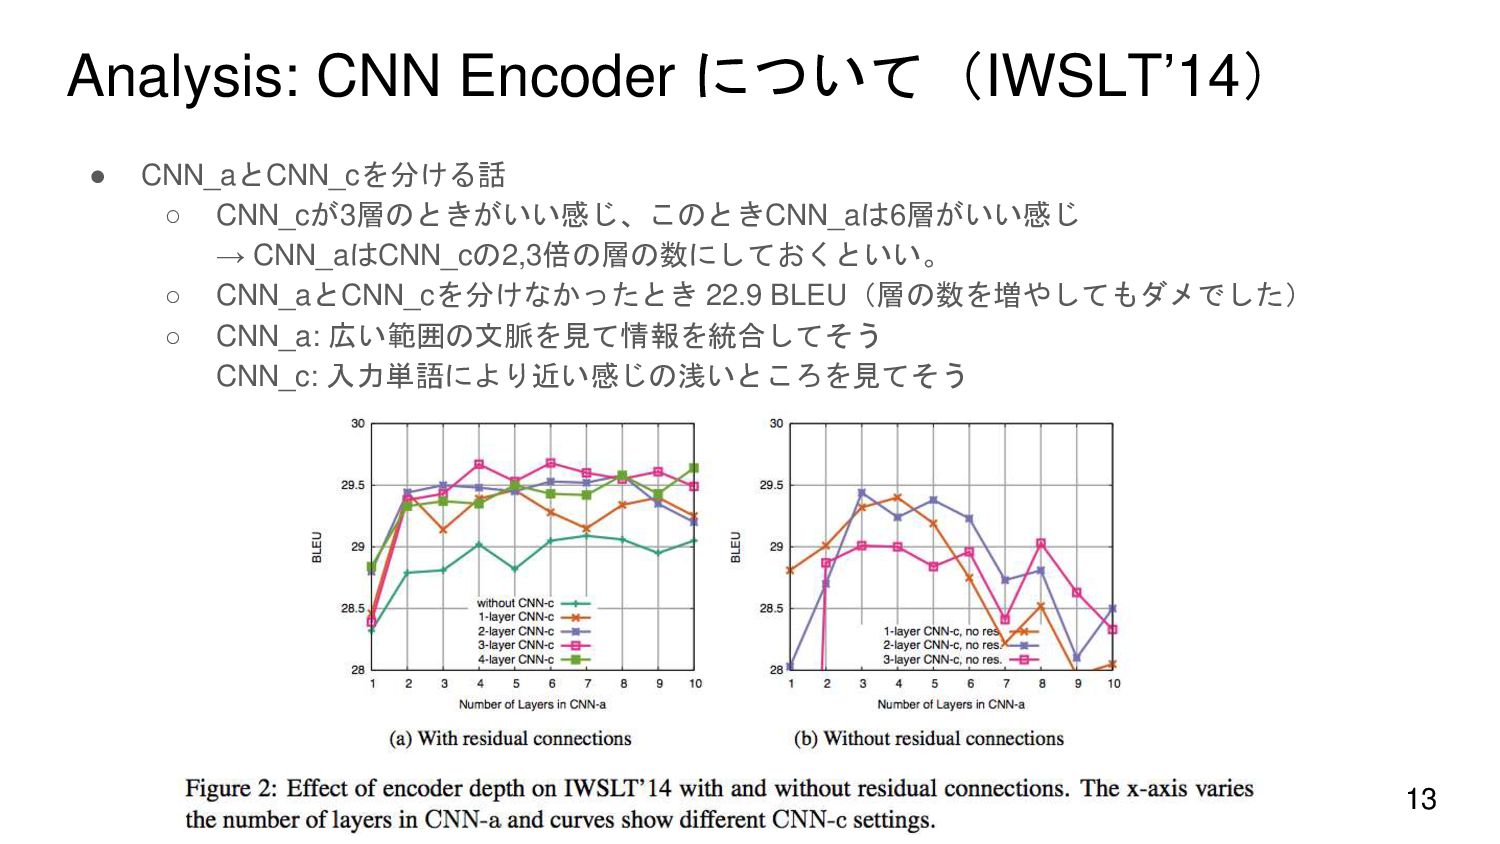
  10. Analysis: CNN Encoder について(IWSLT’14) • CNN_aとCNN_cを分ける話 ◦ CNN_cが3層のときがいい感じ、このときCNN_aは6層がいい感じ → CNN_aはCNN_cの2,3倍の層の数にしておくといい。

    ◦ CNN_aとCNN_cを分けなかったとき 22.9 BLEU(層の数を増やしてもダメでした) ◦ CNN_a: 広い範囲の文脈を見て情報を統合してそう CNN_c: 入力単語により近い感じの浅いところを見てそう 13
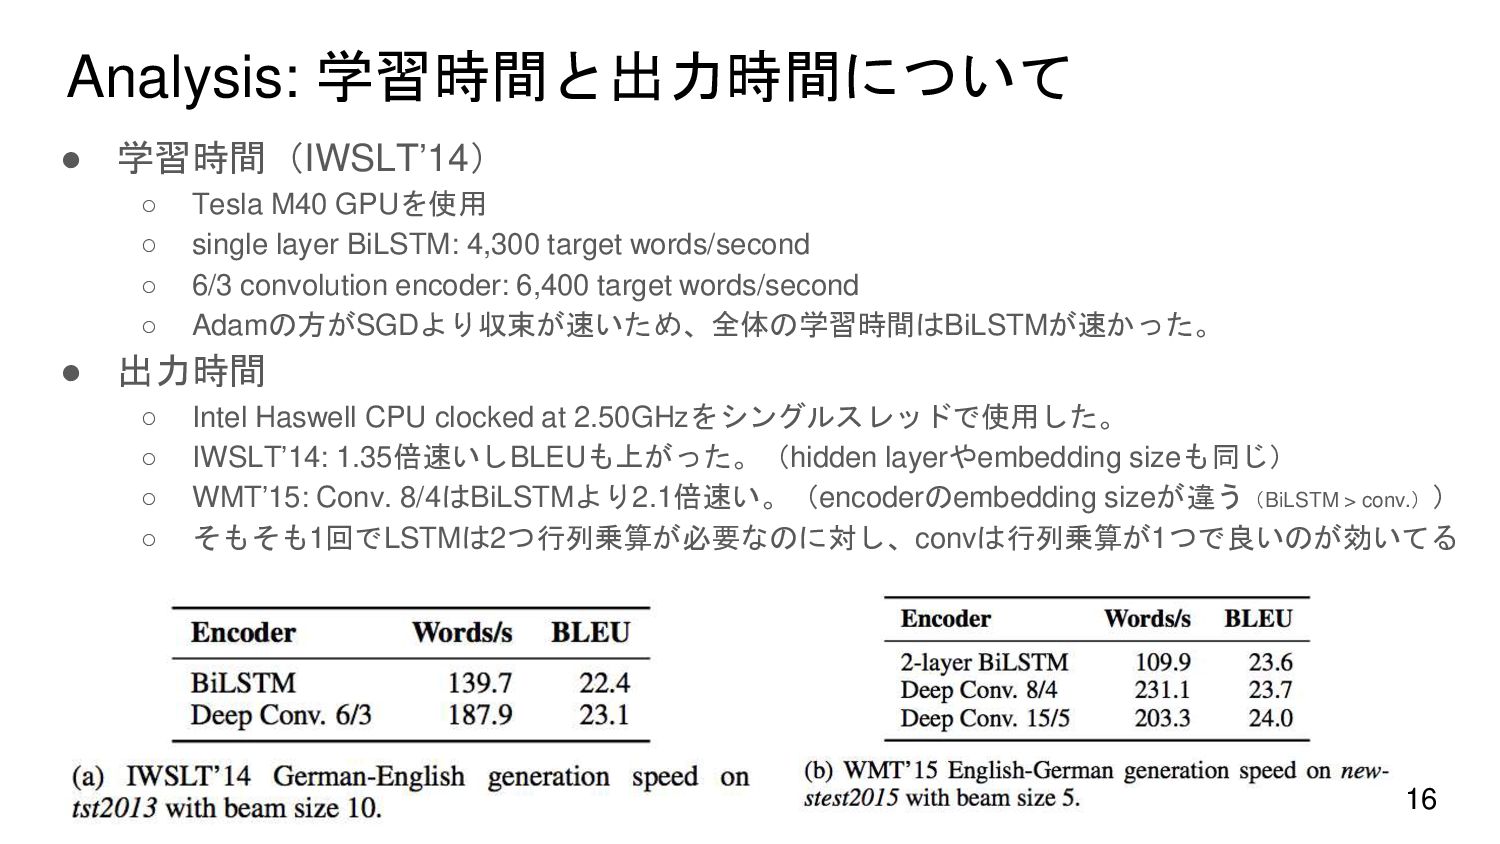
  11. Analysis: 学習時間と出力時間について • 学習時間(IWSLT’14) ◦ Tesla M40 GPUを使用 ◦ single

    layer BiLSTM: 4,300 target words/second ◦ 6/3 convolution encoder: 6,400 target words/second ◦ Adamの方がSGDより収束が速いため、全体の学習時間はBiLSTMが速かった。 • 出力時間 ◦ Intel Haswell CPU clocked at 2.50GHzをシングルスレッドで使用した。 ◦ IWSLT’14: 1.35倍速いしBLEUも上がった。(hidden layerやembedding sizeも同じ) ◦ WMT’15: Conv. 8/4はBiLSTMより2.1倍速い。(encoderのembedding sizeが違う(BiLSTM > conv.)) ◦ そもそも1回でLSTMは2つ行列乗算が必要なのに対し、convは行列乗算が1つで良いのが効いてる 16
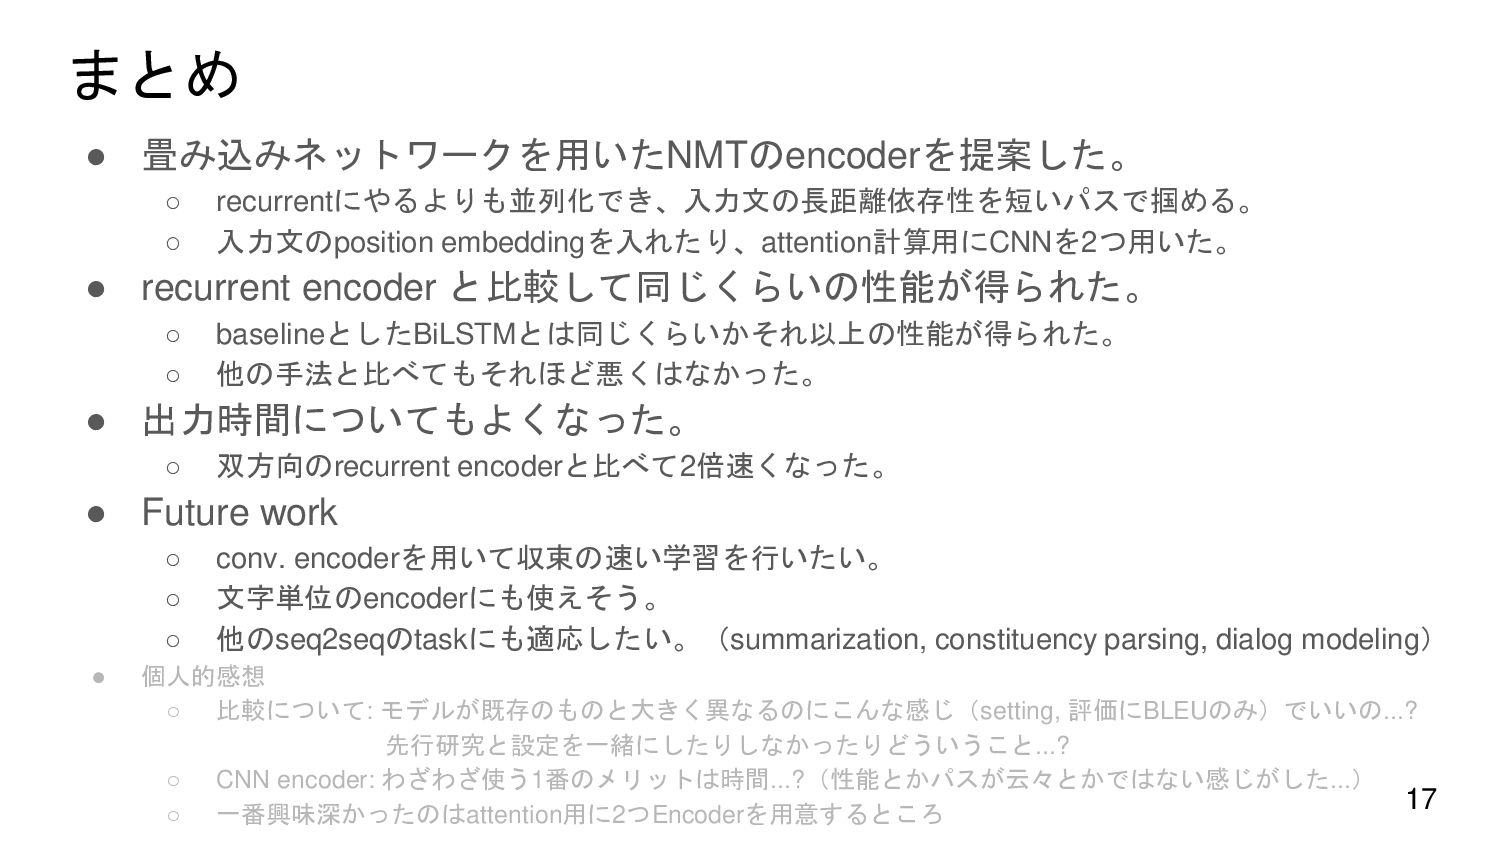
  12. まとめ • 畳み込みネットワークを用いたNMTのencoderを提案した。 ◦ recurrentにやるよりも並列化でき、入力文の長距離依存性を短いパスで掴める。 ◦ 入力文のposition embeddingを入れたり、attention計算用にCNNを2つ用いた。 • recurrent

    encoder と比較して同じくらいの性能が得られた。 ◦ baselineとしたBiLSTMとは同じくらいかそれ以上の性能が得られた。 ◦ 他の手法と比べてもそれほど悪くはなかった。 • 出力時間についてもよくなった。 ◦ 双方向のrecurrent encoderと比べて2倍速くなった。 • Future work ◦ conv. encoderを用いて収束の速い学習を行いたい。 ◦ 文字単位のencoderにも使えそう。 ◦ 他のseq2seqのtaskにも適応したい。(summarization, constituency parsing, dialog modeling) • 個人的感想 ◦ 比較について: モデルが既存のものと大きく異なるのにこんな感じ(setting, 評価にBLEUのみ)でいいの...? 先行研究と設定を一緒にしたりしなかったりどういうこと...? ◦ CNN encoder: わざわざ使う1番のメリットは時間...?(性能とかパスが云々とかではない感じがした...) ◦ 一番興味深かったのはattention用に2つEncoderを用意するところ 17
  13. 参考サイト、論文 • facebookの実装 (lua, torch) ◦ https://github.com/facebookresearch/fairseq • Recurrent Continuous

    Translation Models. Kalchbrenner and Blunsom, EMNLP 2013 • On the Properties of Neural Machine Translation: Encoder–Decoder Approaches . Cho et al., SSST 2014 • Neural Machine Translation in Linear Time. Kalchbrenner et al., arXiv 2016 • Convolutional Encoders for Neural Machine Translation. Lamb and Xie, 2016 ◦ (https://cs224d.stanford.edu/ reports/LambAndrew.pdf) • Encoding Source Language with Convolutional Neural Network for Machine Translation. Meng et al., ACL 2015 • Context-dependent Translation selection using Convolutional Neural Network. Tu et al., ACL-IJCNLP 2015 • Edinburgh neural machine translation systems for wmt 16. Sennrich et al., WMT16 2016 • Schwenk 2014 ◦ (http://www-lium. univ-lemans.fr/ ̃schwenk/cslm_joint_ paper/) • A Simple, Fast, and Effective Reparameterization of IBM Model 2. Dyer et al., ACL 2013 18

More Decks by Satoru Katsumata

Other Decks in Research