Share
Embed
Transcript
40 slides
-
Agenda Goal • 基盤モデルとは • SfM / MVSについて • DUSt3Rとは •
DUSt3Rの派⽣研究 ❏ DUSt3Rが何をするか理解する 想定読者 • 深層学習の仕組みを知っている • ViTを知っている • 3D空間での座標変換を知っている -
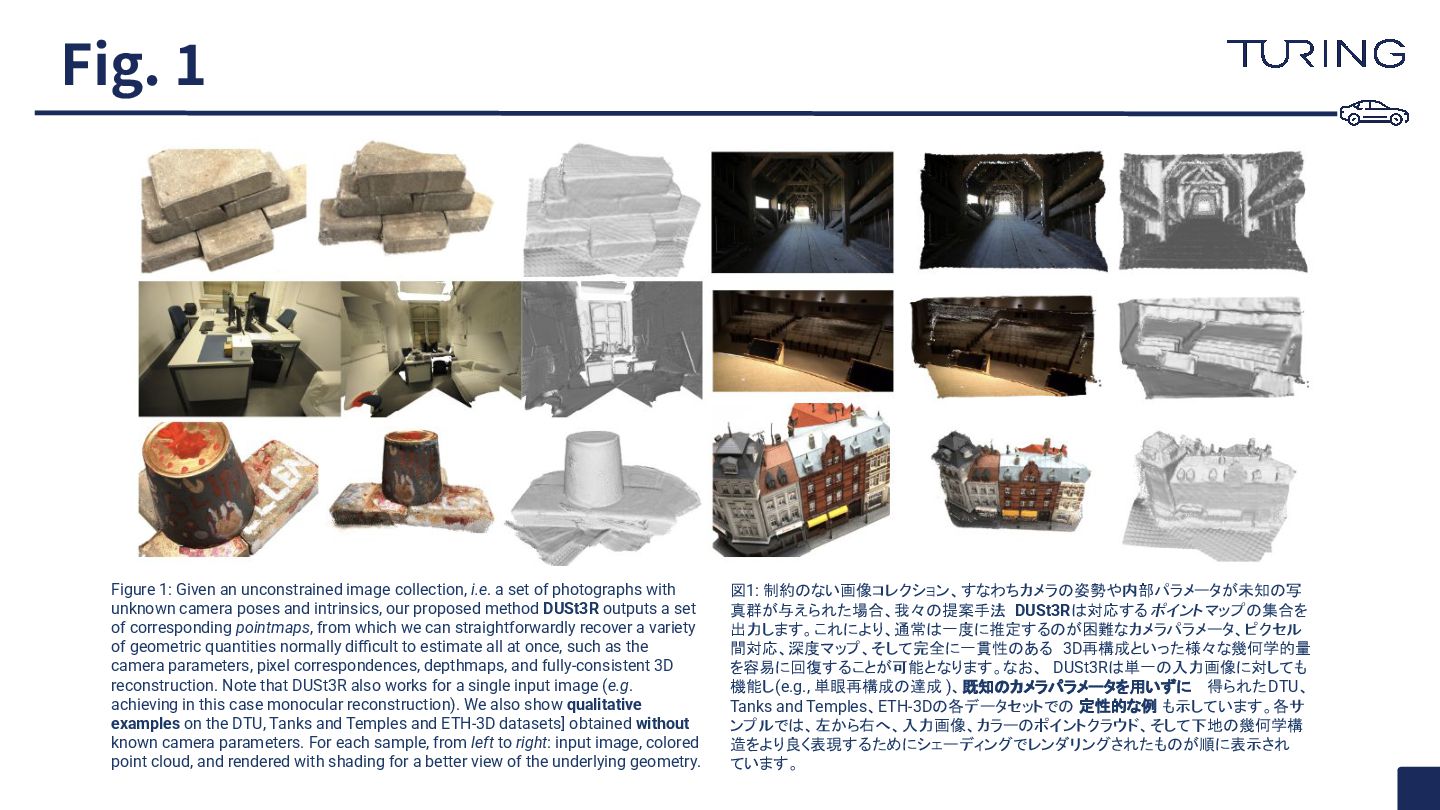
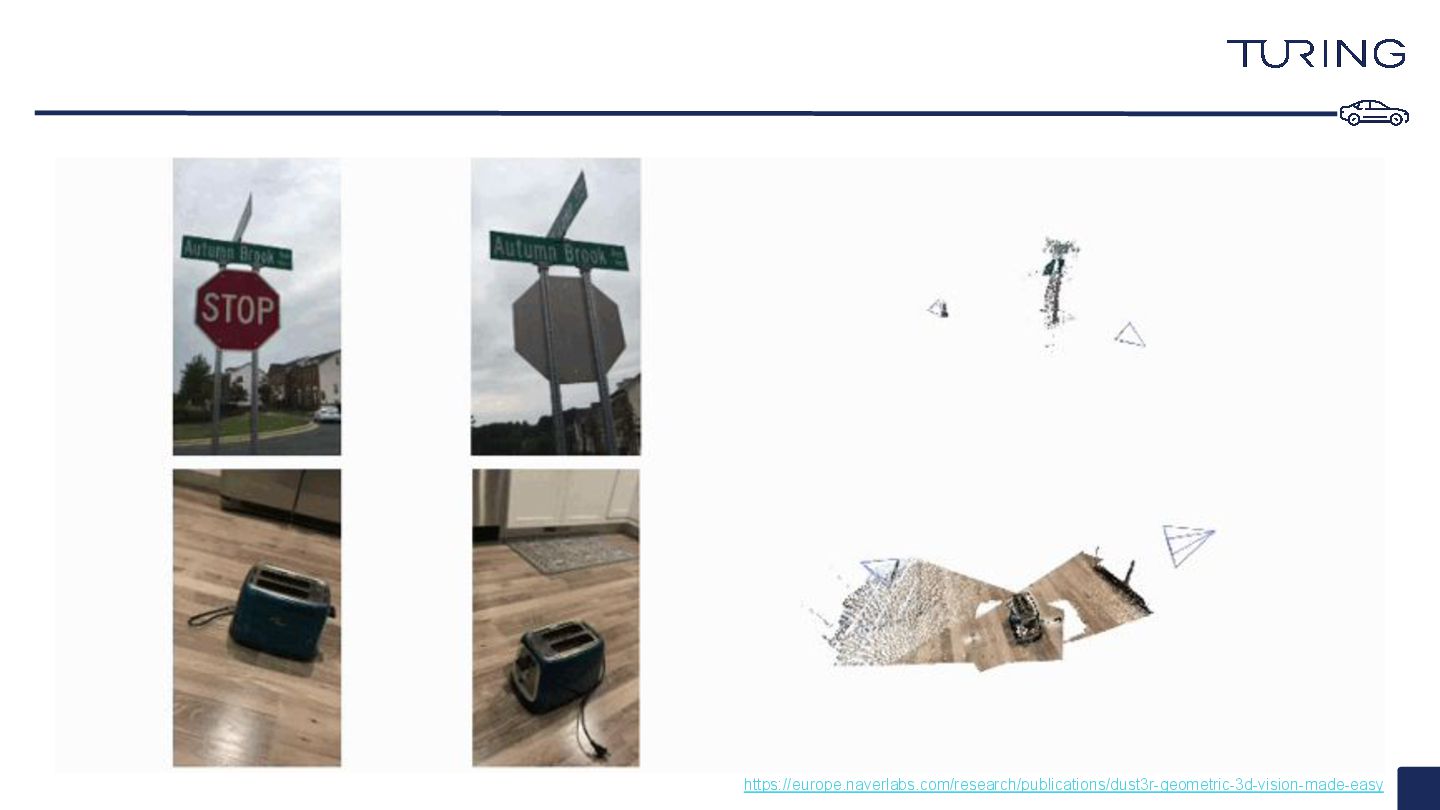
Fig. 1 Figure 1: Given an unconstrained image collection, i.e.
a set of photographs with unknown camera poses and intrinsics, our proposed method DUSt3R outputs a set of corresponding pointmaps, from which we can straightforwardly recover a variety of geometric quantities normally difficult to estimate all at once, such as the camera parameters, pixel correspondences, depthmaps, and fully-consistent 3D reconstruction. Note that DUSt3R also works for a single input image (e.g. achieving in this case monocular reconstruction). We also show qualitative examples on the DTU, Tanks and Temples and ETH-3D datasets] obtained without known camera parameters. For each sample, from left to right: input image, colored point cloud, and rendered with shading for a better view of the underlying geometry. 図1: 制約のない画像コレクション、すなわちカメラの姿勢や内部パラメータが未知の写 真群が与えられた場合、我々の提案手法 DUSt3Rは対応する ポイントマップ の集合を 出力します。これにより、通常は一度に推定するのが困難なカメラパラメータ、ピクセル 間対応、深度マップ、そして完全に一貫性のある 3D再構成といった様々な幾何学的量 を容易に回復することが可能となります。なお、 DUSt3Rは単一の入力画像に対しても 機能し(e.g., 単眼再構成の達成 )、既知のカメラパラメータを用いずに 得られたDTU、 Tanks and Temples、ETH-3Dの各データセットでの 定性的な例 も示しています。各サ ンプルでは、左から右へ、入力画像、カラーのポイントクラウド、そして下地の幾何学構 造をより良く表現するためにシェーディングでレンダリングされたものが順に表示され ています。 -
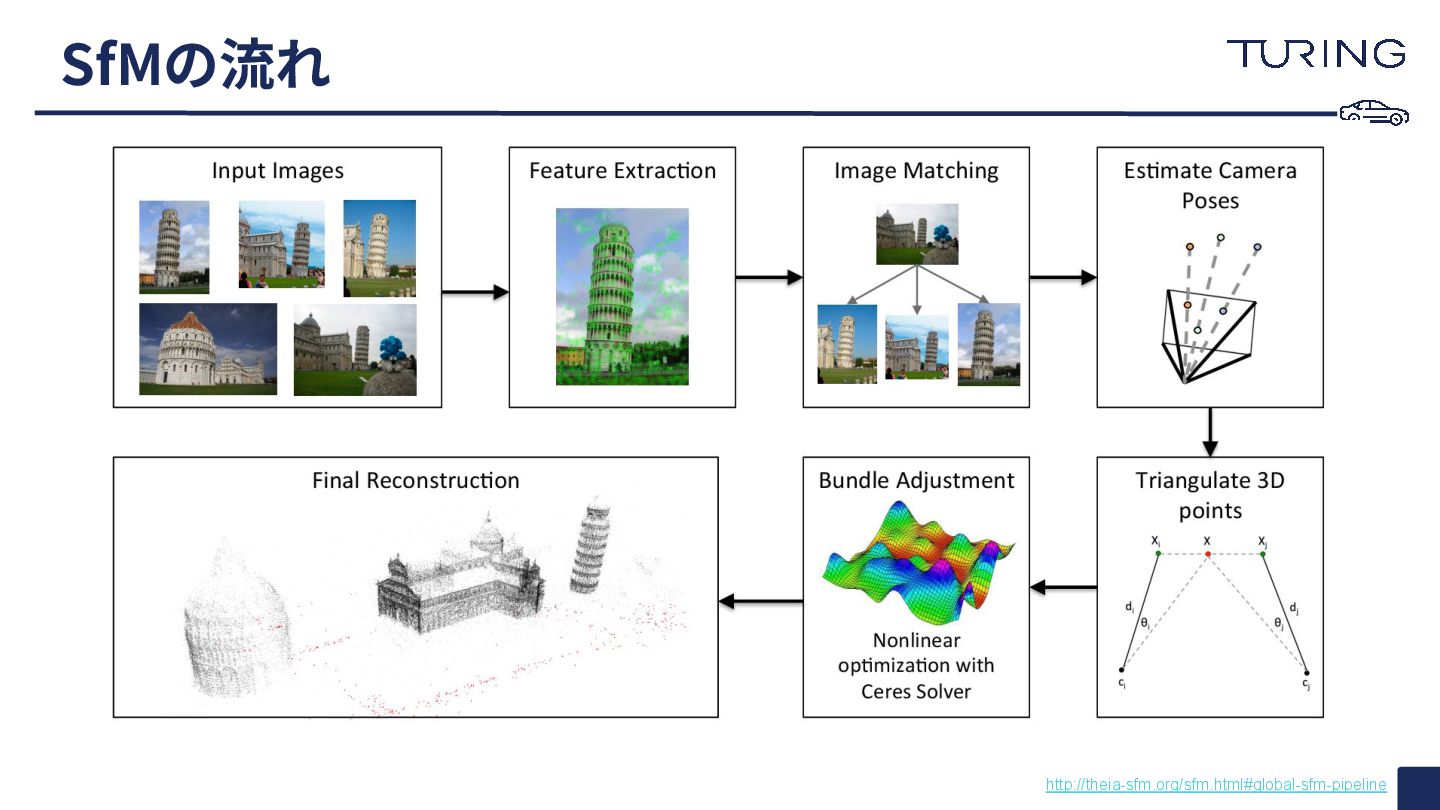
SfM / MVS / COLMAPについて Structure from Motion (SfM) •
複数枚の2次元シーン画像から3次元構造を推定する技術 • 成果物: カメラ位置 (回転‧並進)、スパースな3D点群 など Multi View Stereo (MVS) • シーン画像とSfMの結果をもとに、より密な3次元再構成を⾏う技術 • 成果物: 密な3D点群、テクスチャマッピング など COLMAP • SfMやMVSのパイプラインを統合した汎⽤的なOSS -
基盤モデルとは “膨⼤なデータセットに基づいてトレーニングされた基盤モデル (FM) は、デー タサイエンティストによる機械学習 (ML) へのアプローチを⼀変させた⼤規模な 深層学習ニューラルネットワークです。” AWS, “基盤モデルとは何ですか
?” https://aws.amazon.com/jp/what-is/foundation-models/ -
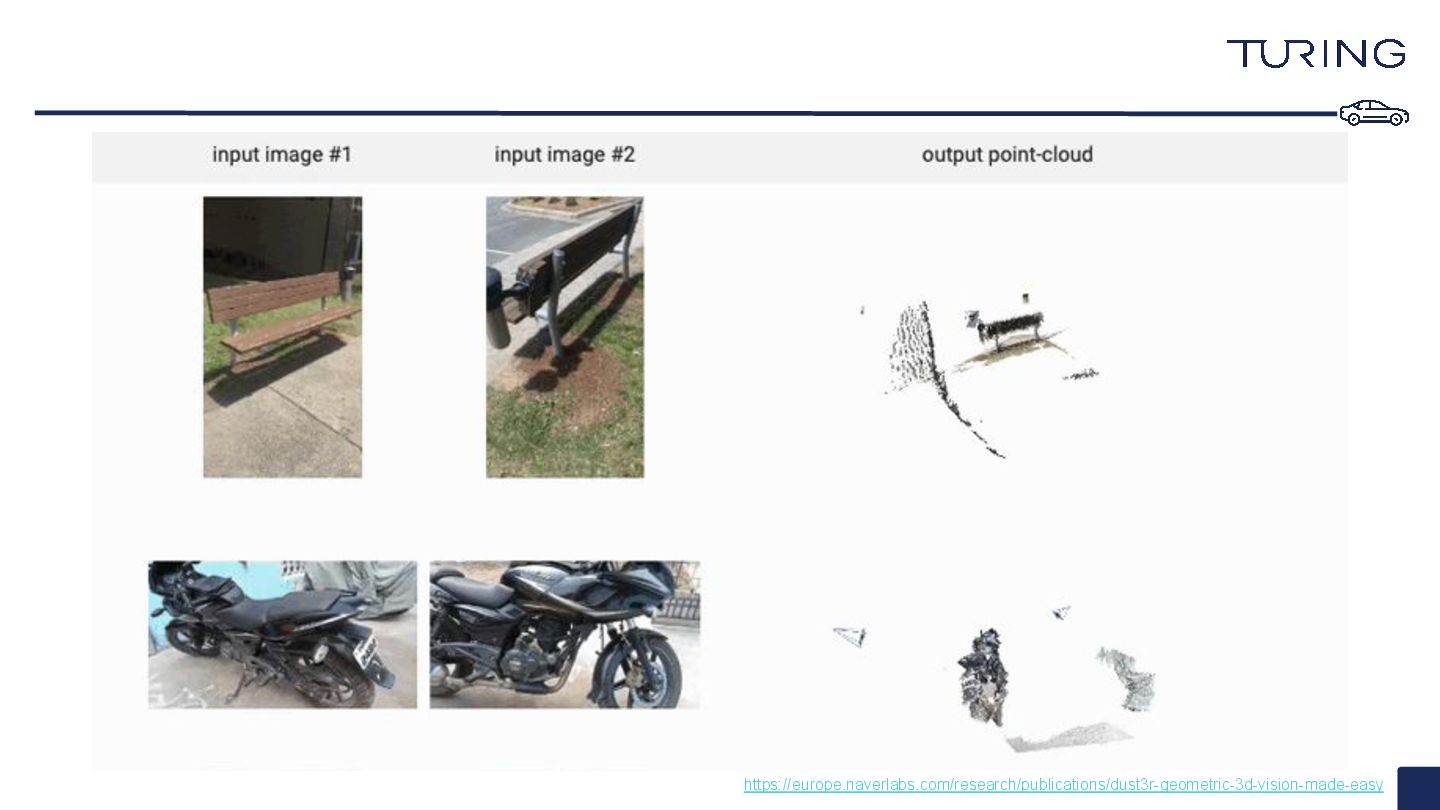
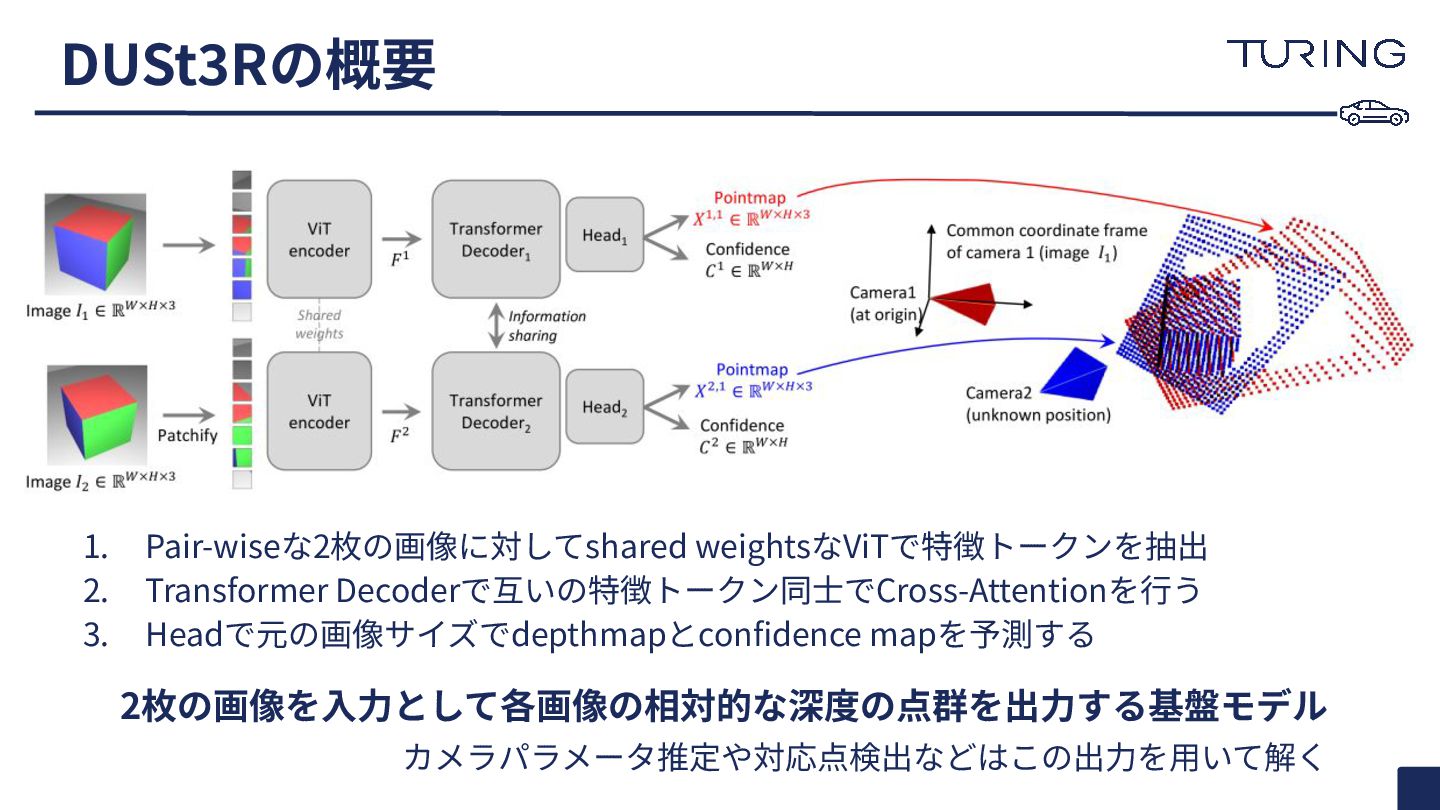
DUSt3Rの概要 1. Pair-wiseな2枚の画像に対してshared weightsなViTで特徴トークンを抽出 2. Transformer Decoderで互いの特徴トークン同⼠でCross-Attentionを⾏う 3. Headで元の画像サイズでdepthmapとconfidence mapを予測する
2枚の画像を⼊⼒として各画像の相対的な深度の点群を出⼒する基盤モデル カメラパラメータ推定や対応点検出などはこの出⼒を⽤いて解く -
*Vision Transformer (ViT) ViT [Dosovitskiy+ 2020] • ViTは画像認識においてTransformerを⽤いた⼿法 (当時のCNNのSoTAと同様の性能) •
MAEやCLIPなど教師データを必要としない⾃⼰教師あり学習が様々提案 ◦ ViTはVLMにも広く⽤いられて、Gemma 3にはSigLIP [Zhai+ 2023] が採⽤ MAE [He+ 2021] -
*CroCo v2 [Weinzaepfel+ ICCV2023] • CroCoから、学習データ作成、RoPEの導⼊、モデルサイズを⼤きくする改善 • Stereo matchingやoptical flowの下流タスクの事前学習として効果的
• DUSt3Rのベース構造で、事前学習はこのCroCo v2を採⽤ -
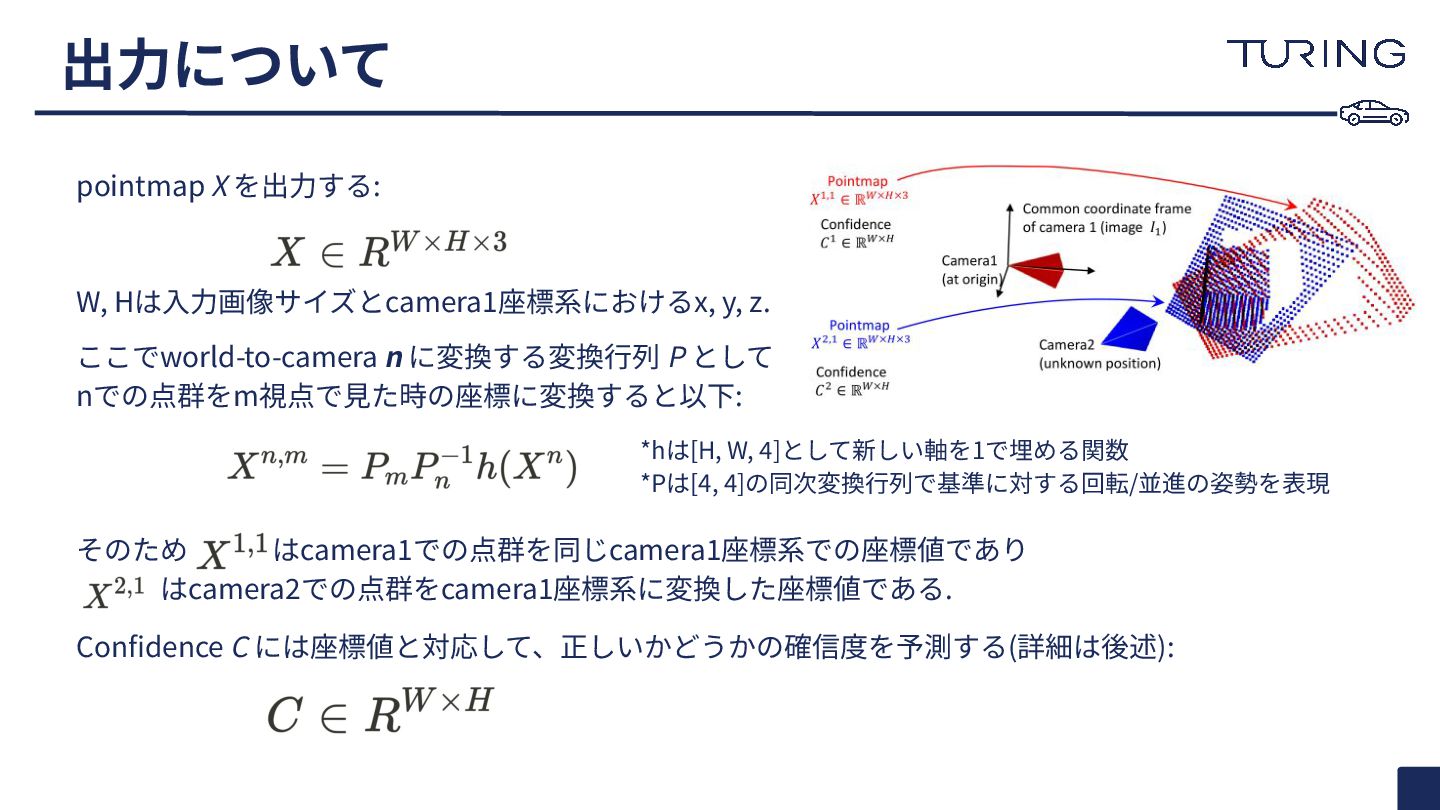
出⼒について pointmap X を出⼒する: W, Hは⼊⼒画像サイズとcamera1座標系におけるx, y, z. ここでworld-to-camera n
に変換する変換⾏列 P として nでの点群をm視点で⾒た時の座標に変換すると以下: そのため はcamera1での点群を同じcamera1座標系での座標値であり はcamera2での点群をcamera1座標系に変換した座標値である. Confidence C には座標値と対応して、正しいかどうかの確信度を予測する(詳細は後述): *hは[H, W, 4]として新しい軸を1で埋める関数 *Pは[4, 4]の同次変換⾏列で基準に対する回転/並進の姿勢を表現 -
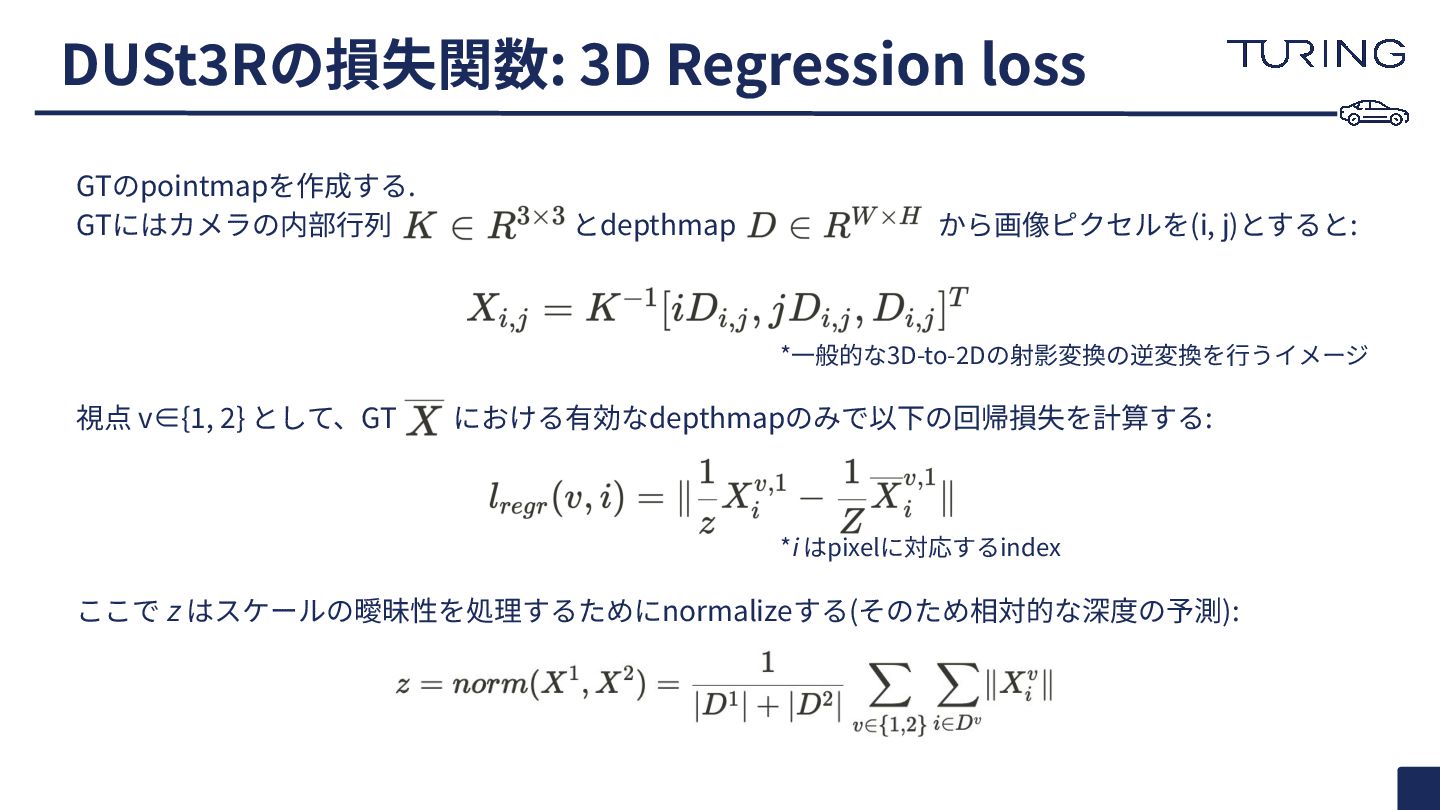
DUSt3Rの損失関数: 3D Regression loss GTのpointmapを作成する. GTにはカメラの内部⾏列 とdepthmap から画像ピクセルを(i, j)とすると:
視点 v∈{1, 2} として、GT における有効なdepthmapのみで以下の回帰損失を計算する: ここで z はスケールの曖昧性を処理するためにnormalizeする(そのため相対的な深度の予測): *⼀般的な3D-to-2Dの射影変換の逆変換を⾏うイメージ *i はpixelに対応するindex -
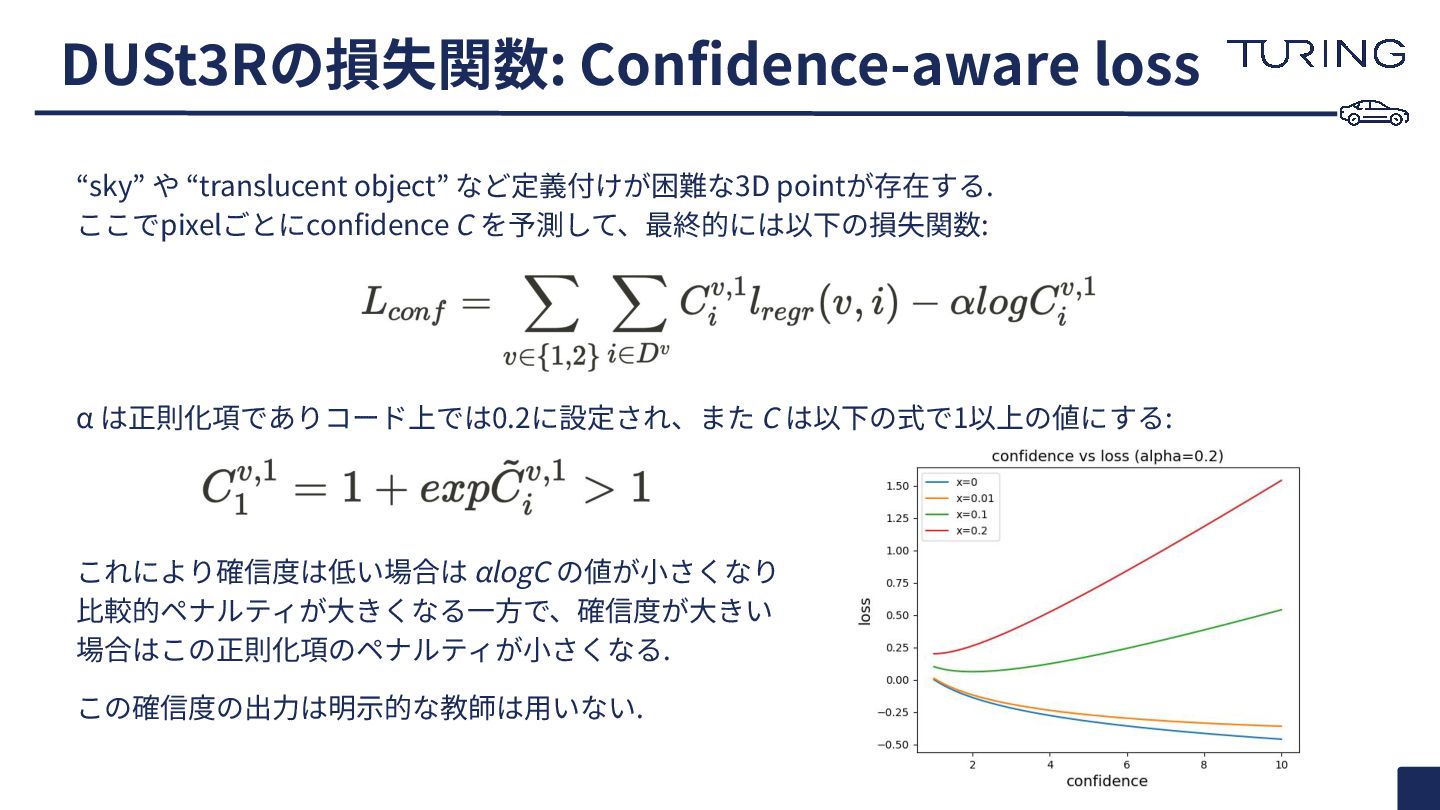
DUSt3Rの損失関数: Confidence-aware loss “sky” や “translucent object” など定義付けが困難な3D pointが存在する. ここでpixelごとにconfidence
C を予測して、最終的には以下の損失関数: α は正則化項でありコード上では0.2に設定され、また C は以下の式で1以上の値にする: これにより確信度は低い場合は αlogC の値が⼩さくなり ⽐較的ペナルティが⼤きくなる⼀⽅で、確信度が⼤きい 場合はこの正則化項のペナルティが⼩さくなる. この確信度の出⼒は明⽰的な教師は⽤いない. -
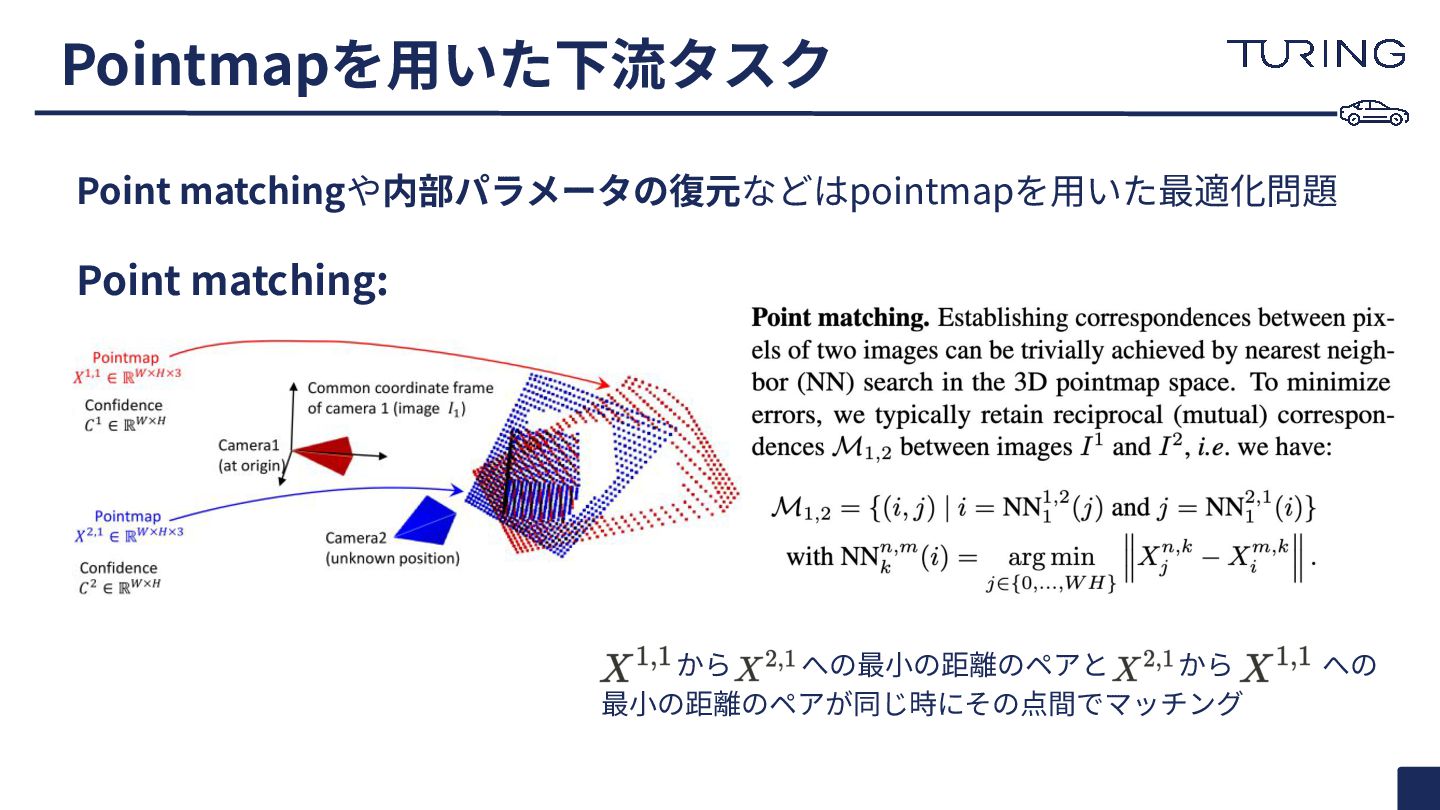
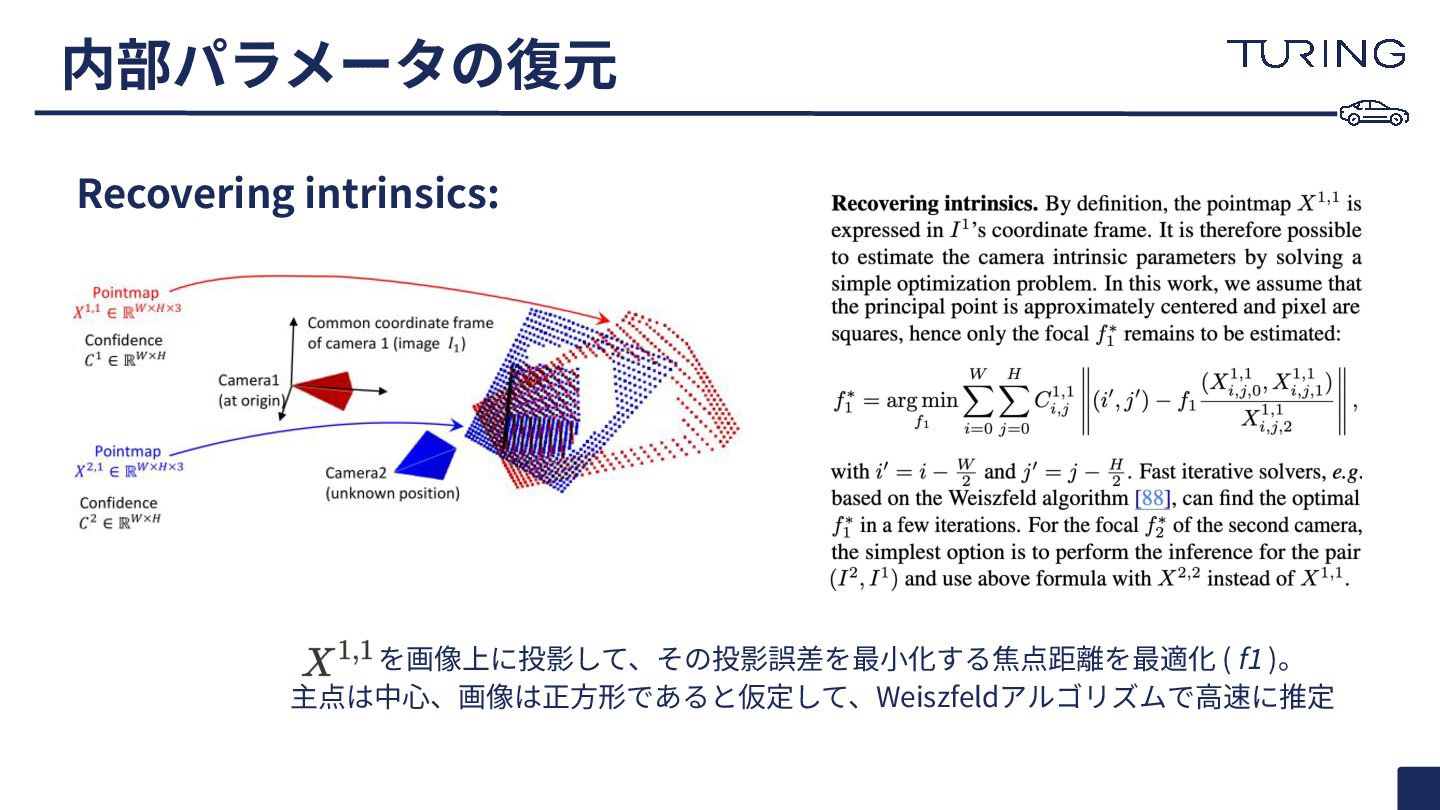
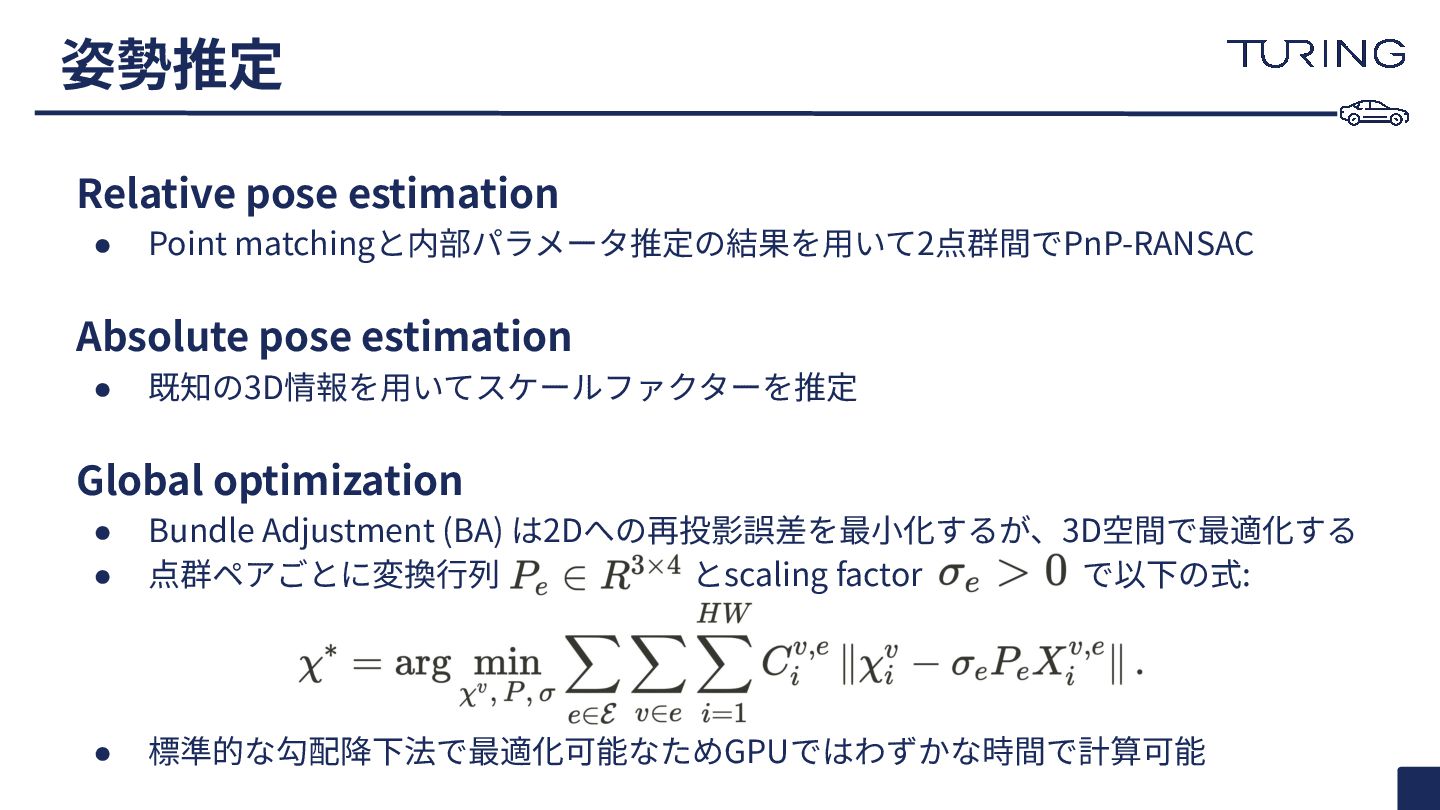
姿勢推定 Relative pose estimation • Point matchingと内部パラメータ推定の結果を⽤いて2点群間でPnP-RANSAC Absolute pose estimation
• 既知の3D情報を⽤いてスケールファクターを推定 Global optimization • Bundle Adjustment (BA) は2Dへの再投影誤差を最⼩化するが、3D空間で最適化する • 点群ペアごとに変換⾏列 とscaling factor で以下の式: • 標準的な勾配降下法で最適化可能なためGPUではわずかな時間で計算可能 -
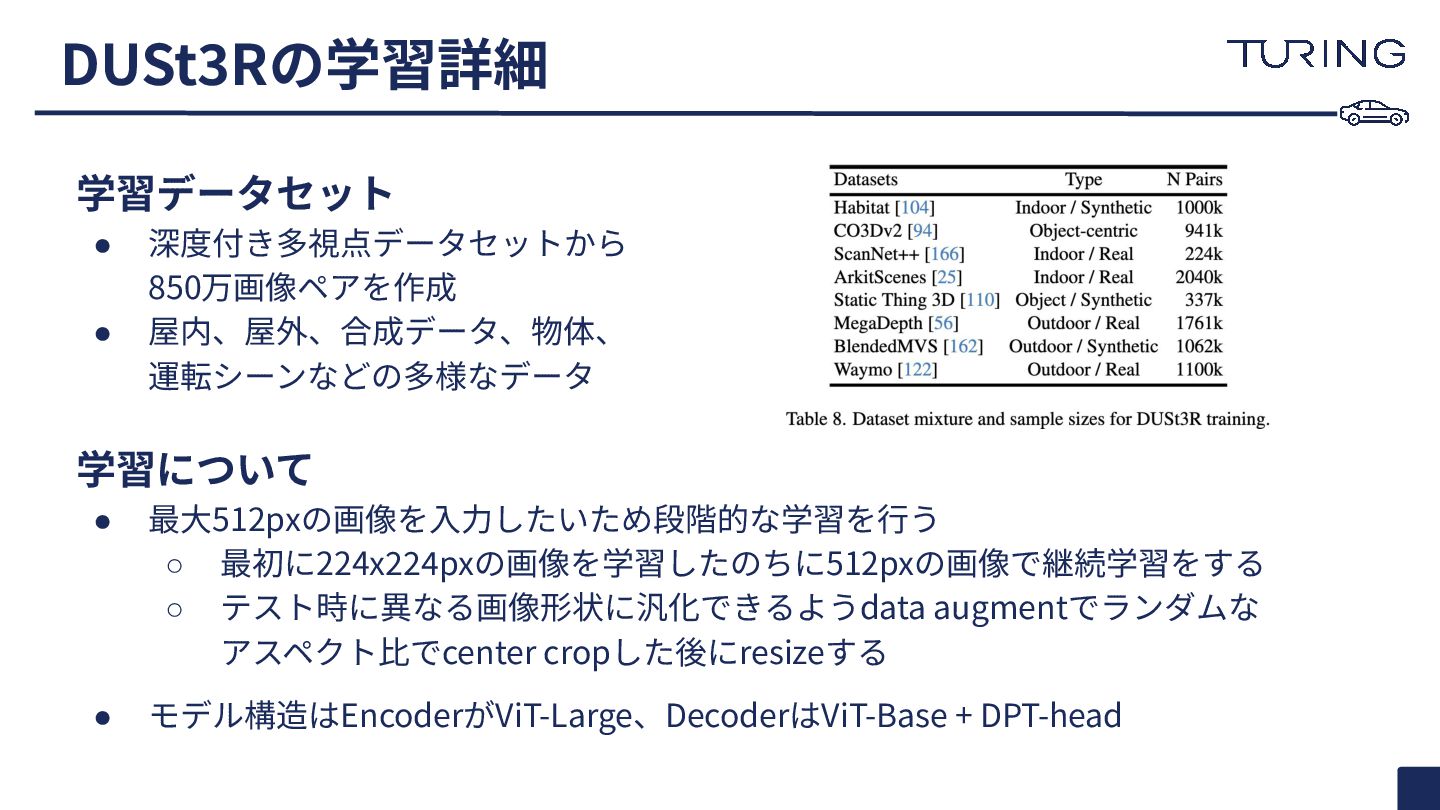
DUSt3Rの学習詳細 学習データセット • 深度付き多視点データセットから 850万画像ペアを作成 • 屋内、屋外、合成データ、物体、 運転シーンなどの多様なデータ 学習について •
最⼤512pxの画像を⼊⼒したいため段階的な学習を⾏う ◦ 最初に224x224pxの画像を学習したのちに512pxの画像で継続学習をする ◦ テスト時に異なる画像形状に汎化できるようdata augmentでランダムな アスペクト⽐でcenter cropした後にresizeする • モデル構造はEncoderがViT-Large、DecoderはViT-Base + DPT-head -
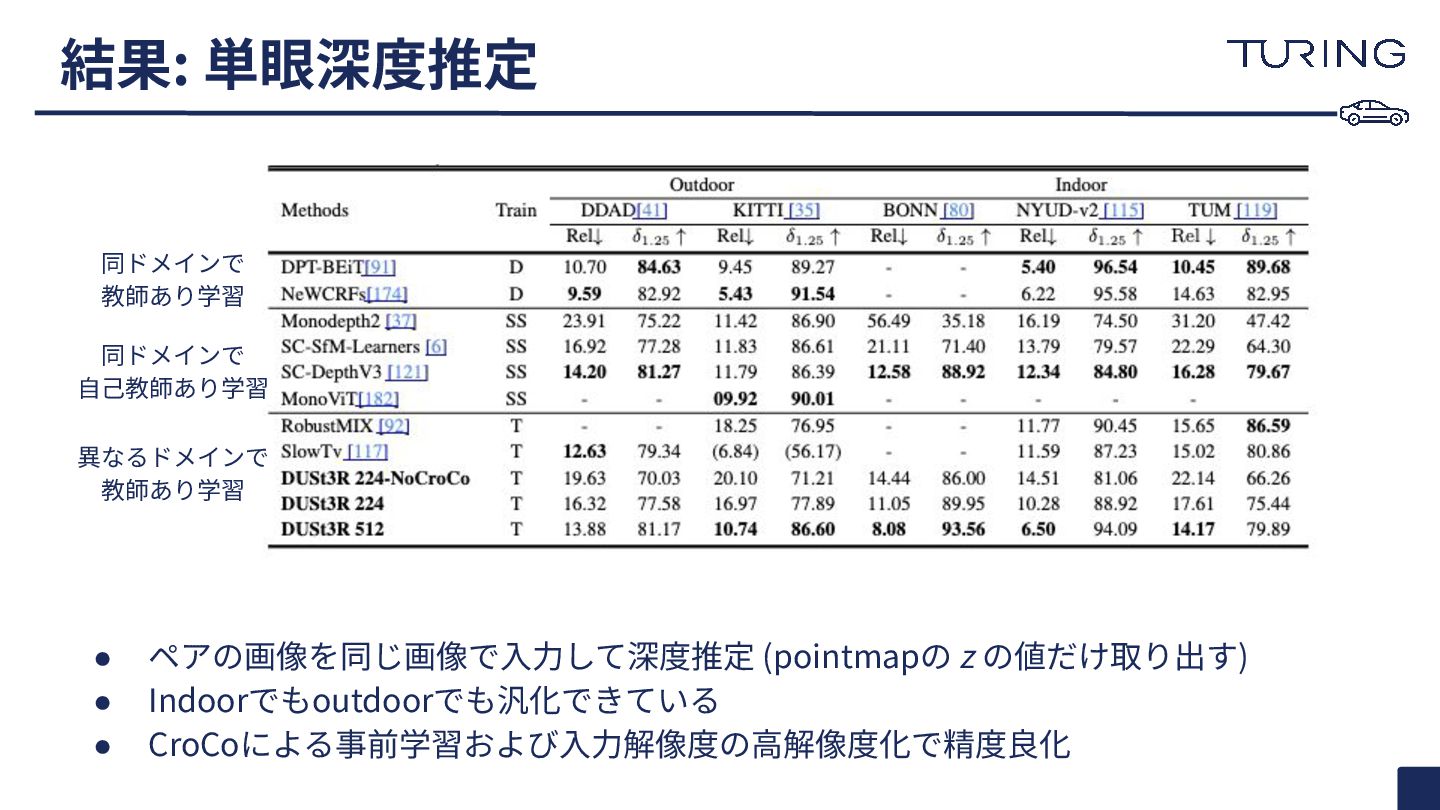
結果: 単眼深度推定 • ペアの画像を同じ画像で⼊⼒して深度推定 (pointmapの z の値だけ取り出す) • Indoorでもoutdoorでも汎化できている •
CroCoによる事前学習および⼊⼒解像度の⾼解像度化で精度良化 同ドメインで 教師あり学習 同ドメインで ⾃⼰教師あり学習 異なるドメインで 教師あり学習 -
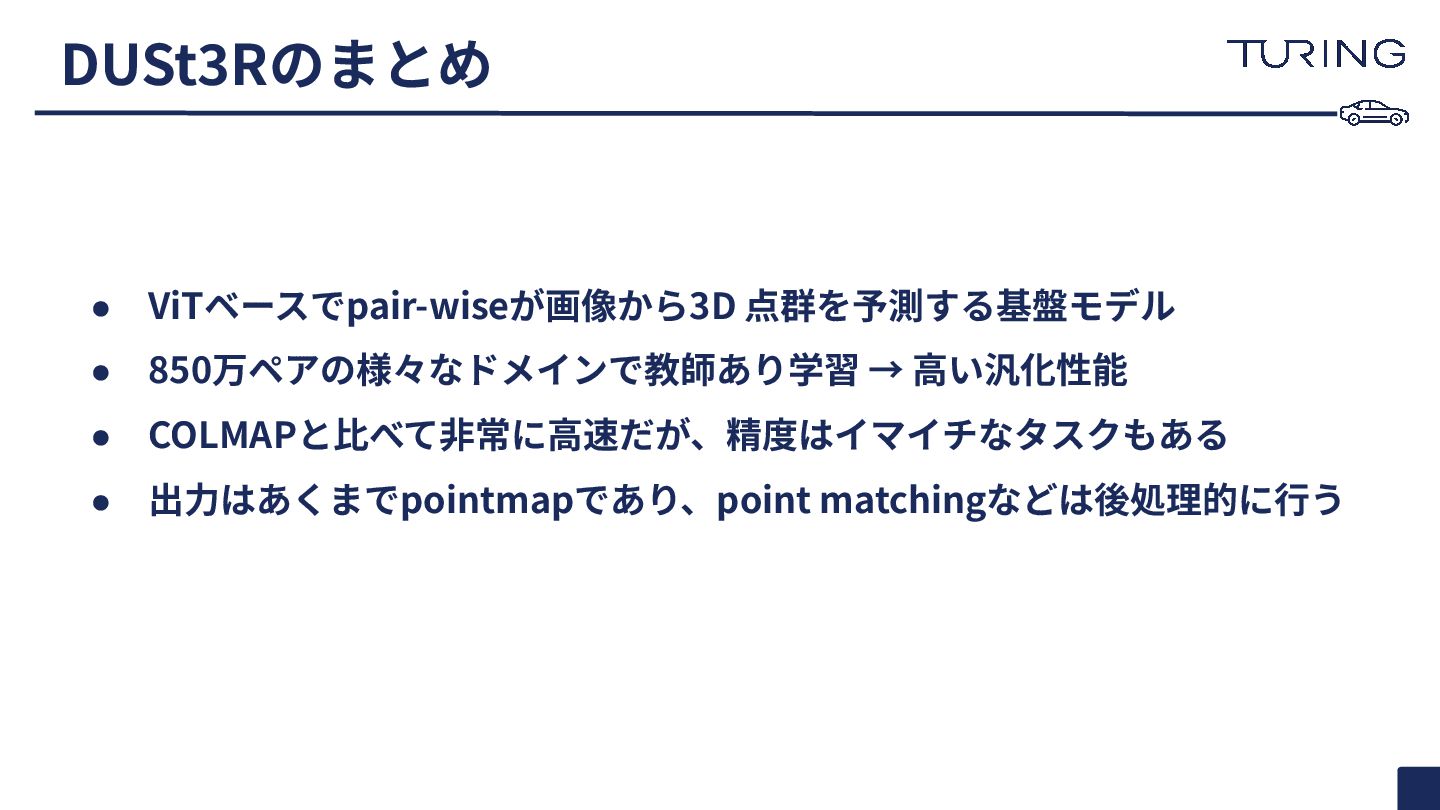
DUSt3Rのまとめ • ViTベースでpair-wiseが画像から3D 点群を予測する基盤モデル • 850万ペアの様々なドメインで教師あり学習 → ⾼い汎化性能 • COLMAPと⽐べて⾮常に⾼速だが、精度はイマイチなタスクもある
• 出⼒はあくまでpointmapであり、point matchingなどは後処理的に⾏う -
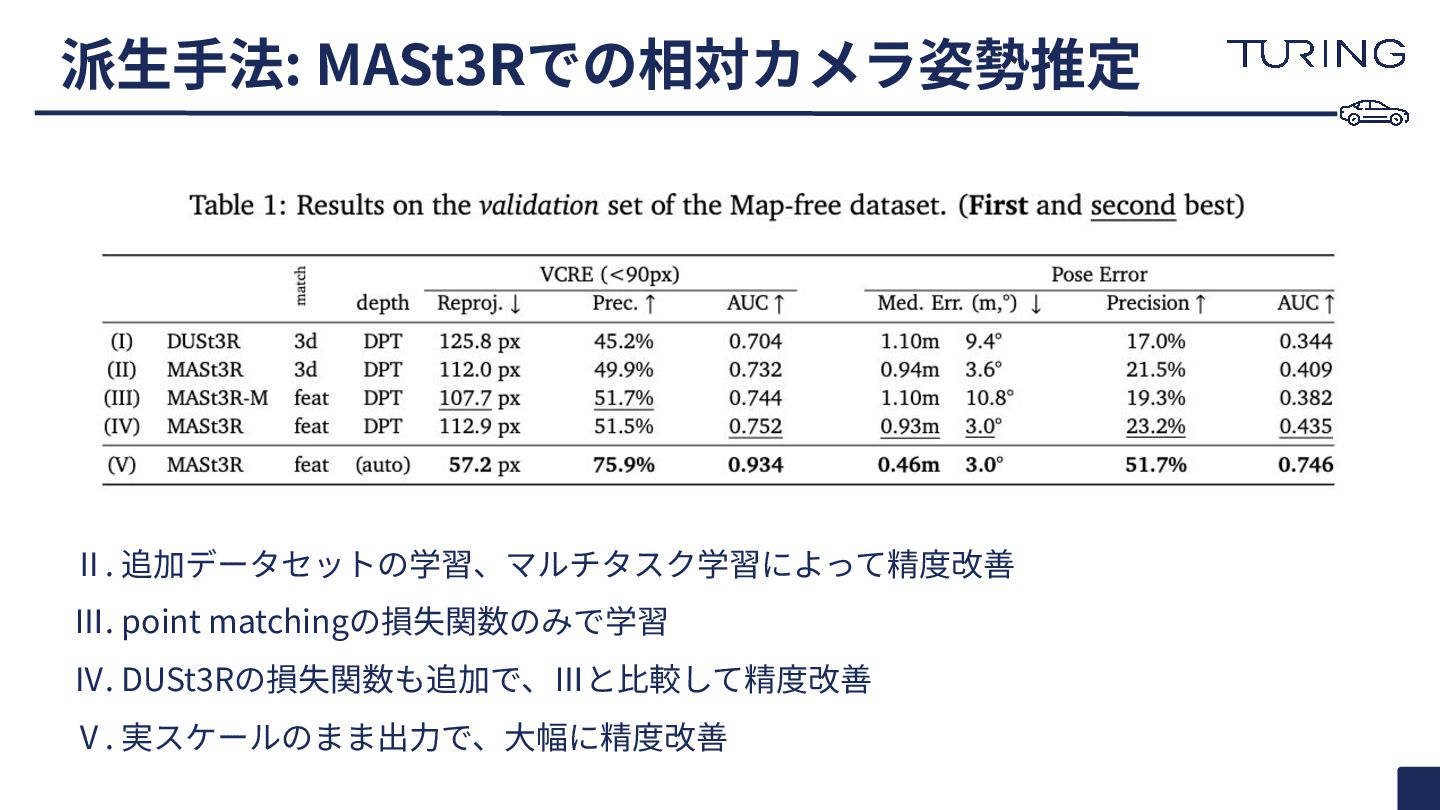
派⽣⼿法: MASt3R [Leroy+ CVPR2024] • DUSt3Rの構造に新しくlocal featureを出⼒するHeadを追加 • DUSt3Rの損失関数に加えてpoint matchingの損失関数を追加
• データセットが実スケールの時に点群スケールを正規化しない i.e., 実スケールで出⼒ -
派⽣⼿法: MonST3R [Zhang+ ICLR2025] • 動的なシーンに対応したDUSt3R系の⼿法 • 時系列で関係する2フレームからpointmapを出⼒後に後処理的にoptical flowを計算 •
動的なGlobal Alignmentに対応 (フレームに対応した3D点群の構築が可能) https://monst3r-project.github.io/ -
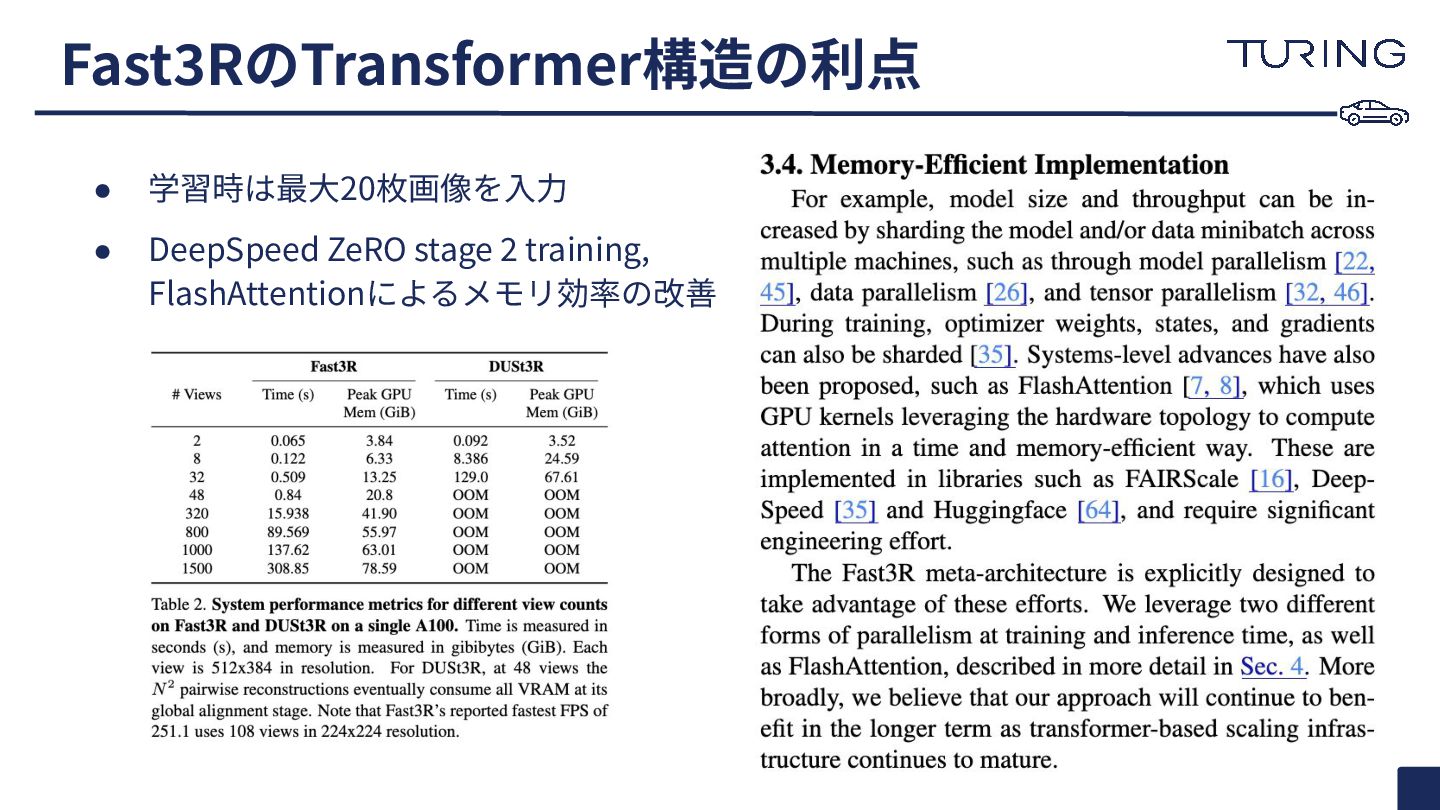
派⽣⼿法: Fast3R [Yang+ CVPR2025] • 任意の複数枚の画像を⼊⼒可能にしたDUSt3R系の⼿法 (テスト時は1,500枚でも可能) • Cross-AttentionのところをカメラIDによるpositional encodingをしてSelf-Attention
• DUSt3R系で必要だったGlobal Alignmentを⾏う必要がなく⽐較的⾼速 -
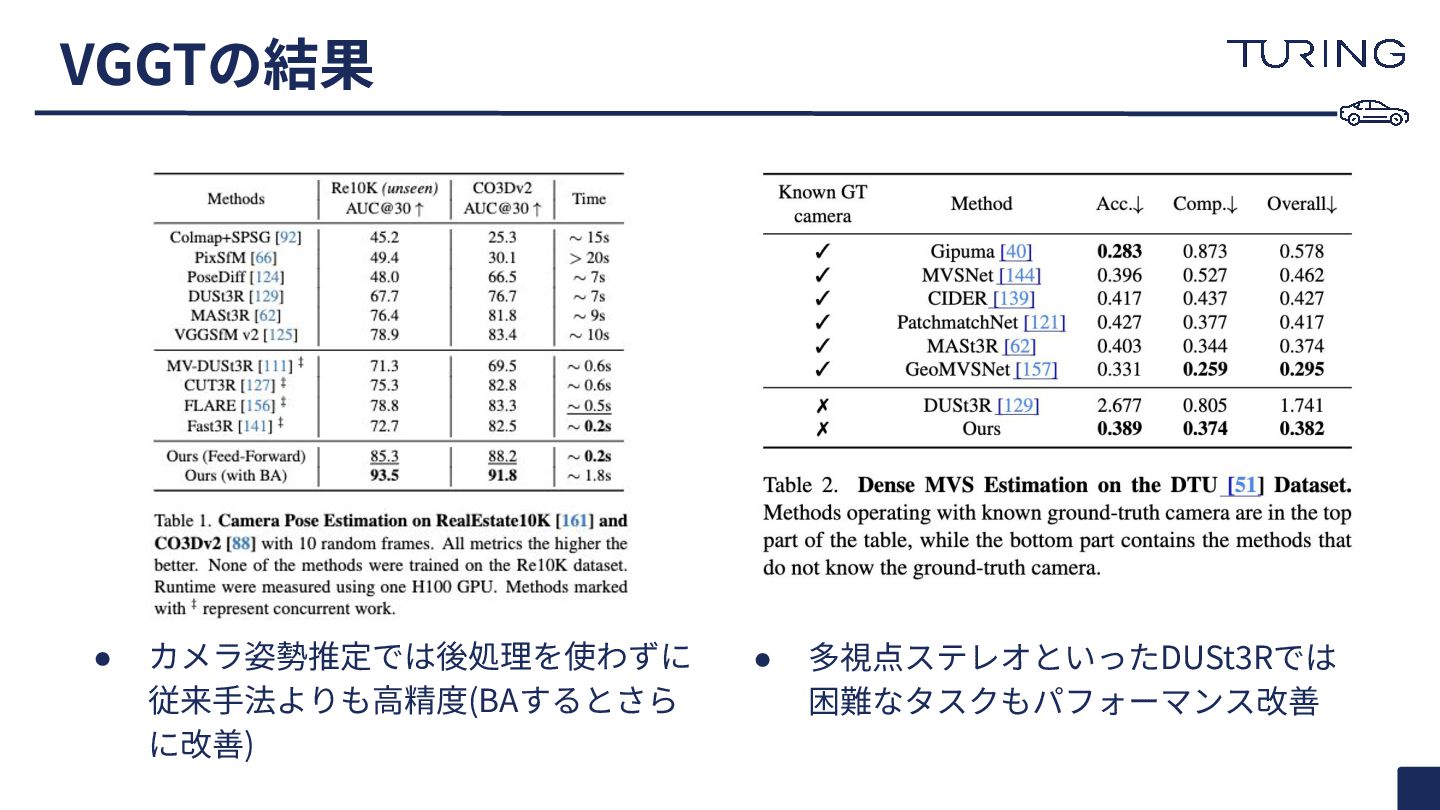
まとめ • Transformerベースで3D Computer Visionの基盤モデルが登場 • 点群出⼒の他に動的シーンの対応や直接カメラパラメータ推定などが可能に • まだCOLMAPが得意な領域もたくさんあるが、⾼速なため使い分けてたい •
モデル構造や学習も⼤事だがデータセット作成が⼤変そう • ここで紹介したDUSt3R系のモデルは全て⾮商⽤ライセンス (CC BY-NC 4.0)