Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[IR Reading 2023春 論文紹介] A Unified Framework for...
Search
Kohei Shinden
PRO
June 10, 2023
Research
390
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[IR Reading 2023春 論文紹介] A Unified Framework for Learned Sparse Retrieval (ECIR 2023) /IR-Reading-2023-Spring
https://sigirtokyo.github.io/post/2023-06-10-irreading_2023spring/
Kohei Shinden
PRO
June 10, 2023
More Decks by Kohei Shinden
See All by Kohei Shinden
[IR Reading 2026春 論文紹介] LLM-based Listwise Reranking under the Effect of Positional Bias (ECIR 2026) /IR-Reading-2026-Spring
koheishinden
PRO
0
450
[IR Reading 2023秋 論文紹介] On the Impact of Outlier Bias on User Clicks (SIGIR 2023) /IR-Reading-2023-Fall
koheishinden
PRO
0
380
[IR Reading 2022秋 論文紹介] Price DOES Matter!: Modeling Price and Interest Preferences in Session-based Recommendation (SIGIR 2022) /IR-Reading-2022-Fall
koheishinden
PRO
0
400
[ACM SIGMOD-J 79] The Web Conference 2022 国際会議報告 Security セッション /ACM-SIGMOD-J-79-The-Web-Conf-2022
koheishinden
PRO
0
380
[IR Reading 2022春 論文紹介] Personalized Transfer of User Preferences for Cross-domain Recommendation (WSDM 2022) /IR-Reading-2022-Spring
koheishinden
PRO
0
390
[IR Reading 2021秋 論文紹介] Fairness among New Items in Cold Start Recommender Systems (SIGIR 2021) /IR-Reading-2022-Fall
koheishinden
PRO
0
380
[IR Reading 2021春 論文紹介] Investigating the Influence of Ads on User Search Performance, Behaviour, and Experience during Information Seeking (CHIIR 2021) /IR-Reading-2021-Spring
koheishinden
PRO
0
380
Other Decks in Research
See All in Research
Ghost in the 7‑Zip: The Shadow of Residential Proxies Creeping into Your Life
nttcom
0
2.1k
ふとした出会いで生まれたSkillが、 社内利用1位になるまで
mikimhk
22
24k
JPA2026_NetworkTutorial_JunKashihara
junkashihara
0
200
最先端NLP 2026 論文紹介: Wait, Wait, Wait... Why Do Reasoning Models Loop? / SNLP Paper Review: Wait, Wait, Wait... Why Do Reasoning Models Loop?
tkng
0
250
高性能計算機クラスタを用いた大規模点群処理による森林の単木抽出と構造解析
kentaitakura
1
140
Cross-Media Human-Information Interaction
signer
PRO
0
260
La génomique au service de la fromageabilité du lait grâce aux spectres MIR
institudelelevage
PRO
0
140
横浜市長(山中氏)の言動にかかる第三者による調査報告書
sishi2026
0
570
[最先端NLP勉強会2026] Agentic Rubrics as Contextual Verifiers for SWE Agents
rfujii
1
370
LA-Bench 2025:実験指示から 実行可能手順を生成するためのデータセット/LA-Bench 2025: A Dataset for Generating Executable Experimental Procedures from Experimental Instructions
stktu
0
190
SOTAのさらに先へ:厳しい推論制約下での高性能モデルのPost-Training
analokmaus
0
1.6k
HAKARI-Bench - 実運用視点での情報検索モデル評価ベンチマーク
hotchpotch
1
780
Featured
See All Featured
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
Color Theory Basics | Prateek | Gurzu
gurzu
1
480
Building an army of robots
kneath
307
47k
Future Trends and Review - Lecture 12 - Web Technologies (1019888BNR)
signer
PRO
0
3.8k
How STYLIGHT went responsive
nonsquared
100
6.3k
The Impact of AI in SEO - AI Overviews June 2024 Edition
aleyda
6
1.2k
世界の人気アプリ100個を分析して見えたペイウォール設計の心得
akihiro_kokubo
PRO
74
42k
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
58k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
21k
How to Grow Your eCommerce with AI & Automation
katarinadahlin
PRO
2
300
Designing Powerful Visuals for Engaging Learning
tmiket
1
590
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
250
Transcript
[論⽂紹介] A Unified Framework for Learned Sparse Retrieval Thong Nguyen1,
Sean MacAvaney2, Andrew Yates1 1University of Amsterdam, 2University of Glasgow ECIR 2023 論⽂紹介する⼈ 筑波⼤学加藤研究室 新⽥洸平 https://sites.google.com/view/kohei-shinden ※スライド中の図表は論⽂より引⽤ 2023年6⽉10⽇ IR Reading 2023 春 ⼀般セッション2 No.3
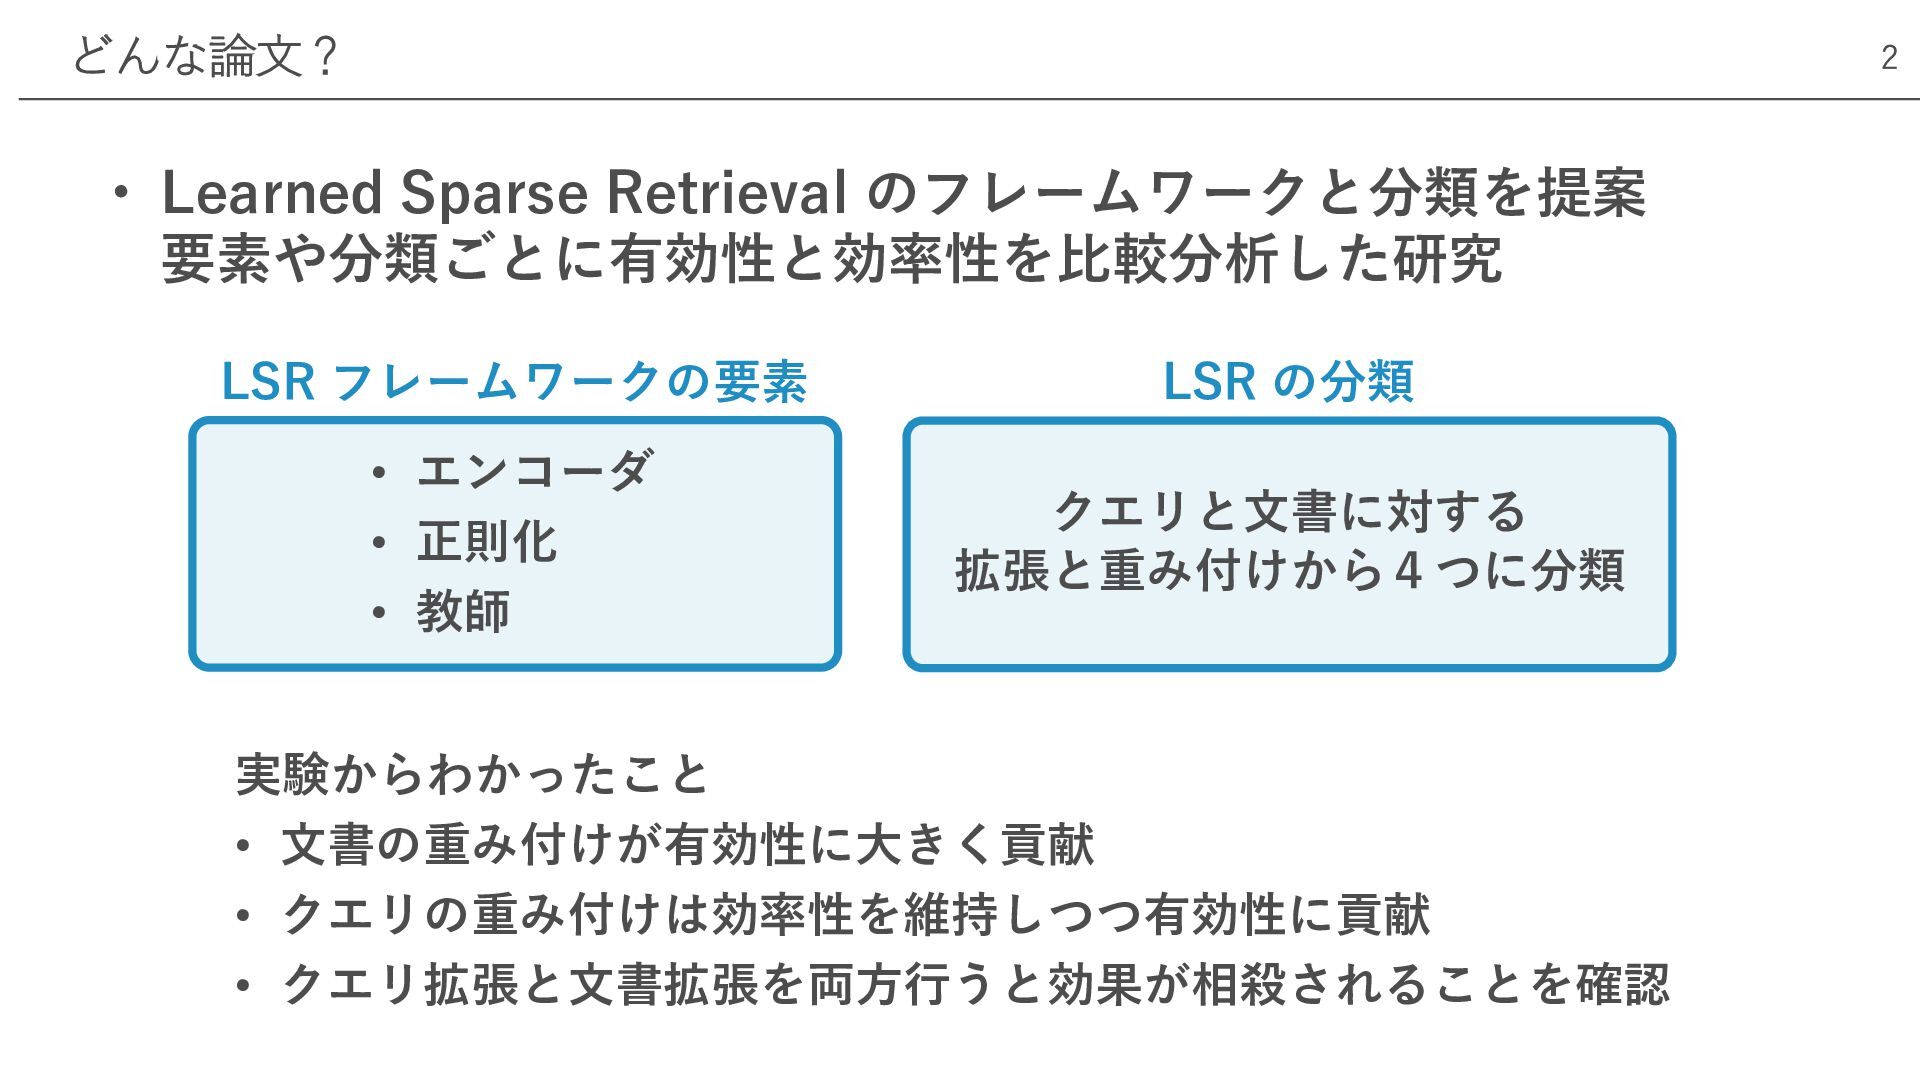
• Learned Sparse Retrieval のフレームワークと分類を提案 要素や分類ごとに有効性と効率性を⽐較分析した研究 どんな論⽂? 2 実験からわかったこと •
⽂書の重み付けが有効性に⼤きく貢献 • クエリの重み付けは効率性を維持しつつ有効性に貢献 • クエリ拡張と⽂書拡張を両⽅⾏うと効果が相殺されることを確認 LSR フレームワークの要素 LSR の分類 • エンコーダ • 正則化 • 教師 クエリと⽂書に対する 拡張と重み付けから4つに分類
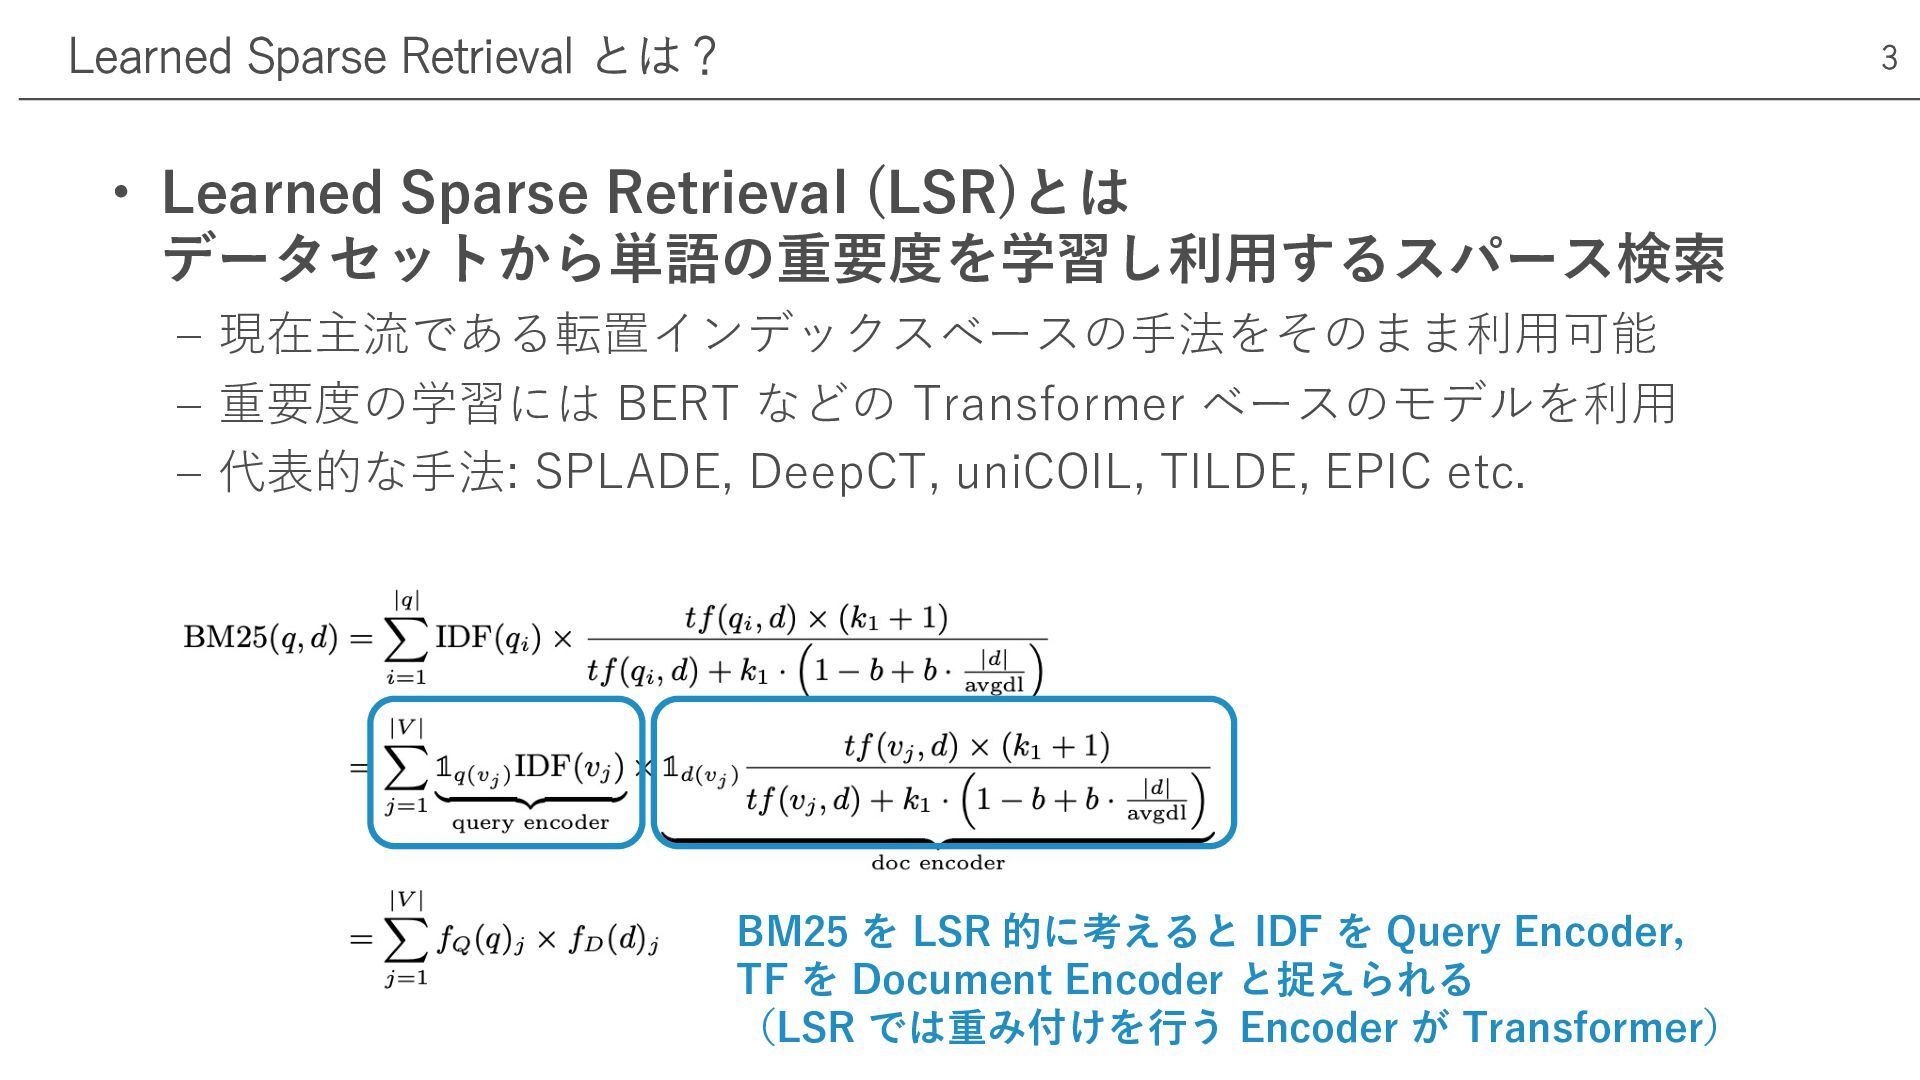
• Learned Sparse Retrieval (LSR)とは データセットから単語の重要度を学習し利⽤するスパース検索 ‒ 現在主流である転置インデックスベースの⼿法をそのまま利⽤可能 ‒ 重要度の学習には
BERT などの Transformer ベースのモデルを利⽤ ‒ 代表的な⼿法: SPLADE, DeepCT, uniCOIL, TILDE, EPIC etc. Learned Sparse Retrieval とは? 3 BM25 を LSR 的に考えると IDF を Query Encoder, TF を Document Encoder と捉えられる (LSR では重み付けを⾏う Encoder が Transformer)
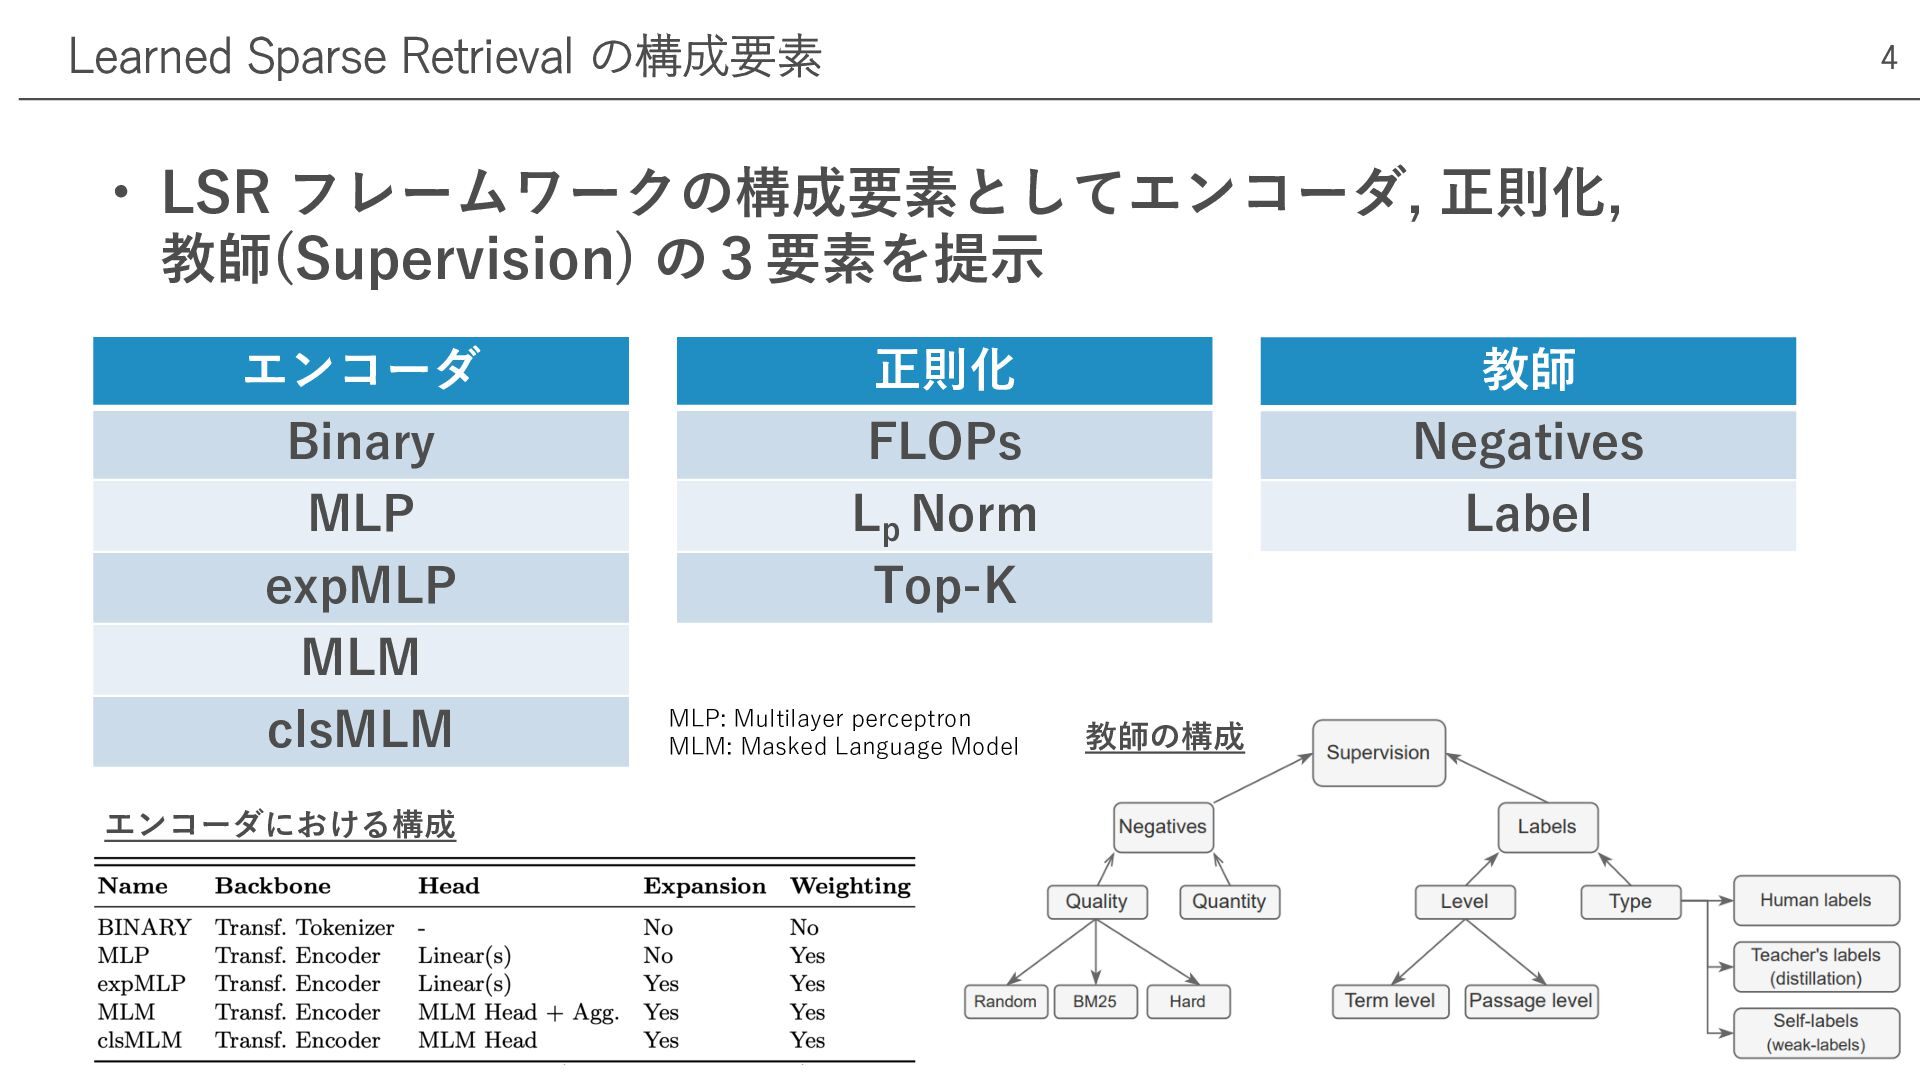
• LSR フレームワークの構成要素としてエンコーダ, 正則化, 教師(Supervision) の3要素を提⽰ Learned Sparse Retrieval の構成要素
4 エンコーダ Binary MLP expMLP MLM clsMLM 正則化 FLOPs Lp Norm Top-K 教師 Negatives Label 教師の構成 エンコーダにおける構成 MLP: Multilayer perceptron MLM: Masked Language Model
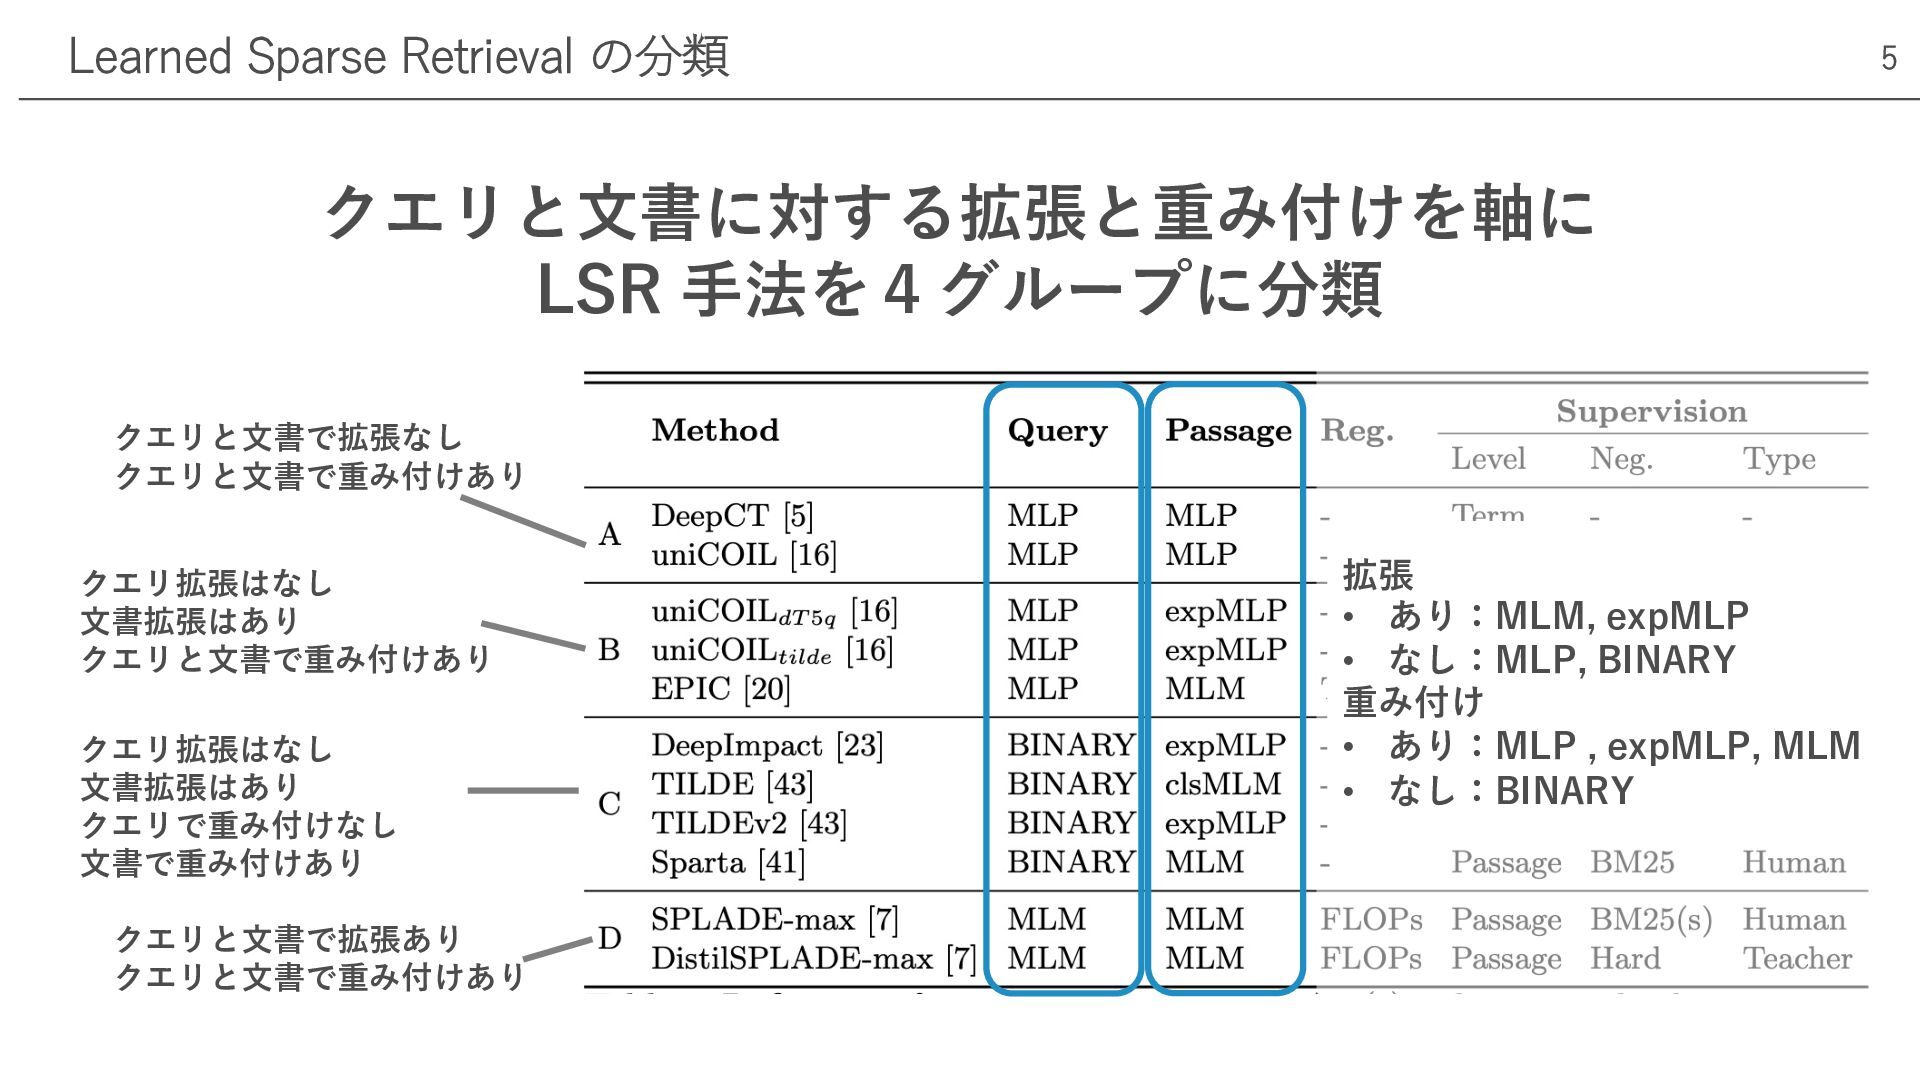
クエリと⽂書に対する拡張と重み付けを軸に LSR ⼿法を4グループに分類 Learned Sparse Retrieval の分類 5 クエリと⽂書で拡張なし クエリと⽂書で重み付けあり
クエリ拡張はなし ⽂書拡張はあり クエリと⽂書で重み付けあり クエリ拡張はなし ⽂書拡張はあり クエリで重み付けなし ⽂書で重み付けあり クエリと⽂書で拡張あり クエリと⽂書で重み付けあり 拡張 • あり:MLM, expMLP • なし:MLP, BINARY 重み付け • あり:MLP , expMLP, MLM • なし:BINARY
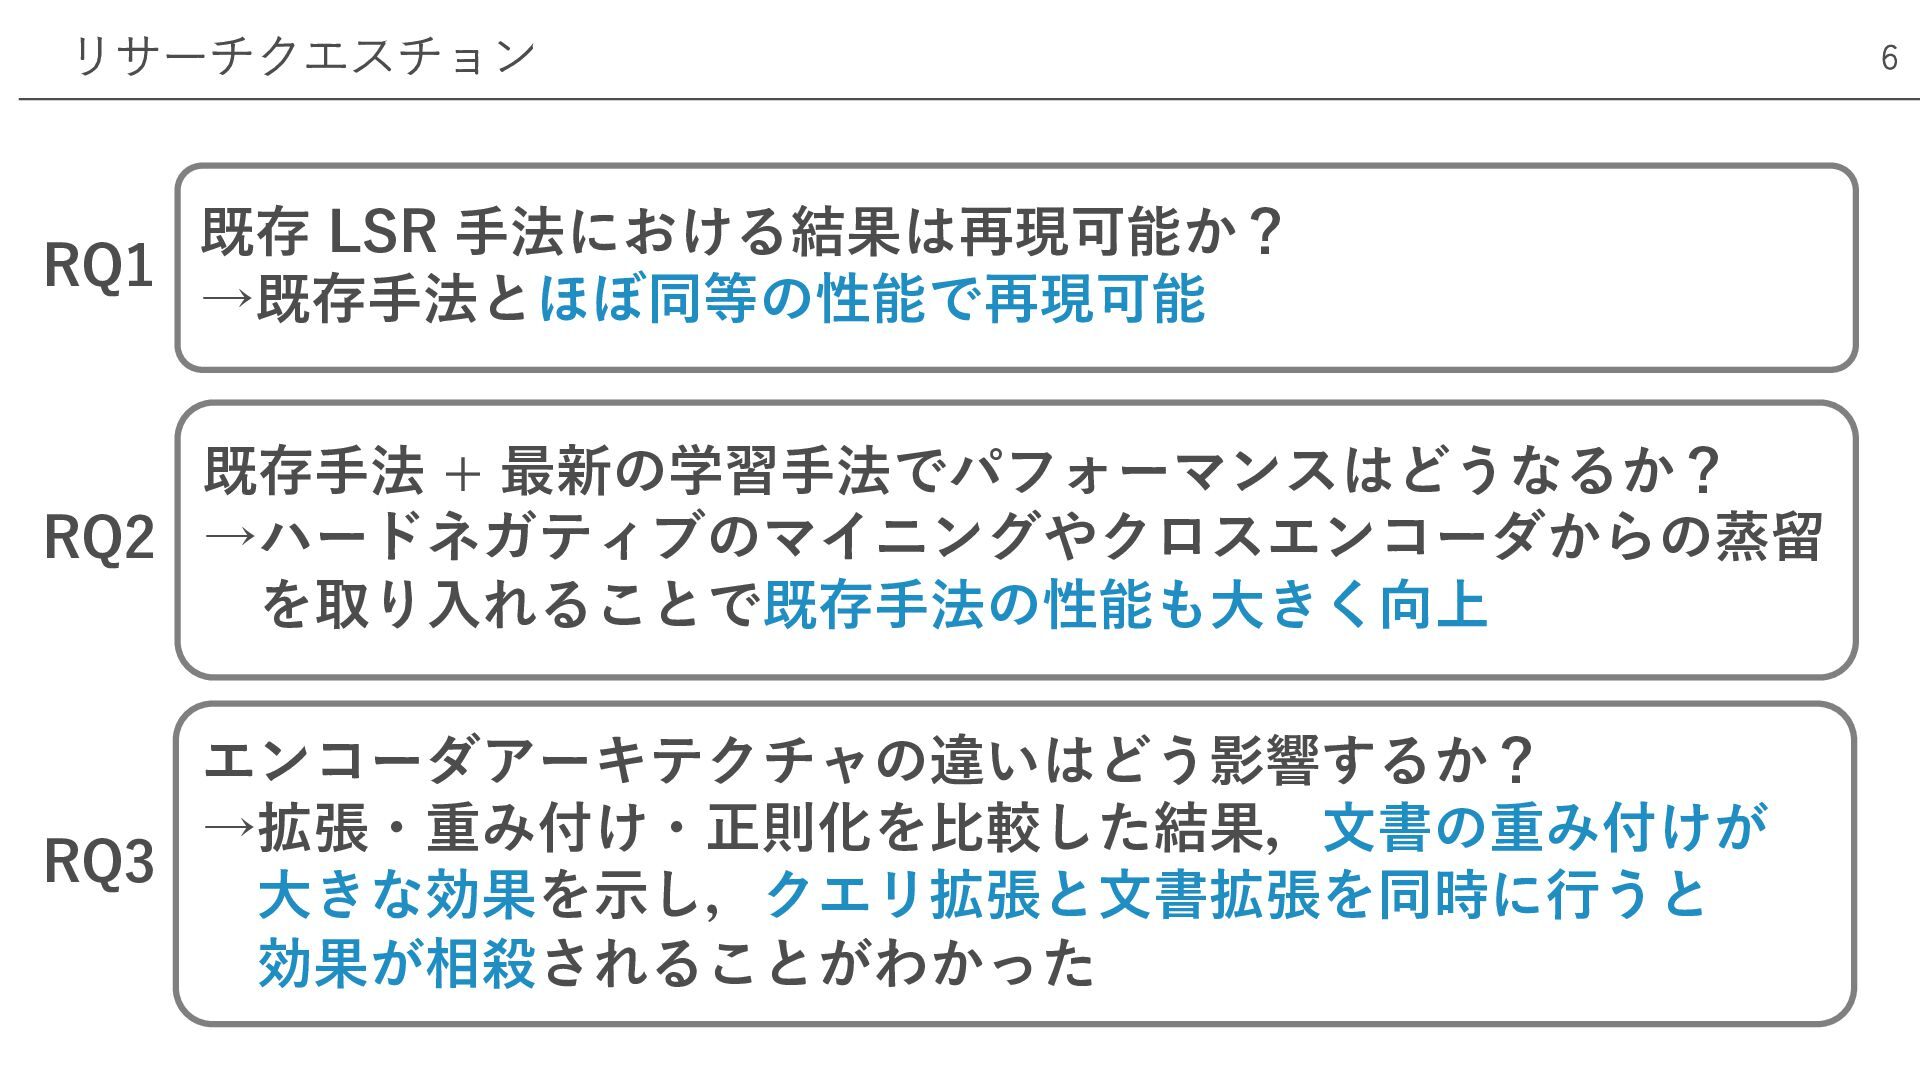
リサーチクエスチョン 6 既存 LSR ⼿法における結果は再現可能か? →既存⼿法とほぼ同等の性能で再現可能 既存⼿法 + 最新の学習⼿法でパフォーマンスはどうなるか? →ハードネガティブのマイニングやクロスエンコーダからの蒸留
を取り⼊れることで既存⼿法の性能も⼤きく向上 エンコーダアーキテクチャの違いはどう影響するか? →拡張・重み付け・正則化を⽐較した結果,⽂書の重み付けが ⼤きな効果を⽰し,クエリ拡張と⽂書拡張を同時に⾏うと 効果が相殺されることがわかった RQ1 RQ2 RQ3
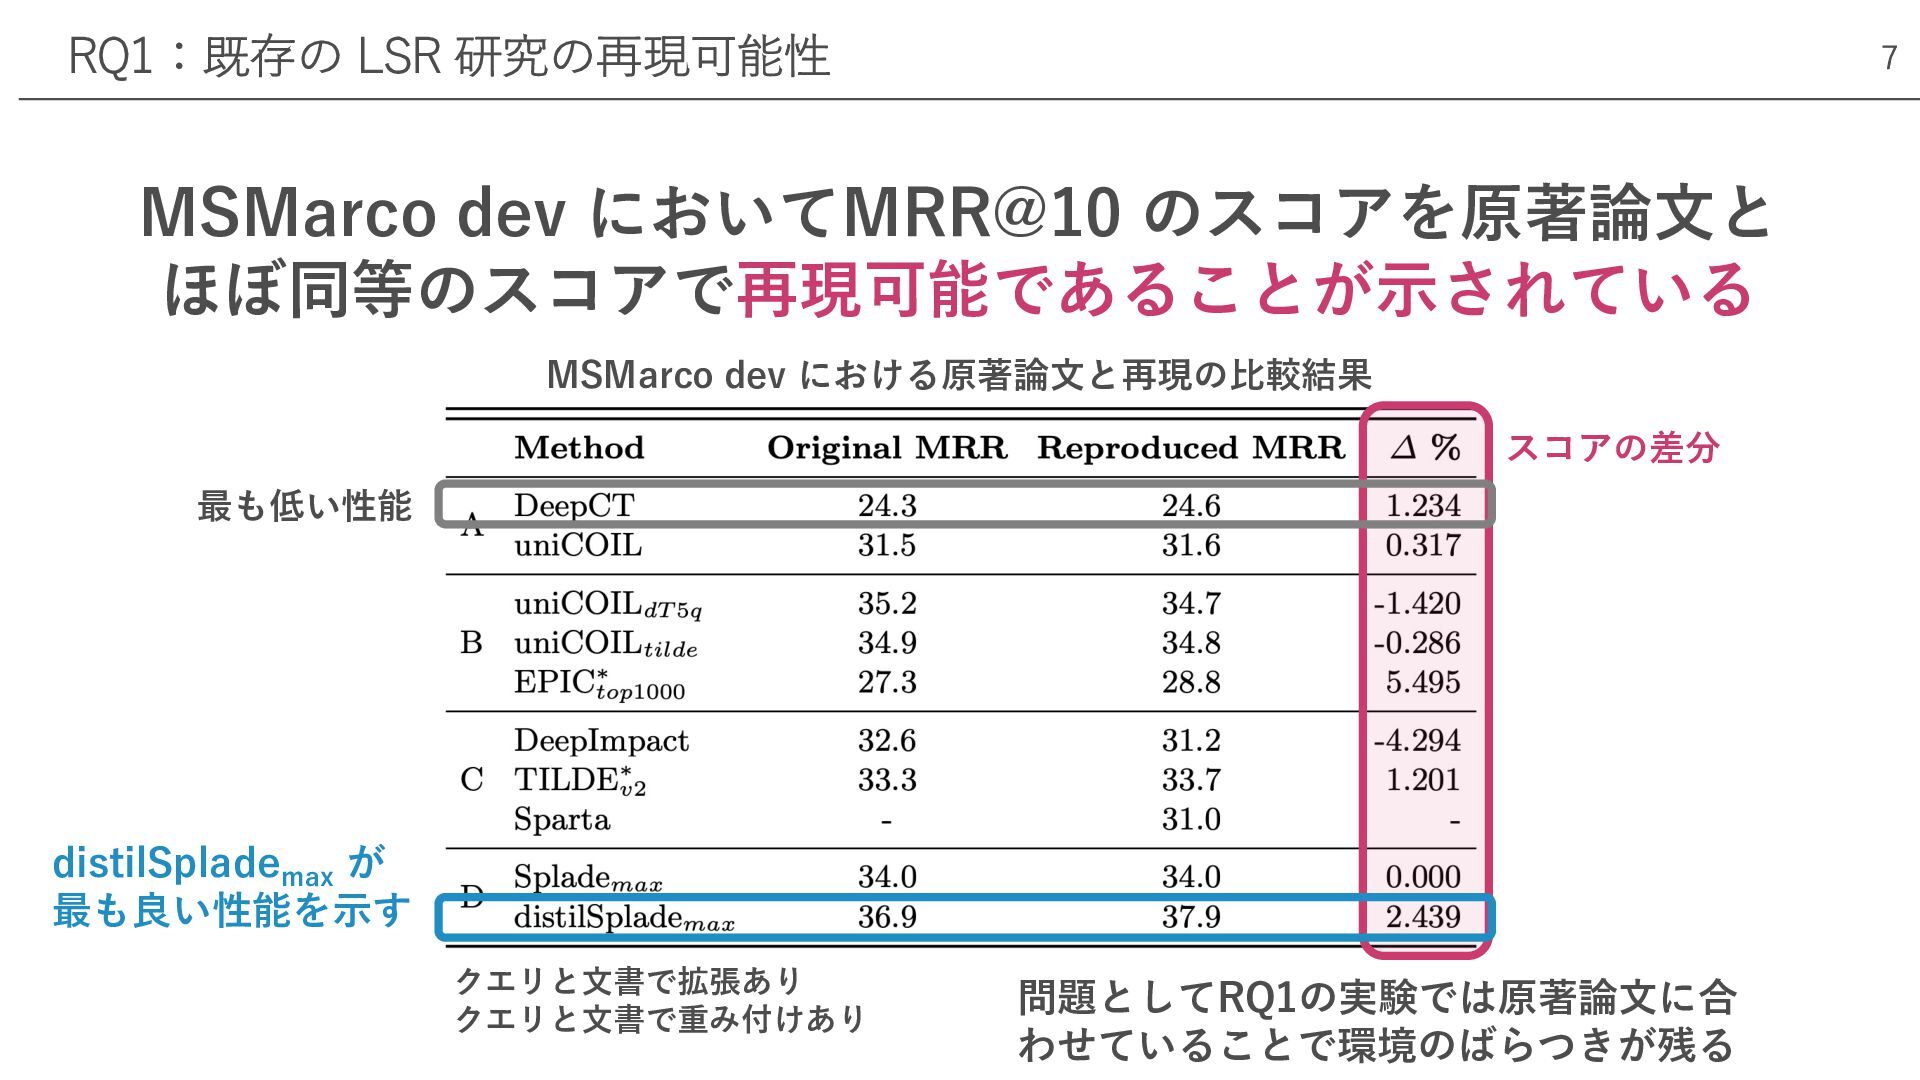
MSMarco dev においてMRR@10 のスコアを原著論⽂と ほぼ同等のスコアで再現可能であることが⽰されている RQ1:既存の LSR 研究の再現可能性 distilSplademax が
最も良い性能を⽰す 7 MSMarco dev における原著論⽂と再現の⽐較結果 スコアの差分 クエリと⽂書で拡張あり クエリと⽂書で重み付けあり 問題としてRQ1の実験では原著論⽂に合 わせていることで環境のばらつきが残る 最も低い性能
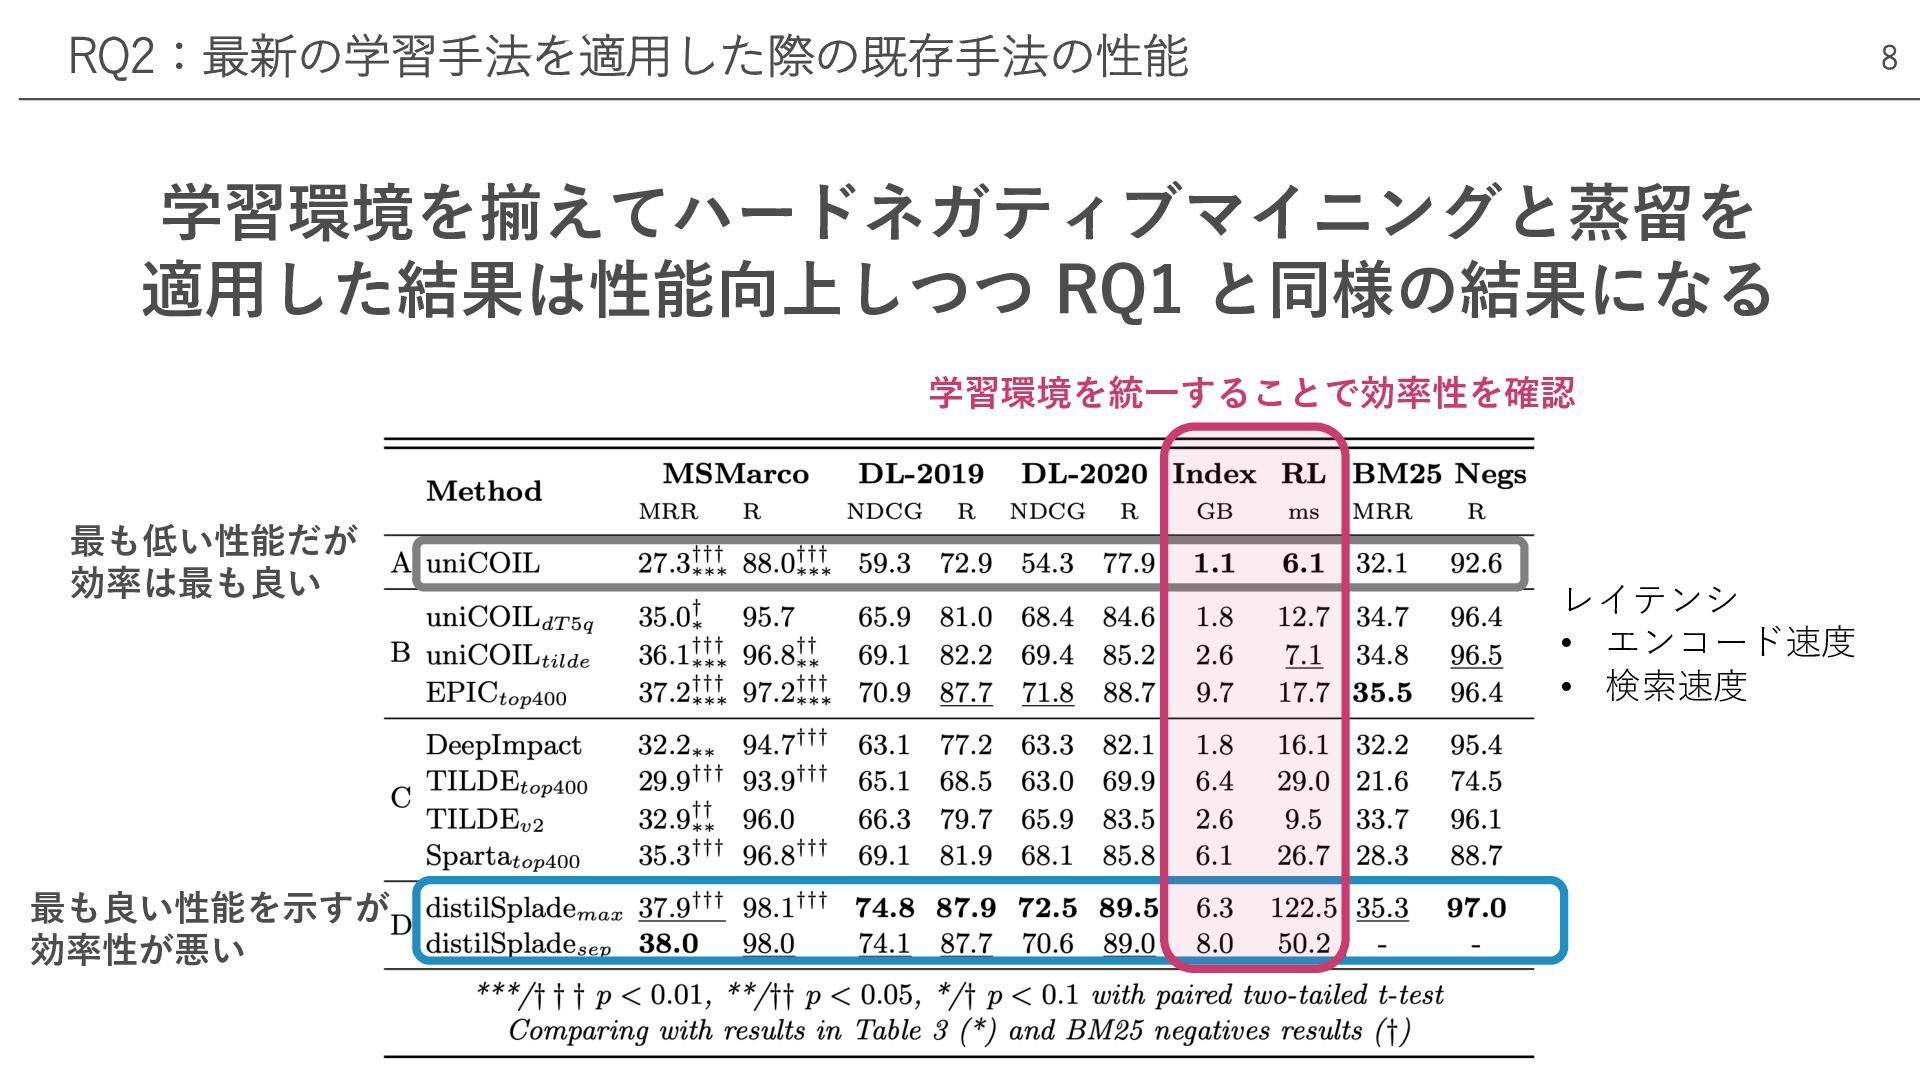
学習環境を揃えてハードネガティブマイニングと蒸留を 適⽤した結果は性能向上しつつ RQ1 と同様の結果になる RQ2:最新の学習⼿法を適⽤した際の既存⼿法の性能 8 最も低い性能だが 効率は最も良い 最も良い性能を⽰すが 効率性が悪い
学習環境を統⼀することで効率性を確認 レイテンシ • エンコード速度 • 検索速度
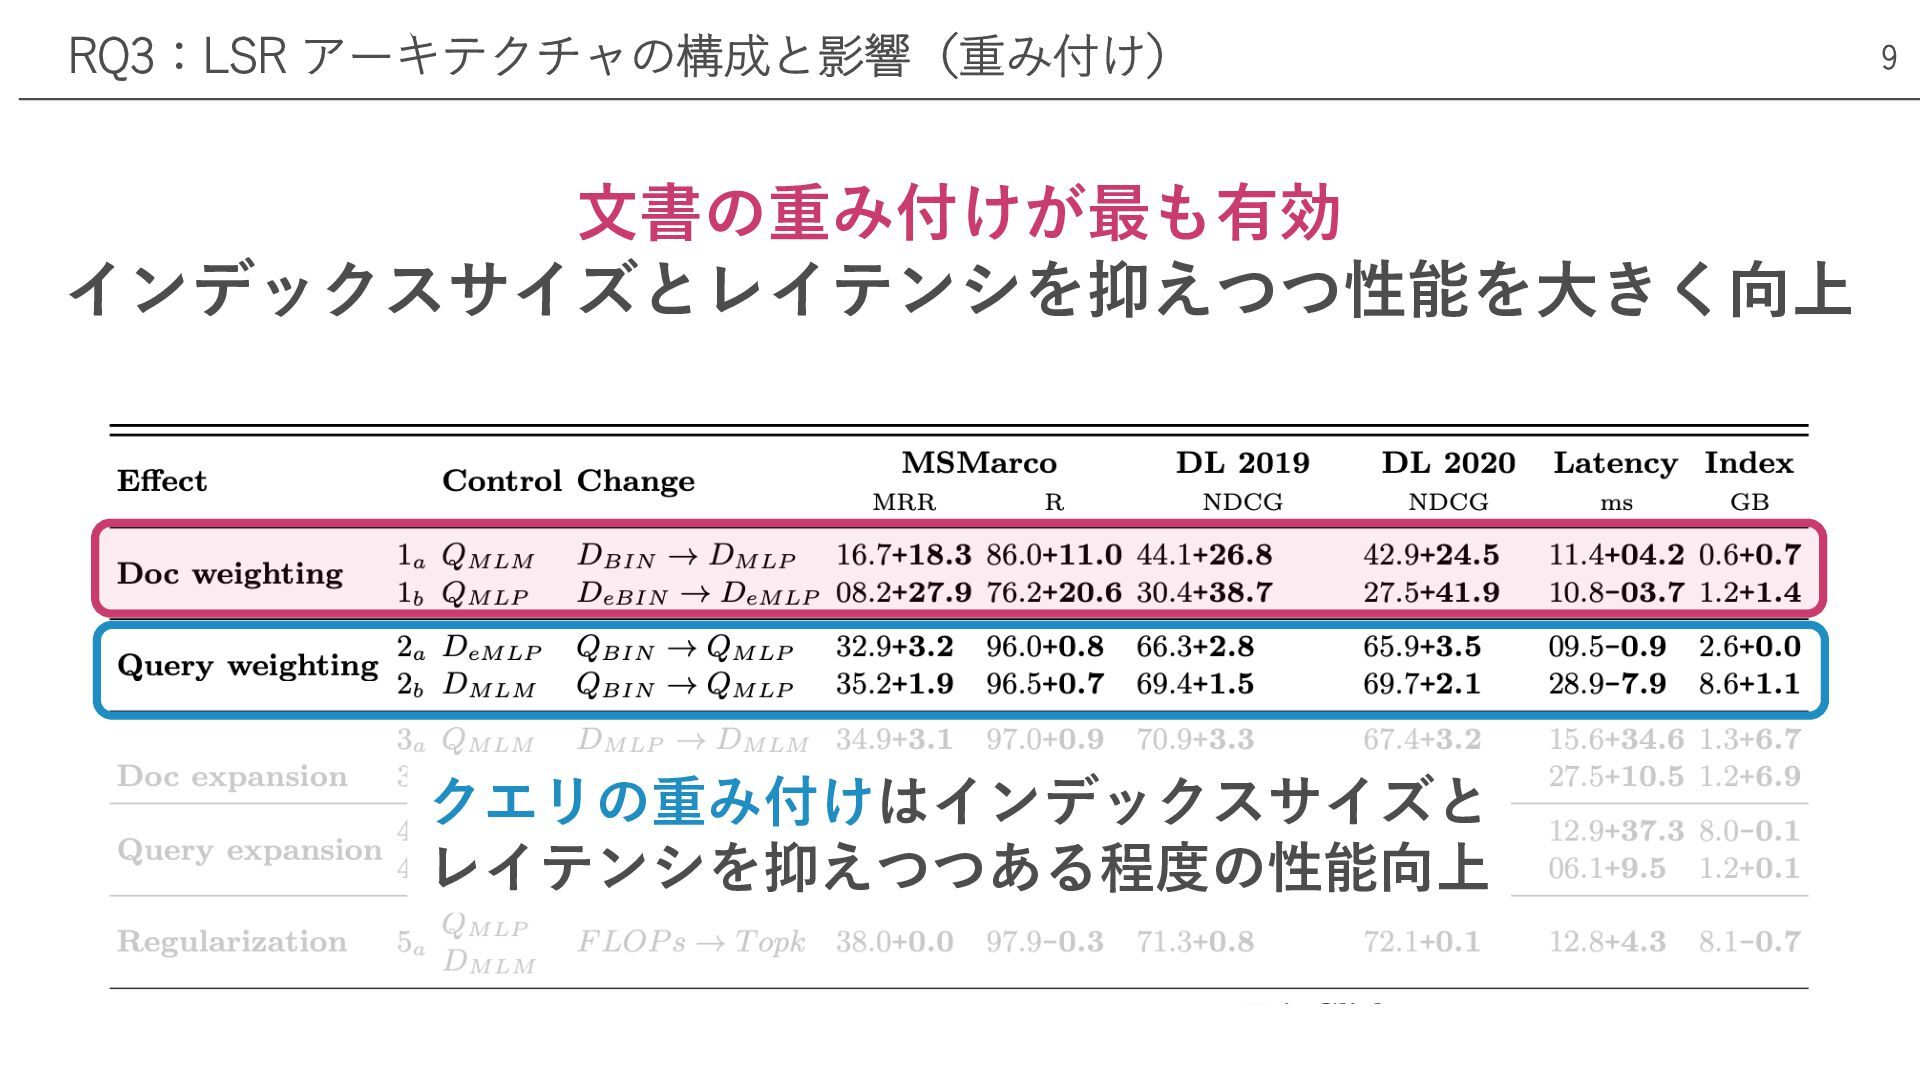
⽂書の重み付けが最も有効 インデックスサイズとレイテンシを抑えつつ性能を⼤きく向上 RQ3:LSR アーキテクチャの構成と影響(重み付け) クエリの重み付けはインデックスサイズと レイテンシを抑えつつある程度の性能向上 9
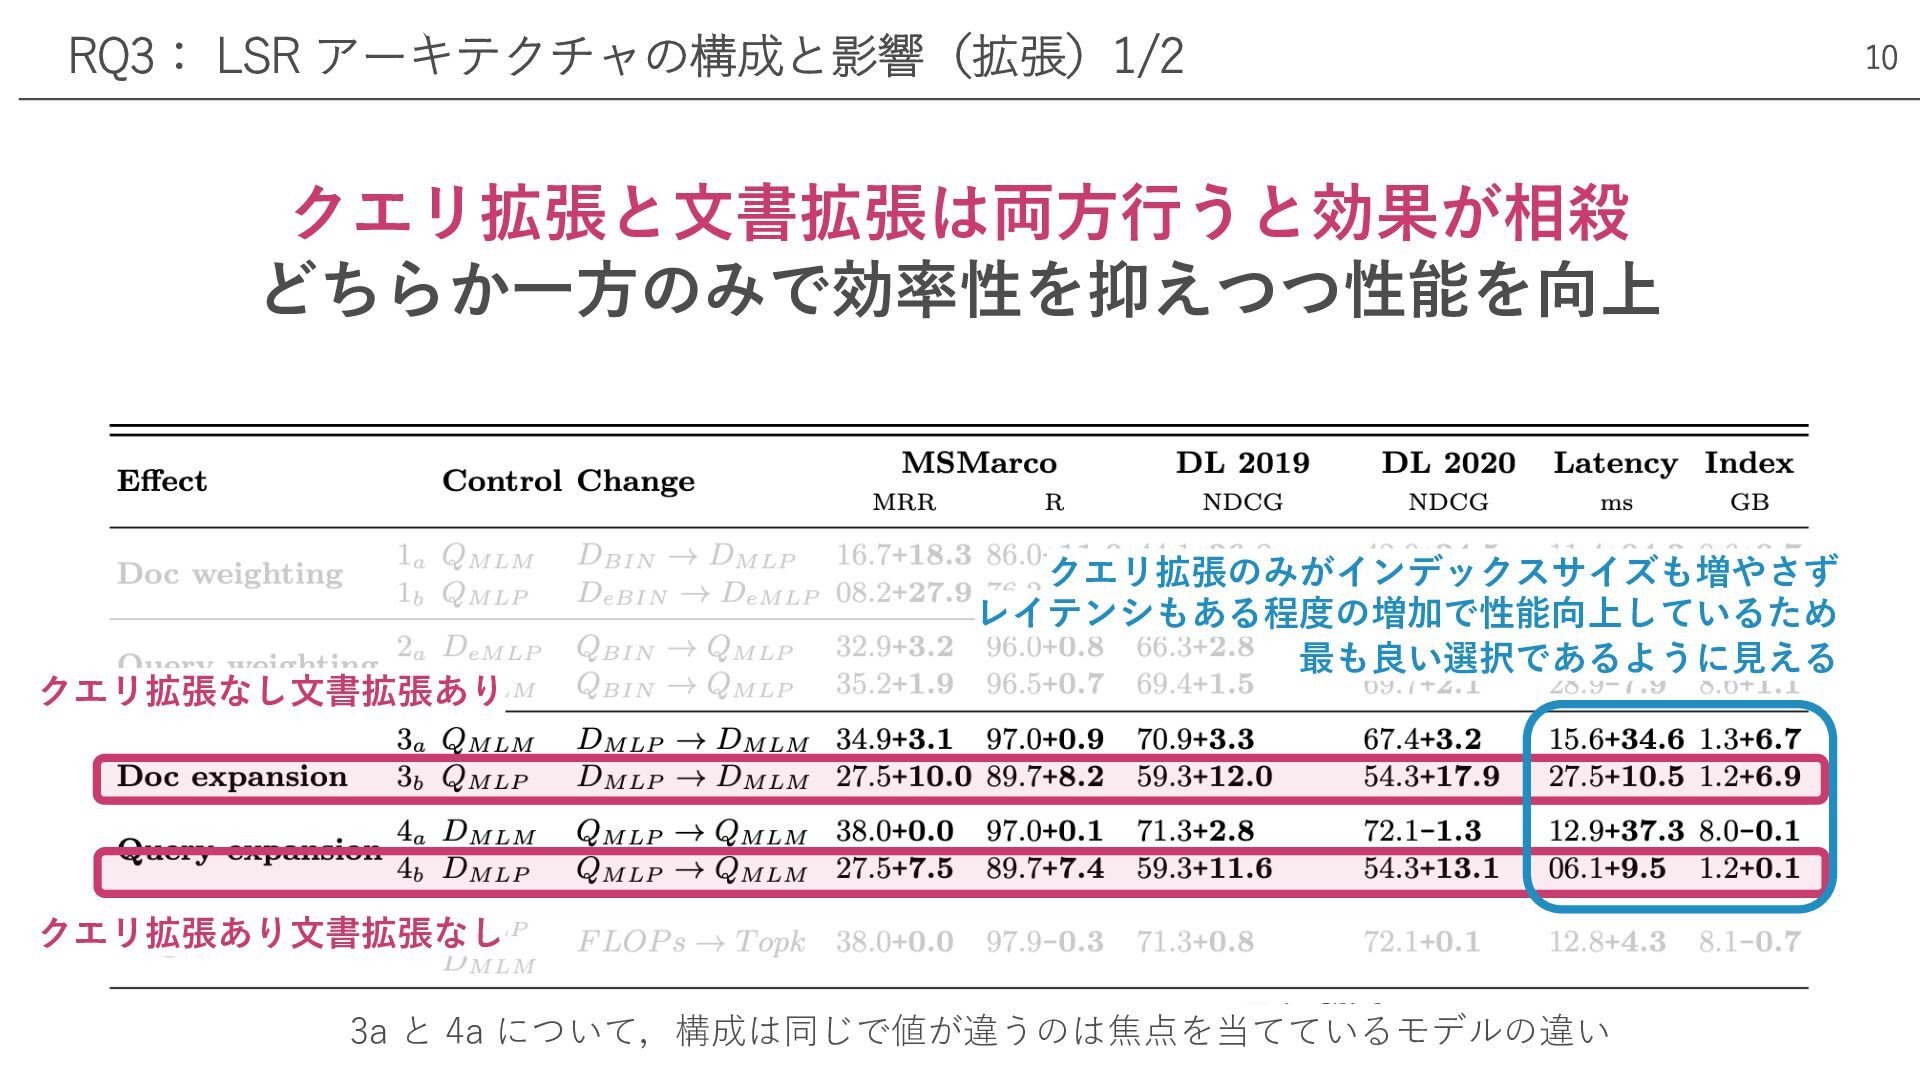
クエリ拡張と⽂書拡張は両⽅⾏うと効果が相殺 どちらか⼀⽅のみで効率性を抑えつつ性能を向上 RQ3: LSR アーキテクチャの構成と影響(拡張)1/2 クエリ拡張なし⽂書拡張あり クエリ拡張あり⽂書拡張なし クエリ拡張のみがインデックスサイズも増やさず レイテンシもある程度の増加で性能向上しているため 最も良い選択であるように⾒える
10 3a と 4a について,構成は同じで値が違うのは焦点を当てているモデルの違い
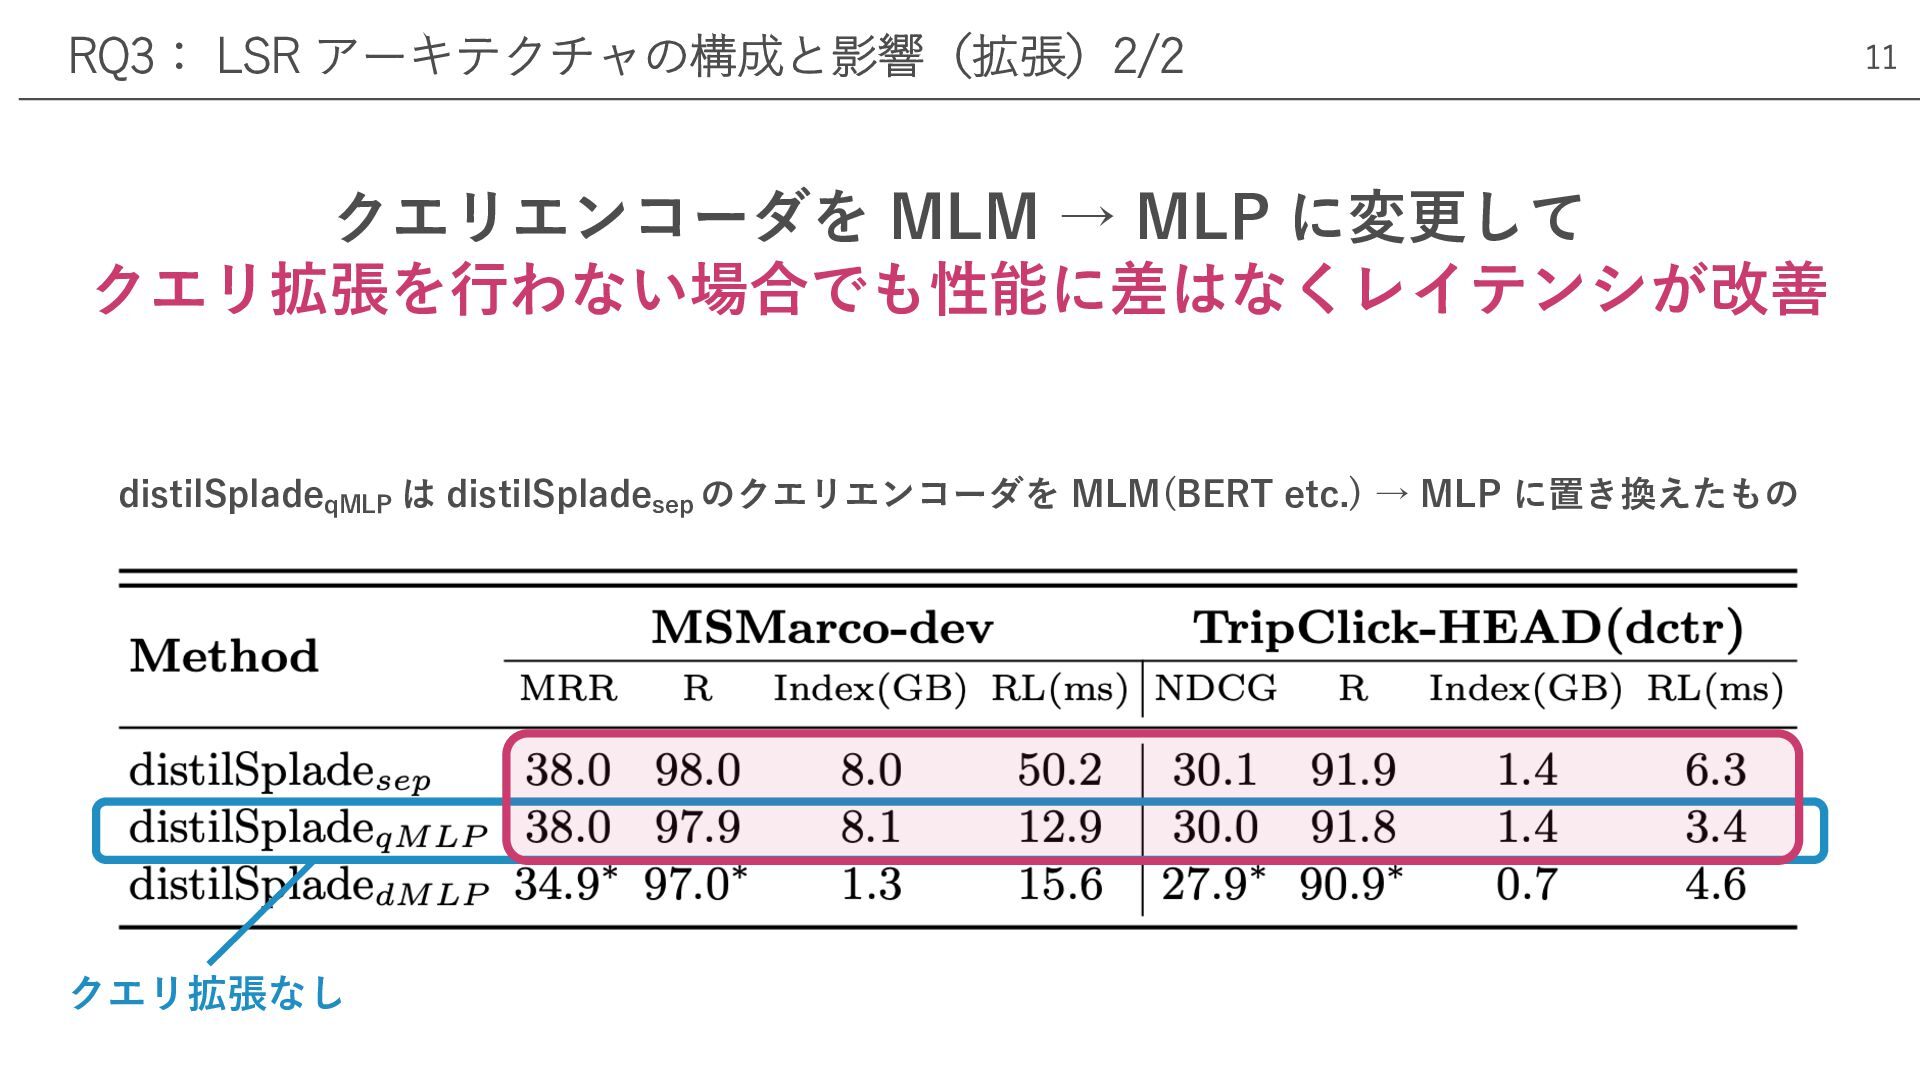
クエリエンコーダを MLM → MLP に変更して クエリ拡張を⾏わない場合でも性能に差はなくレイテンシが改善 RQ3: LSR アーキテクチャの構成と影響(拡張)2/2 クエリ拡張なし
distilSpladeqMLP は distilSpladesep のクエリエンコーダを MLM(BERT etc.) → MLP に置き換えたもの 11
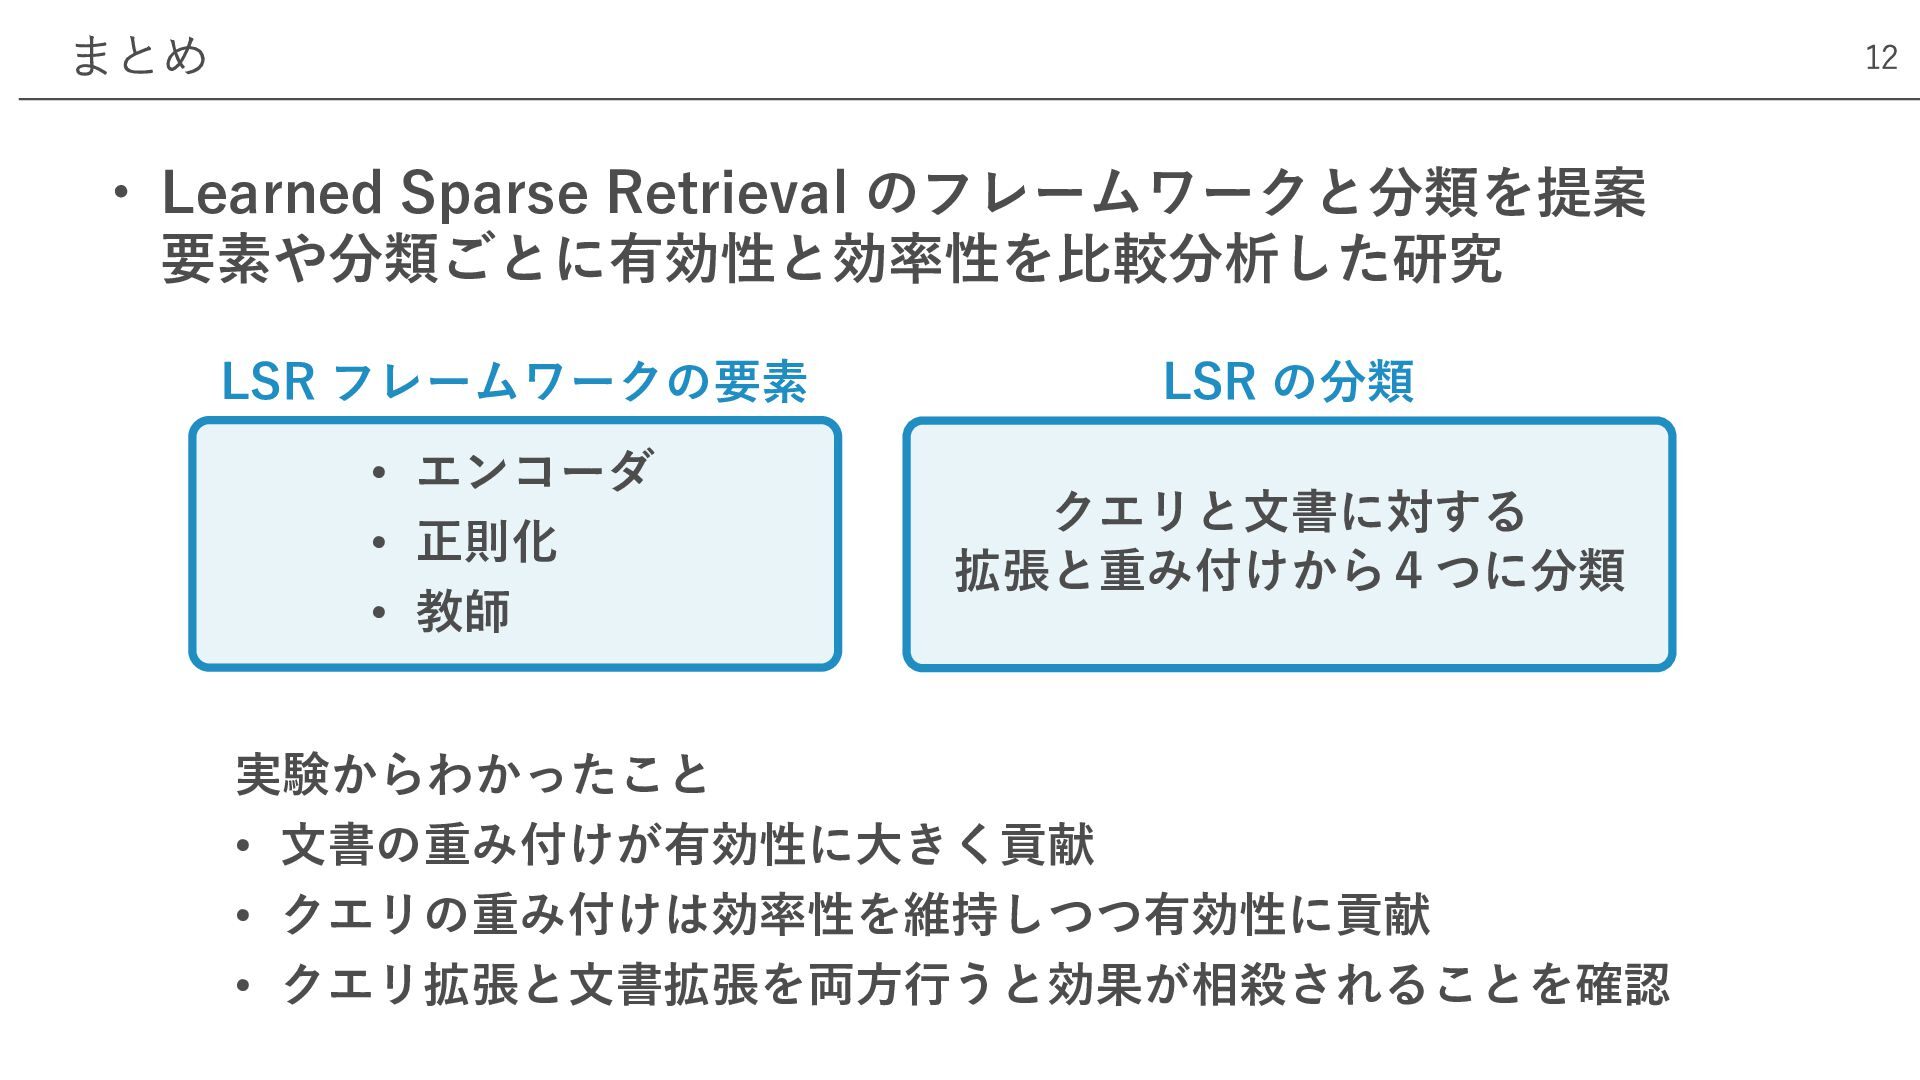
• Learned Sparse Retrieval のフレームワークと分類を提案 要素や分類ごとに有効性と効率性を⽐較分析した研究 まとめ 12 実験からわかったこと •
⽂書の重み付けが有効性に⼤きく貢献 • クエリの重み付けは効率性を維持しつつ有効性に貢献 • クエリ拡張と⽂書拡張を両⽅⾏うと効果が相殺されることを確認 LSR フレームワークの要素 LSR の分類 クエリと⽂書に対する 拡張と重み付けから4つに分類 • エンコーダ • 正則化 • 教師


 koheishinden
 nttcom
 mikimhk
 junkashihara
 tkng
 kentaitakura
 signer
 institudelelevage
 sishi2026
 rfujii
 stktu
 analokmaus
 hotchpotch
 aleyda
 gurzu
 kneath
 nonsquared
 akihiro_kokubo
 soudai
 jeffersonlam
 katarinadahlin
 tmiket
 davidcarrasco