Share
Embed

Transcript
108 slides
-
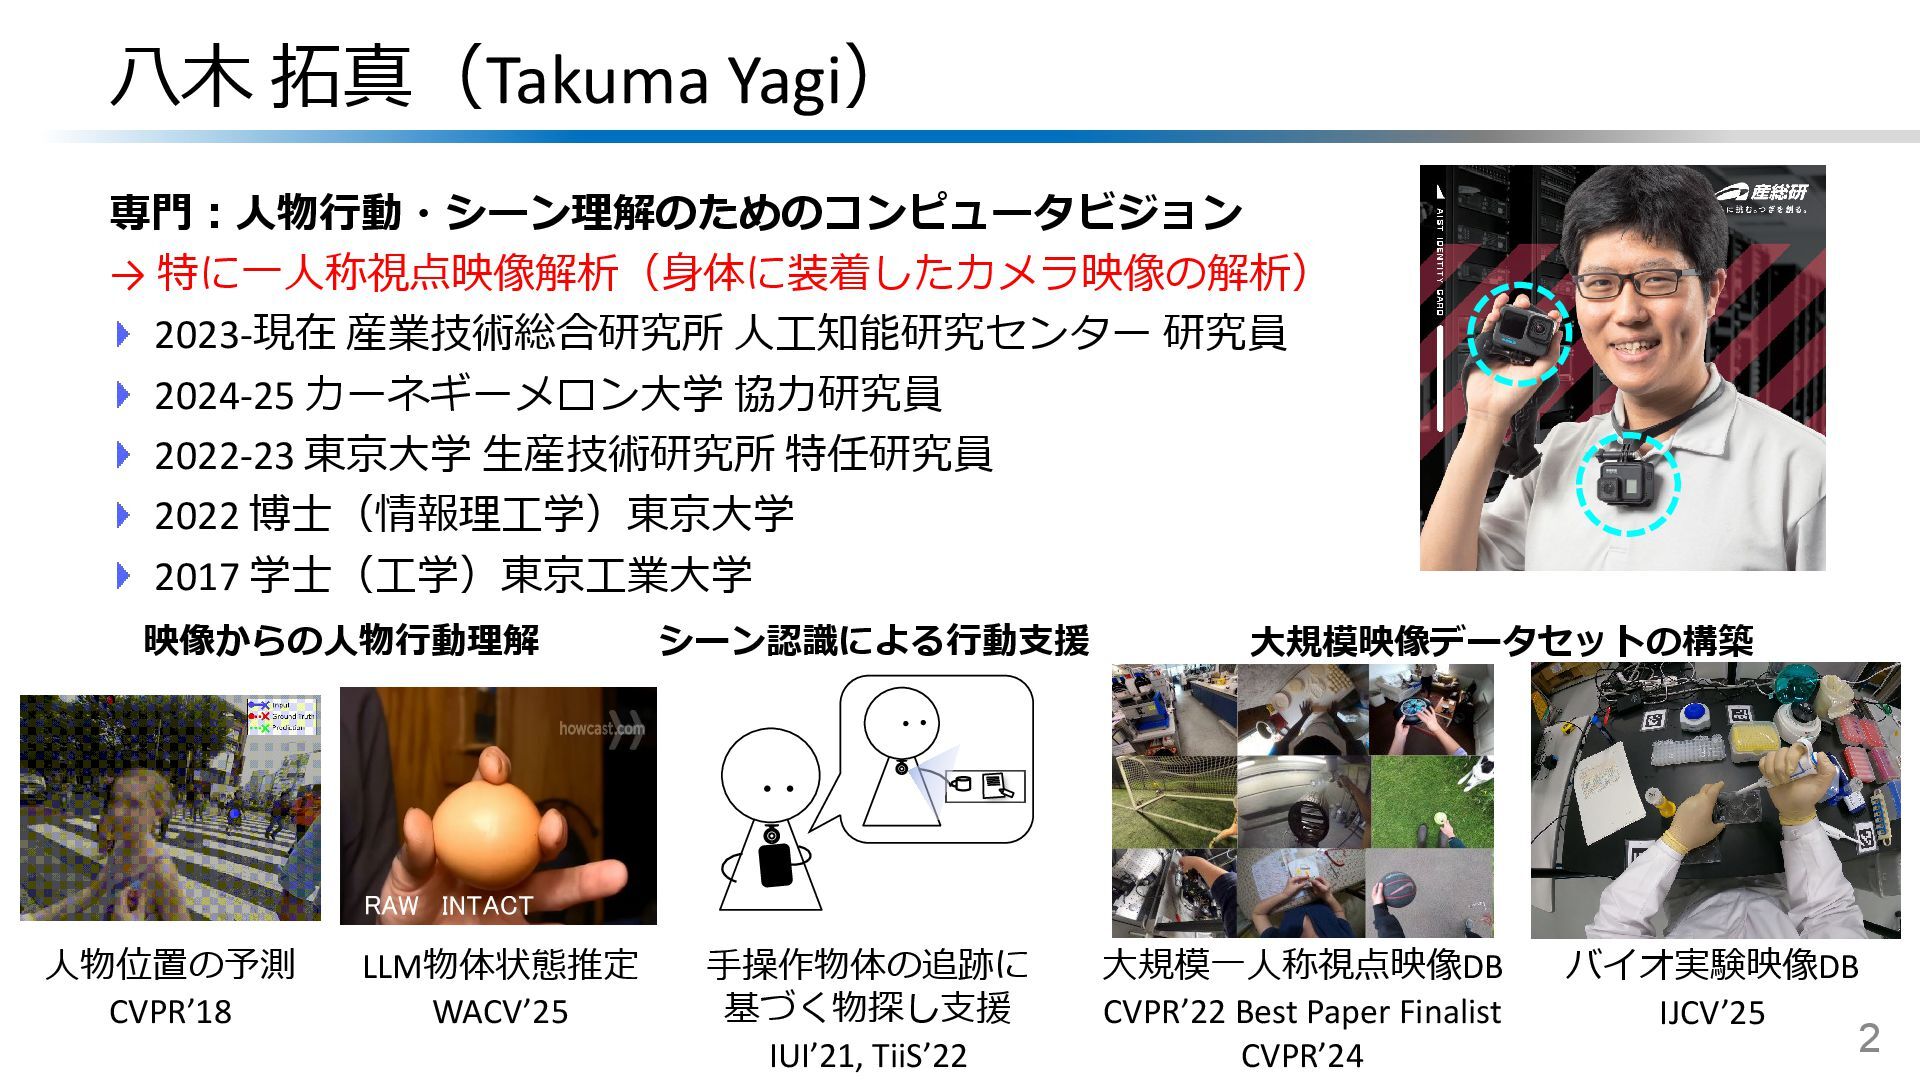
八木 拓真(Takuma Yagi) 2 専門:人物行動・シーン理解のためのコンピュータビジョン → 特に一人称視点映像解析(身体に装着したカメラ映像の解析) 2023-現在 産業技術総合研究所 人工知能研究センター
研究員 2024-25 カーネギーメロン大学 協力研究員 2022-23 東京大学 生産技術研究所 特任研究員 2022 博士(情報理工学)東京大学 2017 学士(工学)東京工業大学 LLM物体状態推定 WACV’25 手操作物体の追跡に 基づく物探し支援 IUI’21, TiiS’22 大規模一人称視点映像DB CVPR’22 Best Paper Finalist CVPR’24 人物位置の予測 CVPR’18 映像からの人物行動理解 シーン認識による行動支援 大規模映像データセットの構築 バイオ実験映像DB IJCV’25 -
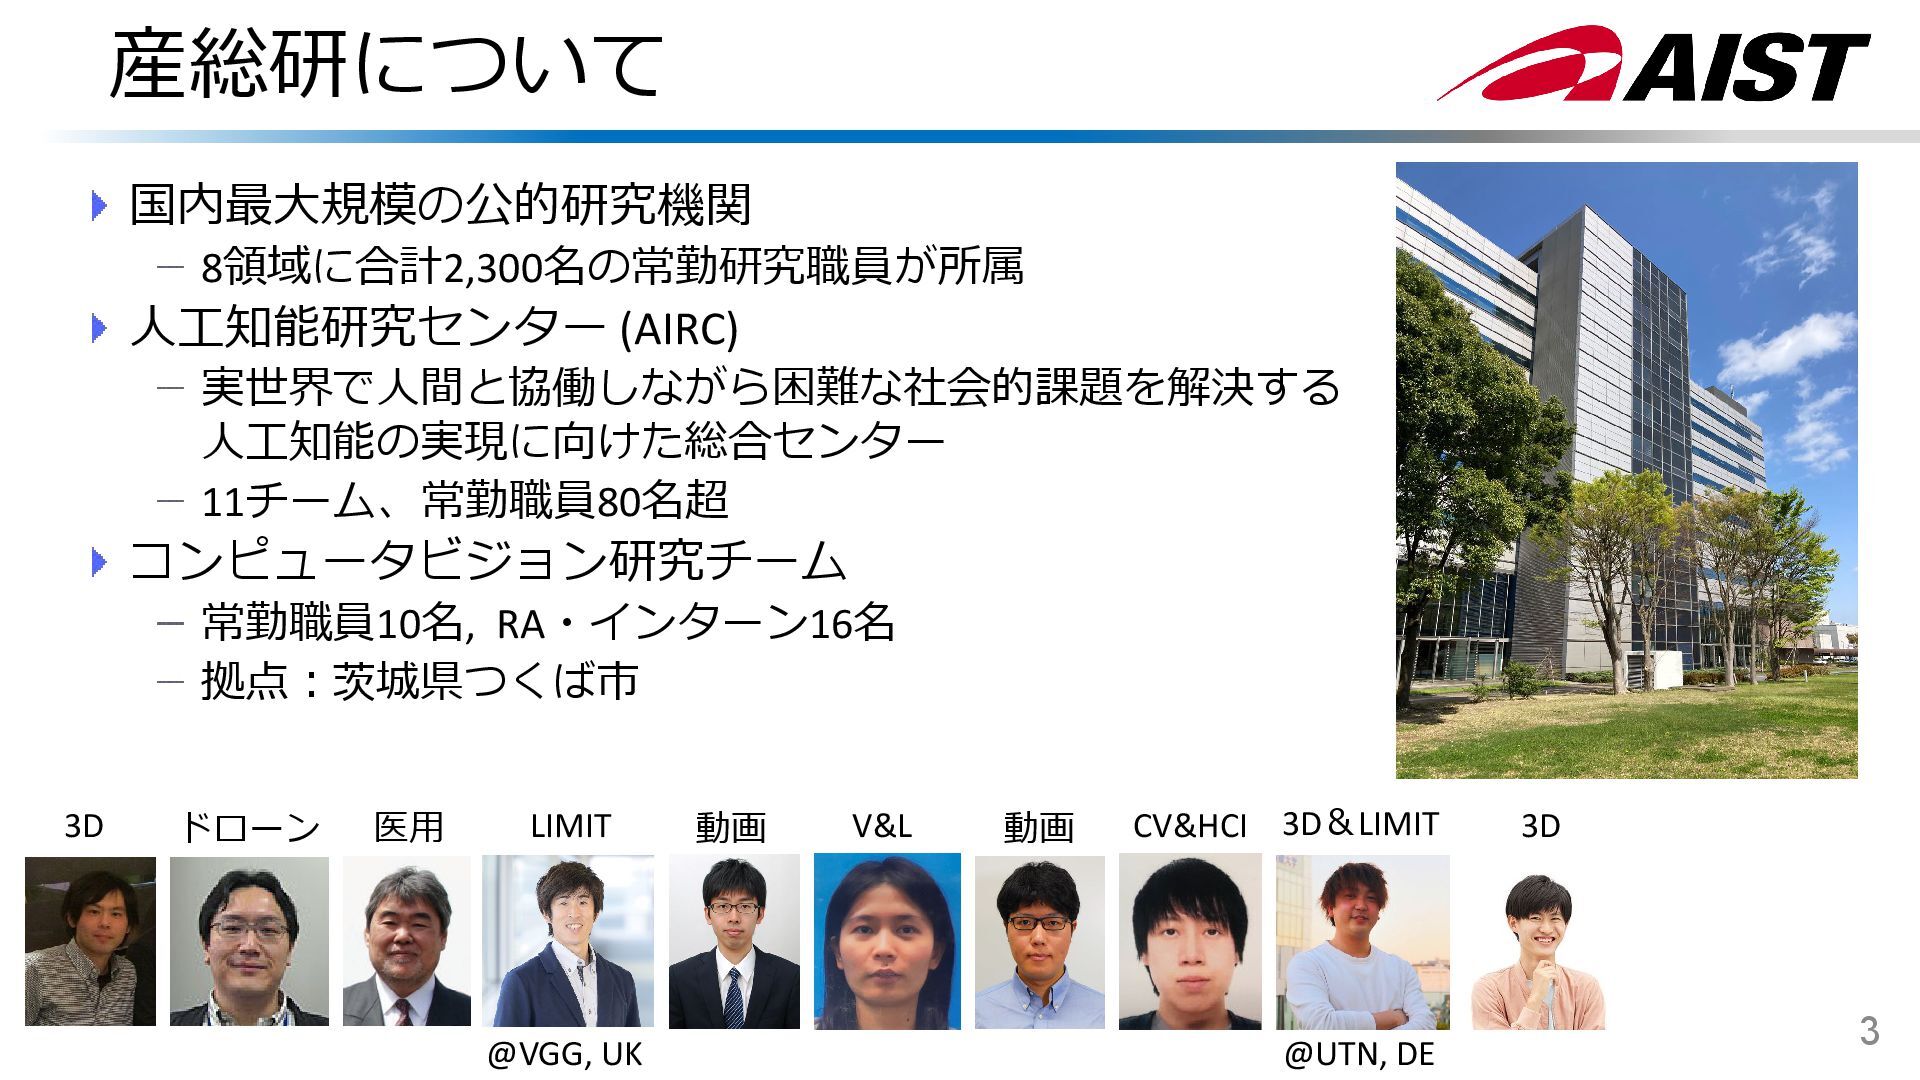
産総研について 国内最大規模の公的研究機関 8領域に合計2,300名の常勤研究職員が所属 人工知能研究センター (AIRC) 実世界で人間と協働しながら困難な社会的課題を解決する 人工知能の実現に向けた総合センター 11チーム、常勤職員80名超 コンピュータビジョン研究チーム 常勤職員10名,
RA・インターン16名 拠点:茨城県つくば市 3 @VGG, UK @UTN, DE 3D ドローン 医用 LIMIT 動画 V&L 動画 CV&HCI 3D&LIMIT 3D -
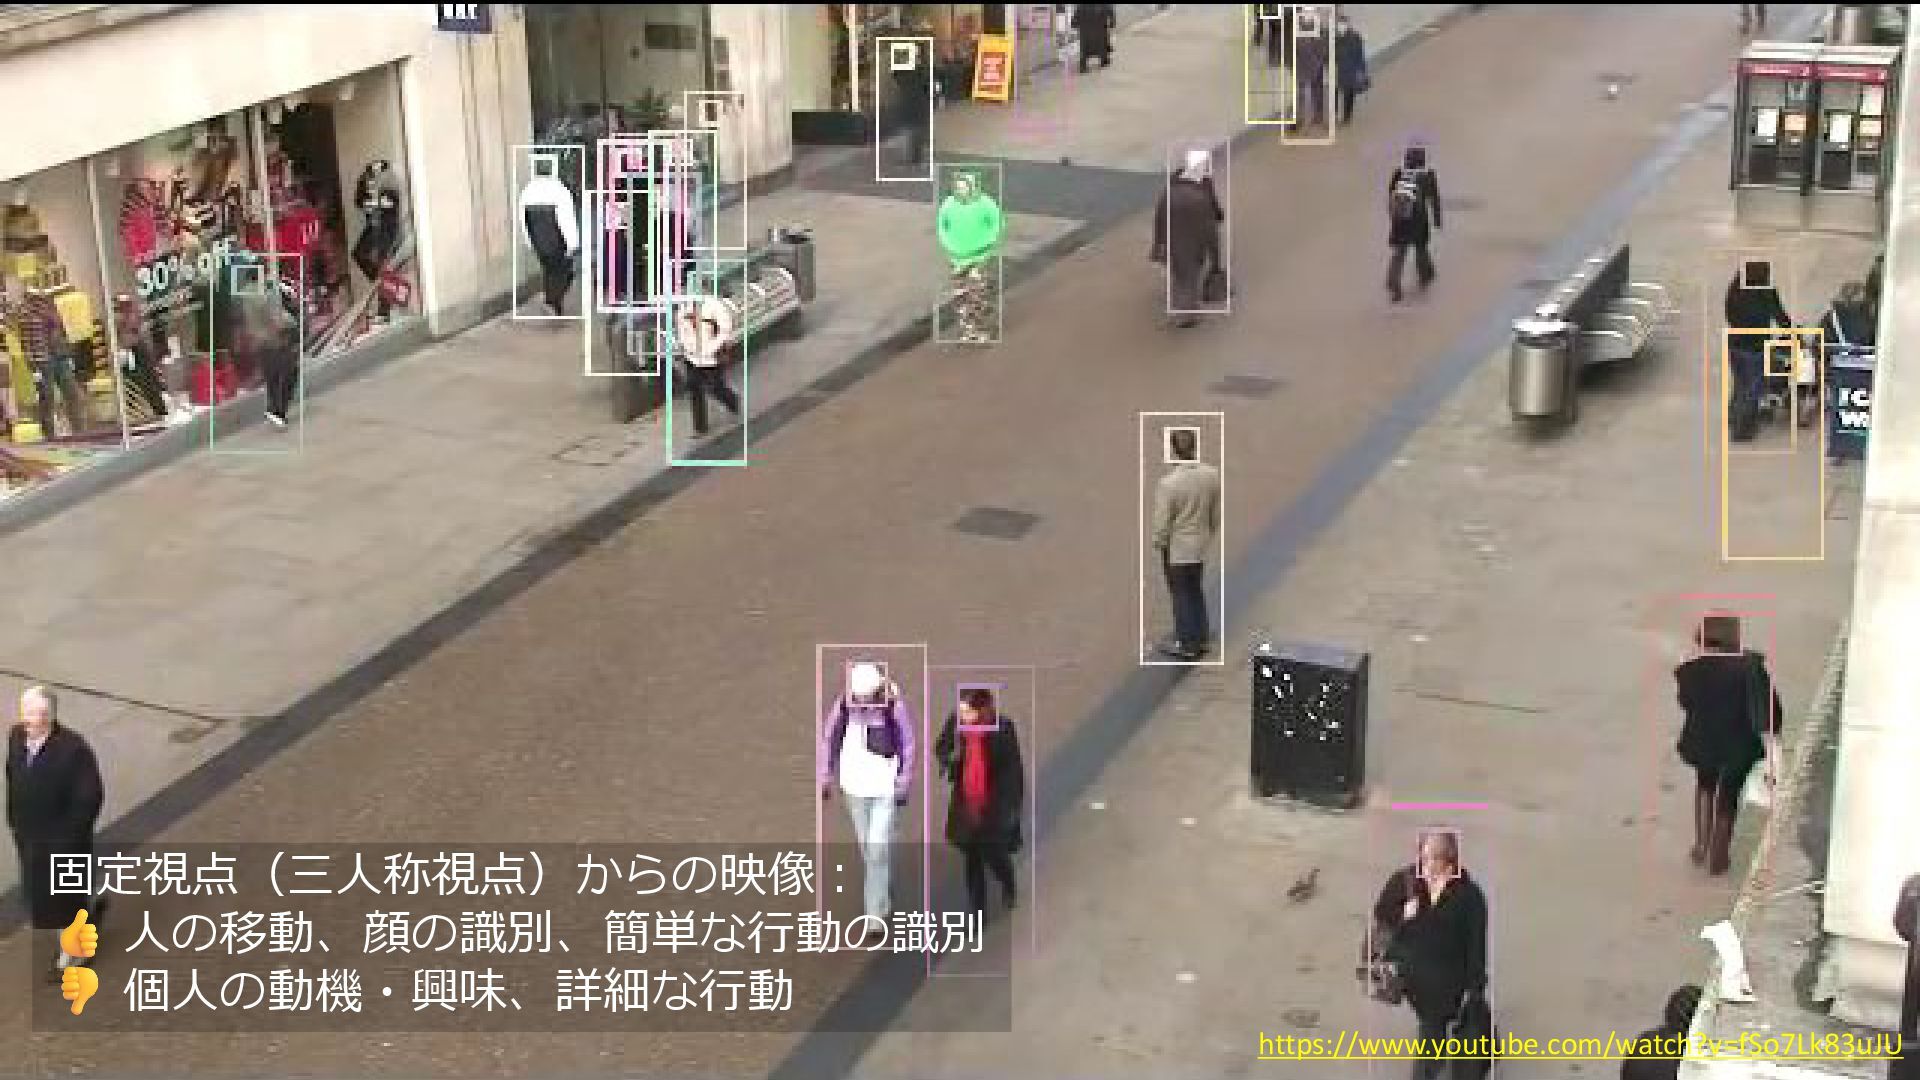
映像からの人物行動認識 YouTubeやTV/映画映像を用いた引きの映像の行動理解に焦点 8 NTU RGB+D [Shahroudy+, CVPR’16] ActivityNet [Heilbron+, CVPR’15]
MSR-VTT [Xu+, CVPR’16] FineGym [Shao+, CVPR’20] -
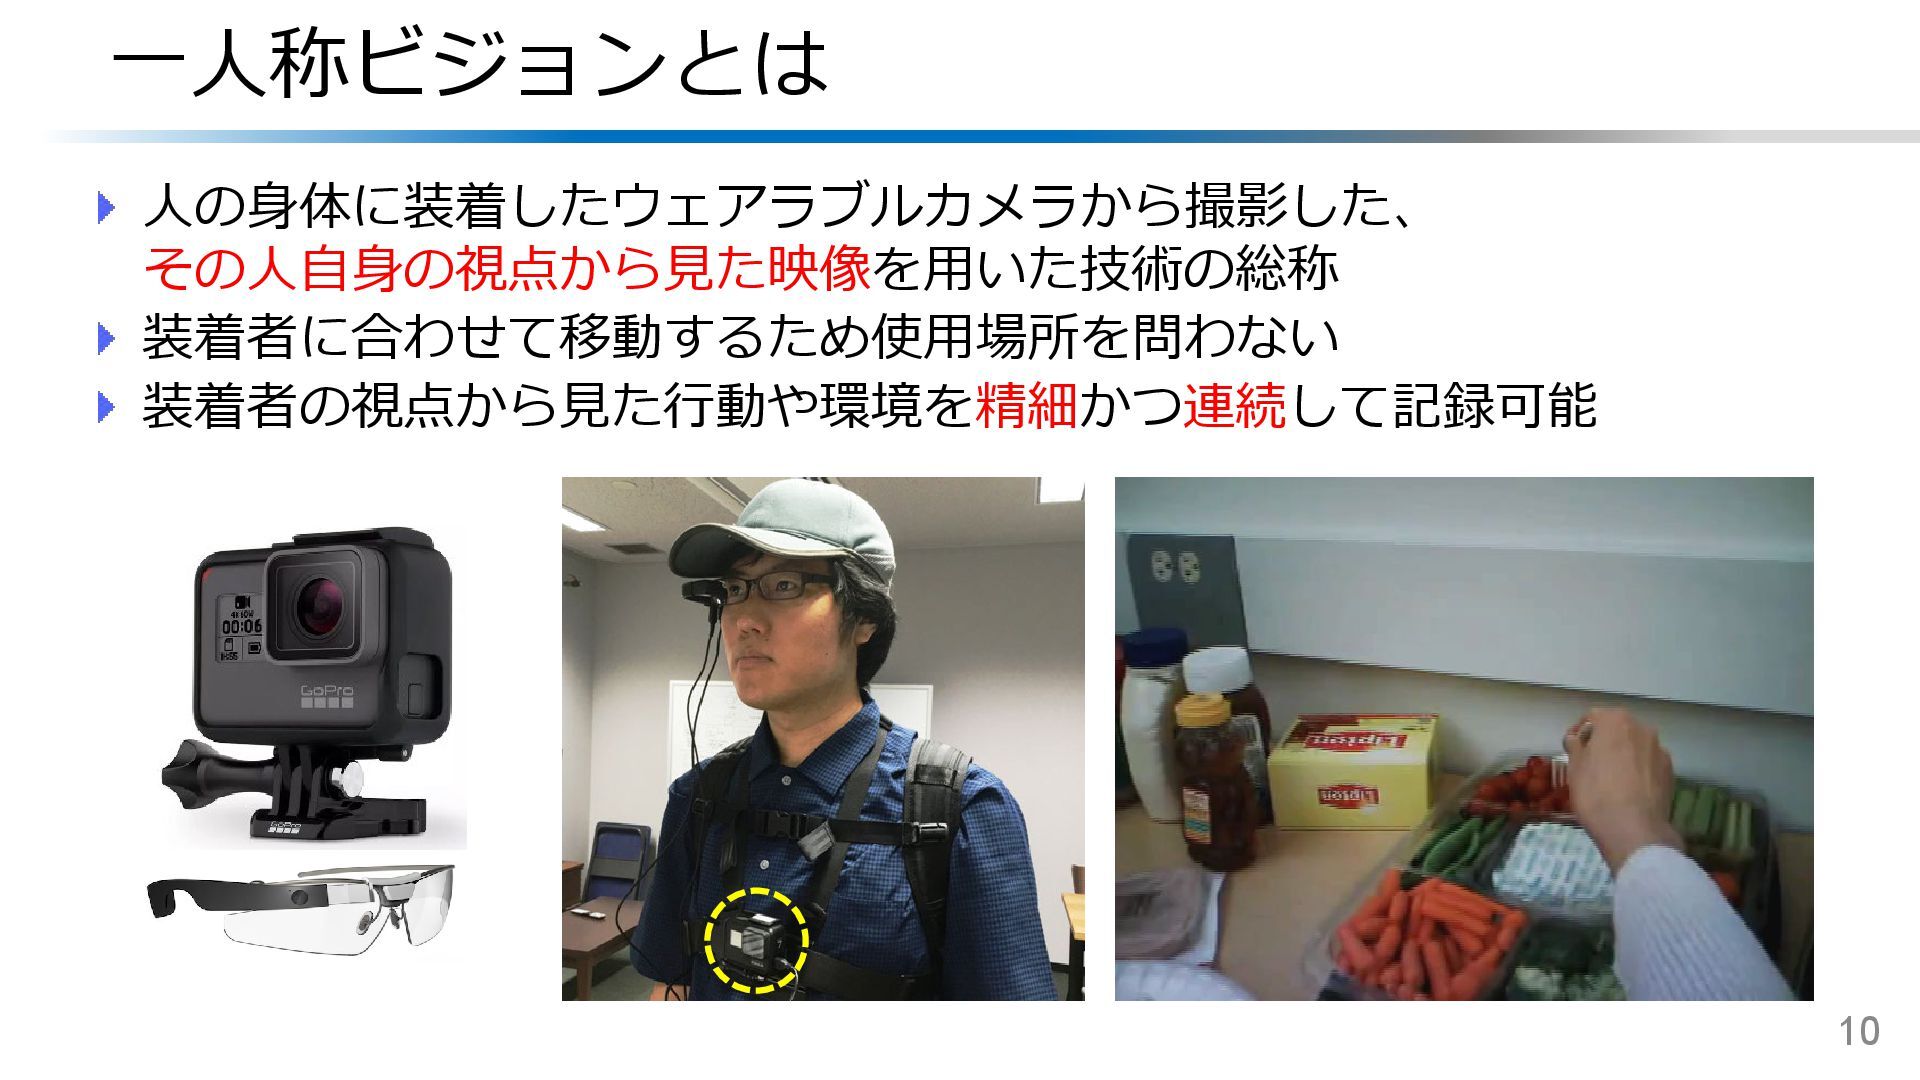
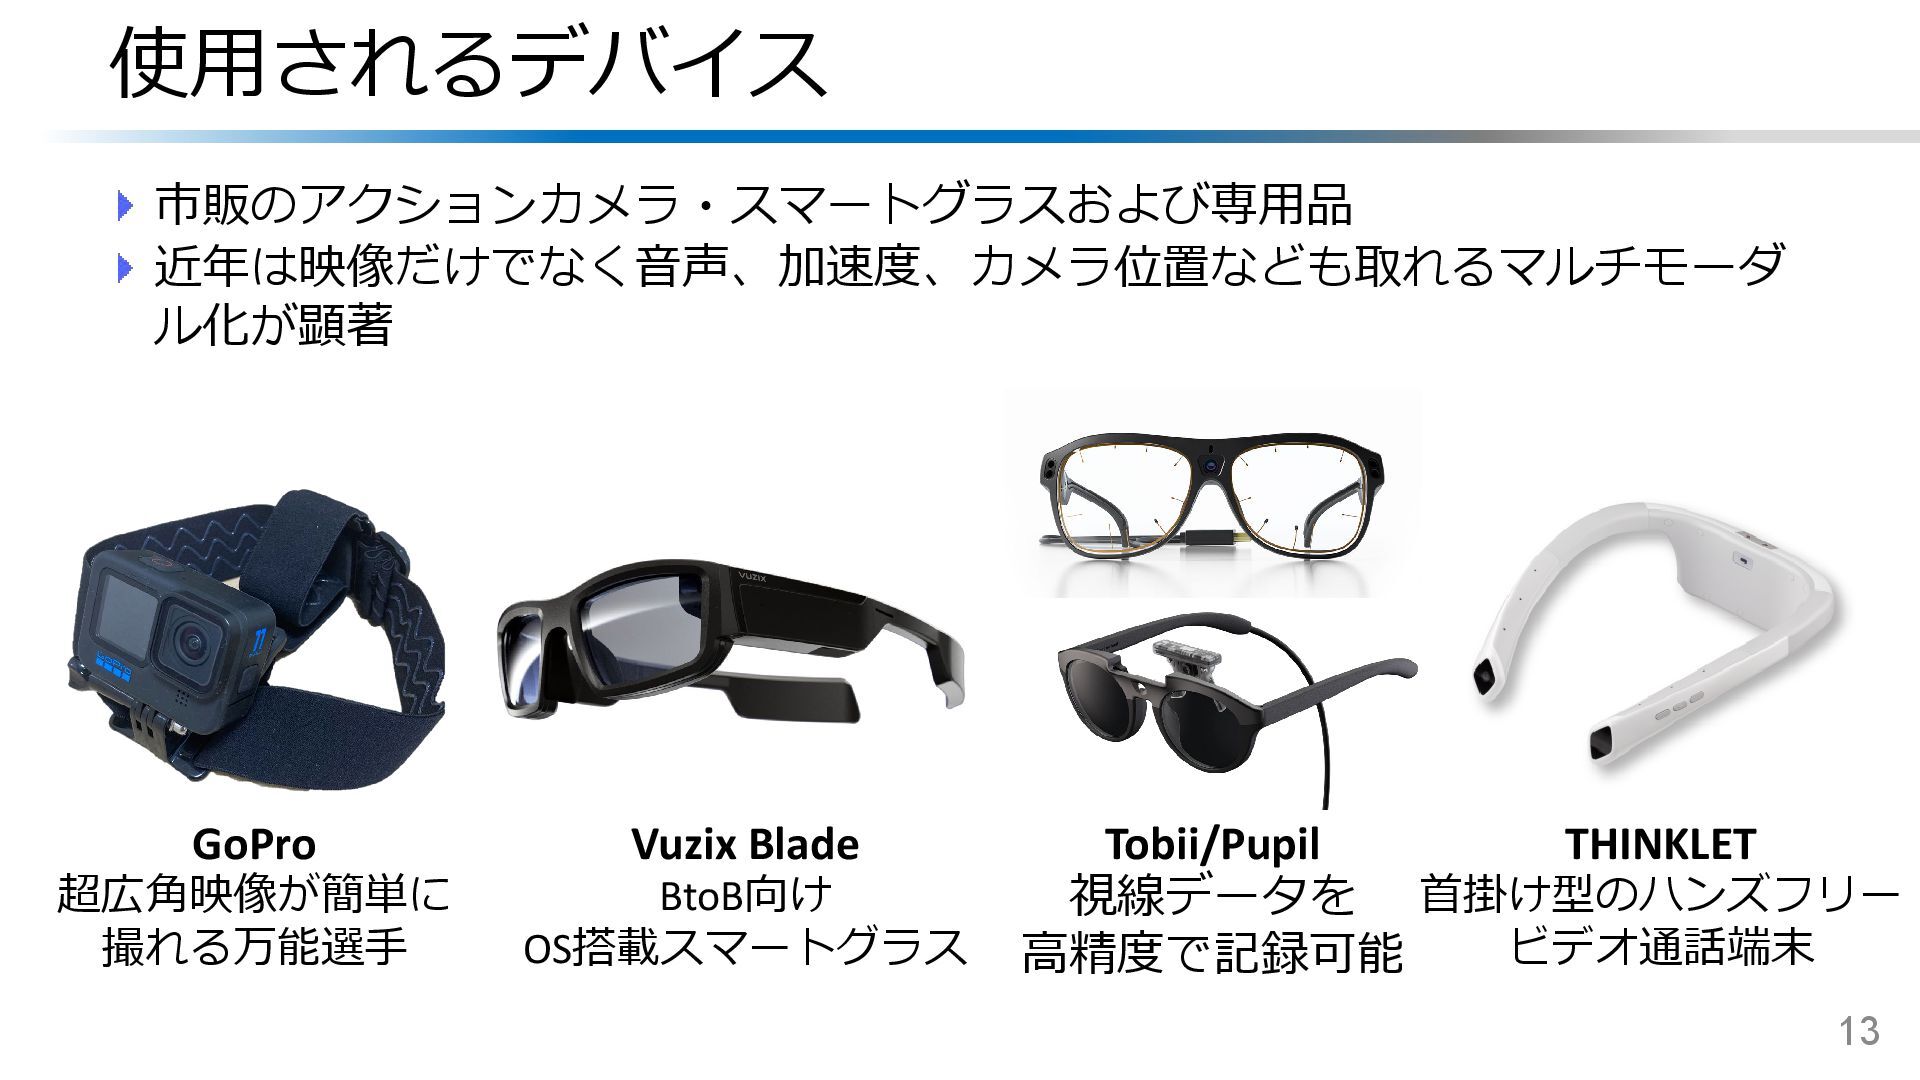
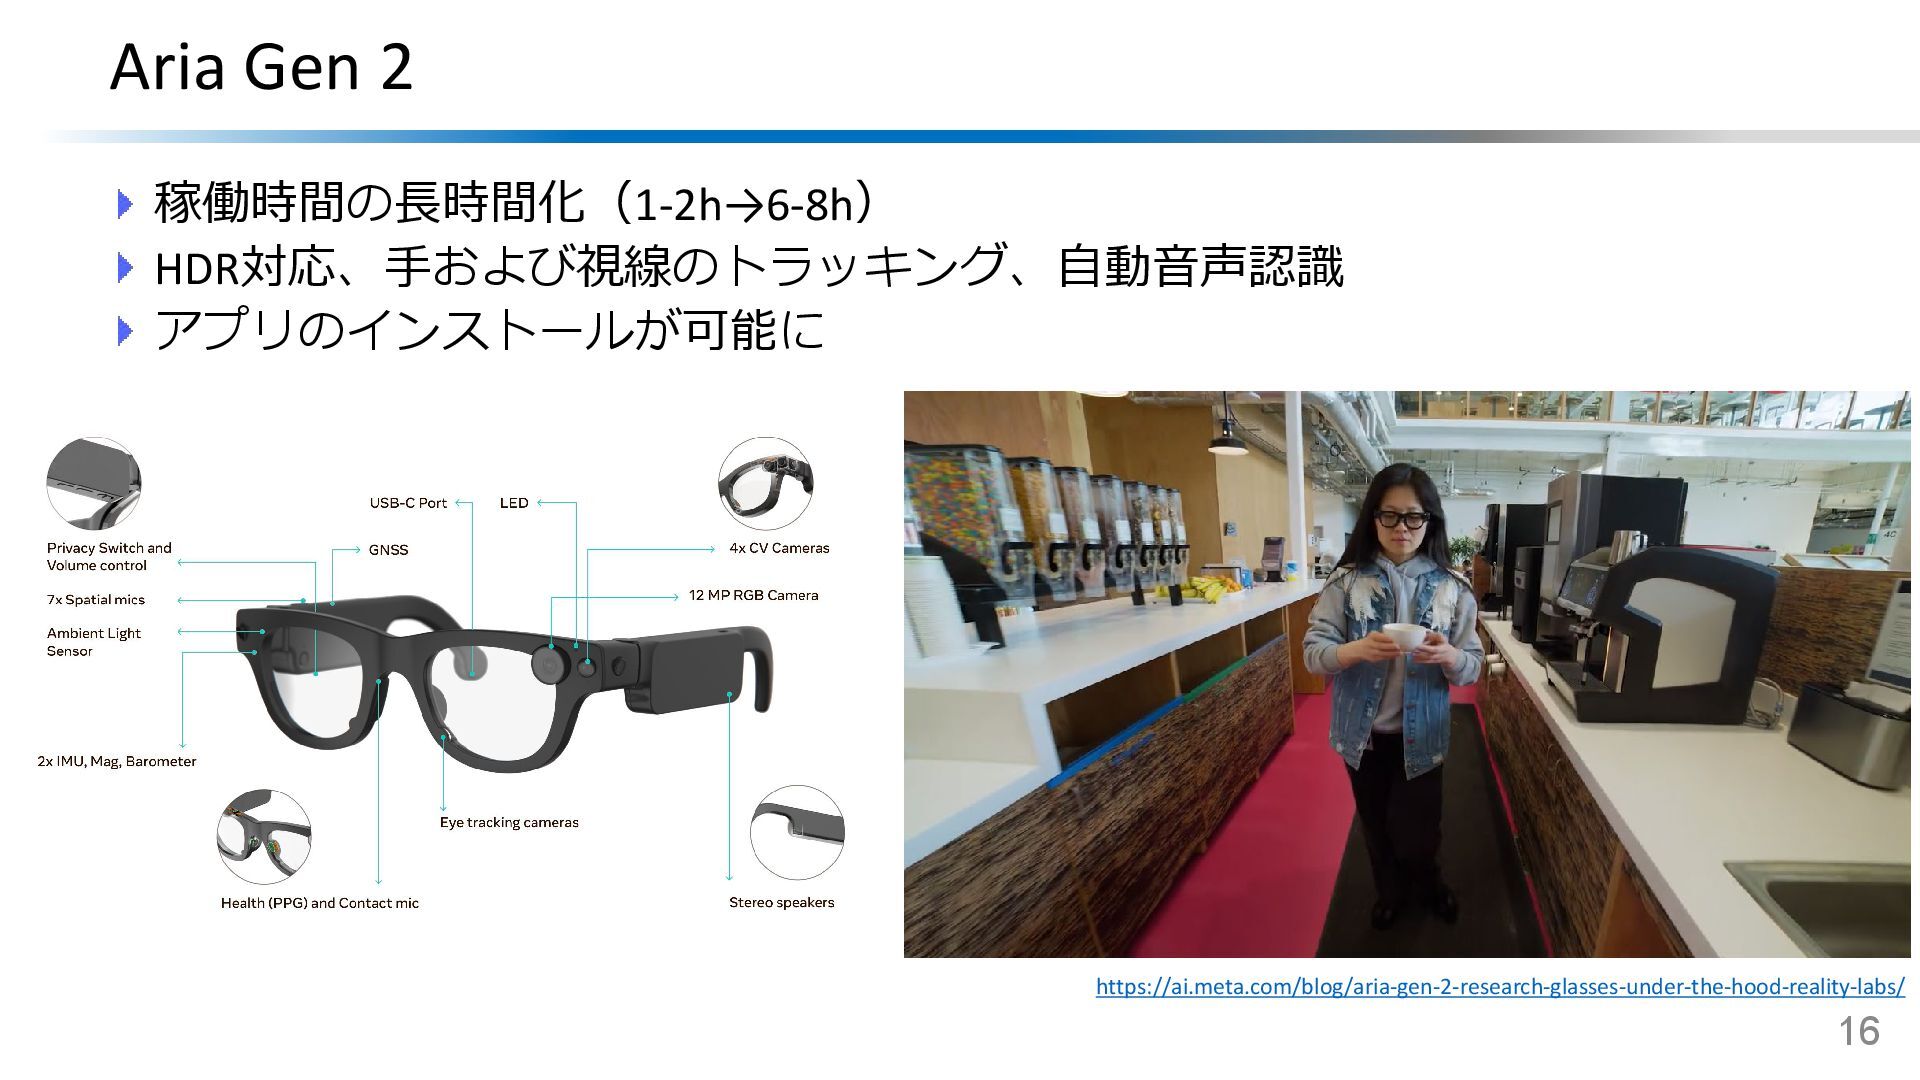
使用されるデバイス 市販のアクションカメラ・スマートグラスおよび専用品 近年は映像だけでなく音声、加速度、カメラ位置なども取れるマルチモーダ ル化が顕著 13 GoPro 超広角映像が簡単に 撮れる万能選手 Vuzix Blade
BtoB向け OS搭載スマートグラス Tobii/Pupil 視線データを 高精度で記録可能 THINKLET 首掛け型のハンズフリー ビデオ通話端末 -
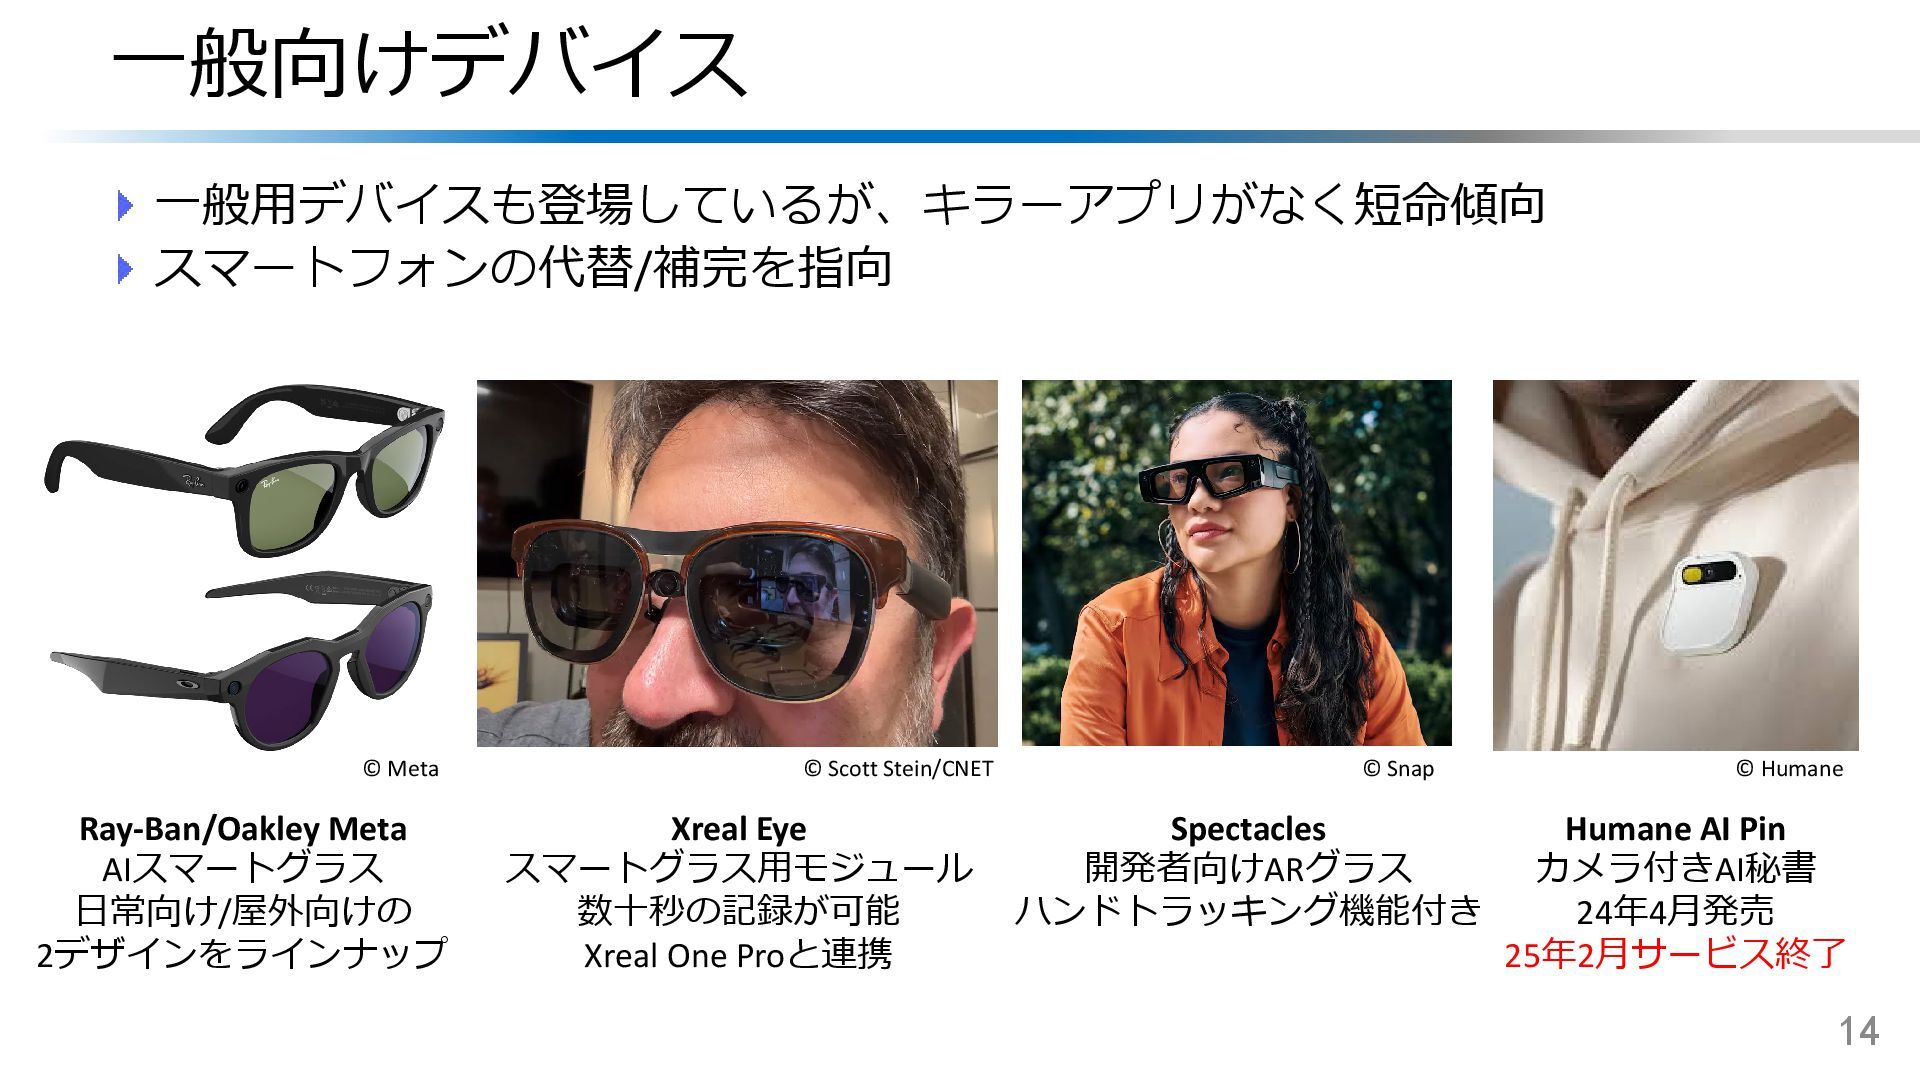
一般向けデバイス 一般用デバイスも登場しているが、キラーアプリがなく短命傾向 スマートフォンの代替/補完を指向 14 © Scott Stein/CNET Xreal Eye スマートグラス用モジュール
数十秒の記録が可能 Xreal One Proと連携 Humane AI Pin カメラ付きAI秘書 24年4月発売 25年2月サービス終了 © Humane © Snap Spectacles 開発者向けARグラス ハンドトラッキング機能付き Ray-Ban/Oakley Meta AIスマートグラス 日常向け/屋外向けの 2デザインをラインナップ © Meta -
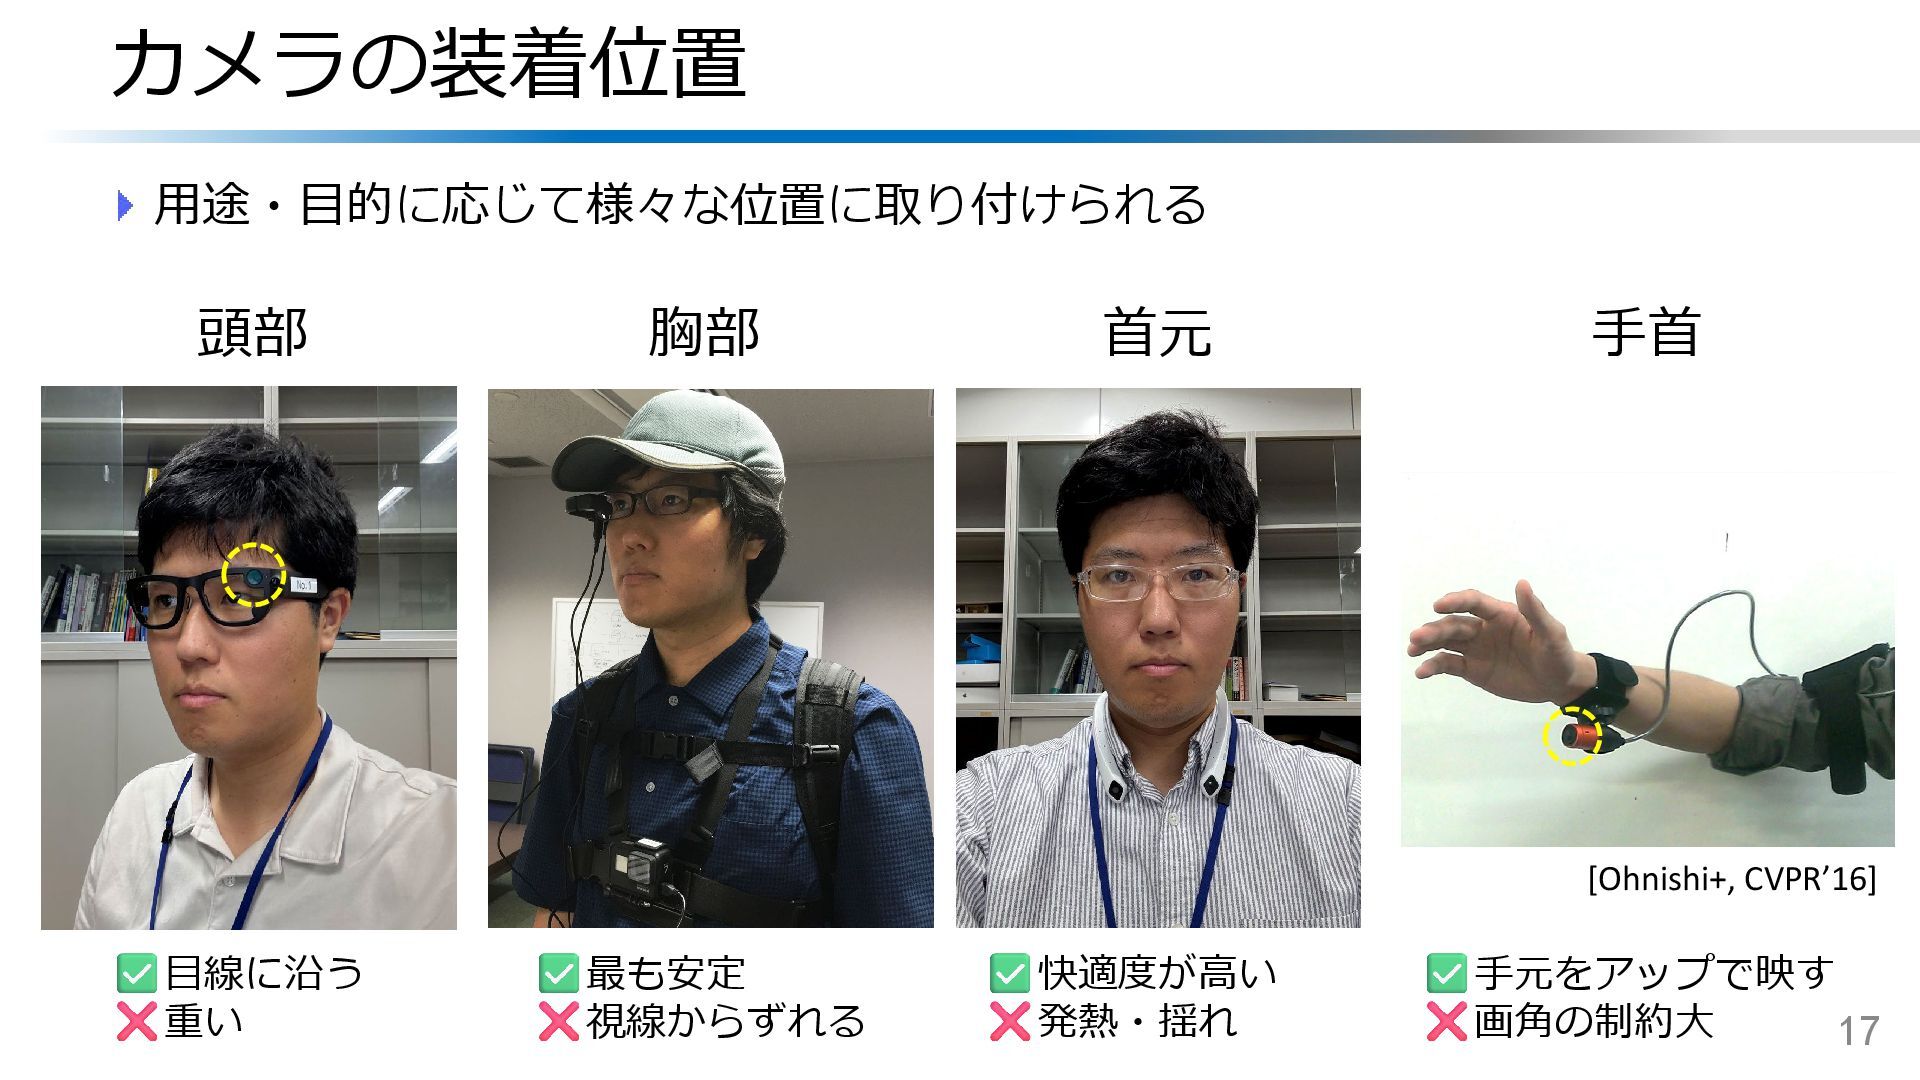
カメラの装着位置 用途・目的に応じて様々な位置に取り付けられる 17 頭部 目線に沿う 重い 胸部 最も安定 視線からずれる 首元
快適度が高い 発熱・揺れ 手首 [Ohnishi+, CVPR’16] 手元をアップで映す 画角の制約大 -
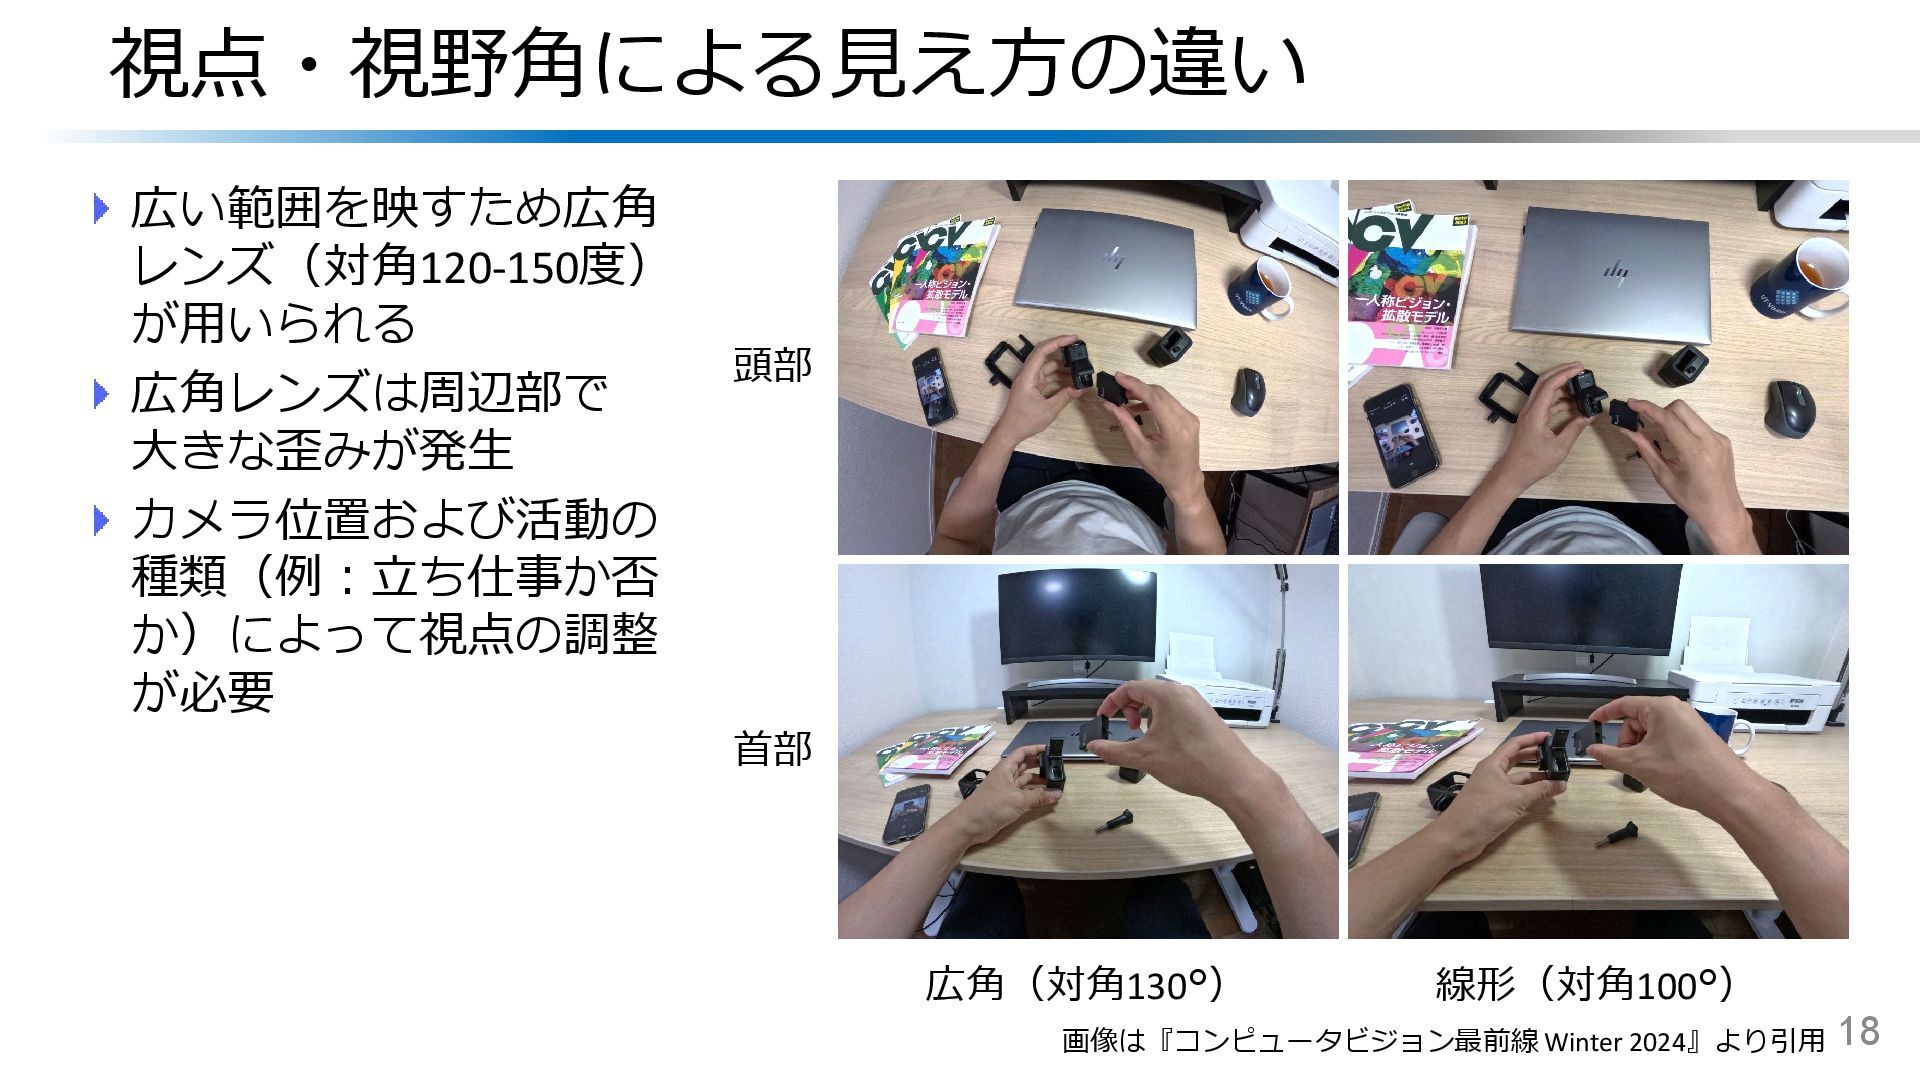
視点・視野角による見え方の違い 広い範囲を映すため広角 レンズ(対角120-150度) が用いられる 広角レンズは周辺部で 大きな歪みが発生 カメラ位置および活動の 種類(例:立ち仕事か否 か)によって視点の調整 が必要
18 頭部 首部 広角(対角130°) 線形(対角100°) 画像は『コンピュータビジョン最前線 Winter 2024』より引用 -
なぜ一人称視点映像なのか? 20 我々は自分の身体を持ち、物体操作・会話など、一人称視点を通して世界と 関わっている 受動的にしか動けないネコは縞模様を認識できない [Held & Hein, ’63] [Held
& Hein, ‘63] [Jayaraman & Grauman, ICCV‘15] 人が能動的に動いた結果何が起こるかを理解する必要がある -
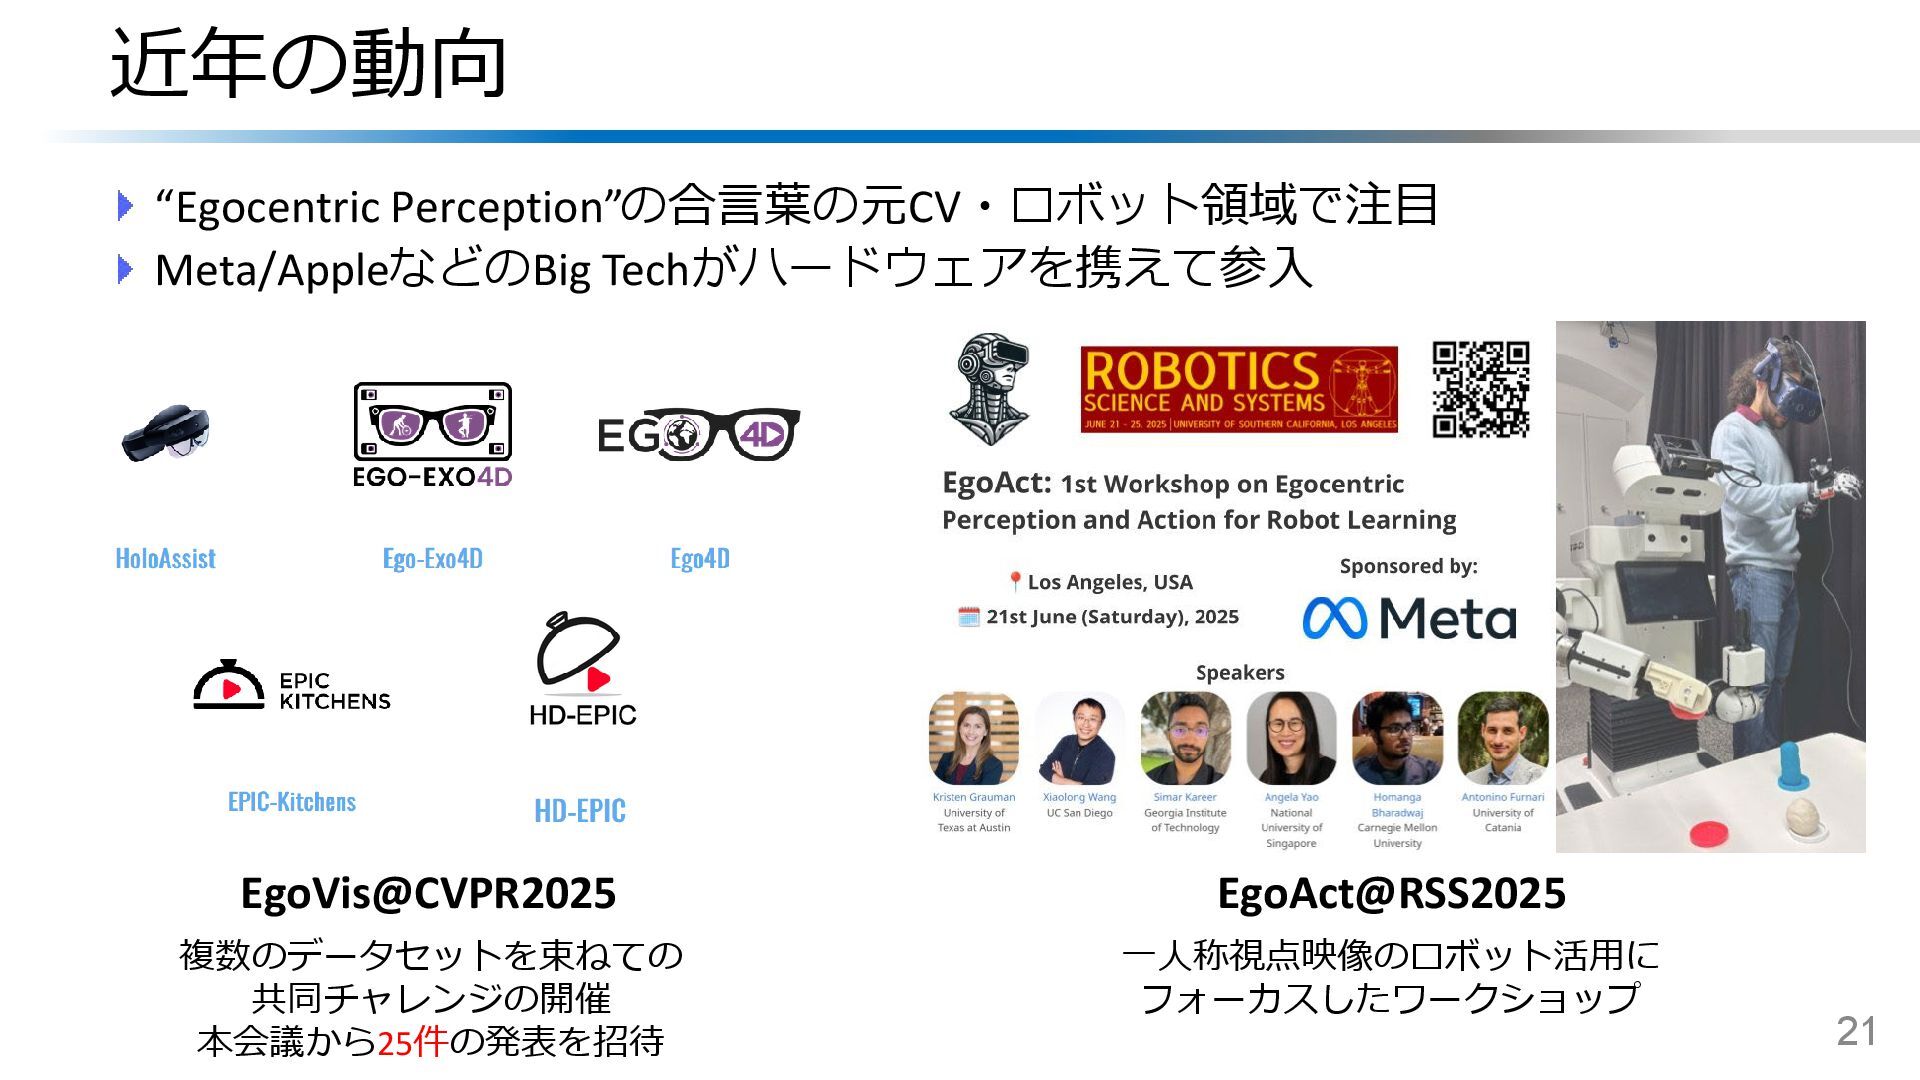
近年の動向 “Egocentric Perception”の合言葉の元CV・ロボット領域で注目 Meta/AppleなどのBig Techがハードウェアを携えて参入 21 EgoAct@RSS2025 EgoVis@CVPR2025 複数のデータセットを束ねての 共同チャレンジの開催
本会議から25件の発表を招待 一人称視点映像のロボット活用に フォーカスしたワークショップ -
視線はタスク依存である [Yarbus, ‘67] 同じ視覚刺激であっても、対象中の何に注目するかによって視線の軌跡 (gaze scanpath)は変化する 25 Free view Age
Clothes Story Positions Summary Wealth 絵画を要素別に注目した際の視線軌跡 -
物体探索タスクにおける視線軌跡推定 [Yang+, CVPR’20] 逆強化学習を用いた物体探索中の視線軌跡推定 粗い画像を入力として「注視」した領域のみの高解像度画像を繰り返し得る 設定で次にどこに視線を向けるかを予測(例:食器らしい領域にまず注目) 26 視線軌跡(黄枠は探索対象) 予測された視線軌跡 注視回数
注視回数と対象物体にたどり着けたかの関係 対象物体到達の累積確率 逆強化学習 モデルの概要 -
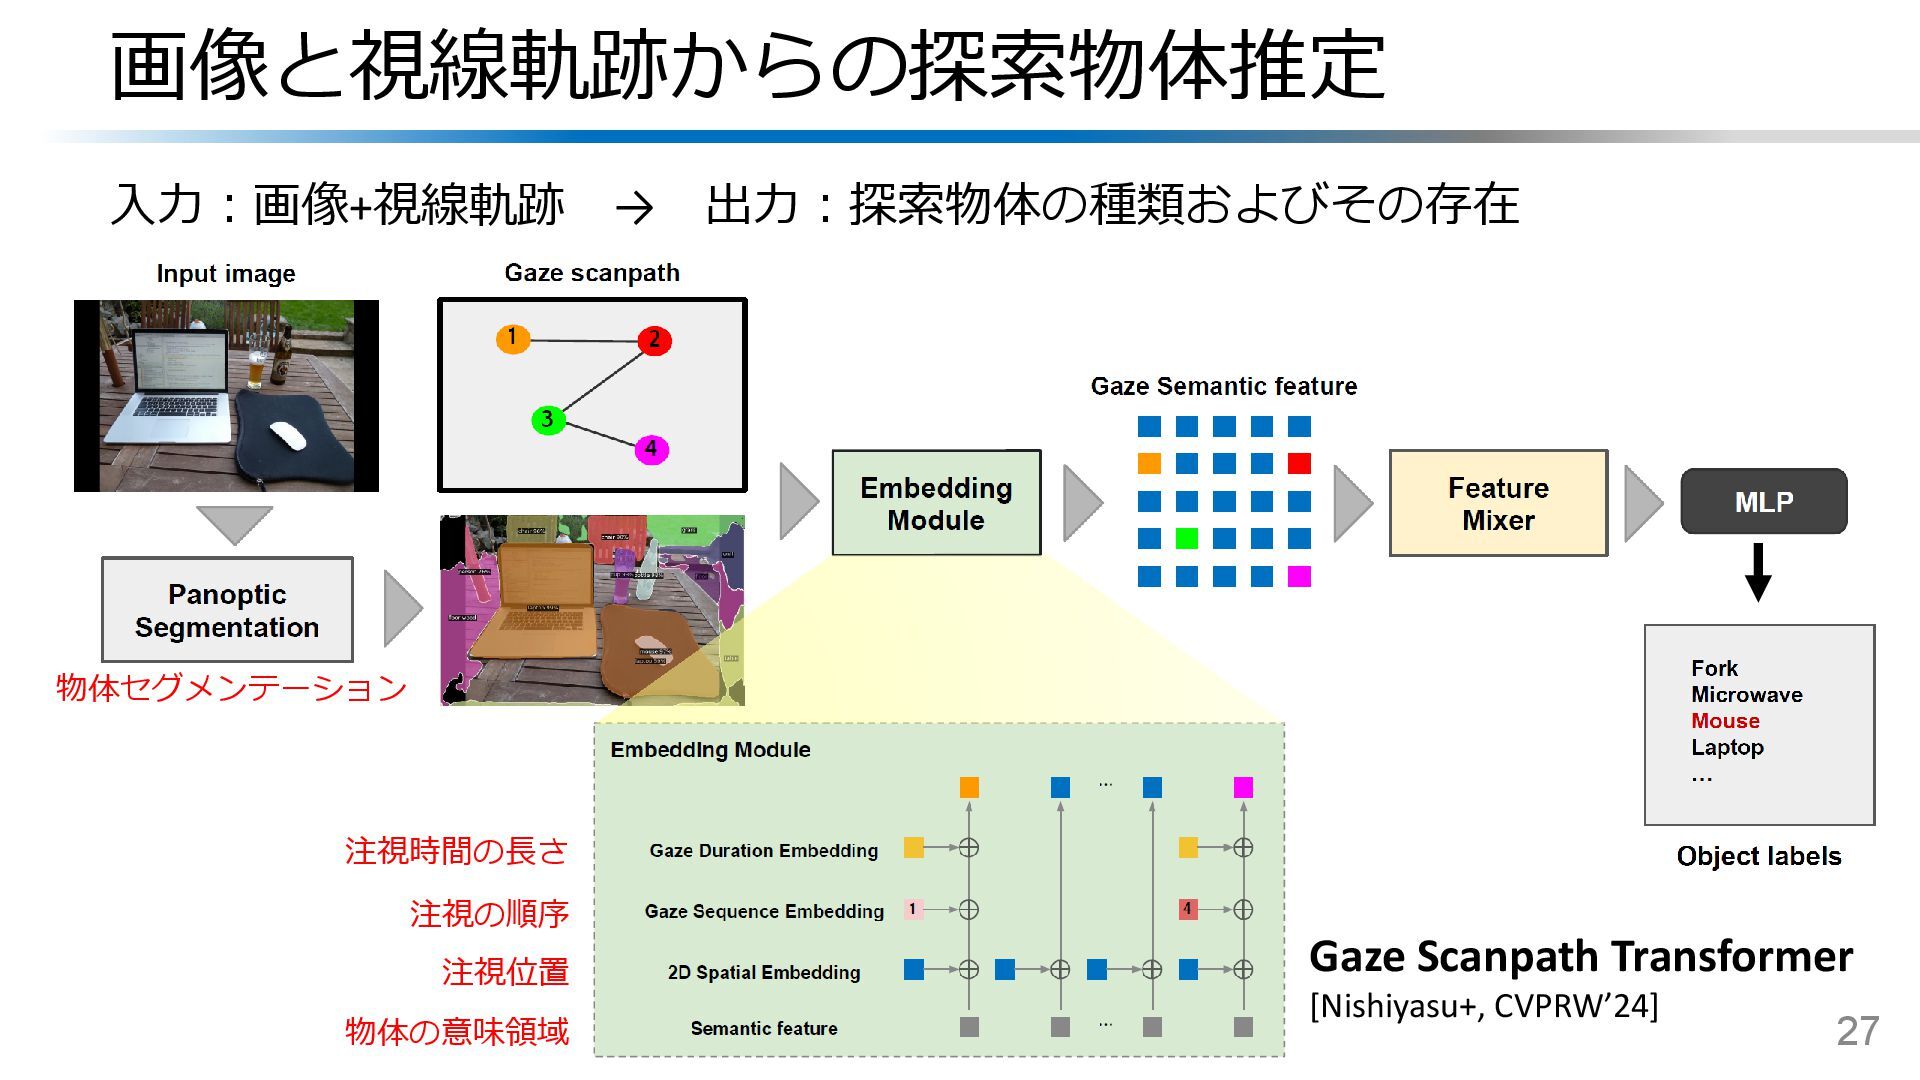
画像と視線軌跡からの探索物体推定 入力:画像+視線軌跡 → 出力:探索物体の種類およびその存在 27 物体セグメンテーション 注視時間の長さ 注視の順序 注視位置 物体の意味領域
Gaze Scanpath Transformer [Nishiyasu+, CVPRW’24] -
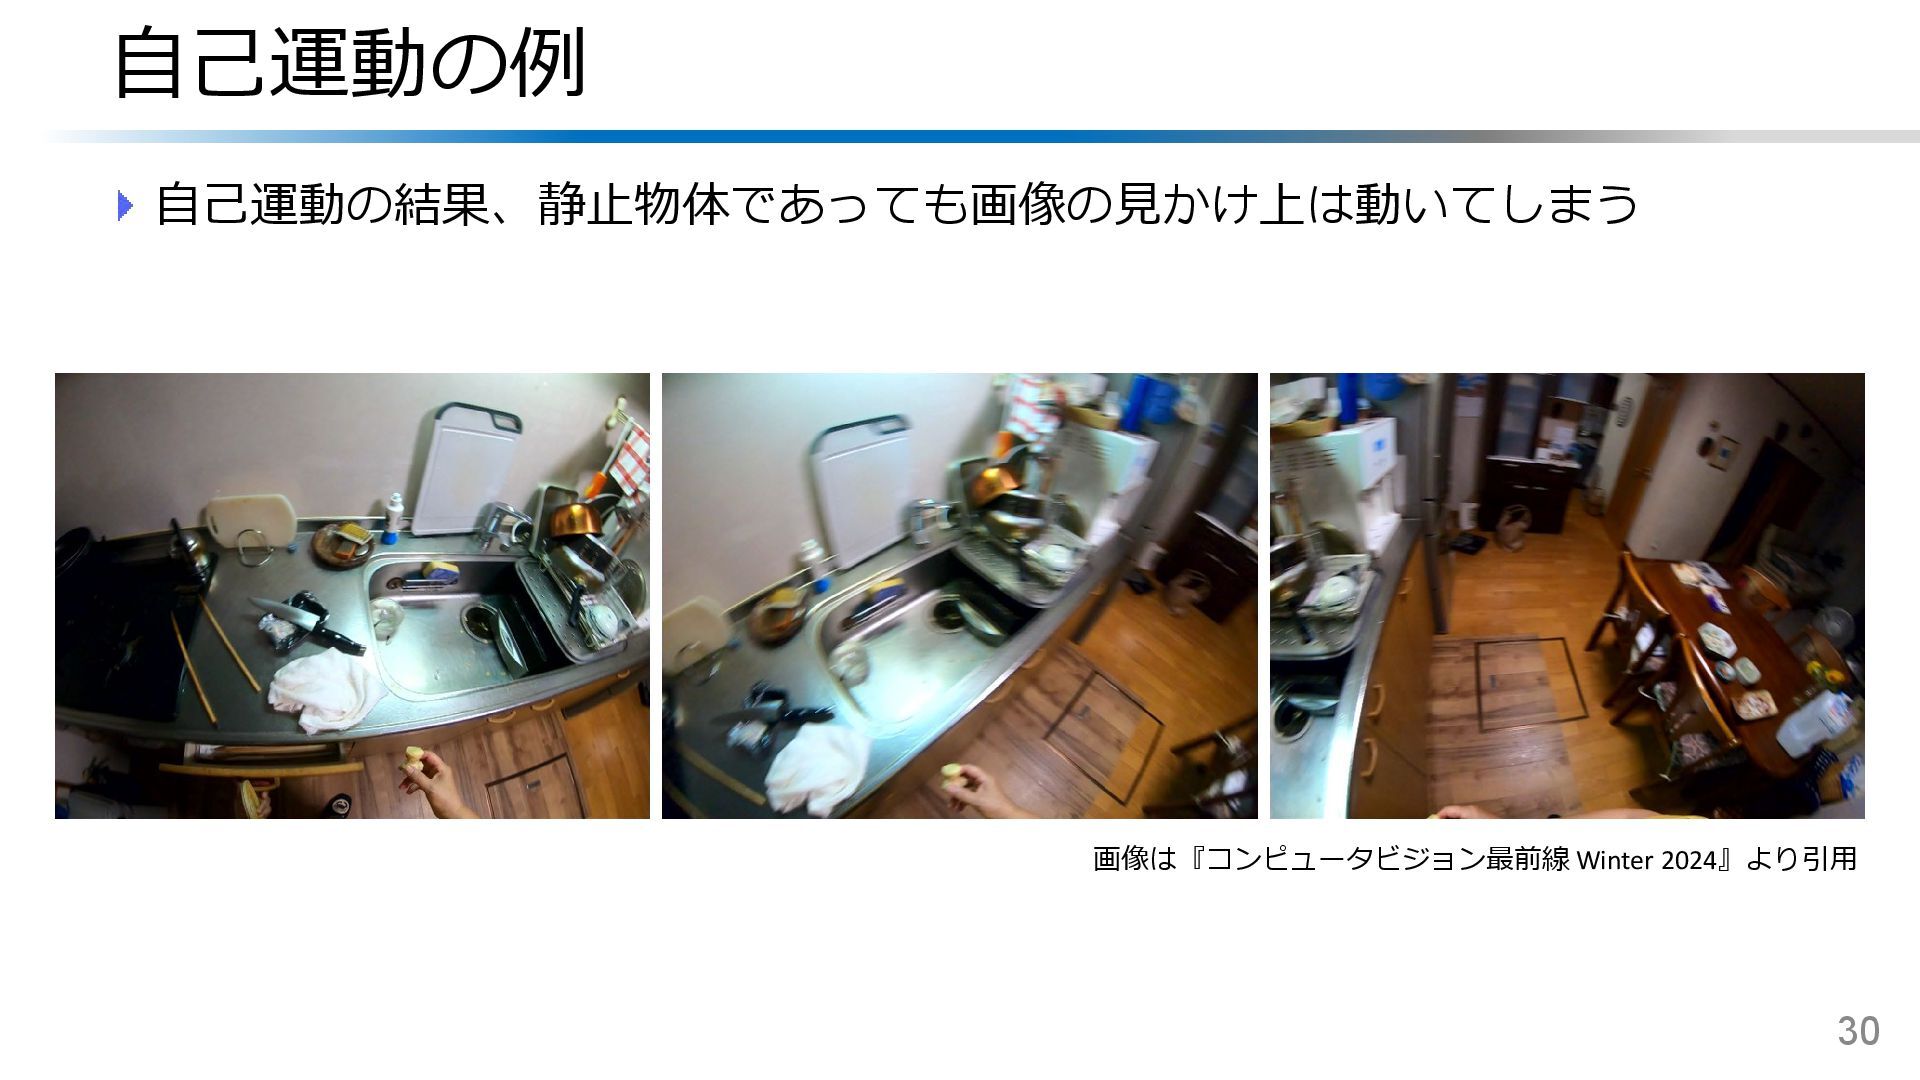
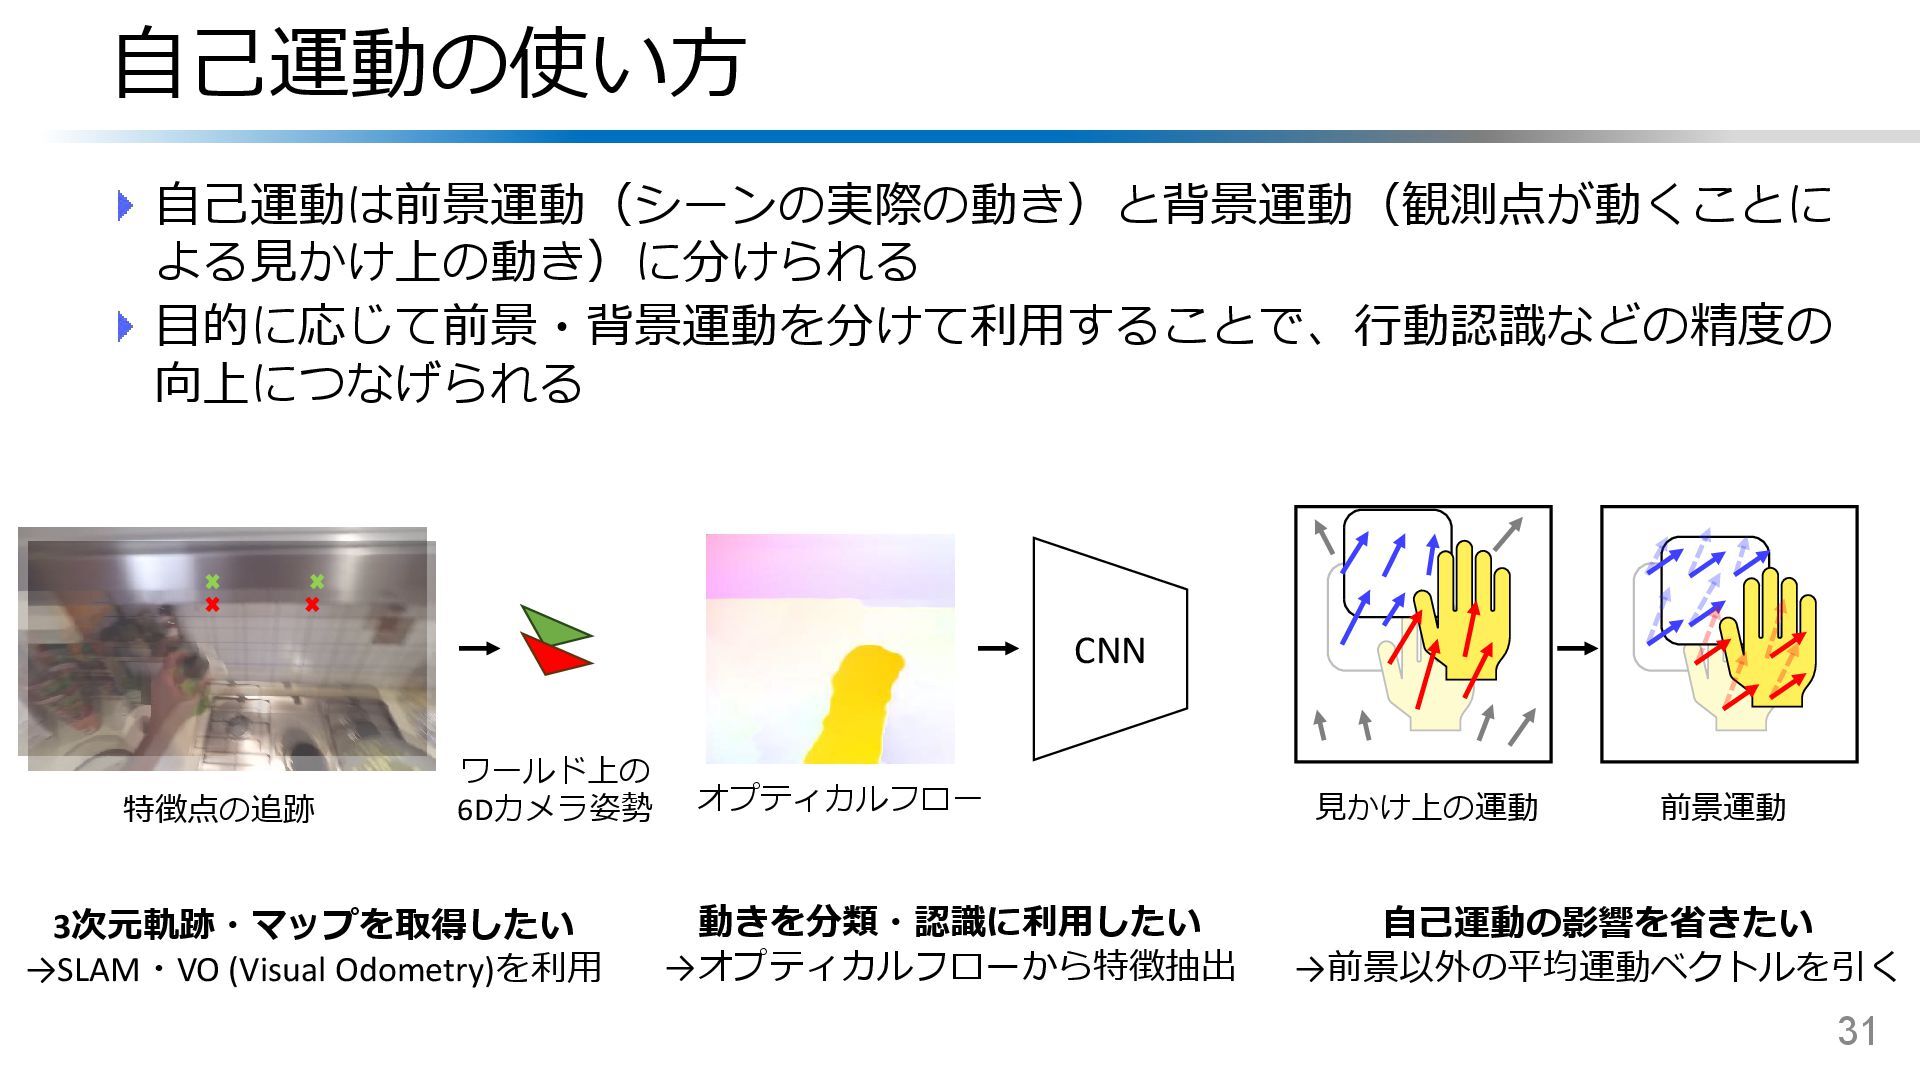
自己運動の使い方 自己運動は前景運動(シーンの実際の動き)と背景運動(観測点が動くことに よる見かけ上の動き)に分けられる 目的に応じて前景・背景運動を分けて利用することで、行動認識などの精度の 向上につなげられる 31 3次元軌跡・マップを取得したい →SLAM・VO (Visual Odometry)を利用
動きを分類・認識に利用したい →オプティカルフローから特徴抽出 自己運動の影響を省きたい →前景以外の平均運動ベクトルを引く 特徴点の追跡 見かけ上の運動 前景運動 CNN オプティカルフロー ワールド上の 6Dカメラ姿勢 -
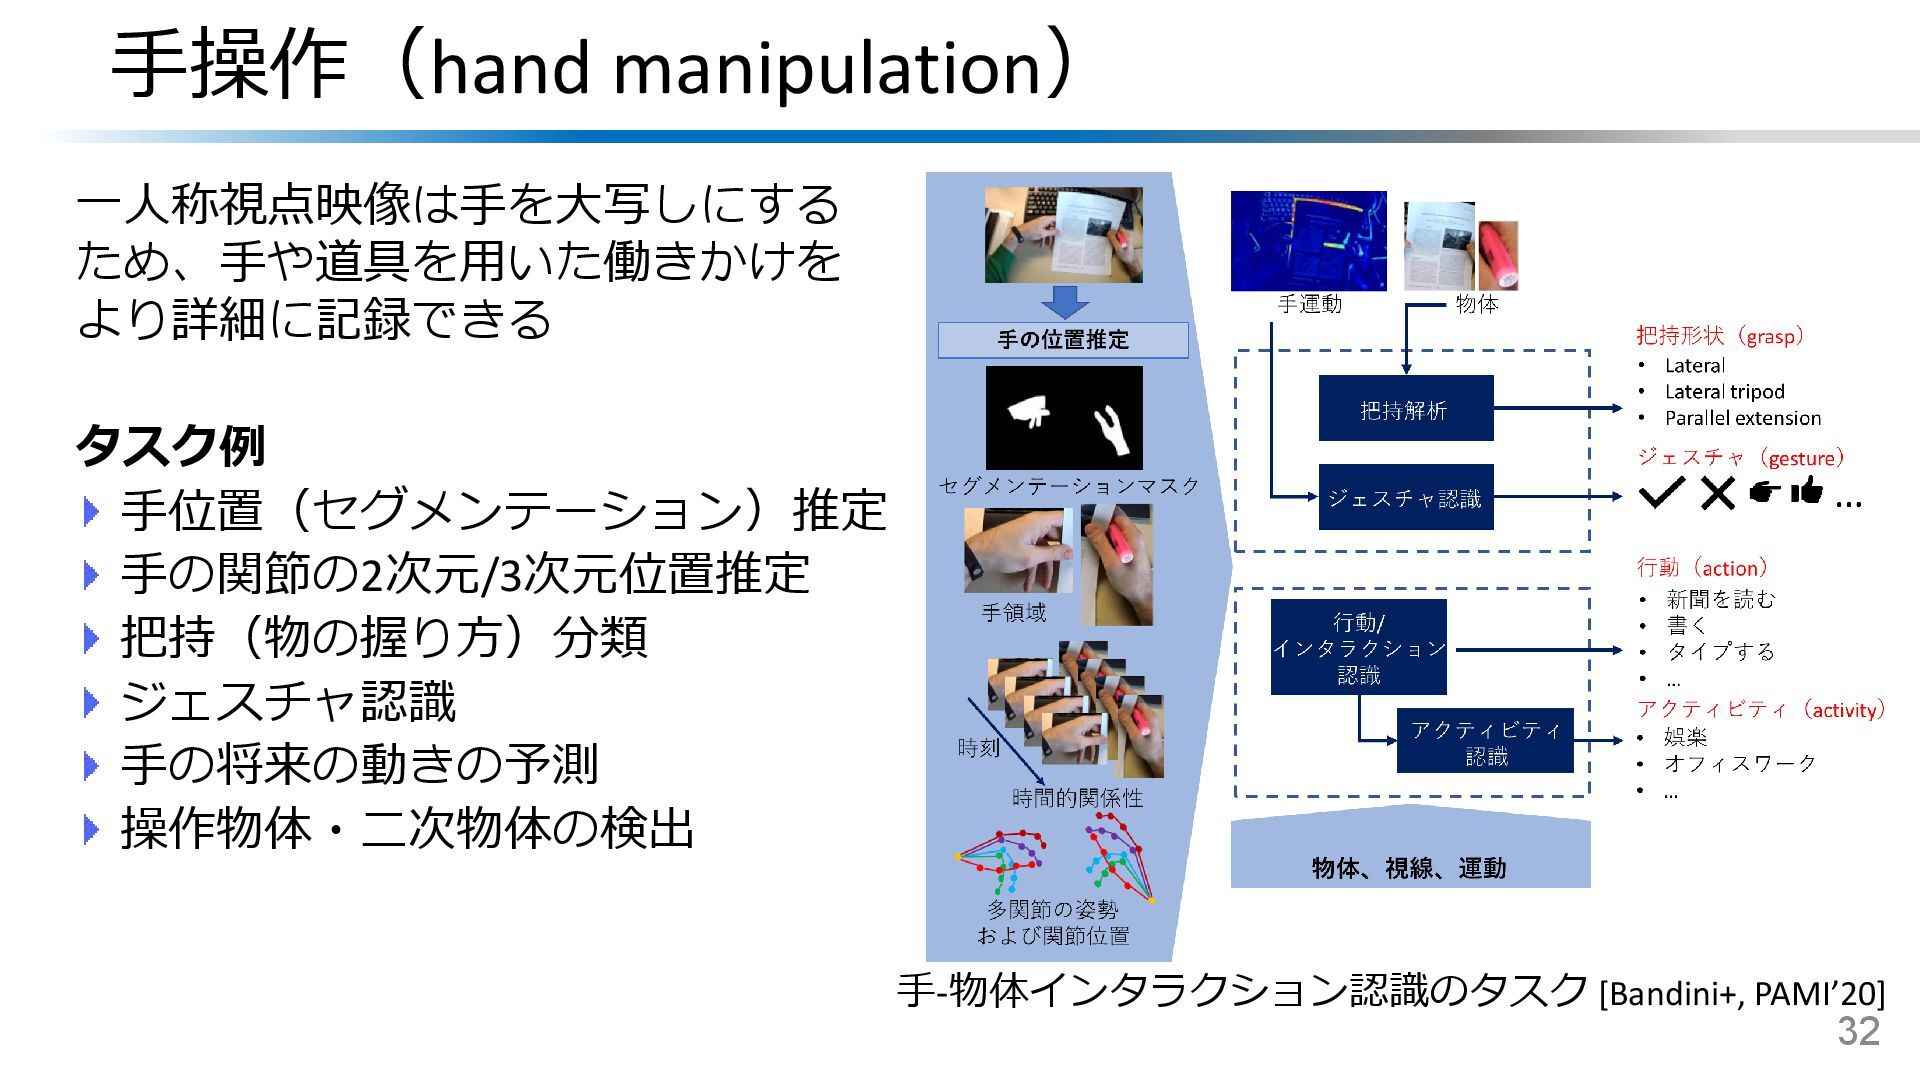
手操作(hand manipulation) 一人称視点映像は手を大写しにする ため、手や道具を用いた働きかけを より詳細に記録できる タスク例 手位置(セグメンテーション)推定 手の関節の2次元/3次元位置推定 把持(物の握り方)分類 ジェスチャ認識
手の将来の動きの予測 操作物体・二次物体の検出 32 手-物体インタラクション認識のタスク [Bandini+, PAMI’20] -
3次元手姿勢の推定 映像中に映る手の手首を起点とした各関節点の位置の推定 AR・VRデバイスに取り付けられたカメラからのジェスチャ・行動認識に有用 指の位置が自身・物体によって隠れるためいかに真値を得るかに課題 33 GANeratedHands [Mueller+’, CVPR’18] 単眼RGB映像からの手姿勢推定 →物体や他の手との相互作用に課題
HOT3D [Banerjee+, CVPR’25] 単眼RGB映像からの手の形状復元・6D物体姿勢推定 -
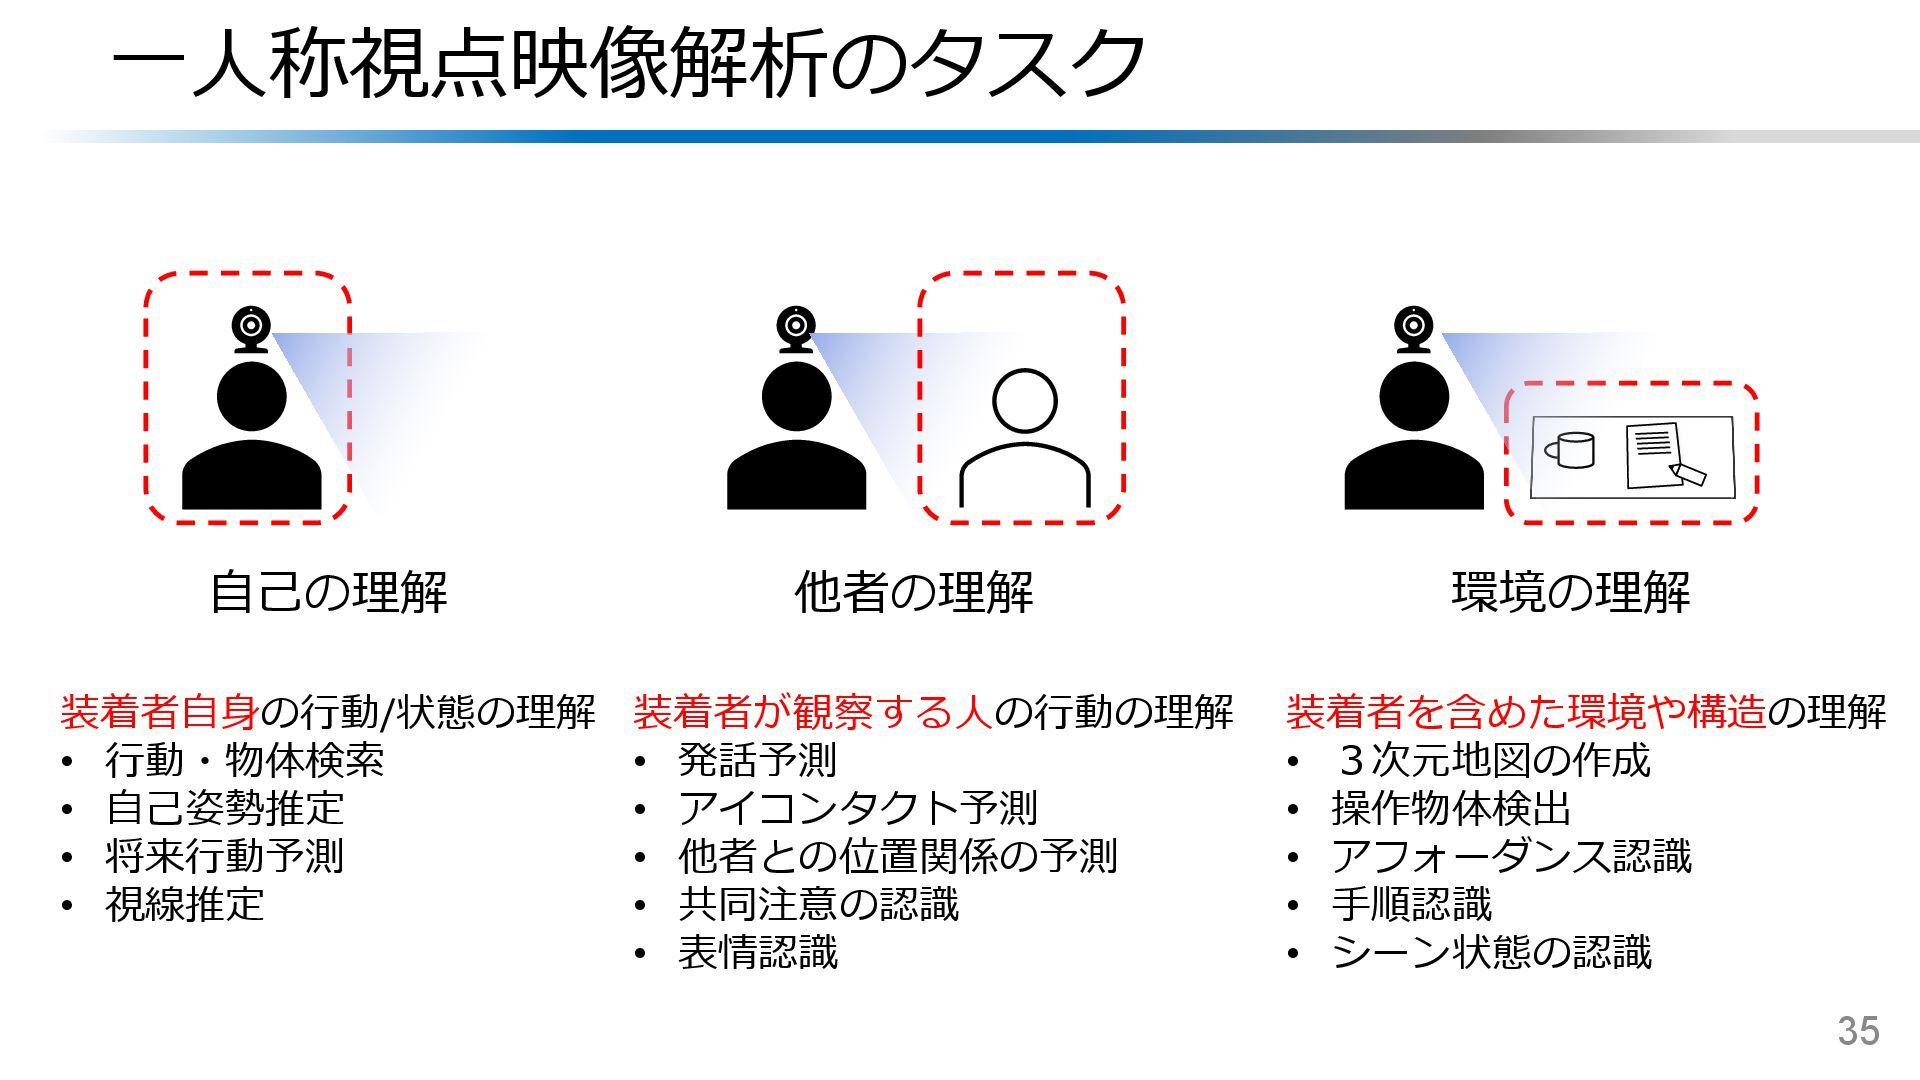
一人称視点映像解析のタスク 35 自己の理解 他者の理解 環境の理解 装着者自身の行動/状態の理解 • 行動・物体検索 • 自己姿勢推定
• 将来行動予測 • 視線推定 装着者が観察する人の行動の理解 • 発話予測 • アイコンタクト予測 • 他者との位置関係の予測 • 共同注意の認識 • 表情認識 装着者を含めた環境や構造の理解 • 3次元地図の作成 • 操作物体検出 • アフォーダンス認識 • 手順認識 • シーン状態の認識 -
自己の理解:装着者の行動・エピソードの理解 一人称視点映像からの個人の経験に関するエピソードの理解 例:過去の行動・物体の種類や位置など 36 Ego4D Episodic Memory Benchmark [Grauman+, CVPR’22]
Visual Query 画像→当該物体の出現タイミング Language Query 言語指示→指示に対応する物体の情報 -
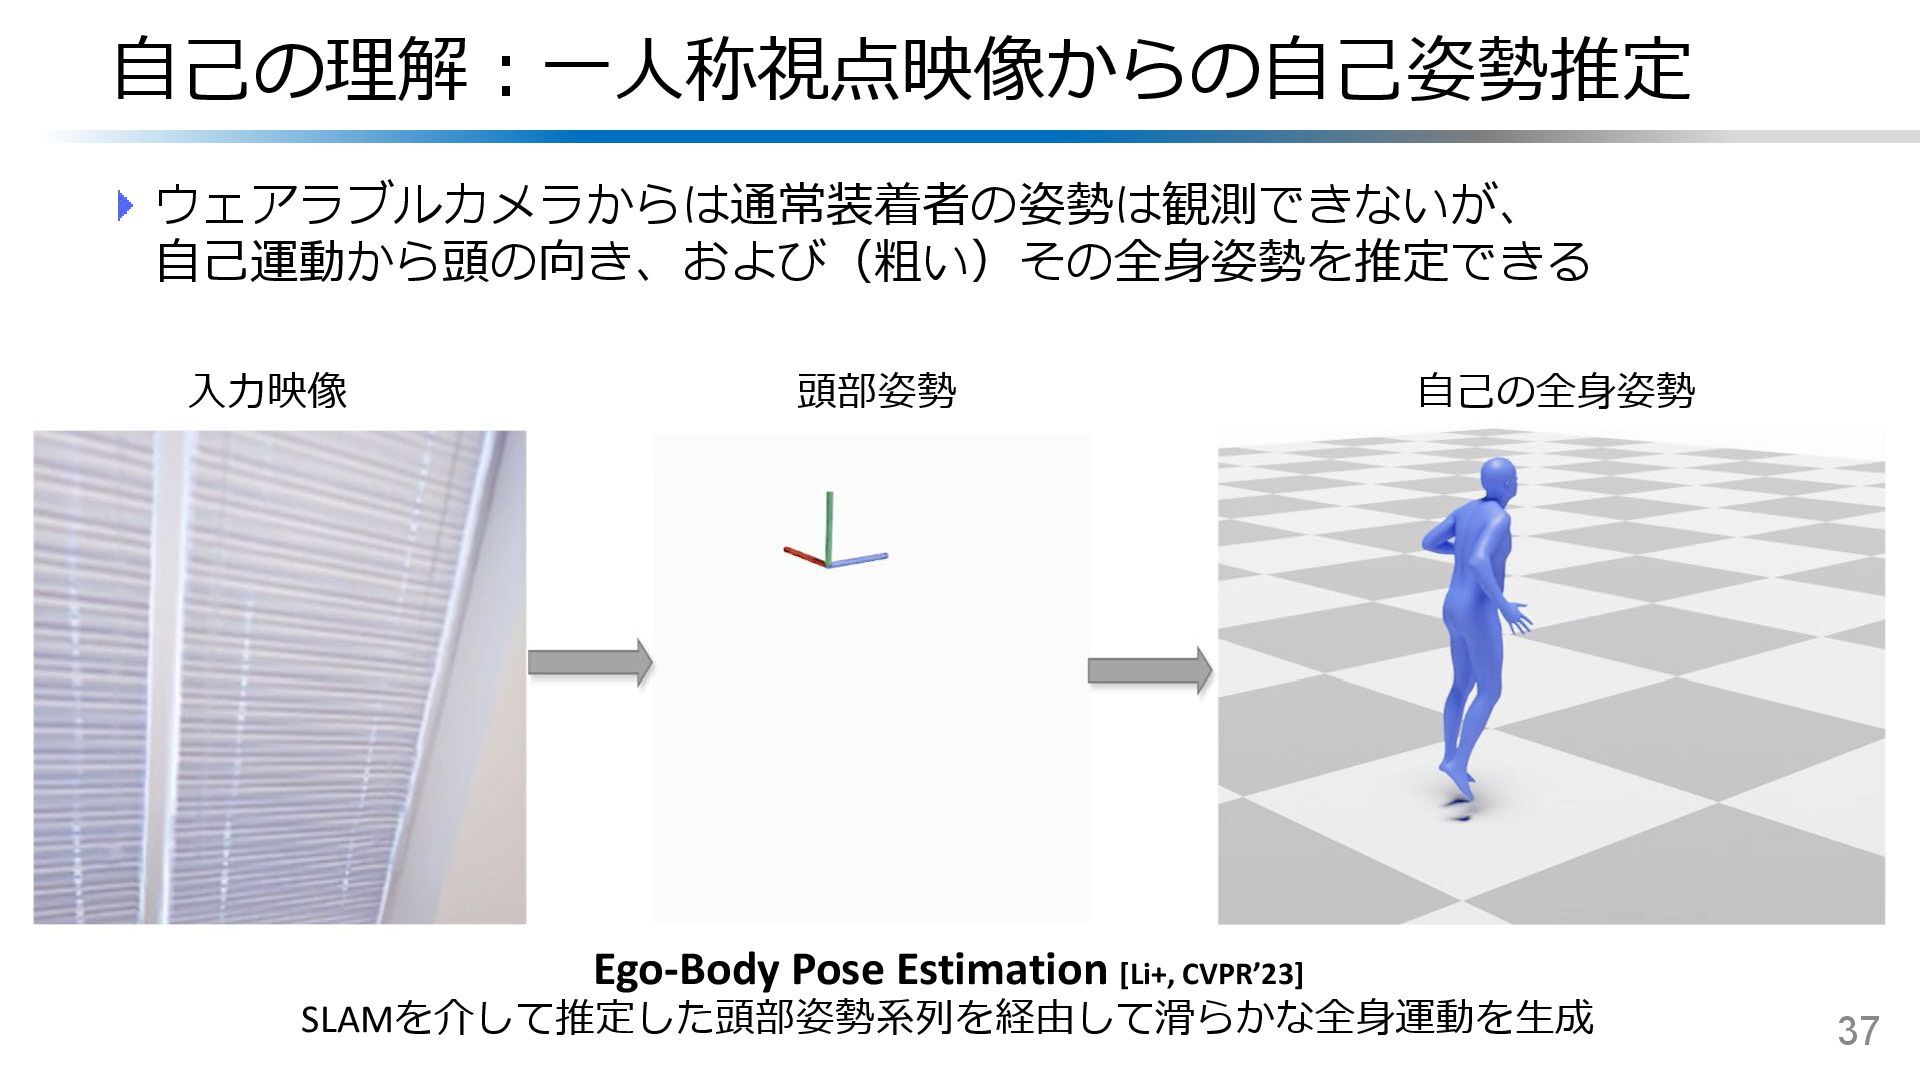
自己の理解:一人称視点映像からの自己姿勢推定 ウェアラブルカメラからは通常装着者の姿勢は観測できないが、 自己運動から頭の向き、および(粗い)その全身姿勢を推定できる 37 入力映像 頭部姿勢 自己の全身姿勢 Ego-Body Pose Estimation
[Li+, CVPR’23] SLAMを介して推定した頭部姿勢系列を経由して滑らかな全身運動を生成 -
近年はHMDを想定した下向きカメラからのより正確な全身姿勢推定や マルチモーダル全身運動の生成が取り組まれている 38 自己の理解:一人称視点映像からの自己姿勢推定 REWIND [Lee+, CVPR’25] HMDに搭載された下向きカメラ映像 からの全身+手指姿勢推定 Ego4o
[Wang+, CVPR’25] 一人称視点画像/IMUからの マルチモーダルモーションキャプチャ ・動作説明文生成 -
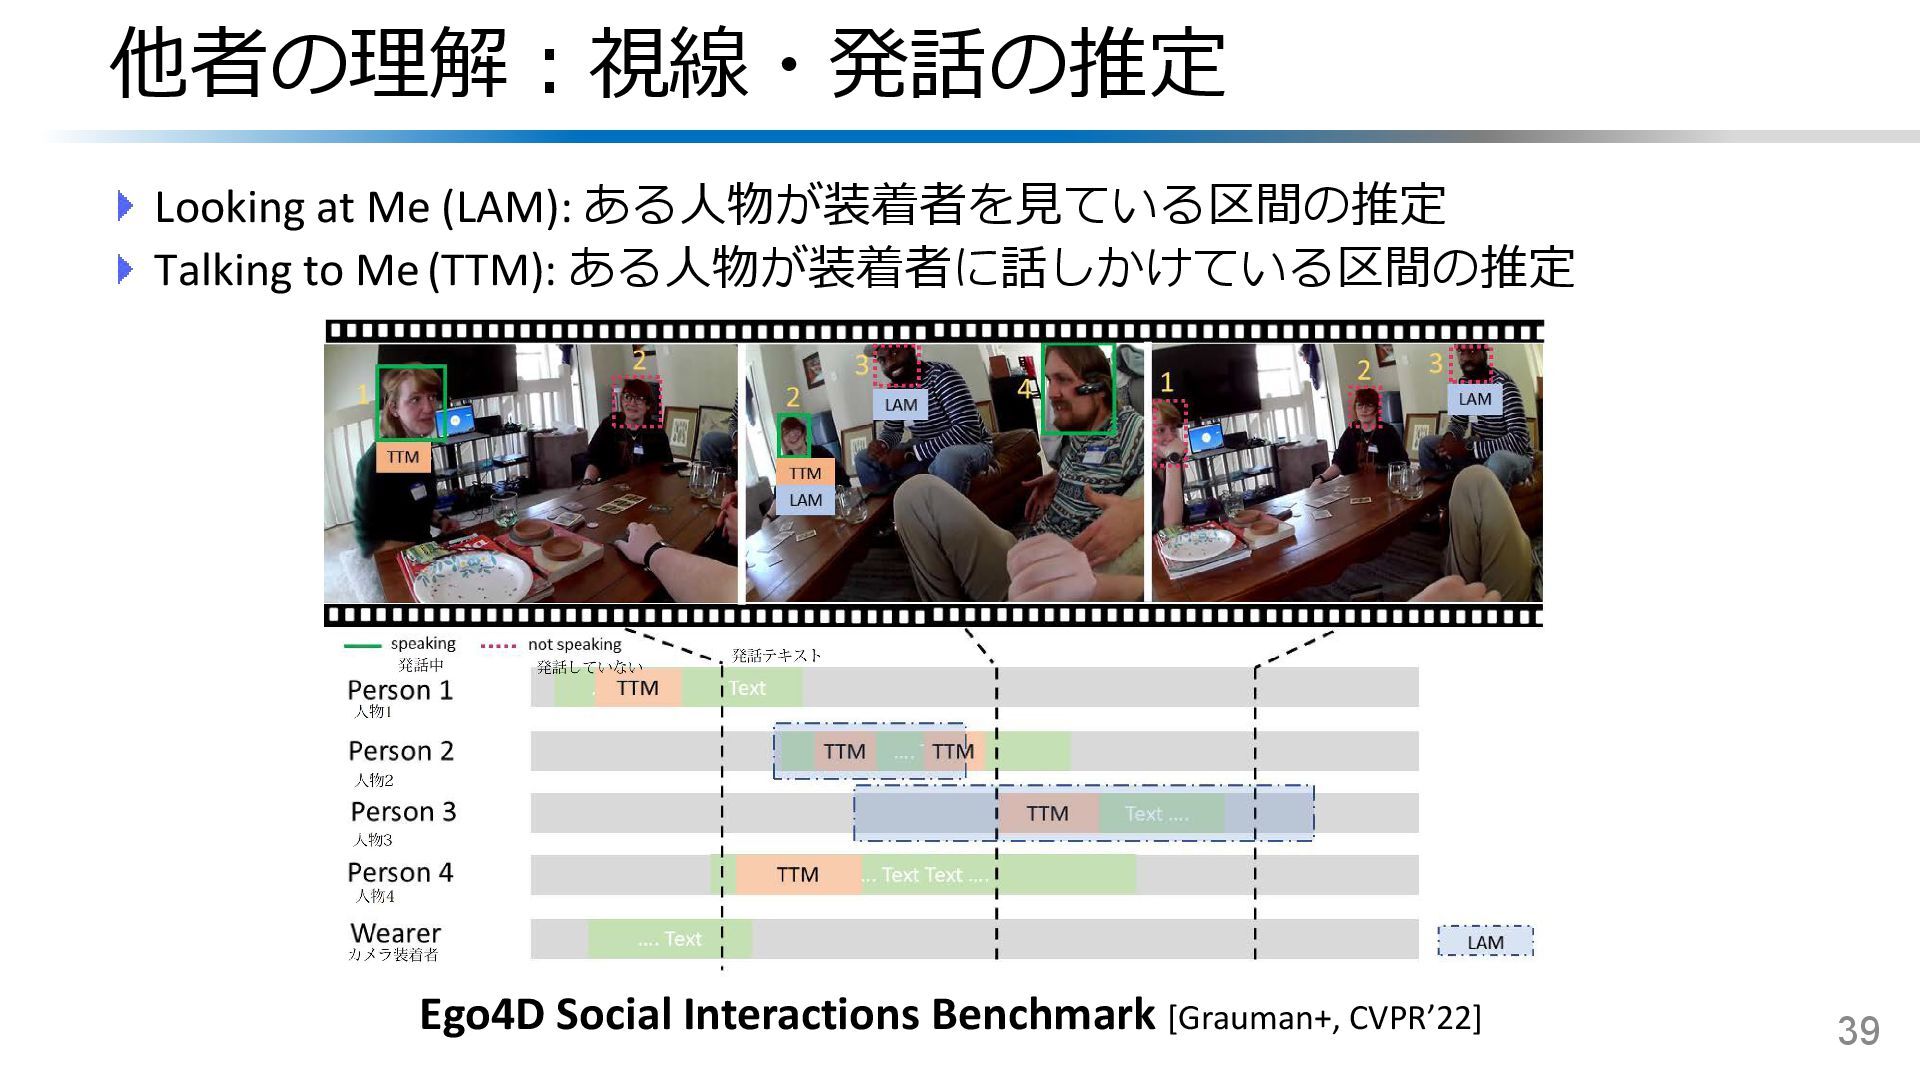
他者の理解:視線・発話の推定 Looking at Me (LAM): ある人物が装着者を見ている区間の推定 Talking to Me(TTM): ある人物が装着者に話しかけている区間の推定
39 Ego4D Social Interactions Benchmark [Grauman+, CVPR’22] -
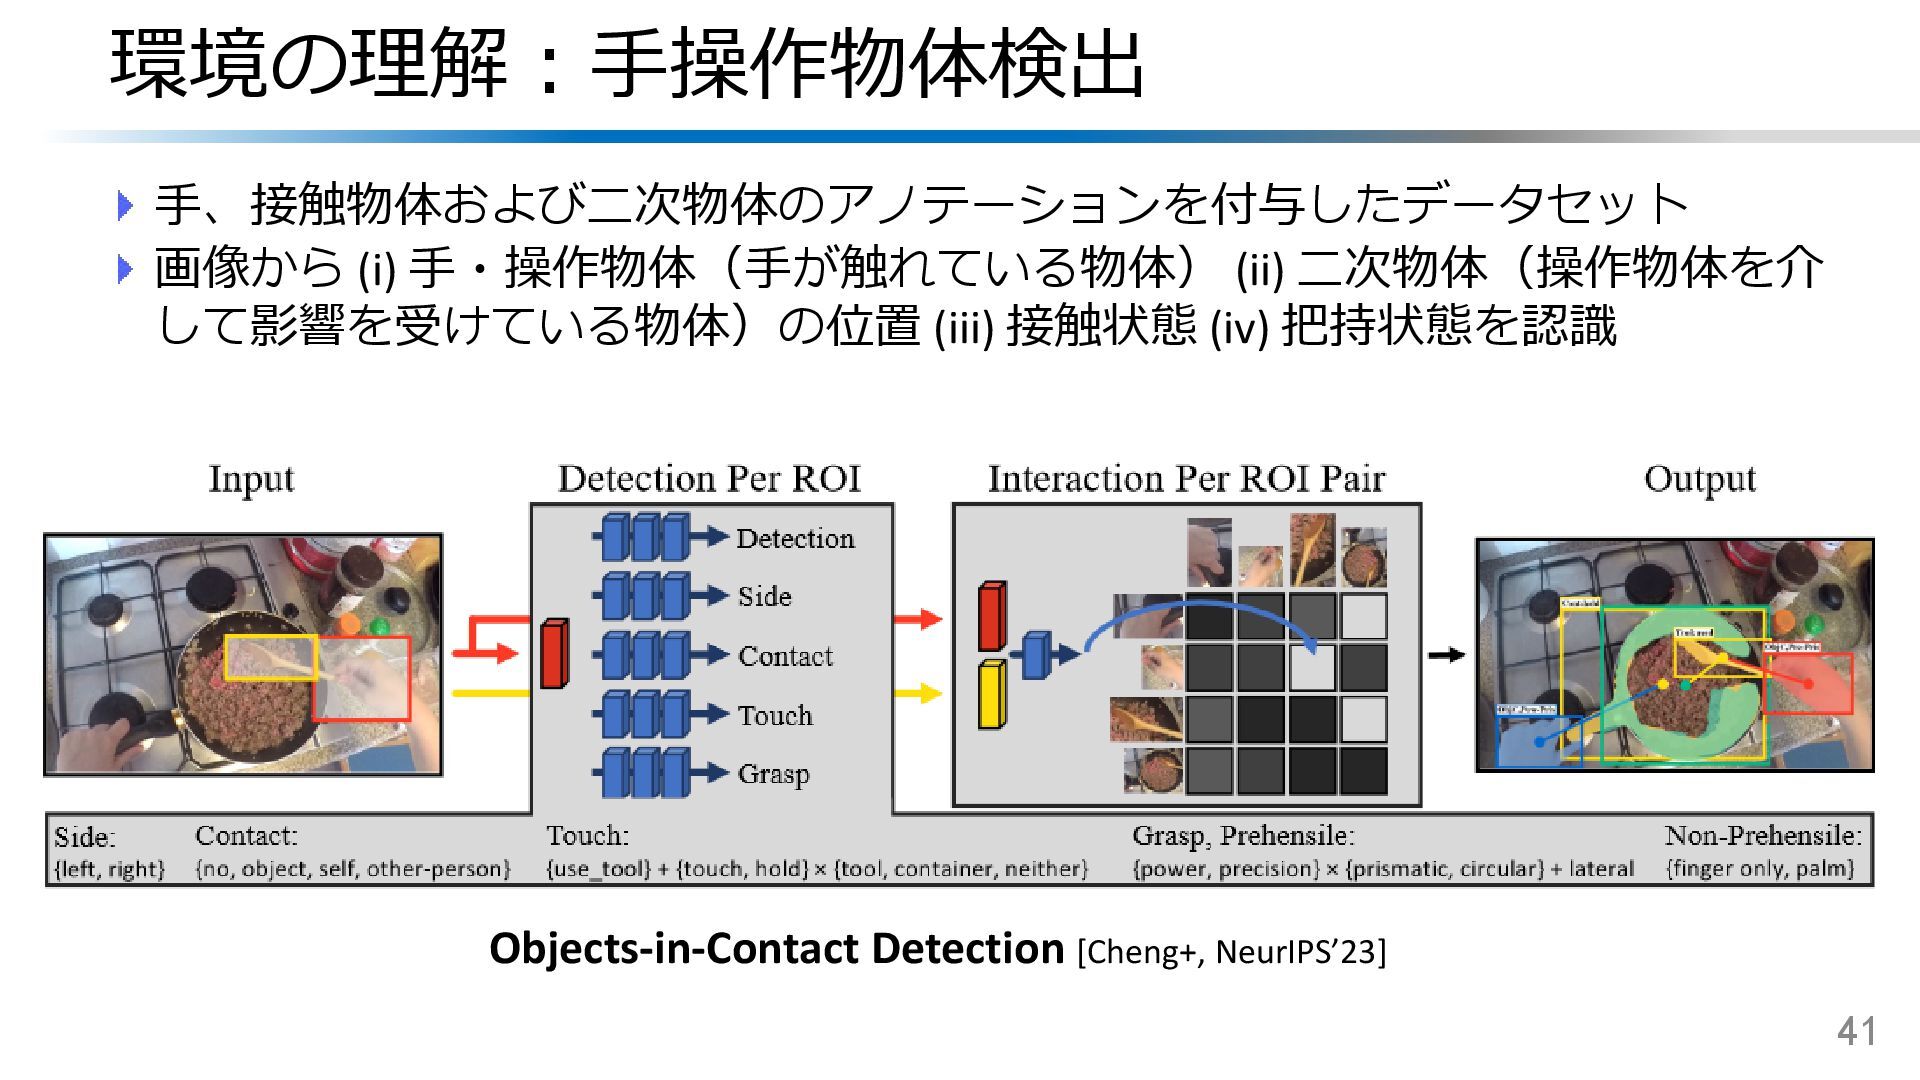
環境の理解:手操作物体検出 手、接触物体および二次物体のアノテーションを付与したデータセット 画像から (i) 手・操作物体(手が触れている物体) (ii) 二次物体(操作物体を介 して影響を受けている物体)の位置 (iii) 接触状態
(iv) 把持状態を認識 41 Objects-in-Contact Detection [Cheng+, NeurIPS’23] -
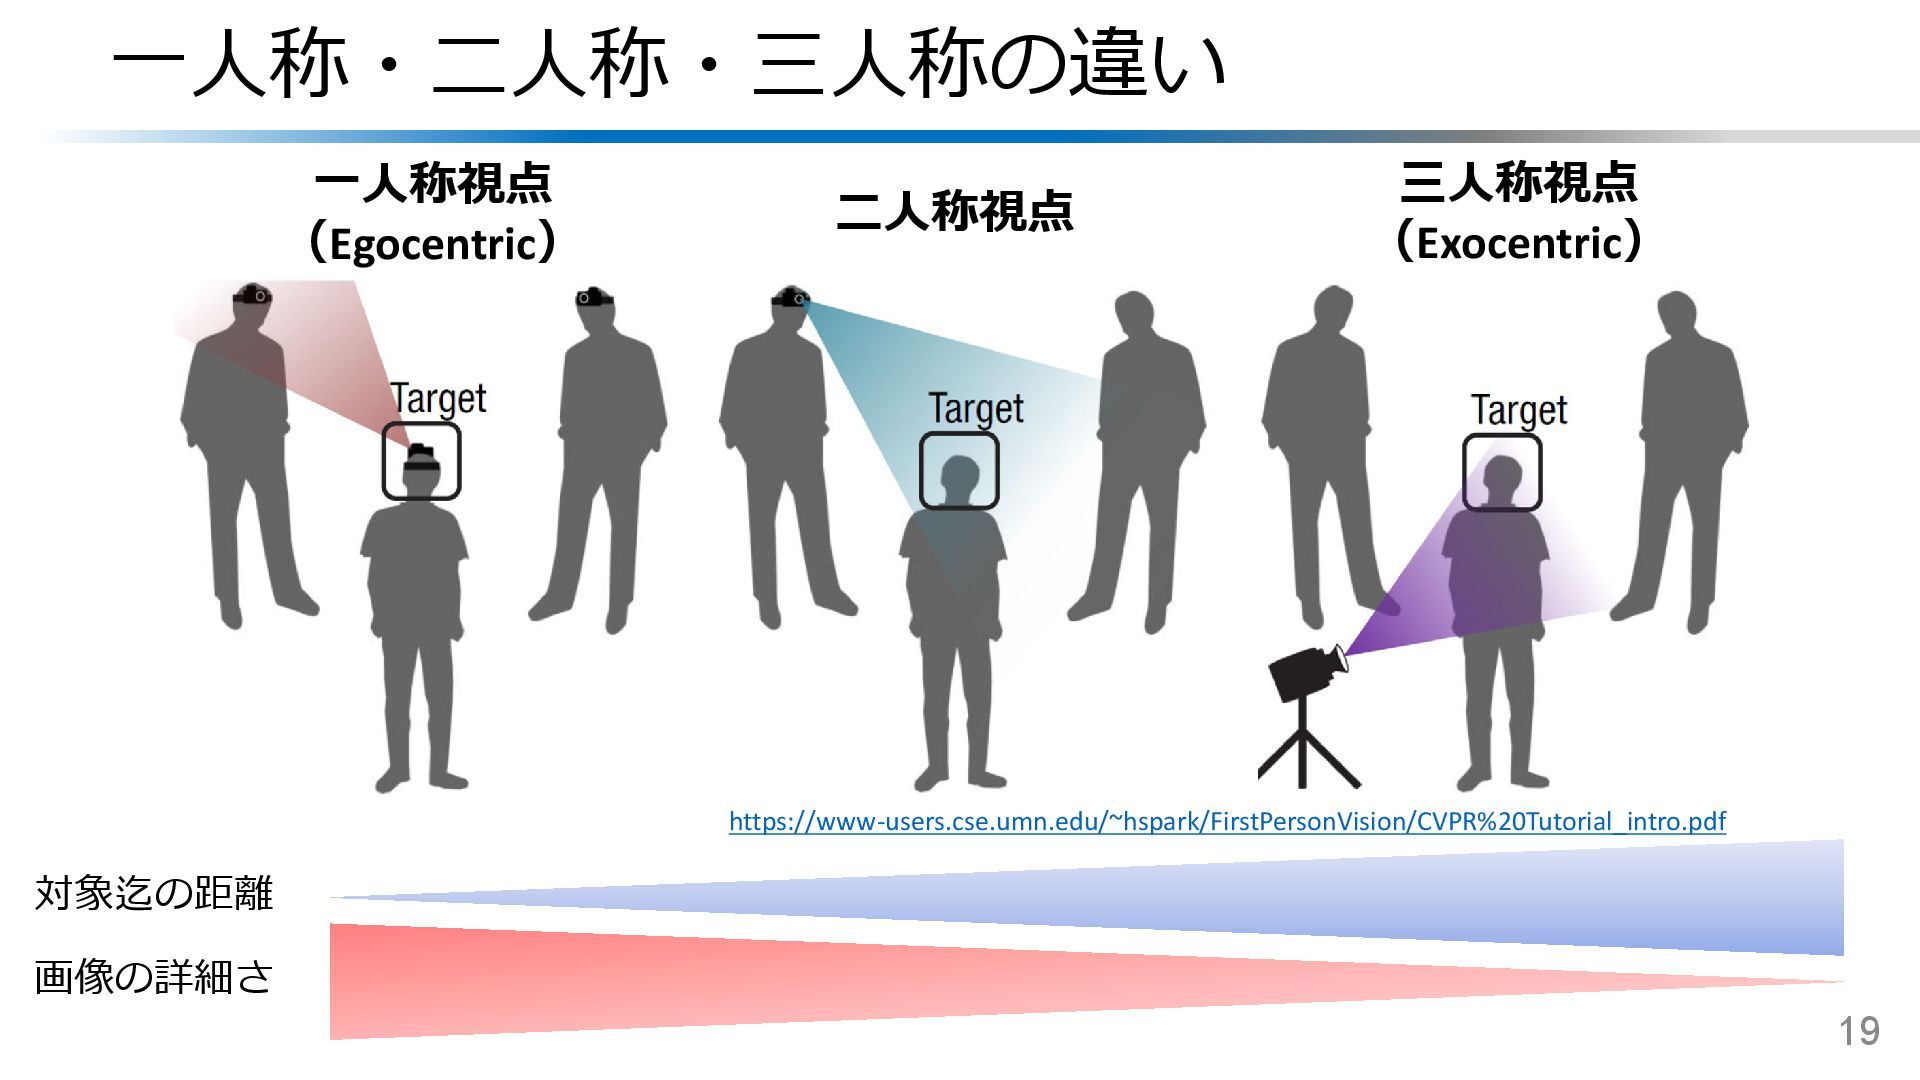
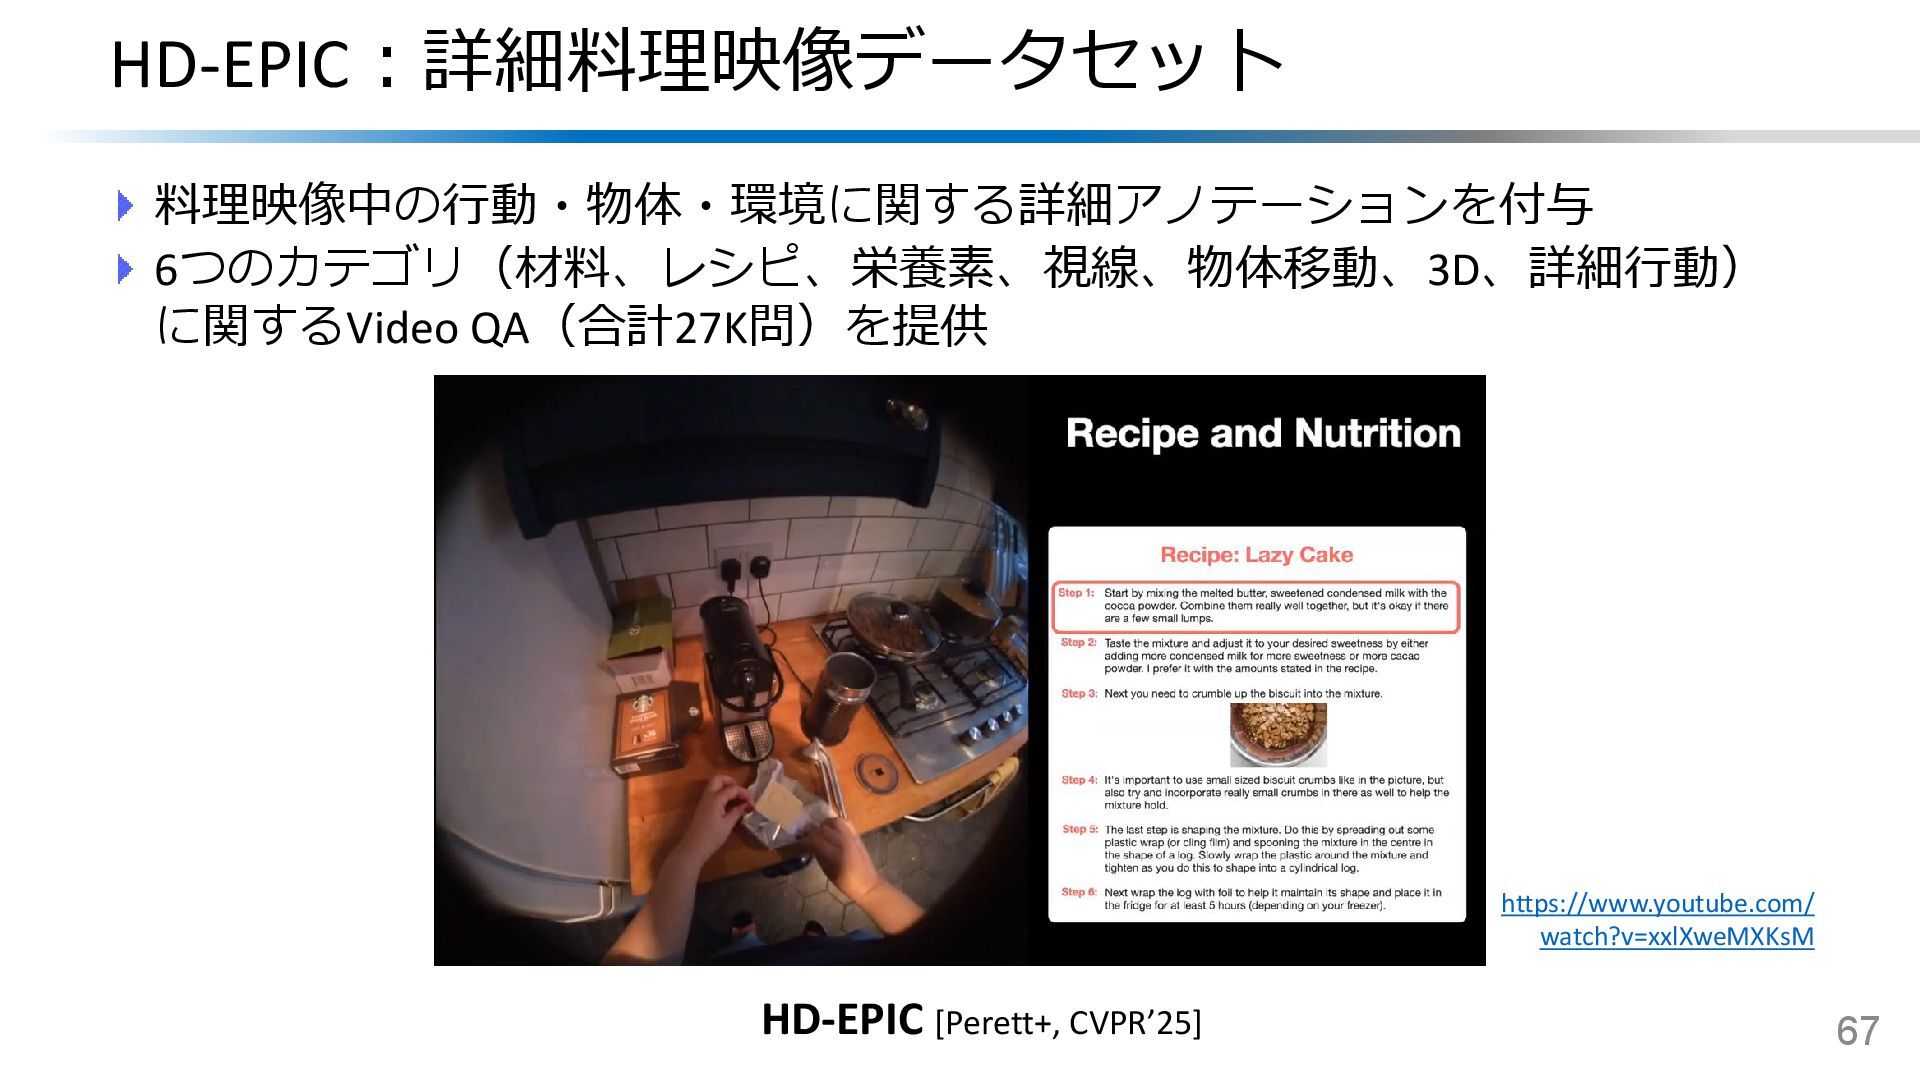
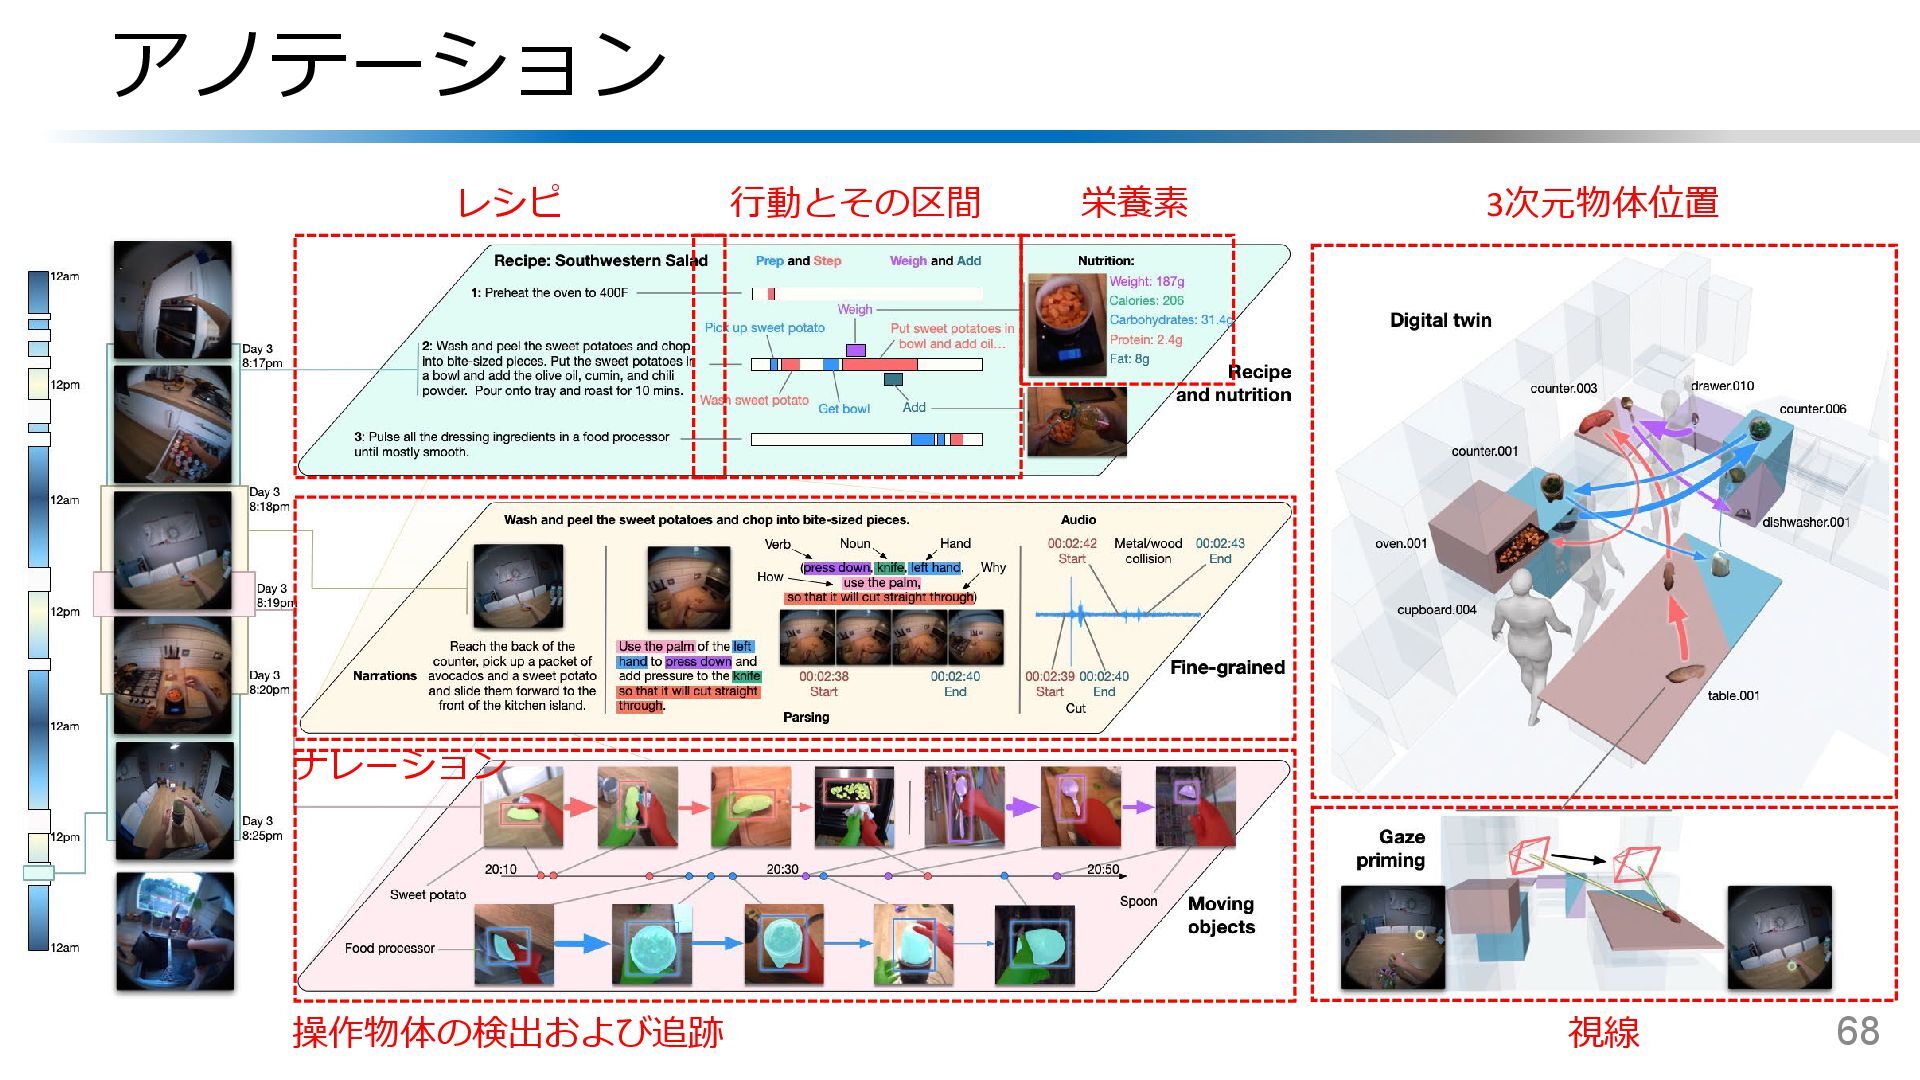
一人称視点映像のデータセット インターネット上に登場しないデータのため、独自に収集する必要がある 近年、多組織連携を通じてより大規模かつ網羅的な映像データセットが整備 47 EPIC-KITCHENS [Damen+, ECCV’18;IJCV’22] Ego4D [Grauman+, CVPR’22]
Ego-Exo4D [Grauman+, CVPR’24] 2か国/2組織/著者11人 9か国/13組織/著者85人 10か国/22組織/著者101人 -
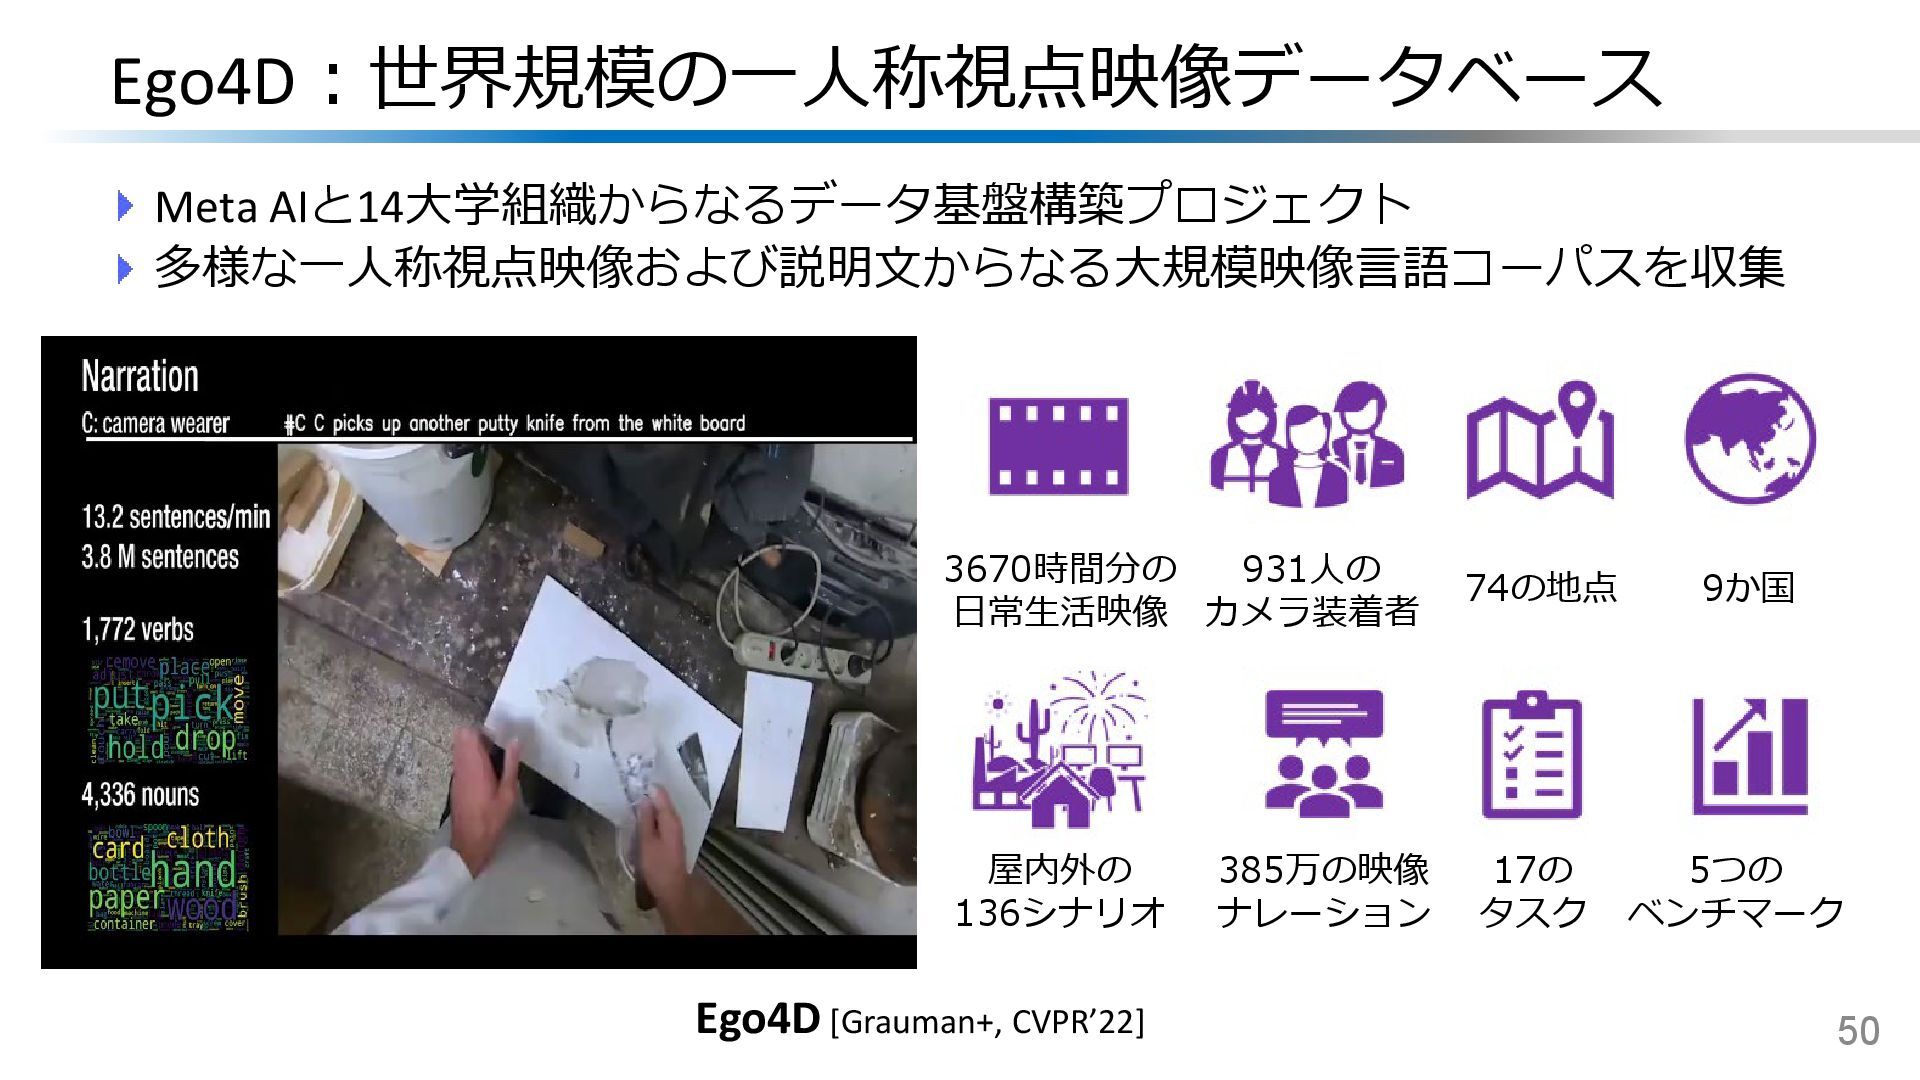
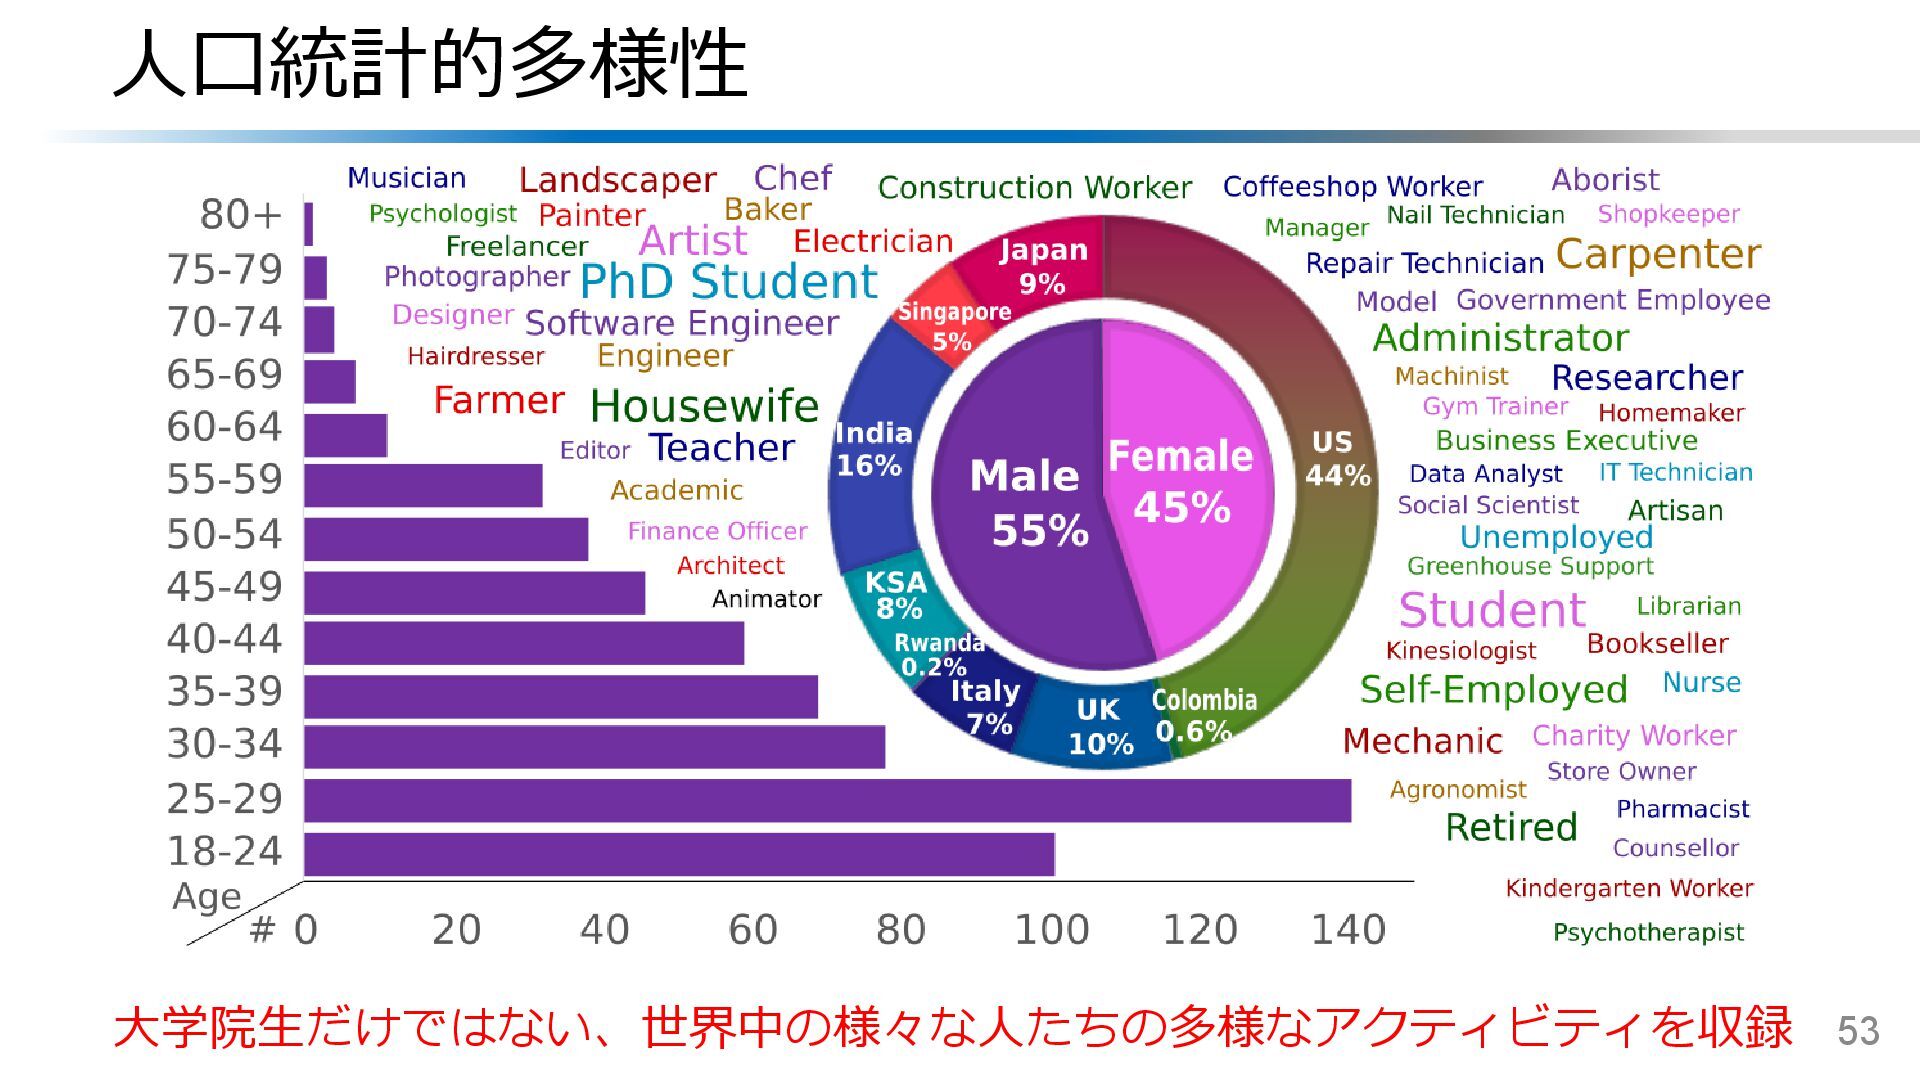
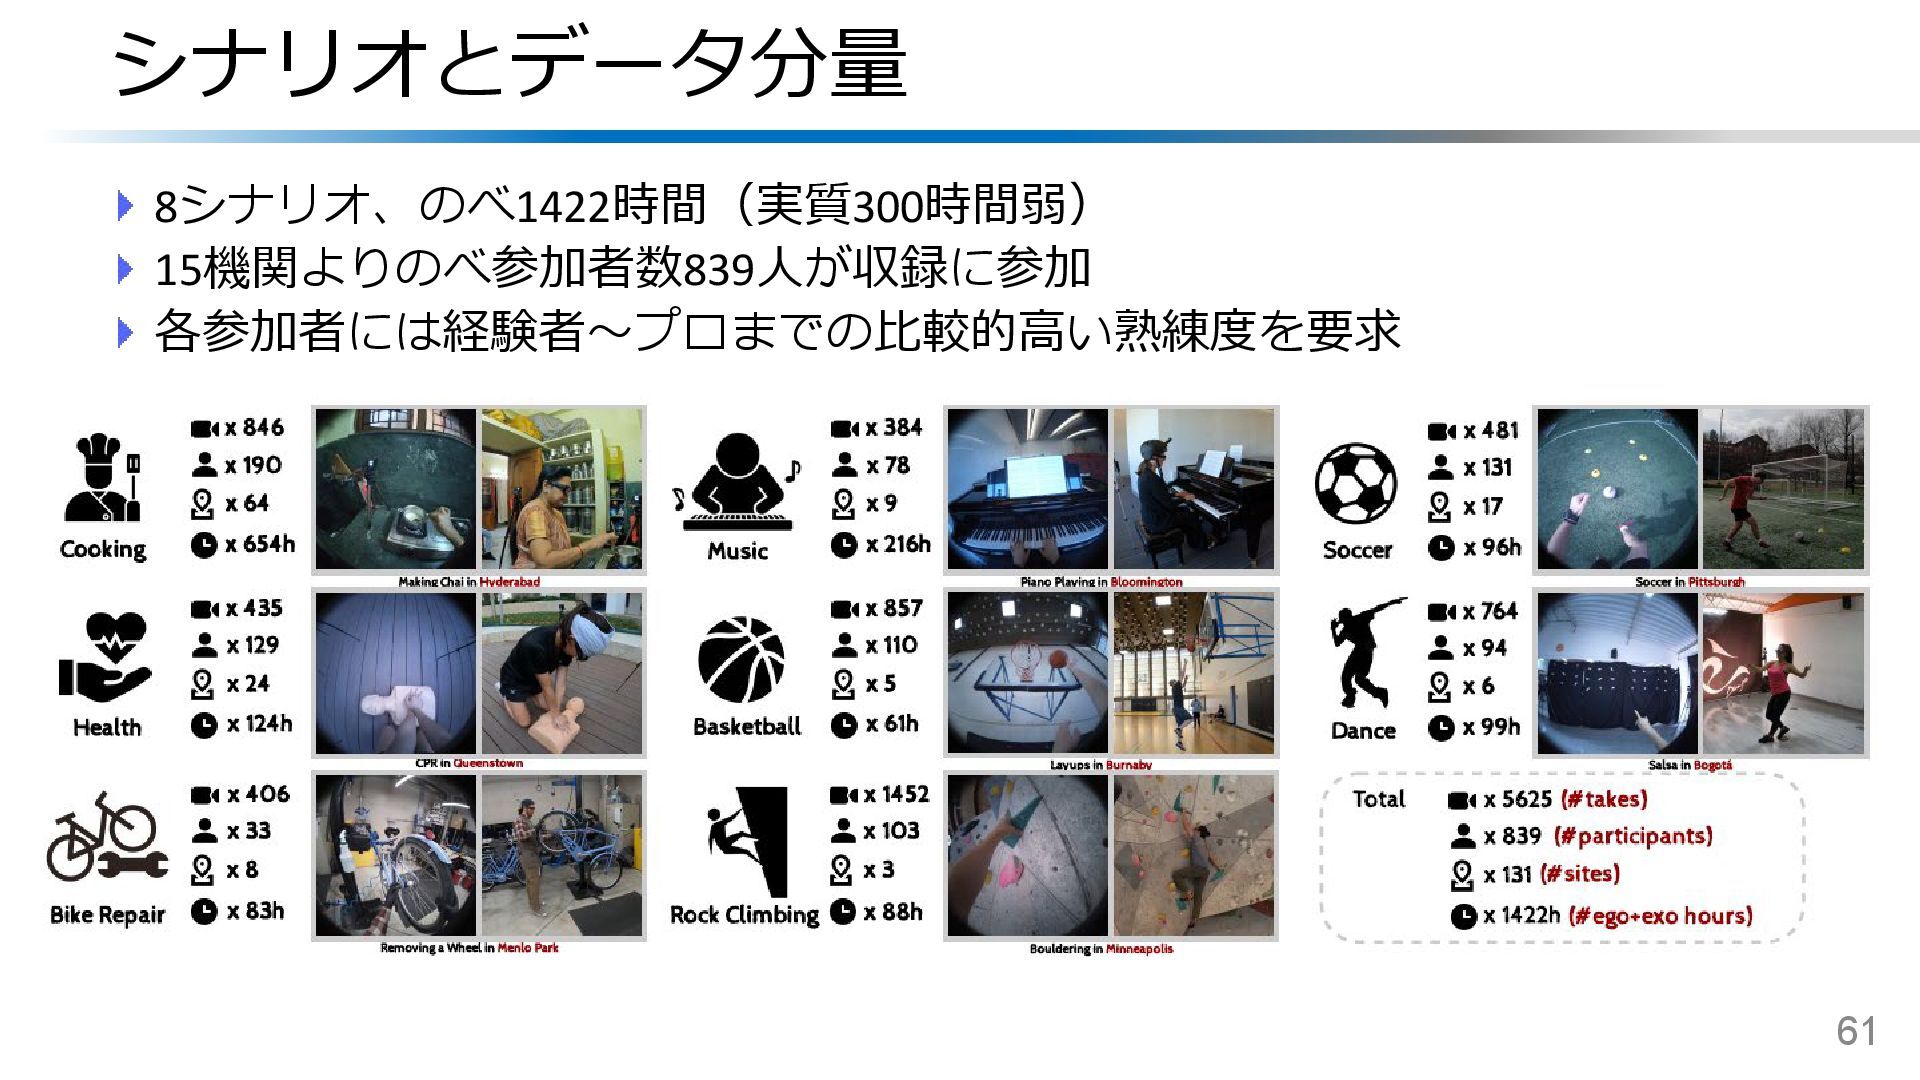
Ego4D:世界規模の一人称視点映像データベース Meta AIと14大学組織からなるデータ基盤構築プロジェクト 多様な一人称視点映像および説明文からなる大規模映像言語コーパスを収集 50 3670時間分の 日常生活映像 931人の カメラ装着者 74の地点
9か国 屋内外の 136シナリオ 385万の映像 ナレーション 17の タスク 5つの ベンチマーク Ego4D [Grauman+, CVPR’22] -
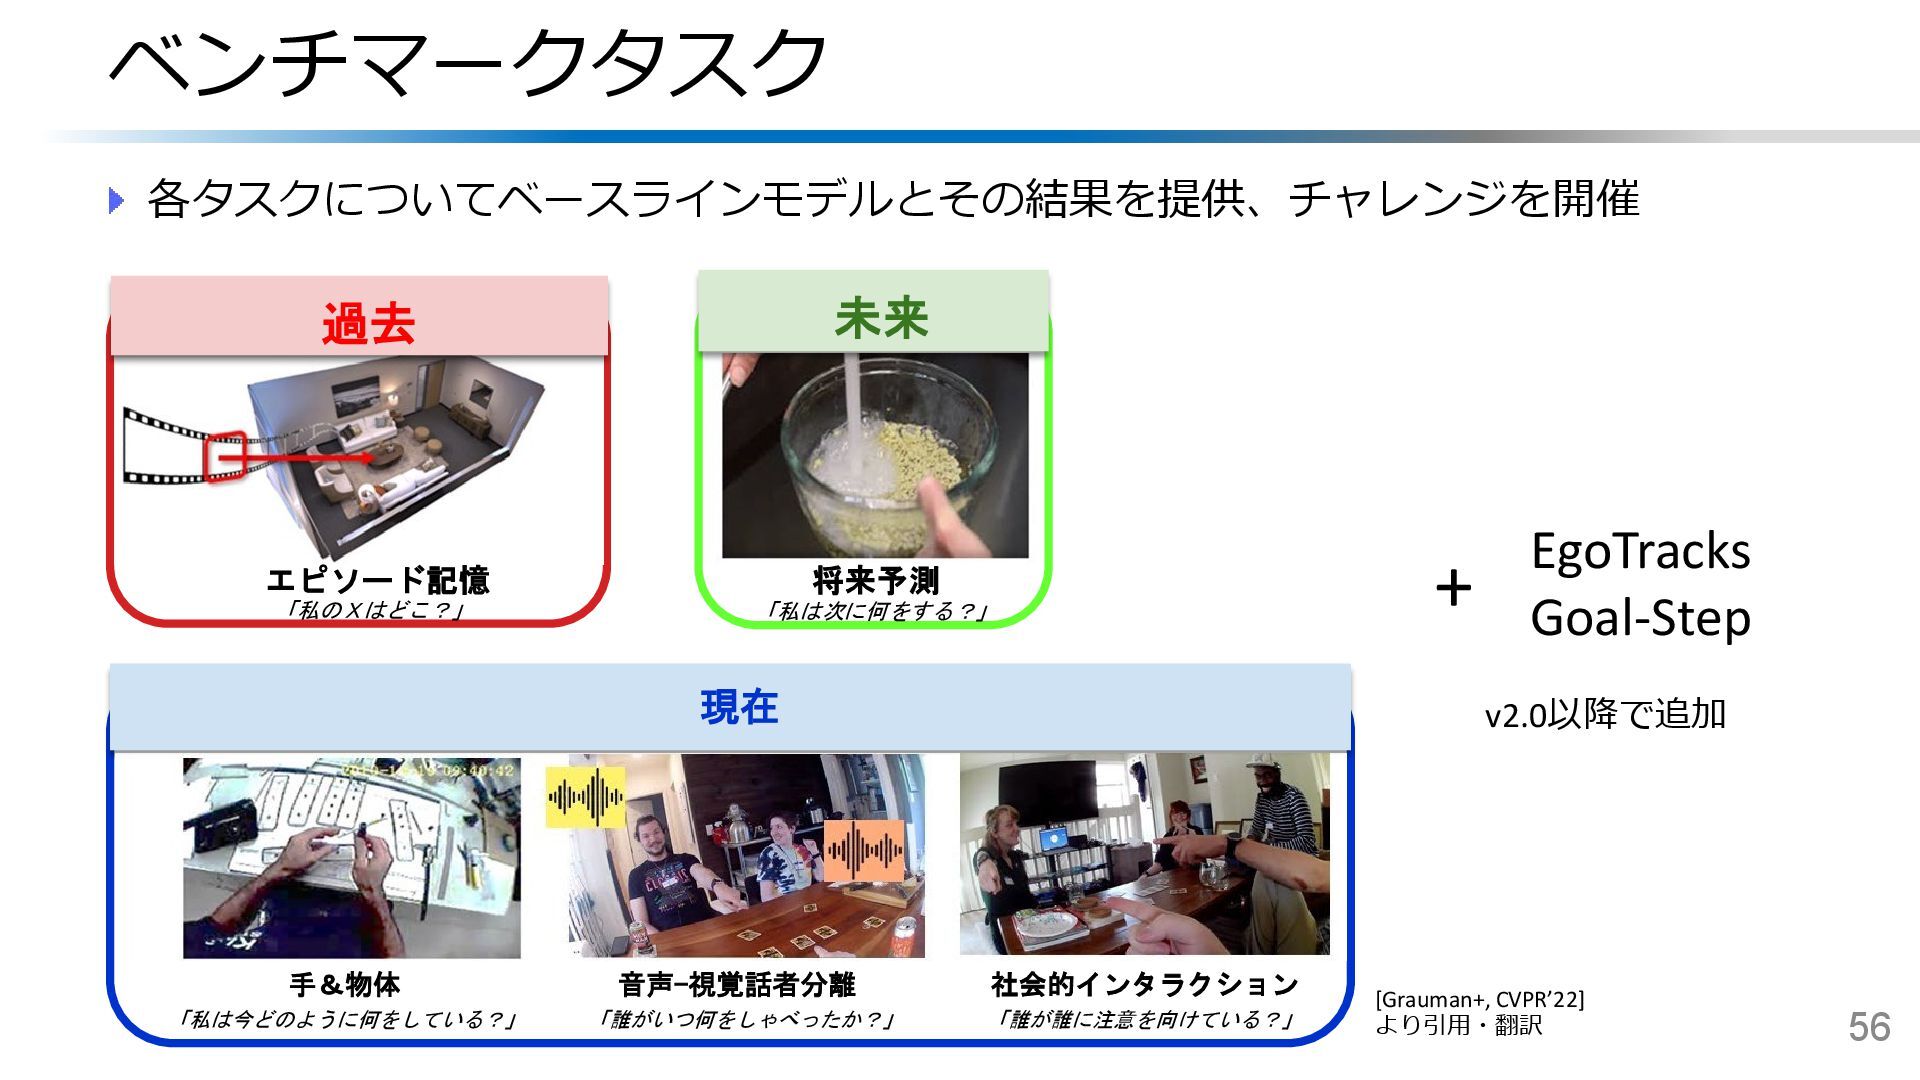
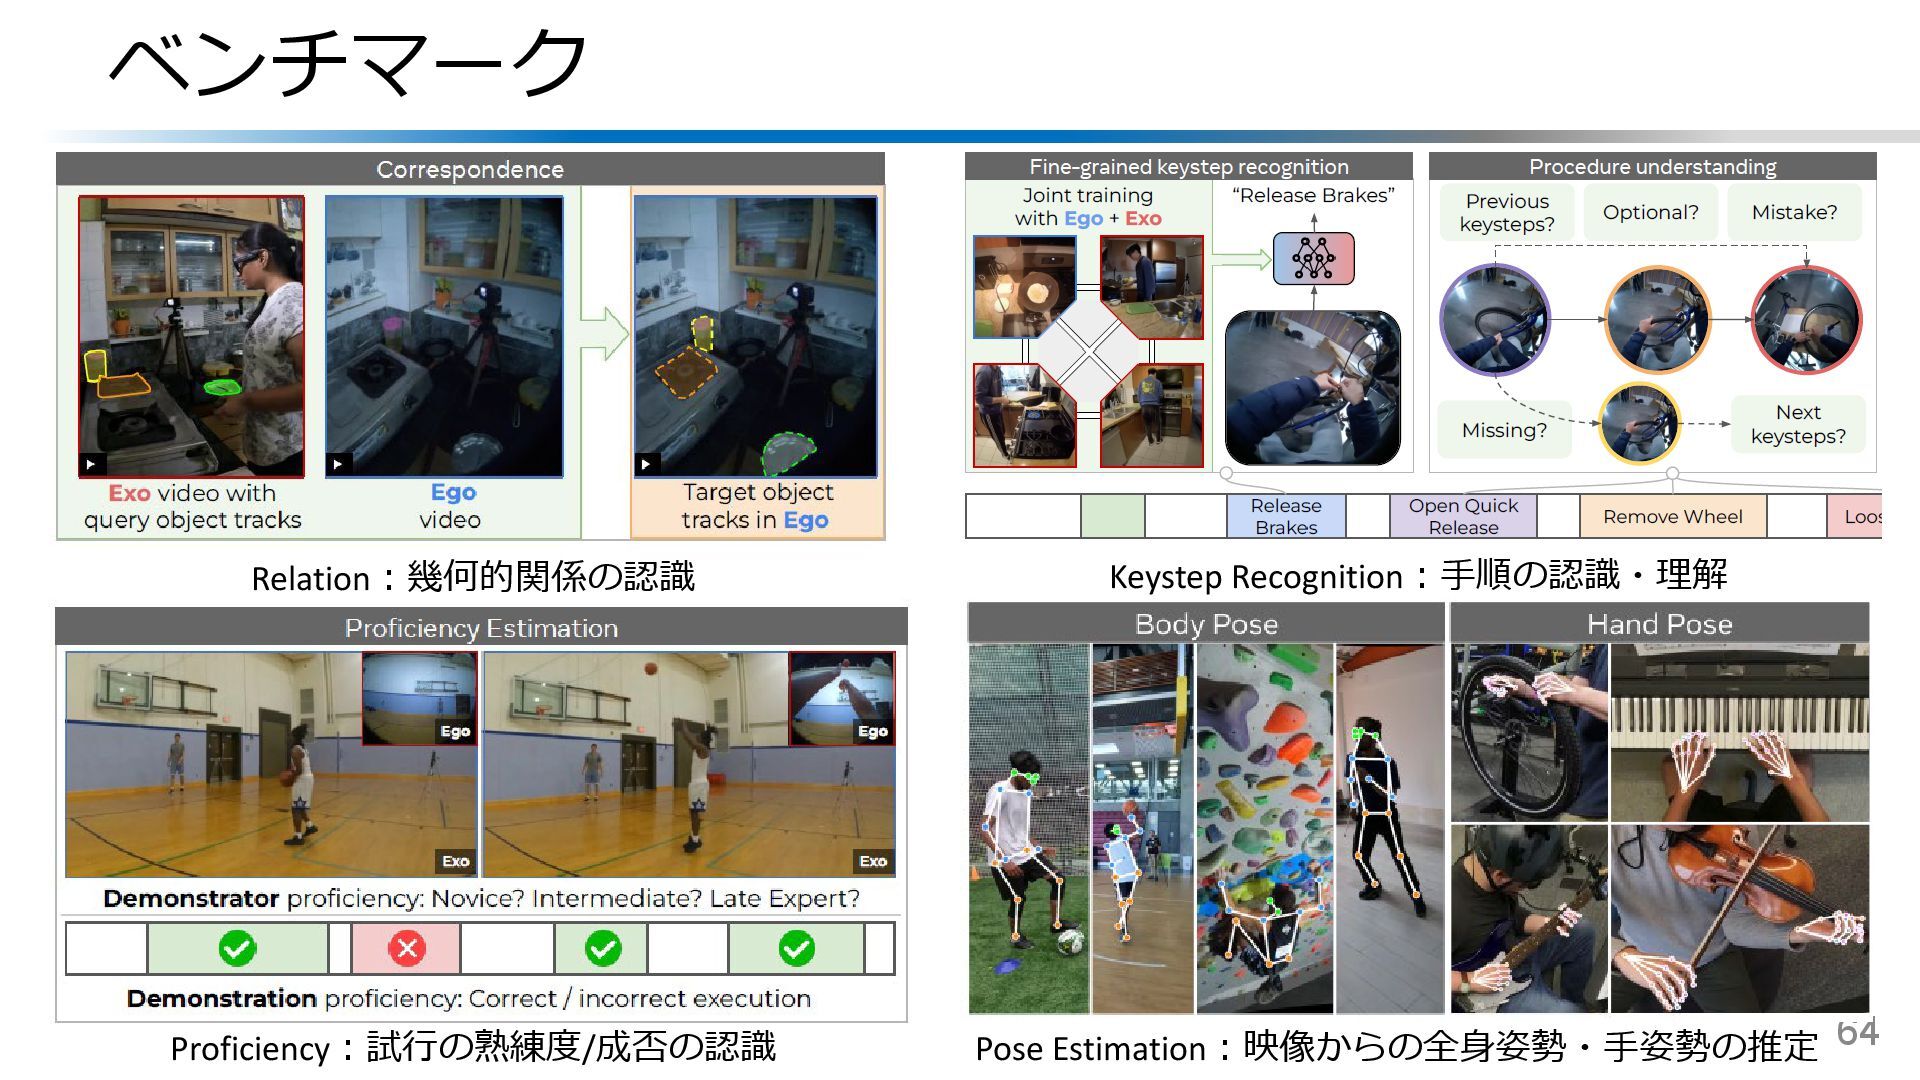
ベンチマークタスク 各タスクについてベースラインモデルとその結果を提供、チャレンジを開催 56 過去 エピソード記憶 「私のXはどこ?」 現在 手&物体 「私は今どのように何をしている?」 音声-視覚話者分離
「誰がいつ何をしゃべったか?」 社会的インタラクション 「誰が誰に注意を向けている?」 将来予測 「私は次に何をする?」 未来 [Grauman+, CVPR’22] より引用・翻訳 + EgoTracks Goal-Step v2.0以降で追加 -
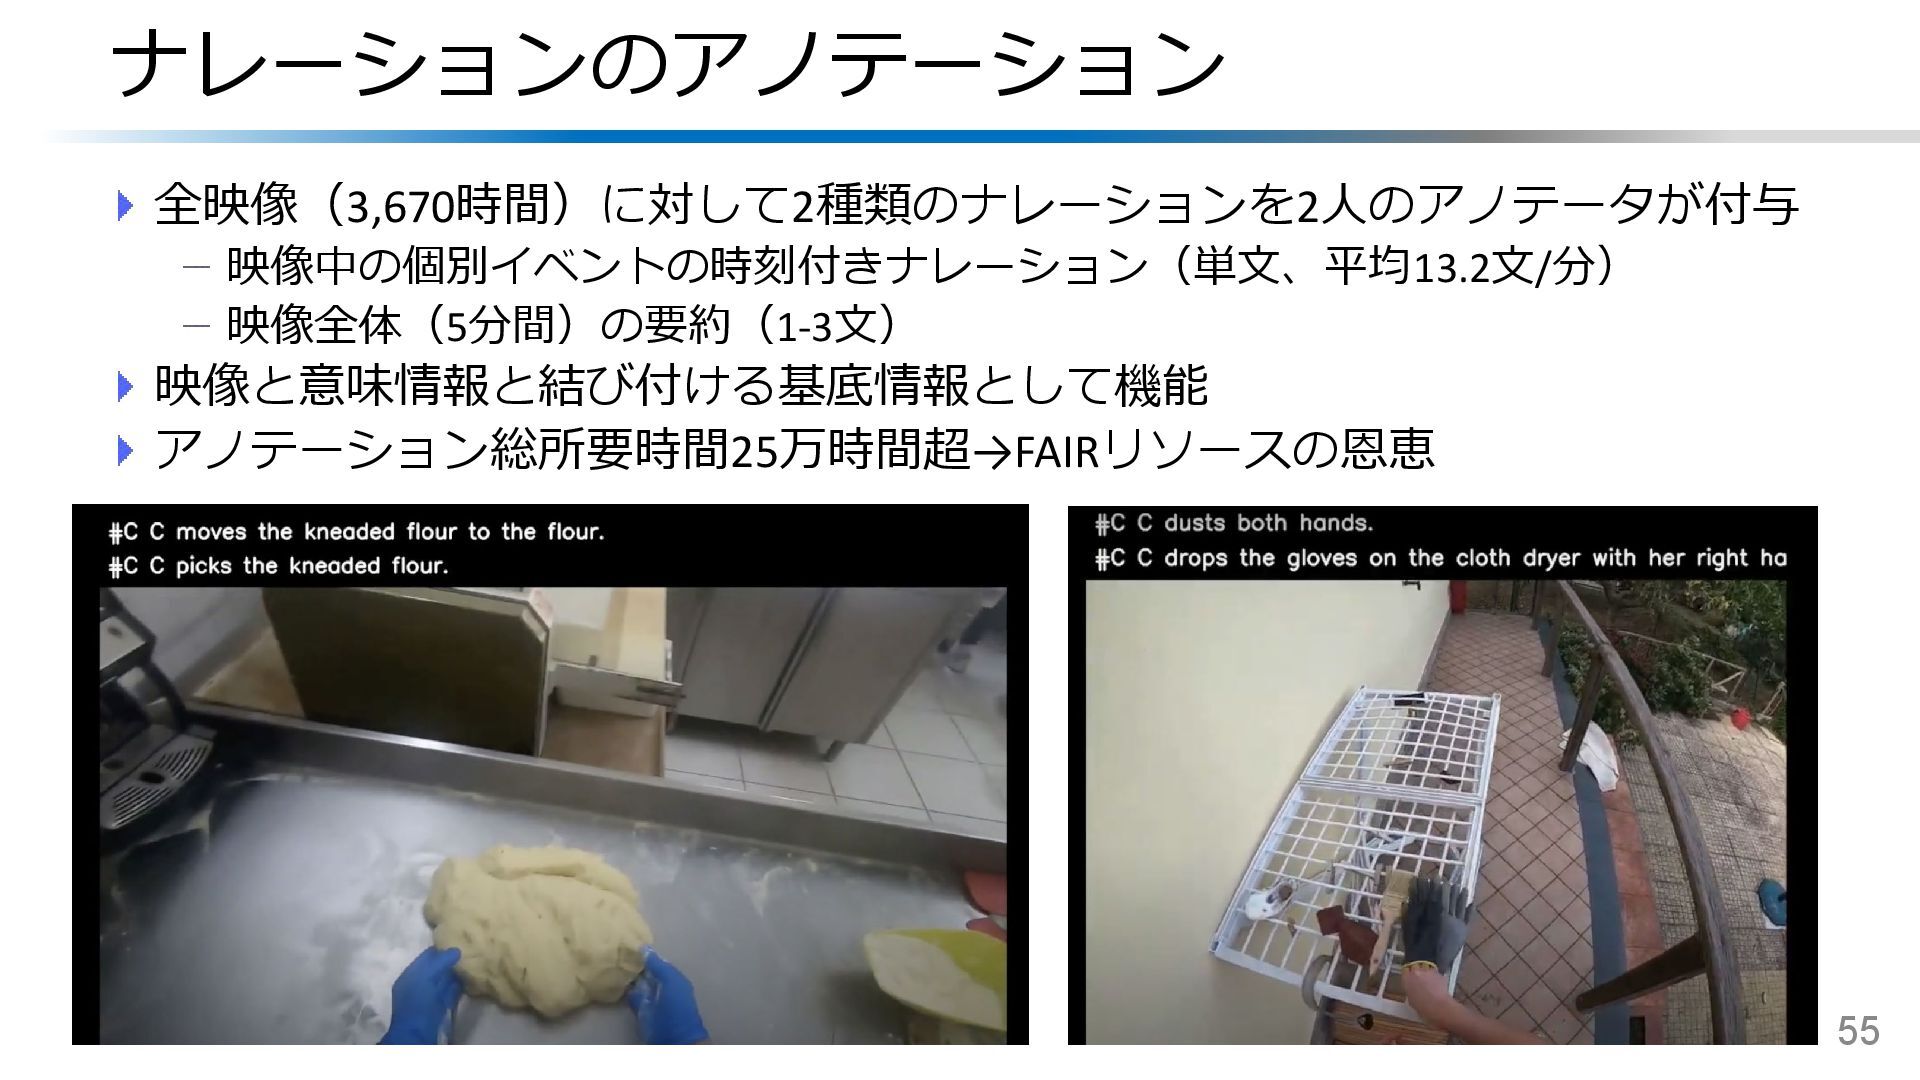
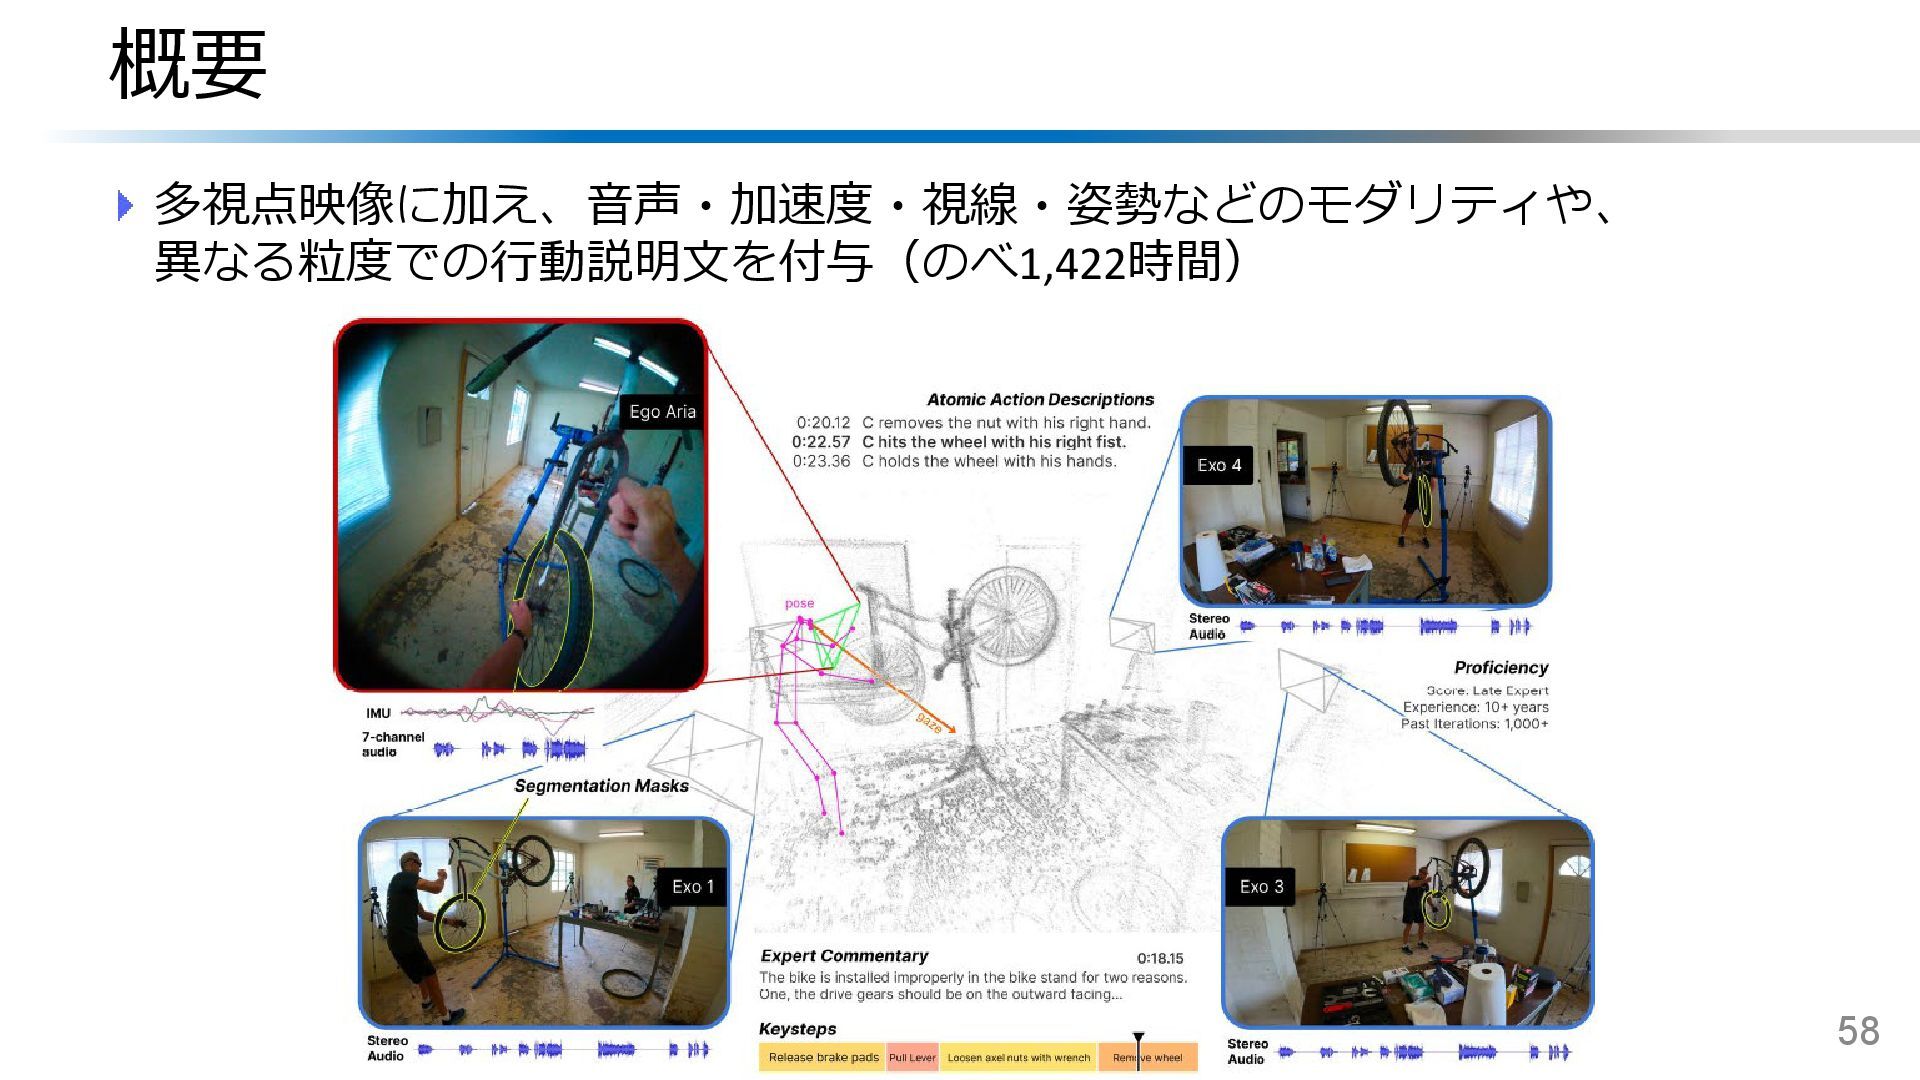
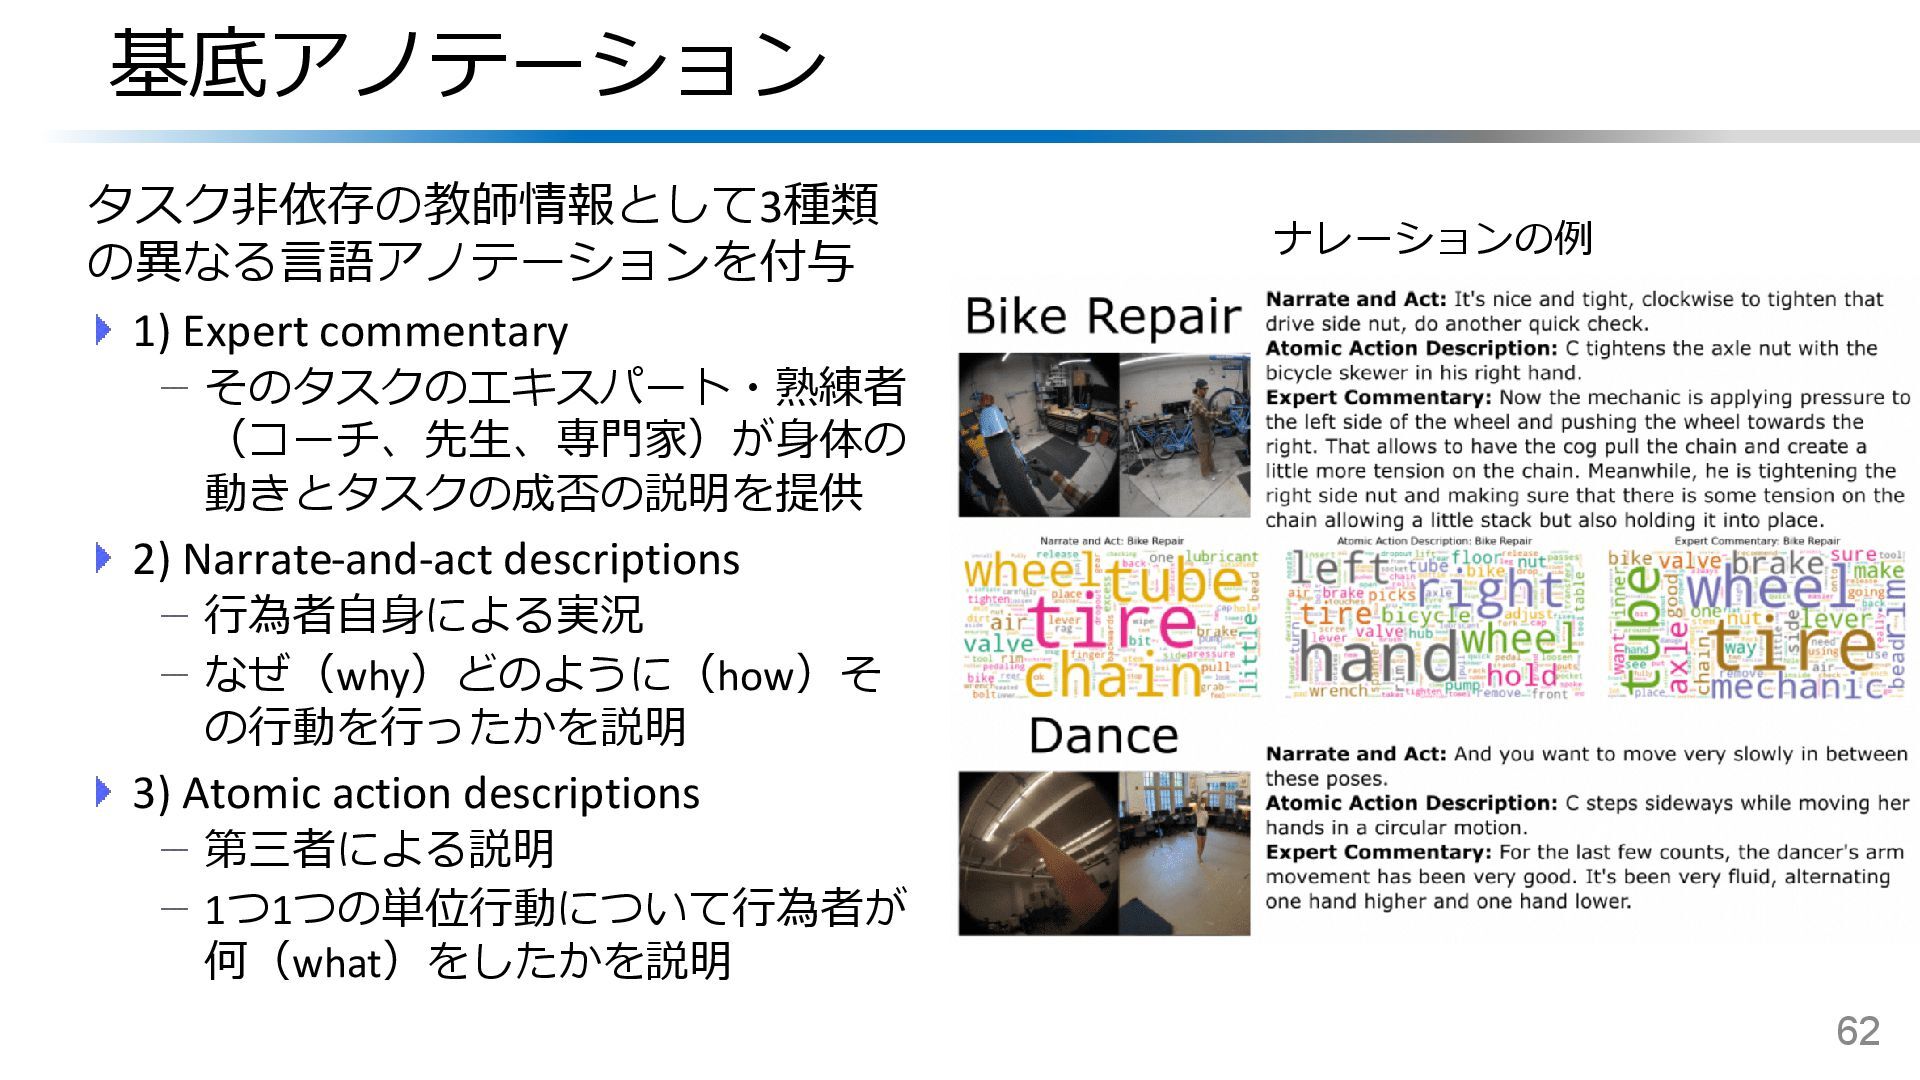
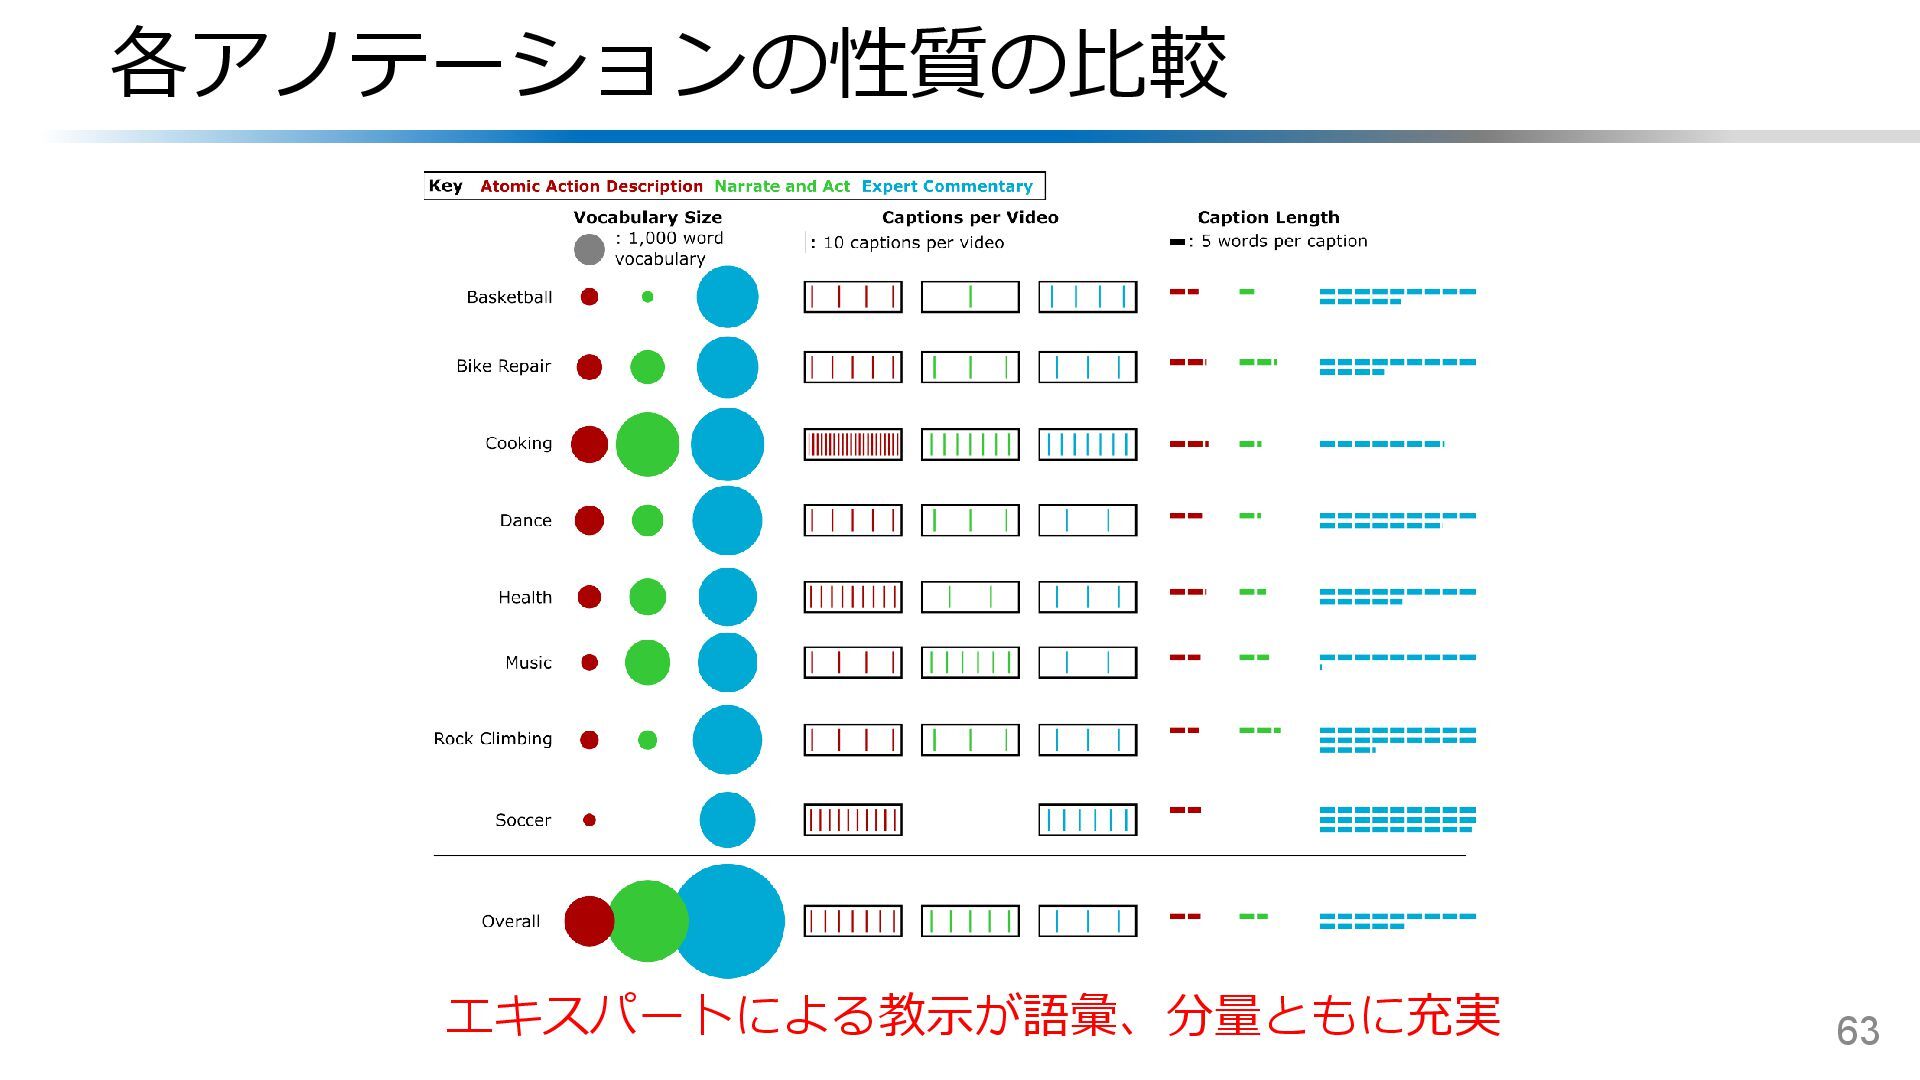
基底アノテーション タスク非依存の教師情報として3種類 の異なる言語アノテーションを付与 1) Expert commentary そのタスクのエキスパート・熟練者 (コーチ、先生、専門家)が身体の 動きとタスクの成否の説明を提供 2)
Narrate-and-act descriptions 行為者自身による実況 なぜ(why)どのように(how)そ の行動を行ったかを説明 3) Atomic action descriptions 第三者による説明 1つ1つの単位行動について行為者が 何(what)をしたかを説明 62 ナレーションの例 -
質問例(Fine-grained Action) 69 以下の文のうち、どれがビデオ内の動作を最もよく表していますか? [00:03:56 – 00:04:03] A. 右手のスポンジでまな板を洗い、その後、裏面も洗えるようにまな板を回転させる B.
右手にスポンジを持ってまな板を洗いながら左手で固定し、その後左手でまな板を水で流して石けんを落とす C. 左手でまな板を食器ラックから取り出し、両手でキッチンカウンターに置く D. 左手でまな板を持ち上げ、その後両手で水道の下にまな板をかざして洗う E. 右手で乾燥ラックからまな板を取り上げ、左手のティータオルでまな板を拭きながら右手でひっくり返して回 転させる 左右の手の操作物体とその操作 -
質問例(Ingredients) 70 このビデオで参加者が計量した赤パプリカは何グラムでしたか? [00:14:04 – 00:14:21] A. 53 g B.
58 g C. 46 g D. 68 g E. 71 g 材料の認識と計器読み取り -
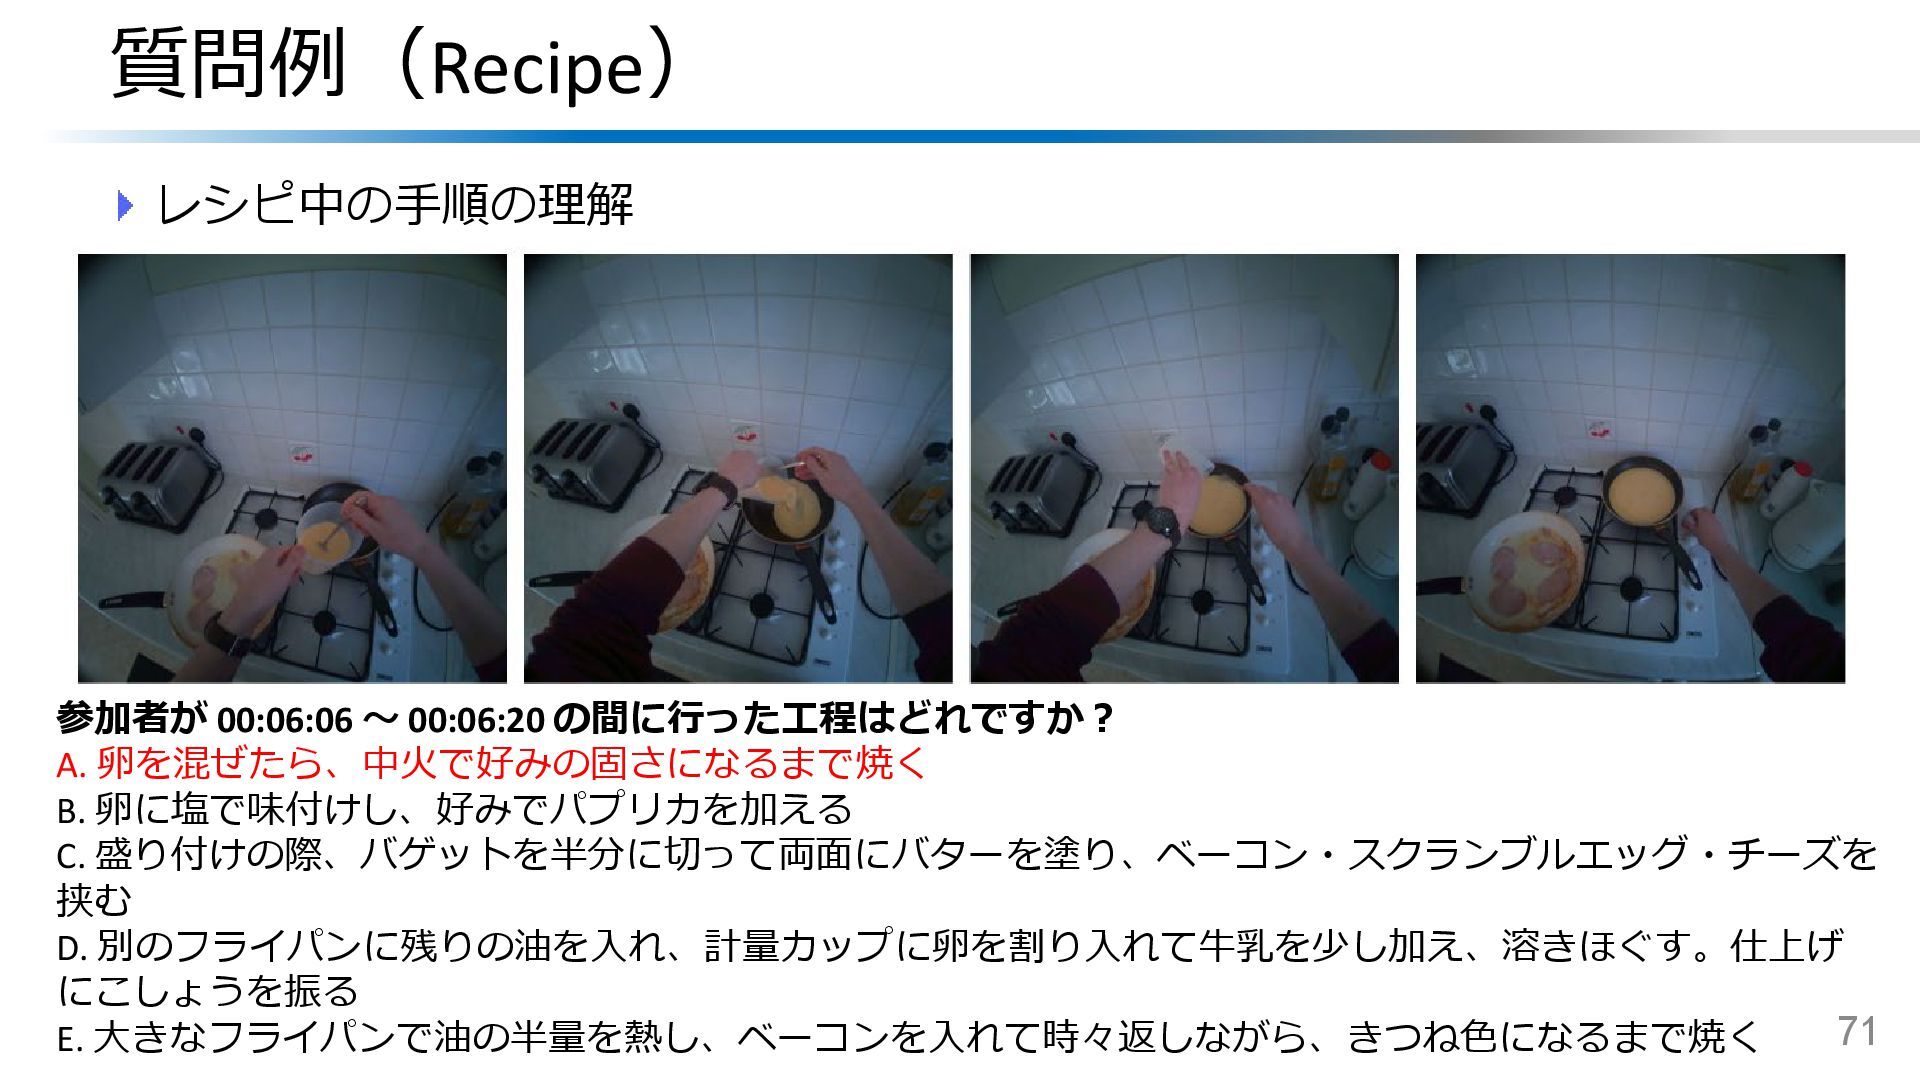
質問例(Recipe) 71 参加者が 00:06:06 〜 00:06:20 の間に行った工程はどれですか? A. 卵を混ぜたら、中火で好みの固さになるまで焼く B.
卵に塩で味付けし、好みでパプリカを加える C. 盛り付けの際、バゲットを半分に切って両面にバターを塗り、ベーコン・スクランブルエッグ・チーズを 挟む D. 別のフライパンに残りの油を入れ、計量カップに卵を割り入れて牛乳を少し加え、溶きほぐす。仕上げ にこしょうを振る E. 大きなフライパンで油の半量を熱し、ベーコンを入れて時々返しながら、きつね色になるまで焼く レシピ中の手順の理解 -
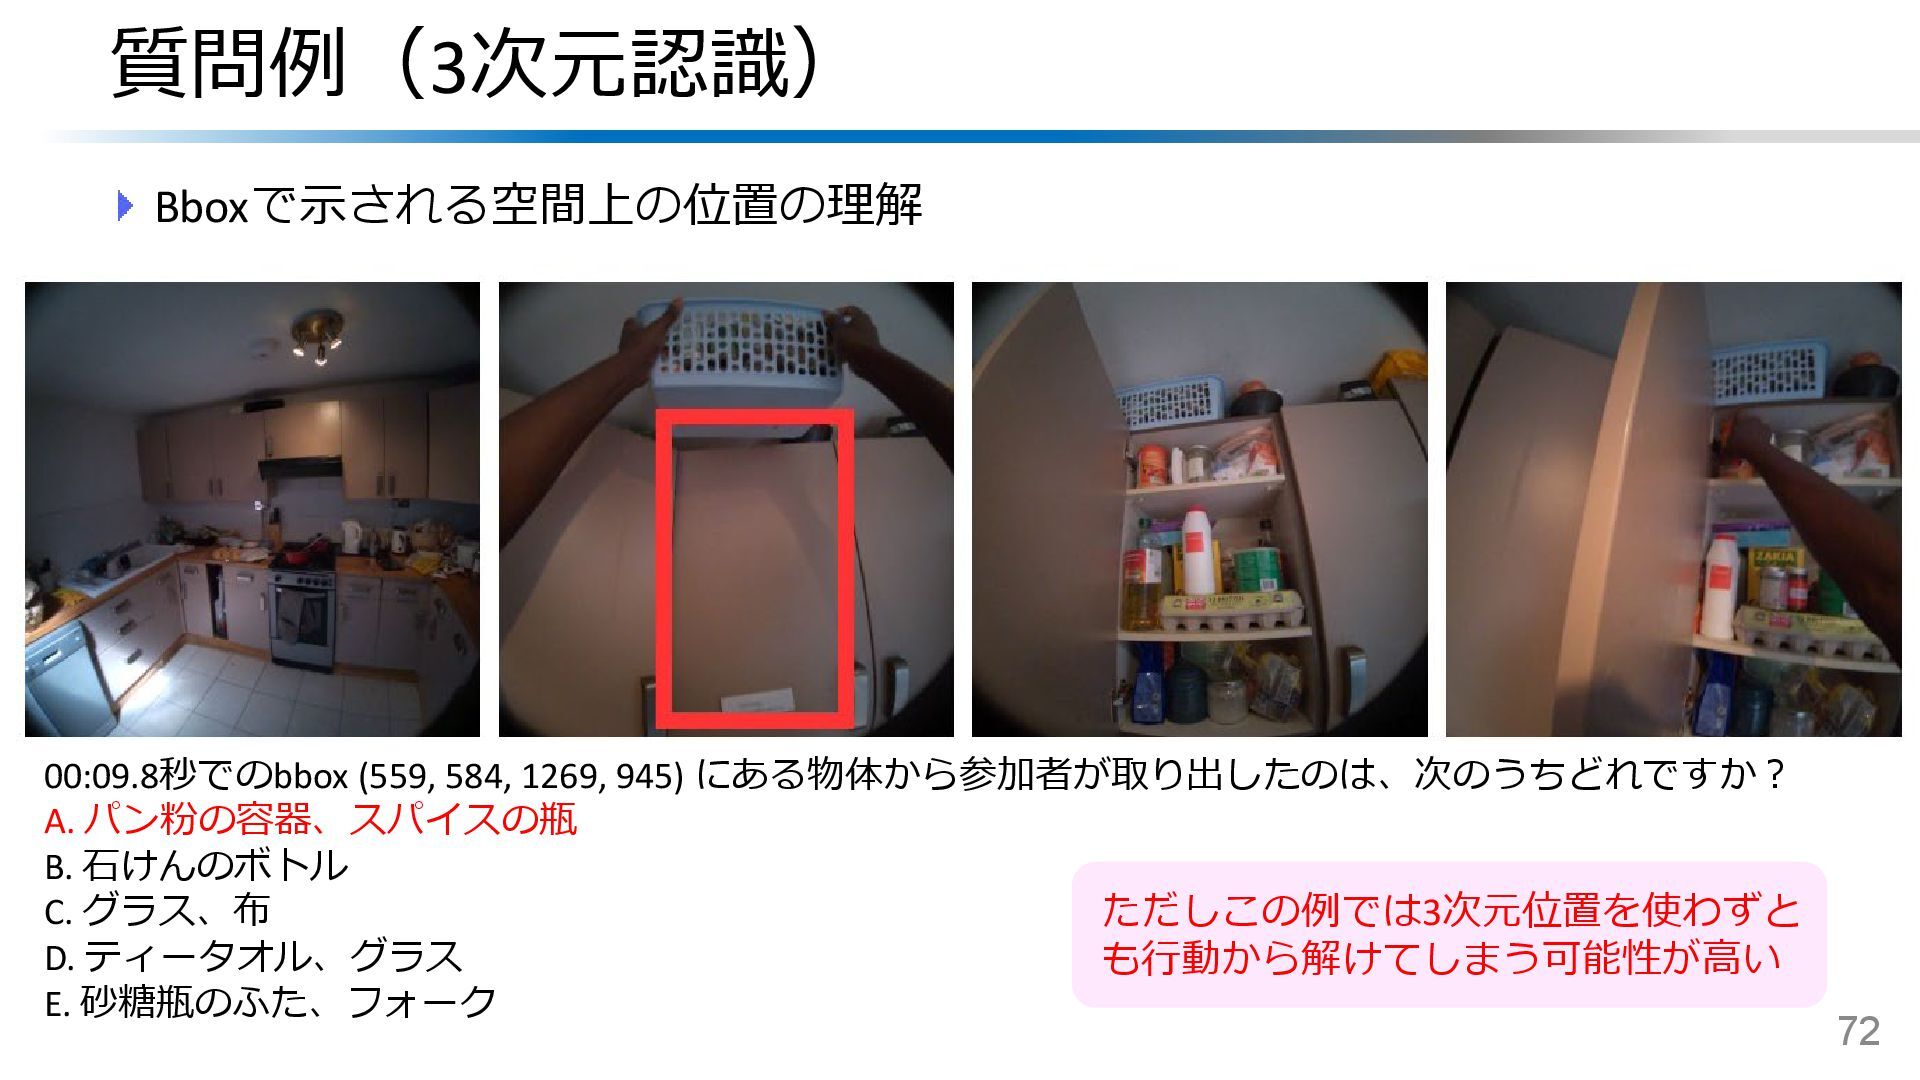
質問例(3次元認識) Bboxで示される空間上の位置の理解 72 00:09.8秒でのbbox (559, 584, 1269, 945) にある物体から参加者が取り出したのは、次のうちどれですか? A.
パン粉の容器、スパイスの瓶 B. 石けんのボトル C. グラス、布 D. ティータオル、グラス E. 砂糖瓶のふた、フォーク ただしこの例では3次元位置を使わずと も行動から解けてしまう可能性が高い -
その他のデータセット・ベンチマーク(1) 73 Assembly101 [Sener+, CVPR’22] 玩具模型の組立 EgoGen [Li+, CVPR’24] 環境認識モデル構築のための
一人称視点人工データジェネレータ EgoSchema [Mangalam+, NeurIPS’24] 映像全体の情報を要求する多肢選択QA Aria Digital Twin [Pan+, ICCV’23] 3次元理解のための屋内データセット -
その他のデータセット・ベンチマーク(2) 74 EgoTextVQA [Zhou+, CVPR’25] 映像中のテキスト理解を要求するVideoQA HanDyVQA [Tateno+, MIRU’25] 詳細手物体インタラクション理解を要求するVideoQA
HoloAssist [Wang+, ICCV’23] 1対1の遠隔教示映像データセット(166時間) Nymeria [Ma+, ECCV’24] 屋内外の全身運動を記録したデータセット(300時間) -
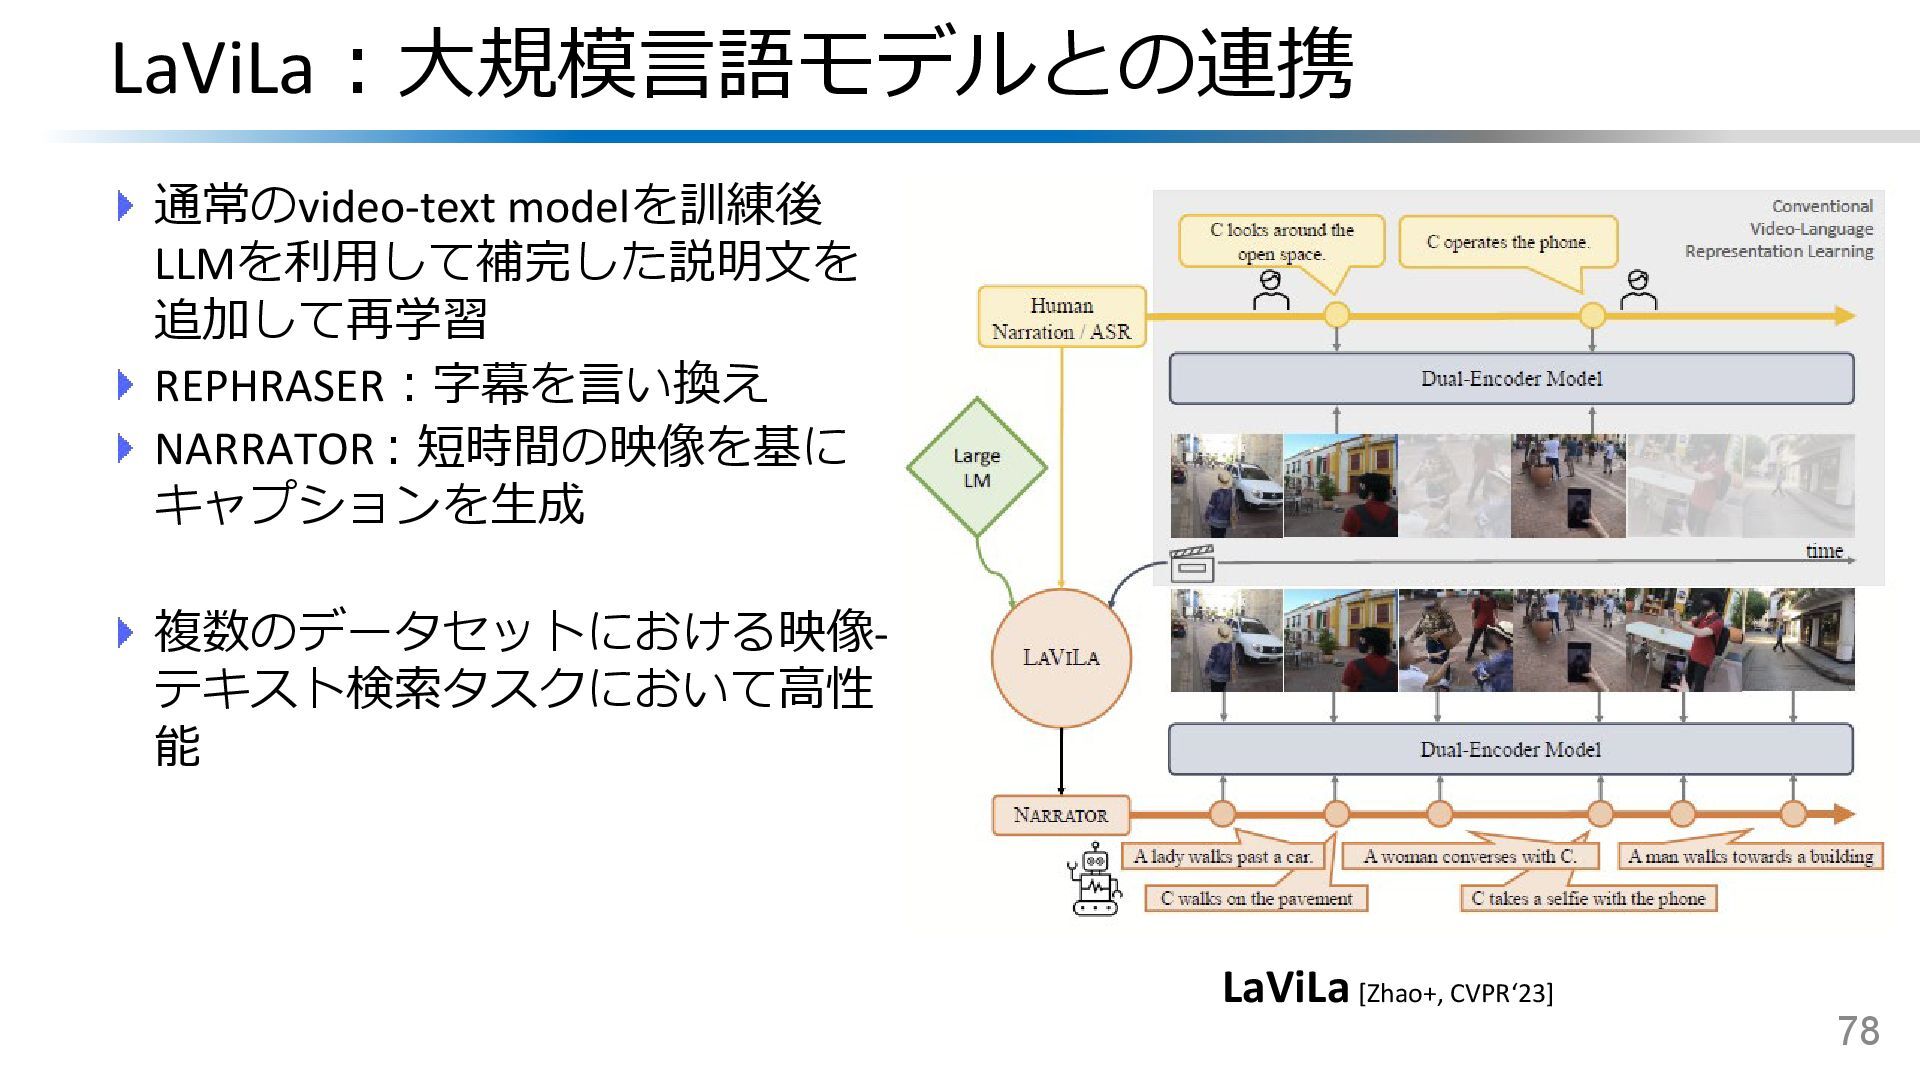
一人称視点映像解析のモデル Dual-Encoder型 EgoVLP [Lin+, CVPR’22] LaViLa [Zhao+, CVPR’23] Multimodal LLM型
MM-Ego [Ye+, ICLR’25] EgoLM [Hong+, CVPR’25] 76 Text Encoder “Take out the battery from the camera…” Video Encoder 映像 テキスト Video Encoder Text Encoder “What is the person doing?” Text Decoder プロンプト 映像 トークン列 Projection 出力 “The person takes out the battery from the camera…” Cosine Similarity 類似度 0.95 -
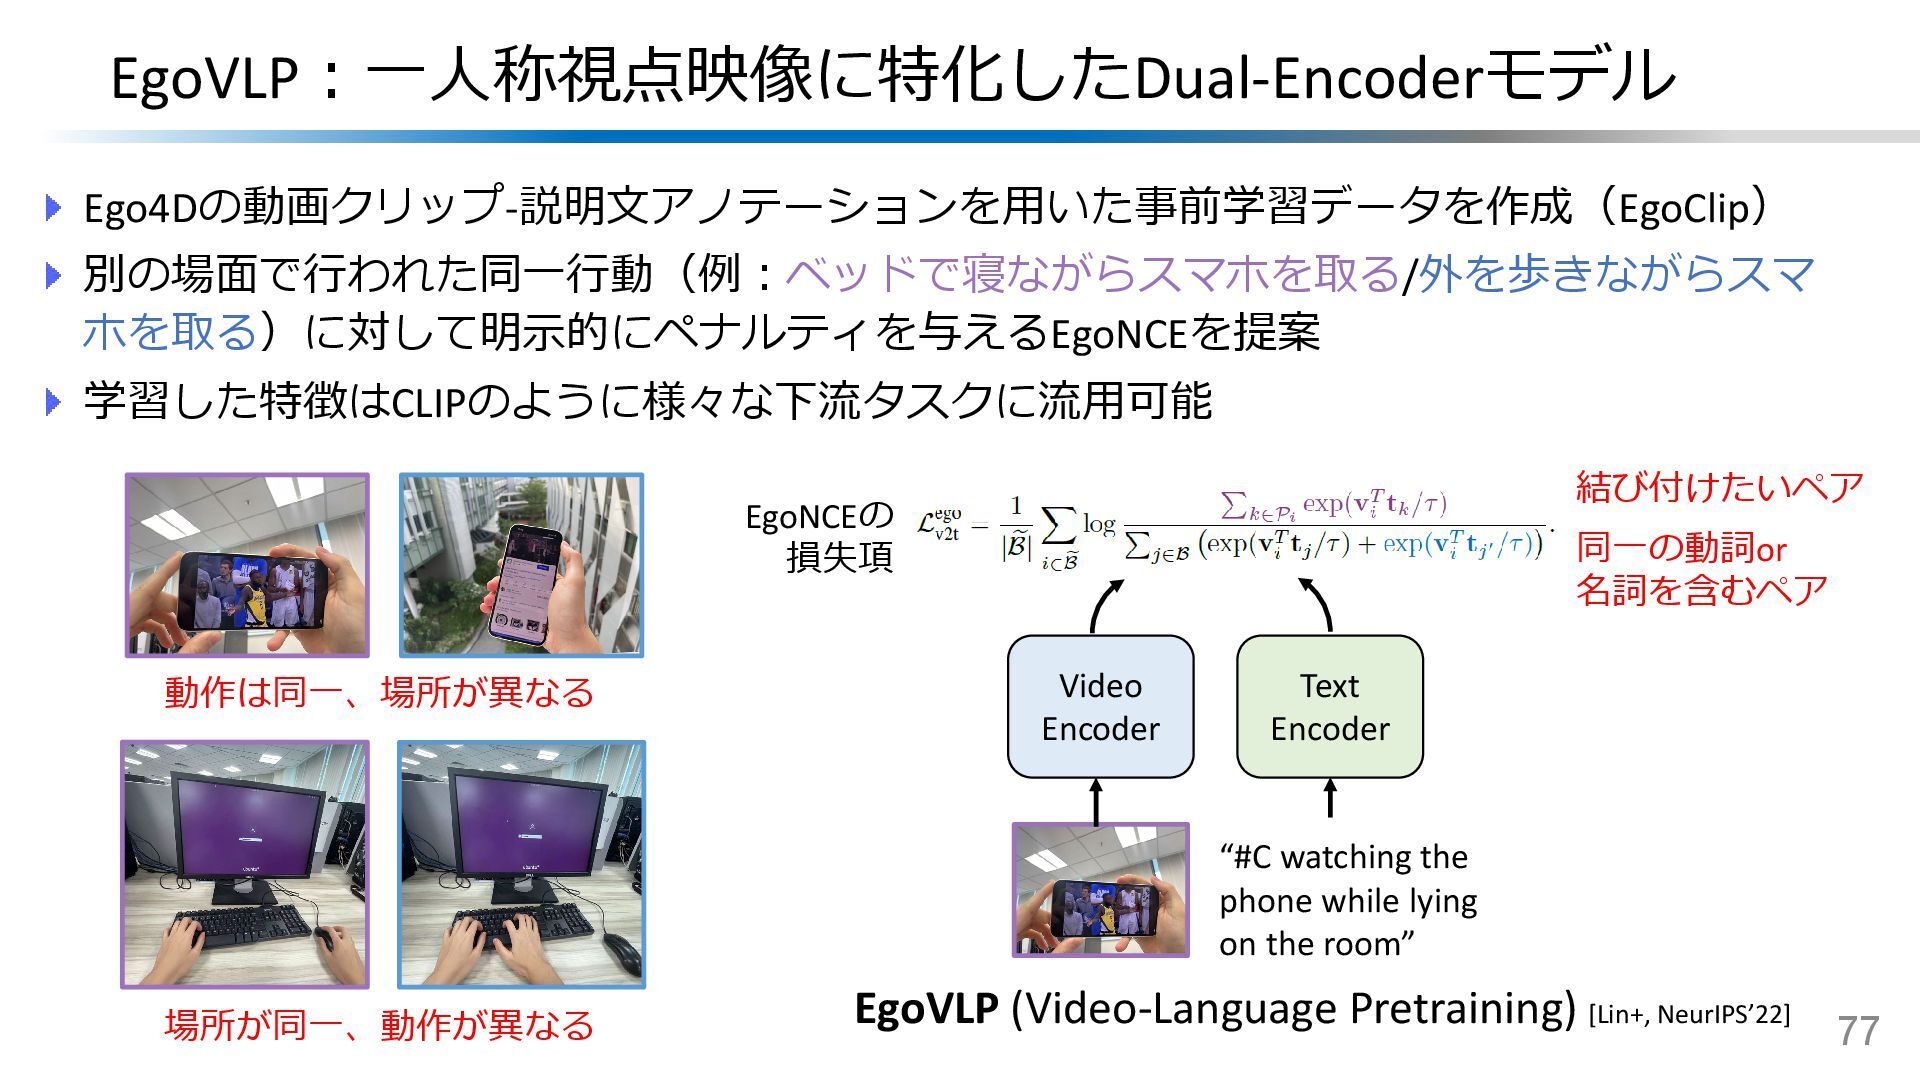
EgoVLP:一人称視点映像に特化したDual-Encoderモデル 77 Ego4Dの動画クリップ-説明文アノテーションを用いた事前学習データを作成(EgoClip) 別の場面で行われた同一行動(例:ベッドで寝ながらスマホを取る/外を歩きながらスマ ホを取る)に対して明示的にペナルティを与えるEgoNCEを提案 学習した特徴はCLIPのように様々な下流タスクに流用可能 結び付けたいペア 同一の動詞or 名詞を含むペア EgoVLP
(Video-Language Pretraining) [Lin+, NeurIPS’22] EgoNCEの 損失項 Video Encoder Text Encoder “#C watching the phone while lying on the room” 動作は同一、場所が異なる 場所が同一、動作が異なる -
MM-Ego:一人称視点映像に特化したMLLM Ego4Dの映像-ナレーションペアをLLMを通じてQAペアに変換 長時間の映像中で重要なタイミングを推定するための2段階推論 79 MM-Ego [Ye+, ICLR’25] LLaVA-OV +Ego SFT
MM-Ego 47.32 55.97 61.27 EgoMemoriaでの精度比較(debiased acc.) -
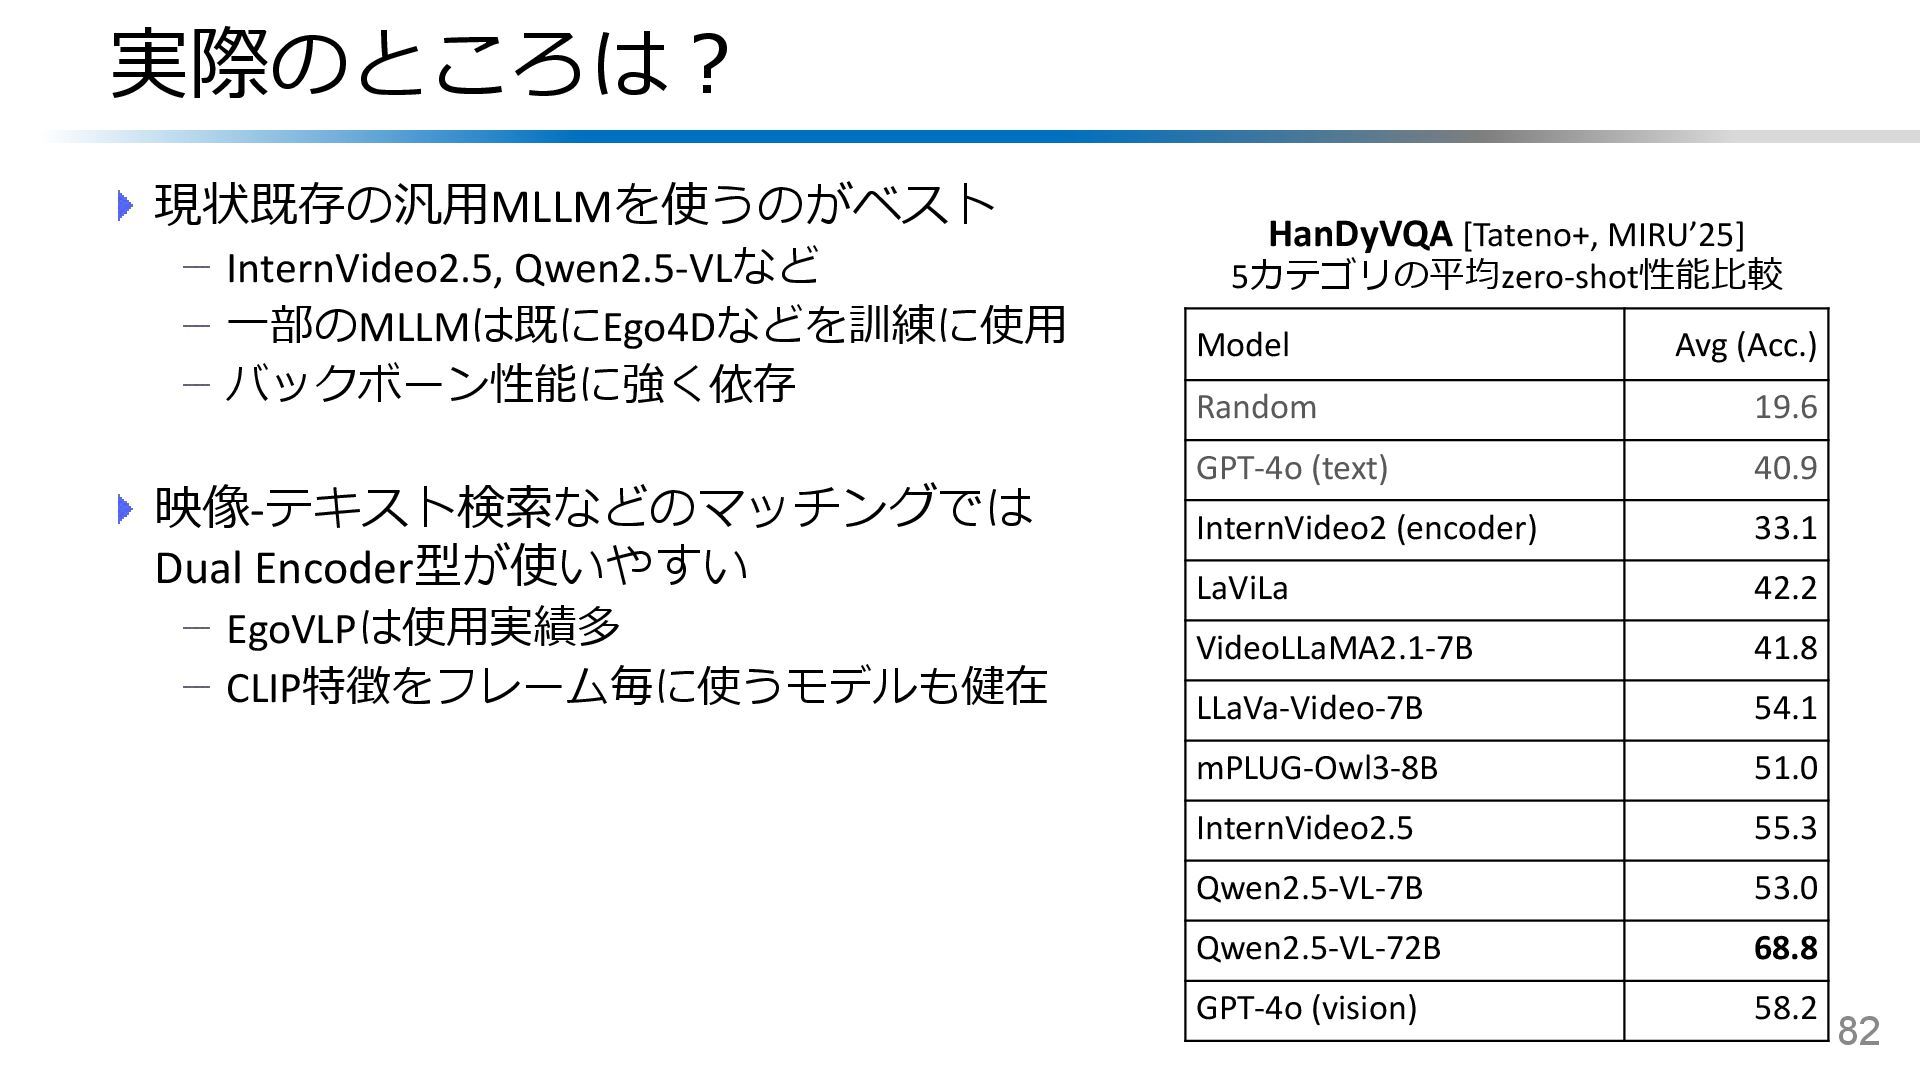
実際のところは? 現状既存の汎用MLLMを使うのがベスト InternVideo2.5, Qwen2.5-VLなど 一部のMLLMは既にEgo4Dなどを訓練に使用 バックボーン性能に強く依存 映像-テキスト検索などのマッチングでは Dual Encoder型が使いやすい EgoVLPは使用実績多
CLIP特徴をフレーム毎に使うモデルも健在 82 Model Avg (Acc.) Random 19.6 GPT-4o (text) 40.9 InternVideo2 (encoder) 33.1 LaViLa 42.2 VideoLLaMA2.1-7B 41.8 LLaVa-Video-7B 54.1 mPLUG-Owl3-8B 51.0 InternVideo2.5 55.3 Qwen2.5-VL-7B 53.0 Qwen2.5-VL-72B 68.8 GPT-4o (vision) 58.2 HanDyVQA [Tateno+, MIRU’25] 5カテゴリの平均zero-shot性能比較 -
応用例:バイオ実験の記録と自動化 87 実験者が作業 手順と結果を自動記録 手順GT 手順予測 FineBio [Yagi+, IJCV’25] 実験行動の自動認識のためのバイオ実験映像
データセット(14.5時間) 手順・単位動作・操作物体に関する階層的 アノテーションを整備 左手GT 右手GT 単位動作 予測 -
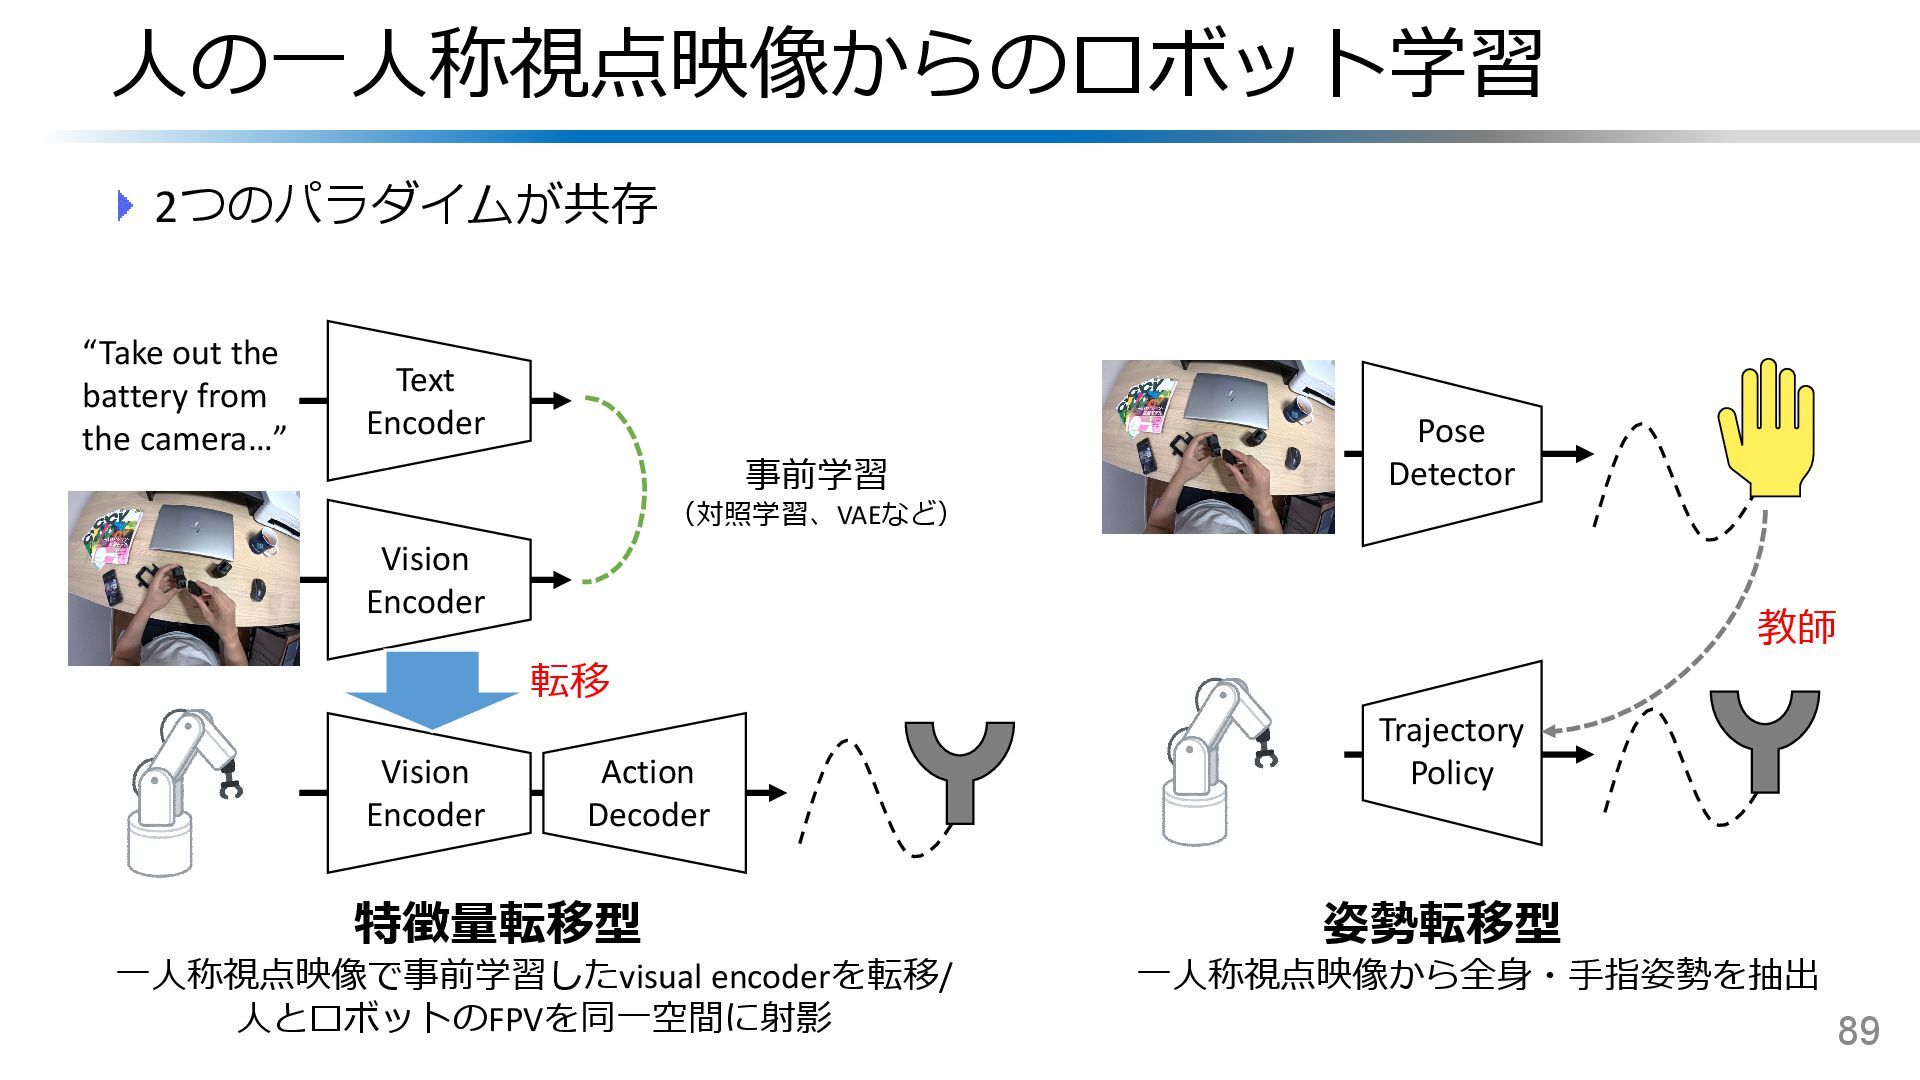
人の一人称視点映像からのロボット学習 89 特徴量転移型 一人称視点映像で事前学習したvisual encoderを転移/ 人とロボットのFPVを同一空間に射影 姿勢転移型 一人称視点映像から全身・手指姿勢を抽出 Vision Encoder
Vision Encoder Action Decoder 2つのパラダイムが共存 “Take out the battery from the camera…” Text Encoder Pose Detector 事前学習 (対照学習、VAEなど) Trajectory Policy 転移 教師 -
姿勢転移型 手指の軌跡データをロボットのハンド部の軌跡学習に利用 高いデータ効率、ただしアクチュエータの違いの吸収の必要あり 同時並行で多数の手法が登場 ZeroMimic [Shi+, ICRA‘25], EgoVLA [Yang+, Arxiv’25],
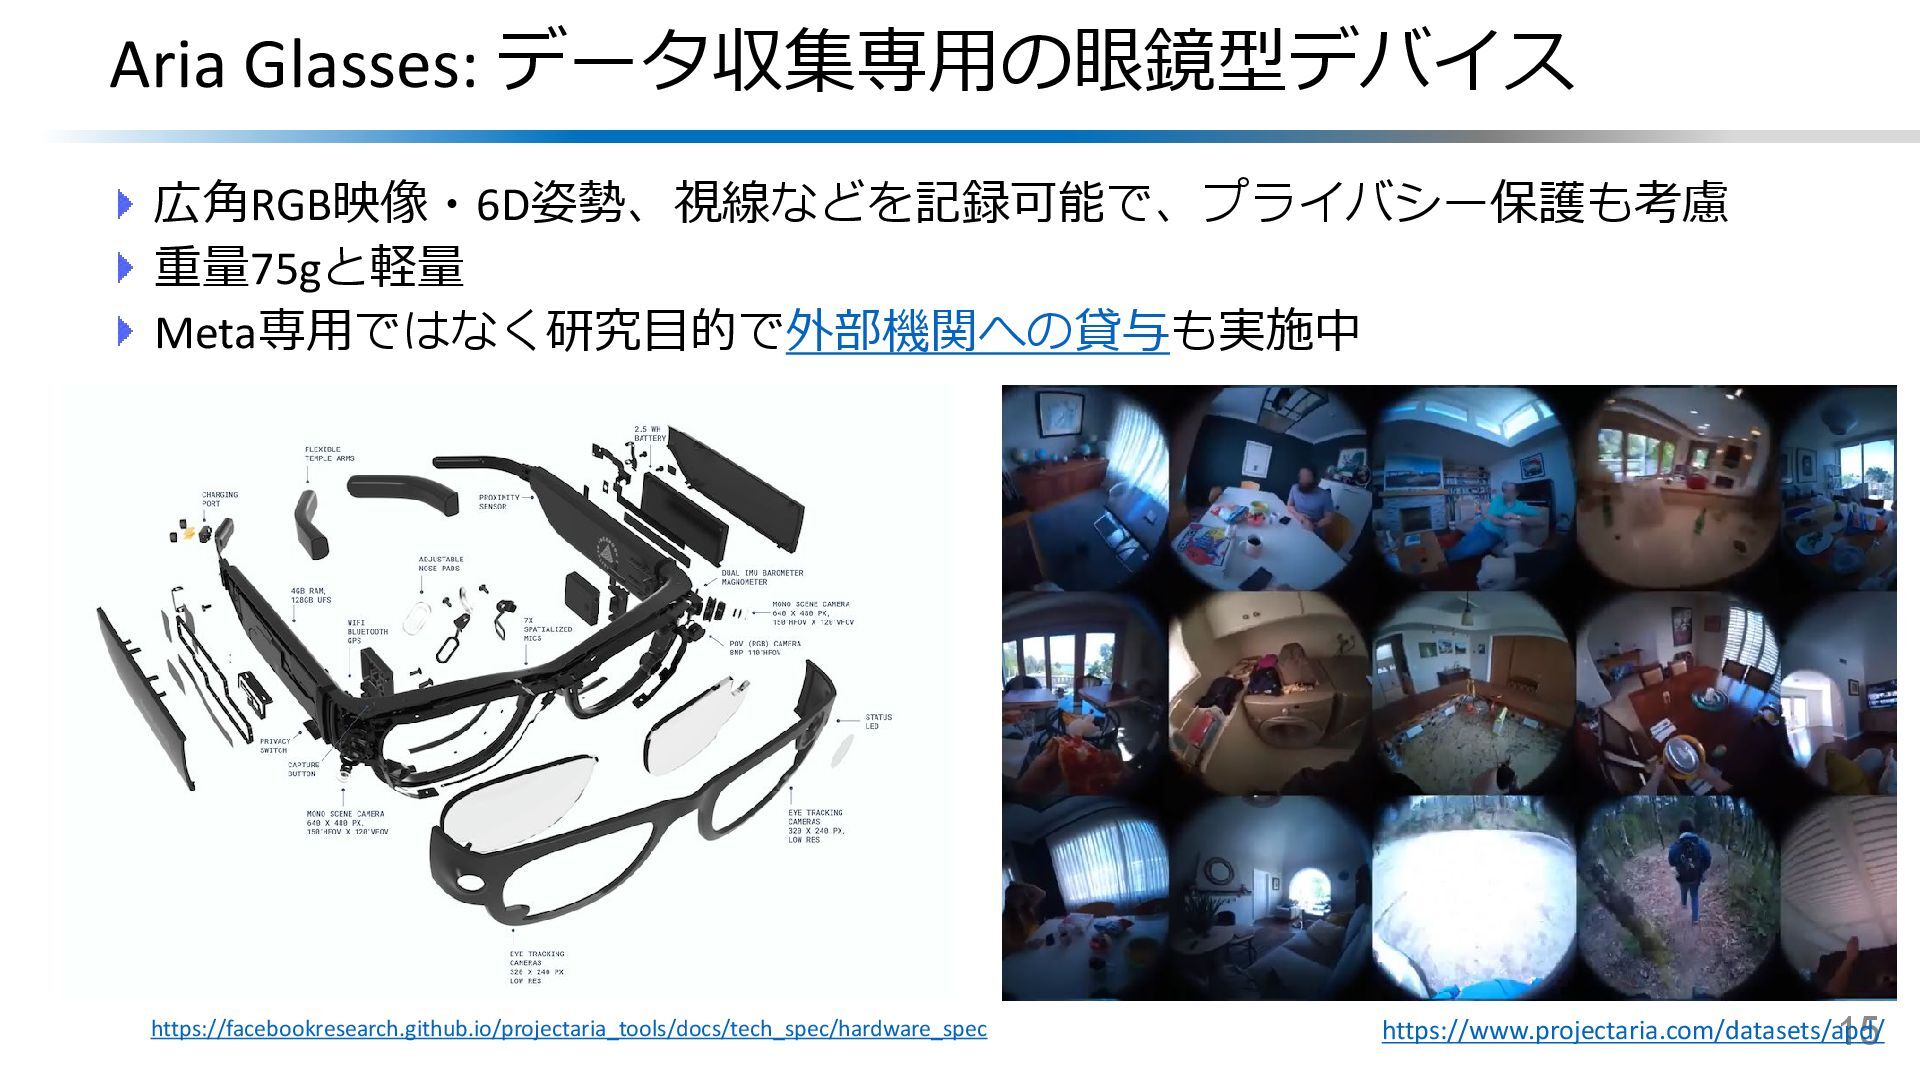
Being-H0 [Luo+, ArXiv’25] 91 EgoMimic [Kareer+, ArXiv’24] 人とロボットで共通のセンサ(Aria Glasses)を利用して手の軌跡で統合学習 -
一人称視点映像解析の現在地 今回扱っていないが重要なトピックは? 音声・音響モデリング(例:EPIC-SOUNDS) リアルタイム・ストリーミング処理(例:ProvideLLM [Chatterjee+, ICCV’25]) ウェアラブルデバイスのユーザビリティ 車載カメラ・ロボット視点映像理解 今後アツいトピックは? 日常生活のためのパーソナル・ウェアラブルAIアシスタントの開発
実験室・製造・物流などにおける専門的作業のモデリング・作業者支援 ロボット学習のための一人称視点映像の収集と活用 100 -
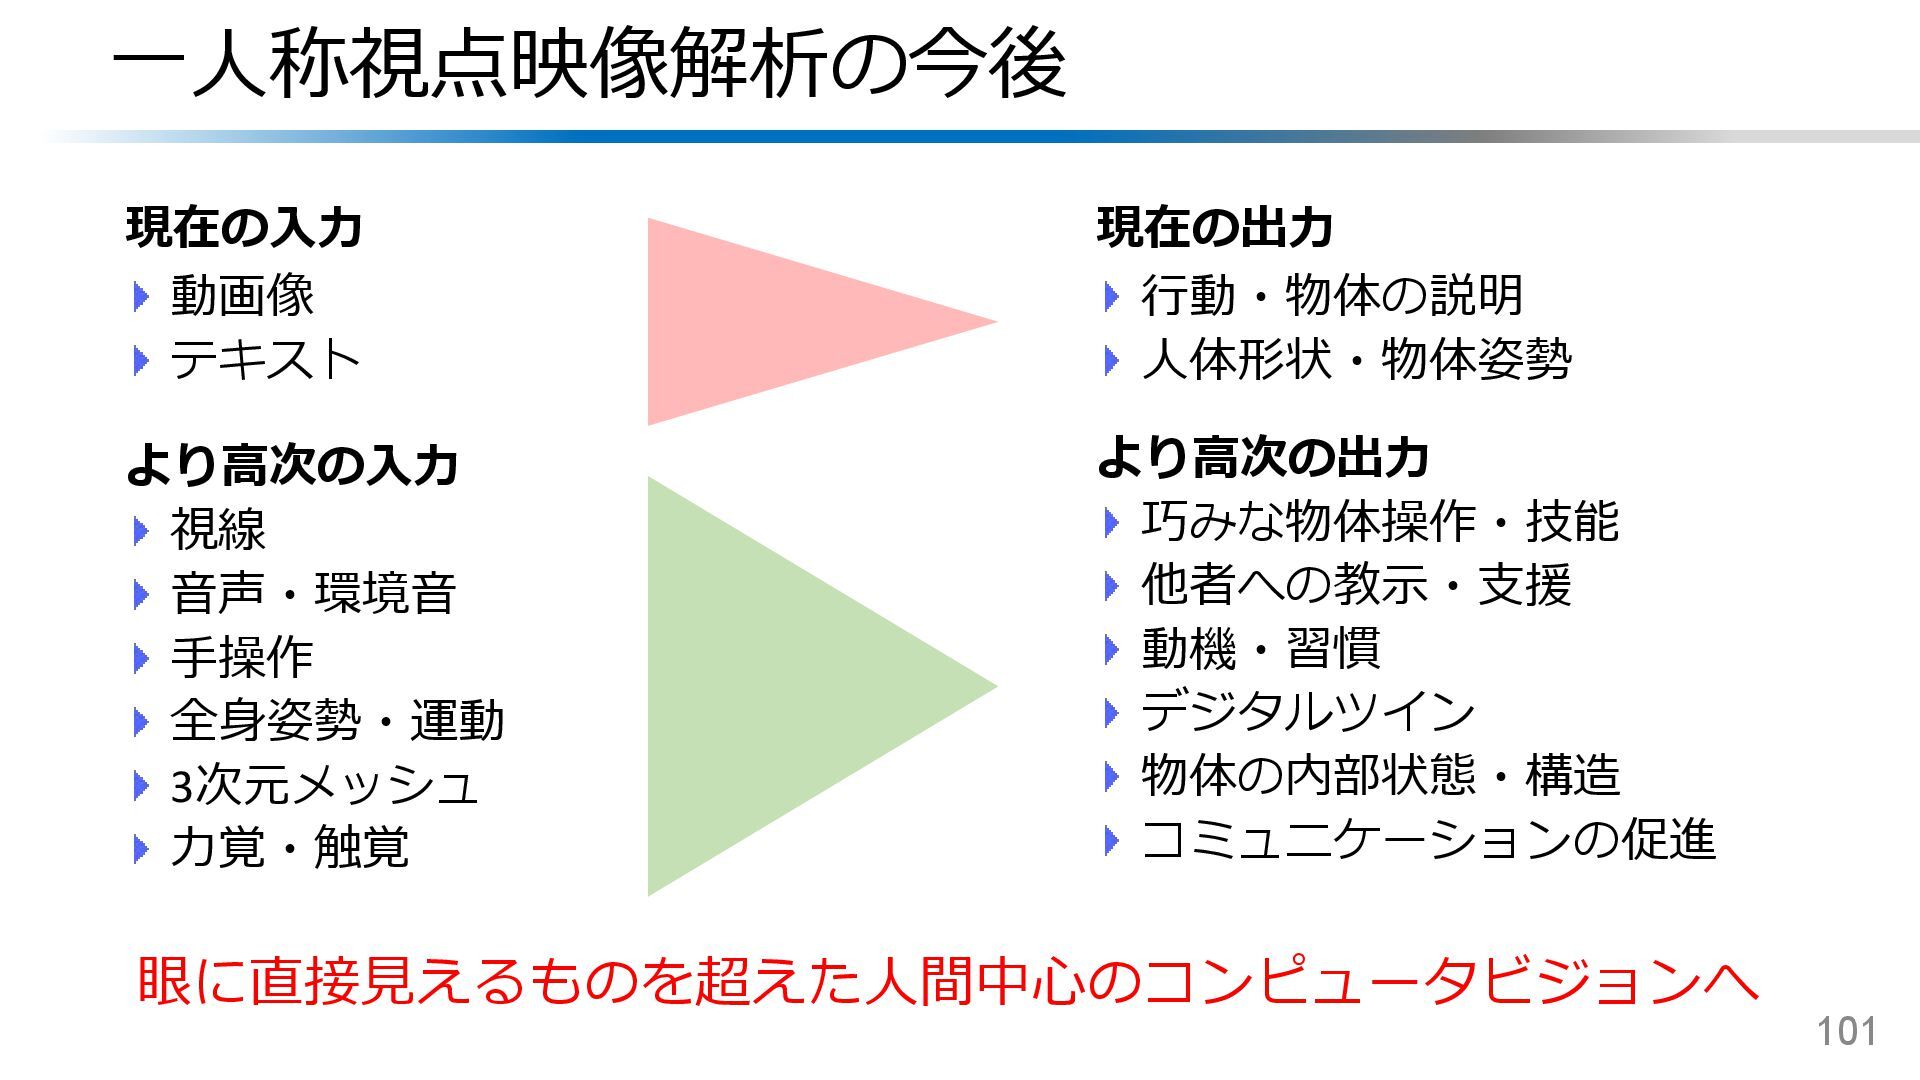
一人称視点映像解析の今後 視線 音声・環境音 手操作 全身姿勢・運動 3次元メッシュ 力覚・触覚 101 眼に直接見えるものを超えた人間中心のコンピュータビジョンへ より高次の入力
より高次の出力 巧みな物体操作・技能 他者への教示・支援 動機・習慣 デジタルツイン 物体の内部状態・構造 コミュニケーションの促進 現在の入力 動画像 テキスト 現在の出力 行動・物体の説明 人体形状・物体姿勢 -
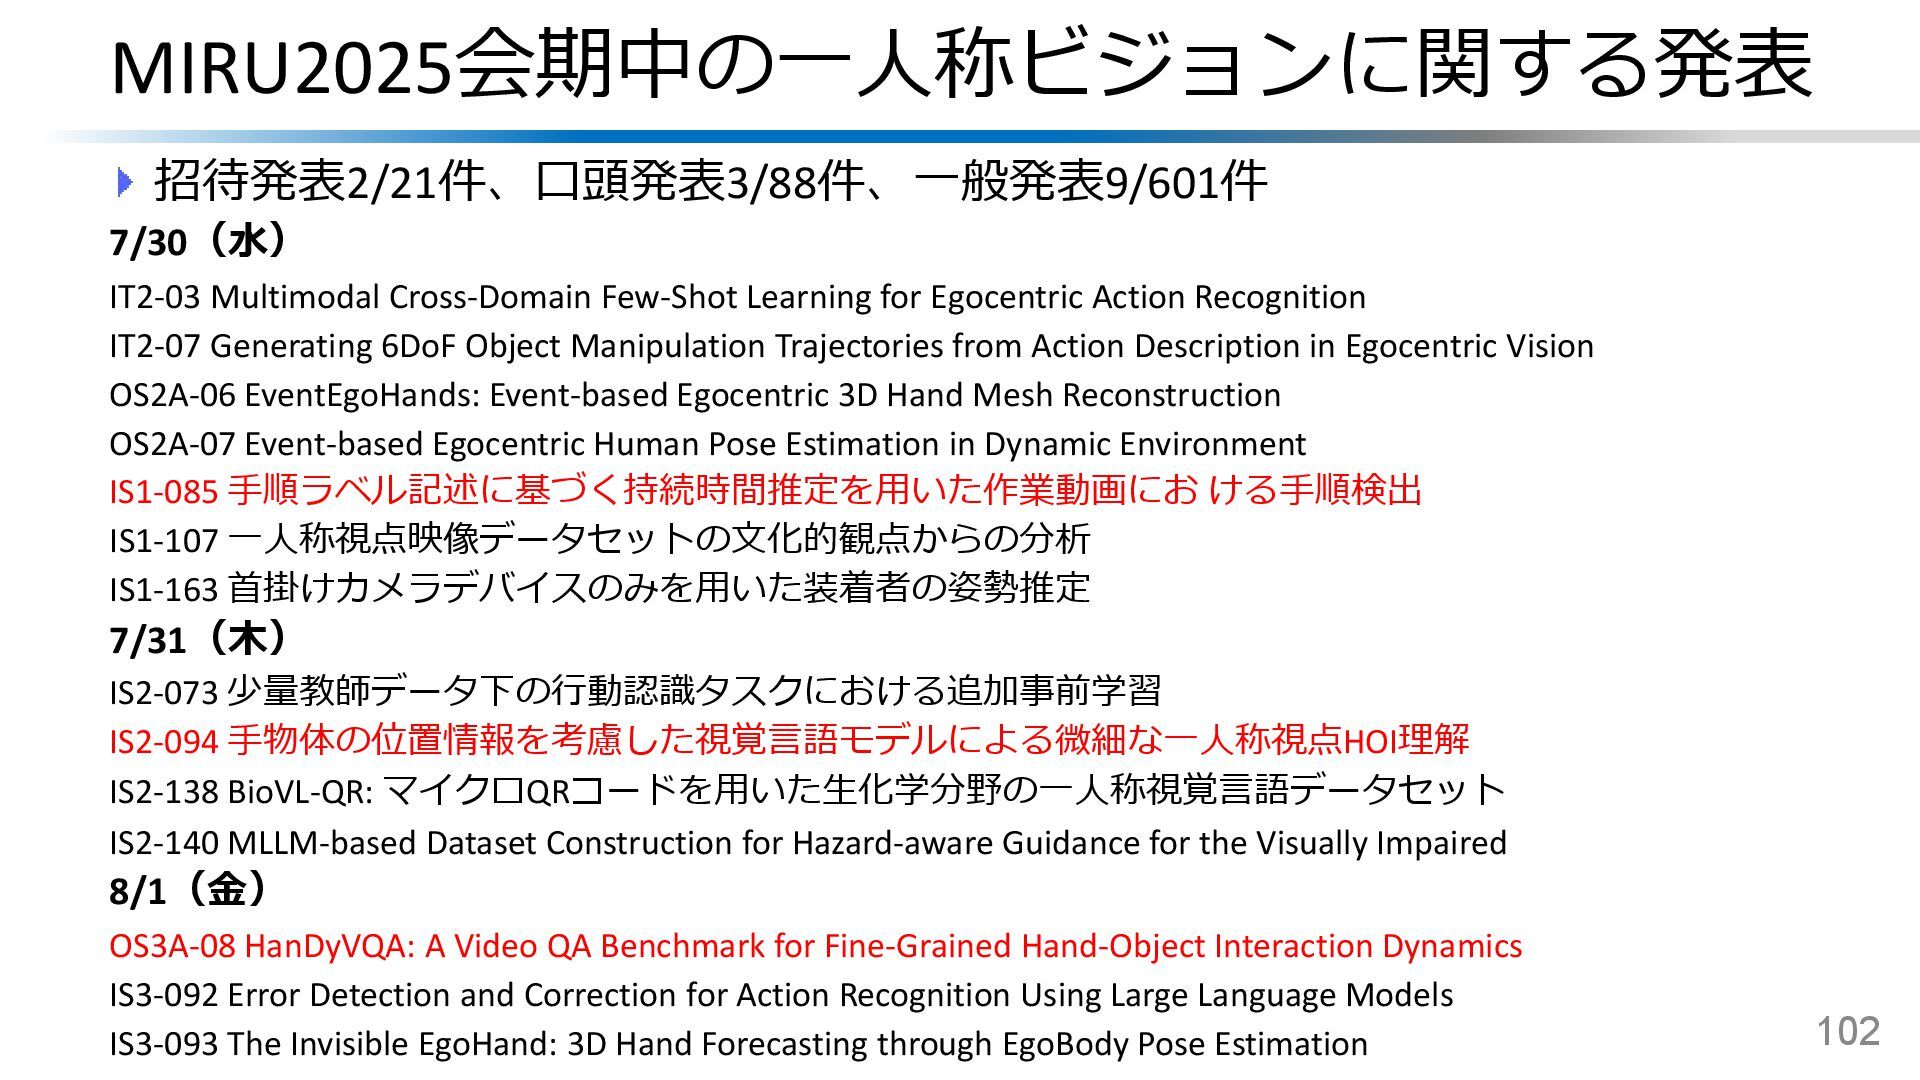
MIRU2025会期中の一人称ビジョンに関する発表 招待発表2/21件、口頭発表3/88件、一般発表9/601件 7/30(水) IT2-03 Multimodal Cross-Domain Few-Shot Learning for Egocentric
Action Recognition IT2-07 Generating 6DoF Object Manipulation Trajectories from Action Description in Egocentric Vision OS2A-06 EventEgoHands: Event-based Egocentric 3D Hand Mesh Reconstruction OS2A-07 Event-based Egocentric Human Pose Estimation in Dynamic Environment IS1-085 手順ラベル記述に基づく持続時間推定を用いた作業動画にお ける手順検出 IS1-107 一人称視点映像データセットの文化的観点からの分析 IS1-163 首掛けカメラデバイスのみを用いた装着者の姿勢推定 7/31(木) IS2-073 少量教師データ下の行動認識タスクにおける追加事前学習 IS2-094 手物体の位置情報を考慮した視覚言語モデルによる微細な一人称視点HOI理解 IS2-138 BioVL-QR: マイクロQRコードを用いた生化学分野の一人称視覚言語データセット IS2-140 MLLM-based Dataset Construction for Hazard-aware Guidance for the Visually Impaired 8/1(金) OS3A-08 HanDyVQA: A Video QA Benchmark for Fine-Grained Hand-Object Interaction Dynamics IS3-092 Error Detection and Correction for Action Recognition Using Large Language Models IS3-093 The Invisible EgoHand: 3D Hand Forecasting through EgoBody Pose Estimation 102 -
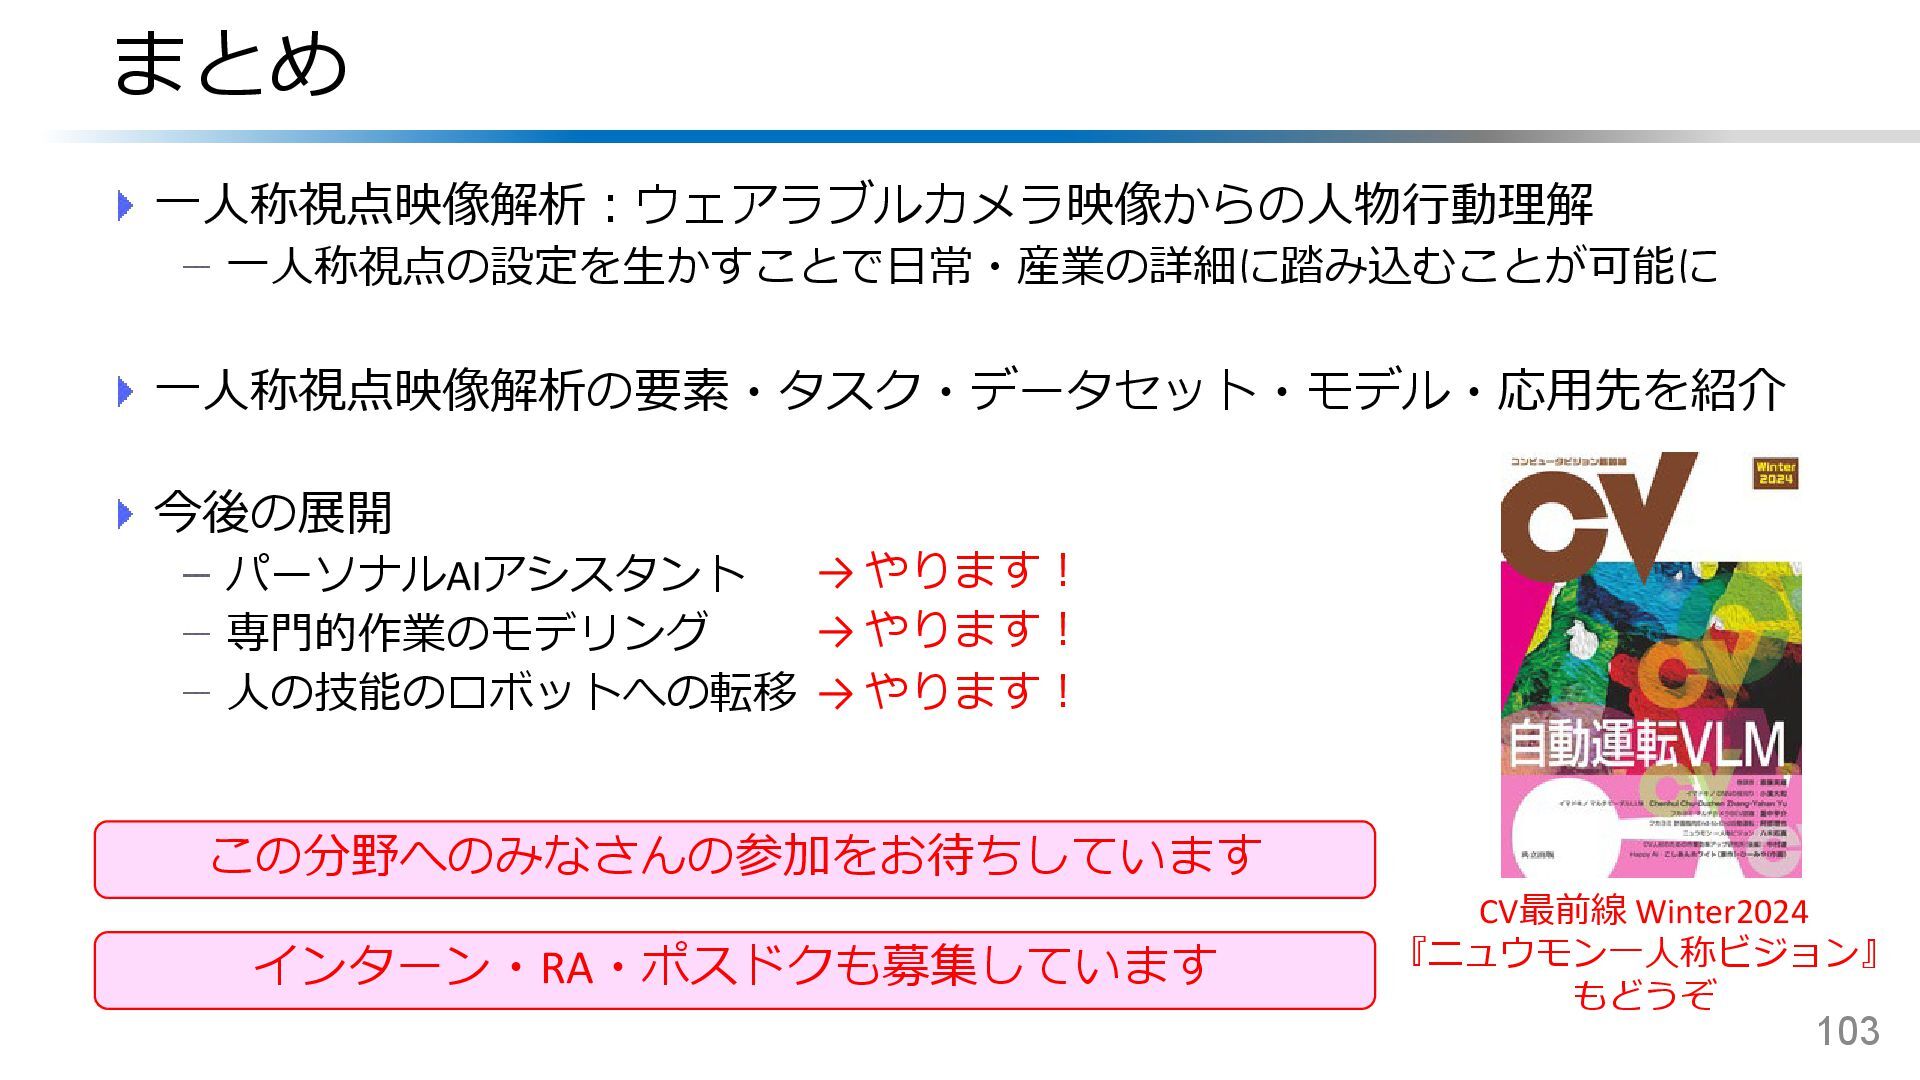
この分野へのみなさんの参加をお待ちしています まとめ 一人称視点映像解析:ウェアラブルカメラ映像からの人物行動理解 一人称視点の設定を生かすことで日常・産業の詳細に踏み込むことが可能に 一人称視点映像解析の要素・タスク・データセット・モデル・応用先を紹介 今後の展開 パーソナルAIアシスタント 専門的作業のモデリング 人の技能のロボットへの転移 103
CV最前線 Winter2024 『ニュウモン一人称ビジョン』 もどうぞ インターン・RA・ポスドクも募集しています → やります! → やります! → やります! -
参考文献(1/6) [Heilbron+, CVPR'15] Caba Heilbron, F., Escorcia, V., Ghanem, B.,
& Carlos Niebles, J. (2015). Activitynet: A large-scale video benchmark for human activity understanding. In Proceedings of the ieee conference on computer vision and pattern recognition (pp. 961-970). [Shahroudy+, CVPR'16] Shahroudy, A., Liu, J., Ng, T. T., & Wang, G. (2016). Ntu rgb+ d: A large scale dataset for 3d human activity analysis. In Proceedings of the IEEE conference on computer vision and pattern recognition (pp. 1010-1019). [Shao+, CVPR'20] Shao, D., Zhao, Y., Dai, B., & Lin, D. (2020). Finegym: A hierarchical video dataset for fine-grained action understanding. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition (pp. 2616-2625). [Rai+, CVPR'21] Rai, N., Chen, H., Ji, J., Desai, R., Kozuka, K., Ishizaka, S., ... & Niebles, J. C. (2021). Home action genome: Cooperative compositional action understanding. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 11184-11193). Xu, J., Mei, T., Yao, T., & Rui, Y. (2016). Msr-vtt: A large video description dataset for bridging video and language. In Proceedings of the IEEE conference on computer vision and pattern recognition (pp. 5288-5296). [Bush, ‘45] Bush, V. (1945). As we may think. The atlantic monthly, 176(1), 101-108. [Ohnishi+, CVPR’16] Ohnishi, K., Kanehira, A., Kanezaki, A., & Harada, T. (2016). Recognizing activities of daily living with a wrist-mounted camera. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (pp. 3103-3111). [Held & Hein, ‘63] Held, R., & Hein, A. (1963). Movement-produced stimulation in the development of visually guided behavior. Journal of comparative and physiological psychology, 56(5), 872. [Jayaraman & Grauman, ICCV’15] Jayaraman, D., & Grauman, K. (2015). Learning image representations tied to ego-motion. In Proceedings of the IEEE International Conference on Computer Vision (pp. 1413-1421). 104 -
参考文献(2/6) [Huang+, ECCV’18] Y. Huang, M. Cai, Z. Li and
Y. Sato, "Predicting Gaze in Egocentric Video by Learning Task-dependent Attention Transition," European Conference on Computer Vision (ECCV), 2018. [Zhou+, CVPR’17] Zhou, T., Brown, M., Snavely, N., & Lowe, D. G. (2017). Unsupervised learning of depth and ego-motion from video. In Proceedings of the IEEE conference on computer vision and pattern recognition (pp. 1851-1858). [Zimmermann+, ICCV’17] Zimmermann, C., & Brox, T. (2017). Learning to estimate 3d hand pose from single rgb images. In Proceedings of the IEEE international conference on computer vision (pp. 4903-4911). [Tsukada+, ICCVW’11] Tsukada, A., Shino, M., Devyver, M., & Kanade, T. (2011, November). Illumination-free gaze estimation method for first-person vision wearable device. In 2011 IEEE International Conference on Computer Vision Workshops (ICCV Workshops) (pp. 2084-2091). IEEE. [Yarbus, ‘67] Yarbus, A. L. Eye Movements and Vision. Plenum. New York. 1967 (Originally published in Russian 1962) [Huang+, ECCV’18] Huang, Y., Cai, M., Li, Z., & Sato, Y. (2018). Predicting gaze in egocentric video by learning task-dependent attention transition. In Proceedings of the European conference on computer vision (ECCV) (pp. 754-769). [Yang+, CVPR’20] Yang, Z., Huang, L., Chen, Y., Wei, Z., Ahn, S., Zelinsky, G., ... & Hoai, M. (2020). Predicting goal-directed human attention using inverse reinforcement learning. In Proceedings of the IEEE/CVF conference on computer vision and pattern recognition (pp. 193-202). [Nishiyasu+, CVPRW’24] Takumi Nishiyasu and Yoichi Sato. Gaze Scanpath Transformer: Predicting Visual Search Target by Spatiotemporal Semantic Modeling of Gaze Scanpath. 6th international workshop on gaze estimation and prediction in the wild in conjunction with CVPR2024. 2024. [Poleg+, ACCV’14] Poleg, Y., Arora, C., & Peleg, S. (2015). Head motion signatures from egocentric videos. In Computer Vision--ACCV 2014: 12th Asian Conference on Computer Vision, Singapore, Singapore, November 1-5, 2014, Revised Selected Papers, Part III 12 (pp. 315-329). Springer International Publishing. [Bandini+, PAMI’20] Bandini, A., & Zariffa, J. (2020). Analysis of the hands in egocentric vision: A survey. IEEE transactions on pattern analysis and machine intelligence, 45(6), 6846-6866. [Mueller+, CVPR'18] Mueller, F., Bernard, F., Sotnychenko, O., Mehta, D., Sridhar, S., Casas, D., & Theobalt, C. (2018). Ganerated hands for real-time 3d hand tracking from monocular rgb. In Proceedings of the IEEE conference on computer vision and pattern recognition (pp. 49-59). [Banerjee+, CVPR'25] Banerjee, P., Shkodrani, S., Moulon, P., Hampali, S., Han, S., Zhang, F., ... & Hodan, T. (2025). Hot3d: Hand and object tracking in 3d from egocentric multi-view videos. In Proceedings of the Computer Vision and Pattern Recognition Conference (pp. 7061-7071). 105 -
参考文献(3/6) [Li+, CVPR’23] Li, J., Liu, K., & Wu, J.
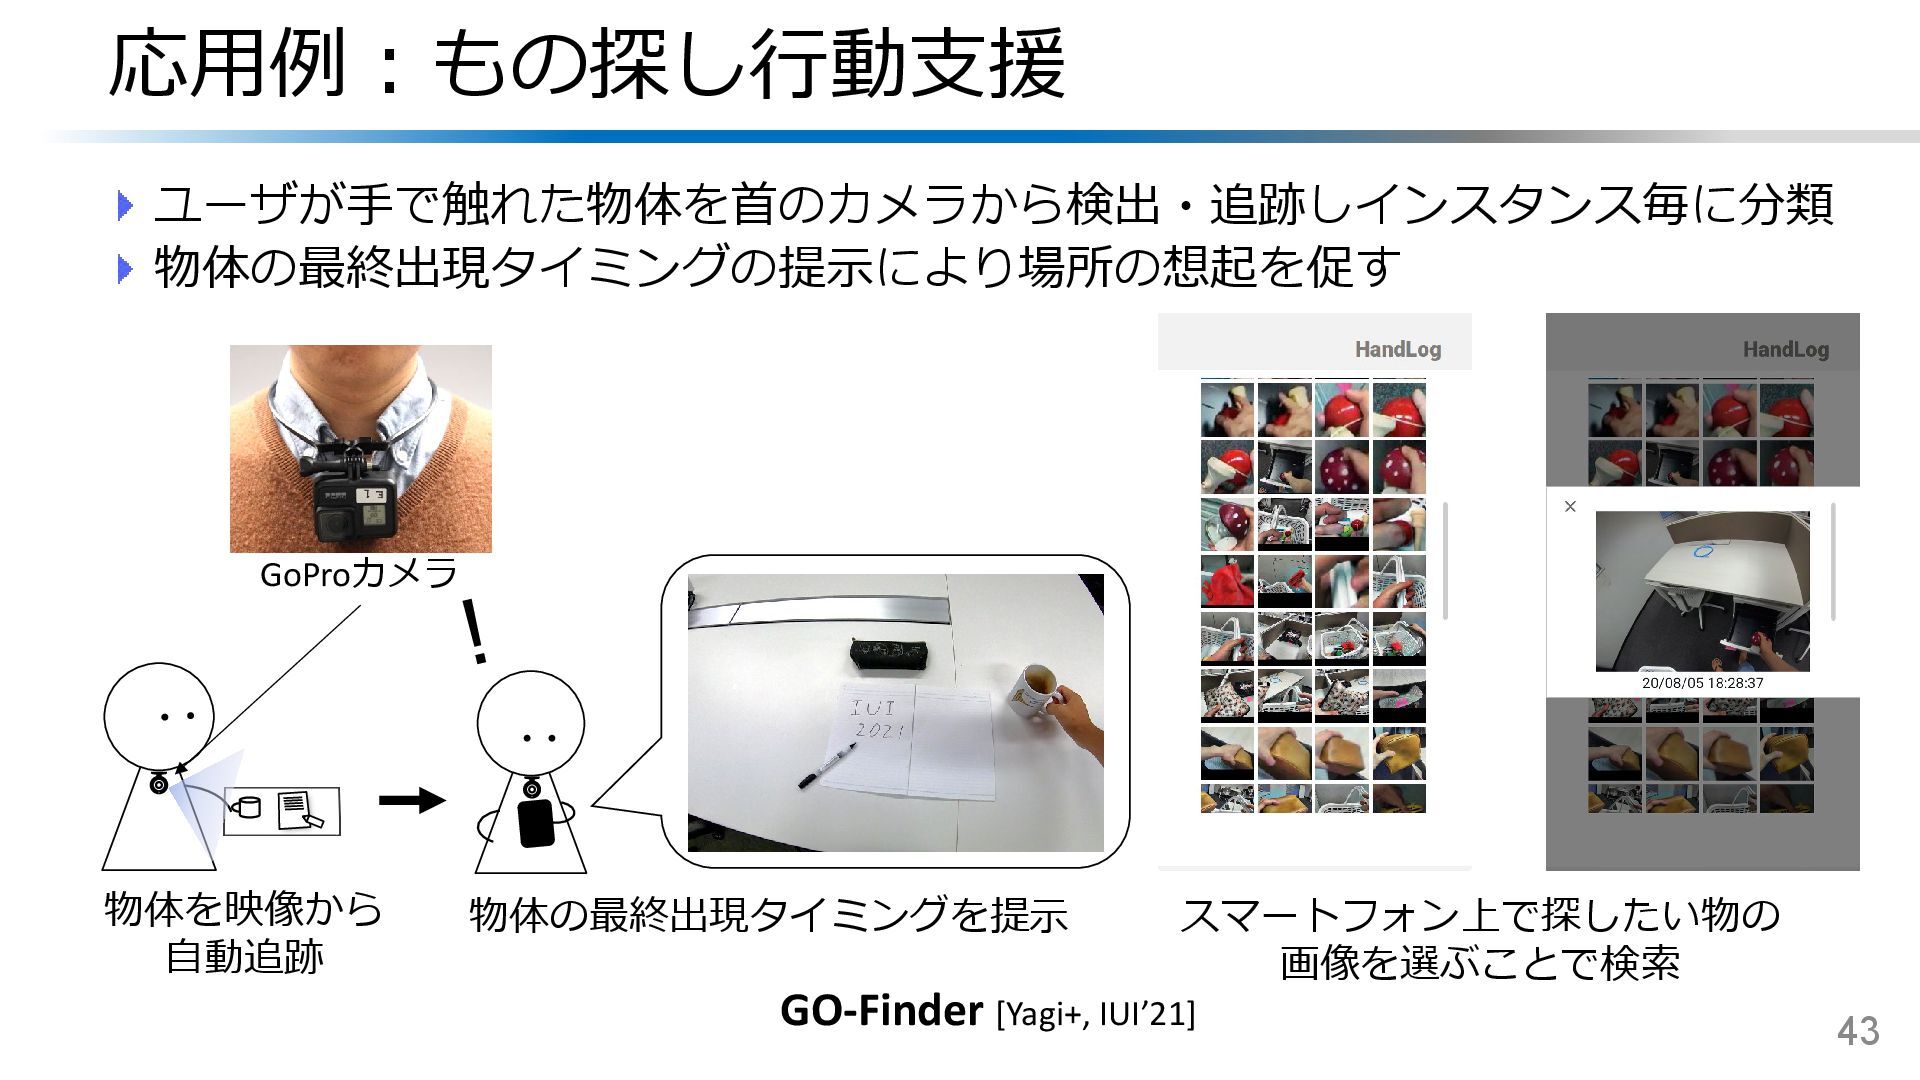
(2023). Ego-body pose estimation via ego-head pose estimation. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 17142-17151). [Grauman+, CVPR’22] Grauman, K., Westbury, A., Byrne, E., Chavis, Z., Furnari, A., Girdhar, R., ... & Malik, J. (2022). Ego4d: Around the world in 3,000 hours of egocentric video. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 18995-19012). [Lee+, CVPR'25] Lee, J., Xu, W., Richard, A., Wei, S. E., Saito, S., Bai, S., ... & Saragih, J. (2025). REWIND: Real-Time Egocentric Whole-Body Motion Diffusion with Exemplar-Based Identity Conditioning. In Proceedings of the Computer Vision and Pattern Recognition Conference (pp. 7095-7104). [Wang+, CVPR'25] Wang, J., Dabral, R., Luvizon, D., Cao, Z., Liu, L., Beeler, T., & Theobalt, C. (2025). Ego4o: Egocentric Human Motion Capture and Understanding from Multi-Modal Input. In Proceedings of the Computer Vision and Pattern Recognition Conference (pp. 22668-22679). [Zhang+. UIST’17] Zhang, X., Sugano, Y., & Bulling, A. (2017, October). Everyday eye contact detection using unsupervised gaze target discovery. In Proceedings of the 30th annual ACM symposium on user interface software and technology (pp. 193-203). [Cheng+, NeurIPS’23] Cheng, T., Shan, D., Hassen, A., Higgins, R., & Fouhey, D. (2023). Towards a richer 2d understanding of hands at scale. Advances in Neural Information Processing Systems, 36, 30453-30465. [Tang+, NeurIPS'23 D&B] Tang, H., Liang, K. J., Grauman, K., Feiszli, M., & Wang, W. (2023). Egotracks: A long-term egocentric visual object tracking dataset. Advances in Neural Information Processing Systems, 36, 75716-75739. [Yagi+, IUI’21] Yagi, T., Nishiyasu, T., Kawasaki, K., Matsuki, M., & Sato, Y. (2021, April). GO-finder: a registration-free wearable system for assisting users in finding lost objects via hand-held object discovery. In 26th International Conference on Intelligent User Interfaces (pp. 139-149). [Song+, NeurIPS'23] Song, Y., Byrne, E., Nagarajan, T., Wang, H., Martin, M., & Torresani, L. (2023). Ego4d goal-step: Toward hierarchical understanding of procedural activities. Advances in Neural Information Processing Systems, 36, 38863-38886. 106 -
参考文献(4/6) [Damen+, ECCV’18] Damen, D., Doughty, H., Farinella, G. M.,
Fidler, S., Furnari, A., Kazakos, E., ... & Wray, M. (2018). Scaling egocentric vision: The epic- kitchens dataset. In Proceedings of the European conference on computer vision (ECCV) (pp. 720-736). [Damen+, IJCV’22] Damen, D., Doughty, H., Farinella, G. M., Furnari, A., Kazakos, E., Ma, J., ... & Wray, M. (2022). Rescaling egocentric vision: Collection, pipeline and challenges for epic-kitchens-100. International Journal of Computer Vision, 1-23. [Grauman+, CVPR’24] Grauman, K., Westbury, A., Torresani, L., Kitani, K., Malik, J., Afouras, T., ... & Wray, M. (2023). Ego-exo4d: Understanding skilled human activity from first-and third-person perspectives. CVPR 2024. [Darkhalil+, NeurIPS’22] Darkhalil, A., Shan, D., Zhu, B., Ma, J., Kar, A., Higgins, R., ... & Damen, D. (2022). Epic-kitchens visor benchmark: Video segmentations and object relations. Advances in Neural Information Processing Systems, 35, 13745-13758. [Huh+ ICASSP’23] Huh, J., Chalk, J., Kazakos, E., Damen, D., & Zisserman, A. (2023, June). Epic-sounds: A large-scale dataset of actions that sound. In ICASSP 2023-2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP) (pp. 1-5). IEEE. [Grauman+, CVPR'24] Grauman, K., Westbury, A., Torresani, L., Kitani, K., Malik, J., Afouras, T., ... & Wray, M. (2024). Ego-exo4d: Understanding skilled human activity from first-and third-person perspectives. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 19383-19400). [Ashutosh+, CVPR'25] Ashutosh, K., Nagarajan, T., Pavlakos, G., Kitani, K., & Grauman, K. (2025). ExpertAF: Expert actionable feedback from video. In Proceedings of the Computer Vision and Pattern Recognition Conference (pp. 13582-13594). [Perett+, CVPR'25] Perrett, T., Darkhalil, A., Sinha, S., Emara, O., Pollard, S., Parida, K. K., ... & Damen, D. (2025). Hd-epic: A highly-detailed egocentric video dataset. In Proceedings of the Computer Vision and Pattern Recognition Conference (pp. 23901-23913). [Sener+, CVPR’22] Sener, F., Chatterjee, D., Shelepov, D., He, K., Singhania, D., Wang, R., & Yao, A. (2022). Assembly101: A large-scale multi-view video dataset for understanding procedural activities. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 21096- 21106). [Mangalam+, NeurIPS’24] Mangalam, K., Akshulakov, R., & Malik, J. (2024). Egoschema: A diagnostic benchmark for very long-form video language understanding. Advances in Neural Information Processing Systems, 36. [Ye+, ICLR'25] Ye, H., Zhang, H., Daxberger, E., Chen, L., Lin, Z., Li, Y., ... & Yang, Y. MMEgo: Towards Building Egocentric Multimodal LLMs for Video QA. In The Thirteenth International Conference on Learning Representations. 107 -
参考文献(5/6) [Pan+, ICCV'23] Pan, X., Charron, N., Yang, Y., Peters,
S., Whelan, T., Kong, C., ... & Ren, Y. C. (2023). Aria digital twin: A new benchmark dataset for egocentric 3d machine perception. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 20133-20143). [Zhao+, CVPR’23] Zhao, Y., Misra, I., Krähenbühl, P., & Girdhar, R. (2023). Learning video representations from large language models. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 6586-6597). [Li+, CVPR’24] Li, G., Zhao, K., Zhang, S., Lyu, X., Dusmanu, M., Zhang, Y., ... & Tang, S. (2024). EgoGen: An Egocentric Synthetic Data Generator. CVPR2024. [Wang+, ICCV'23] Wang, X., Kwon, T., Rad, M., Pan, B., Chakraborty, I., Andrist, S., ... & Pollefeys, M. (2023). Holoassist: an egocentric human interaction dataset for interactive ai assistants in the real world. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 20270-20281). [Ma+, ECCV'24] Ma, L., Ye, Y., Hong, F., Guzov, V., Jiang, Y., Postyeni, R., ... & Newcombe, R. (2024, September). Nymeria: A massive collection of multimodal egocentric daily motion in the wild. In European Conference on Computer Vision (pp. 445-465). Cham: Springer Nature Switzerland. [Zhou+, CVPR'25] Zhou, S., Xiao, J., Li, Q., Li, Y., Yang, X., Guo, D., ... & Yao, A. (2025). Egotextvqa: Towards egocentric scene-text aware video question answering. In Proceedings of the Computer Vision and Pattern Recognition Conference (pp. 3363-3373). [Tateno+, MIRU'25] Tateno, M., Kato, G., Hara, K., Kataoka, H., Sato, Y., and Yagi, T. (2025). HanDyVQA: A Video QA Benchmark for Fine-Grained Hand- Object Interaction Dynamics., 画像の認識・理解シンポジウム. [Lin+, NeurIPS’22] Lin, K. Q., Wang, J., Soldan, M., Wray, M., Yan, R., Xu, E. Z., ... & Shou, M. Z. (2022). Egocentric video-language pretraining. Advances in Neural Information Processing Systems, 35, 7575-7586. [Zhao+, CVPR’23] Zhao, Y., Misra, I., Krähenbühl, P., & Girdhar, R. (2023). Learning video representations from large language models. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 6586-6597). [Hong+, CVPR'25] Hong, F., Guzov, V., Kim, H. J., Ye, Y., Newcombe, R., Liu, Z., & Ma, L. (2025). Egolm: Multi-modal language model of egocentric motions. In Proceedings of the Computer Vision and Pattern Recognition Conference (pp. 5344-5354). 108 -
参考文献(6/6) [Kamikubo+, CHI'25] Kamikubo, R., Kayukawa, S., Kaniwa, Y., Wang,
A., Kacorri, H., Takagi, H., & Asakawa, C. (2025, April). Beyond Omakase: Designing Shared Control for Navigation Robots with Blind People. In Proceedings of the 2025 CHI Conference on Human Factors in Computing Systems (pp. 1-17). [Stanescu+, ISMAR’23] Stanescu, A., Mohr, P., Kozinski, M., Mori, S., Schmalstieg, D., & Kalkofen, D. (2023, October). State-Aware Configuration Detection for Augmented Reality Step-by-Step Tutorials. In 2023 IEEE International Symposium on Mixed and Augmented Reality (ISMAR) (pp. 157-166). IEEE. [Yagi+, IJCV'25] Yagi, T., Ohashi, M., Huang, Y., Furuta, R., Adachi, S., Mitsuyama, T., & Sato, Y. (2025). FineBio: a fine-grained video dataset of biological experiments with hierarchical annotation. International Journal of Computer Vision, 1-16. [Nair+, CoRL’22] Nair, S., Rajeswaran, A., Kumar, V., Finn, C., & Gupta, A. (2022, August). R3M: A Universal Visual Representation for Robot Manipulation. In 6th Annual Conference on Robot Learning. [Kareer+, ArXiv'24] Kareer, S., Patel, D., Punamiya, R., Mathur, P., Cheng, S., Wang, C., ... & Xu, D. (2024). Egomimic: Scaling imitation learning via egocentric video. arXiv preprint arXiv:2410.24221. [Shi+, ICRA‘25] Shi, J., Zhao, Z., Wang, T., Pedroza, I., Luo, A., Wang, J., ... & Jayaraman, D. (2025). ZeroMimic: Distilling Robotic Manipulation Skills from Web Videos, ICRA. [Yang+, Arxiv’25] Yang, R., Yu, Q., Wu, Y., Yan, R., Li, B., Cheng, A. C., ... & Wang, X. (2025). EgoVLA: Learning Vision-Language-Action Models from Egocentric Human Videos. arXiv preprint arXiv:2507.12440. [Luo+, ArXiv’25] Luo, H., Feng, Y., Zhang, W., Zheng, S., Wang, Y., Yuan, H., ... & Lu, Z. (2025). Being-H0: Vision-Language-Action Pretraining from Large-Scale Human Videos. arXiv preprint arXiv:2507.15597. [Bahl+, CVPR'23] Bahl, S., Mendonca, R., Chen, L., Jain, U., & Pathak, D. (2023). Affordances from human videos as a versatile representation for robotics. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 13778-13790). [Hoque+, ArXiv'25] Hoque, R., Huang, P., Yoon, D. J., Sivapurapu, M., & Zhang, J. (2025). EgoDex: Learning Dexterous Manipulation from Large-Scale Egocentric Video. arXiv preprint arXiv:2505.11709. [Singh+, WACV’16] Singh, K. K., Fatahalian, K., & Efros, A. A. (2016, March). Krishnacam: Using a longitudinal, single-person, egocentric dataset for scene understanding tasks. In 2016 IEEE Winter Conference on Applications of Computer Vision (WACV) (pp. 1-9). IEEE. [Yang+, CVPR'25] Yang, J., Liu, S., Guo, H., Dong, Y., Zhang, X., Zhang, S., ... & Liu, Z. (2025). Egolife: Towards egocentric life assistant. In Proceedings of the Computer Vision and Pattern Recognition Conference (pp. 28885-28900). [Chatterjee+, ICCV’25] Chatterjee, D., Remelli, E., Song, Y., Tekin, B., Mittal, A., Bhatnagar, B., ... & Sener, F. (2025). Memory-efficient Streaming VideoLLMs for Real-time Procedural Video Understanding. ICCV. 109
 takumayagi
 rikkabotan7
 hirachan
 institutdelelevage
 pman0214
 hisaokatsumi
 yumulab
 enochan
 anikisencyo
 minecr
 aleyda
 rakko
 honzajavorek
 chriscoyier
 davidcarrasco
 davetheseo
 irinanazarova
 akosma
 addyosmani
 jlugia