Share
Embed
Примерь онлайн: как разработать свою модель виртуальной примерки. Искандер Сафиулин, Senior Data Scientist Lamoda Tech
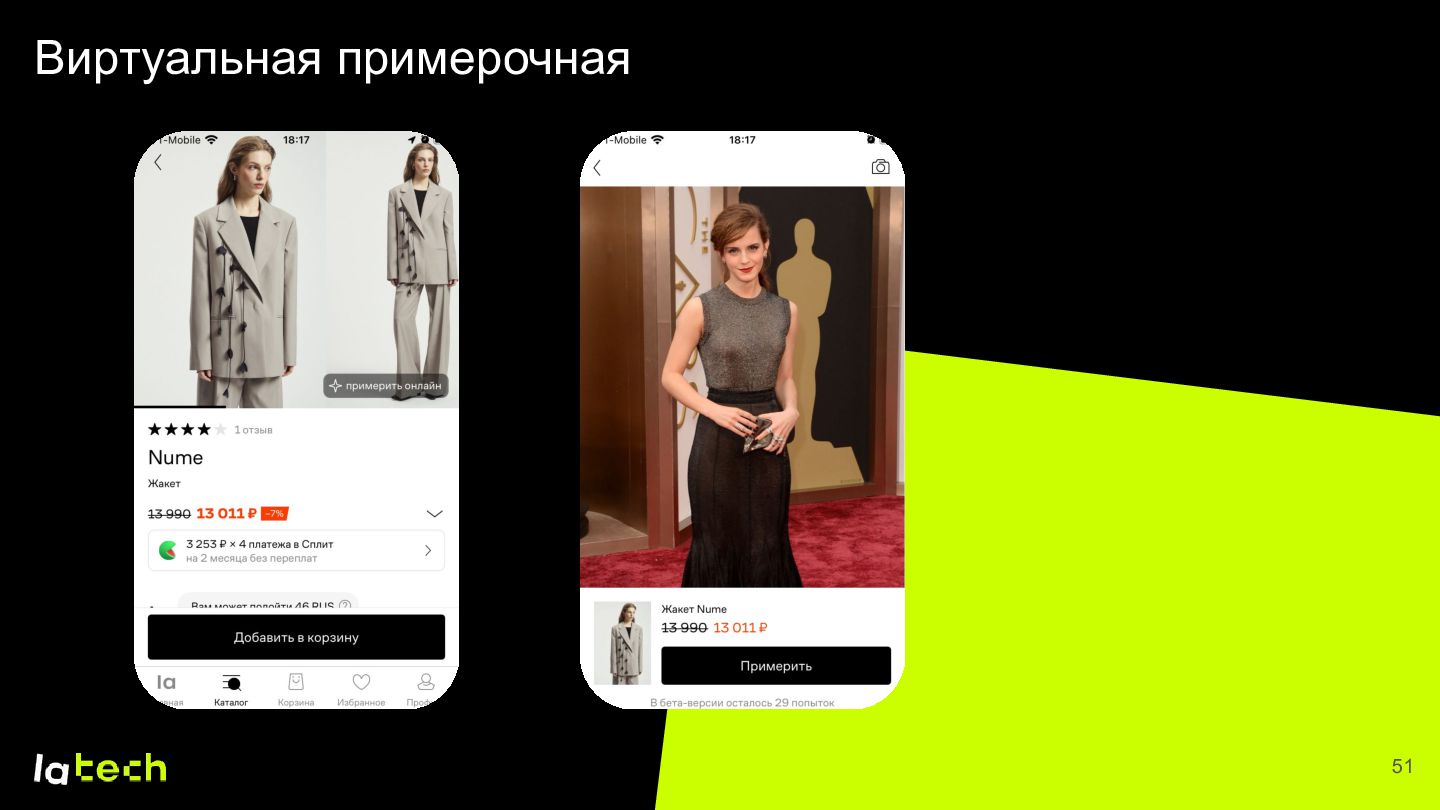
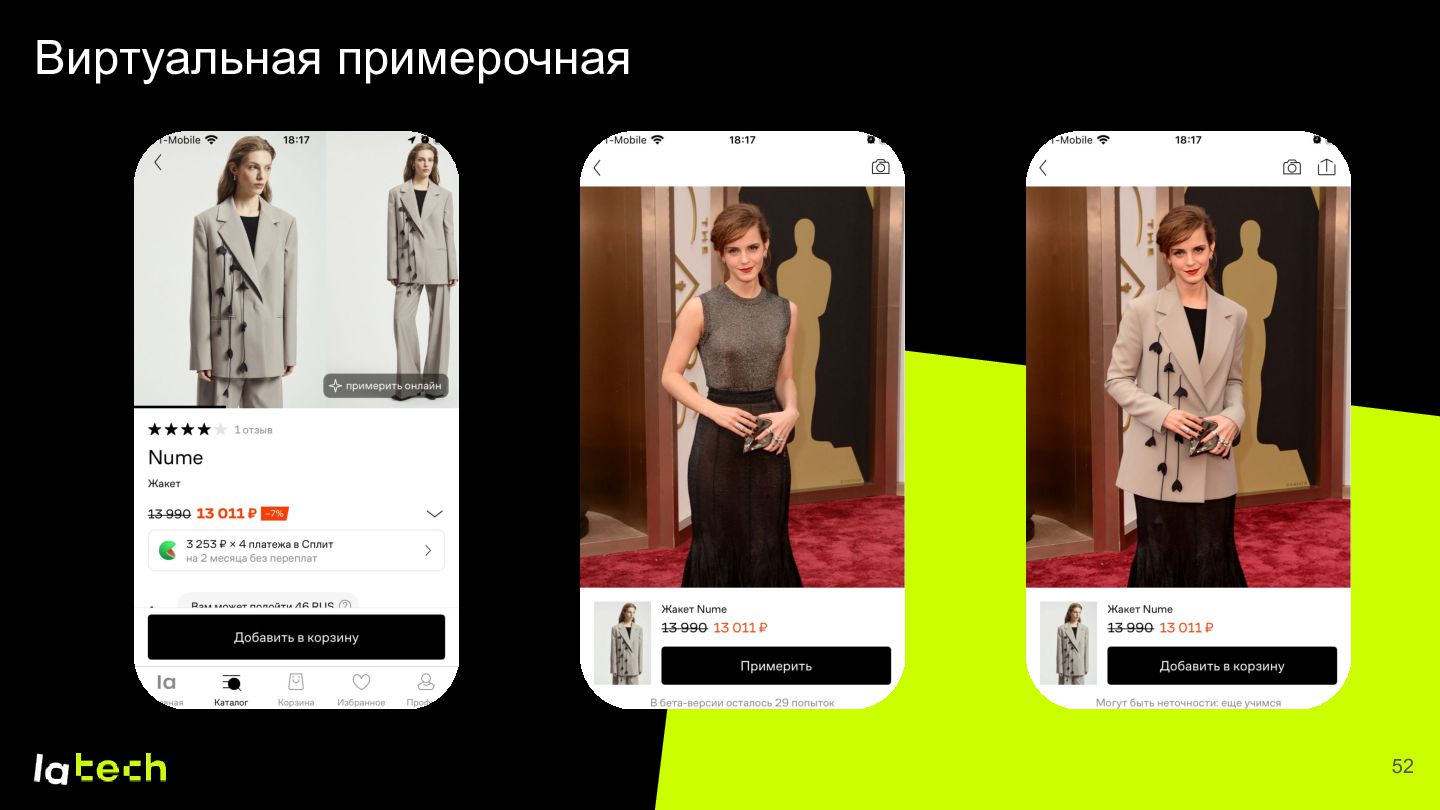
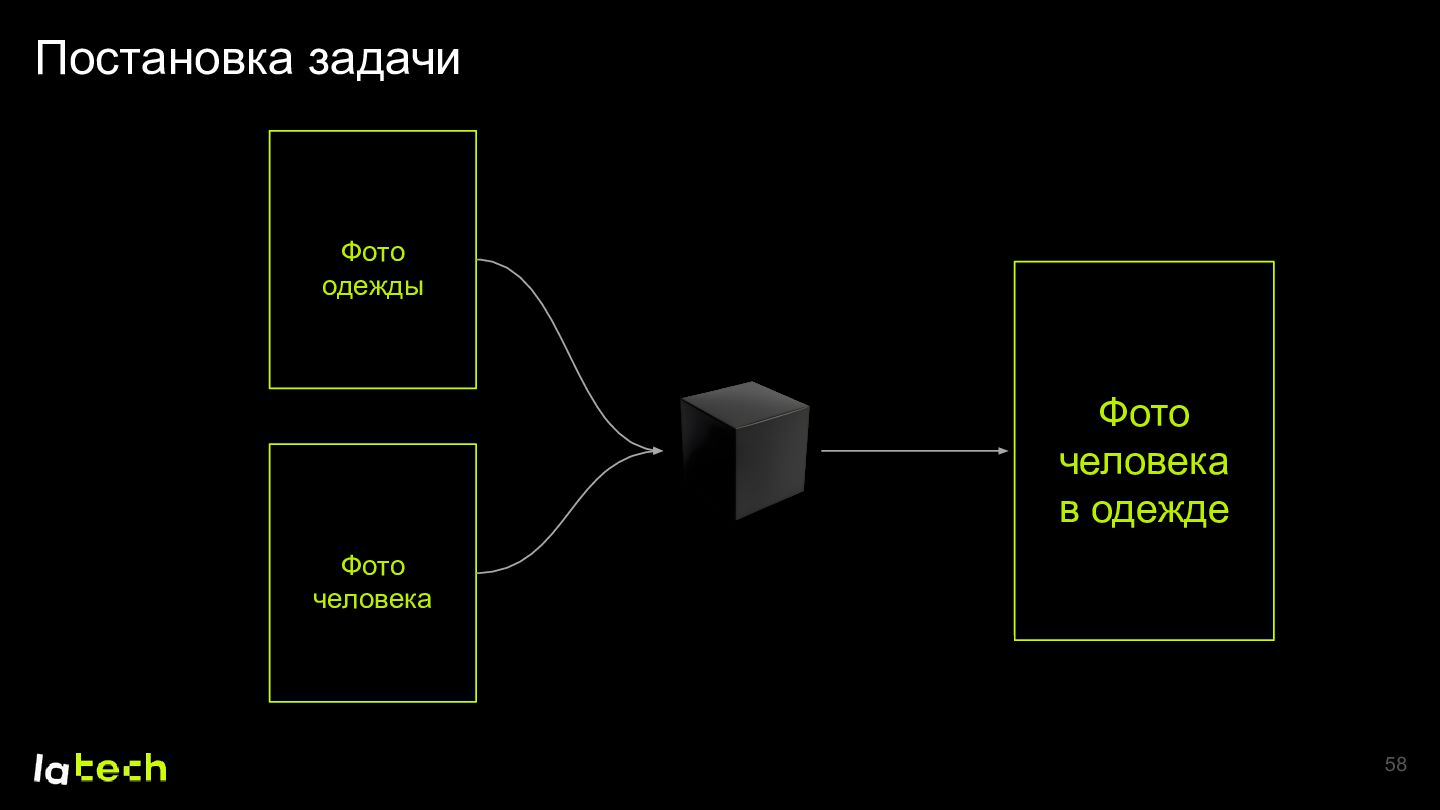
Продукт виртуальной примерки позволяет пользователю безопасно и легко экспериментировать со стилем прямо в приложении. Расскажу про путь, который мы прошли в разработке этой ML-модели:
- Как с нуля обучать модель для подобной задачи — от сбора данных до оценки качества
- С какими сложностями мы столкнулись при обучении, и какую эволюцию прошло наше решение
- Как мы внедряли нашу модель в прод и какие результаты получили
Lamoda Tech
September 03, 2026
Transcript
75 slides
-
О чем поговорим 1 О задаче виртуальной примерки 2 Эволюция
разработки модели - от бейзлайна до SOTA 3 Выкатка модели в прод 48 -
Преимущества своего решения Контроль Качество • • Хостим на контролируемых
ресурсах • Можем точечно исправлять проблемы Обучаем на целевых для нас данных Скорость Стоимость • • Можем настраивать железо под нашу потребность по скорости Генерация своей моделью будет стоить намного дешевле 54 -
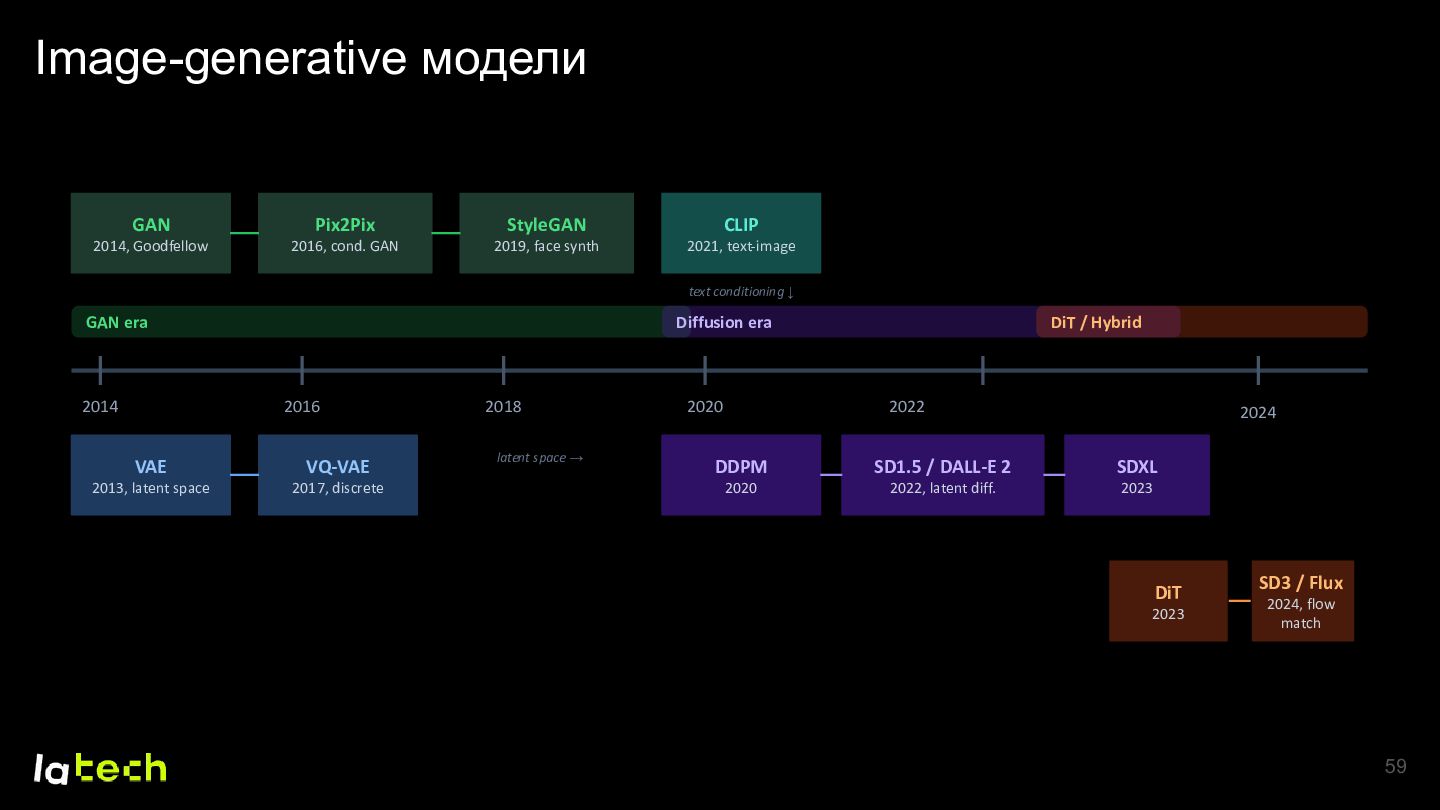
Image-generative модели GAN Pix2Pix StyleGAN CLIP 2014, Goodfellow 2016, cond.
GAN 2019, face synth 2021, text-image text conditioning ↓ GAN era 2014 Diffusion era 2016 VAE VQ-VAE 2013, latent space 2017, discrete 2018 latent space → 2020 DiT / Hybrid 2022 2024 DDPM SD1.5 / DALL-E 2 SDXL 2020 2022, latent diff. 2023 DiT 2023 SD3 / Flux 2024, flow match 59 -
Разработка своей модели • В современном Generative AI — это
всегда дообучение уже существующей “Инициализация весов Qwen-ом” 60 -
Разработка своей модели • В современном Generative AI — это
всегда дообучение уже существующей • За основу мы можем брать только модели, разрешающие коммерческое использование 61 -
Разработка своей модели • В современном Generative AI — это
всегда дообучение уже существующей • За основу мы можем брать только модели, разрешающие коммерческое использование • На старте разработки (Начало 2025) такие модели сильно отставали от закрытых, но за 2025 год ситуация кардинально изменилась 62 -
Путь — от классики к open-source SOTA Наш бейзлайн Stable
Diffusion 1.5/XL 0.9B/2.3B params 63 -
Путь — от классики к open-source SOTA Переходный этап Наш
бейзлайн Stable Diffusion 1.5/XL Flex.2 8B params 0.9B/2.3B params 64 -
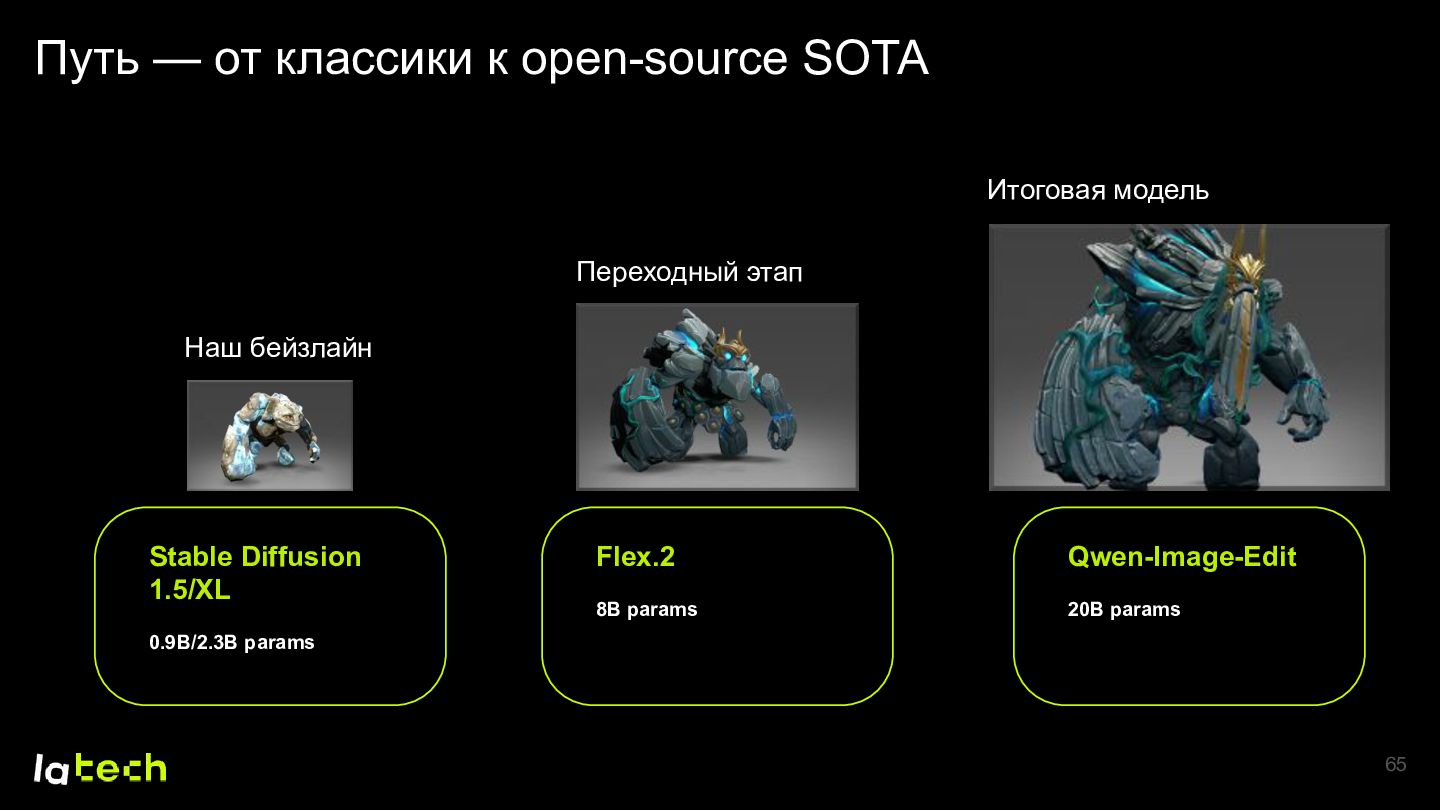
Путь — от классики к open-source SOTA Итоговая модель Переходный
этап Наш бейзлайн Stable Diffusion 1.5/XL Flex.2 Qwen-Image-Edit 8B params 20B params 0.9B/2.3B params 65 -
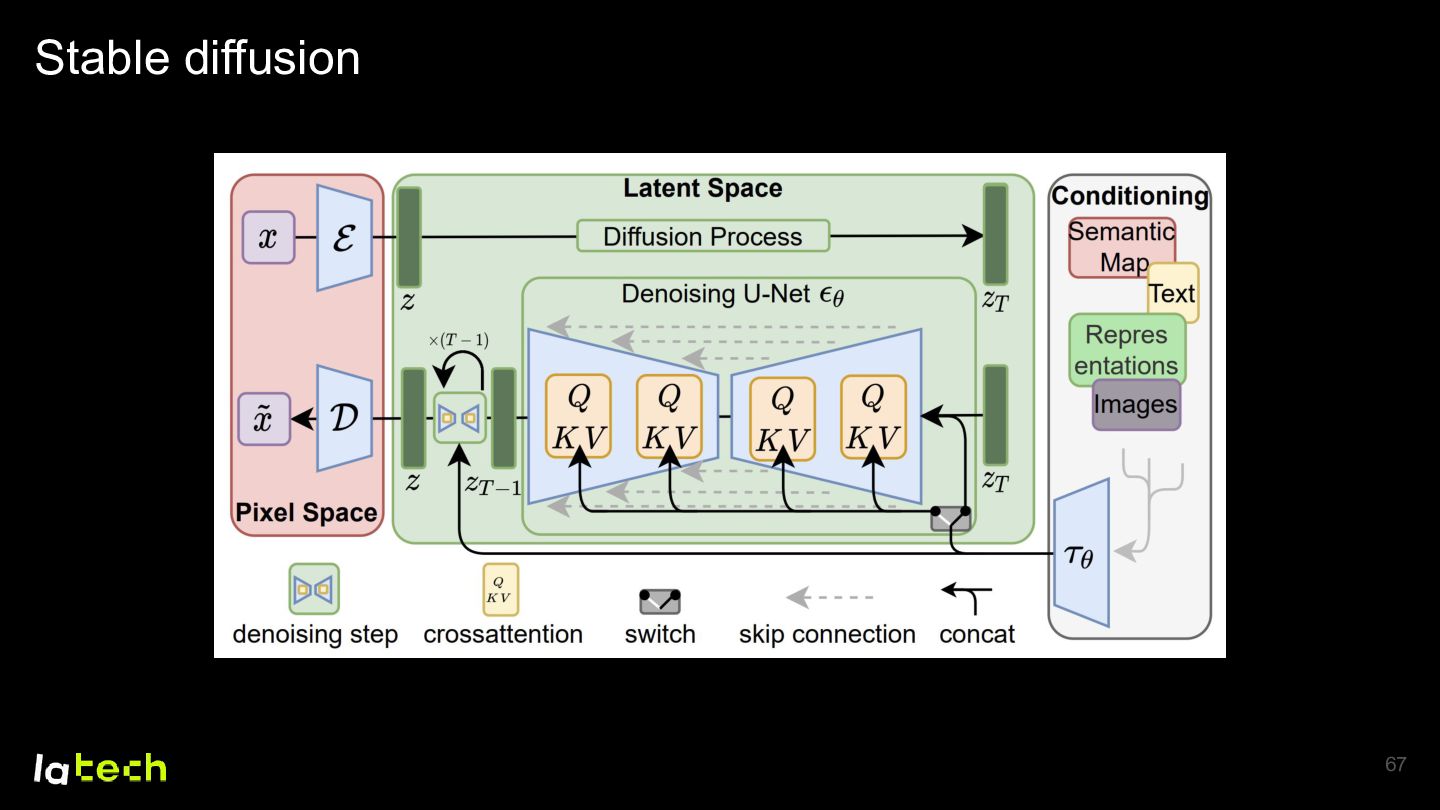
Исследовательская стадия • Большинство подходов из публичного доступа — исследовательские,
не продуктовые • В основном базируются на SD1.5 • Обучены на одном и том же датасете 66 -
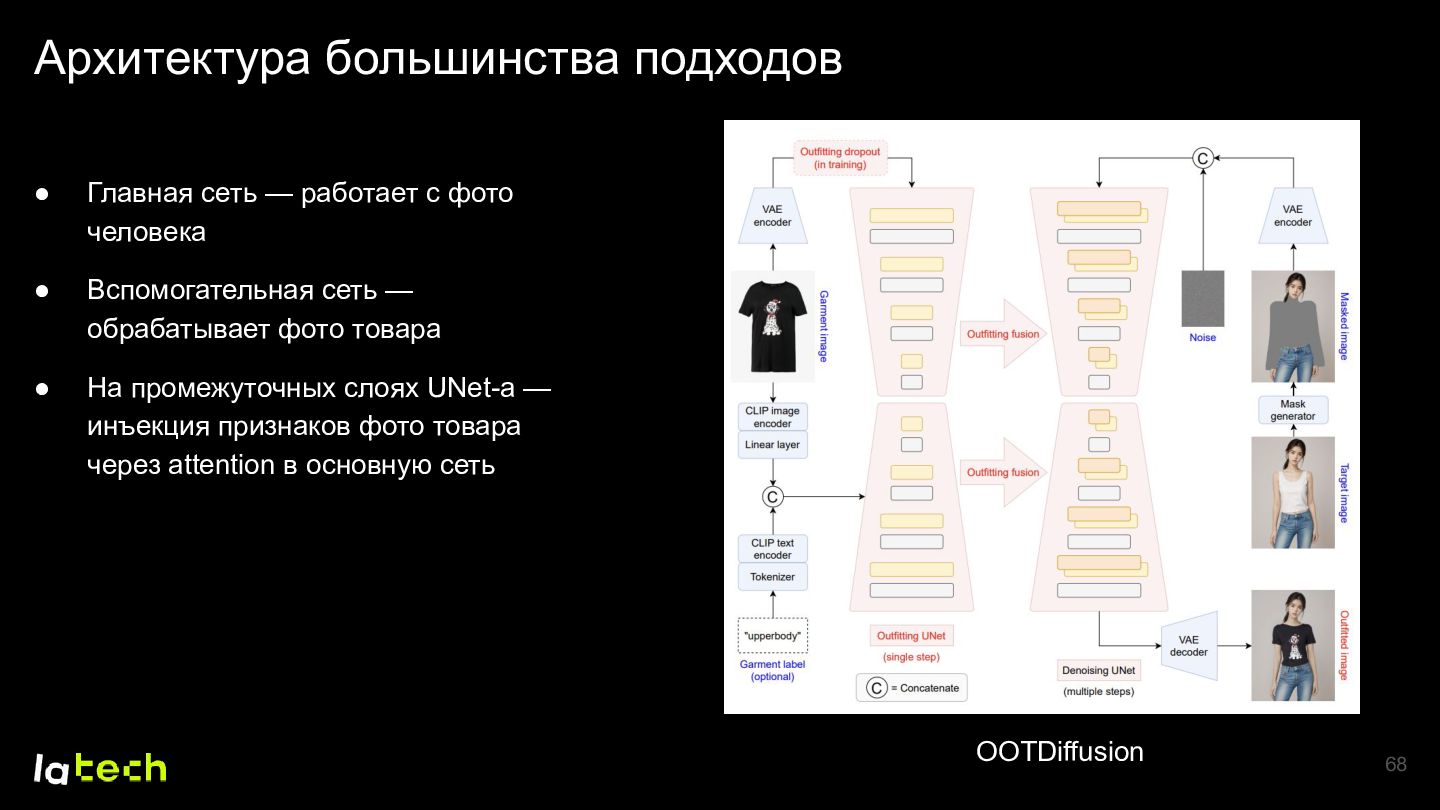
Архитектура большинства подходов • Главная сеть — работает с фото
человека • Вспомогательная сеть — обрабатывает фото товара • На промежуточных слоях UNet-а — инъекция признаков фото товара через attention в основную сеть OOTDiffusion 68 -
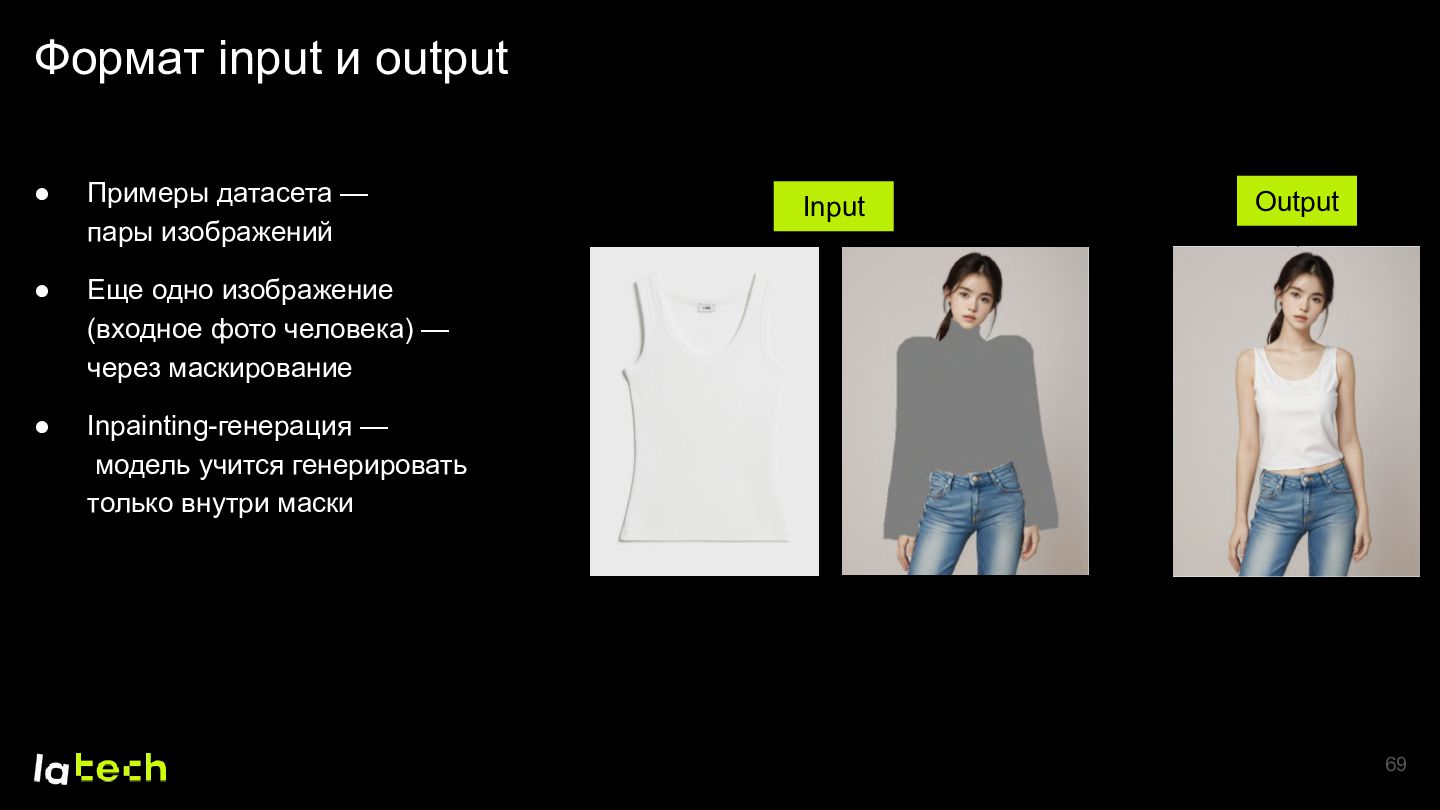
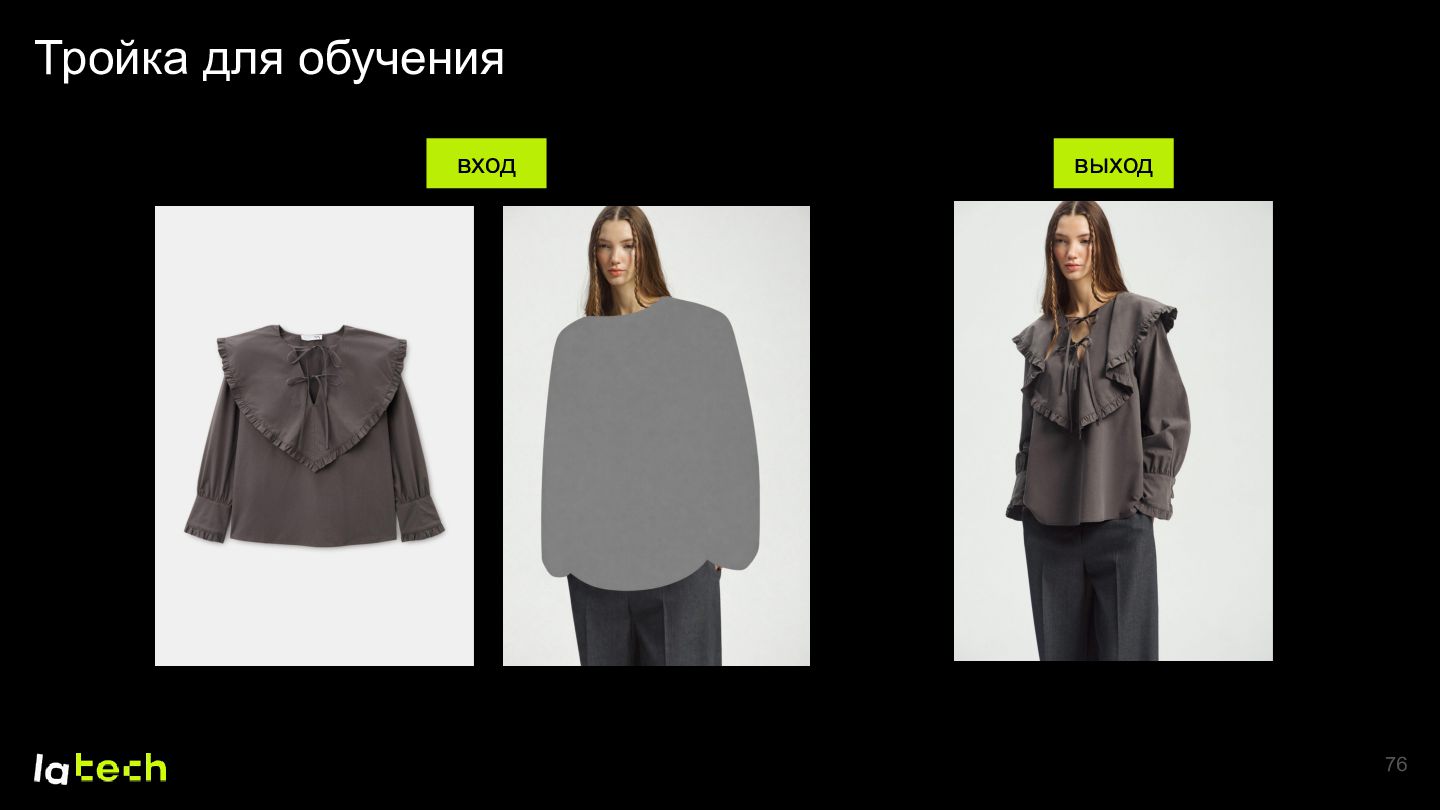
Формат input и output • Примеры датасета — пары изображений
• Еще одно изображение (входное фото человека) — через маскирование • Inpainting-генерация — модель учится генерировать только внутри маски Input Output 69 -
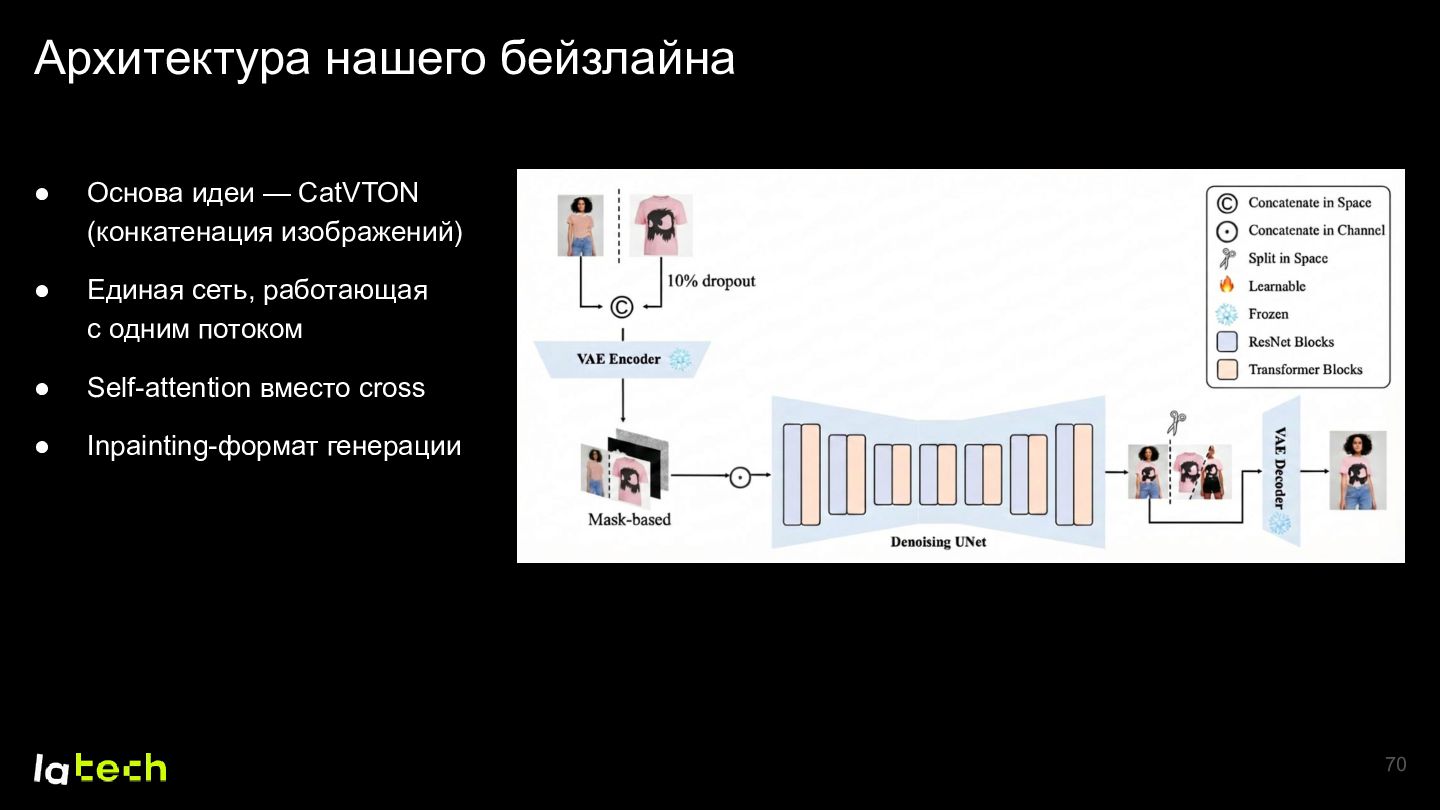
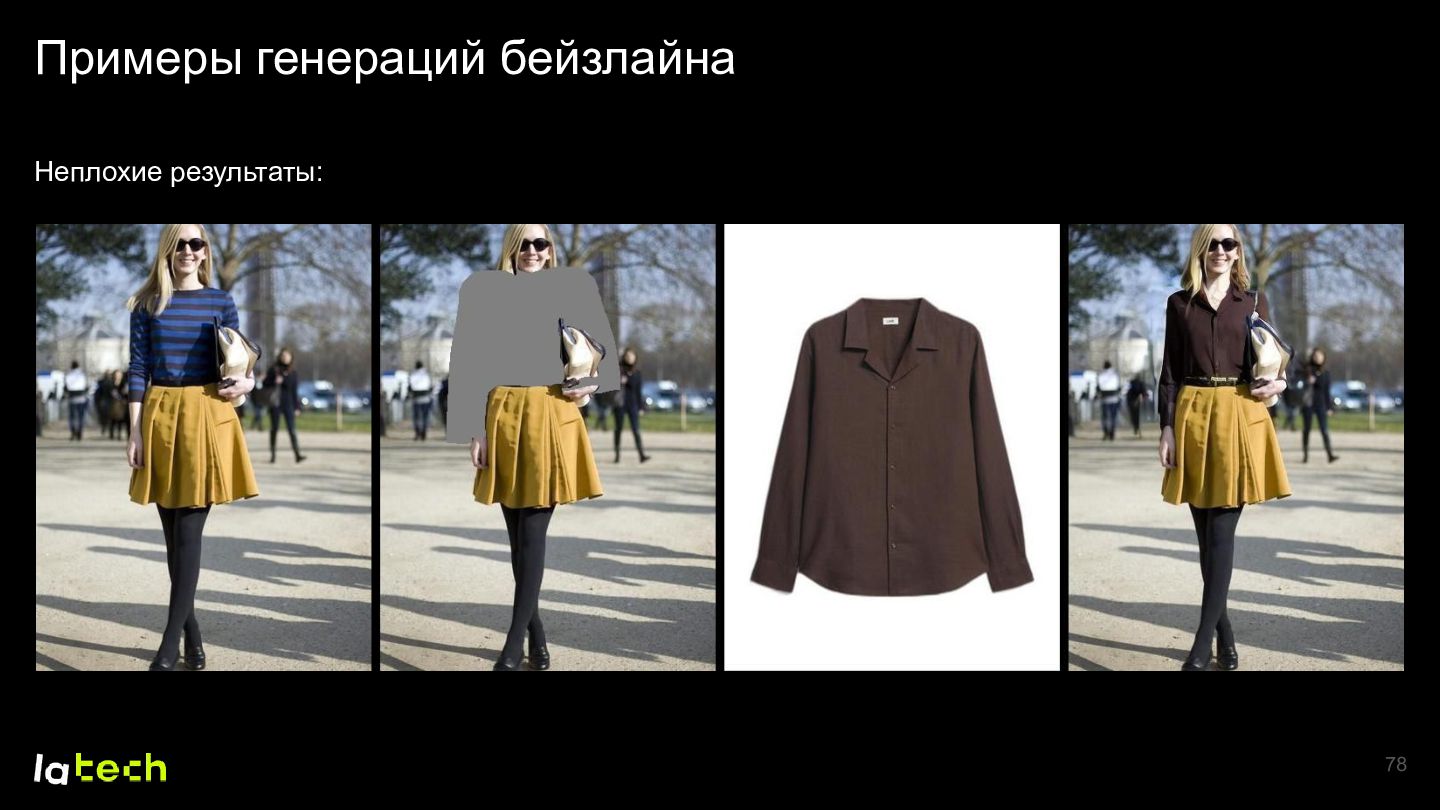
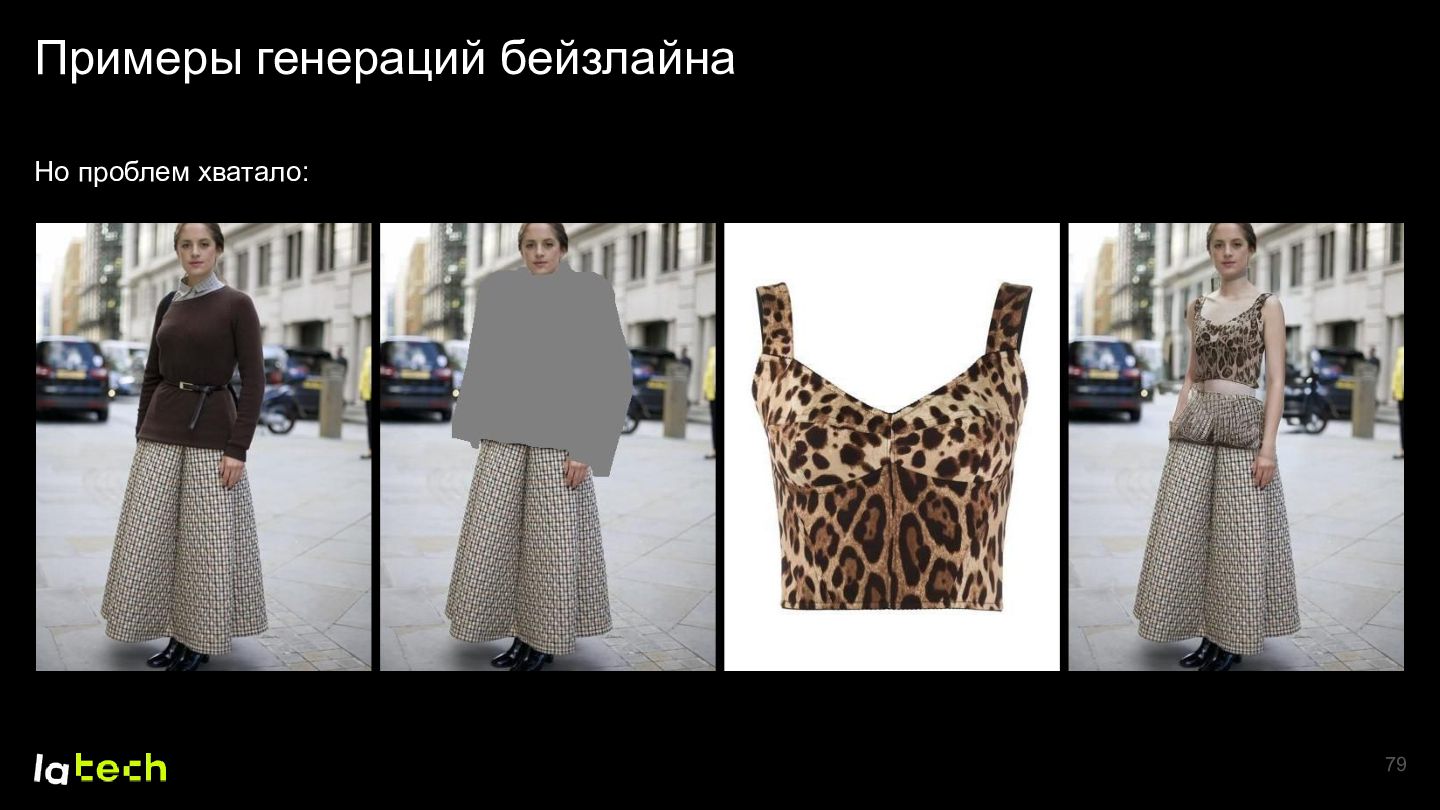
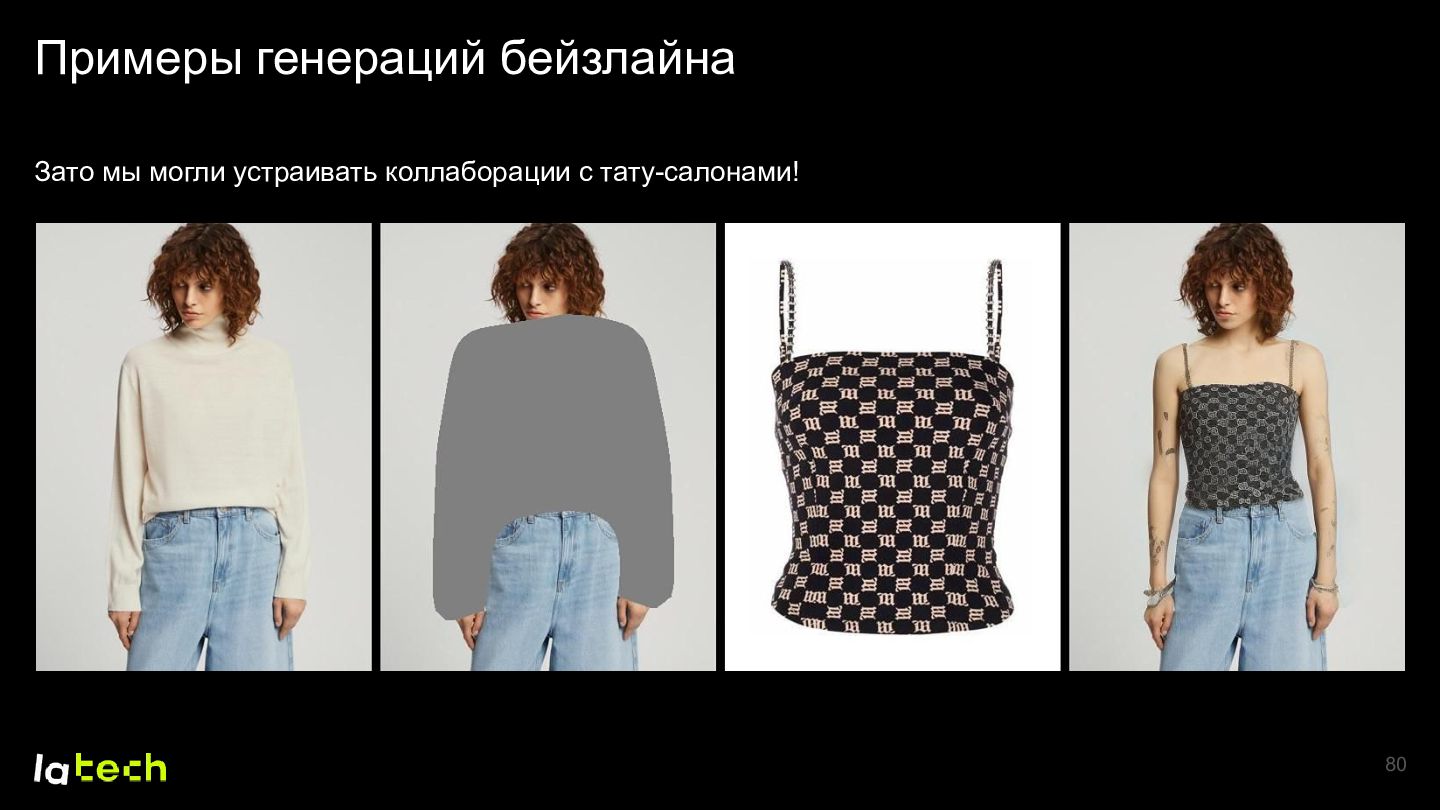
Архитектура нашего бейзлайна • Основа идеи — CatVTON (конкатенация изображений)
• Единая сеть, работающая с одним потоком • Self-attention вместо cross • Inpainting-формат генерации 70 -
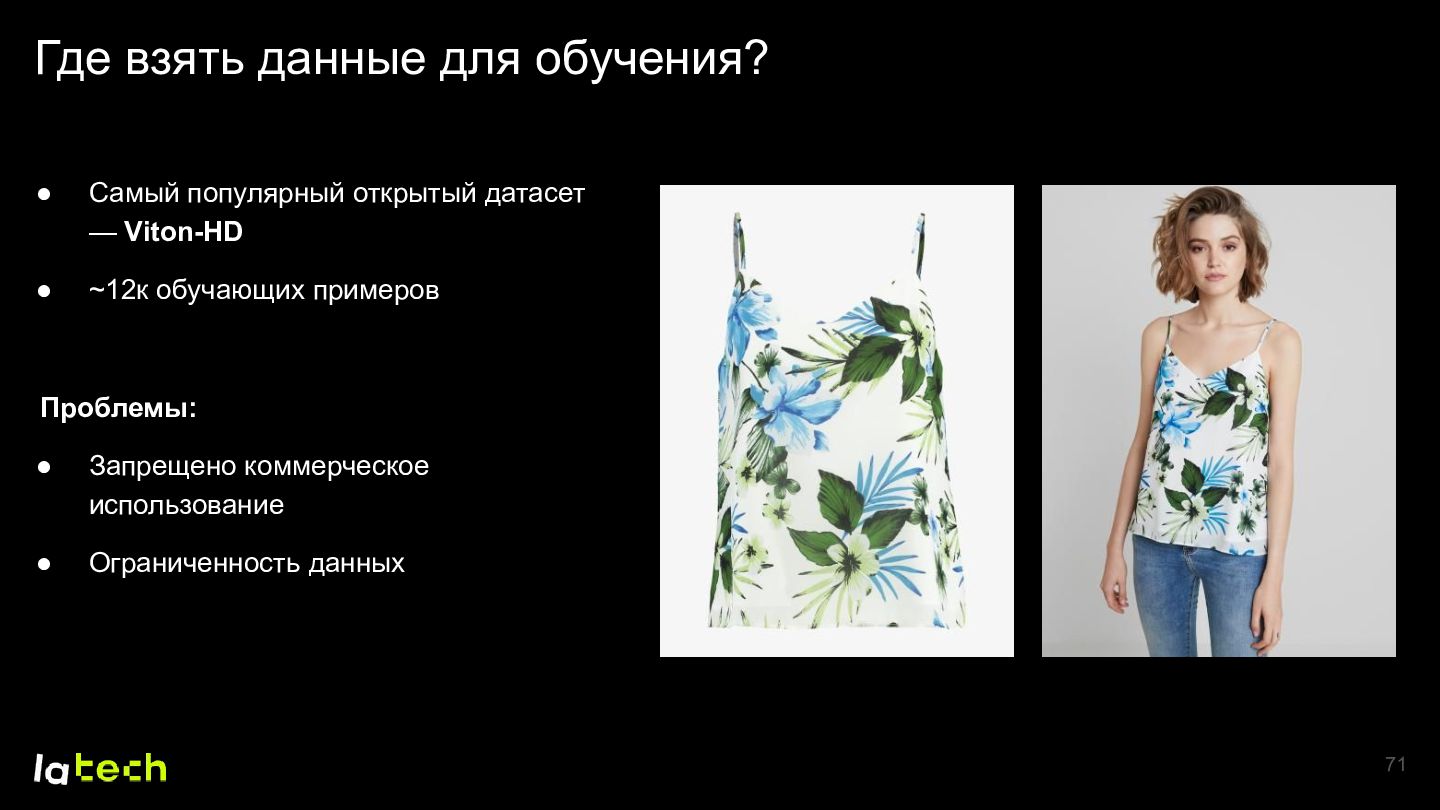
Где взять данные для обучения? • Самый популярный открытый датасет
— Viton-HD • ~12к обучающих примеров Проблемы: • Запрещено коммерческое использование • Ограниченность данных 71 -
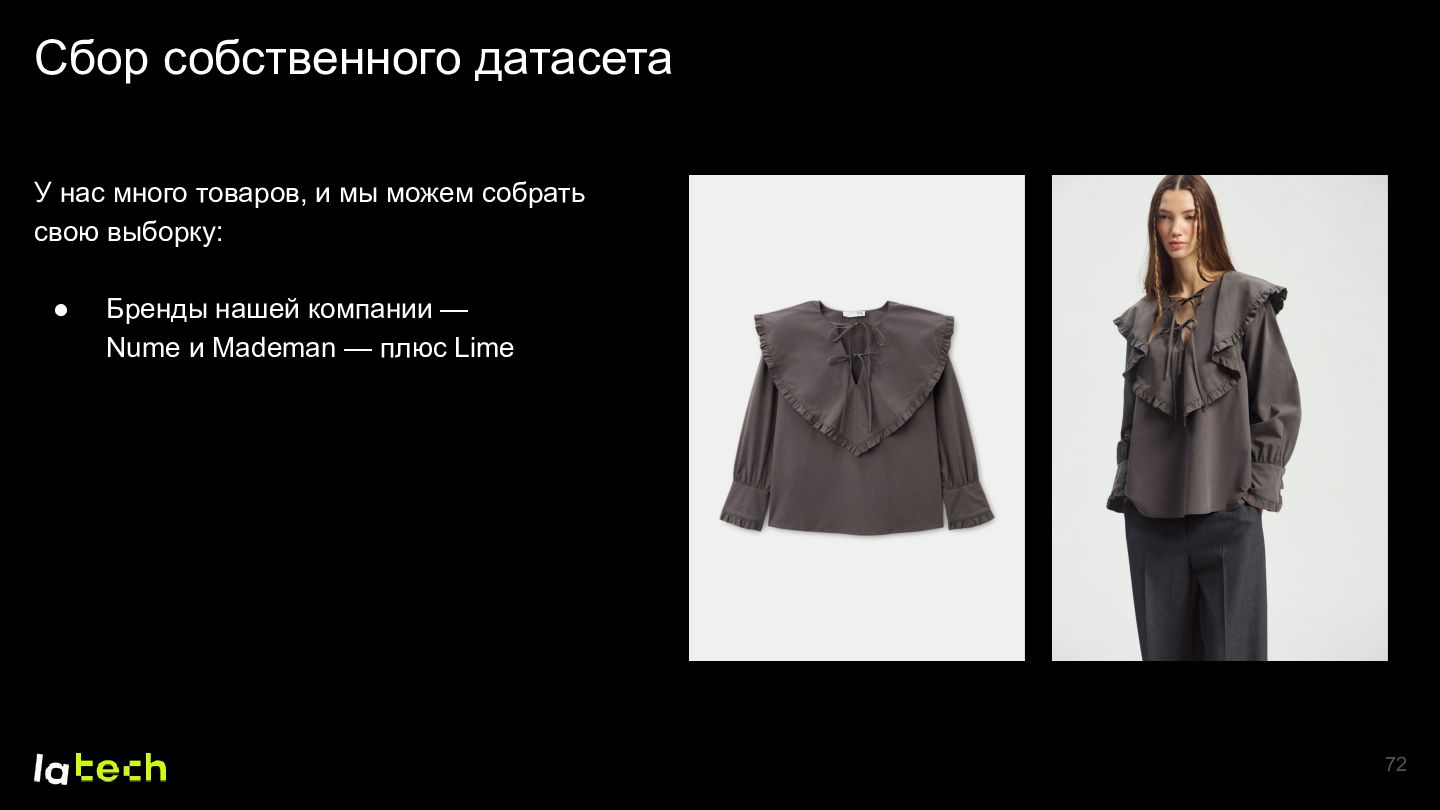
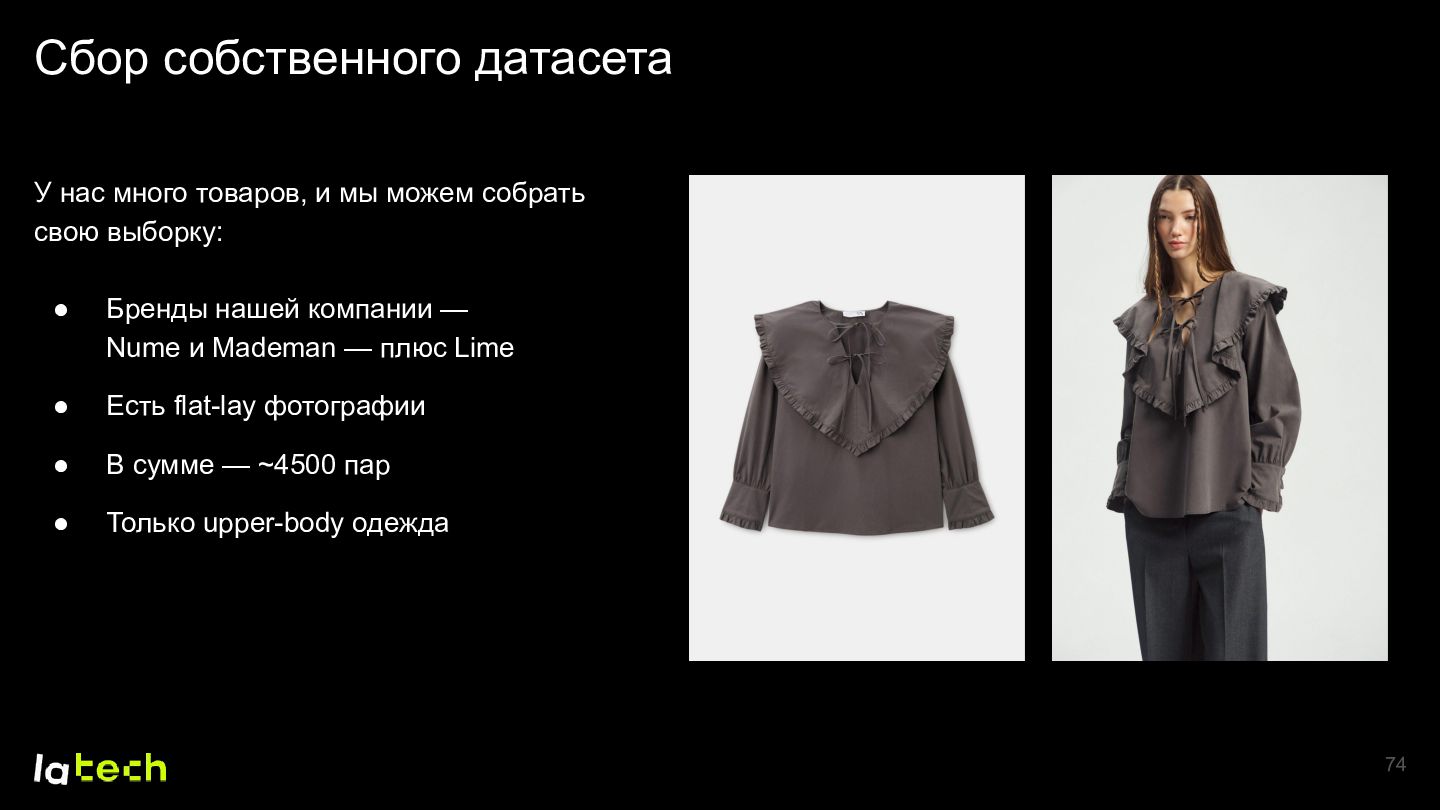
Сбор собственного датасета У нас много товаров, и мы можем
собрать свою выборку: • Бренды нашей компании — Nume и Mademan — плюс Lime 72 -
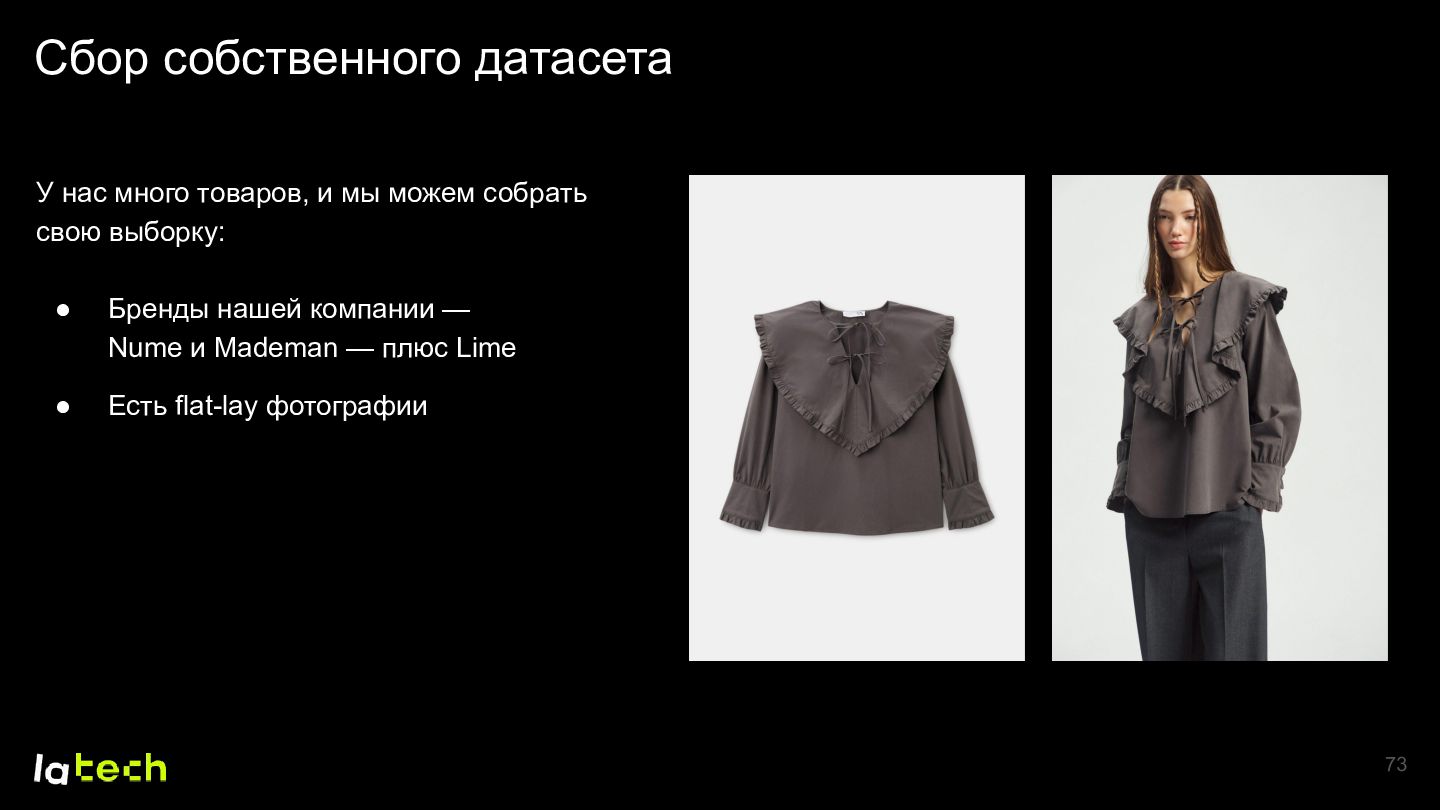
Сбор собственного датасета У нас много товаров, и мы можем
собрать свою выборку: • Бренды нашей компании — Nume и Mademan — плюс Lime • Есть flat-lay фотографии 73 -
Сбор собственного датасета У нас много товаров, и мы можем
собрать свою выборку: • Бренды нашей компании — Nume и Mademan — плюс Lime • Есть flat-lay фотографии • В сумме — ~4500 пар • Только upper-body одежда 74 -
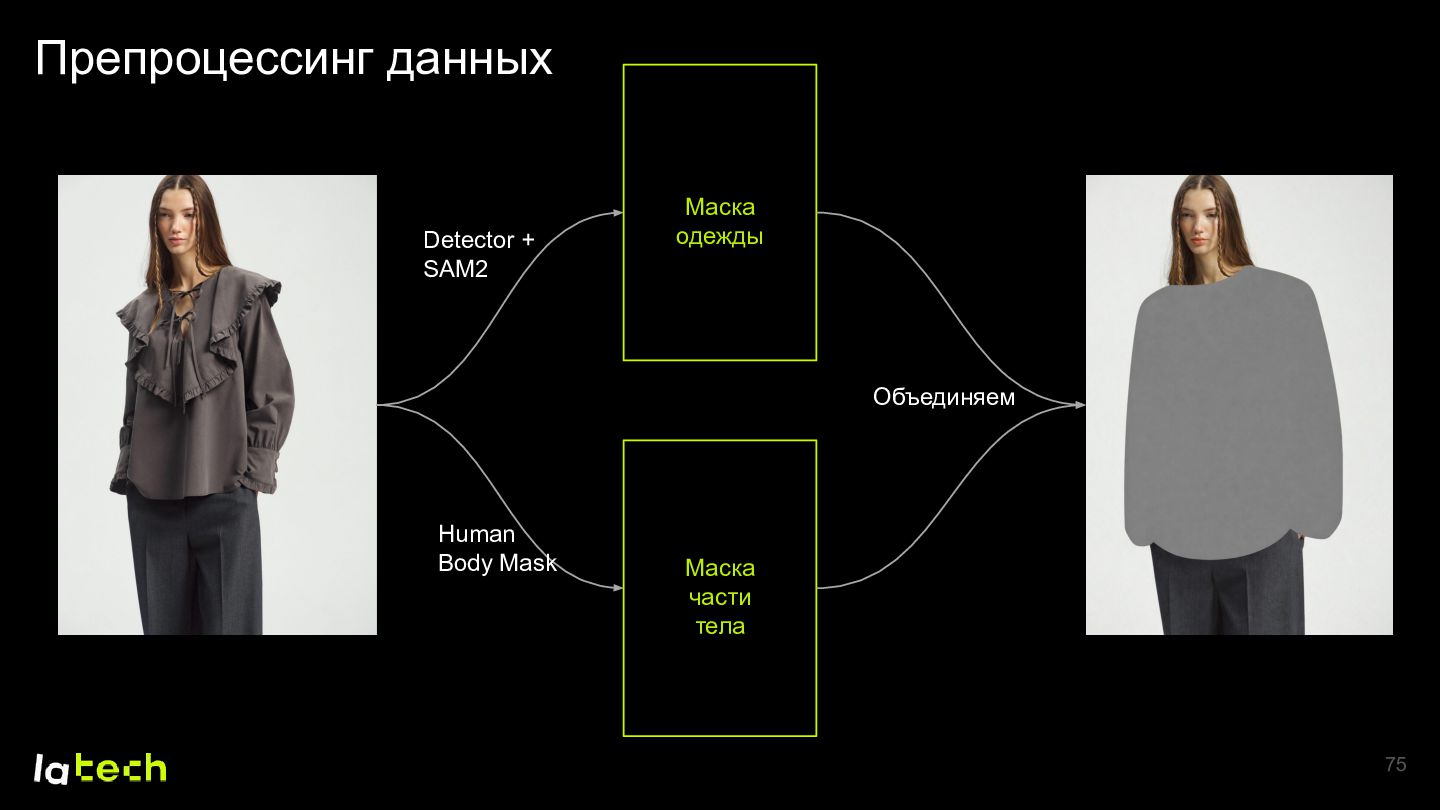
Препроцессинг данных Detector + SAM2 Маска одежды Объединяем Human Body
Mask Маска части тела 75 -
Обучение модели • Стек — pytorch, diffusers • Обучаем все
веса модели • 1 x A100 • BS = 16 • bfloat16 • Train: ~4000 примеров • Val: ~500 примеров • Начали с 512x384, потом — 768x576 • 10к итераций - ~10 часов 77 -
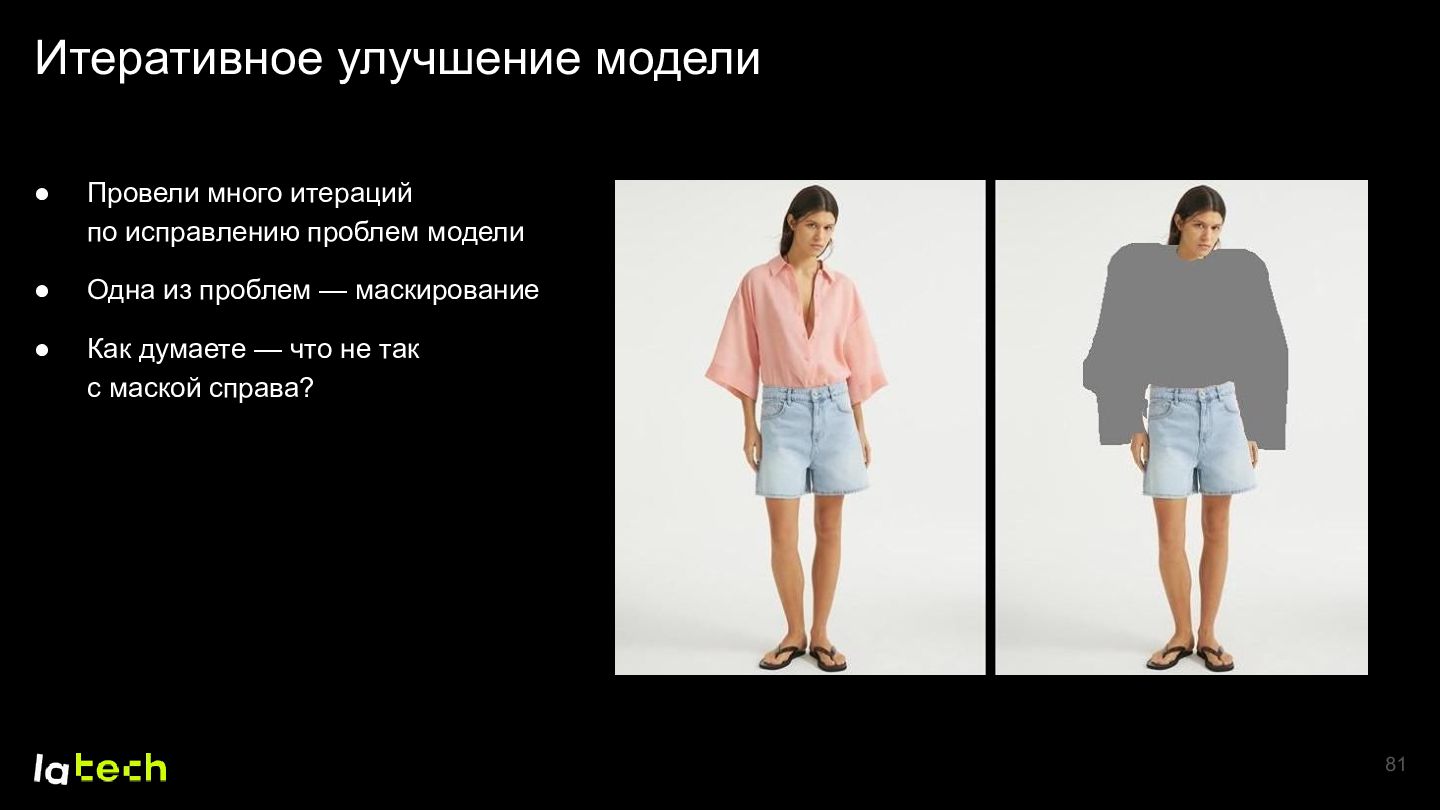
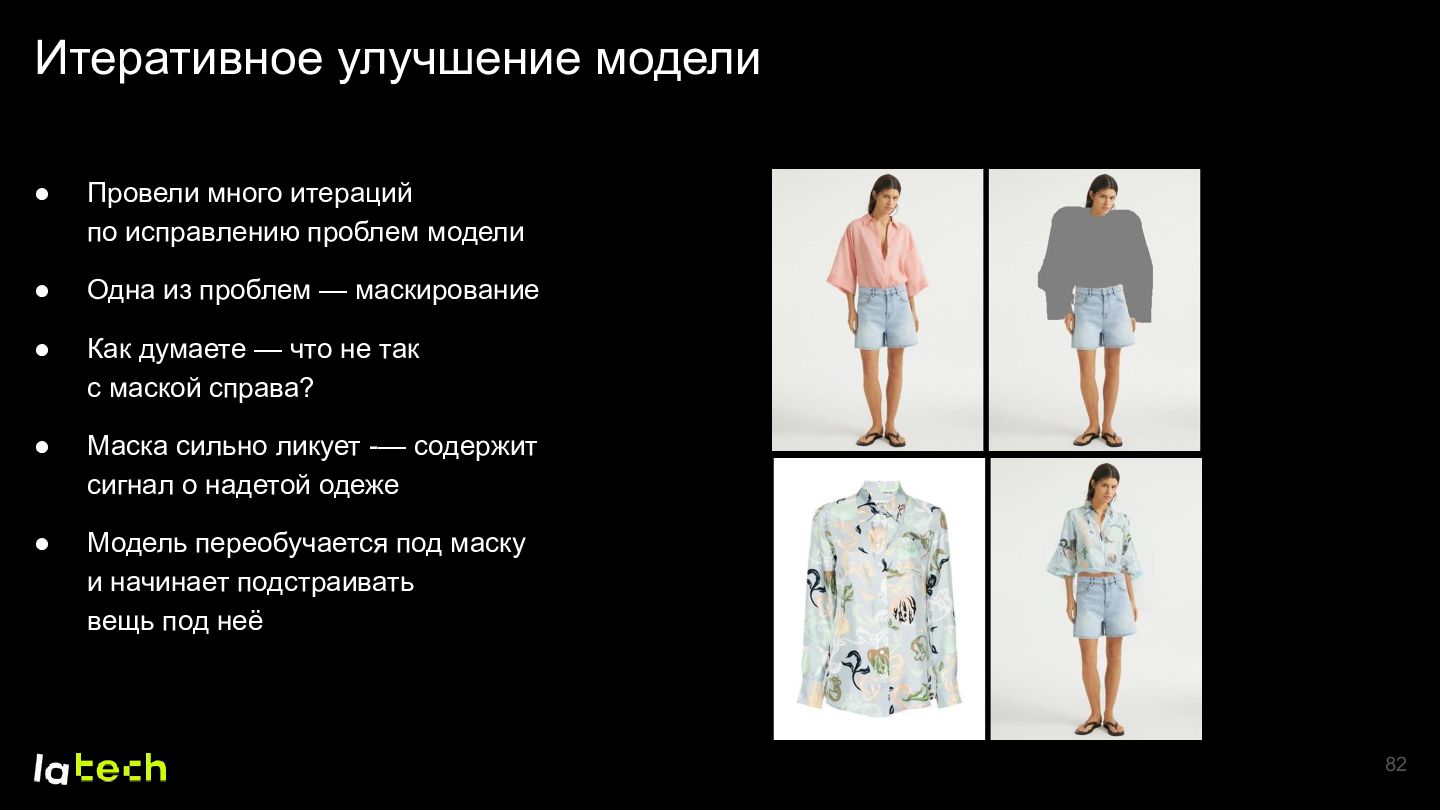
Итеративное улучшение модели • Провели много итераций по исправлению проблем
модели • Одна из проблем — маскирование • Как думаете — что не так с маской справа? 81 -
Итеративное улучшение модели • Провели много итераций по исправлению проблем
модели • Одна из проблем — маскирование • Как думаете — что не так с маской справа? • Маска сильно ликует -— содержит сигнал о надетой одеже • Модель переобучается под маску и начинает подстраивать вещь под неё 82 -
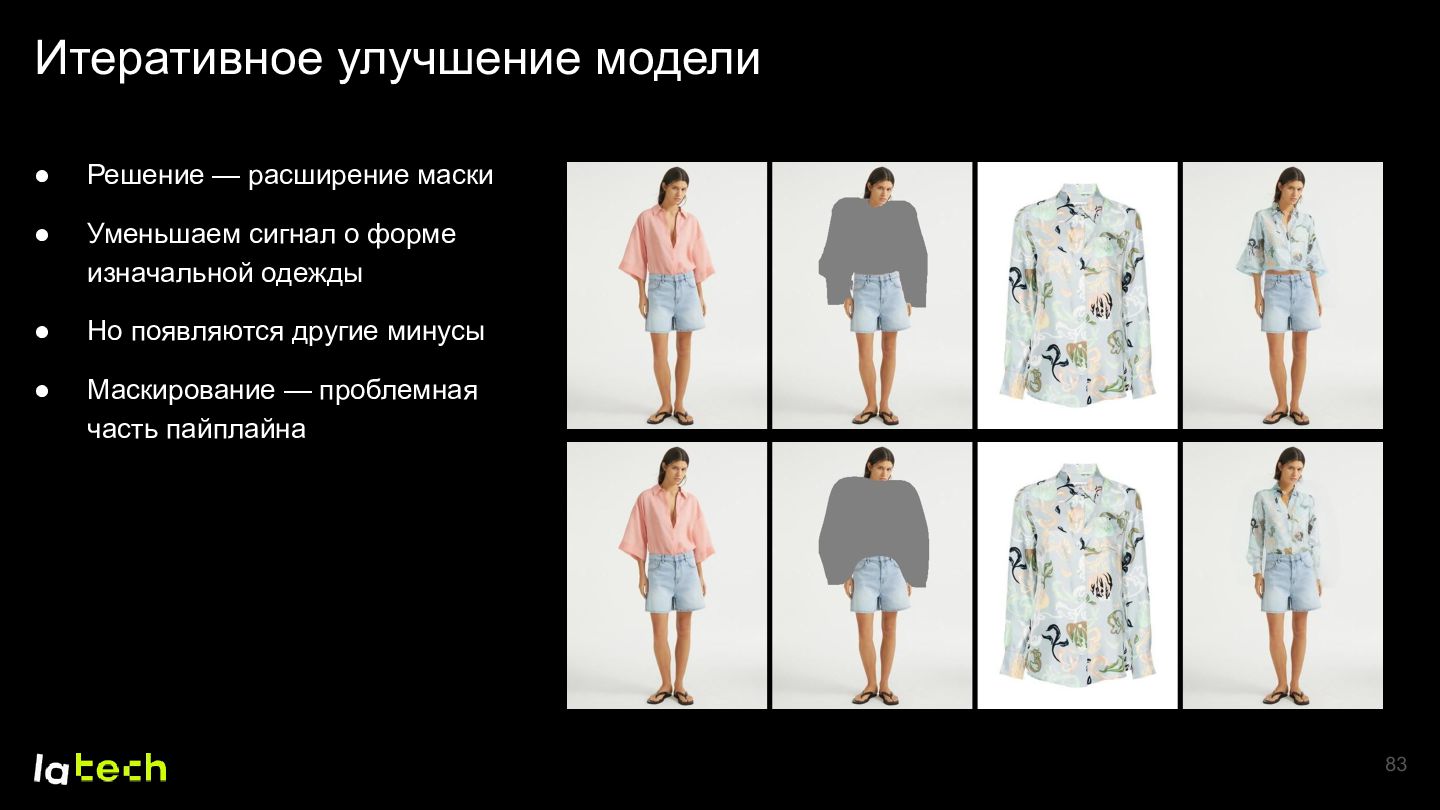
Итеративное улучшение модели • Решение — расширение маски • Уменьшаем
сигнал о форме изначальной одежды • Но появляются другие минусы • Маскирование — проблемная часть пайплайна 83 -
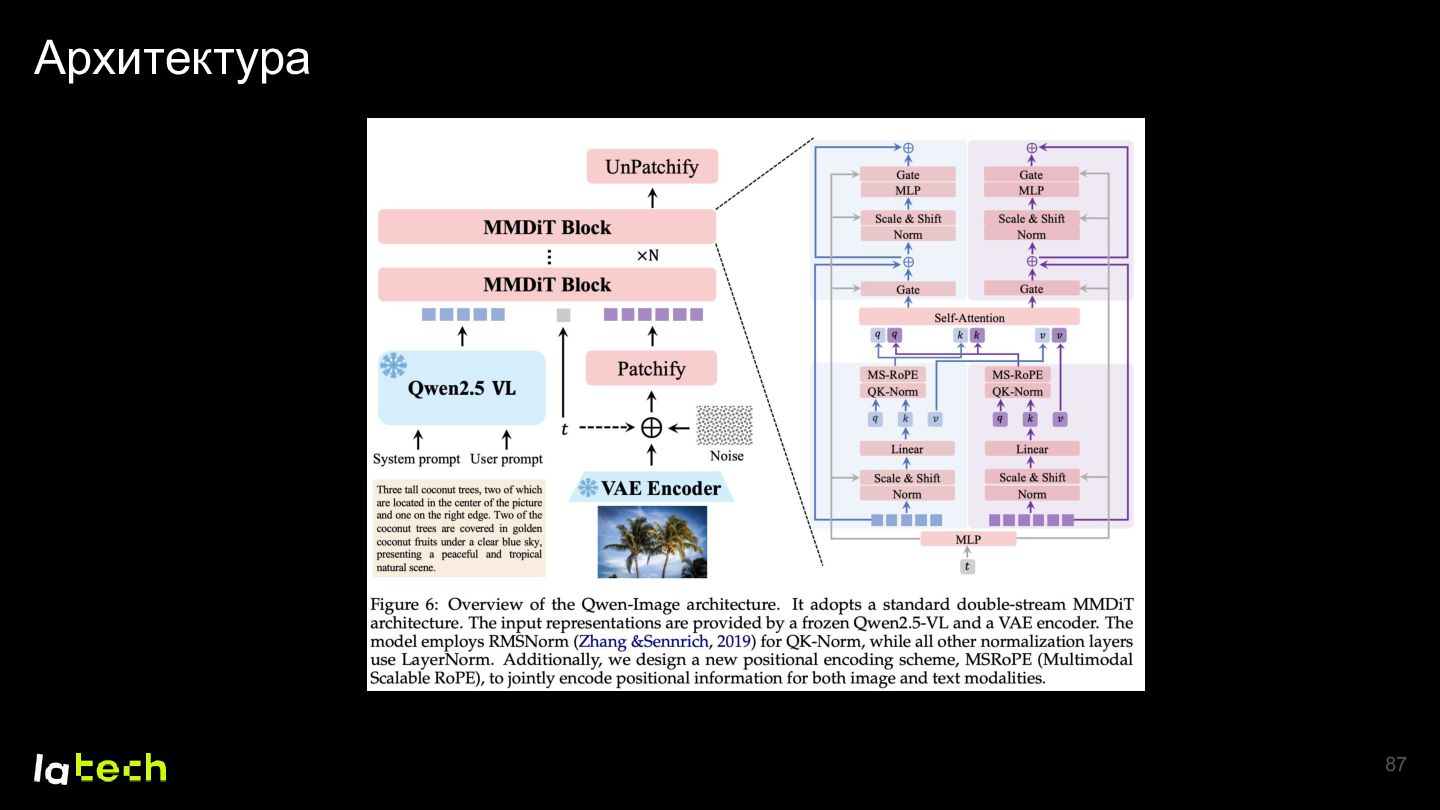
Выход Qwen-Image-Edit меняет правила игры • В августе Alibaba выпускает
модель — Qwen-Image-Edit • 20B параметров, современная архитектура, Apache 2.0 лицензия • Гигантский скачок в open-source качестве 84 -
Испытания Qwen-Image-Edit • Пробуем модель в первый раз • Получаем
~50 секунд генерации на A100 • Грустим — очень долго для нас 85 -
Испытания Qwen-Image-Edit • Пробуем модель в первый раз • Получаем
~50 секунд генерации на A100 • Грустим — очень долго для нас • Через месяц выходит дополнение к модели — Lightning-LoRA • Уменьшает кол-во шагов генерации с 30 до 4/8 • Тестируем — работает за ~10-12 секунд практически без потери качества • Зеленый свет — можем переходить на её обучение 86 -
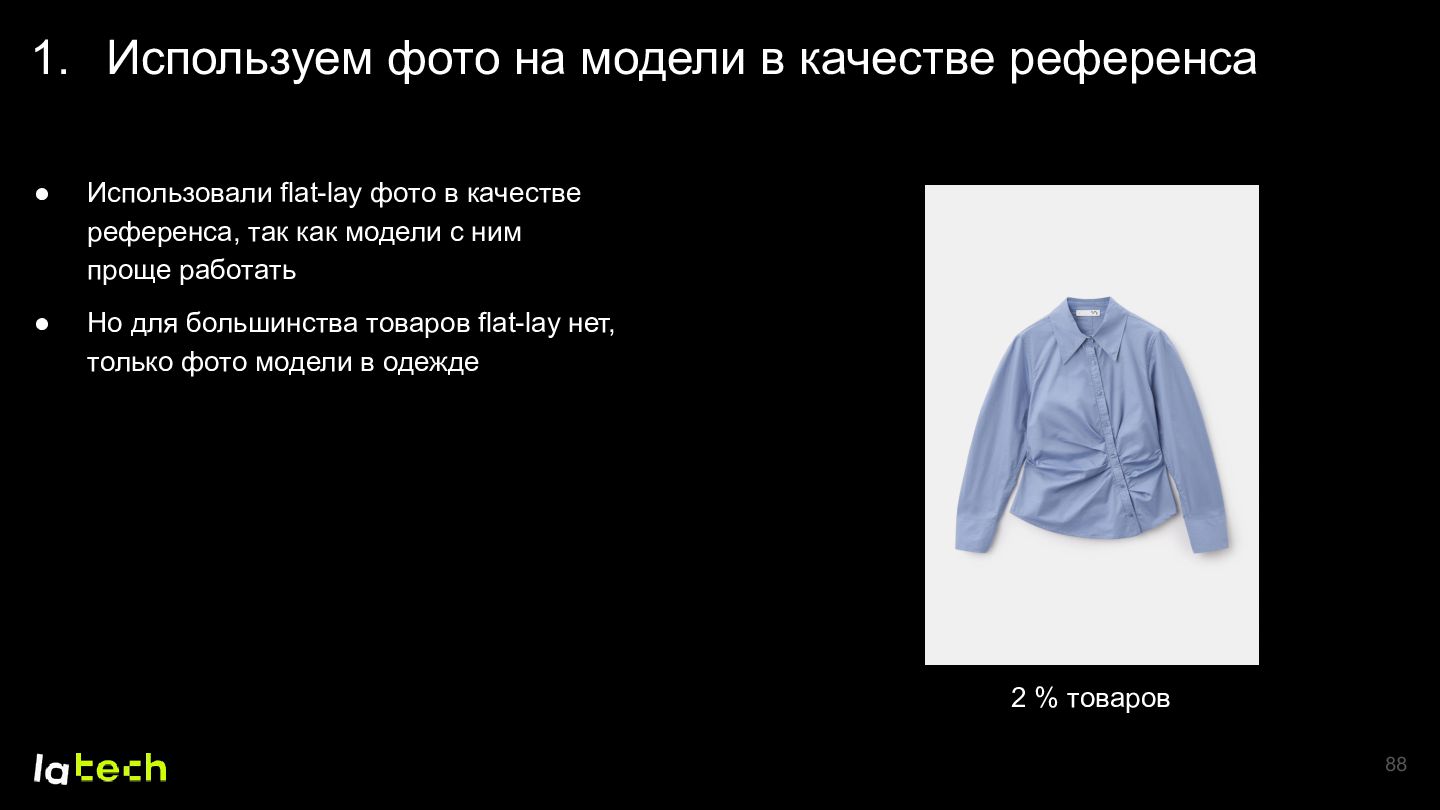
1. Используем фото на модели в качестве референса • Использовали
flat-lay фото в качестве референса, так как модели с ним проще работать • Но для большинства товаров flat-lay нет, только фото модели в одежде 2 % товаров 88 -
1. Используем фото на модели в качестве референса • Использовали
flat-lay фото в качестве референса, так как модели с ним проще работать • Но для большинства товаров flat-lay нет, только фото модели в одежде • Даже разработали TryOff-модель, чтобы решить эту проблему 89 -
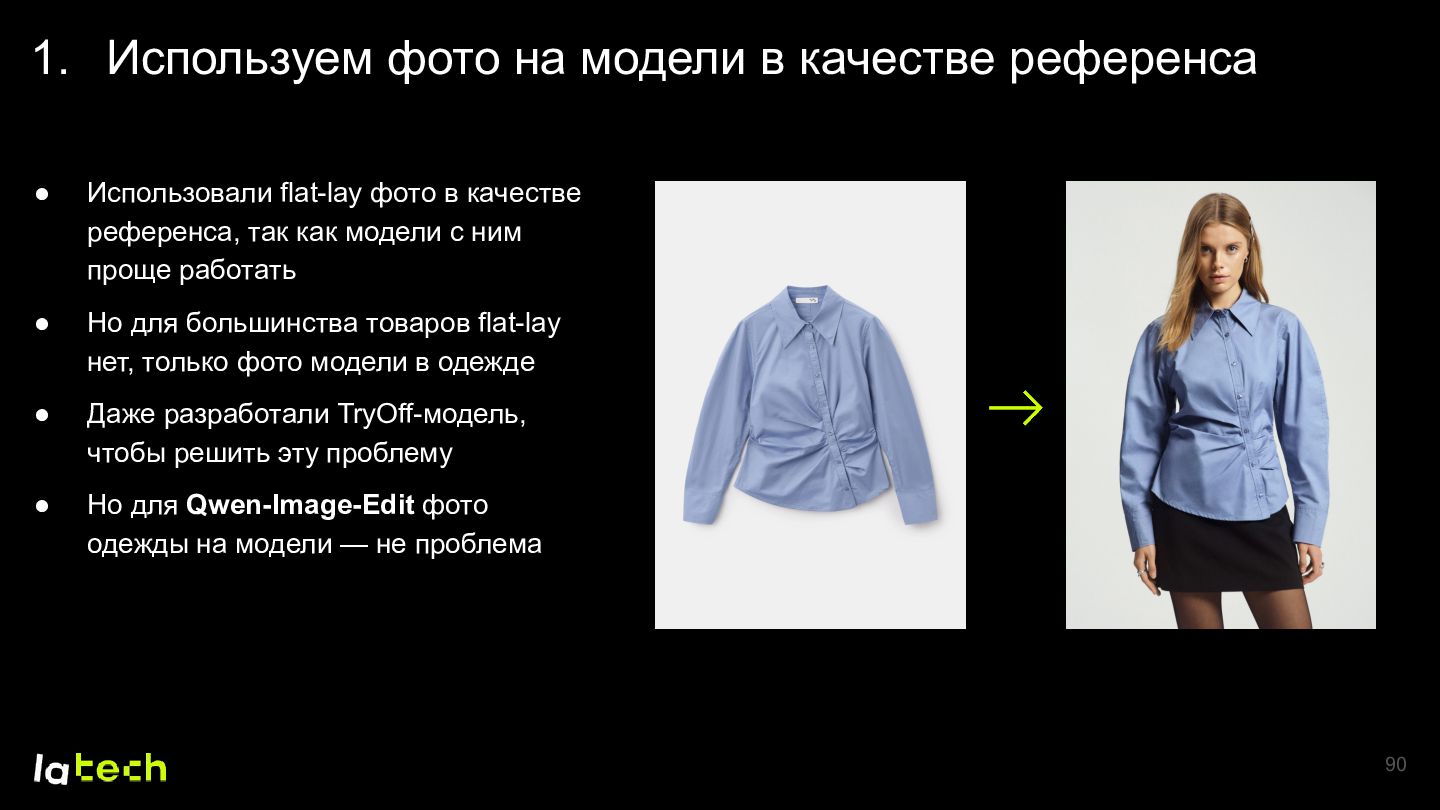
1. Используем фото на модели в качестве референса • Использовали
flat-lay фото в качестве референса, так как модели с ним проще работать • Но для большинства товаров flat-lay нет, только фото модели в одежде • Даже разработали TryOff-модель, чтобы решить эту проблему • Но для Qwen-Image-Edit фото одежды на модели — не проблема 90 -
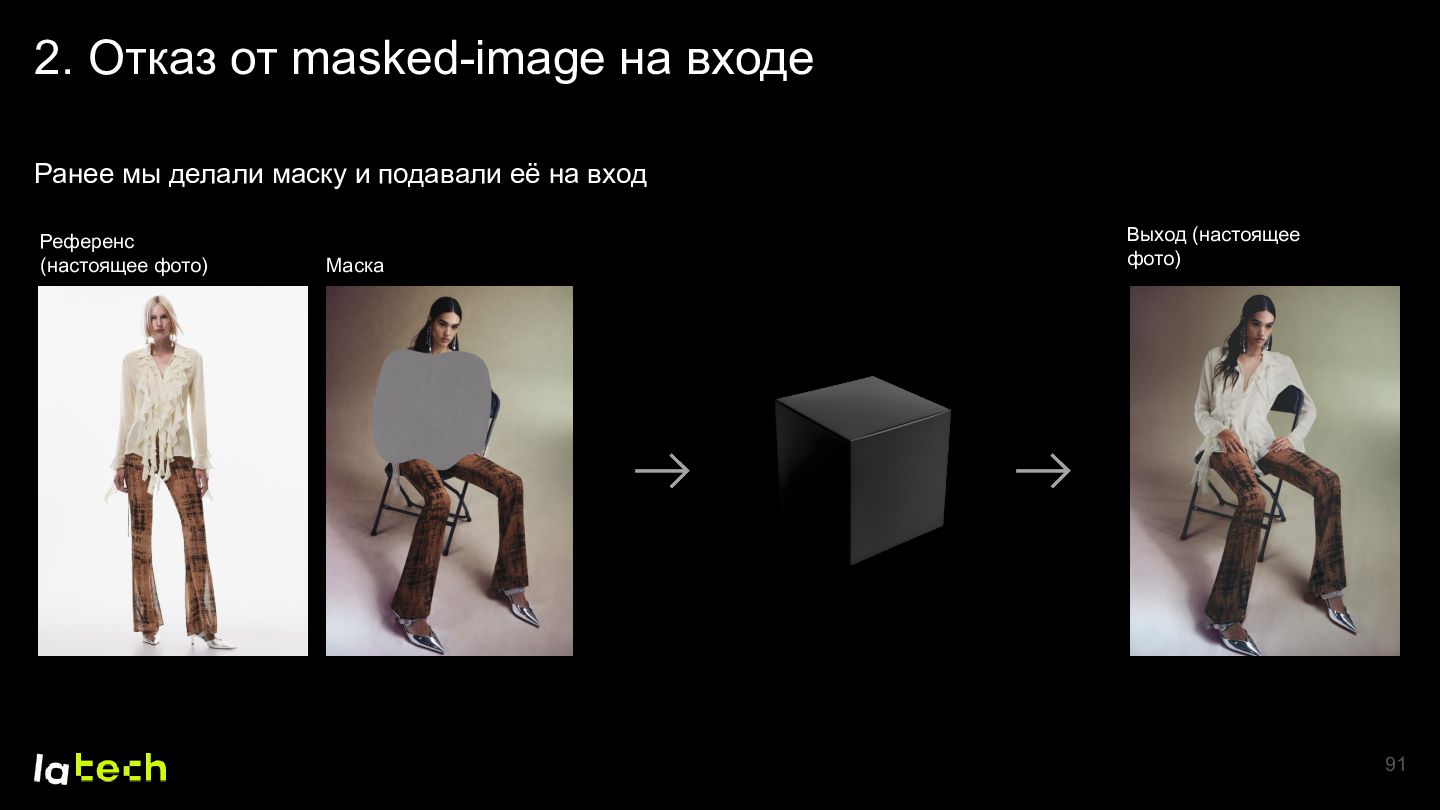
2. Отказ от masked-image на входе Ранее мы делали маску
и подавали её на вход Референс (настоящее фото) Маска Выход (настоящее фото) 91 -
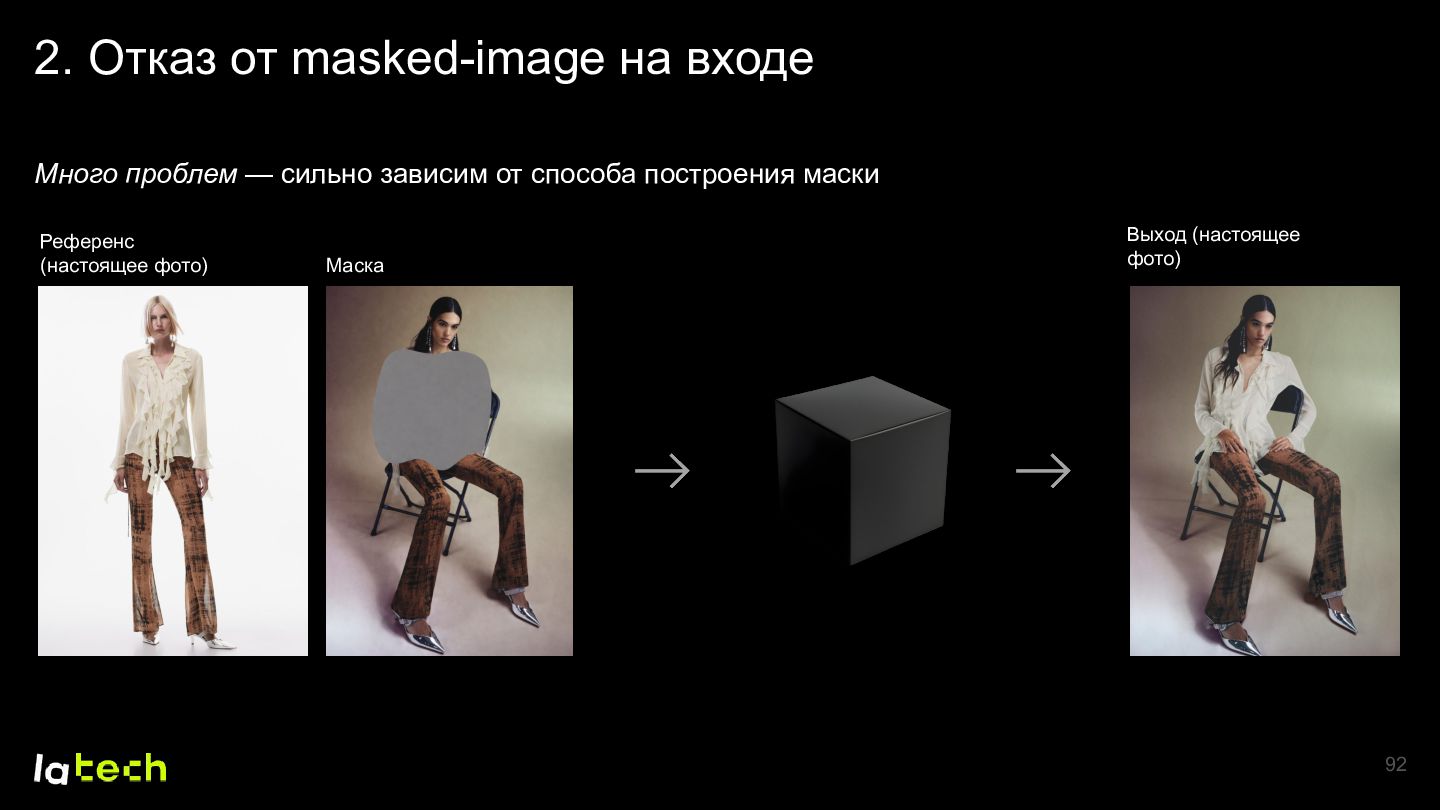
2. Отказ от masked-image на входе Много проблем — сильно
зависим от способа построения маски Референс (настоящее фото) Маска Выход (настоящее фото) 92 -
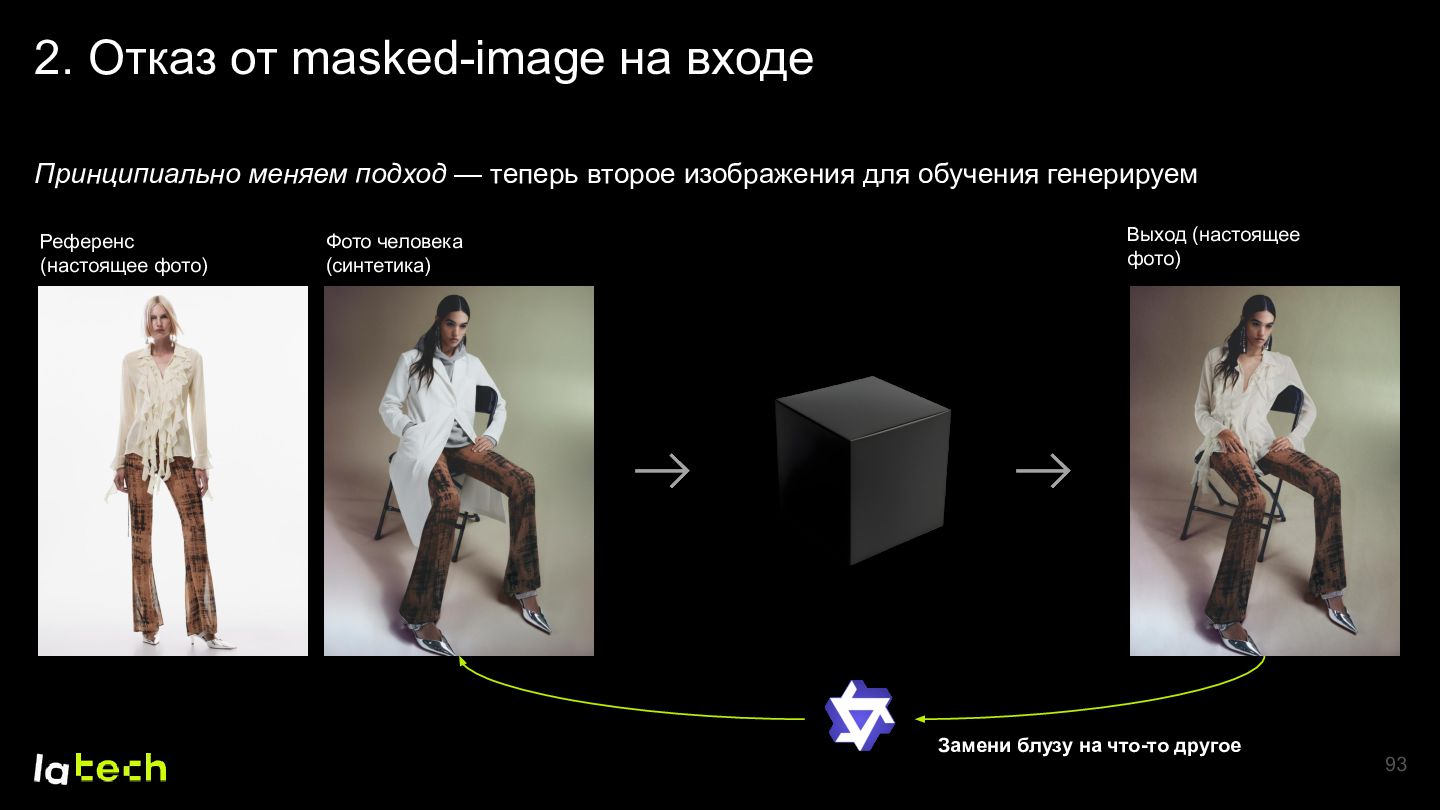
2. Отказ от masked-image на входе Принципиально меняем подход —
теперь второе изображения для обучения генерируем Референс (настоящее фото) Фото человека (синтетика) Выход (настоящее фото) Замени блузу на что-то другое 93 -
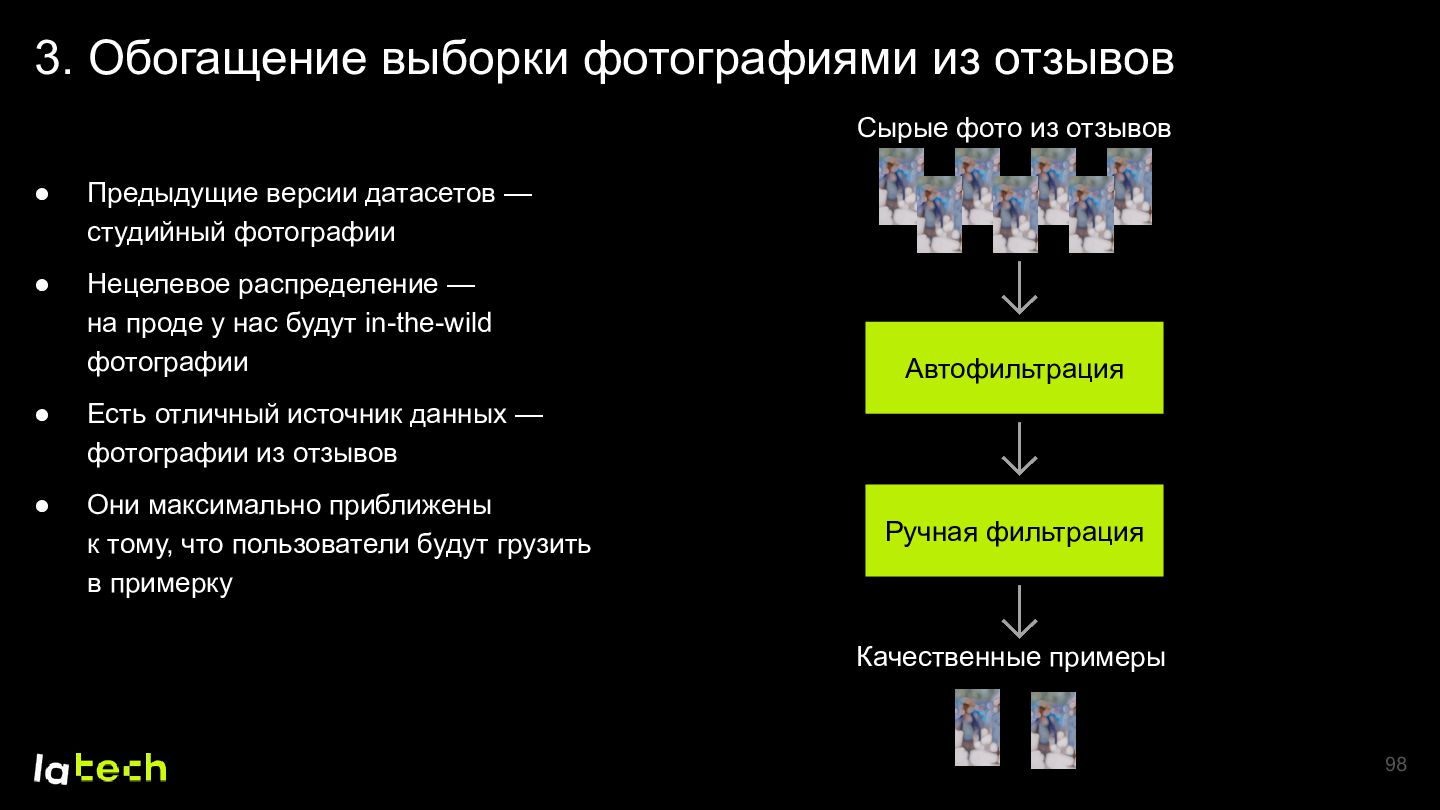
3. Обогащение выборки фотографиями из отзывов Сырые фото из отзывов
• Предыдущие версии датасетов — студийный фотографии • Нецелевое распределение — на проде у нас будут in-the-wild фотографии • Есть отличный источник данных — фотографии из отзывов • Они максимально приближены к тому, что пользователи будут грузить в примерку Автофильтрация Ручная фильтрация Качественные примеры 98 -
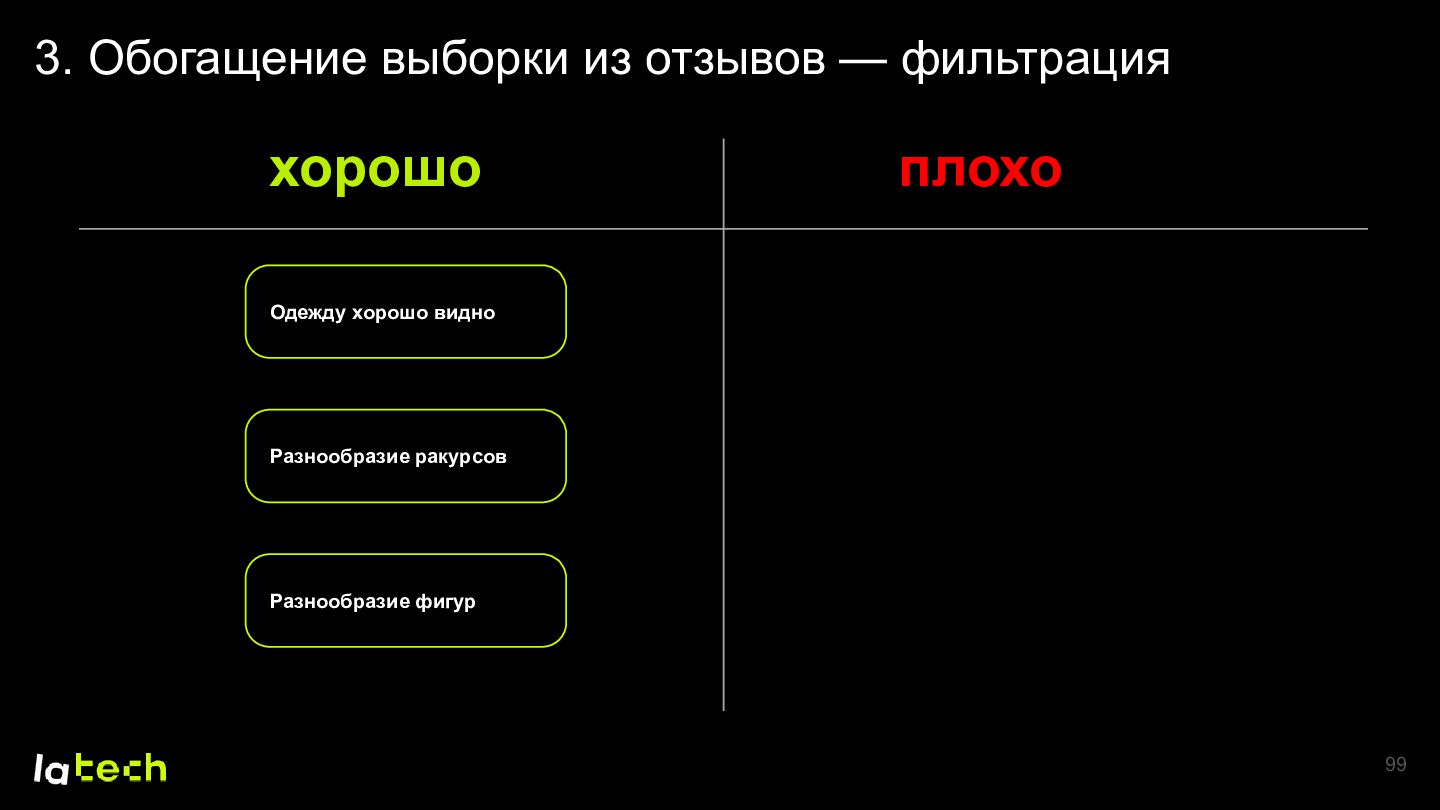
3. Обогащение выборки из отзывов — фильтрация хорошо плохо Одежду
хорошо видно Разнообразие ракурсов Разнообразие фигур 99 -
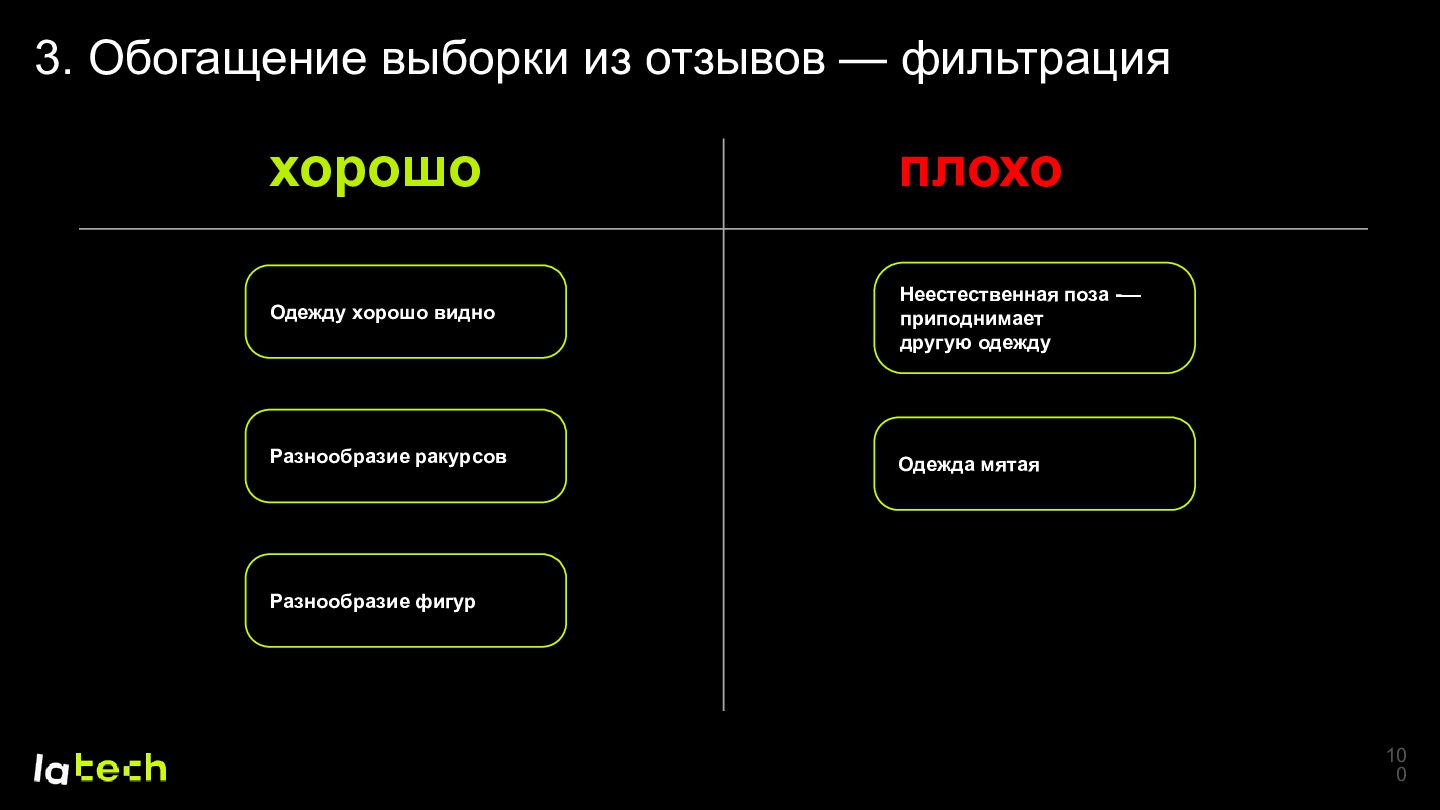
3. Обогащение выборки из отзывов — фильтрация хорошо плохо Одежду
хорошо видно Неестественная поза -— приподнимает другую одежду Разнообразие ракурсов Одежда мятая Разнообразие фигур 10 0 -
Ключевые изменения 1 Новый обучающий датасет 4 Обучаем LoRA вместо
всей модели 2 Генерируем всё изображение 5 Используем фото одежды на модели в качестве референса 3 Переходим на разрешение 1MP 10 1 -
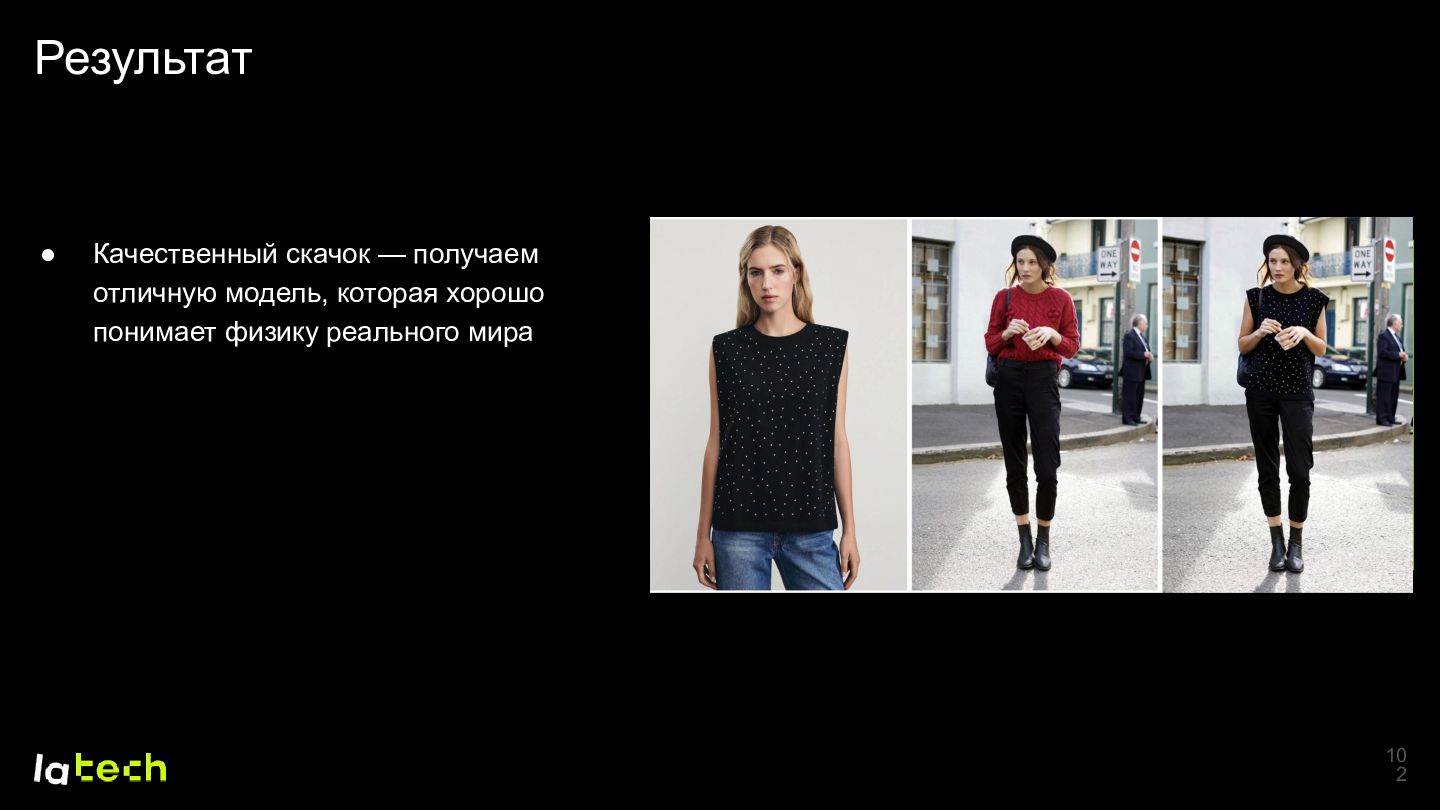
Результат • Качественный скачок — получаем отличную модель, которая хорошо
понимает физику реального мира **Здесь чуть позже будет изображение такого же размера** 10 2 -
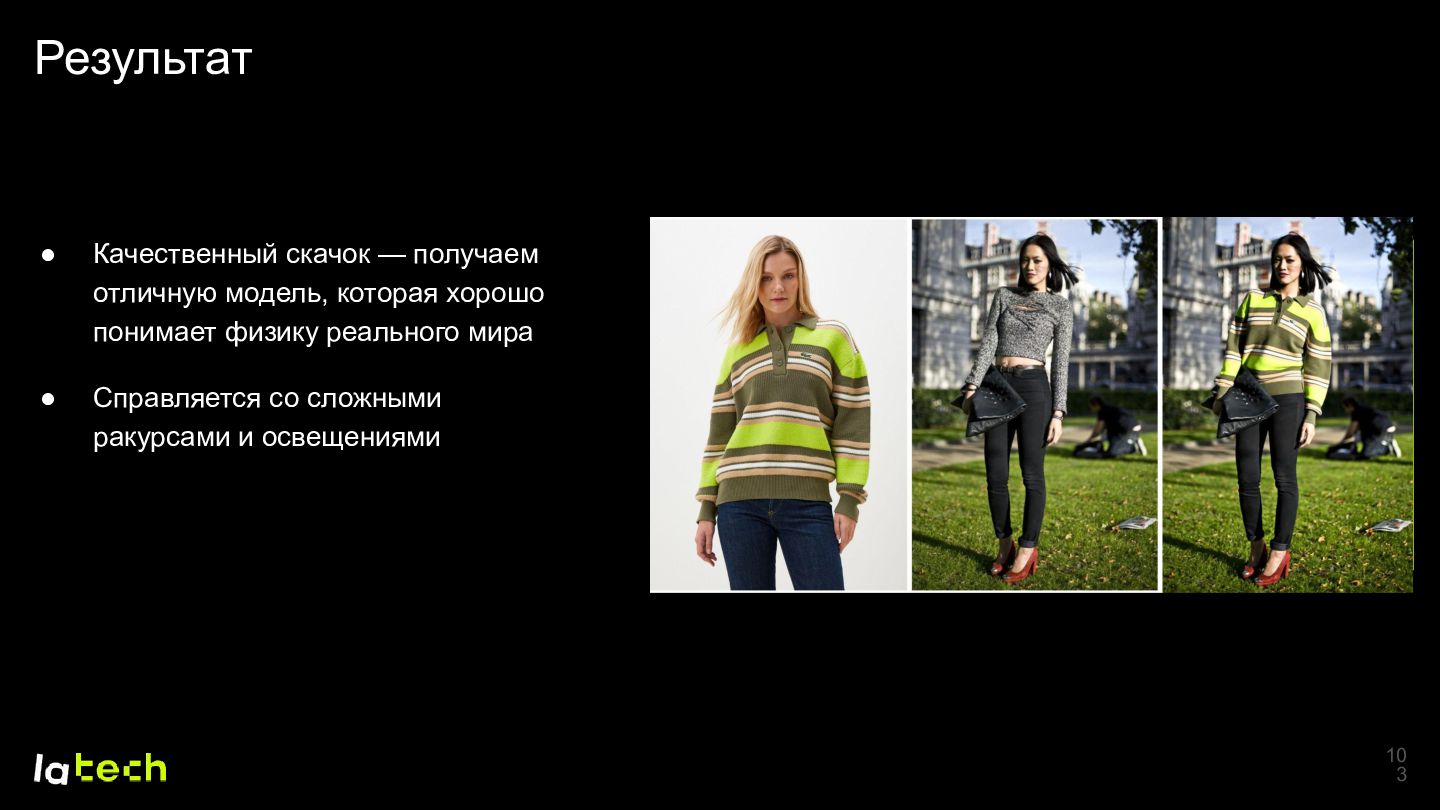
Результат • Качественный скачок — получаем отличную модель, которая хорошо
понимает физику реального мира • Справляется со сложными ракурсами и освещениями **Здесь чуть позже будет изображение такого же размера** 10 3 -
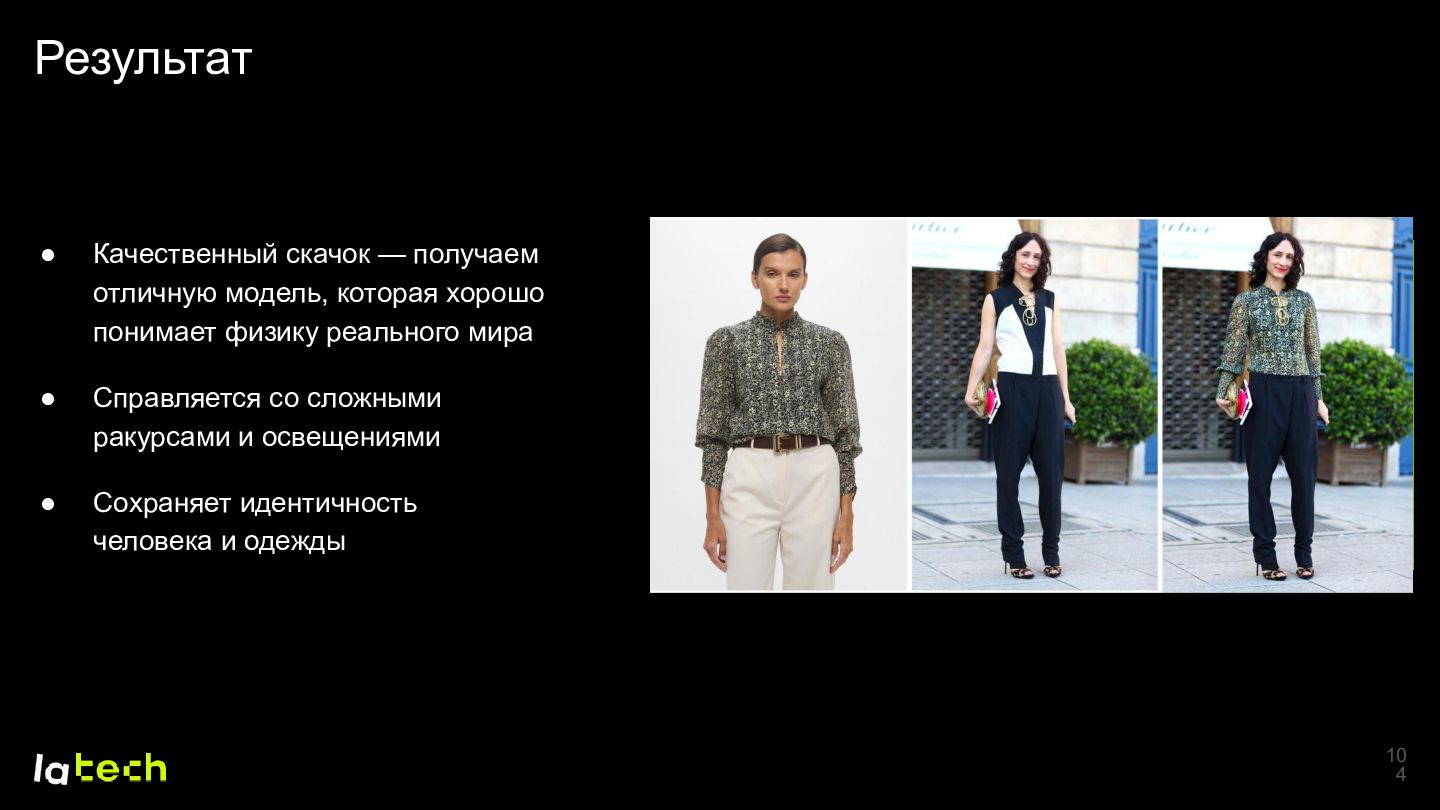
Результат • Качественный скачок — получаем отличную модель, которая хорошо
понимает физику реального мира • Справляется со сложными ракурсами и освещениями • Сохраняет идентичность человека и одежды **Здесь чуть позже будет изображение такого же размера** 10 4 -
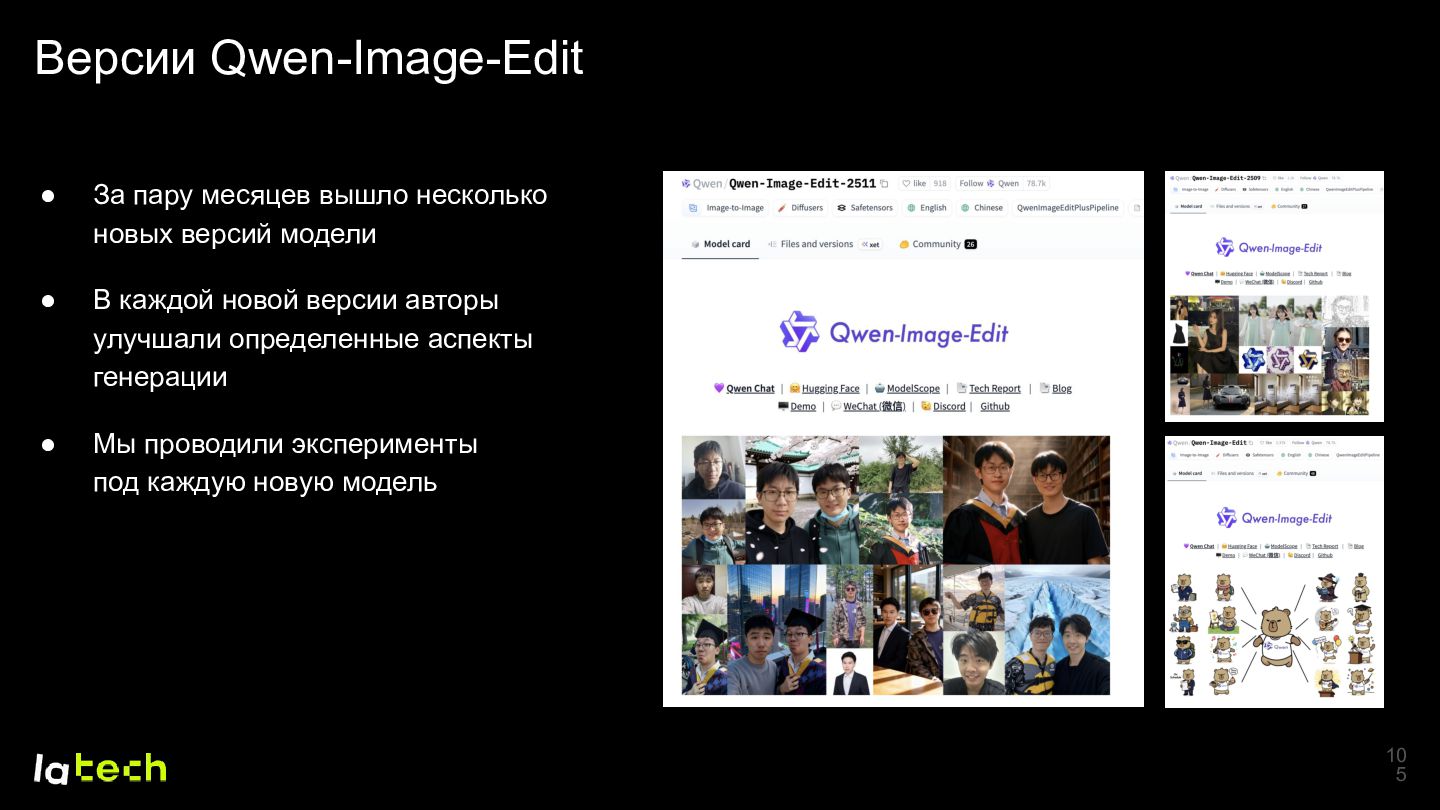
Версии Qwen-Image-Edit • За пару месяцев вышло несколько новых версий
модели • В каждой новой версии авторы улучшали определенные аспекты генерации • Мы проводили эксперименты под каждую новую модель 10 5 -
Версии Qwen-Image-Edit Qwen-Image-Edit: • • Для работы с несколькими изображениями
нужно их конкатенировать Целевое изображение — 0.5 MP Qwen-Image-Edit-2509: • • Поддержка работы с несколькими изображениями отдельно Лучше контраст переносимой одежды Qwen-Image-Edit-2511: • • Идентичность сохраняется на том же уровне Немного больше артефактов с одеждой 10 6 -
Версии Qwen-Image-Edit Qwen-Image-Edit: • • Для работы с несколькими изображениями
нужно их конкатенировать Целевое изображение — 0.5 MP Qwen-Image-Edit-2509: • • Поддержка работы с несколькими изображениями отдельно Лучше контраст переносимой одежды Qwen-Image-Edit-2511: • • Идентичность сохраняется на том же уровне Немного больше артефактов с одеждой 10 7 -
Масштабирование — покрываем больше категорий • По уже выстроенному пайплайну
собираем данные для dress и lower-body категорий • Для каждой - обучаем отдельную LoRA (200 Mb) • На инференсе - переключаем модель в зависимости от типа одежды 10 8 -
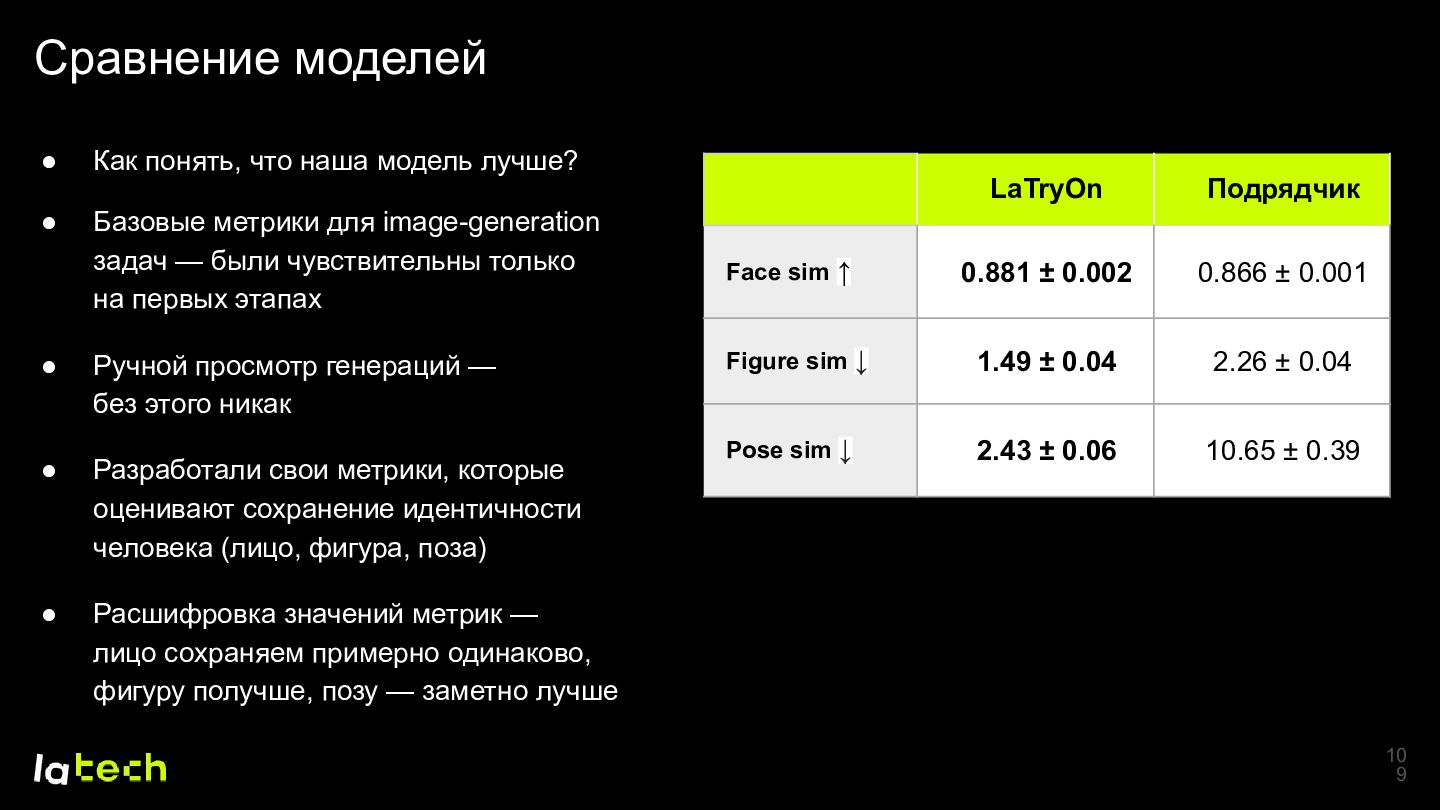
Сравнение моделей • • Как понять, что наша модель лучше?
Базовые метрики для image-generation задач — были чувствительны только на первых этапах • Ручной просмотр генераций — без этого никак • Разработали свои метрики, которые оценивают сохранение идентичности человека (лицо, фигура, поза) • Расшифровка значений метрик — лицо сохраняем примерно одинаково, фигуру получше, позу — заметно лучше LaTryOn Подрядчик Face sim ↑ 0.881 ± 0.002 0.866 ± 0.001 Figure sim ↓ 1.49 ± 0.04 2.26 ± 0.04 Pose sim ↓ 2.43 ± 0.06 10.65 ± 0.39 10 9 -
Модерация фото • Мы решаем задачу генерации изображения • Результаты
модели могут быть разными • Нужны инструменты автоматической проверки генерации 11 1 -
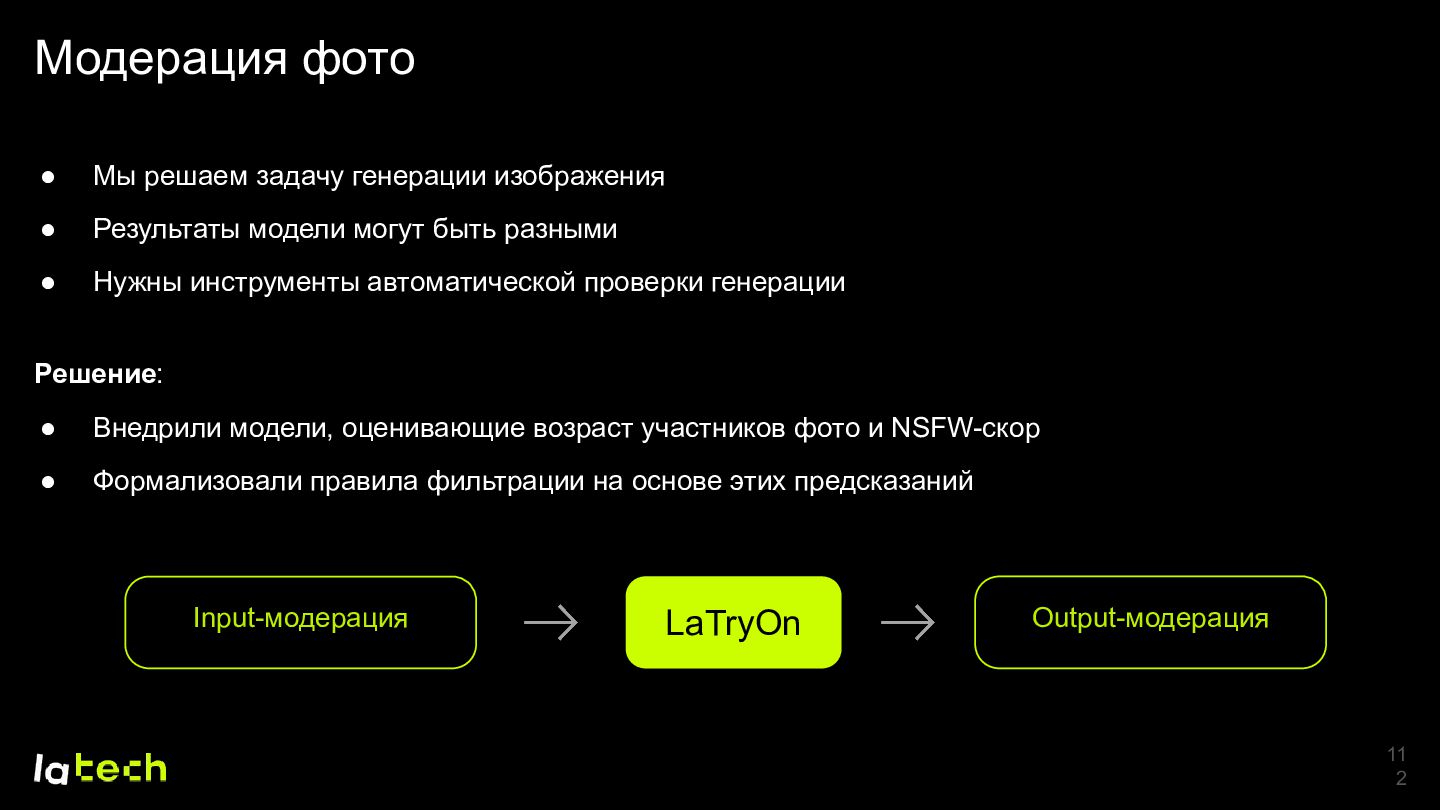
Модерация фото • Мы решаем задачу генерации изображения • Результаты
модели могут быть разными • Нужны инструменты автоматической проверки генерации Решение: • Внедрили модели, оценивающие возраст участников фото и NSFW-скор • Формализовали правила фильтрации на основе этих предсказаний Input-модерация LaTryOn Output-модерация 11 2 -
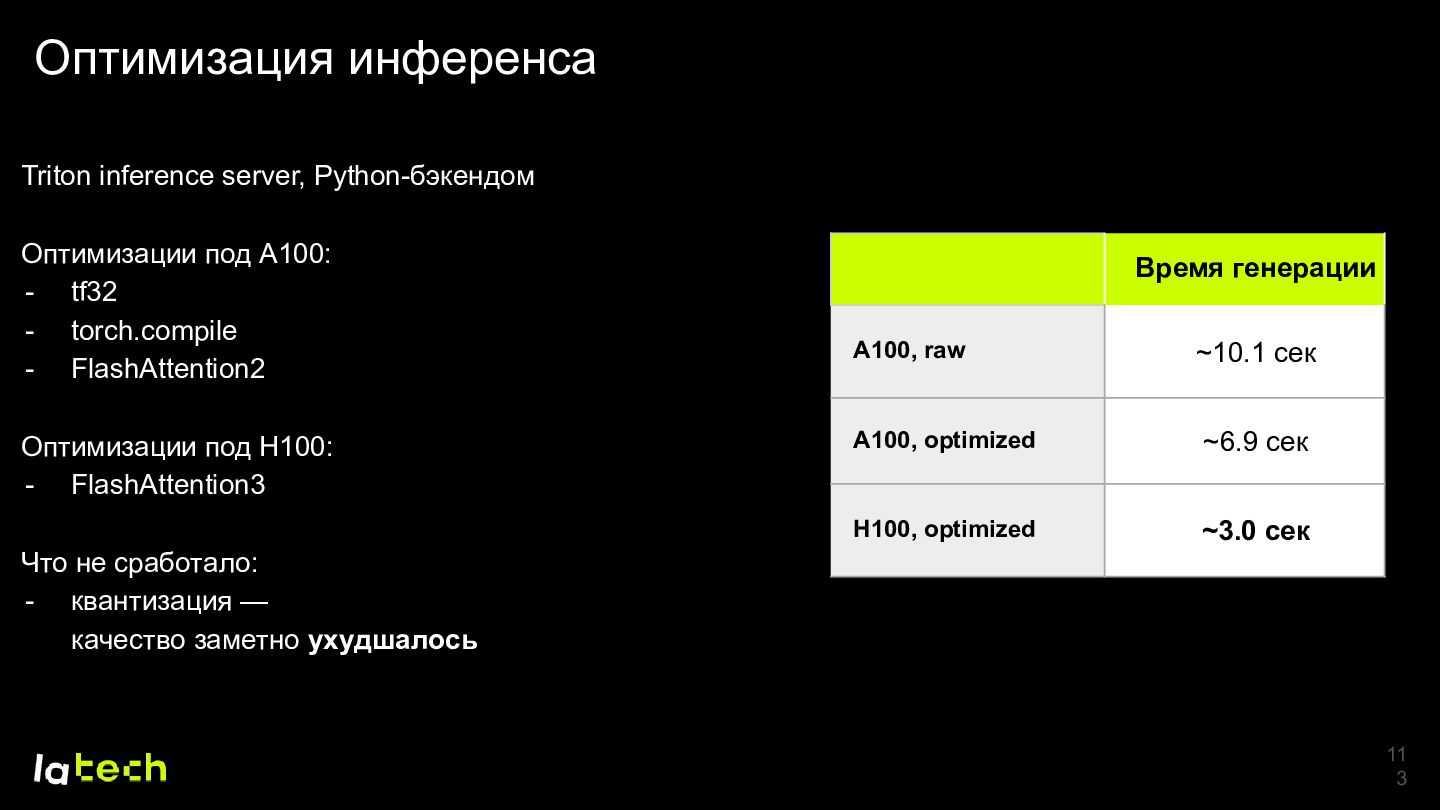
Оптимизация инференса Triton inference server, Python-бэкендом Оптимизации под A100: -
tf32 - torch.compile - FlashAttention2 Оптимизации под H100: - FlashAttention3 Время генерации A100, raw ~10.1 сек A100, optimized ~6.9 сек H100, optimized ~3.0 сек Что не сработало: - квантизация — качество заметно ухудшалось 11 3 -
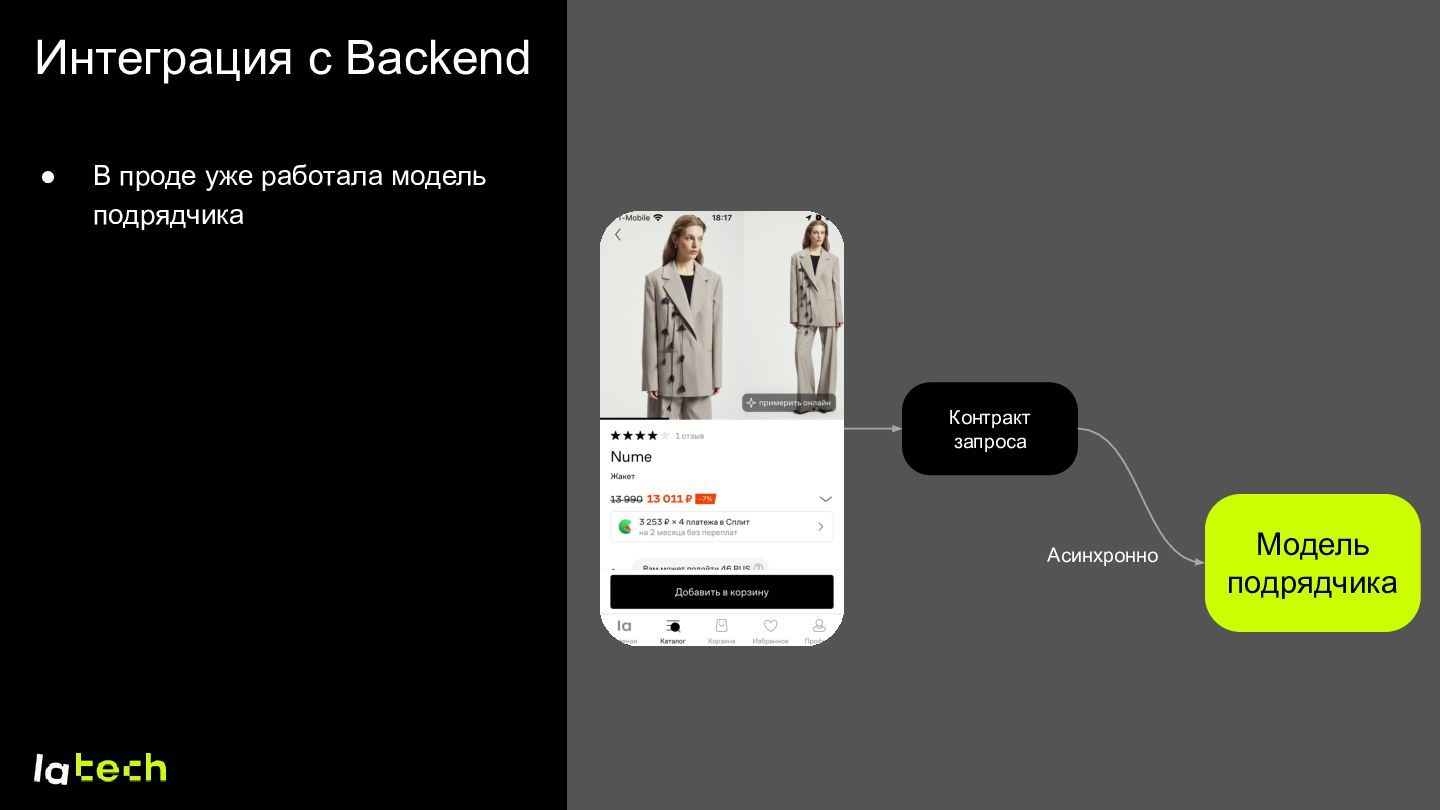
Интеграция с Backend • В проде уже работала модель подрядчика
Контракт запроса Асинхронно Модель подрядчика 11 4 -
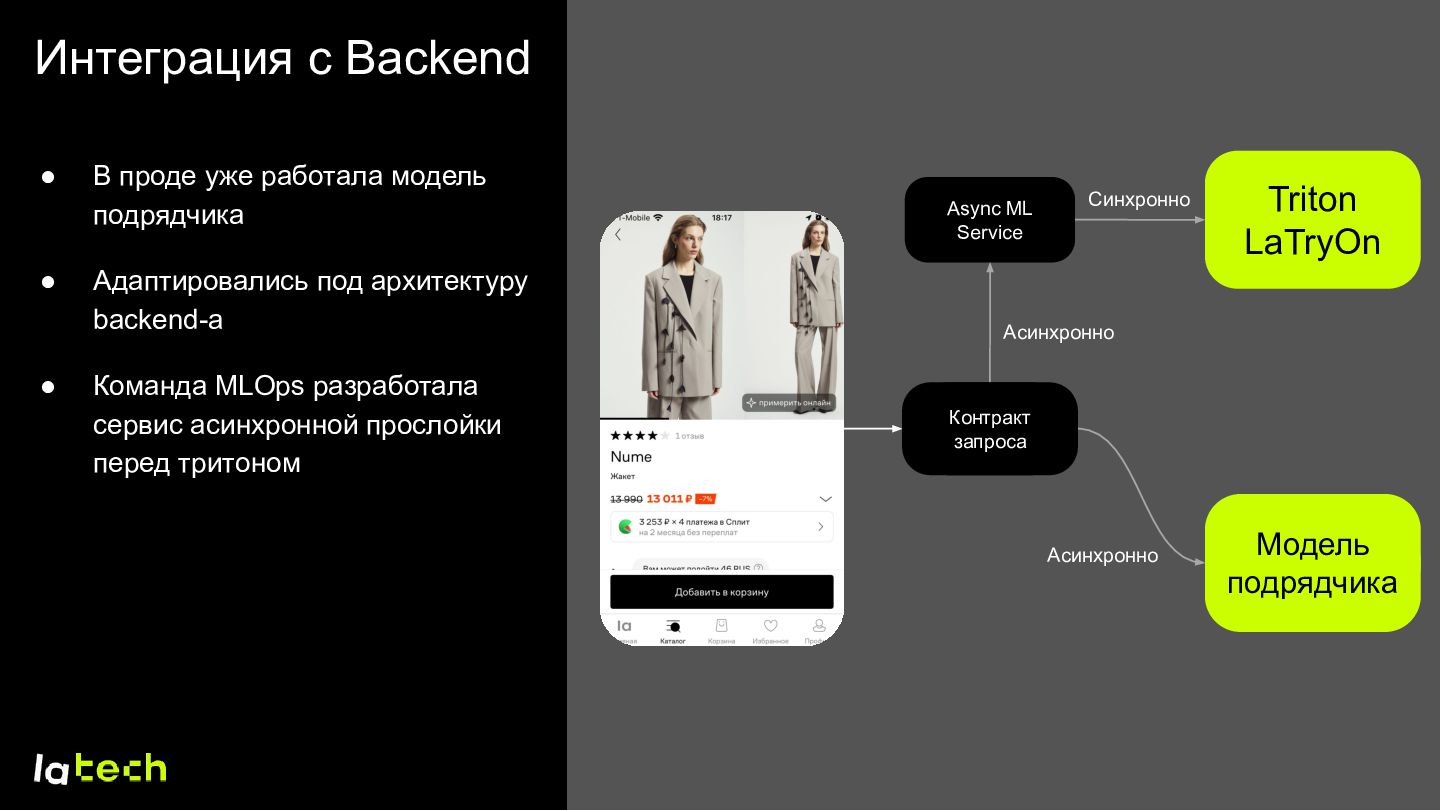
Интеграция с Backend • • • В проде уже работала
модель подрядчика Адаптировались под архитектуру backend-а Команда MLOps разработала сервис асинхронной прослойки перед тритоном Async ML Service Cинхронно Triton LaTryOn Асинхронно Контракт запроса Асинхронно Модель Модель подрядчик подрядчика а 11 5 -
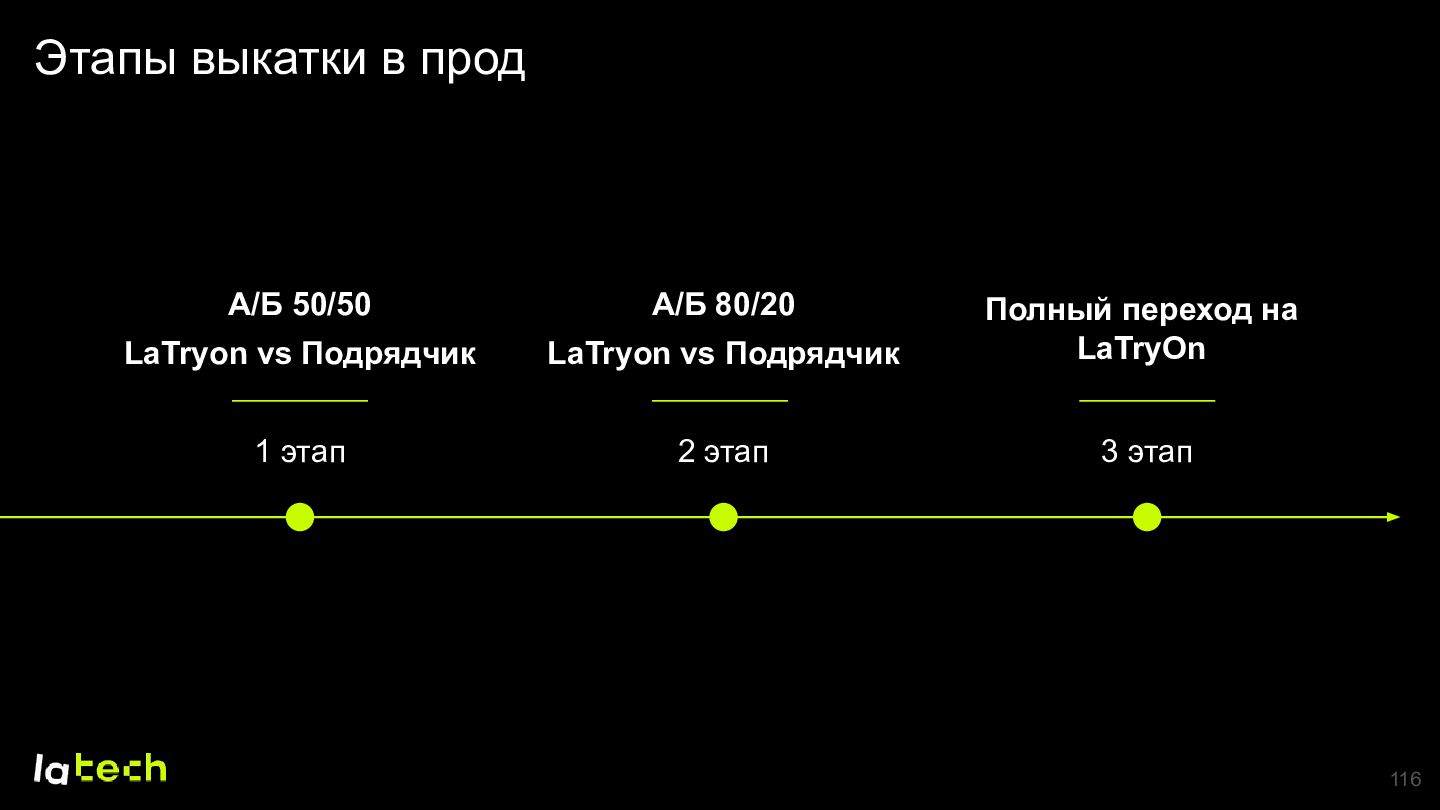
Этапы выкатки в прод А/Б 50/50 А/Б 80/20 LaTryon vs
Подрядчик LaTryon vs Подрядчик Полный переход на LaTryOn 1 этап 2 этап 3 этап 116 -
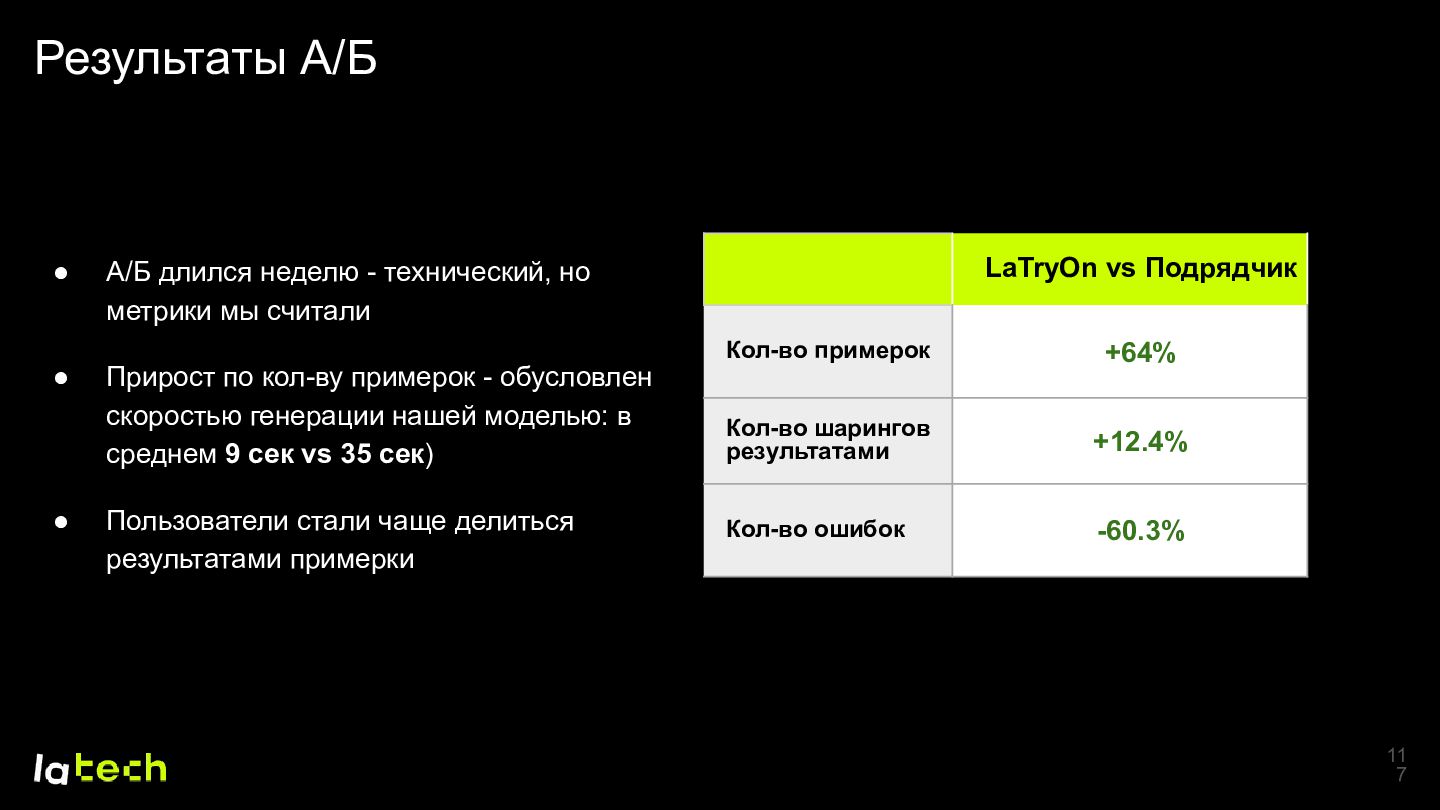
Результаты А/Б • • • LaTryOn vs Подрядчик А/Б длился
неделю - технический, но метрики мы считали Прирост по кол-ву примерок - обусловлен скоростью генерации нашей моделью: в среднем 9 сек vs 35 сек) Пользователи стали чаще делиться результатами примерки Кол-во примерок +64% Кол-во шарингов результатами +12.4% Кол-во ошибок -60.3% 11 7 -
Дальнейшие планы • Работать над проблемными генерациями • Адаптировать решение
под новые open-source модели • Более глубокая оптимизацию инференса 11 8