Share
Embed
100+PB scale Unified Hadoop cluster Federation with 2k+ nodes
Tianyi Wang
LINE Data Platform Department Engineer
https://linedevday.linecorp.com/jp/2019/sessions/D1-5
LINE DevDay 2019
November 20, 2019
Transcript
41 slides
-
2019 DevDay 100+PB Scale Unified Hadoop Cluster Federation With 2k+
Nodes > Tianyi Wang > LINE Data Platform Department Engineer -
Agenda > Introduction of Data Platform > Status, Problems of
Data Infrastructure > Our Solution > Next Steps -
Introduction of Data Platform > What do we do? >
Provide data infrastructure > Manage the whole life cycle of data > Services that we provide > Logging SDK, Ingestion Pipeline, Query Engine, BI Tools > Mission > Provide a governed, self-service data platform > Make Data Driven easy -
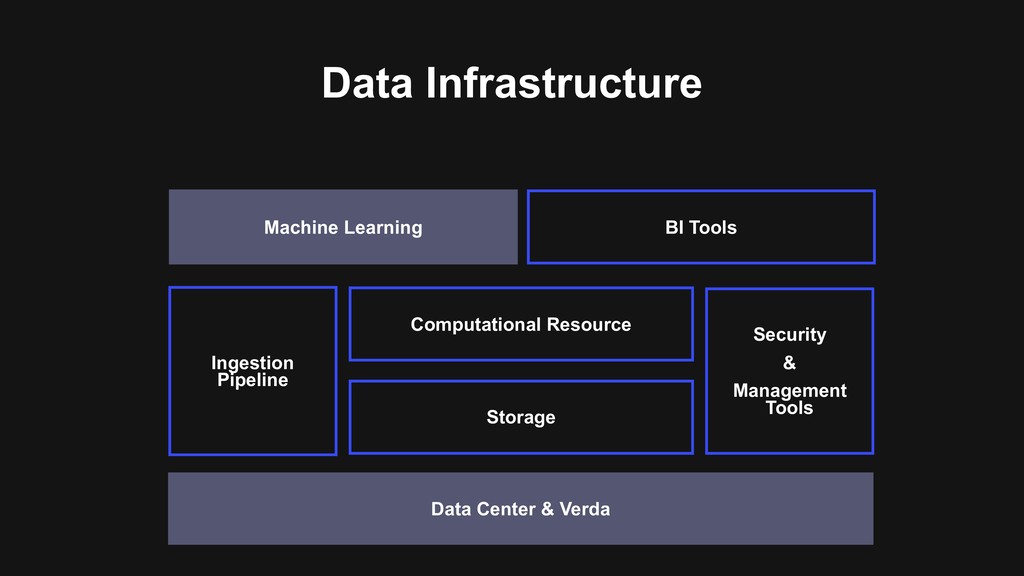
Data Infrastructure Ingestion Pipeline Computational Resource Storage BI Tools Machine
Learning Security & Management Tools Data Center & Verda -
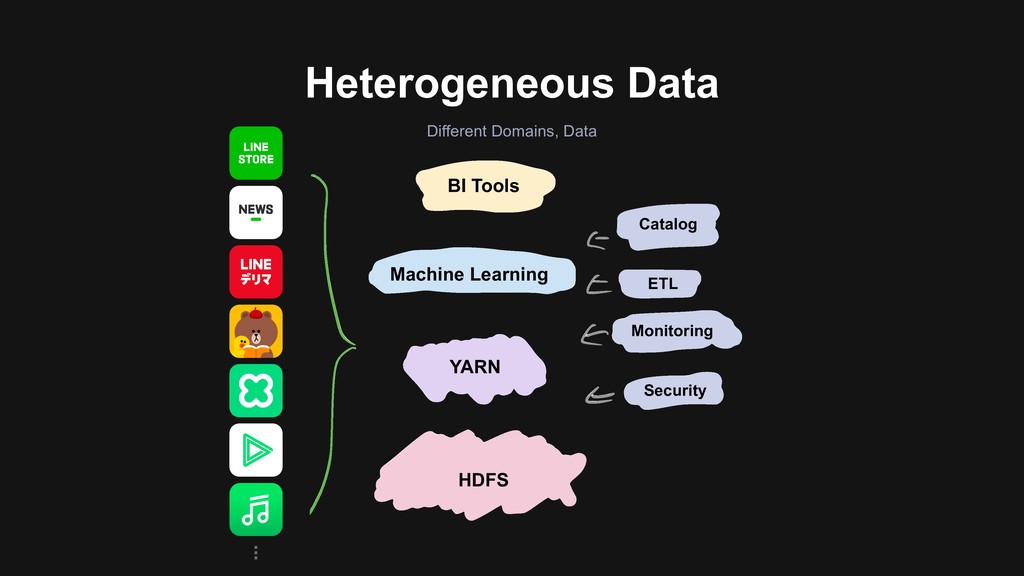
Heterogeneous Data Different Domains, Data BI Tools Machine Learning YARN
HDFS Catalog ETL Monitoring Security . . . -
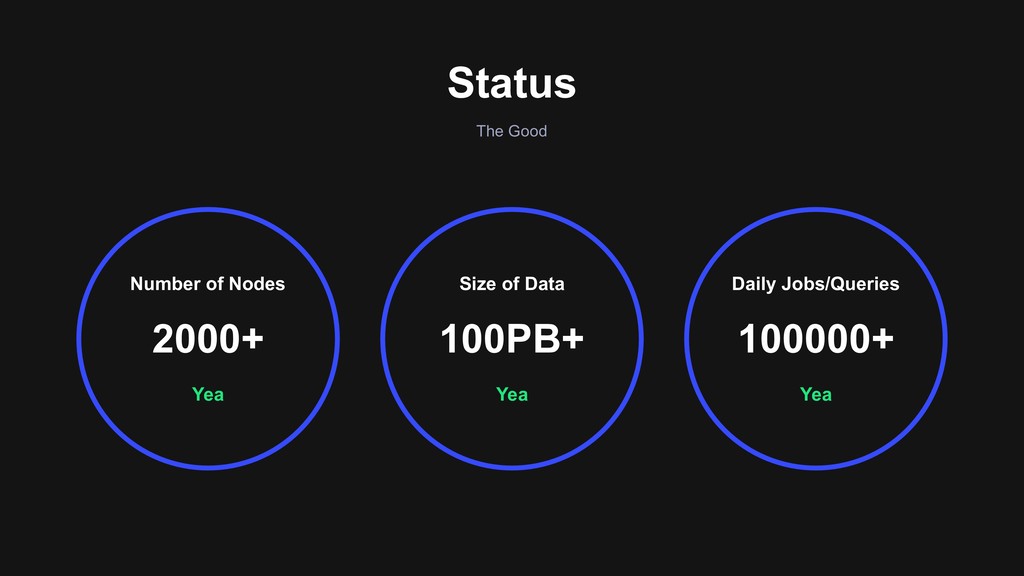
The Good Status Yea Number of Nodes 2000+ Daily Jobs/Queries
100000+ Yea Size of Data 100PB+ Yea -
Heterogeneous Data Different Pipeline, Use Case Sqoop Database Native log
Front log Server log General log Tracking Service Web Tracking Service Datachain Kafka Kafka HDFS HDFS HDFS -
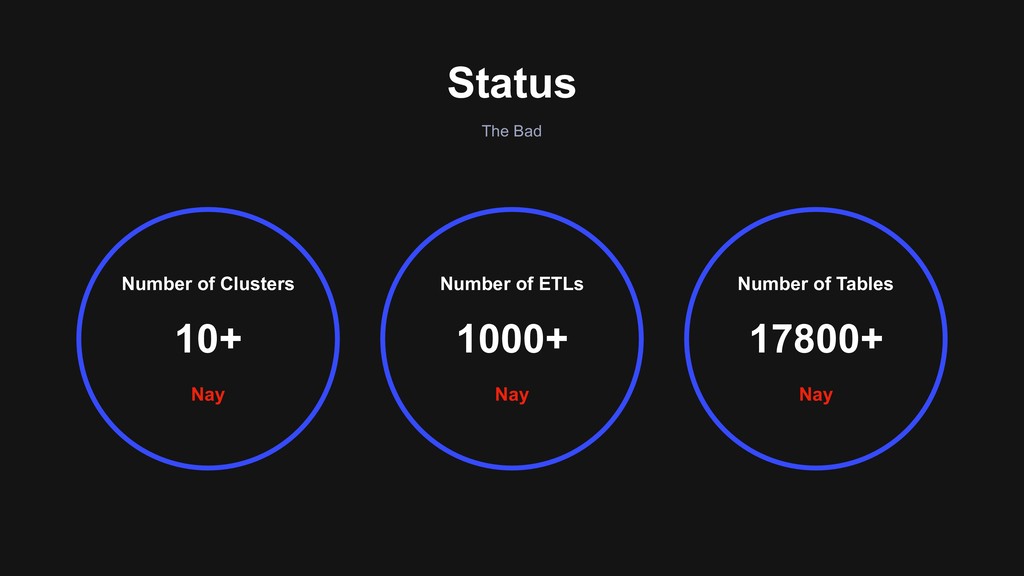
The Bad Status Nay Number of Clusters 10+ Number of
Tables 17800+ Nay Number of ETLs 1000+ Nay -
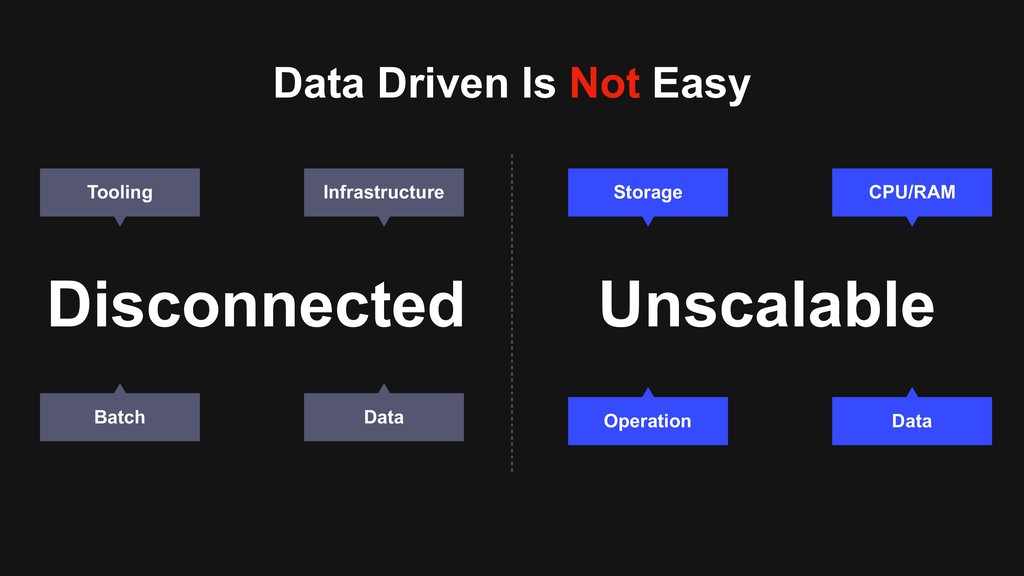
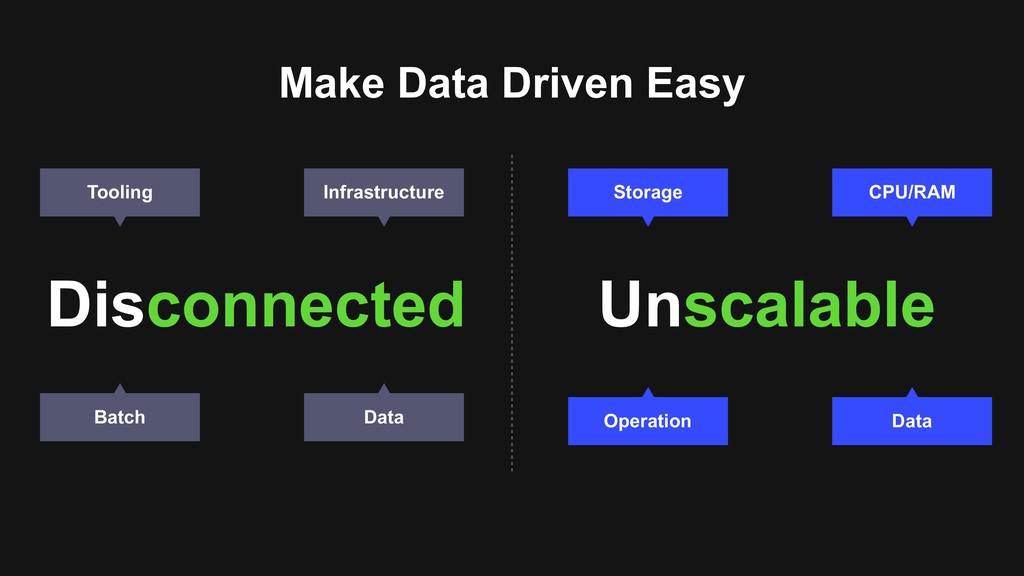
Disconnected Unscalable Tooling Infrastructure Storage CPU/RAM Operation Data Batch Data
Data Driven Is Not Easy -
Disconnected Unscalable Tooling Infrastructure Storage CPU/RAM Operation Data Batch Data
Make Data Driven Easy -
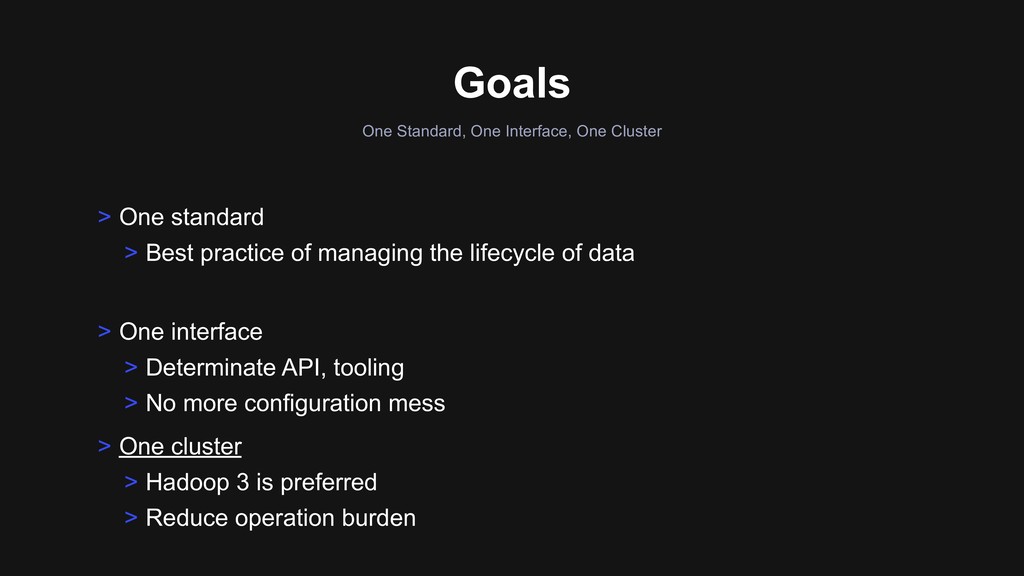
Goals One Standard, One Interface, One Cluster > One interface
> Determinate API, tooling > No more configuration mess > One cluster > Hadoop 3 is preferred > Reduce operation burden > One standard > Best practice of managing the lifecycle of data -
Pay Technical Debt != Throw Them Away > High Security
Level > Minimum Risk > No Compulsive Schedule > Incremental Migration Migration à la Carte No Compromise > Cost-Effectiveness > Upgrade Hadoop in Place > Minimum Breaking Changes > Minimum Downtime Minimum User Effects Lean Criteria -
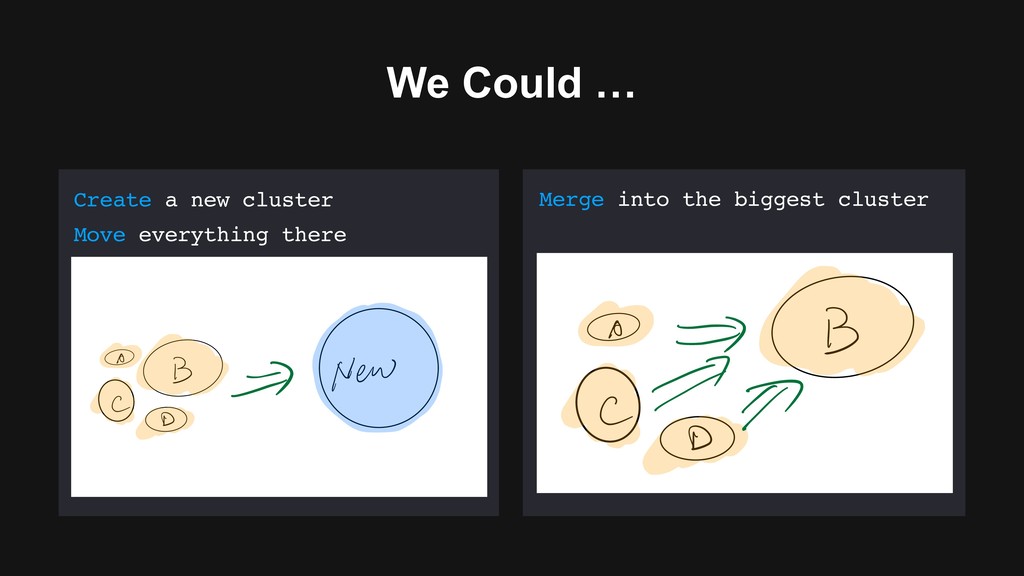
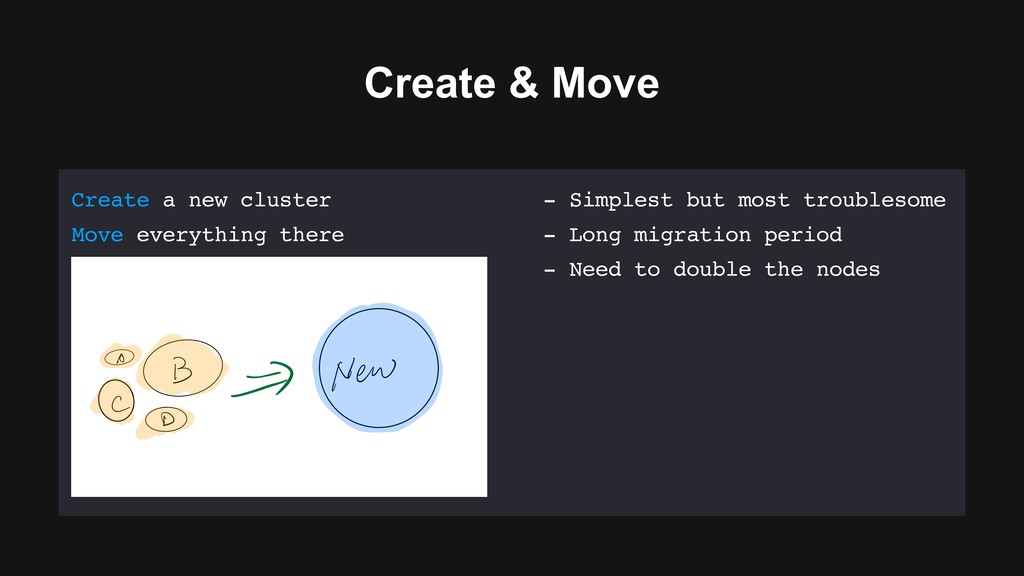
We Could … Create a new cluster Move everything there
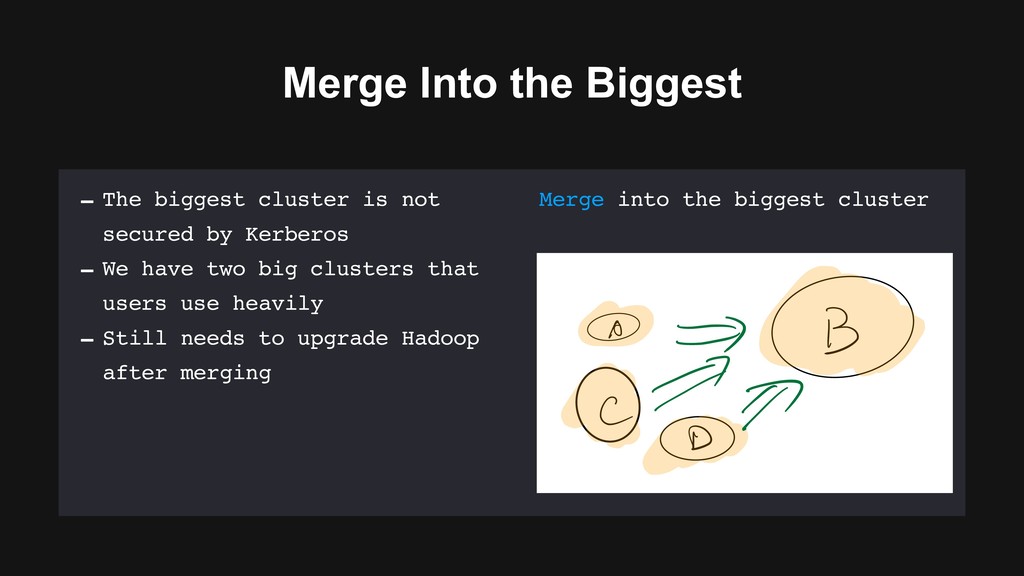
- Simplest but most troublesome - Long transition period - Need to double the nodes Merge into the biggest cluster - // Not fully secured - Major version upgrade remains - i ԫ New in B i ԫ New -
Create & Move - Simplest but most troublesome - Long
migration period - Need to double the nodes i ԫ New Create a new cluster Move everything there -
Merge Into the Biggest - The biggest cluster is not
secured by Kerberos - We have two big clusters that users use heavily - Still needs to upgrade Hadoop after merging Merge into the biggest cluster - // Not fully secured - Major version upgrade remains - i ԫ New in B -
With VIEWFS HDFS Federation <property> <name>fs.defaultFS</name> <value>viewfs://line-cluster</value> </property> <configuration> <property>
<name>fs.viewfs.mounttable.line-cluster.link./apps</name> <value>hdfs://ns1/apps</value> </property> <property> <name>fs.viewfs.mounttable.line-cluster.link./user</name> <value>hdfs://ns2/user</value> </property> <property> <name>fs.viewfs.mounttable.line-cluster.link./logs</name> <value>hdfs://ns3/logs</value> </property> <property> <name>fs.viewfs.mounttable.line-cluster.link./tmp</name> <value>hdfs://ns3/tmp</value> </property> </configuration> Block Pool Block Pool Block Pool Nameservice Nameservice Nameservice Datanode Datanode Datanode Datanode Datanode VIEWFS -
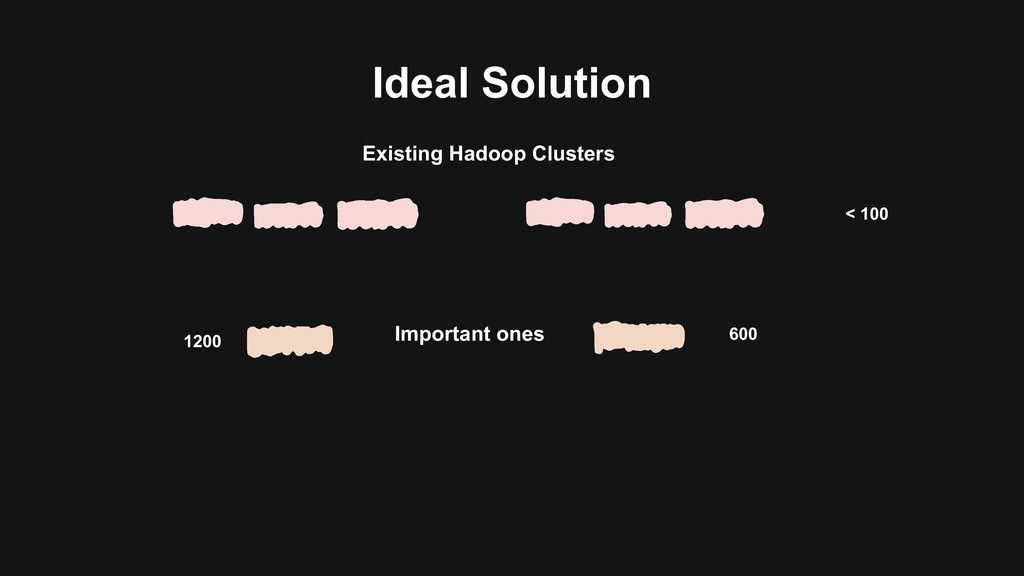
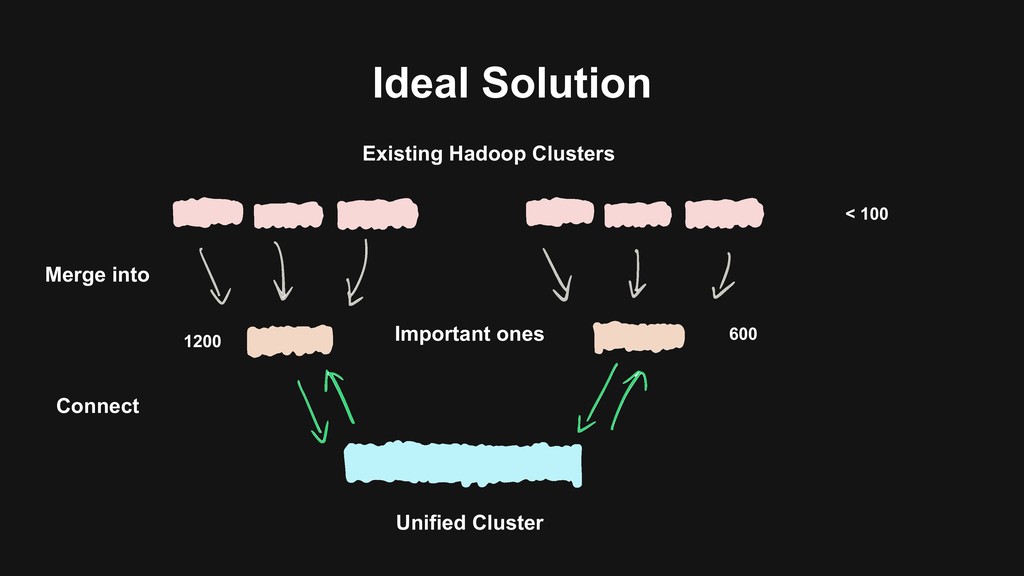
Ideal Solution < 100 600 1200 Existing Hadoop Clusters Important
ones Unified Cluster Merge into Connect -
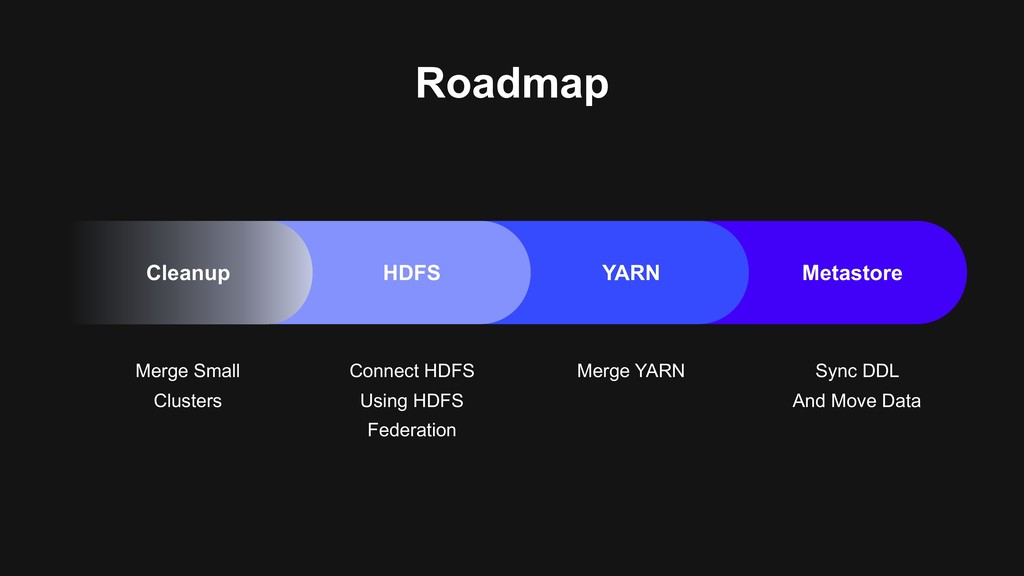
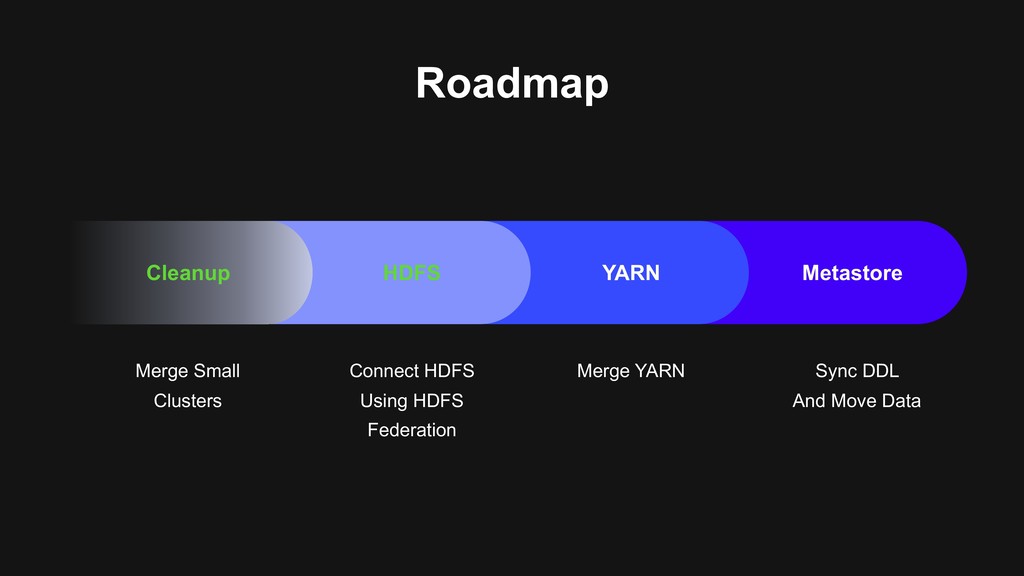
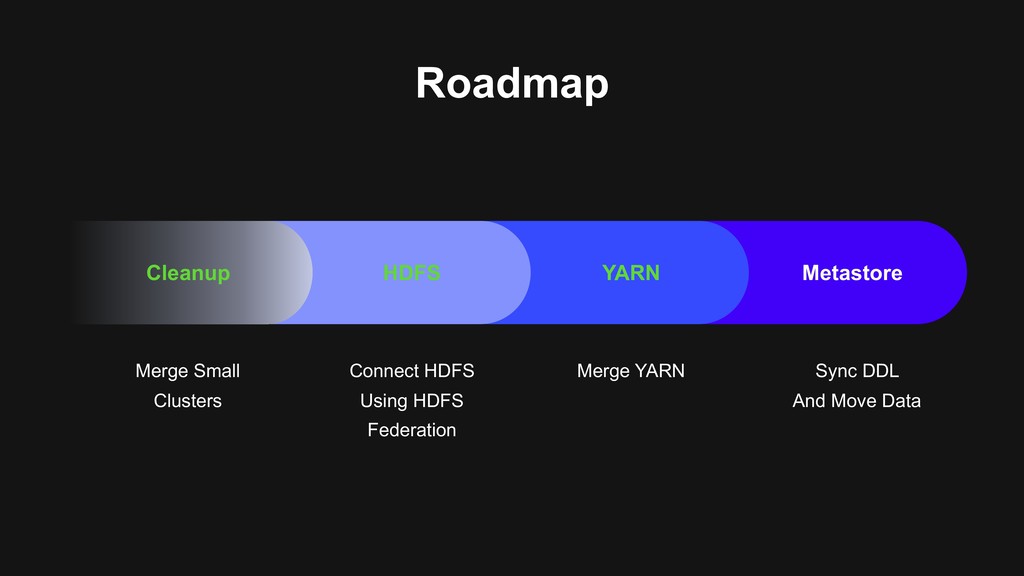
Roadmap Merge Small Clusters Connect HDFS Using HDFS Federation Merge
YARN Sync DDL And Move Data HDFS YARN Metastore Cleanup -
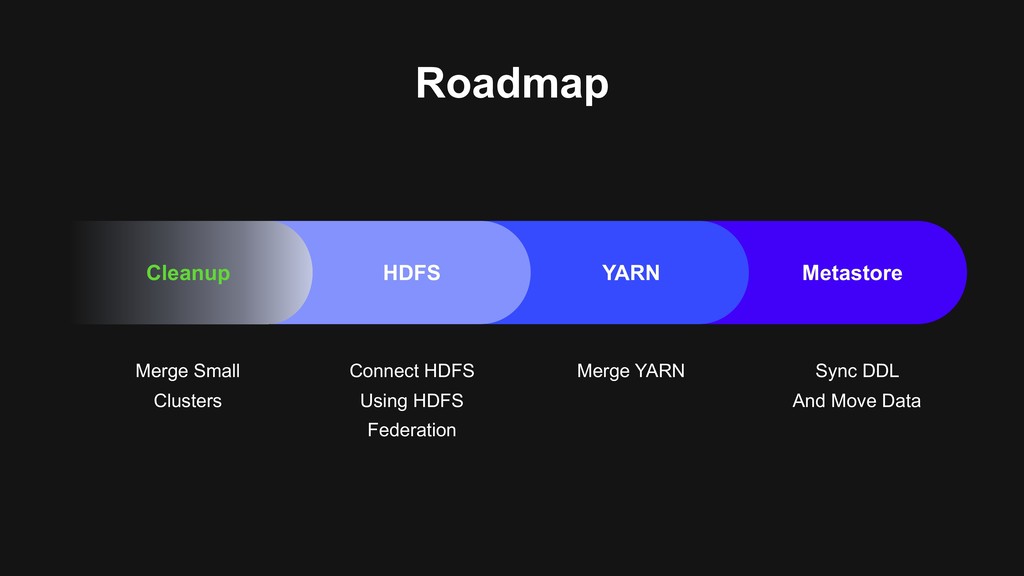
Roadmap Merge Small Clusters Connect HDFS Using HDFS Federation Merge
YARN Sync DDL And Move Data HDFS YARN Metastore Cleanup -
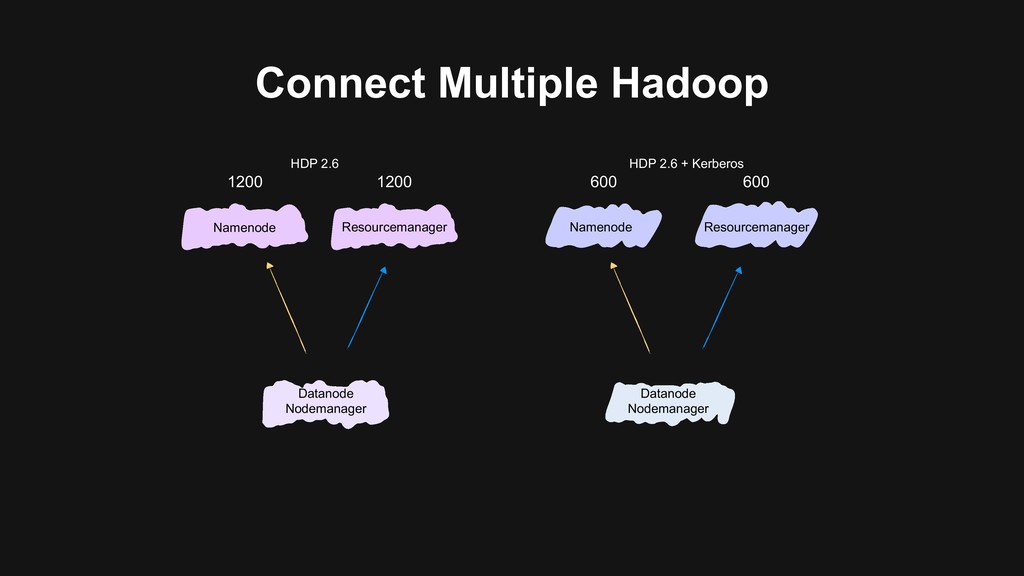
Connect Multiple Hadoop Namenode Namenode Resourcemanager Resourcemanager HDP 2.6 HDP
2.6 + Kerberos Datanode Nodemanager Datanode Nodemanager 1200 600 1200 600 -
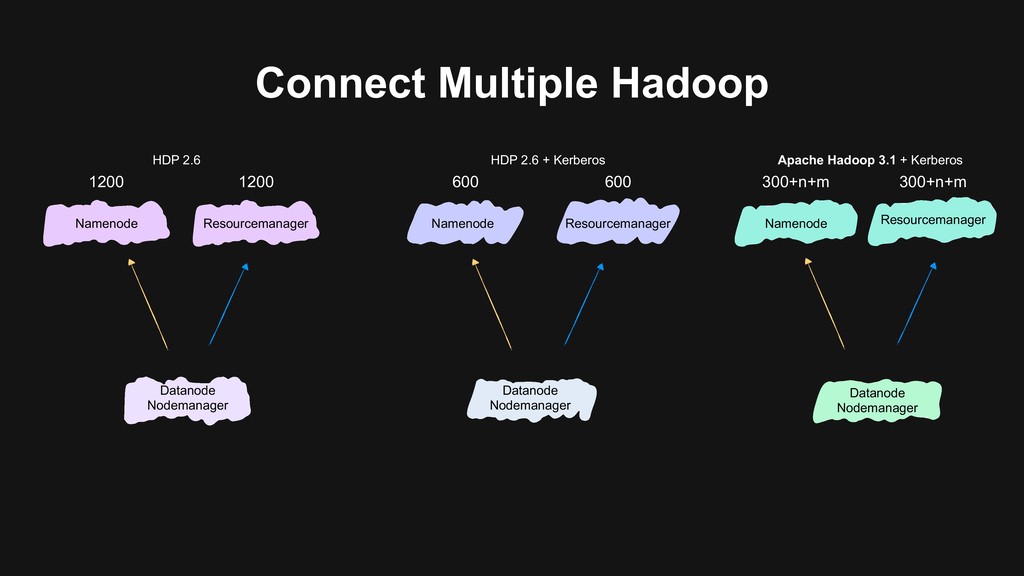
Connect Multiple Hadoop Namenode Namenode Resourcemanager Resourcemanager HDP 2.6 HDP
2.6 + Kerberos Datanode Nodemanager Datanode Nodemanager Apache Hadoop 3.1 + Kerberos Namenode Resourcemanager Datanode Nodemanager 1200 600 300+n+m 600 1200 300+n+m -
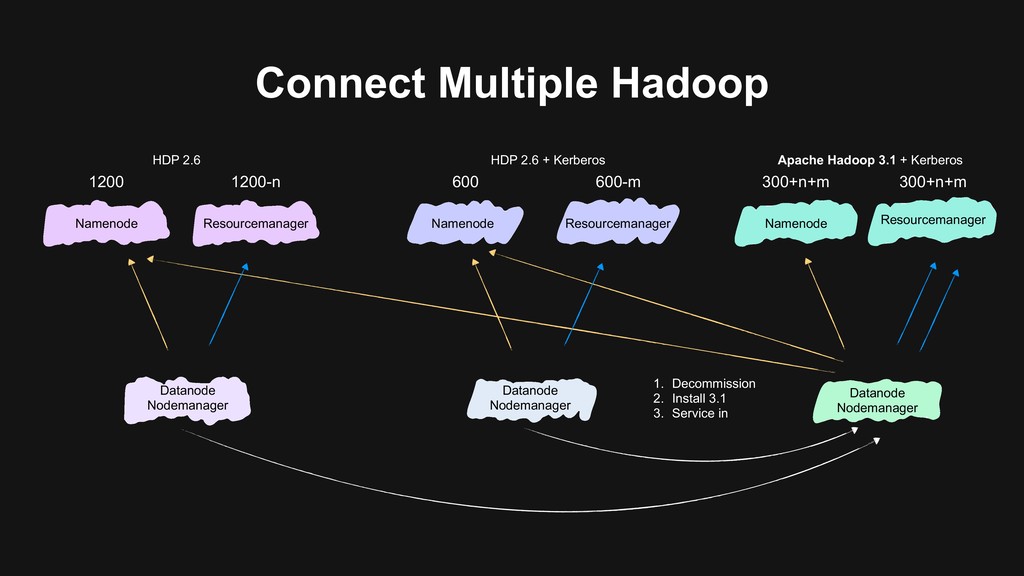
Connect Multiple Hadoop Namenode Namenode Resourcemanager Resourcemanager HDP 2.6 HDP
2.6 + Kerberos Datanode Nodemanager Datanode Nodemanager Apache Hadoop 3.1 + Kerberos Namenode Resourcemanager Datanode Nodemanager 1. Decommission 2. Install 3.1 3. Service in 1200 600 300+n+m 600-m 1200-n 300+n+m -
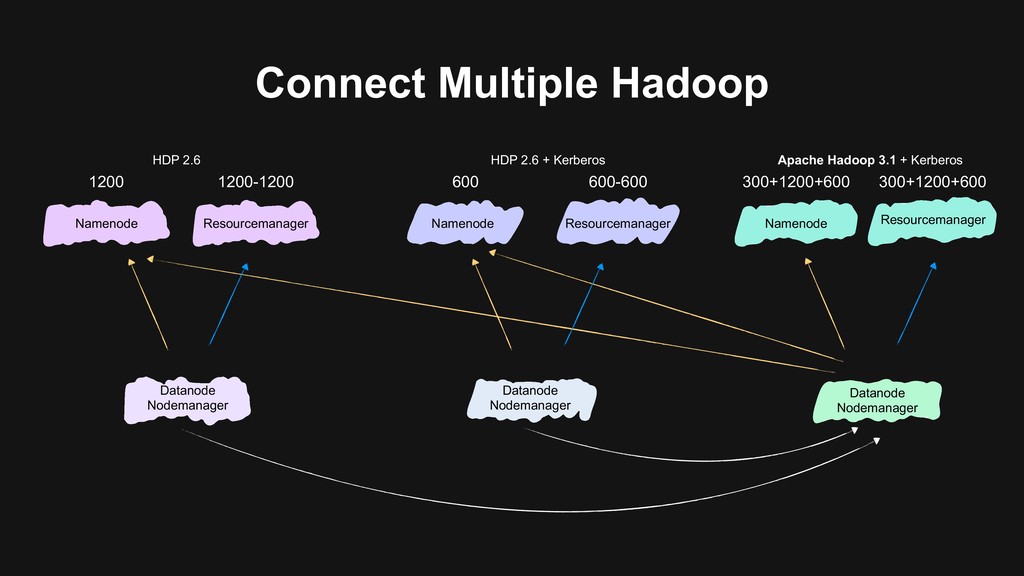
Connect Multiple Hadoop Namenode Namenode HDP 2.6 HDP 2.6 +
Kerberos Datanode Nodemanager Datanode Nodemanager Apache Hadoop 3.1 + Kerberos Namenode Resourcemanager Datanode Nodemanager 300+1200+600 600 Resourcemanager 600-600 1200 Resourcemanager 1200-1200 300+1200+600 -
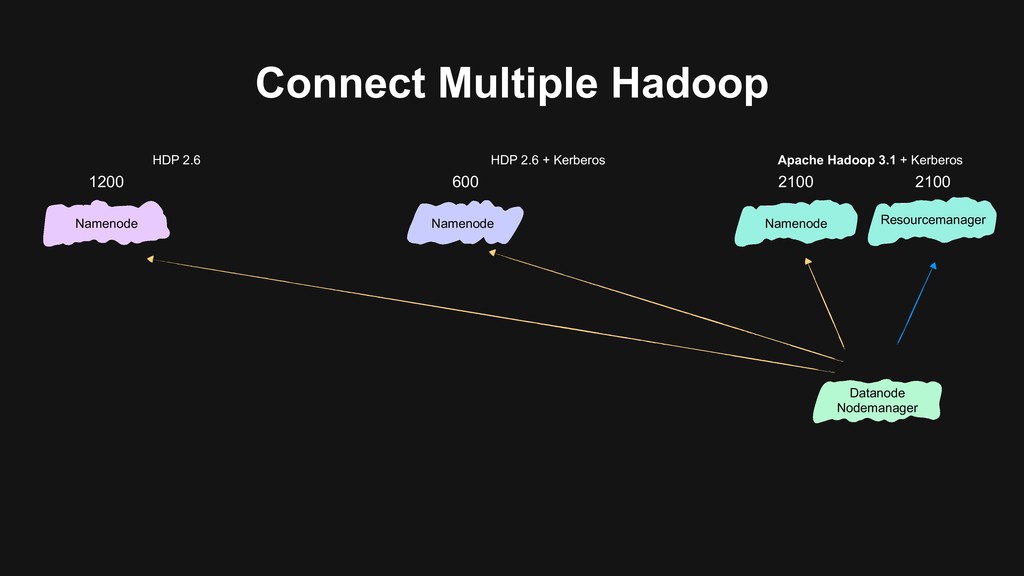
Connect Multiple Hadoop Apache Hadoop 3.1 + Kerberos Namenode Resourcemanager
Datanode Nodemanager Namenode HDP 2.6 1200 Namenode HDP 2.6 + Kerberos 600 2100 2100 -
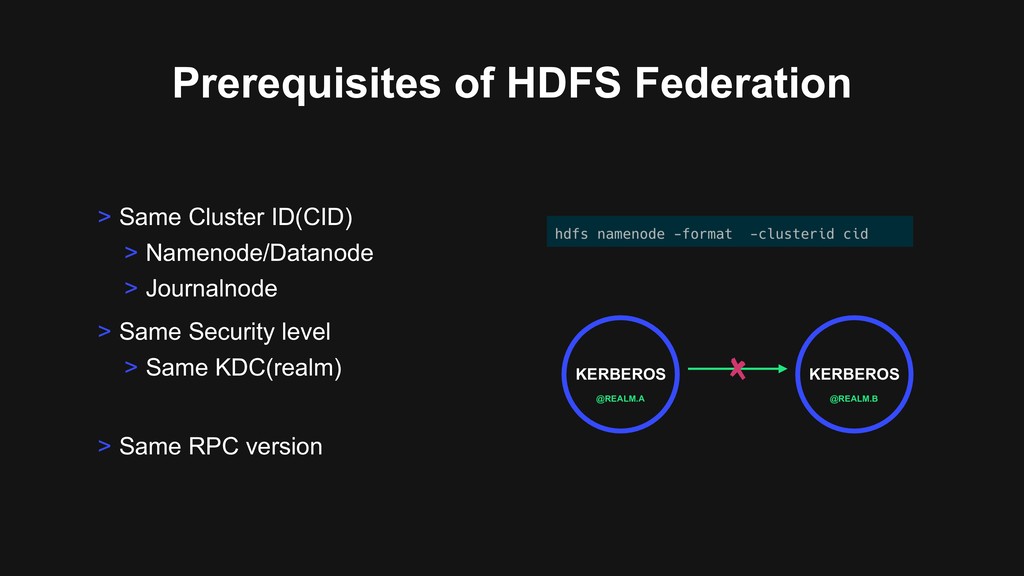
Prerequisites of HDFS Federation > Same Security level > Same
KDC(realm) > Same RPC version > Same Cluster ID(CID) > Namenode/Datanode > Journalnode @REALM.A KERBEROS @REALM.B KERBEROS -
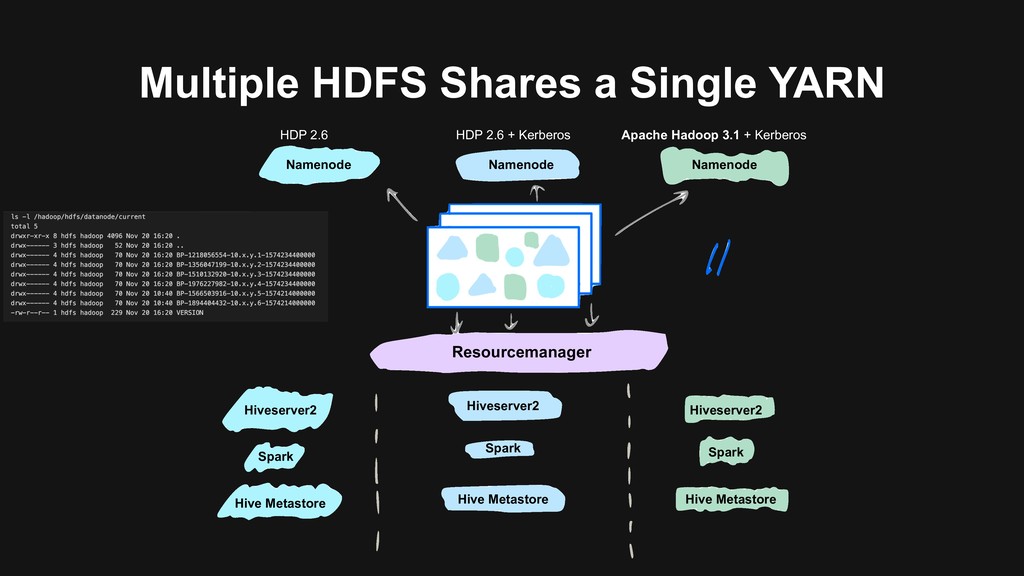
Multiple HDFS Shares a Single YARN HDP 2.6 HDP 2.6
+ Kerberos Apache Hadoop 3.1 + Kerberos Namenode Namenode Namenode Resourcemanager Hiveserver2 Hiveserver2 Hiveserver2 Spark Spark Spark Hive Metastore Hive Metastore Hive Metastore -
Roadmap Merge Small Clusters Connect HDFS Using HDFS Federation Merge
YARN Sync DDL And Move Data HDFS YARN Metastore Cleanup -
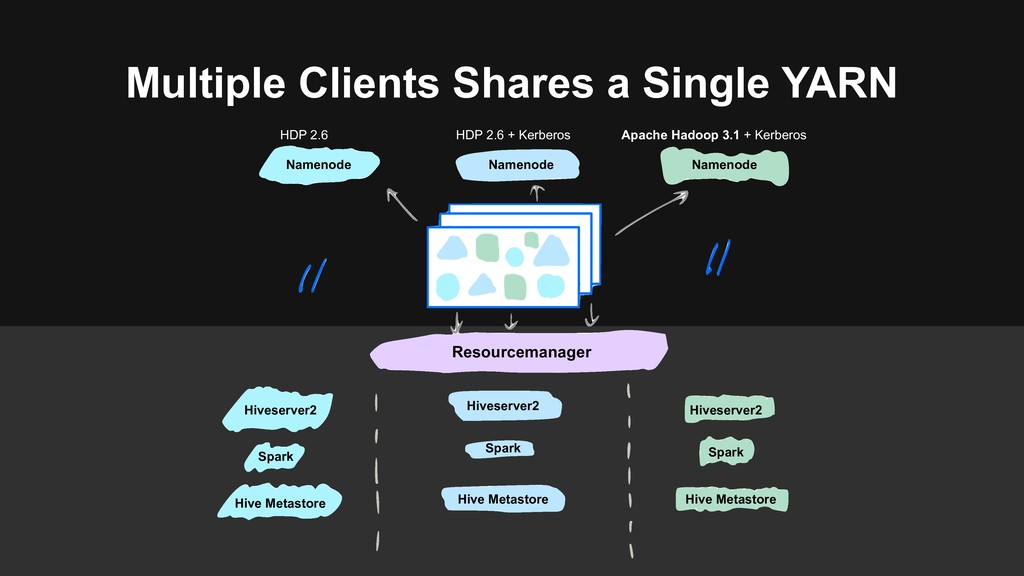
Multiple Clients Shares a Single YARN HDP 2.6 HDP 2.6
+ Kerberos Apache Hadoop 3.1 + Kerberos Namenode Namenode Namenode Resourcemanager Hiveserver2 Hiveserver2 Hiveserver2 Spark Spark Spark Hive Metastore Hive Metastore Hive Metastore -
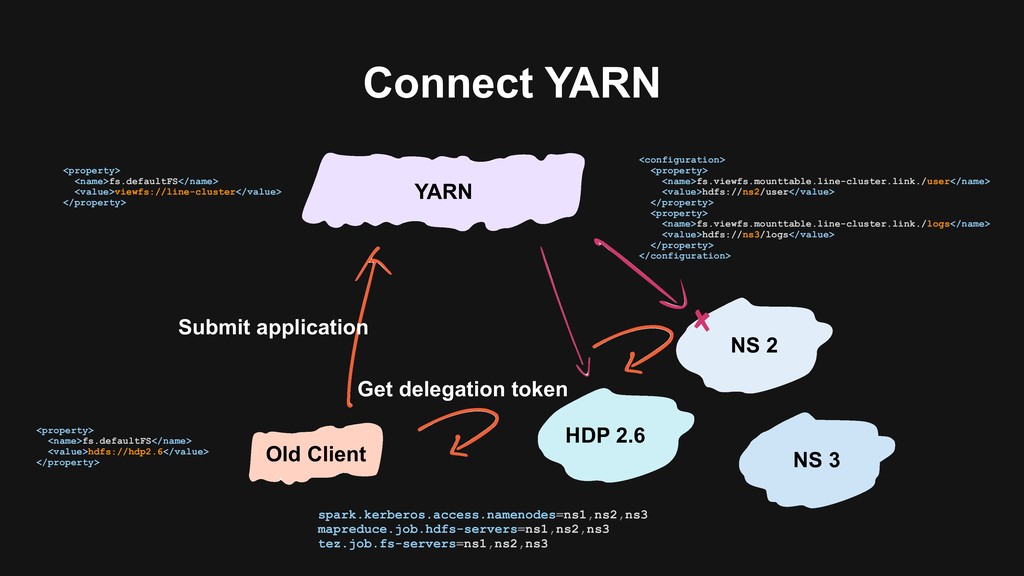
Connect YARN YARN Old Client NS 2 HDP 2.6 NS
3 Get delegation token Submit application <configuration> <property> <name>fs.viewfs.mounttable.line-cluster.link./user</name> <value>hdfs://ns2/user</value> </property> <property> <name>fs.viewfs.mounttable.line-cluster.link./logs</name> <value>hdfs://ns3/logs</value> </property> </configuration> <property> <name>fs.defaultFS</name> <value>viewfs://line-cluster</value> </property> <property> <name>fs.defaultFS</name> <value>hdfs://hdp2.6</value> </property> spark.kerberos.access.namenodes=ns1,ns2,ns3 mapreduce.job.hdfs-servers=ns1,ns2,ns3 tez.job.fs-servers=ns1,ns2,ns3 -
Roadmap Merge Small Clusters Connect HDFS Using HDFS Federation Merge
YARN Sync DDL And Move Data HDFS YARN Metastore Cleanup -
Unify Hive Metastore > Self-service ETL tools to synchronize DDL
and data automatically > Use Hive hook to collect changes and apply to the new cluster > Use Presto to analyze data across different Metastores -
For the Components That Didn’t Support Hadoop 3.x Other Problems
> Fixed by our patches > Fix an order of field numbers for HeartbeatResponseProto > Flink cannot truncate file that have ViewFS path > Allow WebHDFS accesses from insecure NameNodes to secure DataNode > Webhdfs backward compatibility (HDFS-14466 reported by LINER) > Support Hive metastore impersonation(Presto#1441 by LINER) > File Merge tasks fail when containers are reused (HIVE-22373 by LINER) > Backporting 10+ community patches -
What We Have Achieved > Provide an easy way for
users to migrate > Backward-compatibility > Flexible migration schedule > Build the next generation data platform based on Hadoop 3 > Using Erasure Coding > Using Docker on YARN > Build a unified cluster based on old clusters > Upgrade Hadoop at the same time > Storage, computational resources merged