全てを疑え!非自明な挙動と異常系から考える堅牢なカスタムコントローラ開発入門(CNDW2026)
Sponsored
·
 Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→

Share
Embed
全てを疑え!非自明な挙動と異常系から考える堅牢なカスタムコントローラ開発入門(CNDW2026)
CloudNative Days Winter 2026 のセッション "全てを疑え!非自明な挙動と異常系から考える堅牢なカスタムコントローラ開発入門" の登壇資料です

LINEヤフーTech (LY Corporation Tech) PRO
November 17, 2026
Transcript
32 slides
-
全てを疑え! ⾮⾃明な挙動と異常系から考える 堅牢なカスタムコントローラ開発⼊⾨ CloudNative Days Winter 2026 2026/11/18 LINEヤフー株式会社 Senior
Software Engineer 五反⽥ 正太郎 © LY Corporation 1 -
Title Senior Software Engineer Flava Kubernetes Engine PdM Verda Kubernetes
Engine Developer History 五反⽥ 正太郎 @sgotand LINEヤフー株式会社 © LY Corporation 2021 LINE株式会社 ⼊社 Verda Kubernetes Service 開発・運⽤ 2023 LINEヤフー株式会社 発⾜ 統合Kubernetes as a Service 開発開始 2024 Flava / Flava Kubernetes Engine Beta リリース 2025 Flava / Flava Kubernetes Engine GA 2 -
LINEヤフーについて LINEやYahoo! JAPANをはじめ、さまざまなサービスを展開 コミュニケーションアプリ 総合インターネットサービス LINE Yahoo! JAPAN トーク・⾳声通話・ビデオ通話を通じて、 友だちや家族、⼈・情報・サービスと
つながるコミュニケーションアプリ。 © LY Corporation 検索、ニュース、天気、ショッピング、 オークションなど、多様なサービスを スマートフォン・PC向けに提供。 3 -
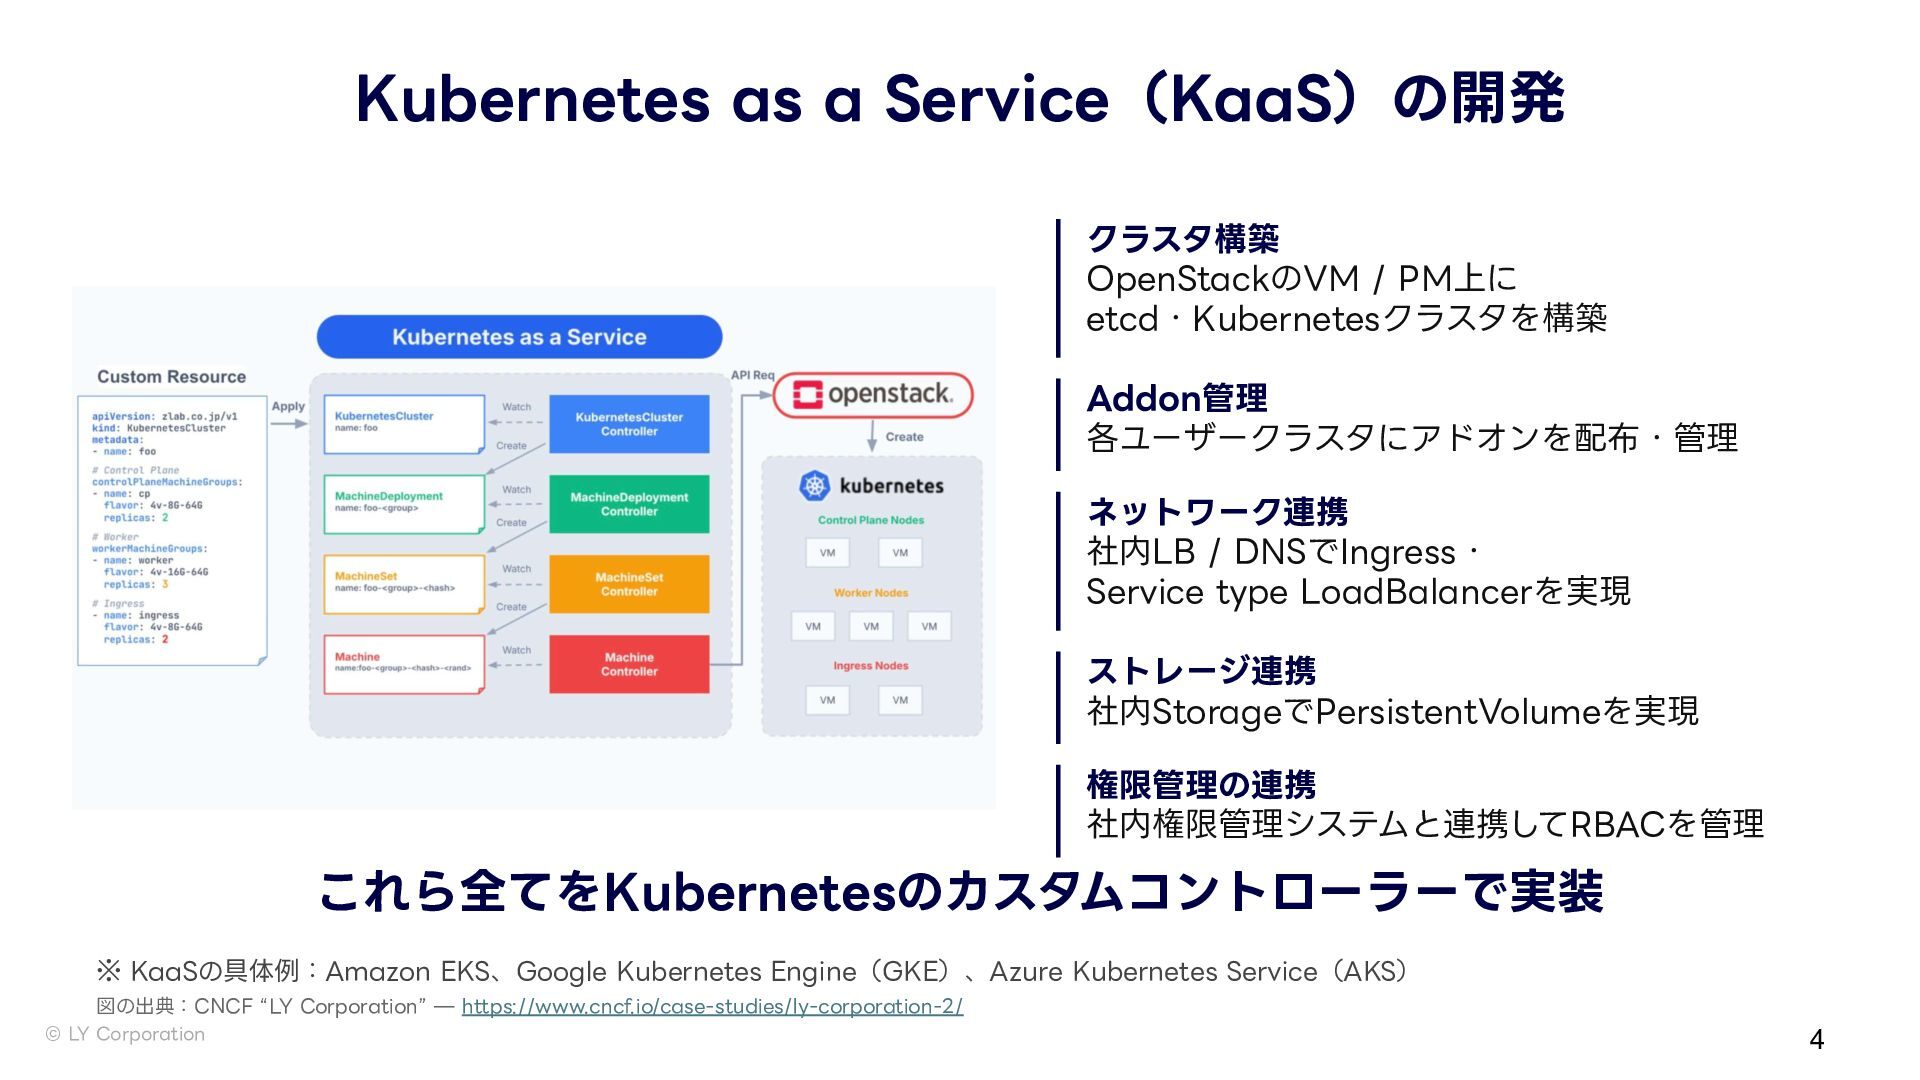
Kubernetes as a Service(KaaS)の開発 クラスタ構築 OpenStackのVM / PM上に etcd・Kubernetesクラスタを構築 Addon管理
各ユーザークラスタにアドオンを配布・管理 ネットワーク連携 社内LB / DNSでIngress・ Service type LoadBalancerを実現 ストレージ連携 社内StorageでPersistentVolumeを実現 権限管理の連携 社内権限管理システムと連携してRBACを管理 これら全てをKubernetesのカスタムコントローラーで実装 ※ KaaSの具体例:Amazon EKS、Google Kubernetes Engine(GKE)、Azure Kubernetes Service(AKS) 図の出典:CNCF “LY Corporation” ̶ https://www.cncf.io/case-studies/ly-corporation-2/ © LY Corporation 4 -
カスタムコントローラとは? 厳密な定義ではなく、本発表での捉え⽅ Kubernetesリソースに宣⾔したマニフェストを期待状態とし、 現実の状態を観測し、期待状態に近づける 処理を繰り返す結果整合な設計パターンと、その実装。 この観測と操作の繰り返しをReconciliation Loopと呼ぶ。 類似の⽤語にOperator Patternがある。公式ドキュメントではOperatorを 「カスタムリソースを利⽤してアプリケーションとその構成要素を管理する」拡張と説明。(訳)
出典:Kubernetes公式ドキュメント Operator pattern / Controllers © LY Corporation 5 -
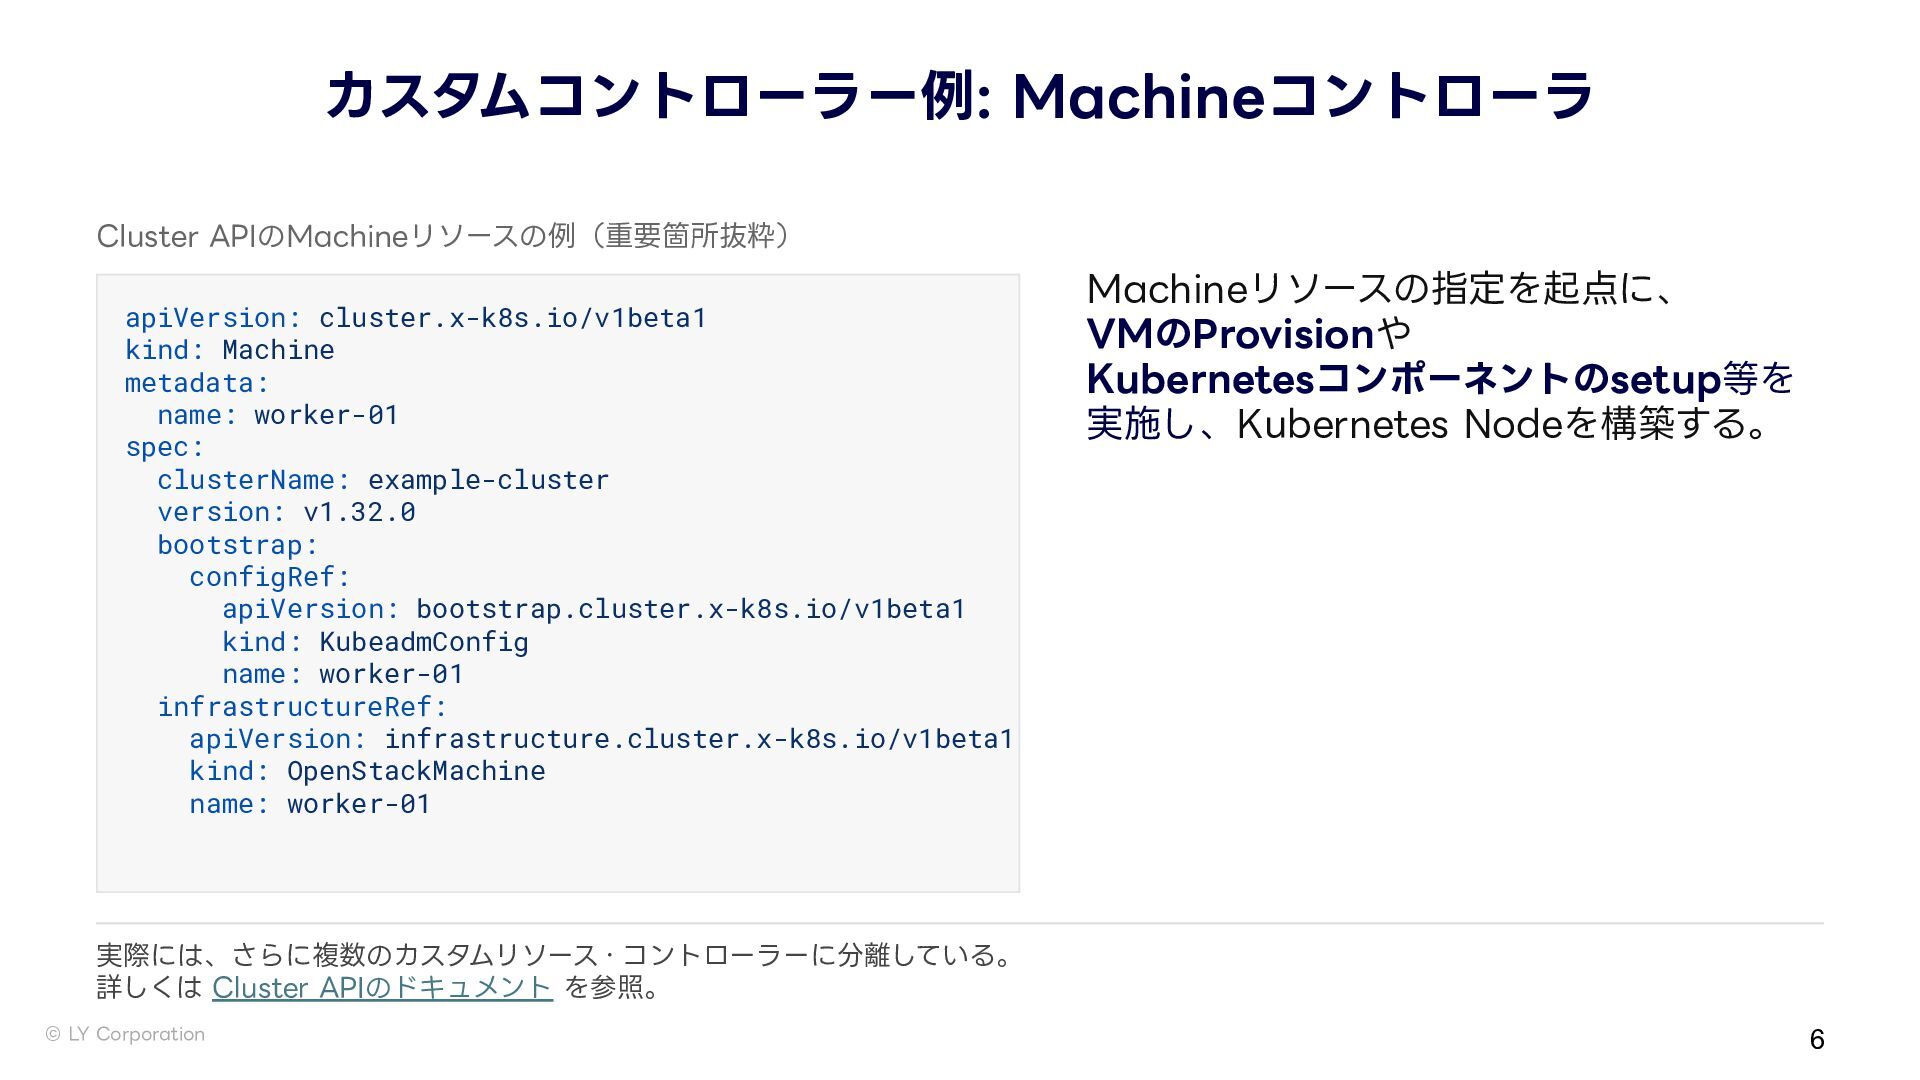
カスタムコントローラー例: Machineコントローラ Cluster APIのMachineリソースの例(重要箇所抜粋) apiVersion: cluster.x-k8s.io/v1beta1 kind: Machine metadata: name:
worker-01 spec: clusterName: example-cluster version: v1.32.0 bootstrap: configRef: apiVersion: bootstrap.cluster.x-k8s.io/v1beta1 kind: KubeadmConfig name: worker-01 infrastructureRef: apiVersion: infrastructure.cluster.x-k8s.io/v1beta1 kind: OpenStackMachine name: worker-01 Machineリソースの指定を起点に、 VMのProvisionや Kubernetesコンポーネントのsetup等を 実施し、Kubernetes Nodeを構築する。 実際には、さらに複数のカスタムリソース・コントローラーに分離している。 詳しくは Cluster APIのドキュメント を参照。 © LY Corporation 6 -
より発展的な取り組み 形式⼿法(Lean、TLA+等) ただし、暗黙に仮定している前提が間違うなど、 形式化そのものを誤る可能性がある。 学術研究 Sun et al. (2022) Automatic
Reliability Testing For Cluster Management Controllers OSDI ʼ22, pp. 143‒159. Xu et al. (2024) An Empirical Study on Kubernetes Operator Bugs ISSTA ʼ24, pp. 1746‒1758. © LY Corporation 9 -
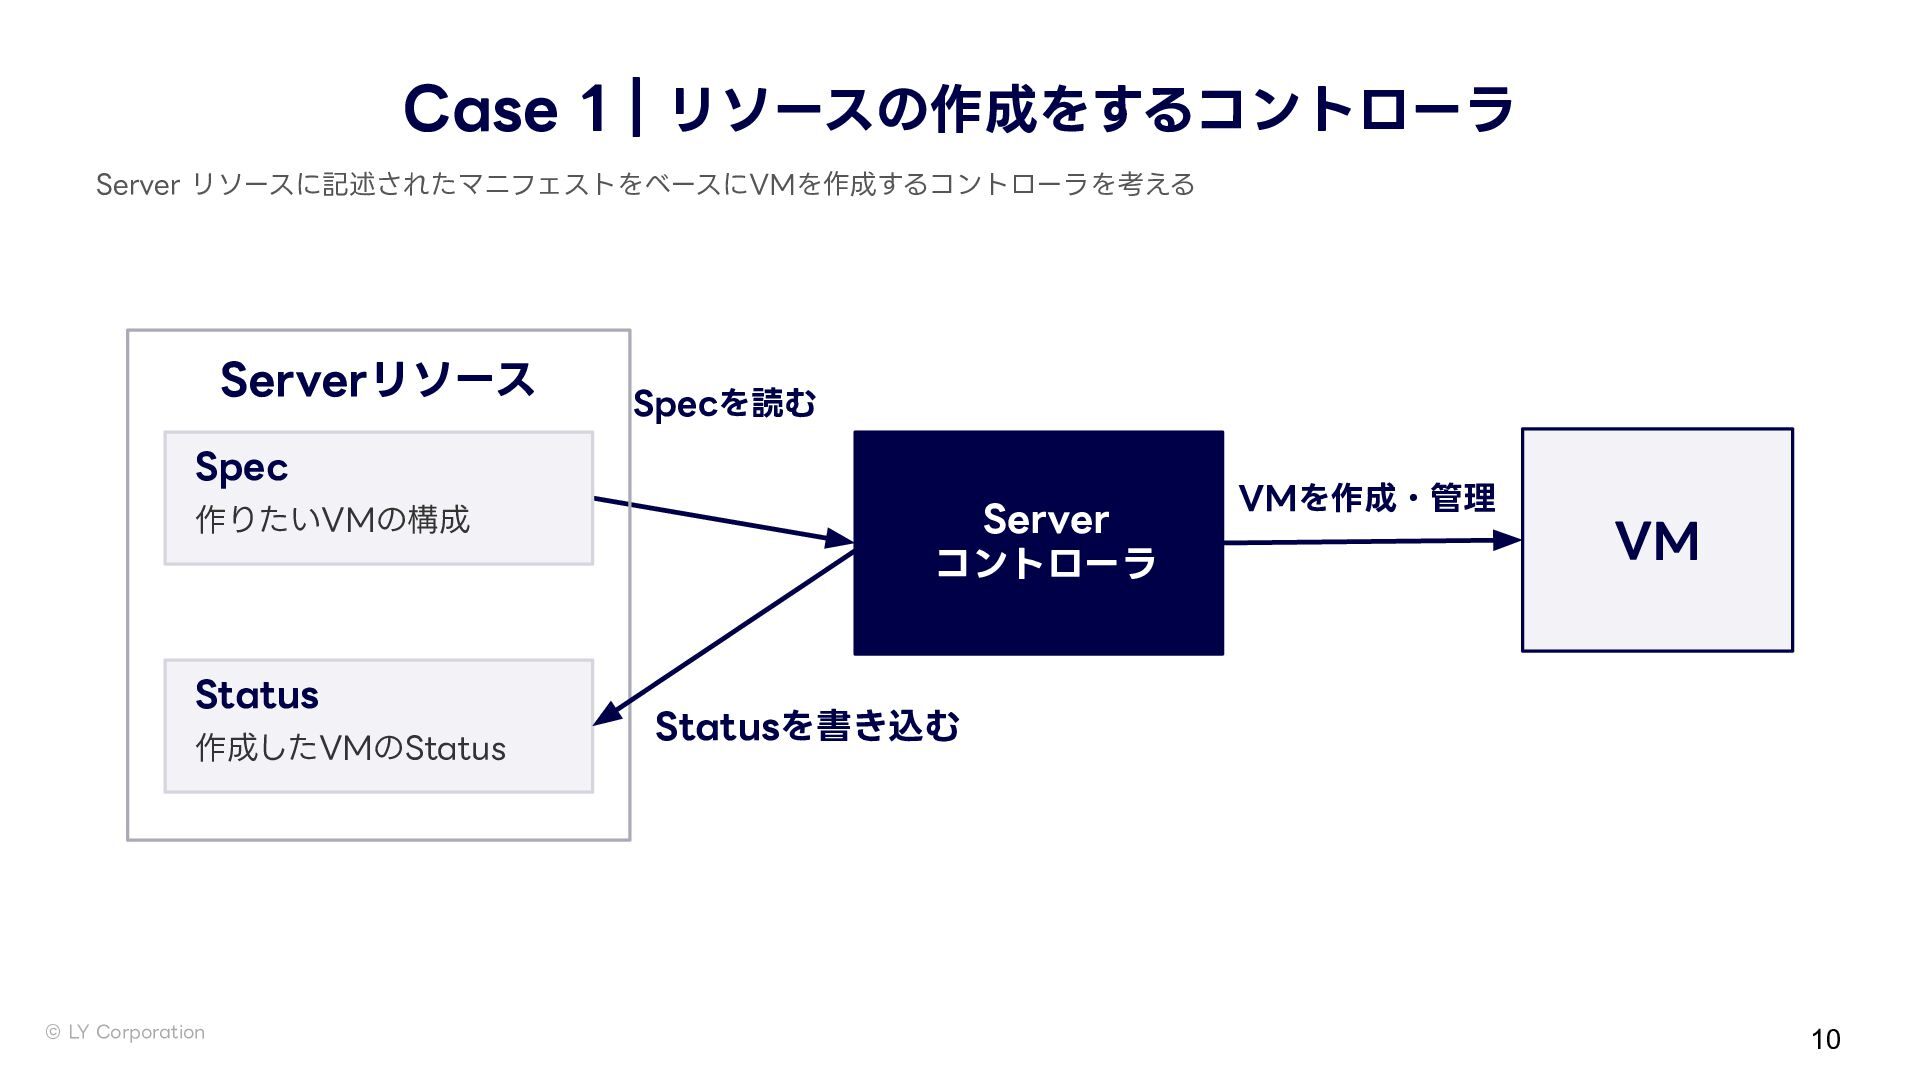
Case 1|リソースの作成をするコントローラ Server リソースに記述されたマニフェストをベースにVMを作成するコントローラを考える Serverリソース Specを読む Spec 作りたいVMの構成 Status 作成したVMのStatus
© LY Corporation Server コントローラ VMを作成・管理 VM Statusを書き込む 10 -
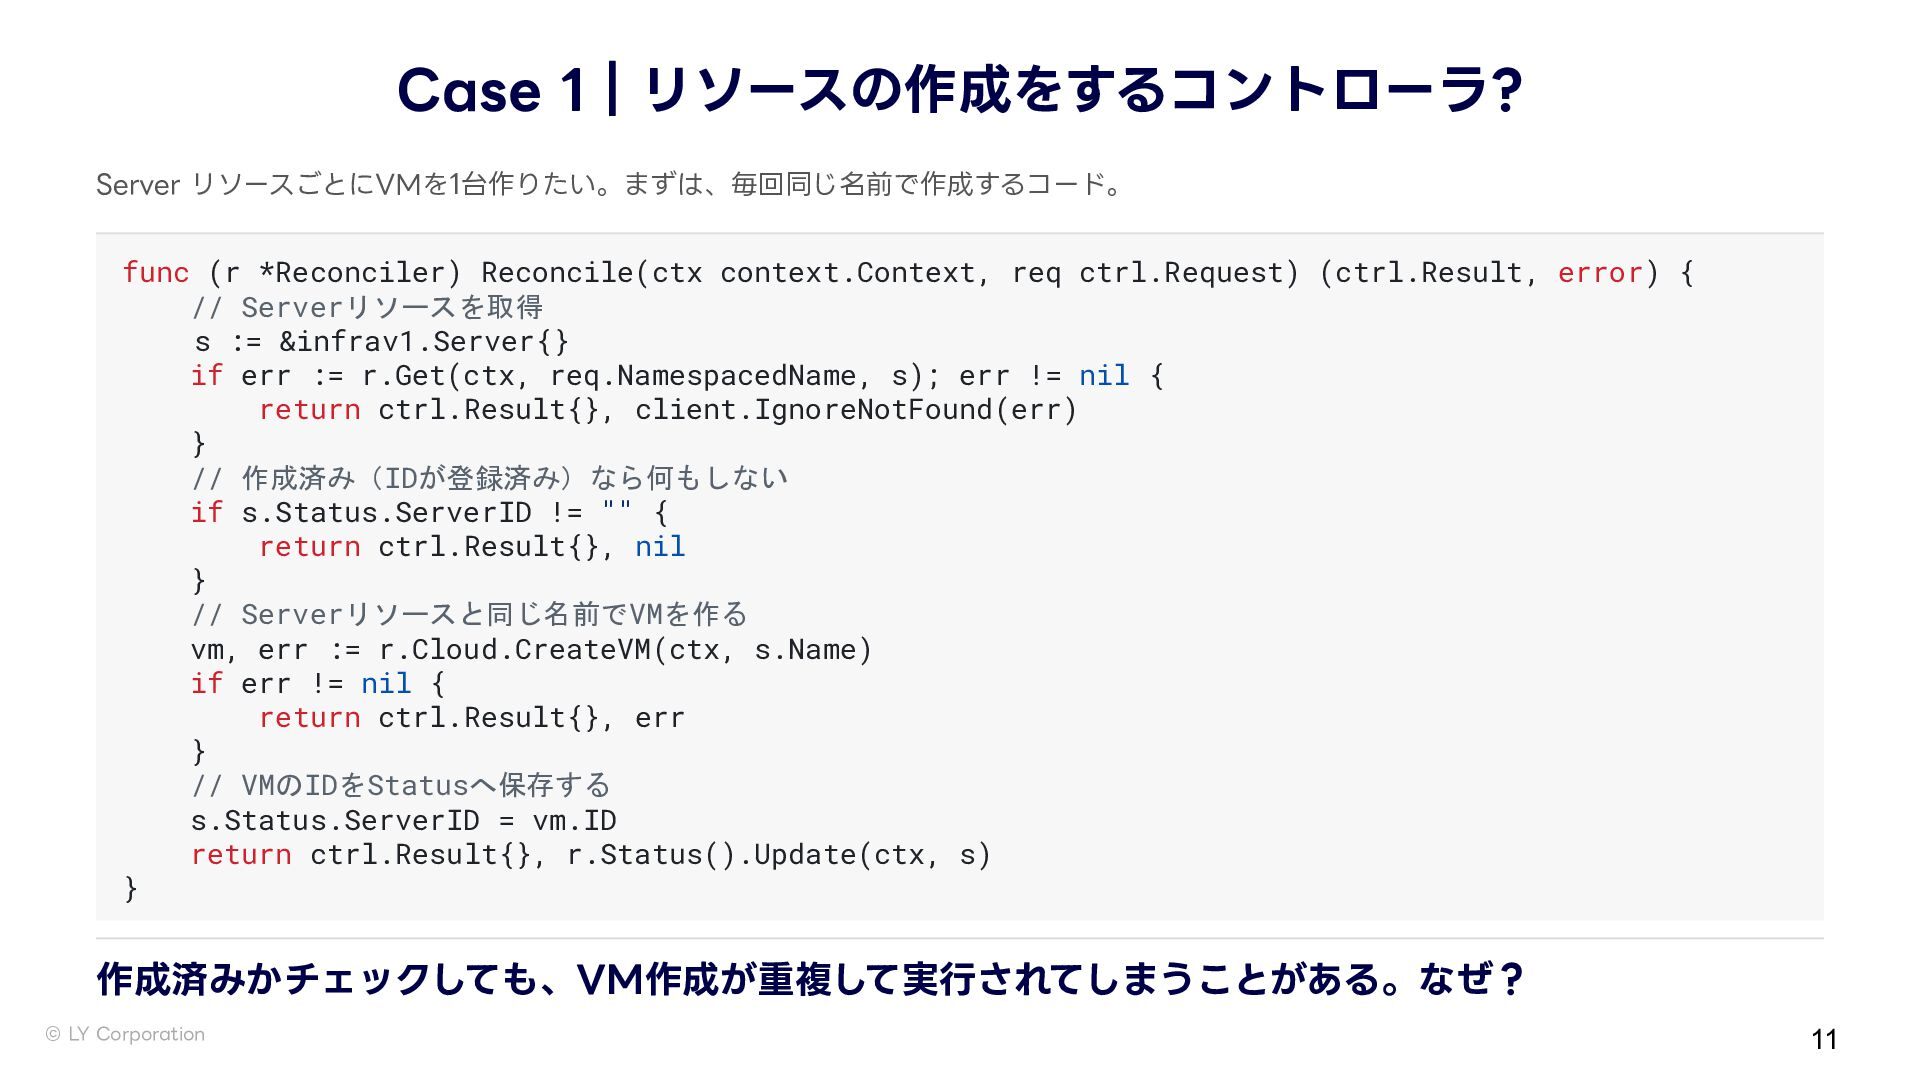
Case 1|リソースの作成をするコントローラ? Server リソースごとにVMを1台作りたい。まずは、毎回同じ名前で作成するコード。 func (r *Reconciler) Reconcile(ctx context.Context, req
ctrl.Request) (ctrl.Result, error) { // Serverリソースを取得 s := &infrav1.Server{} if err := r.Get(ctx, req.NamespacedName, s); err != nil { return ctrl.Result{}, client.IgnoreNotFound(err) } // 作成済み(IDが登録済み)なら何もしない if s.Status.ServerID != "" { return ctrl.Result{}, nil } // Serverリソースと同じ名前でVMを作る vm, err := r.Cloud.CreateVM(ctx, s.Name) if err != nil { return ctrl.Result{}, err } // VMのIDをStatusへ保存する s.Status.ServerID = vm.ID return ctrl.Result{}, r.Status().Update(ctx, s) } 作成済みかチェックしても、VM作成が重複して実⾏されてしまうことがある。なぜ? © LY Corporation 11 -
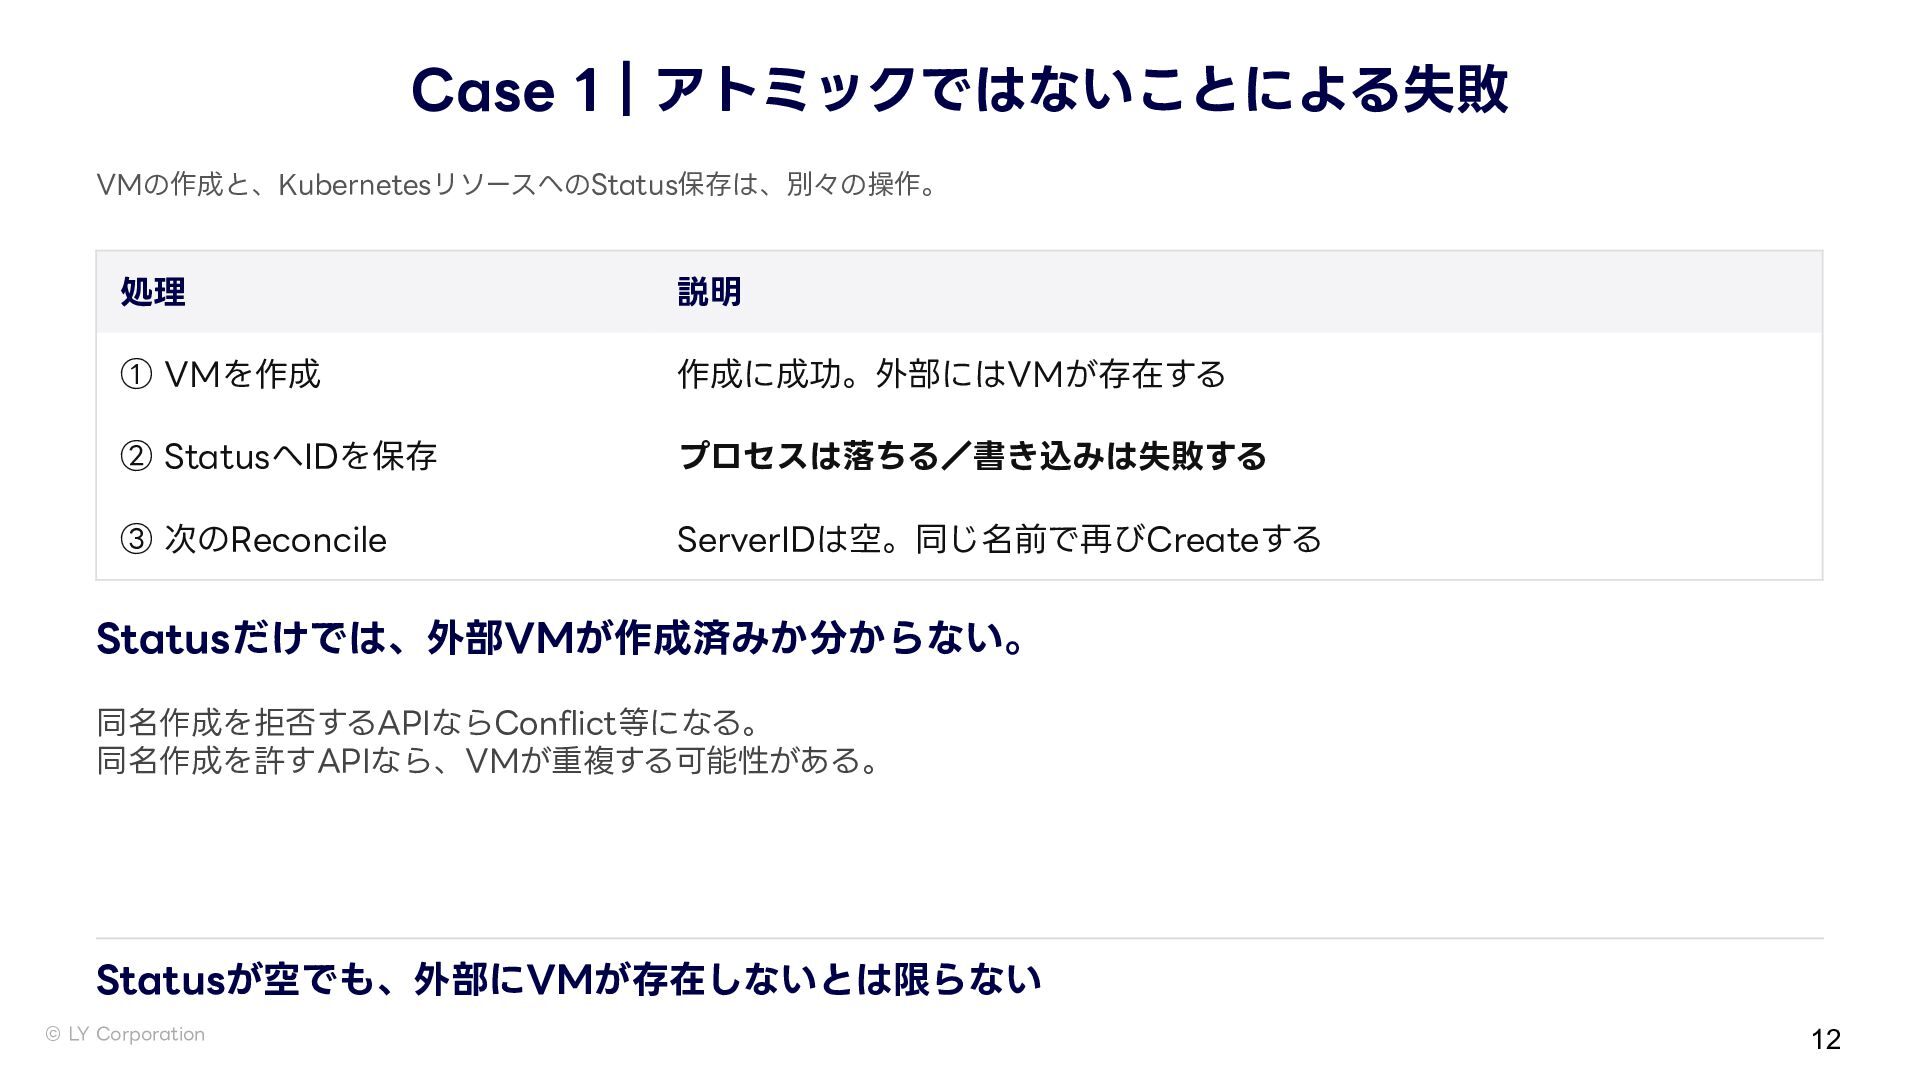
Case 1|アトミックではないことによる失敗 VMの作成と、KubernetesリソースへのStatus保存は、別々の操作。 処理 説明 ① VMを作成 作成に成功。外部にはVMが存在する ② StatusへIDを保存
プロセスは落ちる/書き込みは失敗する ③ 次のReconcile ServerIDは空。同じ名前で再びCreateする Statusだけでは、外部VMが作成済みか分からない。 同名作成を拒否するAPIならConflict等になる。 同名作成を許すAPIなら、VMが重複する可能性がある。 Statusが空でも、外部にVMが存在しないとは限らない © LY Corporation 12 -
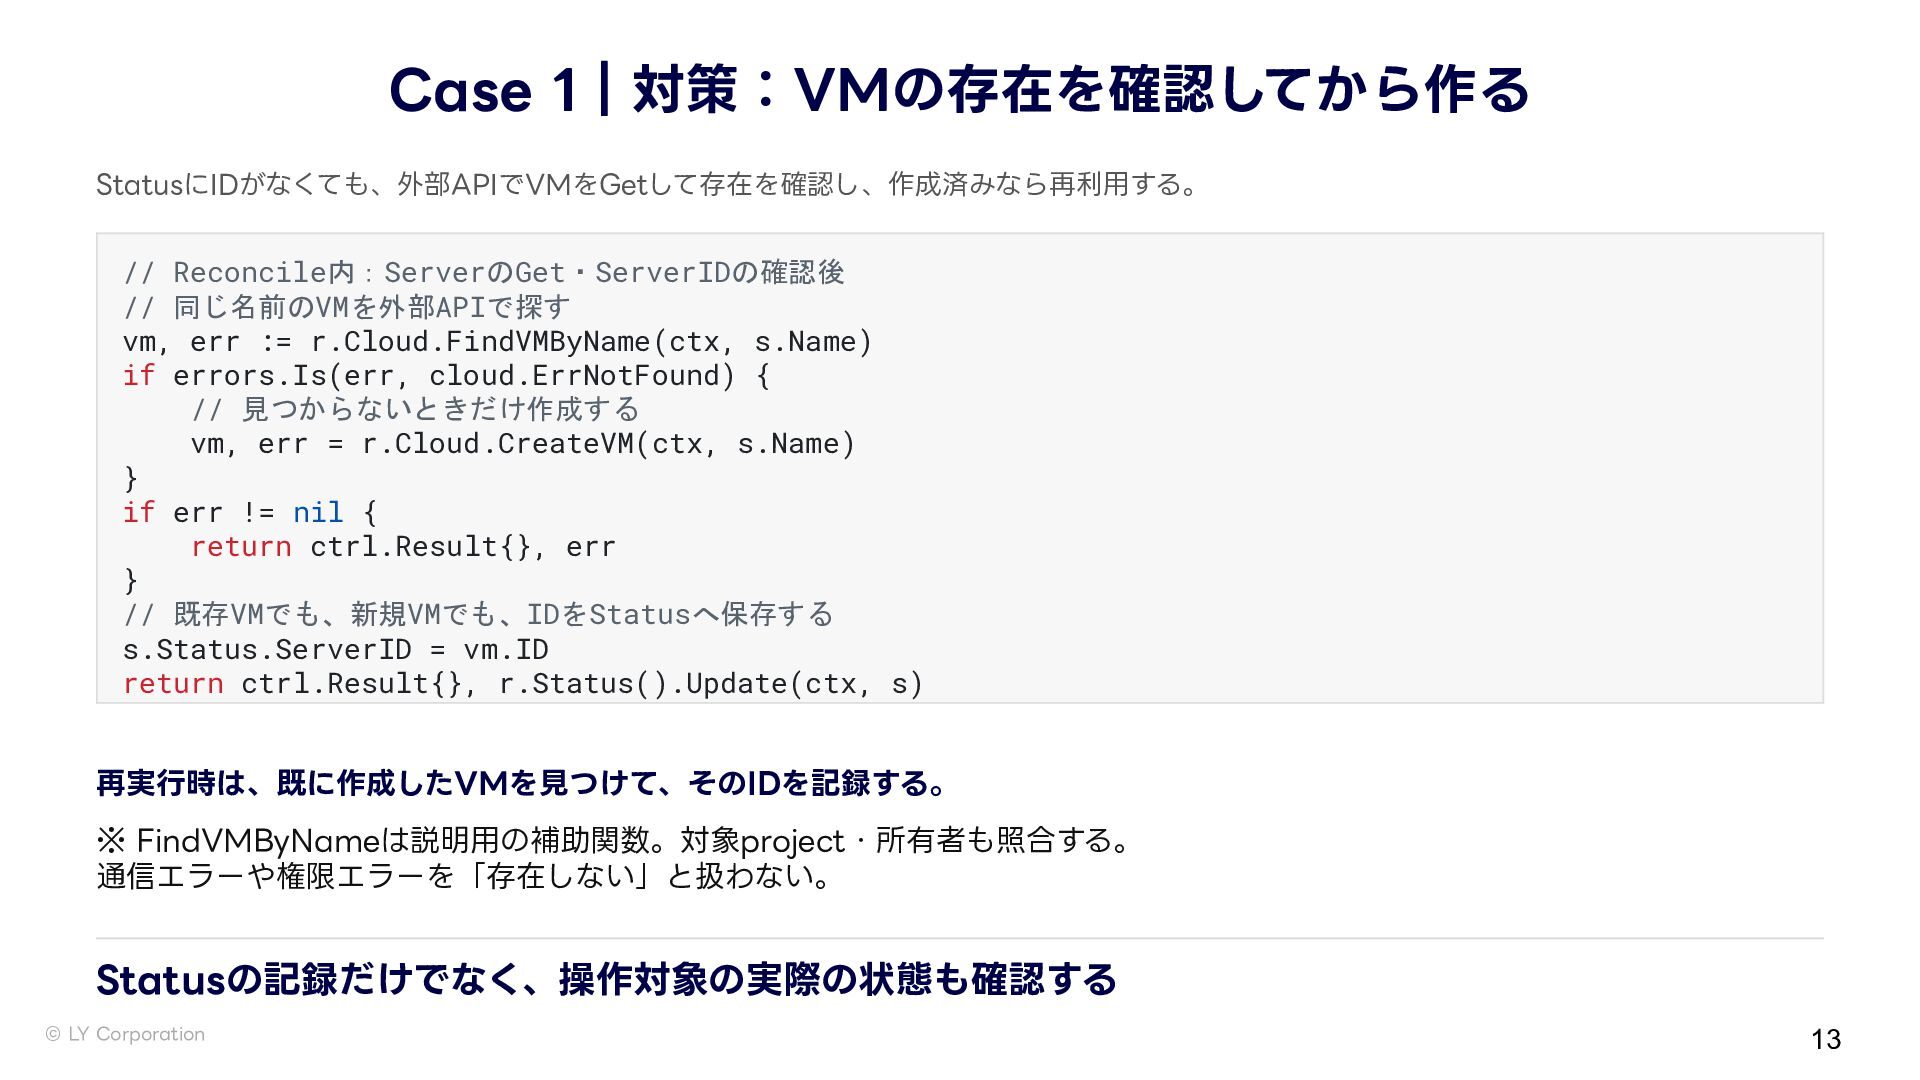
Case 1|対策:VMの存在を確認してから作る StatusにIDがなくても、外部APIでVMをGetして存在を確認し、作成済みなら再利⽤する。 // Reconcile内:ServerのGet・ServerIDの確認後 // 同じ名前のVMを外部APIで探す vm, err :=
r.Cloud.FindVMByName(ctx, s.Name) if errors.Is(err, cloud.ErrNotFound) { // 見つからないときだけ作成する vm, err = r.Cloud.CreateVM(ctx, s.Name) } if err != nil { return ctrl.Result{}, err } // 既存VMでも、新規VMでも、IDをStatusへ保存する s.Status.ServerID = vm.ID return ctrl.Result{}, r.Status().Update(ctx, s) 再実⾏時は、既に作成したVMを⾒つけて、そのIDを記録する。 ※ FindVMByNameは説明⽤の補助関数。対象project・所有者も照合する。 通信エラーや権限エラーを「存在しない」と扱わない。 Statusの記録だけでなく、操作対象の実際の状態も確認する © LY Corporation 13 -
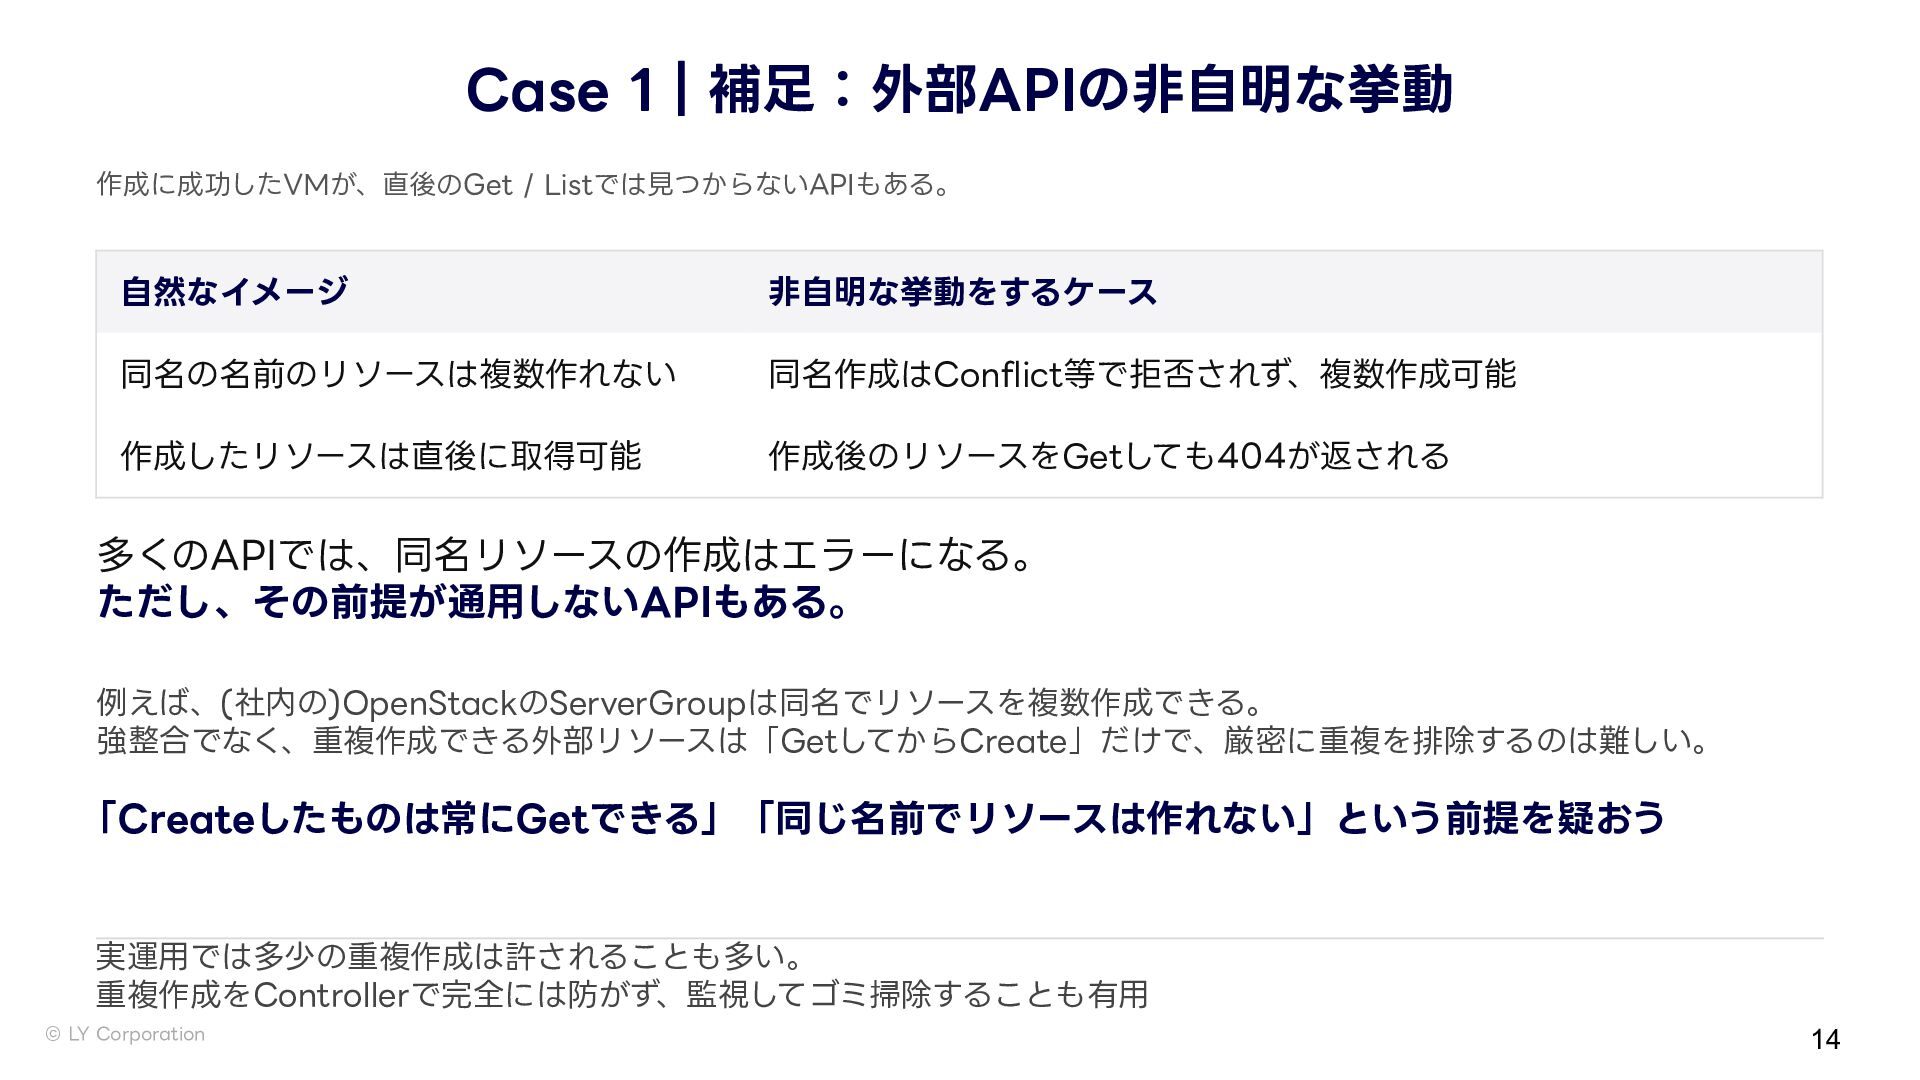
Case 1|補⾜:外部APIの⾮⾃明な挙動 作成に成功したVMが、直後のGet / Listでは⾒つからないAPIもある。 ⾃然なイメージ ⾮⾃明な挙動をするケース 同名の名前のリソースは複数作れない 同名作成はConflict等で拒否されず、複数作成可能 作成したリソースは直後に取得可能
作成後のリソースをGetしても404が返される 多くのAPIでは、同名リソースの作成はエラーになる。 ただし、その前提が通⽤しないAPIもある。 例えば、(社内の)OpenStackのServerGroupは同名でリソースを複数作成できる。 強整合でなく、重複作成できる外部リソースは「GetしてからCreate」だけで、厳密に重複を排除するのは難しい。 「Createしたものは常にGetできる」「同じ名前でリソースは作れない」という前提を疑おう 実運⽤では多少の重複作成は許されることも多い。 重複作成をControllerで完全には防がず、監視してゴミ掃除することも有⽤ © LY Corporation 14 -
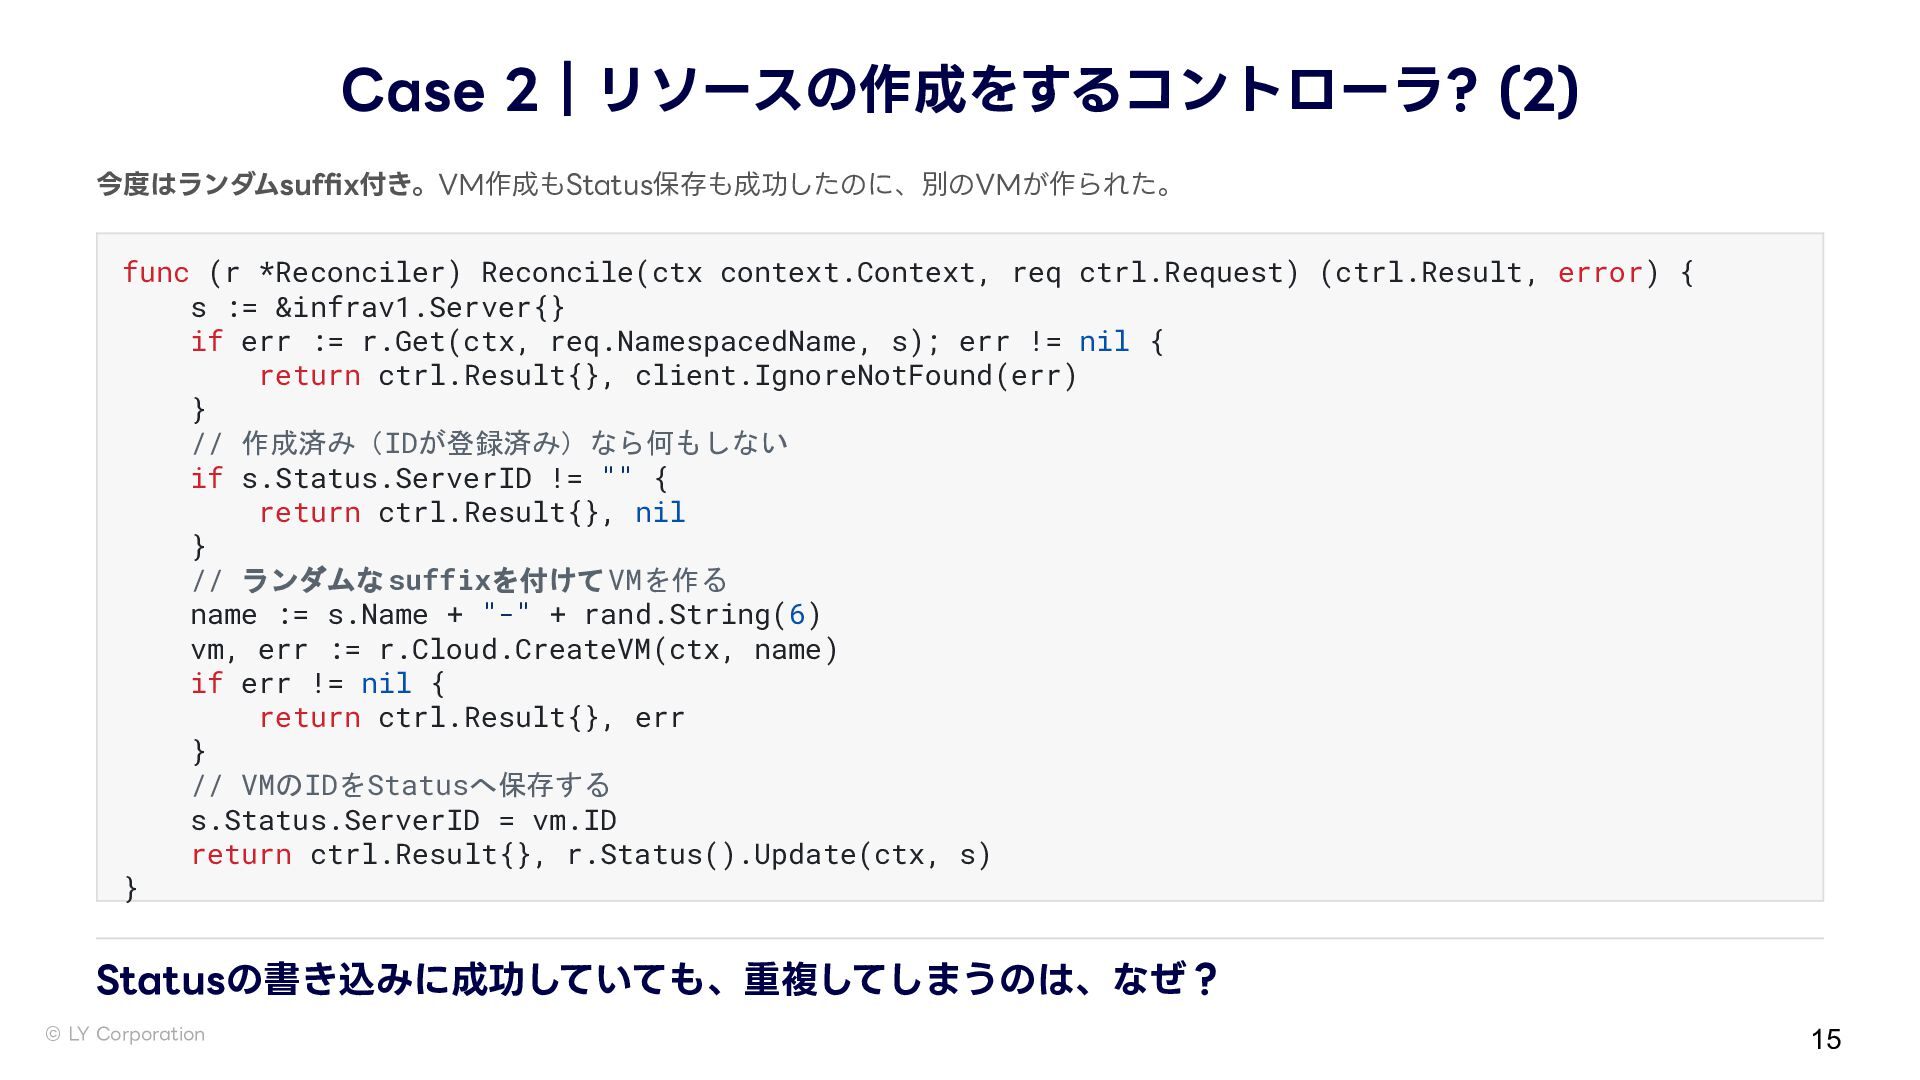
Case 2|リソースの作成をするコントローラ? (2) 今度はランダムsuffix付き。VM作成もStatus保存も成功したのに、別のVMが作られた。 func (r *Reconciler) Reconcile(ctx context.Context, req
ctrl.Request) (ctrl.Result, error) { s := &infrav1.Server{} if err := r.Get(ctx, req.NamespacedName, s); err != nil { return ctrl.Result{}, client.IgnoreNotFound(err) } // 作成済み(IDが登録済み)なら何もしない if s.Status.ServerID != "" { return ctrl.Result{}, nil } // ランダムな suffixを付けて VMを作る name := s.Name + "-" + rand.String(6) vm, err := r.Cloud.CreateVM(ctx, name) if err != nil { return ctrl.Result{}, err } // VMのIDをStatusへ保存する s.Status.ServerID = vm.ID return ctrl.Result{}, r.Status().Update(ctx, s) } Statusの書き込みに成功していても、重複してしまうのは、なぜ? © LY Corporation 15 -
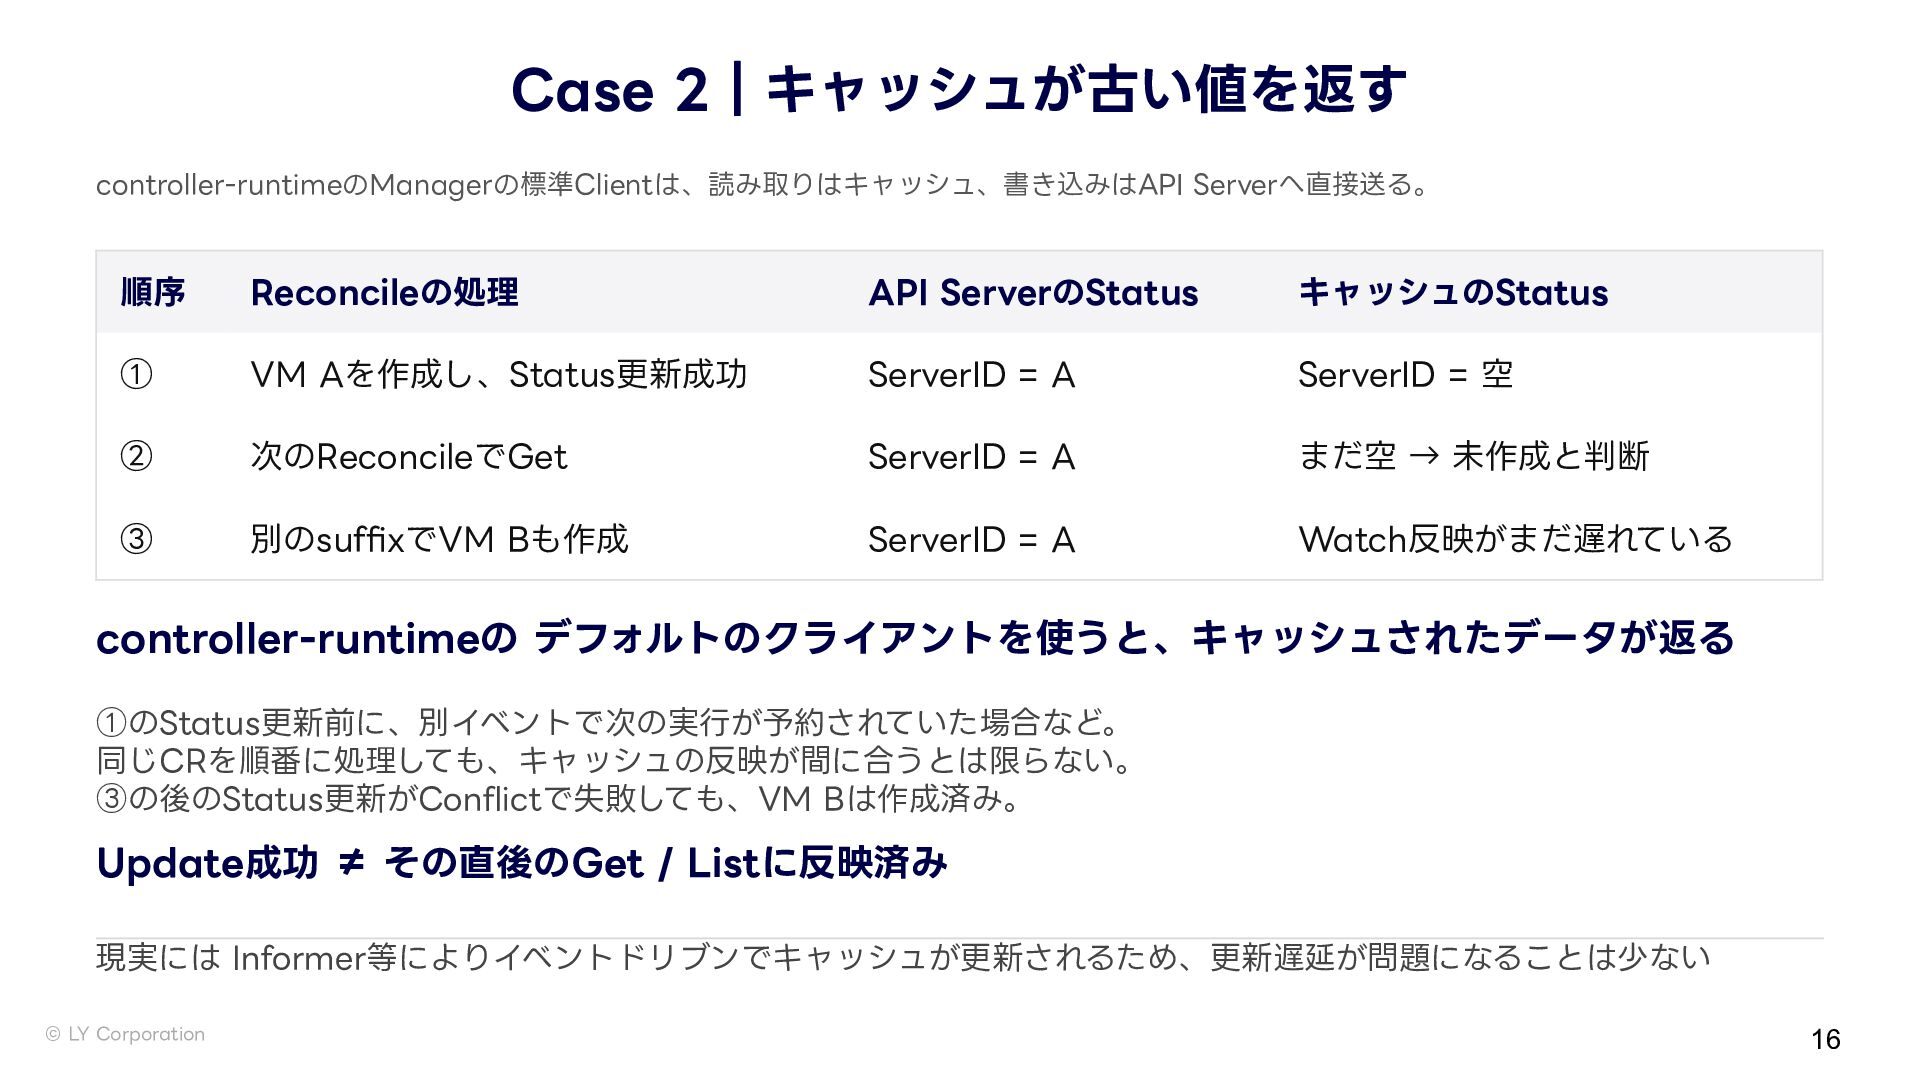
Case 2|キャッシュが古い値を返す controller-runtimeのManagerの標準Clientは、読み取りはキャッシュ、書き込みはAPI Serverへ直接送る。 順序 Reconcileの処理 API ServerのStatus キャッシュのStatus ①
VM Aを作成し、Status更新成功 ServerID = A ServerID = 空 ② 次のReconcileでGet ServerID = A まだ空 → 未作成と判断 ③ 別のsuffixでVM Bも作成 ServerID = A Watch反映がまだ遅れている controller-runtimeの デフォルトのクライアントを使うと、キャッシュされたデータが返る ①のStatus更新前に、別イベントで次の実⾏が予約されていた場合など。 同じCRを順番に処理しても、キャッシュの反映が間に合うとは限らない。 ③の後のStatus更新がConflictで失敗しても、VM Bは作成済み。 Update成功 ≠ その直後のGet / Listに反映済み 現実には Informer等によりイベントドリブンでキャッシュが更新されるため、更新遅延が問題になることは少ない © LY Corporation 16 -
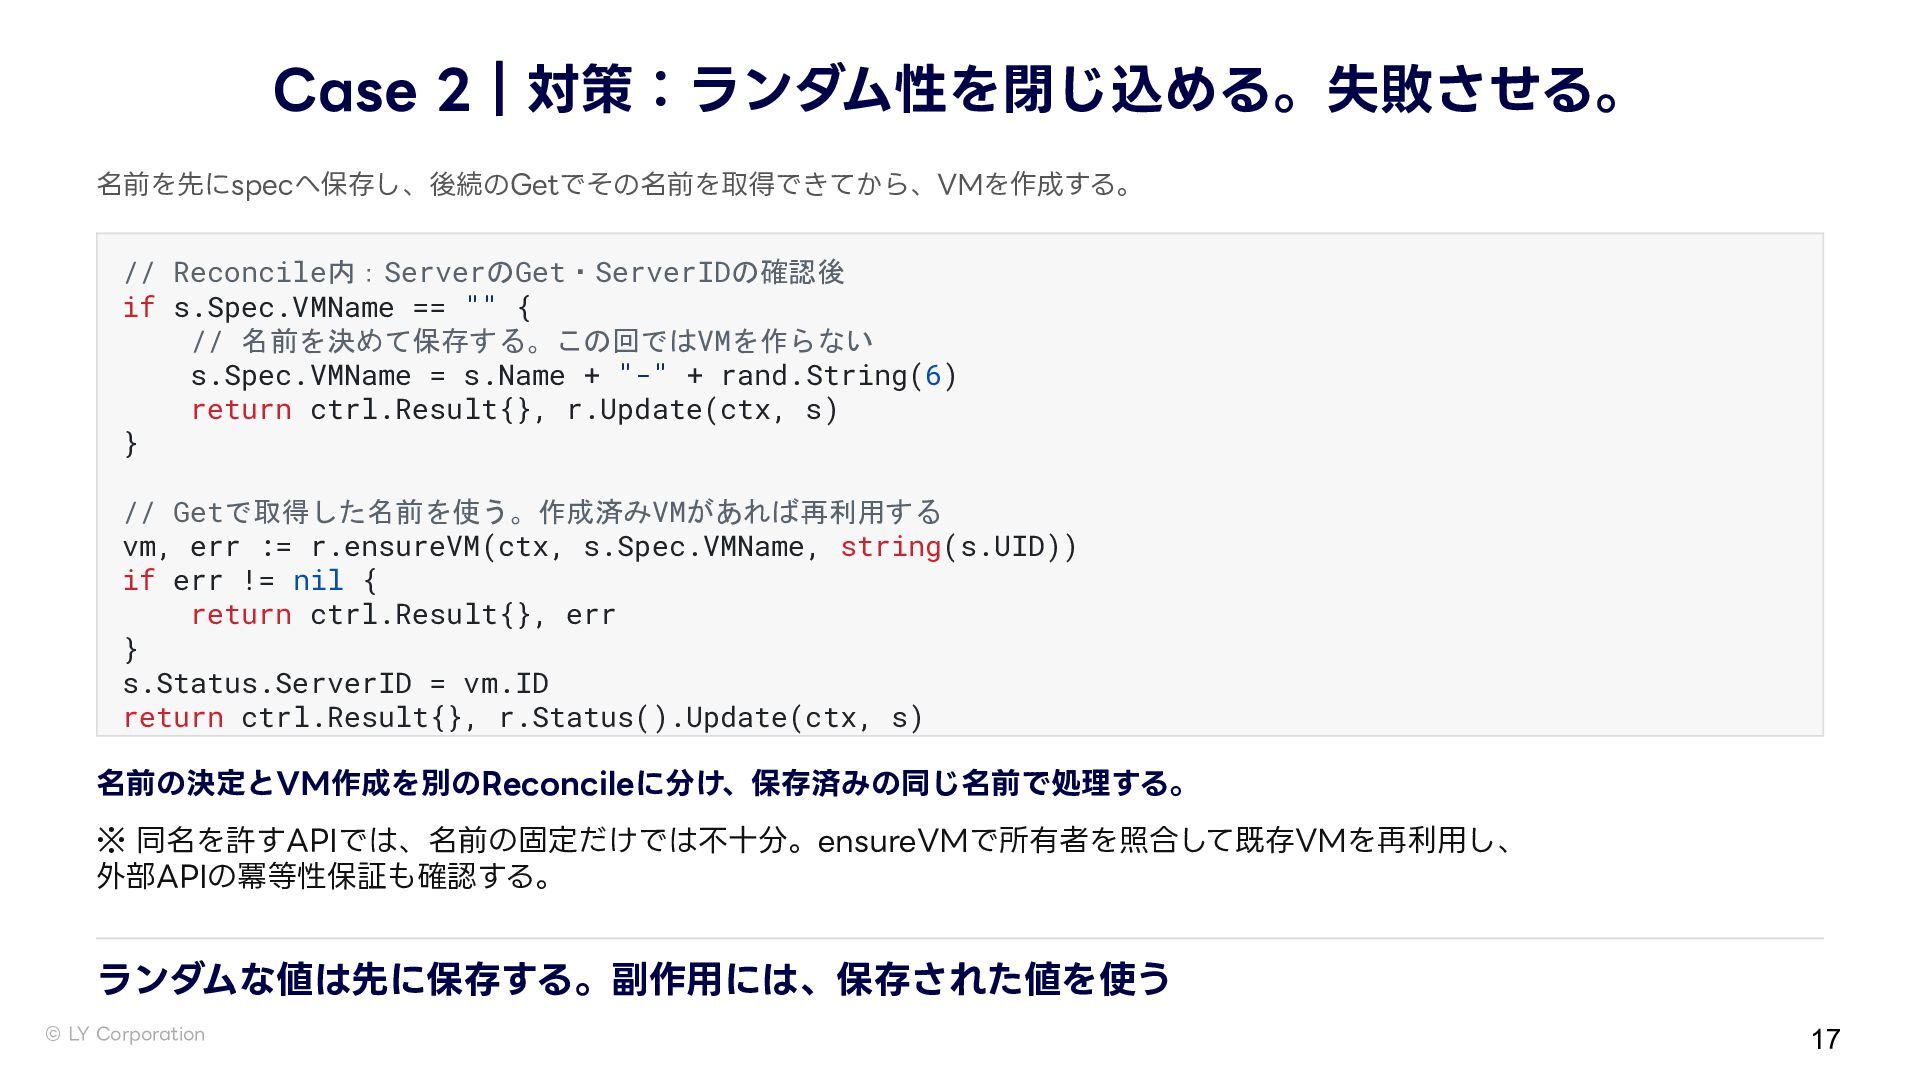
Case 2|対策:ランダム性を閉じ込める。失敗させる。 名前を先にspecへ保存し、後続のGetでその名前を取得できてから、VMを作成する。 // Reconcile内:ServerのGet・ServerIDの確認後 if s.Spec.VMName == "" {
// 名前を決めて保存する。この回ではVMを作らない s.Spec.VMName = s.Name + "-" + rand.String(6) return ctrl.Result{}, r.Update(ctx, s) } // Getで取得した名前を使う。作成済みVMがあれば再利用する vm, err := r.ensureVM(ctx, s.Spec.VMName, string(s.UID)) if err != nil { return ctrl.Result{}, err } s.Status.ServerID = vm.ID return ctrl.Result{}, r.Status().Update(ctx, s) 名前の決定とVM作成を別のReconcileに分け、保存済みの同じ名前で処理する。 ※ 同名を許すAPIでは、名前の固定だけでは不⼗分。ensureVMで所有者を照合して既存VMを再利⽤し、 外部APIの冪等性保証も確認する。 ランダムな値は先に保存する。副作⽤には、保存された値を使う © LY Corporation 17 -
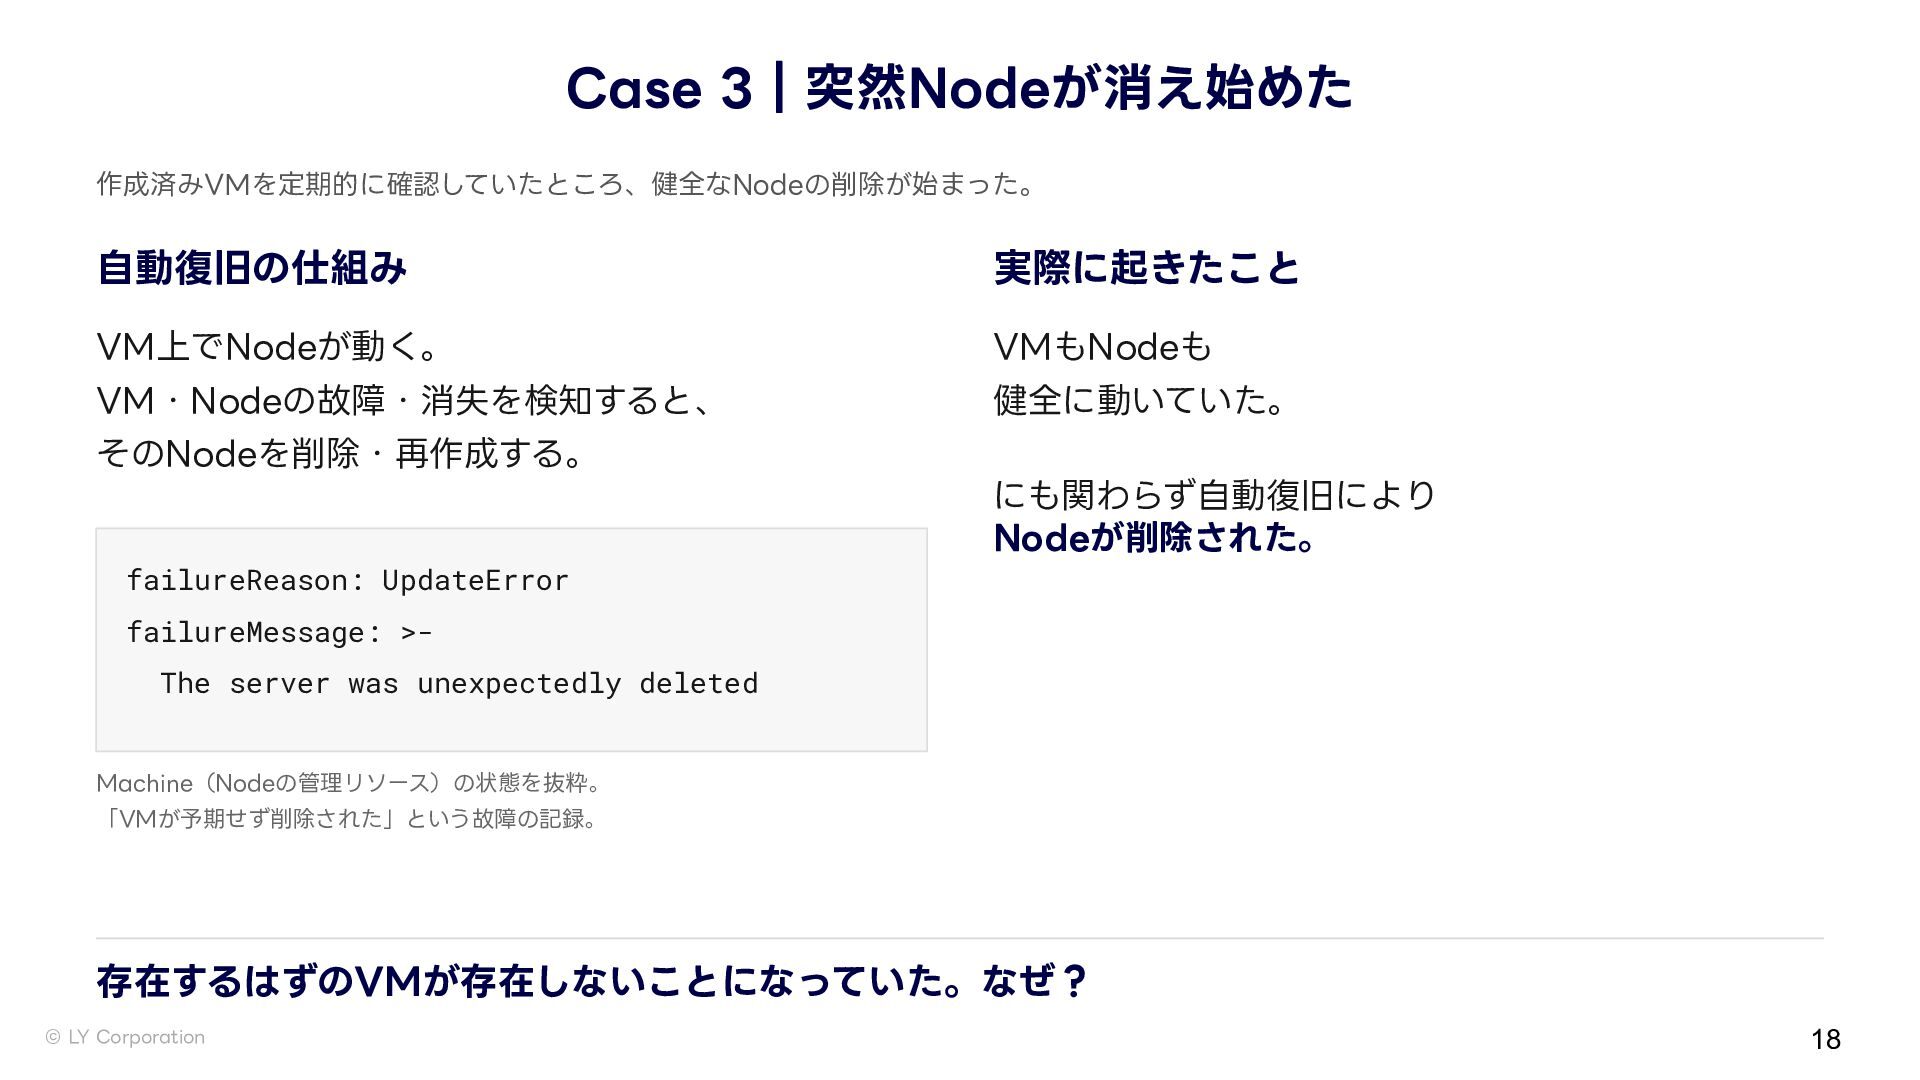
Case 3|突然Nodeが消え始めた 作成済みVMを定期的に確認していたところ、健全なNodeの削除が始まった。 ⾃動復旧の仕組み 実際に起きたこと VM上でNodeが動く。 VMもNodeも VM・Nodeの故障・消失を検知すると、 健全に動いていた。 そのNodeを削除・再作成する。
にも関わらず⾃動復旧により Nodeが削除された。 failureReason: UpdateError failureMessage: >The server was unexpectedly deleted Machine(Nodeの管理リソース)の状態を抜粋。 「VMが予期せず削除された」という故障の記録。 存在するはずのVMが存在しないことになっていた。なぜ? © LY Corporation 18 -
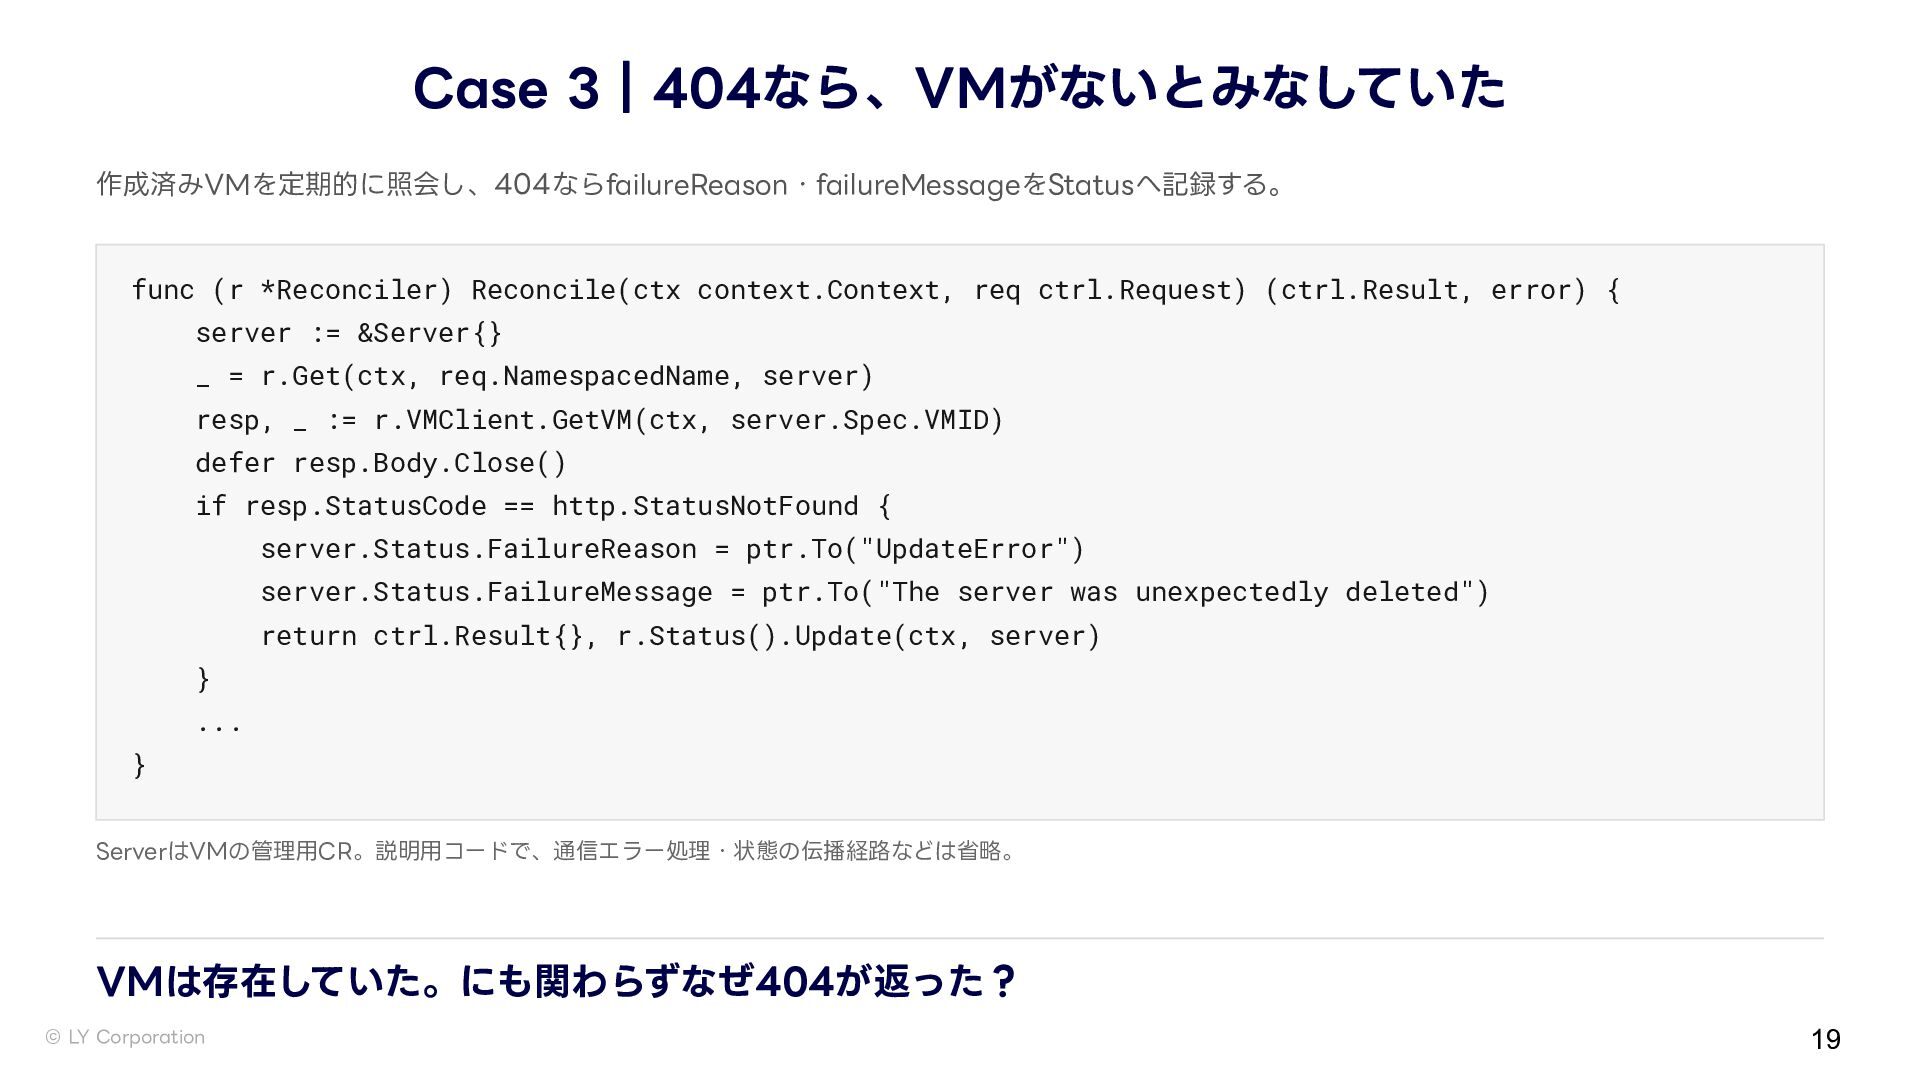
Case 3|404なら、VMがないとみなしていた 作成済みVMを定期的に照会し、404ならfailureReason・failureMessageをStatusへ記録する。 func (r *Reconciler) Reconcile(ctx context.Context, req ctrl.Request)
(ctrl.Result, error) { server := &Server{} _ = r.Get(ctx, req.NamespacedName, server) resp, _ := r.VMClient.GetVM(ctx, server.Spec.VMID) defer resp.Body.Close() if resp.StatusCode == http.StatusNotFound { server.Status.FailureReason = ptr.To("UpdateError") server.Status.FailureMessage = ptr.To("The server was unexpectedly deleted") return ctrl.Result{}, r.Status().Update(ctx, server) } ... } ServerはVMの管理⽤CR。説明⽤コードで、通信エラー処理・状態の伝播経路などは省略。 VMは存在していた。にも関わらずなぜ404が返った? © LY Corporation 19 -
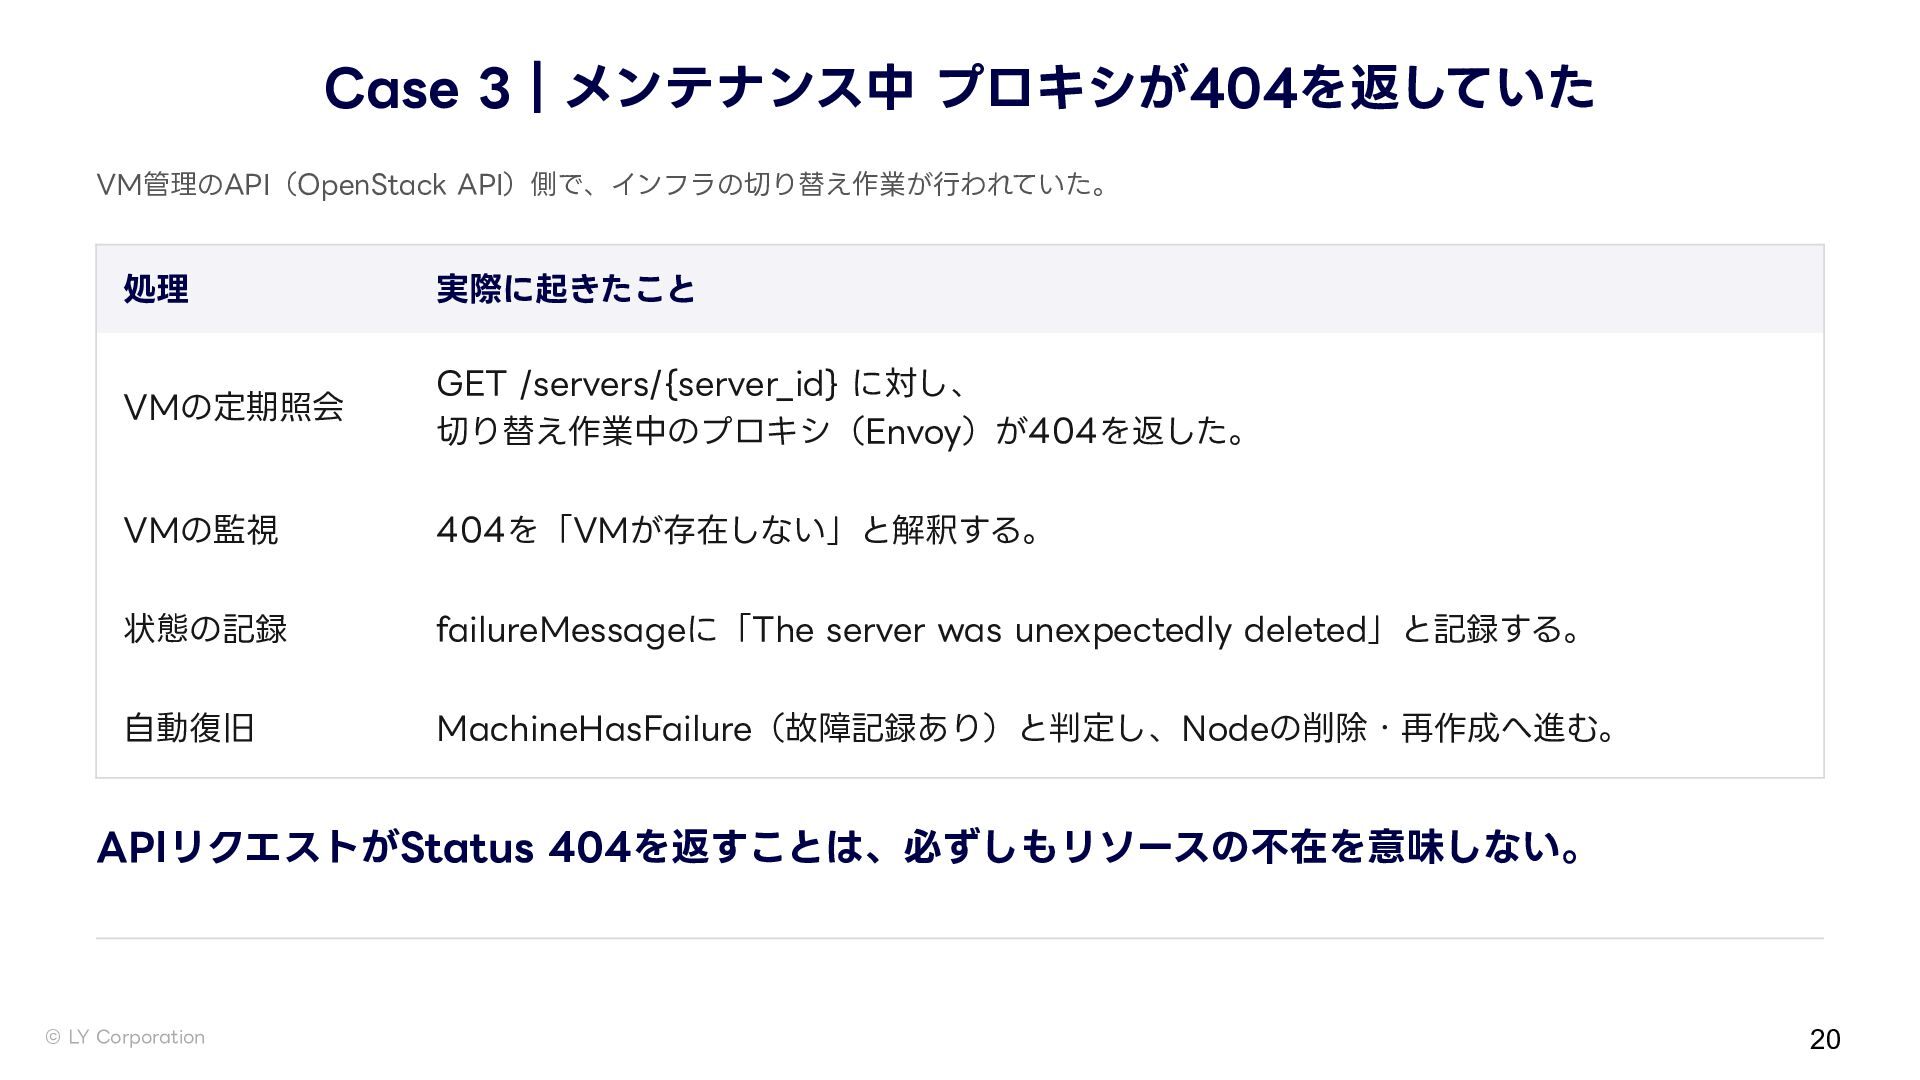
Case 3|メンテナンス中 プロキシが404を返していた VM管理のAPI(OpenStack API)側で、インフラの切り替え作業が⾏われていた。 処理 実際に起きたこと VMの定期照会 GET /servers/{server_id}
に対し、 切り替え作業中のプロキシ(Envoy)が404を返した。 VMの監視 404を「VMが存在しない」と解釈する。 状態の記録 failureMessageに「The server was unexpectedly deleted」と記録する。 ⾃動復旧 MachineHasFailure(故障記録あり)と判定し、Nodeの削除・再作成へ進む。 APIリクエストがStatus 404を返すことは、必ずしもリソースの不在を意味しない。 © LY Corporation 20 -
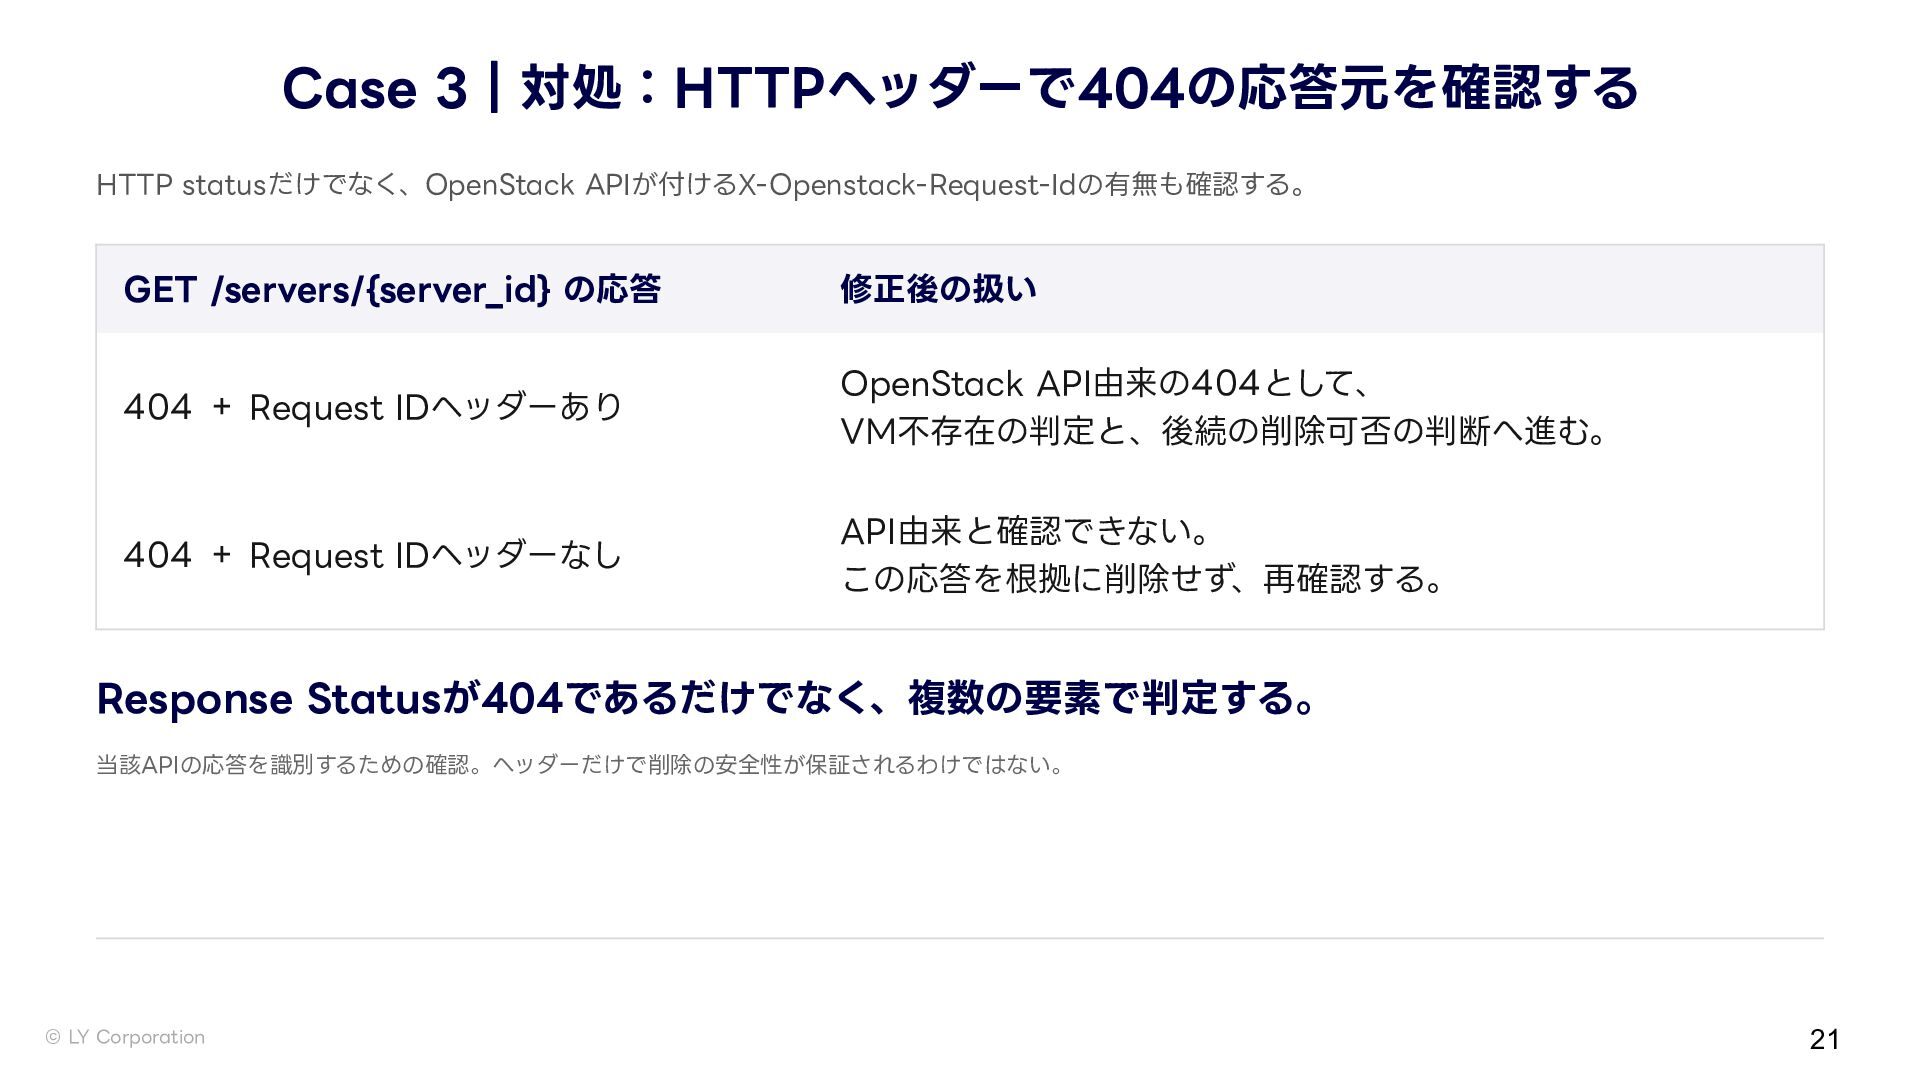
Case 3|対処:HTTPヘッダーで404の応答元を確認する HTTP statusだけでなく、OpenStack APIが付けるX-Openstack-Request-Idの有無も確認する。 GET /servers/{server_id} の応答 修正後の扱い 404
+ Request IDヘッダーあり OpenStack API由来の404として、 VM不存在の判定と、後続の削除可否の判断へ進む。 404 + Request IDヘッダーなし API由来と確認できない。 この応答を根拠に削除せず、再確認する。 Response Statusが404であるだけでなく、複数の要素で判定する。 当該APIの応答を識別するための確認。ヘッダーだけで削除の安全性が保証されるわけではない。 © LY Corporation 21 -
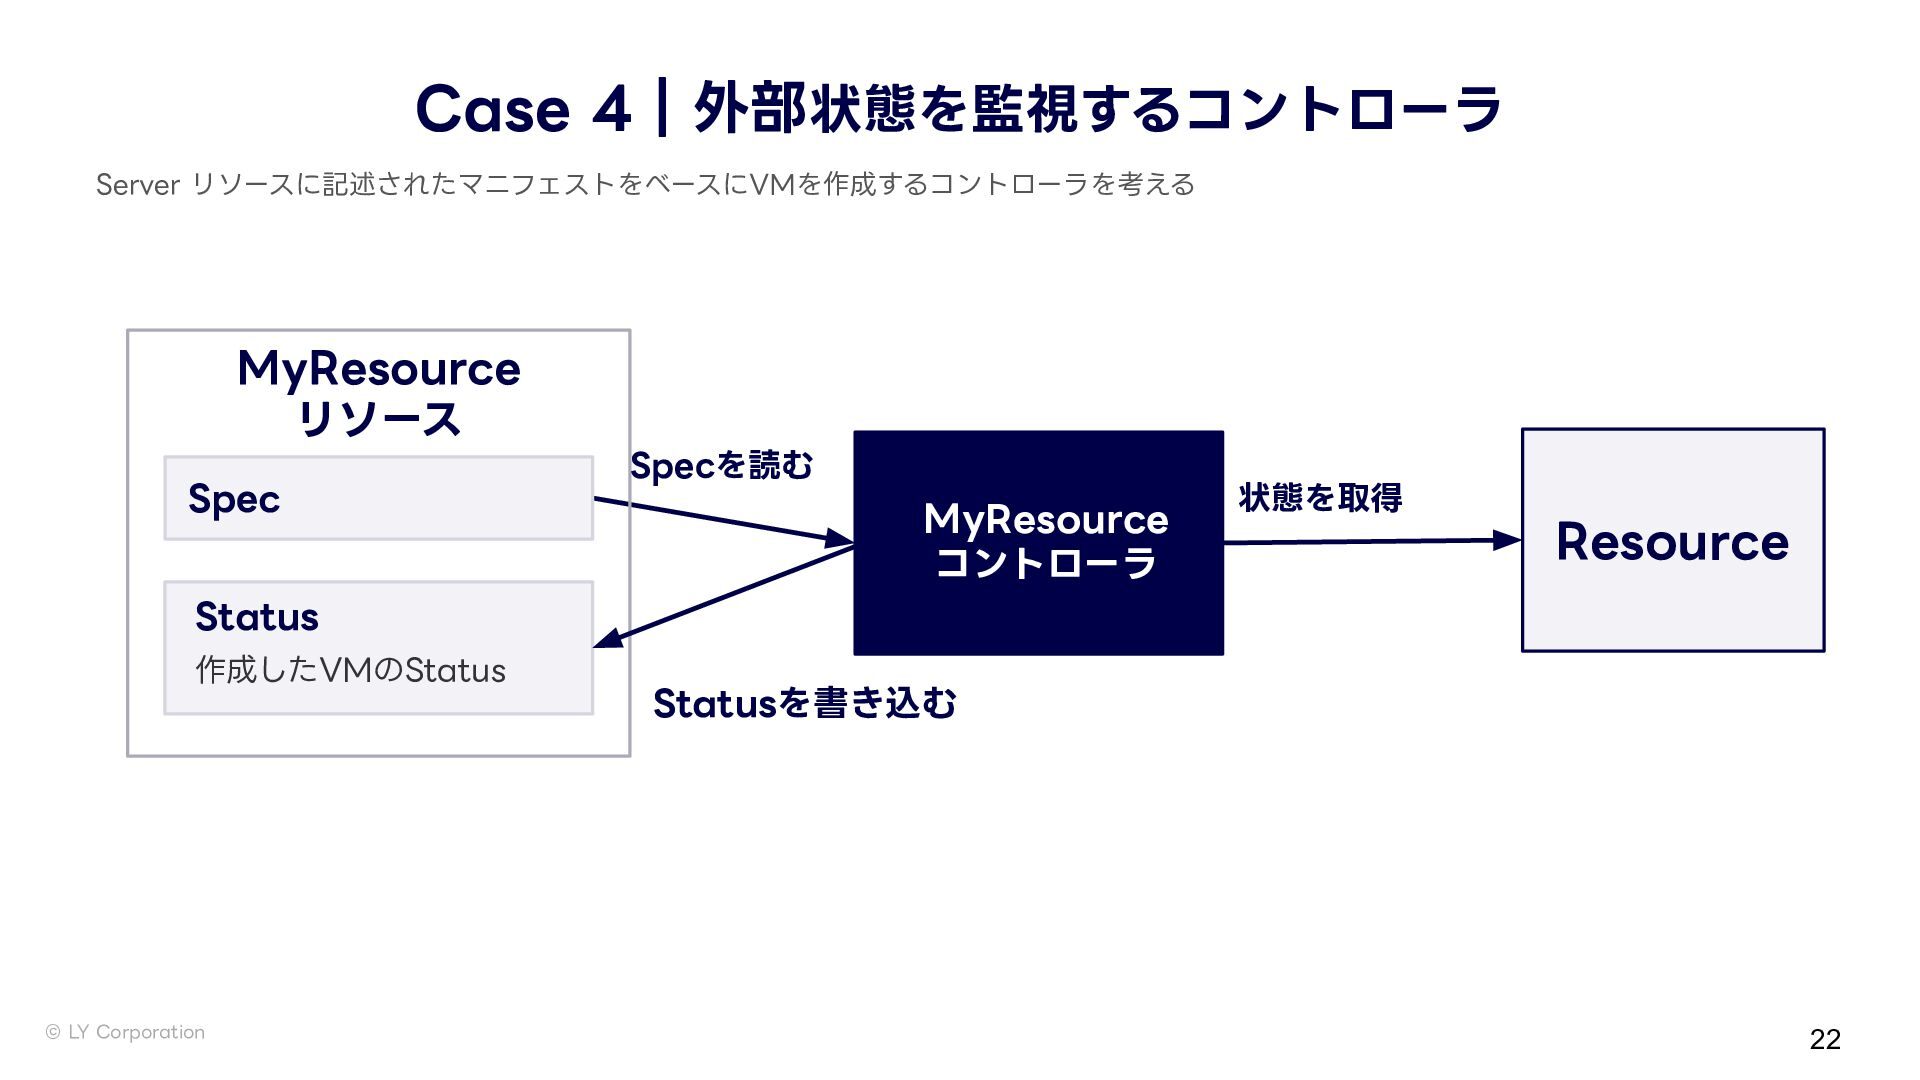
Case 4|外部状態を監視するコントローラ Server リソースに記述されたマニフェストをベースにVMを作成するコントローラを考える MyResource リソース Spec Specを読む MyResource コントローラ
状態を取得 Resource Status 作成したVMのStatus © LY Corporation Statusを書き込む 22 -
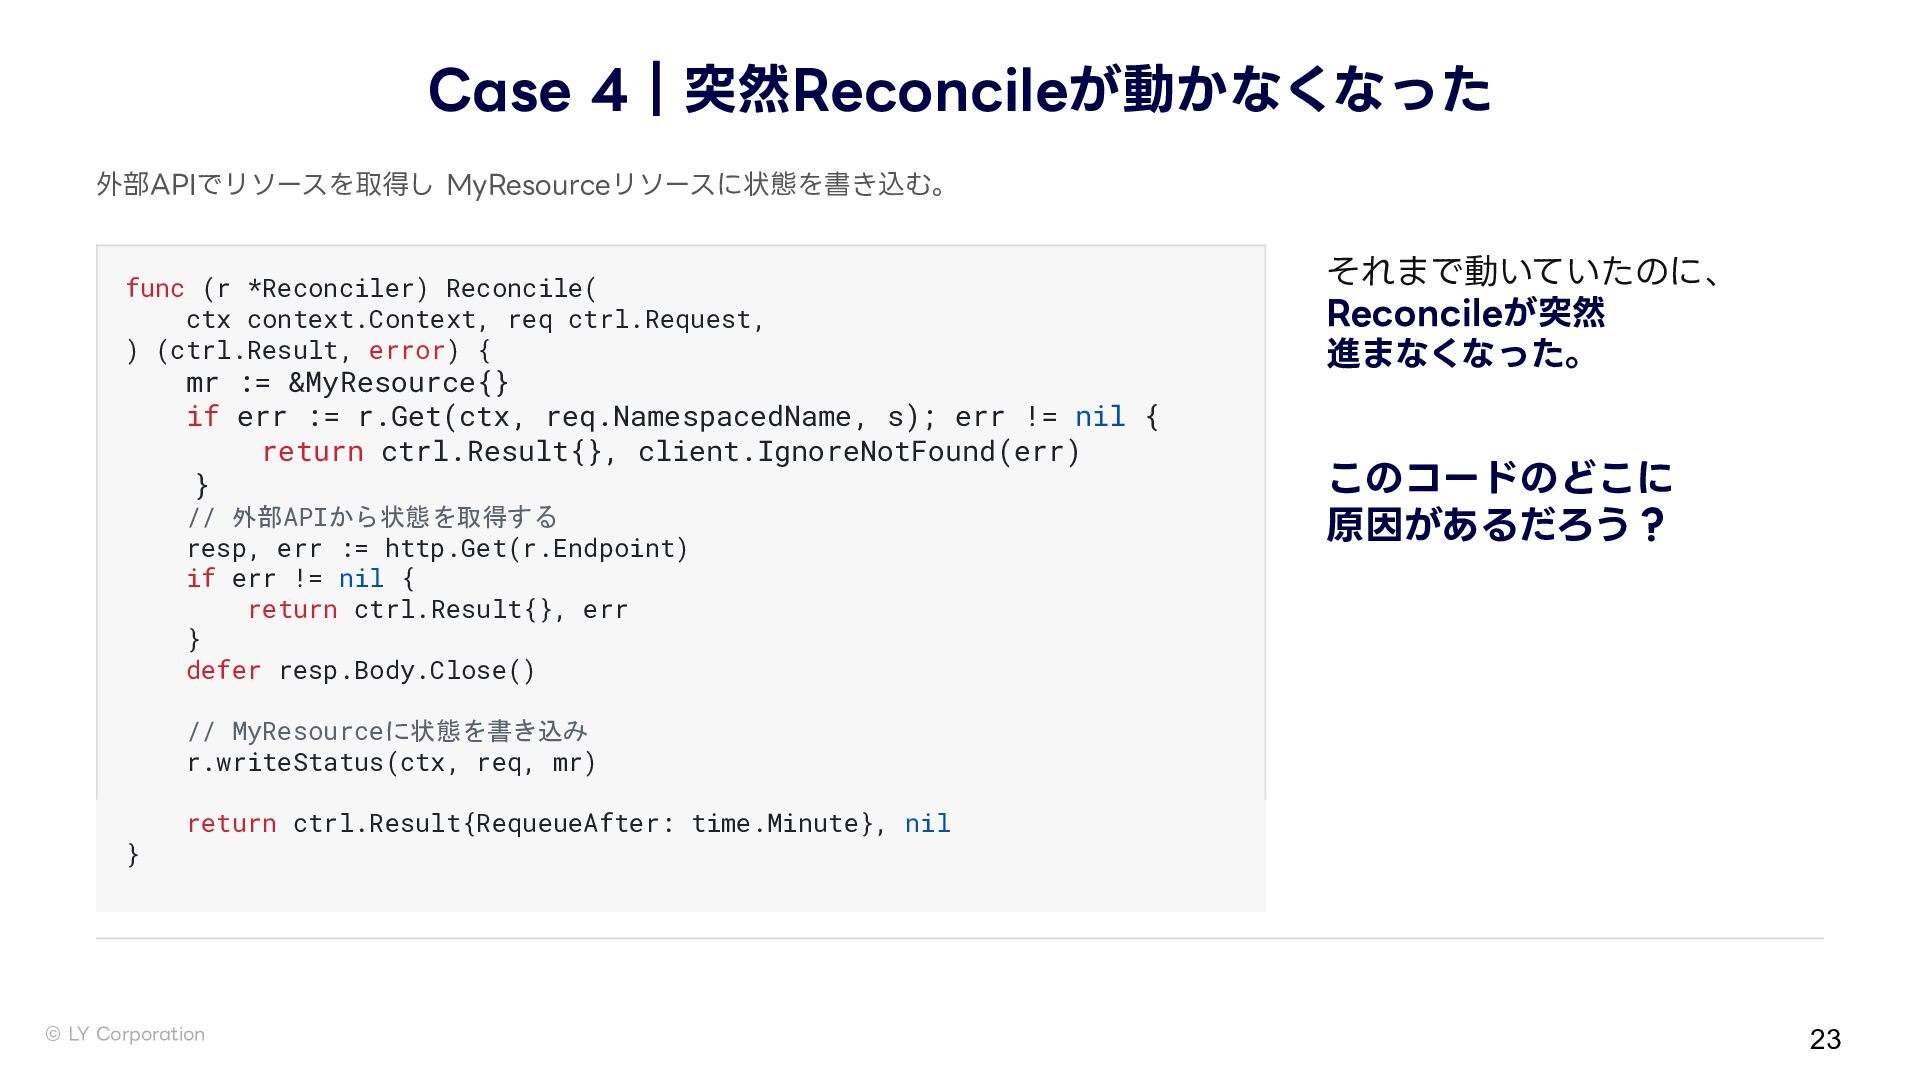
Case 4|突然Reconcileが動かなくなった 外部APIでリソースを取得し MyResourceリソースに状態を書き込む。 func (r *Reconciler) Reconcile( ctx context.Context,
req ctrl.Request, ) (ctrl.Result, error) { mr := &MyResource{} if err := r.Get(ctx, req.NamespacedName, s); err != nil { return ctrl.Result{}, client.IgnoreNotFound(err) } // 外部APIから状態を取得する resp, err := http.Get(r.Endpoint) if err != nil { return ctrl.Result{}, err } defer resp.Body.Close() それまで動いていたのに、 Reconcileが突然 進まなくなった。 このコードのどこに 原因があるだろう? // MyResourceに状態を書き込み r.writeStatus(ctx, req, mr) } return ctrl.Result{RequeueAfter: time.Minute}, nil © LY Corporation 23 -
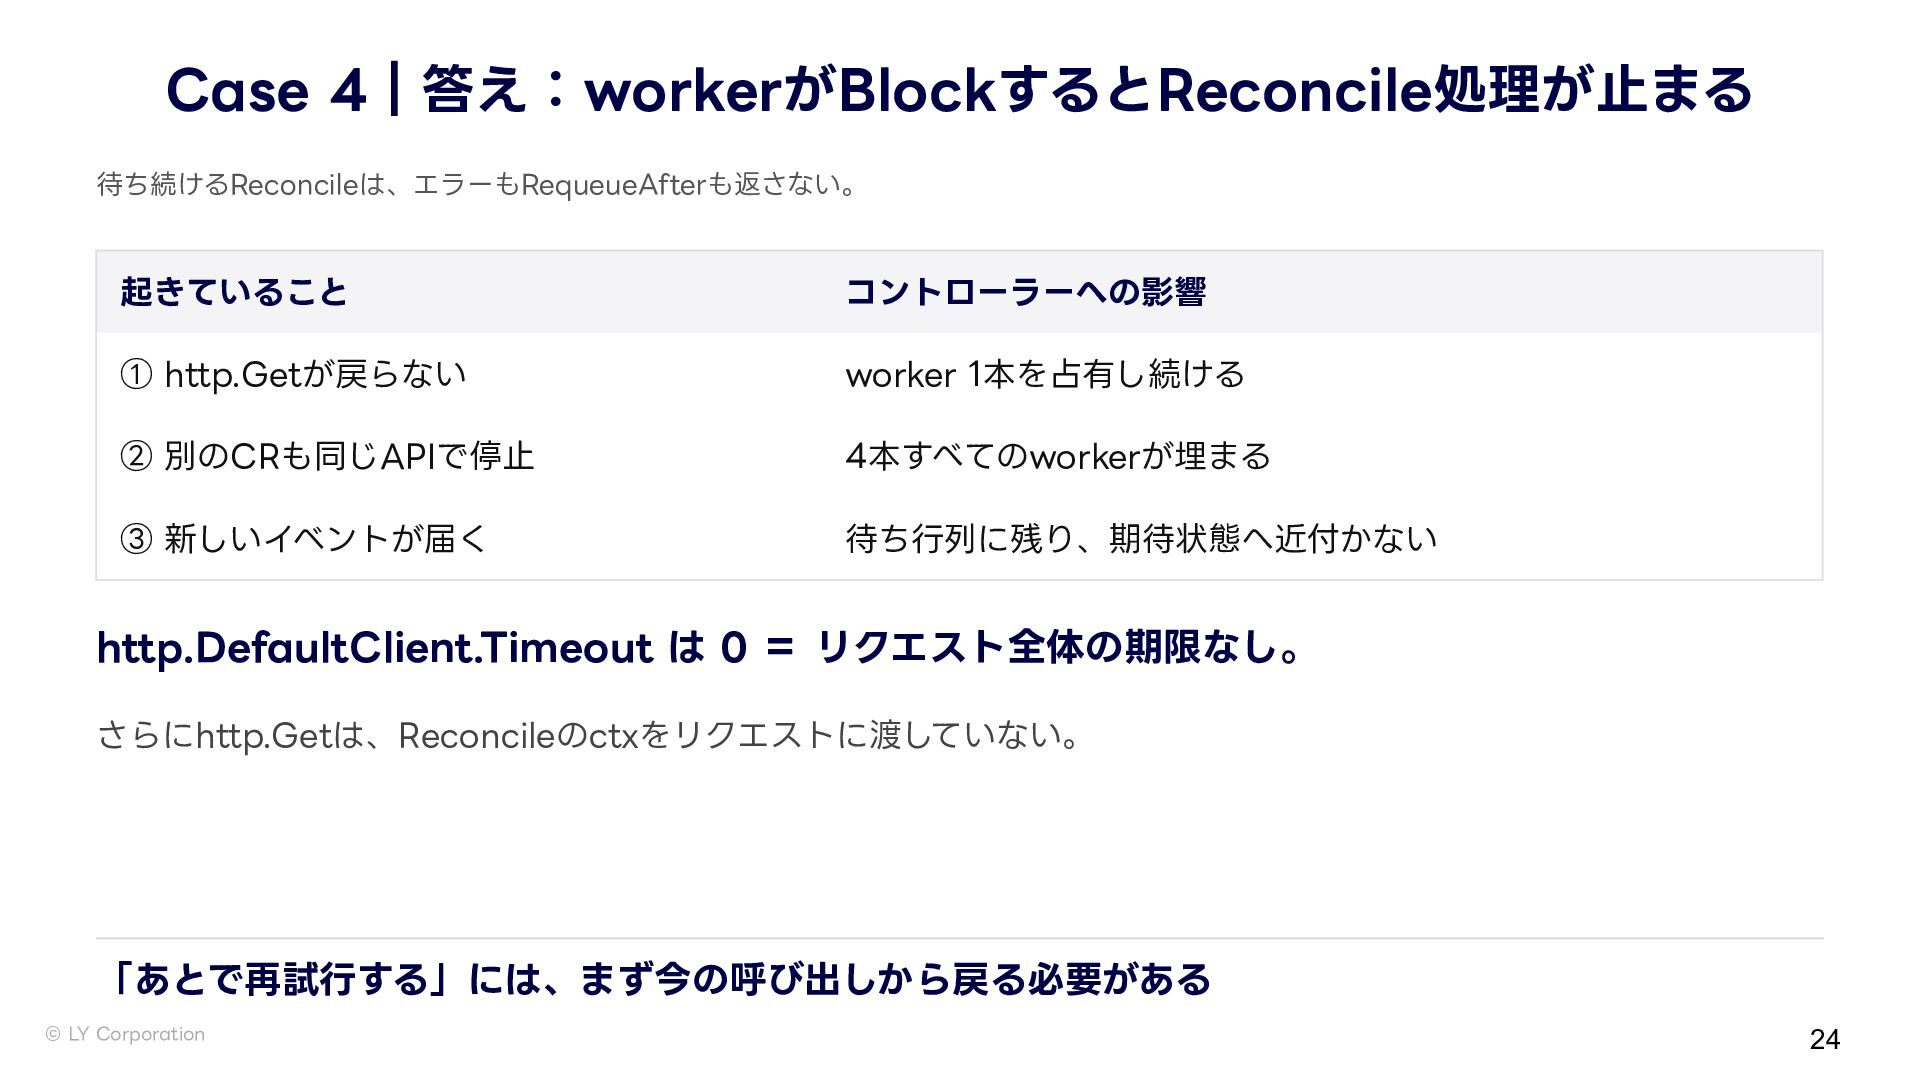
Case 4|答え:workerがBlockするとReconcile処理が⽌まる 待ち続けるReconcileは、エラーもRequeueAfterも返さない。 起きていること コントローラーへの影響 ① http.Getが戻らない worker 1本を占有し続ける ②
別のCRも同じAPIで停⽌ 4本すべてのworkerが埋まる ③ 新しいイベントが届く 待ち⾏列に残り、期待状態へ近付かない http.DefaultClient.Timeout は 0 = リクエスト全体の期限なし。 さらにhttp.Getは、Reconcileのctxをリクエストに渡していない。 「あとで再試⾏する」には、まず今の呼び出しから戻る必要がある © LY Corporation 24 -
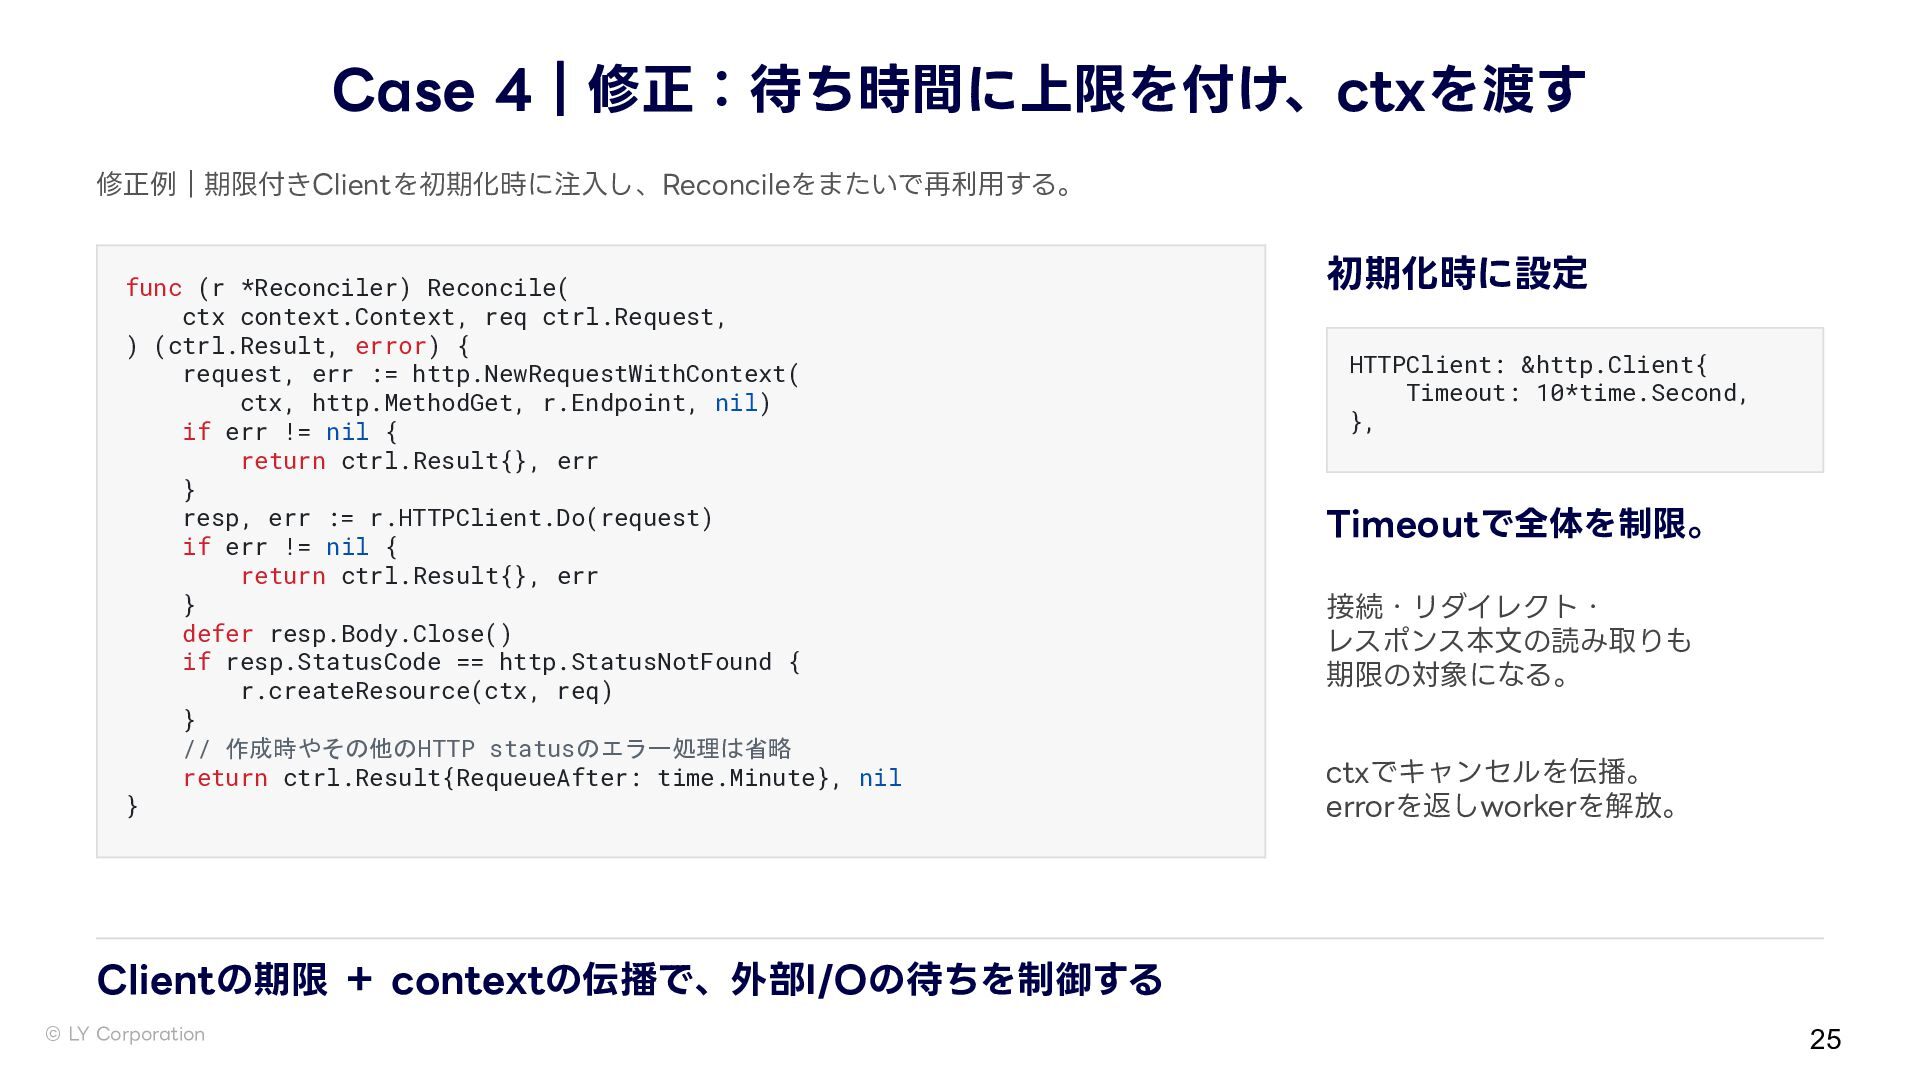
Case 4|修正:待ち時間に上限を付け、ctxを渡す 修正例|期限付きClientを初期化時に注⼊し、Reconcileをまたいで再利⽤する。 func (r *Reconciler) Reconcile( ctx context.Context, req
ctrl.Request, ) (ctrl.Result, error) { request, err := http.NewRequestWithContext( ctx, http.MethodGet, r.Endpoint, nil) if err != nil { return ctrl.Result{}, err } resp, err := r.HTTPClient.Do(request) if err != nil { return ctrl.Result{}, err } defer resp.Body.Close() if resp.StatusCode == http.StatusNotFound { r.createResource(ctx, req) } // 作成時やその他のHTTP statusのエラー処理は省略 return ctrl.Result{RequeueAfter: time.Minute}, nil } 初期化時に設定 HTTPClient: &http.Client{ Timeout: 10*time.Second, }, Timeoutで全体を制限。 接続・リダイレクト・ レスポンス本⽂の読み取りも 期限の対象になる。 ctxでキャンセルを伝播。 errorを返しworkerを解放。 Clientの期限 + contextの伝播で、外部I/Oの待ちを制御する © LY Corporation 25 -
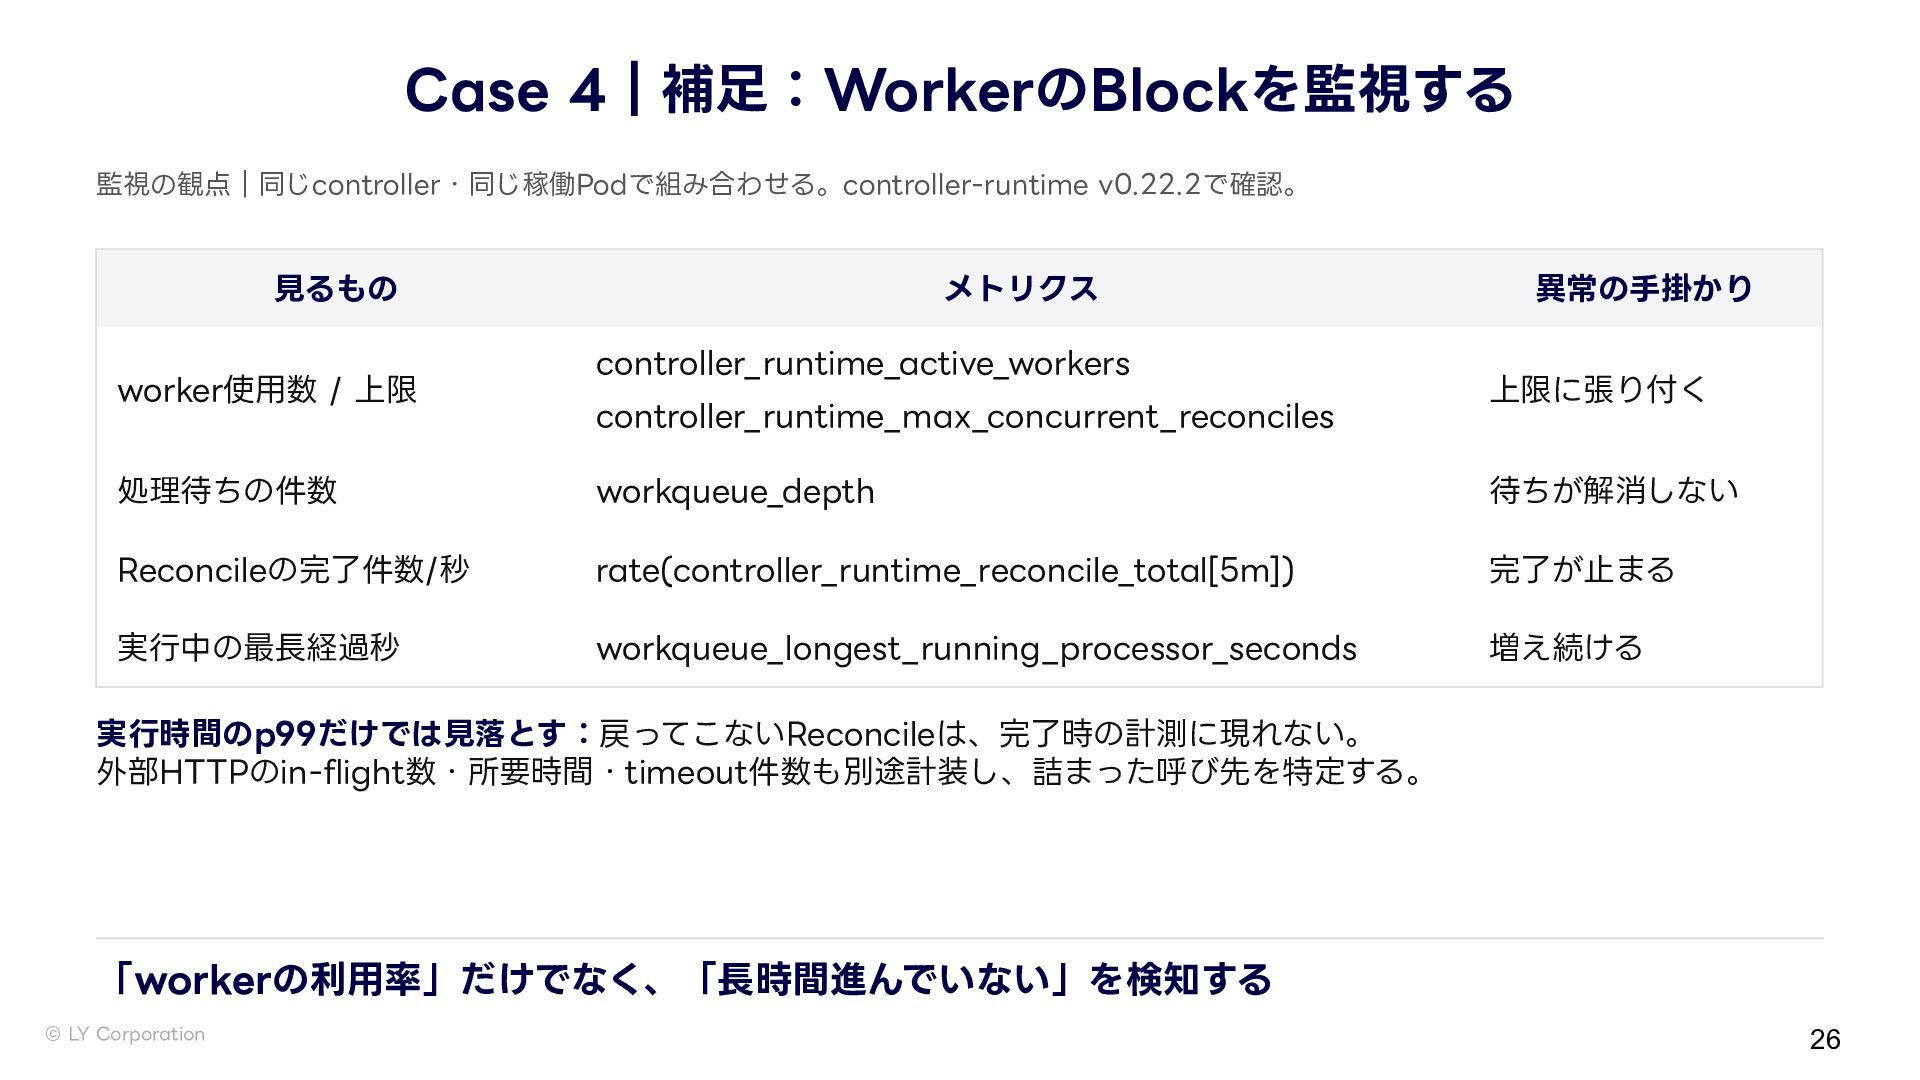
Case 4|補⾜:WorkerのBlockを監視する 監視の観点|同じcontroller・同じ稼働Podで組み合わせる。controller-runtime v0.22.2で確認。 ⾒るもの worker使⽤数 / 上限 メトリクス controller_runtime_active_workers
controller_runtime_max_concurrent_reconciles 異常の⼿掛かり 上限に張り付く 処理待ちの件数 workqueue_depth 待ちが解消しない Reconcileの完了件数/秒 rate(controller_runtime_reconcile_total[5m]) 完了が⽌まる 実⾏中の最⻑経過秒 workqueue_longest_running_processor_seconds 増え続ける 実⾏時間のp99だけでは⾒落とす:戻ってこないReconcileは、完了時の計測に現れない。 外部HTTPのin-flight数・所要時間・timeout件数も別途計装し、詰まった呼び先を特定する。 「workerの利⽤率」だけでなく、「⻑時間進んでいない」を検知する © LY Corporation 26 -
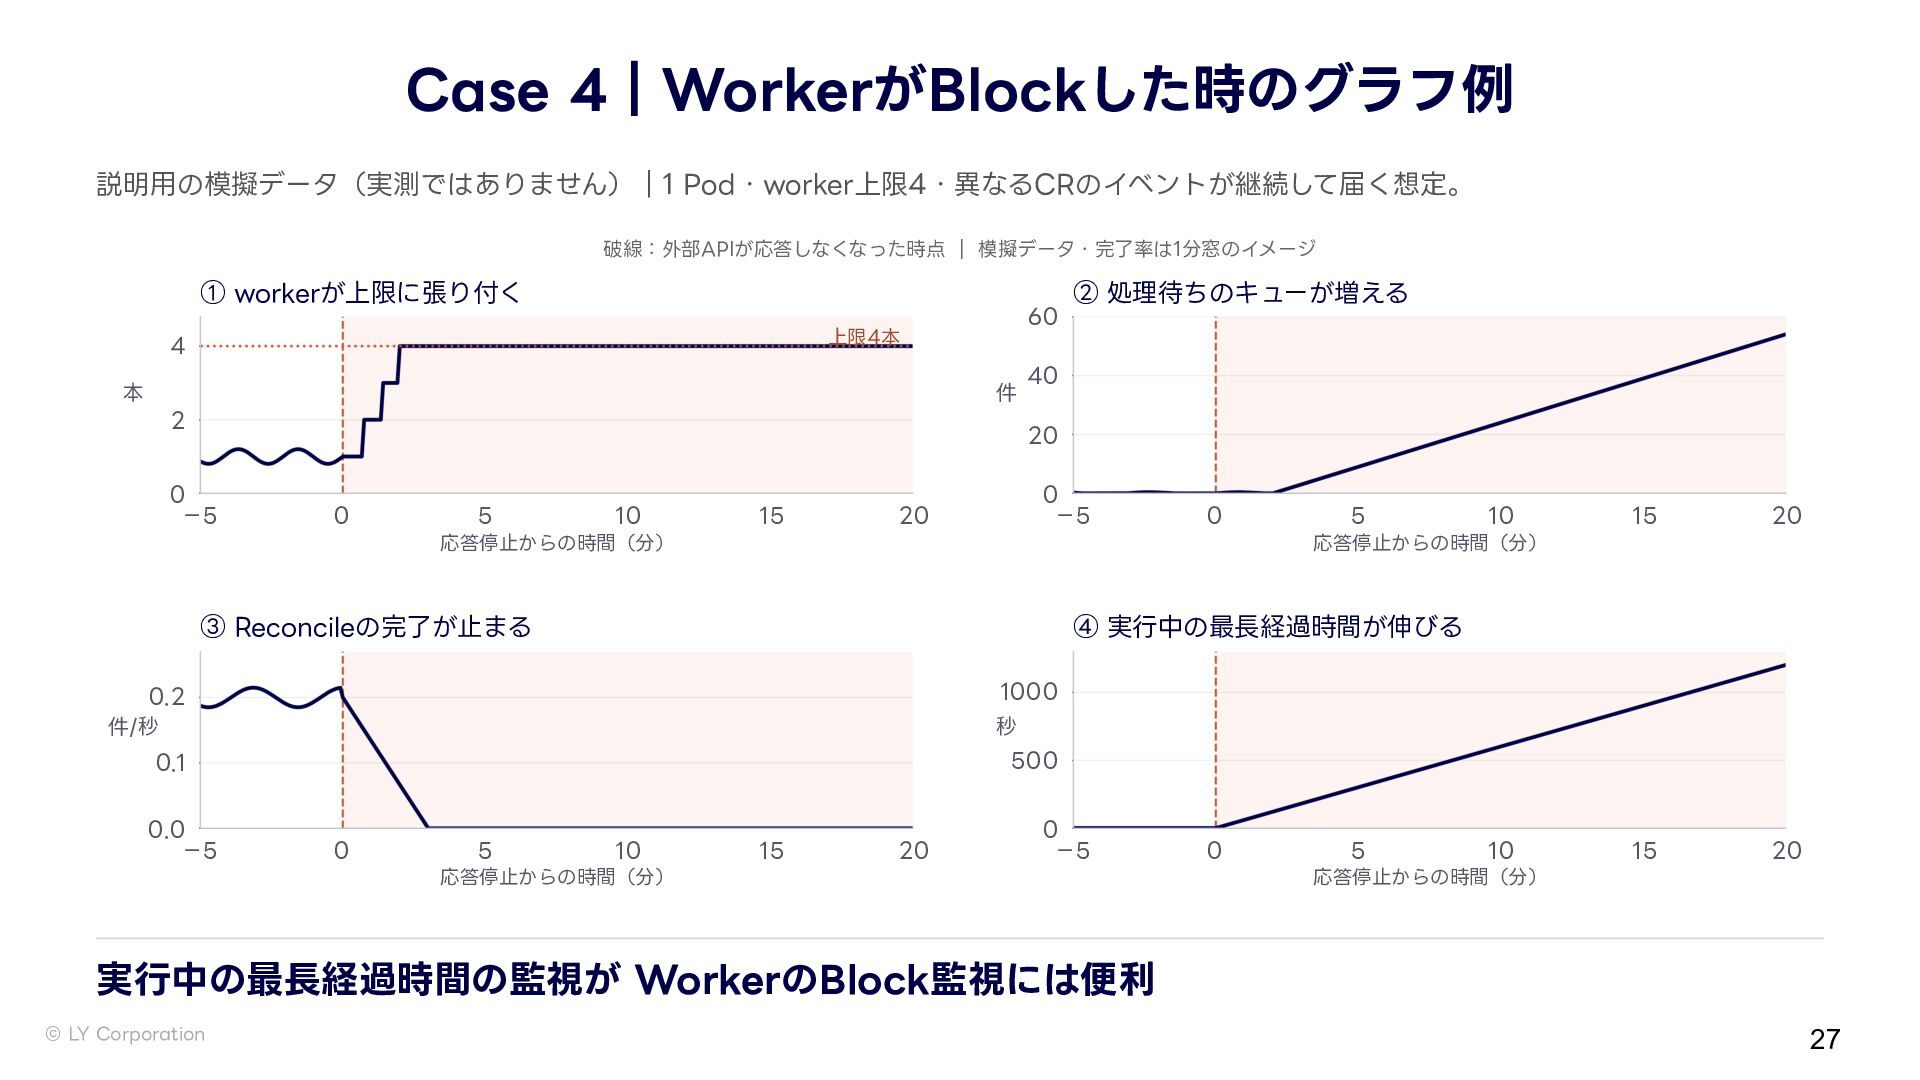
Case 4|WorkerがBlockした時のグラフ例 説明⽤の模擬データ(実測ではありません)|1 Pod・worker上限4・異なるCRのイベントが継続して届く想定。 破線:外部APIが応答しなくなった時点 | 模擬データ・完了率は1分窓のイメージ ① workerが上限に張り付く 60
上限4本 4 本 件 2 ② 処理待ちのキューが増える 40 20 0 −5 0 5 10 15 0 −5 20 0 応答停⽌からの時間(分) ③ Reconcileの完了が⽌まる 10 15 20 15 20 ④ 実⾏中の最⻑経過時間が伸びる 1000 0.2 件/秒 秒 500 0.1 0.0 −5 5 応答停⽌からの時間(分) 0 5 10 15 20 0 −5 応答停⽌からの時間(分) 0 5 10 応答停⽌からの時間(分) 実⾏中の最⻑経過時間の監視が WorkerのBlock監視には便利 © LY Corporation 27 -
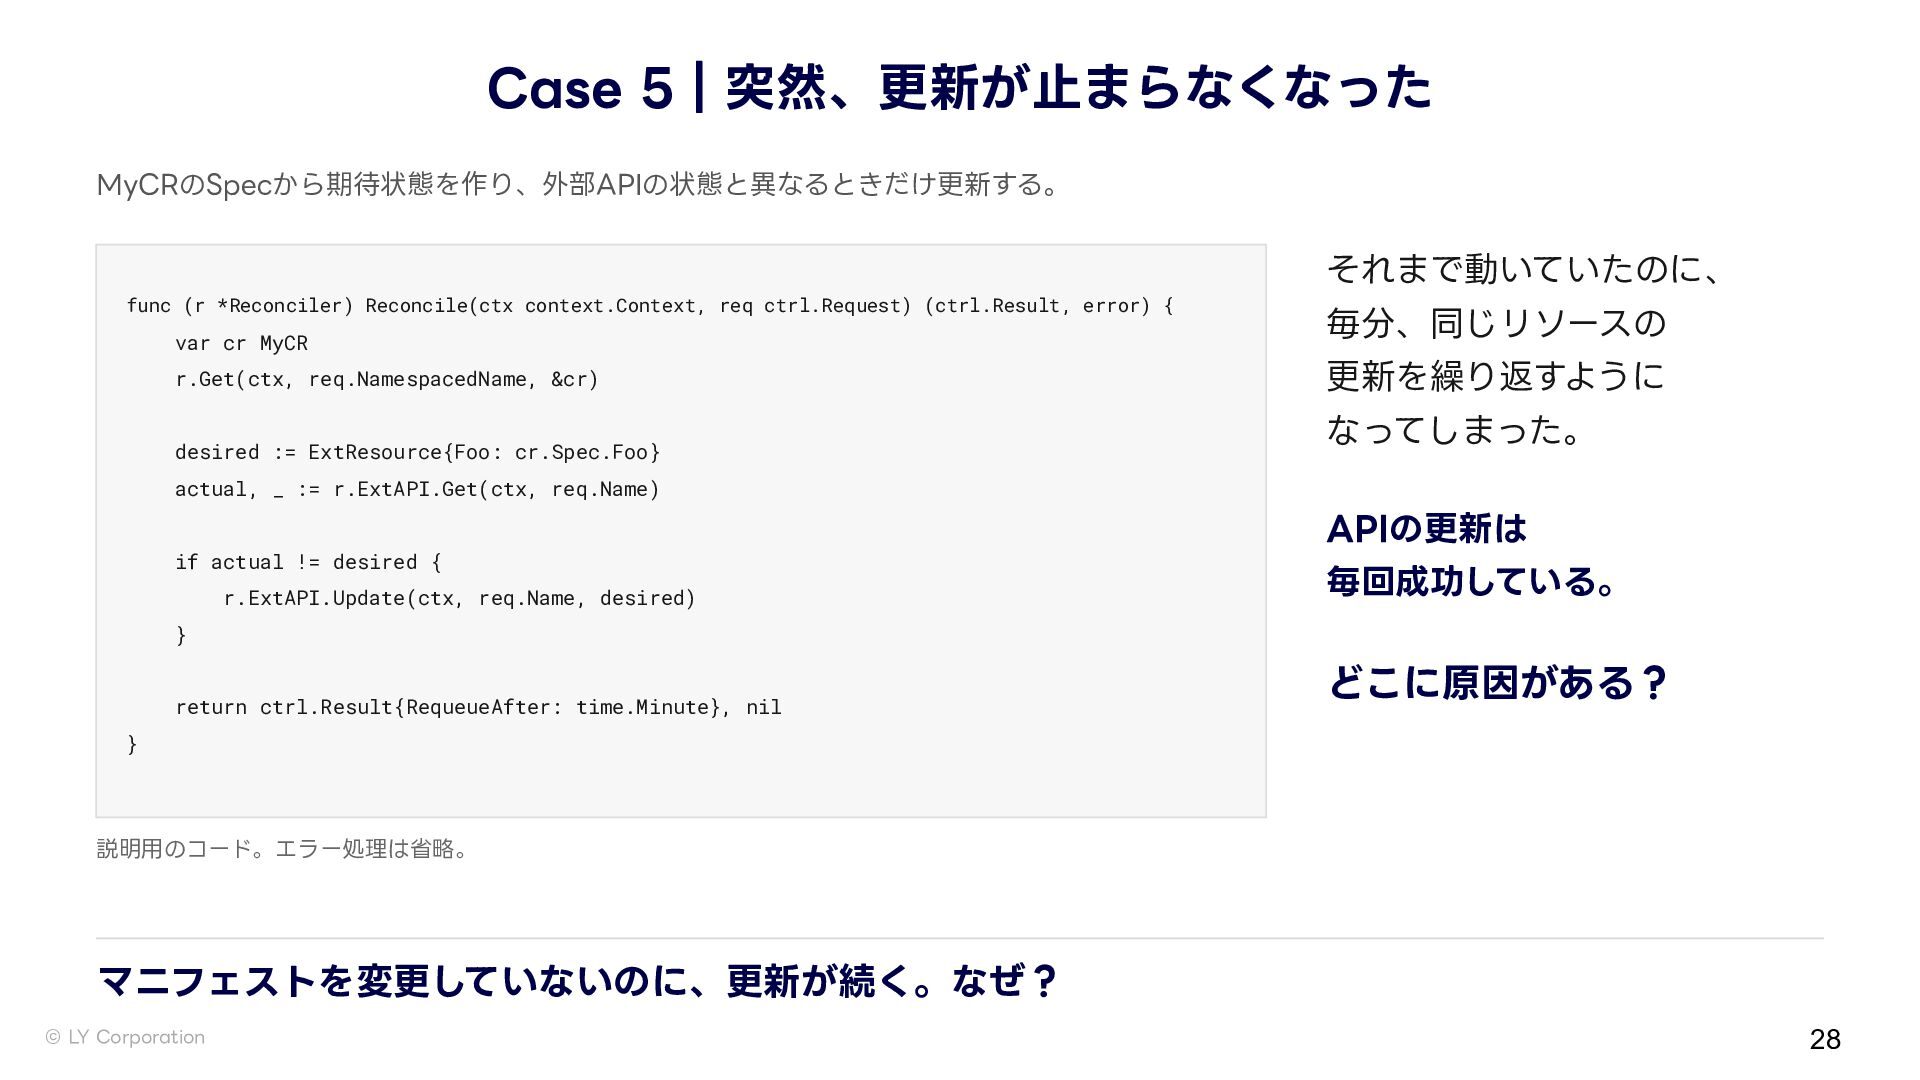
Case 5|突然、更新が⽌まらなくなった MyCRのSpecから期待状態を作り、外部APIの状態と異なるときだけ更新する。 それまで動いていたのに、 func (r *Reconciler) Reconcile(ctx context.Context, req
ctrl.Request) (ctrl.Result, error) { var cr MyCR r.Get(ctx, req.NamespacedName, &cr) desired := ExtResource{Foo: cr.Spec.Foo} 毎分、同じリソースの 更新を繰り返すように なってしまった。 actual, _ := r.ExtAPI.Get(ctx, req.Name) APIの更新は if actual != desired { r.ExtAPI.Update(ctx, req.Name, desired) 毎回成功している。 } return ctrl.Result{RequeueAfter: time.Minute}, nil どこに原因がある? } 説明⽤のコード。エラー処理は省略。 マニフェストを変更していないのに、更新が続く。なぜ? © LY Corporation 28 -
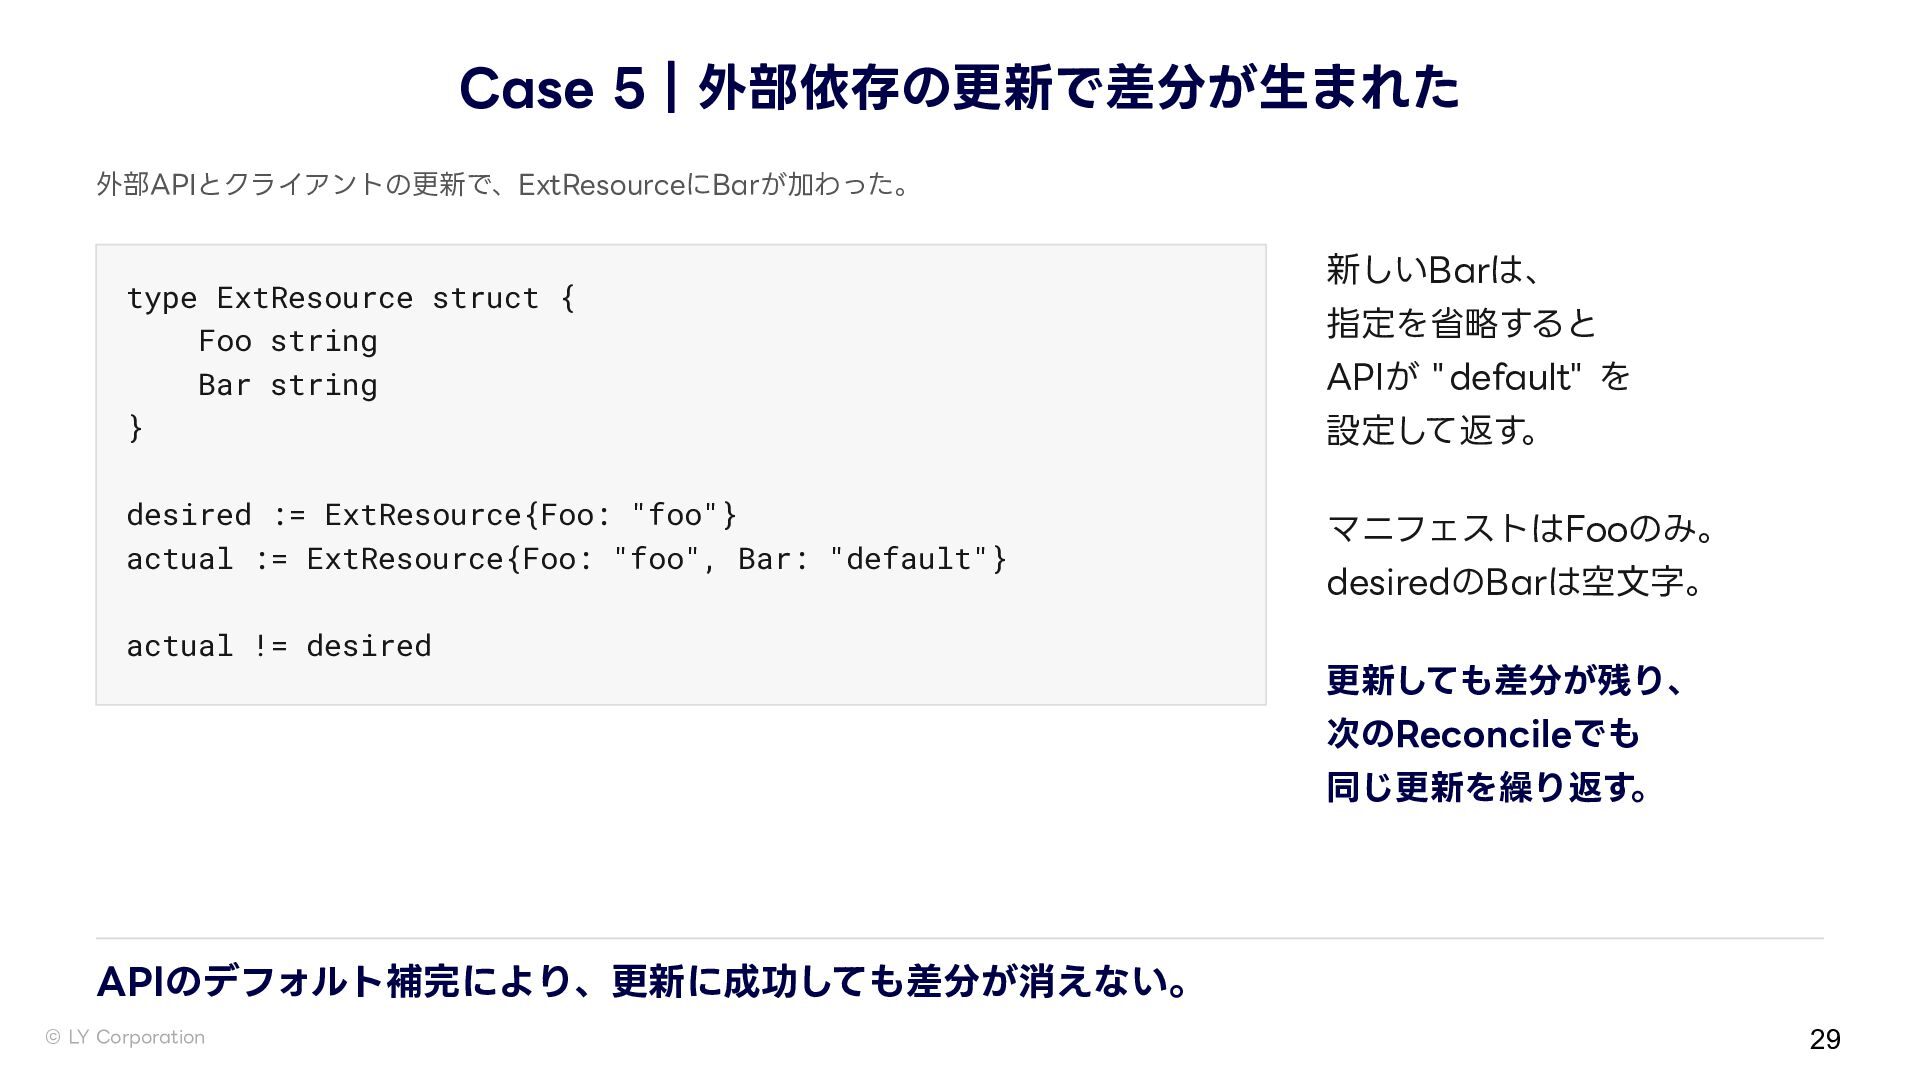
Case 5|外部依存の更新で差分が⽣まれた 外部APIとクライアントの更新で、ExtResourceにBarが加わった。 type ExtResource struct { Foo string Bar
string } desired := ExtResource{Foo: "foo"} actual := ExtResource{Foo: "foo", Bar: "default"} actual != desired 新しいBarは、 指定を省略すると APIが "default" を 設定して返す。 マニフェストはFooのみ。 desiredのBarは空⽂字。 更新しても差分が残り、 次のReconcileでも 同じ更新を繰り返す。 APIのデフォルト補完により、更新に成功しても差分が消えない。 © LY Corporation 29 -
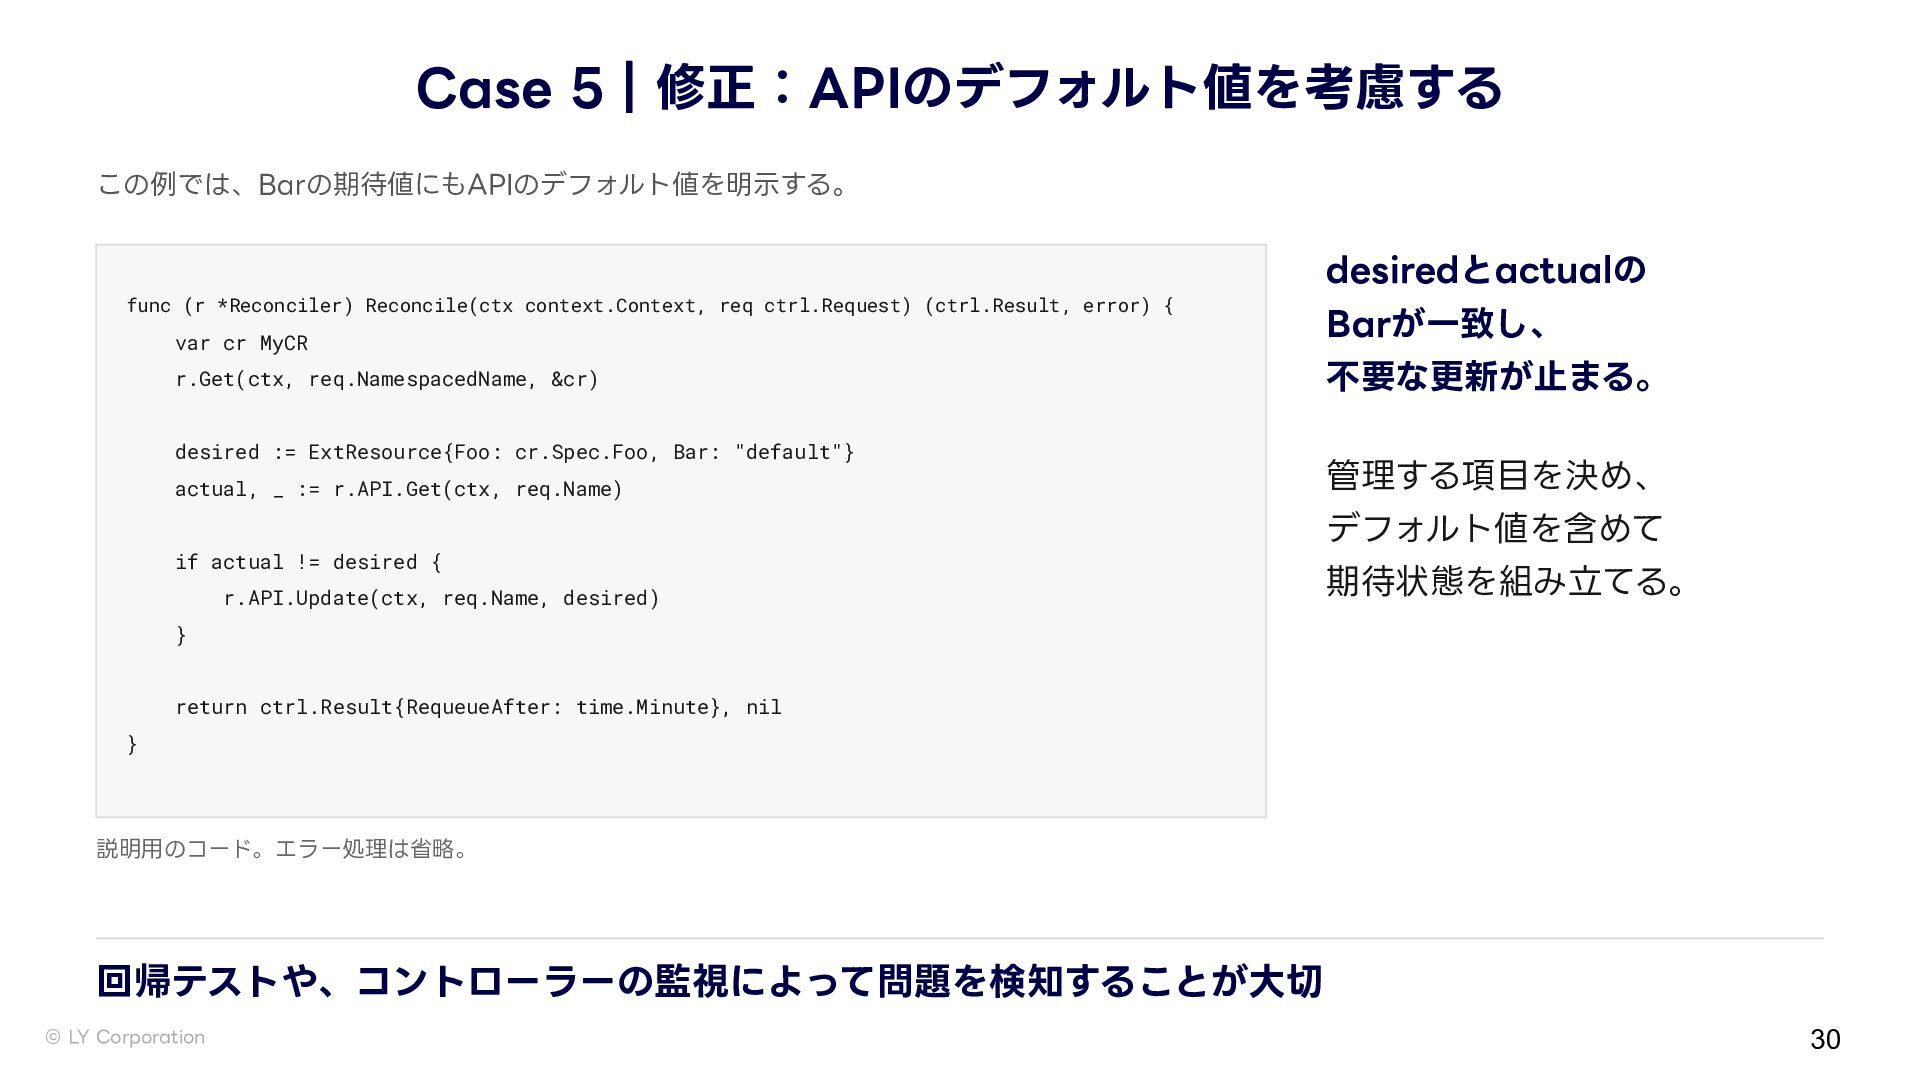
Case 5|修正:APIのデフォルト値を考慮する この例では、Barの期待値にもAPIのデフォルト値を明⽰する。 desiredとactualの func (r *Reconciler) Reconcile(ctx context.Context, req
ctrl.Request) (ctrl.Result, error) { var cr MyCR r.Get(ctx, req.NamespacedName, &cr) desired := ExtResource{Foo: cr.Spec.Foo, Bar: "default"} actual, _ := r.API.Get(ctx, req.Name) Barが⼀致し、 不要な更新が⽌まる。 管理する項⽬を決め、 デフォルト値を含めて if actual != desired { r.API.Update(ctx, req.Name, desired) 期待状態を組み⽴てる。 } return ctrl.Result{RequeueAfter: time.Minute}, nil } 説明⽤のコード。エラー処理は省略。 回帰テストや、コントローラーの監視によって問題を検知することが⼤切 © LY Corporation 30 -
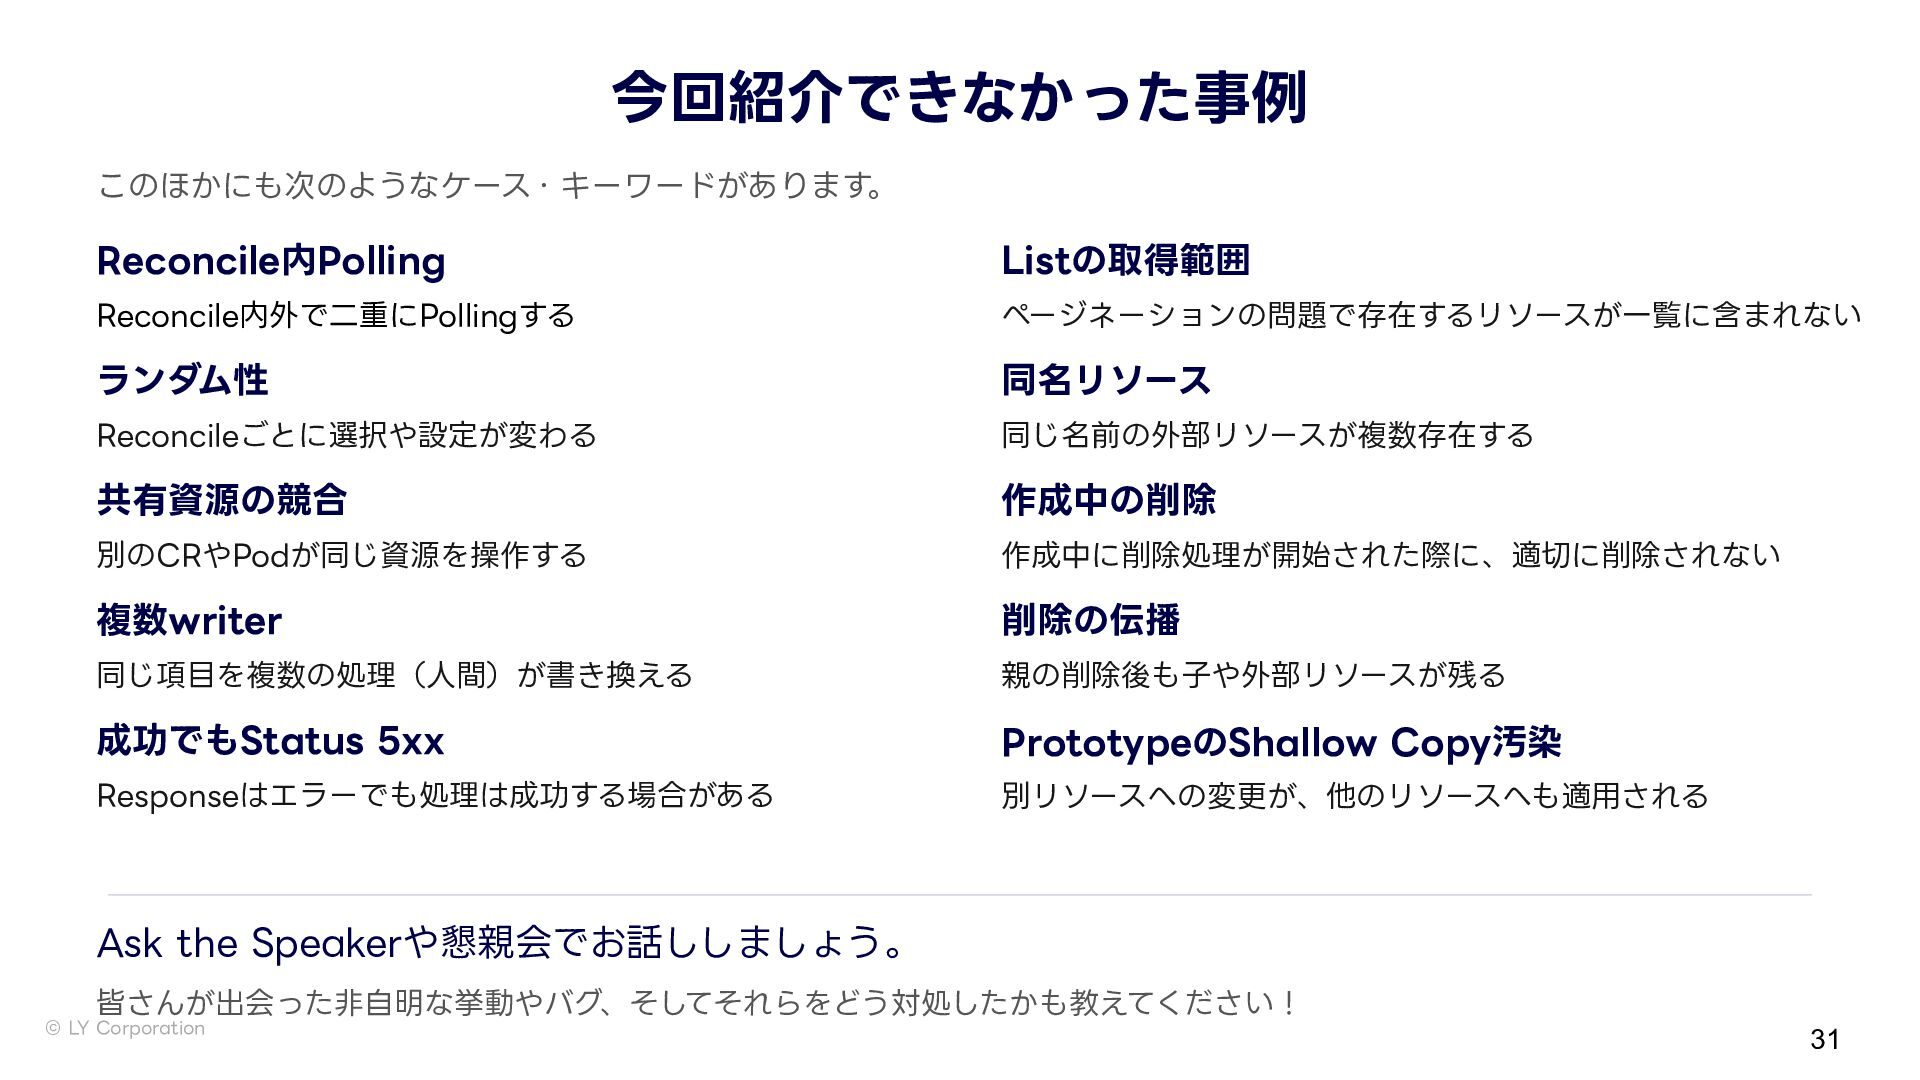
今回紹介できなかった事例 このほかにも次のようなケース・キーワードがあります。 Reconcile内Polling Listの取得範囲 Reconcile内外で⼆重にPollingする ページネーションの問題で存在するリソースが⼀覧に含まれない ランダム性 同名リソース Reconcileごとに選択や設定が変わる 同じ名前の外部リソースが複数存在する
共有資源の競合 作成中の削除 別のCRやPodが同じ資源を操作する 作成中に削除処理が開始された際に、適切に削除されない 複数writer 削除の伝播 同じ項⽬を複数の処理(⼈間)が書き換える 親の削除後も⼦や外部リソースが残る 成功でもStatus 5xx PrototypeのShallow Copy汚染 Responseはエラーでも処理は成功する場合がある 別リソースへの変更が、他のリソースへも適⽤される Ask the Speakerや懇親会でお話ししましょう。 皆さんが出会った⾮⾃明な挙動やバグ、そしてそれらをどう対処したかも教えてください! © LY Corporation 31 -
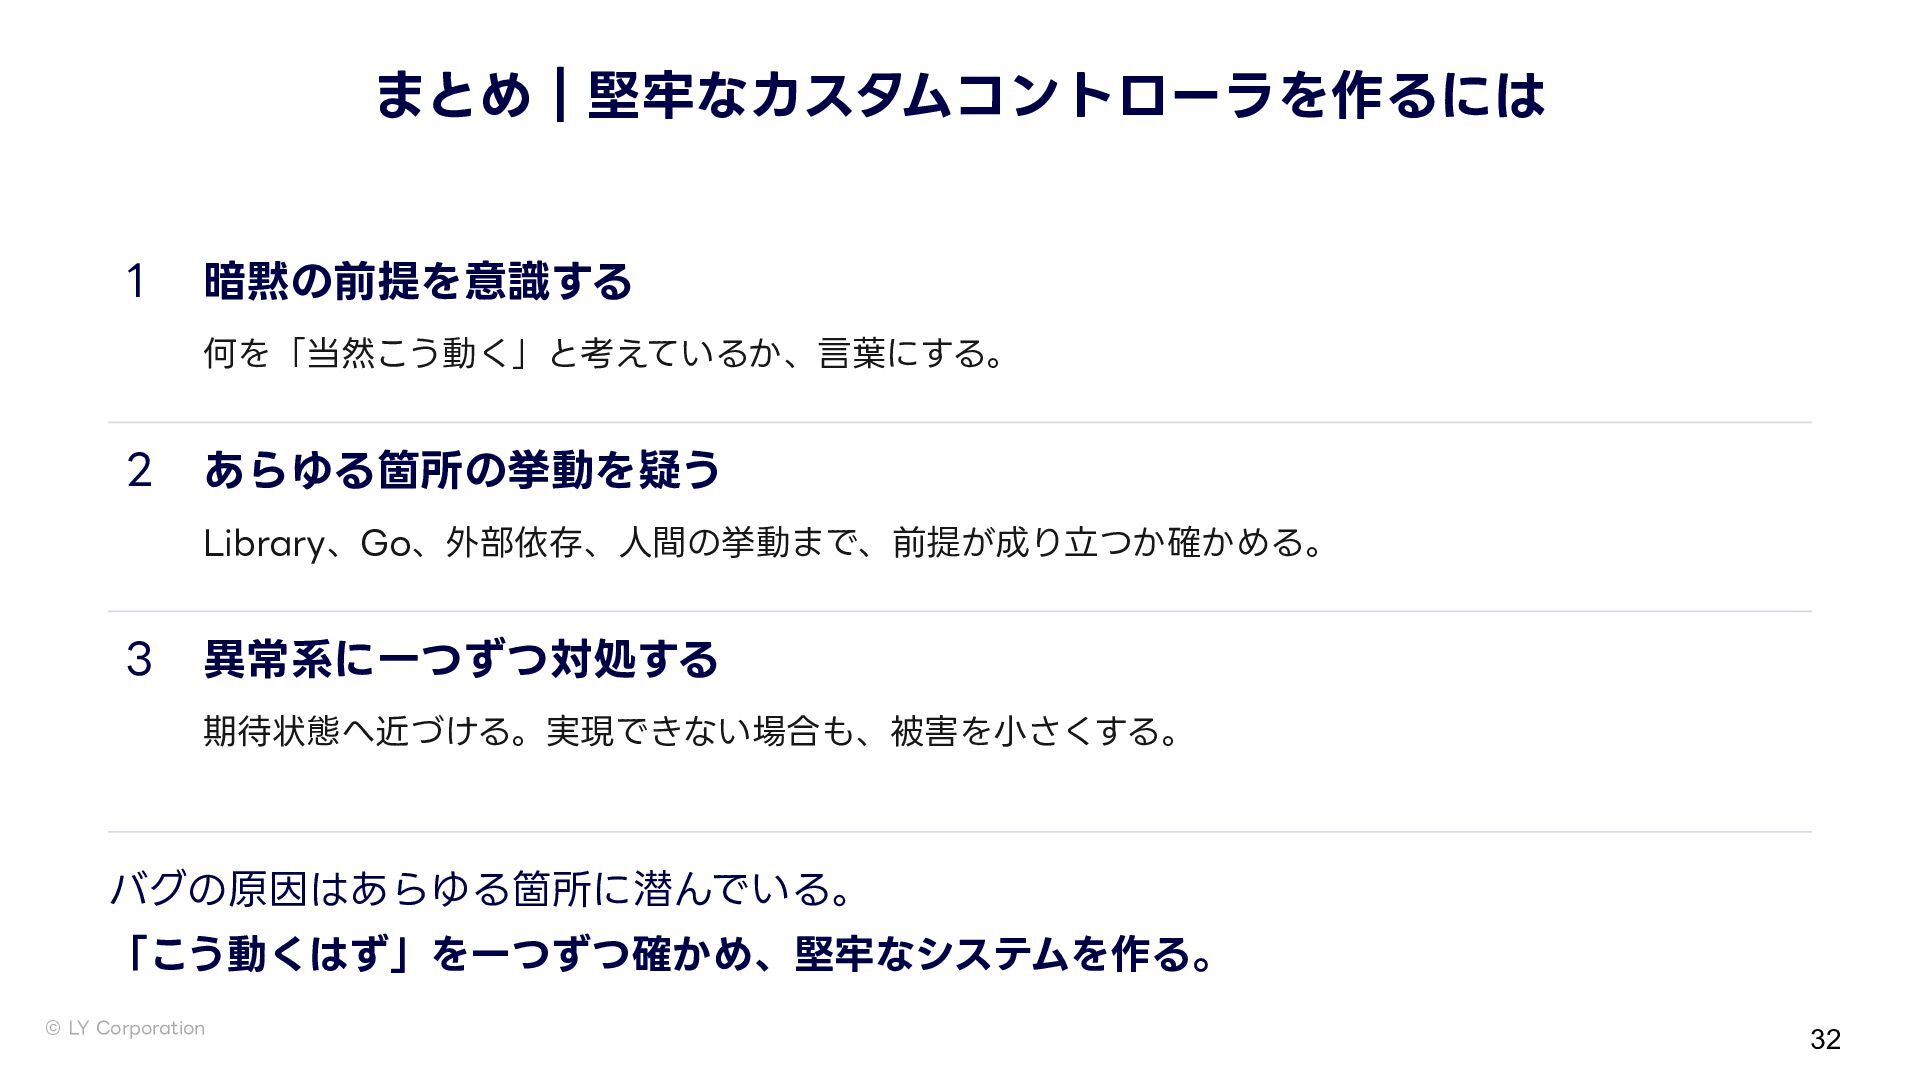
まとめ|堅牢なカスタムコントローラを作るには 1 暗黙の前提を意識する 何を「当然こう動く」と考えているか、⾔葉にする。 2 あらゆる箇所の挙動を疑う Library、Go、外部依存、⼈間の挙動まで、前提が成り⽴つか確かめる。 3 異常系に⼀つずつ対処する 期待状態へ近づける。実現できない場合も、被害を⼩さくする。
バグの原因はあらゆる箇所に潜んでいる。 「こう動くはず」を⼀つずつ確かめ、堅牢なシステムを作る。 © LY Corporation 32
 lycorptech_jp
 z63d
 tkito
 yappli_developers
 ymotongpoo
 kintotechdev
 yusuke427
 yuutosi
 pipepasta
 rist
 kazzpapa3
 masspeaks
 minorun365
 jmmastey
 palkan
 jct
 ivargrimstad
 lynnandtonic
 garrettdimon
 greggifford
 eitanlees
 skipperchong
 akihiro_kokubo
 kneath