Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ボク惡いクローラーじゃないよ
Search
masakuni.ito.19
September 12, 2019
Technology
500
3
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ボク惡いクローラーじゃないよ
LIG Ship for engineersでクローラーについて話しました。
masakuni.ito.19
September 12, 2019
More Decks by masakuni.ito.19
See All by masakuni.ito.19
まだまだbitbucketを信じたい。bitbucket pipelineで行うCodedeploy(仮)
masakuni_ito_19
1
630
Touch my favorite playbooks of Ansible
masakuni_ito_19
0
57
Other Decks in Technology
See All in Technology
並行性の問題を防げ!実践トランザクション入門
occhi
0
280
購入ドメインでの課題と取り組み
ykagano
0
150
自律型 AI をセキュアに実装!Gemini と MIG で作る動的コード実行環境
recruitengineers
PRO
1
230
Incremental HTTP
kazuho
5
2.1k
LLM機能を自作して分かるSnowflake Cortex AIの強み
nayuts
0
330
自主式軟體工廠
philipz
0
250
味覇で作るパスタが美味い - 20261001_yabaubuki.dev
livesense
PRO
0
110
無理せず続ける、子育てエンジニアの学び
codmoninc
PRO
0
510
Datadog の学び方 - あるいは、オブザーバビリティを学ぶとは何か
mananyuki
1
510
20260930_Gemma4_Hands-on
tsho
0
240
生成AIを使って「人が」考える技術 ― AI時代の人機共想と実践ノウハウ|UNITT AC2026
ishiirikie
0
570
カンファレンスに参加した後の浮遊感とセルフケア
pauli
0
320
Featured
See All Featured
Dominate Local Search Results - an insider guide to GBP, reviews, and Local SEO
greggifford
PRO
0
350
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
Balancing Empowerment & Direction
lara
6
1.3k
First, design no harm
axbom
PRO
2
1.3k
Digital Ethics as a Driver of Design Innovation
axbom
PRO
1
450
Dealing with People You Can't Stand - Big Design 2015
cassininazir
367
27k
Evolution of real-time – Irina Nazarova, EuRuKo, 2024
irinanazarova
9
1.6k
The Pragmatic Product Professional
lauravandoore
37
7.5k
Marketing Yourself as an Engineer | Alaka | Gurzu
gurzu
0
320
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
780
Practical Orchestrator
shlominoach
192
12k
Jess Joyce - The Pitfalls of Following Frameworks
techseoconnect
PRO
1
440
Transcript
ボク 惡い クローラーじゃないよ 色々作ったクローラーからの知見
自己紹介 • 伊藤正訓(まさくに) • 1982/10/19 37歳 • 静岡生まれ 静岡育ち そして静岡へ • バックエンドユニットリーダー •
三大聖典 ◦ ドラえもん / ラピュタ / ONE PIECE • 好きなテレビ番組 ◦ 世界ふしぎ発見! • 娘が一人、モルモット飼ってます • Twitter: @masakuni_ito
目次 • クローラーとは • 法律とマナー • 使えるライブラリ • 実装のコツ
クローラーとは
クローラーとは • crawl(腹ばっていく) • Web上のデータを周期的に取得する ◦ 普通Htmlを取得する • リンクをたどったりページを類推して、 Web上のデータを取得すること
• 当然検索エンジンは我が物顔でやってる
ところでスクレイパーって? • scrape(削り取る) • 取得したデータを解析、分解して 自分好みに収集、フォーマッティングすること • 当然悪用できる ◦ データを売るとか、メアド集めるとか
• クローリングとスクレイピングは ほぼ同じように扱われることが多い
法律とマナーの話
法律とマナーの話 • 誰かの大切なデータを集めて操作するので、 権利と義務と、社会的なマナーが発生する • 法律的な前例は不明瞭で怖いものが多い(後述) • マナーは自己解釈と雰囲気にあふれ、あいまい(後述) • エンジニアルール(科学的、原理的)と、
通念ルール(非科学的、通例、雰囲気)が違いすぎる分野 • 色々怖いから今までLIGブログで書けていない
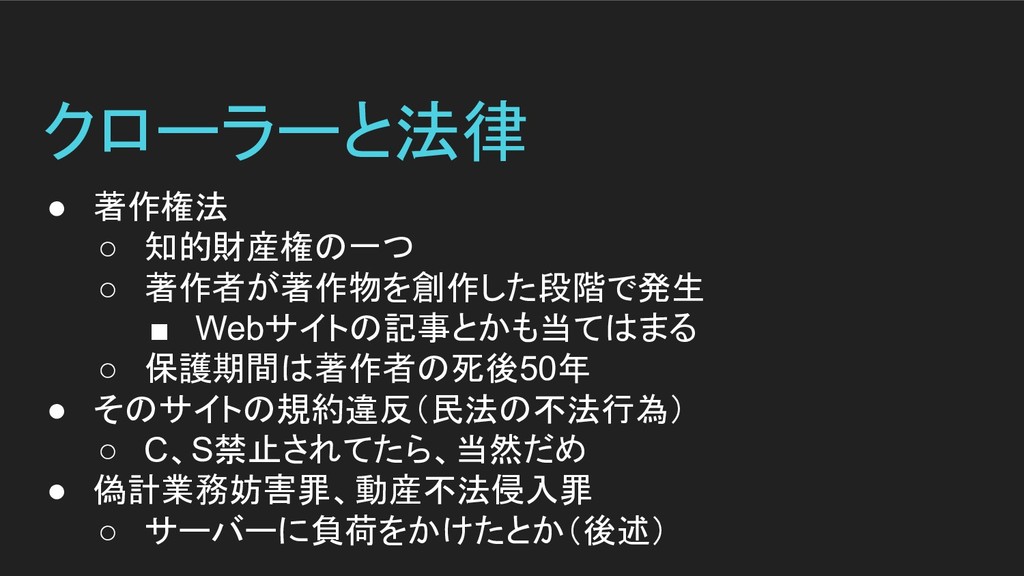
クローラーと法律 • 著作権法 ◦ 知的財産権の一つ ◦ 著作者が著作物を創作した段階で発生 ▪ Webサイトの記事とかも当てはまる ◦
保護期間は著作者の死後50年 • そのサイトの規約違反(民法の不法行為) ◦ C、S禁止されてたら、当然だめ • 偽計業務妨害罪、動産不法侵入罪 ◦ サーバーに負荷をかけたとか(後述)
著作権をもう少し • 著作物たるには独創性があること ◦ Webに公開してある電話番号とかは違う • ただし著作物であっても、公開されていて、 情報解析の場合、取得、保持は問題ない ◦ 譲渡、売却とかはだめ
◦ だから日本のWebはAI市場の価値は高い(らしい) • 日本の著作権等侵害罪は親告罪 ◦ ただし条件付きで非親告罪になる(TPP関連) ▪ 基本的に著作権を犯して金儲けした場合
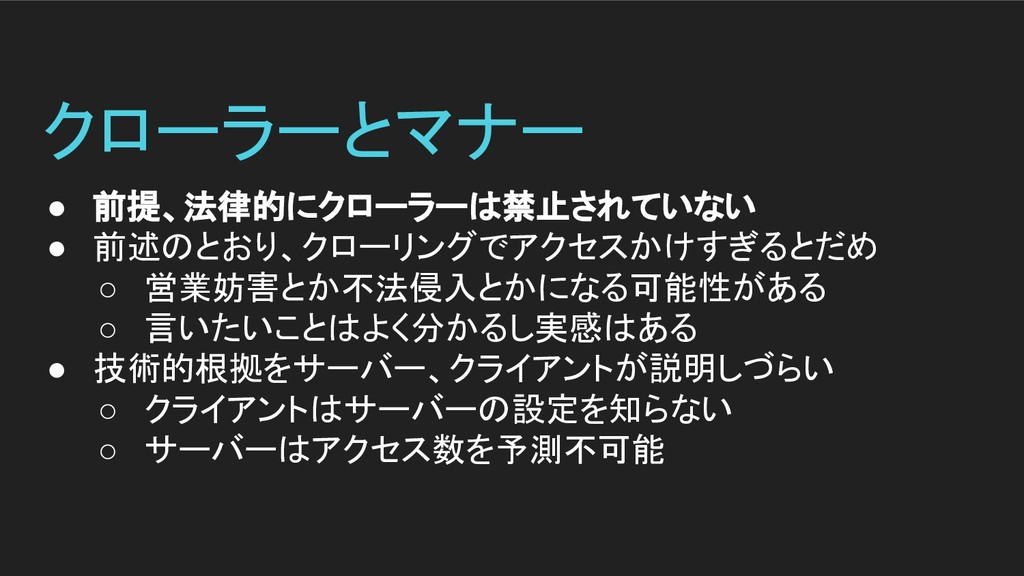
クローラーとマナー • 前提、法律的にクローラーは禁止されていない • 前述のとおり、クローリングでアクセスかけすぎるとだめ ◦ 営業妨害とか不法侵入とかになる可能性がある ◦ 言いたいことはよく分かるし実感はある •
技術的根拠をサーバー、クライアントが説明しづらい ◦ クライアントはサーバーの設定を知らない ◦ サーバーはアクセス数を予測不可能
どうする?
sleep(1)
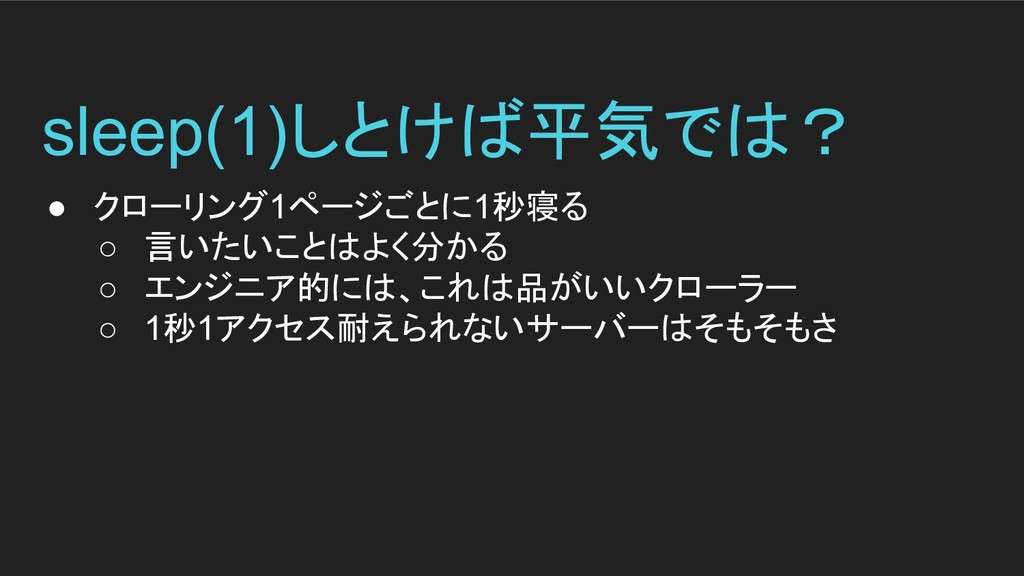
sleep(1)しとけば平気では? • クローリング1ページごとに1秒寝る ◦ 言いたいことはよく分かる ◦ エンジニア的には、これは品がいいクローラー ◦ 1秒1アクセス耐えられないサーバーはそもそもさ
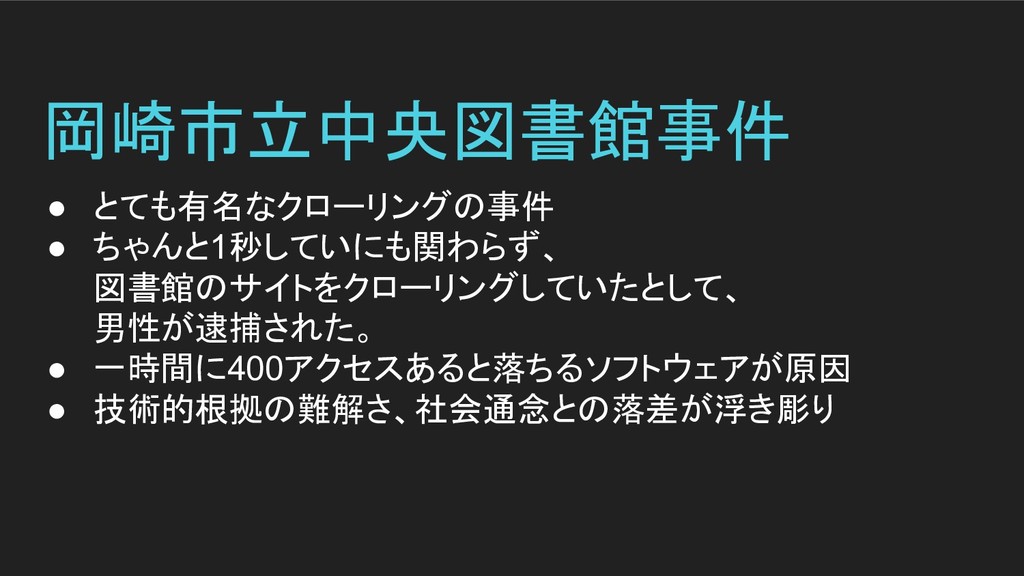
岡崎市立中央図書館事件 • とても有名なクローリングの事件 • ちゃんと1秒していにも関わらず、 図書館のサイトをクローリングしていたとして、 男性が逮捕された。 • 一時間に400アクセスあると落ちるソフトウェアが原因 •
技術的根拠の難解さ、社会通念との落差が浮き彫り
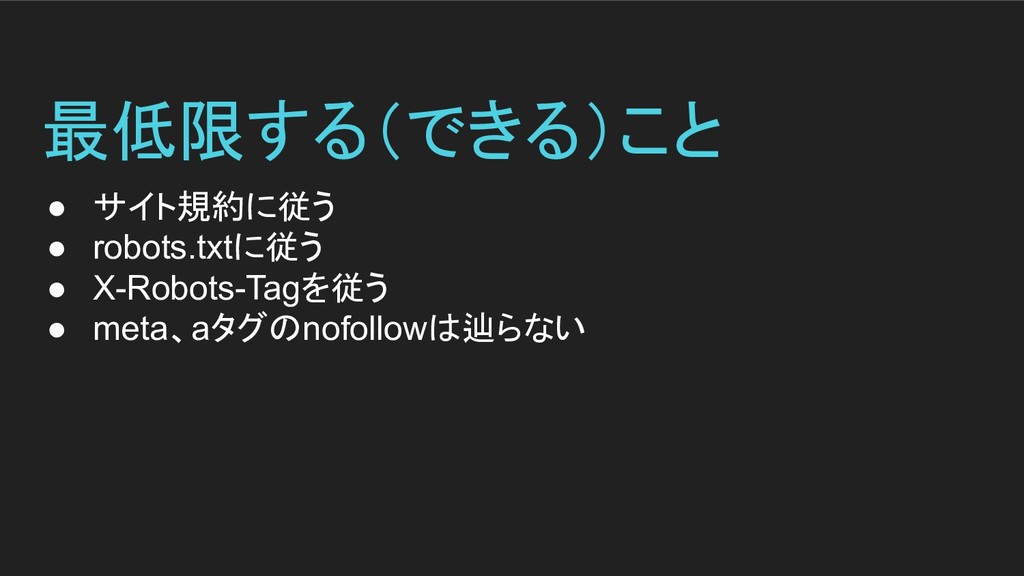
最低限する(できる)こと • サイト規約に従う • robots.txtに従う • X-Robots-Tagを従う • meta、aタグのnofollowは辿らない
サイトの意思に沿い、 サーバーの声を聞くこと
難しいところ サーバーの声
どうすればいいか?
勘
参考 • Webスクレイピングする際のルールとPythonによる規約の読み込み ◦ https://vaaaaaanquish.hatenablog.com/entry/2017/12/01/064227 ◦ 天才 • 文化庁:著作物が自由に使える場合 ◦
http://www.bunka.go.jp/seisaku/chosakuken/seidokaisetsu/gaiyo/chosakub utsu_jiyu.html • Librahack ◦ http://librahack.jp/ ◦ 事件詳細
使えるライブラリ
言語ごと使えるライブラリ • クローラー、httpリクエスト、htmlパーサーに使えるライブラリ • 基本的にだいたい使える(暴論) • パーサーはXPathよりセレクタの方が好み ◦ XPath ▪
XML Path Language ▪ 構造や属性からDomをたどる ◦ セレクタ ▪ 要するにjQuery
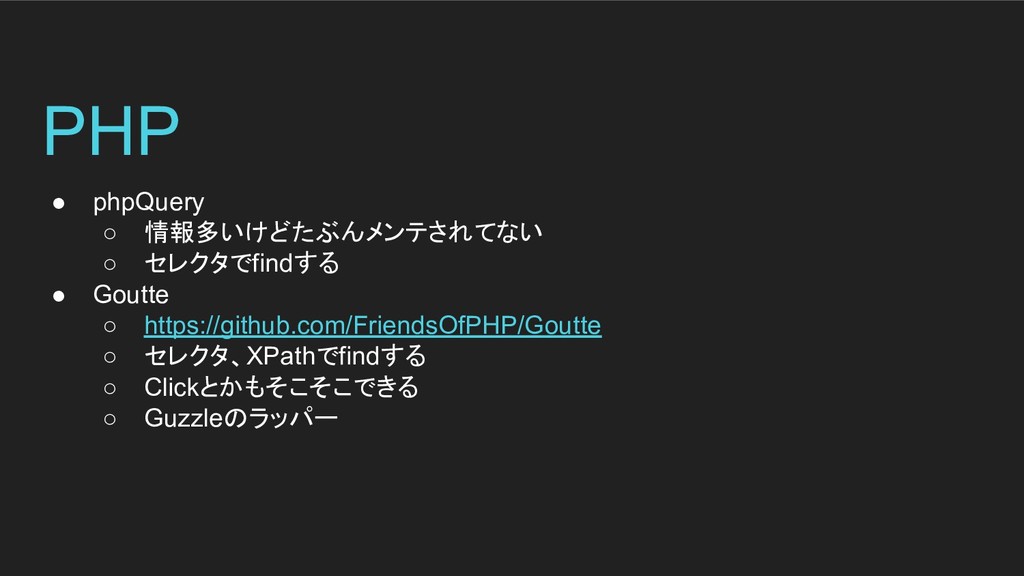
PHP • phpQuery ◦ 情報多いけどたぶんメンテされてない ◦ セレクタでfindする • Goutte ◦
https://github.com/FriendsOfPHP/Goutte ◦ セレクタ、XPathでfindする ◦ Clickとかもそこそこできる ◦ Guzzleのラッパー
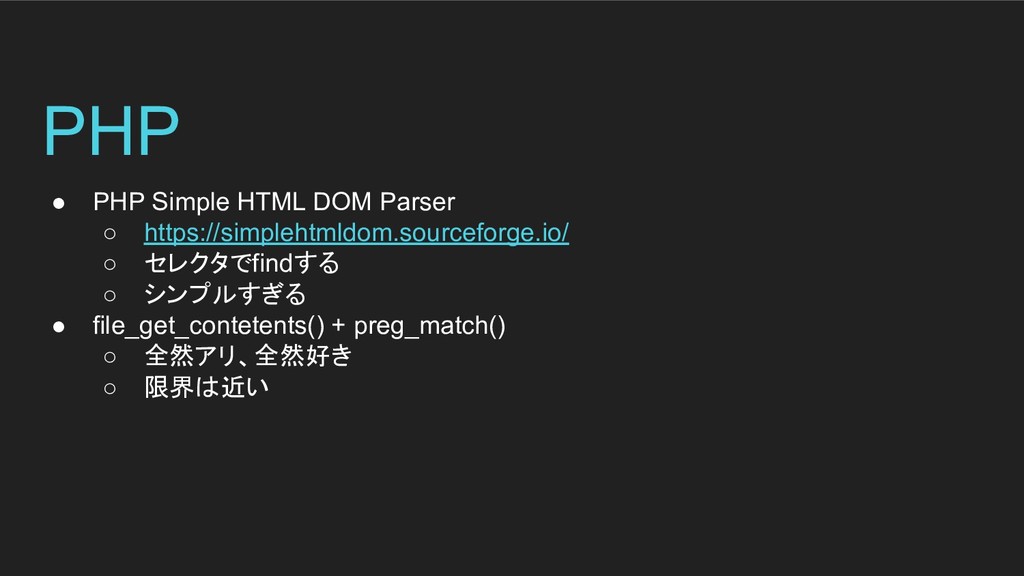
PHP • PHP Simple HTML DOM Parser ◦ https://simplehtmldom.sourceforge.io/ ◦
セレクタでfindする ◦ シンプルすぎる • file_get_contetents() + preg_match() ◦ 全然アリ、全然好き ◦ 限界は近い
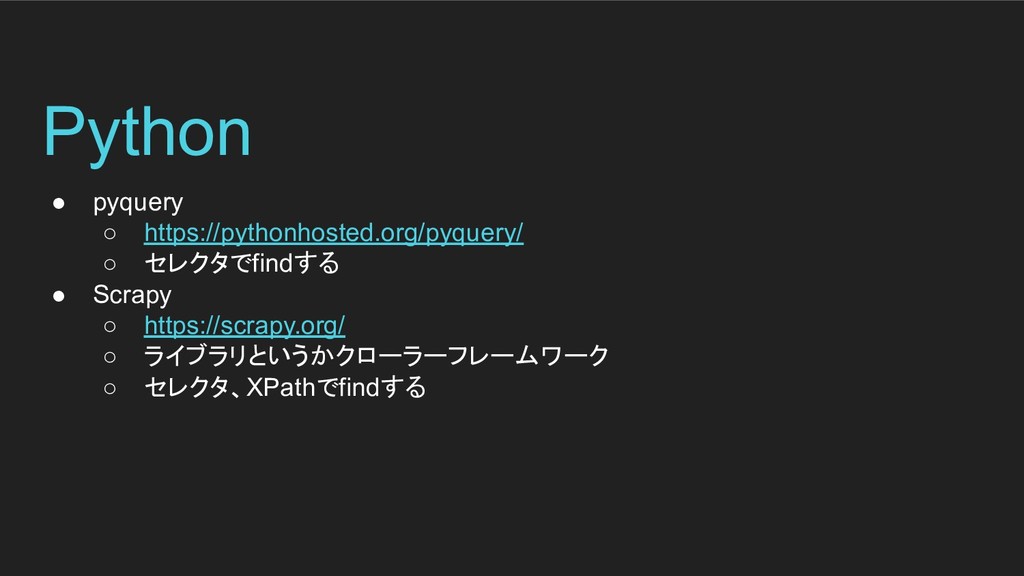
Python • pyquery ◦ https://pythonhosted.org/pyquery/ ◦ セレクタでfindする • Scrapy ◦
https://scrapy.org/ ◦ ライブラリというかクローラーフレームワーク ◦ セレクタ、XPathでfindする
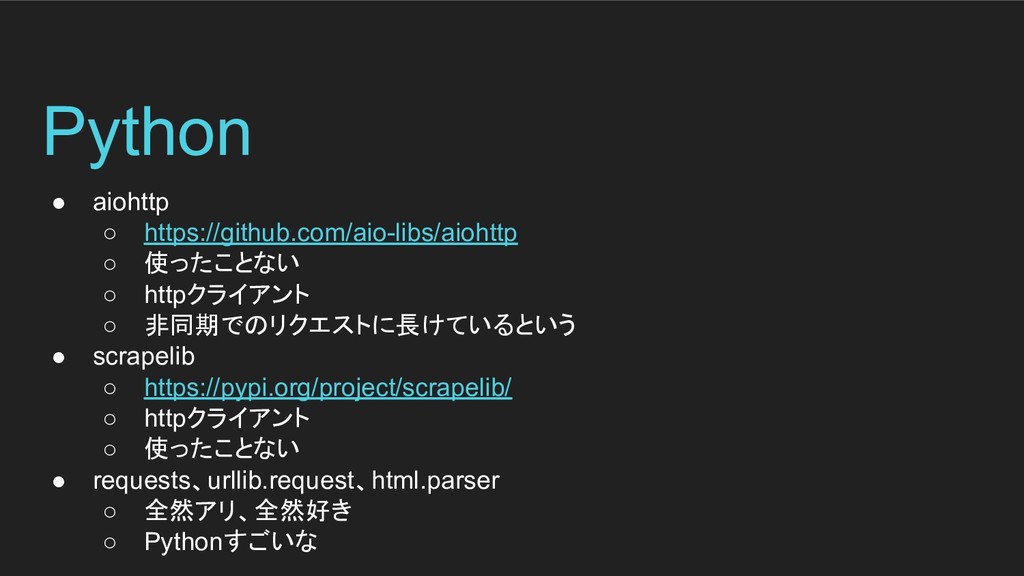
Python • aiohttp ◦ https://github.com/aio-libs/aiohttp ◦ 使ったことない ◦ httpクライアント ◦
非同期でのリクエストに長けているという • scrapelib ◦ https://pypi.org/project/scrapelib/ ◦ httpクライアント ◦ 使ったことない • requests、urllib.request、html.parser ◦ 全然アリ、全然好き ◦ Pythonすごいな
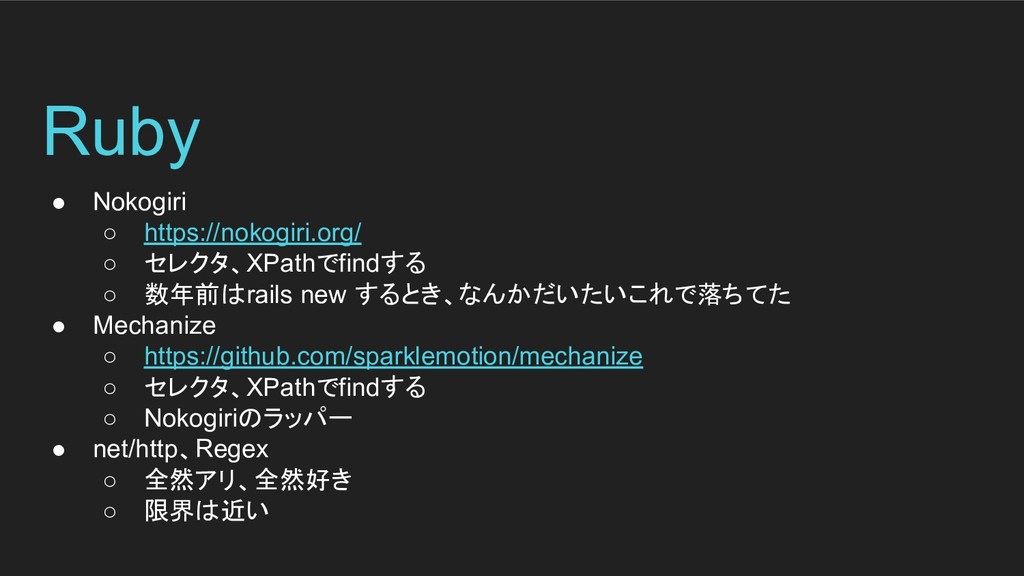
Ruby • Nokogiri ◦ https://nokogiri.org/ ◦ セレクタ、XPathでfindする ◦ 数年前はrails new
するとき、なんかだいたいこれで落ちてた • Mechanize ◦ https://github.com/sparklemotion/mechanize ◦ セレクタ、XPathでfindする ◦ Nokogiriのラッパー • net/http、Regex ◦ 全然アリ、全然好き ◦ 限界は近い
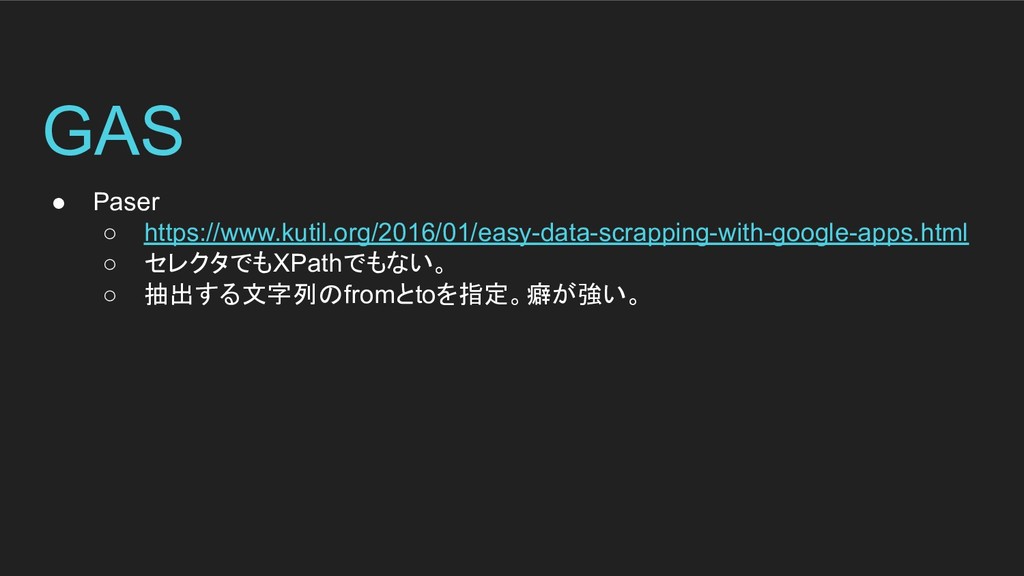
GAS • Paser ◦ https://www.kutil.org/2016/01/easy-data-scrapping-with-google-apps.html ◦ セレクタでもXPathでもない。 ◦ 抽出する文字列のfromとtoを指定。癖が強い。
実装のコツ
時間を短縮しろ
いっぱい集めろ
取得時間を考える • 仕事なのでしめきりがあるし、依頼者はいきり立ってる しかしクローラーは思ってるより全然時間がかかる • いつ終わるかの目算を掛け算して求めて伝えること まず全取得の件数を確認、推定すること • (レスポンス取得3秒 +
パース1秒 + sleep(1)件数) × 50万件
取得時間を考える • 仕事なのでしめきりがあるし、依頼者はいきり立ってる しかしクローラーは思ってるより全然時間がかかる • いつ終わるかの目算を掛け算して求めて伝えること まず全取得の件数を確認、推定すること • (レスポンス取得3秒 +
パース1秒 + sleep(1)件数) × 50万件 ≒29日
いきなり作り始めない • クローリングするサイトをよく観察すること • できるだけシンプルに、 シンプルに目的のデータへアクセスするルートを考える • 1秒の削減は取得時間を半分以下にするかもしれない
まずアタックリストを作る • 基本的に欲しいのは一覧ページじゃなくて詳細ページのデータのはず • それを一つ一つ一覧ページから取得して移動を繰り返しちゃだめ • まず一覧をなめてURLのリストを作り、出力しておき、 詳細ページを舐めるようにすること • できるだけダイレクトのアクセスをおこなう
◦ このリストを作っておけば、 途中でサーバーが落ちてもレジュームできる • よってできるだけステートレスで
アウトプットは一つずつ • 一つのデータができあがったら、CSVなりDBになりに吐き出す • 一見パフォーマンス落ちる気もするが、 処理が落ちて全部失ってレジュームもできないだけまし • また依頼者が途中でもアウトプットを欲しがるかもしれない • できるだけカテゴリで分けて出力する
レジュームや処理落ちのリスク回避のため
要素はないものとして考える • 落ちないために • Divやらaやらでスクレイピングするが、 それがない場合は空白文字を出力した方がいい • 絶対に必要なDomがないことが発生するので、 findをしたときはしつこいほど要素数チェックを入れる 出力するときはデフォルト値を設定できるなら入れる
絶対に迷惑をかけない • どうしても時短のために、同時接続を考えたくなるが、 相手サーバーにはたまったものではない 処理も複雑になるので、よく考える • クローリングは下っ端に任されがちな仕事かもしれないけど 会社の信用を著しく下げる可能性がある • 法律、マナー、技術者としてのモラルを守ること
クローラーは楽しい
クローラーのデータ すなわちWeb
よいWeb Lifeを。
None
ご清聴ありがとうございました。 Life is Good


 masakuni_ito_19
 occhi
 ykagano
 recruitengineers
 kazuho
 nayuts
 philipz
 livesense
 codmoninc
 mananyuki
 tsho
 ishiirikie
 pauli
 greggifford
 codingconduct
 lara
 axbom
 cassininazir
 irinanazarova
 lauravandoore
 gurzu
 marcoroth
 shlominoach
 techseoconnect