Share
Embed
21st ACRi Webinar - Univ of Tokyo Presentation Slide (Ayumi Ohno)
Nao Sumikawa
December 03, 2025
Transcript
47 slides
-
Agenda 1. Application (MSM / 楕円曲線上点加算) について 2. 先⾏研究 3.
⼿法 - AIEにおける剰余乗算の設計 - AIEにおけるキャリー伝搬 - Spatial Mapping 4. 評価 - AI Engine単体シミュレーション評価 - 実機評価 5. 結論 2 -
Application • ゼロ知識証明 (ZKP): 命題が真実であることを、その情報‧根拠を明かさずに を証明する技術 • ZKPのproof generationにおいて、マルチスカラー倍算(MSM)は重い計算 [1]
• MSMは、楕円曲線上点加算(PADD)に分解される PADDは、その他にも楕円曲線暗号全般において重要な演算 3 -
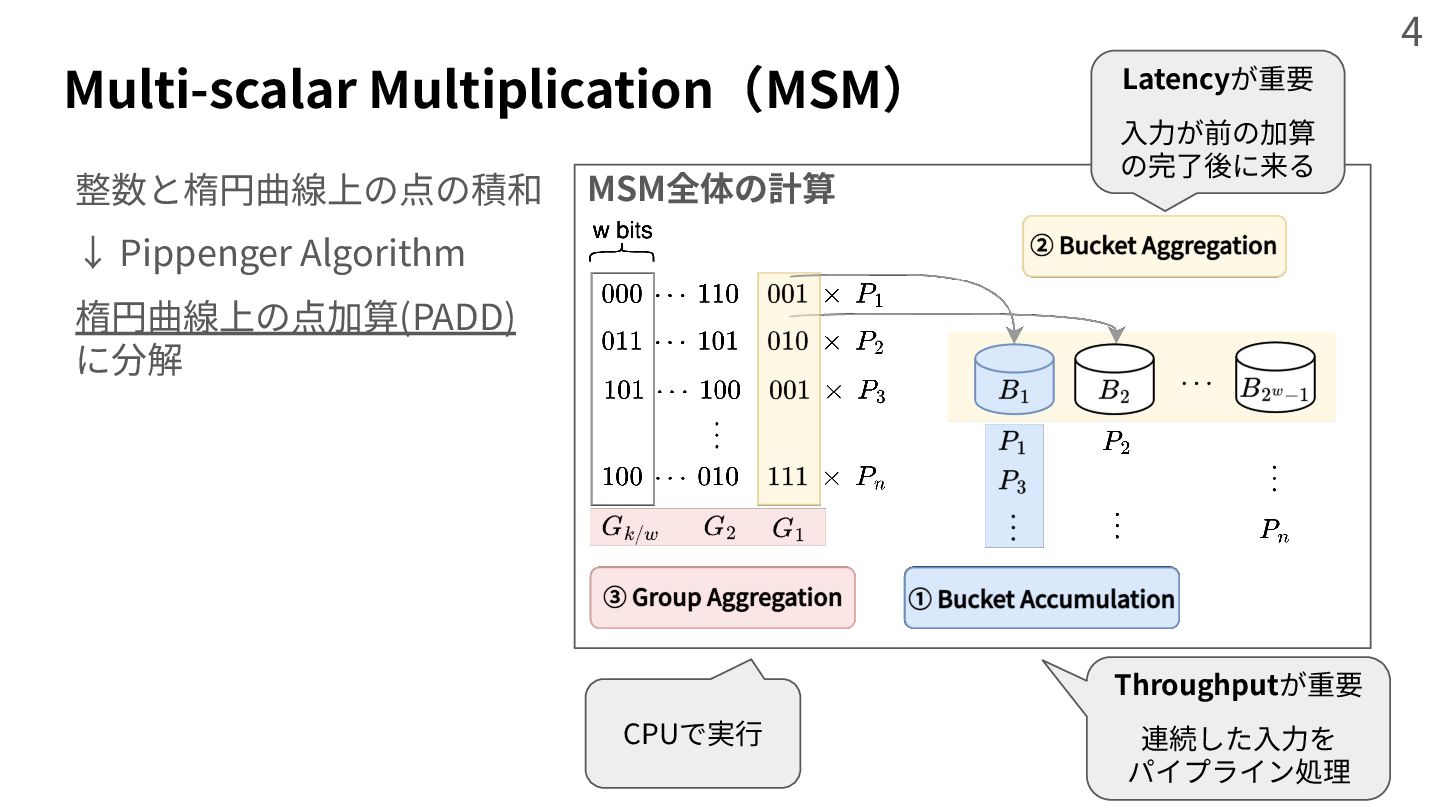
Multi-scalar Multiplication(MSM) CPUで実⾏ 整数と楕円曲線上の点の積和 ↓ Pippenger Algorithm 楕円曲線上の点加算(PADD) に分解 Throughputが重要
連続した⼊⼒を パイプライン処理 4 MSM全体の計算 Latencyが重要 ⼊⼒が前の加算 の完了後に来る -
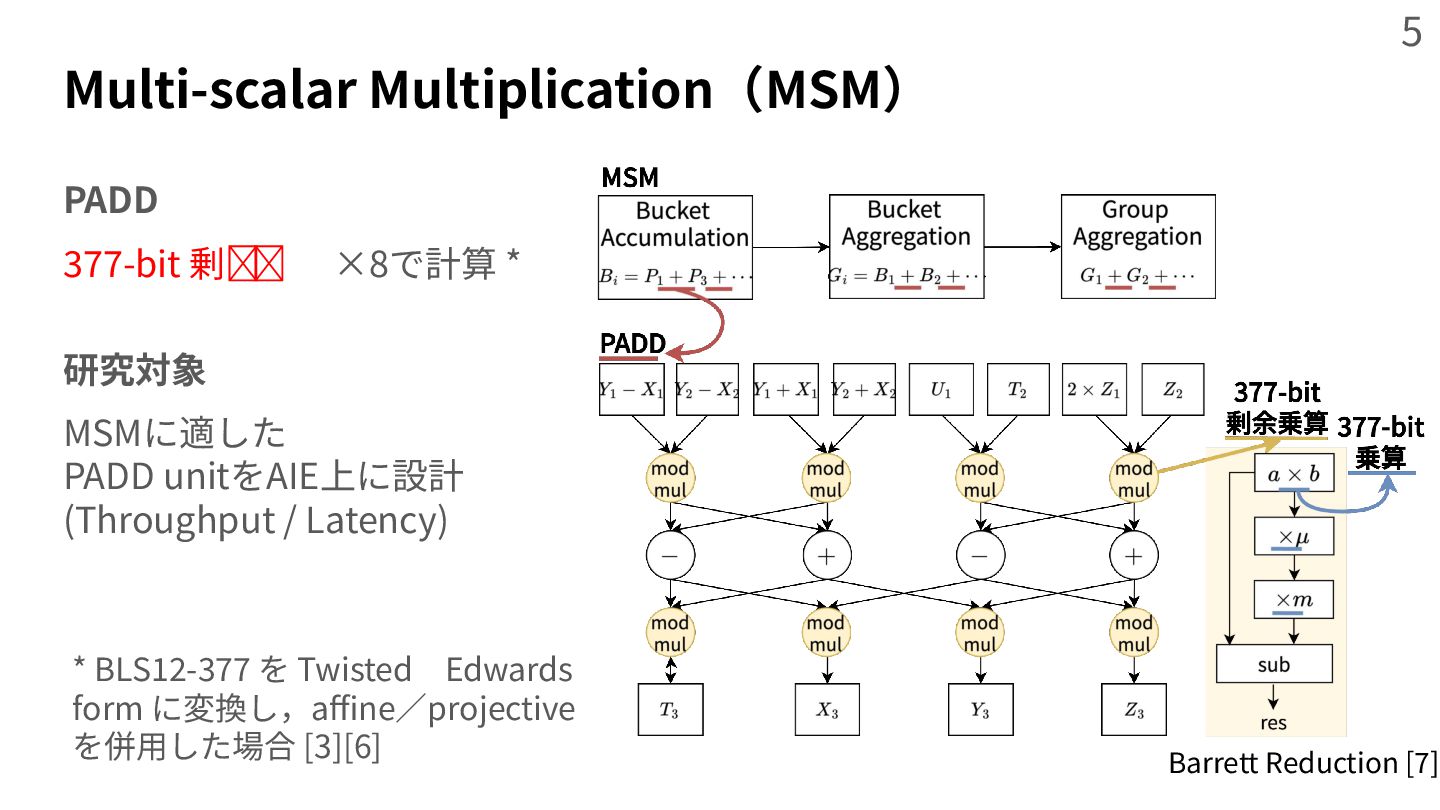
Multi-scalar Multiplication(MSM) PADD 377-bit 剰余乗算×8で計算 * 研究対象 MSMに適した PADD unitをAIE上に設計
(Throughput / Latency) 5 Barrett Reduction [7] * BLS12-377 を Twisted Edwards form に変換し,affine∕projective を併⽤した場合 [3][6] -
Motivation 既存のMSMのAccelerator: GPU: 多数のコアに PADDを分散して高い並列性を実現 - ワークロードの偏り(bucket間の不均衡), エネルギー効率が課題 [1][9] FPGA:
パイプライン化された少数のPADDユニットによる連続ストリーム処理 - bucket 競合や stall を避けるため、複雑なスケジューリングが必要 [2][3] ↓ Versal AI Engineのheterogeneous性を活かせないか? - AIE: 高クロックの乗算でPADDを動作 - PL: bucket 処理・制御フローの柔軟な実装 → まずは、AIEにおけるPADDの高速化を実装・評価 6 -
Agenda 1. Application (MSM / 楕円曲線上点加算) について 2. 先⾏研究 3.
⼿法 - AIEにおける剰余乗算の設計 - AIEにおけるキャリー伝搬 - Spatial Mapping 4. 評価 - AI Engine単体シミュレーション評価 - 実機評価 5. 結論 7 -
先⾏研究:AIM[5](多倍⻑整数乗算@Versal AI Engine) 基本演算(筆算) 8 ① v8acc80 += v16a[0:7] *
v8b[0] ② v8acc80 += v16a[-1:6] * v8b[1] ⋮ ① res = lmac8(res, a, 0, 0x76543210, b, 0, 0); ② res = lmac8(res, a, -1, 0x76543210, b, 1, 0); ⋮ lane selection, multiplication, accumulationが、MAC演算と相性がいい https://download.amd.com/docnav/aiengine/xilinx2021_2/aiengine_intrinsics/intrinsics/group__vect__mult__32x32.html -
Contribution 課題 A. Versal AI Engineの既存研究[4]は ⾏列積等の単純なアプリ B. 先⾏研究AIM[5]の乗算のままでは、 通信律速になる
C. AIEにおけるタスク分割‧ Spatial Mappingが⾮⾃明 10 貢献 A. AIEにおけるPADDの実現 暗号計算の可能性を探索 B. アルゴリズム‧タイル内最適化 1. AIEにおける連続的な 剰余乗算の実現 2. AIEにおけるキャリー伝搬 C. タスク分割‧Spatial Mapping 3. 4種類の⼿法の⽐較検討 -
Agenda 1. Application (MSM / 楕円曲線上点加算) について 2. 先⾏研究 3.
⼿法 - AIEにおける剰余乗算の設計 - AIEにおけるキャリー伝搬 - Spatial Mapping 4. 評価 - AI Engine単体シミュレーション評価 - 実機評価 5. 結論 11 -
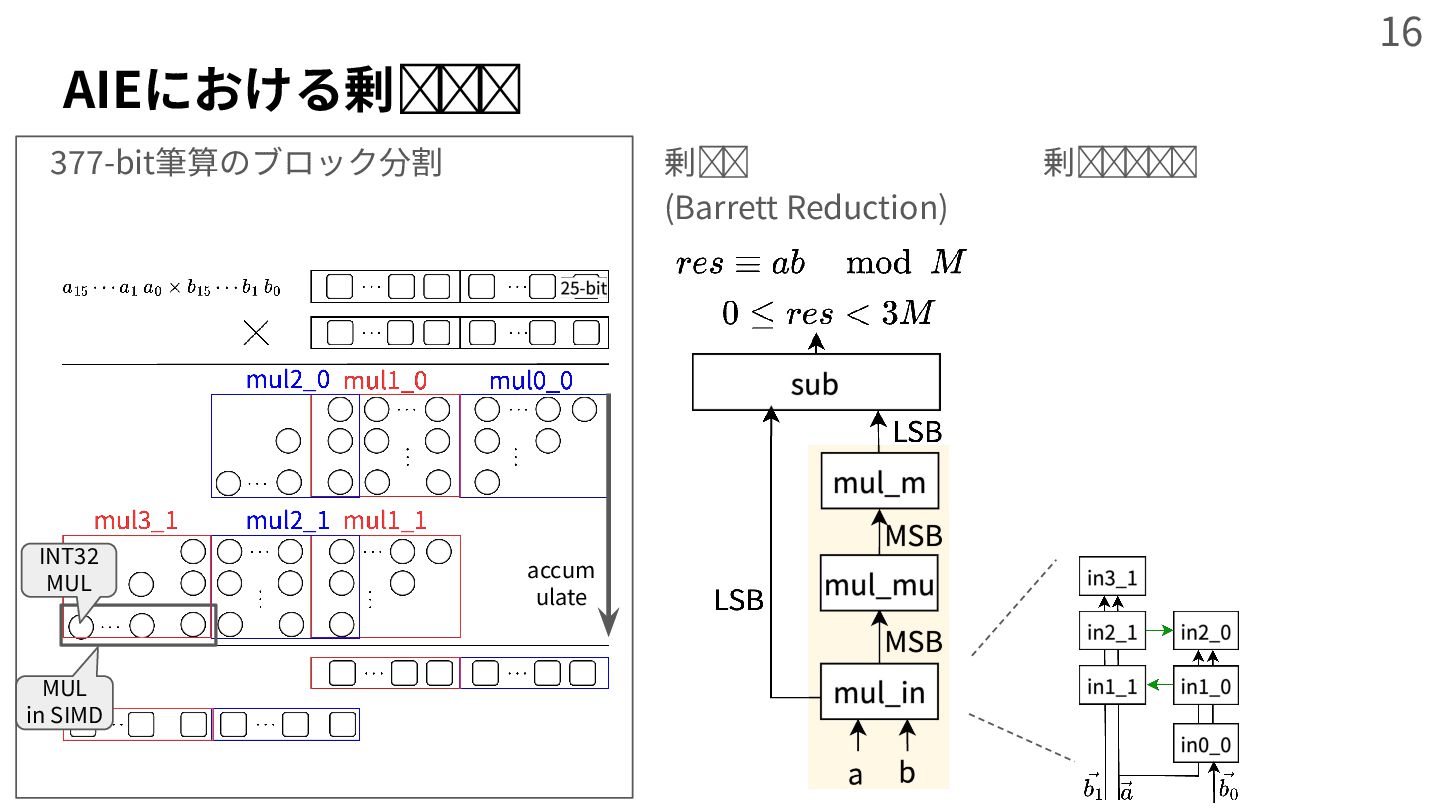
15 INT32 MUL MUL in SIMD 377-bit筆算のブロック分割 剰余乗算 [7] (Barrett
Reduction) AIEにおける剰余乗算の設計 剰余乗算に筆算をマップ -
16 INT32 MUL MUL in SIMD accum ulate 377-bit筆算のブロック分割 剰余乗算
[7] (Barrett Reduction) AIEにおける剰余乗算の設計 剰余乗算に筆算をマップ -
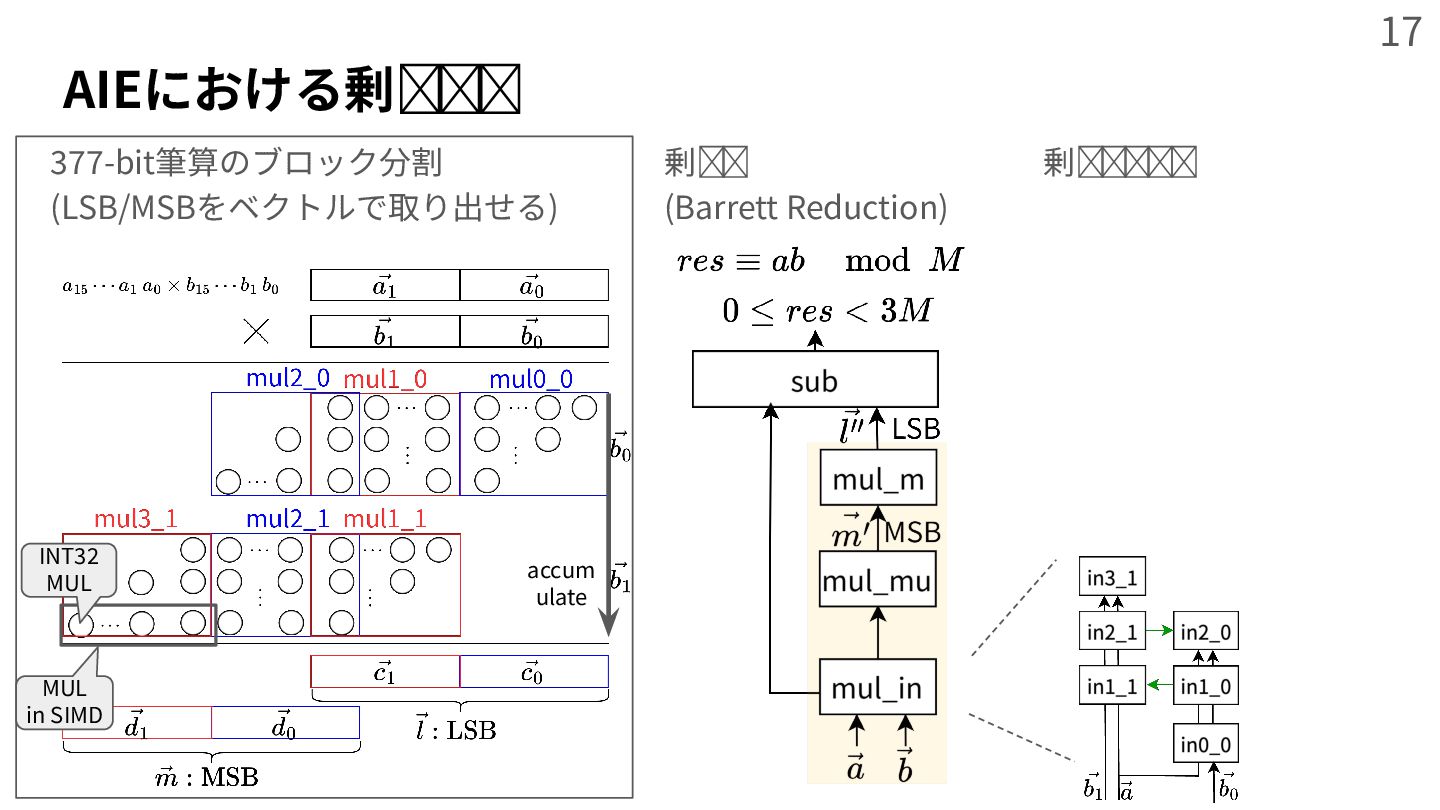
17 377-bit筆算のブロック分割 (LSB/MSBをベクトルで取り出せる) MUL in SIMD INT32 MUL accum ulate
剰余乗算 [7] (Barrett Reduction) AIEにおける剰余乗算の設計 剰余乗算に筆算をマップ -
18 右90°回転 accum ulate 377-bit筆算のブロック分割 (LSB/MSBをベクトルで取り出せる) 剰余乗算 [7] (Barrett Reduction)
AIEにおける剰余乗算の設計 剰余乗算に筆算をマップ INT32 MUL MUL in SIMD -
19 剰余乗算に筆算をマップ accum ulate 377-bit筆算のブロック分割 (LSB/MSBをベクトルで取り出せる) 剰余乗算 [7] (Barrett Reduction)
AIEにおける剰余乗算の設計 INT32 MUL MUL in SIMD -
Agenda 1. Application (MSM / 楕円曲線上点加算) について 2. 先⾏研究 3.
⼿法 - AIEにおける剰余乗算の設計 - AIEにおけるキャリー伝搬 - Spatial Mapping 4. 評価 - AI Engine単体シミュレーション評価 - 実機評価 5. 結論 20 -
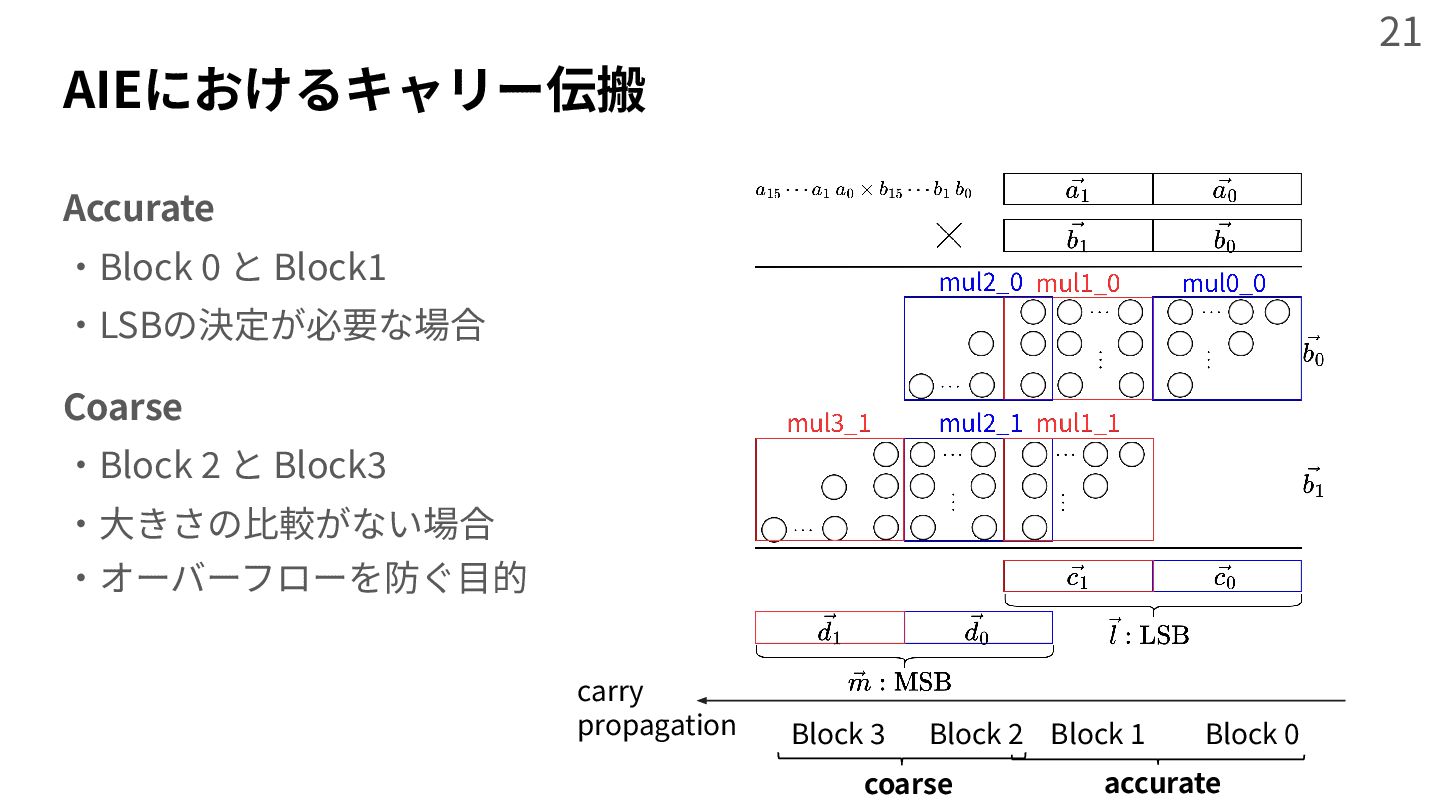
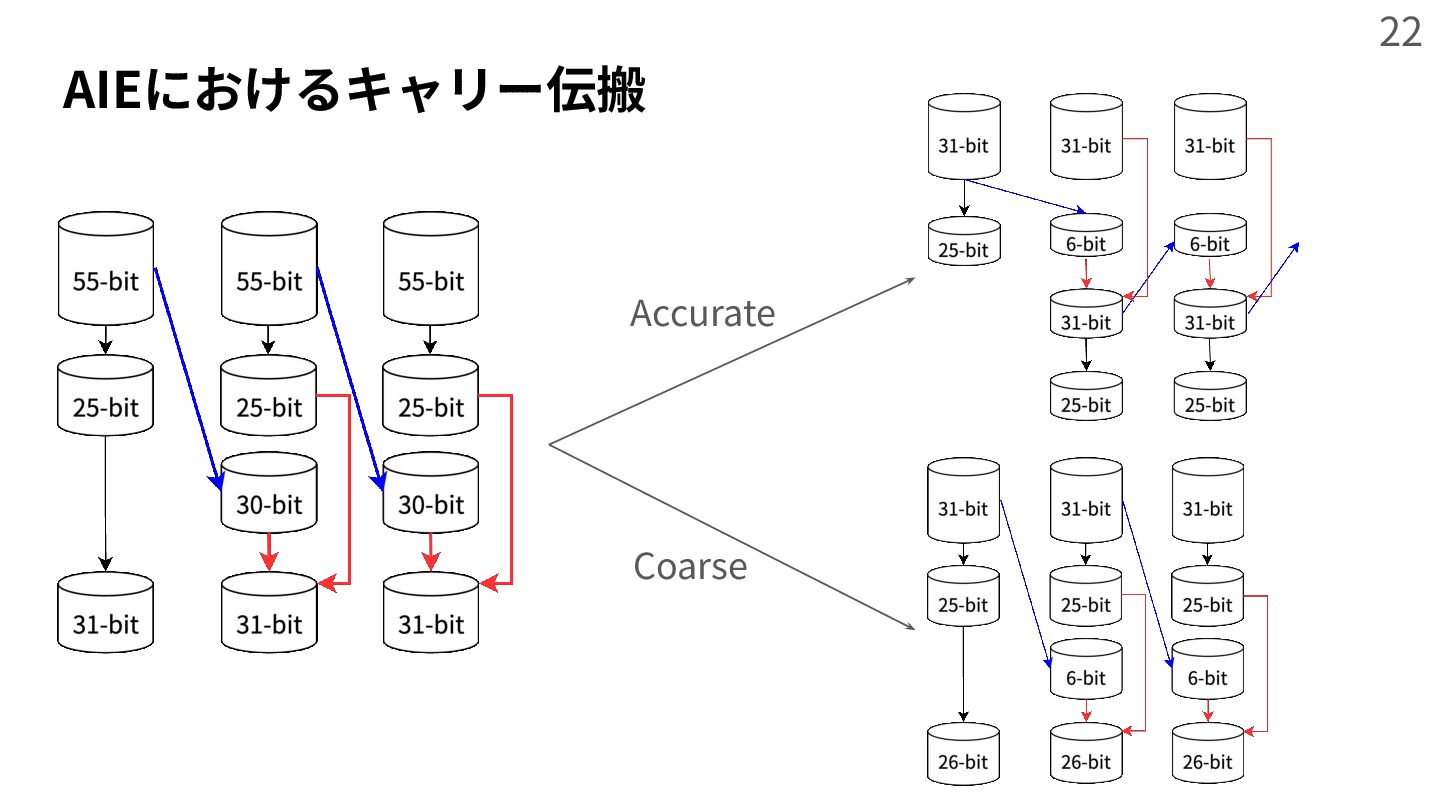
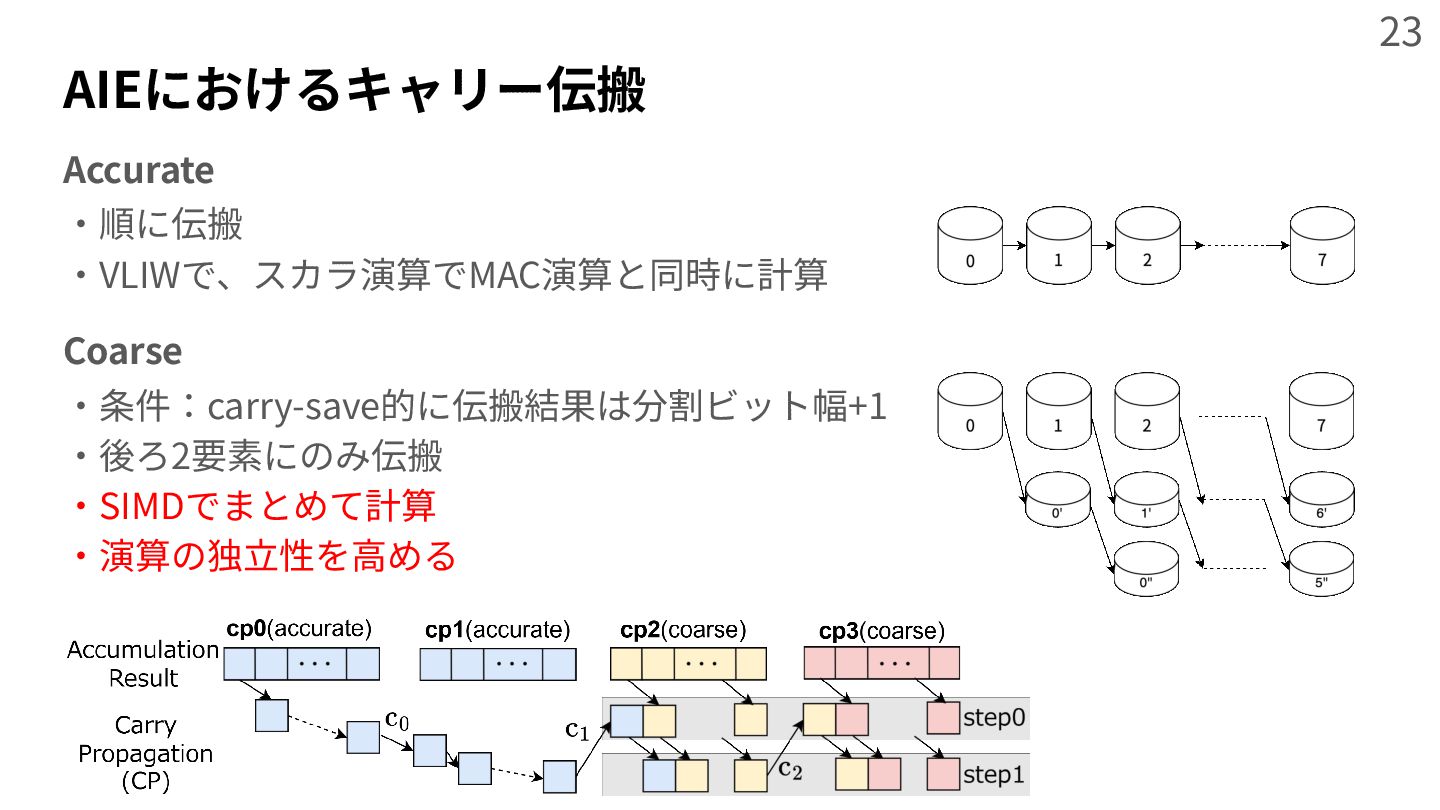
21 carry propagation Block 0 Block 1 Block 2 Block
3 coarse accurate Accurate ‧Block 0 と Block1 ‧LSBの決定が必要な場合 Coarse ‧Block 2 と Block3 ‧⼤きさの⽐較がない場合 ‧オーバーフローを防ぐ⽬的 AIEにおけるキャリー伝搬 -
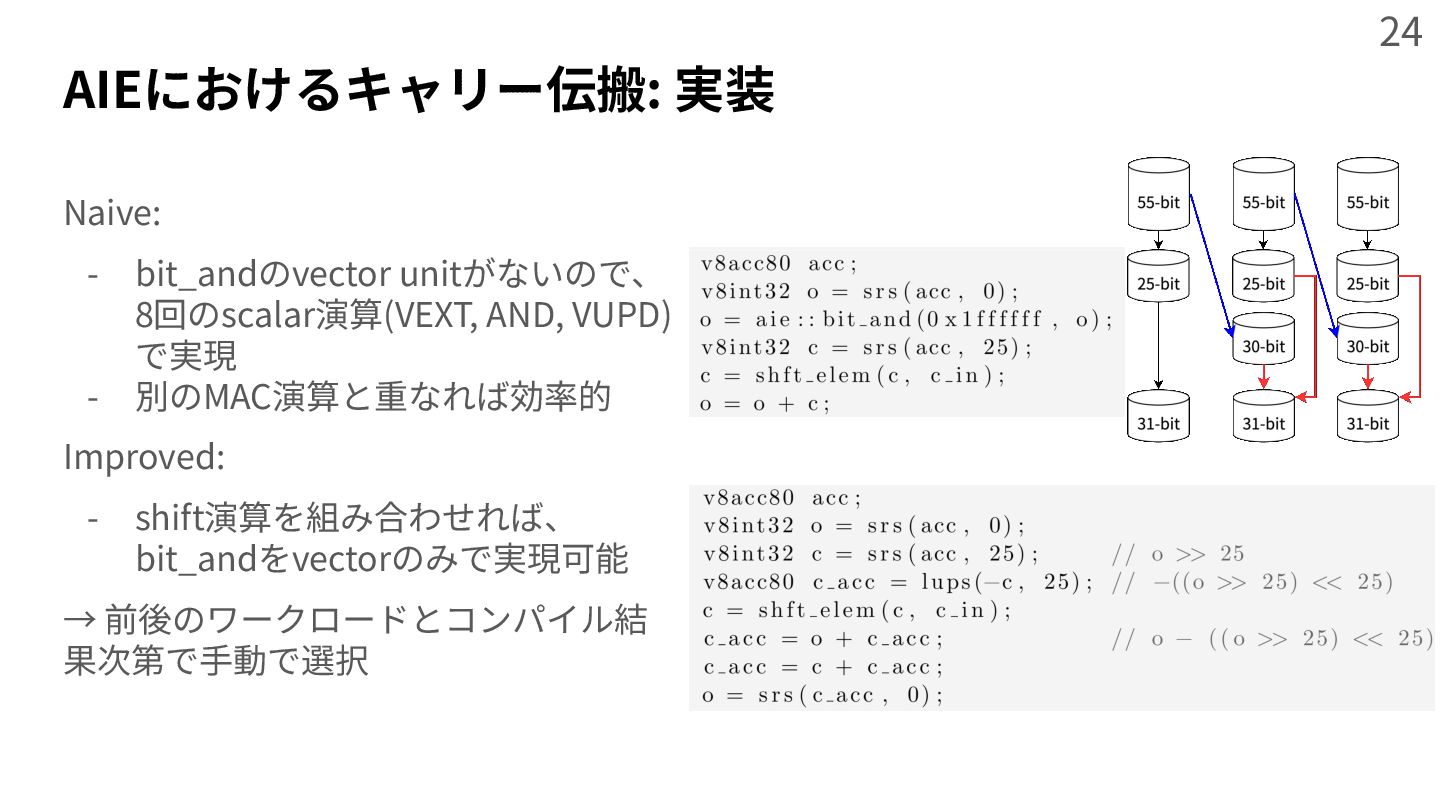
AIEにおけるキャリー伝搬: 実装 Naive: - bit_andのvector unitがないので、 8回のscalar演算(VEXT, AND, VUPD) で実現
- 別のMAC演算と重なれば効率的 Improved: - shift演算を組み合わせれば、 bit_andをvectorのみで実現可能 → 前後のワークロードとコンパイル結 果次第で⼿動で選択 24 -
Agenda 1. Application (MSM / 楕円曲線上点加算) について 2. 先⾏研究 3.
⼿法 - AIEにおける剰余乗算の設計 - AIEにおけるキャリー伝搬 - Spatial Mapping 4. 評価 - AI Engine単体シミュレーション評価 - 実機評価 5. 結論 25 -
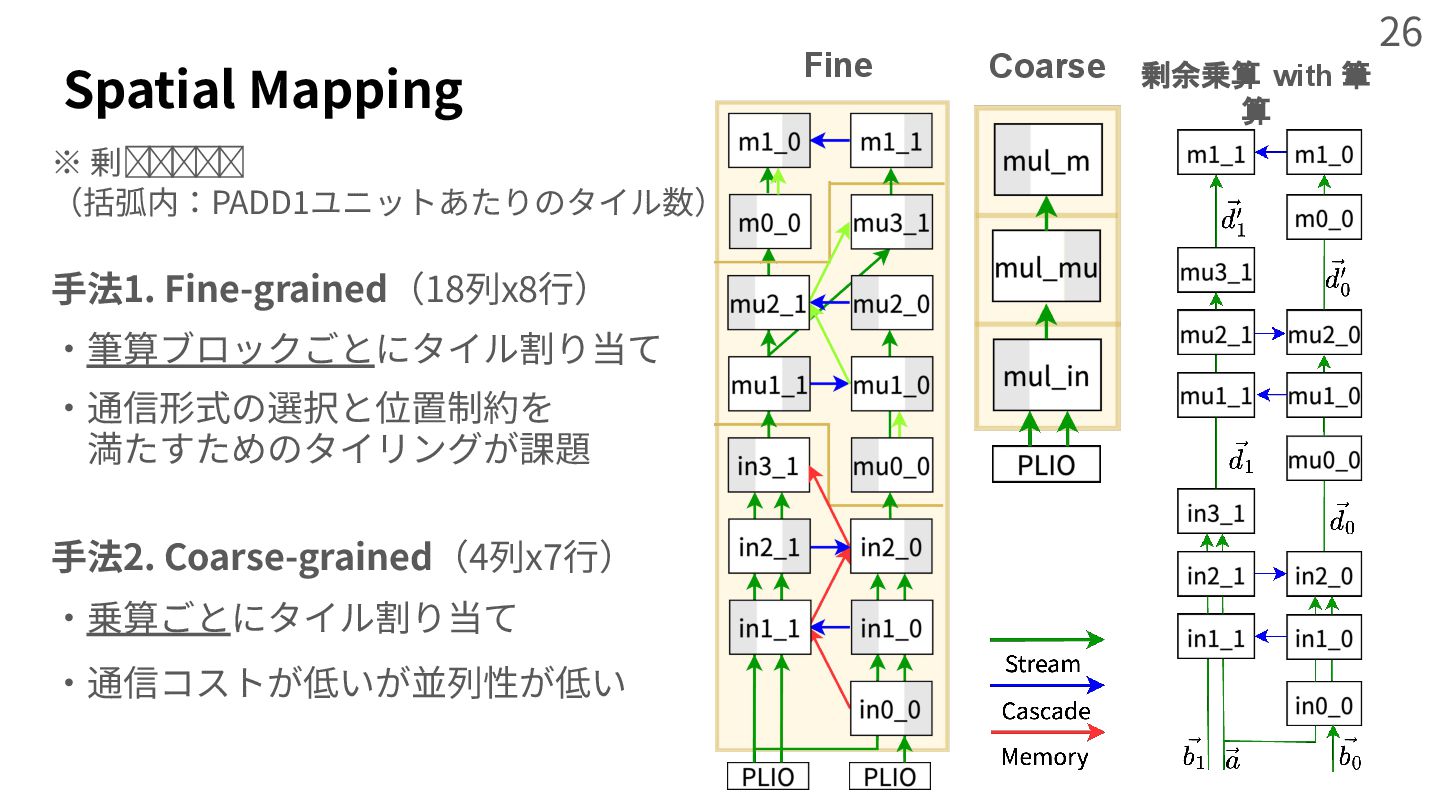
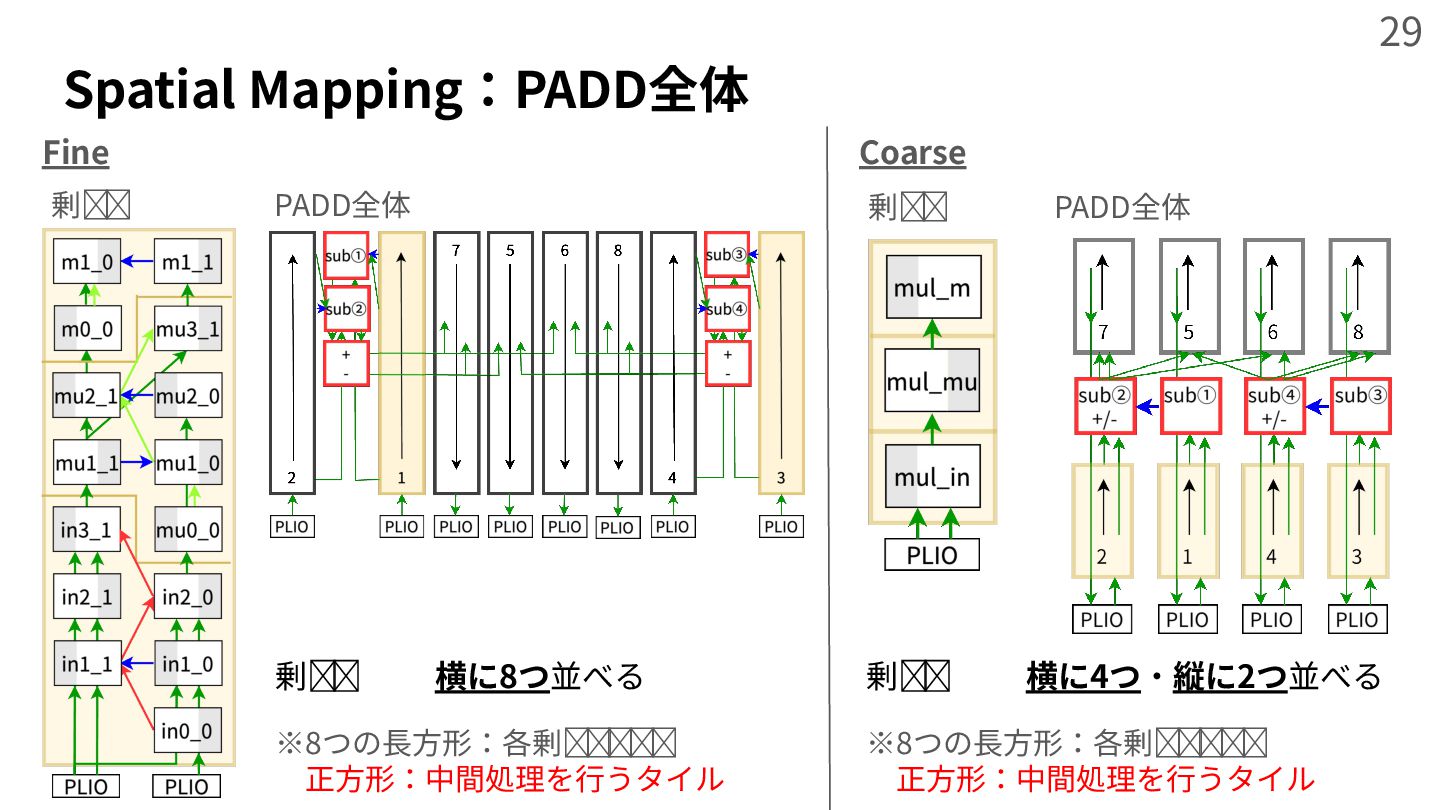
Spatial Mapping ※ 剰余乗算部分に限定 (括弧内:PADD1ユニットあたりのタイル数) ⼿法1. Fine-grained(18列x8⾏) ‧筆算ブロックごとにタイル割り当て ‧通信形式の選択と位置制約を 満たすためのタイリングが課題
⼿法2. Coarse-grained(4列x7⾏) ‧乗算ごとにタイル割り当て ‧通信コストが低いが並列性が低い Fine Coarse 26 剰余乗算 with 筆 算 -
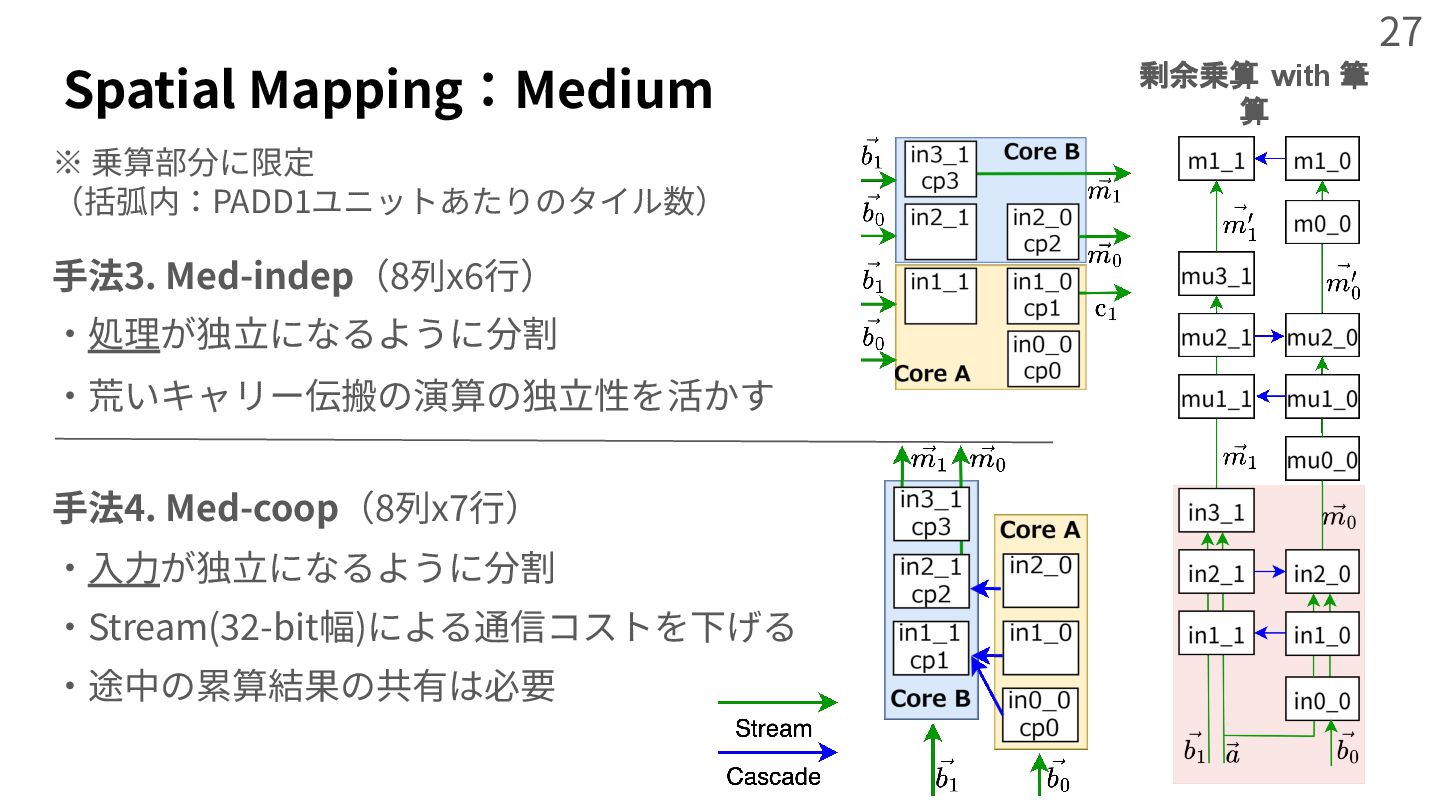
Spatial Mapping:Medium ⼿法4. Med-coop(8列x7⾏) ‧⼊⼒が独⽴になるように分割 ‧Stream(32-bit幅)による通信コストを下げる ‧途中の累算結果の共有は必要 ⼿法3. Med-indep(8列x6⾏) ‧処理が独⽴になるように分割
‧荒いキャリー伝搬の演算の独⽴性を活かす 27 ※ 乗算部分に限定 (括弧内:PADD1ユニットあたりのタイル数) 剰余乗算 with 筆 算 -
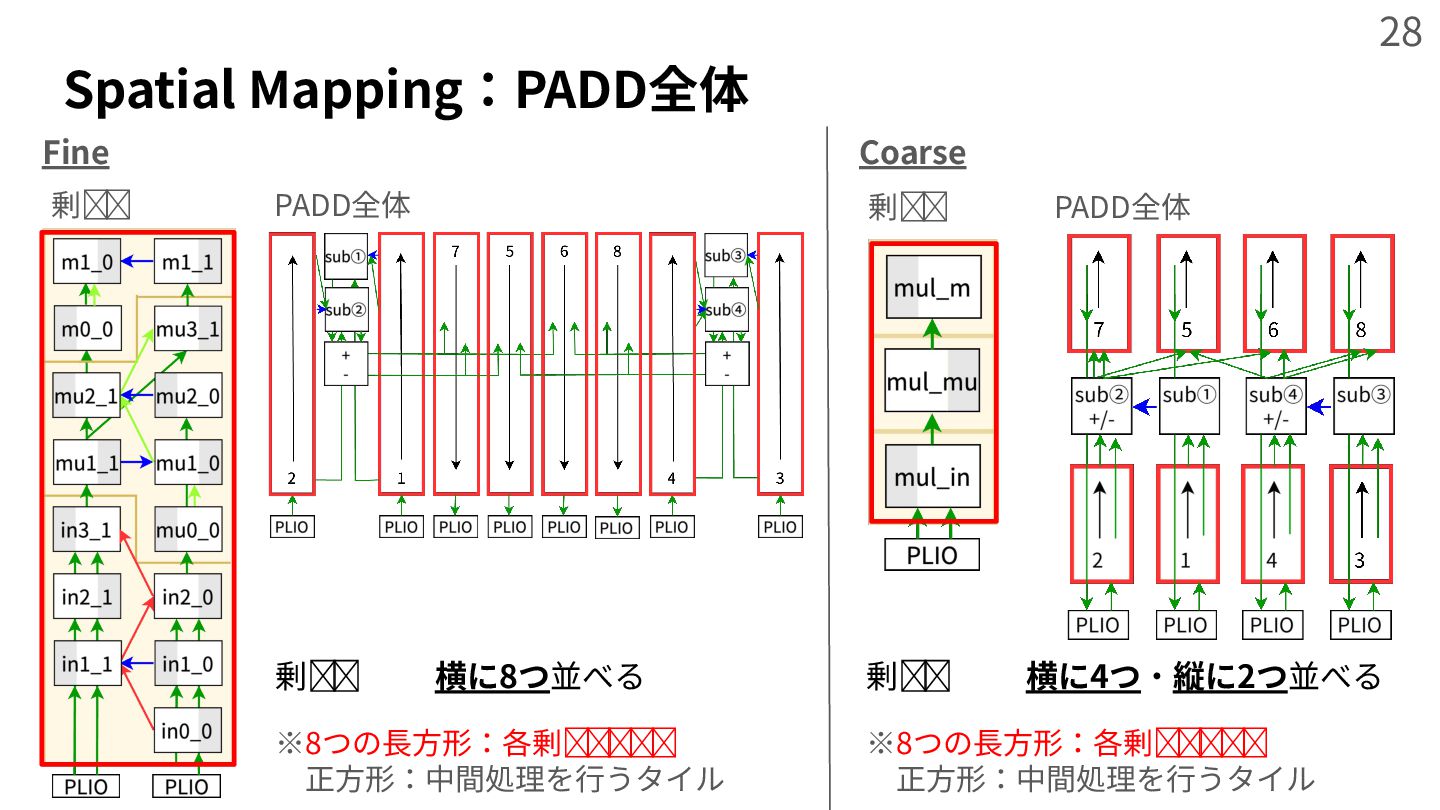
Spatial Mapping:PADD全体 28 剰余乗算 PADD全体 ※8つの⻑⽅形:各剰余乗算のブロック 正⽅形:中間処理を⾏うタイル 剰余乗算 PADD全体 Fine
Coarse 剰余乗算を横に8つ並べる 剰余乗算を横に4つ‧縦に2つ並べる ※8つの⻑⽅形:各剰余乗算のブロック 正⽅形:中間処理を⾏うタイル -
Spatial Mapping:PADD全体 29 剰余乗算 PADD全体 ※8つの⻑⽅形:各剰余乗算のブロック 正⽅形:中間処理を⾏うタイル 剰余乗算 PADD全体 Fine
Coarse ※8つの⻑⽅形:各剰余乗算のブロック 正⽅形:中間処理を⾏うタイル 剰余乗算を横に8つ並べる 剰余乗算を横に4つ‧縦に2つ並べる -
Spatial Mapping:PADDユニット間並列 32 1種類のみの場合: - Fine:1ユニット18列使うので、横に2ユニット並べる - Coarse:1ユニット4列使うので、横に12ユニット並べる - Medium:1ユニット8列使うので、横に6ユニット並べる
Throughput優先ワークロードにCoarseを使⽤ Latency優先ワークロードにMediumを使⽤する場合: coarse -
Agenda 1. Application (MSM / 楕円曲線上点加算) について 2. 先⾏研究 3.
⼿法 - AIEにおける剰余乗算の設計 - AIEにおけるキャリー伝搬 - Spatial Mapping 4. 評価 - AI Engine単体シミュレーション評価 - 実機評価 5. 結論 33 -
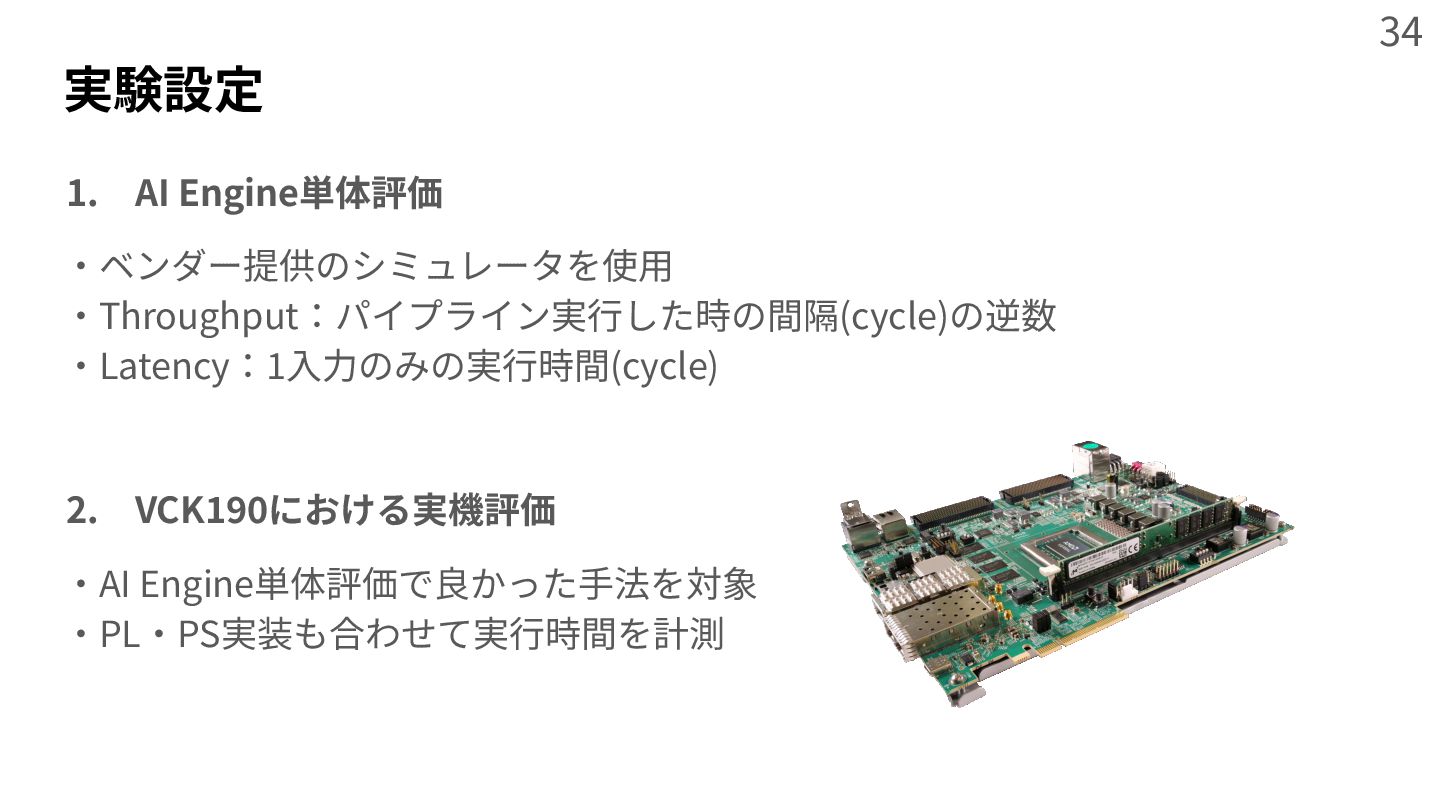
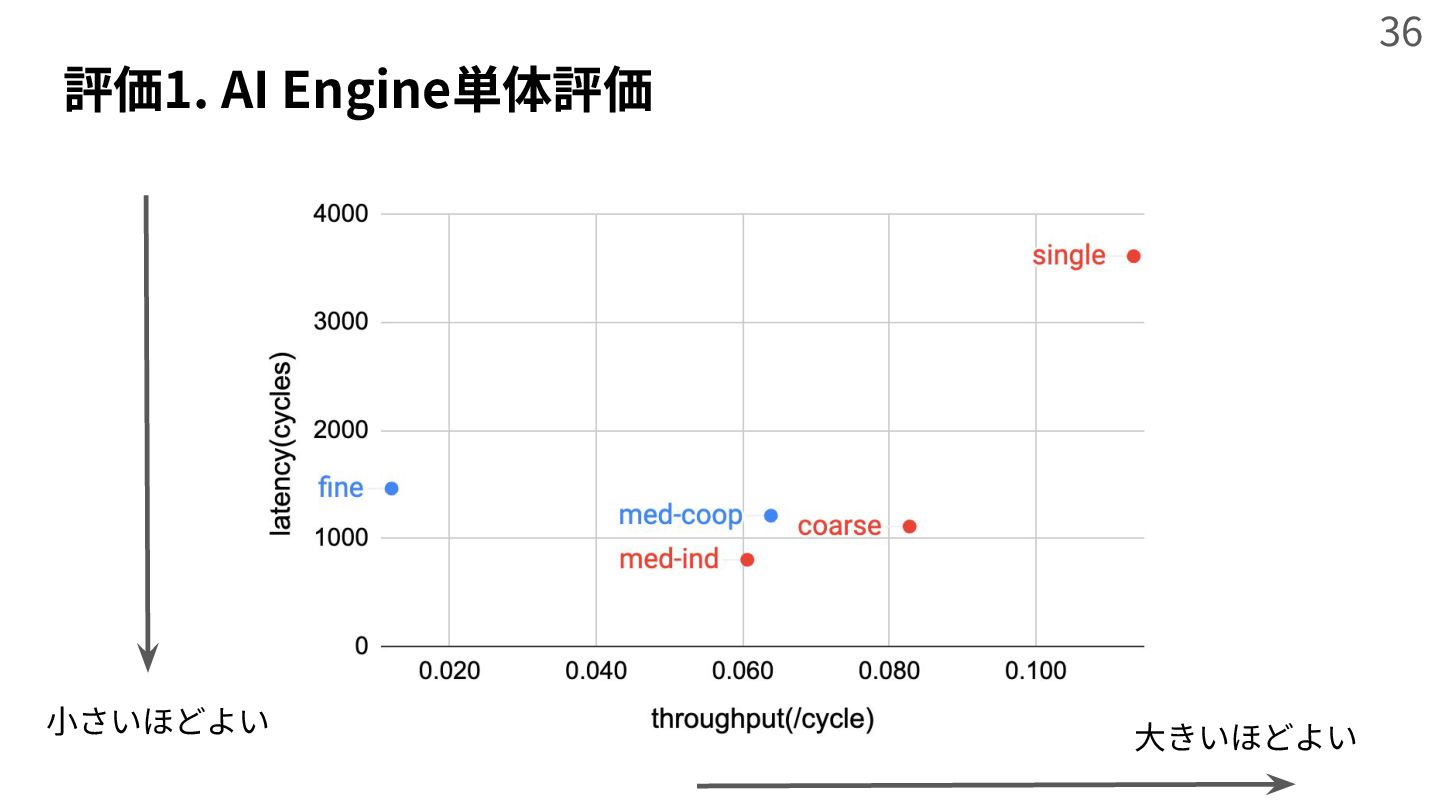
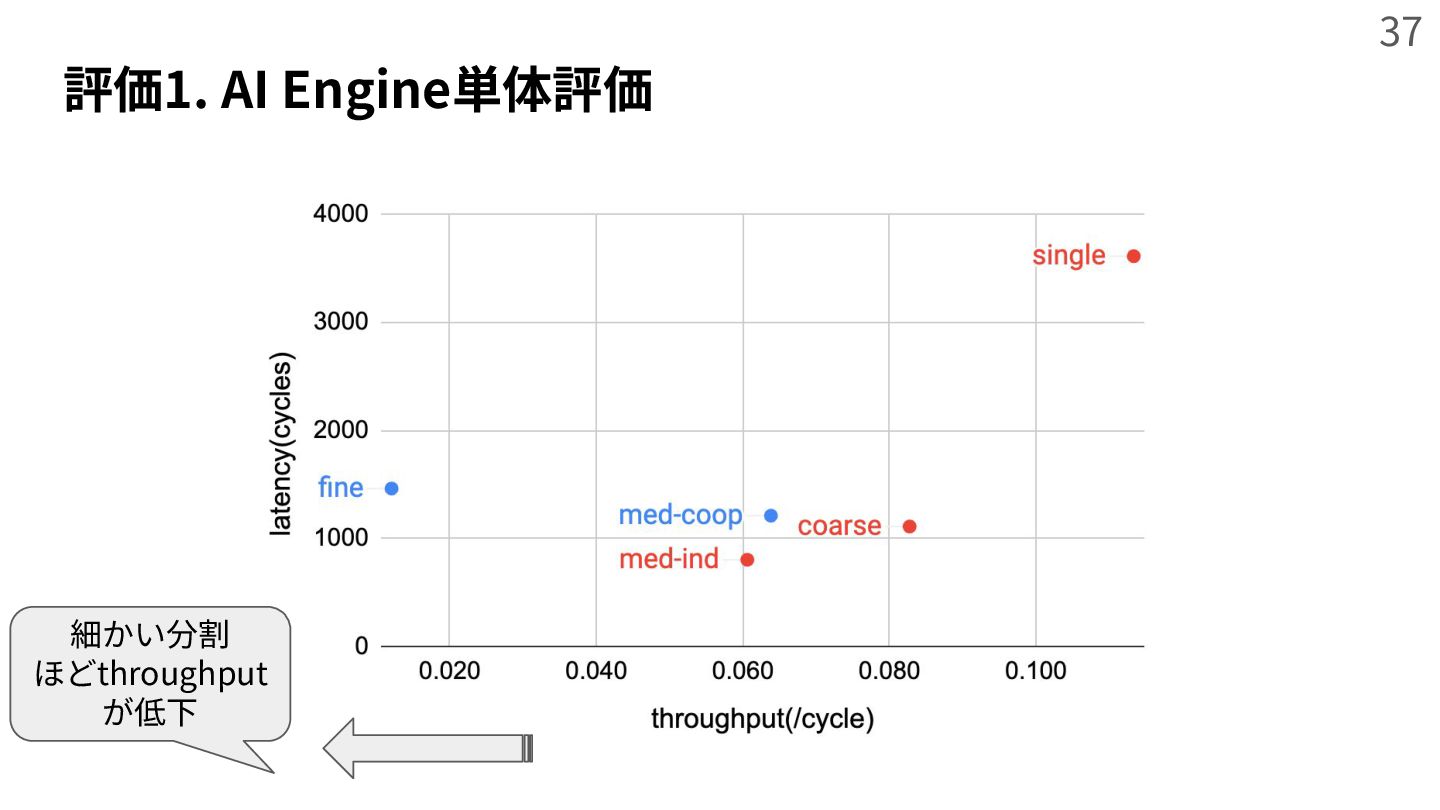
実験設定 1. AI Engine単体評価 ‧ベンダー提供のシミュレータを使⽤ ‧Throughput:パイプライン実⾏した時の間隔(cycle)の逆数 ‧Latency:1⼊⼒のみの実⾏時間(cycle) 2. VCK190における実機評価 ‧AI
Engine単体評価で良かった⼿法を対象 ‧PL‧PS実装も合わせて実⾏時間を計測 34 -
Agenda 1. Application (MSM / 楕円曲線上点加算) について 2. 先⾏研究 3.
⼿法 - AIEにおける剰余乗算の設計 - AIEにおけるキャリー伝搬 - Spatial Mapping 4. 評価 - AI Engine単体シミュレーション評価 - 実機評価 5. 結論 35 -
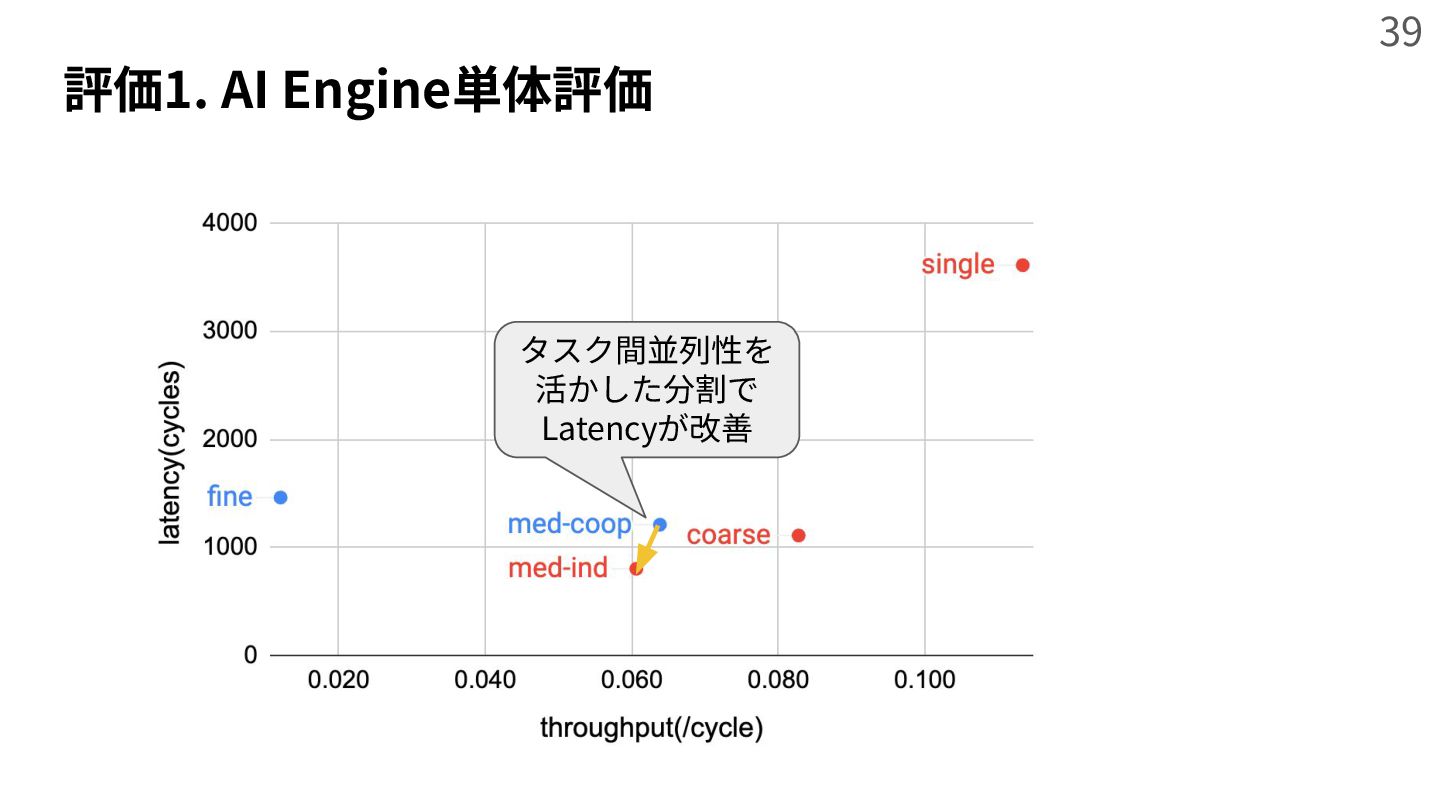
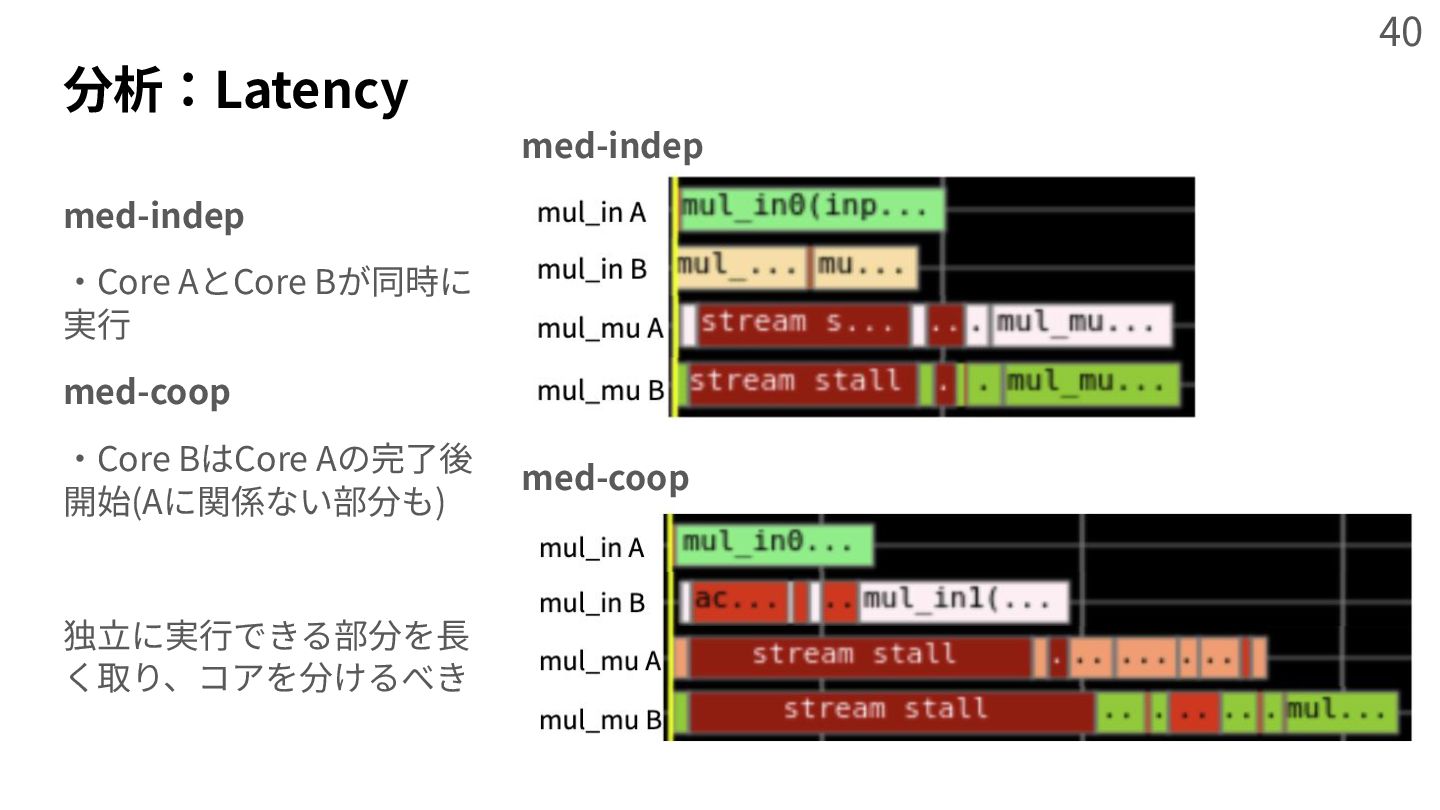
分析:Latency med-indep ‧Core AとCore Bが同時に 実⾏ med-coop ‧Core BはCore Aの完了後
開始(Aに関係ない部分も) 独⽴に実⾏できる部分を⻑ く取り、コアを分けるべき med-indep med-coop 40 -
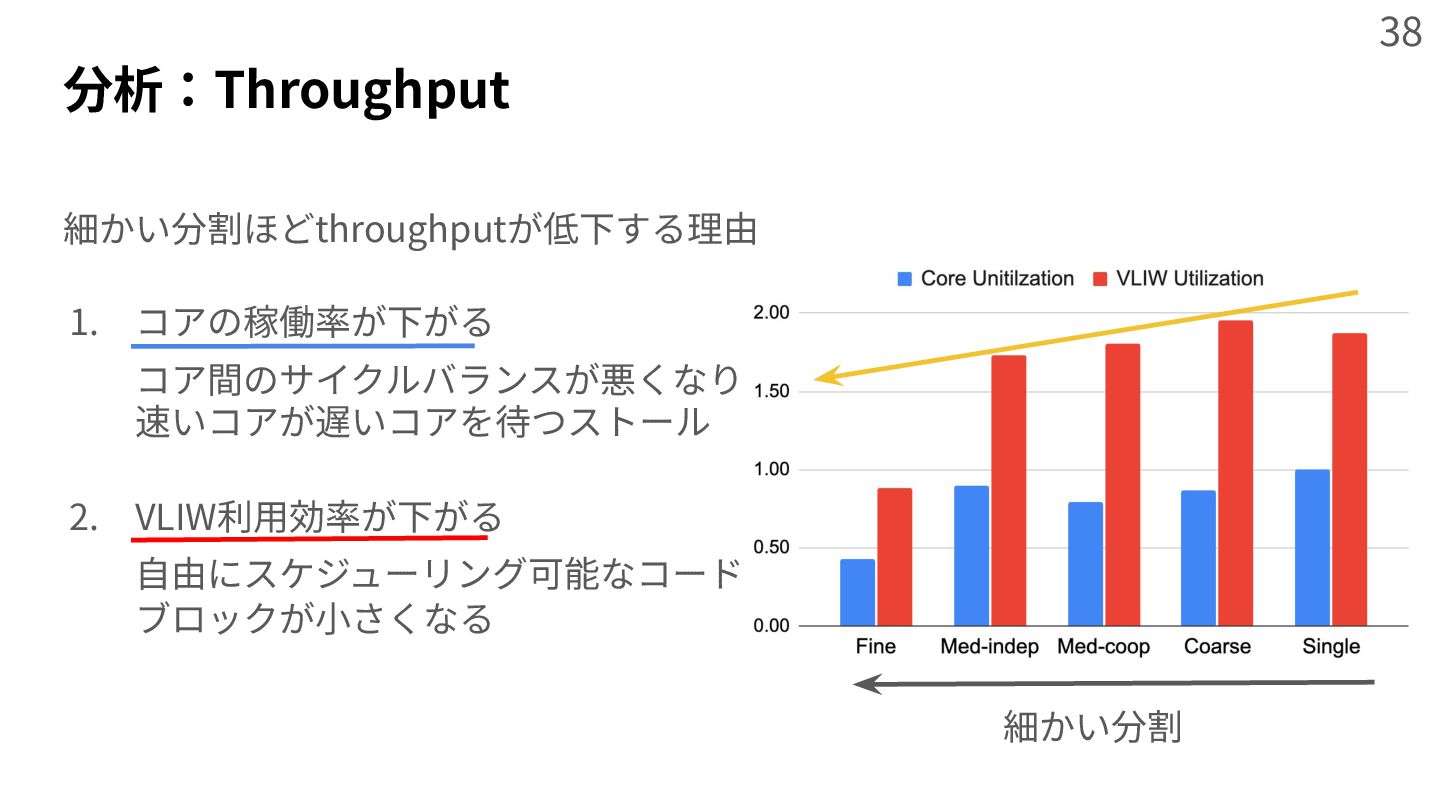
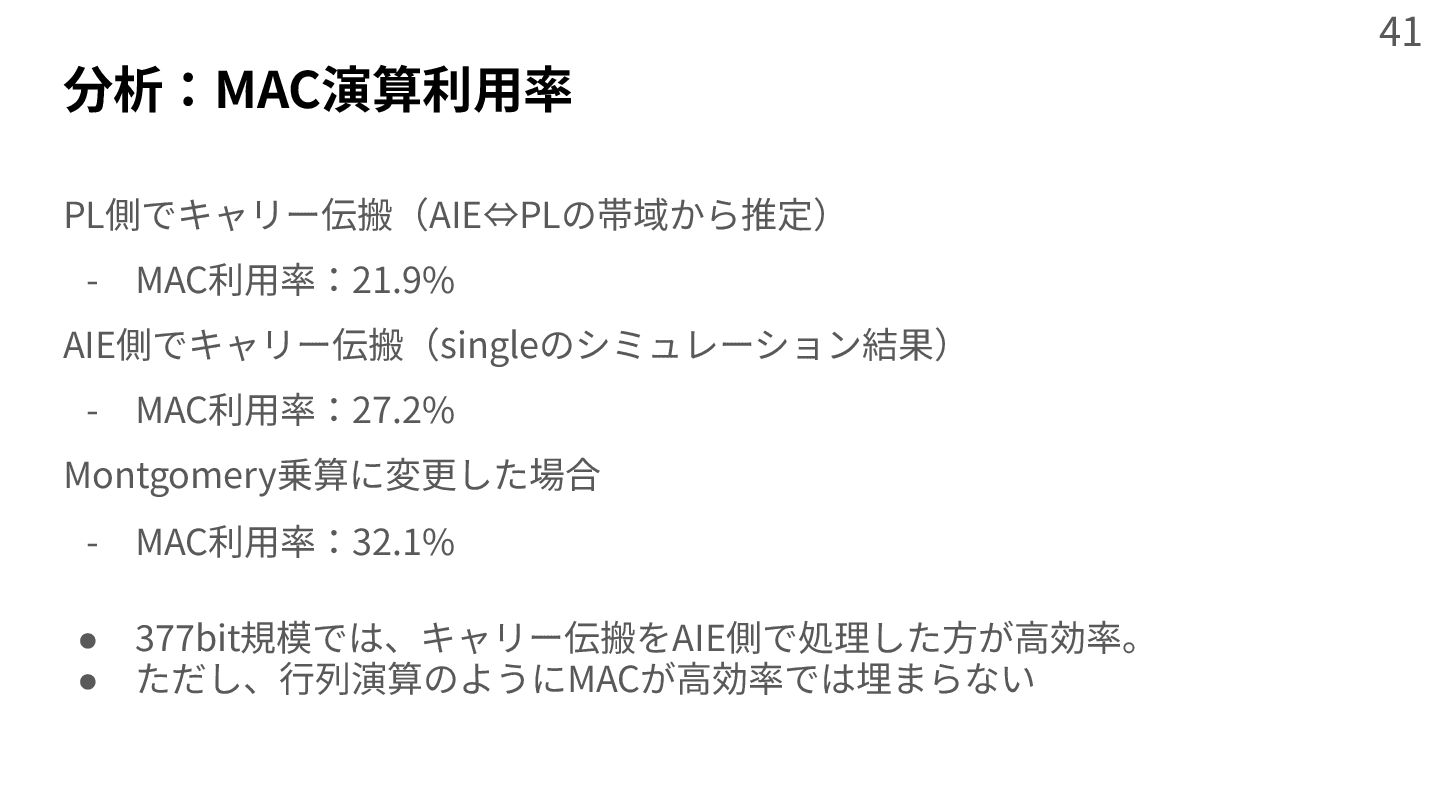
分析:MAC演算利⽤率 PL側でキャリー伝搬(AIE⇔PLの帯域から推定) - MAC利⽤率:21.9% AIE側でキャリー伝搬(singleのシミュレーション結果) - MAC利⽤率:27.2% Montgomery乗算に変更した場合 - MAC利⽤率:32.1%
• 377bit規模では、キャリー伝搬をAIE側で処理した⽅が⾼効率。 • ただし、⾏列演算のようにMACが⾼効率では埋まらない 41 -
Agenda 1. Application (MSM / 楕円曲線上点加算) について 2. 先⾏研究 3.
⼿法 - AIEにおける剰余乗算の設計 - AIEにおけるキャリー伝搬 - Spatial Mapping 4. 評価 - AI Engine単体シミュレーション評価 - 実機評価 5. 結論 42 -
評価2:実機評価 43 ‧同じボードのCPU*と⽐べ、569× ⾼速化 ‧FPGA(U250)上のアクセラレータBSTMSM[2]よりは遅い(次のスライドで説明) Throughput (coarse) (10並列) BSTMSMと⽐べ 1.22×倍増加したが,
BSTMSMの29%の乗算資源で実現 → タスク分割が効率的だった Latency (med-indep) BSTMSM [2] CPU Ours Throughput (M task/s) 600.0 0.12 68.4 Bandwidth Utilization (%) - - 51.3 BSTMSM [2] CPU Ours Latency (μs/task) 0.87 9.88 1.06 DSP48E2 2920 - - AIE Tiles - - 50 INT32 Muls 1386 - 400 * GMP[8] の多倍⻑整数乗算と剰余演算 を利⽤して実装 -
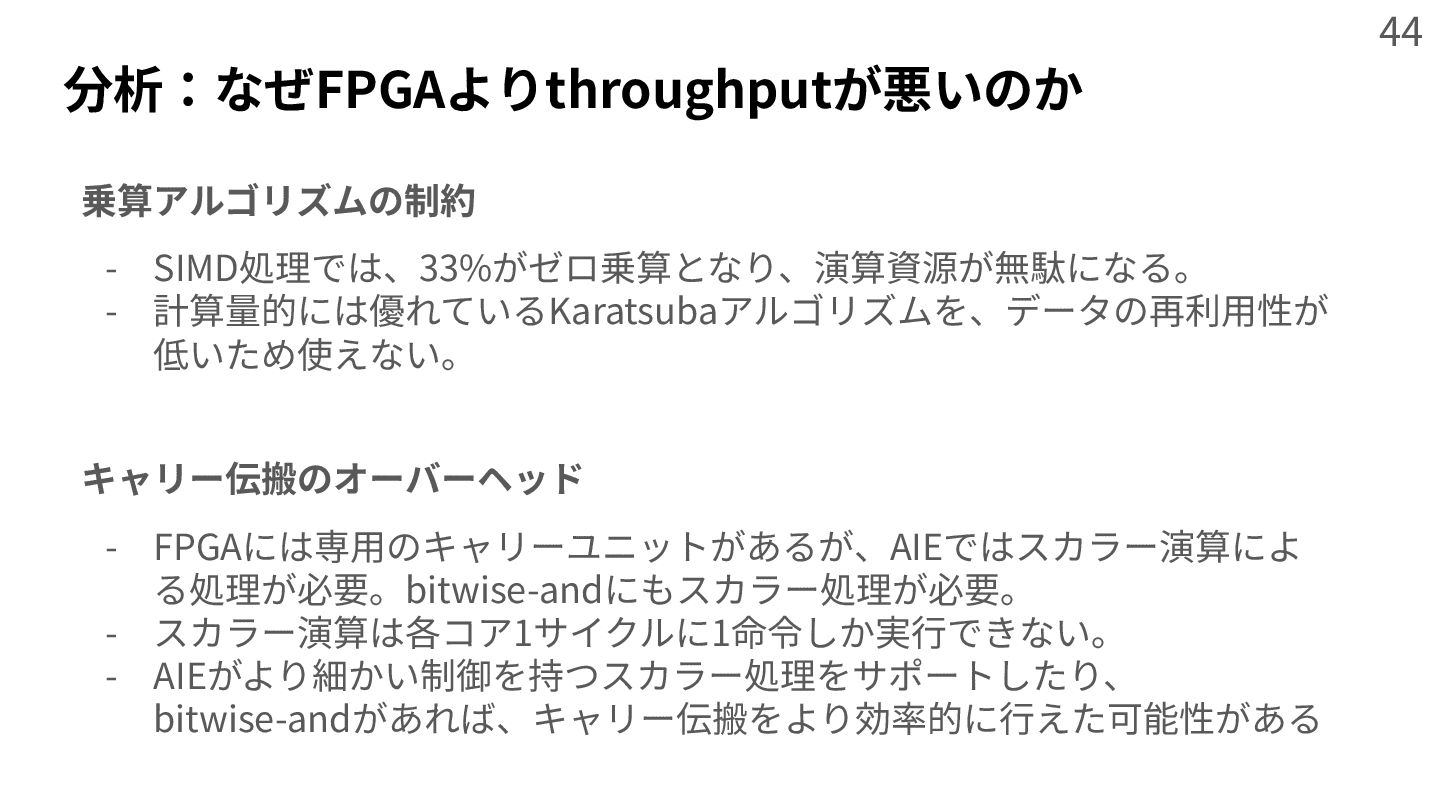
分析:なぜFPGAよりthroughputが悪いのか 44 乗算アルゴリズムの制約 - SIMD処理では、33%がゼロ乗算となり、演算資源が無駄になる。 - 計算量的には優れているKaratsubaアルゴリズムを、データの再利⽤性が 低いため使えない。 キャリー伝搬のオーバーヘッド -
FPGAには専⽤のキャリーユニットがあるが、AIEではスカラー演算によ る処理が必要。bitwise-andにもスカラー処理が必要。 - スカラー演算は各コア1サイクルに1命令しか実⾏できない。 - AIEがより細かい制御を持つスカラー処理をサポートしたり、 bitwise-andがあれば、キャリー伝搬をより効率的に⾏えた可能性がある -
Agenda 1. Application (MSM / 楕円曲線上点加算) について 2. 先⾏研究 3.
⼿法 - AIEにおける剰余乗算の設計 - AIEにおけるキャリー伝搬 - Spatial Mapping 4. 評価 - AI Engine単体シミュレーション評価 - 実機評価 5. 結論 45 -
参考⽂献 [1] W. Ma et al., “Gzkp: A gpu accelerated
zero knowledge proof system,” in Proceedings of the 28th ACM International Conference on Architectural Support for Programming Languages and Operating Systems, Volume 2, 2023, pp. 340‒353. [2] B. Zhao, W. Huang, T. Li, and Y. Huang, “Bstmsm: A high-performance fpga-based multi-scalar multiplication hardware accelerator,” in 2023 International Conference on Field Programmable Technology (ICFPT). IEEE, 2023, pp. 35‒43. [3] K. Aasaraai, D. Beaver, E. Cesena, R. Maganti, N. Stalder, and J. Varela, “Fpga acceleration of multiscalar multiplication: Cyclonemsm,” Cryptology ePrint Archive, 2022. [4] J. Zhuang et al., “Charm: Composing heterogeneous accelerators for matrix multiply on versal acap architecture,” in Proceedings of the 2023 ACM/SIGDA International Symposium on Field Programmable Gate Arrays, 2023, pp. 153‒164. [5] Z. Yang, J. Zhuang, J. Yin, C. Yu, A. K. Jones, and P. Zhou, “Aim: Accelerating arbitrary-precision integer multiplication on heterogeneous reconfigurable computing platform versal acap,” in 2023 IEEE/ACM International Conference on Computer Aided Design (ICCAD). IEEE, 2023, pp. 1‒9. [6] H. Hisil, K. K.-H. Wong, G. Carter, and E. Dawson, “Twisted edwards curves revisited,” in International Conference on the Theory and Application of Cryptology and Information Security. Springer, 2008, pp. 326‒343. [7] M. Langhammer and B. Pasca, “Efficient fpga modular multiplication implementation,” in The 2021 ACM/SIGDA International Symposium on Field Programmable Gate Arrays, 2021, pp. 217‒223. [8] GMP. The gnu mp bignum library. [Online] https://gmplib.org [9] Z. Ji, Z. Zhang, J. Xu, and L. Ju, “Accelerating multi-scalar multiplication for efficient zero knowledge proofs with multi-gpu systems,” in Proceedings of the 29th ACM International Conference on Architectural Support for Programming Languages and Operating Systems, Volume 3, 2024, pp. 57‒70. 47