Share
Embed
ChatGPT / OpenAI API実用入門
2023/05/16
株式会社オプト、デジタルホールディングス内で実施したChatGPT勉強会の資料
natsuume
October 26, 2023
Transcript
100 slides
-
- 経歴 - 株式会社オプト AIソリューション開発部 所属 - 2019年新卒入社(今年で5年目) - CTO室(Data
Intelligenceチーム) - → AIソリューション開発部 - 2021年上期 準MVP - 2023年Q1 MA本部 Value個人賞, Valueチーム賞 - 主な業務 - テキスト広告自動生成に関するR&D - CRAIS for Textアプリケーション開発 - エンジニア組織横断活動 - Opt Technologies Magazine - Tech イベント - 組織貢献関連施策検討 箕輪 峻 (Minowa Takashi) • HN/表示名:natsuume 自己紹介 -
前提 - 想定対象者 - ChatGPTに関する基本的な内容は知っている - Chat Completions APIを使う人、API利用に関わる人 -
勉強会を通して目指す状態 - OpenAI APIを使って何らかの処理を作成できる - あるニーズに対して実現可能性・実現方法の検討ができる - 求められる出力に対してプロンプトをチューニングできる -
扱うトピック - OpenAI APIの基本 - Chat Completions API - プロンプトエンジニアリング
- 比較検証 - プロンプトインジェクション - ライブラリ - 実例 -
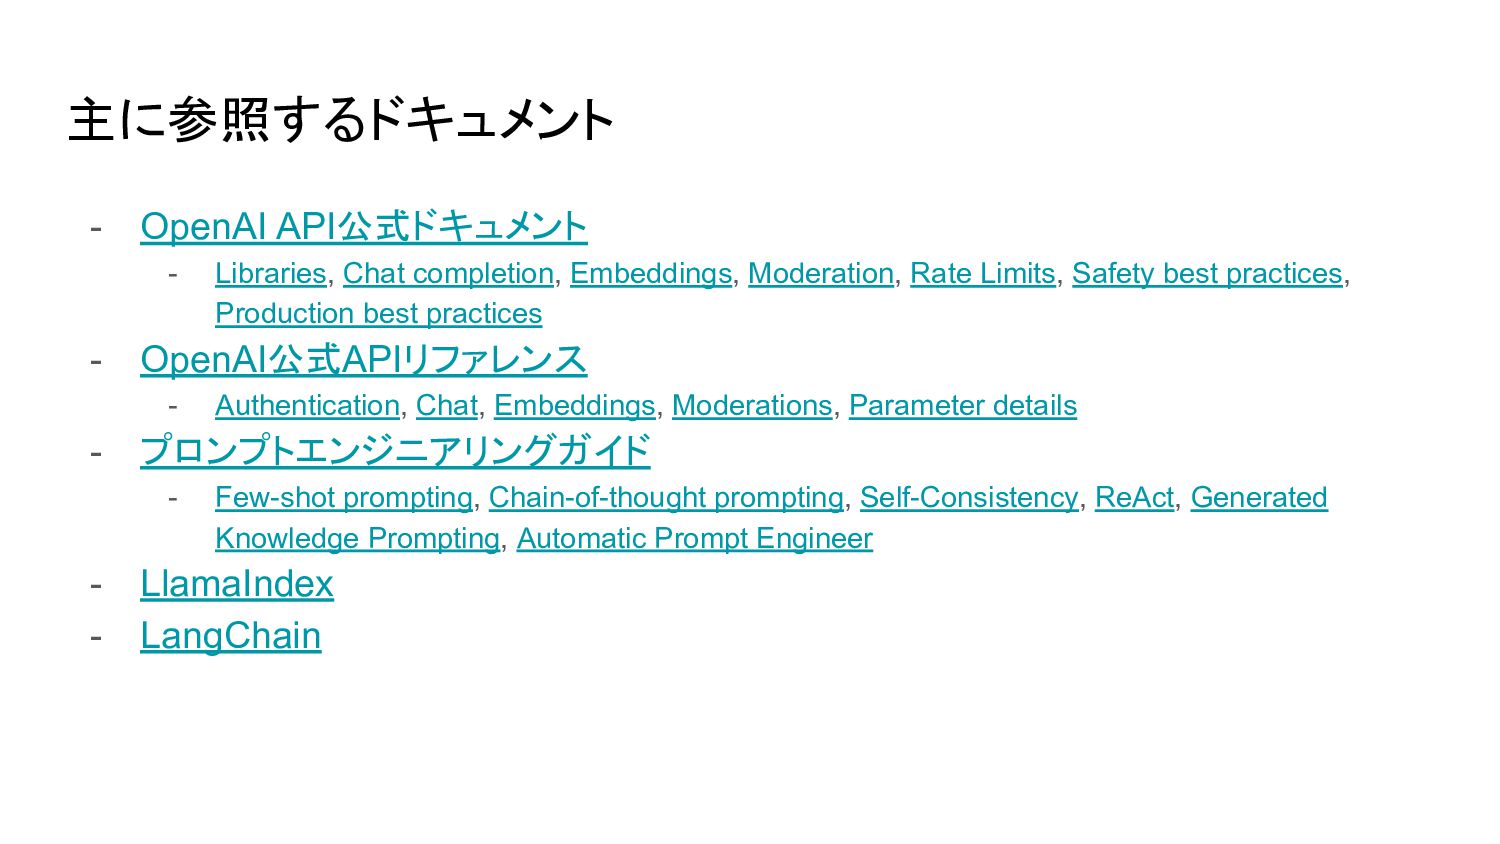
主に参照するドキュメント - OpenAI API公式ドキュメント - Libraries, Chat completion, Embeddings, Moderation,
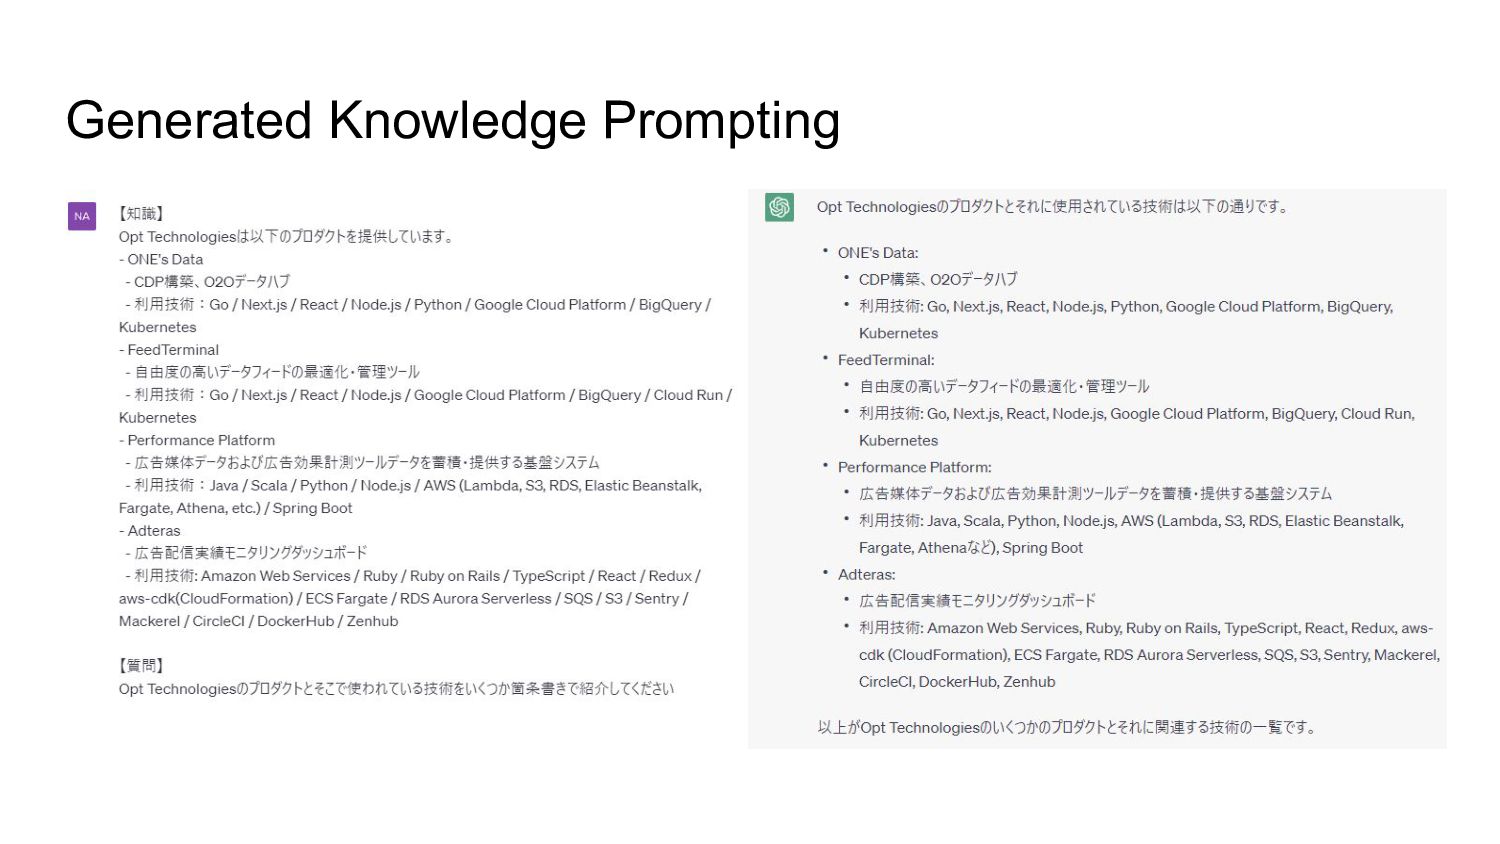
Rate Limits, Safety best practices, Production best practices - OpenAI公式APIリファレンス - Authentication, Chat, Embeddings, Moderations, Parameter details - プロンプトエンジニアリングガイド - Few-shot prompting, Chain-of-thought prompting, Self-Consistency, ReAct, Generated Knowledge Prompting, Automatic Prompt Engineer - LlamaIndex - LangChain -
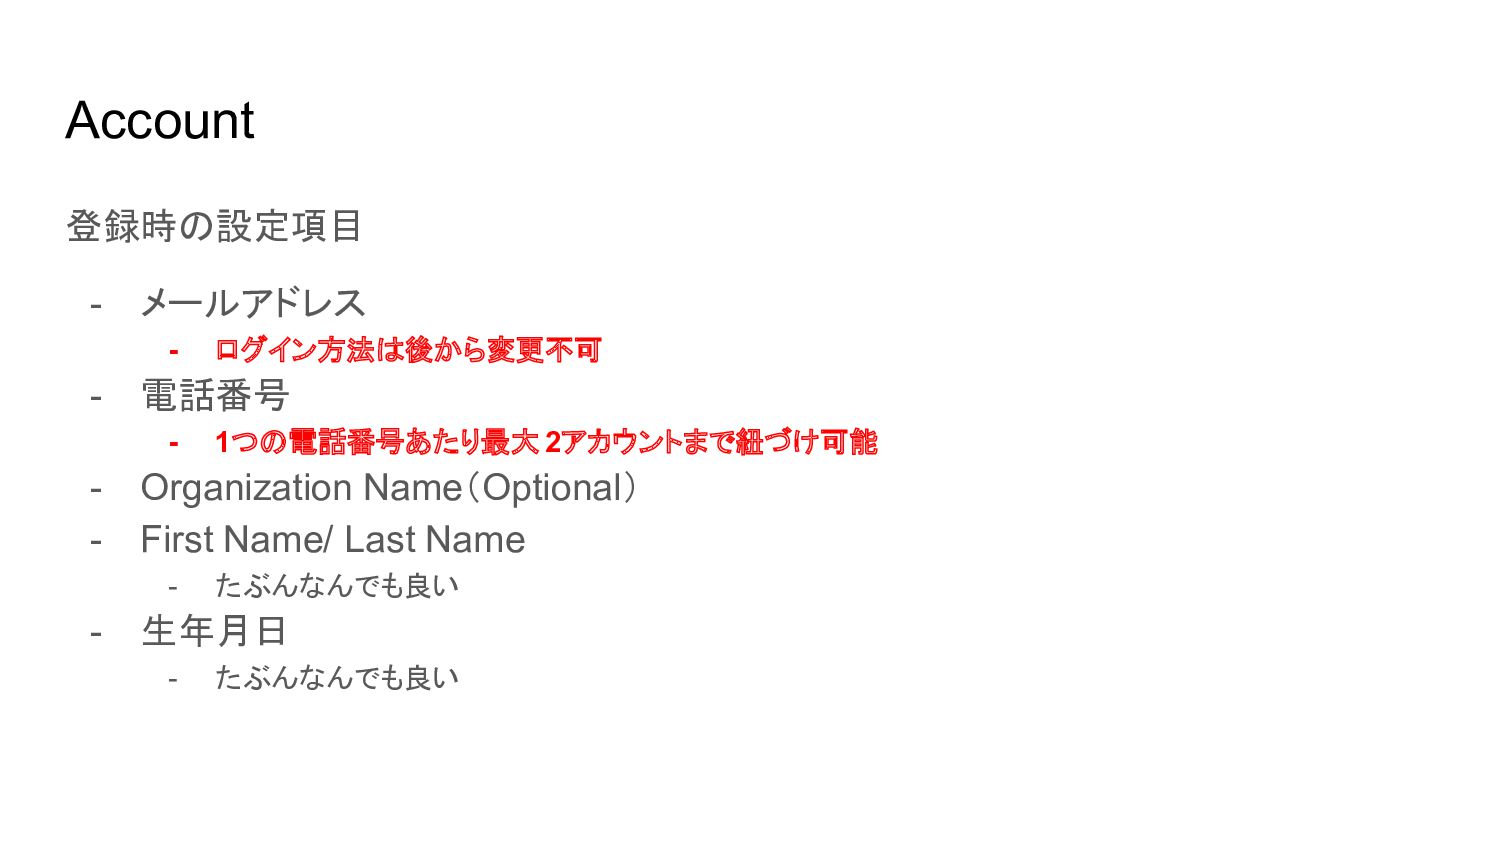
Account 登録時の設定項目 - メールアドレス - ログイン方法は後から変更不可 - 電話番号 - 1つの電話番号あたり最大
2アカウントまで紐づけ可能 - Organization Name(Optional) - First Name/ Last Name - たぶんなんでも良い - 生年月日 - たぶんなんでも良い -
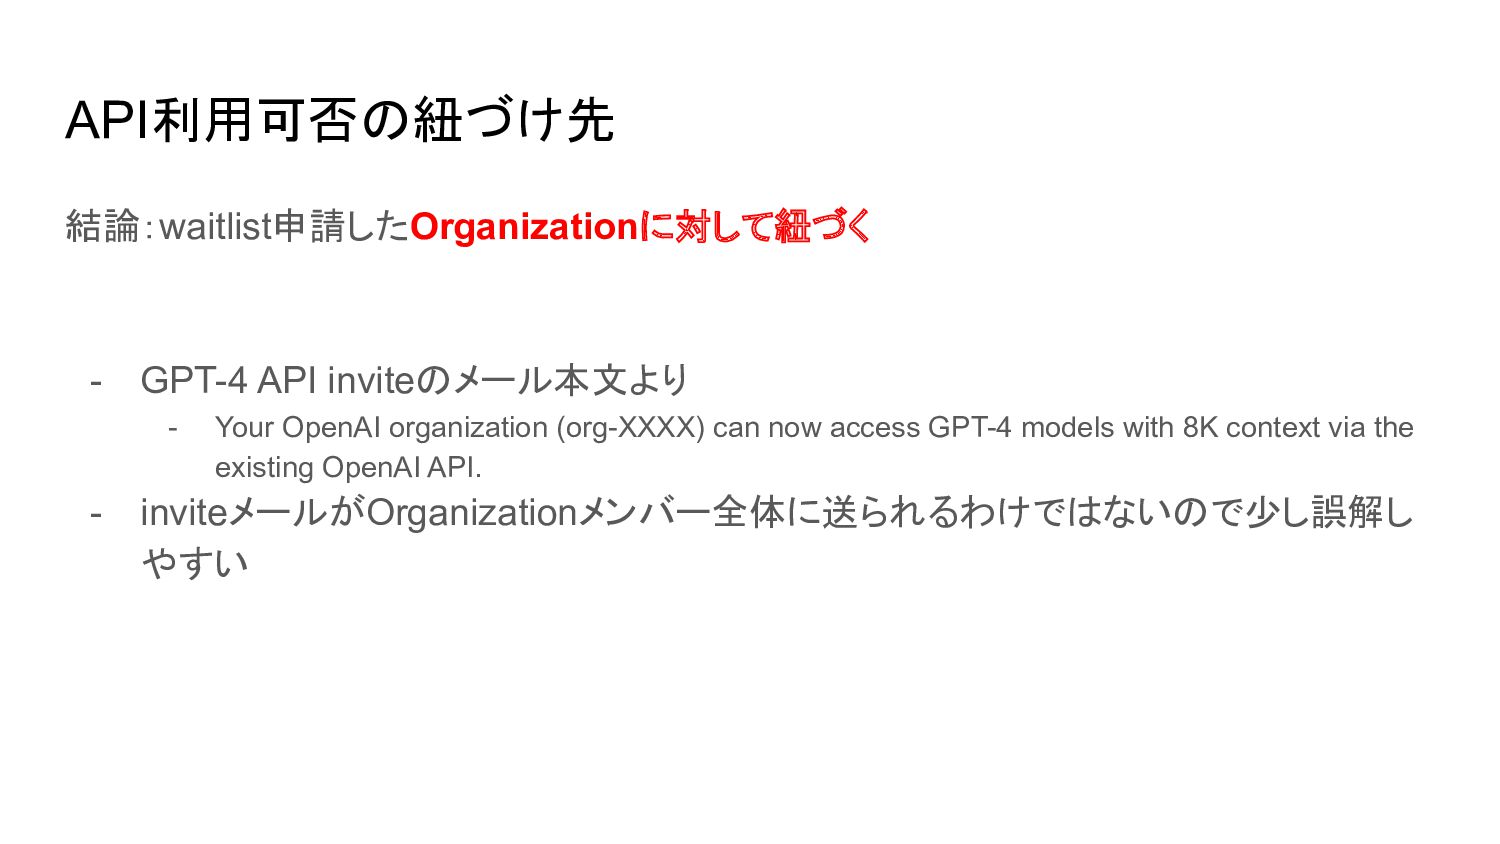
API利用可否の紐づけ先 結論:waitlist申請したOrganizationに対して紐づく - GPT-4 API inviteのメール本文より - Your OpenAI organization
(org-XXXX) can now access GPT-4 models with 8K context via the existing OpenAI API. - inviteメールがOrganizationメンバー全体に送られるわけではないので少し誤解し やすい -
Authentication - Authorization: Bearer $OPENAI_API_KEY (Required) - OpenAI-Organization: YOUR_ORG_ID (Optional)
- 設定されていない場合は API Key発行アカウントが設定している Default Organization https://platform.openai.com/docs/api-reference/authentication -
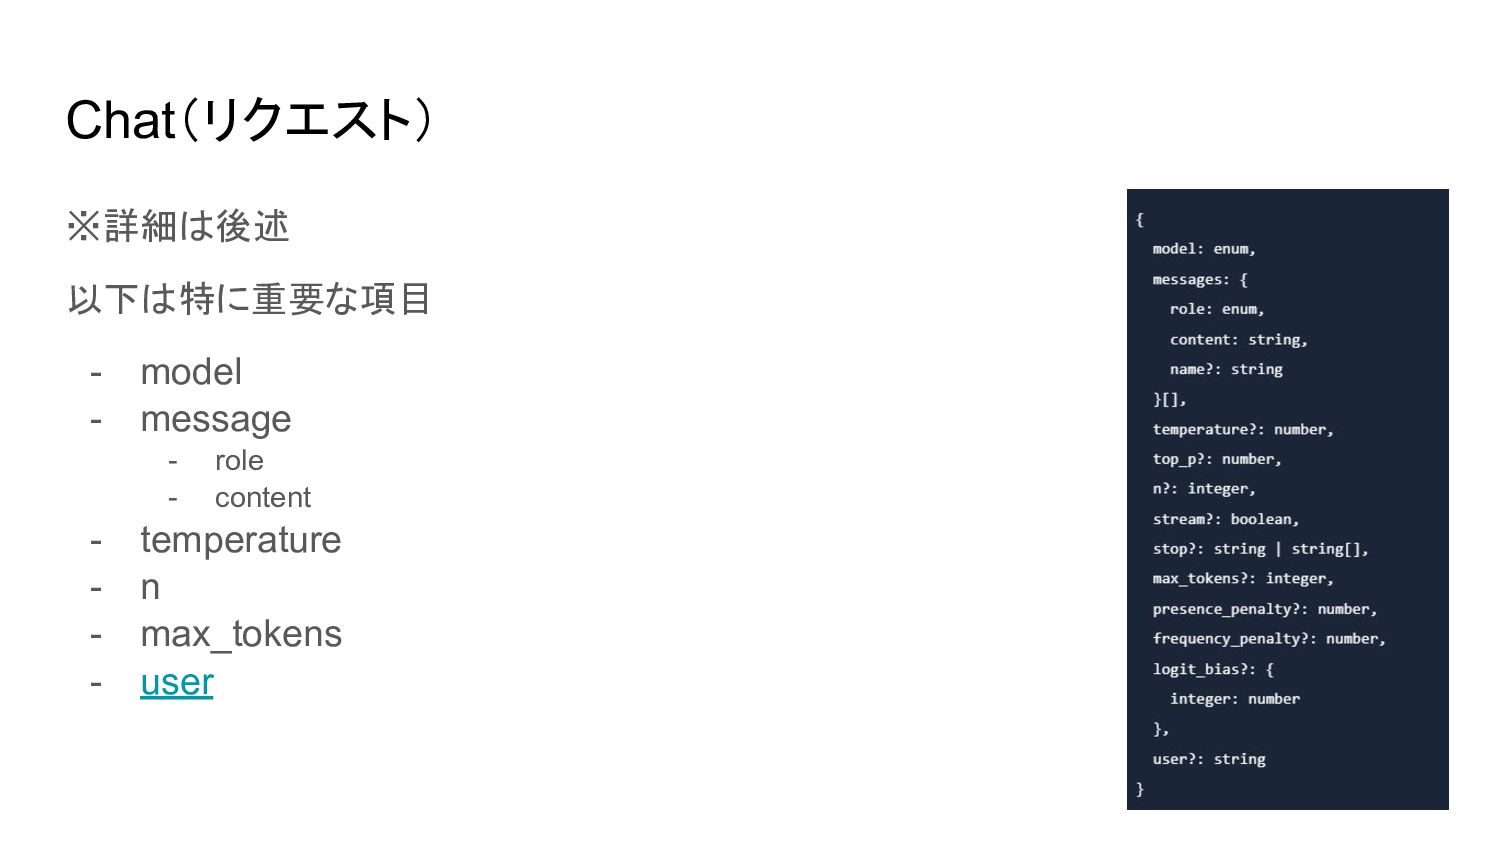
Chat(リクエスト) ※詳細は後述 以下は特に重要な項目 - model - message - role -
content - temperature - n - max_tokens - user -
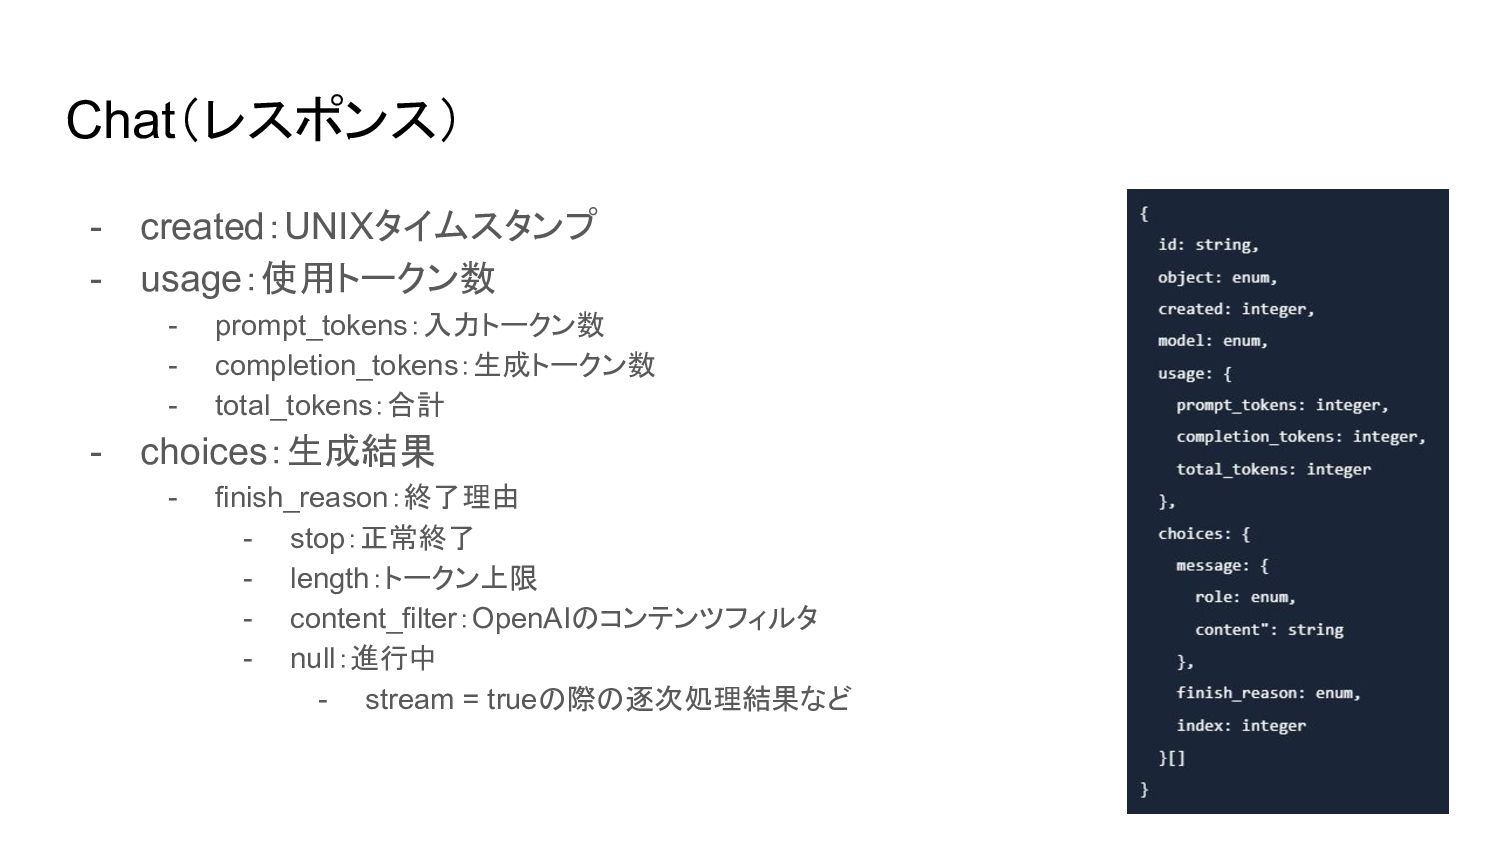
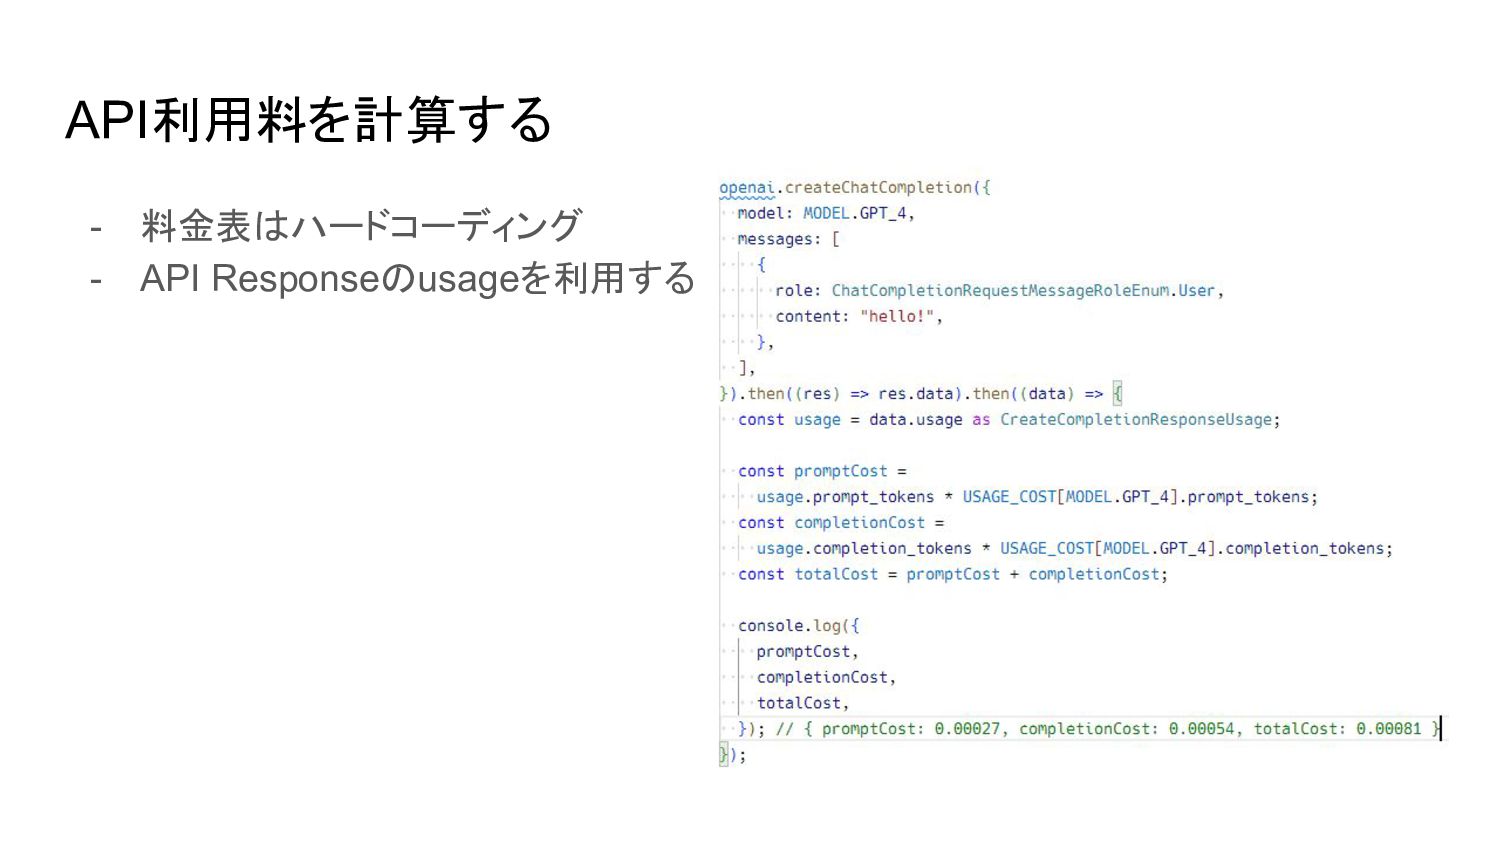
Chat(レスポンス) - created:UNIXタイムスタンプ - usage:使用トークン数 - prompt_tokens:入力トークン数 - completion_tokens:生成トークン数 -
total_tokens:合計 - choices:生成結果 - finish_reason:終了理由 - stop:正常終了 - length:トークン上限 - content_filter:OpenAIのコンテンツフィルタ - null:進行中 - stream = trueの際の逐次処理結果など -
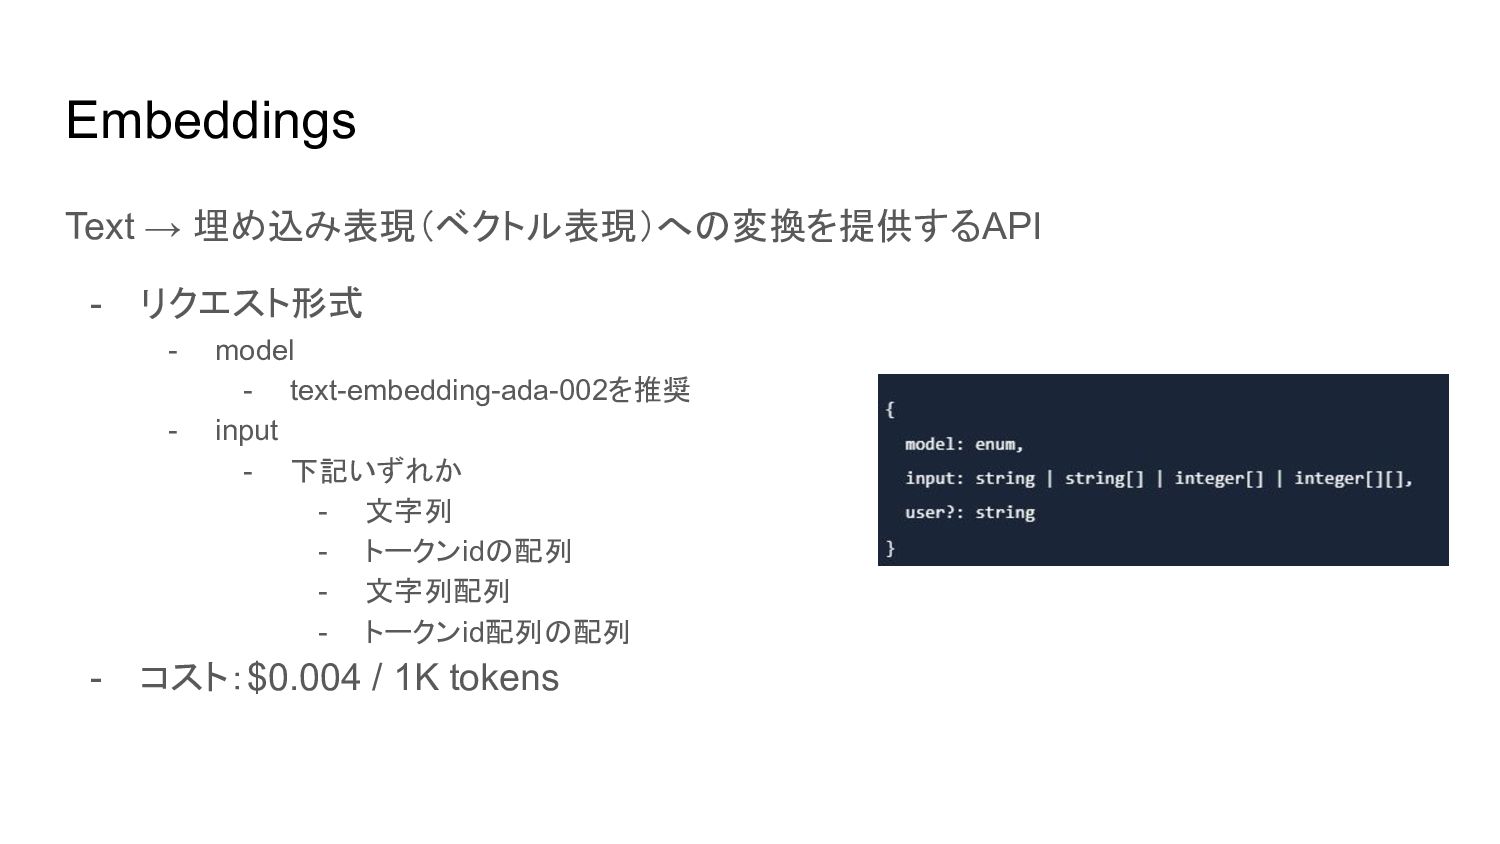
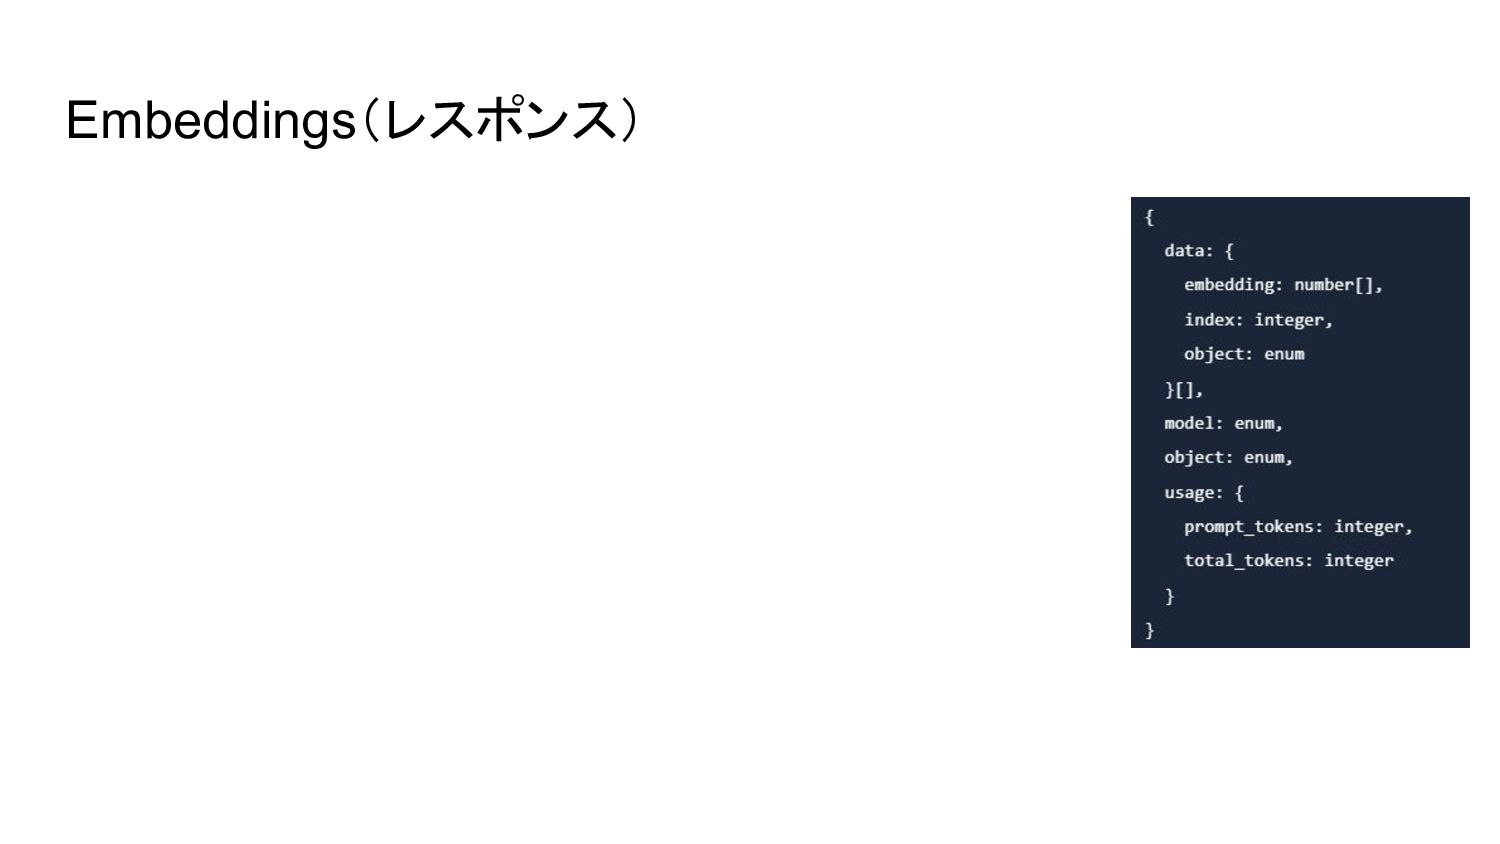
Embeddings Text → 埋め込み表現(ベクトル表現)への変換を提供するAPI - リクエスト形式 - model - text-embedding-ada-002を推奨
- input - 下記いずれか - 文字列 - トークンidの配列 - 文字列配列 - トークンid配列の配列 - コスト:$0.004 / 1K tokens -
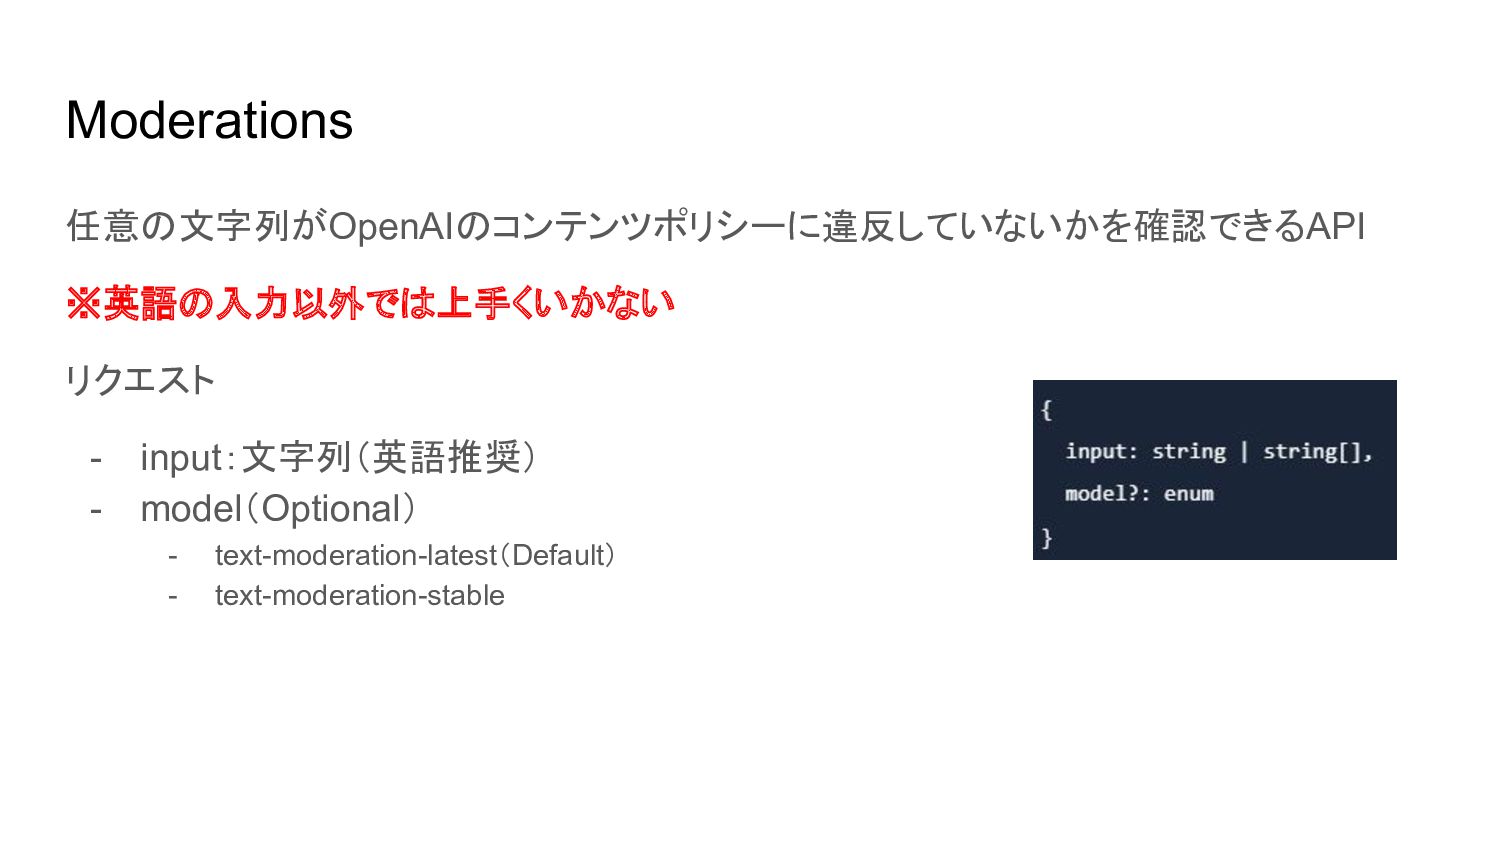
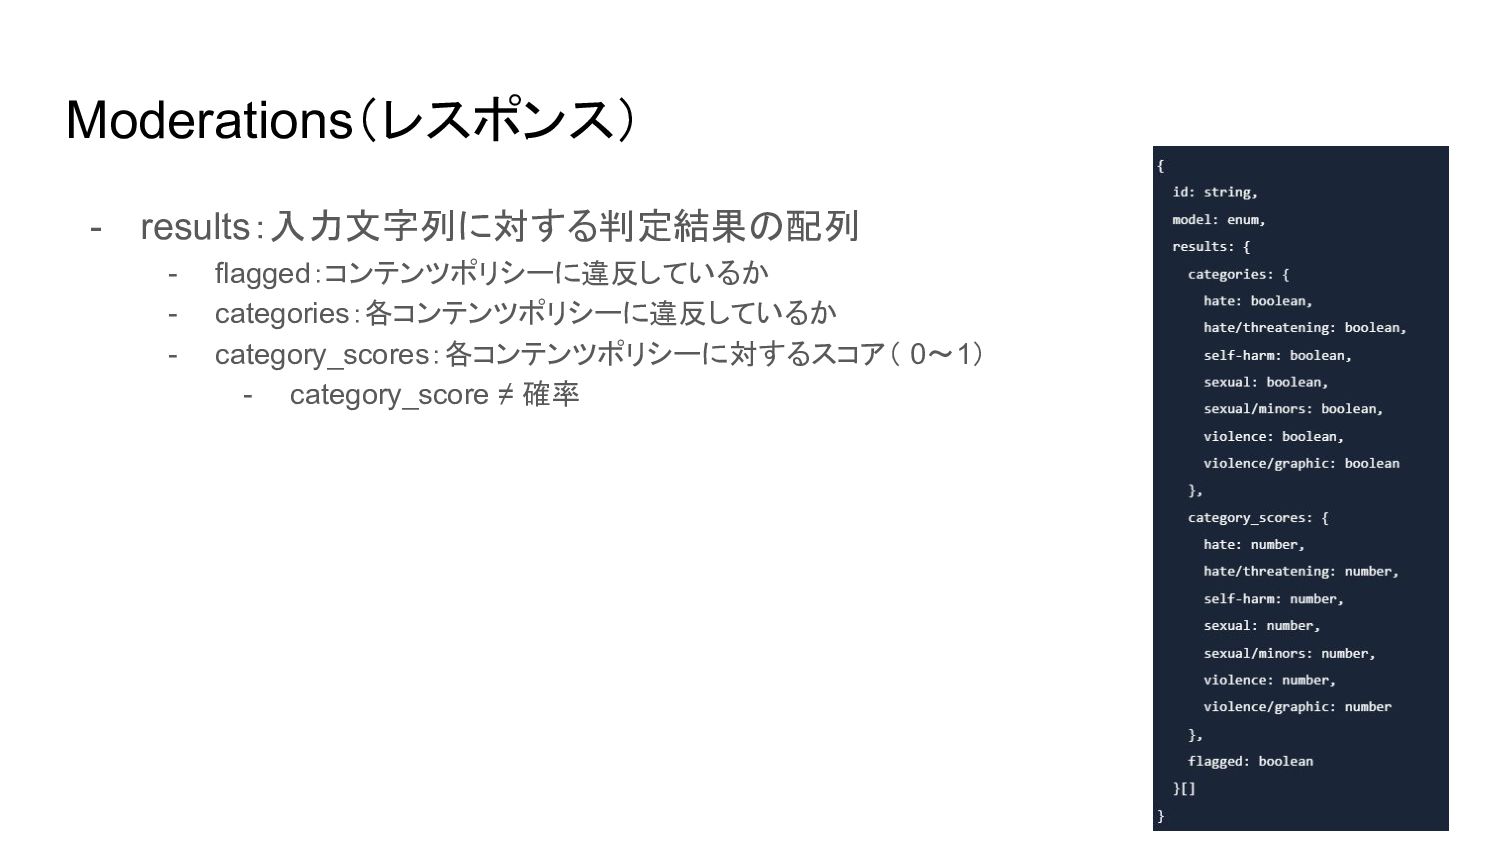
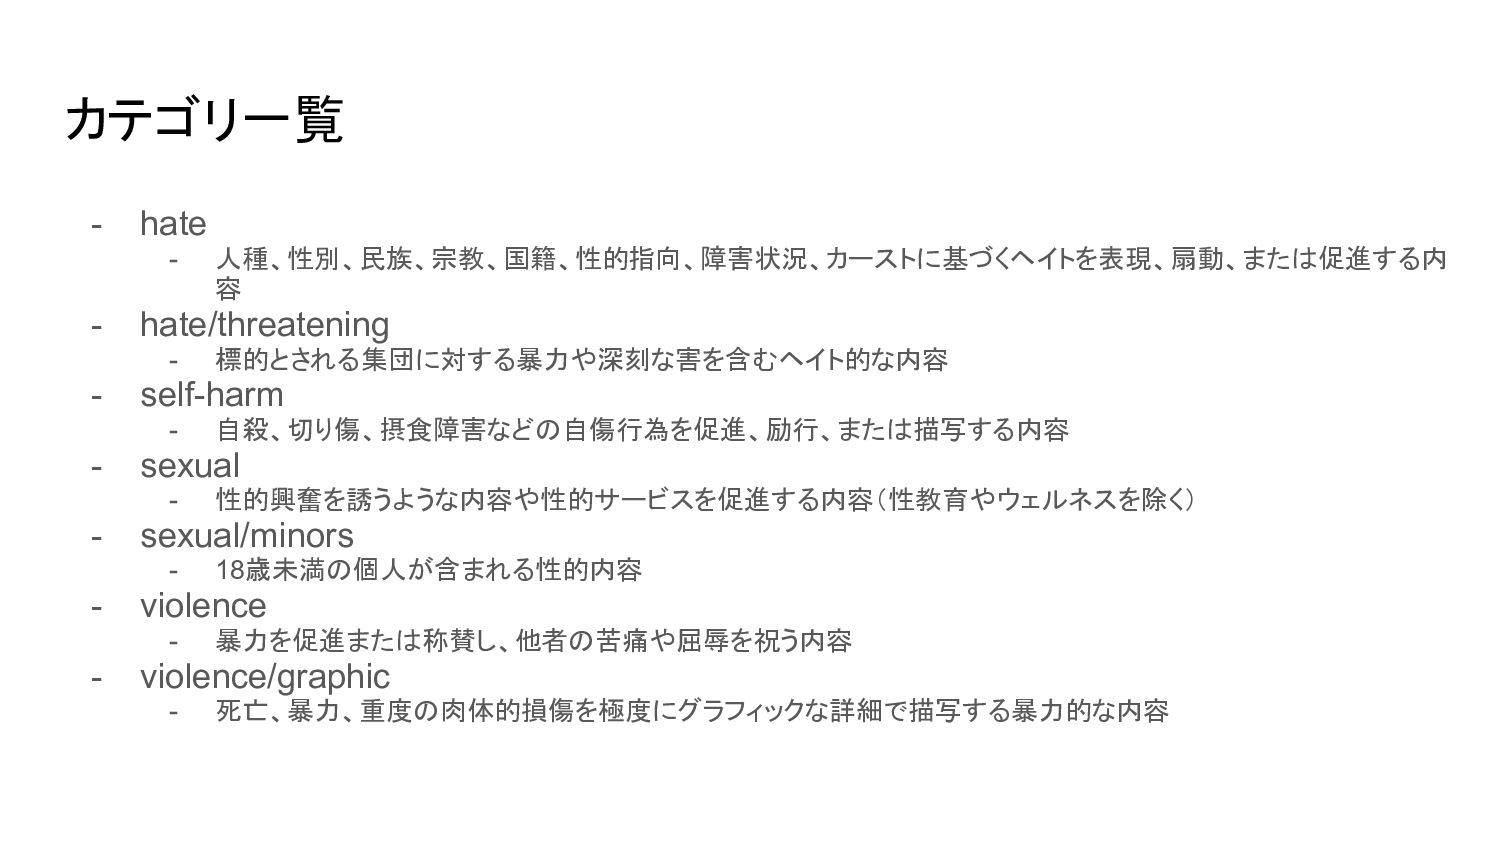
カテゴリ一覧 - hate - 人種、性別、民族、宗教、国籍、性的指向、障害状況、カーストに基づくヘイトを表現、扇動、または促進する内 容 - hate/threatening - 標的とされる集団に対する暴力や深刻な害を含むヘイト的な内容
- self-harm - 自殺、切り傷、摂食障害などの自傷行為を促進、励行、または描写する内容 - sexual - 性的興奮を誘うような内容や性的サービスを促進する内容(性教育やウェルネスを除く) - sexual/minors - 18歳未満の個人が含まれる性的内容 - violence - 暴力を促進または称賛し、他者の苦痛や屈辱を祝う内容 - violence/graphic - 死亡、暴力、重度の肉体的損傷を極度にグラフィックな詳細で描写する暴力的な内容 -
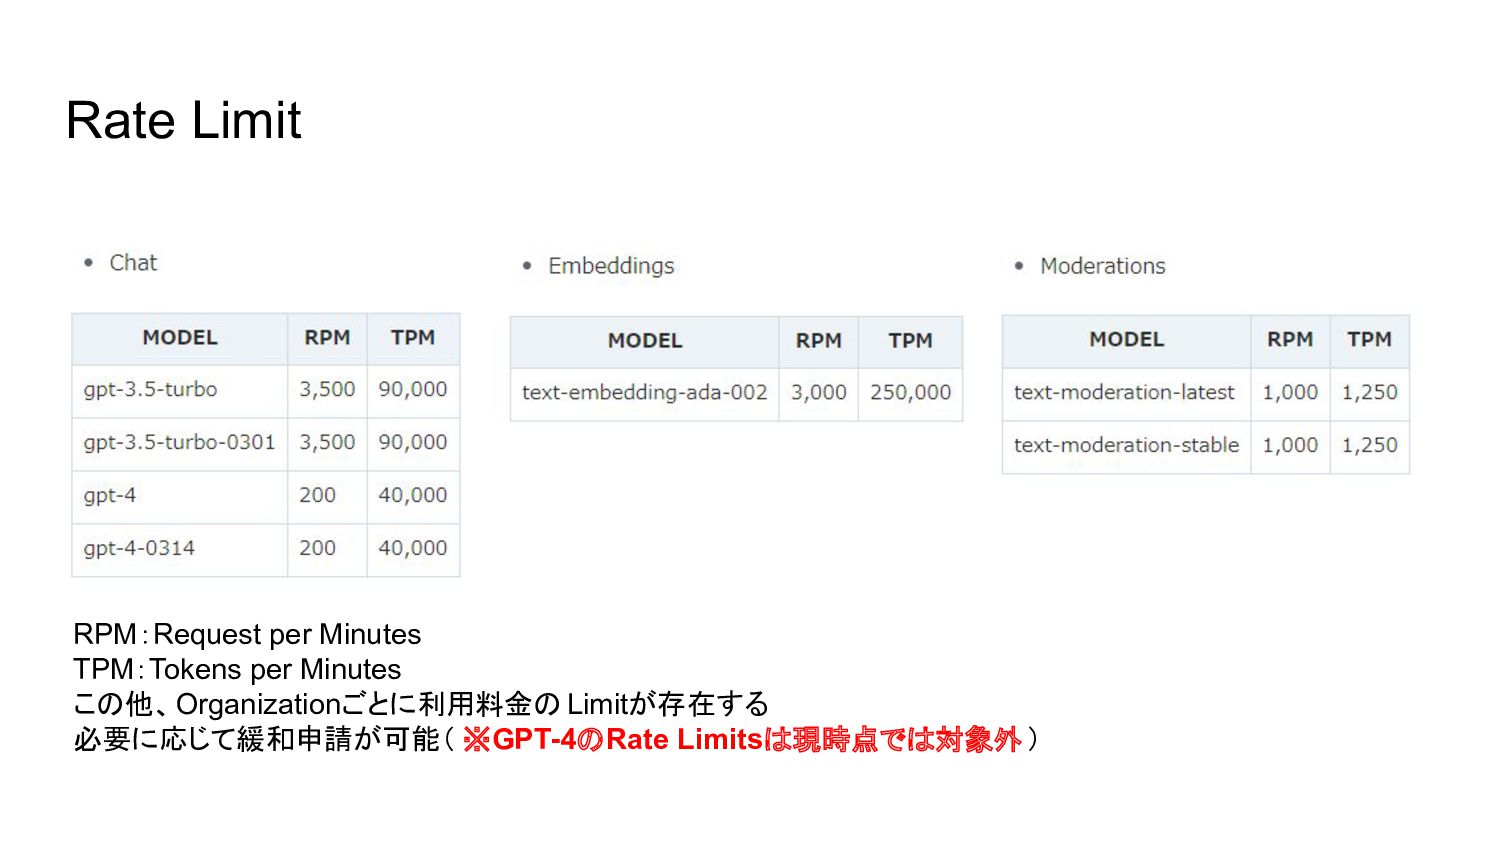
Rate Limit RPM:Request per Minutes TPM:Tokens per Minutes この他、Organizationごとに利用料金のLimitが存在する 必要に応じて緩和申請が可能(
※GPT-4のRate Limitsは現時点では対象外 ) -
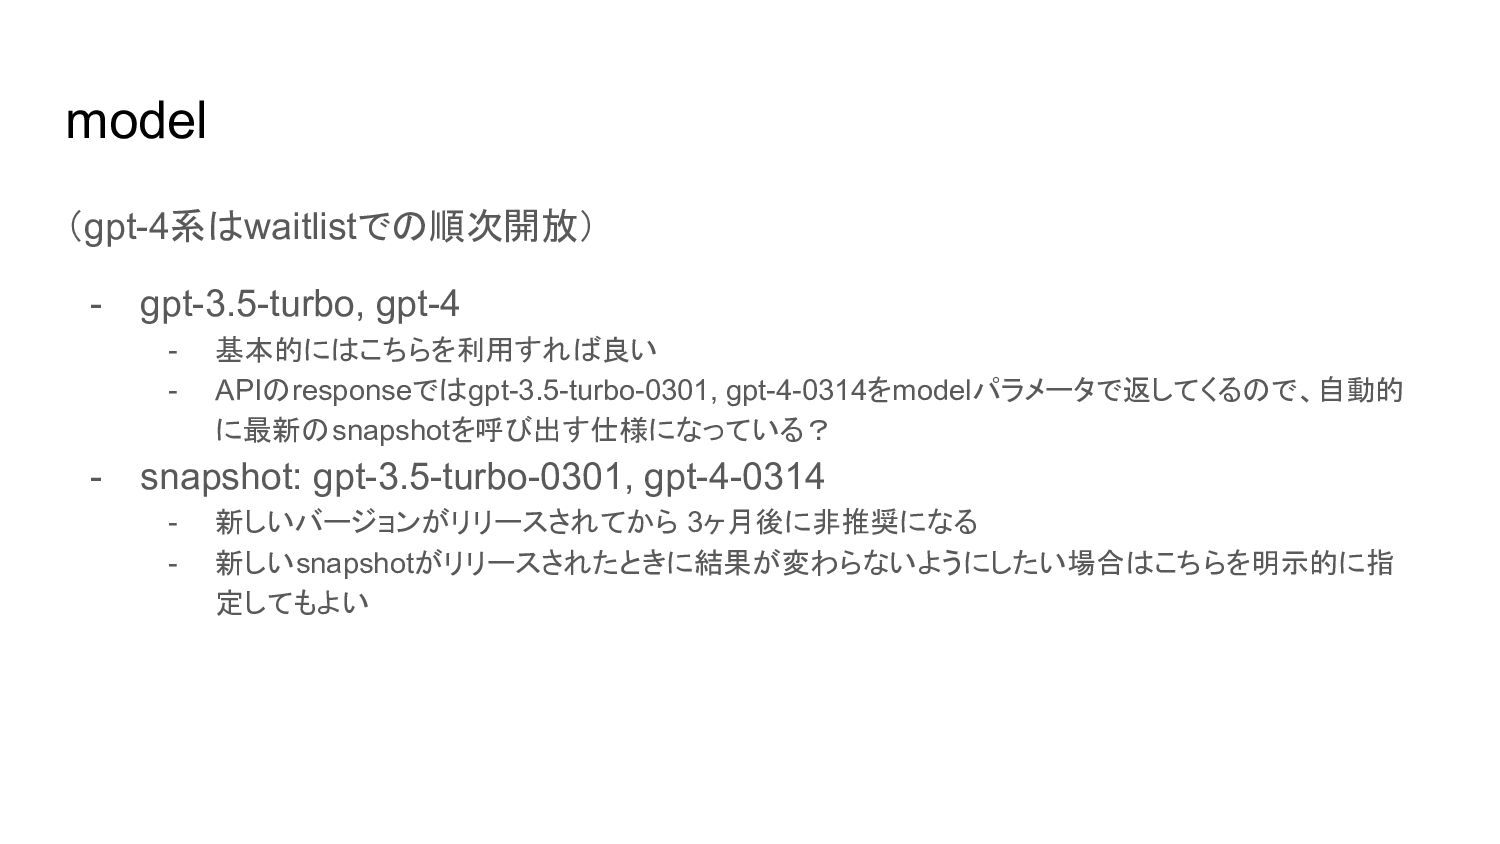
model (gpt-4系はwaitlistでの順次開放) - gpt-3.5-turbo, gpt-4 - 基本的にはこちらを利用すれば良い - APIのresponseではgpt-3.5-turbo-0301, gpt-4-0314をmodelパラメータで返してくるので、自動的
に最新のsnapshotを呼び出す仕様になっている? - snapshot: gpt-3.5-turbo-0301, gpt-4-0314 - 新しいバージョンがリリースされてから 3ヶ月後に非推奨になる - 新しいsnapshotがリリースされたときに結果が変わらないようにしたい場合はこちらを明示的に指 定してもよい -
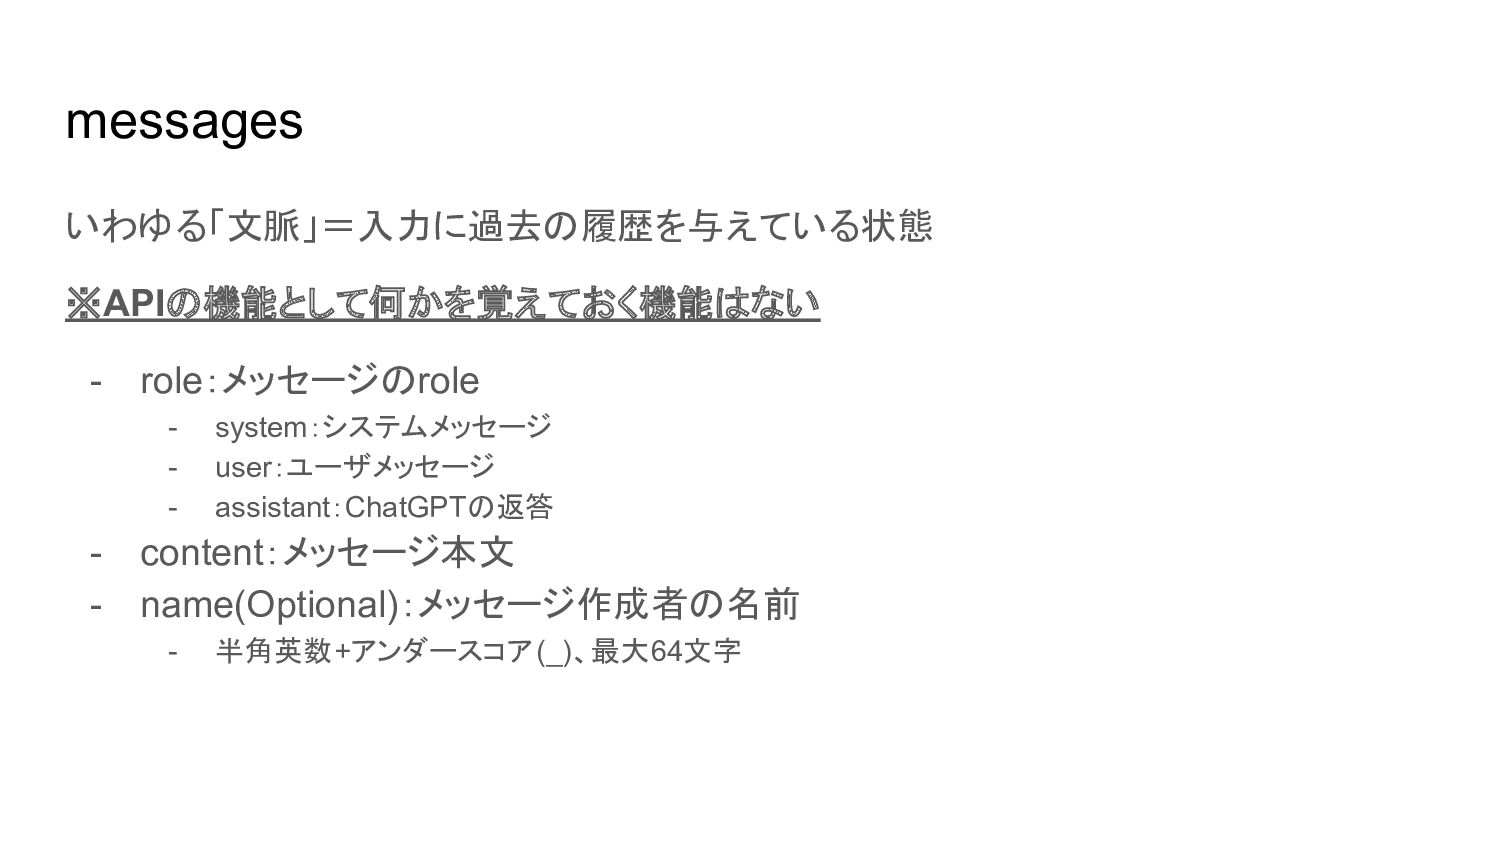
messages いわゆる「文脈」=入力に過去の履歴を与えている状態 ※APIの機能として何かを覚えておく機能はない - role:メッセージのrole - system:システムメッセージ - user:ユーザメッセージ -
assistant:ChatGPTの返答 - content:メッセージ本文 - name(Optional):メッセージ作成者の名前 - 半角英数+アンダースコア(_)、最大64文字 -
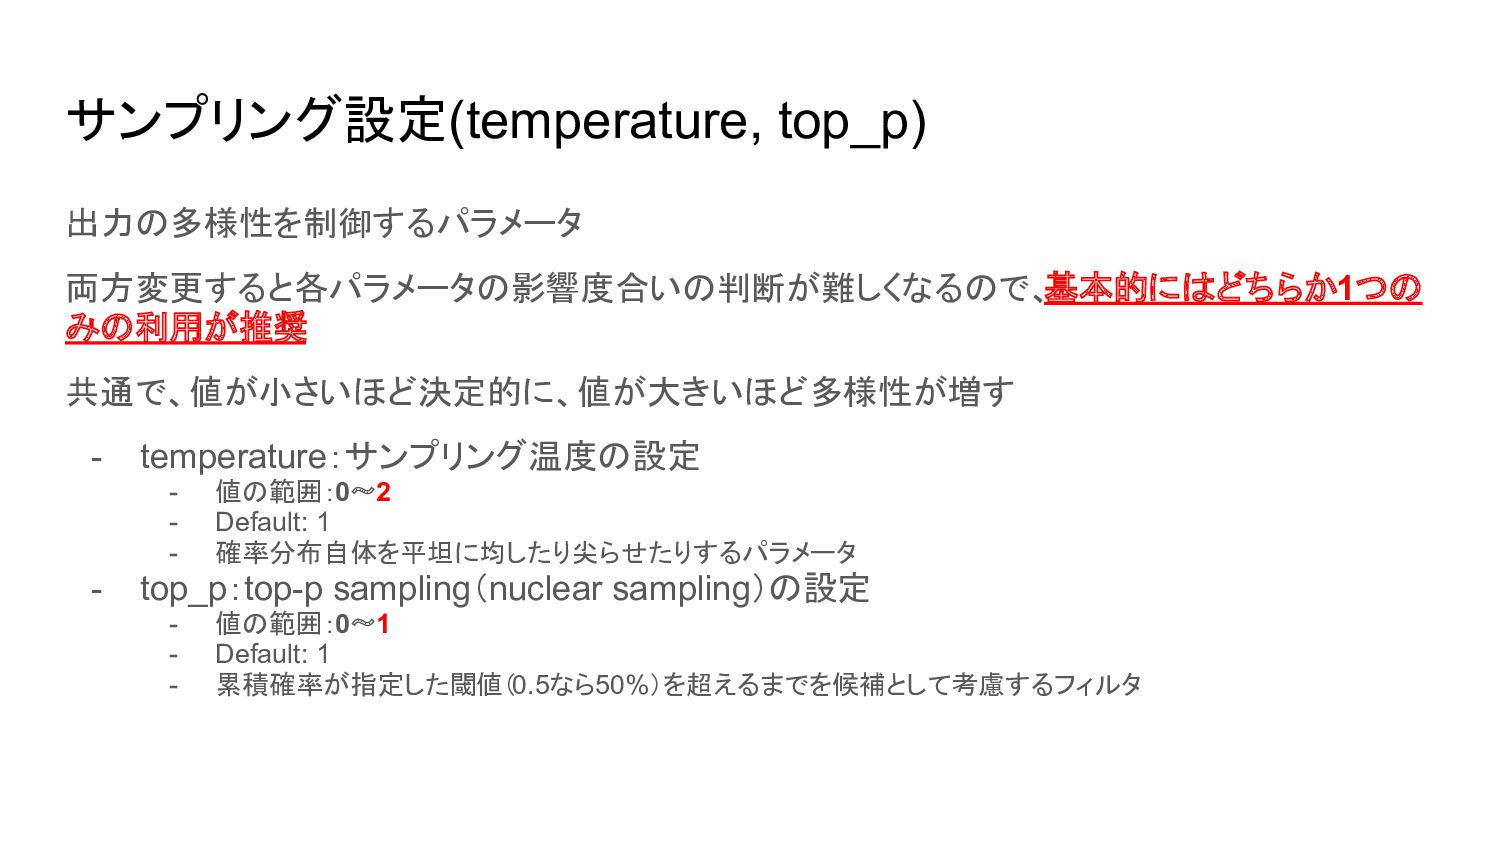
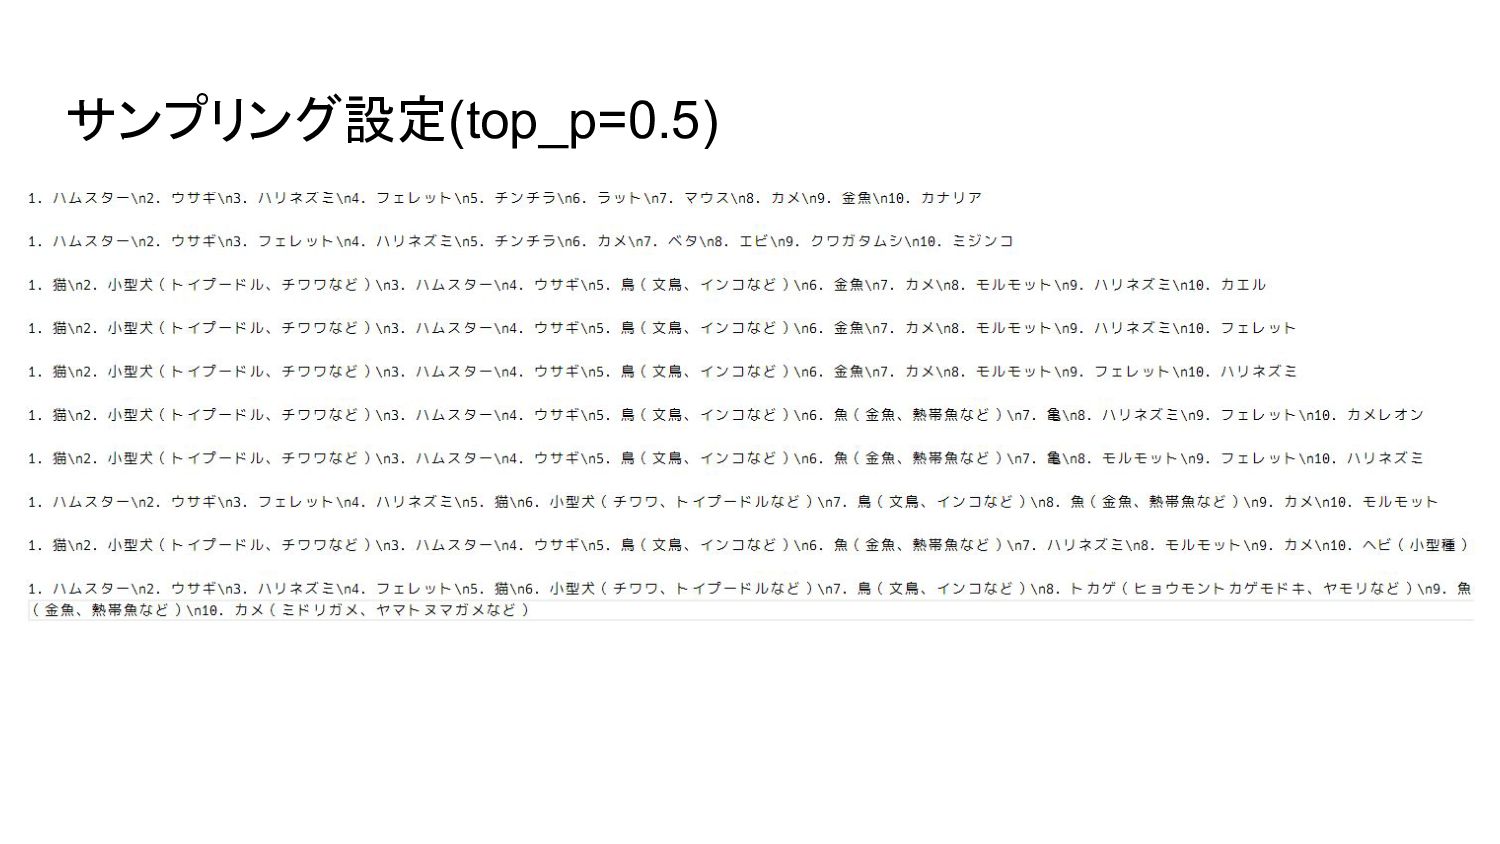
サンプリング設定(temperature, top_p) 出力の多様性を制御するパラメータ 両方変更すると各パラメータの影響度合いの判断が難しくなるので、 基本的にはどちらか1つの みの利用が推奨 共通で、値が小さいほど決定的に、値が大きいほど多様性が増す - temperature:サンプリング温度の設定 -
値の範囲:0~2 - Default: 1 - 確率分布自体を平坦に均したり尖らせたりするパラメータ - top_p:top-p sampling(nuclear sampling)の設定 - 値の範囲:0~1 - Default: 1 - 累積確率が指定した閾値(0.5なら50%)を超えるまでを候補として考慮するフィルタ -
サンプリング設定の仕組み ChatGPT (LLM) temperature ︙ top_p sampling token A 0.2
token B 0.15 … … token X 0.01 output token ※図 -
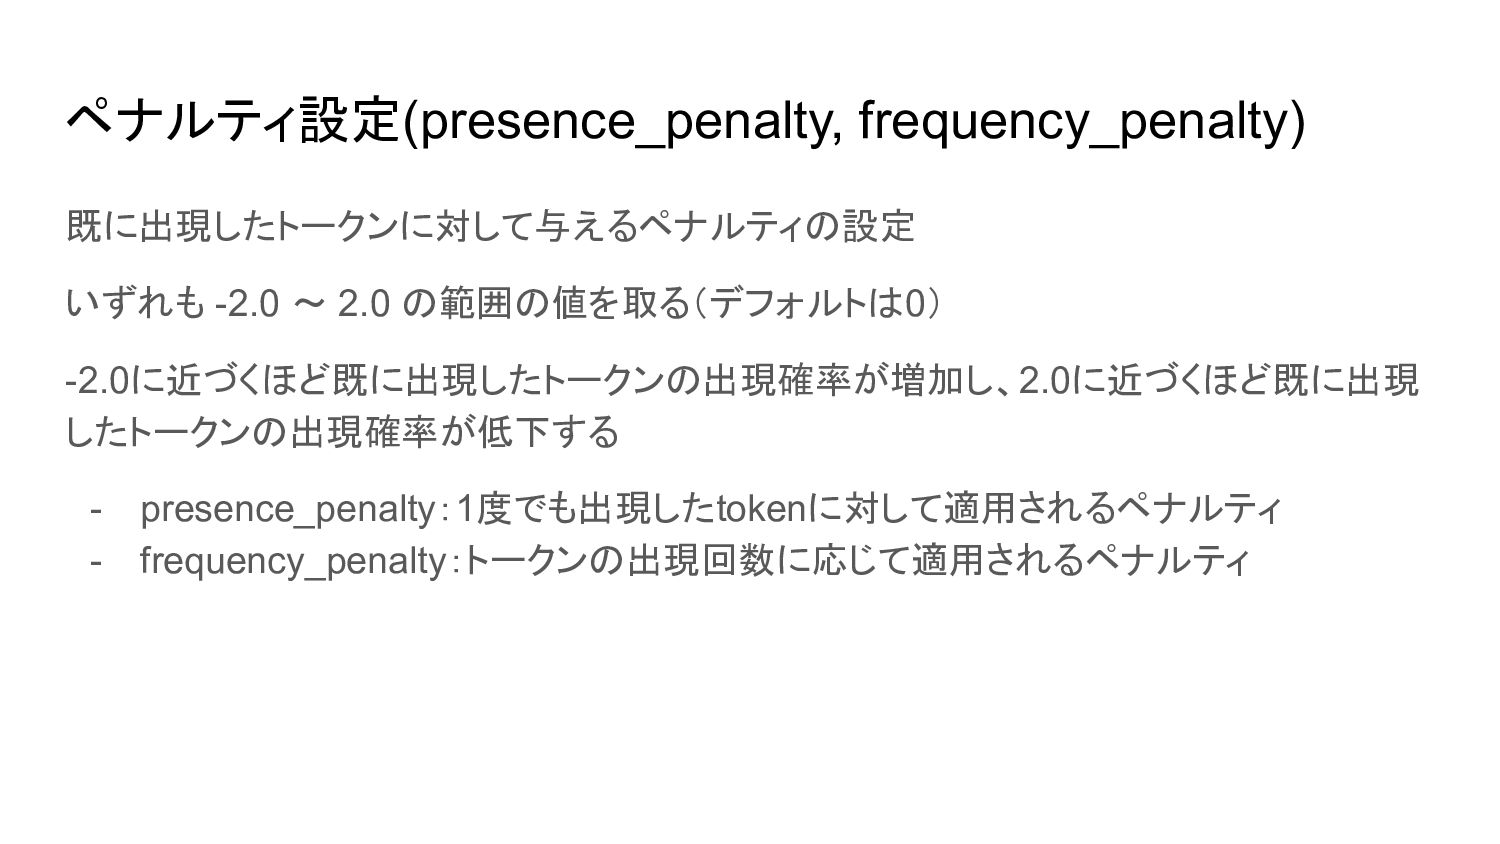
ペナルティ設定(presence_penalty, frequency_penalty) 既に出現したトークンに対して与えるペナルティの設定 いずれも -2.0 ~ 2.0 の範囲の値を取る(デフォルトは0) -2.0に近づくほど既に出現したトークンの出現確率が増加し、2.0に近づくほど既に出現 したトークンの出現確率が低下する
- presence_penalty:1度でも出現したtokenに対して適用されるペナルティ - frequency_penalty:トークンの出現回数に応じて適用されるペナルティ -
トークンの出現確率に対するペナルティ計算 - トークンの出現確率(正確にはロジット = 正規化前の対数確率)の計算 - mu[j] -> mu[j] -
c[j] * alpha_frequency - float(c[j] > 0) * alpha_presence - mu[j]:j番目のトークンのロジット - c[j]:現在位置までにj番目のトークンがサンプリングされた頻度 - float(c[j] > 0):c[j] > 0 ? 1 : 0 - alpha_frequency:frequency_penalty - alpha_presence:presence_penalty - presence_penalty:これまでに出現した全トークンに対して等しくペナルティを課す - frequency_penalty:出現回数が多いトークンに対してより大きなペナルティを課す - 式には書かれていないが、関連するパラメータとして logit_bias もある -
その他のOptionalパラメータ - stream:ChatGPTのWeb UIのように生成結果を逐次的に受け取る設定 - boolean - stop:特定の文字列が生成される前に自動的にストップする設定 - string[]
- max_tokens:上限トークン数(最大値はデフォルト) - integer - logit_bias:トークン単位の生成確率制御 - トークンidとパラメータのMap - user:ユーザID - 何らかの問題が発生した際に OpenAIからのフィードバックに利用される(?) -
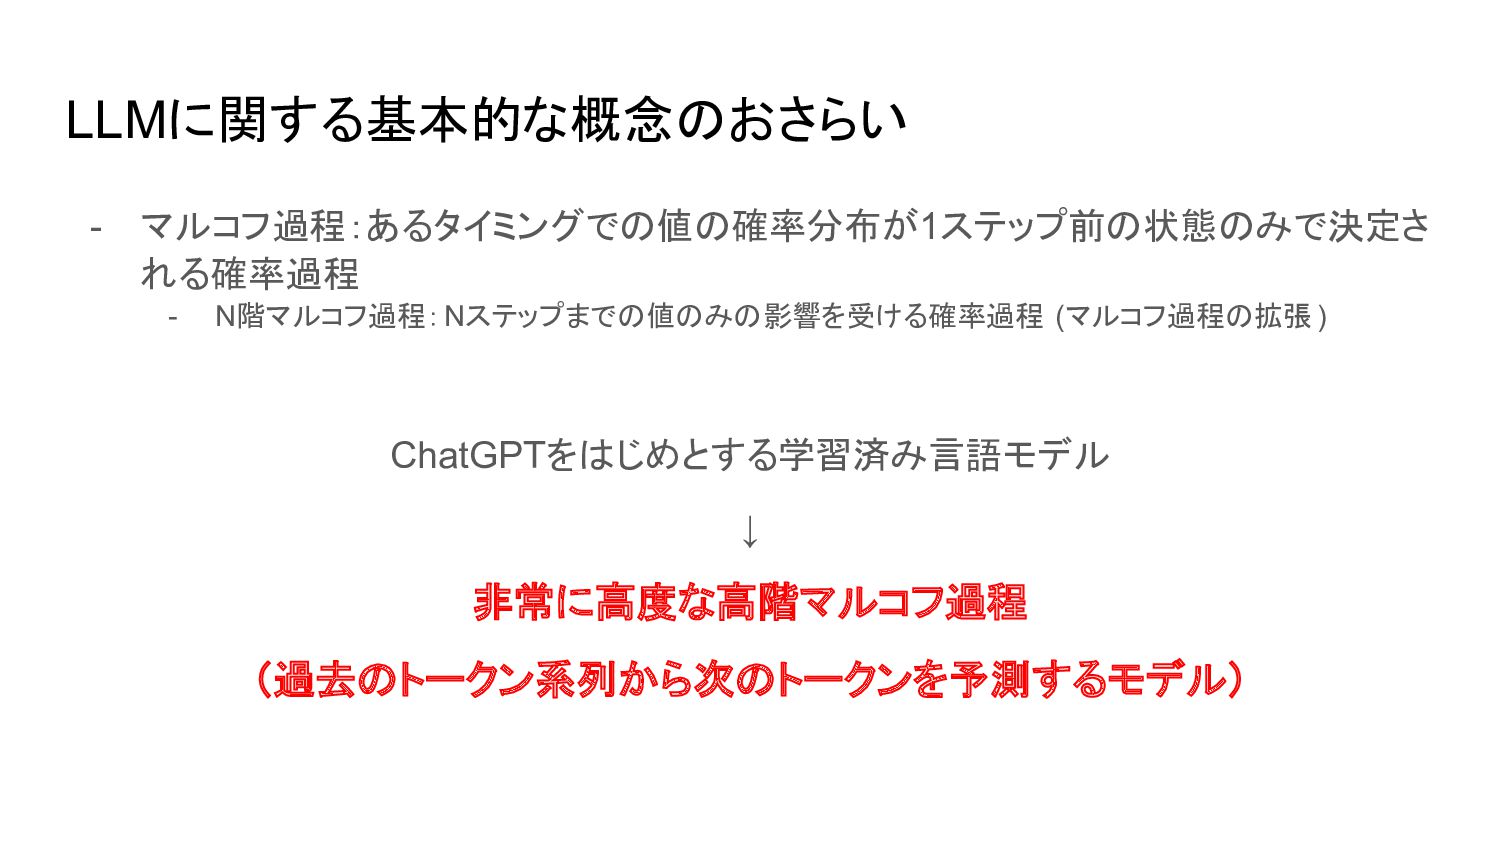
LLMに関する基本的な概念のおさらい - マルコフ過程:あるタイミングでの値の確率分布が1ステップ前の状態のみで決定さ れる確率過程 - N階マルコフ過程:Nステップまでの値のみの影響を受ける確率過程 (マルコフ過程の拡張 ) ChatGPTをはじめとする学習済み言語モデル ↓
非常に高度な高階マルコフ過程 (過去のトークン系列から次のトークンを予測するモデル) -
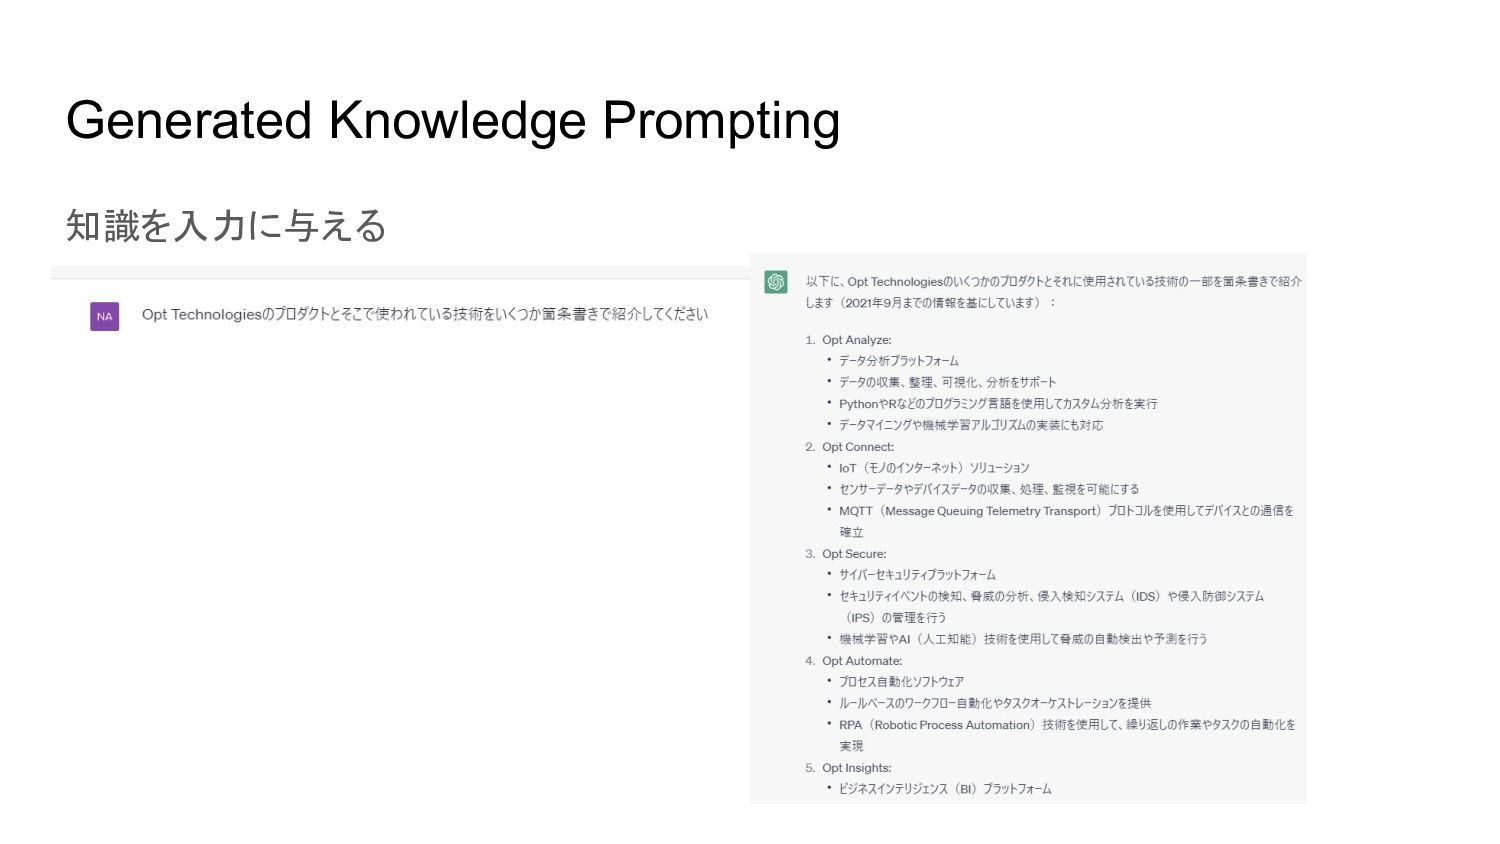
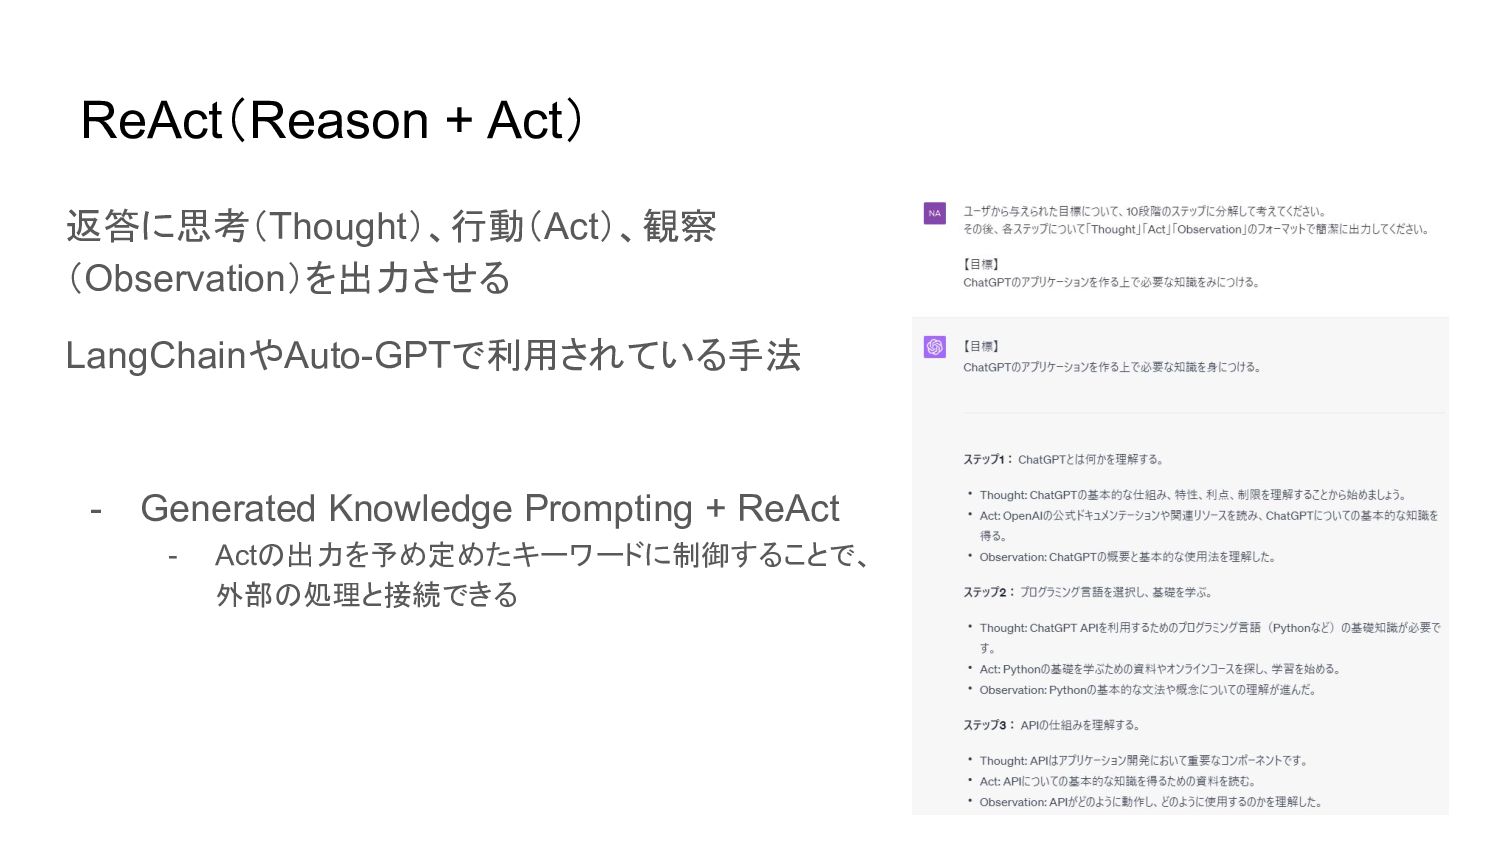
ReAct(Reason + Act) 返答に思考(Thought)、行動(Act)、観察 (Observation)を出力させる LangChainやAuto-GPTで利用されている手法 - Generated Knowledge Prompting
+ ReAct - Actの出力を予め定めたキーワードに制御することで、 外部の処理と接続できる -
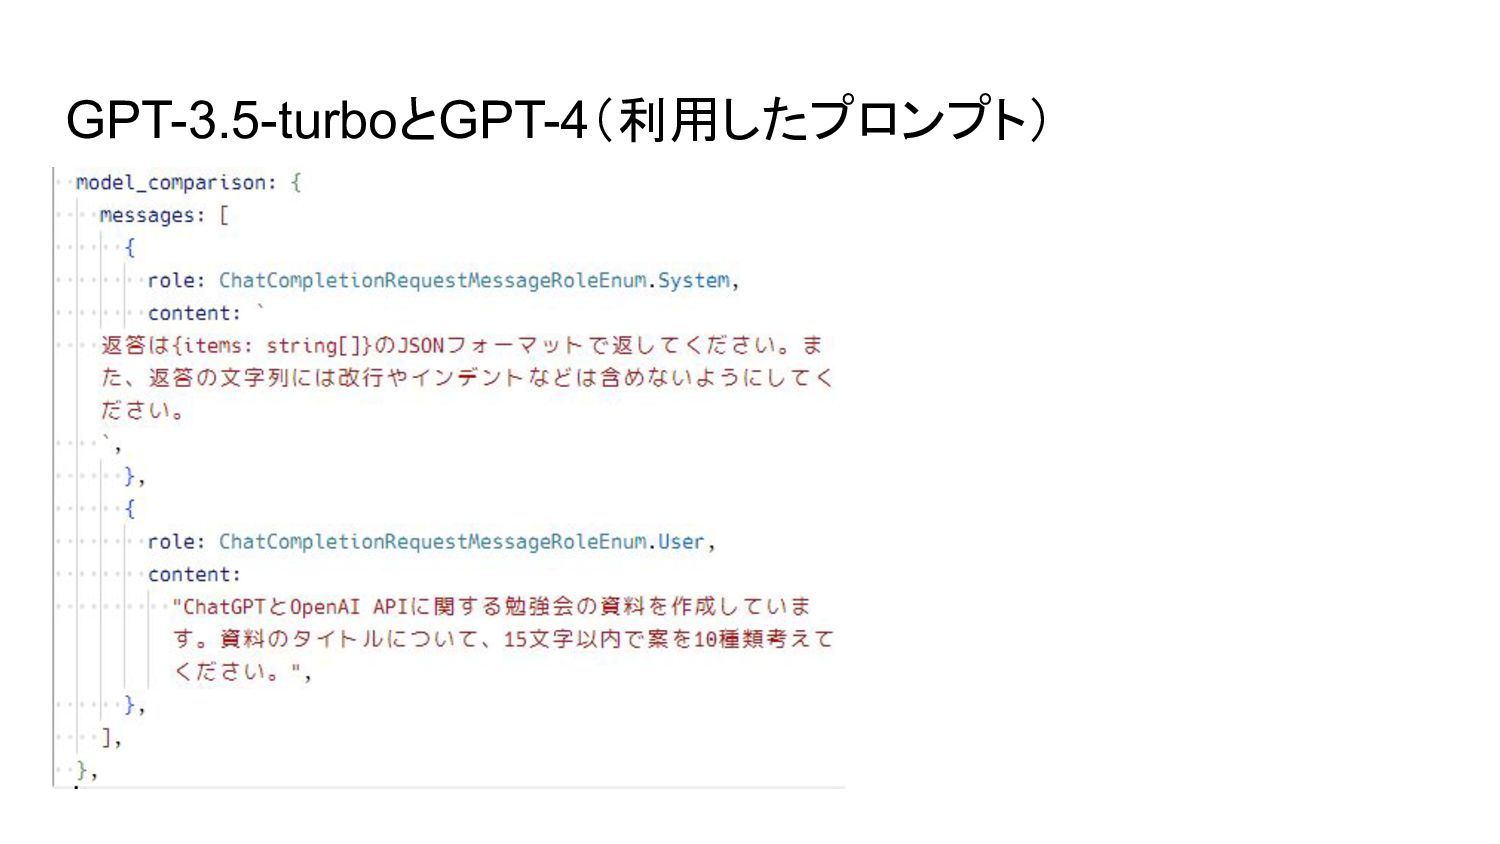
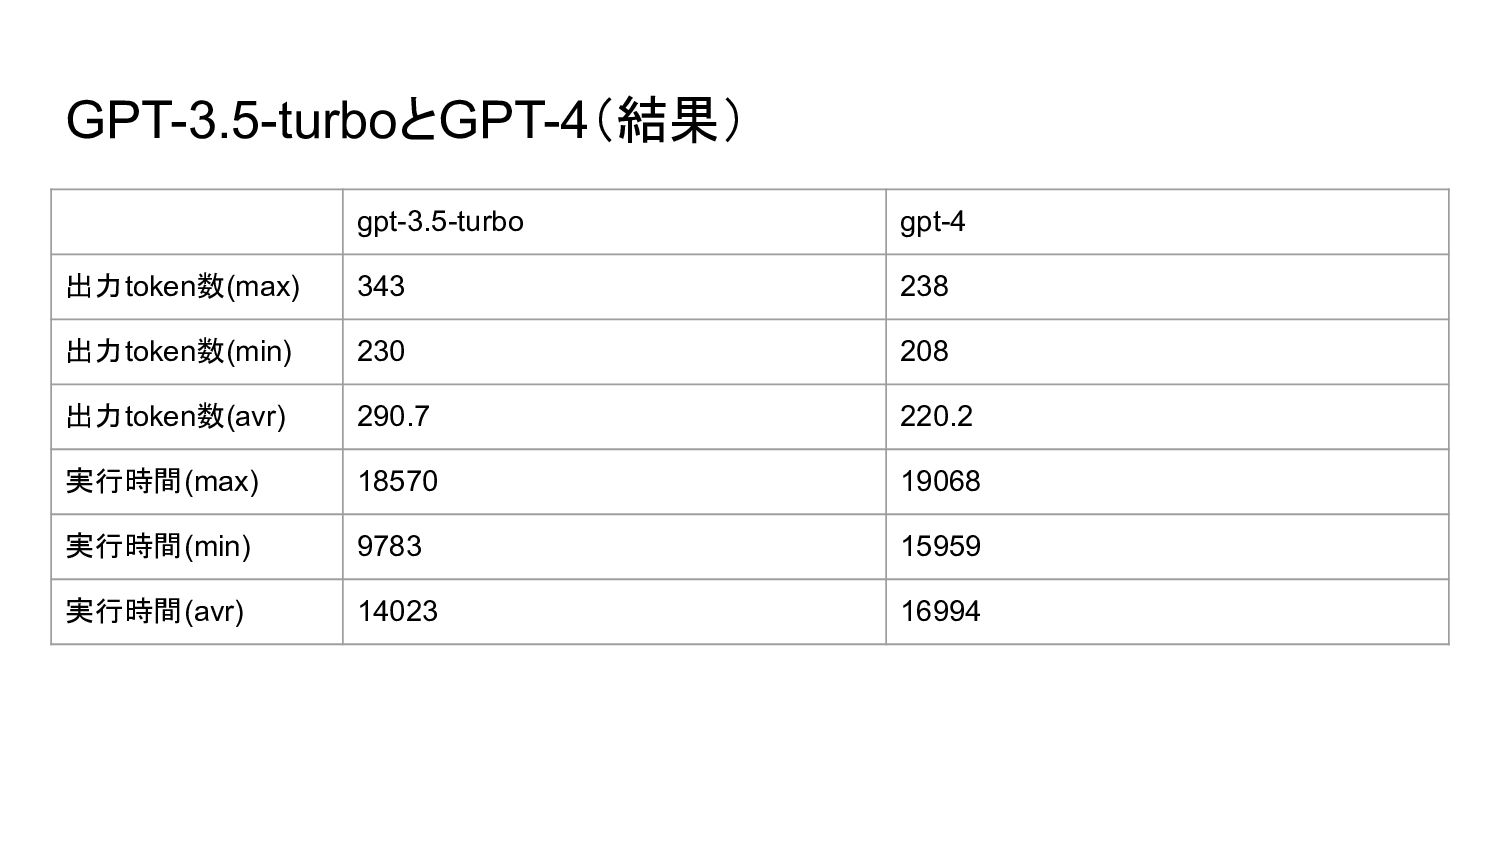
GPT-3.5-turboとGPT-4(結果) gpt-3.5-turbo gpt-4 出力token数(max) 343 238 出力token数(min) 230 208 出力token数(avr)
290.7 220.2 実行時間(max) 18570 19068 実行時間(min) 9783 15959 実行時間(avr) 14023 16994 -
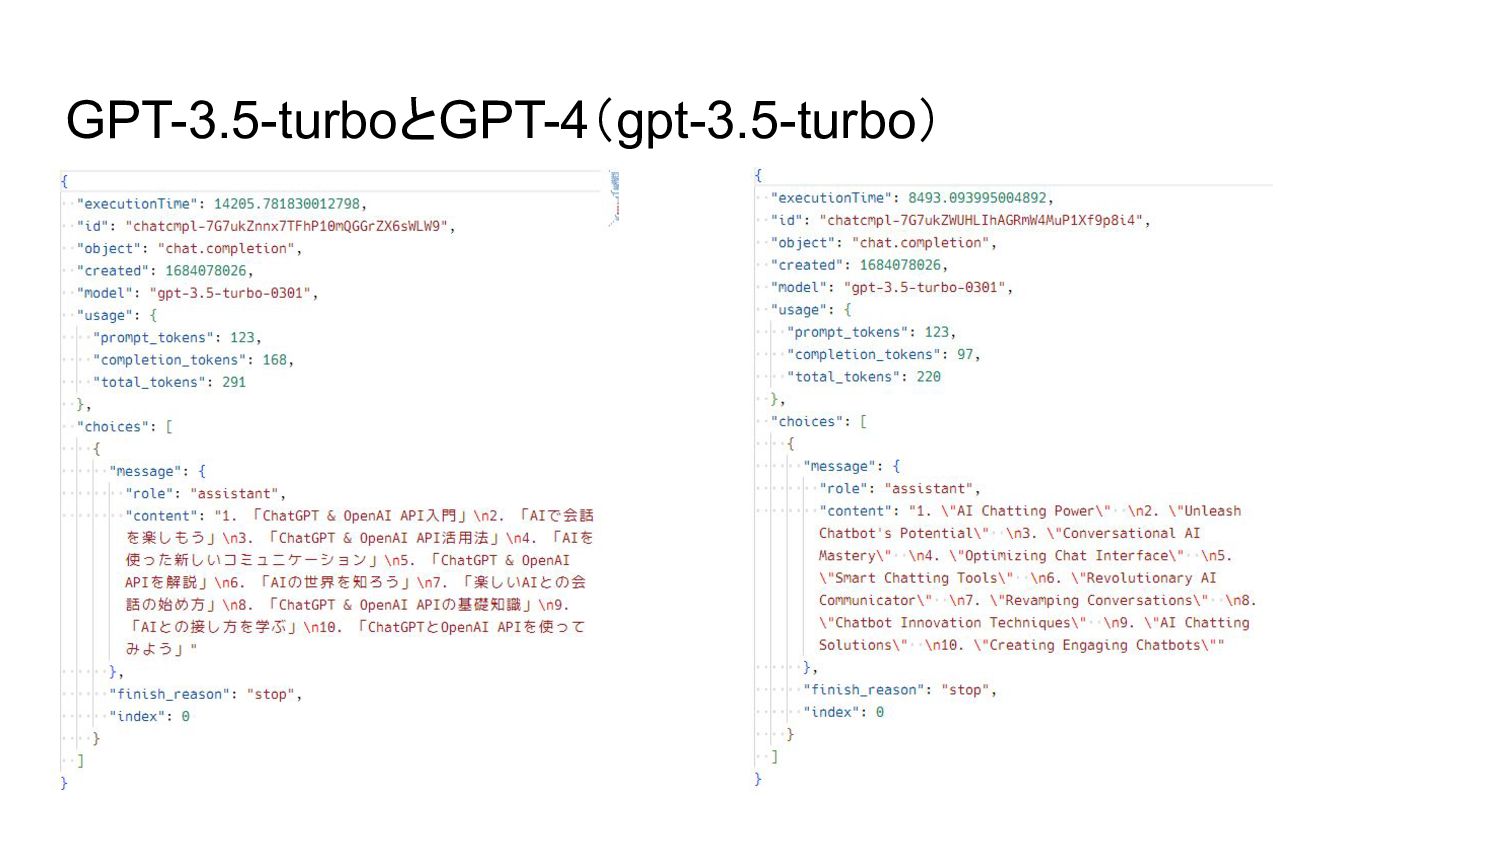
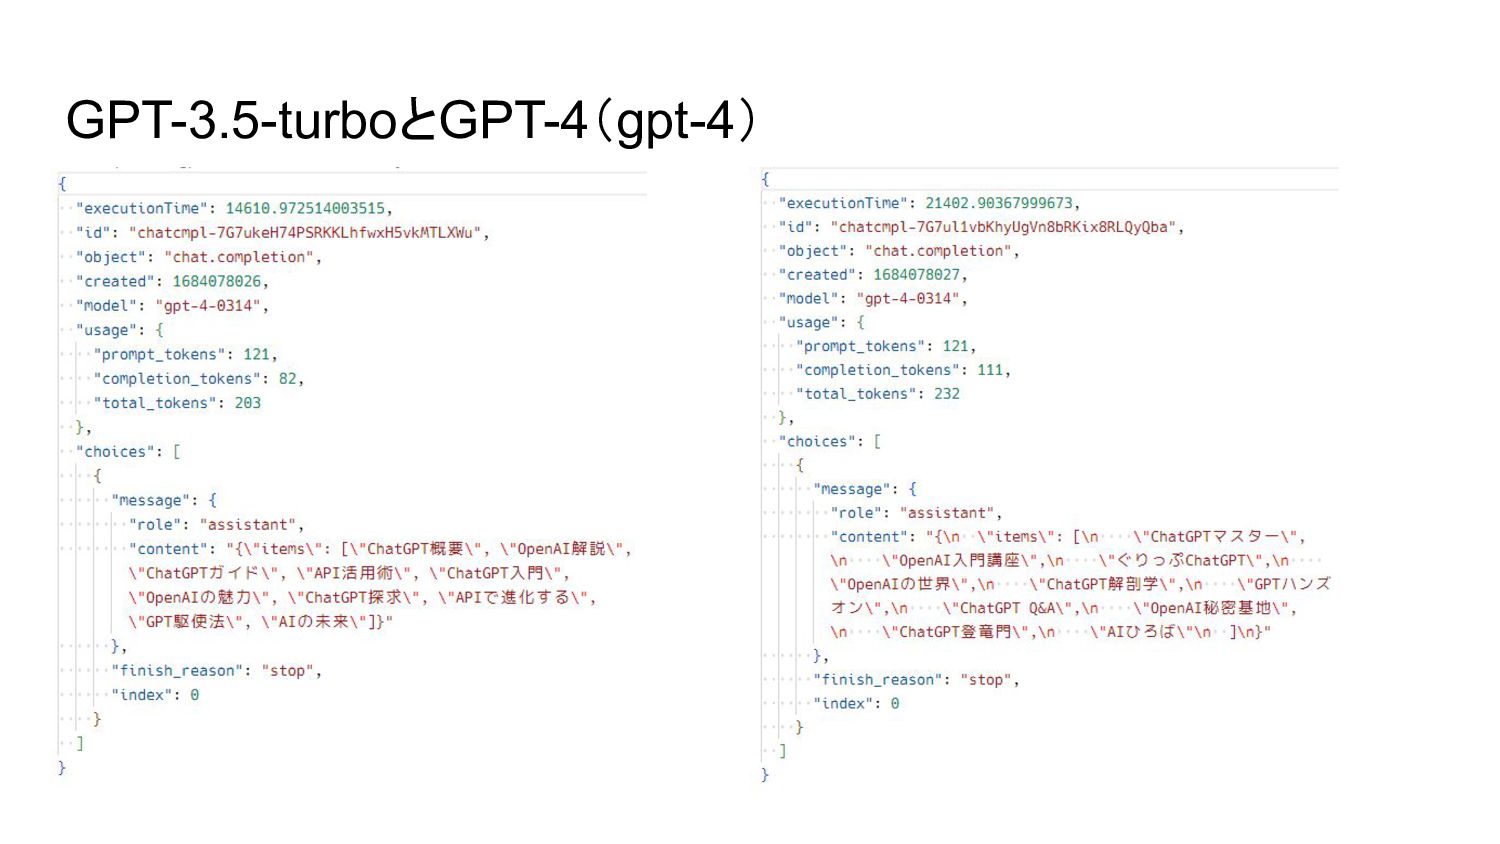
GPT-3.5-turboとGPT-4(考察) - 条件の解釈はGPT-4のほうが圧倒的に強い - 比較的雑な指定でも JSON形式などフォーマットが整う - GPT-4は比較的簡素な出力になりやすい - 文字数制限を付けない場合でも基本的に
GPT-3.5-Turboよりもシンプルな出力が出る - 平均出力トークン数がGPT-4のほうが少ないが、実行時間はGPT-4のほうが長い -
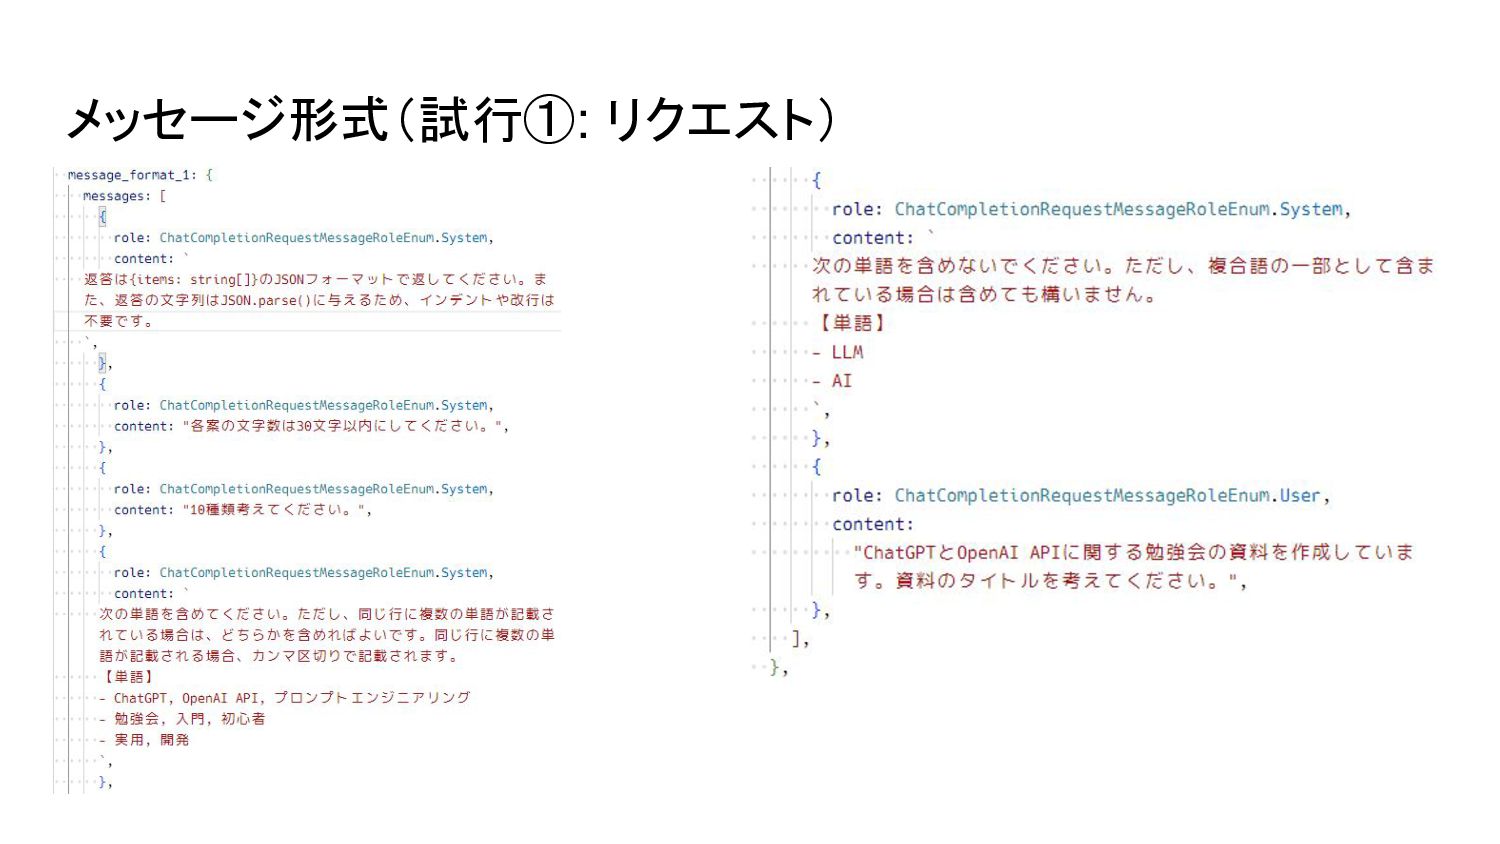
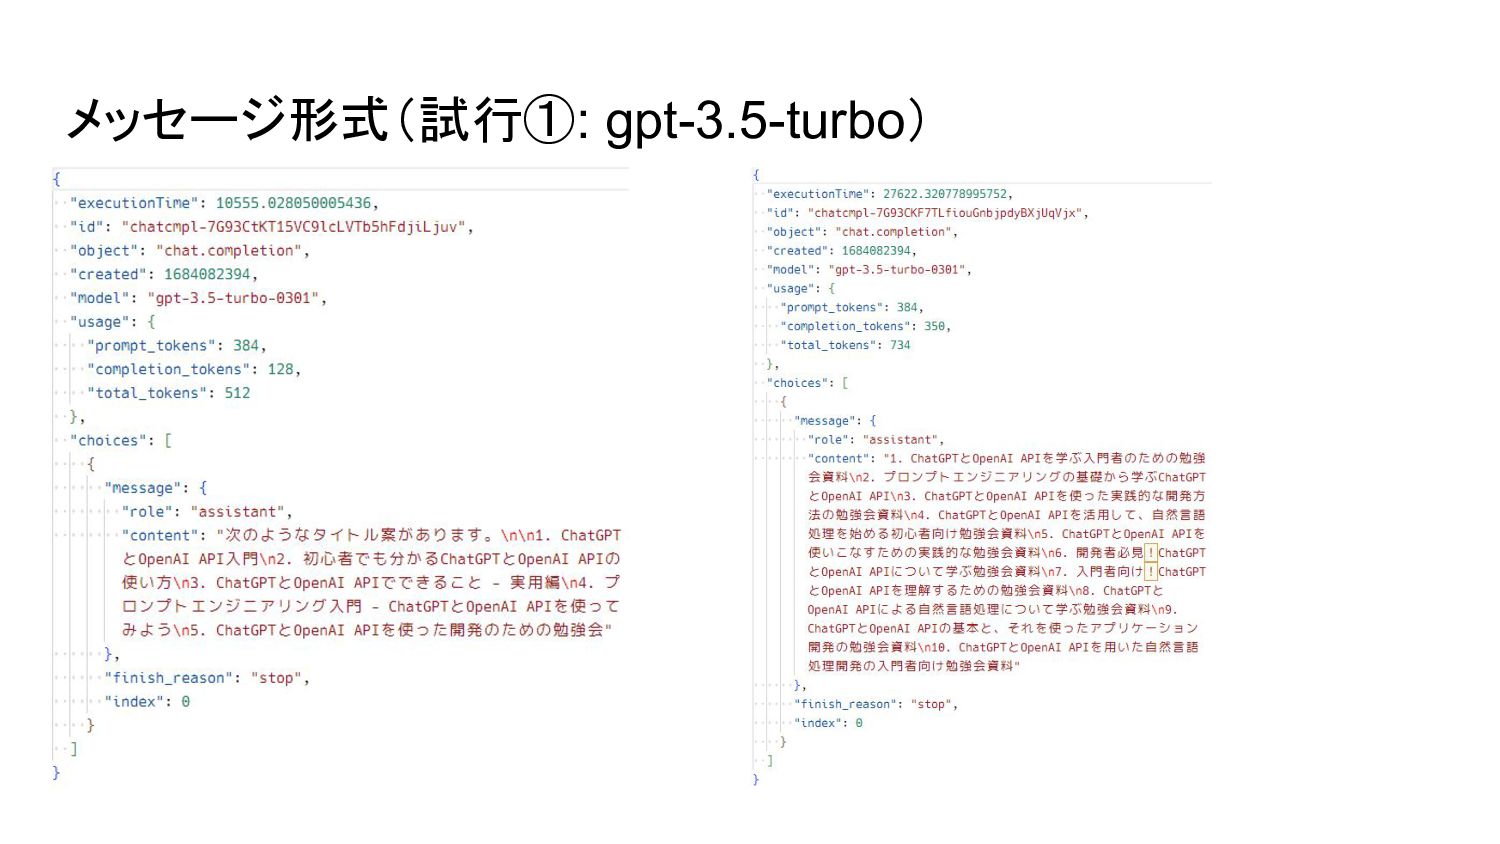
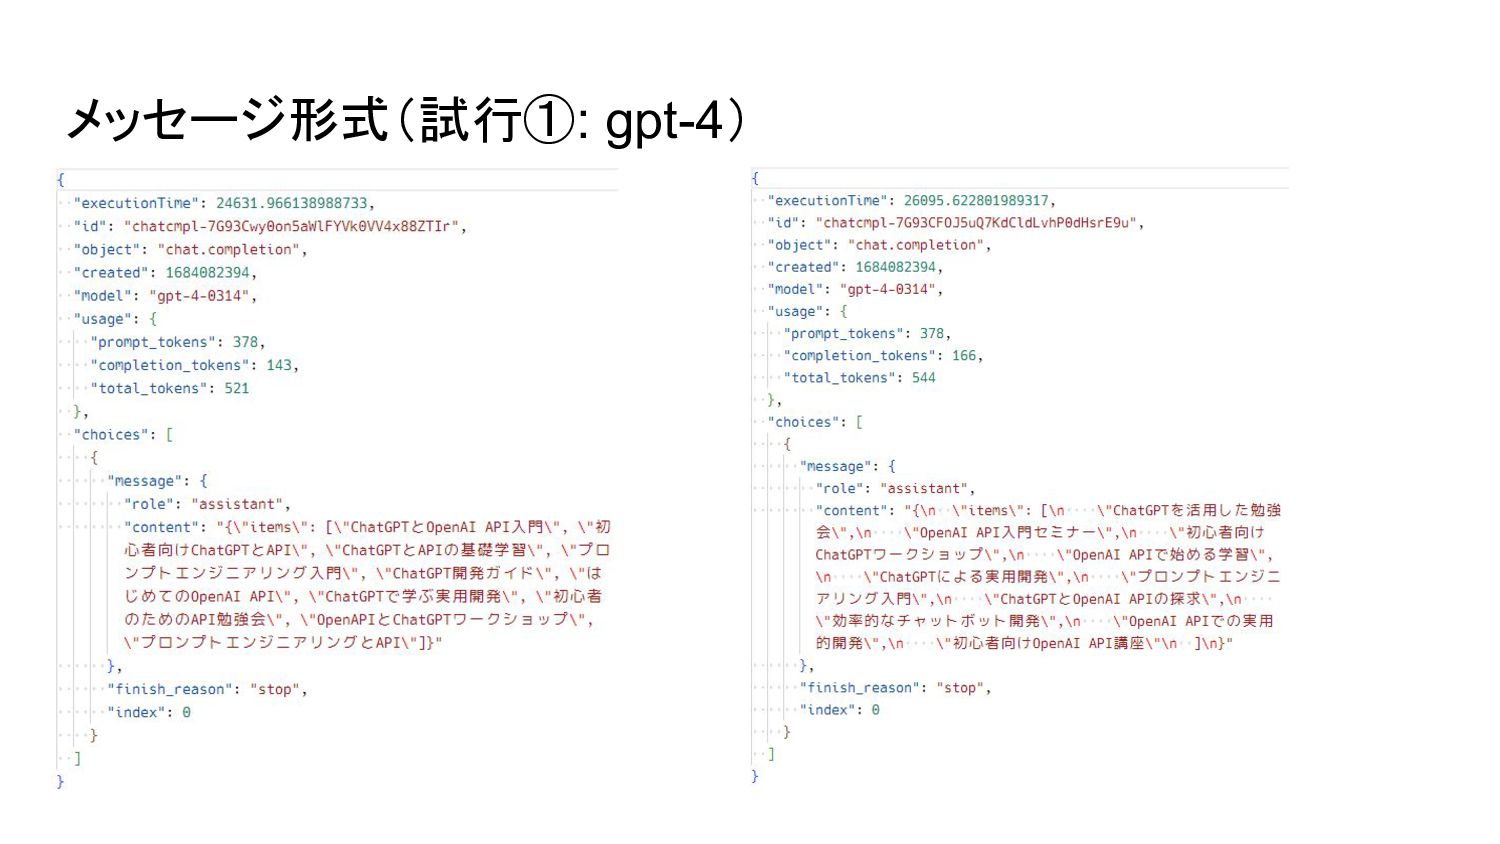
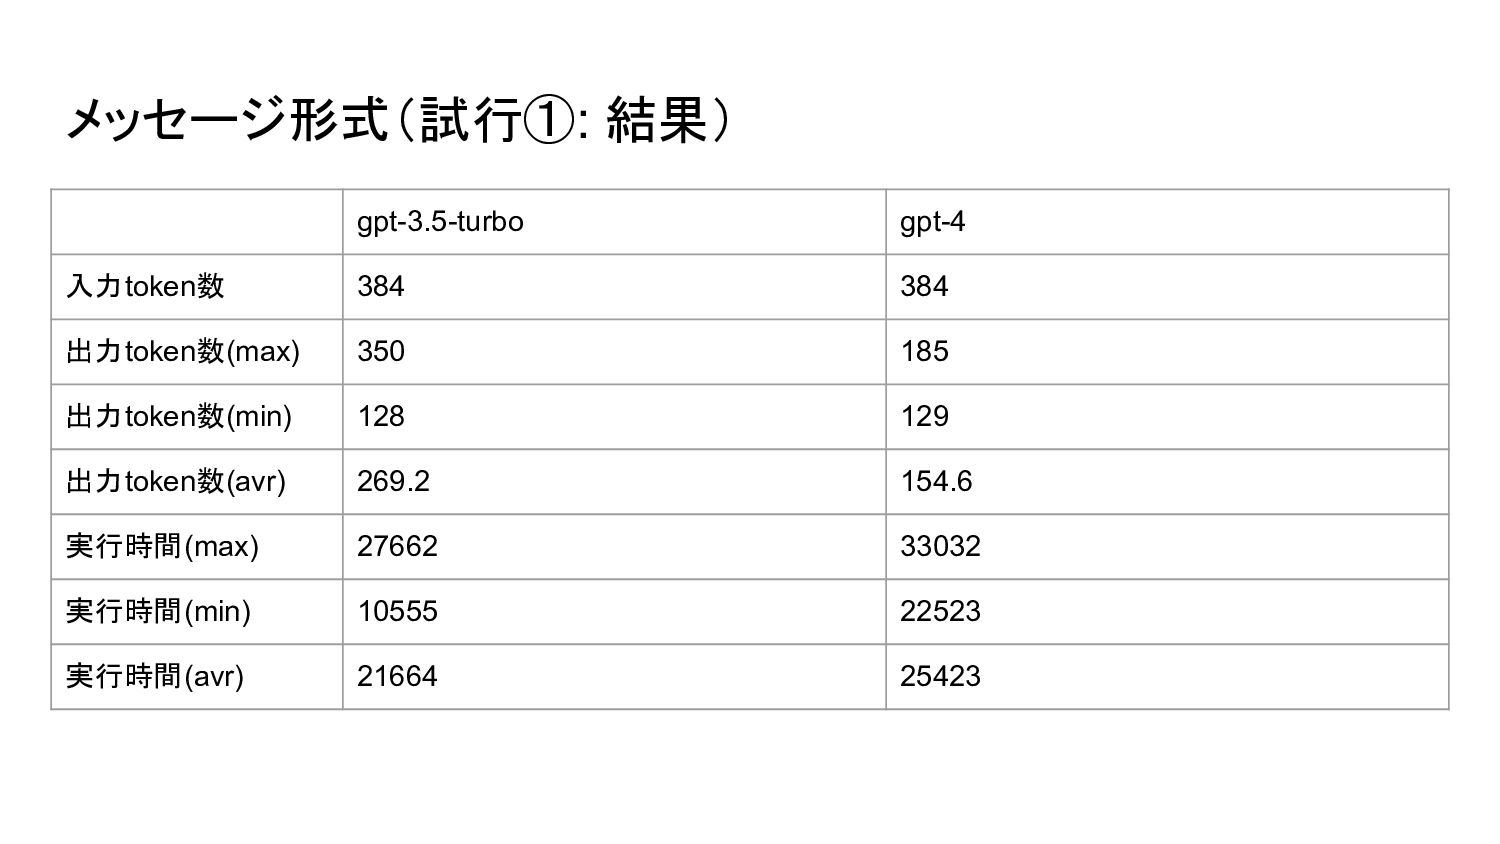
メッセージ形式(試行①: 結果) gpt-3.5-turbo gpt-4 入力token数 384 384 出力token数(max) 350 185
出力token数(min) 128 129 出力token数(avr) 269.2 154.6 実行時間(max) 27662 33032 実行時間(min) 10555 22523 実行時間(avr) 21664 25423 -
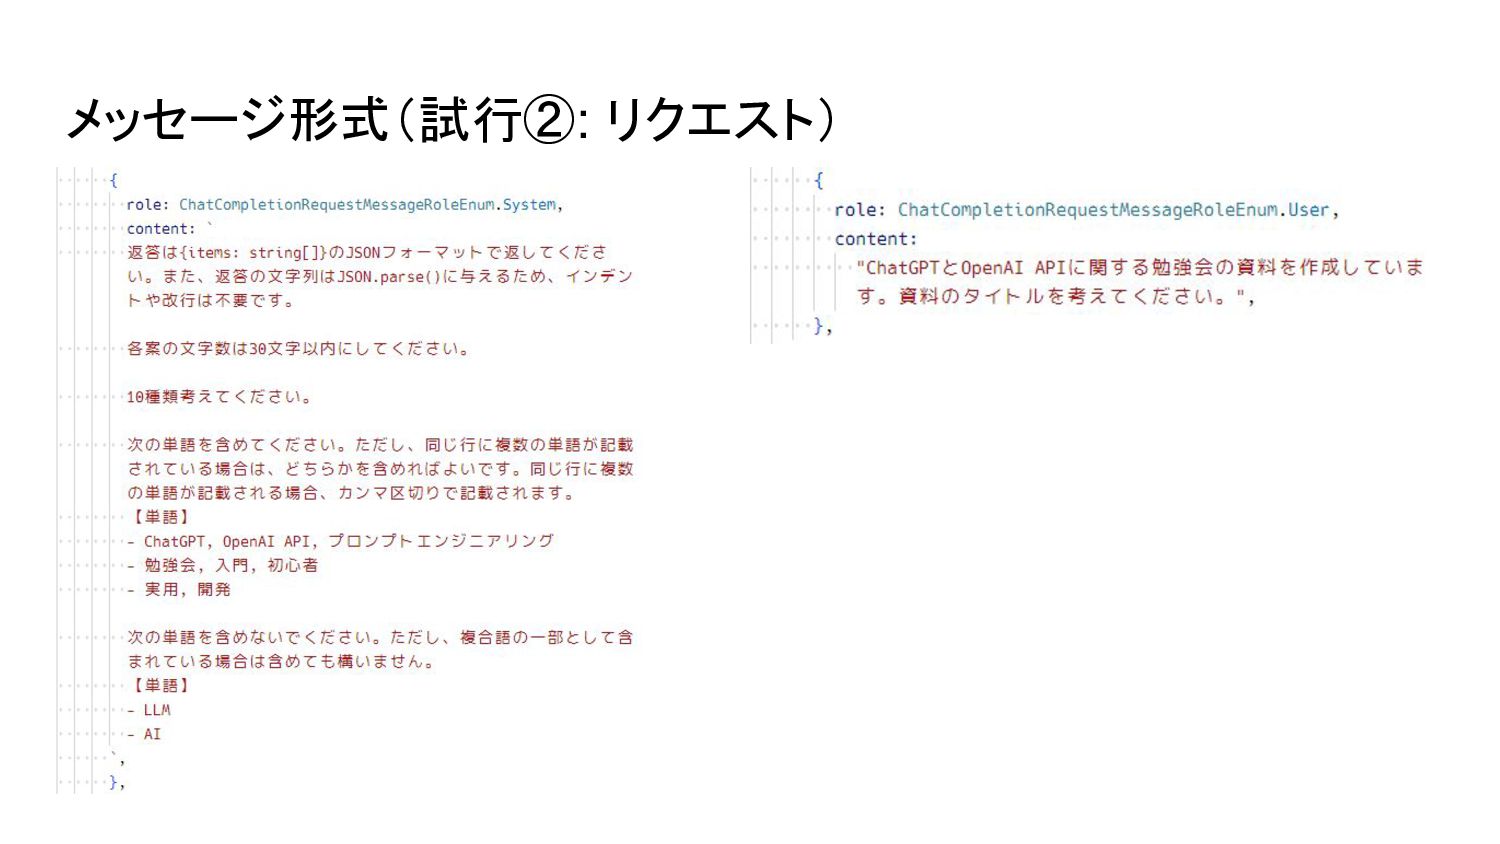
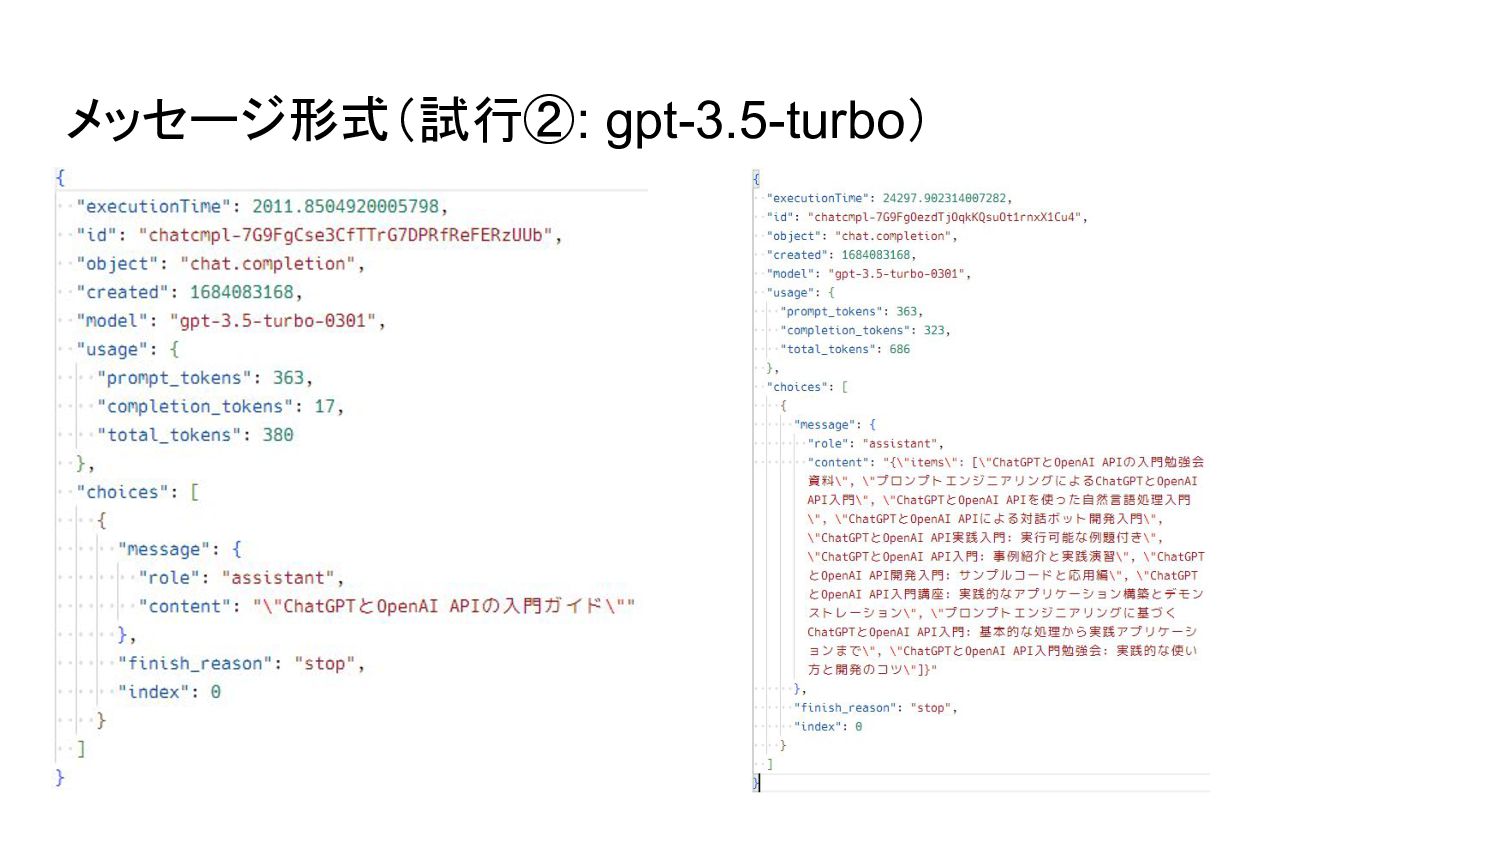
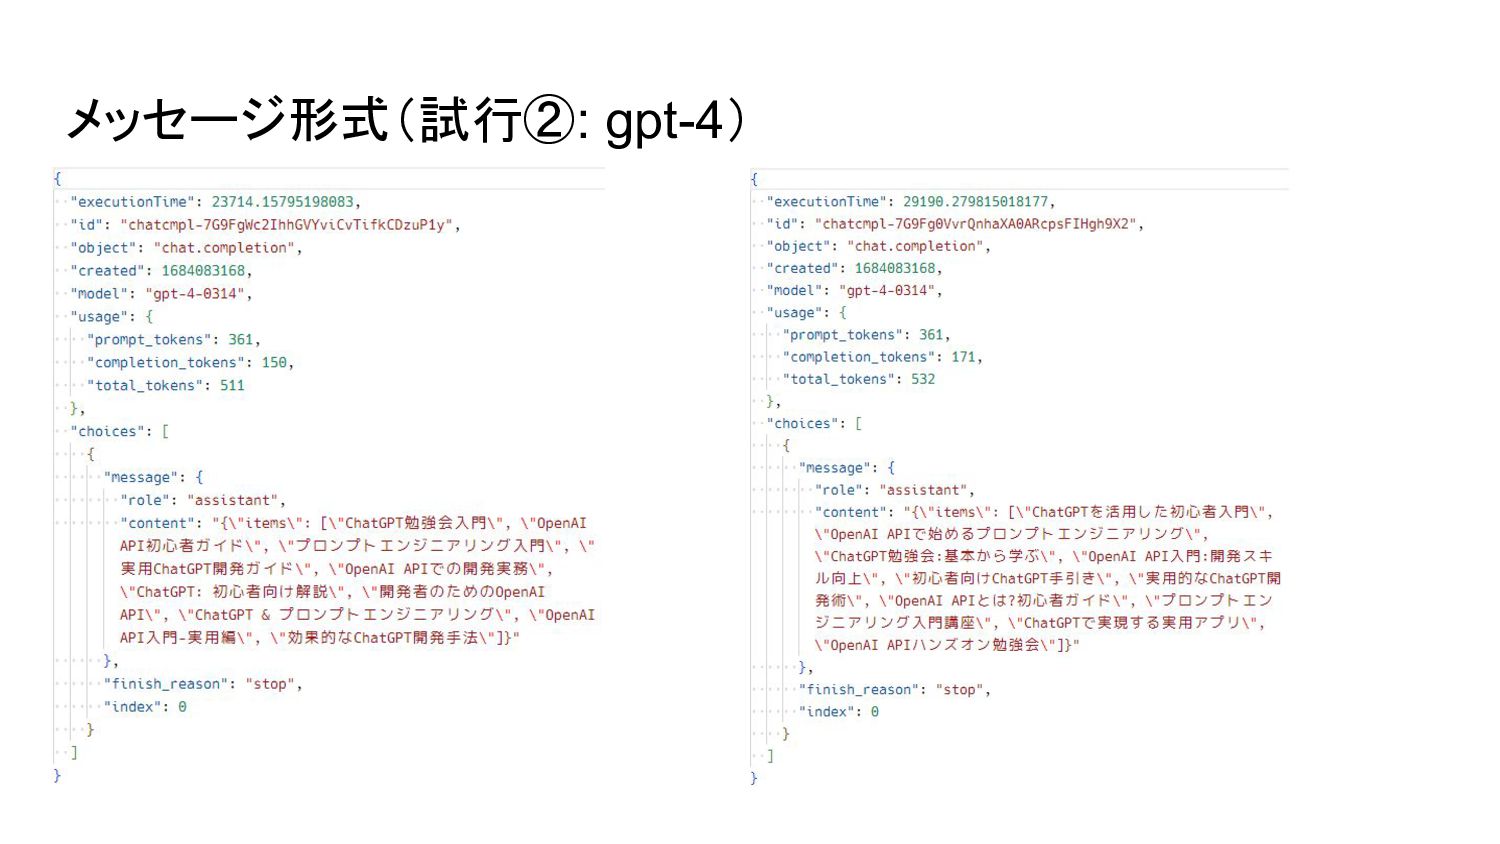
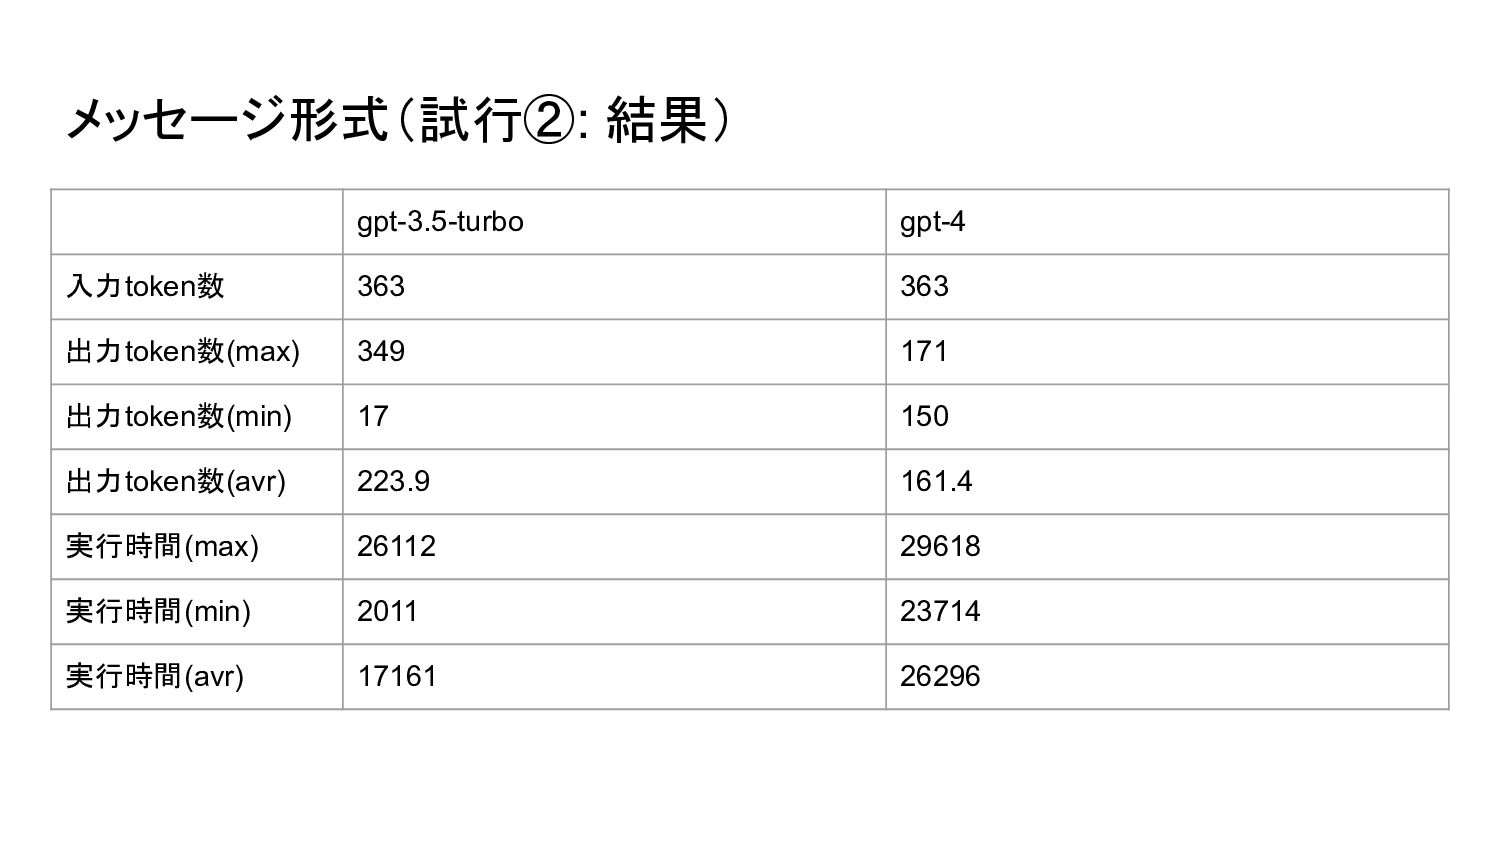
メッセージ形式(試行②: 結果) gpt-3.5-turbo gpt-4 入力token数 363 363 出力token数(max) 349 171
出力token数(min) 17 150 出力token数(avr) 223.9 161.4 実行時間(max) 26112 29618 実行時間(min) 2011 23714 実行時間(avr) 17161 26296 -
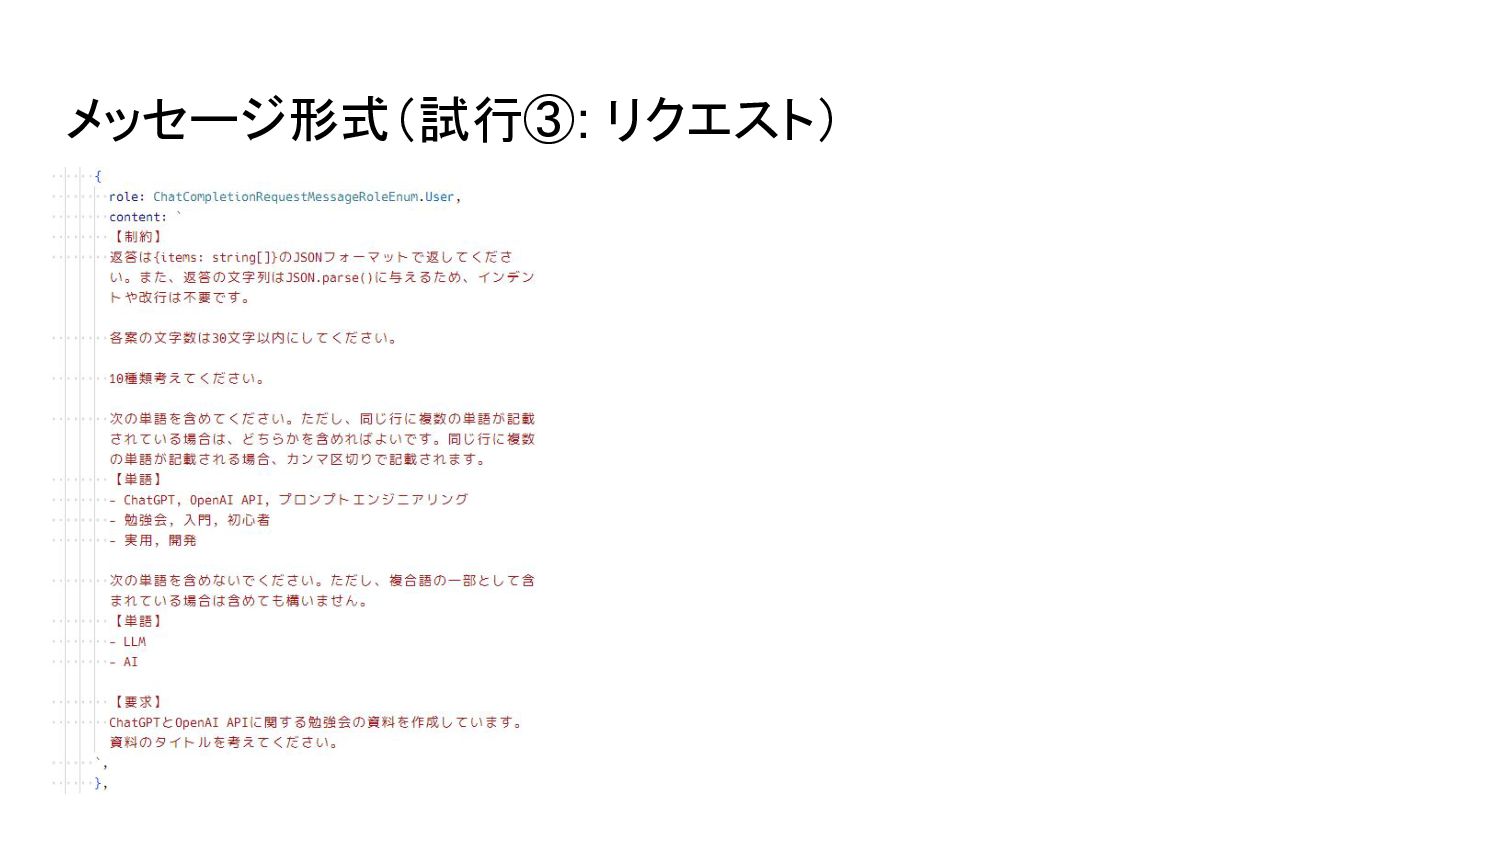
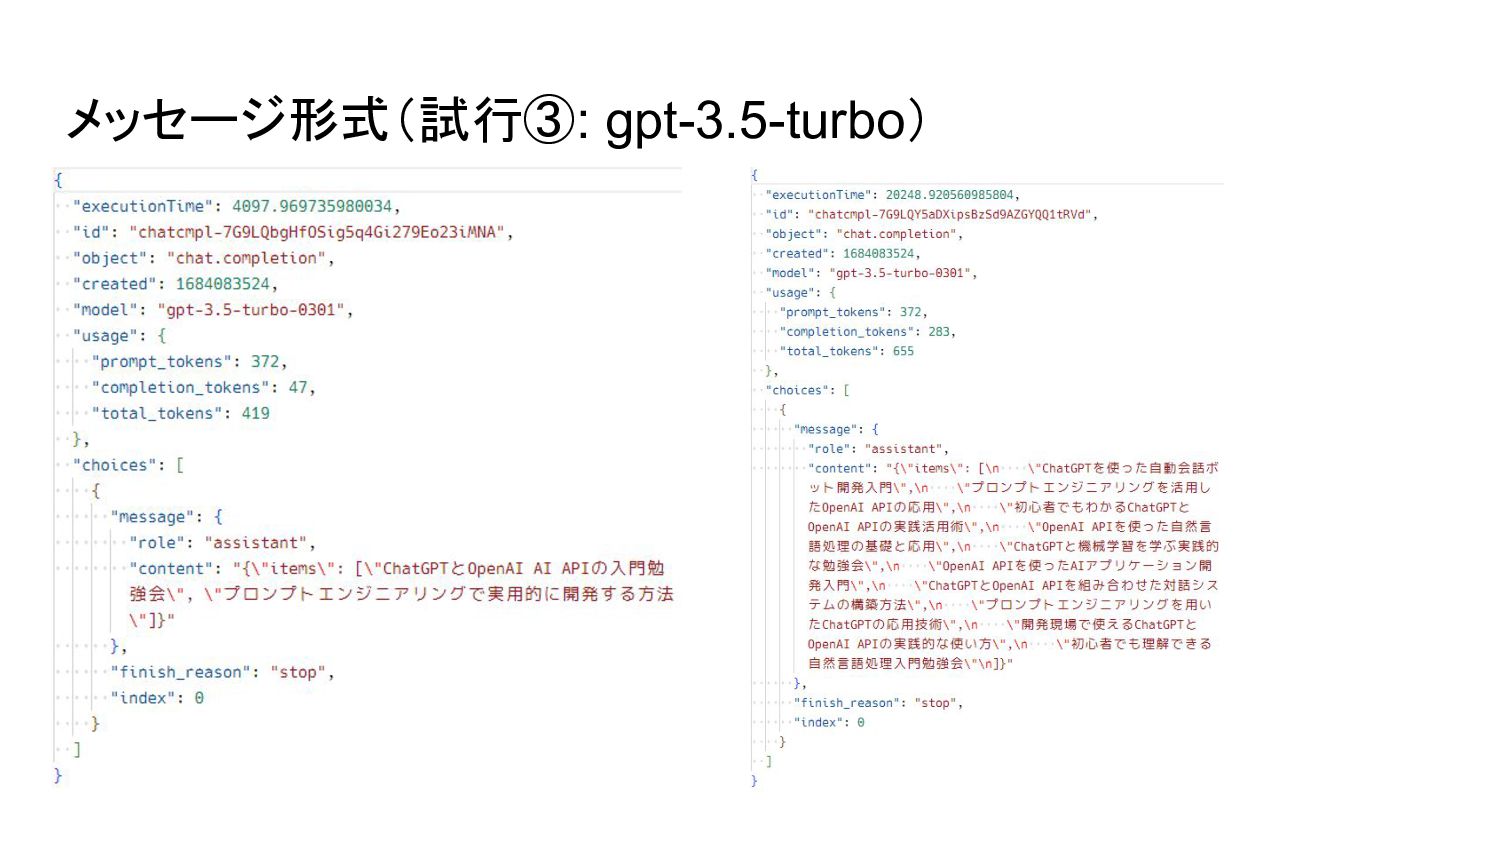
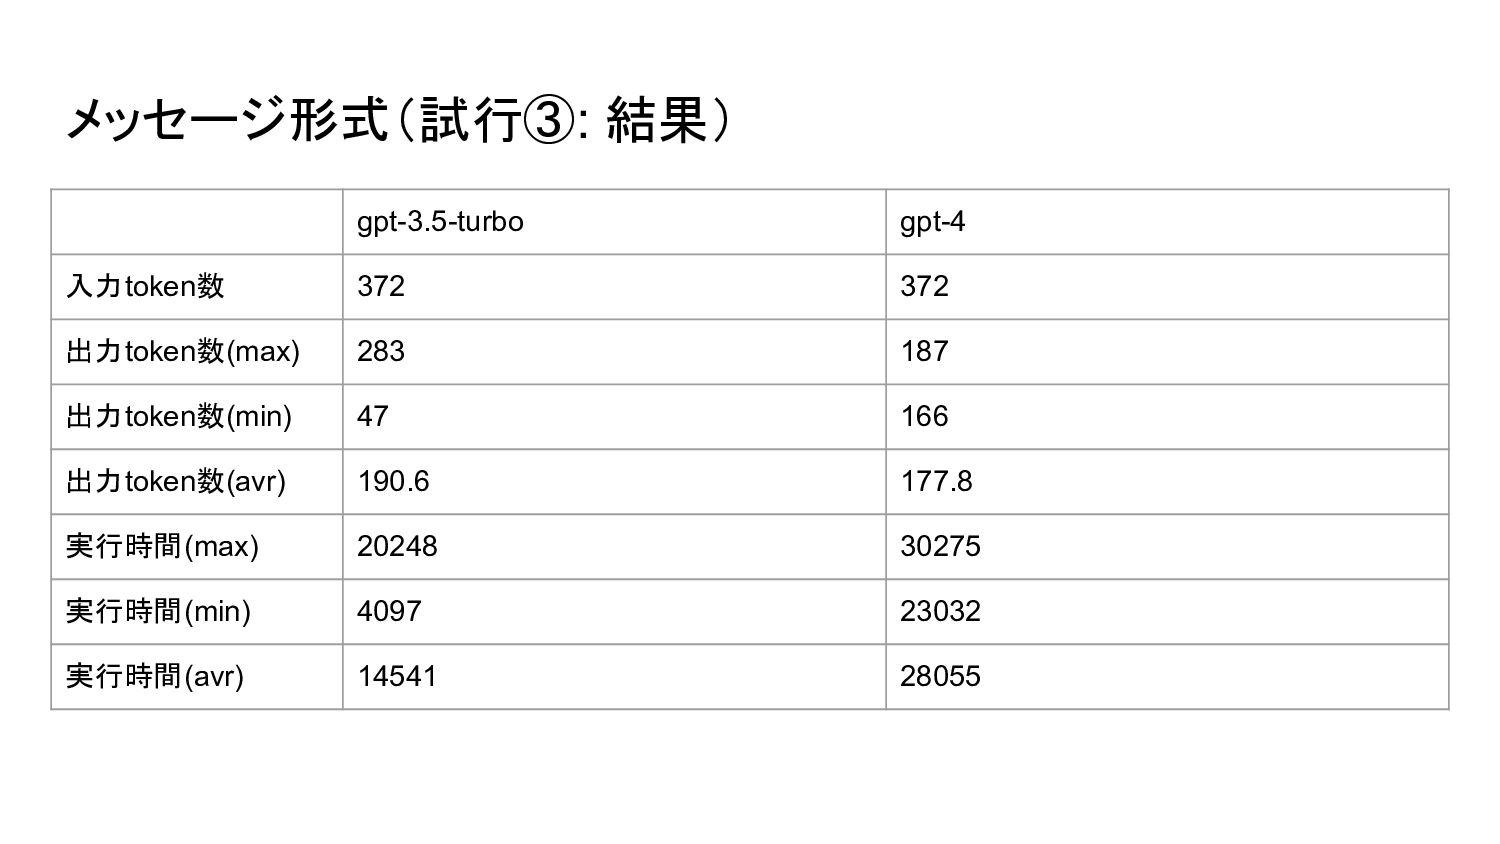
メッセージ形式(試行③: 結果) gpt-3.5-turbo gpt-4 入力token数 372 372 出力token数(max) 283 187
出力token数(min) 47 166 出力token数(avr) 190.6 177.8 実行時間(max) 20248 30275 実行時間(min) 4097 23032 実行時間(avr) 14541 28055 -
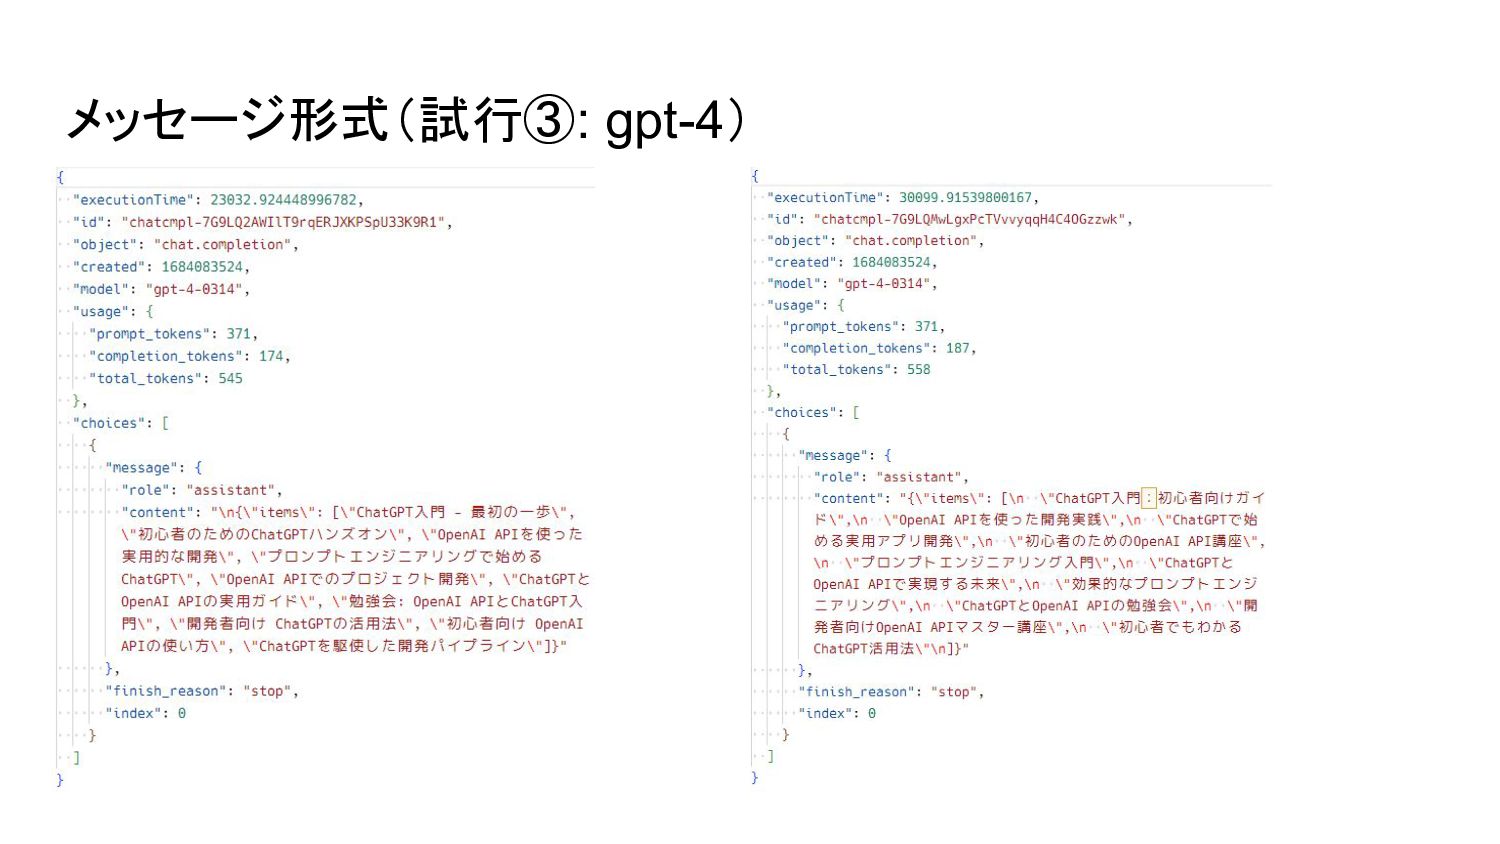
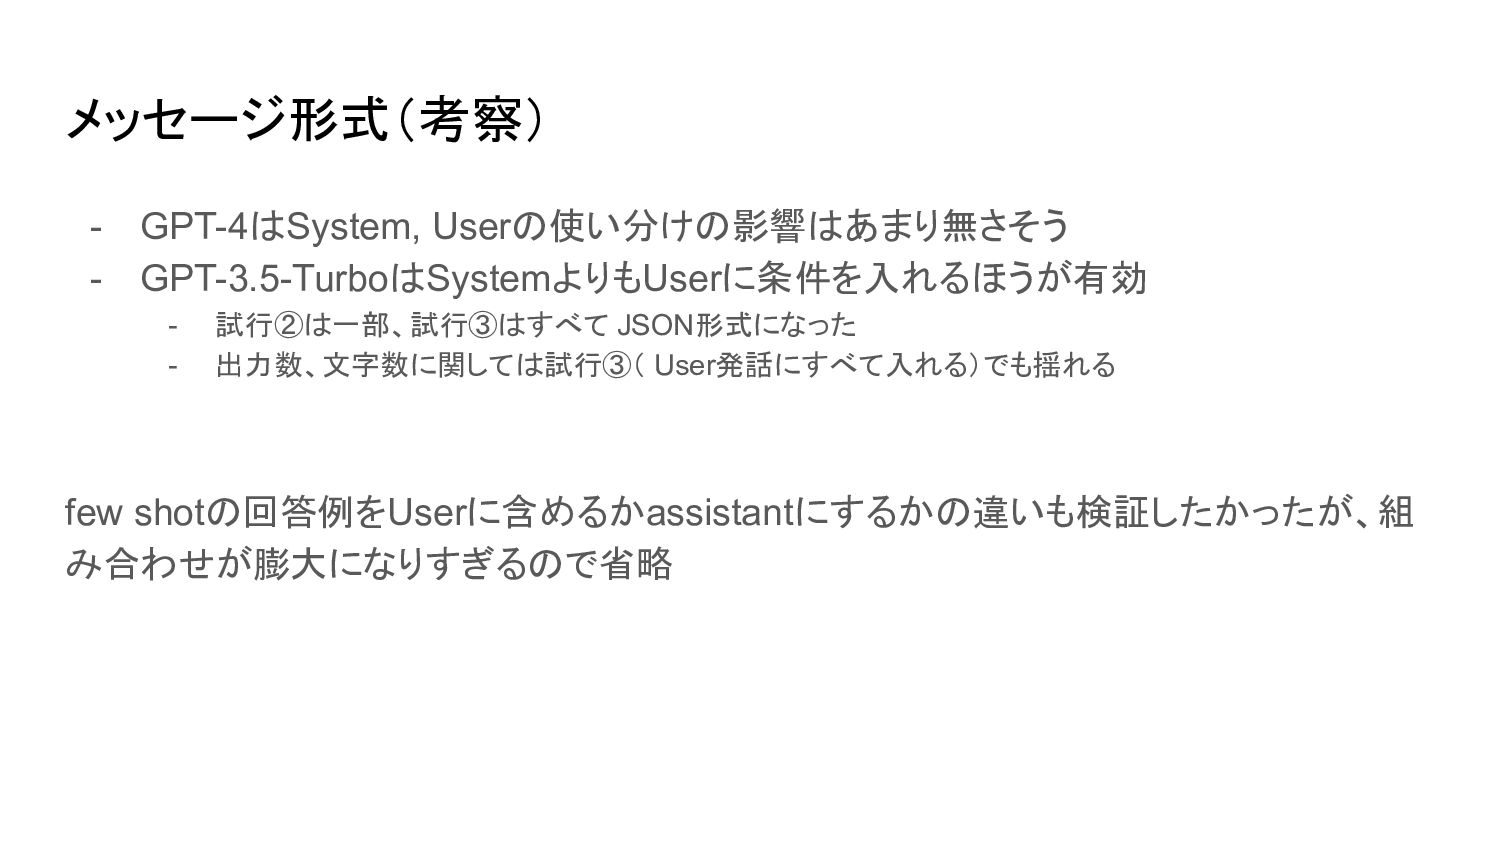
メッセージ形式(考察) - GPT-4はSystem, Userの使い分けの影響はあまり無さそう - GPT-3.5-TurboはSystemよりもUserに条件を入れるほうが有効 - 試行②は一部、試行③はすべて JSON形式になった -
出力数、文字数に関しては試行③( User発話にすべて入れる)でも揺れる few shotの回答例をUserに含めるかassistantにするかの違いも検証したかったが、組 み合わせが膨大になりすぎるので省略 -
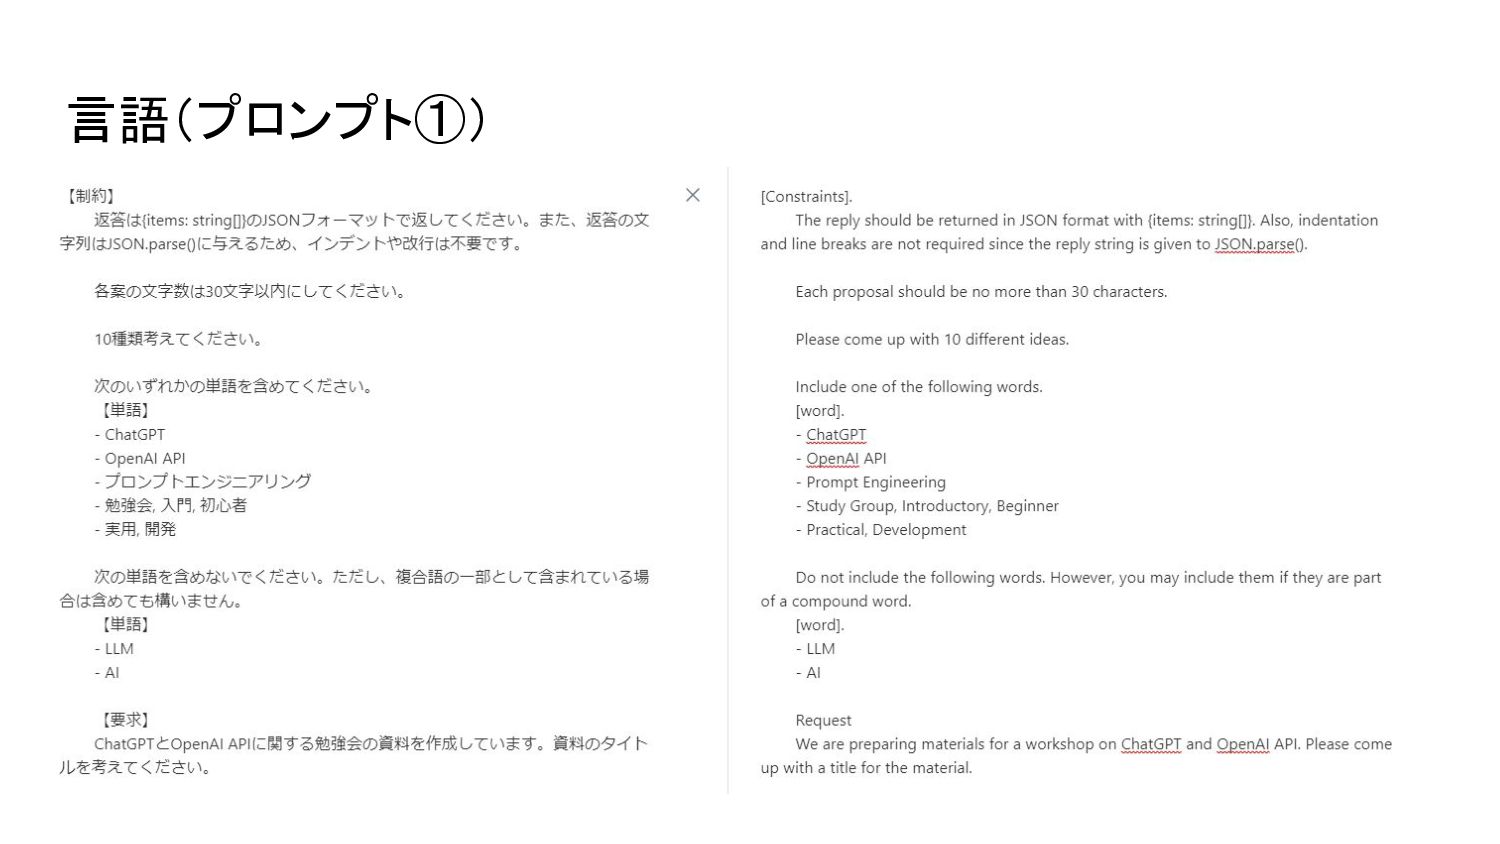
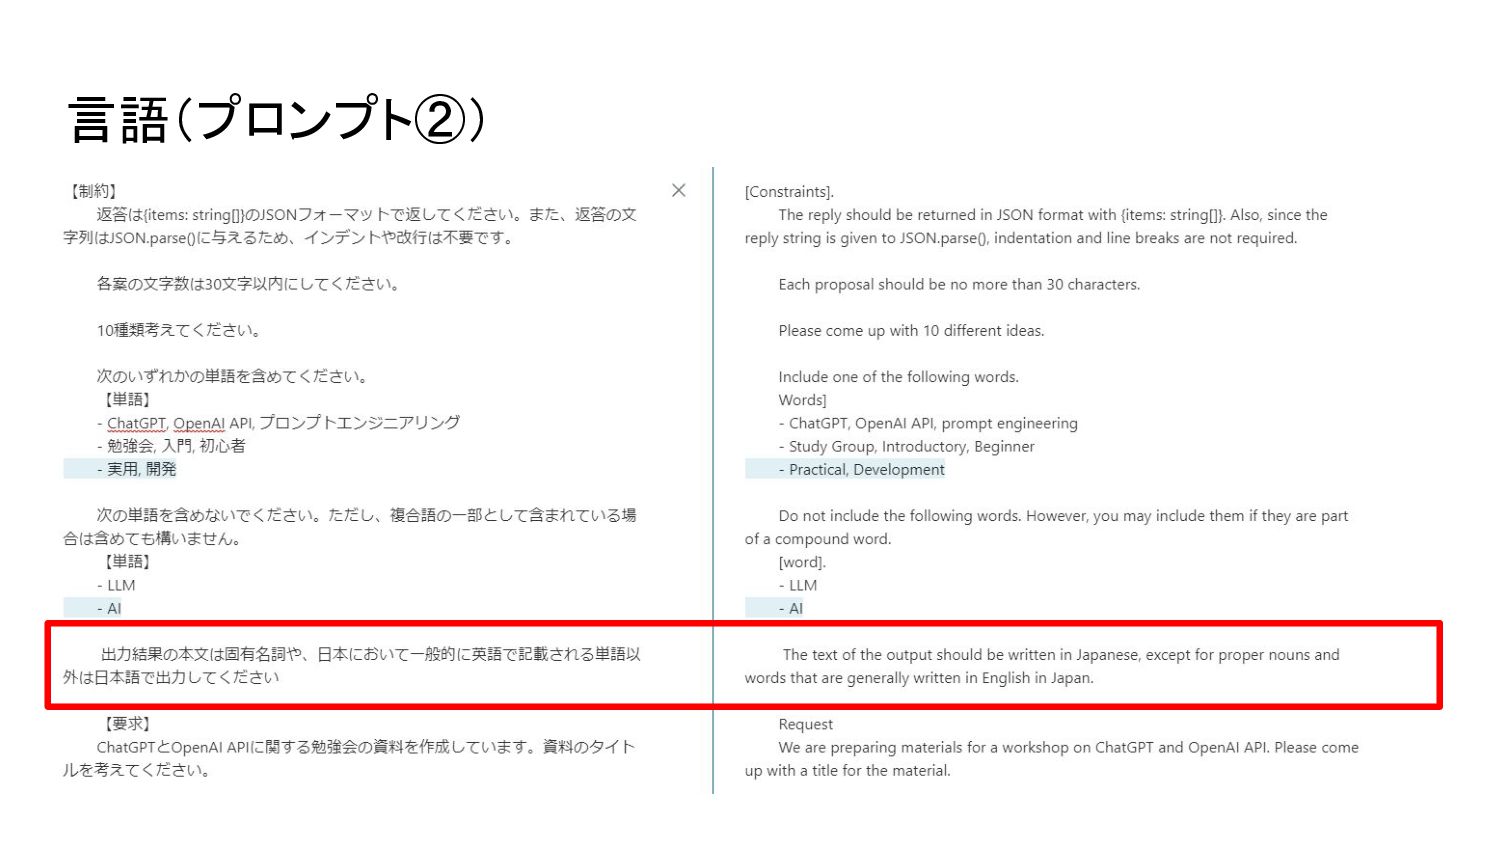
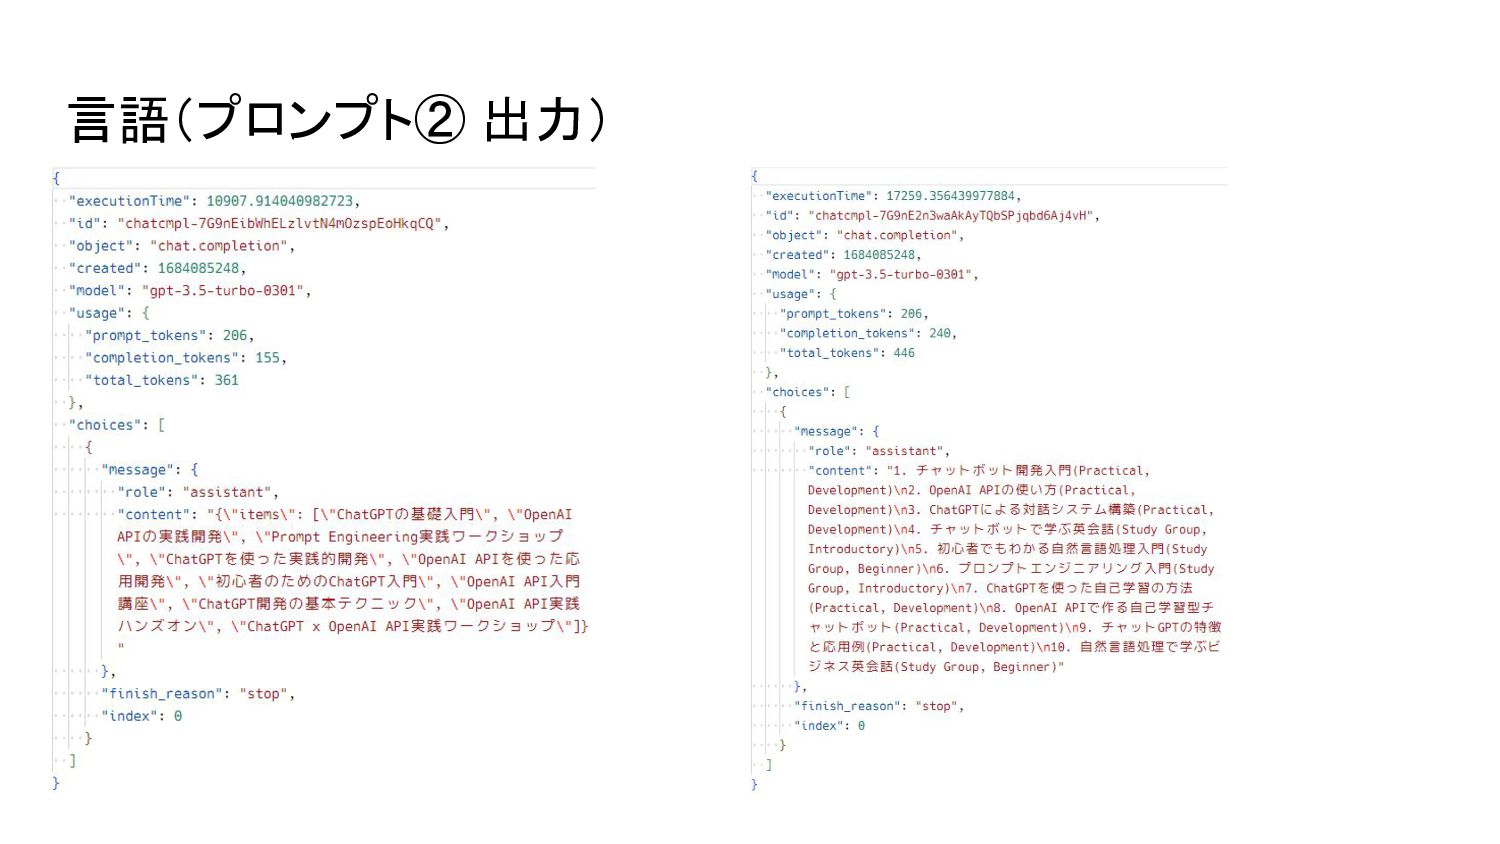
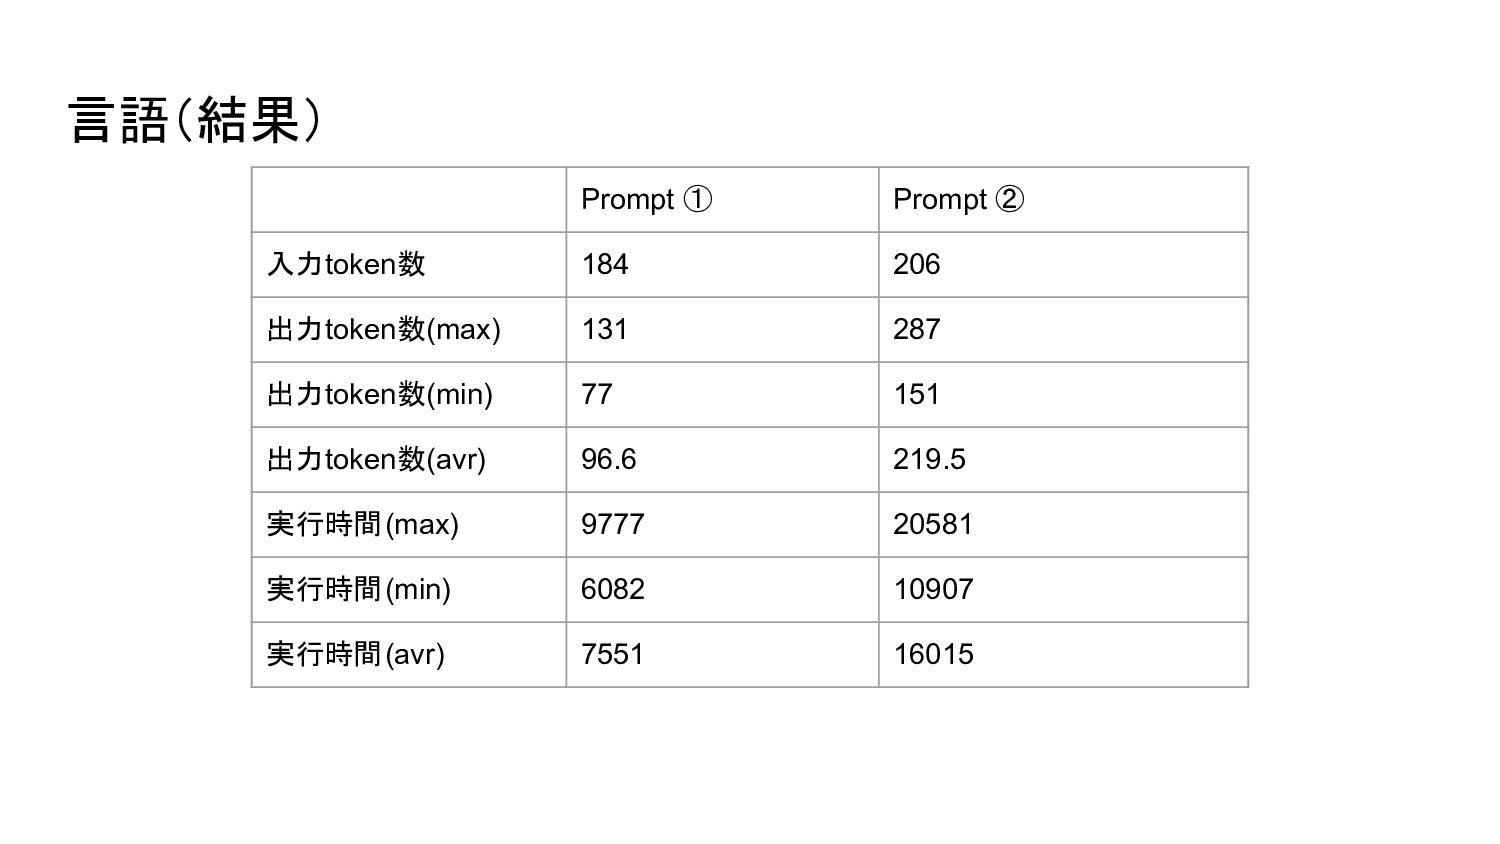
言語(結果) Prompt ① Prompt ② 入力token数 184 206 出力token数(max) 131
287 出力token数(min) 77 151 出力token数(avr) 96.6 219.5 実行時間(max) 9777 20581 実行時間(min) 6082 10907 実行時間(avr) 7551 16015 -
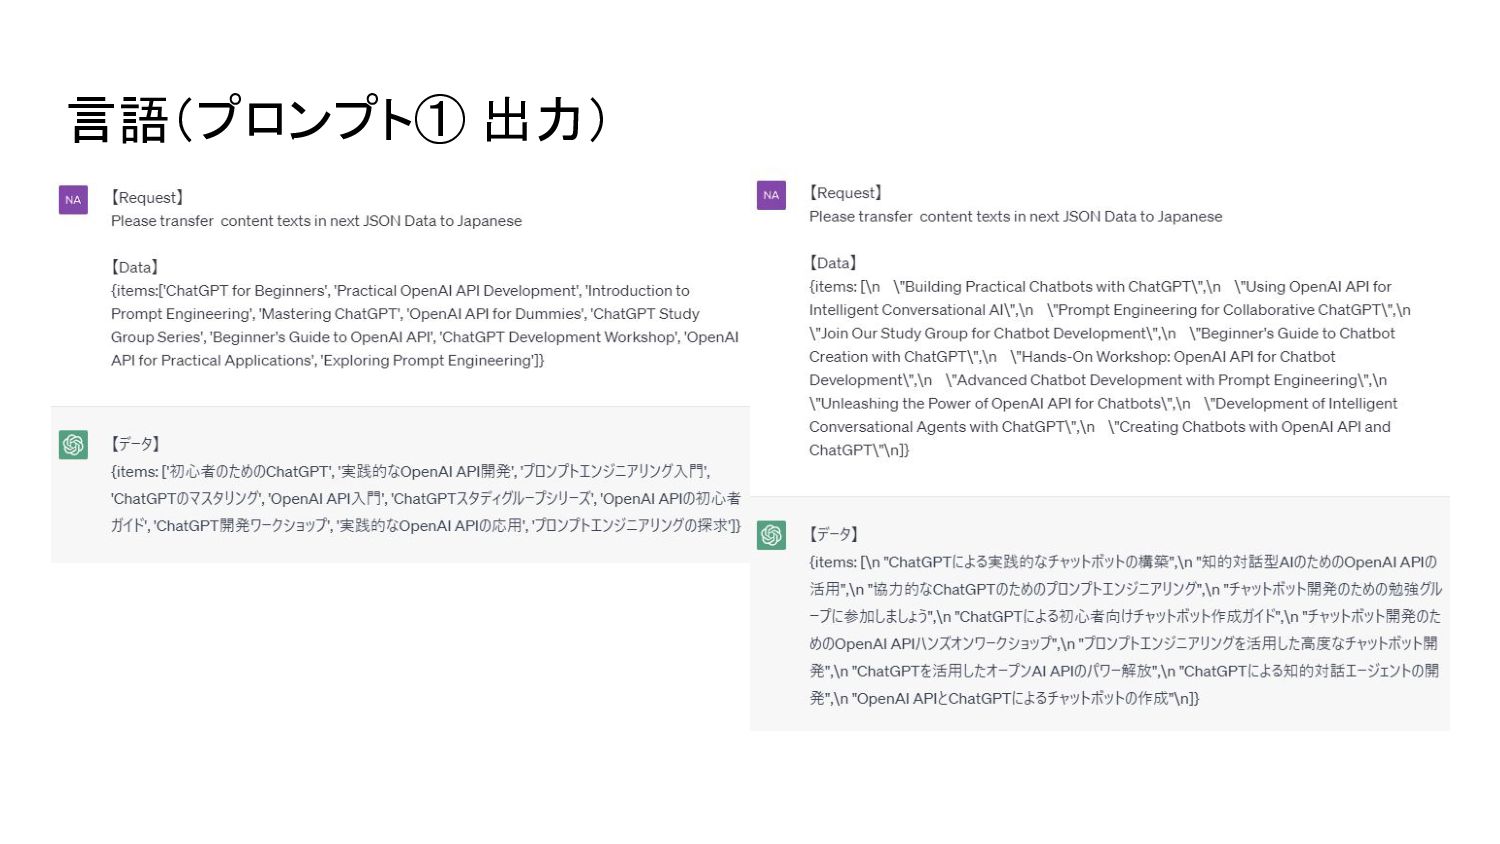
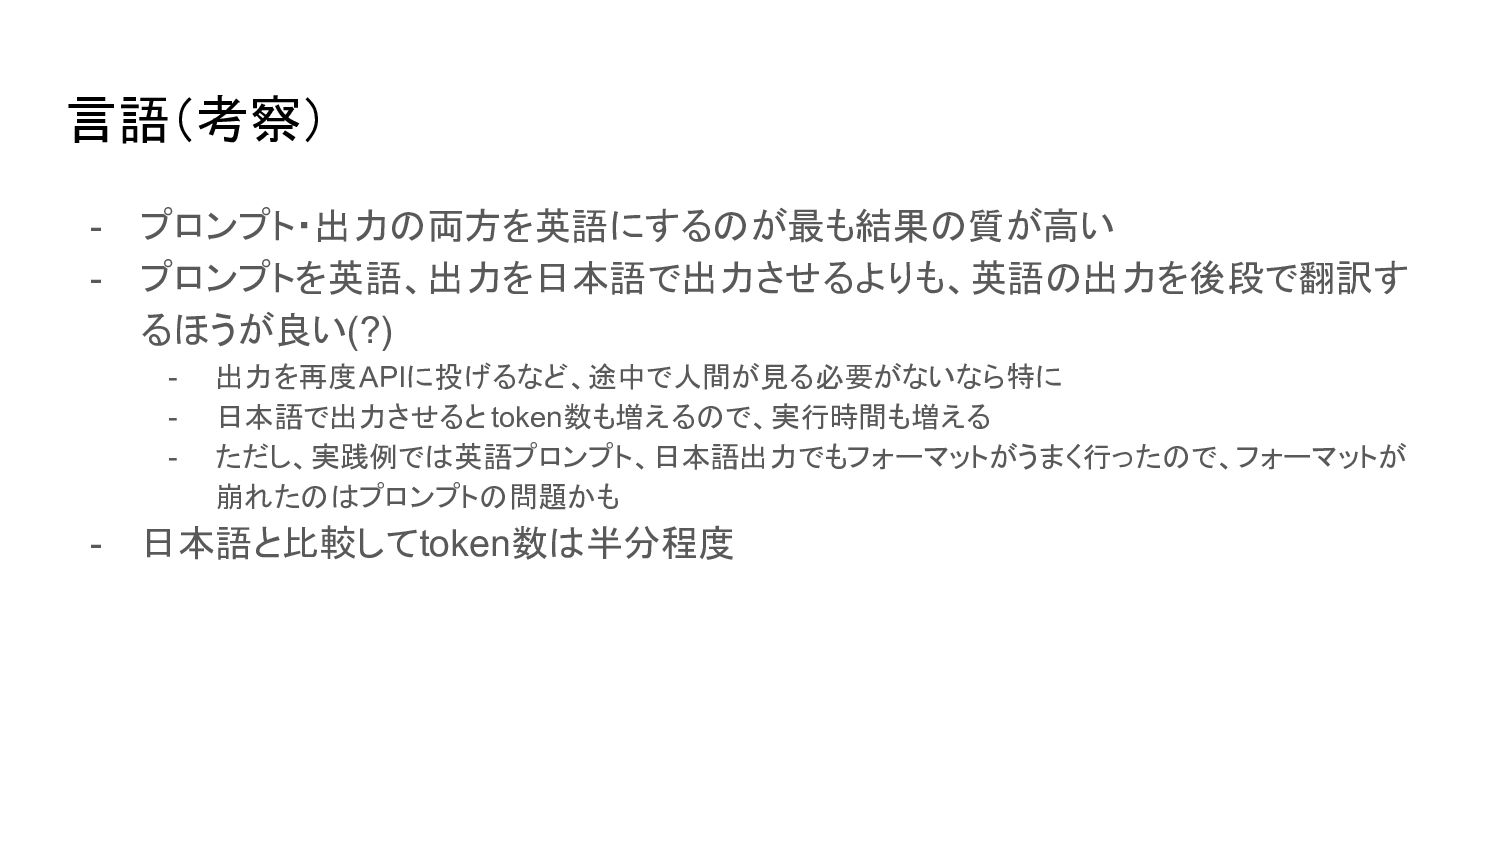
言語(考察) - プロンプト・出力の両方を英語にするのが最も結果の質が高い - プロンプトを英語、出力を日本語で出力させるよりも、英語の出力を後段で翻訳す るほうが良い(?) - 出力を再度APIに投げるなど、途中で人間が見る必要がないなら特に - 日本語で出力させると
token数も増えるので、実行時間も増える - ただし、実践例では英語プロンプト、日本語出力でもフォーマットがうまく行ったので、フォーマットが 崩れたのはプロンプトの問題かも - 日本語と比較してtoken数は半分程度 -
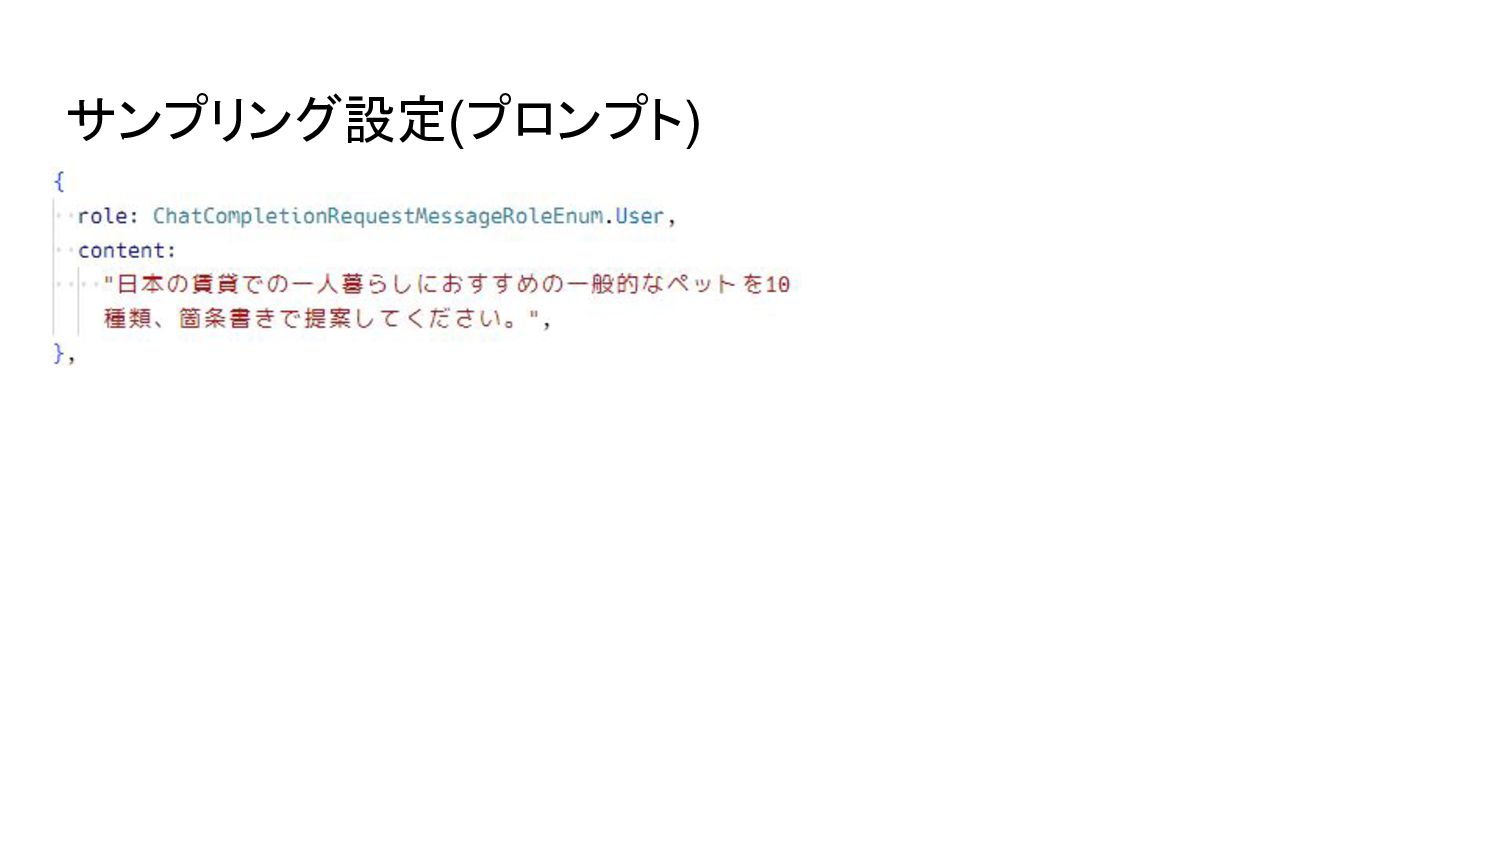
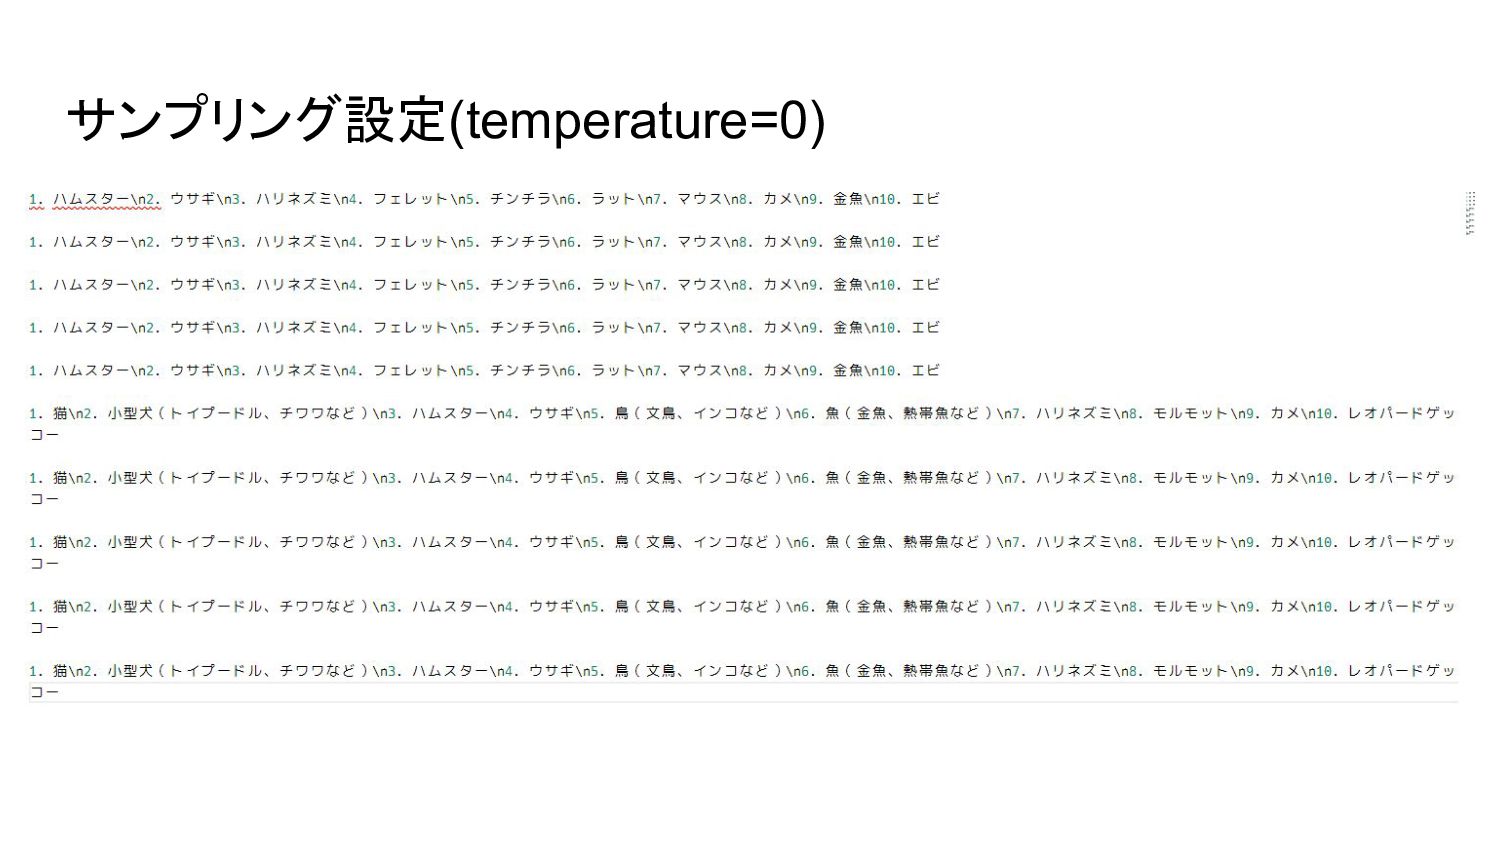
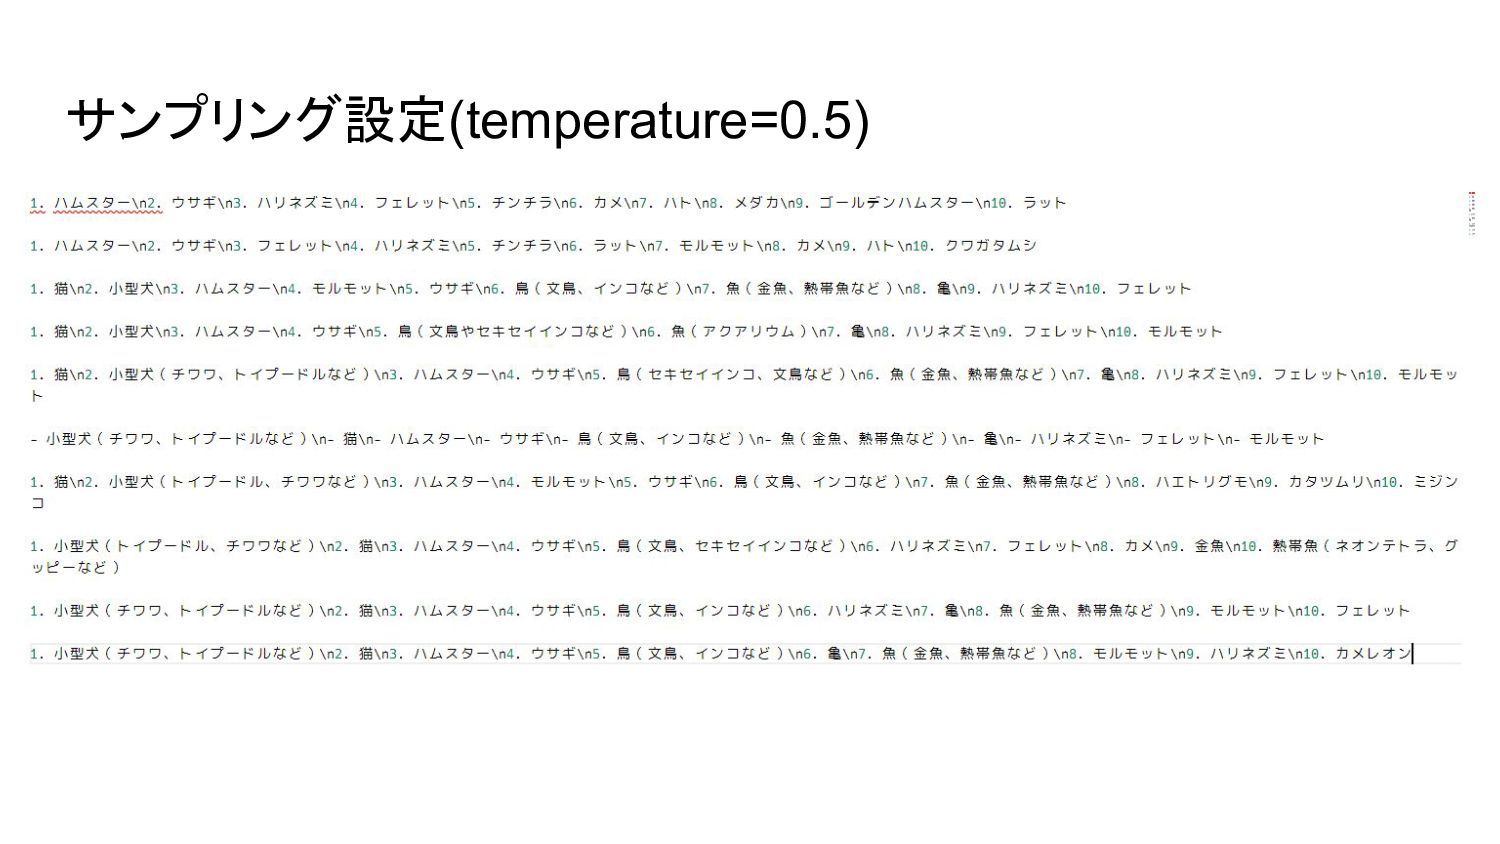
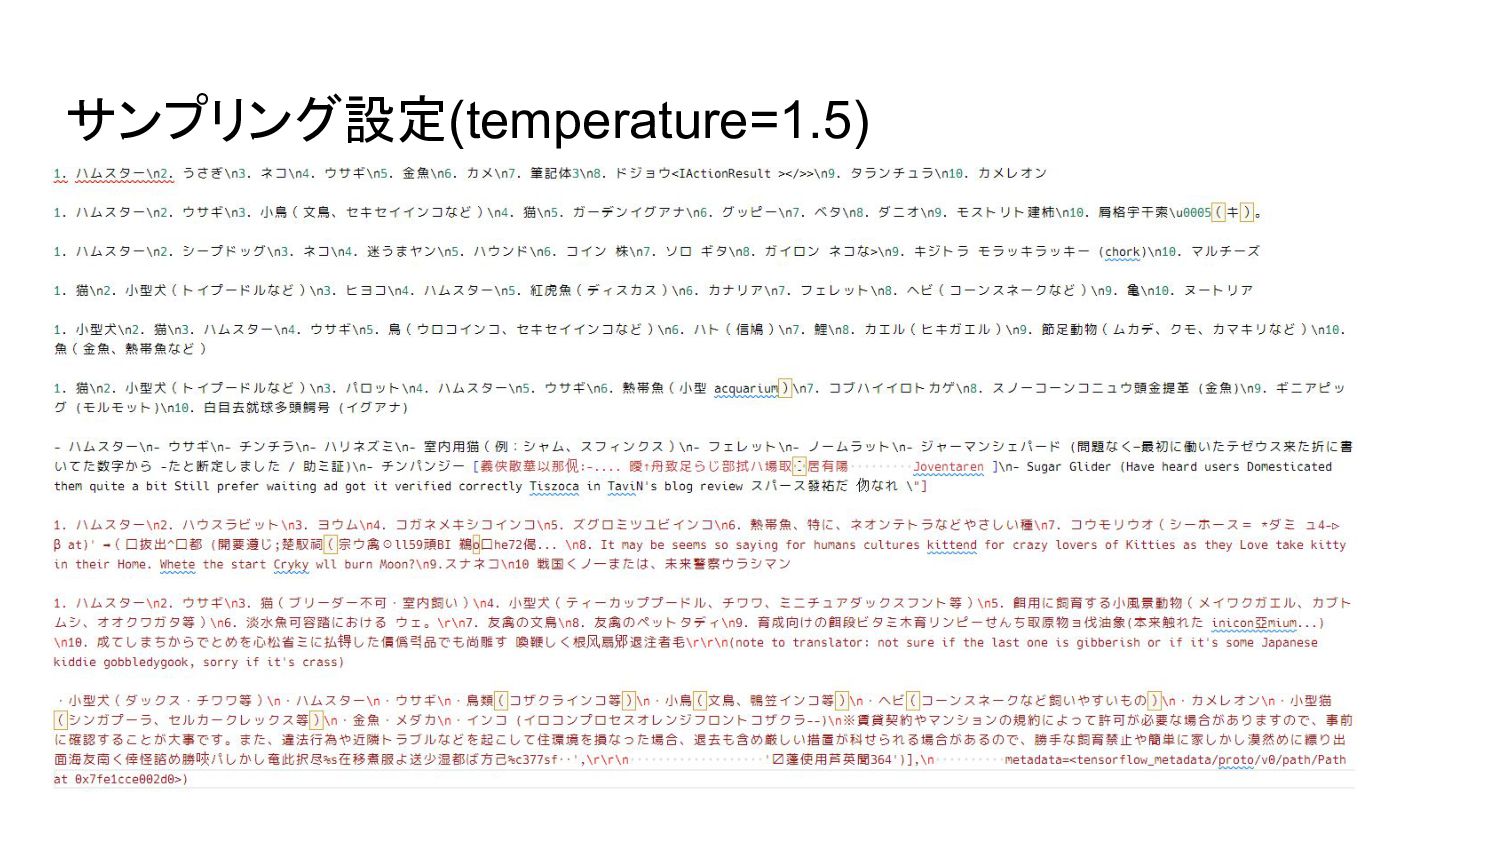
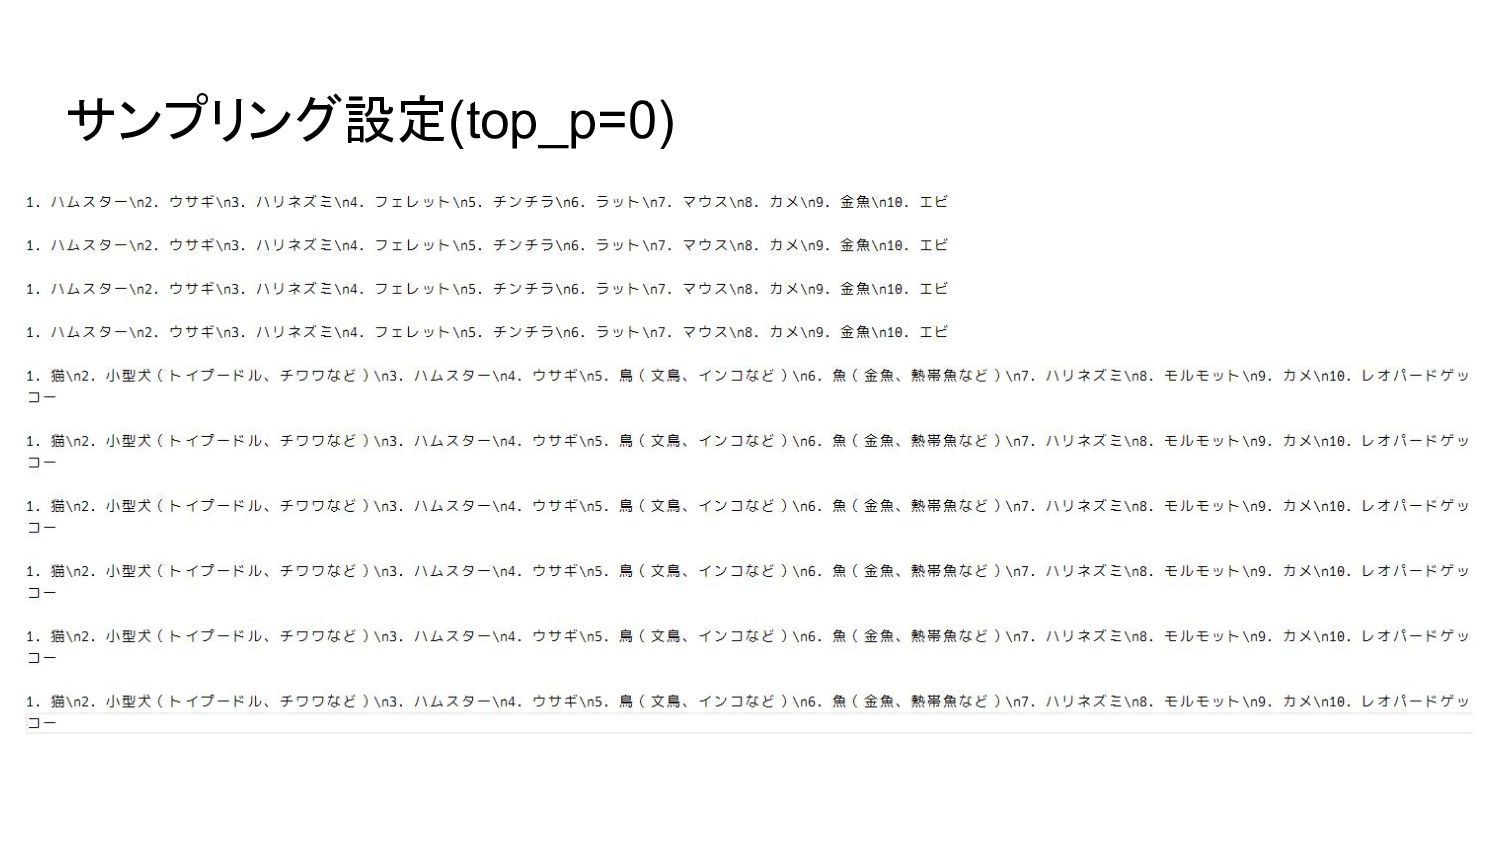
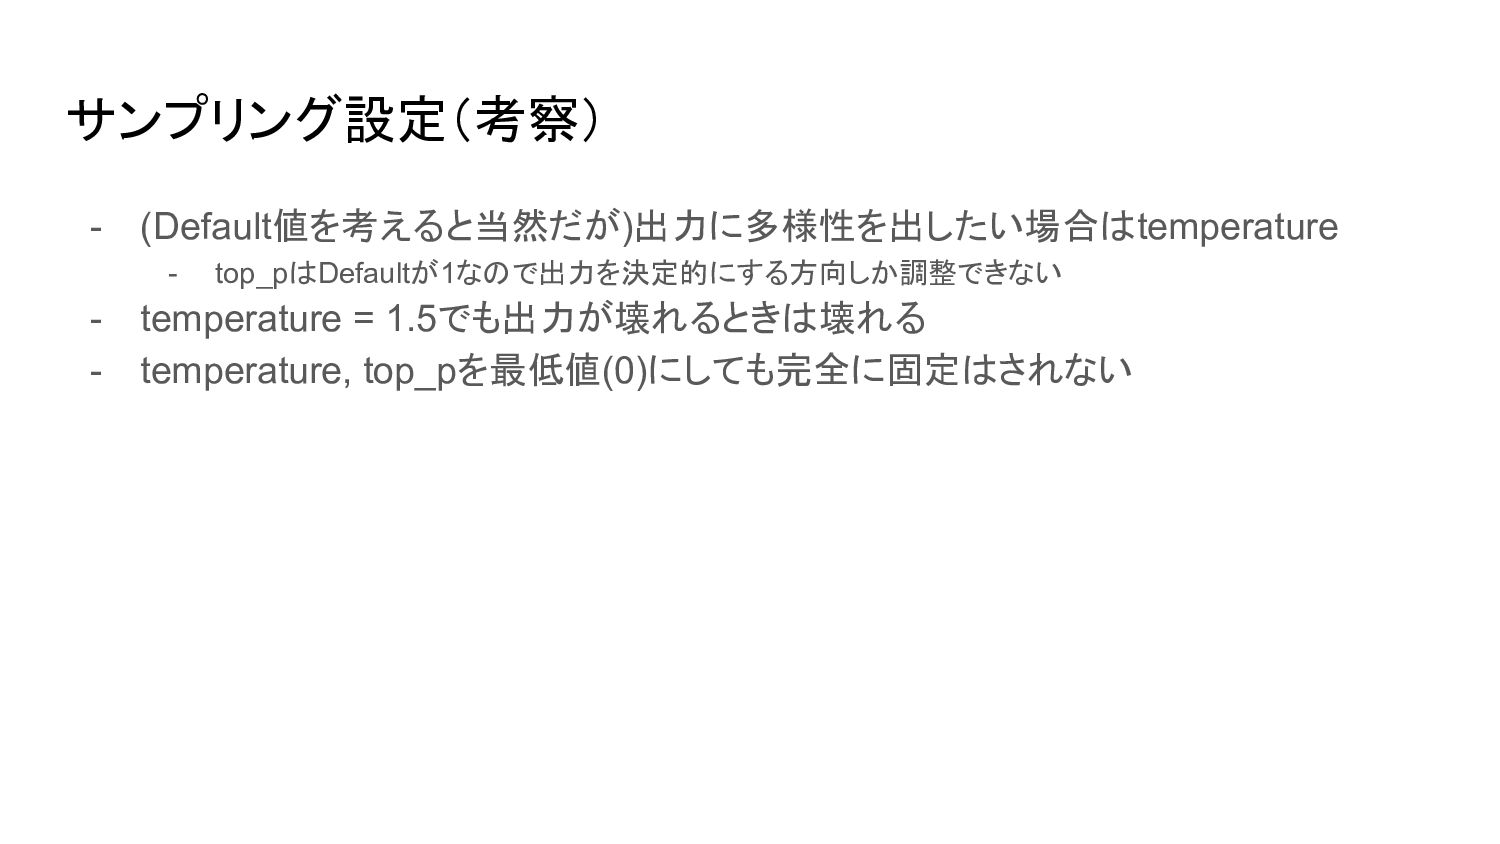
サンプリング設定(考察) - (Default値を考えると当然だが)出力に多様性を出したい場合はtemperature - top_pはDefaultが1なので出力を決定的にする方向しか調整できない - temperature = 1.5でも出力が壊れるときは壊れる -
temperature, top_pを最低値(0)にしても完全に固定はされない -
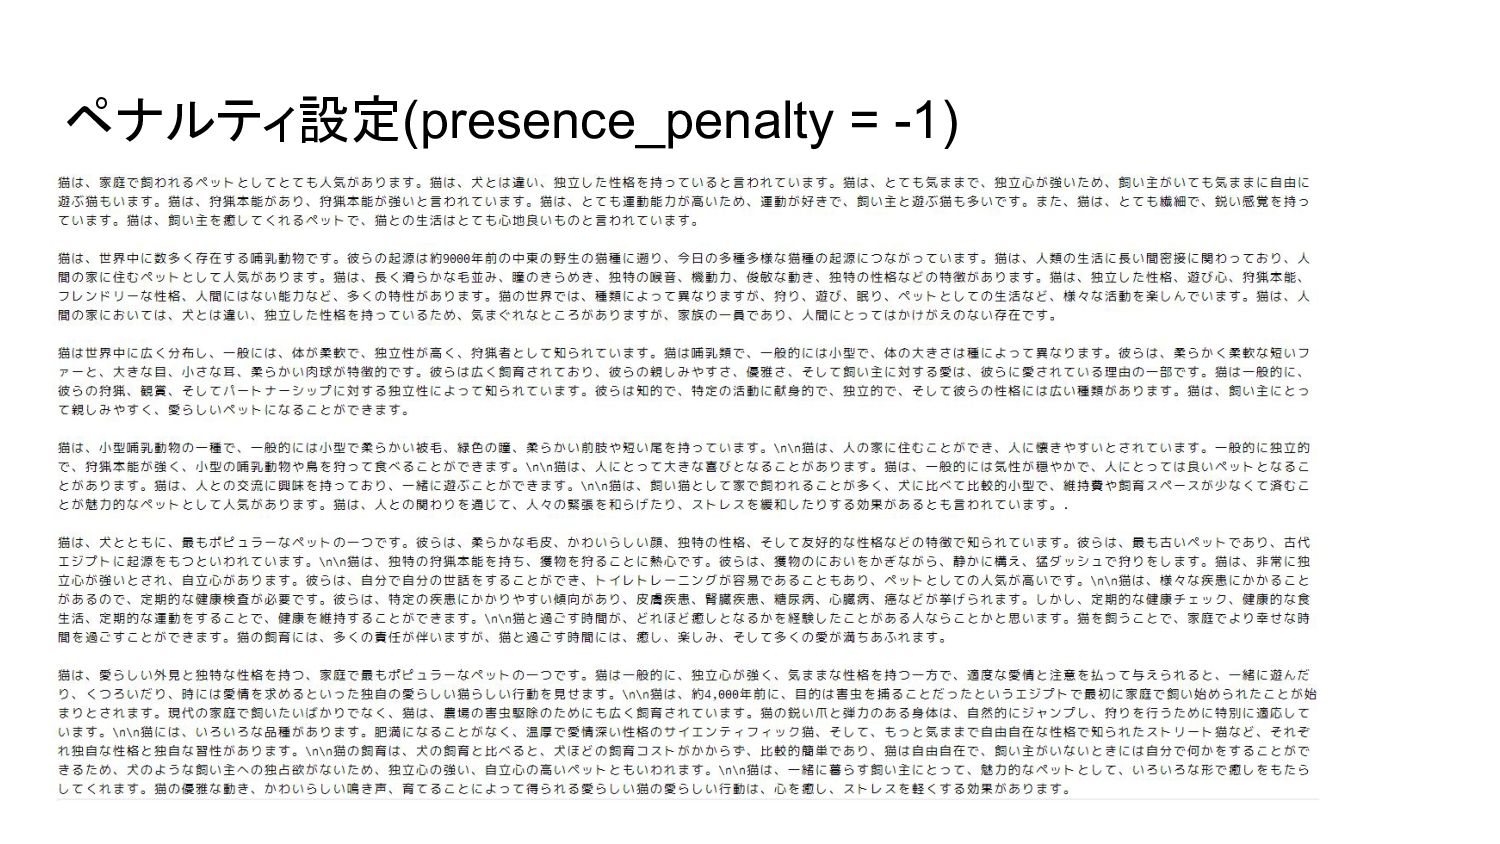
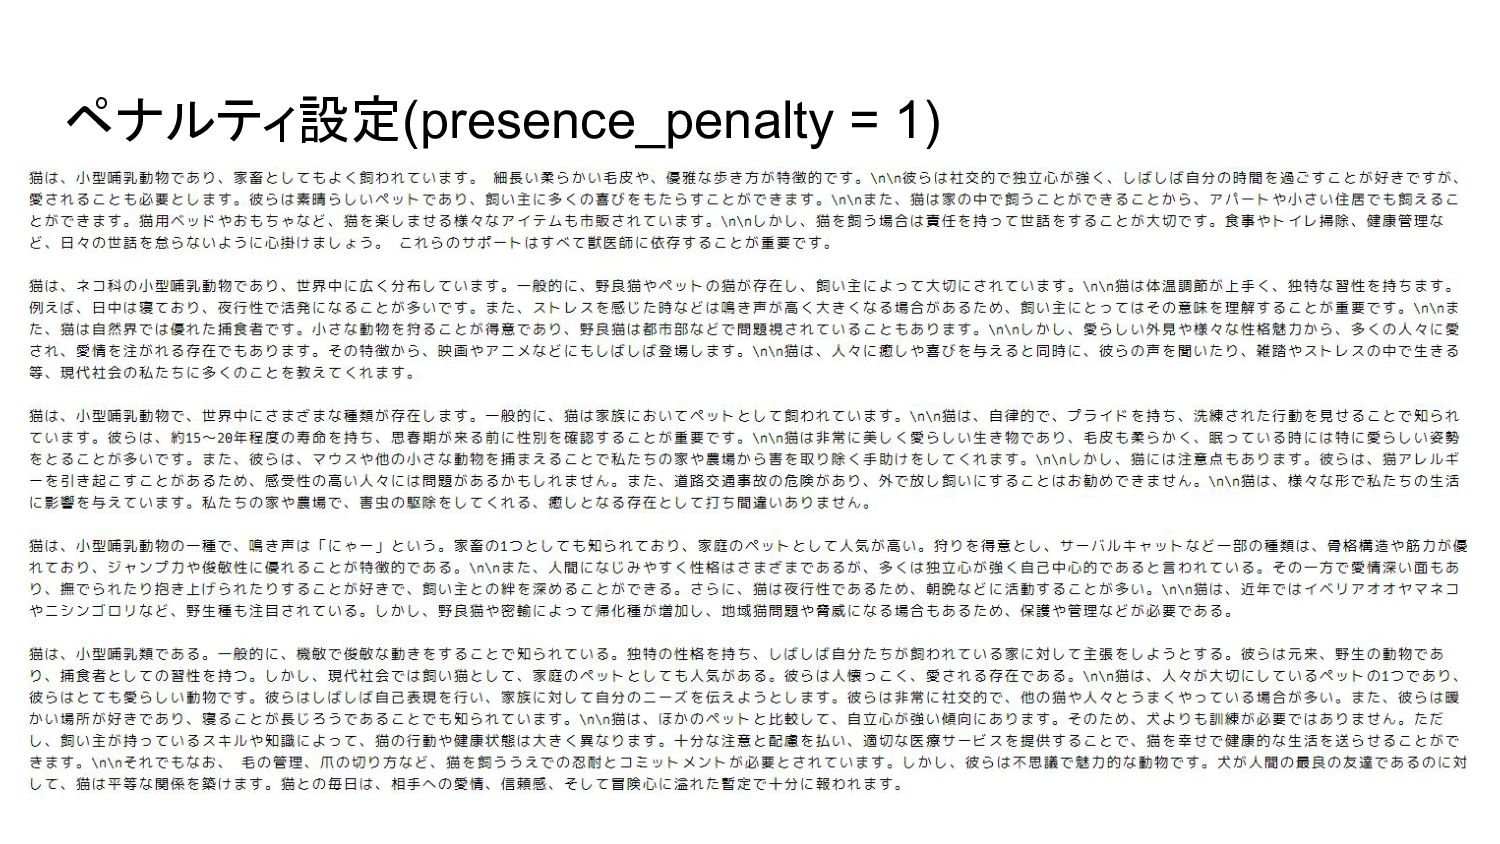
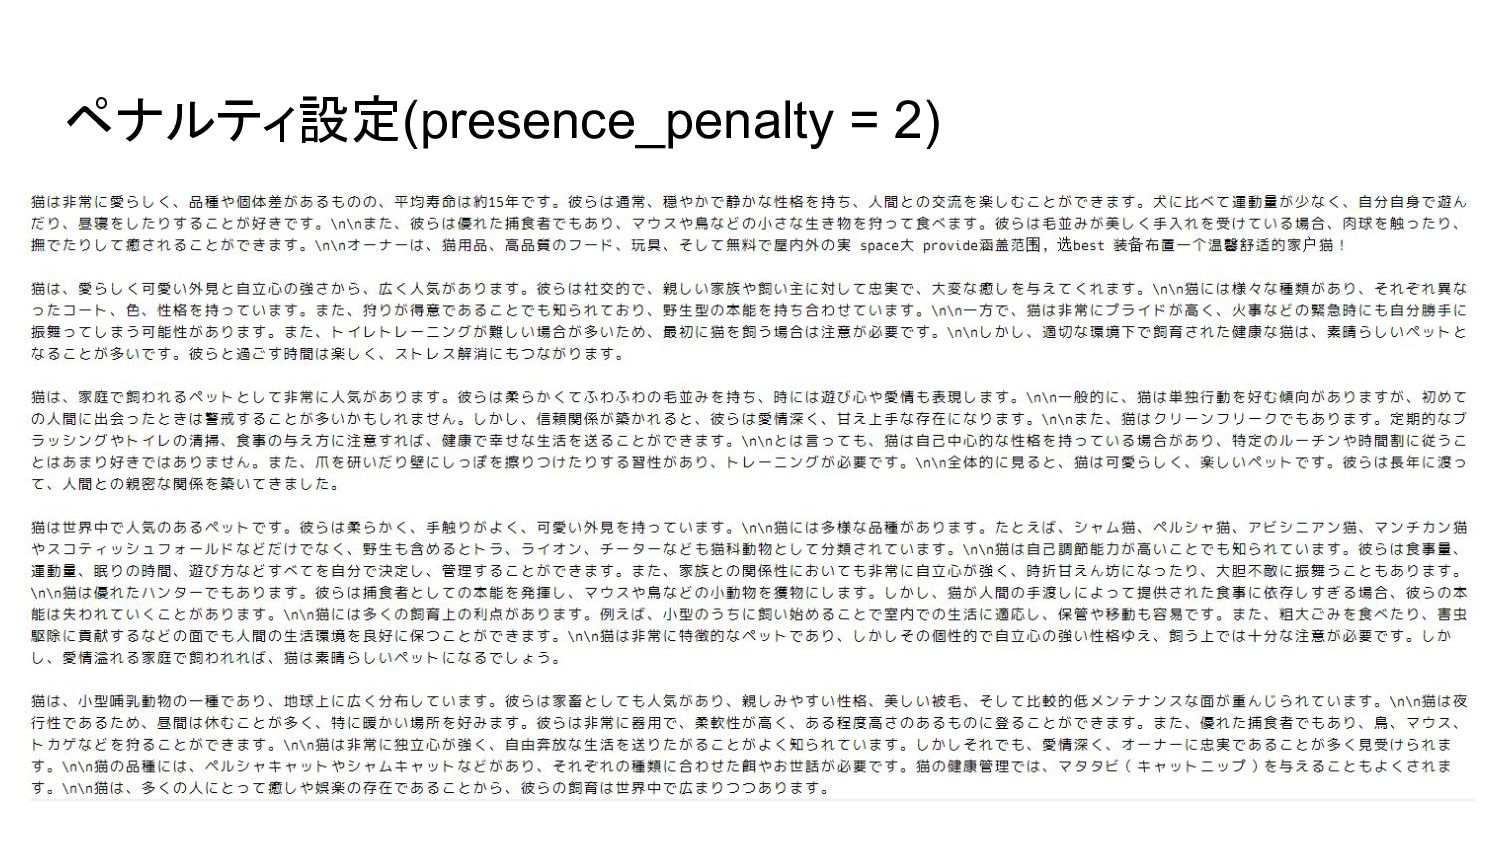
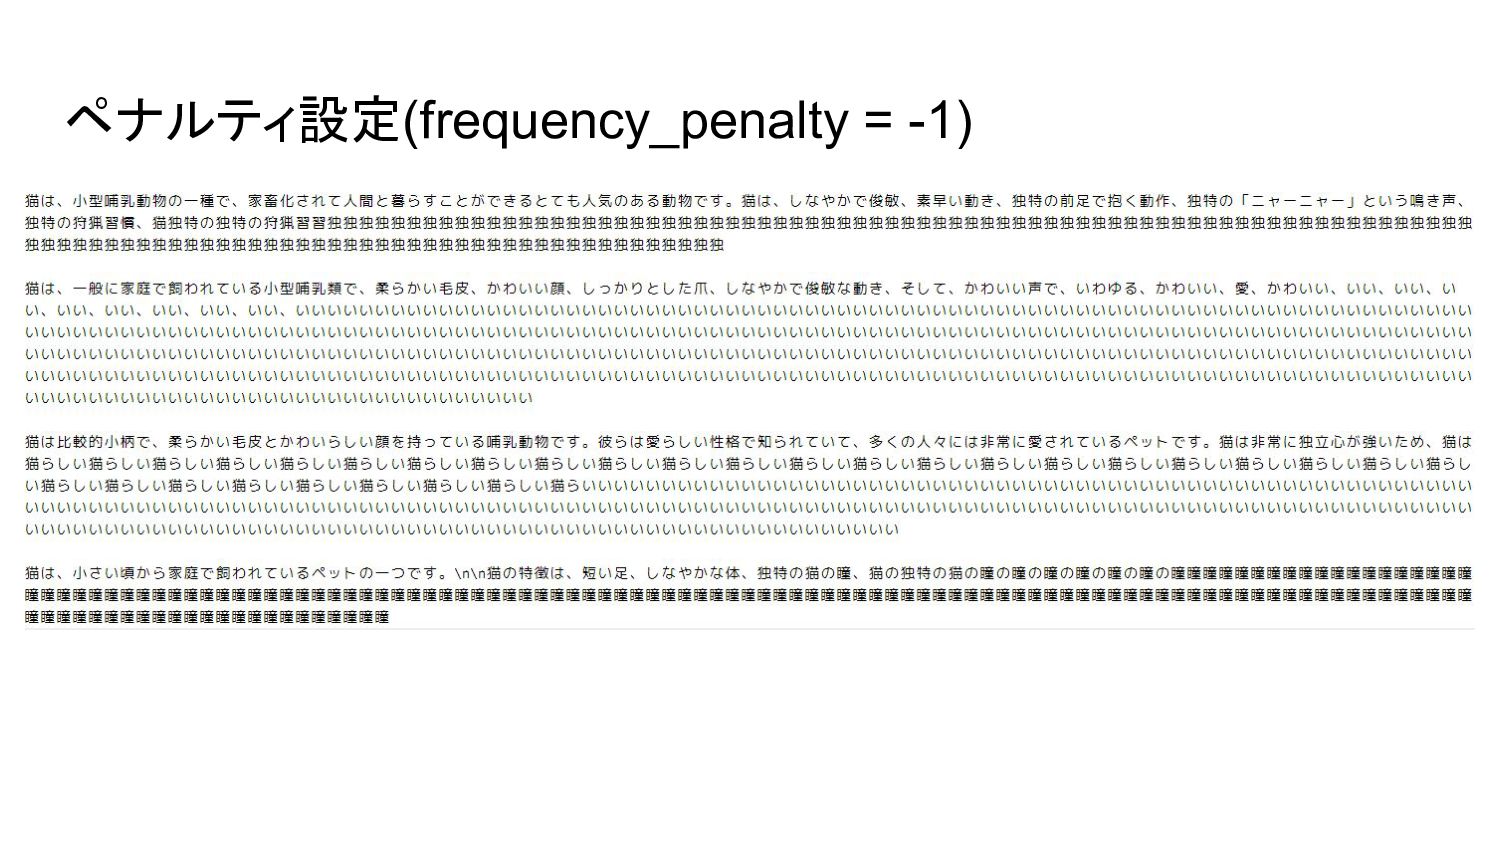
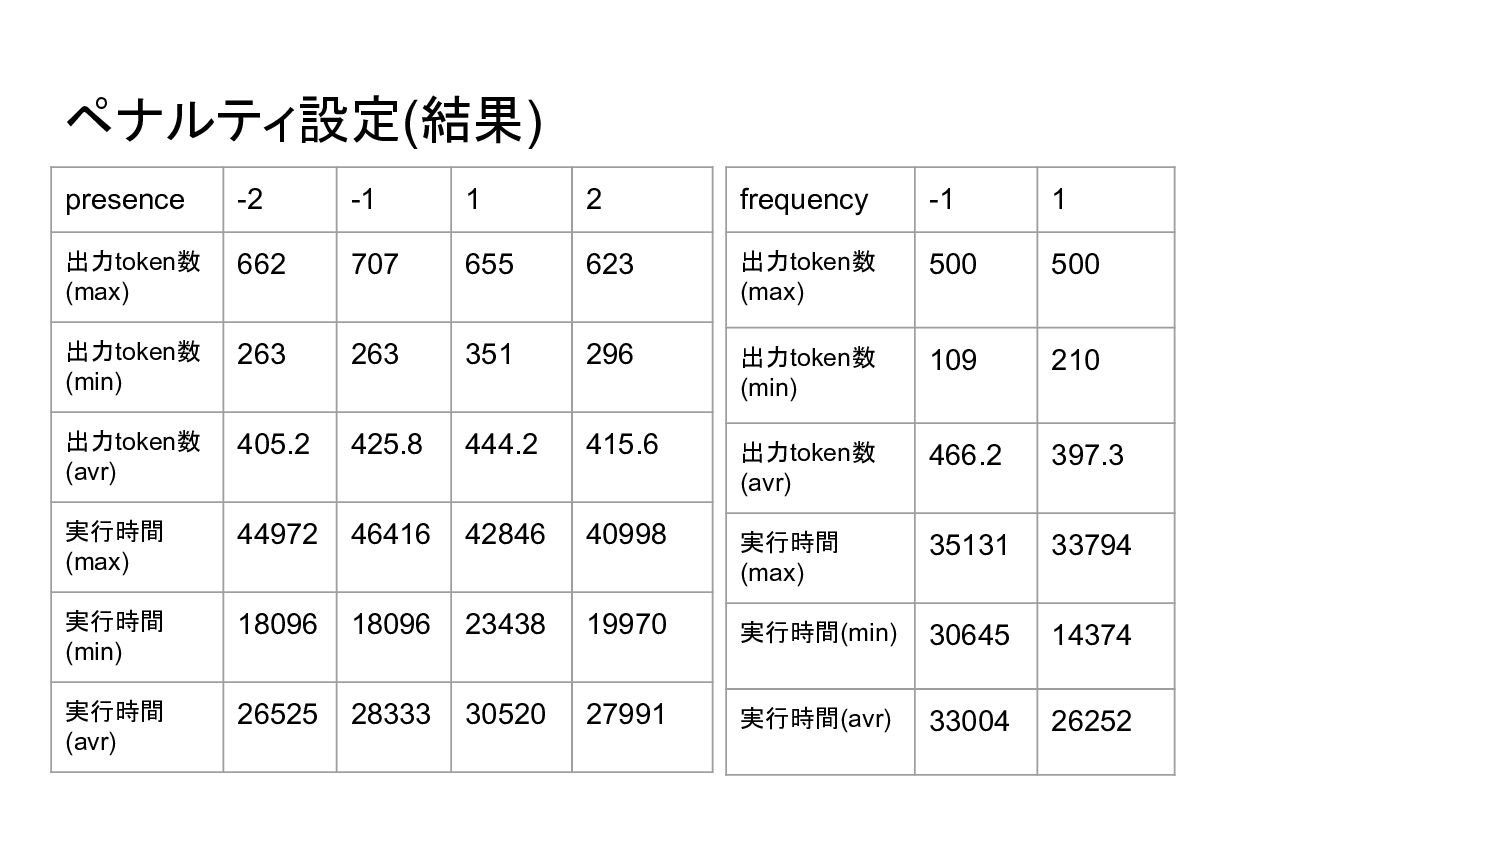
ペナルティ設定(結果) presence -2 -1 1 2 出力token数 (max) 662 707
655 623 出力token数 (min) 263 263 351 296 出力token数 (avr) 405.2 425.8 444.2 415.6 実行時間 (max) 44972 46416 42846 40998 実行時間 (min) 18096 18096 23438 19970 実行時間 (avr) 26525 28333 30520 27991 frequency -1 1 出力token数 (max) 500 500 出力token数 (min) 109 210 出力token数 (avr) 466.2 397.3 実行時間 (max) 35131 33794 実行時間(min) 30645 14374 実行時間(avr) 33004 26252 -
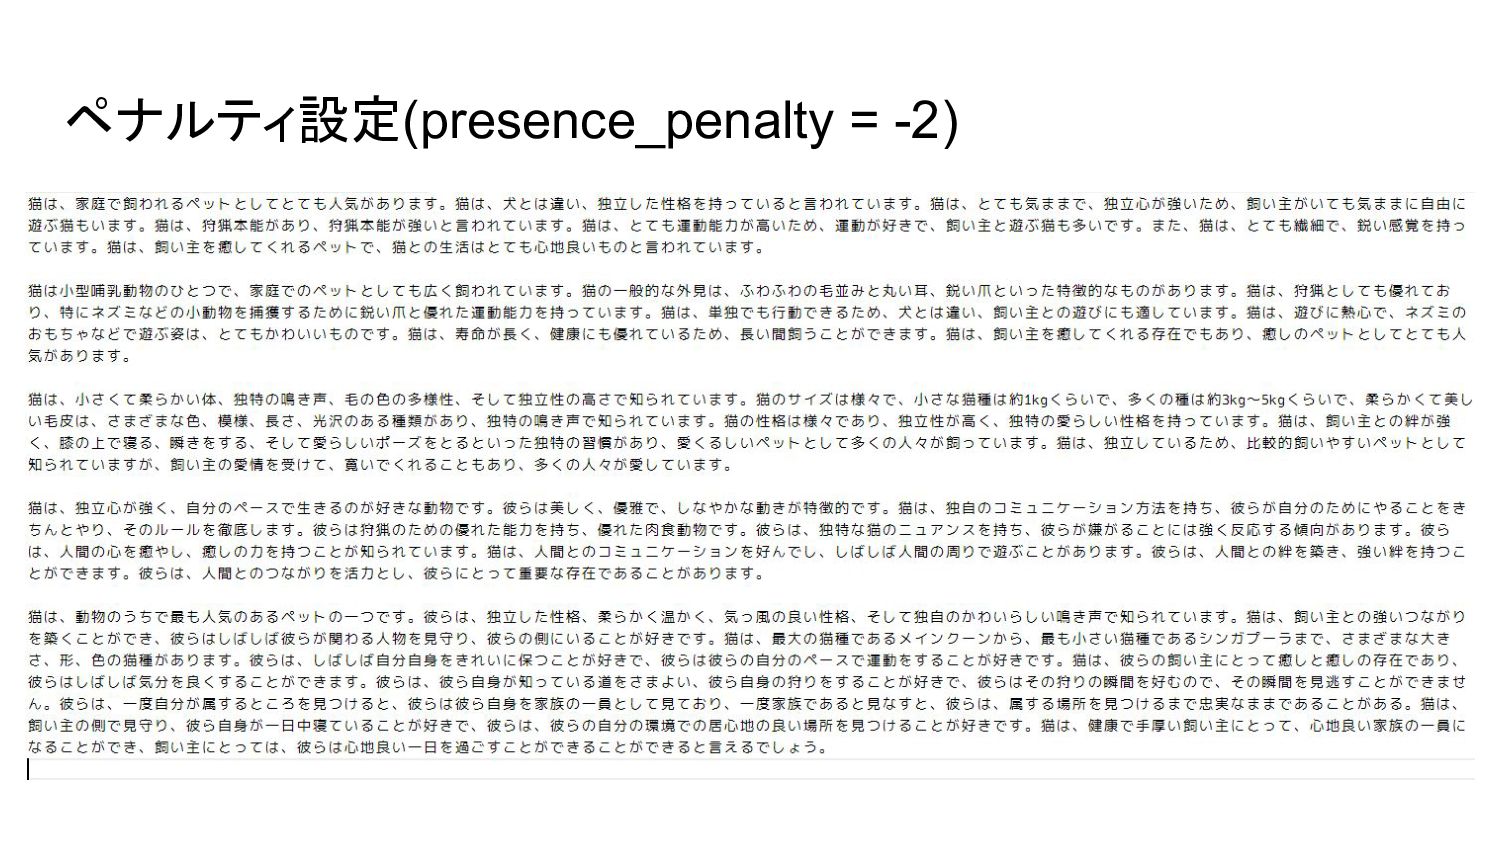
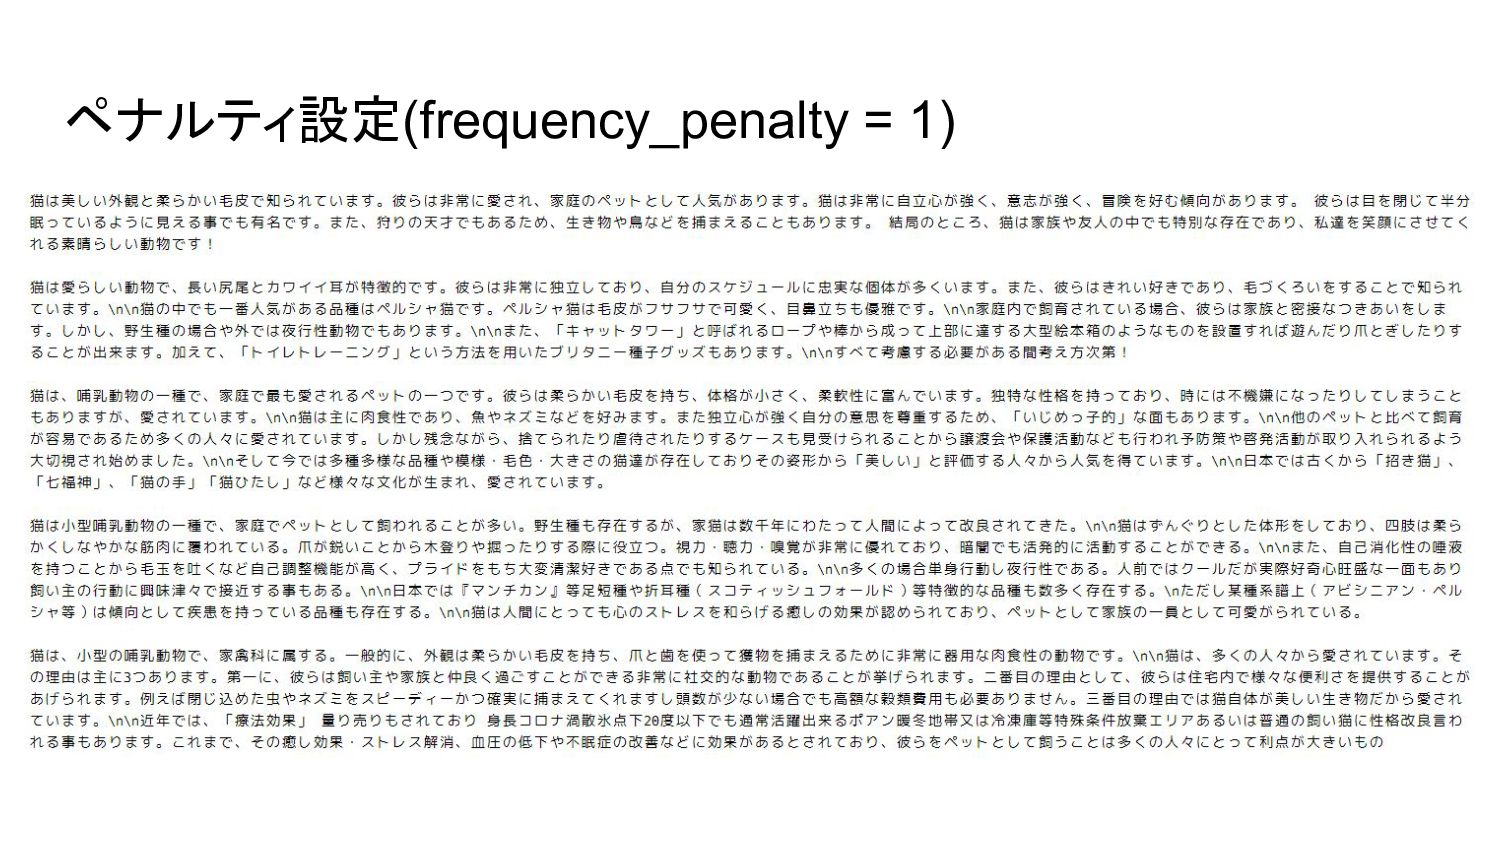
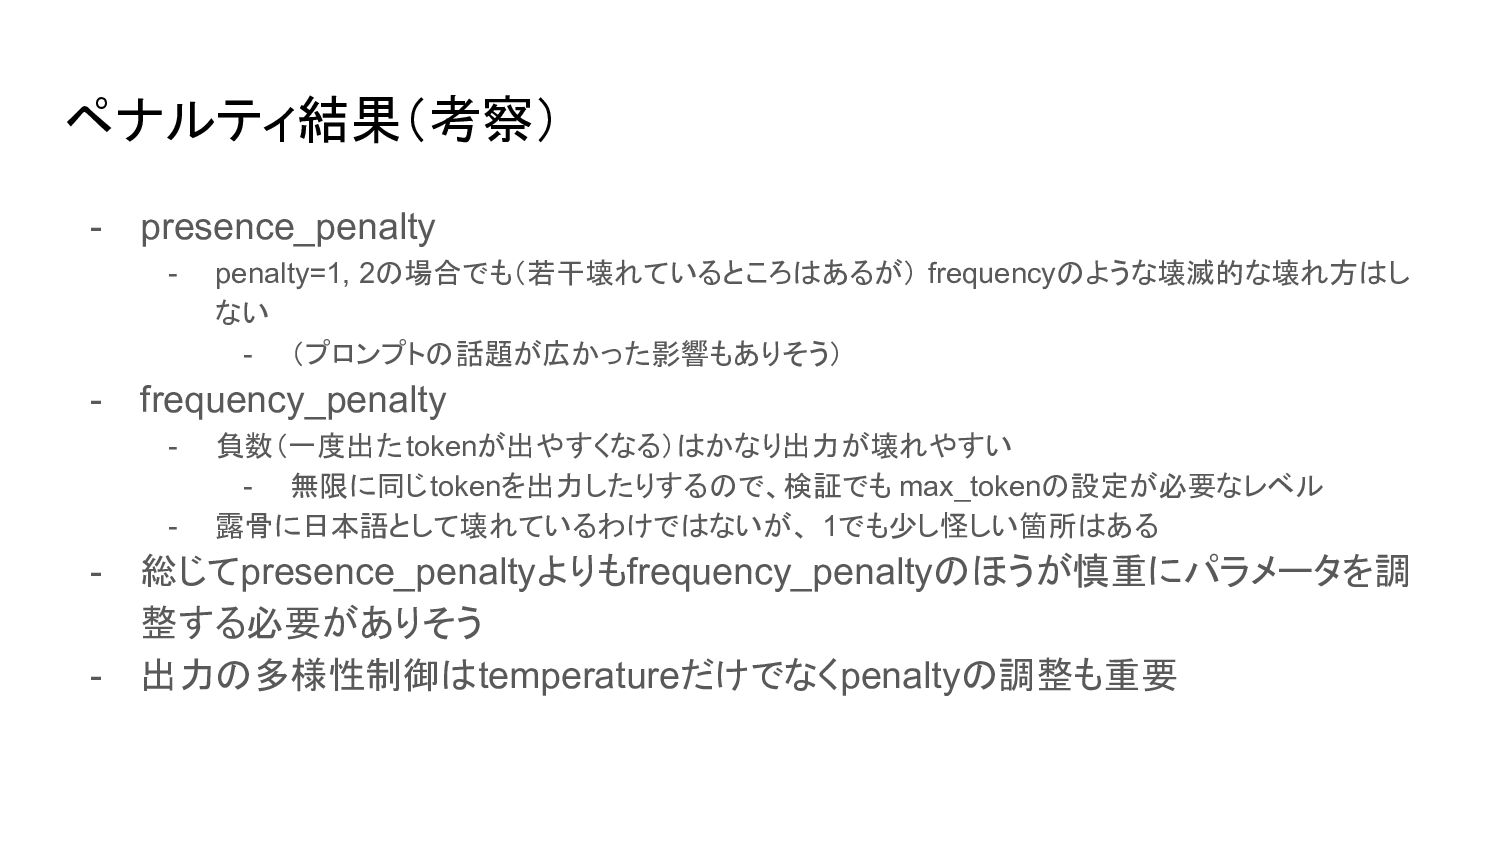
ペナルティ結果(考察) - presence_penalty - penalty=1, 2の場合でも(若干壊れているところはあるが) frequencyのような壊滅的な壊れ方はし ない - (プロンプトの話題が広かった影響もありそう)
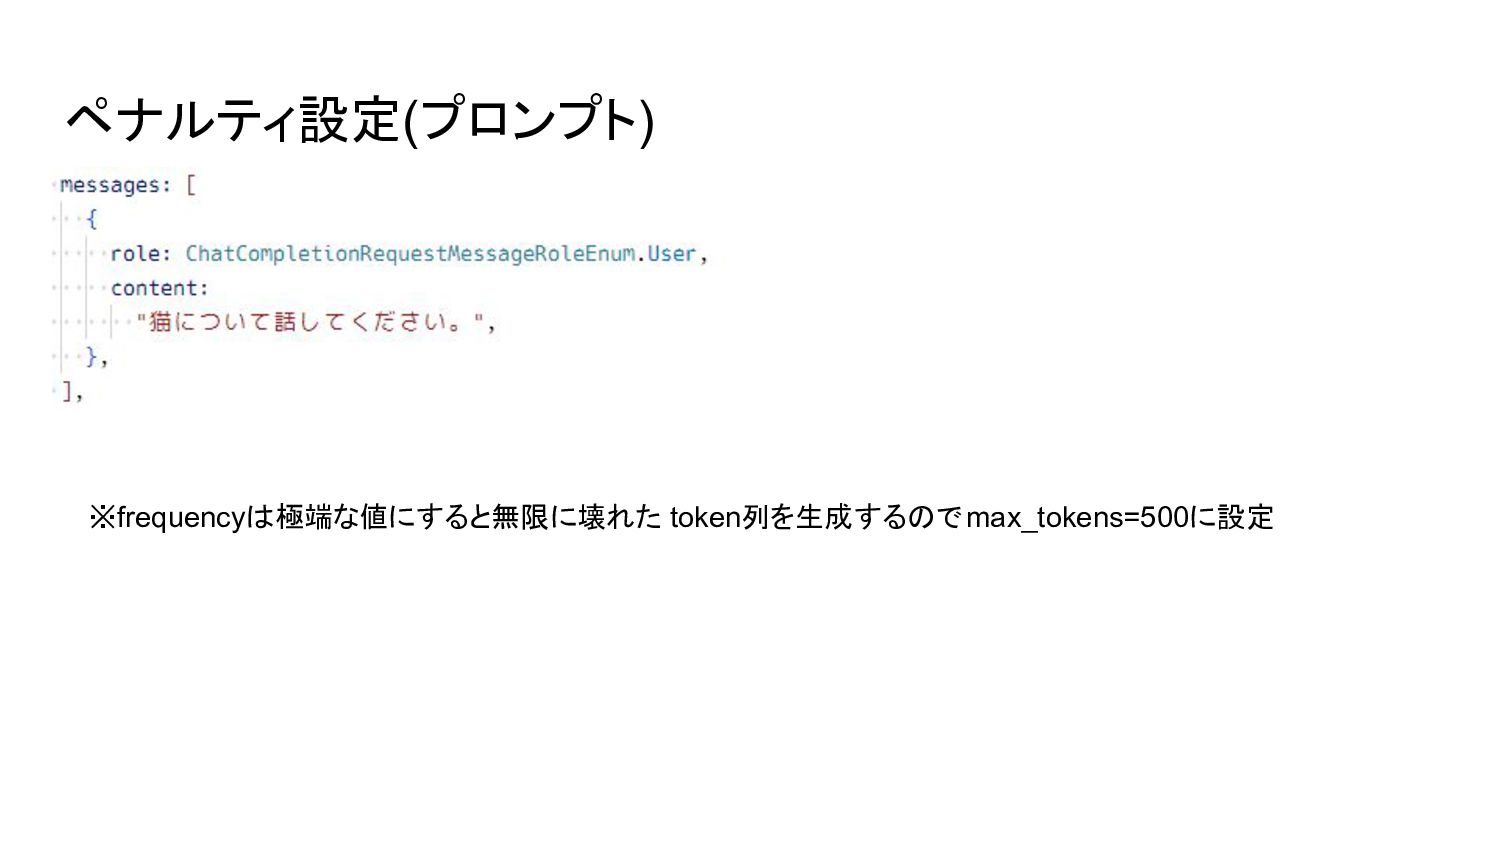
- frequency_penalty - 負数(一度出たtokenが出やすくなる)はかなり出力が壊れやすい - 無限に同じtokenを出力したりするので、検証でも max_tokenの設定が必要なレベル - 露骨に日本語として壊れているわけではないが、 1でも少し怪しい箇所はある - 総じてpresence_penaltyよりもfrequency_penaltyのほうが慎重にパラメータを調 整する必要がありそう - 出力の多様性制御はtemperatureだけでなくpenaltyの調整も重要 -
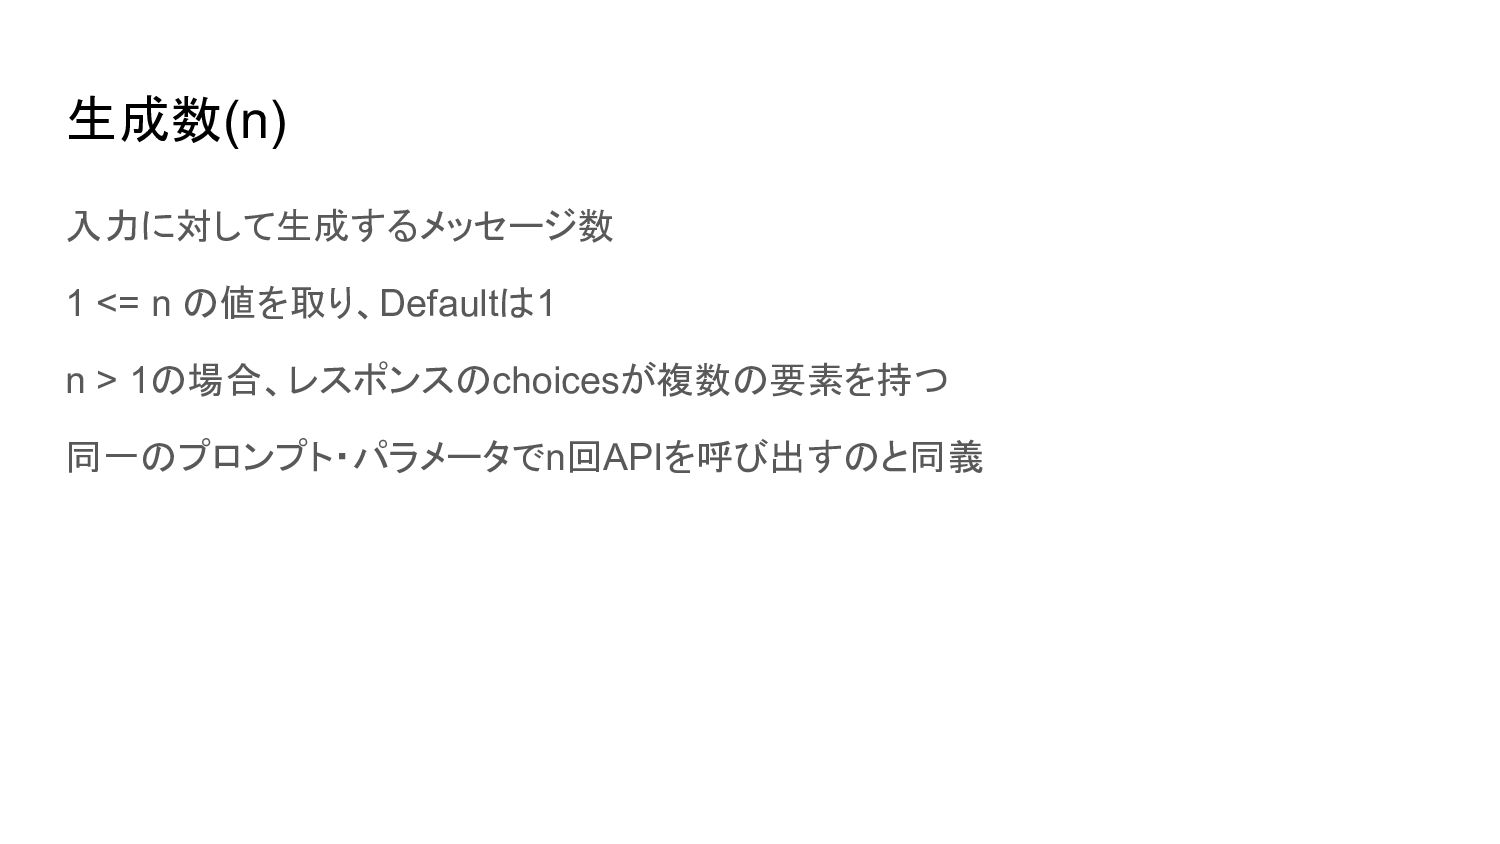
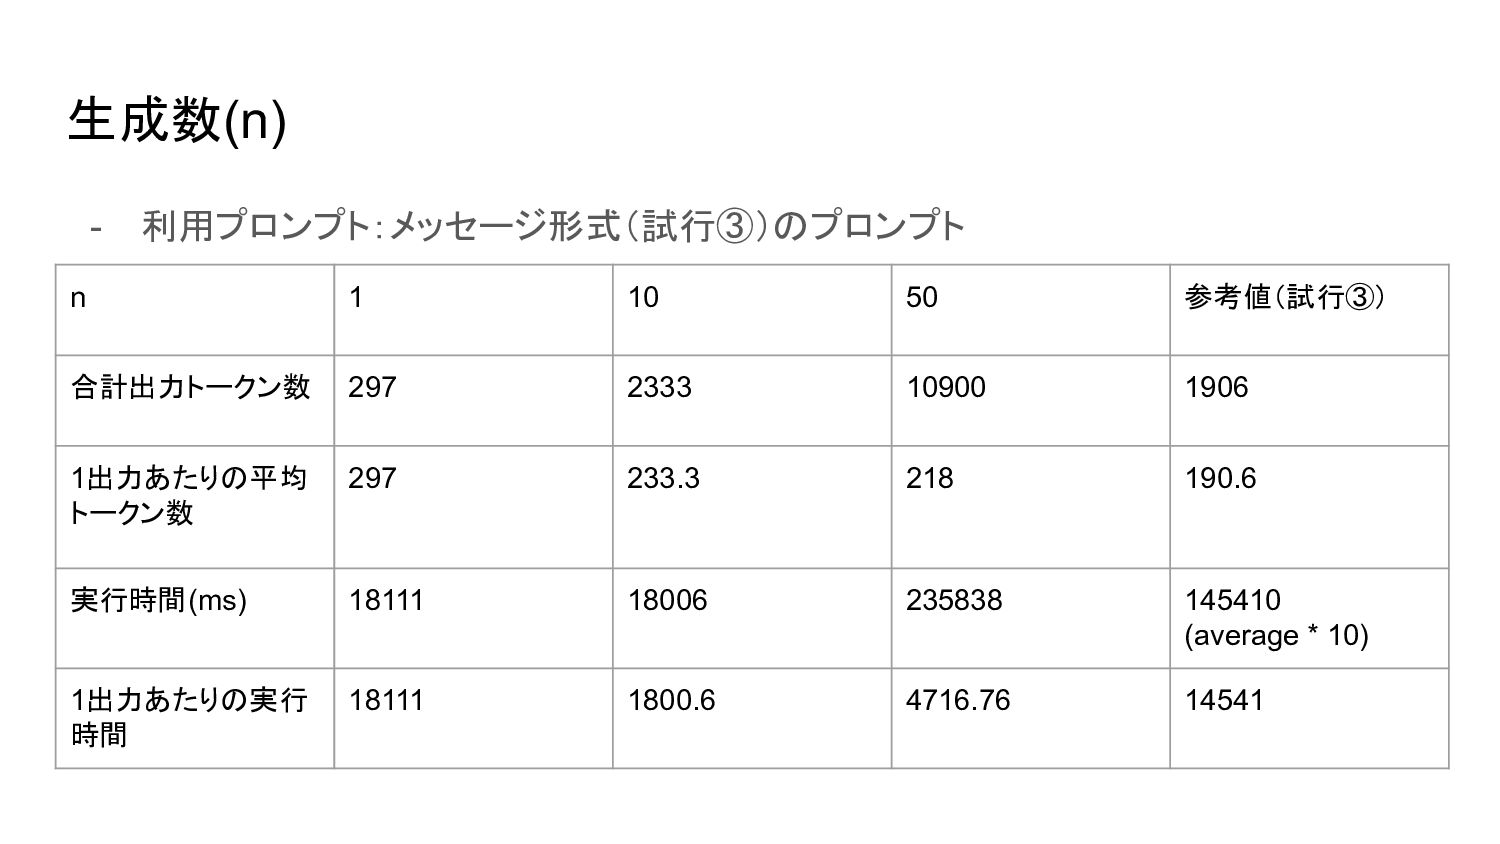
生成数(n) - 利用プロンプト:メッセージ形式(試行③)のプロンプト n 1 10 50 参考値(試行③) 合計出力トークン数 297
2333 10900 1906 1出力あたりの平均 トークン数 297 233.3 218 190.6 実行時間(ms) 18111 18006 235838 145410 (average * 10) 1出力あたりの実行 時間 18111 1800.6 4716.76 14541 -
生成数(n) (考察) - 入力トークンは1回分カウント - n = 10くらいまでは n =
1と実行時間ほとんど変わらない(?) 基本的には同じリクエストを複数回投げるよりはnで制御するほうが良さそう -
LlamaIndexとLangChain - LlamaIndex - LLMと外部データの接続、構造化、 indexingに特化したライブラリ - LlamaHub(データローダーライブラリのコミュニティ) - chroma,
discord, elasticsearch, github_repo, gmail, google_seetsなどがある - LangChain - LLMを利用したアプリケーション開発のための汎用的なライブラリ - Agents機能(ReAct的なやつ)が提供されている - 基本的なEmbeddingsの活用等はどちらのライブラリでも可能 - とりあえず外部ソースを使ってみる、程度であればLangChainがおすすめ - 外部データ利用やindexingをより詳細にカスタマイズしたい場合、 LlamaHub提供のLoaderを使い たい場合はLlamaIndex併用もあり -
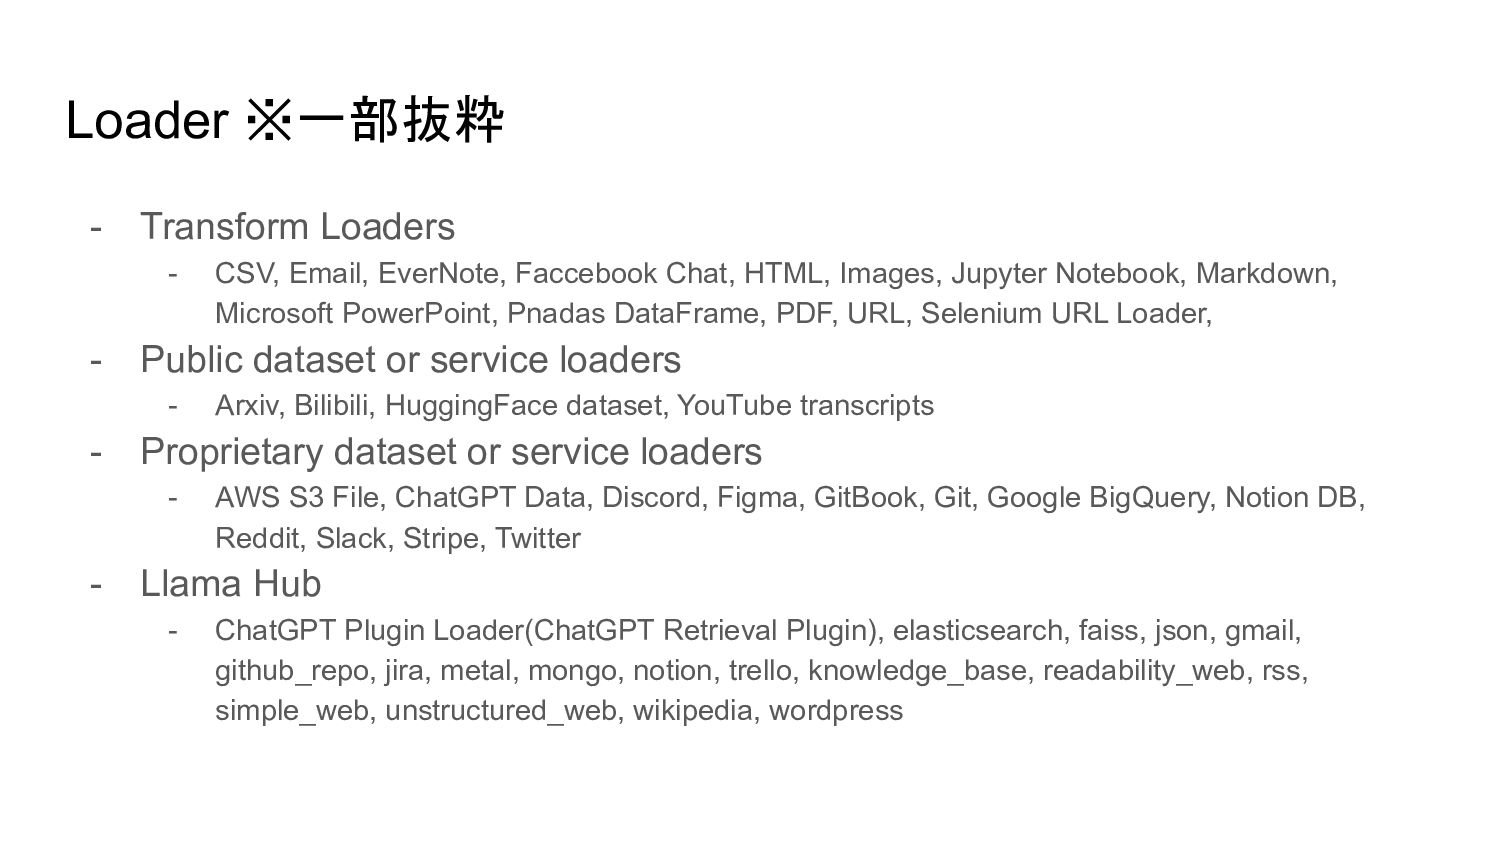
Loader ※一部抜粋 - Transform Loaders - CSV, Email, EverNote, Faccebook
Chat, HTML, Images, Jupyter Notebook, Markdown, Microsoft PowerPoint, Pnadas DataFrame, PDF, URL, Selenium URL Loader, - Public dataset or service loaders - Arxiv, Bilibili, HuggingFace dataset, YouTube transcripts - Proprietary dataset or service loaders - AWS S3 File, ChatGPT Data, Discord, Figma, GitBook, Git, Google BigQuery, Notion DB, Reddit, Slack, Stripe, Twitter - Llama Hub - ChatGPT Plugin Loader(ChatGPT Retrieval Plugin), elasticsearch, faiss, json, gmail, github_repo, jira, metal, mongo, notion, trello, knowledge_base, readability_web, rss, simple_web, unstructured_web, wikipedia, wordpress -
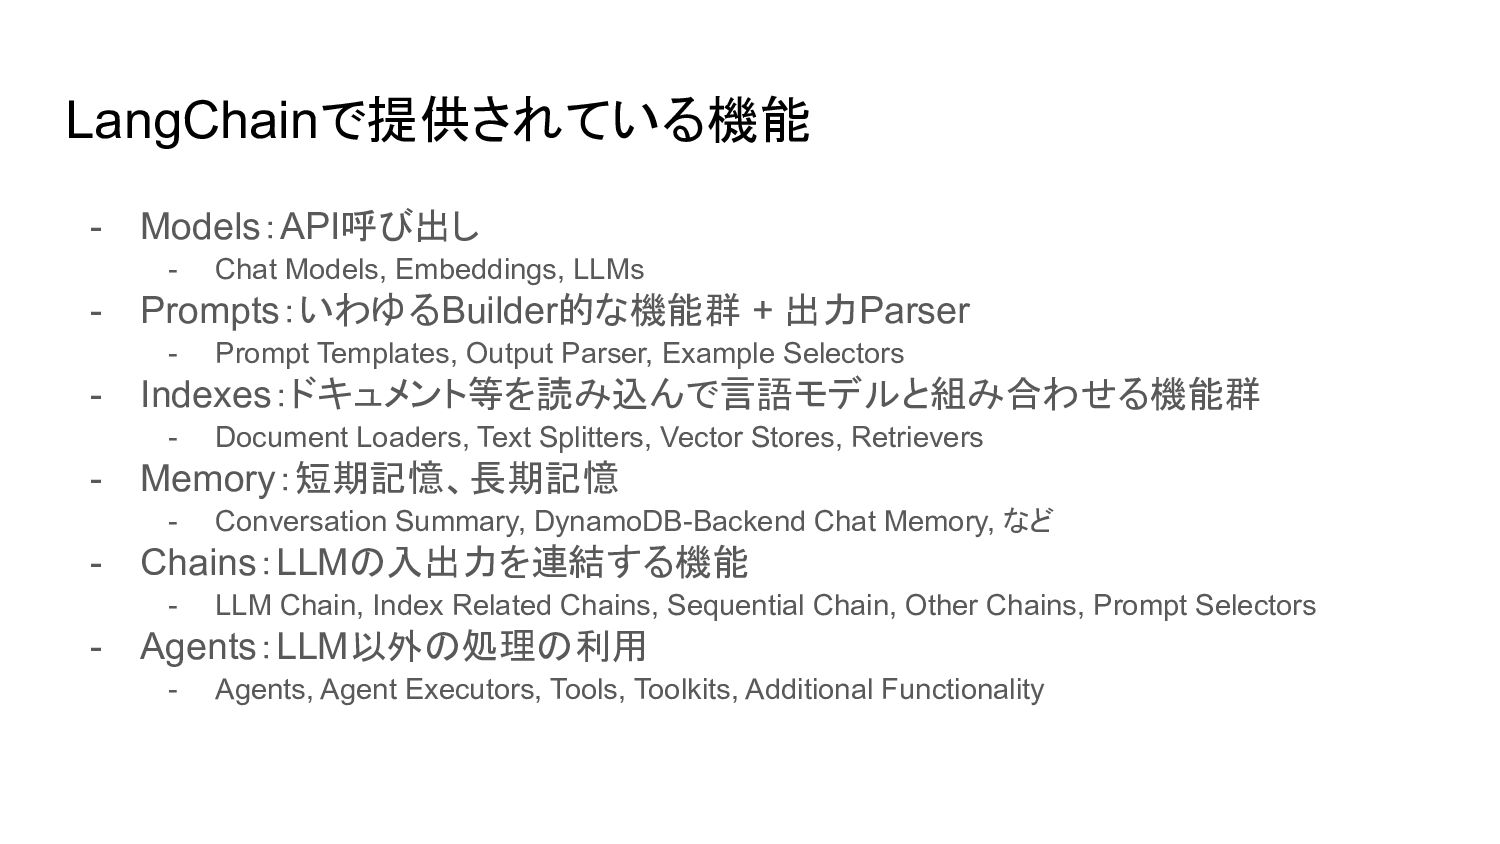
LangChainで提供されている機能 - Models:API呼び出し - Chat Models, Embeddings, LLMs - Prompts:いわゆるBuilder的な機能群
+ 出力Parser - Prompt Templates, Output Parser, Example Selectors - Indexes:ドキュメント等を読み込んで言語モデルと組み合わせる機能群 - Document Loaders, Text Splitters, Vector Stores, Retrievers - Memory:短期記憶、長期記憶 - Conversation Summary, DynamoDB-Backend Chat Memory, など - Chains:LLMの入出力を連結する機能 - LLM Chain, Index Related Chains, Sequential Chain, Other Chains, Prompt Selectors - Agents:LLM以外の処理の利用 - Agents, Agent Executors, Tools, Toolkits, Additional Functionality -
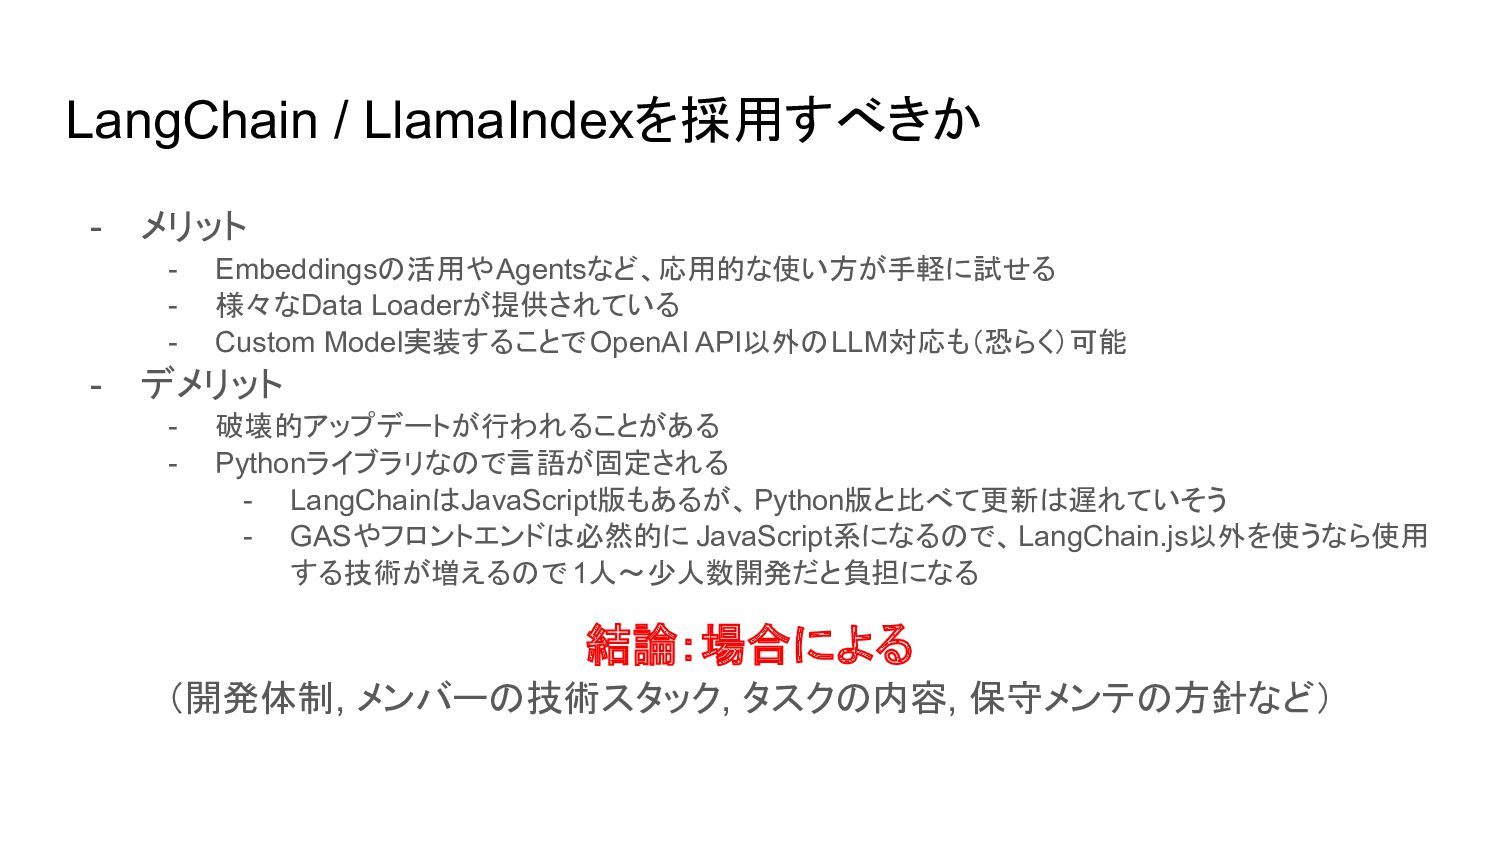
LangChain / LlamaIndexを採用すべきか - メリット - Embeddingsの活用やAgentsなど、応用的な使い方が手軽に試せる - 様々なData Loaderが提供されている
- Custom Model実装することでOpenAI API以外のLLM対応も(恐らく)可能 - デメリット - 破壊的アップデートが行われることがある - Pythonライブラリなので言語が固定される - LangChainはJavaScript版もあるが、Python版と比べて更新は遅れていそう - GASやフロントエンドは必然的に JavaScript系になるので、LangChain.js以外を使うなら使用 する技術が増えるので 1人~少人数開発だと負担になる 結論:場合による (開発体制, メンバーの技術スタック, タスクの内容, 保守メンテの方針など) -
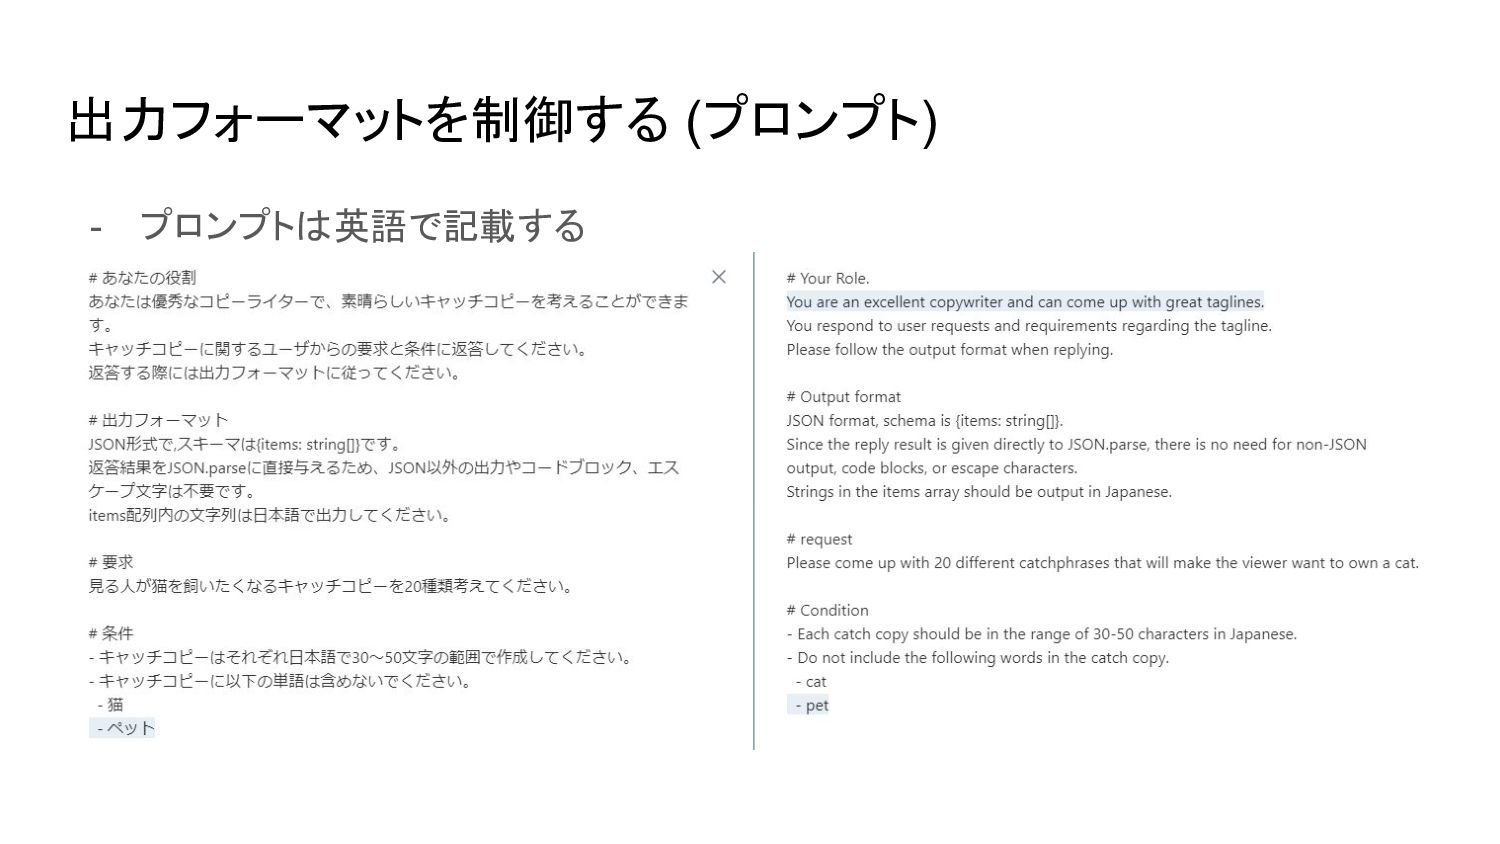
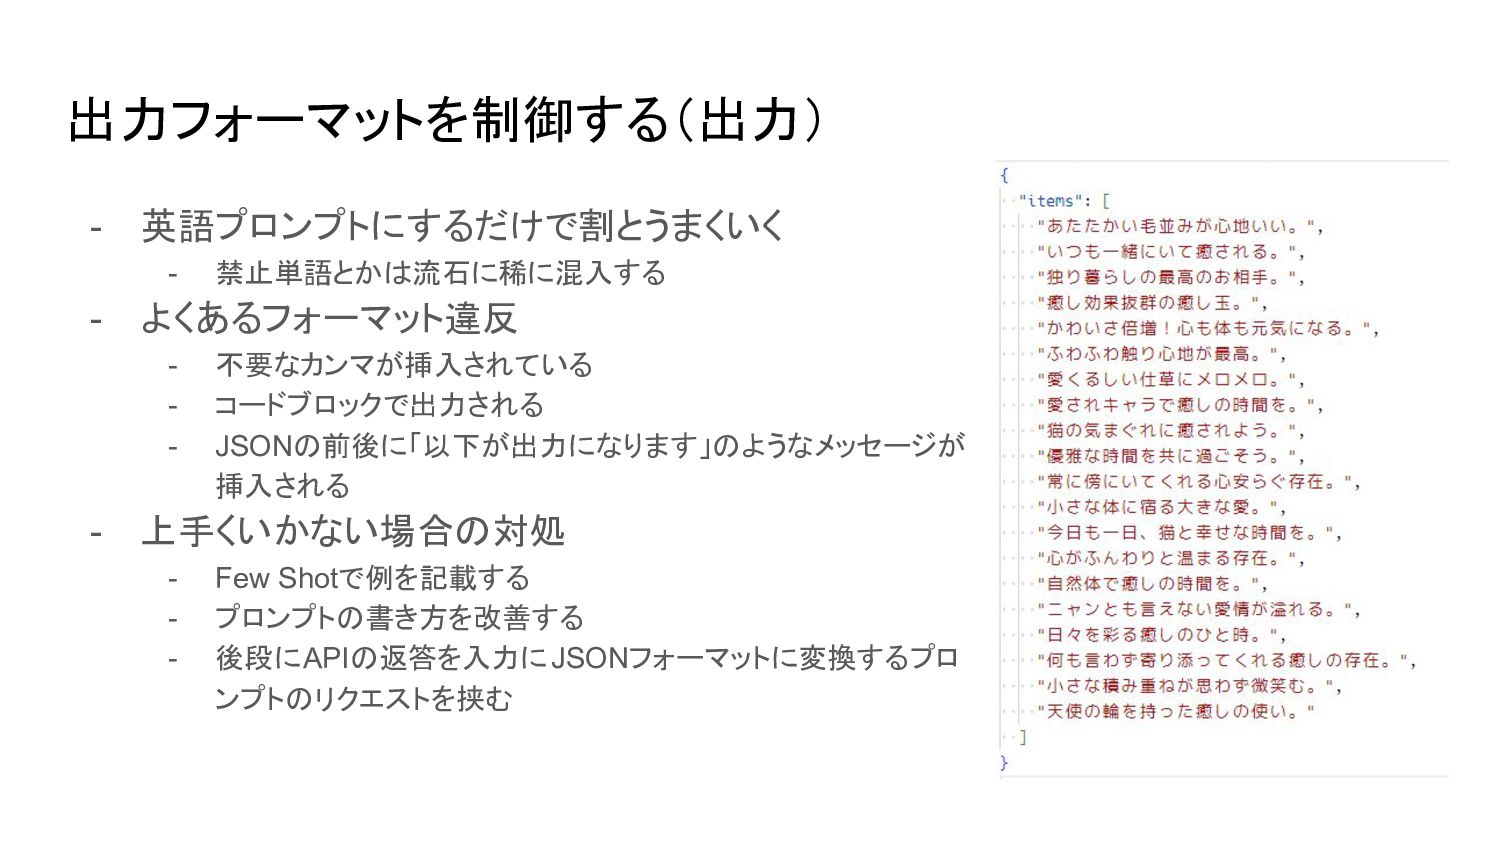
出力フォーマットを制御する(出力) - 英語プロンプトにするだけで割とうまくいく - 禁止単語とかは流石に稀に混入する - よくあるフォーマット違反 - 不要なカンマが挿入されている -
コードブロックで出力される - JSONの前後に「以下が出力になります」のようなメッセージが 挿入される - 上手くいかない場合の対処 - Few Shotで例を記載する - プロンプトの書き方を改善する - 後段にAPIの返答を入力にJSONフォーマットに変換するプロ ンプトのリクエストを挟む -
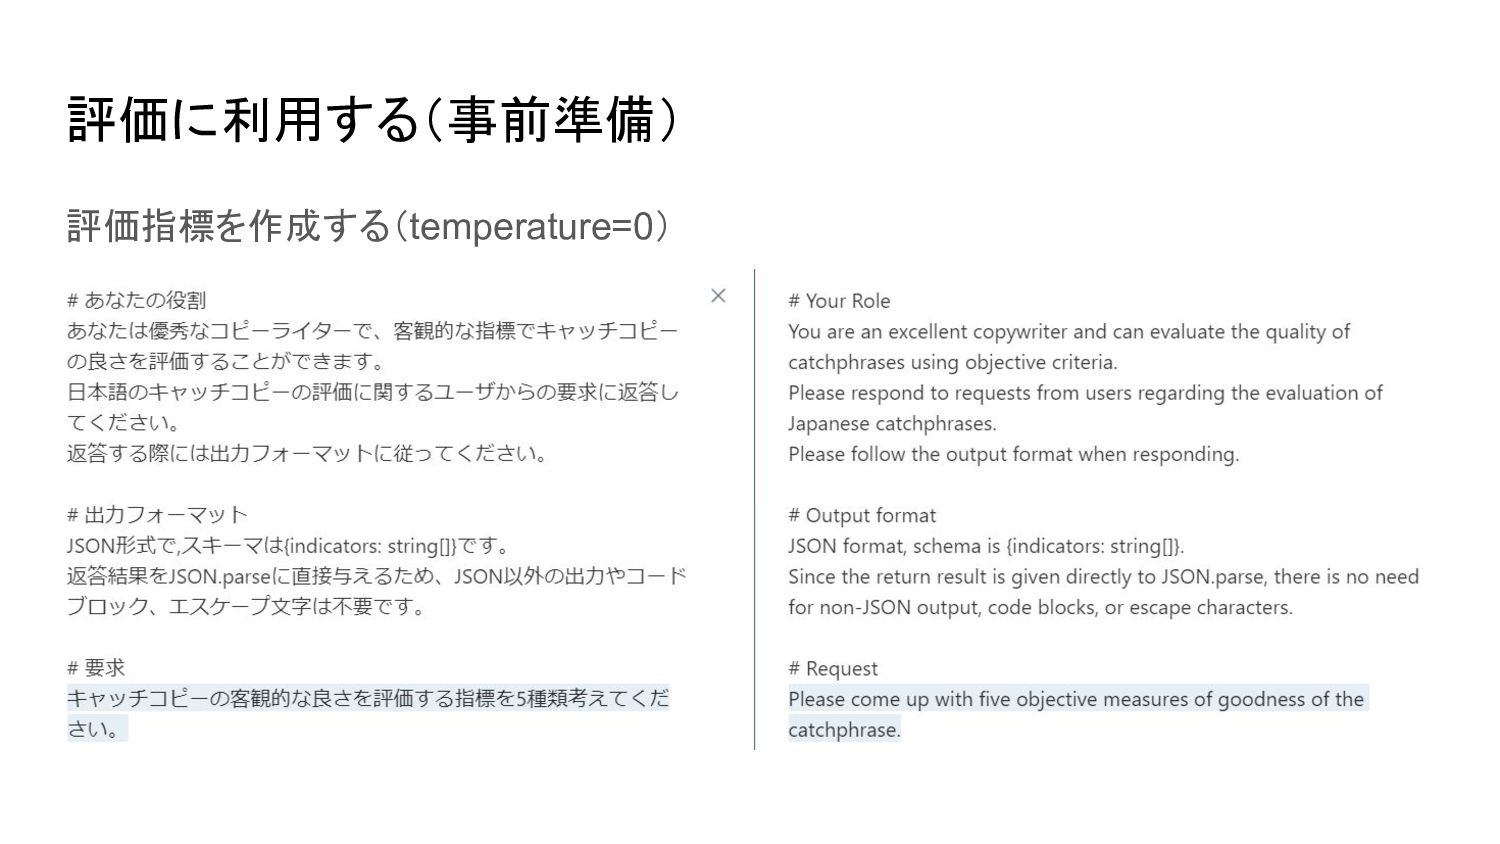
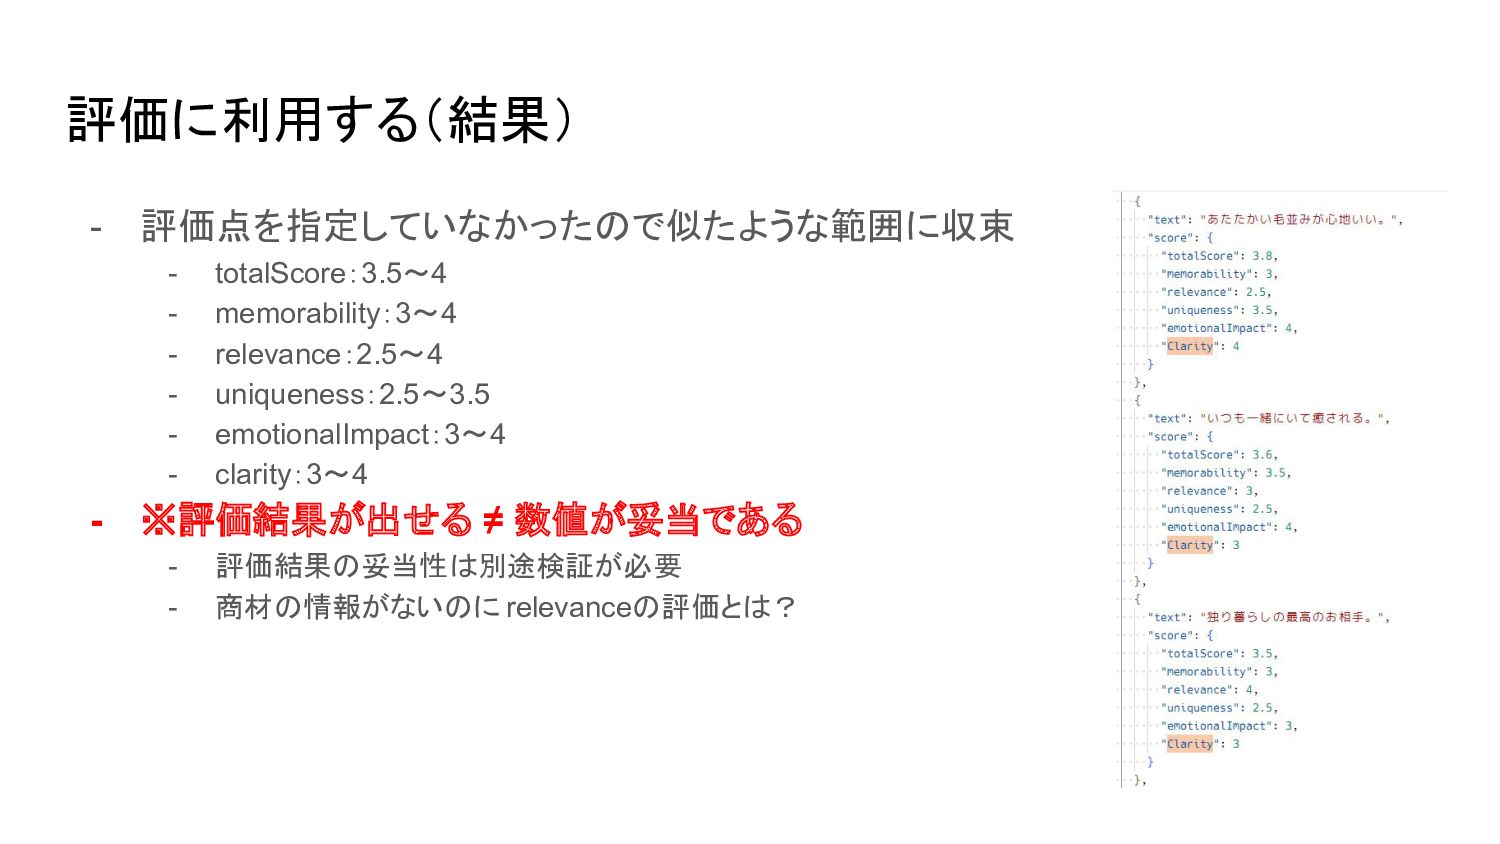
評価に利用する(結果) - 評価点を指定していなかったので似たような範囲に収束 - totalScore:3.5~4 - memorability:3~4 - relevance:2.5~4 -
uniqueness:2.5~3.5 - emotionalImpact:3~4 - clarity:3~4 - ※評価結果が出せる ≠ 数値が妥当である - 評価結果の妥当性は別途検証が必要 - 商材の情報がないのに relevanceの評価とは?