Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Chat Completions APIにおける実行時間の検証
Search
natsuume
July 28, 2023
Technology
490
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Chat Completions APIにおける実行時間の検証
第2回 AI/ML Tech Night発表資料
https://opt.connpass.com/event/287568/
natsuume
July 28, 2023
More Decks by natsuume
See All by natsuume
Prompt-Based Hooksの罠
natsuume
0
410
線で考える画面構成
natsuume
1
1k
5W1H ~LLM活用プロジェクトを推進するうえで考えるべきこと~
natsuume
0
980
LLM API活用における業務要件の検討
natsuume
0
280
自然言語処理基礎の基礎
natsuume
0
320
5分ですこしわかった気になる Deep Learning概要
natsuume
0
120
ChatGPT / OpenAI API実用入門
natsuume
0
310
Other Decks in Technology
See All in Technology
「とりあえず動く」の先へ。 AI時代のチーム開発と内部設計/2026-slsdays
slsops
0
110
AI Made Us Faster at Solving the Wrong Problems
marceloancelmo
0
140
Execution in the Kingdom of Agents: Reflections on Abstraction and Complexity
bcantrill
0
710
TiDBファミリーにDWHが新登場!! TiDB最新情報 / TiDB update 202609
yoshiakiyamasaki
0
190
Incremental HTTP
kazuho
5
2k
Lambda MicroVMsは常駐サーバーの代わりに なるか? Kiro Crew を動かして検証してみた / Kiro Crew on Lambda MicroVMs
k_adachi_01
2
350
覗いてみよう 関数型ビジュアル言語×2Dグラフィックスの世界
yohyamasaki
0
160
スキルを作る、その前に!複数人で使われるスキルを 作るためのプロセス
junkifurukawa
2
180
Databricksメトリクスビューはじめてのもくもく会
taka_aki
0
160
GitHub Agentic Workflows を触ってみる
htkym
2
920
10年欲しかった音楽管理アプリを、AIと一緒に作りはじめた
judau
1
200
React Nativeでの OTA Updateって、 どう説明する?
ichiki1023
0
140
Featured
See All Featured
I Don’t Have Time: Getting Over the Fear to Launch Your Podcast
jcasabona
35
2.9k
Marketing to machines
jonoalderson
1
5.8k
Organizational Design Perspectives: An Ontology of Organizational Design Elements
kimpetersen
PRO
1
840
Leveraging LLMs for student feedback in introductory data science courses - posit::conf(2025)
minecr
1
410
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
270
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
The agentic SEO stack - context over prompts
schlessera
0
950
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
930
The Cult of Friendly URLs
andyhume
79
7k
Getting science done with accelerated Python computing platforms
jacobtomlinson
2
500
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
560
Transcript
Chat Completions API における実行時間の検証 2023/07/28 第2回 AI/ML Tech Night
自己紹介 natsuume (Twitter: @_natsuume) 所属:株式会社オプト - NLPer → LLM・アプリケーションエンジニア -
最近やっていること: https://tech-magazine.opt.ne.jp/entry/2023/06/23/144625
Function Calling - GPT-3.5-turbo-0613, GPT-4-0613モデルから利用可能になった機能 - 事前に定義したJSONスキーマの形式で返答が返ってくる機能 - 従来よりも簡単に出力の制御が可能になった -
色々な検証にも使える Function Callingを使って実行時間の検証してみる
検証方法 例(入力トークン数と実行時間の検証) - 右のようなFunctionを用いて、入力テキストに 関わらず出力内容を固定 - 他の実験でも同様
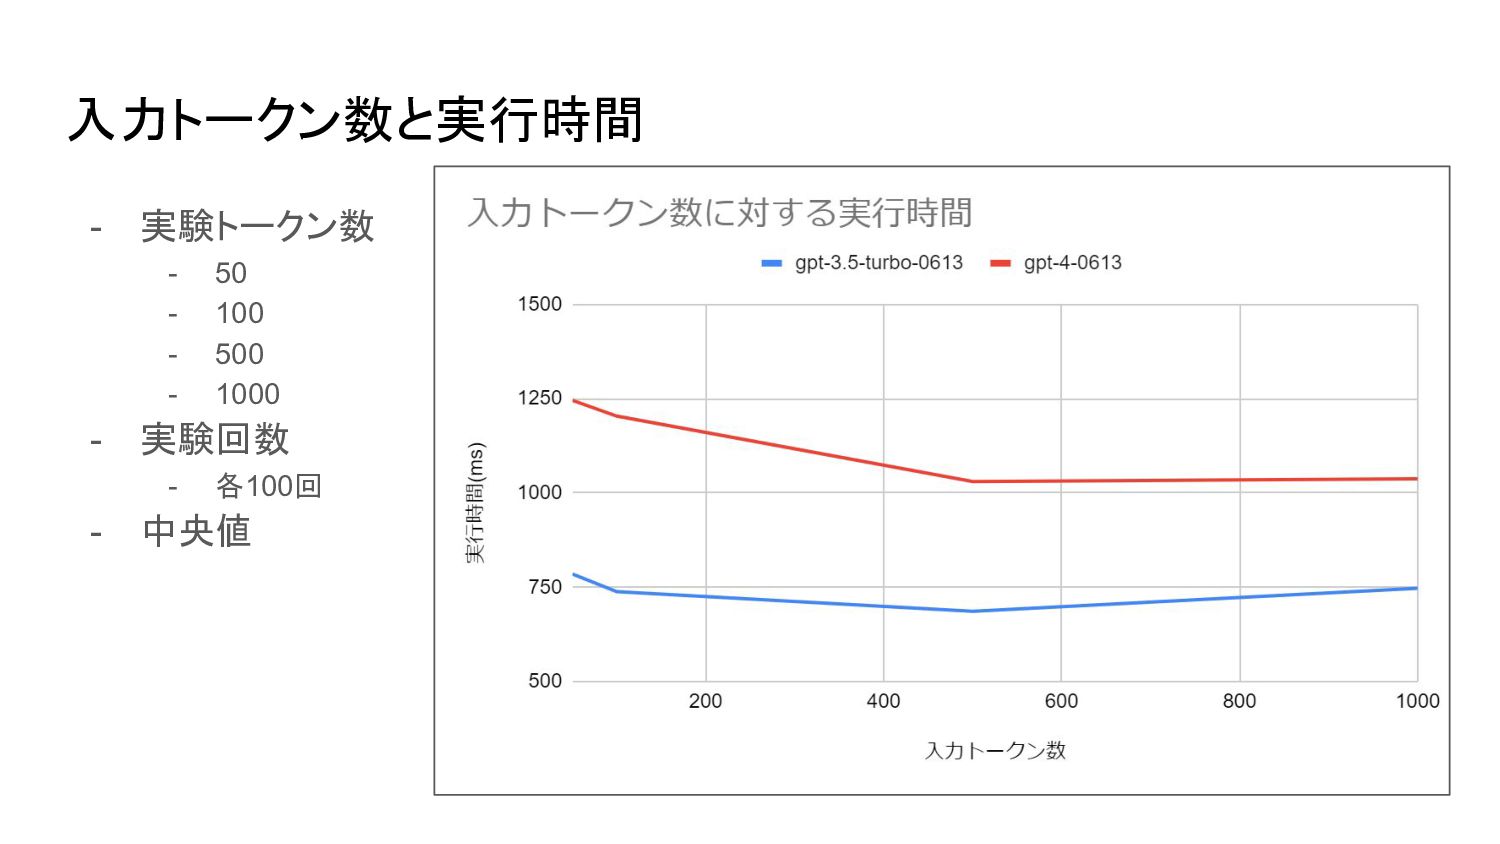
入力トークン数と実行時間 - 実験トークン数 - 50 - 100 - 500 -
1000 - 実験回数 - 各100回 - 中央値
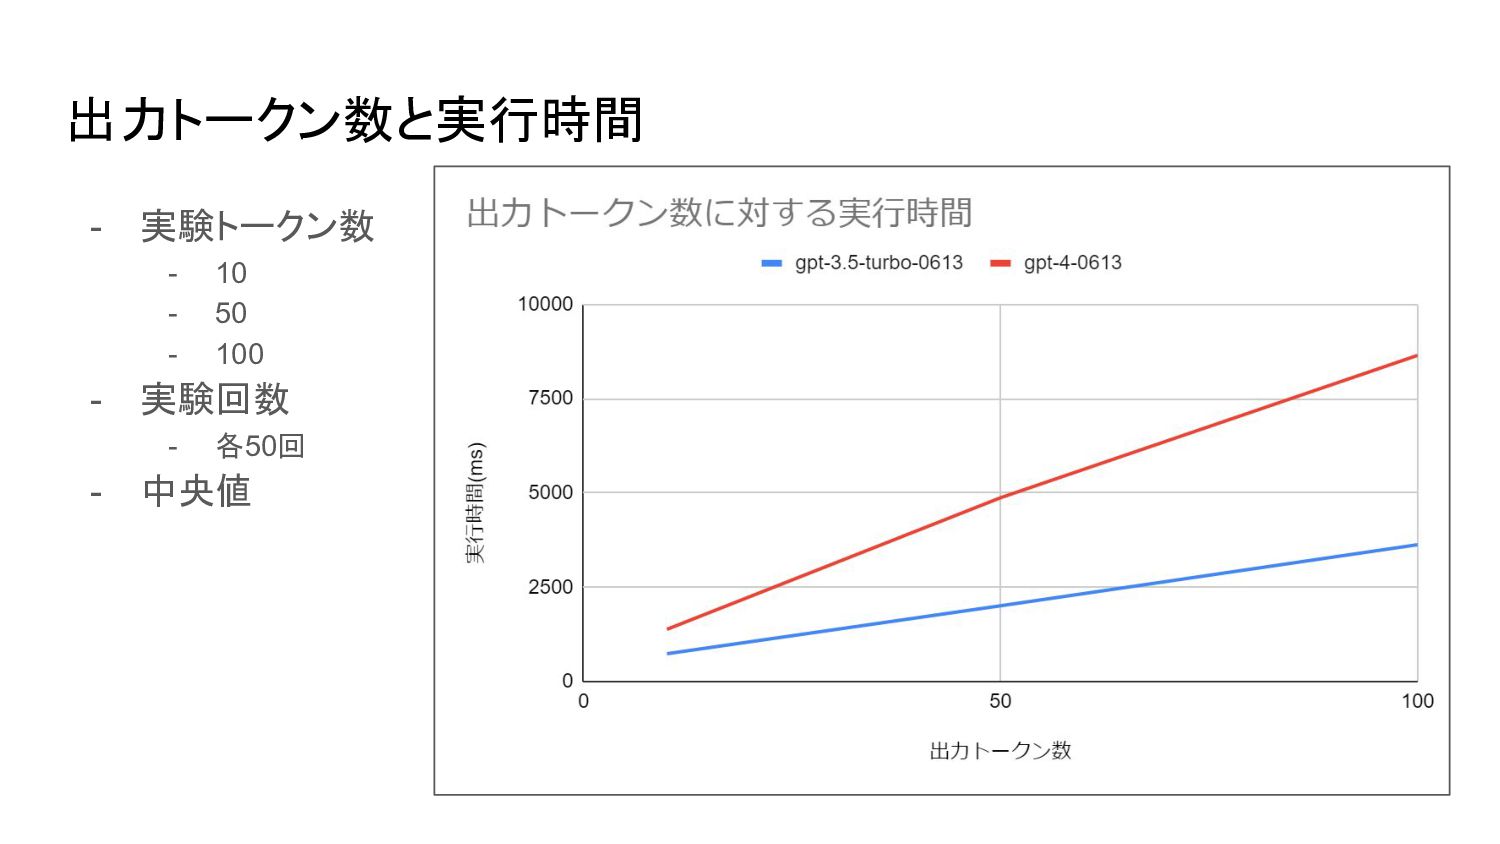
出力トークン数と実行時間 - 実験トークン数 - 10 - 50 - 100 -
実験回数 - 各50回 - 中央値
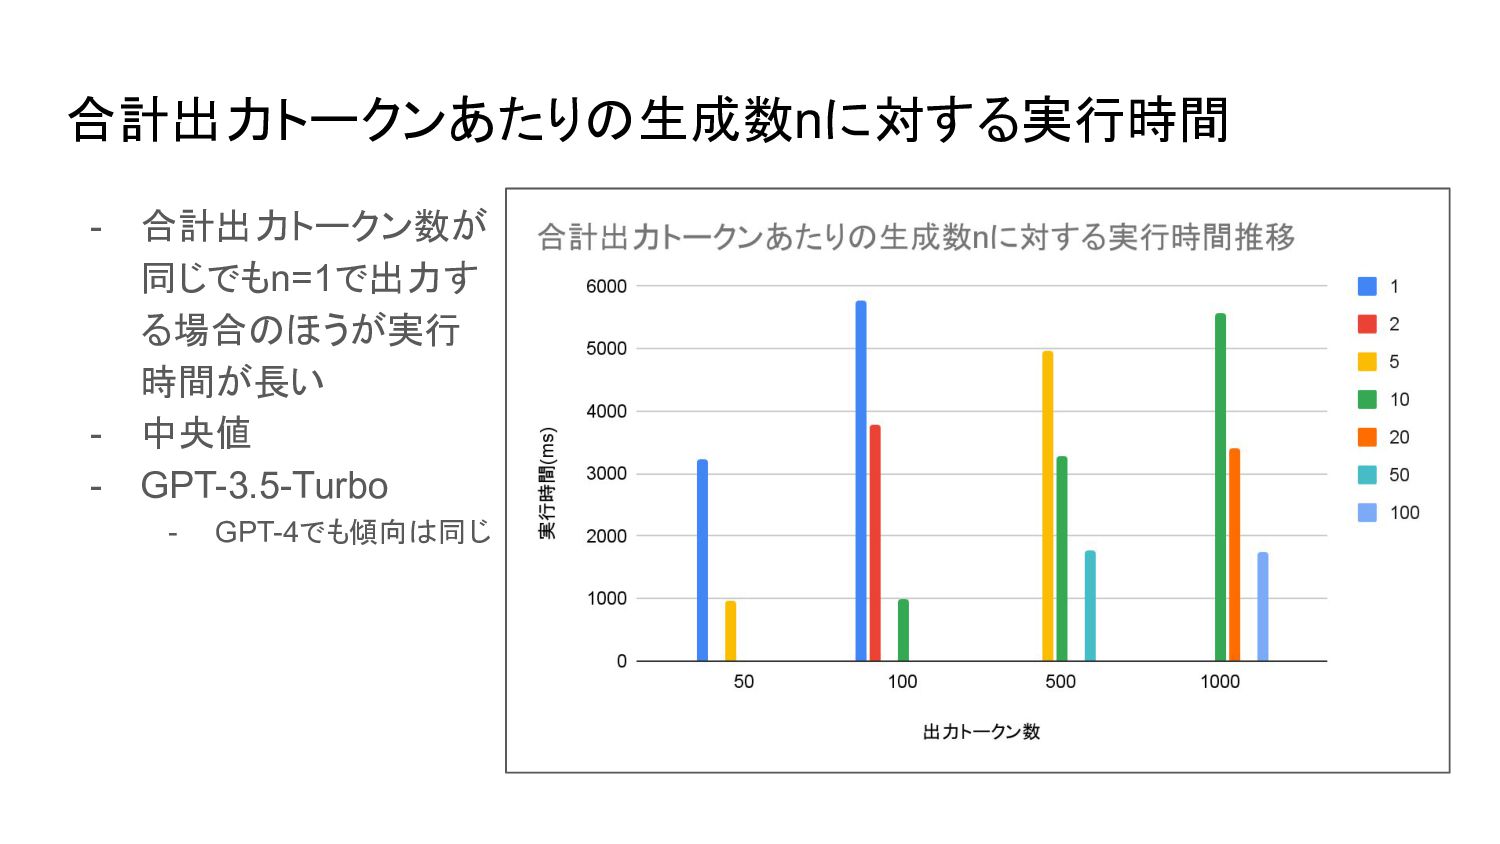
出力数nと実行時間 - 出力トークン数を固定し、nを変化させたときの実行時間の変化 - 例:出力トークン数: 100 - n=1(100×1) - n=2(50×2)
- n=10(10×10) - n=1における単位出力トークンは先程の実験と同様に10, 50, 100の3パターン - 合計の出力トークン数は次の4パターン - 50(10×5, 50×1) - 100(10×10, 50×2, 100×1) - 500(10×50, 50×10, 100×5) - 1000(10×100, 50×20, 100×10) - 試行回数はn=1の場合は前述の実験データを利用、それ以外は各10回
合計出力トークンあたりの生成数nに対する実行時間 - 合計出力トークン数が 同じでもn=1で出力す る場合のほうが実行 時間が長い - 中央値 - GPT-3.5-Turbo
- GPT-4でも傾向は同じ
nに対する実行時間の推移 - nを増やしても実行時 間は変化なし~微増 - 中央値 - GPT-3.5-Turbo - GPT-4でも傾向は同じ
検証を通して気づいたFunction Callingの所感 - Function Callingとはいえ、本質的にはGPTアーキテクチャのモデル - 100%完全に出力を制御できるわけではない - 心なしかGPT-3.5-TurboよりもGPT-4のほうがFunction Callingの結果壊れやすい
感じがある - 定型文を返すfunction定義などGPT-3.5-Turboは愚直に定義した内容を返してくれることが多い が、GPT-4はdescriptionをよろしく解釈してしまうので壊れることがある印象 - プロンプトインジェクションの余地がある - Function Callingだから、と油断して出力をチェックせずに DB等に流すのは危険
まとめ - 入力トークン - 実行時間への影響はなさそう - 出力トークン - トークン数に応じて(おおよそ)線形に実行時間が増加する -
トークン数あたりの増加量は GPT-3.5-Turboに対してGPT-4は2~2.5倍程度 - 生成数N - 出力トークン数の合計が同じでも単位生成あたりのトークン数が少ない方が高速 - 例:実行時間は 1000 × 1 > 100 × 10 > 10 × 100 の関係 - 複数候補を生成するような用途の場合、生成数 nパラメータの利用を積極的に検討する価値があり そう


 natsuume
 slsops
 marceloancelmo
 bcantrill
 yoshiakiyamasaki
 kazuho
 k_adachi_01
 yohyamasaki
 junkifurukawa
 taka_aki
 htkym
 judau
 ichiki1023
 jcasabona
 jonoalderson
 kimpetersen
 minecr
 sonatard
 sabderemane
 marcduiker
 schlessera
 nmsamuel
 andyhume
 jacobtomlinson
 mfonobong