Nearest Neighbor Search Introduction: Approaches to Improving ANNS Hierarchical Indexing (HI) posting list를 SSD에 저장해 메모리 사용량 절감 SPANN: posting list는 SSD에, centroid와 navigation graph는 Host Memory에 저장 query 처리 시 SSD에서 posting list를 읽어야 하므로 I/O 부담이 남음 Product Quantization (PQ) 벡터 메모리 사용량을 최대 95% 줄이고 검색을 가속 압축률이 높아지면 검색 정확도가 낮아질 수 있음 GPU Acceleration 데이터가 HBM에 들어가면 대량의 거리 계산을 빠르게 처리 Billion-scale에서는 HBM 용량 제약으로 GPU·호스트 메모리·SSD 간 데이터 이동 부담 증가 → 기존 기법만으로는 Billion-scale 환경에서 처리량·지연시간·정확도를 동시에 달성하기 어려움
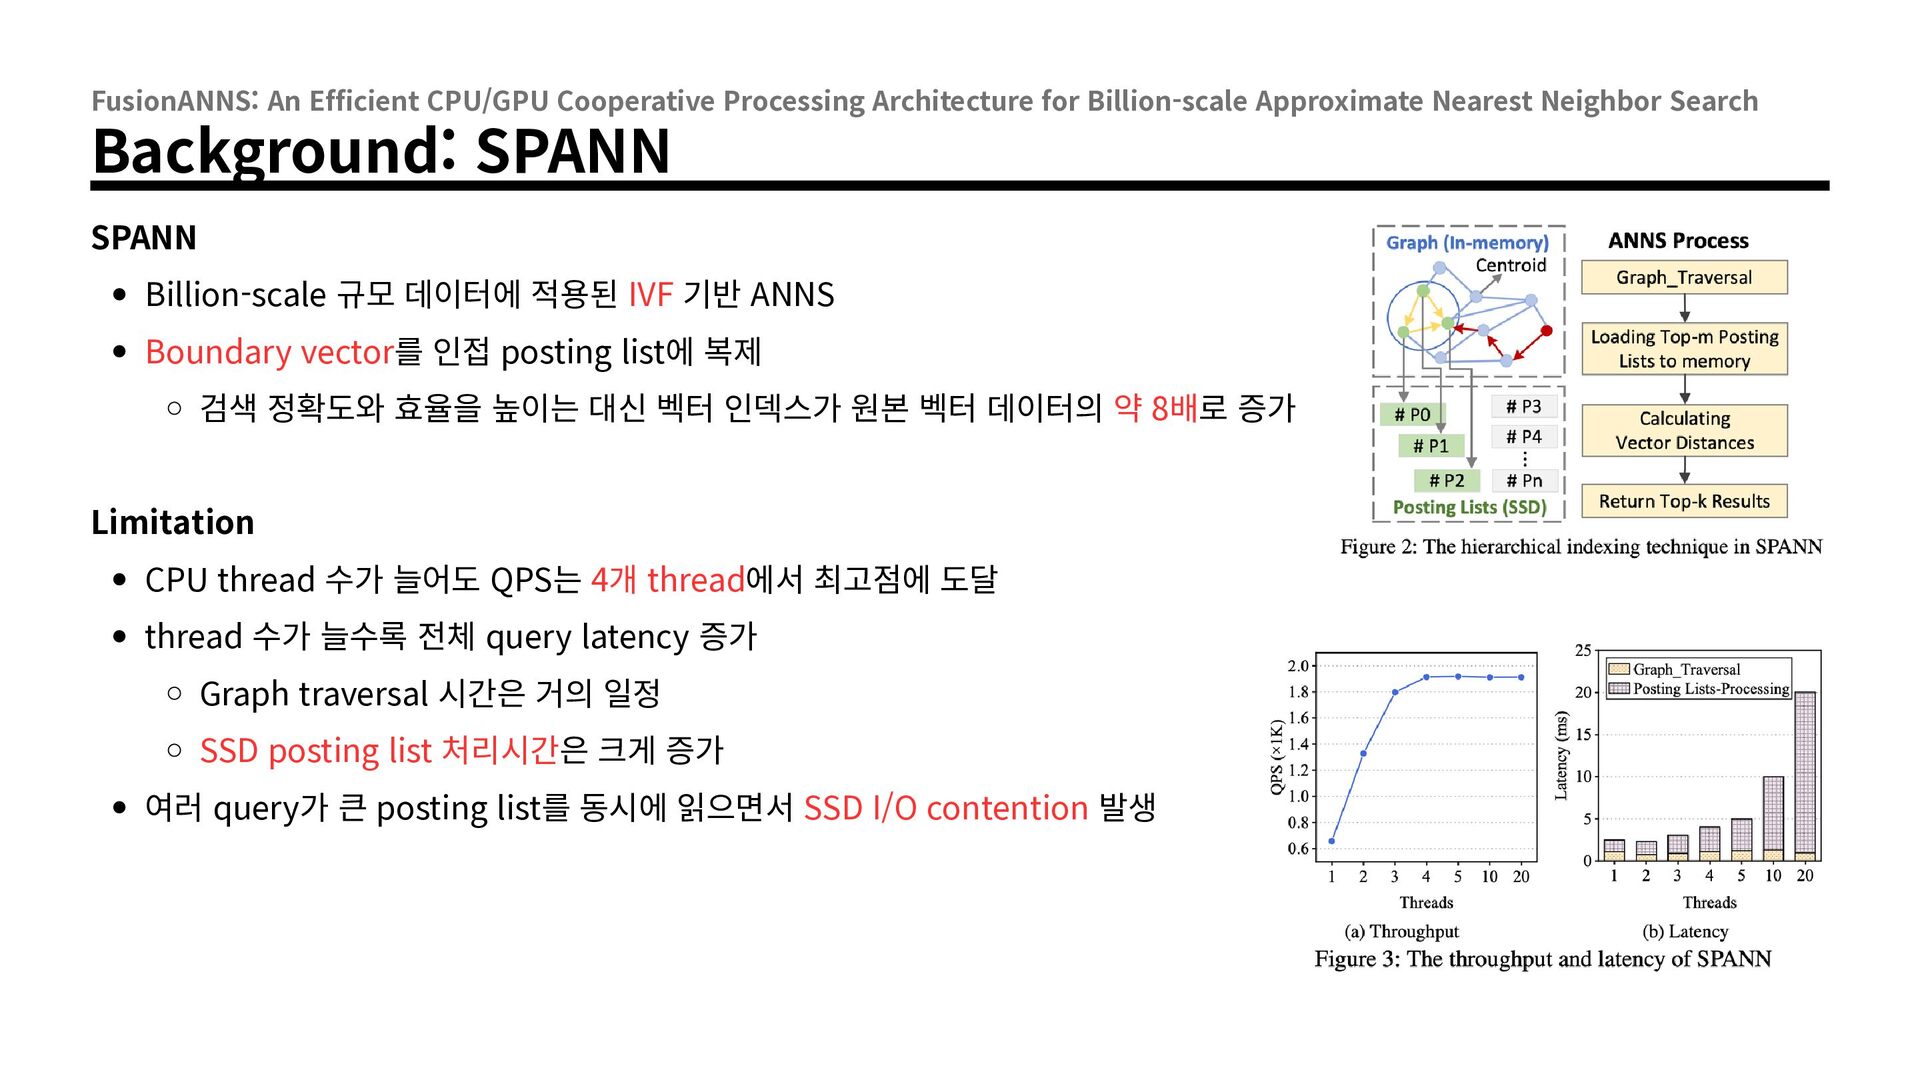
Nearest Neighbor Search Background: SPANN SPANN Billion-scale 규모 데이터에 적용된 IVF 기반 ANNS Boundary vector를 인접 posting list에 복제 검색 정확도와 효율을 높이는 대신 벡터 인덱스가 원본 벡터 데이터의 약 8배로 증가 Limitation CPU thread 수가 늘어도 QPS는 4개 thread에서 최고점에 도달 thread 수가 늘수록 전체 query latency 증가 Graph traversal 시간은 거의 일정 SSD posting list 처리시간은 크게 증가 여러 query가 큰 posting list를 동시에 읽으면서 SSD I/O contention 발생
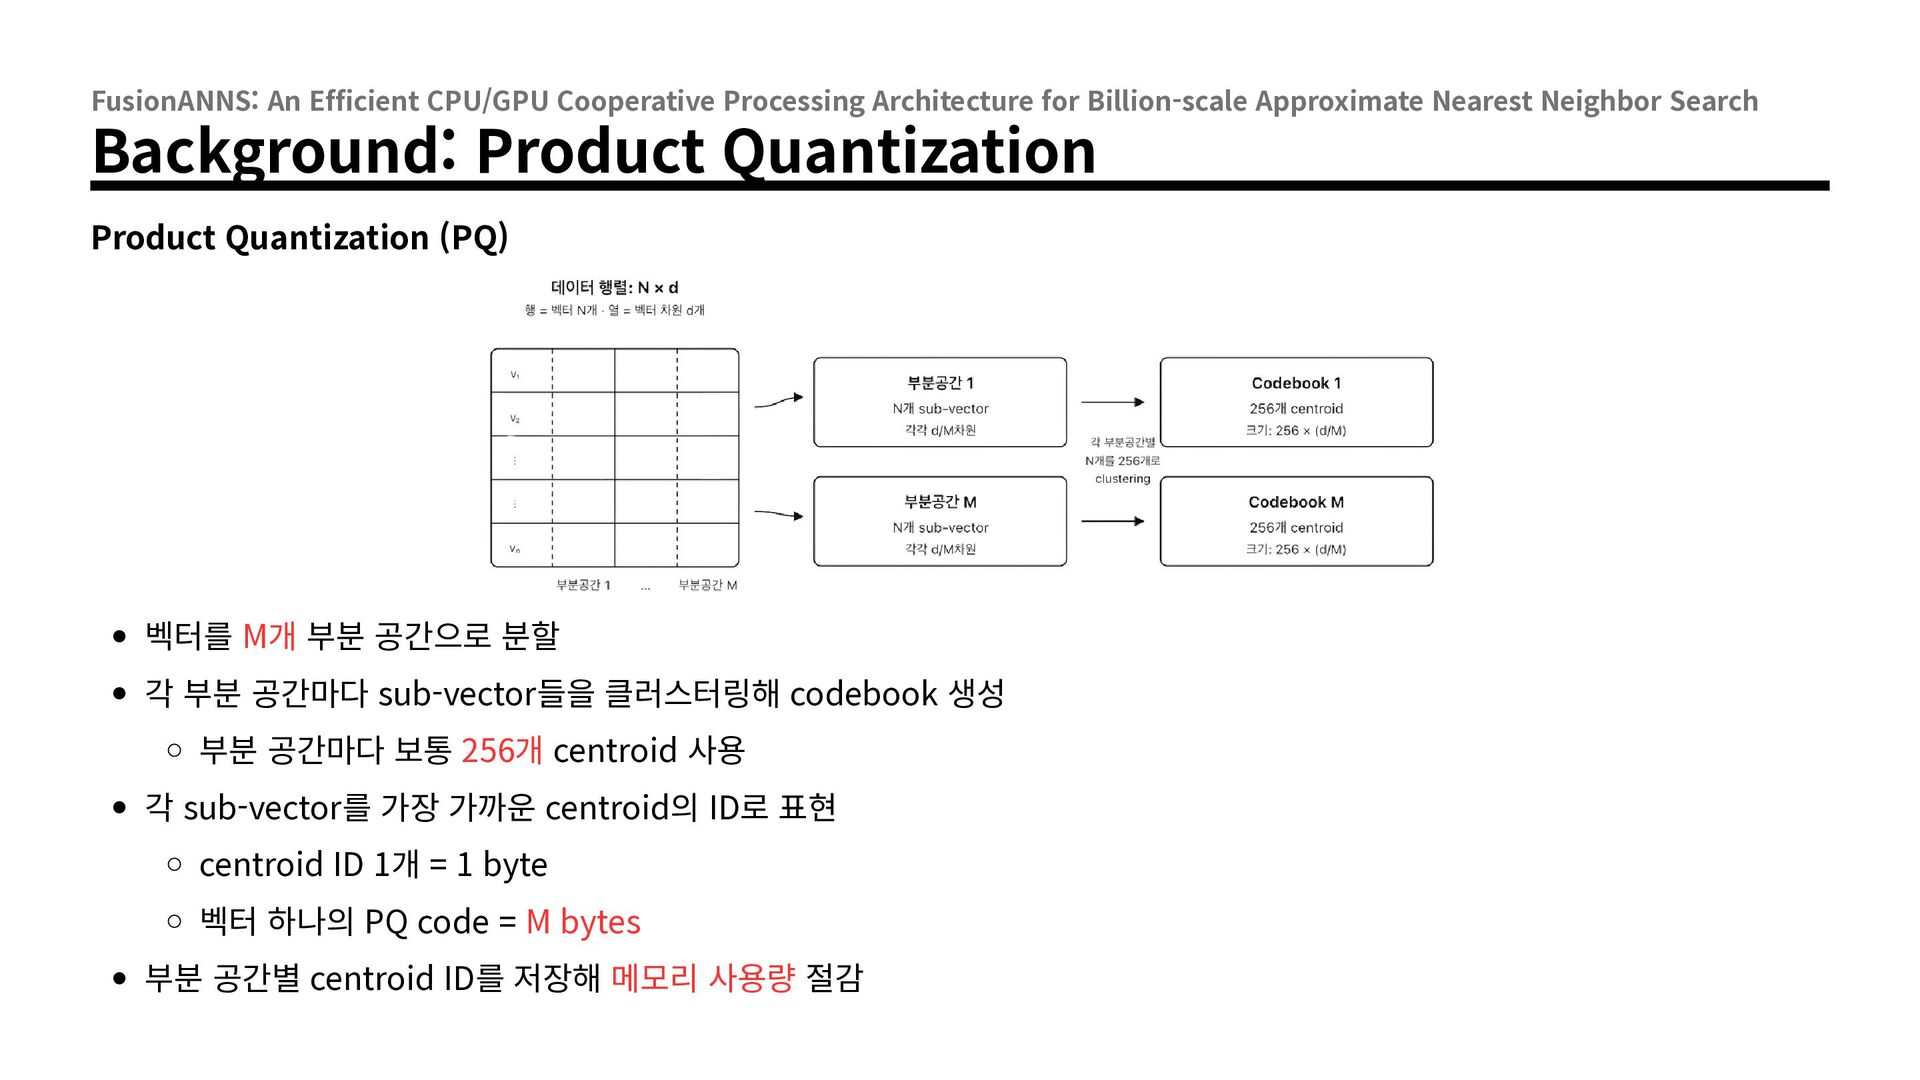
Nearest Neighbor Search Background: Product Quantization Product Quantization (PQ) 벡터를 M개 부분 공간으로 분할 각 부분 공간마다 sub-vector들을 클러스터링해 codebook 생성 부분 공간마다 보통 256개 centroid 사용 각 sub-vector를 가장 가까운 centroid의 ID로 표현 centroid ID 1개 = 1 byte 벡터 하나의 PQ code = M bytes 부분 공간별 centroid ID를 저장해 메모리 사용량 절감
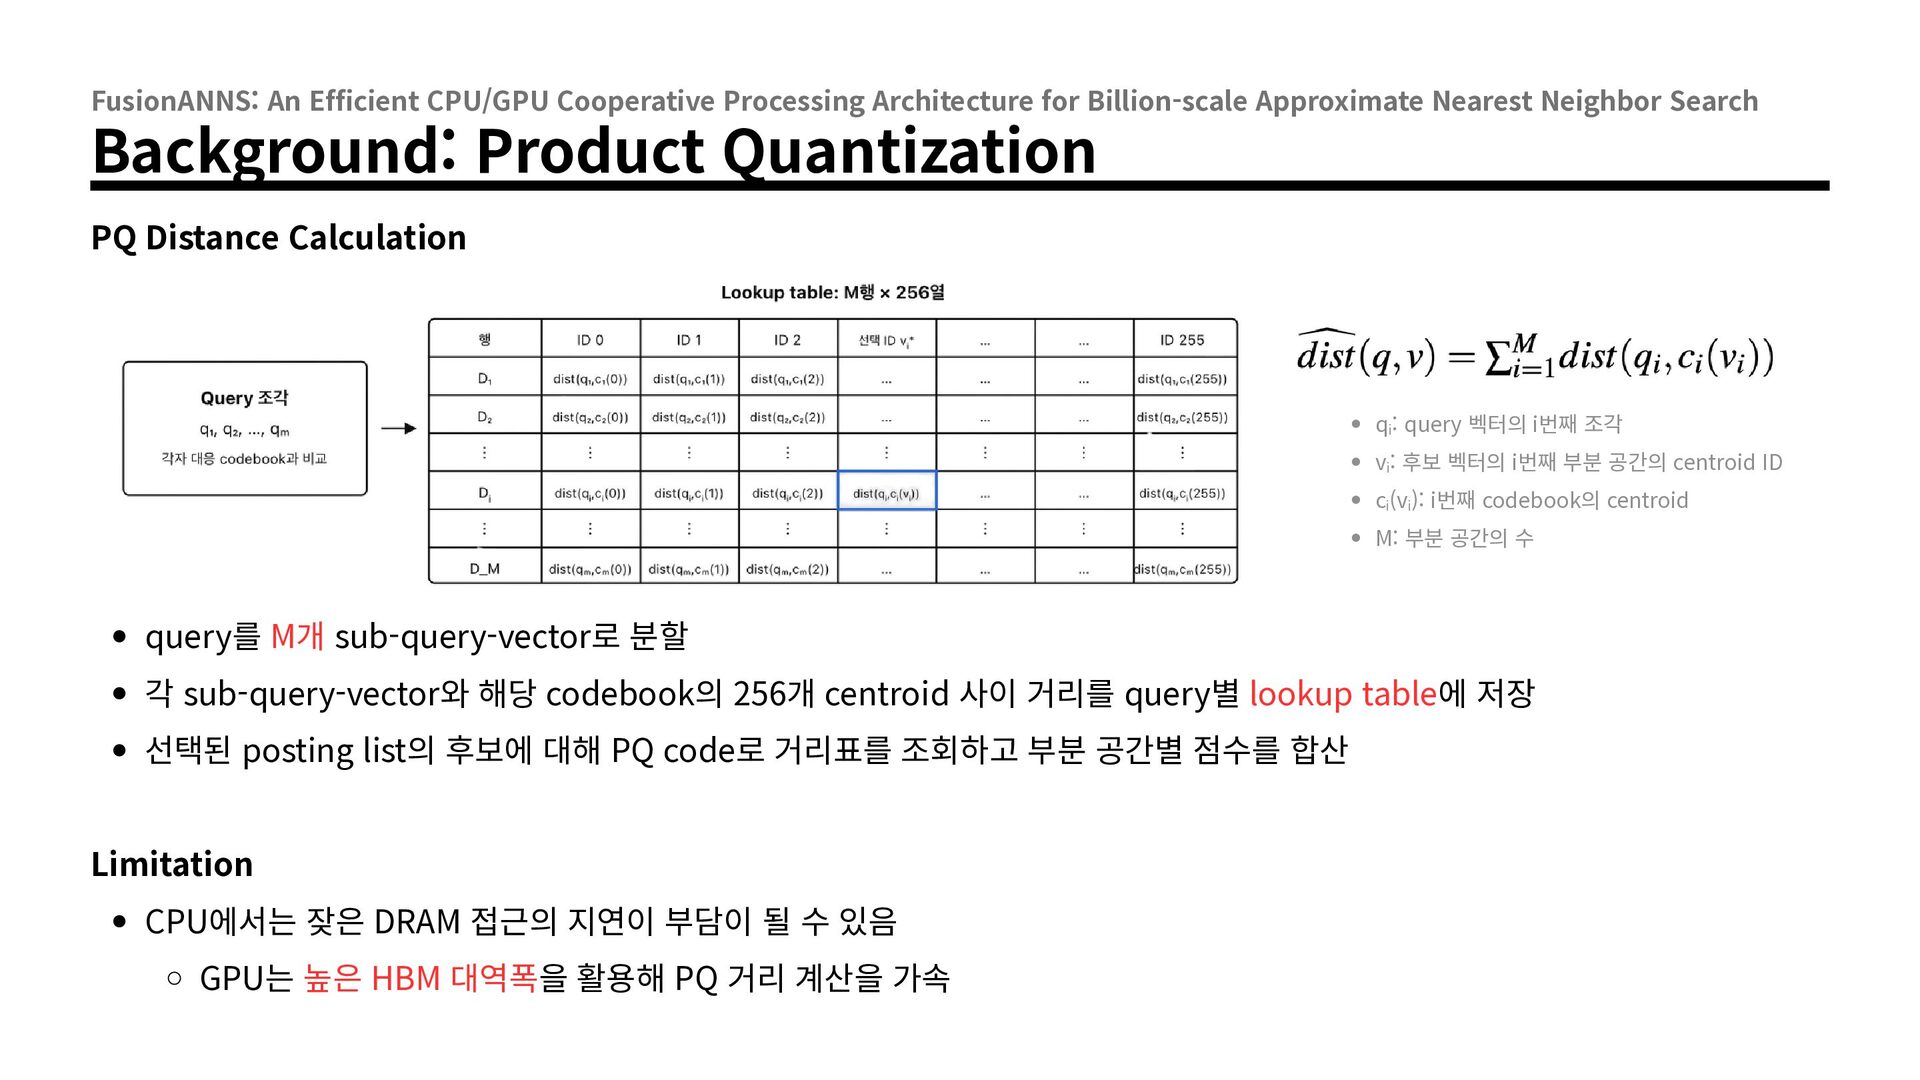
Nearest Neighbor Search Background: Product Quantization PQ Distance Calculation qi: query 벡터의 i번째 조각 vi: 후보 벡터의 i번째 부분 공간의 centroid ID ci(vi): i번째 codebook의 centroid M: 부분 공간의 수 query를 M개 sub-query-vector로 분할 각 sub-query-vector와 해당 codebook의 256개 centroid 사이 거리를 query별 lookup table에 저장 선택된 posting list의 후보에 대해 PQ code로 거리표를 조회하고 부분 공간별 점수를 합산 Limitation CPU에서는 잦은 DRAM 접근의 지연이 부담이 될 수 있음 GPU는 높은 HBM 대역폭을 활용해 PQ 거리 계산을 가속
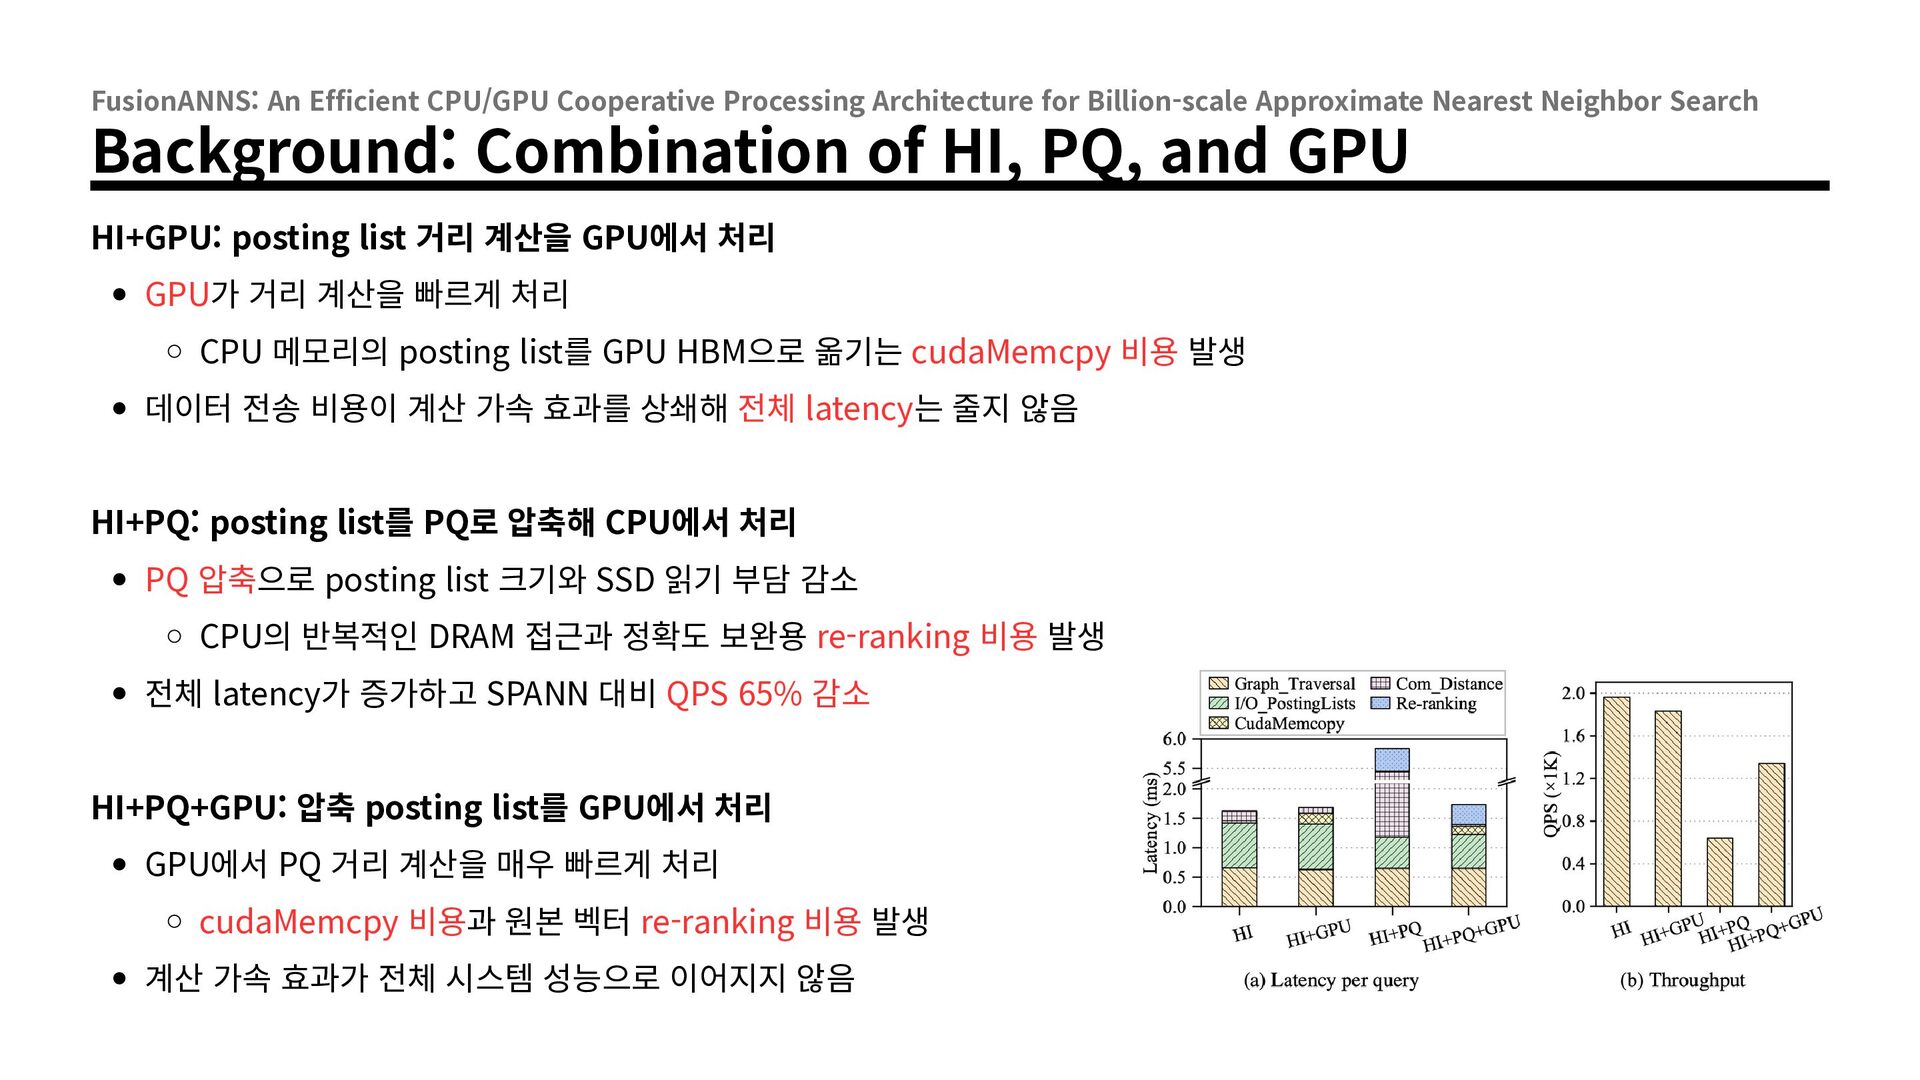
Nearest Neighbor Search Background: Combination of HI, PQ, and GPU HI+GPU: posting list 거리 계산을 GPU에서 처리 GPU가 거리 계산을 빠르게 처리 CPU 메모리의 posting list를 GPU HBM으로 옮기는 cudaMemcpy 비용 발생 데이터 전송 비용이 계산 가속 효과를 상쇄해 전체 latency는 줄지 않음 HI+PQ: posting list를 PQ로 압축해 CPU에서 처리 PQ 압축으로 posting list 크기와 SSD 읽기 부담 감소 CPU의 반복적인 DRAM 접근과 정확도 보완용 re-ranking 비용 발생 전체 latency가 증가하고 SPANN 대비 QPS 65% 감소 HI+PQ+GPU: 압축 posting list를 GPU에서 처리 GPU에서 PQ 거리 계산을 매우 빠르게 처리 cudaMemcpy 비용과 원본 벡터 re-ranking 비용 발생 계산 가속 효과가 전체 시스템 성능으로 이어지지 않음
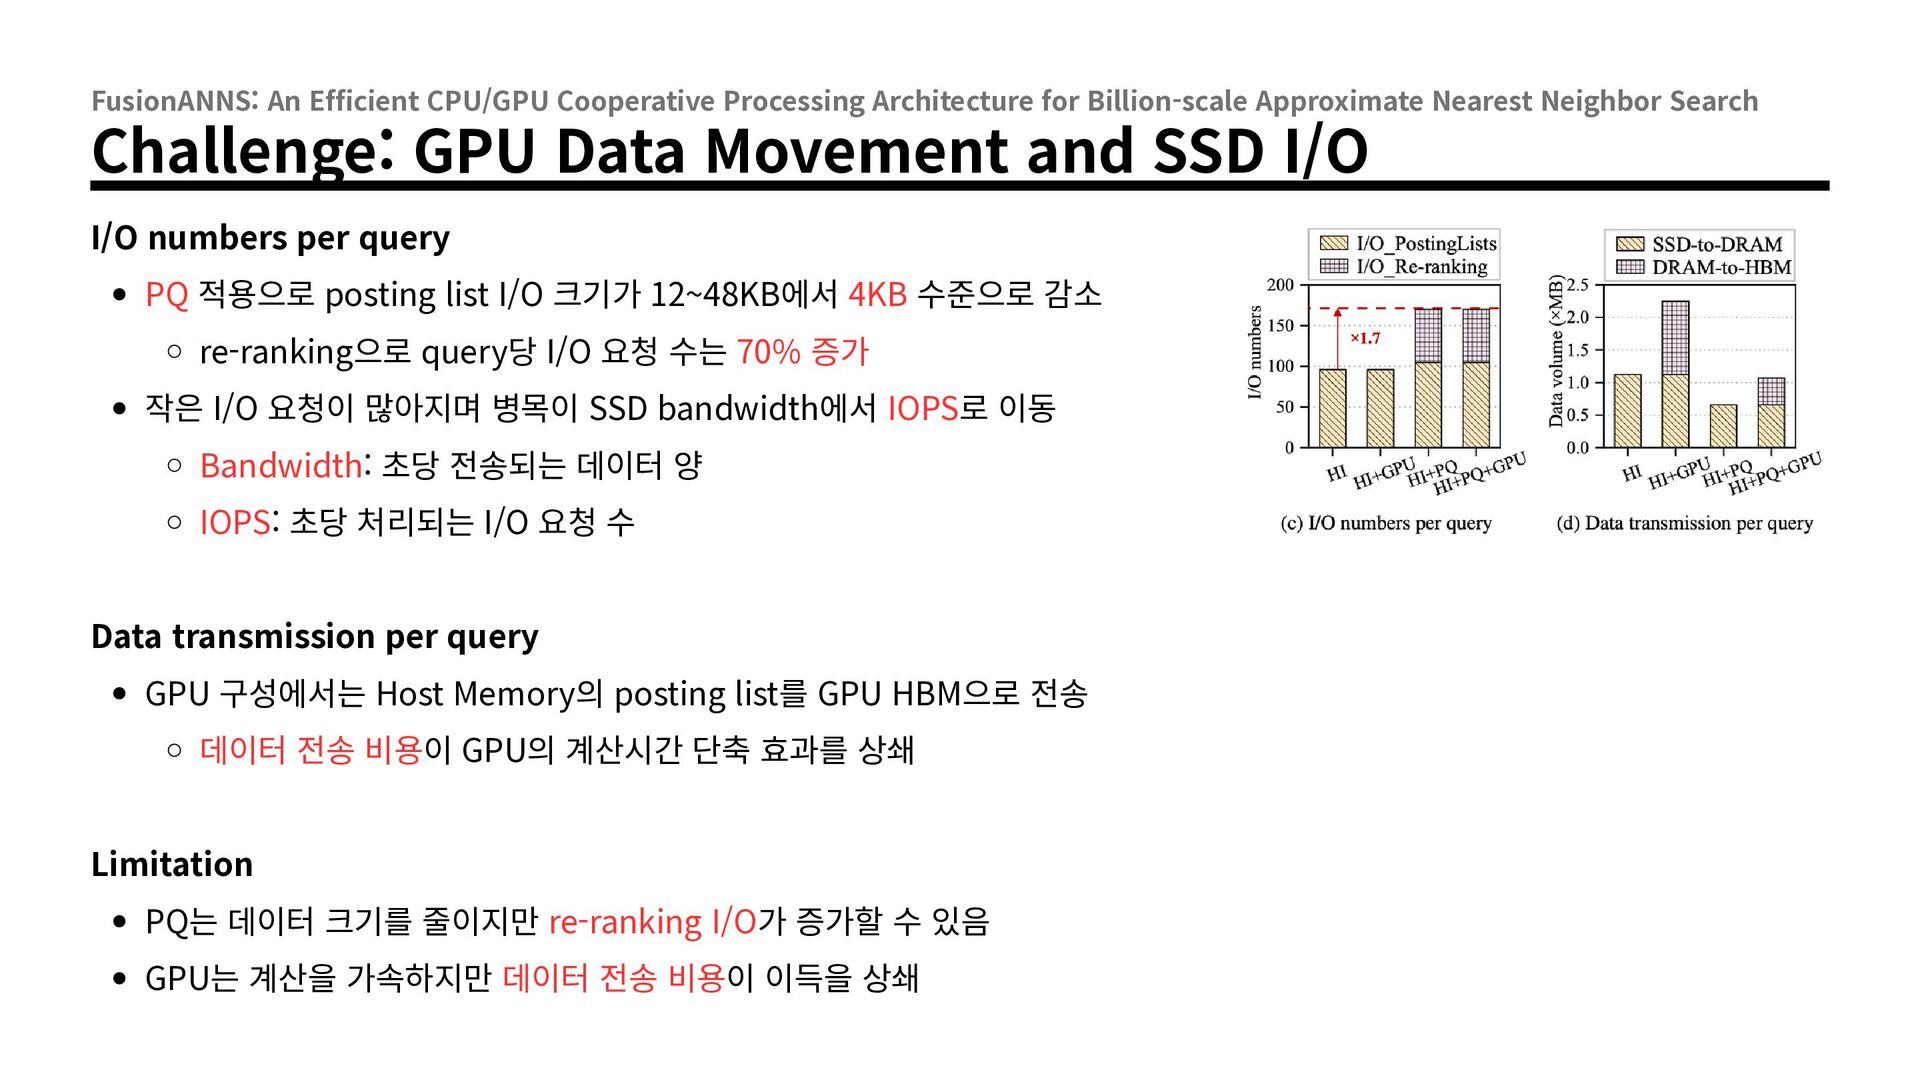
Nearest Neighbor Search Challenge: GPU Data Movement and SSD I/O I/O numbers per query PQ 적용으로 posting list I/O 크기가 12~48KB에서 4KB 수준으로 감소 re-ranking으로 query당 I/O 요청 수는 70% 증가 작은 I/O 요청이 많아지며 병목이 SSD bandwidth에서 IOPS로 이동 Bandwidth: 초당 전송되는 데이터 양 IOPS: 초당 처리되는 I/O 요청 수 Data transmission per query GPU 구성에서는 Host Memory의 posting list를 GPU HBM으로 전송 데이터 전송 비용이 GPU의 계산시간 단축 효과를 상쇄 Limitation PQ는 데이터 크기를 줄이지만 re-ranking I/O가 증가할 수 있음 GPU는 계산을 가속하지만 데이터 전송 비용이 이득을 상쇄
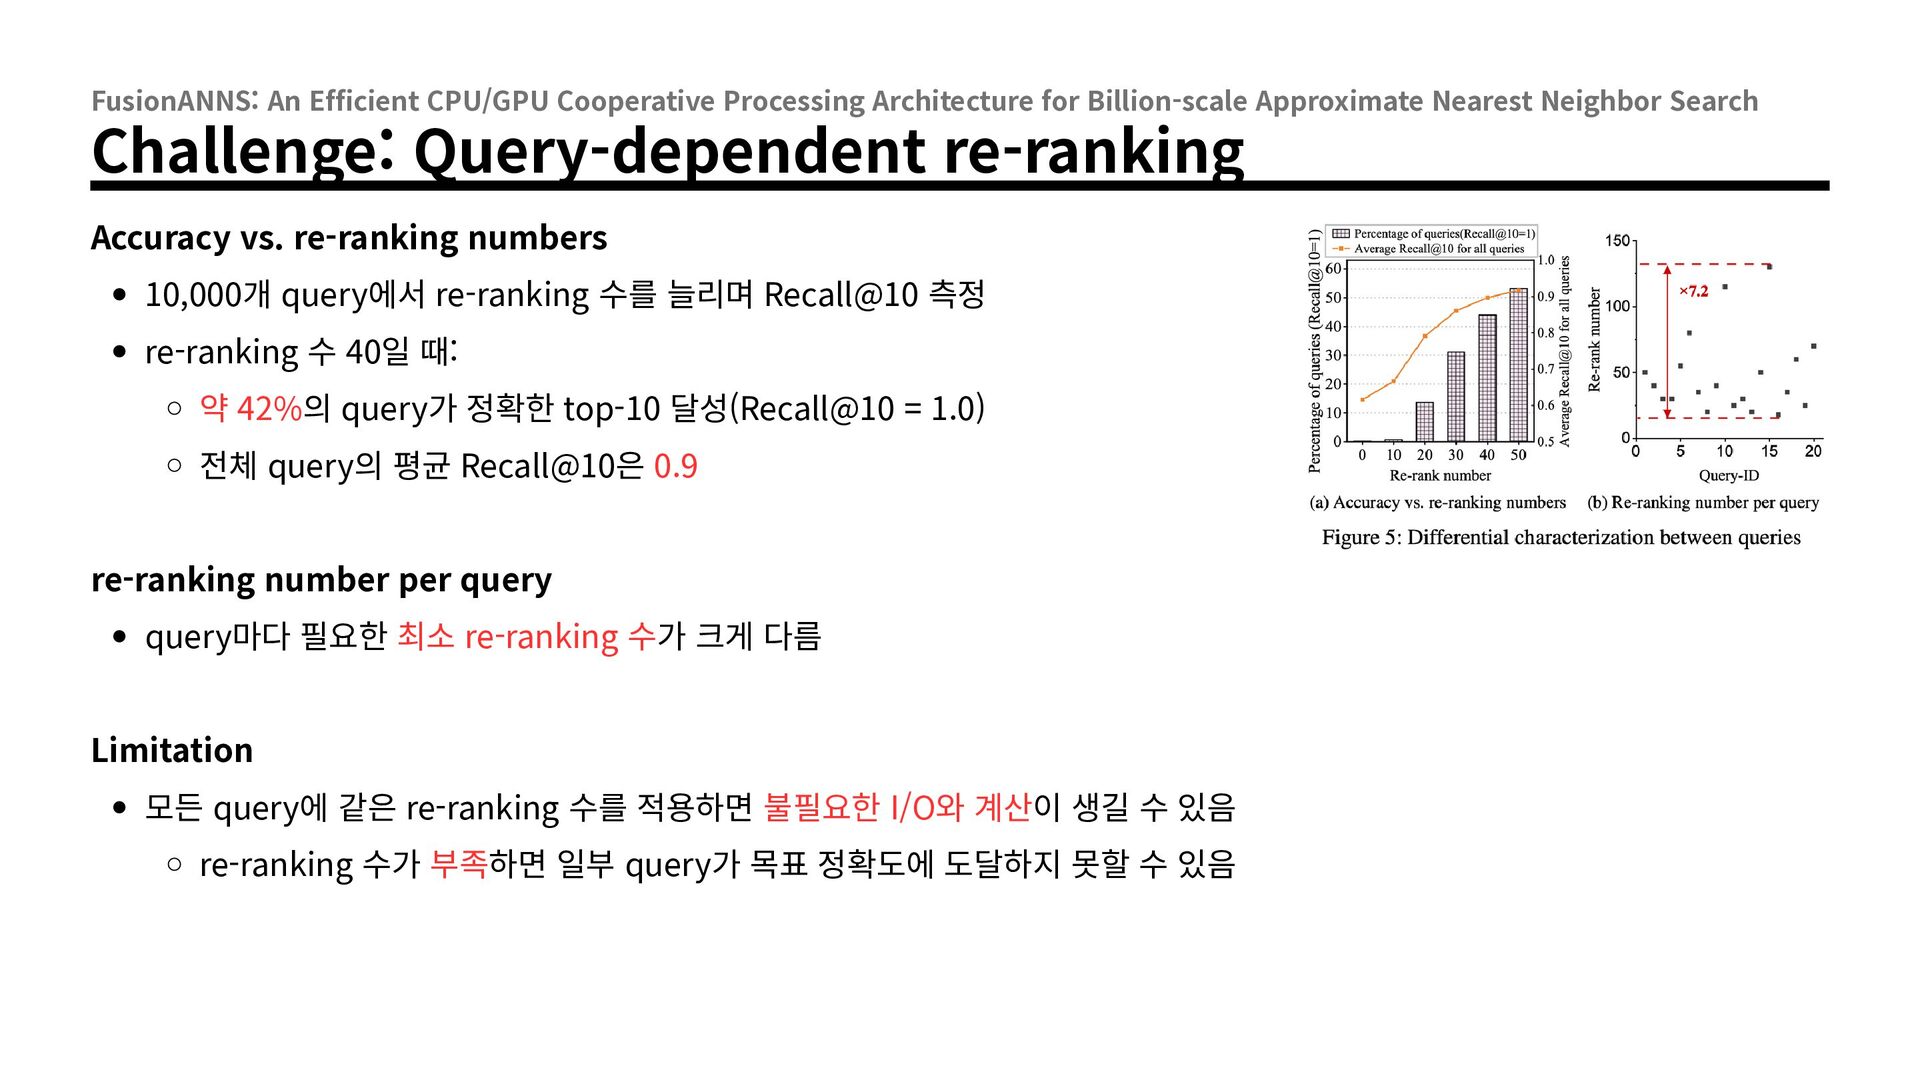
Nearest Neighbor Search Challenge: Query-dependent re-ranking Accuracy vs. re-ranking numbers 10,000개 query에서 re-ranking 수를 늘리며 Recall@10 측정 re-ranking 수 40일 때: 약 42%의 query가 정확한 top-10 달성(Recall@10 = 1.0) 전체 query의 평균 Recall@10은 0.9 re-ranking number per query query마다 필요한 최소 re-ranking 수가 크게 다름 Limitation 모든 query에 같은 re-ranking 수를 적용하면 불필요한 I/O와 계산이 생길 수 있음 re-ranking 수가 부족하면 일부 query가 목표 정확도에 도달하지 못할 수 있음
Nearest Neighbor Search Challenge: Three Design Challenges HBM Capacity PQ 압축 후에도 복제된 posting list 전체는 GPU HBM에 들어가지 않음 CPU–GPU 데이터 이동이 성능 병목이 됨 Query-dependent re-ranking query마다 필요한 최소 re-ranking 수가 다름 고정된 re-ranking 수는 불필요한 I/O·계산이나 정확도 부족을 일으킬 수 있음 SSD Read Amplification 원본 vector는 128~384Bytes지만 SSD는 보통 4KB page 단위로 읽음 작은 vector를 요청해도 page 단위로 읽으므로 I/O 효율이 낮아짐
Nearest Neighbor Search Contributions Multi-tiered Index SSD: 원본 vector GPU HBM: PQ 압축 vector Host Memory: posting list의 vector ID와 navigation graph Heuristic re-ranking re-ranking을 여러 mini-batch로 나누어 순차 처리 각 mini-batch 뒤 feedback control model로 후속 batch의 기여를 확인 Redundant-aware I/O Deduplication 유사한 원본 vector가 SSD에서 가까운 위치에 놓이도록 저장 같은 SSD page 요청을 mini-batch 안에서 병합 DRAM buffer를 활용해 후속 mini-batch의 중복 읽기 제거
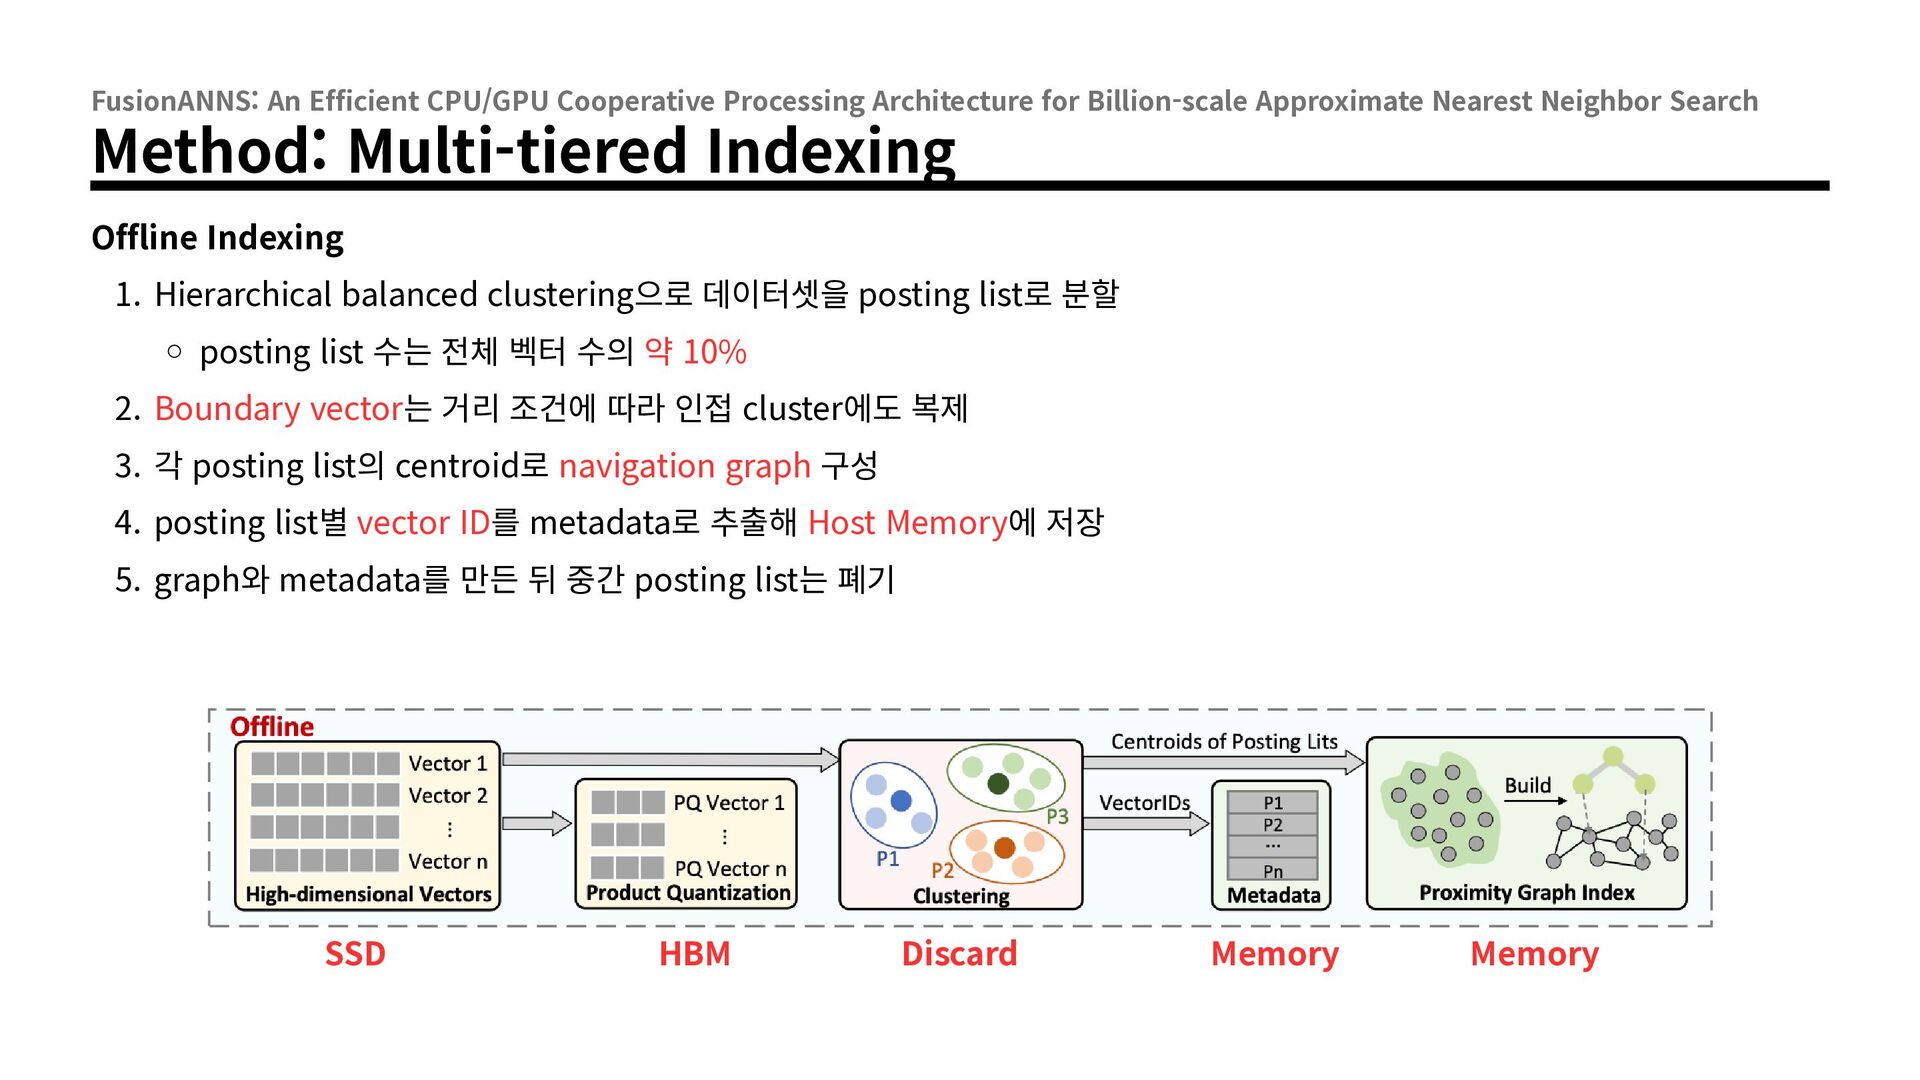
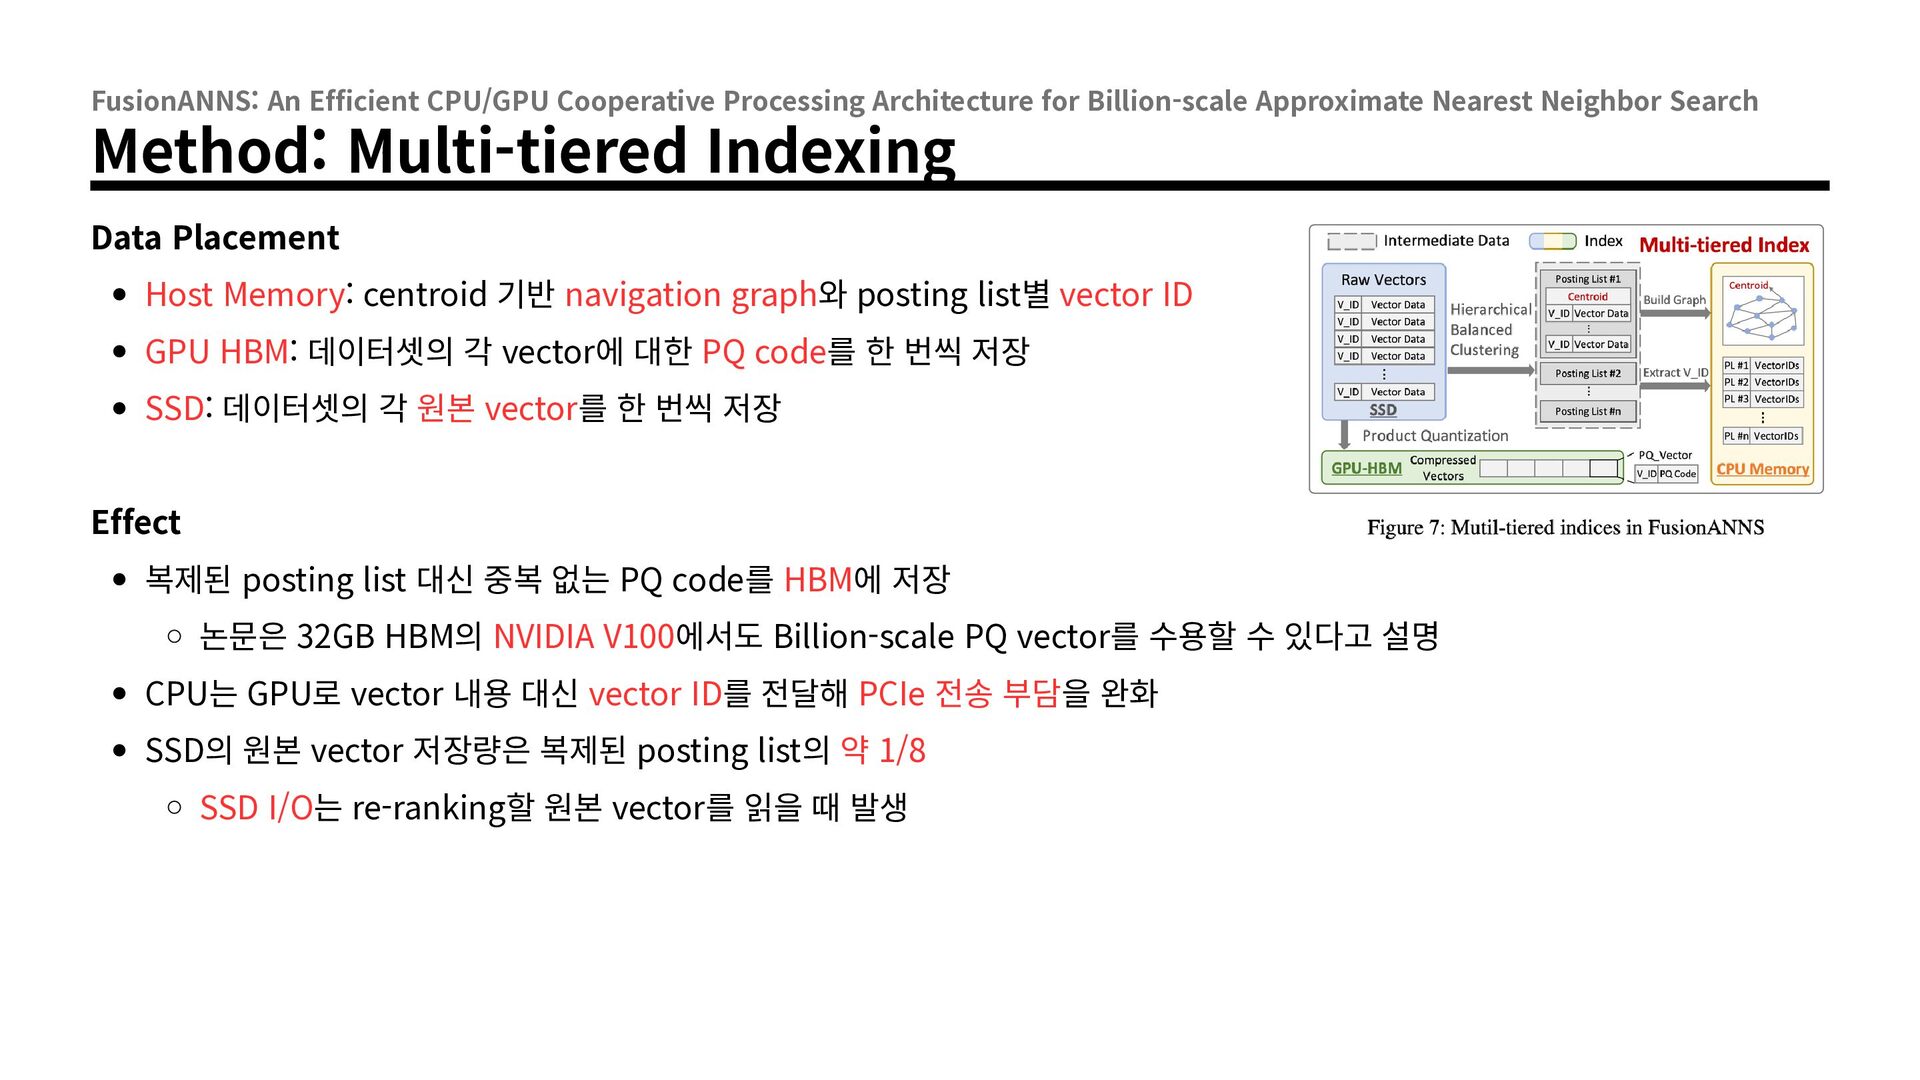
Nearest Neighbor Search Method: Multi-tiered Indexing Offline Indexing 1. Hierarchical balanced clustering으로 데이터셋을 posting list로 분할 posting list 수는 전체 벡터 수의 약 10% 2. Boundary vector는 거리 조건에 따라 인접 cluster에도 복제 3. 각 posting list의 centroid로 navigation graph 구성 4. posting list별 vector ID를 metadata로 추출해 Host Memory에 저장 5. graph와 metadata를 만든 뒤 중간 posting list는 폐기 SSD HBM Discard Memory Memory
Nearest Neighbor Search Method: Multi-tiered Indexing Data Placement Host Memory: centroid 기반 navigation graph와 posting list별 vector ID GPU HBM: 데이터셋의 각 vector에 대한 PQ code를 한 번씩 저장 SSD: 데이터셋의 각 원본 vector를 한 번씩 저장 Effect 복제된 posting list 대신 중복 없는 PQ code를 HBM에 저장 논문은 32GB HBM의 NVIDIA V100에서도 Billion-scale PQ vector를 수용할 수 있다고 설명 CPU는 GPU로 vector 내용 대신 vector ID를 전달해 PCIe 전송 부담을 완화 SSD의 원본 vector 저장량은 복제된 posting list의 약 1/8 SSD I/O는 re-ranking할 원본 vector를 읽을 때 발생
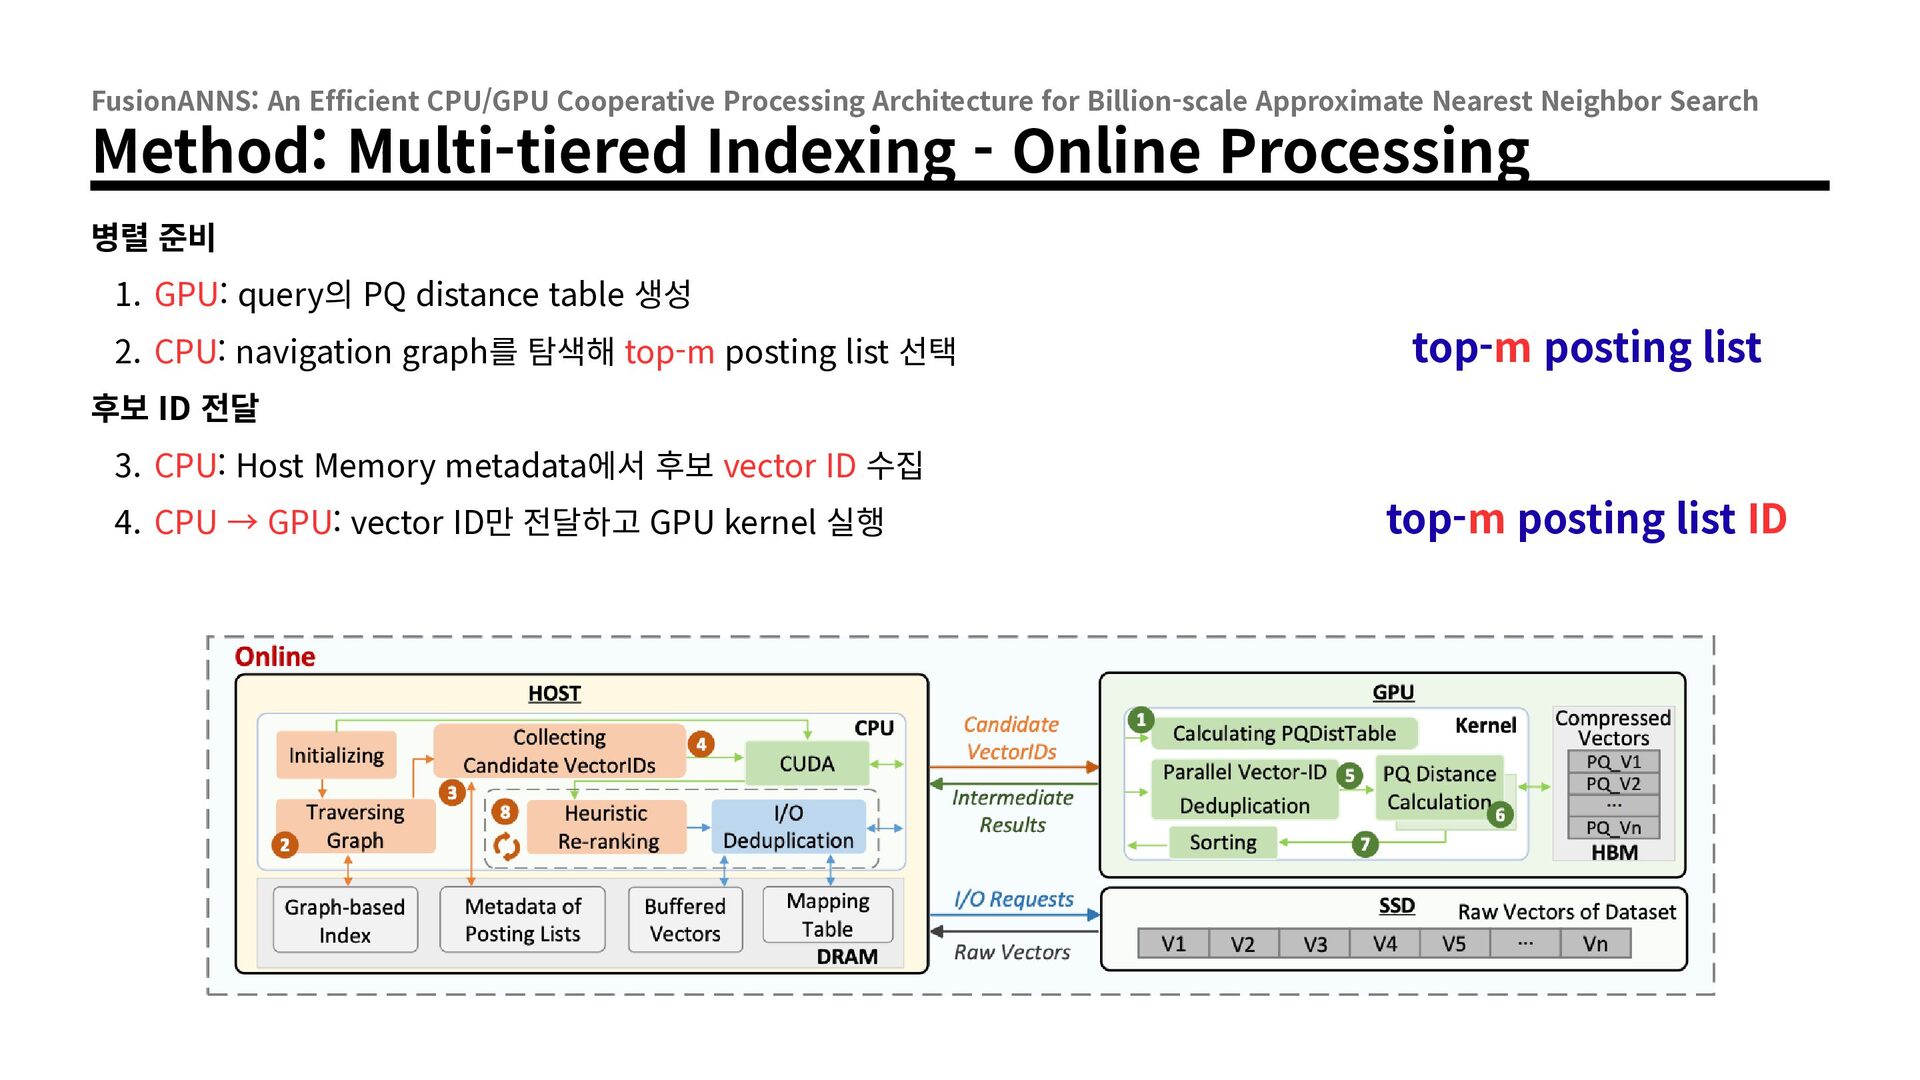
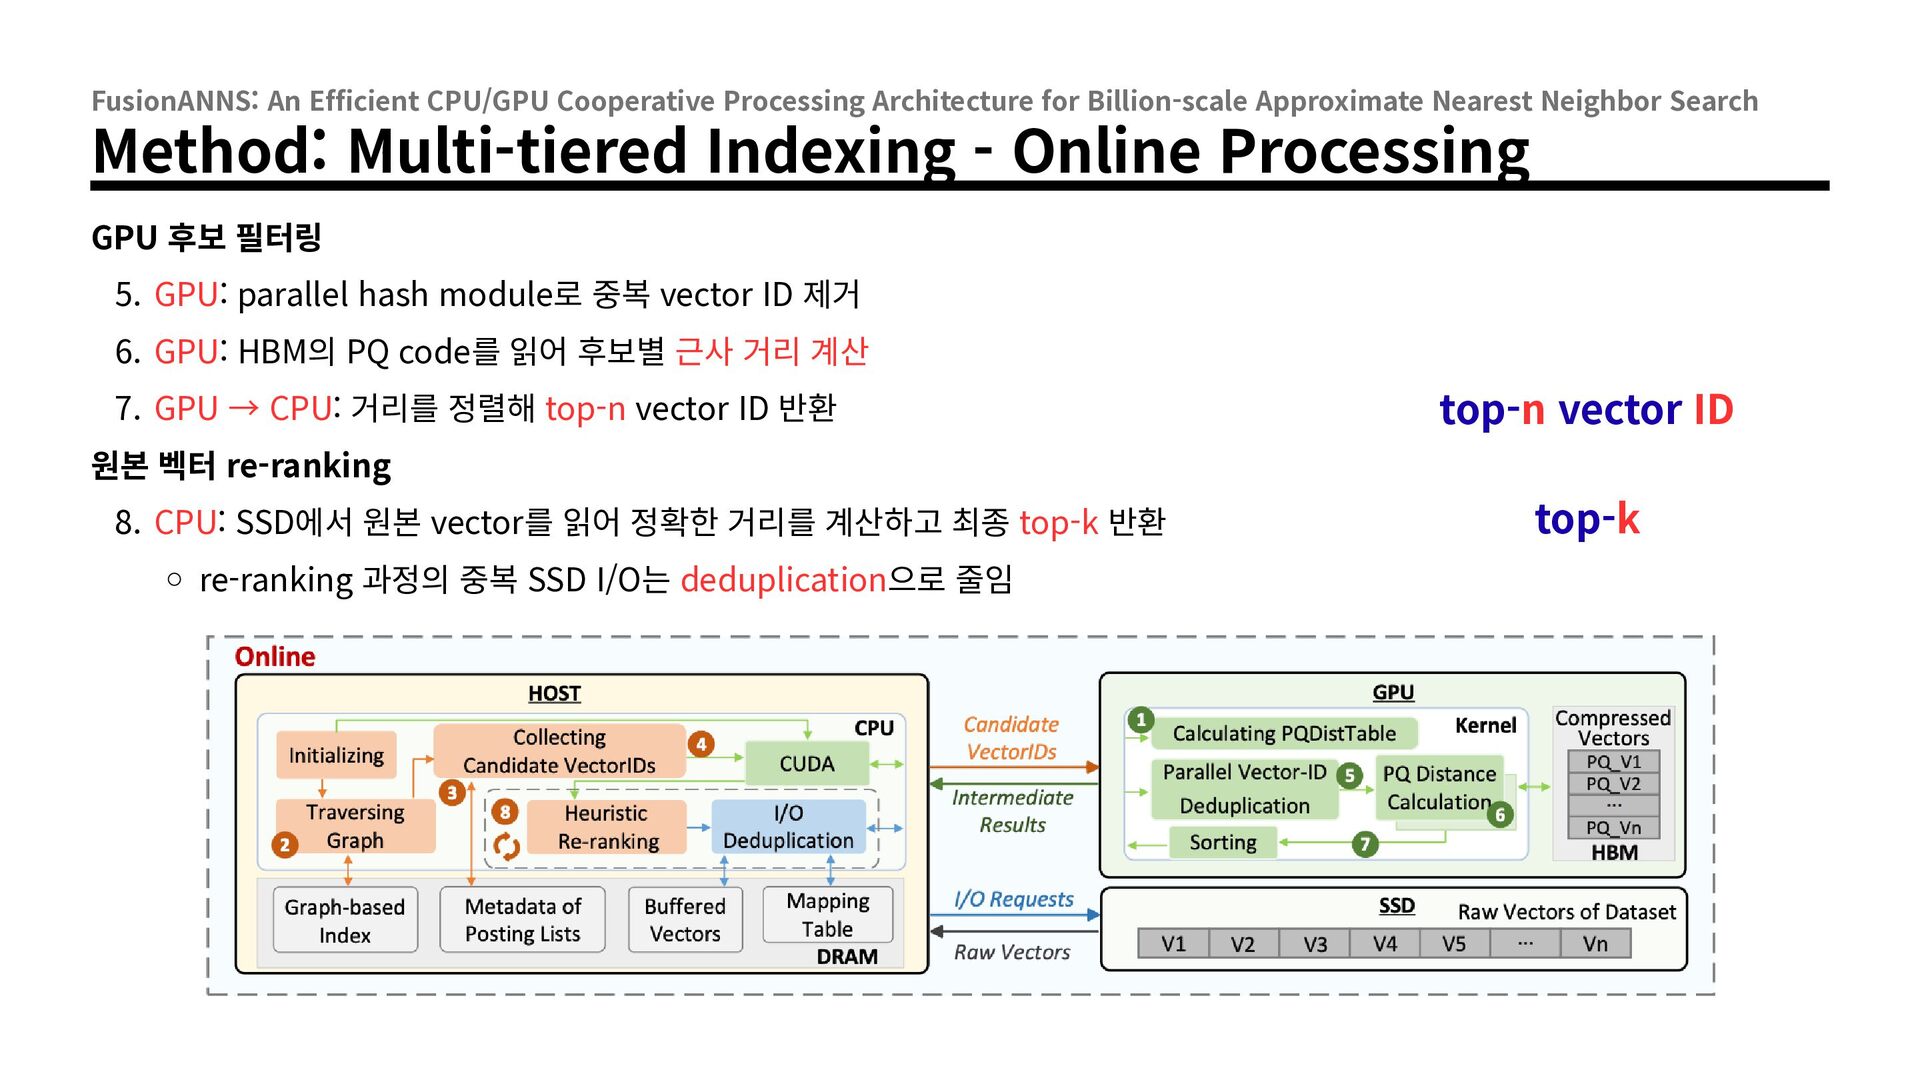
Nearest Neighbor Search Method: Multi-tiered Indexing - Online Processing 병렬 준비 1. GPU: query의 PQ distance table 생성 2. CPU: navigation graph를 탐색해 top-m posting list 선택 top-m posting list 후보 ID 전달 3. CPU: Host Memory metadata에서 후보 vector ID 수집 4. CPU → GPU: vector ID만 전달하고 GPU kernel 실행 top-m posting list ID
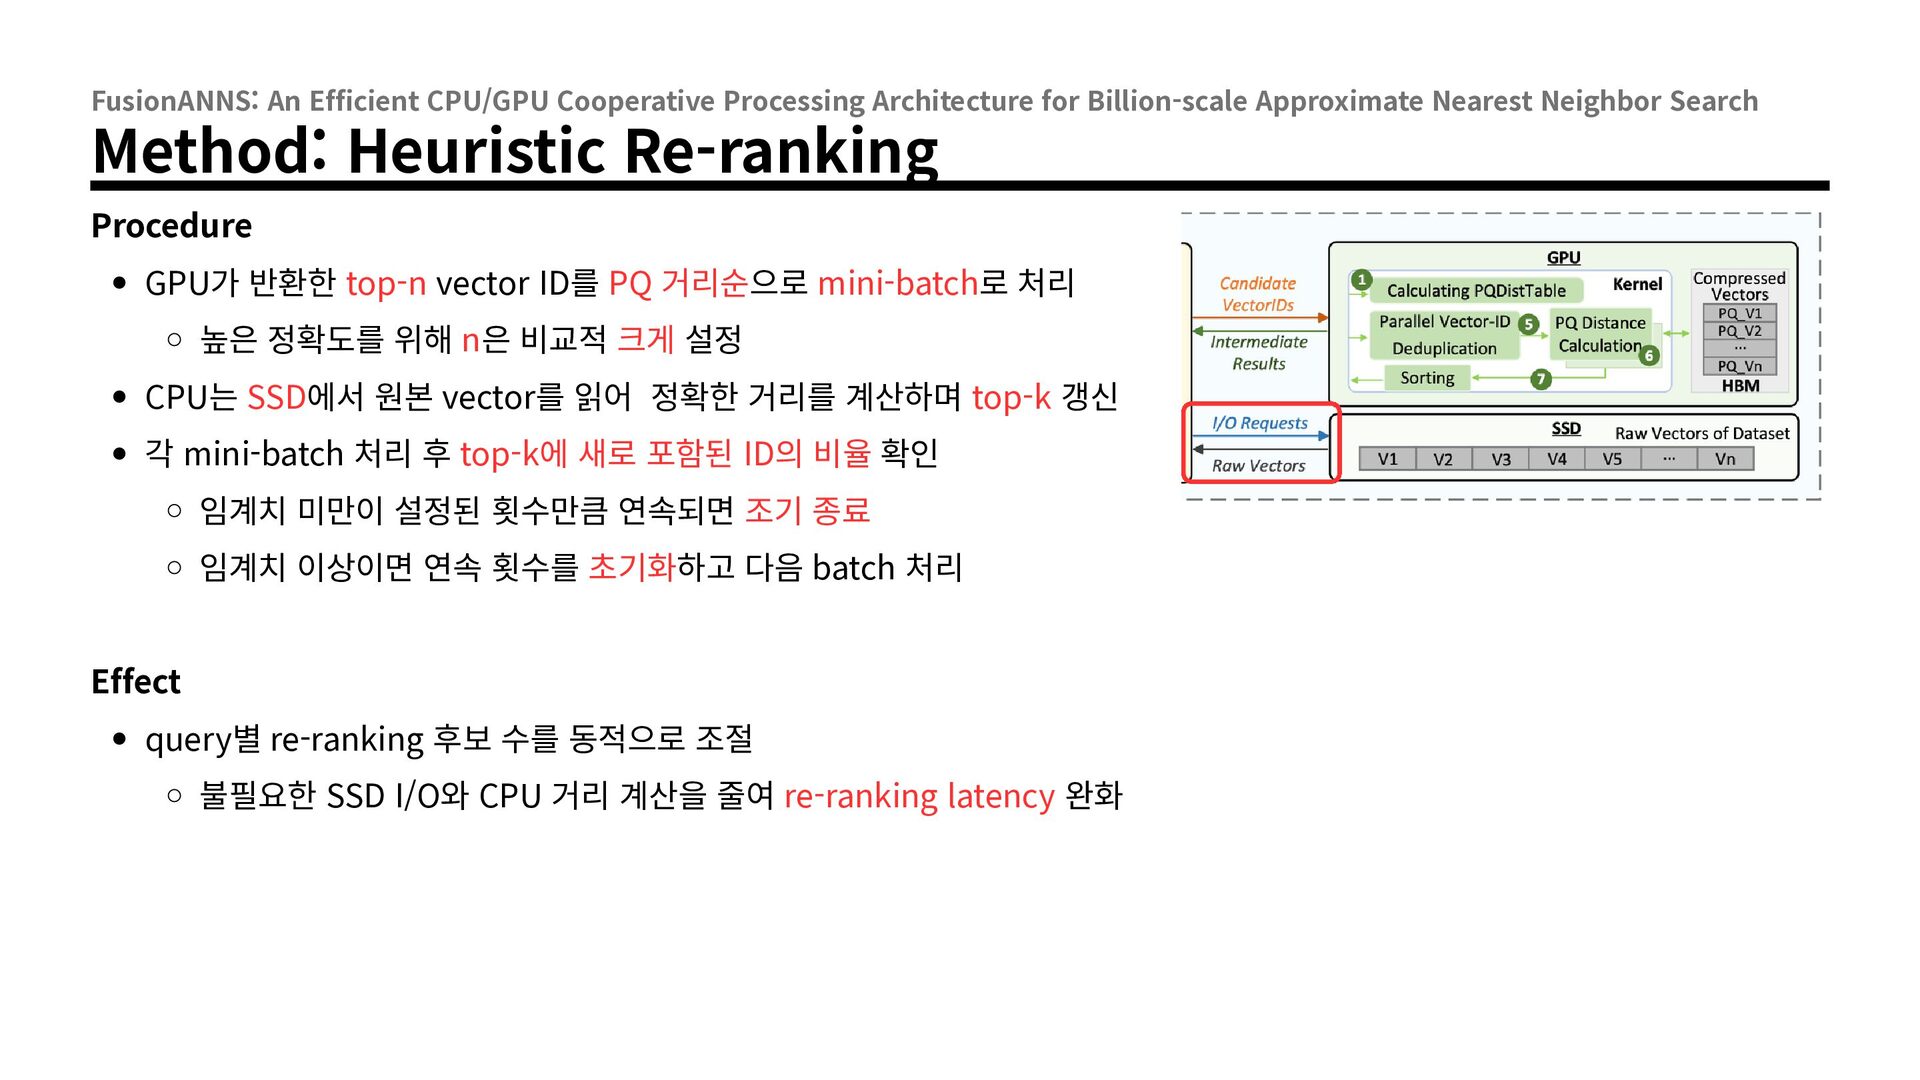
Nearest Neighbor Search Method: Heuristic Re-ranking Procedure GPU가 반환한 top-n vector ID를 PQ 거리순으로 mini-batch로 처리 높은 정확도를 위해 n은 비교적 크게 설정 CPU는 SSD에서 원본 vector를 읽어 정확한 거리를 계산하며 top-k 갱신 각 mini-batch 처리 후 top-k에 새로 포함된 ID의 비율 확인 임계치 미만이 설정된 횟수만큼 연속되면 조기 종료 임계치 이상이면 연속 횟수를 초기화하고 다음 batch 처리 Effect query별 re-ranking 후보 수를 동적으로 조절 불필요한 SSD I/O와 CPU 거리 계산을 줄여 re-ranking latency 완화
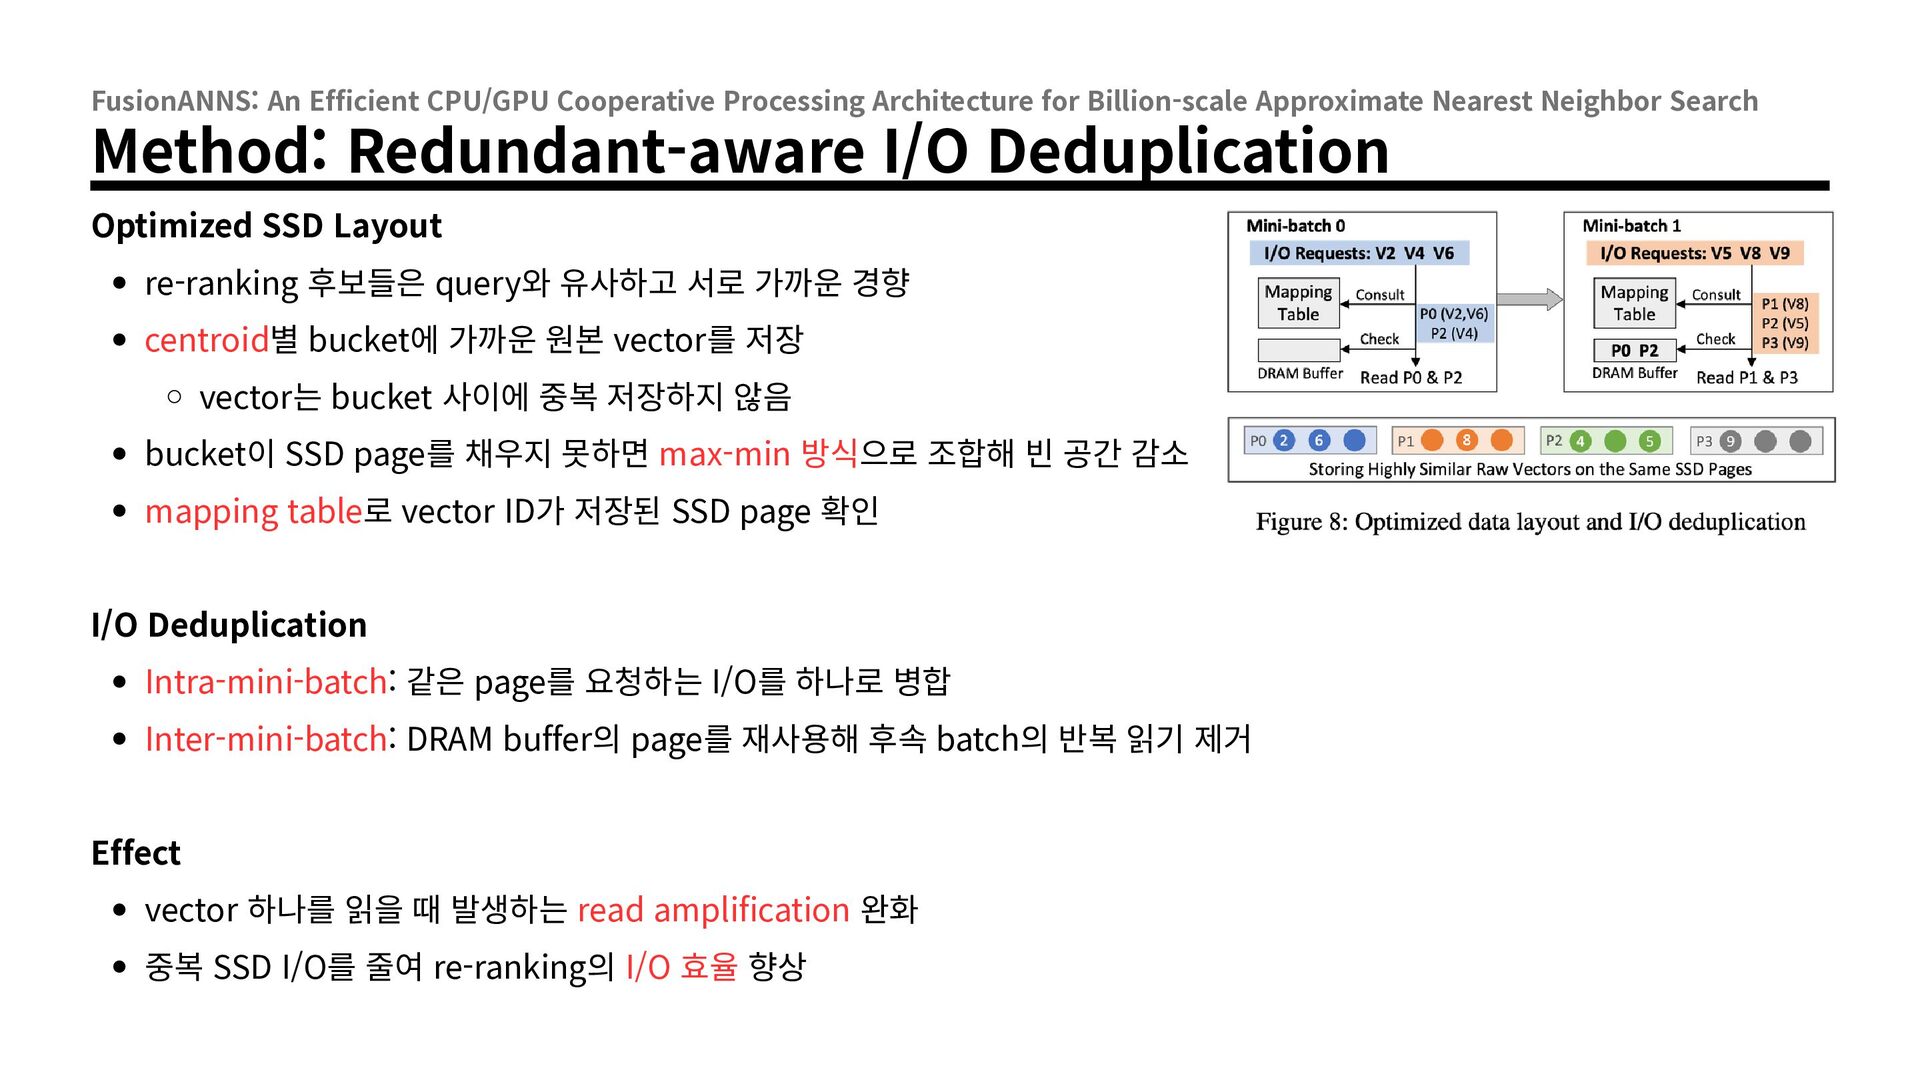
Nearest Neighbor Search Method: Redundant-aware I/O Deduplication Optimized SSD Layout re-ranking 후보들은 query와 유사하고 서로 가까운 경향 centroid별 bucket에 가까운 원본 vector를 저장 vector는 bucket 사이에 중복 저장하지 않음 bucket이 SSD page를 채우지 못하면 max-min 방식으로 조합해 빈 공간 감소 mapping table로 vector ID가 저장된 SSD page 확인 I/O Deduplication Intra-mini-batch: 같은 page를 요청하는 I/O를 하나로 병합 Inter-mini-batch: DRAM buffer의 page를 재사용해 후속 batch의 반복 읽기 제거 Effect vector 하나를 읽을 때 발생하는 read amplification 완화 중복 SSD I/O를 줄여 re-ranking의 I/O 효율 향상
Nearest Neighbor Search Implementation Contention-free GPU Memory Management 초기화 때 PQ 압축 vector를 GPU HBM에 적재 남은 HBM을 query 작업용 memory pool로 구성 pool을 독립적인 block으로 나눠 query마다 하나씩 할당 query가 끝난 block은 대기 중인 query에 재사용 Efficient GPU Kernels vector 차원에 따라 여러 GPU thread를 할당해 PQ 거리 계산 병렬화 후보 vector ID마다 thread를 할당해 hash table에서 중복 제거 spinlock으로 hash table entry의 동시 접근과 갱신 보호 Effect GPU 메모리의 반복 할당과 query 간 lock contention 감소 PQ 거리 계산과 vector ID 중복 제거를 GPU 병렬성으로 가속
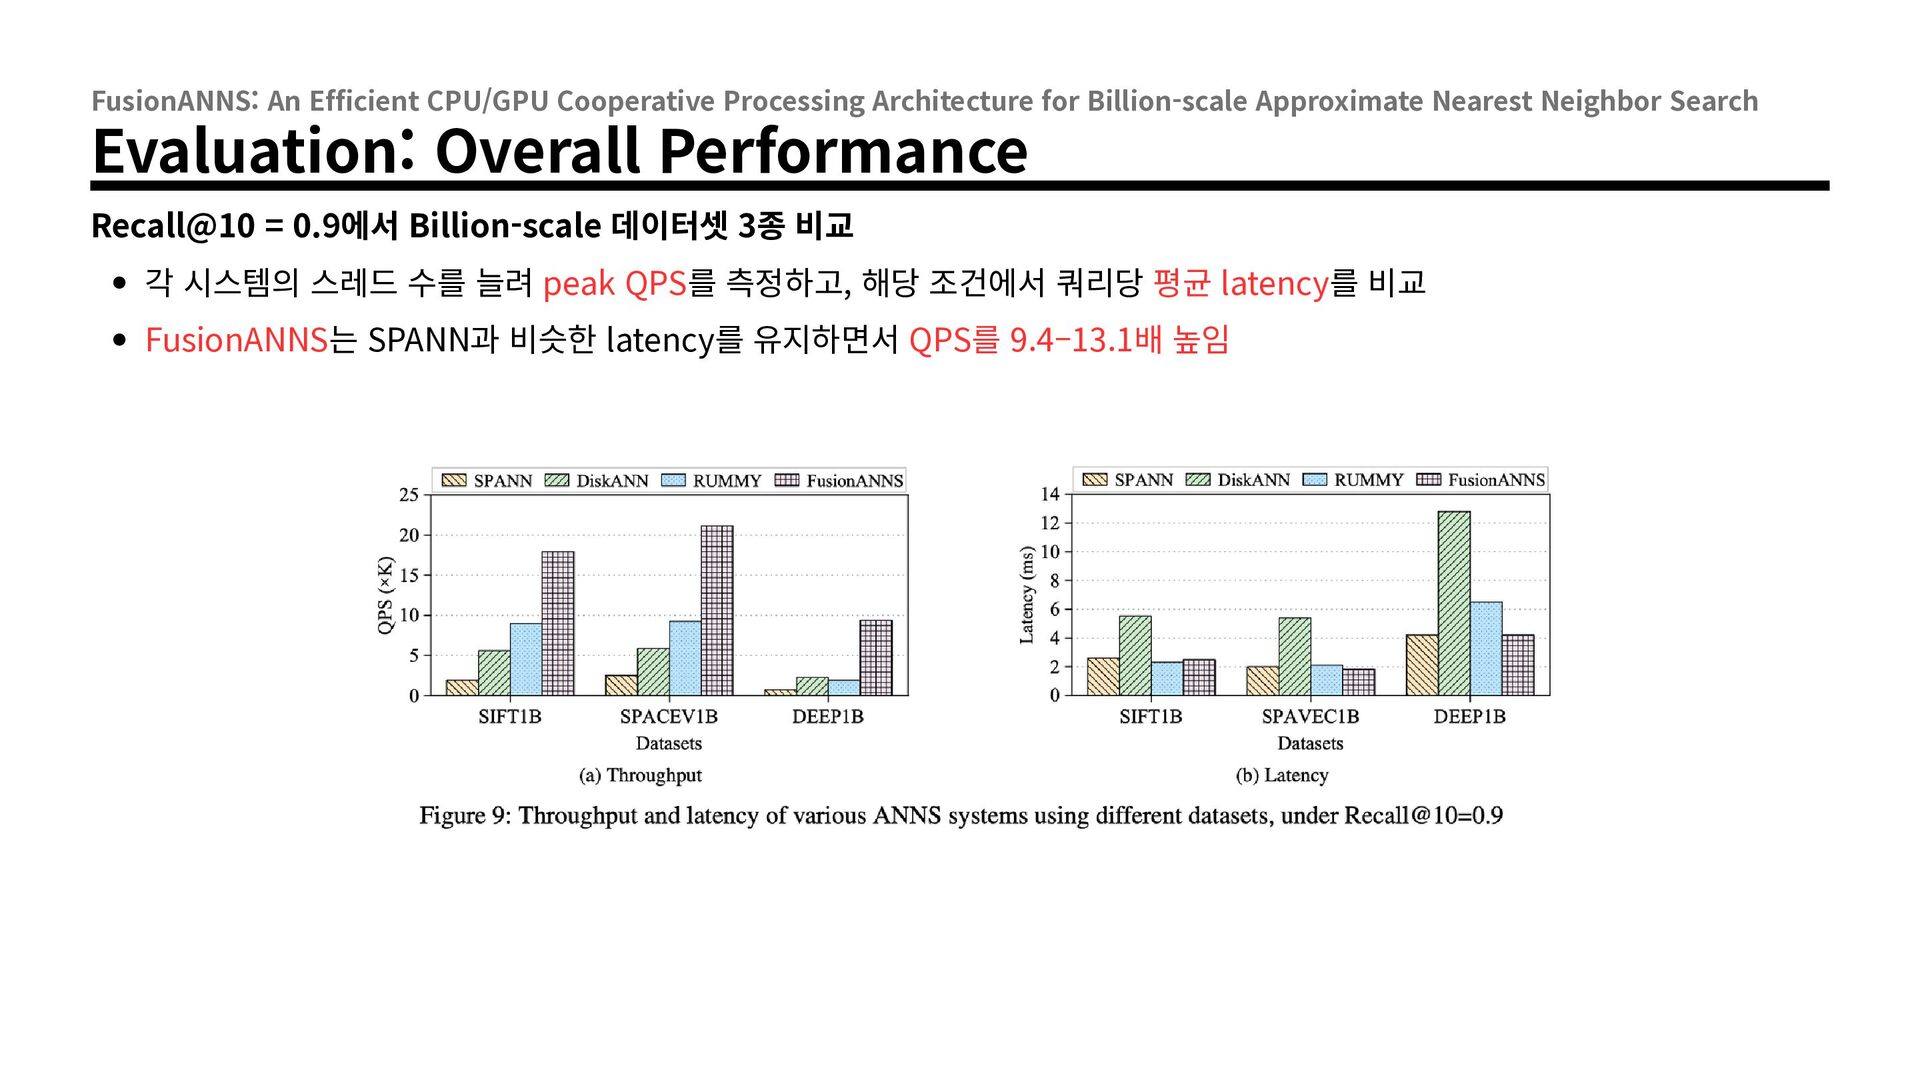
Nearest Neighbor Search Evaluation: Overall Performance Recall@10 = 0.9에서 Billion-scale 데이터셋 3종 비교 각 시스템의 스레드 수를 늘려 peak QPS를 측정하고, 해당 조건에서 쿼리당 평균 latency를 비교 FusionANNS는 SPANN과 비슷한 latency를 유지하면서 QPS를 9.4–13.1배 높임
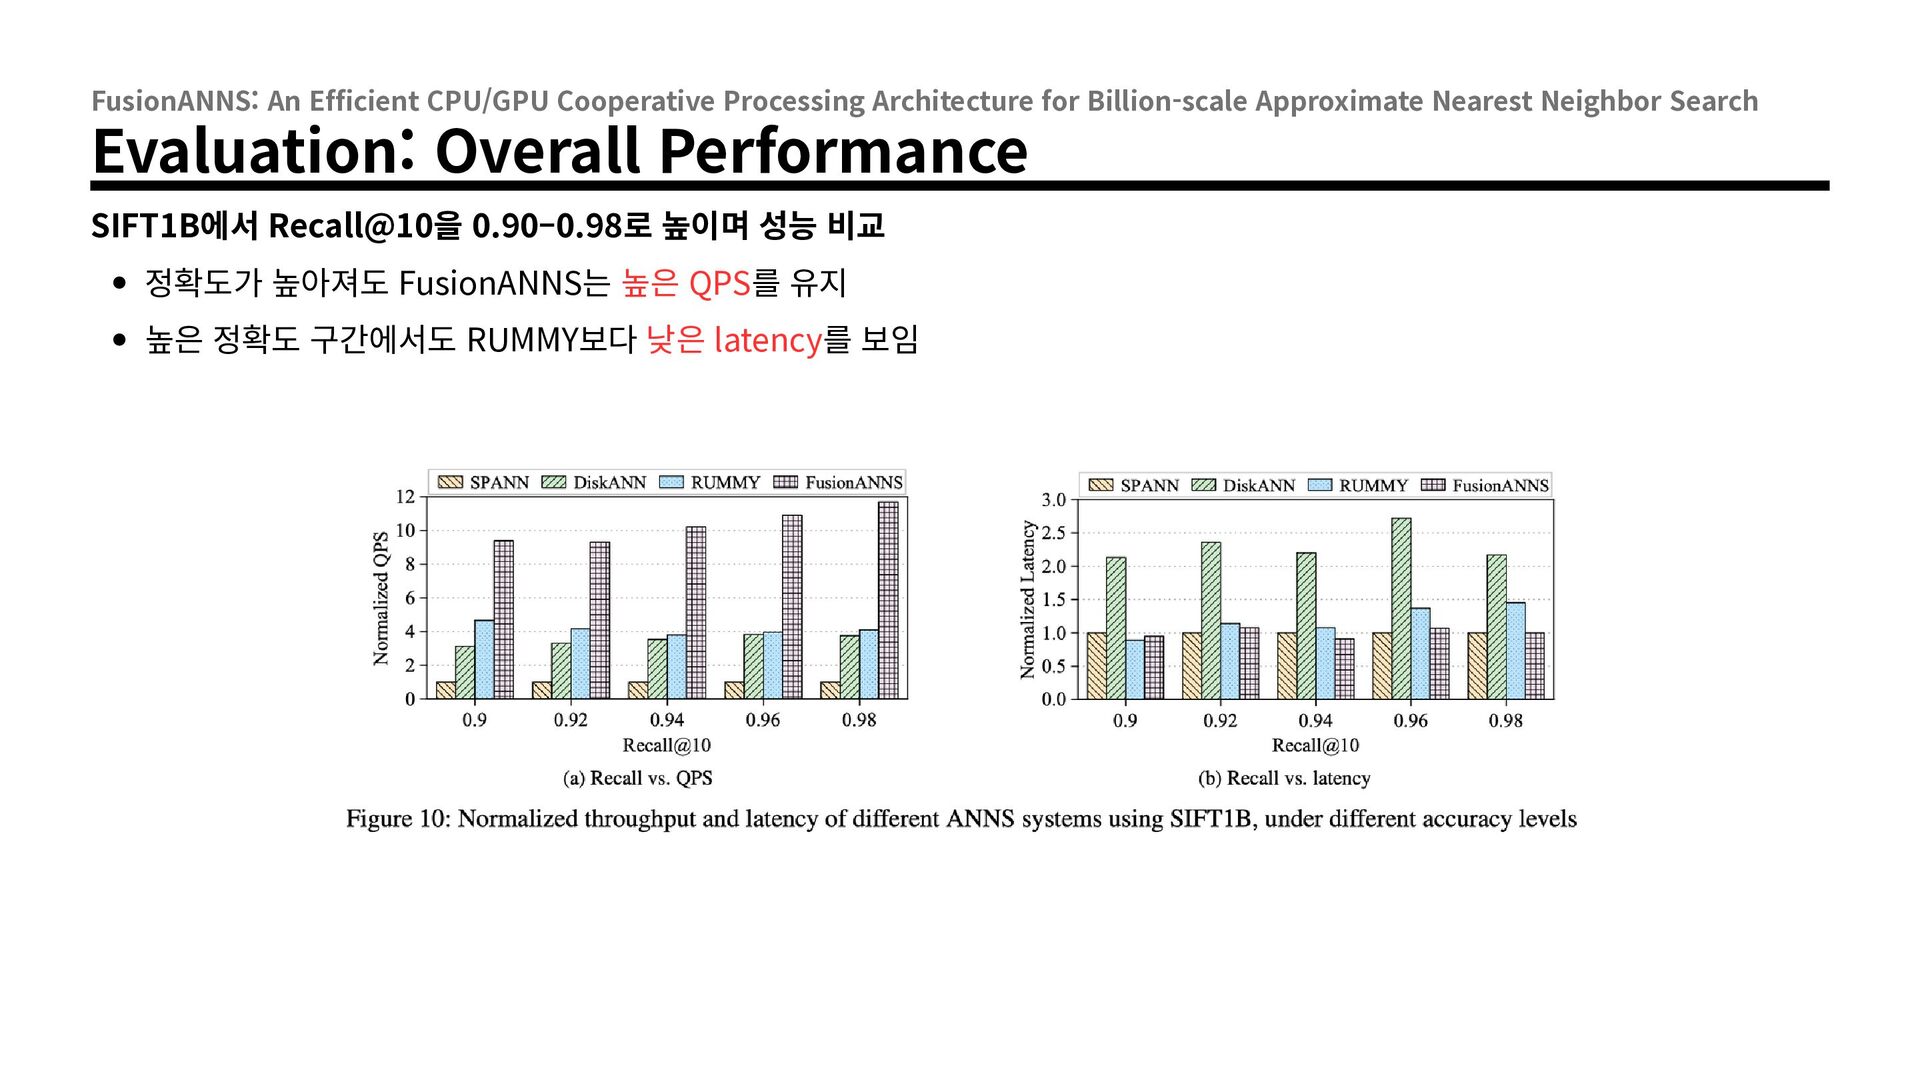
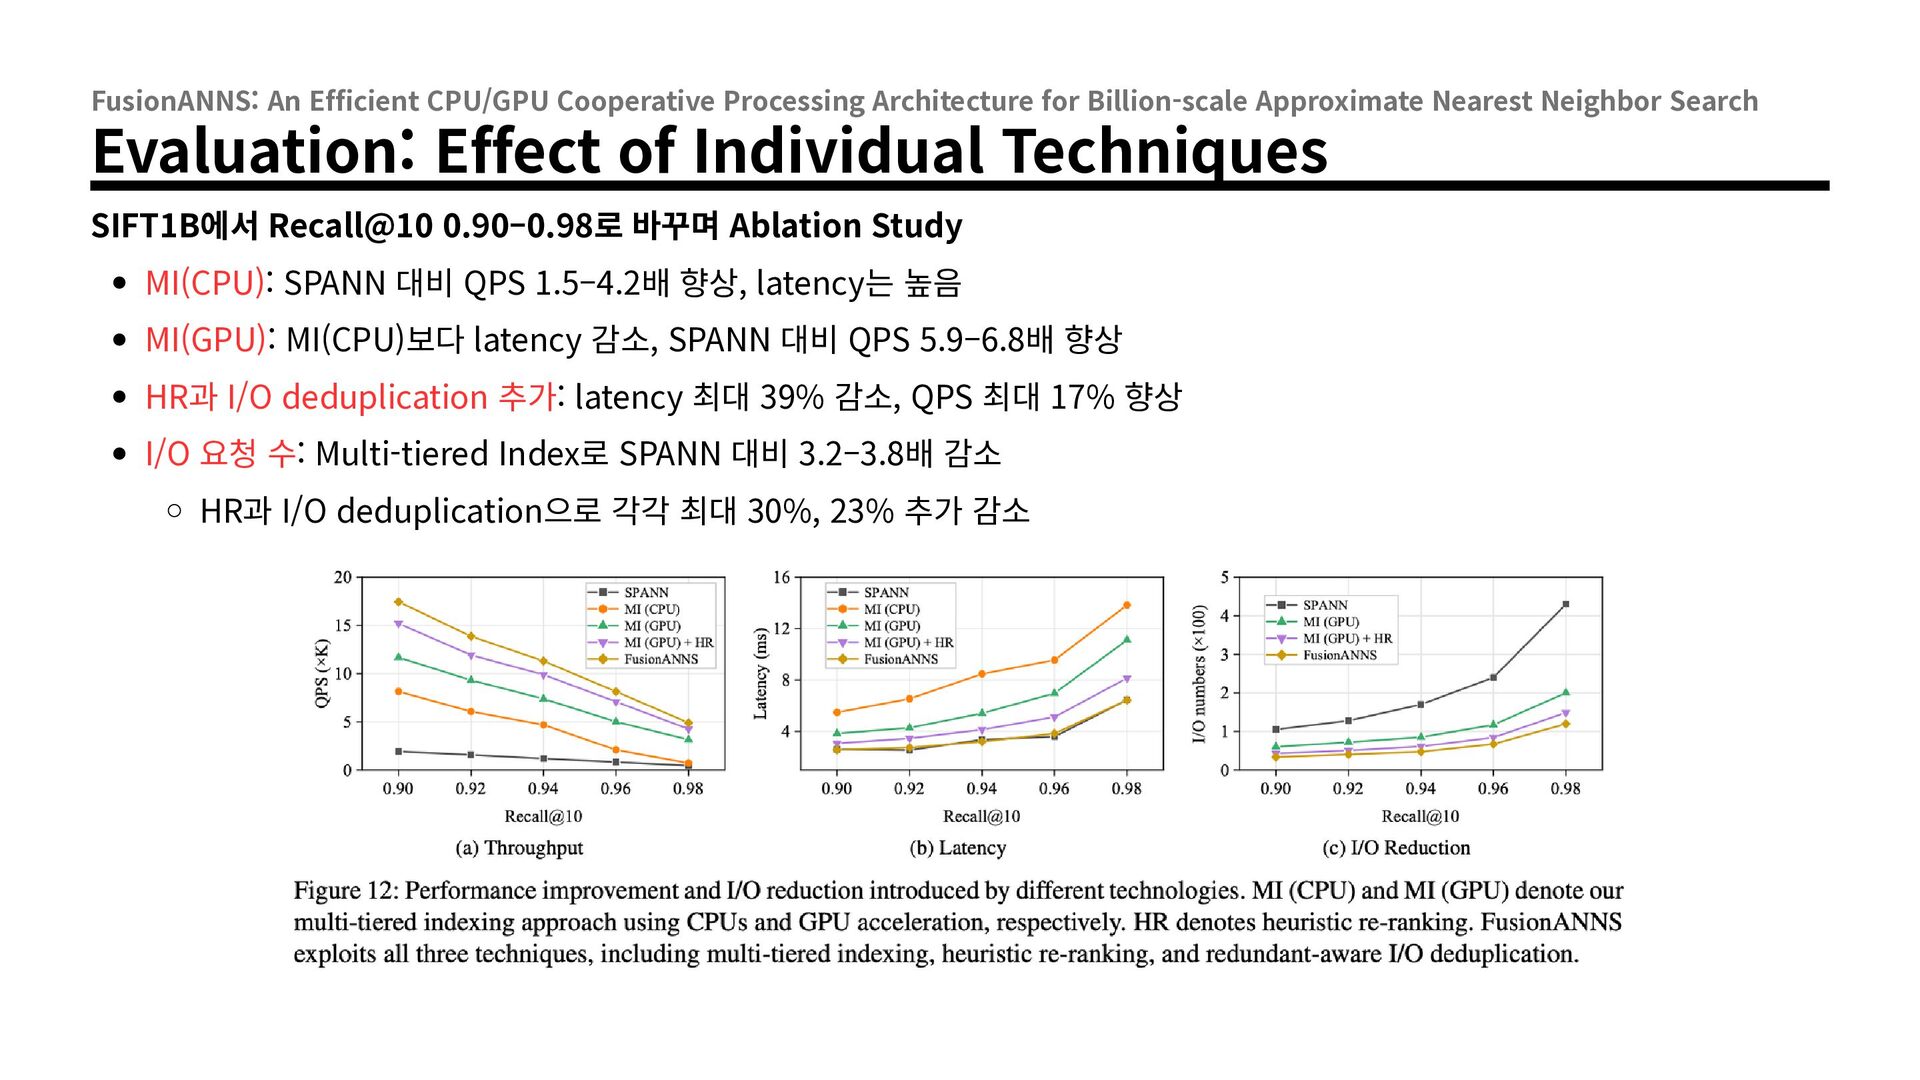
Nearest Neighbor Search Evaluation: Overall Performance SIFT1B에서 Recall@10을 0.90–0.98로 높이며 성능 비교 정확도가 높아져도 FusionANNS는 높은 QPS를 유지 높은 정확도 구간에서도 RUMMY보다 낮은 latency를 보임
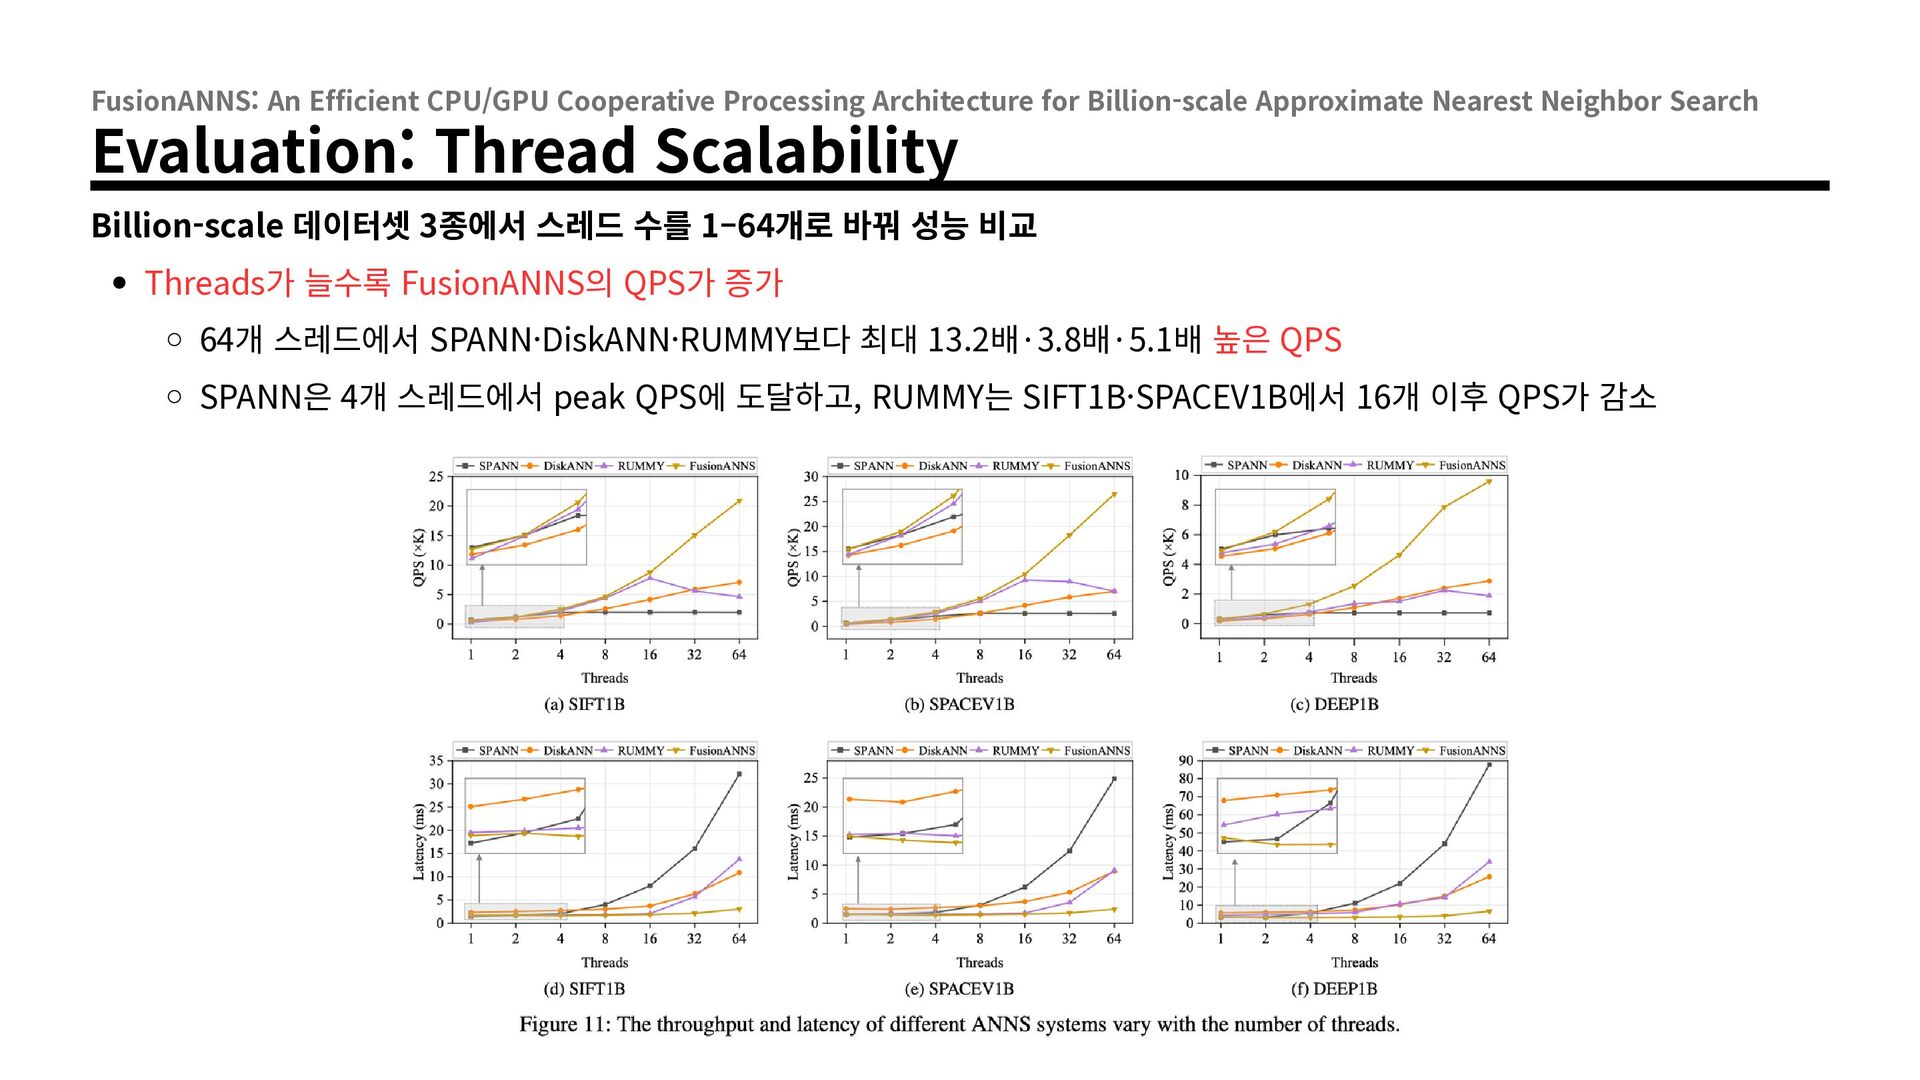
Nearest Neighbor Search Evaluation: Thread Scalability Billion-scale 데이터셋 3종에서 스레드 수를 1–64개로 바꿔 성능 비교 Threads가 늘수록 FusionANNS의 QPS가 증가 64개 스레드에서 SPANN·DiskANN·RUMMY보다 최대 13.2배·3.8배·5.1배 높은 QPS SPANN은 4개 스레드에서 peak QPS에 도달하고, RUMMY는 SIFT1B·SPACEV1B에서 16개 이후 QPS가 감소


 nawkwoo
 dk999
 satai
 kento1109
 institutdelelevage
 afroscript
 ftakahashi
 fr0gger
 takasehideki
 ept
 aleyda
 lara
 aki_iinuma
 samtorres
 swwweet
 seathinner
 samanthasiow
 auna
 codingconduct
 honnibal
 marktimemedia
 tammyeverts