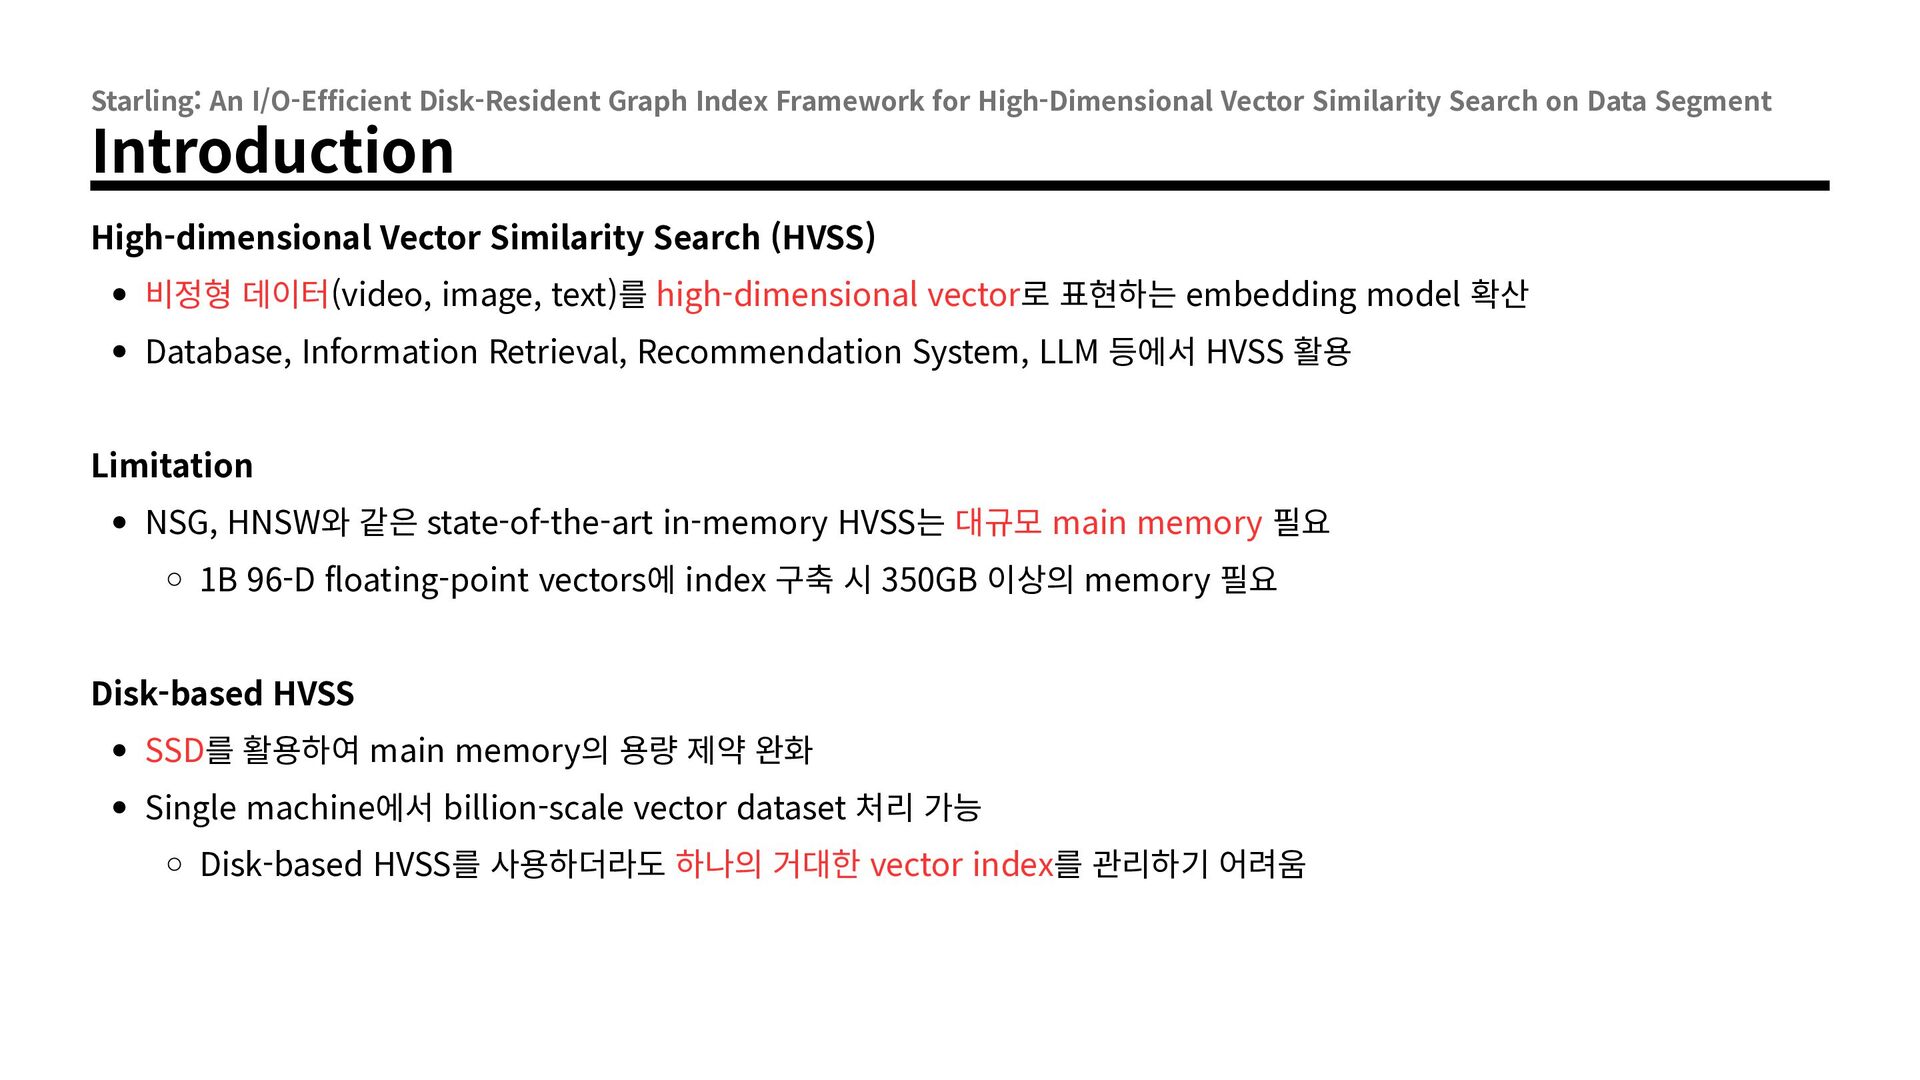
Similarity Search on Data Segment Introduction High-dimensional Vector Similarity Search (HVSS) 비정형 데이터(video, image, text)를 high-dimensional vector로 표현하는 embedding model 확산 Database, Information Retrieval, Recommendation System, LLM 등에서 HVSS 활용 Limitation NSG, HNSW와 같은 state-of-the-art in-memory HVSS는 대규모 main memory 필요 1B 96-D floating-point vectors에 index 구축 시 350GB 이상의 memory 필요 Disk-based HVSS SSD를 활용하여 main memory의 용량 제약 완화 Single machine에서 billion-scale vector dataset 처리 가능 Disk-based HVSS를 사용하더라도 하나의 거대한 vector index를 관리하기 어려움
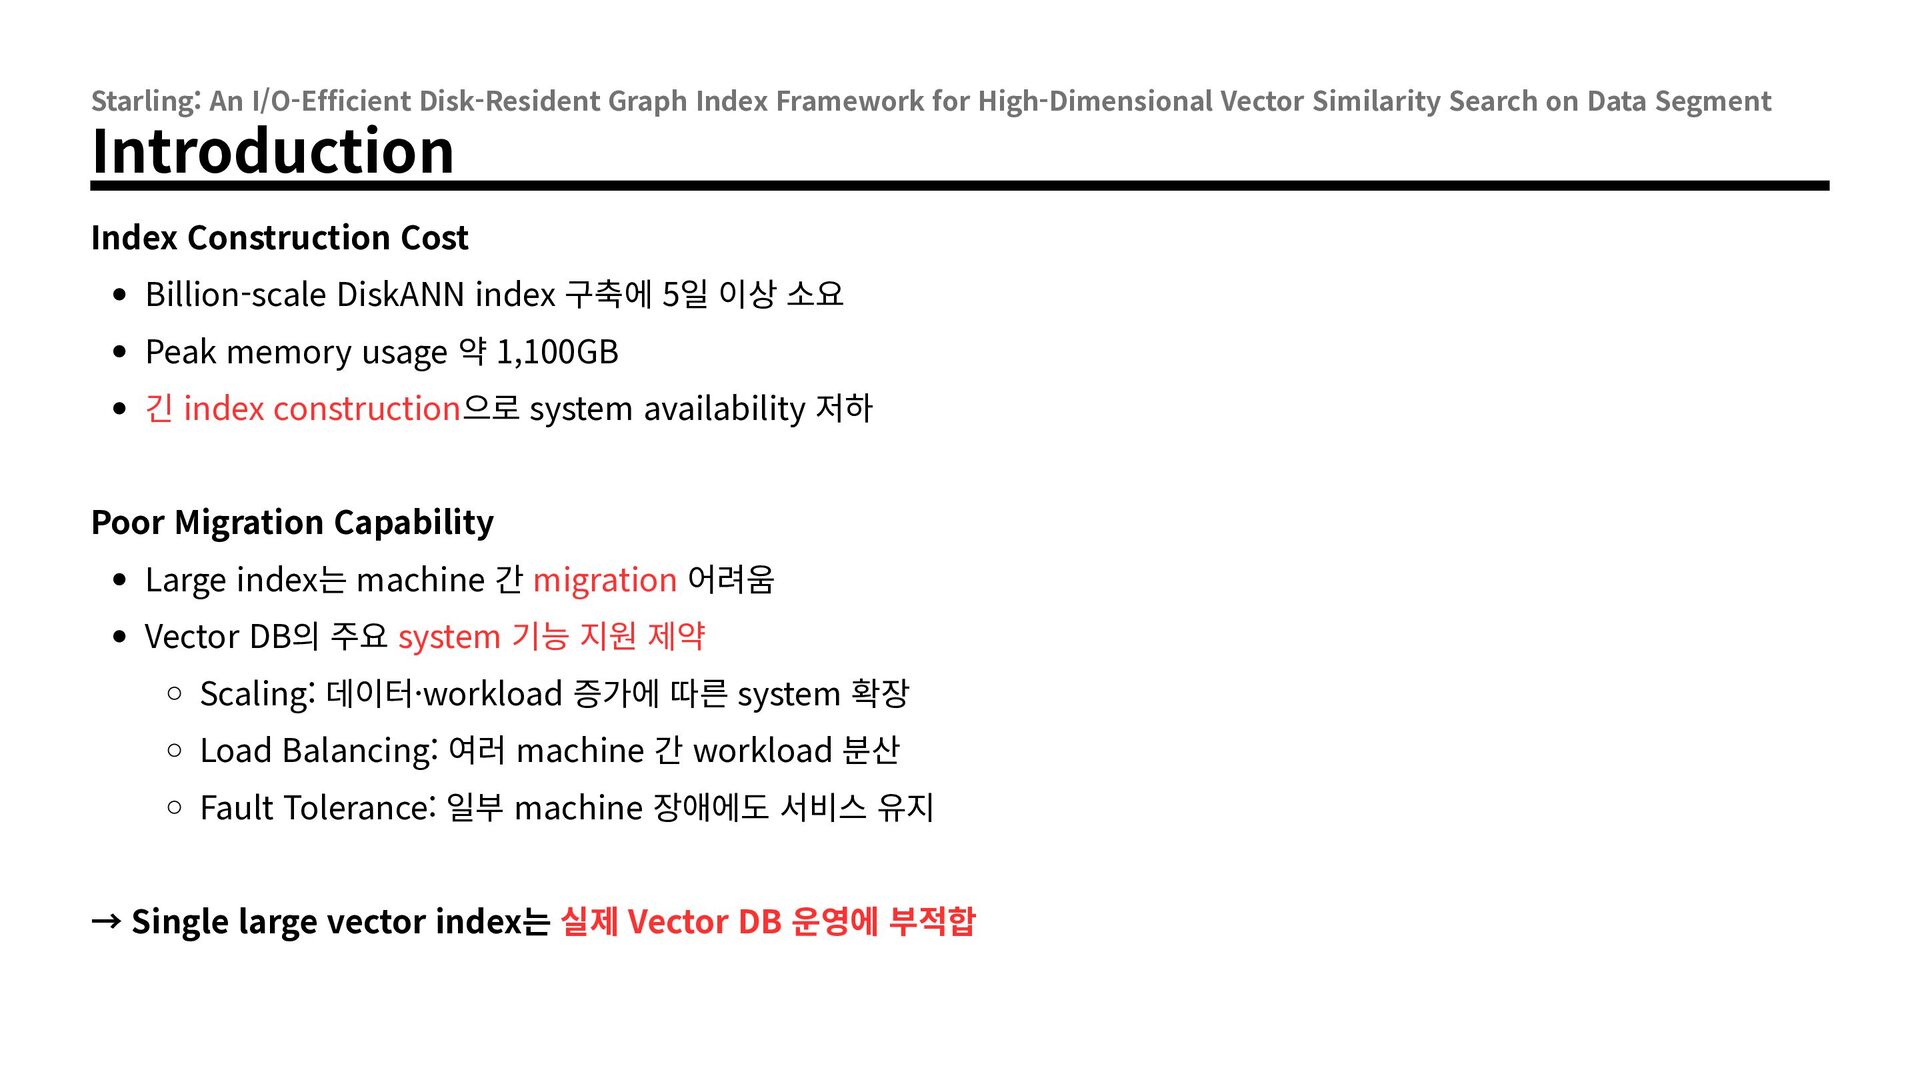
Similarity Search on Data Segment Introduction Index Construction Cost Billion-scale DiskANN index 구축에 5일 이상 소요 Peak memory usage 약 1,100GB 긴 index construction으로 system availability 저하 Poor Migration Capability Large index는 machine 간 migration 어려움 Vector DB의 주요 system 기능 지원 제약 Scaling: 데이터·workload 증가에 따른 system 확장 Load Balancing: 여러 machine 간 workload 분산 Fault Tolerance: 일부 machine 장애에도 서비스 유지 → Single large vector index는 실제 Vector DB 운영에 부적합
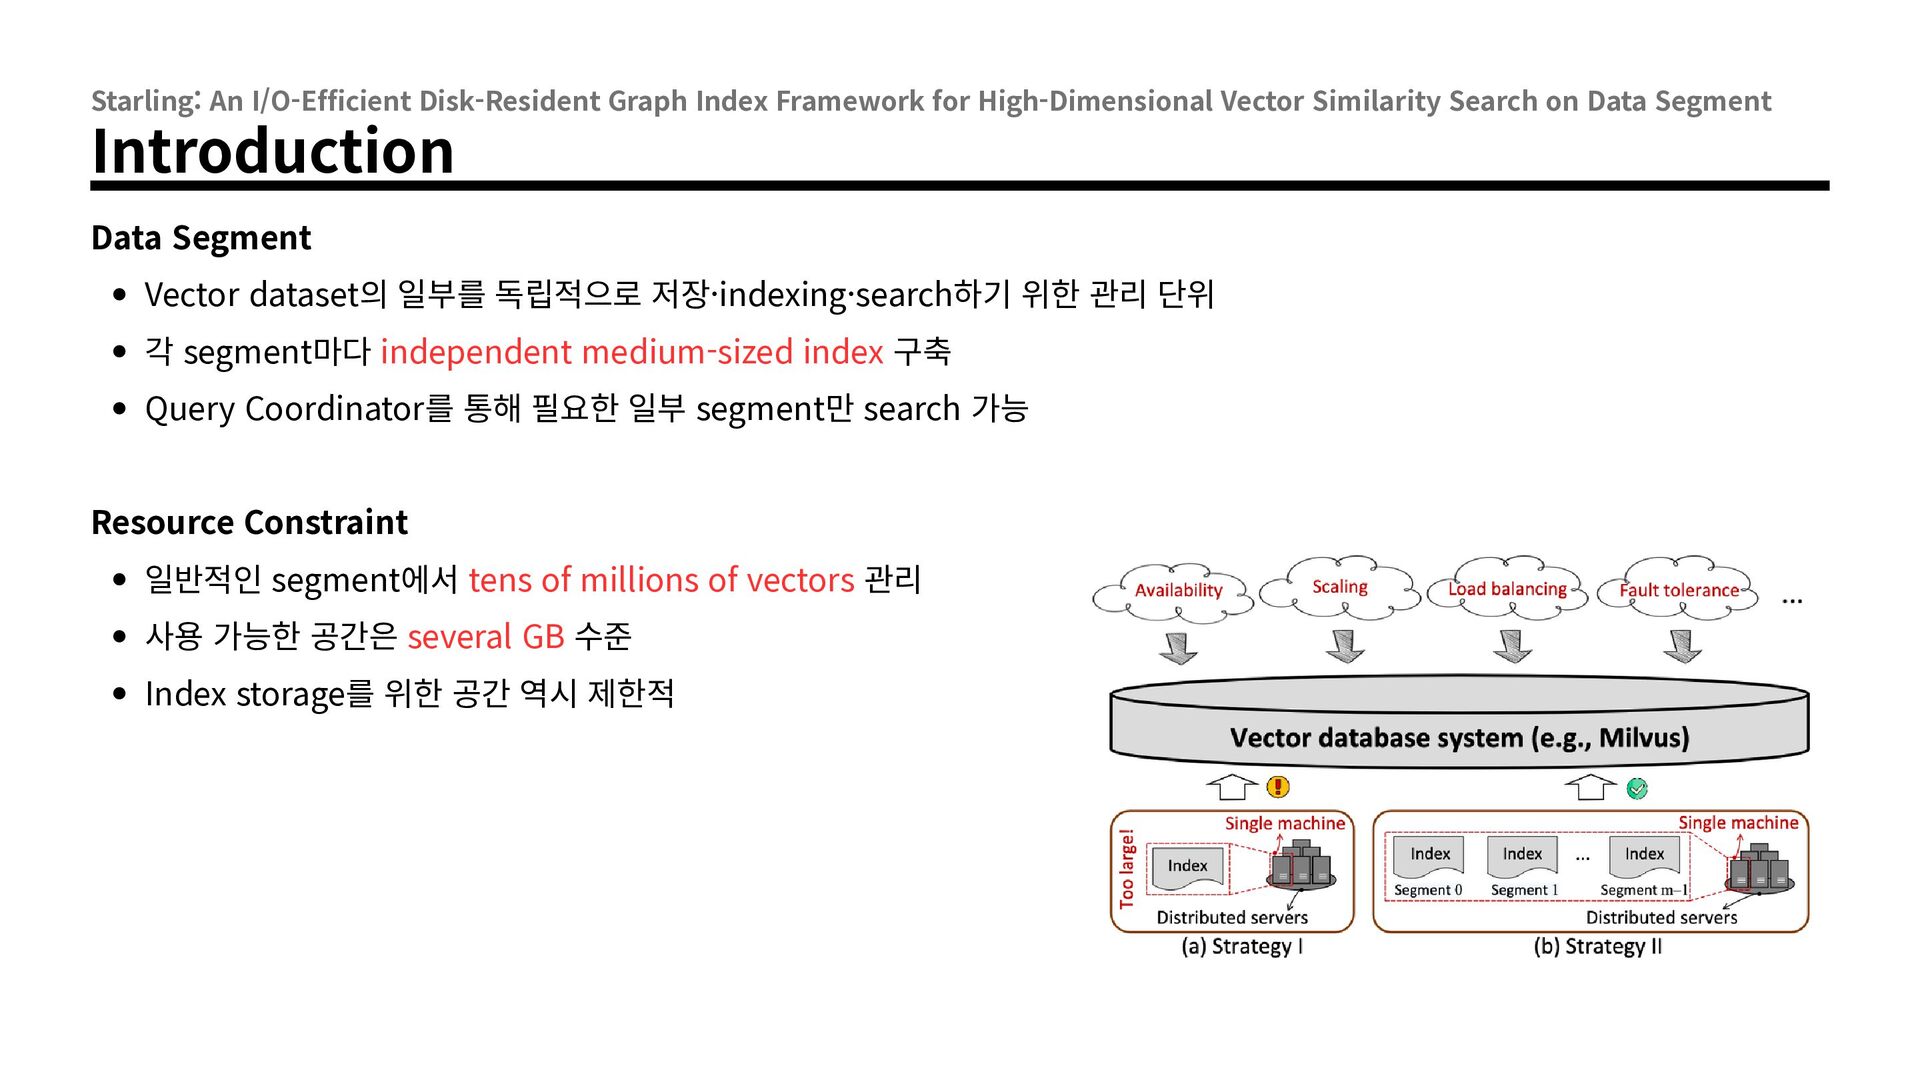
Similarity Search on Data Segment Introduction Data Segment Vector dataset의 일부를 독립적으로 저장·indexing·search하기 위한 관리 단위 각 segment마다 independent medium-sized index 구축 Query Coordinator를 통해 필요한 일부 segment만 search 가능 Resource Constraint 일반적인 segment에서 tens of millions of vectors 관리 사용 가능한 공간은 several GB 수준 Index storage를 위한 공간 역시 제한적
Similarity Search on Data Segment Introduction SPANN 검색 정확도를 보완하기 위해 vector replication 사용 하나의 vector를 최대 8번까지 복제 → 높은 Disk Space Overhead Segment replica까지 고려하면 추가적인 storage overhead 발생 높은 Disk Space Cost → Data Segment의 제한된 Resource 환경에 부적합 DiskANN Vector index를 제한된 segment disk capacity에 저장 가능 Search 과정에서 많은 Disk I/O 발생 → 높은 Query Latency → Search Performance와 Space Cost를 동시에 만족하기 어려움
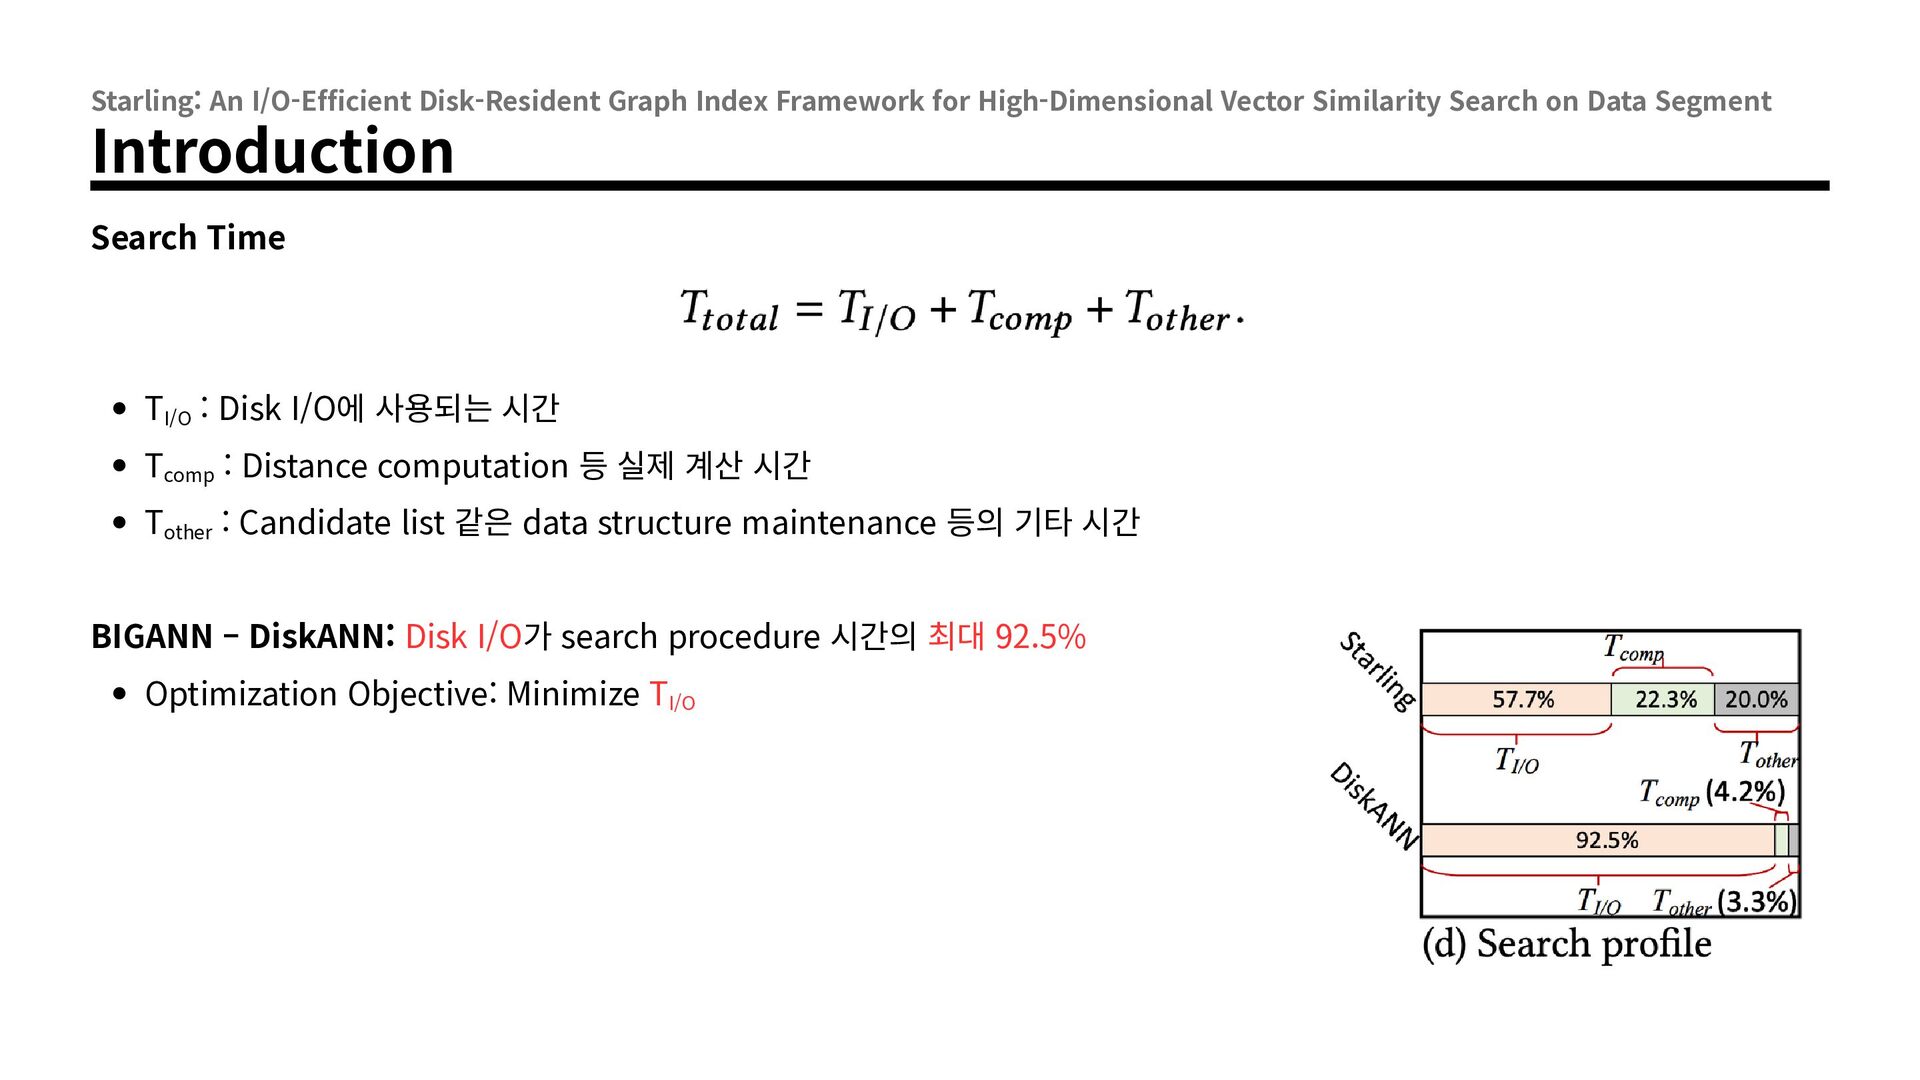
Similarity Search on Data Segment Introduction Search Time TI/O : Disk I/O에 사용되는 시간 Tcomp : Distance computation 등 실제 계산 시간 Tother : Candidate list 같은 data structure maintenance 등의 기타 시간 BIGANN – DiskANN: Disk I/O가 search procedure 시간의 최대 92.5% Optimization Objective: Minimize TI/O
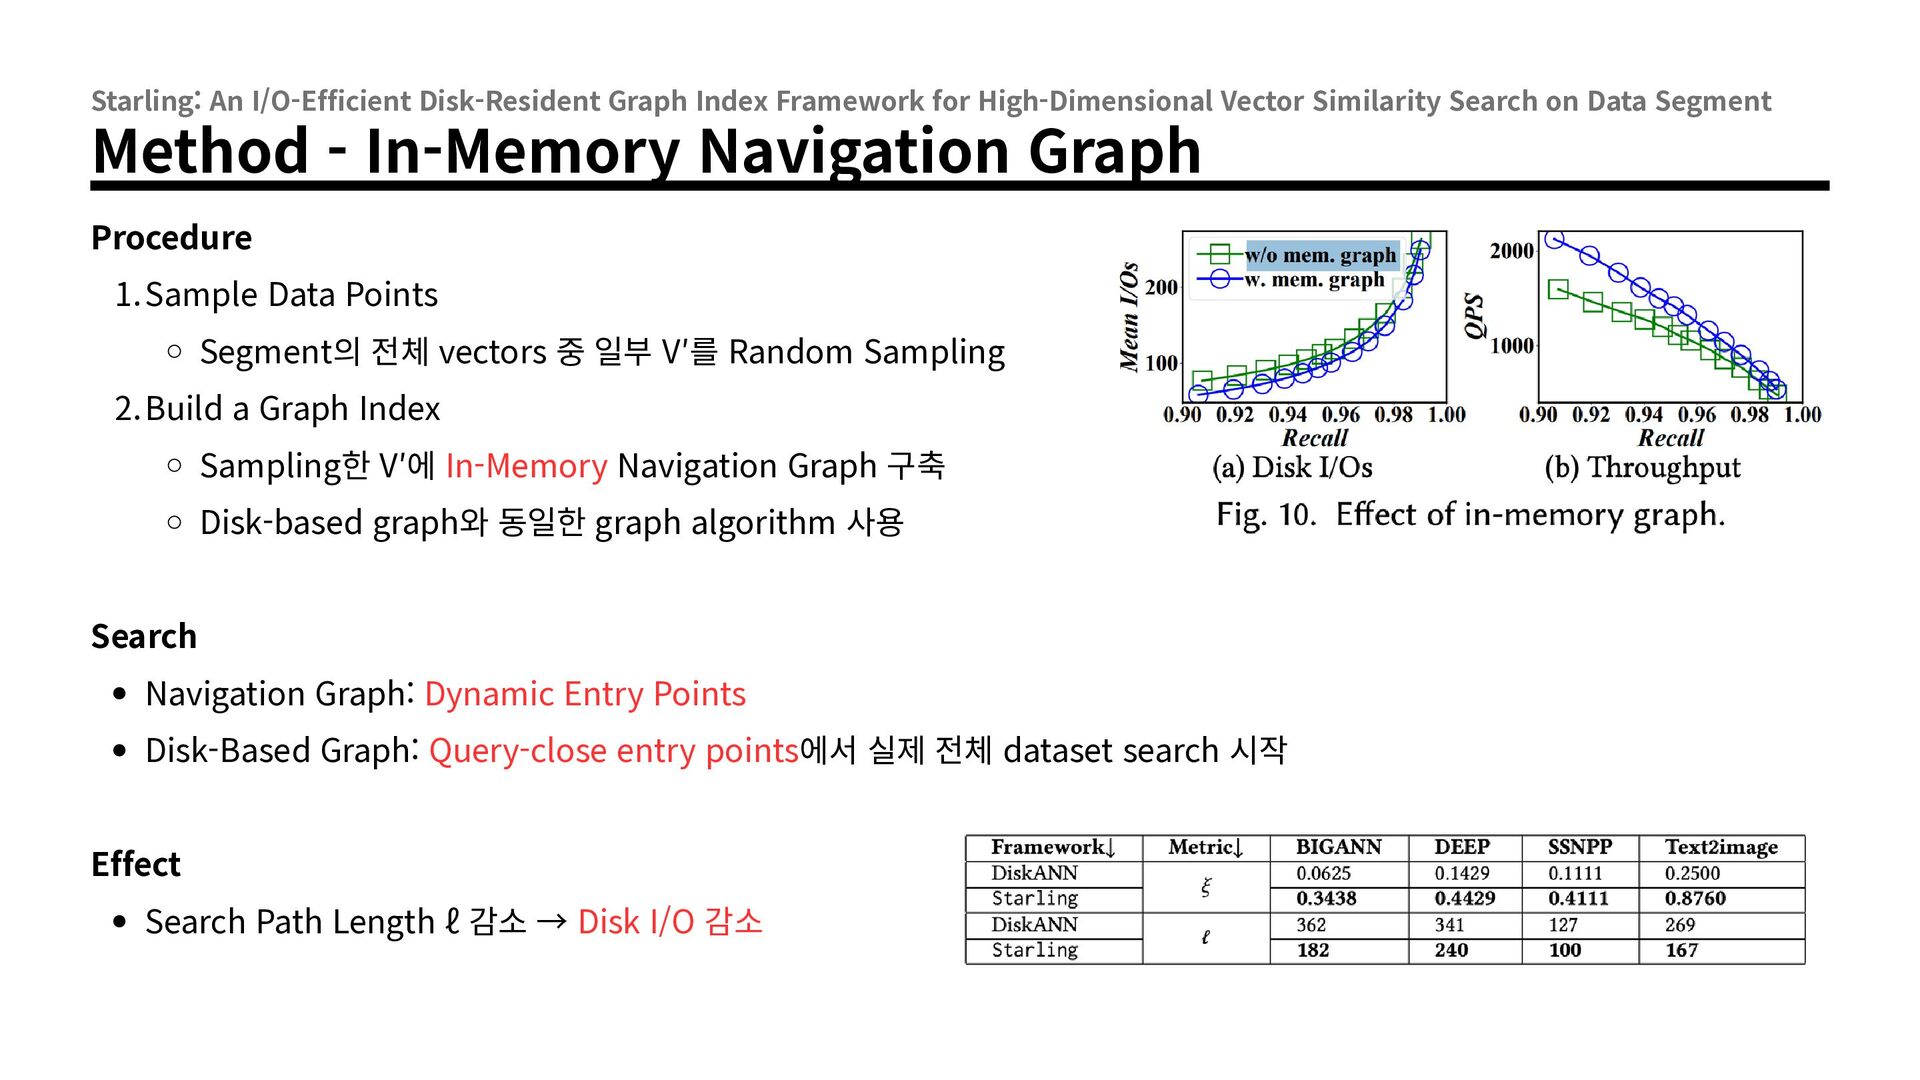
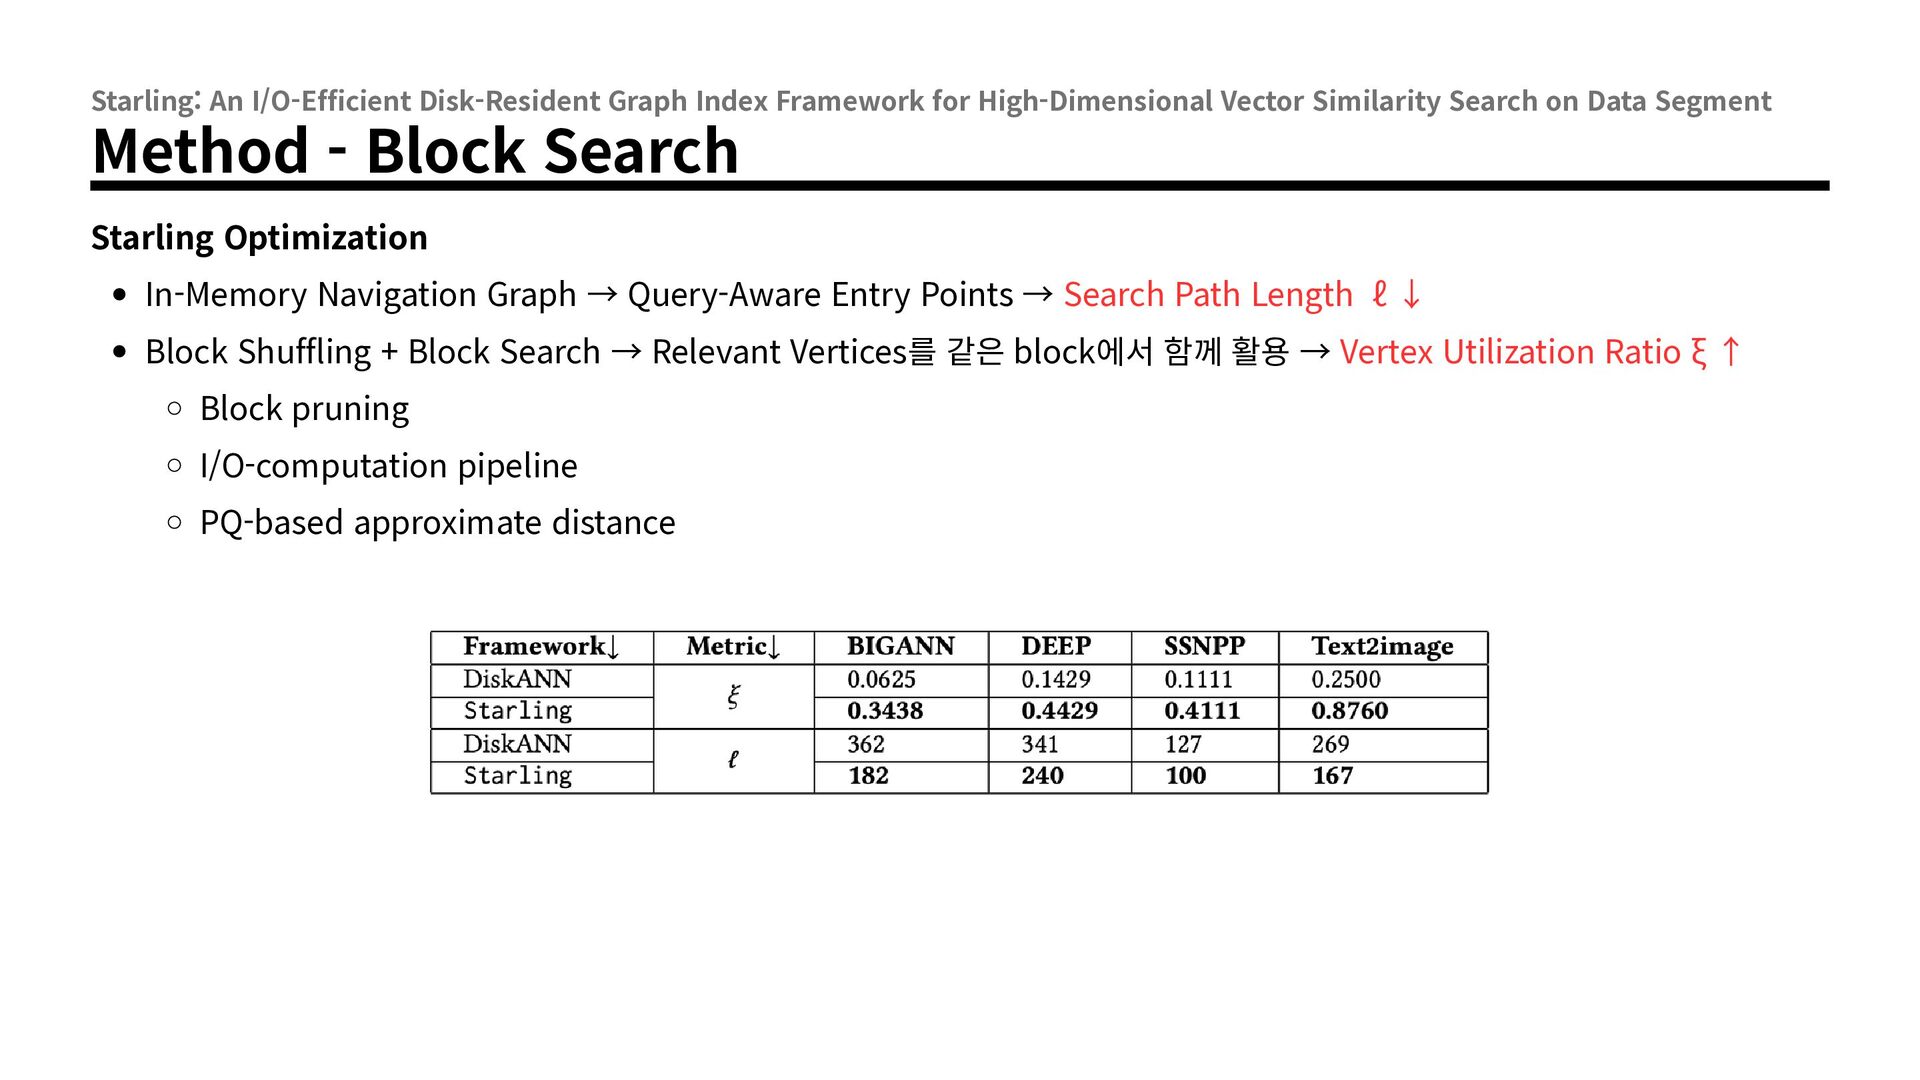
Similarity Search on Data Segment Analysis Long Search Path Disk-based graph search는 Search Path의 각 vertex를 탐색하는 과정에서 연속적인 Disk I/O 발생 Fixed or Random Entry Point는 query와 멀리 떨어져 있을 수 있음 Query와 가까운 영역까지 도달하기 위해 불필요하게 긴 Search Path 발생 Tens-of-millions dataset에서는 Top-10 NN search에서도 높은 accuracy를 위해 hundreds of hops가 발생할 수 있음 Search Path Length ℓ Entry Point에서 Result까지 탐색하는 데 필요한 hop 수 Search Path Length ℓ ↑→ Vertex Access ↑ → Disk I/O ↑ → Query Latency ↑
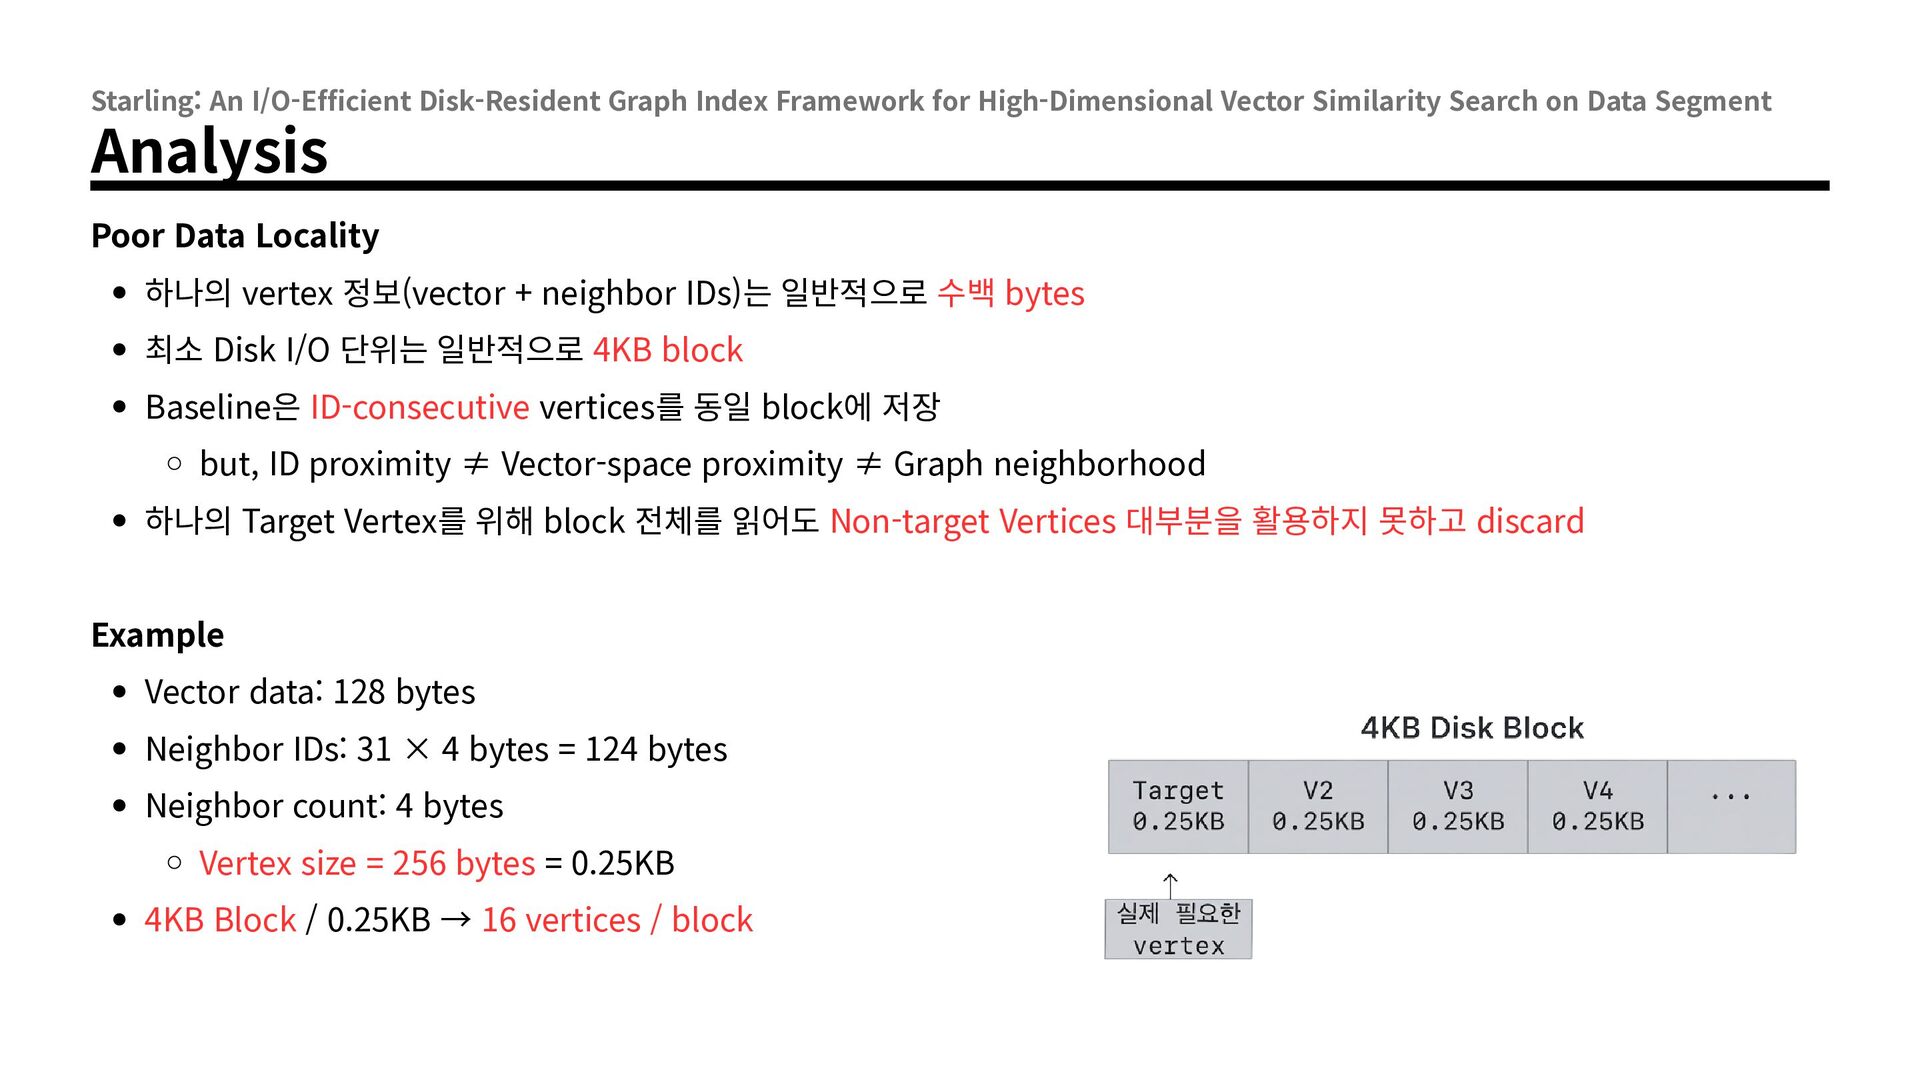
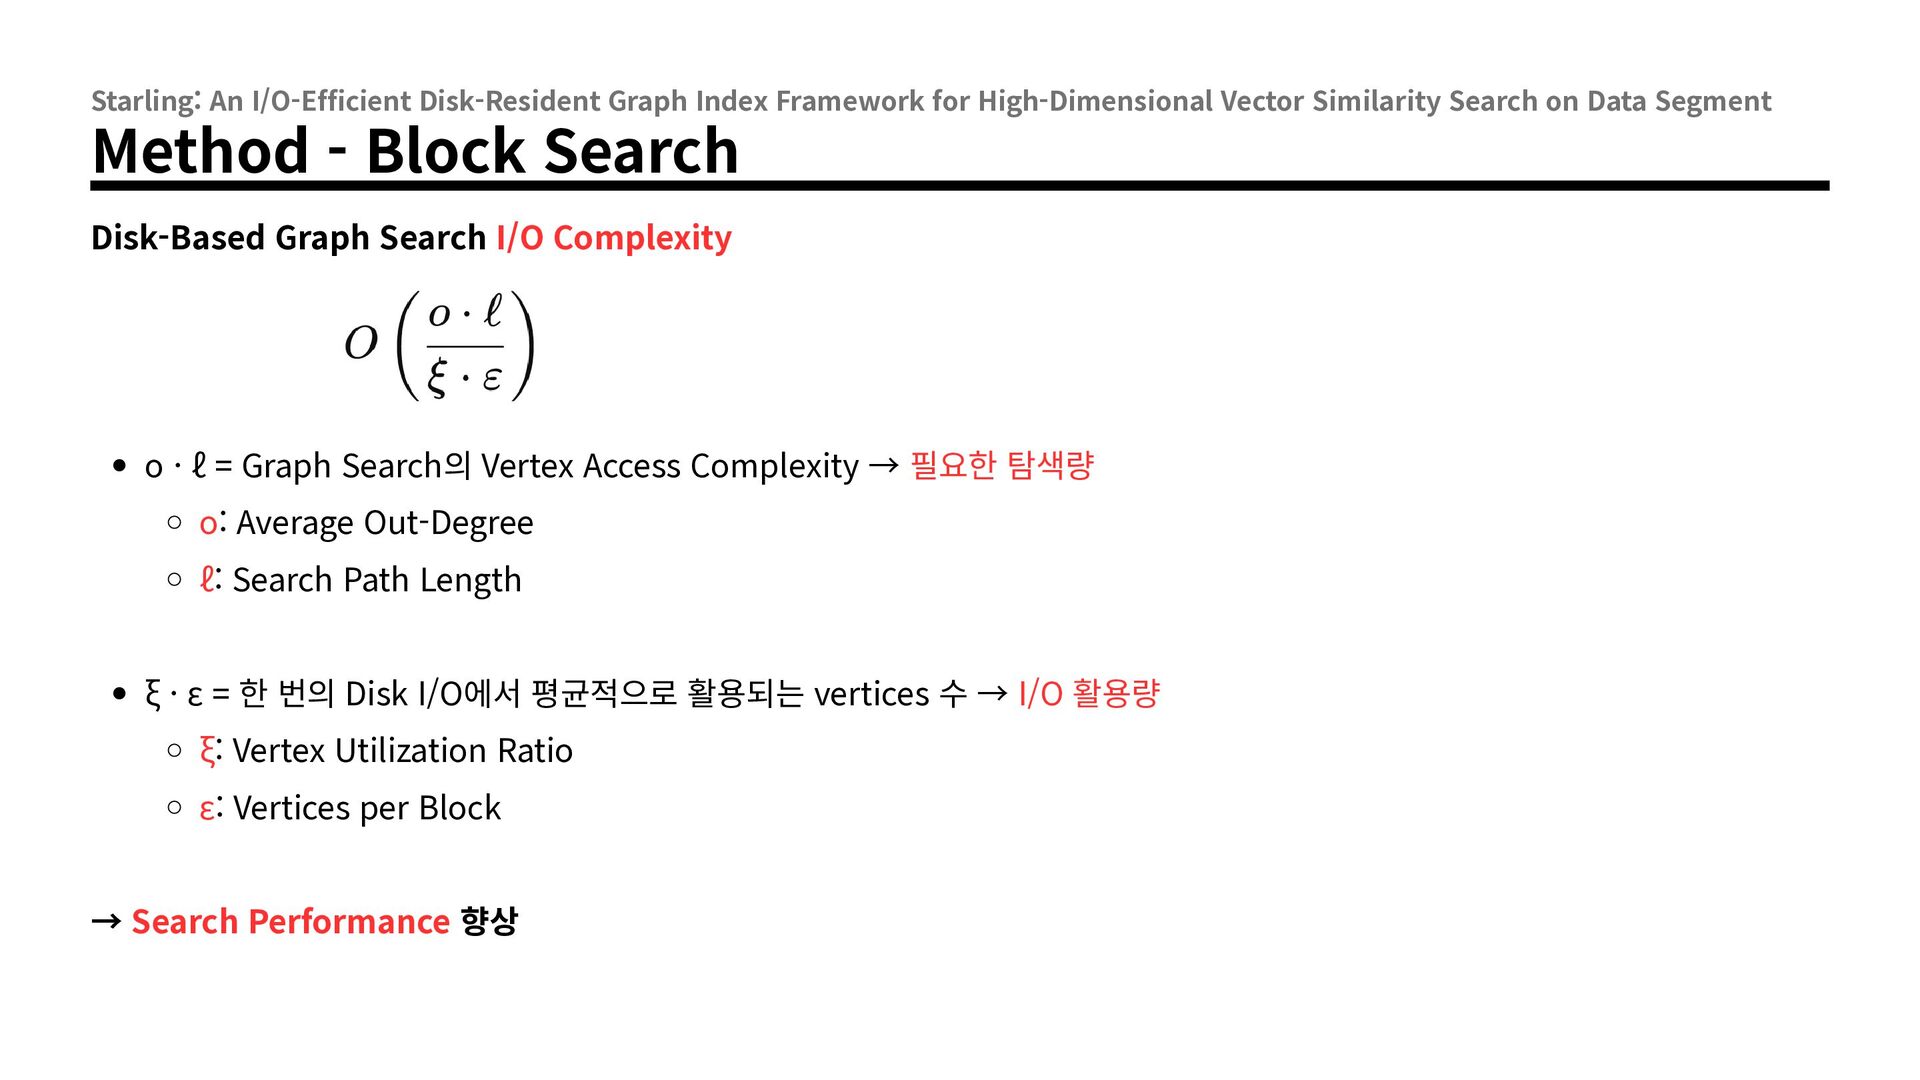
Similarity Search on Data Segment Analysis Poor Data Locality 하나의 vertex 정보(vector + neighbor IDs)는 일반적으로 수백 bytes 최소 Disk I/O 단위는 일반적으로 4KB block Baseline은 ID-consecutive vertices를 동일 block에 저장 but, ID proximity ≠ Vector-space proximity ≠ Graph neighborhood 하나의 Target Vertex를 위해 block 전체를 읽어도 Non-target Vertices 대부분을 활용하지 못하고 discard Example Vector data: 128 bytes Neighbor IDs: 31 × 4 bytes = 124 bytes Neighbor count: 4 bytes Vertex size = 256 bytes = 0.25KB 4KB Block / 0.25KB → 16 vertices / block
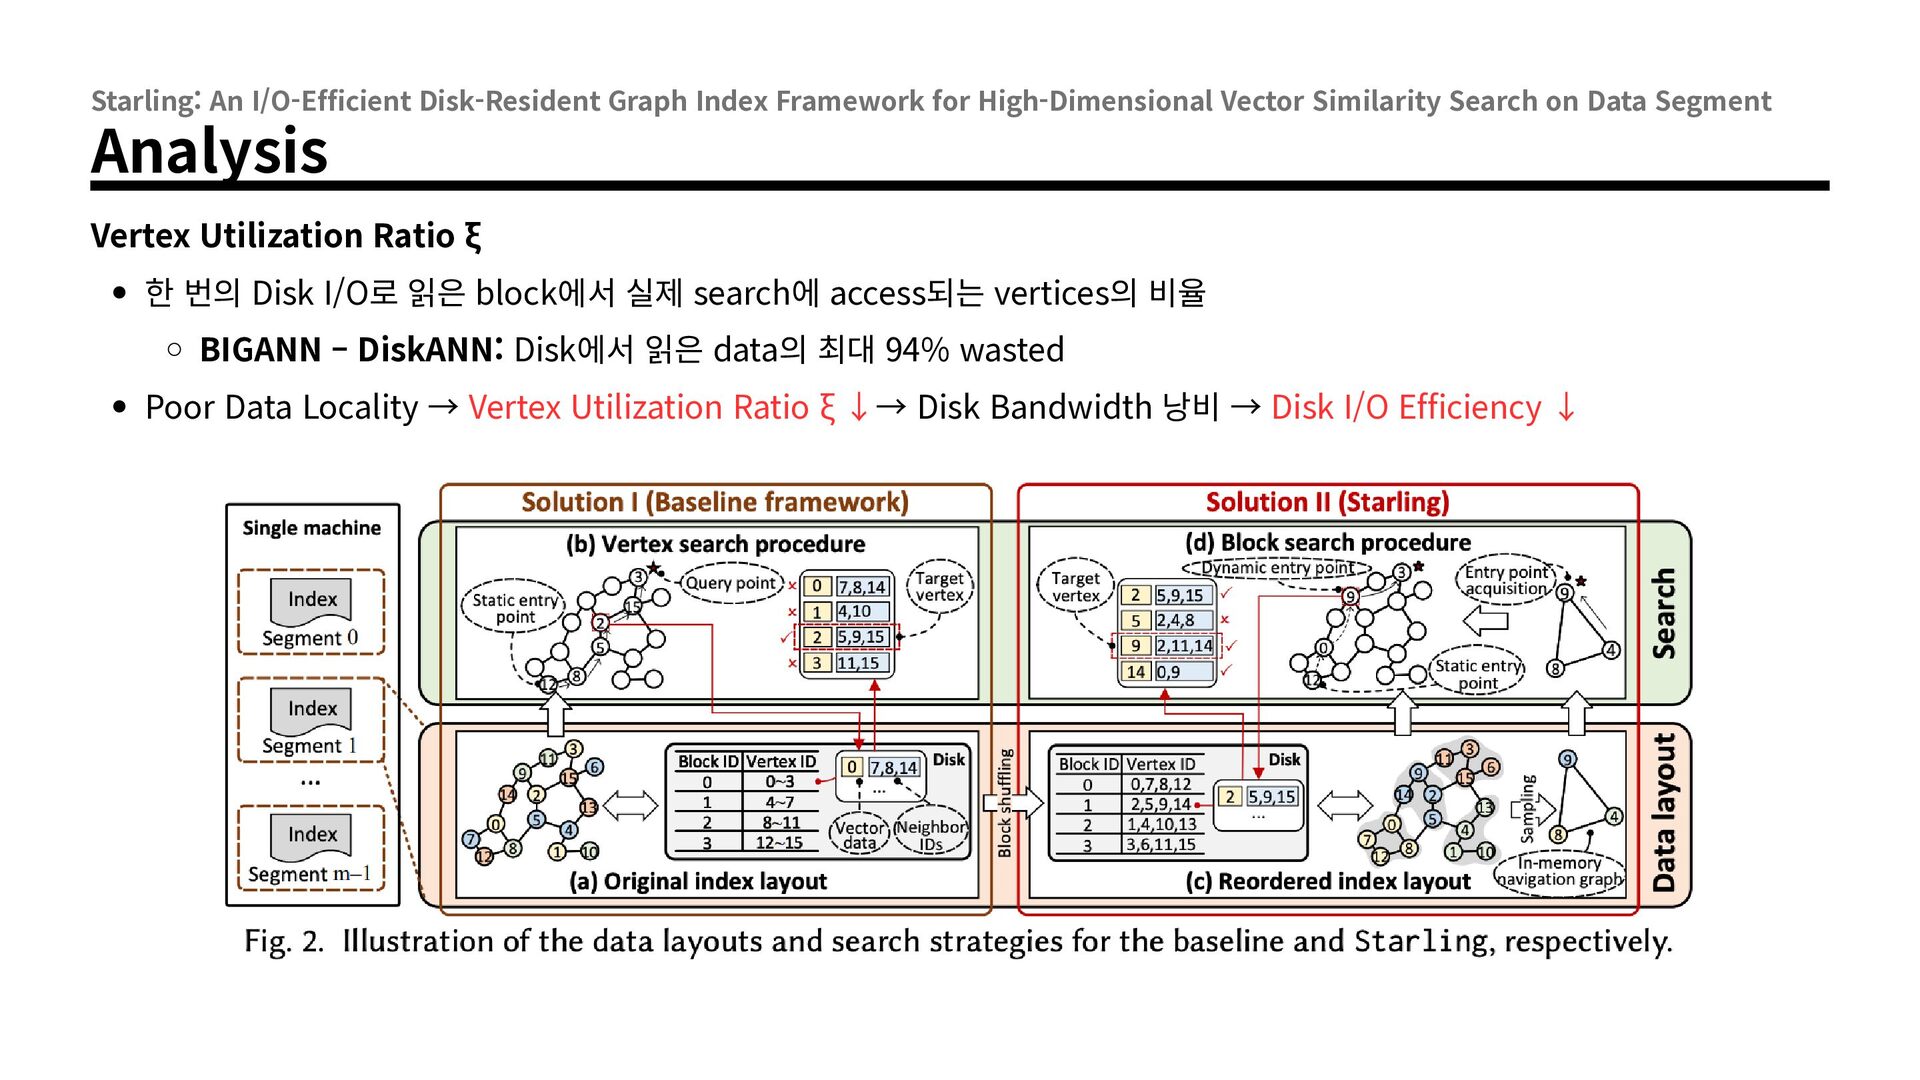
Similarity Search on Data Segment Analysis Vertex Utilization Ratio ξ 한 번의 Disk I/O로 읽은 block에서 실제 search에 access되는 vertices의 비율 BIGANN – DiskANN: Disk에서 읽은 data의 최대 94% wasted Poor Data Locality → Vertex Utilization Ratio ξ ↓→ Disk Bandwidth 낭비 → Disk I/O Efficiency ↓
Similarity Search on Data Segment Contributions Starling: I/O-efficient disk-resident graph index framework for HVSS on a Data Segment Data Layout In-Memory Navigation Graph → Dynamic Entry Points를 통해 Search Path Length 감소 Block Shuffling → Graph neighbors를 동일 block에 배치하여 Data Locality 향상 Search Strategy Block Search → 한 번의 Disk I/O에서 여러 relevant vertices 활용 ANNS / Range Search 지원 Result 추가 disk space 없이, segment space budget 내에서 Search Performance 향상 동일 accuracy에서 최대 43.9× higher throughput 최대 98% lower query latency
Similarity Search on Data Segment Background HVSS on Data Segment Large-scale vector data를 여러 Data Segment로 partition 하나의 segment는 strict space constraint에서 동작 Memory < 2GB Disk < 10GB Raw vector data로 인해 index를 위한 remaining space가 제한적 BIGANN – DiskANN: 33M vectors → raw data 약 4GB Search efficiency를 위해 additional space overhead를 크게 증가시킬 수 없음 Two Query Types for HVSS K Nearest Neighbor Search (KNNS) Query와 가장 가까운 k개의 vectors 탐색 Range Search (RS) Query로부터 주어진 distance r 이내의 모든 vectors 탐색
Similarity Search on Data Segment Method - In-Memory Navigation Graph Procedure 1.Sample Data Points Segment의 전체 vectors 중 일부 V′를 Random Sampling 2.Build a Graph Index Sampling한 V′에 In-Memory Navigation Graph 구축 Disk-based graph와 동일한 graph algorithm 사용 Search Navigation Graph: Dynamic Entry Points Disk-Based Graph: Query-close entry points에서 실제 전체 dataset search 시작 Effect Search Path Length ℓ 감소 → Disk I/O 감소
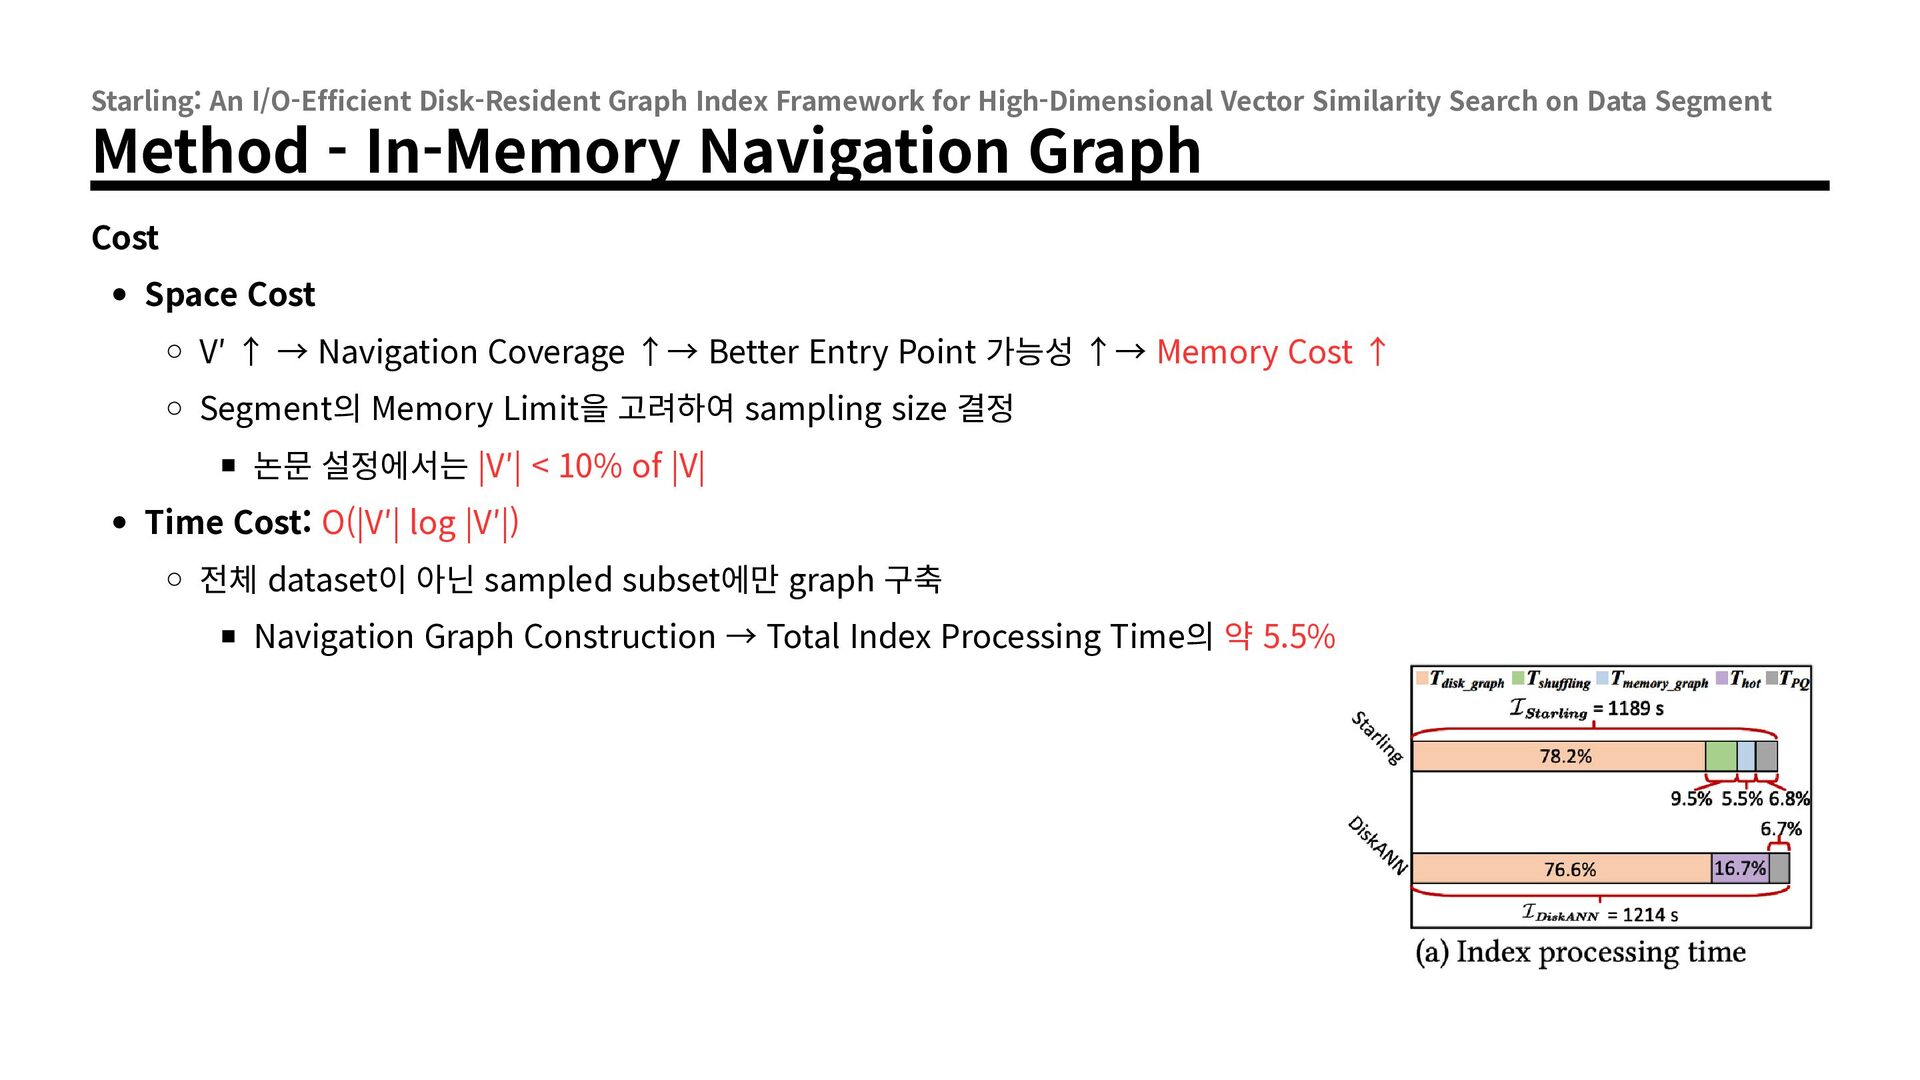
Similarity Search on Data Segment Method - In-Memory Navigation Graph Cost Space Cost V′ ↑ → Navigation Coverage ↑→ Better Entry Point 가능성 ↑→ Memory Cost ↑ Segment의 Memory Limit을 고려하여 sampling size 결정 논문 설정에서는 |V′| < 10% of |V| Time Cost: O(|V′| log |V′|) 전체 dataset이 아닌 sampled subset에만 graph 구축 Navigation Graph Construction → Total Index Processing Time의 약 5.5%
Similarity Search on Data Segment Method - Notations Vertex Storage 각 vertex는 γ KB의 storage 사용 Vector Data Neighbor Count λ Neighbor IDs λ = 해당 vertex의 실제 neighbor 수 Λ = 저장 가능한 최대 neighbor 수 (λ ≤ Λ) Disk Block N(u): 정점 u의 neighbor set B(u): 정점 u가 저장된 disk block η : Disk Block 크기 (KB) ε = floor(η / γ): Vertices per Block ρ = ceil(|V| / ε): Number of Disk Blocks
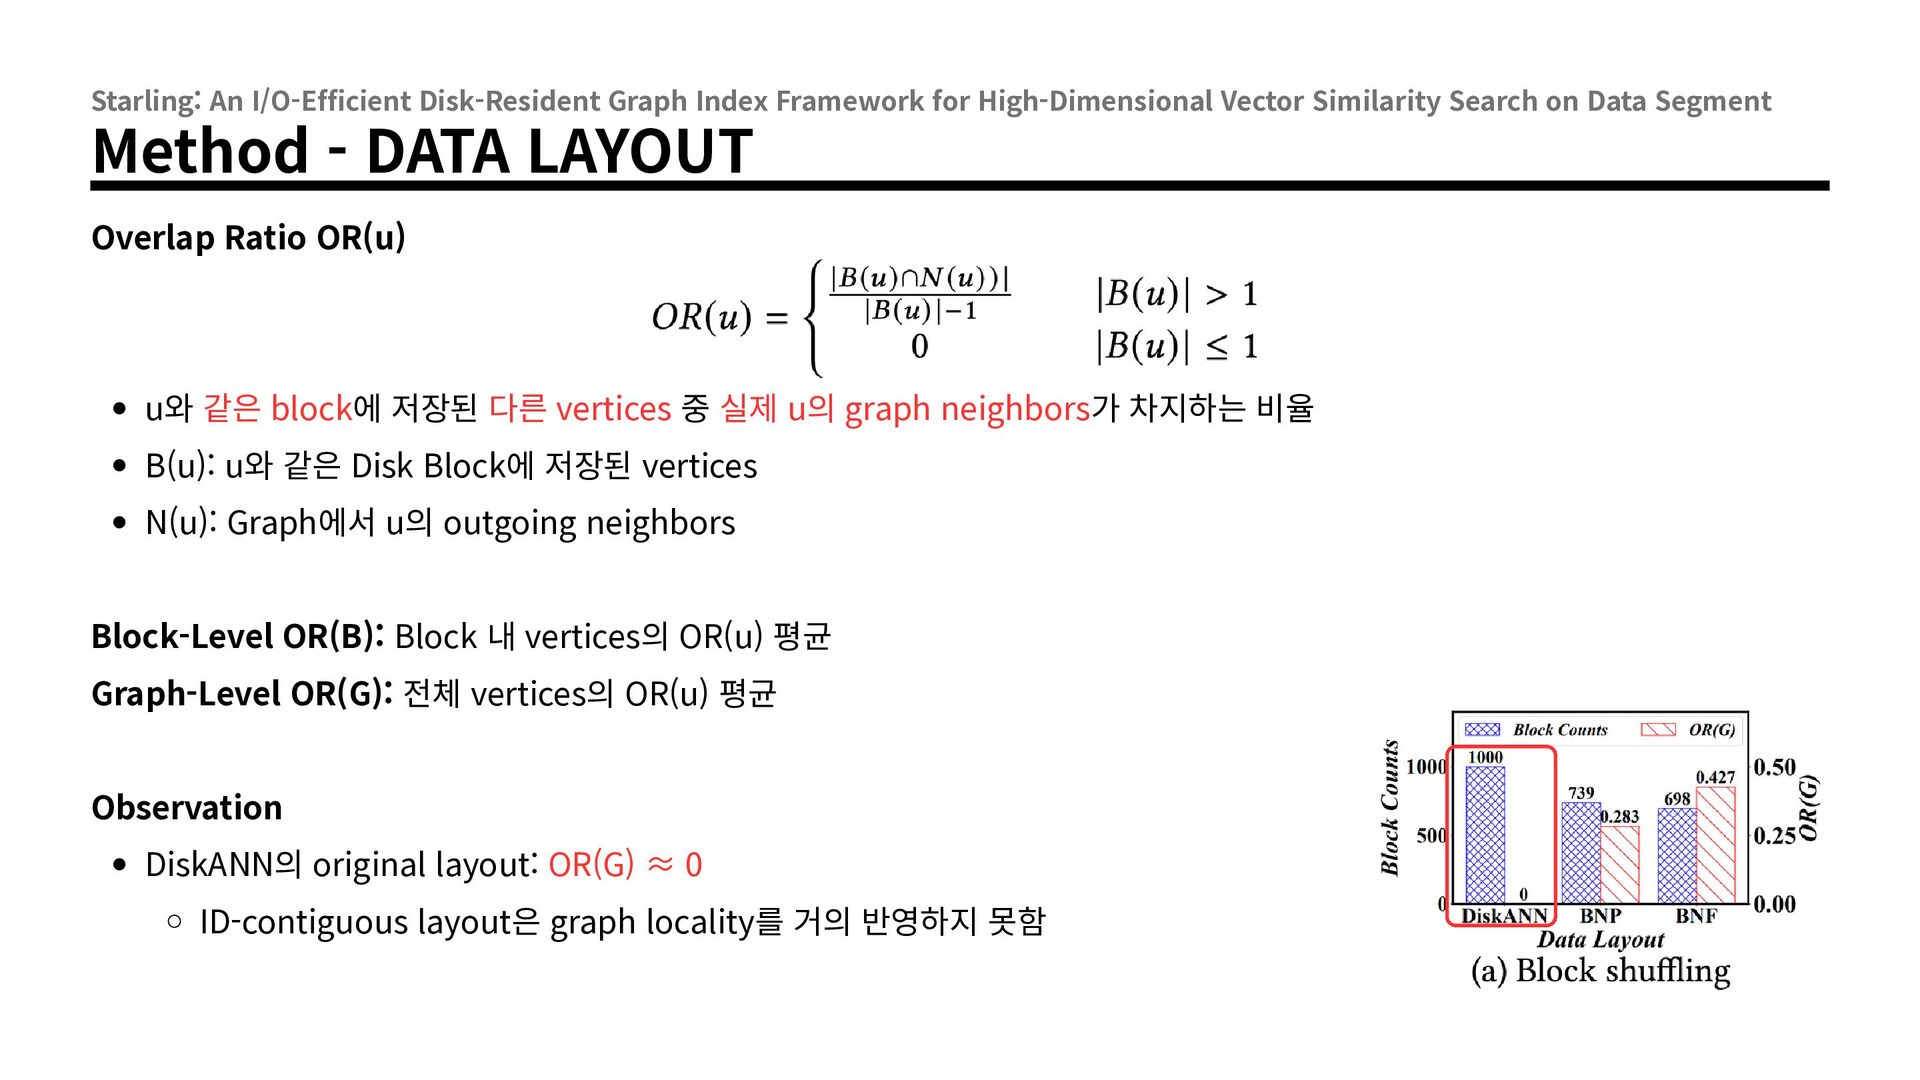
Similarity Search on Data Segment Method - DATA LAYOUT Overlap Ratio OR(u) u와 같은 block에 저장된 다른 vertices 중 실제 u의 graph neighbors가 차지하는 비율 B(u): u와 같은 Disk Block에 저장된 vertices N(u): Graph에서 u의 outgoing neighbors Block-Level OR(B): Block 내 vertices의 OR(u) 평균 Graph-Level OR(G): 전체 vertices의 OR(u) 평균 Observation DiskANN의 original layout: OR(G) ≈ 0 ID-contiguous layout은 graph locality를 거의 반영하지 못함
Similarity Search on Data Segment Method - DATA LAYOUT Block Shuffling on the Disk Graph topology는 유지하면서 Disk Block assignment만 변경 Vertex Replication × Graph Topology Modification × Physical Layout Reordering → Maximize OR(G) Why is it difficult? High-dimensional graph의 edge는 두 가지 특성을 함께 가짐 Similarity → 가까운 vectors를 연결 Navigation → Graph search를 위해 다른 영역까지 연결 모든 block에서 OR(B) = 1을 만드는 것은 매우 어려움 OR(G)를 효과적으로 높이기 위한 3가지 heuristic algorithm 제안
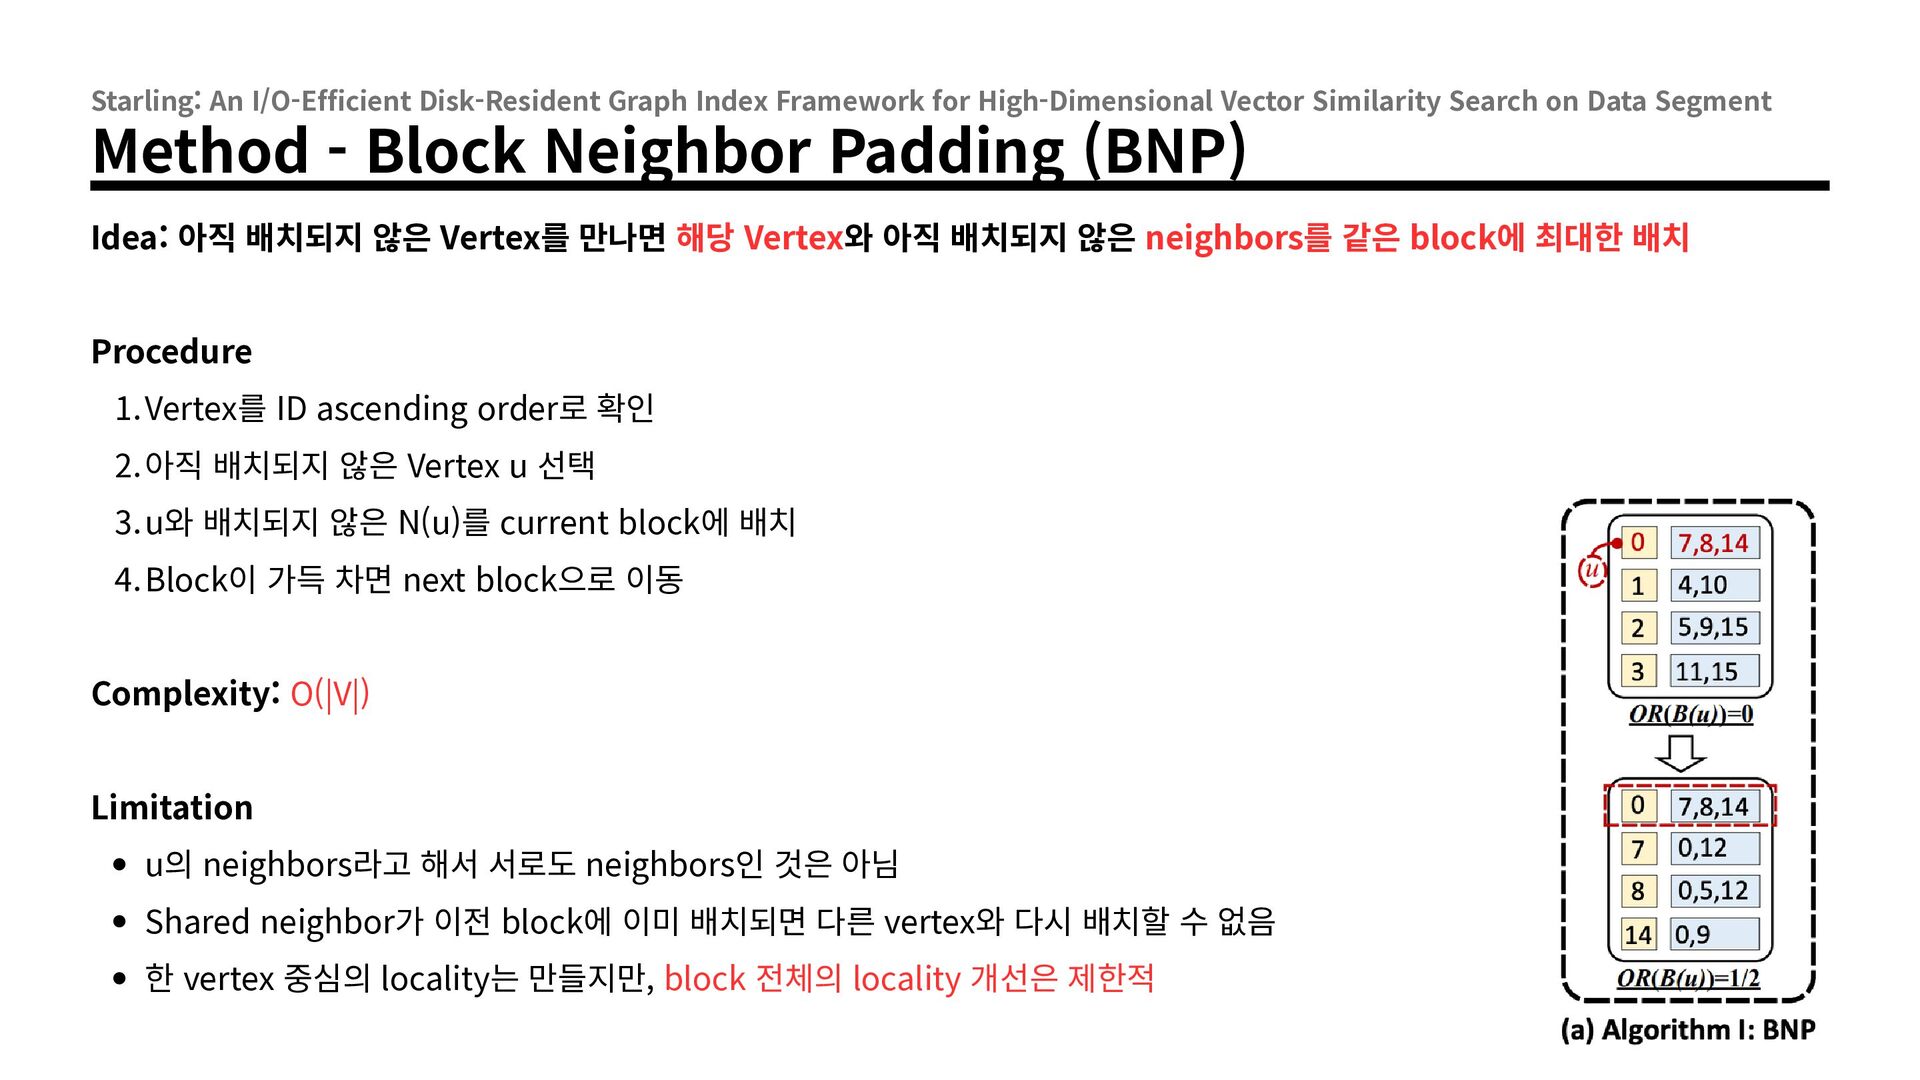
Similarity Search on Data Segment Method - Block Neighbor Padding (BNP) Idea: 아직 배치되지 않은 Vertex를 만나면 해당 Vertex와 아직 배치되지 않은 neighbors를 같은 block에 최대한 배치 Procedure 1.Vertex를 ID ascending order로 확인 2.아직 배치되지 않은 Vertex u 선택 3.u와 배치되지 않은 N(u)를 current block에 배치 4.Block이 가득 차면 next block으로 이동 Complexity: O(|V|) Limitation u의 neighbors라고 해서 서로도 neighbors인 것은 아님 Shared neighbor가 이전 block에 이미 배치되면 다른 vertex와 다시 배치할 수 없음 한 vertex 중심의 locality는 만들지만, block 전체의 locality 개선은 제한적
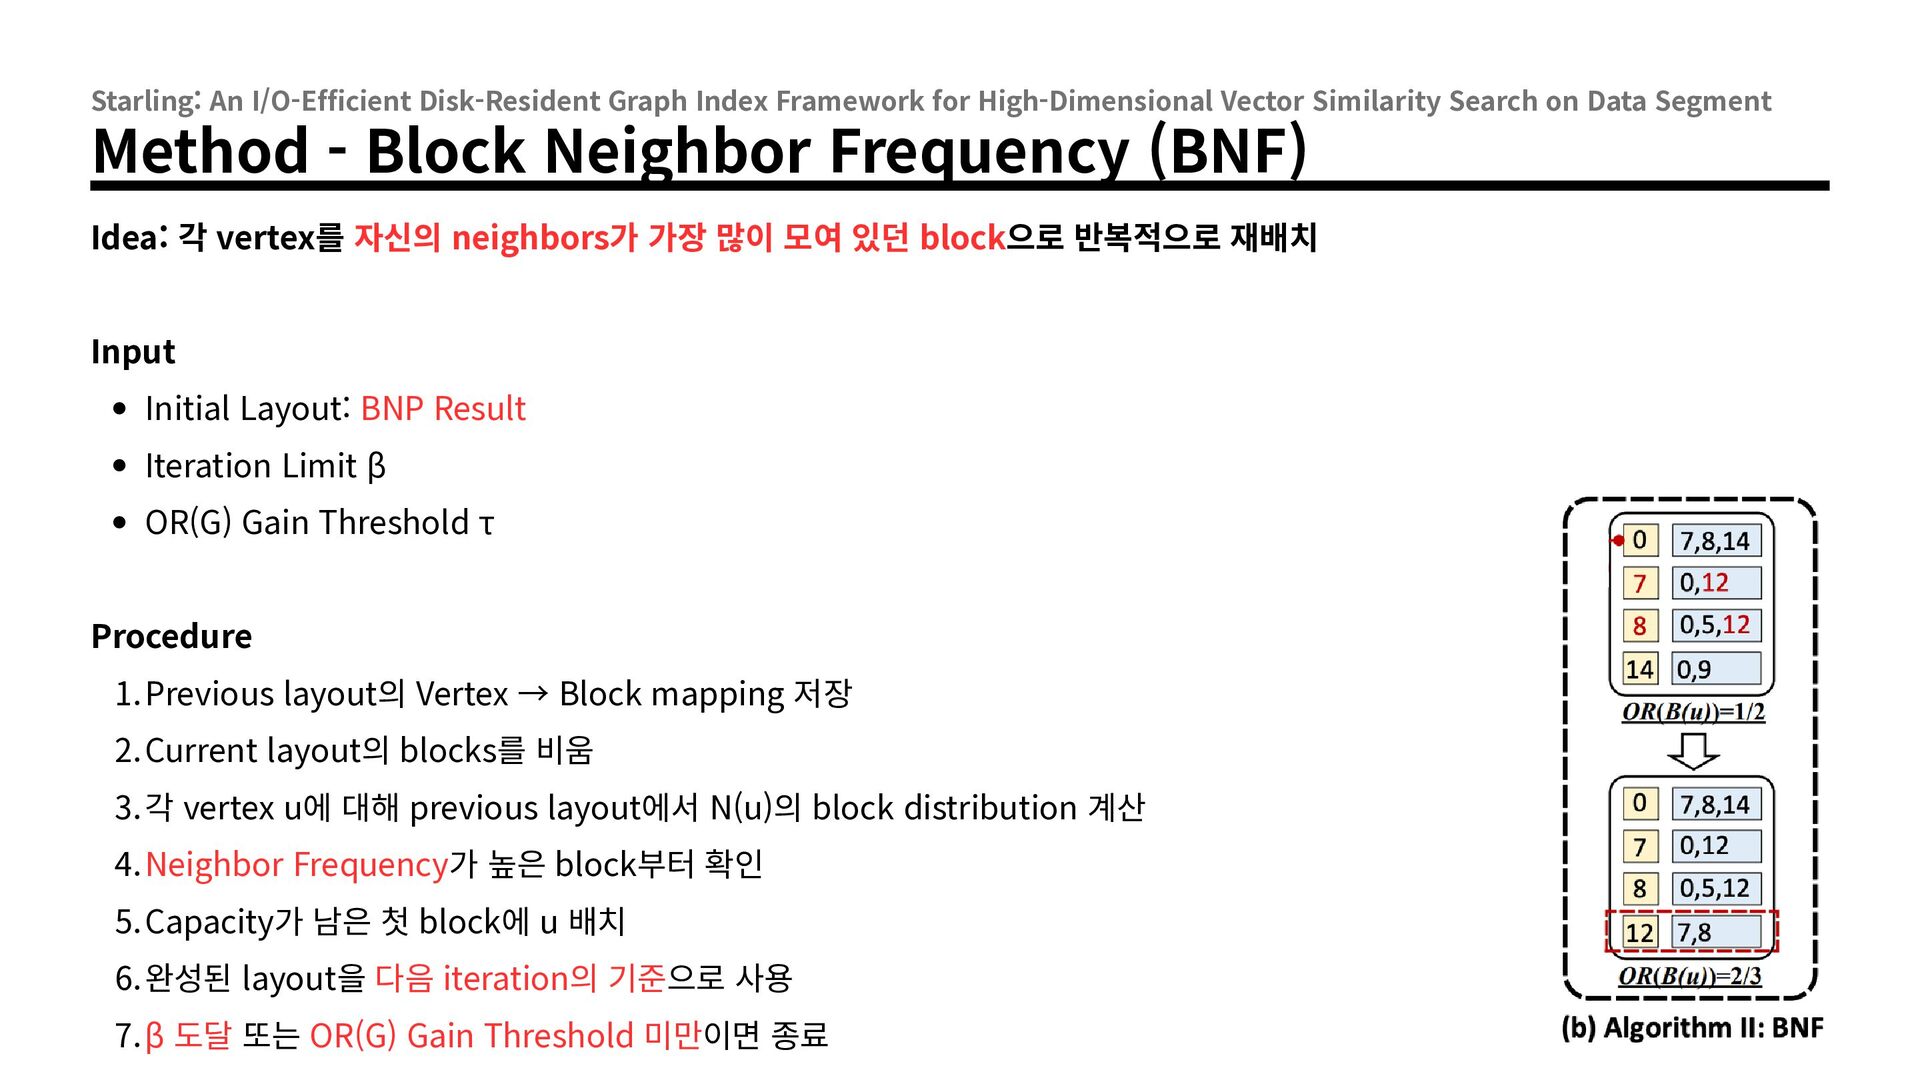
Similarity Search on Data Segment Method - Block Neighbor Frequency (BNF) Idea: 각 vertex를 자신의 neighbors가 가장 많이 모여 있던 block으로 반복적으로 재배치 Input Initial Layout: BNP Result Iteration Limit β OR(G) Gain Threshold τ Procedure 1.Previous layout의 Vertex → Block mapping 저장 2.Current layout의 blocks를 비움 3.각 vertex u에 대해 previous layout에서 N(u)의 block distribution 계산 4.Neighbor Frequency가 높은 block부터 확인 5.Capacity가 남은 첫 block에 u 배치 6.완성된 layout을 다음 iteration의 기준으로 사용 7.β 도달 또는 OR(G) Gain Threshold 미만이면 종료
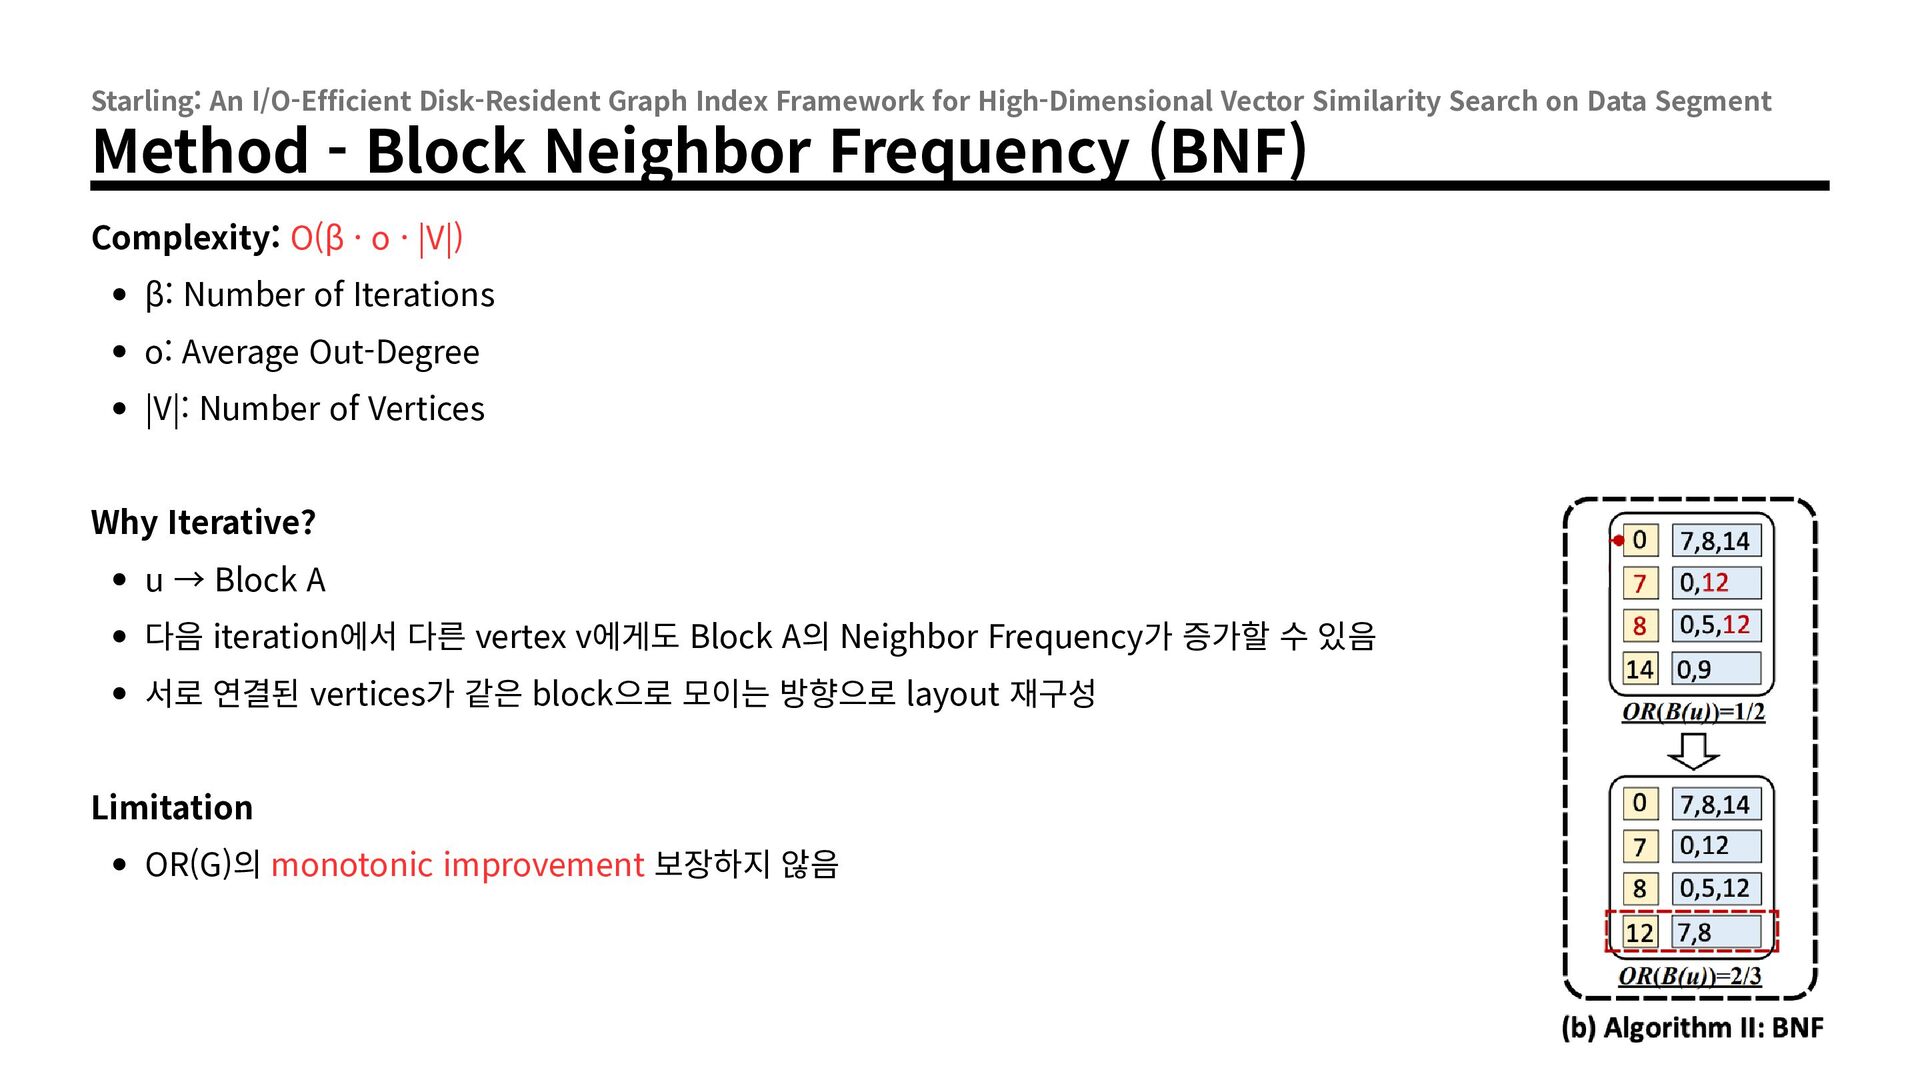
Similarity Search on Data Segment Method - Block Neighbor Frequency (BNF) Complexity: O(β · o · |V|) β: Number of Iterations o: Average Out-Degree |V|: Number of Vertices Why Iterative? u → Block A 다음 iteration에서 다른 vertex v에게도 Block A의 Neighbor Frequency가 증가할 수 있음 서로 연결된 vertices가 같은 block으로 모이는 방향으로 layout 재구성 Limitation OR(G)의 monotonic improvement 보장하지 않음
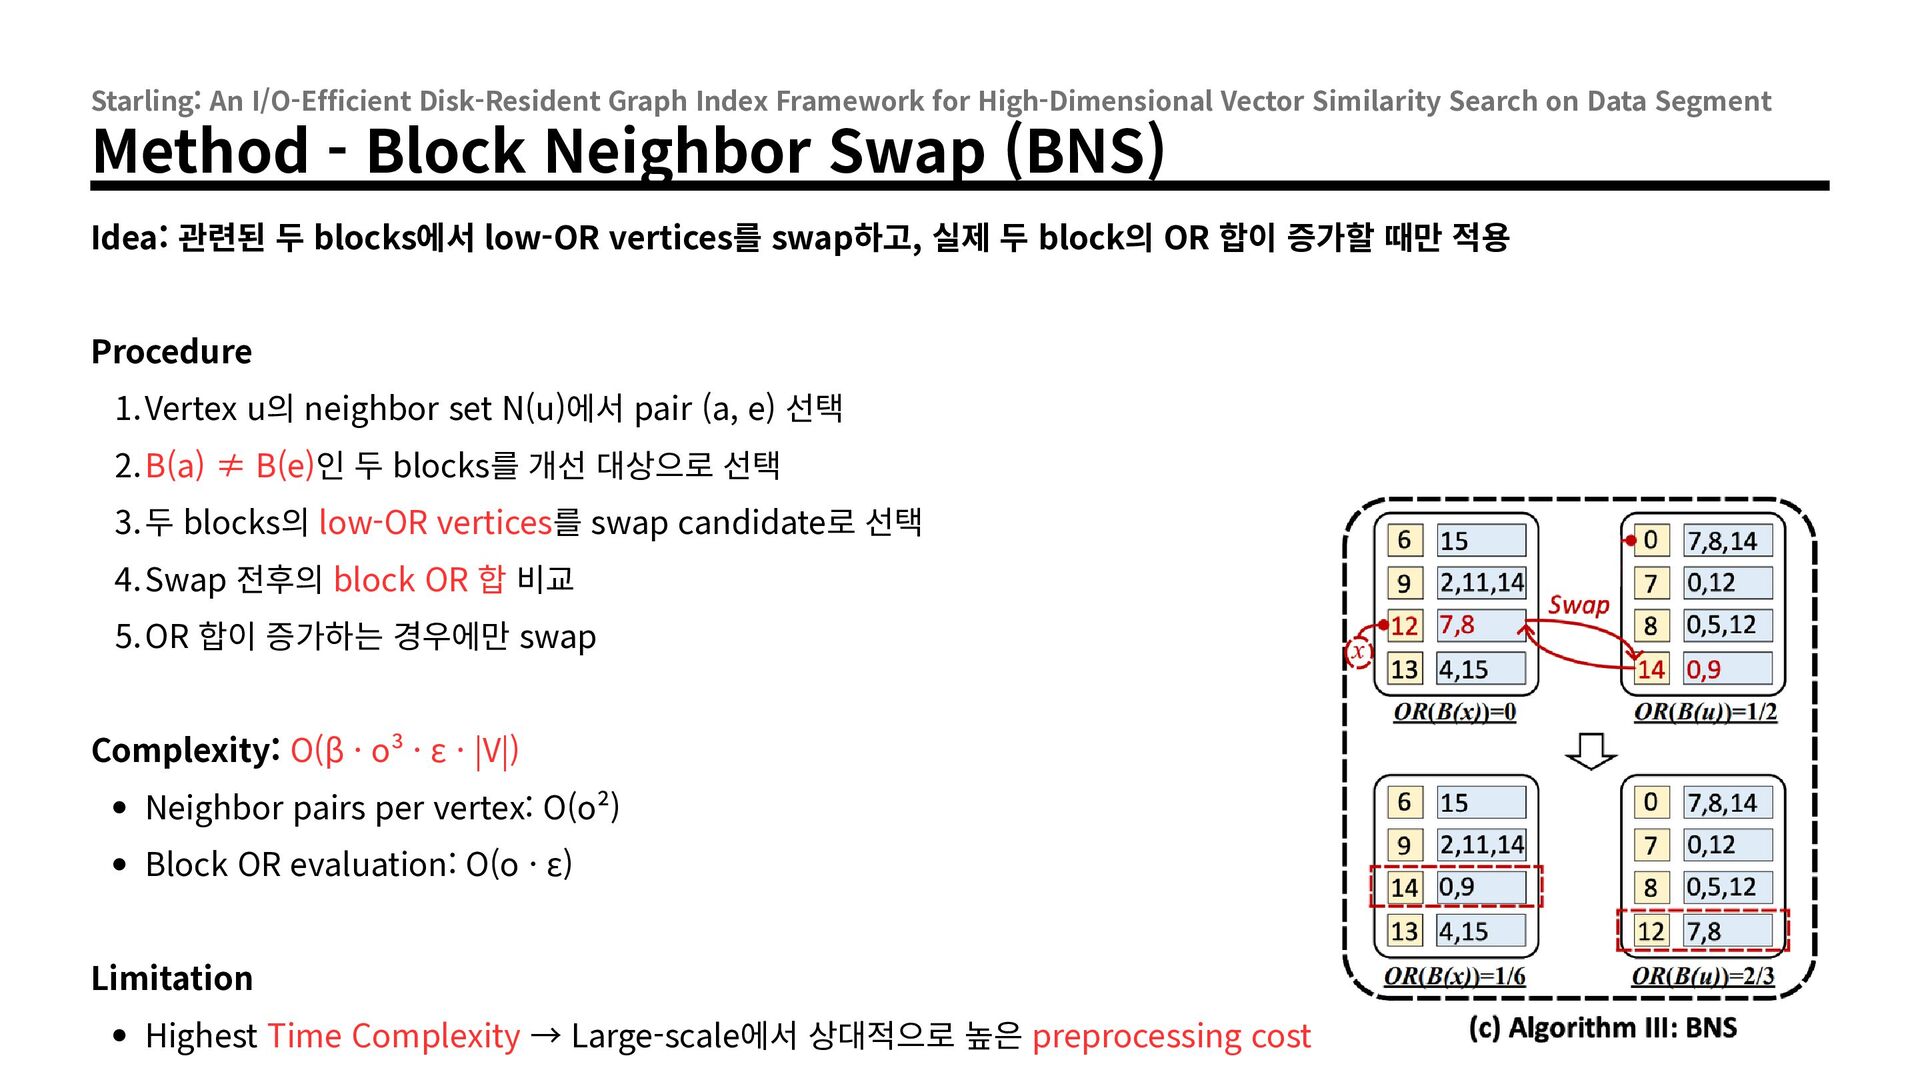
Similarity Search on Data Segment Method - Block Neighbor Swap (BNS) Idea: 관련된 두 blocks에서 low-OR vertices를 swap하고, 실제 두 block의 OR 합이 증가할 때만 적용 Procedure 1.Vertex u의 neighbor set N(u)에서 pair (a, e) 선택 2.B(a) ≠ B(e)인 두 blocks를 개선 대상으로 선택 3.두 blocks의 low-OR vertices를 swap candidate로 선택 4.Swap 전후의 block OR 합 비교 5.OR 합이 증가하는 경우에만 swap Complexity: O(β · o³ · ε · |V|) Neighbor pairs per vertex: O(o²) Block OR evaluation: O(o · ε) Limitation Highest Time Complexity → Large-scale에서 상대적으로 높은 preprocessing cost
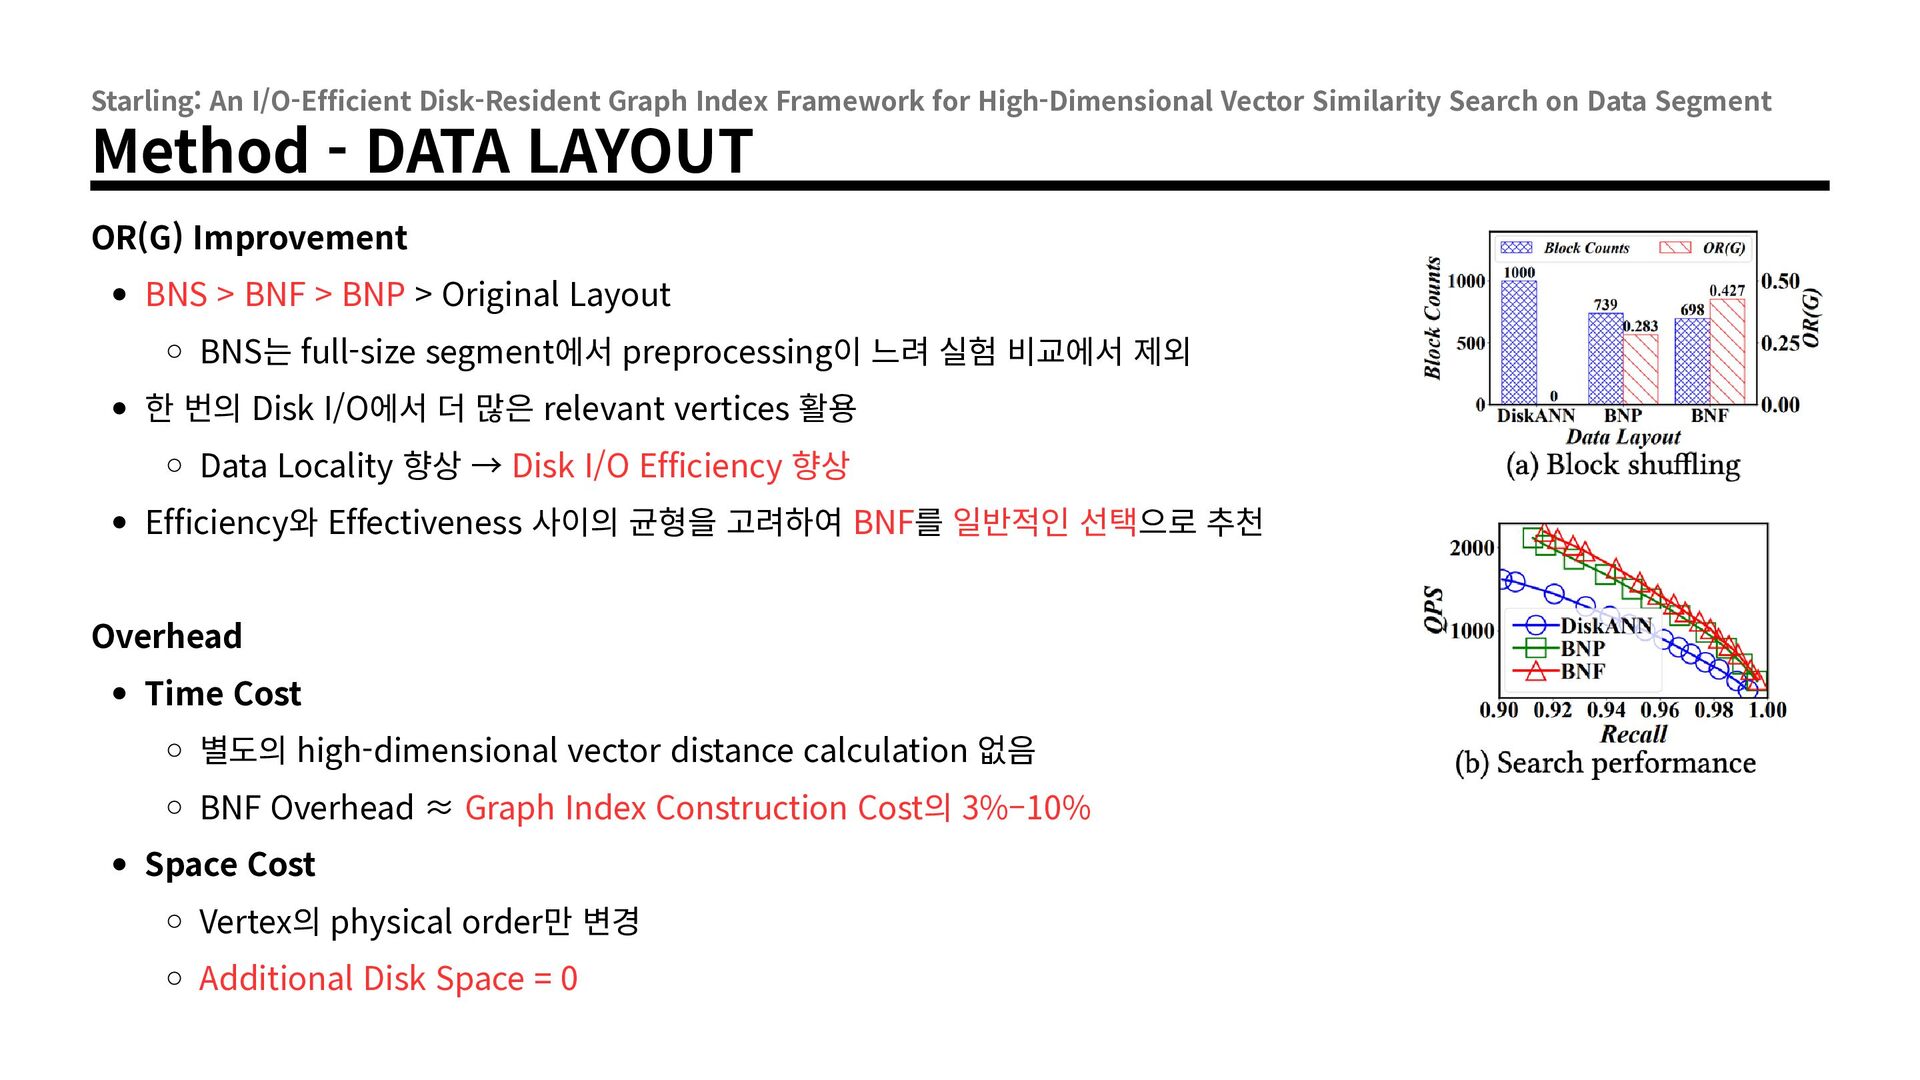
Similarity Search on Data Segment Method - DATA LAYOUT OR(G) Improvement BNS > BNF > BNP > Original Layout BNS는 full-size segment에서 preprocessing이 느려 실험 비교에서 제외 한 번의 Disk I/O에서 더 많은 relevant vertices 활용 Data Locality 향상 → Disk I/O Efficiency 향상 Efficiency와 Effectiveness 사이의 균형을 고려하여 BNF를 일반적인 선택으로 추천 Overhead Time Cost 별도의 high-dimensional vector distance calculation 없음 BNF Overhead ≈ Graph Index Construction Cost의 3%–10% Space Cost Vertex의 physical order만 변경 Additional Disk Space = 0
Similarity Search on Data Segment Method - Block Search Motivation Offline에서 graph neighbors가 같은 block에 위치하도록 재배치 한 번의 Disk I/O로 여러 relevant vertices를 함께 load but, 기존처럼 target vertex만 탐색하고 나머지를 버리면 개선된 Data Locality를 활용할 수 없음 Fundamental Block Search 한 번 읽어온 block의 non-target vertices까지 search에 활용 Limitation Block Search는 한 번의 Disk I/O에서 더 많은 데이터를 활용하지만, Irrelevant vertices에 대한 불필요한 computation Disk Read와 Distance Computation의 serial execution Block 밖 neighbors에 대한 추가 Disk I/O
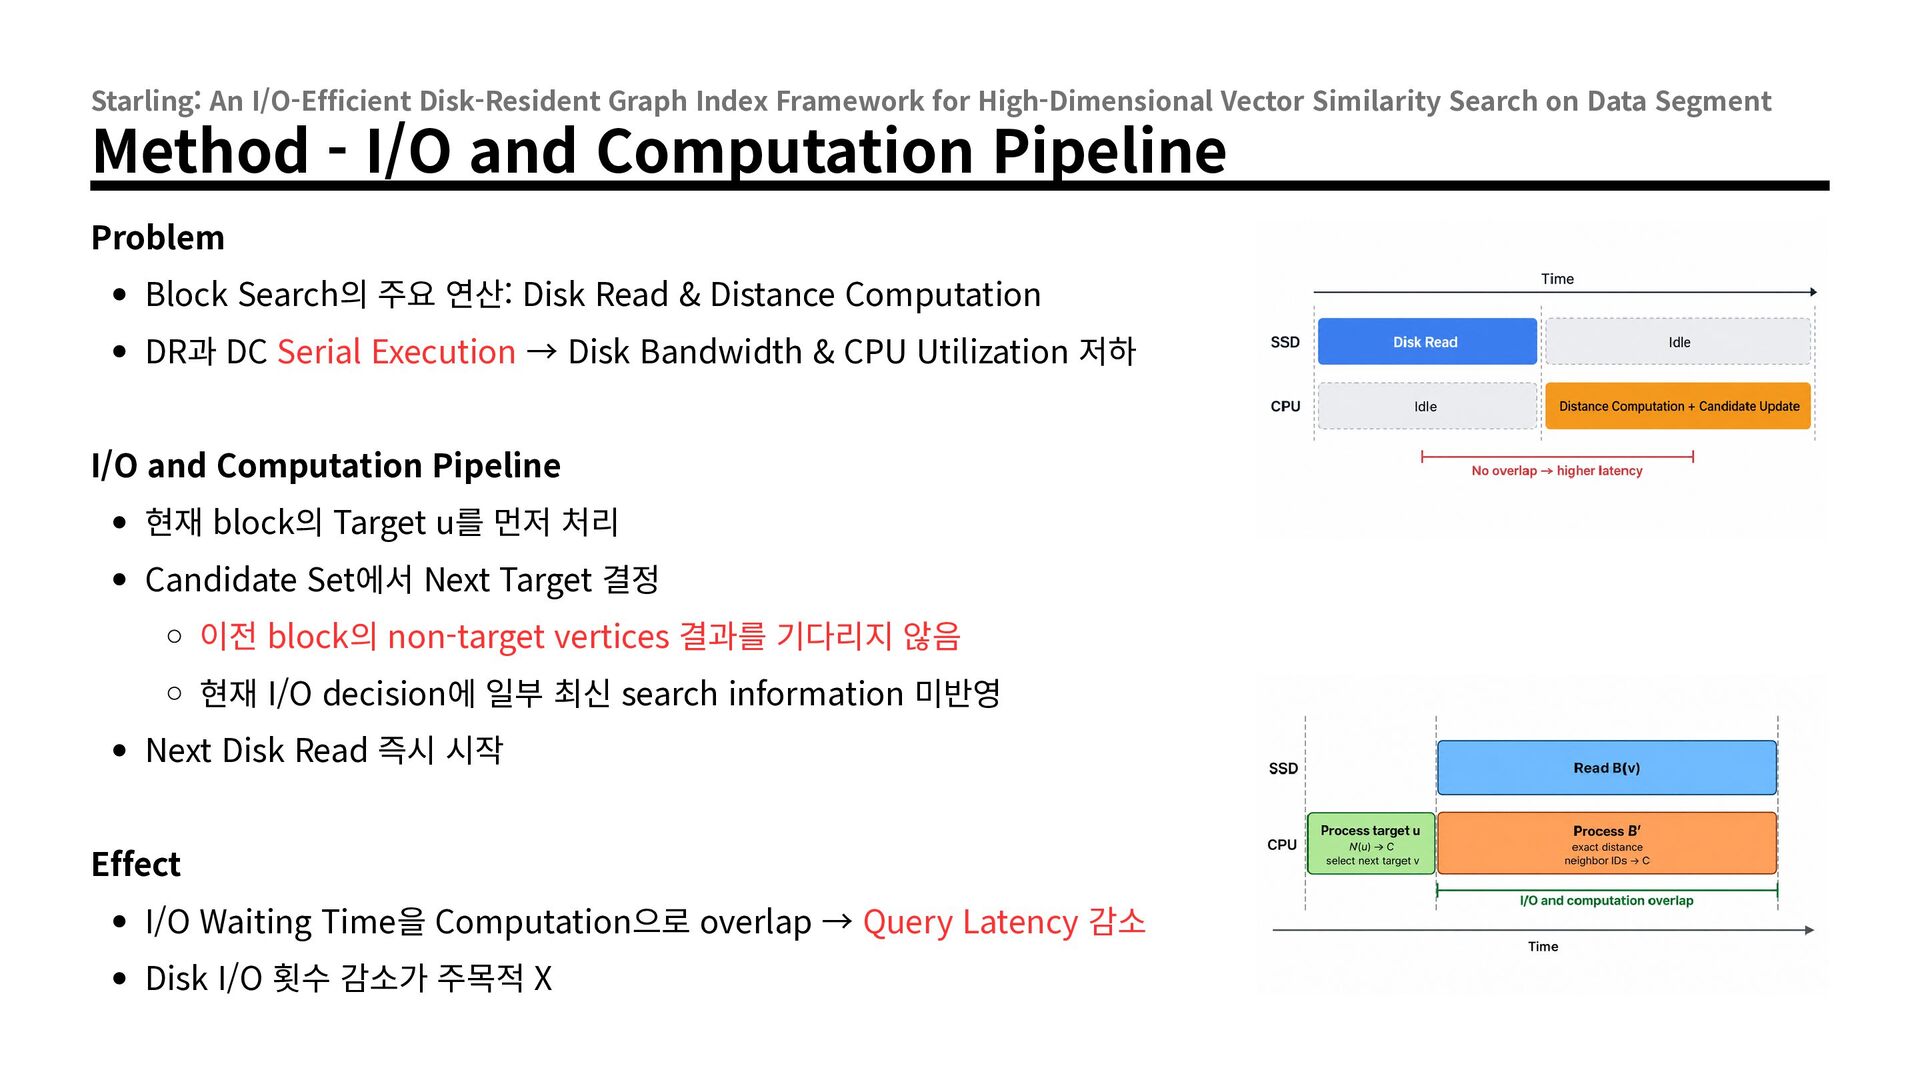
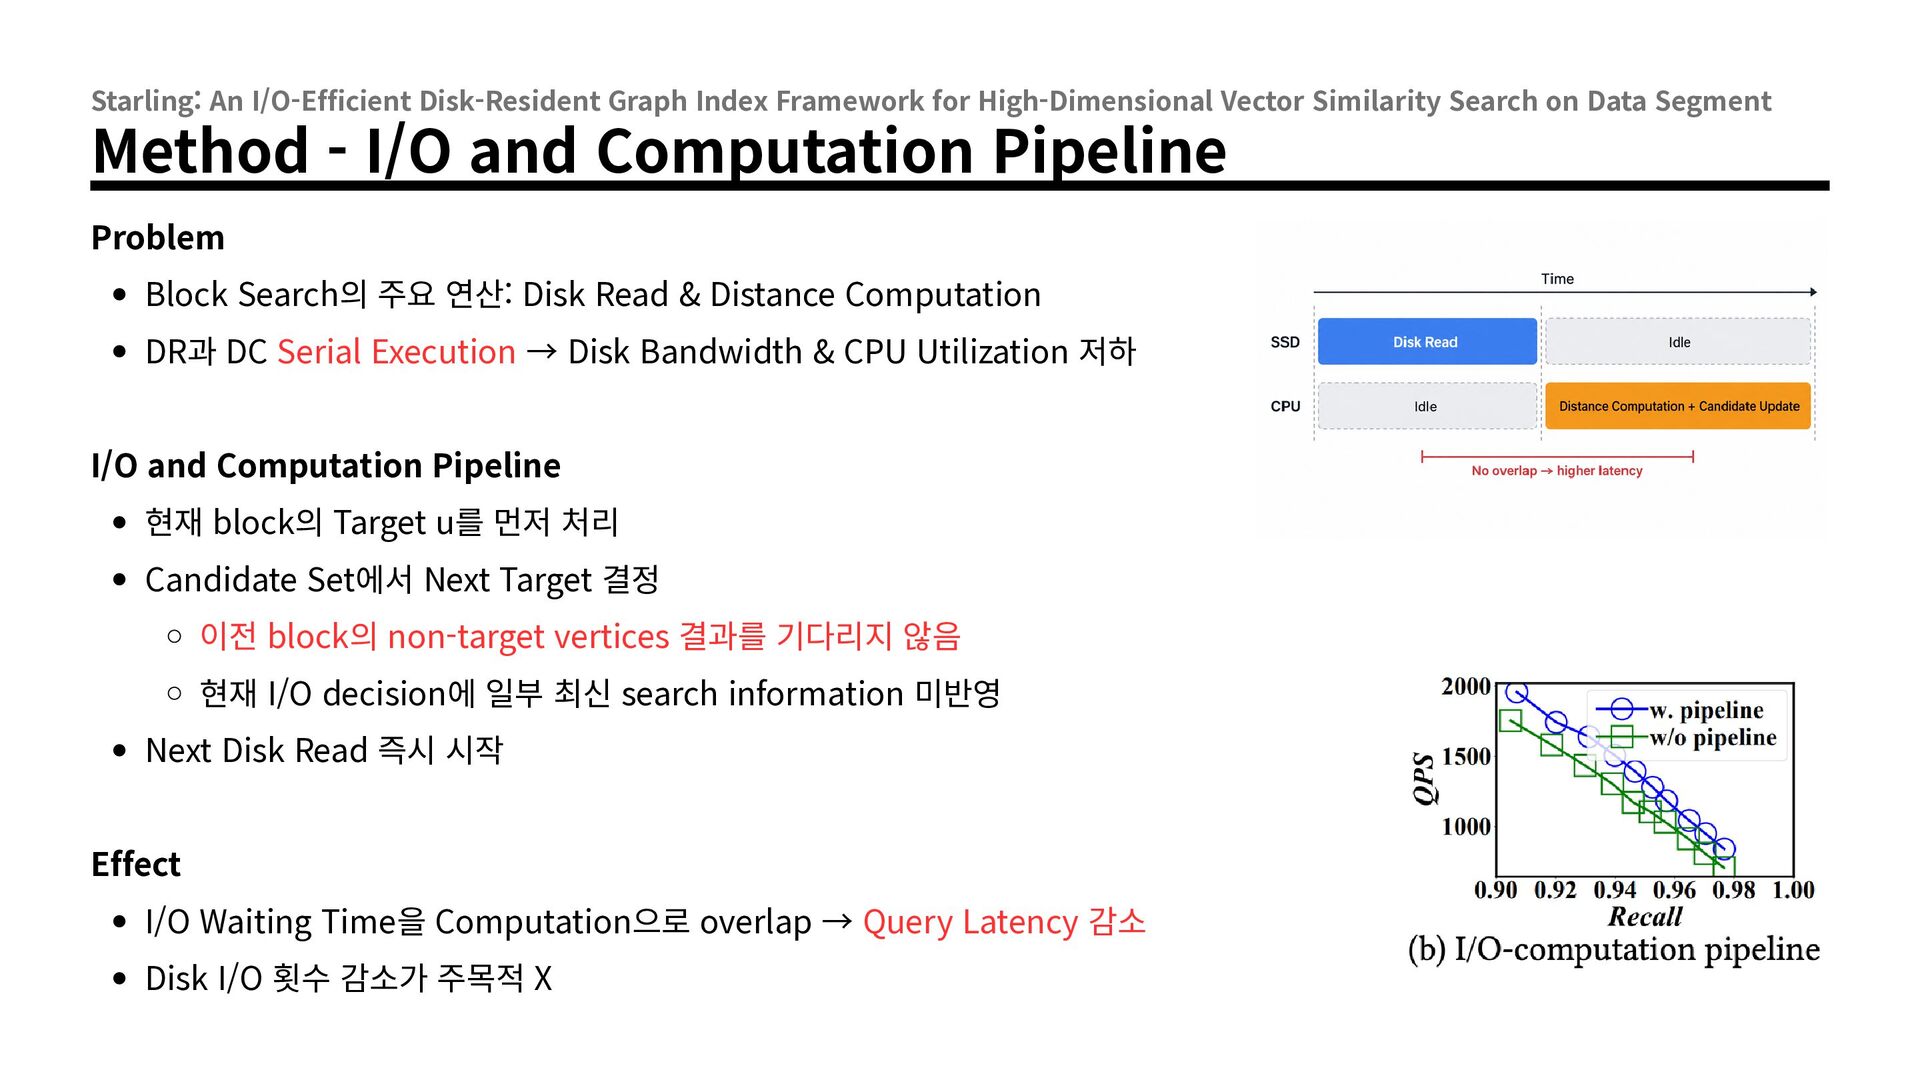
Similarity Search on Data Segment Method - I/O and Computation Pipeline Problem Block Search의 주요 연산: Disk Read & Distance Computation DR과 DC Serial Execution → Disk Bandwidth & CPU Utilization 저하 I/O and Computation Pipeline 현재 block의 Target u를 먼저 처리 Candidate Set에서 Next Target 결정 이전 block의 non-target vertices 결과를 기다리지 않음 현재 I/O decision에 일부 최신 search information 미반영 Next Disk Read 즉시 시작 Effect I/O Waiting Time을 Computation으로 overlap → Query Latency 감소 Disk I/O 횟수 감소가 주목적 X
Similarity Search on Data Segment Method - I/O and Computation Pipeline Problem Block Search의 주요 연산: Disk Read & Distance Computation DR과 DC Serial Execution → Disk Bandwidth & CPU Utilization 저하 I/O and Computation Pipeline 현재 block의 Target u를 먼저 처리 Candidate Set에서 Next Target 결정 이전 block의 non-target vertices 결과를 기다리지 않음 현재 I/O decision에 일부 최신 search information 미반영 Next Disk Read 즉시 시작 Effect I/O Waiting Time을 Computation으로 overlap → Query Latency 감소 Disk I/O 횟수 감소가 주목적 X
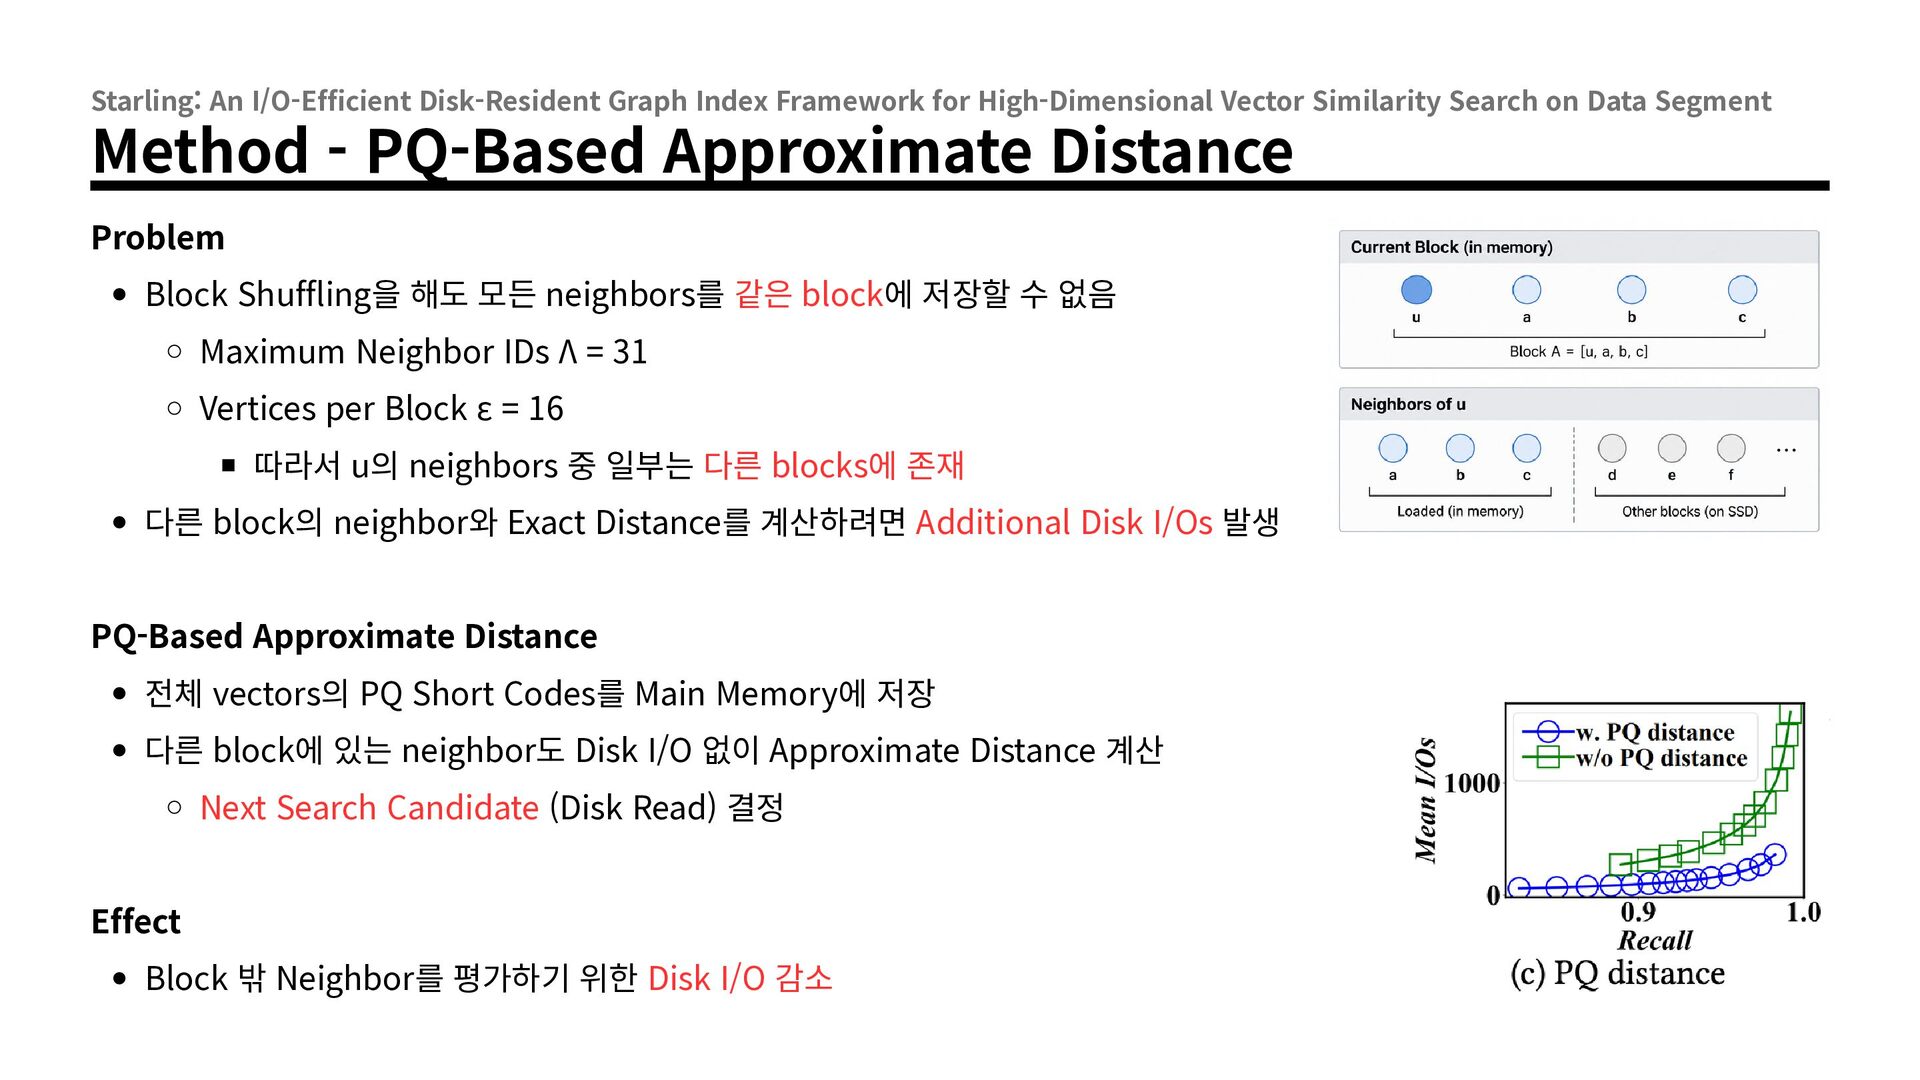
Similarity Search on Data Segment Method - PQ-Based Approximate Distance Problem Block Shuffling을 해도 모든 neighbors를 같은 block에 저장할 수 없음 Maximum Neighbor IDs Λ = 31 Vertices per Block ε = 16 따라서 u의 neighbors 중 일부는 다른 blocks에 존재 다른 block의 neighbor와 Exact Distance를 계산하려면 Additional Disk I/Os 발생 PQ-Based Approximate Distance 전체 vectors의 PQ Short Codes를 Main Memory에 저장 다른 block에 있는 neighbor도 Disk I/O 없이 Approximate Distance 계산 Next Search Candidate (Disk Read) 결정 Effect Block 밖 Neighbor를 평가하기 위한 Disk I/O 감소
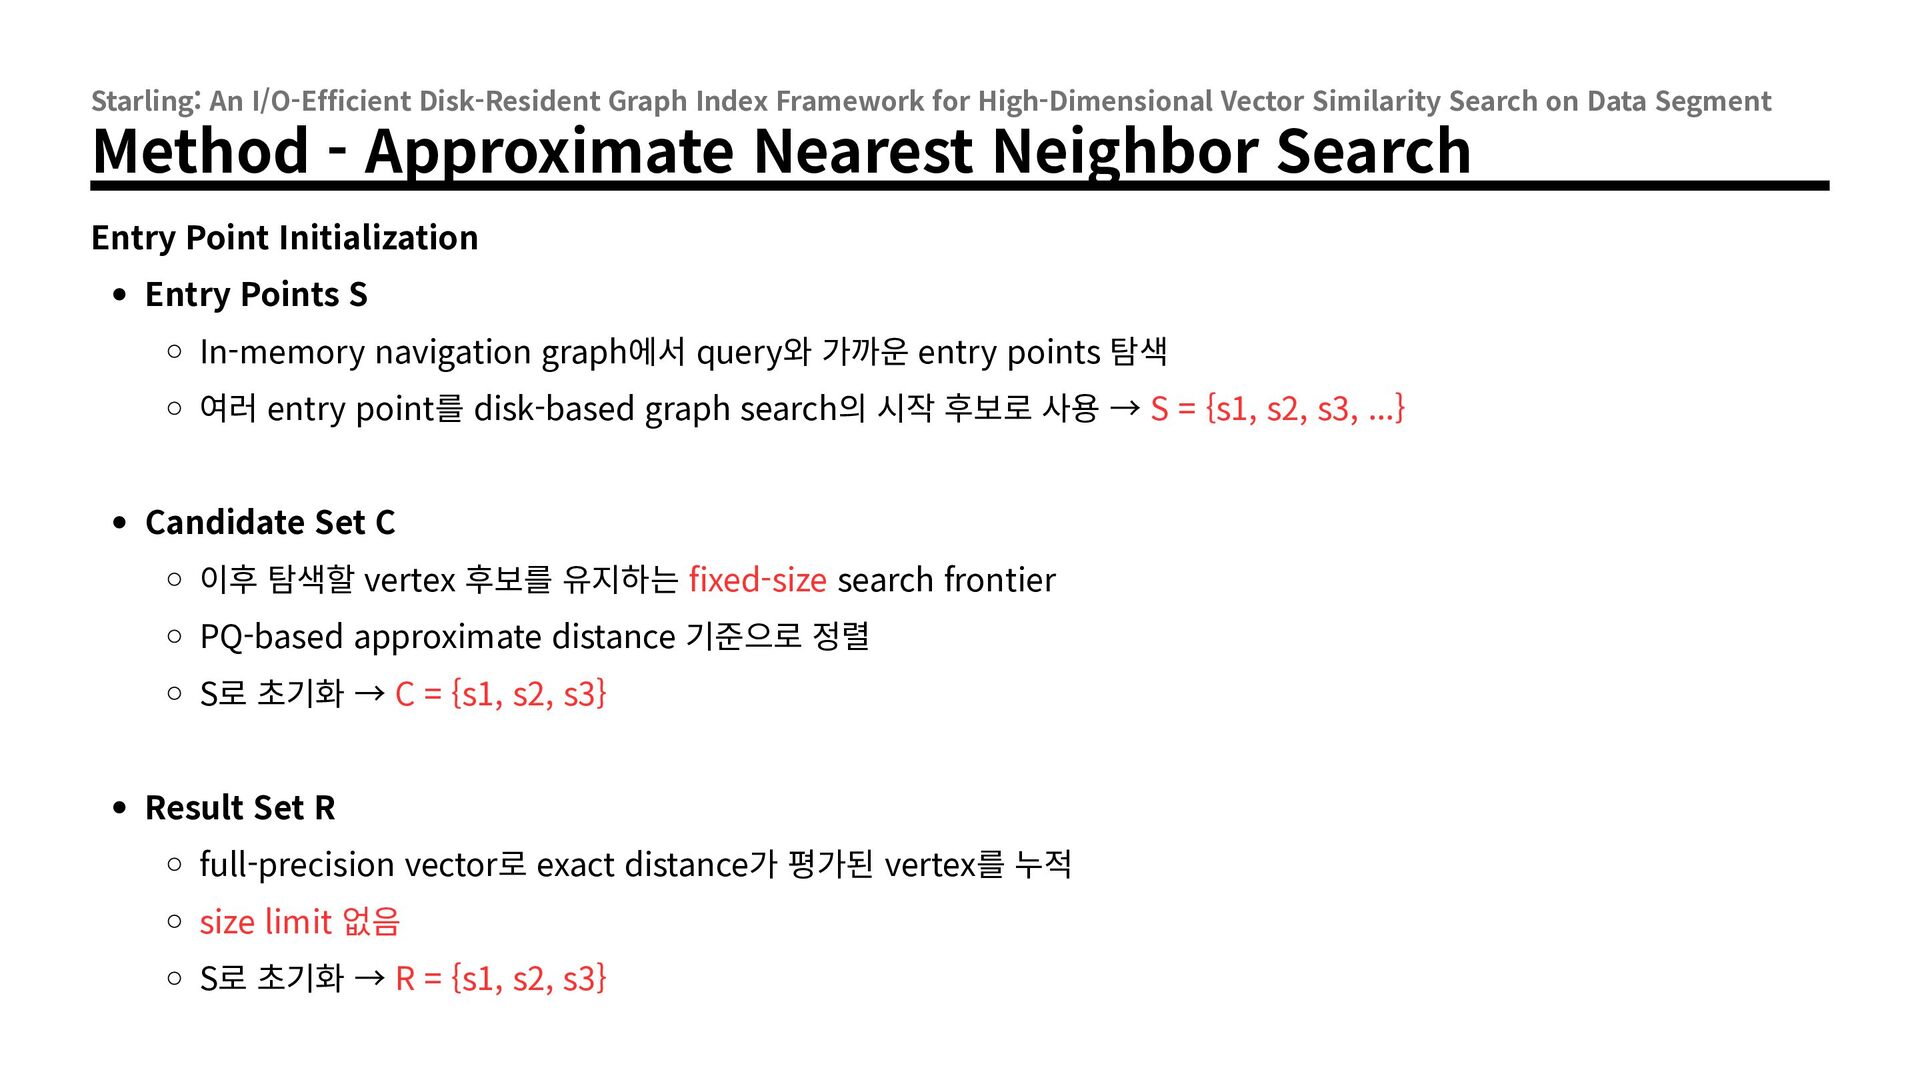
Similarity Search on Data Segment Method - Approximate Nearest Neighbor Search Entry Point Initialization Entry Points S In-memory navigation graph에서 query와 가까운 entry points 탐색 여러 entry point를 disk-based graph search의 시작 후보로 사용 → S = {s1, s2, s3, ...} Candidate Set C 이후 탐색할 vertex 후보를 유지하는 fixed-size search frontier PQ-based approximate distance 기준으로 정렬 S로 초기화 → C = {s1, s2, s3} Result Set R full-precision vector로 exact distance가 평가된 vertex를 누적 size limit 없음 S로 초기화 → R = {s1, s2, s3}
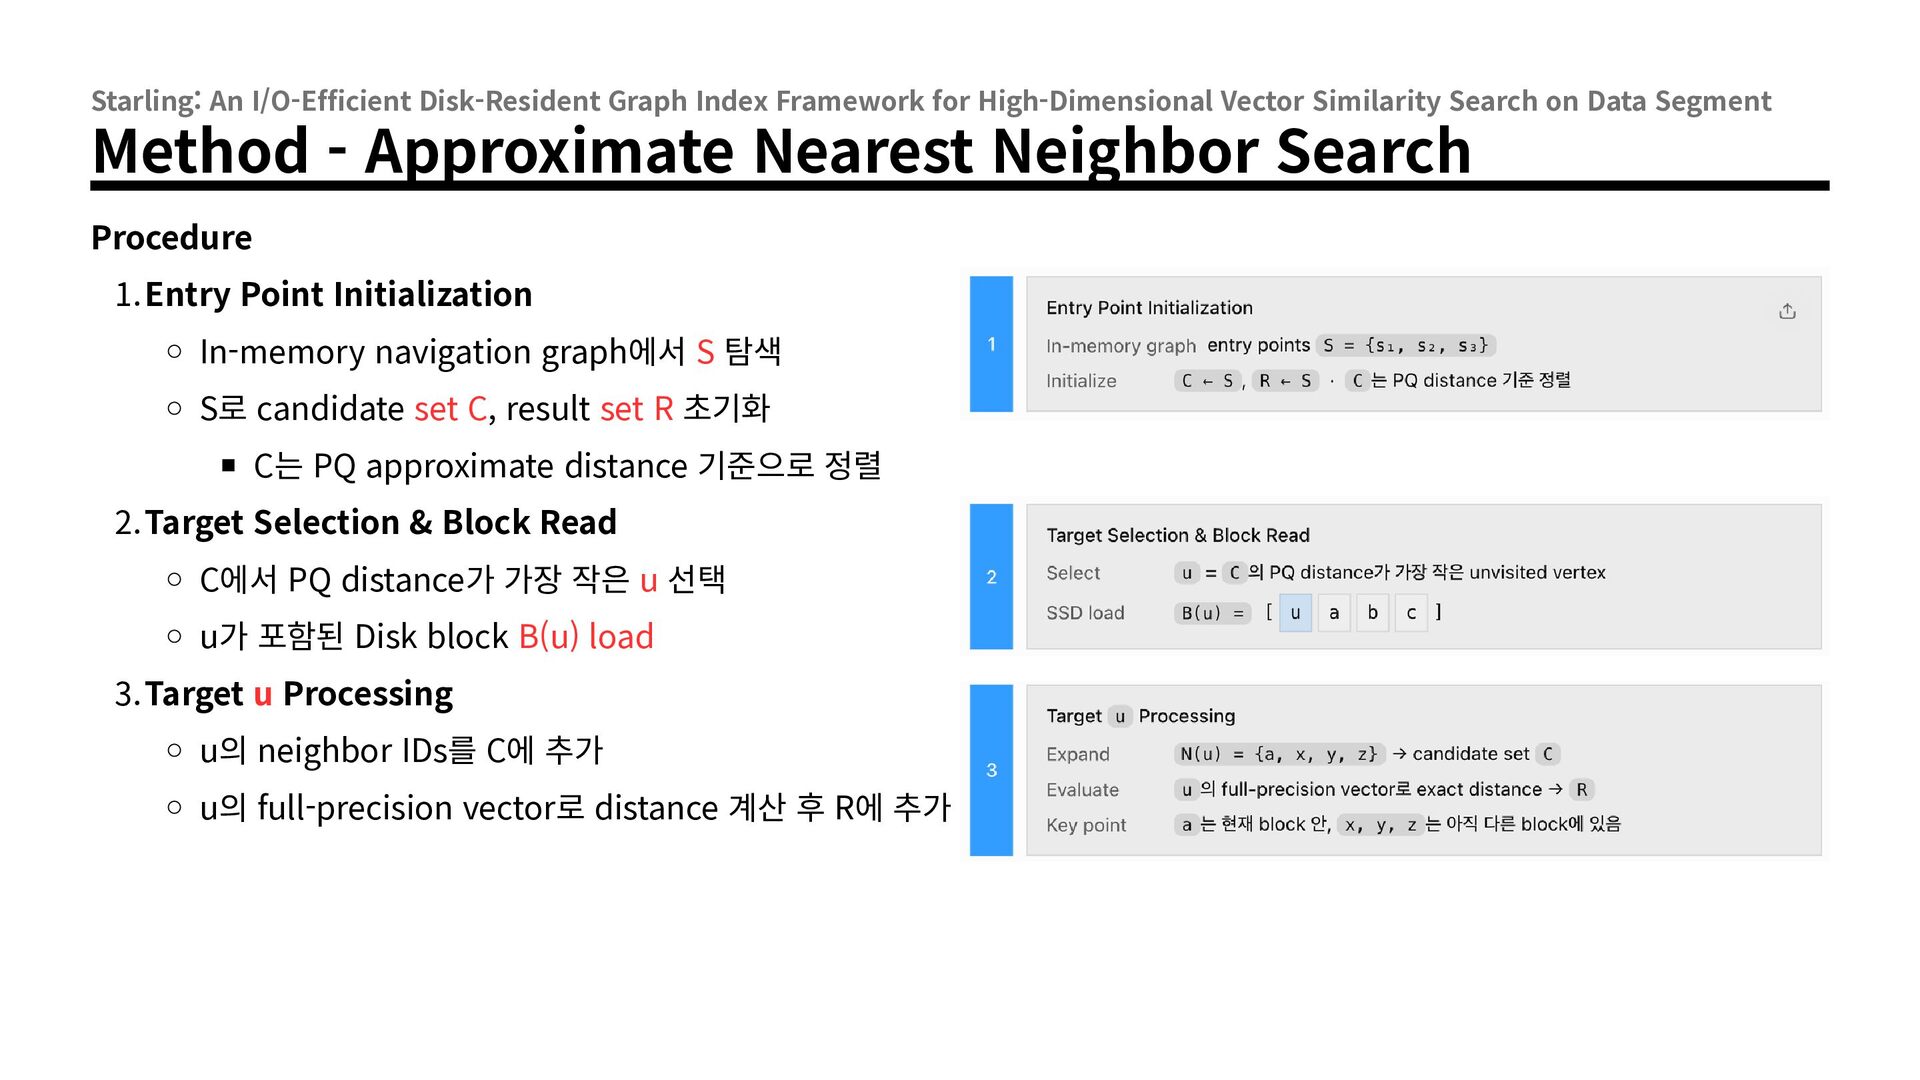
Similarity Search on Data Segment Method - Approximate Nearest Neighbor Search Procedure 1.Entry Point Initialization In-memory navigation graph에서 S 탐색 S로 candidate set C, result set R 초기화 C는 PQ approximate distance 기준으로 정렬 2.Target Selection & Block Read C에서 PQ distance가 가장 작은 u 선택 u가 포함된 Disk block B(u) load 3.Target u Processing u의 neighbor IDs를 C에 추가 u의 full-precision vector로 distance 계산 후 R에 추가
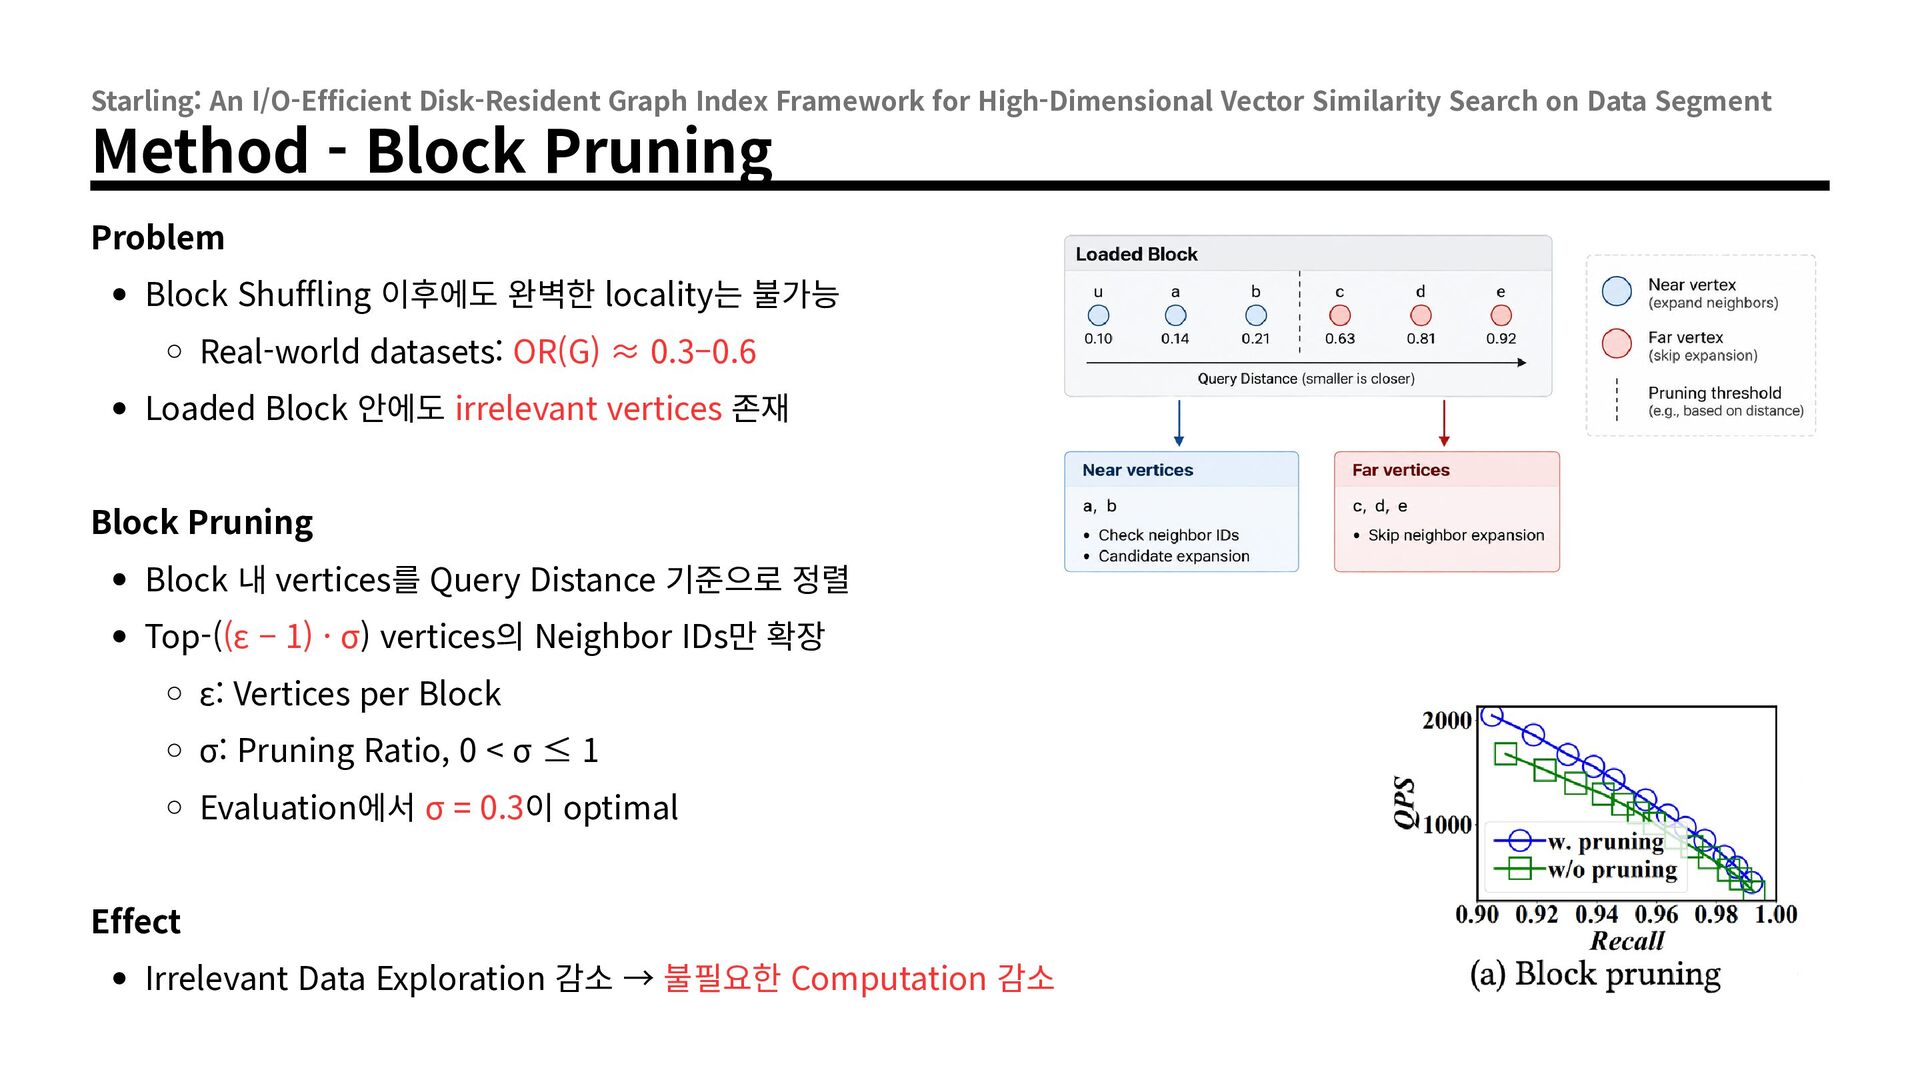
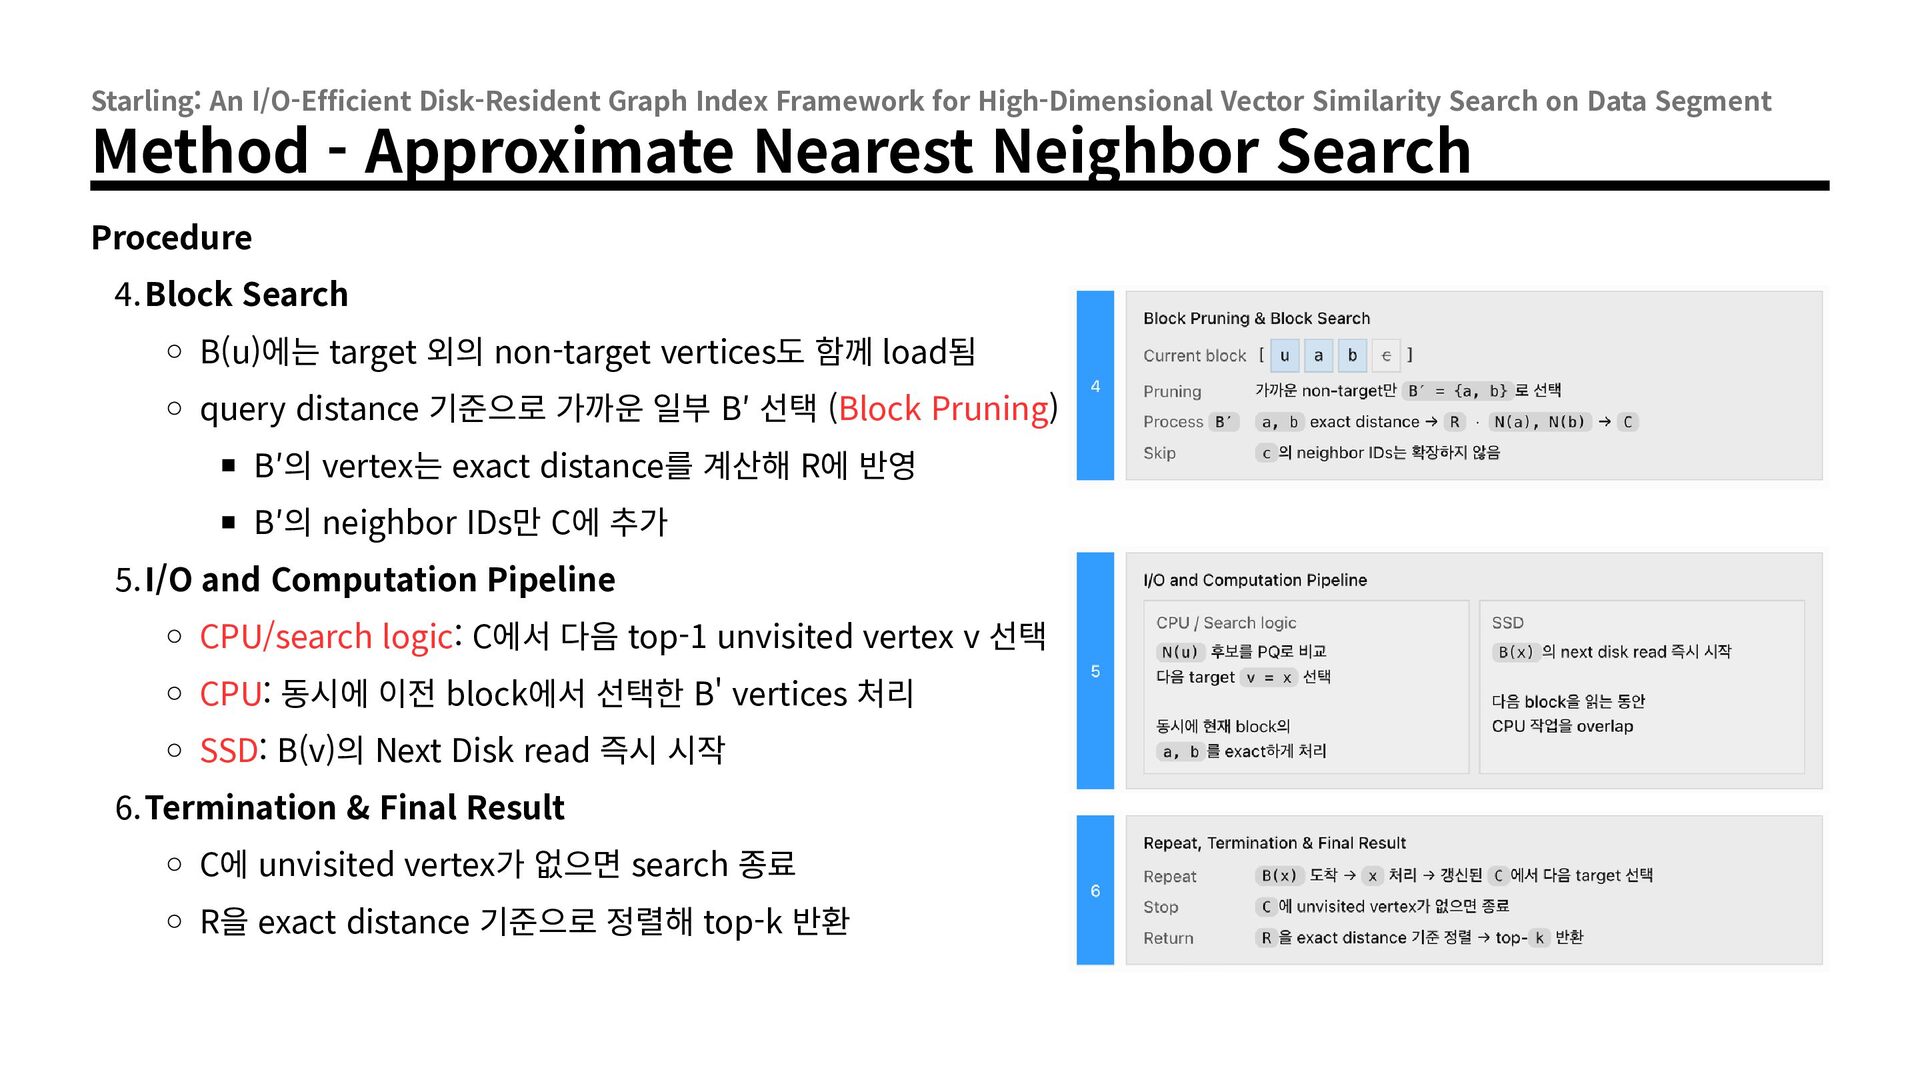
Similarity Search on Data Segment Method - Approximate Nearest Neighbor Search Procedure 4.Block Search B(u)에는 target 외의 non-target vertices도 함께 load됨 query distance 기준으로 가까운 일부 B′ 선택 (Block Pruning) B′의 vertex는 exact distance를 계산해 R에 반영 B′의 neighbor IDs만 C에 추가 5.I/O and Computation Pipeline CPU/search logic: C에서 다음 top-1 unvisited vertex v 선택 CPU: 동시에 이전 block에서 선택한 B' vertices 처리 SSD: B(v)의 Next Disk read 즉시 시작 6.Termination & Final Result C에 unvisited vertex가 없으면 search 종료 R을 exact distance 기준으로 정렬해 top-k 반환
Similarity Search on Data Segment Method - Range Search Range Search (RS) Search Radius r 이내의 모든 vectors를 반환 같은 radius r에서도 query마다 result length가 0~thousands로 달라짐 Naive Approach Result Length를 모르기 때문에 k를 증가시키며 ANNS 반복 k = 10 → 20 → 30 → ... Problem 동일한 vertices를 반복적으로 탐색 Extra Computation → Extra Disk I/Os
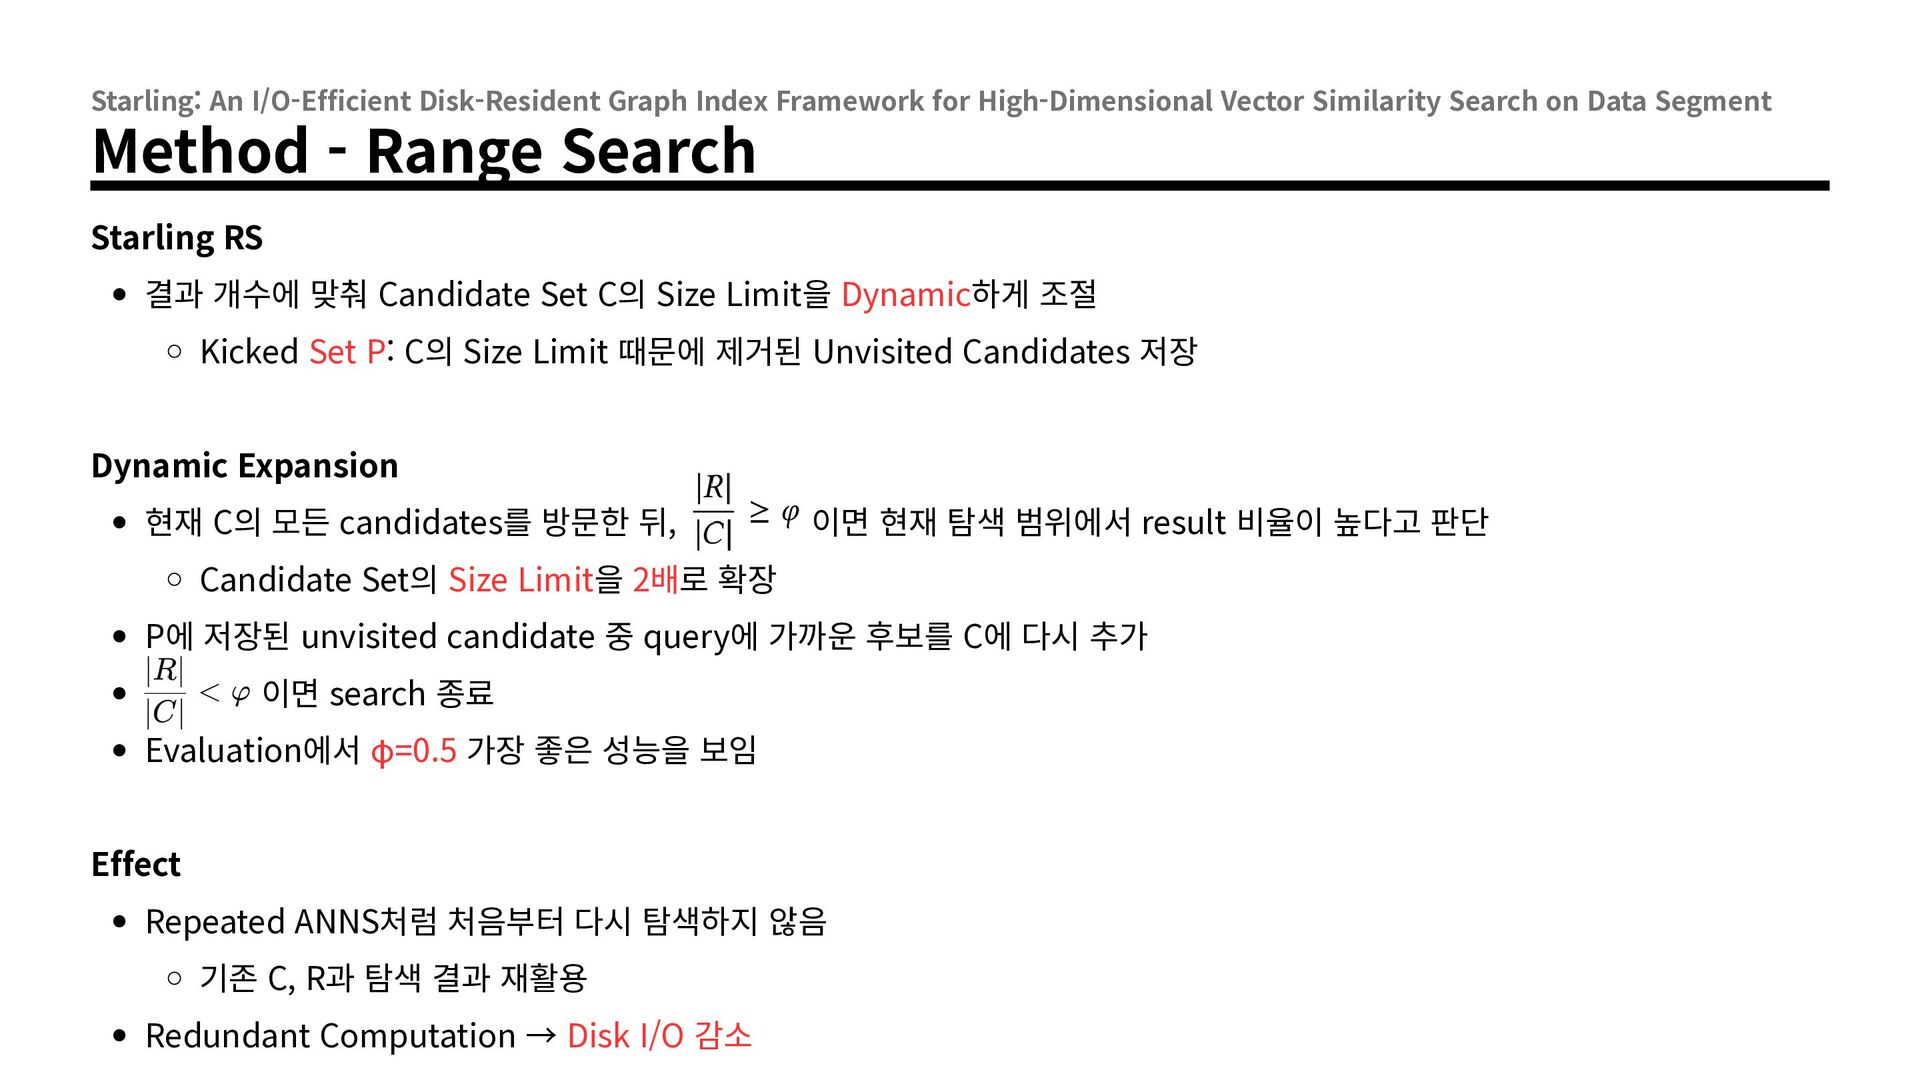
Similarity Search on Data Segment Method - Range Search Starling RS 결과 개수에 맞춰 Candidate Set C의 Size Limit을 Dynamic하게 조절 Kicked Set P: C의 Size Limit 때문에 제거된 Unvisited Candidates 저장 Dynamic Expansion 현재 C의 모든 candidates를 방문한 뒤, 이면 현재 탐색 범위에서 result 비율이 높다고 판단 Candidate Set의 Size Limit을 2배로 확장 P에 저장된 unvisited candidate 중 query에 가까운 후보를 C에 다시 추가 이면 search 종료 Evaluation에서 φ=0.5 가장 좋은 성능을 보임 Effect Repeated ANNS처럼 처음부터 다시 탐색하지 않음 기존 C, R과 탐색 결과 재활용 Redundant Computation → Disk I/O 감소
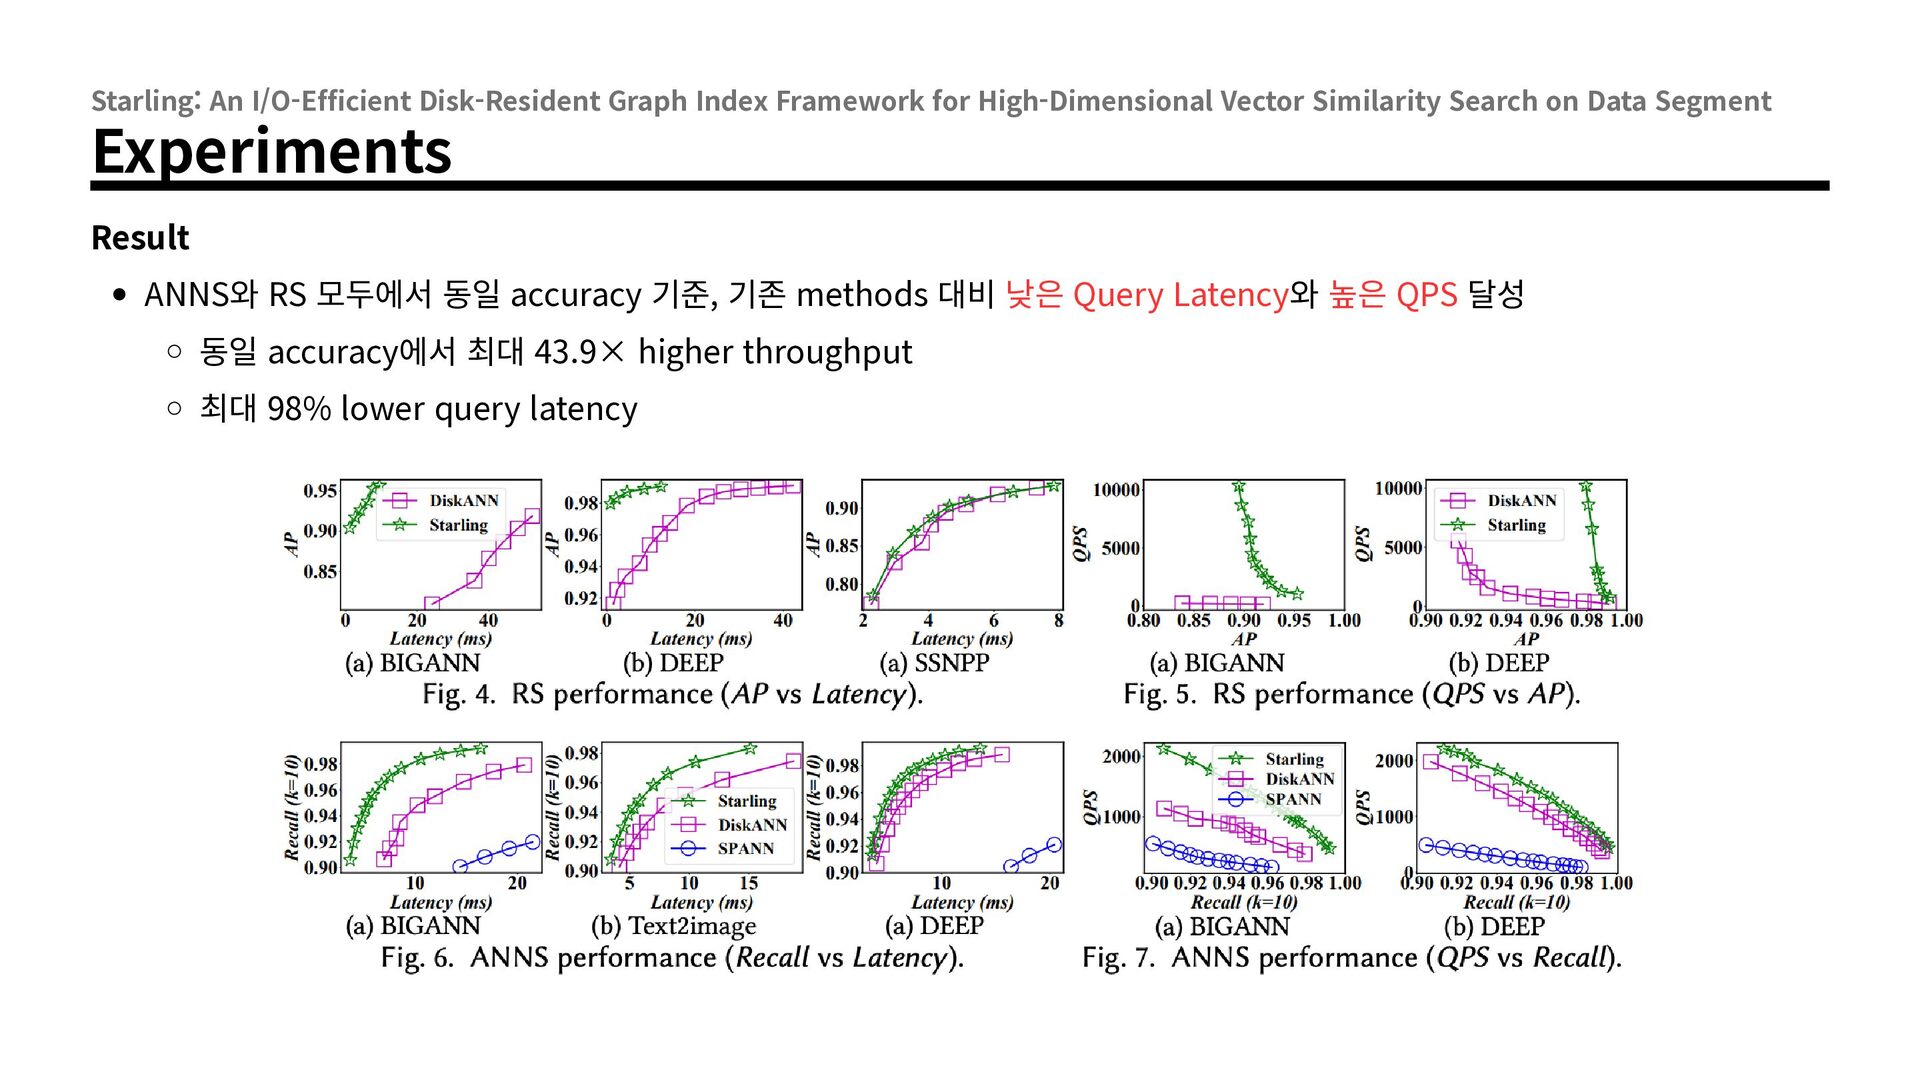
Similarity Search on Data Segment Experiments Result ANNS와 RS 모두에서 동일 accuracy 기준, 기존 methods 대비 낮은 Query Latency와 높은 QPS 달성 동일 accuracy에서 최대 43.9× higher throughput 최대 98% lower query latency
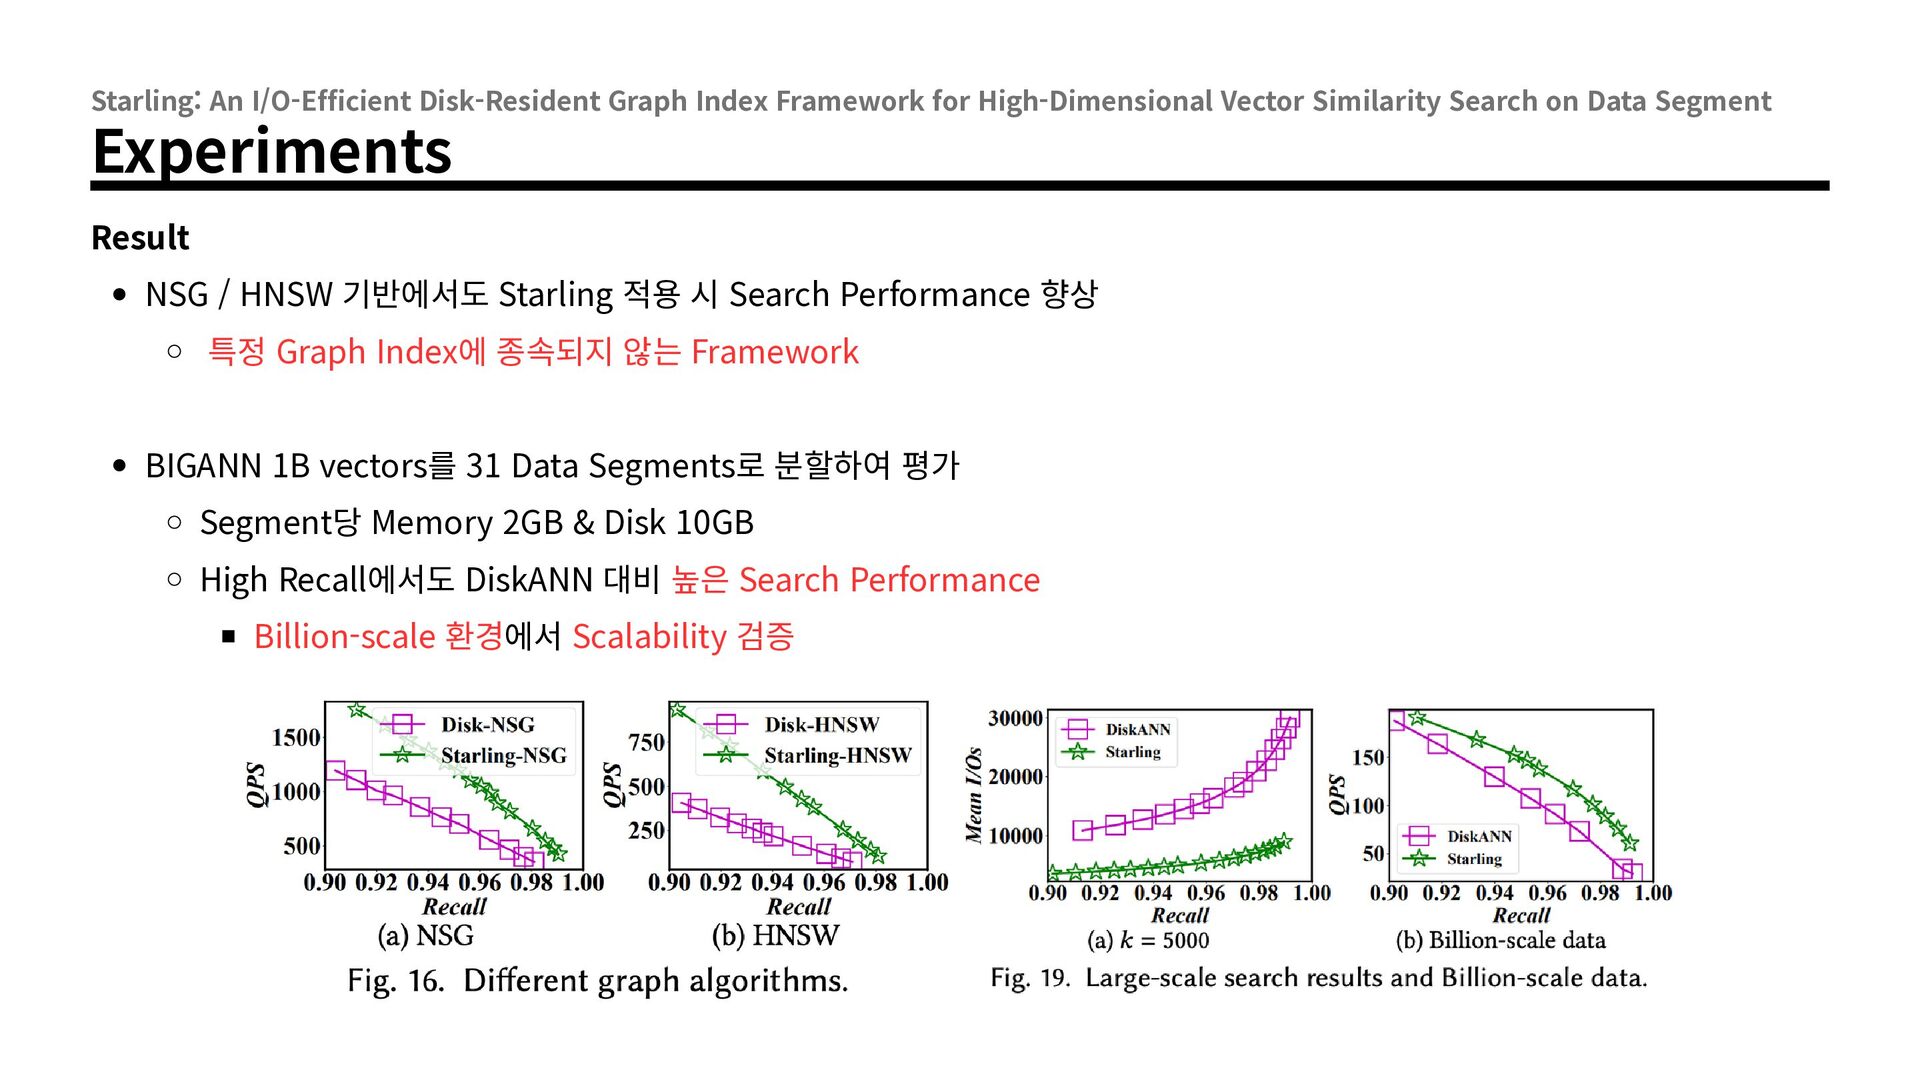
Similarity Search on Data Segment Experiments Result NSG / HNSW 기반에서도 Starling 적용 시 Search Performance 향상 특정 Graph Index에 종속되지 않는 Framework BIGANN 1B vectors를 31 Data Segments로 분할하여 평가 Segment당 Memory 2GB & Disk 10GB High Recall에서도 DiskANN 대비 높은 Search Performance Billion-scale 환경에서 Scalability 검증
Similarity Search on Data Segment Conclusion Starling Data Segment 환경의 I/O-efficient Disk-Resident Graph Index Framework 기존 Graph Topology를 유지하면서 Data Layout + Search Strategy 최적화 Key Idea Search Path Length ℓ ↓ → In-Memory Navigation Graph Vertex Utilization Ratio ξ ↑ → Block Shuffling + Block Search Effect 불필요한 Disk I/O 감소 State-of-the-art methods 대비 Search Performance 향상 Small Space Overhead 유지


 nawkwoo
 kentaitakura
 hotchpotch
 kzmssk
 junkashihara
 kohlerjohannes
 mickey_0226
 satai
 shibuiwilliam
 gpeyre
 institutdelelevage
 junkurihara
 palkan
 seathinner
 bcantrill
 inesmontani
 chriscoyier
 3n
 marketingsoph
 bkeepers
 afnizarnur
 varn
 mayunak