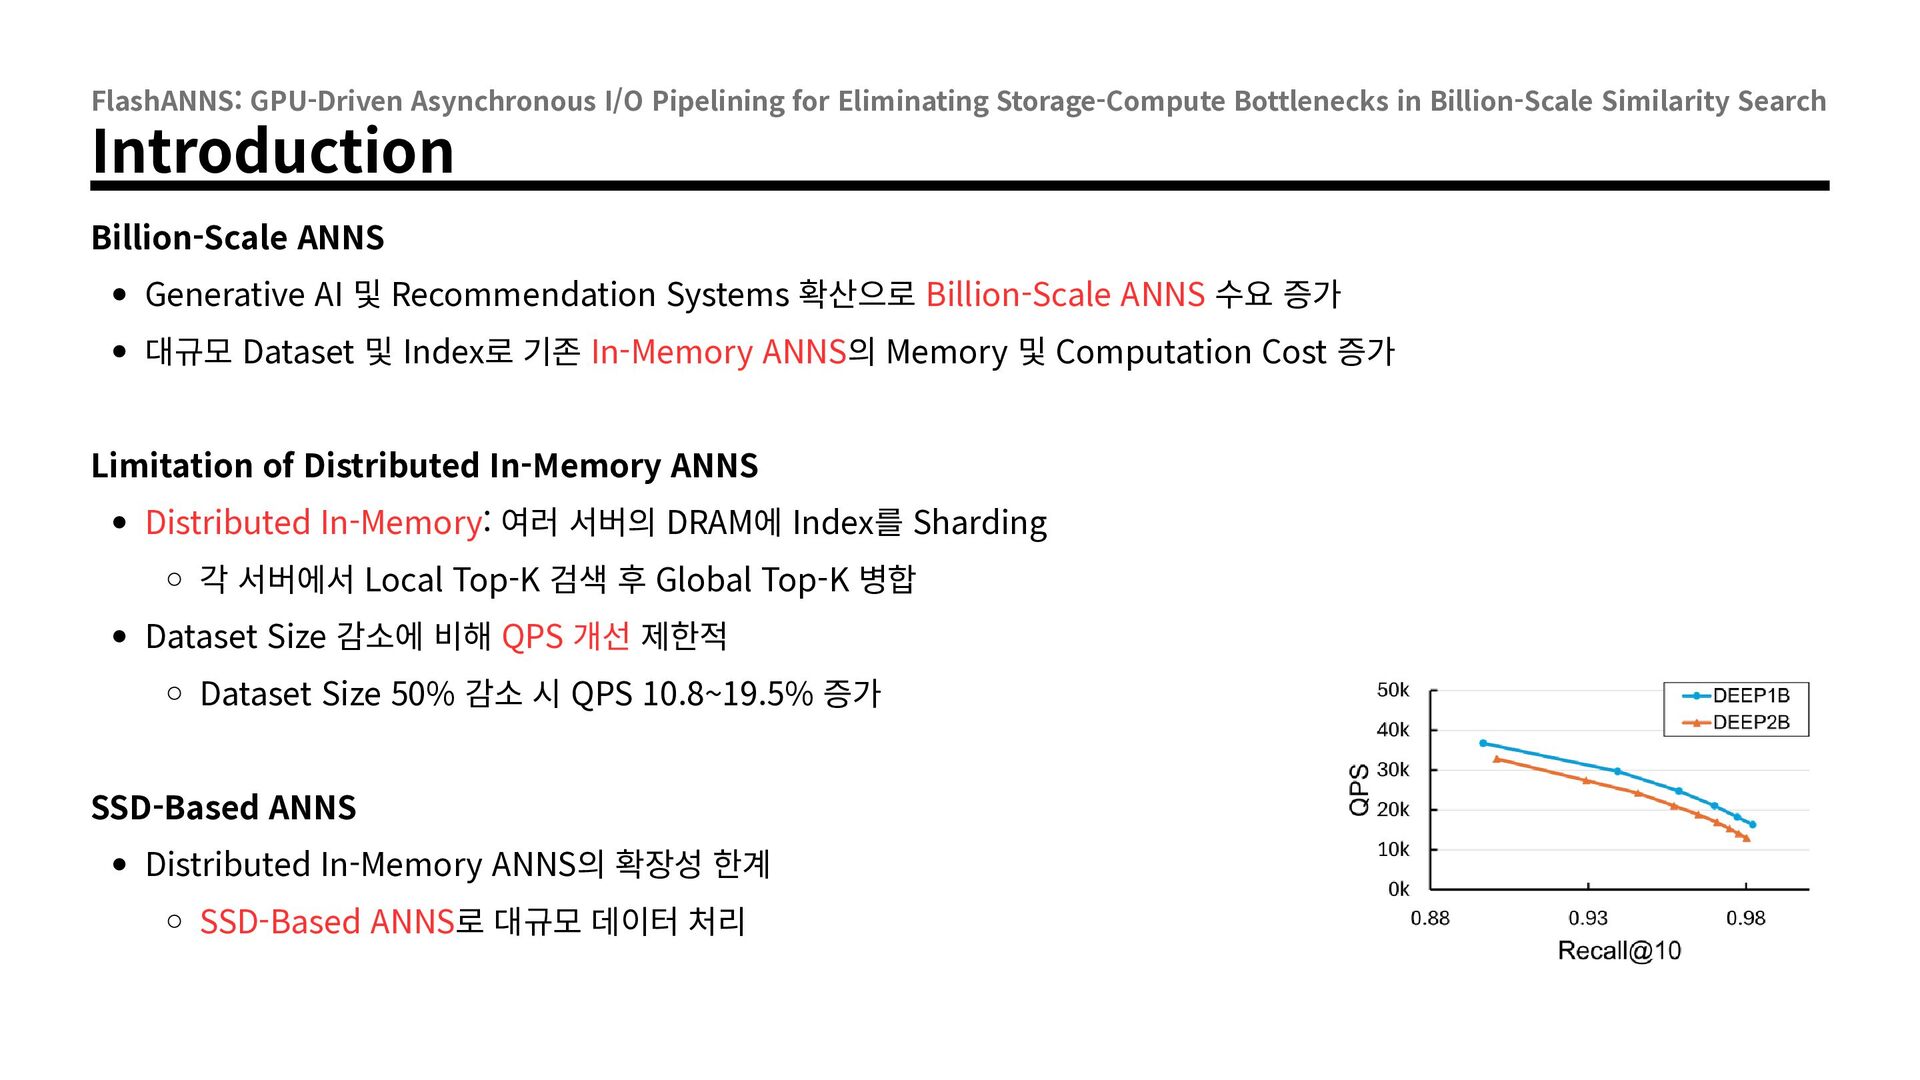
Billion-Scale Similarity Search Introduction Billion-Scale ANNS Generative AI 및 Recommendation Systems 확산으로 Billion-Scale ANNS 수요 증가 대규모 Dataset 및 Index로 기존 In-Memory ANNS의 Memory 및 Computation Cost 증가 Limitation of Distributed In-Memory ANNS Distributed In-Memory: 여러 서버의 DRAM에 Index를 Sharding 각 서버에서 Local Top-K 검색 후 Global Top-K 병합 Dataset Size 감소에 비해 QPS 개선 제한적 Dataset Size 50% 감소 시 QPS 10.8~19.5% 증가 SSD-Based ANNS Distributed In-Memory ANNS의 확장성 한계 SSD-Based ANNS로 대규모 데이터 처리
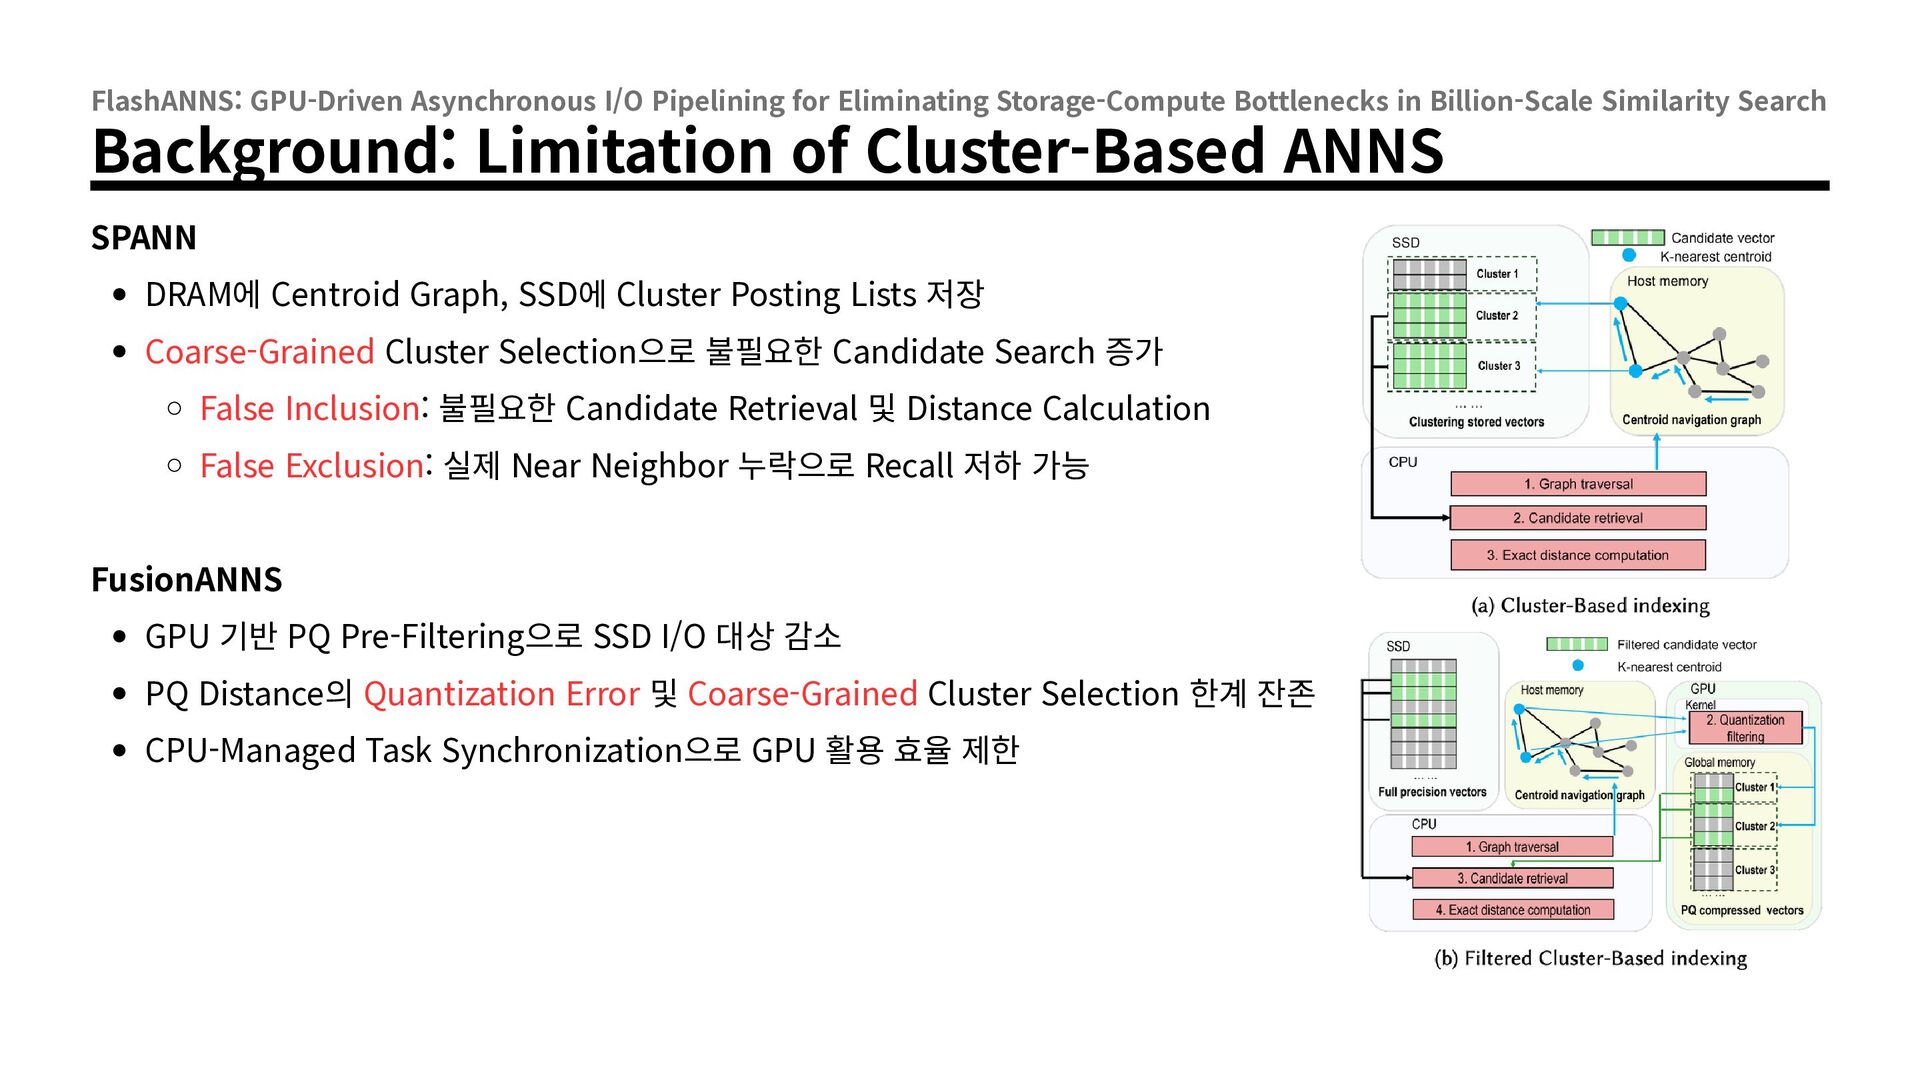
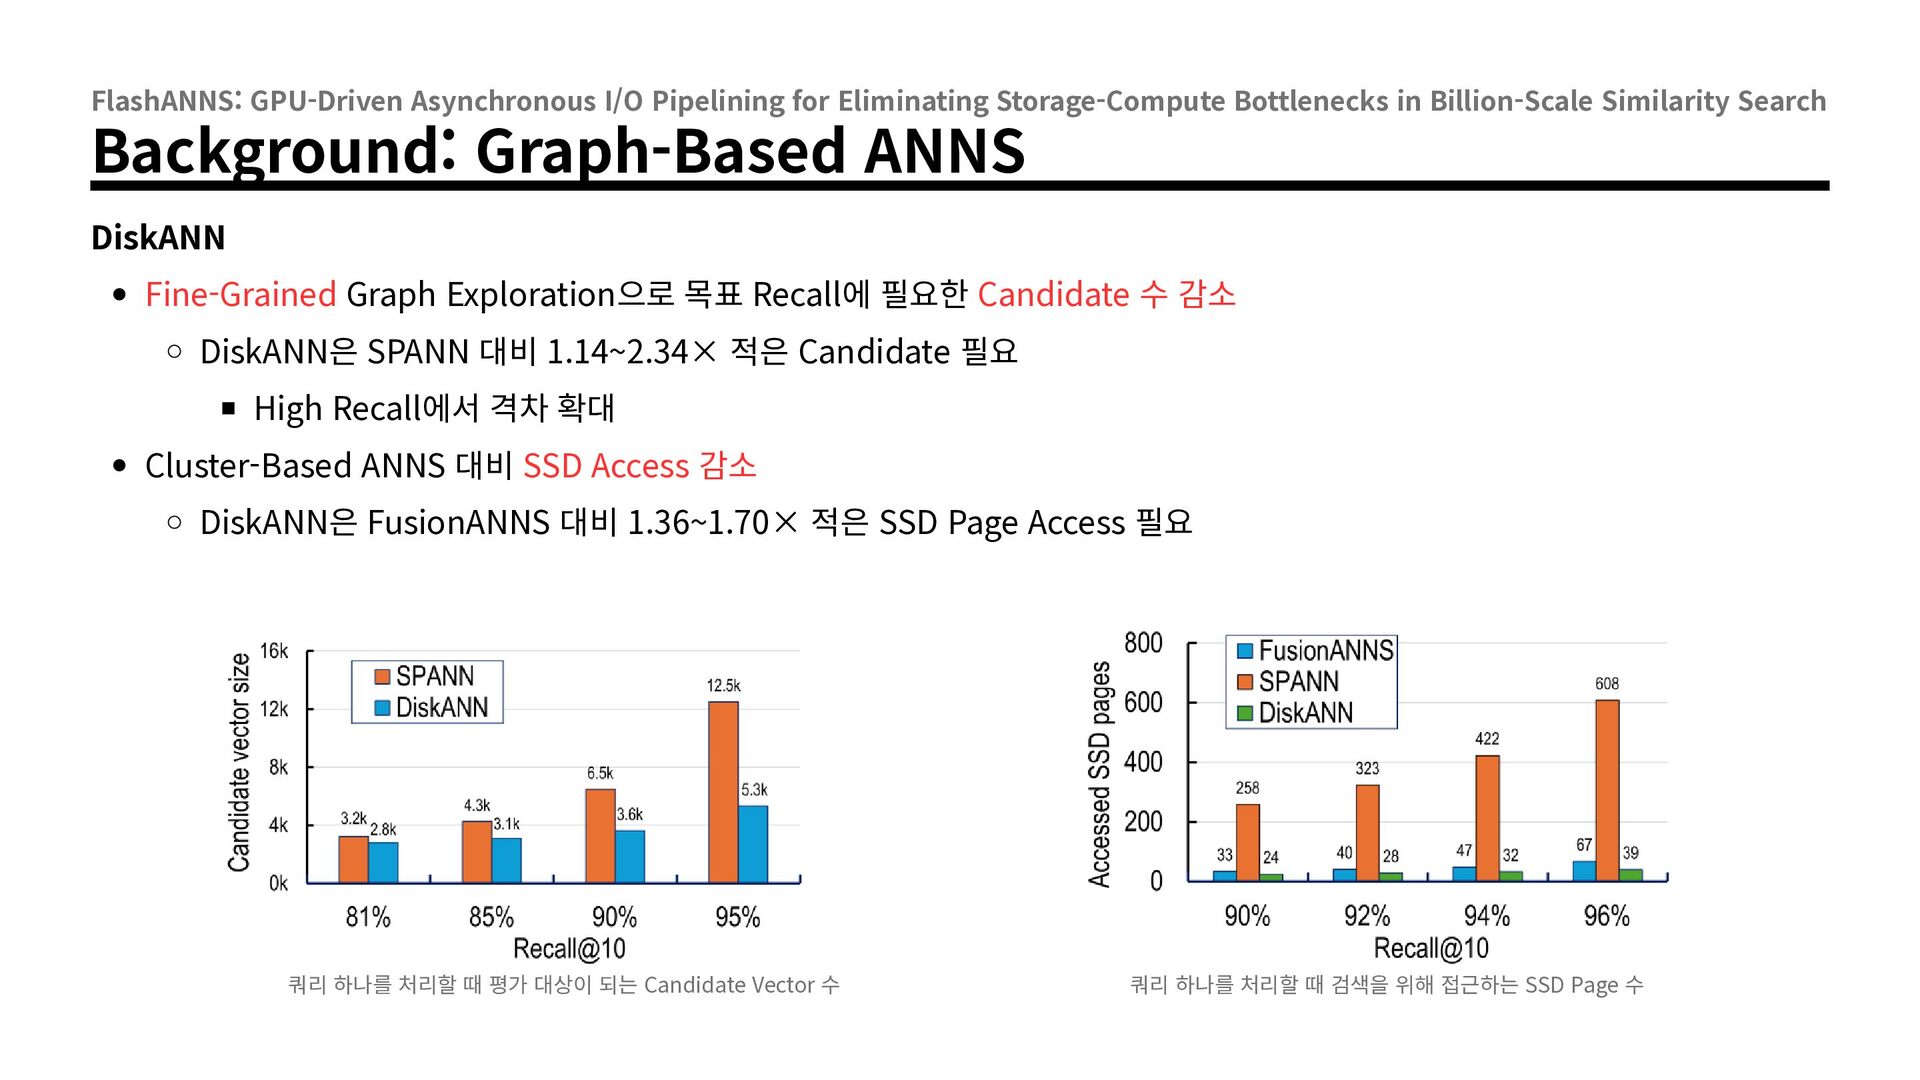
Billion-Scale Similarity Search Background: Graph-Based ANNS DiskANN Fine-Grained Graph Exploration으로 목표 Recall에 필요한 Candidate 수 감소 DiskANN은 SPANN 대비 1.14~2.34× 적은 Candidate 필요 High Recall에서 격차 확대 Cluster-Based ANNS 대비 SSD Access 감소 DiskANN은 FusionANNS 대비 1.36~1.70× 적은 SSD Page Access 필요 쿼리 하나를 처리할 때 평가 대상이 되는 Candidate Vector 수 쿼리 하나를 처리할 때 검색을 위해 접근하는 SSD Page 수
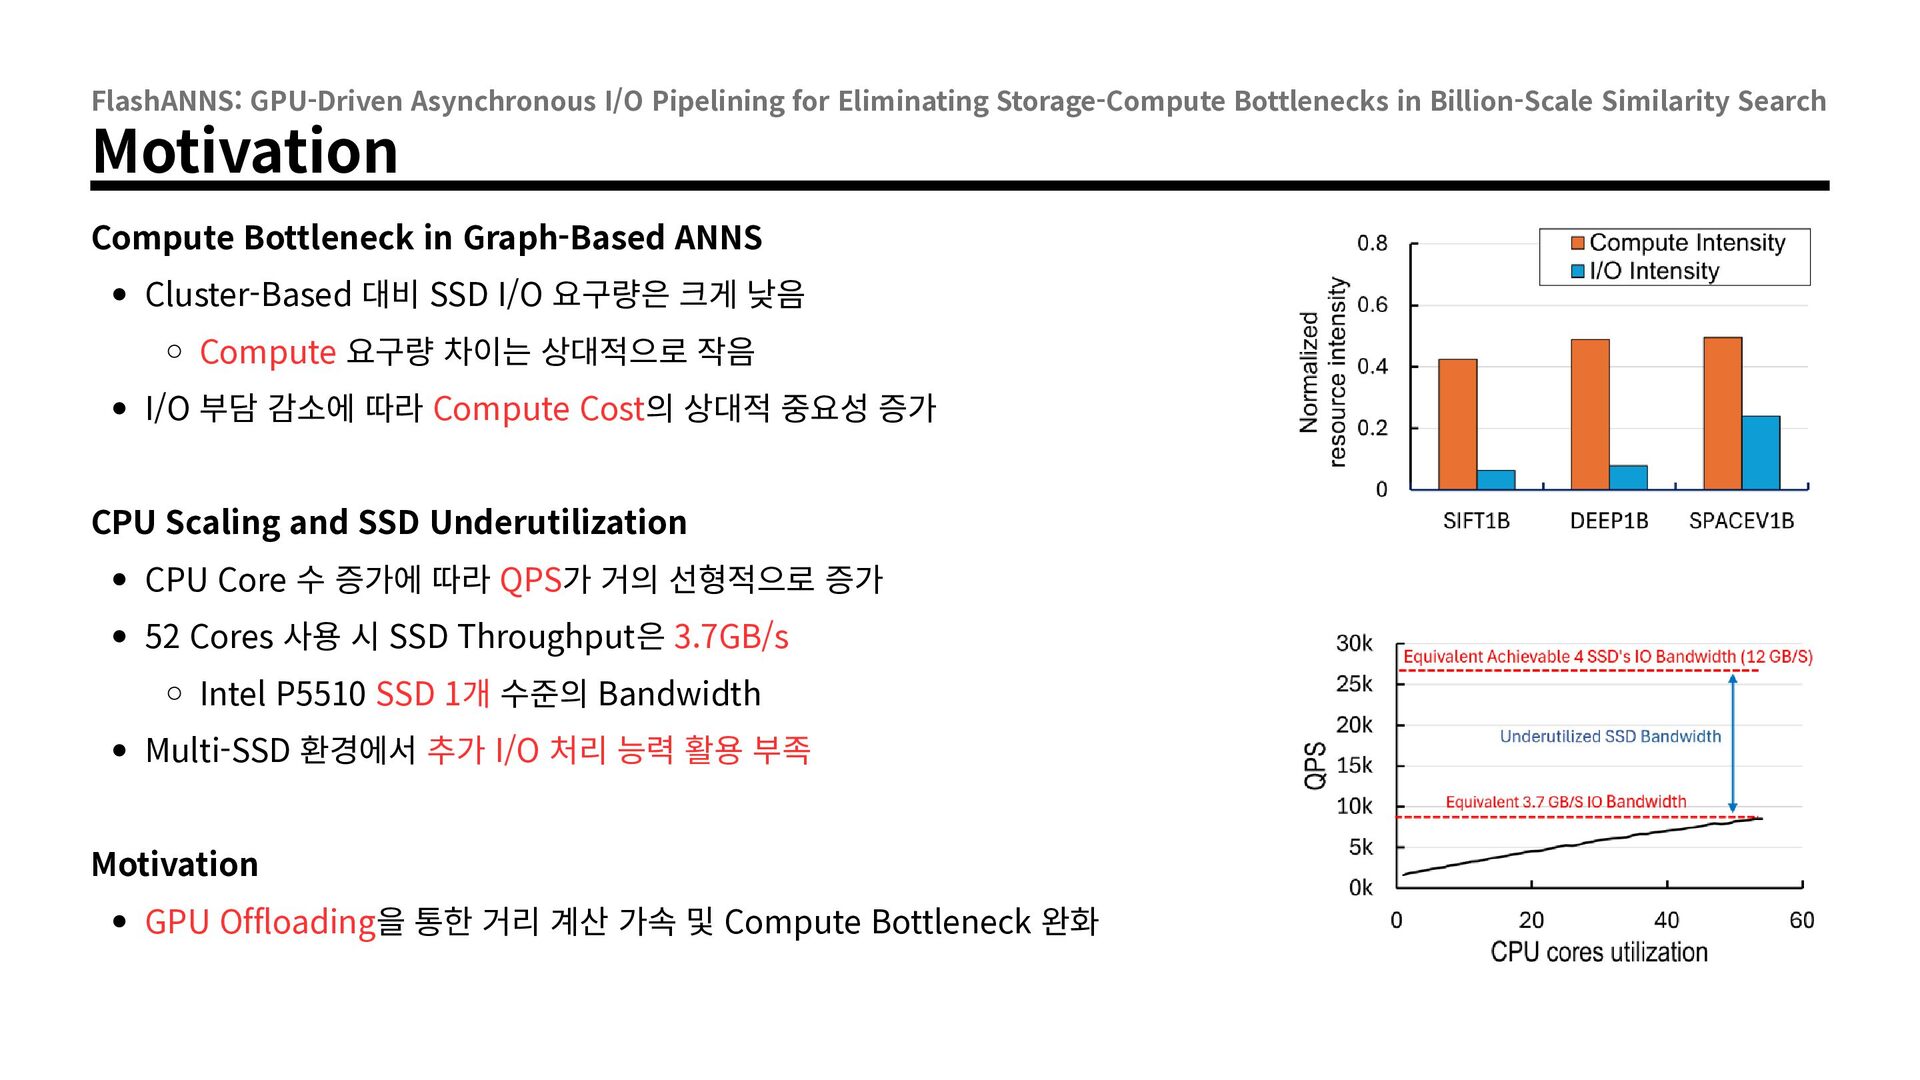
Billion-Scale Similarity Search Motivation Compute Bottleneck in Graph-Based ANNS Cluster-Based 대비 SSD I/O 요구량은 크게 낮음 Compute 요구량 차이는 상대적으로 작음 I/O 부담 감소에 따라 Compute Cost의 상대적 중요성 증가 CPU Scaling and SSD Underutilization CPU Core 수 증가에 따라 QPS가 거의 선형적으로 증가 52 Cores 사용 시 SSD Throughput은 3.7GB/s Intel P5510 SSD 1개 수준의 Bandwidth Multi-SSD 환경에서 추가 I/O 처리 능력 활용 부족 Motivation GPU Offloading을 통한 거리 계산 가속 및 Compute Bottleneck 완화
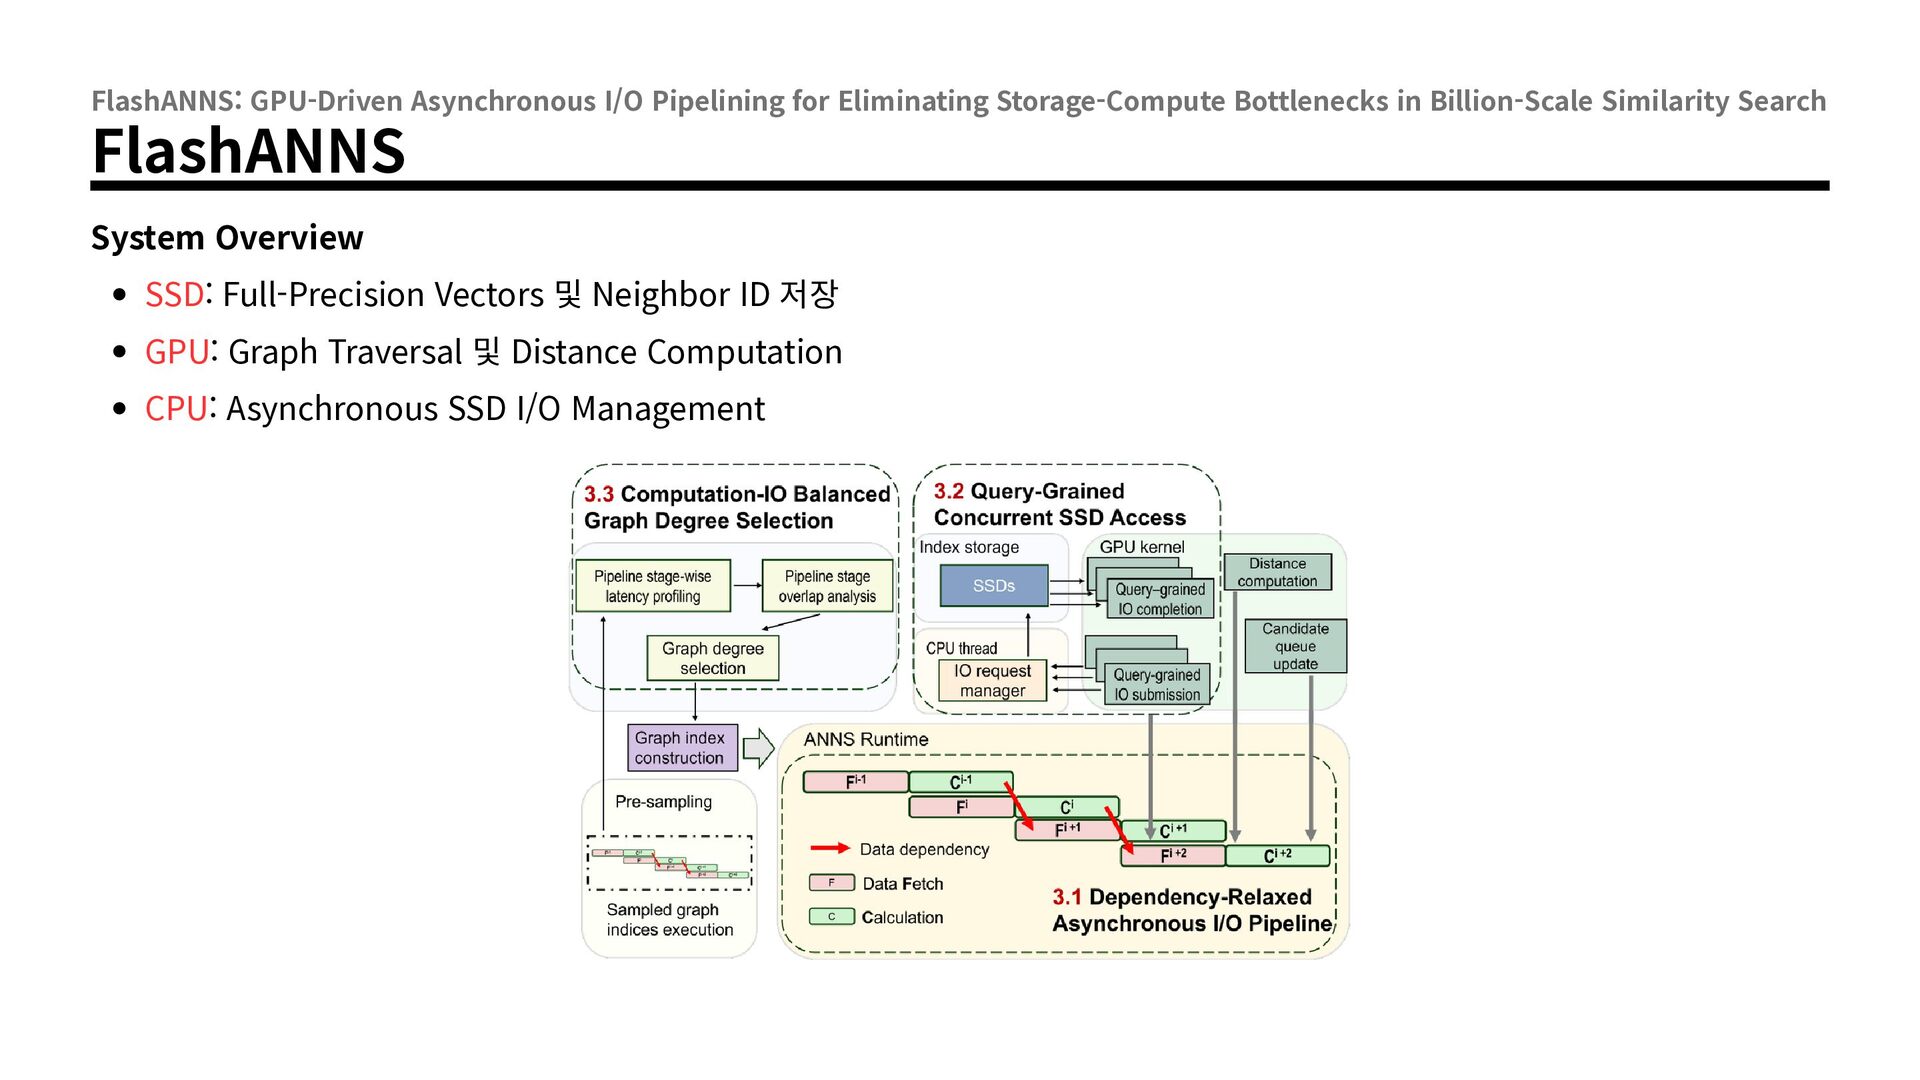
Billion-Scale Similarity Search FlashANNS System Overview SSD: Full-Precision Vectors 및 Neighbor ID 저장 GPU: Graph Traversal 및 Distance Computation CPU: Asynchronous SSD I/O Management
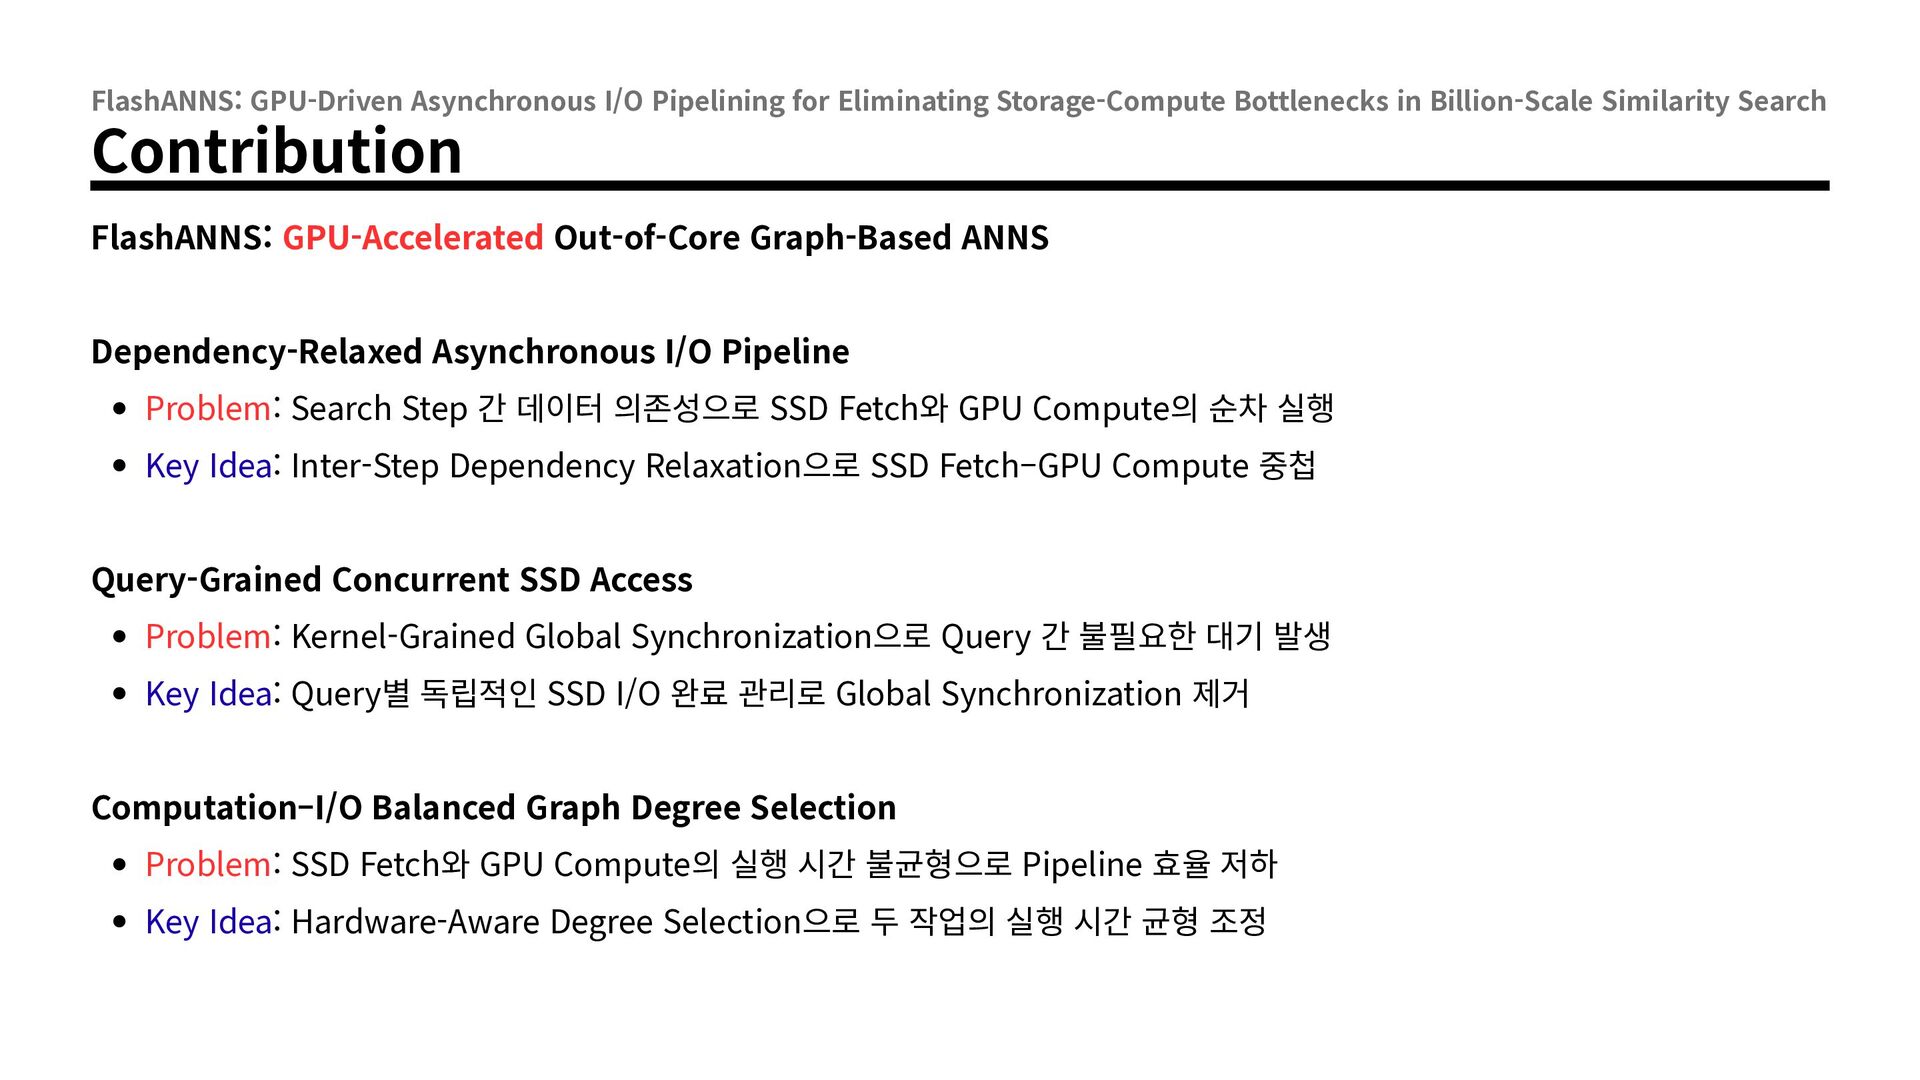
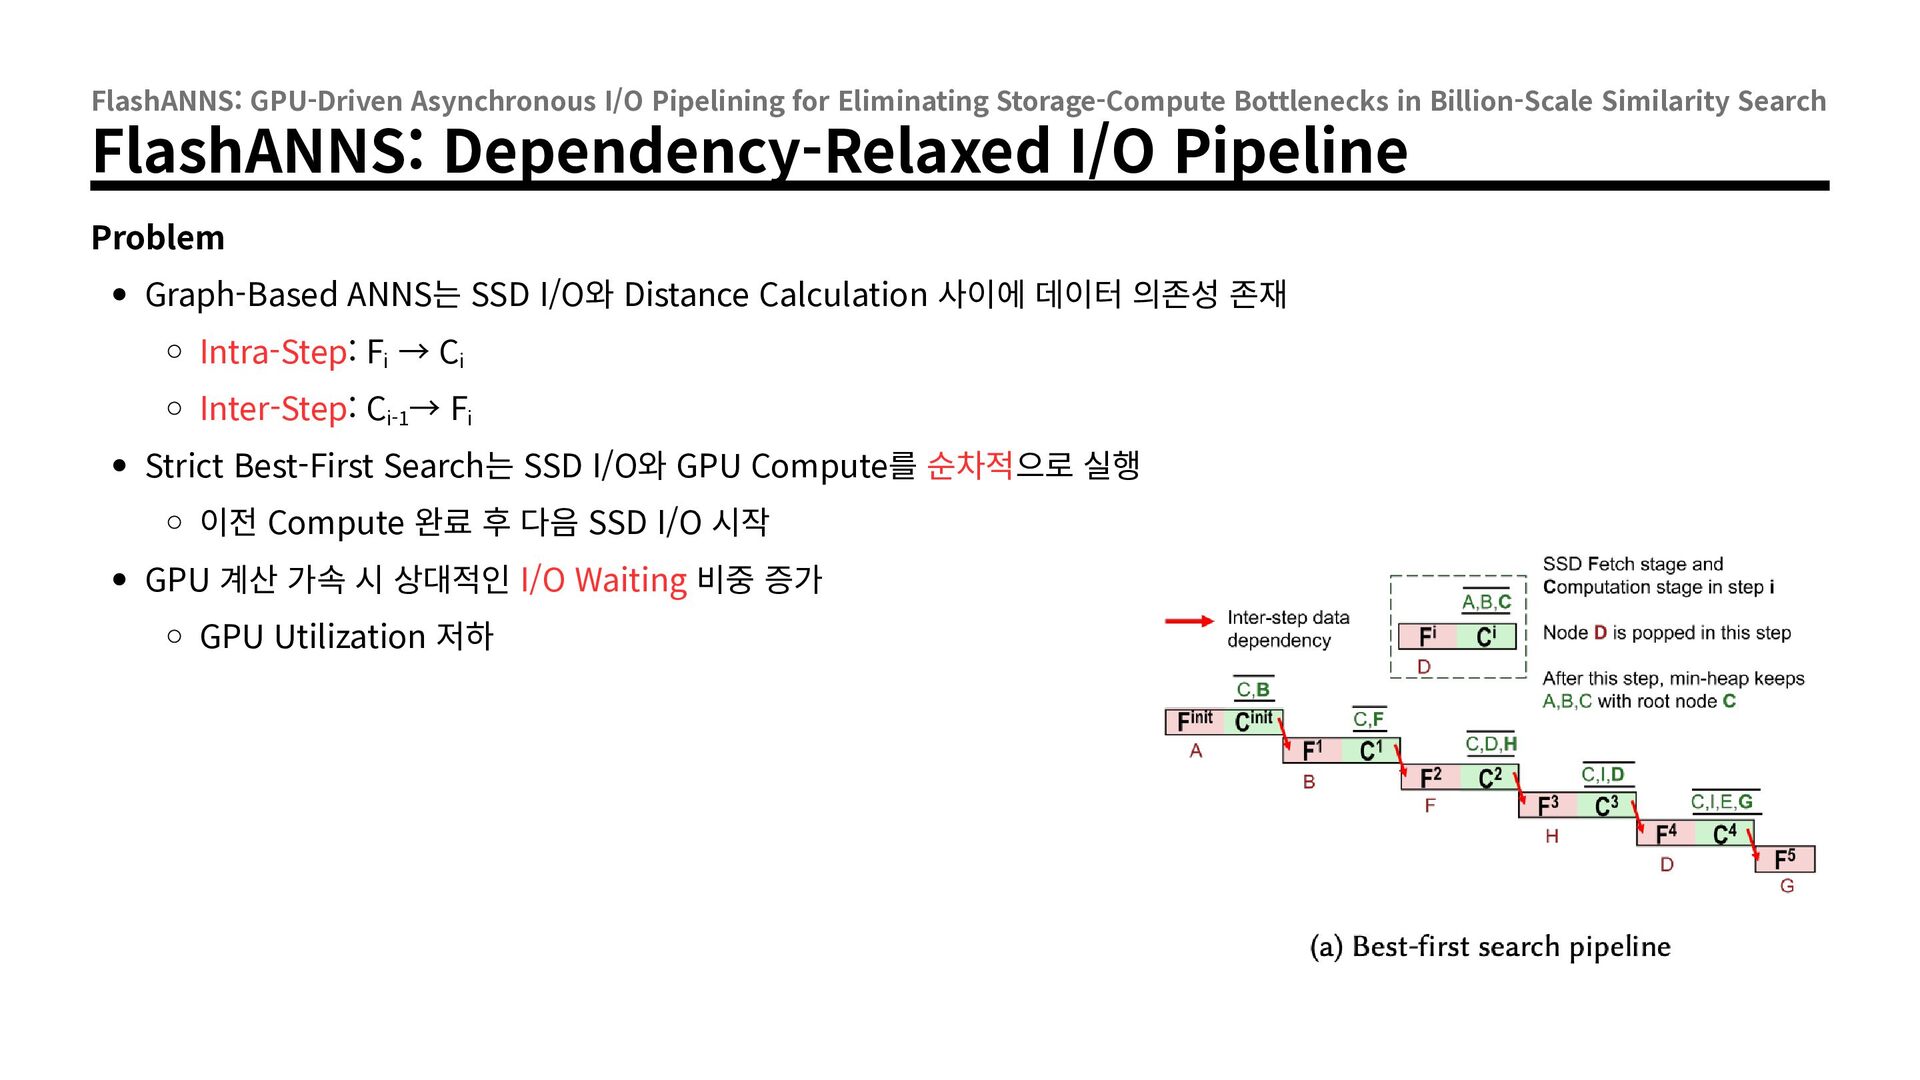
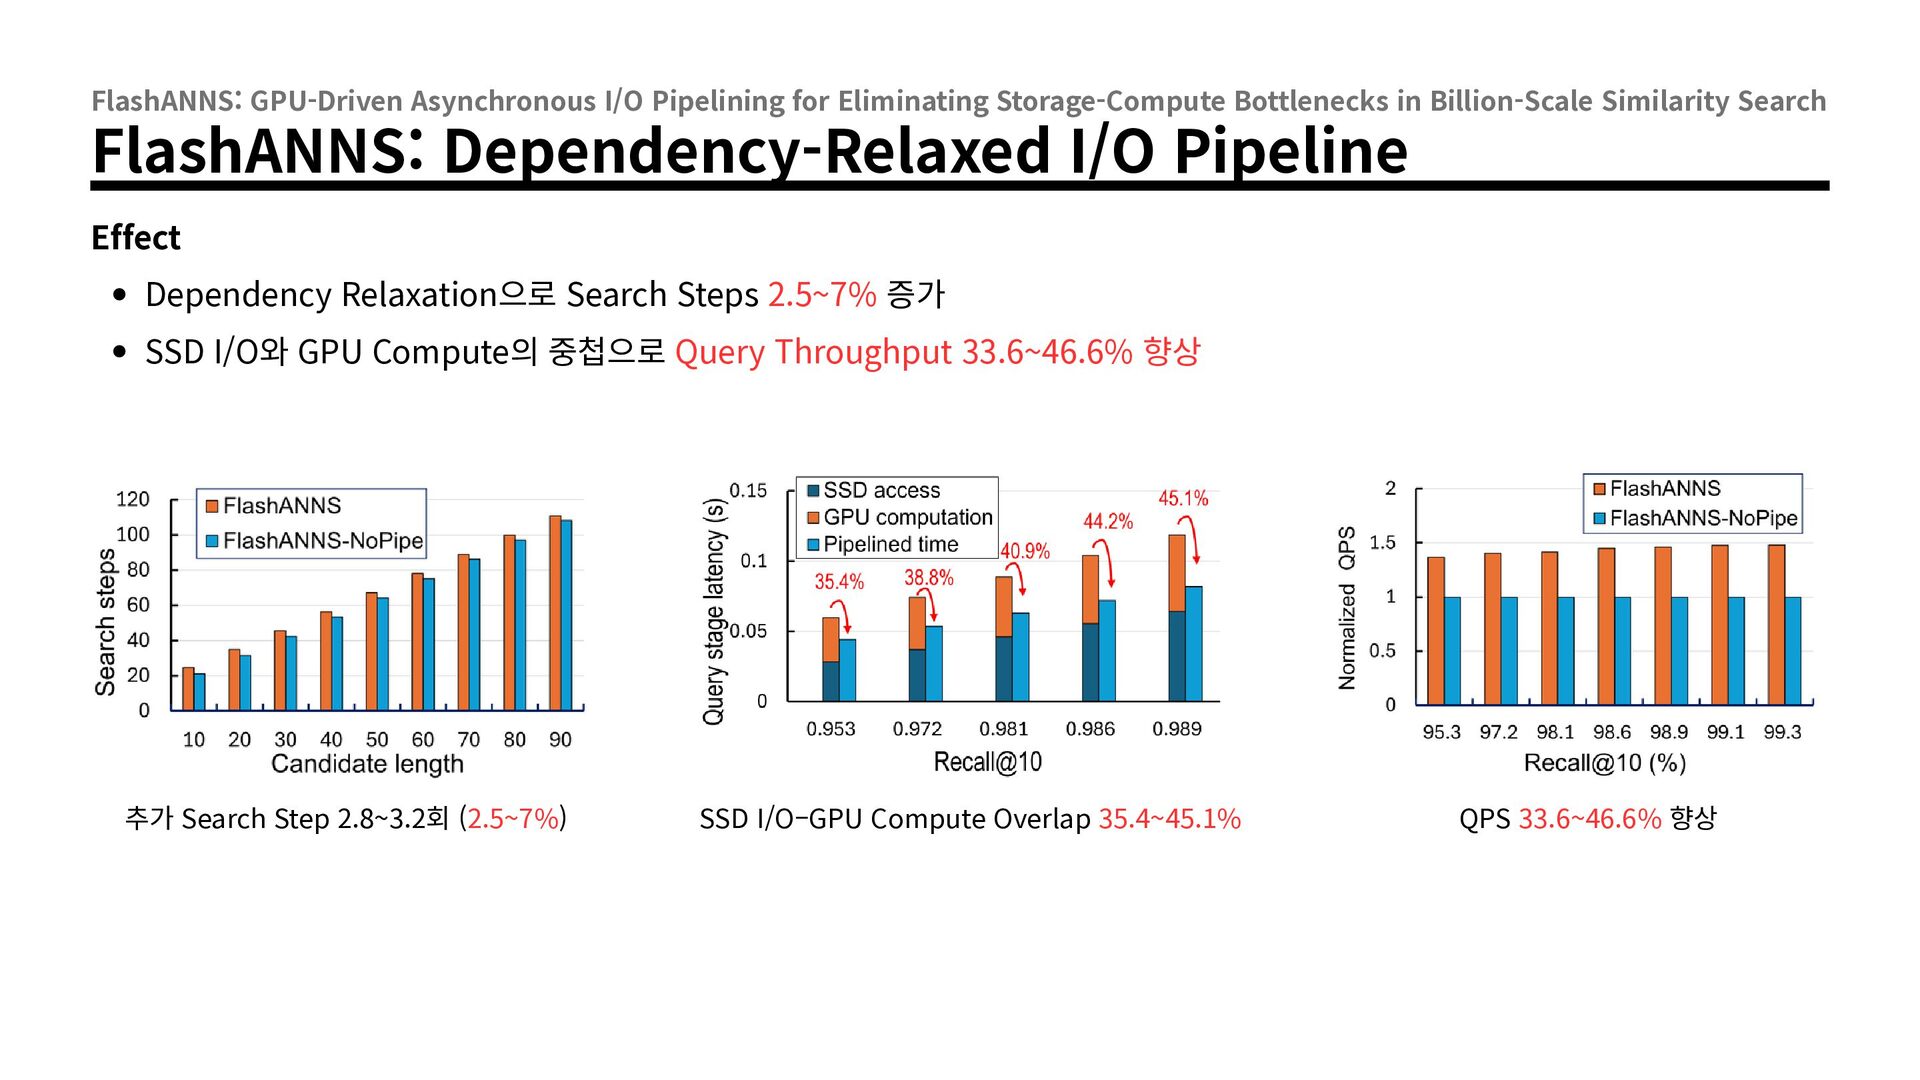
Billion-Scale Similarity Search FlashANNS: Dependency-Relaxed I/O Pipeline Problem Graph-Based ANNS는 SSD I/O와 Distance Calculation 사이에 데이터 의존성 존재 Intra-Step: Fi → Ci Inter-Step: Ci-1→ Fi Strict Best-First Search는 SSD I/O와 GPU Compute를 순차적으로 실행 이전 Compute 완료 후 다음 SSD I/O 시작 GPU 계산 가속 시 상대적인 I/O Waiting 비중 증가 GPU Utilization 저하
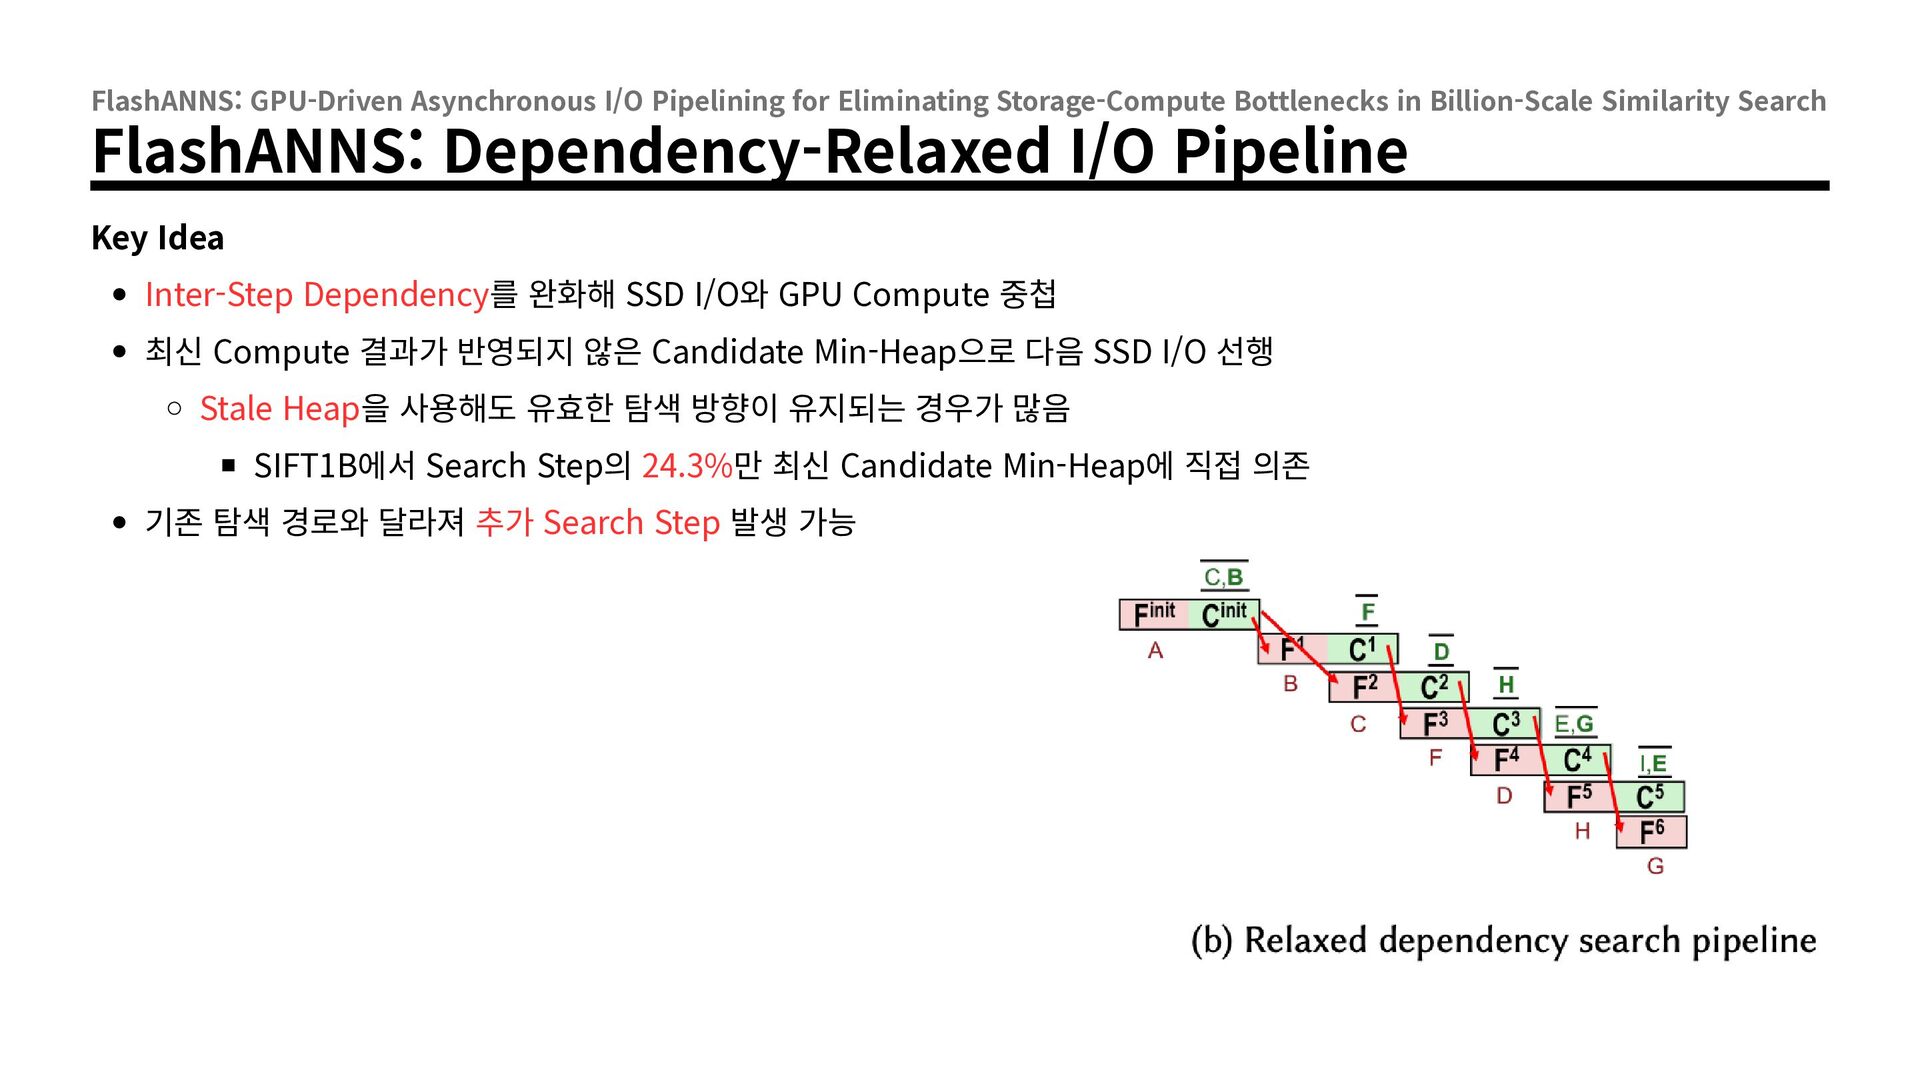
Billion-Scale Similarity Search FlashANNS: Dependency-Relaxed I/O Pipeline Key Idea Inter-Step Dependency를 완화해 SSD I/O와 GPU Compute 중첩 최신 Compute 결과가 반영되지 않은 Candidate Min-Heap으로 다음 SSD I/O 선행 Stale Heap을 사용해도 유효한 탐색 방향이 유지되는 경우가 많음 SIFT1B에서 Search Step의 24.3%만 최신 Candidate Min-Heap에 직접 의존 기존 탐색 경로와 달라져 추가 Search Step 발생 가능
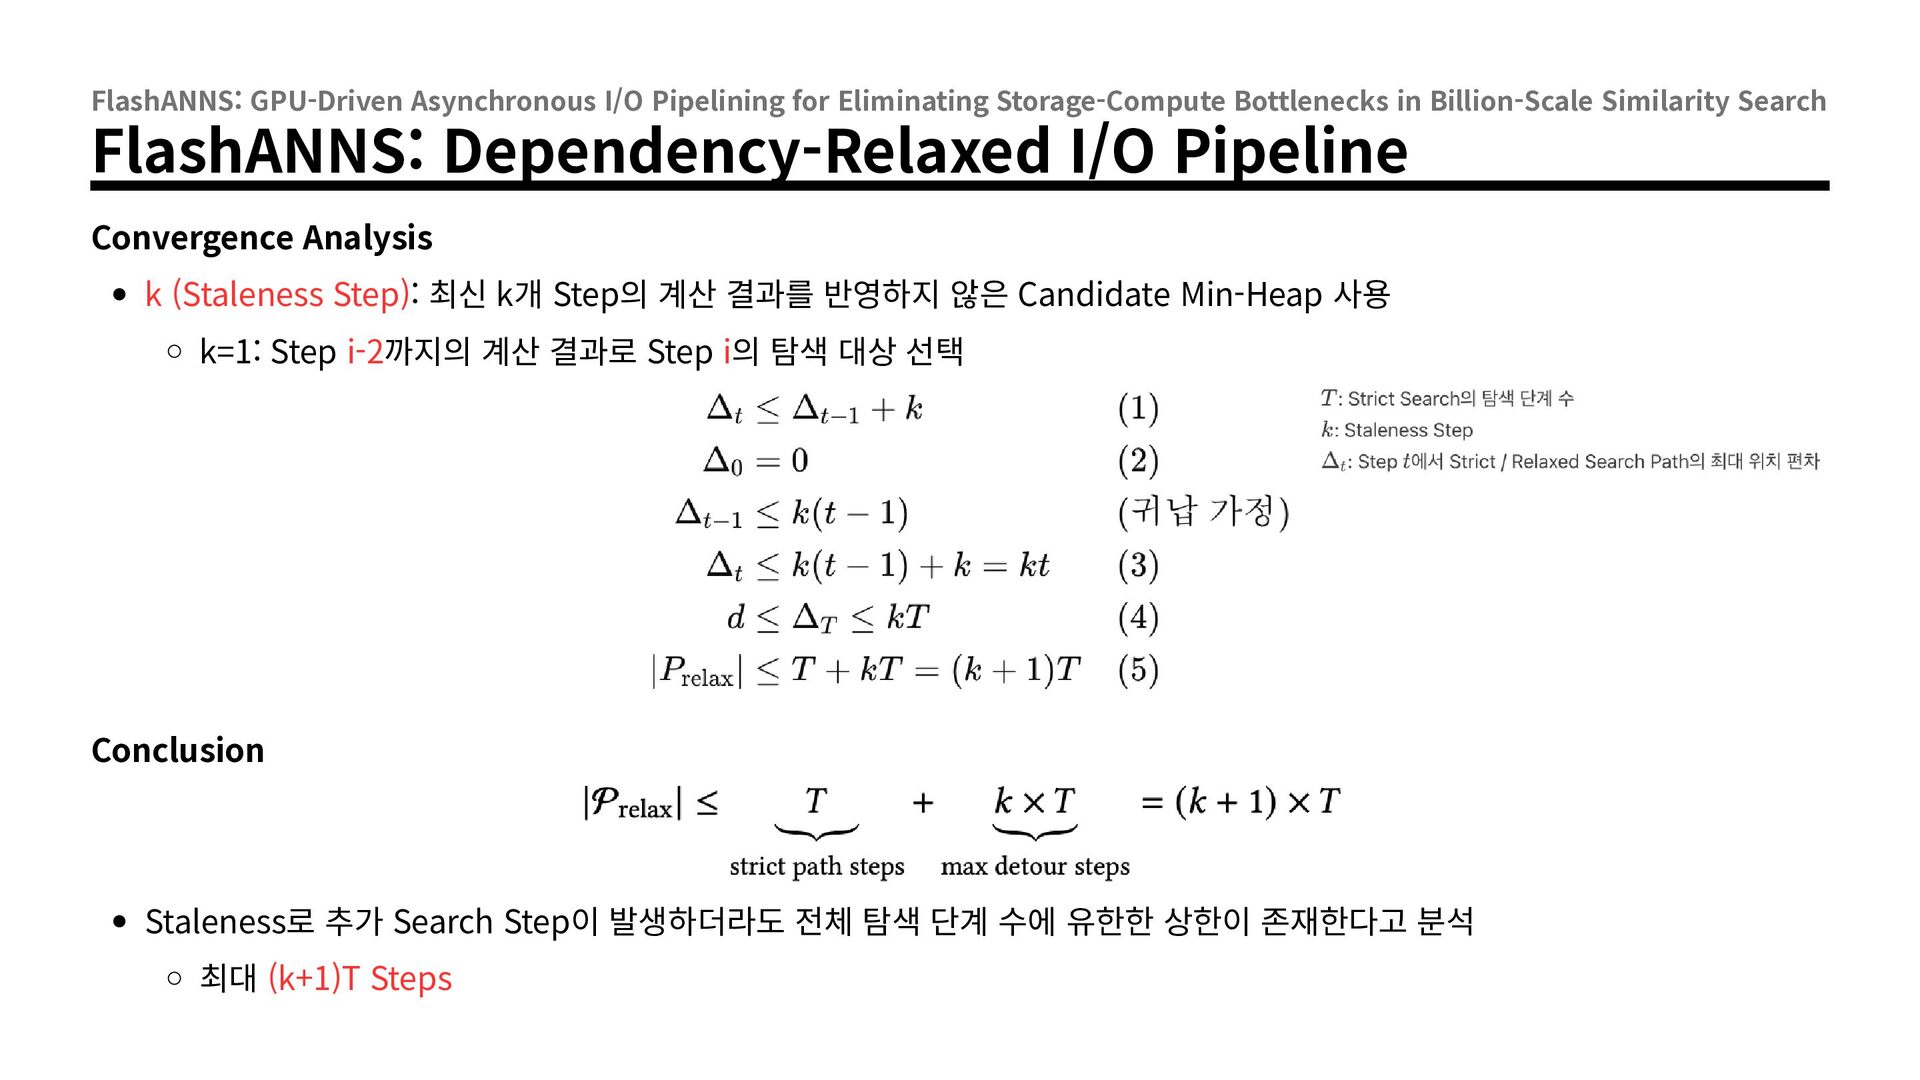
Billion-Scale Similarity Search FlashANNS: Dependency-Relaxed I/O Pipeline Convergence Analysis k (Staleness Step): 최신 k개 Step의 계산 결과를 반영하지 않은 Candidate Min-Heap 사용 k=1: Step i-2까지의 계산 결과로 Step i의 탐색 대상 선택 Conclusion Staleness로 추가 Search Step이 발생하더라도 전체 탐색 단계 수에 유한한 상한이 존재한다고 분석 최대 (k+1)T Steps
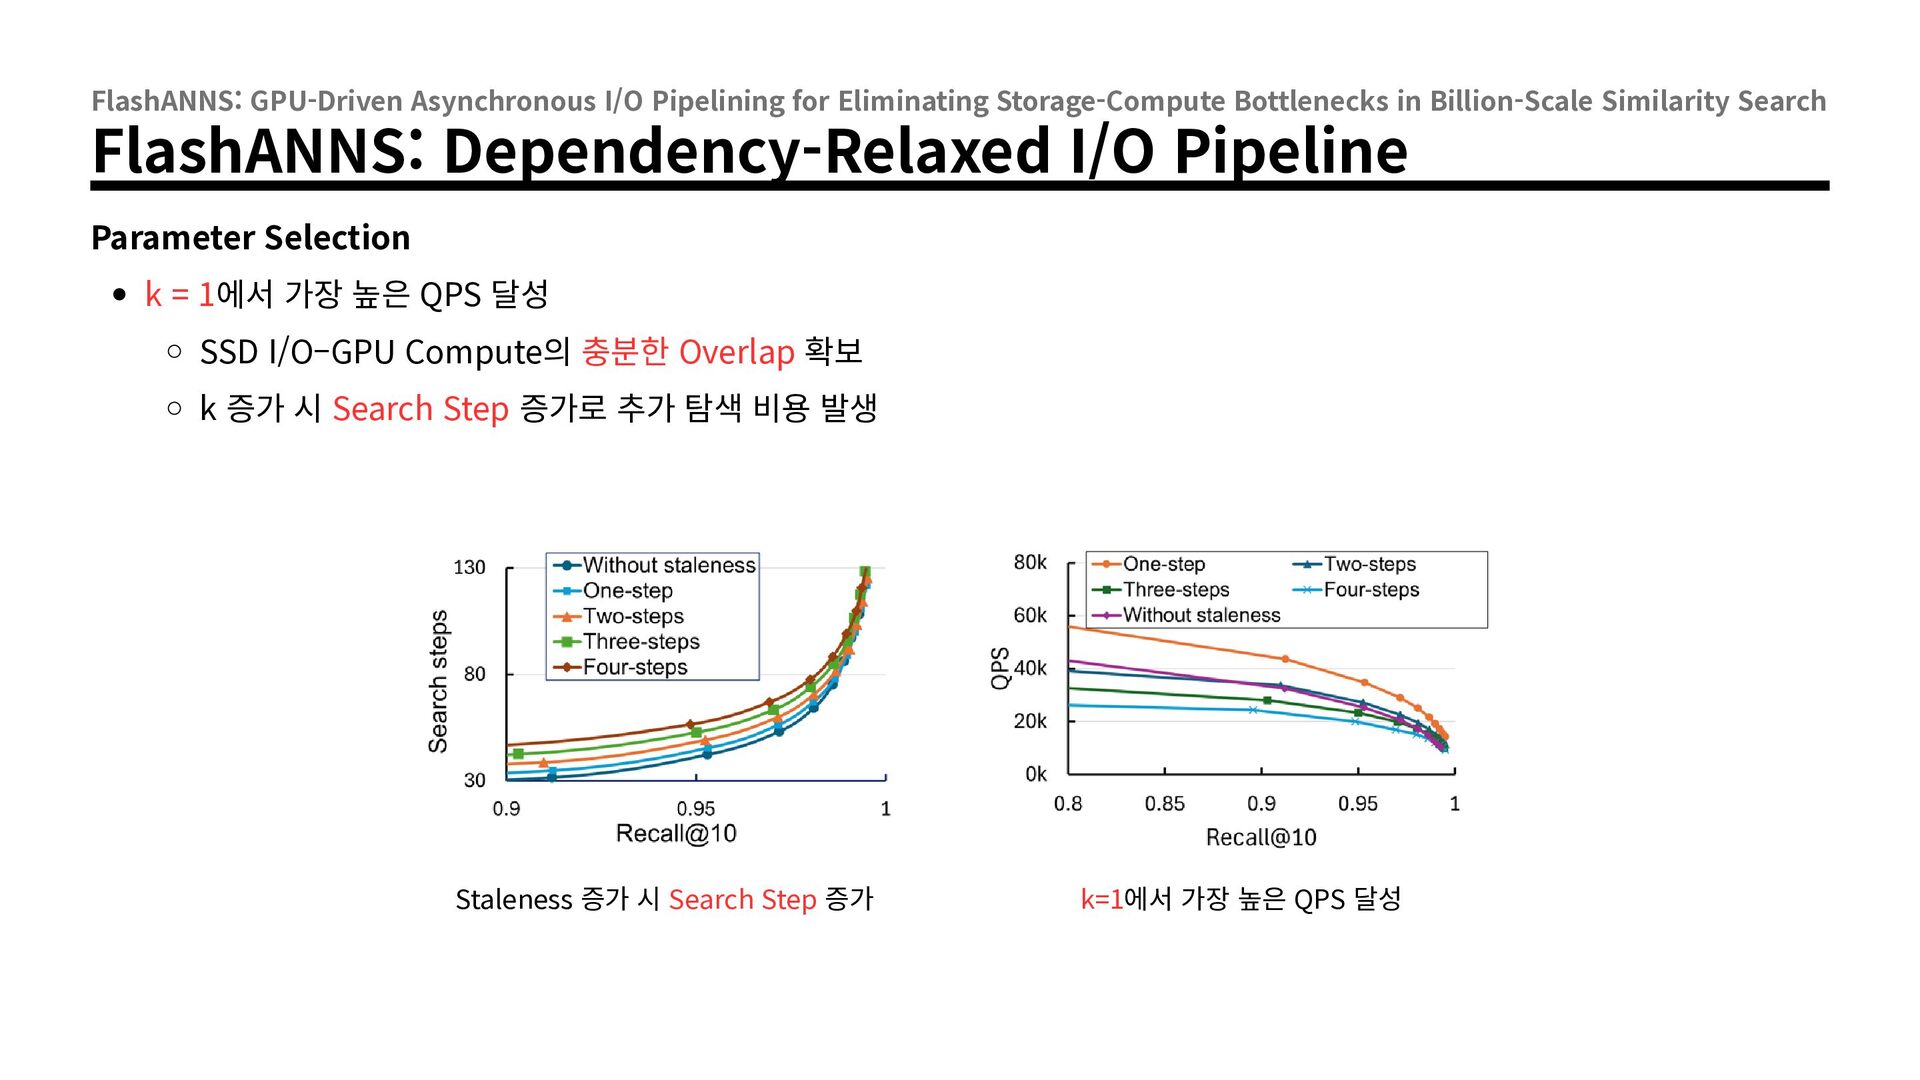
Billion-Scale Similarity Search FlashANNS: Dependency-Relaxed I/O Pipeline Parameter Selection k = 1에서 가장 높은 QPS 달성 SSD I/O–GPU Compute의 충분한 Overlap 확보 k 증가 시 Search Step 증가로 추가 탐색 비용 발생 Staleness 증가 시 Search Step 증가 k=1에서 가장 높은 QPS 달성
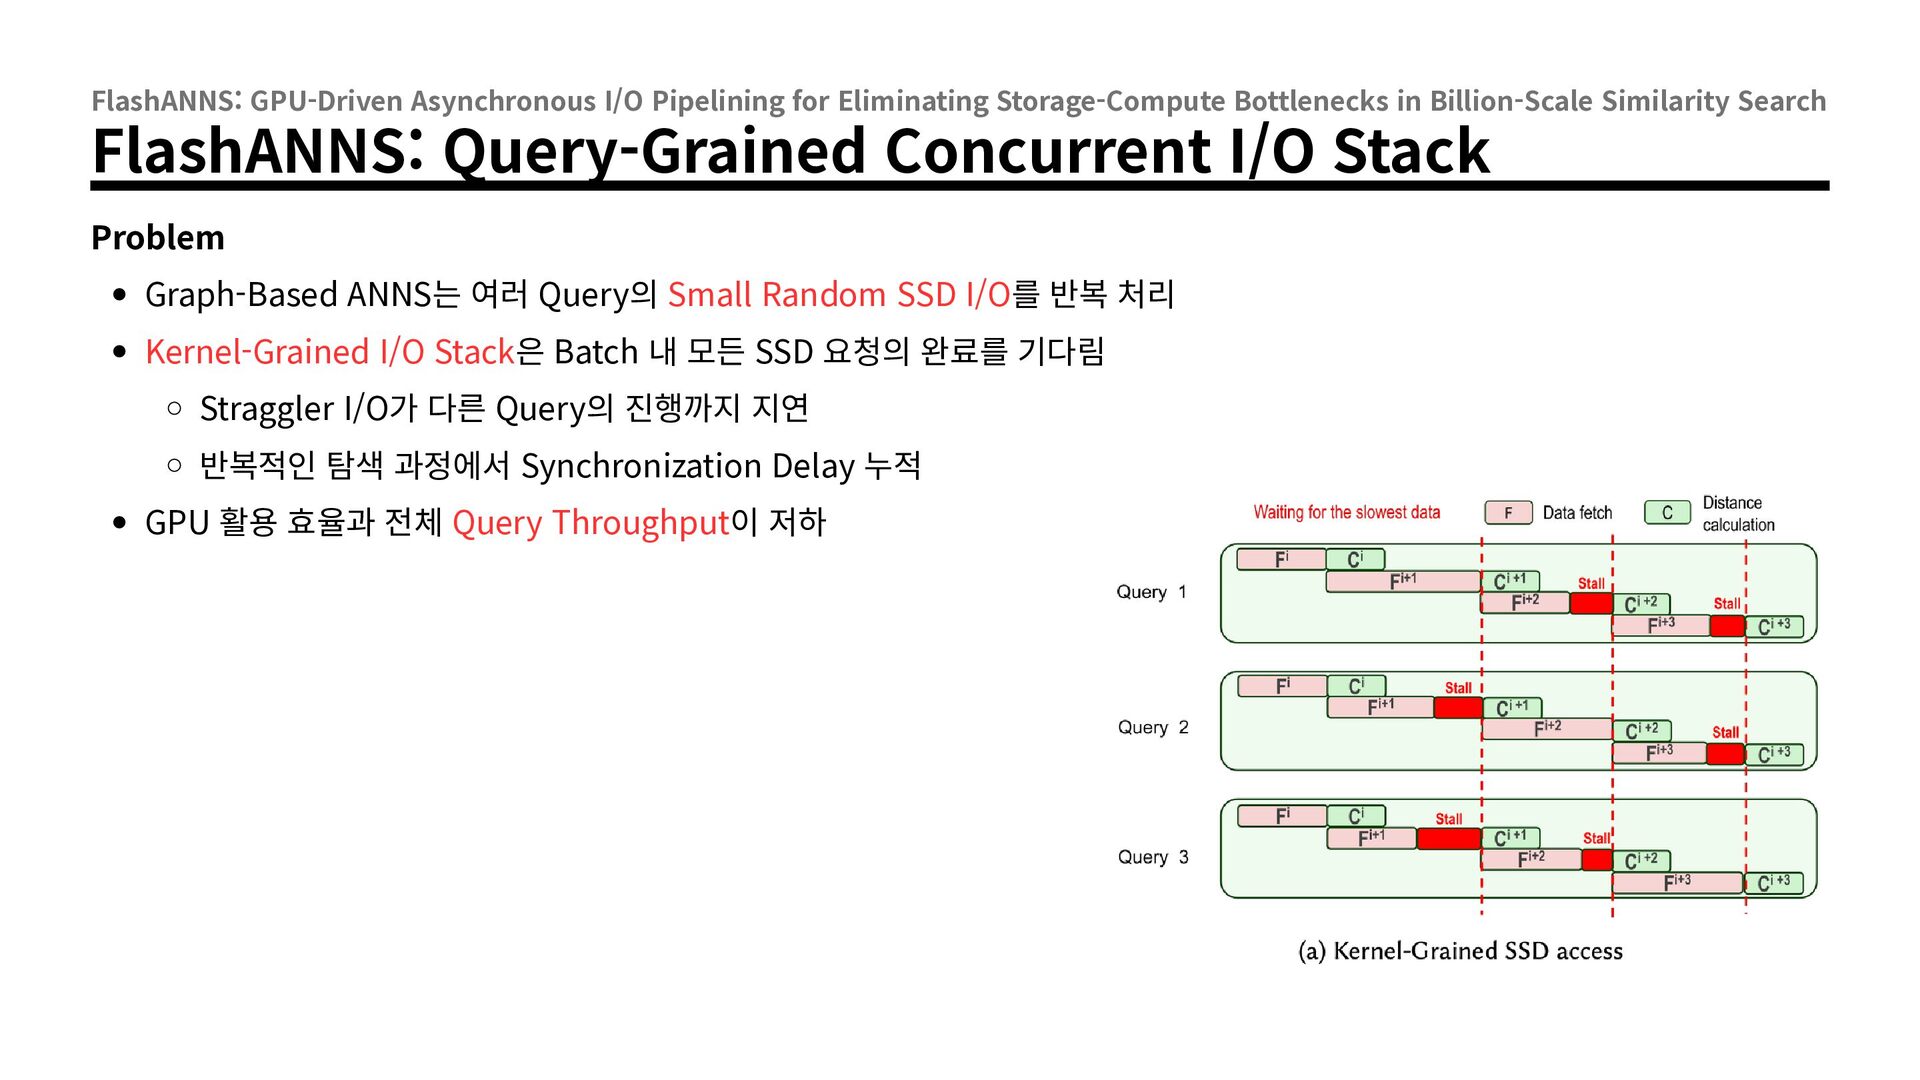
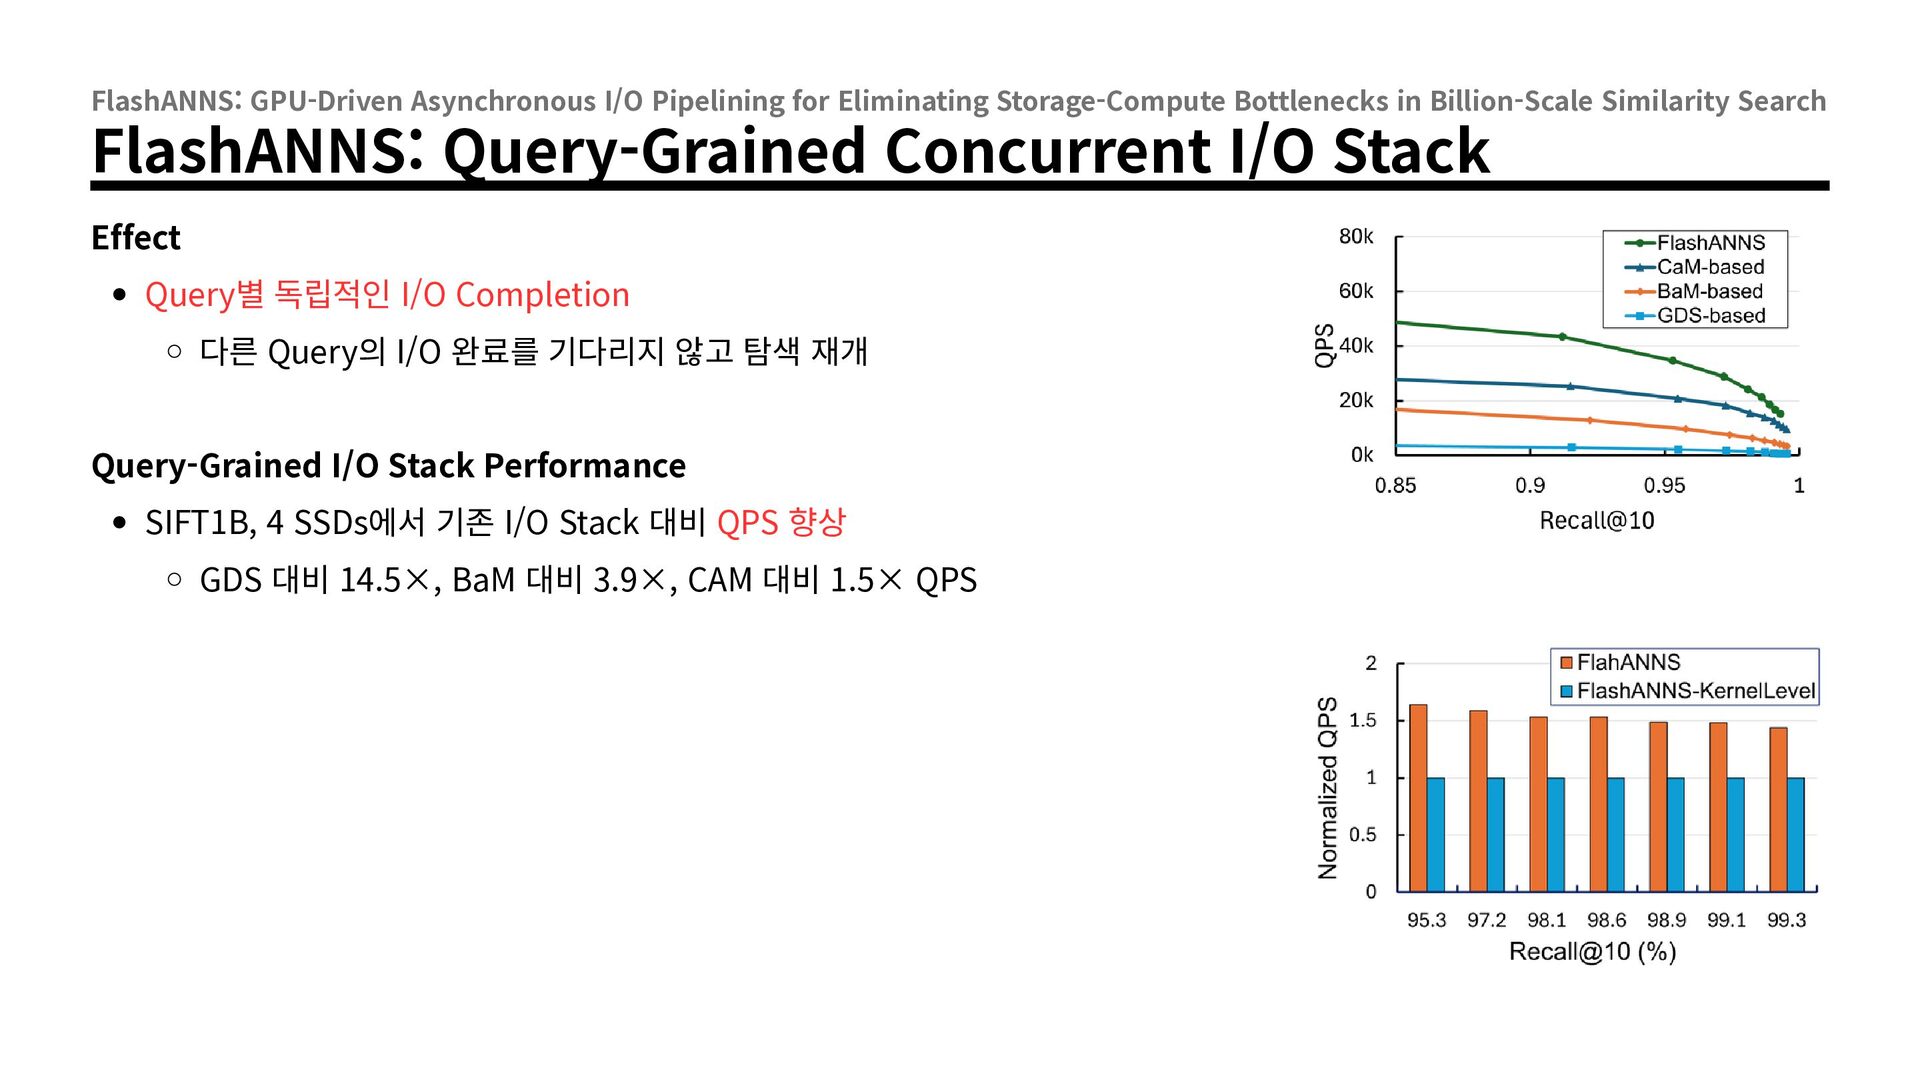
Billion-Scale Similarity Search FlashANNS: Query-Grained Concurrent I/O Stack Problem Graph-Based ANNS는 여러 Query의 Small Random SSD I/O를 반복 처리 Kernel-Grained I/O Stack은 Batch 내 모든 SSD 요청의 완료를 기다림 Straggler I/O가 다른 Query의 진행까지 지연 반복적인 탐색 과정에서 Synchronization Delay 누적 GPU 활용 효율과 전체 Query Throughput이 저하
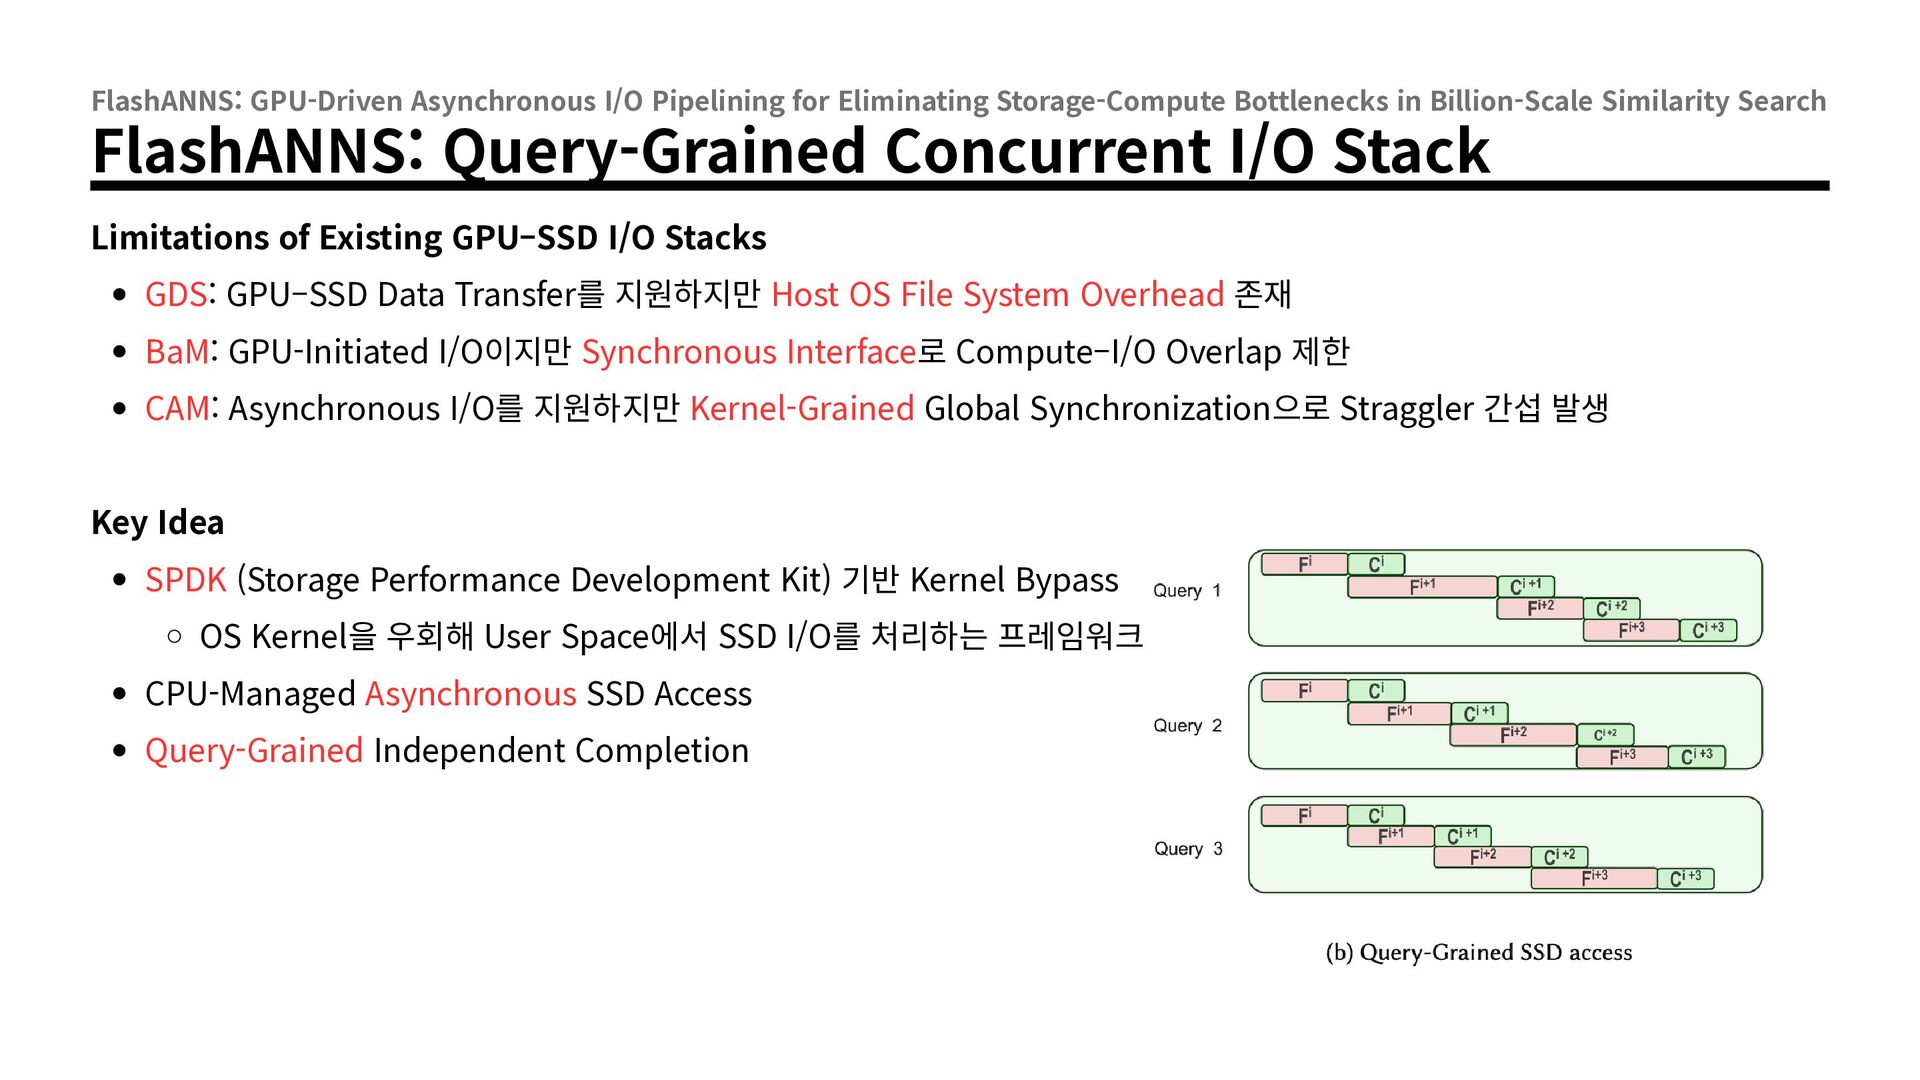
Billion-Scale Similarity Search FlashANNS: Query-Grained Concurrent I/O Stack Limitations of Existing GPU–SSD I/O Stacks GDS: GPU–SSD Data Transfer를 지원하지만 Host OS File System Overhead 존재 BaM: GPU-Initiated I/O이지만 Synchronous Interface로 Compute–I/O Overlap 제한 CAM: Asynchronous I/O를 지원하지만 Kernel-Grained Global Synchronization으로 Straggler 간섭 발생 Key Idea SPDK (Storage Performance Development Kit) 기반 Kernel Bypass OS Kernel을 우회해 User Space에서 SSD I/O를 처리하는 프레임워크 CPU-Managed Asynchronous SSD Access Query-Grained Independent Completion
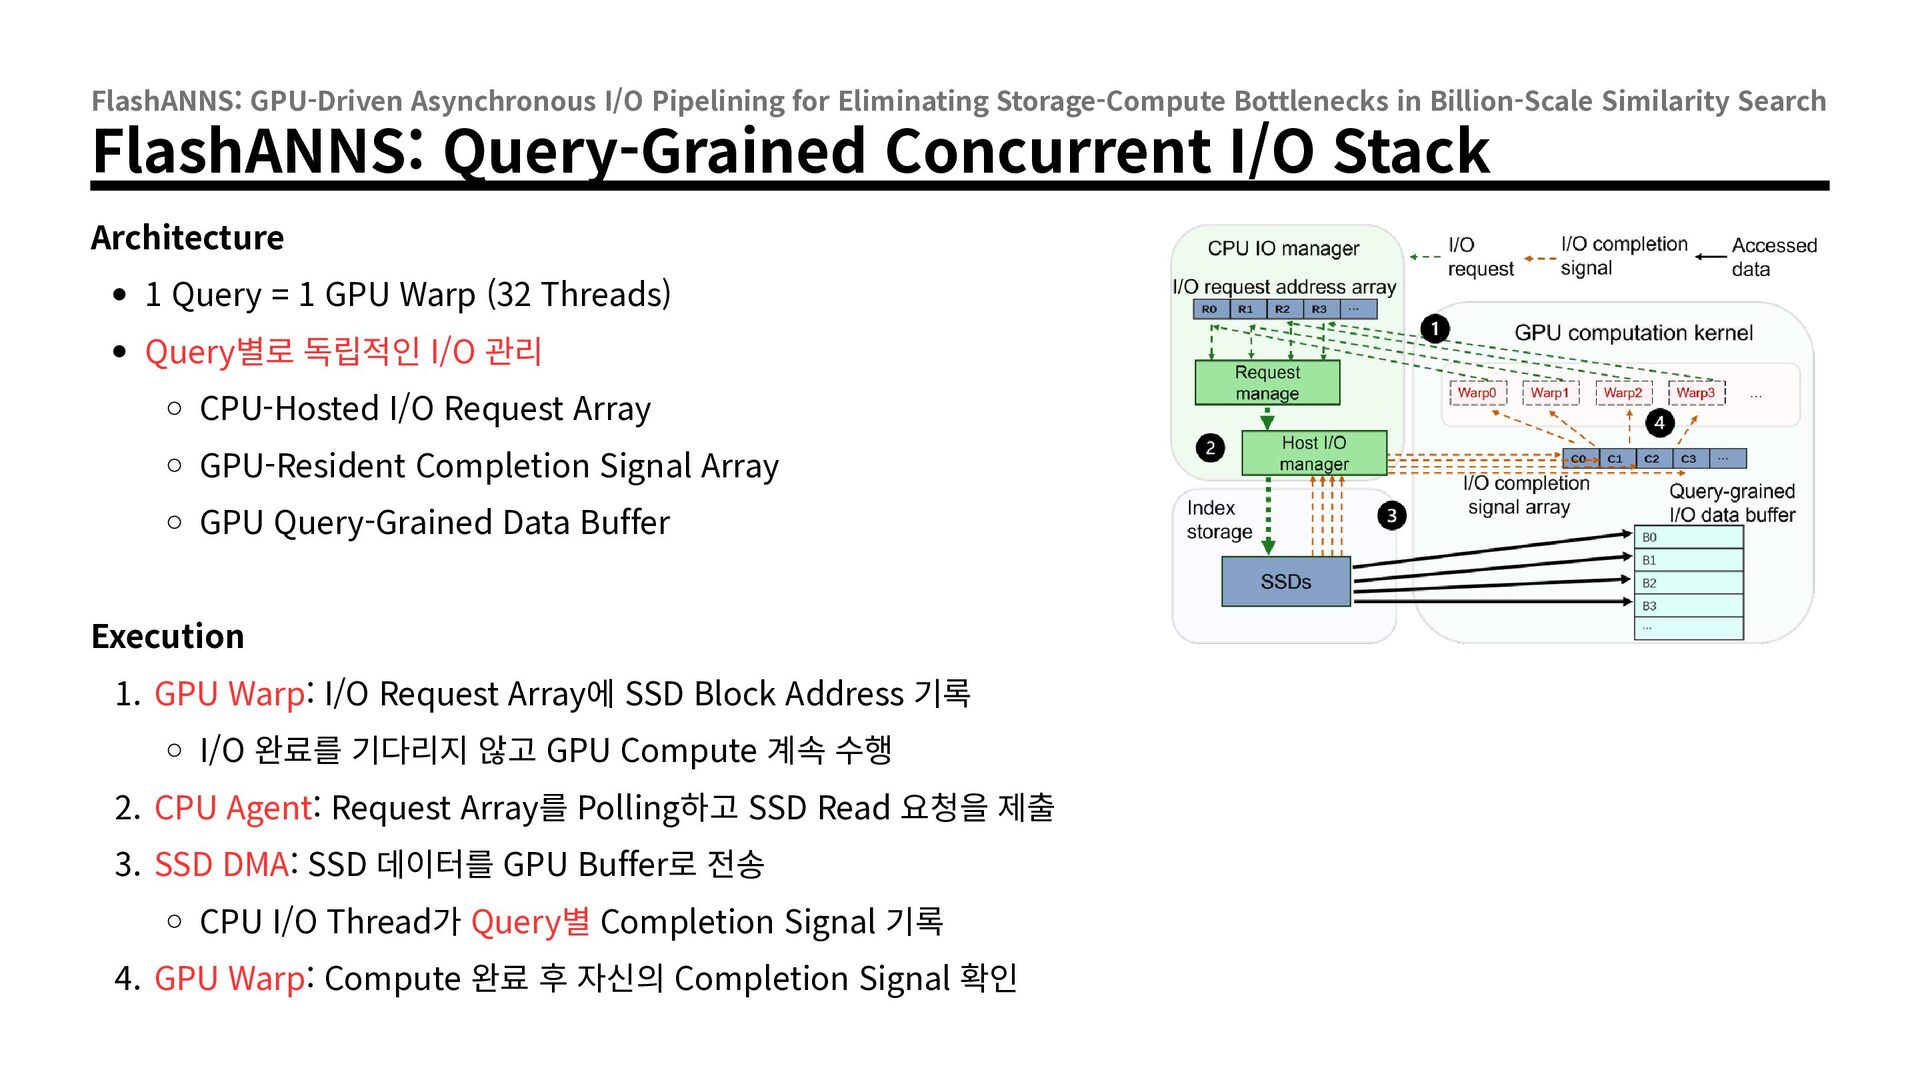
Billion-Scale Similarity Search FlashANNS: Query-Grained Concurrent I/O Stack Architecture 1 Query = 1 GPU Warp (32 Threads) Query별로 독립적인 I/O 관리 CPU-Hosted I/O Request Array GPU-Resident Completion Signal Array GPU Query-Grained Data Buffer Execution 1. GPU Warp: I/O Request Array에 SSD Block Address 기록 I/O 완료를 기다리지 않고 GPU Compute 계속 수행 2. CPU Agent: Request Array를 Polling하고 SSD Read 요청을 제출 3. SSD DMA: SSD 데이터를 GPU Buffer로 전송 CPU I/O Thread가 Query별 Completion Signal 기록 4. GPU Warp: Compute 완료 후 자신의 Completion Signal 확인
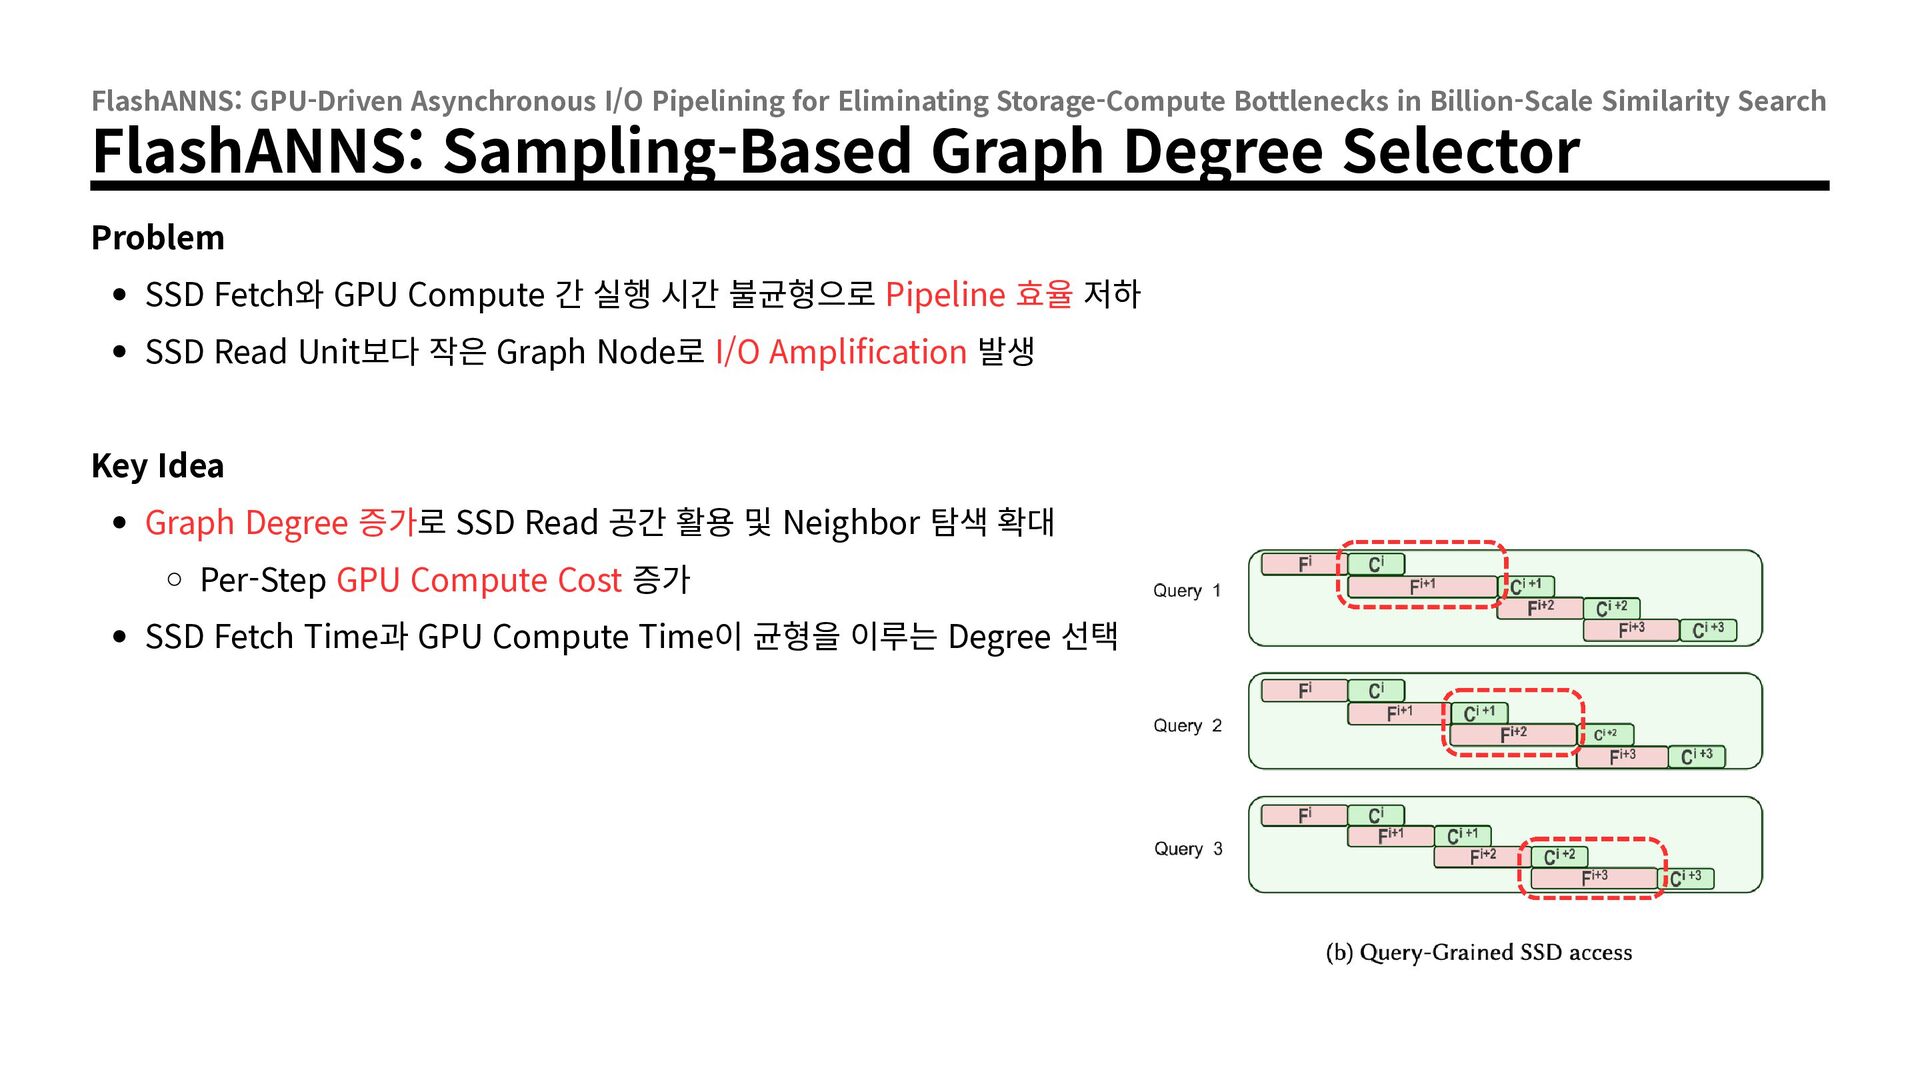
Billion-Scale Similarity Search FlashANNS: Sampling-Based Graph Degree Selector Problem SSD Fetch와 GPU Compute 간 실행 시간 불균형으로 Pipeline 효율 저하 SSD Read Unit보다 작은 Graph Node로 I/O Amplification 발생 Key Idea Graph Degree 증가로 SSD Read 공간 활용 및 Neighbor 탐색 확대 Per-Step GPU Compute Cost 증가 SSD Fetch Time과 GPU Compute Time이 균형을 이루는 Degree 선택
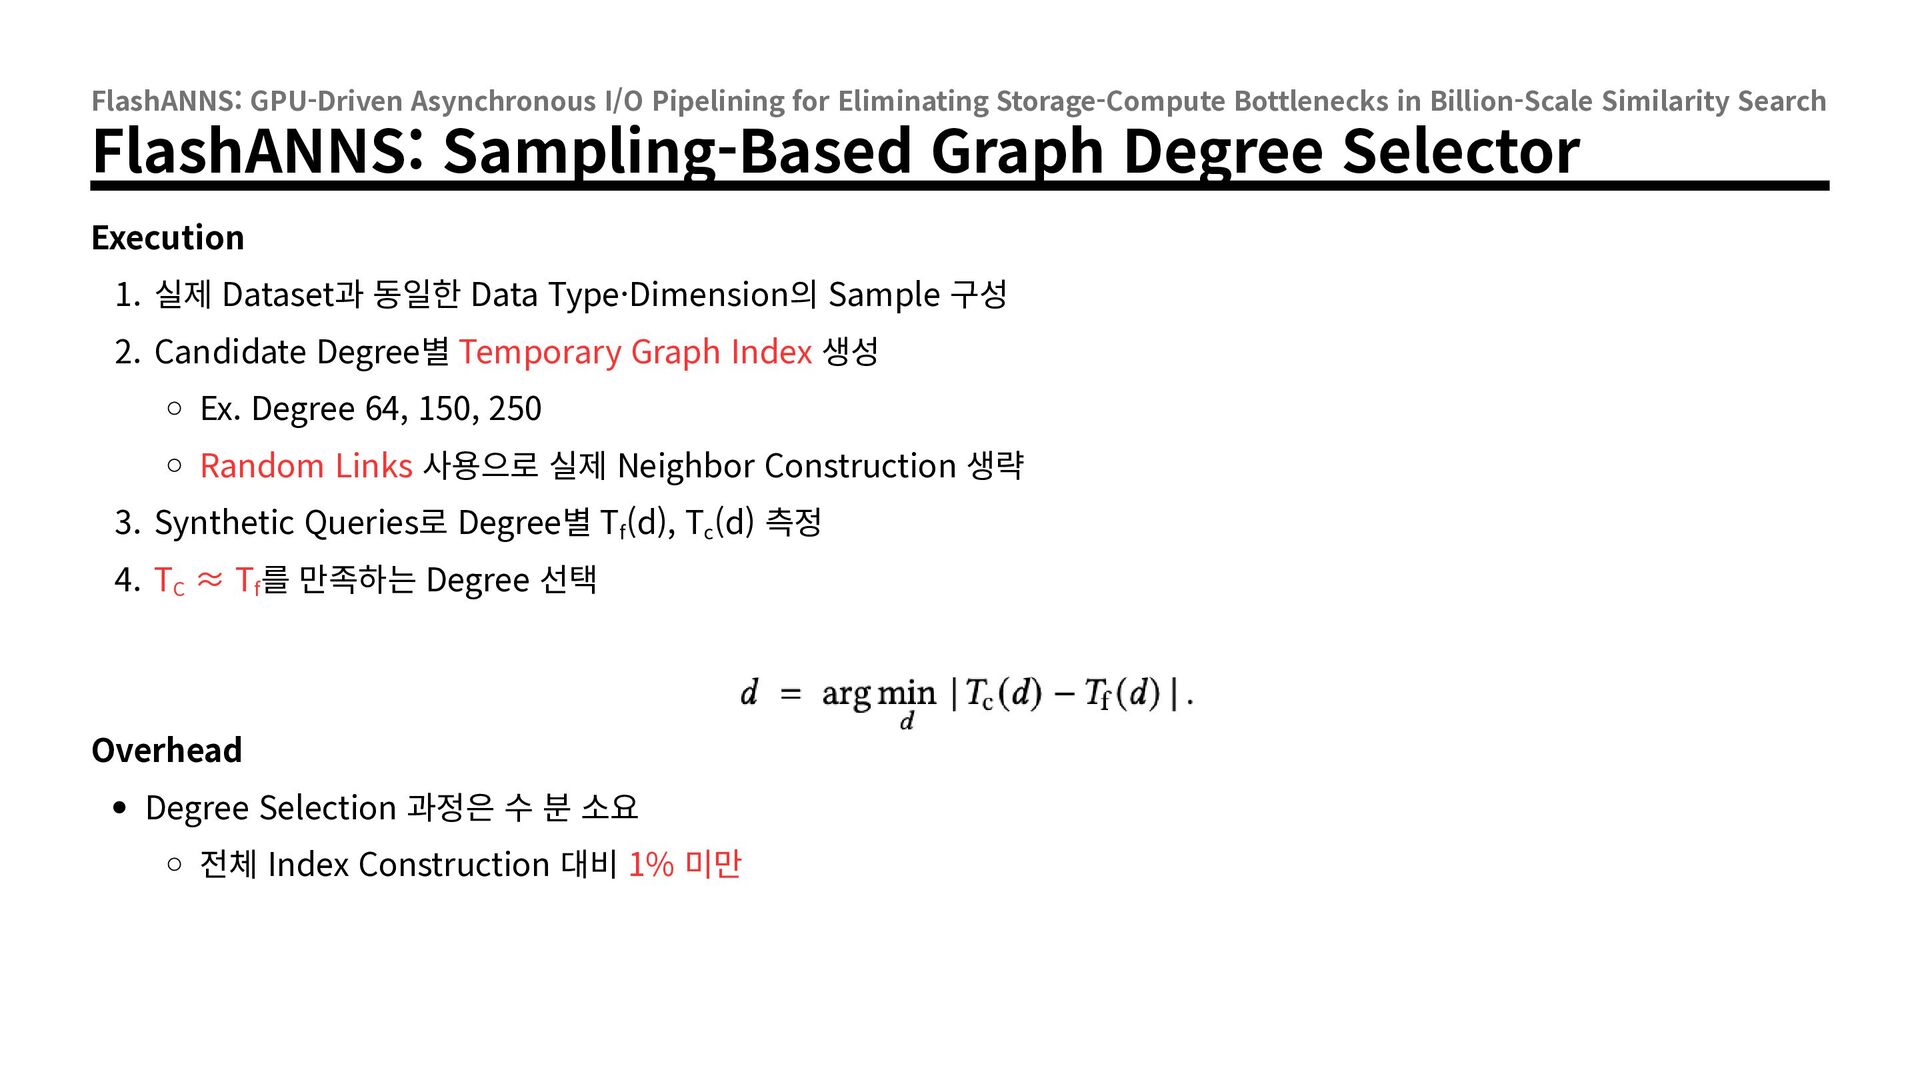
Billion-Scale Similarity Search FlashANNS: Sampling-Based Graph Degree Selector Execution 1. 실제 Dataset과 동일한 Data Type·Dimension의 Sample 구성 2. Candidate Degree별 Temporary Graph Index 생성 Ex. Degree 64, 150, 250 Random Links 사용으로 실제 Neighbor Construction 생략 3. Synthetic Queries로 Degree별 Tf(d), Tc(d) 측정 4. TC ≈ Tf를 만족하는 Degree 선택 Overhead Degree Selection 과정은 수 분 소요 전체 Index Construction 대비 1% 미만
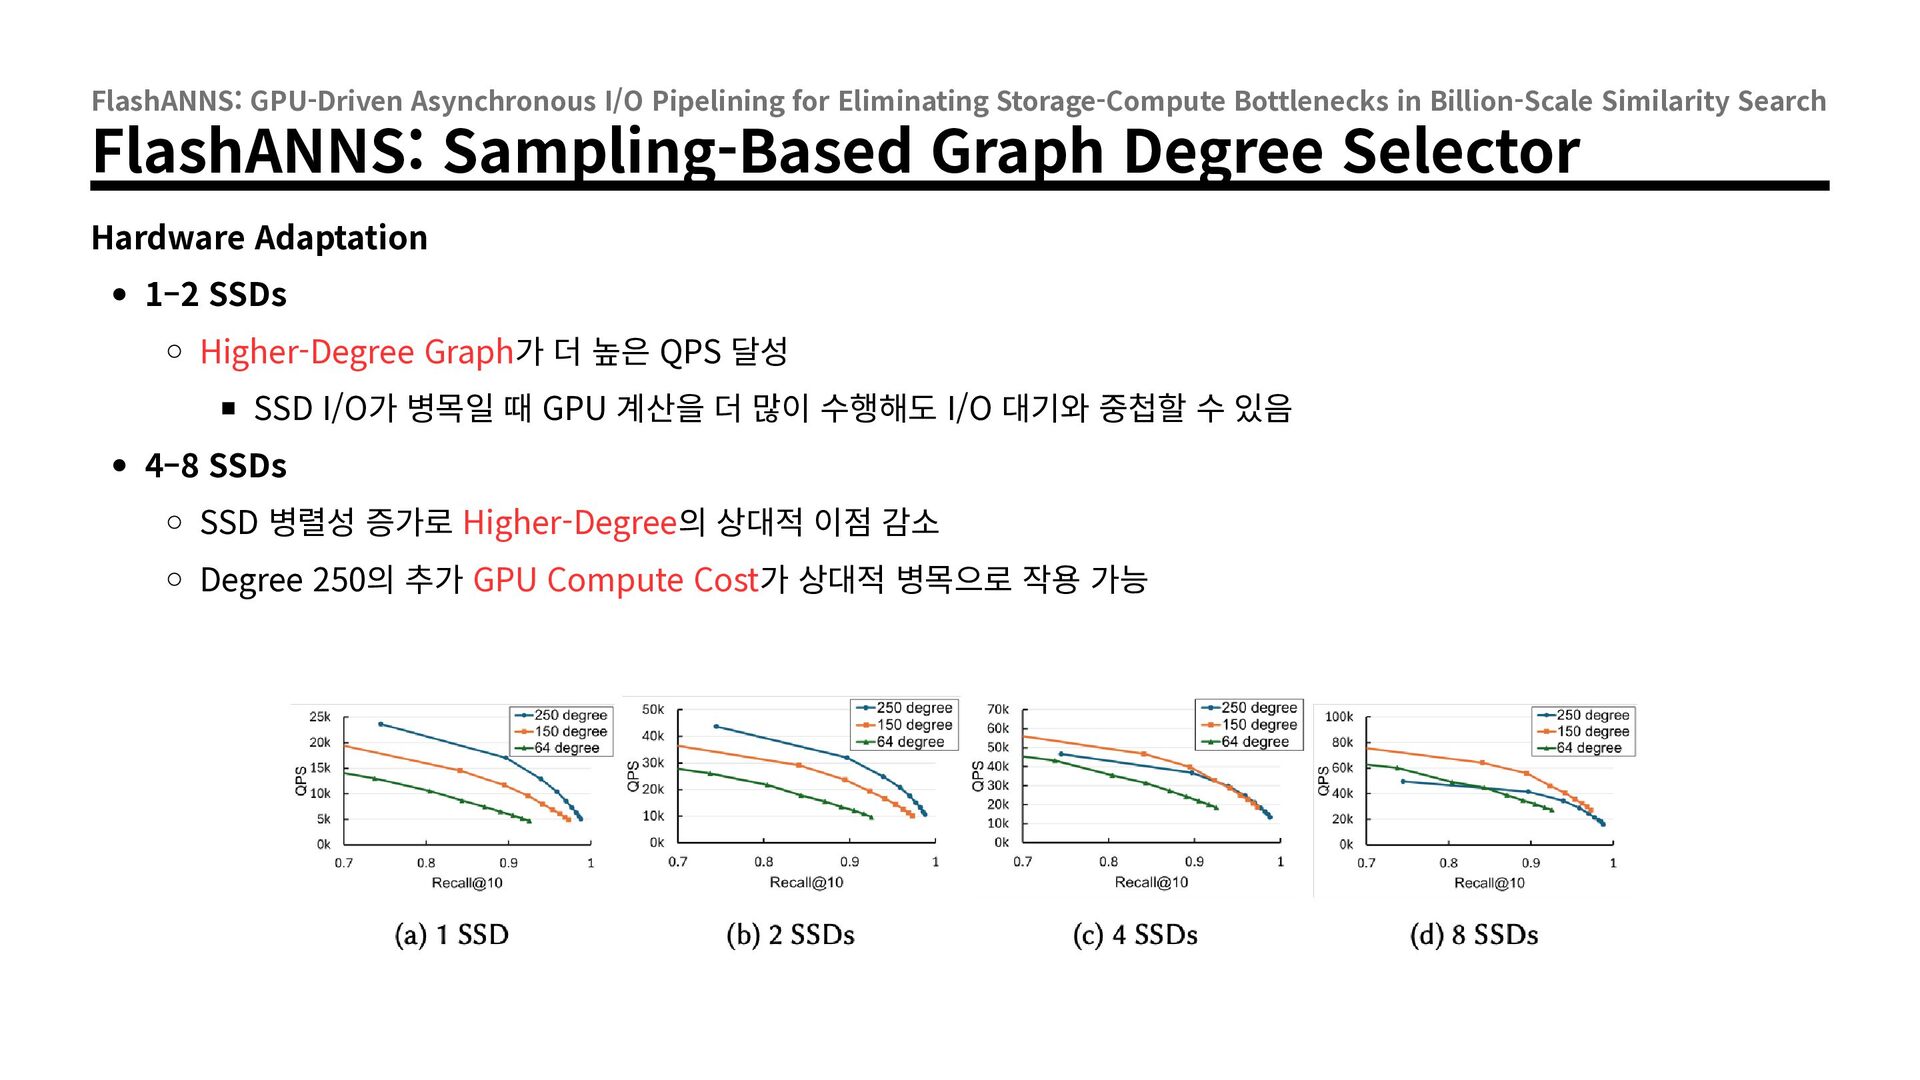
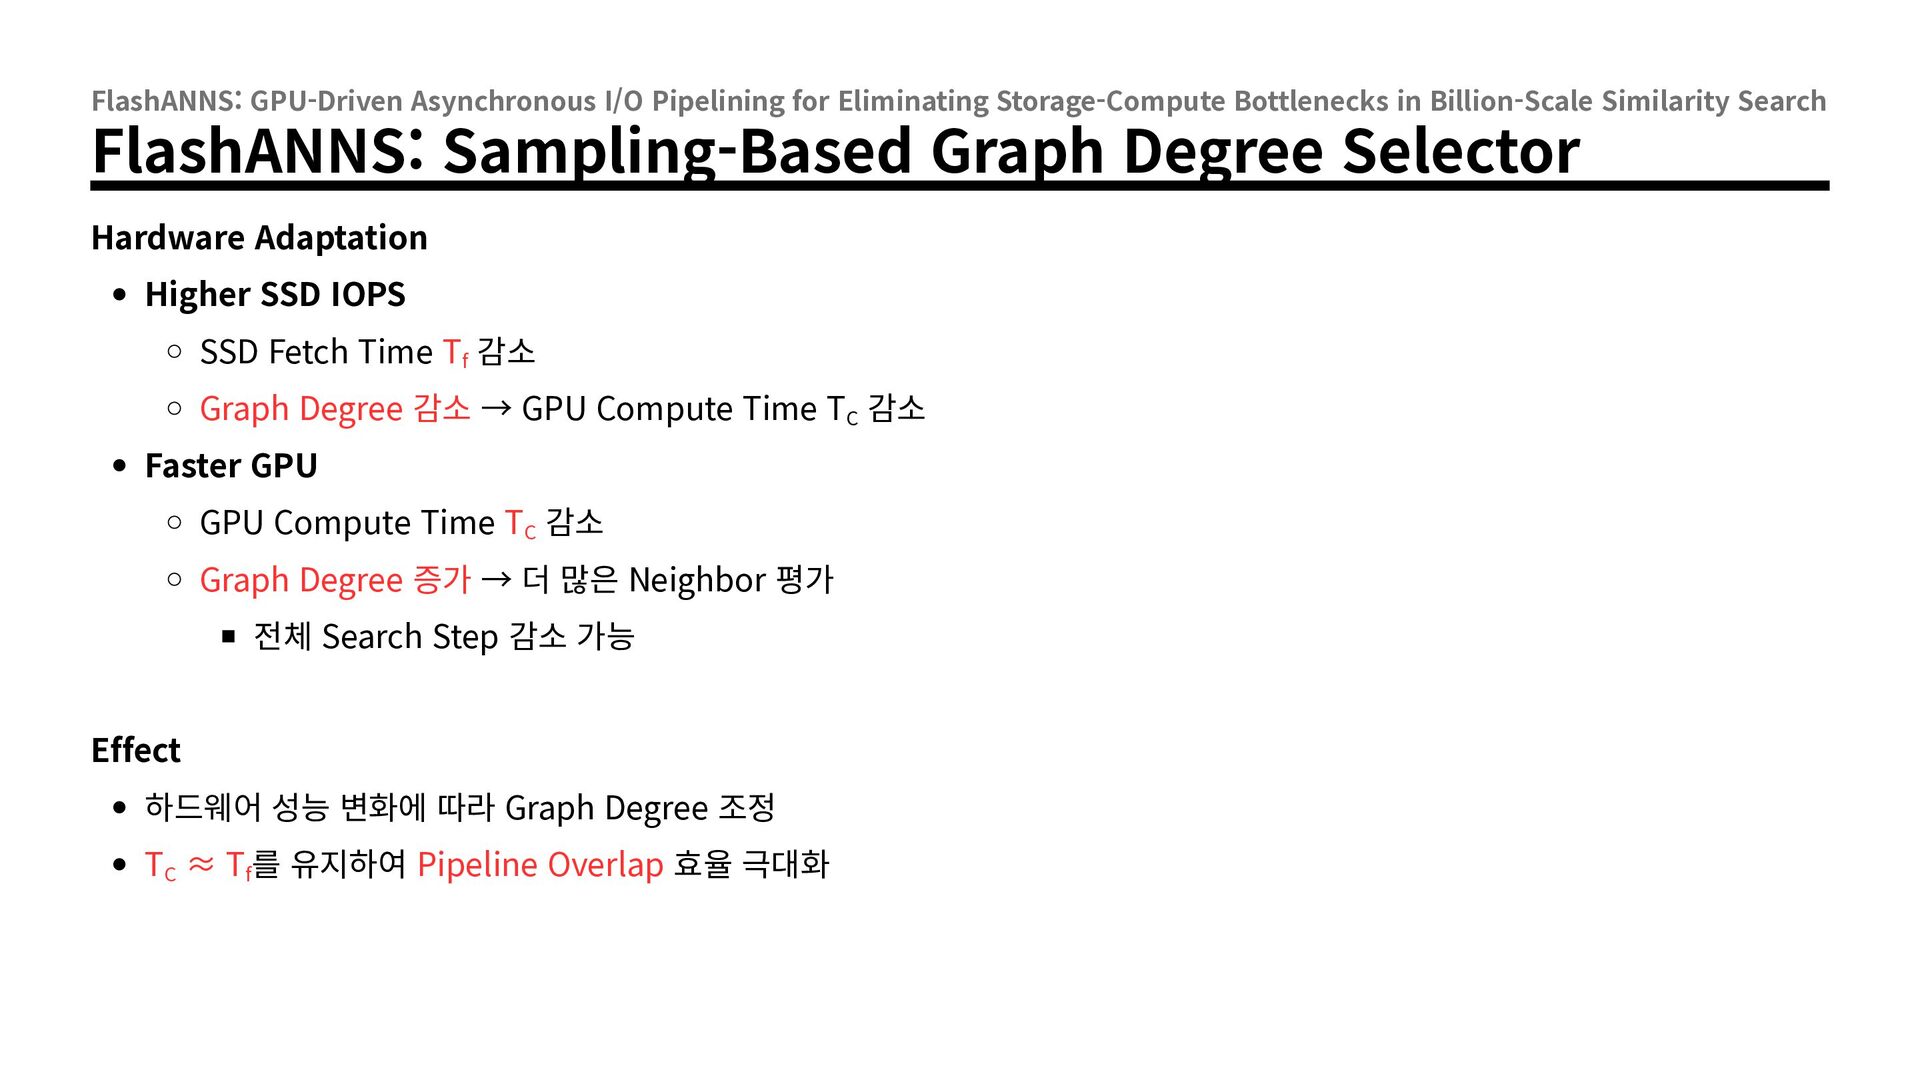
Billion-Scale Similarity Search FlashANNS: Sampling-Based Graph Degree Selector Hardware Adaptation Higher SSD IOPS SSD Fetch Time Tf 감소 Graph Degree 감소 → GPU Compute Time TC 감소 Faster GPU GPU Compute Time TC 감소 Graph Degree 증가 → 더 많은 Neighbor 평가 전체 Search Step 감소 가능 Effect 하드웨어 성능 변화에 따라 Graph Degree 조정 TC ≈ Tf를 유지하여 Pipeline Overlap 효율 극대화
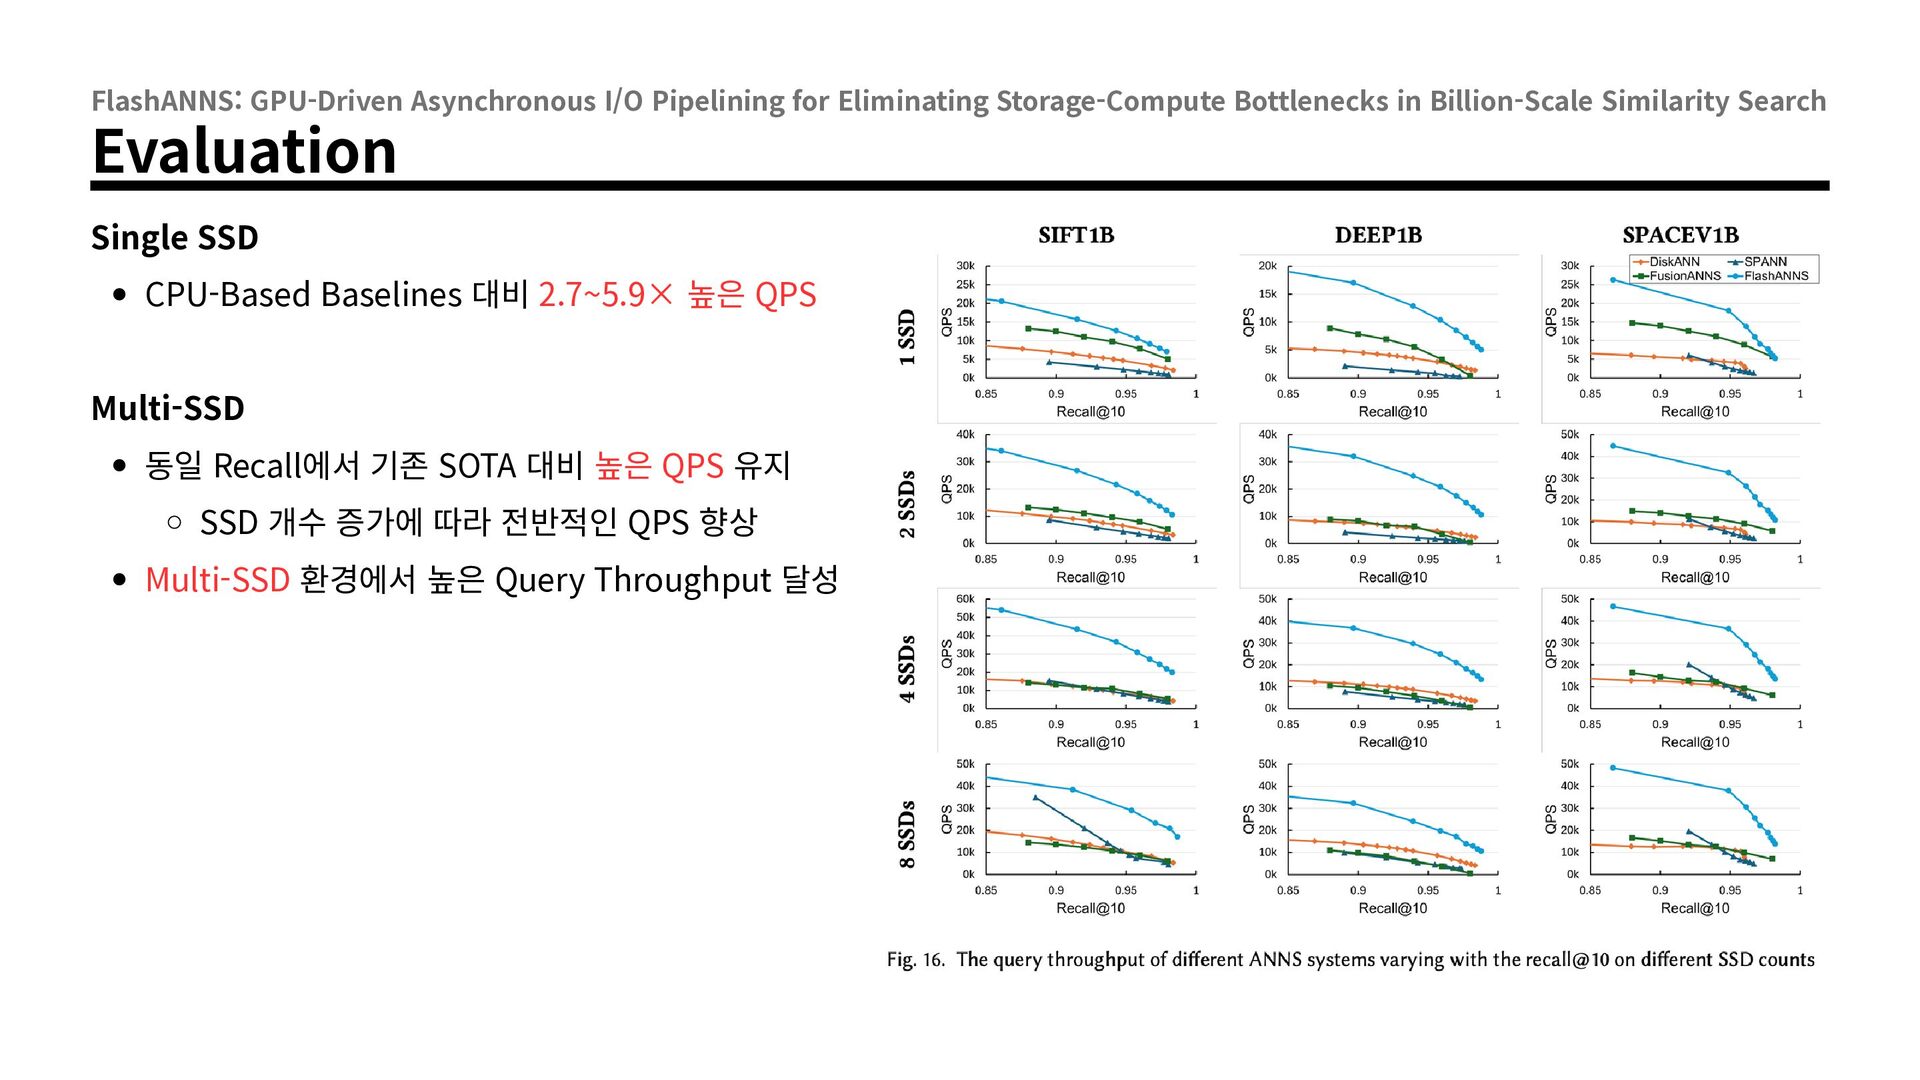
Billion-Scale Similarity Search Evaluation Single SSD CPU-Based Baselines 대비 2.7~5.9× 높은 QPS Multi-SSD 동일 Recall에서 기존 SOTA 대비 높은 QPS 유지 SSD 개수 증가에 따라 전반적인 QPS 향상 Multi-SSD 환경에서 높은 Query Throughput 달성
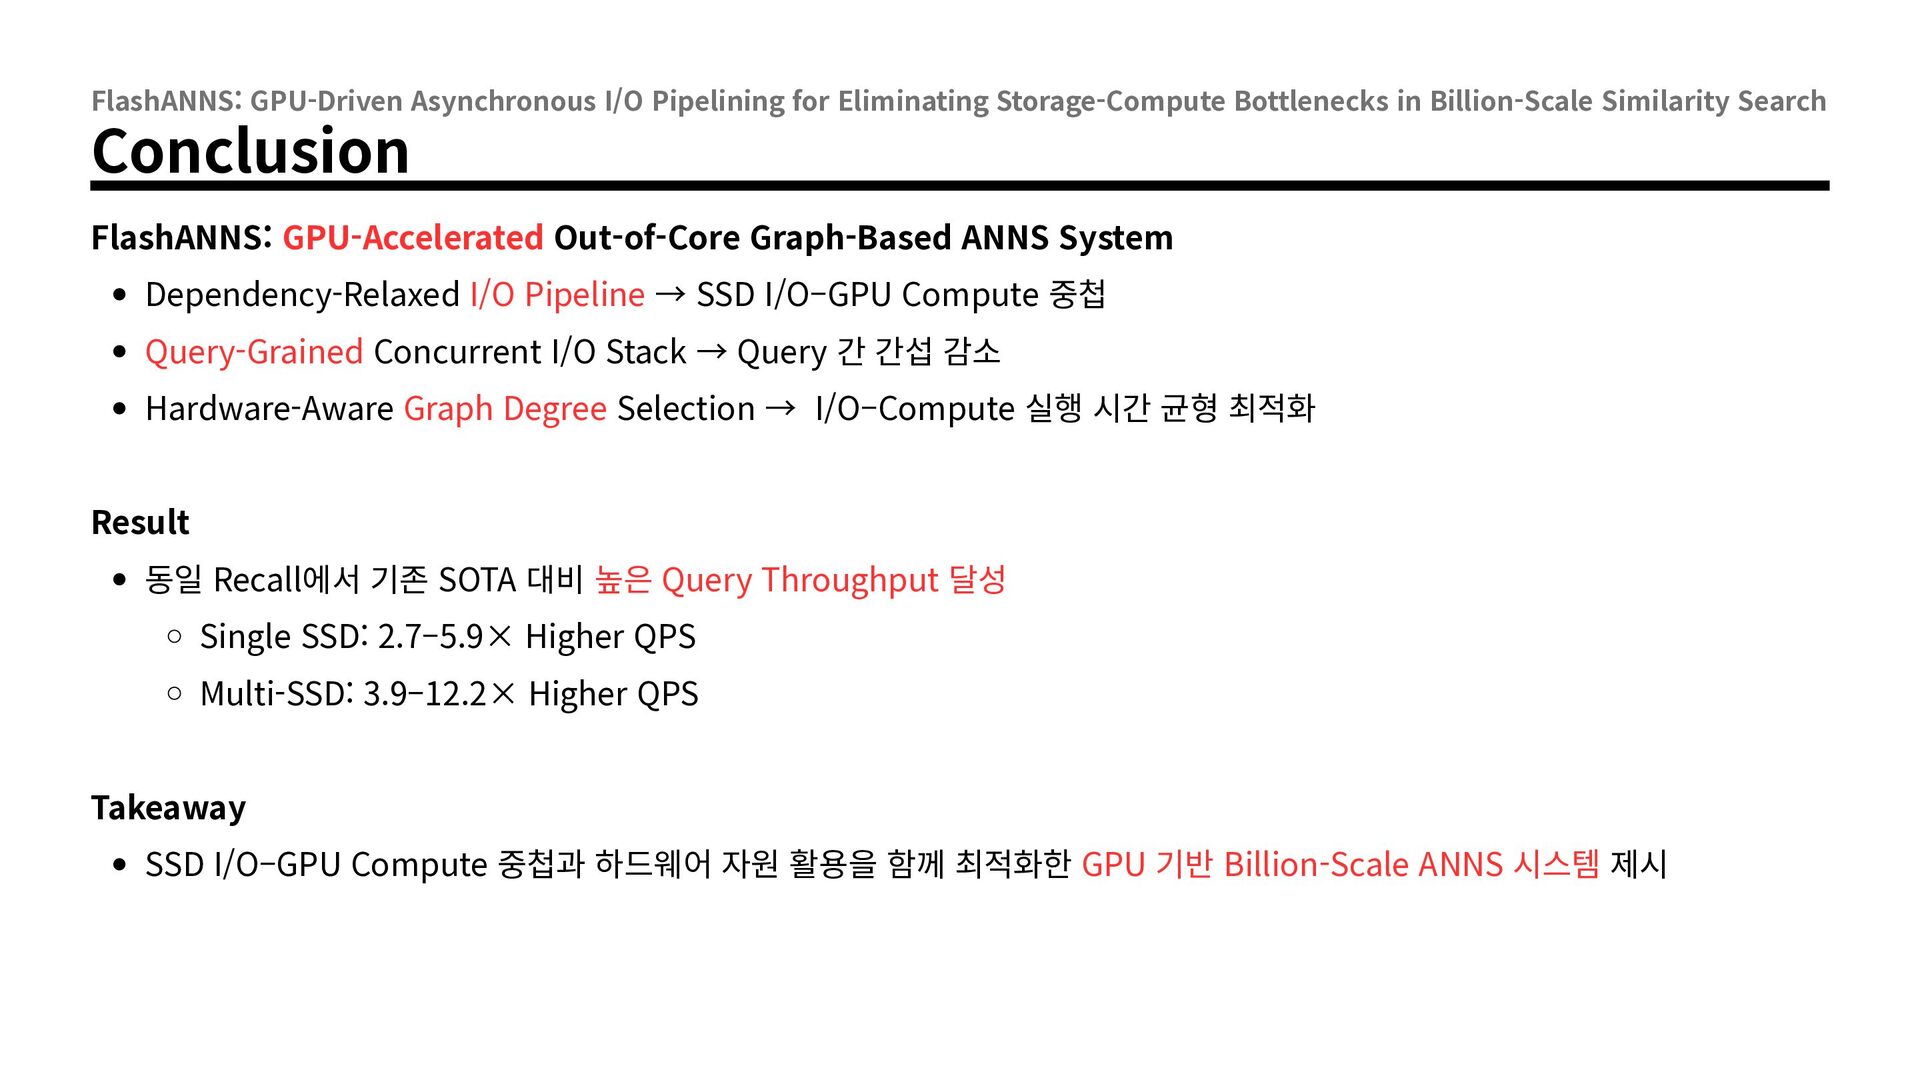
Billion-Scale Similarity Search Conclusion FlashANNS: GPU-Accelerated Out-of-Core Graph-Based ANNS System Dependency-Relaxed I/O Pipeline → SSD I/O–GPU Compute 중첩 Query-Grained Concurrent I/O Stack → Query 간 간섭 감소 Hardware-Aware Graph Degree Selection → I/O–Compute 실행 시간 균형 최적화 Result 동일 Recall에서 기존 SOTA 대비 높은 Query Throughput 달성 Single SSD: 2.7–5.9× Higher QPS Multi-SSD: 3.9–12.2× Higher QPS Takeaway SSD I/O–GPU Compute 중첩과 하드웨어 자원 활용을 함께 최적화한 GPU 기반 Billion-Scale ANNS 시스템 제시


 nawkwoo
 dk999
 tattaka
 institutdelelevage
 hisaokatsumi
 satai
 kohlerjohannes
 mickey_0226
 sishi2026
 hf149
 wataruuuuu
 nnchiba
 frankvandijk
 aleyda
 takai
 mfonobong
 maltzj
 panda_program
 reverentgeek
 axbom
 techseoconnect
 jonoalderson
 swwweet
 chriscoyier