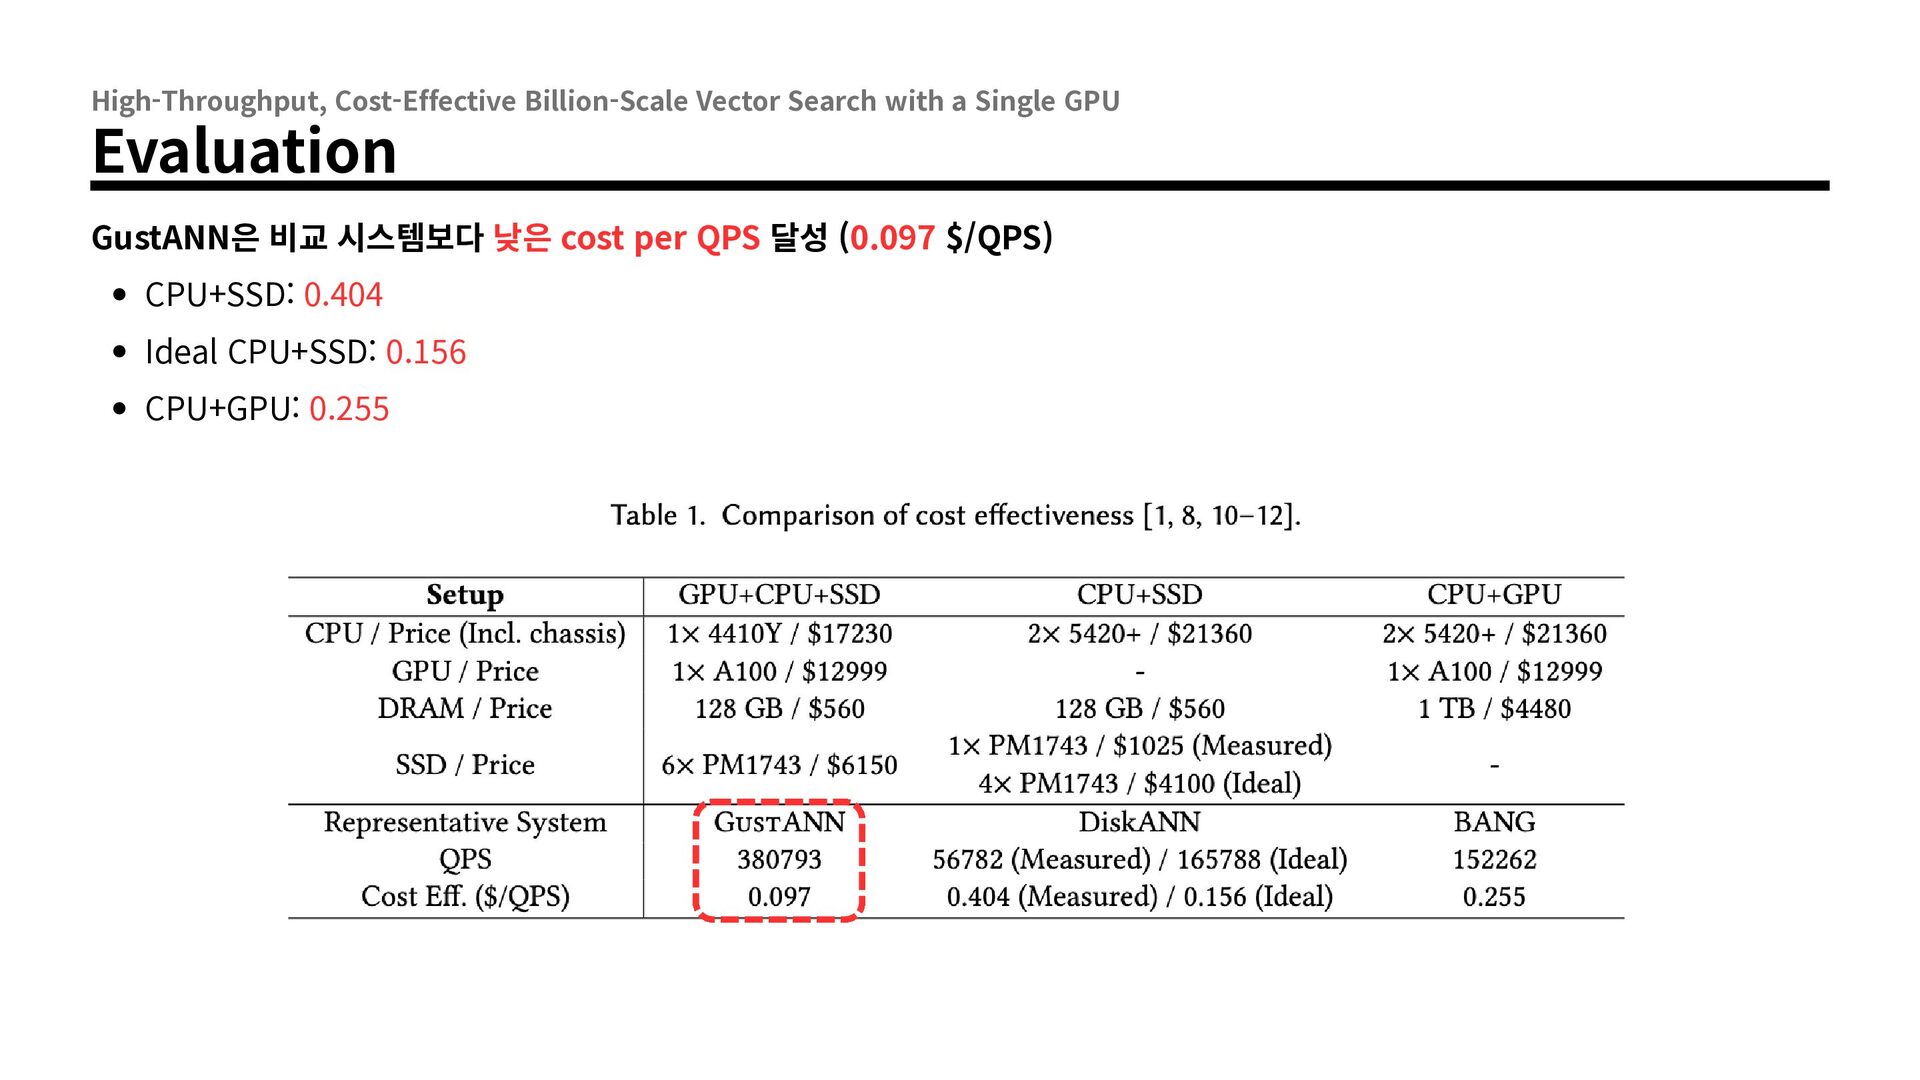
ANNS Use Cases ANNS는 Web Search, Recommendation Systems, RAG 등에 활용 실제 서비스에서 Billion-scale Dataset과 약 100K QPS 규모의 검색 수요 발생 Needs for High-throughput, Cost-effective ANNS Billion-scale Vector Search에서 높은 Throughput과 Cost-effectiveness 요구 $/QPS = 시스템 하드웨어 비용 ÷ QPS (낮을수록 효율적) On-SSD Graph-based ANNS: 동일 Hardware Configuration에서 Cluster-based 대비 높은 Throughput 제공 GustANN: On-SSD Graph-based ANNS의 시스템 성능 최적화에 초점
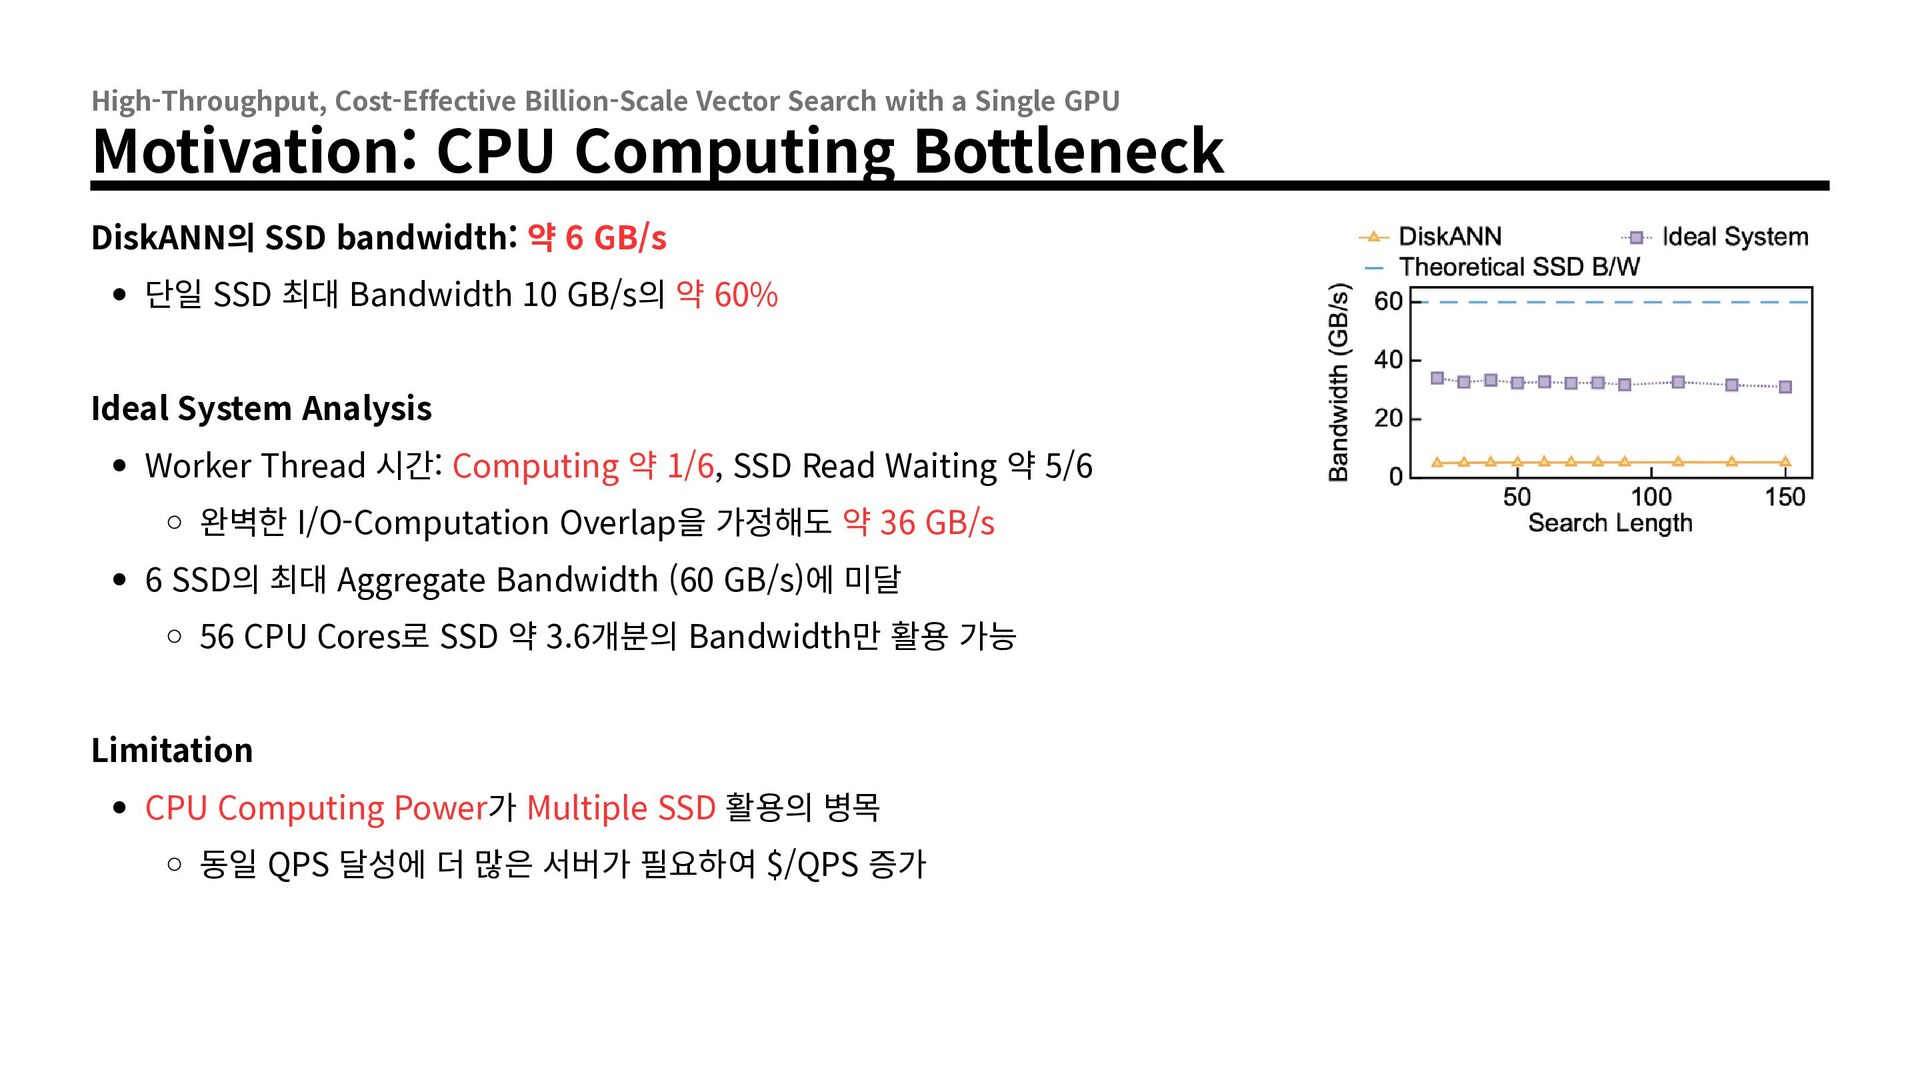
CPU Computing Bottleneck DiskANN의 SSD bandwidth: 약 6 GB/s 단일 SSD 최대 Bandwidth 10 GB/s의 약 60% Ideal System Analysis Worker Thread 시간: Computing 약 1/6, SSD Read Waiting 약 5/6 완벽한 I/O-Computation Overlap을 가정해도 약 36 GB/s 6 SSD의 최대 Aggregate Bandwidth (60 GB/s)에 미달 56 CPU Cores로 SSD 약 3.6개분의 Bandwidth만 활용 가능 Limitation CPU Computing Power가 Multiple SSD 활용의 병목 동일 QPS 달성에 더 많은 서버가 필요하여 $/QPS 증가
Limitations of Existing GPU-based ANNS CPU-centric, GPU-assisted CPU에서 Main Search Process를 수행하고 GPU에 Vector Computation Offloading Cluster-based ANNS: 높은 Distance Computation 비중으로 GPU Offloading이 효과적 Graph-based ANNS: 상대적으로 낮은 Computation 비중으로 GPU Offloading 효과 제한 GPU-only Graph Traversal과 Vector Computation 모두 GPU에서 수행 CPU Search Bottleneck 해소 Limitations CPU-centric, GPU-assisted → CPU Search Bottleneck 잔존 GPU-only → GPU Memory 및 Inbound Transfer Bandwidth가 새로운 병목으로 작용
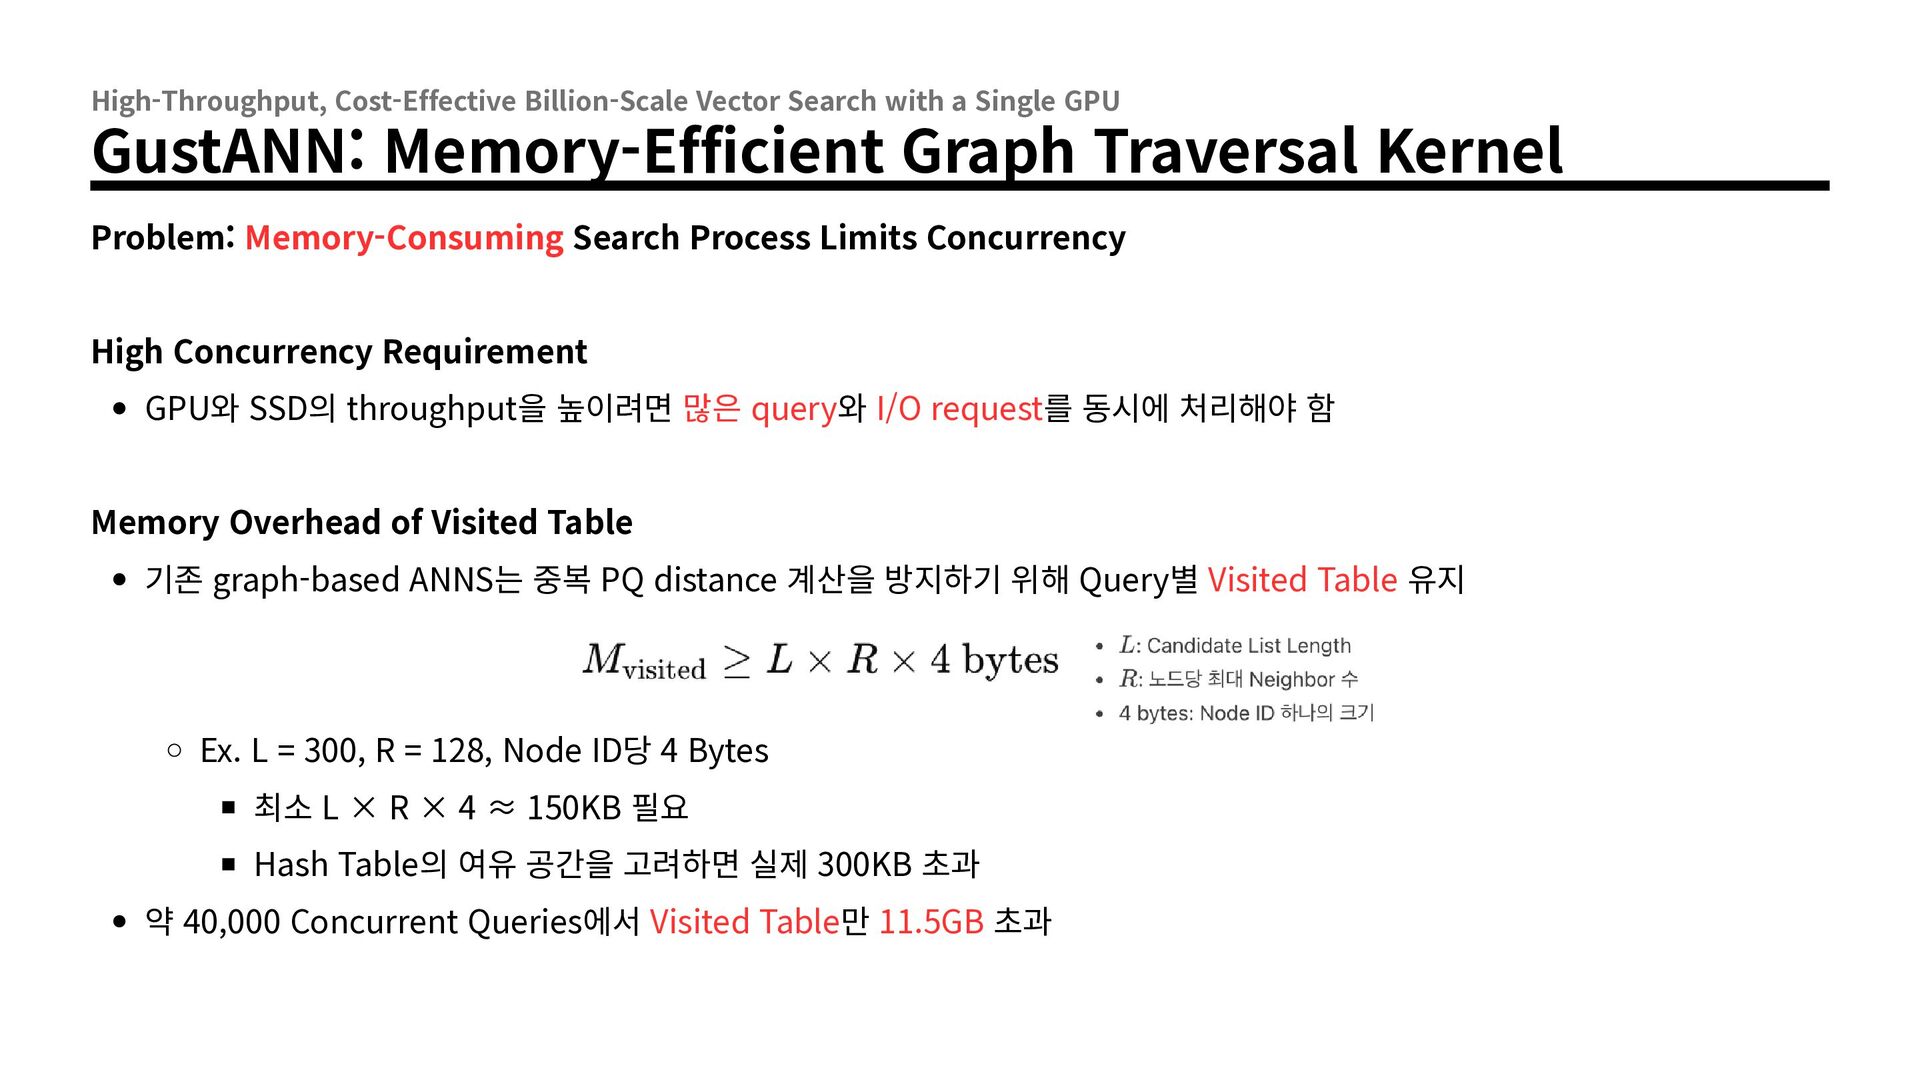
Memory-Efficient Graph Traversal Kernel Problem: Memory-Consuming Search Process Limits Concurrency High Concurrency Requirement GPU와 SSD의 throughput을 높이려면 많은 query와 I/O request를 동시에 처리해야 함 Memory Overhead of Visited Table 기존 graph-based ANNS는 중복 PQ distance 계산을 방지하기 위해 Query별 Visited Table 유지 Ex. L = 300, R = 128, Node ID당 4 Bytes 최소 L × R × 4 ≈ 150KB 필요 Hash Table의 여유 공간을 고려하면 실제 300KB 초과 약 40,000 Concurrent Queries에서 Visited Table만 11.5GB 초과
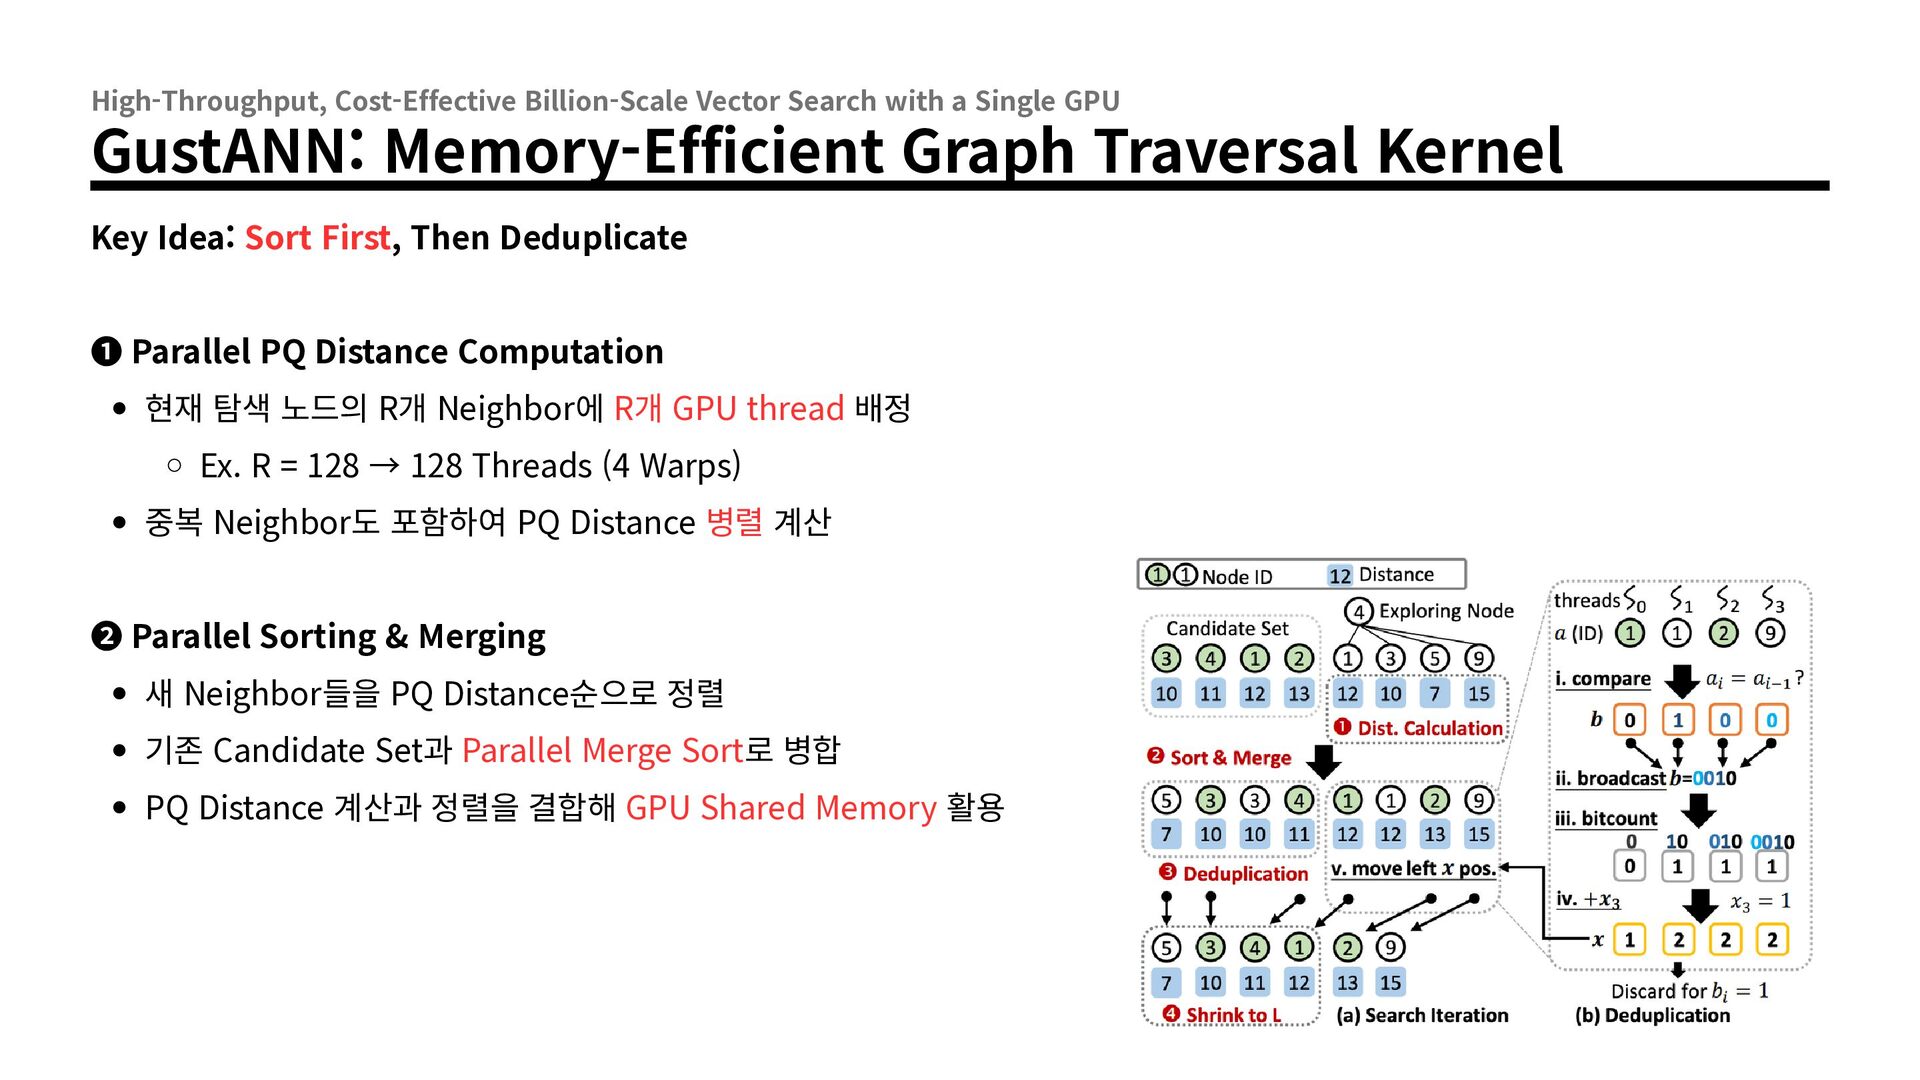
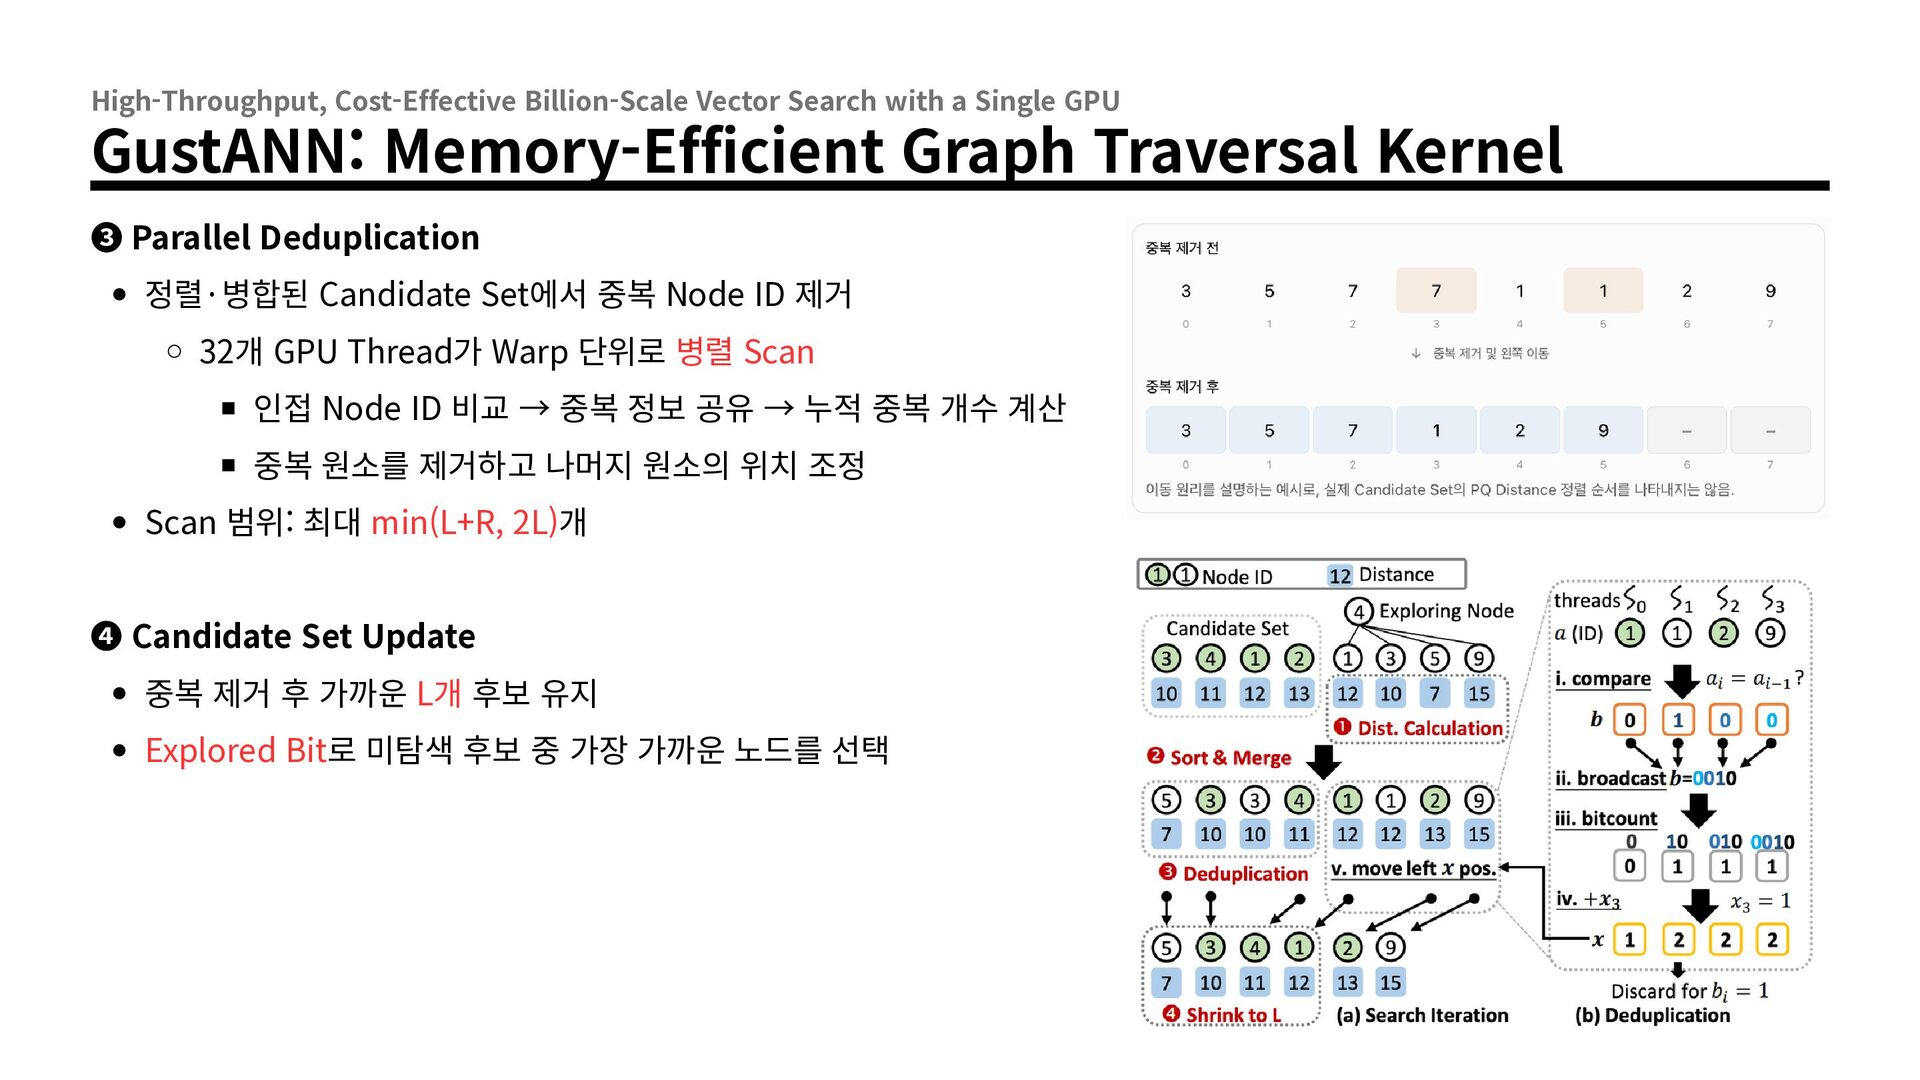
Memory-Efficient Graph Traversal Kernel ➌ Parallel Deduplication 정렬·병합된 Candidate Set에서 중복 Node ID 제거 32개 GPU Thread가 Warp 단위로 병렬 Scan 인접 Node ID 비교 → 중복 정보 공유 → 누적 중복 개수 계산 중복 원소를 제거하고 나머지 원소의 위치 조정 Scan 범위: 최대 min(L+R, 2L)개 ➍ Candidate Set Update 중복 제거 후 가까운 L개 후보 유지 Explored Bit로 미탐색 후보 중 가장 가까운 노드를 선택
Memory-Efficient Graph Traversal Kernel Effect: Memory-Efficient GPU Search Lower Search-State Memory Footprint Query별 Visited Table을 제거해 GPU 메모리 사용량 감소 Per-query Memory: 480KB → 40.22KB (11.93× 절감) BANG 대비, SIFT100M 기준 (L=100, k=10) Higher GPU·SSD Concurrency 절약한 GPU 메모리로 더 큰 Batch Size와 높은 Query Concurrency 지원 40,000 Concurrent Queries 기준 메모리 사용량 BANG: 18.3GB → GustANN: 1.53GB 더 많은 Query와 I/O Request를 동시에 처리해 GPU·SSD 활용률을 높일 수 있는 기반 마련
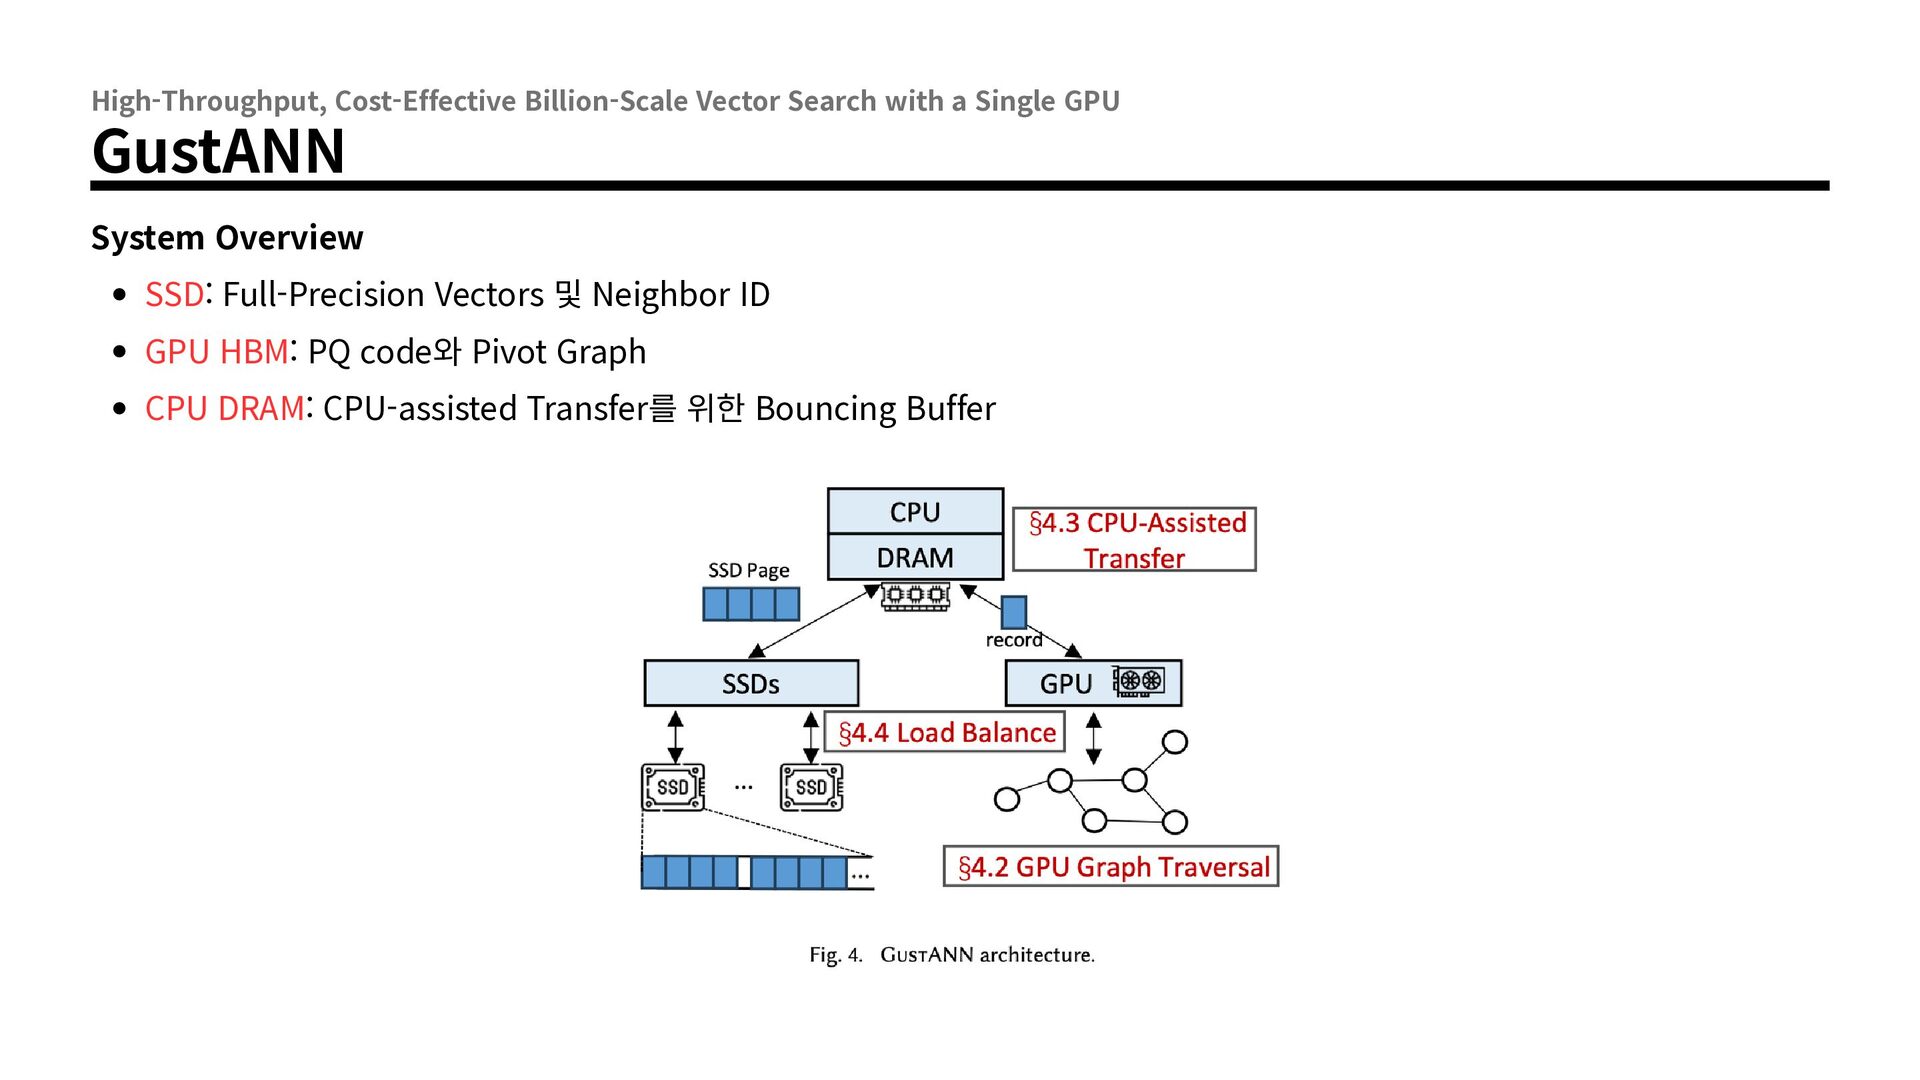
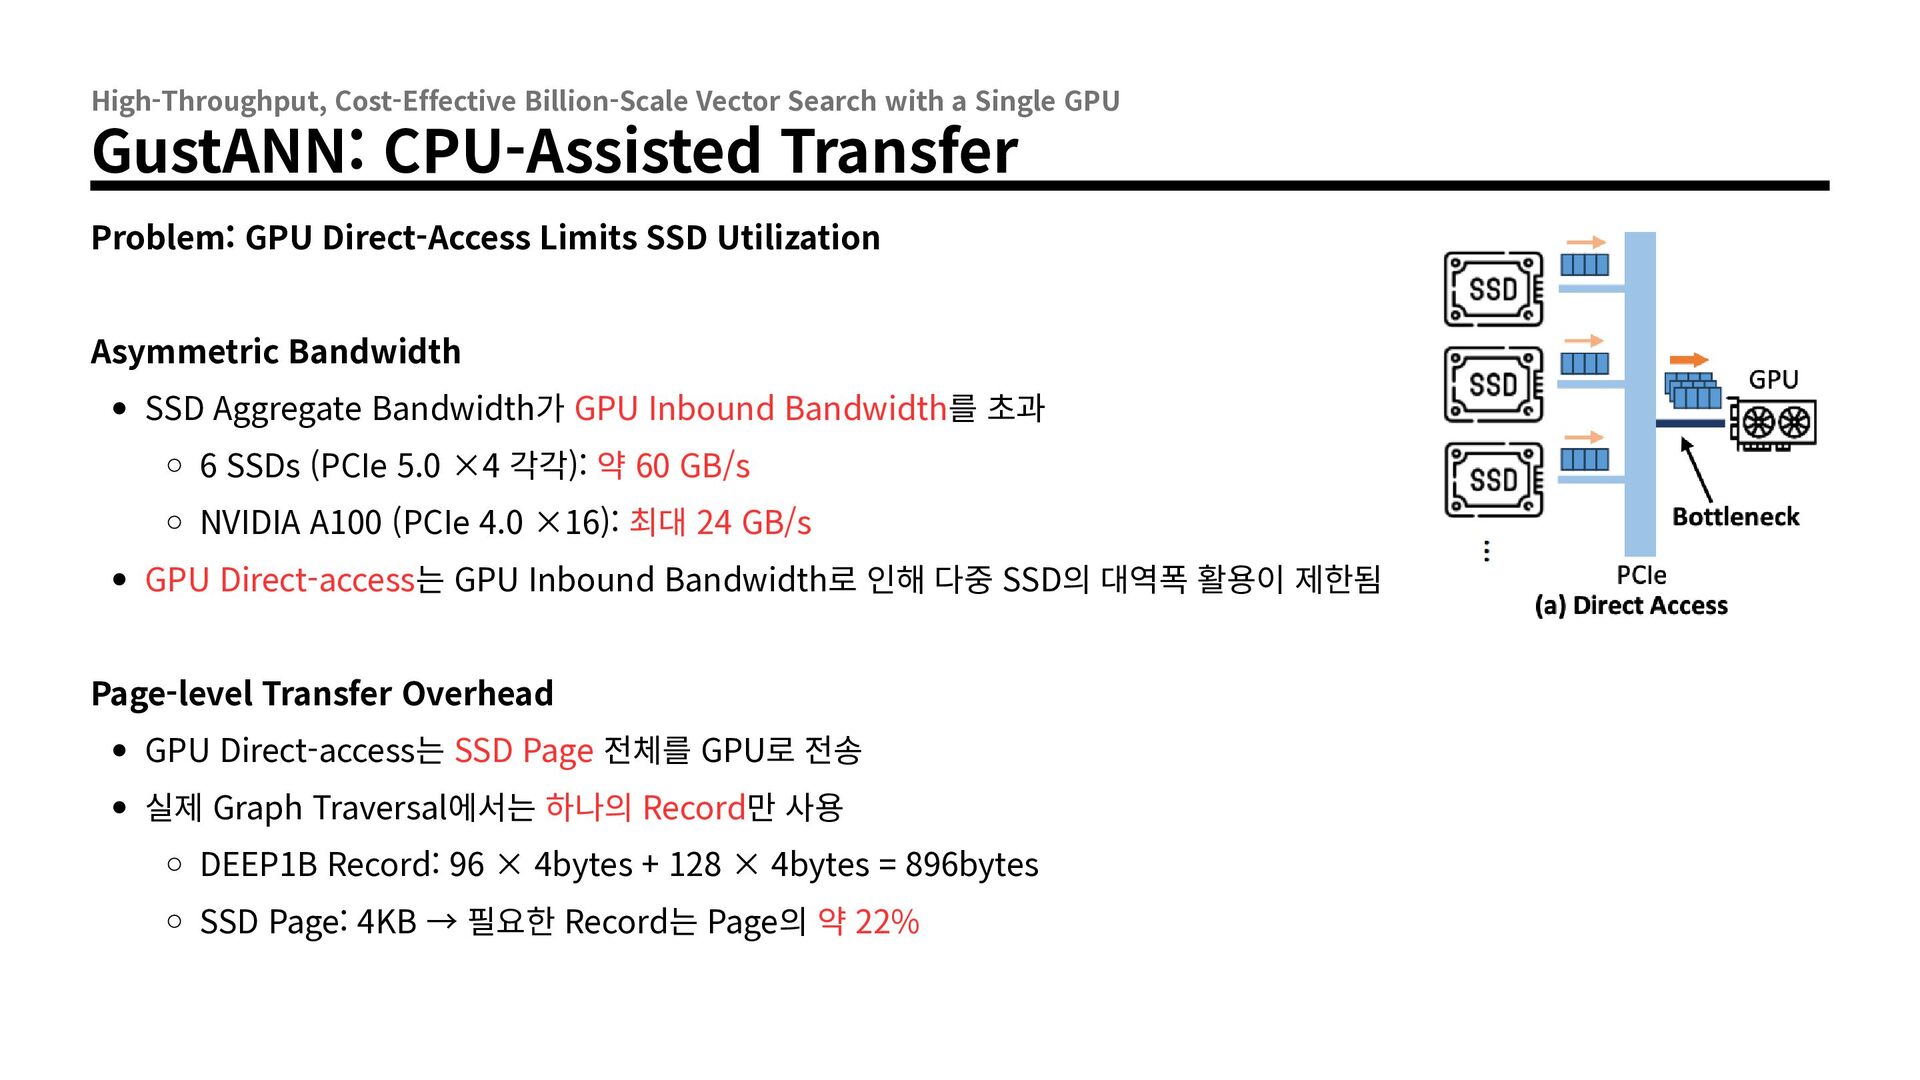
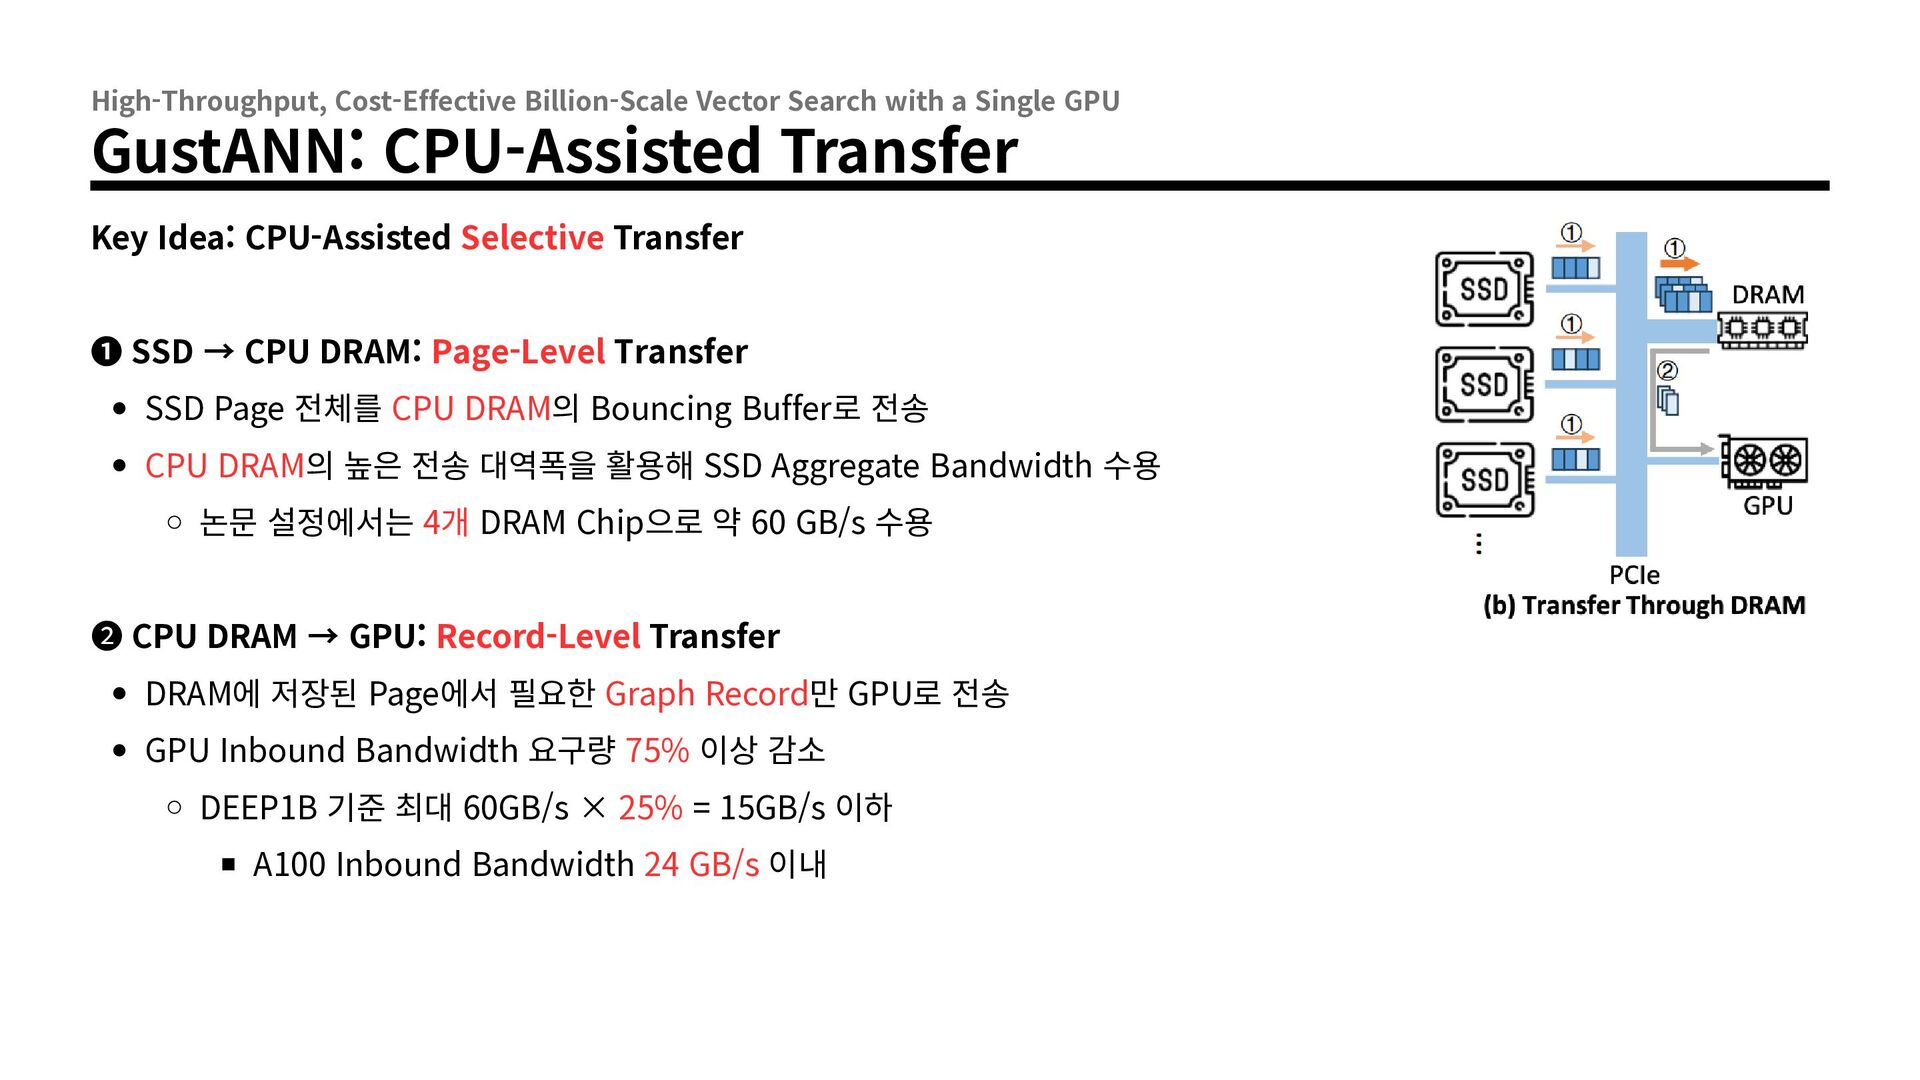
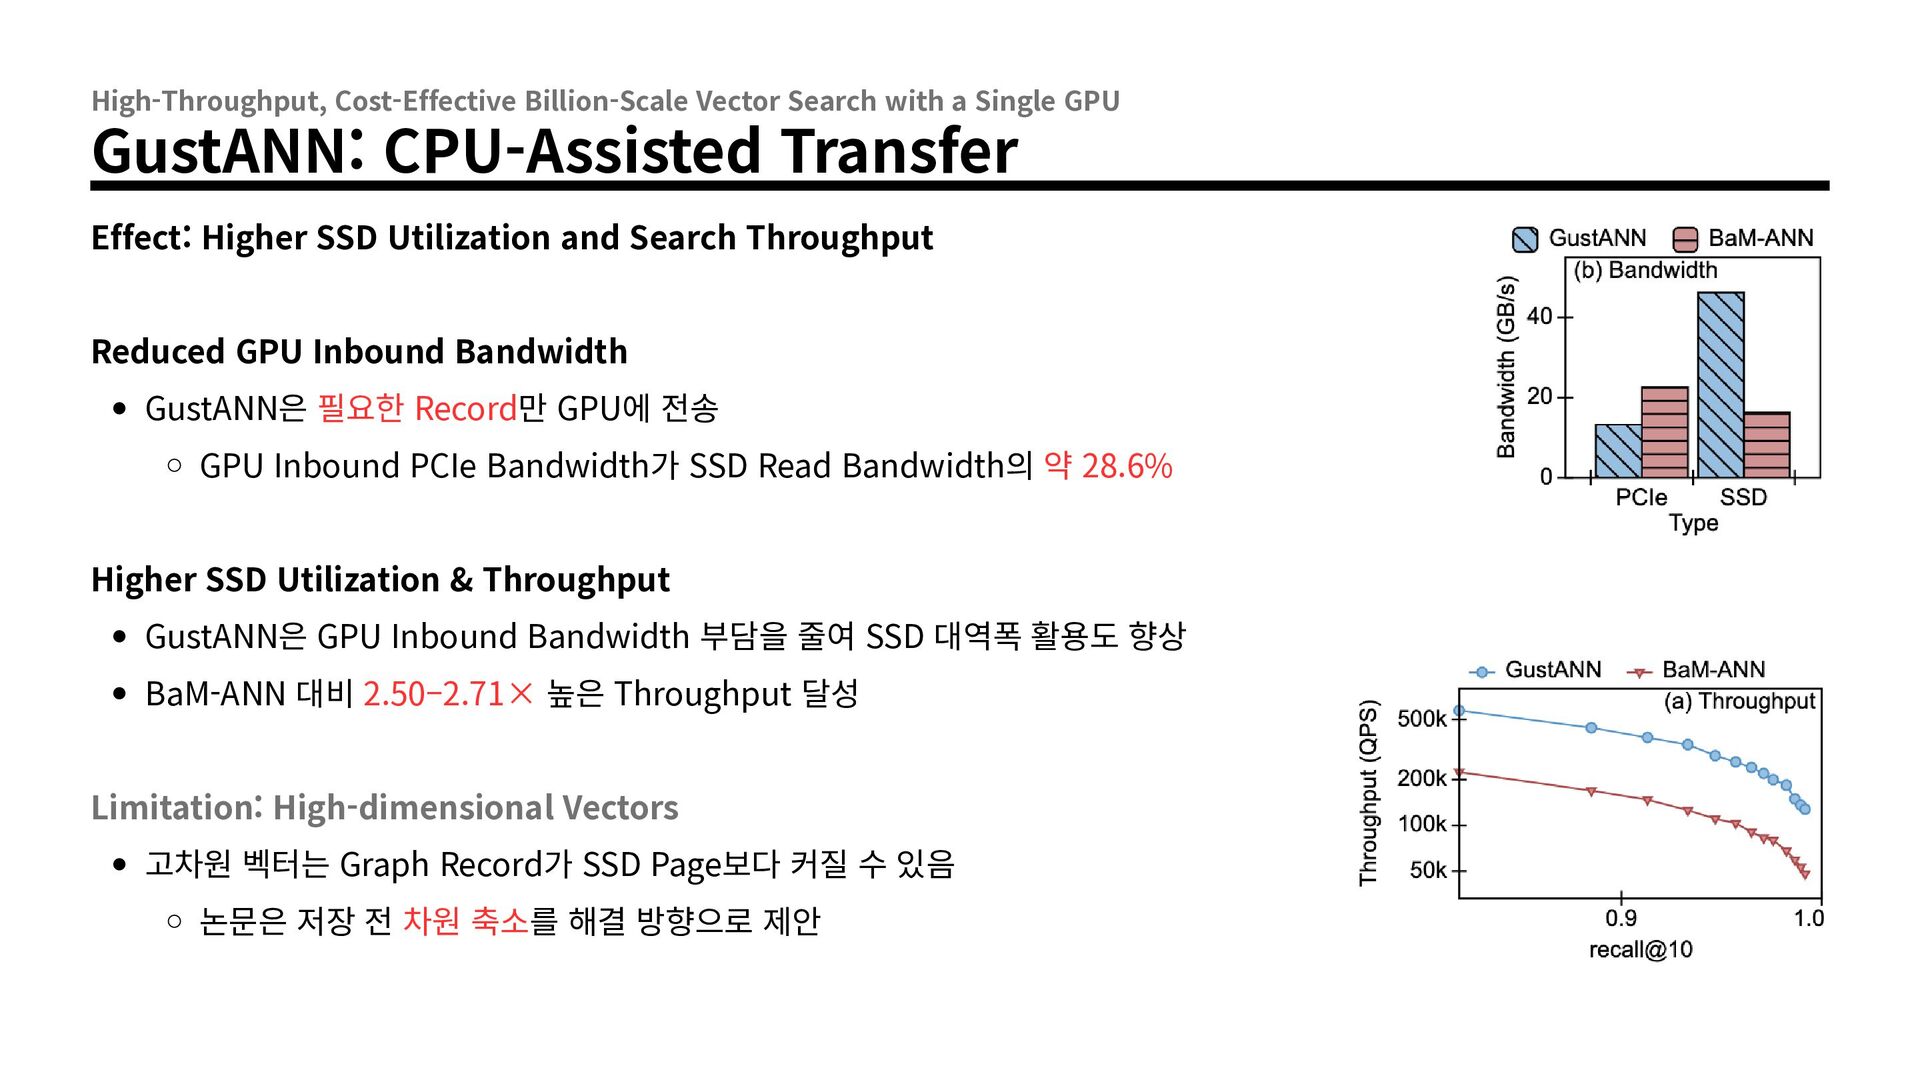
CPU-Assisted Transfer Key Idea: CPU-Assisted Selective Transfer ➊ SSD → CPU DRAM: Page-Level Transfer SSD Page 전체를 CPU DRAM의 Bouncing Buffer로 전송 CPU DRAM의 높은 전송 대역폭을 활용해 SSD Aggregate Bandwidth 수용 논문 설정에서는 4개 DRAM Chip으로 약 60 GB/s 수용 ➋ CPU DRAM → GPU: Record-Level Transfer DRAM에 저장된 Page에서 필요한 Graph Record만 GPU로 전송 GPU Inbound Bandwidth 요구량 75% 이상 감소 DEEP1B 기준 최대 60GB/s × 25% = 15GB/s 이하 A100 Inbound Bandwidth 24 GB/s 이내
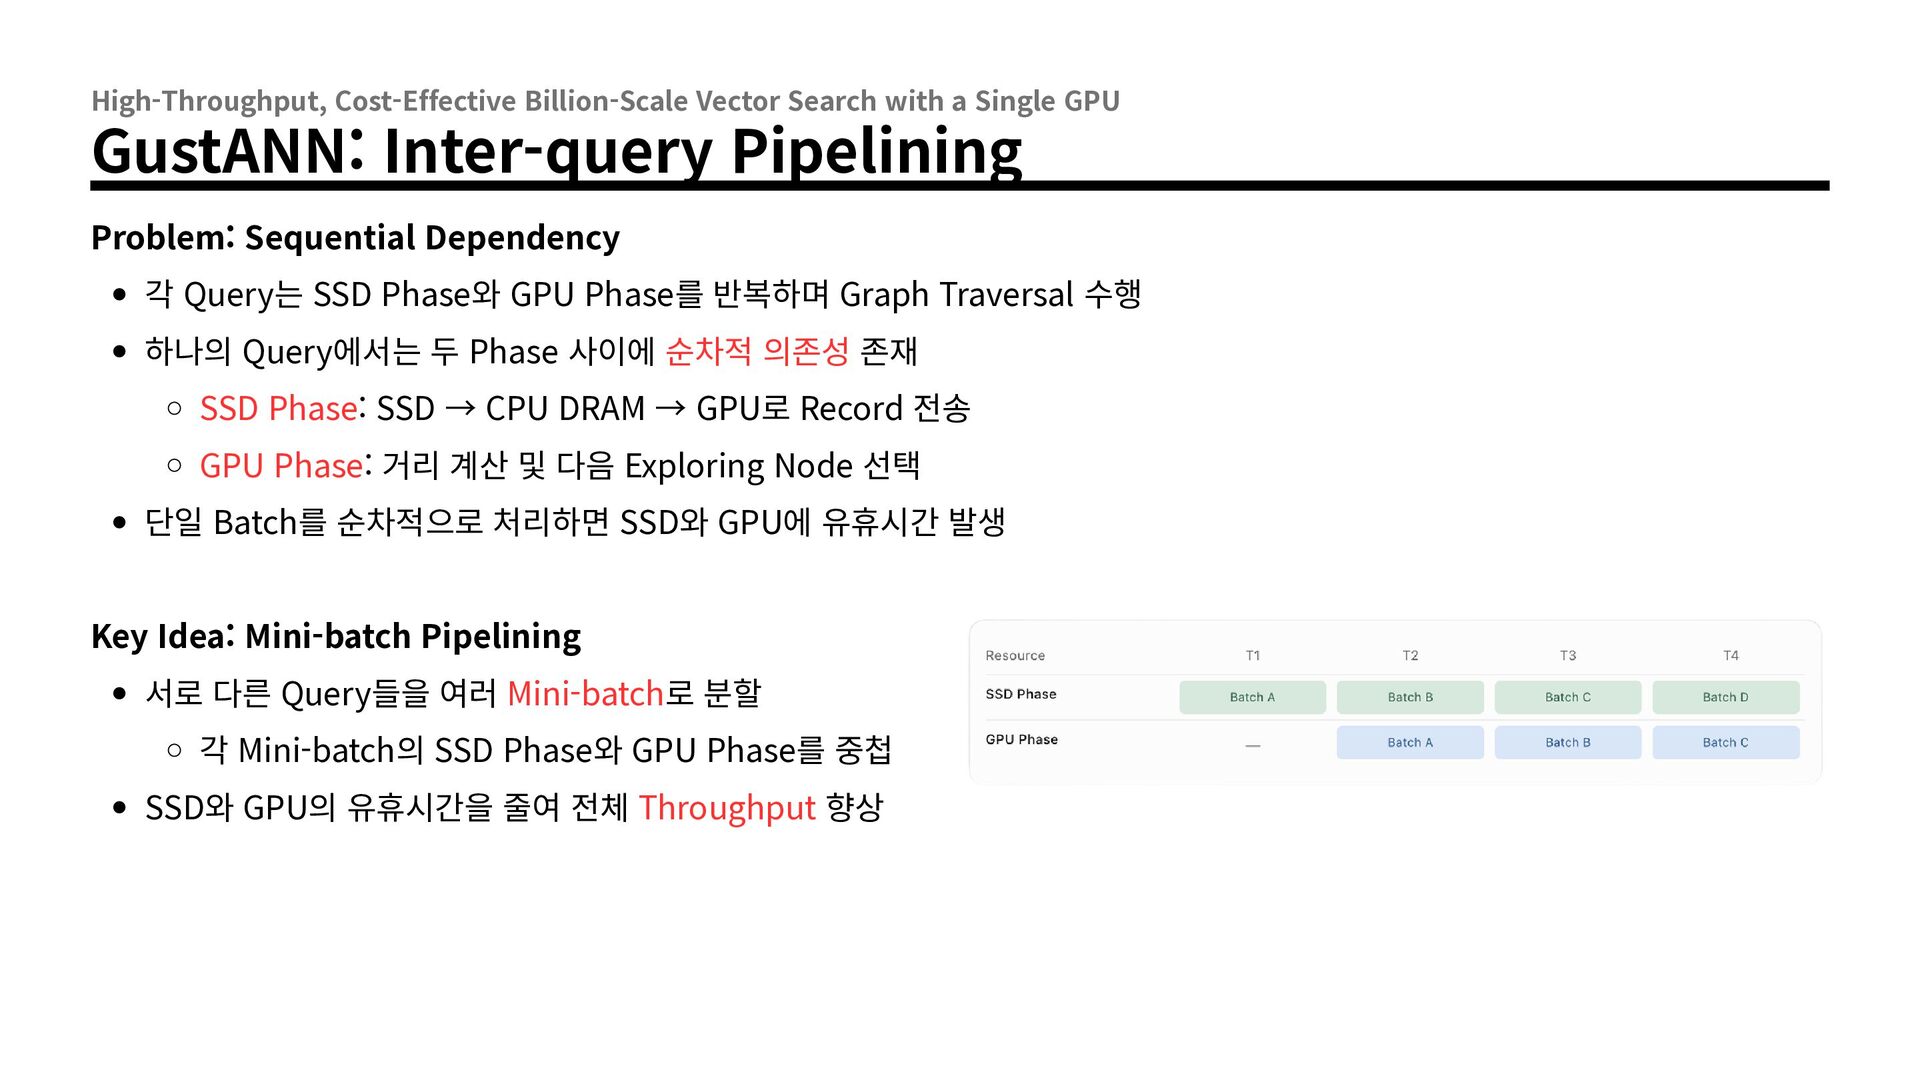
Inter-query Pipelining Problem: Sequential Dependency 각 Query는 SSD Phase와 GPU Phase를 반복하며 Graph Traversal 수행 하나의 Query에서는 두 Phase 사이에 순차적 의존성 존재 SSD Phase: SSD → CPU DRAM → GPU로 Record 전송 GPU Phase: 거리 계산 및 다음 Exploring Node 선택 단일 Batch를 순차적으로 처리하면 SSD와 GPU에 유휴시간 발생 Key Idea: Mini-batch Pipelining 서로 다른 Query들을 여러 Mini-batch로 분할 각 Mini-batch의 SSD Phase와 GPU Phase를 중첩 SSD와 GPU의 유휴시간을 줄여 전체 Throughput 향상
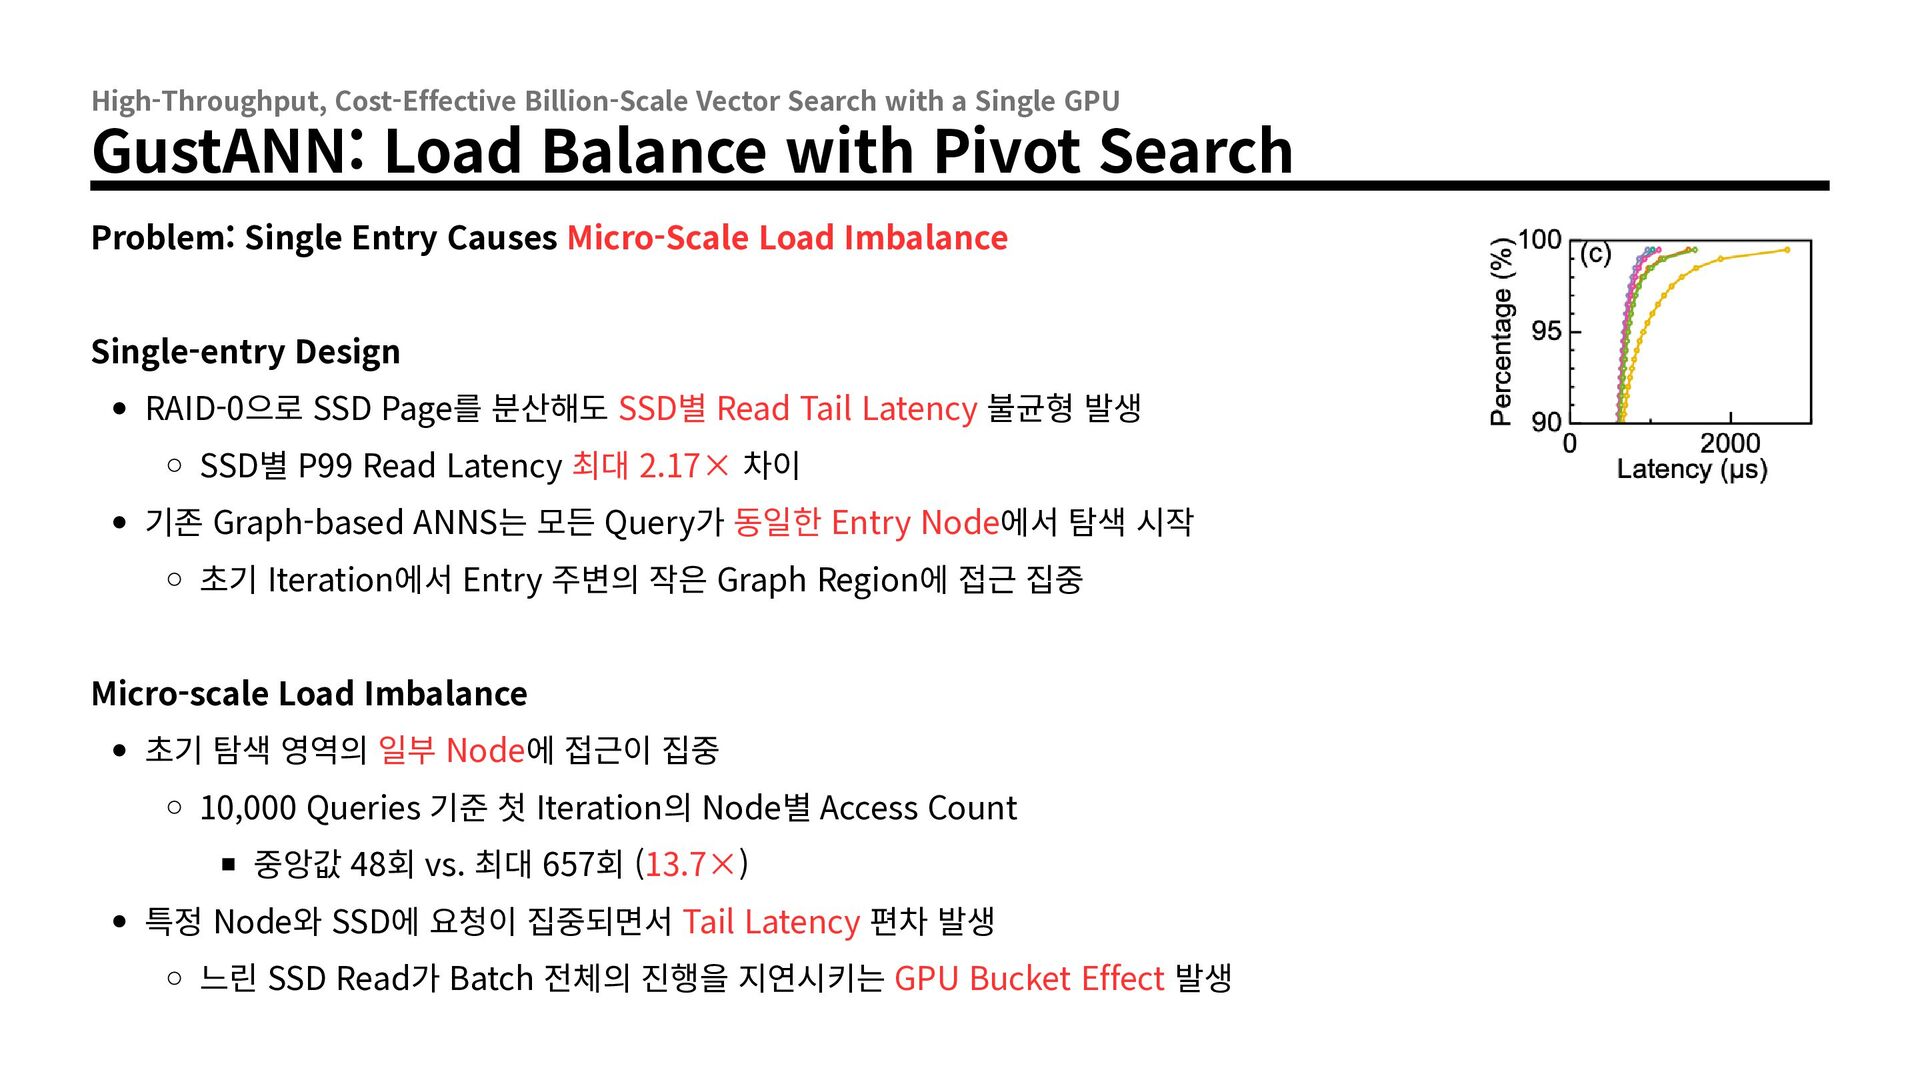
Load Balance with Pivot Search Problem: Single Entry Causes Micro-Scale Load Imbalance Single-entry Design RAID-0으로 SSD Page를 분산해도 SSD별 Read Tail Latency 불균형 발생 SSD별 P99 Read Latency 최대 2.17× 차이 기존 Graph-based ANNS는 모든 Query가 동일한 Entry Node에서 탐색 시작 초기 Iteration에서 Entry 주변의 작은 Graph Region에 접근 집중 Micro-scale Load Imbalance 초기 탐색 영역의 일부 Node에 접근이 집중 10,000 Queries 기준 첫 Iteration의 Node별 Access Count 중앙값 48회 vs. 최대 657회 (13.7×) 특정 Node와 SSD에 요청이 집중되면서 Tail Latency 편차 발생 느린 SSD Read가 Batch 전체의 진행을 지연시키는 GPU Bucket Effect 발생
Load Balance with Pivot Search Key Idea: GPU-Resident Pivot Graph for Load Balancing ➊ GPU-Resident Pivot Graph Construction 전체 Dataset에서 일부 Pivot Vector를 무작위로 Sampling Ex. Billion-scale dataset의 0.1% Pivot vector로 작은 Pivot Graph G' 구축하고 GPU HBM에 저장 ➋ Query-Specific Entry Selection 각 Query가 GPU의 Pivot Graph에서 Top-1 Pivot Search 수행 선택된 Pivot Node를 Entry Node로 사용해 SSD-resident Graph Search 시작 Lightweight Pivot Search 1. Search Length = 4 → 높은 Pivot Search Recall이 불필요하므로 탐색 비용 감소 2. Full-precision Vector → 작은 Pivot Graph이므로 PQ 압축 없이 거리 계산 3. Selection Sort → 작은 Candidate Set에서 GPU 병렬화에 유리
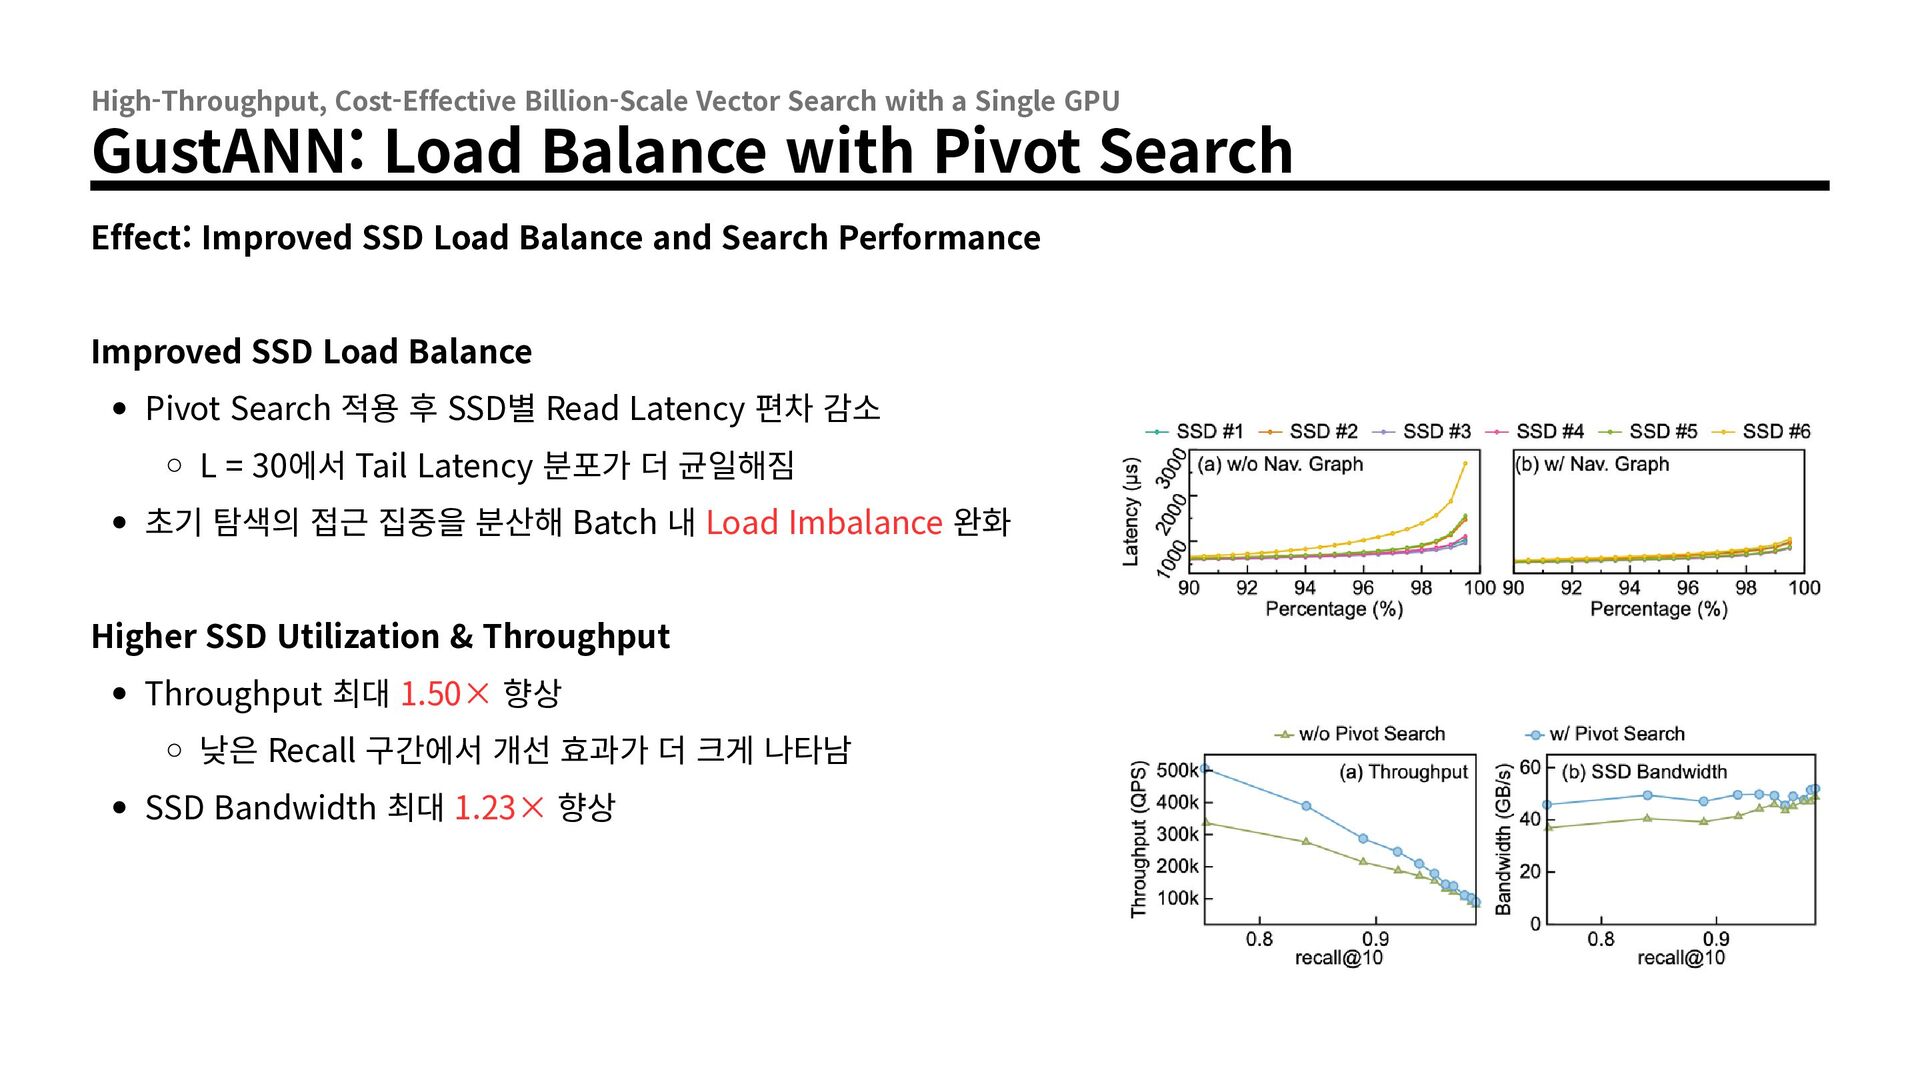
Load Balance with Pivot Search Effect: Improved SSD Load Balance and Search Performance Improved SSD Load Balance Pivot Search 적용 후 SSD별 Read Latency 편차 감소 L = 30에서 Tail Latency 분포가 더 균일해짐 초기 탐색의 접근 집중을 분산해 Batch 내 Load Imbalance 완화 Higher SSD Utilization & Throughput Throughput 최대 1.50× 향상 낮은 Recall 구간에서 개선 효과가 더 크게 나타남 SSD Bandwidth 최대 1.23× 향상
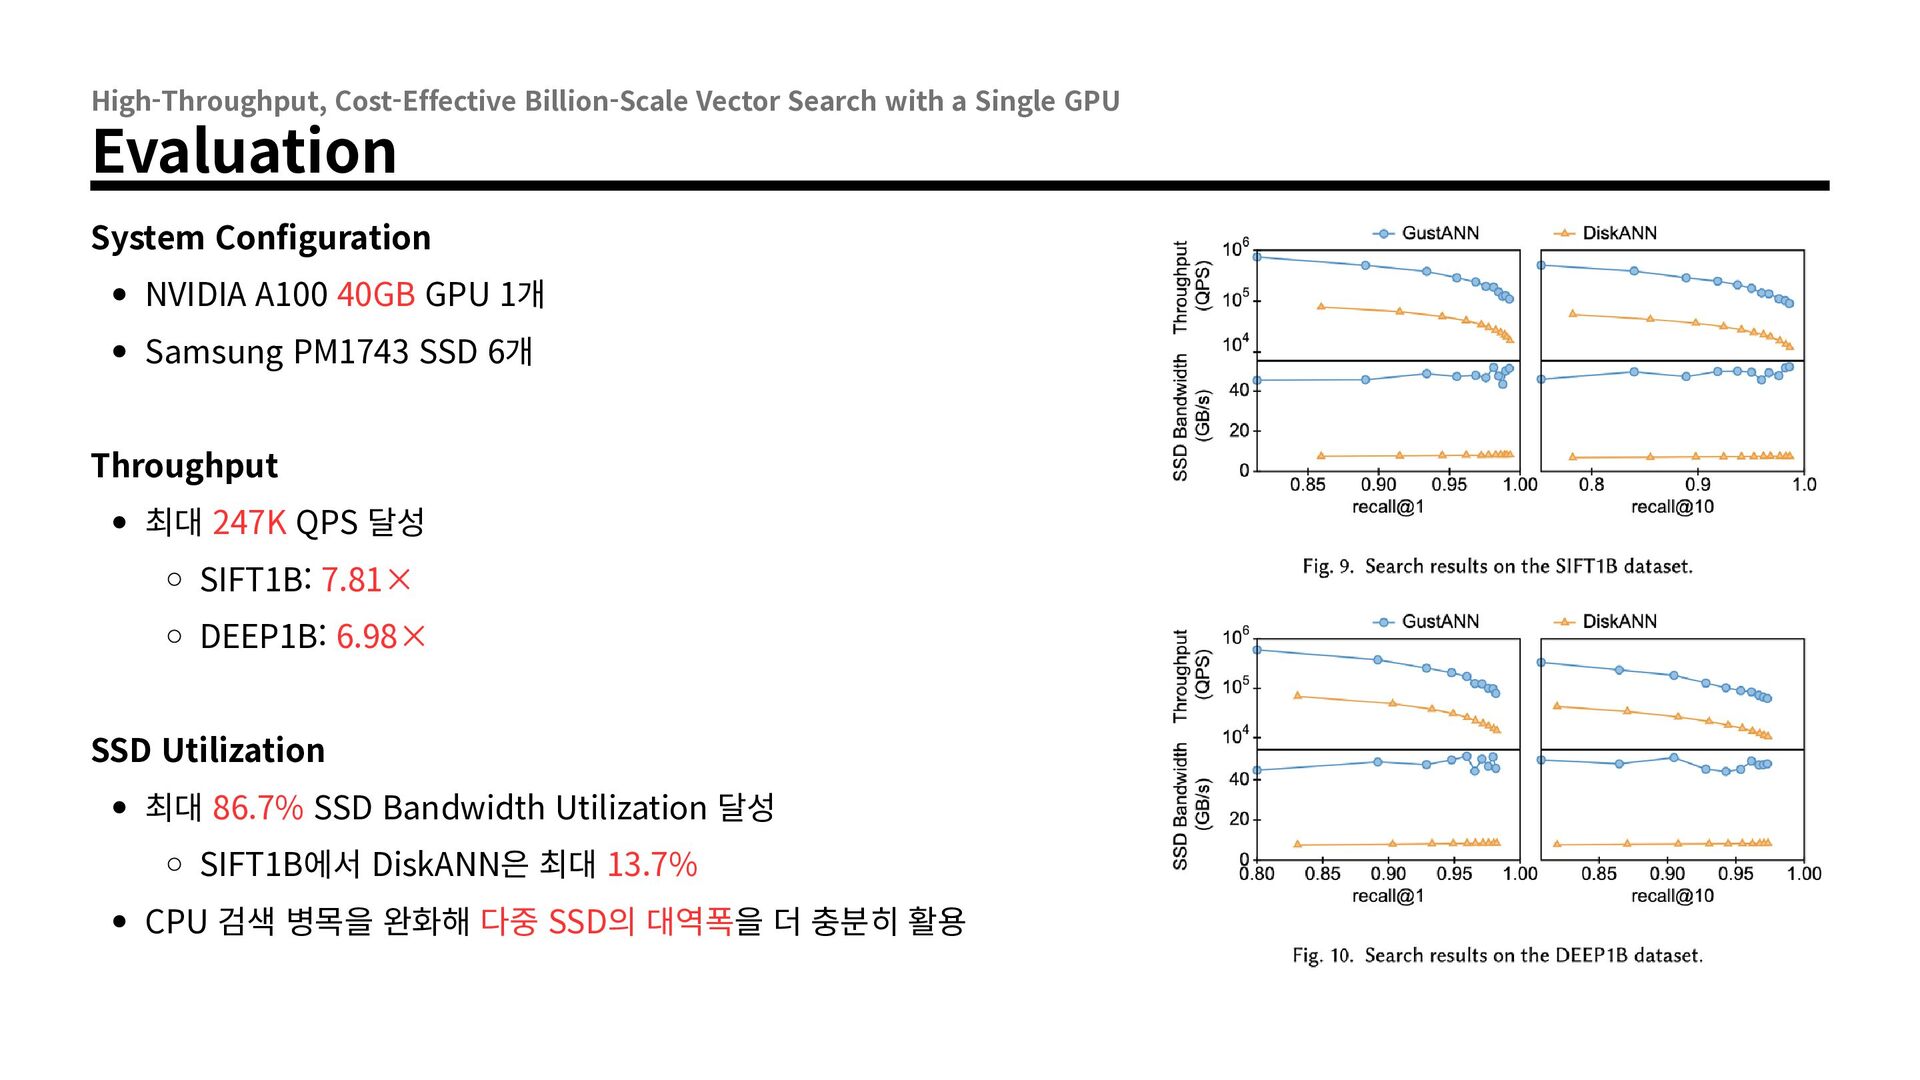
System Configuration NVIDIA A100 40GB GPU 1개 Samsung PM1743 SSD 6개 Throughput 최대 247K QPS 달성 SIFT1B: 7.81× DEEP1B: 6.98× SSD Utilization 최대 86.7% SSD Bandwidth Utilization 달성 SIFT1B에서 DiskANN은 최대 13.7% CPU 검색 병목을 완화해 다중 SSD의 대역폭을 더 충분히 활용
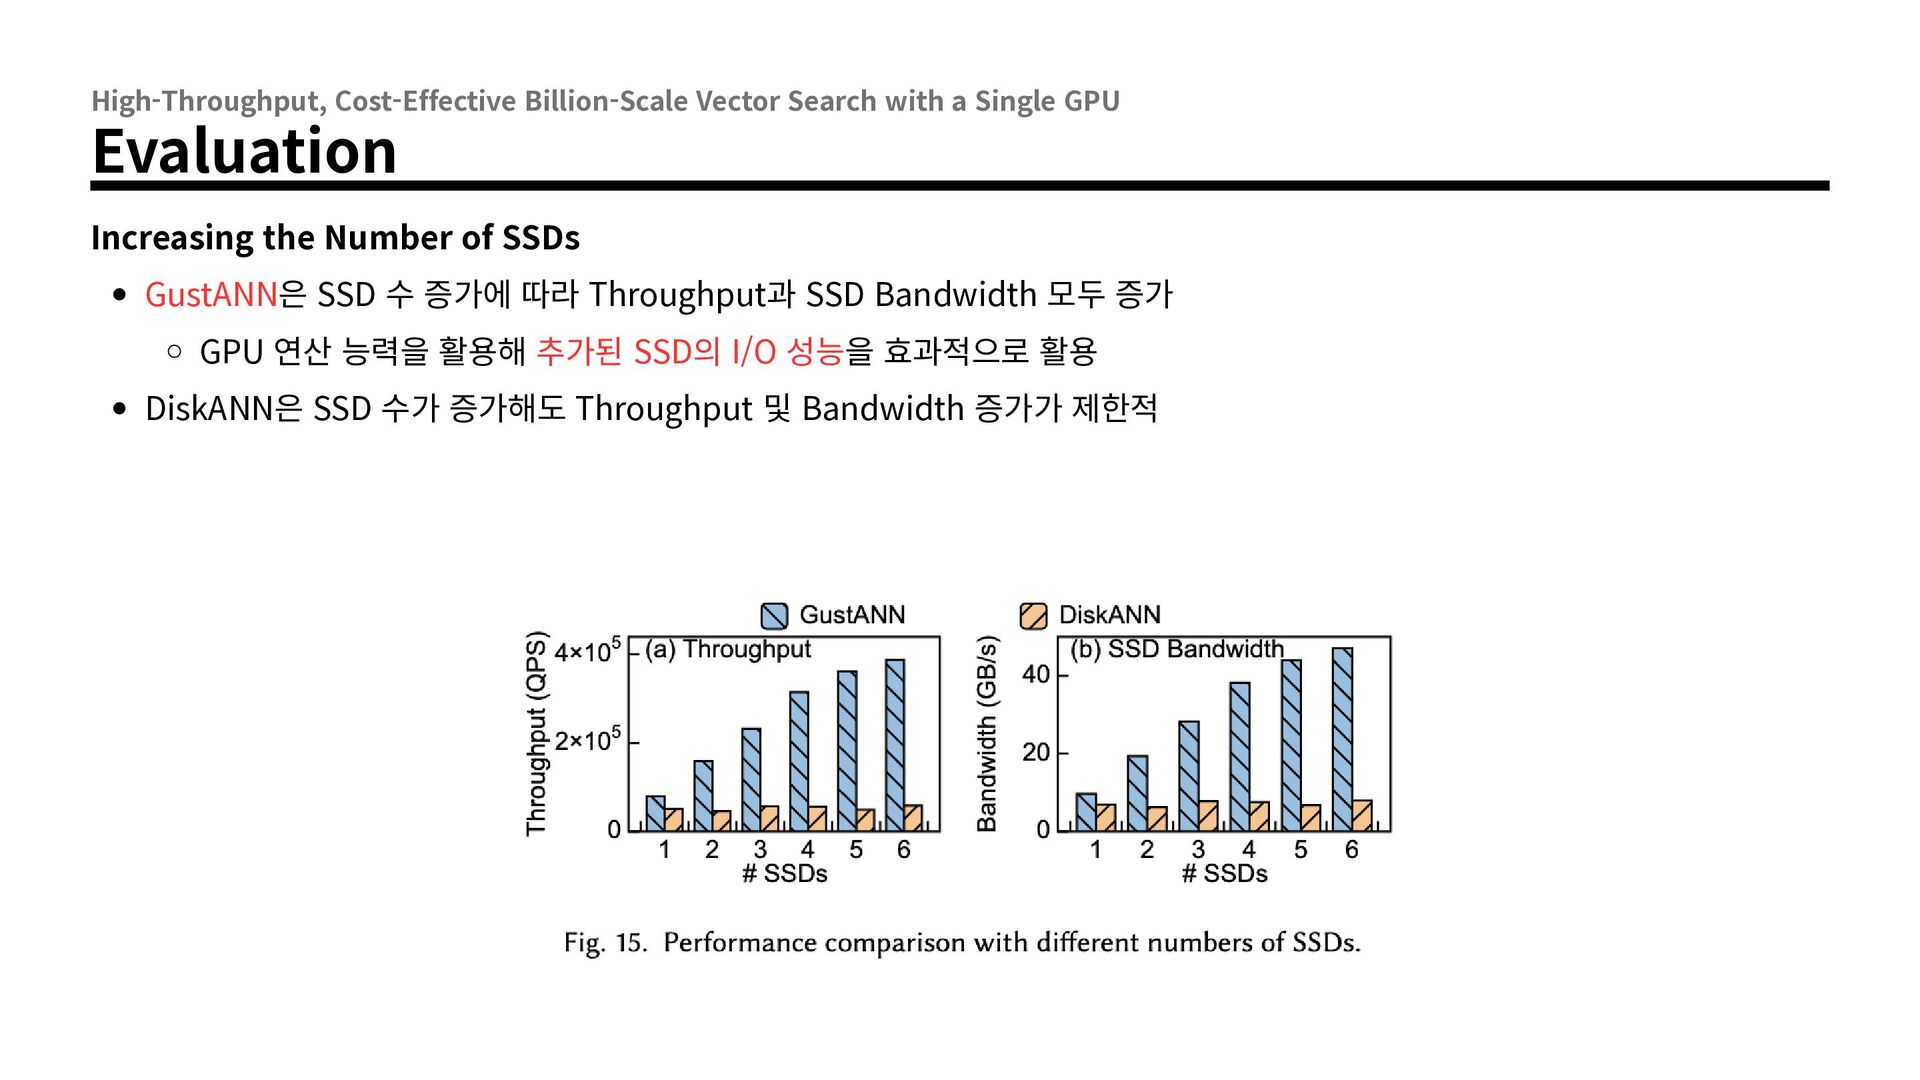
Increasing the Number of SSDs GustANN은 SSD 수 증가에 따라 Throughput과 SSD Bandwidth 모두 증가 GPU 연산 능력을 활용해 추가된 SSD의 I/O 성능을 효과적으로 활용 DiskANN은 SSD 수가 증가해도 Throughput 및 Bandwidth 증가가 제한적
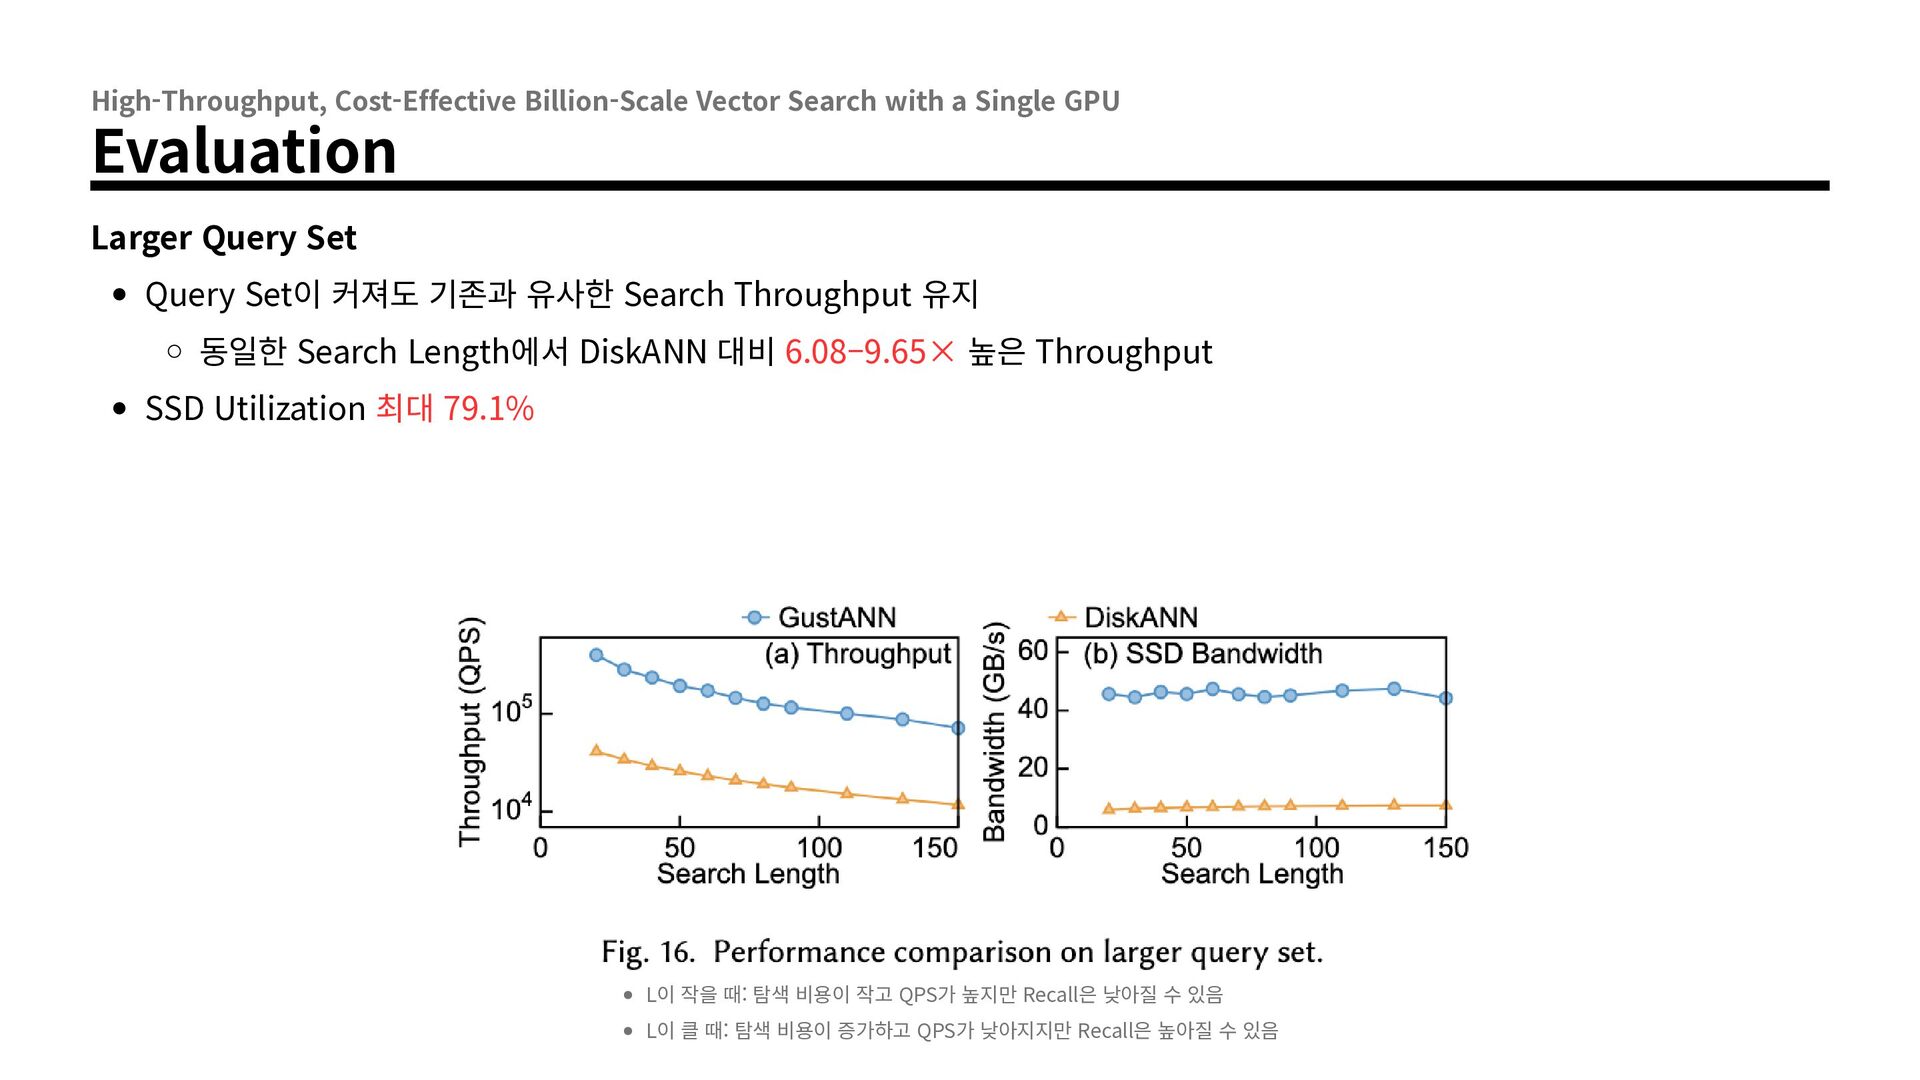
Larger Query Set Query Set이 커져도 기존과 유사한 Search Throughput 유지 동일한 Search Length에서 DiskANN 대비 6.08–9.65× 높은 Throughput SSD Utilization 최대 79.1% L이 작을 때: 탐색 비용이 작고 QPS가 높지만 Recall은 낮아질 수 있음 L이 클 때: 탐색 비용이 증가하고 QPS가 낮아지지만 Recall은 높아질 수 있음
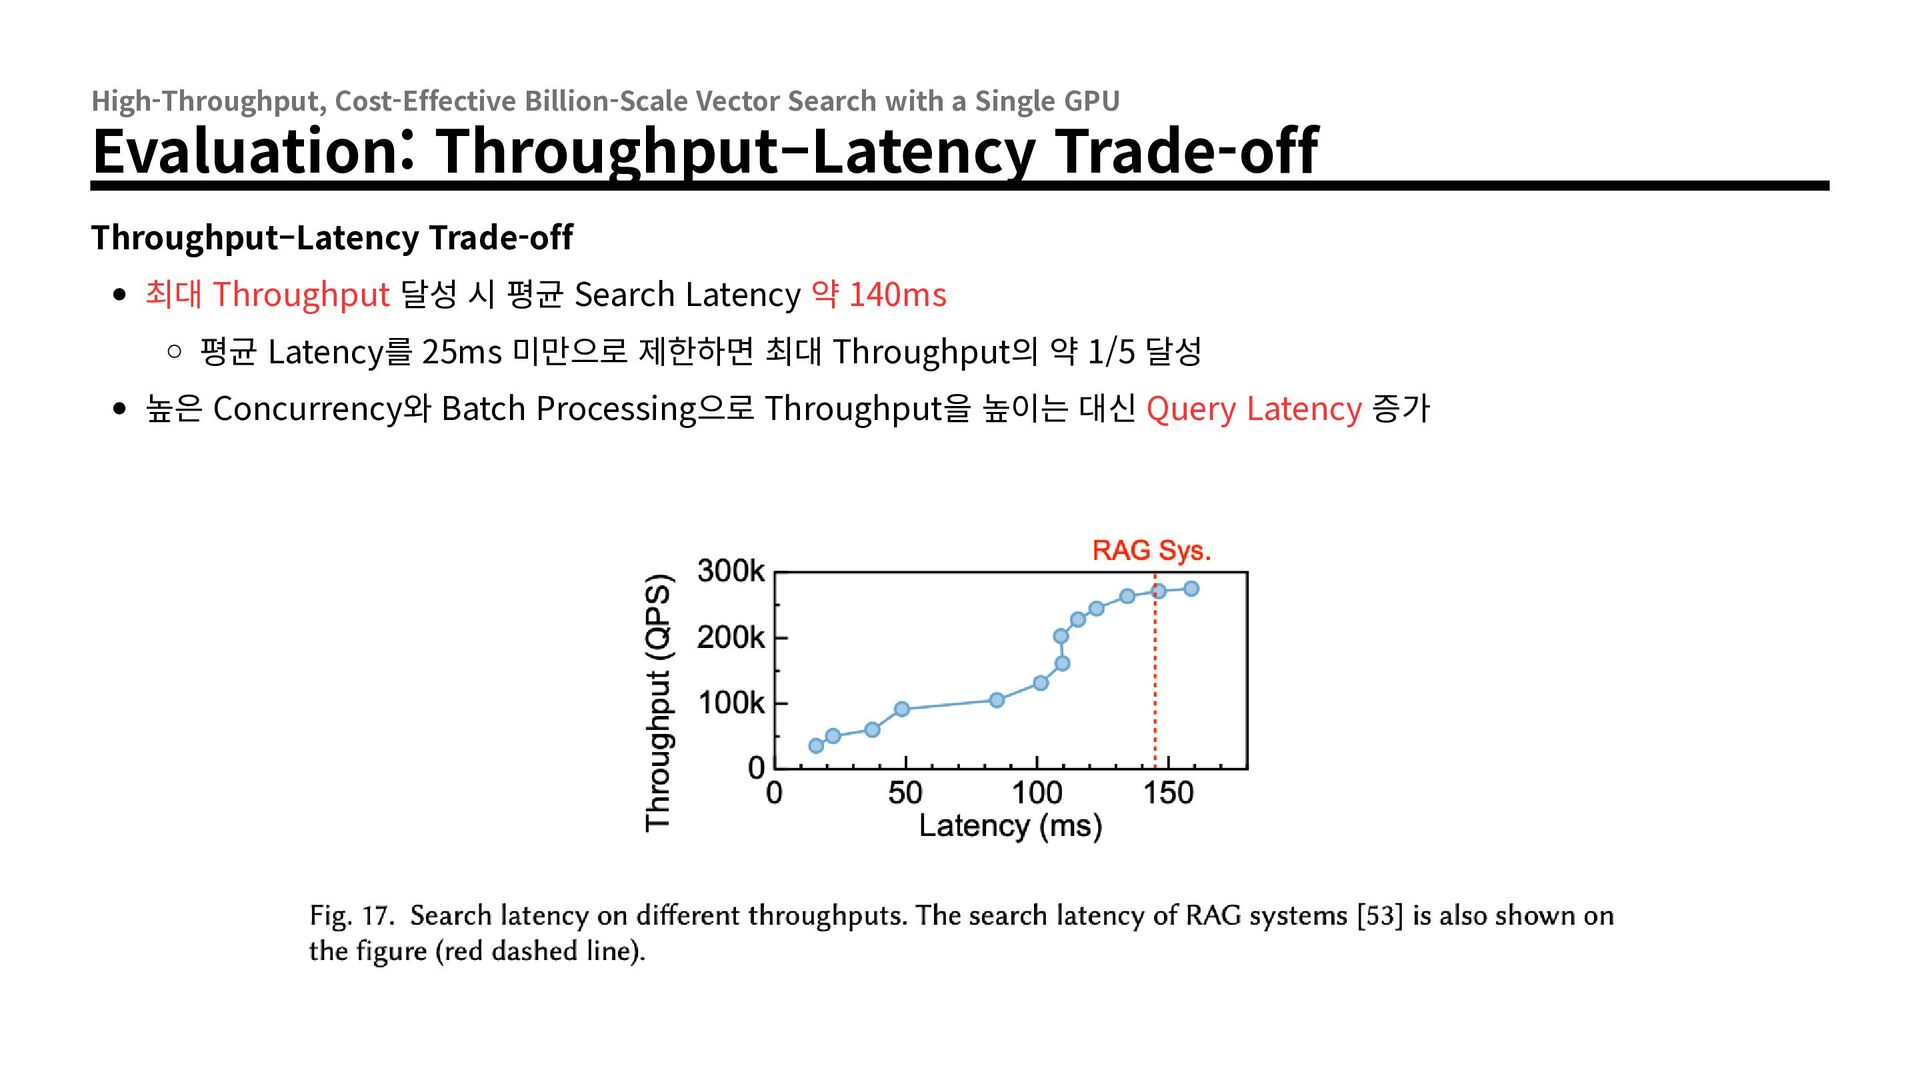
Throughput–Latency Trade-off Throughput–Latency Trade-off 최대 Throughput 달성 시 평균 Search Latency 약 140ms 평균 Latency를 25ms 미만으로 제한하면 최대 Throughput의 약 1/5 달성 높은 Concurrency와 Batch Processing으로 Throughput을 높이는 대신 Query Latency 증가
GustANN: High-Throughput GPU-Centric, CPU-Assisted ANNS System Memory-Efficient GPU Graph Traversal → GPU Memory 사용량 감소 및 Query Concurrency 향상 CPU-Assisted Selective Transfer → GPU Inbound Bandwidth 병목 완화 GPU-Resident Pivot Search → 다중 SSD 간 Load Imbalance 완화 Result 동일 Recall에서 기존 ANNS 시스템 대비 높은 Query Throughput 달성 기존 시스템 대비 높은 Cost-effectiveness 달성 Takeaway GPU Graph Traversal과 CPU-assisted Transfer를 결합해 다중 SSD의 대역폭 활용 극대화 메모리·전송·부하 불균형을 최적화한 High-Throughput ANNS 시스템 제시


 nawkwoo
 sishi
 hellosct1
 institutdelelevage
 takehaya
 rikkabotan7
 takasehideki
 tkng
 yukiar
 yumaichikawa
 sirmatrixpage
 hf149
 thirion
 tammyeverts
 rasmusluckow
 lara
 uxyall
 mlcsv
 jcasabona
 pedronauck
 rakko
 moore
 rocio