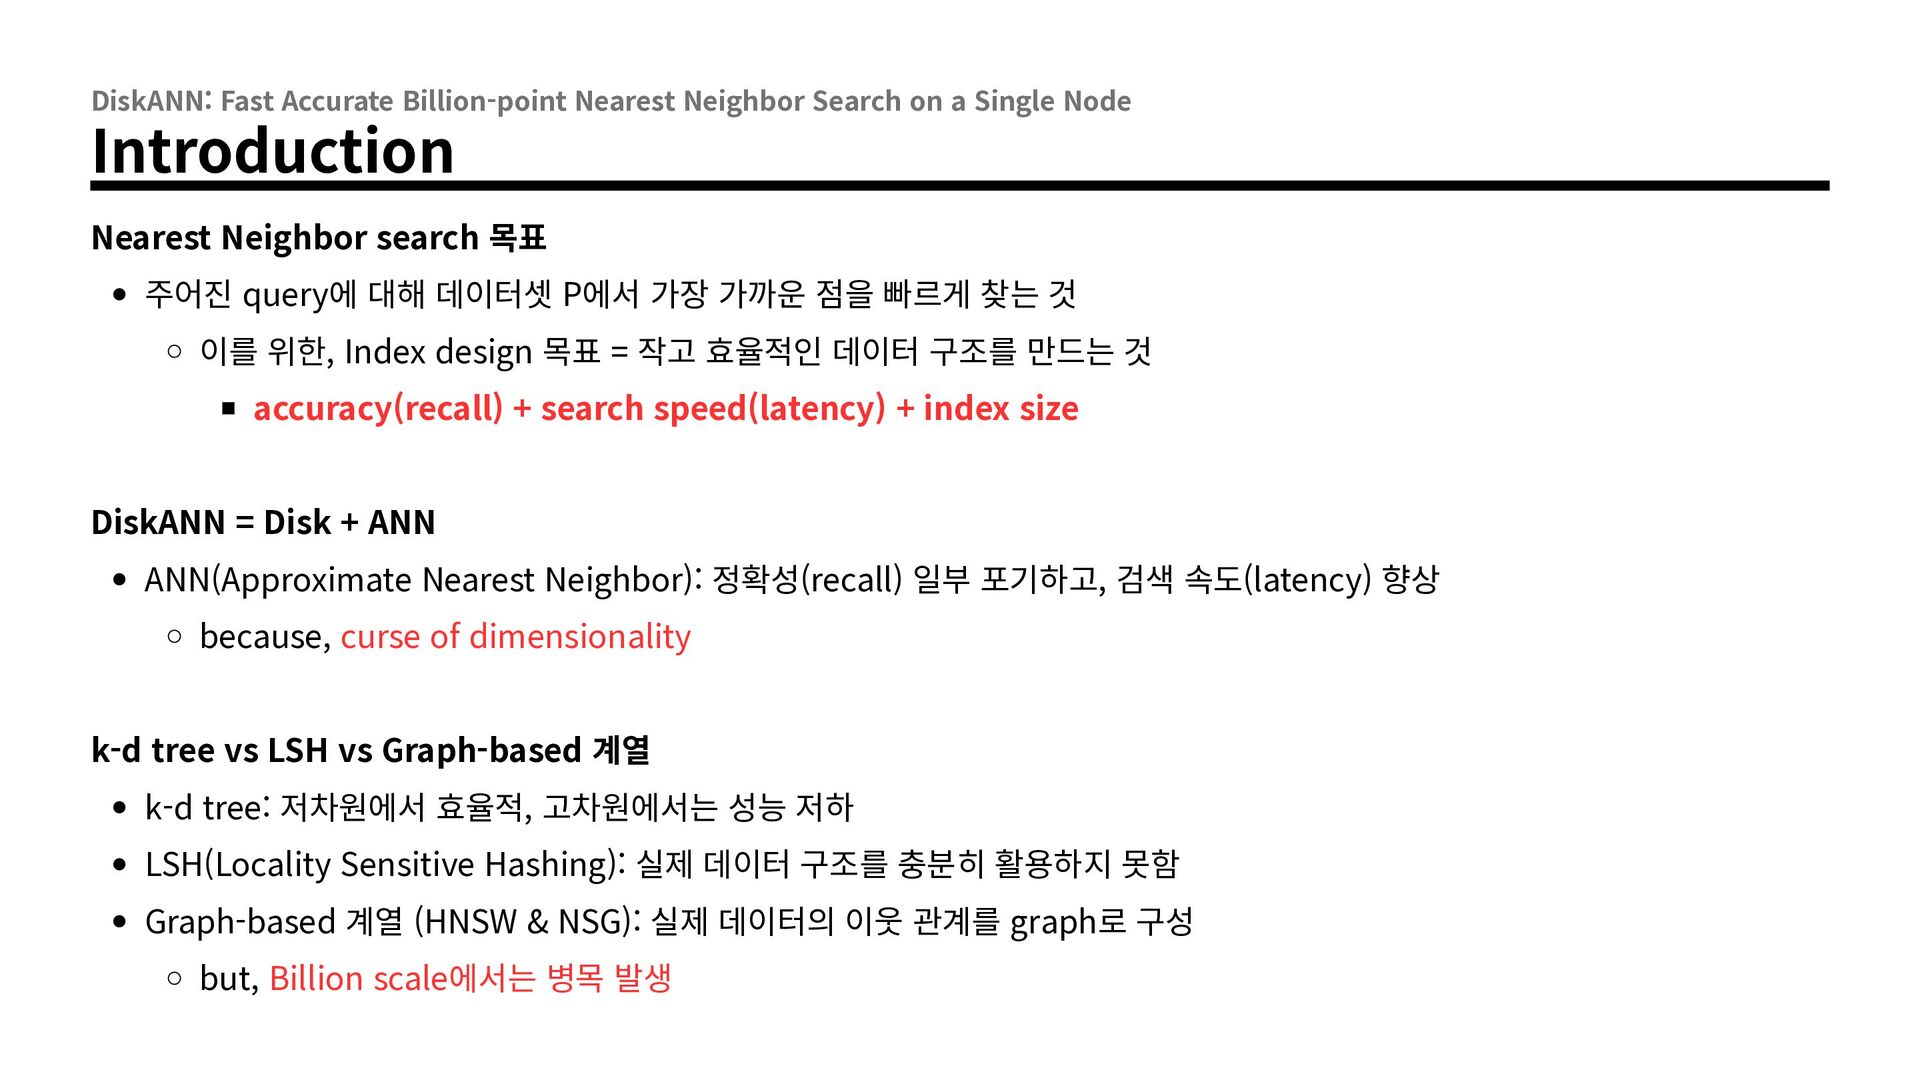
Node Introduction Nearest Neighbor search 목표 주어진 query에 대해 데이터셋 P에서 가장 가까운 점을 빠르게 찾는 것 이를 위한, Index design 목표 = 작고 효율적인 데이터 구조를 만드는 것 accuracy(recall) + search speed(latency) + index size DiskANN = Disk + ANN ANN(Approximate Nearest Neighbor): 정확성(recall) 일부 포기하고, 검색 속도(latency) 향상 because, curse of dimensionality k-d tree vs LSH vs Graph-based 계열 k-d tree: 저차원에서 효율적, 고차원에서는 성능 저하 LSH(Locality Sensitive Hashing): 실제 데이터 구조를 충분히 활용하지 못함 Graph-based 계열 (HNSW & NSG): 실제 데이터의 이웃 관계를 graph로 구성 but, Billion scale에서는 병목 발생
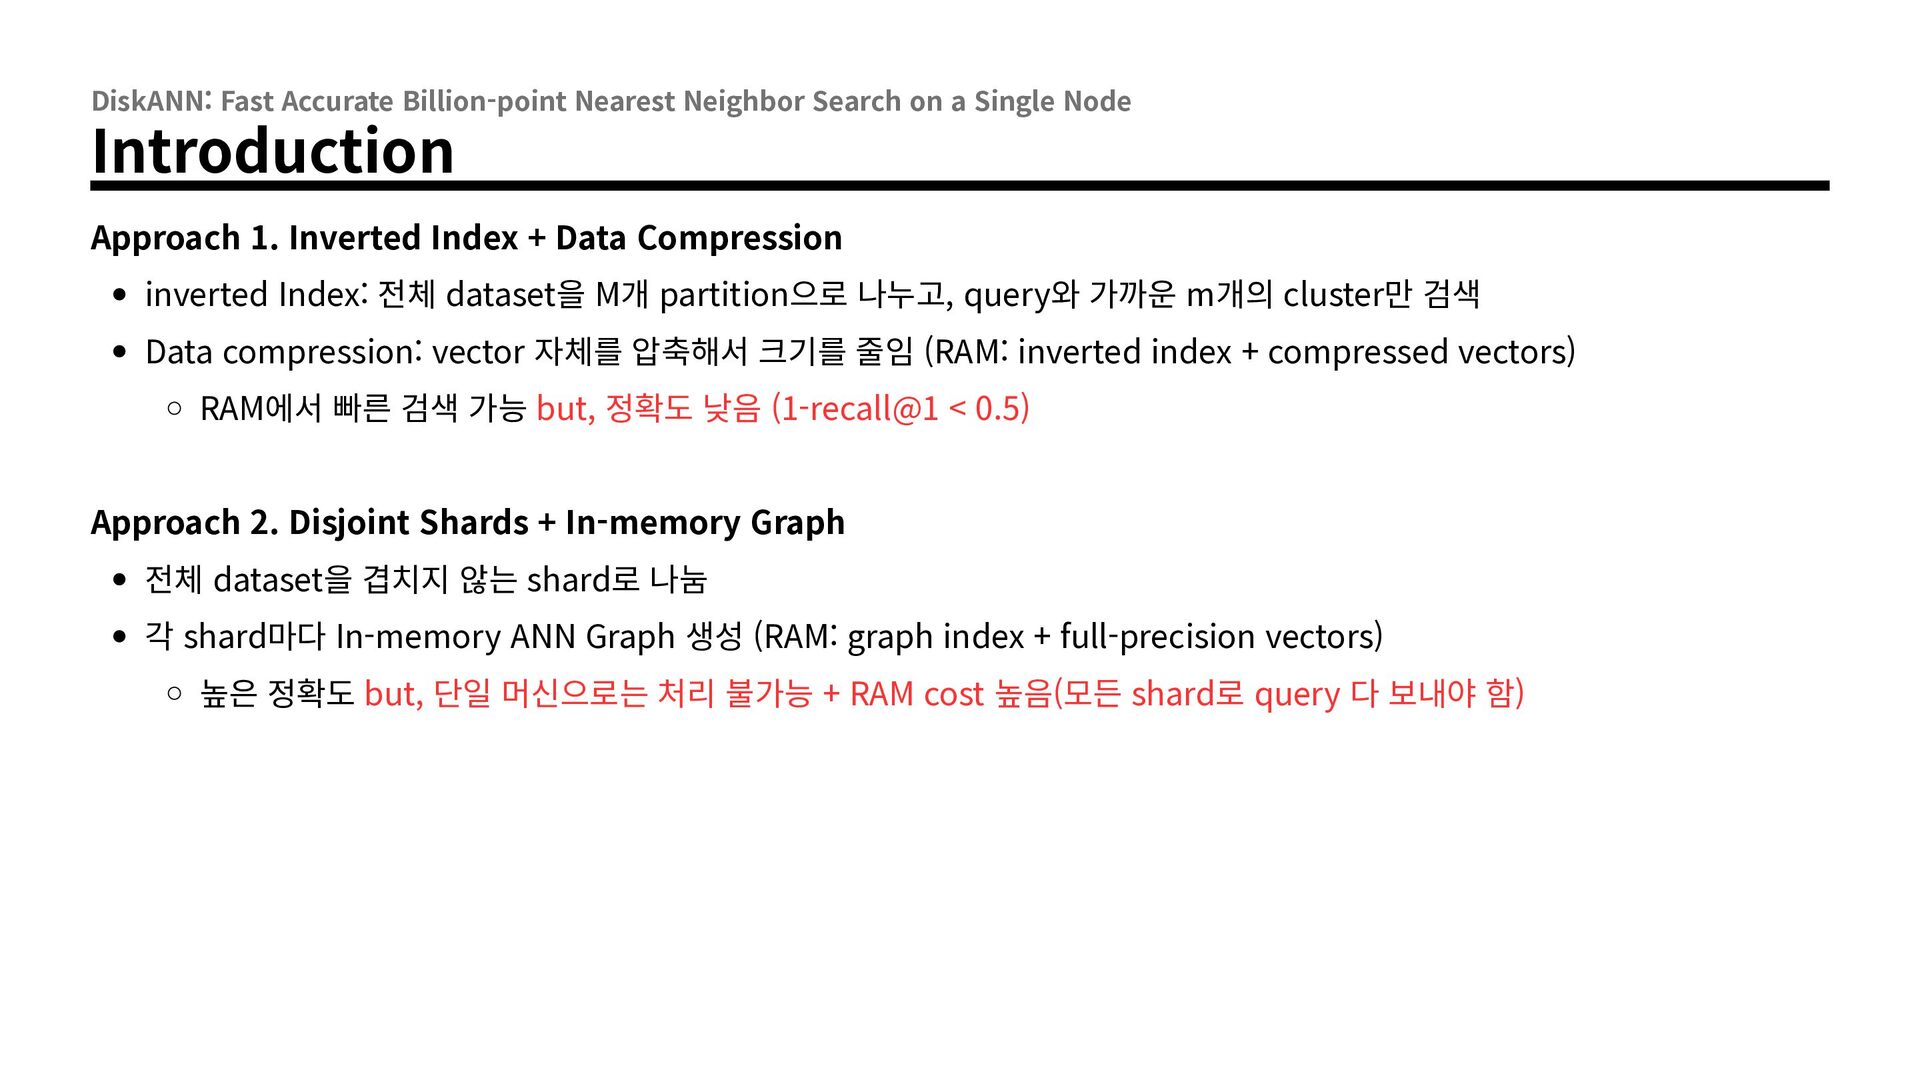
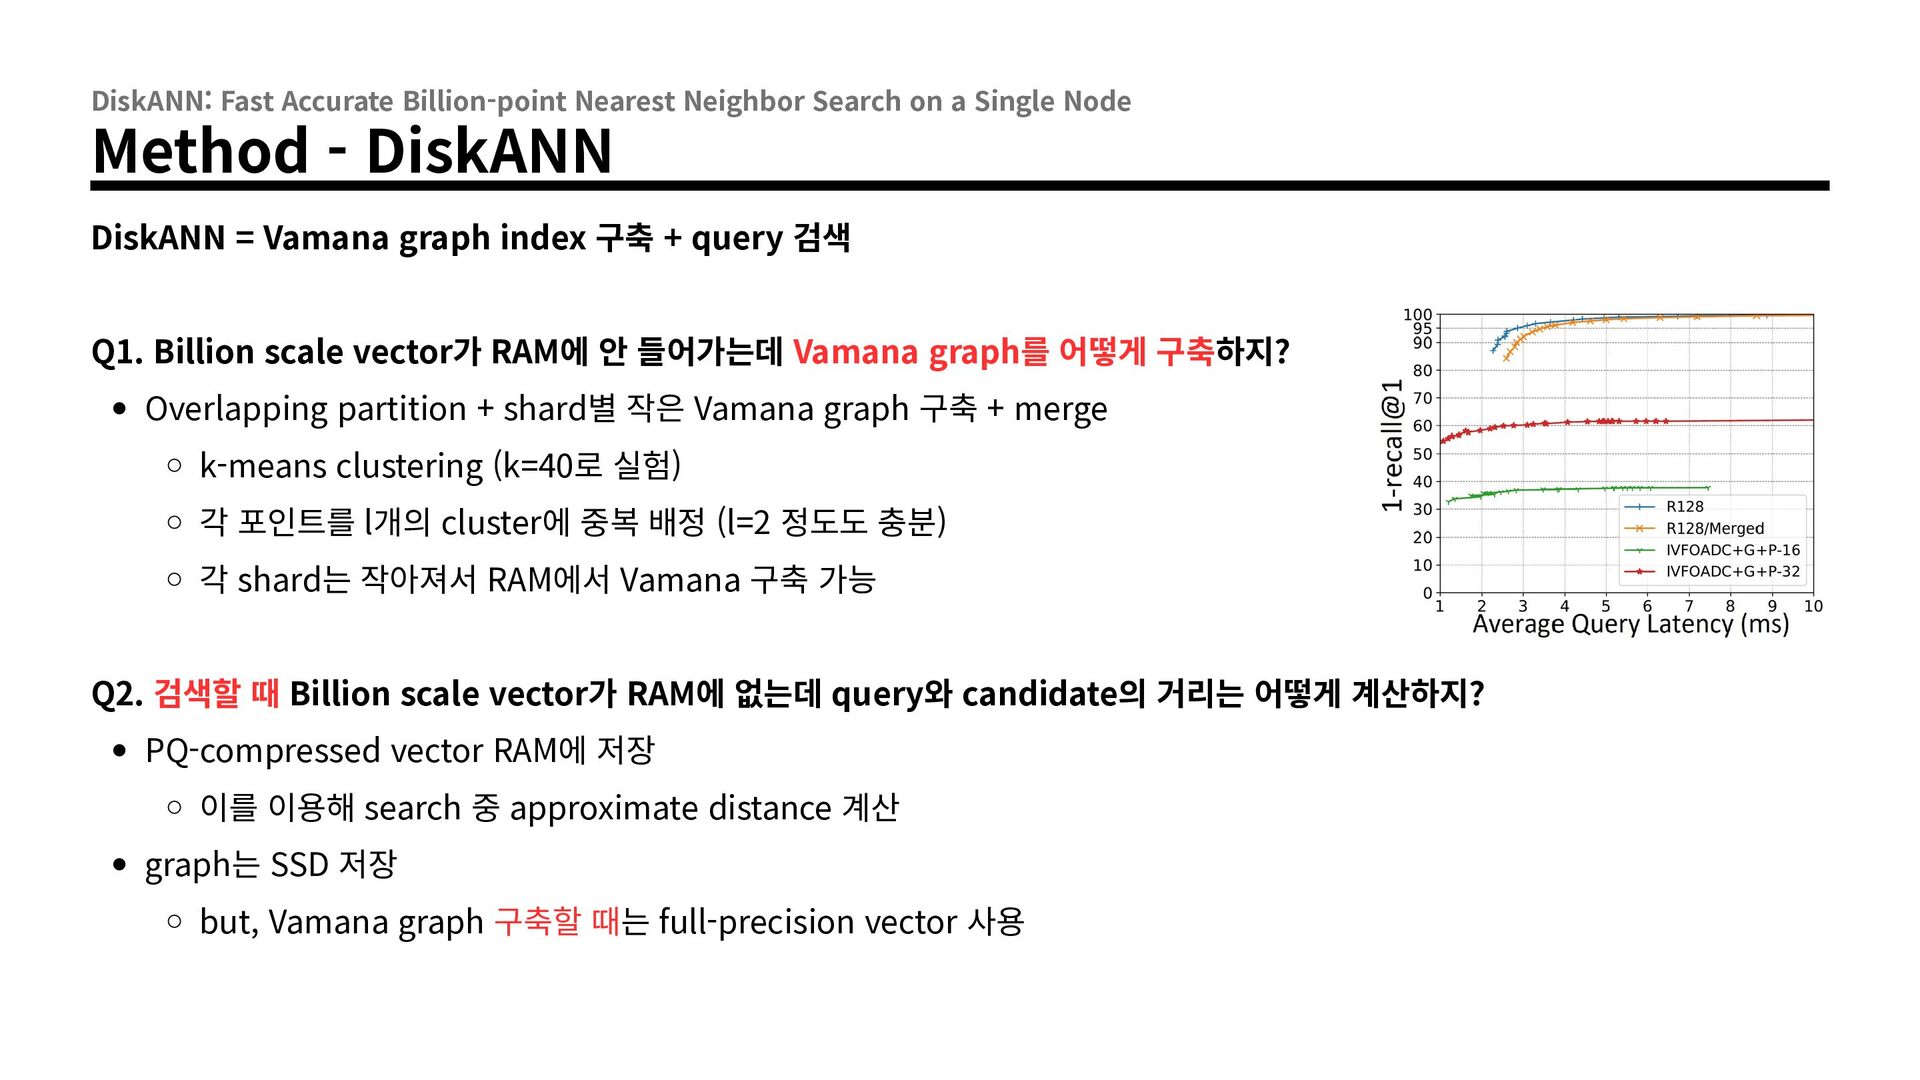
Node Introduction Approach 1. Inverted Index + Data Compression inverted Index: 전체 dataset을 M개 partition으로 나누고, query와 가까운 m개의 cluster만 검색 Data compression: vector 자체를 압축해서 크기를 줄임 (RAM: inverted index + compressed vectors) RAM에서 빠른 검색 가능 but, 정확도 낮음 (1-recall@1 < 0.5) Approach 2. Disjoint Shards + In-memory Graph 전체 dataset을 겹치지 않는 shard로 나눔 각 shard마다 In-memory ANN Graph 생성 (RAM: graph index + full-precision vectors) 높은 정확도 but, 단일 머신으로는 처리 불가능 + RAM cost 높음(모든 shard로 query 다 보내야 함)
Node Introduction 모두 index(graph)를 RAM 위에서 serving하도록 설계 그럼 Graph를 SSD에 둘까? No, 그대로 옮기면 SSD cost 폭발 SSD cost Random accesses / query query 하나가 SSD를 총 몇 번 읽는지 커지면 throughput 나빠짐 Round-trips / query SSD 응답을 몇 번 순차적으로 기다려야 하는지 커지면 latency 커짐 SSD를 사용하면서 Graph ANN의 accuracy(recall) + search speed(latency) 모두 챙길 수 있을까?
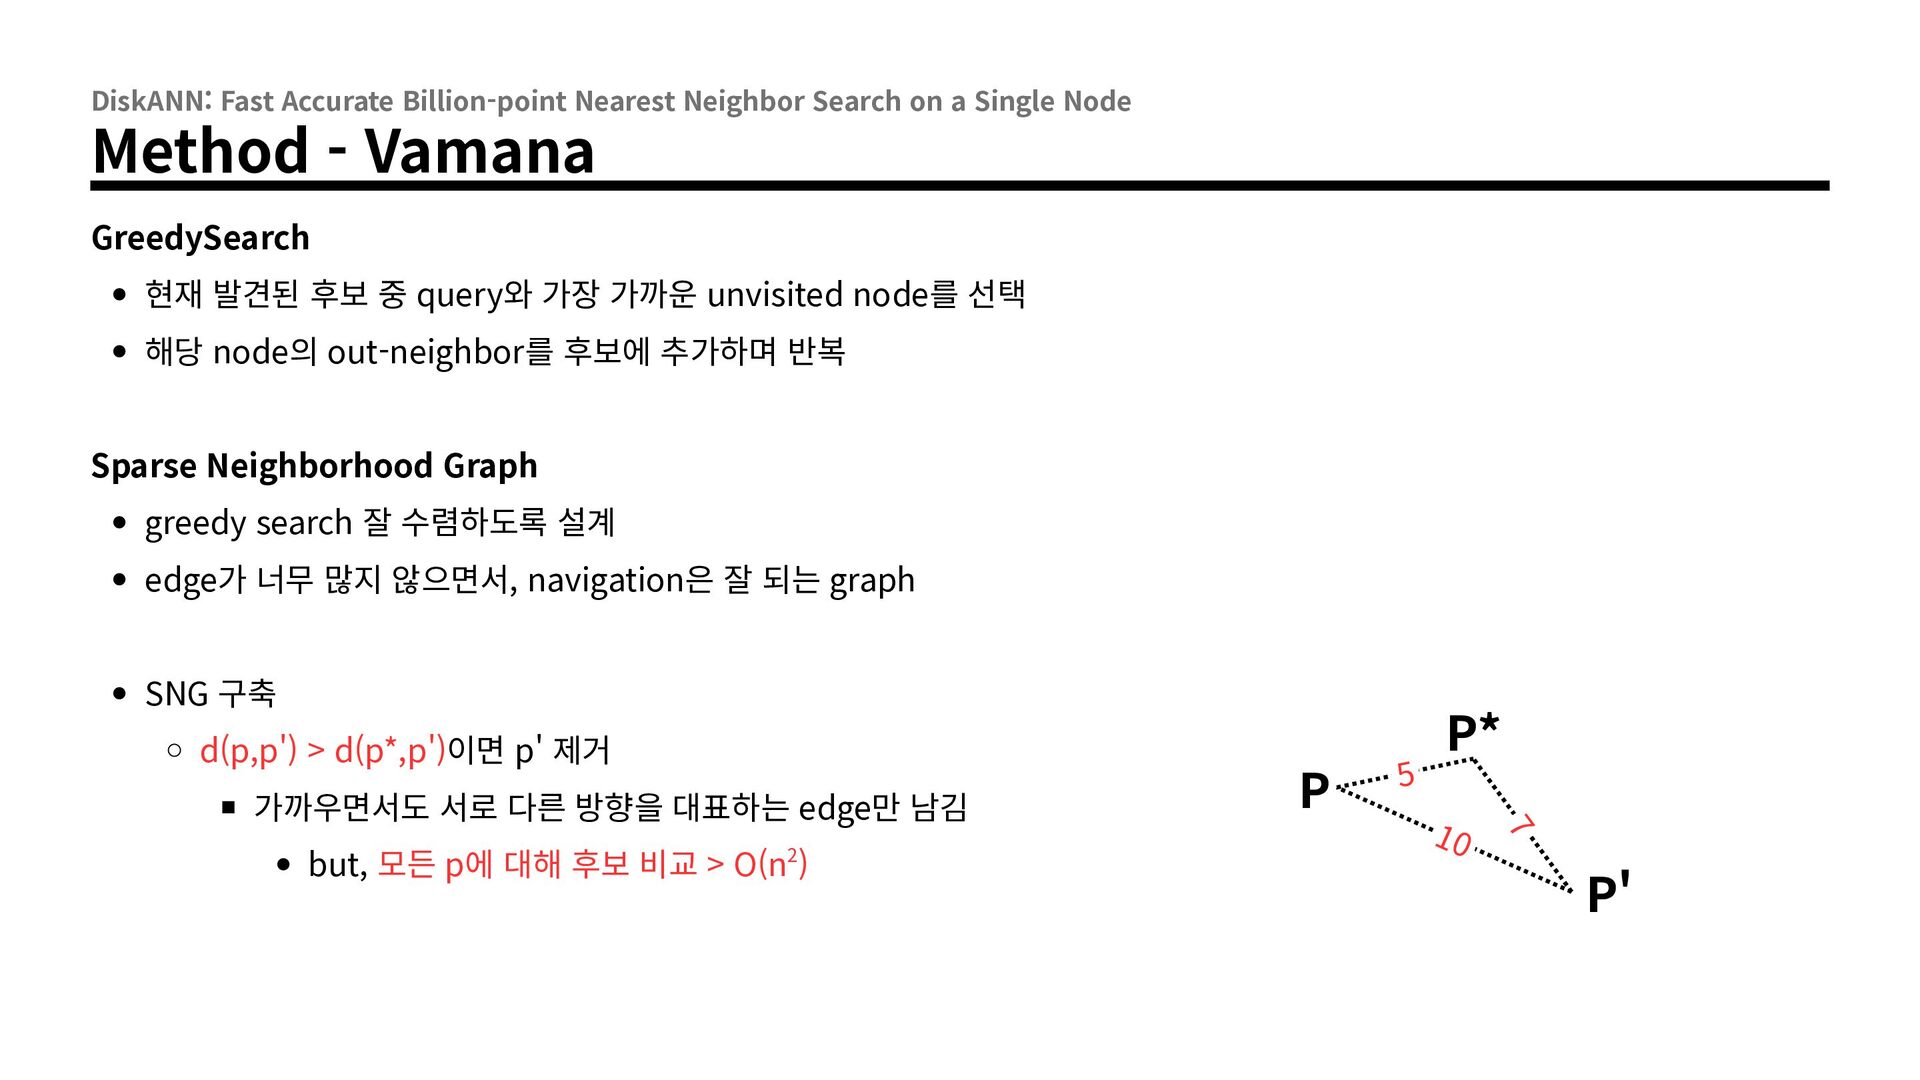
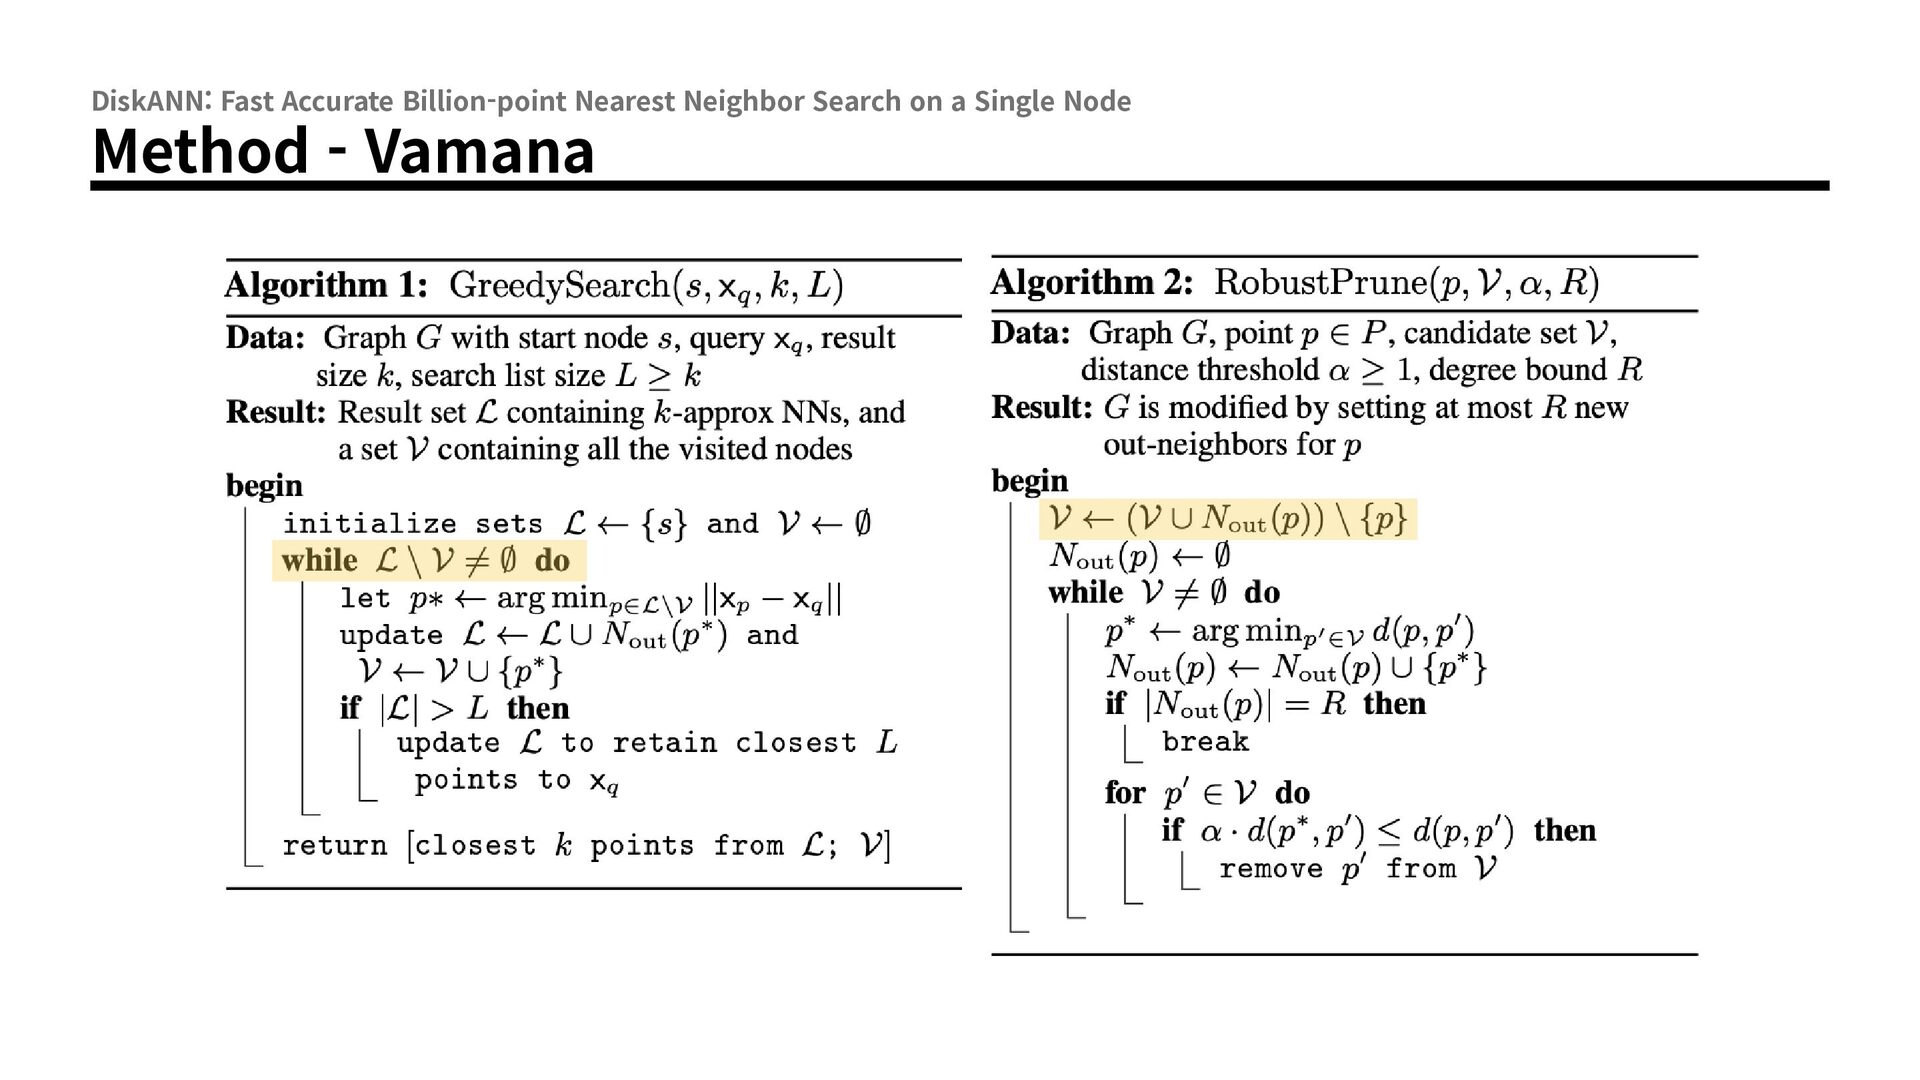
Node Method - Vamana GreedySearch 현재 발견된 후보 중 query와 가장 가까운 unvisited node를 선택 해당 node의 out-neighbor를 후보에 추가하며 반복 Sparse Neighborhood Graph greedy search 잘 수렴하도록 설계 edge가 너무 많지 않으면서, navigation은 잘 되는 graph SNG 구축 d(p,p') > d(p*,p')이면 p' 제거 but, 모든 p에 대해 후보 비교 > O(n ) 2 P 10 7 가까우면서도 서로 다른 방향을 대표하는 edge만 남김 5 P* P'
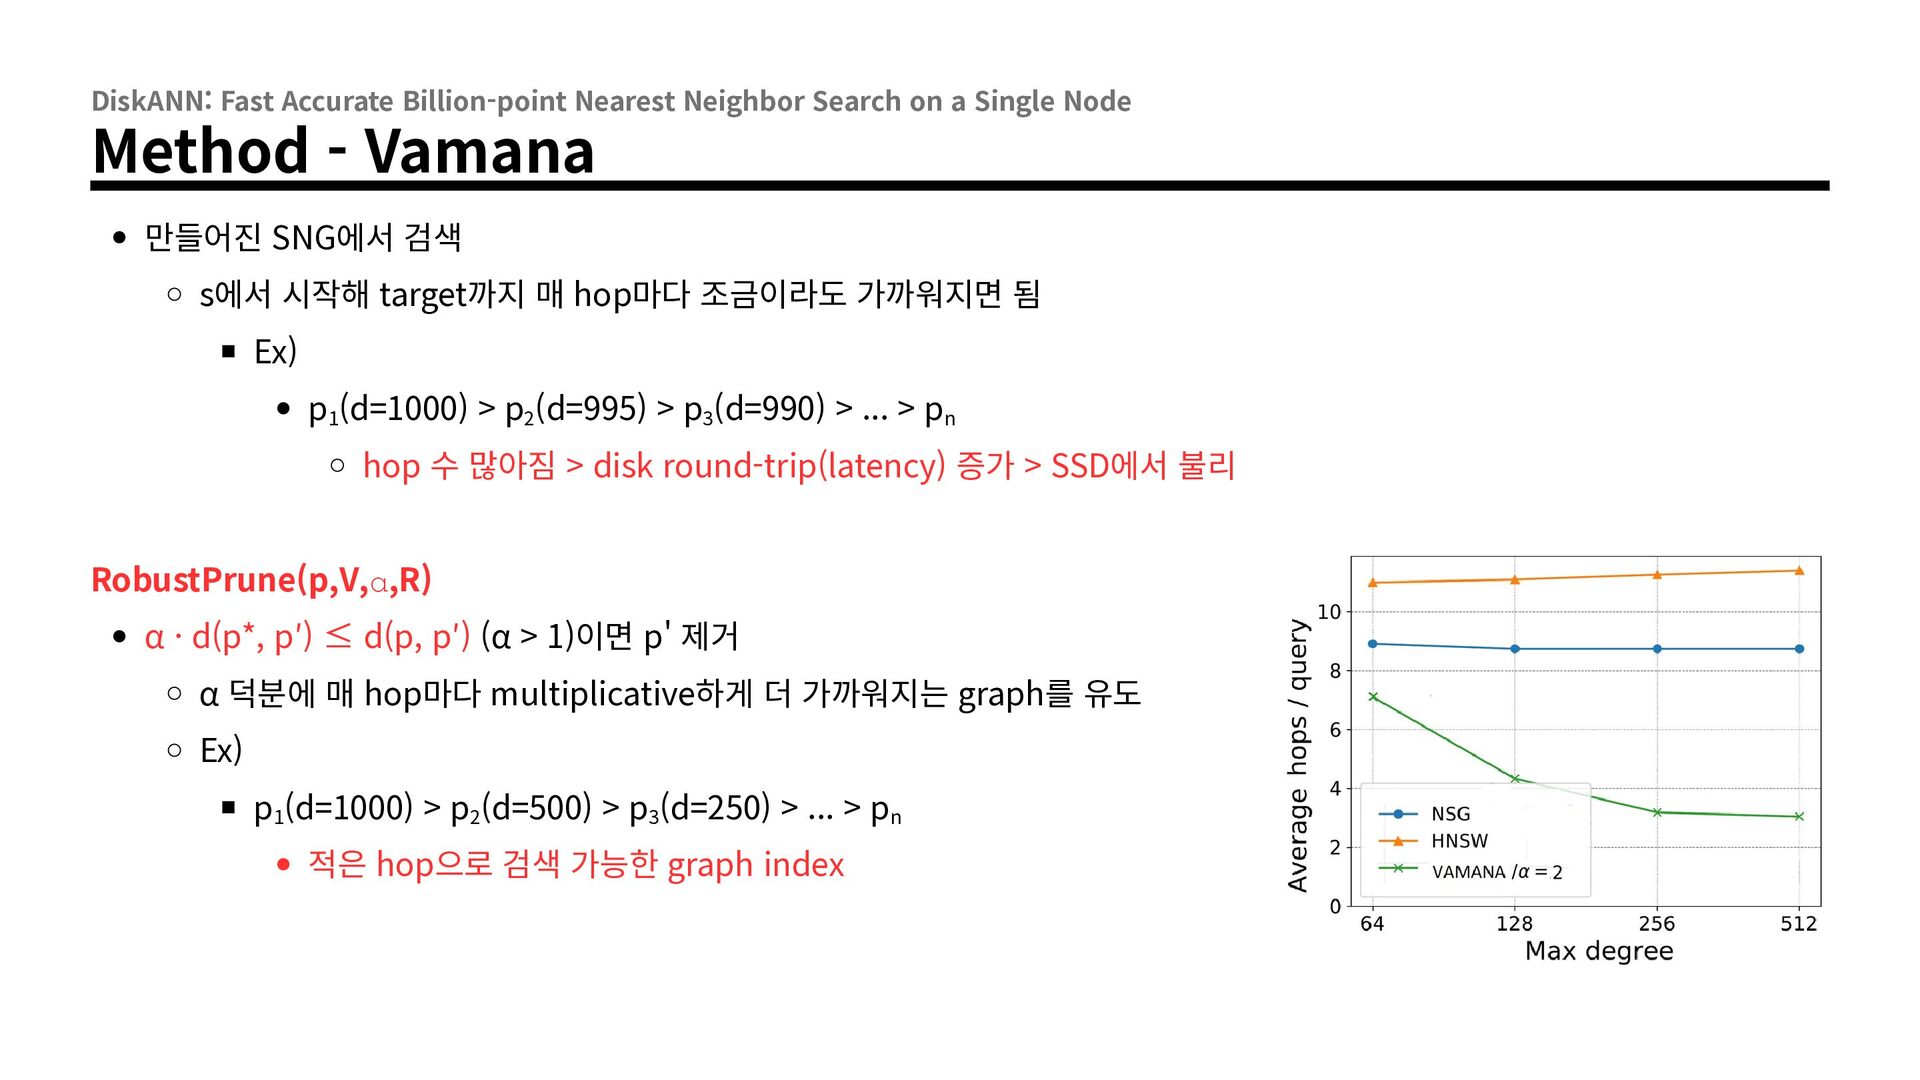
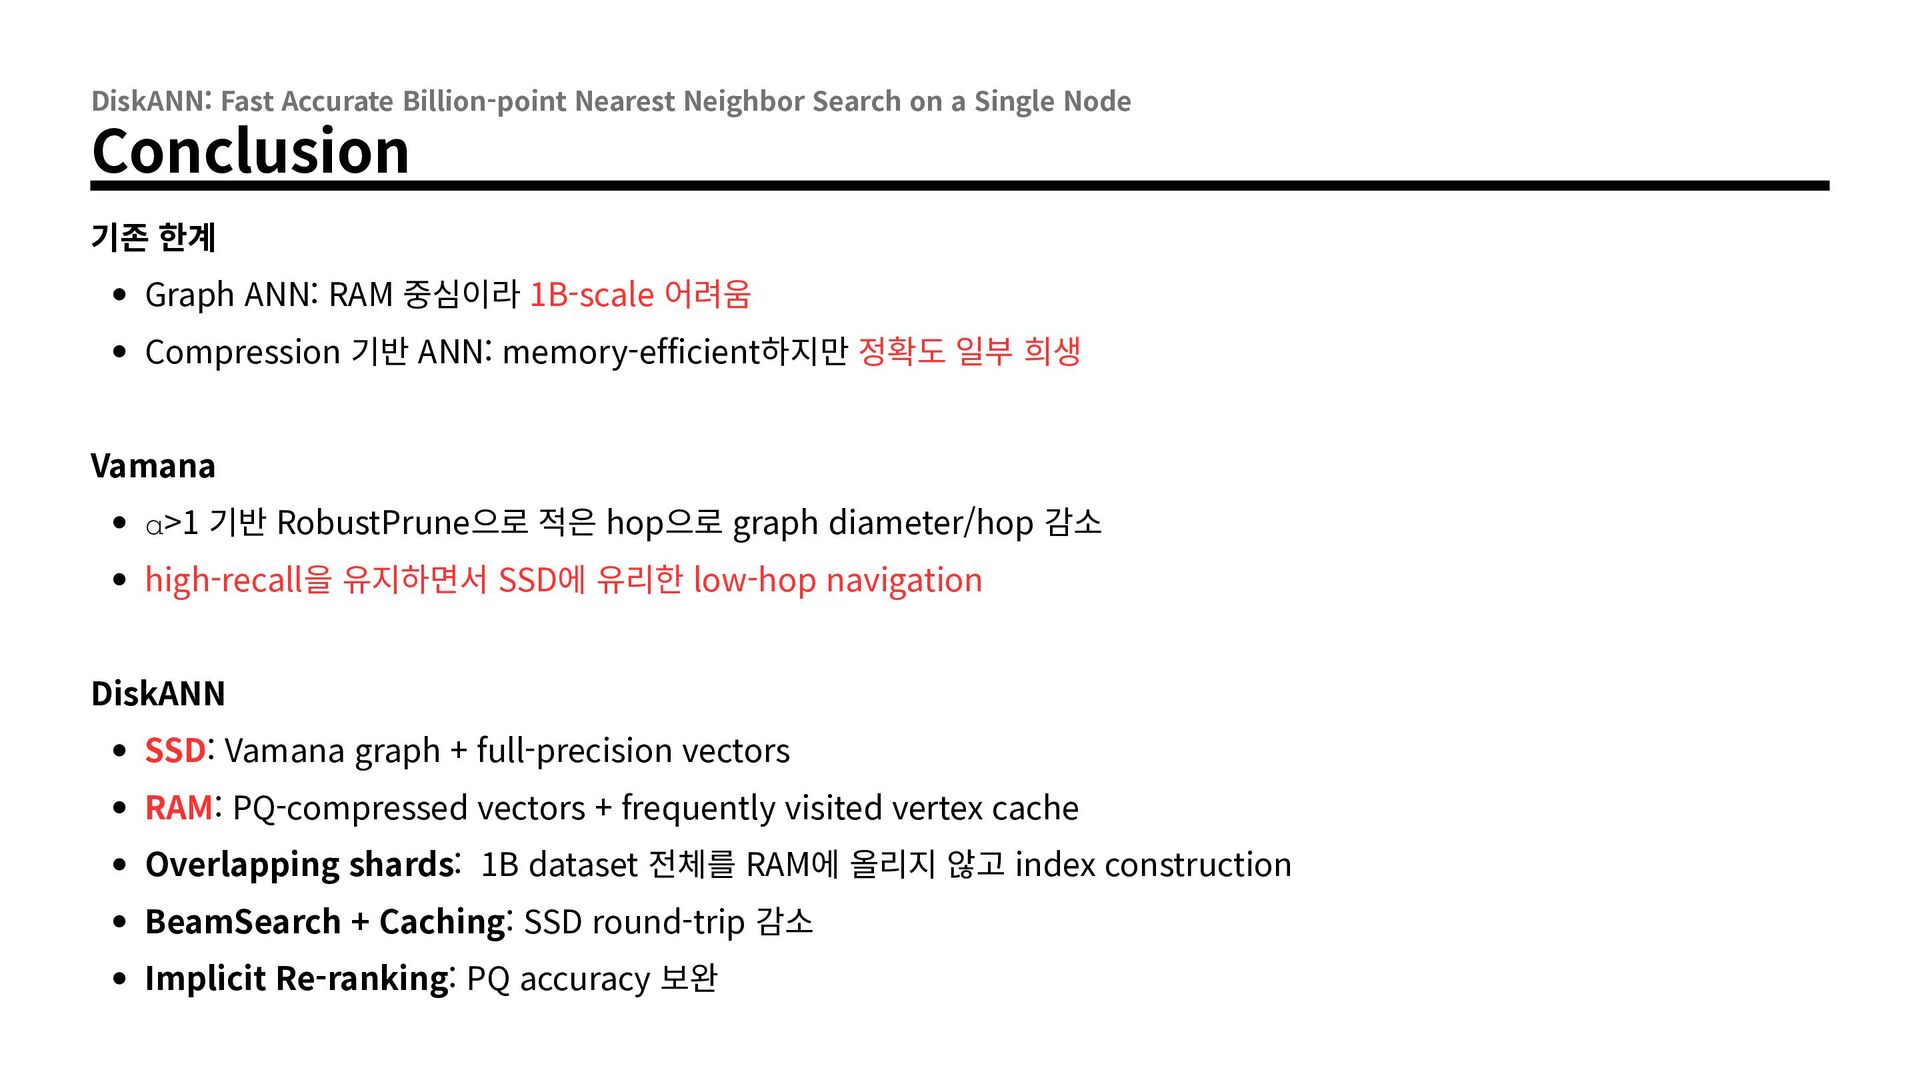
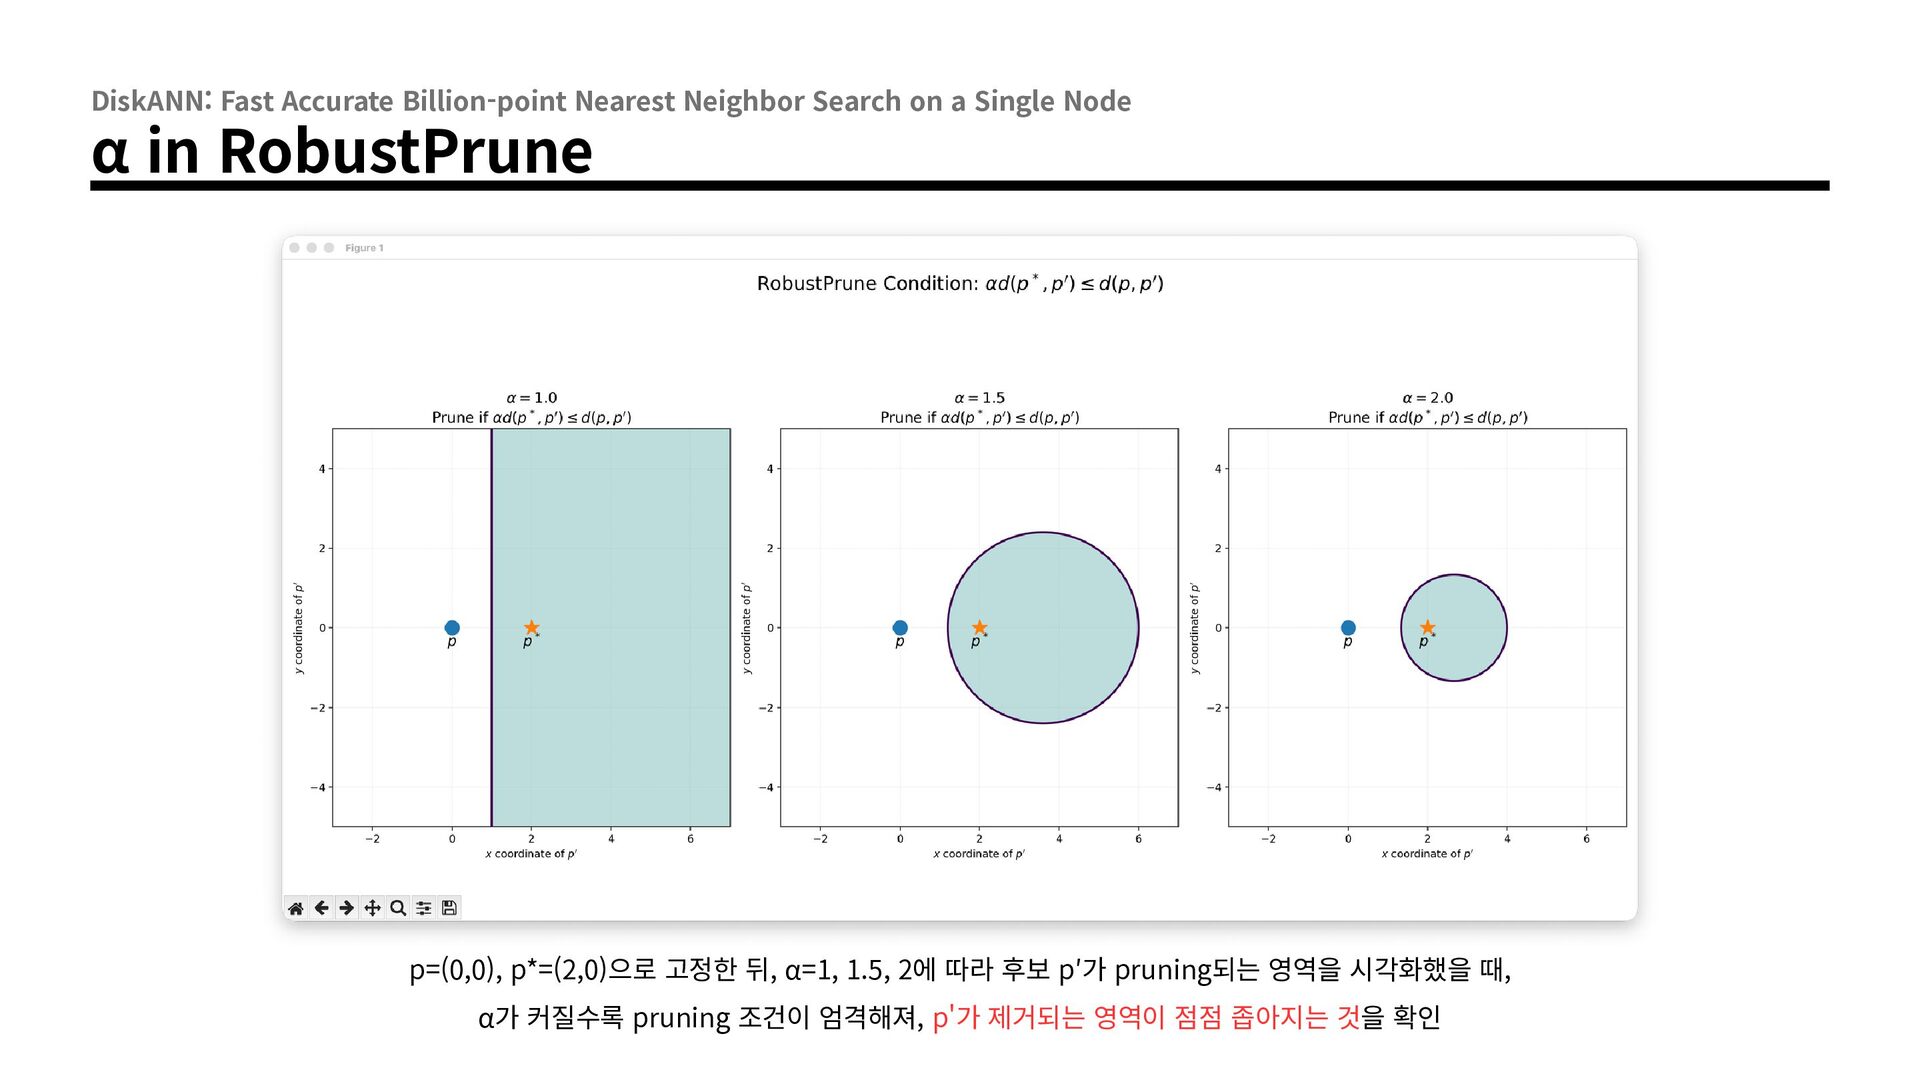
Node Method - Vamana 만들어진 SNG에서 검색 s에서 시작해 target까지 매 hop마다 조금이라도 가까워지면 됨 Ex) p1(d=1000) > p2(d=995) > p3(d=990) > ... > pn hop 수 많아짐 > disk round-trip(latency) 증가 > SSD에서 불리 RobustPrune(p,V,⍺,R) α · d(p*, p′) ≤ d(p, p′) (α > 1)이면 p' 제거 α 덕분에 매 hop마다 multiplicative하게 더 가까워지는 graph를 유도 Ex) p1(d=1000) > p2(d=500) > p3(d=250) > ... > pn 적은 hop으로 검색 가능한 graph index
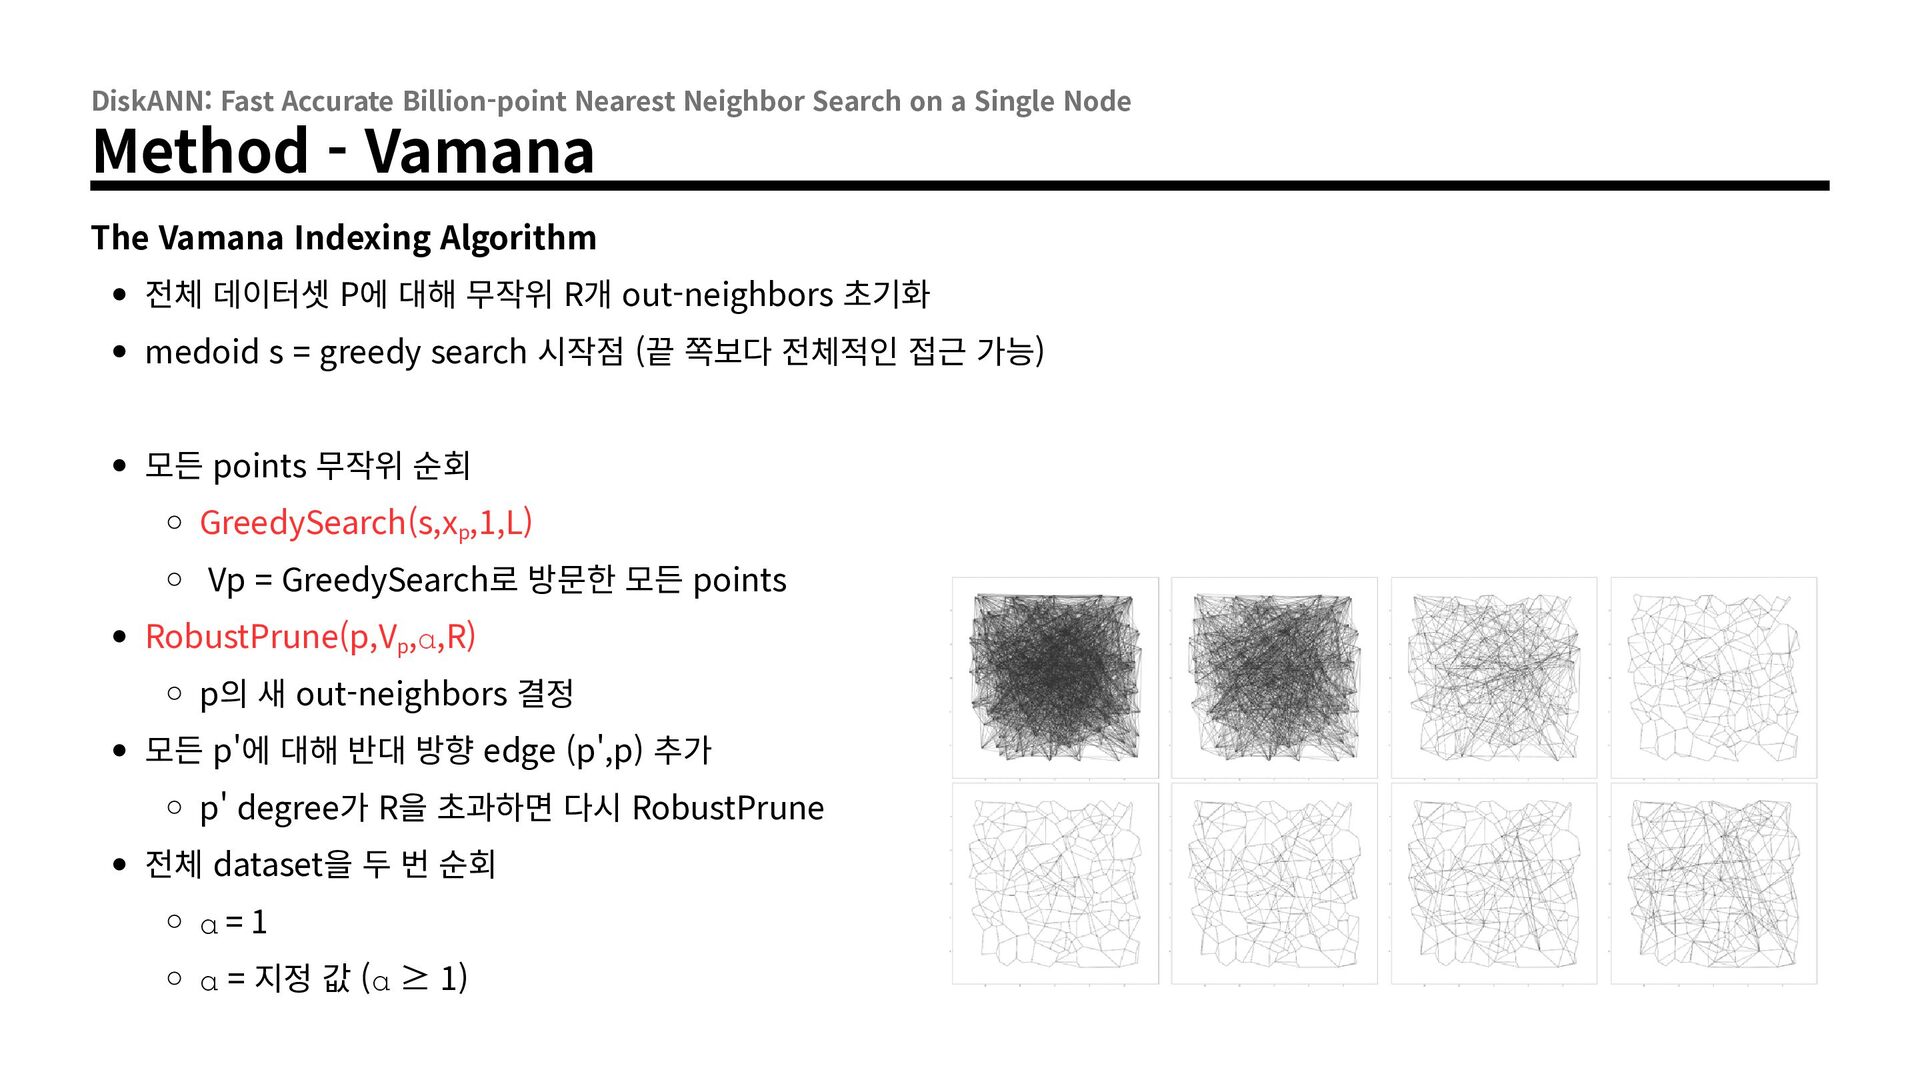
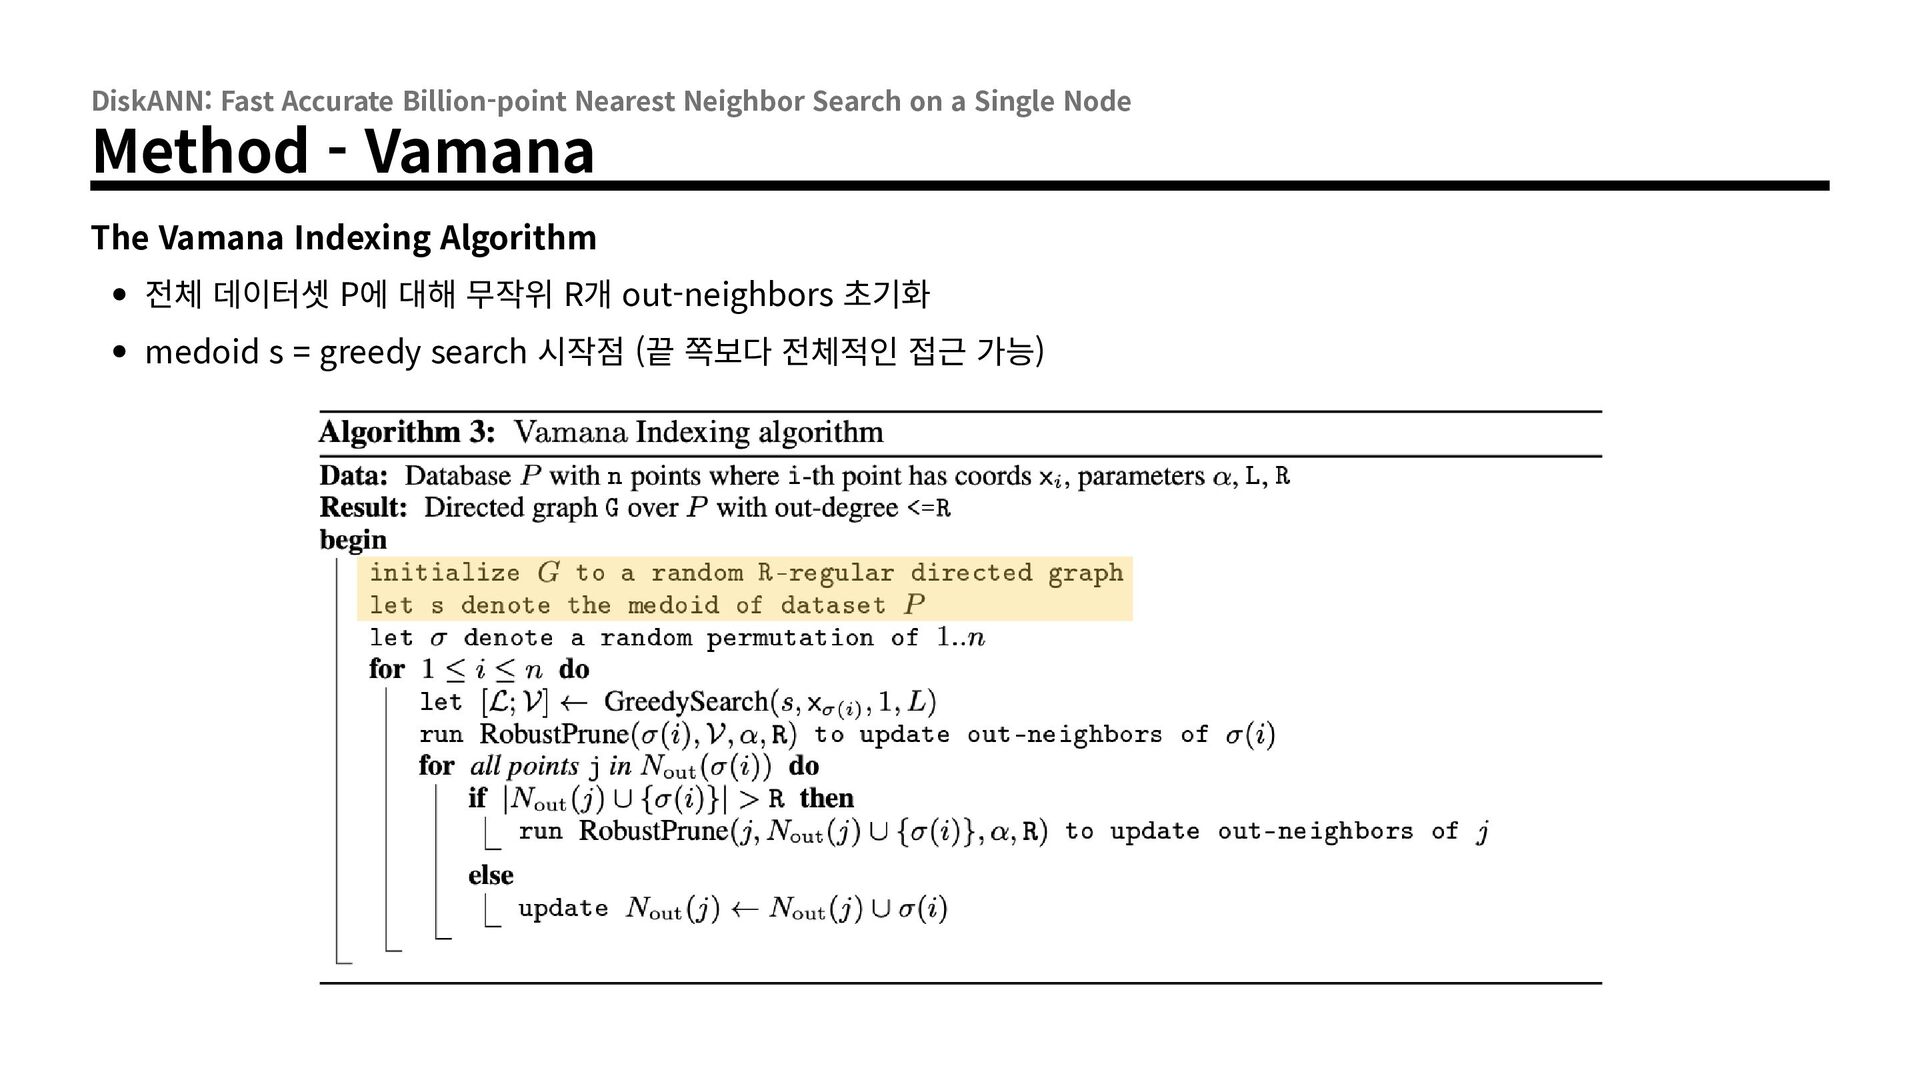
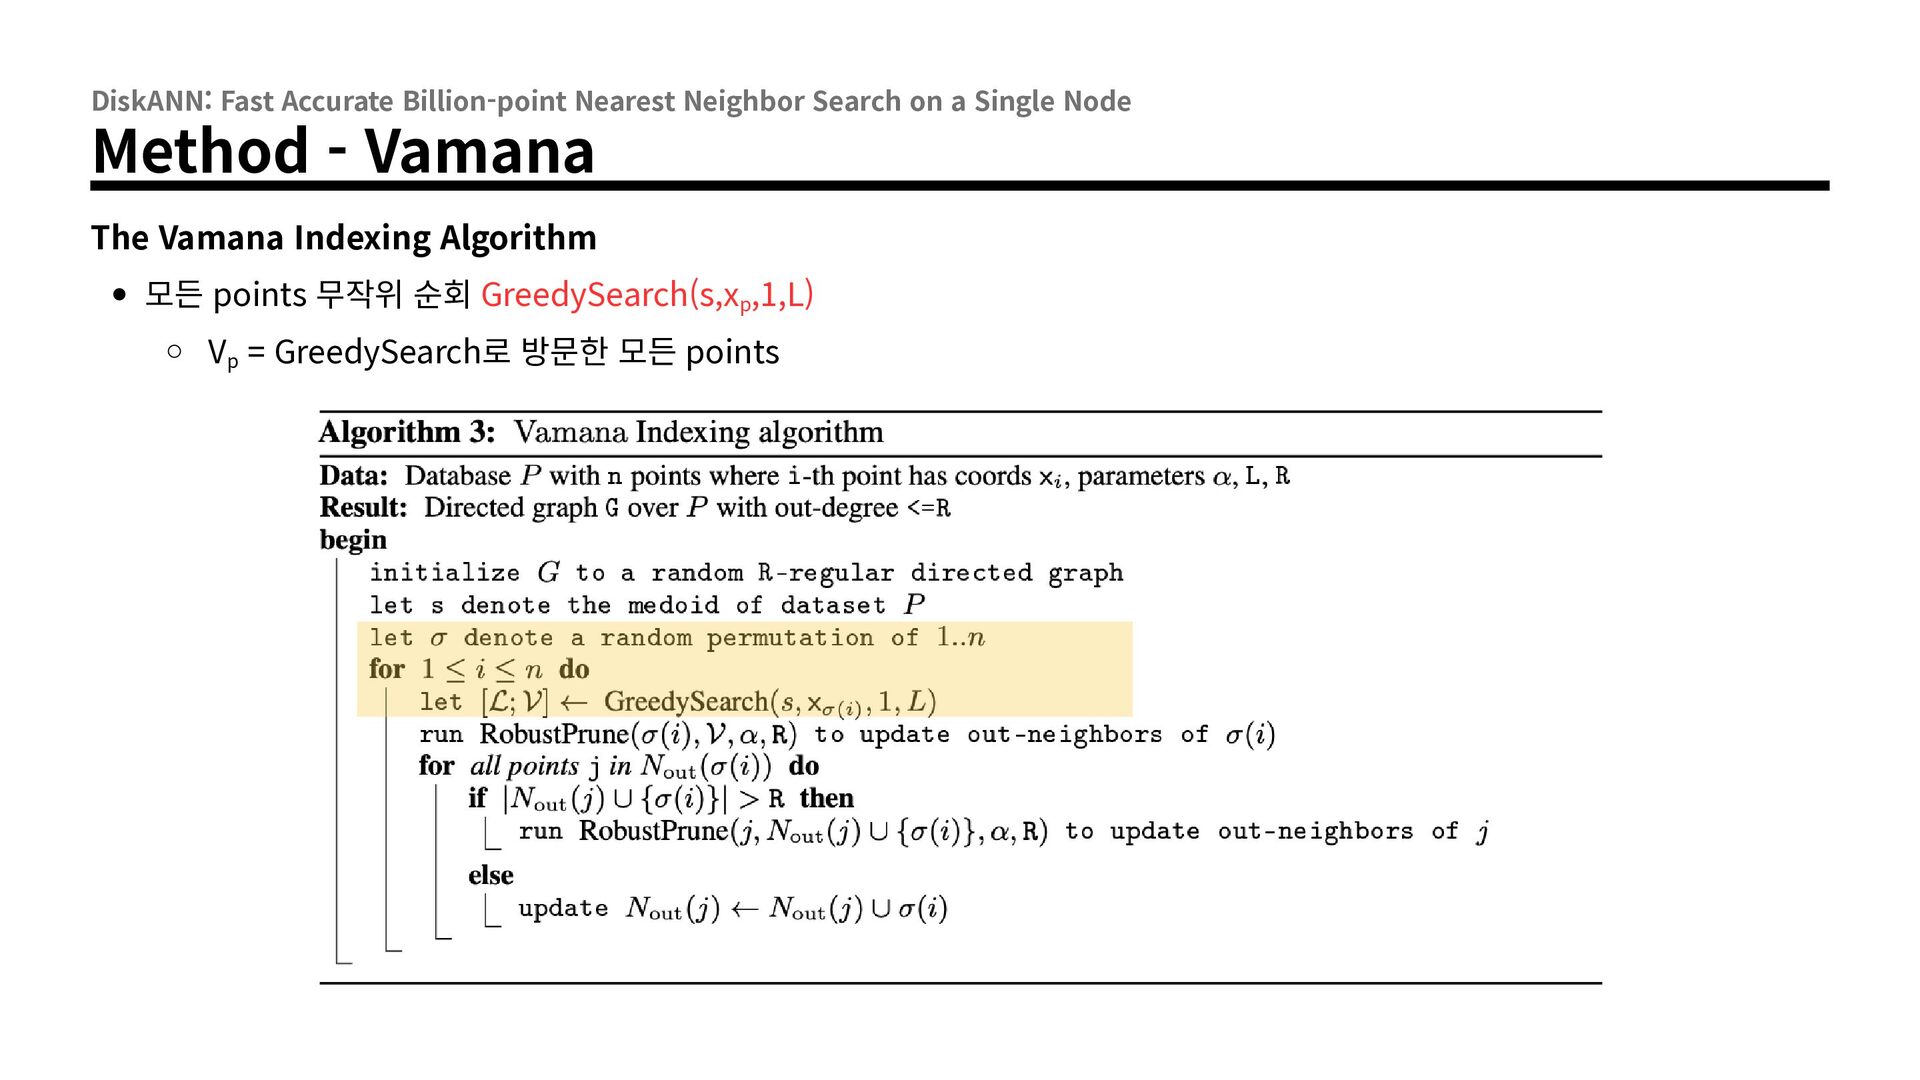
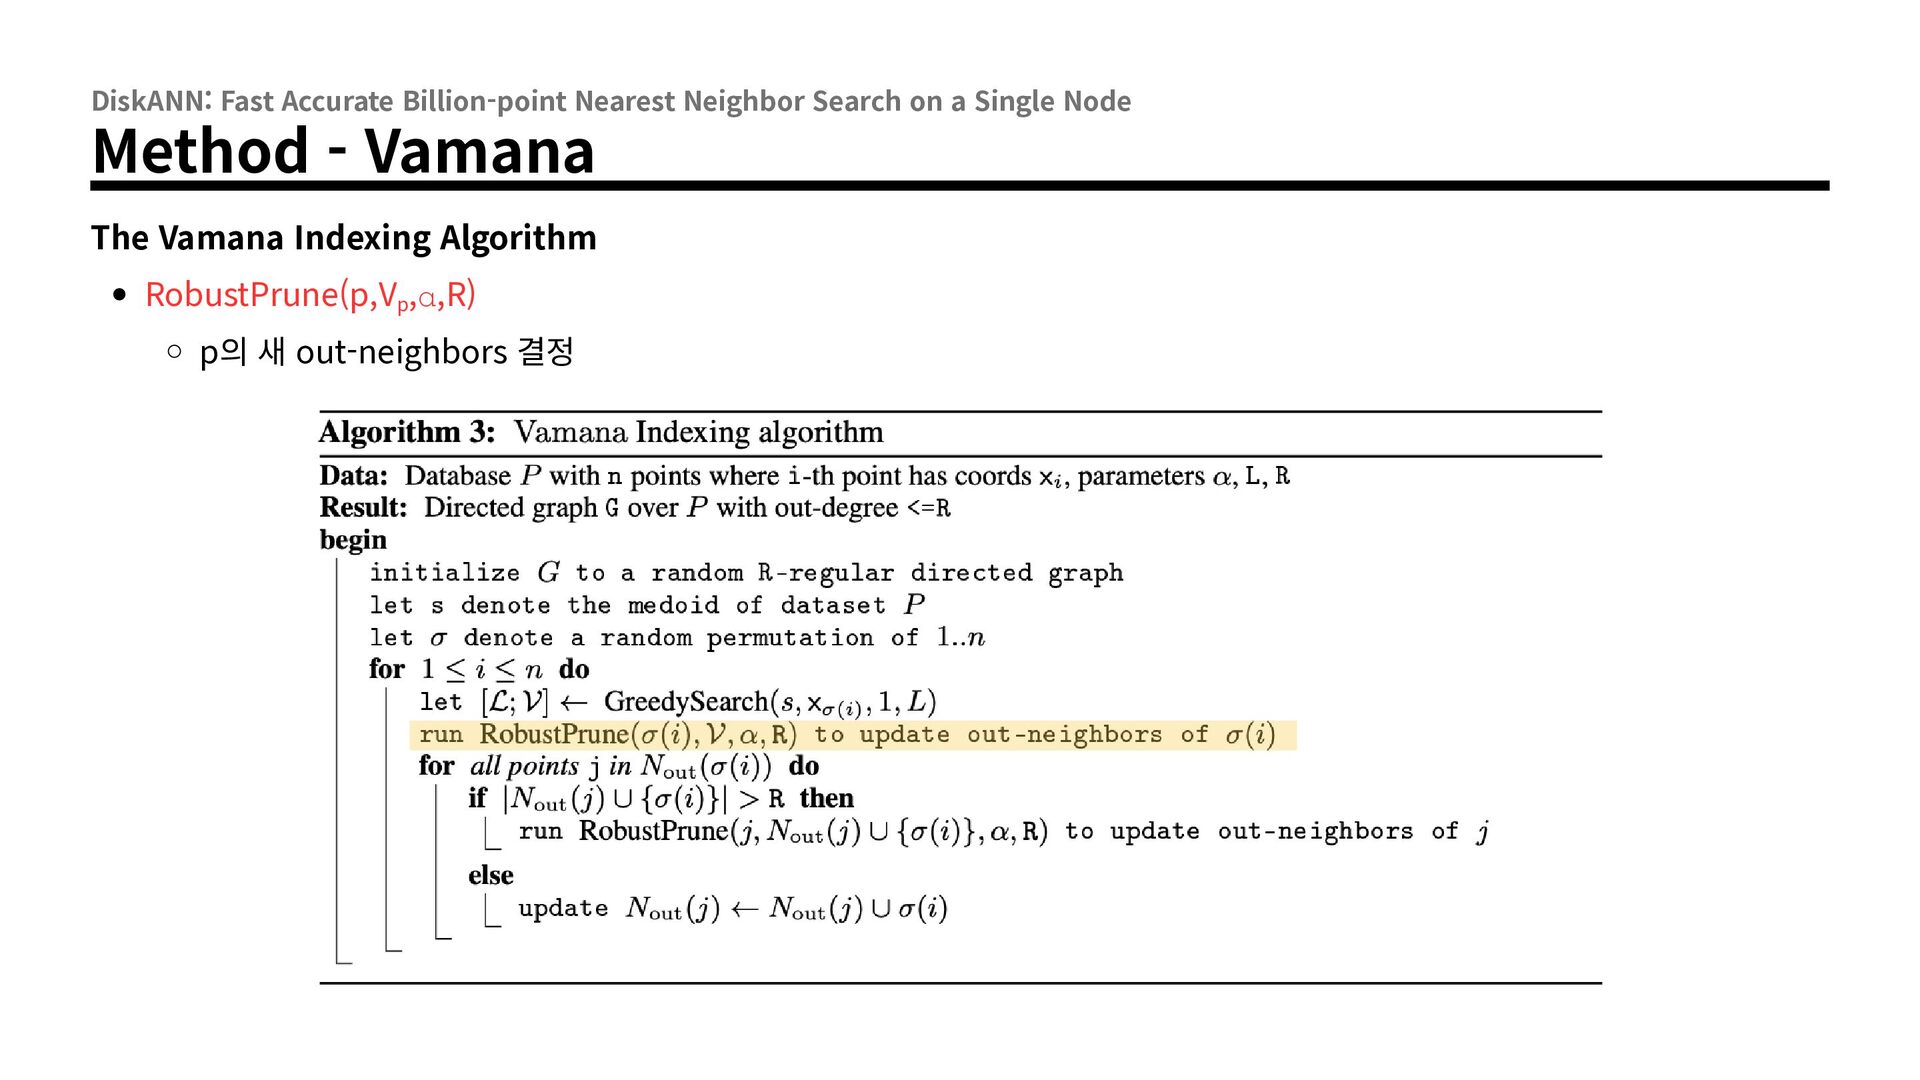
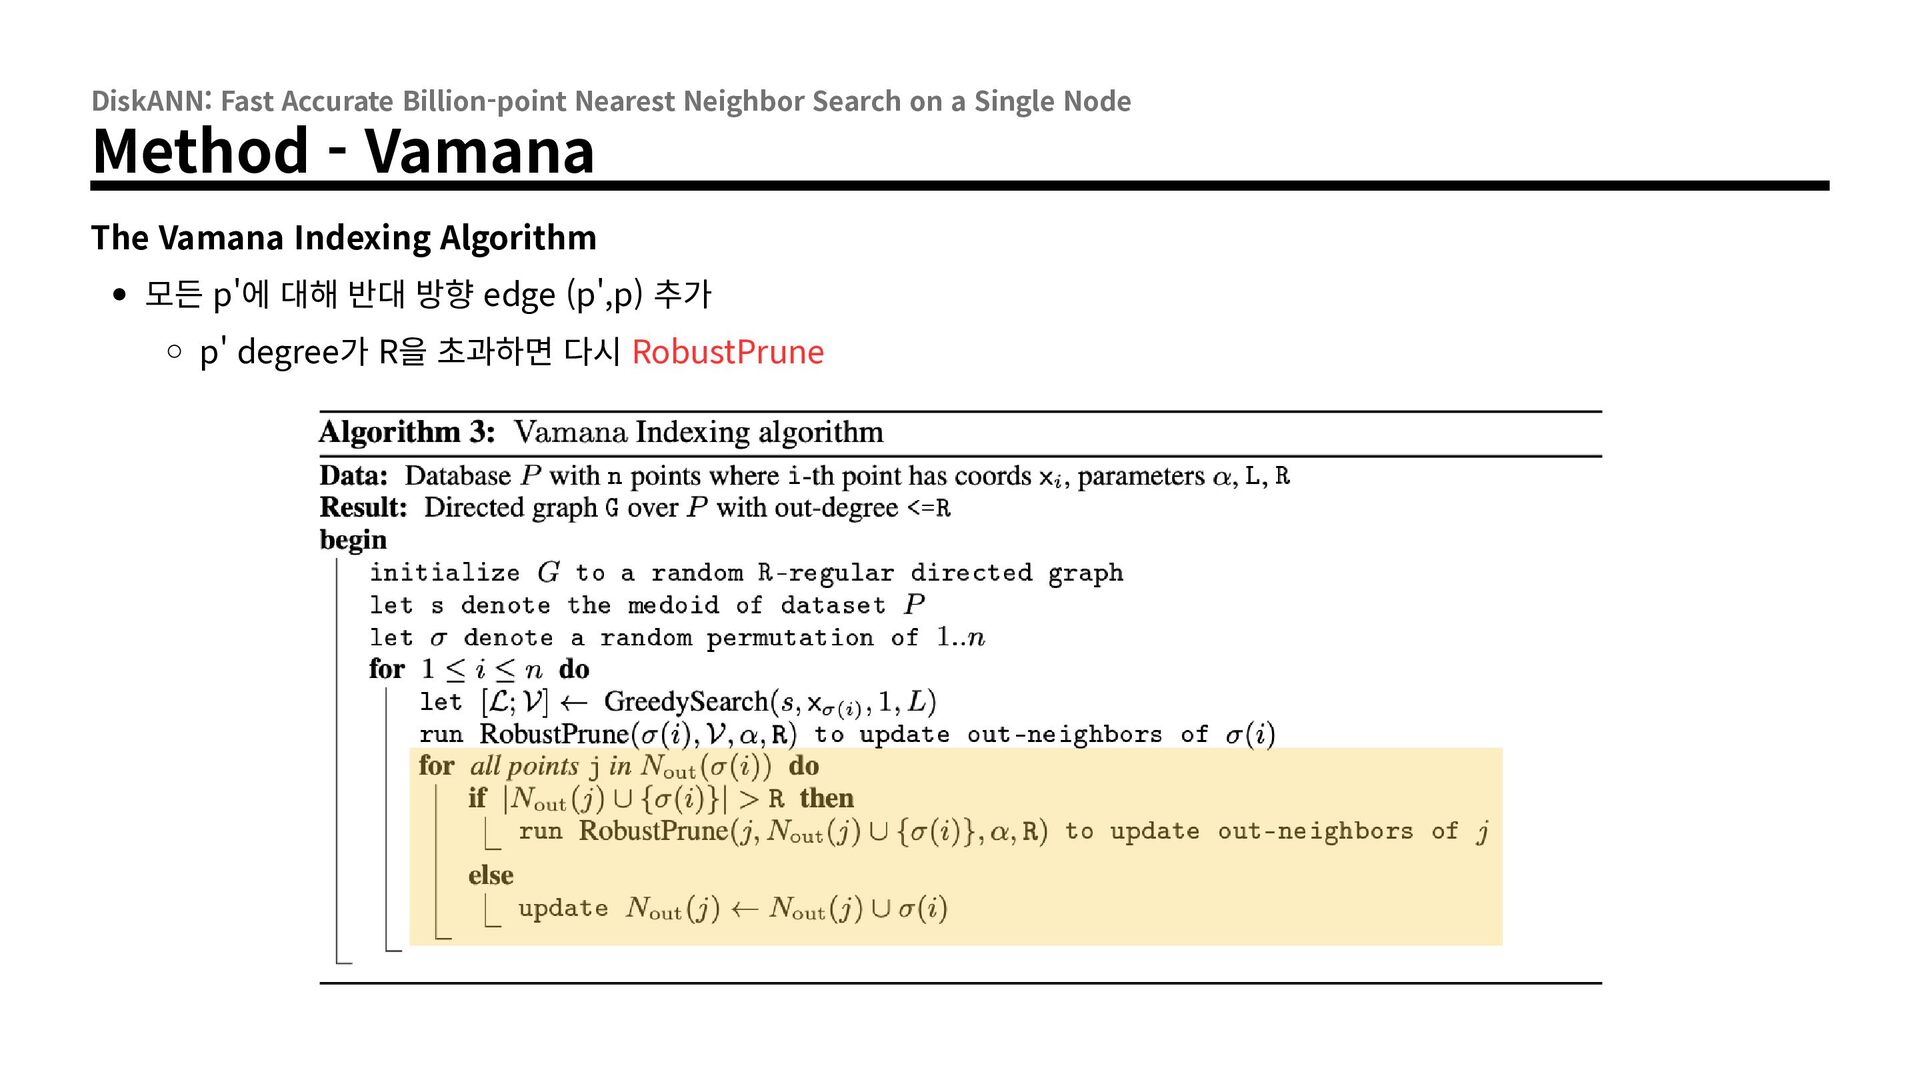
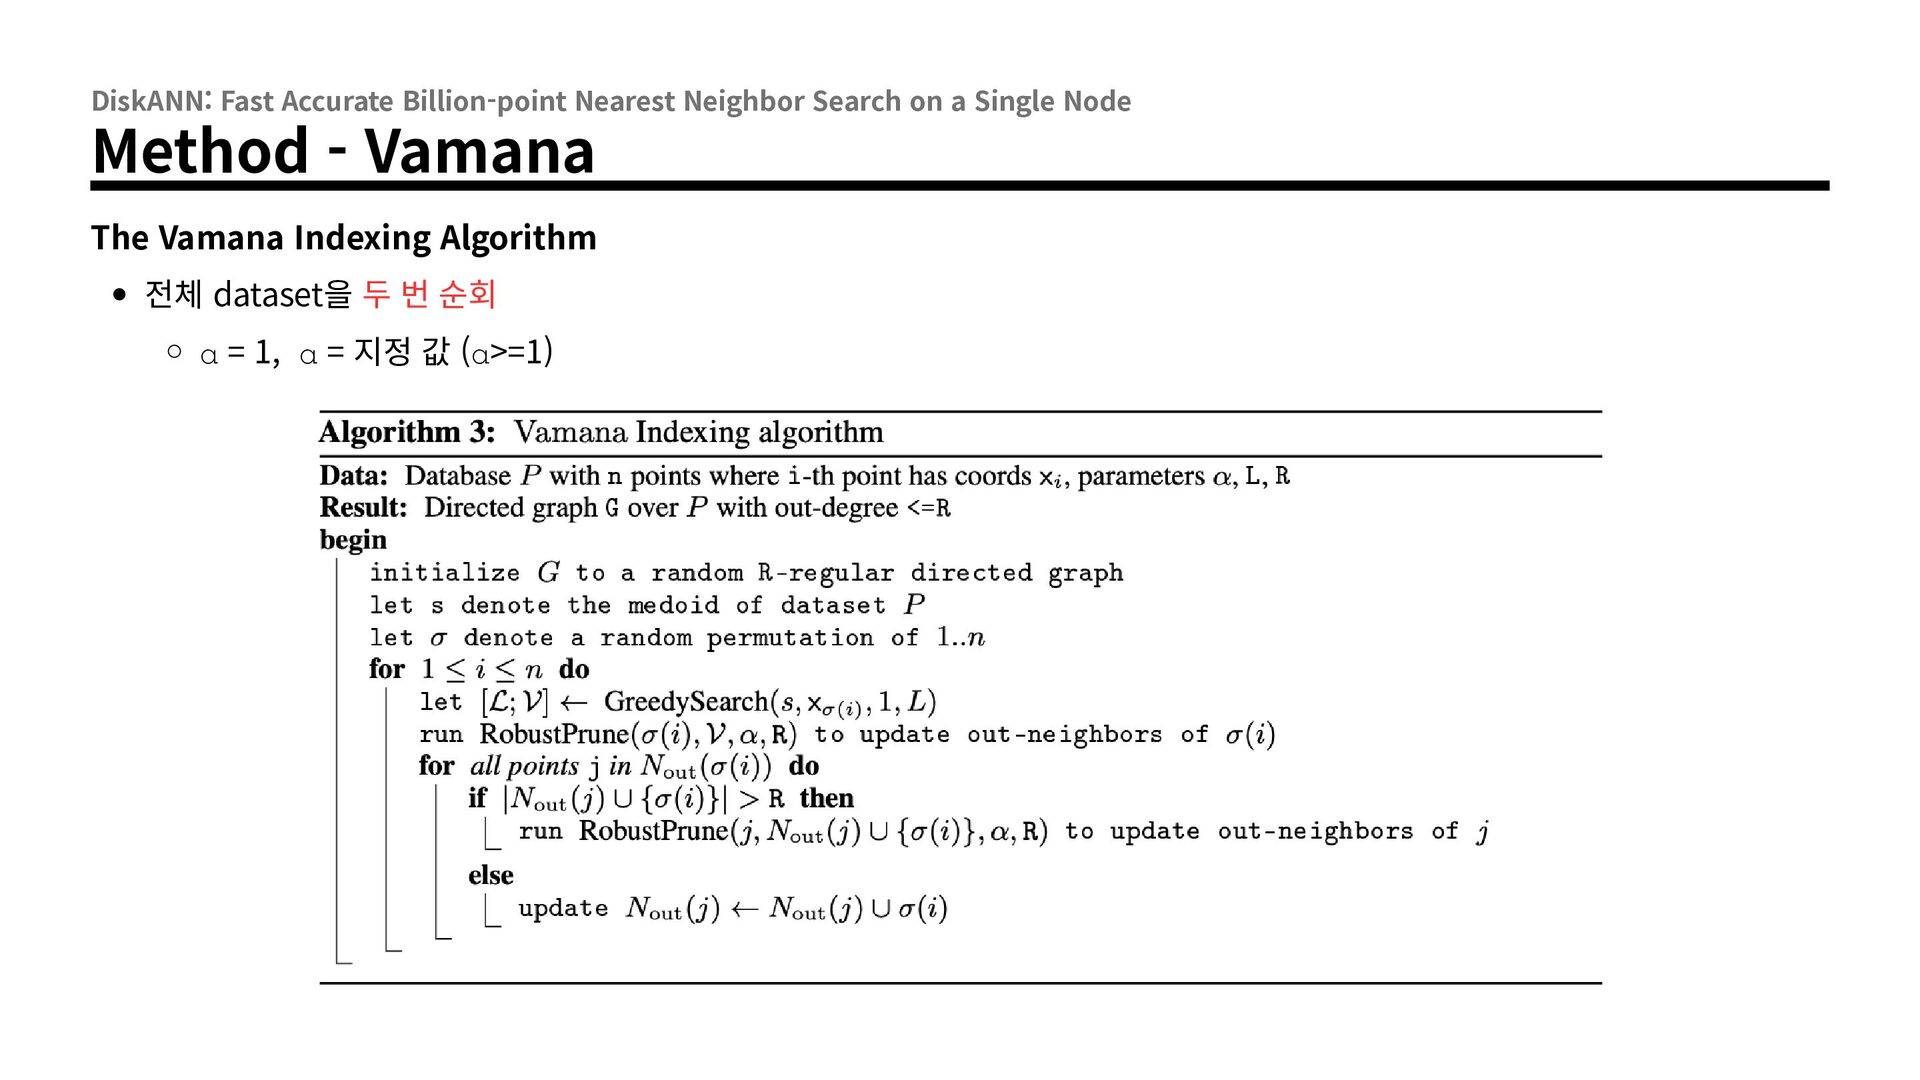
Node Method - Vamana The Vamana Indexing Algorithm 전체 데이터셋 P에 대해 무작위 R개 out-neighbors 초기화 medoid s = greedy search 시작점 (끝 쪽보다 전체적인 접근 가능) 모든 points 무작위 순회 GreedySearch(s,xp,1,L) Vp = GreedySearch로 방문한 모든 points RobustPrune(p,Vp,⍺,R) p의 새 out-neighbors 결정 모든 p'에 대해 반대 방향 edge (p',p) 추가 p' degree가 R을 초과하면 다시 RobustPrune 전체 dataset을 두 번 순회 ⍺=1 ⍺ = 지정 값 (⍺ ≥ 1)
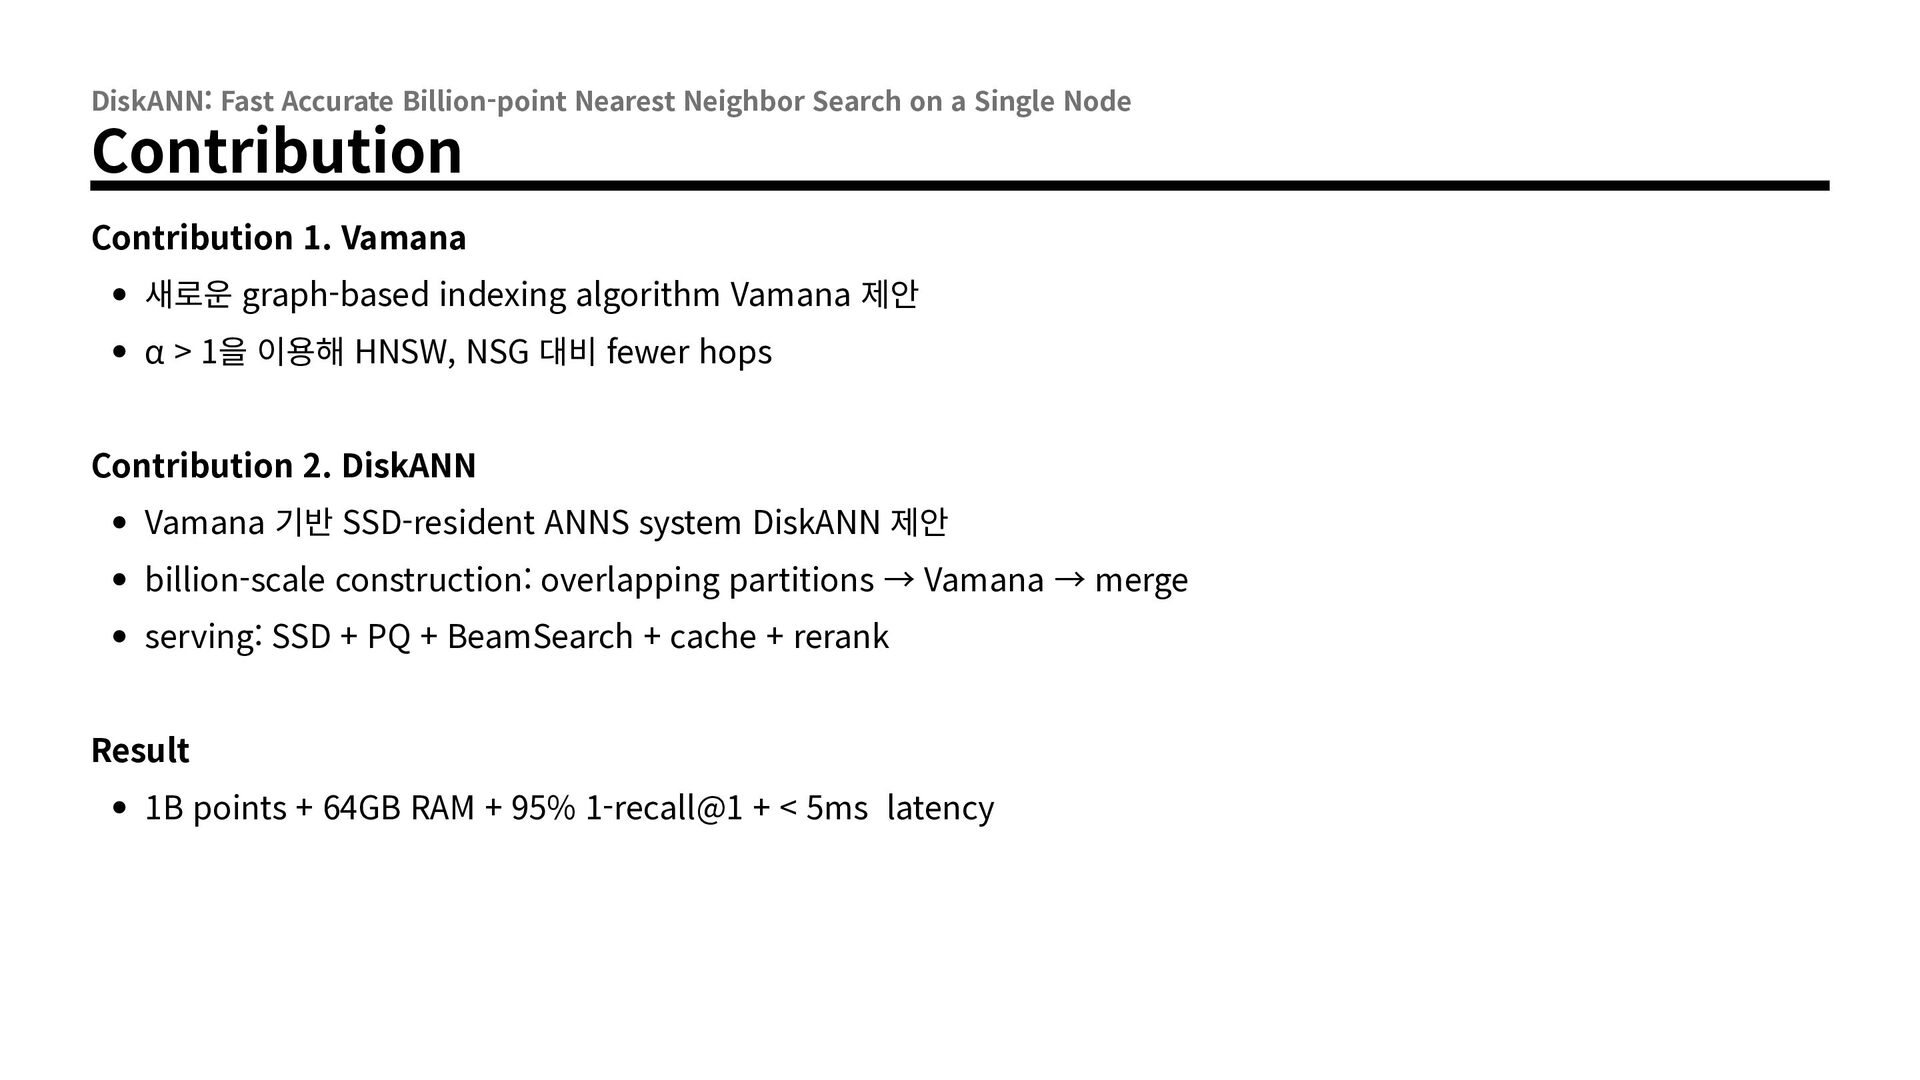
Node Method - DiskANN DiskANN = Vamana graph index 구축 + query 검색 Q1. Billion scale vector가 RAM에 안 들어가는데 Vamana graph를 어떻게 구축하지? Overlapping partition + shard별 작은 Vamana graph 구축 + merge k-means clustering (k=40로 실험) 각 포인트를 l개의 cluster에 중복 배정 (l=2 정도도 충분) 각 shard는 작아져서 RAM에서 Vamana 구축 가능 Q2. 검색할 때 Billion scale vector가 RAM에 없는데 query와 candidate의 거리는 어떻게 계산하지? PQ-compressed vector RAM에 저장 이를 이용해 search 중 approximate distance 계산 graph는 SSD 저장 but, Vamana graph 구축할 때는 full-precision vector 사용
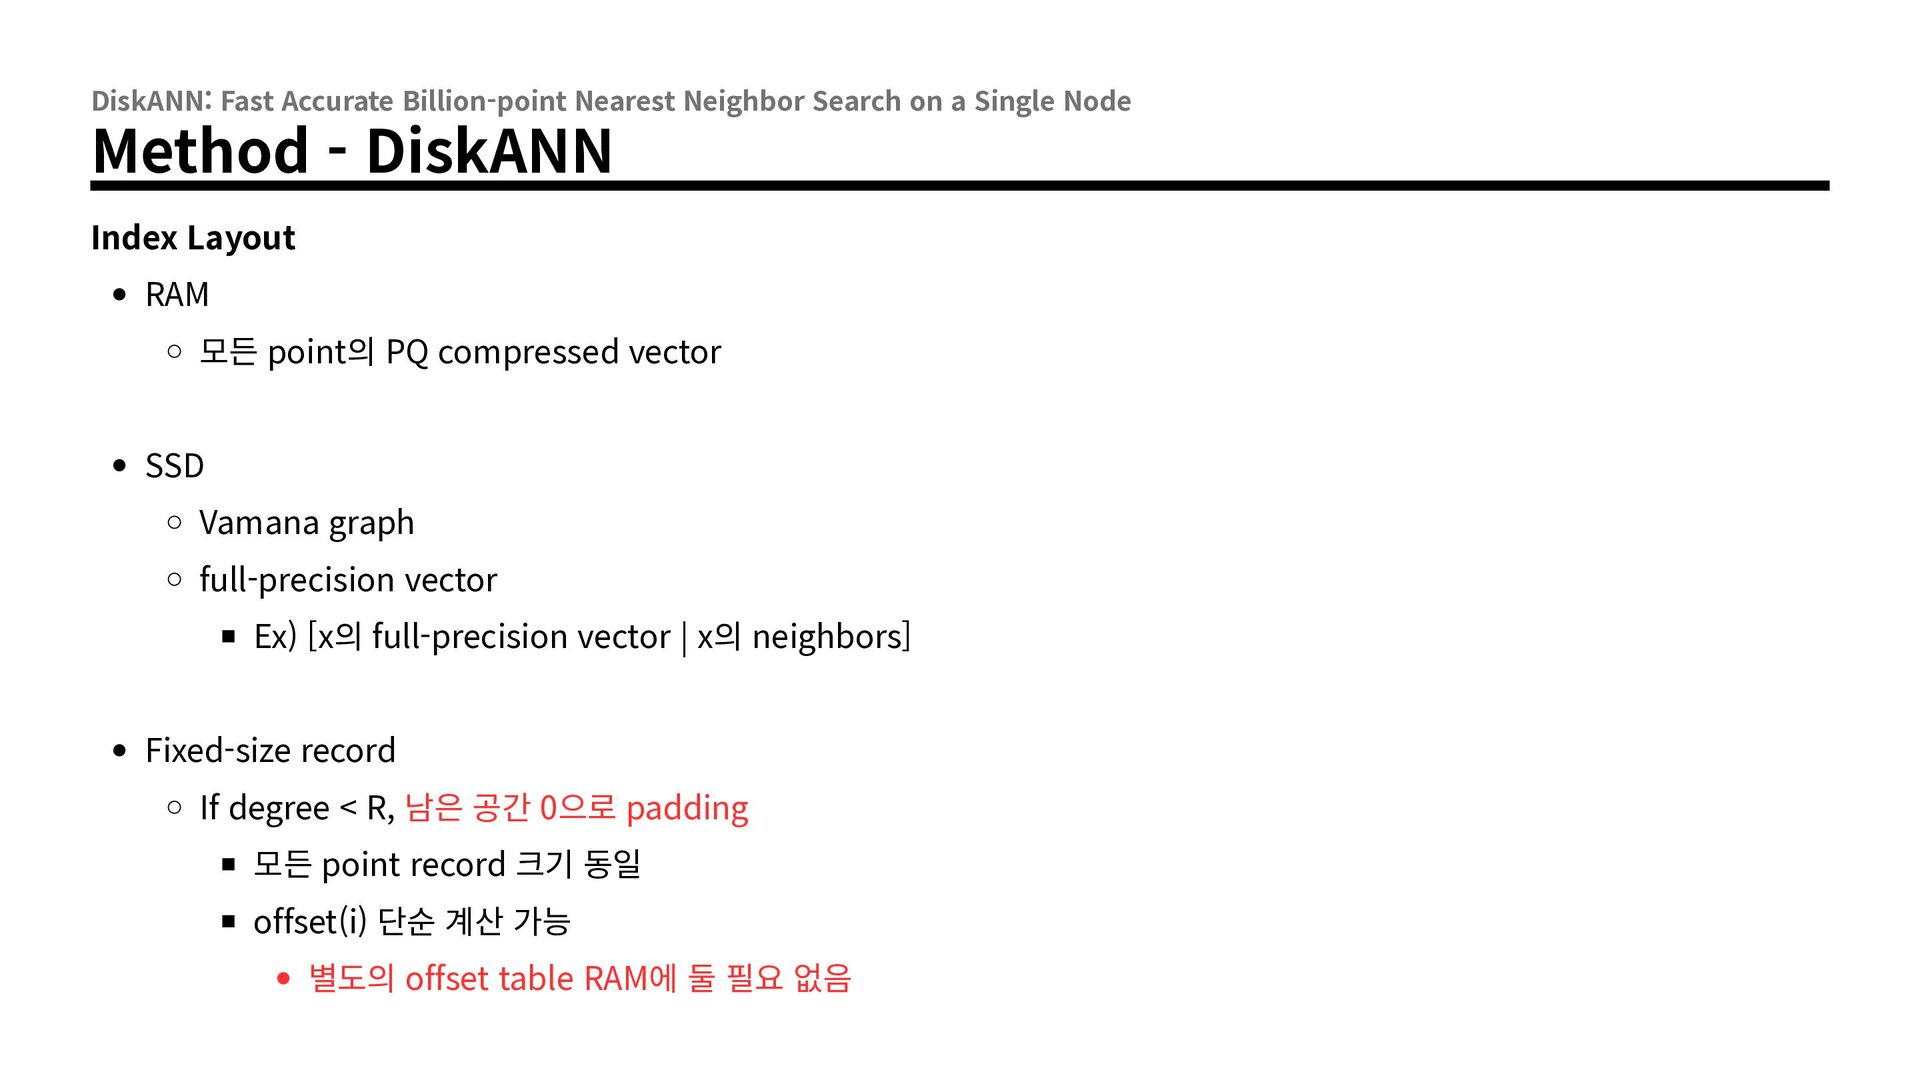
Node Method - DiskANN Index Layout RAM 모든 point의 PQ compressed vector SSD Vamana graph full-precision vector Ex) [x의 full-precision vector | x의 neighbors] Fixed-size record If degree < R, 남은 공간 0으로 padding 모든 point record 크기 동일 offset(i) 단순 계산 가능 별도의 offset table RAM에 둘 필요 없음
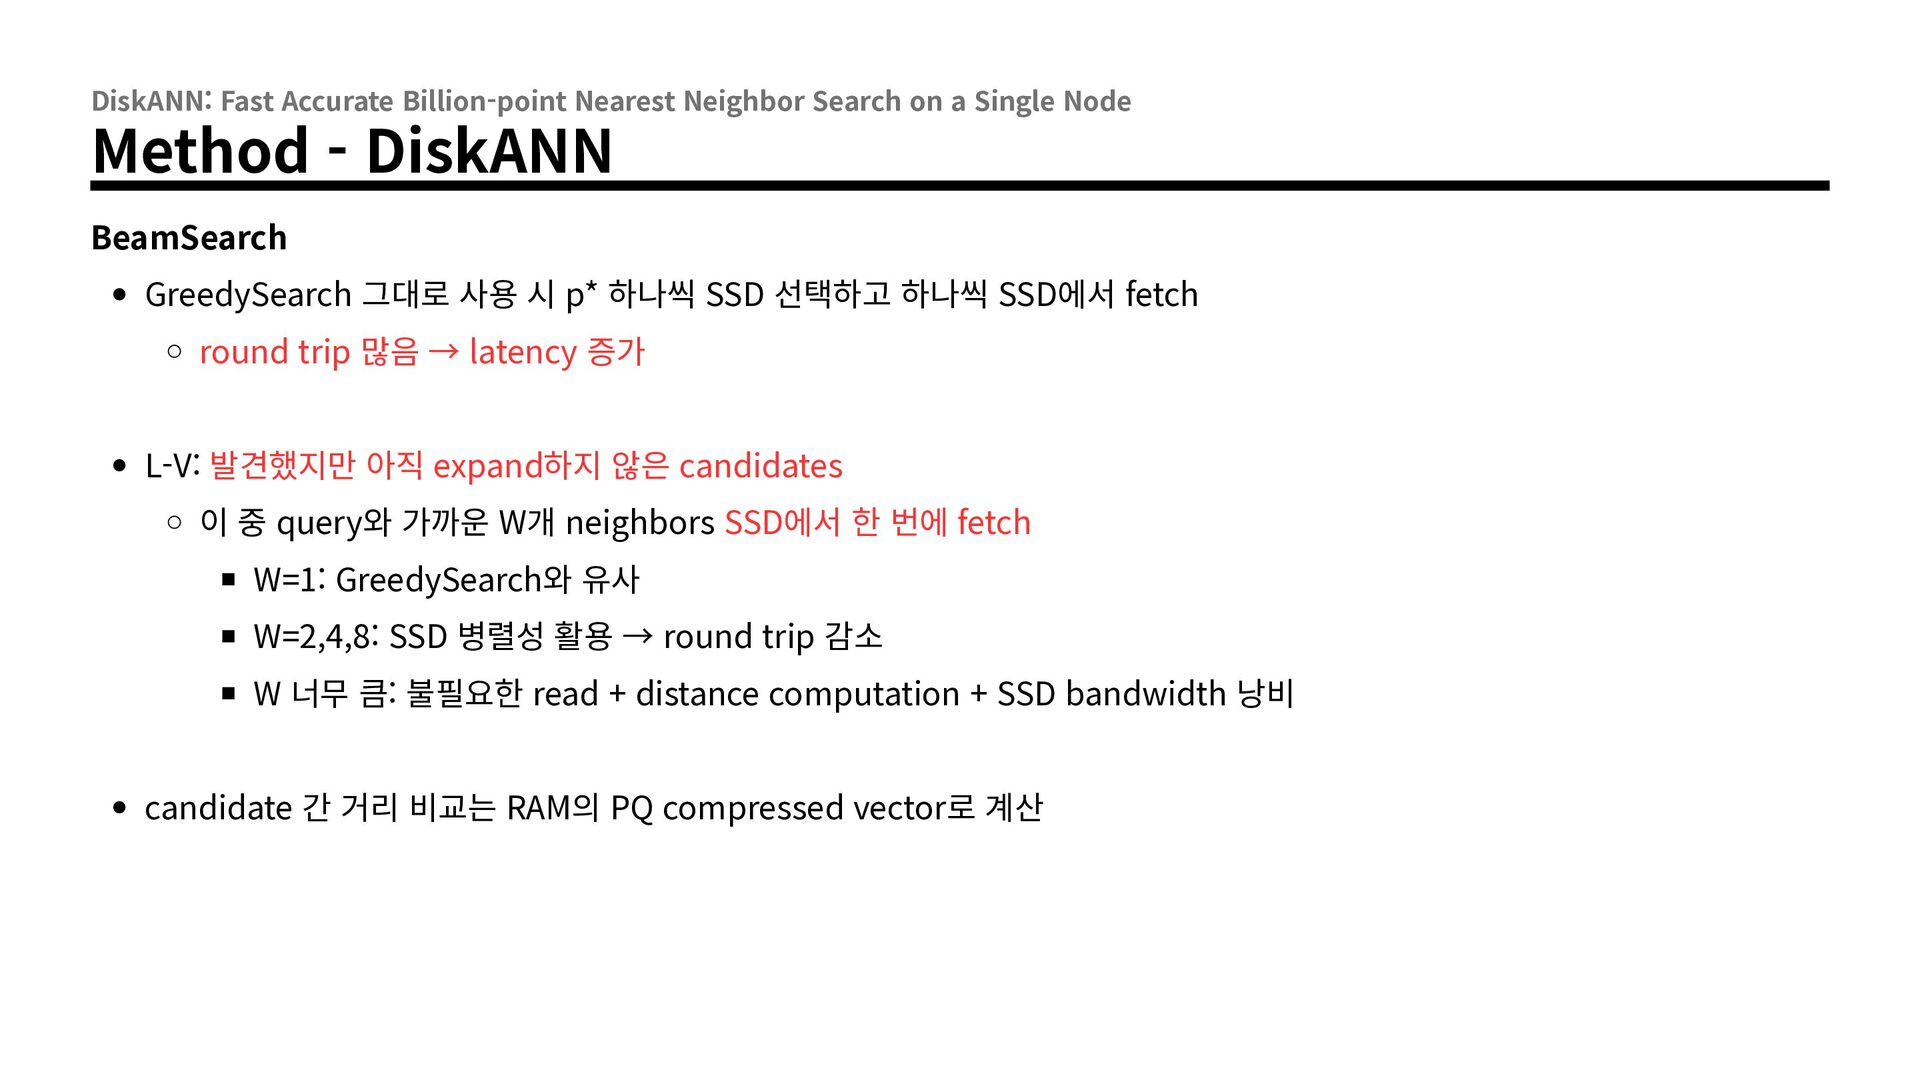
Node Method - DiskANN BeamSearch GreedySearch 그대로 사용 시 p* 하나씩 SSD 선택하고 하나씩 SSD에서 fetch round trip 많음 → latency 증가 L-V: 발견했지만 아직 expand하지 않은 candidates 이 중 query와 가까운 W개 neighbors SSD에서 한 번에 fetch W=1: GreedySearch와 유사 W=2,4,8: SSD 병렬성 활용 → round trip 감소 W 너무 큼: 불필요한 read + distance computation + SSD bandwidth 낭비 candidate 간 거리 비교는 RAM의 PQ compressed vector로 계산
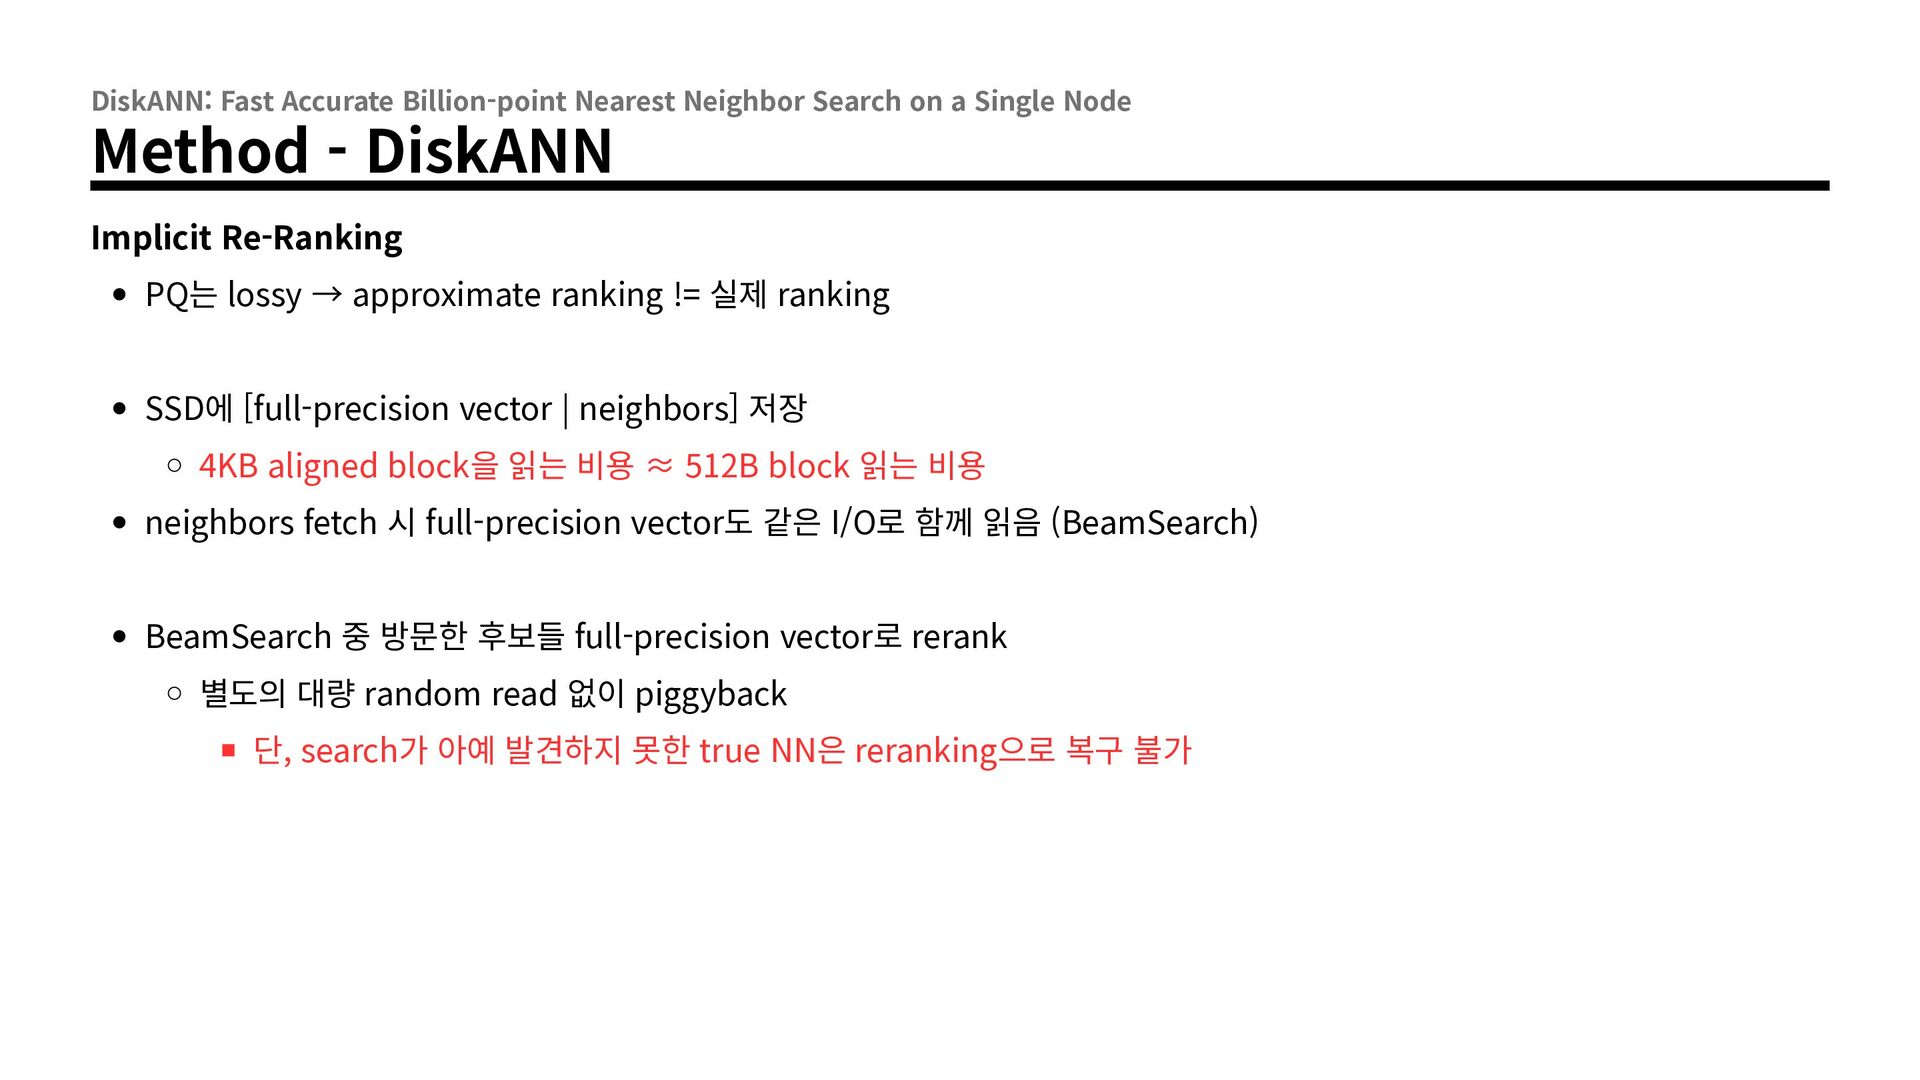
Node Method - DiskANN Implicit Re-Ranking PQ는 lossy → approximate ranking != 실제 ranking SSD에 [full-precision vector | neighbors] 저장 4KB aligned block을 읽는 비용 ≈ 512B block 읽는 비용 neighbors fetch 시 full-precision vector도 같은 I/O로 함께 읽음 (BeamSearch) BeamSearch 중 방문한 후보들 full-precision vector로 rerank 별도의 대량 random read 없이 piggyback 단, search가 아예 발견하지 못한 true NN은 reranking으로 복구 불가
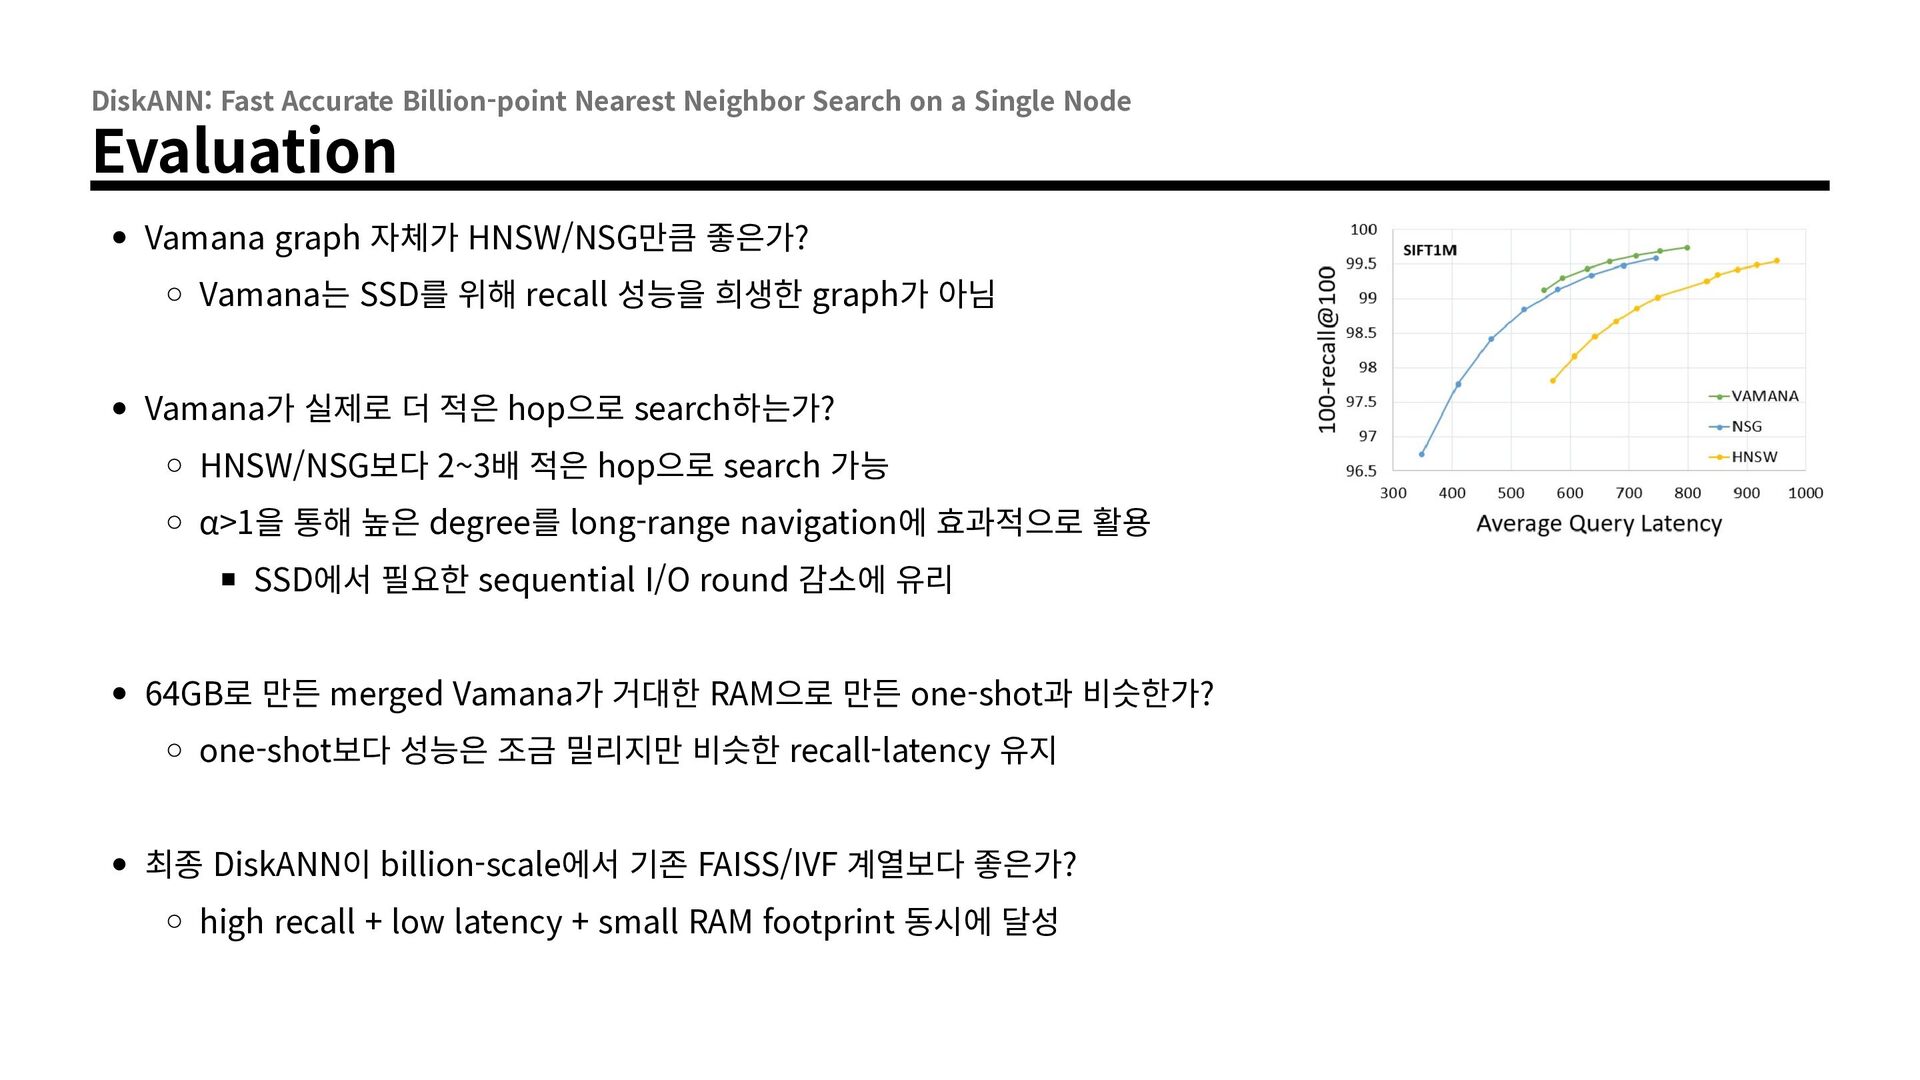
Node Evaluation Vamana graph 자체가 HNSW/NSG만큼 좋은가? Vamana는 SSD를 위해 recall 성능을 희생한 graph가 아님 Vamana가 실제로 더 적은 hop으로 search하는가? HNSW/NSG보다 2~3배 적은 hop으로 search 가능 α>1을 통해 높은 degree를 long-range navigation에 효과적으로 활용 SSD에서 필요한 sequential I/O round 감소에 유리 64GB로 만든 merged Vamana가 거대한 RAM으로 만든 one-shot과 비슷한가? one-shot보다 성능은 조금 밀리지만 비슷한 recall-latency 유지 최종 DiskANN이 billion-scale에서 기존 FAISS/IVF 계열보다 좋은가? high recall + low latency + small RAM footprint 동시에 달성
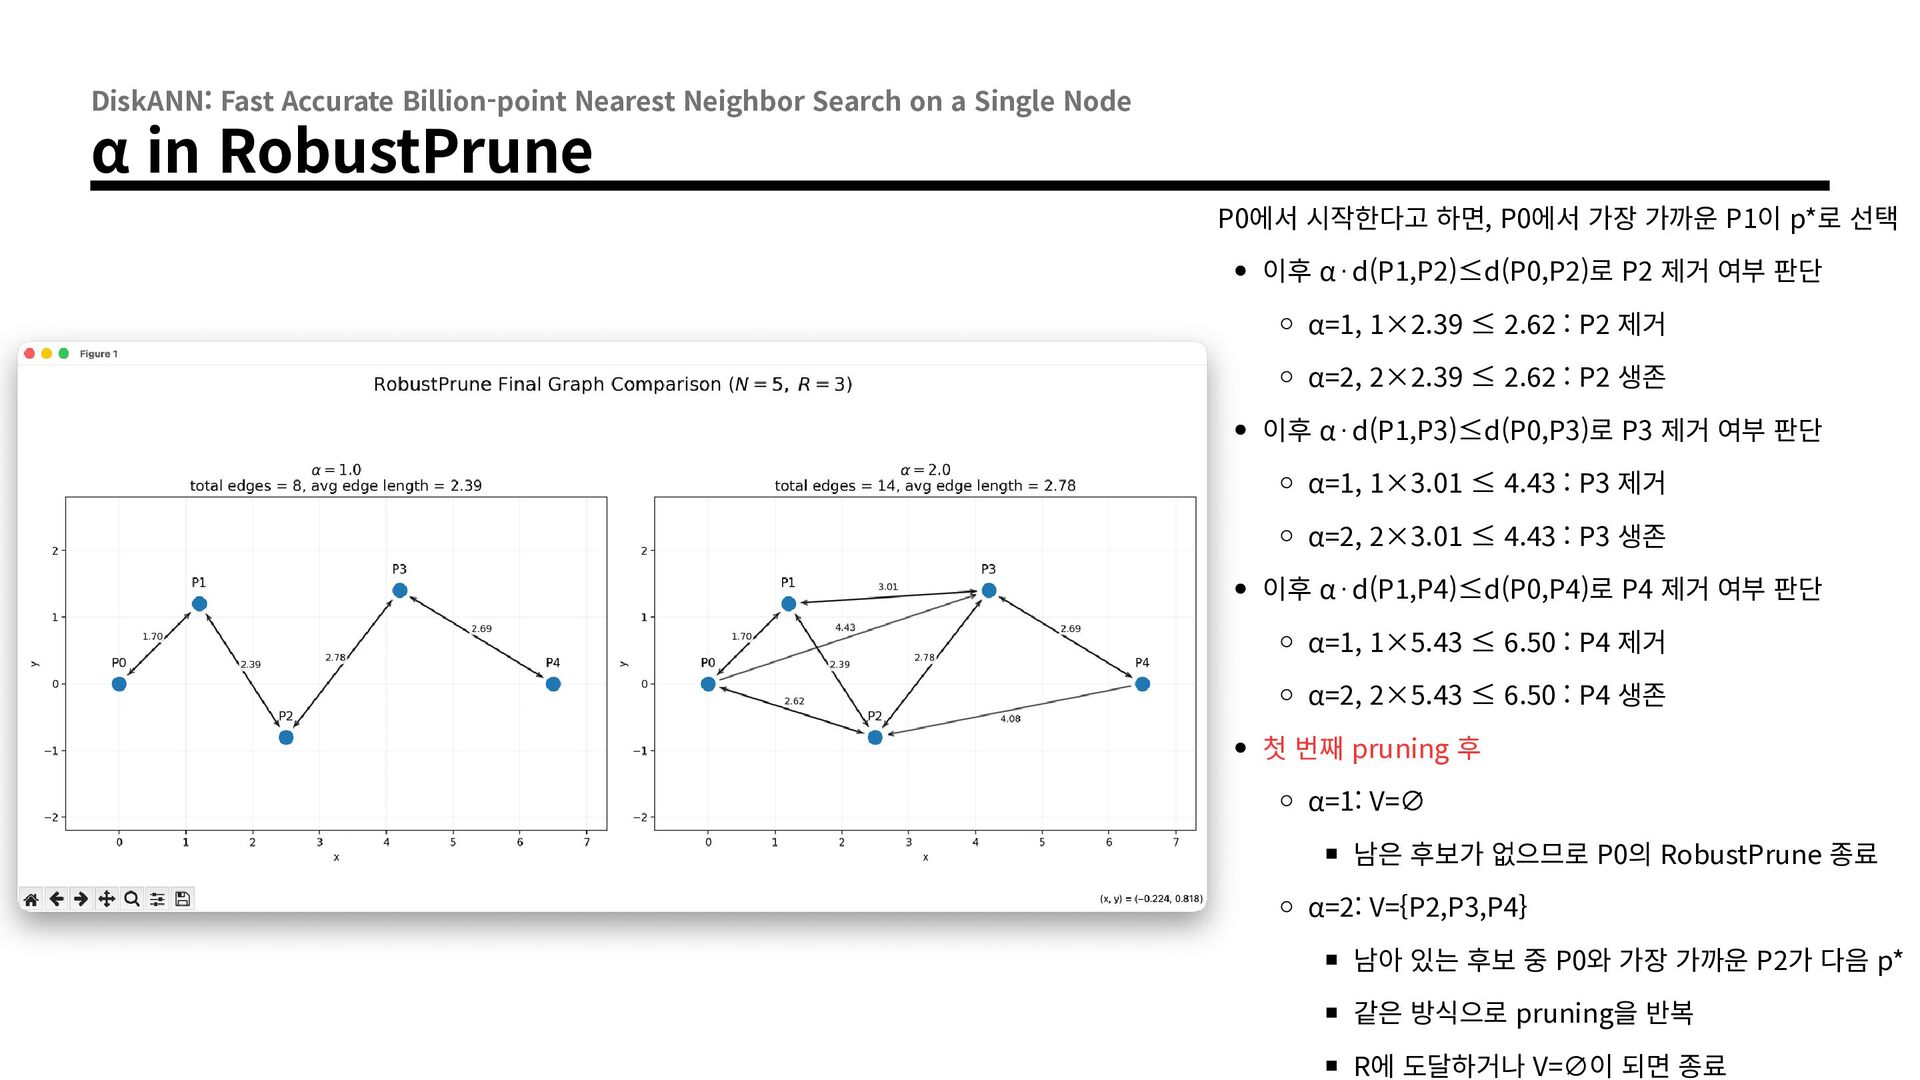
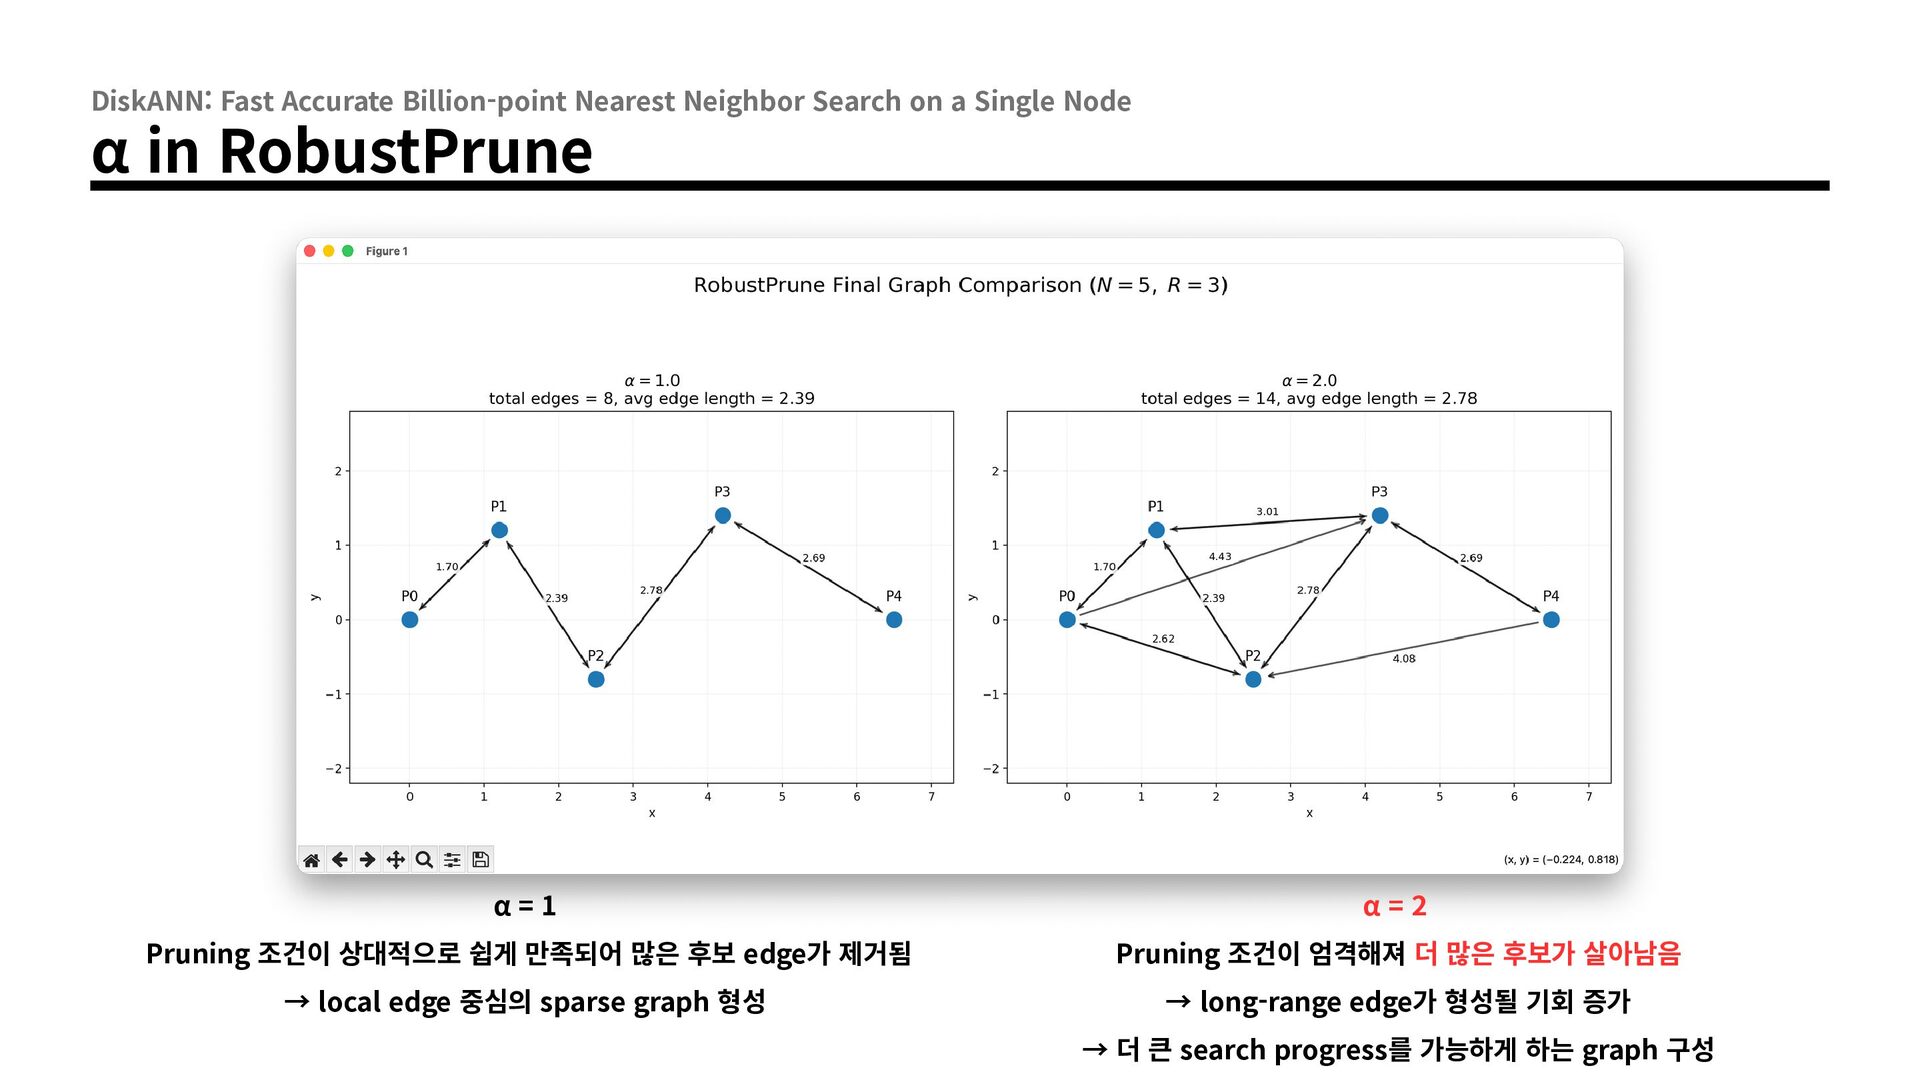
Node α in RobustPrune P0에서 시작한다고 하면, P0에서 가장 가까운 P1이 p*로 선택 이후 α⋅d(P1,P2)≤d(P0,P2)로 P2 제거 여부 판단 α=1, 1×2.39 ≤ 2.62 : P2 제거 α=2, 2×2.39 ≤ 2.62 : P2 생존 이후 α⋅d(P1,P3)≤d(P0,P3)로 P3 제거 여부 판단 α=1, 1×3.01 ≤ 4.43 : P3 제거 α=2, 2×3.01 ≤ 4.43 : P3 생존 이후 α⋅d(P1,P4)≤d(P0,P4)로 P4 제거 여부 판단 α=1, 1×5.43 ≤ 6.50 : P4 제거 α=2, 2×5.43 ≤ 6.50 : P4 생존 첫 번째 pruning 후 α=1: V=∅ 남은 후보가 없으므로 P0의 RobustPrune 종료 α=2: V={P2,P3,P4} 남아 있는 후보 중 P0와 가장 가까운 P2가 다음 p* 같은 방식으로 pruning을 반복 R에 도달하거나 V=∅이 되면 종료
Node α in RobustPrune α=1 α=2 Pruning 조건이 상대적으로 쉽게 만족되어 많은 후보 edge가 제거됨 Pruning 조건이 엄격해져 더 많은 후보가 살아남음 → local edge 중심의 sparse graph 형성 → long-range edge가 형성될 기회 증가 → 더 큰 search progress를 가능하게 하는 graph 구성
Node α in RobustPrune SNG는 GreedySearch가 target으로 잘 수렴할 수 있도록 설계된 이론적 graph 구조 RobustPrune은 기존 pruning 기준에 α를 도입한 Vamana의 핵심 edge selection 방식 α를 통해 더 큰 search progress를 만들 수 있는 edge 구축 유도 적은 hop으로 탐색 가능 ≠ 전체 edge 수 자체가 감소 RobustPrune은 edge 수 자체를 최소화하는 방식이 아니라, 제한된 degree R 안에서 long-range edge 구축을 유도하여 search hop을 줄이는 방식 성찰 적은 hop으로 멀리 갈 수 있다는 것을 전체 edge 수 자체가 줄어든다는 의미로 혼동 이 때문에 수식상으로는 α가 커질수록 pruning 조건이 더 엄격해진다는 점을 확인했지만, 이것이 search hop 감소와 어떻게 이어지는지에 대한 이해가 부족했음


 nawkwoo
 kogoro
 satai
 takasehideki
 tomonom
 hellosct1
 koide3
 rikkabotan7
 institutdelelevage
 hotchpotch
 microbaseinc
 kzmssk
 casualconc
 aki_iinuma
 palkan
 tenderlove
 andyhume
 tammyeverts
 addyosmani
 lynnandtonic
 nikkihalliwell
 ryanjones
 eileencodes
 colly
 rkendrick25