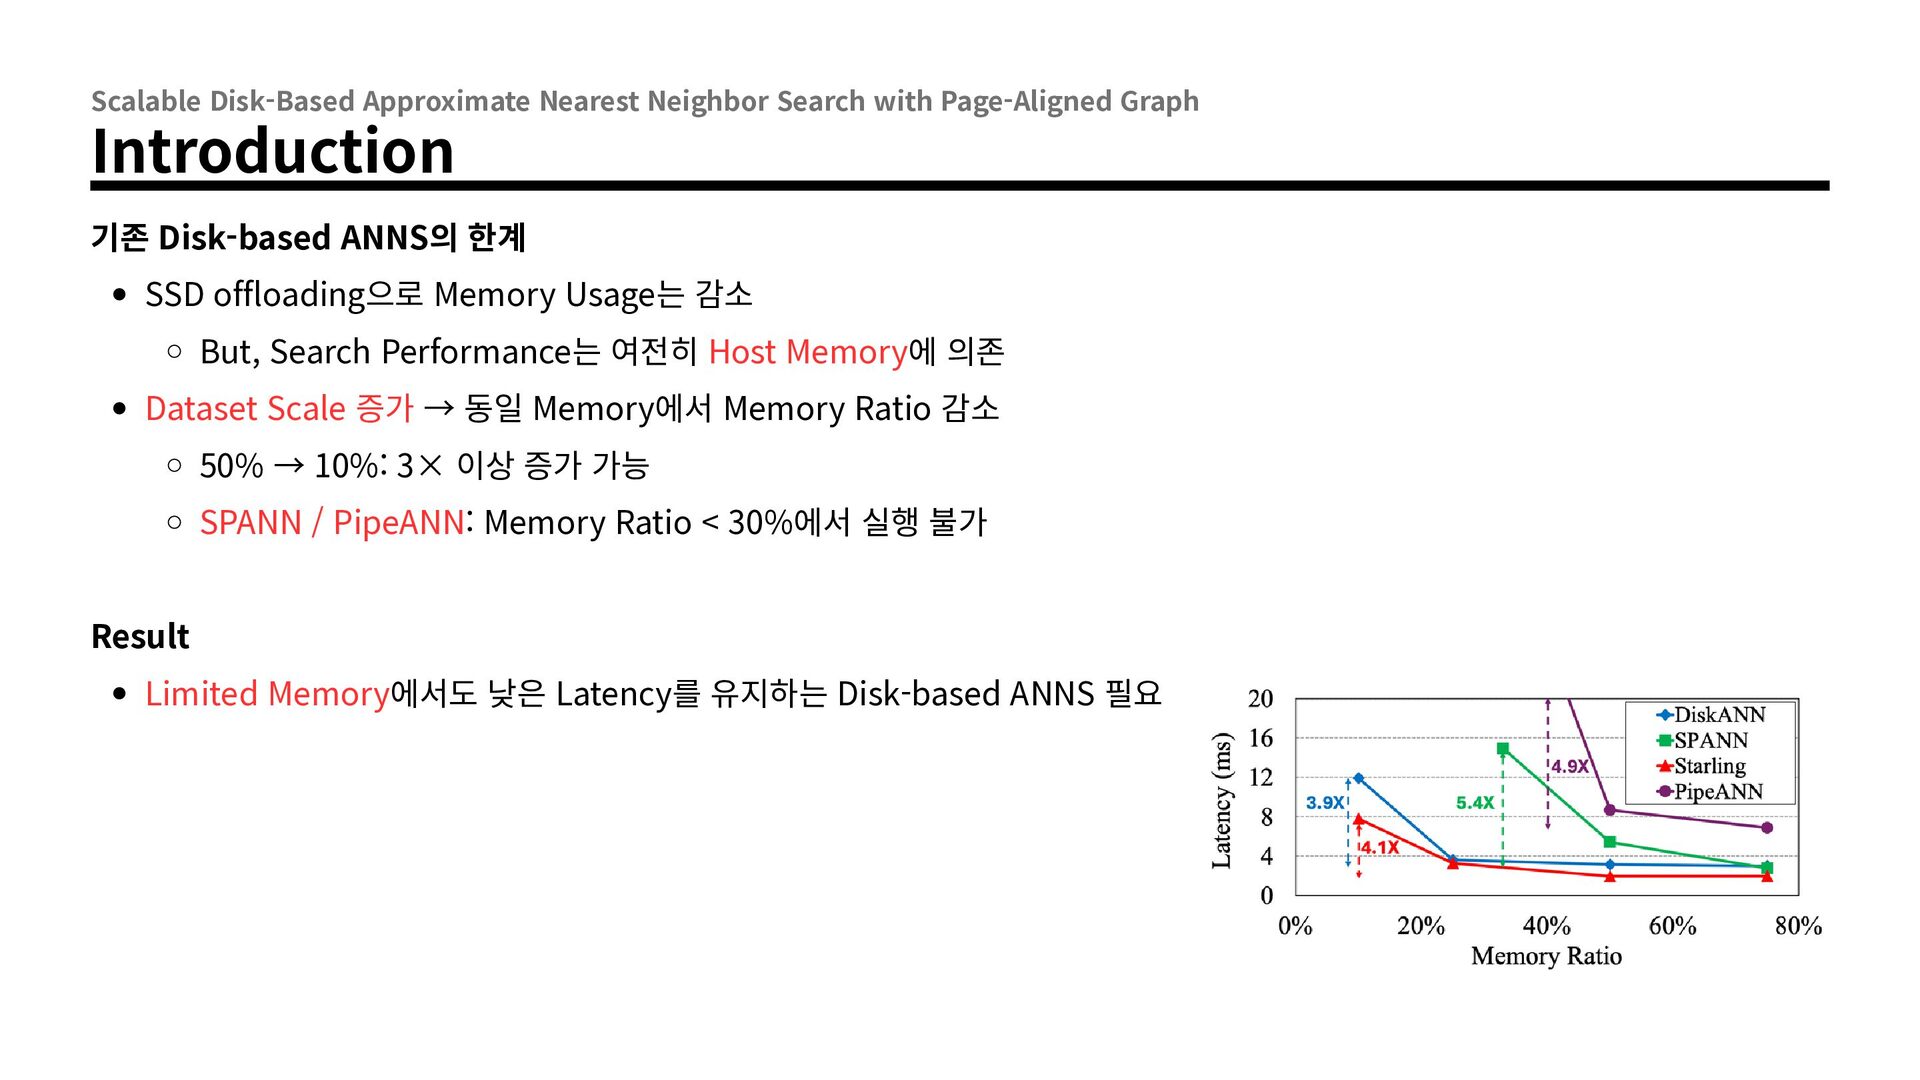
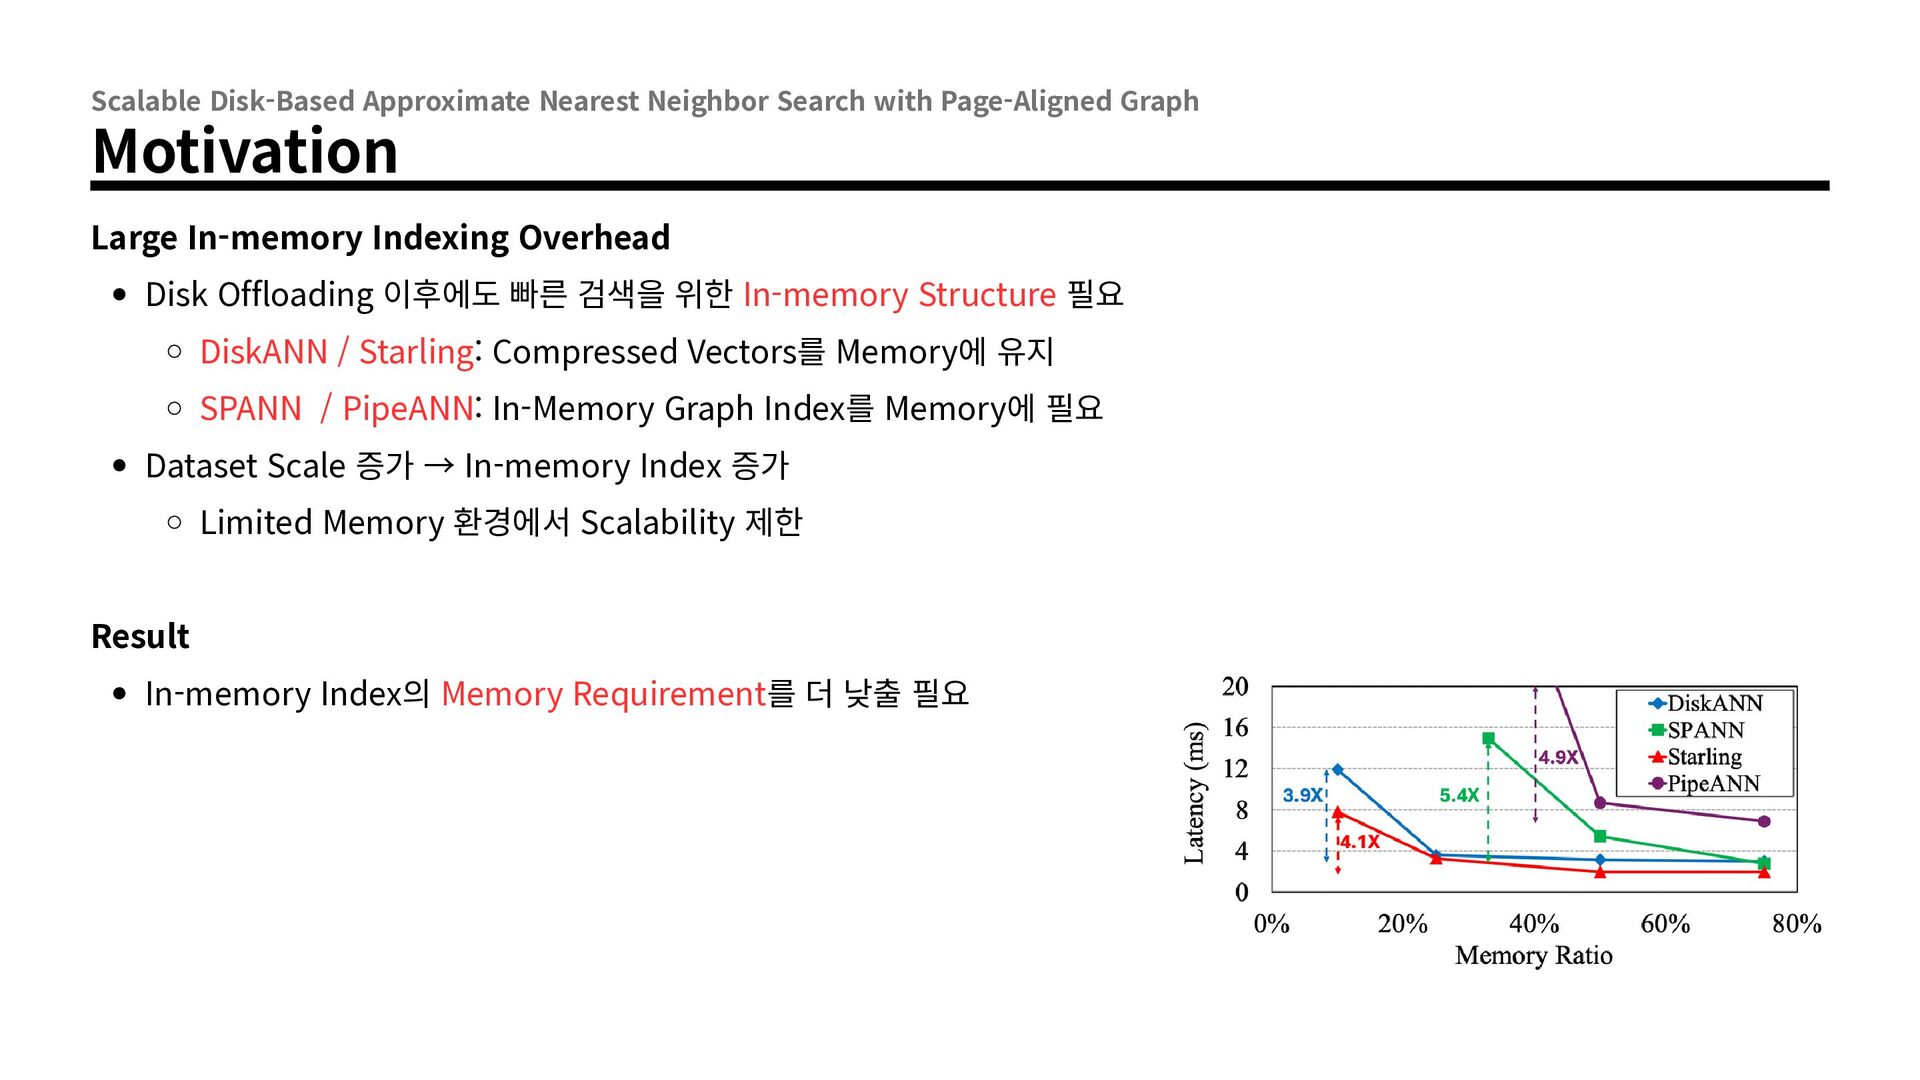
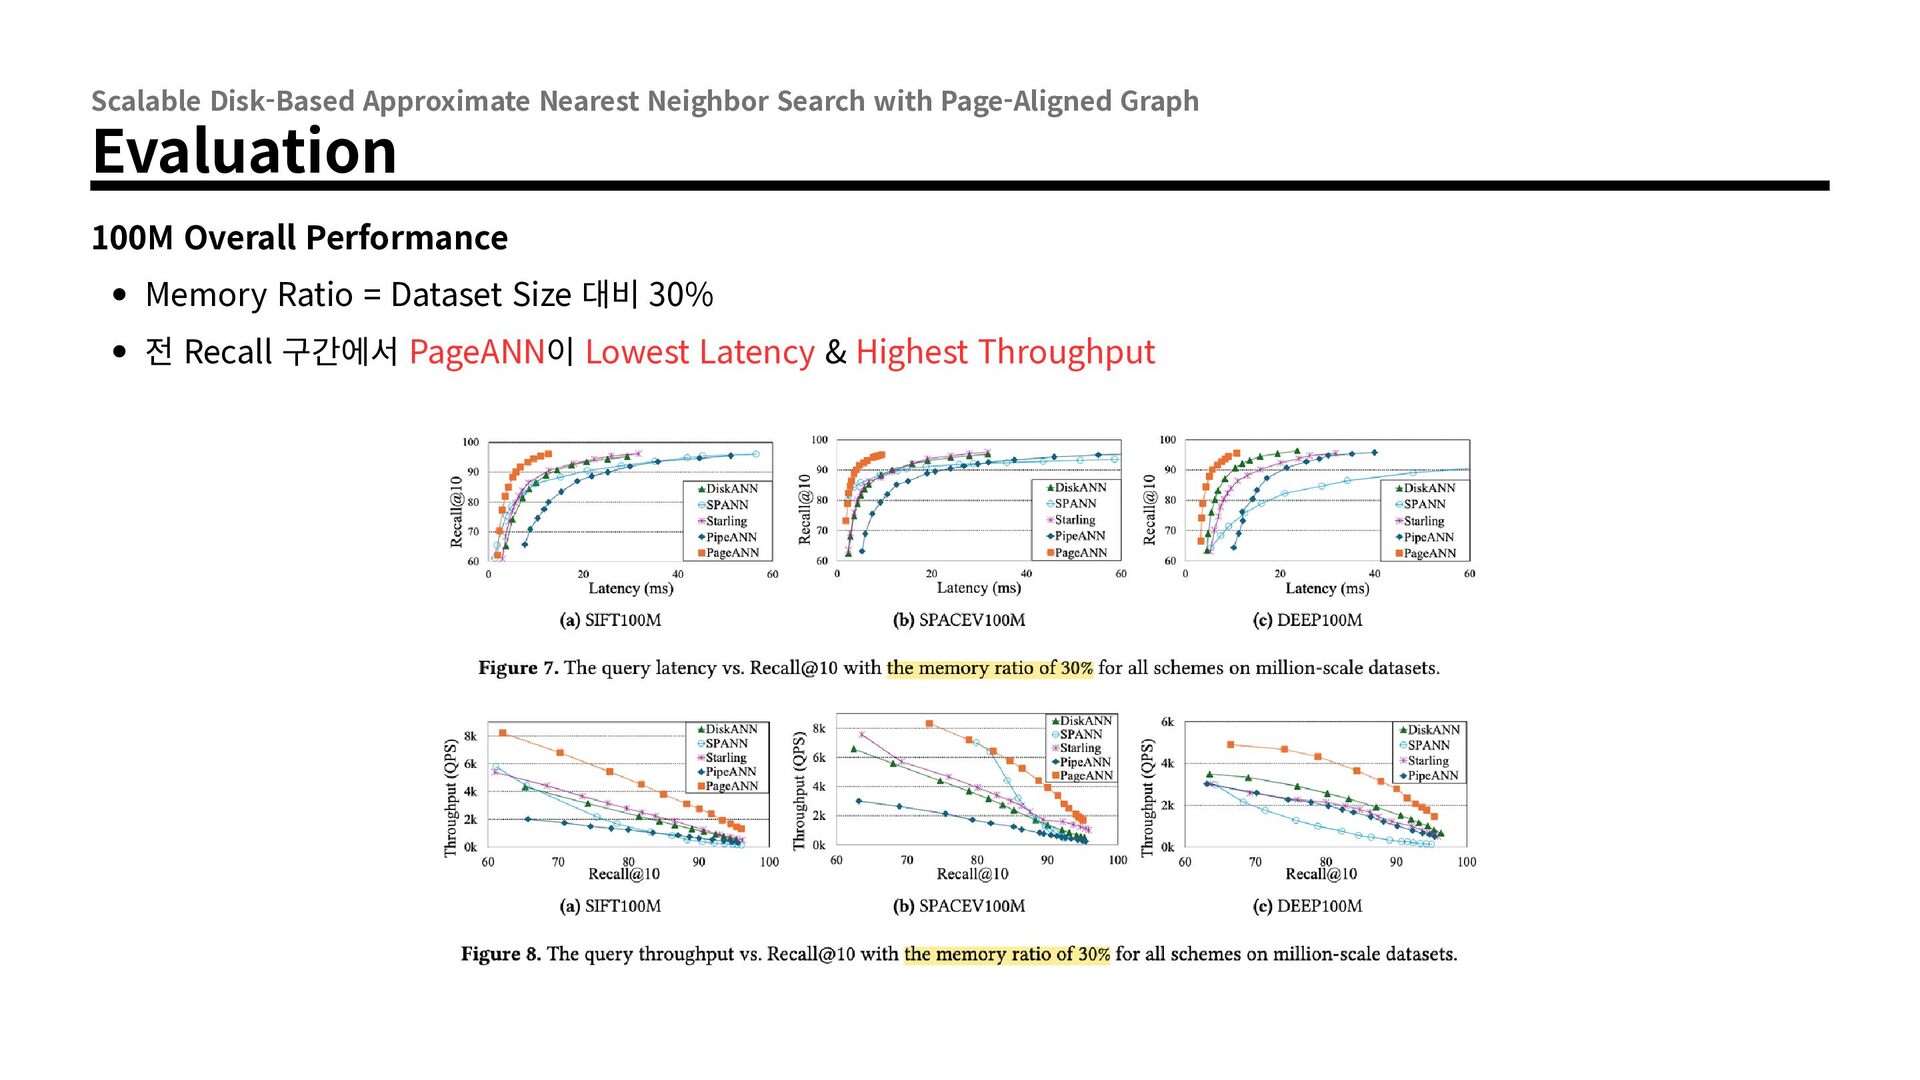
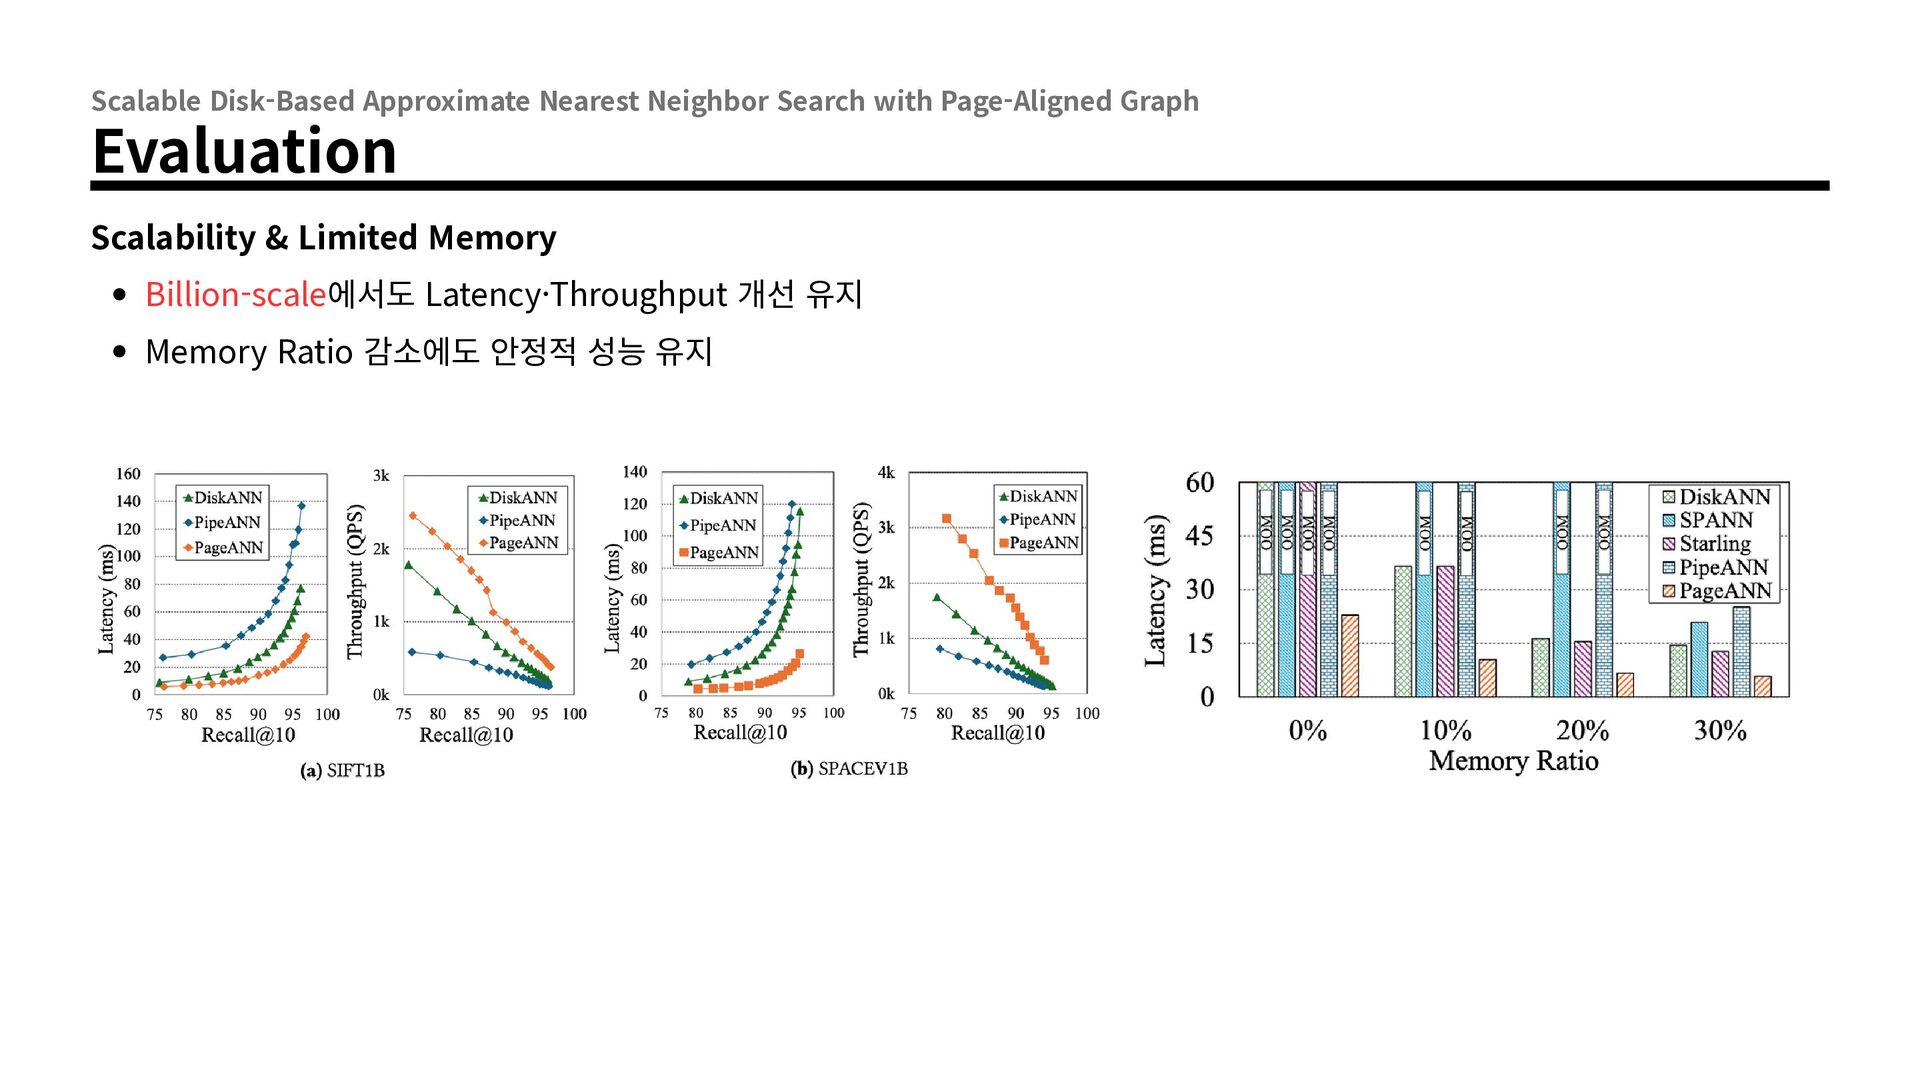
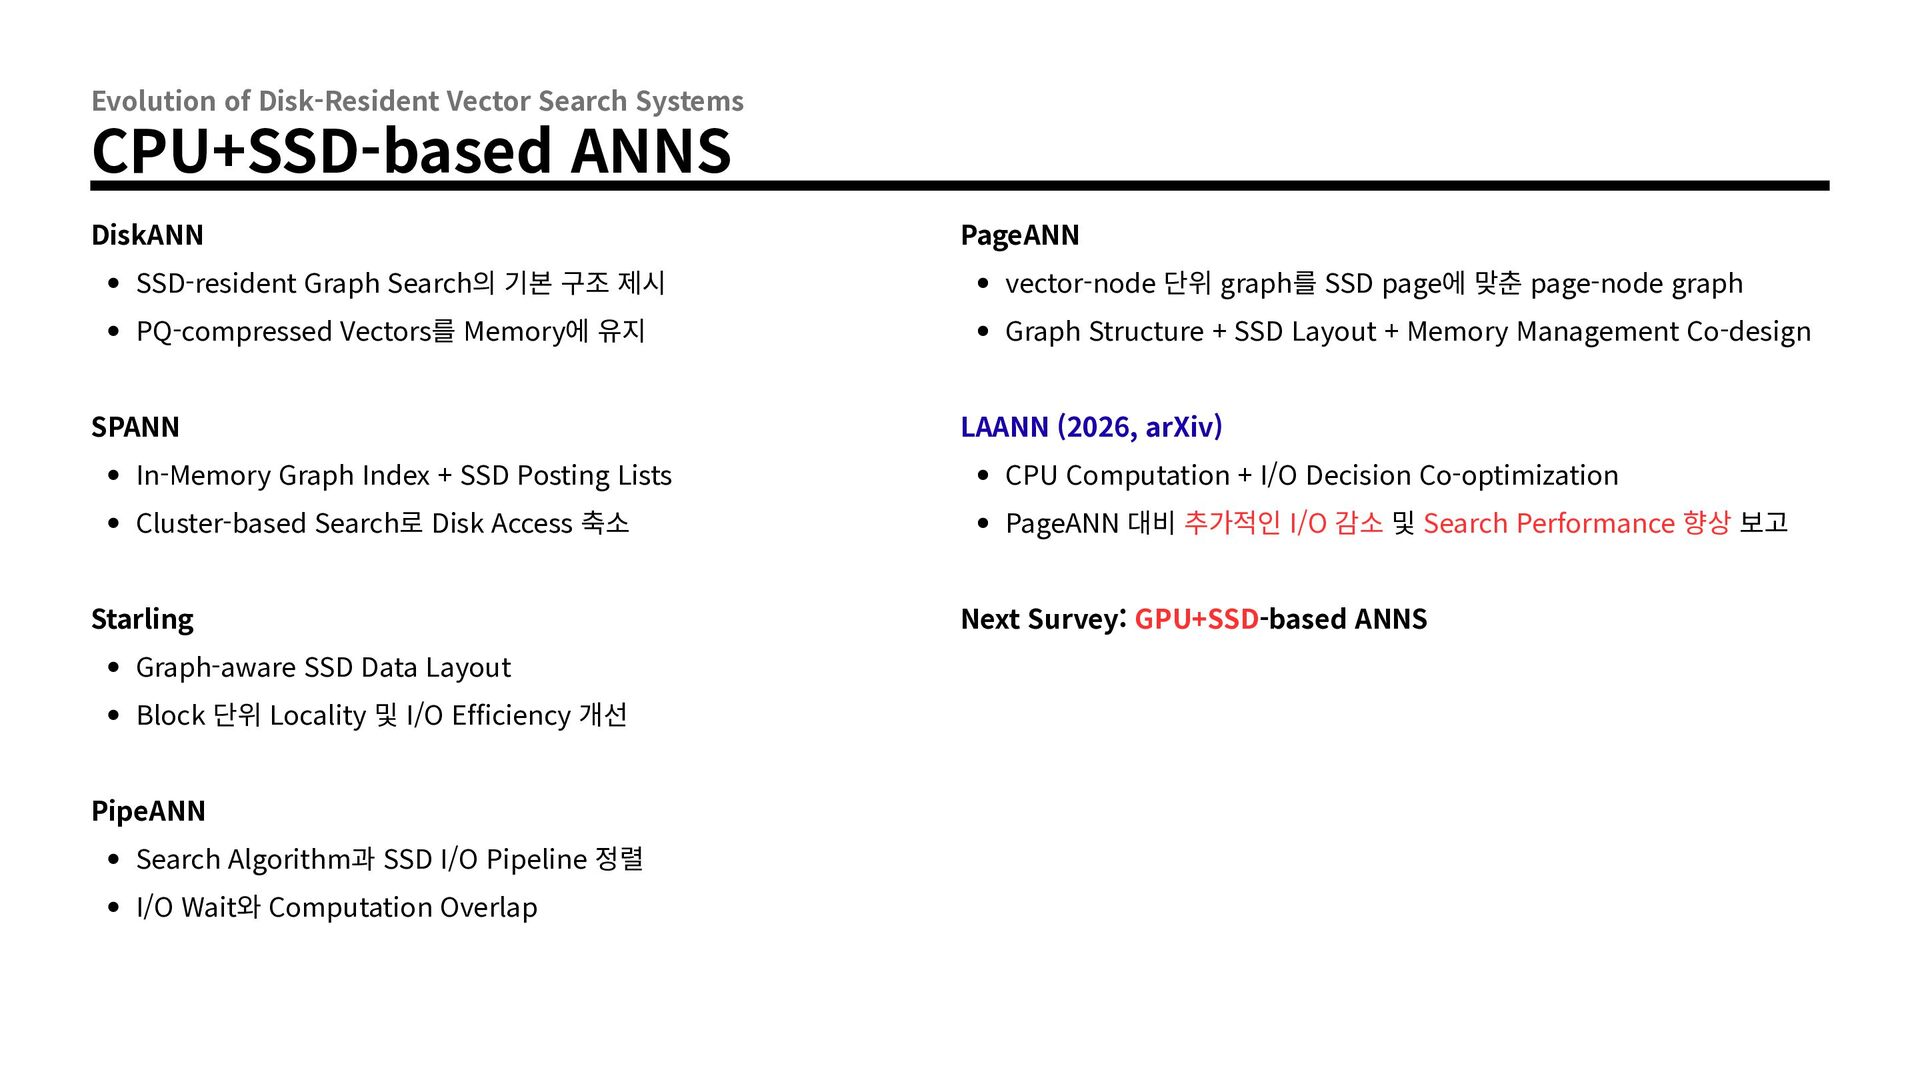
기존 Disk-based ANNS의 한계 SSD offloading으로 Memory Usage는 감소 But, Search Performance는 여전히 Host Memory에 의존 Dataset Scale 증가 → 동일 Memory에서 Memory Ratio 감소 50% → 10%: 3× 이상 증가 가능 SPANN / PipeANN: Memory Ratio < 30%에서 실행 불가 Result Limited Memory에서도 낮은 Latency를 유지하는 Disk-based ANNS 필요
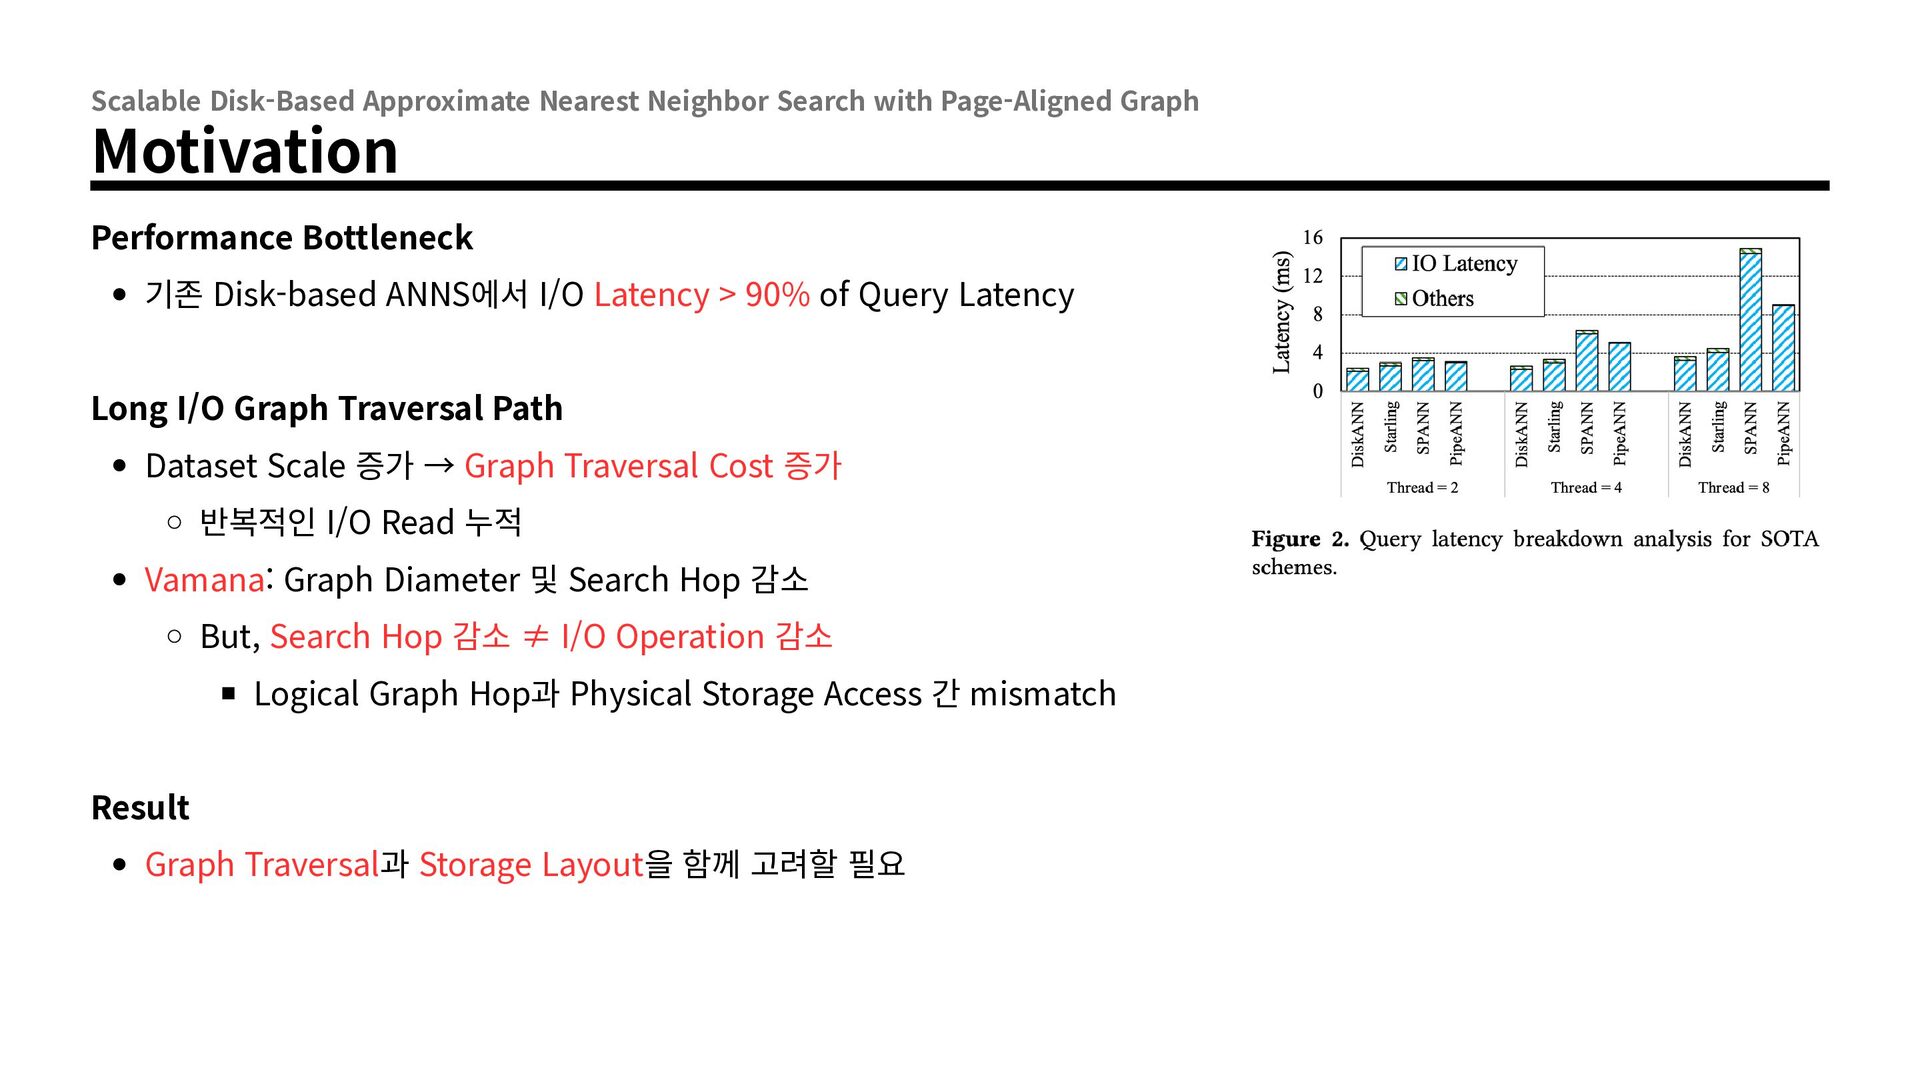
Performance Bottleneck 기존 Disk-based ANNS에서 I/O Latency > 90% of Query Latency Long I/O Graph Traversal Path Dataset Scale 증가 → Graph Traversal Cost 증가 반복적인 I/O Read 누적 Vamana: Graph Diameter 및 Search Hop 감소 But, Search Hop 감소 ≠ I/O Operation 감소 Logical Graph Hop과 Physical Storage Access 간 mismatch Result Graph Traversal과 Storage Layout을 함께 고려할 필요
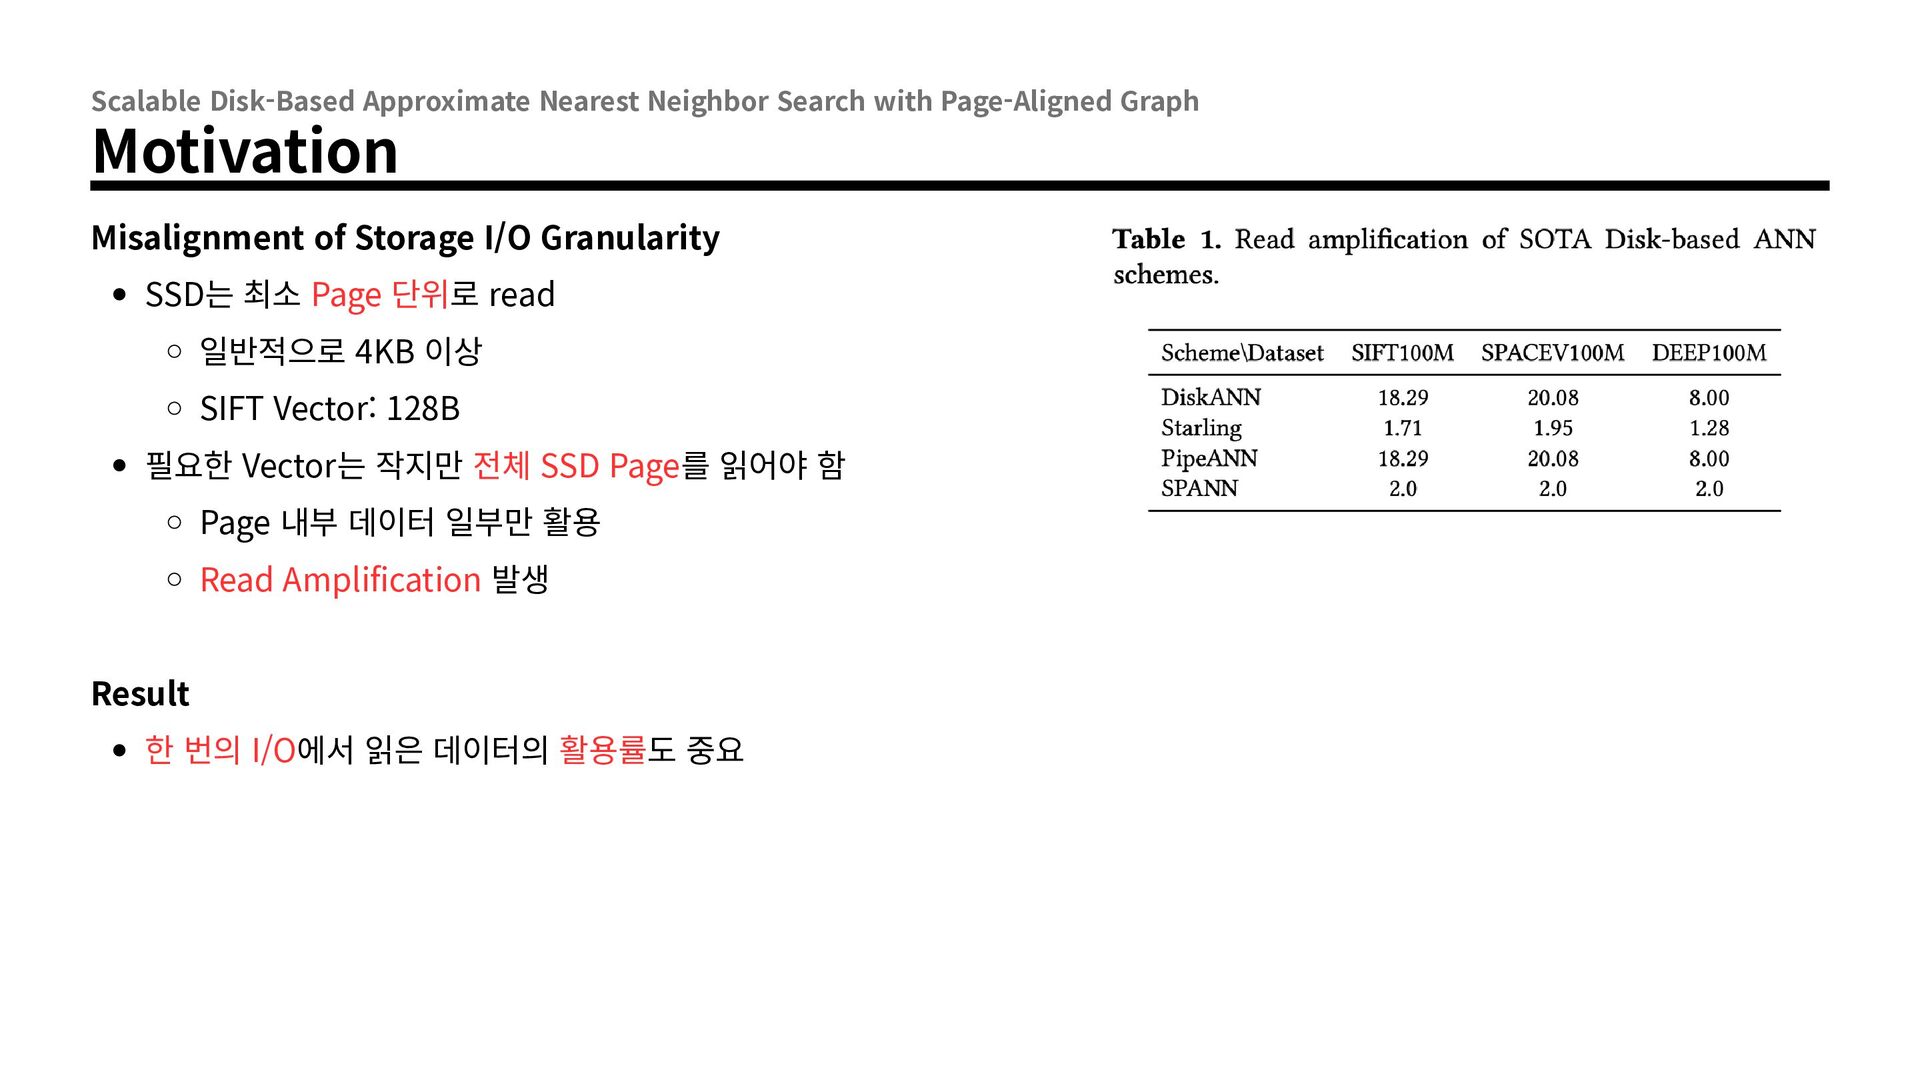
Misalignment of Storage I/O Granularity SSD는 최소 Page 단위로 read 일반적으로 4KB 이상 SIFT Vector: 128B 필요한 Vector는 작지만 전체 SSD Page를 읽어야 함 Page 내부 데이터 일부만 활용 Read Amplification 발생 Result 한 번의 I/O에서 읽은 데이터의 활용률도 중요
Large In-memory Indexing Overhead Disk Offloading 이후에도 빠른 검색을 위한 In-memory Structure 필요 DiskANN / Starling: Compressed Vectors를 Memory에 유지 SPANN / PipeANN: In-Memory Graph Index를 Memory에 필요 Dataset Scale 증가 → In-memory Index 증가 Limited Memory 환경에서 Scalability 제한 Result In-memory Index의 Memory Requirement를 더 낮출 필요
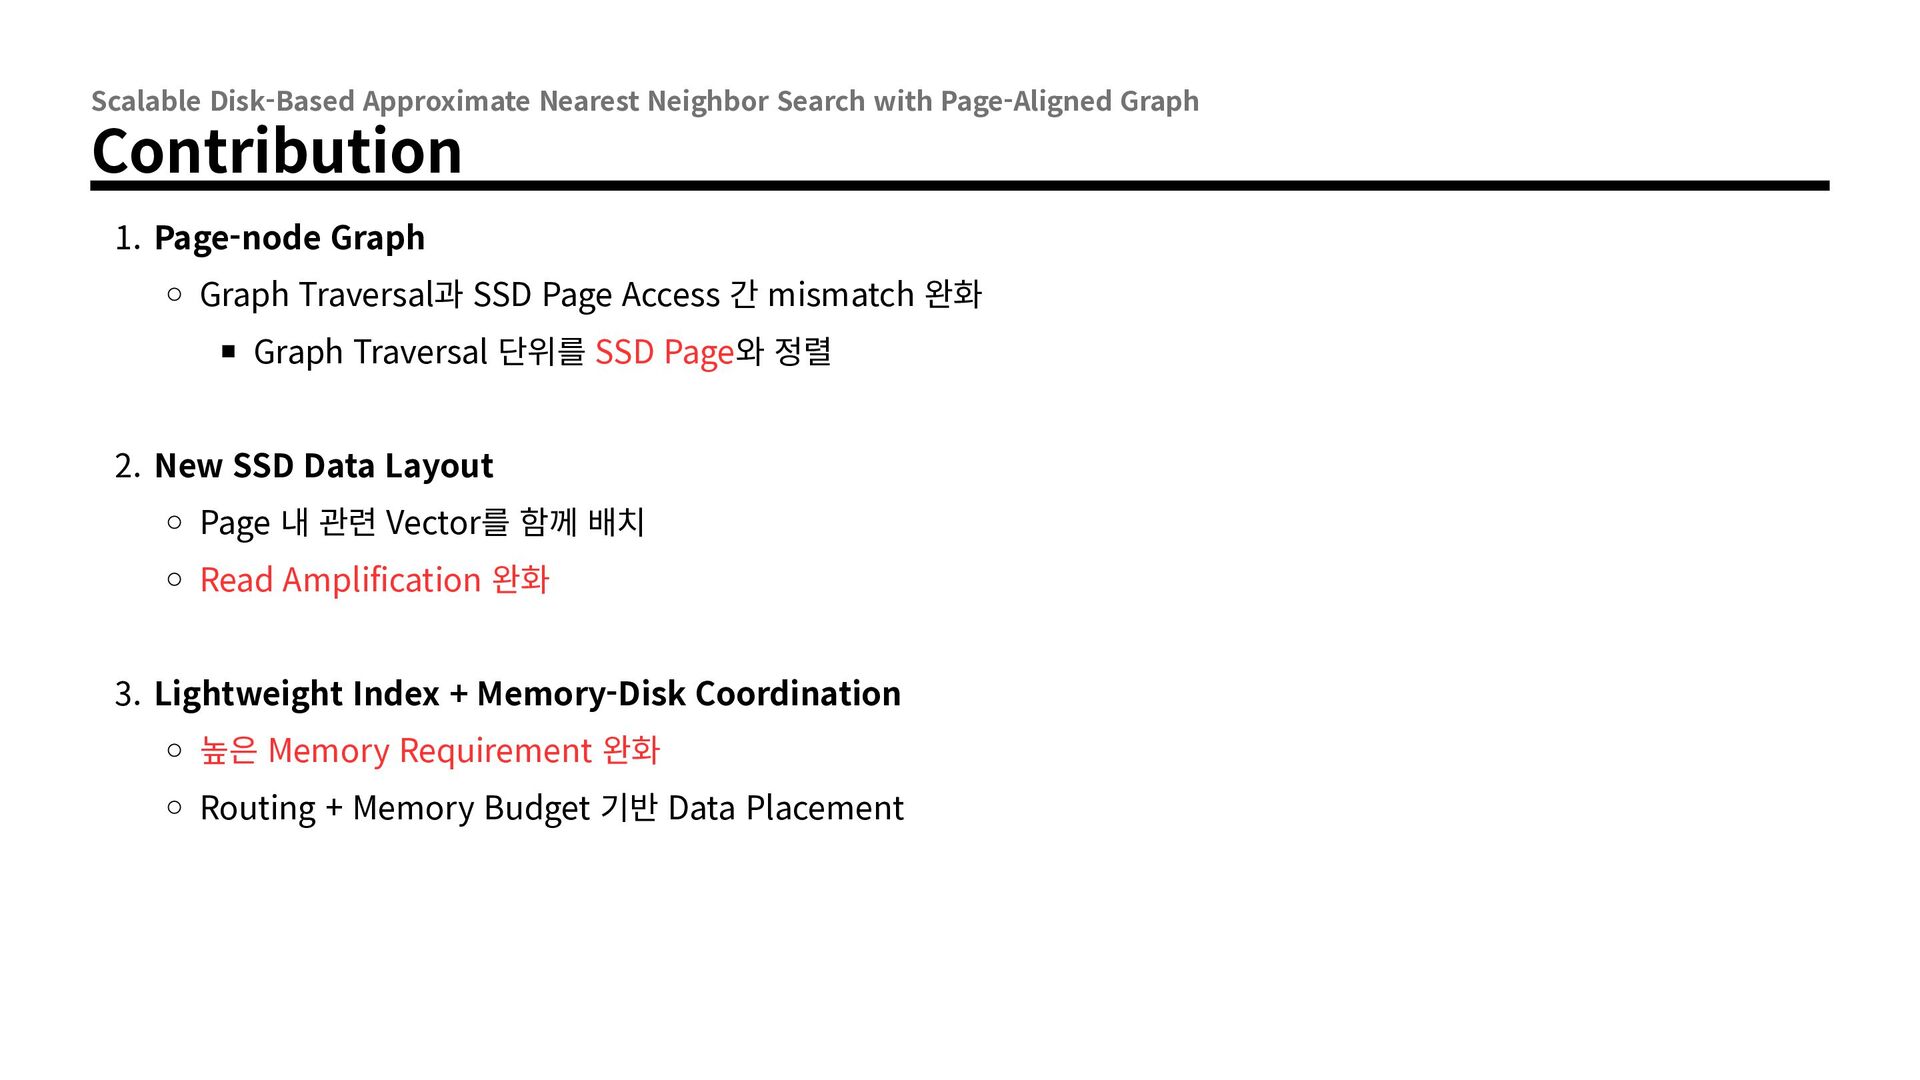
1. Page-node Graph Graph Traversal과 SSD Page Access 간 mismatch 완화 Graph Traversal 단위를 SSD Page와 정렬 2. New SSD Data Layout Page 내 관련 Vector를 함께 배치 Read Amplification 완화 3. Lightweight Index + Memory-Disk Coordination 높은 Memory Requirement 완화 Routing + Memory Budget 기반 Data Placement
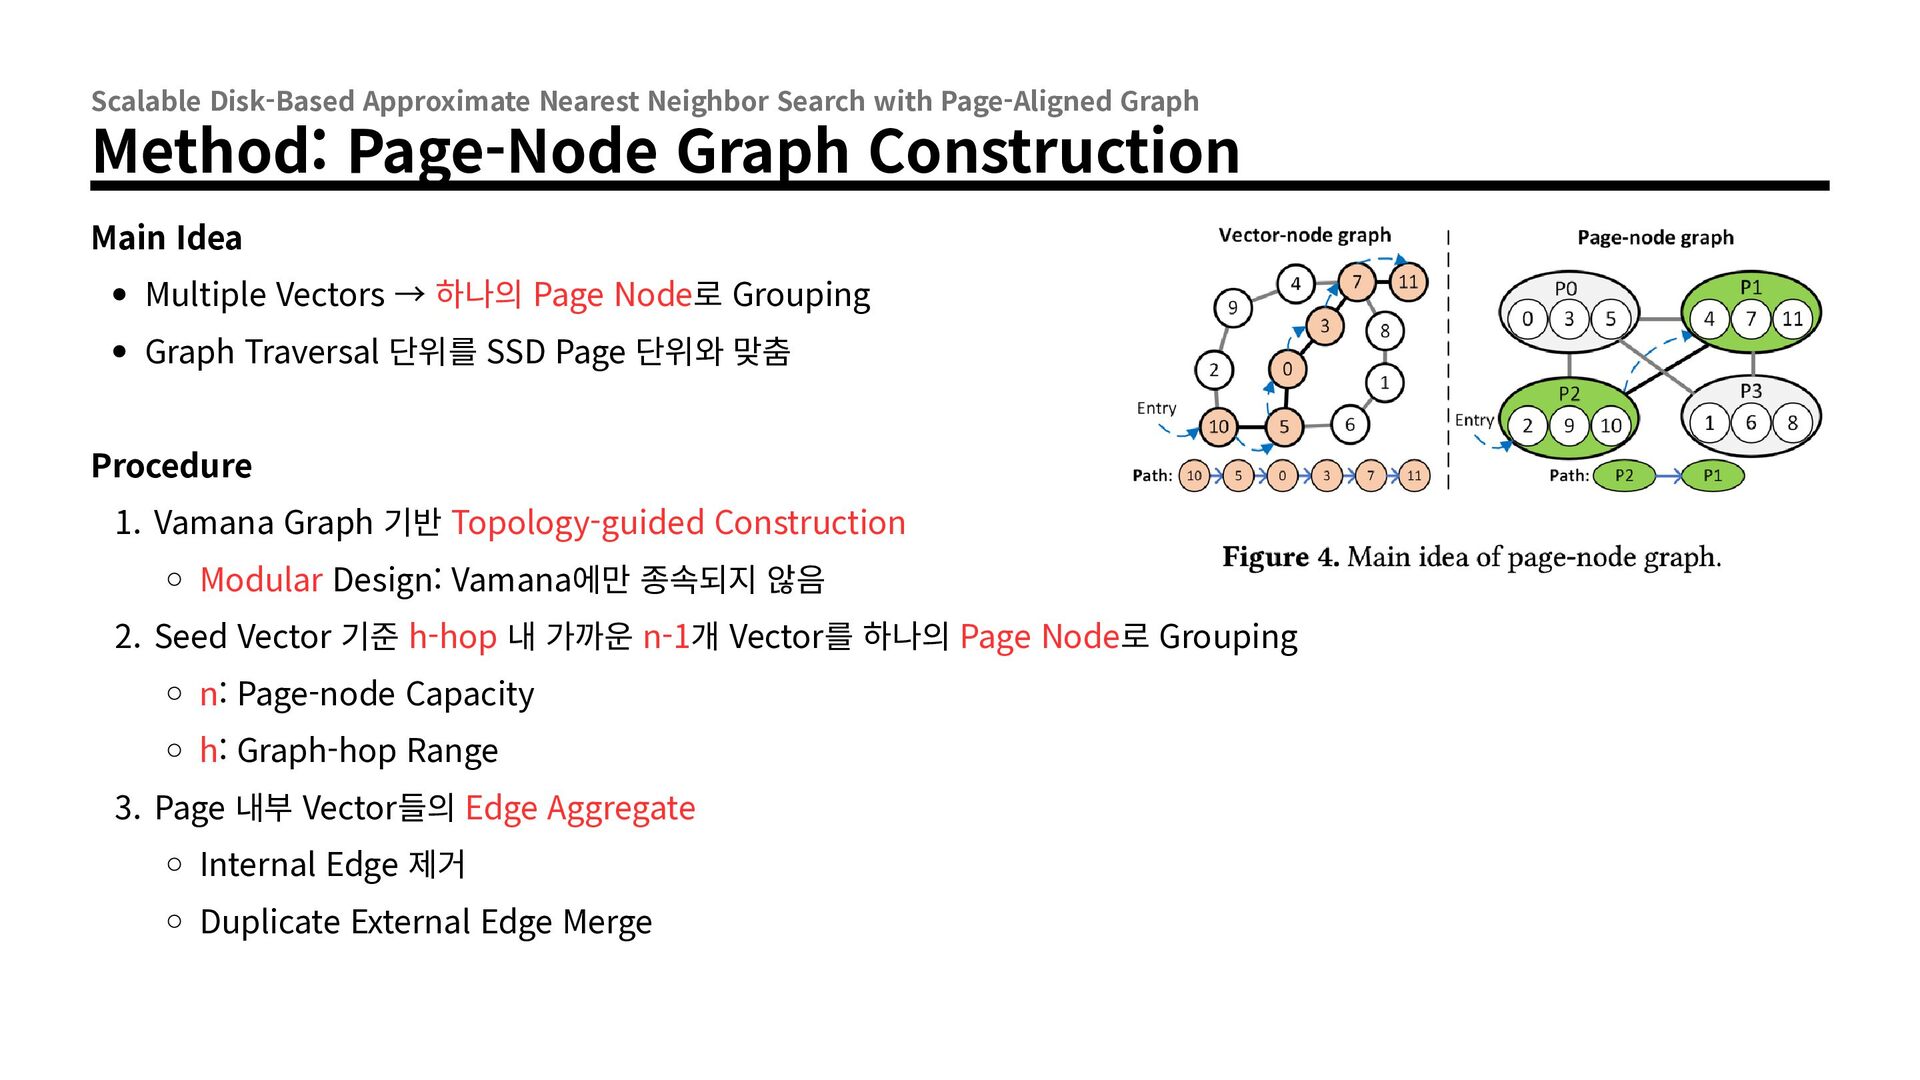
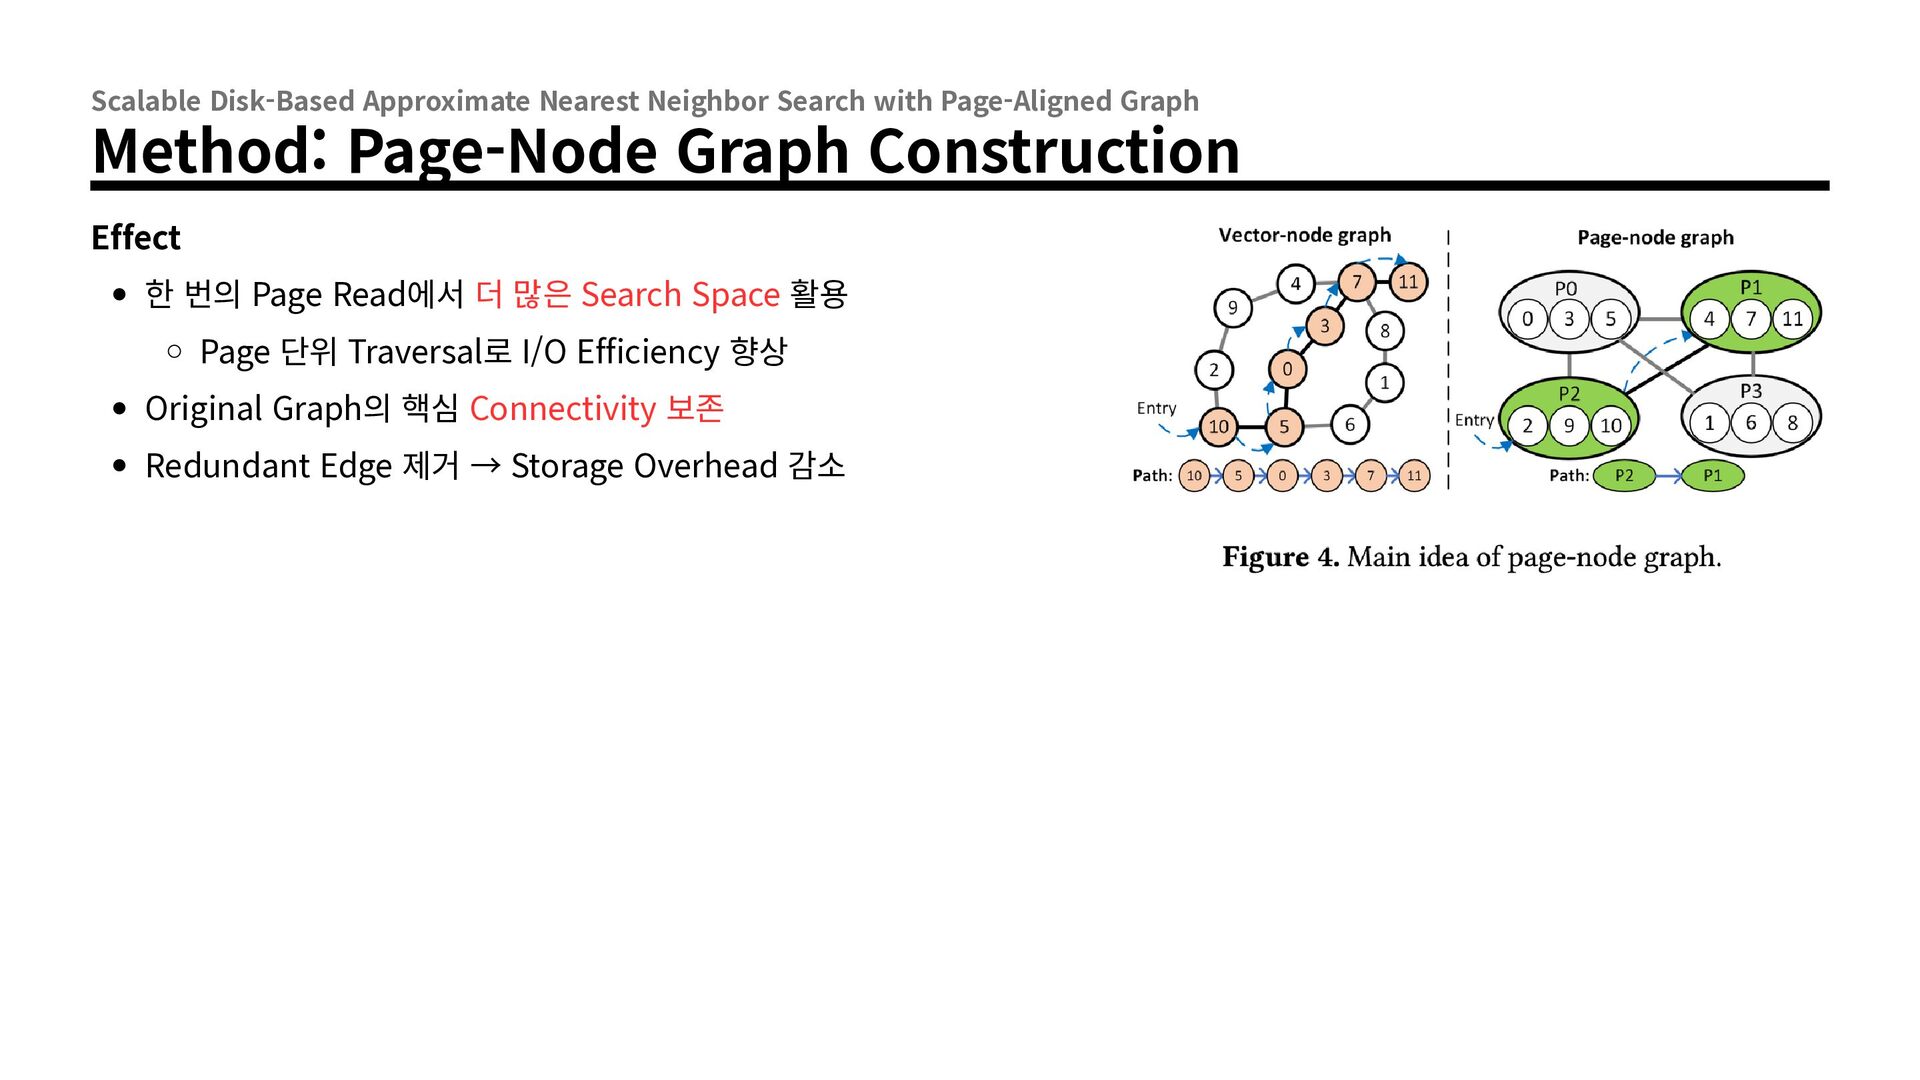
Page-Node Graph Construction Main Idea Multiple Vectors → 하나의 Page Node로 Grouping Graph Traversal 단위를 SSD Page 단위와 맞춤 Procedure 1. Vamana Graph 기반 Topology-guided Construction Modular Design: Vamana에만 종속되지 않음 2. Seed Vector 기준 h-hop 내 가까운 n-1개 Vector를 하나의 Page Node로 Grouping n: Page-node Capacity h: Graph-hop Range 3. Page 내부 Vector들의 Edge Aggregate Internal Edge 제거 Duplicate External Edge Merge
Page-Node Graph Construction Effect 한 번의 Page Read에서 더 많은 Search Space 활용 Page 단위 Traversal로 I/O Efficiency 향상 Original Graph의 핵심 Connectivity 보존 Redundant Edge 제거 → Storage Overhead 감소
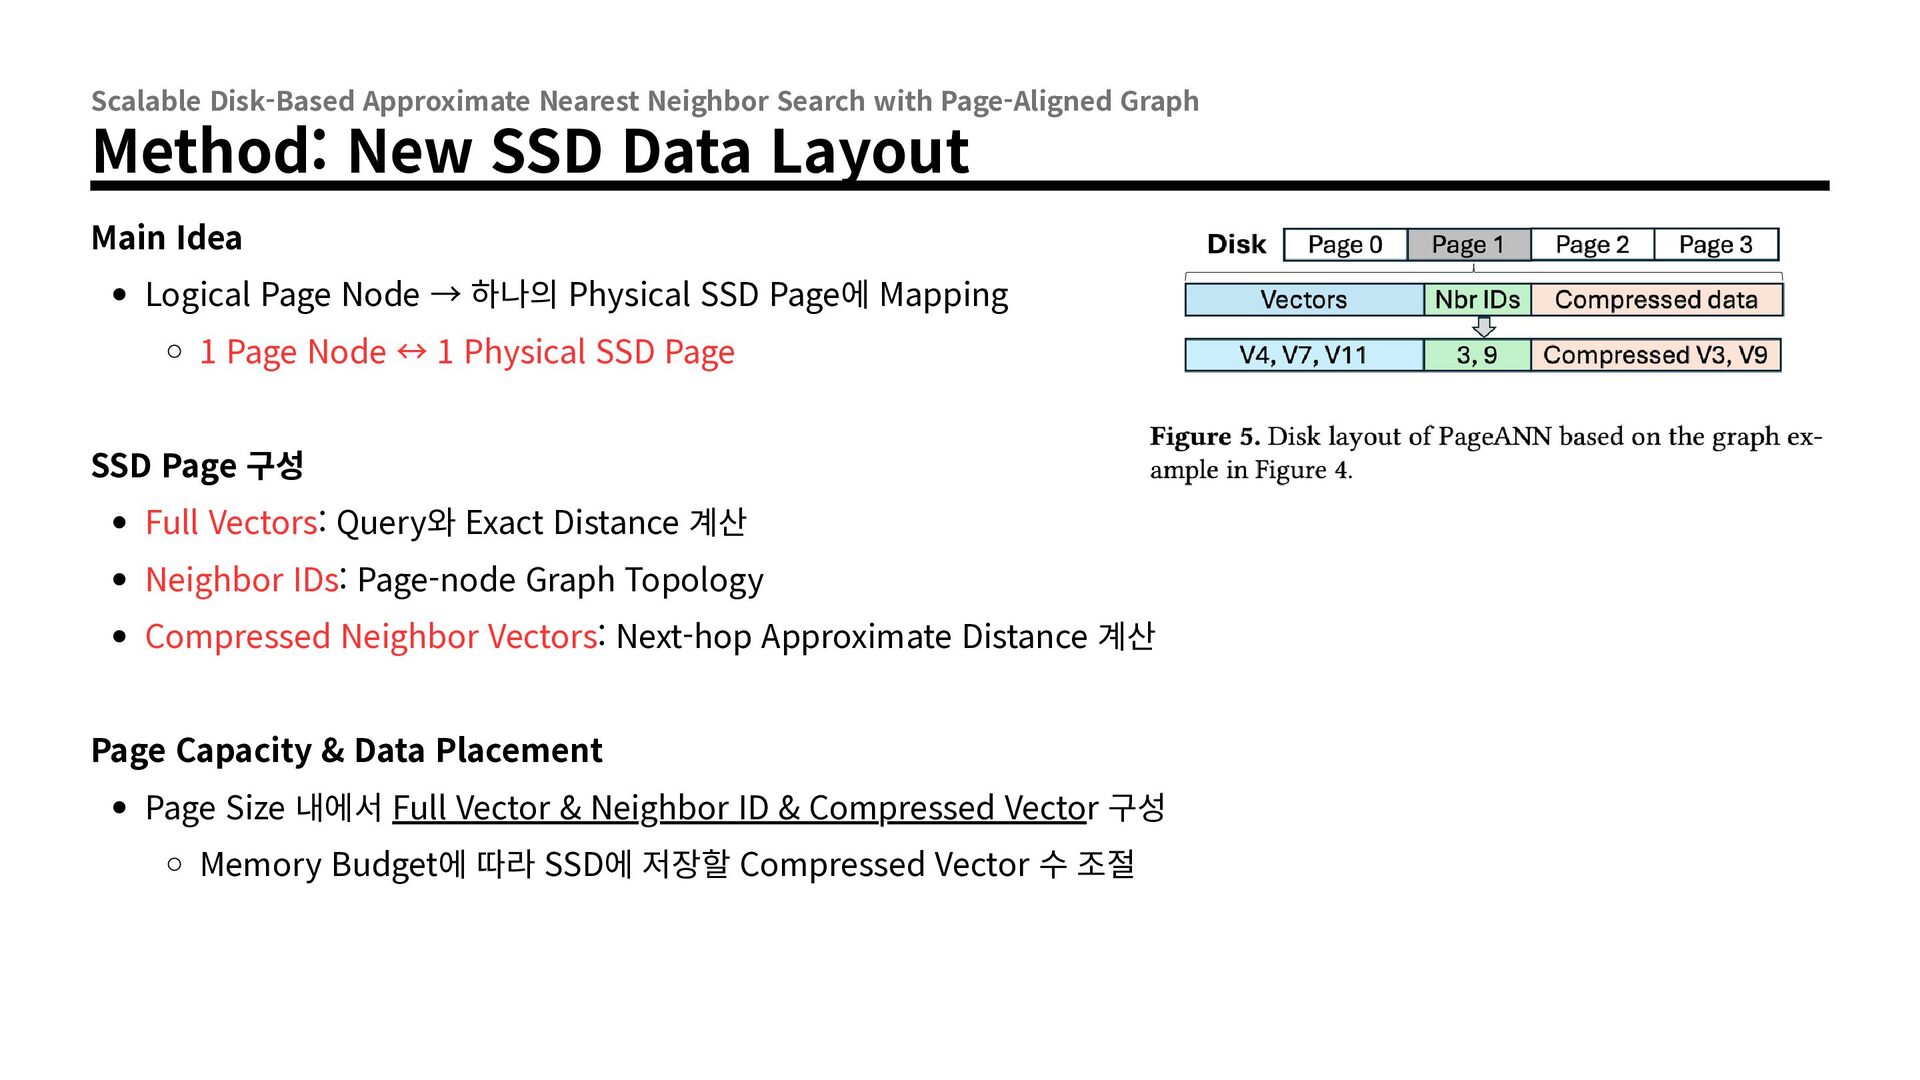
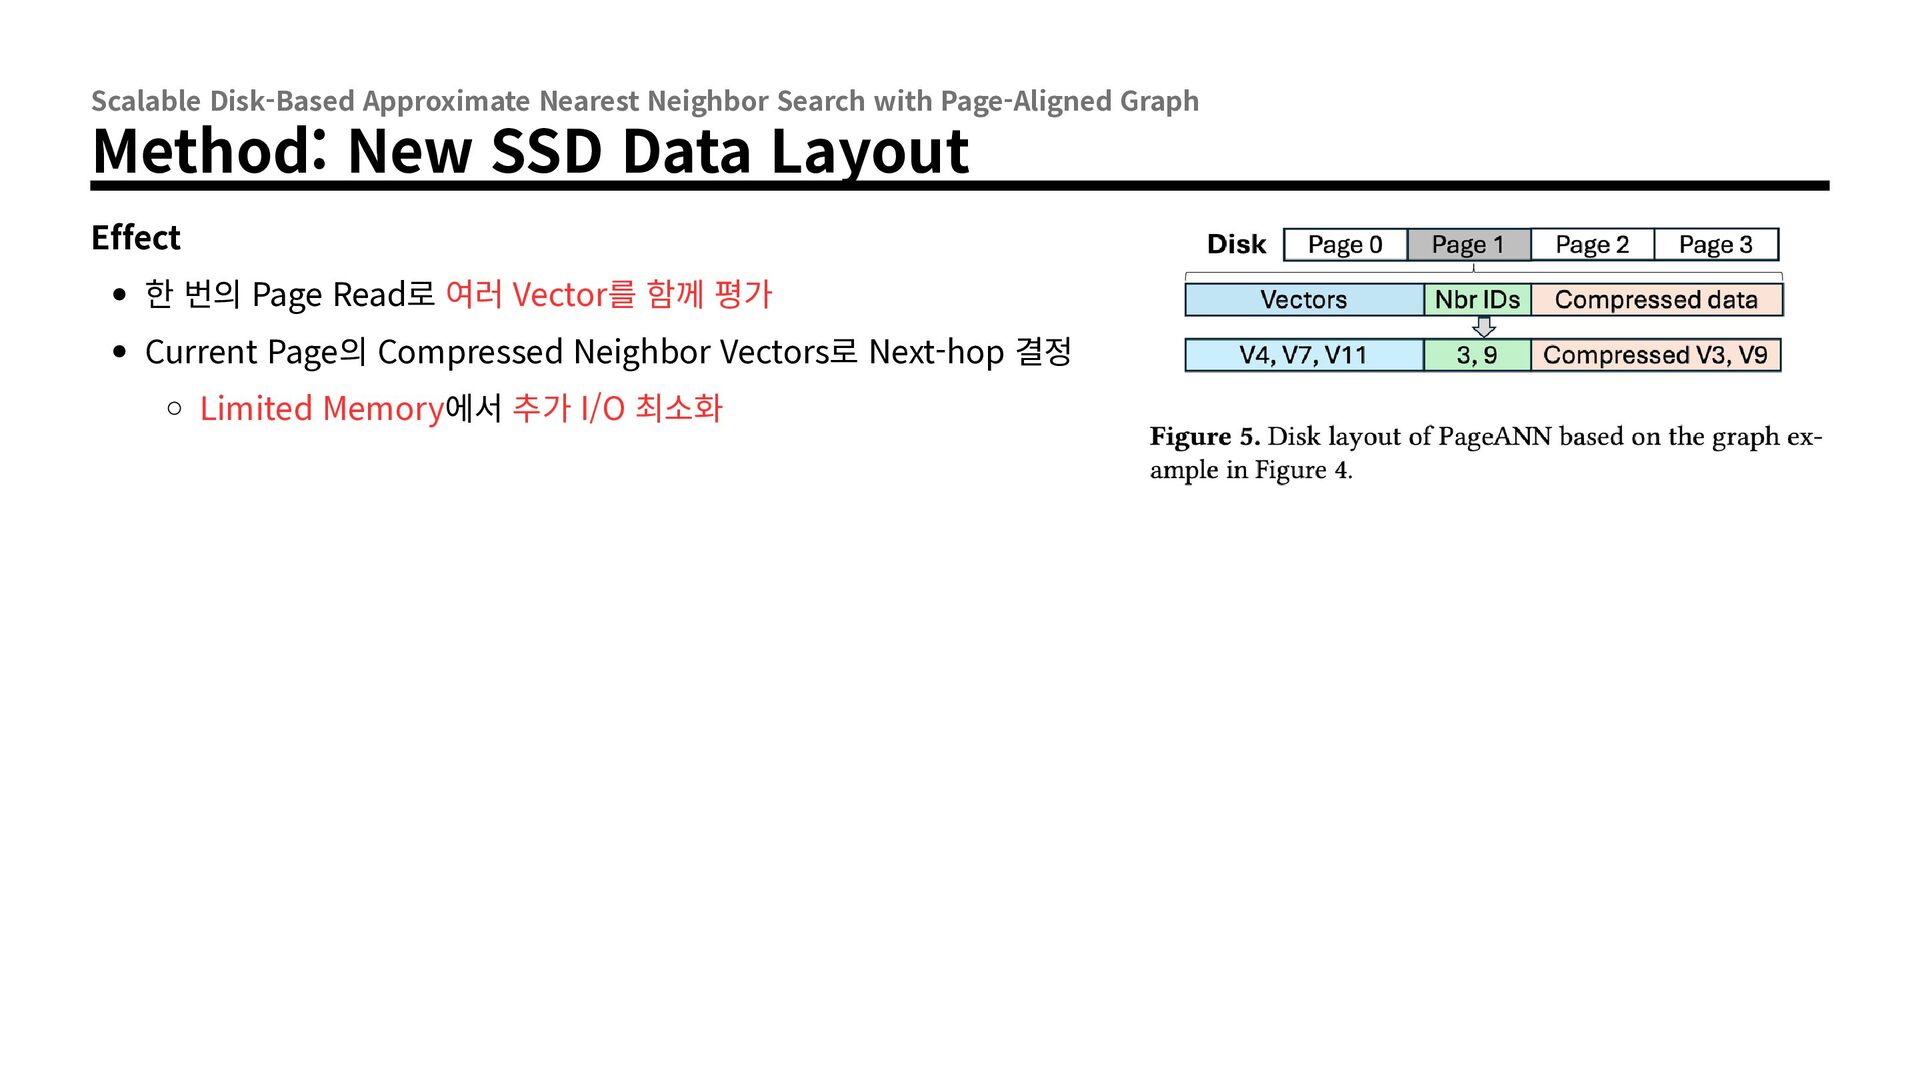
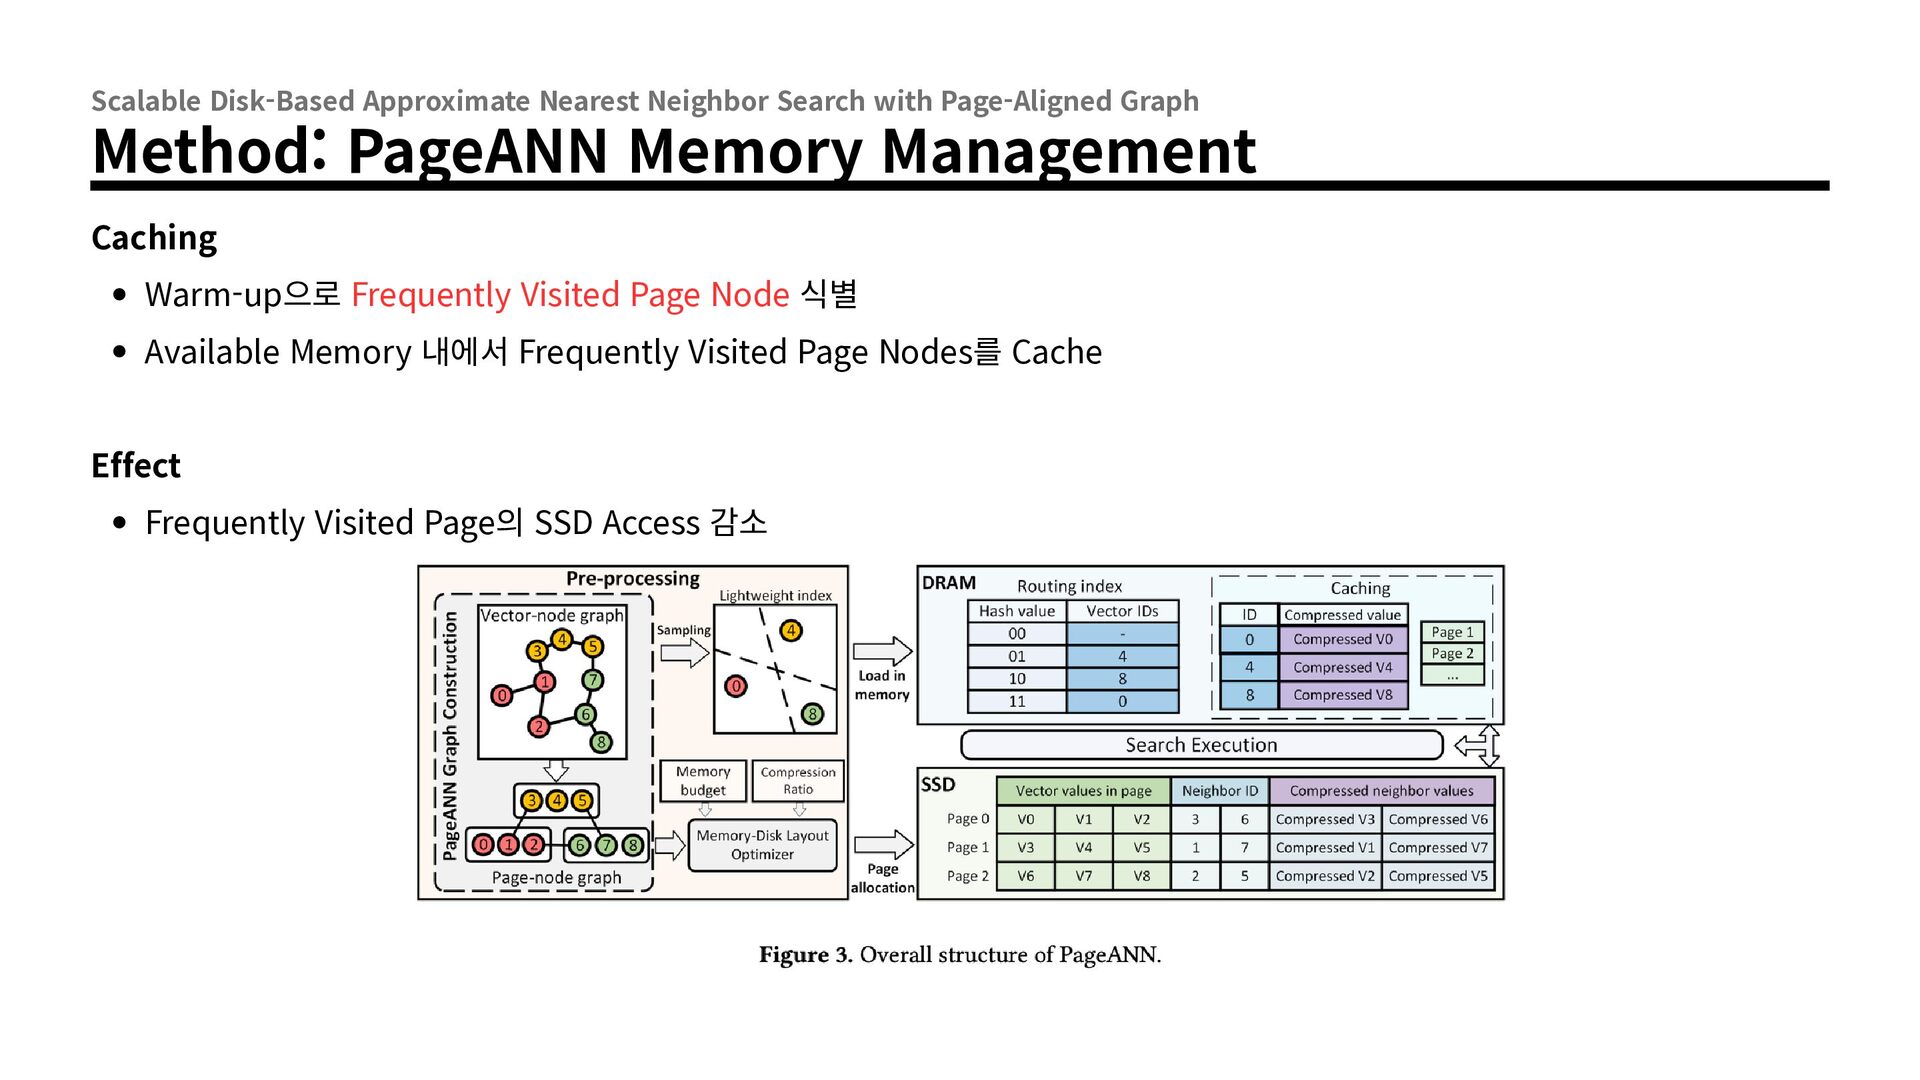
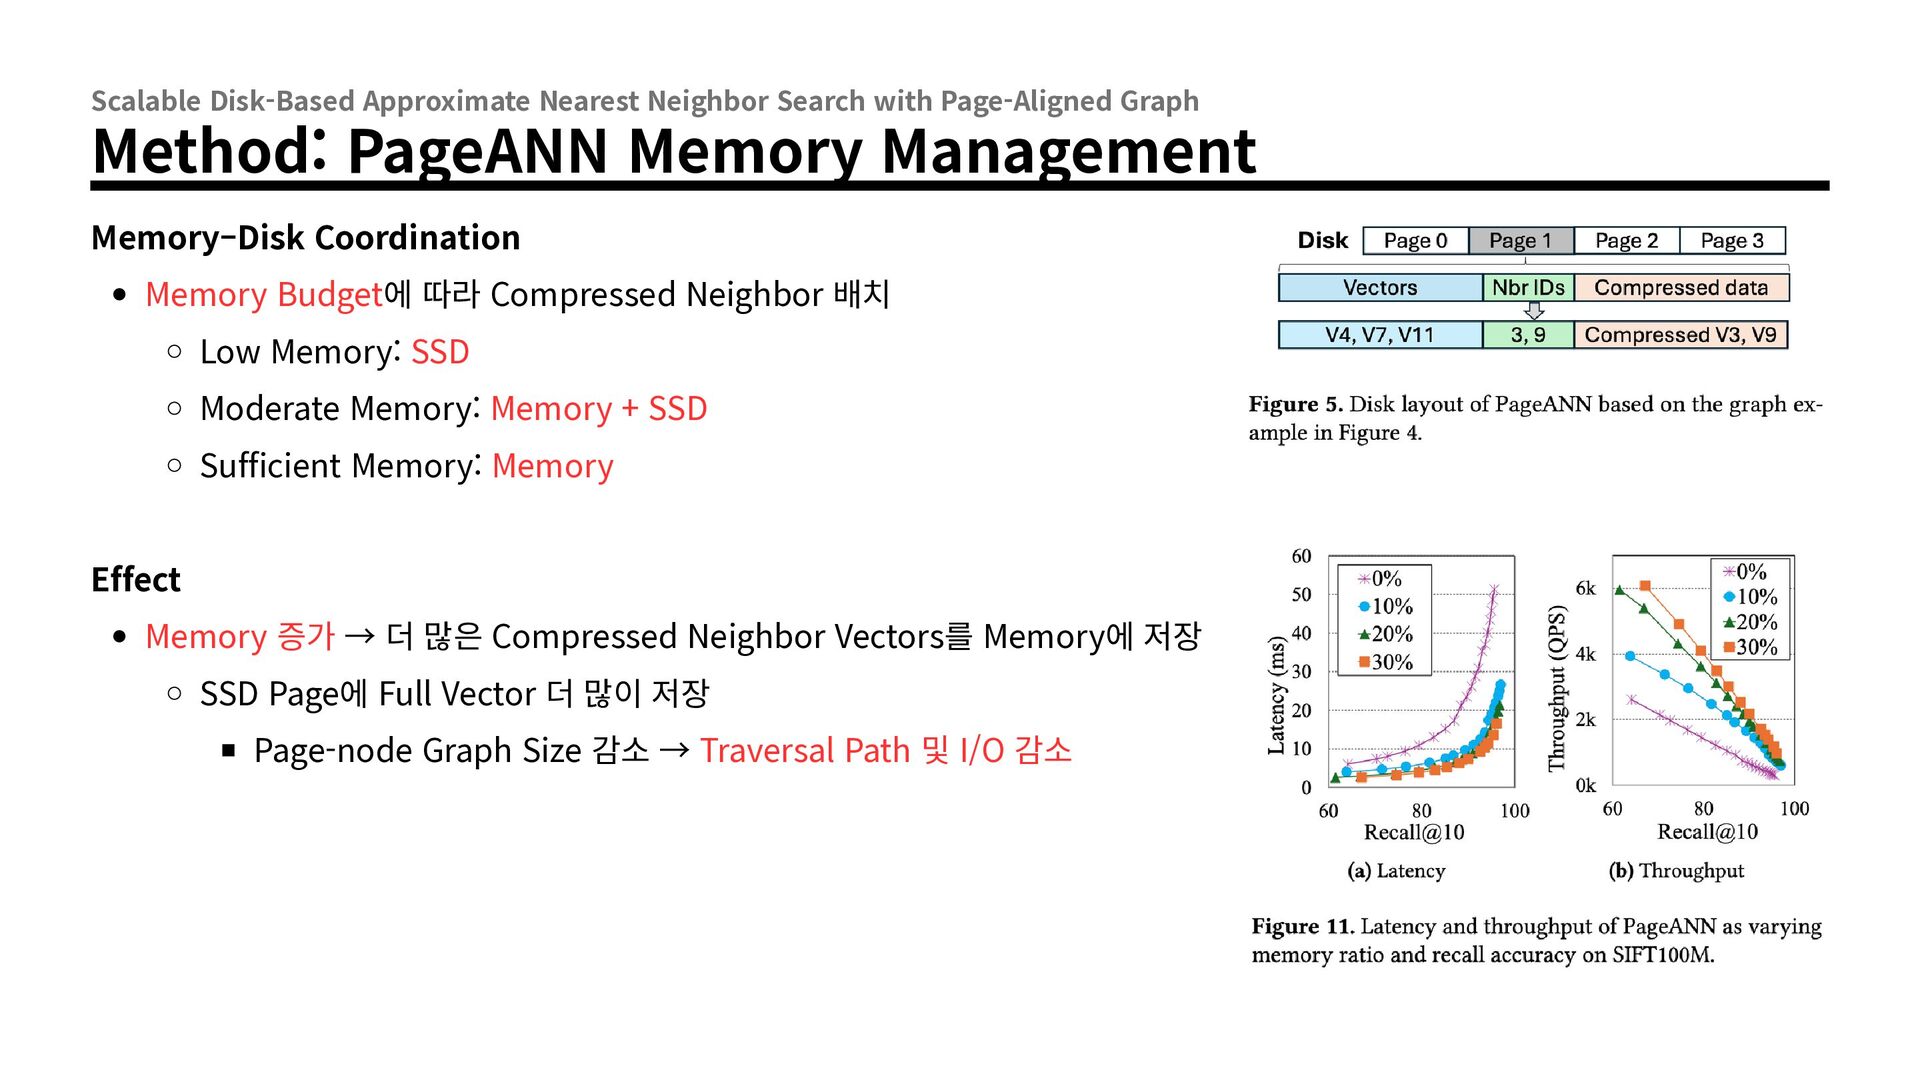
New SSD Data Layout Main Idea Logical Page Node → 하나의 Physical SSD Page에 Mapping 1 Page Node ↔ 1 Physical SSD Page SSD Page 구성 Full Vectors: Query와 Exact Distance 계산 Neighbor IDs: Page-node Graph Topology Compressed Neighbor Vectors: Next-hop Approximate Distance 계산 Page Capacity & Data Placement Page Size 내에서 Full Vector & Neighbor ID & Compressed Vector 구성 Memory Budget에 따라 SSD에 저장할 Compressed Vector 수 조절
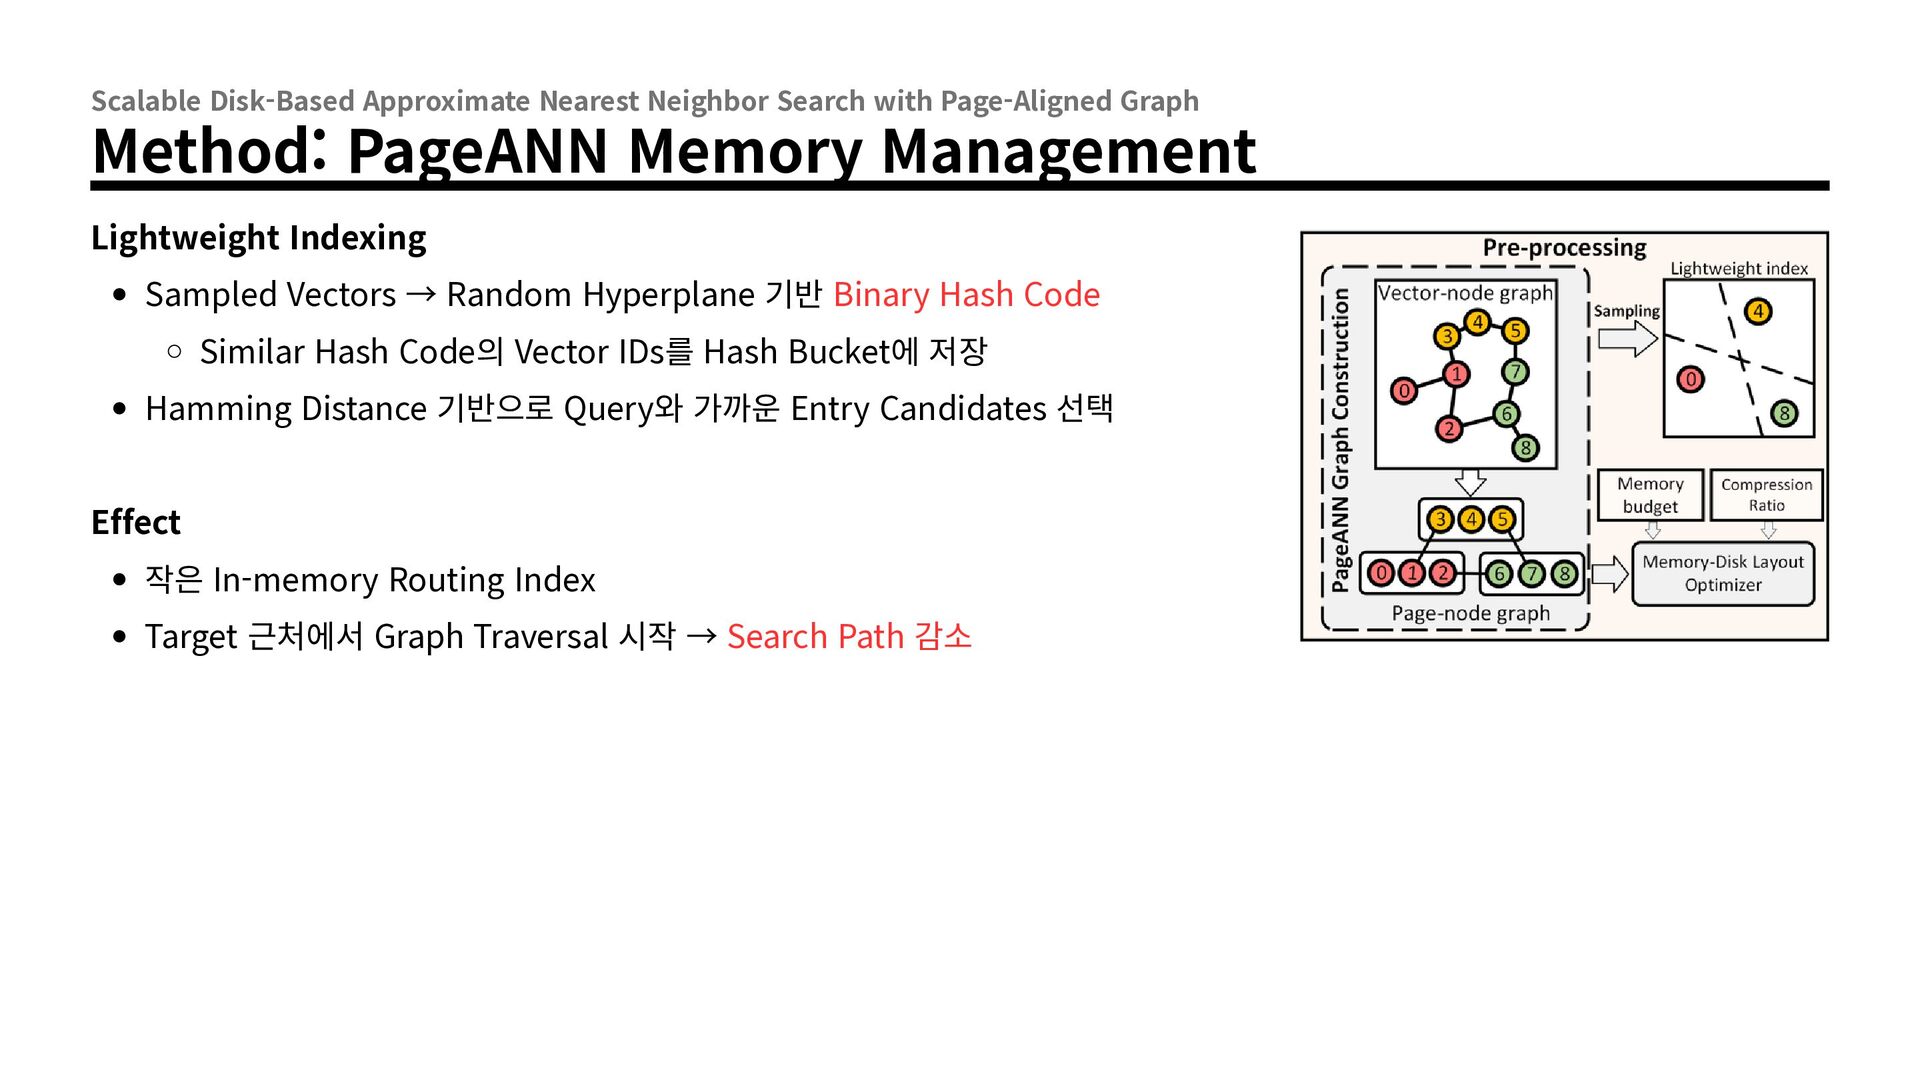
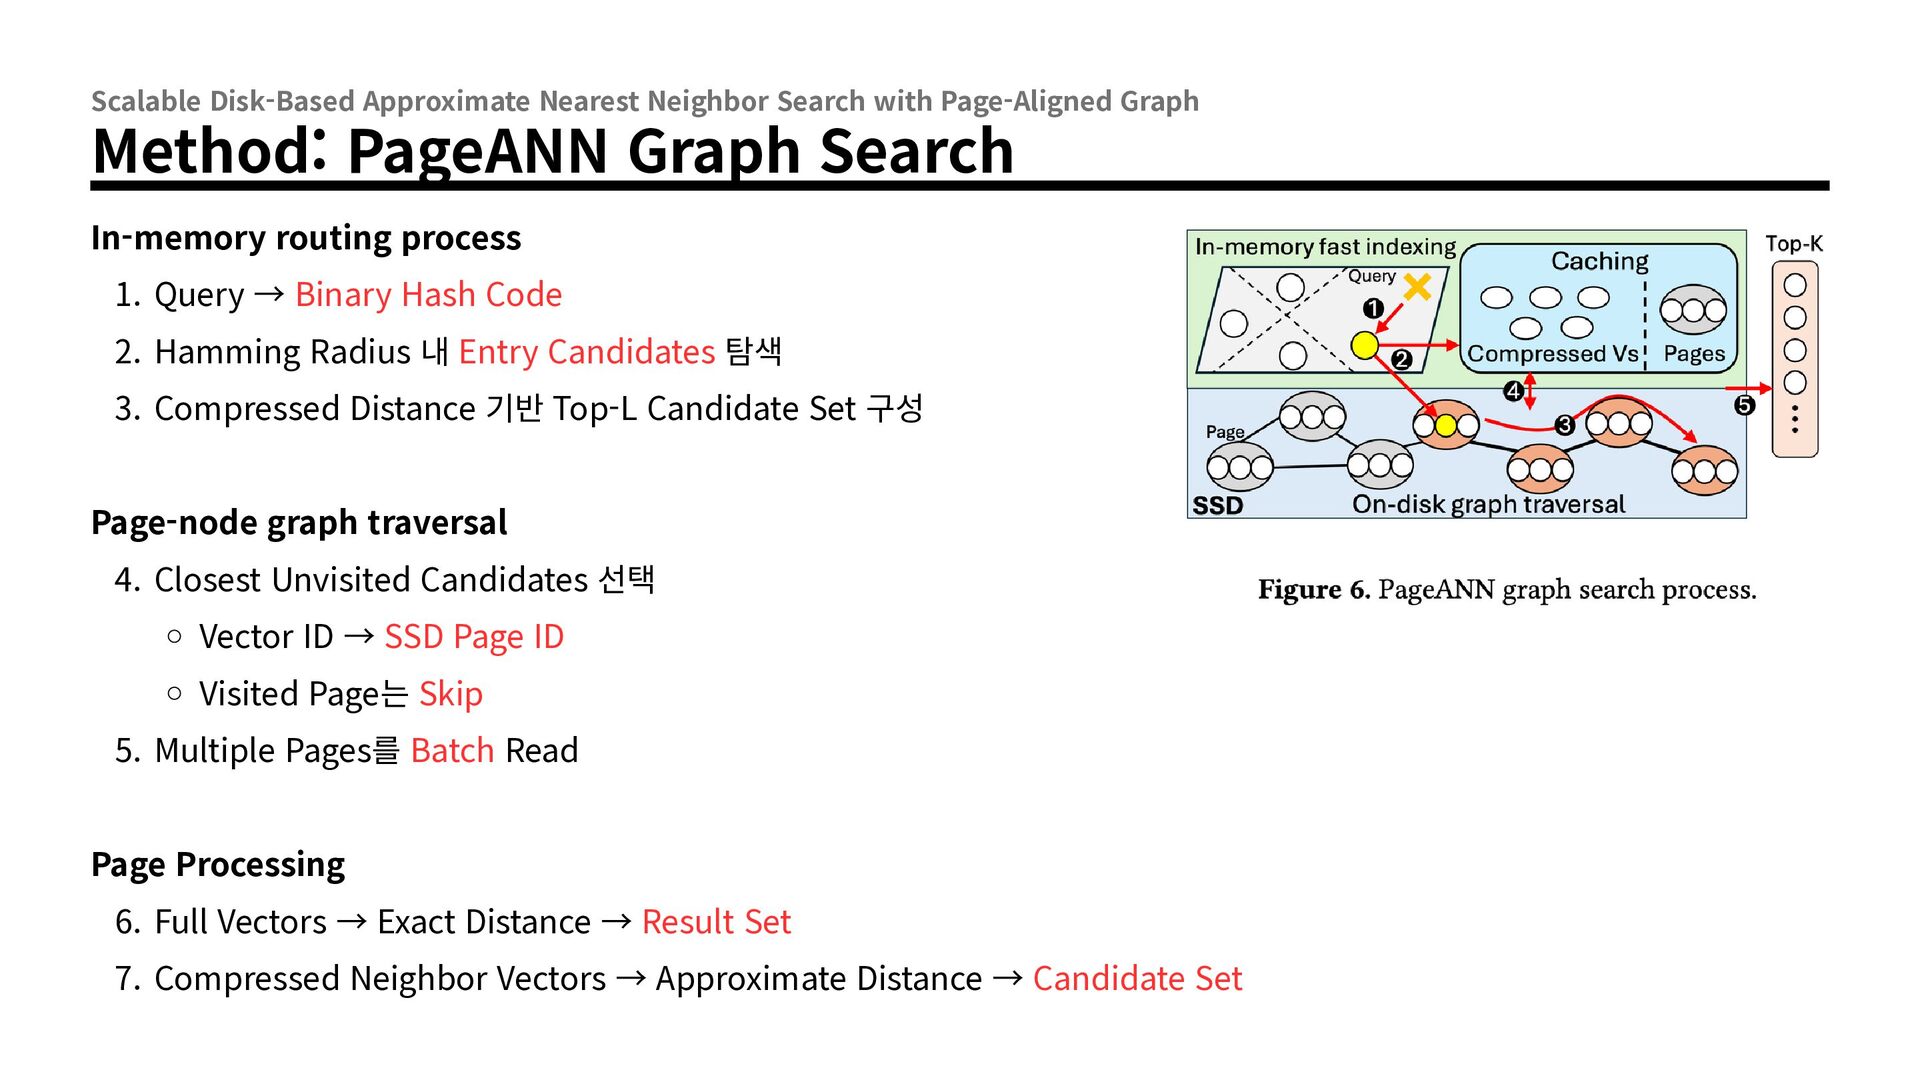
PageANN Memory Management Lightweight Indexing Sampled Vectors → Random Hyperplane 기반 Binary Hash Code Similar Hash Code의 Vector IDs를 Hash Bucket에 저장 Hamming Distance 기반으로 Query와 가까운 Entry Candidates 선택 Effect 작은 In-memory Routing Index Target 근처에서 Graph Traversal 시작 → Search Path 감소
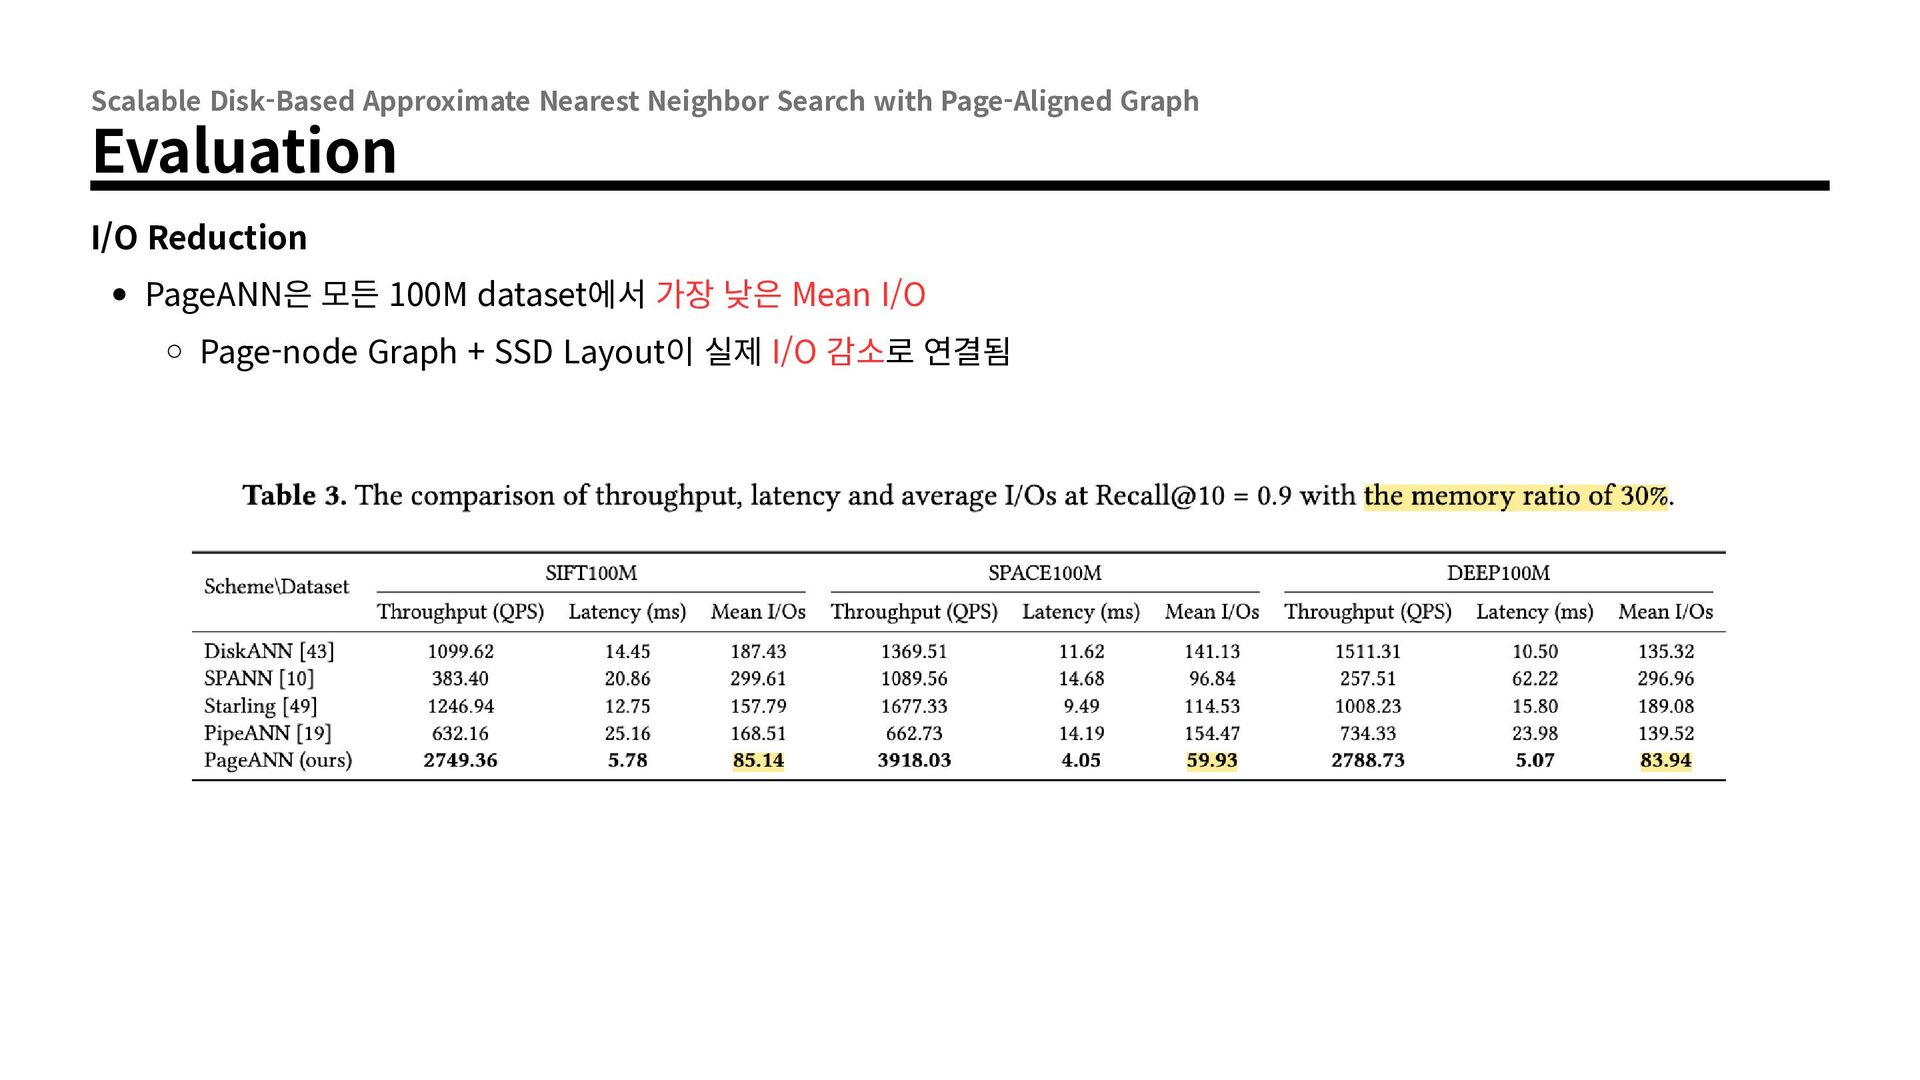
PageANN Memory Management Memory–Disk Coordination Memory Budget에 따라 Compressed Neighbor 배치 Low Memory: SSD Moderate Memory: Memory + SSD Sufficient Memory: Memory Effect Memory 증가 → 더 많은 Compressed Neighbor Vectors를 Memory에 저장 SSD Page에 Full Vector 더 많이 저장 Page-node Graph Size 감소 → Traversal Path 및 I/O 감소
Vector ID & Data Layout Page Grouping 이후 Page 순서에 맞게 Vector ID 재부여 변경된 Vector ID에 맞춰 Neighbor ID도 함께 갱신 각 Page Node를 대응되는 SSD Page에 저장 I/O–Computation Pipeline Linux AIO 기반 Asynchronous Page Read 다음 I/O를 기다리는 동안 이전 Page의 Distance Computation 수행 I/O Latency와 Computation Overlap Memory Structures Compressed Vector Cache: Vector ID → Compressed Vector Lightweight Routing Index: Hash Code → Sampled Vector IDs Page Cache: Page-node ID → Cached Page
PageANN Graph Structure + Storage Layout + Memory Management Co-design Page-node Graph로 Graph Traversal과 SSD I/O 정렬 New SSD Layout으로 Page Utilization 향상 Lightweight Routing + Memory–Disk Coordination으로 Limited Memory 대응 Result Throughput: 1.85×–10.83× 증가 Latency: 51.7%–91.9% 감소 High Recall Accuracy 유지 Takeaway Graph 탐색과 SSD 저장 방식을 함께 설계해 제한된 메모리에서도 높은 검색 성능을 달성할 수 있음


 nawkwoo
 resolutionfoundation
 shibuiwilliam
 kentaitakura
 datascientistsociety
 ayaniwa
 institutdelelevage
 nnchiba
 sishi
 tomonom
 polipoli
 tkng
 rocio
 gurzu
 schlessera
 techseoconnect
 frankvandijk
 bcantrill
 hannesfritz
 inesmontani
 caitiem20
 tamaranovitovic
 maltzj
 kimpetersen