Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
最新の物体検出モデルに関するサーベイ A Survey of the Latest Objec...
Search
Neurogica
April 21, 2026
Technology
170
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
最新の物体検出モデルに関するサーベイ A Survey of the Latest Object Detection Models
Neurogica
April 21, 2026
More Decks by Neurogica
See All by Neurogica
MapReduceを読む - 大量データを分担する Understanding MapReduce — Distributing Large-Scale Data Processing
neurogica
0
4
Sparse Autoencoder 〜 大規模言語モデルの内部表現を読む 〜 Sparse Autoencoder: Understanding LLM's Latent Representations
neurogica
0
39
LLMは“⼼”をモデル化しているのか? Do LLMs Model the Mind?
neurogica
0
18
LLM-MAS×時系列予測 LLM-MAS × Time-Series Forecasting
neurogica
0
51
推薦タスクの整理と 時系列基盤モデル活用を考える How Recommender Systems Use Time-Series Data and Where Foundation Models Fit
neurogica
0
21
画像生成AIの生成速度の遅さと 画風のばらつきを解決する手法 Methods for Solving Image Generation AI's Slowness and Style Inconsistency
neurogica
0
24
DBコネクションプール Database Connection Pooling
neurogica
0
71
時系列基盤モデルは作れるのか? Can We Build a Foundation Model for Time Series?
neurogica
1
130
双曲空間と機械学習 〜 階層性を活かした学習〜 Hyperbolic Space and Machine Learning ~ Learning that Leverages Hierarchical Structure ~
neurogica
0
51
Other Decks in Technology
See All in Technology
脆弱性診断って、何をしているの? 〜弱点を見つけて、会社の改善につなげるまで〜
keeg
0
830
DevelopersIO 2026 知識の地図を描く ─ オントロジーとは何か?
ishikawa_satoru
1
1.3k
AI駆動開発、viviONの1年 ── うまくいったこと・いかなかったこと
vivion
0
290
パッチ更新でterraform initが落ちた日
grimoh
1
120
「事実」を「計測」して、「解釈」する 〜AWS Lambdaのメモリ最適解の見つけ方〜
maimyyym
0
130
オンラインゲームのシステム全体像 - コロプラ 2026年度 新卒研修
colopl
0
1.1k
OSC2026on_the-world-is-waiting-for-your-voice.pdf
naruoga
0
370
Claude Code本は、どのように執筆チームで書かれたか
oikon48
1
360
全PRの83%が AIレビューだけでマージできるようになった開発組織は その後どうなったか @2026/10
athug
0
140
ビジネスを止めない技術的負債の返済のための戦略とその手法 - 技術的負債と向き合う / Complexity and Simplicity
soudai
PRO
3
680
OpenSharing について熱く語る 〜AI アセットの共有について〜
kameitomohiro
0
250
「Docker Desktop不要の時代」は 来たのか?
ueponx
0
460
Featured
See All Featured
How to Ace a Technical Interview
jacobian
280
24k
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
Optimising Largest Contentful Paint
csswizardry
37
4k
Performance Is Good for Brains [We Love Speed 2024]
tammyeverts
12
1.9k
Creating an realtime collaboration tool: Agile Flush - .NET Oxford
marcduiker
35
2.6k
The Organizational Zoo: Understanding Human Behavior Agility Through Metaphoric Constructive Conversations (based on the works of Arthur Shelley, Ph.D)
kimpetersen
PRO
0
490
Building Better People: How to give real-time feedback that sticks.
wjessup
370
20k
How GitHub (no longer) Works
holman
316
150k
Paper Plane
katiecoart
PRO
4
54k
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
HDC tutorial
michielstock
2
950
Transcript
最新の物体検出モデルに関するサーベイ 株式会社ニューロジカ 開発部 佐藤太陽 最新の物体検出モデルに関するサーベイ
1. はじめに:物体検出とは 2. YOLO ・YOLO26(2026) ・YOLO-World(2024) 3. DETR ・RT-DETRv4(2025) 4.
SAM ・SAM3(2025) 5. まとめ アジェンダ アジェンダ はじめに YOLO DETR SAM まとめ © Neurogica Inc.
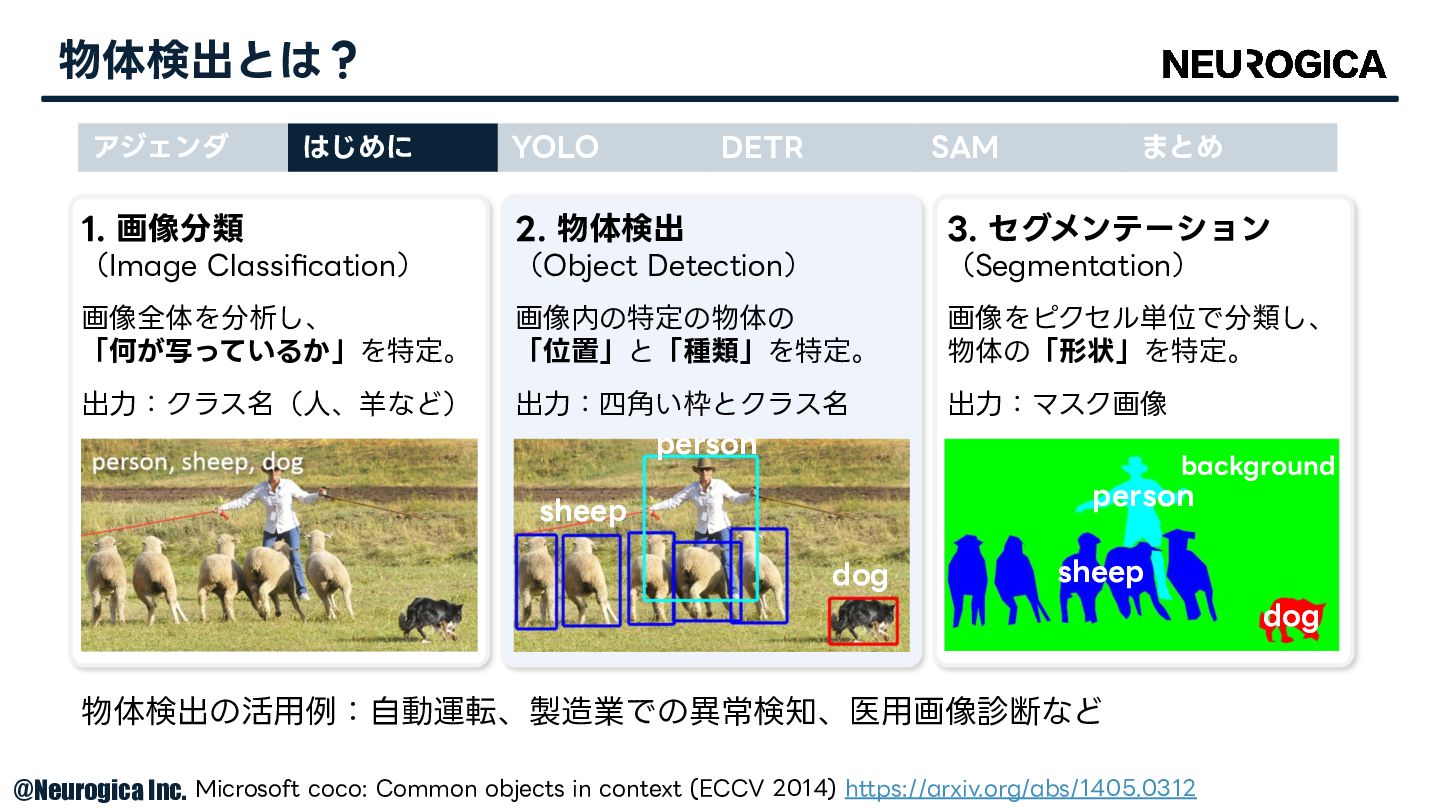
物体検出とは? アジェンダ はじめに YOLO DETR SAM まとめ Microsoft coco: Common
objects in context (ECCV 2014) https://arxiv.org/abs/1405.0312 person sheep dog person sheep background dog 1. 画像分類 (Image Classification) 画像全体を分析し、 「何が写っているか」を特定。 出⼒:クラス名(⼈、⽺など) 2. 物体検出 (Object Detection) 画像内の特定の物体の 「位置」と「種類」を特定。 出⼒:四⾓い枠とクラス名 3. セグメンテーション (Segmentation) 画像をピクセル単位で分類し、 物体の「形状」を特定。 出⼒:マスク画像 物体検出の活⽤例:⾃動運転、製造業での異常検知、医⽤画像診断など © Neurogica Inc.
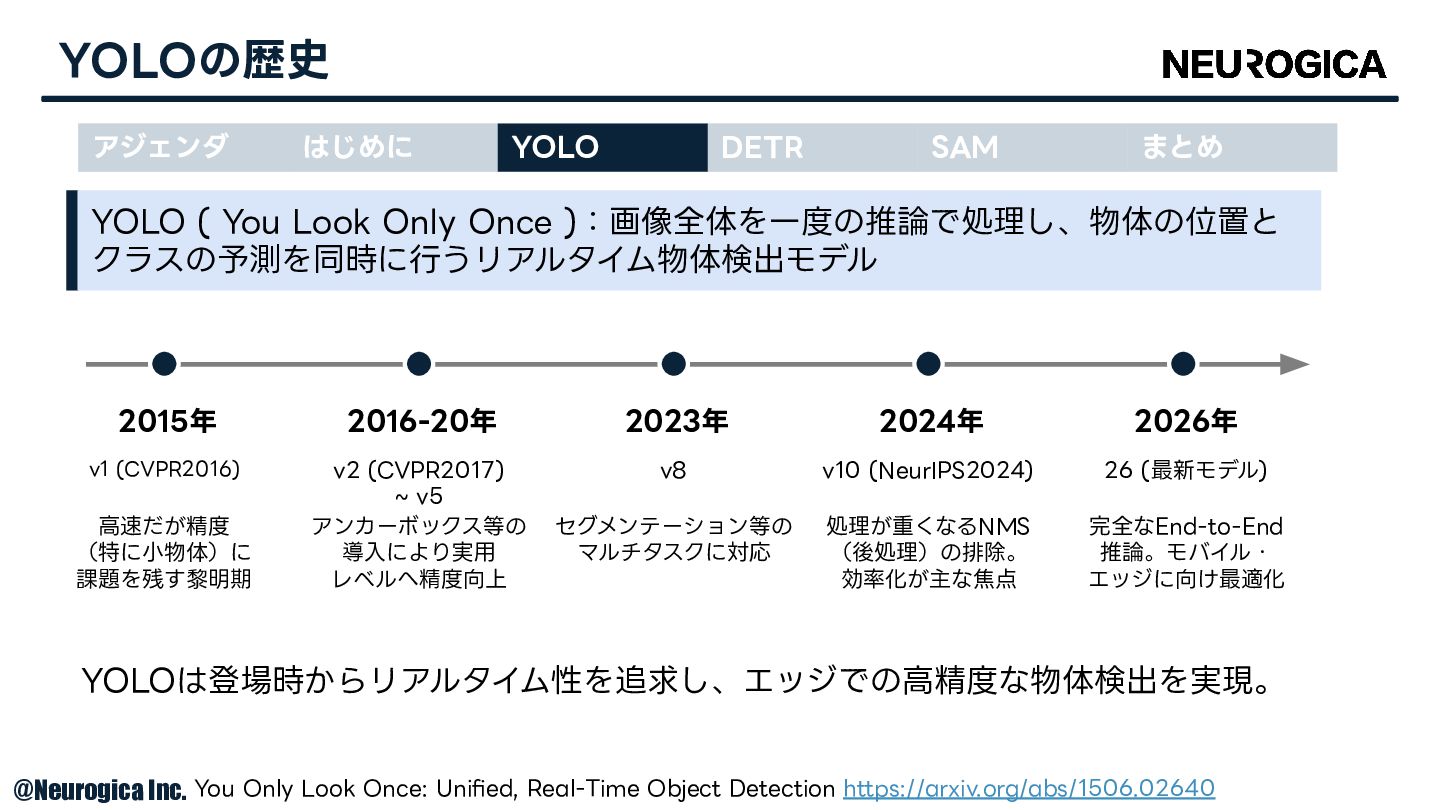
v1 (CVPR2016) YOLOの歴史 YOLO ( You Look Only Once ):画像全体を⼀度の推論で処理し、物体の位置と
クラスの予測を同時に⾏うリアルタイム物体検出モデル 2015年 2016-20年 2023年 2024年 2026年 v2 (CVPR2017) ~ v5 v8 v10 (NeurIPS2024) 26 (最新モデル) ⾼速だが精度 (特に⼩物体)に 課題を残す黎明期 アンカーボックス等の 導⼊により実⽤ レベルへ精度向上 セグメンテーション等の マルチタスクに対応 処理が重くなるNMS (後処理)の排除。 効率化が主な焦点 完全なEnd-to-End 推論。モバイル・ エッジに向け最適化 YOLOは登場時からリアルタイム性を追求し、エッジでの⾼精度な物体検出を実現。 You Only Look Once: Unified, Real-Time Object Detection https://arxiv.org/abs/1506.02640 アジェンダ はじめに YOLO DETR SAM まとめ © Neurogica Inc.
YOLO26 対応タスク 物体検出、セグメンテーション、姿勢推定、OBB、 画像分類 学習・必要データ 教師あり学習。実⽤には1クラスあたり100〜1,000 枚の画像データ(アノテーション済み)が必要。 エッジデバイスでの運⽤可能性 パラメータ数は2.4Mから55.7Mなので搭載可能。 CPUでの処理速度も⼗分速い。
YOLO26: Key Architectural Enhancements and Performance Benchmarking for Real-Time Object Detection https://arxiv.org/abs/2509.25164 アジェンダ はじめに YOLO DETR SAM まとめ https://www.youtube.com/watch?v=pJLXmhyuHzA © Neurogica Inc.
YOLO-World (CVPR2024) 対応タスク テキスト条件付きOpen-Vocabulary物体検出 アジェンダ はじめに YOLO DETR SAM まとめ
学習・必要データ 膨⼤な視覚・⾔語ペアデータで事前学習済み。 追加学習データなし(ゼロショット)で利⽤可能。 エッジデバイスでの運⽤可能性 パラメータ数は13Mから48Mなので搭載可能。 YOLO-World: Real-Time Open-Vocabulary Object Detection https://arxiv.org/abs/2401.17270 プロンプト条件なし検出とプロンプト条件あり検出 https://www.youtube.com/watch?v=sWEm3dIGKU8 © Neurogica Inc.
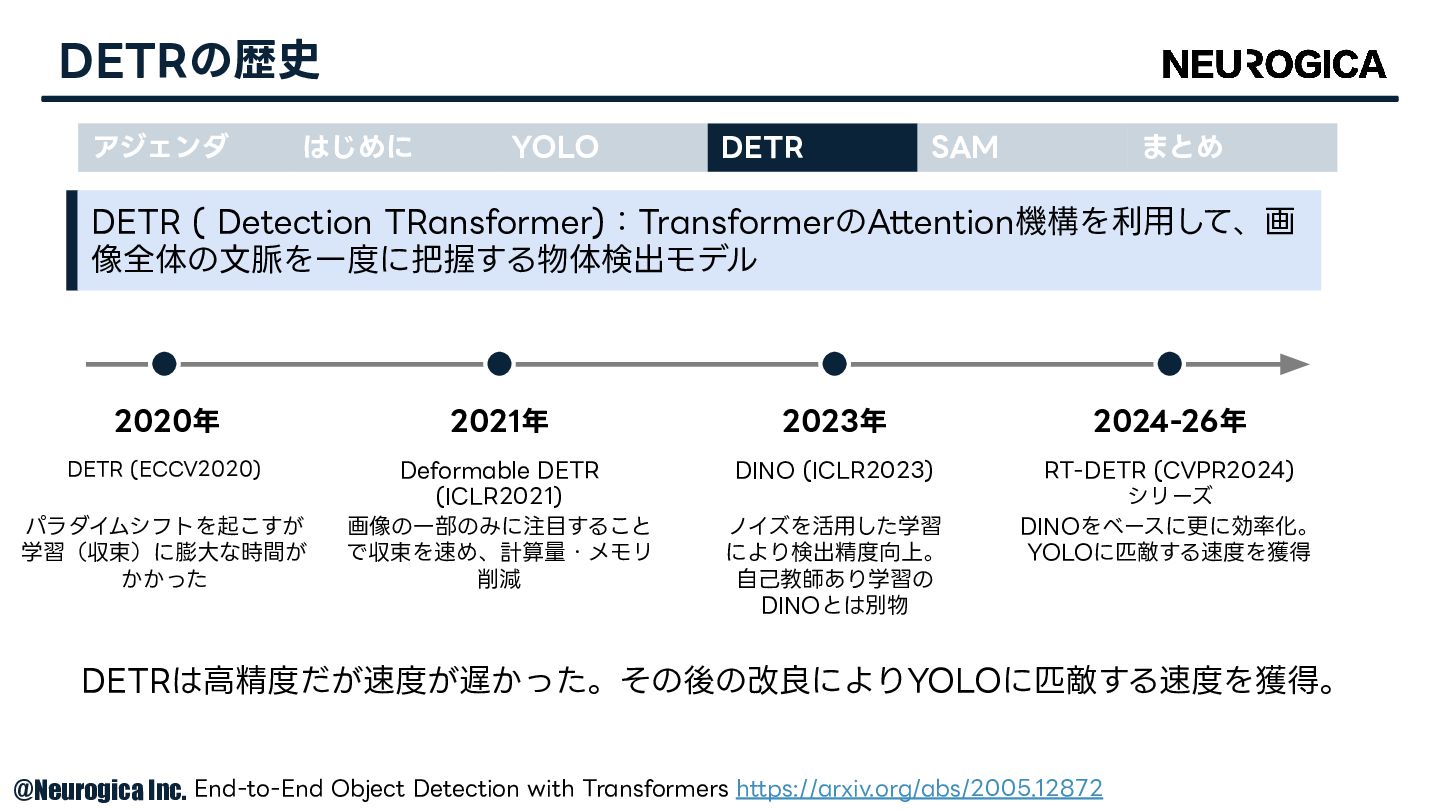
DETRの歴史 アジェンダ はじめに YOLO DETR SAM まとめ DETR (ECCV2020) DETR
( Detection TRansformer):TransformerのAttention機構を利⽤して、画 像全体の⽂脈を⼀度に把握する物体検出モデル 2020年 2021年 2023年 2024-26年 Deformable DETR (ICLR2021) DINO (ICLR2023) RT-DETR (CVPR2024) シリーズ パラダイムシフトを起こすが 学習(収束)に膨⼤な時間が かかった 画像の⼀部のみに注⽬すること で収束を速め、計算量・メモリ 削減 ノイズを活⽤した学習 により検出精度向上。 ⾃⼰教師あり学習の DINOとは別物 DINOをベースに更に効率化。 YOLOに匹敵する速度を獲得 DETRは⾼精度だが速度が遅かった。その後の改良によりYOLOに匹敵する速度を獲得。 End-to-End Object Detection with Transformers https://arxiv.org/abs/2005.12872 © Neurogica Inc.
RT-DETRv4 アジェンダ はじめに YOLO DETR SAM まとめ 対応タスク 物体検出(※内部で物体候補の分類は⾏うが、画像 分類モデルとしては⽤いない。)
学習・必要データ 教師あり学習。基盤モデルからの蒸留を活⽤するた め、必要数は⽐較的少ない(具体的な枚数不明)。 エッジデバイスでの運⽤可能性 パラメータ数は10Mから62Mなので搭載可能。 CPUでの処理速度も⼗分速い。 RT-DETRv4: Painlessly Furthering Real-Time Object Detection with Vision Foundation Models https://arxiv.org/abs/2510.25257 https://github.com/RT-DETRs/RT-DETRv4 © Neurogica Inc.
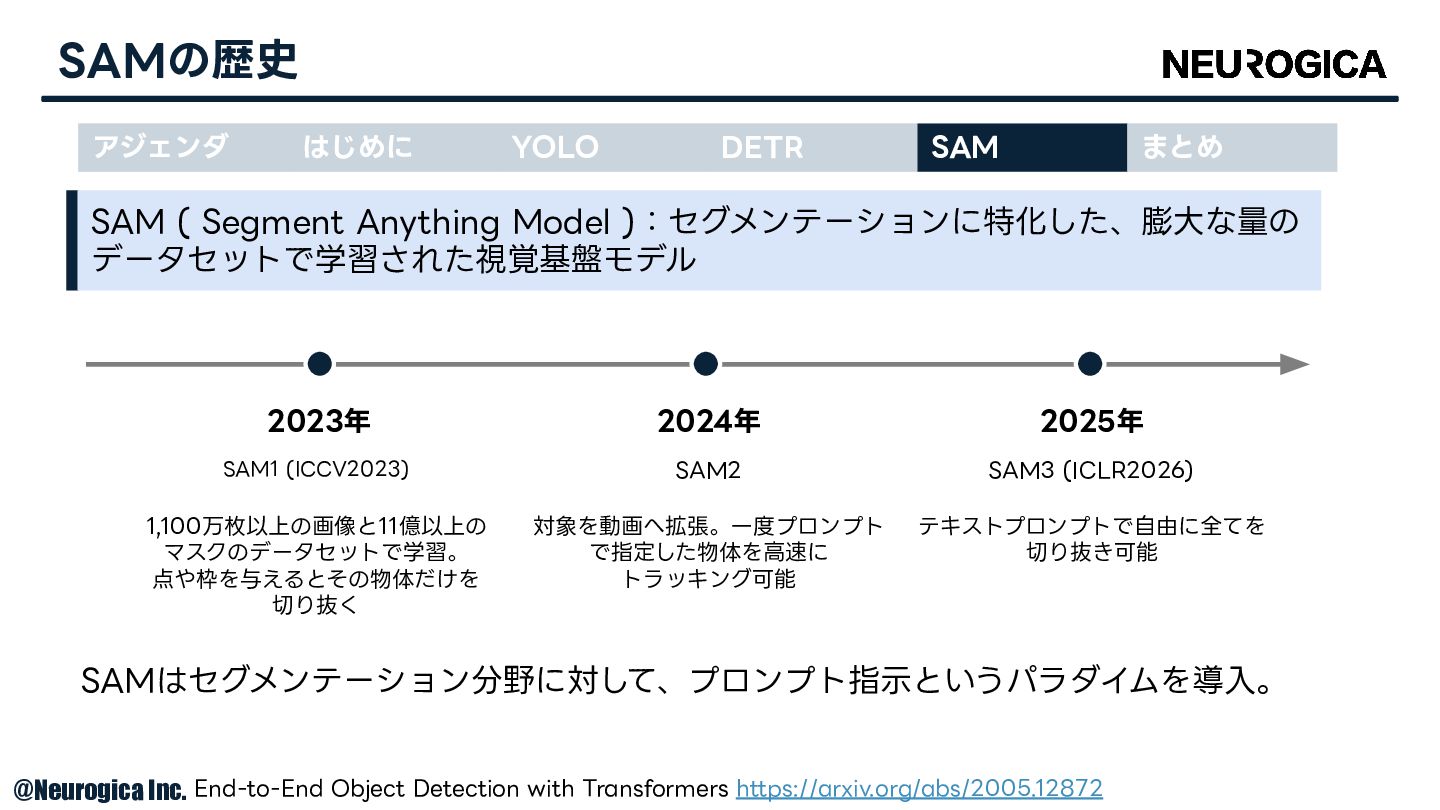
SAMの歴史 アジェンダ はじめに YOLO DETR SAM まとめ SAM1 (ICCV2023) SAM
( Segment Anything Model ):セグメンテーションに特化した、膨⼤な量の データセットで学習された視覚基盤モデル 2023年 2024年 2025年 SAM2 SAM3 (ICLR2026) 1,100万枚以上の画像と11億以上の マスクのデータセットで学習。 点や枠を与えるとその物体だけを 切り抜く 対象を動画へ拡張。⼀度プロンプト で指定した物体を⾼速に トラッキング可能 テキストプロンプトで⾃由に全てを 切り抜き可能 SAMはセグメンテーション分野に対して、プロンプト指⽰というパラダイムを導⼊。 End-to-End Object Detection with Transformers https://arxiv.org/abs/2005.12872 © Neurogica Inc.
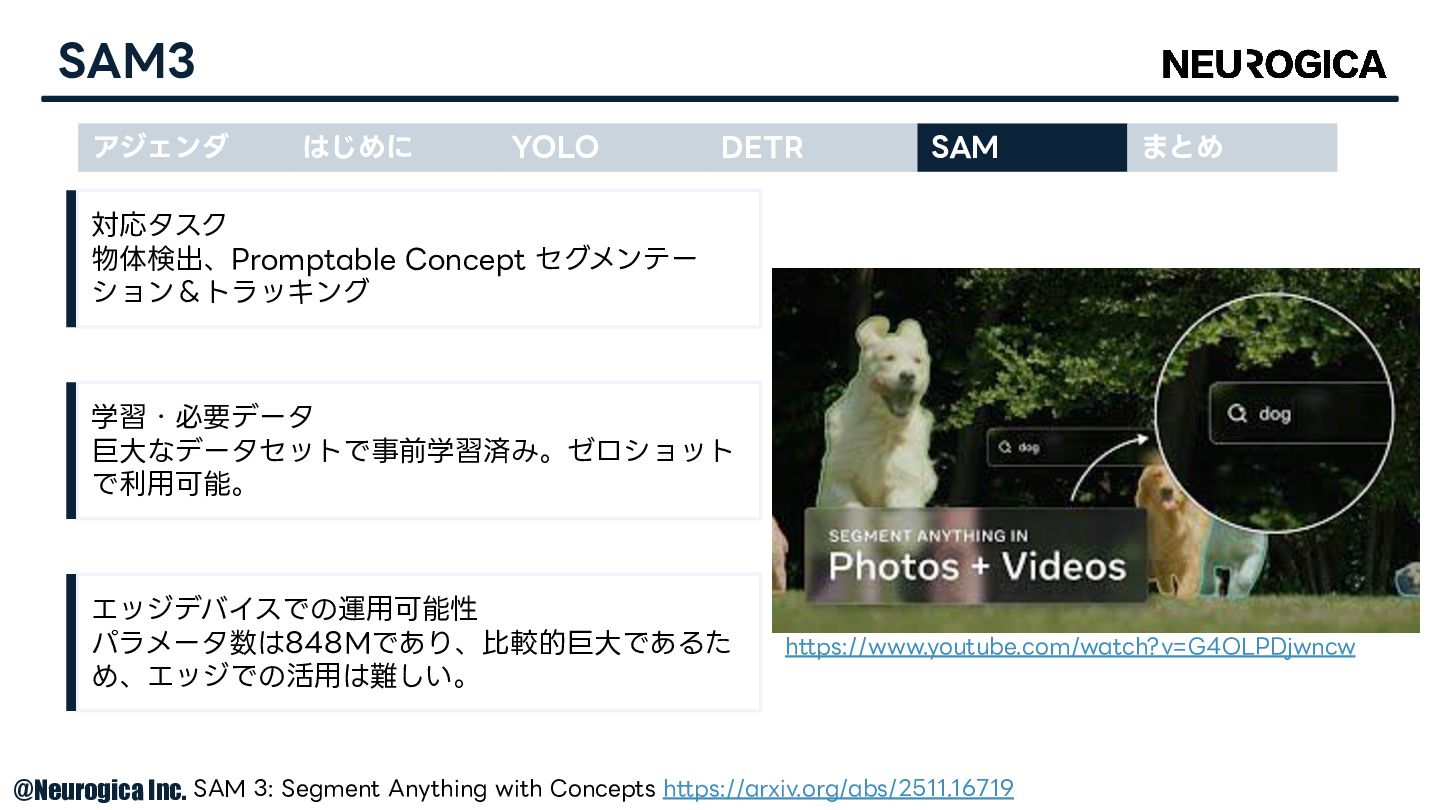
SAM3 アジェンダ はじめに YOLO DETR SAM まとめ 対応タスク 物体検出、Promptable Concept
セグメンテー ション&トラッキング 学習・必要データ 巨⼤なデータセットで事前学習済み。ゼロショット で利⽤可能。 エッジデバイスでの運⽤可能性 パラメータ数は848Mであり、⽐較的巨⼤であるた め、エッジでの活⽤は難しい。 SAM 3: Segment Anything with Concepts https://arxiv.org/abs/2511.16719 https://www.youtube.com/watch?v=G4OLPDjwncw © Neurogica Inc.
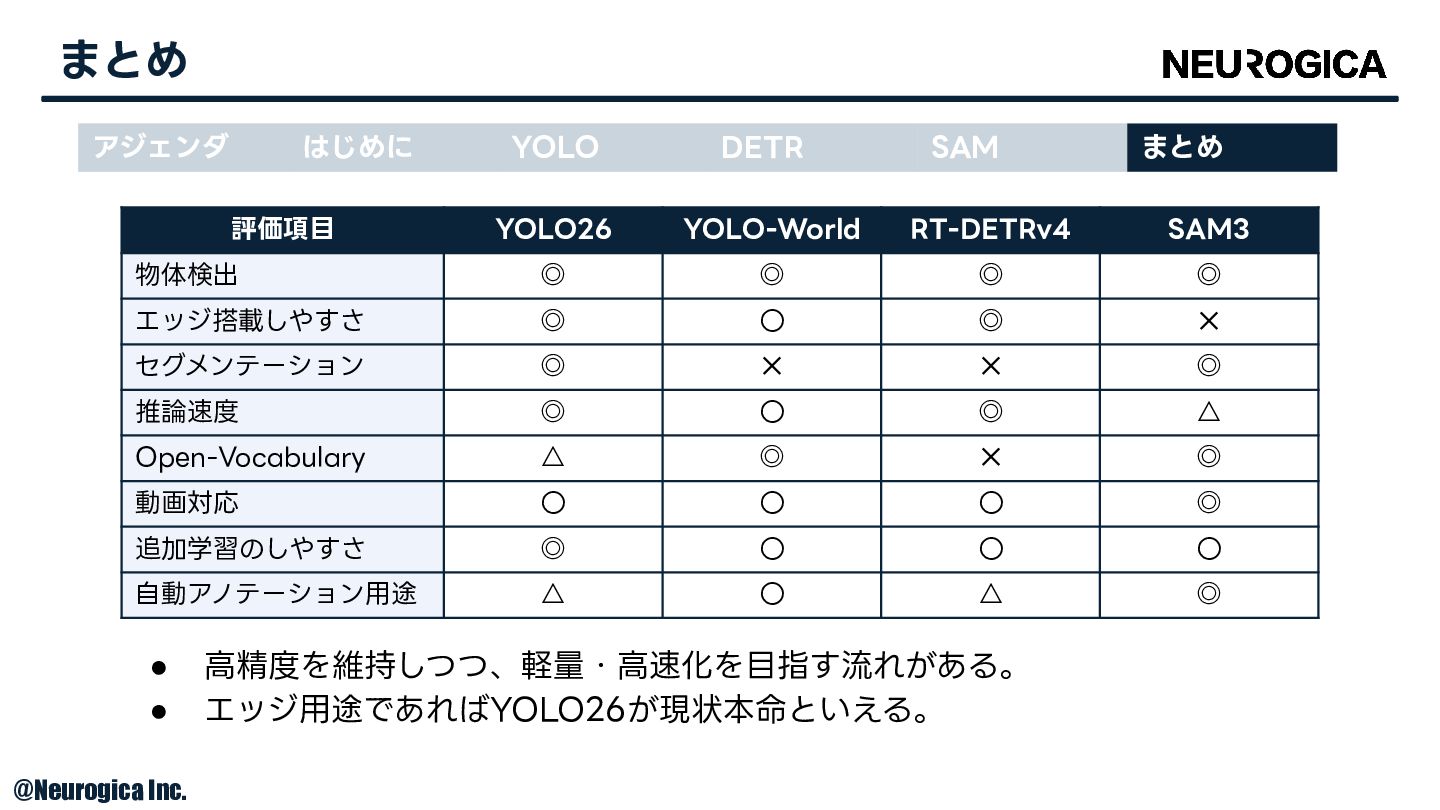
まとめ アジェンダ はじめに YOLO DETR SAM まとめ 評価項⽬ YOLO26 YOLO-World
RT-DETRv4 SAM3 物体検出 ◎ ◎ ◎ ◎ エッジ搭載しやすさ ◎ 〇 ◎ ✕ セグメンテーション ◎ ✕ ✕ ◎ 推論速度 ◎ 〇 ◎ △ Open-Vocabulary △ ◎ ✕ ◎ 動画対応 〇 〇 〇 ◎ 追加学習のしやすさ ◎ 〇 〇 〇 ⾃動アノテーション⽤途 △ 〇 △ ◎ • ⾼精度を維持しつつ、軽量・⾼速化を⽬指す流れがある。 • エッジ⽤途であればYOLO26が現状本命といえる。 © Neurogica Inc.


 neurogica
 keeg
 ishikawa_satoru
 vivion
 grimoh
 maimyyym
 colopl
 naruoga
 oikon48
 athug
 soudai
 kameitomohiro
 ueponx
 jacobian
 codingconduct
 csswizardry
 tammyeverts
 marcduiker
 kimpetersen
 wjessup
 holman
 katiecoart
 keavy
 chrisshort
 michielstock