Share
Embed
Transcript
21 slides
-
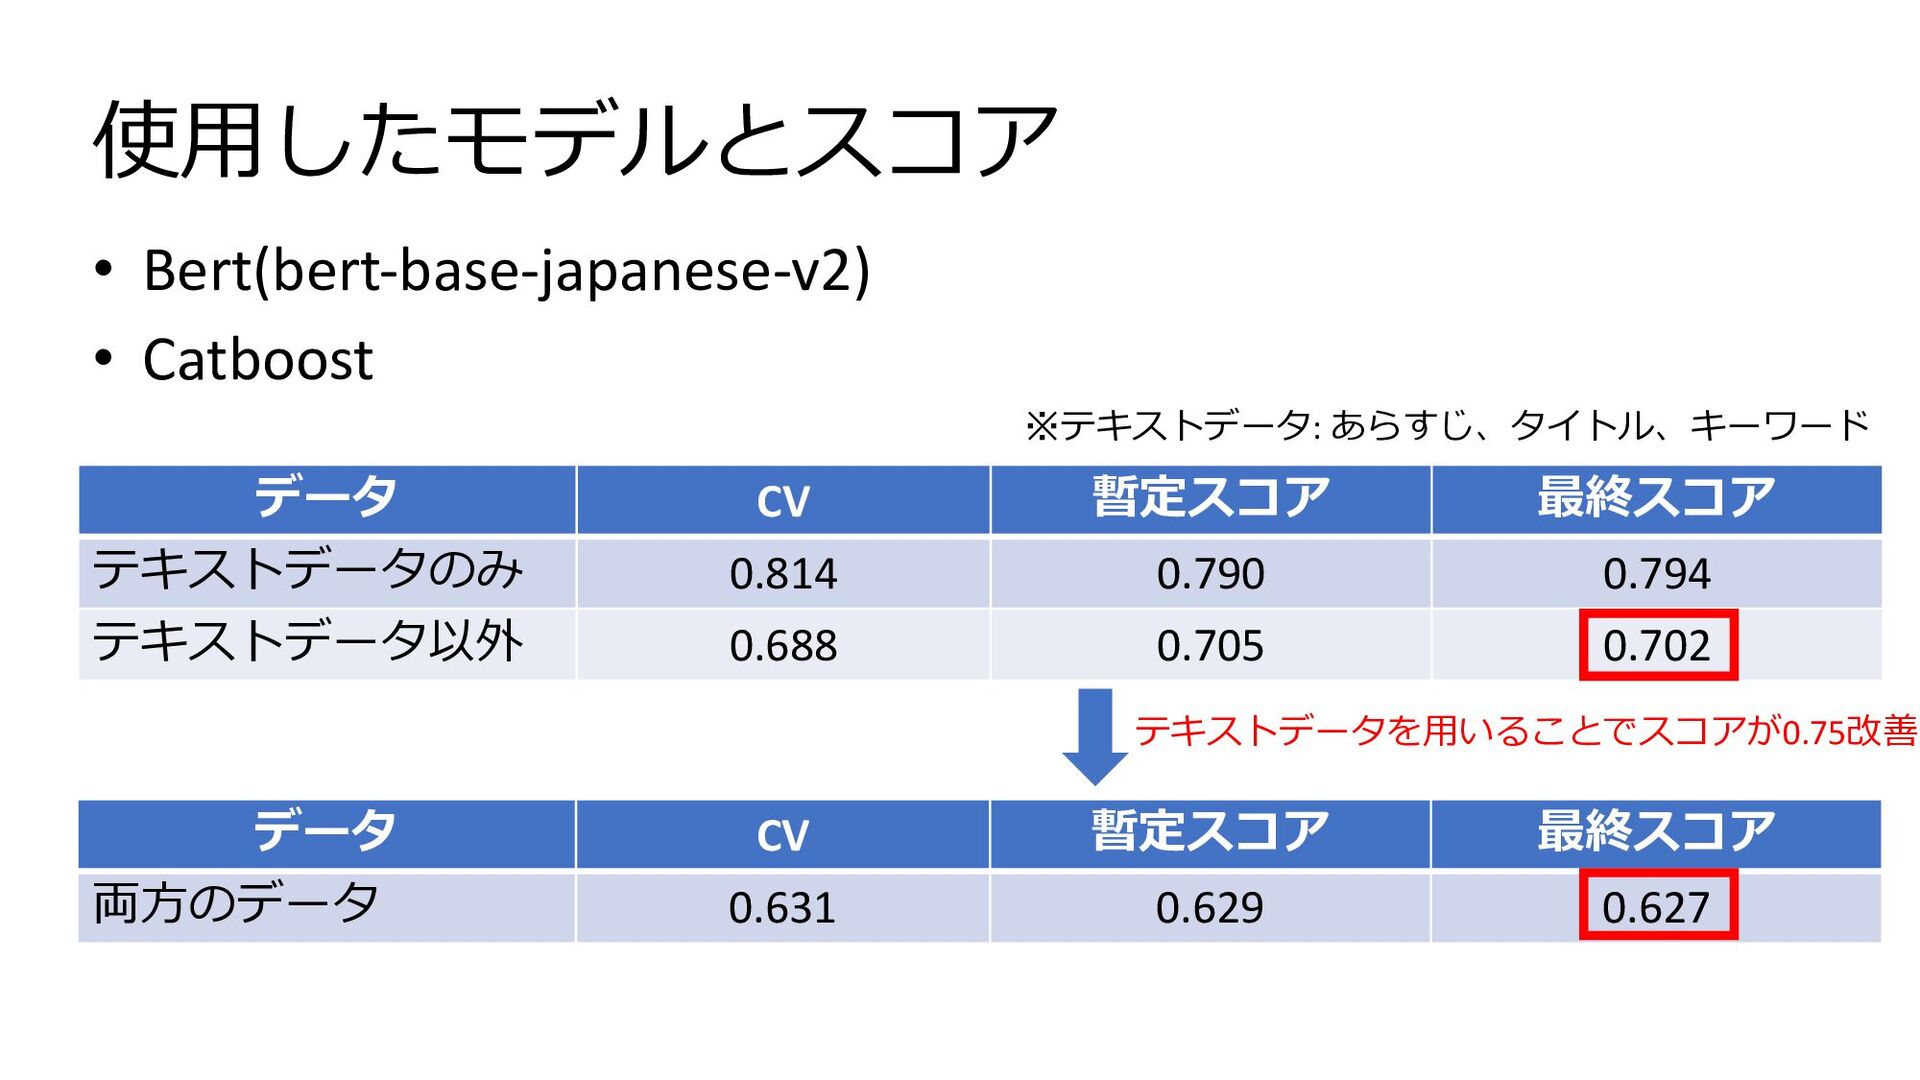
使⽤したモデルとスコア • Bert(bert-base-japanese-v2) • Catboost データ CV 暫定スコア 最終スコア テキストデータのみ
0.814 0.790 0.794 テキストデータ以外 0.688 0.705 0.702 データ CV 暫定スコア 最終スコア 両⽅のデータ 0.631 0.629 0.627 ※テキストデータ: あらすじ、タイトル、キーワード テキストデータを⽤いることでスコアが0.75改善 -
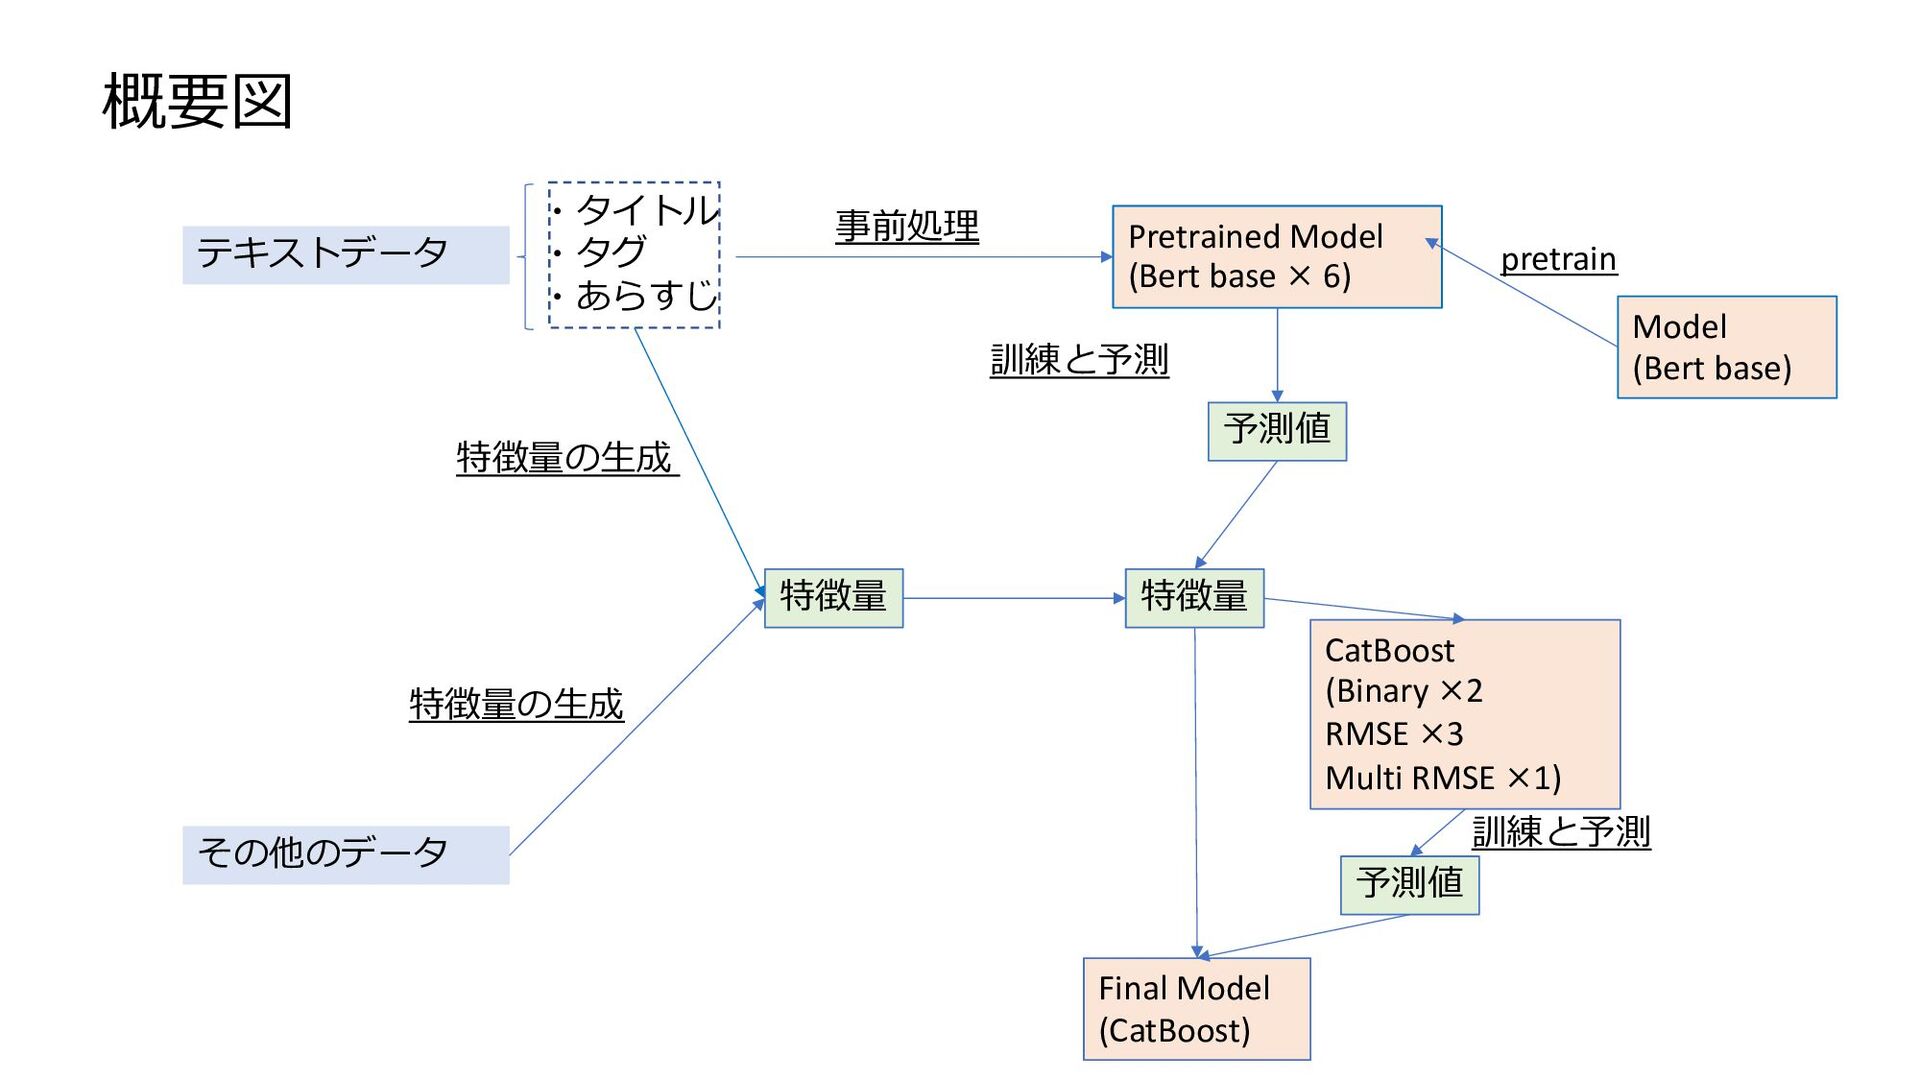
テキストデータ その他のデータ ・タイトル ・タグ ・あらすじ Pretrained Model (Bert base ×
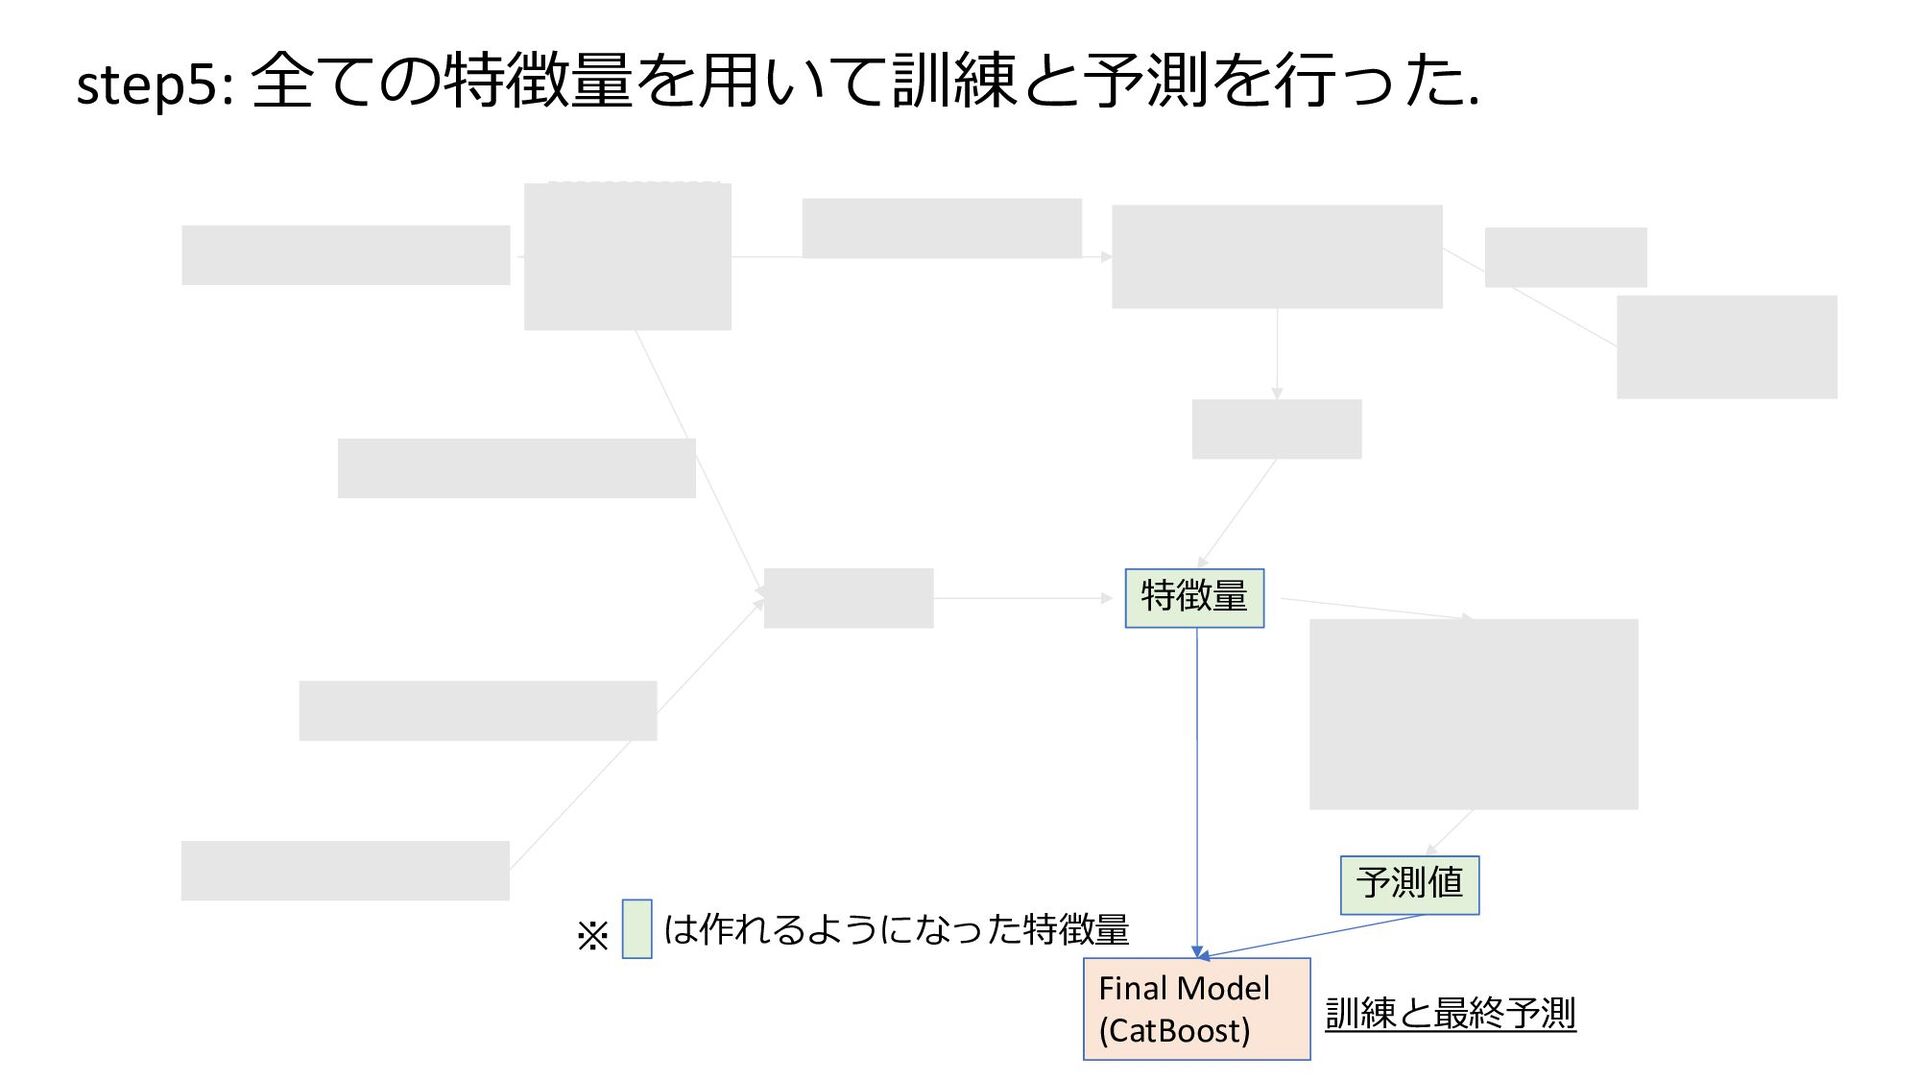
6) 特徴量 CatBoost (Binary ×2 RMSE ×3 Multi RMSE ×1) Final Model (CatBoost) 特徴量 予測値 事前処理 Model (Bert base) pretrain 予測値 特徴量の⽣成 訓練と予測 訓練と予測 特徴量の⽣成 概要図 -
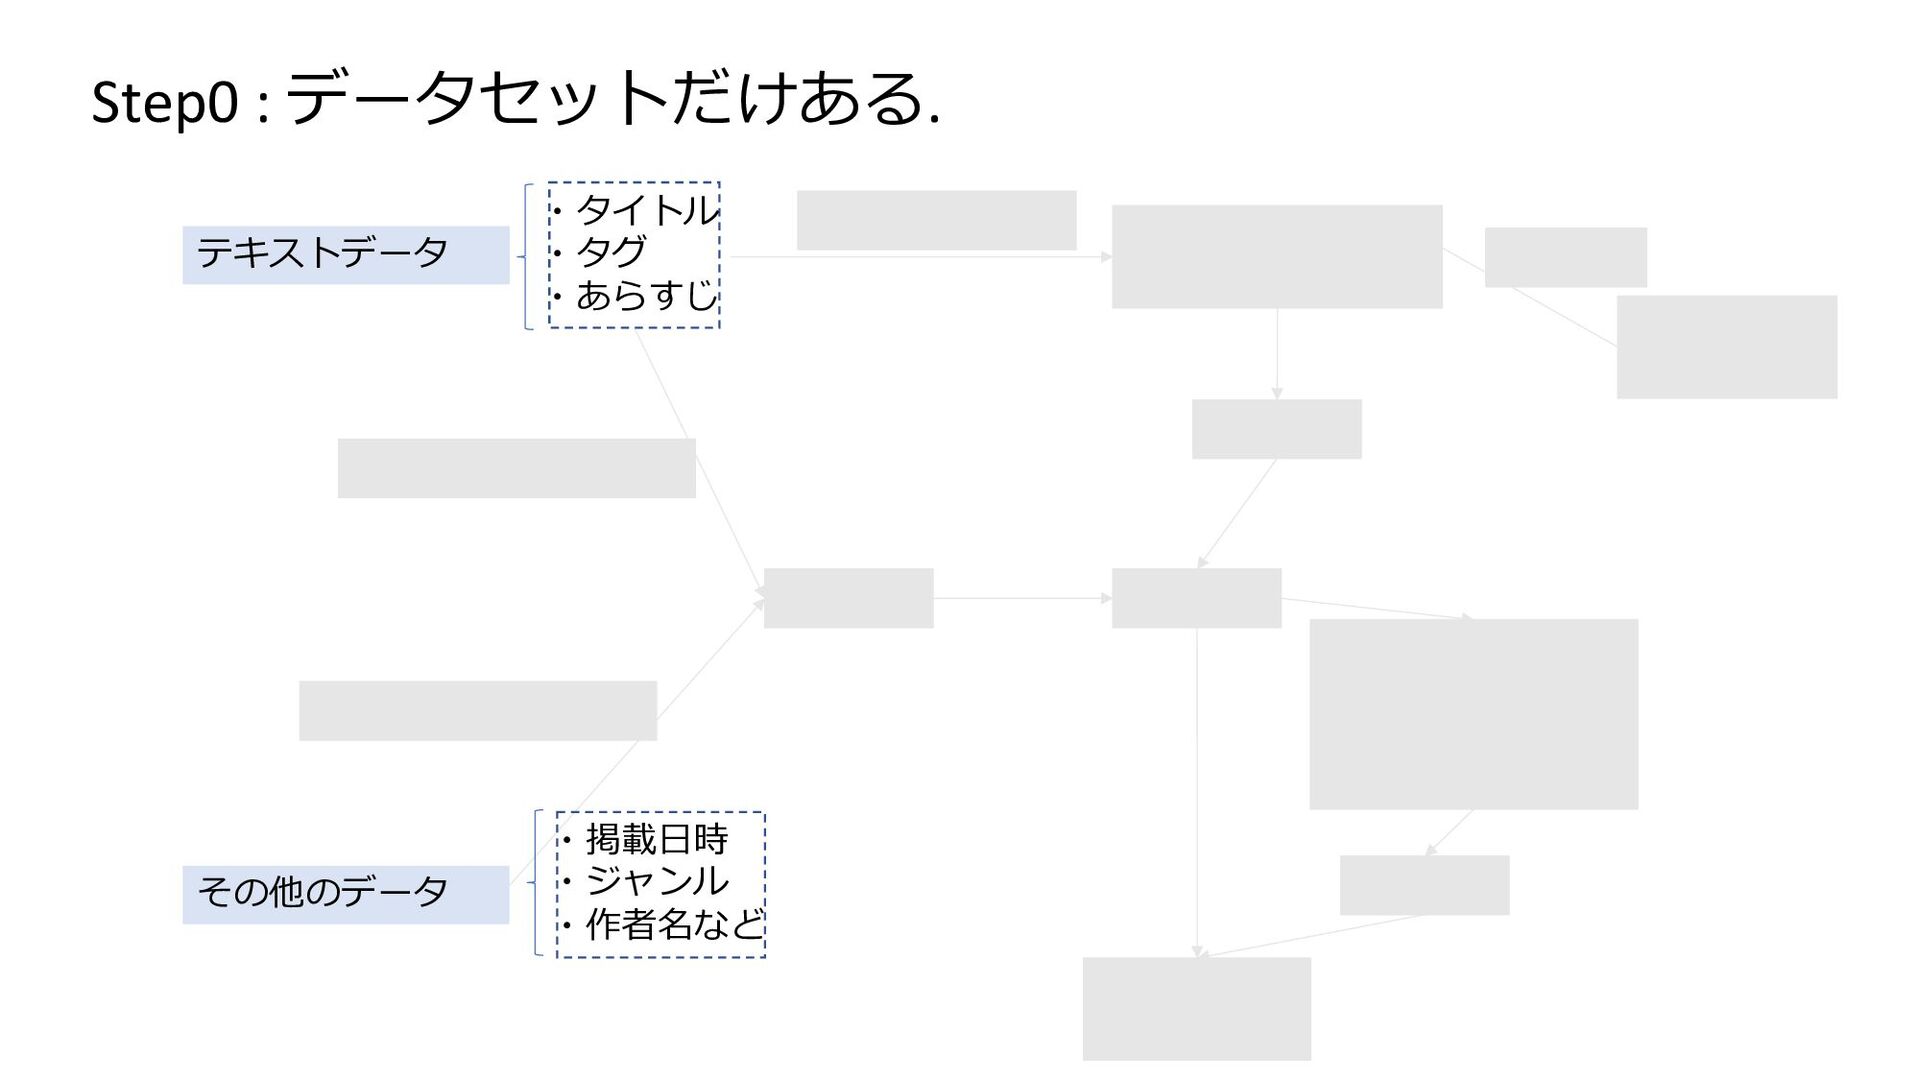
Pretrained Model (Bert base × 6) features Model (CatBoost) (Binary
×2 RMSE ×3 Multi RMSE ×1) Final Model (CatBoost) features features preprocess feature engineering Model (Bert base) pretrain features feature engineering テキストデータ ・タイトル ・タグ ・あらすじ その他のデータ ・掲載⽇時 ・ジャンル ・作者名など Step0 : データセットだけある. -
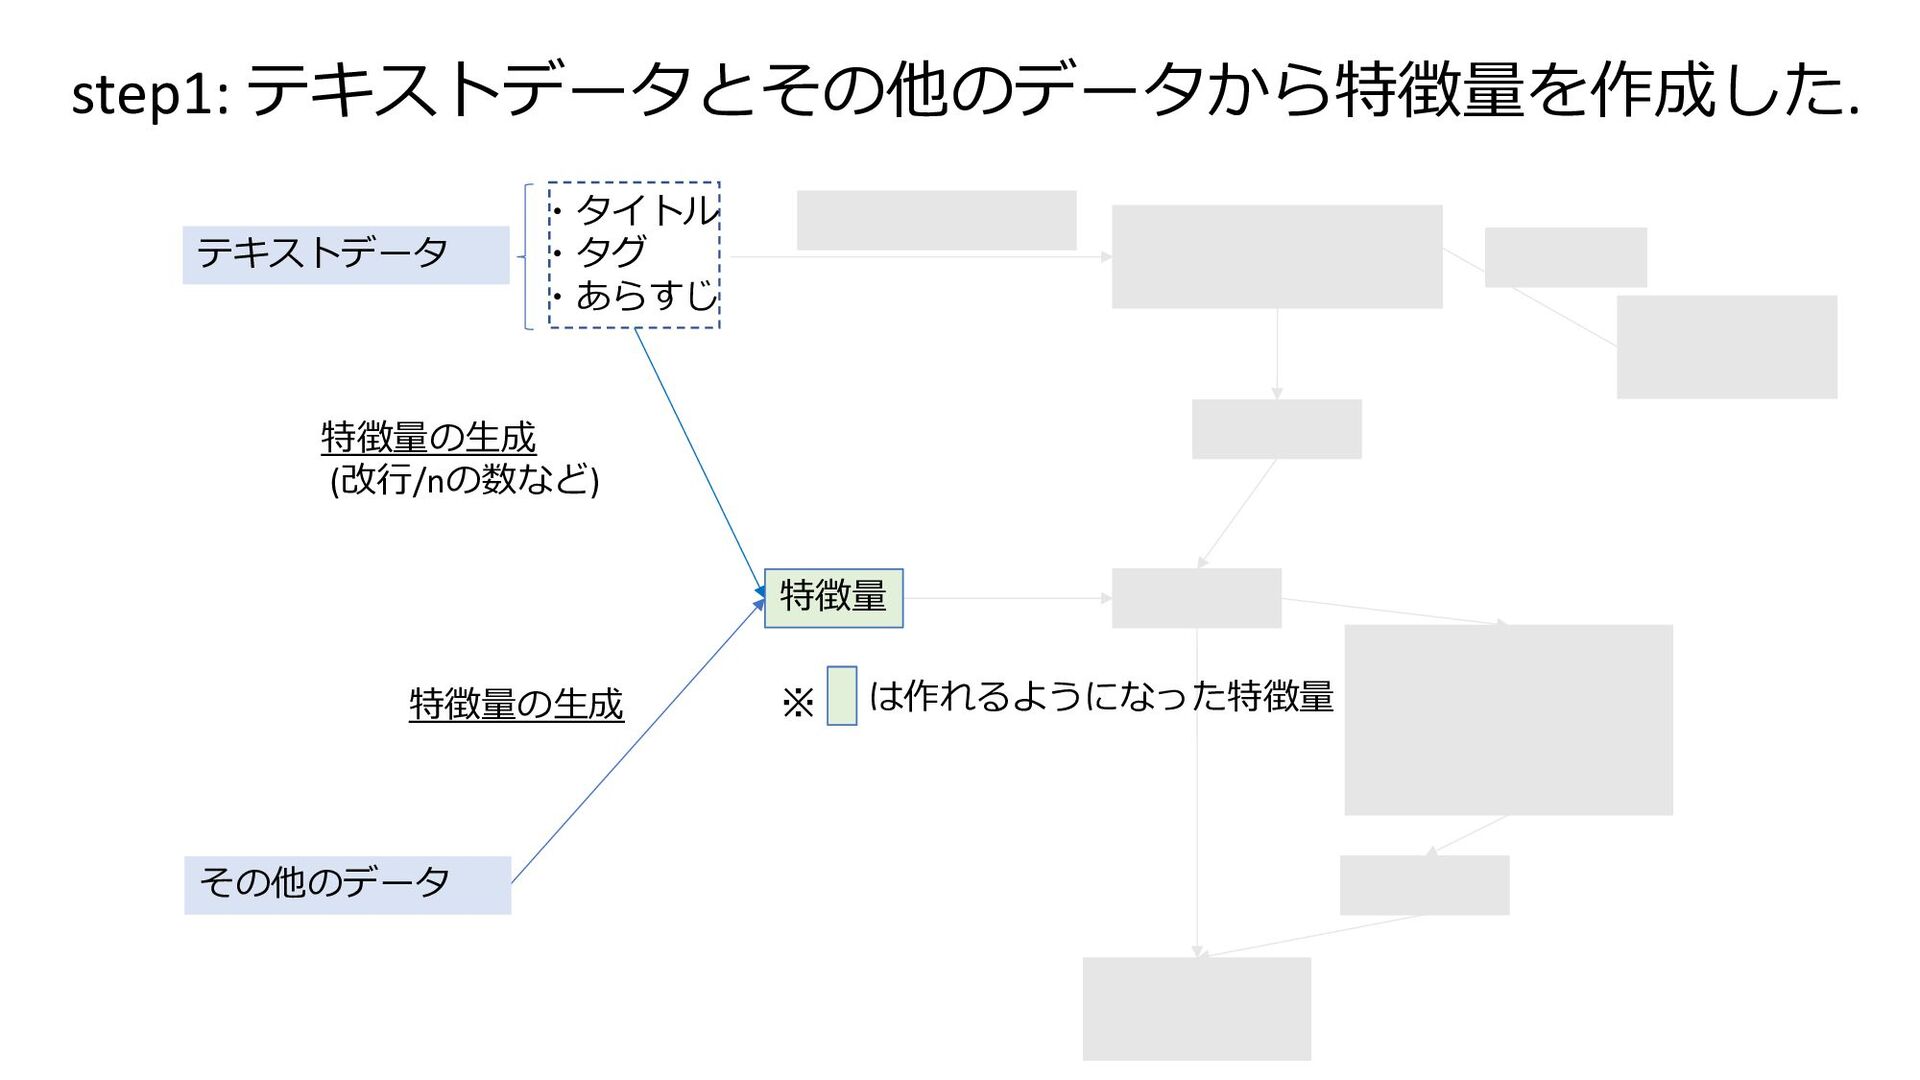
Pretrained Model (Bert base × 6) Model (CatBoost) (Binary ×2
RMSE ×3 Multi RMSE ×1) Final Model (CatBoost) features features preprocess Model (Bert base) pretrain features は作れるようになった特徴量 ※ テキストデータ その他のデータ 特徴量の⽣成 (改⾏/nの数など) 特徴量の⽣成 ・タイトル ・タグ ・あらすじ 特徴量 step1: テキストデータとその他のデータから特徴量を作成した. -
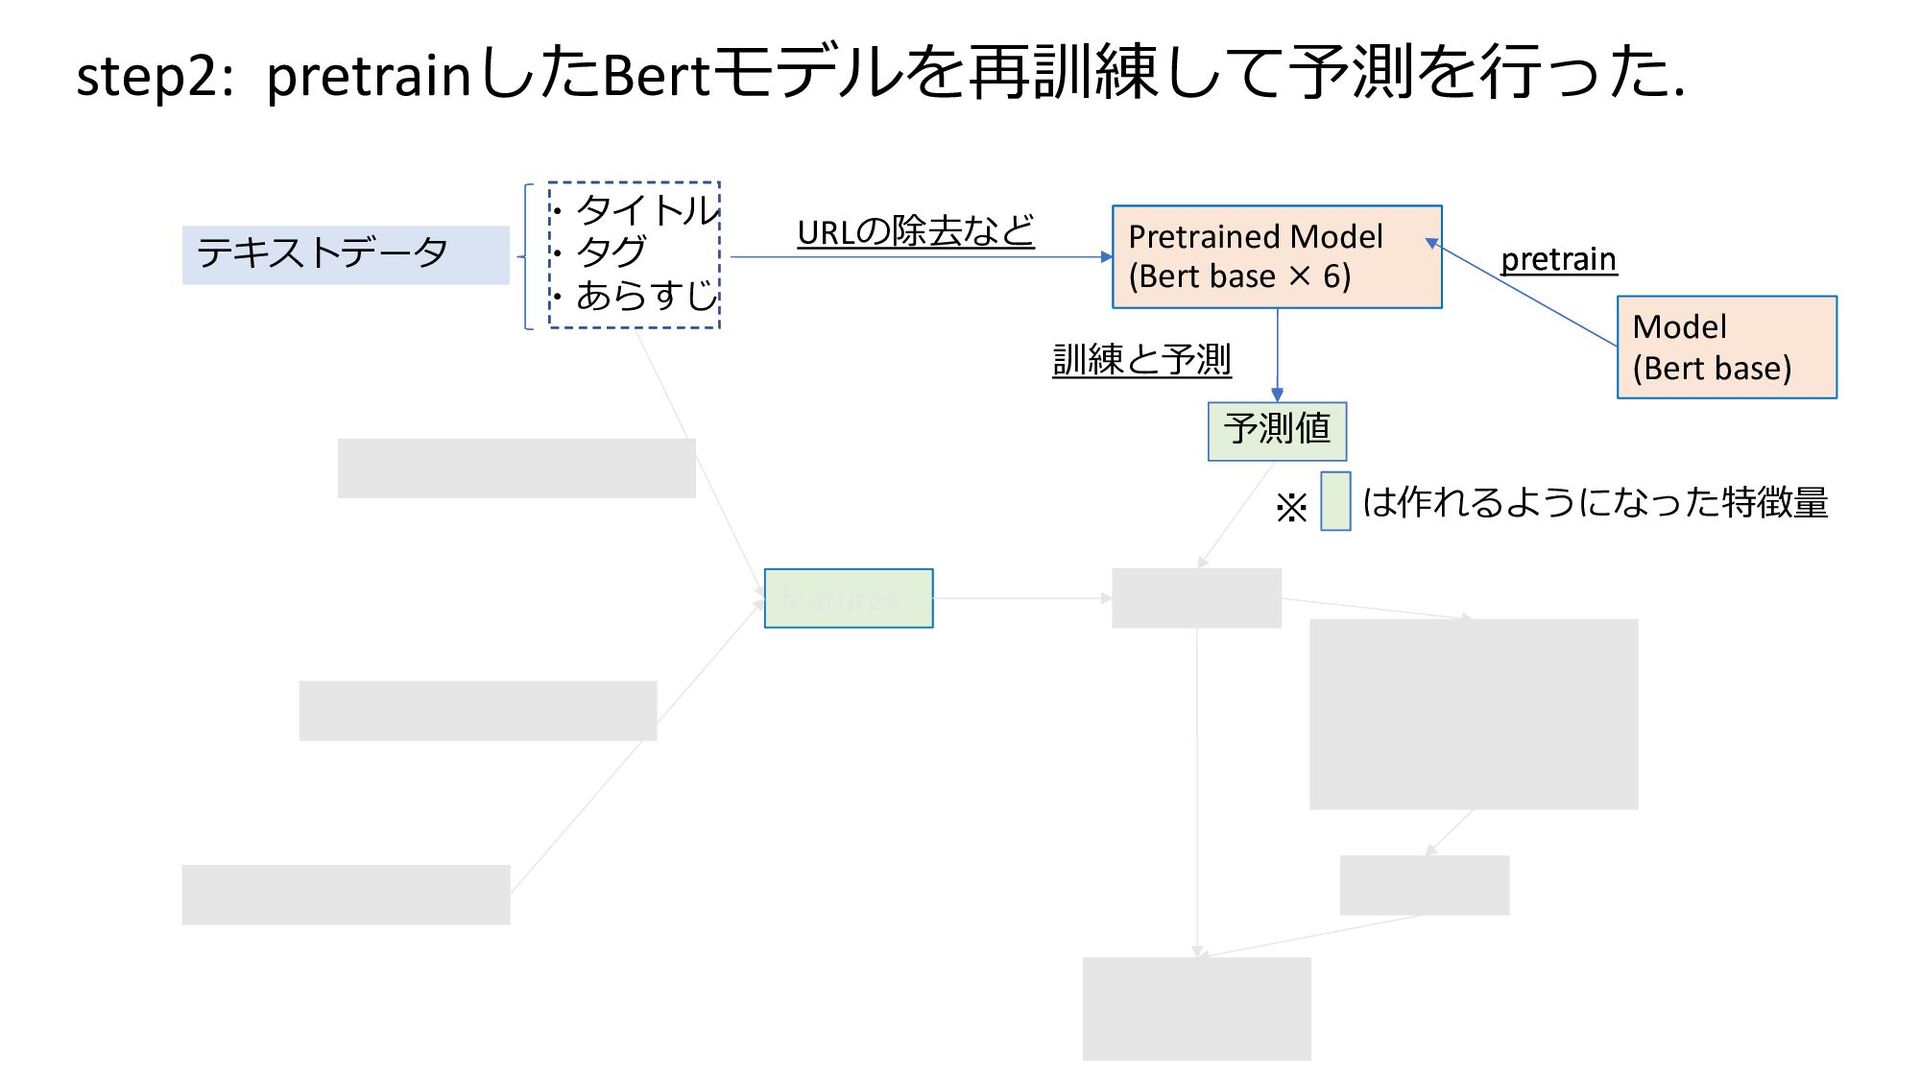
Text data Categorical data Pretrained Model (Bert base × 6)
features Model (CatBoost) (Binary ×2 RMSE ×3 MulI RMSE ×1) Final Model (CatBoost) features features feature engineering Model (Bert base) pretrain feature engineering は作れるようになった特徴量 ※ テキストデータ ・タイトル ・タグ ・あらすじ Pretrained Model (Bert base × 6) Model (Bert base) pretrain 予測値 訓練と予測 URLの除去など step2: pretrainしたBertモデルを再訓練して予測を⾏った. -
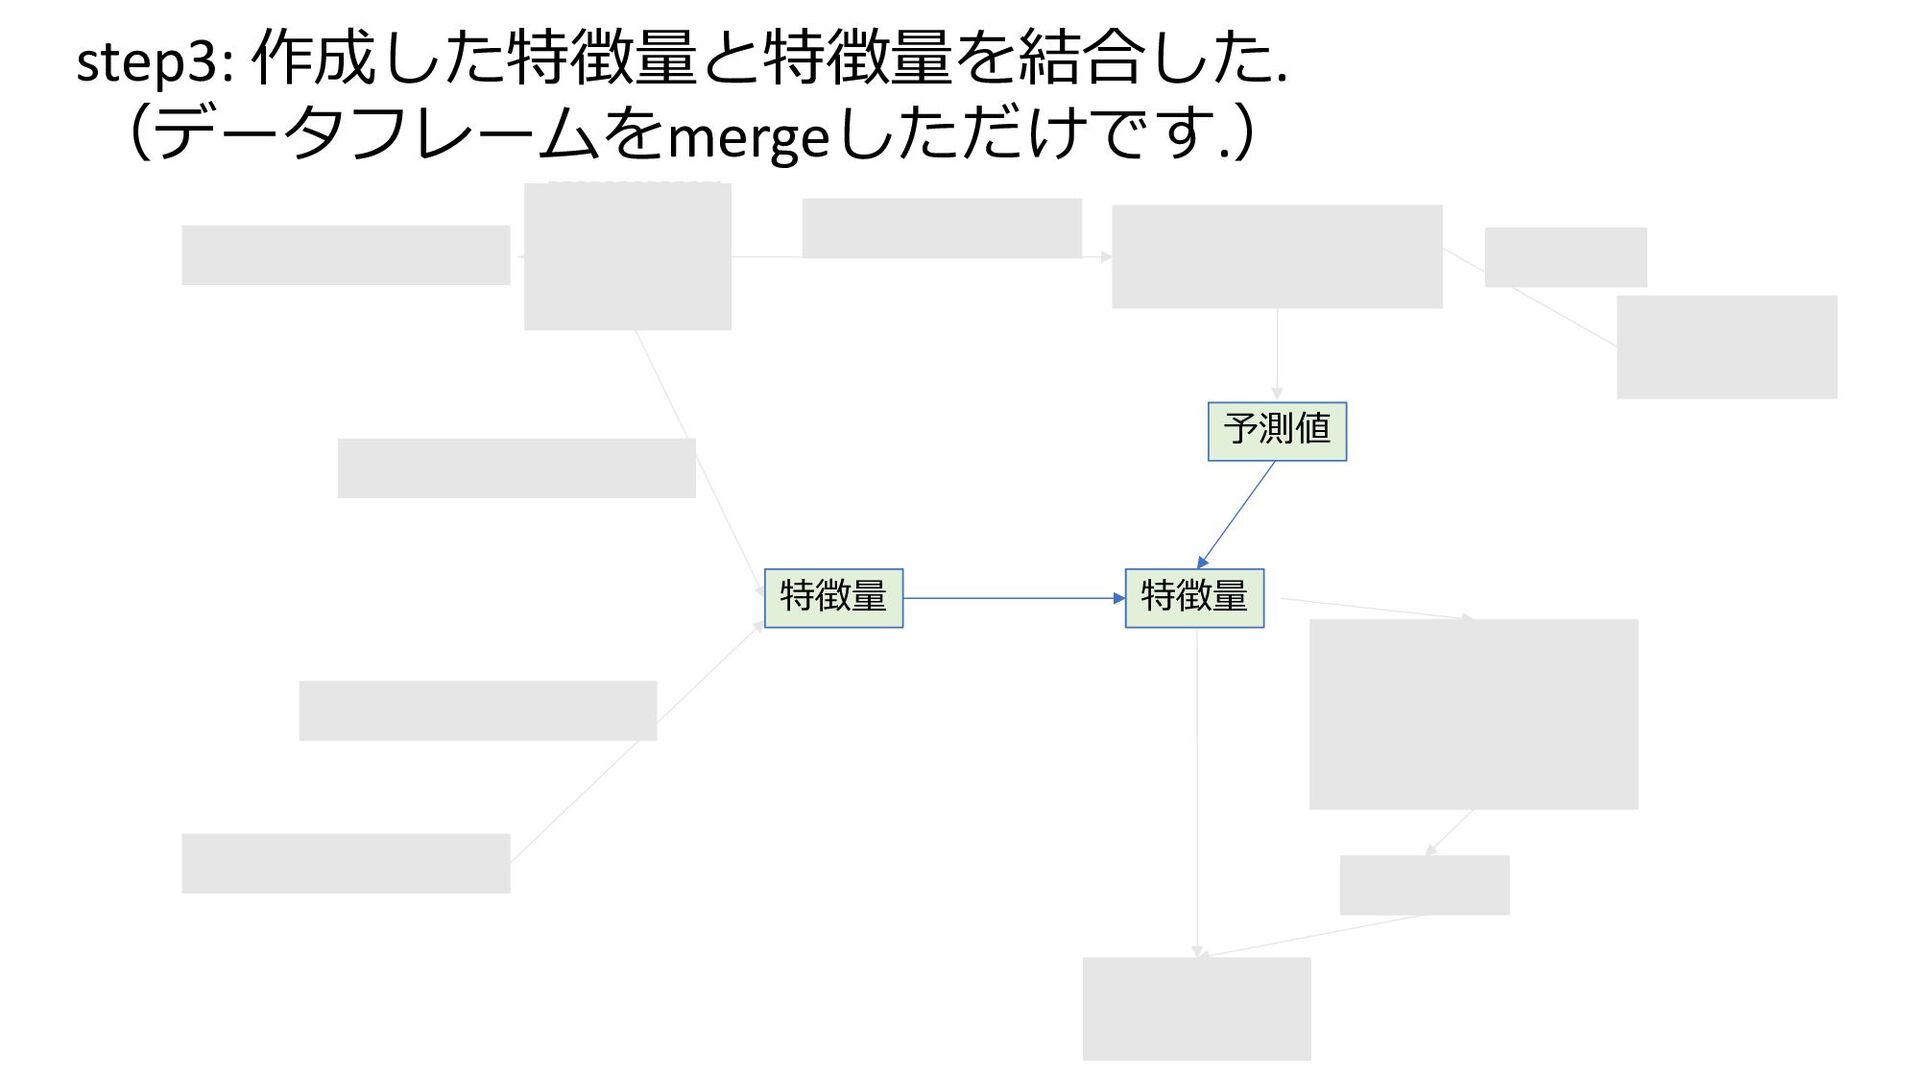
Text data Categorical dat ・title ・keyword ・story Pretrained Model (Bert
base × 6) Model (CatBoost) (Binary ×2 RMSE ×3 MulI RMSE ×1) Final Model (CatBoost) features preprocess feature engineering Model (Bert base) pretrain feature engineering 特徴量 特徴量 予測値 step3: 作成した特徴量と特徴量を結合した. (データフレームをmergeしただけです.) -
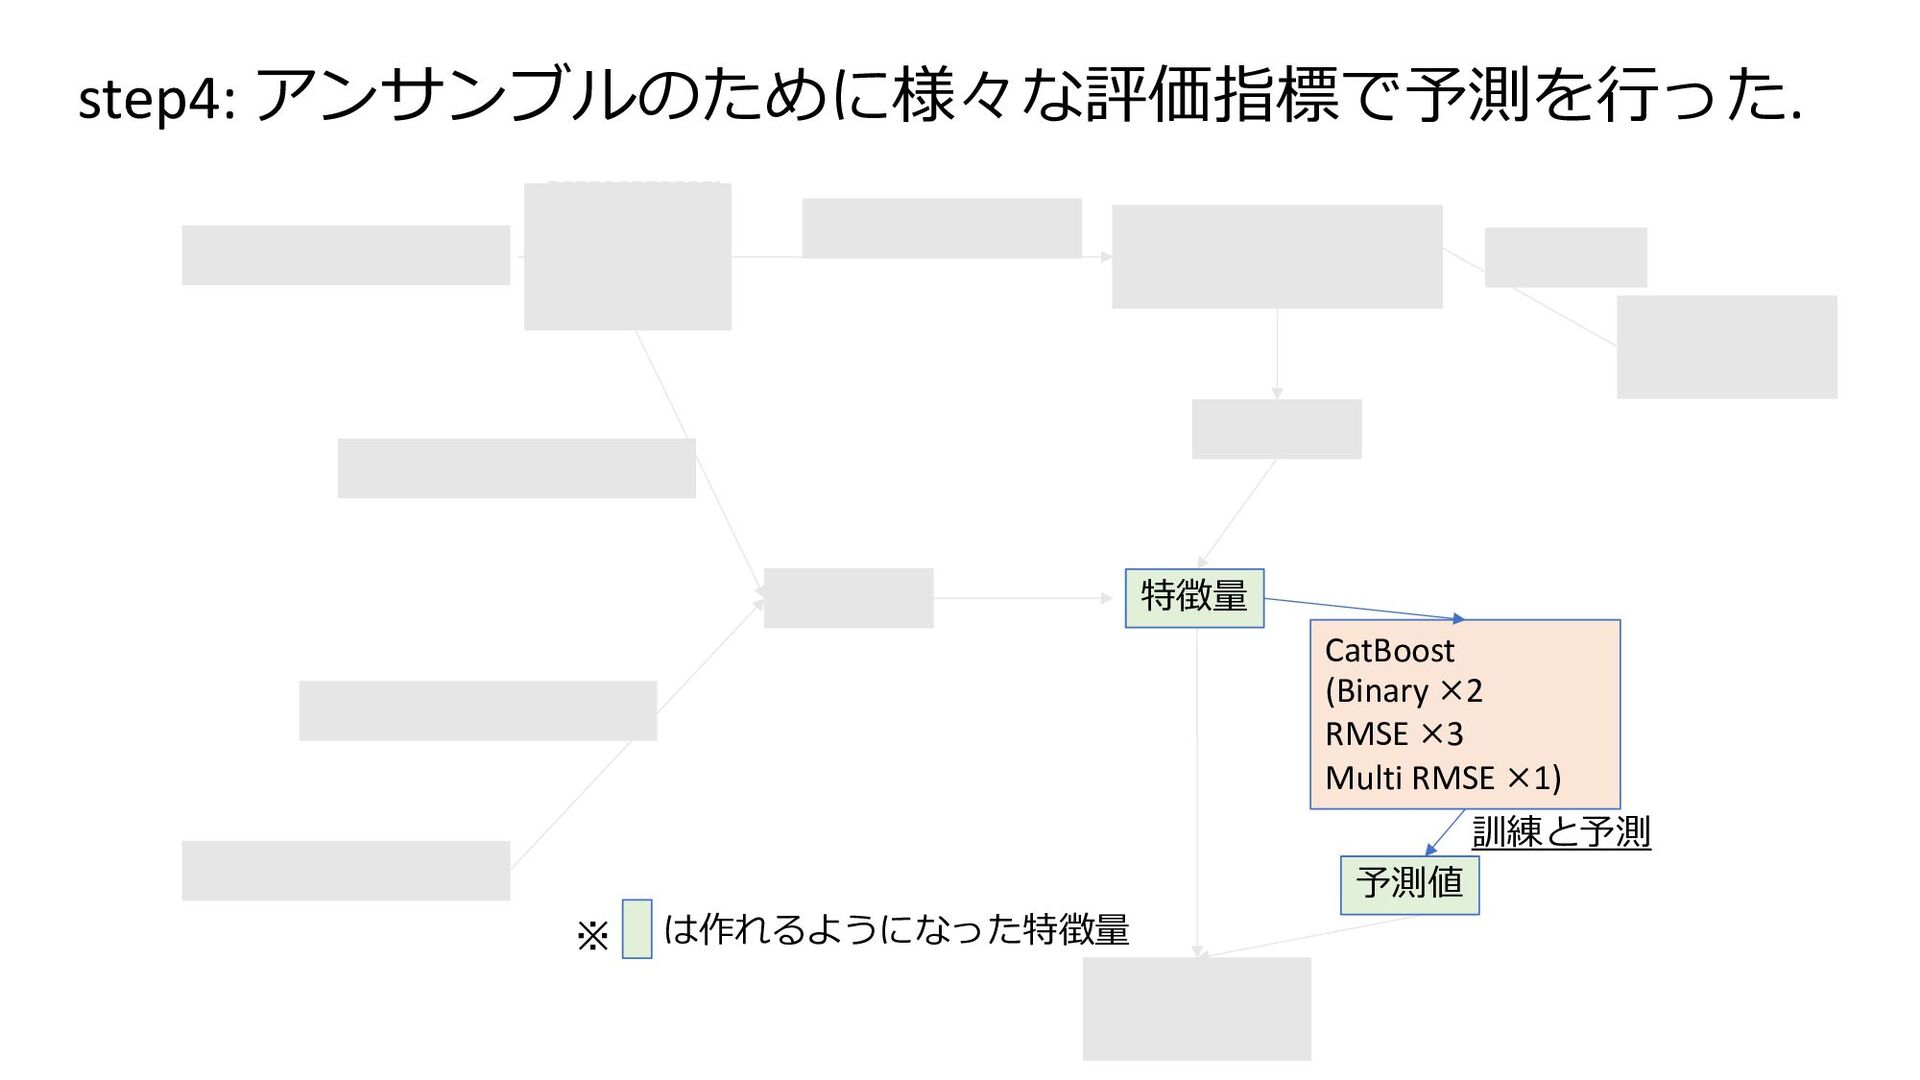
Text data Categorical data ・title ・keyword ・story Pretrained Model (Bert
base × 6) features CatBoost (Binary ×2 RMSE ×3 Multi RMSE ×1) Final Model (CatBoost) preprocess feature engineering Model (Bert base) pretrain features feature engineering は作れるようになった特徴量 ※ 特徴量 訓練と予測 予測値 step4: アンサンブルのために様々な評価指標で予測を⾏った. -
Text data Categorical data ・title ・keyword ・story Pretrained Model (Bert
base × 6) features Model (CatBoost) (Binary ×2 RMSE ×3 Multi RMSE ×1) Final Model (CatBoost) preprocess feature engineering Model (Bert base) pretrain features feature engineering は作れるようになった特徴量 ※ 予測値 特徴量 訓練と最終予測 step5: 全ての特徴量を⽤いて訓練と予測を⾏った. -
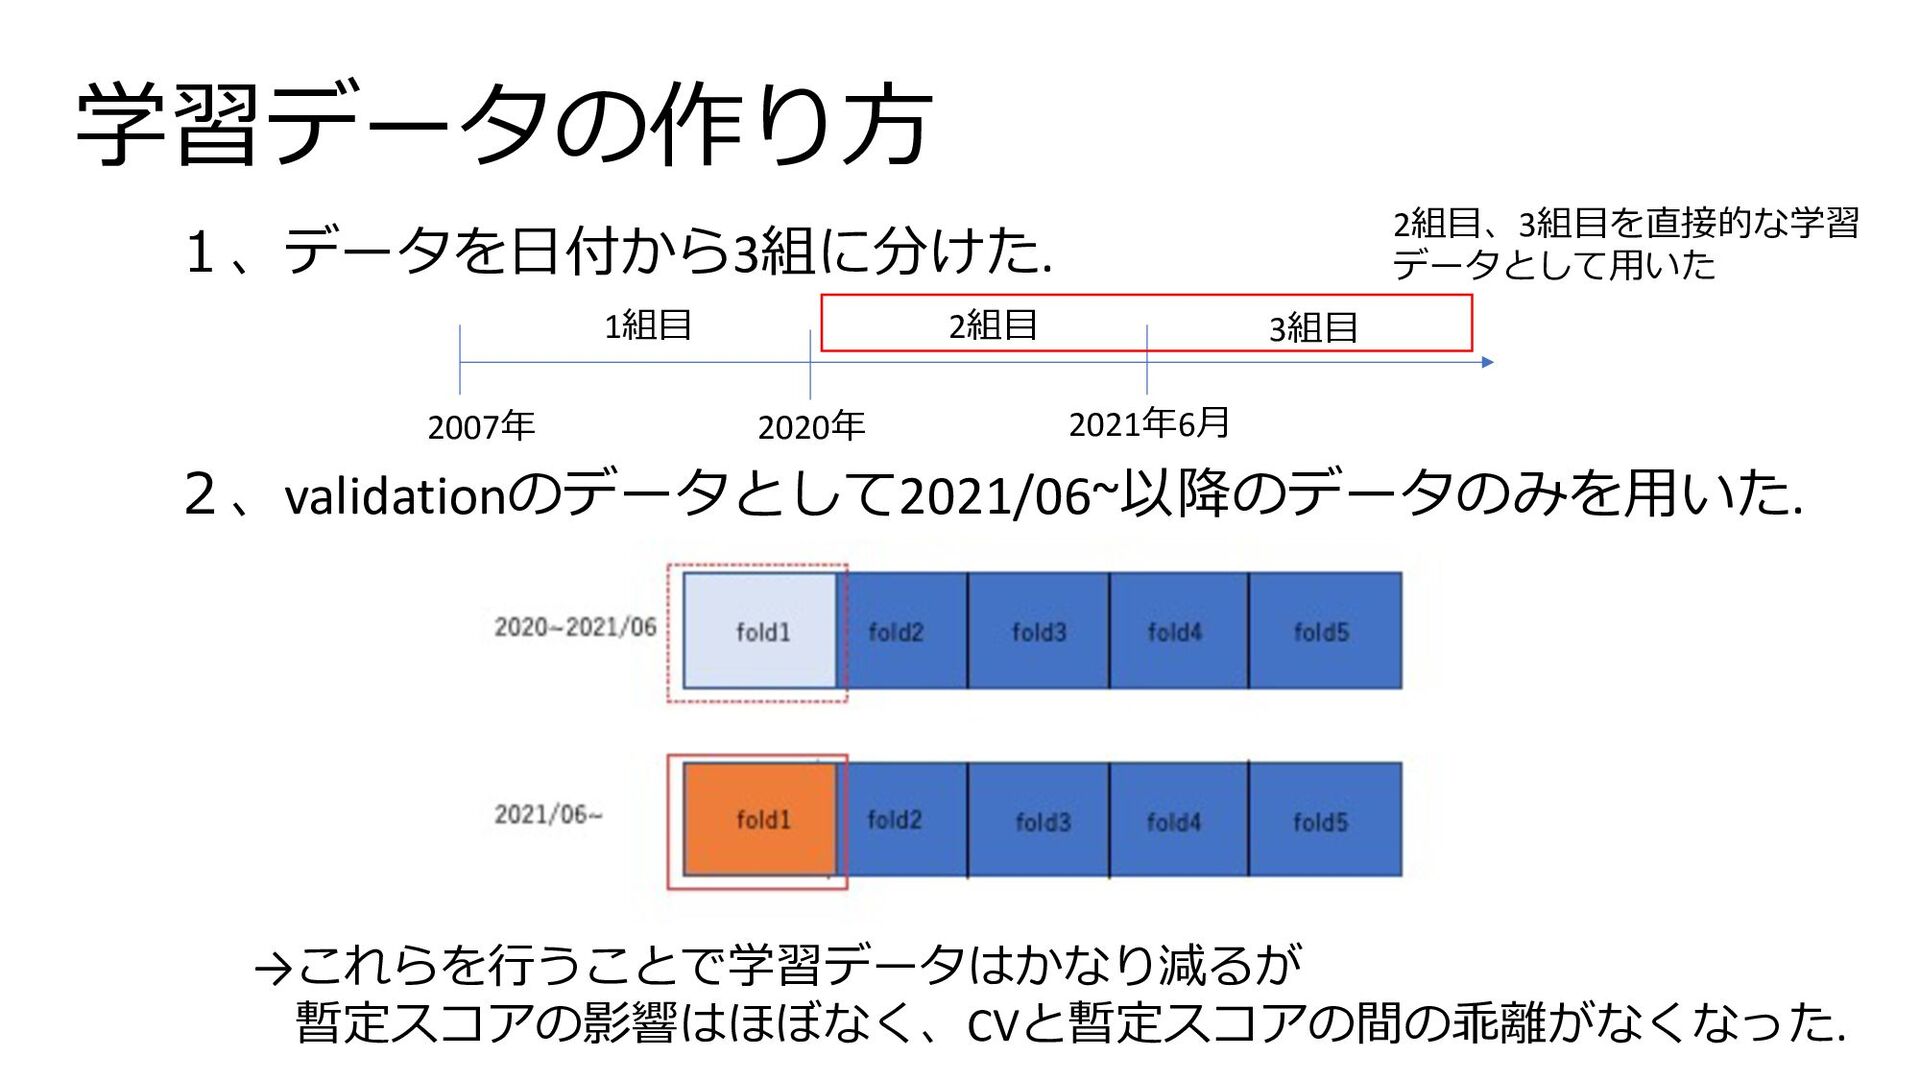
学習データの作り⽅ 1、データを⽇付から3組に分けた. 2、validationのデータとして2021/06~以降のデータのみを⽤いた. 2020年 2021年6⽉ 2007年 1組⽬ 2組⽬ 3組⽬ 2組⽬、3組⽬を直接的な学習
データとして⽤いた →これらを⾏うことで学習データはかなり減るが 暫定スコアの影響はほぼなく、CVと暫定スコアの間の乖離がなくなった. -
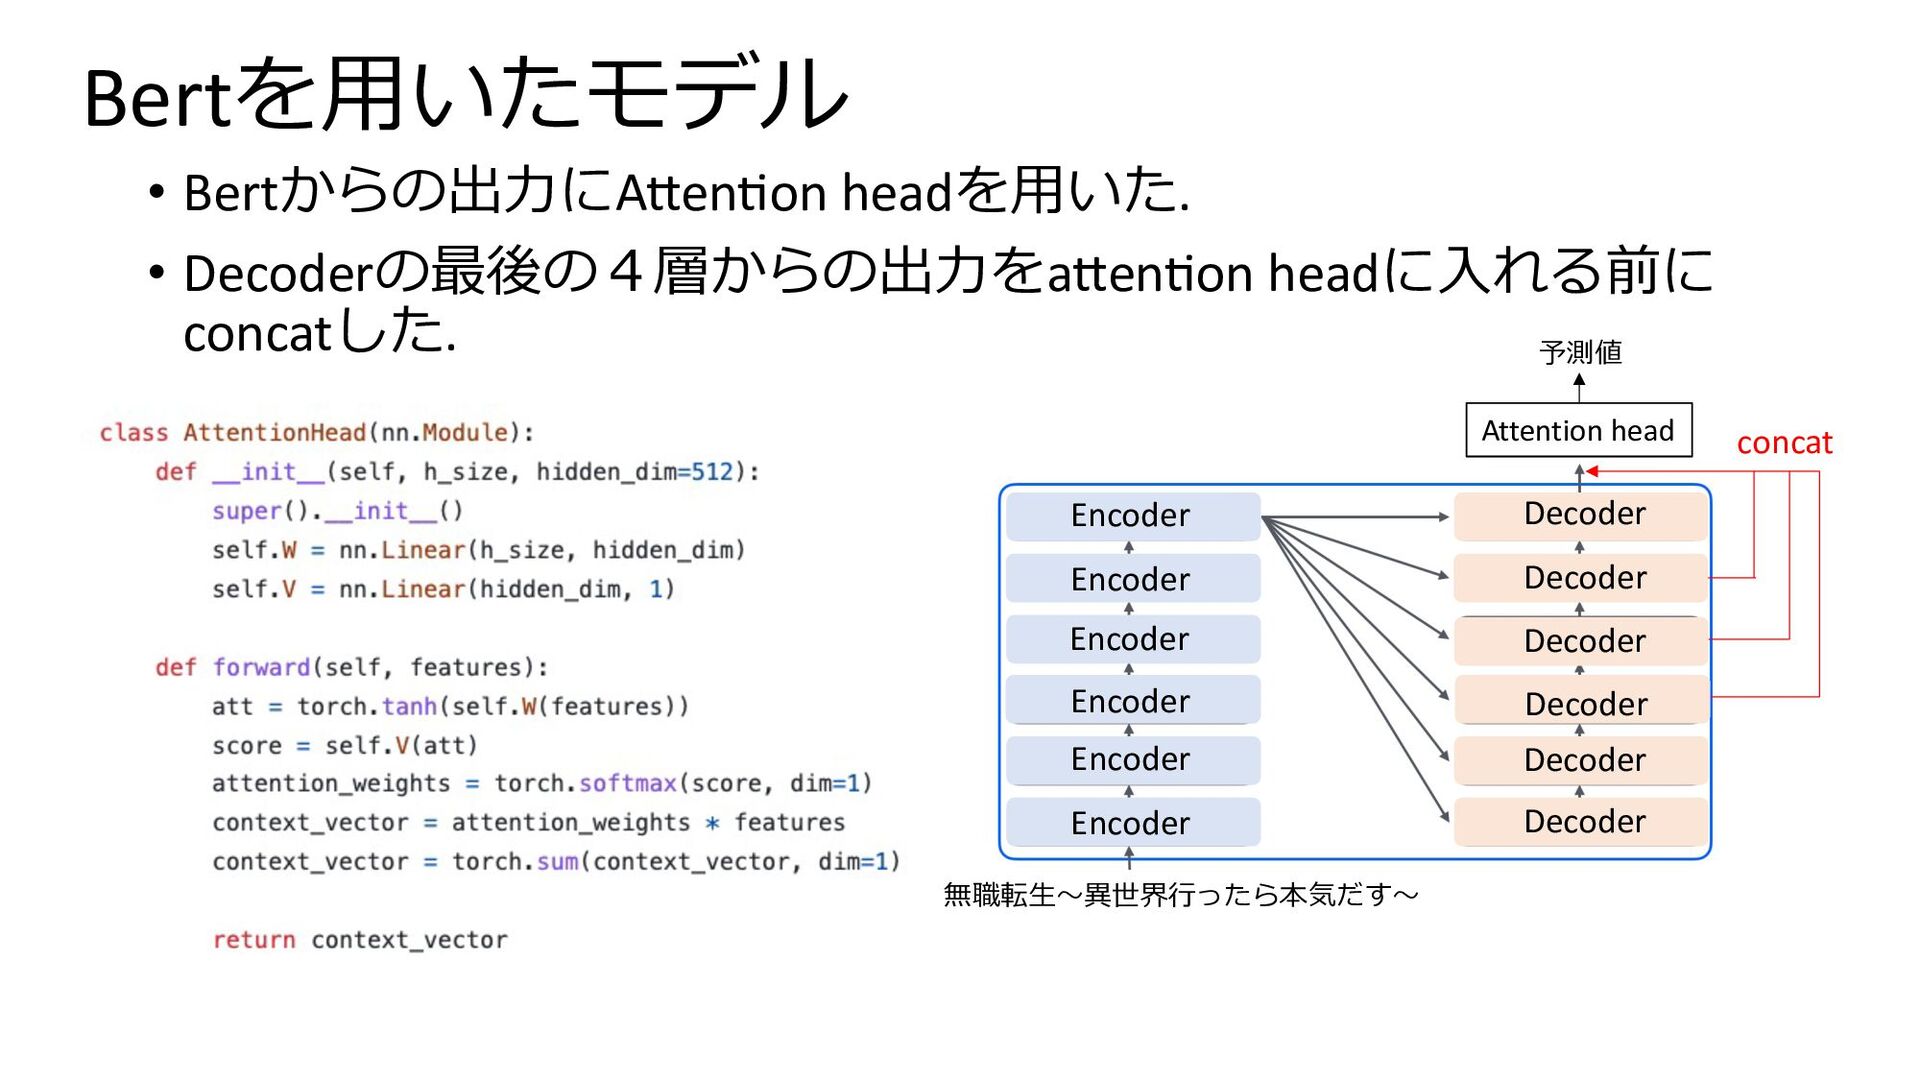
concat Bertを⽤いたモデル • Bertからの出⼒にAJenKon headを⽤いた. • Decoderの最後の4層からの出⼒をaJenKon headに⼊れる前に concatした. 予測値
無職転⽣〜異世界⾏ったら本気だす〜 Attention head Encoder Encoder Encoder Encoder Encoder Encoder Decoder Decoder Decoder Decoder Decoder Decoder -
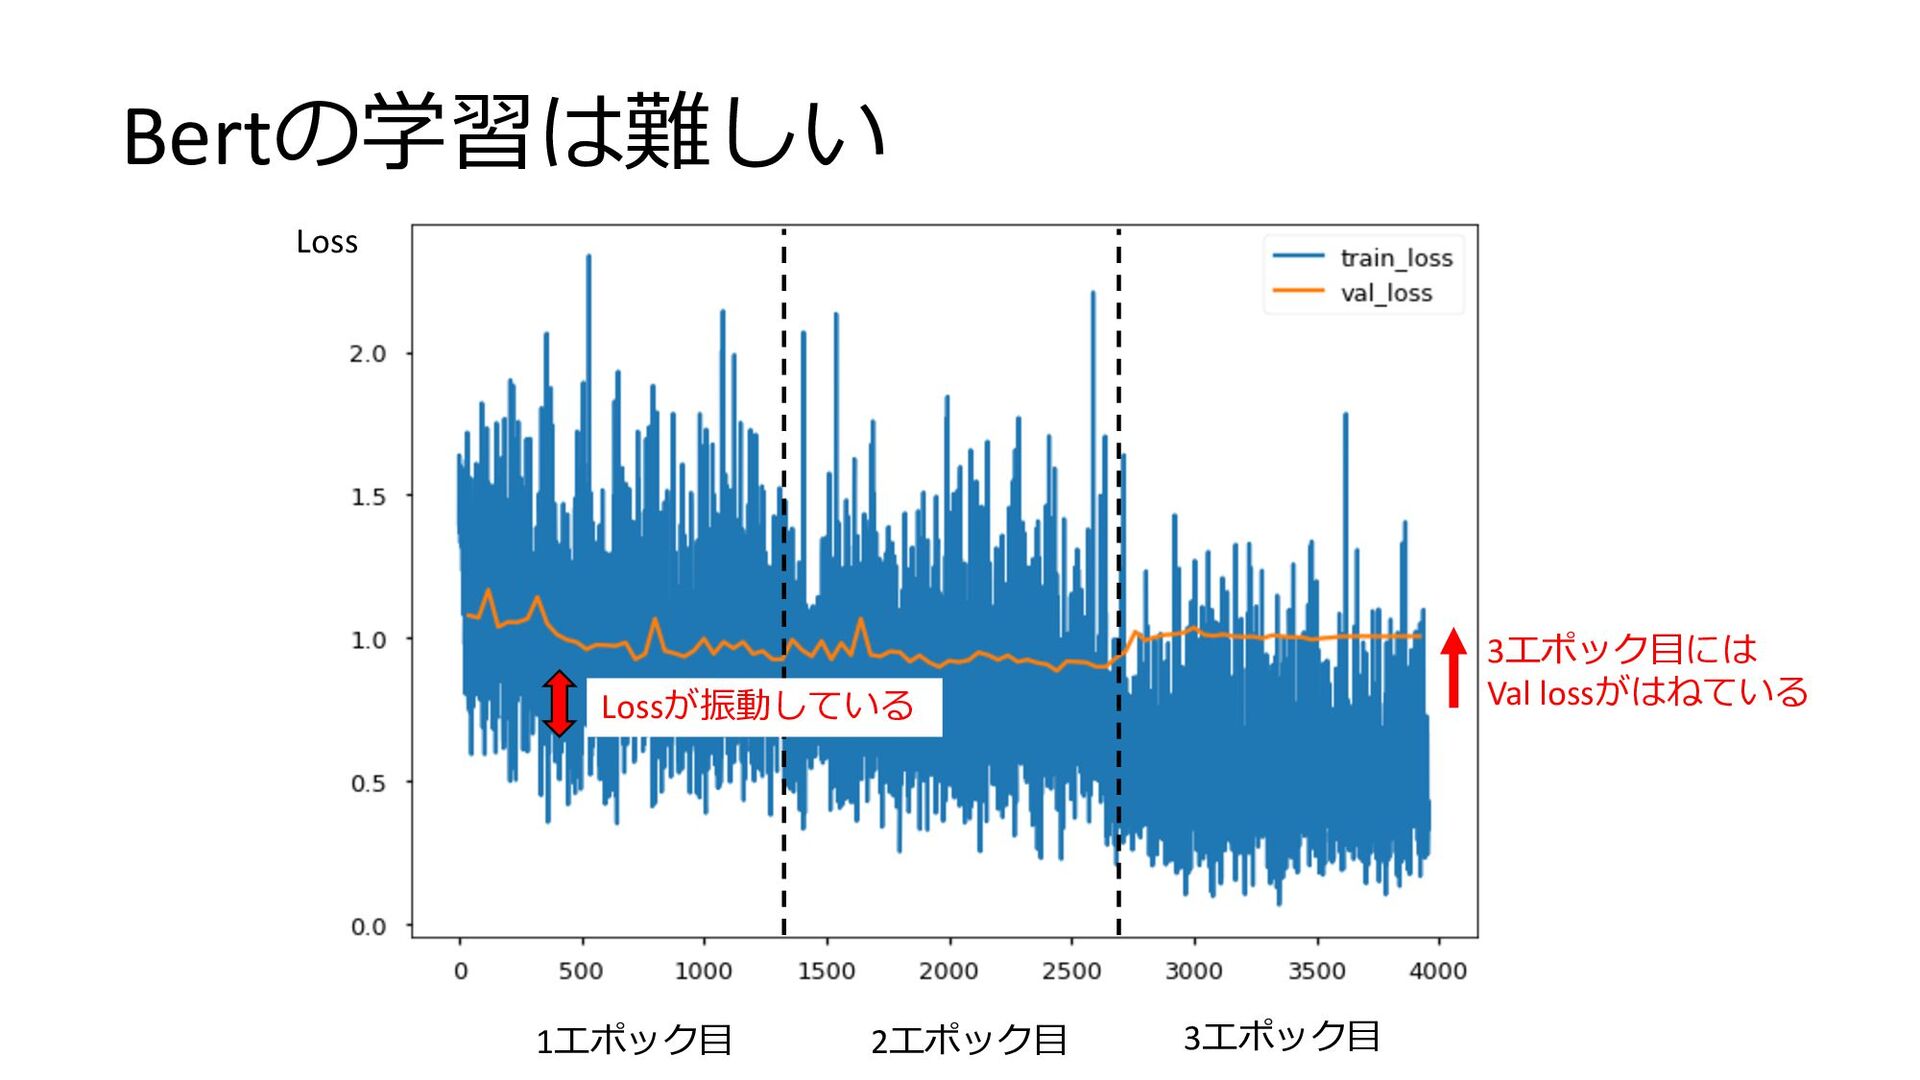
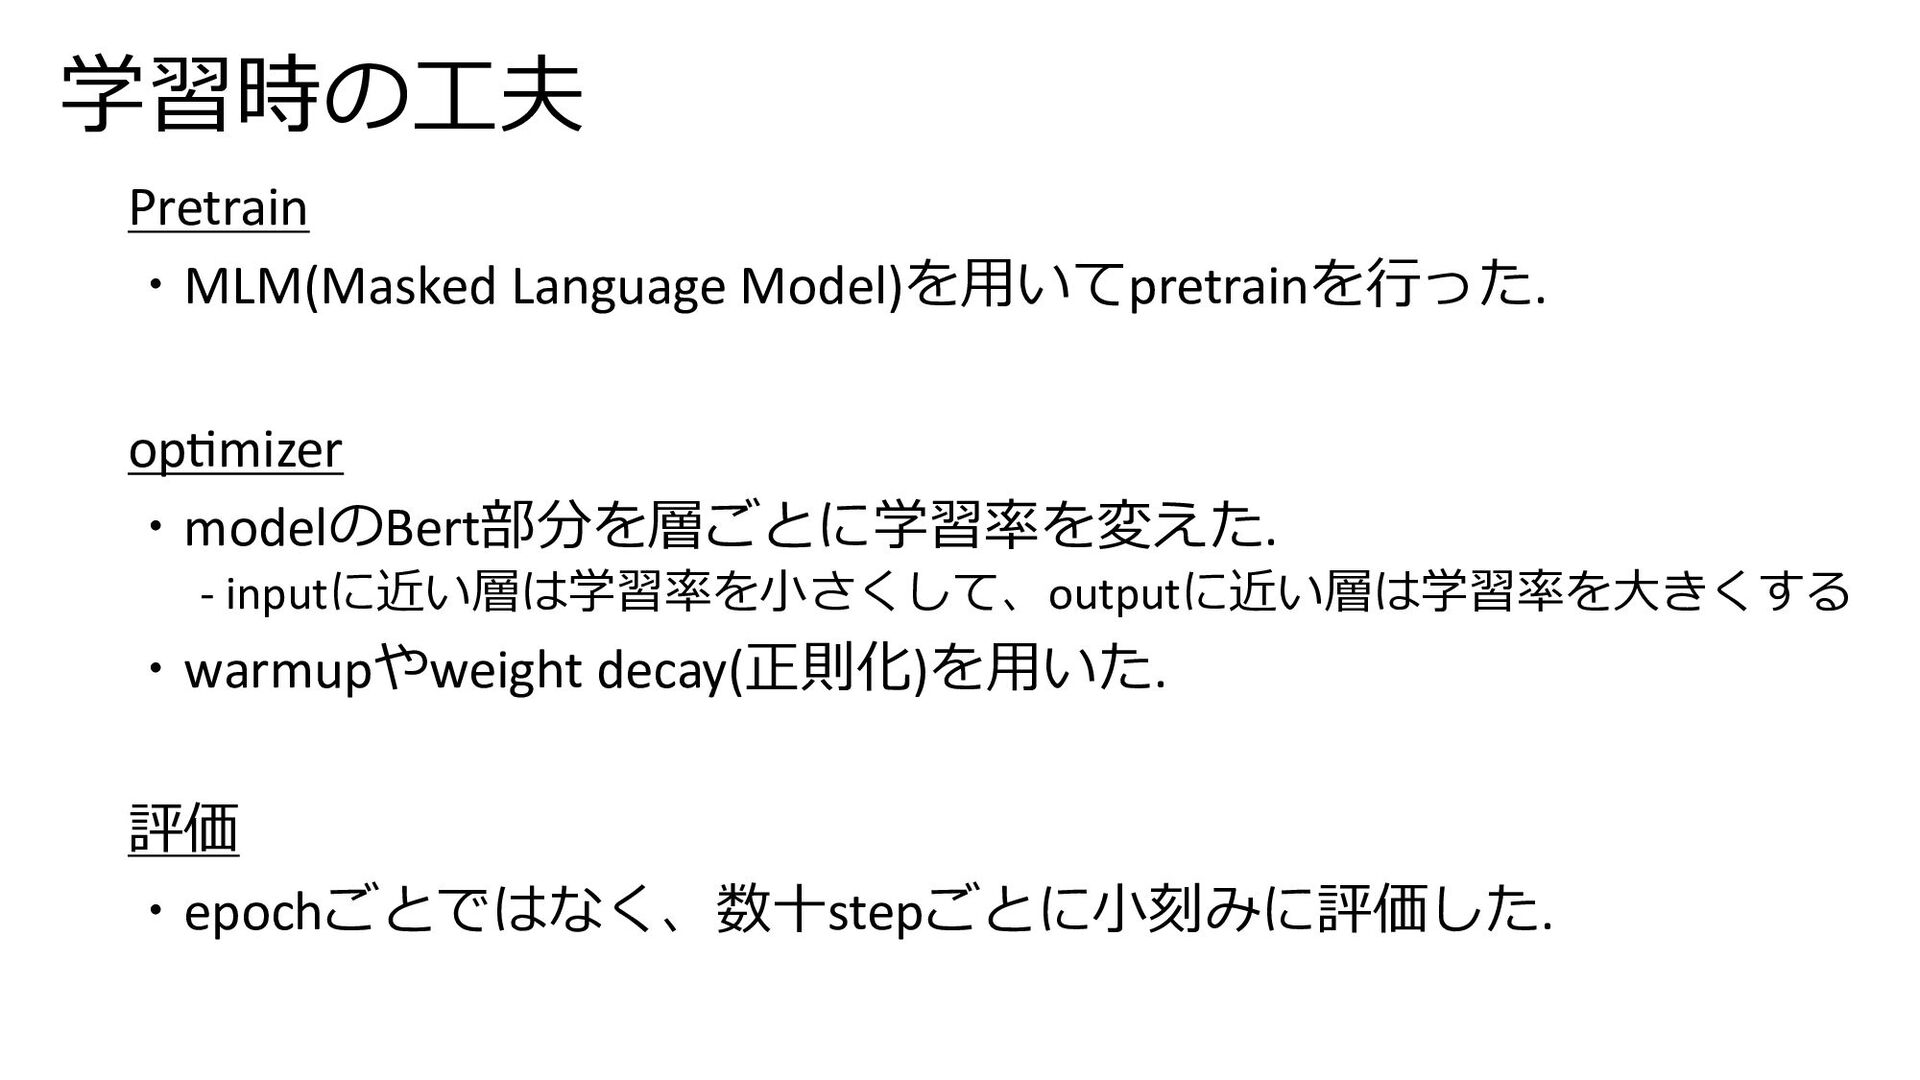
学習時の⼯夫 Pretrain ・MLM(Masked Language Model)を⽤いてpretrainを⾏った. opKmizer ・modelのBert部分を層ごとに学習率を変えた. - inputに近い層は学習率を⼩さくして、outputに近い層は学習率を⼤きくする ・warmupやweight
decay(正則化)を⽤いた. 評価 ・epochごとではなく、数⼗stepごとに⼩刻みに評価した. -
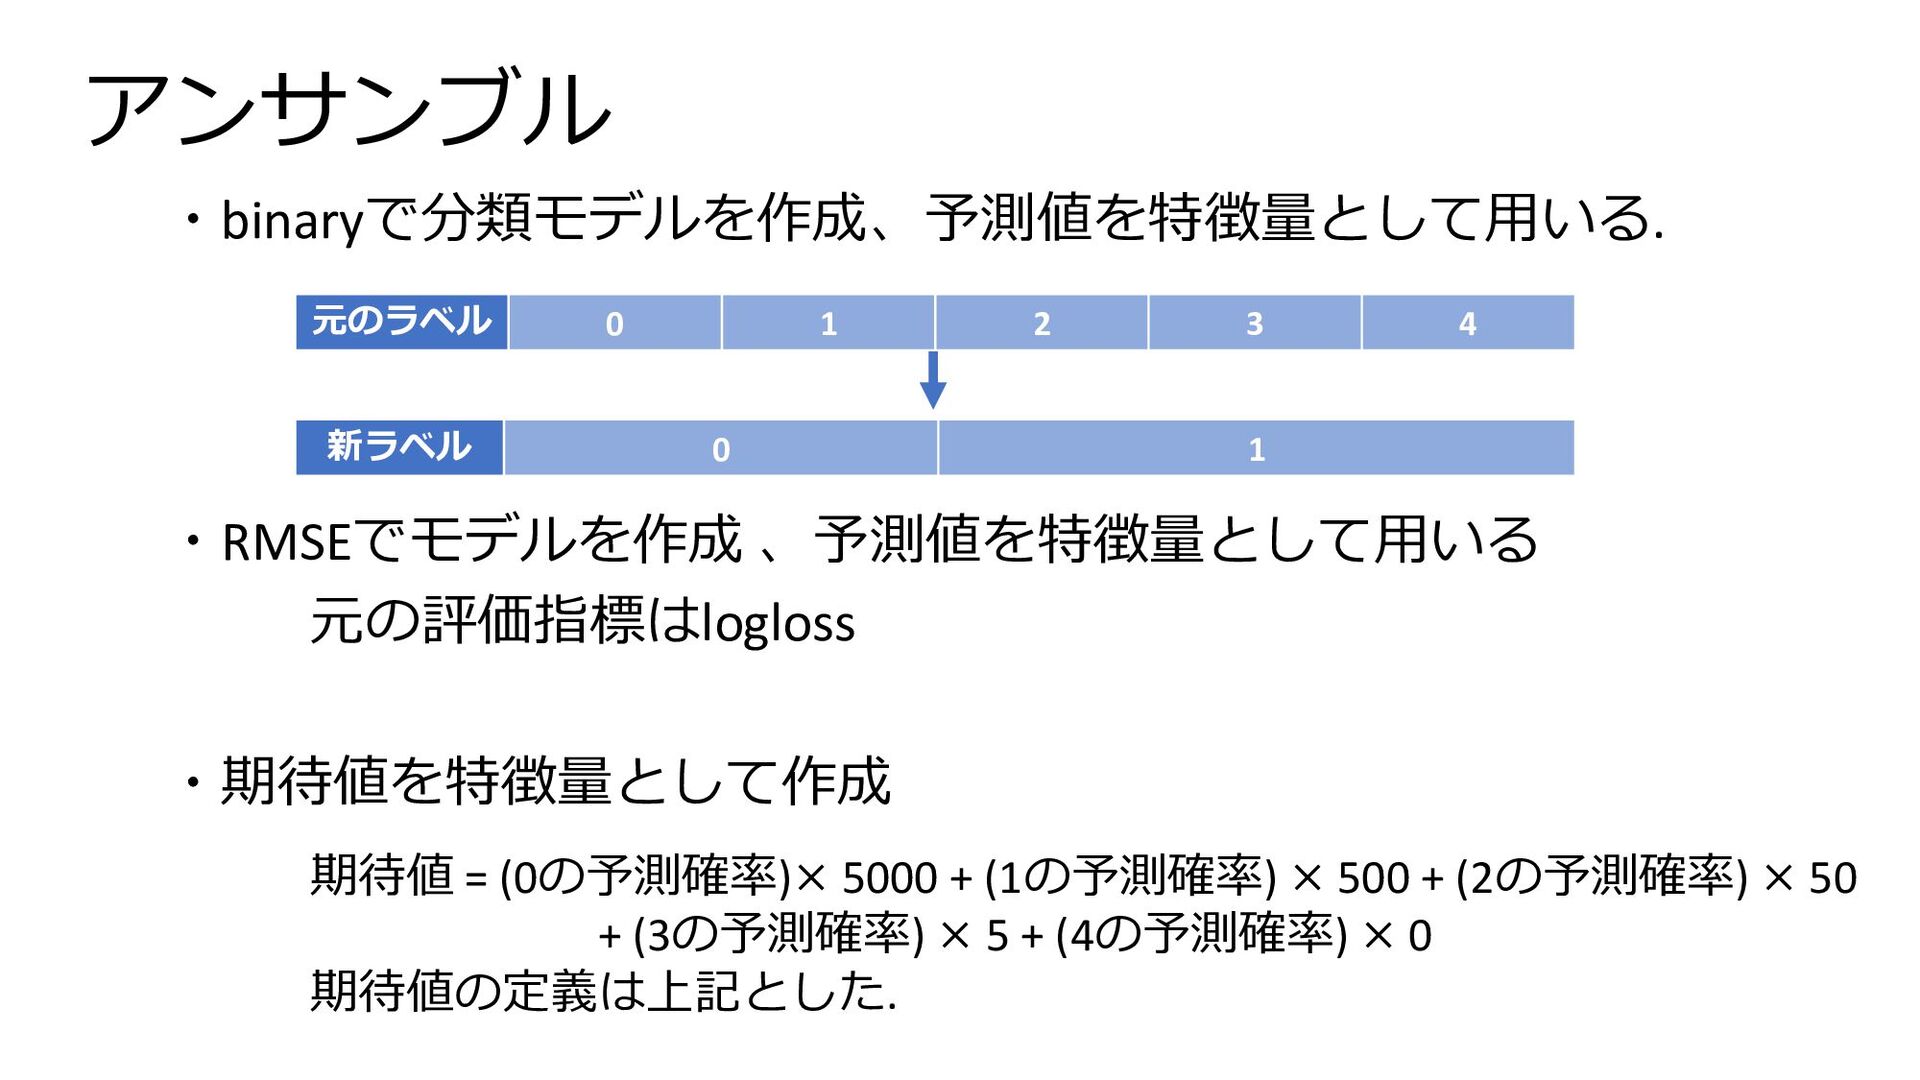
アンサンブル ・binaryで分類モデルを作成、予測値を特徴量として⽤いる. ・RMSEでモデルを作成 、予測値を特徴量として⽤いる 元の評価指標はlogloss ・期待値を特徴量として作成 元のラベル 0 1 2
3 4 新ラベル 0 1 期待値 = (0の予測確率)× 5000 + (1の予測確率) × 500 + (2の予測確率) × 50 + (3の予測確率) × 5 + (4の予測確率) × 0 期待値の定義は上記とした.