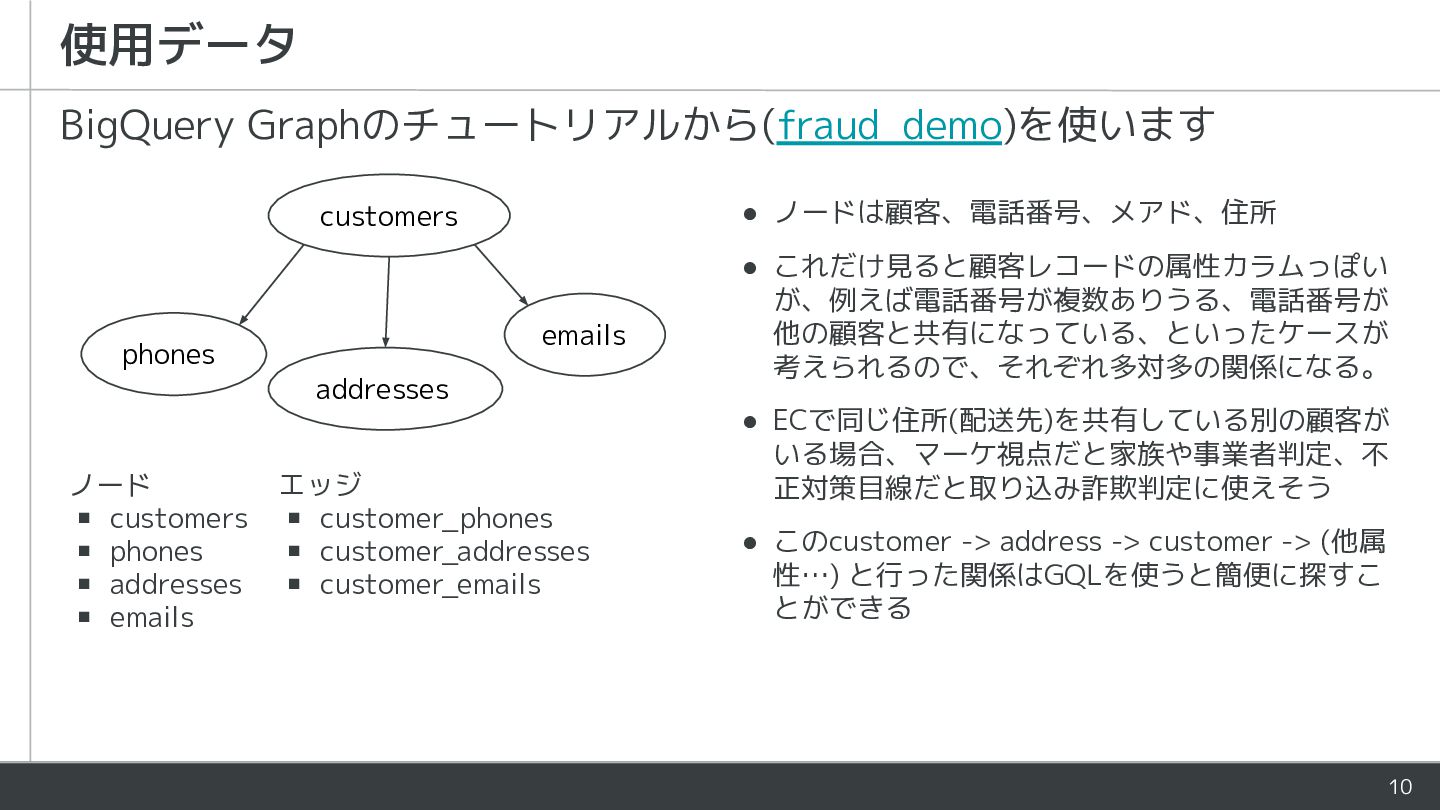
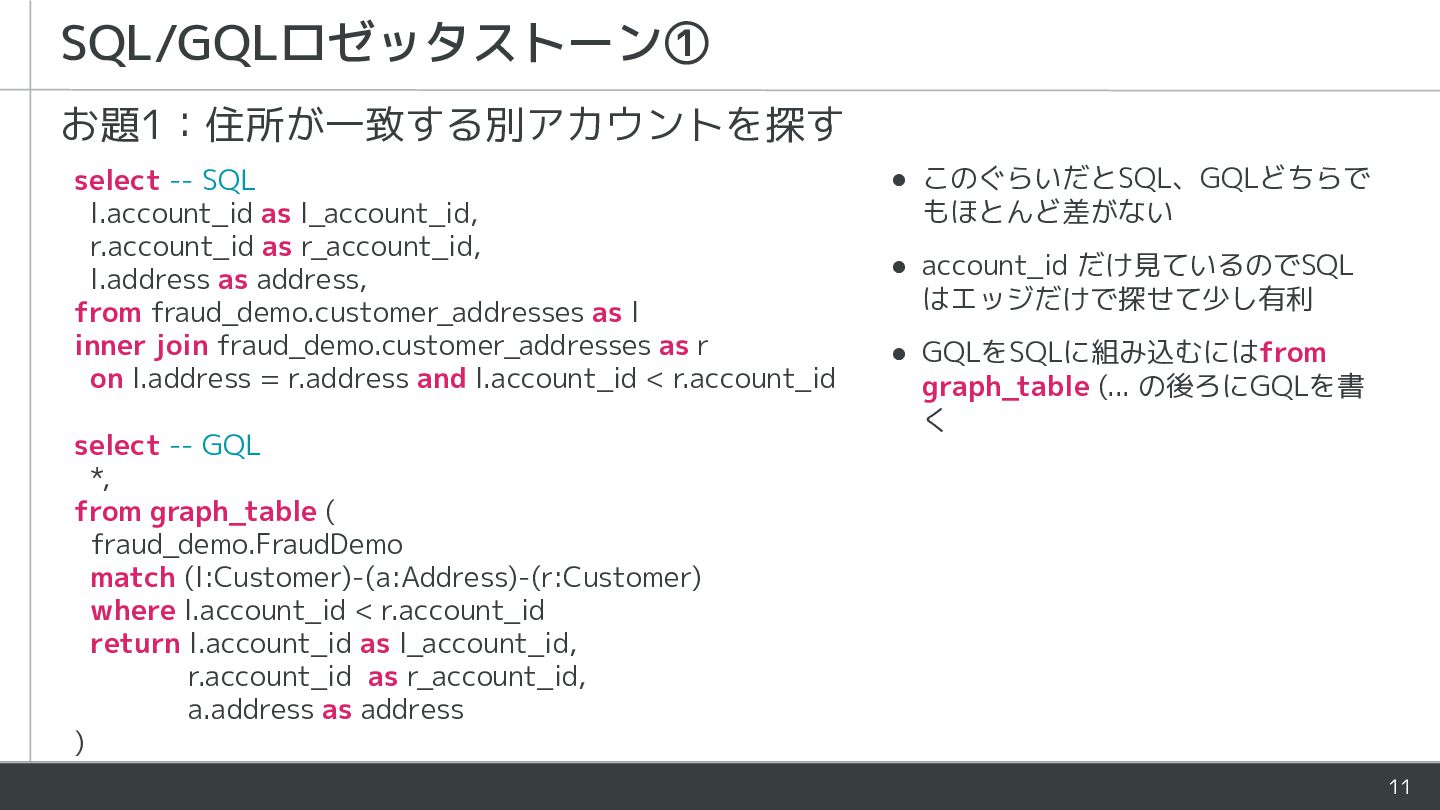
r_account_id, l.address as address, from fraud_demo.customer_addresses as l inner join fraud_demo.customer_addresses as r on l.address = r.address and l.account_id < r.account_id select -- GQL *, from graph_table ( fraud_demo.FraudDemo match (l:Customer)-(a:Address)-(r:Customer) where l.account_id < r.account_id return l.account_id as l_account_id, r.account_id as r_account_id, a.address as address ) • このぐらいだとSQL、GQLどちらで もほとんど差がない • account_id だけ見ているのでSQL はエッジだけで探せて少し有利 • GQLをSQLに組み込むにはfrom graph_table (... の後ろにGQLを書 く 11
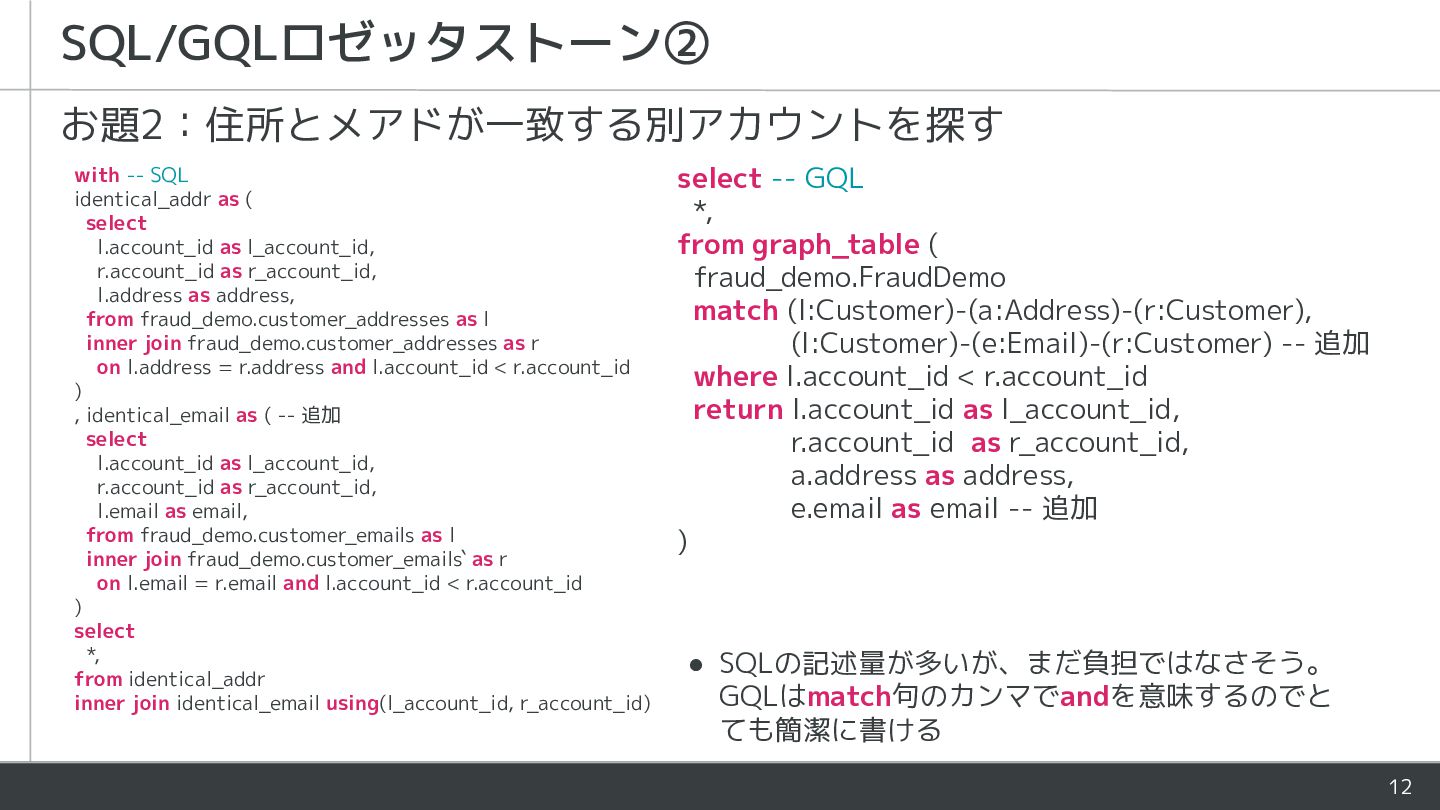
as l_account_id, r.account_id as r_account_id, l.address as address, from fraud_demo.customer_addresses as l inner join fraud_demo.customer_addresses as r on l.address = r.address and l.account_id < r.account_id ) , identical_email as ( -- 追加 select l.account_id as l_account_id, r.account_id as r_account_id, l.email as email, from fraud_demo.customer_emails as l inner join fraud_demo.customer_emails` as r on l.email = r.email and l.account_id < r.account_id ) select *, from identical_addr inner join identical_email using(l_account_id, r_account_id) select -- GQL *, from graph_table ( fraud_demo.FraudDemo match (l:Customer)-(a:Address)-(r:Customer), (l:Customer)-(e:Email)-(r:Customer) -- 追加 where l.account_id < r.account_id return l.account_id as l_account_id, r.account_id as r_account_id, a.address as address, e.email as email -- 追加 ) • SQLの記述量が多いが、まだ負担ではなさそう。 GQLはmatch句のカンマでandを意味するのでと ても簡潔に書ける 12
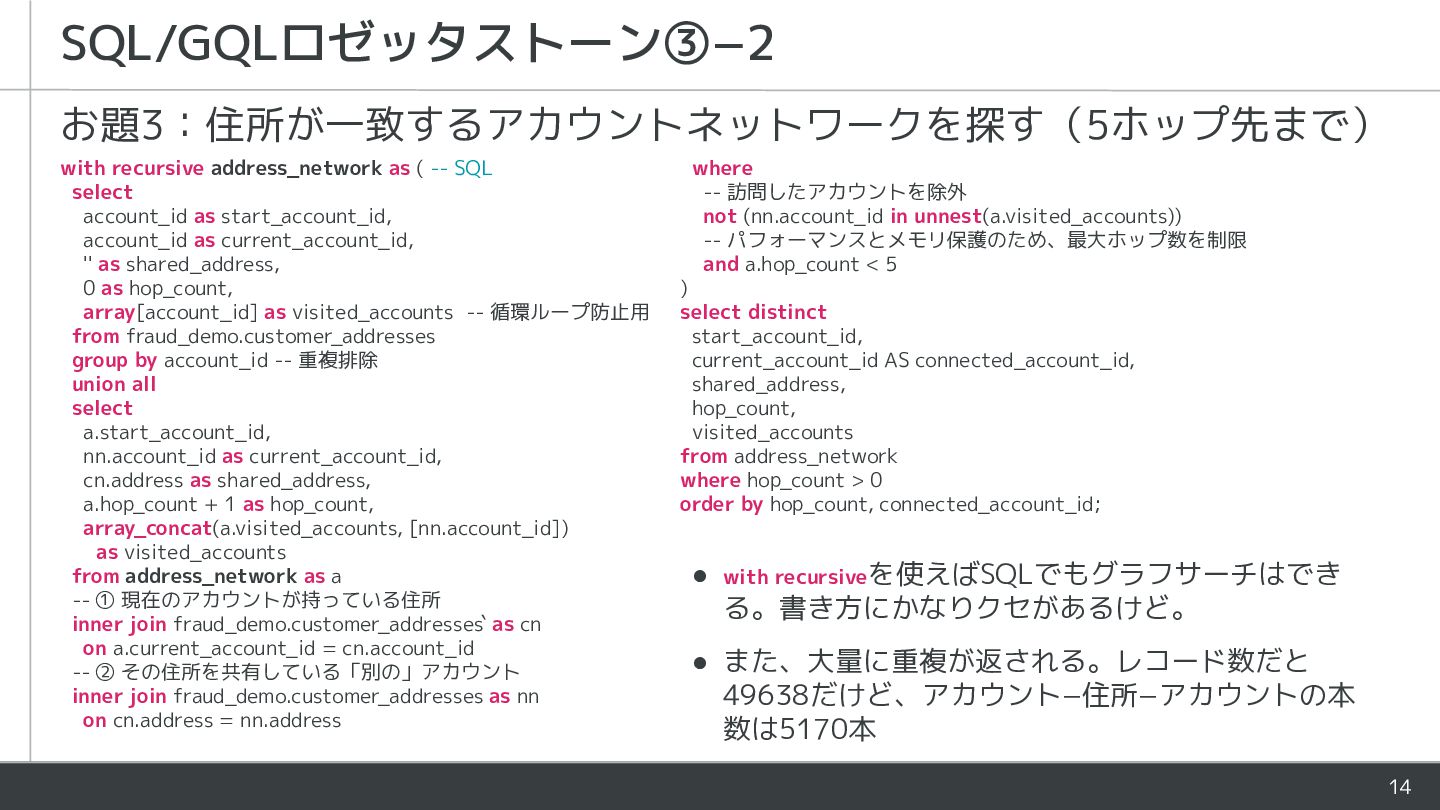
account_id as start_account_id, account_id as current_account_id, '' as shared_address, 0 as hop_count, array[account_id] as visited_accounts -- 循環ループ防止用 from fraud_demo.customer_addresses group by account_id -- 重複排除 union all select a.start_account_id, nn.account_id as current_account_id, cn.address as shared_address, a.hop_count + 1 as hop_count, array_concat(a.visited_accounts, [nn.account_id]) as visited_accounts from address_network as a -- ① 現在のアカウントが持っている住所 inner join fraud_demo.customer_addresses` as cn on a.current_account_id = cn.account_id -- ② その住所を共有している「別の」アカウント inner join fraud_demo.customer_addresses as nn on cn.address = nn.address where -- 訪問したアカウントを除外 not (nn.account_id in unnest(a.visited_accounts)) -- パフォーマンスとメモリ保護のため、最大ホップ数を制限 and a.hop_count < 5 ) select distinct start_account_id, current_account_id AS connected_account_id, shared_address, hop_count, visited_accounts from address_network where hop_count > 0 order by hop_count, connected_account_id; • with recursiveを使えばSQLでもグラフサーチはでき る。書き方にかなりクセがあるけど。 • また、大量に重複が返される。レコード数だと 49638だけど、アカウント−住所−アカウントの本 数は5170本 14
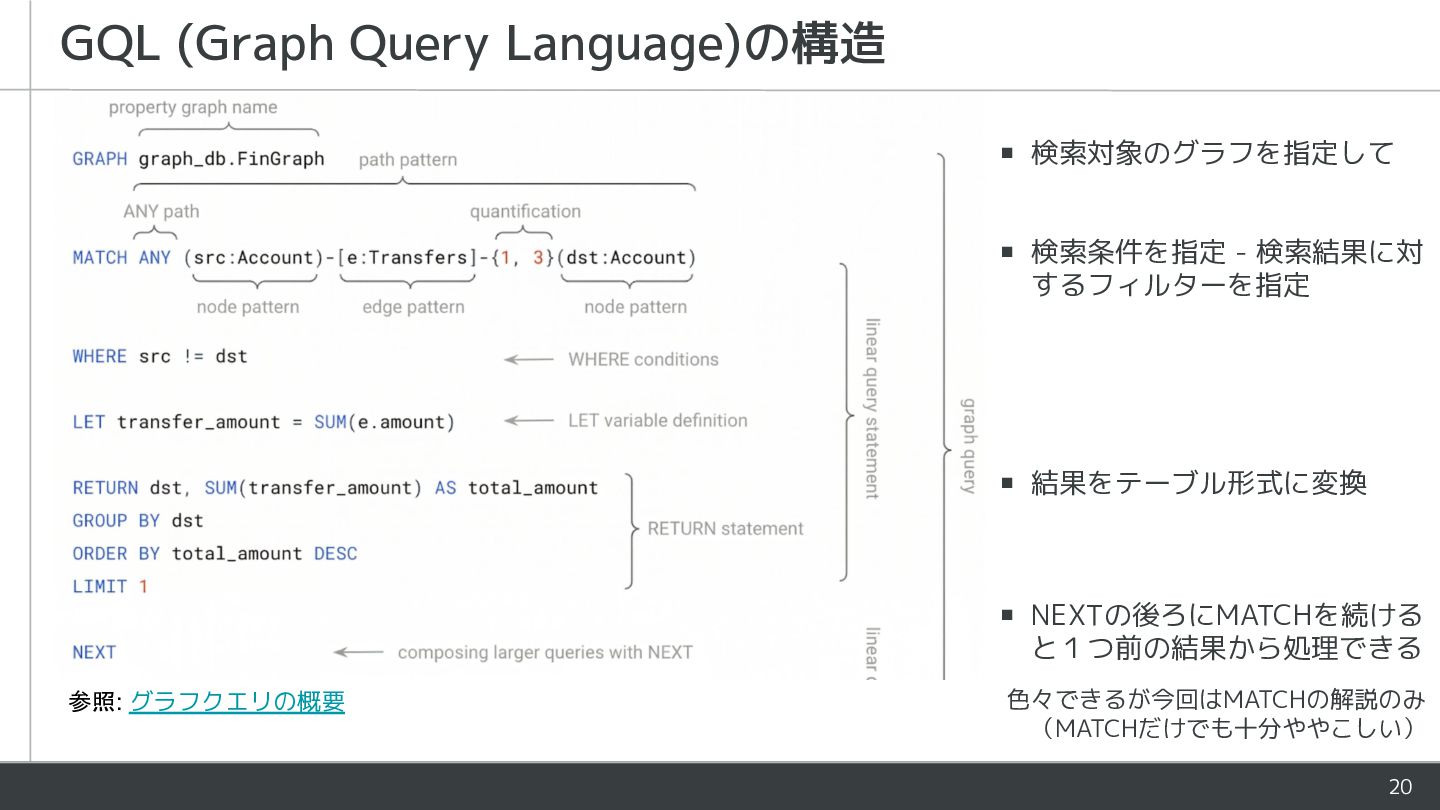
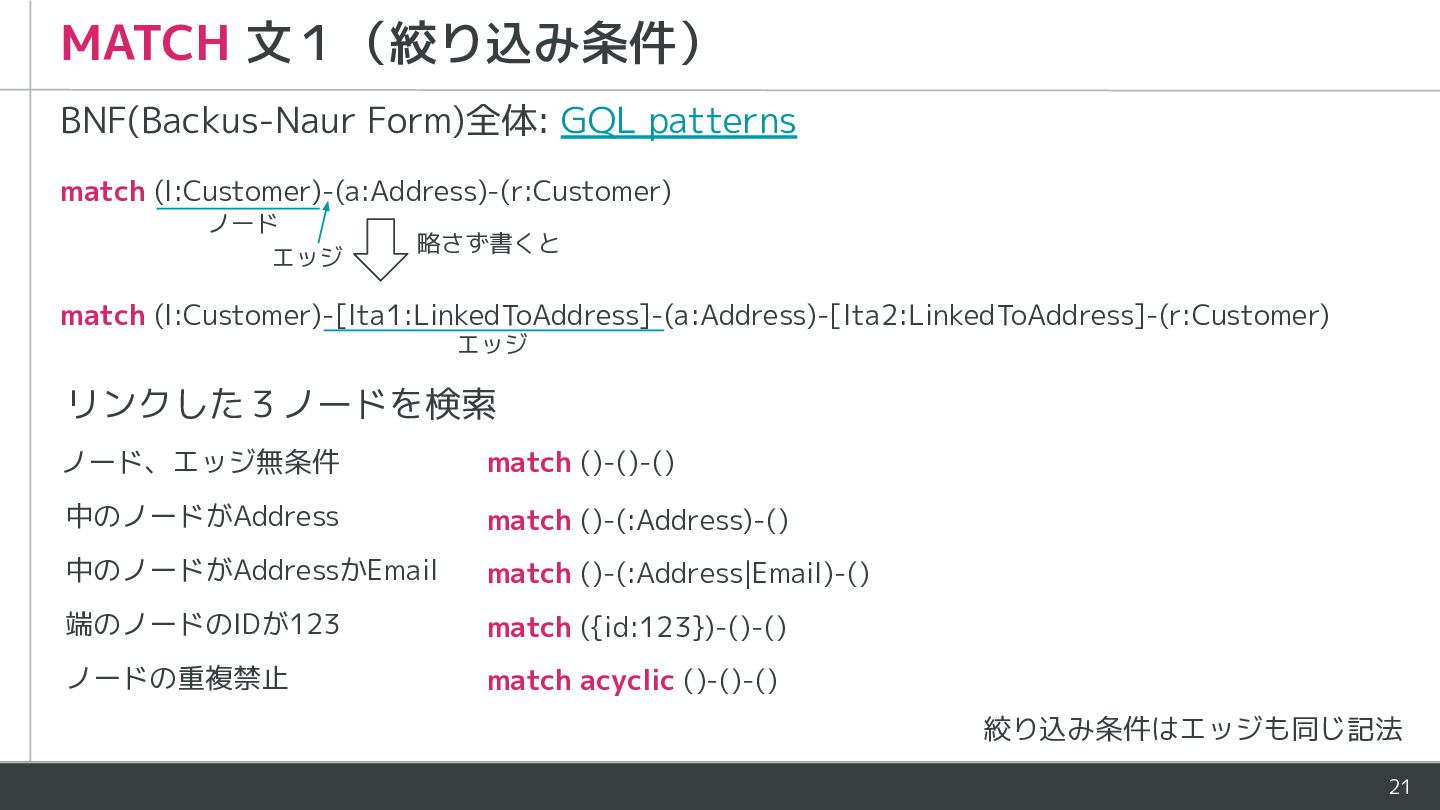
略さず書くと match (l:Customer)-[lta1:LinkedToAddress]-(a:Address)-[lta2:LinkedToAddress]-(r:Customer) エッジ リンクした3ノードを検索 ノード、エッジ無条件 match ()-()-() 中のノードがAddress match ()-(:Address)-() 中のノードがAddressかEmail match ()-(:Address|Email)-() 端のノードのIDが123 match ({id:123})-()-() ノードの重複禁止 match acyclic ()-()-() 絞り込み条件はエッジも同じ記法 21


 nishikawadaisuke
 hacobu
 har1101
 yusukeshimizu
 kworkdev
 yutanonaka
 ryotarai
 shisyu_gaku
 kitagawaz
 dip_tech
 yoshiakiyamasaki
 nasuvitz
 maimyyym
 letsgokoyo
 pauljervisheath
 jnunemaker
 erikaheidi
 pedronauck
 michielstock
 mayunak
 codingconduct
 rocio
 wayneb77
 jeffersonlam
 irinanazarova