The (unknown) collections module
Sponsored
·
 SiteGround - Reliable hosting with speed, security, and support you can count on.
→
SiteGround - Reliable hosting with speed, security, and support you can count on.
→

Share
Embed
The (unknown) collections module
Everyone knows Python's basic datatypes and their most common containers (list, tuple, dict and set).
However, few people know that they should use a deque to implement a queue, that using defaultdict their code would be cleaner and that they could be a bit more efficient using namedtuples instead of creating new classes.
This talk will review the data structures of Python's "collections" module of the standard library (namedtuple, deque, Counter, defaultdict and OrderedDict) and we will also compare them with the built-in basic datatypes.

Pablo E
November 24, 2013
Transcript
55 slides
-
{“event”: “PyCon ES 2013” “author”: “Pablo Enfedaque” “twi2er”:
“pablitoev56” The unknown COLLECTIONS module -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
Today we are going to talk about the (unknown) collections module And also about built-‐‑in containers Welcome! -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
“This module implements specialized container datatypes providing alternatives to Python’s general purpose built-‐‑in containers, dict, list, set, and tuple” The collections module -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
Let’s start with Python’s most used container -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
dict >>> d = {'a': 1, 'b': 2, 'c': 3} >>> d['b'] 2 >>> d['d'] = 4 >>> d {'d': 4, 'b': 2, 'c': 3, 'a': 1} >>> d['e'] Traceback (most recent call last): File "<stdin>", line 1, in <module> KeyError: 'e' >>> print(d.get('e')) None >>> d.get('e', 5) 5 -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
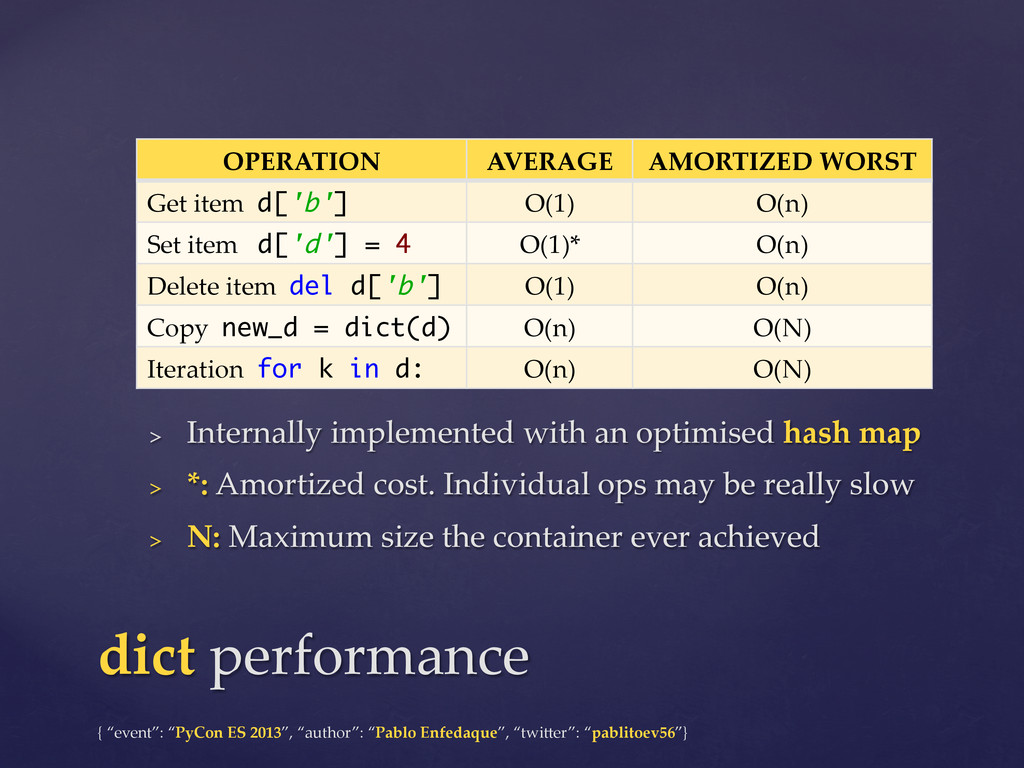
OPERATION AVERAGE AMORTIZED WORST Get item d['b'] O(1) O(n) Set item d['d'] = 4 O(1)* O(n) Delete item del d['b'] O(1) O(n) Copy new_d = dict(d) O(n) O(N) Iteration for k in d: O(n) O(N) dict performance > Internally implemented with an optimised hash map > *: Amortized cost. Individual ops may be really slow > N: Maximum size the container ever achieved -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
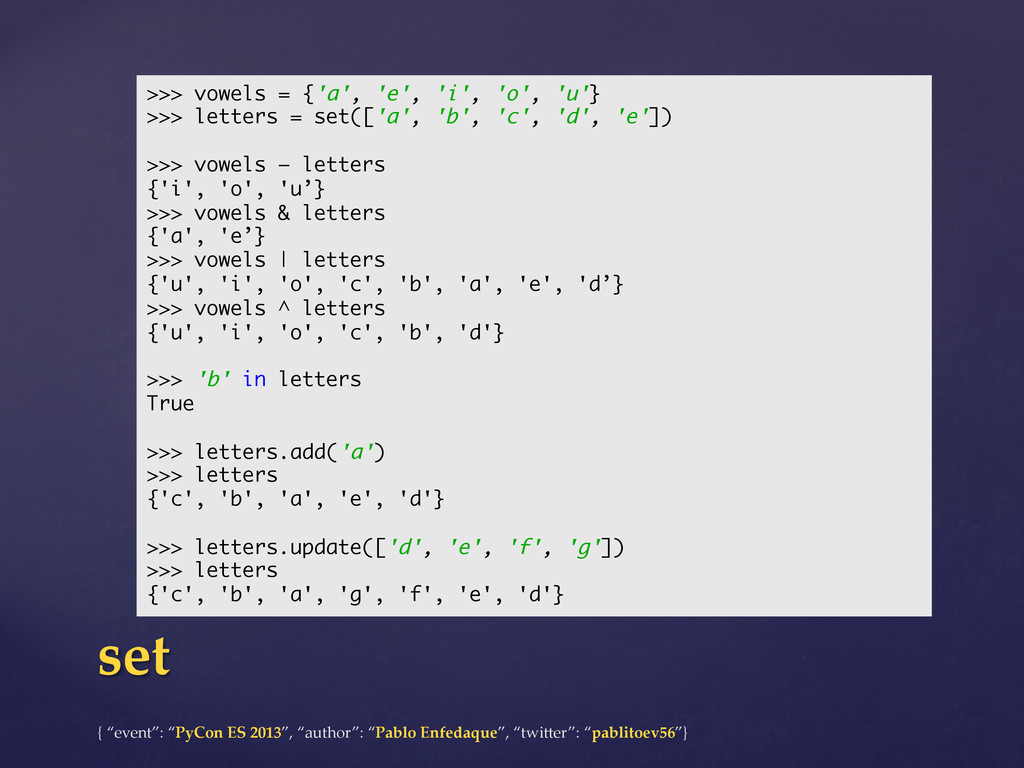
set >>> vowels = {'a', 'e', 'i', 'o', 'u'} >>> letters = set(['a', 'b', 'c', 'd', 'e']) >>> vowels – letters {'i', 'o', 'u’} >>> vowels & letters {'a', 'e’} >>> vowels | letters {'u', 'i', 'o', 'c', 'b', 'a', 'e', 'd’} >>> vowels ^ letters {'u', 'i', 'o', 'c', 'b', 'd'} >>> 'b' in letters True >>> letters.add('a') >>> letters {'c', 'b', 'a', 'e', 'd'} >>> letters.update(['d', 'e', 'f', 'g']) >>> letters {'c', 'b', 'a', 'g', 'f', 'e', 'd'} -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
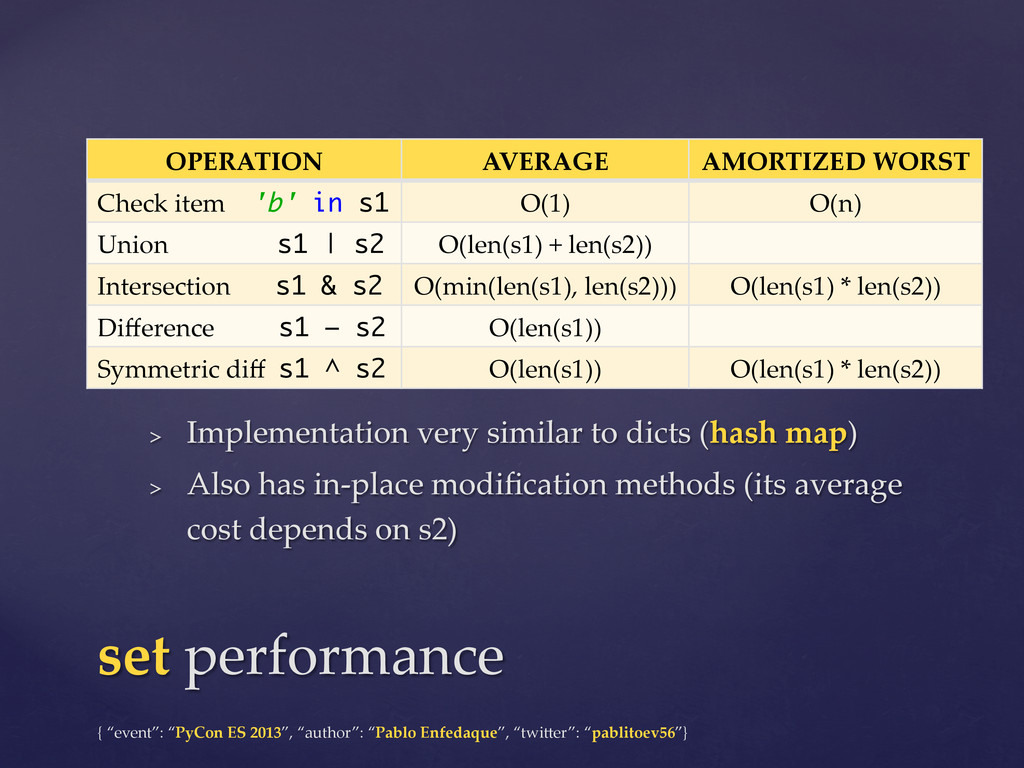
OPERATION AVERAGE AMORTIZED WORST Check item 'b' in s1 O(1) O(n) Union s1 | s2 O(len(s1) + len(s2)) Intersection s1 & s2 O(min(len(s1), len(s2))) O(len(s1) * len(s2)) Difference s1 – s2 O(len(s1)) Symmetric diff s1 ^ s2 O(len(s1)) O(len(s1) * len(s2)) set performance > Implementation very similar to dicts (hash map) > Also has in-‐‑place modification methods (its average cost depends on s2) -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
A bit boring, isn’t it? -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
Let'ʹs do something more appealing -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
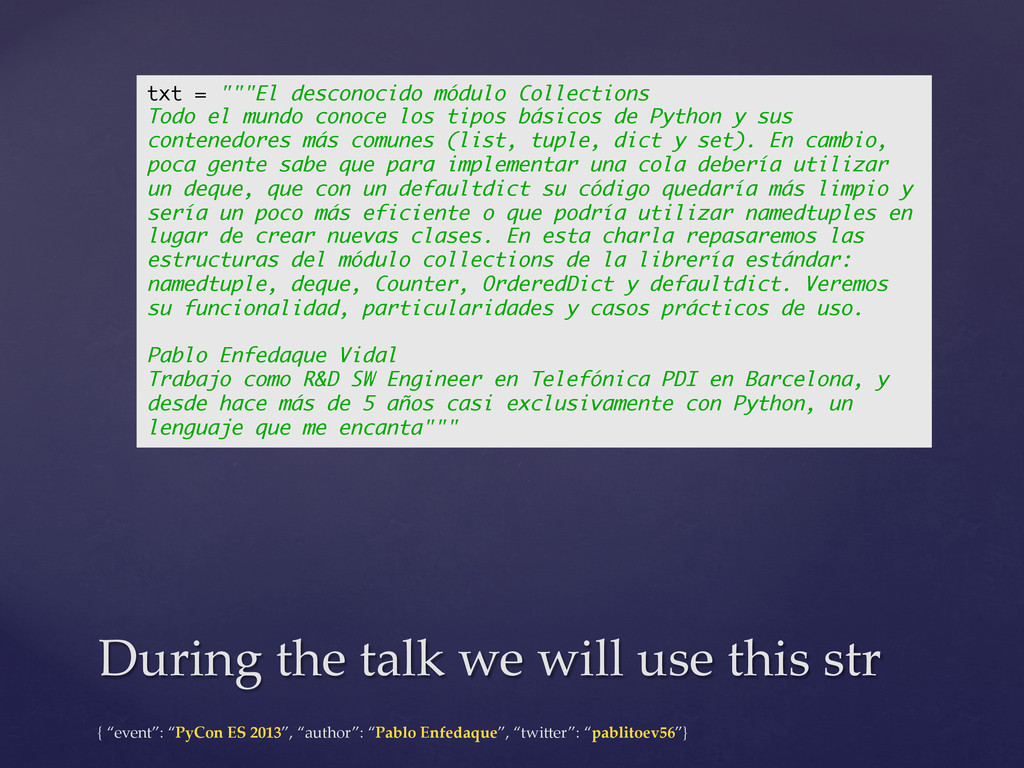
During the talk we will use this str txt = """El desconocido módulo Collections Todo el mundo conoce los tipos básicos de Python y sus contenedores más comunes (list, tuple, dict y set). En cambio, poca gente sabe que para implementar una cola debería utilizar un deque, que con un defaultdict su código quedaría más limpio y sería un poco más eficiente o que podría utilizar namedtuples en lugar de crear nuevas clases. En esta charla repasaremos las estructuras del módulo collections de la librería estándar: namedtuple, deque, Counter, OrderedDict y defaultdict. Veremos su funcionalidad, particularidades y casos prácticos de uso. Pablo Enfedaque Vidal Trabajo como R&D SW Engineer en Telefónica PDI en Barcelona, y desde hace más de 5 años casi exclusivamente con Python, un lenguaje que me encanta""" -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
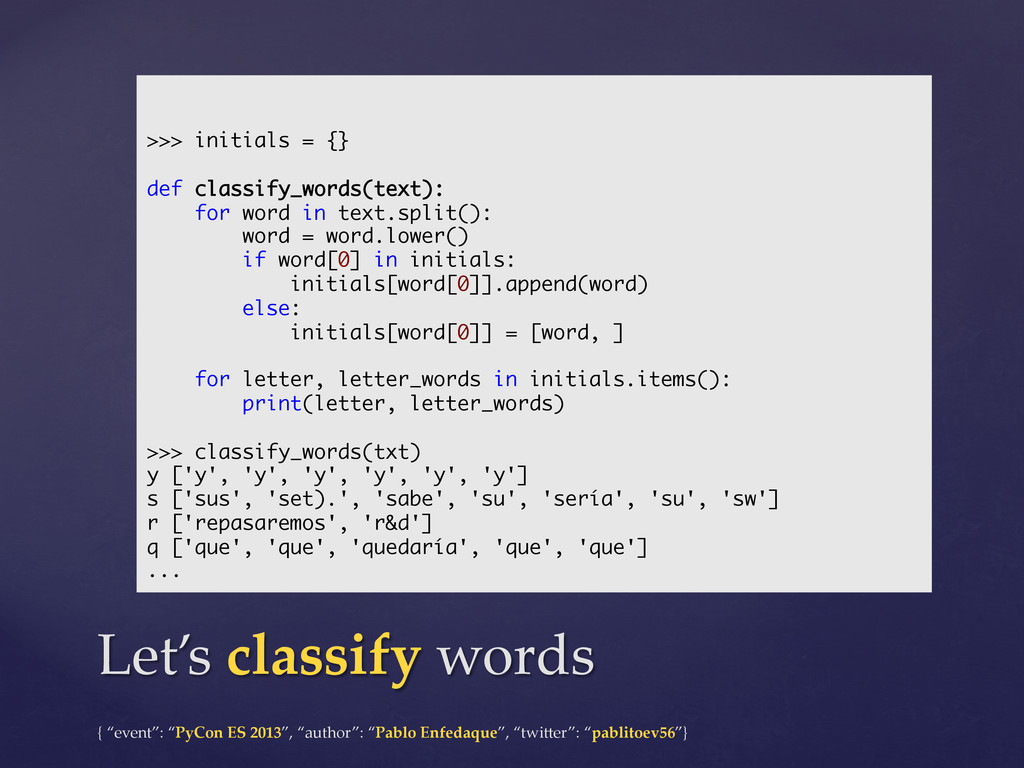
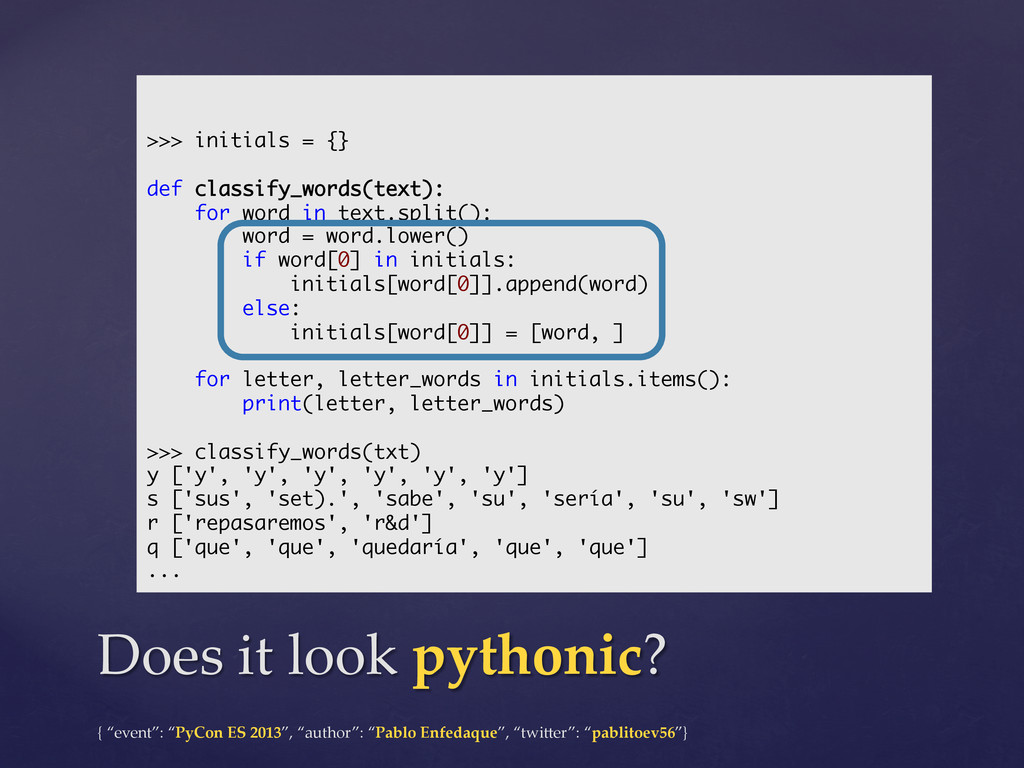
Let’s classify words >>> initials = {} def classify_words(text): for word in text.split(): word = word.lower() if word[0] in initials: initials[word[0]].append(word) else: initials[word[0]] = [word, ] for letter, letter_words in initials.items(): print(letter, letter_words) >>> classify_words(txt) y ['y', 'y', 'y', 'y', 'y', 'y'] s ['sus', 'set).', 'sabe', 'su', 'sería', 'su', 'sw'] r ['repasaremos', 'r&d'] q ['que', 'que', 'quedaría', 'que', 'que'] ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
Does it look pythonic? >>> initials = {} def classify_words(text): for word in text.split(): word = word.lower() if word[0] in initials: initials[word[0]].append(word) else: initials[word[0]] = [word, ] for letter, letter_words in initials.items(): print(letter, letter_words) >>> classify_words(txt) y ['y', 'y', 'y', 'y', 'y', 'y'] s ['sus', 'set).', 'sabe', 'su', 'sería', 'su', 'sw'] r ['repasaremos', 'r&d'] q ['que', 'que', 'quedaría', 'que', 'que'] ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
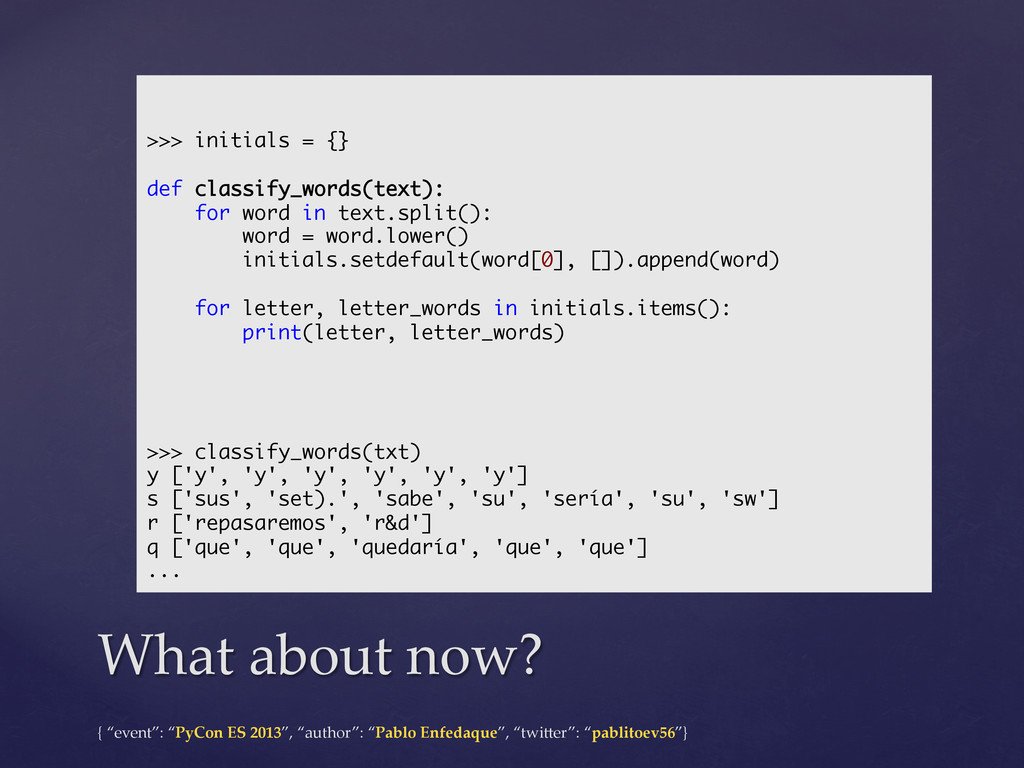
What about now? >>> initials = {} def classify_words(text): for word in text.split(): word = word.lower() initials.setdefault(word[0], []).append(word) for letter, letter_words in initials.items(): print(letter, letter_words) >>> classify_words(txt) y ['y', 'y', 'y', 'y', 'y', 'y'] s ['sus', 'set).', 'sabe', 'su', 'sería', 'su', 'sw'] r ['repasaremos', 'r&d'] q ['que', 'que', 'quedaría', 'que', 'que'] ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
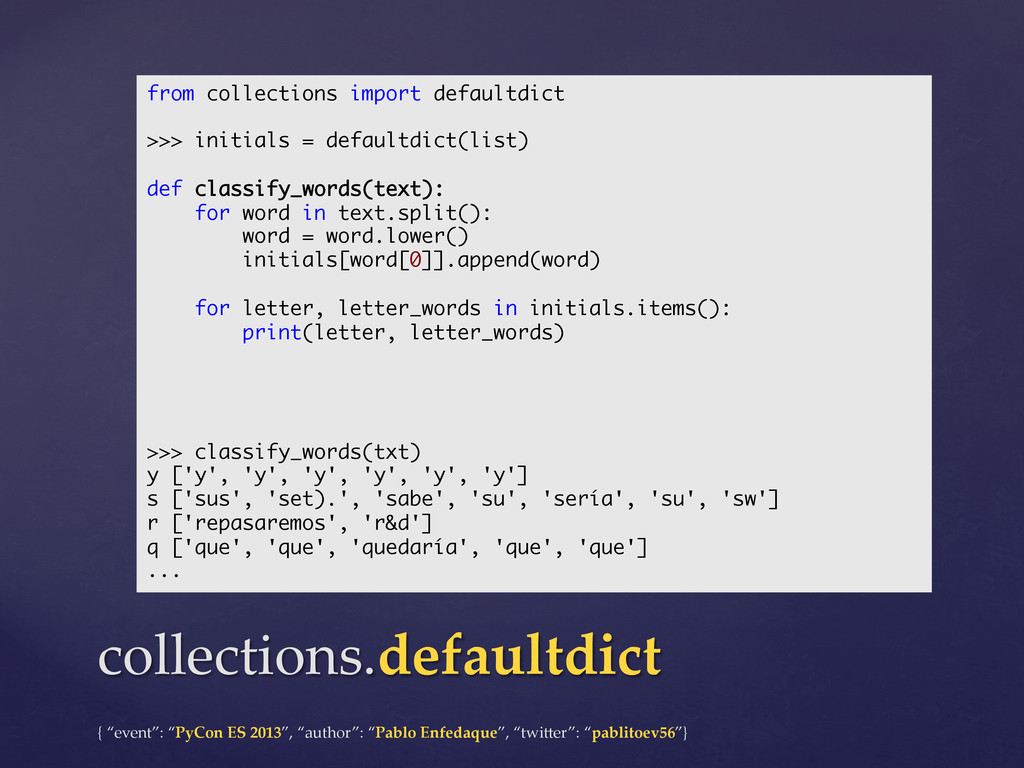
collections.defaultdict from collections import defaultdict >>> initials = defaultdict(list) def classify_words(text): for word in text.split(): word = word.lower() initials[word[0]].append(word) for letter, letter_words in initials.items(): print(letter, letter_words) >>> classify_words(txt) y ['y', 'y', 'y', 'y', 'y', 'y'] s ['sus', 'set).', 'sabe', 'su', 'sería', 'su', 'sw'] r ['repasaremos', 'r&d'] q ['que', 'que', 'quedaría', 'que', 'que'] ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
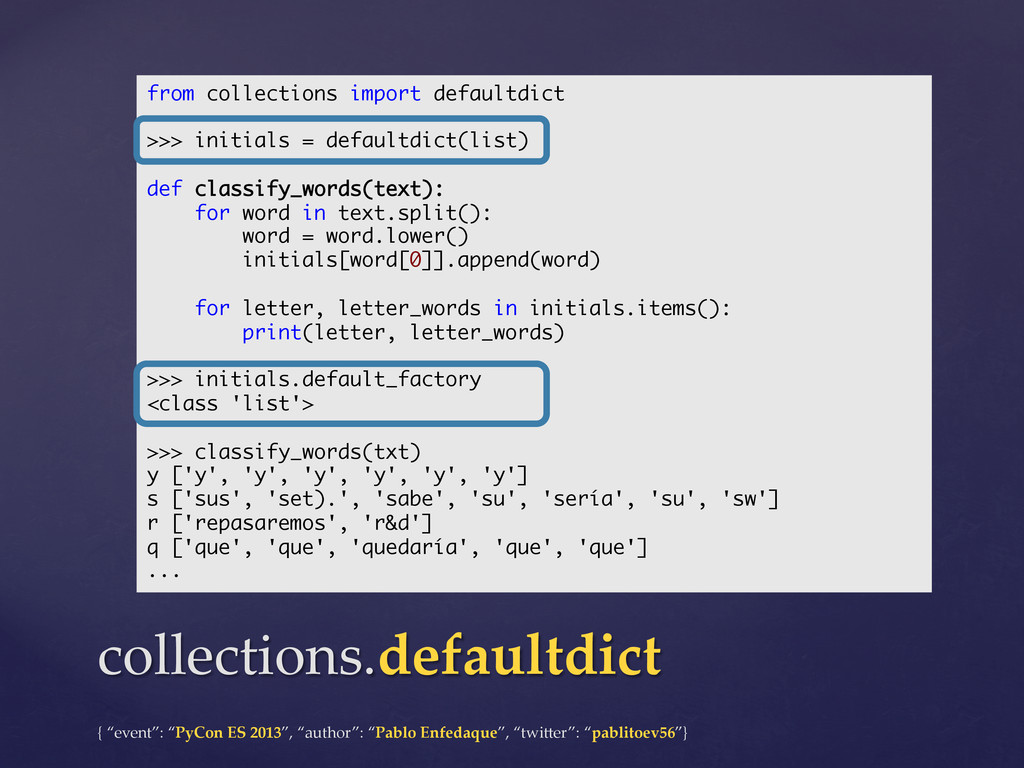
collections.defaultdict from collections import defaultdict >>> initials = defaultdict(list) def classify_words(text): for word in text.split(): word = word.lower() initials[word[0]].append(word) for letter, letter_words in initials.items(): print(letter, letter_words) >>> initials.default_factory <class 'list'> >>> classify_words(txt) y ['y', 'y', 'y', 'y', 'y', 'y'] s ['sus', 'set).', 'sabe', 'su', 'sería', 'su', 'sw'] r ['repasaremos', 'r&d'] q ['que', 'que', 'quedaría', 'que', 'que'] ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
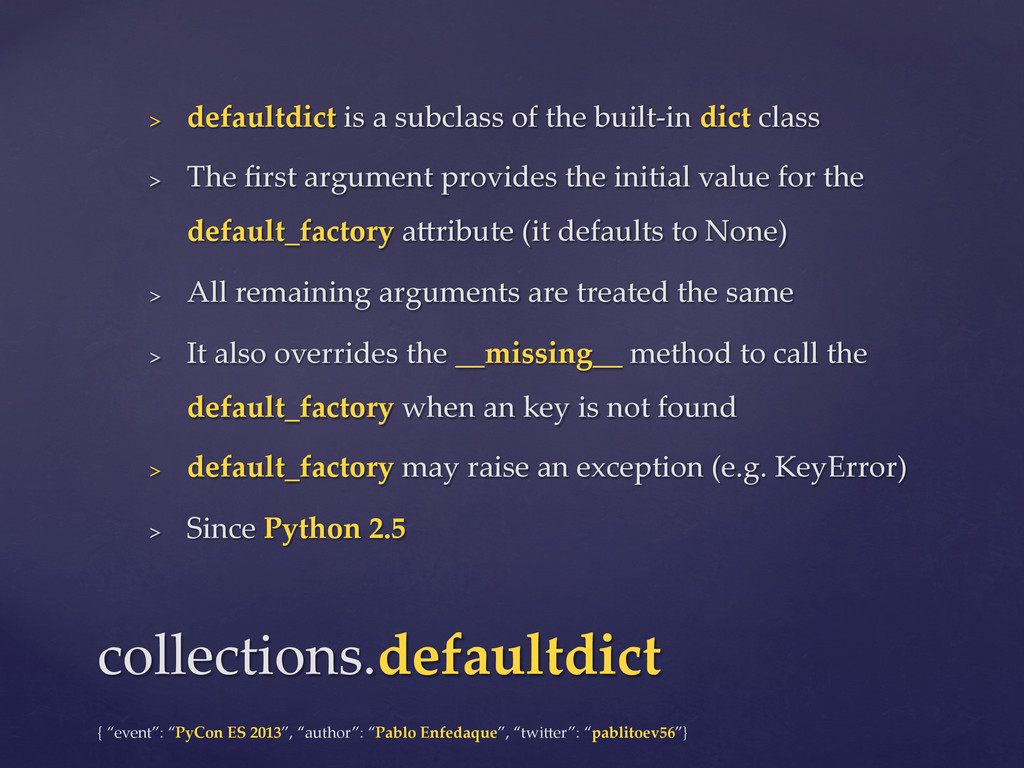
> defaultdict is a subclass of the built-‐‑in dict class > The first argument provides the initial value for the default_factory a2ribute (it defaults to None) > All remaining arguments are treated the same > It also overrides the __missing__ method to call the default_factory when an key is not found > default_factory may raise an exception (e.g. KeyError) > Since Python 2.5 collections.defaultdict -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
Let’s continue classifying words -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
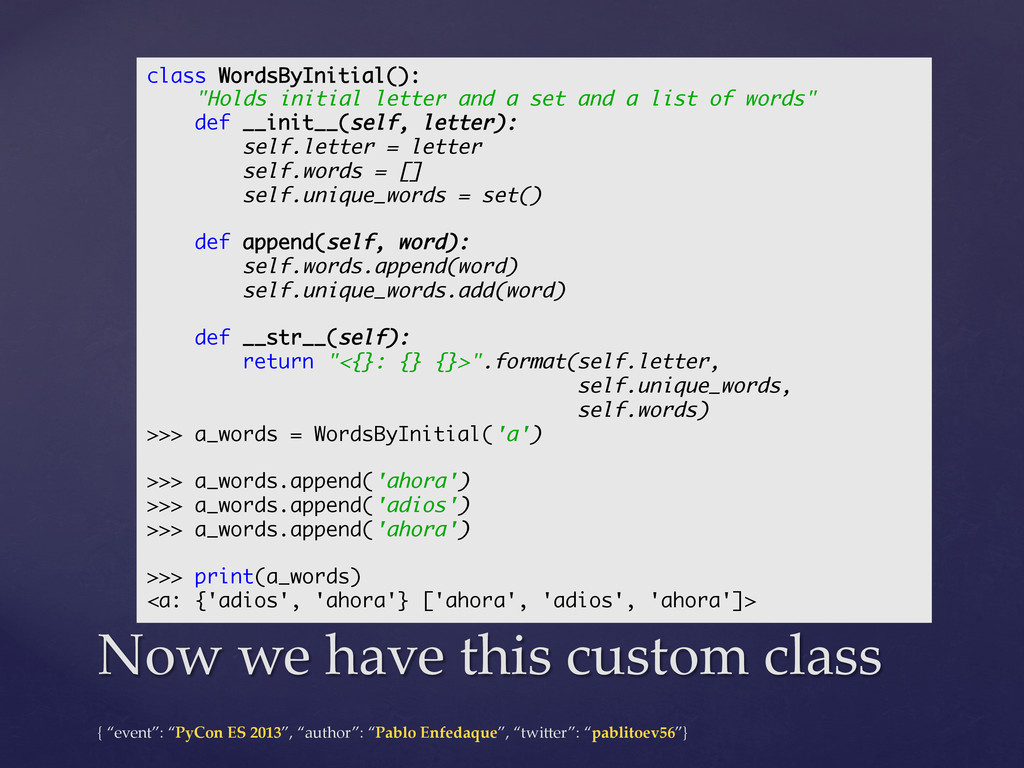
Now we have this custom class class WordsByInitial(): "Holds initial letter and a set and a list of words" def __init__(self, letter): self.letter = letter self.words = [] self.unique_words = set() def append(self, word): self.words.append(word) self.unique_words.add(word) def __str__(self): return "<{}: {} {}>".format(self.letter, self.unique_words, self.words) >>> a_words = WordsByInitial('a') >>> a_words.append('ahora') >>> a_words.append('adios') >>> a_words.append('ahora') >>> print(a_words) <a: {'adios', 'ahora'} ['ahora', 'adios', 'ahora']> -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
What if we want to use our class with defaultdict? -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
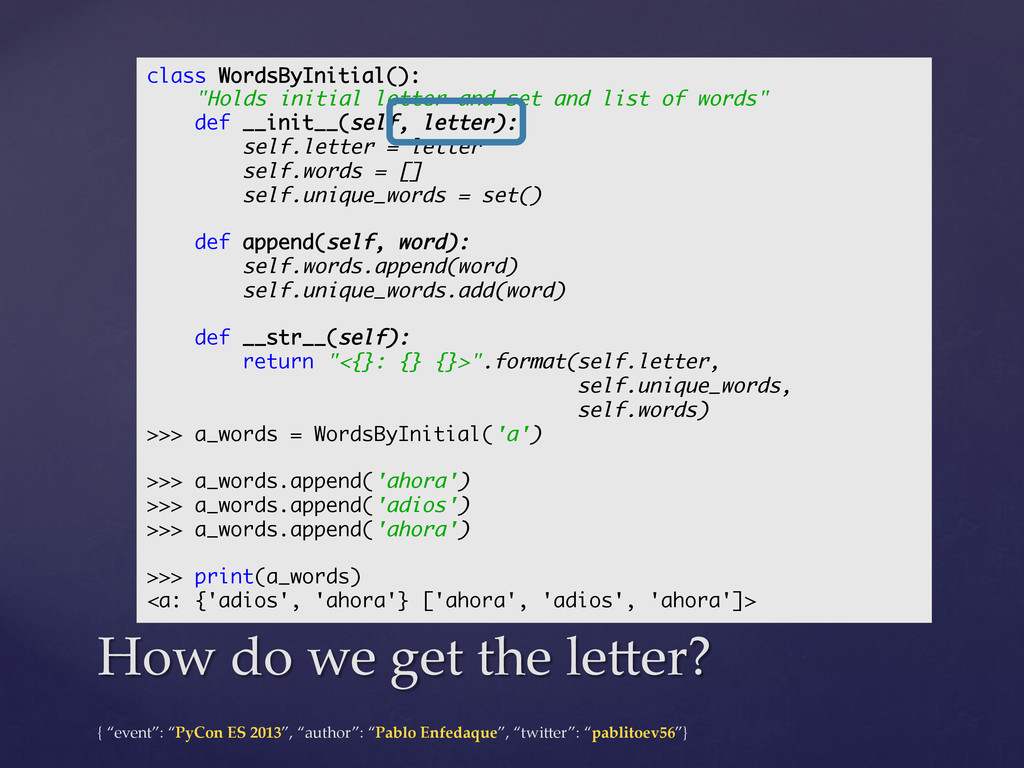
How do we get the le2er? class WordsByInitial(): "Holds initial letter and set and list of words" def __init__(self, letter): self.letter = letter self.words = [] self.unique_words = set() def append(self, word): self.words.append(word) self.unique_words.add(word) def __str__(self): return "<{}: {} {}>".format(self.letter, self.unique_words, self.words) >>> a_words = WordsByInitial('a') >>> a_words.append('ahora') >>> a_words.append('adios') >>> a_words.append('ahora') >>> print(a_words) <a: {'adios', 'ahora'} ['ahora', 'adios', 'ahora']> -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
What if we want the default_factory to receive the missing key? -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
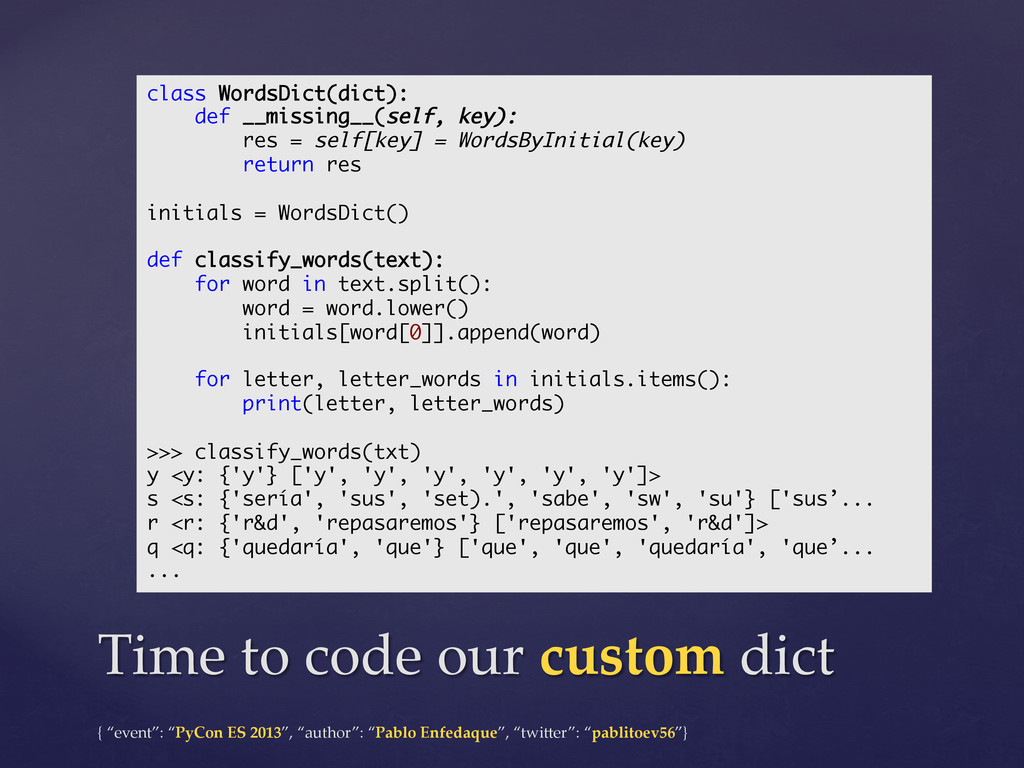
Time to code our custom dict class WordsDict(dict): def __missing__(self, key): res = self[key] = WordsByInitial(key) return res initials = WordsDict() def classify_words(text): for word in text.split(): word = word.lower() initials[word[0]].append(word) for letter, letter_words in initials.items(): print(letter, letter_words) >>> classify_words(txt) y <y: {'y'} ['y', 'y', 'y', 'y', 'y', 'y']> s <s: {'sería', 'sus', 'set).', 'sabe', 'sw', 'su'} ['sus’... r <r: {'r&d', 'repasaremos'} ['repasaremos', 'r&d']> q <q: {'quedaría', 'que'} ['que', 'que', 'quedaría', 'que’... ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
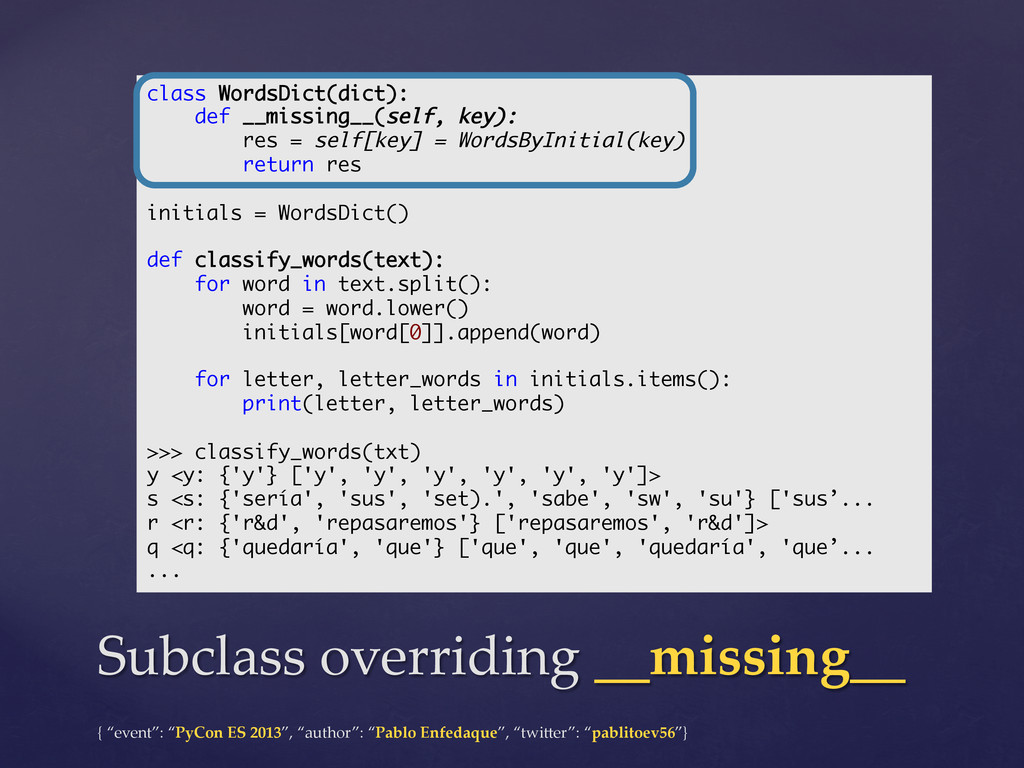
Subclass overriding __missing__ class WordsDict(dict): def __missing__(self, key): res = self[key] = WordsByInitial(key) return res initials = WordsDict() def classify_words(text): for word in text.split(): word = word.lower() initials[word[0]].append(word) for letter, letter_words in initials.items(): print(letter, letter_words) >>> classify_words(txt) y <y: {'y'} ['y', 'y', 'y', 'y', 'y', 'y']> s <s: {'sería', 'sus', 'set).', 'sabe', 'sw', 'su'} ['sus’... r <r: {'r&d', 'repasaremos'} ['repasaremos', 'r&d']> q <q: {'quedaría', 'que'} ['que', 'que', 'quedaría', 'que’... ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
Let'ʹs move on to something different -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
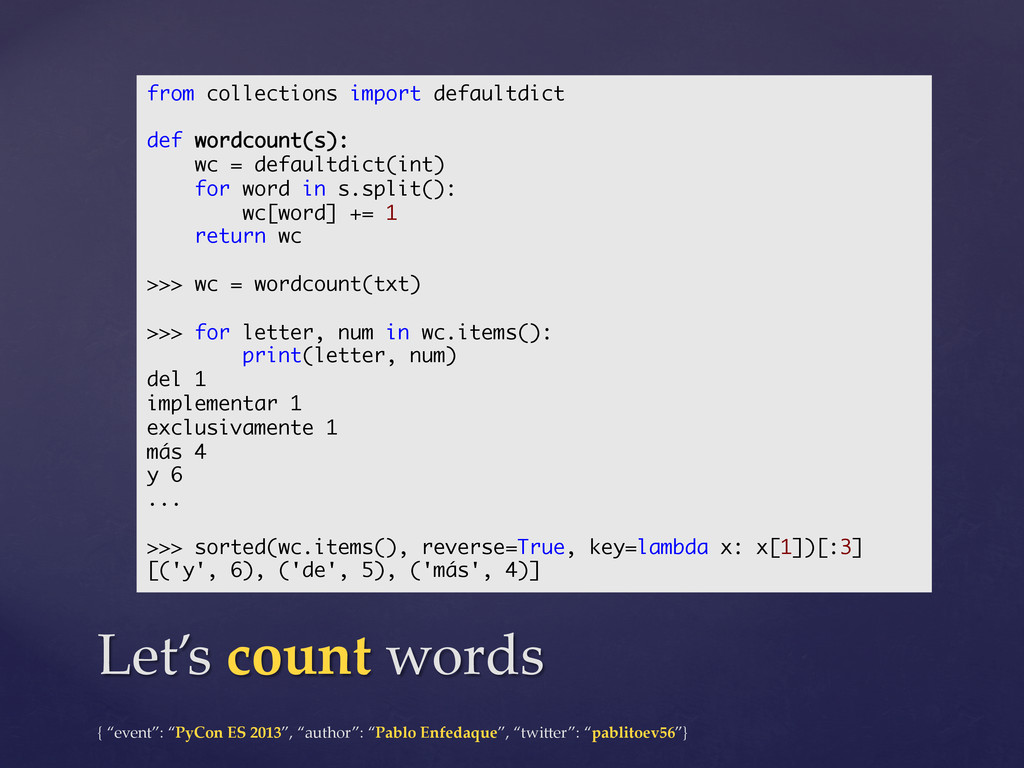
Let’s count words from collections import defaultdict def wordcount(s): wc = defaultdict(int) for word in s.split(): wc[word] += 1 return wc >>> wc = wordcount(txt) >>> for letter, num in wc.items(): print(letter, num) del 1 implementar 1 exclusivamente 1 más 4 y 6 ... >>> sorted(wc.items(), reverse=True, key=lambda x: x[1])[:3] [('y', 6), ('de', 5), ('más', 4)] -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
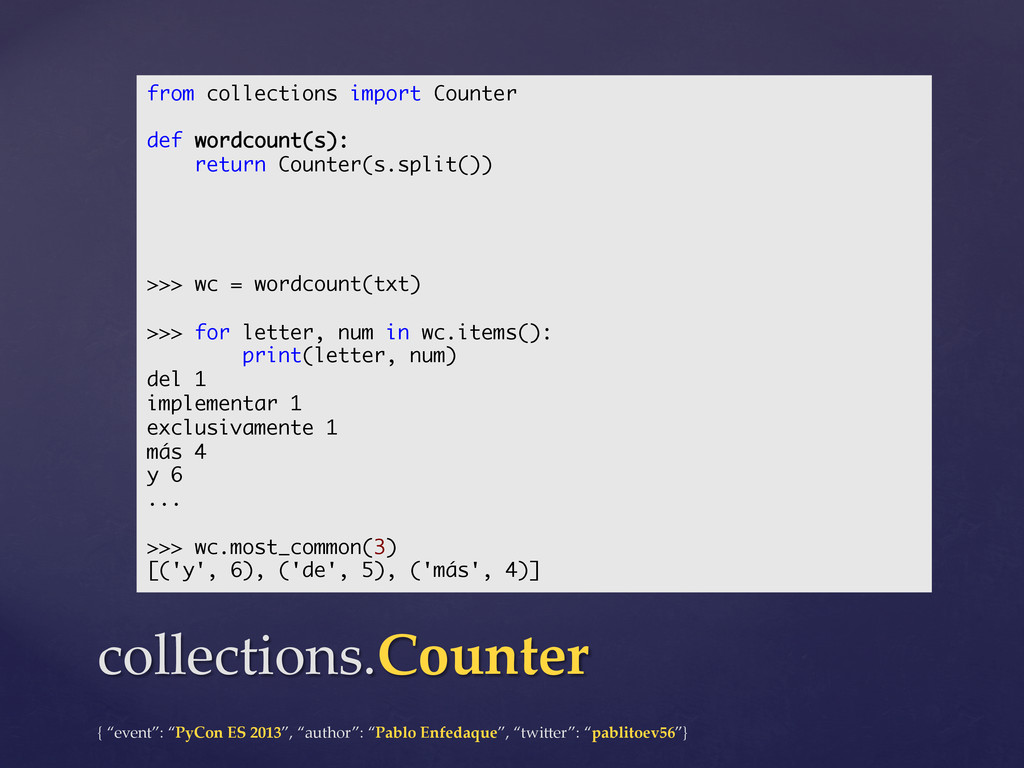
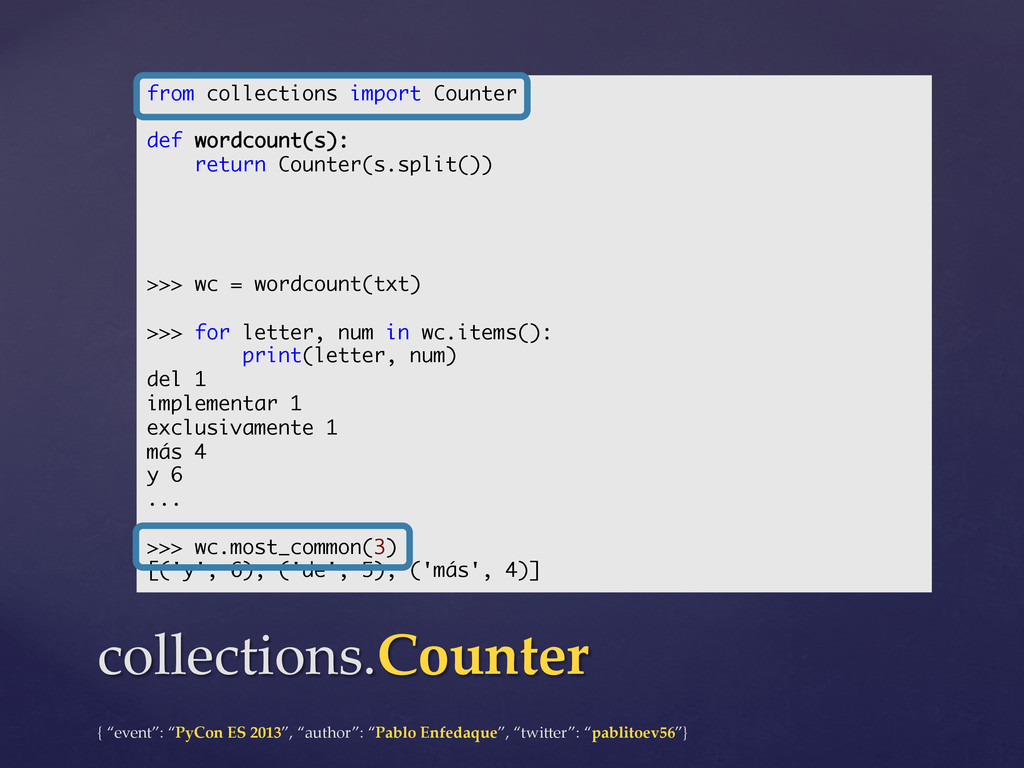
collections.Counter from collections import Counter def wordcount(s): return Counter(s.split()) >>> wc = wordcount(txt) >>> for letter, num in wc.items(): print(letter, num) del 1 implementar 1 exclusivamente 1 más 4 y 6 ... >>> wc.most_common(3) [('y', 6), ('de', 5), ('más', 4)] -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
collections.Counter from collections import Counter def wordcount(s): return Counter(s.split()) >>> wc = wordcount(txt) >>> for letter, num in wc.items(): print(letter, num) del 1 implementar 1 exclusivamente 1 más 4 y 6 ... >>> wc.most_common(3) [('y', 6), ('de', 5), ('más', 4)] -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
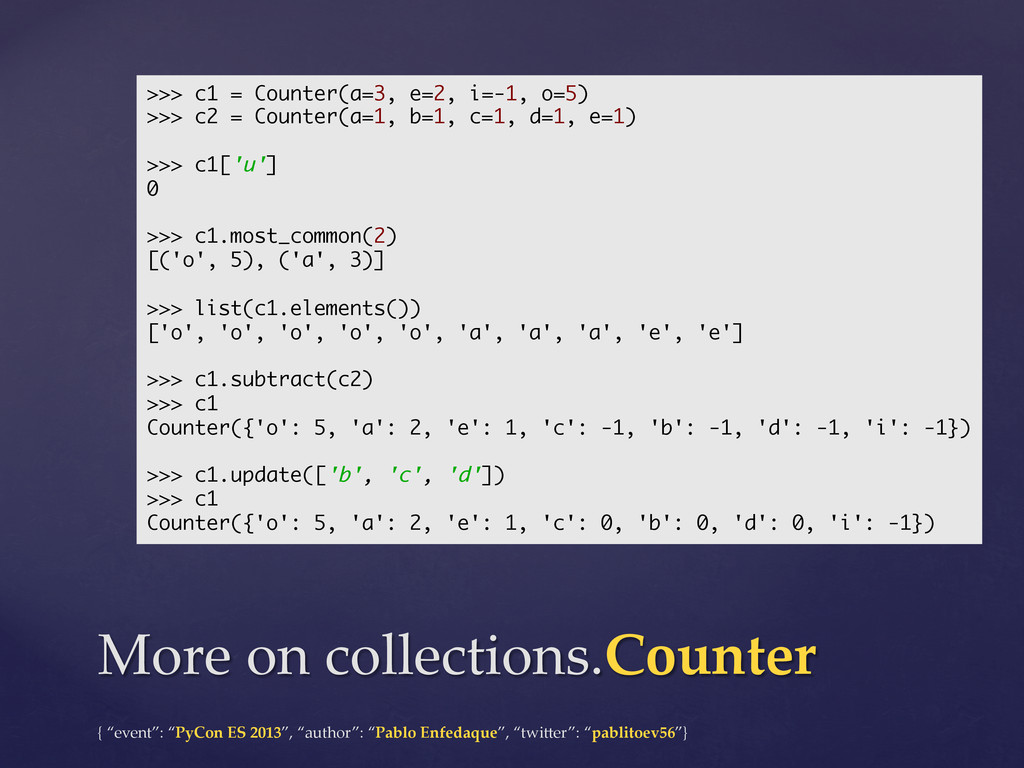
More on collections.Counter >>> c1 = Counter(a=3, e=2, i=-1, o=5) >>> c2 = Counter(a=1, b=1, c=1, d=1, e=1) >>> c1['u'] 0 >>> c1.most_common(2) [('o', 5), ('a', 3)] >>> list(c1.elements()) ['o', 'o', 'o', 'o', 'o', 'a', 'a', 'a', 'e', 'e'] >>> c1.subtract(c2) >>> c1 Counter({'o': 5, 'a': 2, 'e': 1, 'c': -1, 'b': -1, 'd': -1, 'i': -1}) >>> c1.update(['b', 'c', 'd']) >>> c1 Counter({'o': 5, 'a': 2, 'e': 1, 'c': 0, 'b': 0, 'd': 0, 'i': -1}) -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
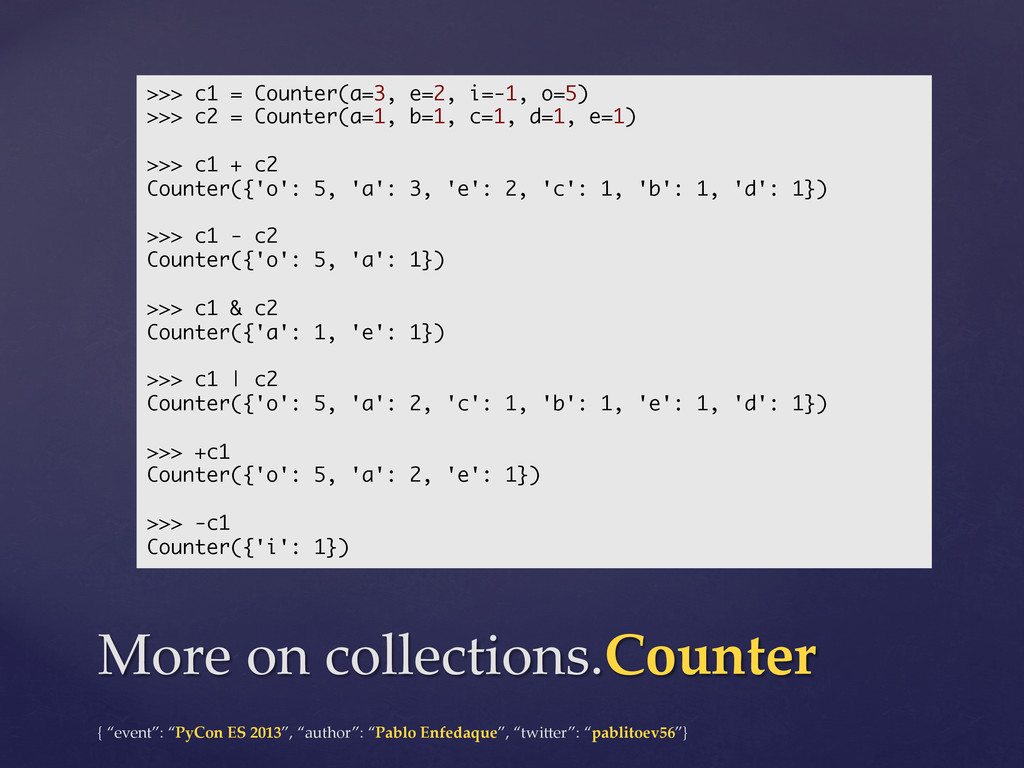
More on collections.Counter >>> c1 = Counter(a=3, e=2, i=-1, o=5) >>> c2 = Counter(a=1, b=1, c=1, d=1, e=1) >>> c1 + c2 Counter({'o': 5, 'a': 3, 'e': 2, 'c': 1, 'b': 1, 'd': 1}) >>> c1 - c2 Counter({'o': 5, 'a': 1}) >>> c1 & c2 Counter({'a': 1, 'e': 1}) >>> c1 | c2 Counter({'o': 5, 'a': 2, 'c': 1, 'b': 1, 'e': 1, 'd': 1}) >>> +c1 Counter({'o': 5, 'a': 2, 'e': 1}) >>> -c1 Counter({'i': 1}) -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
> Counter is a dict subclass for counting hashable objects > dict interface but they return 0 instead of KeyError > Three additional methods: most_common, elements, subtract > update method has been overriden > Support for mathematical operators: +, -‐‑, &, | > Since Python 2.7 collections.Counter -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
Let'ʹs go back to words classification -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
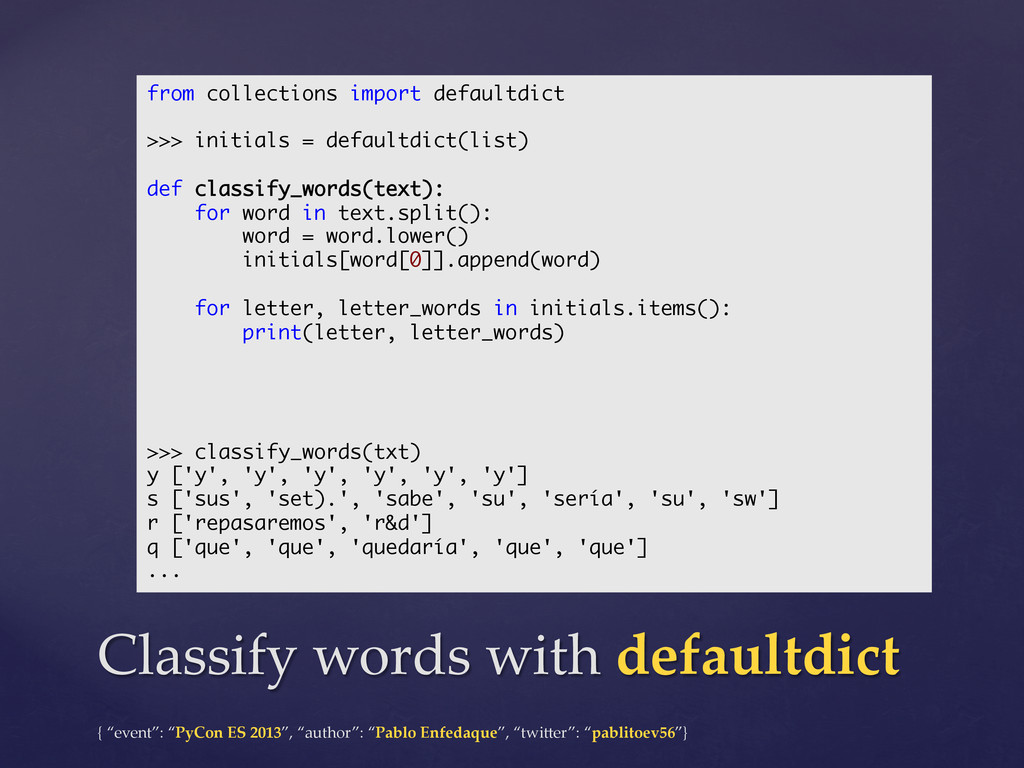
Classify words with defaultdict from collections import defaultdict >>> initials = defaultdict(list) def classify_words(text): for word in text.split(): word = word.lower() initials[word[0]].append(word) for letter, letter_words in initials.items(): print(letter, letter_words) >>> classify_words(txt) y ['y', 'y', 'y', 'y', 'y', 'y'] s ['sus', 'set).', 'sabe', 'su', 'sería', 'su', 'sw'] r ['repasaremos', 'r&d'] q ['que', 'que', 'quedaría', 'que', 'que'] ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
What if we only want to keep the last three words for each le2er? -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
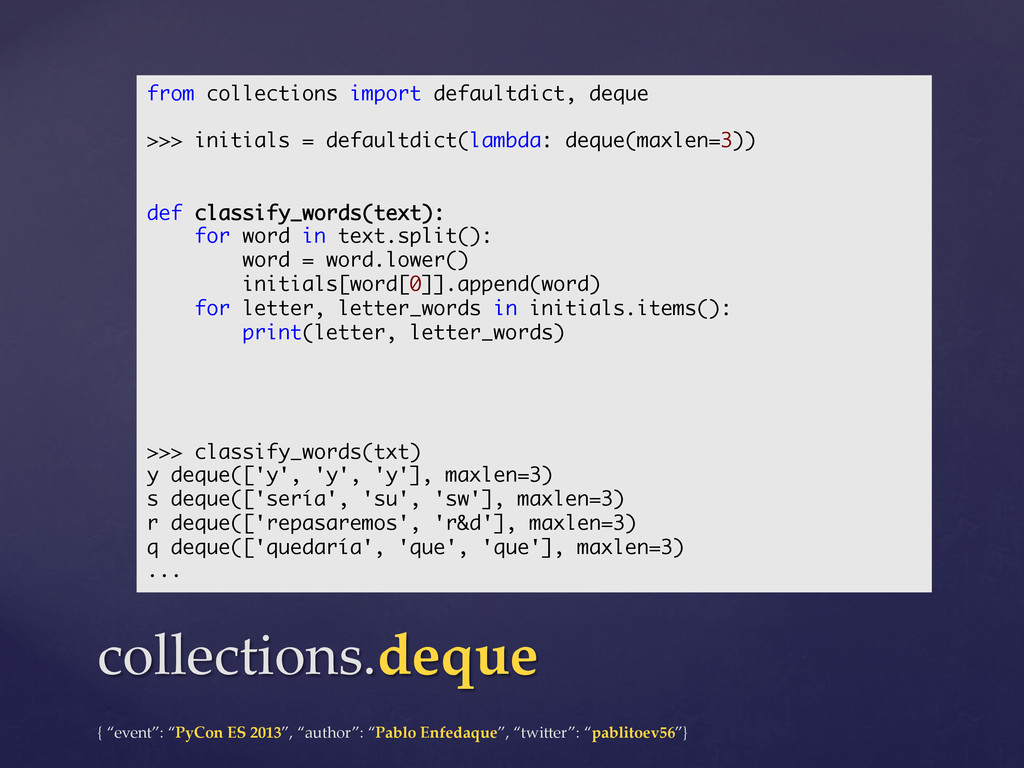
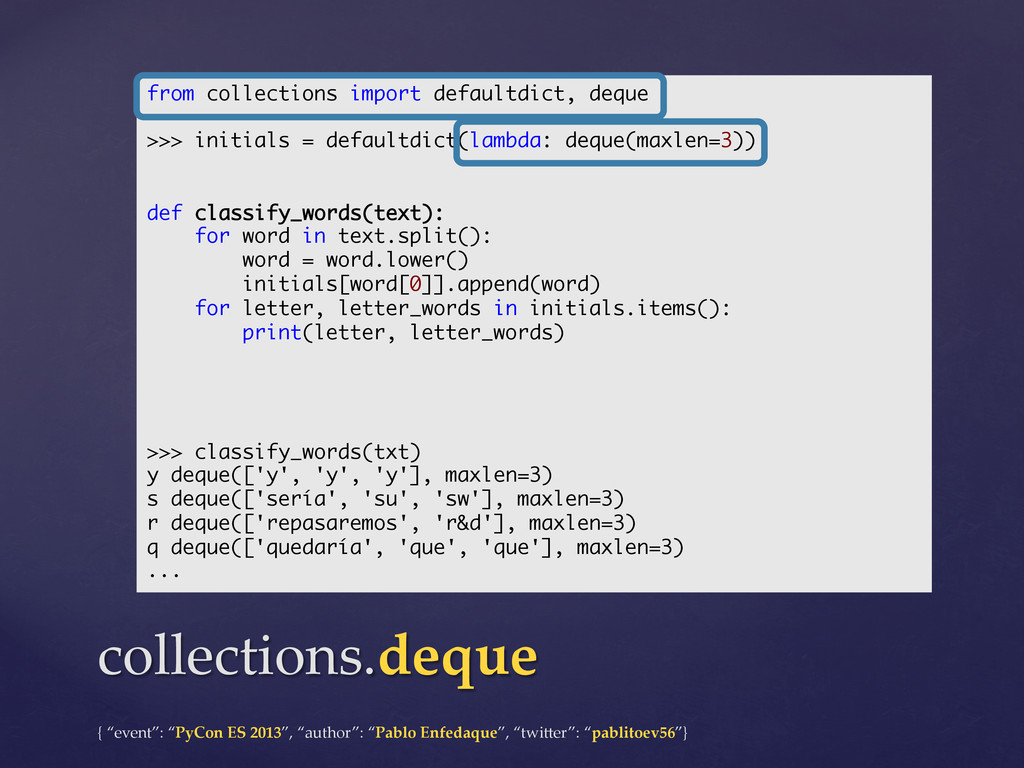
collections.deque from collections import defaultdict, deque >>> initials = defaultdict(lambda: deque(maxlen=3)) def classify_words(text): for word in text.split(): word = word.lower() initials[word[0]].append(word) for letter, letter_words in initials.items(): print(letter, letter_words) >>> classify_words(txt) y deque(['y', 'y', 'y'], maxlen=3) s deque(['sería', 'su', 'sw'], maxlen=3) r deque(['repasaremos', 'r&d'], maxlen=3) q deque(['quedaría', 'que', 'que'], maxlen=3) ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
collections.deque from collections import defaultdict, deque >>> initials = defaultdict(lambda: deque(maxlen=3)) def classify_words(text): for word in text.split(): word = word.lower() initials[word[0]].append(word) for letter, letter_words in initials.items(): print(letter, letter_words) >>> classify_words(txt) y deque(['y', 'y', 'y'], maxlen=3) s deque(['sería', 'su', 'sw'], maxlen=3) r deque(['repasaremos', 'r&d'], maxlen=3) q deque(['quedaría', 'que', 'que'], maxlen=3) ... -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
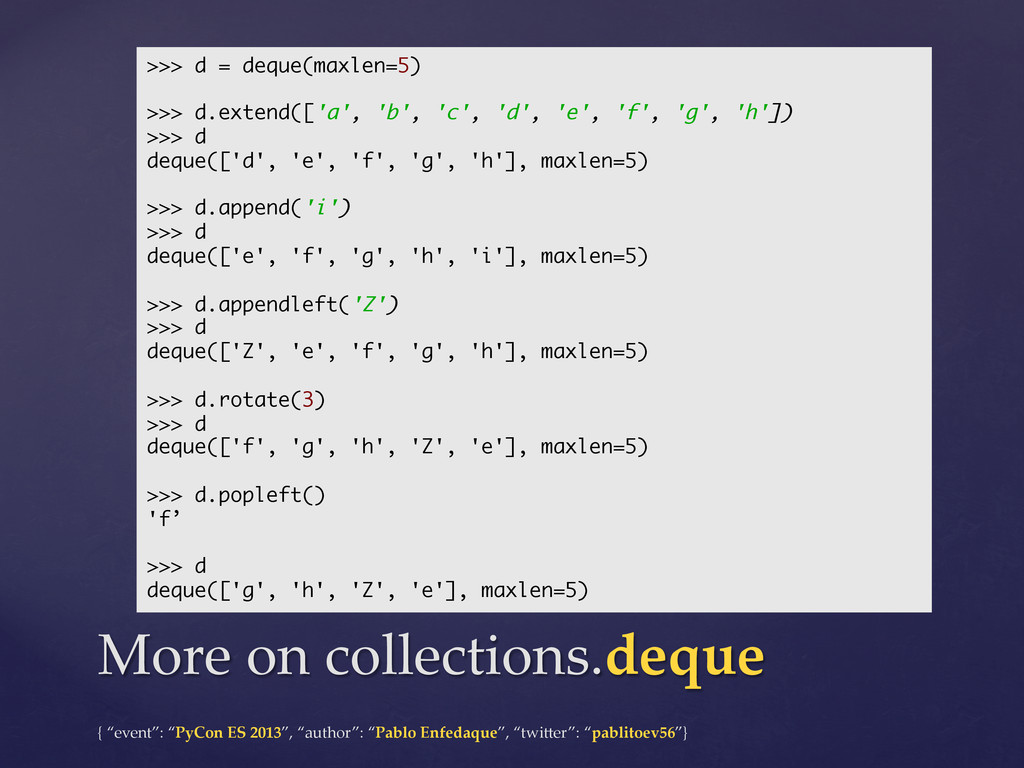
More on collections.deque >>> d = deque(maxlen=5) >>> d.extend(['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h']) >>> d deque(['d', 'e', 'f', 'g', 'h'], maxlen=5) >>> d.append('i') >>> d deque(['e', 'f', 'g', 'h', 'i'], maxlen=5) >>> d.appendleft('Z') >>> d deque(['Z', 'e', 'f', 'g', 'h'], maxlen=5) >>> d.rotate(3) >>> d deque(['f', 'g', 'h', 'Z', 'e'], maxlen=5) >>> d.popleft() 'f’ >>> d deque(['g', 'h', 'Z', 'e'], maxlen=5) -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
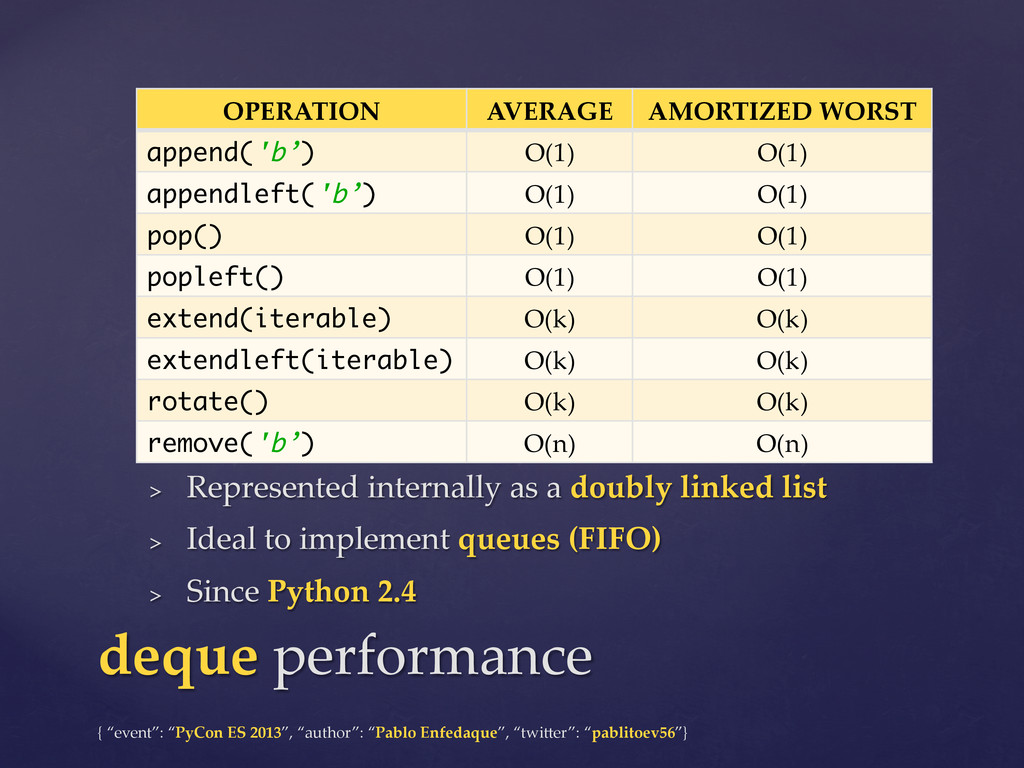
OPERATION AVERAGE AMORTIZED WORST append('b’) O(1) O(1) appendleft('b’) O(1) O(1) pop() O(1) O(1) popleft() O(1) O(1) extend(iterable) O(k) O(k) extendleft(iterable) O(k) O(k) rotate() O(k) O(k) remove('b’) O(n) O(n) deque performance > Represented internally as a doubly linked list > Ideal to implement queues (FIFO) > Since Python 2.4 -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
OPERATION AVERAGE AMORTIZED WORST append('b’) O(1)* O(1)* insert(index, 'b’) O(n) O(n) Get item d[4] O(1) O(1) Set item d[4] = 'd' O(1) O(1) Delete item del d[4] O(n) O(n) extend(iterable) O(k)* O(k)* Check item 'b' in list O(n) O(n) Sort O(n log n) O(n log n) list performance > Represented internally as an array > *: Amortized cost. Individual ops may be really slow > Ideal to implement stacks (LIFO) -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
Let’s move to a different example -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
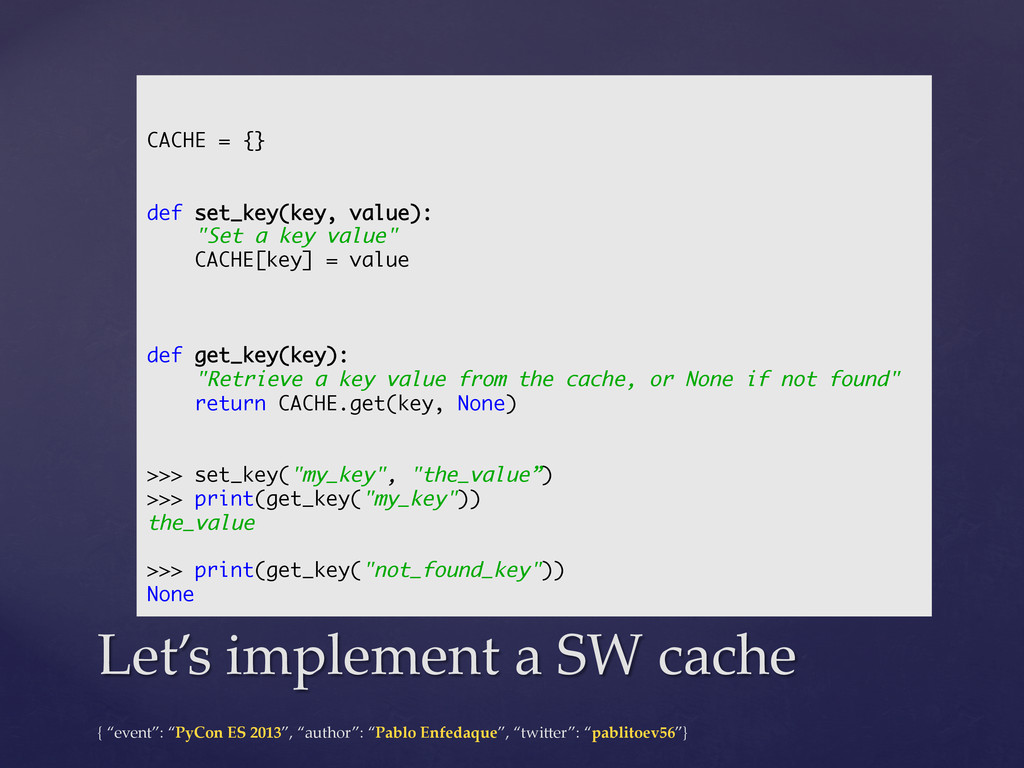
Let’s implement a SW cache CACHE = {} def set_key(key, value): "Set a key value" CACHE[key] = value def get_key(key): "Retrieve a key value from the cache, or None if not found" return CACHE.get(key, None) >>> set_key("my_key", "the_value”) >>> print(get_key("my_key")) the_value >>> print(get_key("not_found_key")) None -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
What if we want to limit its size? -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
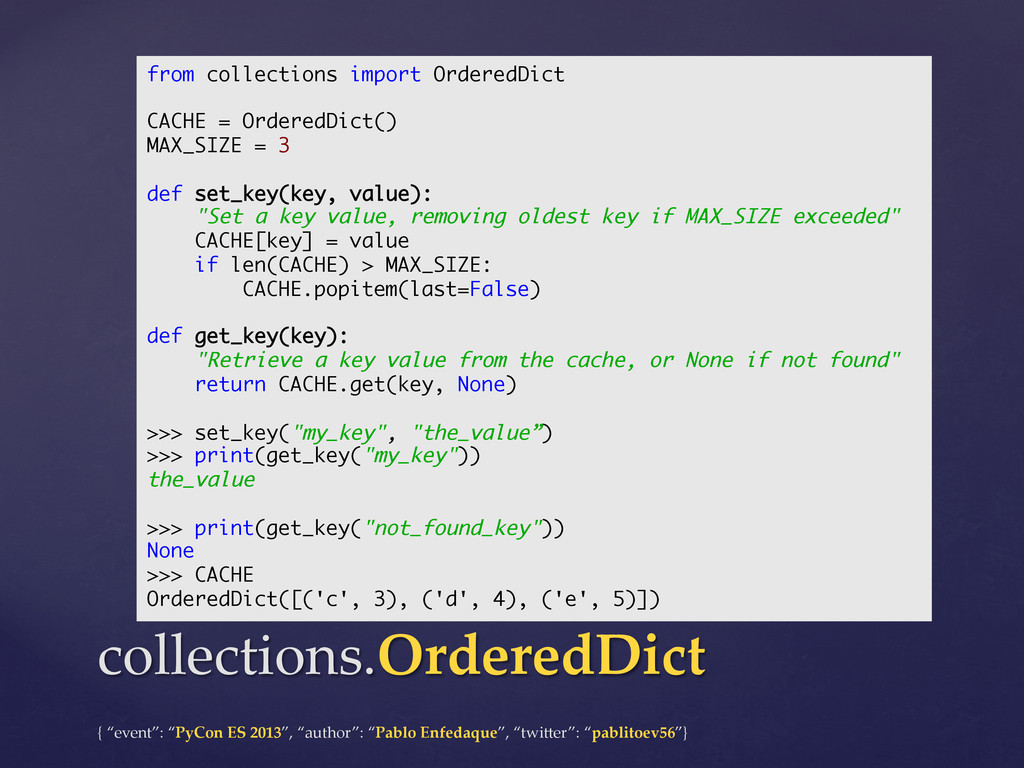
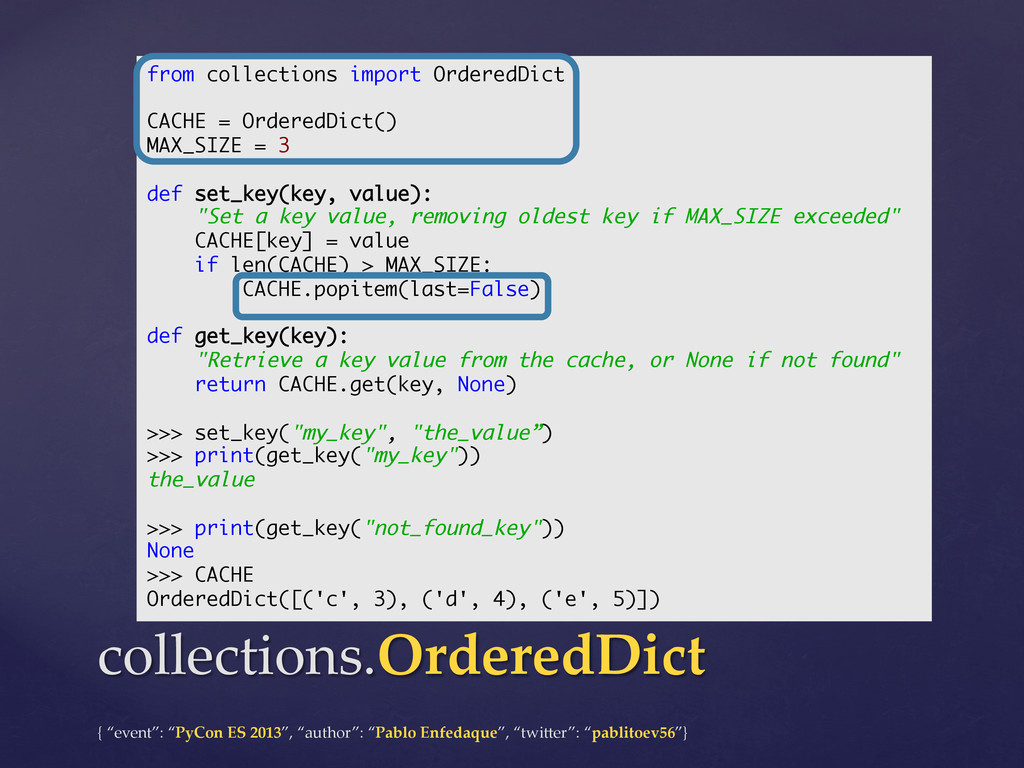
collections.OrderedDict from collections import OrderedDict CACHE = OrderedDict() MAX_SIZE = 3 def set_key(key, value): "Set a key value, removing oldest key if MAX_SIZE exceeded" CACHE[key] = value if len(CACHE) > MAX_SIZE: CACHE.popitem(last=False) def get_key(key): "Retrieve a key value from the cache, or None if not found" return CACHE.get(key, None) >>> set_key("my_key", "the_value”) >>> print(get_key("my_key")) the_value >>> print(get_key("not_found_key")) None >>> CACHE OrderedDict([('c', 3), ('d', 4), ('e', 5)]) -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
collections.OrderedDict from collections import OrderedDict CACHE = OrderedDict() MAX_SIZE = 3 def set_key(key, value): "Set a key value, removing oldest key if MAX_SIZE exceeded" CACHE[key] = value if len(CACHE) > MAX_SIZE: CACHE.popitem(last=False) def get_key(key): "Retrieve a key value from the cache, or None if not found" return CACHE.get(key, None) >>> set_key("my_key", "the_value”) >>> print(get_key("my_key")) the_value >>> print(get_key("not_found_key")) None >>> CACHE OrderedDict([('c', 3), ('d', 4), ('e', 5)]) -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
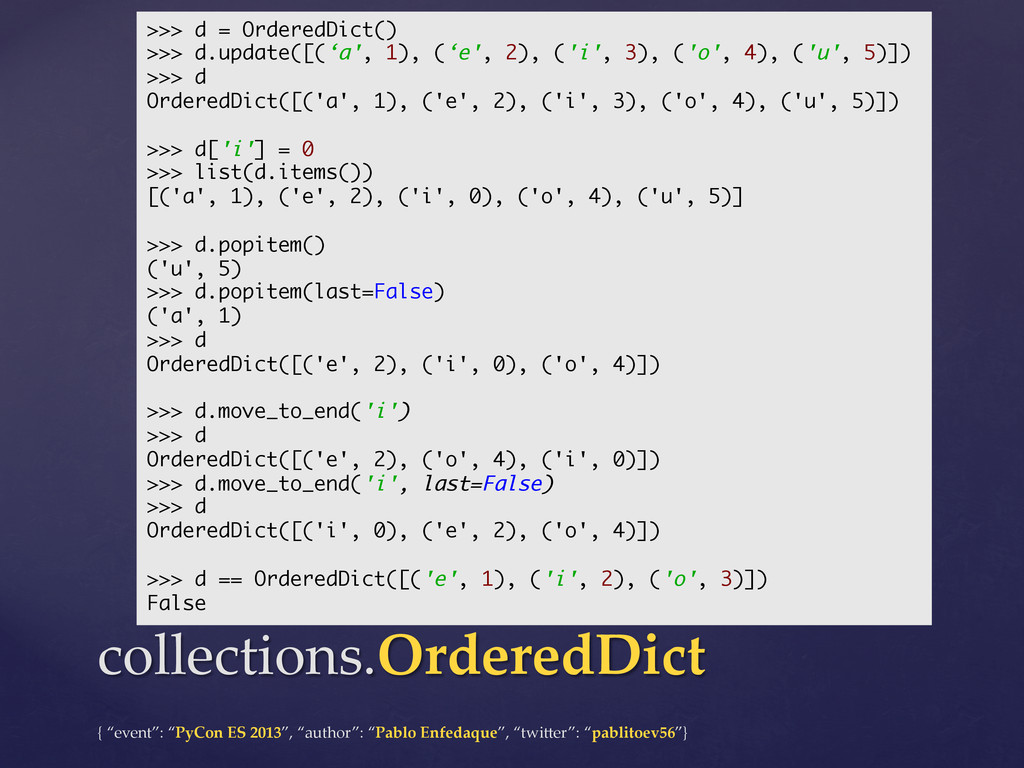
collections.OrderedDict >>> d = OrderedDict() >>> d.update([(‘a', 1), (‘e', 2), ('i', 3), ('o', 4), ('u', 5)]) >>> d OrderedDict([('a', 1), ('e', 2), ('i', 3), ('o', 4), ('u', 5)]) >>> d['i'] = 0 >>> list(d.items()) [('a', 1), ('e', 2), ('i', 0), ('o', 4), ('u', 5)] >>> d.popitem() ('u', 5) >>> d.popitem(last=False) ('a', 1) >>> d OrderedDict([('e', 2), ('i', 0), ('o', 4)]) >>> d.move_to_end('i') >>> d OrderedDict([('e', 2), ('o', 4), ('i', 0)]) >>> d.move_to_end('i', last=False) >>> d OrderedDict([('i', 0), ('e', 2), ('o', 4)]) >>> d == OrderedDict([('e', 1), ('i', 2), ('o', 3)]) False -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
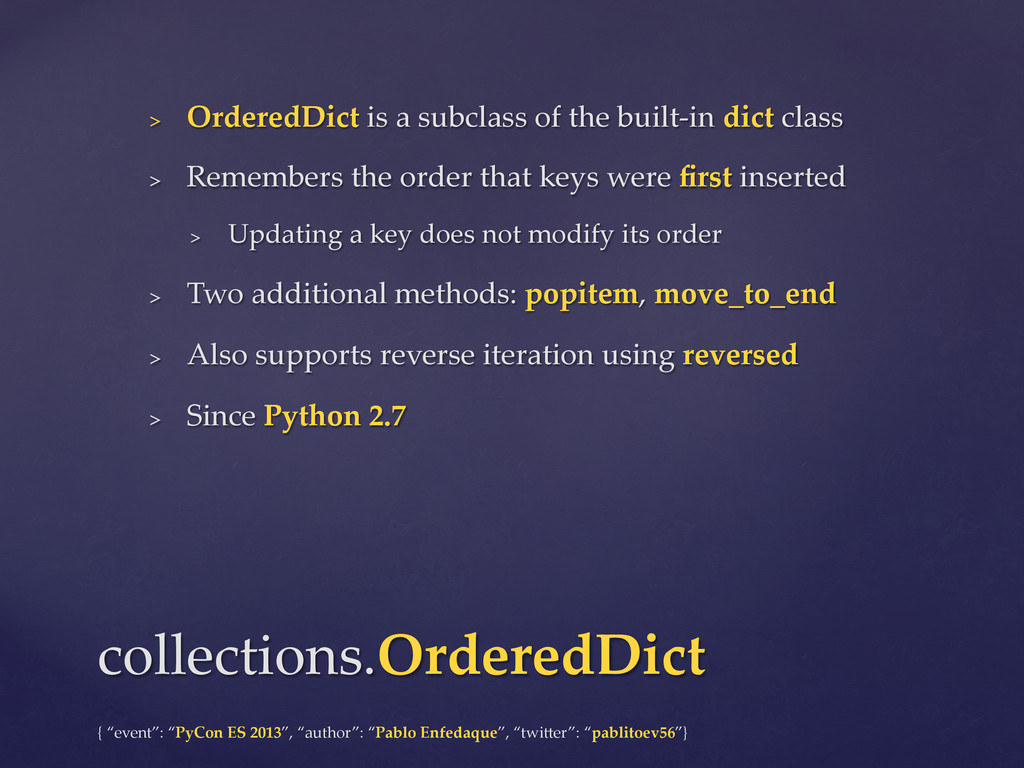
> OrderedDict is a subclass of the built-‐‑in dict class > Remembers the order that keys were first inserted > Updating a key does not modify its order > Two additional methods: popitem, move_to_end > Also supports reverse iteration using reversed > Since Python 2.7 collections.OrderedDict -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
And finally, one last example -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
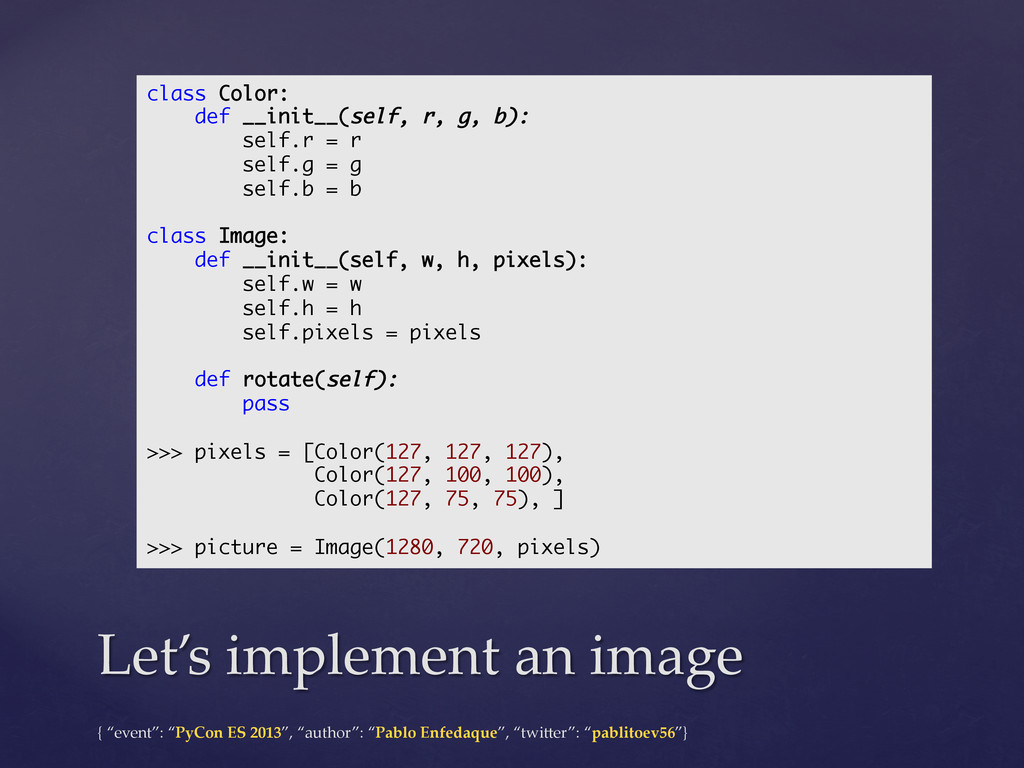
Let’s implement an image class Color: def __init__(self, r, g, b): self.r = r self.g = g self.b = b class Image: def __init__(self, w, h, pixels): self.w = w self.h = h self.pixels = pixels def rotate(self): pass >>> pixels = [Color(127, 127, 127), Color(127, 100, 100), Color(127, 75, 75), ] >>> picture = Image(1280, 720, pixels) -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
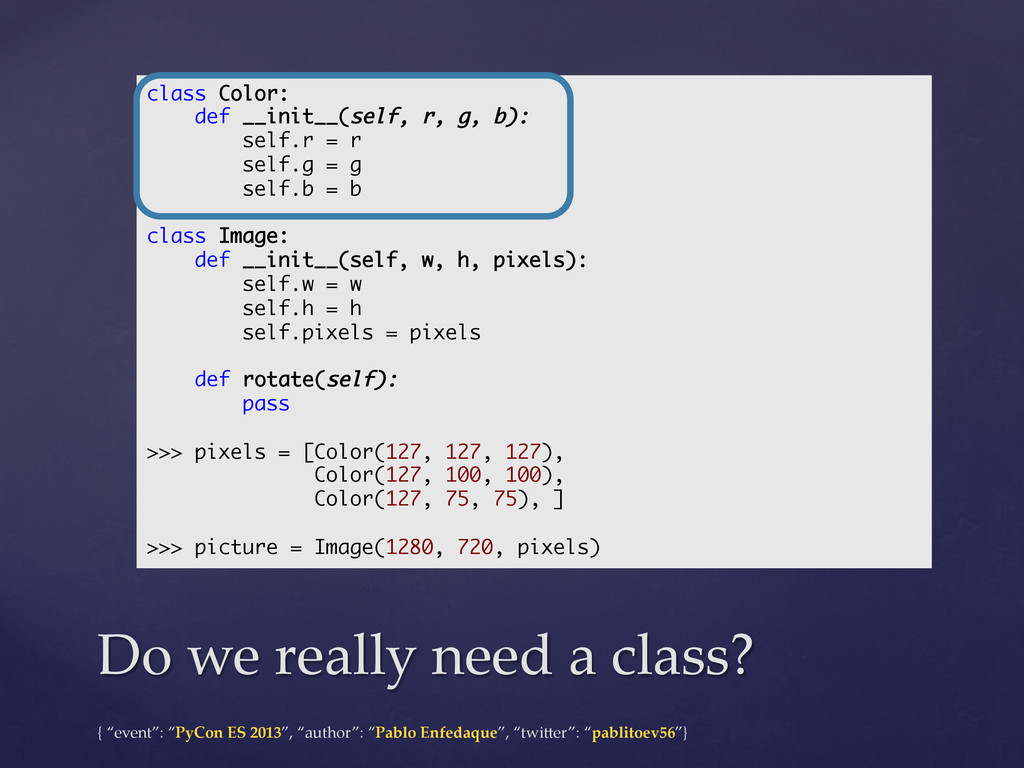
Do we really need a class? class Color: def __init__(self, r, g, b): self.r = r self.g = g self.b = b class Image: def __init__(self, w, h, pixels): self.w = w self.h = h self.pixels = pixels def rotate(self): pass >>> pixels = [Color(127, 127, 127), Color(127, 100, 100), Color(127, 75, 75), ] >>> picture = Image(1280, 720, pixels) -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
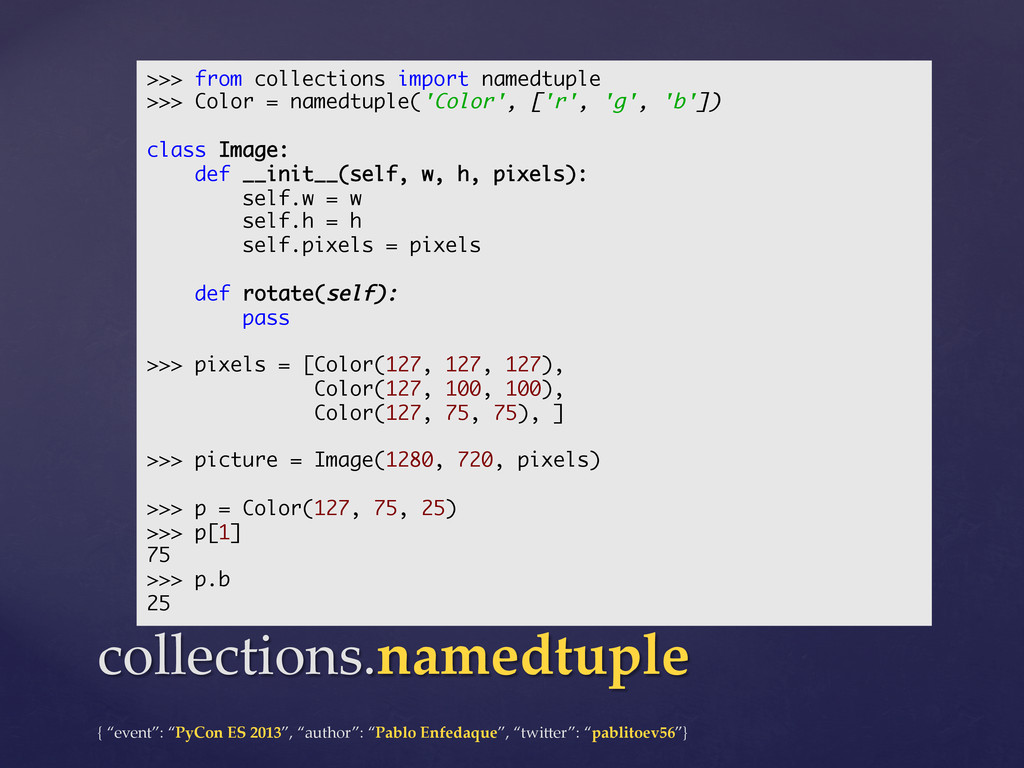
collections.namedtuple >>> from collections import namedtuple >>> Color = namedtuple('Color', ['r', 'g', 'b']) class Image: def __init__(self, w, h, pixels): self.w = w self.h = h self.pixels = pixels def rotate(self): pass >>> pixels = [Color(127, 127, 127), Color(127, 100, 100), Color(127, 75, 75), ] >>> picture = Image(1280, 720, pixels) >>> p = Color(127, 75, 25) >>> p[1] 75 >>> p.b 25 -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
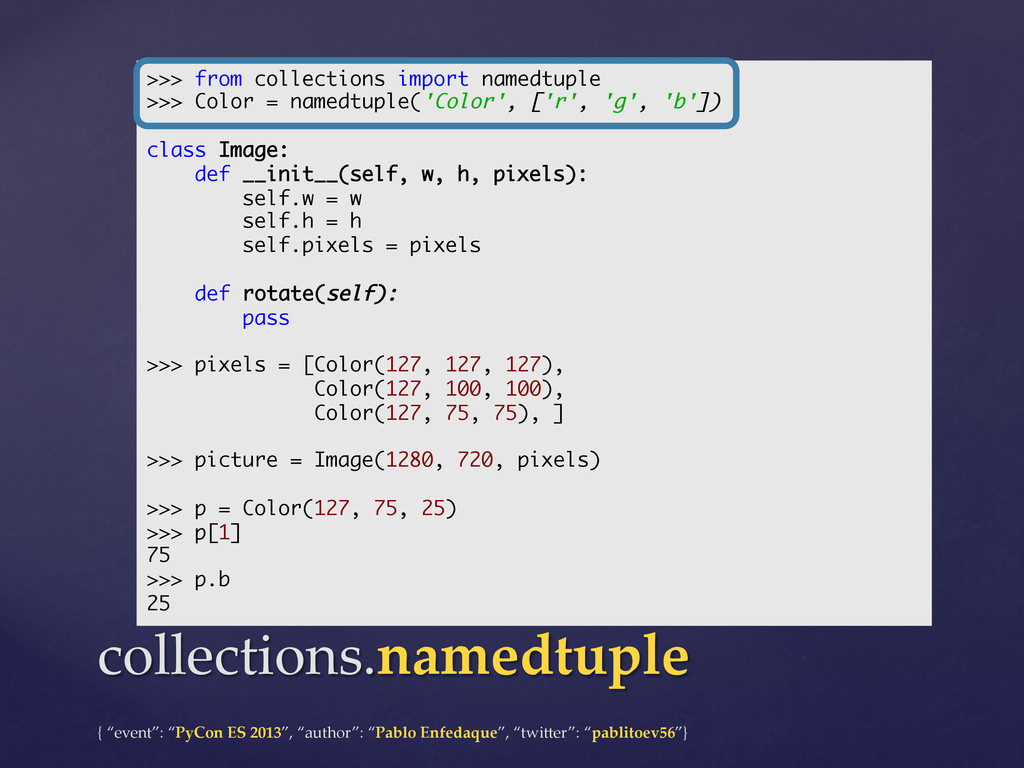
collections.namedtuple >>> from collections import namedtuple >>> Color = namedtuple('Color', ['r', 'g', 'b']) class Image: def __init__(self, w, h, pixels): self.w = w self.h = h self.pixels = pixels def rotate(self): pass >>> pixels = [Color(127, 127, 127), Color(127, 100, 100), Color(127, 75, 75), ] >>> picture = Image(1280, 720, pixels) >>> p = Color(127, 75, 25) >>> p[1] 75 >>> p.b 25 -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
> Tuple sublcasses factory > A2ribute lookup > Indexable > Iterable > Helpful docstring and repr > Since Python 2.6 collections.namedtuple -
{ “event”: “PyCon ES 2013”, “author”: “Pablo Enfedaque”, “twi2er”: “pablitoev56”}
Q&A Thanks for coming! Slides:
 pablito56
 kosukesaigusa
 seyfoyun
 yahir0
 ktombow
 utakaha
 yosuke_furukawa
 yuta_onishi_97
 drumath2237
 ziobrando
 steliosf
 marcoroth
 soudai
 frankvandijk
 kneath
 smashingmag
 eileencodes
 axbom
 pwiseman
 csswizardry
 ivargrimstad
 garrettdimon
 letsgokoyo
 lindahogenes