Share
Embed
Search platform migration at MercariUS/Mercari USにおけるElasticsearchへの検索基盤移行:マイグレーションの知見と課題
ElasticsearchJP #53
Kazuma Arimura
April 26, 2023
Transcript
47 slides
-
2023 Contents (~30min) • プロジェクトの全容 • 準備 : 安定運用のための事前準備 •
実践 : 直面した課題とクエリチューニング • 教育 : 未経験メンバーが短期間でオンボードするために -
Got stuff you don’t use? Sell or buy almost
anything from home. メルカリは、世界的なマーケットプレイスを創ることを目指し、創業翌年から海外展開を推し進めています。 2014年9月にUS事業を開始し、現地の嗜好やマーケットの特徴に合わせたブランディングやUI・UXの改良、配送網 の構築等に取り組んでいます。巨大かつ多様性に富む人口基盤を有するUSでの成功が、メルカリのミッションを実 現する上で重要なマイルストーンであると認識しており、注力しています。 5 Your Marketplace US事業について Factbookより引用 -
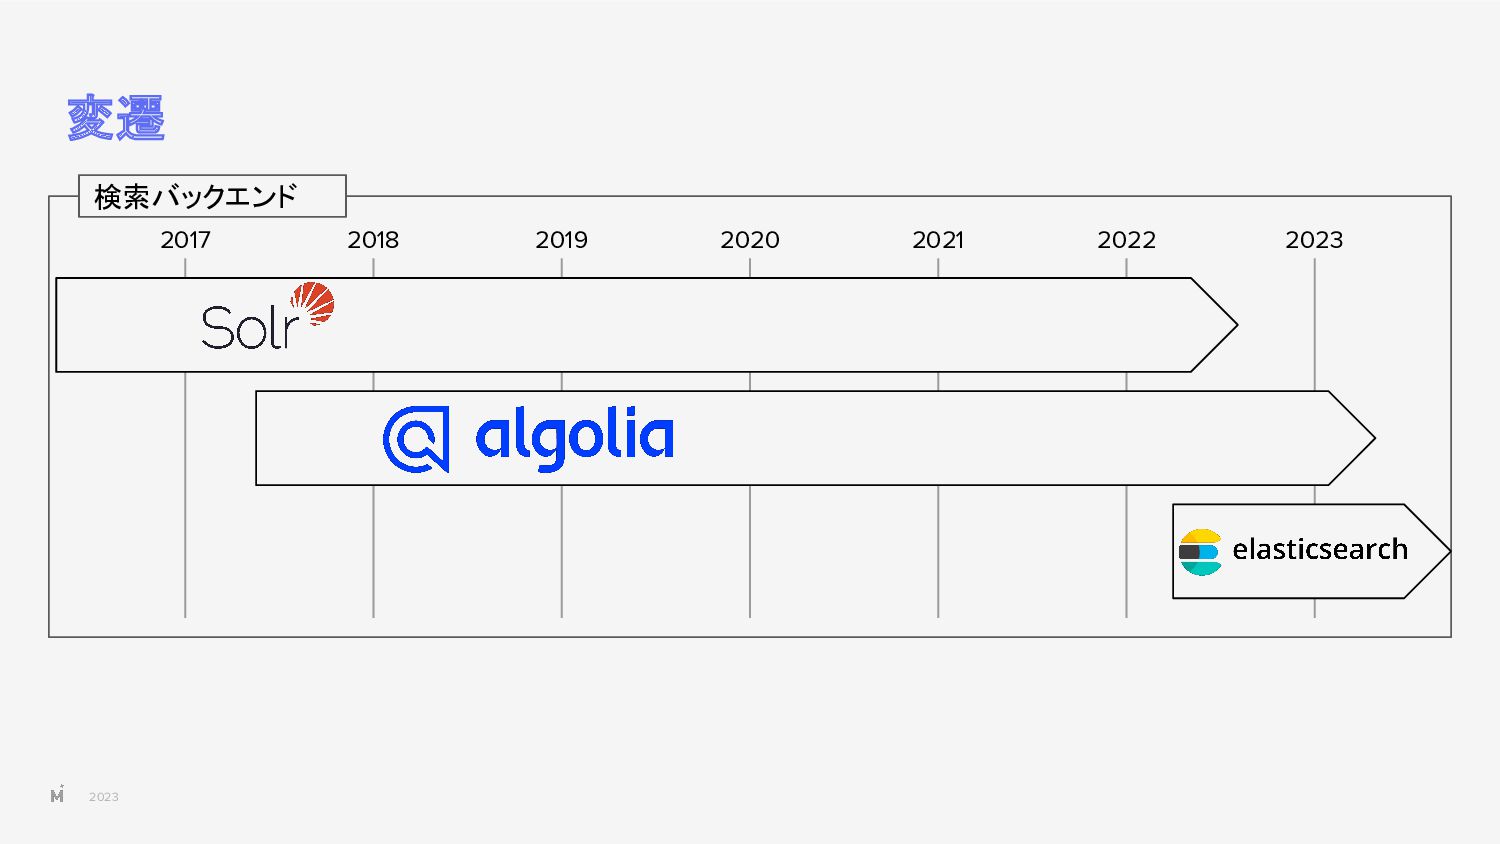
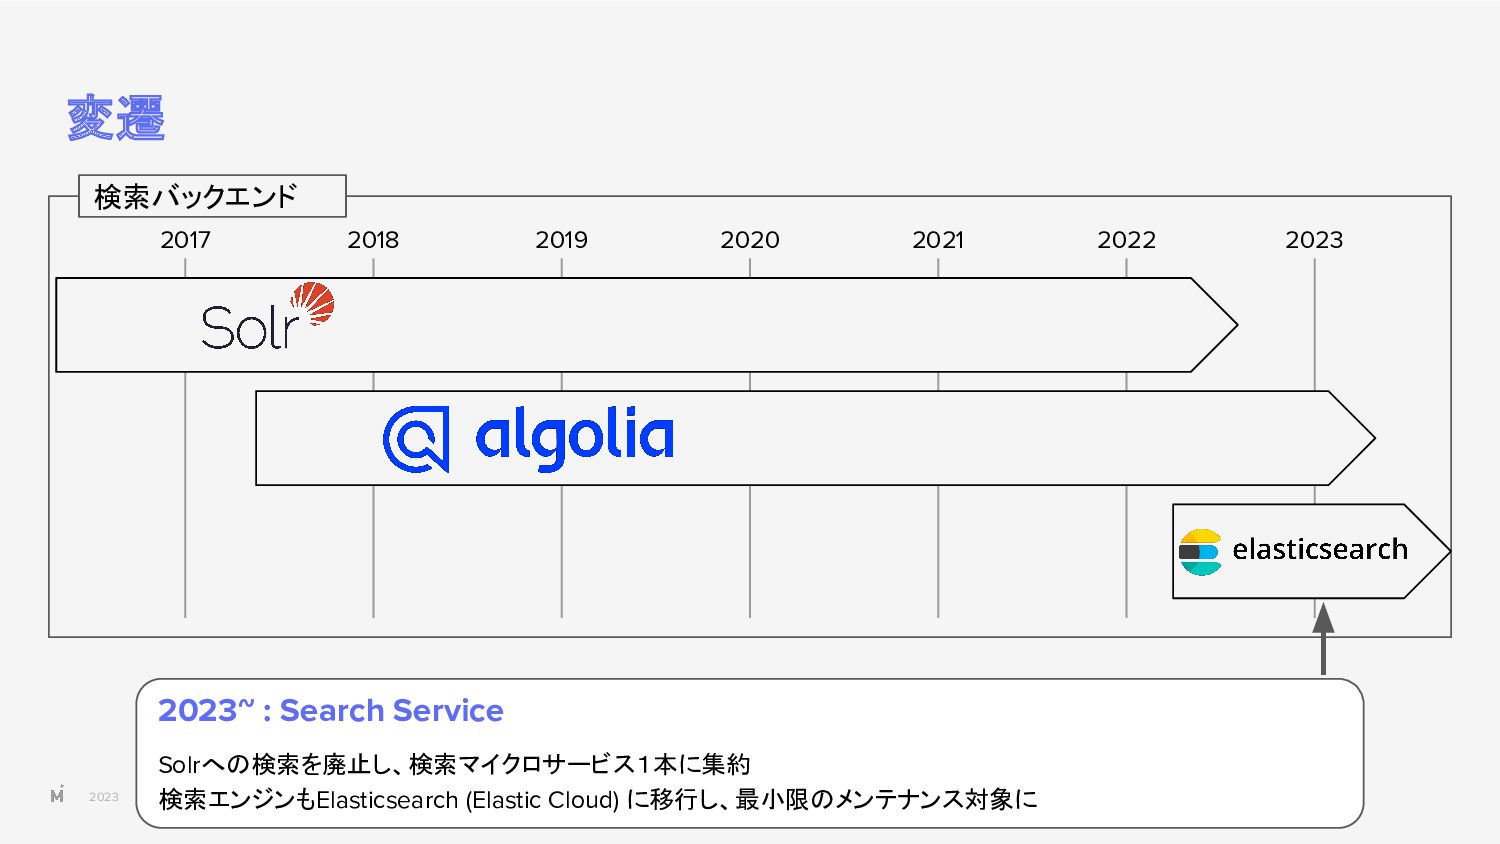
2023 変遷 検索バックエンド 2017 2018 2019 2020 2021 2022 2023
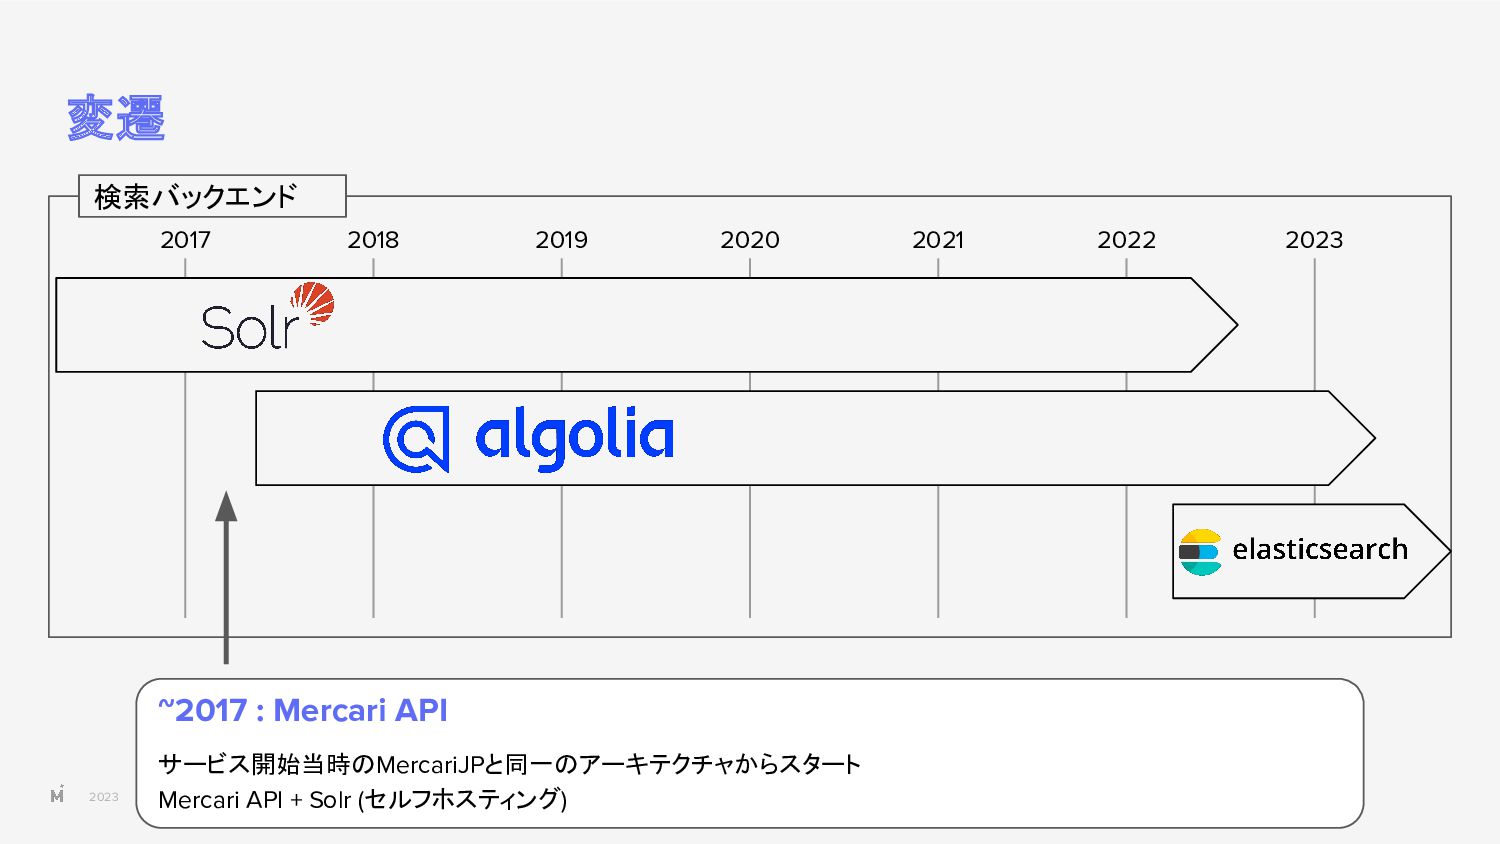
~2017 : Mercari API サービス開始当時のMercariJPと同一のアーキテクチャからスタート Mercari API + Solr (セルフホスティング) -
2023 変遷 検索バックエンド 2017 2018 2019 2020 2021 2022 2023
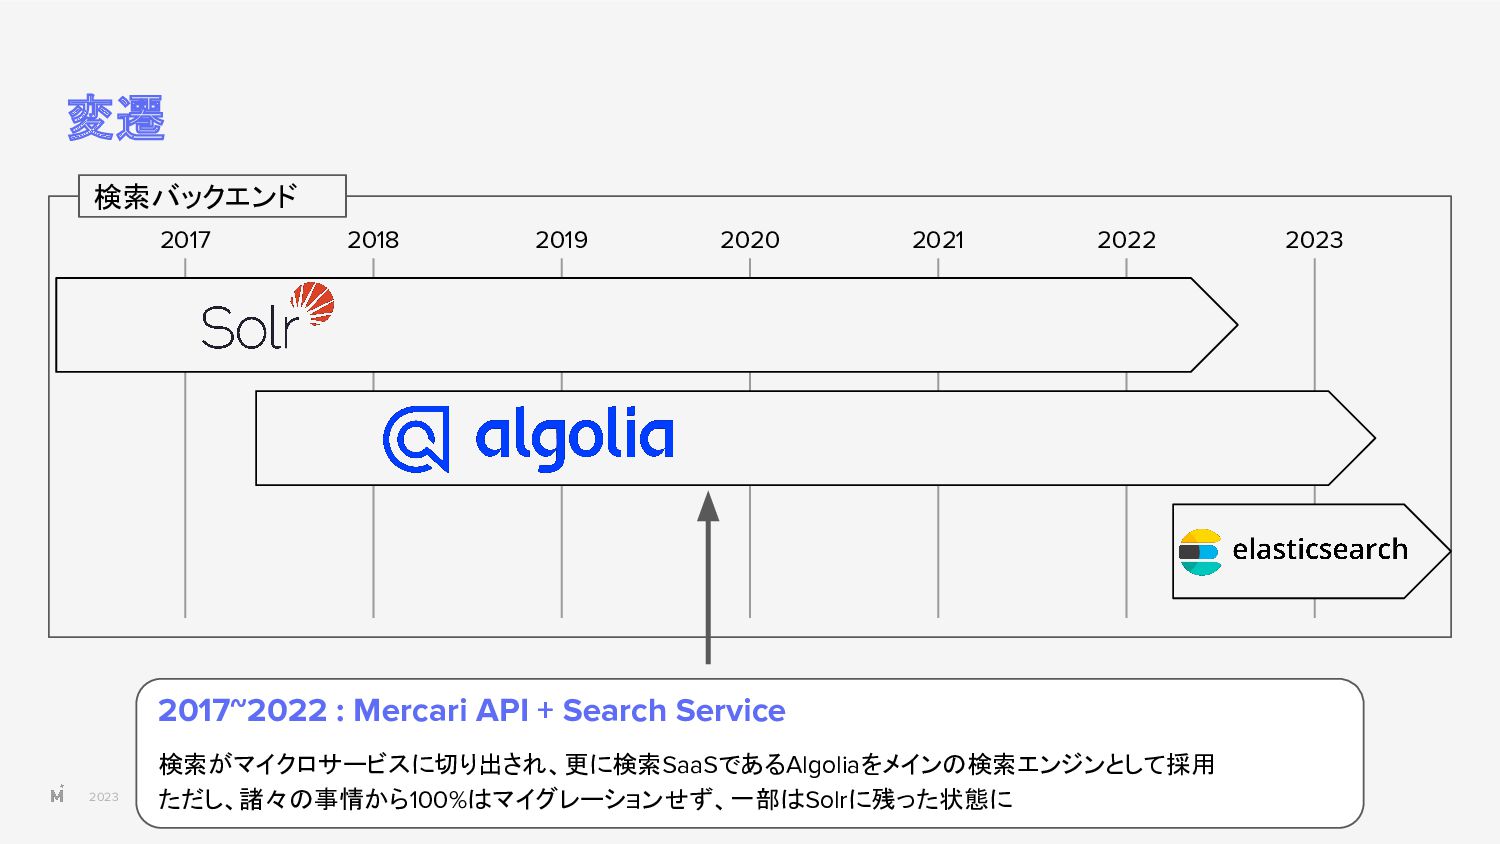
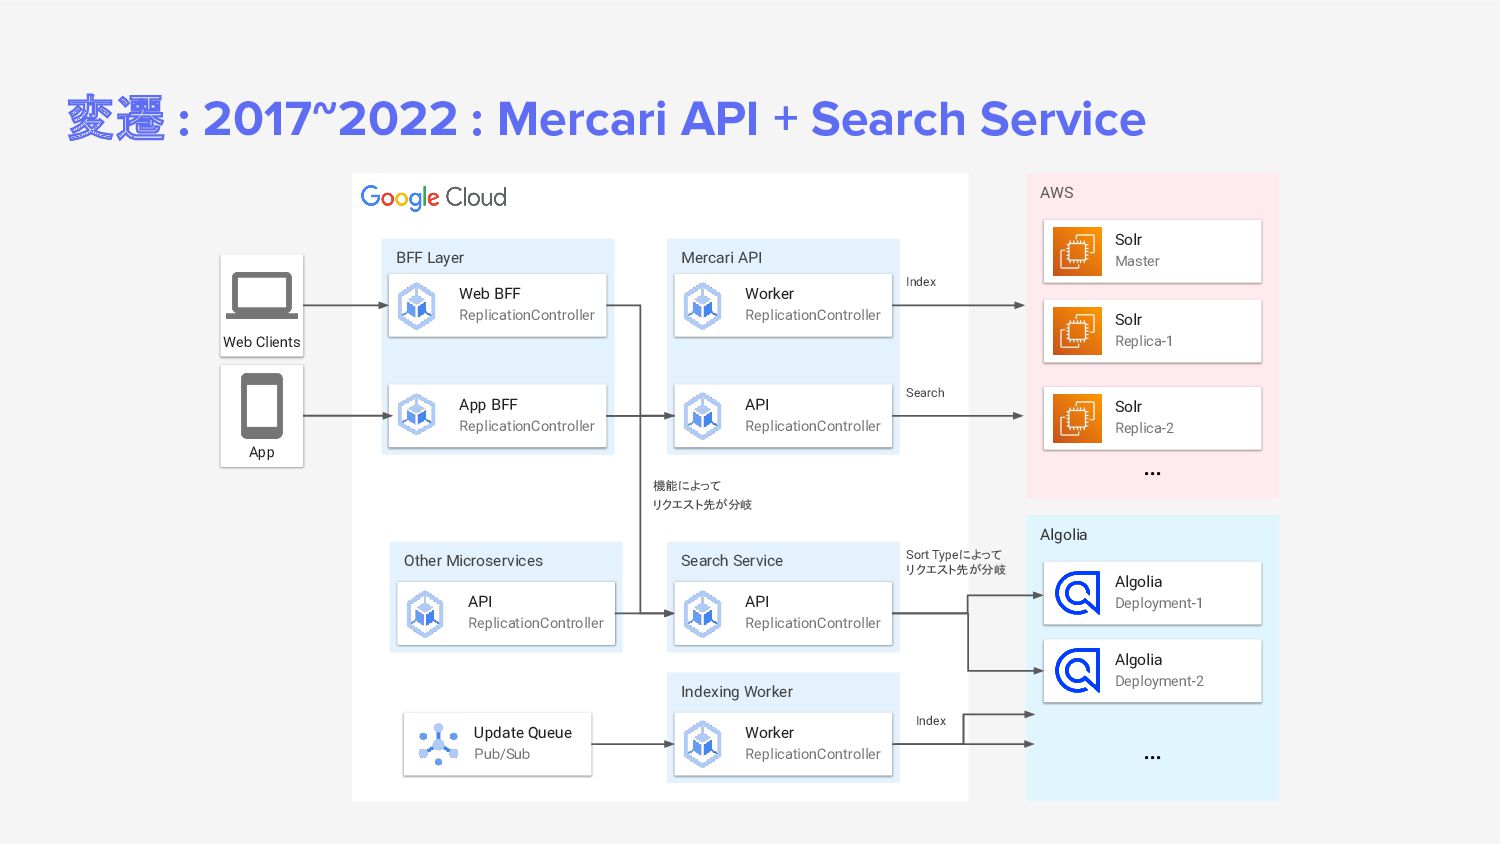
2017~2022 : Mercari API + Search Service 検索がマイクロサービスに切り出され、更に検索SaaSであるAlgoliaをメインの検索エンジンとして採用 ただし、諸々の事情から100%はマイグレーションせず、一部はSolrに残った状態に -
AWS Web Clients BFF Layer App BFF ReplicationController Web BFF
ReplicationController App Algolia Mercari API API ReplicationController Worker ReplicationController Solr Master Solr Replica-1 Solr Replica-2 … Index Search Search Service API ReplicationController Indexing Worker Worker ReplicationController Update Queue Pub/Sub Algolia Deployment-1 Algolia Deployment-2 … 機能によって リクエスト先が分岐 Sort Typeによって リクエスト先が分岐 Index Other Microservices API ReplicationController 変遷 : 2017~2022 : Mercari API + Search Service -
2023 変遷 検索バックエンド 2017 2018 2019 2020 2021 2022 2023
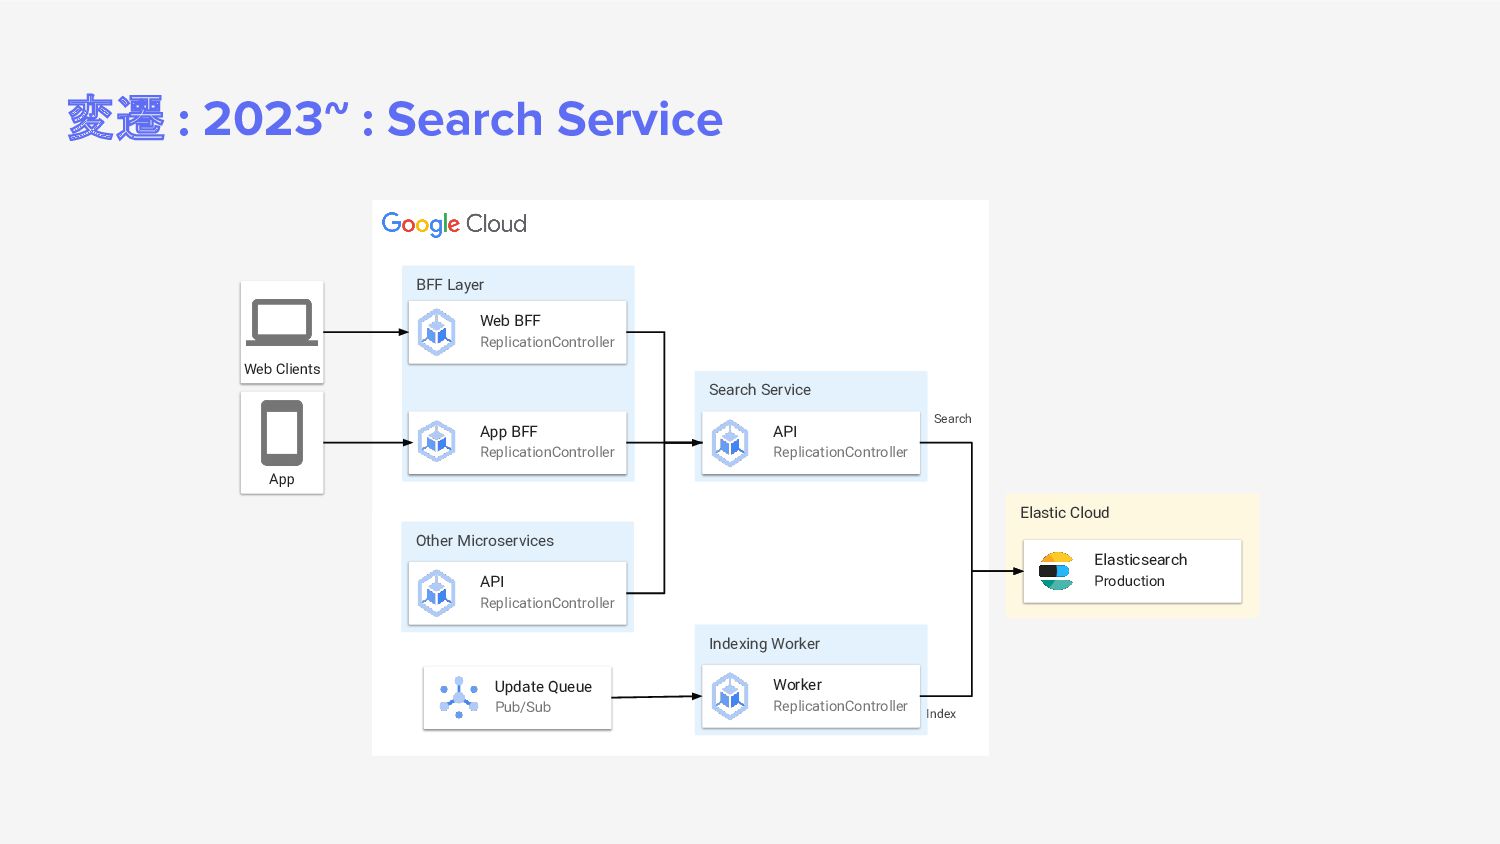
2023~ : Search Service Solrへの検索を廃止し、検索マイクロサービス1本に集約 検索エンジンもElasticsearch (Elastic Cloud) に移行し、最小限のメンテナンス対象に -
変遷 : 2023~ : Search Service Elastic Cloud Web Clients
BFF Layer App BFF ReplicationController Web BFF ReplicationController App Search Service API ReplicationController Indexing Worker Worker ReplicationController Update Queue Pub/Sub Elasticsearch Production Index Other Microservices API ReplicationController Search -
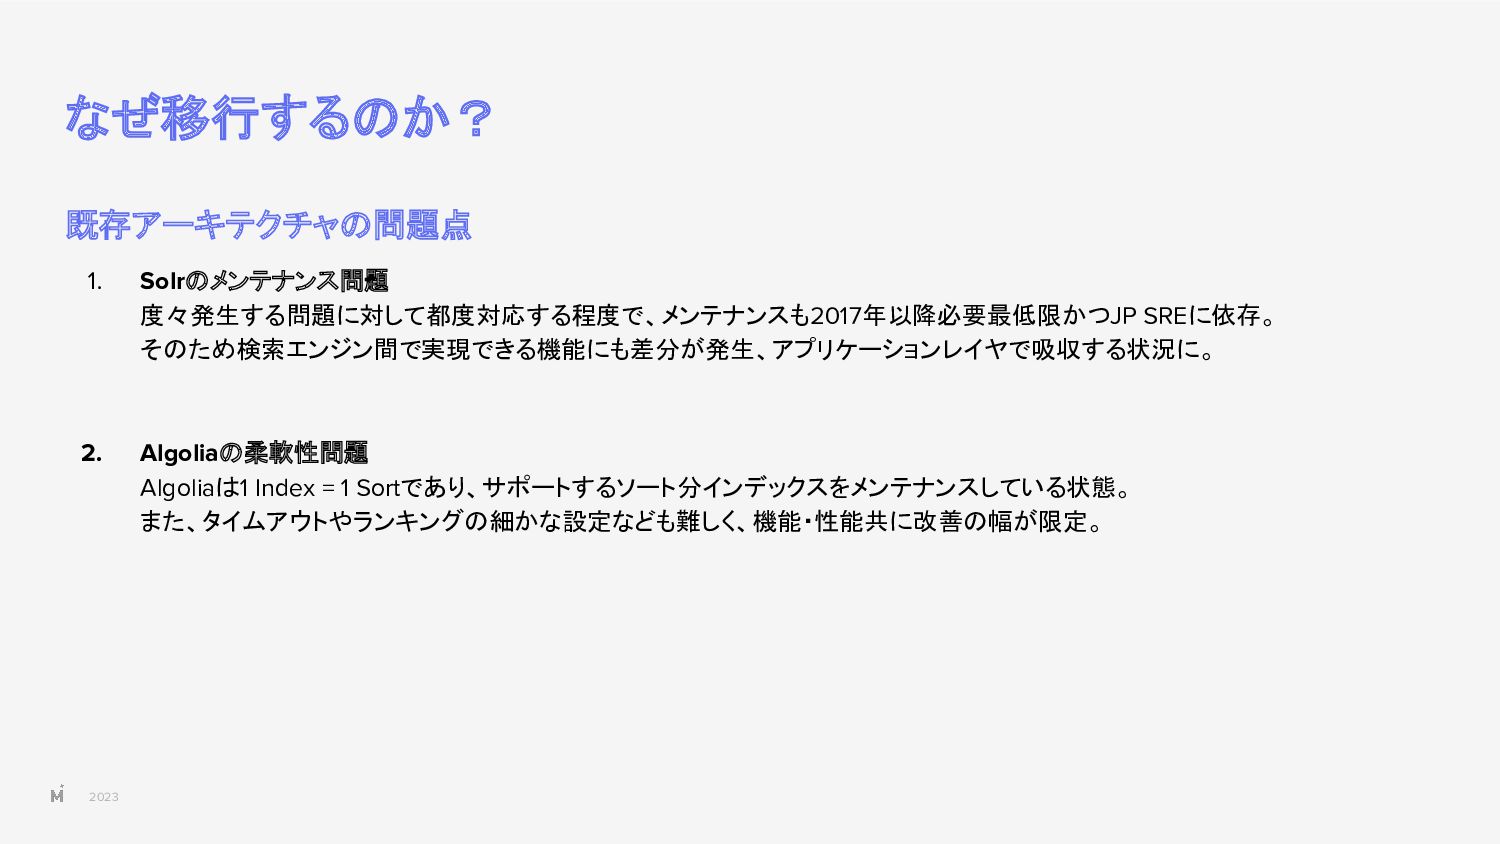
2023 なぜ移行するのか? 既存アーキテクチャの問題点 1. Solrのメンテナンス問題 度々発生する問題に対して都度対応する程度で、メンテナンスも2017年以降必要最低限かつJP SREに依存。 そのため検索エンジン間で実現できる機能にも差分が発生、アプリケーションレイヤで吸収する状況に。 2. Algoliaの柔軟性問題
Algoliaは1 Index = 1 Sortであり、サポートするソート分インデックスをメンテナンスしている状態。 また、タイムアウトやランキングの細かな設定なども難しく、機能・性能共に改善の幅が限定。 -
2023 なぜ移行するのか? 1. Flexibility さらなる改善のため、より細かな条件で細かなランキング・機能改 善が行える環境が求められた。 2. Scalability & Availability
今後も商品数・リクエスト数が増える事を加味すると、 柔軟なスケーリングが必須条件となった。 3. Maintainability 自分たちではコントロールしようのない事象が度々発生。 透明性が高く自らコードレベルで調査できる検索エンジンが好まし かった。 Migration by Nick Youngson CC BY-SA 3.0 Pix4free -
2023 マイグレーションしてどう変わったか? 👍改善した点 • インフラコスト面の改善 ◦ SolrとAlgoliaをElasticsearchに集約できたこともあり、大幅な削減に • Recallの改善 ◦
レイテンシ等の制約からAlgoliaの内部処理で一部結果が切り捨てられており、思わぬ収穫に • クエリ表現を含めた柔軟性の向上 ◦ マイグレーションと並行して様々な改善を行っており、半年で大小合わせ10個以上のA/Bテストを実施 👎課題点 • オペレーションコストの増加 • Algoliaで利用していたOptimization機能の一部がまだ実装しきれていない • スケーリング ◦ 前回の勉強会で@k-yomoが発表したAuto Scalerを試験運用中 -
2023 1. 負荷試験 / スケーリング特性の調査 調査目的 • コスト感の把握 • サービスが要求するレベルのオペレーションに耐えられるか
調査項目 • インデキシングのスループット評価 • 検索のスケーリング特性評価 調査方法 • インデキシング => Algolia上にあるドキュメント同等のデータのスループット計測 • 検索 => GKE上にLocustを構築し、クエリログから仮のクエリを作成、テスト -
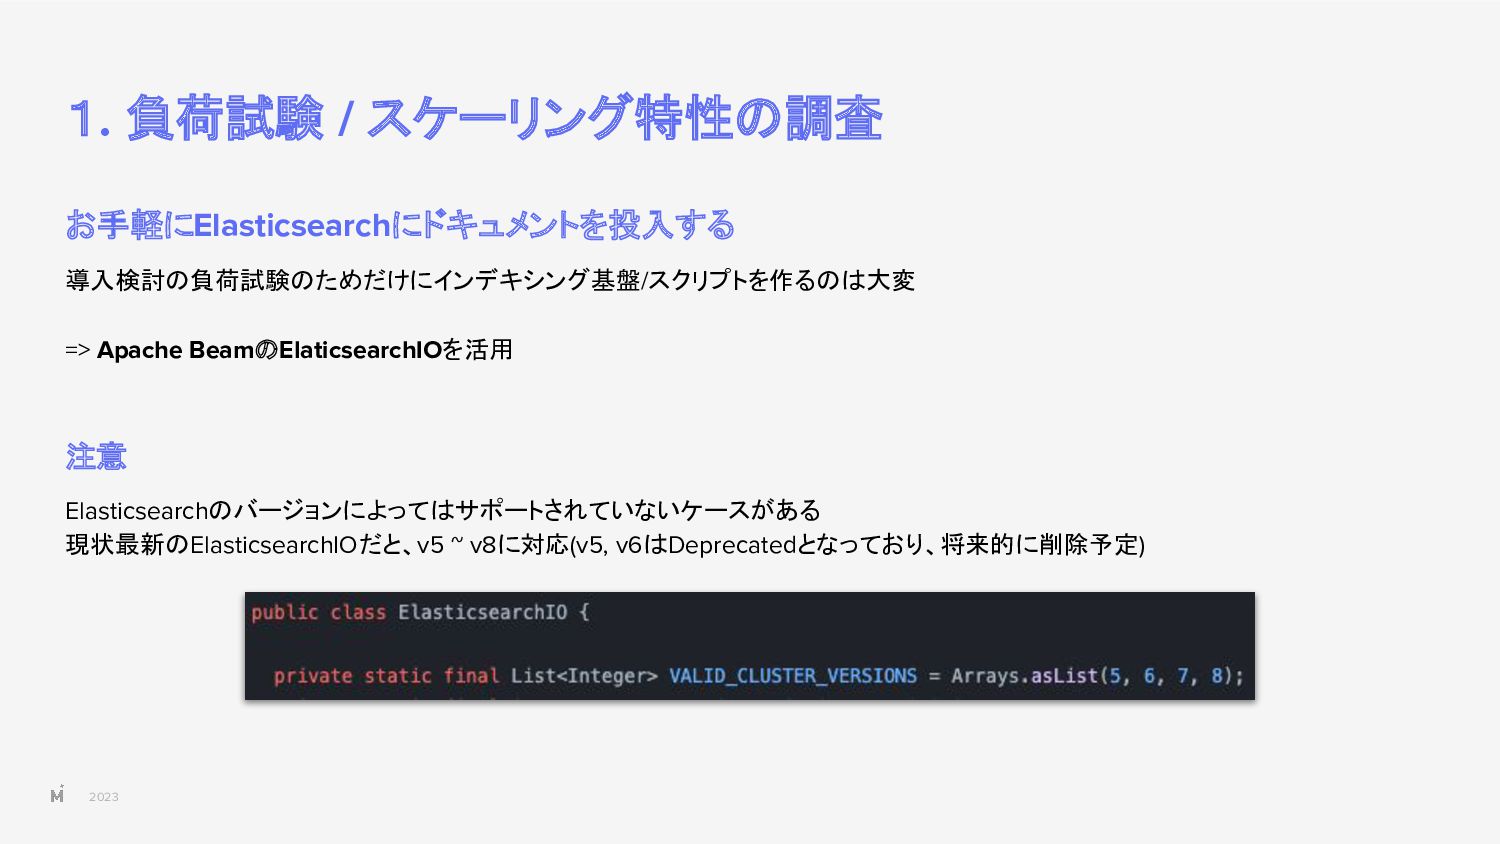
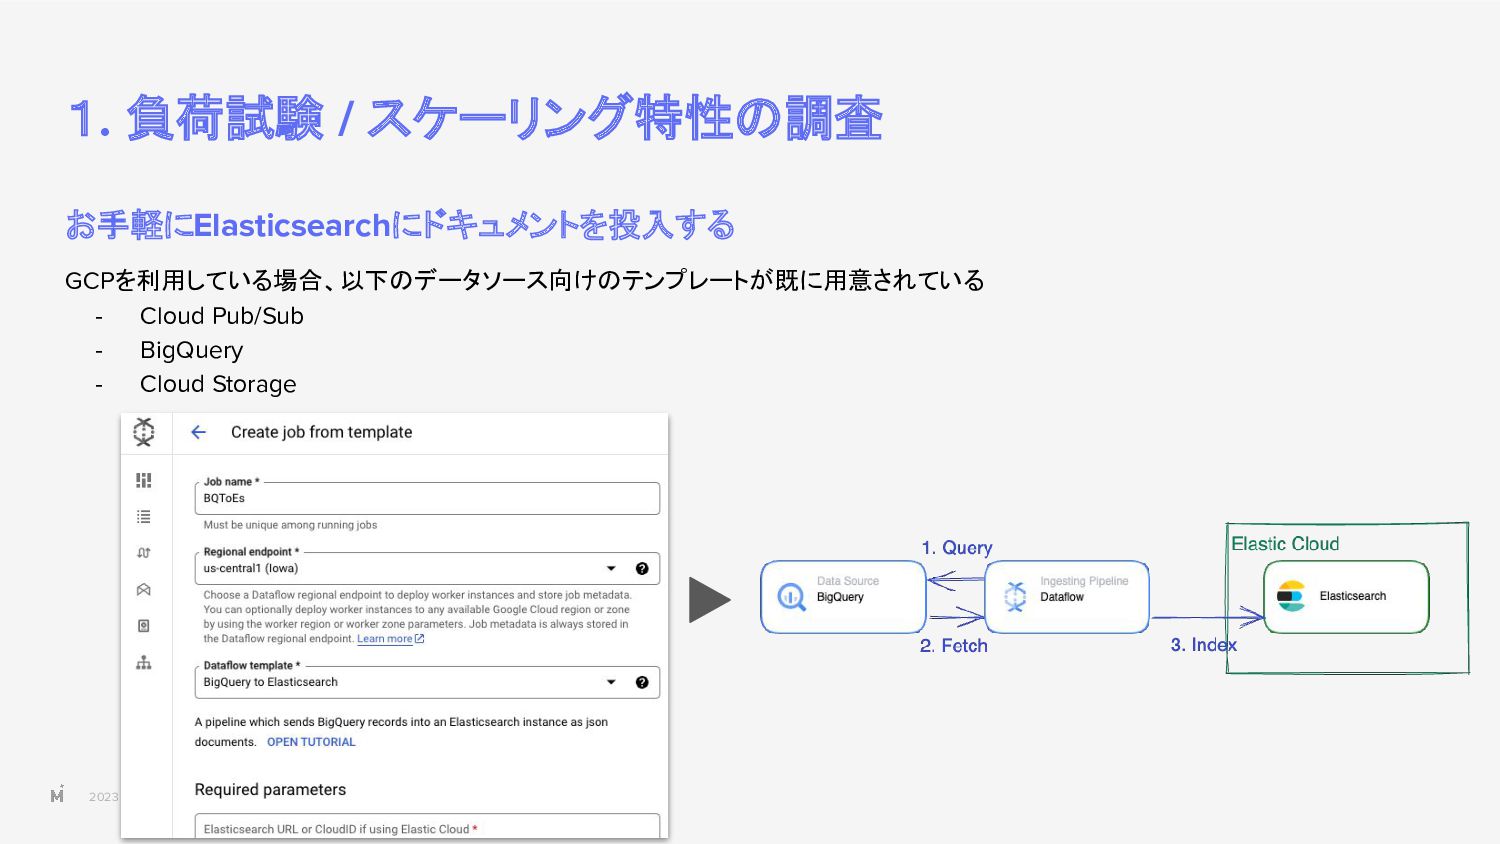
2023 1. 負荷試験 / スケーリング特性の調査 お手軽にElasticsearchにドキュメントを投入する 導入検討の負荷試験のためだけにインデキシング基盤/スクリプトを作るのは大変 => Apache BeamのElaticsearchIOを活用
注意 Elasticsearchのバージョンによってはサポートされていないケースがある 現状最新のElasticsearchIOだと、v5 ~ v8に対応(v5, v6はDeprecatedとなっており、将来的に削除予定) -
2023 1. 負荷試験 / スケーリング特性の調査 調査目的 • コスト感の把握 • サービスが要求するレベルのオペレーションに耐えられるか
調査項目 • インデキシングのスループット評価 • 検索のスケーリング特性評価 調査方法 • インデキシング => Algolia上にあるドキュメント同等のデータのスループット計測 • 検索 => GKE上にLocustを構築し、クエリログから仮のクエリを作成、テスト -
2023 1. 負荷試験 / スケーリング特性の調査 調査目的 • コスト感の把握 • サービスが要求するレベルのオペレーションに耐えられるか
調査項目 • インデキシングのスループット評価 ◦ ✅要求するインデキシングのスループットを達成 • 検索のスケーリング特性評価 調査方法 • インデキシング => Algolia上にあるドキュメント同等のデータのスループット計測 • 検索 => GKE上にLocustを構築し、クエリログから仮のクエリを作成、テスト -
2023 1. 負荷試験 / スケーリング特性の調査 調査目的 • コスト感の把握 • サービスが要求するレベルのオペレーションに耐えられるか
調査項目 • インデキシングのスループット評価 • 検索のスケーリング特性評価 ◦ ✅ノード数にほぼ比例する形でスループットがスケール ◦ ✅既存検索エンジンと比較してもコスト面で移行メリットがあることを確認 調査方法 • インデキシング => Algolia上にあるドキュメント同等のデータのスループット計測 • 検索 => GKE上にLocustを構築し、クエリログから仮のクエリを作成、テスト -
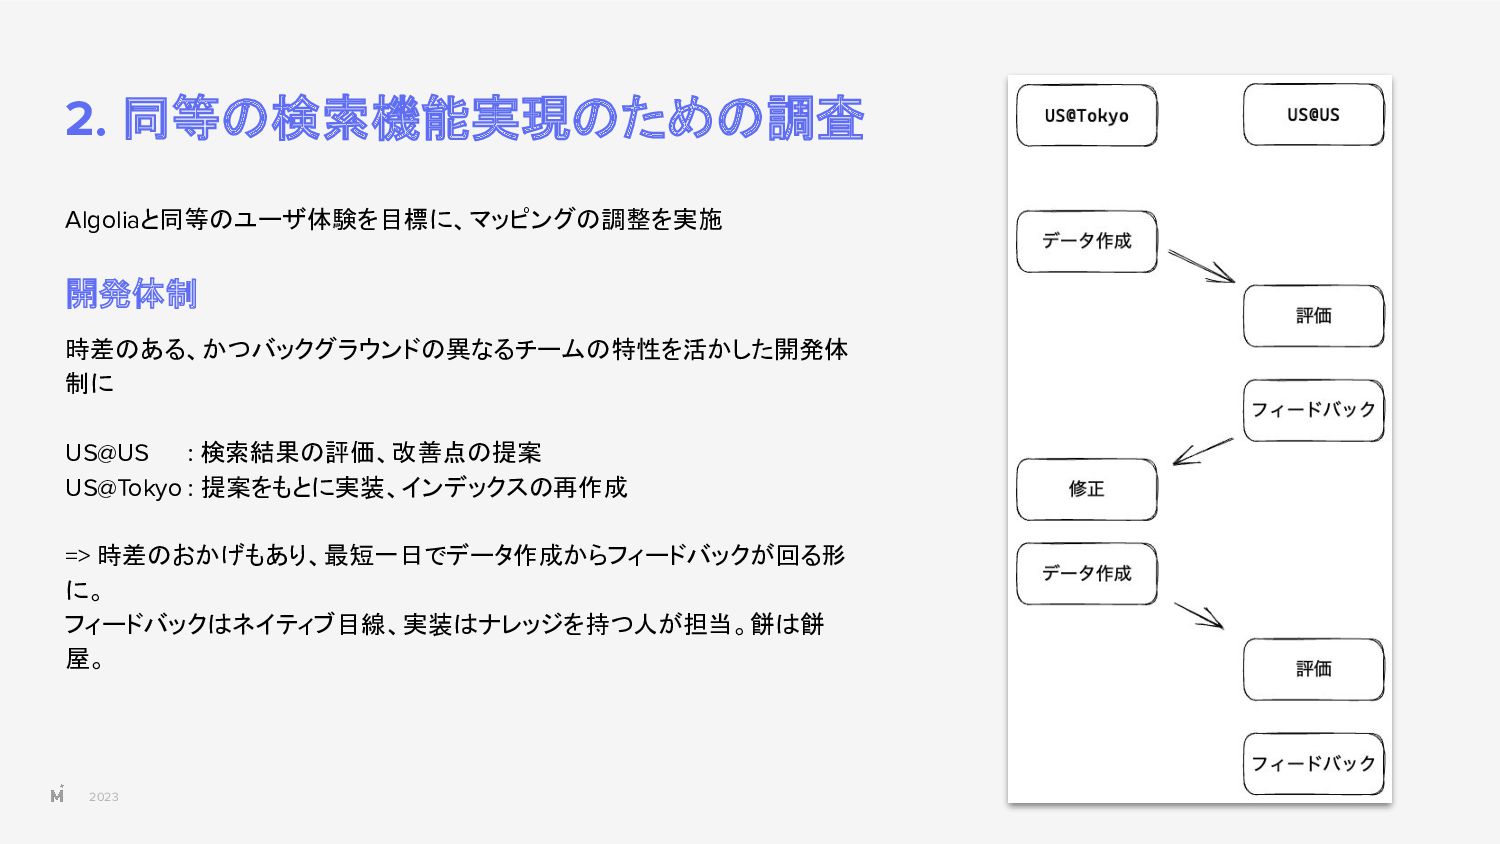
2023 2. 同等の検索機能実現のための調査 Algoliaと同等のユーザ体験を目標に、マッピングの調整を実施 開発体制 時差のある、かつバックグラウンドの異なるチームの特性を活かした開発体 制に US@US : 検索結果の評価、改善点の提案
US@Tokyo : 提案をもとに実装、インデックスの再作成 => 時差のおかげもあり、最短一日でデータ作成からフィードバックが回る形 に。 フィードバックはネイティブ目線、実装はナレッジを持つ人が担当。餅は餅 屋。 -
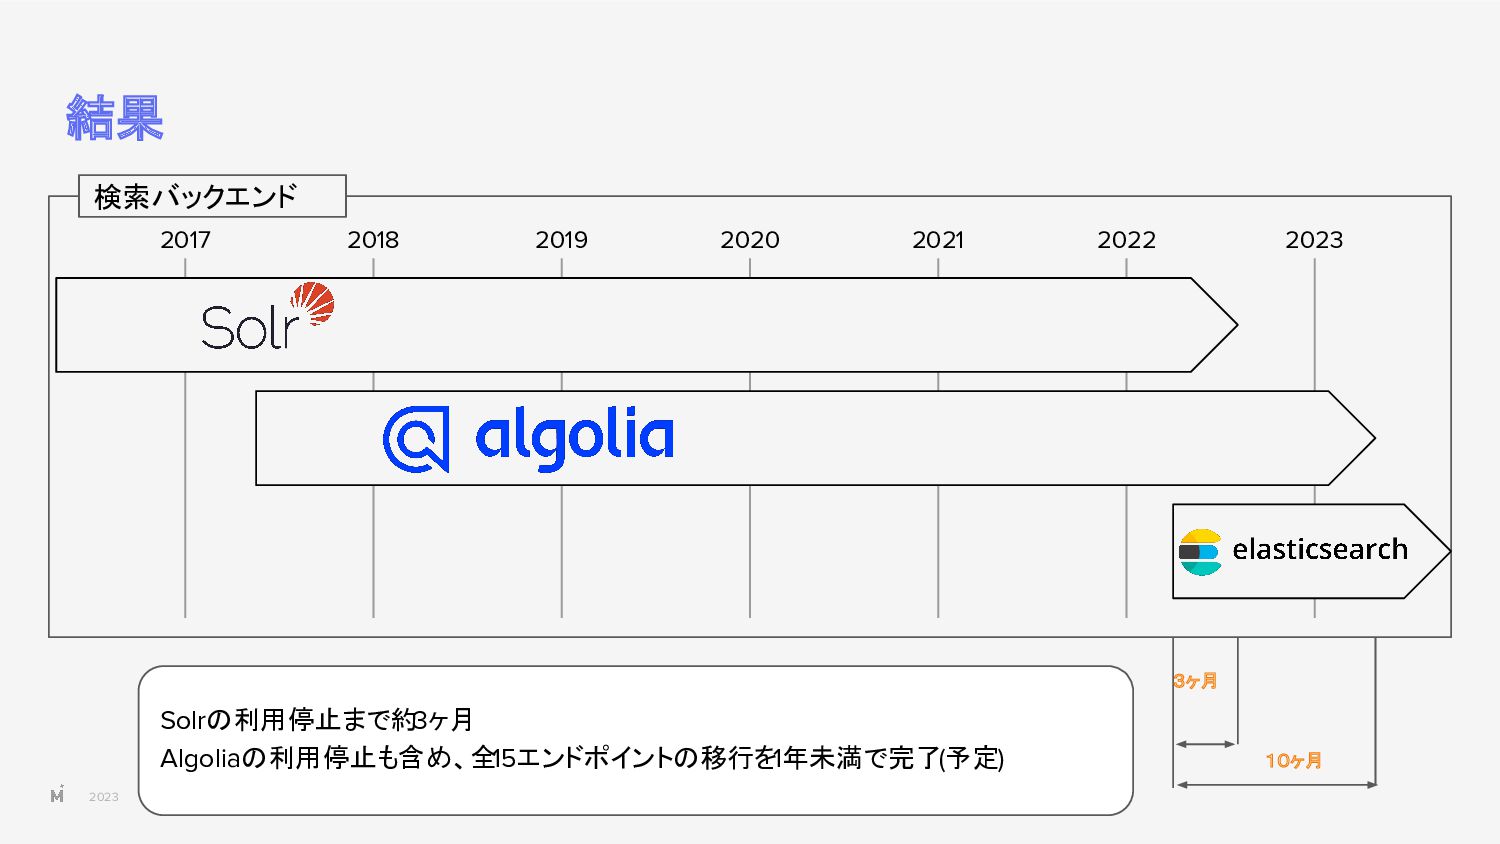
2023 結果 検索バックエンド 2017 2018 2019 2020 2021 2022 2023
Solrの利用停止まで約3ヶ月 Algoliaの利用停止も含め、全15エンドポイントの移行を1年未満で完了(予定) 3ヶ月 10ヶ月 -
2023 Kosuke Arase 株式会社メルカリ Software Engineer at US@Tokyo ・検索エンジン周り運用 ・検索システムの信頼性、可用性向上
@KosukeArase / @KosukeArase -
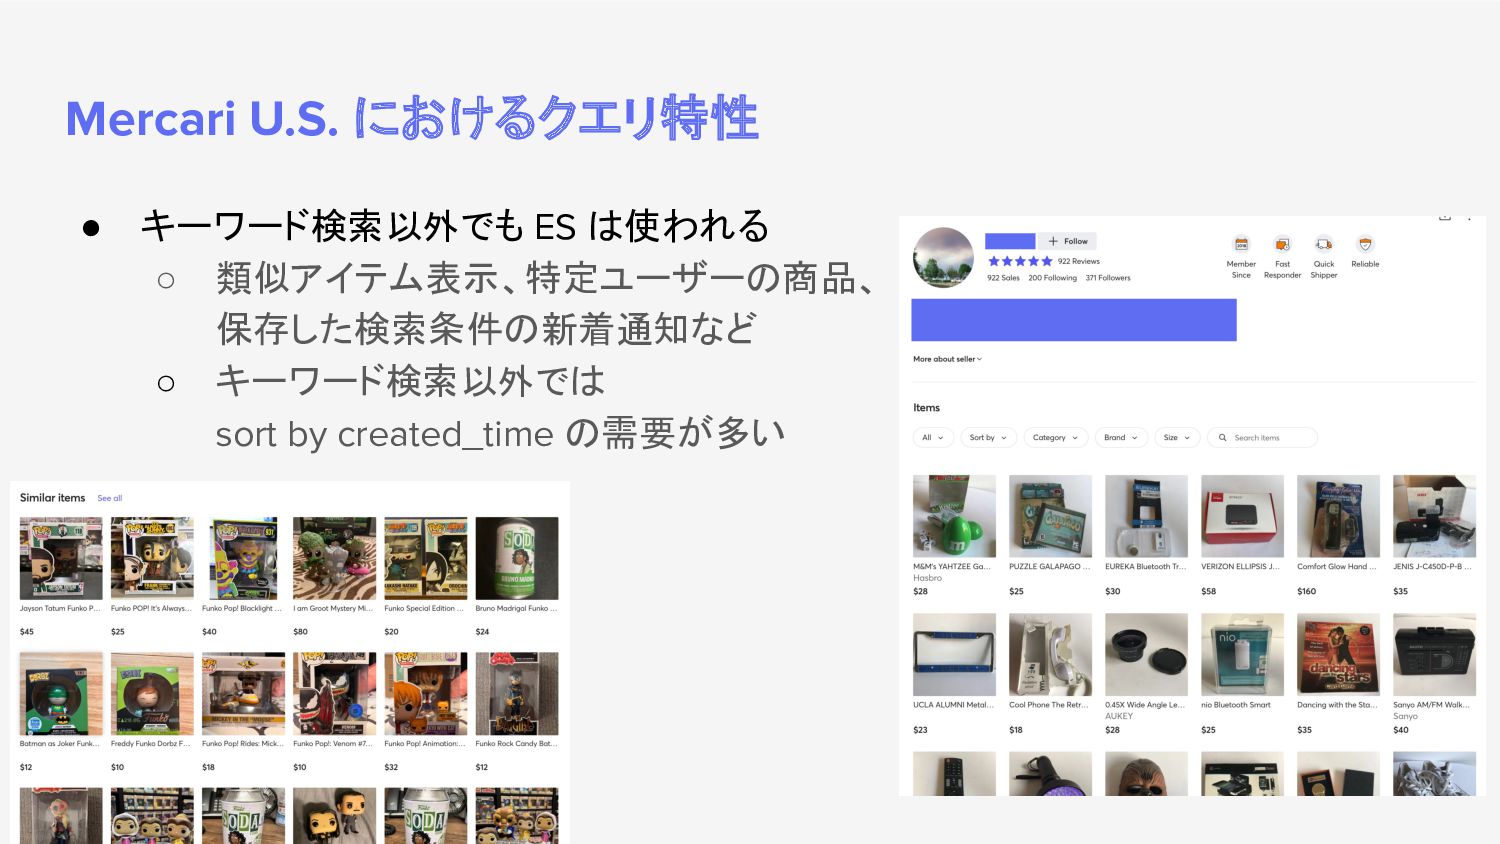
2023 Mercari U.S. におけるクエリ特性 • キーワード検索以外でも ES は使われる ◦ 類似アイテム表示、特定ユーザーの商品、
保存した検索条件の新着通知など ◦ キーワード検索以外では sort by created_time の需要が多い -
2023 • 他の EC と違い在庫という概念がないため、ユーザーには同一商品を複数出品す るインセンティブが大きい → 重複商品の排除ロジックが必要 ◦ 商品情報から
hash を計算しておいて field collapsing により重複排除 Mercari U.S. におけるクエリ特性 -
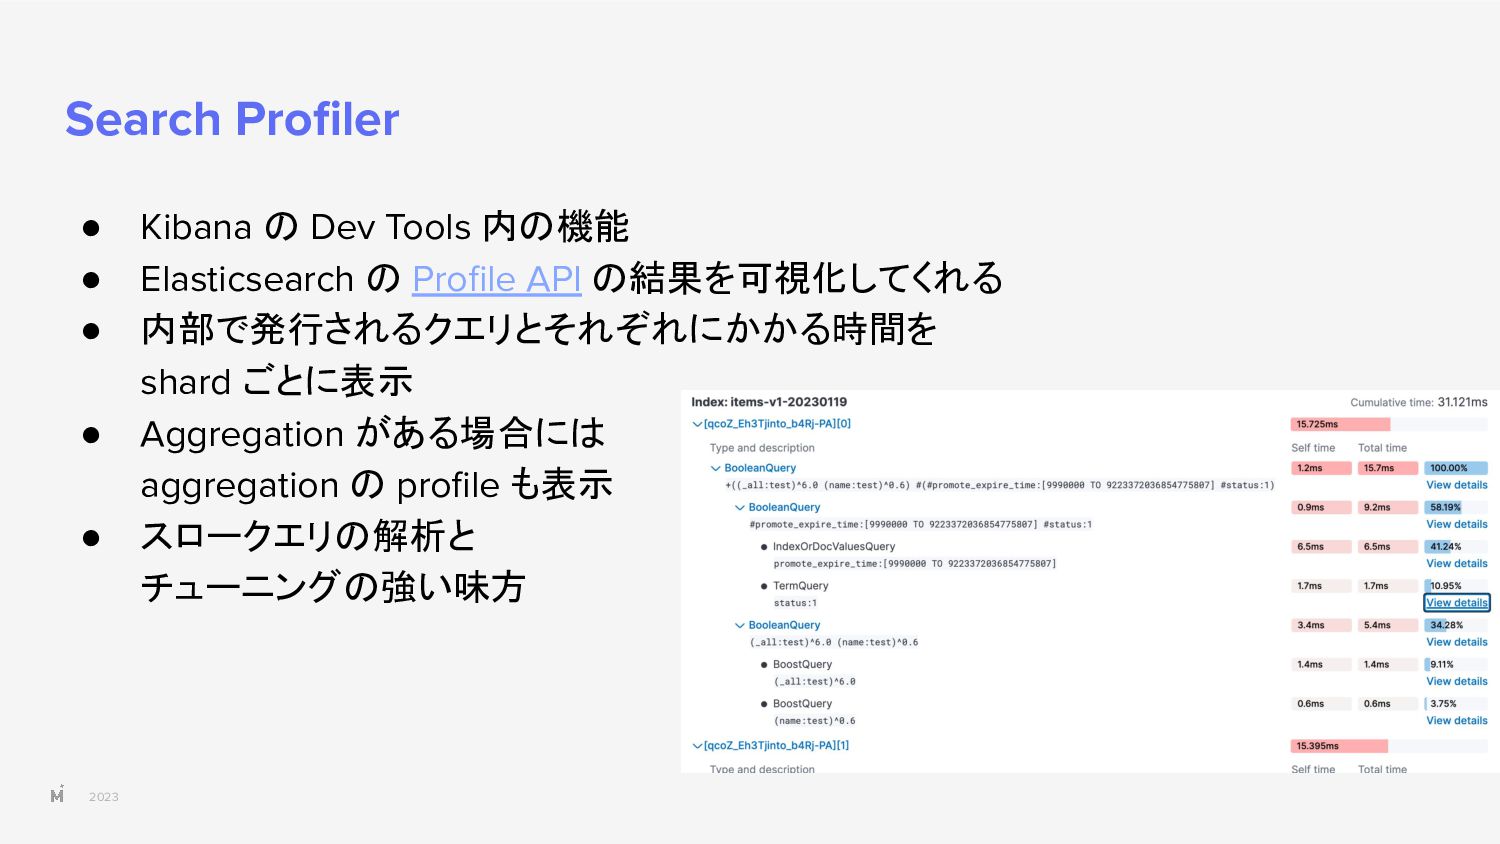
2023 Search Profiler • Kibana の Dev Tools 内の機能 •
Elasticsearch の Profile API の結果を可視化してくれる • 内部で発行されるクエリとそれぞれにかかる時間を shard ごとに表示 • Aggregation がある場合には aggregation の profile も表示 • スロークエリの解析と チューニングの強い味方 -
2023 Index Sorting • 通常の検索以外では、キーワードがなくカテゴリやブランドのみのような hit 数が大きいクエリが多い • sort by
created_time のクエリが比較的多いため、Index Sorting はかなり有効 ◦ 各 segment 内での順序を指定し、index 時に sort ◦ Sort 順を index sort と同一にすることで、 走査時に early termination を行うため効率が良い ◦ track_total_hits を false にすることで、 size の分だけ走査 ◦ AND フィルターの高速化にもなどにも効く(ref) • hit 数が大きいクエリで特に顕著に改善 (数百ms -> 10ms) -
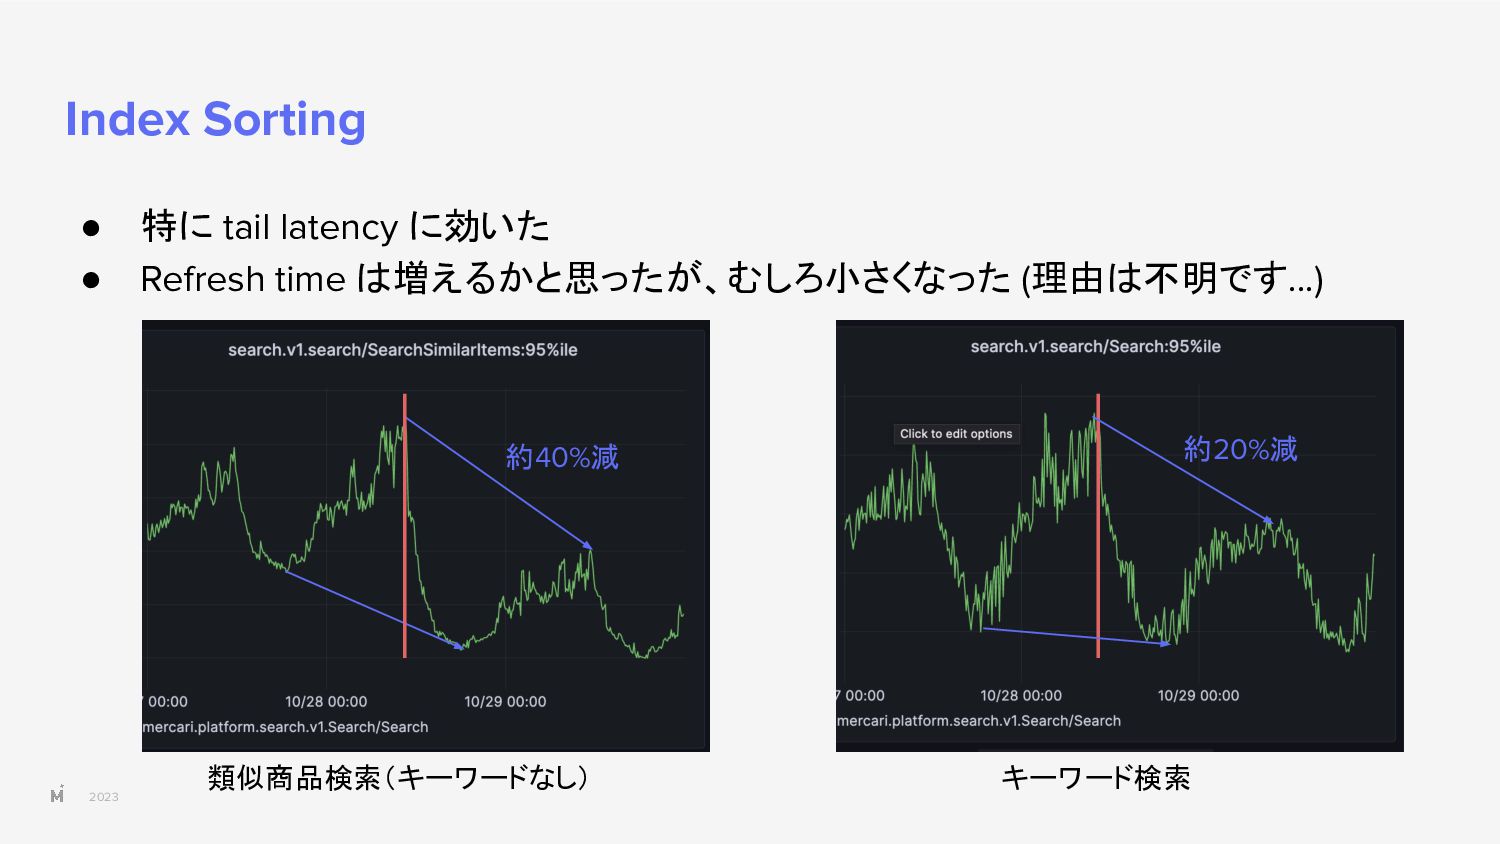
2023 Index Sorting • 特に tail latency に効いた • Refresh
time は増えるかと思ったが、むしろ小さくなった (理由は不明です...) 類似商品検索(キーワードなし) キーワード検索 約40%減 約20%減 -
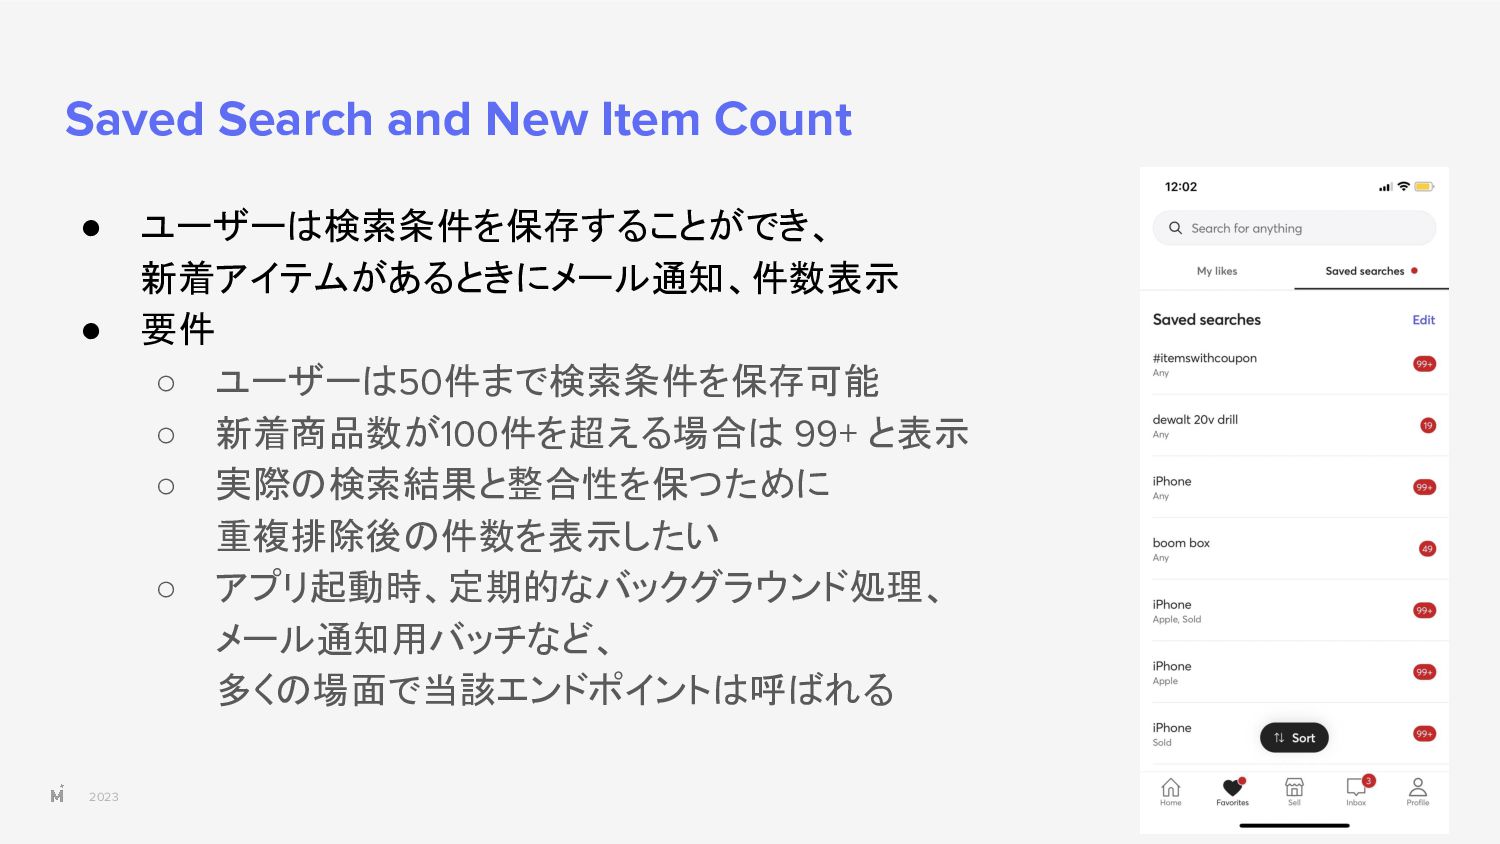
2023 Saved Search and New Item Count • ユーザーは検索条件を保存することができ、 新着アイテムがあるときにメール通知、件数表示
• 要件 ◦ ユーザーは50件まで検索条件を保存可能 ◦ 新着商品数が100件を超える場合は 99+ と表示 ◦ 実際の検索結果と整合性を保つために 重複排除後の件数を表示したい ◦ アプリ起動時、定期的なバックグラウンド処理、 メール通知用バッチなど、 多くの場面で当該エンドポイントは呼ばれる -
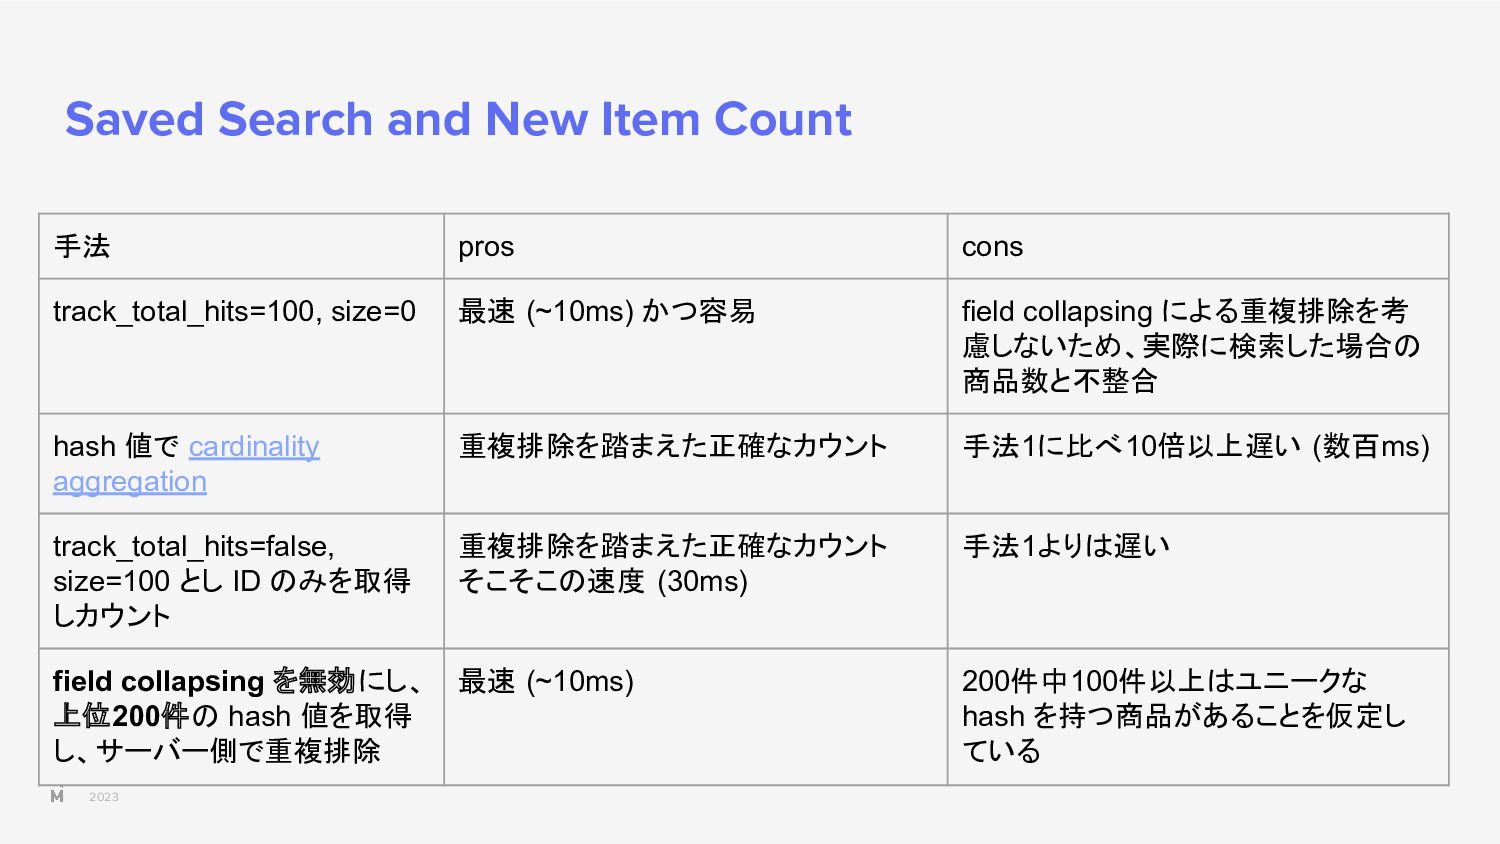
2023 手法 pros cons track_total_hits=100, size=0 最速 (~10ms) かつ容易 field
collapsing による重複排除を考 慮しないため、実際に検索した場合の 商品数と不整合 hash 値で cardinality aggregation 重複排除を踏まえた正確なカウント 手法1に比べ10倍以上遅い (数百ms) track_total_hits=false, size=100 とし ID のみを取得 しカウント 重複排除を踏まえた正確なカウント そこそこの速度 (30ms) 手法1よりは遅い field collapsing を無効にし、 上位200件の hash 値を取得 し、サーバー側で重複排除 最速 (~10ms) 200件中100件以上はユニークな hash を持つ商品があることを仮定し ている Saved Search and New Item Count -
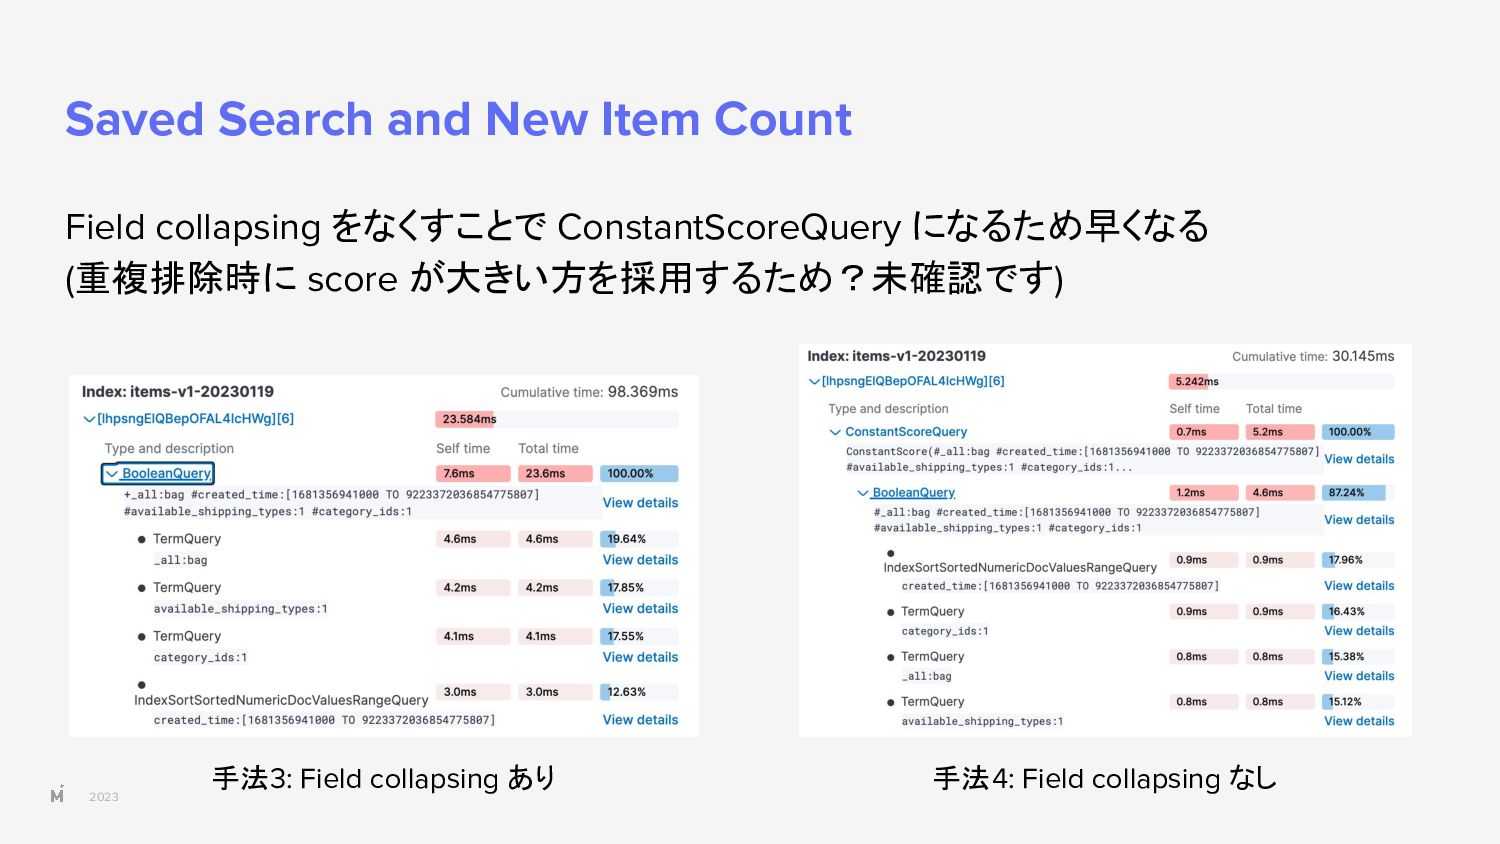
2023 Field collapsing をなくすことで ConstantScoreQuery になるため早くなる (重複排除時に score が大きい方を採用するため?未確認です) 手法3:
Field collapsing あり 手法4: Field collapsing なし Saved Search and New Item Count -
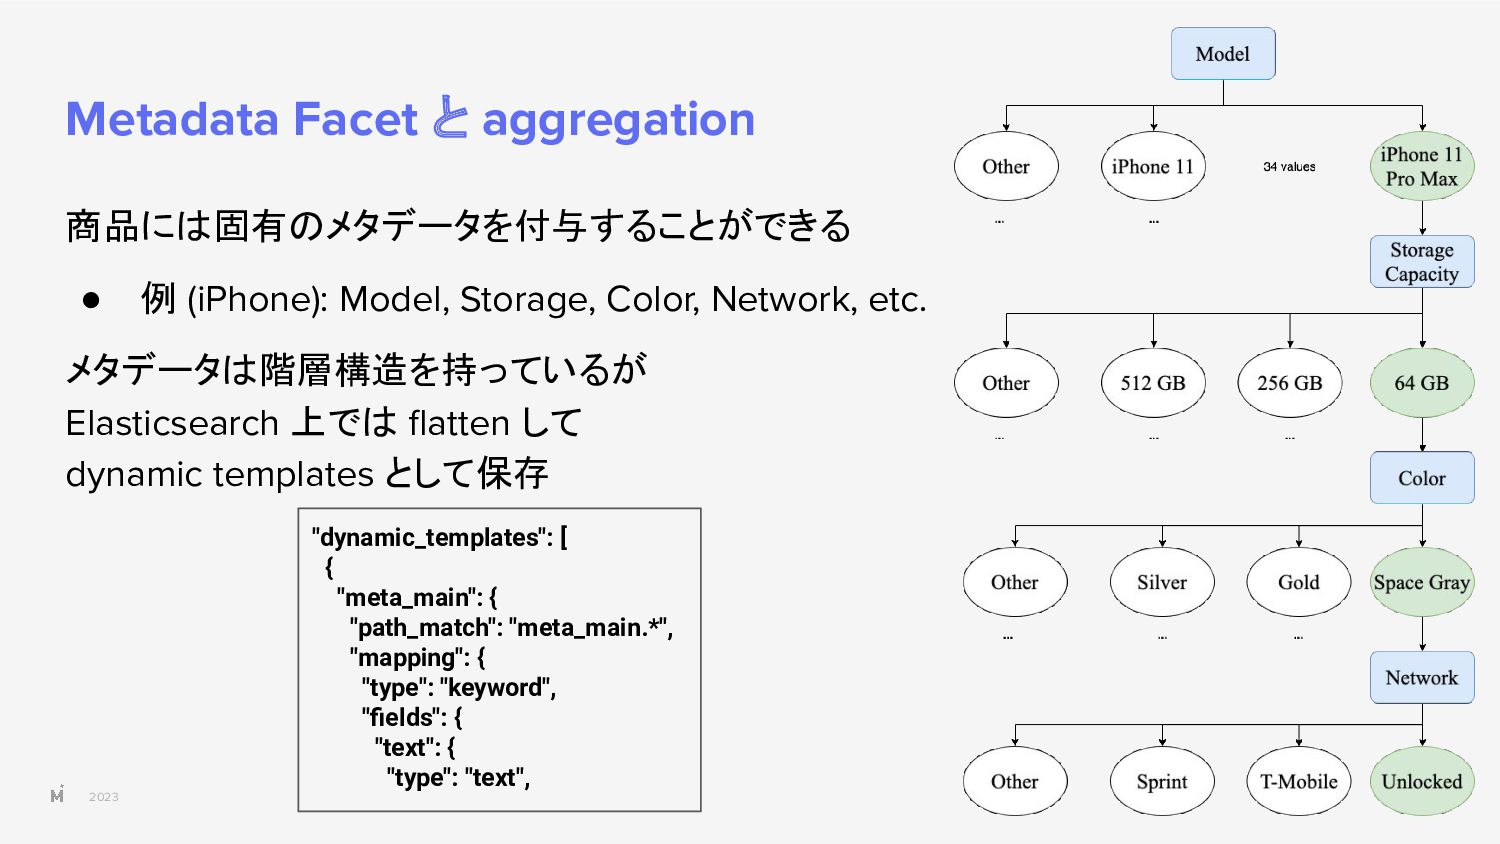
2023 Metadata Facet と aggregation 商品には固有のメタデータを付与することができる • 例 (iPhone): Model,
Storage, Color, Network, etc. メタデータは階層構造を持っているが Elasticsearch 上では flatten して dynamic templates として保存 "dynamic_templates": [ { "meta_main": { "path_match": "meta_main.*", "mapping": { "type": "keyword", "fields": { "text": { "type": "text", -
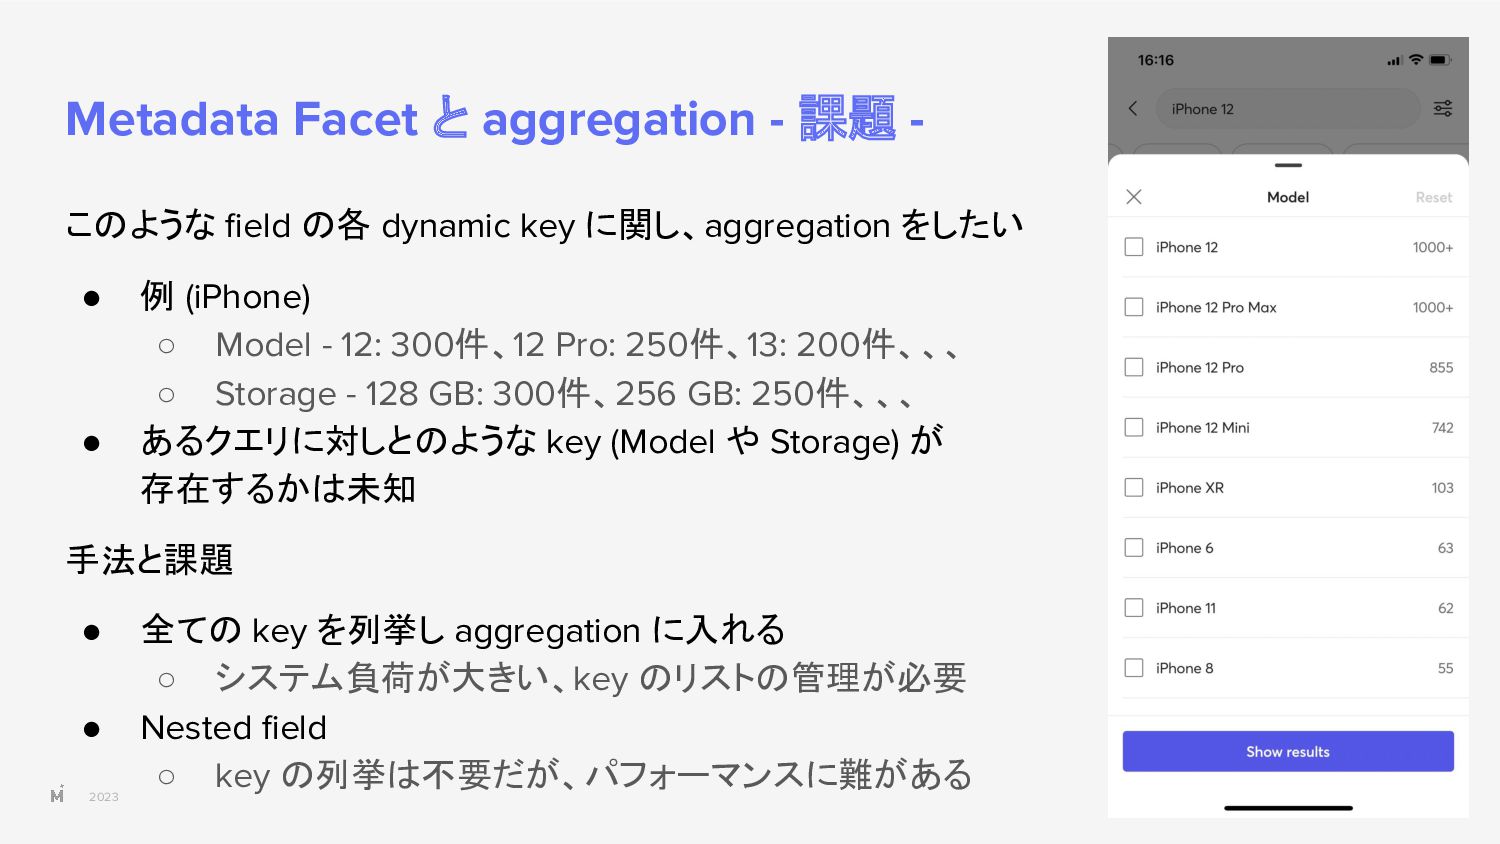
2023 このような field の各 dynamic key に関し、aggregation をしたい • 例
(iPhone) ◦ Model - 12: 300件、12 Pro: 250件、13: 200件、、、 ◦ Storage - 128 GB: 300件、256 GB: 250件、、、 • あるクエリに対しとのような key (Model や Storage) が 存在するかは未知 手法と課題 • 全ての key を列挙し aggregation に入れる ◦ システム負荷が大きい、key のリストの管理が必要 • Nested field ◦ key の列挙は不要だが、パフォーマンスに難がある Metadata Facet と aggregation - 課題 - -
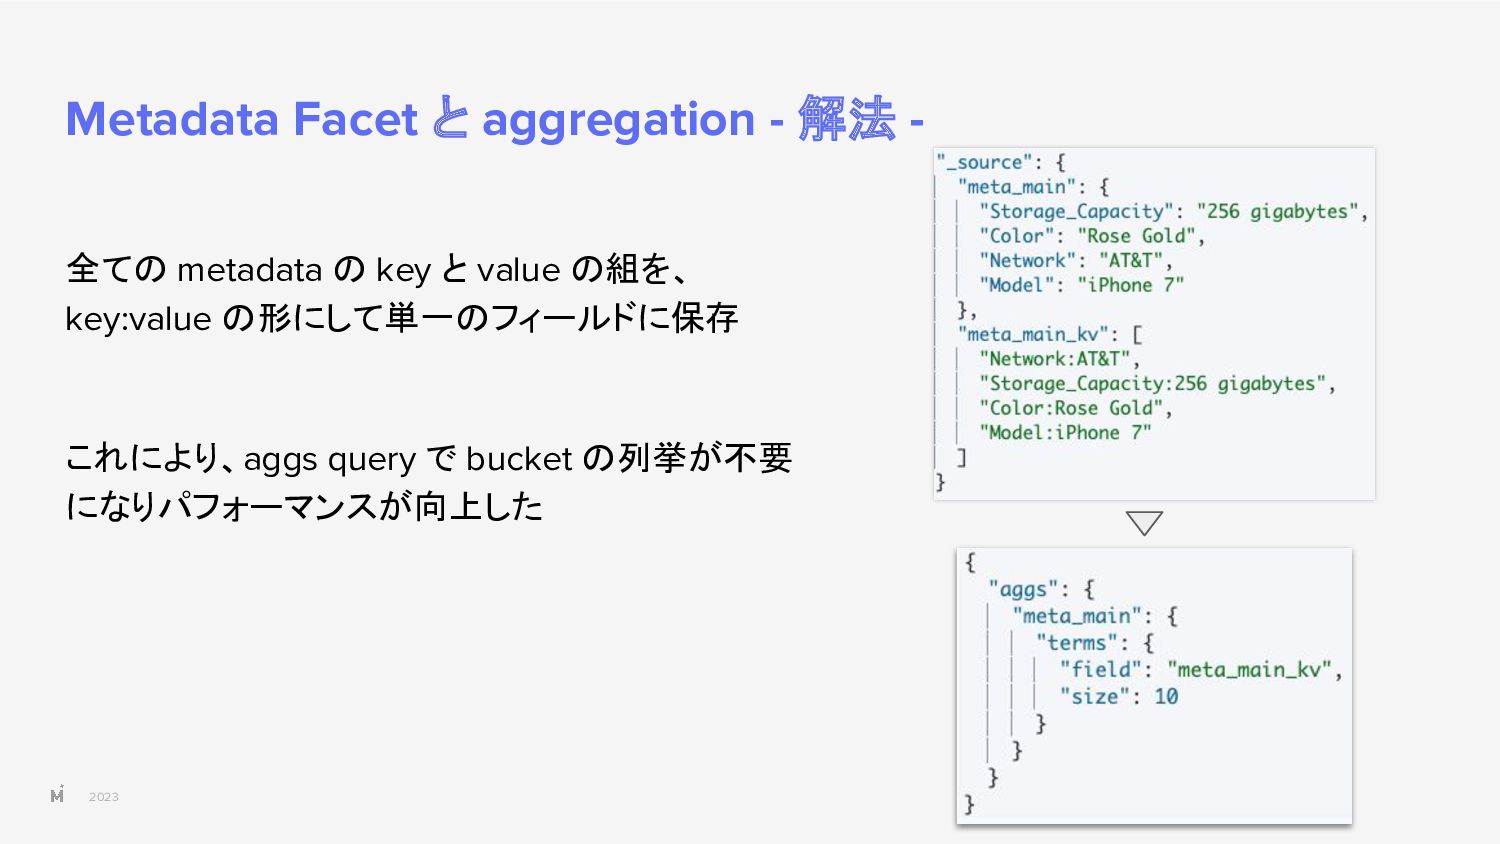
2023 全ての metadata の key と value の組を、 key:value の形にして単一のフィールドに保存
これにより、aggs query で bucket の列挙が不要 になりパフォーマンスが向上した Metadata Facet と aggregation - 解法 - -
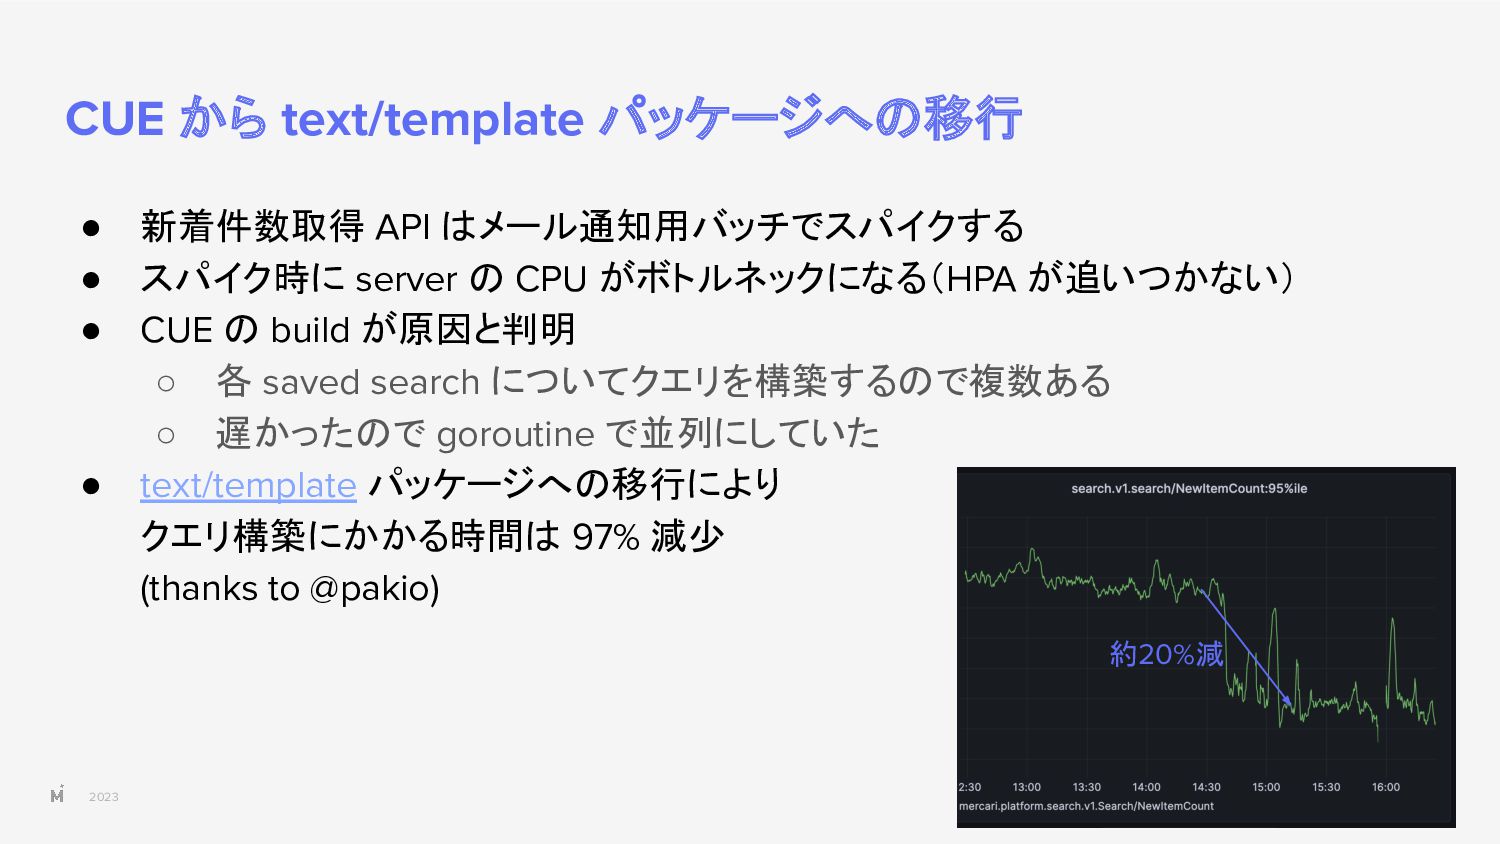
2023 CUE から text/template パッケージへの移行 • 新着件数取得 API はメール通知用バッチでスパイクする •
スパイク時に server の CPU がボトルネックになる(HPA が追いつかない) • CUE の build が原因と判明 ◦ 各 saved search についてクエリを構築するので複数ある ◦ 遅かったので goroutine で並列にしていた • text/template パッケージへの移行により クエリ構築にかかる時間は 97% 減少 (thanks to @pakio) 約20%減 -
2023 Migration 開始時の状況 • 検索は SaaS (Algolia) を利用しており、 Elasticsearch の経験があるメンバーは
search team にはいなかった ◦ そもそも search team に1.5人しかバックエンドエンジニアがいなかった • @pakio が入社し、migration プロジェクトを主導 ◦ 既存メンバーがキャッチアップしている間に Elastic Cloud の構築、index を定義 -
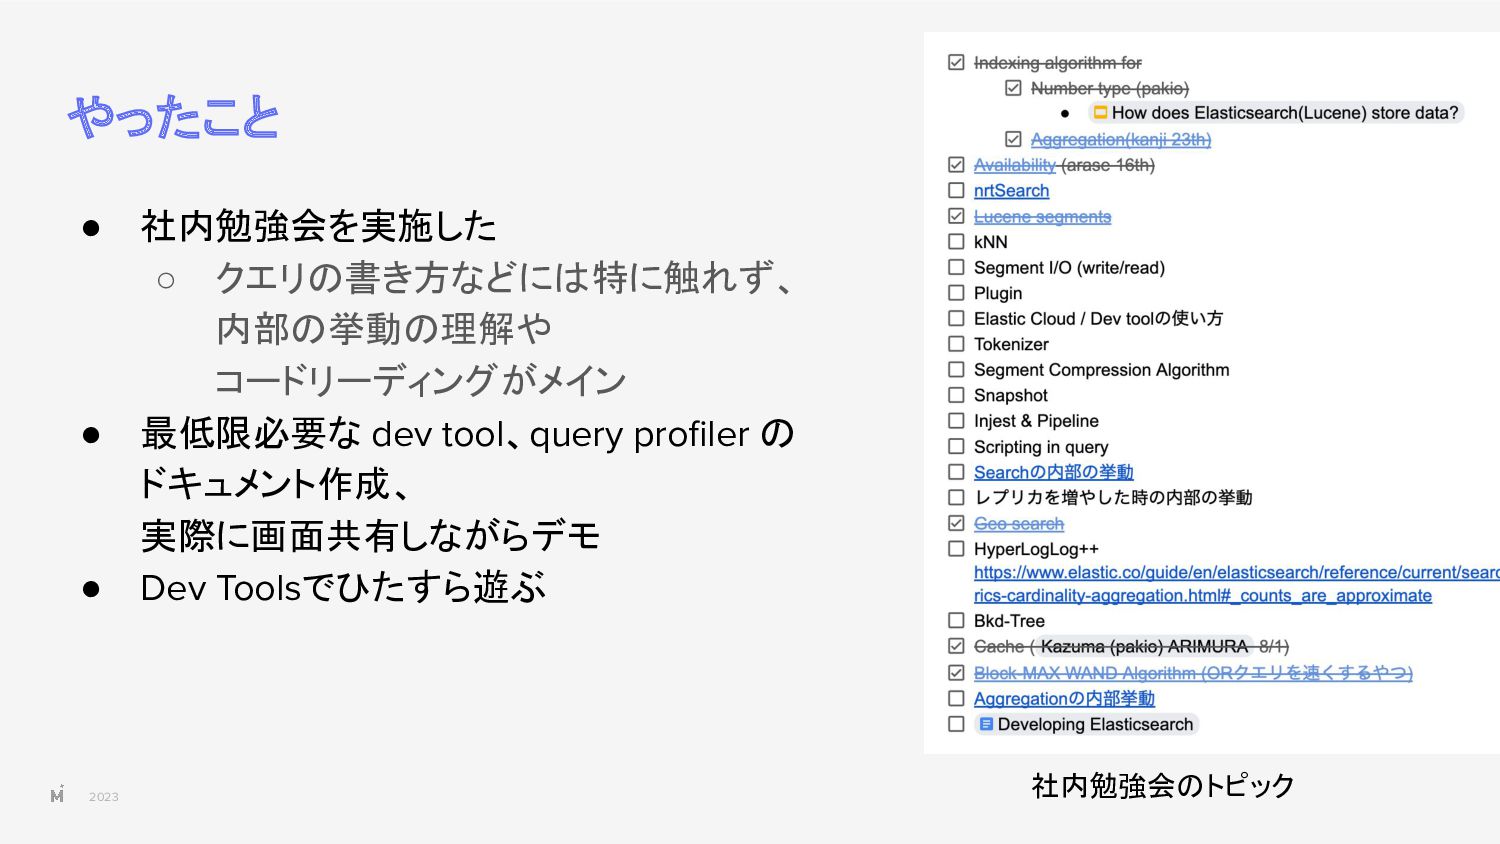
2023 やったこと • 社内勉強会を実施した ◦ クエリの書き方などには特に触れず、 内部の挙動の理解や コードリーディングがメイン • 最低限必要な
dev tool、query profiler の ドキュメント作成、 実際に画面共有しながらデモ • Dev Toolsでひたすら遊ぶ 社内勉強会のトピック -
2023 知見 • How の部分は後から学ぶ方が効率が良い • 序盤で内部挙動の理解に時間を使ったことは 後の設計・クエリチューニングに活かされている • 最低1人プロフェッショナルがいて、その人が環境整備系をしてくれている間に
キャッチアップし、あとは自由に触って試すのが効率が良かった気がする