Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
新規検索基盤でマッチング精度向上に挑む! ~『ホットペッパーグルメ』の開発事例 技術編
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Recruit
PRO
March 06, 2025
Technology
910
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
新規検索基盤でマッチング精度向上に挑む! ~『ホットペッパーグルメ』の開発事例 技術編
2025/2/20に開催したRecruit Tech Conference 2025の須藤の資料です
Recruit
PRO
March 06, 2025
More Decks by Recruit
See All by Recruit
つくって納得、つかって実感! 大規模言語モデルことはじめ ver2.0
recruitengineers
PRO
6
2.6k
ブラウザ研修 2026
recruitengineers
PRO
8
1.8k
事業価値と Engineering 2026年度版
recruitengineers
PRO
59
29k
トヨタ⽣産⽅式(TPS)⼊⾨
recruitengineers
PRO
3
1.4k
JavaScript 研修 (2026)
recruitengineers
PRO
2
900
TypeScript入門 2026
recruitengineers
PRO
3
1.5k
モダンフロントエンド 開発研修
recruitengineers
PRO
4
1.3k
Webアクセシビリティ入門 2026
recruitengineers
PRO
3
1.1k
攻撃と防御で学ぶAI時代のプロダクトセキュリティ演習
recruitengineers
PRO
9
4k
Other Decks in Technology
See All in Technology
SREへの勘違いに気づいた後の話
tomodakengo
0
150
AIエージェントを最高のパートナーに育てる方法|評価と判断軸を育てる5つのステップ
koichiaoki
1
160
What the customer really needed
kawaguti
PRO
3
220
データ界隈LT祭 第1回LT登壇
taromatsui_cccmkhd
2
1.5k
Oracle Cloud Network Path Analyzerを試してみた/I Tried Out Oracle Cloud Network Path Analyzer
masakiokuda
1
110
おい、エージェントを使って終わらせろ
nwiizo
3
900
SREの視点で考えるSIEM活用術 〜AWS環境でのセキュリティ強化〜
cscengineer
PRO
0
320
「ピッケル本」日本語版は4.0(第6版)が出版されるべき / pickaxe4-nagoyark05
kakutani
2
290
その Lambda、8分で 管理者権限まで奪われます
k1nakayama
7
3.6k
AIに賢く動いてもらうためのコンテキスト〜Snowflake女子会 vol.8
snowwmn0824
0
170
顧客に向き合う開発組織へ。リアーキテクチャとフィーチャーチーム化で挑む組織改革
safie
0
2.4k
【技術的負債conf】事業成長に伴う技術的負債の説明責任とAIによるモニタリング、認知的負債について
i35_267
4
2.1k
Featured
See All Featured
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.5k
Building a A Zero-Code AI SEO Workflow
portentint
PRO
0
730
Scaling GitHub
holman
464
140k
SEO Brein meetup: CTRL+C is not how to scale international SEO
lindahogenes
2
2.9k
Thoughts on Productivity
jonyablonski
76
5.4k
SEO in 2025: How to Prepare for the Future of Search
ipullrank
3
3.8k
Skip the Path - Find Your Career Trail
mkilby
1
240
My Coaching Mixtape
mlcsv
0
320
Building AI with AI
inesmontani
PRO
1
1.2k
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
710
ReactJS: Keep Simple. Everything can be a component!
pedronauck
666
130k
Ruling the World: When Life Gets Gamed
codingconduct
0
360
Transcript
新規検索基盤でマッチング精度向上に挑む! ~『ホットペッパーグルメ』の開発事例 RECRUIT TECH CONFERENCE 2025 技術編 須藤 遼介 株式会社リクルート
プロダクトディベロップメント室
須藤 遼介 ゲーム・NBA観戦・ラーメン 経歴 / Career 2019年にリクルートにキャリア採用入社。 機械学習エンジニアとして各種領域を担当 2024年より飲食領域の検索基盤開発・ロジック開発を担当 趣味
/ Hobbies データ推進室 販促領域データソリューション3ユニット (飲食・ビューティー) 飲食・ビューティーデータソリューション部 飲食・ビューティーデータエンジニアリングG
新規検索基盤の構築
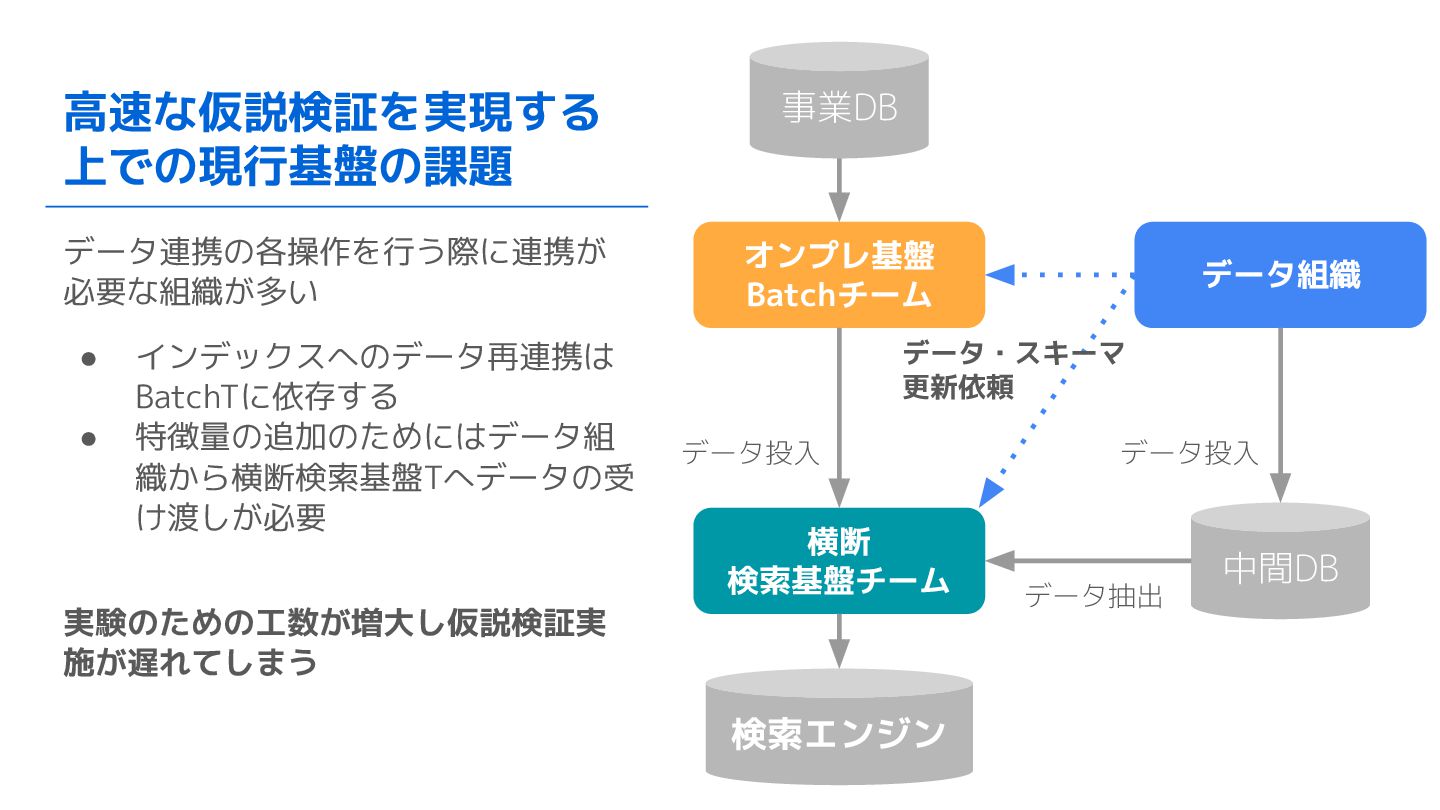
高速な仮説検証を実現する 上での現行基盤の課題 データ連携の各操作を行う際に連携が 必要な組織が多い • インデックスへのデータ再連携は BatchTに依存する • 特徴量の追加のためにはデータ組 織から横断検索基盤Tへデータの受
け渡しが必要 実験のための工数が増大し仮説検証実 施が遅れてしまう オンプレ基盤 Batchチーム 横断 検索基盤チーム データ組織 データ投入 事業DB 中間DB データ抽出 データ・スキーマ 更新依頼 データ投入 検索エンジン
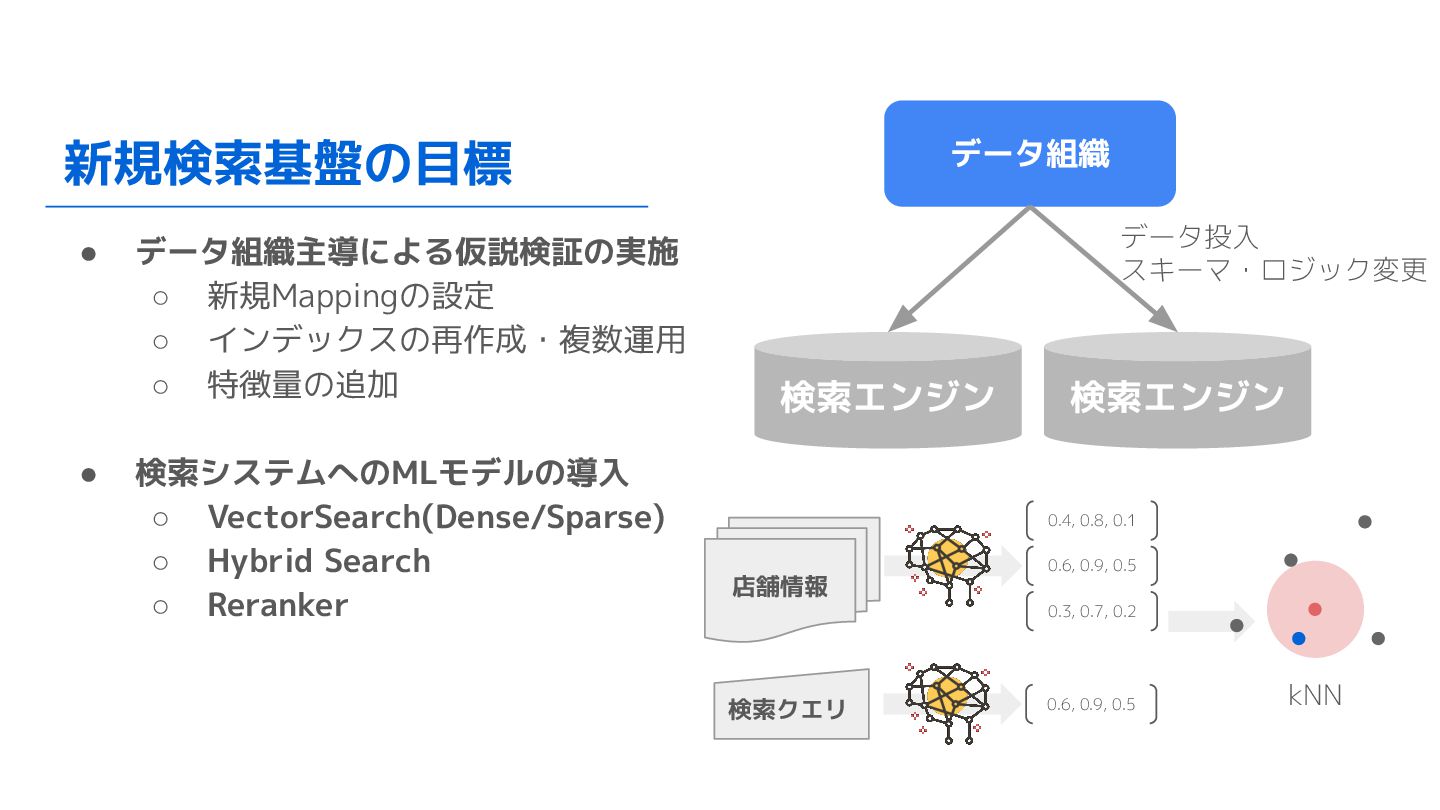
新規検索基盤の目標 • データ組織主導による仮説検証の実施 ◦ 新規Mappingの設定 ◦ インデックスの再作成・複数運用 ◦ 特徴量の追加 •
検索システムへのMLモデルの導入 ◦ VectorSearch(Dense/Sparse) ◦ Hybrid Search ◦ Reranker データ組織 データ投入 スキーマ・ロジック変更 検索エンジン 店舗情報 0.4, 0.8, 0.1 0.6, 0.9, 0.5 0.3, 0.7, 0.2 検索クエリ 0.6, 0.9, 0.5 kNN 検索エンジン
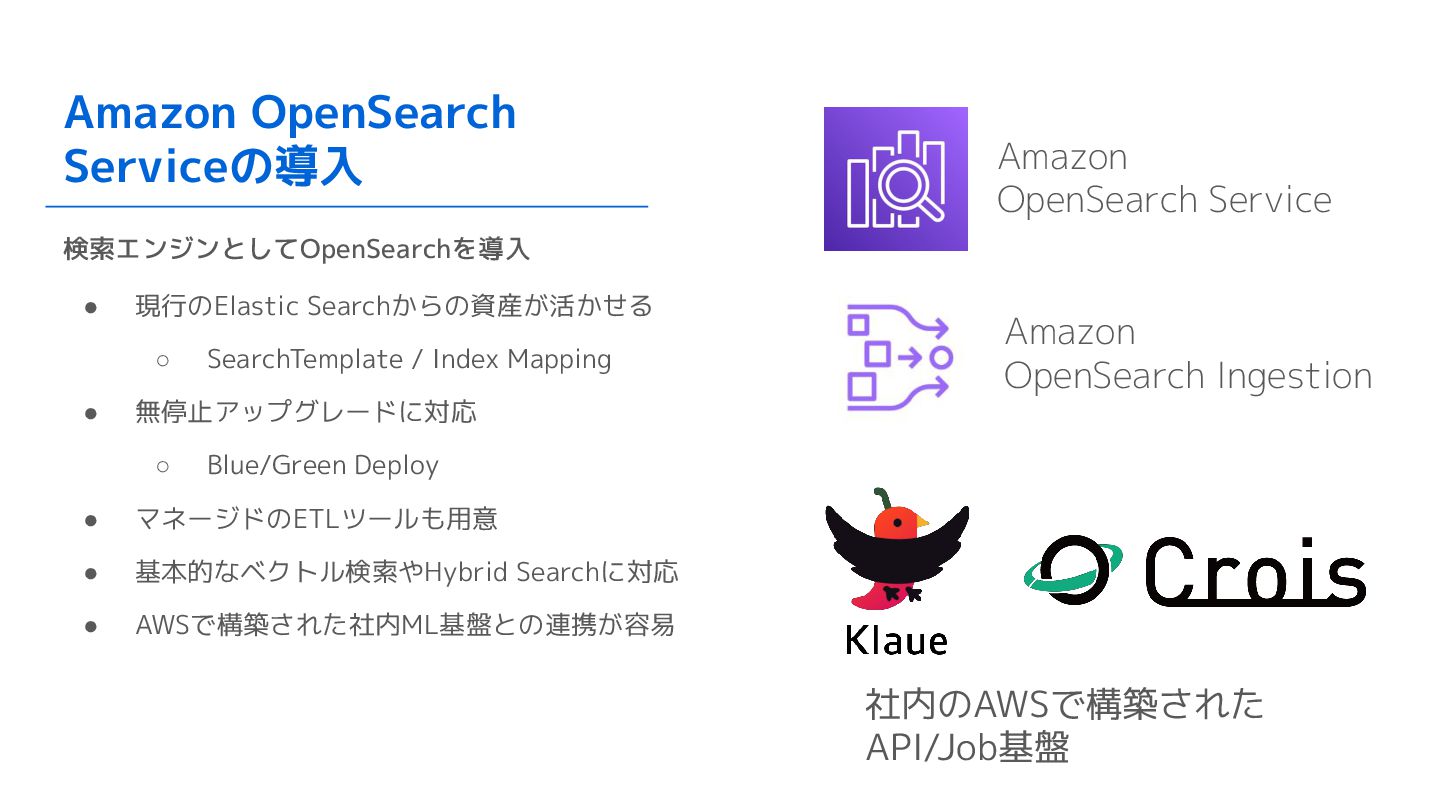
Amazon OpenSearch Serviceの導入 検索エンジンとしてOpenSearchを導入 • 現行のElastic Searchからの資産が活かせる ◦ SearchTemplate /
Index Mapping • 無停止アップグレードに対応 ◦ Blue/Green Deploy • マネージドのETLツールも用意 • 基本的なベクトル検索やHybrid Searchに対応 • AWSで構築された社内ML基盤との連携が容易 社内のAWSで構築された API/Job基盤 Amazon OpenSearch Service Amazon OpenSearch Ingestion
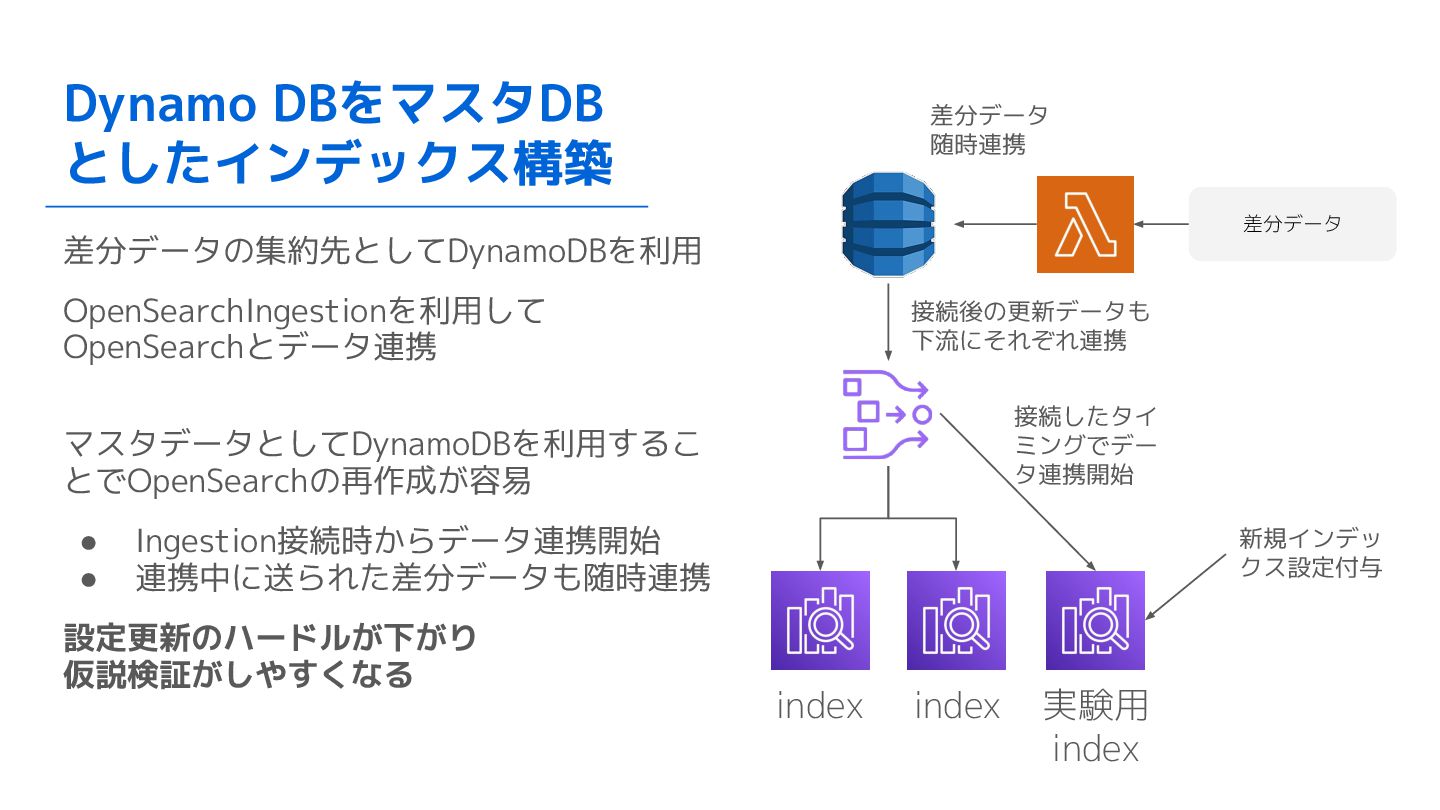
Dynamo DBをマスタDB としたインデックス構築 差分データの集約先としてDynamoDBを利用 OpenSearchIngestionを利用して OpenSearchとデータ連携 マスタデータとしてDynamoDBを利用するこ とでOpenSearchの再作成が容易 • Ingestion接続時からデータ連携開始
• 連携中に送られた差分データも随時連携 設定更新のハードルが下がり 仮説検証がしやすくなる 差分データ 新規インデッ クス設定付与 接続したタイ ミングでデー タ連携開始 index index 実験用 index 差分データ 随時連携 接続後の更新データも 下流にそれぞれ連携
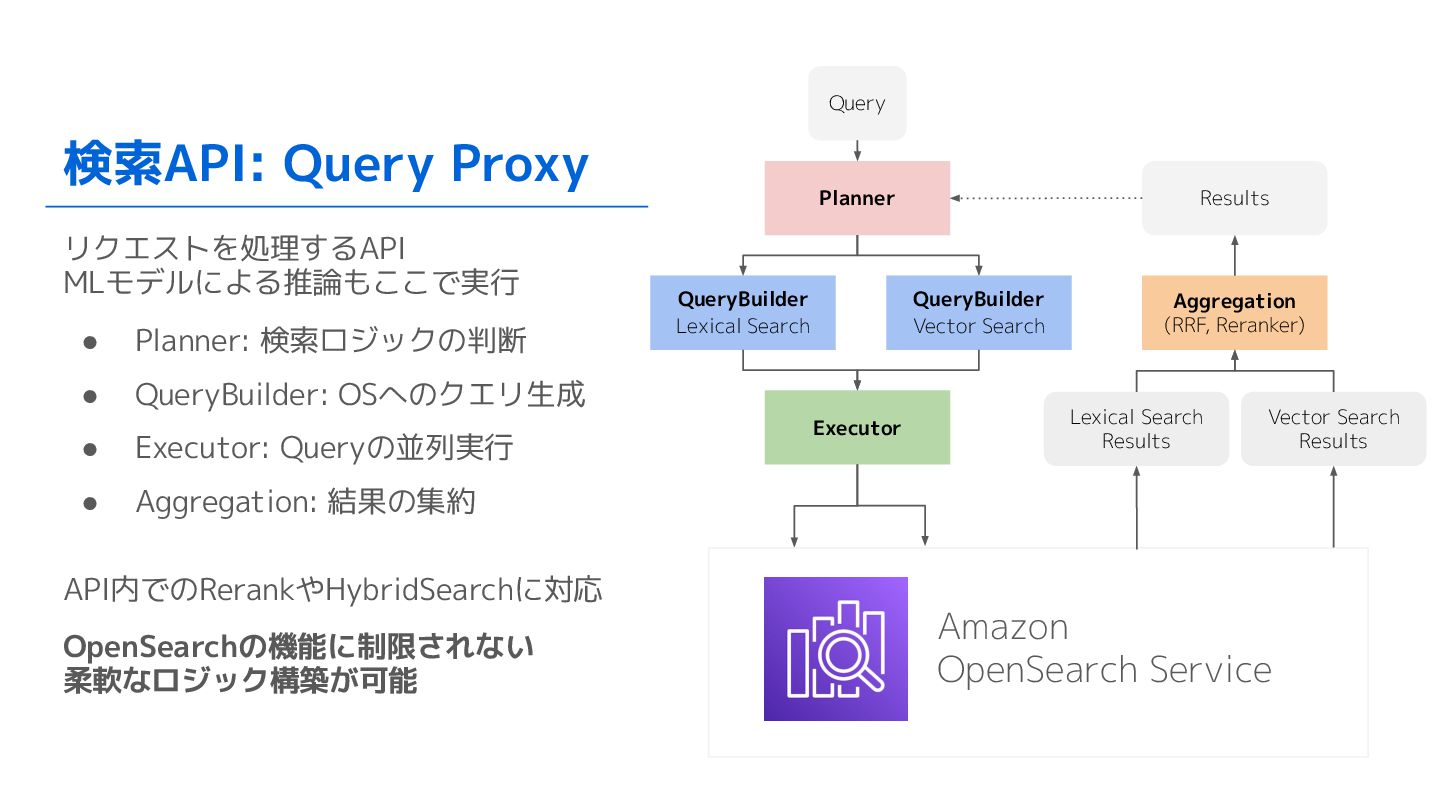
検索API: Query Proxy リクエストを処理するAPI MLモデルによる推論もここで実行 • Planner: 検索ロジックの判断 • QueryBuilder:
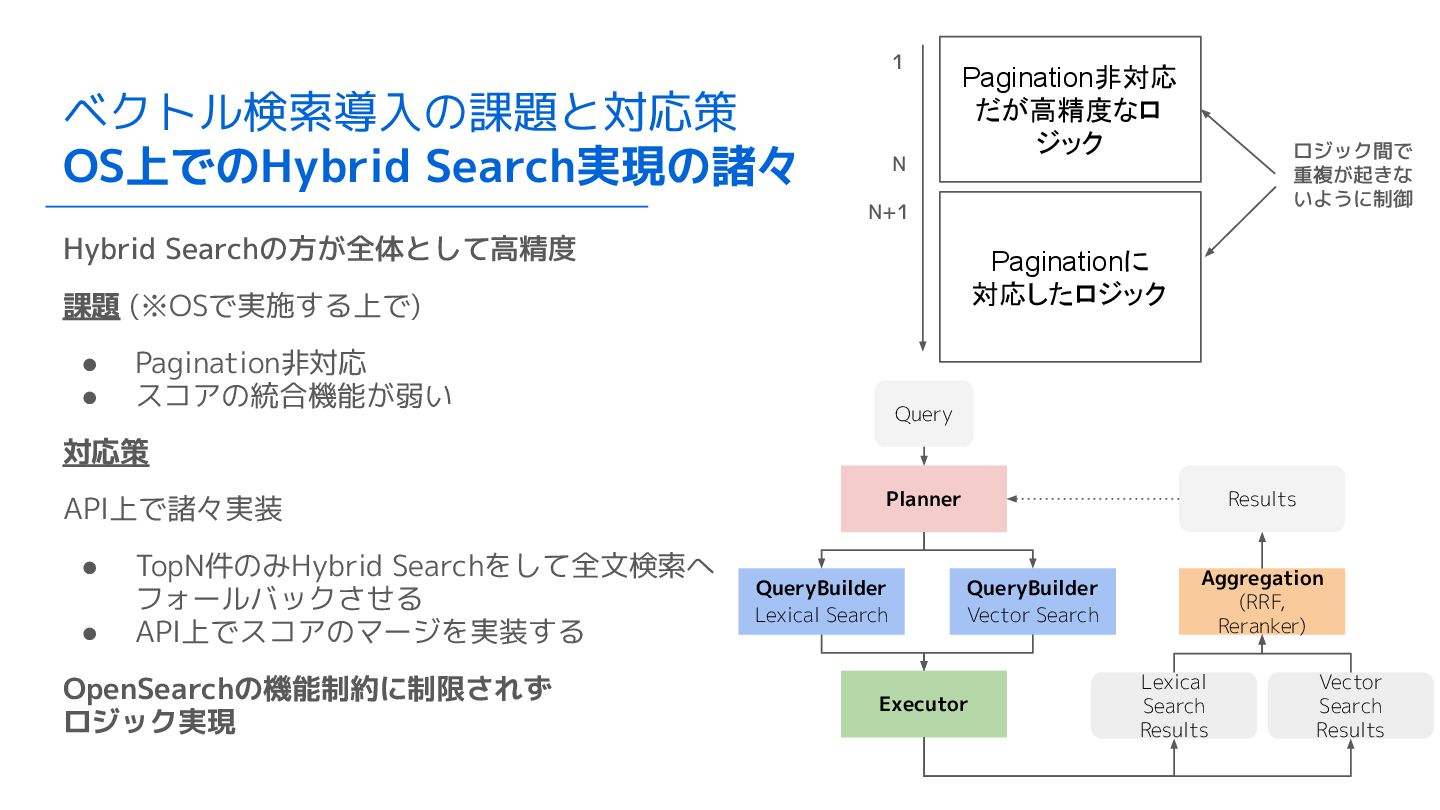
OSへのクエリ生成 • Executor: Queryの並列実行 • Aggregation: 結果の集約 API内でのRerankやHybridSearchに対応 OpenSearchの機能に制限されない 柔軟なロジック構築が可能 Planner QueryBuilder Lexical Search QueryBuilder Vector Search Executor Lexical Search Results Vector Search Results Aggregation (RRF, Reranker) Results Query Amazon OpenSearch Service
実際に運用してみて • インデックスの再作成のハードルは非常に下がった ◦ Mappingの変更などは非常に簡単に行える • OpenSearchIngestionはかなりハマりポイントが多かった ◦ 更なるドキュメントの拡充を期待! •
OpenSearchのベクトル検索機能は限定的 ◦ ベクトル検索の機能を外出しするのは必須の判断だったかも
検索ロジックの改善
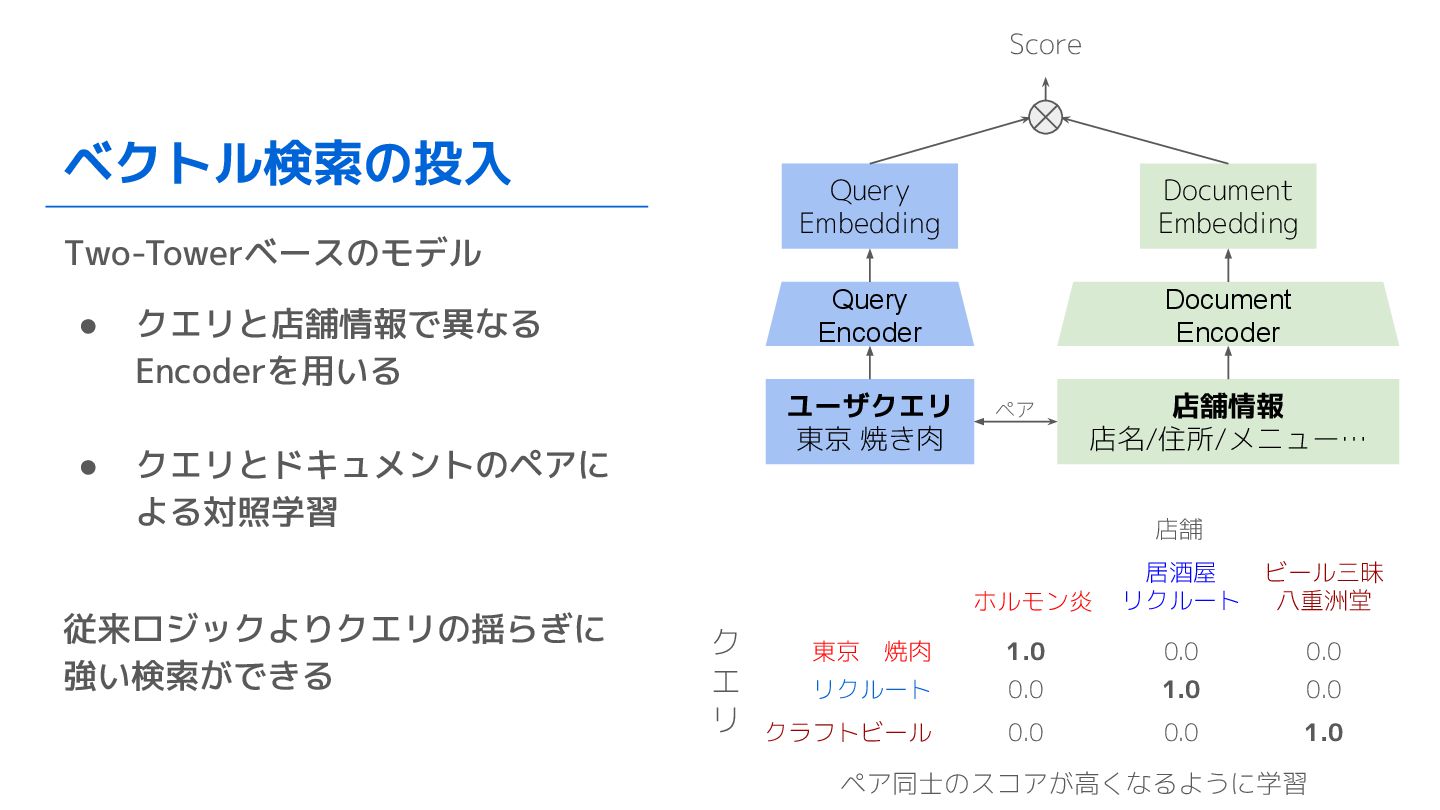
ベクトル検索の投入 Two-Towerベースのモデル • クエリと店舗情報で異なる Encoderを用いる • クエリとドキュメントのペアに よる対照学習 従来ロジックよりクエリの揺らぎに 強い検索ができる
東京 焼肉 リクルート クラフトビール ホルモン炎 居酒屋 リクルート ビール三昧 八重洲堂 1.0 1.0 1.0 0.0 0.0 0.0 0.0 0.0 0.0 ユーザクエリ 東京 焼き肉 店舗情報 店名/住所/メニュー… Query Encoder Document Encoder Query Embedding Document Embedding ペア Score ク エ リ 店舗 ペア同士のスコアが高くなるように学習
ベクトル検索導入の課題と対応策 OS上でのHybrid Search実現の諸々 Hybrid Searchの方が全体として高精度 課題 (※OSで実施する上で) • Pagination非対応 •
スコアの統合機能が弱い 対応策 API上で諸々実装 • TopN件のみHybrid Searchをして全文検索へ フォールバックさせる • API上でスコアのマージを実装する OpenSearchの機能制約に制限されず ロジック実現 Pagination非対応 だが高精度なロ ジック Paginationに 対応したロジック Planner QueryBuilder Lexical Search QueryBuilder Vector Search Executor Lexical Search Results Vector Search Results Aggregation (RRF, Reranker) Results Query ロジック間で 重複が起きな いように制御 1 N N+1
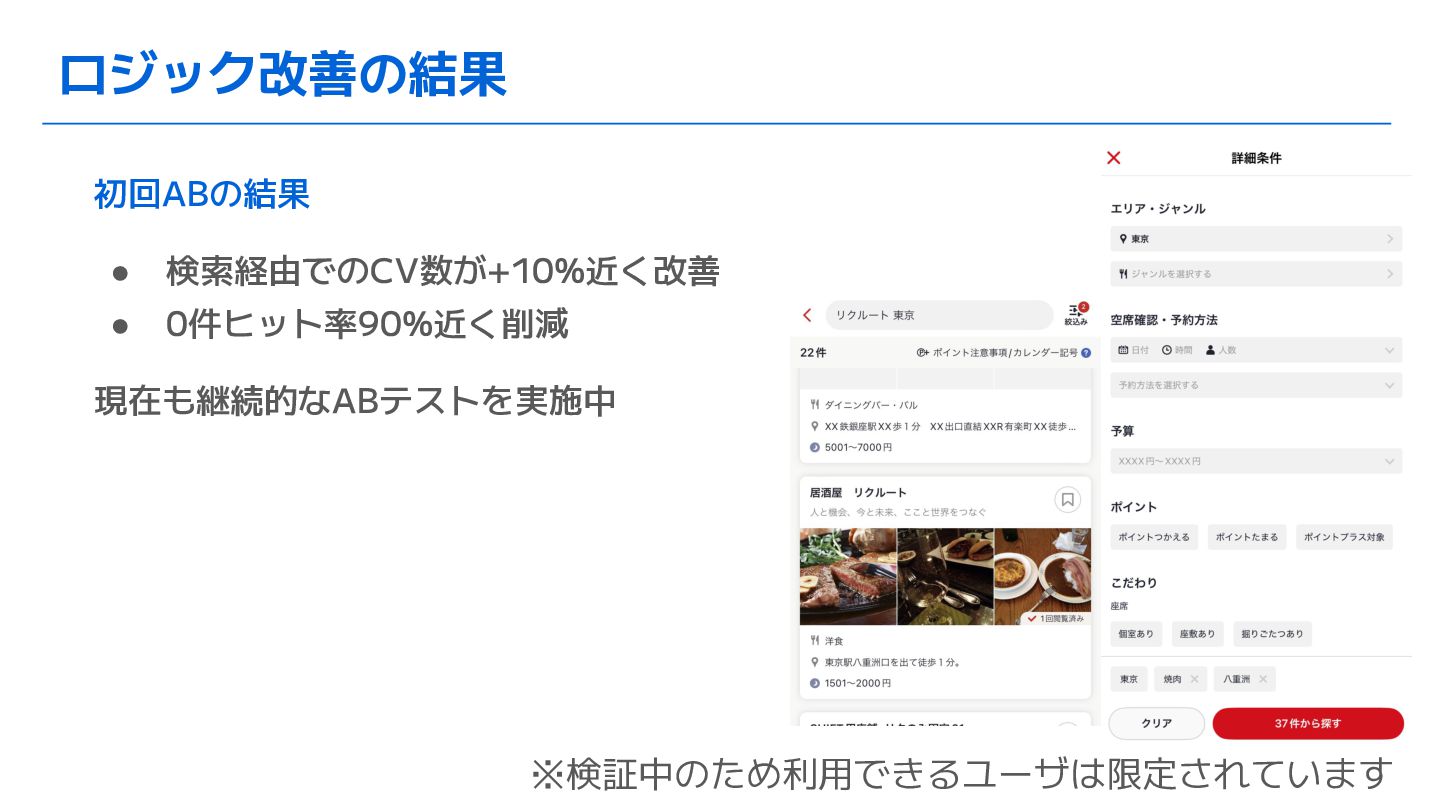
ロジック改善の結果 初回ABの結果 • 検索経由でのCV数が+10%近く改善 • 0件ヒット率90%近く削減 現在も継続的なABテストを実施中 ※検証中のため利用できるユーザは限定されています
まとめ 基盤 • 設定変更・再構築のしやすい検索システムを構築 Open Search/Ingestion/DynamoDB • API上でHybridSearch/Rerankingを行うことでOSの制約にとらわれない ロジックの実装に対応 ロジック
• Two-Towerモデルを中心にしたベクトル検索ロジックを作成 • 各種精度向上の工夫により本番ABテストで10%近くのCV向上を実現


 recruitengineers
 tomodakengo
 koichiaoki
 kawaguti
 taromatsui_cccmkhd
 masakiokuda
 nwiizo
 cscengineer
 kakutani
 k1nakayama
 snowwmn0824
 safie
 i35_267
 inesmontani
 portentint
 holman
 lindahogenes
 jonyablonski
 ipullrank
 mkilby
 mlcsv
 pedronauck
 codingconduct