Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Estadística Computacional y Métodos Cuantitativ...

Estadística Computacional y Métodos Cuantitativos con R

Avatar for Abraham Zamudio

Abraham Zamudio

October 06, 2026

More Decks by Abraham Zamudio

Other Decks in Education

Transcript

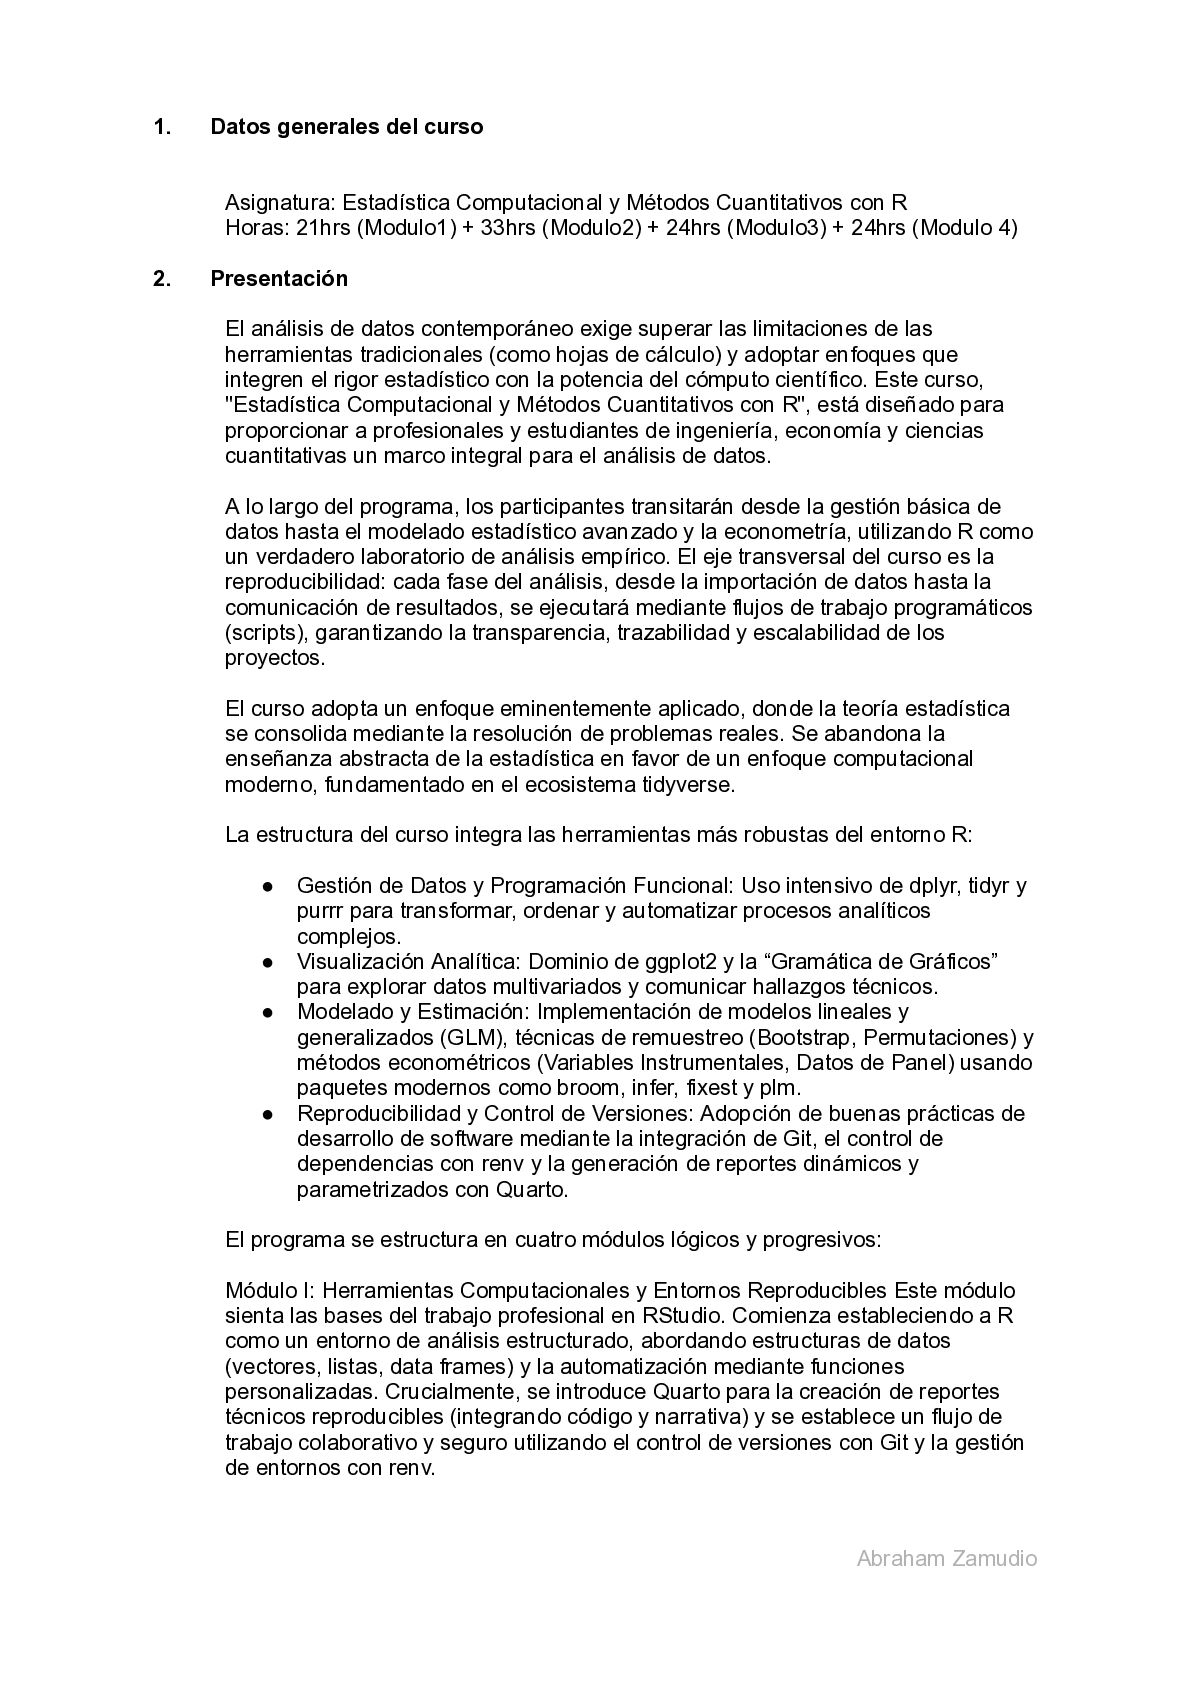
  1. 1.​ Datos generales del curso Asignatura: Estadística Computacional y Métodos

    Cuantitativos con R Horas: 21hrs (Modulo1) + 33hrs (Modulo2) + 24hrs (Modulo3) + 24hrs (Modulo 4) 2.​ Presentación El análisis de datos contemporáneo exige superar las limitaciones de las herramientas tradicionales (como hojas de cálculo) y adoptar enfoques que integren el rigor estadístico con la potencia del cómputo científico. Este curso, "Estadística Computacional y Métodos Cuantitativos con R", está diseñado para proporcionar a profesionales y estudiantes de ingeniería, economía y ciencias cuantitativas un marco integral para el análisis de datos. A lo largo del programa, los participantes transitarán desde la gestión básica de datos hasta el modelado estadístico avanzado y la econometría, utilizando R como un verdadero laboratorio de análisis empírico. El eje transversal del curso es la reproducibilidad: cada fase del análisis, desde la importación de datos hasta la comunicación de resultados, se ejecutará mediante flujos de trabajo programáticos (scripts), garantizando la transparencia, trazabilidad y escalabilidad de los proyectos. El curso adopta un enfoque eminentemente aplicado, donde la teoría estadística se consolida mediante la resolución de problemas reales. Se abandona la enseñanza abstracta de la estadística en favor de un enfoque computacional moderno, fundamentado en el ecosistema tidyverse. La estructura del curso integra las herramientas más robustas del entorno R: •​ Gestión de Datos y Programación Funcional: Uso intensivo de dplyr, tidyr y purrr para transformar, ordenar y automatizar procesos analíticos complejos. •​ Visualización Analítica: Dominio de ggplot2 y la “Gramática de Gráficos” para explorar datos multivariados y comunicar hallazgos técnicos. •​ Modelado y Estimación: Implementación de modelos lineales y generalizados (GLM), técnicas de remuestreo (Bootstrap, Permutaciones) y métodos econométricos (Variables Instrumentales, Datos de Panel) usando paquetes modernos como broom, infer, fixest y plm. •​ Reproducibilidad y Control de Versiones: Adopción de buenas prácticas de desarrollo de software mediante la integración de Git, el control de dependencias con renv y la generación de reportes dinámicos y parametrizados con Quarto. El programa se estructura en cuatro módulos lógicos y progresivos: Módulo I: Herramientas Computacionales y Entornos Reproducibles Este módulo sienta las bases del trabajo profesional en RStudio. Comienza estableciendo a R como un entorno de análisis estructurado, abordando estructuras de datos (vectores, listas, data frames) y la automatización mediante funciones personalizadas. Crucialmente, se introduce Quarto para la creación de reportes técnicos reproducibles (integrando código y narrativa) y se establece un flujo de trabajo colaborativo y seguro utilizando el control de versiones con Git y la gestión de entornos con renv. Abraham Zamudio
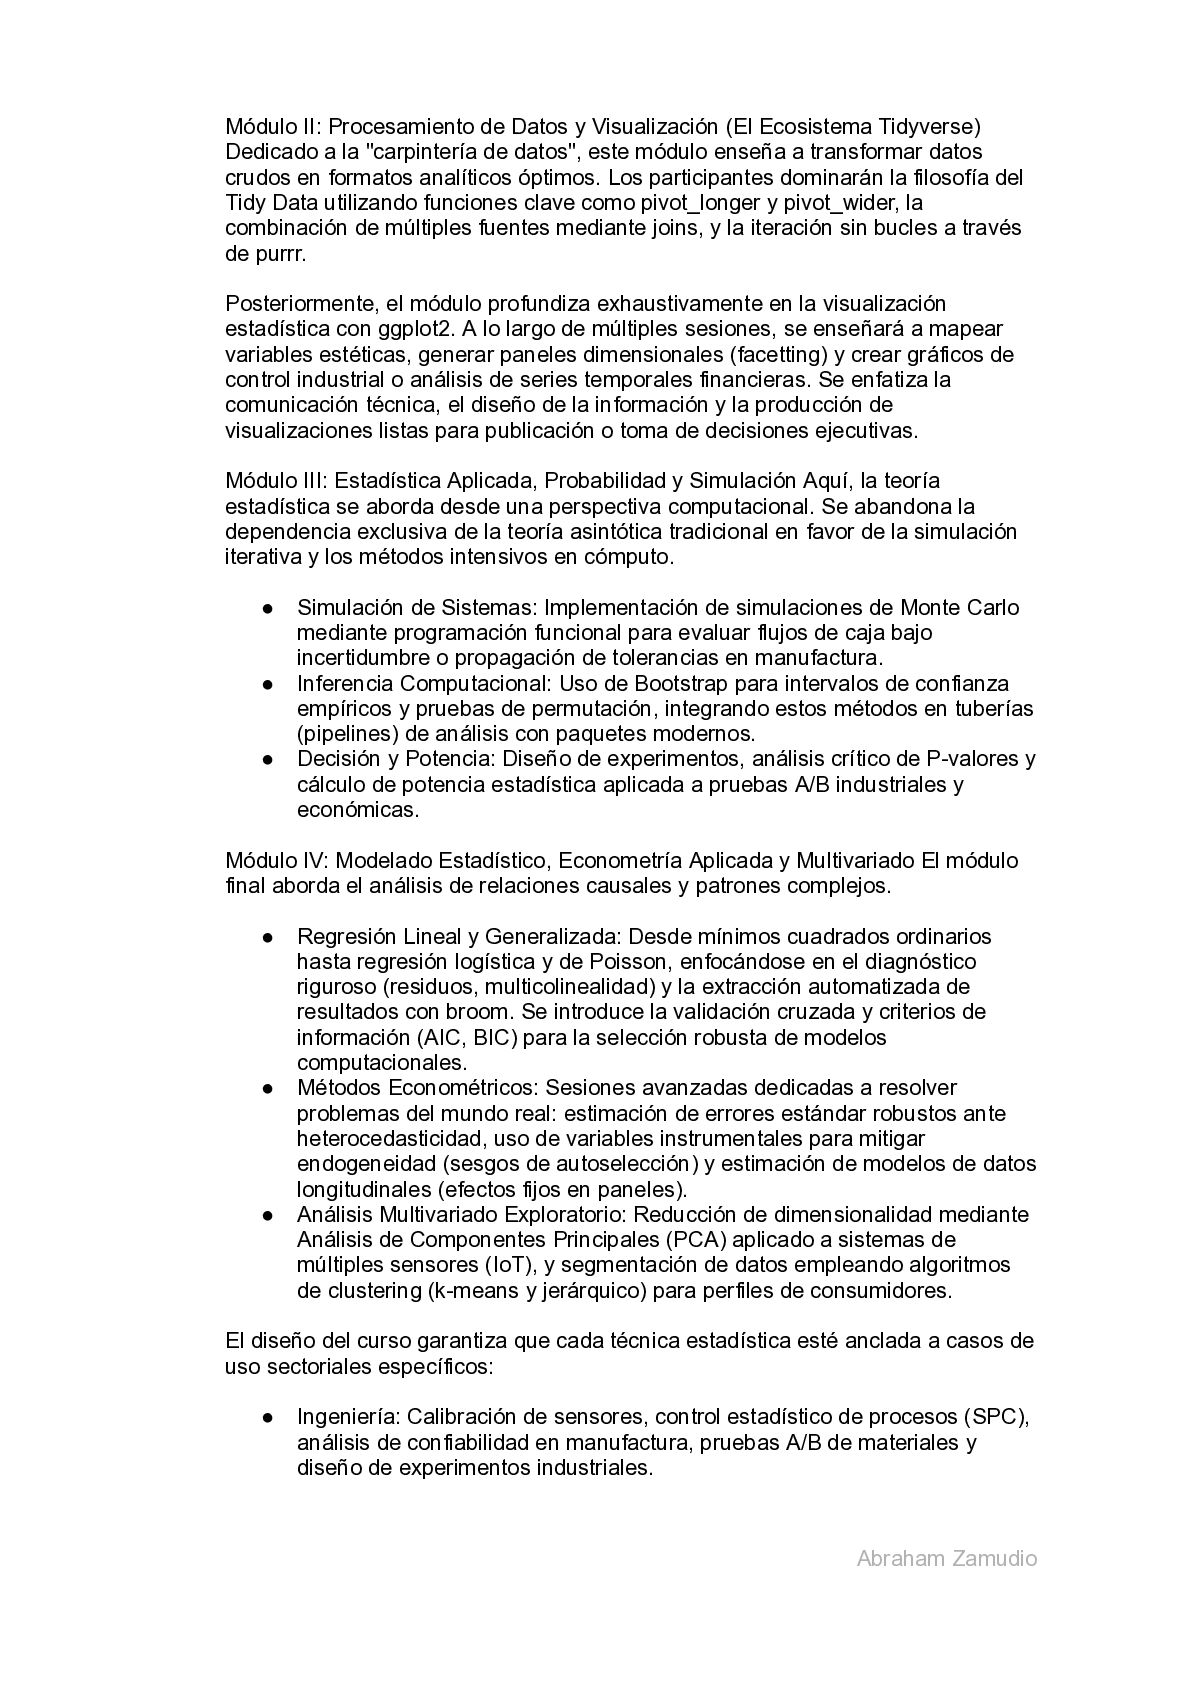
  2. Módulo II: Procesamiento de Datos y Visualización (El Ecosistema Tidyverse)

    Dedicado a la "carpintería de datos", este módulo enseña a transformar datos crudos en formatos analíticos óptimos. Los participantes dominarán la filosofía del Tidy Data utilizando funciones clave como pivot_longer y pivot_wider, la combinación de múltiples fuentes mediante joins, y la iteración sin bucles a través de purrr. Posteriormente, el módulo profundiza exhaustivamente en la visualización estadística con ggplot2. A lo largo de múltiples sesiones, se enseñará a mapear variables estéticas, generar paneles dimensionales (facetting) y crear gráficos de control industrial o análisis de series temporales financieras. Se enfatiza la comunicación técnica, el diseño de la información y la producción de visualizaciones listas para publicación o toma de decisiones ejecutivas. Módulo III: Estadística Aplicada, Probabilidad y Simulación Aquí, la teoría estadística se aborda desde una perspectiva computacional. Se abandona la dependencia exclusiva de la teoría asintótica tradicional en favor de la simulación iterativa y los métodos intensivos en cómputo. •​ Simulación de Sistemas: Implementación de simulaciones de Monte Carlo mediante programación funcional para evaluar flujos de caja bajo incertidumbre o propagación de tolerancias en manufactura. •​ Inferencia Computacional: Uso de Bootstrap para intervalos de confianza empíricos y pruebas de permutación, integrando estos métodos en tuberías (pipelines) de análisis con paquetes modernos. •​ Decisión y Potencia: Diseño de experimentos, análisis crítico de P-valores y cálculo de potencia estadística aplicada a pruebas A/B industriales y económicas. Módulo IV: Modelado Estadístico, Econometría Aplicada y Multivariado El módulo final aborda el análisis de relaciones causales y patrones complejos. •​ Regresión Lineal y Generalizada: Desde mínimos cuadrados ordinarios hasta regresión logística y de Poisson, enfocándose en el diagnóstico riguroso (residuos, multicolinealidad) y la extracción automatizada de resultados con broom. Se introduce la validación cruzada y criterios de información (AIC, BIC) para la selección robusta de modelos computacionales. •​ Métodos Econométricos: Sesiones avanzadas dedicadas a resolver problemas del mundo real: estimación de errores estándar robustos ante heterocedasticidad, uso de variables instrumentales para mitigar endogeneidad (sesgos de autoselección) y estimación de modelos de datos longitudinales (efectos fijos en paneles). •​ Análisis Multivariado Exploratorio: Reducción de dimensionalidad mediante Análisis de Componentes Principales (PCA) aplicado a sistemas de múltiples sensores (IoT), y segmentación de datos empleando algoritmos de clustering (k-means y jerárquico) para perfiles de consumidores. El diseño del curso garantiza que cada técnica estadística esté anclada a casos de uso sectoriales específicos: •​ Ingeniería: Calibración de sensores, control estadístico de procesos (SPC), análisis de confiabilidad en manufactura, pruebas A/B de materiales y diseño de experimentos industriales. Abraham Zamudio
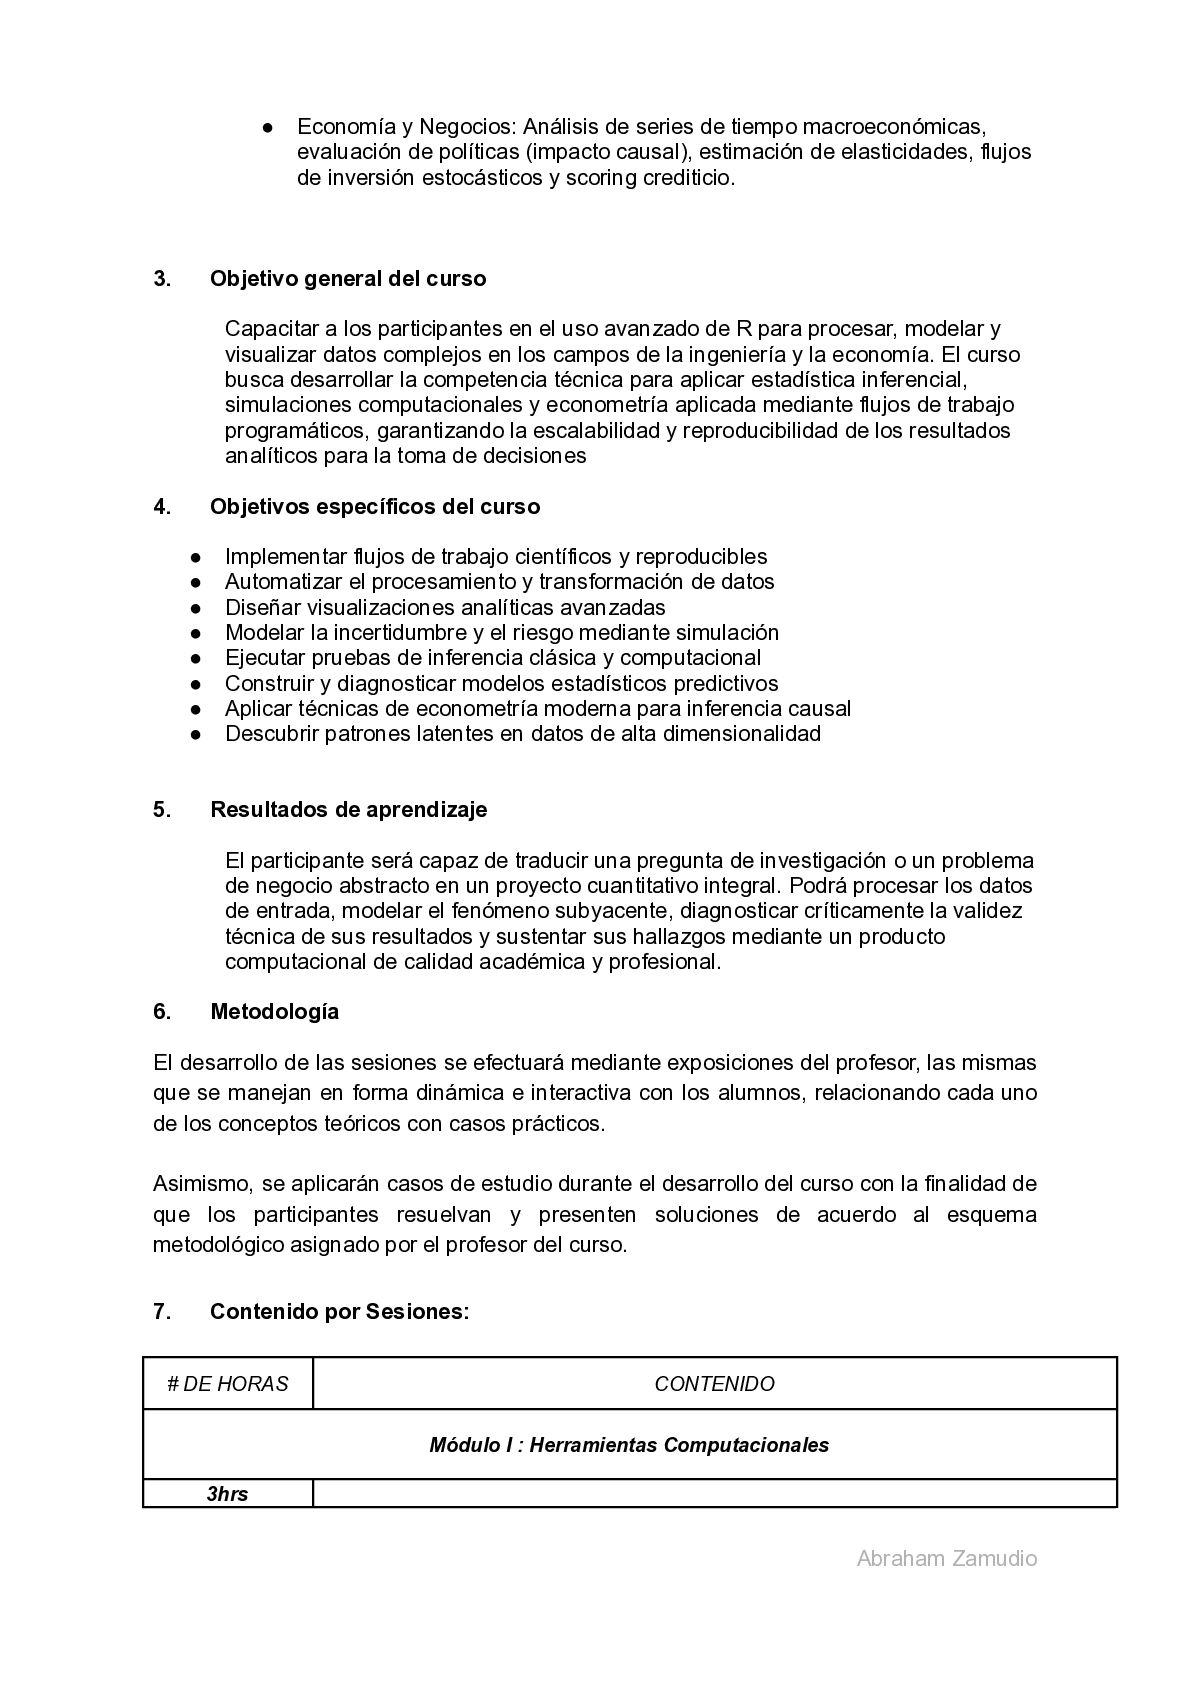
  3. •​ Economía y Negocios: Análisis de series de tiempo macroeconómicas,

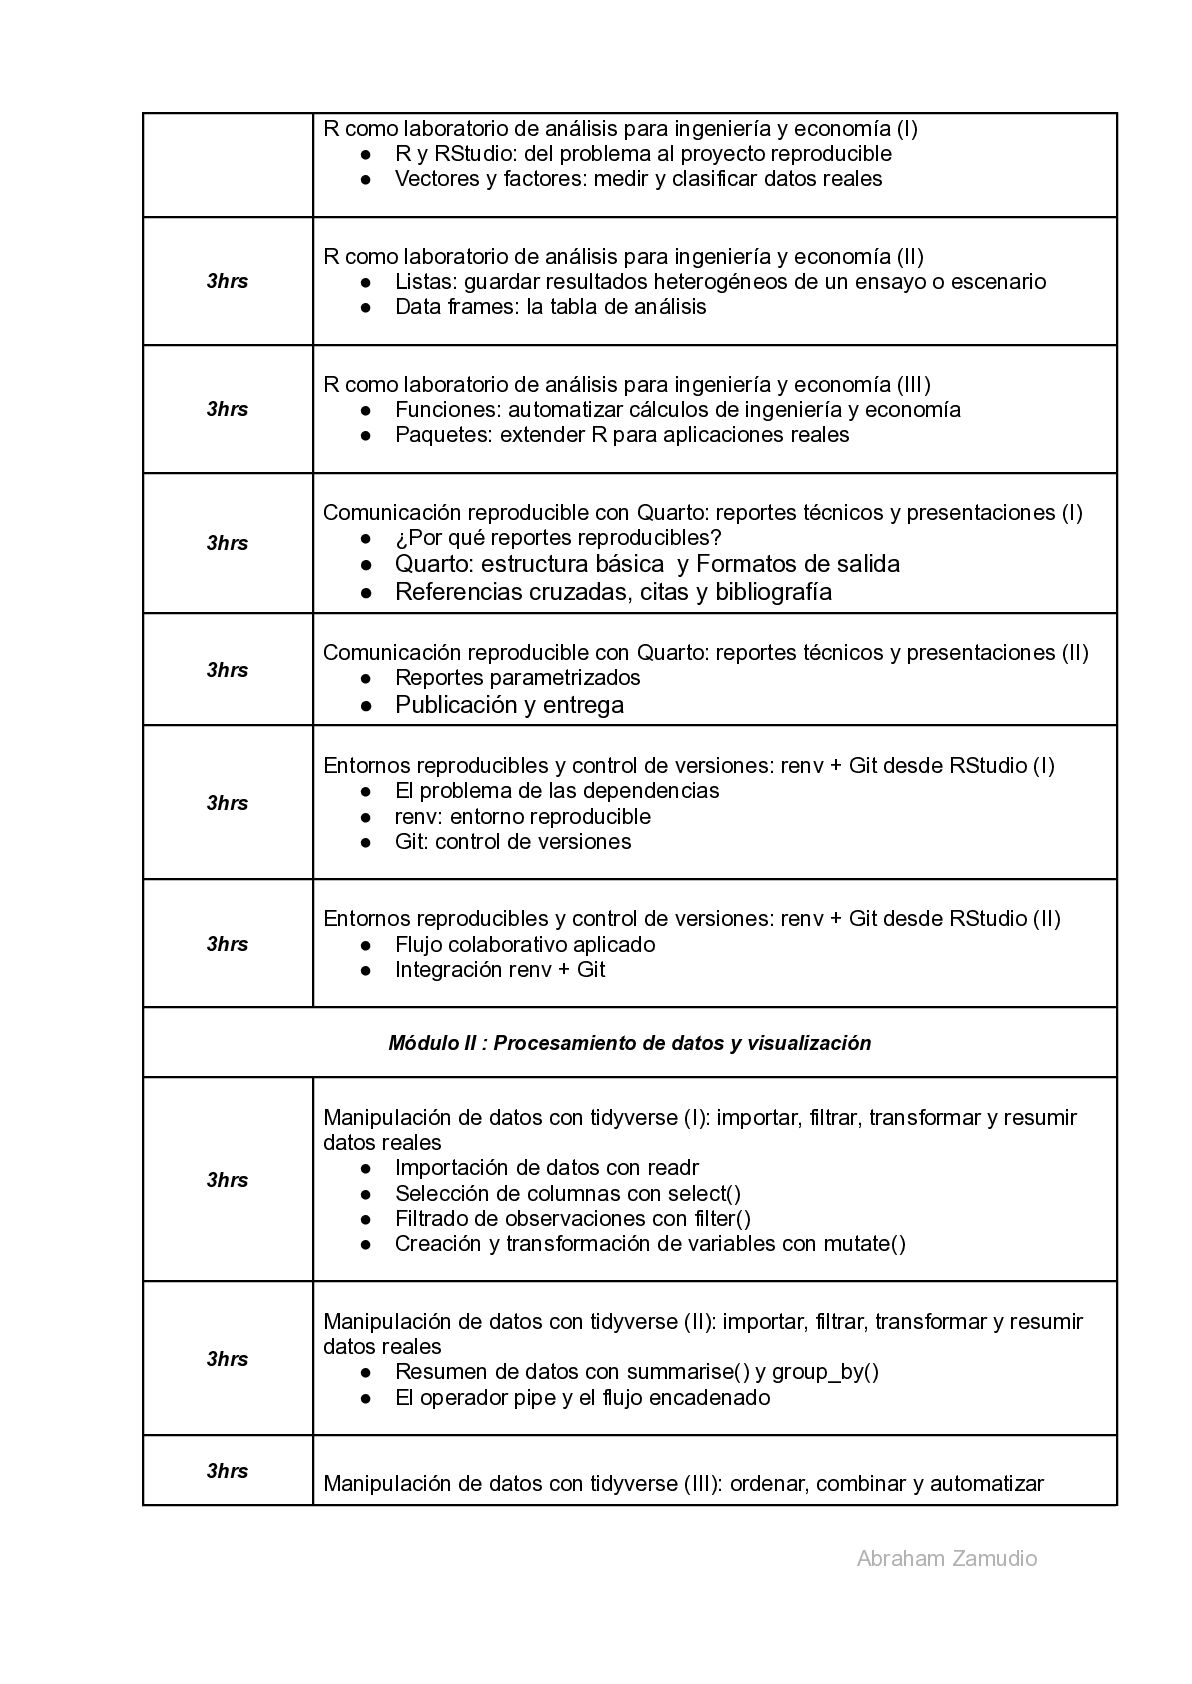
    evaluación de políticas (impacto causal), estimación de elasticidades, flujos de inversión estocásticos y scoring crediticio. 3.​ Objetivo general del curso Capacitar a los participantes en el uso avanzado de R para procesar, modelar y visualizar datos complejos en los campos de la ingeniería y la economía. El curso busca desarrollar la competencia técnica para aplicar estadística inferencial, simulaciones computacionales y econometría aplicada mediante flujos de trabajo programáticos, garantizando la escalabilidad y reproducibilidad de los resultados analíticos para la toma de decisiones 4.​ Objetivos específicos del curso •​ •​ •​ •​ •​ •​ •​ •​ 5.​ Implementar flujos de trabajo científicos y reproducibles Automatizar el procesamiento y transformación de datos Diseñar visualizaciones analíticas avanzadas Modelar la incertidumbre y el riesgo mediante simulación Ejecutar pruebas de inferencia clásica y computacional Construir y diagnosticar modelos estadísticos predictivos Aplicar técnicas de econometría moderna para inferencia causal Descubrir patrones latentes en datos de alta dimensionalidad Resultados de aprendizaje El participante será capaz de traducir una pregunta de investigación o un problema de negocio abstracto en un proyecto cuantitativo integral. Podrá procesar los datos de entrada, modelar el fenómeno subyacente, diagnosticar críticamente la validez técnica de sus resultados y sustentar sus hallazgos mediante un producto computacional de calidad académica y profesional. 6.​ Metodología El desarrollo de las sesiones se efectuará mediante exposiciones del profesor, las mismas que se manejan en forma dinámica e interactiva con los alumnos, relacionando cada uno de los conceptos teóricos con casos prácticos. Asimismo, se aplicarán casos de estudio durante el desarrollo del curso con la finalidad de que los participantes resuelvan y presenten soluciones de acuerdo al esquema metodológico asignado por el profesor del curso. 7.​ Contenido por Sesiones: # DE HORAS CONTENIDO Módulo I : Herramientas Computacionales 3hrs Abraham Zamudio
  4. R como laboratorio de análisis para ingeniería y economía (I)

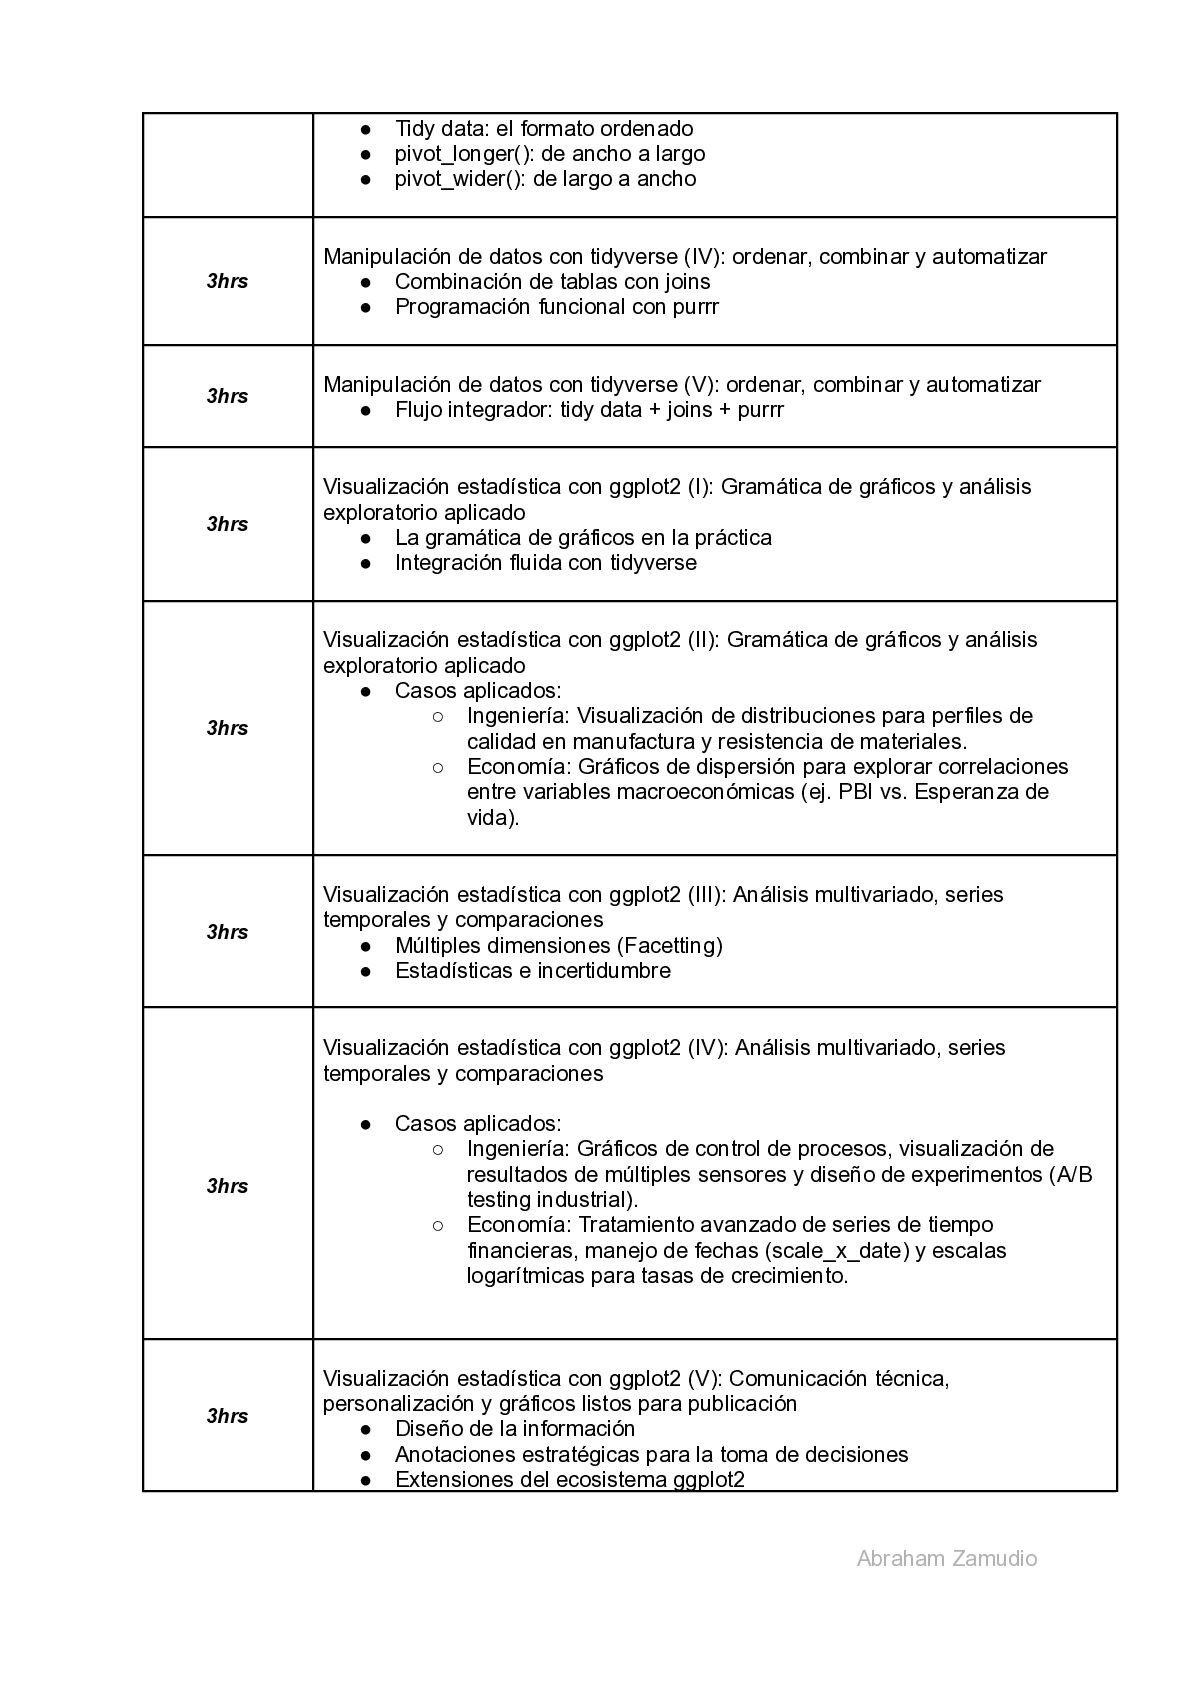
    •​ R y RStudio: del problema al proyecto reproducible •​ Vectores y factores: medir y clasificar datos reales 3hrs R como laboratorio de análisis para ingeniería y economía (II) •​ Listas: guardar resultados heterogéneos de un ensayo o escenario •​ Data frames: la tabla de análisis 3hrs R como laboratorio de análisis para ingeniería y economía (III) •​ Funciones: automatizar cálculos de ingeniería y economía •​ Paquetes: extender R para aplicaciones reales 3hrs ​ Comunicación reproducible con Quarto: reportes técnicos y presentaciones (I) •​ ¿Por qué reportes reproducibles? 3hrs Comunicación reproducible con Quarto: reportes técnicos y presentaciones (II) •​ Reportes parametrizados •​ Quarto: estructura básica y Formatos de salida •​ Referencias cruzadas, citas y bibliografía •​ Publicación y entrega 3hrs Entornos reproducibles y control de versiones: renv + Git desde RStudio (I) •​ El problema de las dependencias •​ renv: entorno reproducible •​ Git: control de versiones 3hrs Entornos reproducibles y control de versiones: renv + Git desde RStudio (II) •​ Flujo colaborativo aplicado •​ Integración renv + Git Módulo II : Procesamiento de datos y visualización 3hrs 3hrs 3hrs Manipulación de datos con tidyverse (I): importar, filtrar, transformar y resumir datos reales •​ Importación de datos con readr •​ Selección de columnas con select() •​ Filtrado de observaciones con filter() •​ Creación y transformación de variables con mutate() ​ ​ Manipulación de datos con tidyverse (II): importar, filtrar, transformar y resumir datos reales •​ Resumen de datos con summarise() y group_by() •​ El operador pipe y el flujo encadenado Manipulación de datos con tidyverse (III): ordenar, combinar y automatizar Abraham Zamudio
  5. •​ Tidy data: el formato ordenado •​ pivot_longer(): de ancho

    a largo •​ pivot_wider(): de largo a ancho 3hrs Manipulación de datos con tidyverse (IV): ordenar, combinar y automatizar •​ Combinación de tablas con joins •​ Programación funcional con purrr 3hrs Manipulación de datos con tidyverse (V): ordenar, combinar y automatizar •​ Flujo integrador: tidy data + joins + purrr 3hrs ​ ​ ​ Visualización estadística con ggplot2 (I): Gramática de gráficos y análisis exploratorio aplicado •​ La gramática de gráficos en la práctica •​ Integración fluida con tidyverse 3hrs Visualización estadística con ggplot2 (II): Gramática de gráficos y análisis exploratorio aplicado •​ Casos aplicados: ◦​ Ingeniería: Visualización de distribuciones para perfiles de calidad en manufactura y resistencia de materiales. ◦​ Economía: Gráficos de dispersión para explorar correlaciones entre variables macroeconómicas (ej. PBI vs. Esperanza de vida). 3hrs Visualización estadística con ggplot2 (III): Análisis multivariado, series temporales y comparaciones •​ Múltiples dimensiones (Facetting) •​ Estadísticas e incertidumbre Visualización estadística con ggplot2 (IV): Análisis multivariado, series temporales y comparaciones 3hrs 3hrs •​ Casos aplicados: ◦​ Ingeniería: Gráficos de control de procesos, visualización de resultados de múltiples sensores y diseño de experimentos (A/B testing industrial). ◦​ Economía: Tratamiento avanzado de series de tiempo financieras, manejo de fechas (scale_x_date) y escalas logarítmicas para tasas de crecimiento. Visualización estadística con ggplot2 (V): Comunicación técnica, personalización y gráficos listos para publicación •​ Diseño de la información •​ Anotaciones estratégicas para la toma de decisiones •​ Extensiones del ecosistema ggplot2 Abraham Zamudio
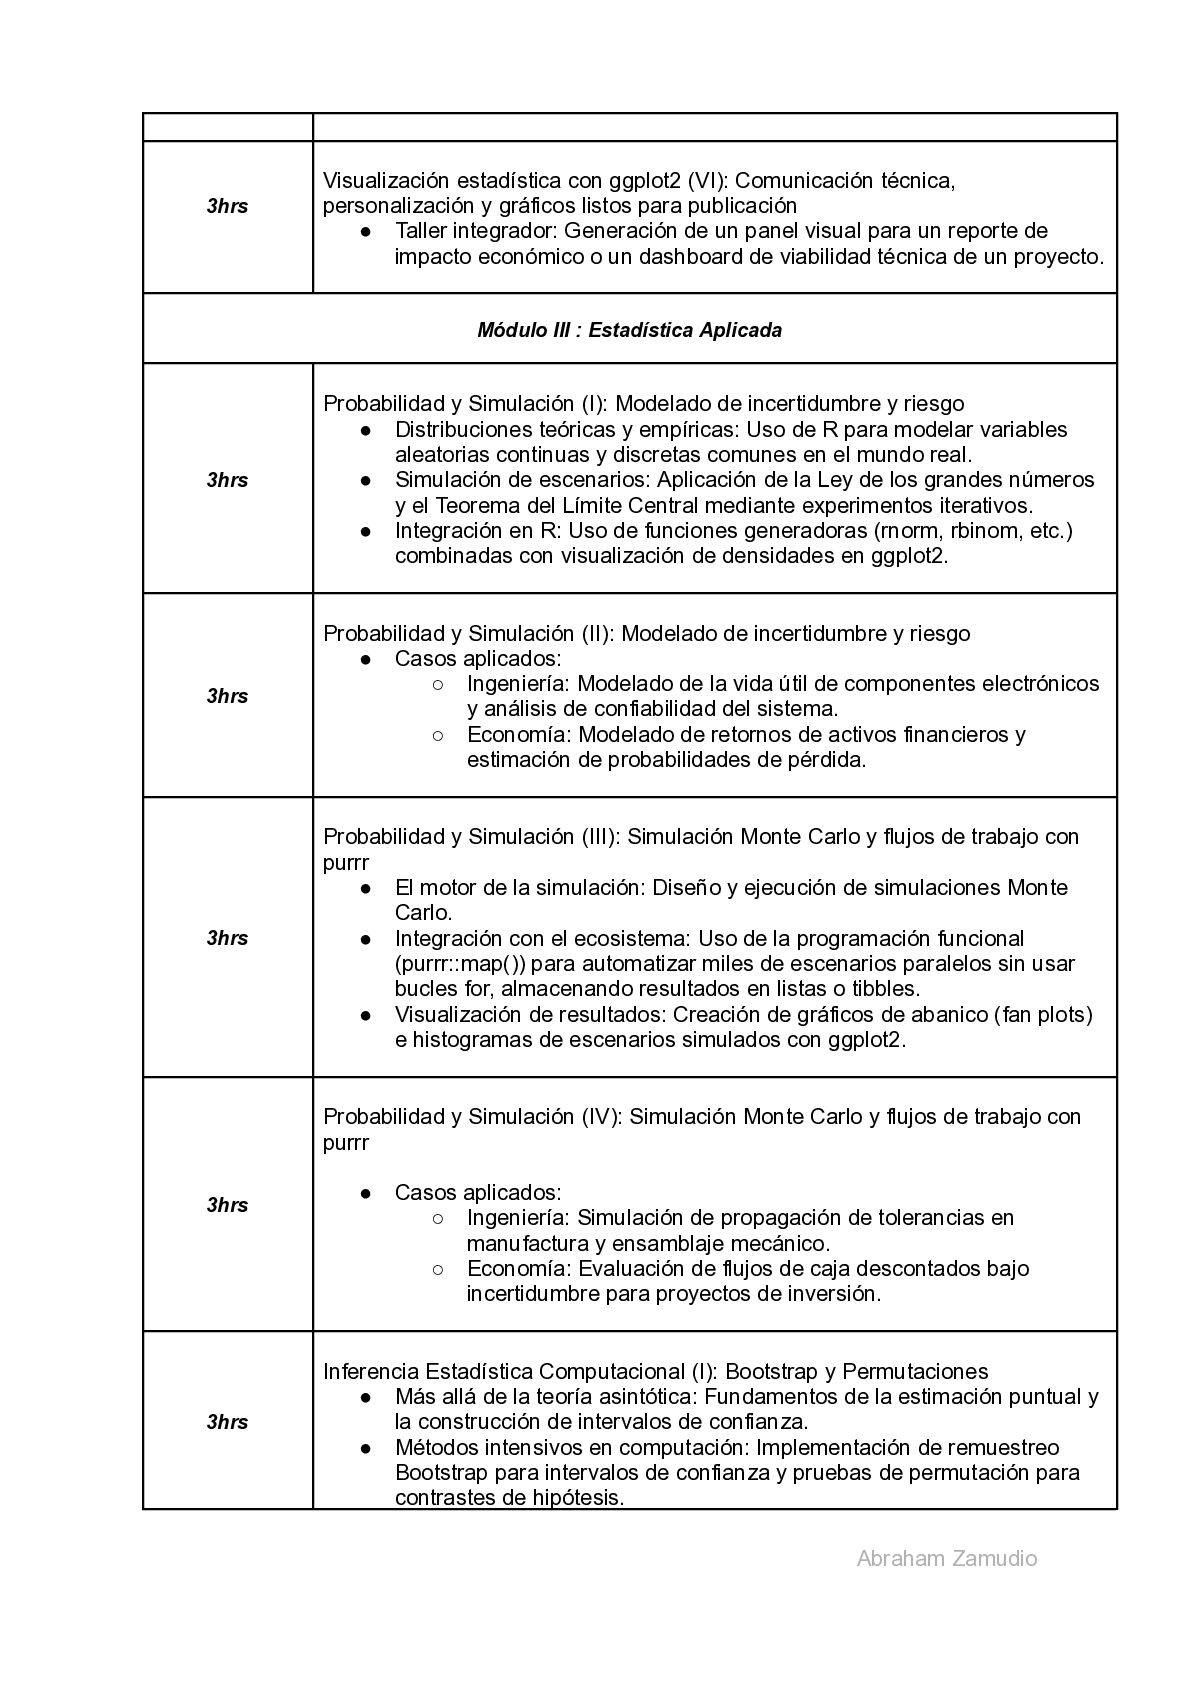
  6. 3hrs Visualización estadística con ggplot2 (VI): Comunicación técnica, personalización y

    gráficos listos para publicación •​ Taller integrador: Generación de un panel visual para un reporte de impacto económico o un dashboard de viabilidad técnica de un proyecto. Módulo III : Estadística Aplicada 3hrs Probabilidad y Simulación (I): Modelado de incertidumbre y riesgo •​ Distribuciones teóricas y empíricas: Uso de R para modelar variables aleatorias continuas y discretas comunes en el mundo real. •​ Simulación de escenarios: Aplicación de la Ley de los grandes números y el Teorema del Límite Central mediante experimentos iterativos. •​ Integración en R: Uso de funciones generadoras (rnorm, rbinom, etc.) combinadas con visualización de densidades en ggplot2. 3hrs Probabilidad y Simulación (II): Modelado de incertidumbre y riesgo •​ Casos aplicados: ◦​ Ingeniería: Modelado de la vida útil de componentes electrónicos y análisis de confiabilidad del sistema. ◦​ Economía: Modelado de retornos de activos financieros y estimación de probabilidades de pérdida. 3hrs Probabilidad y Simulación (III): Simulación Monte Carlo y flujos de trabajo con purrr •​ El motor de la simulación: Diseño y ejecución de simulaciones Monte Carlo. •​ Integración con el ecosistema: Uso de la programación funcional (purrr::map()) para automatizar miles de escenarios paralelos sin usar bucles for, almacenando resultados en listas o tibbles. •​ Visualización de resultados: Creación de gráficos de abanico (fan plots) e histogramas de escenarios simulados con ggplot2. Probabilidad y Simulación (IV): Simulación Monte Carlo y flujos de trabajo con purrr 3hrs 3hrs •​ Casos aplicados: ◦​ Ingeniería: Simulación de propagación de tolerancias en manufactura y ensamblaje mecánico. ◦​ Economía: Evaluación de flujos de caja descontados bajo incertidumbre para proyectos de inversión. Inferencia Estadística Computacional (I): Bootstrap y Permutaciones •​ Más allá de la teoría asintótica: Fundamentos de la estimación puntual y la construcción de intervalos de confianza. •​ Métodos intensivos en computación: Implementación de remuestreo Bootstrap para intervalos de confianza y pruebas de permutación para contrastes de hipótesis. Abraham Zamudio
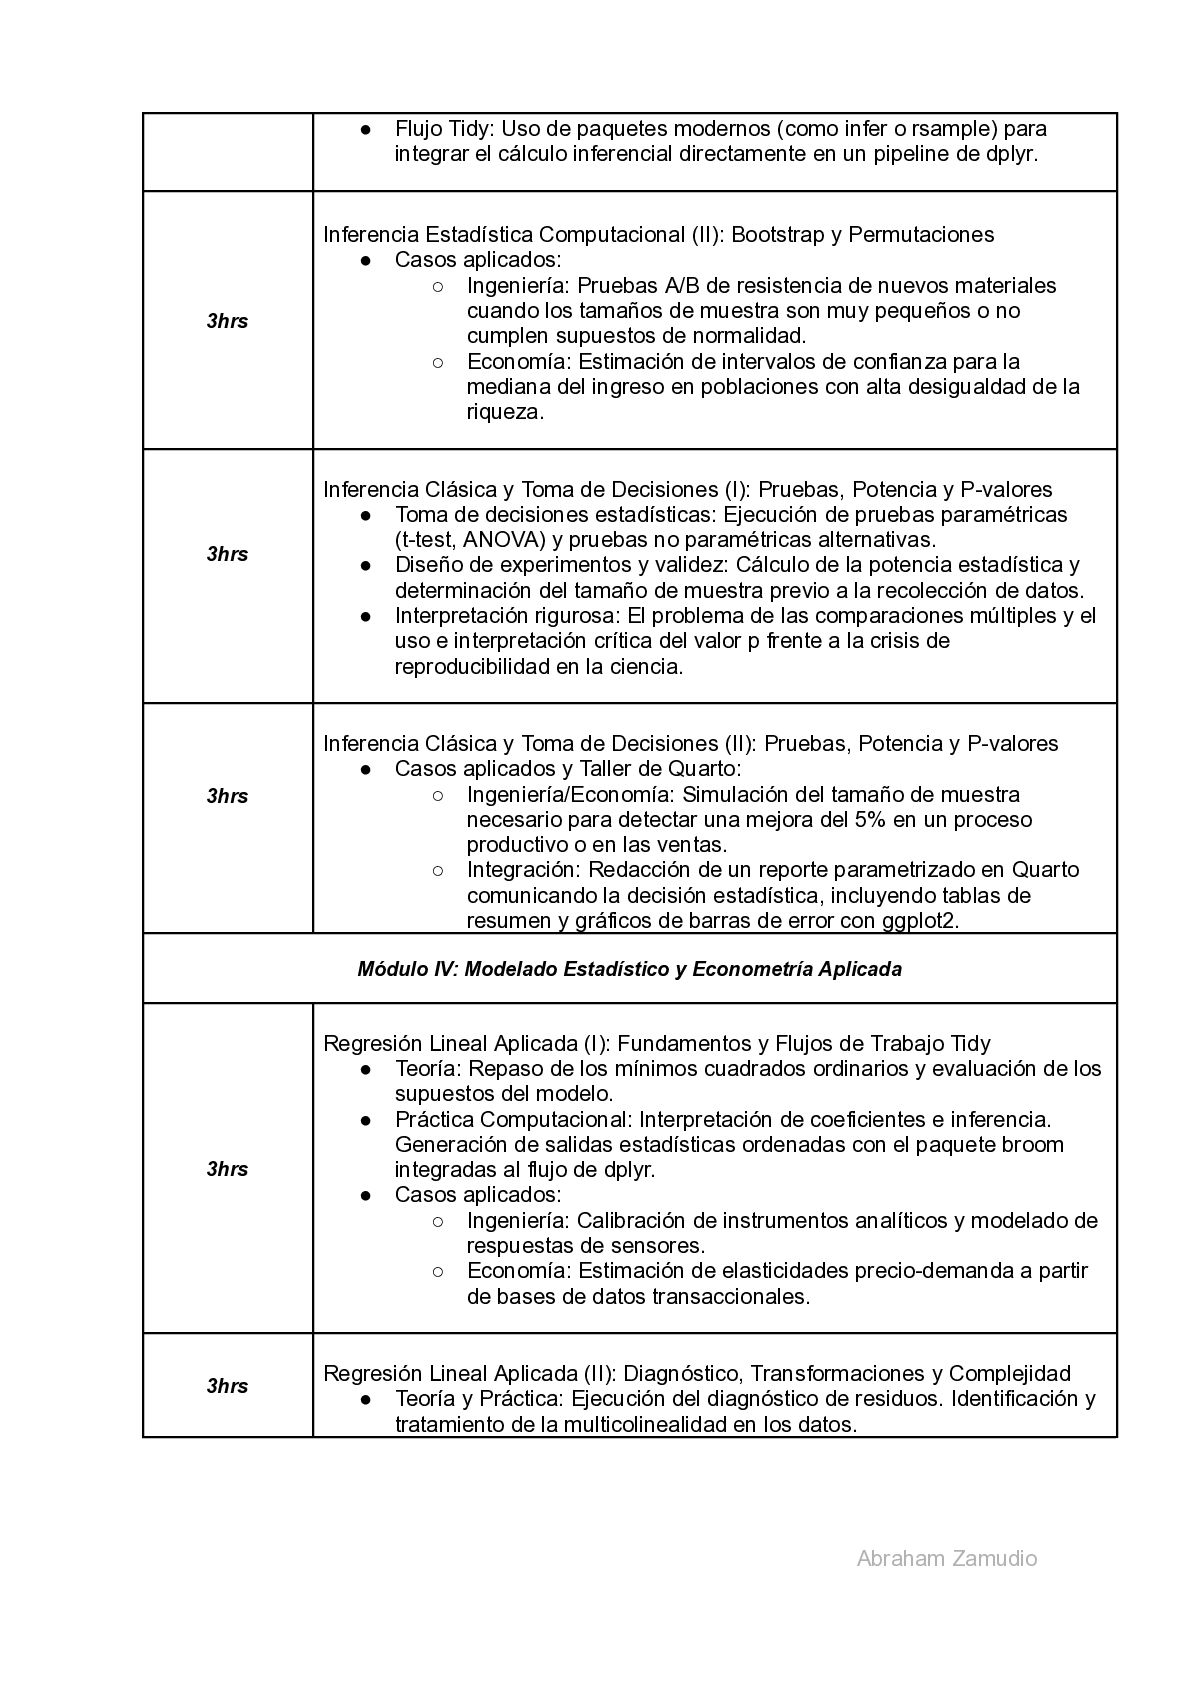
  7. •​ Flujo Tidy: Uso de paquetes modernos (como infer o

    rsample) para integrar el cálculo inferencial directamente en un pipeline de dplyr. 3hrs 3hrs 3hrs Inferencia Estadística Computacional (II): Bootstrap y Permutaciones •​ Casos aplicados: ◦​ Ingeniería: Pruebas A/B de resistencia de nuevos materiales cuando los tamaños de muestra son muy pequeños o no cumplen supuestos de normalidad. ◦​ Economía: Estimación de intervalos de confianza para la mediana del ingreso en poblaciones con alta desigualdad de la riqueza. Inferencia Clásica y Toma de Decisiones (I): Pruebas, Potencia y P-valores •​ Toma de decisiones estadísticas: Ejecución de pruebas paramétricas (t-test, ANOVA) y pruebas no paramétricas alternativas. •​ Diseño de experimentos y validez: Cálculo de la potencia estadística y determinación del tamaño de muestra previo a la recolección de datos. •​ Interpretación rigurosa: El problema de las comparaciones múltiples y el uso e interpretación crítica del valor p frente a la crisis de reproducibilidad en la ciencia. Inferencia Clásica y Toma de Decisiones (II): Pruebas, Potencia y P-valores •​ Casos aplicados y Taller de Quarto: ◦​ Ingeniería/Economía: Simulación del tamaño de muestra necesario para detectar una mejora del 5% en un proceso productivo o en las ventas. ◦​ Integración: Redacción de un reporte parametrizado en Quarto comunicando la decisión estadística, incluyendo tablas de resumen y gráficos de barras de error con ggplot2. Módulo IV: Modelado Estadístico y Econometría Aplicada 3hrs 3hrs ​ ​ Regresión Lineal Aplicada (I): Fundamentos y Flujos de Trabajo Tidy •​ Teoría: Repaso de los mínimos cuadrados ordinarios y evaluación de los supuestos del modelo. •​ Práctica Computacional: Interpretación de coeficientes e inferencia. Generación de salidas estadísticas ordenadas con el paquete broom integradas al flujo de dplyr. •​ Casos aplicados: ◦​ Ingeniería: Calibración de instrumentos analíticos y modelado de respuestas de sensores. ◦​ Economía: Estimación de elasticidades precio-demanda a partir de bases de datos transaccionales. ​ ​ ​ Regresión Lineal Aplicada (II): Diagnóstico, Transformaciones y Complejidad •​ Teoría y Práctica: Ejecución del diagnóstico de residuos. Identificación y tratamiento de la multicolinealidad en los datos. Abraham Zamudio
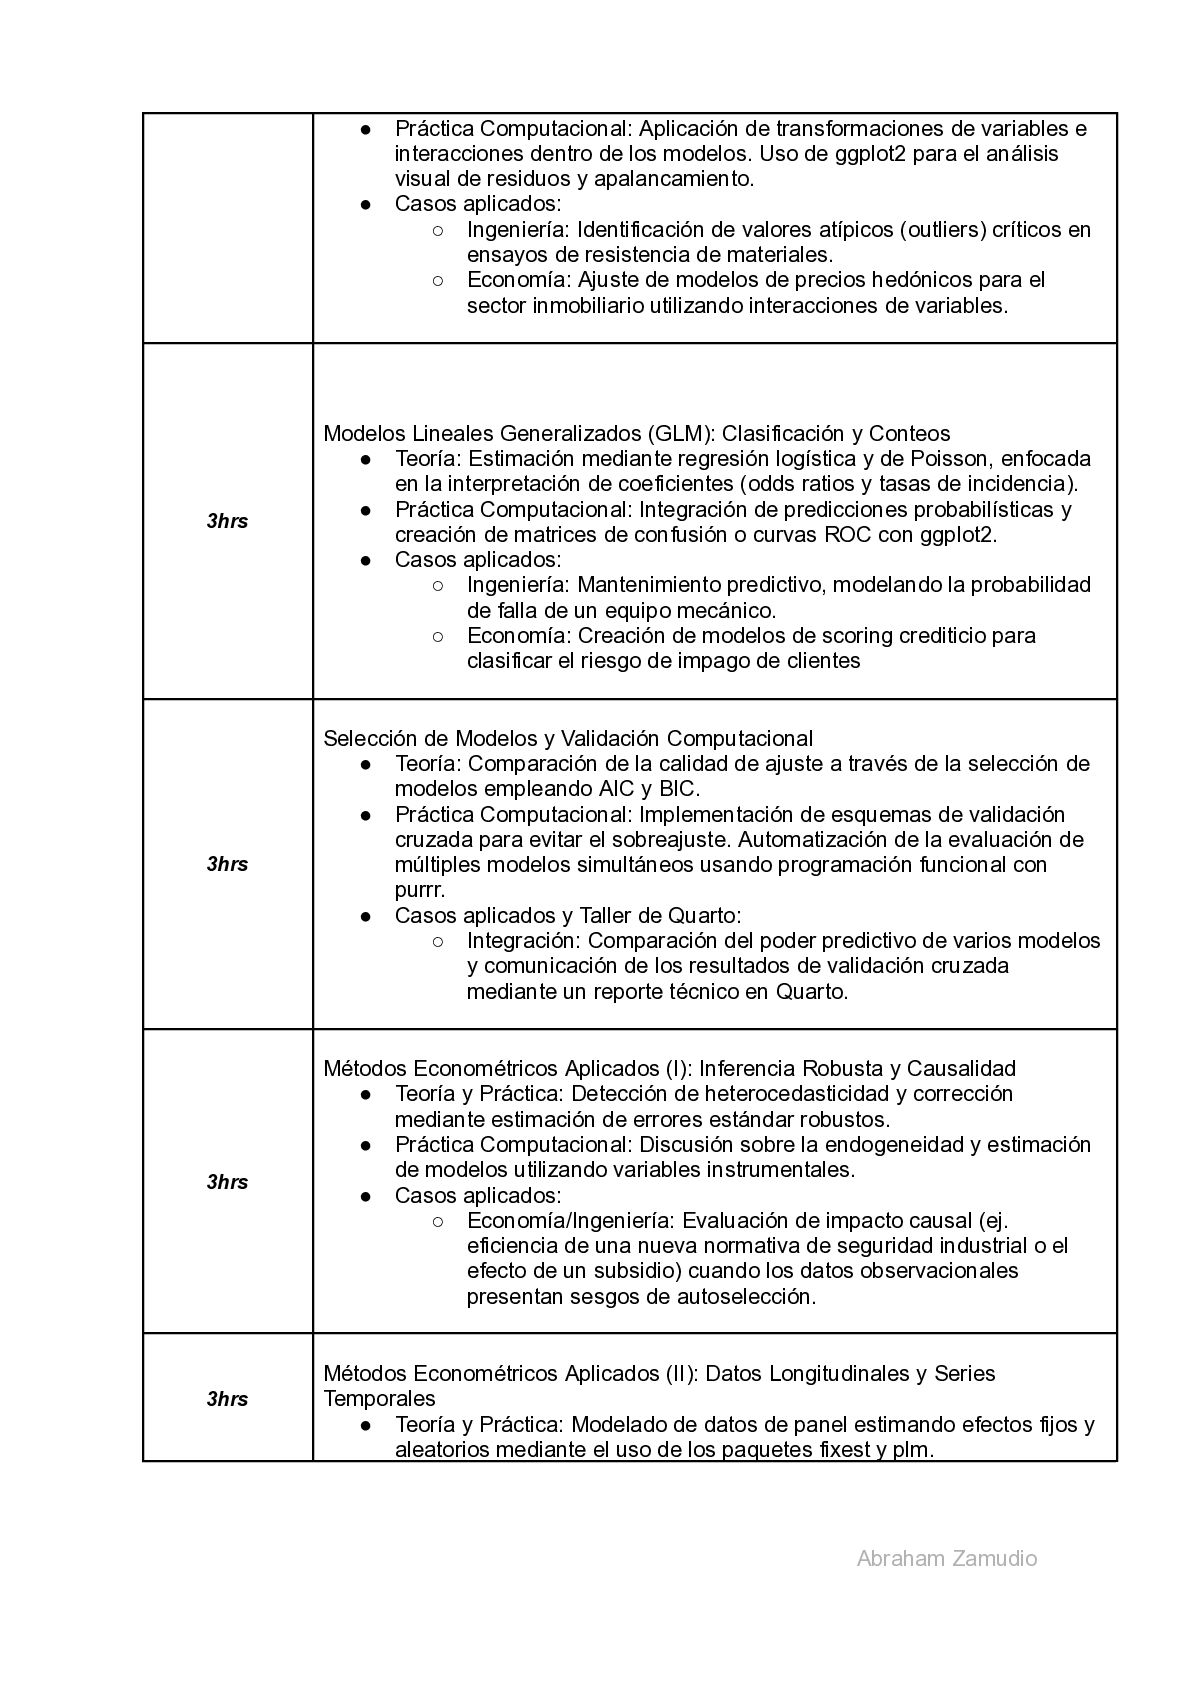
  8. •​ Práctica Computacional: Aplicación de transformaciones de variables e interacciones

    dentro de los modelos. Uso de ggplot2 para el análisis visual de residuos y apalancamiento. •​ Casos aplicados: ◦​ Ingeniería: Identificación de valores atípicos (outliers) críticos en ensayos de resistencia de materiales. ◦​ Economía: Ajuste de modelos de precios hedónicos para el sector inmobiliario utilizando interacciones de variables. ​ 3hrs 3hrs 3hrs 3hrs ​ Modelos Lineales Generalizados (GLM): Clasificación y Conteos •​ Teoría: Estimación mediante regresión logística y de Poisson, enfocada en la interpretación de coeficientes (odds ratios y tasas de incidencia). •​ Práctica Computacional: Integración de predicciones probabilísticas y creación de matrices de confusión o curvas ROC con ggplot2. •​ Casos aplicados: ◦​ Ingeniería: Mantenimiento predictivo, modelando la probabilidad de falla de un equipo mecánico. ◦​ Economía: Creación de modelos de scoring crediticio para clasificar el riesgo de impago de clientes ​ ​ Selección de Modelos y Validación Computacional •​ Teoría: Comparación de la calidad de ajuste a través de la selección de modelos empleando AIC y BIC. •​ Práctica Computacional: Implementación de esquemas de validación cruzada para evitar el sobreajuste. Automatización de la evaluación de múltiples modelos simultáneos usando programación funcional con purrr. •​ Casos aplicados y Taller de Quarto: ◦​ Integración: Comparación del poder predictivo de varios modelos y comunicación de los resultados de validación cruzada mediante un reporte técnico en Quarto. ​ ​ Métodos Econométricos Aplicados (I): Inferencia Robusta y Causalidad •​ Teoría y Práctica: Detección de heterocedasticidad y corrección mediante estimación de errores estándar robustos. •​ Práctica Computacional: Discusión sobre la endogeneidad y estimación de modelos utilizando variables instrumentales. •​ Casos aplicados: ◦​ Economía/Ingeniería: Evaluación de impacto causal (ej. eficiencia de una nueva normativa de seguridad industrial o el efecto de un subsidio) cuando los datos observacionales presentan sesgos de autoselección.​ Métodos Econométricos Aplicados (II): Datos Longitudinales y Series Temporales •​ Teoría y Práctica: Modelado de datos de panel estimando efectos fijos y aleatorios mediante el uso de los paquetes fixest y plm. Abraham Zamudio
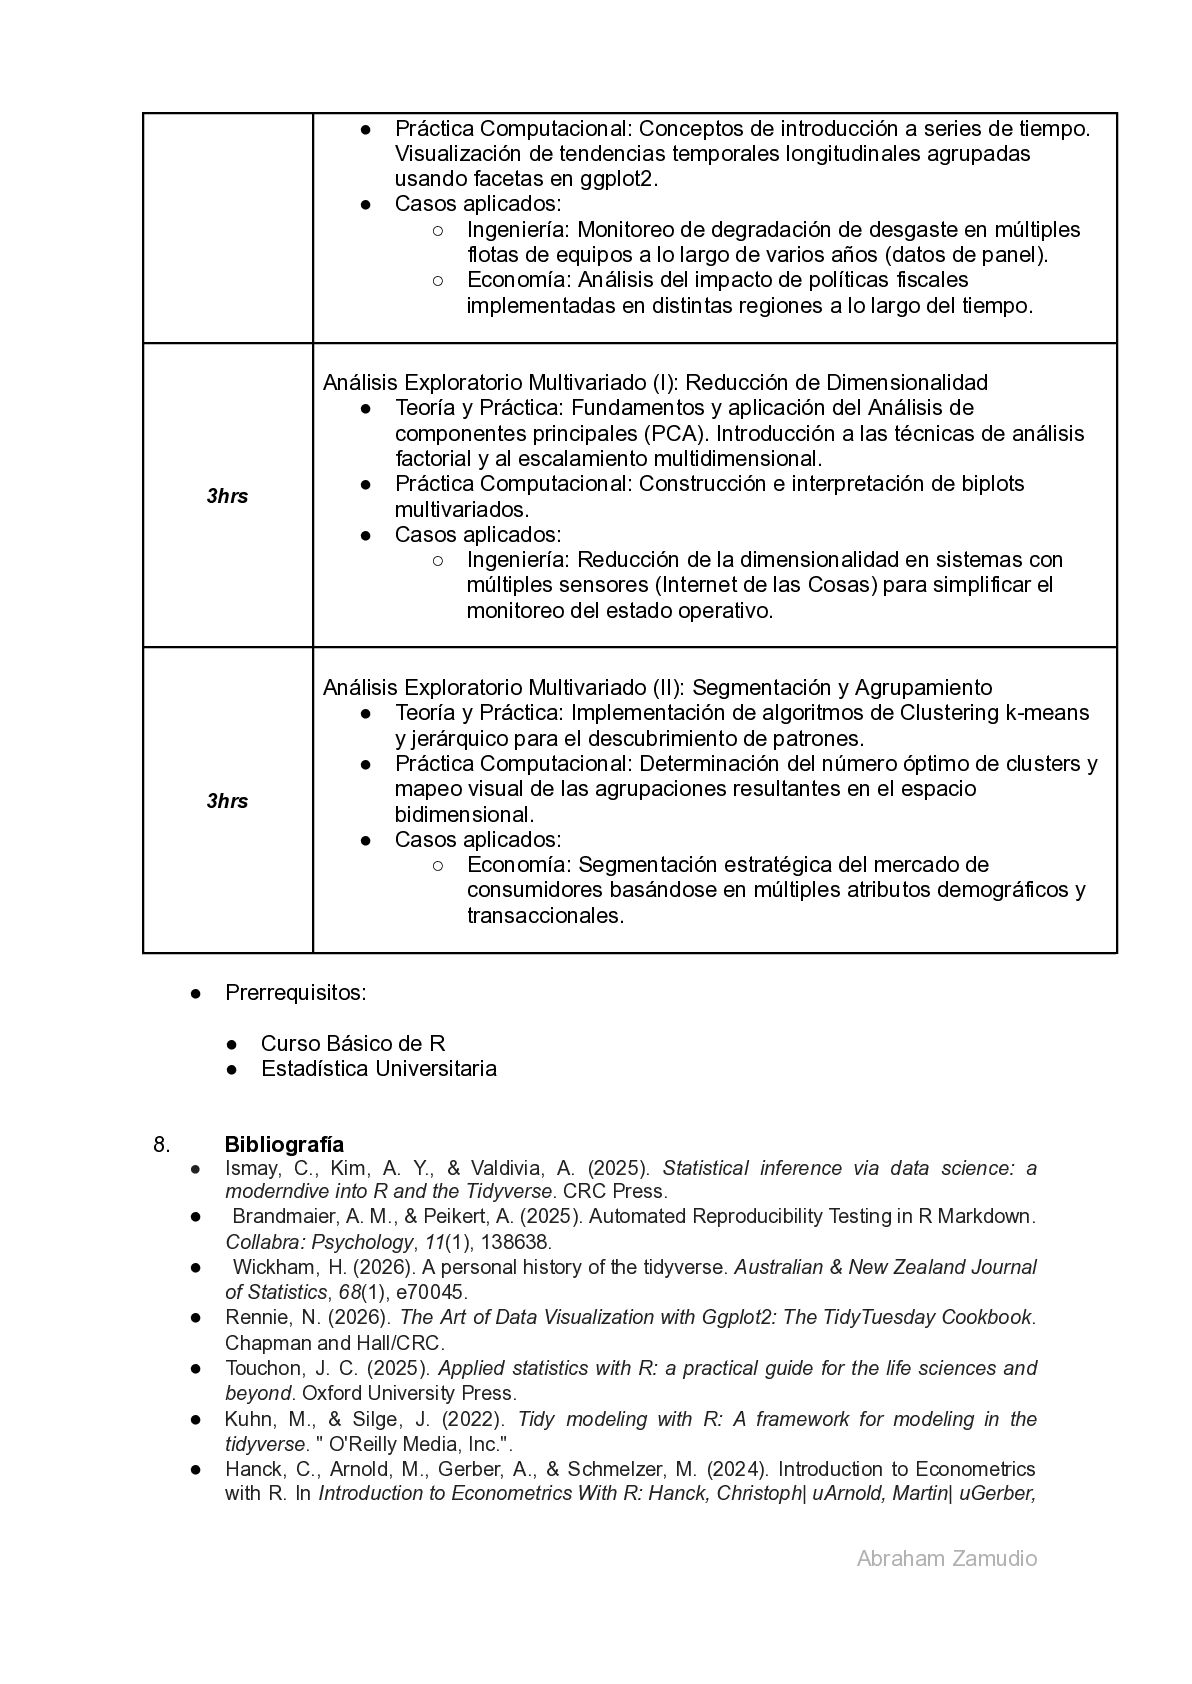
  9. •​ Práctica Computacional: Conceptos de introducción a series de tiempo.

    Visualización de tendencias temporales longitudinales agrupadas usando facetas en ggplot2. •​ Casos aplicados: ◦​ Ingeniería: Monitoreo de degradación de desgaste en múltiples flotas de equipos a lo largo de varios años (datos de panel). ◦​ Economía: Análisis del impacto de políticas fiscales implementadas en distintas regiones a lo largo del tiempo.​ 3hrs Análisis Exploratorio Multivariado (I): Reducción de Dimensionalidad •​ Teoría y Práctica: Fundamentos y aplicación del Análisis de componentes principales (PCA). Introducción a las técnicas de análisis factorial y al escalamiento multidimensional. •​ Práctica Computacional: Construcción e interpretación de biplots multivariados. •​ Casos aplicados: ◦​ Ingeniería: Reducción de la dimensionalidad en sistemas con múltiples sensores (Internet de las Cosas) para simplificar el monitoreo del estado operativo. 3hrs Análisis Exploratorio Multivariado (II): Segmentación y Agrupamiento •​ Teoría y Práctica: Implementación de algoritmos de Clustering k-means y jerárquico para el descubrimiento de patrones. •​ Práctica Computacional: Determinación del número óptimo de clusters y mapeo visual de las agrupaciones resultantes en el espacio bidimensional. •​ Casos aplicados: ◦​ Economía: Segmentación estratégica del mercado de consumidores basándose en múltiples atributos demográficos y transaccionales. •​ Prerrequisitos:​ •​ Curso Básico de R •​ Estadística Universitaria 8.​ Bibliografía •​ Ismay, C., Kim, A. Y., & Valdivia, A. (2025). Statistical inference via data science: a moderndive into R and the Tidyverse. CRC Press. •​ Brandmaier, A. M., & Peikert, A. (2025). Automated Reproducibility Testing in R Markdown. Collabra: Psychology, 11(1), 138638. •​ Wickham, H. (2026). A personal history of the tidyverse. Australian & New Zealand Journal of Statistics, 68(1), e70045. •​ Rennie, N. (2026). The Art of Data Visualization with Ggplot2: The TidyTuesday Cookbook. Chapman and Hall/CRC. •​ Touchon, J. C. (2025). Applied statistics with R: a practical guide for the life sciences and beyond. Oxford University Press. •​ Kuhn, M., & Silge, J. (2022). Tidy modeling with R: A framework for modeling in the tidyverse. " O'Reilly Media, Inc.". •​ Hanck, C., Arnold, M., Gerber, A., & Schmelzer, M. (2024). Introduction to Econometrics with R. In Introduction to Econometrics With R: Hanck, Christoph| uArnold, Martin| uGerber, Abraham Zamudio
  10. Alexander| uSchmelzer, Martin. Essen, Germany: University of Duisburg-Essen, Department of

    Business Administration and Economics, Chair of Econometrics. •​ Hansen, B. (2022). Econometrics. Princeton University Press. Abraham Zamudio