Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Python para Investigación Cuantitativa

Python para Investigación Cuantitativa

Avatar for Abraham Zamudio

Abraham Zamudio

October 06, 2026

More Decks by Abraham Zamudio

Other Decks in Education

Transcript

  1. 1.​ Datos generales del curso Asignatura: Python para Investigación Cuantitativa

    Horas: número total de horas 2.​ Presentación El curso Python para Investigación Cuantitativa es un programa intensivo, teórico-práctico, diseñado para que personas que desarrollan proyectos de investigación cuantitativa adquieran las competencias necesarias para incorporar Python como herramienta central en su flujo de trabajo científico. A lo largo de veintidós sesiones de tres horas, equivalentes a sesenta y seis horas totales, el participante recorrerá desde la configuración del entorno y el control de versiones hasta la computación numérica, el análisis de datos, la visualización científica y la automatización de pipelines reproducibles. La propuesta no se limita a enseñar sintaxis, sino que busca formar investigadores capaces de producir ciencia reproducible, auditable y escalable, integrando buenas prácticas de programación, herramientas modernas de desarrollo y criterios de calidad propios del quehacer científico. El nombre del curso, Python para Investigación Cuantitativa, refleja con precisión su propósito: proporcionar un dominio aplicado del lenguaje y de su ecosistema científico para abordar problemas de investigación que requieren tratamiento sistemático de datos, modelado matemático, simulación y comunicación de resultados. El curso está dirigido a estudiantes de pregrado y posgrado, investigadores en formación, docentes y profesionales que necesiten procesar, analizar, modelar y visualizar datos de manera sistemática y reproducible. No se exige experiencia avanzada en programación: el programa comienza con una nivelación y avanza progresivamente hacia aplicaciones científicas de mayor complejidad. La estructura curricular ha sido pensada para que cada participante pueda aplicar lo aprendido a sus propios datos y problemas de investigación, de modo que el aprendizaje sea significativo y transferible. El objetivo general es capacitar en el uso del ecosistema científico de Python para desarrollar proyectos de investigación cuantitativa reproducibles, abarcando la preparación del entorno, la escritura de código robusto, el análisis de datos, la modelación numérica, la visualización y la automatización de experimentos computacionales. La metodología combina exposiciones breves con práctica intensiva en laboratorio. Se trabaja con Jupyter Notebook y Visual Studio Code, dos herramientas ampliamente utilizadas en el ámbito científico y profesional. Se utilizan entornos virtuales gestionados con Anaconda o uv, lo que permite aislar dependencias y garantizar la reproducibilidad de los análisis. Desde las primeras sesiones se incorpora Git y GitHub para el versionado de código, de modo que los participantes aprendan a registrar la evolución de sus proyectos, experimentar con ramificaciones y sincronizar repositorios remotos. A lo largo del curso se promueven buenas prácticas de programación científica, como el cumplimiento de PEP 8, la documentación mediante docstrings, el tipado opcional, la escritura de pruebas básicas con pytest y el uso responsable de asistentes de inteligencia artificial para código. El cierre es un proyecto integrador sobre datos del área de cada participante, que abarca ingesta, limpieza, cálculo y visualización, con versionado en Git y presentación de resultados. Abraham Zamudio
  2. Los contenidos se organizan en bloques temáticos que van de

    lo fundamental a lo aplicado. El primer bloque aborda el entorno de trabajo y la nivelación: instalación con Anaconda o uv, creación y gestión de entornos virtuales, flujo de trabajo con Jupyter Notebook y VS Code, y fundamentos de Git y GitHub, incluyendo commit, push y el repositorio del curso. El segundo bloque profundiza en Git y GitHub: fundamentos y repositorios locales, ramificaciones y experimentación, y sincronización remota. El tercer bloque se dedica a los fundamentos del lenguaje Python I: tipos de datos, operadores y estructuras de control; estructuras de datos como listas, tuplas, diccionarios y conjuntos. El cuarto bloque continúa con fundamentos del lenguaje Python II: funciones y argumentos, comprensiones. El quinto bloque cubre módulos y paquetes. El sexto bloque trata el manejo de errores y la lectura/escritura de archivos. El séptimo bloque introduce las buenas prácticas de programación científica I: PEP 8, docstrings, tipado opcional y una introducción al paradigma de la programación orientada a objetos mediante clases para modelos simples. El octavo bloque aborda las pruebas básicas con pytest. El noveno bloque se centra en el uso responsable de asistentes de IA para código. A partir de la décima sesión, el curso se adentra en la computación matricial aplicada con NumPy. El primer bloque de NumPy trata el procesamiento masivo y la optimización de datos: gestión y filtrado de datos multidimensionales, vectorización y broadcasting para eliminar bucles y escalar modelos matemáticos a millones de registros, y auditoría de rendimiento computacional mediante profiling. El segundo bloque de NumPy aborda el modelamiento cuantitativo y la simulación estocástica: resolución de sistemas complejos con numpy.linalg, autovalores y descomposiciones matriciales, modelado estocástico y análisis de riesgo. Posteriormente, el curso introduce los métodos numéricos aplicados con SciPy. El primer bloque de SciPy cubre optimización, estimación y reconstrucción de datos: optimización de recursos y ajuste paramétrico con scipy.optimize, integración numérica para sistemas continuos con scipy.integrate, e interpolación espacial y temporal con scipy.interpolate. El segundo bloque de SciPy se enfoca en la simulación de sistemas dinámicos y análisis de riesgo: simulación de sistemas dinámicos mediante ecuaciones diferenciales ordinarias con scipy.integrate, y modelado probabilístico y confiabilidad con scipy.stats. La ingesta y estructuración de datos empíricos se desarrolla con Pandas. El primer bloque de Pandas sienta las bases para el modelado cuantitativo: Series y DataFrame, ingesta masiva y multiformato con lectura de CSV, Excel, JSON y Parquet, y extracción paramétrica y optimización mediante técnicas de filtrado condicional. El segundo bloque aborda limpieza, curación y control de calidad de datos: tratamiento estadístico de anomalías, estandarización de variables complejas y auditoría de datos mediante flujos de validación y control de calidad. El tercer bloque se centra en la consolidación de bases de datos y transformación estructural: agregaciones multidimensionales con groupby, integración de fuentes heterogéneas con merge y join, y transposición y el principio de Tidy Data con pivot y melt. El cuarto bloque desarrolla el análisis de series temporales y optimización de procesos: manejo algorítmico del tiempo, suavizado de señales y remuestreo, e ingeniería de pipelines analíticos. La visualización técnica y los gráficos científicos para publicación se trabajan con Matplotlib y Seaborn. Con Matplotlib se estudia la arquitectura gráfica orientada a objetos, el control milimétrico sobre la anatomía de la figura (ejes, subgráficos) para representar sistemas multivariables, los estándares de grado publicación, y la exportación y reproducibilidad. Con Seaborn se aborda el análisis exploratorio visual y el diagnóstico de datos multivariados: mapeo de distribuciones y Abraham Zamudio
  3. relaciones estructurales, diseño de paneles comparativos (Facets) y principios cognitivos

    en la visualización analítica. La automatización del flujo de investigación se divide en dos bloques. El primero, "De la exploración a la producción de scripts robustos", trata la transición del entorno interactivo al código de producción, la parametrización de modelos con argparse, la gestión agnóstica de rutas con pathlib, y la trazabilidad y auditoría de ejecución con logging. El segundo bloque, "Escalamiento y estandarización reproducible", aborda el procesamiento por lotes y la automatización masiva, la orquestación de experimentos computacionales, la arquitectura de un proyecto de investigación reproducible y la garantía de auditoría científica. El curso culmina con una sesión de proyecto integrador, en la que cada participante construye un pipeline completo sobre datos de su área: ingesta, limpieza, cálculo y visualización, con versionado en Git y presentación de resultados. Al finalizar el curso, los participantes serán capaces de configurar un entorno de trabajo reproducible y versionar sus proyectos con Git y GitHub; escribir código Python claro, modular y documentado, siguiendo buenas prácticas científicas; procesar y analizar datos multivariados con NumPy, Pandas y SciPy; resolver problemas de optimización, simulación e integración numérica; generar visualizaciones técnicas de calidad para publicación; automatizar flujos de investigación y garantizar la trazabilidad de sus experimentos; e integrar todas las herramientas en un pipeline completo aplicado a su propia investigación cuantitativa. La evaluación se basa en ejercicios prácticos, participación en laboratorios y la presentación del proyecto integrador final, en el que cada estudiante aplica lo aprendido a datos de su área. El curso culmina con la exposición de resultados y su respectivo versionado en Git. Python para Investigación Cuantitativa no se limita a enseñar sintaxis: forma investigadores capaces de producir ciencia reproducible, auditable y escalable, con una base sólida para enfrentar los desafíos computacionales de la investigación contemporánea. Su enfoque integral permite que el participante no solo aprenda a usar herramientas, sino que desarrolle un criterio metodológico para decidir cuándo y cómo aplicar cada técnica, documentar sus procesos y comunicar sus resultados con rigor. Así, el curso se convierte en un puente entre la formación disciplinar y la práctica computacional avanzada, indispensable en el contexto actual de la investigación cuantitativa. 3.​ Objetivo general del curso Capacitar al participante en el uso del ecosistema científico de Python para desarrollar proyectos de investigación reproducibles, abarcando la preparación del entorno, la escritura de código robusto, el análisis de datos, la modelación numérica, la visualización y la automatización de experimentos computacionales. 4.​ Objetivos específicos del curso •​ Configurar entornos de trabajo reproducibles con Anaconda o uv, Jupyter Notebook y VS Code, aplicando control de versiones con Git y GitHub. •​ Aplicar los fundamentos del lenguaje Python —estructuras de control, datos, funciones, módulos, manejo de errores, POO básica, pruebas con pytest y buenas prácticas— para escribir código científico claro y documentado.​ Abraham Zamudio
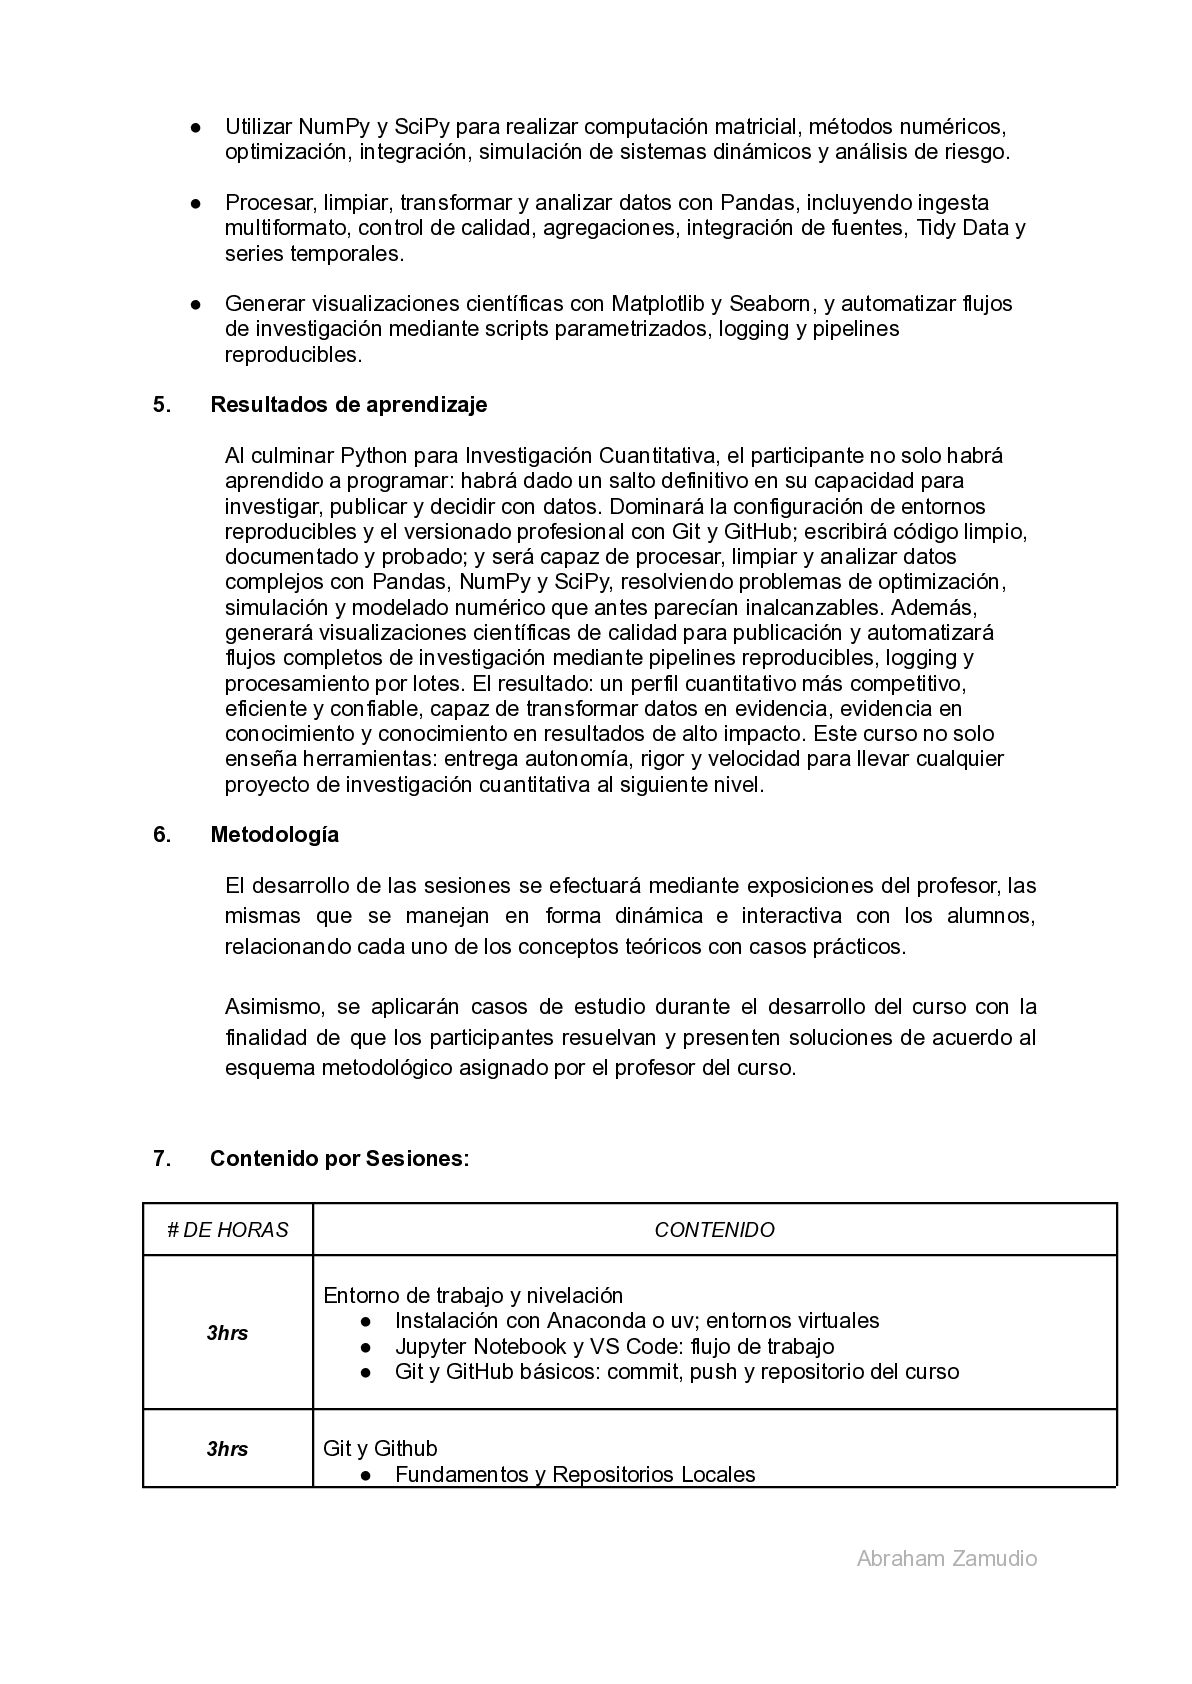
  4. •​ Utilizar NumPy y SciPy para realizar computación matricial, métodos

    numéricos, optimización, integración, simulación de sistemas dinámicos y análisis de riesgo.​ •​ Procesar, limpiar, transformar y analizar datos con Pandas, incluyendo ingesta multiformato, control de calidad, agregaciones, integración de fuentes, Tidy Data y series temporales.​ •​ Generar visualizaciones científicas con Matplotlib y Seaborn, y automatizar flujos de investigación mediante scripts parametrizados, logging y pipelines reproducibles. 5.​ Resultados de aprendizaje Al culminar Python para Investigación Cuantitativa, el participante no solo habrá aprendido a programar: habrá dado un salto definitivo en su capacidad para investigar, publicar y decidir con datos. Dominará la configuración de entornos reproducibles y el versionado profesional con Git y GitHub; escribirá código limpio, documentado y probado; y será capaz de procesar, limpiar y analizar datos complejos con Pandas, NumPy y SciPy, resolviendo problemas de optimización, simulación y modelado numérico que antes parecían inalcanzables. Además, generará visualizaciones científicas de calidad para publicación y automatizará flujos completos de investigación mediante pipelines reproducibles, logging y procesamiento por lotes. El resultado: un perfil cuantitativo más competitivo, eficiente y confiable, capaz de transformar datos en evidencia, evidencia en conocimiento y conocimiento en resultados de alto impacto. Este curso no solo enseña herramientas: entrega autonomía, rigor y velocidad para llevar cualquier proyecto de investigación cuantitativa al siguiente nivel. 6.​ Metodología El desarrollo de las sesiones se efectuará mediante exposiciones del profesor, las mismas que se manejan en forma dinámica e interactiva con los alumnos, relacionando cada uno de los conceptos teóricos con casos prácticos. Asimismo, se aplicarán casos de estudio durante el desarrollo del curso con la finalidad de que los participantes resuelvan y presenten soluciones de acuerdo al esquema metodológico asignado por el profesor del curso. 7.​ Contenido por Sesiones: # DE HORAS 3hrs 3hrs CONTENIDO Entorno de trabajo y nivelación •​ Instalación con Anaconda o uv; entornos virtuales •​ Jupyter Notebook y VS Code: flujo de trabajo •​ Git y GitHub básicos: commit, push y repositorio del curso Git y Github •​ Fundamentos y Repositorios Locales Abraham Zamudio
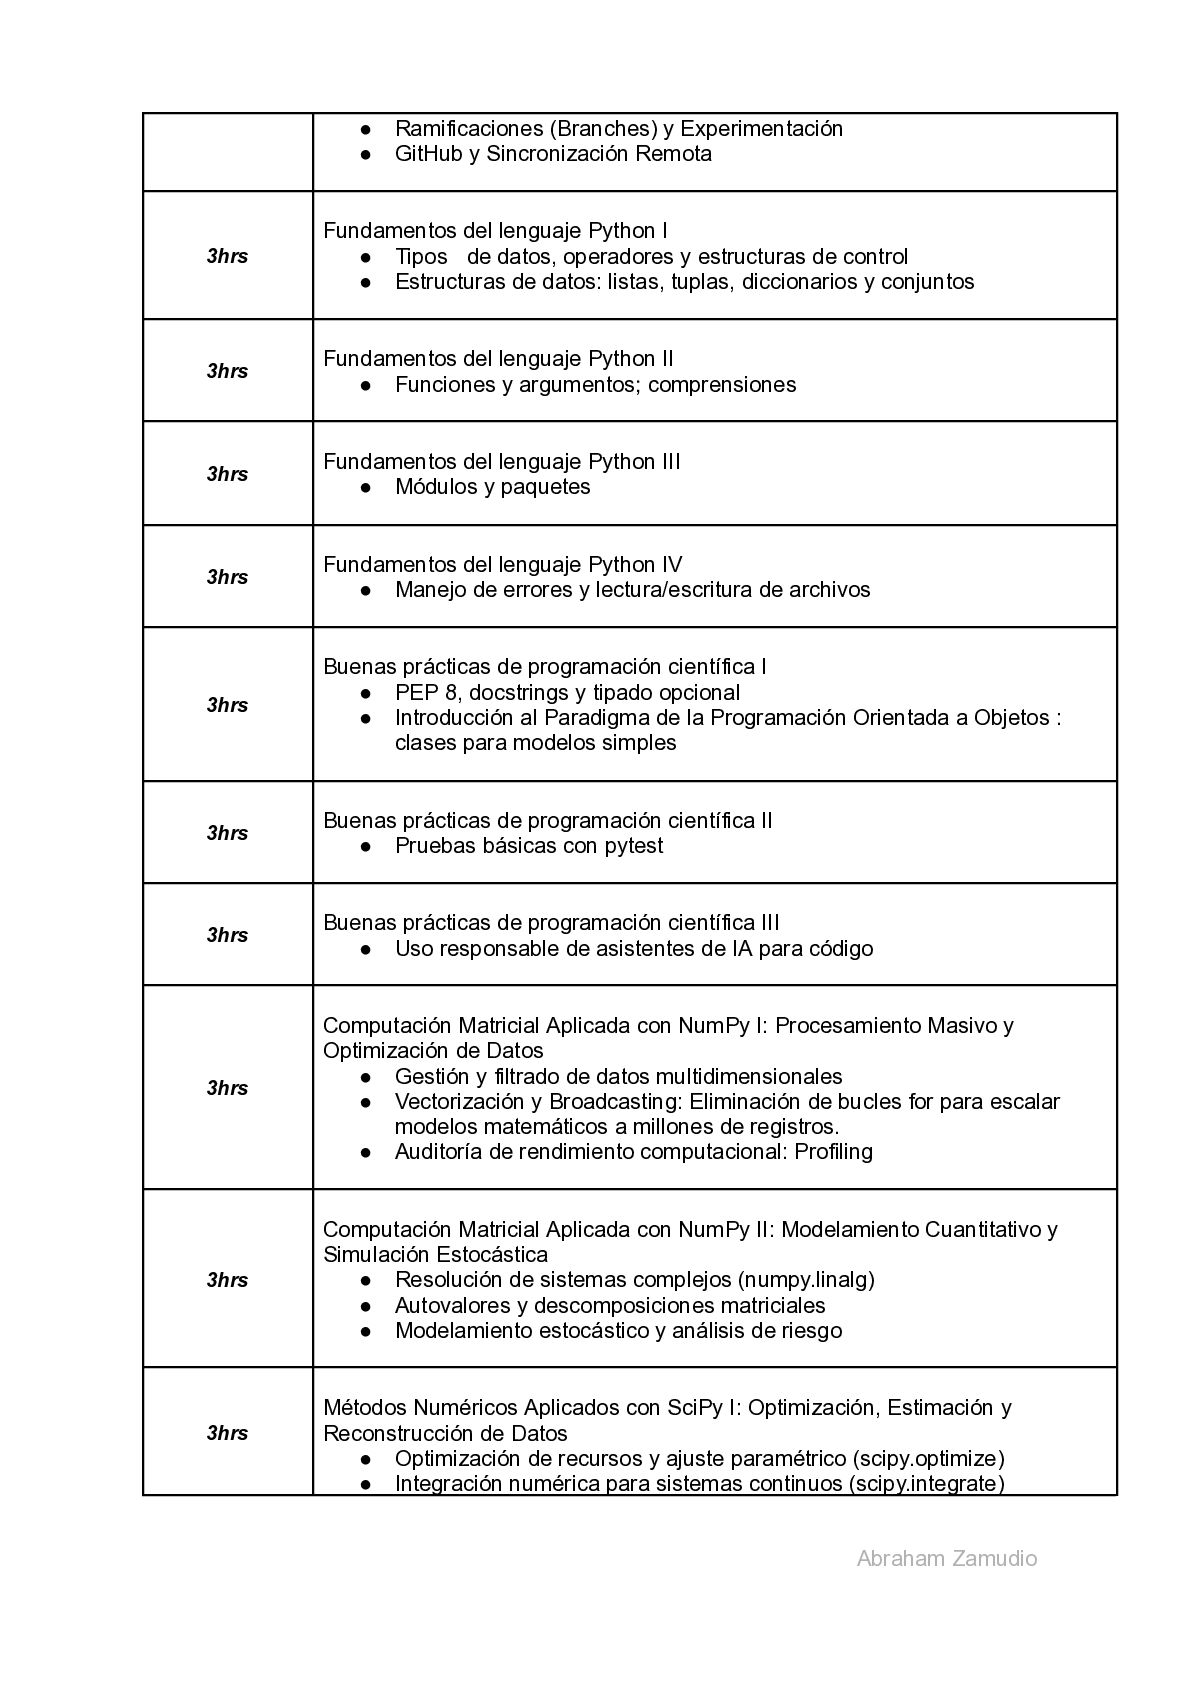
  5. •​ Ramificaciones (Branches) y Experimentación •​ GitHub y Sincronización Remota

    3hrs Fundamentos del lenguaje Python I •​ Tipos ​ de datos, operadores y estructuras de control •​ Estructuras de datos: listas, tuplas, diccionarios y conjuntos 3hrs Fundamentos del lenguaje Python II •​ Funciones y argumentos; comprensiones 3hrs Fundamentos del lenguaje Python III •​ Módulos y paquetes 3hrs Fundamentos del lenguaje Python IV •​ Manejo de errores y lectura/escritura de archivos 3hrs Buenas prácticas de programación científica I •​ PEP 8, docstrings y tipado opcional •​ Introducción al Paradigma de la Programación Orientada a Objetos : clases para modelos simples 3hrs Buenas prácticas de programación científica II •​ Pruebas básicas con pytest 3hrs Buenas prácticas de programación científica III •​ Uso responsable de asistentes de IA para código 3hrs 3hrs 3hrs ​ Computación Matricial Aplicada con NumPy I: Procesamiento Masivo y Optimización de Datos •​ Gestión y filtrado de datos multidimensionales •​ Vectorización y Broadcasting: Eliminación de bucles for para escalar modelos matemáticos a millones de registros. •​ Auditoría de rendimiento computacional: Profiling ​ ​ Computación Matricial Aplicada con NumPy II: Modelamiento Cuantitativo y Simulación Estocástica •​ Resolución de sistemas complejos (numpy.linalg) •​ Autovalores y descomposiciones matriciales •​ Modelamiento estocástico y análisis de riesgo ​ Métodos Numéricos Aplicados con SciPy I: Optimización, Estimación y Reconstrucción de Datos •​ Optimización de recursos y ajuste paramétrico (scipy.optimize) •​ Integración numérica para sistemas continuos (scipy.integrate) Abraham Zamudio
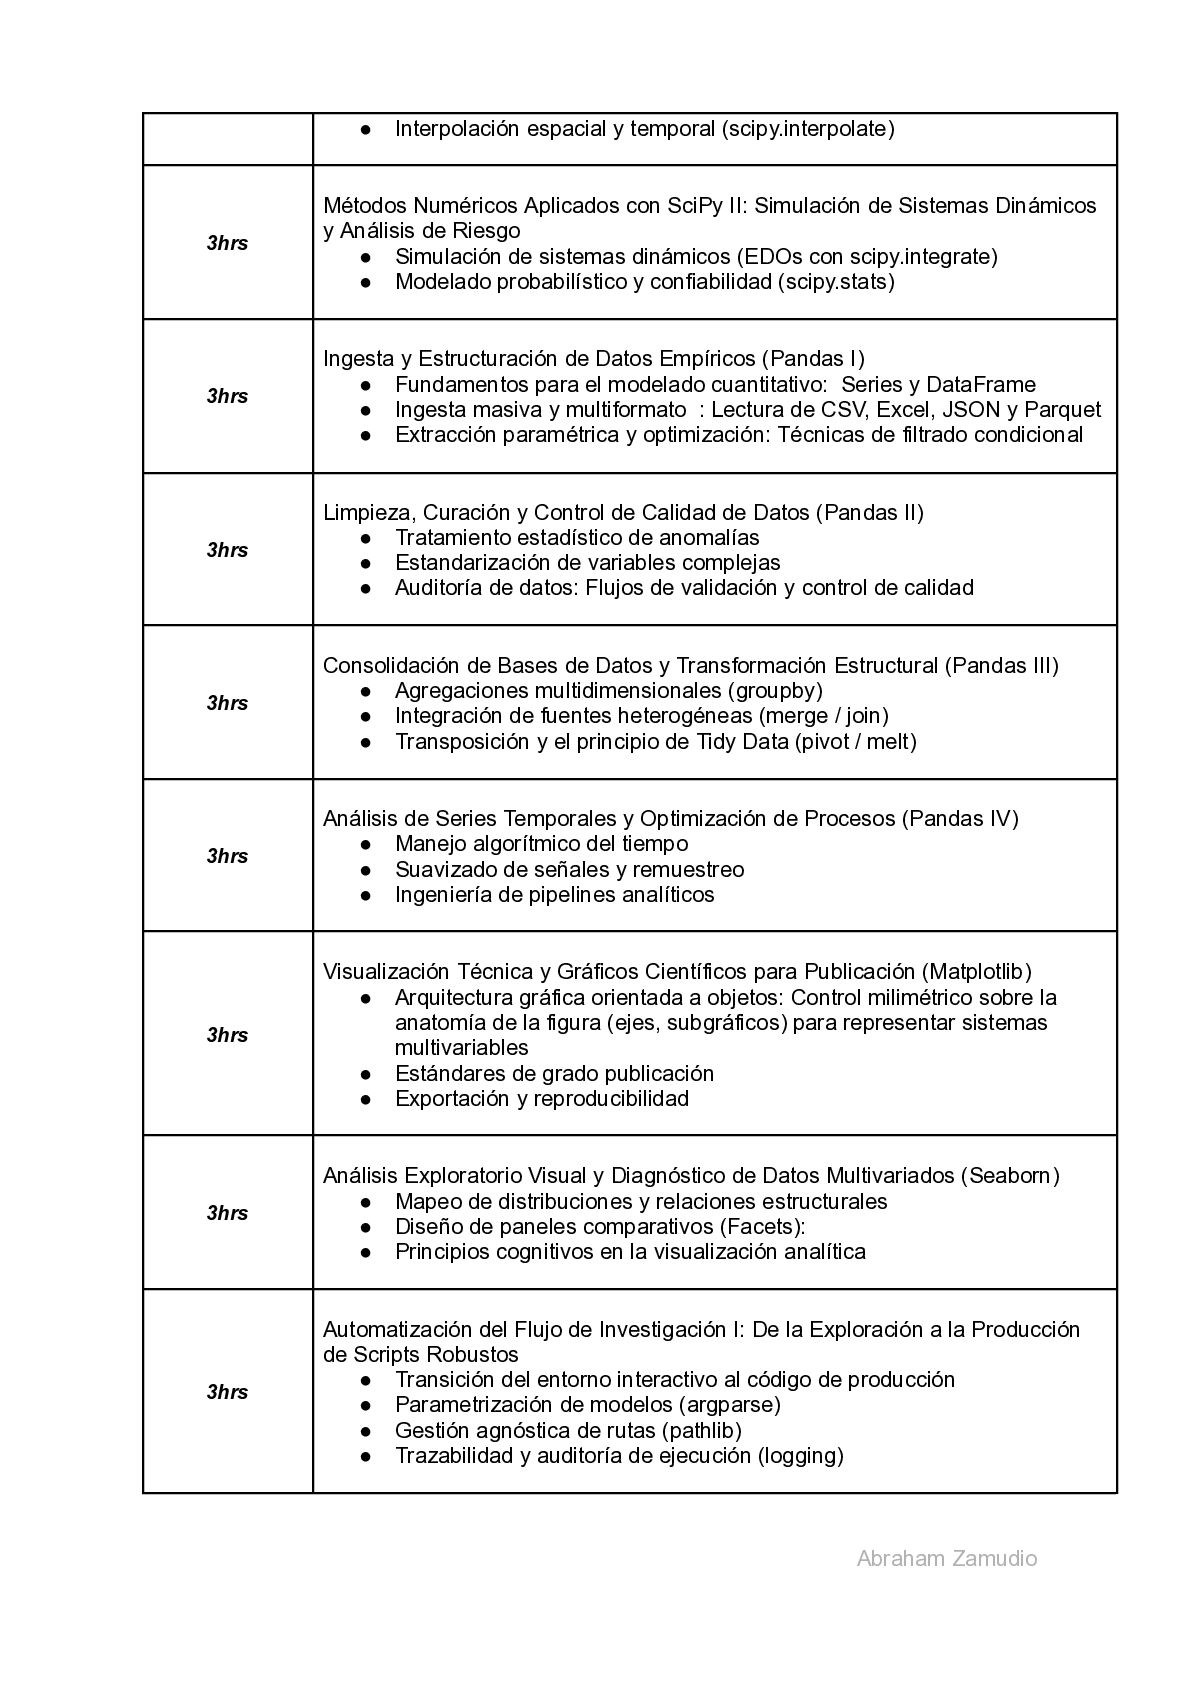
  6. •​ Interpolación espacial y temporal (scipy.interpolate) 3hrs ​ ​ Métodos

    Numéricos Aplicados con SciPy II: Simulación de Sistemas Dinámicos y Análisis de Riesgo •​ Simulación de sistemas dinámicos (EDOs con scipy.integrate) •​ Modelado probabilístico y confiabilidad (scipy.stats) 3hrs Ingesta y Estructuración de Datos Empíricos (Pandas I) •​ Fundamentos para el modelado cuantitativo: Series y DataFrame •​ Ingesta masiva y multiformato : Lectura de CSV, Excel, JSON y Parquet •​ Extracción paramétrica y optimización: Técnicas de filtrado condicional 3hrs Limpieza, Curación y Control de Calidad de Datos (Pandas II) •​ Tratamiento estadístico de anomalías •​ Estandarización de variables complejas •​ Auditoría de datos: Flujos de validación y control de calidad 3hrs Consolidación de Bases de Datos y Transformación Estructural (Pandas III) •​ Agregaciones multidimensionales (groupby) •​ Integración de fuentes heterogéneas (merge / join) •​ Transposición y el principio de Tidy Data (pivot / melt) 3hrs 3hrs 3hrs 3hrs ​ ​ Análisis de Series Temporales y Optimización de Procesos (Pandas IV) •​ Manejo algorítmico del tiempo •​ Suavizado de señales y remuestreo •​ Ingeniería de pipelines analíticos ​ ​ Visualización Técnica y Gráficos Científicos para Publicación (Matplotlib) •​ Arquitectura gráfica orientada a objetos: Control milimétrico sobre la anatomía de la figura (ejes, subgráficos) para representar sistemas multivariables •​ Estándares de grado publicación •​ Exportación y reproducibilidad ​ ​ Análisis Exploratorio Visual y Diagnóstico de Datos Multivariados (Seaborn) •​ Mapeo de distribuciones y relaciones estructurales •​ Diseño de paneles comparativos (Facets): •​ Principios cognitivos en la visualización analítica ​ Automatización del Flujo de Investigación I: De la Exploración a la Producción de Scripts Robustos •​ Transición del entorno interactivo al código de producción •​ Parametrización de modelos (argparse) •​ Gestión agnóstica de rutas (pathlib) •​ Trazabilidad y auditoría de ejecución (logging) Abraham Zamudio
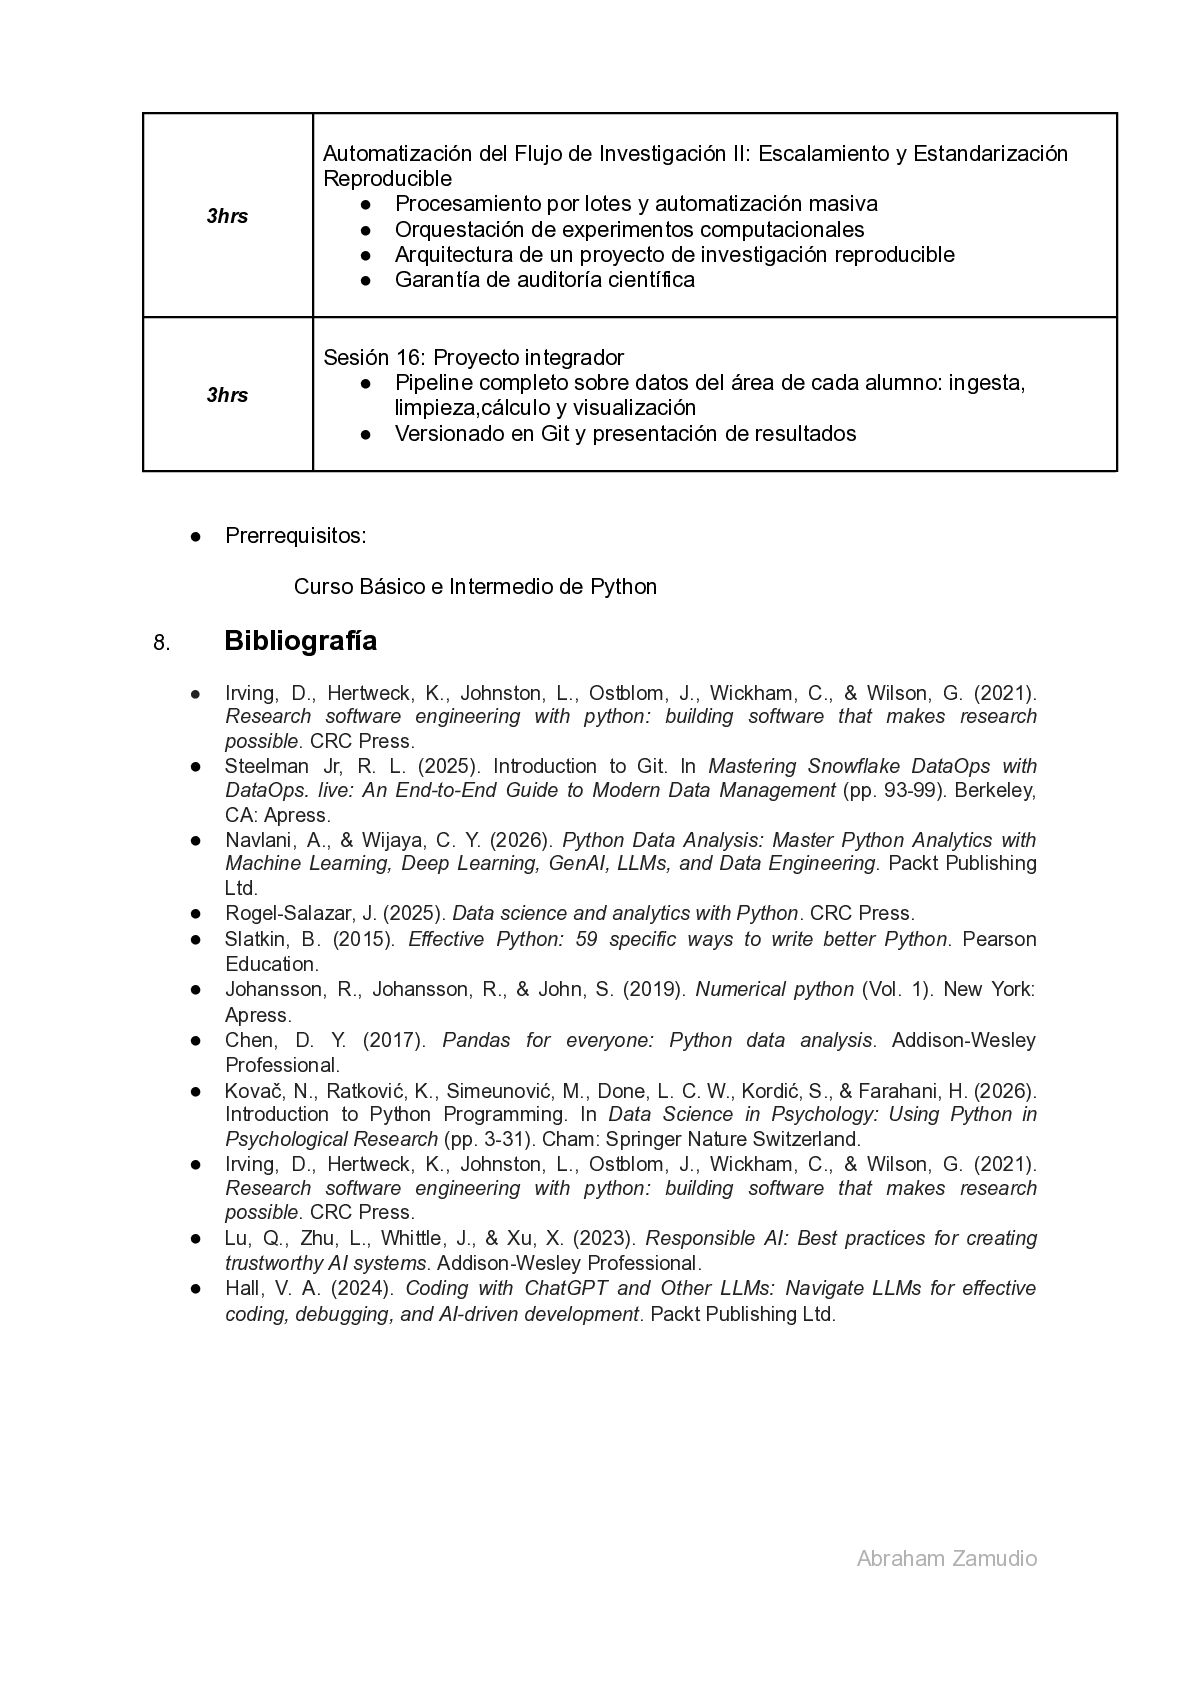
  7. 3hrs 3hrs Automatización del Flujo de Investigación II: Escalamiento y

    Estandarización Reproducible •​ Procesamiento por lotes y automatización masiva •​ Orquestación de experimentos computacionales •​ Arquitectura de un proyecto de investigación reproducible •​ Garantía de auditoría científica ​ ​ ​ Sesión 16: Proyecto integrador •​ Pipeline completo sobre datos del área de cada alumno: ingesta, limpieza,cálculo y visualización •​ Versionado en Git y presentación de resultados •​ Prerrequisitos:​ Curso Básico e Intermedio de Python 8.​ Bibliografía ​ •​ Irving, D., Hertweck, K., Johnston, L., Ostblom, J., Wickham, C., & Wilson, G. (2021). Research software engineering with python: building software that makes research possible. CRC Press. •​ Steelman Jr, R. L. (2025). Introduction to Git. In Mastering Snowflake DataOps with DataOps. live: An End-to-End Guide to Modern Data Management (pp. 93-99). Berkeley, CA: Apress. •​ Navlani, A., & Wijaya, C. Y. (2026). Python Data Analysis: Master Python Analytics with Machine Learning, Deep Learning, GenAI, LLMs, and Data Engineering. Packt Publishing Ltd. •​ Rogel-Salazar, J. (2025). Data science and analytics with Python. CRC Press. •​ Slatkin, B. (2015). Effective Python: 59 specific ways to write better Python. Pearson Education. •​ Johansson, R., Johansson, R., & John, S. (2019). Numerical python (Vol. 1). New York: Apress. •​ Chen, D. Y. (2017). Pandas for everyone: Python data analysis. Addison-Wesley Professional. •​ Kovač, N., Ratković, K., Simeunović, M., Done, L. C. W., Kordić, S., & Farahani, H. (2026). Introduction to Python Programming. In Data Science in Psychology: Using Python in Psychological Research (pp. 3-31). Cham: Springer Nature Switzerland. •​ Irving, D., Hertweck, K., Johnston, L., Ostblom, J., Wickham, C., & Wilson, G. (2021). Research software engineering with python: building software that makes research possible. CRC Press. •​ Lu, Q., Zhu, L., Whittle, J., & Xu, X. (2023). Responsible AI: Best practices for creating trustworthy AI systems. Addison-Wesley Professional. •​ Hall, V. A. (2024). Coding with ChatGPT and Other LLMs: Navigate LLMs for effective coding, debugging, and AI-driven development. Packt Publishing Ltd. Abraham Zamudio