Upgrade to Pro — share decks privately, control downloads, hide ads and more …

スパコンTSUBAMEシリーズにおけるリソース分割戦略

Sponsored · Your Podcast. Everywhere. Effortlessly. Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.

 スパコンTSUBAMEシリーズにおけるリソース分割戦略

Avatar for Akihiro Nomura

Akihiro Nomura

August 08, 2024

Other Decks in Research

Transcript

  1. 1 2024年8月8日(木) SWoPP 2024 @ 徳島 東京工業大学 学術国際情報センター 野村 哲弘,

    遠藤 敏夫 [email protected] スパコンTSUBAMEシリーズに おけるリソース分割戦略
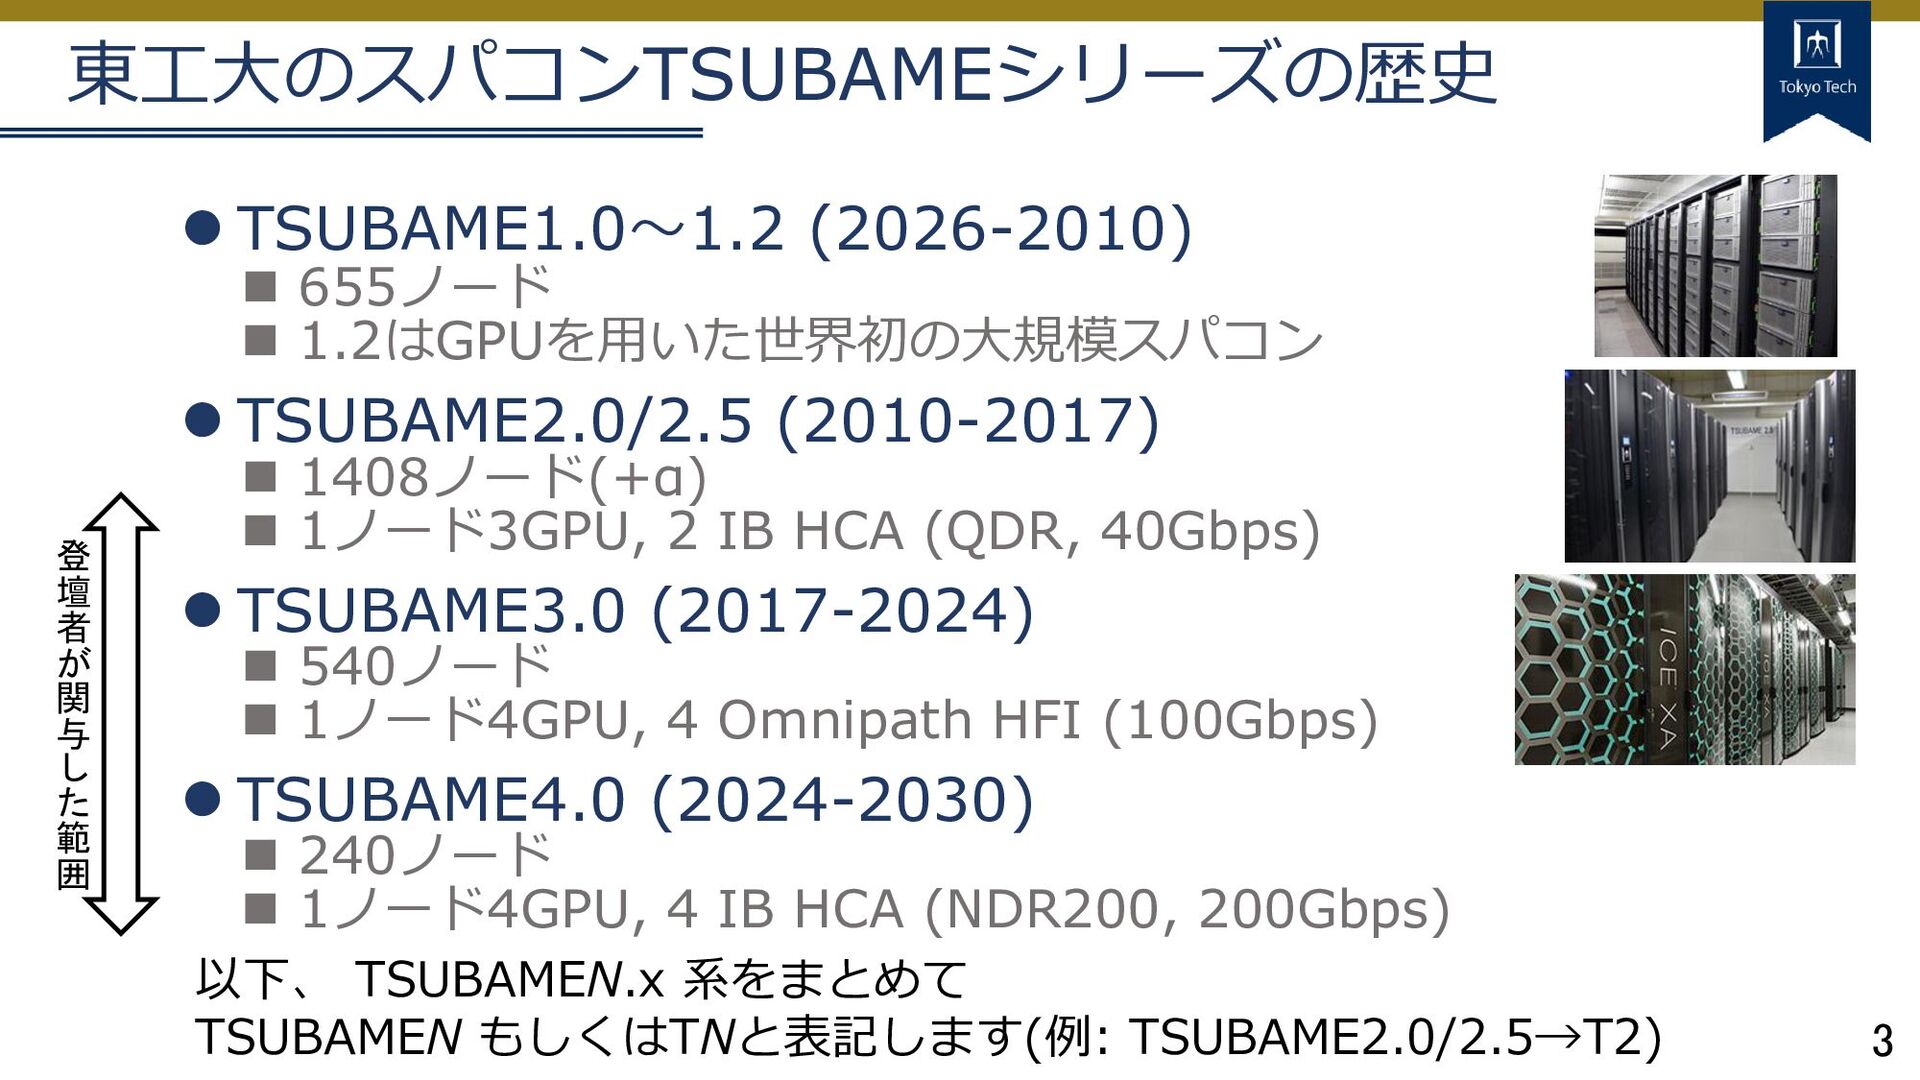
  2. 3 東工大のスパコンTSUBAMEシリーズの歴史 ⚫ TSUBAME1.0~1.2 (2026-2010) ◼ 655ノード ◼ 1.2はGPUを用いた世界初の大規模スパコン ⚫

    TSUBAME2.0/2.5 (2010-2017) ◼ 1408ノード(+α) ◼ 1ノード3GPU, 2 IB HCA (QDR, 40Gbps) ⚫ TSUBAME3.0 (2017-2024) ◼ 540ノード ◼ 1ノード4GPU, 4 Omnipath HFI (100Gbps) ⚫ TSUBAME4.0 (2024-2030) ◼ 240ノード ◼ 1ノード4GPU, 4 IB HCA (NDR200, 200Gbps) 以下、 TSUBAMEN.x 系をまとめて TSUBAMEN もしくはTNと表記します(例: TSUBAME2.0/2.5→T2) 登 壇 者 が 関 与 し た 範 囲
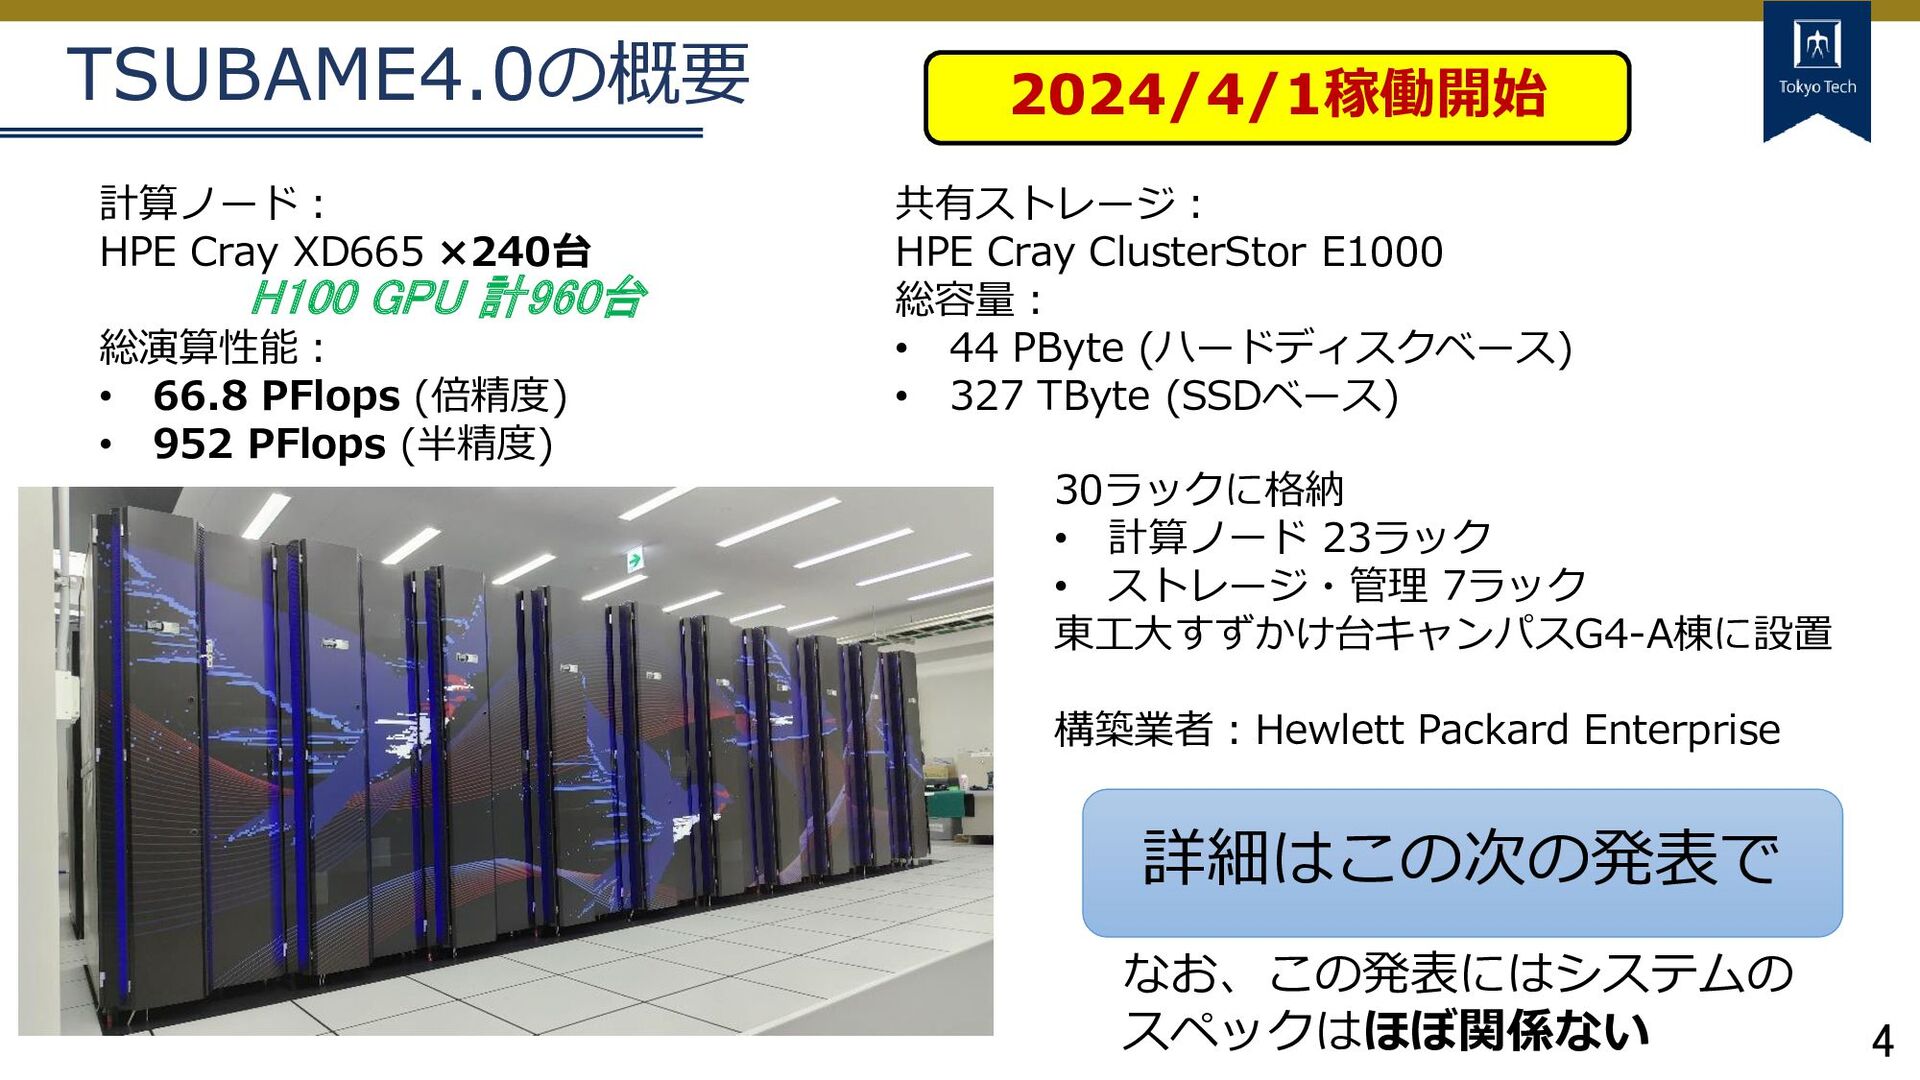
  3. 4 TSUBAME4.0の概要 計算ノード: HPE Cray XD665 ×240台 総演算性能: • 66.8

    PFlops (倍精度) • 952 PFlops (半精度) 共有ストレージ: HPE Cray ClusterStor E1000 総容量: • 44 PByte (ハードディスクベース) • 327 TByte (SSDベース) 30ラックに格納 • 計算ノード 23ラック • ストレージ・管理 7ラック 東工大すずかけ台キャンパスG4-A棟に設置 構築業者:Hewlett Packard Enterprise H100 GPU 計960台 2024/4/1稼働開始 詳細はこの次の発表で なお、この発表にはシステムの スペックはほぼ関係ない
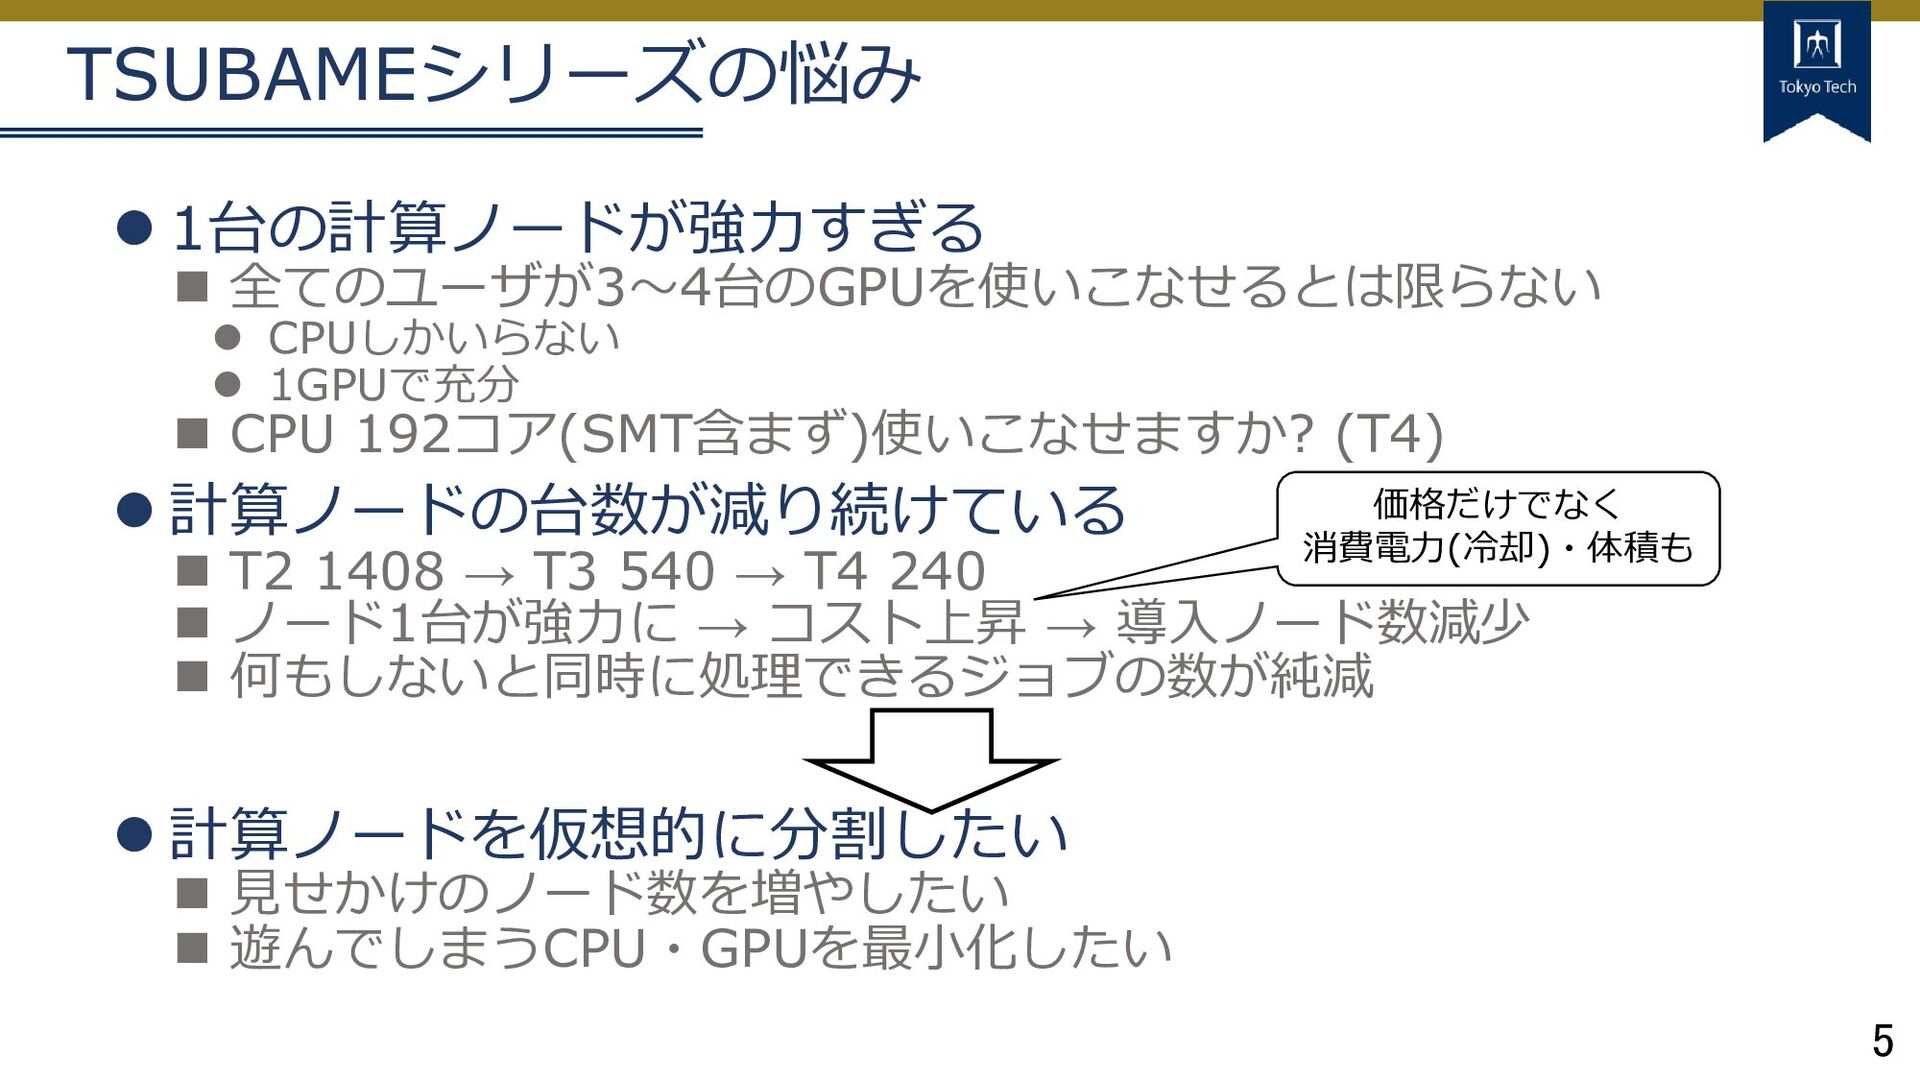
  4. 5 TSUBAMEシリーズの悩み ⚫ 1台の計算ノードが強力すぎる ◼ 全てのユーザが3~4台のGPUを使いこなせるとは限らない ⚫ CPUしかいらない ⚫ 1GPUで充分

    ◼ CPU 192コア(SMT含まず)使いこなせますか? (T4) ⚫ 計算ノードの台数が減り続けている ◼ T2 1408 → T3 540 → T4 240 ◼ ノード1台が強力に → コスト上昇 → 導入ノード数減少 ◼ 何もしないと同時に処理できるジョブの数が純減 ⚫ 計算ノードを仮想的に分割したい ◼ 見せかけのノード数を増やしたい ◼ 遊んでしまうCPU・GPUを最小化したい 価格だけでなく 消費電力(冷却)・体積も
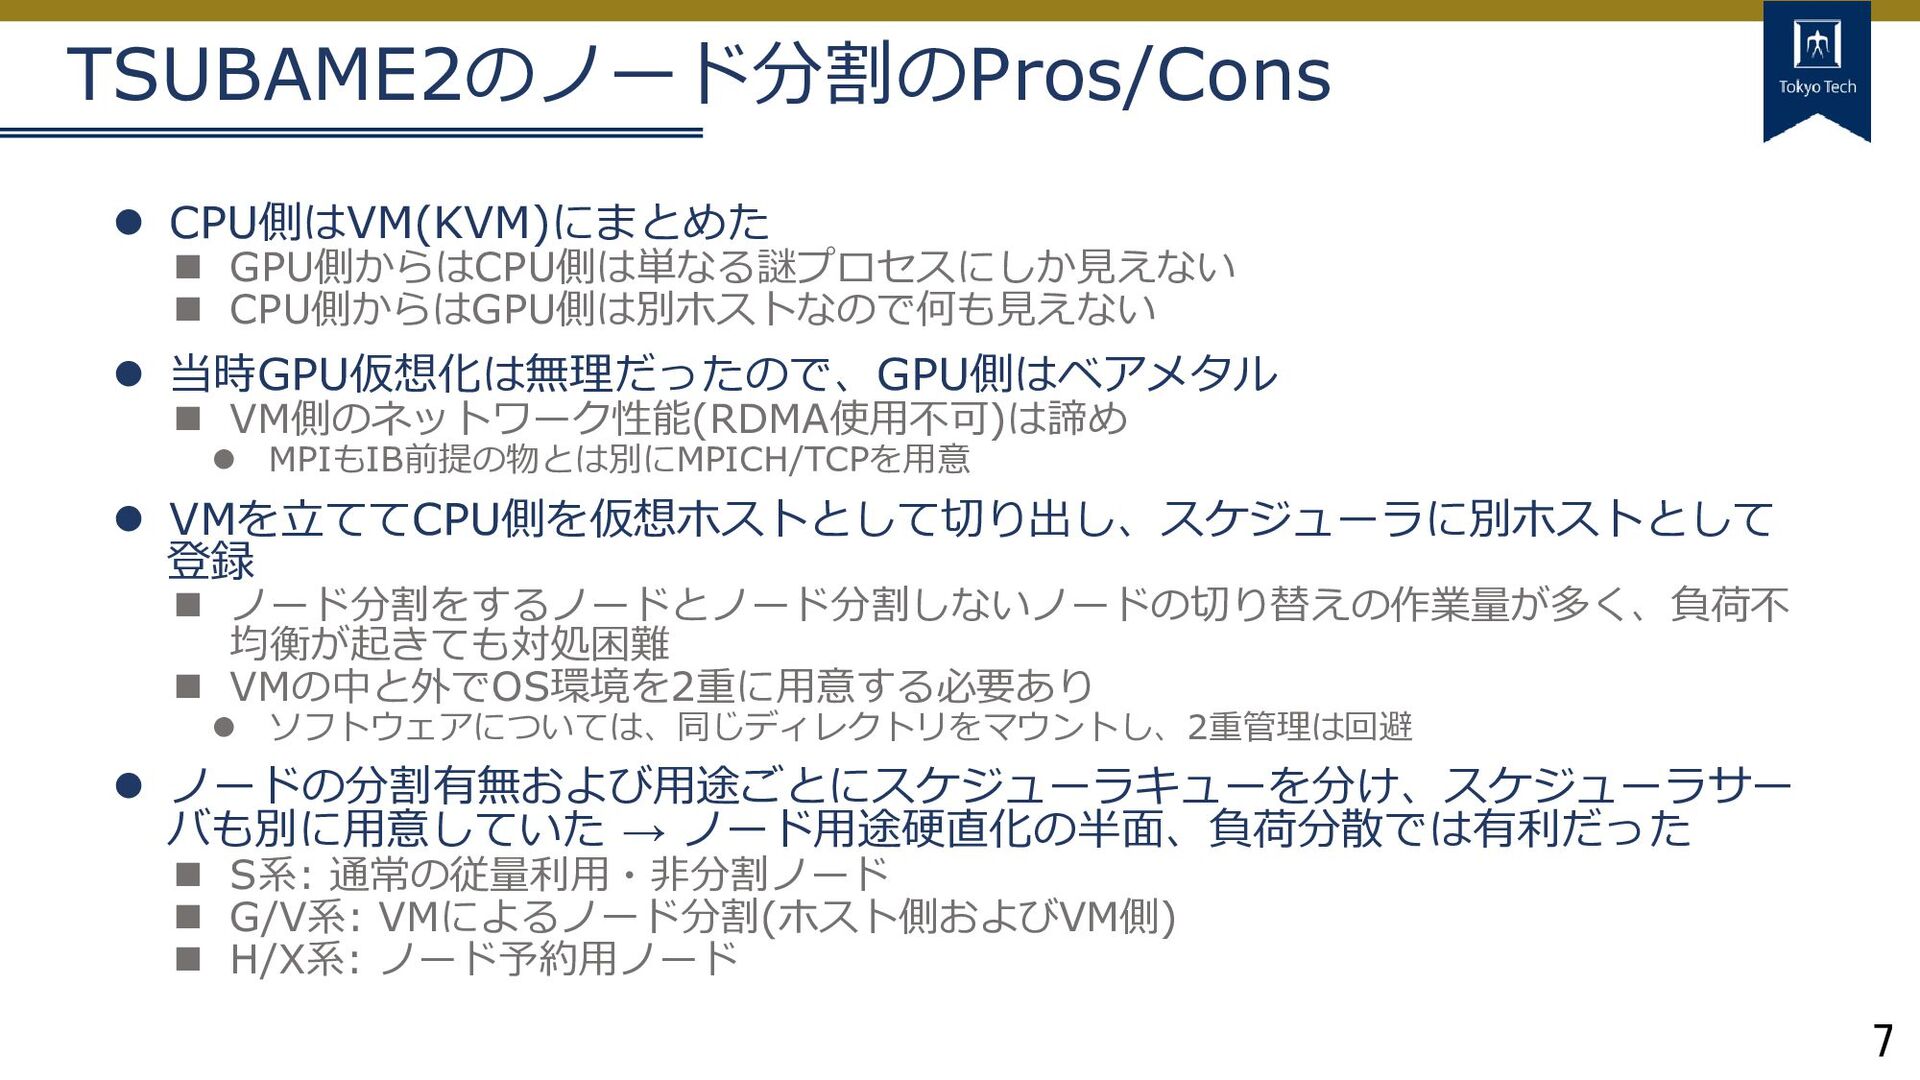
  5. 7 TSUBAME2のノード分割のPros/Cons ⚫ CPU側はVM(KVM)にまとめた ◼ GPU側からはCPU側は単なる謎プロセスにしか見えない ◼ CPU側からはGPU側は別ホストなので何も見えない ⚫ 当時GPU仮想化は無理だったので、GPU側はベアメタル

    ◼ VM側のネットワーク性能(RDMA使用不可)は諦め ⚫ MPIもIB前提の物とは別にMPICH/TCPを用意 ⚫ VMを立ててCPU側を仮想ホストとして切り出し、スケジューラに別ホストとして 登録 ◼ ノード分割をするノードとノード分割しないノードの切り替えの作業量が多く、負荷不 均衡が起きても対処困難 ◼ VMの中と外でOS環境を2重に用意する必要あり ⚫ ソフトウェアについては、同じディレクトリをマウントし、2重管理は回避 ⚫ ノードの分割有無および用途ごとにスケジューラキューを分け、スケジューラサー バも別に用意していた → ノード用途硬直化の半面、負荷分散では有利だった ◼ S系: 通常の従量利用・非分割ノード ◼ G/V系: VMによるノード分割(ホスト側およびVM側) ◼ H/X系: ノード予約用ノード
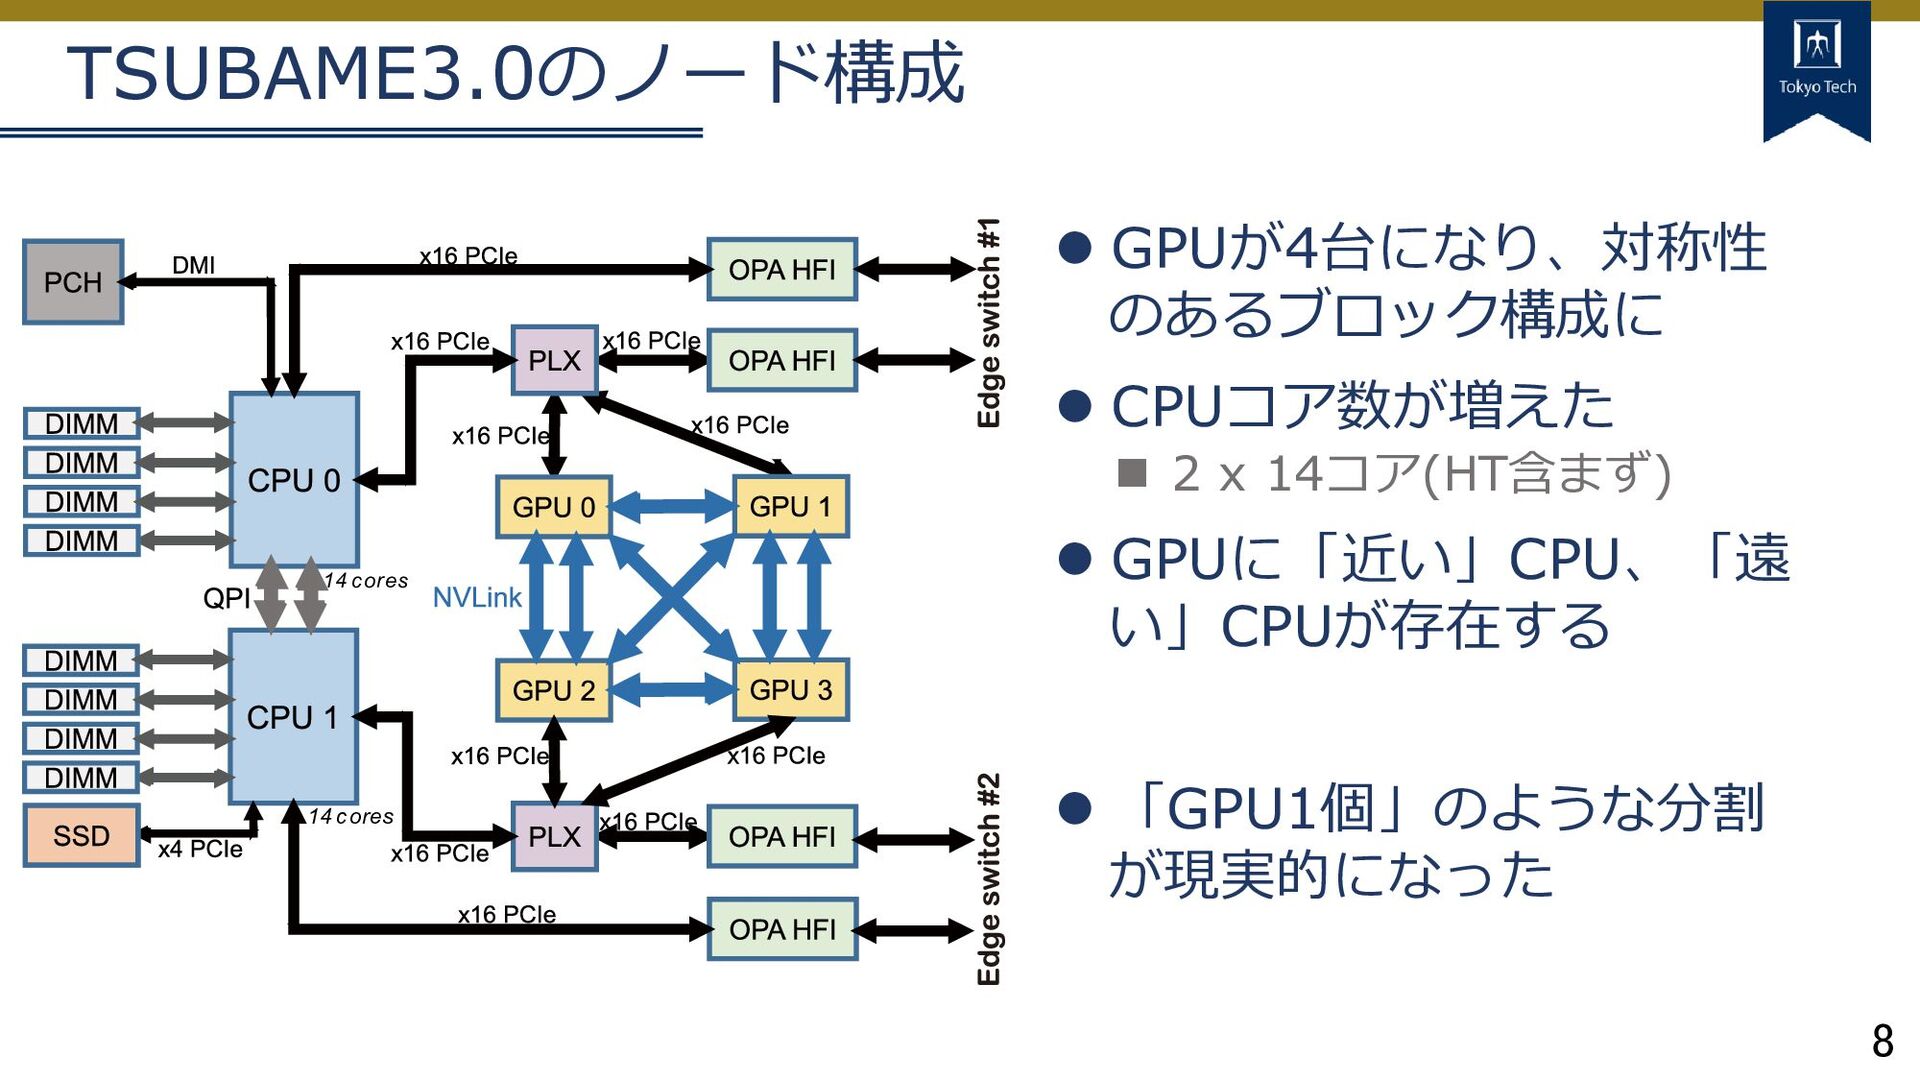
  6. 8 TSUBAME3.0のノード構成 ⚫ GPUが4台になり、対称性 のあるブロック構成に ⚫ CPUコア数が増えた ◼ 2 x

    14コア(HT含まず) ⚫ GPUに「近い」CPU、「遠 い」CPUが存在する ⚫ 「GPU1個」のような分割 が現実的になった
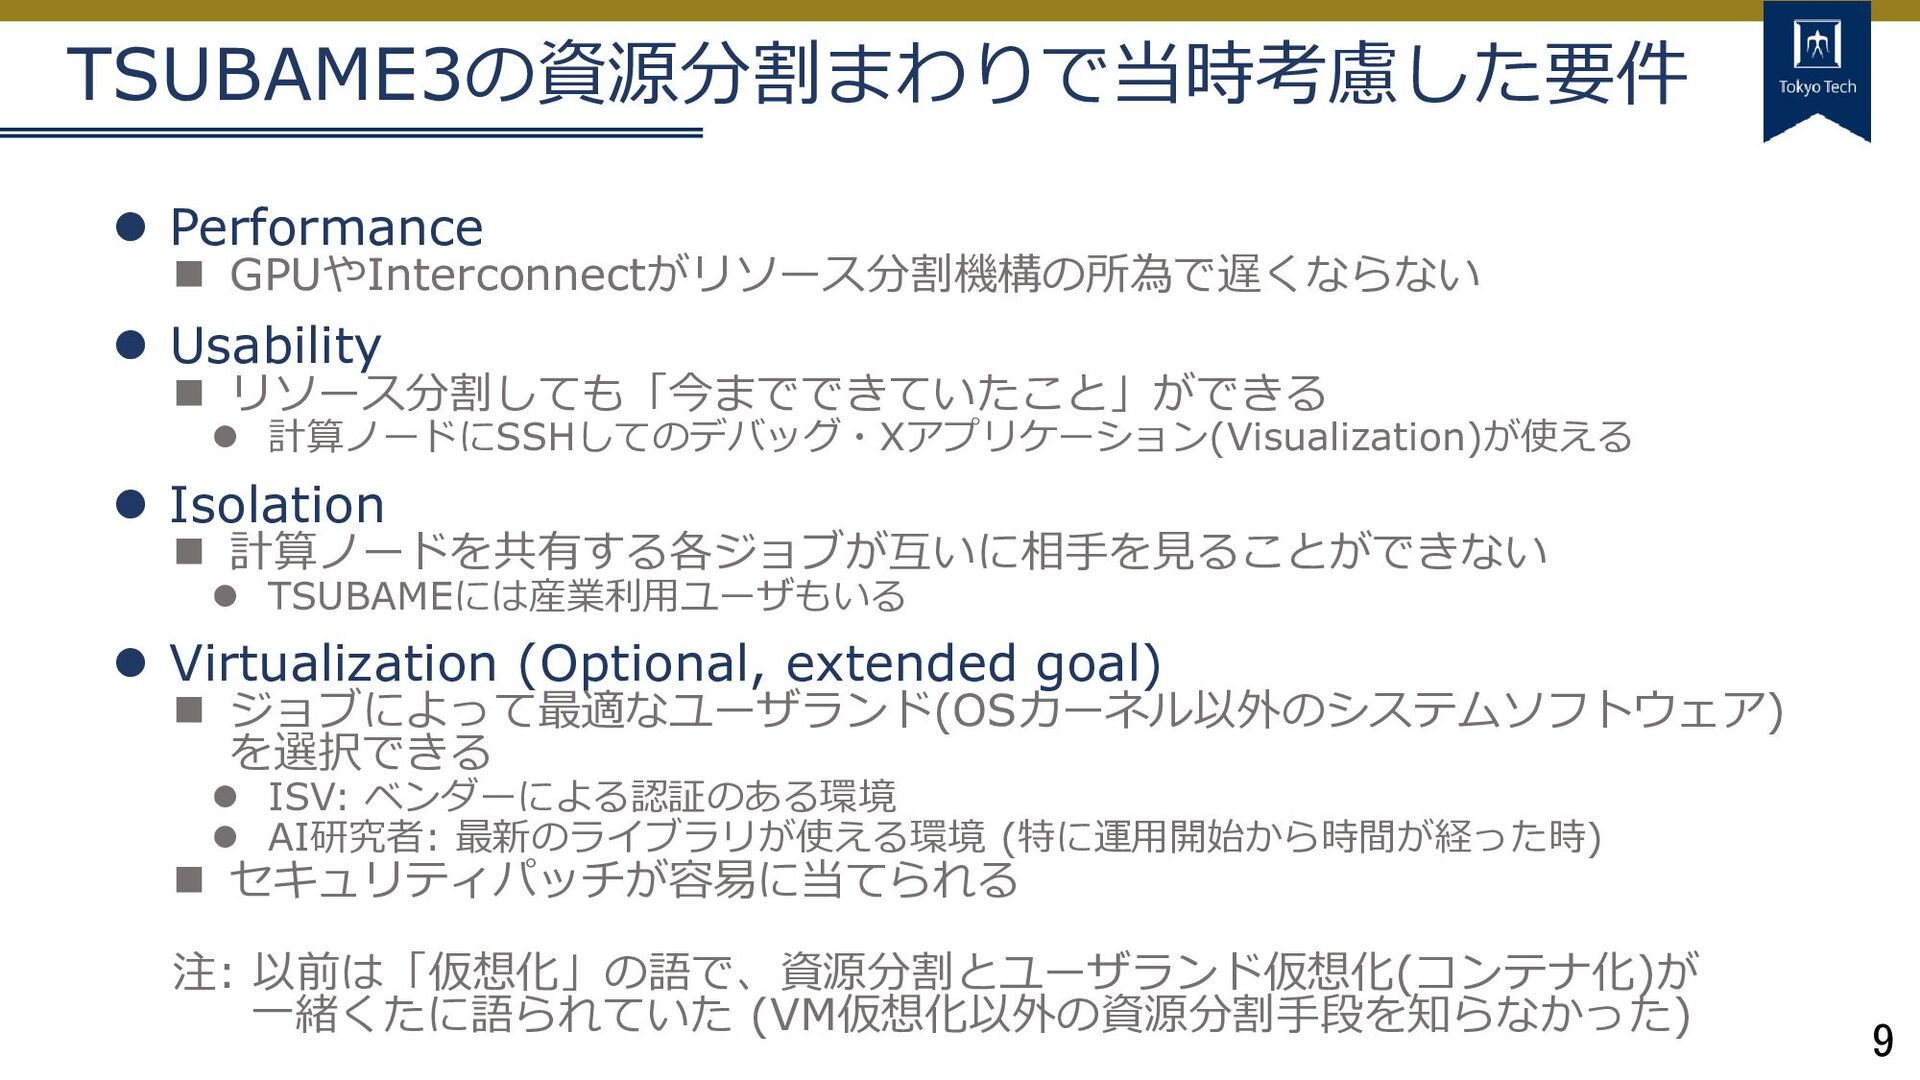
  7. 9 TSUBAME3の資源分割まわりで当時考慮した要件 ⚫ Performance ◼ GPUやInterconnectがリソース分割機構の所為で遅くならない ⚫ Usability ◼ リソース分割しても「今までできていたこと」ができる

    ⚫ 計算ノードにSSHしてのデバッグ・Xアプリケーション(Visualization)が使える ⚫ Isolation ◼ 計算ノードを共有する各ジョブが互いに相手を見ることができない ⚫ TSUBAMEには産業利用ユーザもいる ⚫ Virtualization (Optional, extended goal) ◼ ジョブによって最適なユーザランド(OSカーネル以外のシステムソフトウェア) を選択できる ⚫ ISV: ベンダーによる認証のある環境 ⚫ AI研究者: 最新のライブラリが使える環境 (特に運用開始から時間が経った時) ◼ セキュリティパッチが容易に当てられる 注: 以前は「仮想化」の語で、資源分割とユーザランド仮想化(コンテナ化)が 一緒くたに語られていた (VM仮想化以外の資源分割手段を知らなかった)
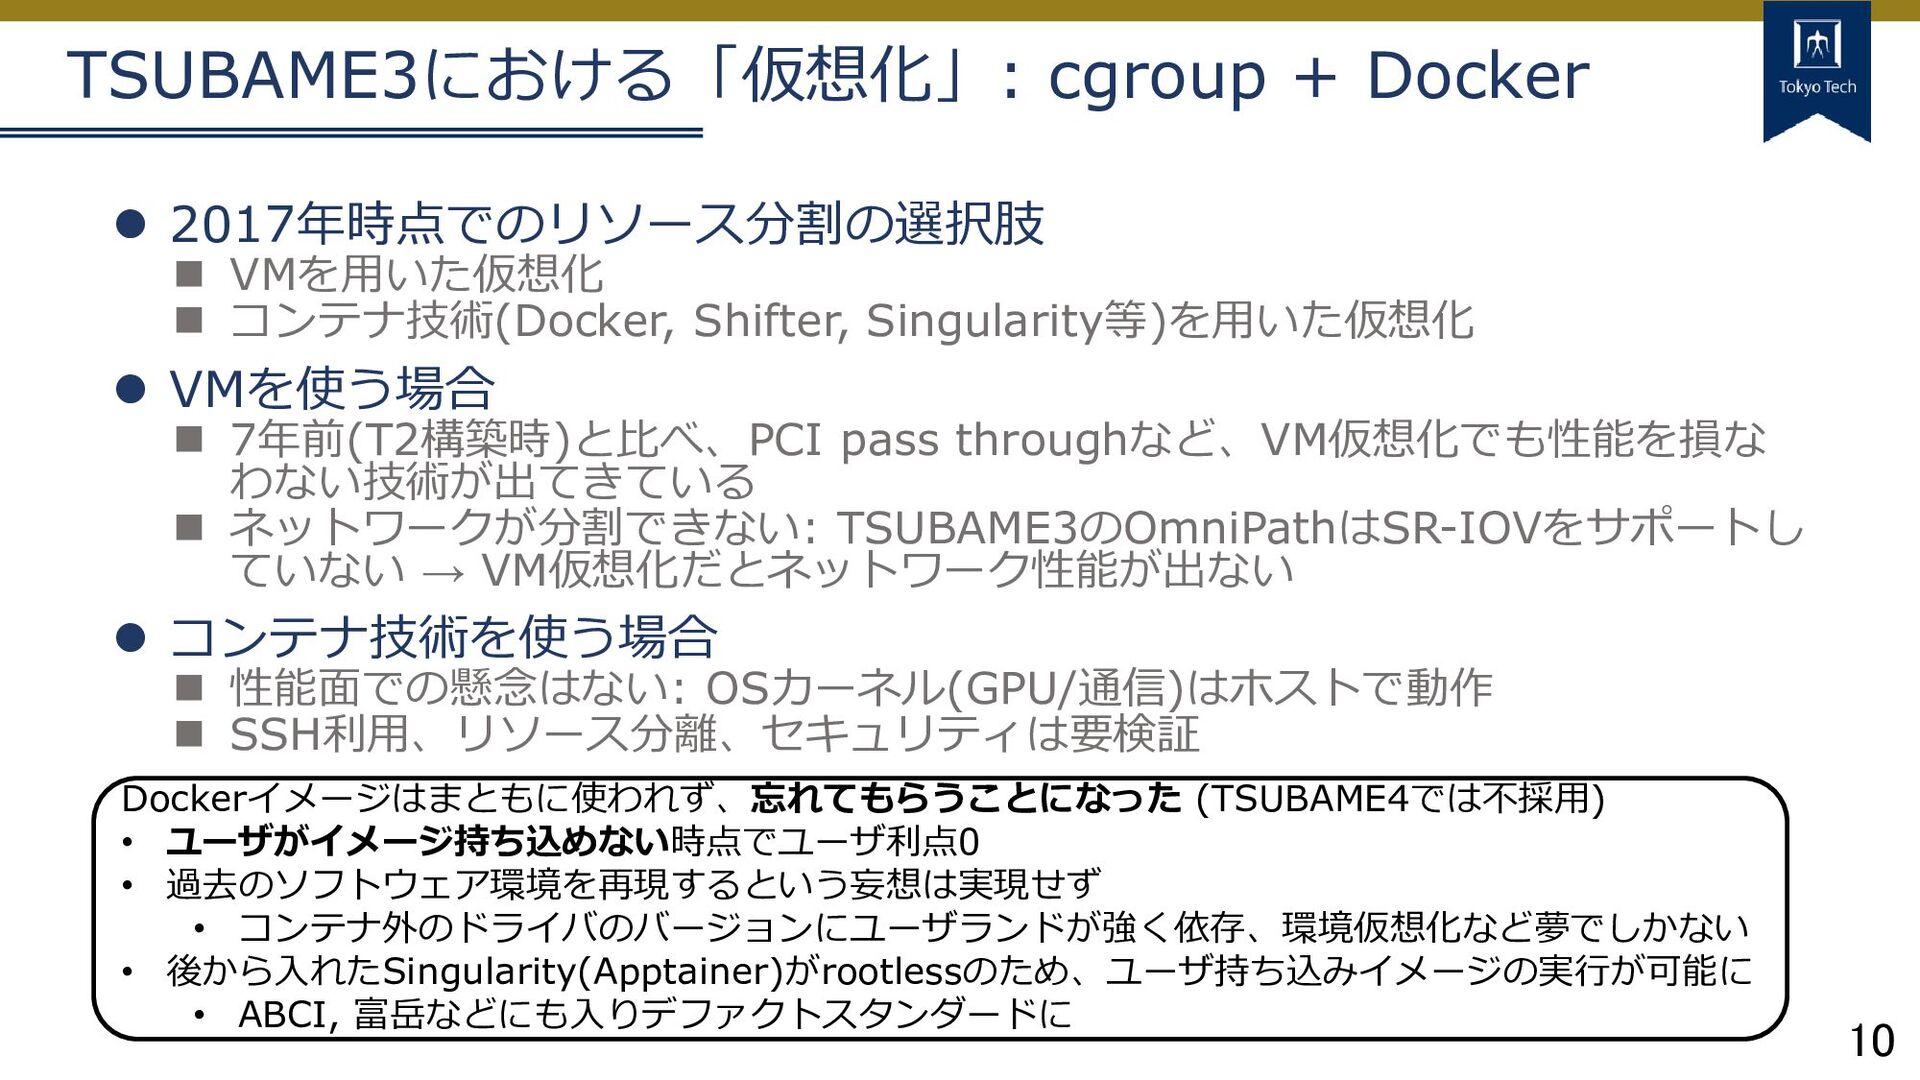
  8. 10 TSUBAME3における「仮想化」: cgroup + Docker ⚫ 2017年時点でのリソース分割の選択肢 ◼ VMを用いた仮想化 ◼

    コンテナ技術(Docker, Shifter, Singularity等)を用いた仮想化 ⚫ VMを使う場合 ◼ 7年前(T2構築時)と比べ、PCI pass throughなど、VM仮想化でも性能を損な わない技術が出てきている ◼ ネットワークが分割できない: TSUBAME3のOmniPathはSR-IOVをサポートし ていない → VM仮想化だとネットワーク性能が出ない ⚫ コンテナ技術を使う場合 ◼ 性能面での懸念はない: OSカーネル(GPU/通信)はホストで動作 ◼ SSH利用、リソース分離、セキュリティは要検証 ⚫ TSUBAME3.0ではDockerを導入 ◼ 運用開始時は試験的サービスとしてテスト ◼ 将来的には全てのジョブでDocker利用を強制 ◼ Dockerイメージの持ち込みは当面許可しない (セキュリティの問題が未解決) Dockerイメージはまともに使われず、忘れてもらうことになった (TSUBAME4では不採用) • ユーザがイメージ持ち込めない時点でユーザ利点0 • 過去のソフトウェア環境を再現するという妄想は実現せず • コンテナ外のドライバのバージョンにユーザランドが強く依存、環境仮想化など夢でしかない • 後から入れたSingularity(Apptainer)がrootlessのため、ユーザ持ち込みイメージの実行が可能に • ABCI, 富岳などにも入りデファクトスタンダードに
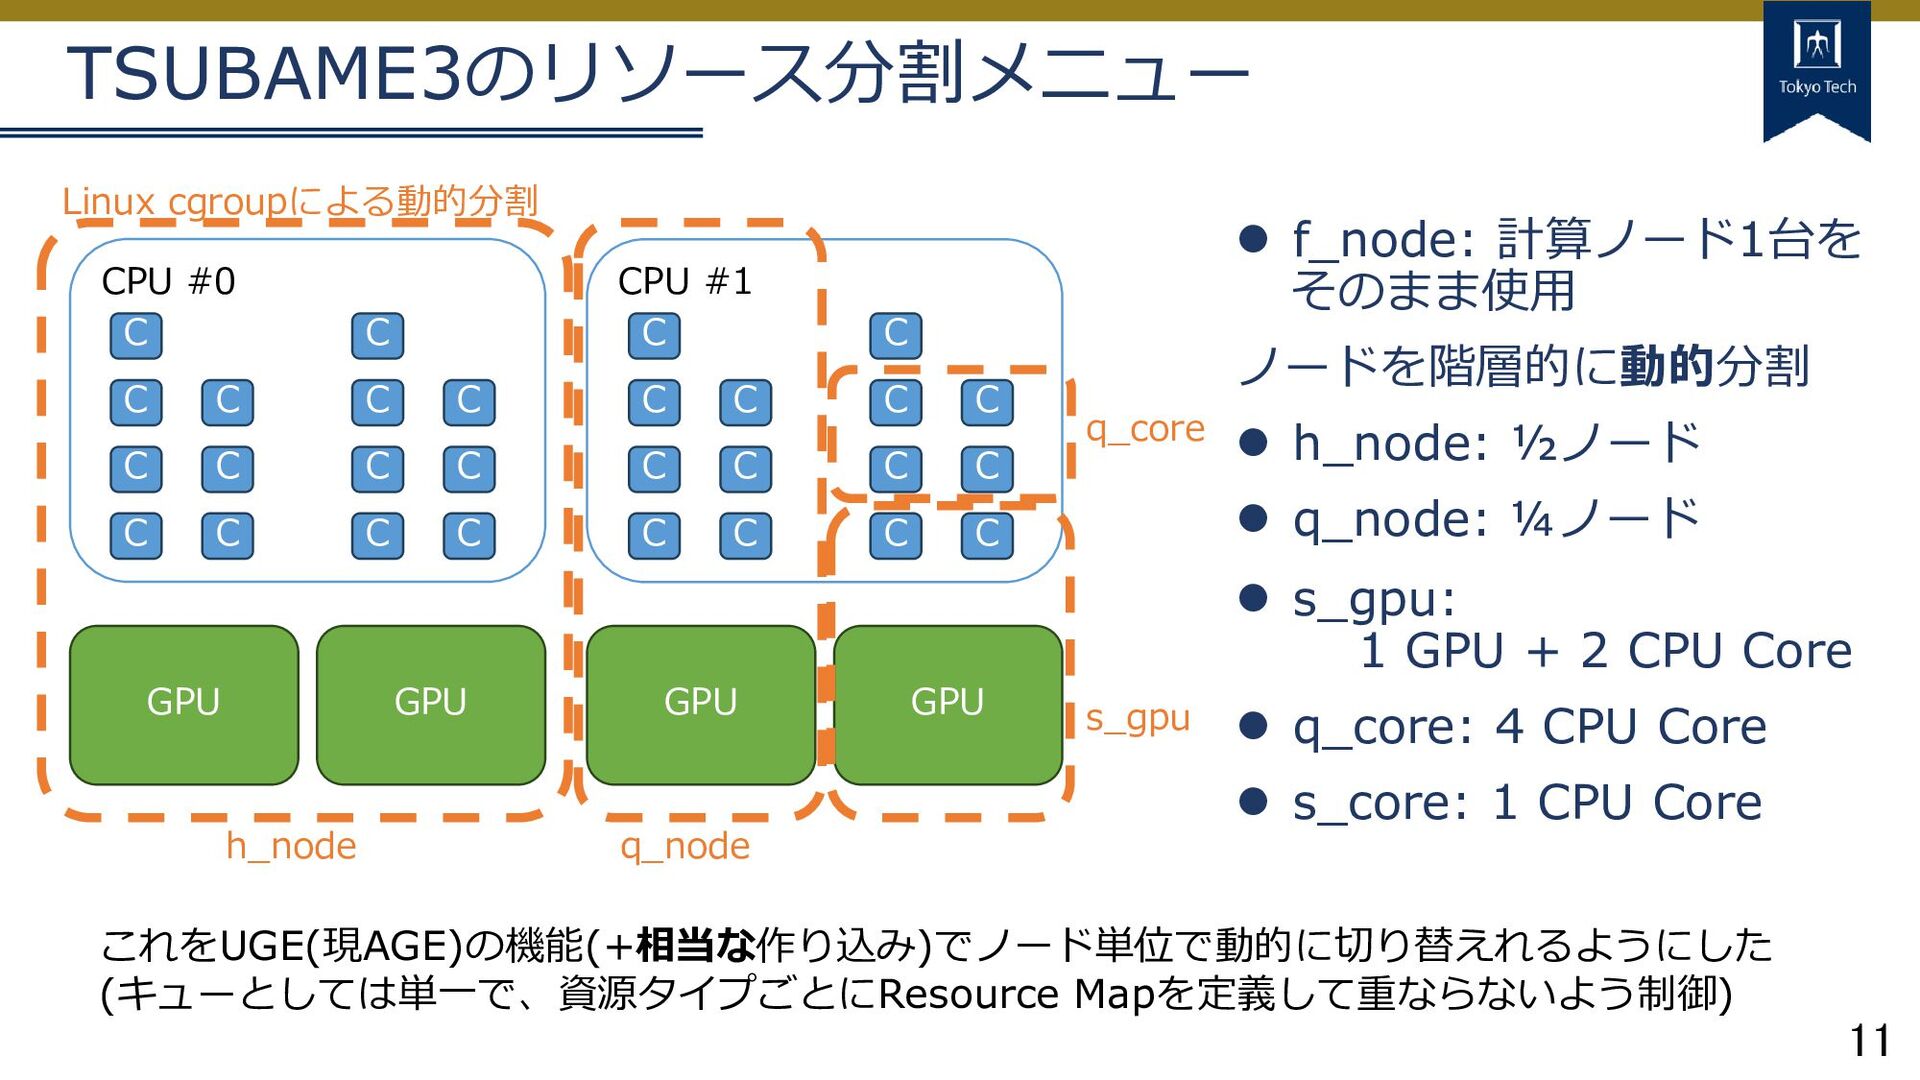
  9. 11 TSUBAME3のリソース分割メニュー ⚫ f_node: 計算ノード1台を そのまま使用 ノードを階層的に動的分割 ⚫ h_node: ½ノード

    ⚫ q_node: ¼ノード ⚫ s_gpu: 1 GPU + 2 CPU Core ⚫ q_core: 4 CPU Core ⚫ s_core: 1 CPU Core これをUGE(現AGE)の機能(+相当な作り込み)でノード単位で動的に切り替えれるようにした (キューとしては単一で、資源タイプごとにResource Mapを定義して重ならないよう制御) GPU GPU GPU CPU #0 CPU #1 C GPU C C C C C C C C C C C C C C C C C C C C C C C C C C C h_node q_node s_gpu q_core Linux cgroupによる動的分割
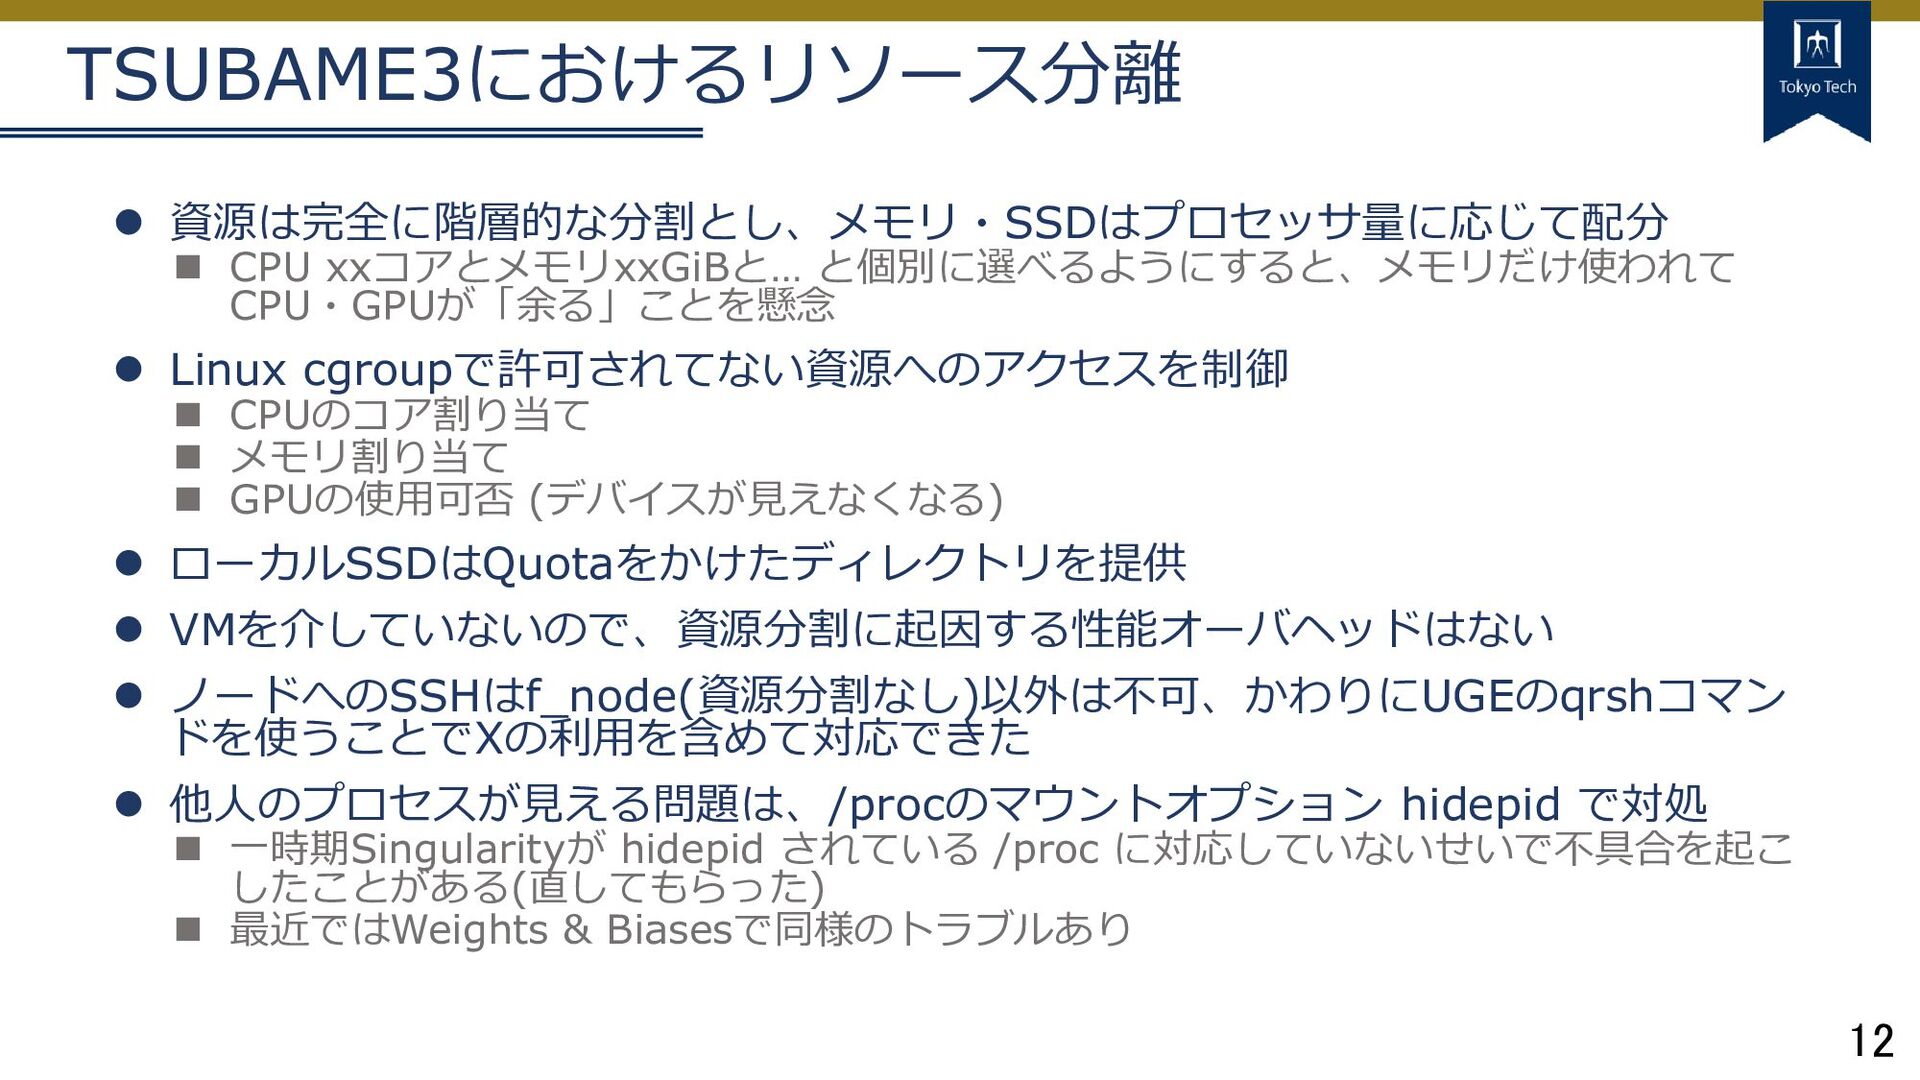
  10. 12 TSUBAME3におけるリソース分離 ⚫ 資源は完全に階層的な分割とし、メモリ・SSDはプロセッサ量に応じて配分 ◼ CPU xxコアとメモリxxGiBと… と個別に選べるようにすると、メモリだけ使われて CPU・GPUが「余る」ことを懸念 ⚫

    Linux cgroupで許可されてない資源へのアクセスを制御 ◼ CPUのコア割り当て ◼ メモリ割り当て ◼ GPUの使用可否 (デバイスが見えなくなる) ⚫ ローカルSSDはQuotaをかけたディレクトリを提供 ⚫ VMを介していないので、資源分割に起因する性能オーバヘッドはない ⚫ ノードへのSSHはf_node(資源分割なし)以外は不可、かわりにUGEのqrshコマン ドを使うことでXの利用を含めて対応できた ⚫ 他人のプロセスが見える問題は、/procのマウントオプション hidepid で対処 ◼ 一時期Singularityが hidepid されている /proc に対応していないせいで不具合を起こ したことがある(直してもらった) ◼ 最近ではWeights & Biasesで同様のトラブルあり
  11. 13 TSUBAME3でのユーザランド仮想化 ⚫Dockerはコンテナ内のroot=ホストのroot ◼ ユーザに任意のイメージを持ってきてもらうのは困難 ◼ (最近は Rootless Dockerもある) ⚫Singularity

    ◼ HPC環境で動作することを前提に開発された コンテナランタイム ◼ 実行時に原則 root 不要 ⚫ その分できることは限られる(すべきでないことができないことを担保) ◼ TSUBAME3導入後、ユーザの希望を受けて整備 ◼ 現在は Singularity Pro/CE と Apptainer にフォーク ⚫ いまのところ機能分化は進んでいない、T4では後者を利用中
  12. 14 インタラクティブジョブ専用ノードの導入 ⚫ TSUBAME3の運用開始から早々に、「京」停止に伴うHPCIユーザの流入があり、 TSUBAMEが超混雑 ⚫ デバッグや可視化のための対話利用が困難に ◼ TSUBAME2ではGPUつきノードをログインノード(20台)にして、対話的利用はそこで やってもらっていた

    (インタラクティブノードと呼んでいた) ◼ TSUBAME3ではログインノードは2台、GPUもつけず、デバッグ利用等には利用不可 ⚫ TSUBAME3の4ノード(<1%)を切り出して、インタラクティブジョブ専用にした ◼ ありものの改造で作ったので、基本はq_node(1/4ノード) ◼ ただし同じcgroup領域に7ジョブまで同時着弾可能に ⚫ スケジューラ的には1コアジョブとして管理、同じcgroupに属する7コア分が結果的に混ざる ◼ SSDの大半をswapfileとすることで、メモリ量の見せかけの制約を緩和 ◼ ノード共用、swapfileに見られるように「性能度外視」キュー ⚫ のちに、インタラクティブジョブのみ別のスケジューラサーバに移動 ◼ ジョブ数が多くなりすぎ、qrsh(インタラクティブジョブ投入)の実行からジョブ開始に 1分ぐらいかかるようになってしまっていたので、負荷を「逃がした」 ◼ TSUBAME2に較べサーバ1台の仕事量は5倍ぐらい ⚫ T2: 400ノード/サーバ → T3: 4(資源分割)x540ノード/サーバ
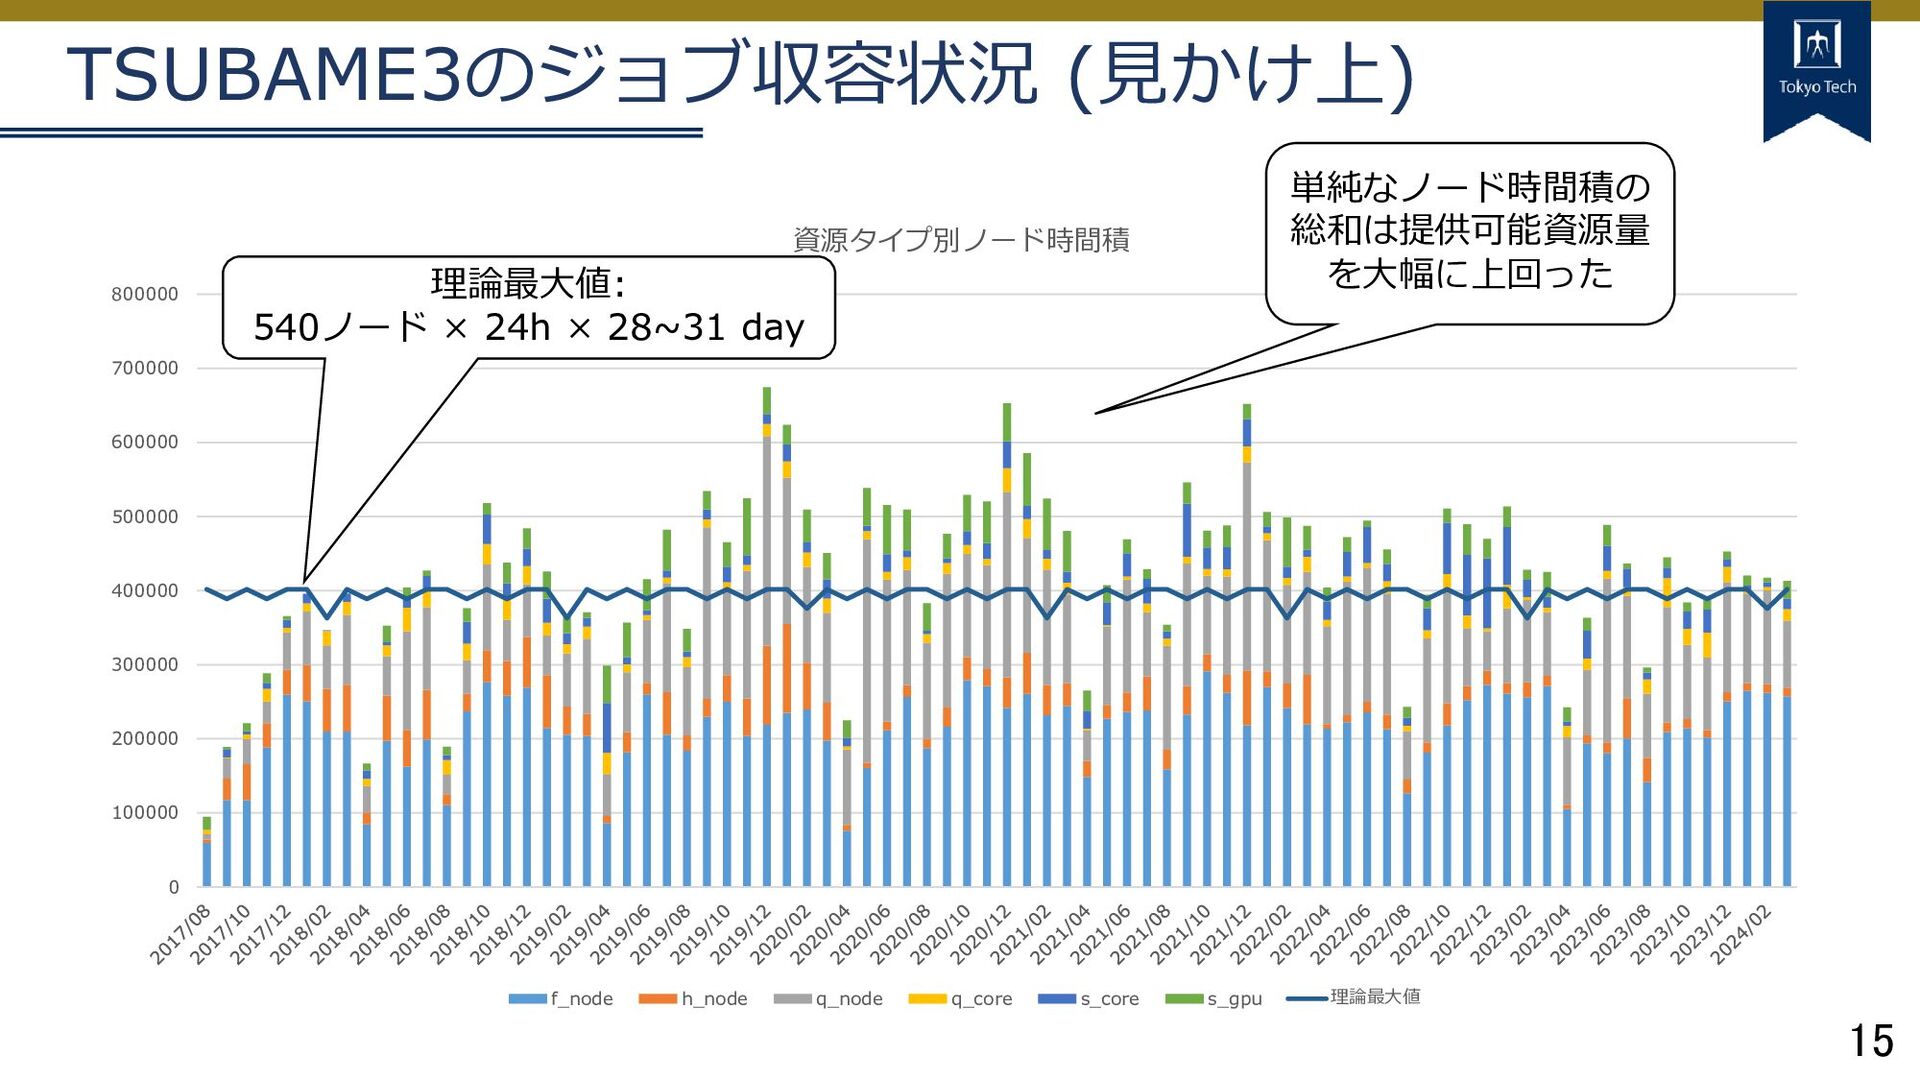
  13. 15 TSUBAME3のジョブ収容状況 (見かけ上) 0 100000 200000 300000 400000 500000 600000

    700000 800000 資源タイプ別ノード時間積 f_node h_node q_node q_core s_core s_gpu 理論最大値 単純なノード時間積の 総和は提供可能資源量 を大幅に上回った 理論最大値: 540ノード × 24h × 28~31 day
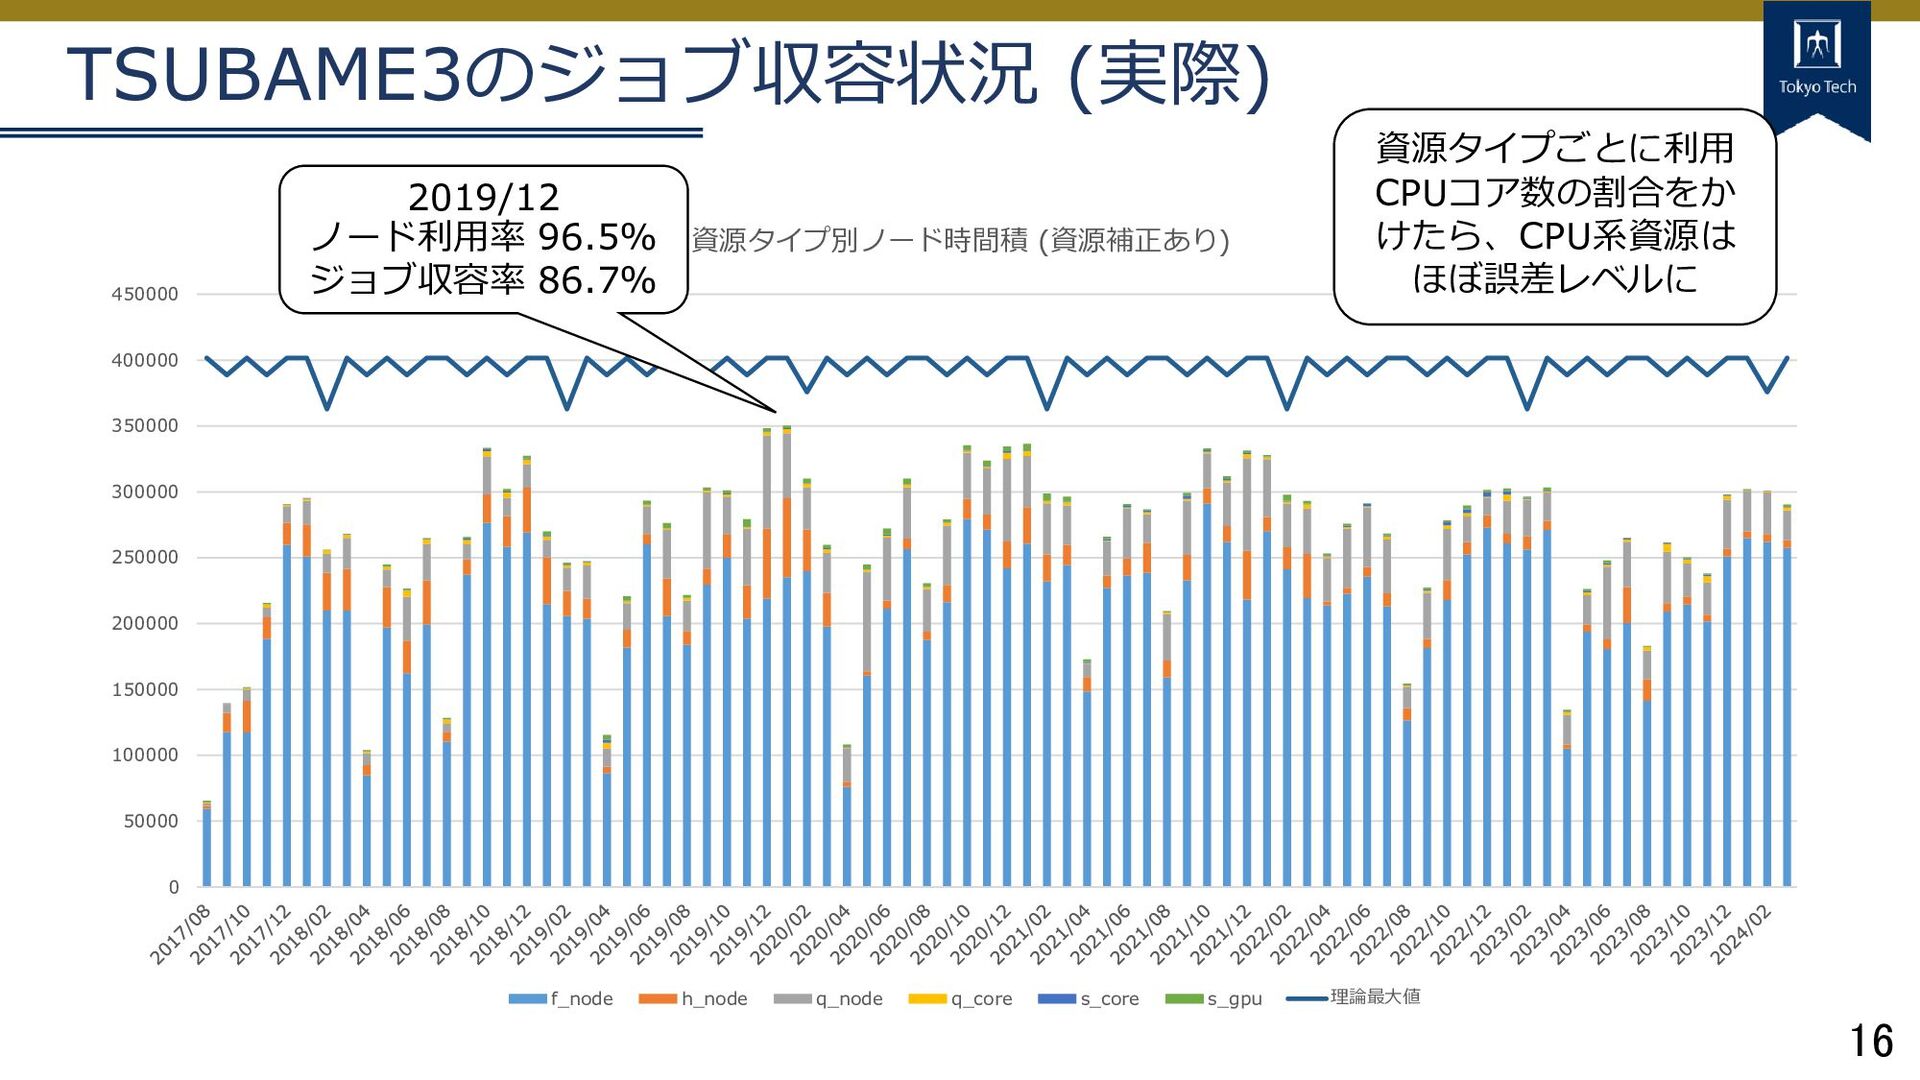
  14. 16 TSUBAME3のジョブ収容状況 (実際) 0 50000 100000 150000 200000 250000 300000

    350000 400000 450000 資源タイプ別ノード時間積 (資源補正あり) f_node h_node q_node q_core s_core s_gpu 理論最大値 資源タイプごとに利用 CPUコア数の割合をか けたら、CPU系資源は ほぼ誤差レベルに 2019/12 ノード利用率 96.5% ジョブ収容率 86.7%
  15. 17 TSUBAME3 その他雑多なこと ⚫ ノード予約の実装の柔軟化 ◼ TSUBAME2では半自動で予約キューを毎朝切り替え → 1日単位での予約 ⚫

    毎朝SEが予約ノードの状況を確認しており、休日はたまに事故った ◼ TSUBAME3ではAGEのAdvance Reservation(AR)機能で、1時間単位 の予約が完全自動でできるようになった ⚫ ARの機構上は任意の時間で予約できるけど、予約枠管理の都合上1時間ごとに ⚫ 予約枠の最後の5分はシステム利用とすることで、予約枠切り替え処理(未終了ジョブ のkill他)の時間を確保 ⚫ 資源分割ジョブはパッキングできない ◼ 例えば、ノード2台が丸々空いていても、そこに8x¼ノード は入らない ◼ ジョブ内で参加ノードを弁別するのにホスト名を使っているため ⚫ ジョブ内で他ノードに接続時、 qrsh -inherit hostname を rsh/sshの代わりに使う ⚫ CPUユーザがメモリを求めてf_nodeを使ってた ◼ CPU系資源が最大で4コア, メモリ30GiBしかないので、メモリをいっぱ い使いたいユーザはGPUつき資源を使わざるをえなかった
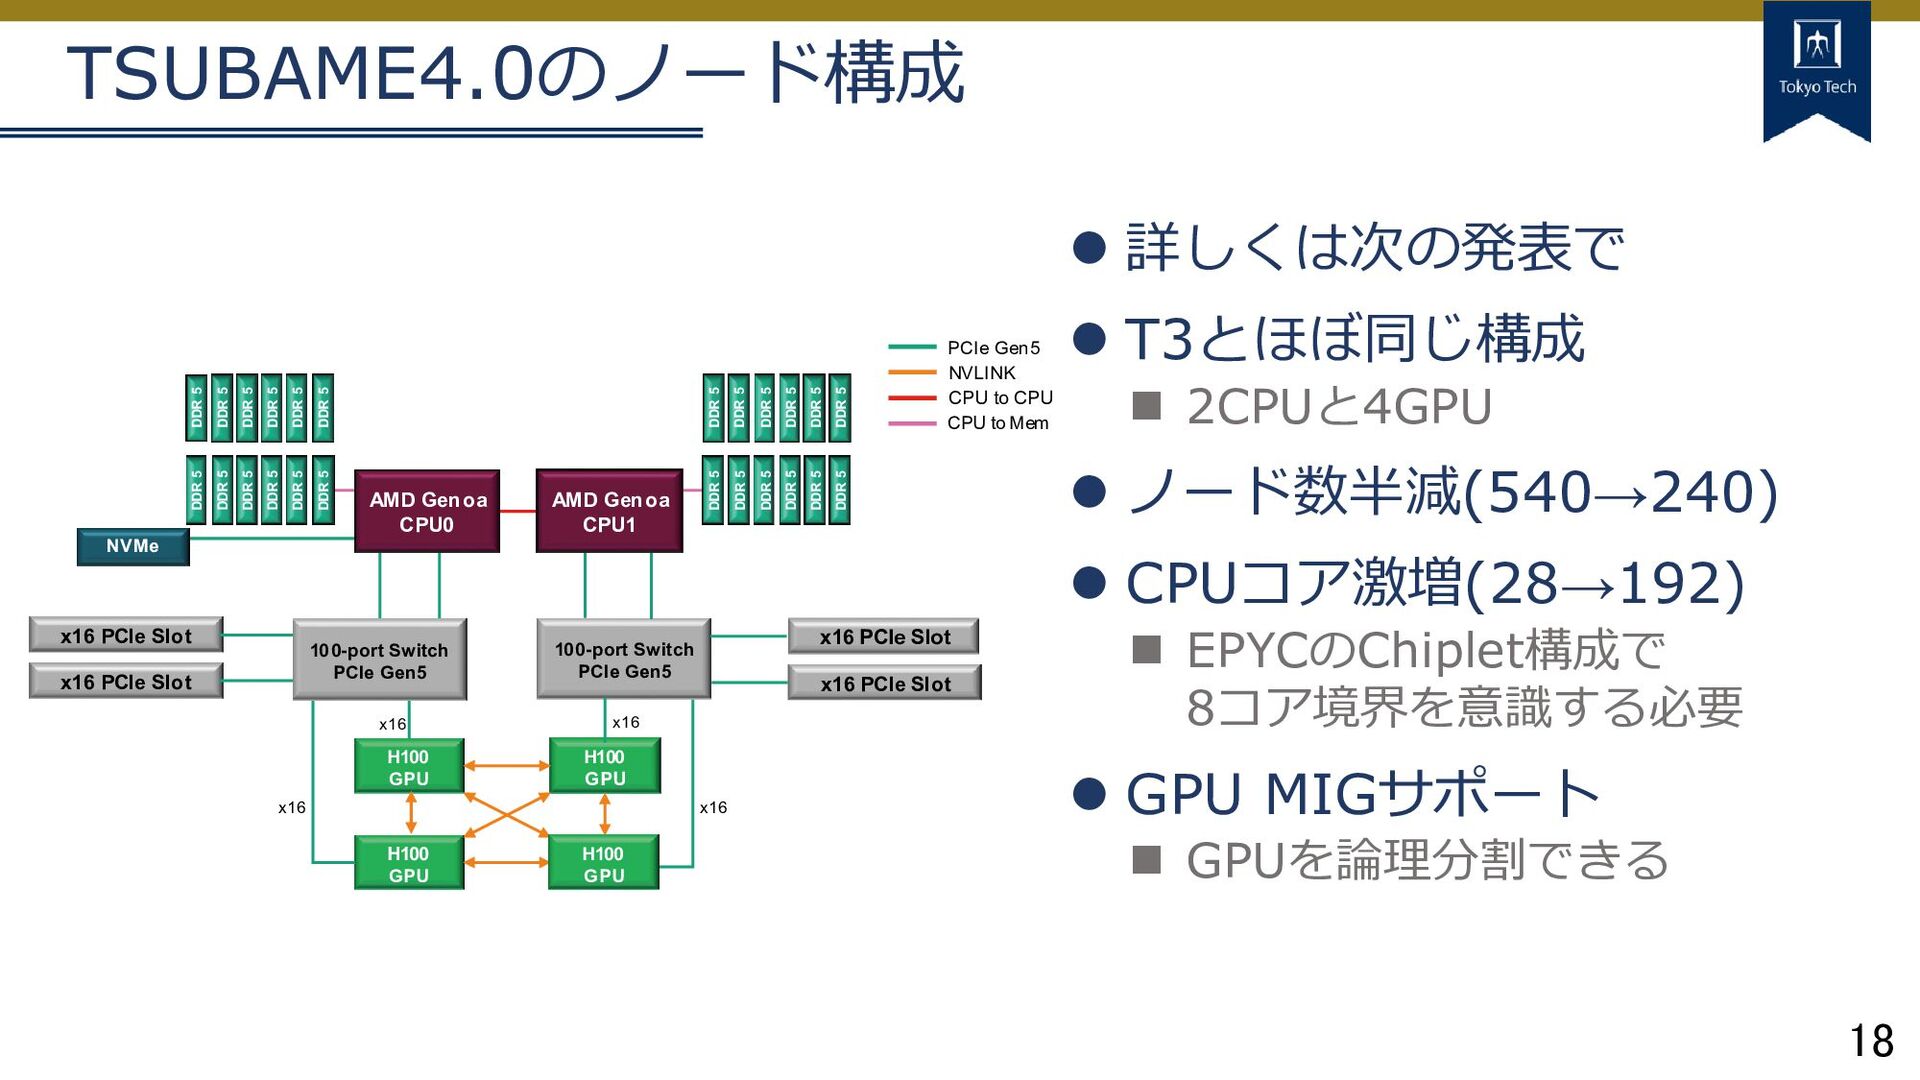
  16. 18 TSUBAME4.0のノード構成 ⚫ 詳しくは次の発表で ⚫ T3とほぼ同じ構成 ◼ 2CPUと4GPU ⚫ ノード数半減(540→240)

    ⚫ CPUコア激増(28→192) ◼ EPYCのChiplet構成で 8コア境界を意識する必要 ⚫ GPU MIGサポート ◼ GPUを論理分割できる
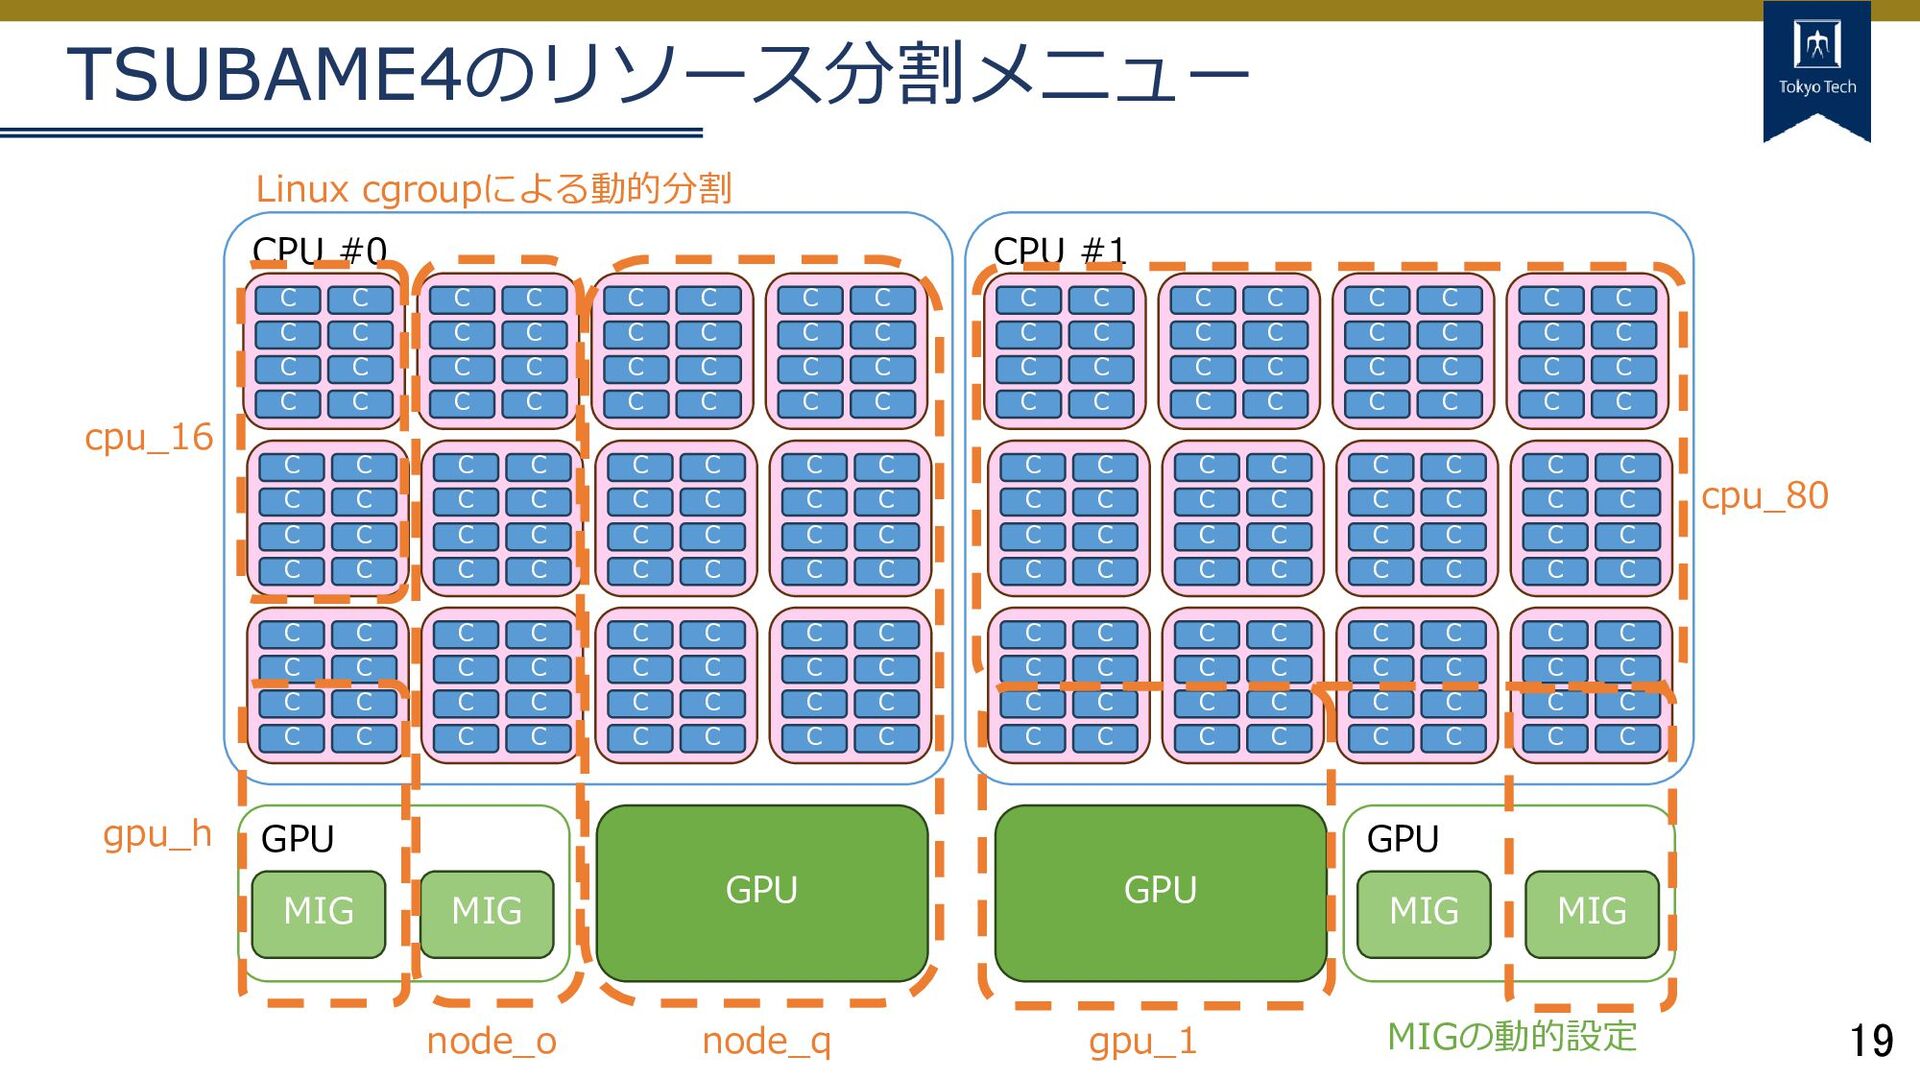
  17. 19 TSUBAME4のリソース分割メニュー CPU #0 C C C C C C

    C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C CPU #1 C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C C GPU GPU GPU MIG MIG node_q MIGの動的設定 node_o gpu_h GPU MIG MIG cpu_16 gpu_1 cpu_80 Linux cgroupによる動的分割
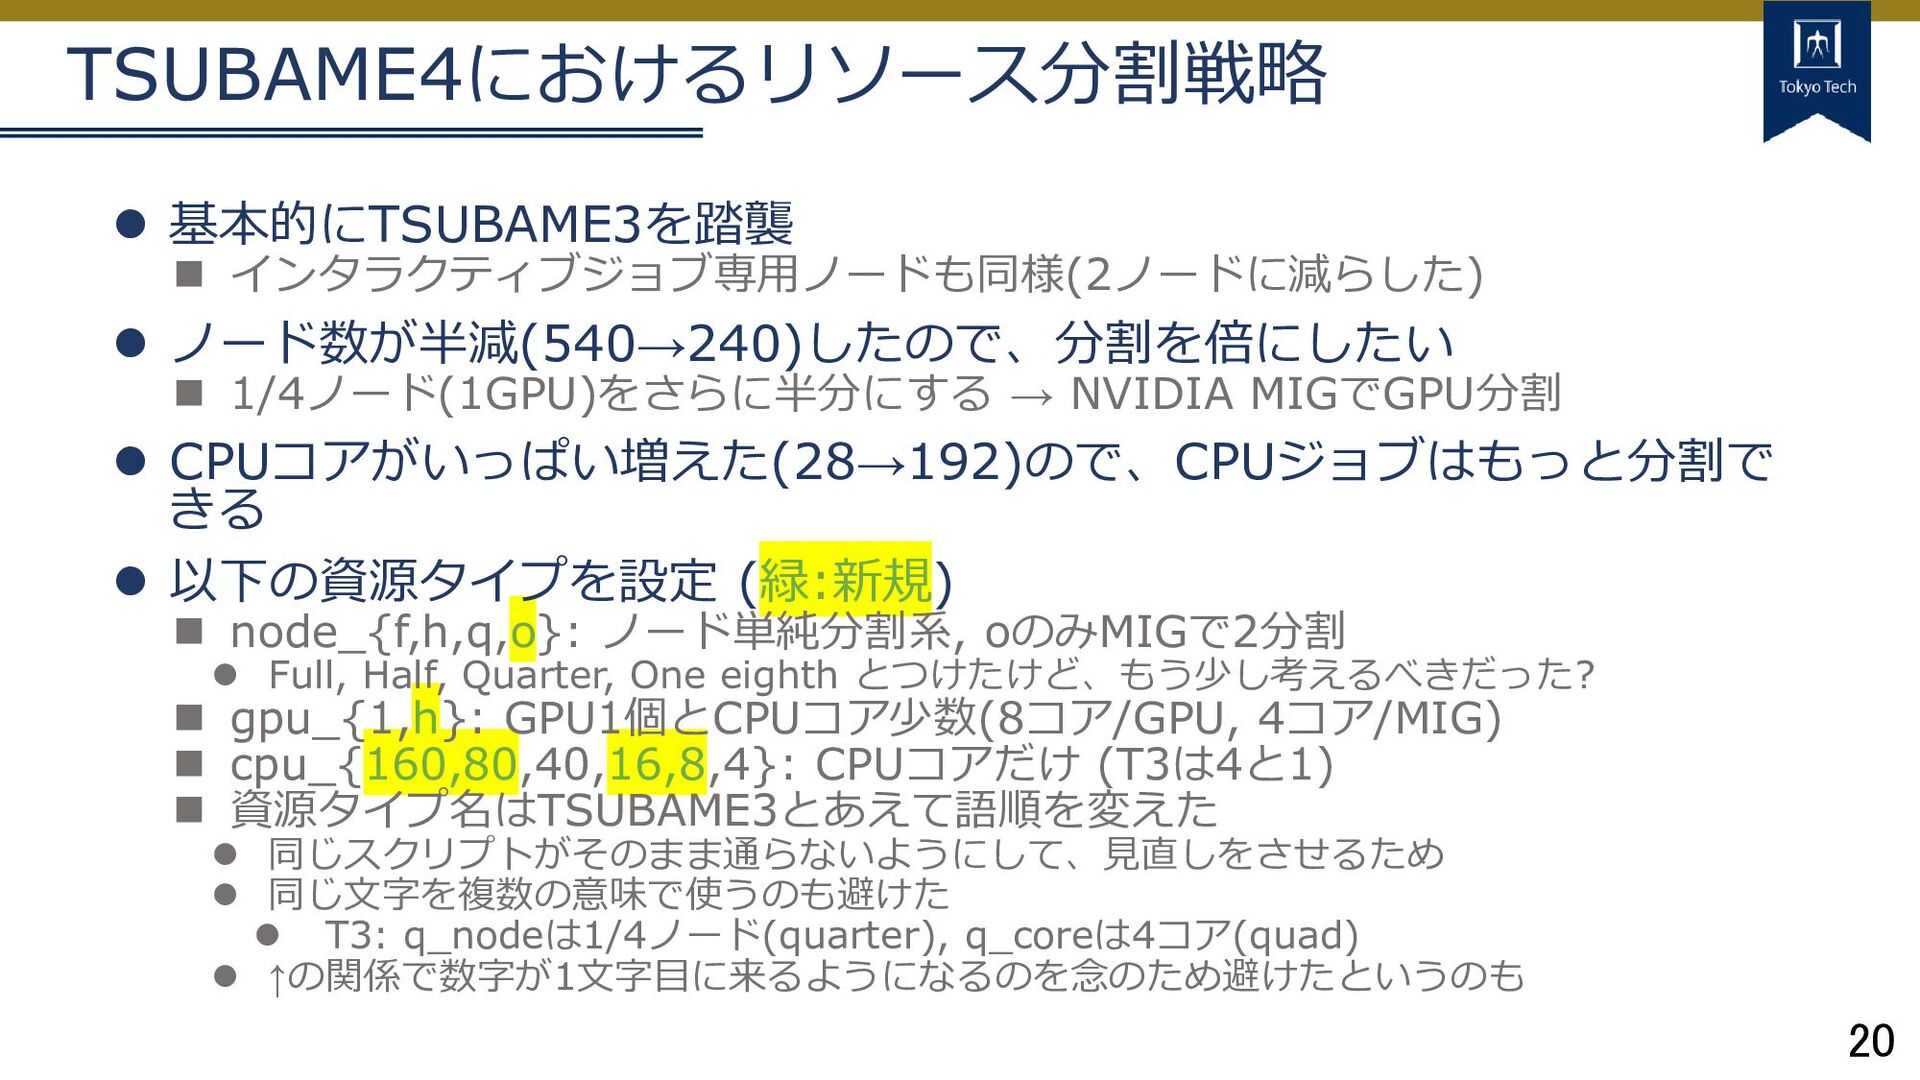
  18. 20 TSUBAME4におけるリソース分割戦略 ⚫ 基本的にTSUBAME3を踏襲 ◼ インタラクティブジョブ専用ノードも同様(2ノードに減らした) ⚫ ノード数が半減(540→240)したので、分割を倍にしたい ◼ 1/4ノード(1GPU)をさらに半分にする

    → NVIDIA MIGでGPU分割 ⚫ CPUコアがいっぱい増えた(28→192)ので、CPUジョブはもっと分割で きる ⚫ 以下の資源タイプを設定 (緑:新規) ◼ node_{f,h,q,o}: ノード単純分割系, oのみMIGで2分割 ⚫ Full, Half, Quarter, One eighth とつけたけど、もう少し考えるべきだった? ◼ gpu_{1,h}: GPU1個とCPUコア少数(8コア/GPU, 4コア/MIG) ◼ cpu_{160,80,40,16,8,4}: CPUコアだけ (T3は4と1) ◼ 資源タイプ名はTSUBAME3とあえて語順を変えた ⚫ 同じスクリプトがそのまま通らないようにして、見直しをさせるため ⚫ 同じ文字を複数の意味で使うのも避けた ⚫ T3: q_nodeは1/4ノード(quarter), q_coreは4コア(quad) ⚫ ↑の関係で数字が1文字目に来るようになるのを念のため避けたというのも
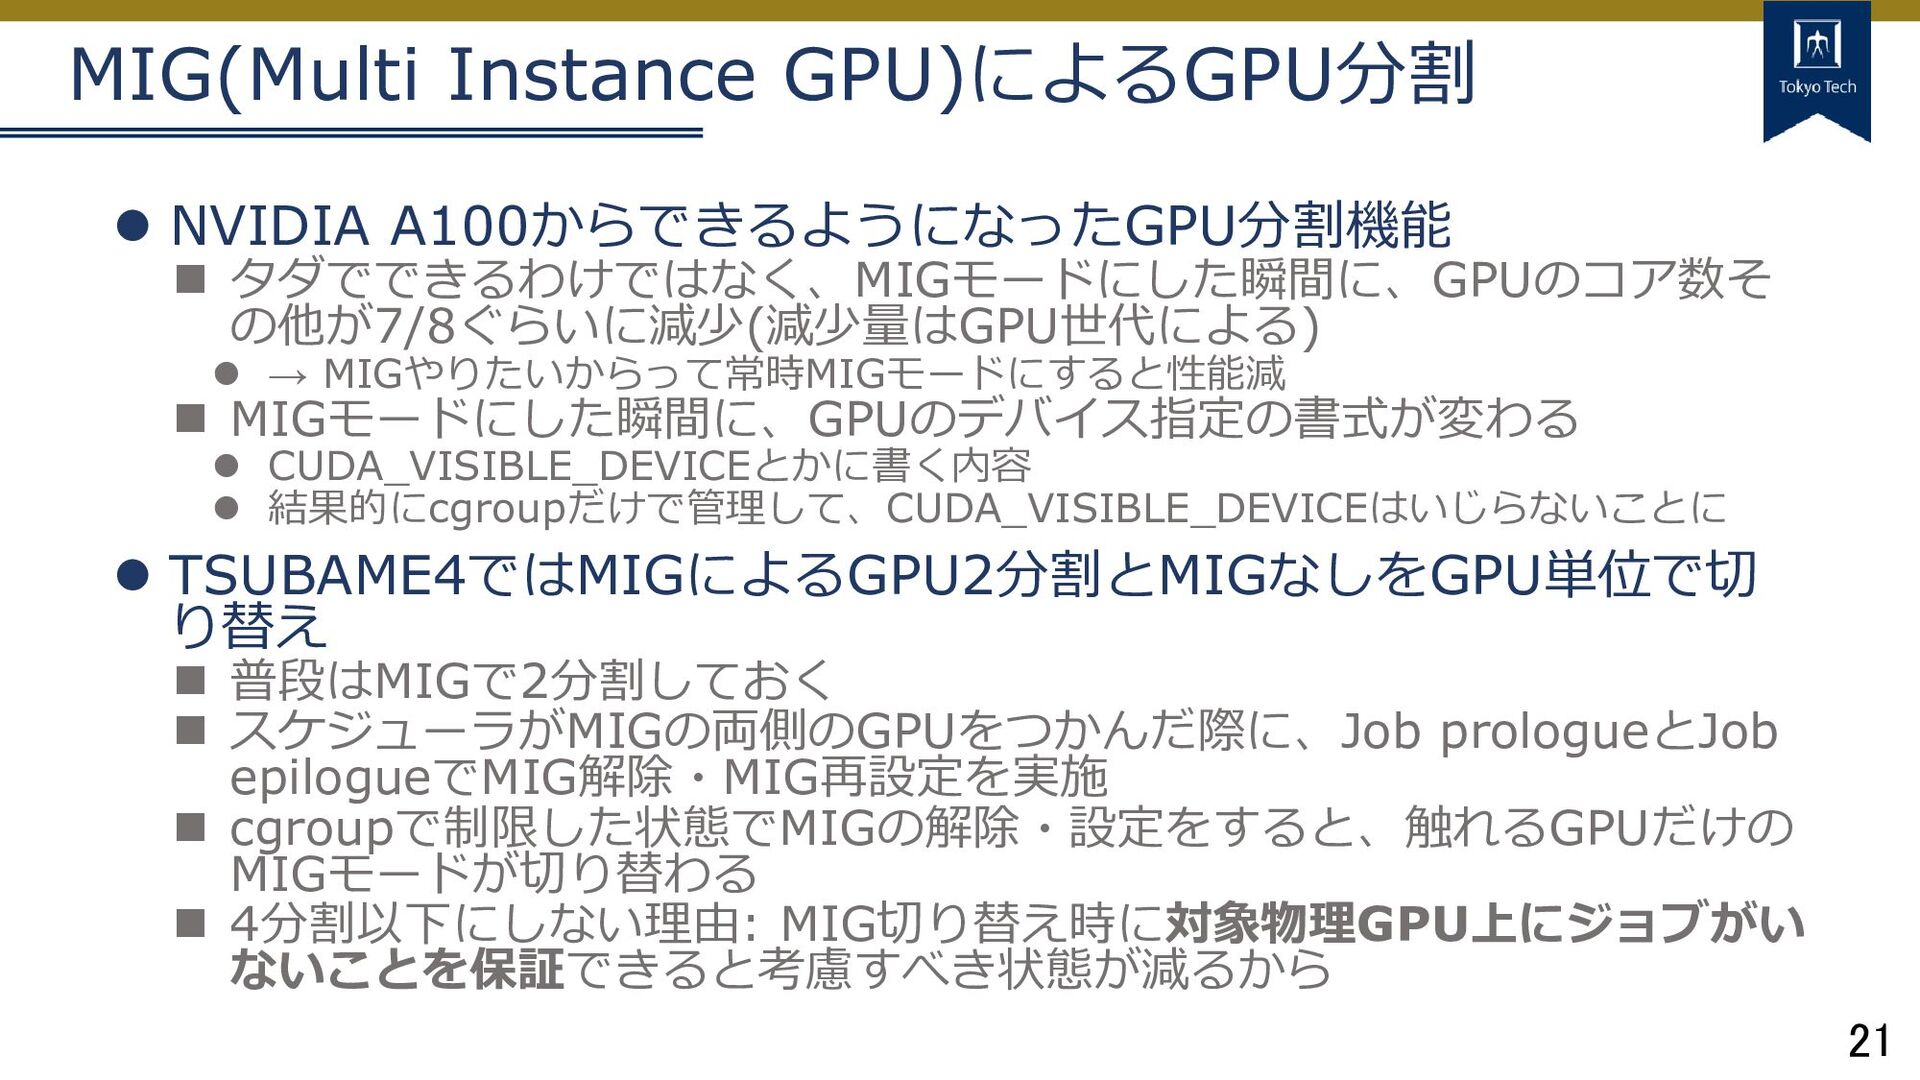
  19. 21 MIG(Multi Instance GPU)によるGPU分割 ⚫ NVIDIA A100からできるようになったGPU分割機能 ◼ タダでできるわけではなく、MIGモードにした瞬間に、GPUのコア数そ の他が7/8ぐらいに減少(減少量はGPU世代による)

    ⚫ → MIGやりたいからって常時MIGモードにすると性能減 ◼ MIGモードにした瞬間に、GPUのデバイス指定の書式が変わる ⚫ CUDA_VISIBLE_DEVICEとかに書く内容 ⚫ 結果的にcgroupだけで管理して、CUDA_VISIBLE_DEVICEはいじらないことに ⚫ TSUBAME4ではMIGによるGPU2分割とMIGなしをGPU単位で切 り替え ◼ 普段はMIGで2分割しておく ◼ スケジューラがMIGの両側のGPUをつかんだ際に、Job prologueとJob epilogueでMIG解除・MIG再設定を実施 ◼ cgroupで制限した状態でMIGの解除・設定をすると、触れるGPUだけの MIGモードが切り替わる ◼ 4分割以下にしない理由: MIG切り替え時に対象物理GPU上にジョブがい ないことを保証できると考慮すべき状態が減るから
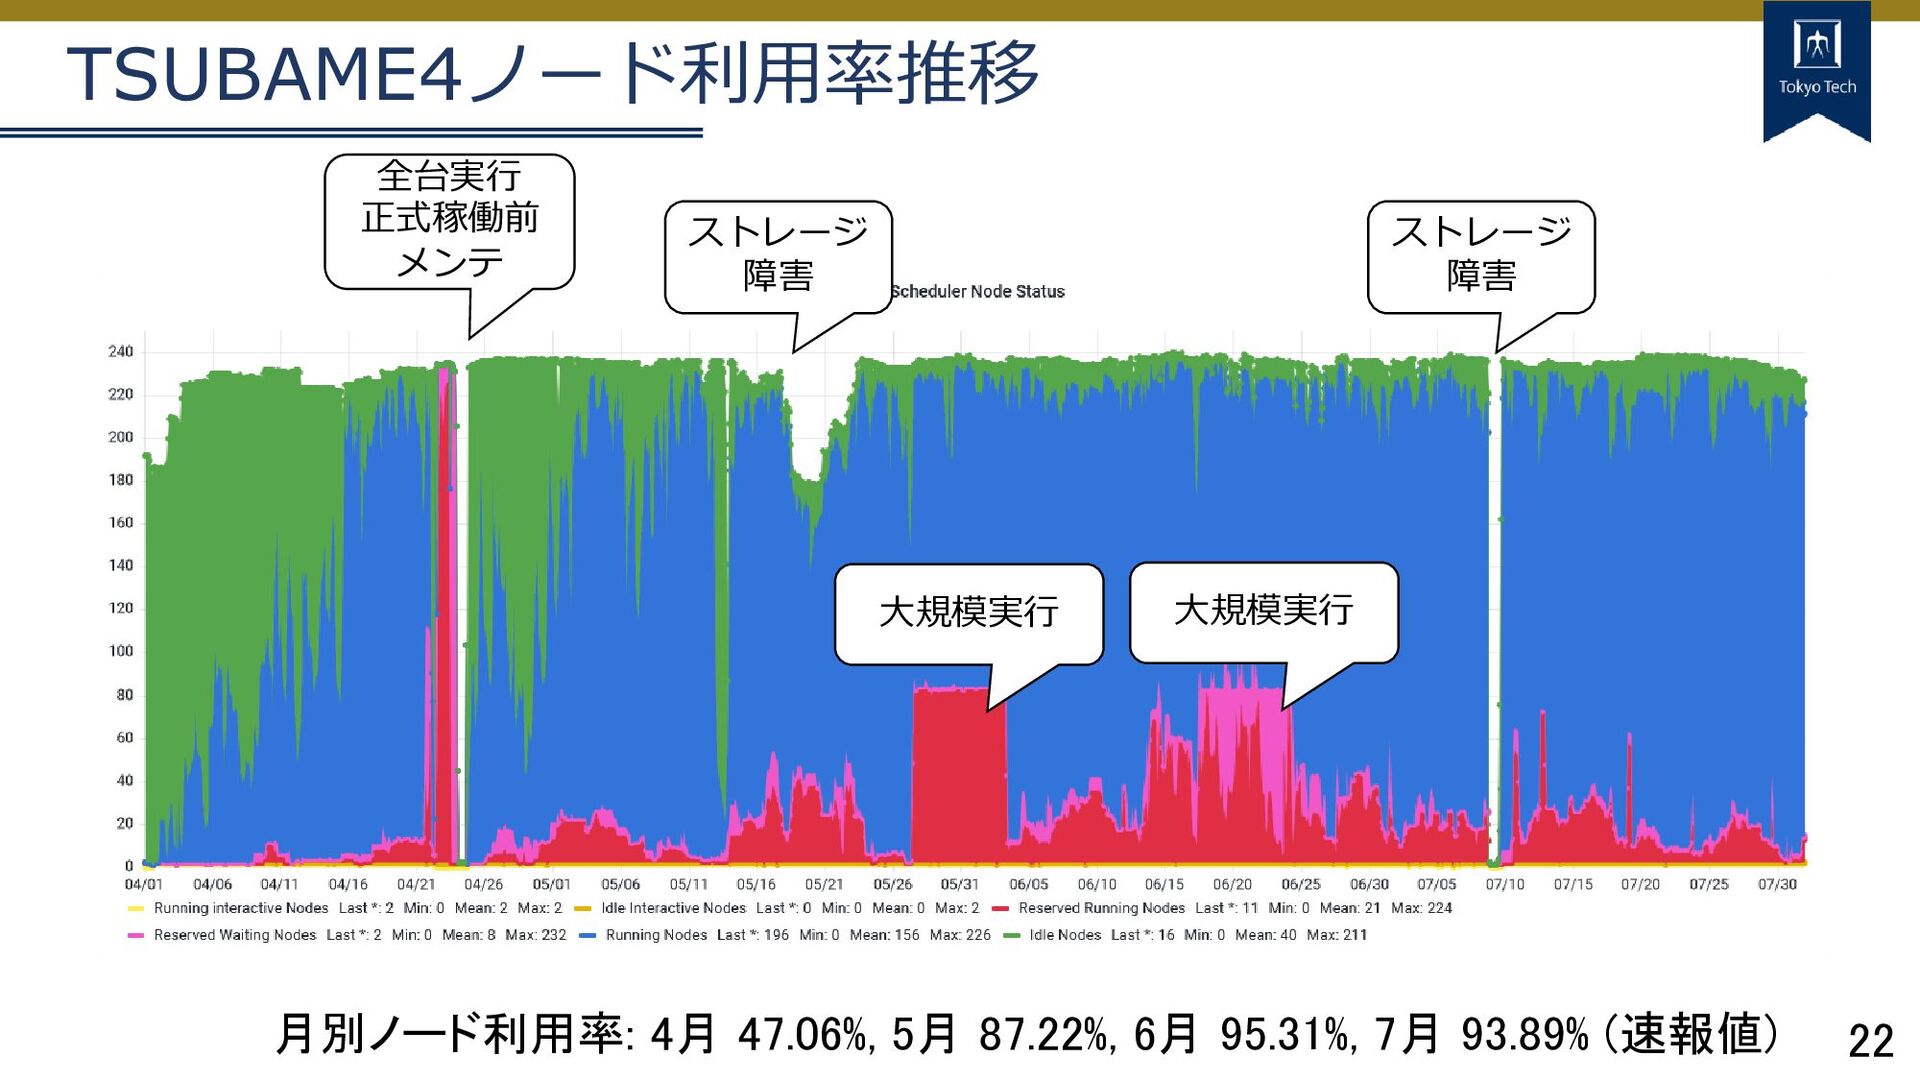
  20. 22 TSUBAME4ノード利用率推移 ストレージ 障害 ストレージ 障害 全台実行 正式稼働前 メンテ 大規模実行

    大規模実行 月別ノード利用率: 4月 47.06%, 5月 87.22%, 6月 95.31%, 7月 93.89% (速報値)
  21. 23 定額制(使い放題プラン)の試験導入 ⚫ 計算ノードを占有したいというリクエストはたまに頂く ◼ 繁忙期における資源の安定確保 ◼ 予算管理の側面 (従量制で使いきれなかった際に予算元から文句を言われる) ⚫

    月極で1ノード単位で購入可能 1グループ・1予算責任者あたり2ノードまで、全体で50ノードまで ⚫ 年度頭の時点で、直近の月から連続して購入することを条件に3月までのノードを確保する ことが可能 ◼ 年頭に混雑期の11~3月だけ買うというのは不可 ⚫ 確保したノードでは、購入者のグループのジョブが最優先で実行される、ただし実行時間1 時間未満の他ユーザの従量制ジョブも実行されうる ◼ ジョブ投入から最長で1時間後の実行開始を保証 ◼ 実装としては、キューを分けておき、1h未満ジョブは両方のキューに登録する ⚫ キューの設定変更を伴うため、切替は月初の第1営業日の昼に実施 購入は切替日の2営業日前の昼に締め切る (事前にカレンダーで告知) ⚫ 制度と実装は用意したけど、今のところほぼ使われてない ◼ むしろミニキャンプイベント時などにしくみを転用できたことの方が大きい ◼ 年度末にどうなるか