Share
Embed
Большие данные - лекция-7 - регрессия - разведочный анализ
Регрессия, регрессионная модель — модель предсказания целевой переменной в непрерывной шкале
Часть 1: разведочный анализ, распределение значений, отношения переменных, корреляция
Обновлено: 26.03.2020
https://vk.com/video53223390_456239423
Anton
March 27, 2019
Transcript
77 slides
-
Регрессия, регрессионная модель — модель предсказания целевой переменной в непрерывной
шкале Часть 1: разведочный анализ, распределение значений, отношения переменных, корреляция -
Переменная на непрерывной шкале • Температура, • влажность, • площадь,
• цена, • возраст • и т.п -
Разведочный анализ • Exploratory data analysis (EDA) • Посмотреть, что
из себя представляют данные: - Распределение значений переменной • Есть ли между признаками заметная связь: - Визуализация отношений переменных: точечные графики - Корреляция • В перспективе: построить предсказательную модель — предсказывать значение неизвестной целевой переменной по значениям известных признаков -
Boston Housing, 1978 • Жилищный фонд в пригородах Бостона, 1978
• 506 образцов • Здесь больше нет archive.ics.uci.edu/ml/datasets/Housing • Осталось здесь archive.ics.uci.edu/ml/machine-learning-databases/housing/ • Или поиск по датасетам на Каггле: www.kaggle.com/altavish/boston-housing-dataset -
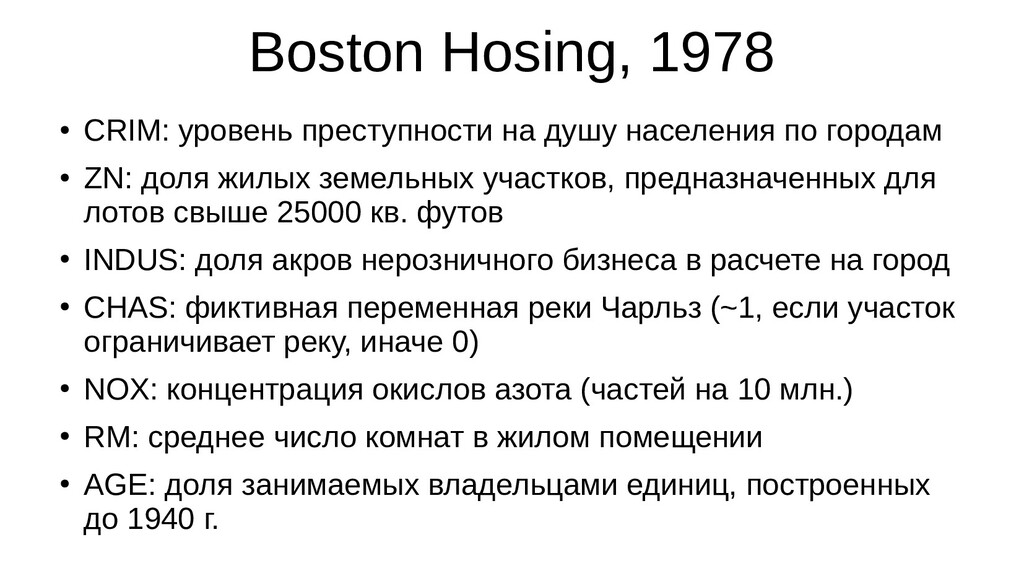
Boston Hosing, 1978 • CRIM: уровень преступности на душу населения
по городам • ZN: доля жилых земельных участков, предназначенных для лотов свыше 25000 кв. футов • INDUS: доля акров нерозничного бизнеса в расчете на город • CHAS: фиктивная переменная реки Чарльз (~1, если участок ограничивает реку, иначе 0) • NOX: концентрация окислов азота (частей на 10 млн.) • RM: среднее число комнат в жилом помещении • AGE: доля занимаемых владельцами единиц, построенных до 1940 г. -
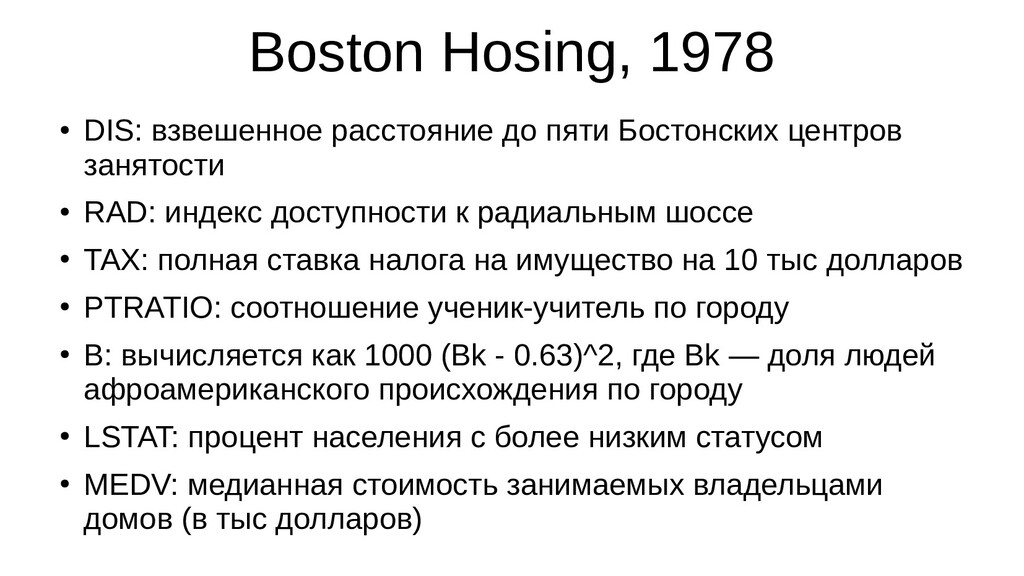
Boston Hosing, 1978 • DIS: взвешенное расстояние до пяти Бостонских
центров занятости • RAD: индекс доступности к радиальным шоссе • TAX: полная ставка налога на имущество на 10 тыс долларов • PTRATIO: соотношение ученик-учитель по городу • B: вычисляется как 1000 (Bk - 0.63)^2, где Bk — доля людей афроамериканского происхождения по городу • LSTAT: процент населения с более низким статусом • MEDV: медианная стоимость занимаемых владельцами домов (в тыс долларов) -
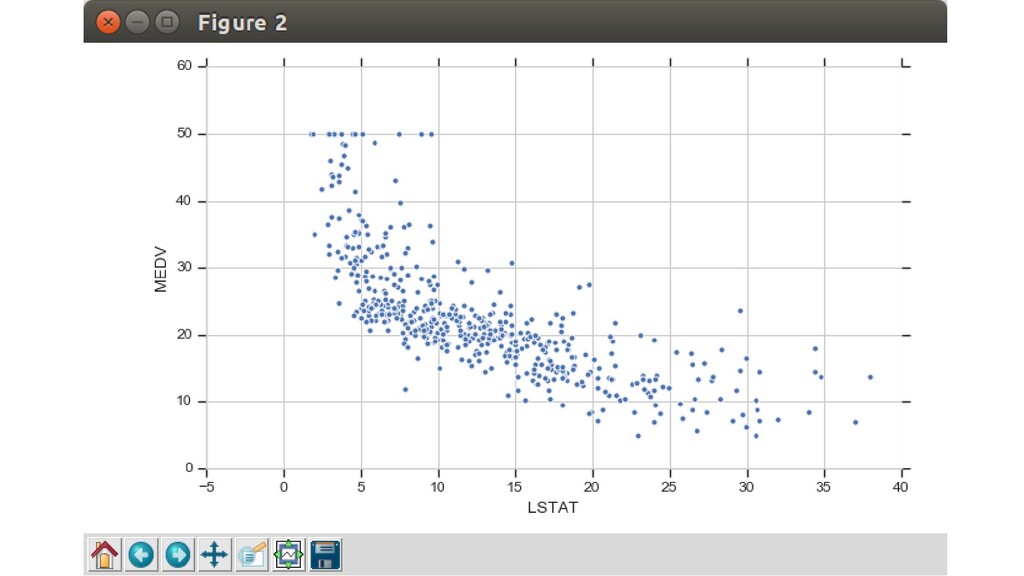
Что с чем может коррелировать? • Стоимость (MEDV) vs низкий
статус (LSTAT)? • Преступность (CRIM) vs низкий статус (LSTAT)? • Нерозничный бизнес (INDUS) (фабрики?) vs окислы азота (NOX)? • … • Проверим интуицию математикой и фактами -
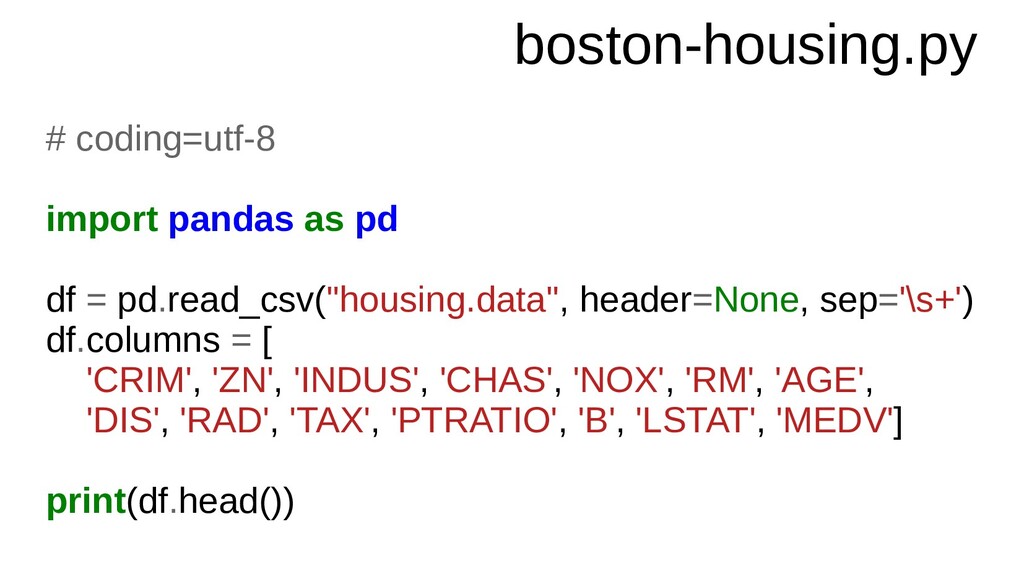
boston-housing.py # coding=utf-8 import pandas as pd df = pd.read_csv("housing.data",
header=None, sep='\s+') df.columns = [ 'CRIM', 'ZN', 'INDUS', 'CHAS', 'NOX', 'RM', 'AGE', 'DIS', 'RAD', 'TAX', 'PTRATIO', 'B', 'LSTAT', 'MEDV'] print(df.head()) -
Seaborn — больше графиков • Библиотека визуализации данных, на базе
matplotlib seaborn.pydata.org • pip install --user seaborn (на Python 2.7 может потребоваться обновить pip до 19-й версии или выше, иначе ругается на зависимости) pip install --upgrade pip -
При установке может изменить стили matplotlib • Вернуть обратно: import
seaborn as sns sns.reset_orig() • Опять выставить: sns.reset_defaults() • Так и не заметил, на что это влияет -
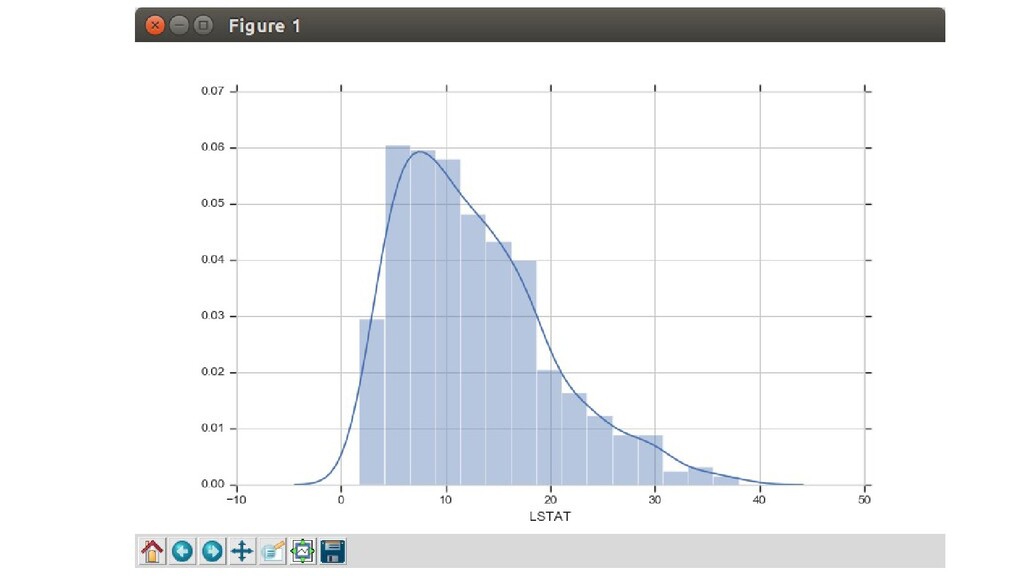
График распределения значений признака • Distplot — одномерное распределение (univariate
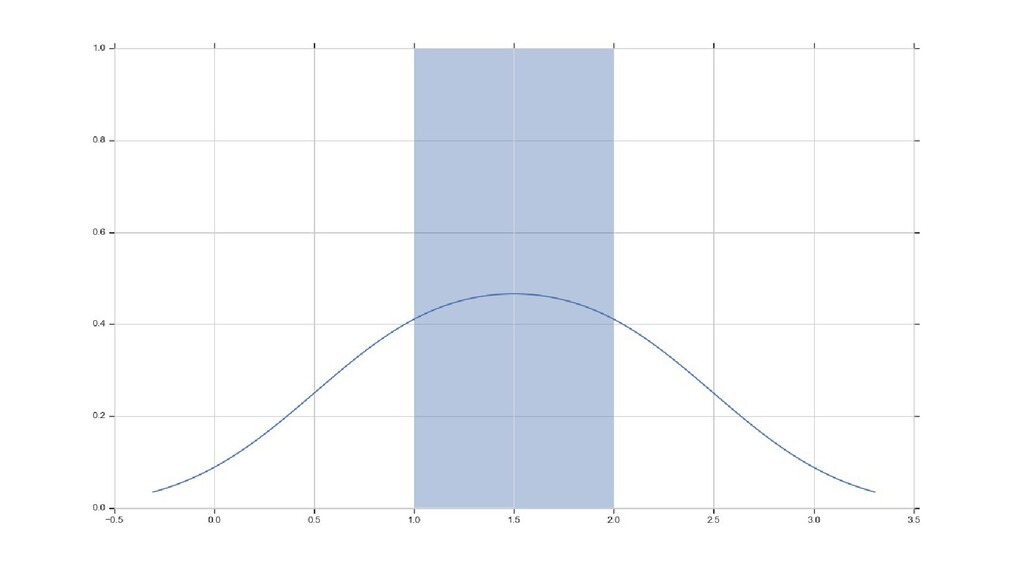
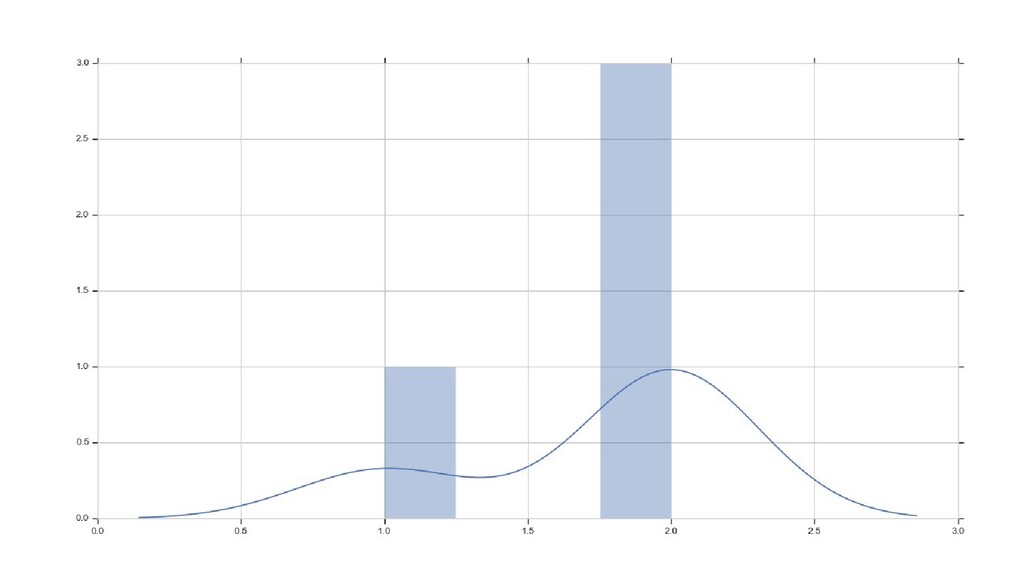
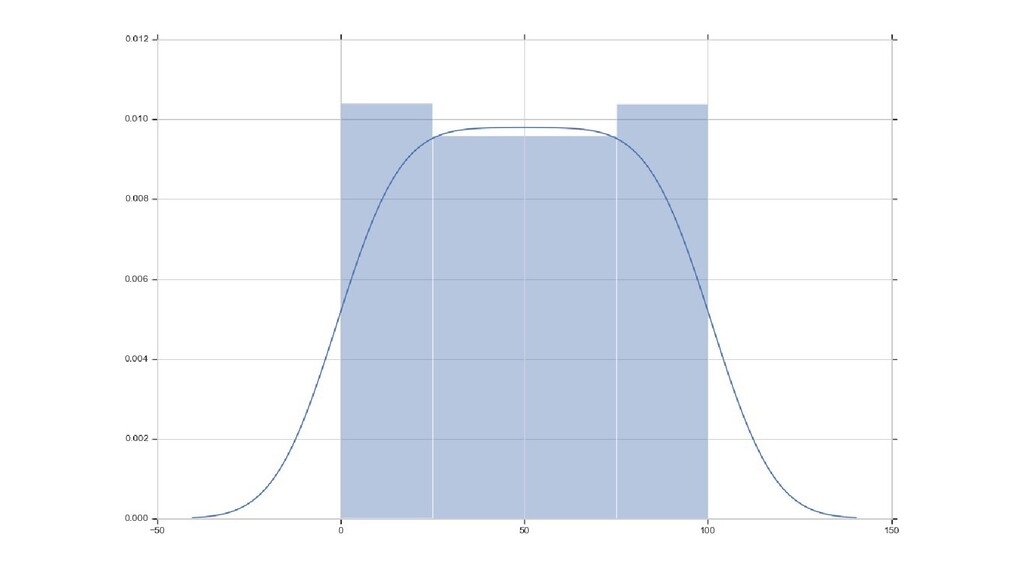
distribution) случайной величины seaborn.pydata.org/generated/seaborn.distplot.html stackoverflow.com/questions/51666784/what-is-y-axis-in-seaborn-distplot • По X — значения параметра, разбитые на группы (диапазоны) (столбцы гистограммы — группы значений) • По Y: площадь столбца — вероятность появления значения из данного диапазона (грубо: нормализованное количество элементов в каждой группе) • сумма площадей всех столбцов графика равна 1 -
Инструменты теории вероятностей • Мы можем рассматривать (интерпретировать) значения числового
признака X m как выборку значений случайной величины — по одному результату «эксперимента» на строку • Основываясь на значениях выборки, мы можем посчитать вероятность попадания значения в тот или иной диапазон на шкале • Чем больше значений выборки (значений признака X m ) попадают в данный диапазон, тем больше вероятность в него попасть. -
distplot-demo.py # coding=utf-8 import matplotlib.pyplot as plt import seaborn as
sns import numpy as np # симпатичная сетка на белом фоне sns.set(style='whitegrid') -
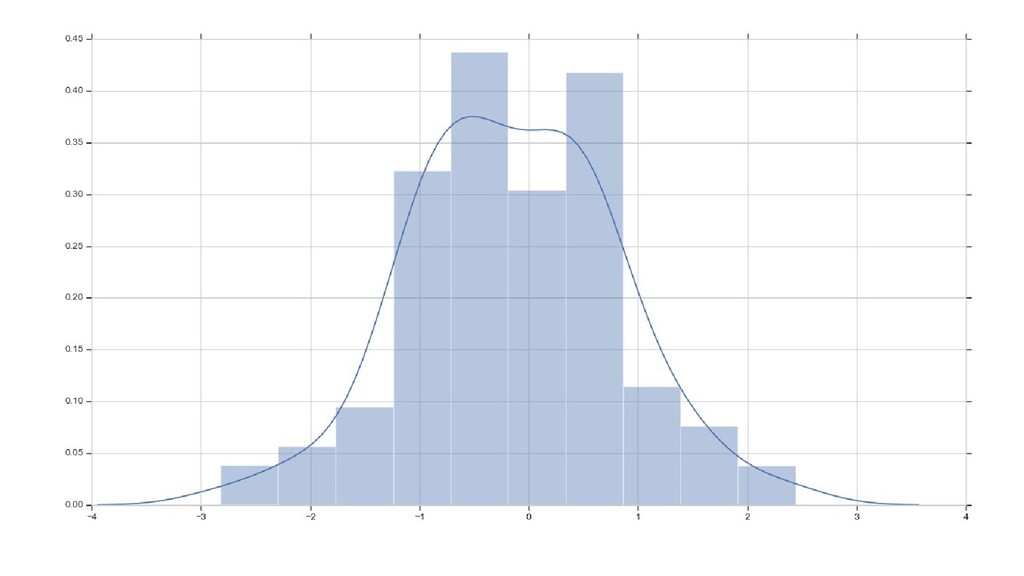
distplot-demo.py # случайные значения со стандартным # нормальным распределением #
https://ru.wikipedia.org/wiki/Нормальное_распределение sns.distplot(np.random.randn(100)) plt.show() -
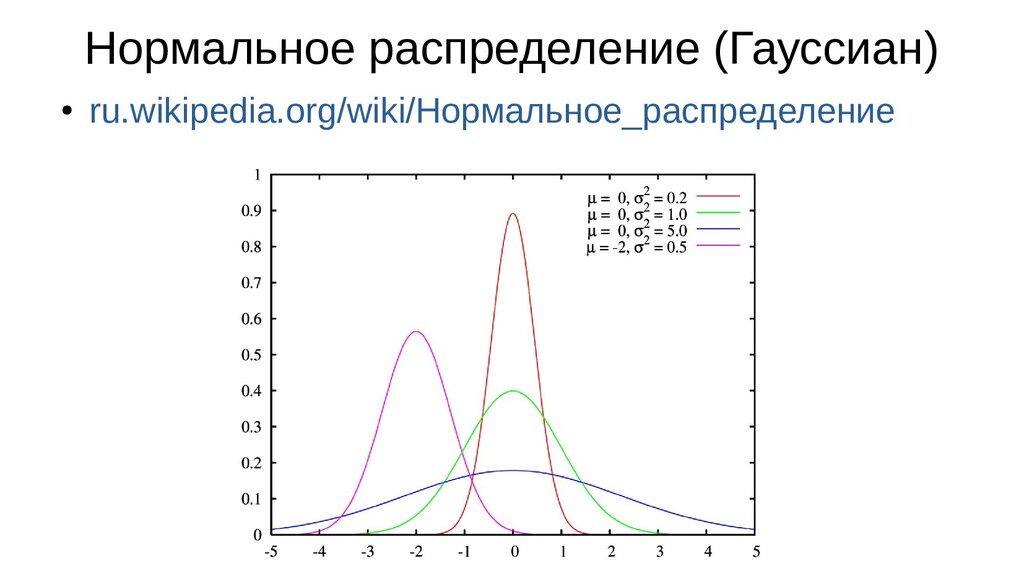
Нормальное распределение • Математическое ожидание — среднее значение случайной величины
• Стандартное отклонение — показатель рассеивания случайной величины относительно её матожидания • Стрелок целится в мишень: он не всегда будет в нее попадать, но скорее всего выстрелы буду ложиться где-то недалеко - Мишень — матожидание выстрела - Чем меньше стандартное отклонение, чем ближе выстрелы ложатся к центру мишени -
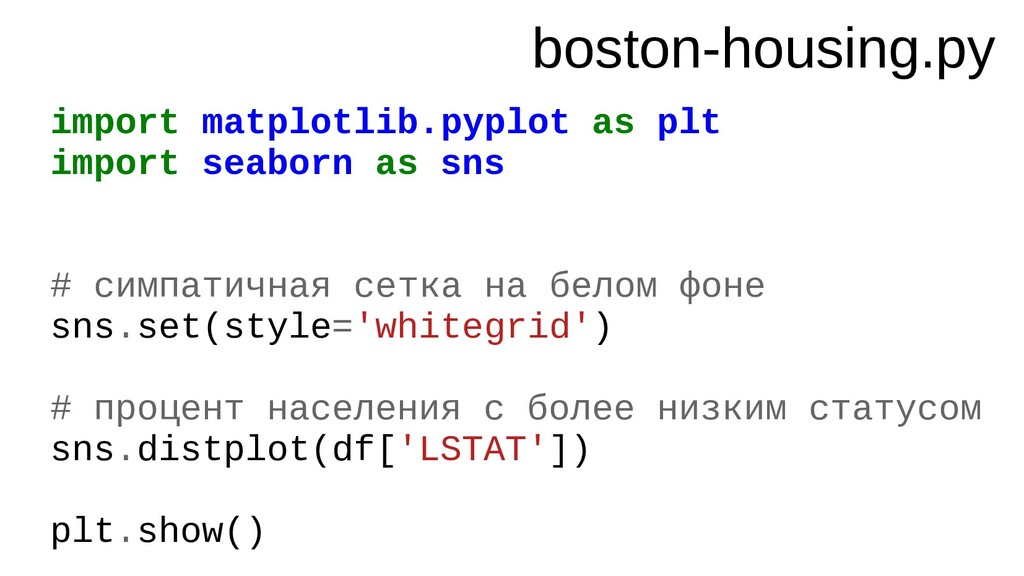
boston-housing.py import matplotlib.pyplot as plt import seaborn as sns #
симпатичная сетка на белом фоне sns.set(style='whitegrid') # процент населения с более низким статусом sns.distplot(df['LSTAT']) plt.show() -
Точечный график — отношения между двумя величинами • Relplot seaborn.pydata.org/generated/seaborn.relplot.h
tml • По X — значение величины 1, • по Y — значение величины 2 для этой же строки -
relplot-demo.py # coding=utf-8 import matplotlib.pyplot as plt import seaborn as
sns import pandas as pd import numpy as np # симпатичная сетка на белом фоне sns.set(style='whitegrid') -
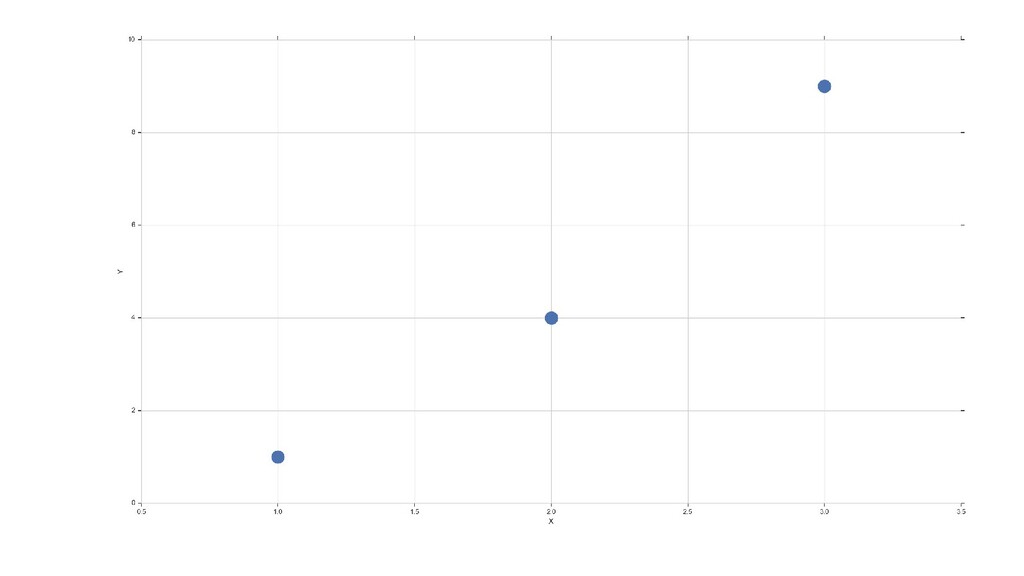
relplot-demo.py df = pd.DataFrame( data={'X': [1,2,3], 'Y': np.array([1,2,3])**2}) sns.relplot(x='X', y='Y',
data=df, s=500) plt.show() -
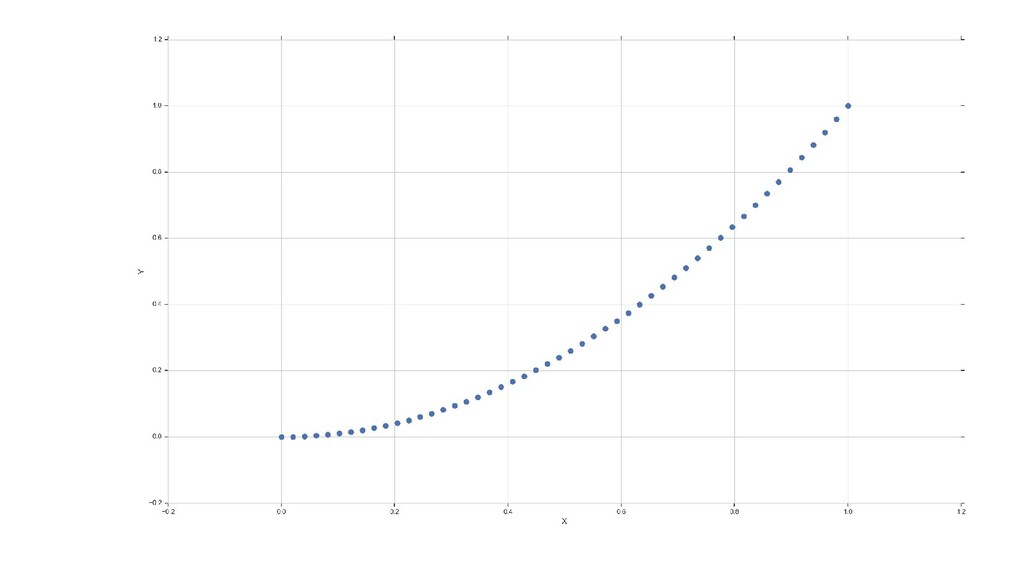
relplot-demo.py df = pd.DataFrame( data={ 'X': np.linspace(0,1), 'Y': np.linspace(0,1)**2 })
sns.relplot(x='X', y='Y', data=df, s=100) plt.show() -
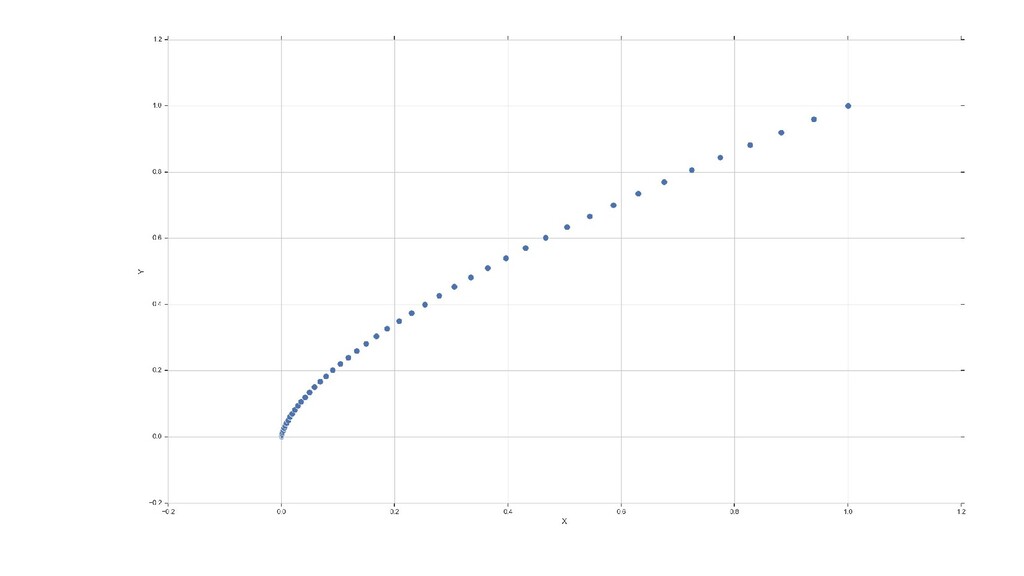
relplot-demo.py df = pd.DataFrame( data={ 'X': np.linspace(0,1)**3, 'Y': np.linspace(0,1)**2}) sns.relplot(x='X',
y='Y', data=df, s=50) plt.show() -
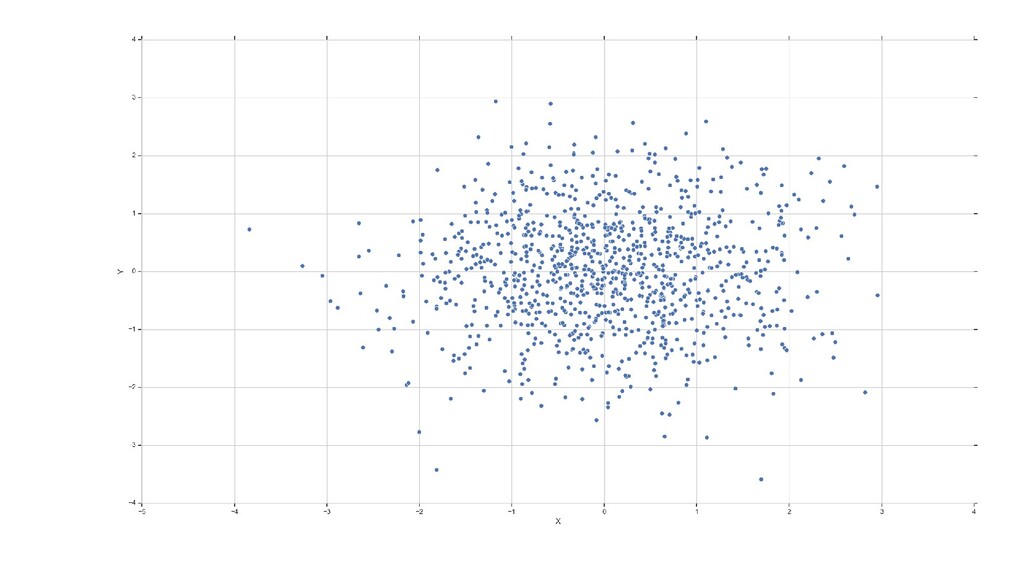
relplot-demo.py df = pd.DataFrame( data={ 'X': np.random.randn(1000), 'Y': np.random.randn(1000) })
sns.relplot(x='X', y='Y', data=df) plt.show() -
boston-housing.py import matplotlib.pyplot as plt import seaborn as sns #
симпатичная сетка на белом фоне sns.set(style='whitegrid') # LSTAT: процент населения с низким статусом # MEDV: медианная стоимость домов sns.relplot(x='LSTAT', y='MEDV', data=df) plt.show() -
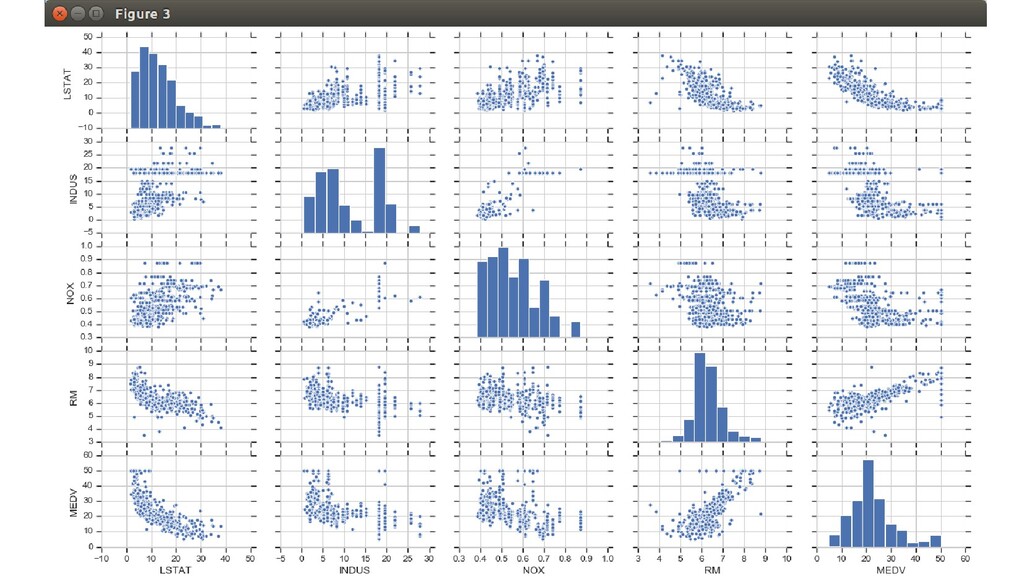
Групповой график распределений и попарных отношений • Pairplot — поиск
попарных корреляций между разными признаками seaborn.pydata.org/generated/seaborn.pairplot.html • Матрица точечных графиков Relplot • По диагонали — графики распределения Distplot -
boston-housing.py import matplotlib.pyplot as plt import seaborn as sns #
симпатичная сетка на белом фоне sns.set(style='whitegrid') sns.pairplot(df[ ['LSTAT', 'INDUS', 'NOX', 'RM', 'MEDV']]) plt.show() -
• LSTAT: процент населения с более низким статусом • INDUS:
доля акров нерозничного бизнеса в расчете на город • NOX: концентрация окислов азота (частей на 10 млн.) • RM: среднее число комнат в жилом помещении • MEDV: медианная стоимость занимаемых владельцами домов (в тыс долларов) -
Интуитивно • Чем больше графики двух величин похожи друг на
друга, тем сильнее они коррелируют • Чем больше данных отражено в каждой точке (значение элемента) и чем больше элементов в выборке (протяженность наблюдений по времени), тем наблюдаемая корреляция достовернее -
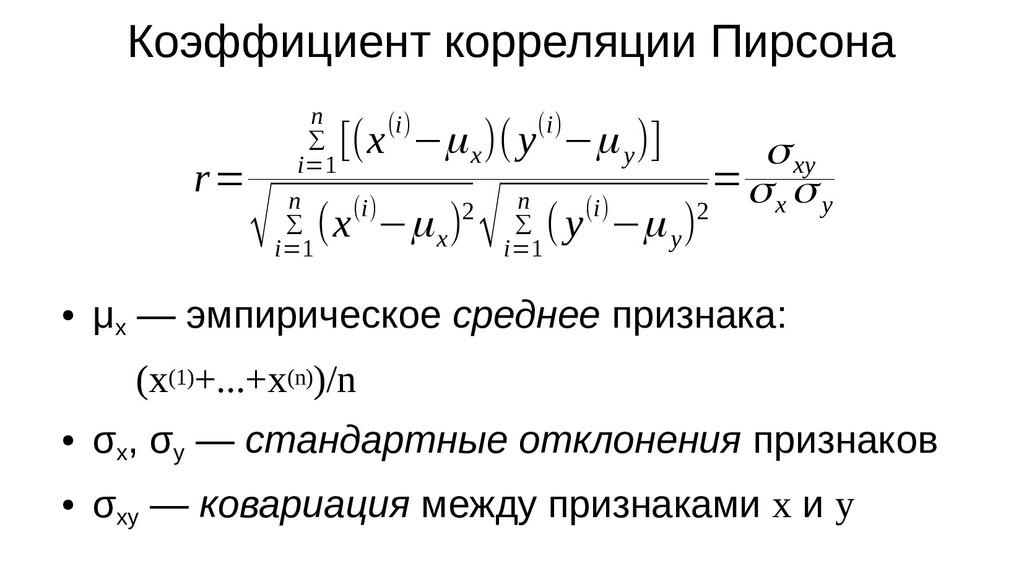
Коэффициент корреляции Пирсона • Измеряет линейную зависимость между парой признаков
• r = [-1, 1] • r = 1: абсолютная положительная корреляция • r = 0: полное отсутствие корреляции • r = -1: абсолютная отрицательная корреляция -
Коэффициент корреляции Пирсона Интерпретация по модулю • |r| < 0.3:
слабая • 0.3 < |r| < 0.5: умеренная • 0.5 < |r| < 0.7: заметная • 0.7 < |r| < 0.9: высокая • |r| > 0.9: весьма высокая -
Коэффициент корреляции Пирсона • μ x — эмпирическое среднее признака:
(x(1)+...+x(n))/n • σ x , σ y — стандартные отклонения признаков • σ xy — ковариация между признаками x и y r= ∑ i=1 n [(x(i)−μx )( y(i)−μy )] √ ∑ i=1 n (x(i)−μx )2 √ ∑ i=1 n ( y(i)−μy )2 = σxy σx σy -
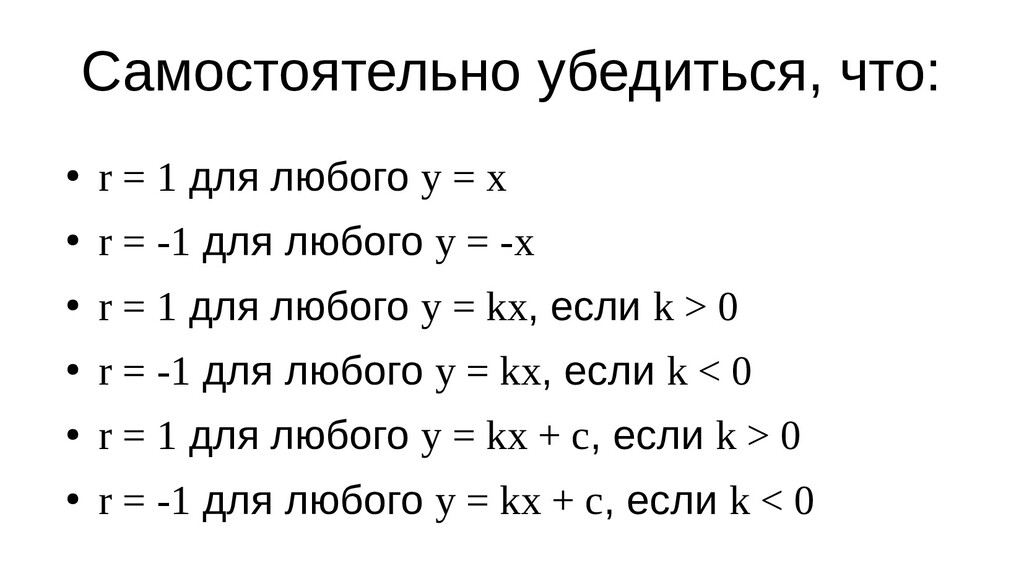
Самостоятельно убедиться, что: • r = 1 для любого y
= x • r = -1 для любого y = -x • r = 1 для любого y = kx, если k > 0 • r = -1 для любого y = kx, если k < 0 • r = 1 для любого y = kx + c, если k > 0 • r = -1 для любого y = kx + c, если k < 0 -
Пример 1 • x = [1, 2, 3] • y
= [5, 7, 9] • μ x = (1+2+3)/3 = 6/3 = 2 • μ y = (5+7+9)/3 = 21/3 = 7 • σ xy = (1-2)(5-7)+(2-2)(7-7)+(3-2)(9-7) = 4 • σ x = sqrt (1-2)^2+(2-2)^2+(3-2)^2 = sqrt (2) = ~1.41 • σ y = sqrt (5-7)^2+(7-7)^2+(9-7)^2 = sqrt (8) = ~2.83 • r = 4/(1.41 * 2.83) = 1 -
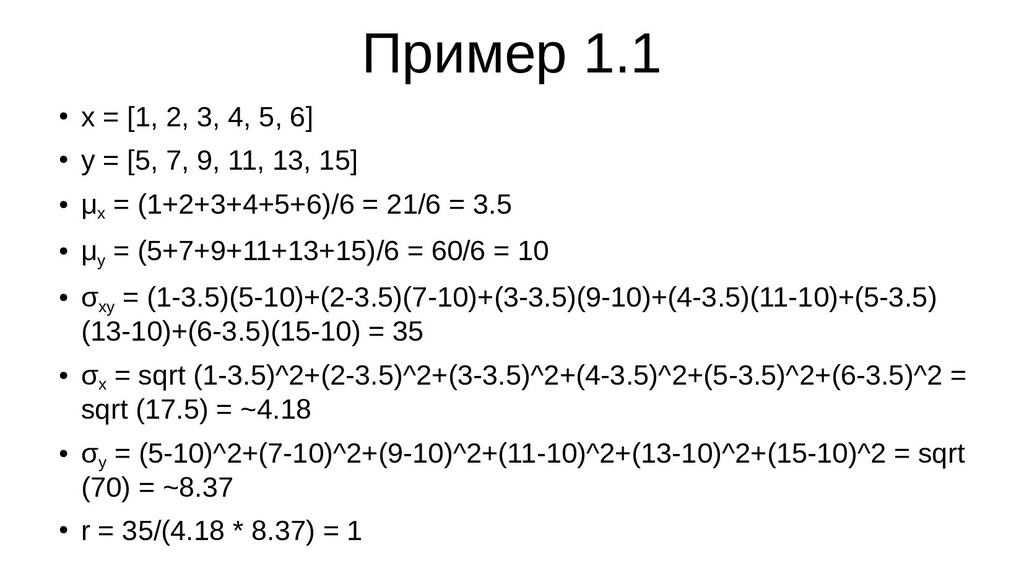
Пример 1.1 • x = [1, 2, 3, 4, 5,
6] • y = [5, 7, 9, 11, 13, 15] • μ x = (1+2+3+4+5+6)/6 = 21/6 = 3.5 • μ y = (5+7+9+11+13+15)/6 = 60/6 = 10 • σ xy = (1-3.5)(5-10)+(2-3.5)(7-10)+(3-3.5)(9-10)+(4-3.5)(11-10)+(5-3.5) (13-10)+(6-3.5)(15-10) = 35 • σ x = sqrt (1-3.5)^2+(2-3.5)^2+(3-3.5)^2+(4-3.5)^2+(5-3.5)^2+(6-3.5)^2 = sqrt (17.5) = ~4.18 • σ y = (5-10)^2+(7-10)^2+(9-10)^2+(11-10)^2+(13-10)^2+(15-10)^2 = sqrt (70) = ~8.37 • r = 35/(4.18 * 8.37) = 1 -
Пример 2 • x = [1, 2, 3] • y
= [9, 7, 5] • μ x = (1+2+3)/3 = 6/3 = 2 • μ y = (9+7+5)/3 = 21/3 = 7 • σ xy = (1-2)(9-7)+(2-2)(7-7)+(3-2)(5-7) = -4 • σ x = sqrt (1-2)^2+(2-2)^2+(3-2)^2 = sqrt (2) = ~1.41 • σ y = sqrt (9-7)^2+(7-7)^2+(5-7)^2 = sqrt (8) = ~2.83 • r = -4/(1.41 * 2.83) = -1 -
Пример 3 • x = [1, 2, 3] • y
= [1, 4, 9] (y = x^2) • μ x = (1+2+3)/3 = 6/3 = 2 • Μ y = (1+4+9)/3 = 14/3 = ~4.67 • σ xy = (1-2)(1-4.67)+(2-2)(4-4.67)+(3-2)(9-4.67) = 8 • σ x = sqrt (1-2)^2+(2-2)^2+(3-2)^2 = sqrt (2) = ~1.41 • σ y = sqrt (1-4.67)^2+(4-4.67)^2+(9-4.67)^2 = sqrt (32.67) = ~5.72 • r = 8/(1.41 * 5.72) = 0.99 -
Пример 4 • x = [1, 2, 3] • y
= [1, 8, 27] (y = x^3) • μ x = (1+2+3)/3 = 6/3 = 2 • Μ y = (1+8+27)/3 = 36/3 = 12 • σ xy = (1-2)(1-12)+(2-2)(8-12)+(3-2)(27-12) = 26 • σ x = sqrt (1-2)^2+(2-2)^2+(3-2)^2 = sqrt (2) = ~1.41 • σ y = sqrt (1-12)^2+(8-12)^2+(27-12)^2 = sqrt (362) = ~19.03 • r = 26/(1.41 * 19.03) = 0.97 -
Пример 5 • x = [1, 2, 3] • y
= [11, 19, 0] • μ x = (1+2+3)/3 = 6/3 = 2 • Μ y = (11+19+0)/3 = 30/3 = 10 • σ xy = (1-2)(11-10)+(2-2)(19-10)+(3-2)(0-10) = -11 • σ x = sqrt (1-2)^2+(2-2)^2+(3-2)^2 = sqrt (2) = ~1.41 • σ y = sqrt (11-10)^2+(19-10)^2+(0-10)^2 = sqrt (182) = ~13.49 • r = -11/(1.41 * 13.49) = -0.58 -
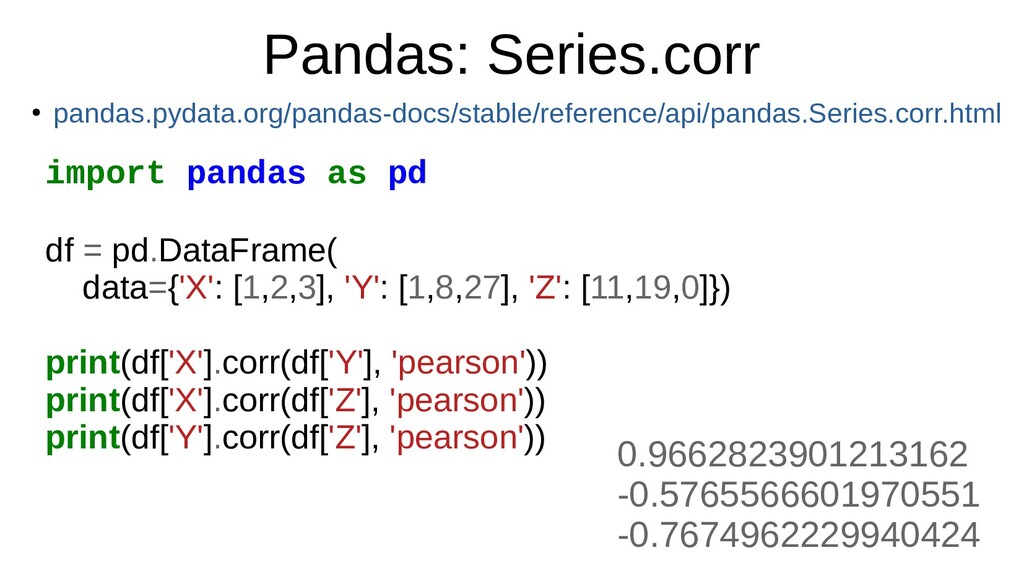
Pandas: Series.corr import pandas as pd df = pd.DataFrame( data={'X':
[1,2,3], 'Y': [1,8,27], 'Z': [11,19,0]}) print(df['X'].corr(df['Y'], 'pearson')) print(df['X'].corr(df['Z'], 'pearson')) print(df['Y'].corr(df['Z'], 'pearson')) • pandas.pydata.org/pandas-docs/stable/reference/api/pandas.Series.corr.html 0.9662823901213162 -0.5765566601970551 -0.7674962229940424 -
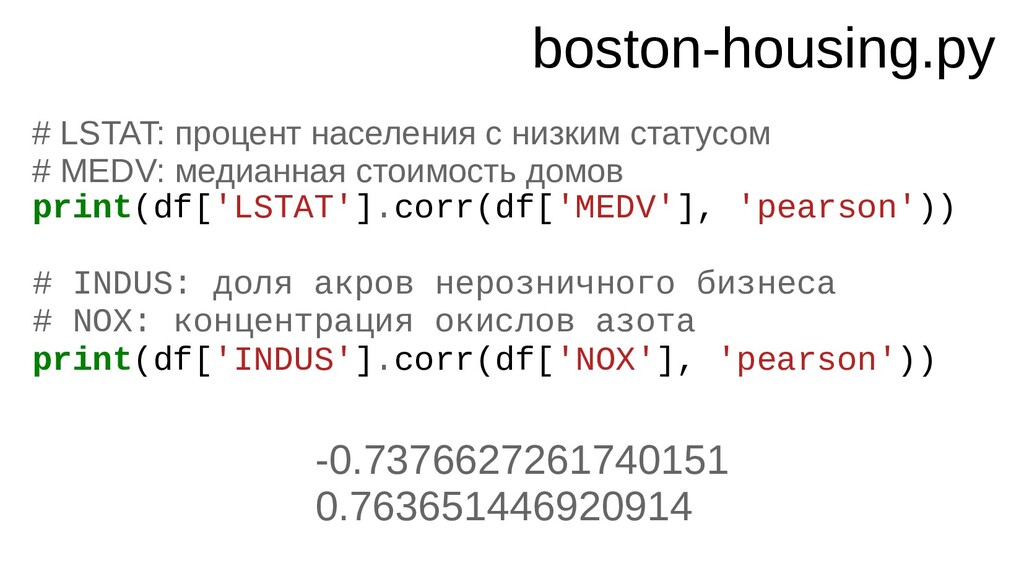
boston-housing.py # LSTAT: процент населения с низким статусом # MEDV:
медианная стоимость домов print(df['LSTAT'].corr(df['MEDV'], 'pearson')) # INDUS: доля акров нерозничного бизнеса # NOX: концентрация окислов азота print(df['INDUS'].corr(df['NOX'], 'pearson')) -0.7376627261740151 0.763651446920914 -
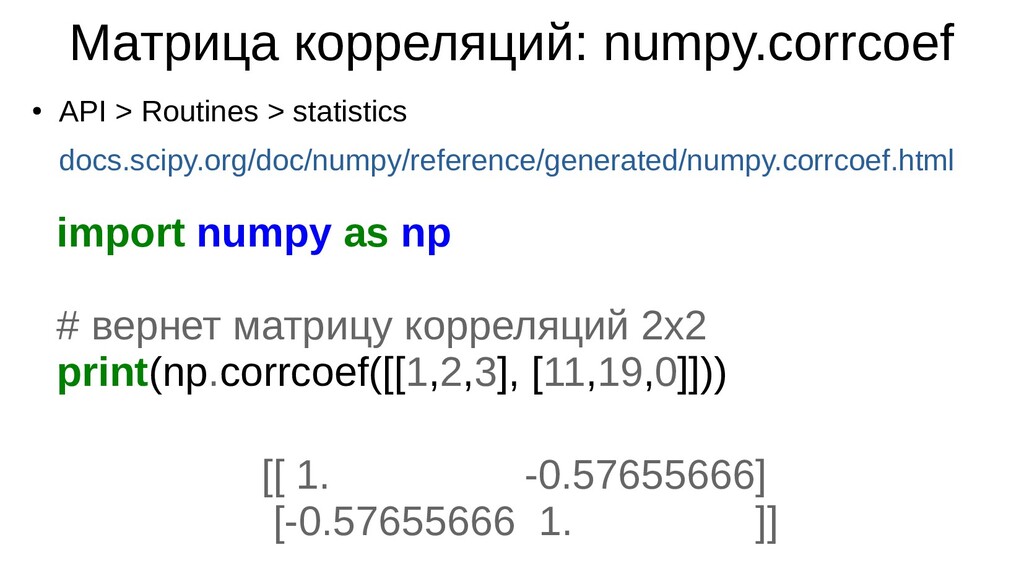
Матрица корреляций: numpy.corrcoef import numpy as np # вернет матрицу
корреляций 2x2 print(np.corrcoef([[1,2,3], [11,19,0]])) [[ 1. -0.57655666] [-0.57655666 1. ]] • API > Routines > statistics docs.scipy.org/doc/numpy/reference/generated/numpy.corrcoef.html -
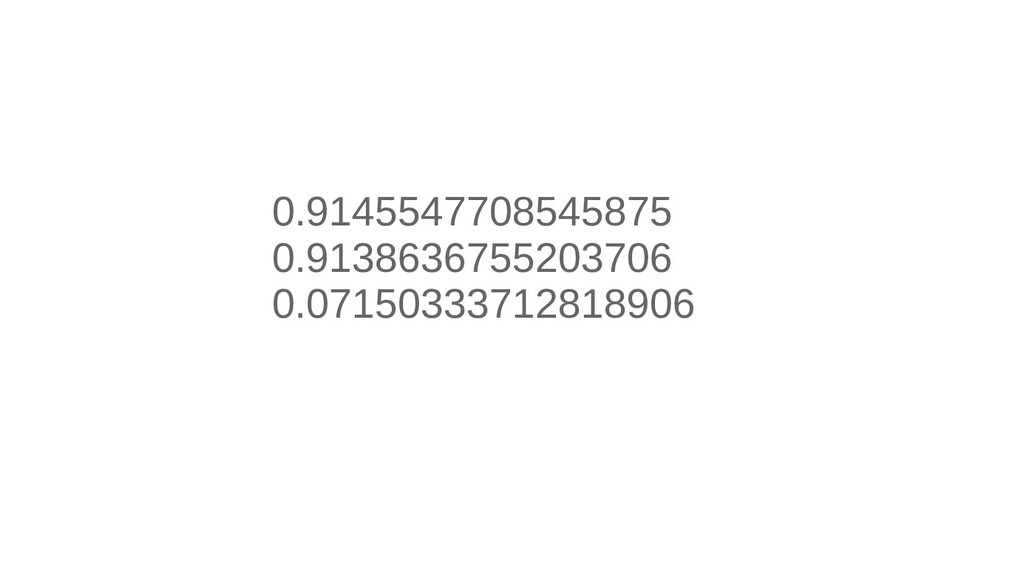
Матрица корреляций: numpy.corrcoef # возьмем правое верхнее значение: print(np.corrcoef([[1,2,3], [1,2,3]])[0][1])
print(np.corrcoef([[1,2,3], [5,7,9]])[0][1]) print(np.corrcoef([[1,2,3,4,5,6], [5,7,9,11,13,15]])[0][1]) print(np.corrcoef([[1,2,3], [1,4,9]])[0][1]) print(np.corrcoef([[1,2,3], [1,8,27]])[0][1]) print(np.corrcoef([[1,2,3], [11,19,0]])[0][1]) 1.0 1.0 1.0 0.989743318610787 0.9662823901213162 -0.5765566601970551 -
Матрица корреляций: numpy.corrcoef # матрица 3x3 print(np.corrcoef([[1,2,3], [1,8,27], [11,19,0]])) [[
1. 0.96628239 -0.57655666] [ 0.96628239 1. -0.76749622] [-0.57655666 -0.76749622 1. ]] -
Матрица корреляций: numpy.corrcoef x=np.linspace(0,100) y=x**3 print(np.corrcoef([x, y])[0][1]) y=x**3-x**2 print(np.corrcoef([x, y])[0][1])
print(np.corrcoef([ np.random.randn(100), np.random.randn(100) ])[0][1]) -
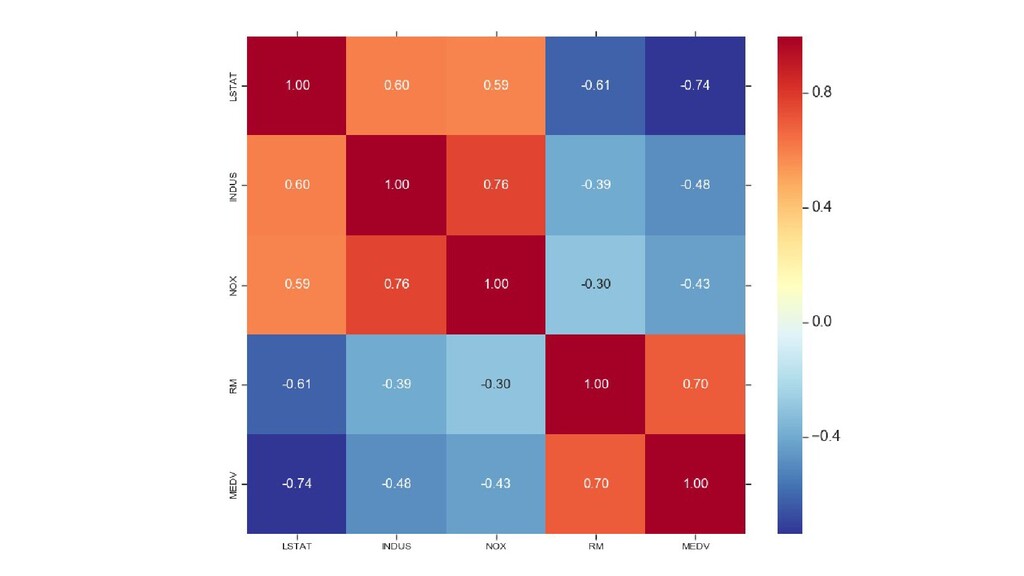
Тепловая карта корреляций • Heatmap — нарисовать 2д-массив чисел в
виде разноцветной матрицы • seaborn.pydata.org/generated/seaborn.heatma p.html -
boston-housing.py cols = ['LSTAT', 'INDUS', 'NOX', 'RM', 'MEDV'] # .T
- транспонировать cm = np.corrcoef(df[cols].to_numpy().T) print(cm) sns.set(font_scale=1.5) sns.heatmap(cm, cmap='RdYlBu_r', cbar=True, annot=True, square=True, fmt='0.2f', annot_kws={'size': 15}, yticklabels=cols, xticklabels=cols) plt.show() -
В консольке [[ 1. 0.60379972 0.59087892 -0.61380827 -0.73766273] [ 0.60379972
1. 0.76365145 -0.39167585 -0.48372516] [ 0.59087892 0.76365145 1. -0.30218819 -0.42732077] [-0.61380827 -0.39167585 -0.30218819 1. 0.69535995] [-0.73766273 -0.48372516 -0.42732077 0.69535995 1. ]] -
• LSTAT: процент населения с более низким статусом • INDUS:
доля акров нерозничного бизнеса в расчете на город • NOX: концентрация окислов азота (частей на 10 млн.) • RM: среднее число комнат в жилом помещении • MEDV: медианная стоимость занимаемых владельцами домов (в тыс долларов) -
Палитра для heatmap:cmap • Подходят палитры из библиотеки matplotlib •
Здесь списка палитр нет: seaborn.pydata.org/tutorial/color_palettes.html seaborn.pydata.org/generated/seaborn.color_palette.html • Здесь есть: matplotlib.org/examples/color/colormaps_reference.html • Или задать некорректное значение в cmap и полный список доступных палитр будет выведен вместе с ошибкой в консоль • Для тепловой карты хорошее значение cmap='RdYlBu_r' (красный- желтый-синий) -
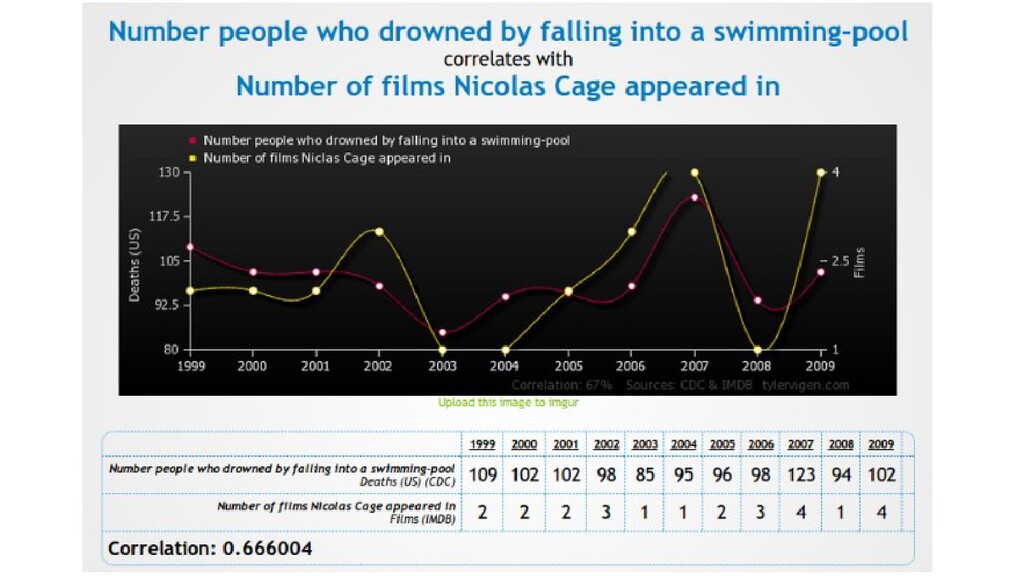
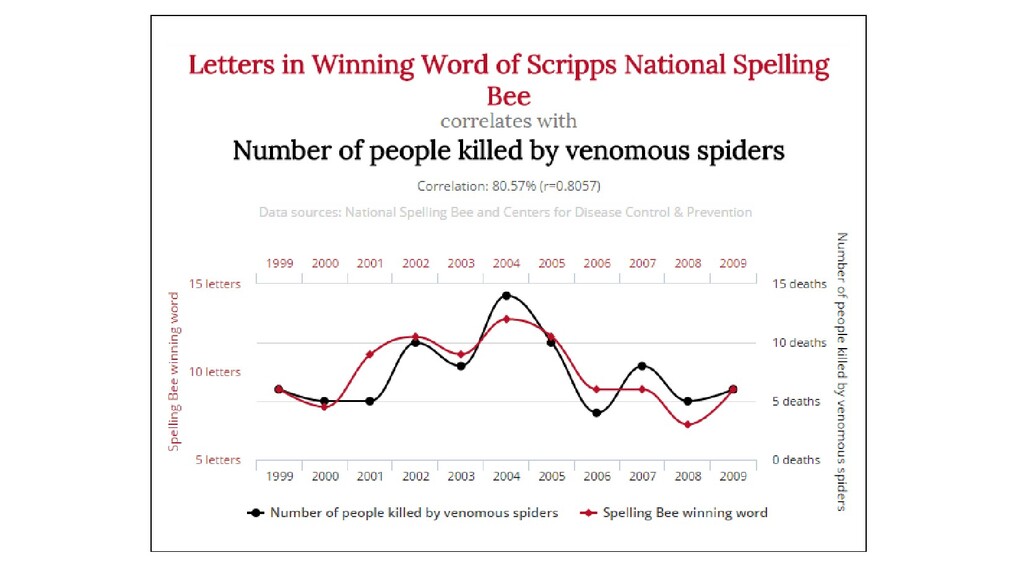
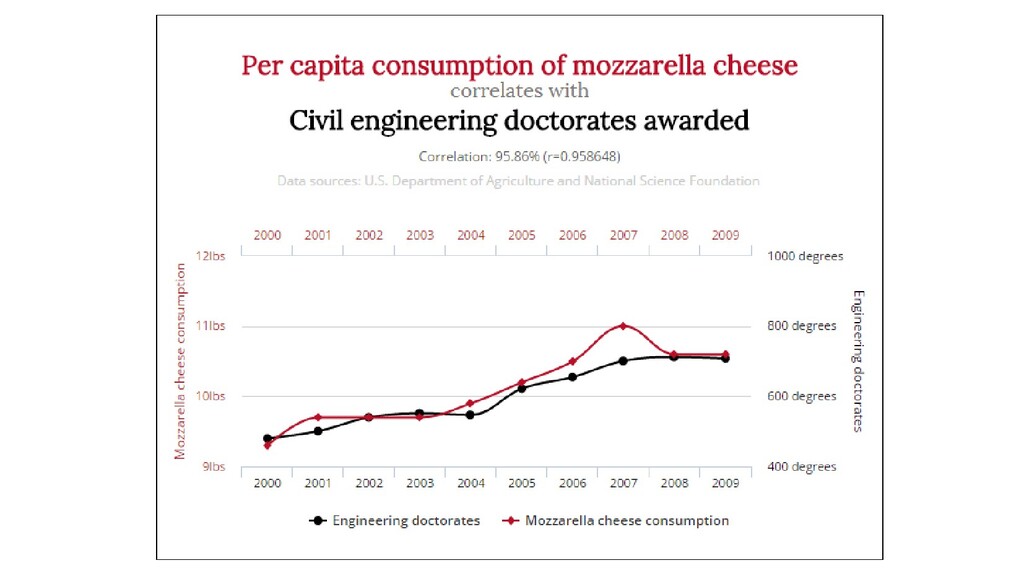
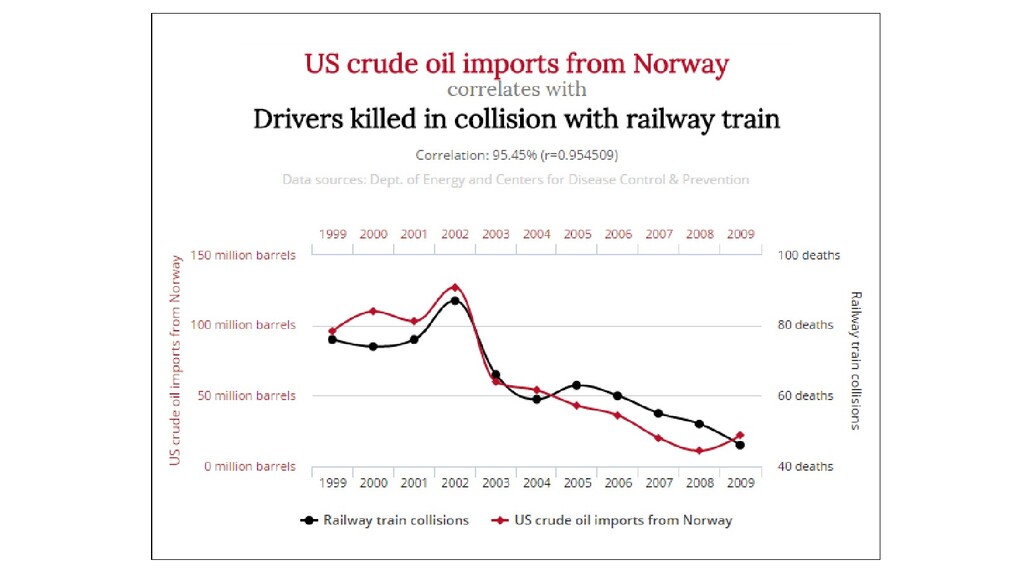
Высокая корреляция != причинно-следственная связь • Обе переменные равноправны в
формуле • На оба события может влиять 3-я причина (любые сезонные явления скорее всего будут коррелировать) • Смотрите на объем собранных данных для каждого элемента и продолжительность наблюдений -
Самостоятельная работа: Николас Кейдж vs бассейны • Найти исходные данные
(источники) • Проверить вычисления, приведенные на графике (фактчек) • Убедиться, что источники содержат актуализированные данные за период времени после 2009 года • Вычислить корреляцию для новых данных (2009-2019) • Построить новый график и вычислить корреляцию для всего периода (1999 — 2019) • еще: www.tylervigen.com/spurious-correlations -
Задание: рынок недвижимости, данные от Сбербанка • kaggle: Sberbank Russian
Housing Market www.kaggle.com/c/sberbank-russian-housing-market/data • Высказать интуитивные гипотезы на основе названий колонок • Провести разведочный анализ датасета: построить графики распределений и отношений переменных, точечные графики, посчитать попарные коэффициенты корреляции, тепловая карта корреляций • Выявить признаки, которые наилучшим образом коррелируют • Построить для них предсказательные модели