Share
Embed
Transcript
29 slides
-
ViT-1.58b: Mobile Vision Transformers in the 1-bit Era d-hacks 2024.11.7
論文輪読 B2 aokiti https://arxiv.org/abs/2406.18051 1 -
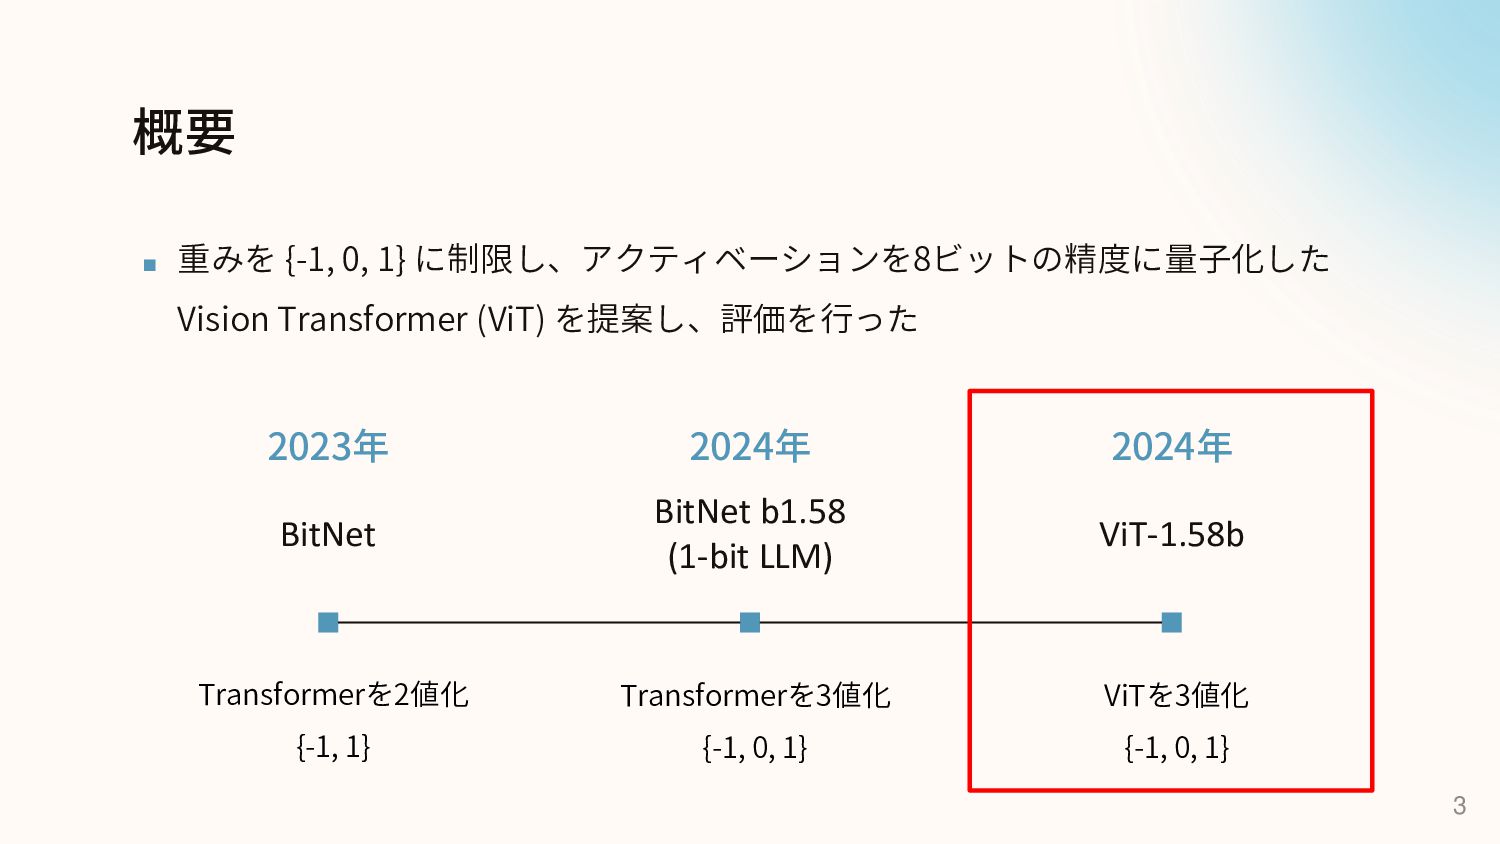
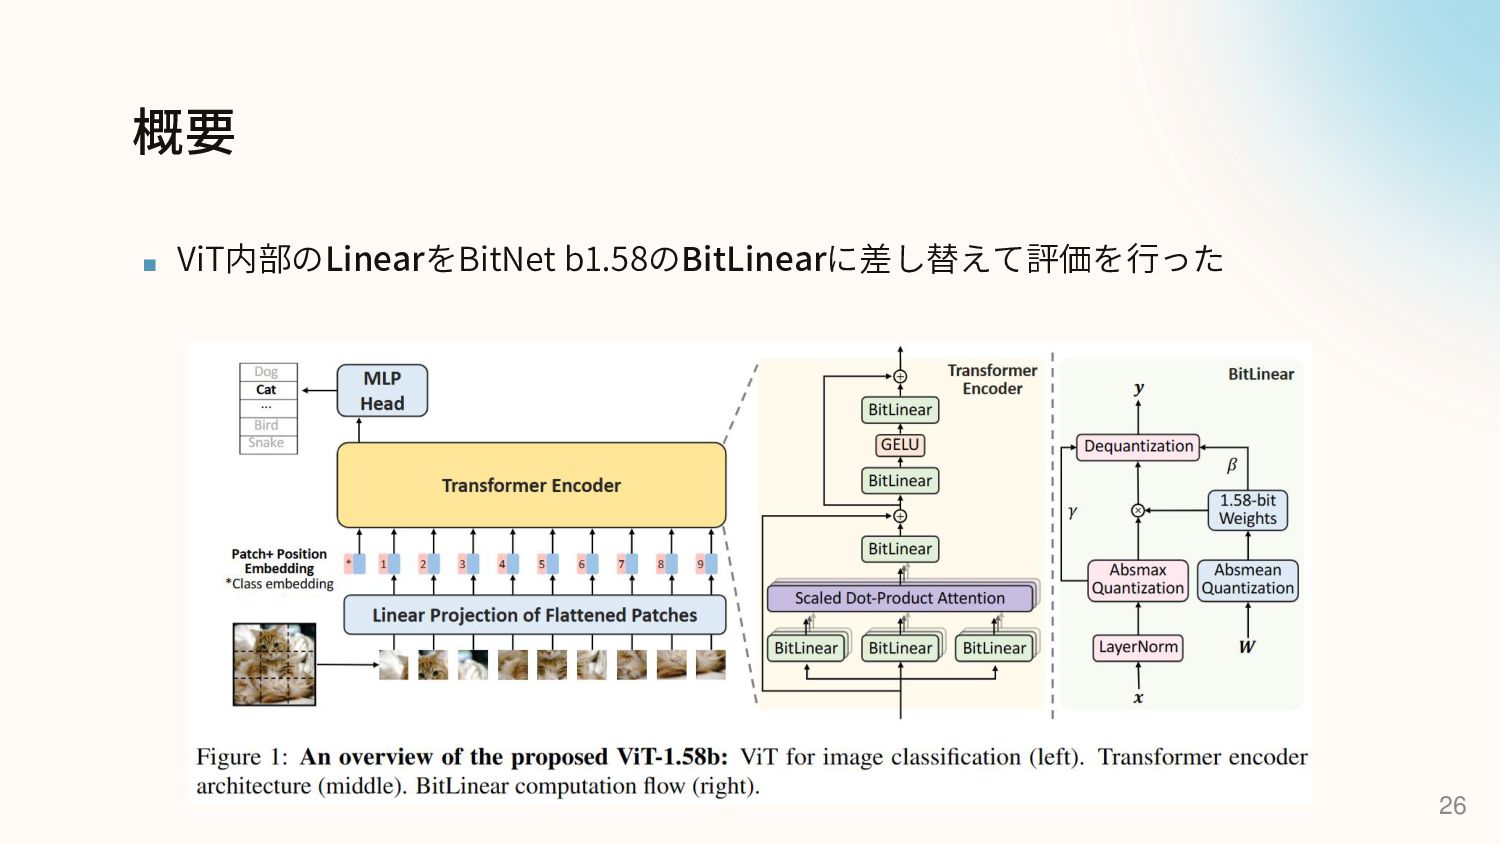
概要 ▪ 重みを {-1, 0, 1} に制限し、アクティベーションを8ビットの精度に量子化した Vision Transformer (ViT)
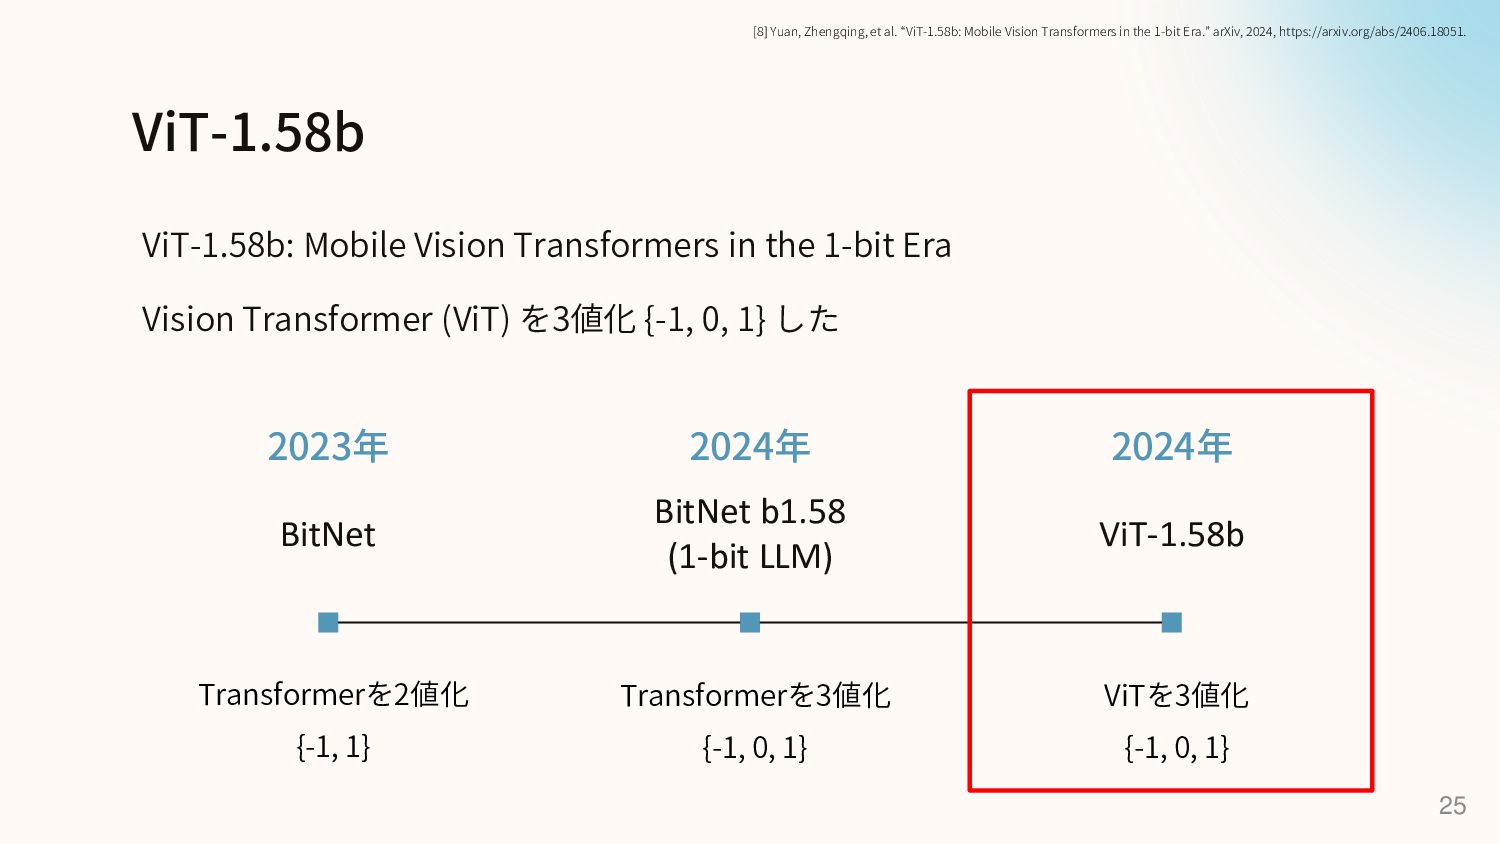
を提案し、評価を行った 3 2023年 BitNet 2024年 BitNet b1.58 (1-bit LLM) 2024年 ViT-1.58b Transformerを2値化 {-1, 1} Transformerを3値化 {-1, 0, 1} ViTを3値化 {-1, 0, 1} -
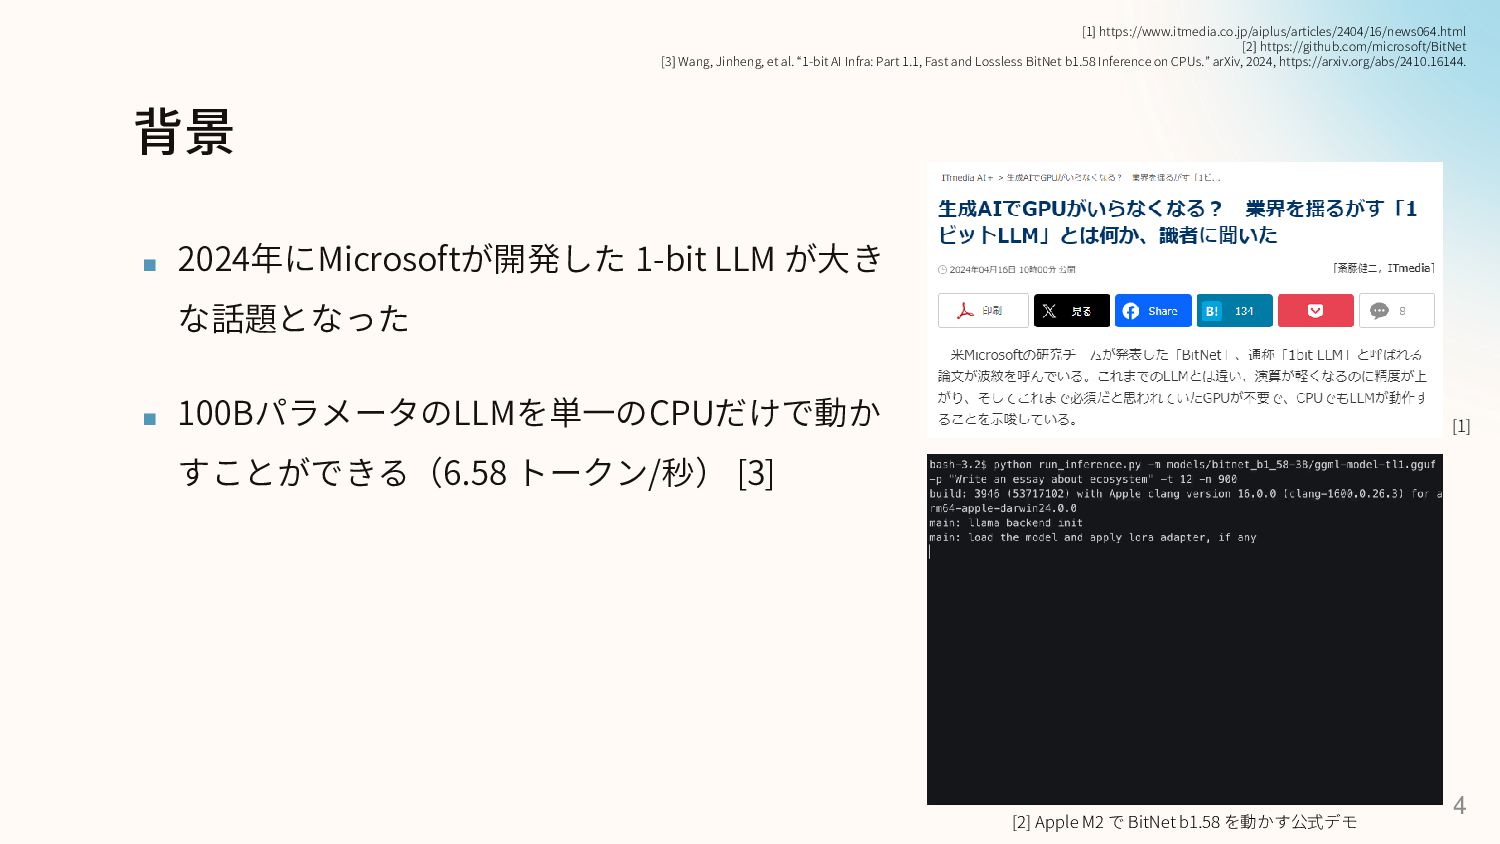
背景 ▪ 2024年にMicrosoftが開発した 1-bit LLM が大き な話題となった ▪ 100BパラメータのLLMを単一のCPUだけで動か すことができる(6.58
トークン/秒) [3] 4 [1] [2] Apple M2 で BitNet b1.58 を動かす公式デモ [1] https://www.itmedia.co.jp/aiplus/articles/2404/16/news064.html [2] https://github.com/microsoft/BitNet [3] Wang, Jinheng, et al. “1-bit AI Infra: Part 1.1, Fast and Lossless BitNet b1.58 Inference on CPUs.” arXiv, 2024, https://arxiv.org/abs/2410.16144. -
用語: Vision Transformer (ViT) [4] 5 1. 画像をパッチに分け、各パッチを単語 (トークン) とみなして入力する
2. TransformerのEncoderで処理 ※1 3. MLP Headによって最終的な予測値や分 類クラスに変換する [4] Dosovitskiy, Alexey, et al. “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale.” International Conference on Learning Representations, 2021, https://openreview.net/forum?id=YicbFdNTTy. ① ② ③ Transformerを画像認識タスクに適用したモデル ※1 オリジナルのEncoderとほぼ同じ。ただし、Pre-Normと活性化関数のGELUに変更している -
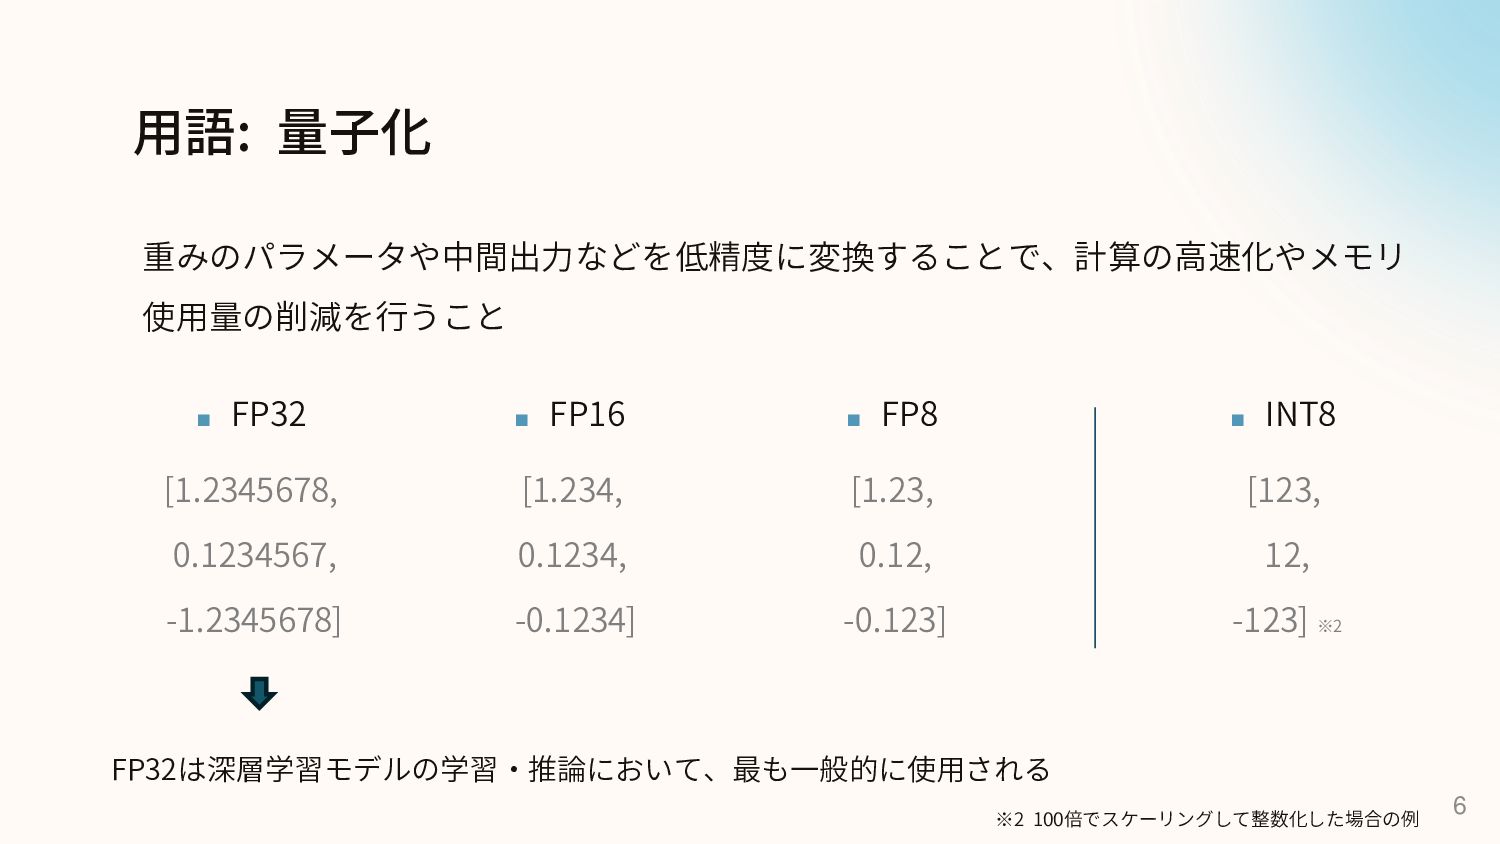
用語: 量子化 6 ▪ FP32 ▪ FP16 ▪ INT8 ▪
FP8 FP32は深層学習モデルの学習・推論において、最も一般的に使用される [1.2345678, 0.1234567, -1.2345678] [1.234, 0.1234, -0.1234] [1.23, 0.12, -0.123] [123, 12, -123] ※2 ※2 100倍でスケーリングして整数化した場合の例 重みのパラメータや中間出力などを低精度に変換することで、計算の高速化やメモリ 使用量の削減を行うこと -
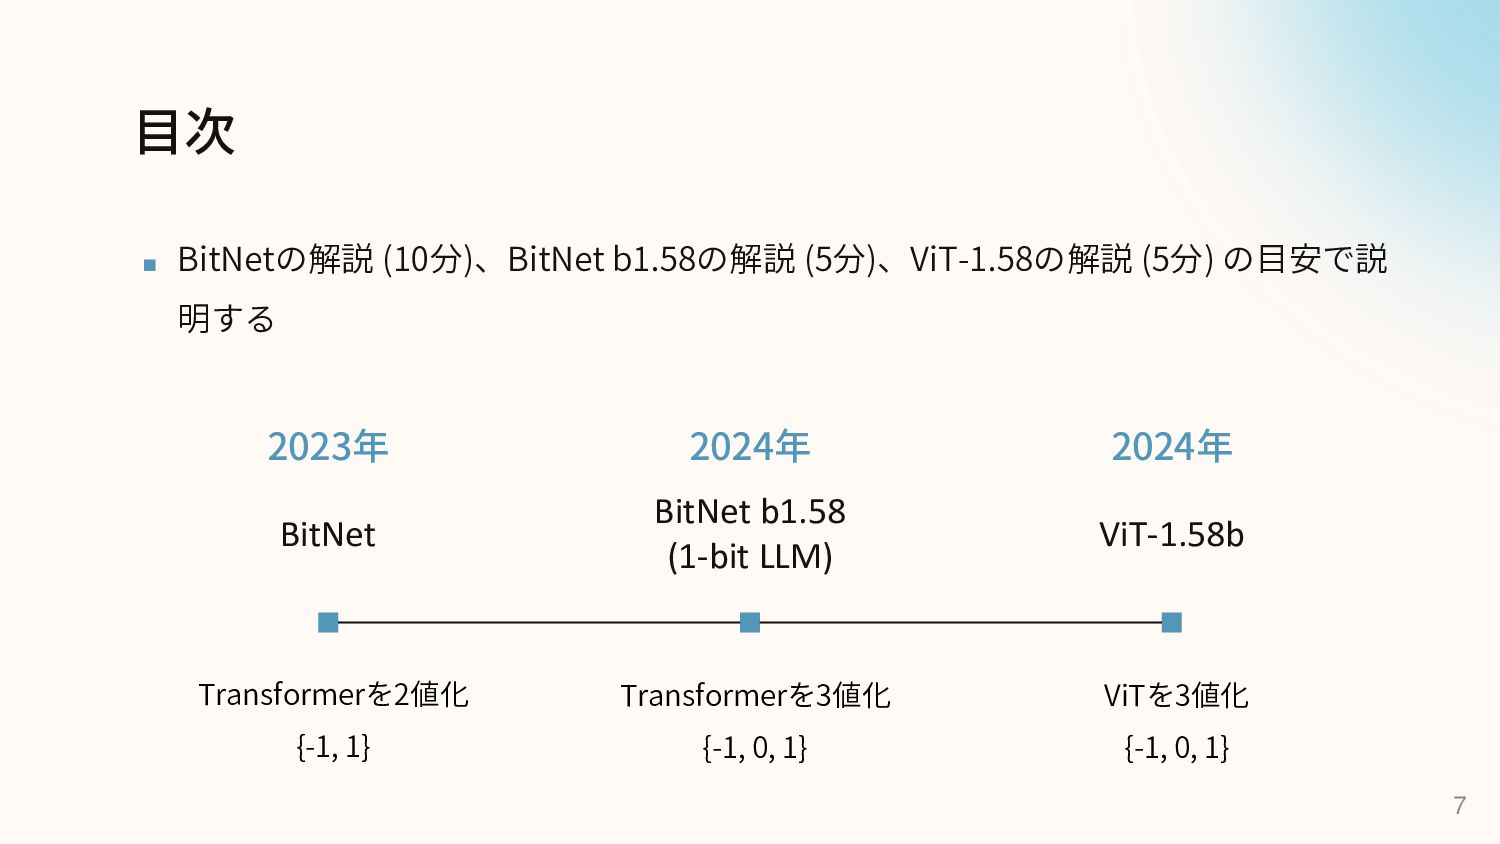
目次 ▪ BitNetの解説 (10分)、BitNet b1.58の解説 (5分)、ViT-1.58の解説 (5分) の目安で説 明する 7
2023年 BitNet 2024年 BitNet b1.58 (1-bit LLM) 2024年 ViT-1.58b Transformerを2値化 {-1, 1} Transformerを3値化 {-1, 0, 1} ViTを3値化 {-1, 0, 1} -
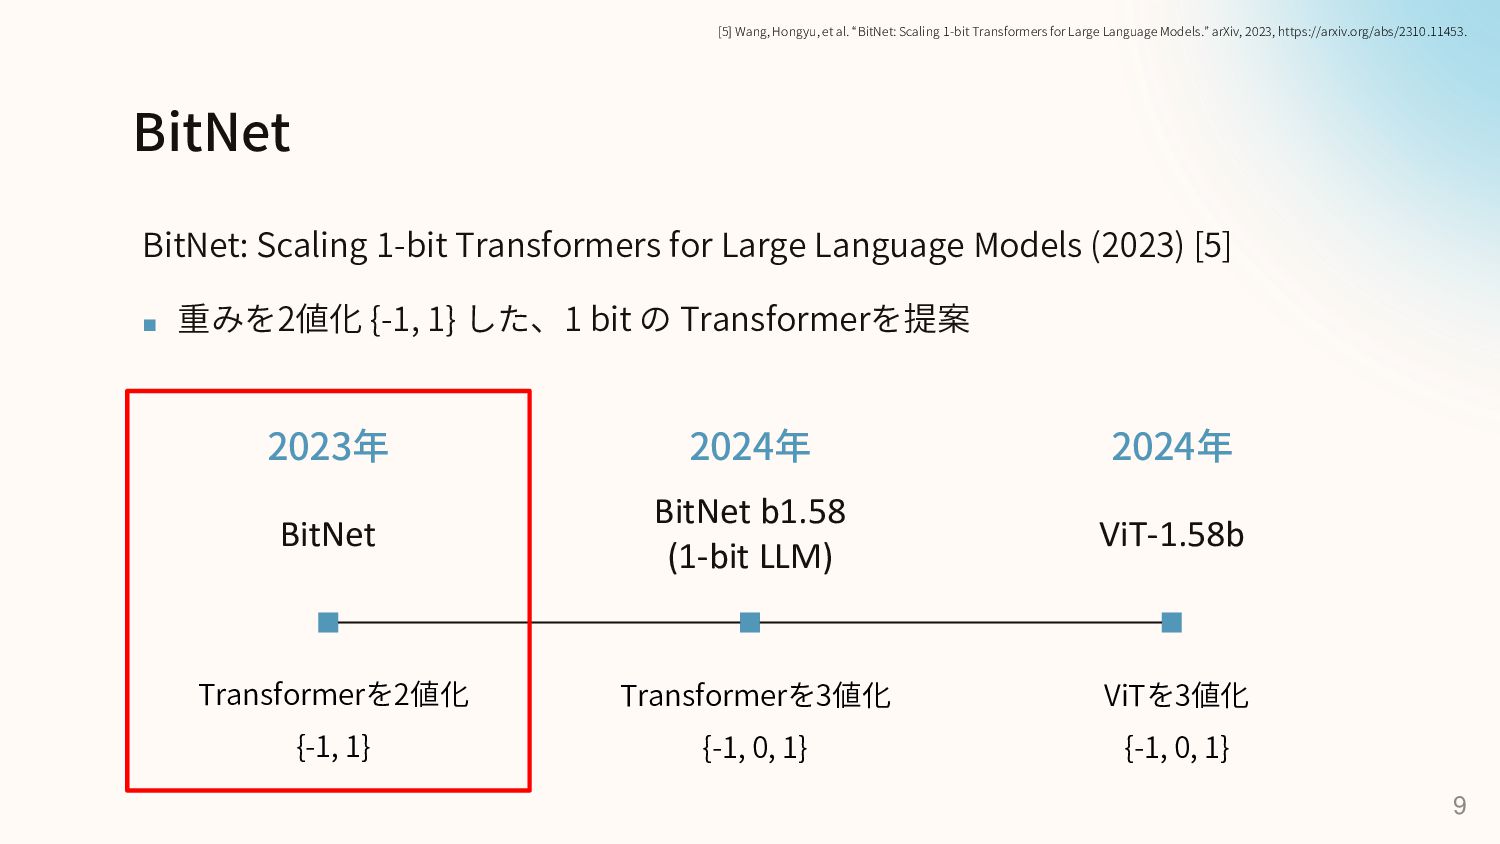
BitNet 9 BitNet: Scaling 1-bit Transformers for Large Language Models
(2023) [5] ▪ 重みを2値化 {-1, 1} した、1 bit の Transformerを提案 [5] Wang, Hongyu, et al. “BitNet: Scaling 1-bit Transformers for Large Language Models.” arXiv, 2023, https://arxiv.org/abs/2310.11453. 2023年 BitNet 2024年 BitNet b1.58 (1-bit LLM) 2024年 ViT-1.58b Transformerを2値化 {-1, 1} Transformerを3値化 {-1, 0, 1} ViTを3値化 {-1, 0, 1} -
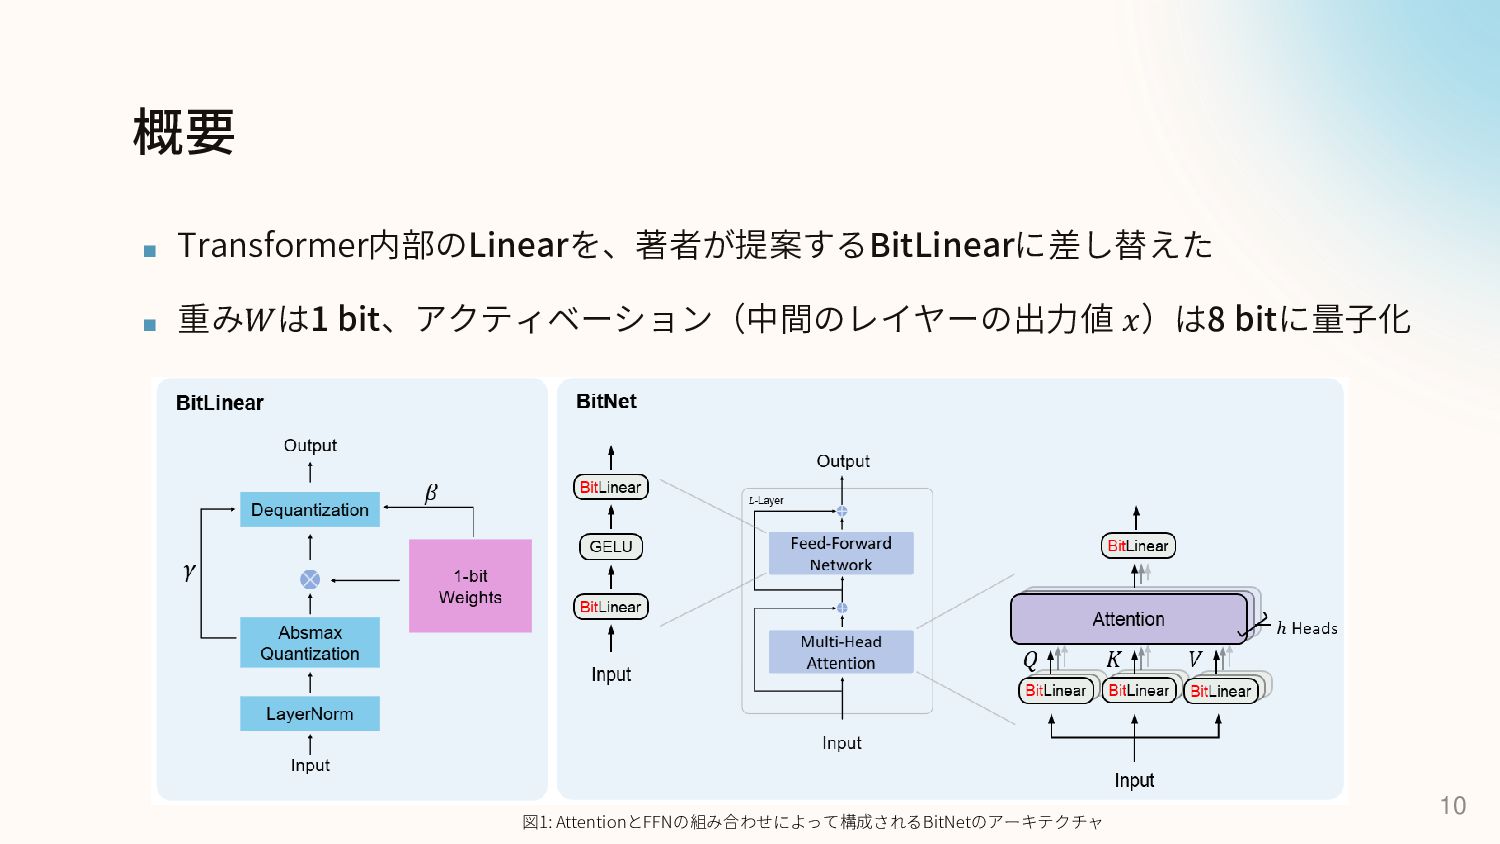
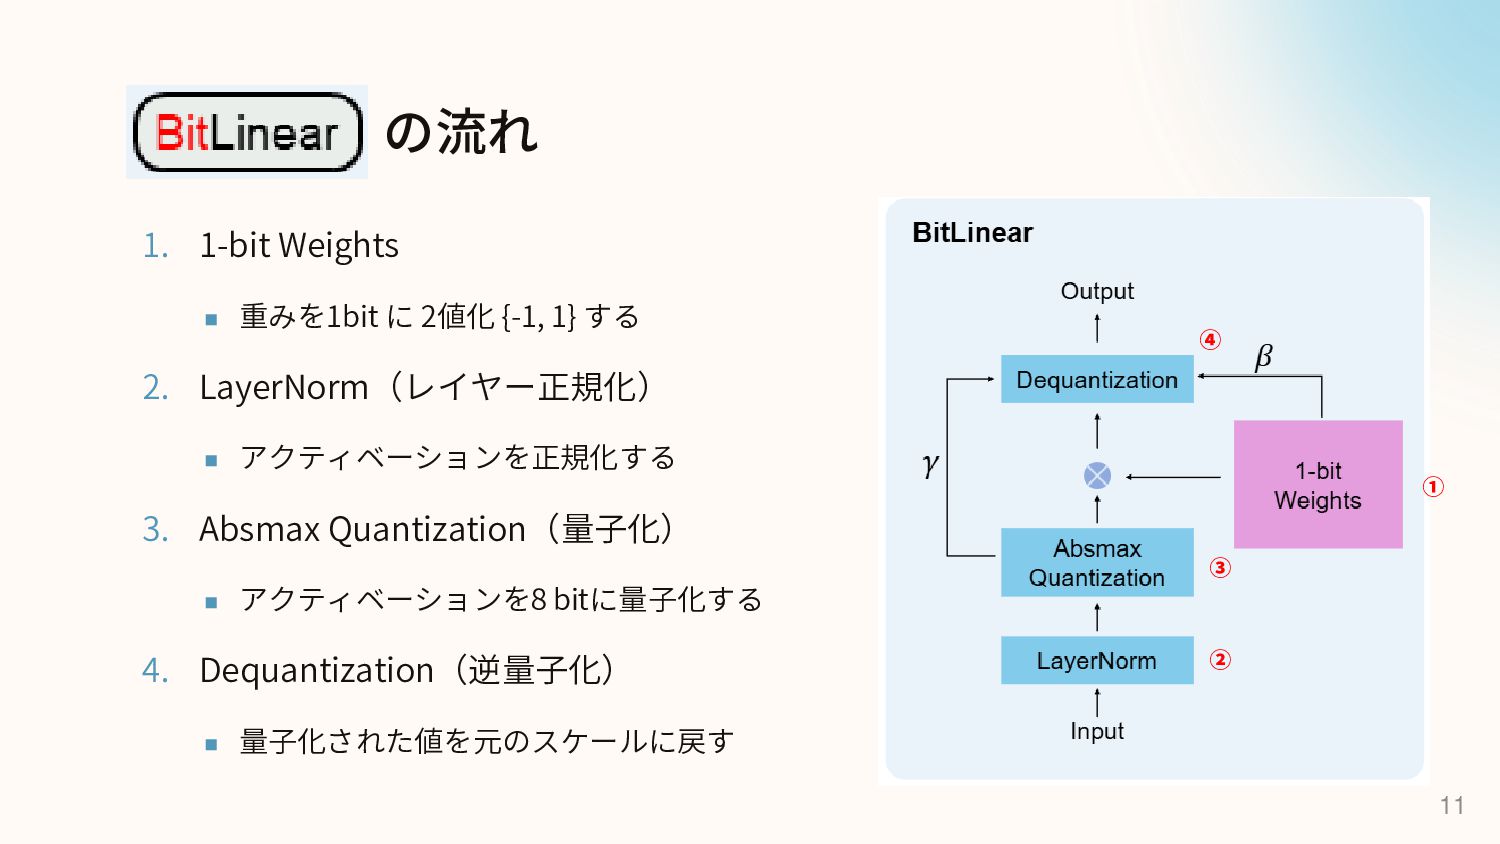
概要 10 ▪ Transformer内部のLinearを、著者が提案するBitLinearに差し替えた ▪ 重み𝑊は1 bit、アクティベーション(中間のレイヤーの出力値 𝑥)は8 bitに量子化 図1:
AttentionとFFNの組み合わせによって構成されるBitNetのアーキテクチャ -
BitLinear の流れ 11 1. 1-bit Weights ◼ 重みを1bit に 2値化
{-1, 1} する 2. LayerNorm(レイヤー正規化) ◼ アクティベーションを正規化する 3. Absmax Quantization(量子化) ◼ アクティベーションを8 bitに量子化する 4. Dequantization(逆量子化) ◼ 量子化された値を元のスケールに戻す ② ③ ① ④ -
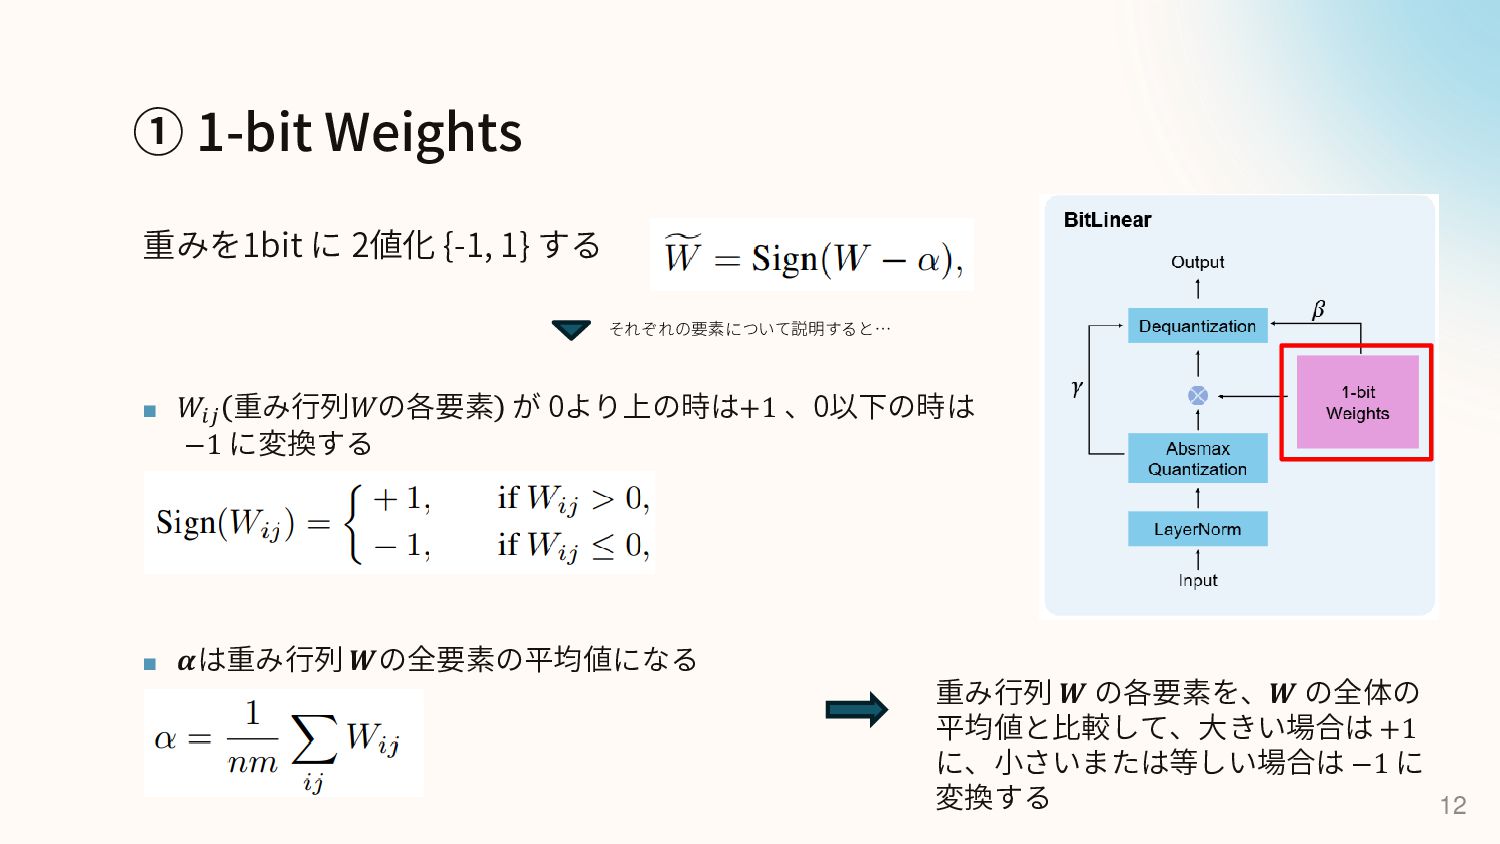
① 1-bit Weights 12 重みを1bit に 2値化 {-1, 1} する
▪ 𝑊𝑖𝑗 重み行列𝑊の各要素 が 0より上の時は+1 、0以下の時は −1 に変換する ▪ 𝜶は重み行列 𝑾の全要素の平均値になる 重み行列 𝑾 の各要素を、𝑾 の全体の 平均値と比較して、大きい場合は +1 に、小さいまたは等しい場合は −1 に 変換する それぞれの要素について説明すると… -
② LayerNorm(レイヤー正規化) 13 [6] Wang, Hongyu, et al. “Magneto: A
Foundation Transformer.” Proceedings of the 40th International Conference on Machine Learning, 2023, pp. 36077–36092, https://proceedings.mlr.press/v202/wang23u.html. アクティベーションを正規化する ◼ FP32の計算では、重みの初期化によって出力の分散が1 になる → 学習が安定する ◼ 8 bitに量子化するとこれが使えないため、アクティベー ション前に SubLN[6] によるレイヤー正規化を行う -
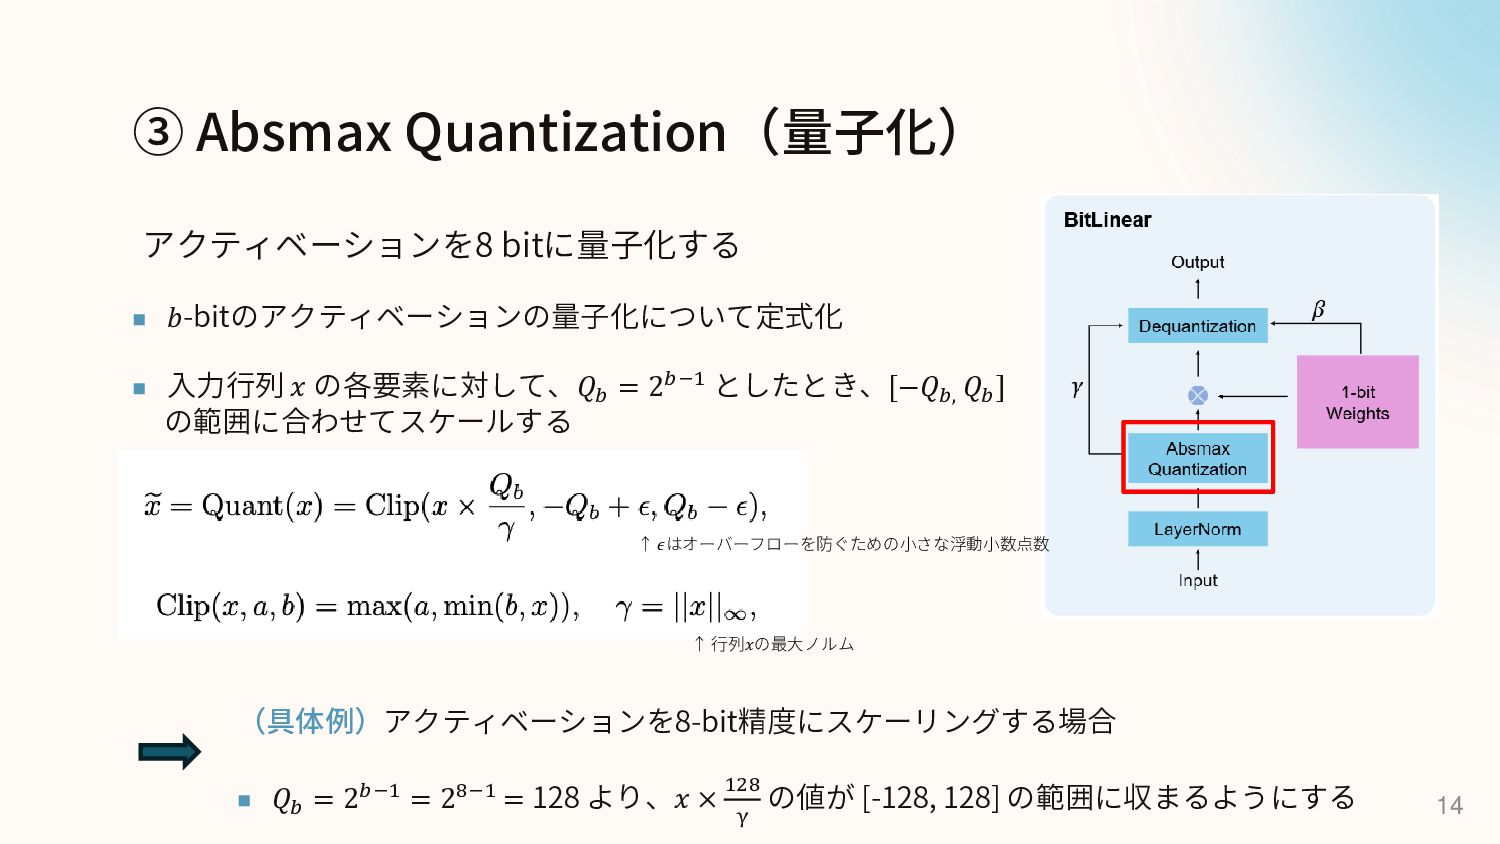
③ Absmax Quantization(量子化) 14 アクティベーションを8 bitに量子化する ◼ 𝑏-bitのアクティベーションの量子化について定式化 ◼ 入力行列
𝑥 の各要素に対して、𝑄𝑏 = 2𝑏−1 としたとき、[−𝑄𝑏, 𝑄𝑏 ] の範囲に合わせてスケールする (具体例)アクティベーションを8-bit精度にスケーリングする場合 ◼ 𝑄𝑏 = 2𝑏−1 = 28−1 = 128 より、𝑥 × 128 γ の値が [-128, 128] の範囲に収まるようにする ↑ 𝜖はオーバーフローを防ぐための小さな浮動小数点数 ↑ 行列𝑥の最大ノルム -
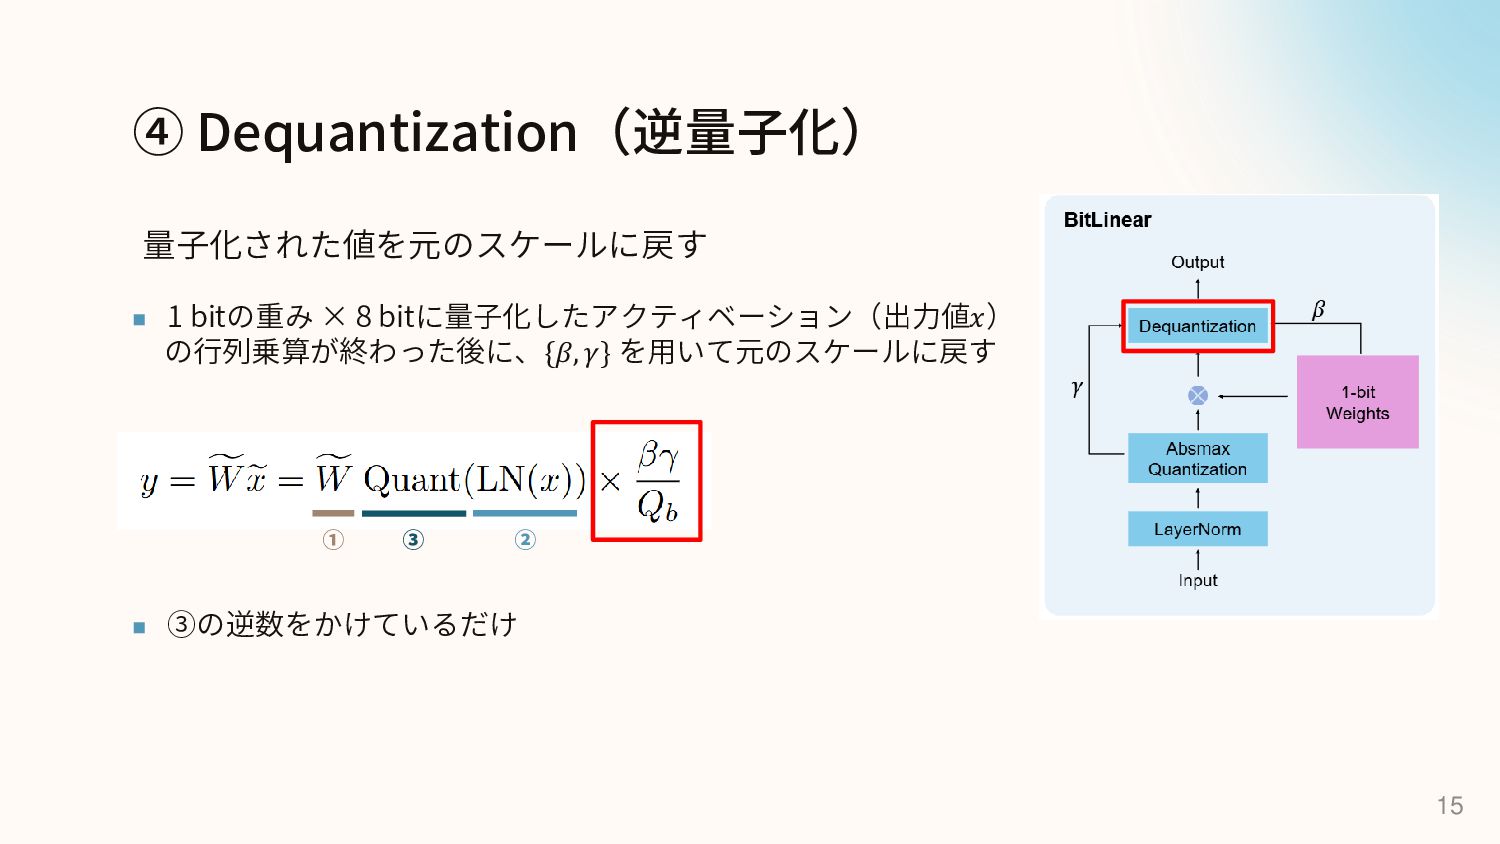
④ Dequantization(逆量子化) 15 量子化された値を元のスケールに戻す ◼ 1 bitの重み × 8 bitに量子化したアクティベーション(出力値𝑥)
の行列乗算が終わった後に、{𝛽, 𝛾} を用いて元のスケールに戻す ◼ ③の逆数をかけているだけ ② ③ ① -
その他の工夫 16 ▪ 1 bitモデルはそのままだと学習できないため、Straight-through estimator (STE) を用いて誤差 逆伝播法を近似する ▪
微分不可能な関数の影響を受けることなく勾配を近似できる ▪ (詳しくは7/4の論文輪読で取り上げたBNNスライドを参照) ▪ https://speakerdeck.com/sakusaku3939/lun-wen-lun-du-binarized-neural-networks?slide=8 ▪ 混合精度 (Mixed Precision) を用いた学習を行い、勾配と最適化状態は高精度で保存しておく ▪ グループ量子化と正規化によるモデルの並列化 ▪ 1 bitだと重みにほとんど違いが生じないため、学習率を大きくしておく -
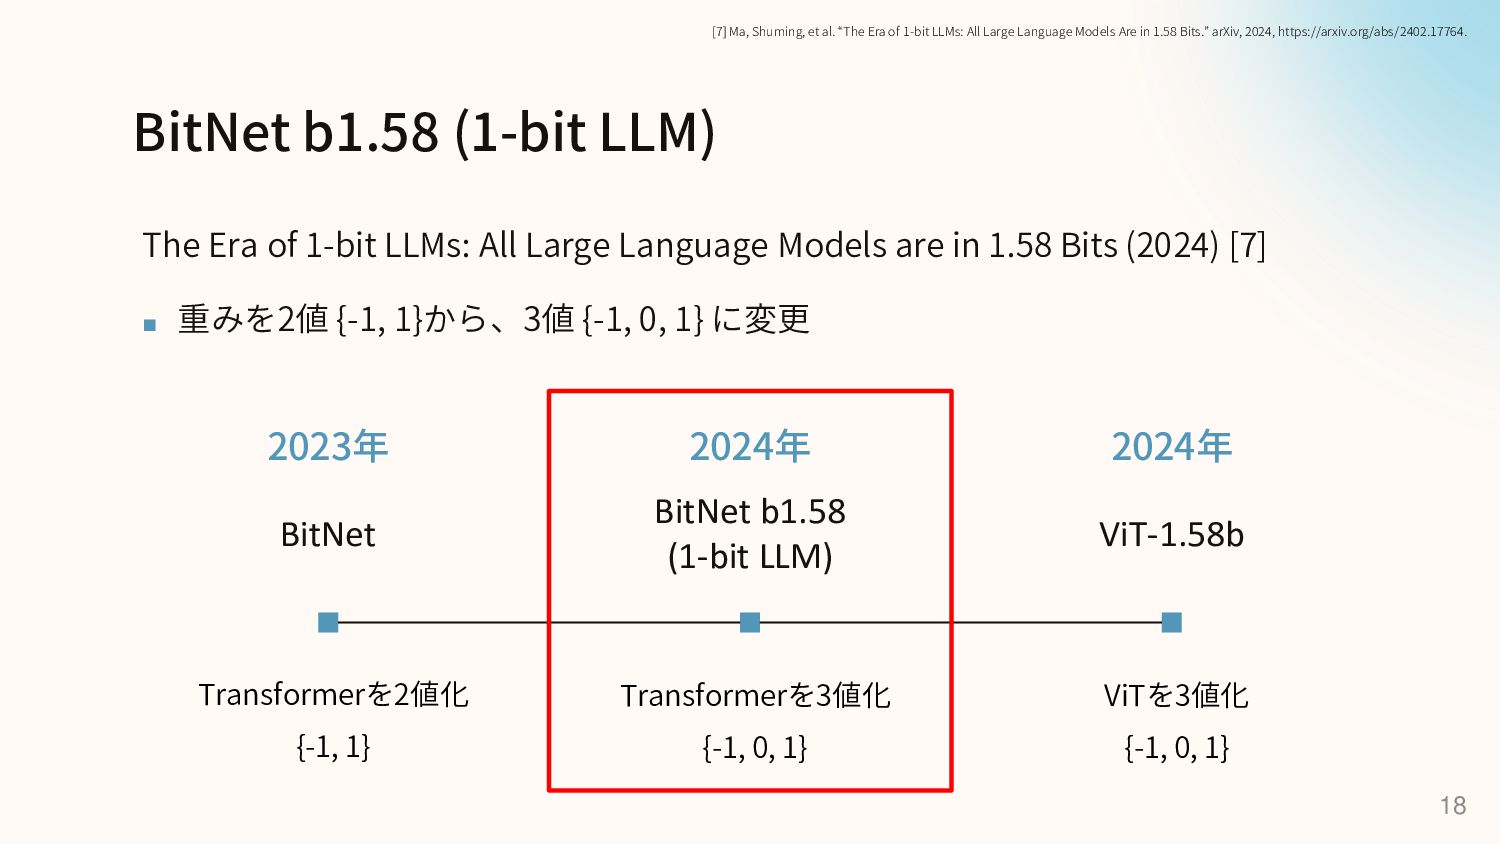
BitNet b1.58 (1-bit LLM) 18 The Era of 1-bit LLMs:
All Large Language Models are in 1.58 Bits (2024) [7] ▪ 重みを2値 {-1, 1}から、3値 {-1, 0, 1} に変更 [7] Ma, Shuming, et al. “The Era of 1-bit LLMs: All Large Language Models Are in 1.58 Bits.” arXiv, 2024, https://arxiv.org/abs/2402.17764. 2023年 BitNet 2024年 BitNet b1.58 (1-bit LLM) 2024年 ViT-1.58b Transformerを2値化 {-1, 1} Transformerを3値化 {-1, 0, 1} ViTを3値化 {-1, 0, 1} -
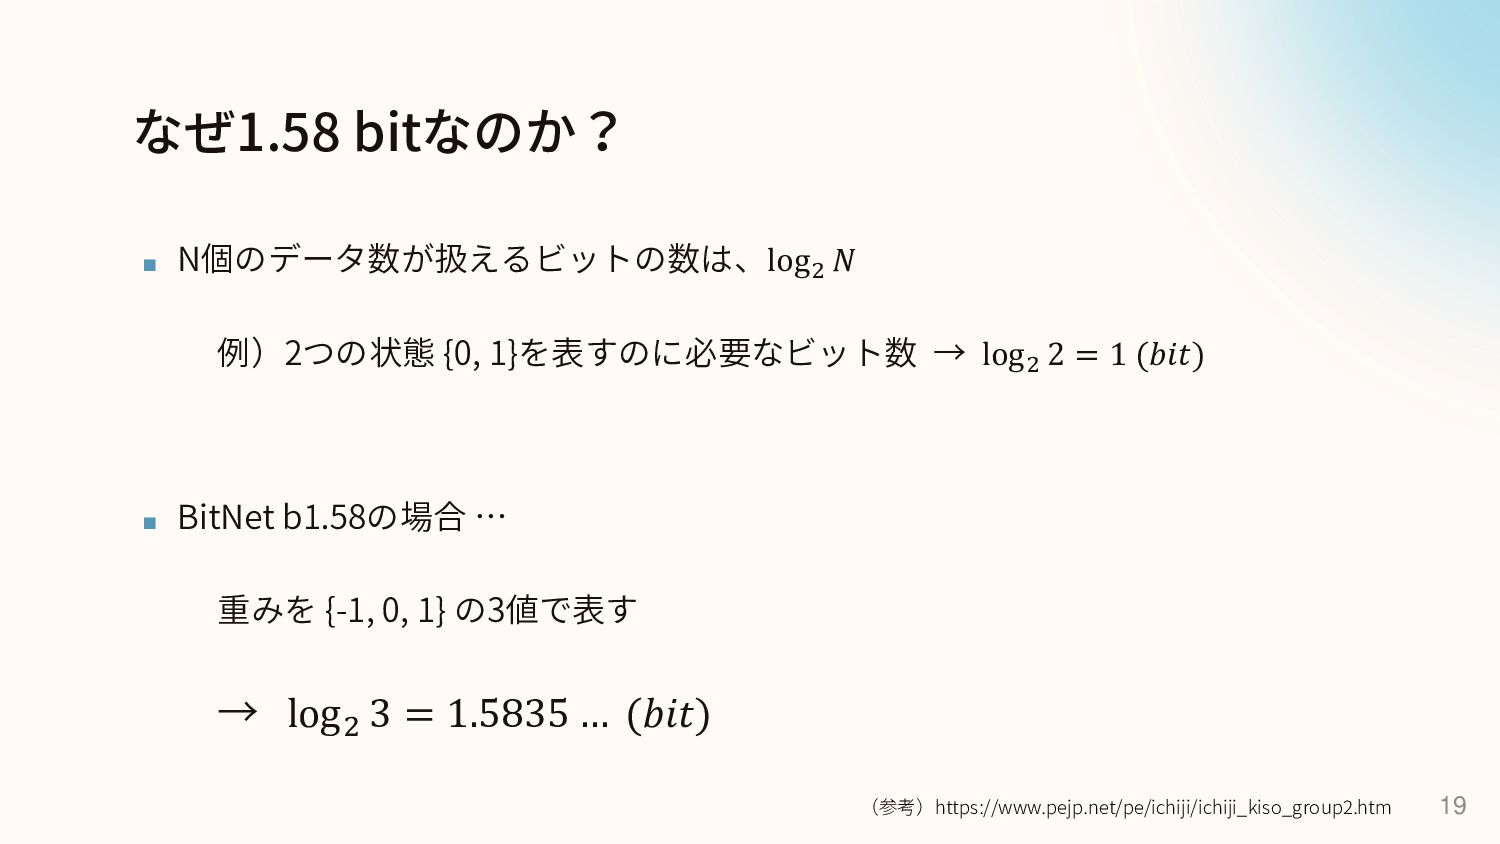
なぜ1.58 bitなのか? 19 ▪ N個のデータ数が扱えるビットの数は、log2 𝑁 例)2つの状態 {0, 1}を表すのに必要なビット数 →
log2 2 = 1 (𝑏𝑖𝑡) ▪ BitNet b1.58の場合 … 重みを {-1, 0, 1} の3値で表す → log2 3 = 1.5835 … (𝑏𝑖𝑡) (参考)https://www.pejp.net/pe/ichiji/ichiji_kiso_group2.htm -
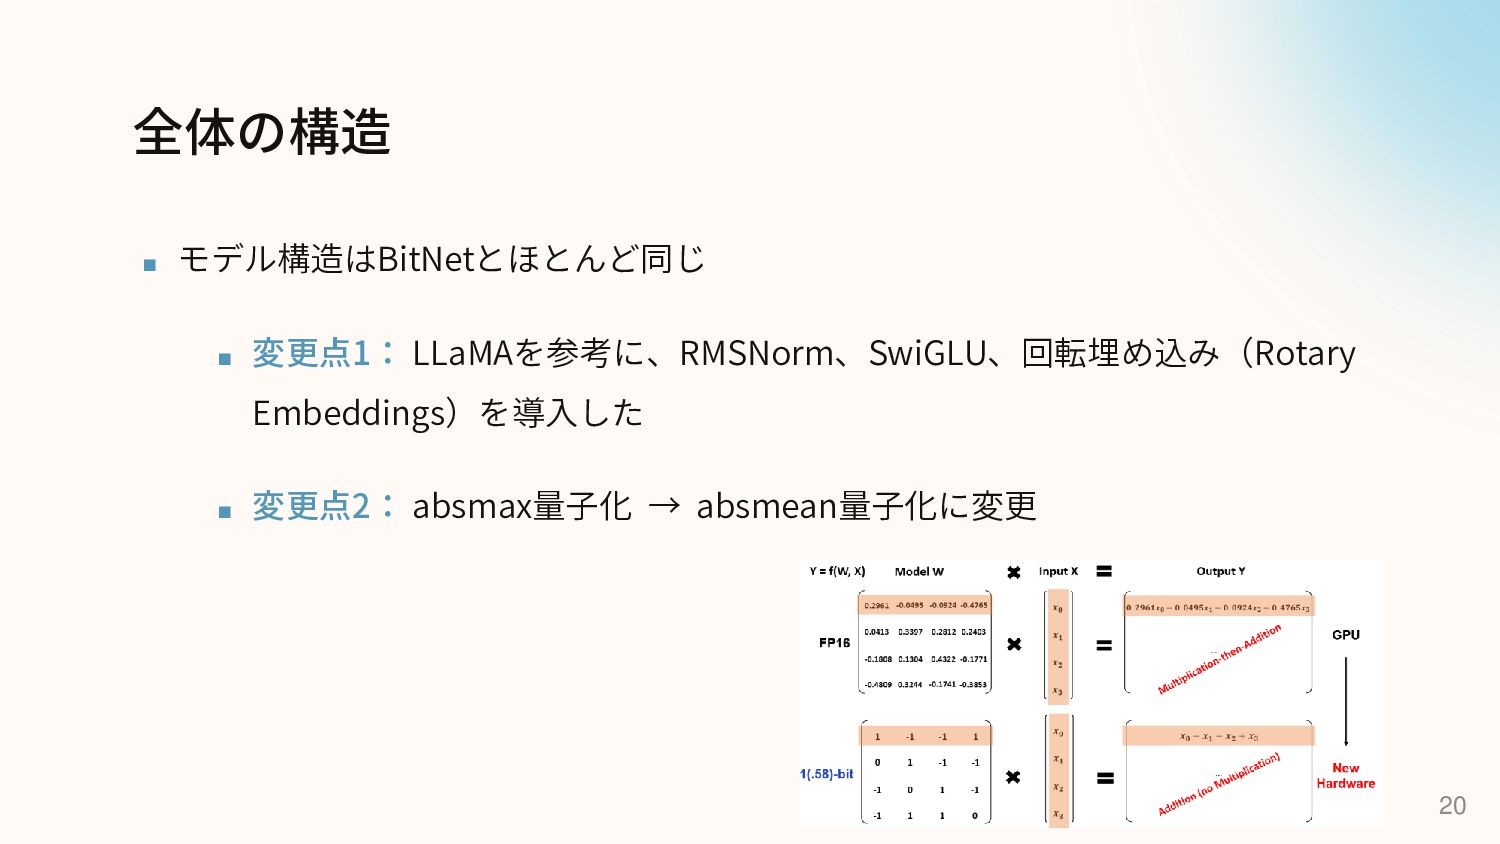
全体の構造 20 ▪ モデル構造はBitNetとほとんど同じ ▪ 変更点1: LLaMAを参考に、RMSNorm、SwiGLU、回転埋め込み(Rotary Embeddings)を導入した ▪ 変更点2:
absmax量子化 → absmean量子化に変更 -
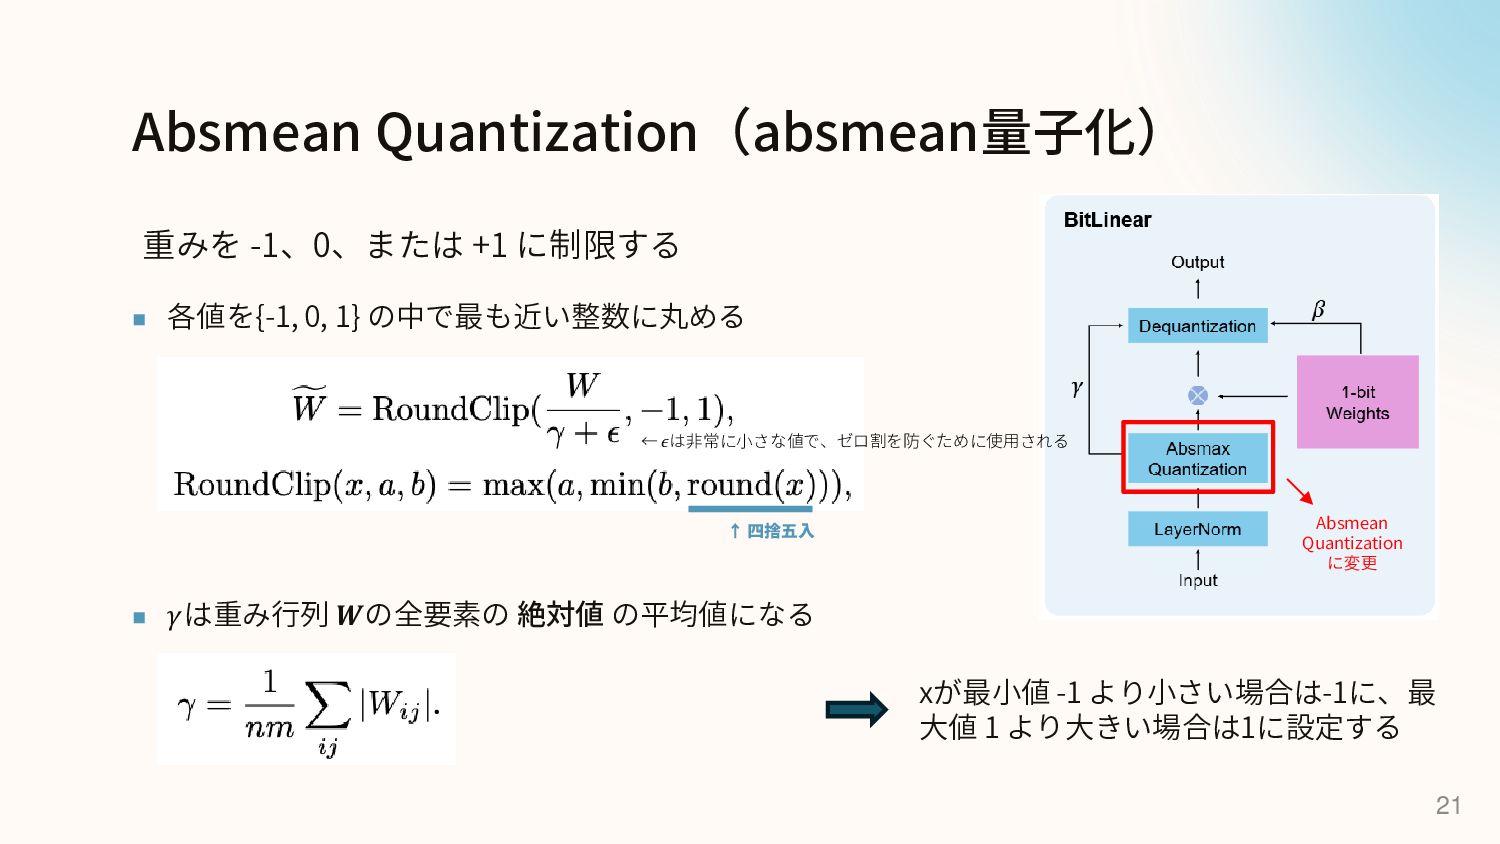
Absmean Quantization(absmean量子化) 21 重みを -1、0、または +1 に制限する ◼ 各値を{-1, 0,
1} の中で最も近い整数に丸める ◼ 𝛾は重み行列 𝑾の全要素の 絶対値 の平均値になる Absmean Quantization に変更 xが最小値 -1 より小さい場合は-1に、最 大値 1 より大きい場合は1に設定する ← 𝜖は非常に小さな値で、ゼロ割を防ぐために使用される ↑ 四捨五入 -
その他 23 ▪ 2週間前の技術レポート論文より、100BパラメータのLLMを単一のCPU(Apple M2) だけで動かすことができる(6.58 トークン/秒) [3] ▪ Intel
i7-13700Hでは、100Bを1.70 トークン/秒で動かせた [3] Wang, Jinheng, et al. “1-bit AI Infra: Part 1.1, Fast and Lossless BitNet b1.58 Inference on CPUs.” arXiv, 2024, https://arxiv.org/abs/2410.16144. [2] Apple M2 で BitNet b1.58 を動かす公式デモ -
ViT-1.58b 25 ViT-1.58b: Mobile Vision Transformers in the 1-bit Era
Vision Transformer (ViT) を3値化 {-1, 0, 1} した [8] Yuan, Zhengqing, et al. “ViT-1.58b: Mobile Vision Transformers in the 1-bit Era.” arXiv, 2024, https://arxiv.org/abs/2406.18051. 2023年 BitNet 2024年 BitNet b1.58 (1-bit LLM) 2024年 ViT-1.58b Transformerを2値化 {-1, 1} Transformerを3値化 {-1, 0, 1} ViTを3値化 {-1, 0, 1} -
実験 27 ▪ CIFAR-10、ImageNet-1kの2つのデータセットで評価 ▪ 通常の32 bitのViT-L(ViT-Large)と16 bit、8 bit、4 bitに量子化したViT-Lでそれ
ぞれ比較した ▪ GPU環境は80GBのVRAMを持つ NVIDIA TESLA A100 × 4 -
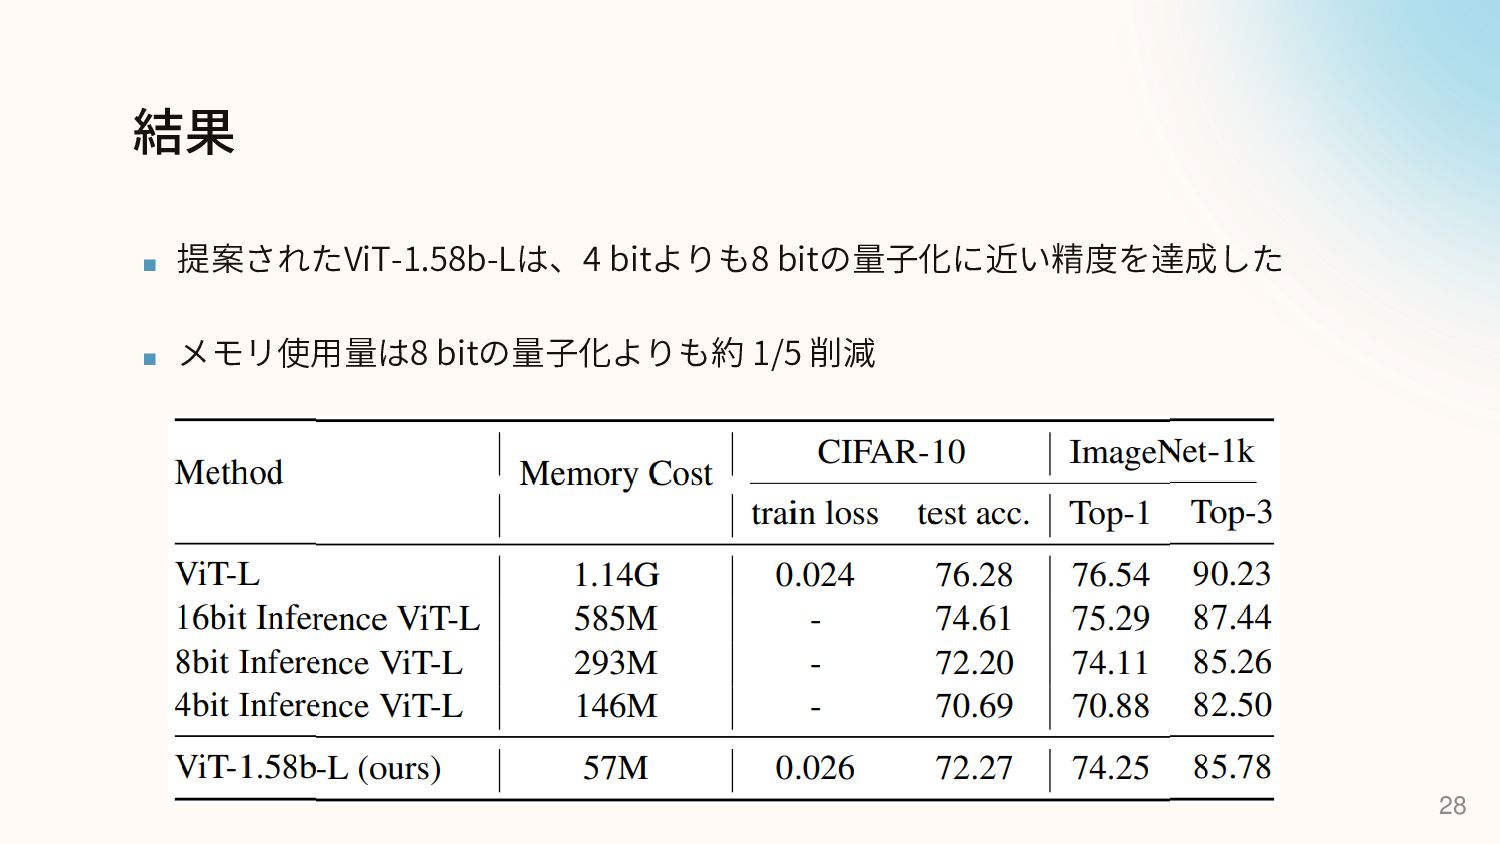
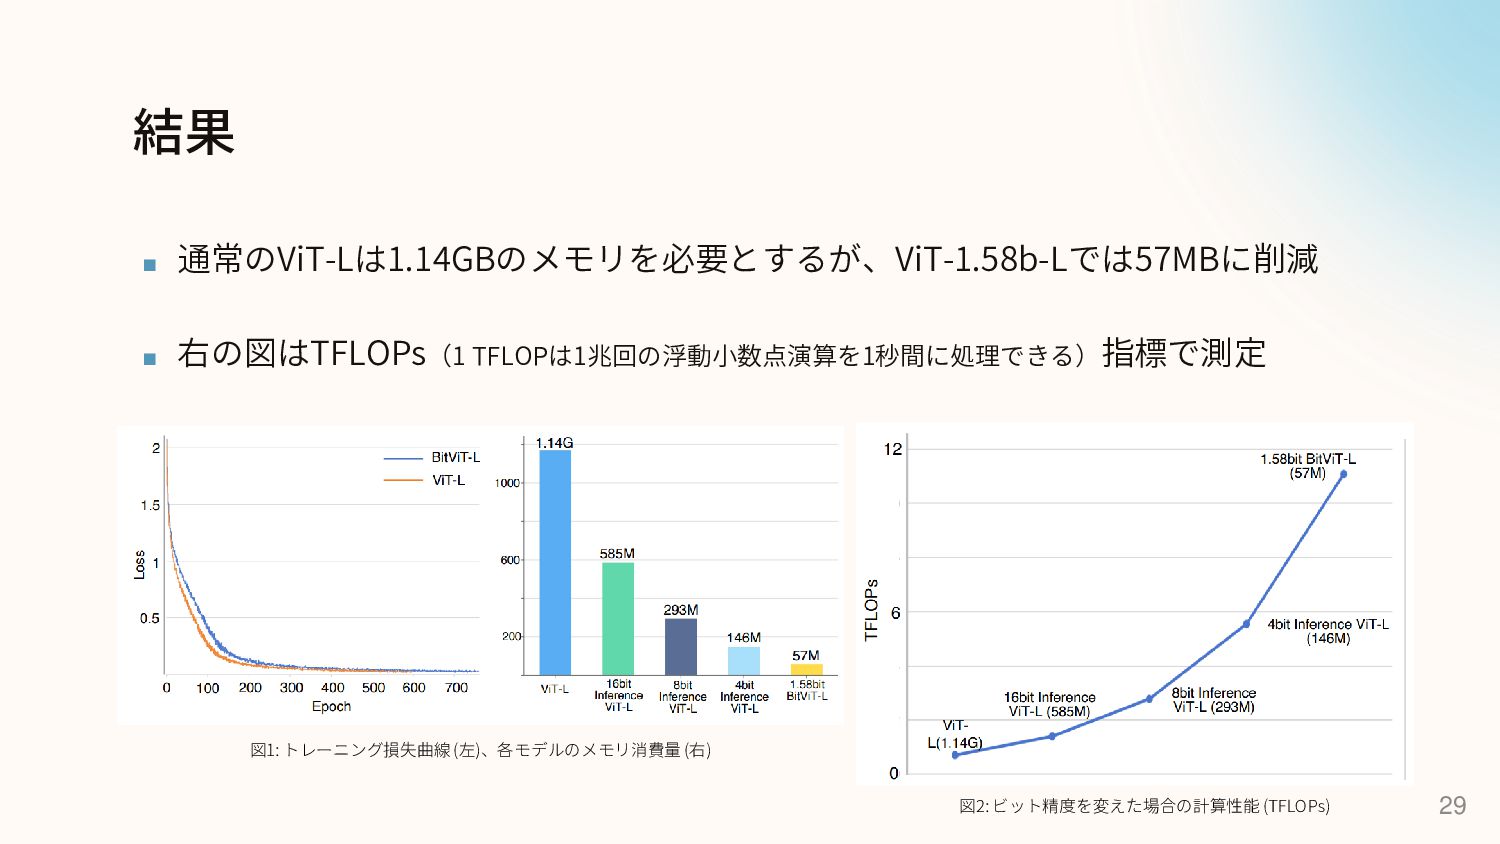
結果 29 ▪ 通常のViT-Lは1.14GBのメモリを必要とするが、ViT-1.58b-Lでは57MBに削減 ▪ 右の図はTFLOPs(1 TFLOPは1兆回の浮動小数点演算を1秒間に処理できる)指標で測定 図1: トレーニング損失曲線 (左)、各モデルのメモリ消費量
(右) 図2: ビット精度を変えた場合の計算性能 (TFLOPs) -
所感 30 ▪ そこまで劇的な精度は出ていない? ▪ FP8と同じ精度 ▪ BitNet b1.58では、自然言語処理においてFP16のLLaMAと同じ精度が出てい たため、ViTでなぜ下がったのか気になるところ
▪ FP8と同精度でメモリ使用量は約 1/5 削減できたため、今後のエッジデバイス (CPU、FPGA、NPU)の画像認識において主流になる可能性