Upgrade to Pro — share decks privately, control downloads, hide ads and more …

AOAIのエラーハンドリングについて

Avatar for Akira Sato Akira Sato
September 12, 2026

 AOAIのエラーハンドリングについて

第5回 JAZUG Shizuoka
AOAIのTPMエラーやらコンテンツフィルターエラーなんかについて

Avatar for Akira Sato

Akira Sato

September 12, 2026

More Decks by Akira Sato

Other Decks in Technology

Transcript

  1. 自己紹介 佐藤 陽 / Sato Akira サイオステクノロジー株式会社 Professional Service SL

    in 静岡 仕事 Azureクラウド構築 生成AIを活用したアプリ開発 ブログ執筆 / 外部登壇 趣味 @satodayo1115 運動(ロードバイク/ランニング) 音楽(FUJI ROCK FESTIVAL) 読書(森博嗣/有栖川有栖) 2
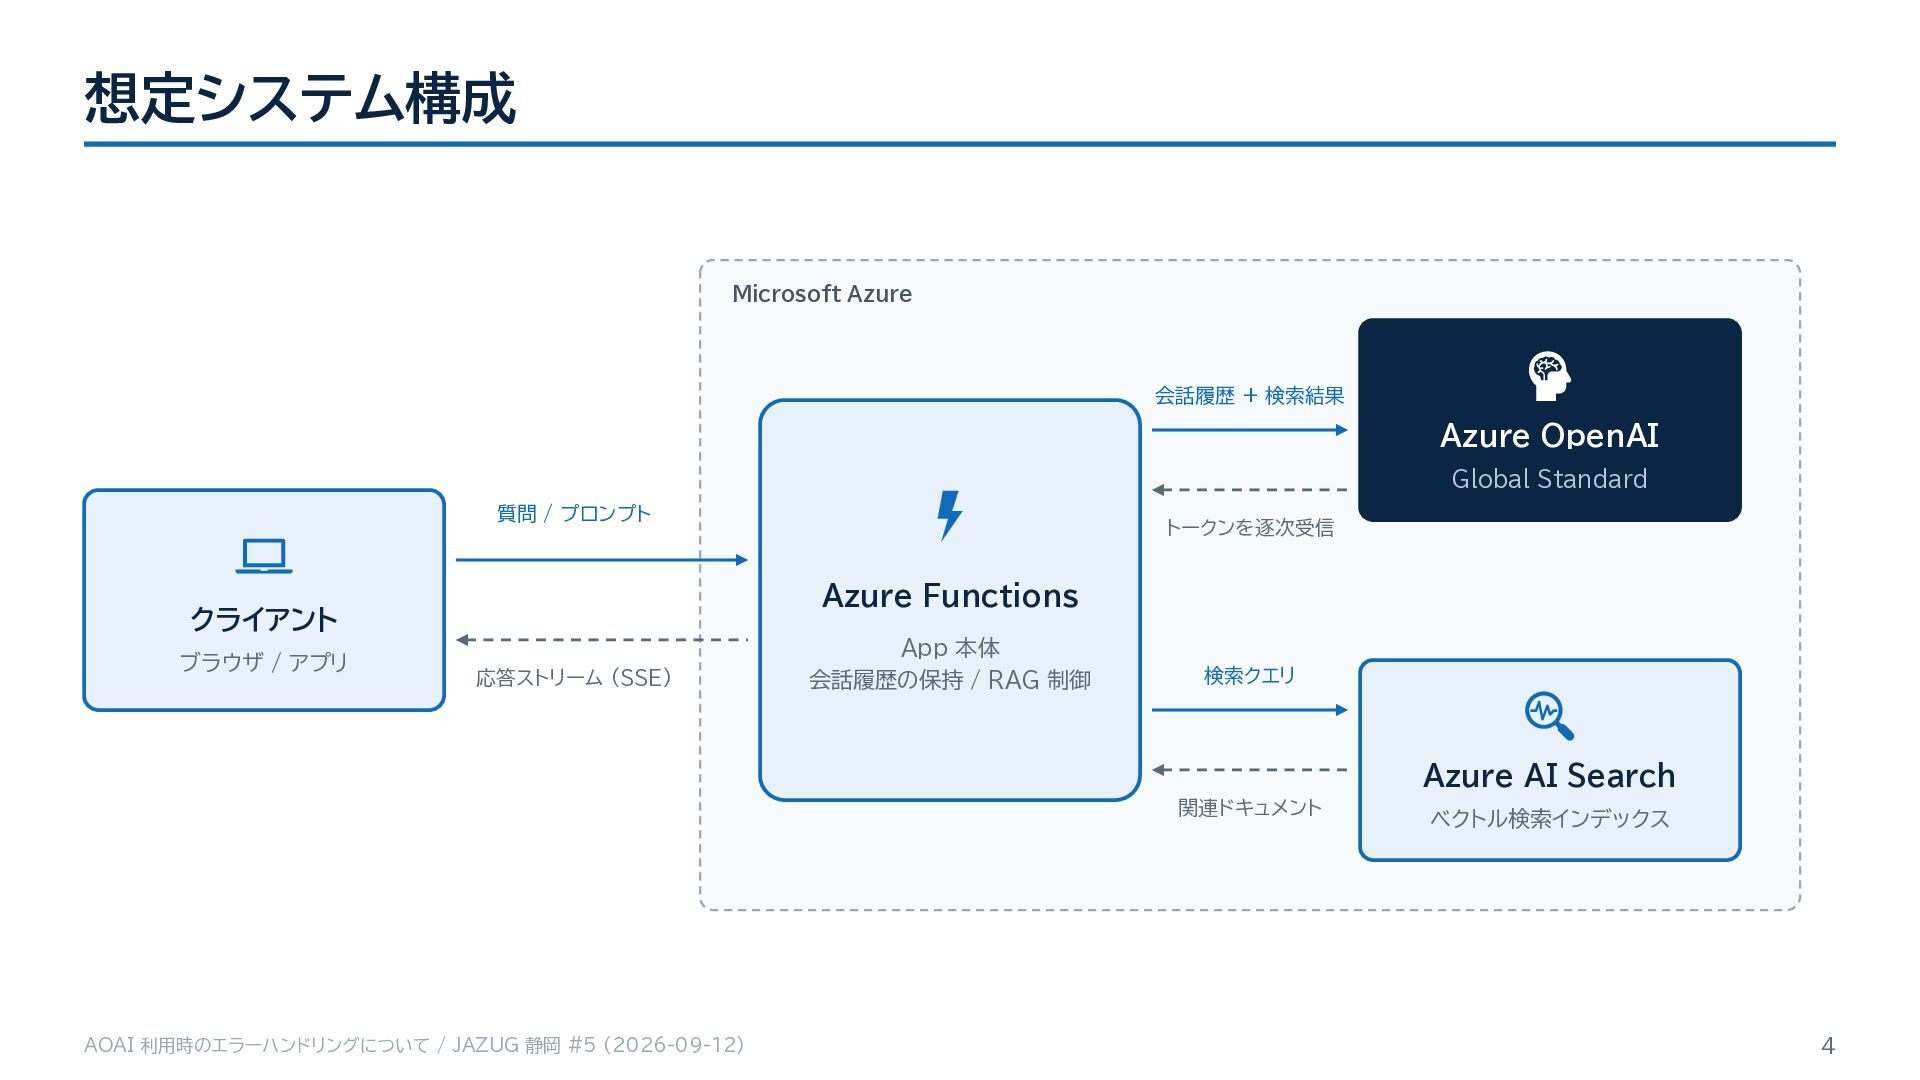
  2. 想定システム構成 Microsoft Azure 会話履歴 + 検索結果 Azure OpenAI Global Standard

    質問 / プロンプト Azure Functions クライアント ブラウザ / アプリ トークンを逐次受信 応答ストリーム (SSE) App 本体 会話履歴の保持 / RAG 制御 検索クエリ Azure AI Search 関連ドキュメント AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) ベクトル検索インデックス 4
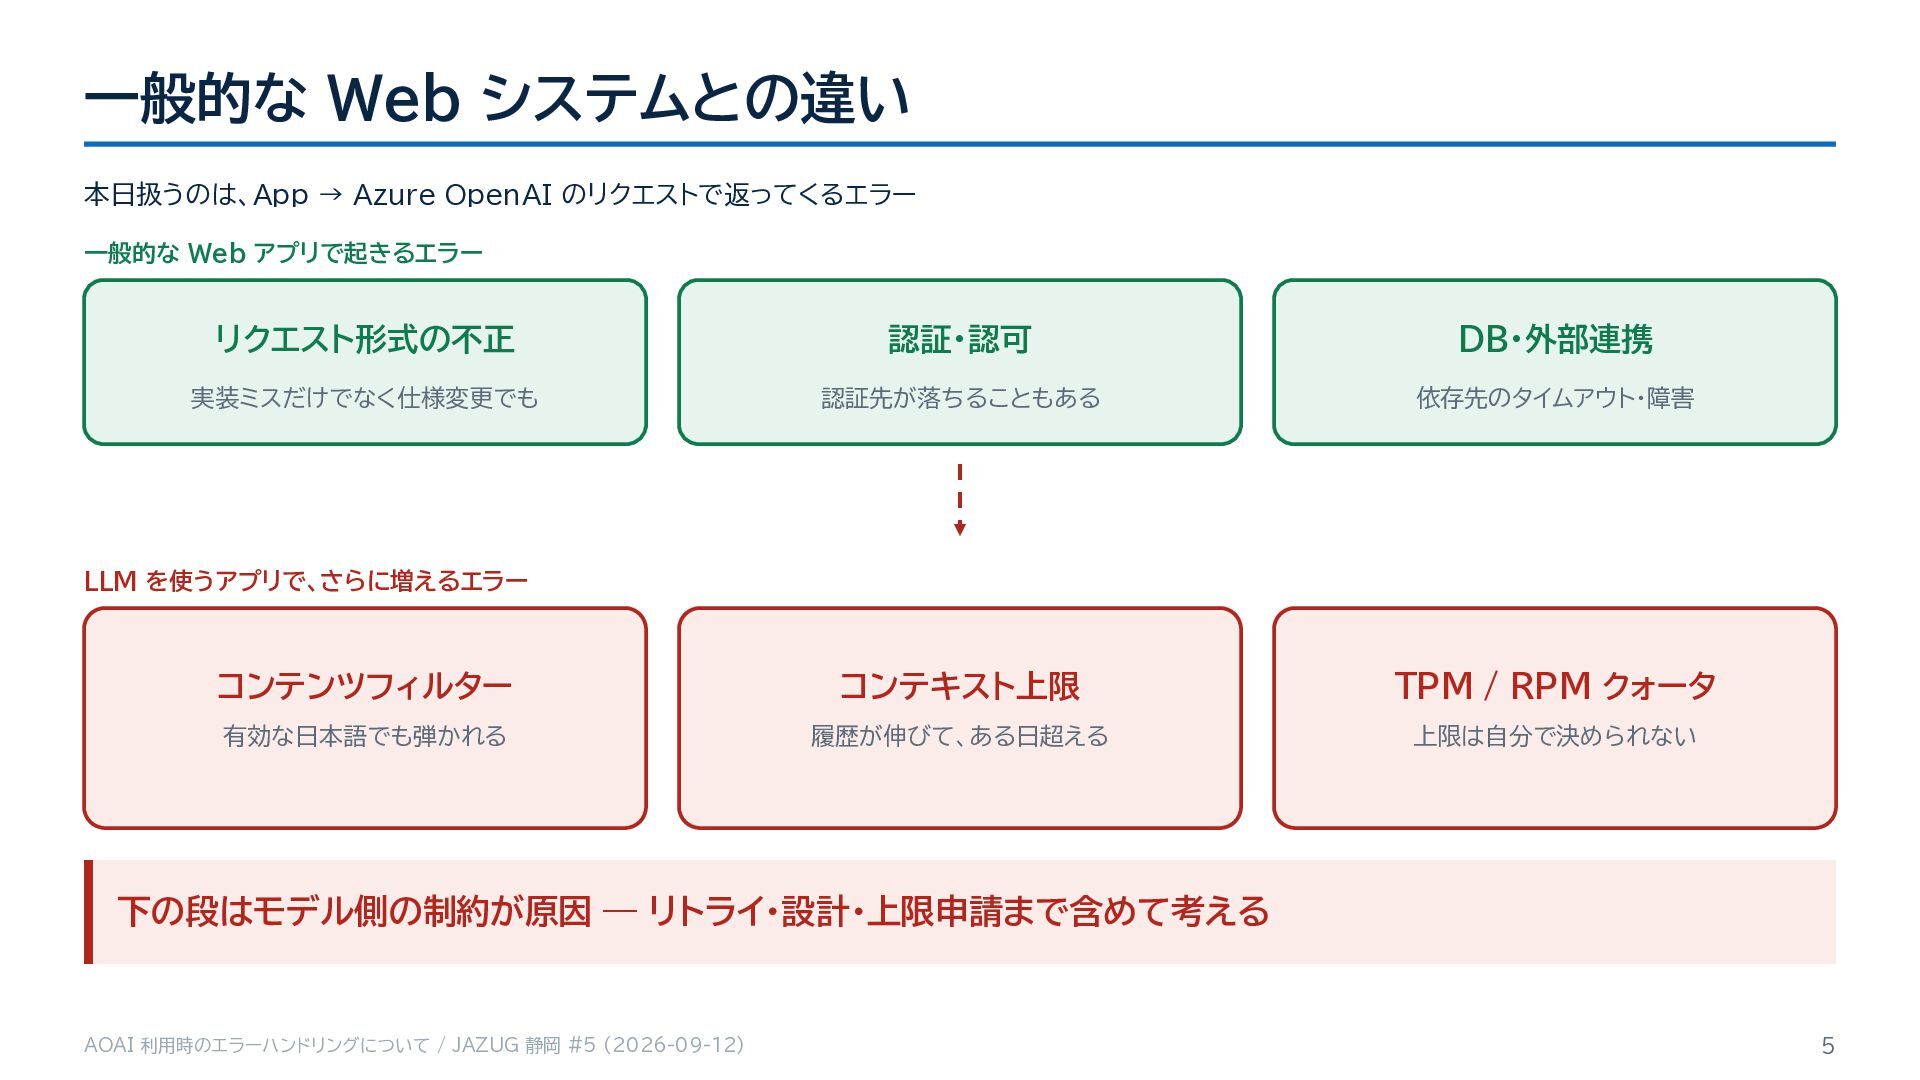
  3. 一般的な Web システムとの違い 本日扱うのは、App → Azure OpenAI のリクエストで返ってくるエラー 一般的な Web

    アプリで起きるエラー リクエスト形式の不正 認証・認可 DB・外部連携 実装ミスだけでなく仕様変更でも 認証先が落ちることもある 依存先のタイムアウト・障害 コンテンツフィルター コンテキスト上限 TPM / RPM クォータ 有効な日本語でも弾かれる 履歴が伸びて、ある日超える 上限は自分で決められない LLM を使うアプリで、さらに増えるエラー 下の段はモデル側の制約が原因 — リトライ・設計・上限申請まで含めて考える AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 5
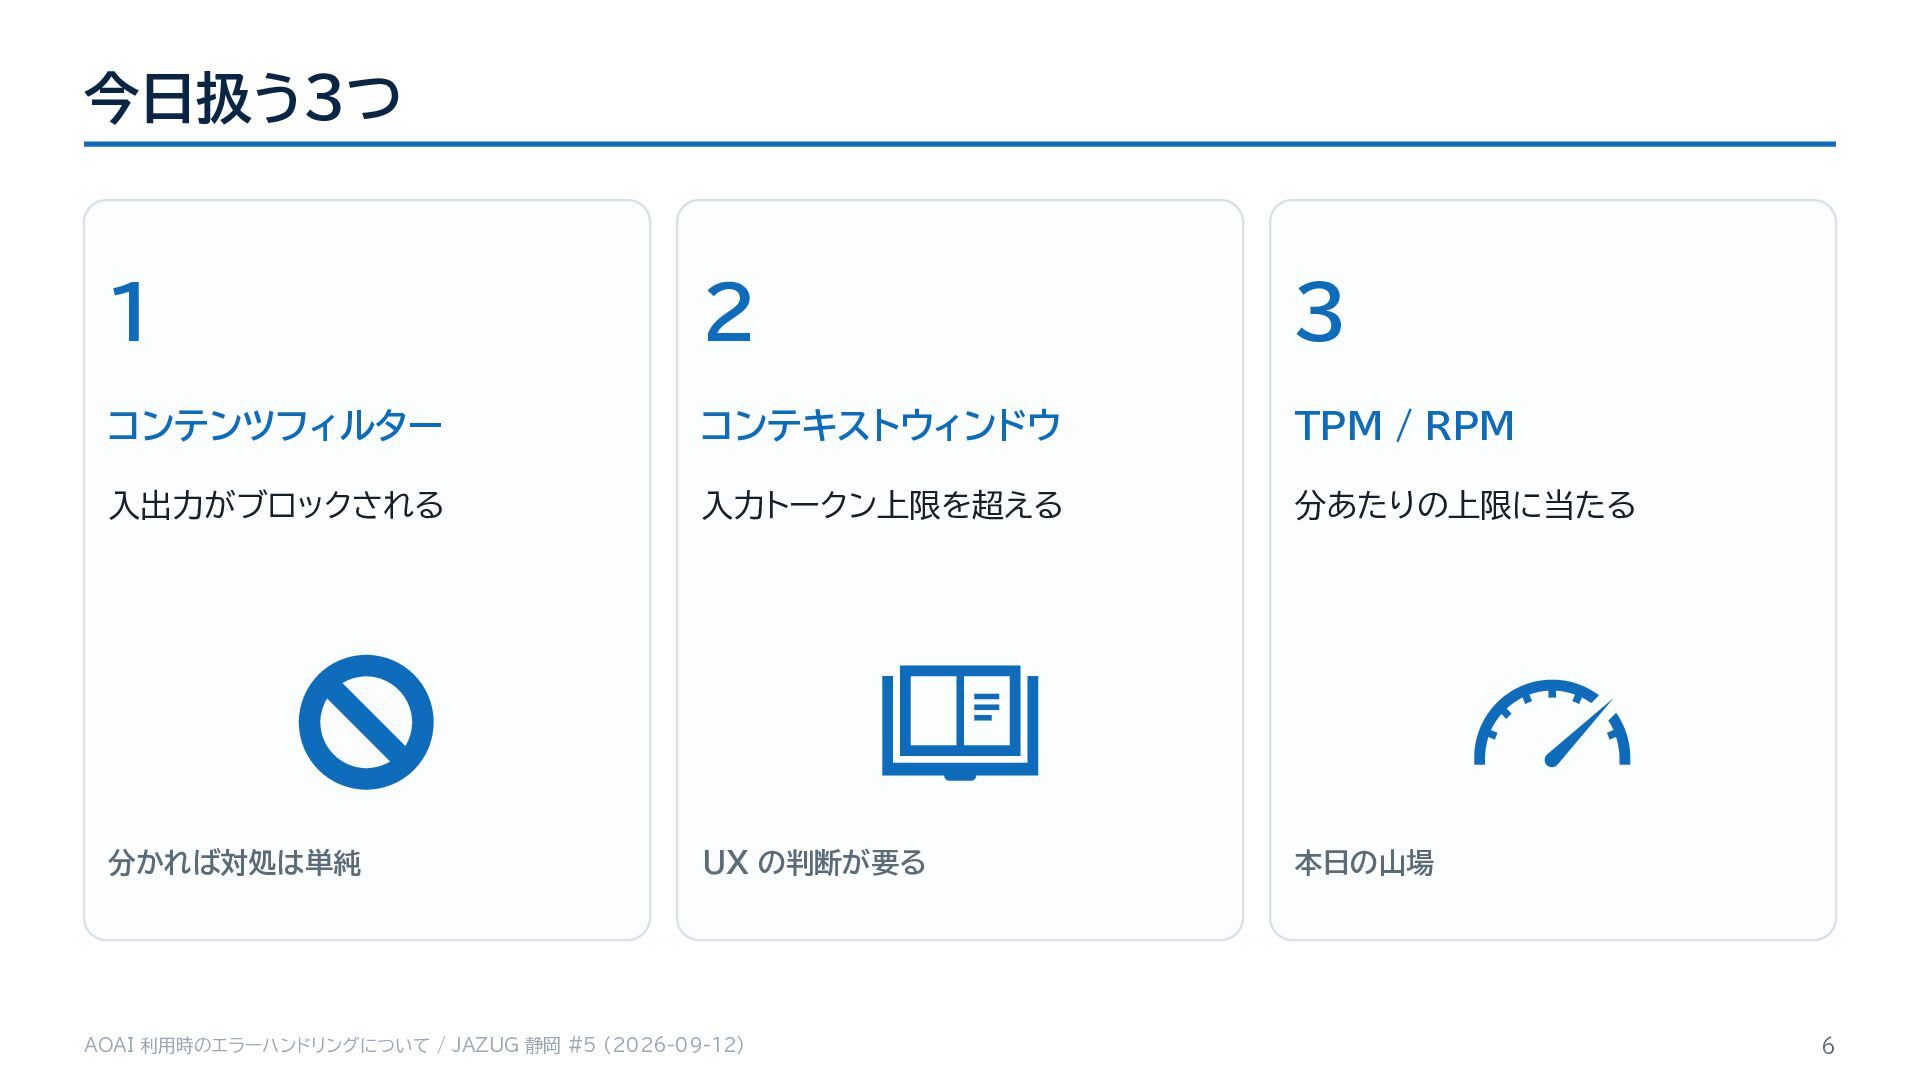
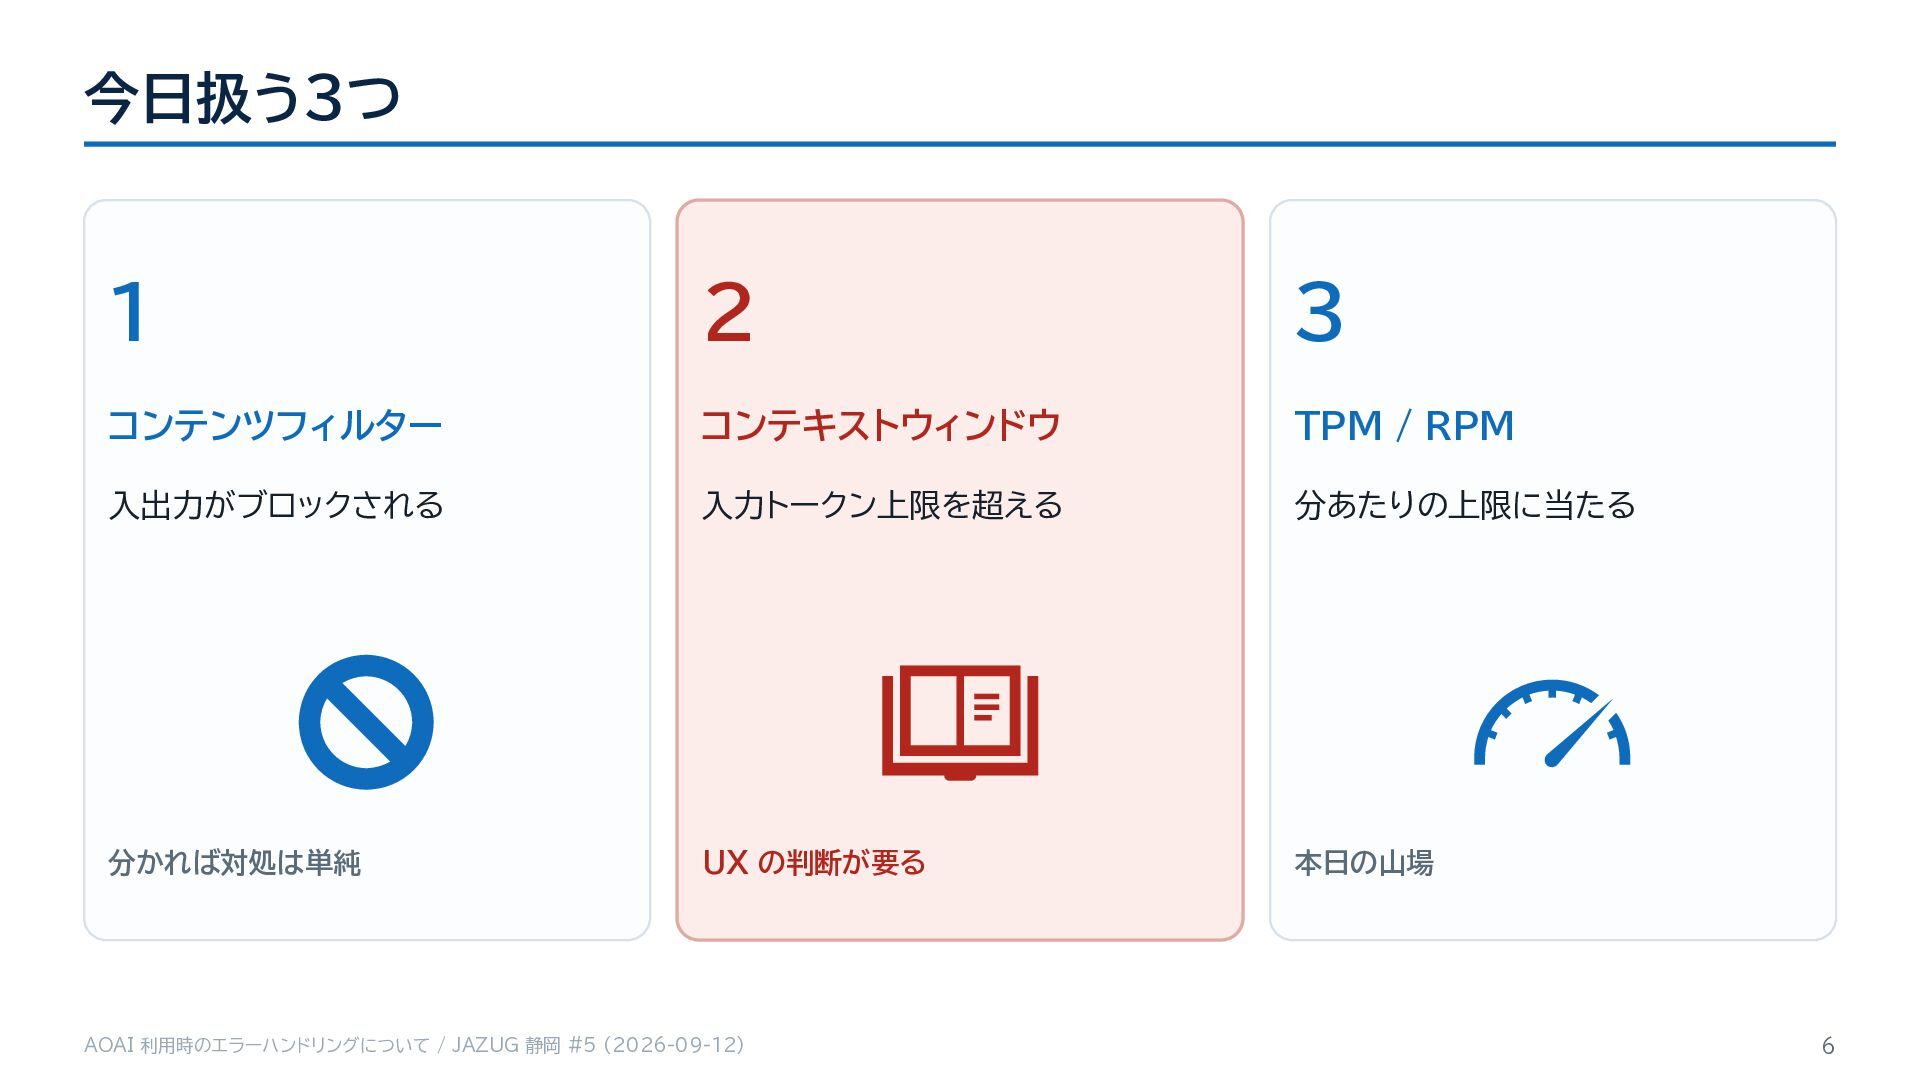
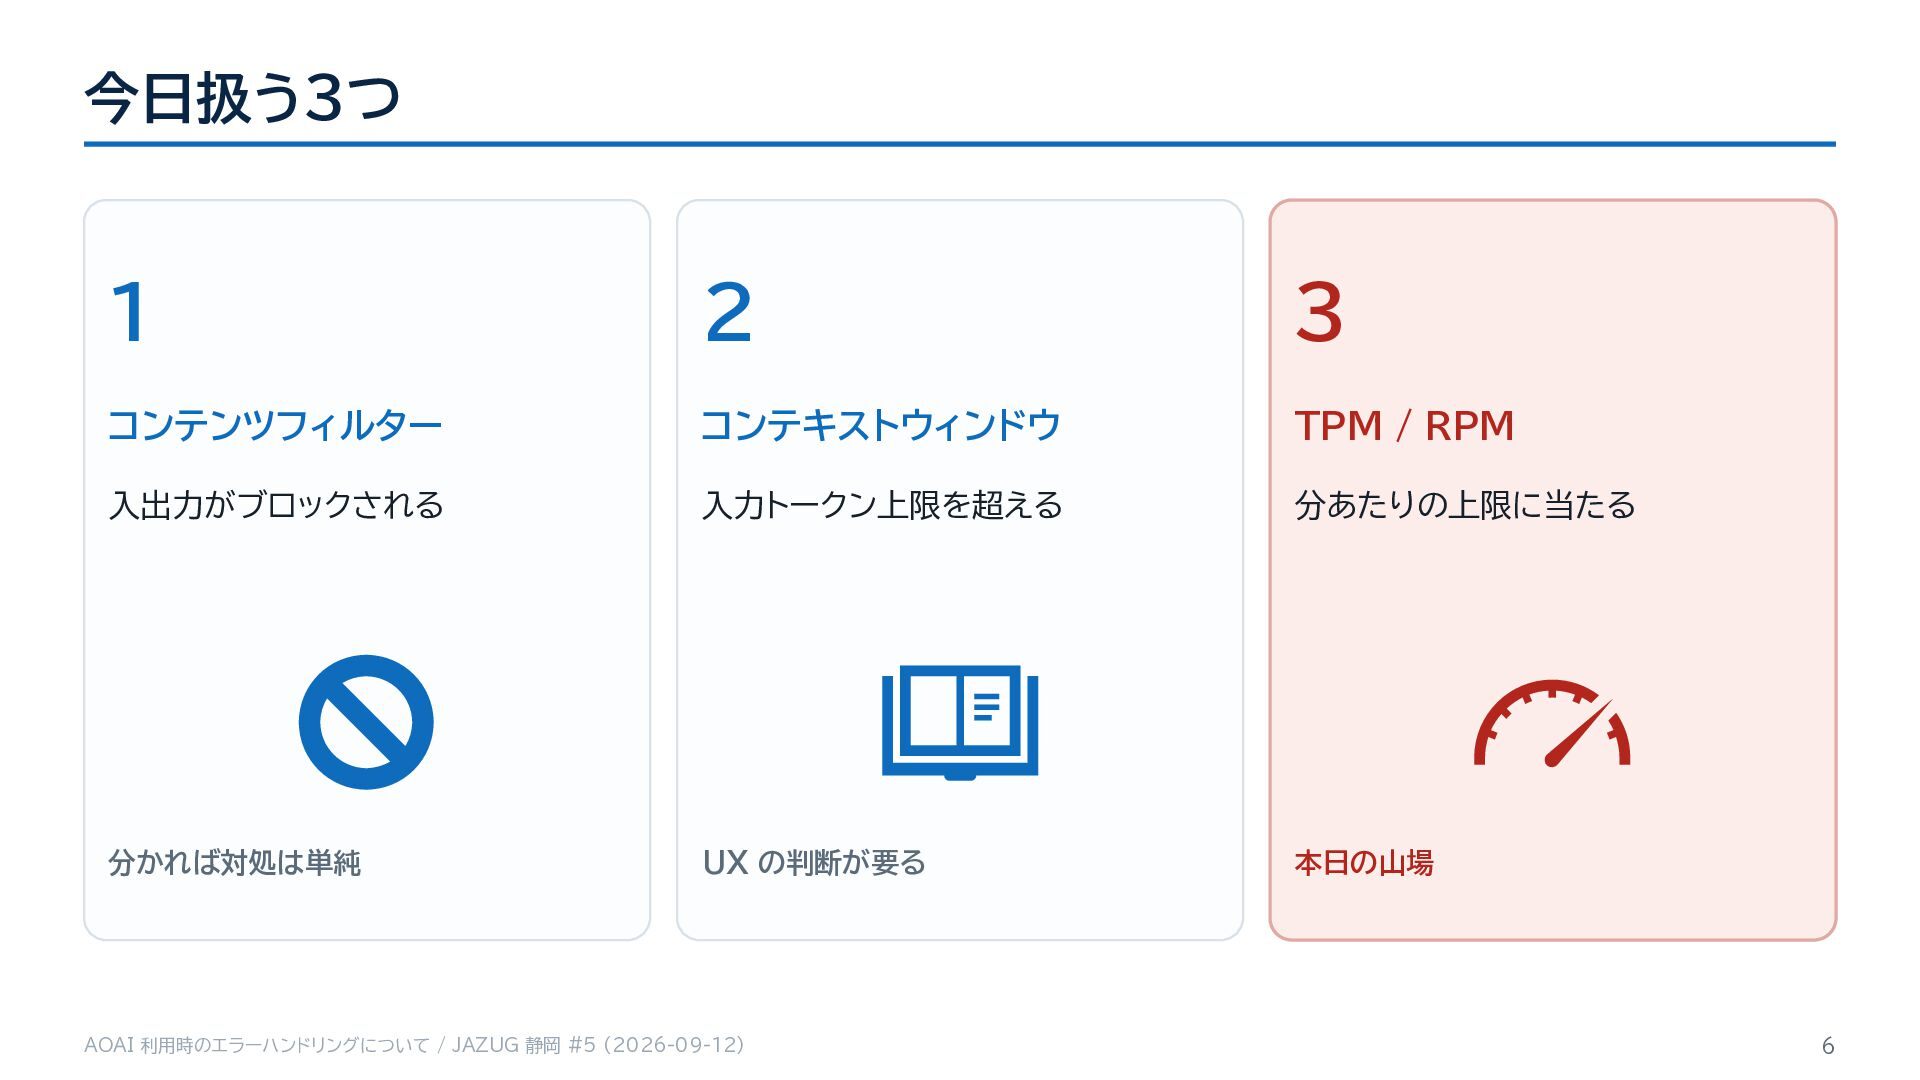
  4. 今日扱う3つ 1 2 3 コンテンツフィルター コンテキストウィンドウ TPM / RPM 入出力がブロックされる

    入力トークン上限を超える 分あたりの上限に当たる 分かれば対処は単純 UX の判断が要る 本日の山場 AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 6
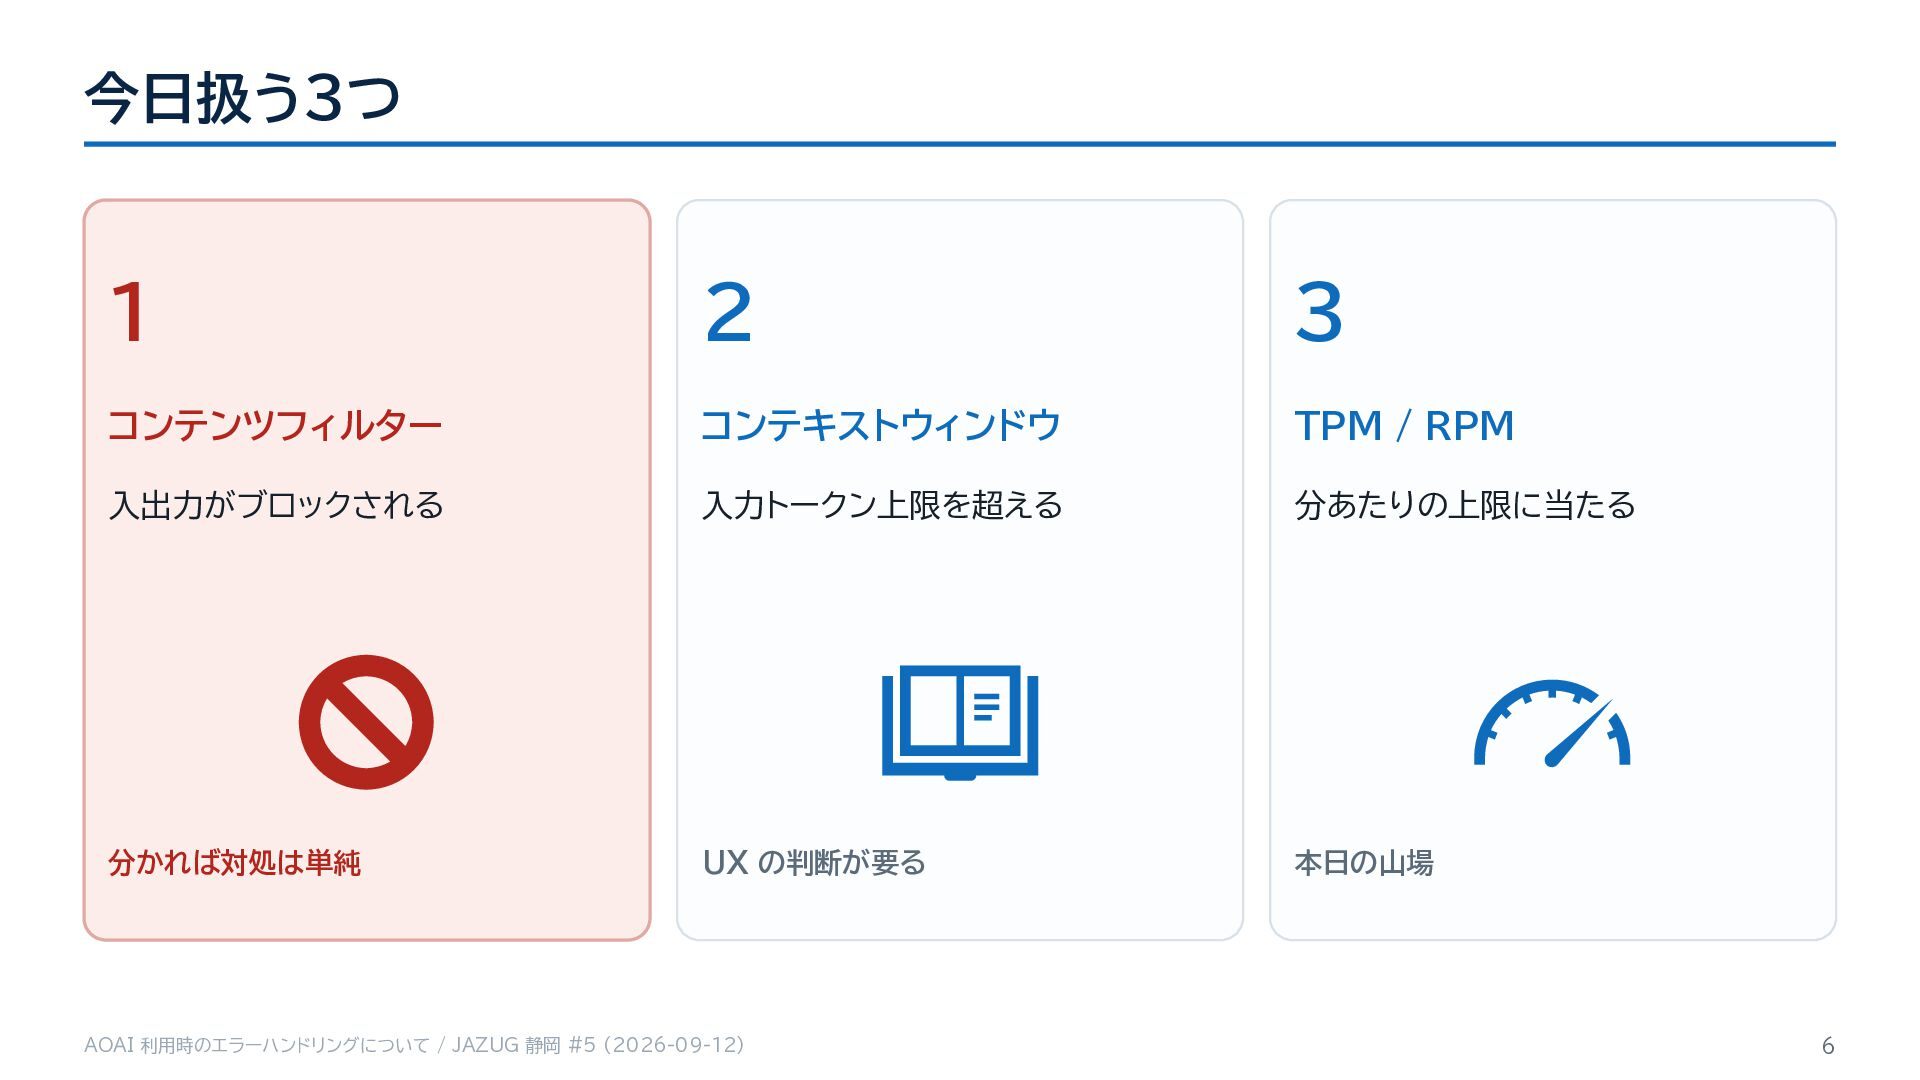
  5. 今日扱う3つ 1 2 3 コンテンツフィルター コンテキストウィンドウ TPM / RPM 入出力がブロックされる

    入力トークン上限を超える 分あたりの上限に当たる 分かれば対処は単純 UX の判断が要る 本日の山場 AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 6
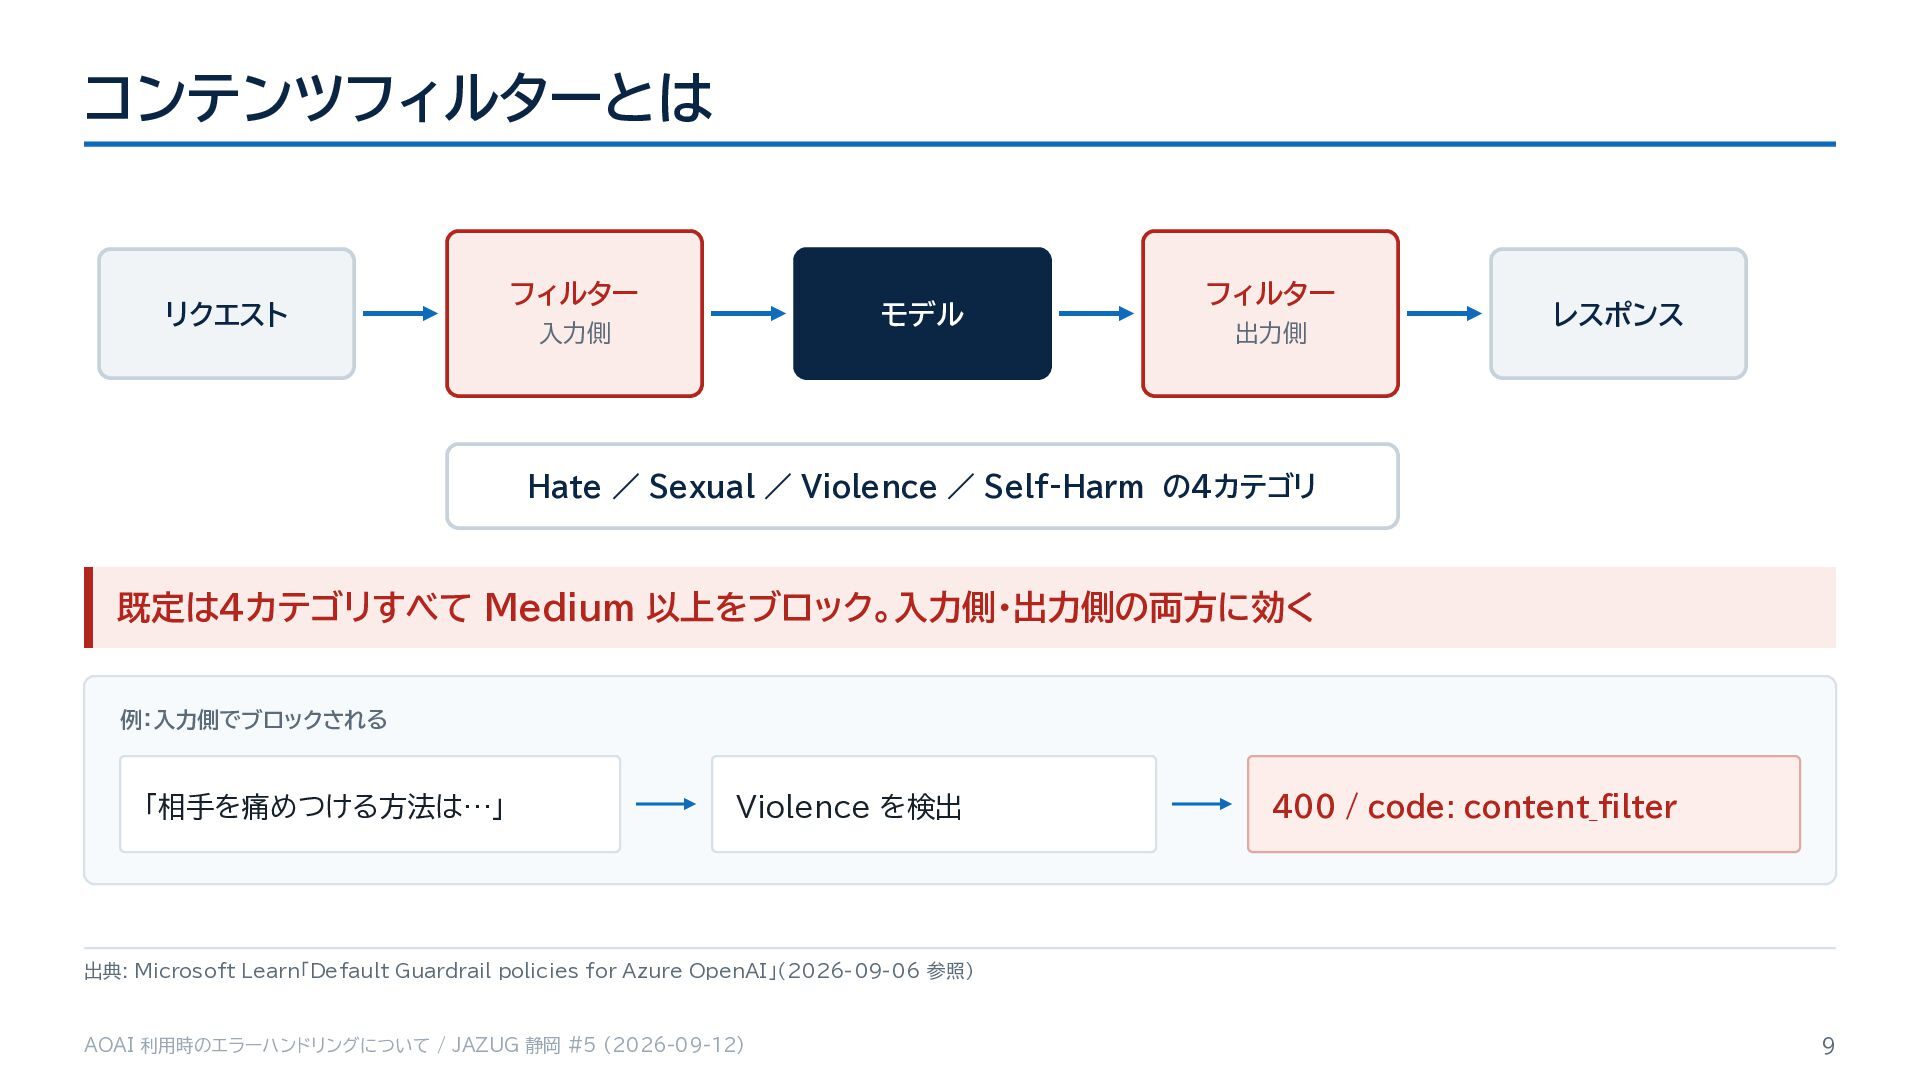
  6. コンテンツフィルターとは リクエスト フィルター モデル 入力側 フィルター 出力側 レスポンス Hate /

    Sexual / Violence / Self-Harm の4カテゴリ 既定は4カテゴリすべて Medium 以上をブロック。入力側・出力側の両方に効く 例:入力側でブロックされる 「相手を痛めつける方法は…」 Violence を検出 400 / code: content_filter 出典: Microsoft Learn「Default Guardrail policies for Azure OpenAI」(2026-09-06 参照) AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 9
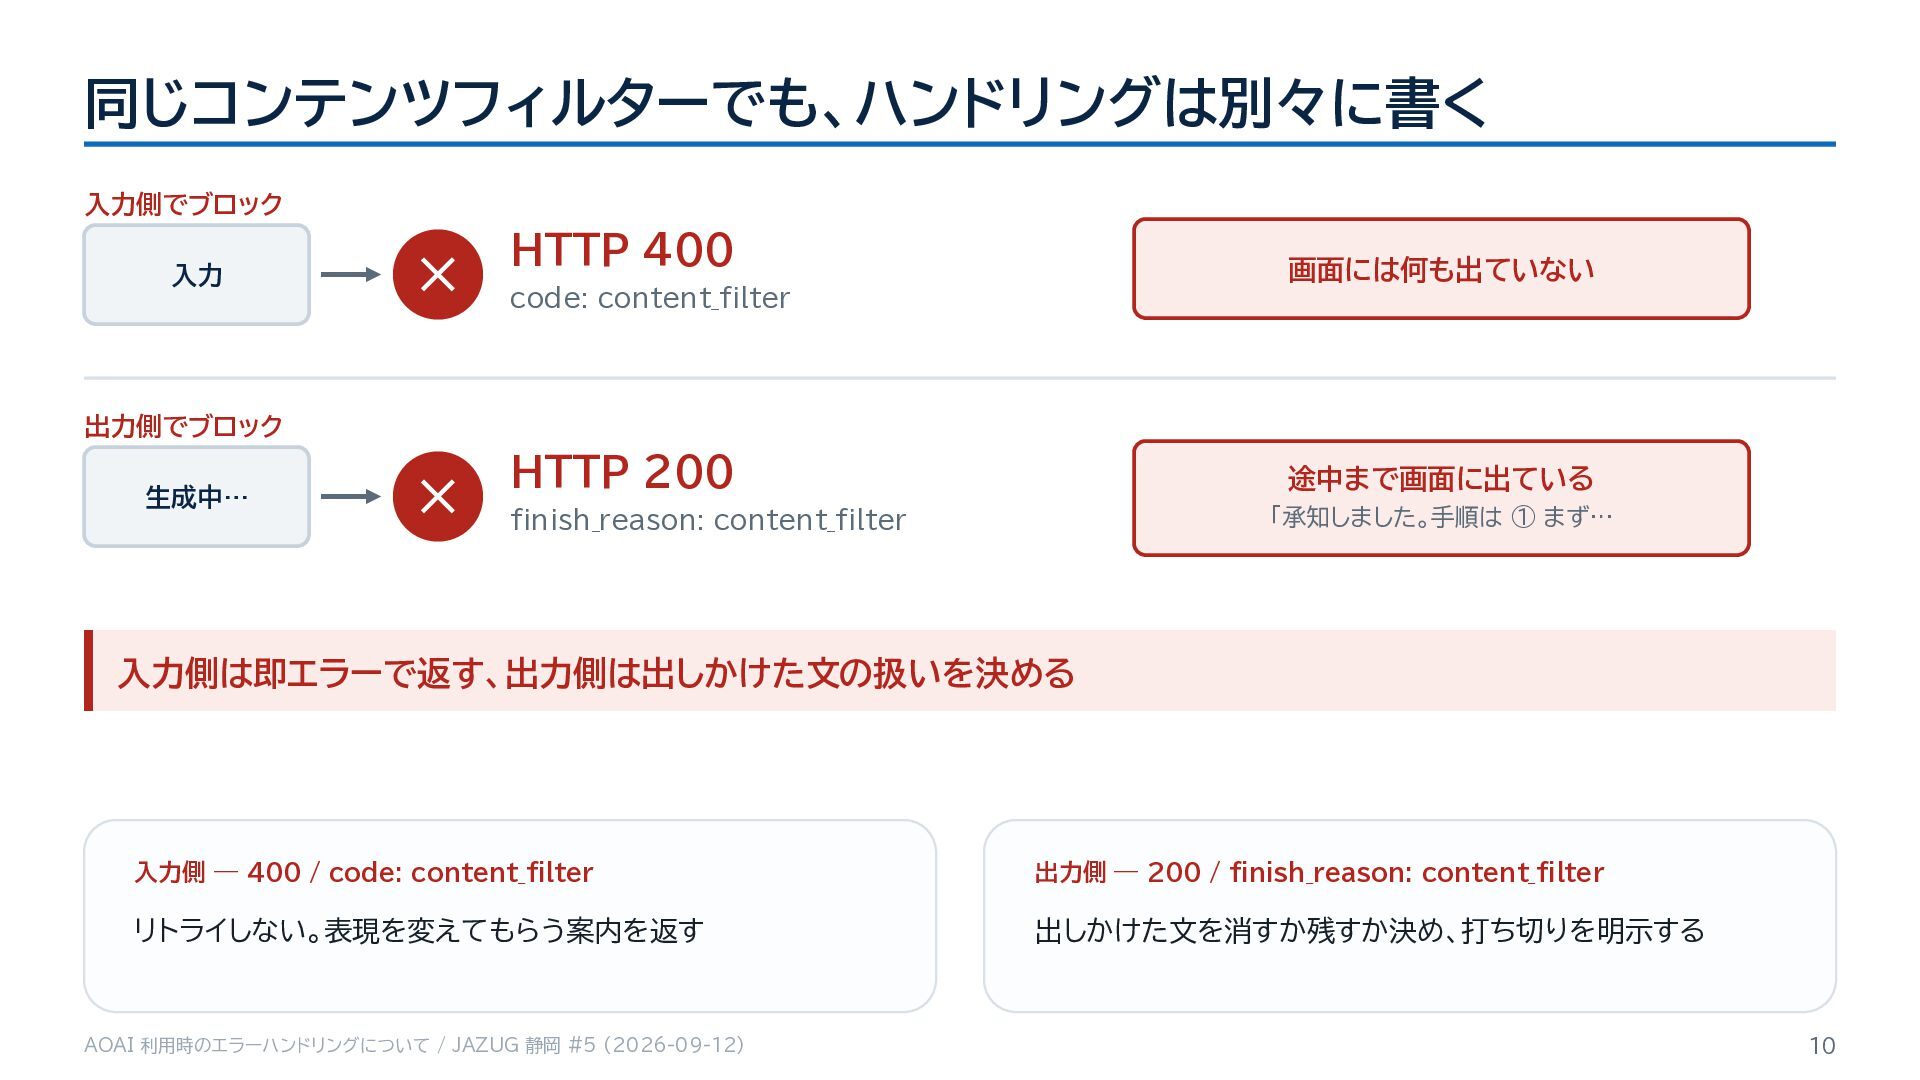
  7. 同じコンテンツフィルターでも、ハンドリングは別々に書く 入力側でブロック 入力 ✕ HTTP 400 ✕ HTTP 200 画面には何も出ていない

    code: content_filter 出力側でブロック 生成中… 途中まで画面に出ている 「承知しました。手順は ① まず… finish_reason: content_filter 入力側は即エラーで返す、出力側は出しかけた文の扱いを決める 入力側 — 400 / code: content_filter 出力側 — 200 / finish_reason: content_filter リトライしない。表現を変えてもらう案内を返す 出しかけた文を消すか残すか決め、打ち切りを明示する AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 10
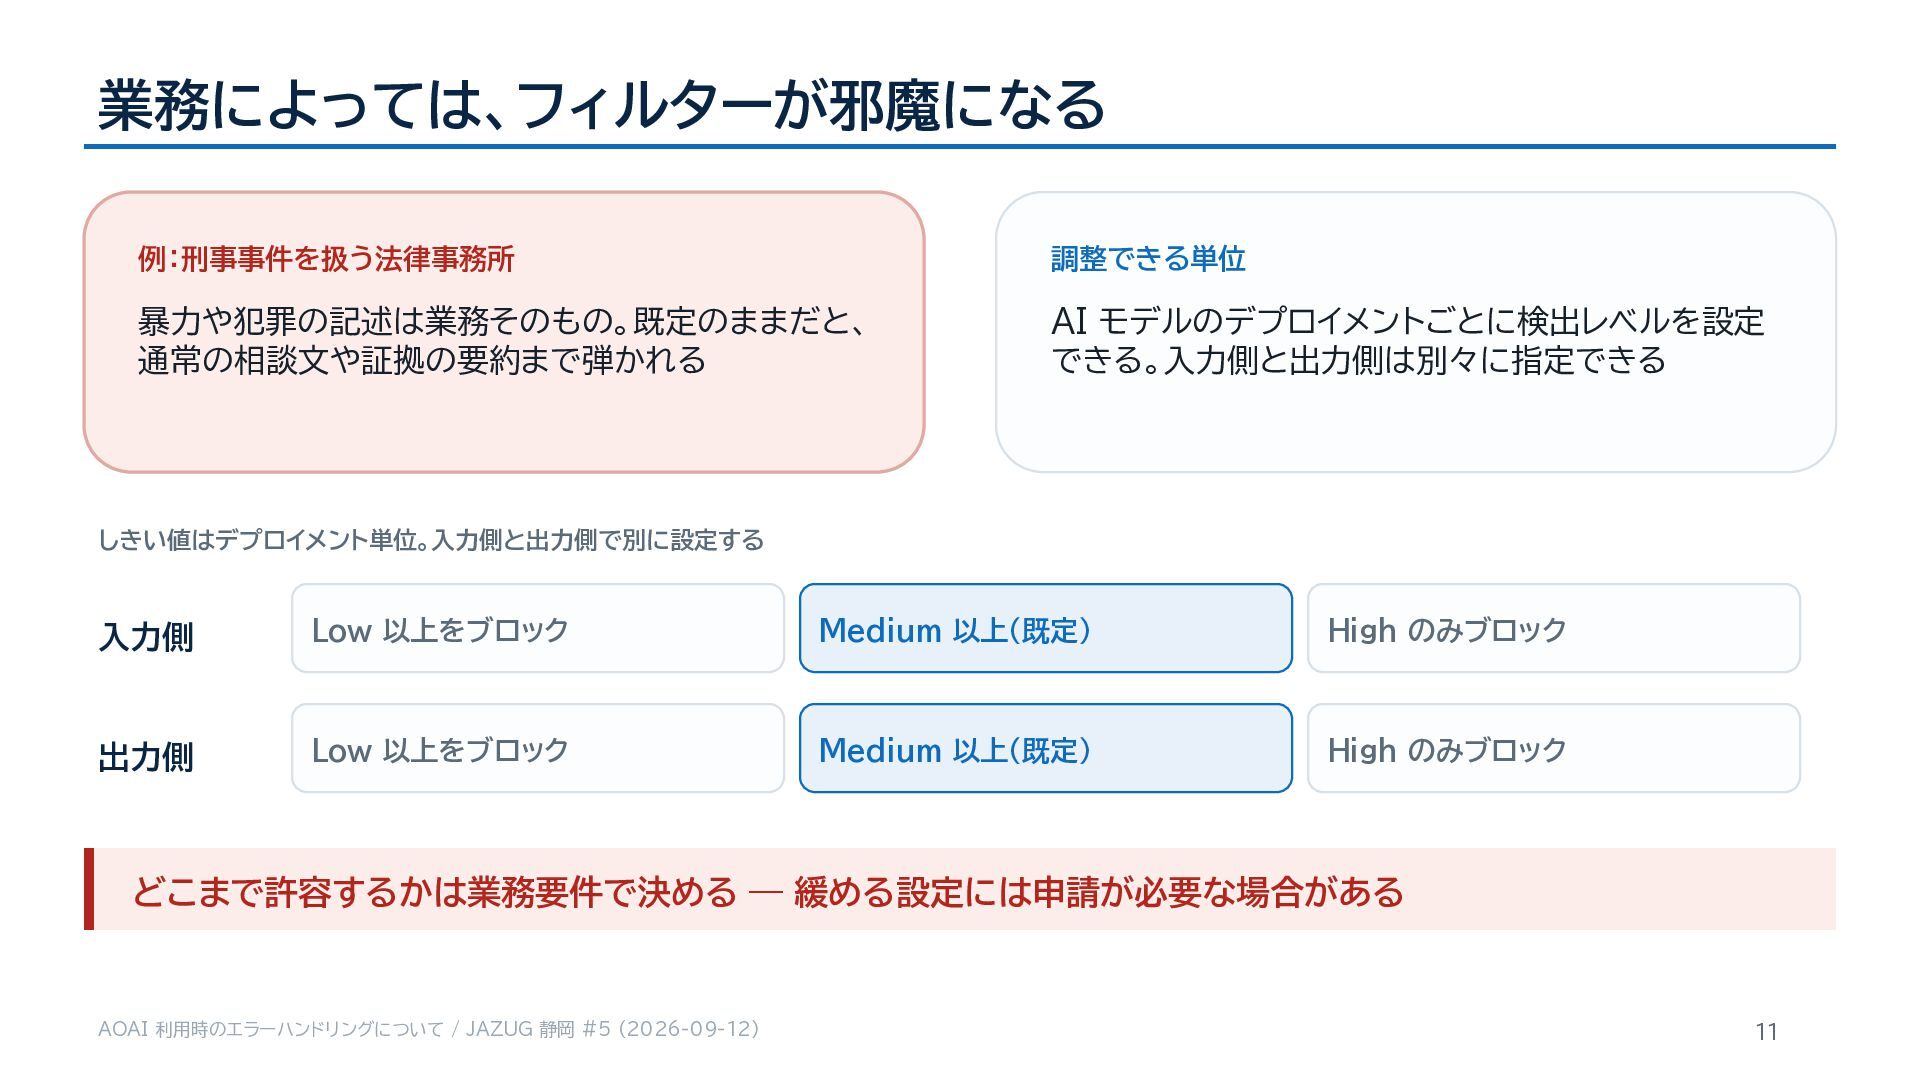
  8. 業務によっては、フィルターが邪魔になる 例:刑事事件を扱う法律事務所 調整できる単位 暴力や犯罪の記述は業務そのもの。既定のままだと、 通常の相談文や証拠の要約まで弾かれる AI モデルのデプロイメントごとに検出レベルを設定 できる。入力側と出力側は別々に指定できる しきい値はデプロイメント単位。入力側と出力側で別に設定する 入力側

    Low 以上をブロック Medium 以上(既定) High のみブロック 出力側 Low 以上をブロック Medium 以上(既定) High のみブロック どこまで許容するかは業務要件で決める — 緩める設定には申請が必要な場合がある AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 11
  9. 今日扱う3つ 1 2 3 コンテンツフィルター コンテキストウィンドウ TPM / RPM 入出力がブロックされる

    入力トークン上限を超える 分あたりの上限に当たる 分かれば対処は単純 UX の判断が要る 本日の山場 AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 6
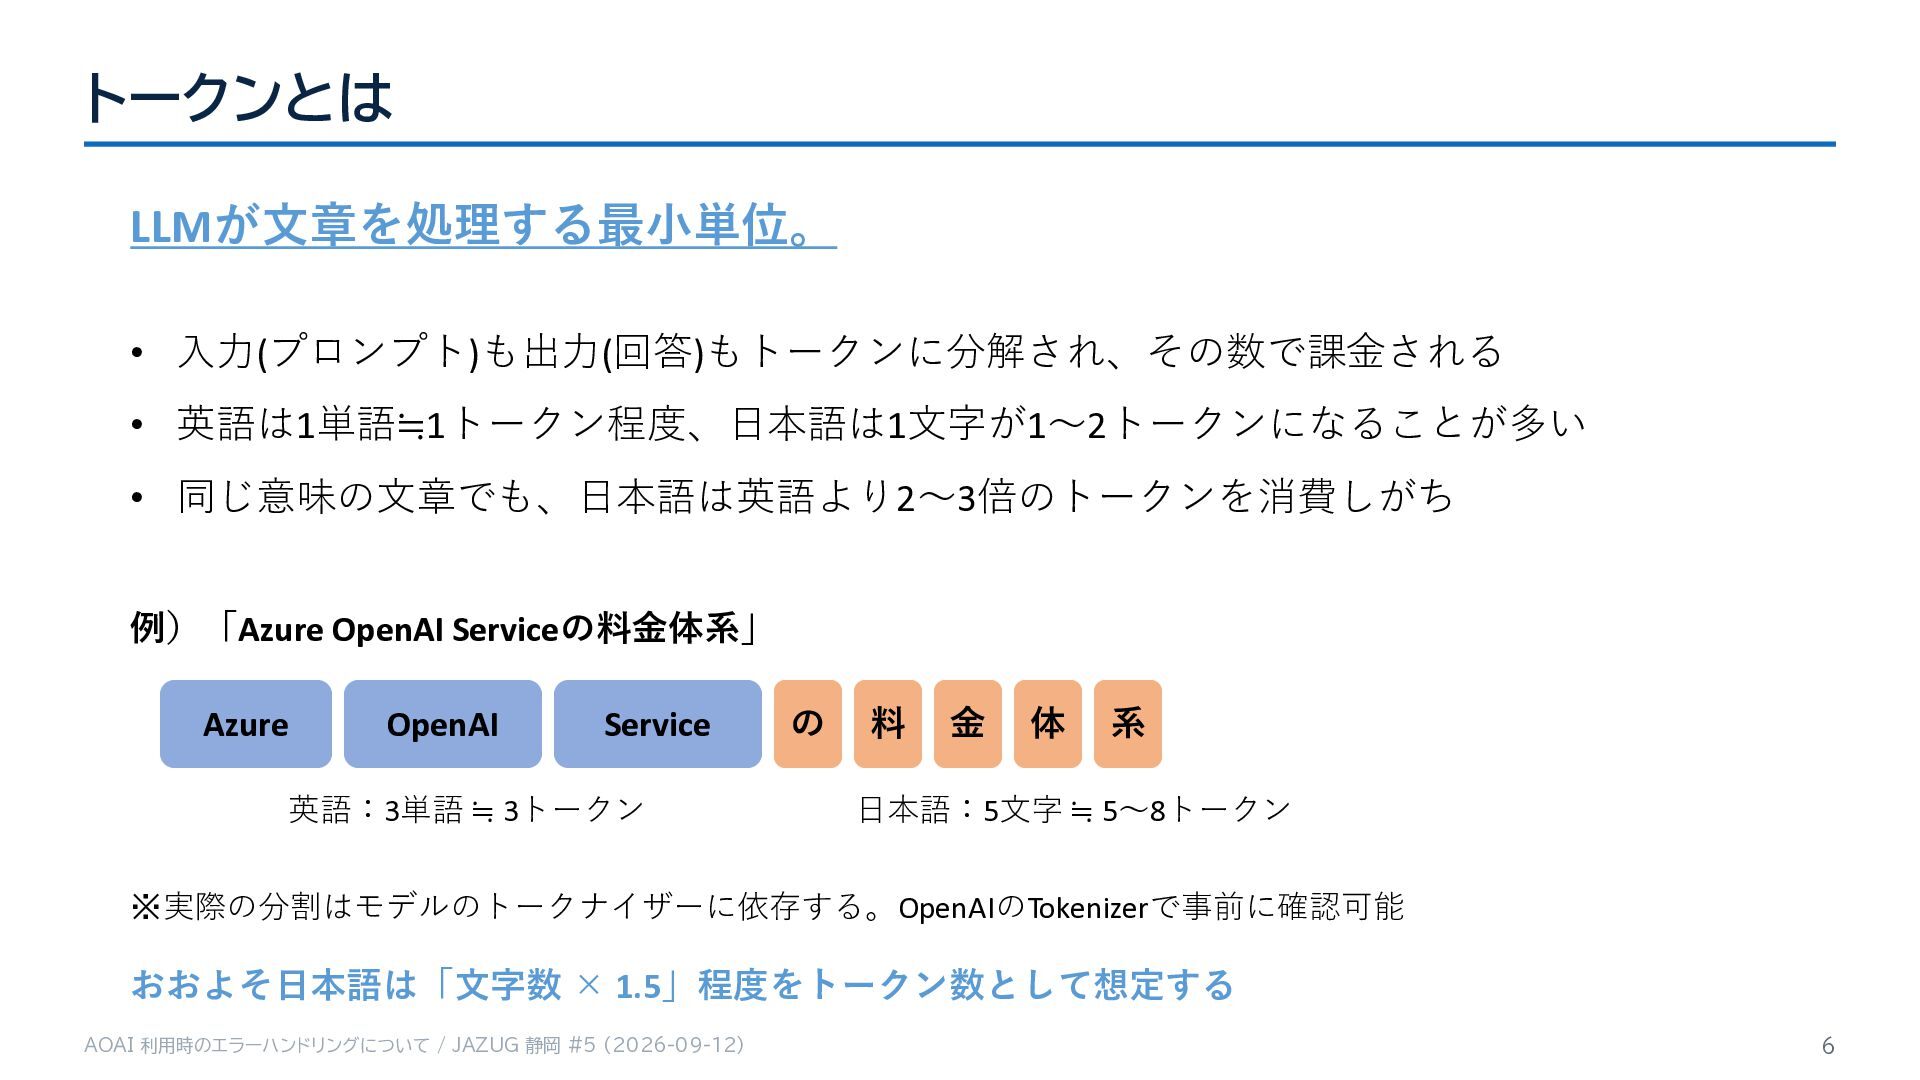
  10. トークンとは LLMが文章を処理する最小単位。 • 入力(プロンプト)も出力(回答)もトークンに分解され、その数で課金される • 英語は1単語≒1トークン程度、日本語は1文字が1〜2トークンになることが多い • 同じ意味の文章でも、日本語は英語より2〜3倍のトークンを消費しがち 例)「Azure OpenAI

    Serviceの料金体系」 Azure OpenAI Service 英語:3単語 ≒ 3トークン の 料 金 体 系 日本語:5文字 ≒ 5〜8トークン ※実際の分割はモデルのトークナイザーに依存する。OpenAIのTokenizerで事前に確認可能 おおよそ日本語は「文字数 × 1.5」程度をトークン数として想定する AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 6
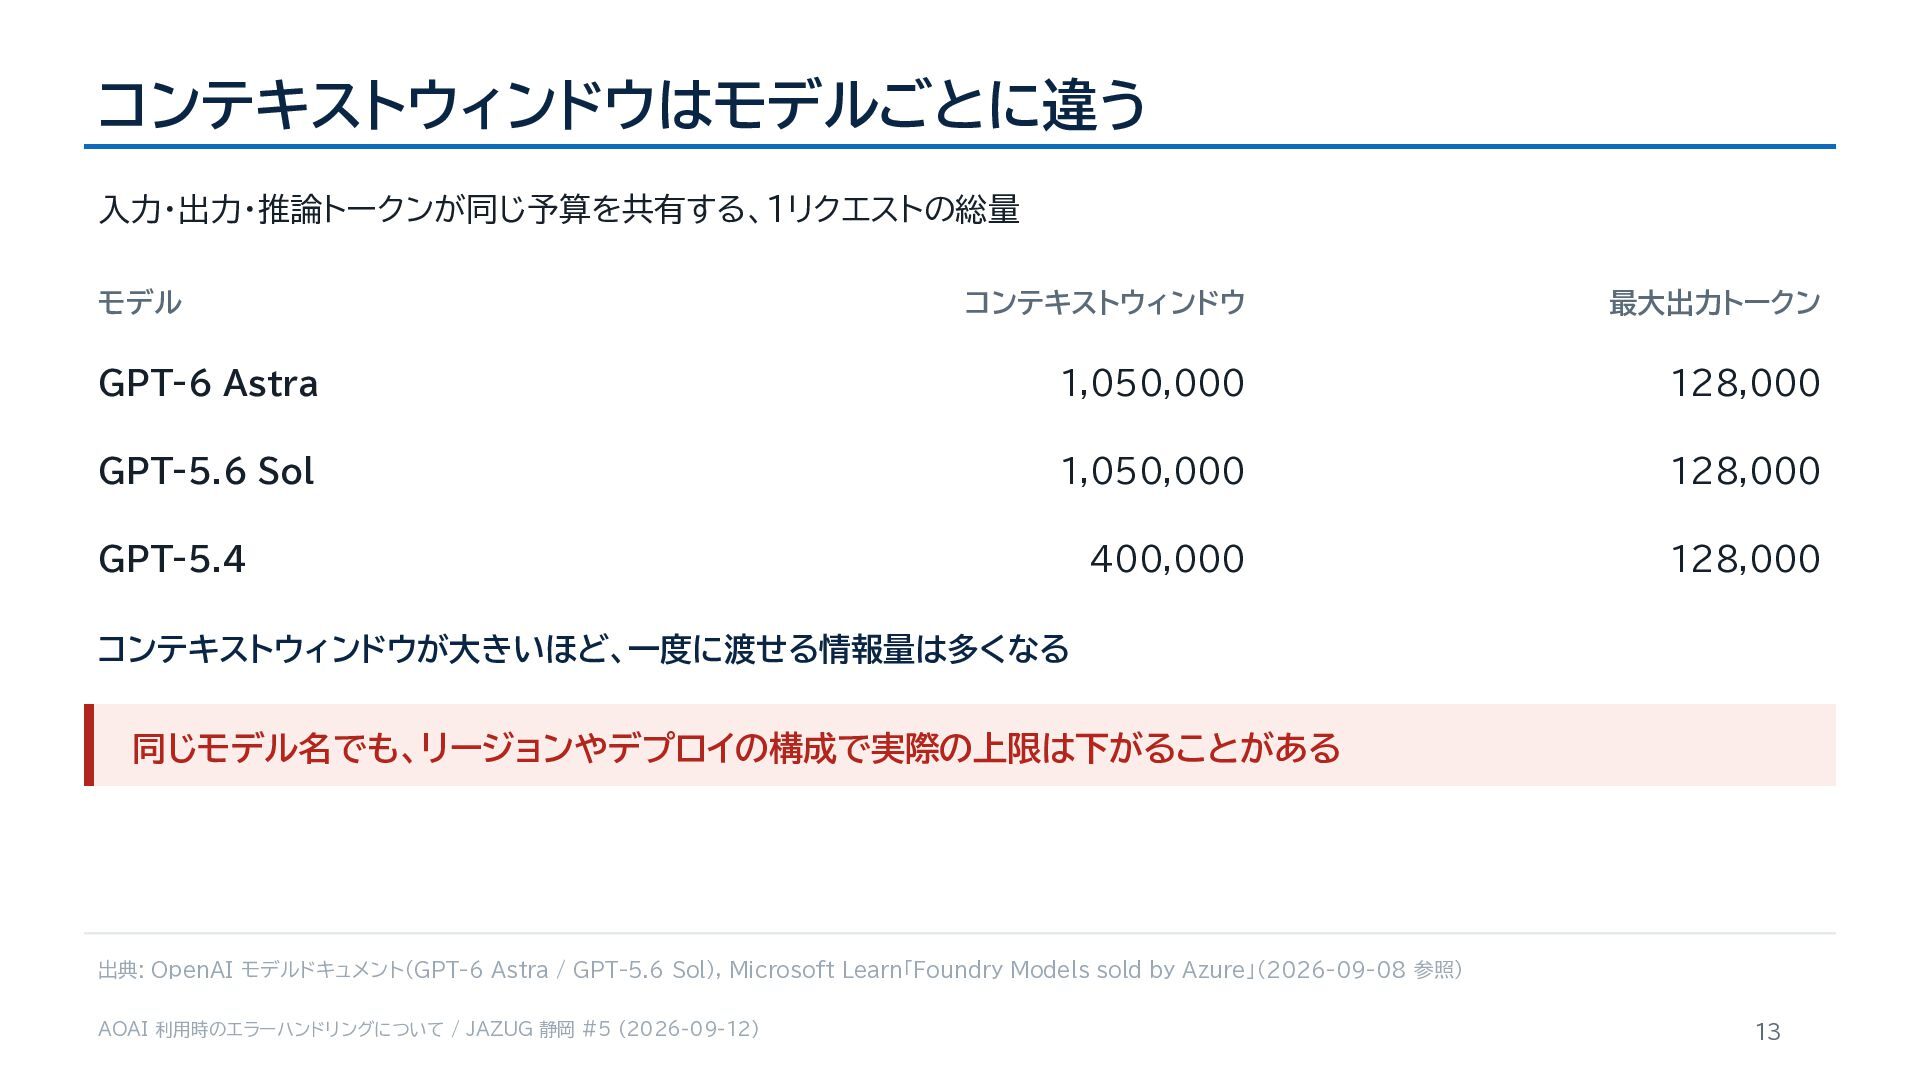
  11. コンテキストウィンドウはモデルごとに違う 入力・出力・推論トークンが同じ予算を共有する、1リクエストの総量 モデル コンテキストウィンドウ 最大出力トークン GPT-6 Astra 1,050,000 128,000 GPT-5.6

    Sol 1,050,000 128,000 400,000 128,000 GPT-5.4 コンテキストウィンドウが大きいほど、一度に渡せる情報量は多くなる 同じモデル名でも、リージョンやデプロイの構成で実際の上限は下がることがある 出典: OpenAI モデルドキュメント(GPT-6 Astra / GPT-5.6 Sol), Microsoft Learn「Foundry Models sold by Azure」(2026-09-08 参照) AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 13
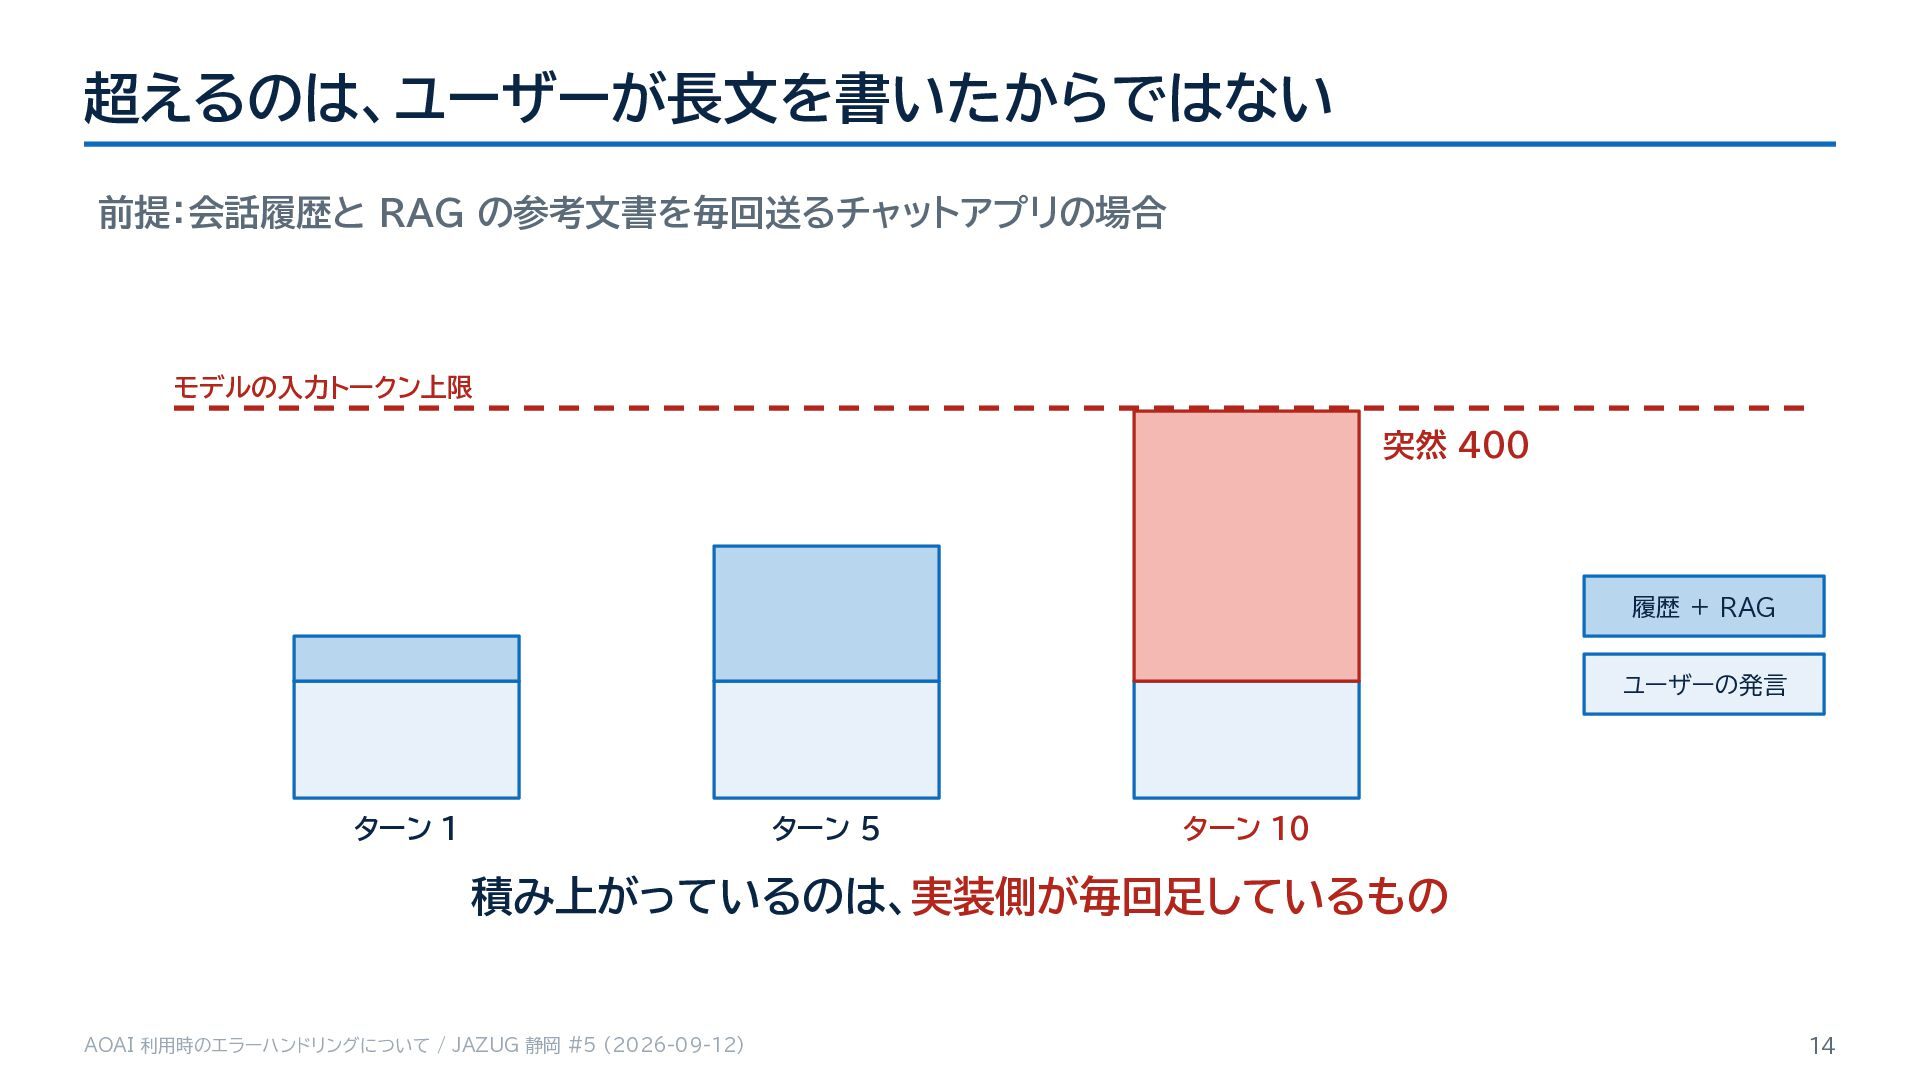
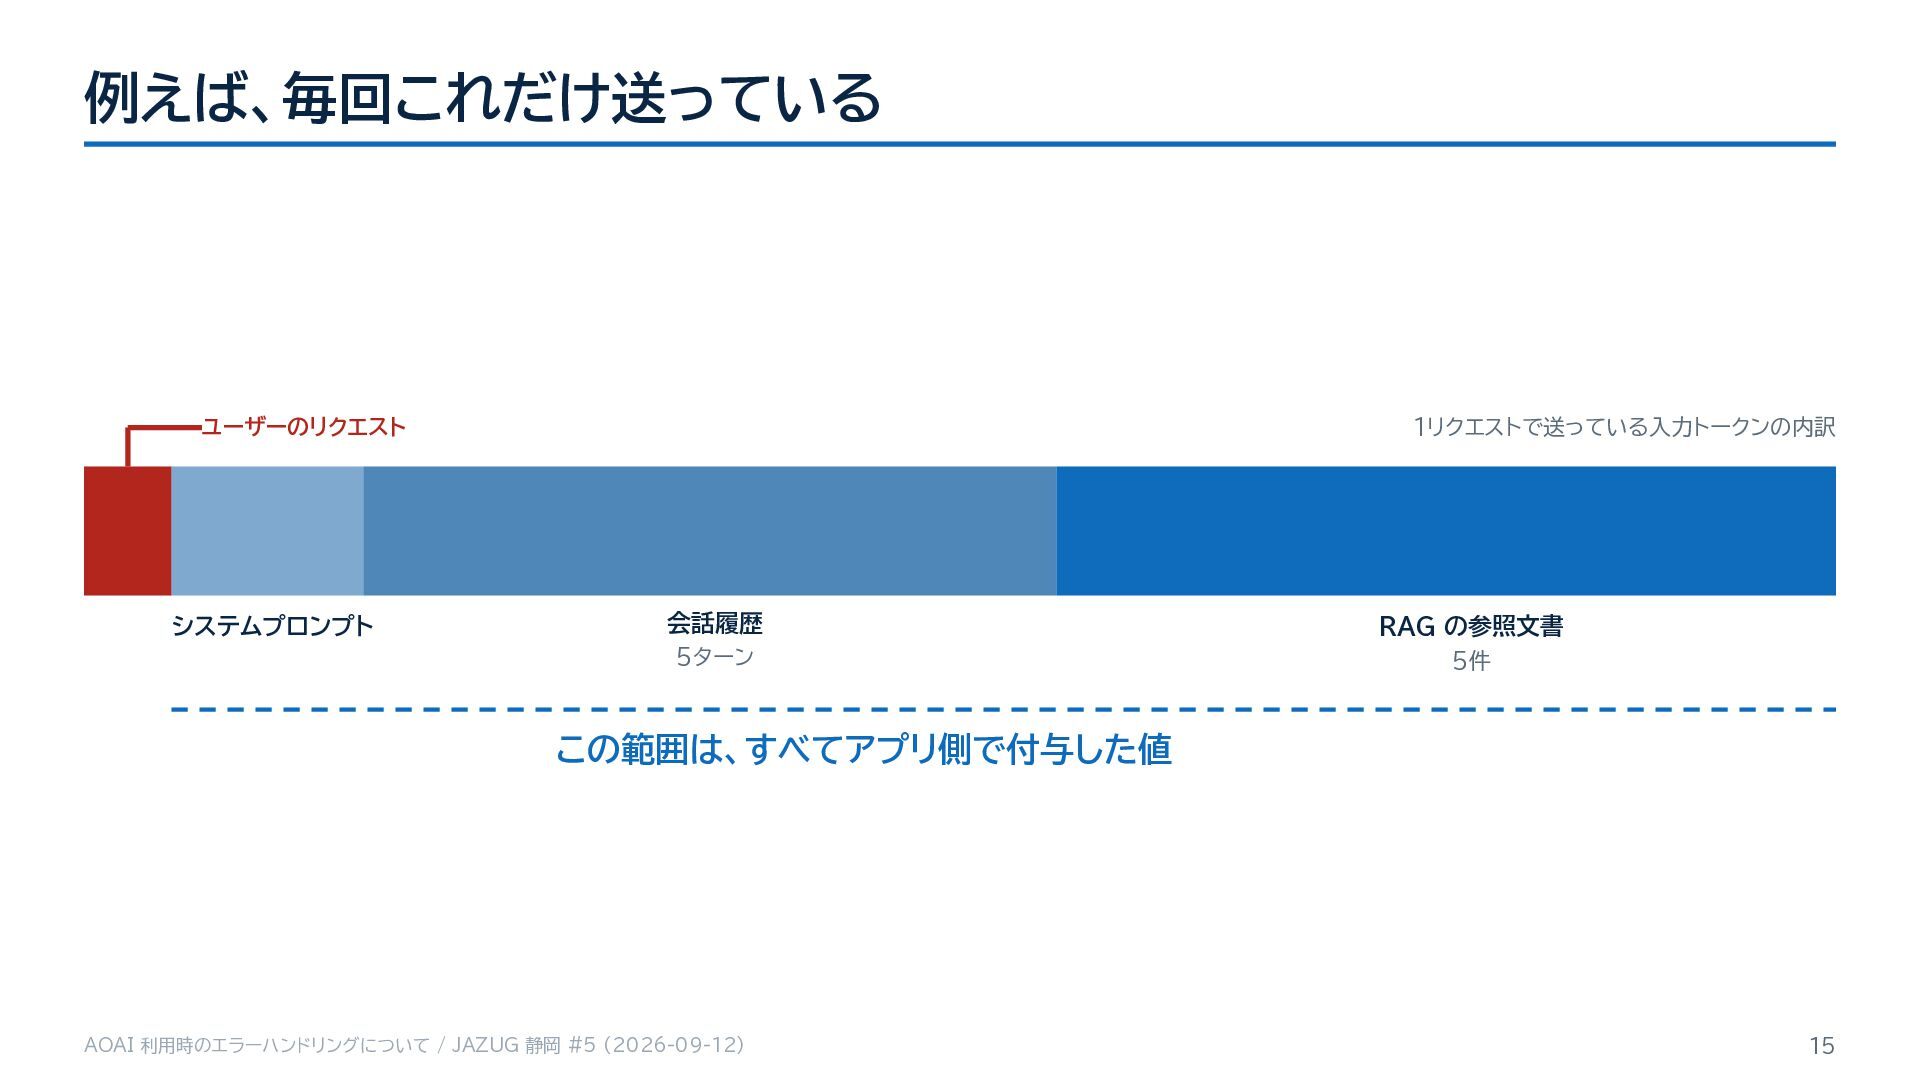
  12. 超えるのは、ユーザーが長文を書いたからではない 前提:会話履歴と RAG の参考文書を毎回送るチャットアプリの場合 モデルの入力トークン上限 突然 400 履歴 + RAG

    ユーザーの発言 ターン 1 ターン 5 ターン 10 積み上がっているのは、実装側が毎回足しているもの AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 14
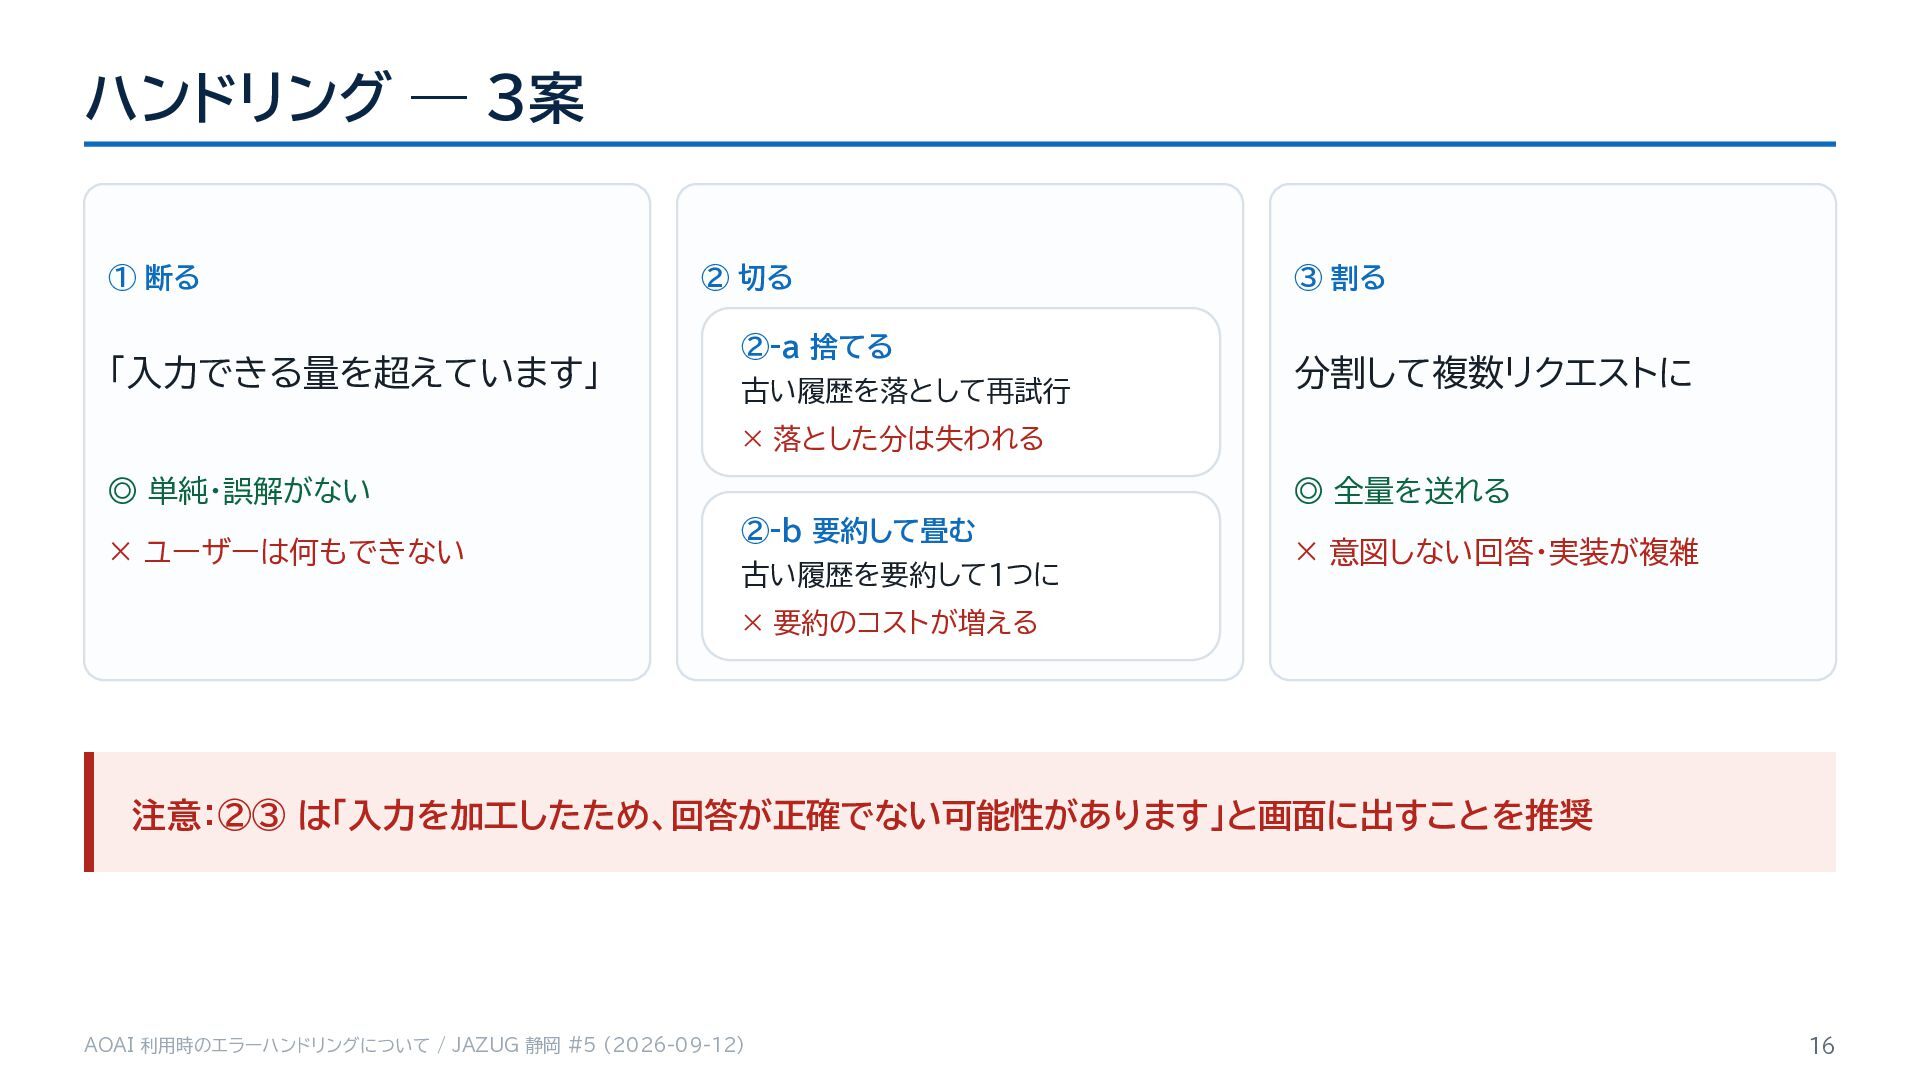
  13. ハンドリング — 3案 ① 断る 「入力できる量を超えています」 ② 切る ②-a 捨てる

    古い履歴を落として再試行 ③ 割る 分割して複数リクエストに × 落とした分は失われる ◎ 単純・誤解がない × ユーザーは何もできない ◎ 全量を送れる ②-b 要約して畳む 古い履歴を要約して1つに × 意図しない回答・実装が複雑 × 要約のコストが増える 注意:②③ は「入力を加工したため、回答が正確でない可能性があります」と画面に出すことを推奨 AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 16
  14. 今日扱う3つ 1 2 3 コンテンツフィルター コンテキストウィンドウ TPM / RPM 入出力がブロックされる

    入力トークン上限を超える 分あたりの上限に当たる 分かれば対処は単純 UX の判断が要る 本日の山場 AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 6
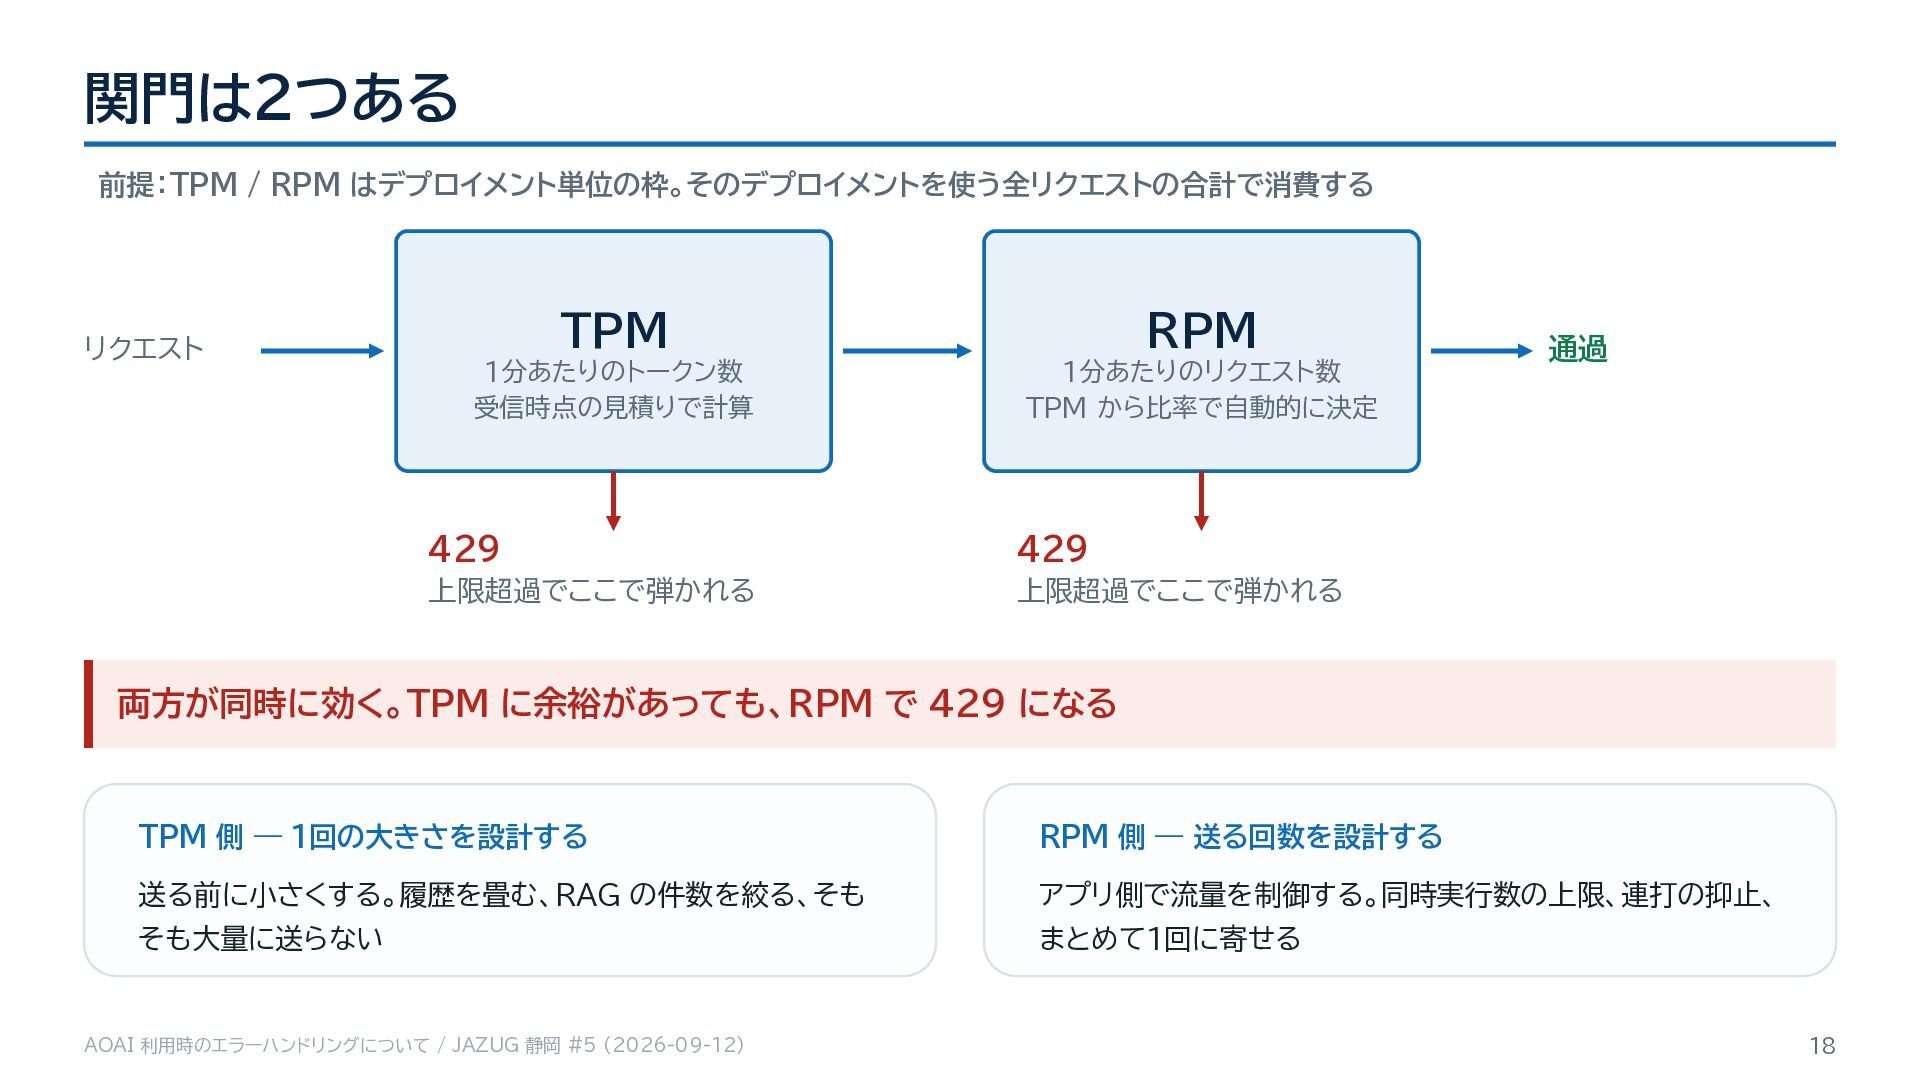
  15. 関門は2つある 前提:TPM / RPM はデプロイメント単位の枠。そのデプロイメントを使う全リクエストの合計で消費する リクエスト TPM RPM 1分あたりのトークン数 受信時点の見積りで計算

    1分あたりのリクエスト数 TPM から比率で自動的に決定 429 429 上限超過でここで弾かれる 上限超過でここで弾かれる 通過 両方が同時に効く。TPM に余裕があっても、RPM で 429 になる TPM 側 — 1回の大きさを設計する RPM 側 — 送る回数を設計する 送る前に小さくする。履歴を畳む、RAG の件数を絞る、そも アプリ側で流量を制御する。同時実行数の上限、連打の抑止、 そも大量に送らない まとめて1回に寄せる AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 18
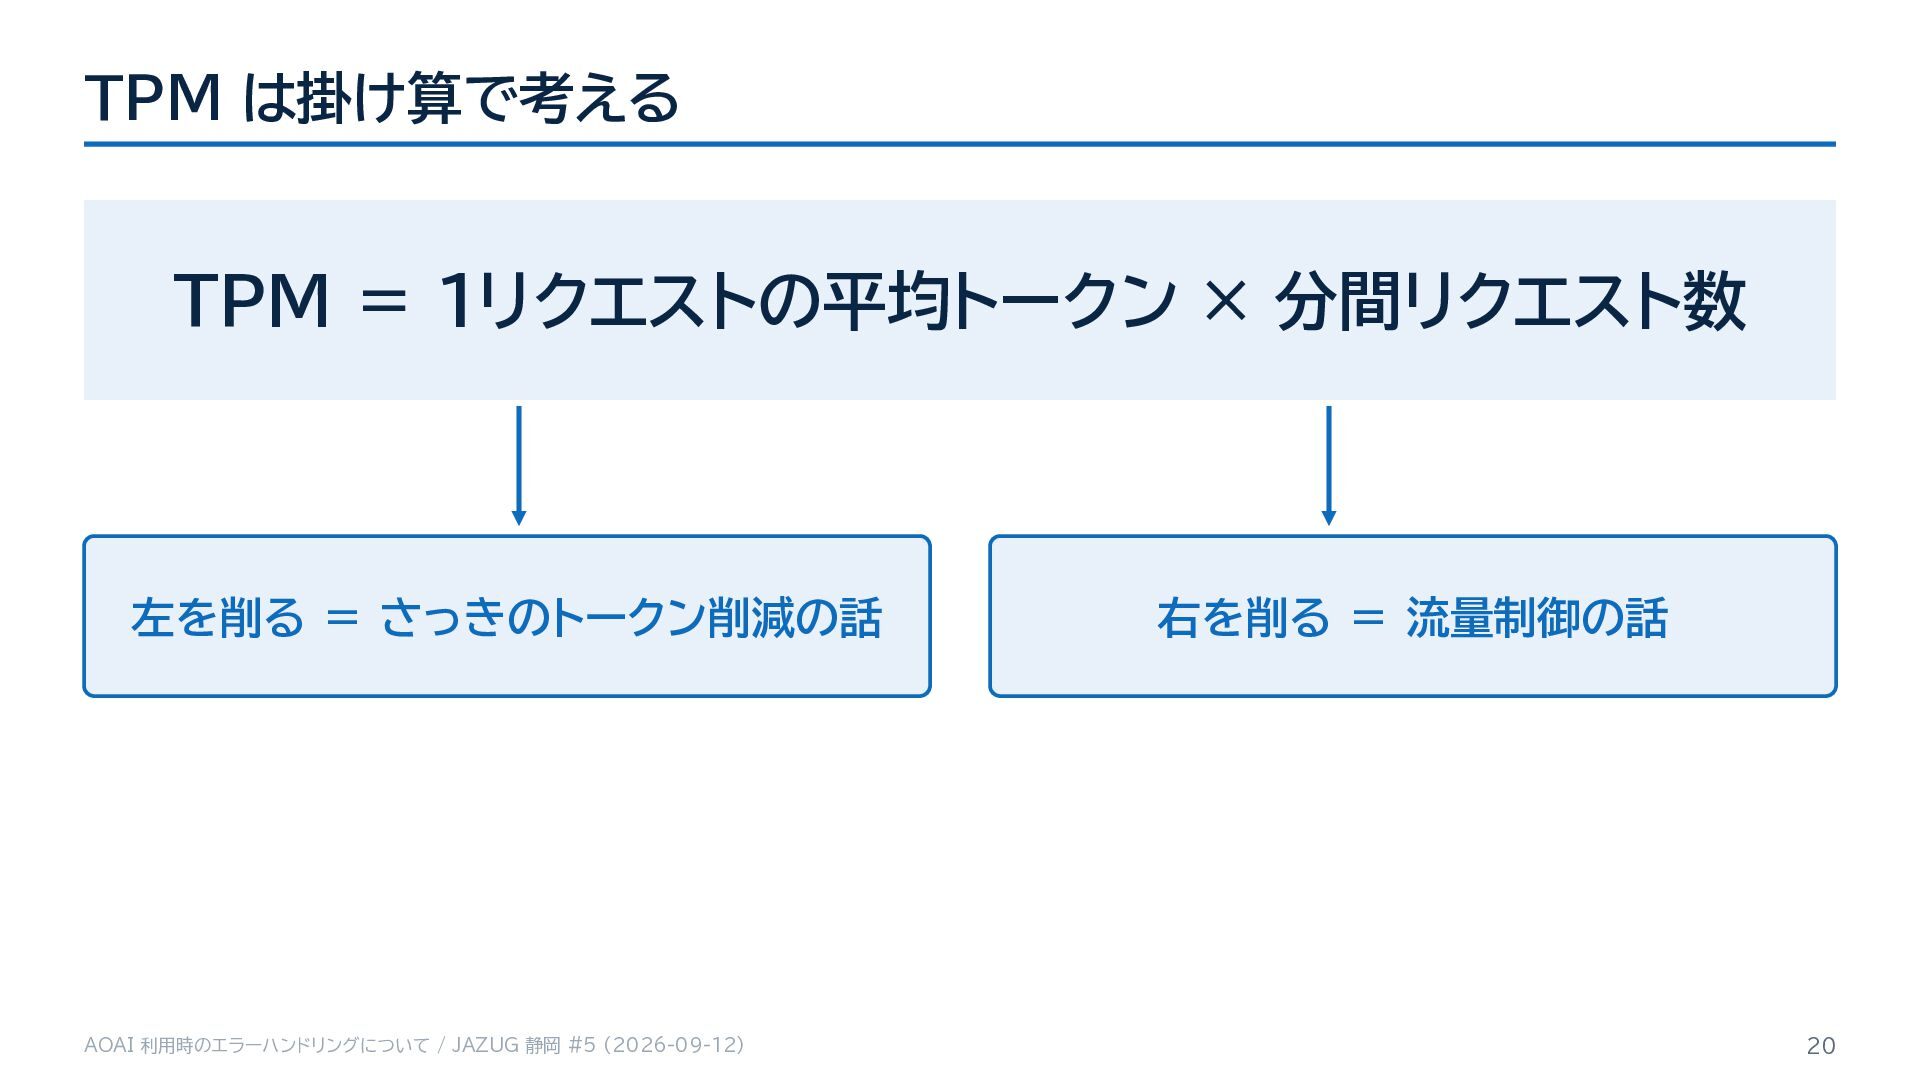
  16. TPM は掛け算で考える TPM = 1リクエストの平均トークン × 分間リクエスト数 左を削る = さっきのトークン削減の話

    AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 右を削る = 流量制御の話 20
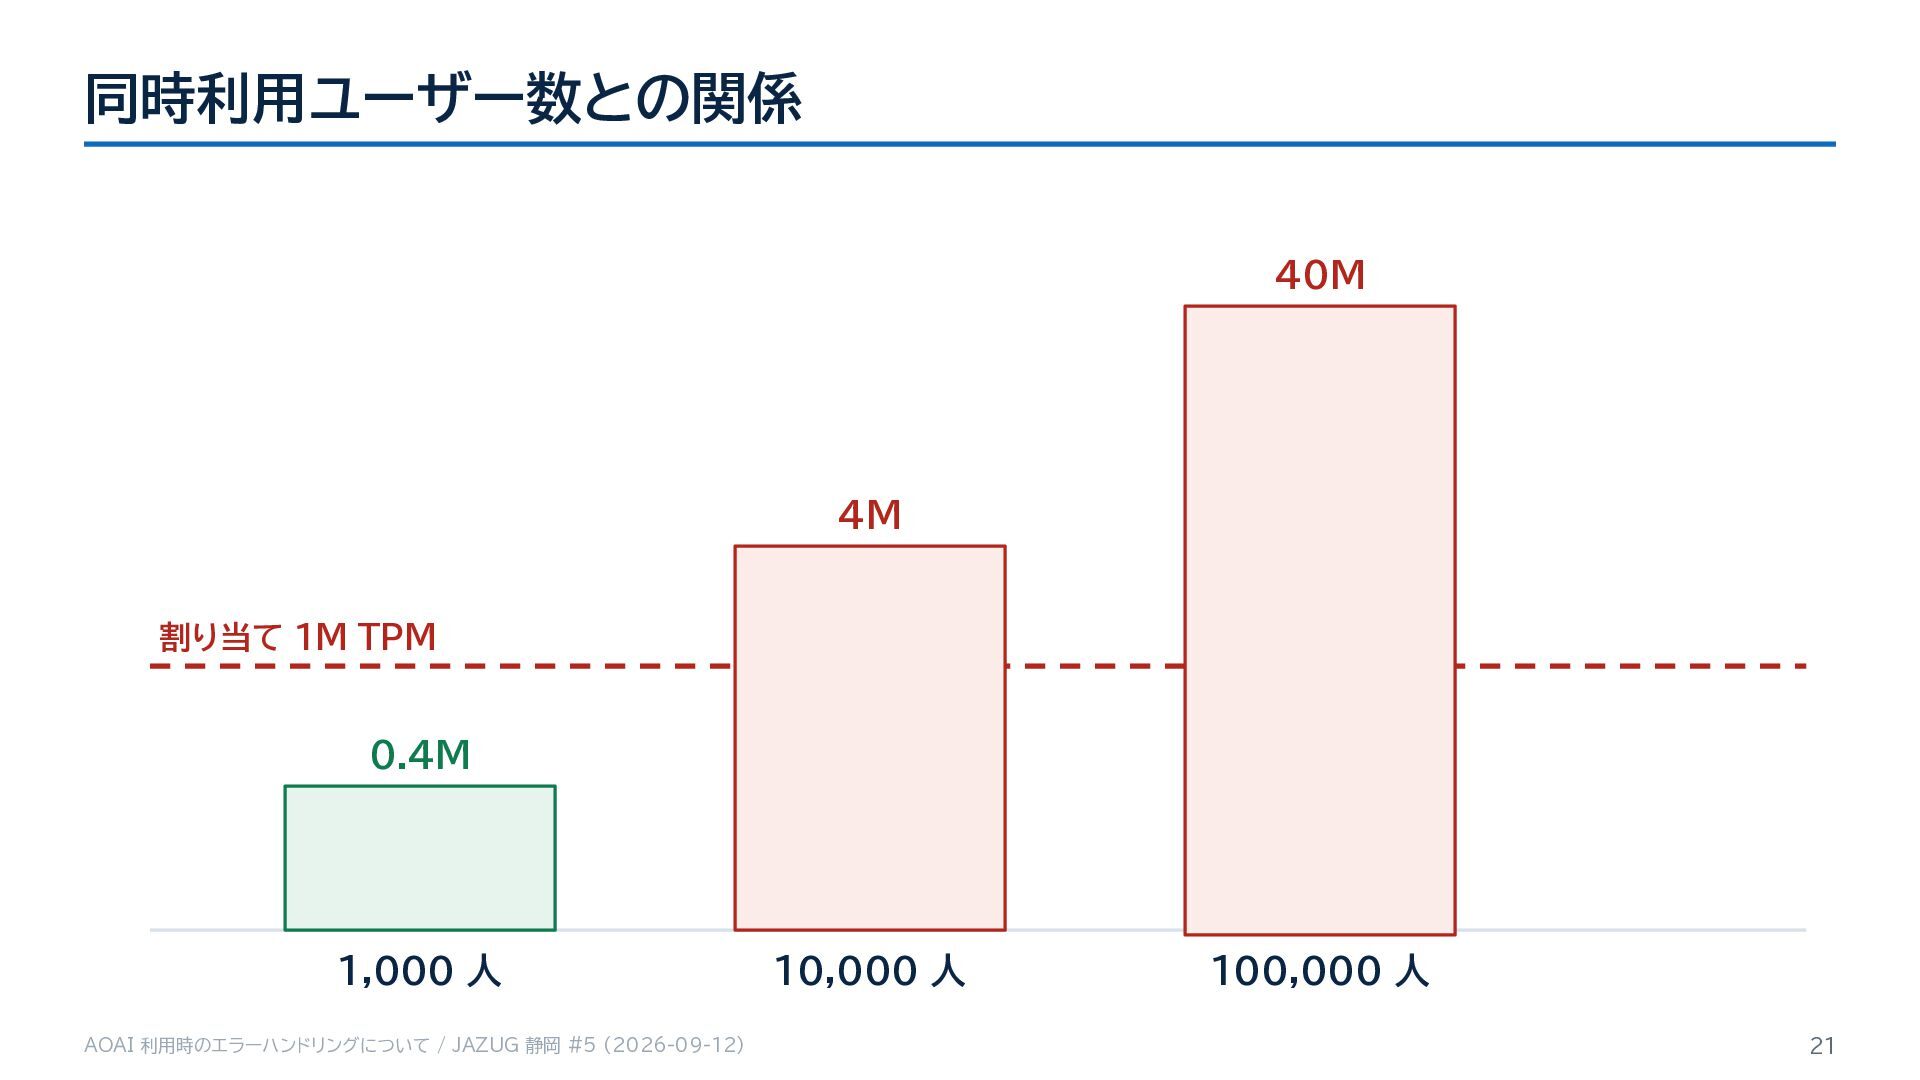
  17. 同時利用ユーザー数との関係 40M 4M 割り当て 1M TPM 0.4M 1,000 人 AOAI

    利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 10,000 人 100,000 人 21
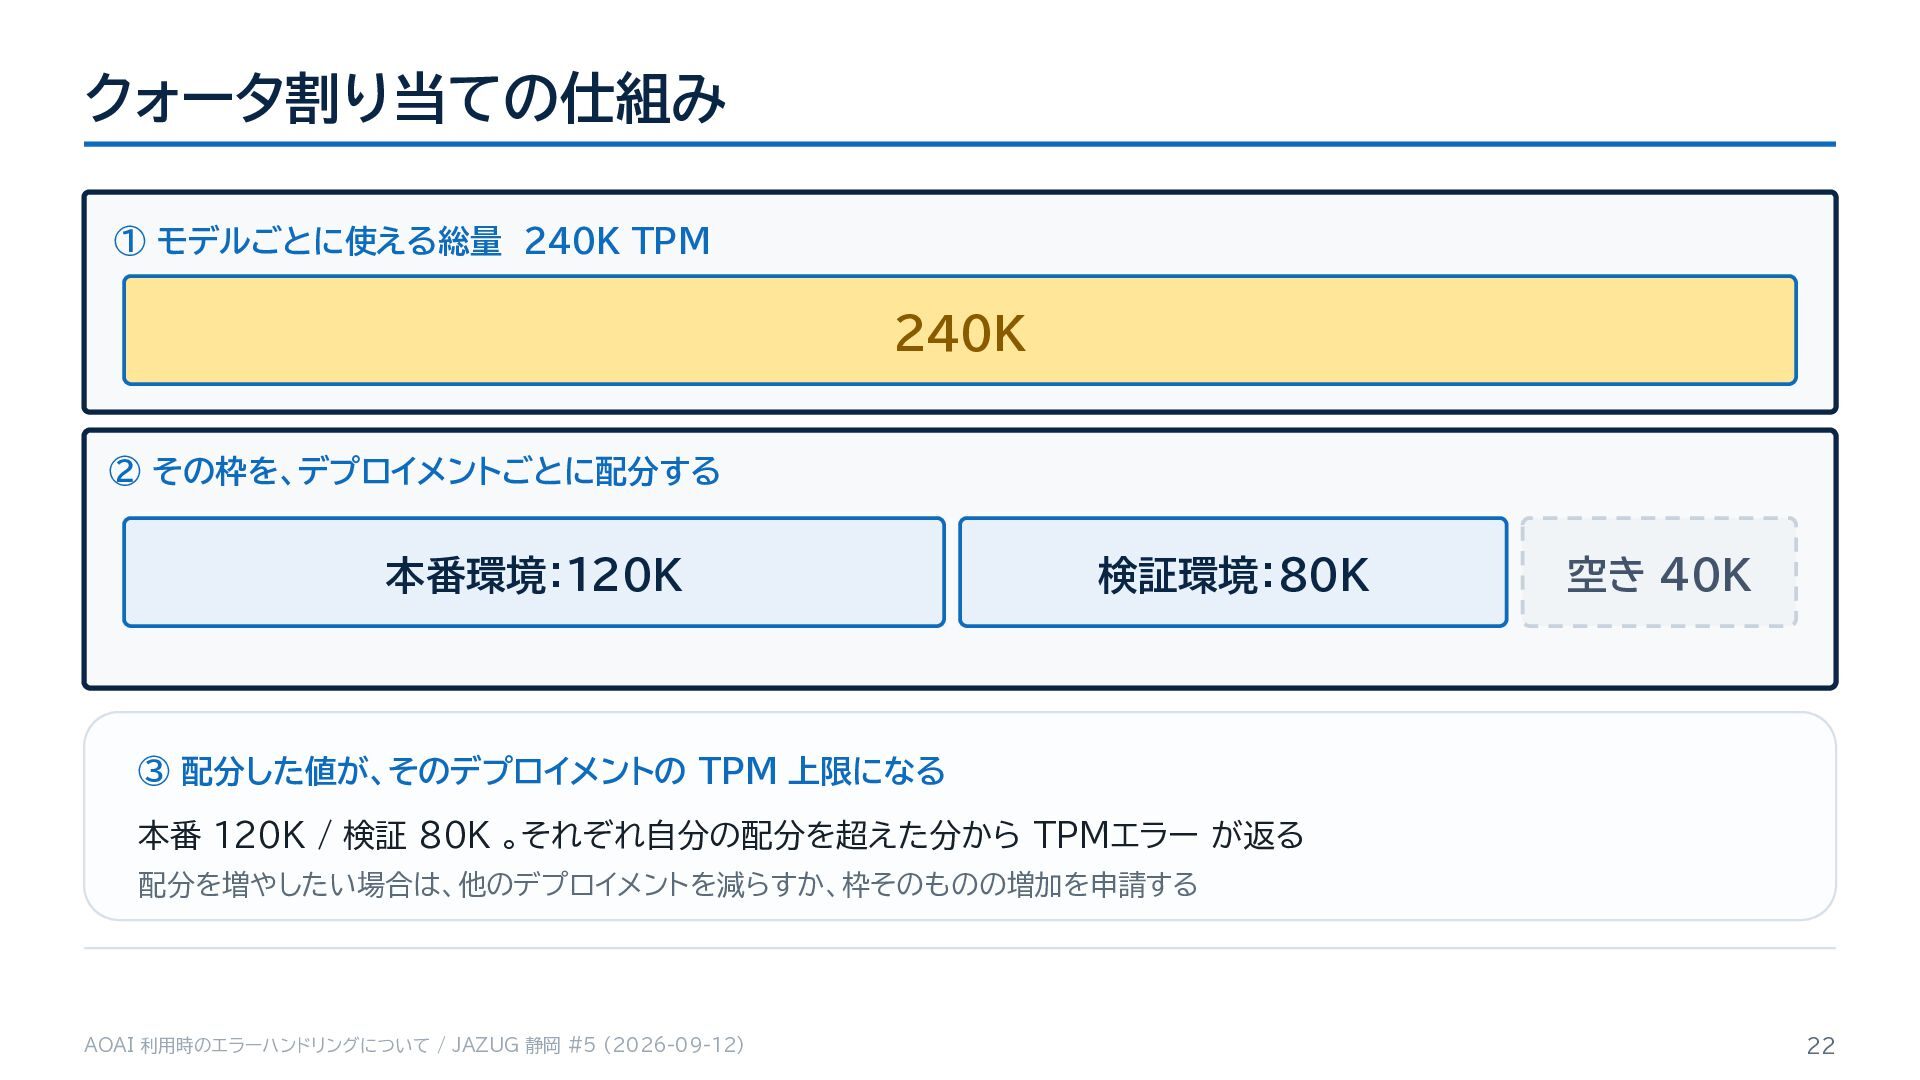
  18. クォータ割り当ての仕組み ① モデルごとに使える総量 240K TPM 240K ② その枠を、デプロイメントごとに配分する 本番環境:120K 検証環境:80K

    空き 40K ③ 配分した値が、そのデプロイメントの TPM 上限になる 本番 120K / 検証 80K 。それぞれ自分の配分を超えた分から TPMエラー が返る 配分を増やしたい場合は、他のデプロイメントを減らすか、枠そのものの増加を申請する AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 22
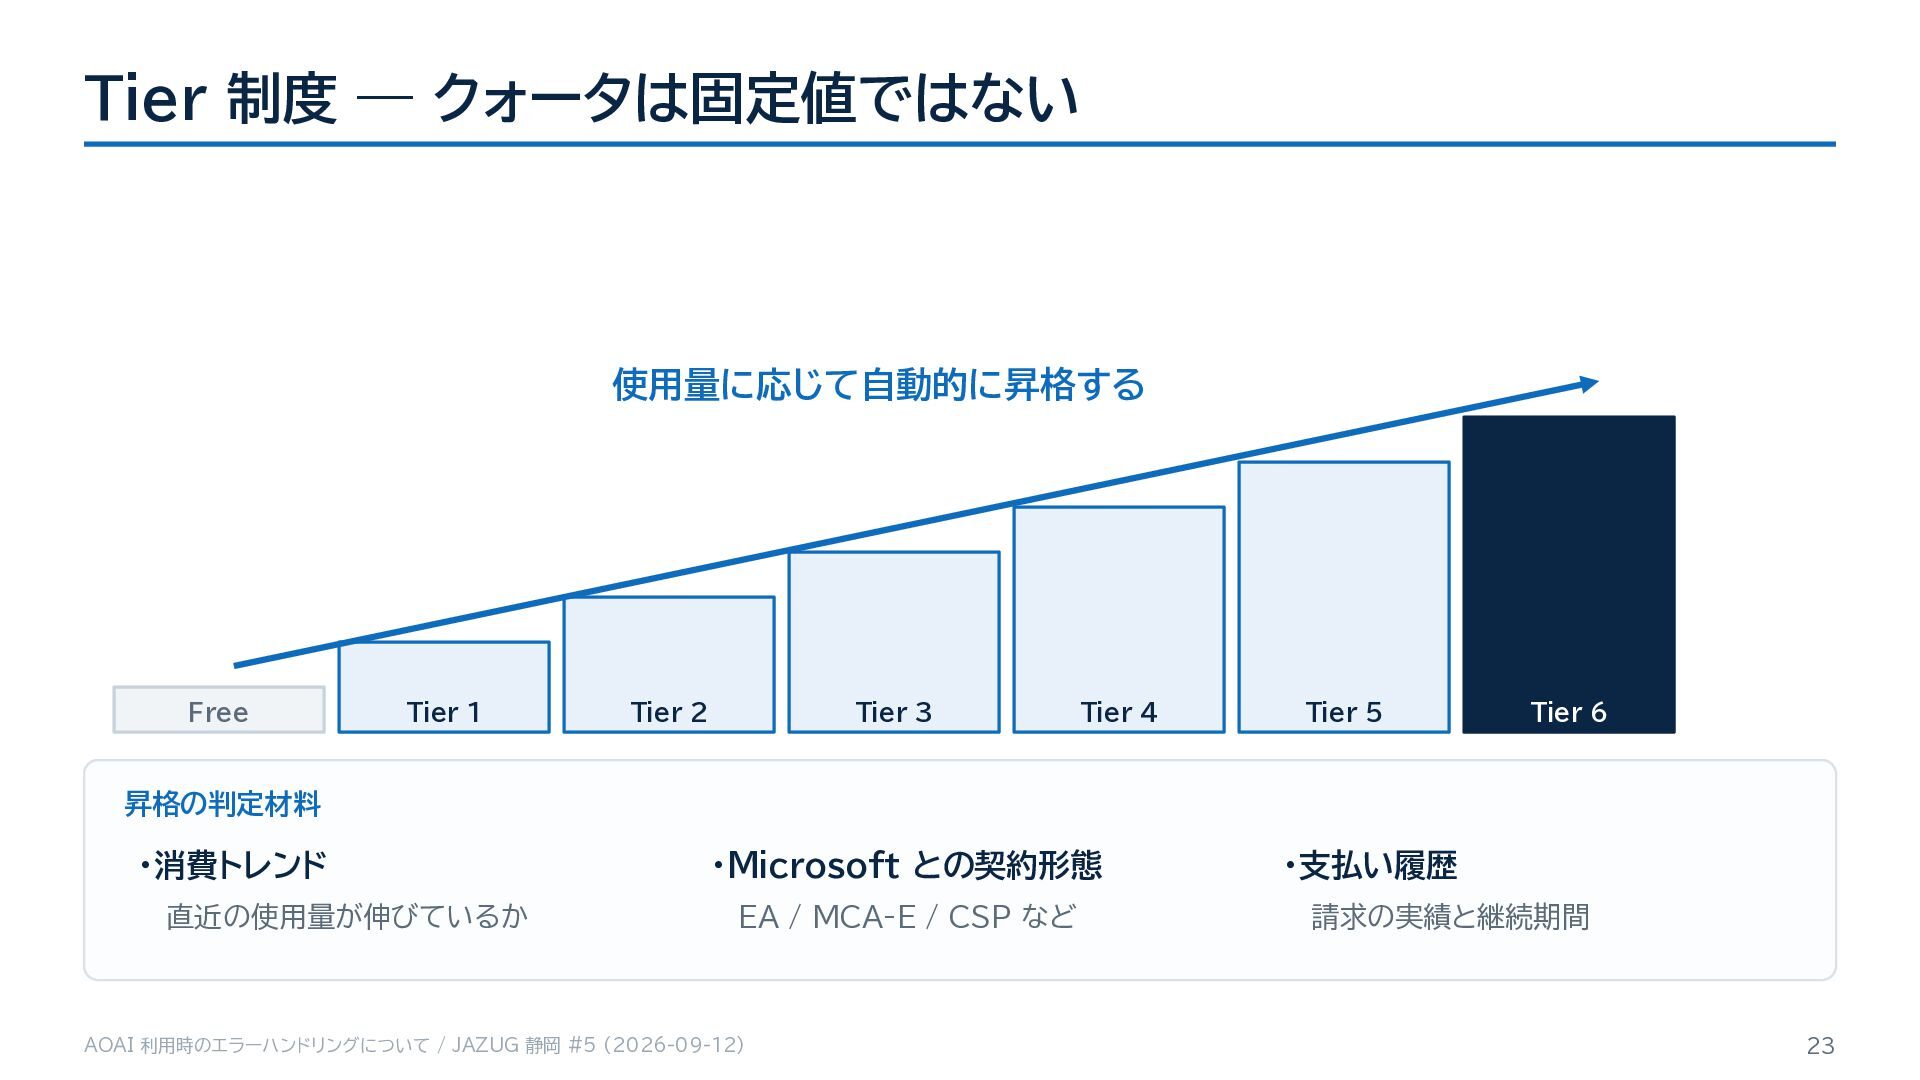
  19. Tier 制度 — クォータは固定値ではない 使用量に応じて自動的に昇格する Free Tier 1 Tier 2

    Tier 3 Tier 4 Tier 5 Tier 6 昇格の判定材料 ・消費トレンド 直近の使用量が伸びているか ・Microsoft との契約形態 EA / MCA-E / CSP など AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) ・支払い履歴 請求の実績と継続期間 23
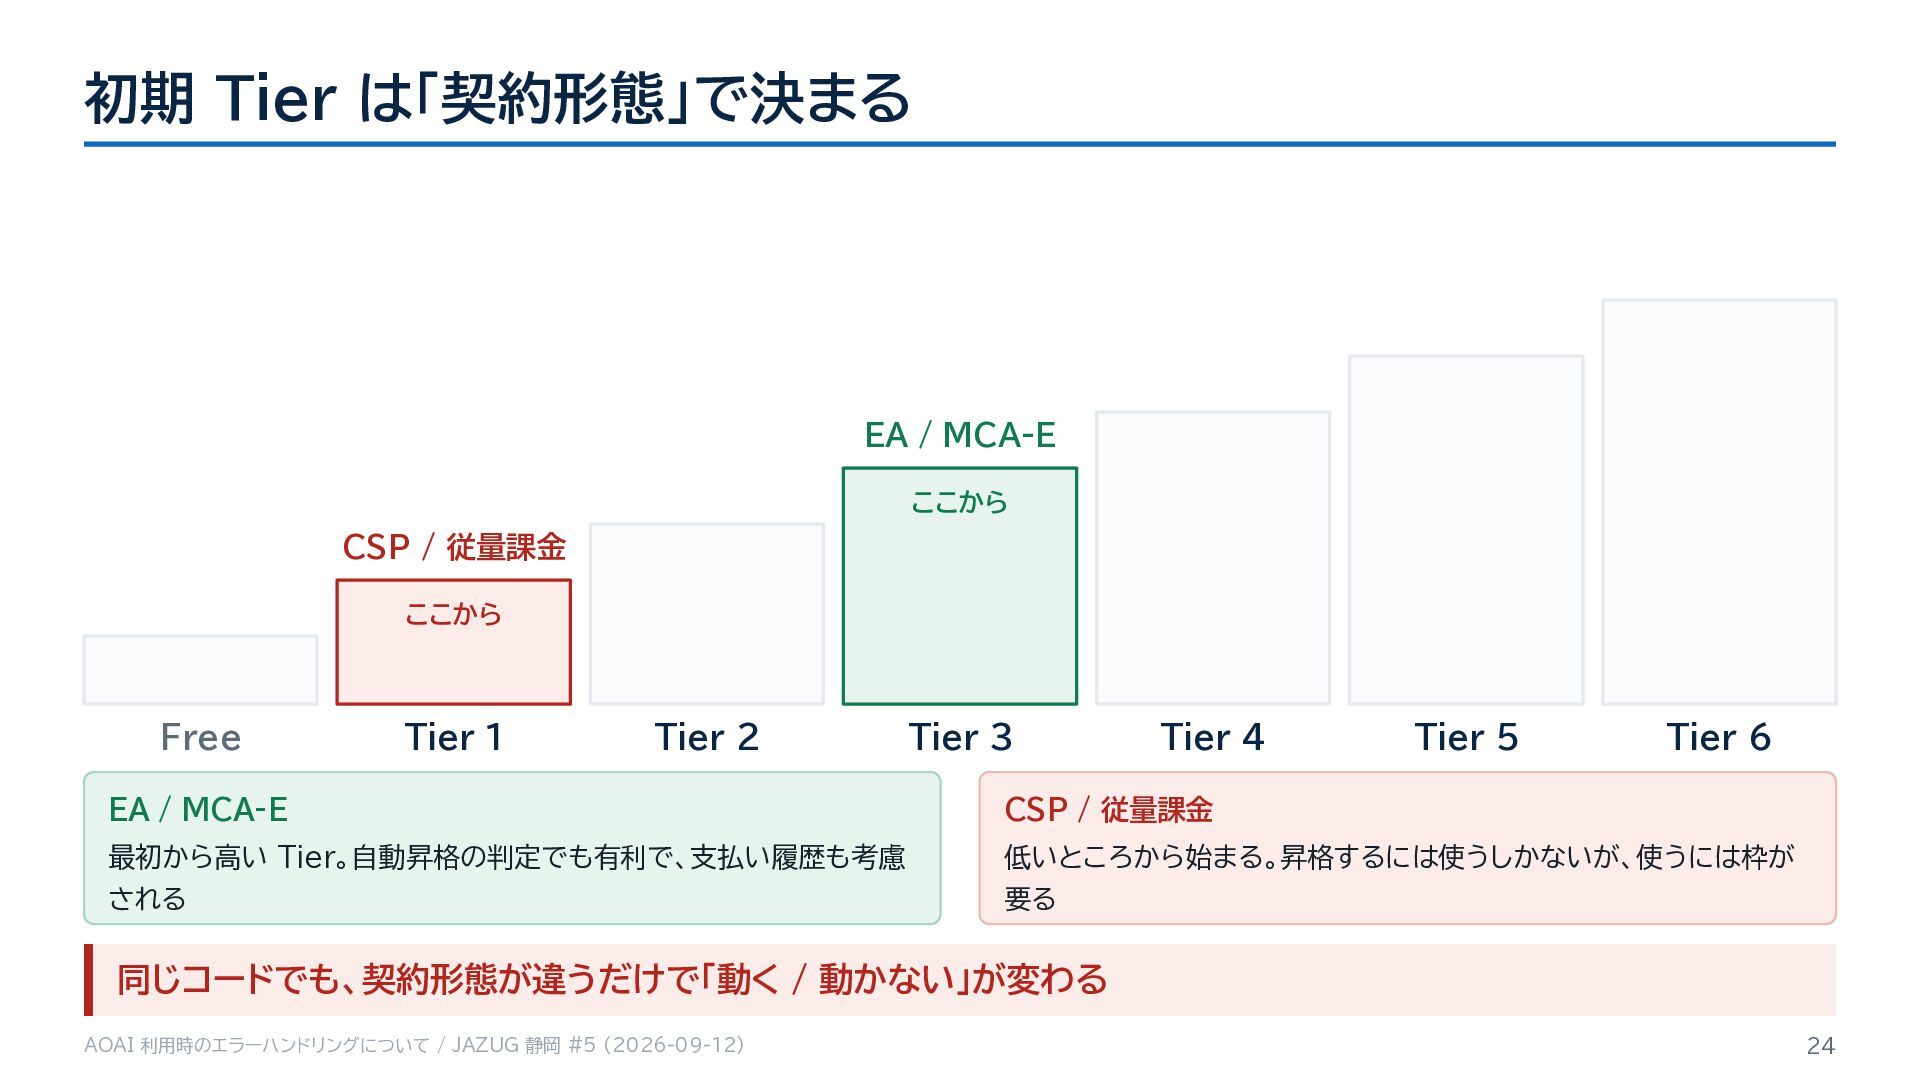
  20. 初期 Tier は「契約形態」で決まる EA / MCA-E ここから CSP / 従量課金

    ここから Free Tier 1 Tier 2 Tier 3 Tier 4 Tier 5 Tier 6 EA / MCA-E CSP / 従量課金 最初から高い Tier。自動昇格の判定でも有利で、支払い履歴も考慮 低いところから始まる。昇格するには使うしかないが、使うには枠が される 要る 同じコードでも、契約形態が違うだけで「動く / 動かない」が変わる AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 24
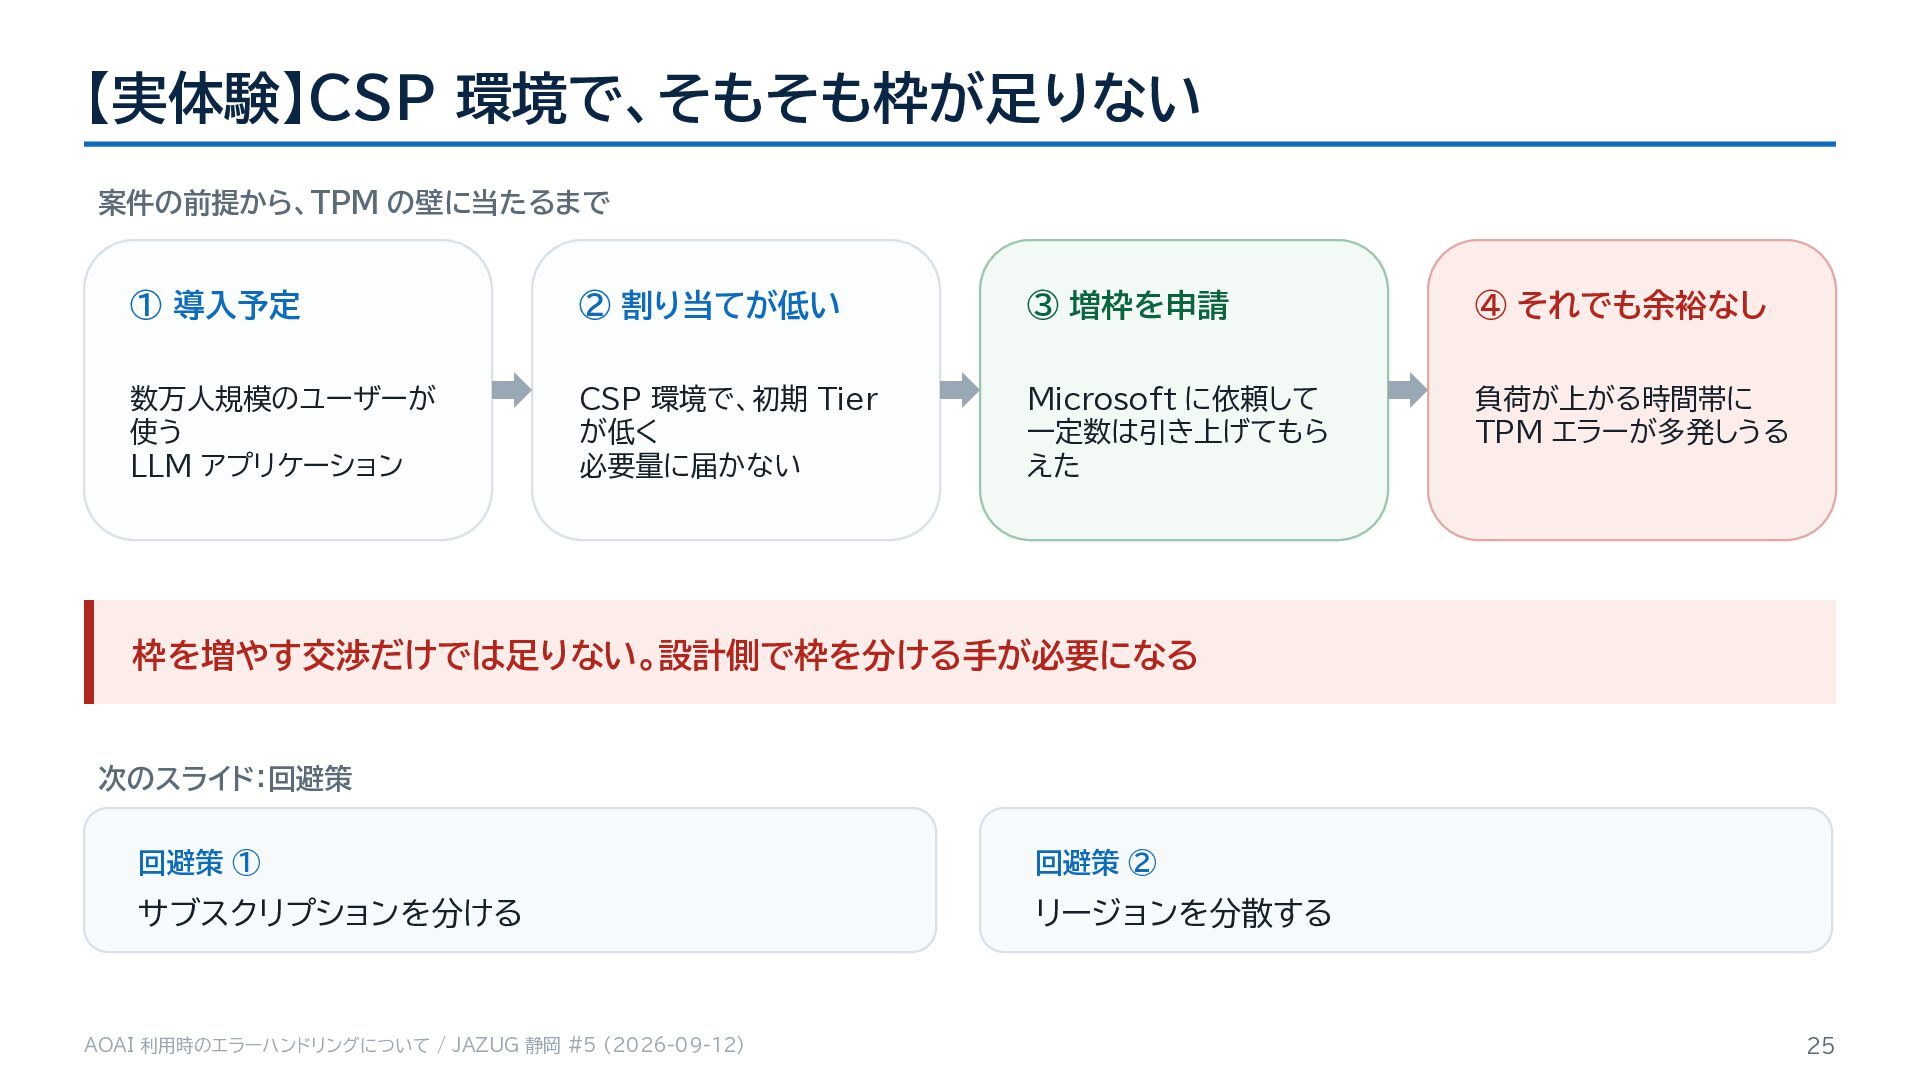
  21. 【実体験】CSP 環境で、そもそも枠が足りない 案件の前提から、TPM の壁に当たるまで ① 導入予定 ② 割り当てが低い ③ 増枠を申請

    ④ それでも余裕なし 数万人規模のユーザーが 使う LLM アプリケーション CSP 環境で、初期 Tier が低く 必要量に届かない Microsoft に依頼して 一定数は引き上げてもら えた 負荷が上がる時間帯に TPM エラーが多発しうる 枠を増やす交渉だけでは足りない。設計側で枠を分ける手が必要になる 次のスライド:回避策 回避策 ① 回避策 ② サブスクリプションを分ける リージョンを分散する AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 25
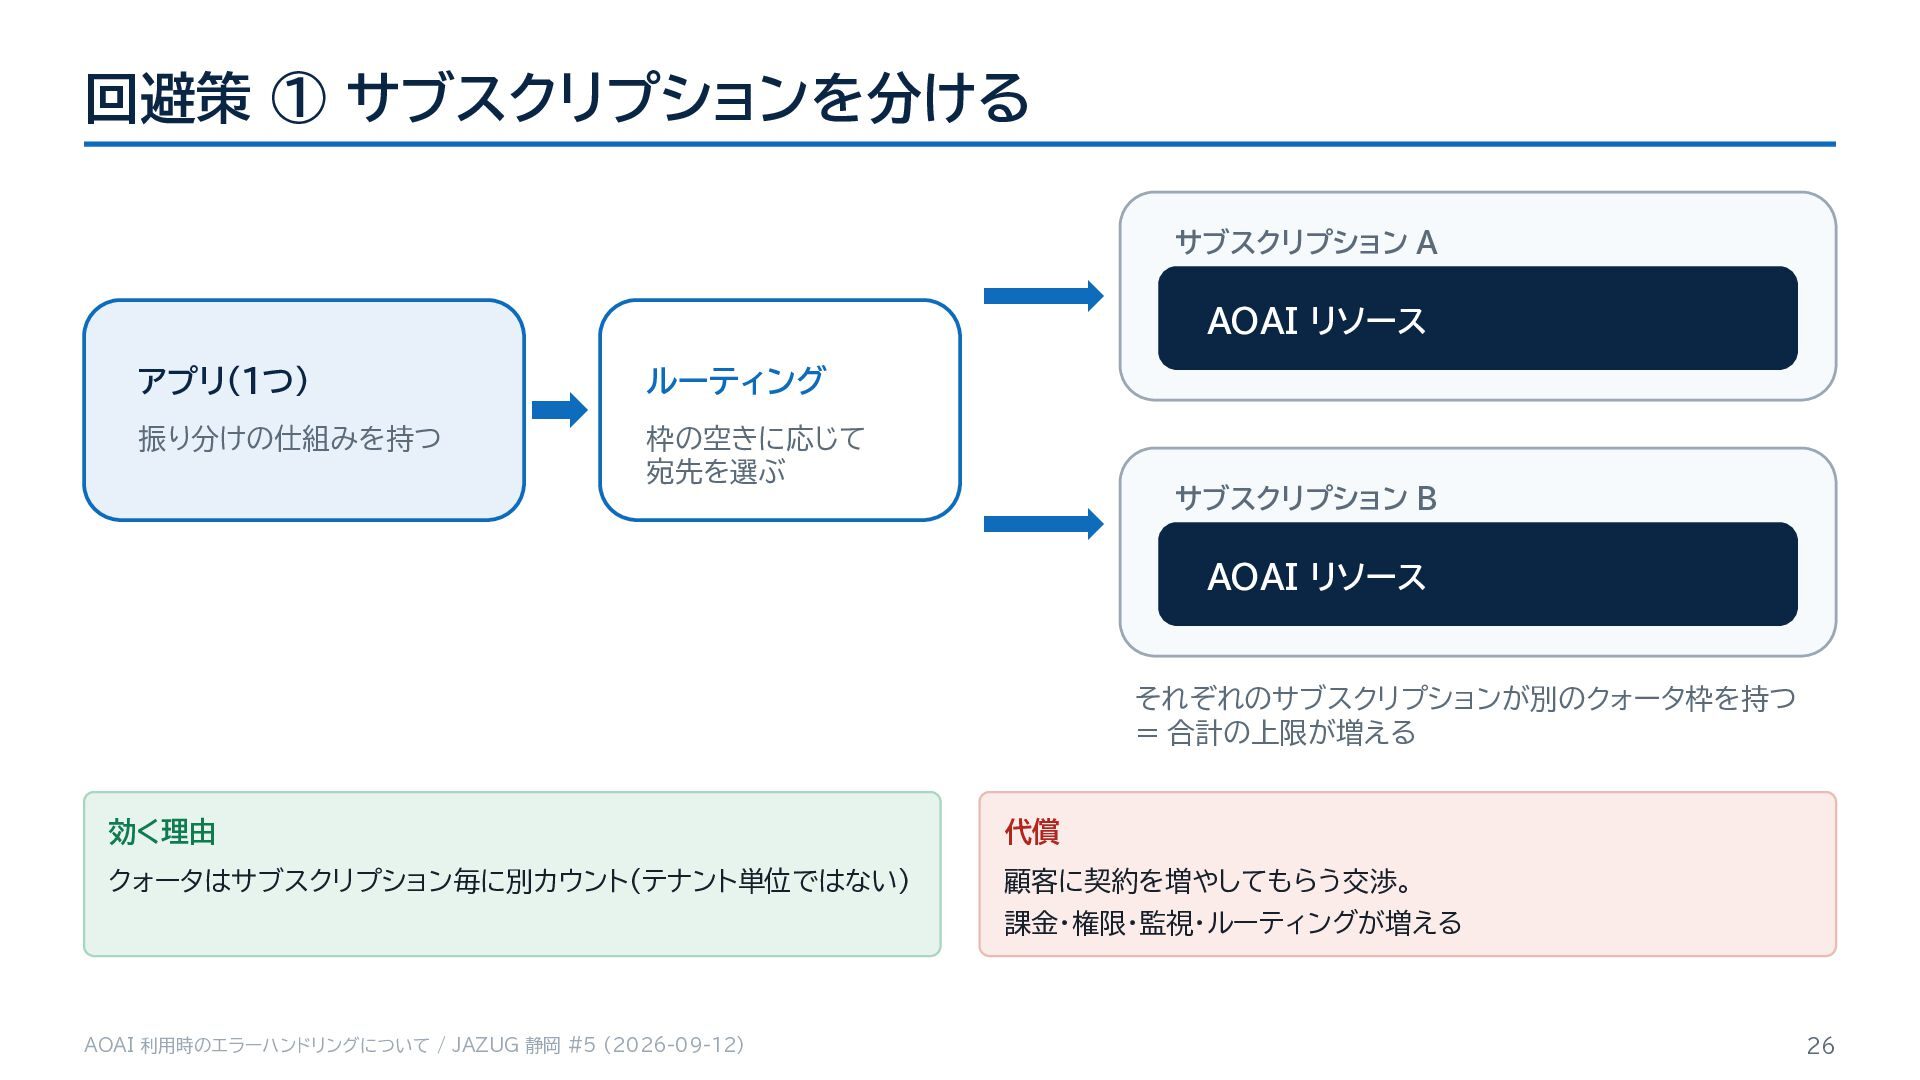
  22. 回避策 ① サブスクリプションを分ける サブスクリプション A AOAI リソース アプリ(1つ) ルーティング 振り分けの仕組みを持つ

    枠の空きに応じて 宛先を選ぶ サブスクリプション B AOAI リソース それぞれのサブスクリプションが別のクォータ枠を持つ = 合計の上限が増える 効く理由 代償 クォータはサブスクリプション毎に別カウント(テナント単位ではない) 顧客に契約を増やしてもらう交渉。 課金・権限・監視・ルーティングが増える AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 26
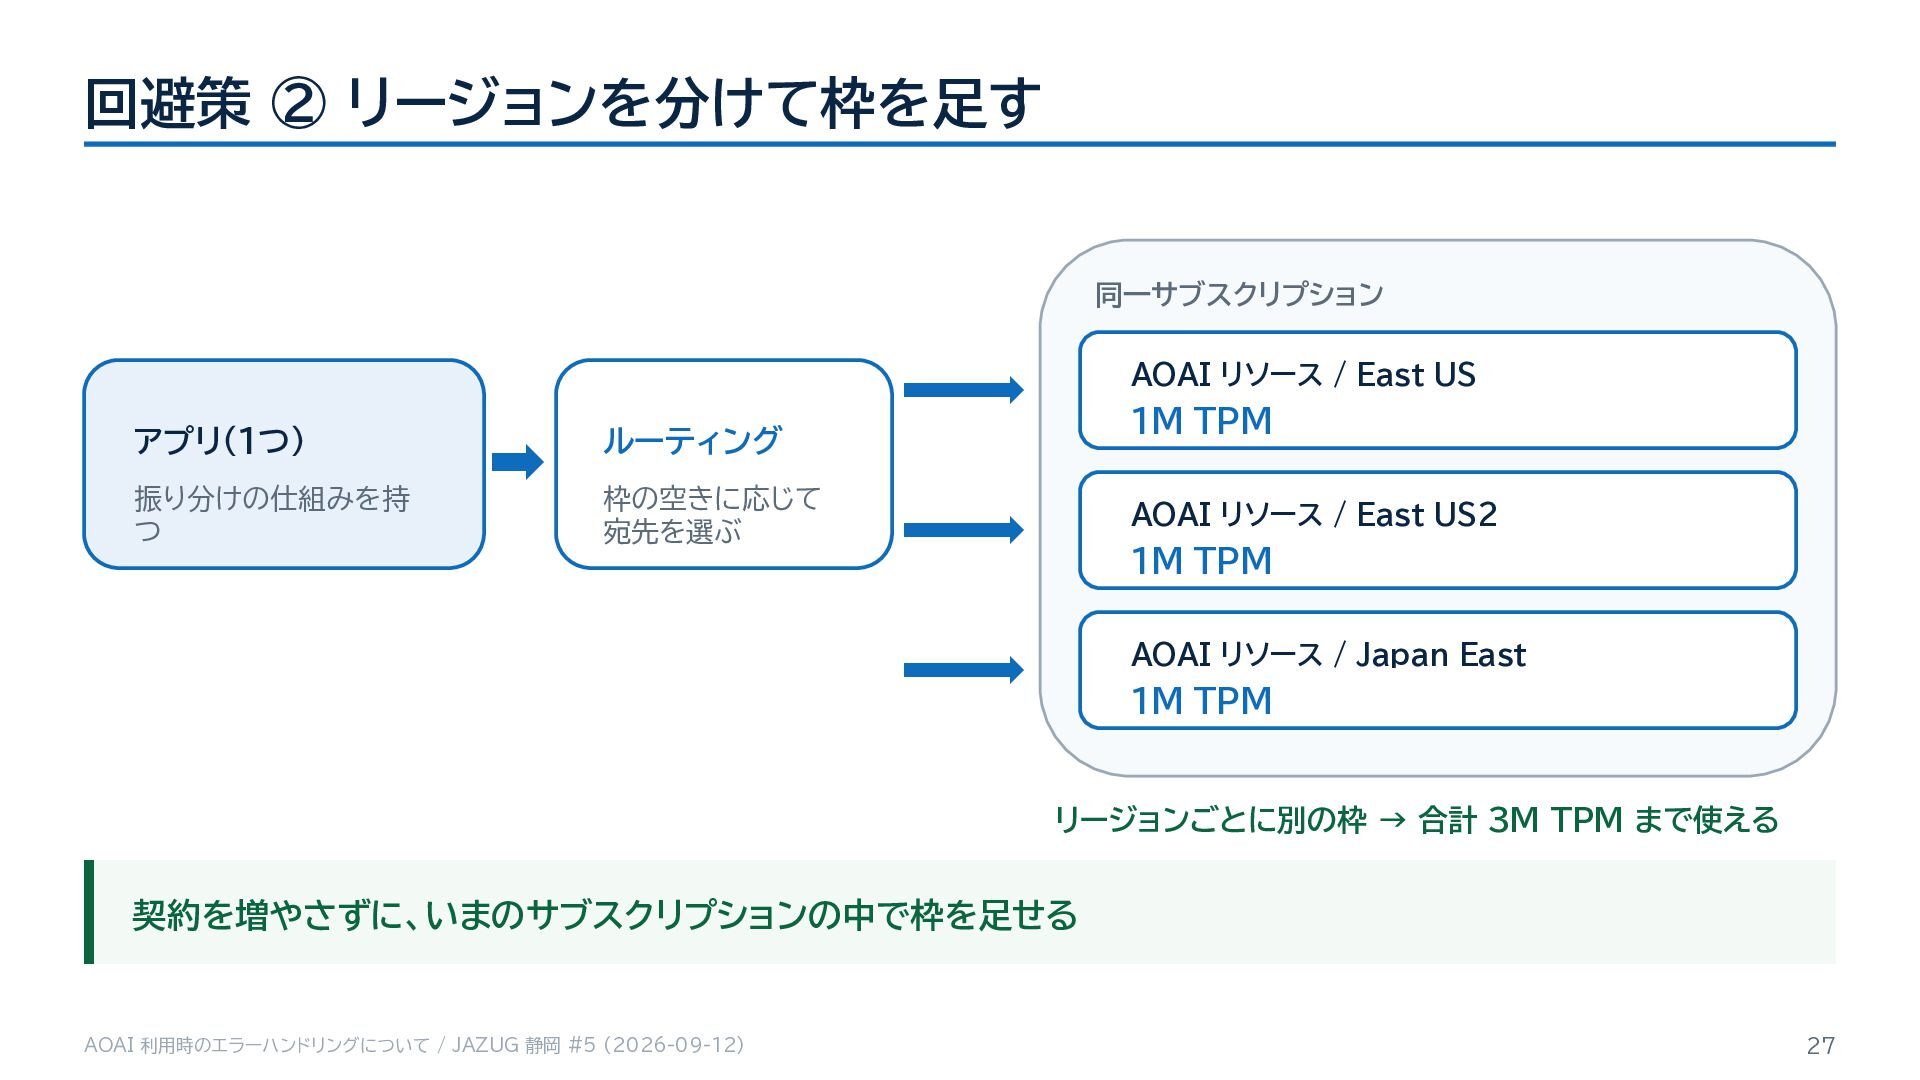
  23. 回避策 ② リージョンを分けて枠を足す 同一サブスクリプション AOAI リソース / East US アプリ(1つ)

    ルーティング 振り分けの仕組みを持 つ 枠の空きに応じて 宛先を選ぶ 1M TPM AOAI リソース / East US2 1M TPM AOAI リソース / Japan East 1M TPM リージョンごとに別の枠 → 合計 3M TPM まで使える 契約を増やさずに、いまのサブスクリプションの中で枠を足せる AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 27
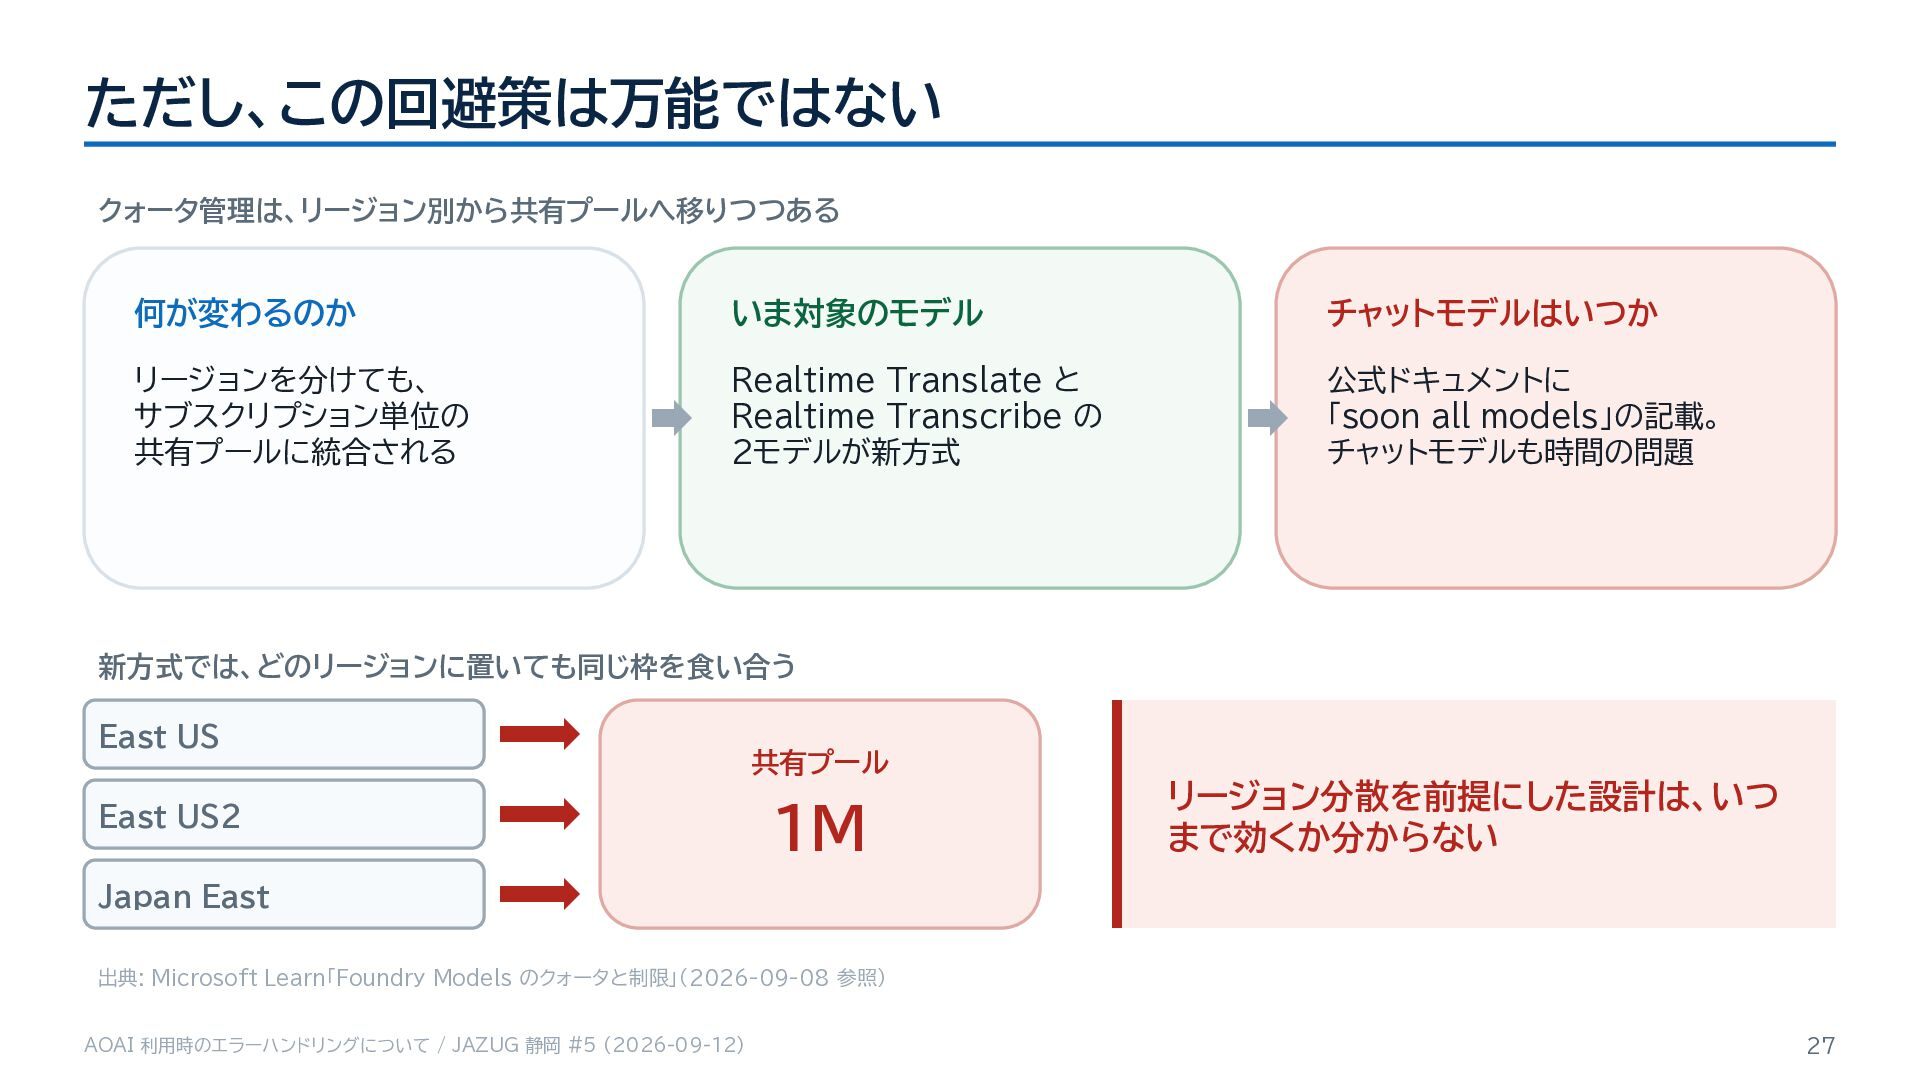
  24. ただし、この回避策は万能ではない クォータ管理は、リージョン別から共有プールへ移りつつある 何が変わるのか いま対象のモデル チャットモデルはいつか リージョンを分けても、 サブスクリプション単位の 共有プールに統合される Realtime Translate

    と Realtime Transcribe の 2モデルが新方式 公式ドキュメントに 「soon all models」の記載。 チャットモデルも時間の問題 新方式では、どのリージョンに置いても同じ枠を食い合う East US East US2 共有プール 1M リージョン分散を前提にした設計は、いつ まで効くか分からない Japan East 出典: Microsoft Learn「Foundry Models のクォータと制限」(2026-09-08 参照) AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 27
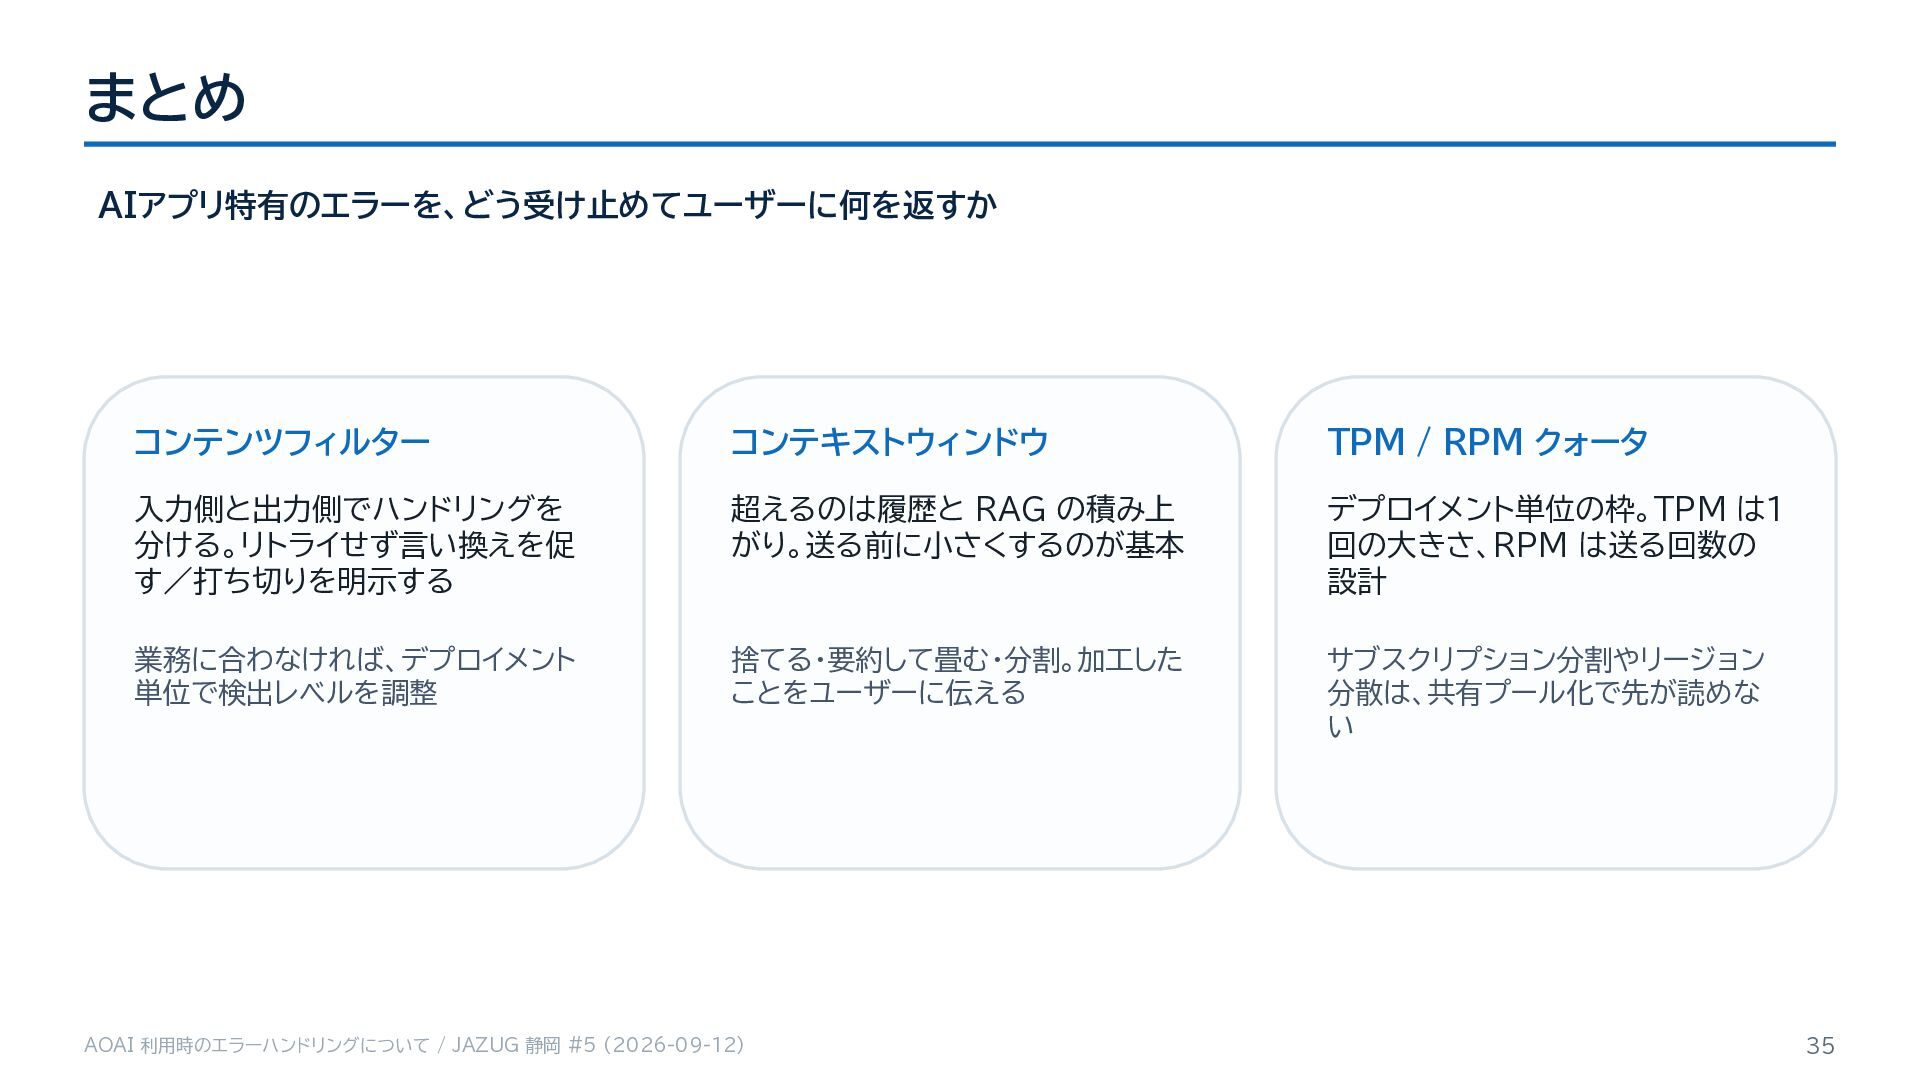
  25. まとめ AIアプリ特有のエラーを、どう受け止めてユーザーに何を返すか コンテンツフィルター コンテキストウィンドウ TPM / RPM クォータ 入力側と出力側でハンドリングを 分ける。リトライせず言い換えを促

    す/打ち切りを明示する 超えるのは履歴と RAG の積み上 がり。送る前に小さくするのが基本 デプロイメント単位の枠。TPM は1 回の大きさ、RPM は送る回数の 設計 業務に合わなければ、デプロイメント 単位で検出レベルを調整 捨てる・要約して畳む・分割。加工した ことをユーザーに伝える サブスクリプション分割やリージョン 分散は、共有プール化で先が読めな い AOAI 利用時のエラーハンドリングについて / JAZUG 静岡 #5 (2026-09-12) 35