Upgrade to Pro — share decks privately, control downloads, hide ads and more …

今から学ぶベクトルデータベース 基礎知識からAmazon Bedrock Knowledge ...

Sponsored · SiteGround - Reliable hosting with speed, security, and support you can count on.

今から学ぶベクトルデータベース 基礎知識からAmazon Bedrock Knowledge Basesまで

Avatar for Satoshi Kaneyasu
Satoshi Kaneyasu

September 15, 2026

More Decks by Satoshi Kaneyasu

Other Decks in Programming

Transcript

  1. Speaker Introduction 氏名:兼安 聡 所属:株式会社サーバーワークス アプリケーションサービス本部 在住:広島 担当: PM、SM、DevOps、仕様駆動開発 SNS(X):@satoshi256kbyte

    • • • • • • 2026 Japan AWS Ambassadors 2024-26 Japan AWS Top Engineers 2024-26 Japan AWS All Certifications Engineers 2025-26 AWS Community Builders 認定スクラムマスター PMP 2
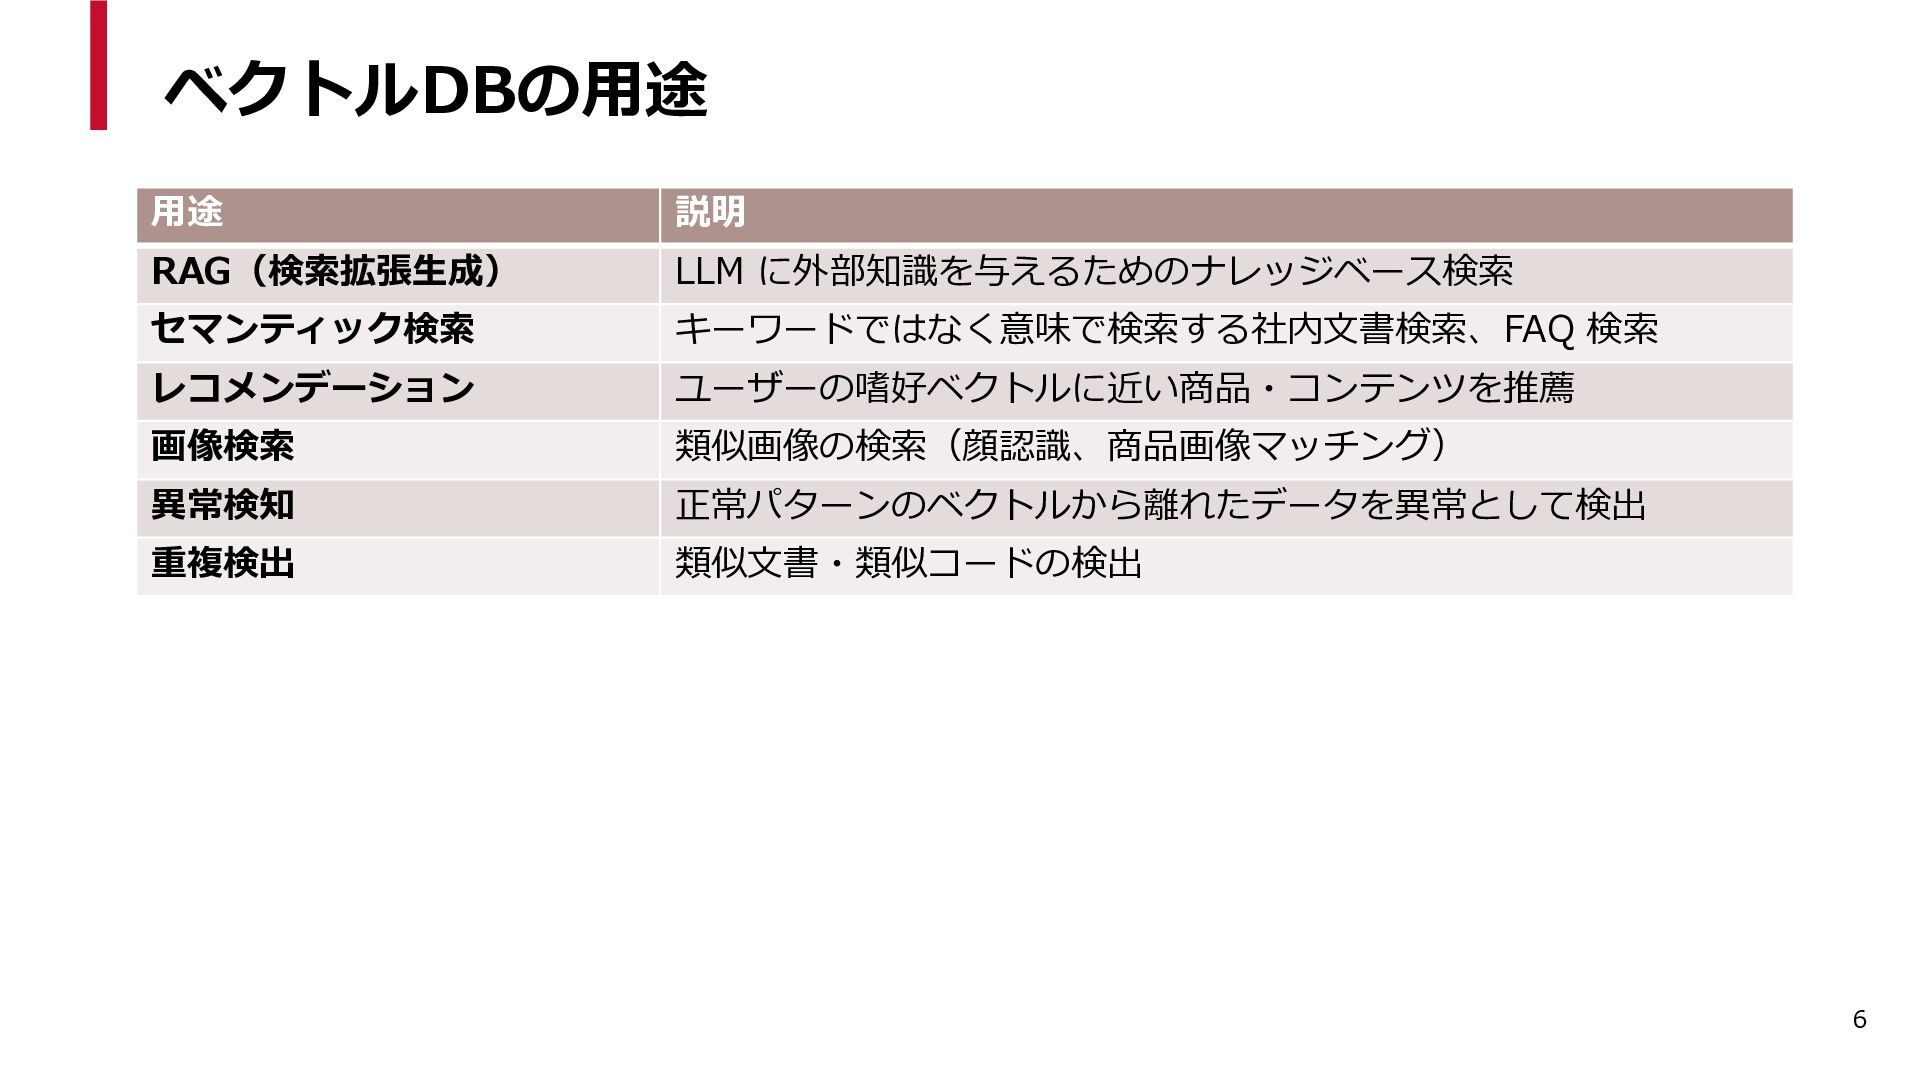
  2. ベクトルDBの用途 用途 説明 RAG(検索拡張生成) LLM に外部知識を与えるためのナレッジベース検索 セマンティック検索 キーワードではなく意味で検索する社内文書検索、FAQ 検索 レコメンデーション

    ユーザーの嗜好ベクトルに近い商品・コンテンツを推薦 画像検索 類似画像の検索(顔認識、商品画像マッチング) 異常検知 正常パターンのベクトルから離れたデータを異常として検出 重複検出 類似文書・類似コードの検出 6
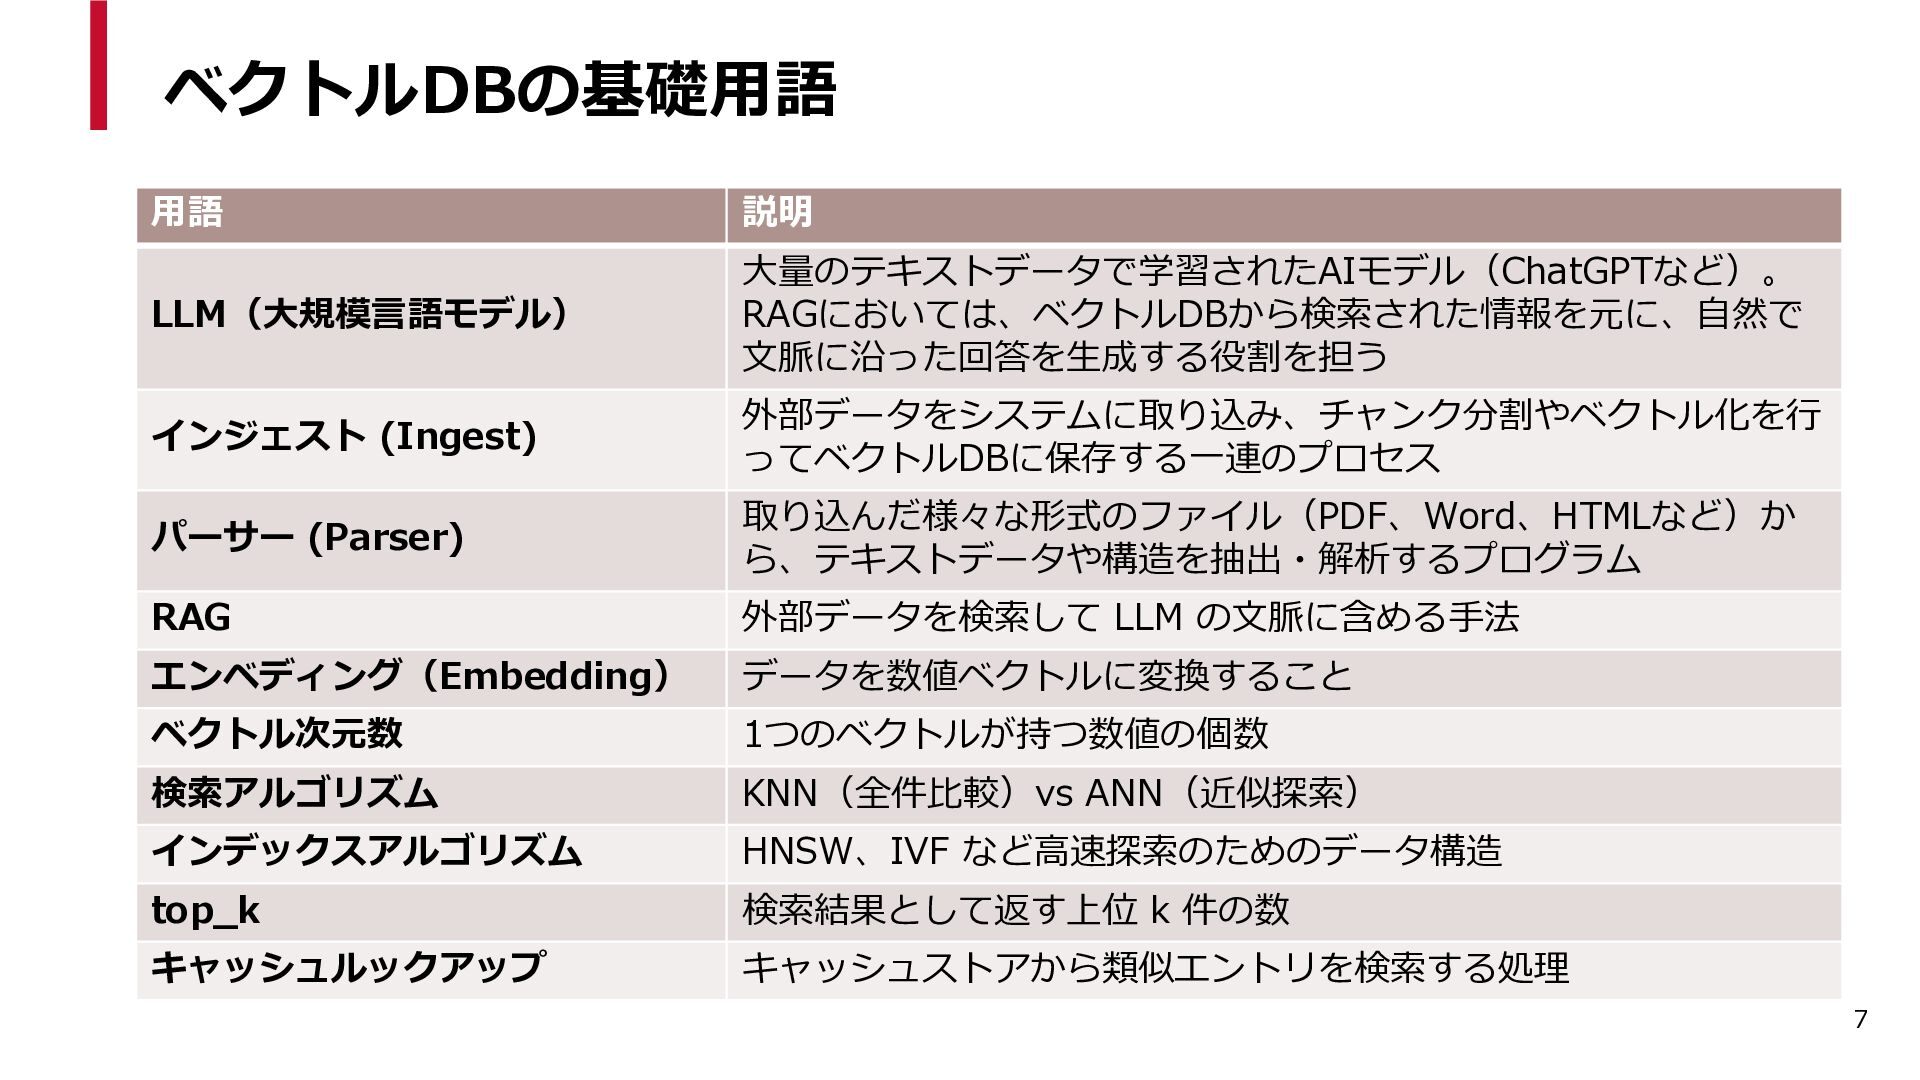
  3. ベクトルDBの基礎用語 用語 説明 LLM(大規模言語モデル) 大量のテキストデータで学習されたAIモデル(ChatGPTなど)。 RAGにおいては、ベクトルDBから検索された情報を元に、自然で 文脈に沿った回答を生成する役割を担う インジェスト (Ingest) 外部データをシステムに取り込み、チャンク分割やベクトル化を行

    ってベクトルDBに保存する一連のプロセス パーサー (Parser) 取り込んだ様々な形式のファイル(PDF、Word、HTMLなど)か ら、テキストデータや構造を抽出・解析するプログラム RAG 外部データを検索して LLM の文脈に含める手法 エンベディング(Embedding) データを数値ベクトルに変換すること ベクトル次元数 1つのベクトルが持つ数値の個数 検索アルゴリズム KNN(全件比較)vs ANN(近似探索) インデックスアルゴリズム HNSW、IVF など高速探索のためのデータ構造 top_k 検索結果として返す上位 k 件の数 キャッシュルックアップ キャッシュストアから類似エントリを検索する処理 7
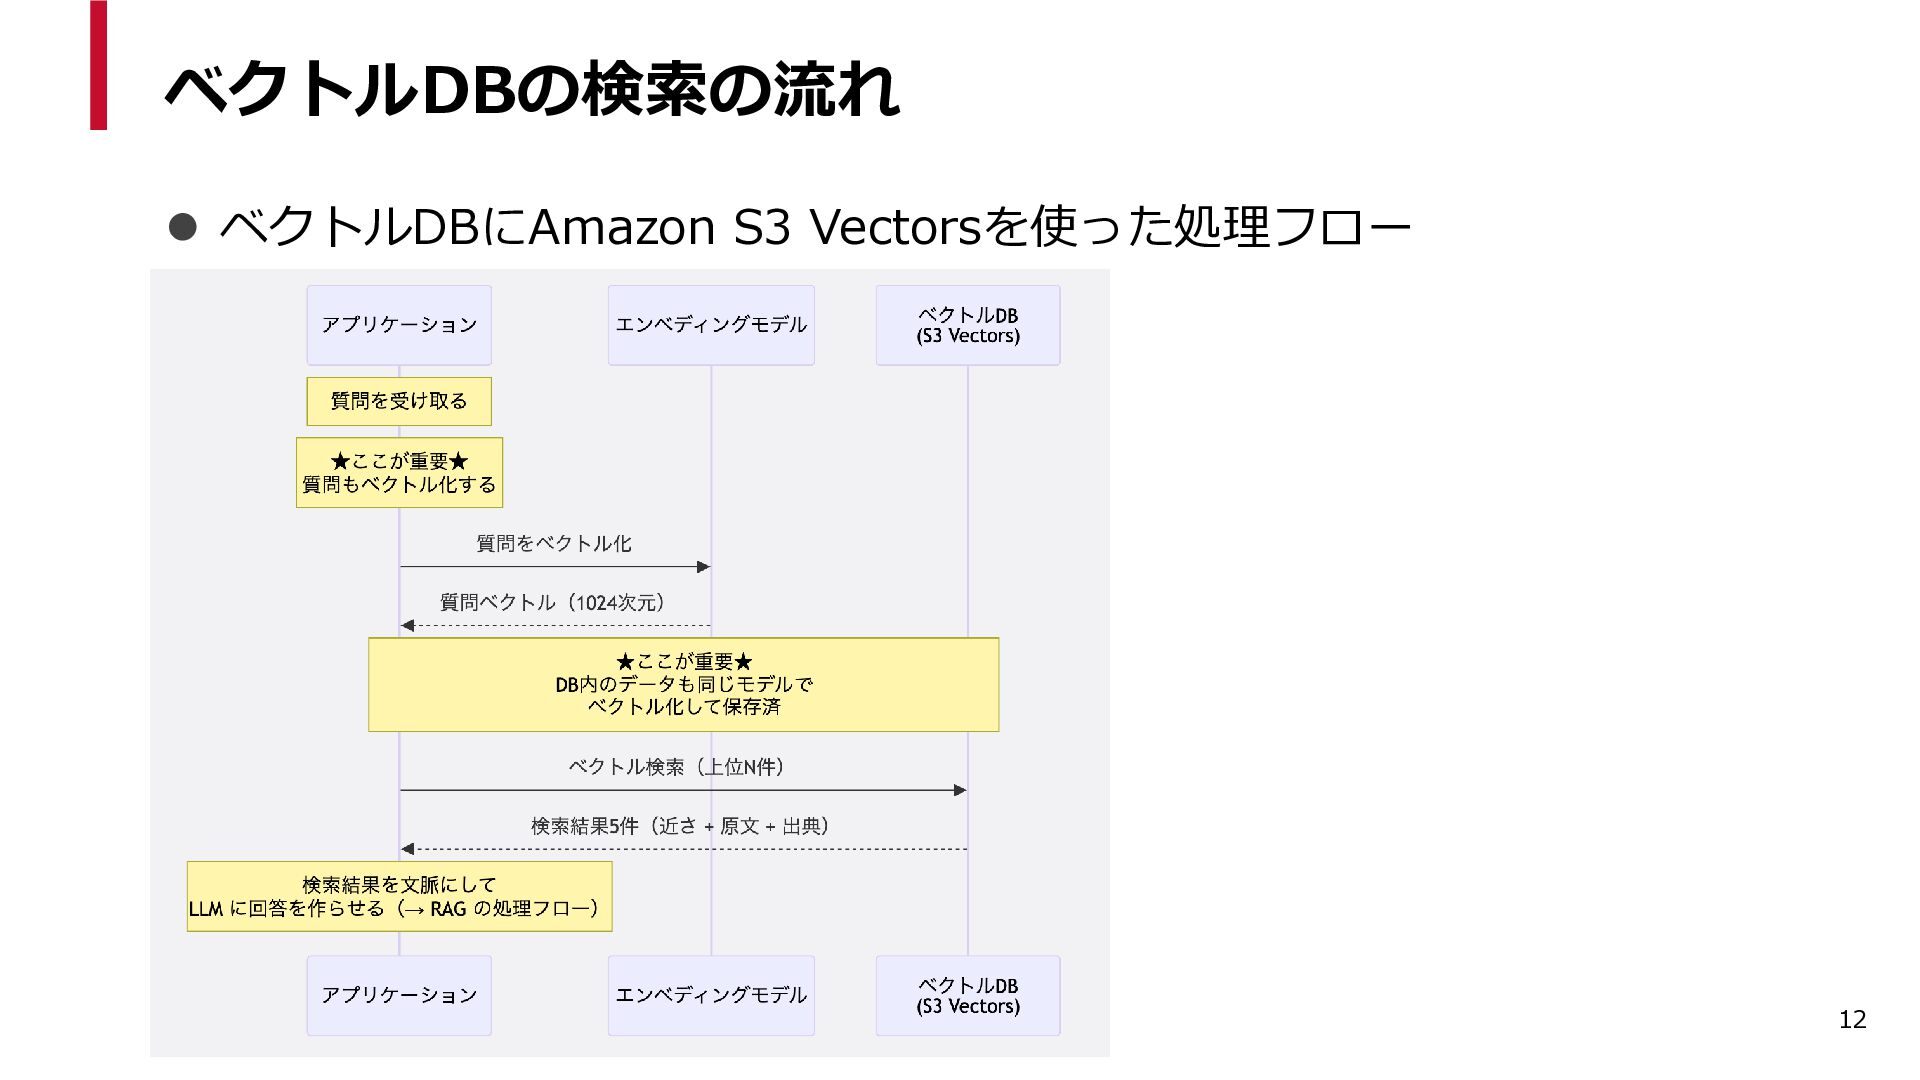
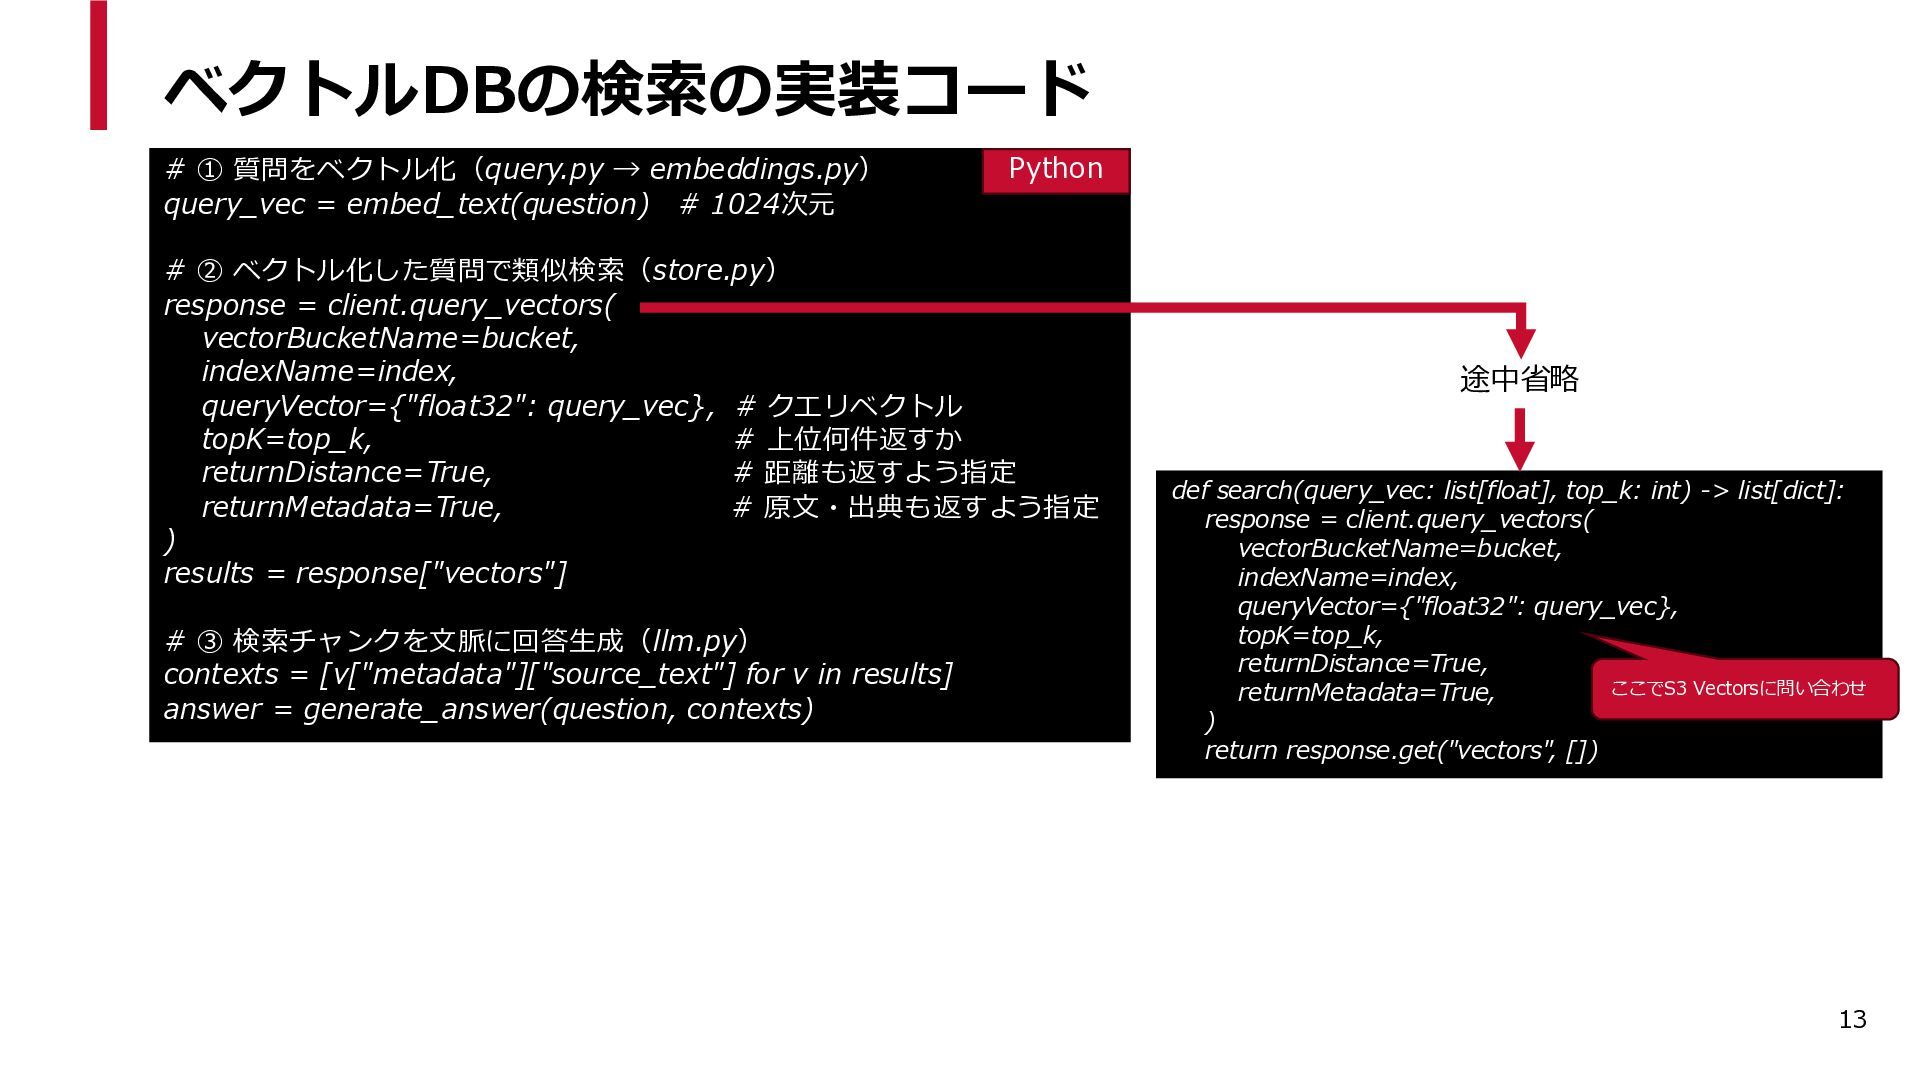
  4. ベクトルDBの検索の実装コード # ① 質問をベクトル化(query.py → embeddings.py) query_vec = embed_text(question) #

    1024次元 Python # ② ベクトル化した質問で類似検索(store.py) response = client.query_vectors( vectorBucketName=bucket, indexName=index, queryVector={"float32": query_vec}, # クエリベクトル topK=top_k, # 上位何件返すか returnDistance=True, # 距離も返すよう指定 returnMetadata=True, # 原文・出典も返すよう指定 ) results = response["vectors"] # ③ 検索チャンクを文脈に回答生成(llm.py) contexts = [v["metadata"]["source_text"] for v in results] answer = generate_answer(question, contexts) 途中省略 def search(query_vec: list[float], top_k: int) -> list[dict]: response = client.query_vectors( vectorBucketName=bucket, indexName=index, queryVector={"float32": query_vec}, topK=top_k, returnDistance=True, ここでS3 Vectorsに問い合わせ returnMetadata=True, ) return response.get("vectors", []) 13
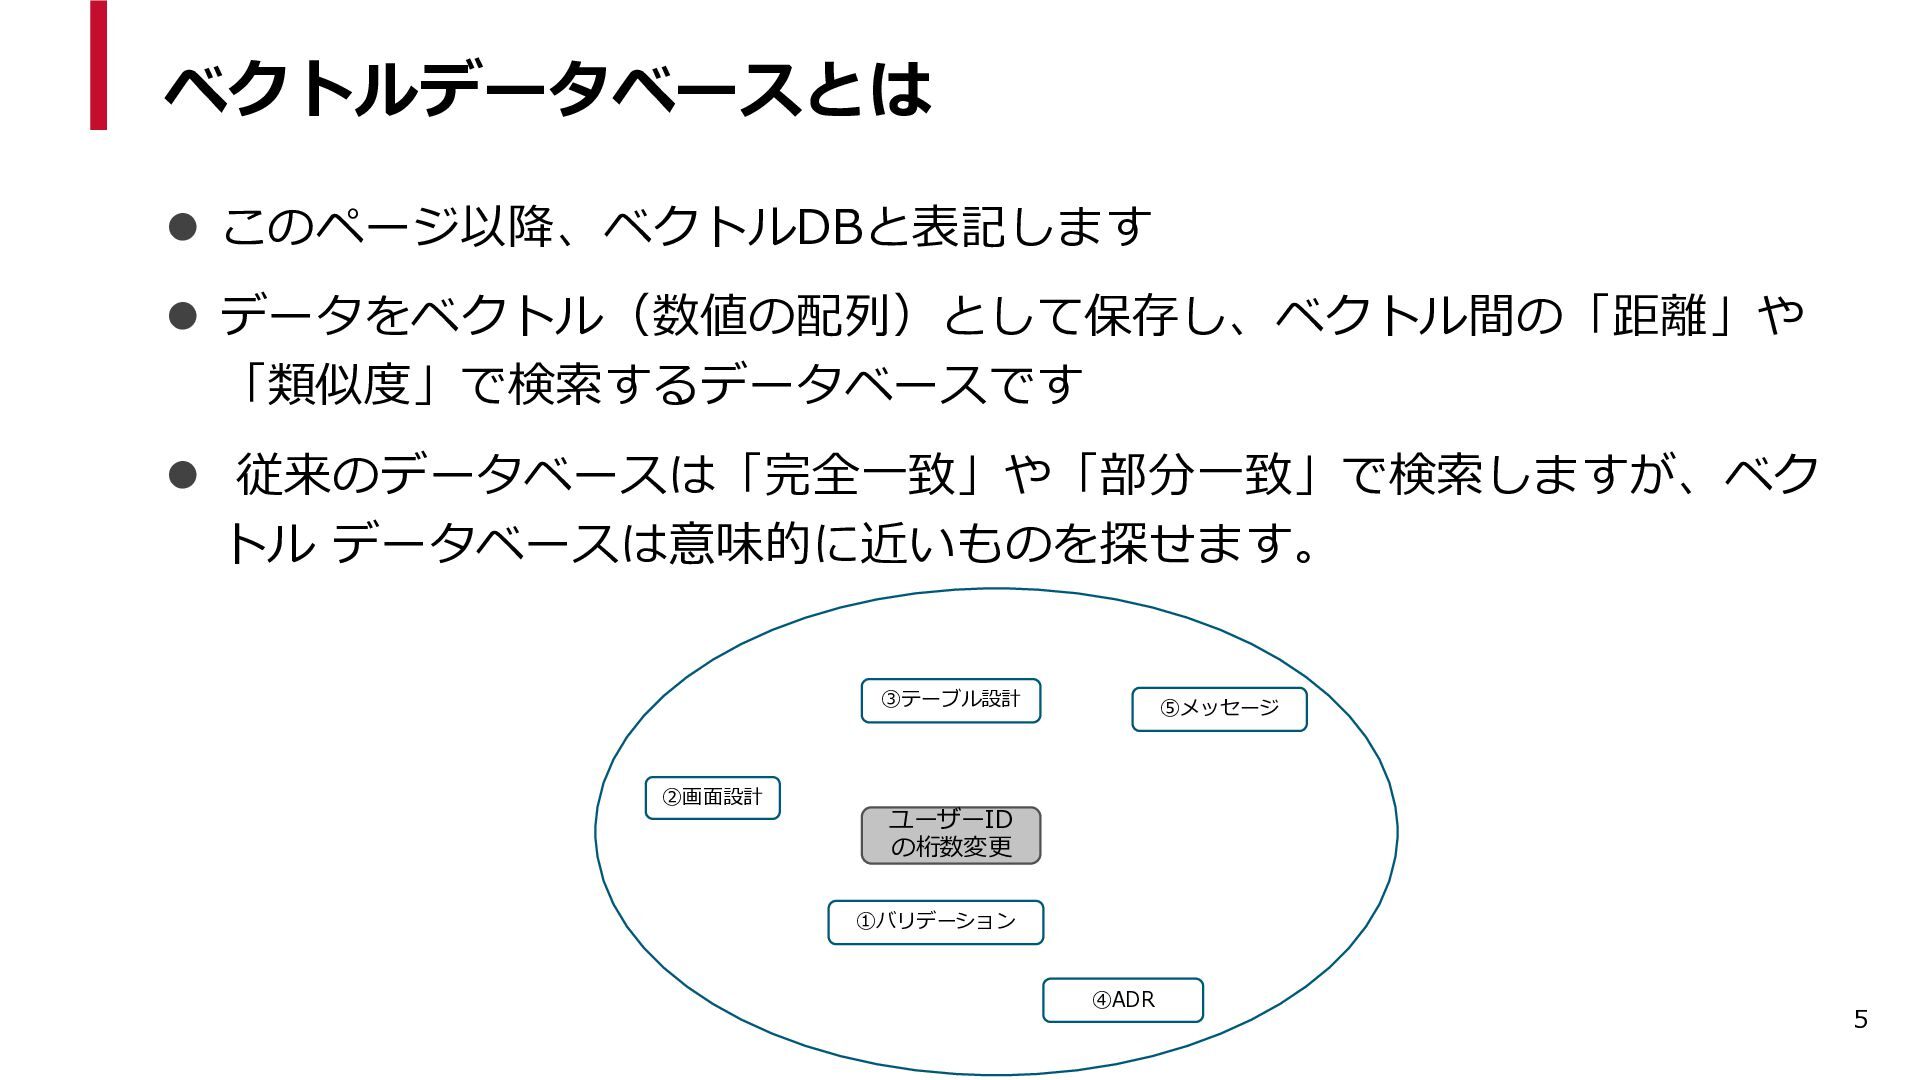
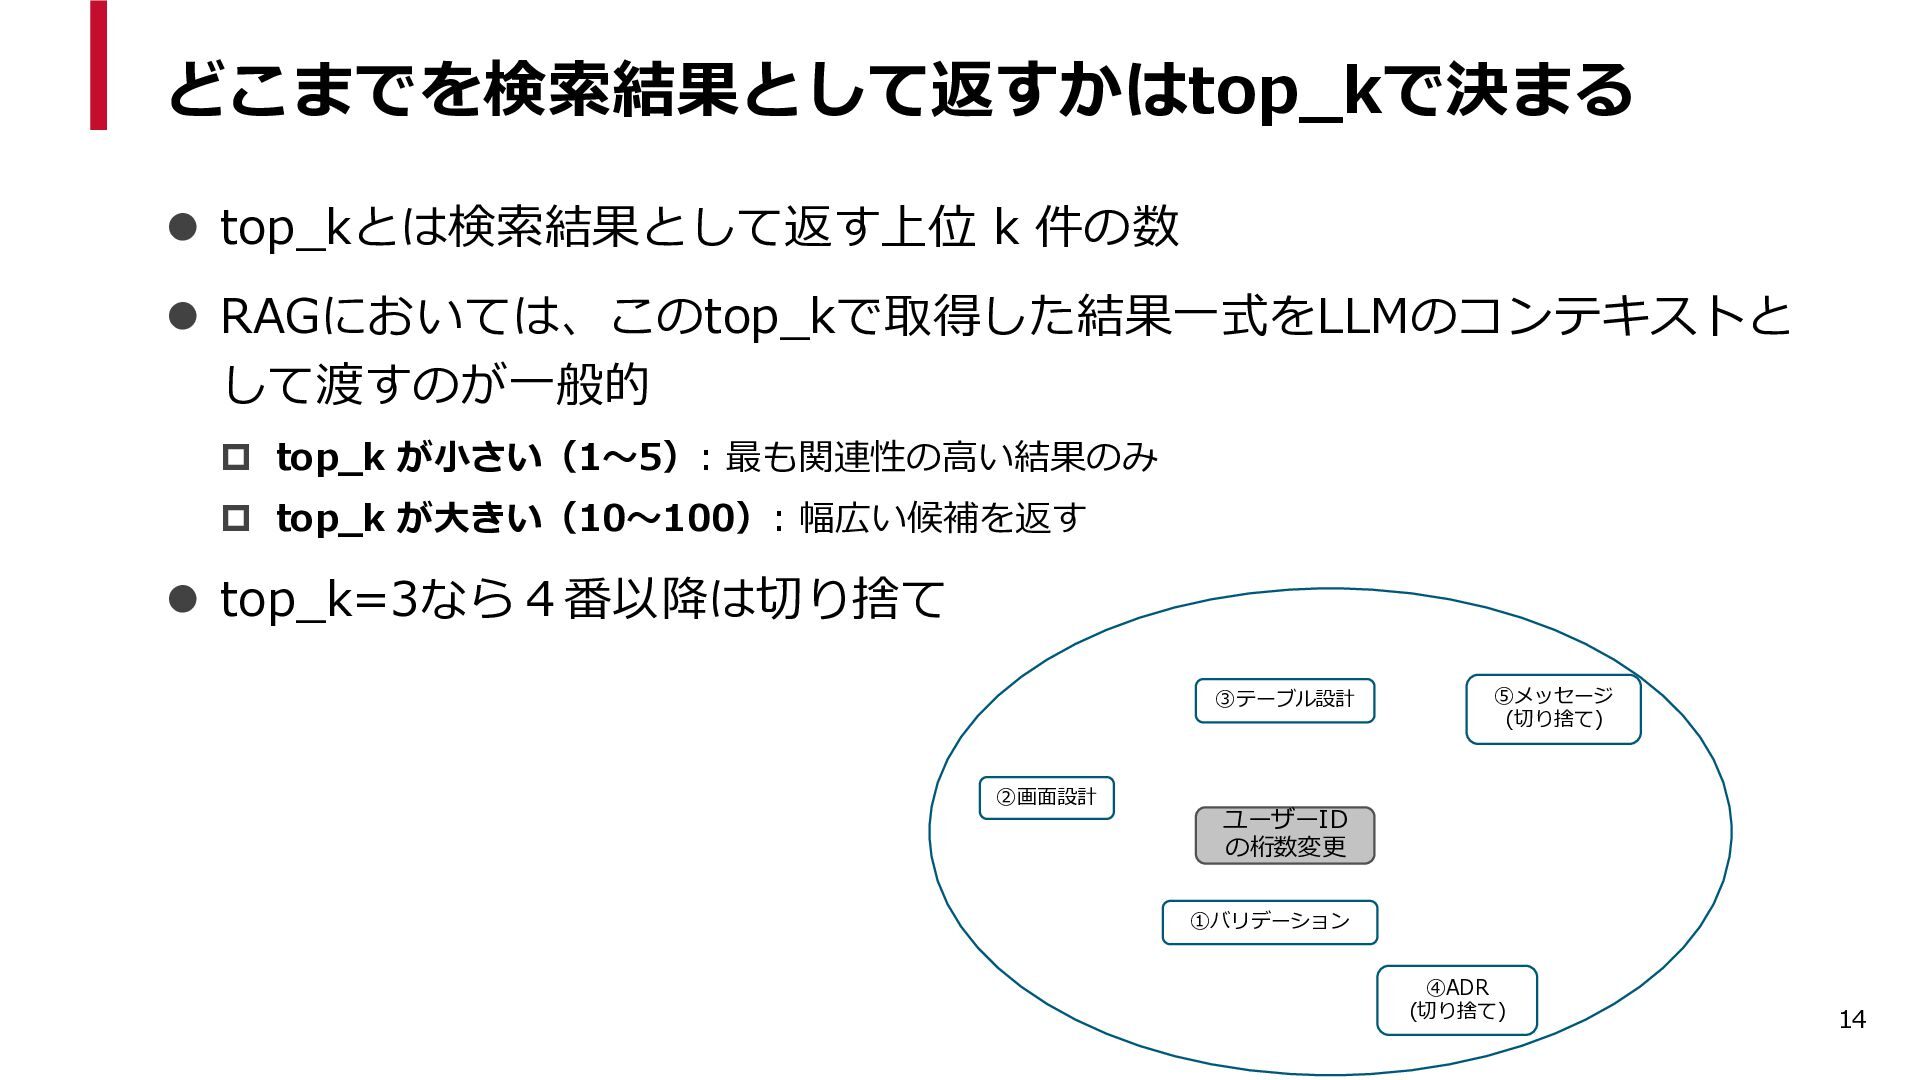
  5. どこまでを検索結果として返すかはtop_kで決まる ⚫ top_kとは検索結果として返す上位 k 件の数 ⚫ RAGにおいては、このtop_kで取得した結果一式をLLMのコンテキストと して渡すのが一般的  top_k

    が小さい(1〜5): 最も関連性の高い結果のみ  top_k が大きい(10〜100): 幅広い候補を返す ⚫ top_k=3なら4番以降は切り捨て ③テーブル設計 ②画面設計 ⑤メッセージ (切り捨て) ユーザーID の桁数変更 ①バリデーション ④ADR (切り捨て) 14
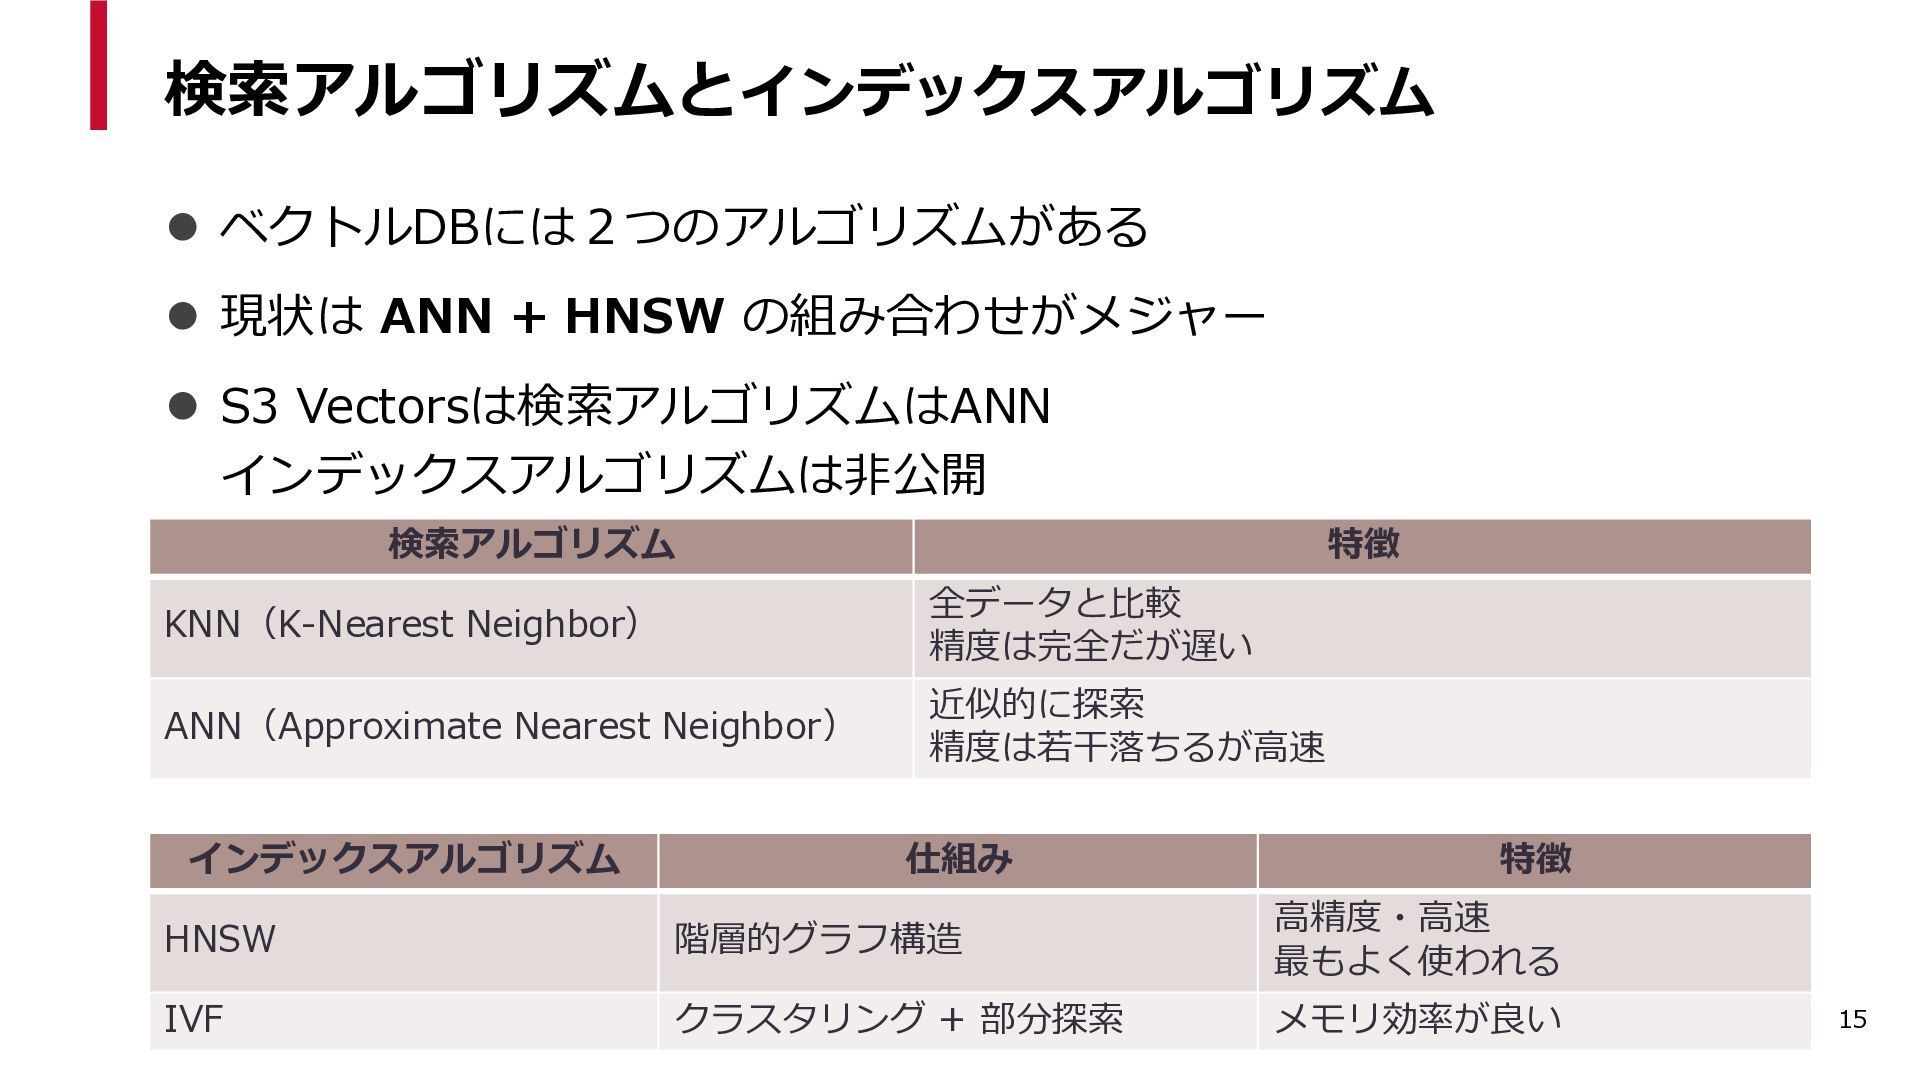
  6. 検索アルゴリズムとインデックスアルゴリズム ⚫ ベクトルDBには2つのアルゴリズムがある ⚫ 現状は ANN + HNSW の組み合わせがメジャー ⚫

    S3 Vectorsは検索アルゴリズムはANN インデックスアルゴリズムは非公開 検索アルゴリズム 特徴 KNN(K-Nearest Neighbor) 全データと比較 精度は完全だが遅い ANN(Approximate Nearest Neighbor) 近似的に探索 精度は若干落ちるが高速 インデックスアルゴリズム 仕組み 特徴 HNSW 階層的グラフ構造 高精度・高速 最もよく使われる IVF クラスタリング + 部分探索 メモリ効率が良い 15
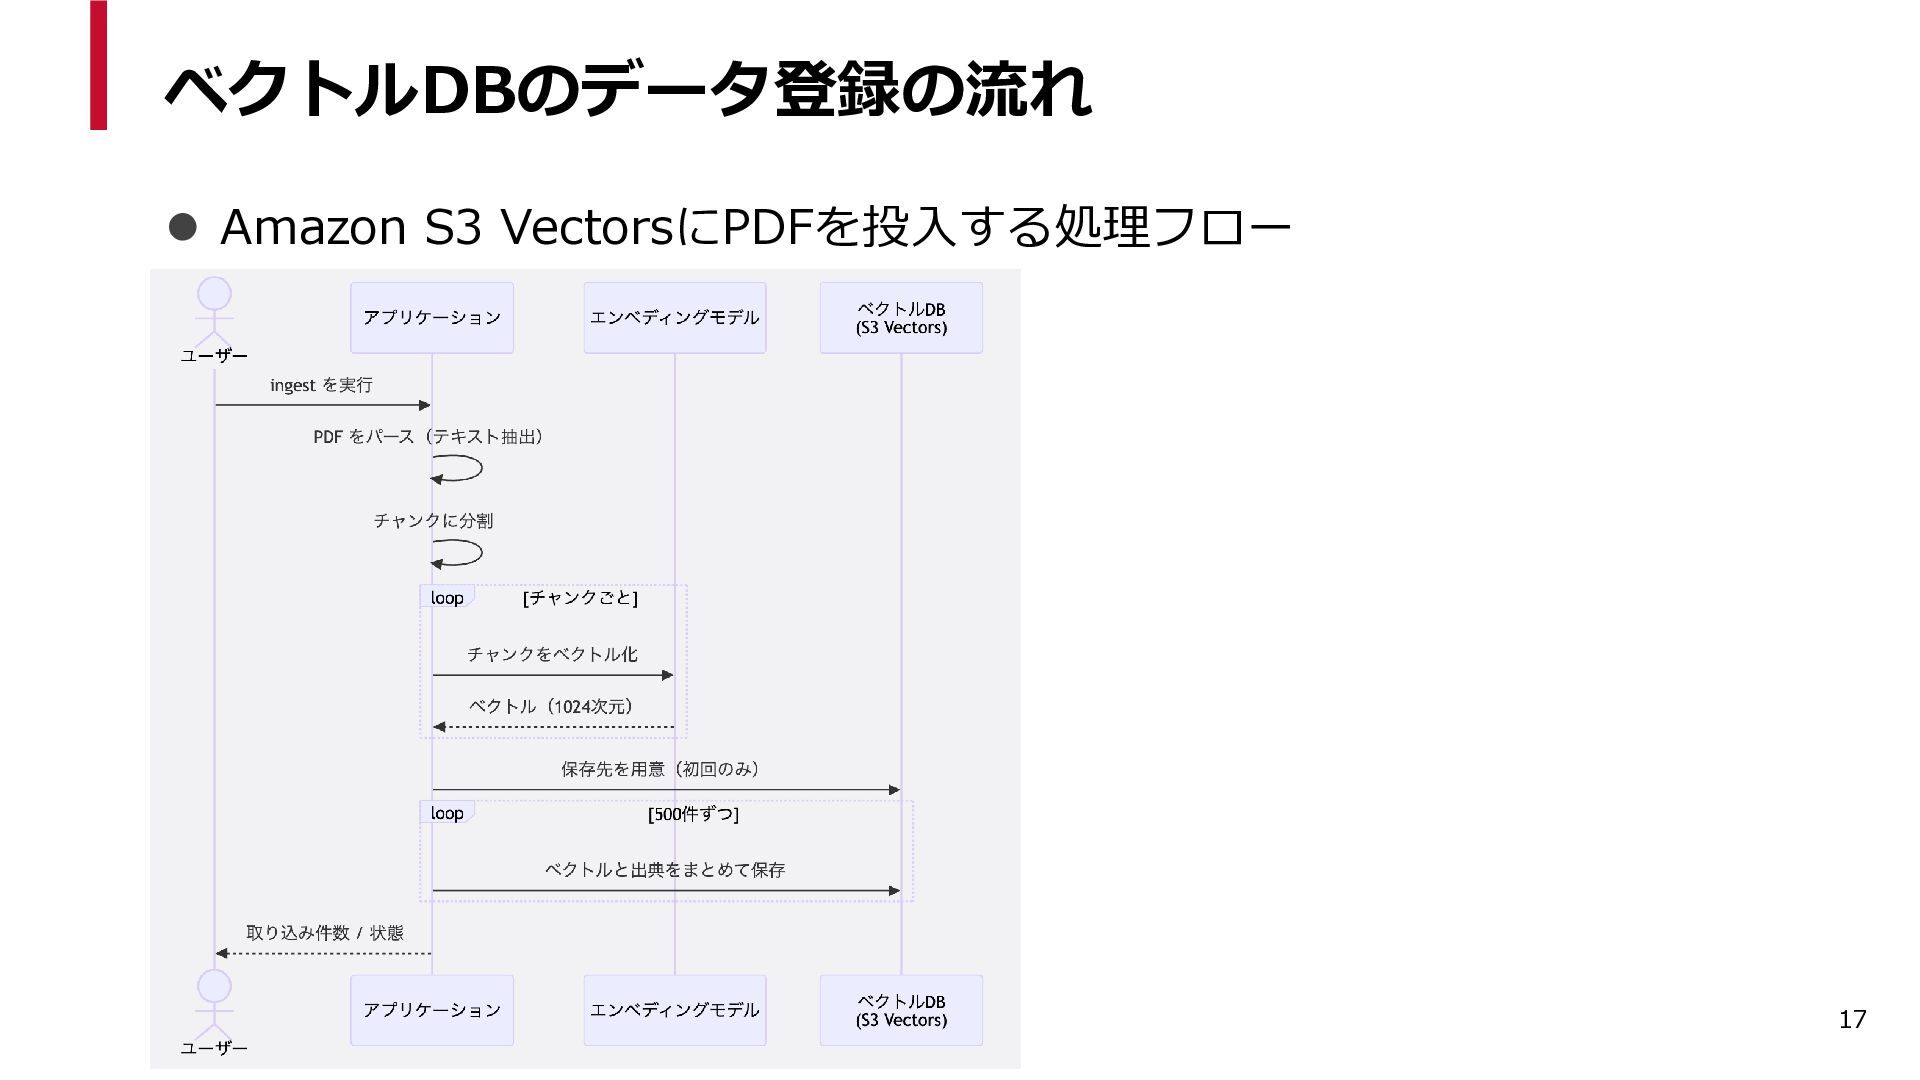
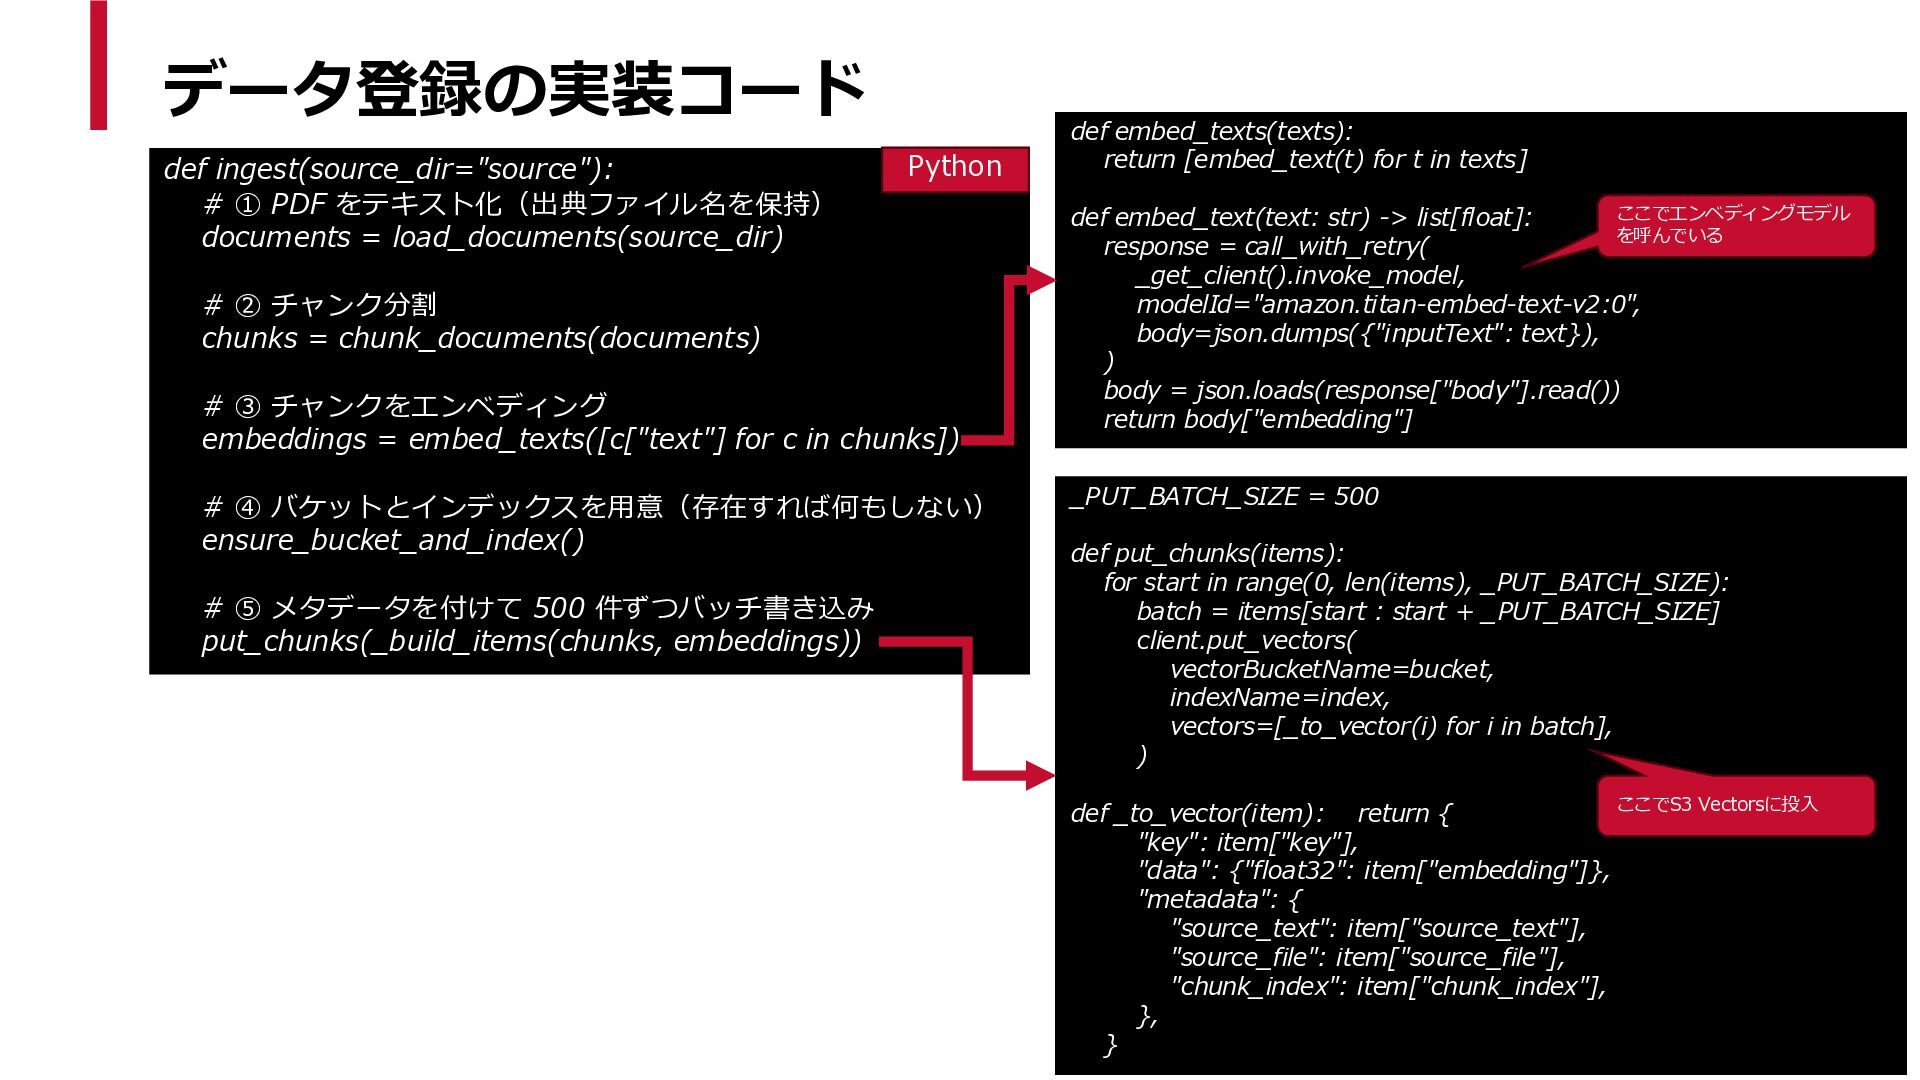
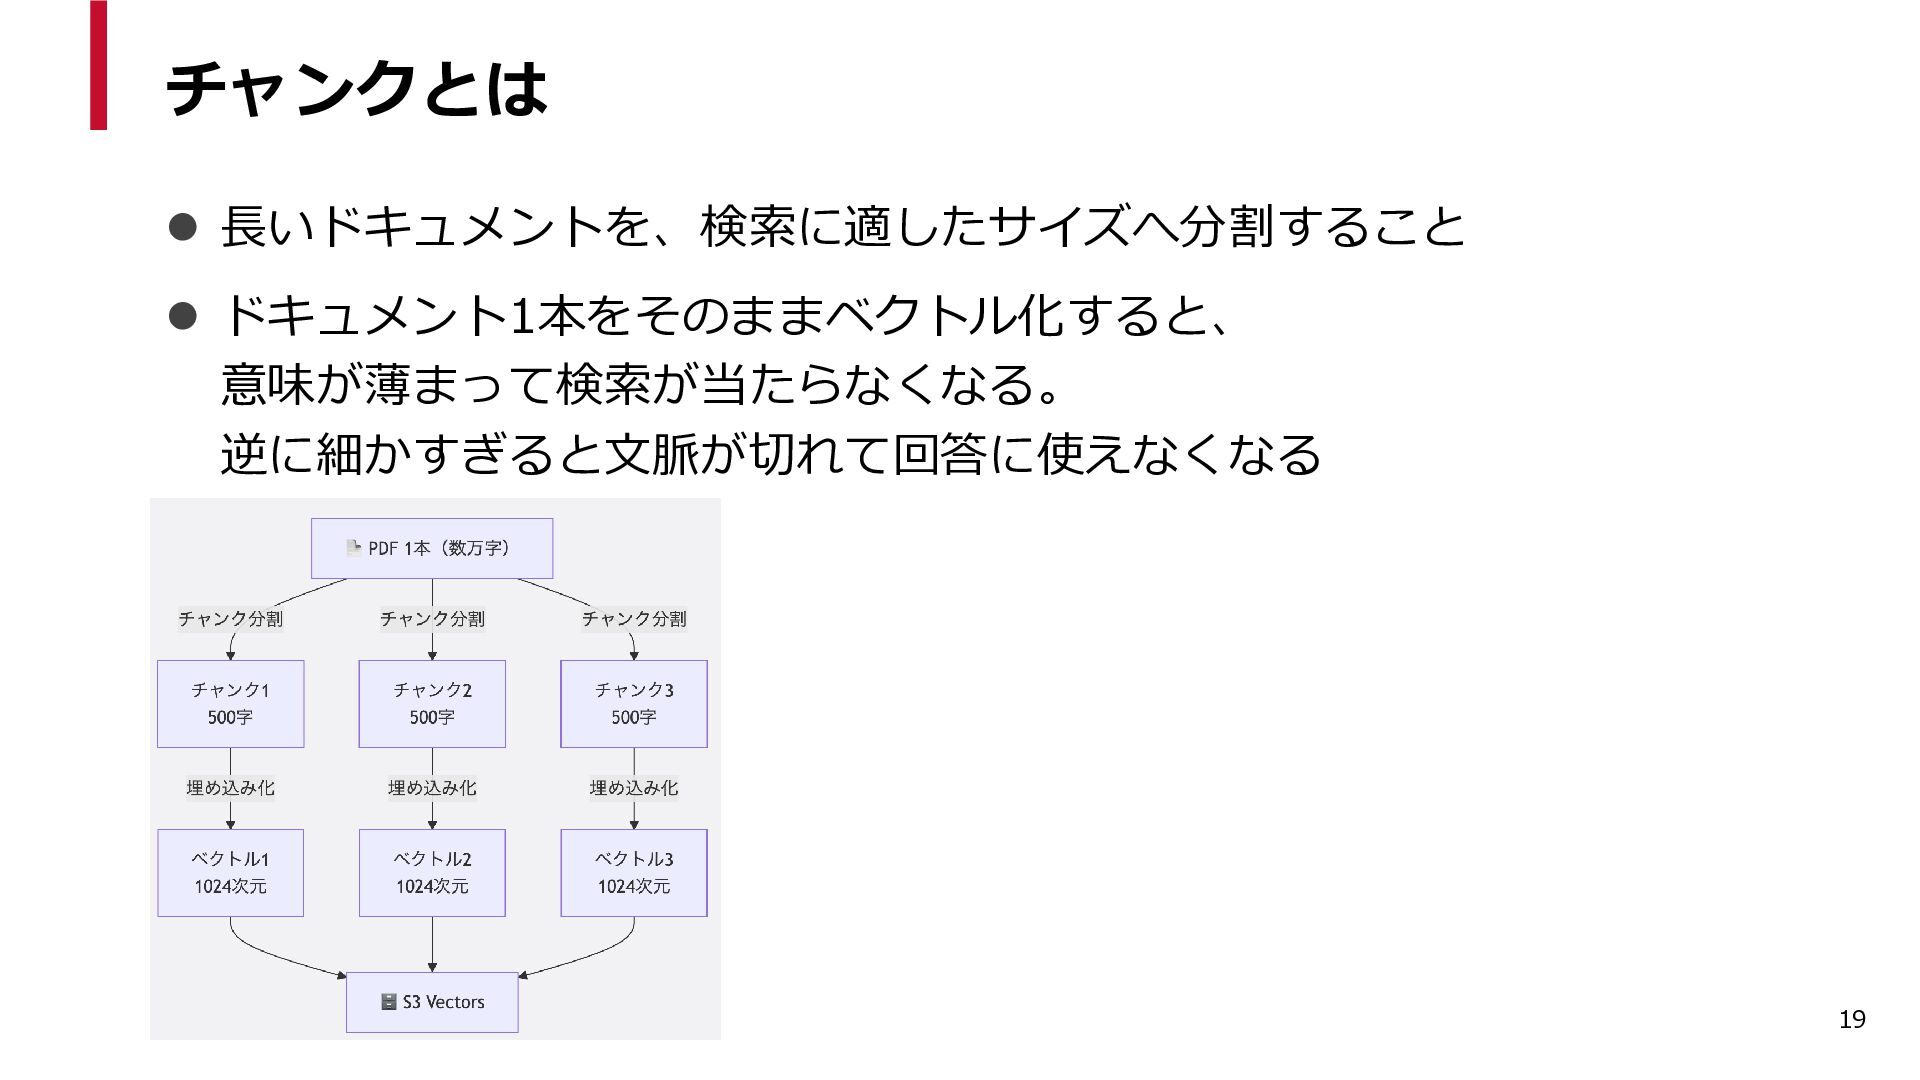
  7. データ登録の実装コード def ingest(source_dir="source"): # ① PDF をテキスト化(出典ファイル名を保持) documents = load_documents(source_dir)

    Python # ② チャンク分割 chunks = chunk_documents(documents) # ③ チャンクをエンベディング embeddings = embed_texts([c["text"] for c in chunks]) # ④ バケットとインデックスを用意(存在すれば何もしない) ensure_bucket_and_index() # ⑤ メタデータを付けて 500 件ずつバッチ書き込み put_chunks(_build_items(chunks, embeddings)) def embed_texts(texts): return [embed_text(t) for t in texts] ここでエンベディングモデル def embed_text(text: str) -> list[float]: を呼んでいる response = call_with_retry( _get_client().invoke_model, modelId="amazon.titan-embed-text-v2:0", body=json.dumps({"inputText": text}), ) body = json.loads(response["body"].read()) return body["embedding"] _PUT_BATCH_SIZE = 500 def put_chunks(items): for start in range(0, len(items), _PUT_BATCH_SIZE): batch = items[start : start + _PUT_BATCH_SIZE] client.put_vectors( vectorBucketName=bucket, indexName=index, vectors=[_to_vector(i) for i in batch], ) ここでS3 Vectorsに投入 def _to_vector(item): return { "key": item["key"], "data": {"float32": item["embedding"]}, "metadata": { "source_text": item["source_text"], "source_file": item["source_file"], "chunk_index": item["chunk_index"], }, 18 }
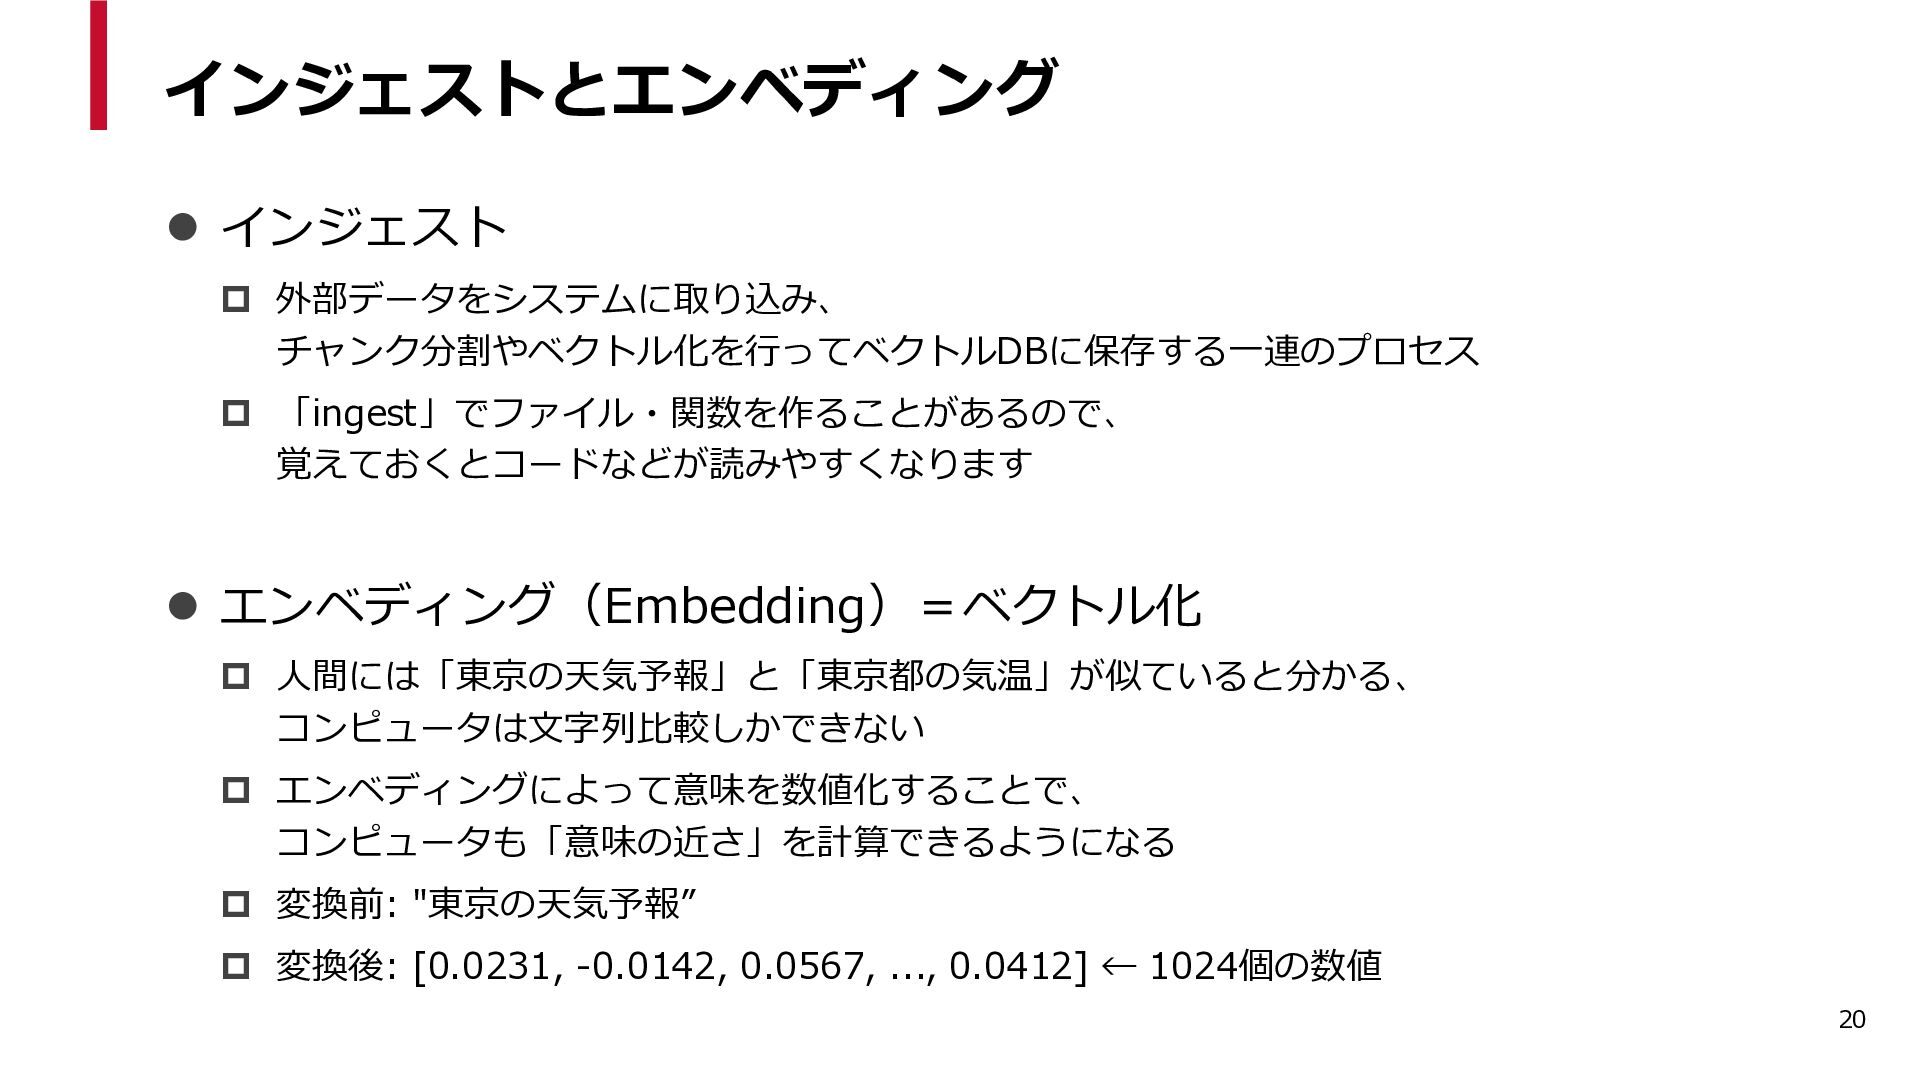
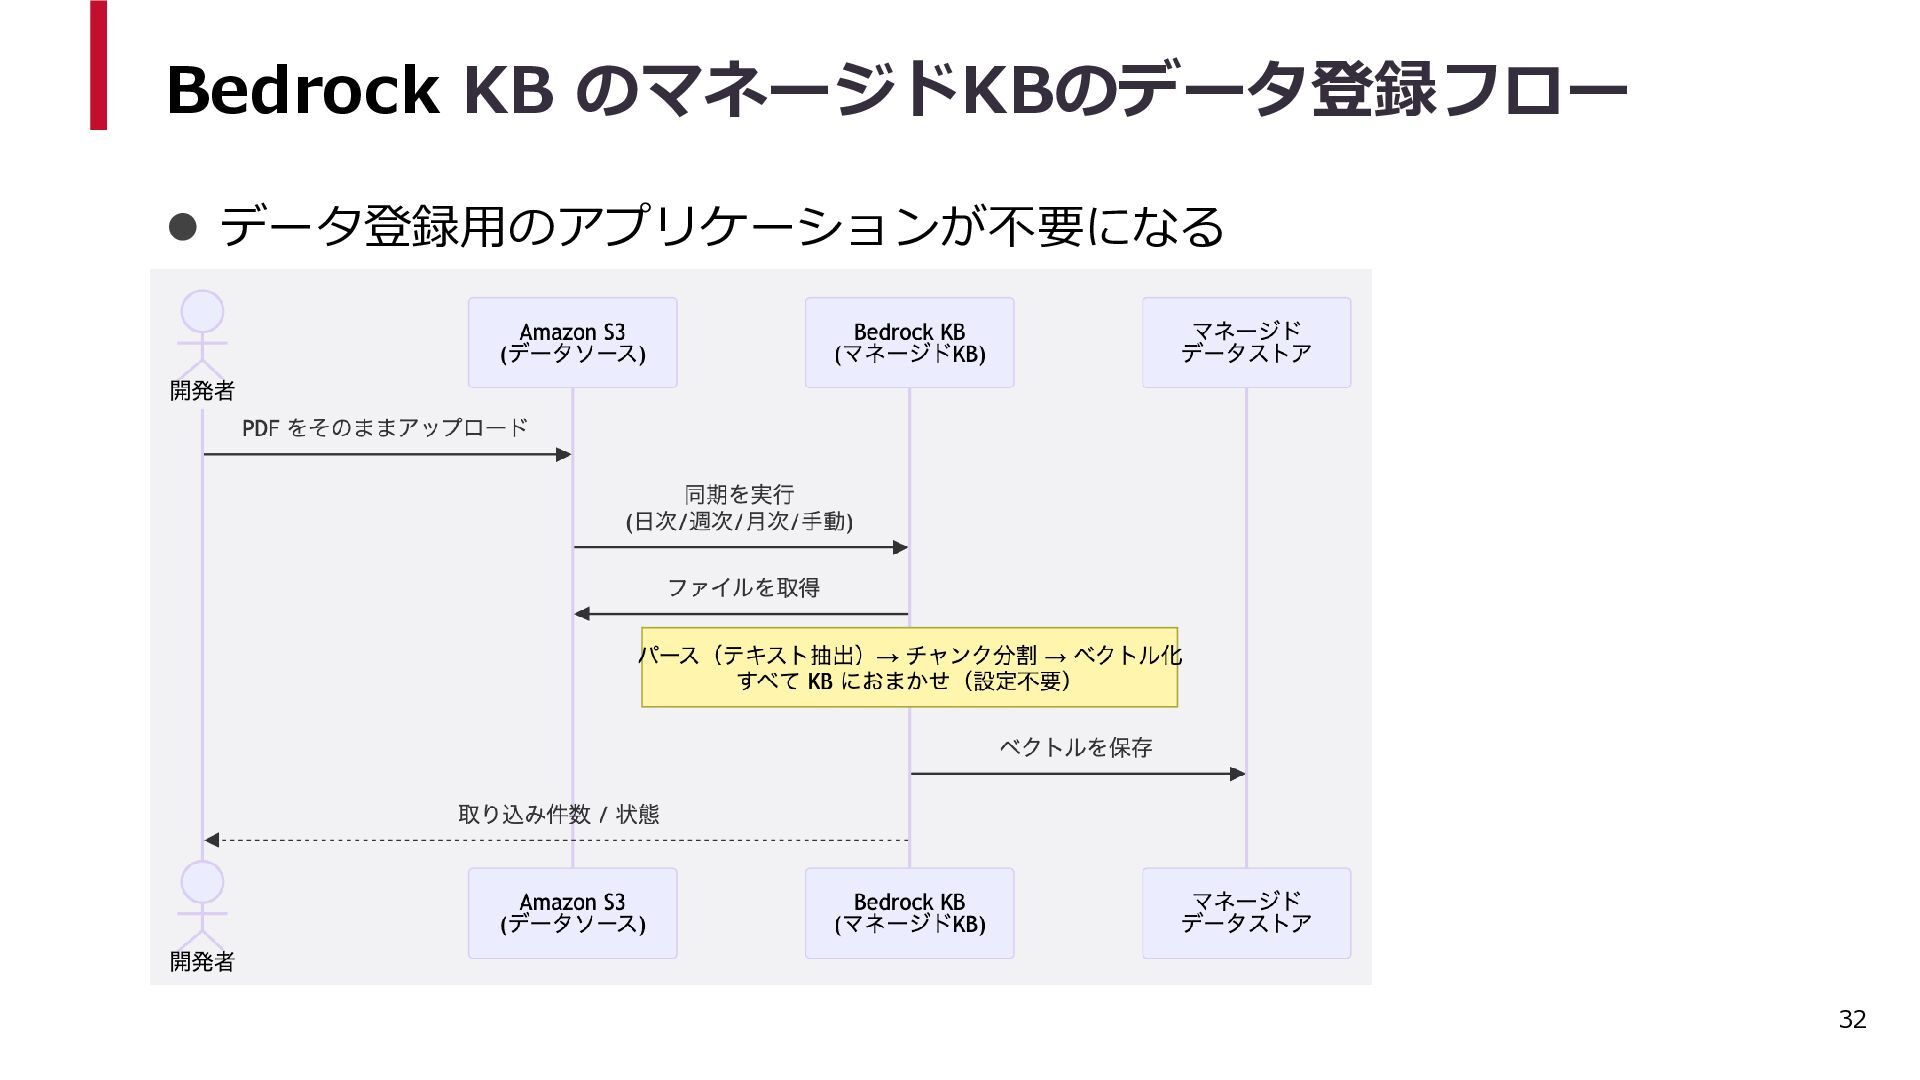
  8. インジェストとエンベディング ⚫ インジェスト  外部データをシステムに取り込み、 チャンク分割やベクトル化を行ってベクトルDBに保存する一連のプロセス  「ingest」でファイル・関数を作ることがあるので、 覚えておくとコードなどが読みやすくなります ⚫

    エンベディング(Embedding)=ベクトル化  人間には「東京の天気予報」と「東京都の気温」が似ていると分かる、 コンピュータは文字列比較しかできない  エンベディングによって意味を数値化することで、 コンピュータも「意味の近さ」を計算できるようになる  変換前: "東京の天気予報”  変換後: [0.0231, -0.0142, 0.0567, ..., 0.0412] ← 1024個の数値 20
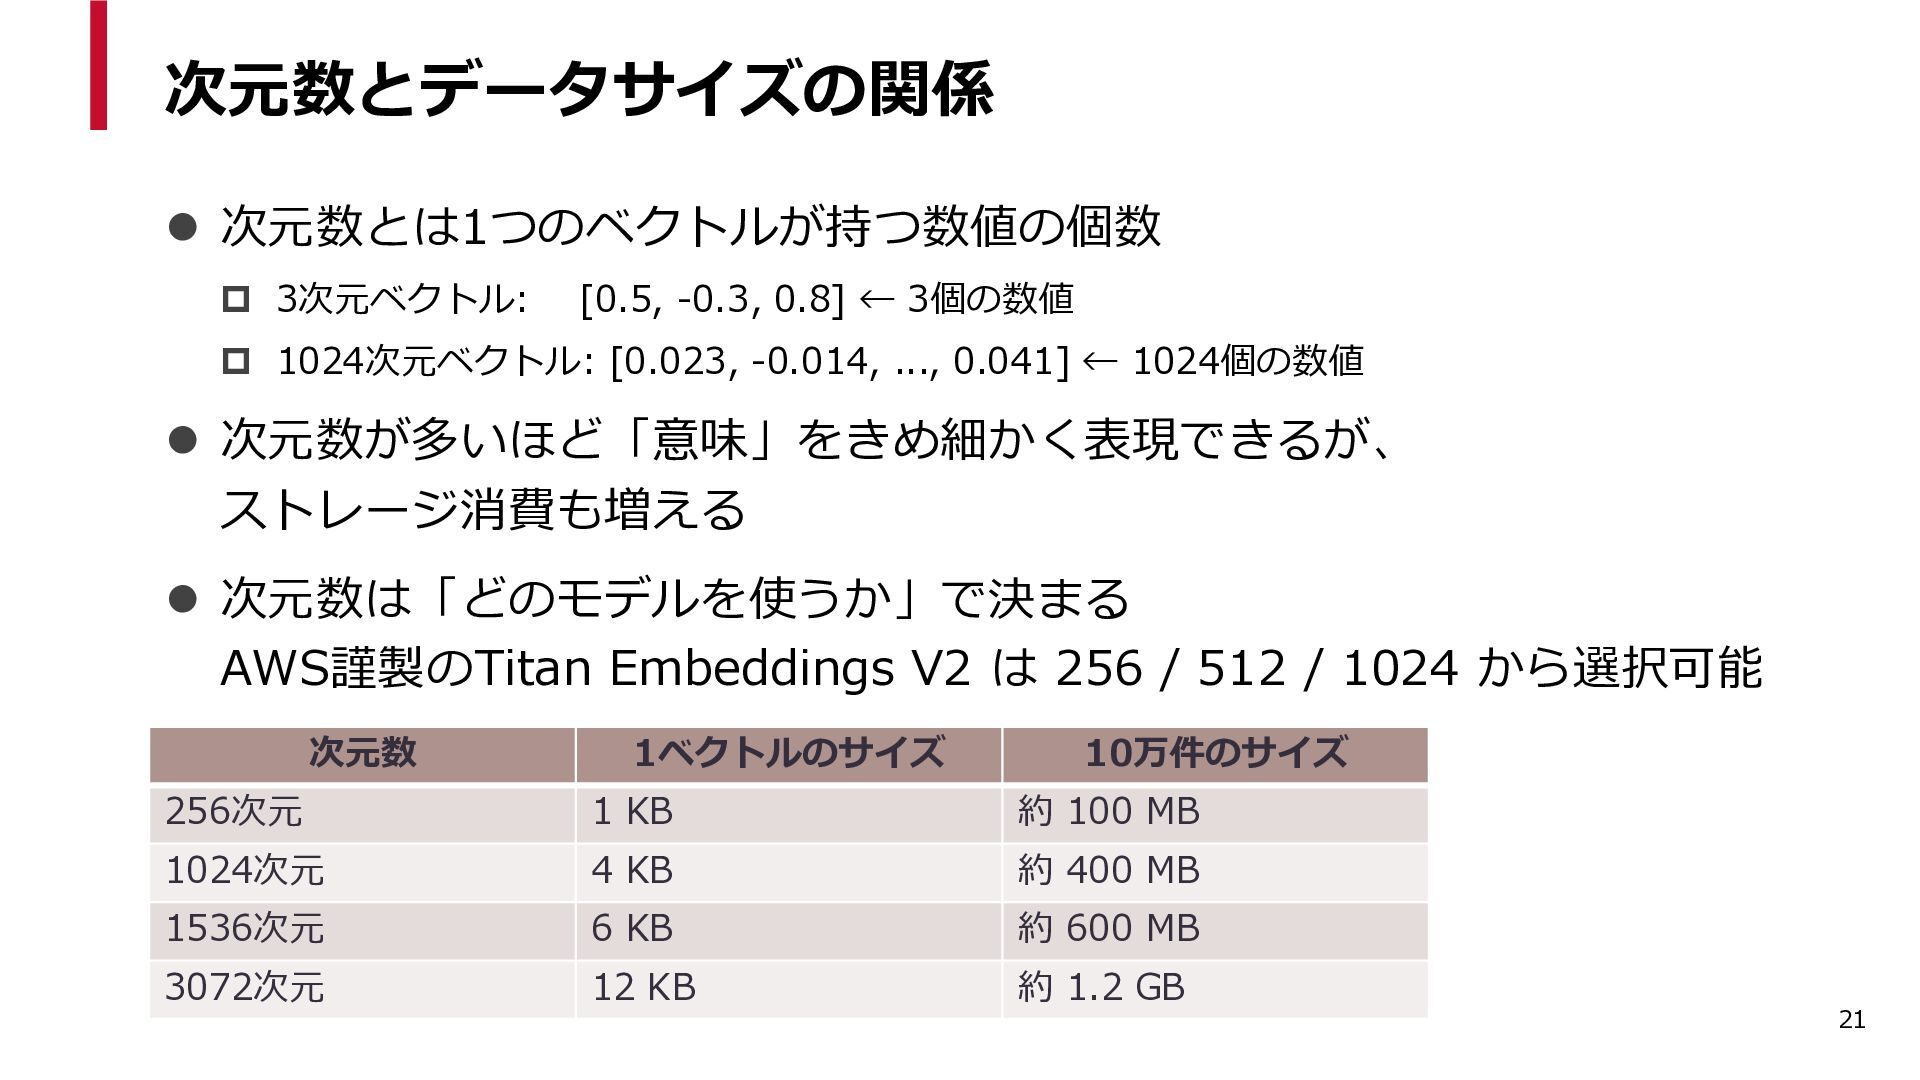
  9. 次元数とデータサイズの関係 ⚫ 次元数とは1つのベクトルが持つ数値の個数  3次元ベクトル: [0.5, -0.3, 0.8] ← 3個の数値

     1024次元ベクトル: [0.023, -0.014, ..., 0.041] ← 1024個の数値 ⚫ 次元数が多いほど「意味」をきめ細かく表現できるが、 ストレージ消費も増える ⚫ 次元数は「どのモデルを使うか」で決まる AWS謹製のTitan Embeddings V2 は 256 / 512 / 1024 から選択可能 次元数 1ベクトルのサイズ 10万件のサイズ 256次元 1 KB 約 100 MB 1024次元 4 KB 約 400 MB 1536次元 6 KB 約 600 MB 3072次元 12 KB 約 1.2 GB 21
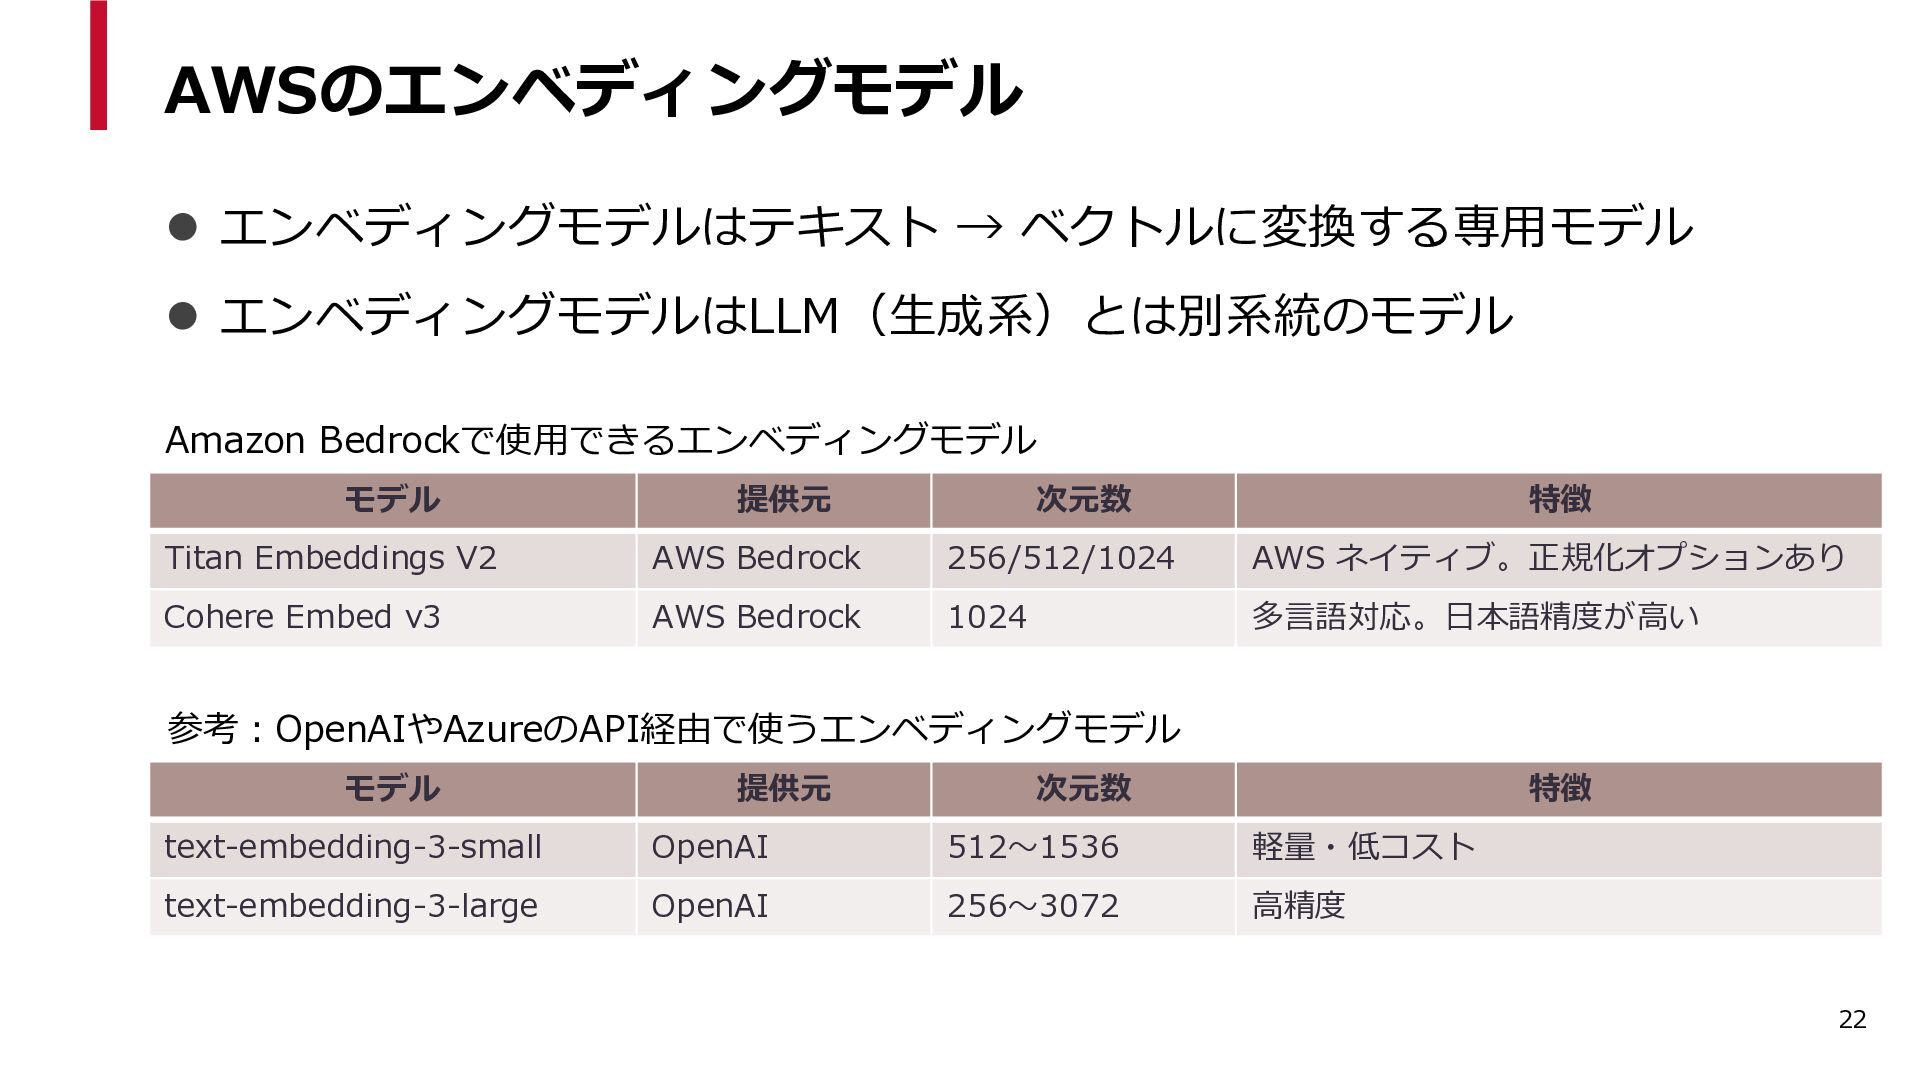
  10. AWSのエンベディングモデル ⚫ エンベディングモデルはテキスト → ベクトルに変換する専用モデル ⚫ エンベディングモデルはLLM(生成系)とは別系統のモデル Amazon Bedrockで使用できるエンベディングモデル モデル

    提供元 次元数 特徴 Titan Embeddings V2 AWS Bedrock 256/512/1024 AWS ネイティブ。正規化オプションあり Cohere Embed v3 AWS Bedrock 1024 多言語対応。日本語精度が高い 参考:OpenAIやAzureのAPI経由で使うエンベディングモデル モデル 提供元 次元数 特徴 text-embedding-3-small OpenAI 512〜1536 軽量・低コスト text-embedding-3-large OpenAI 256〜3072 高精度 22
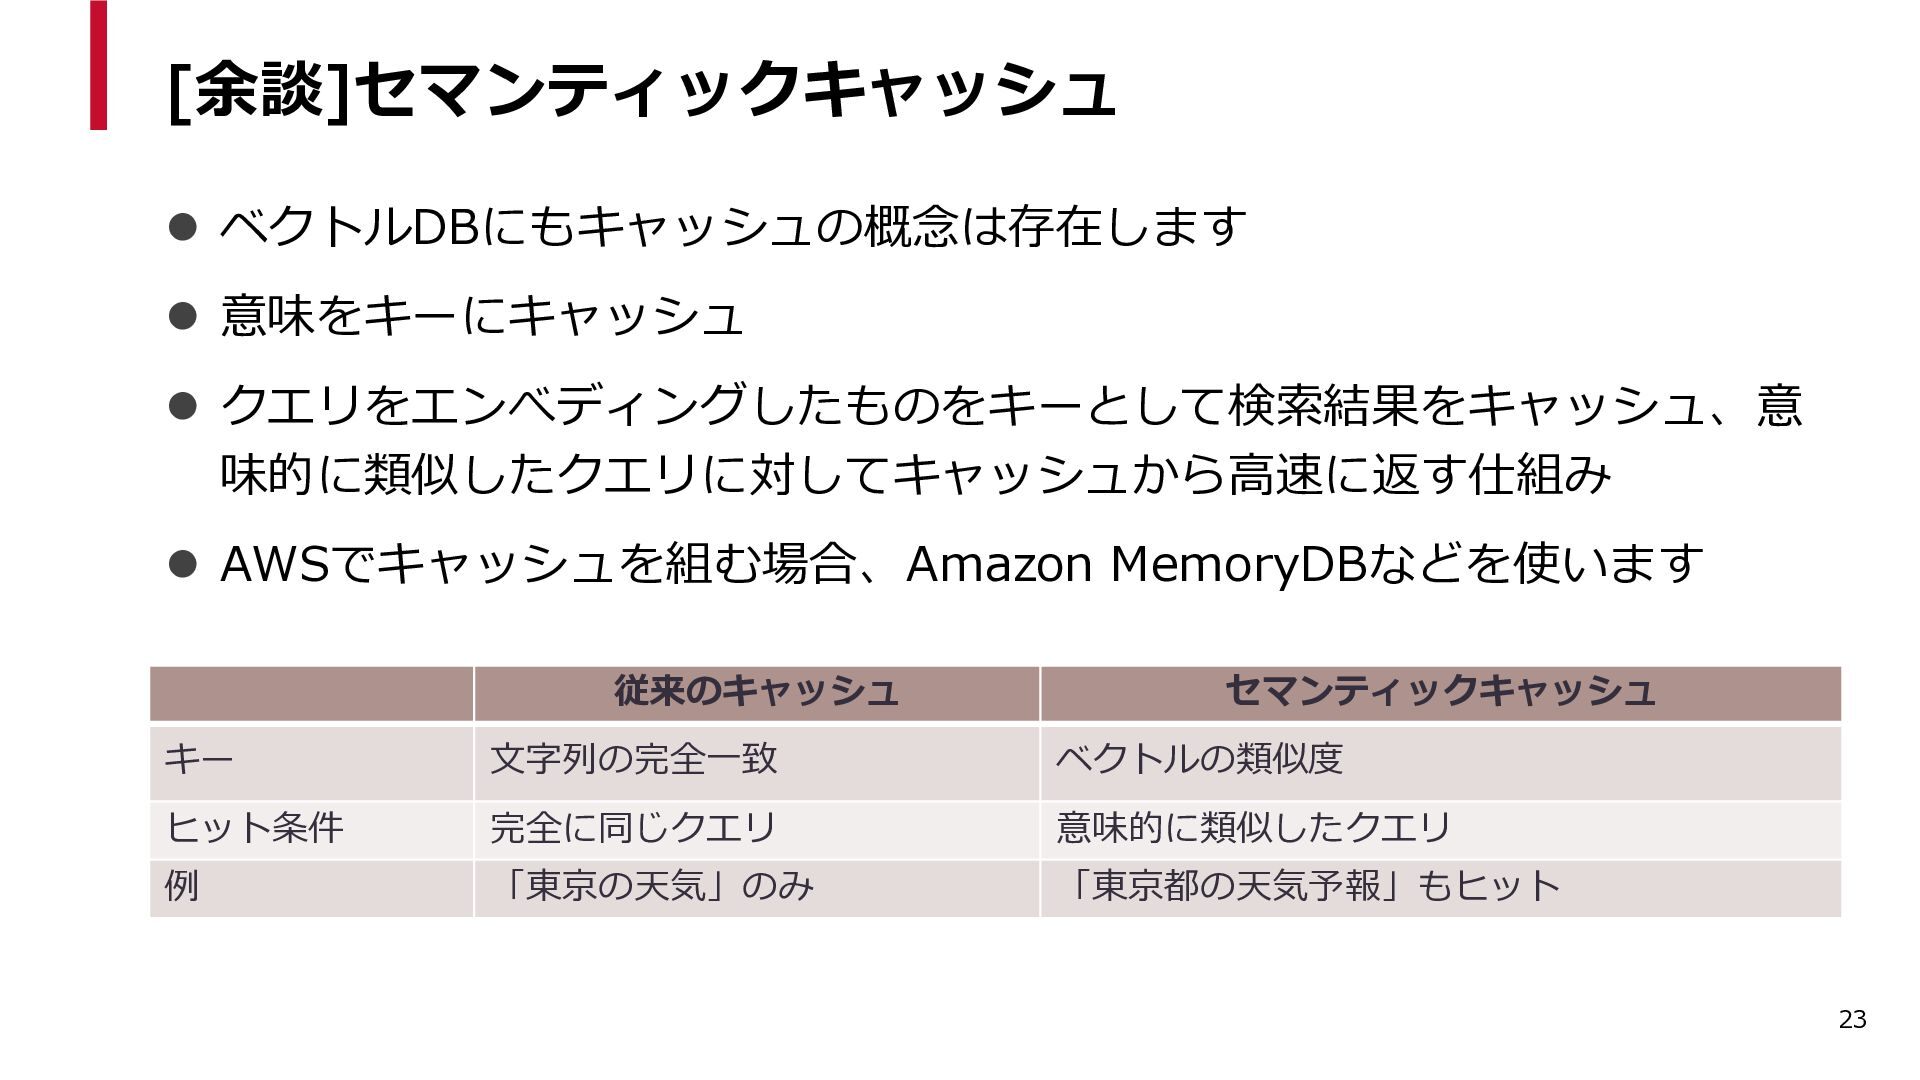
  11. [余談]セマンティックキャッシュ ⚫ ベクトルDBにもキャッシュの概念は存在します ⚫ 意味をキーにキャッシュ ⚫ クエリをエンべディングしたものをキーとして検索結果をキャッシュ、意 味的に類似したクエリに対してキャッシュから高速に返す仕組み ⚫ AWSでキャッシュを組む場合、Amazon

    MemoryDBなどを使います 従来のキャッシュ セマンティックキャッシュ キー 文字列の完全一致 ベクトルの類似度 ヒット条件 完全に同じクエリ 意味的に類似したクエリ 例 「東京の天気」のみ 「東京都の天気予報」もヒット 23
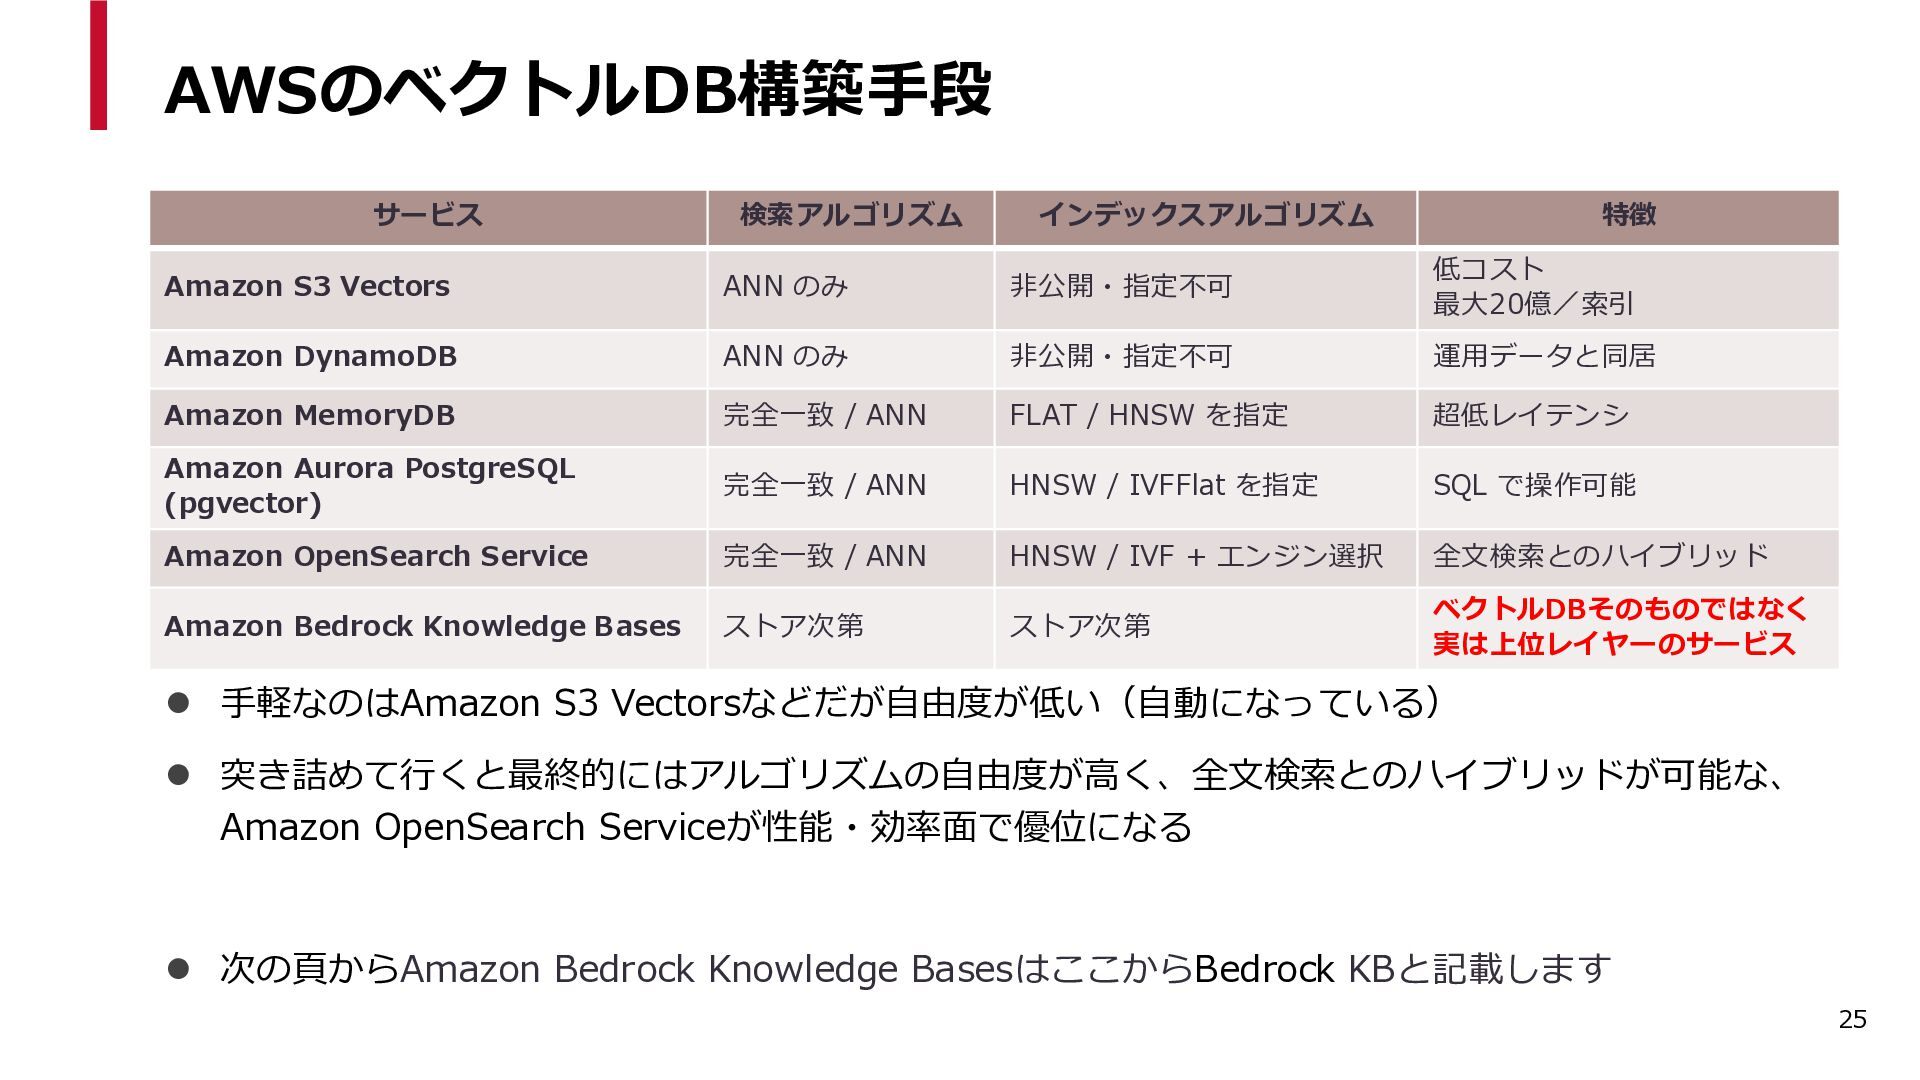
  12. AWSのベクトルDB構築手段 サービス 検索アルゴリズム インデックスアルゴリズム 特徴 Amazon S3 Vectors ANN のみ

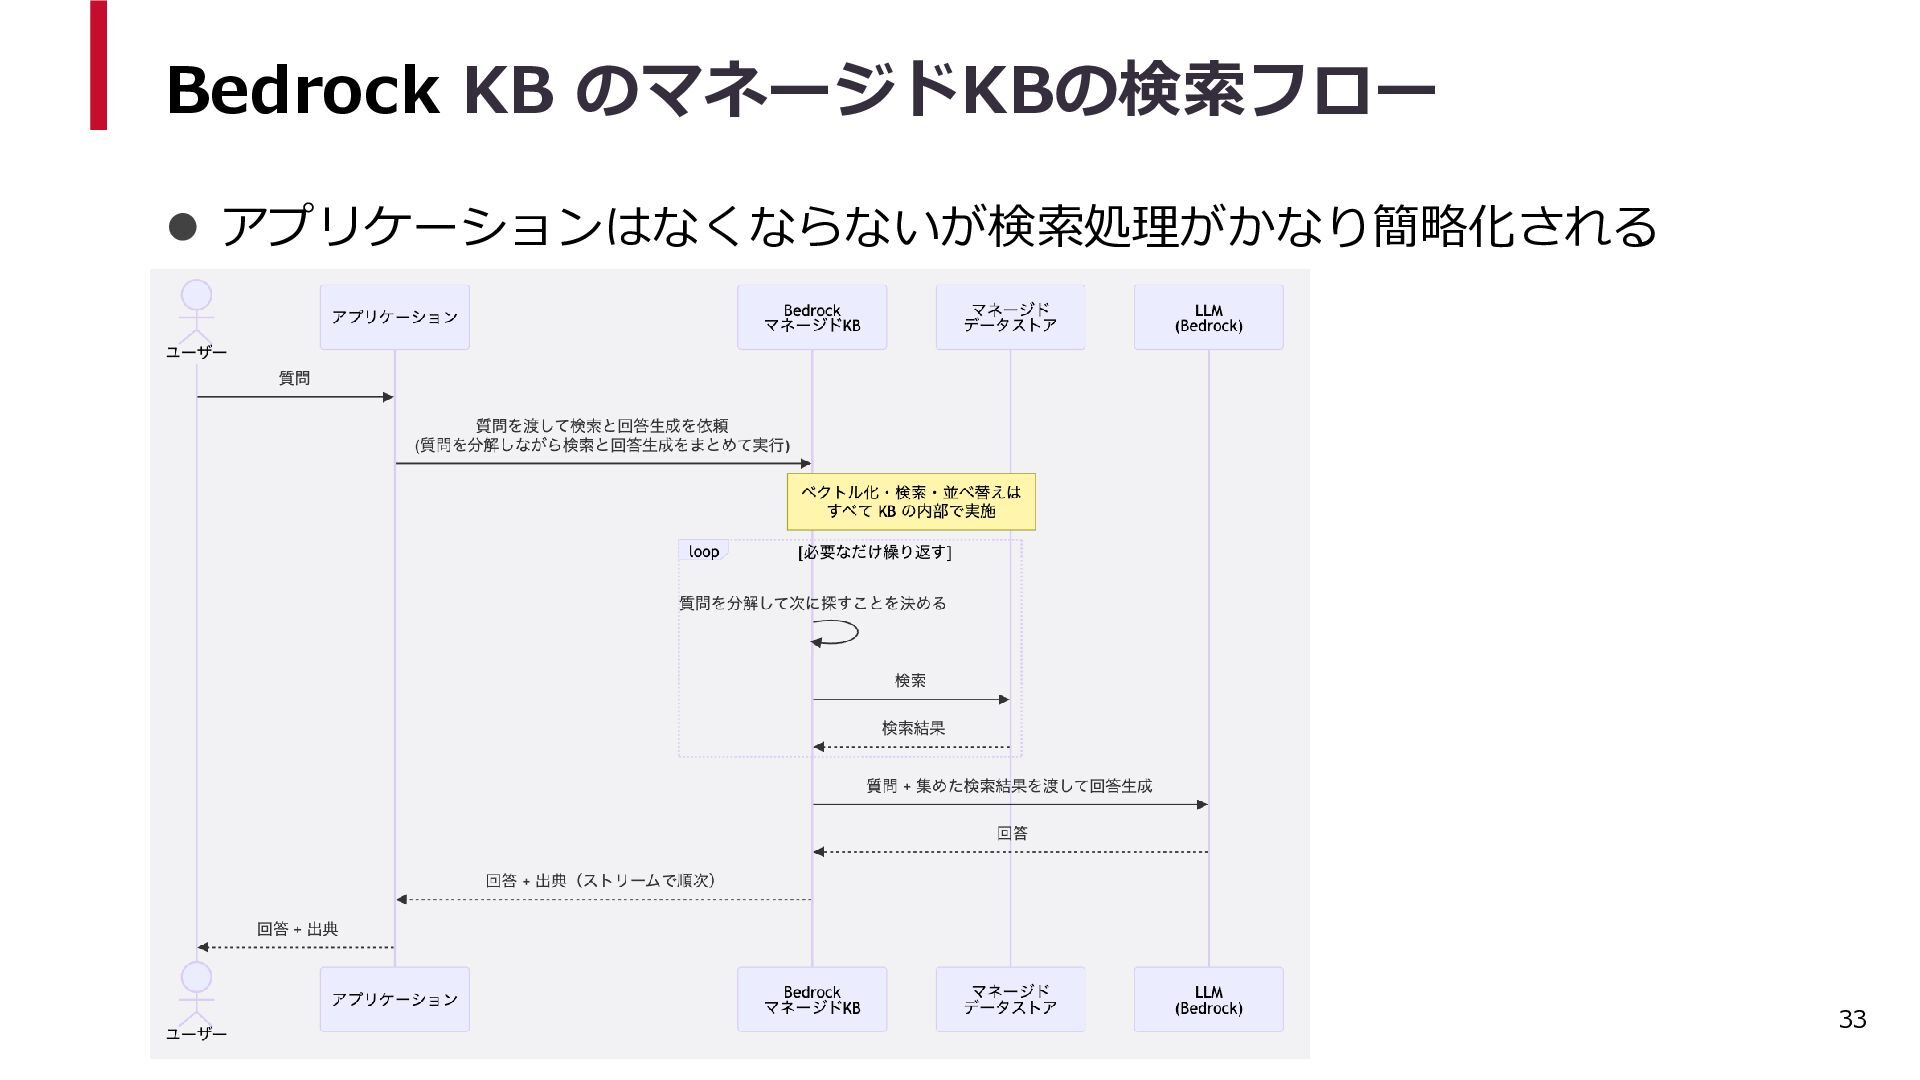
    非公開・指定不可 低コスト 最大20億/索引 Amazon DynamoDB ANN のみ 非公開・指定不可 運用データと同居 Amazon MemoryDB 完全一致 / ANN FLAT / HNSW を指定 超低レイテンシ Amazon Aurora PostgreSQL (pgvector) 完全一致 / ANN HNSW / IVFFlat を指定 SQL で操作可能 Amazon OpenSearch Service 完全一致 / ANN HNSW / IVF + エンジン選択 全文検索とのハイブリッド Amazon Bedrock Knowledge Bases ストア次第 ストア次第 ベクトルDBそのものではなく 実は上位レイヤーのサービス ⚫ 手軽なのはAmazon S3 Vectorsなどだが自由度が低い(自動になっている) ⚫ 突き詰めて行くと最終的にはアルゴリズムの自由度が高く、全文検索とのハイブリッドが可能な、 Amazon OpenSearch Serviceが性能・効率面で優位になる ⚫ 次の頁からAmazon Bedrock Knowledge BasesはここからBedrock KBと記載します 25
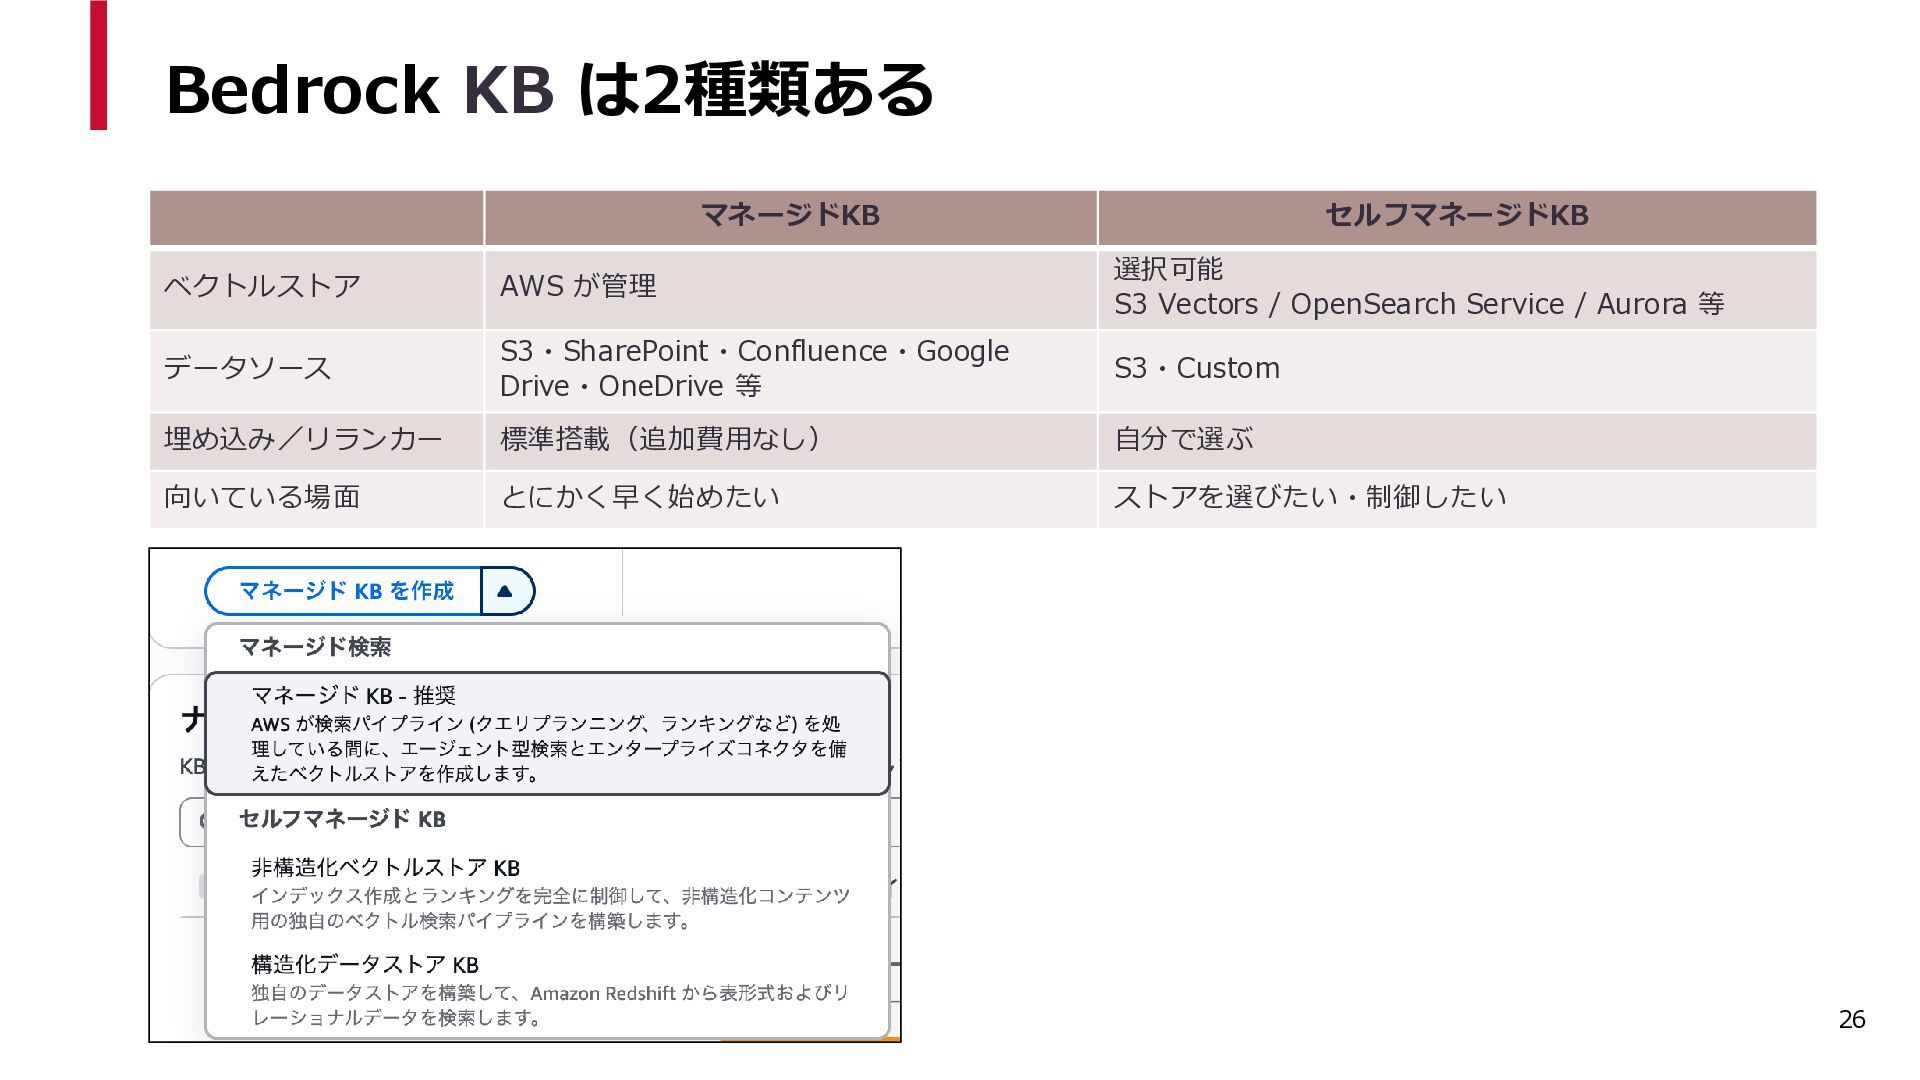
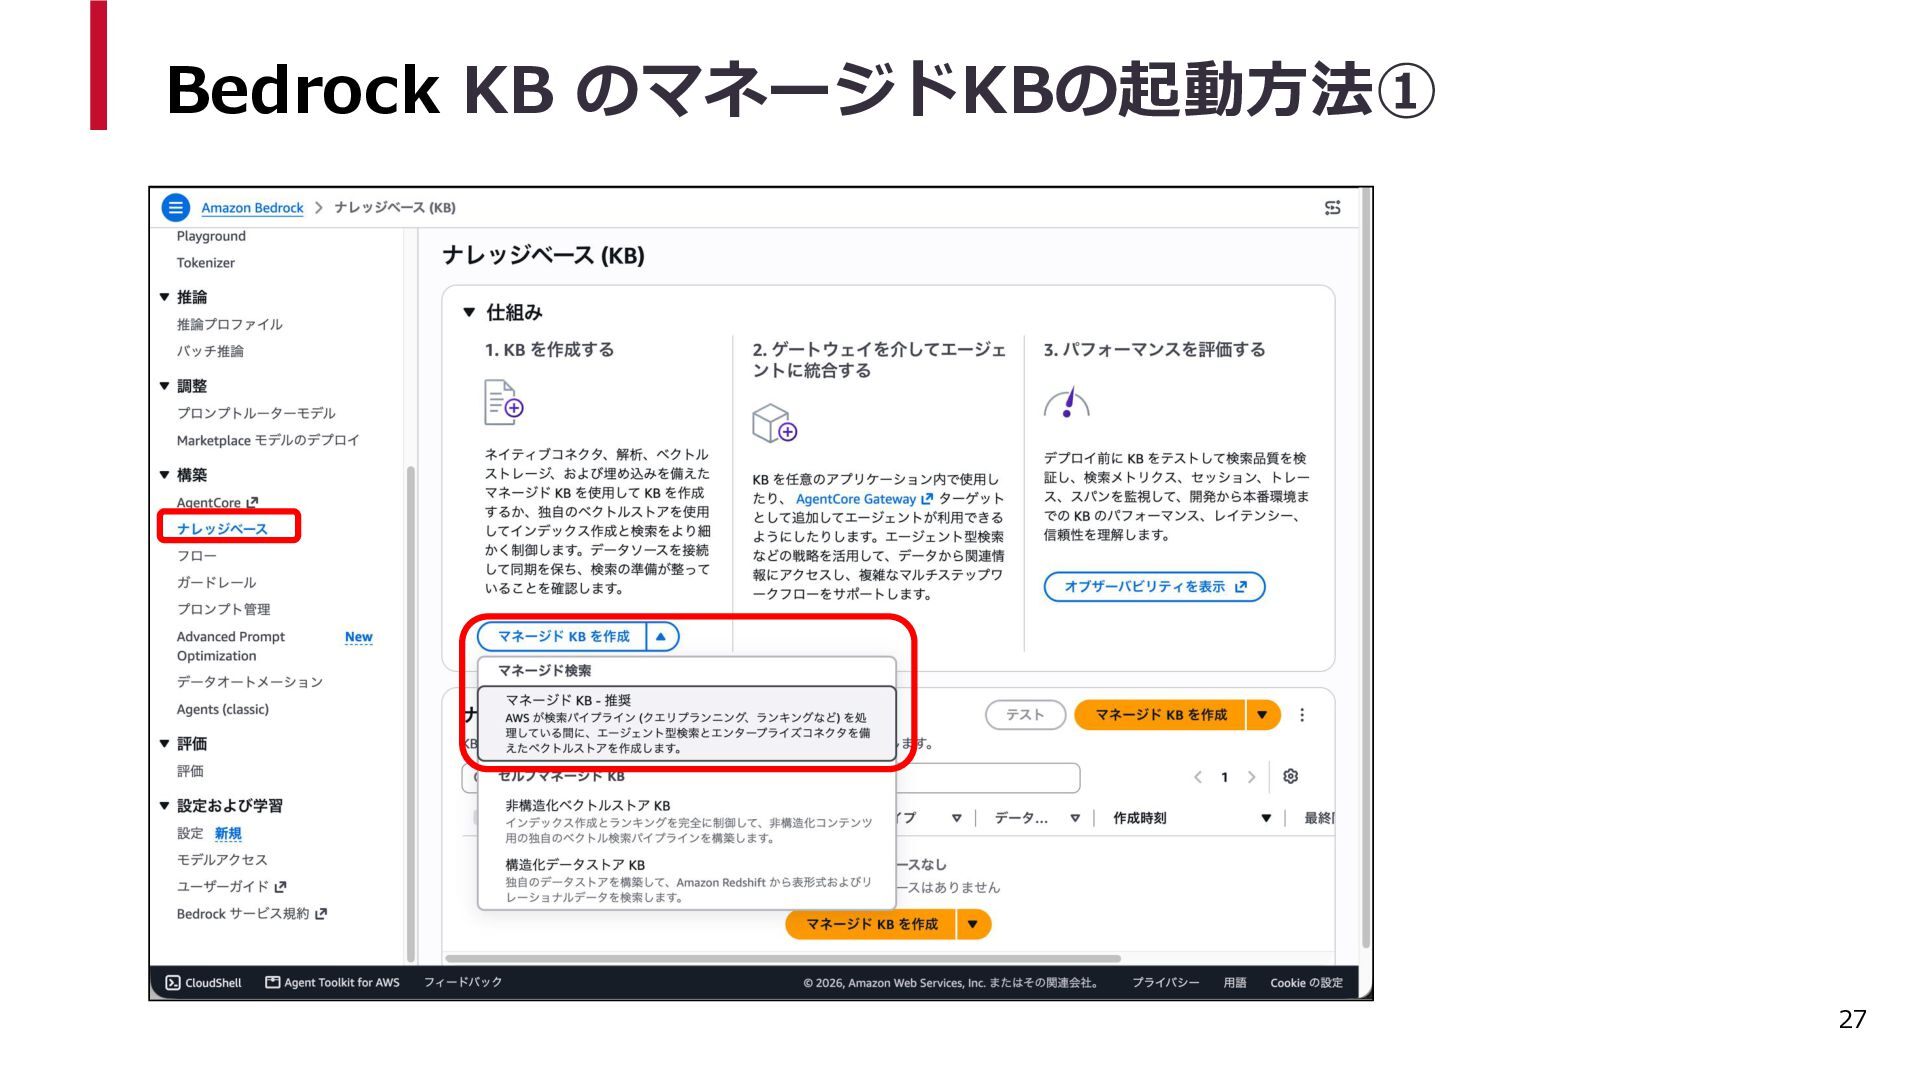
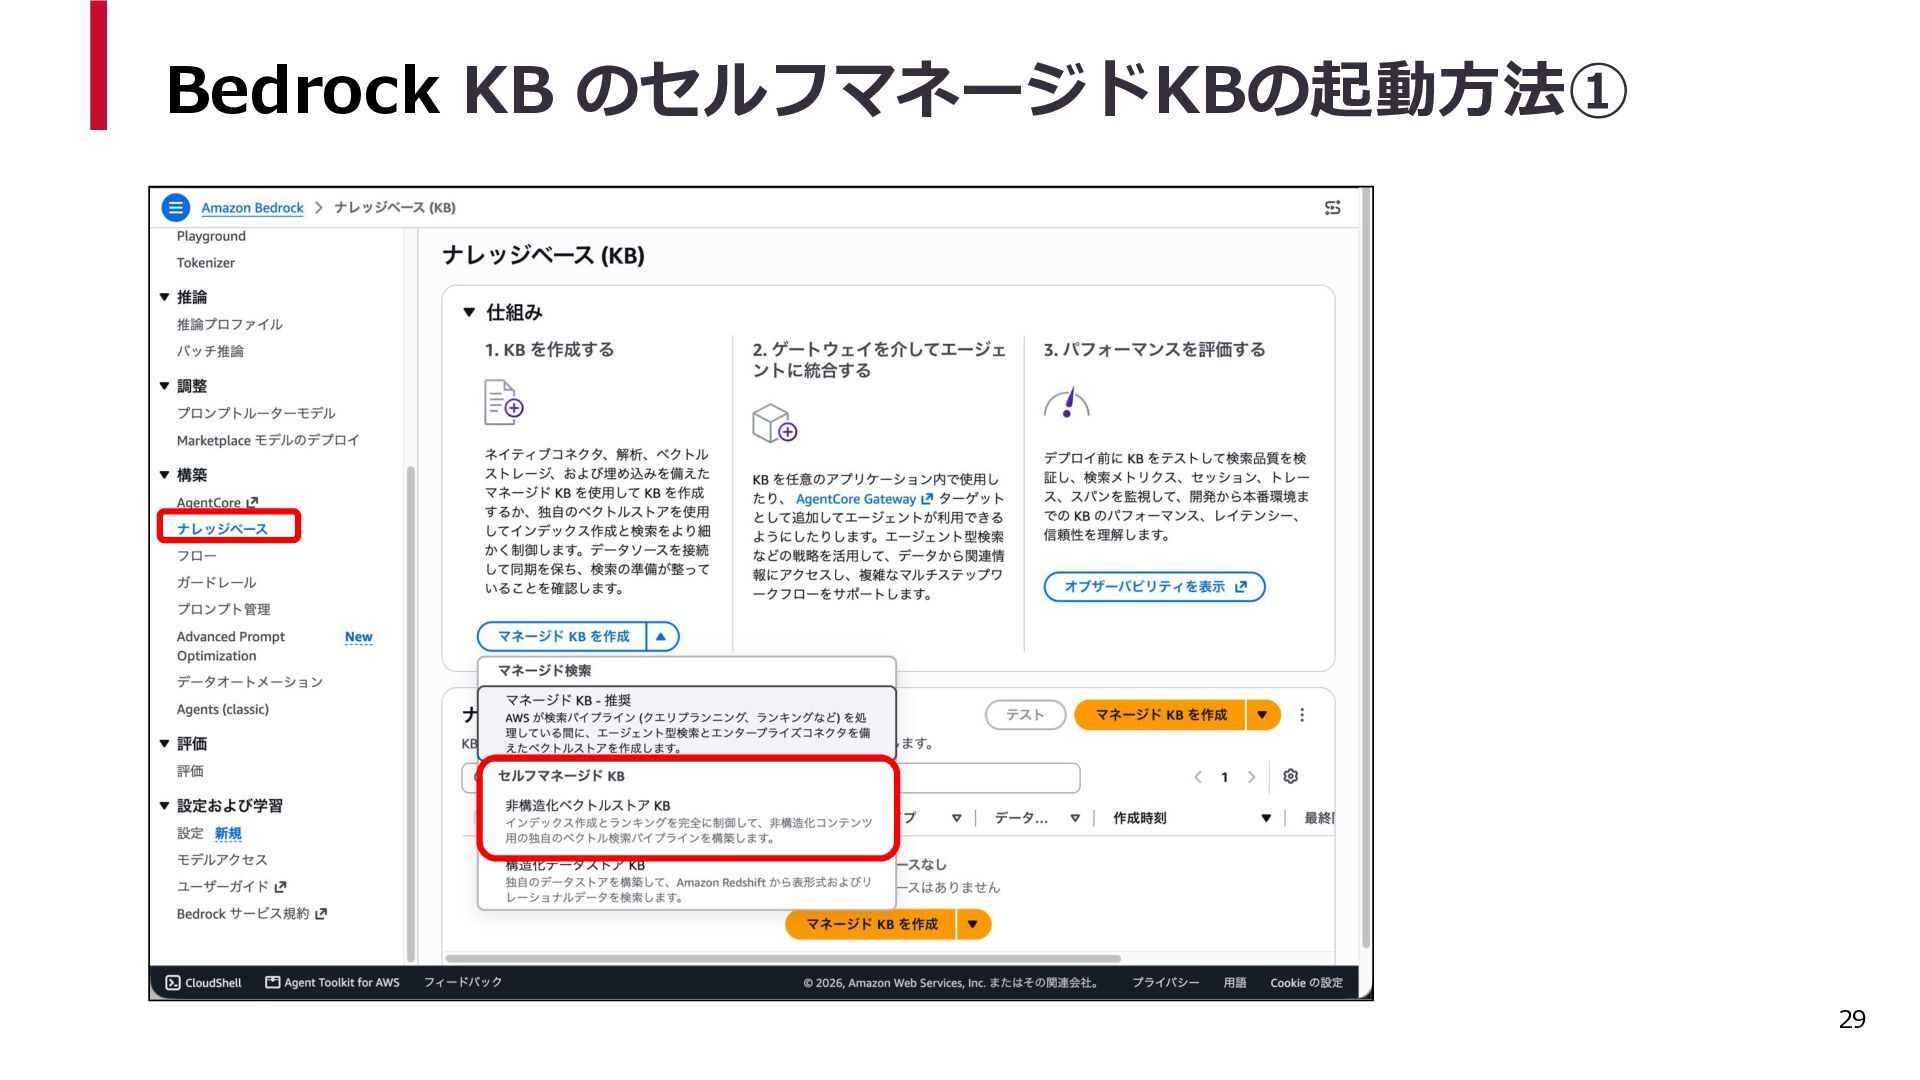
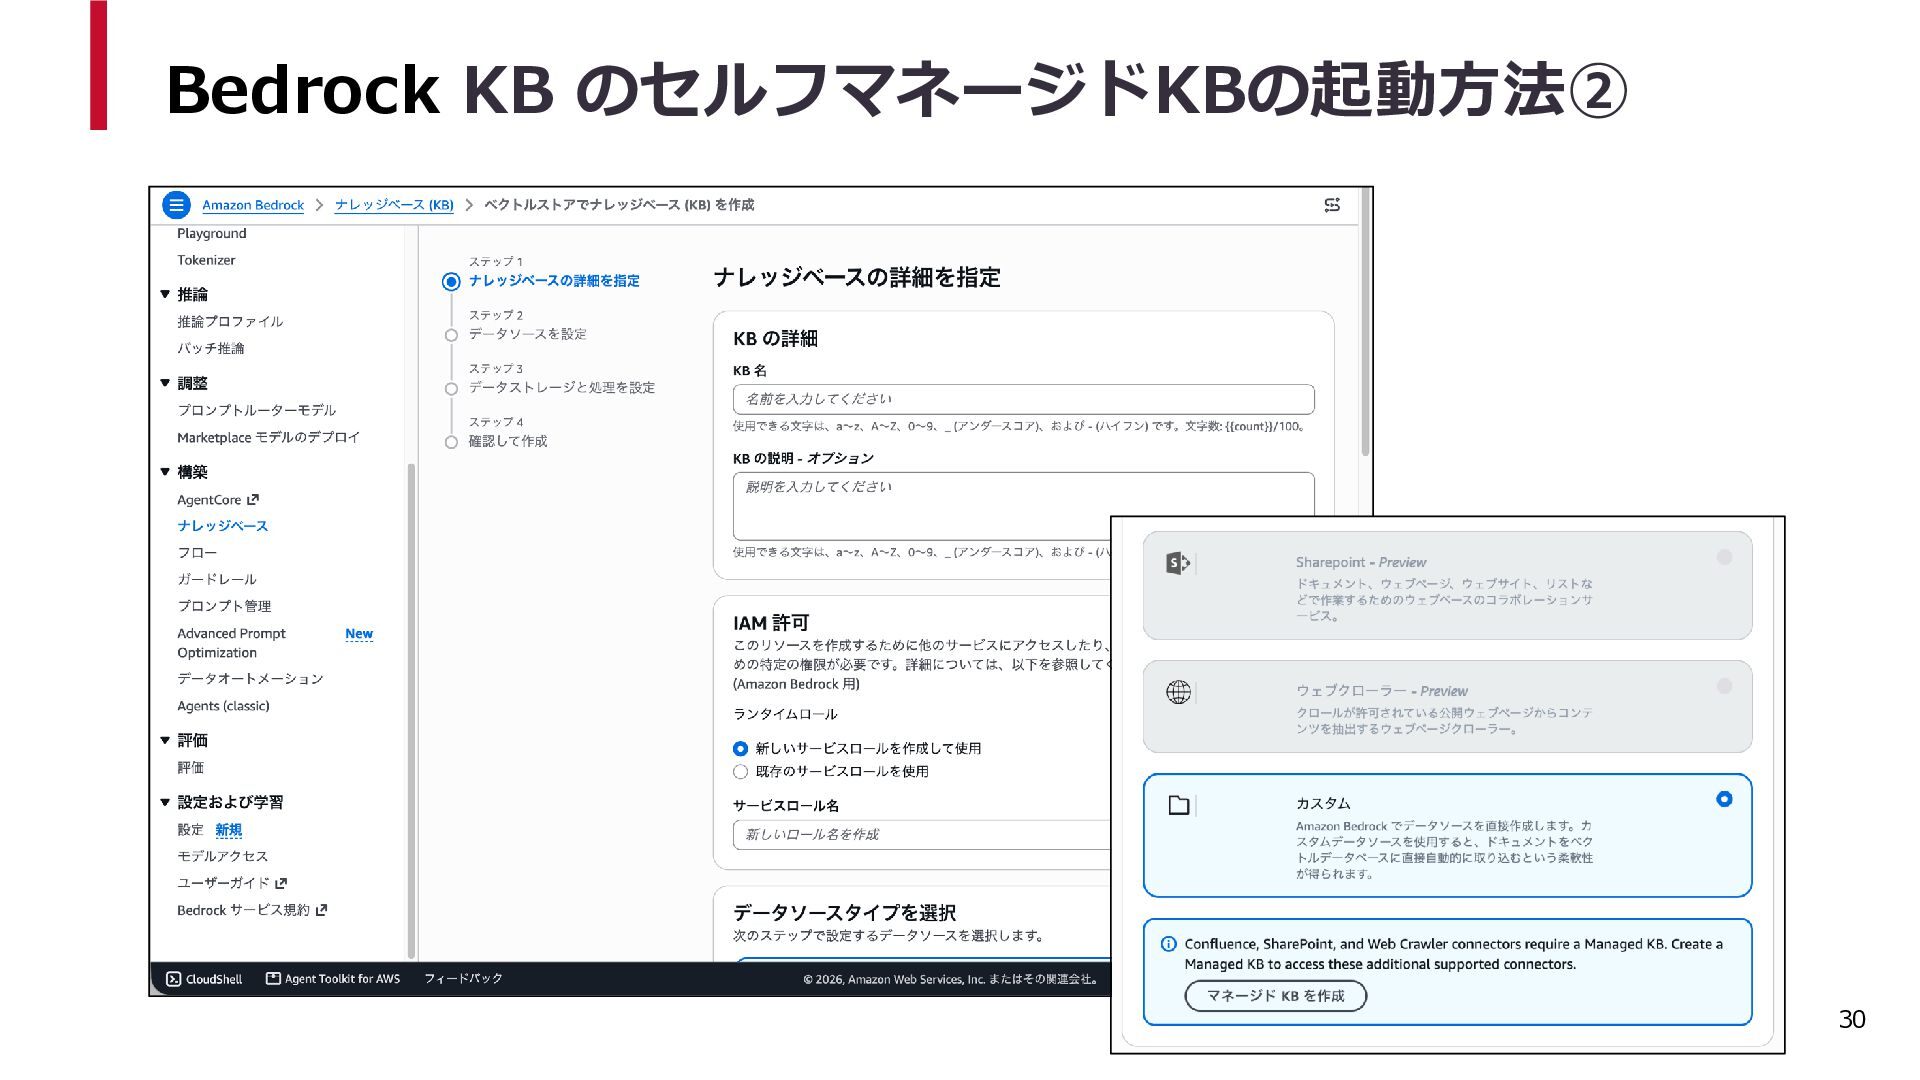
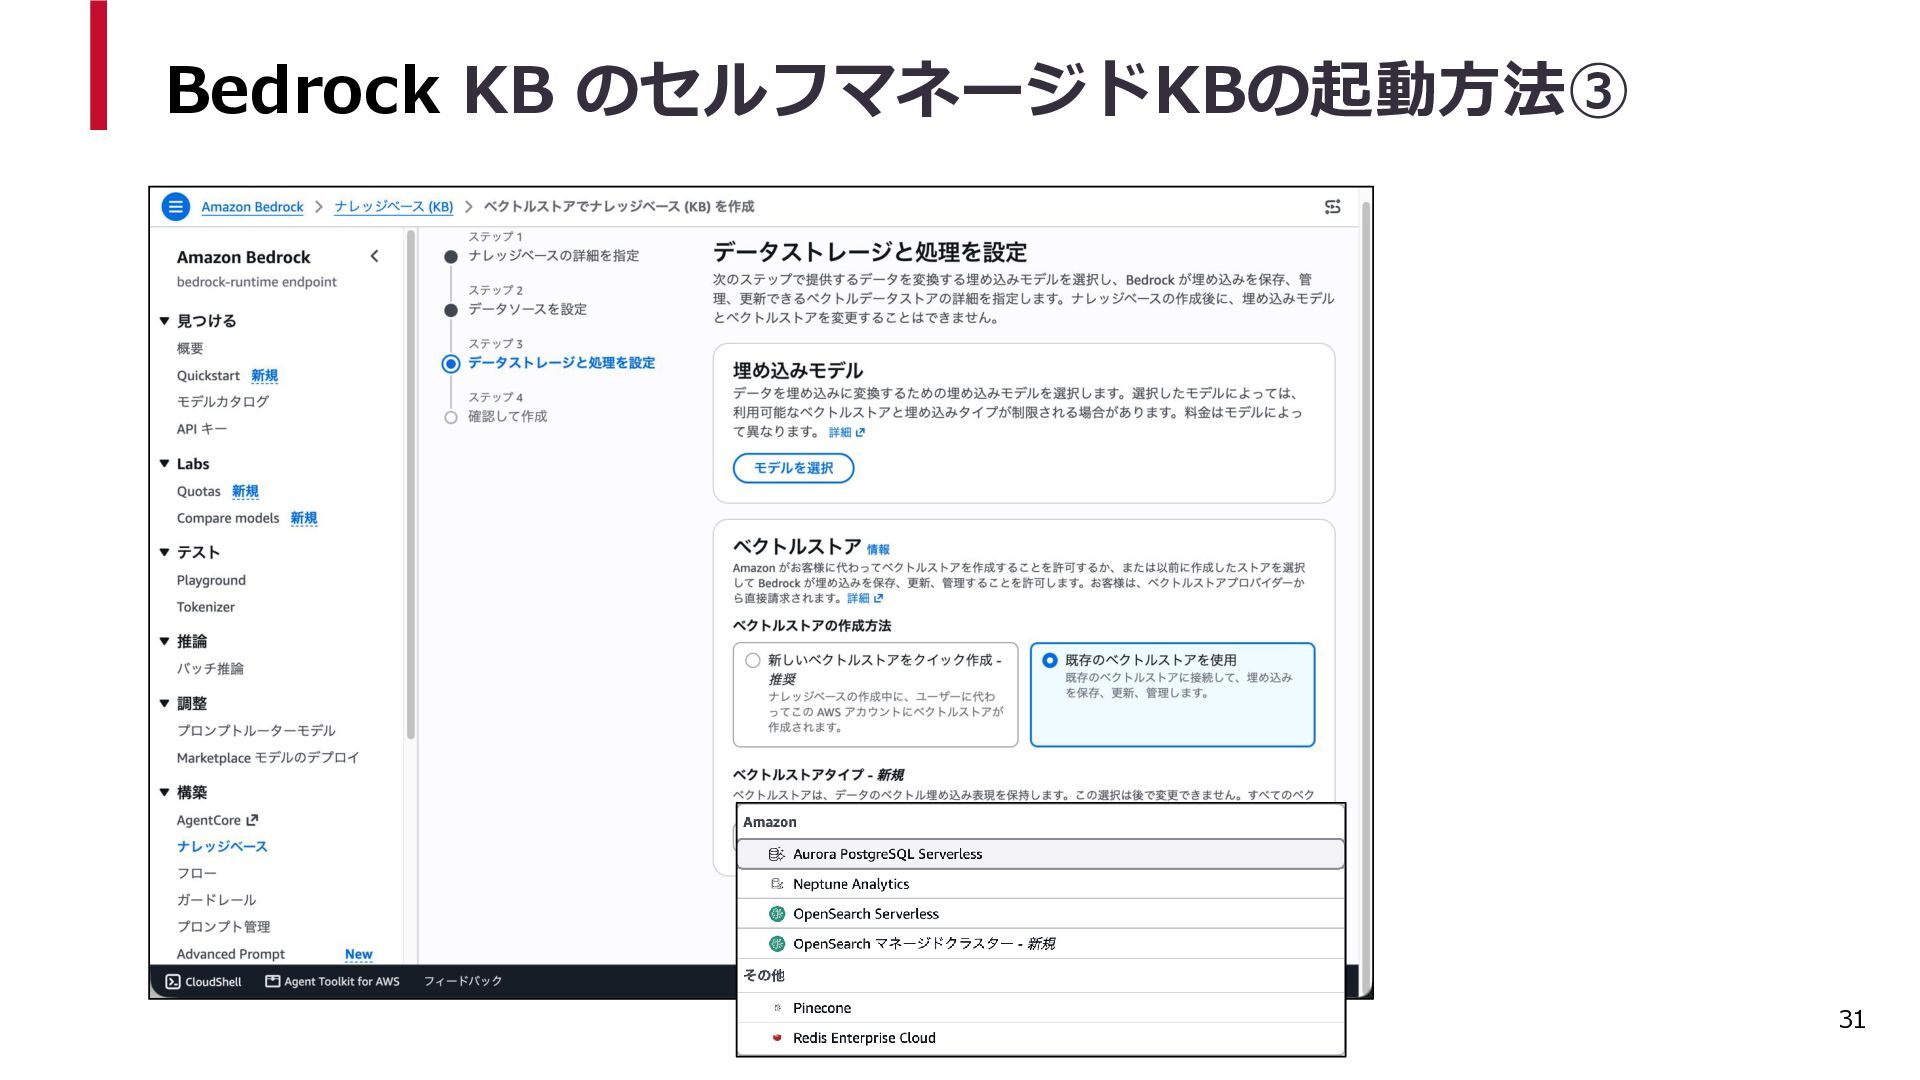
  13. Bedrock KB は2種類ある マネージドKB セルフマネージドKB ベクトルストア AWS が管理 選択可能 S3

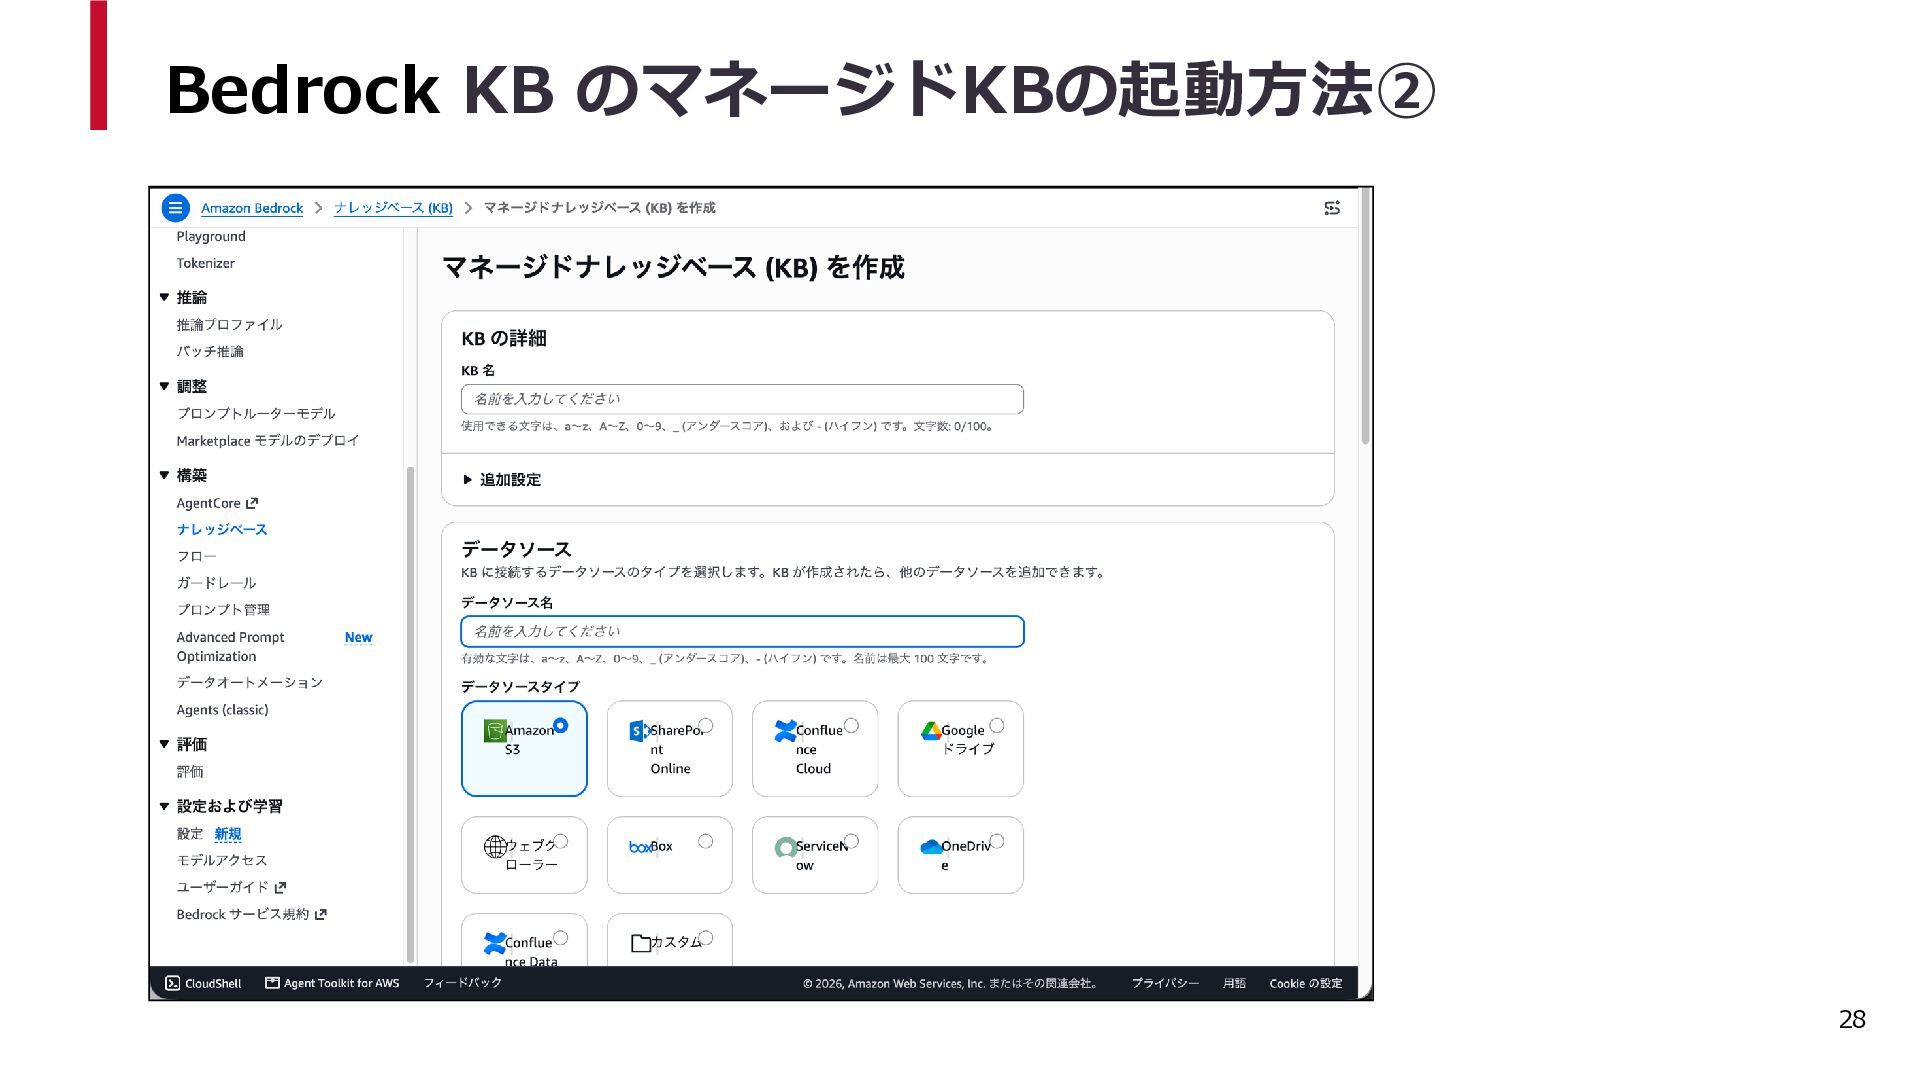
    Vectors / OpenSearch Service / Aurora 等 データソース S3・SharePoint・Confluence・Google Drive・OneDrive 等 S3・Custom 埋め込み/リランカー 標準搭載(追加費用なし) 自分で選ぶ 向いている場面 とにかく早く始めたい ストアを選びたい・制御したい 26
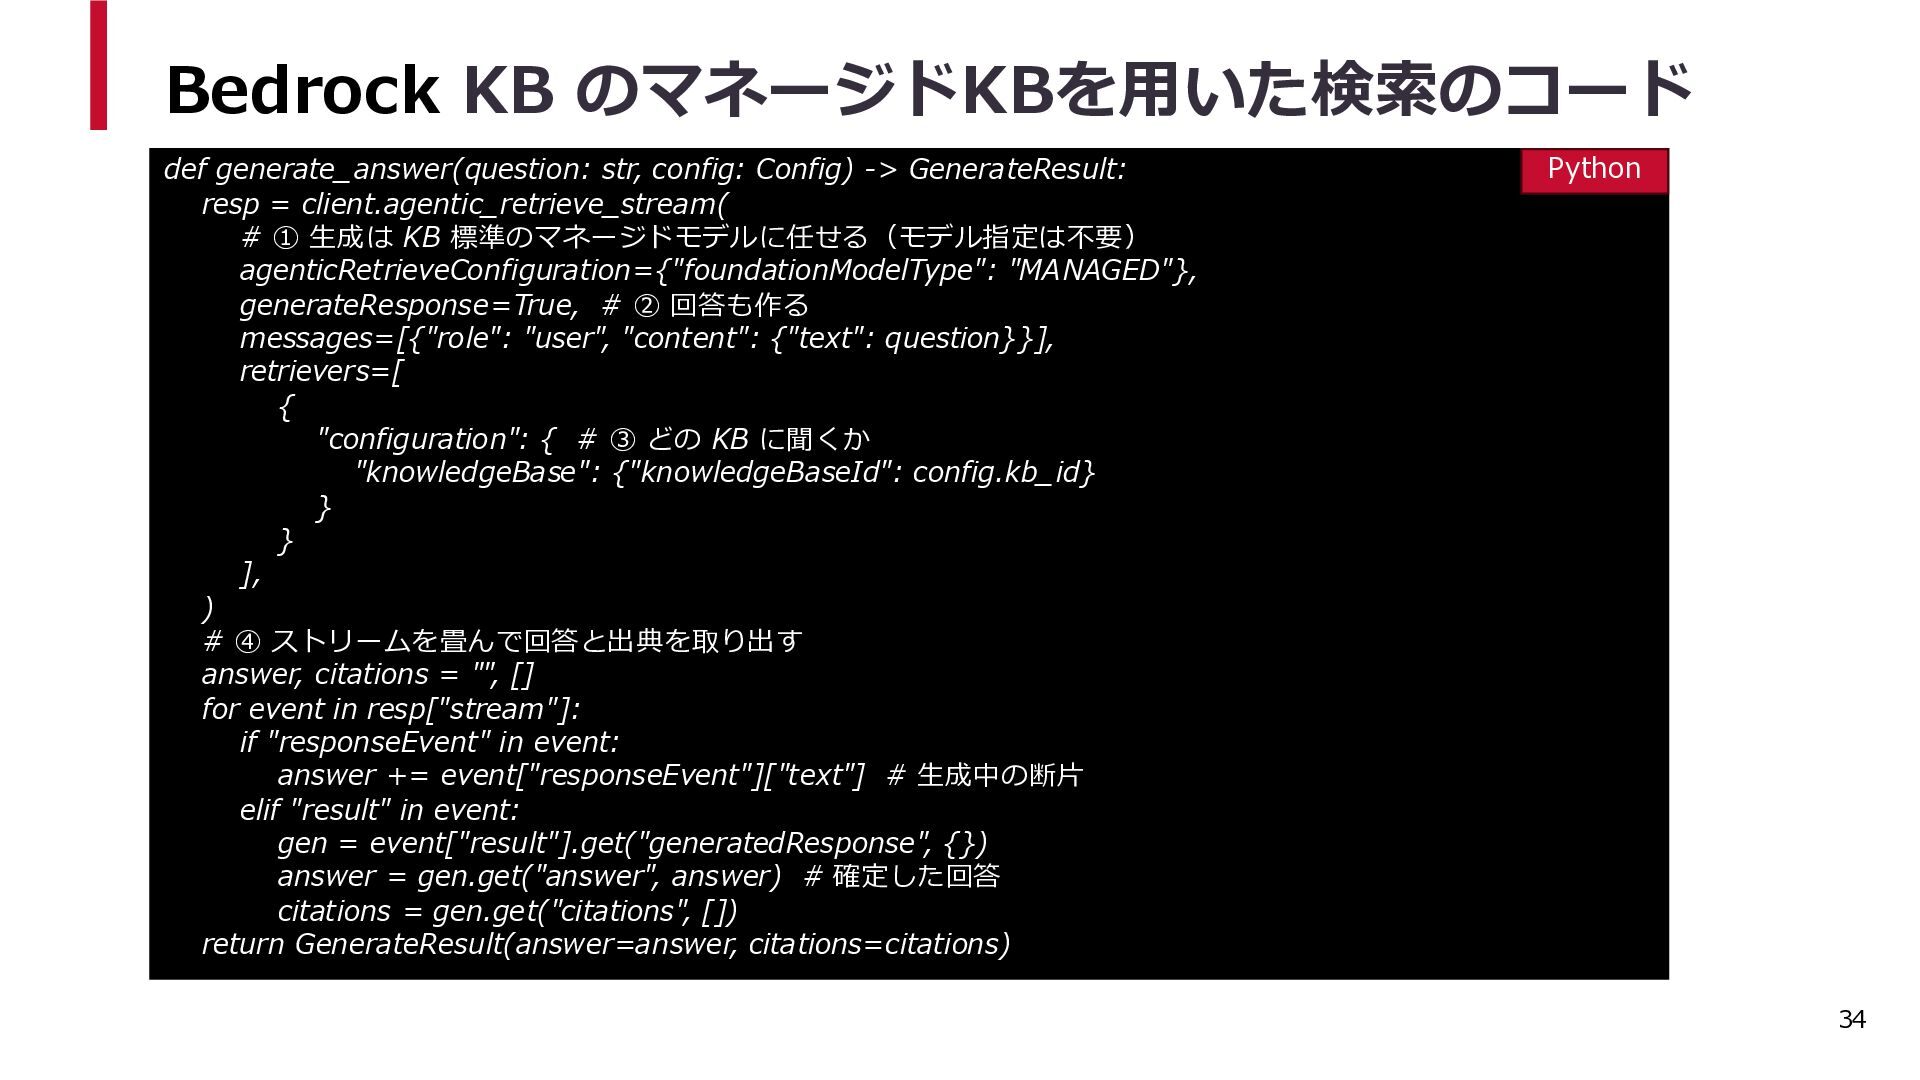
  14. Bedrock KB のマネージドKBを用いた検索のコード def generate_answer(question: str, config: Config) -> GenerateResult:

    resp = client.agentic_retrieve_stream( # ① 生成は KB 標準のマネージドモデルに任せる(モデル指定は不要) agenticRetrieveConfiguration={"foundationModelType": "MANAGED"}, generateResponse=True, # ② 回答も作る messages=[{"role": "user", "content": {"text": question}}], retrievers=[ { "configuration": { # ③ どの KB に聞くか "knowledgeBase": {"knowledgeBaseId": config.kb_id} } } ], ) # ④ ストリームを畳んで回答と出典を取り出す answer, citations = "", [] for event in resp["stream"]: if "responseEvent" in event: answer += event["responseEvent"]["text"] # 生成中の断片 elif "result" in event: gen = event["result"].get("generatedResponse", {}) answer = gen.get("answer", answer) # 確定した回答 citations = gen.get("citations", []) return GenerateResult(answer=answer, citations=citations) Python 34
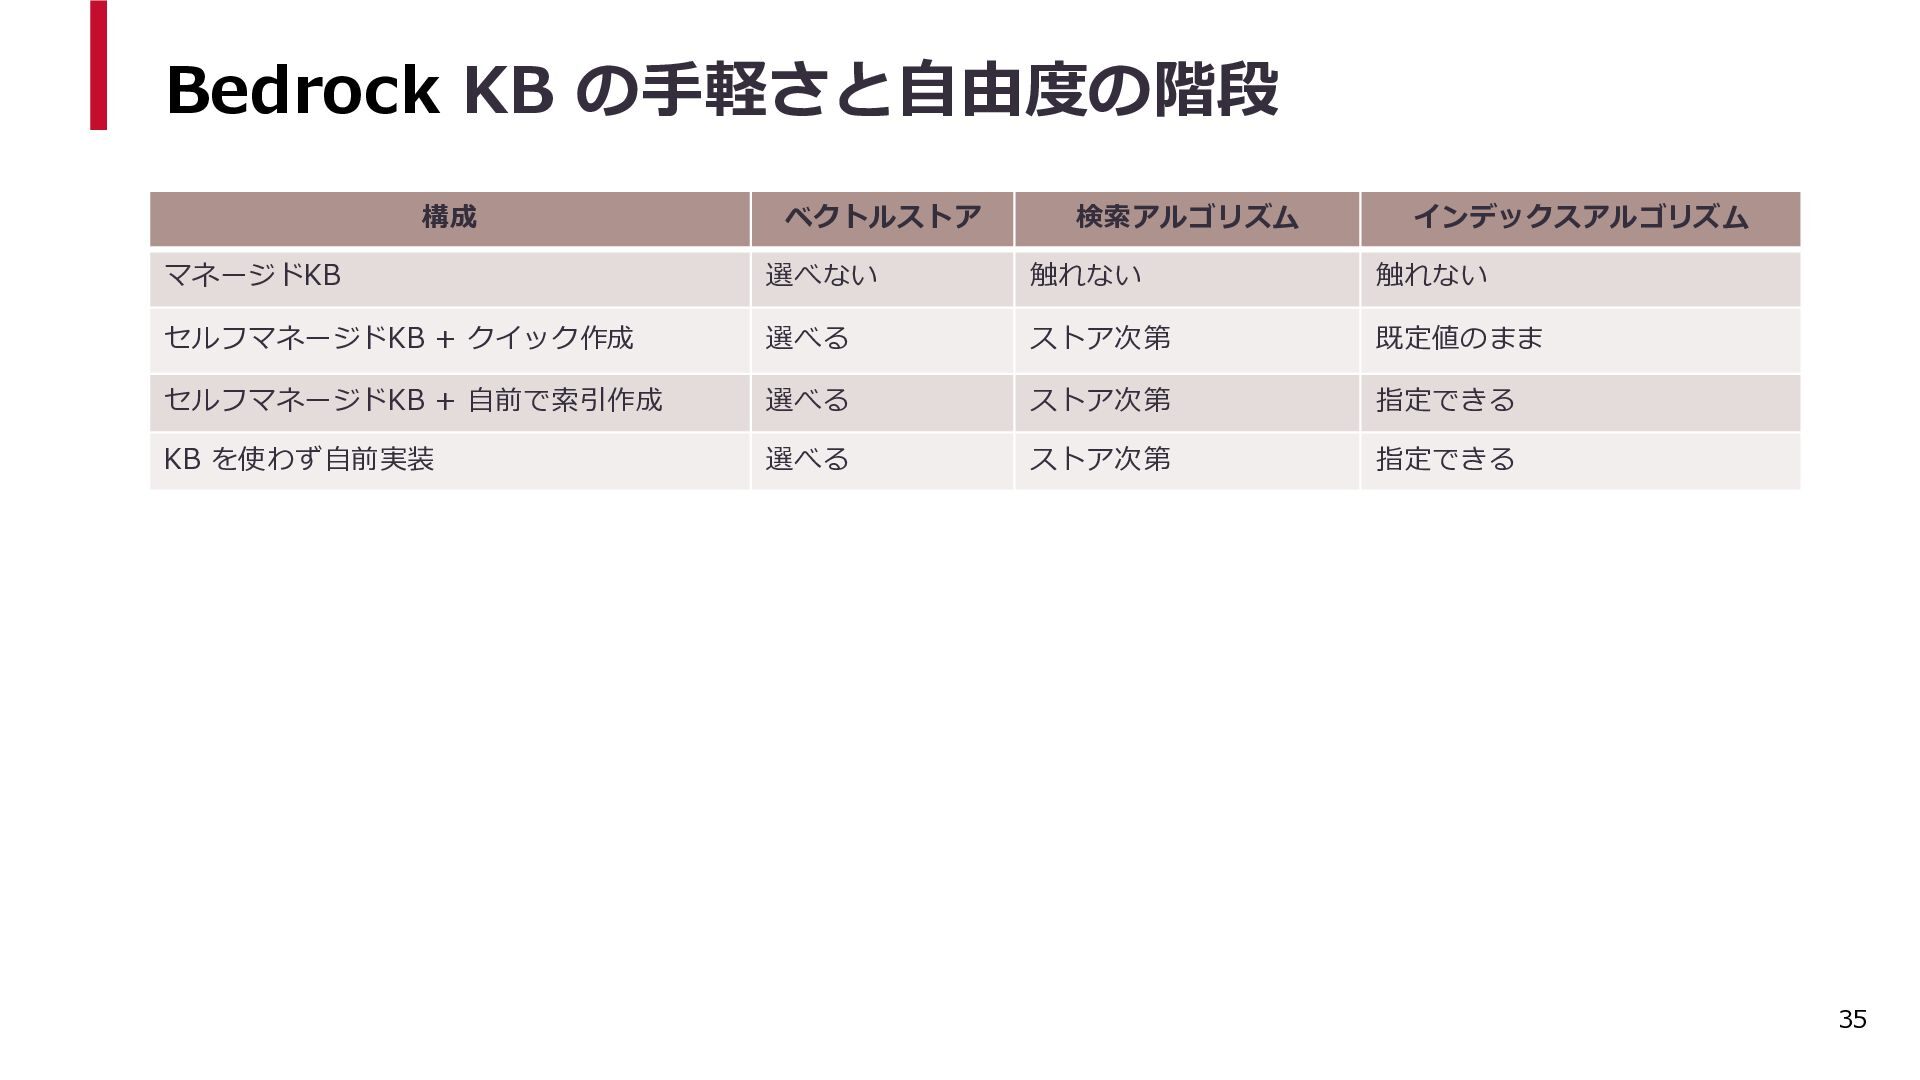
  15. Bedrock KB の手軽さと自由度の階段 構成 ベクトルストア 検索アルゴリズム インデックスアルゴリズム マネージドKB 選べない 触れない

    触れない セルフマネージドKB + クイック作成 選べる ストア次第 既定値のまま セルフマネージドKB + 自前で索引作成 選べる ストア次第 指定できる KB を使わず自前実装 選べる ストア次第 指定できる 35
  16. 参考 ⚫ Amazon Bedrock Managed Knowledge Base now supports automatic

    sync scheduling for data source connectors ⚫ Sync your data with your Amazon Bedrock knowledge base ⚫ Sync a data source ⚫ Build and deploy an automatic sync solution for Amazon Bedrock Knowledge Bases ⚫ Amazon S3 Vectors 39