Share
Embed
統合データ基盤構築 ~dbt導入とセットで考える GCPプロジェクト構成とIAM管理
株式会社アイスタイルでは統合データ基盤を構築していく上で、パイプラインの開発としてdbtの導入を検討しています。
dbtの技術調査をしていく過程で、GCPのプロジェクトの構成やIAM管理もセットで見直す必要性が出てきました。
社内の課題感と合わせて、新しい基盤をどうやって構築していくのかの方針に関するお話をさせていただきます。
Toshifumi Suga
June 10, 2022
Transcript
23 slides
-
統合データ基盤構築 dbt導入とセットで考える GCPプロジェクト構成とIAM管理 istyle Data Talk #02 © istyle Inc.
No.0 株式会社アイスタイル 須賀 俊文 -
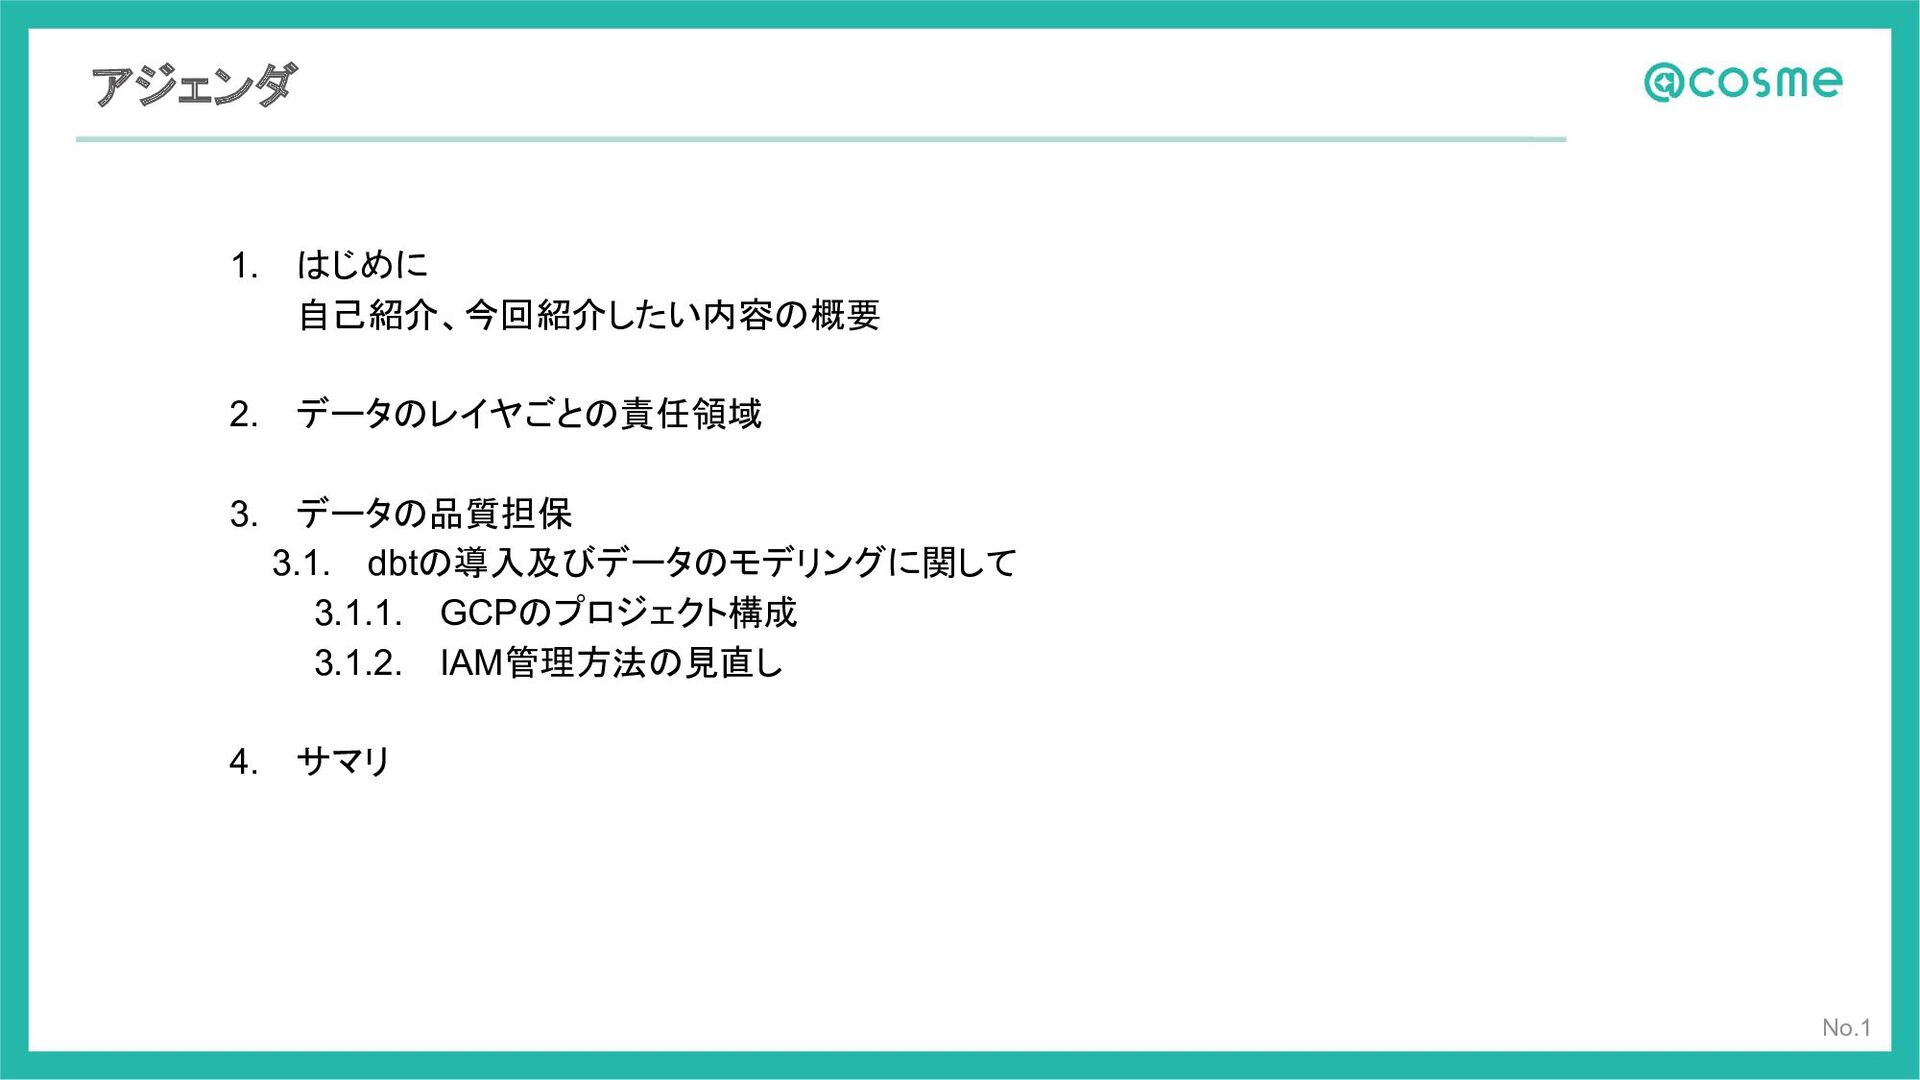
アジェンダ No.1 1. はじめに 自己紹介、今回紹介したい内容の概要 2. データのレイヤごとの責任領域 3. データの品質担保 3.1.
dbtの導入及びデータのモデリングに関して 3.1.1. GCPのプロジェクト構成 3.1.2. IAM管理方法の見直し 4. サマリ -
1. 自己紹介 No.2 © istyle Inc. 須賀 俊文 Toshifumi Suga
データ分析システム部 株式会社アイスタイルに2019年4月に中途入社。 入社当初は社内のデータ抽出業務及びRedashの運用を担当。 その後、embulkやdigdagの運用を通して全社基盤の運用保守、Tableauを利用したデー タ利活用の推進を行っていました。 現在も全社データ基盤の運用保守を行いつつ、オンプレ上に構築されたデータ基盤の クラウド移行PJTの開発に関わっています。 休日は麻雀や筋トレをして過ごすことが多いです。 またアークナイツというタワーディフェンスゲームに嵌ってます。 -
1. はじめに No.3 • データ関連の人材規模 ◦ データアナリスト:10名ほど ◦ データエンジニア:8名ほど
機械学習基盤を見ていたり、別プロダクトの運用保守をしていたり、専任メンバーは少ない • 今回お伝えしたいこと 新しいデータ基盤の開発方針を定め、データの品質向上のためにdbtを導入予定 それとセットで考えたときに、 GCPのプロジェクト構成やIAMの権限管理方法を見直すことが必要、と考えています。 まずは現状の課題と、それを将来どうしていくのかに関してお話しします。 -
リソース都合でアナリストの担当領域が広がってしまった No.5 データ ソース データマート データ収集基盤 データレイク データウェアハウス データエンジニアの担当領域 データ分析部門の担当領域
• データエンジニアのリソースがかなり限定されていた ◦ オンプレ環境のデータ基盤のクラウド化などに注力したため • データ分析部門でDWH、データマートの構築を吸収してもらった ◦ アイスタイルではtroccoを導入し、アナリストでもSQLのみでパイプラインを構築できる環境 -
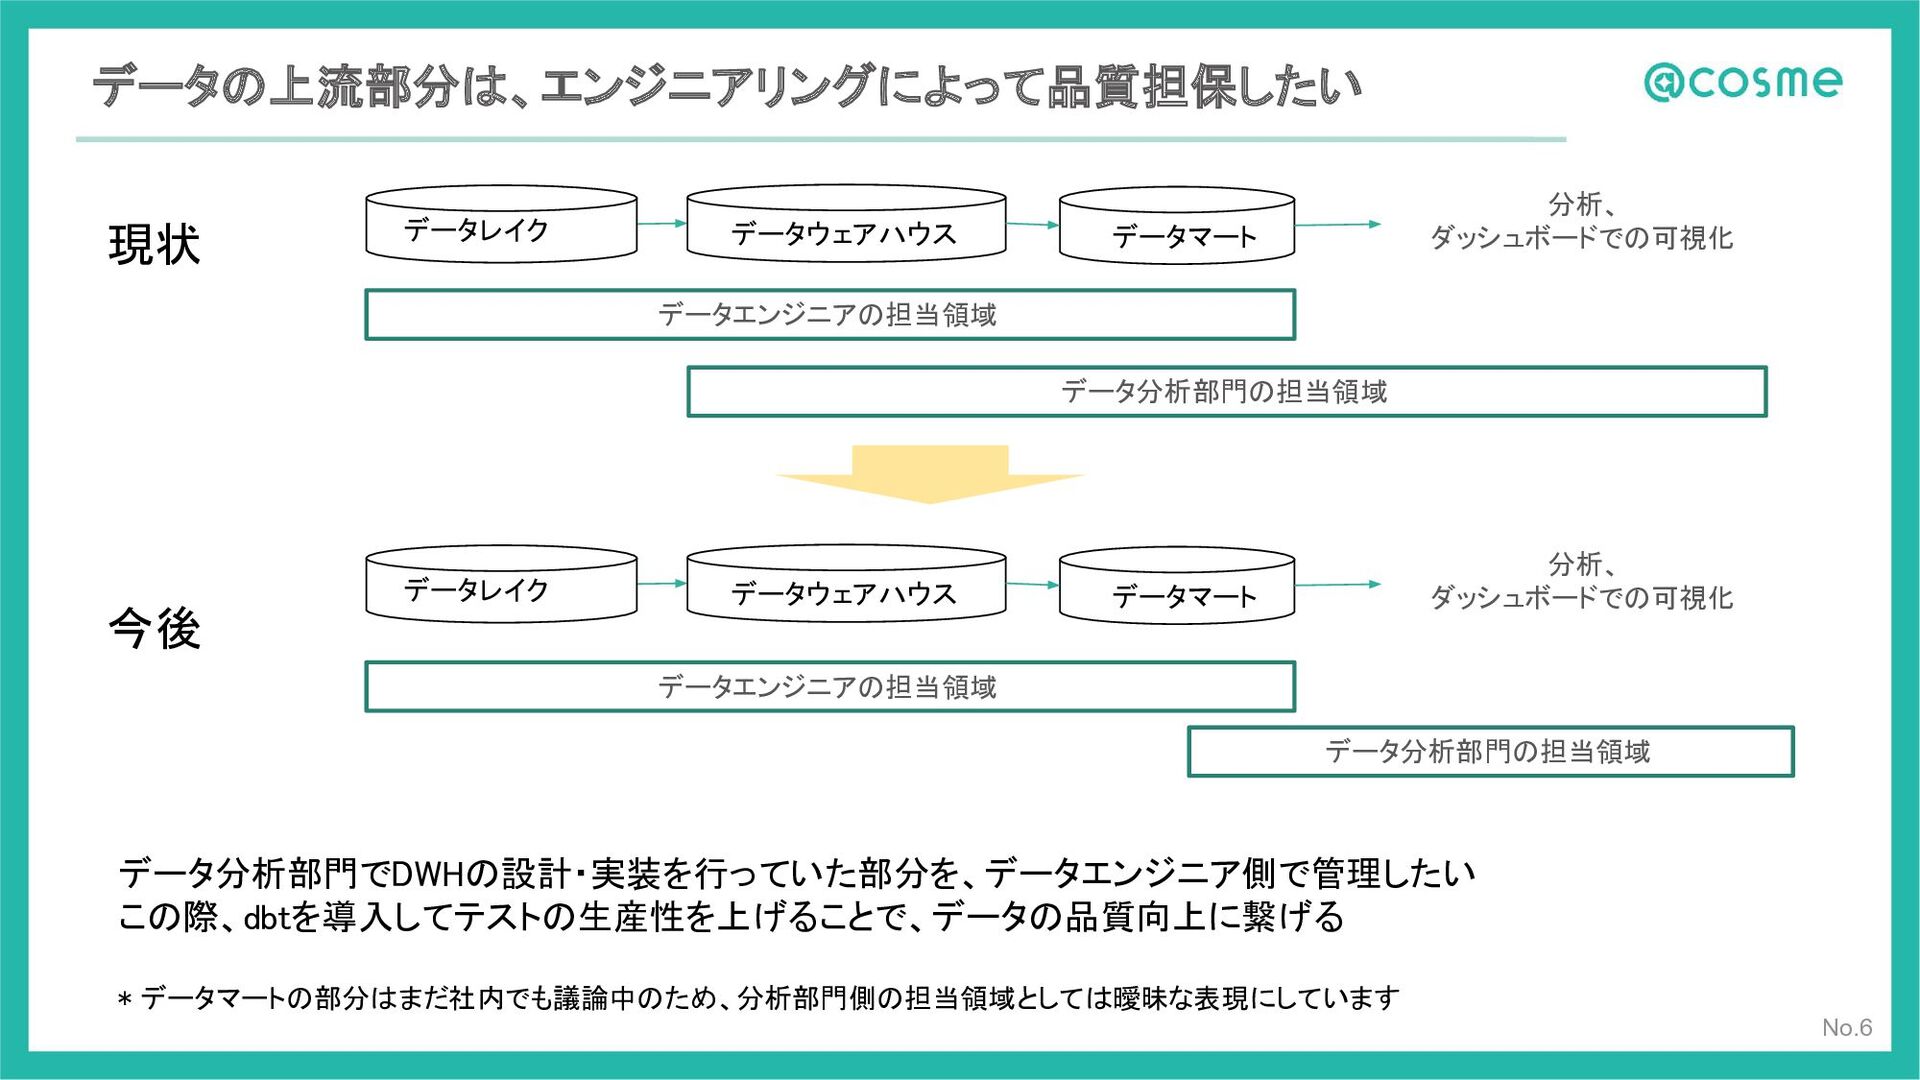
データの上流部分は、エンジニアリングによって品質担保したい No.6 データマート データレイク データウェアハウス データエンジニアの担当領域 データ分析部門の担当領域 データエンジニアの担当領域 データ分析部門の担当領域 分析、
ダッシュボードでの可視化 データマート データレイク データウェアハウス 分析、 ダッシュボードでの可視化 現状 今後 データ分析部門でDWHの設計・実装を行っていた部分を、データエンジニア側で管理したい この際、dbtを導入してテストの生産性を上げることで、データの品質向上に繋げる * データマートの部分はまだ社内でも議論中のため、分析部門側の担当領域としては曖昧な表現にしています -
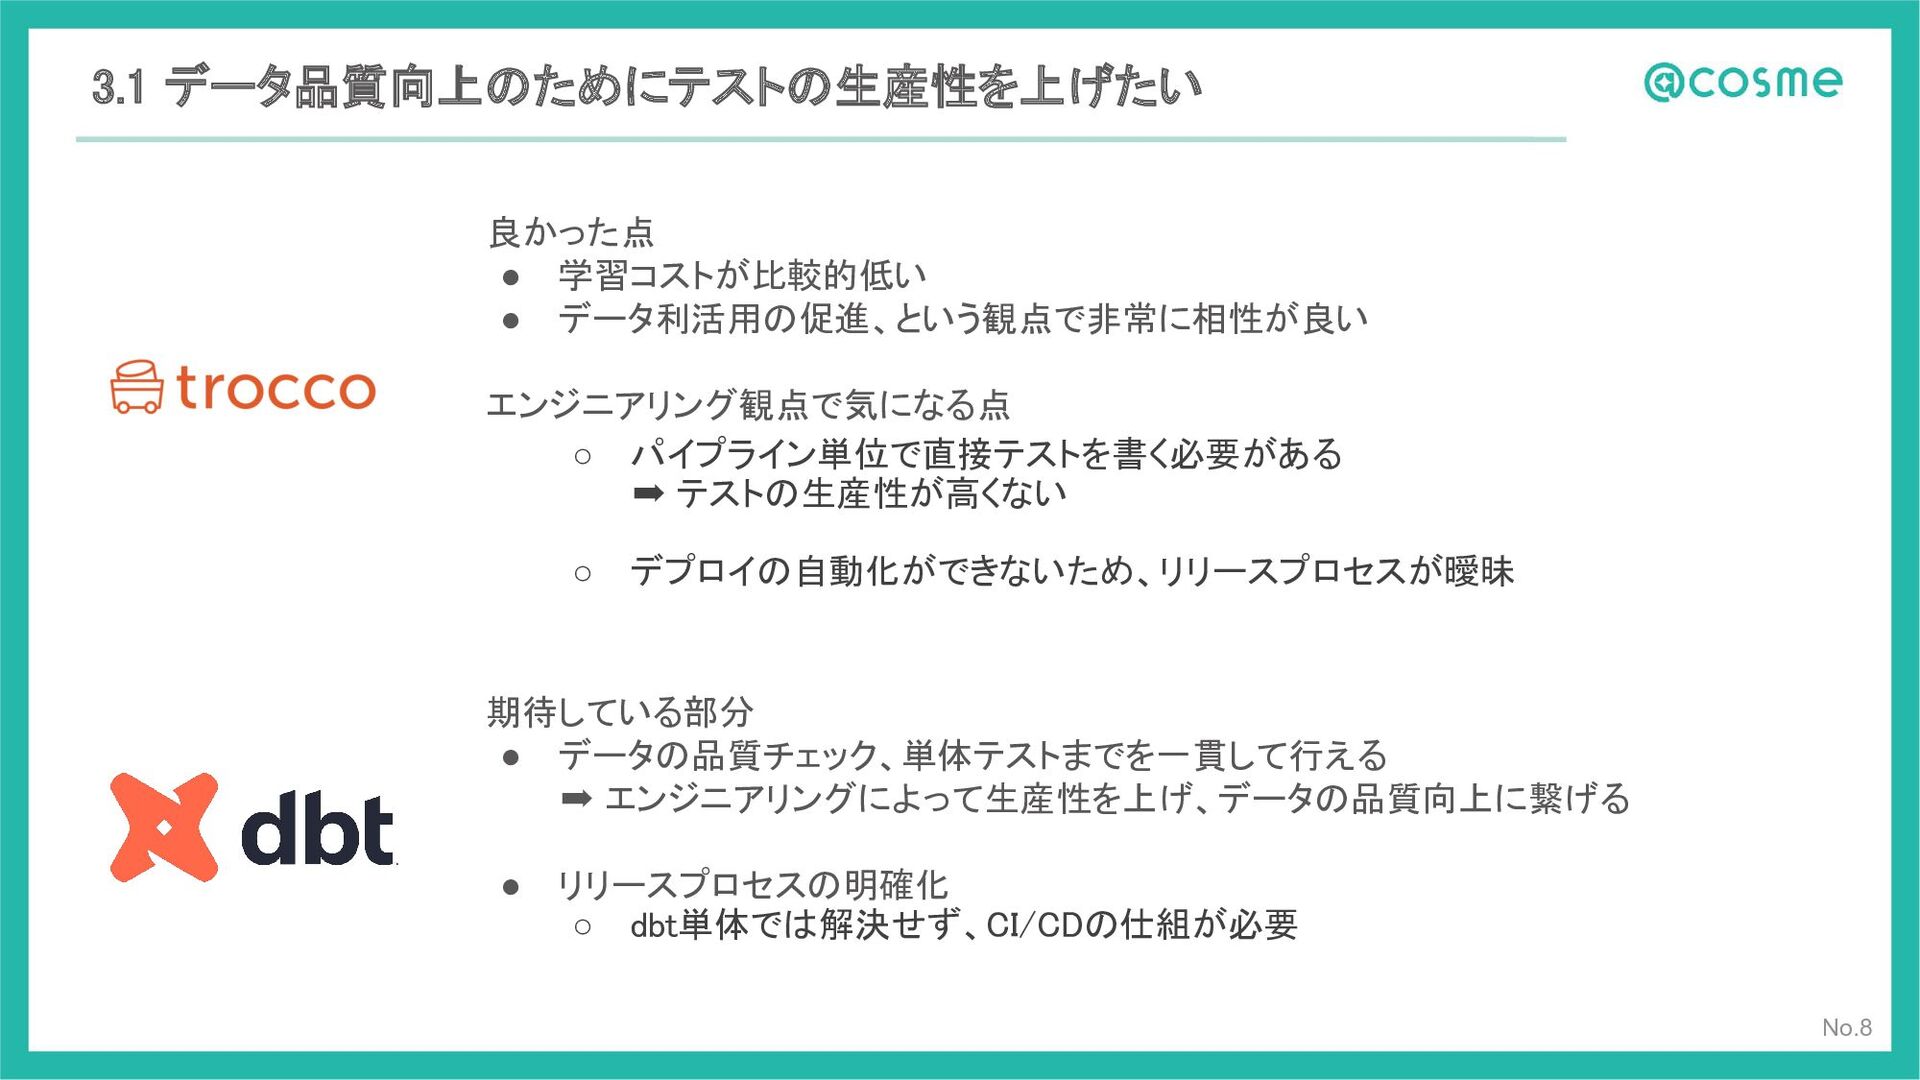
3.1 データ品質向上のためにテストの生産性を上げたい No.8 良かった点 • 学習コストが比較的低い • データ利活用の促進、という観点で非常に相性が良い エンジニアリング観点で気になる点
◦ パイプライン単位で直接テストを書く必要がある ➡ テストの生産性が高くない ◦ デプロイの自動化ができないため、リリースプロセスが曖昧 期待している部分 • データの品質チェック、単体テストまでを一貫して行える ➡ エンジニアリングによって生産性を上げ、データの品質向上に繋げる • リリースプロセスの明確化 ◦ dbt単体では解決せず、CI/CDの仕組が必要 -
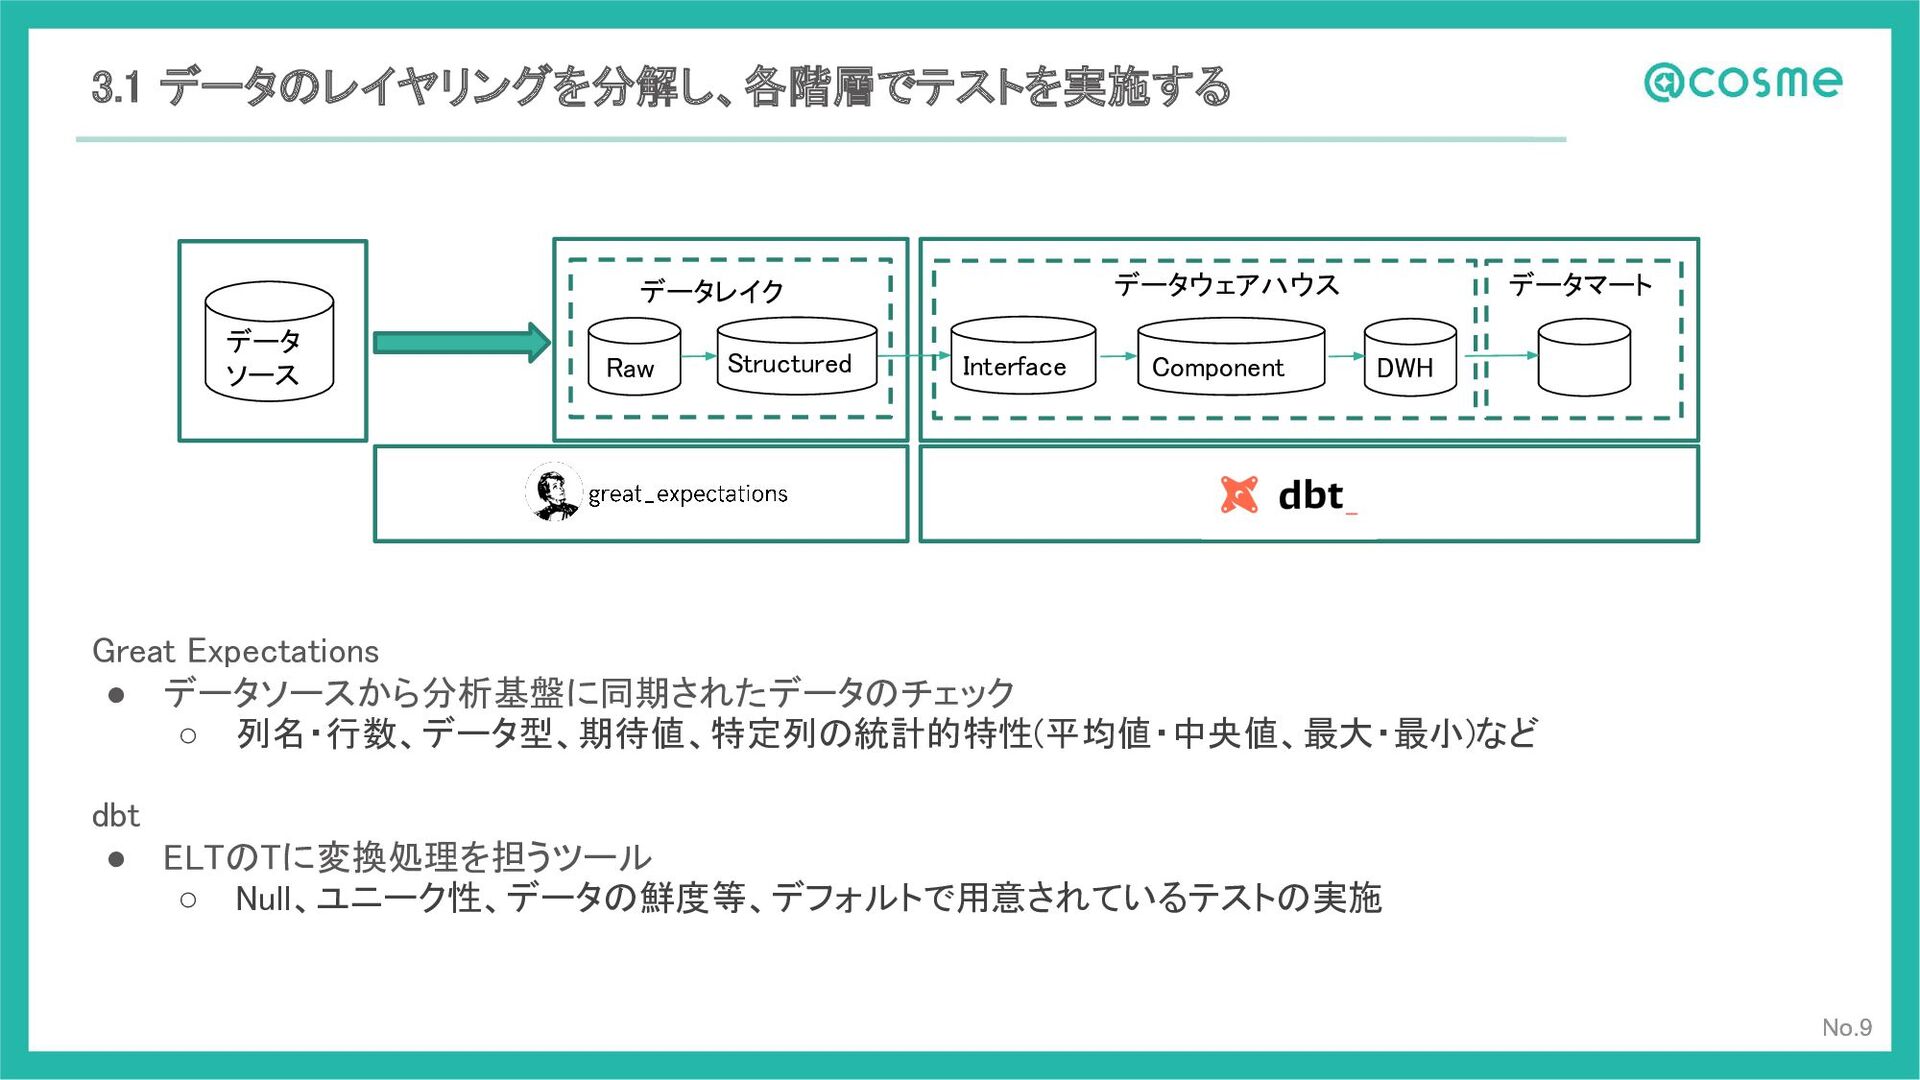
3.1 データのレイヤリングを分解し、各階層でテストを実施する No.9 Great Expectations • データソースから分析基盤に同期されたデータのチェック ◦ 列名・行数、データ型、期待値、特定列の統計的特性(平均値・中央値、最大・最小)など
dbt • ELTのTに変換処理を担うツール ◦ Null、ユニーク性、データの鮮度等、デフォルトで用意されているテストの実施 No.9 データレイク データウェアハウス データマート Raw Structured Interface Component DWH データ ソース -
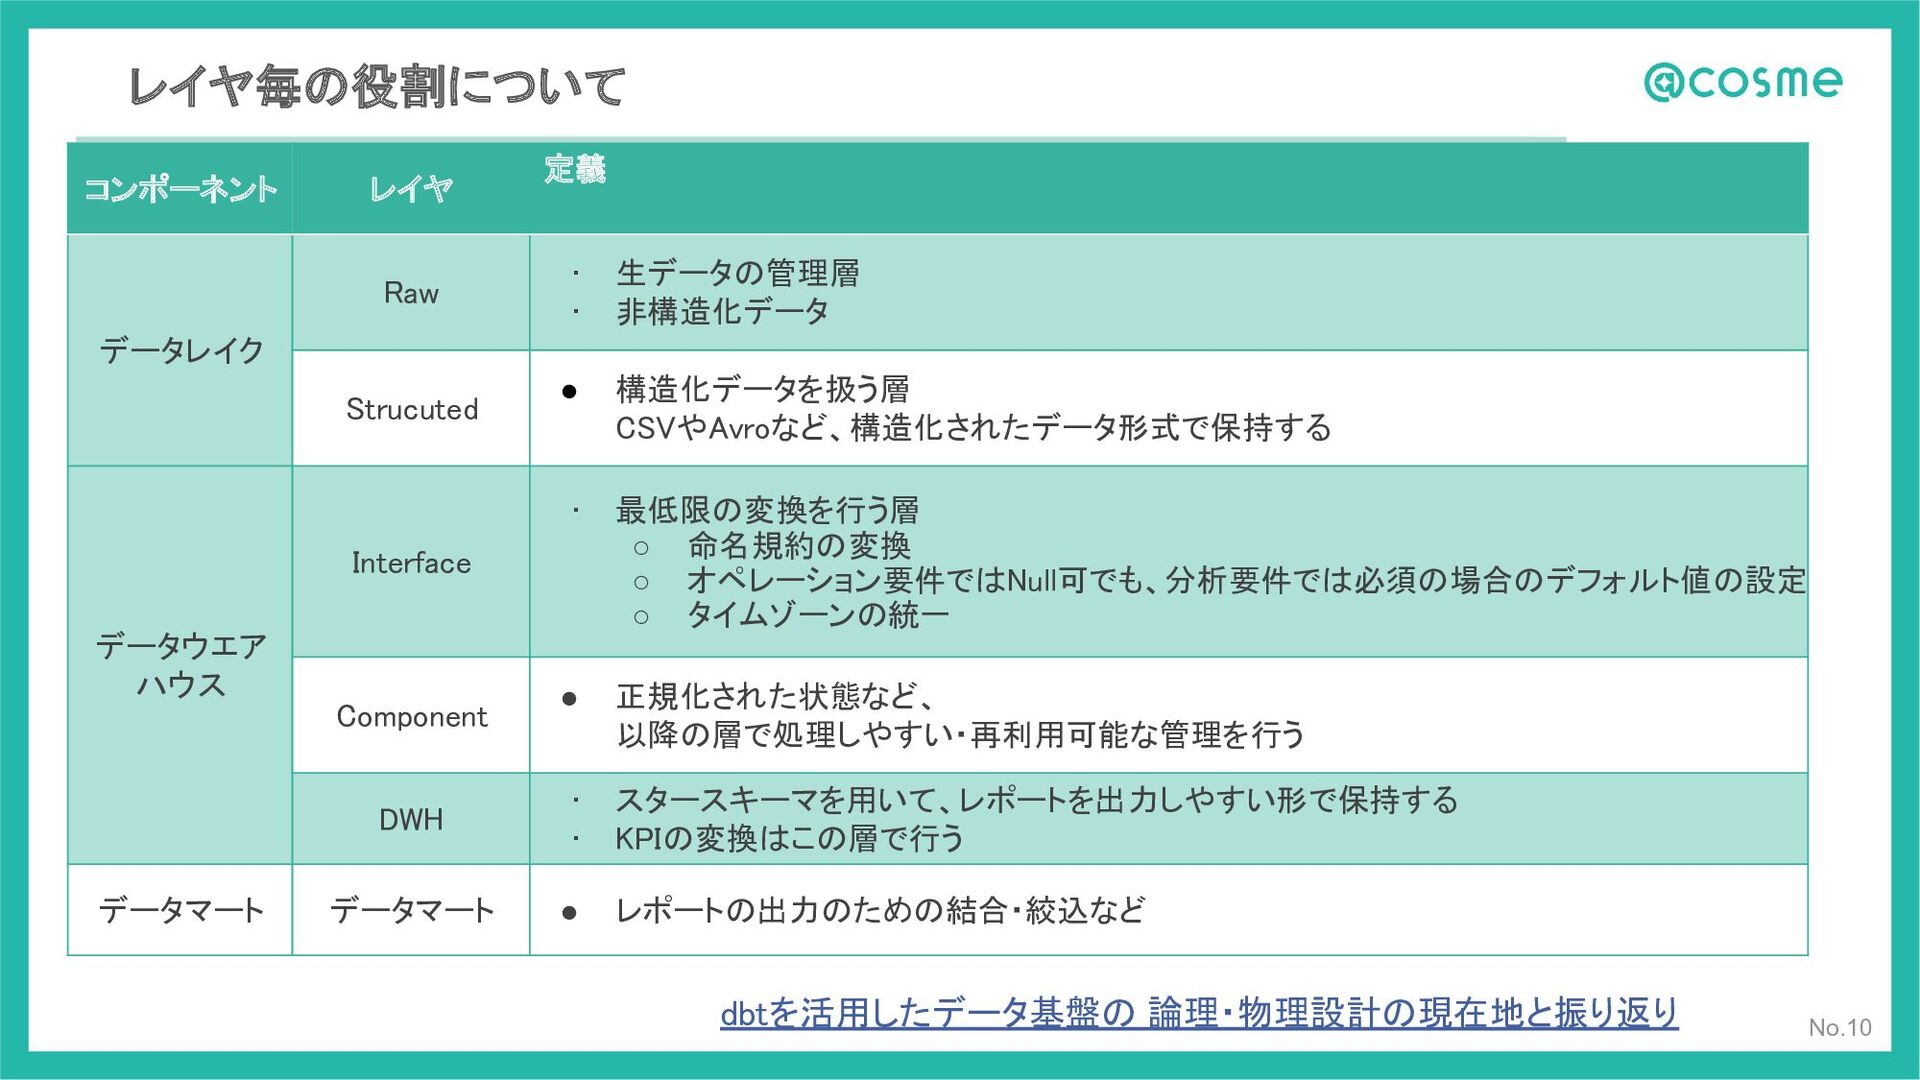
レイヤ毎の役割について No.10 コンポーネント レイヤ 定義 データレイク Raw • 生データの管理層 •
非構造化データ Strucuted • 構造化データを扱う層 CSVやAvroなど、構造化されたデータ形式で保持する データウエア ハウス Interface • 最低限の変換を行う層 ◦ 命名規約の変換 ◦ オペレーション要件ではNull可でも、分析要件では必須の場合のデフォルト値の設定 ◦ タイムゾーンの統一 Component • 正規化された状態など、 以降の層で処理しやすい・再利用可能な管理を行う DWH • スタースキーマを用いて、レポートを出力しやすい形で保持する • KPIの変換はこの層で行う データマート データマート • レポートの出力のための結合・絞込など dbtを活用したデータ基盤の 論理・物理設計の現在地と振り返り -
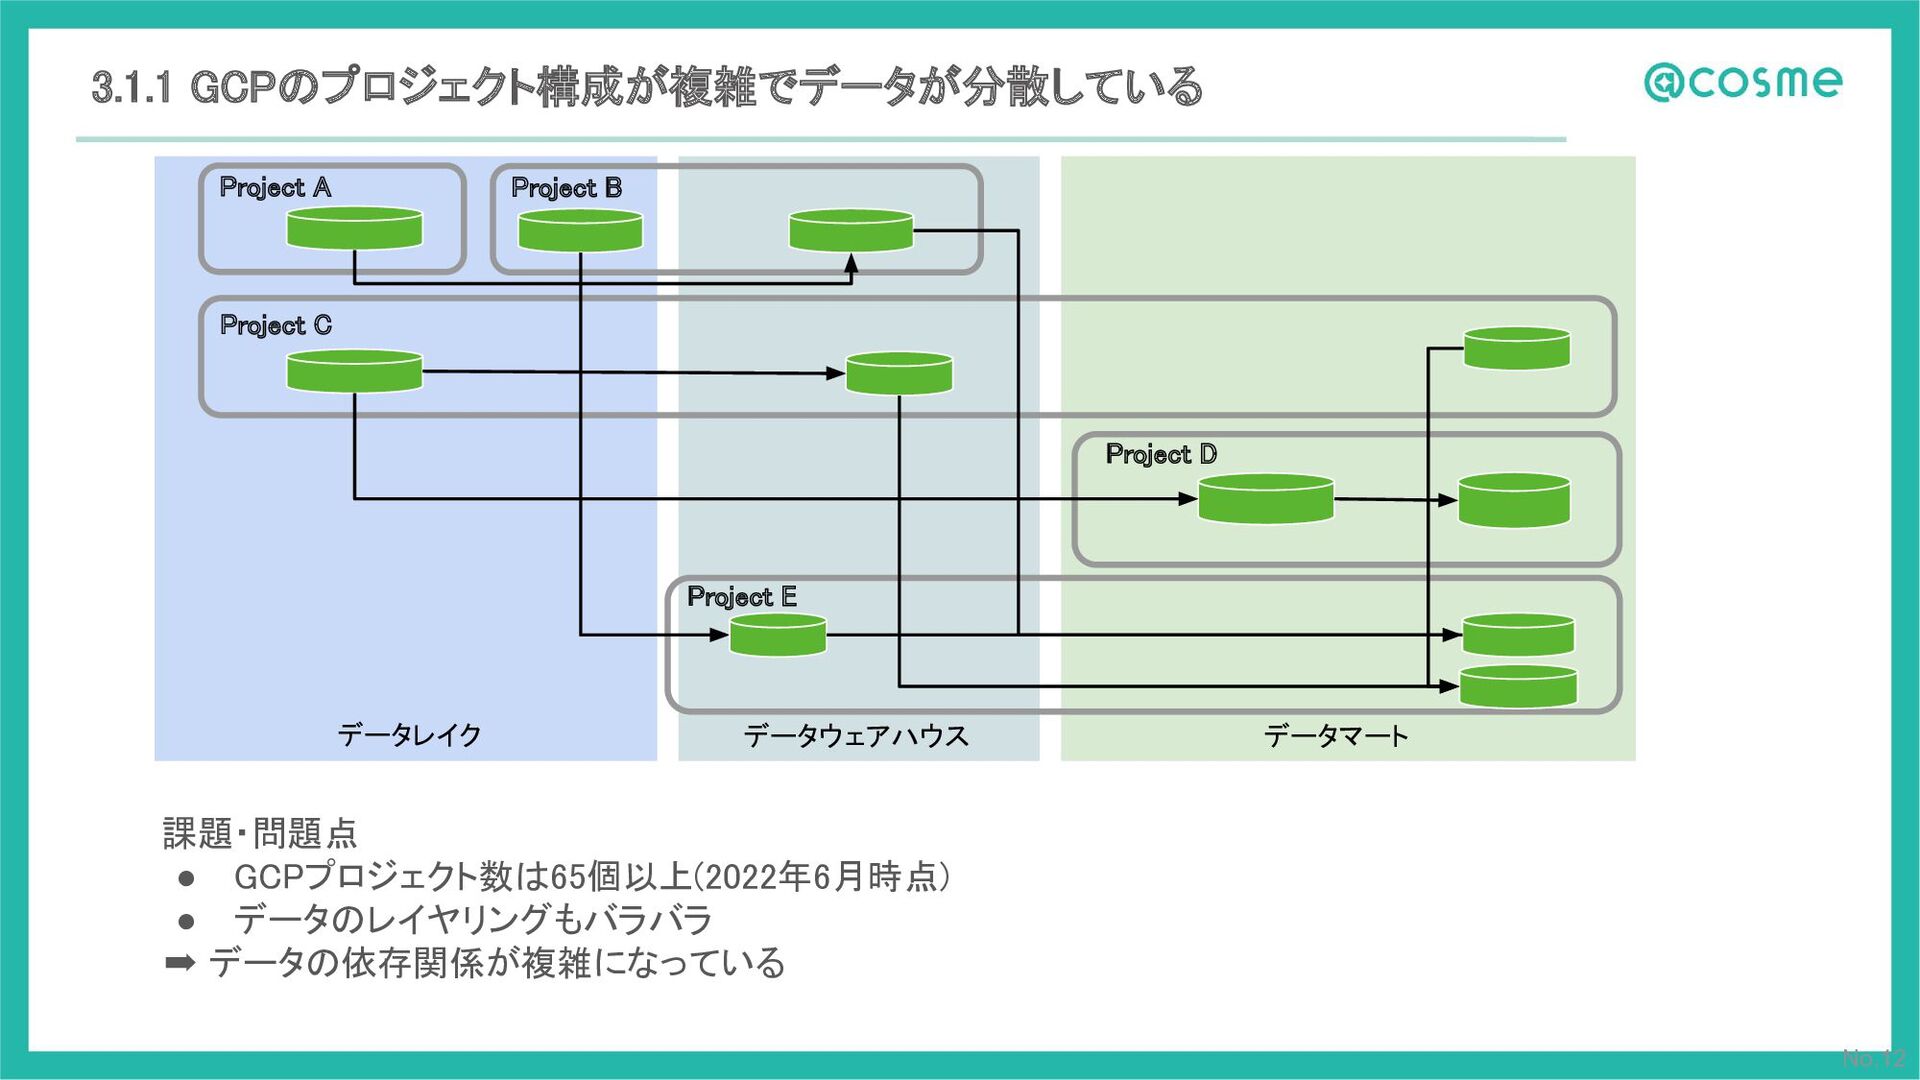
No.12 Project B Project C Project E
Project D Project A データレイク データウェアハウス データマート 3.1.1 GCPのプロジェクト構成が複雑でデータが分散している 課題・問題点 • GCPプロジェクト数は65個以上(2022年6月時点) • データのレイヤリングもバラバラ ➡ データの依存関係が複雑になっている -
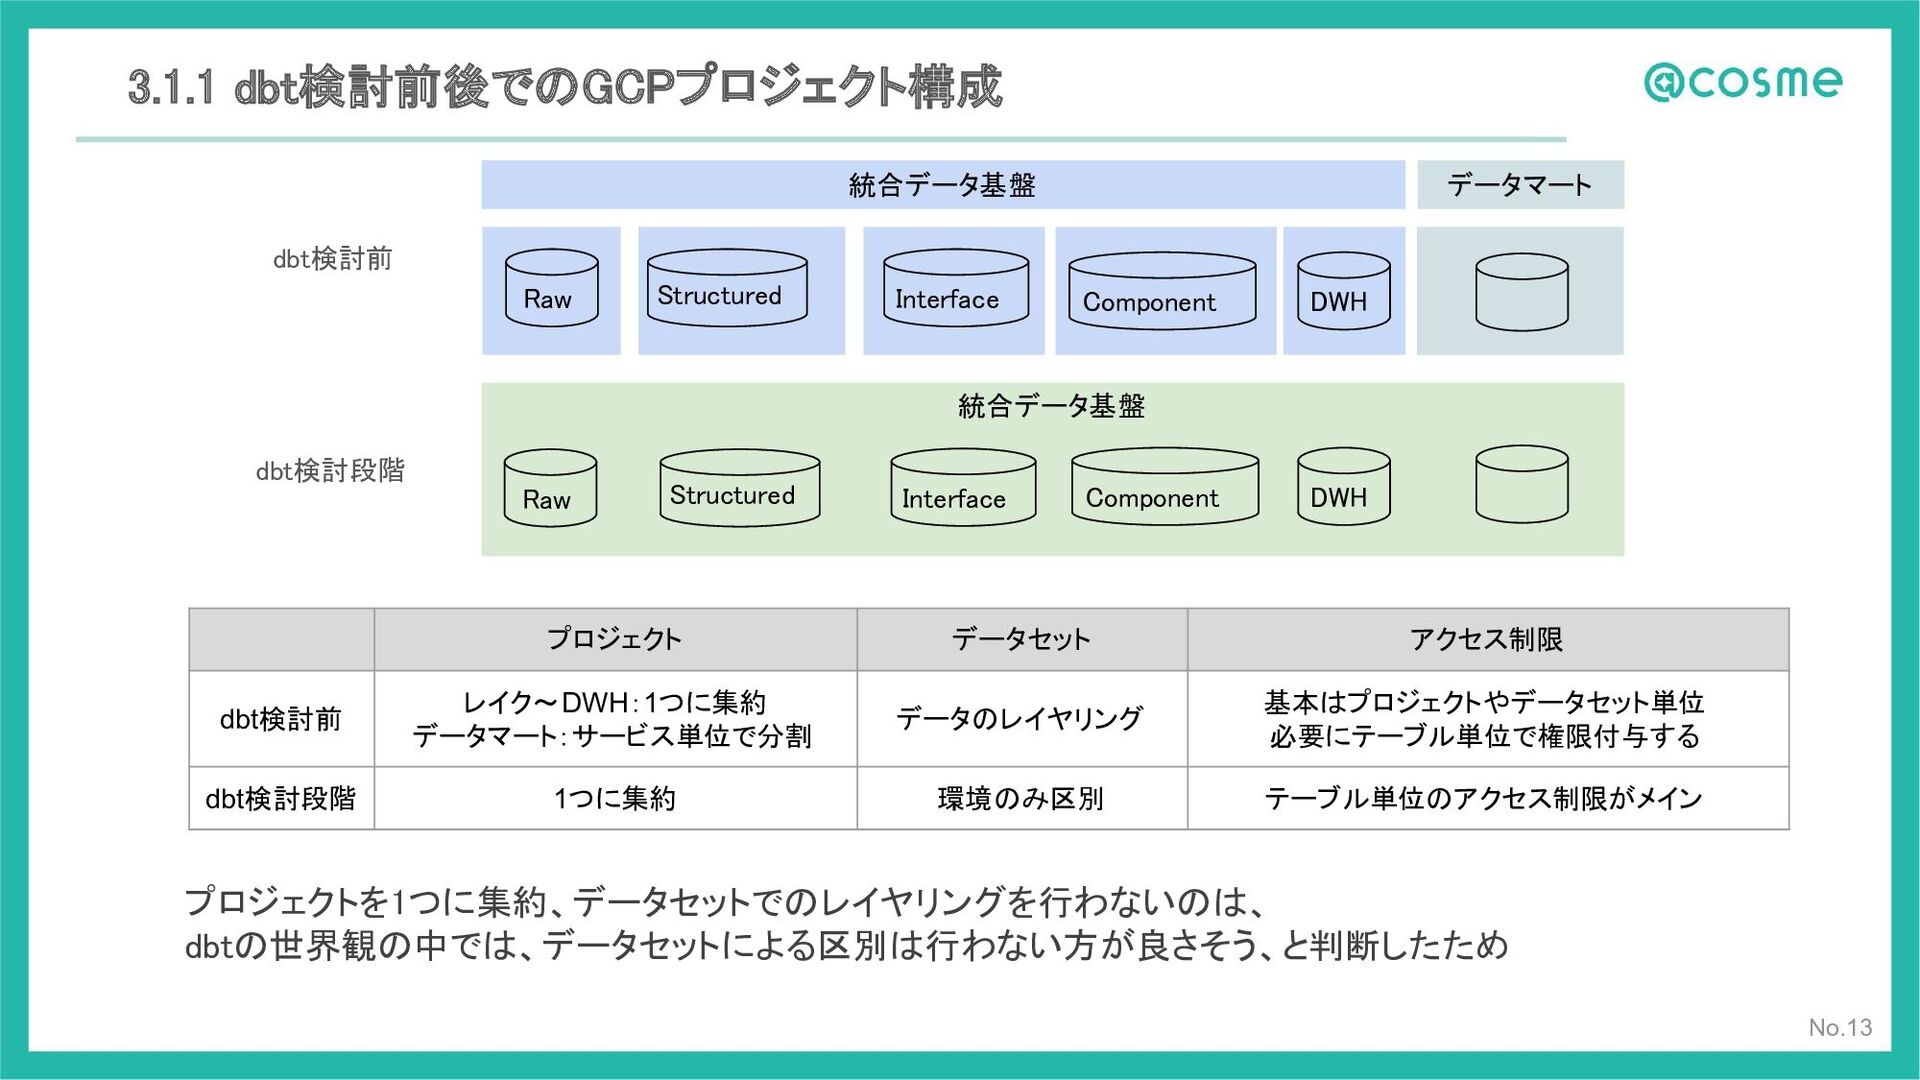
統合データ基盤 3.1.1 dbt検討前後でのGCPプロジェクト構成 No.13 Raw Structured Interface Component DWH Raw
Structured Interface Component DWH dbt検討段階 dbt検討前 統合データ基盤 データマート プロジェクト データセット アクセス制限 dbt検討前 レイク~DWH:1つに集約 データマート:サービス単位で分割 データのレイヤリング 基本はプロジェクトやデータセット単位 必要にテーブル単位で権限付与する dbt検討段階 1つに集約 環境のみ区別 テーブル単位のアクセス制限がメイン プロジェクトを1つに集約、データセットでのレイヤリングを行わないのは、 dbtの世界観の中では、データセットによる区別は行わない方が良さそう、と判断したため -
No.15 Project B Project C Project E
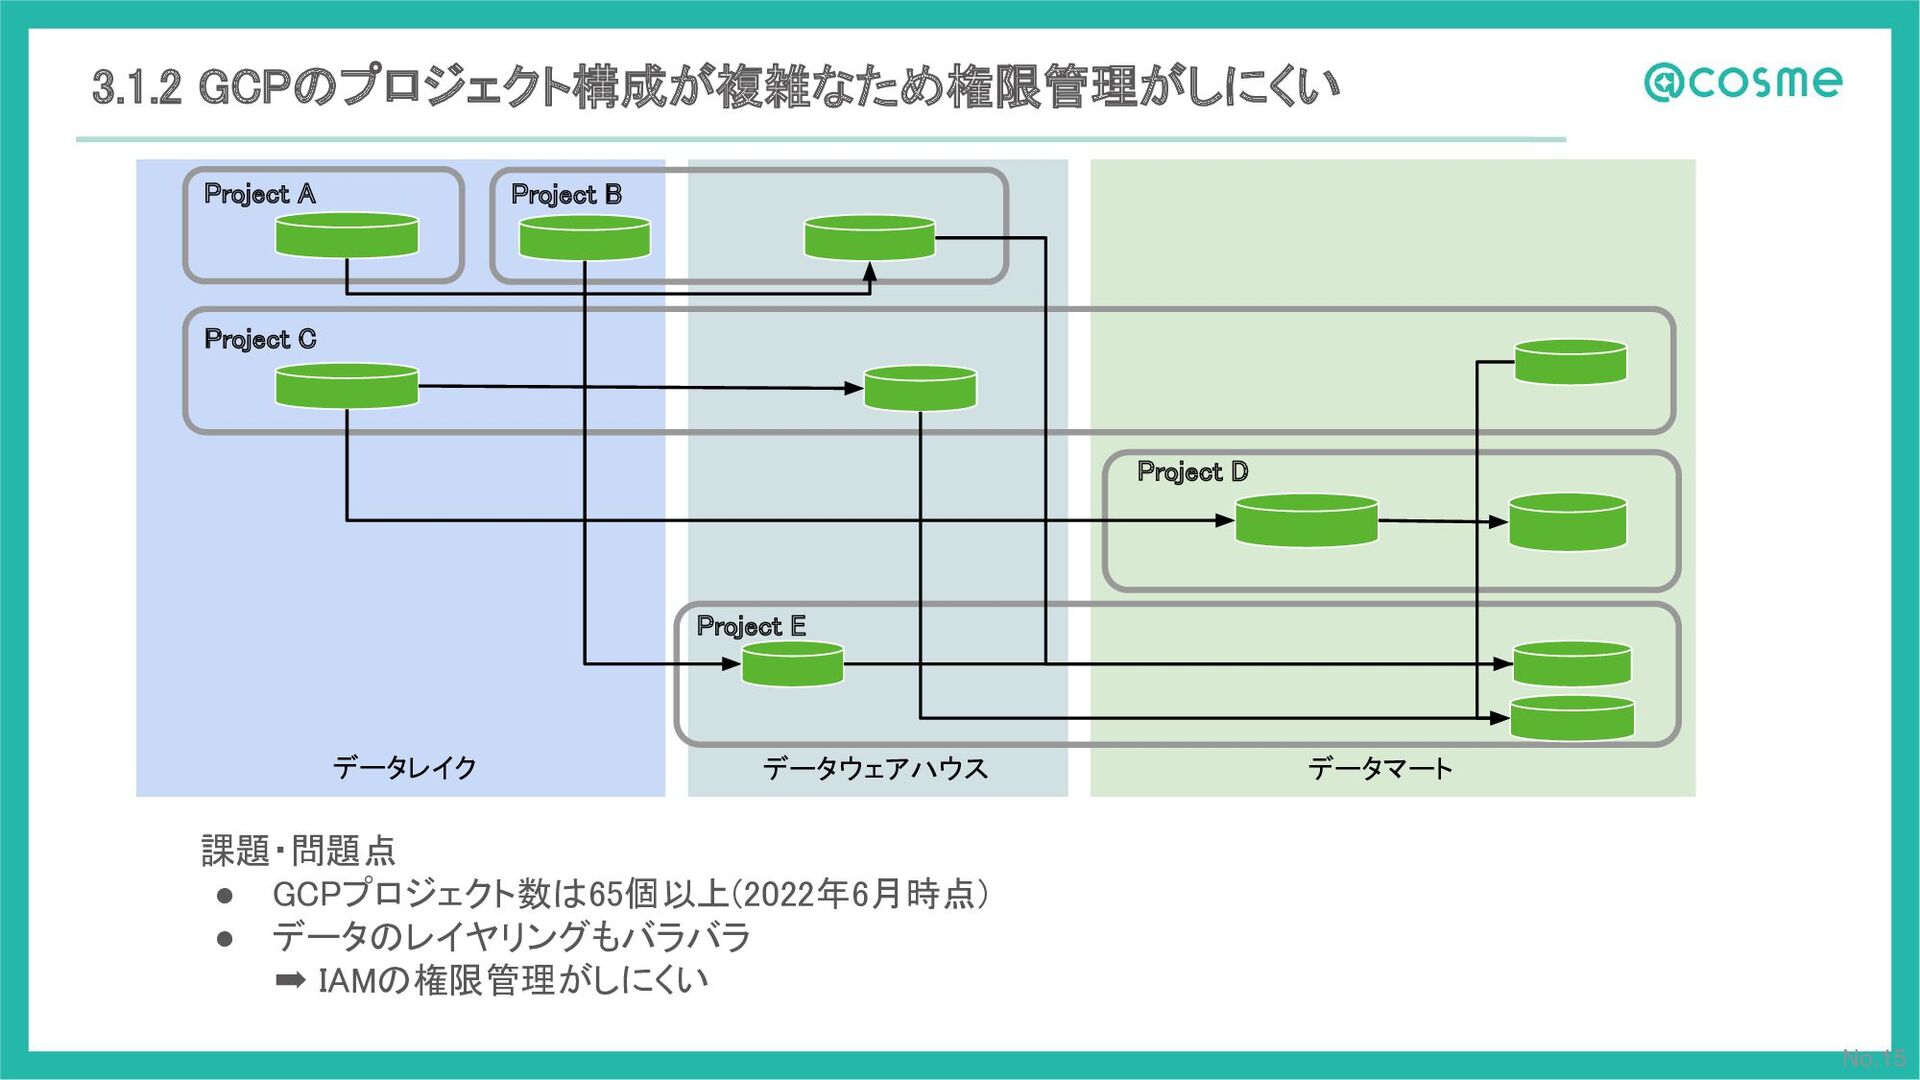
Project D Project A データレイク データウェアハウス データマート 3.1.2 GCPのプロジェクト構成が複雑なため権限管理がしにくい 課題・問題点 • GCPプロジェクト数は65個以上(2022年6月時点) • データのレイヤリングもバラバラ ➡ IAMの権限管理がしにくい -
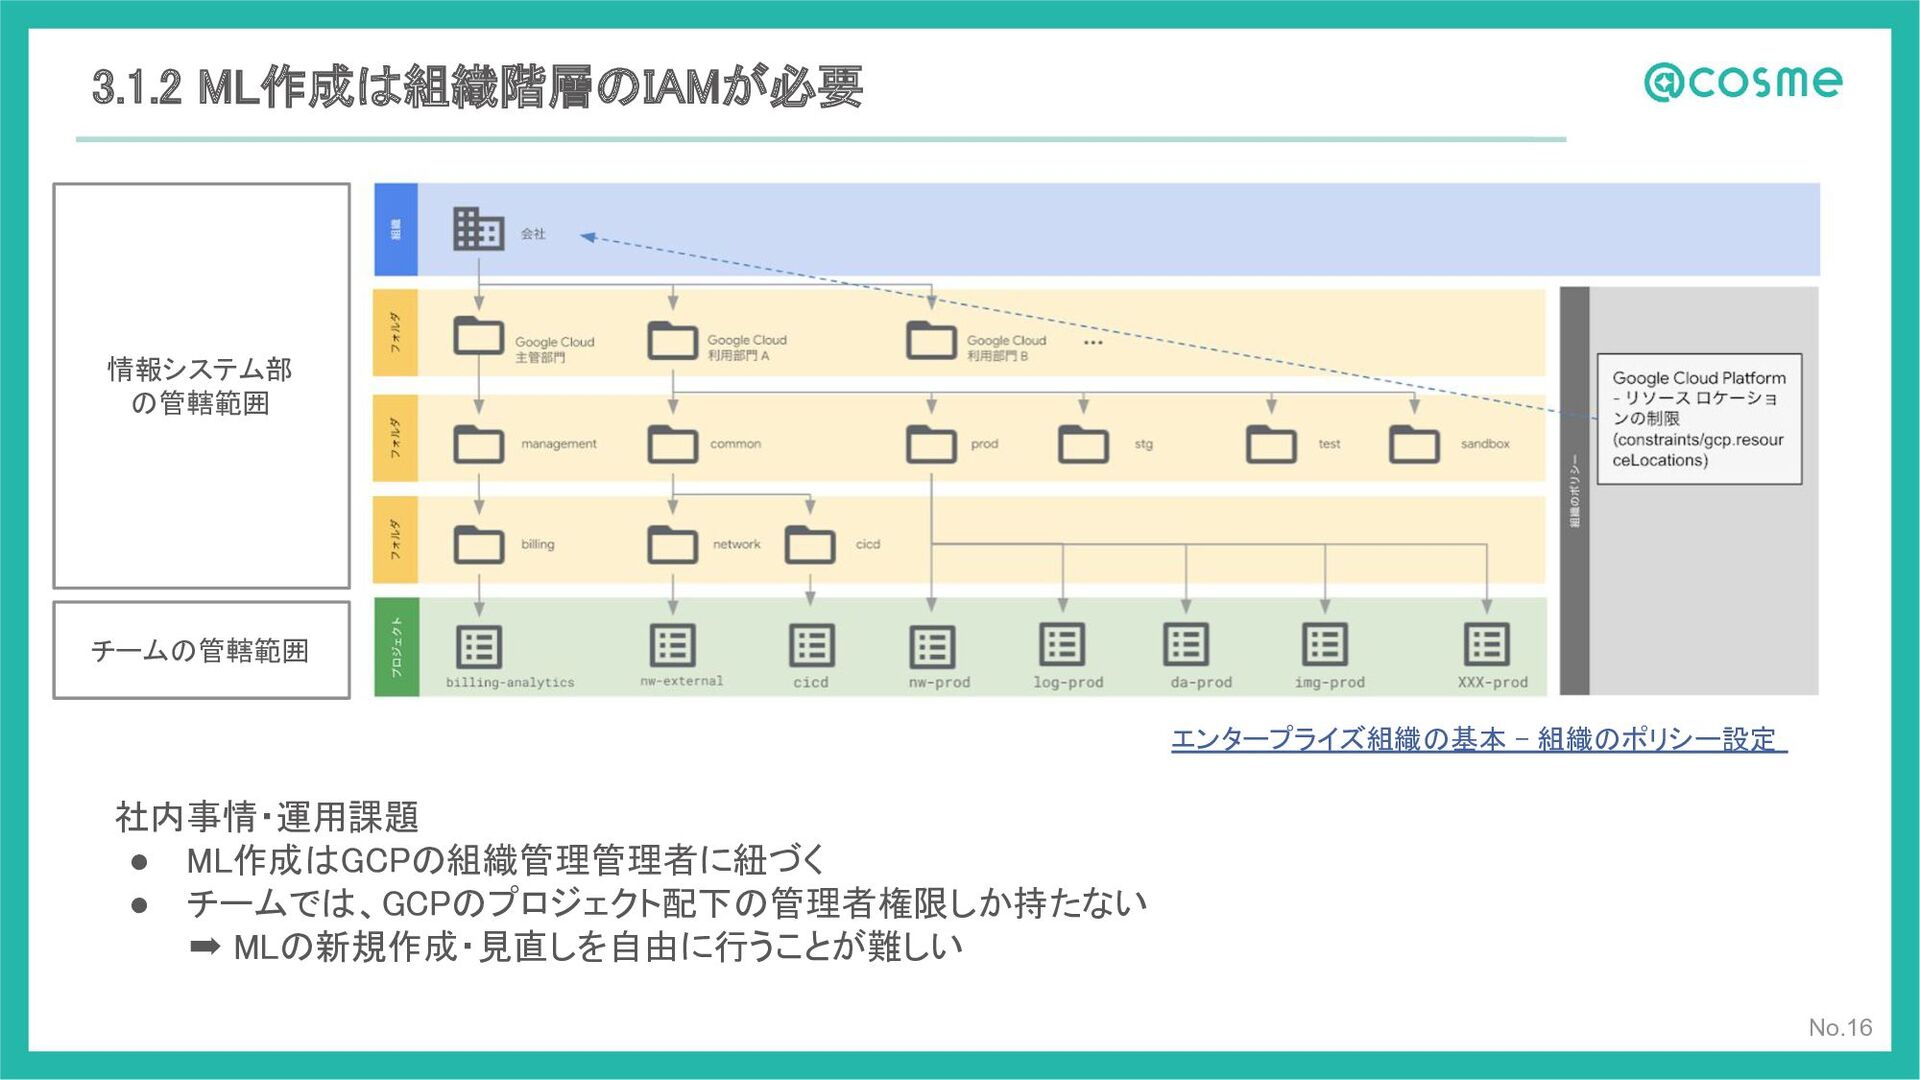
3.1.2 ML作成は組織階層のIAMが必要 No.16 エンタープライズ組織の基本 - 組織のポリシー設定 社内事情・運用課題 • ML作成はGCPの組織管理管理者に紐づく
• チームでは、GCPのプロジェクト配下の管理者権限しか持たない ➡ MLの新規作成・見直しを自由に行うことが難しい チームの管轄範囲 情報システム部 の管轄範囲 -
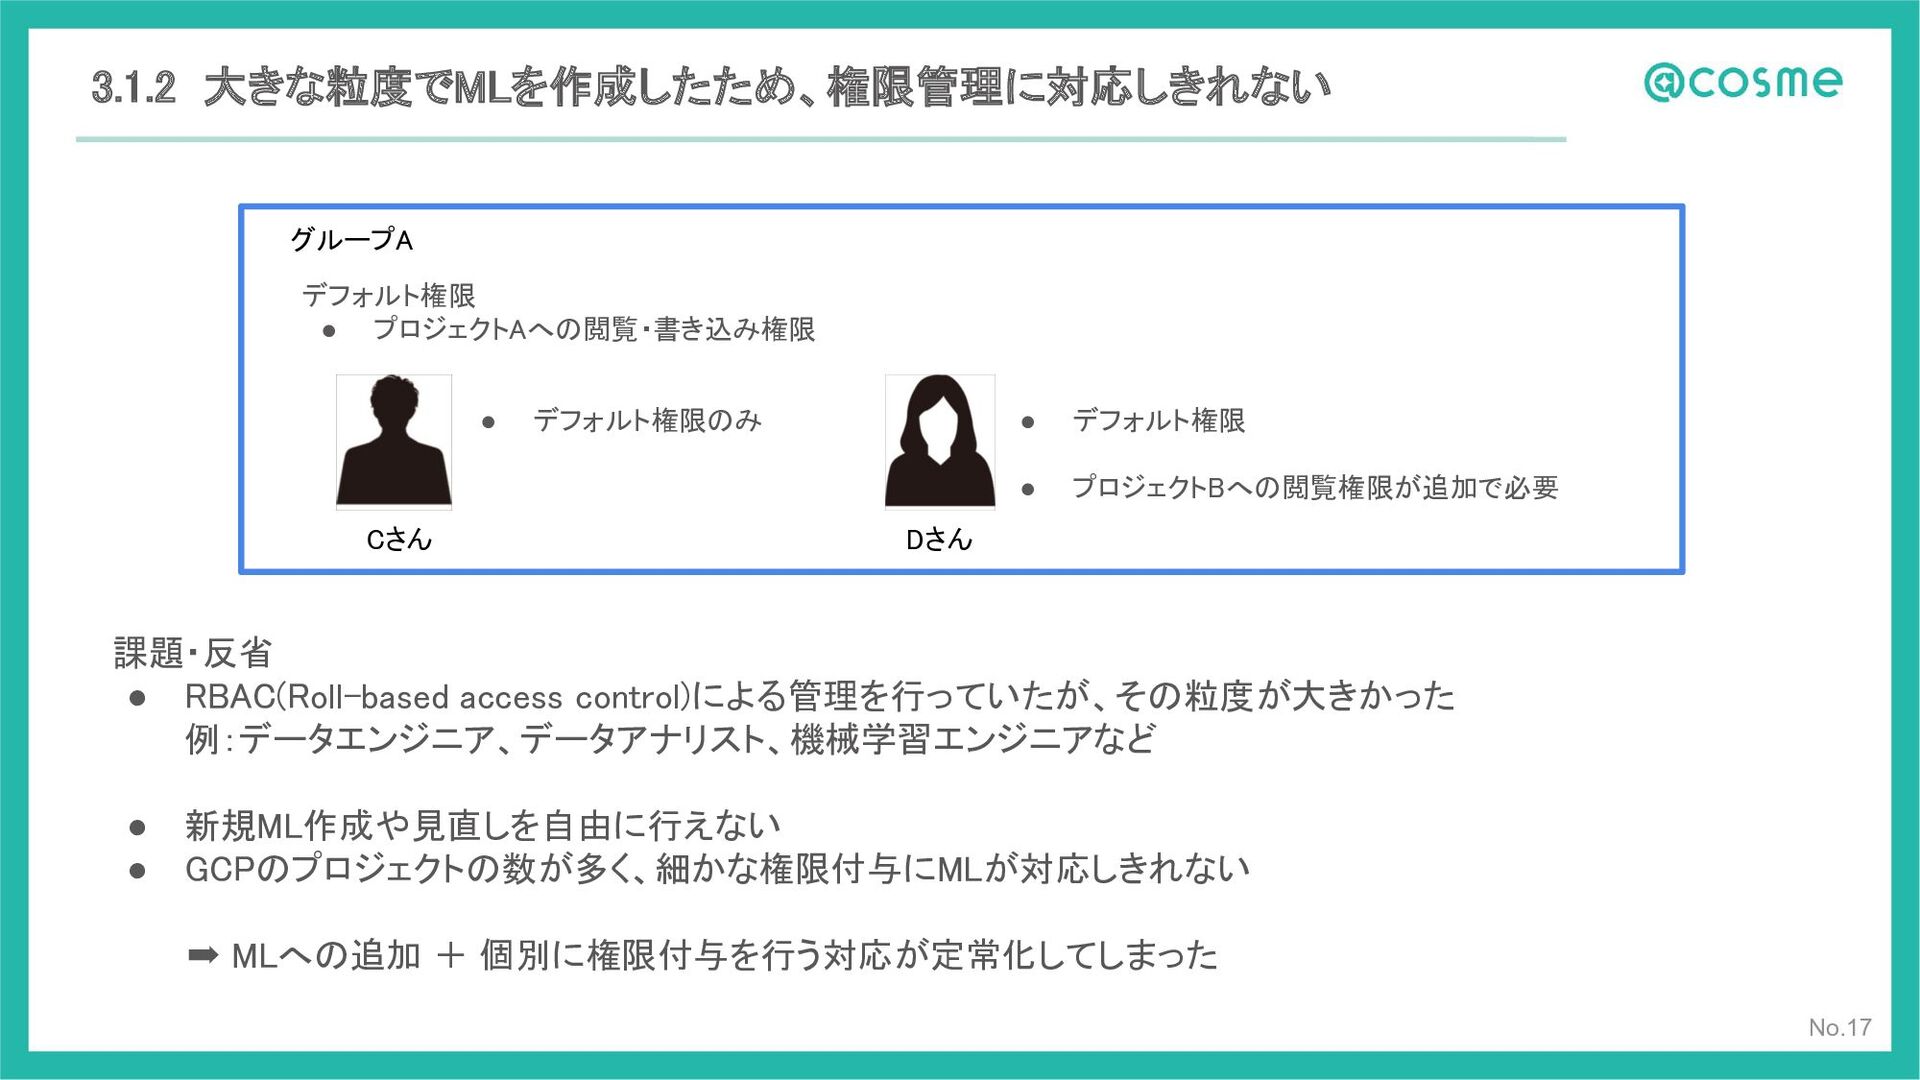
3.1.2 大きな粒度でMLを作成したため、権限管理に対応しきれない No.17 課題・反省 • RBAC(Roll-based access control)による管理を行っていたが、その粒度が大きかった 例:データエンジニア、データアナリスト、機械学習エンジニアなど
• 新規ML作成や見直しを自由に行えない • GCPのプロジェクトの数が多く、細かな権限付与にMLが対応しきれない ➡ MLへの追加 + 個別に権限付与を行う対応が定常化してしまった デフォルト権限 • プロジェクトAへの閲覧・書き込み権限 • デフォルト権限 • プロジェクトBへの閲覧権限が追加で必要 グループA • デフォルト権限のみ Cさん Dさん -
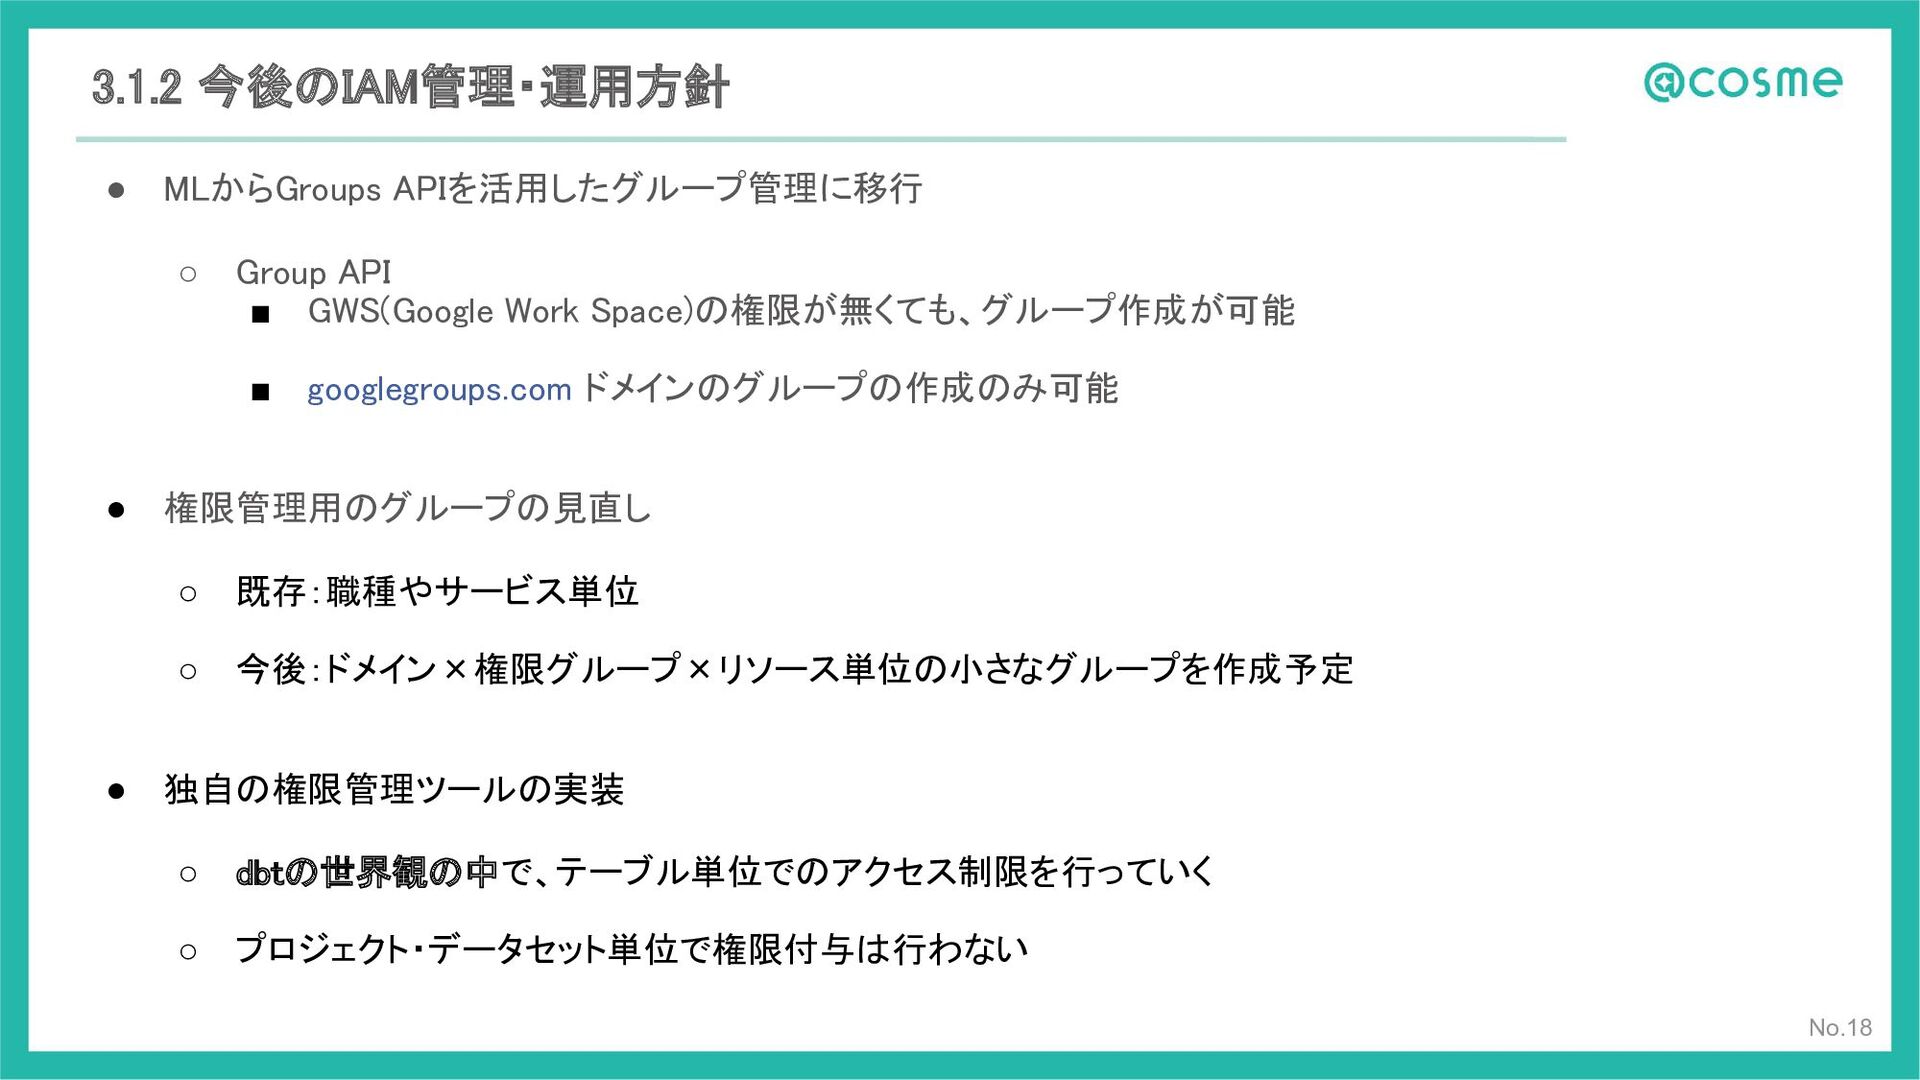
3.1.2 今後のIAM管理・運用方針 No.18 • MLからGroups APIを活用したグループ管理に移行 ◦ Group API
▪ GWS(Google Work Space)の権限が無くても、グループ作成が可能 ▪ googlegroups.com ドメインのグループの作成のみ可能 • 権限管理用のグループの見直し ◦ 既存:職種やサービス単位 ◦ 今後:ドメイン×権限グループ×リソース単位の小さなグループを作成予定 • 独自の権限管理ツールの実装 ◦ dbtの世界観の中で、テーブル単位でのアクセス制限を行っていく ◦ プロジェクト・データセット単位で権限付与は行わない -
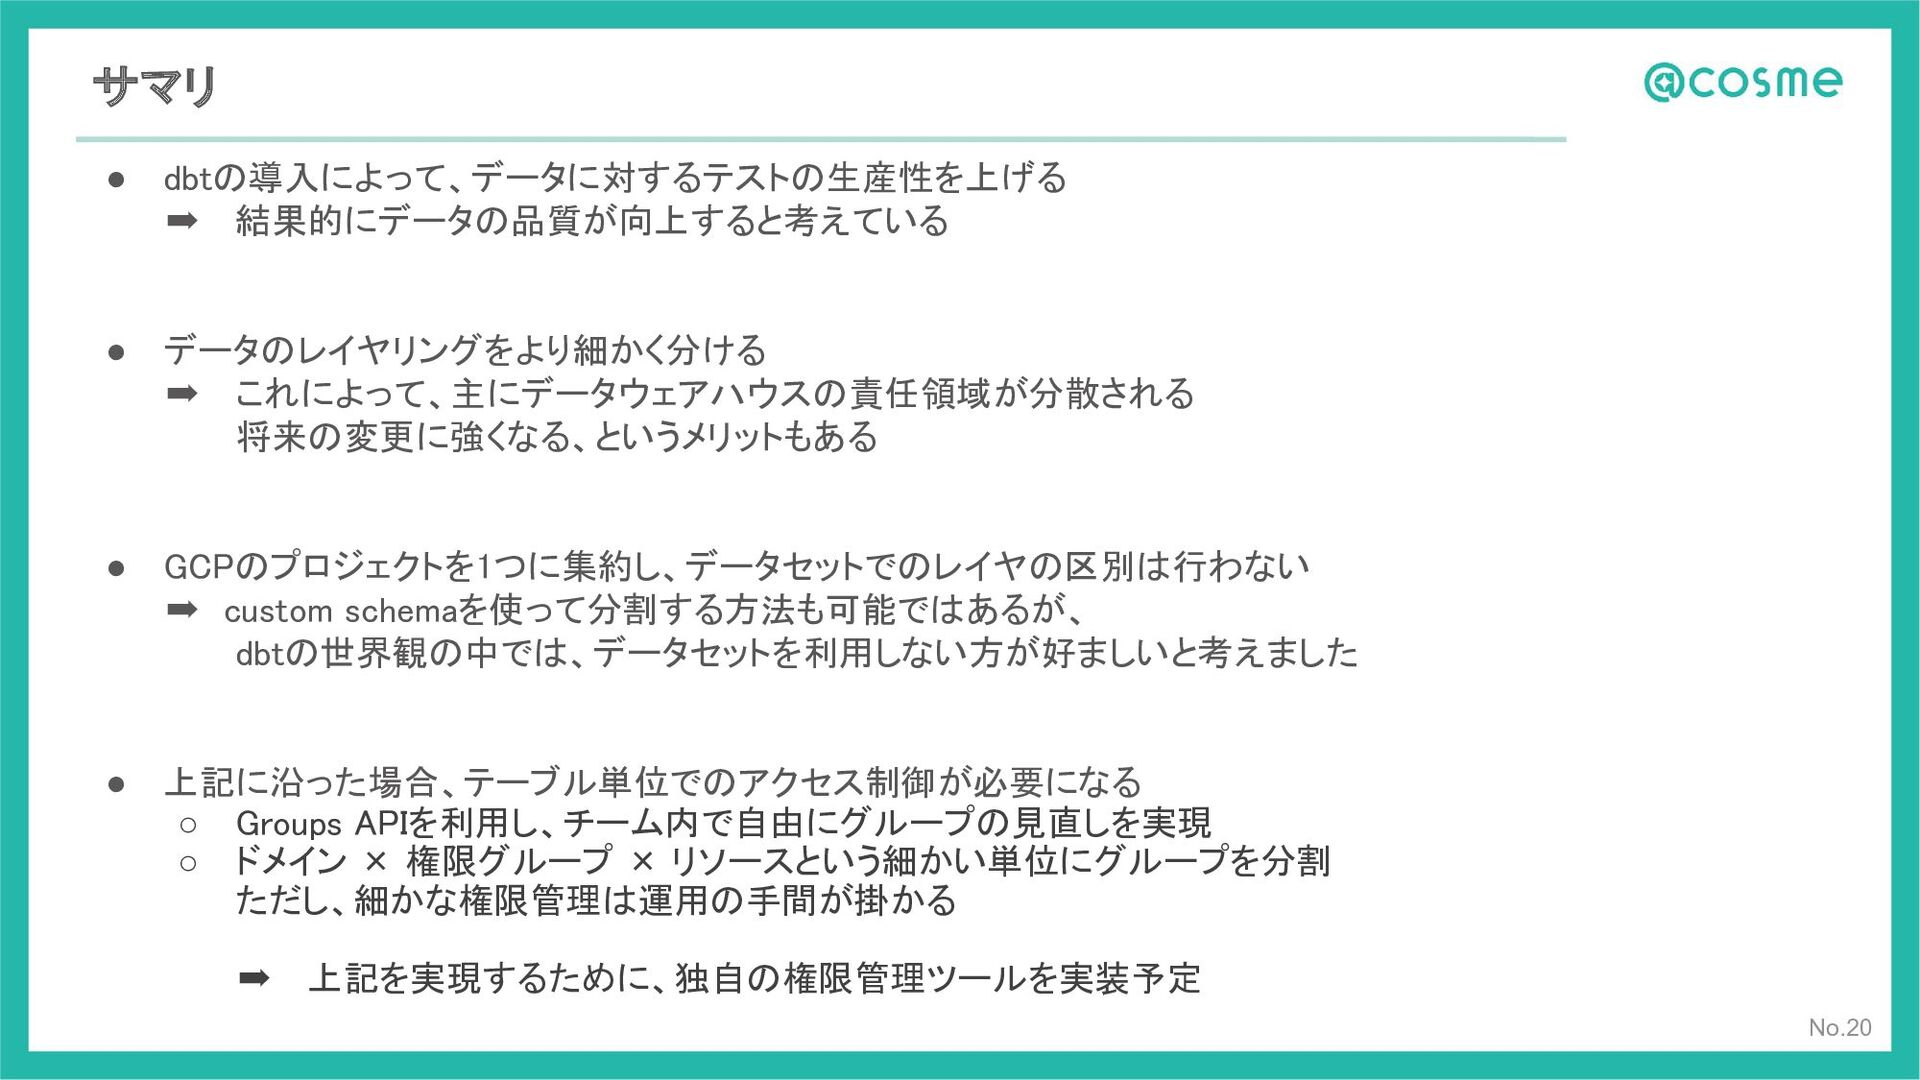
サマリ No.20 • dbtの導入によって、データに対するテストの生産性を上げる ➡ 結果的にデータの品質が向上すると考えている • データのレイヤリングをより細かく分ける
➡ これによって、主にデータウェアハウスの責任領域が分散される 将来の変更に強くなる、というメリットもある • GCPのプロジェクトを1つに集約し、データセットでのレイヤの区別は行わない ➡ custom schemaを使って分割する方法も可能ではあるが、 dbtの世界観の中では、データセットを利用しない方が好ましいと考えました • 上記に沿った場合、テーブル単位でのアクセス制御が必要になる ◦ Groups APIを利用し、チーム内で自由にグループの見直しを実現 ◦ ドメイン × 権限グループ × リソースという細かい単位にグループを分割 ただし、細かな権限管理は運用の手間が掛かる ➡ 上記を実現するために、独自の権限管理ツールを実装予定 -
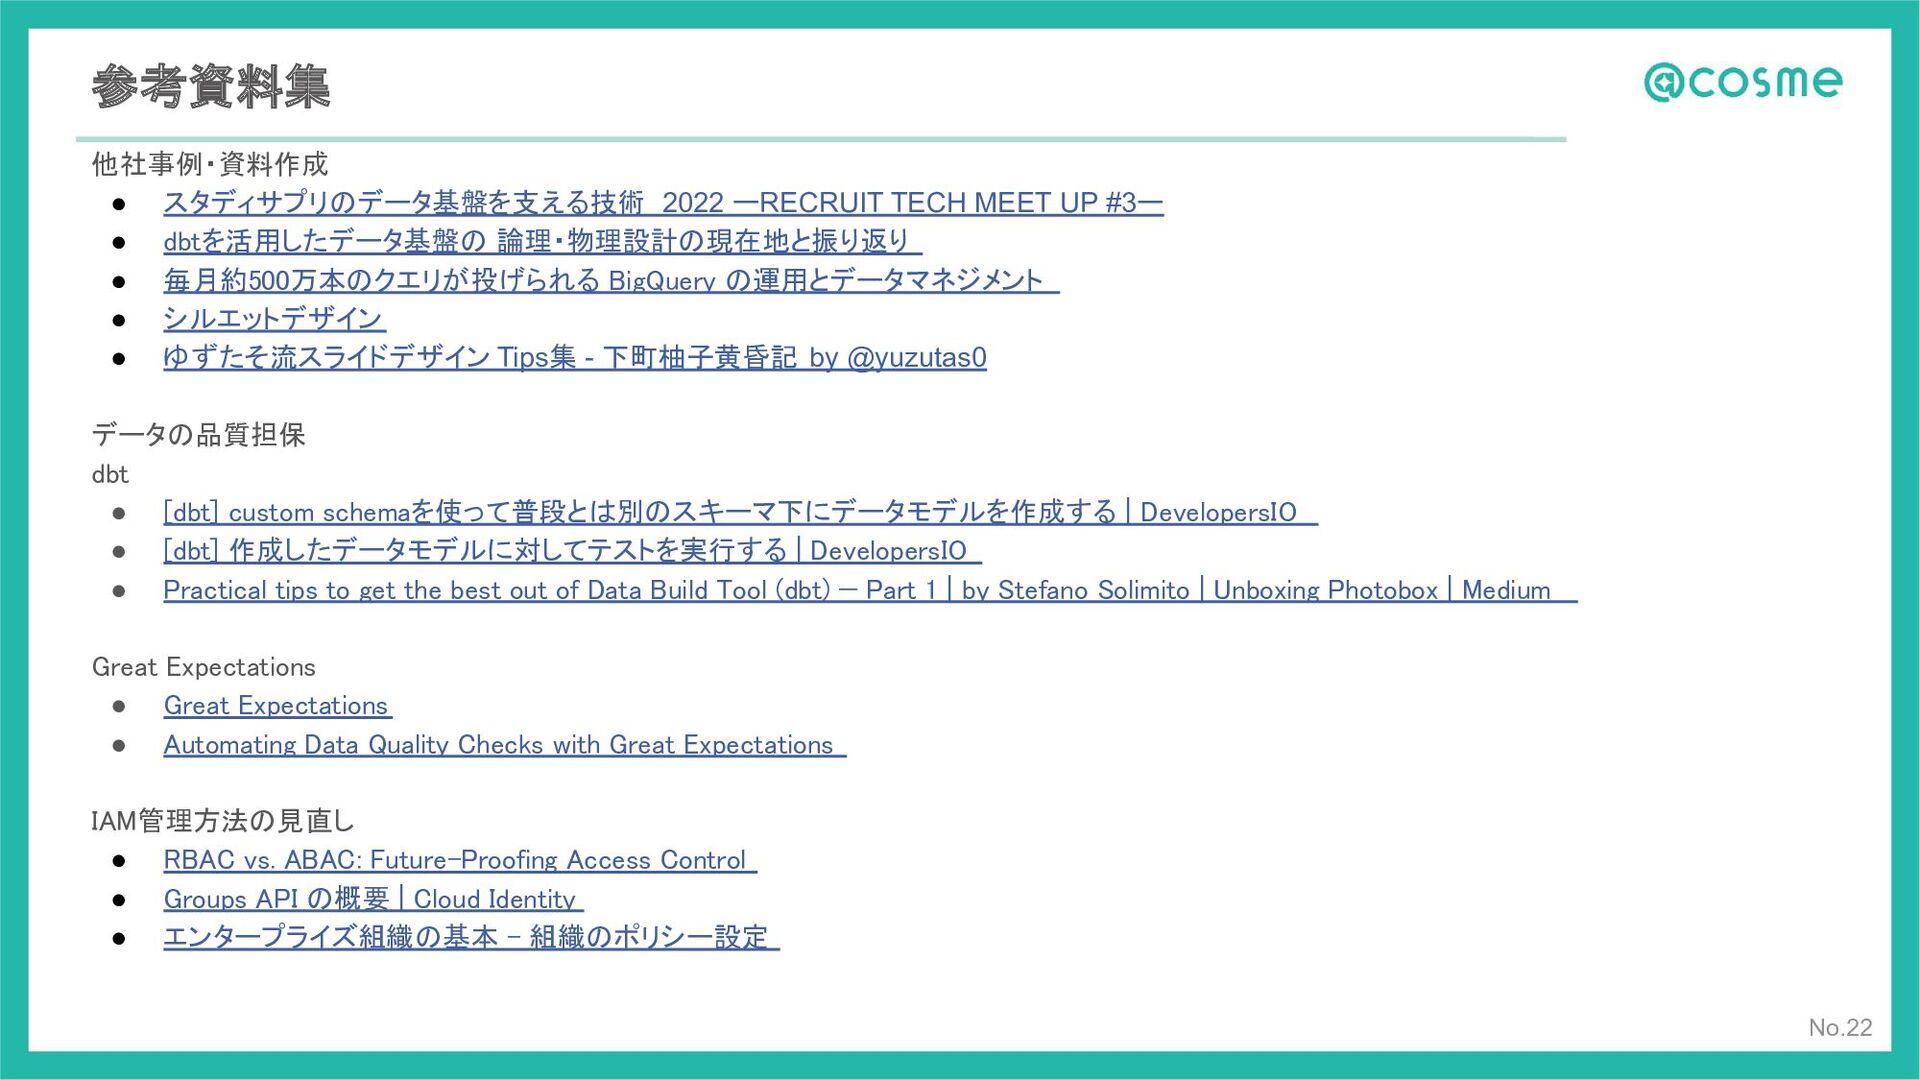
参考資料集 No.22 他社事例・資料作成 • スタディサプリのデータ基盤を支える技術 2022 ーRECRUIT TECH MEET
UP #3ー • dbtを活用したデータ基盤の 論理・物理設計の現在地と振り返り • 毎月約500万本のクエリが投げられる BigQuery の運用とデータマネジメント • シルエットデザイン • ゆずたそ流スライドデザイン Tips集 - 下町柚子黄昏記 by @yuzutas0 データの品質担保 dbt • [dbt] custom schemaを使って普段とは別のスキーマ下にデータモデルを作成する | DevelopersIO • [dbt] 作成したデータモデルに対してテストを実行する | DevelopersIO • Practical tips to get the best out of Data Build Tool (dbt) — Part 1 | by Stefano Solimito | Unboxing Photobox | Medium Great Expectations • Great Expectations • Automating Data Quality Checks with Great Expectations IAM管理方法の見直し • RBAC vs. ABAC: Future-Proofing Access Control • Groups API の概要 | Cloud Identity • エンタープライズ組織の基本 - 組織のポリシー設定