Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
名古屋検索勉強会#18
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
tetsukitazawa
October 09, 2019
Science
44
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
名古屋検索勉強会#18
tetsukitazawa
October 09, 2019
Other Decks in Science
See All in Science
データベース06: SQL (3/3) 副問い合わせ
trycycle
PRO
1
1.1k
Inside the Mind of an LLM
baggiponte
0
330
知能とはなにか -ヒトとAIのあいだ-
tagtag
PRO
0
190
AI(人工知能)の過去・現在・未来 ~AIは人類を越えるのか~
tagtag
PRO
0
160
機械学習 - ニューラルネットワーク入門
trycycle
PRO
0
1.3k
因果推論と機械学習
sshimizu2006
1
1.5k
社内で活躍できるデータサイエンティストになるために
aikinohara
1
170
20260722【JAWS-UG東京 ランチタイムLT会 #37④】AWS Well-Architectedフレームワークに沿った回答をするAIエージェントを作ってみた
nozakijcom
1
140
勾配流から乖離した学習ダイナミクス
hanbao
1
1k
機械学習 - DBSCAN
trycycle
PRO
0
2.1k
2026 Introduction to University Math 01
kanaya
0
150
白金鉱業Meetup Vol.25 【初学者向け発表枠】「で、この施策って効いてるの」に答える効果検証の基礎 ~ATE / ATT / CATE / LATEを現場の問いに翻訳する~
brainpadpr
0
210
Featured
See All Featured
Principles of Awesome APIs and How to Build Them.
keavy
128
18k
AI: The stuff that nobody shows you
jnunemaker
PRO
10
1k
How GitHub (no longer) Works
holman
316
150k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
21k
StorybookのUI Testing Handbookを読んだ
zakiyama
31
6.9k
Kristin Tynski - Automating Marketing Tasks With AI
techseoconnect
PRO
0
520
GraphQLとの向き合い方2022年版
quramy
50
15k
Amusing Abliteration
ianozsvald
1
310
Navigating the Design Leadership Dip - Product Design Week Design Leaders+ Conference 2024
apolaine
2
430
HTML-Aware ERB: The Path to Reactive Rendering @ RubyCon 2026, Rimini, Italy
marcoroth
5
680
How to Think Like a Performance Engineer
csswizardry
28
2.8k
Optimizing for Happiness
mojombo
378
71k
Transcript
名古屋検索勉強会 #18 18.行列の分解と潜在意味インデックス @tetsukitazawa
18.行列の分解と潜在意味インデックス •18.1 線形代数の復習 •18.2 用語文書行列と特異値分解 •18.3 低階数近似 •18.4 潜在意味インデックス
行列の分解と潜在意味インデックス 6.3スコア付ベクトル空間で導入した用語文書行列C(M*N)を扱う際に 数学手法を用いて楽に退治してしまおう。 使うテクニック 18.1 行列分解・・・行列を扱いやすい正方行列に変形させる 18.3 低階数近似・低階数近似インデックスと文書取り出し 18.4 低階数近似を応用した潜在意味インデックスを検証する ー文書コレクションを含む領域でクラスタリング手法 として残ってる
18.1 線形代数の復習 復活ッ復活ッ 数C行列復活ッッッ
18.1 線形代数の復習
18.1 線形代数の復習 飛ばします(´º﹃º`)
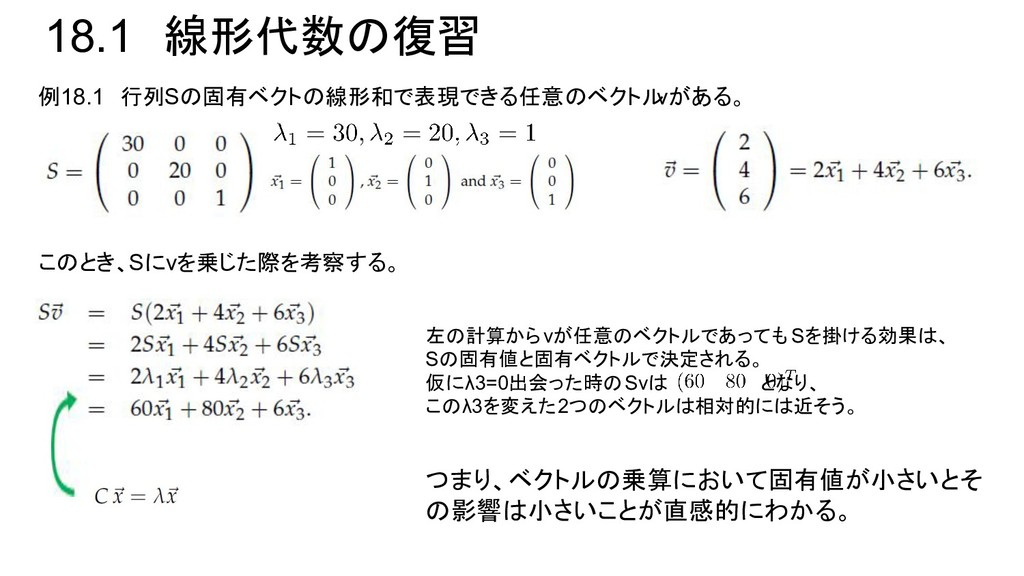
左の計算からvが任意のベクトルであっても Sを掛ける効果は、 Sの固有値と固有ベクトルで決定される。 仮にλ3=0出会った時のSvは となり、 このλ3を変えた2つのベクトルは相対的には近そう。 つまり、ベクトルの乗算において固有値が小さいとそ の影響は小さいことが直感的にわかる。 18.1 線形代数の復習 例18.1 行列Sの固有ベクトの線形和で表現できる任意のベクトル vがある。
このとき、Sにvを乗じた際を考察する。
18.2 用語文書行列と特異値分解 [用語×文書]行列C のサイズは[M×N]で対称行列でもないことがほとんど。 数学的手法で楽に扱えるように、Cを特異値分解(SVD)で対称対角分解できる状態 にしよう。 定理18.3:用語文書行列Cは以下のSVDが可能。 C:任意の行列[M×N](用語文書行列) U、V: の固有値ベクトルの集まりの直交行列 Σ: の固有値の平方根(特異値)を並べた対角行列 直交行列とは?
各列互いに垂直で大きさ 1のもの このとき を計算すると以下のようになる。 ※直交行列の性質 転置行列を掛けると 単位行列になる
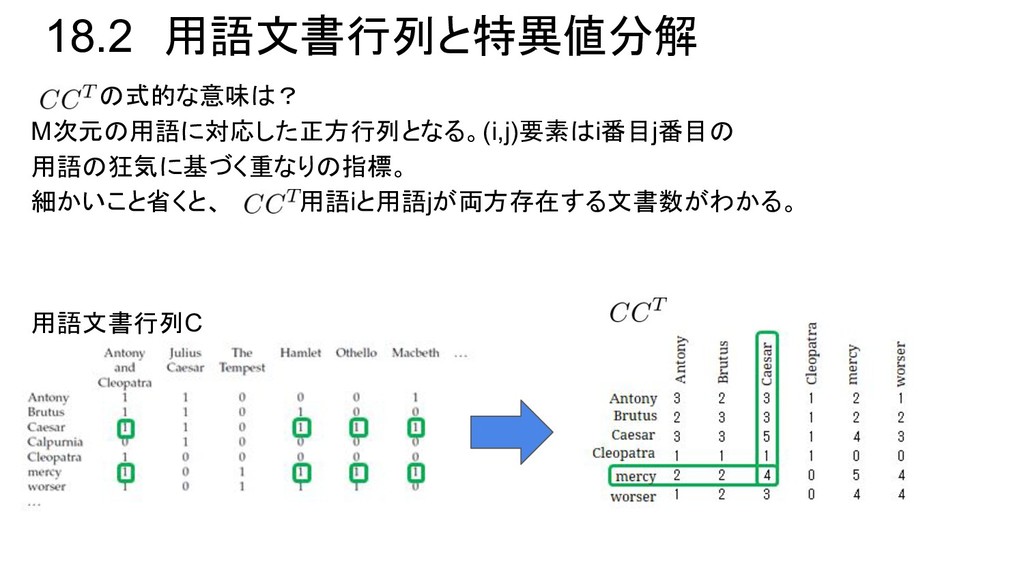
18.2 用語文書行列と特異値分解 の式的な意味は? M次元の用語に対応した正方行列となる。(i,j)要素はi番目j番目の 用語の狂気に基づく重なりの指標。 細かいこと省くと、 は用語iと用語jが両方存在する文書数がわかる。 用語文書行列C
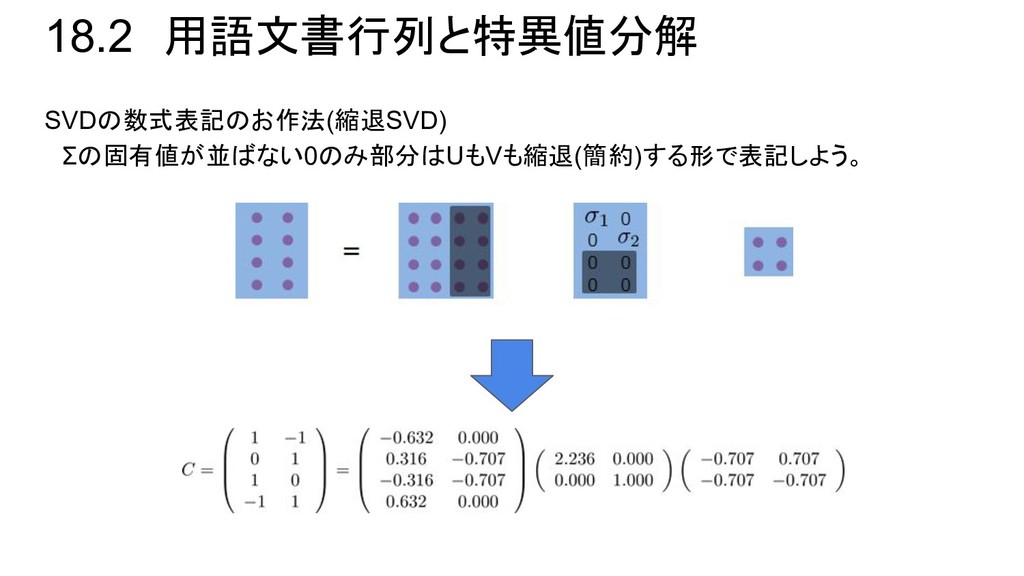
SVDの数式表記のお作法(縮退SVD) Σの固有値が並ばない0のみ部分はUもVも縮退(簡約)する形で表記しよう。 18.2 用語文書行列と特異値分解
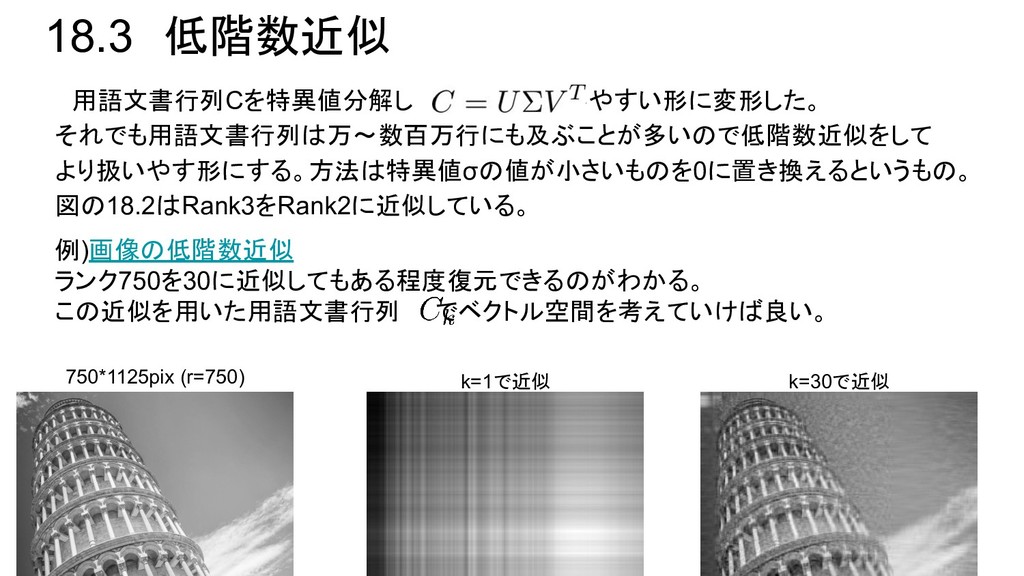
18.3 低階数近似 用語文書行列Cを特異値分解し で扱いやすい形に変形した。 それでも用語文書行列は万~数百万行にも及ぶことが多いので低階数近似をして より扱いやす形にする。方法は特異値σの値が小さいものを0に置き換えるというもの。 図の18.2はRank3をRank2に近似している。 例)画像の低階数近似 ランク750を30に近似してもある程度復元できるのがわかる。 この近似を用いた用語文書行列 でベクトル空間を考えていけば良い。 750*1125pix
(r=750) k=1で近似 k=30で近似
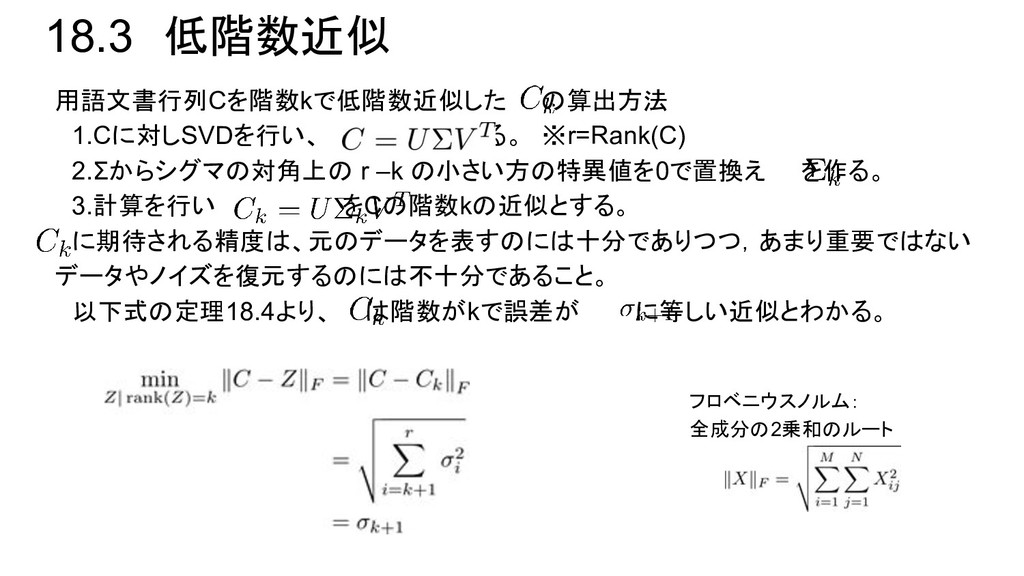
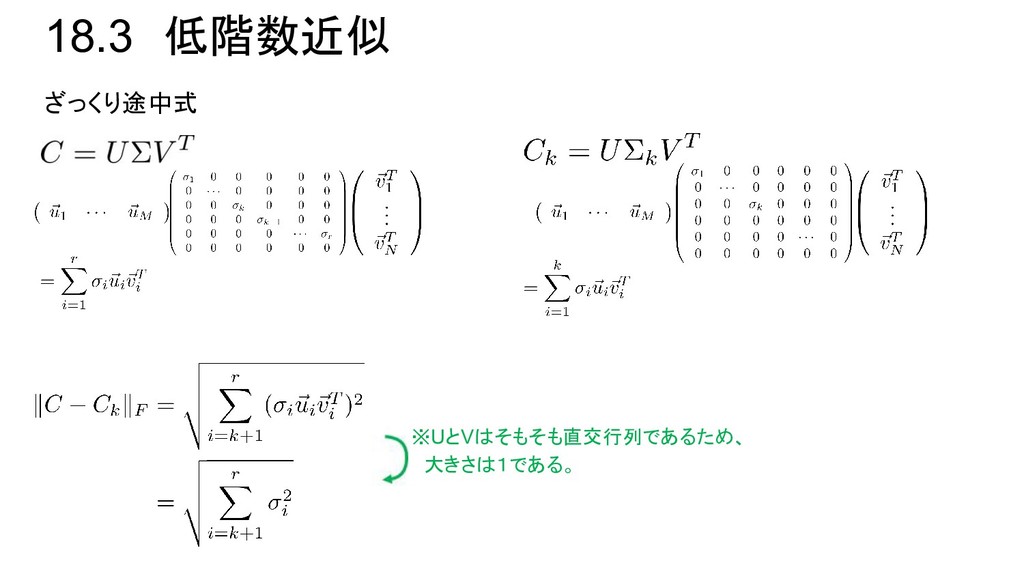
18.3 低階数近似 用語文書行列Cを階数kで低階数近似した の算出方法 1.Cに対しSVDを行い、 をつくる。 ※r=Rank(C) 2.Σからシグマの対角上の r –k の小さい方の特異値を0で置換え を作る。 3.計算を行い をCの階数kの近似とする。 に期待される精度は、元のデータを表すのには十分でありつつ,あまり重要ではない
データやノイズを復元するのには不十分であること。 以下式の定理18.4より、 は階数がkで誤差が に等しい近似とわかる。 フロベニウスノルム: 全成分の2乗和のルート
18.3 低階数近似 ※UとVはそもそも直交行列であるため、 大きさは1である。 ざっくり途中式
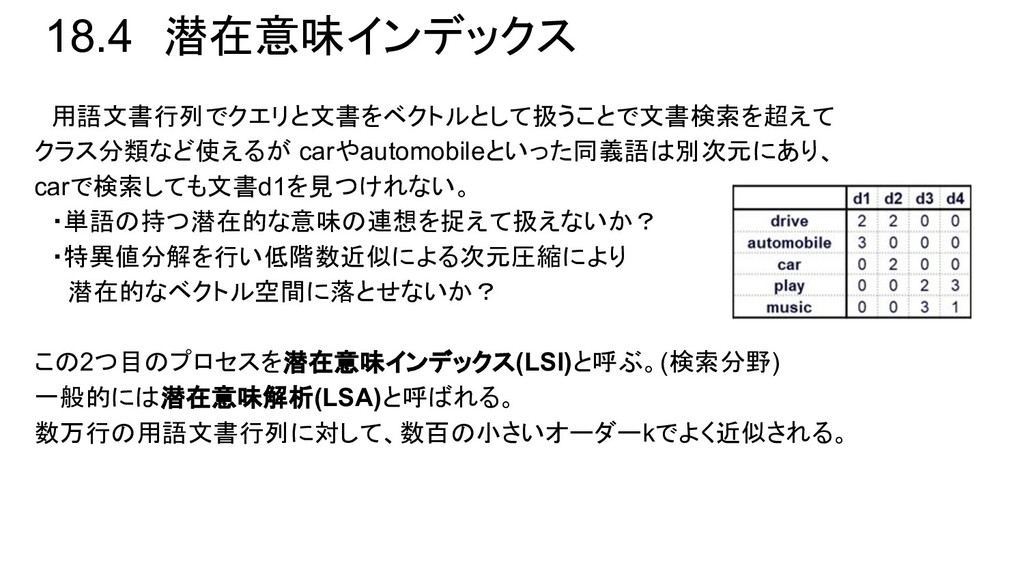
18.4 潜在意味インデックス 用語文書行列でクエリと文書をベクトルとして扱うことで文書検索を超えて クラス分類など使えるが carやautomobileといった同義語は別次元にあり、 carで検索しても文書d1を見つけれない。 ・単語の持つ潜在的な意味の連想を捉えて扱えないか? ・特異値分解を行い低階数近似による次元圧縮により 潜在的なベクトル空間に落とせないか? この2つ目のプロセスを潜在意味インデックス(LSI)と呼ぶ。(検索分野) 一般的には潜在意味解析(LSA)と呼ばれる。
数万行の用語文書行列に対して、数百の小さいオーダーkでよく近似される。
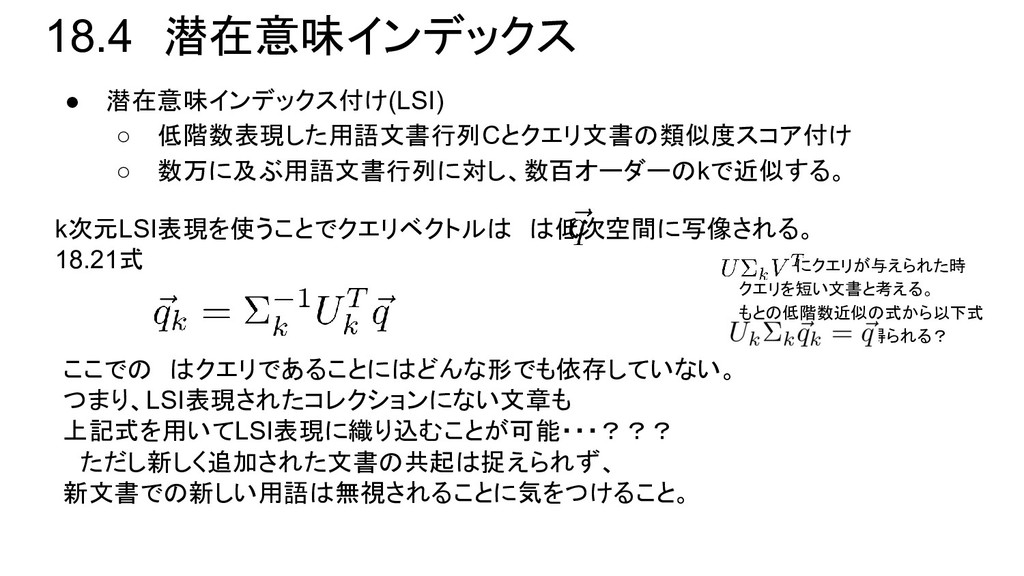
k次元LSI表現を使うことでクエリベクトルは は低次空間に写像される。 18.21式 18.4 潜在意味インデックス • 潜在意味インデックス付け(LSI) ◦ 低階数表現した用語文書行列Cとクエリ文書の類似度スコア付け ◦ 数万に及ぶ用語文書行列に対し、数百オーダーのkで近似する。 ここでの はクエリであることにはどんな形でも依存していない。
つまり、LSI表現されたコレクションにない文章も 上記式を用いてLSI表現に織り込むことが可能・・・??? ただし新しく追加された文書の共起は捉えられず、 新文書での新しい用語は無視されることに気をつけること。 にクエリが与えられた時 クエリを短い文書と考える。 もとの低階数近似の式から以下式 が得られる?
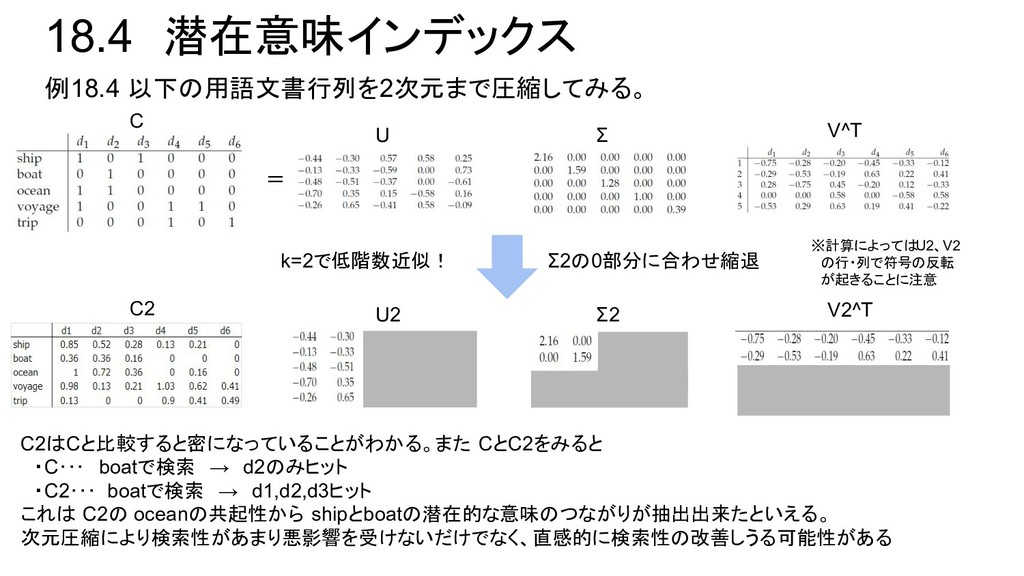
18.4 潜在意味インデックス 例18.4 以下の用語文書行列を2次元まで圧縮してみる。 = C U Σ V^T C2 U2
Σ2 V2^T C2はCと比較すると密になっていることがわかる。また CとC2をみると ・C・・・ boatで検索 → d2のみヒット ・C2・・・ boatで検索 → d1,d2,d3ヒット これは C2の oceanの共起性から shipとboatの潜在的な意味のつながりが抽出出来たといえる。 次元圧縮により検索性があまり悪影響を受けないだけでなく、直感的に検索性の改善しうる可能性がある k=2で低階数近似! ※計算によってはU2、V2 の行・列で符号の反転 が起きることに注意 Σ2の0部分に合わせ縮退
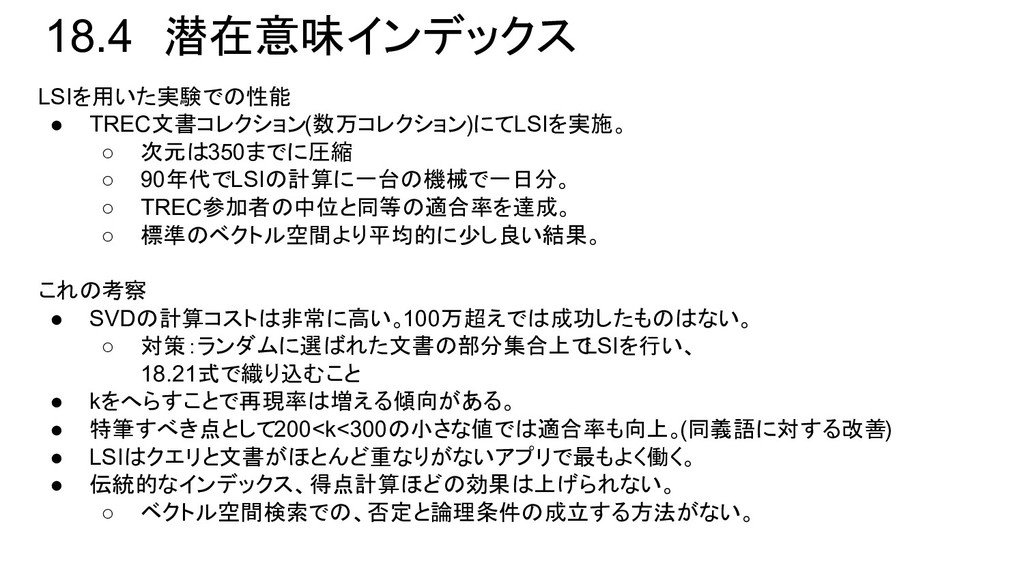
18.4 潜在意味インデックス LSIを用いた実験での性能 • TREC文書コレクション(数万コレクション)にてLSIを実施。 ◦ 次元は350までに圧縮 ◦ 90年代でLSIの計算に一台の機械で一日分。 ◦ TREC参加者の中位と同等の適合率を達成。
◦ 標準のベクトル空間より平均的に少し良い結果。 これの考察 • SVDの計算コストは非常に高い。100万超えでは成功したものはない。 ◦ 対策:ランダムに選ばれた文書の部分集合上で LSIを行い、 18.21式で織り込むこと • kをへらすことで再現率は増える傾向がある。 • 特筆すべき点として200<k<300の小さな値では適合率も向上。 (同義語に対する改善) • LSIはクエリと文書がほとんど重なりがないアプリで最もよく働く。 • 伝統的なインデックス、得点計算ほどの効果は上げられない。 ◦ ベクトル空間検索での、否定と論理条件の成立する方法がない。
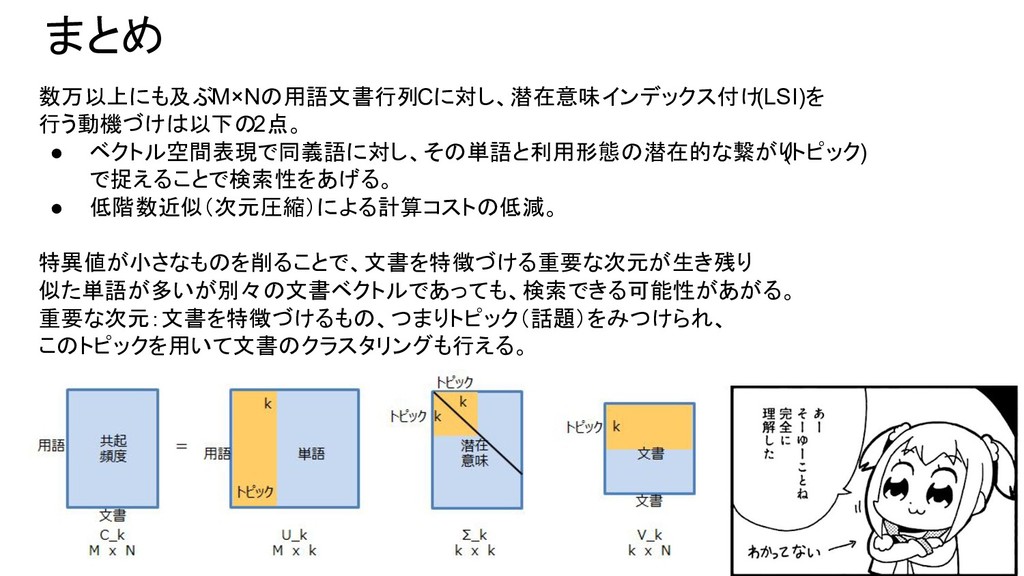
まとめ 数万以上にも及ぶM×Nの用語文書行列Cに対し、潜在意味インデックス付け (LSI)を 行う動機づけは以下の2点。 • ベクトル空間表現で同義語に対し、その単語と利用形態の潜在的な繋がり (トピック) で捉えることで検索性をあげる。 • 低階数近似(次元圧縮)による計算コストの低減。
特異値が小さなものを削ることで、文書を特徴づける重要な次元が生き残り 似た単語が多いが別々の文書ベクトルであっても、検索できる可能性があがる。 重要な次元:文書を特徴づけるもの、つまりトピック(話題)をみつけられ、 このトピックを用いて文書のクラスタリングも行える。


 trycycle
 baggiponte
 tagtag
 sshimizu2006
 aikinohara
 nozakijcom
 hanbao
 kanaya
 brainpadpr
 keavy
 jnunemaker
 holman
 jeffersonlam
 zakiyama
 techseoconnect
 quramy
 ianozsvald
 apolaine
 marcoroth
 csswizardry
 mojombo
 U、V: の固有値ベクトルの集まりの直交行列 Σ: の固有値の平方根(特異値)を並べた対角行列 直交行列とは?](https://files.speakerdeck.com/presentations/f60e7f37a09e4beeb50bf50481c2dd91/slide_7.jpg)