Upgrade to Pro — share decks privately, control downloads, hide ads and more …

O básico que ainda deveríamos entender sobre Un...

O básico que ainda deveríamos entender sobre Unicode e encondings

Representar caracteres em computadores evoluiu muito nas últimas 3 décadas. Como funcionam exatamente: Unicode, conjunto de caracteres, ��� (diamante preto com interrogação), plain text, ASCII, UTF-8, BOM? Essas e outras coisas básicas que todo(a) desenvolvedor(a) ainda deveria saber em 2019.

Thiago Colares

March 24, 2019

Transcript

60 slides
  1. Thiago Colares Agilize Contabilidade Online O b�sico que ainda dever�amos

    entender sobre Unicode e encondings Semana de Computação da UFBA, 24/03/2019
  2. OLÁ! THIAGO COLARES CTO e Co-fundador @ Agilize Google Launchpad

    Accelerator Colaborador de projetos FLOSS thicolares.com
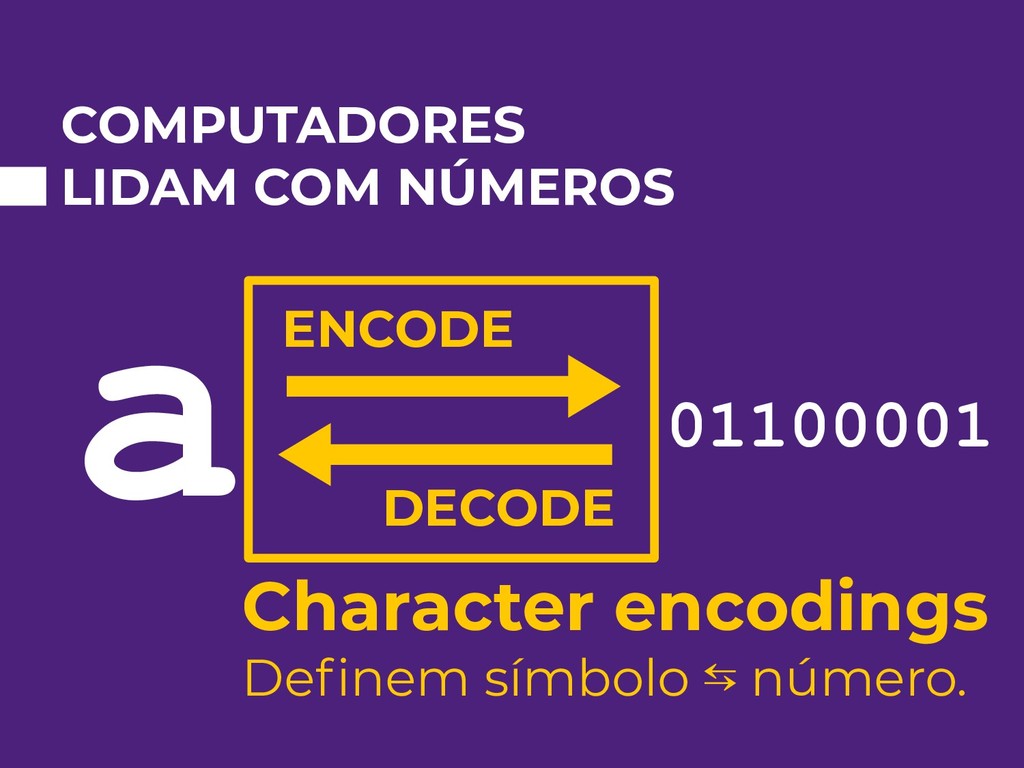
  3. ASCII American Standard Code for Information Interchange ◦ 1960 ◦

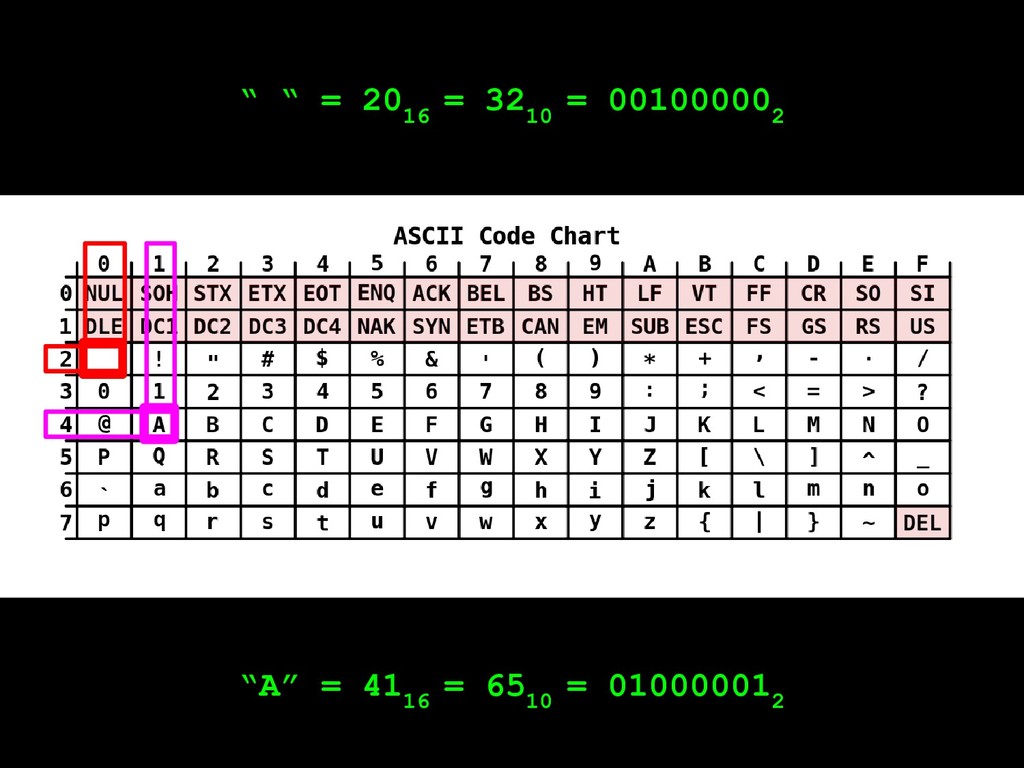
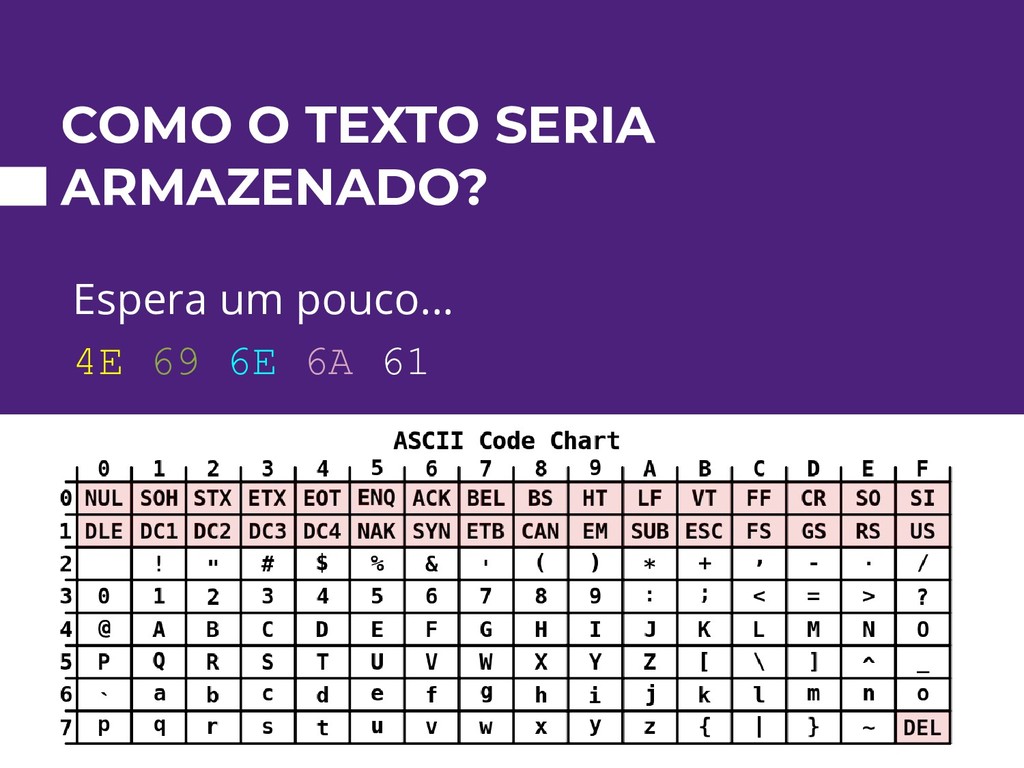
    É um character encoding ◦ Só letras em Inglês antigo importavam ◦ Um caracter em 7 bits ◦ Usa a faixa entre 32 e 127 ◦ Abaixo de 32: não imprimíveis (controle)
  4. “ “ = 20 16 = 32 10 = 00100000

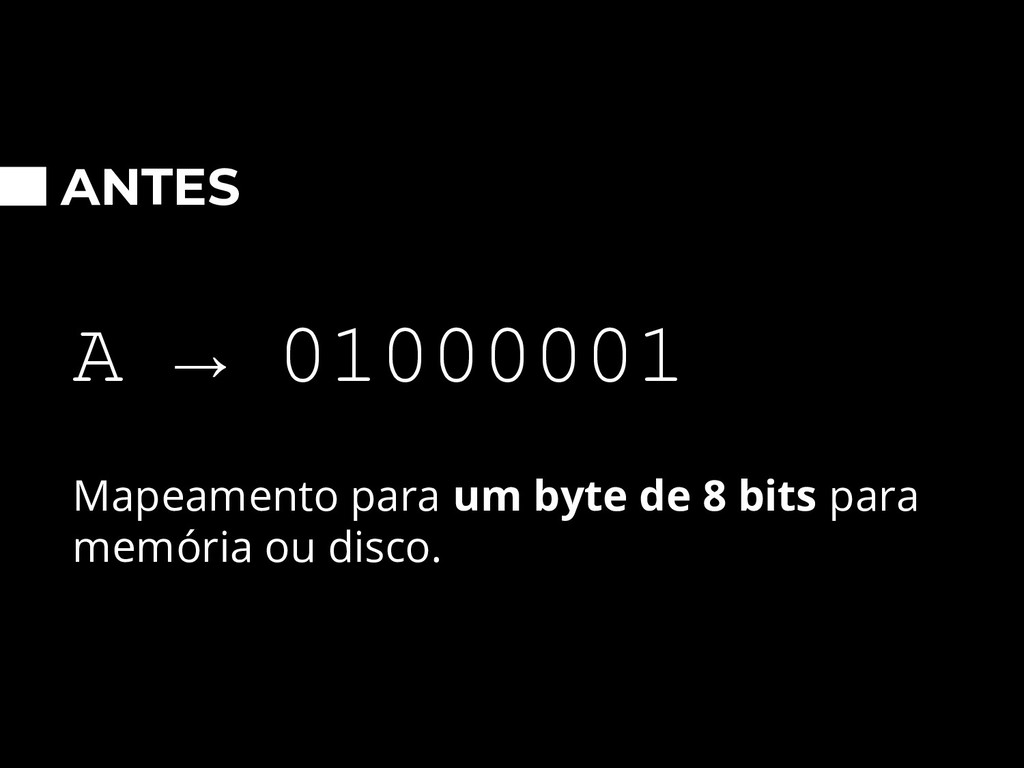
    2 “A” = 41 16 = 65 10 = 01000001 2
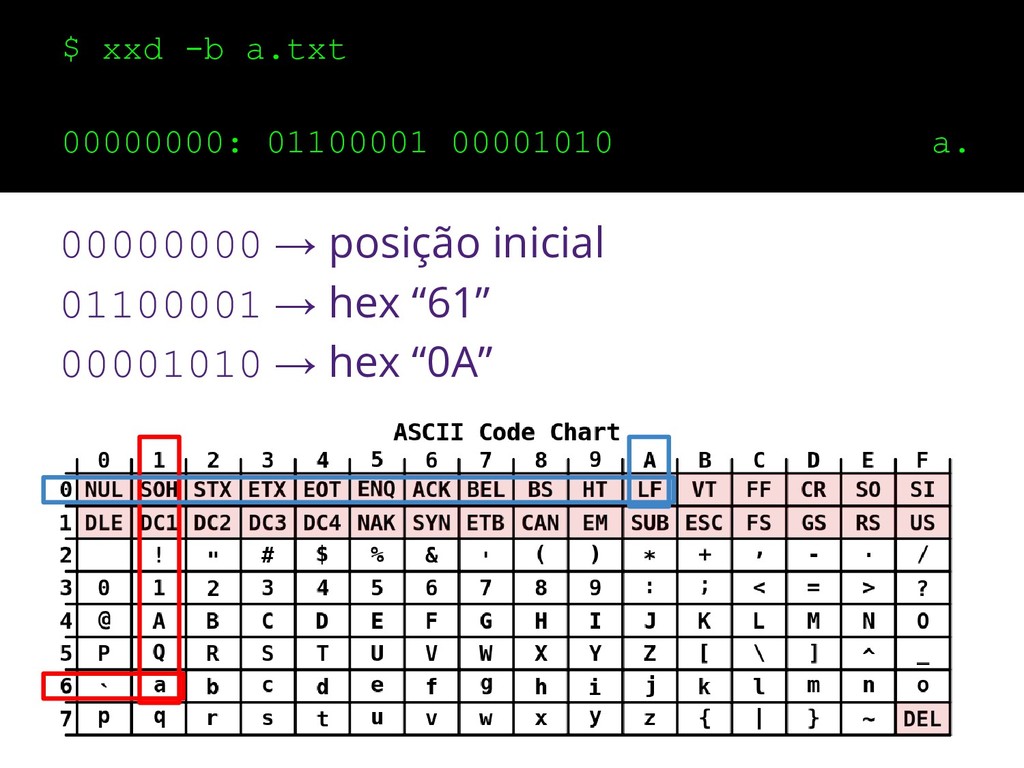
  5. $ xxd -b a.txt 00000000: 01100001 00001010 a. 00000000 →

    posição inicial 01100001 → hex “61” 00001010 → hex “0A”
  6. TEM 1 BIT LIVRE! MAN, VAMOS USAR OS CÓDIGOS 128-255

    PARA NOSSAS NECESSIDADES! VÁRIOS PENSARAM A MESMA COISA.
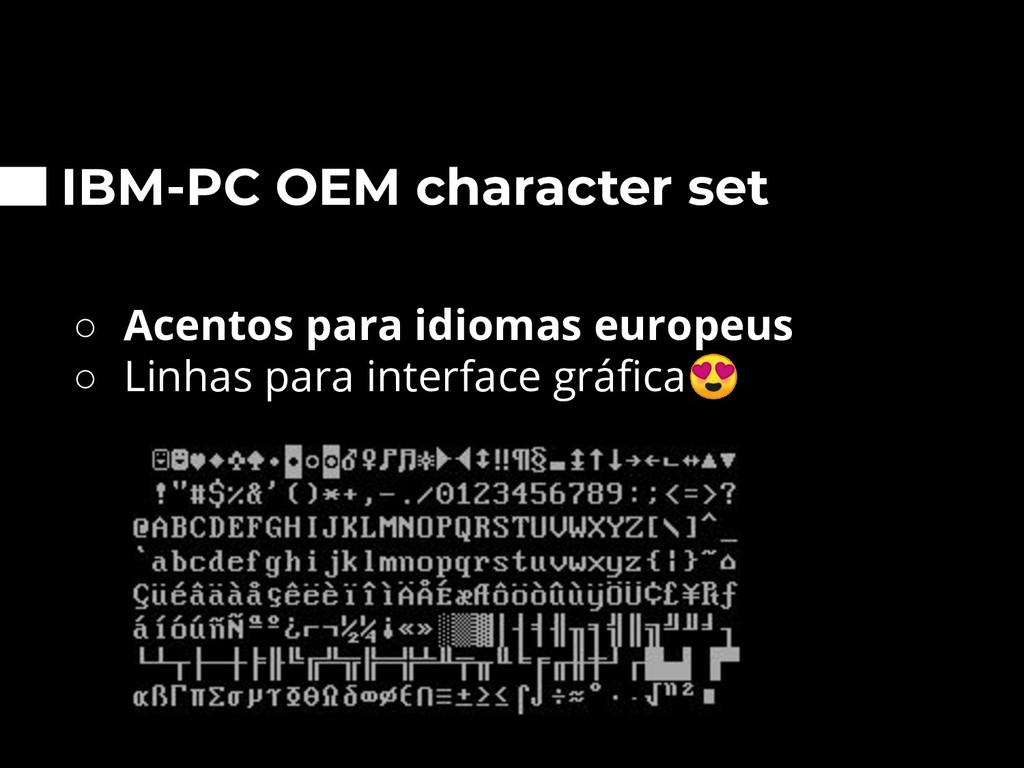
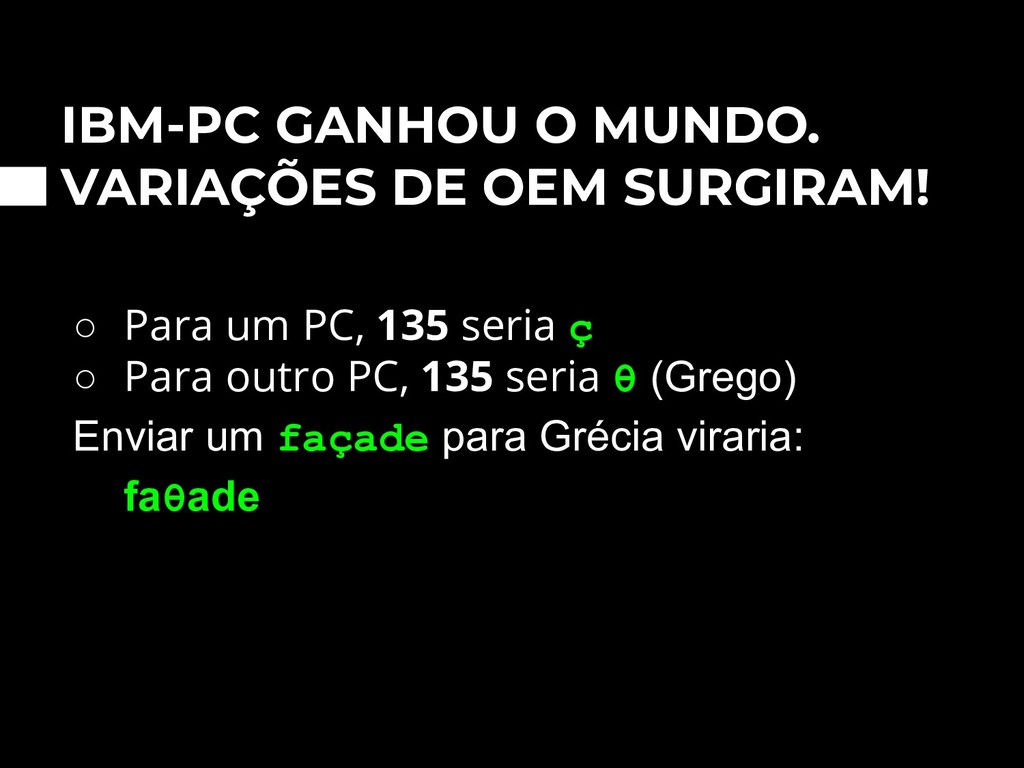
  7. IBM-PC GANHOU O MUNDO. VARIAÇÕES DE OEM SURGIRAM! ◦ Para

    um PC, 135 seria ç ◦ Para outro PC, 135 seria θ (Grego) Enviar um façade para Grécia viraria: faθade
  8. E MULTI-LÍNGUAS EM UM PC SÓ? ◦ MS-DOS: vendido com

    várias code pages ◦ E dois idiomas ao mesmo tempo? ◦ Esperanto e Galego? Ok! ◦ Grego e Ídiche? Não dá! ◦ Alguns idiomas usam códigos muito diferentes ◦ Vou deixar a Ásia para sua imaginação
  9. É UM CÓDIGO 16-BITS ◦ É um character encoding ◦

    Mapeia letras com até 16 bits ◦ 65.536 caracteres possíveis ◦ Não é verdade! ◦ Unicode pensa diferente
  10. UNICODE ◦ É um tabelão com códigos universais ◦ Mapeados

    por vários character encodings ◦ Todos os sistemas de escritas do mundo ◦ Inclusive da ficção, como Klingon
  11. UNICODE A → U+0041 → ?? ◦ Letras e símbolos

    → code point ◦ U+ significa “Unicode” ◦ Números na base hexadecimal ◦ Representação na memória? Depende do character encoding!
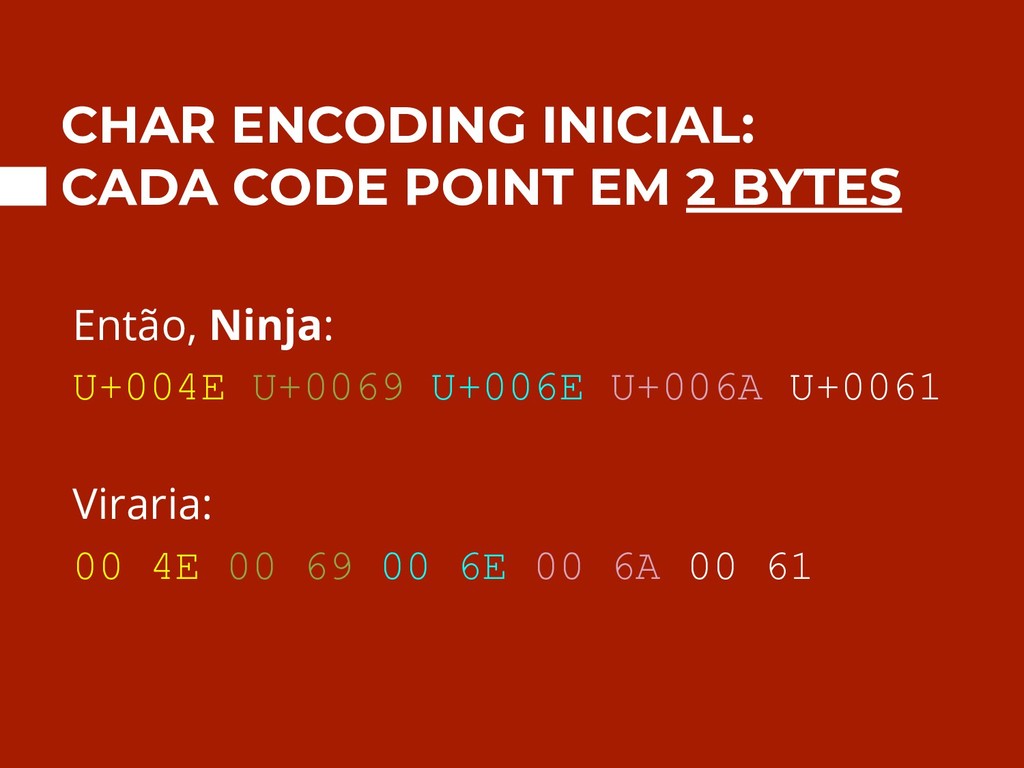
  12. CHAR ENCODING INICIAL: CADA CODE POINT EM 2 BYTES Então,

    Ninja: U+004E U+0069 U+006E U+006A U+0061 Viraria: 00 4E 00 69 00 6E 00 6A 00 61
  13. DIFERENTES ESTRATÉGIAS DE ORDENAÇÃO DE BITS Esse é o modo

    high-endian: 00 4E 00 69 00 6E 00 6A 00 61 Se eu precisar do modo low-endian? 4E 00 69 00 6E 00 6A 00 61 00
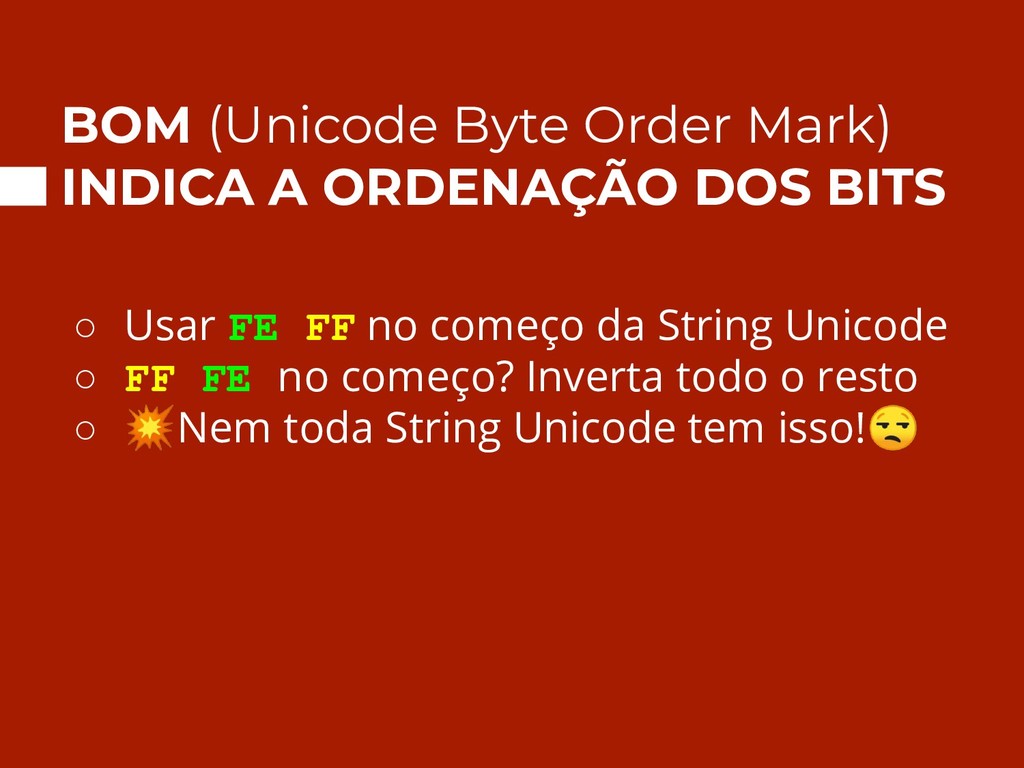
  14. BOM (Unicode Byte Order Mark) INDICA A ORDENAÇÃO DOS BITS

    ◦ Usar FE FF no começo da String Unicode ◦ FF FE no começo? Inverta todo o resto ◦ Nem toda String Unicode tem isso!
  15. ◦ “E essa quantidade toda de zeros?” • No Inglês,

    quase não se usa letra acima de U+00FF ◦ “Ah, já tem muita coisa em ANSI, DBCS…” • Ninguém queria converter ◦ Unicode foi ignorado por muito tempo QUE TAL UM ENCODING PADRÃO?
  16. UTF-8 Unicode Transformation Format de 8 bits Um character encoding

    para Unicode code points usando bytes de 8-bits.
  17. UTF-8 ◦ Code points de 0-127 → em um único

    byte ◦ Code points a partir de 128 → até 6 bytes ◦ Uso de espaço sob demanda ◦ Grego e Klingon ao mesmo tempo
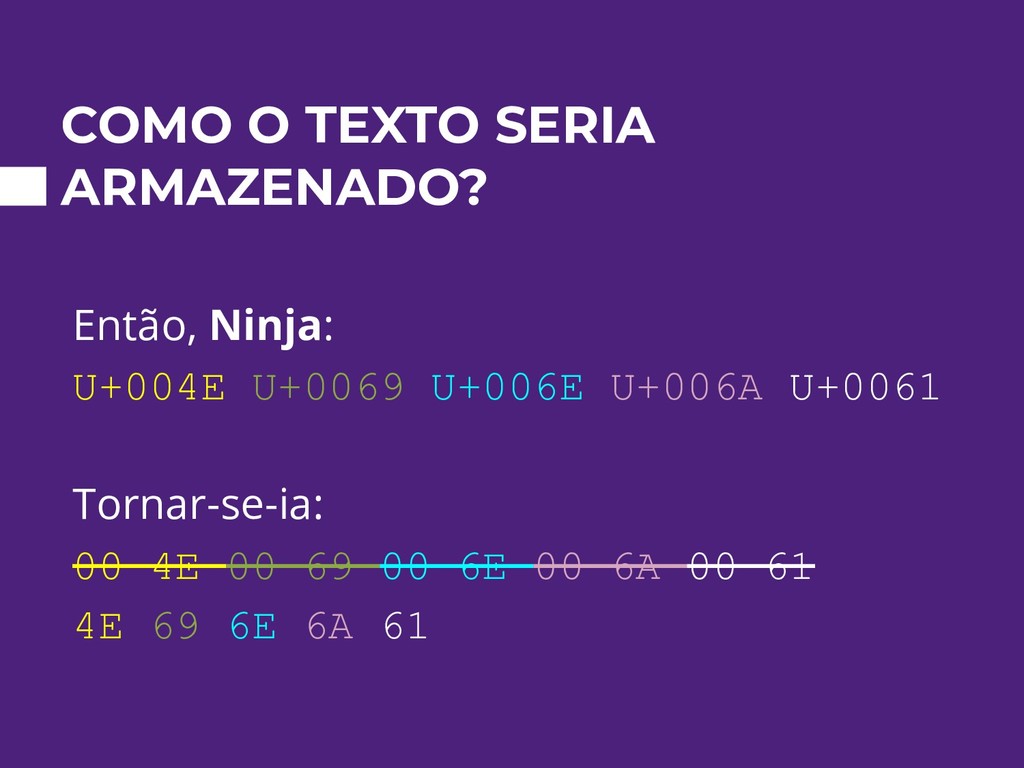
  18. COMO O TEXTO SERIA ARMAZENADO? Então, Ninja: U+004E U+0069 U+006E

    U+006A U+0061 Tornar-se-ia: 00 4E 00 69 00 6E 00 6A 00 61 4E 69 6E 6A 61
  19. UTF-8 PARA OS AMERICANOS ◦ Compatível com ASCII, ANSI, OEMs!

    ◦ Sem zeros extras ◦ Mesma quantidade de bits ◦ Começou a adotado
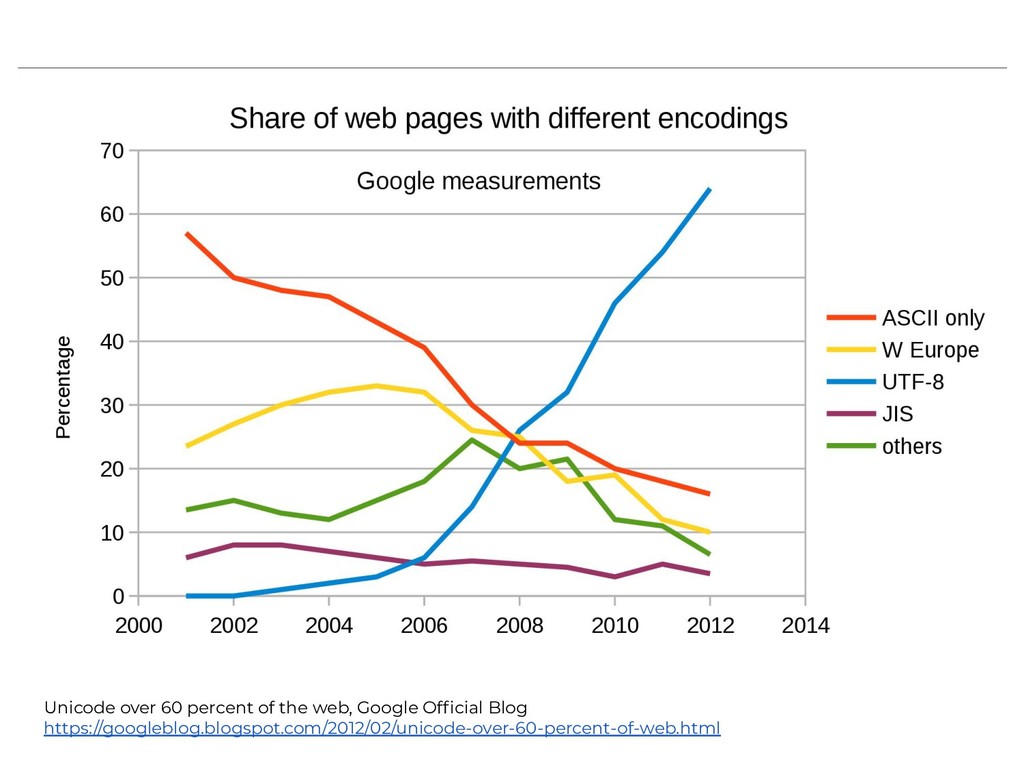
  20. Unicode over 60 percent of the web, Google Official Blog

    https://googleblog.blogspot.com/2012/02/unicode-over-60-percent-of-web.html
  21. UTF-8 is used by 93.3% of all the websites whose

    character encoding we know and that rank in the top 1,000,000. https://w3techs.com/technologies/cross/character_encoding/ranking
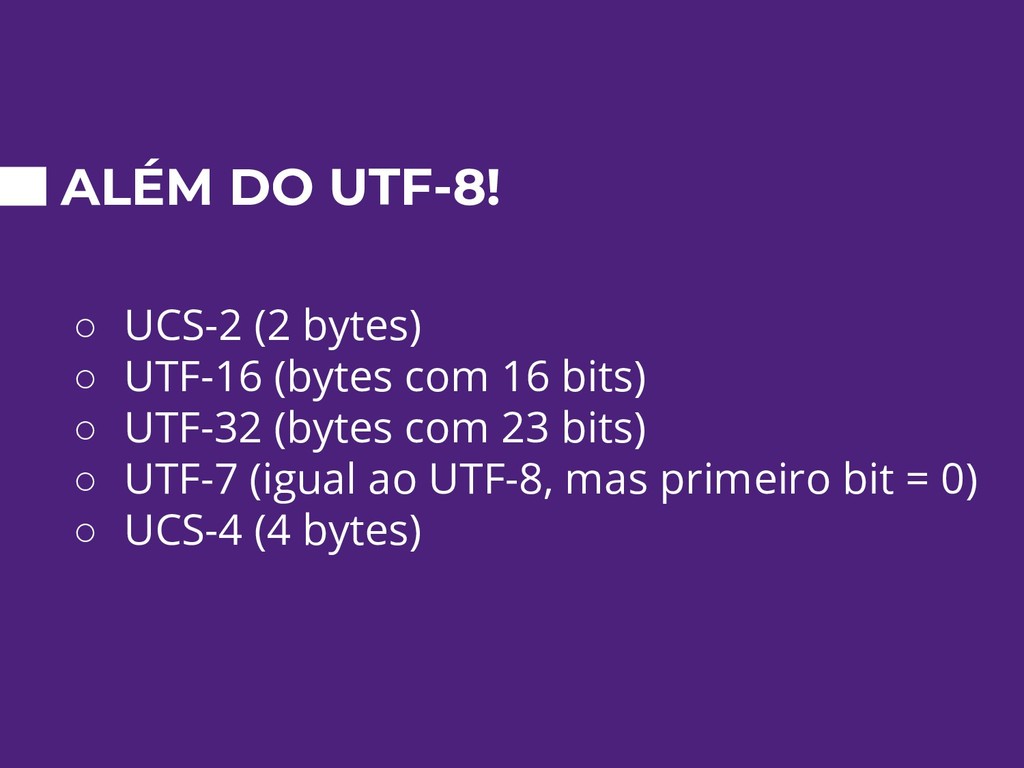
  22. ALÉM DO UTF-8! ◦ UCS-2 (2 bytes) ◦ UTF-16 (bytes

    com 16 bits) ◦ UTF-32 (bytes com 23 bits) ◦ UTF-7 (igual ao UTF-8, mas primeiro bit = 0) ◦ UCS-4 (4 bytes)
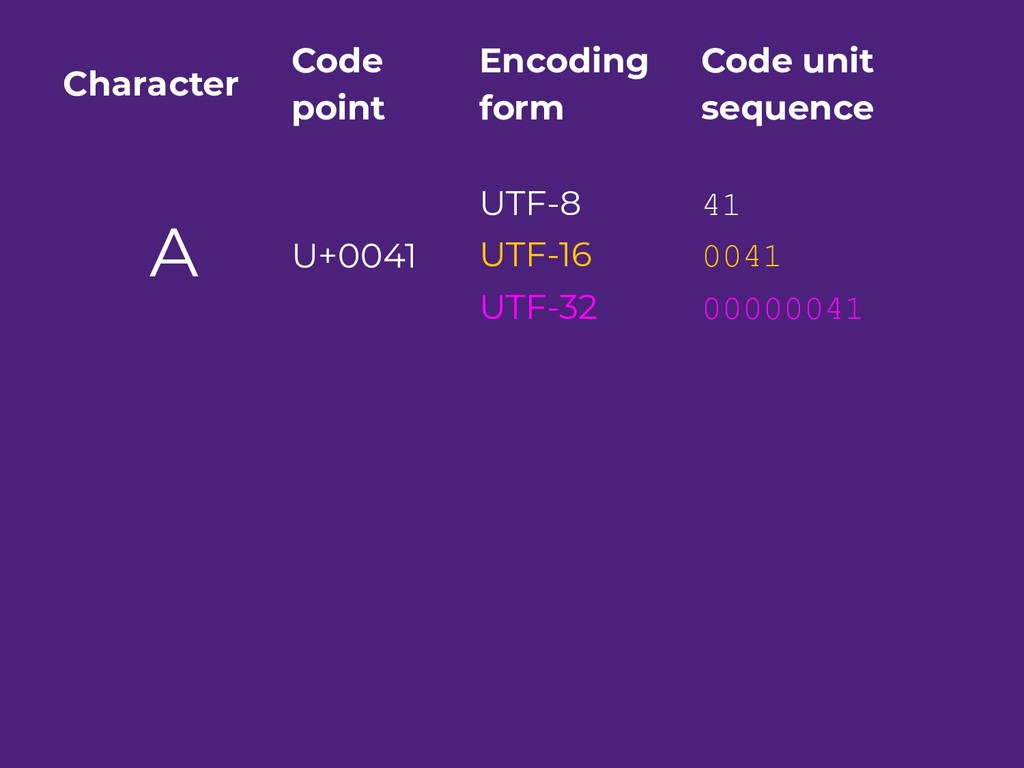
  23. Character Code point Encoding form Code unit sequence A U+0041

    UTF-8 41 UTF-16 0041 UTF-32 00000041 ឩ U+17A9 UTF-8 E1 9E A9 UTF-16 17A9 UTF-32 000017A9 U+1F60A UTF-8 F0 9F 98 8A UTF-16 D83D DE0A UTF-32 0001F60A
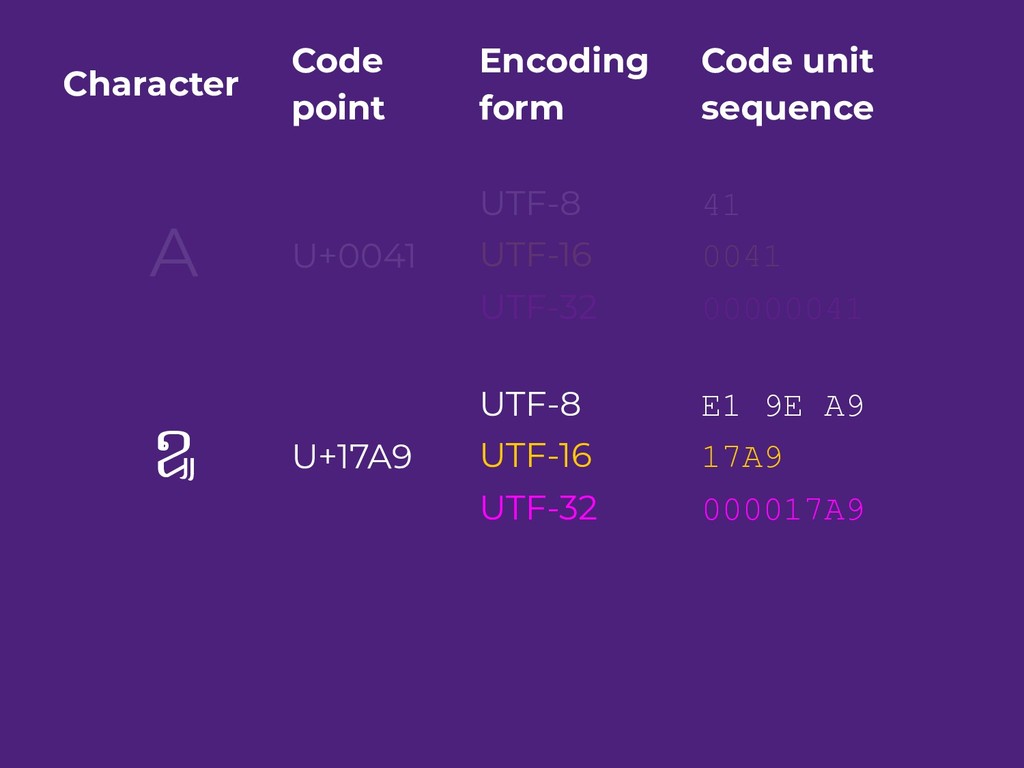
  24. Character Code point Encoding form Code unit sequence A U+0041

    UTF-8 41 UTF-16 0041 UTF-32 00000041 ឩ U+17A9 UTF-8 E1 9E A9 UTF-16 17A9 UTF-32 000017A9 U+1F60A UTF-8 F0 9F 98 8A UTF-16 D83D DE0A UTF-32 0001F60A
  25. Character Code point Encoding form Code unit sequence A U+0041

    UTF-8 41 UTF-16 0041 UTF-32 00000041 ឩ U+17A9 UTF-8 E1 9E A9 UTF-16 17A9 UTF-32 000017A9 U+1F60A UTF-8 F0 9F 98 8A UTF-16 D83D DE0A UTF-32 0001F60A
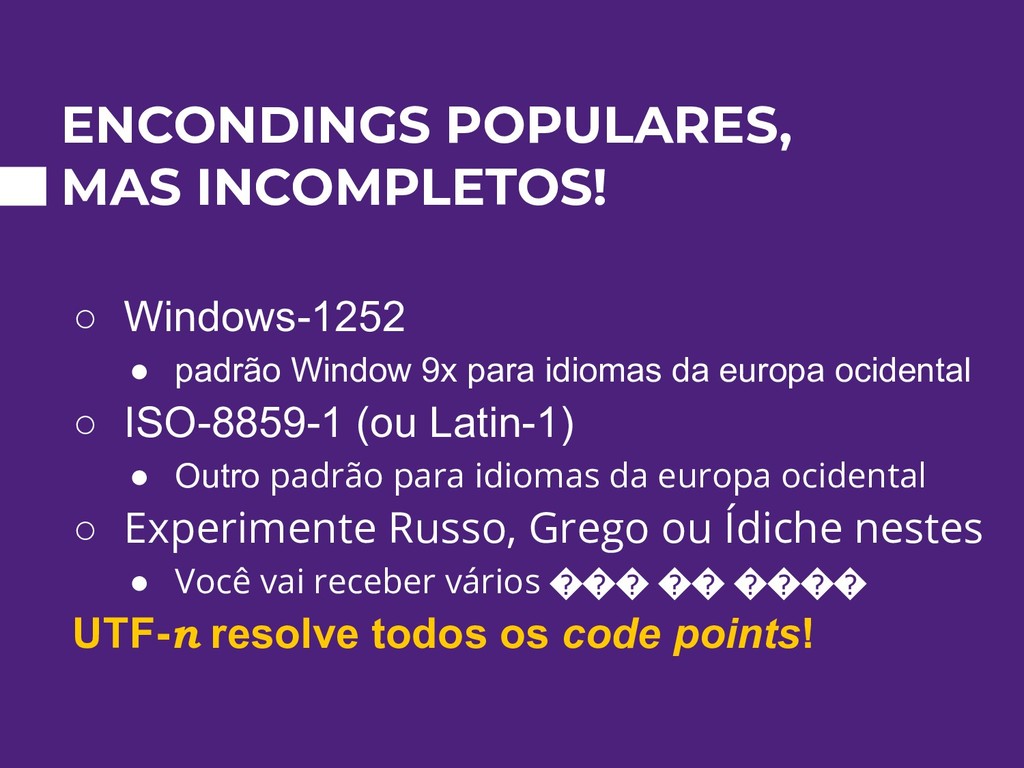
  26. ENCONDINGS POPULARES, MAS INCOMPLETOS! ◦ Windows-1252 • padrão Window 9x

    para idiomas da europa ocidental ◦ ISO-8859-1 (ou Latin-1) • Outro padrão para idiomas da europa ocidental ◦ Experimente Russo, Grego ou Ídiche nestes • Você vai receber vários ��� �� ���� UTF-n resolve todos os code points!
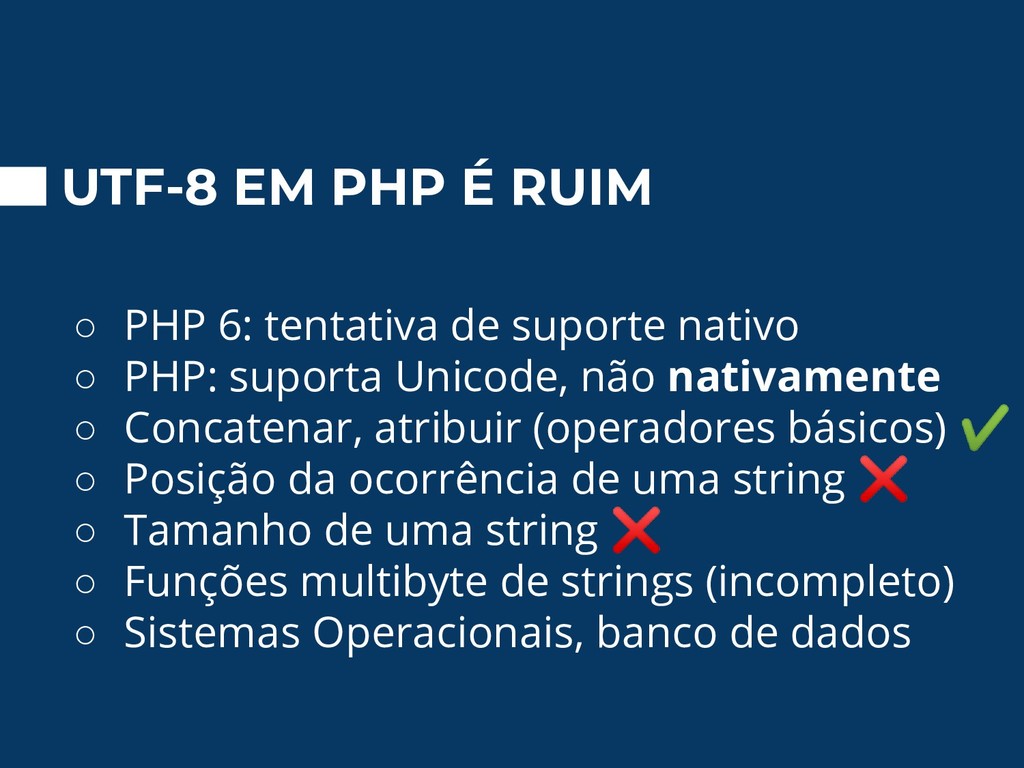
  27. UTF-8 EM PHP É RUIM ◦ PHP 6: tentativa de

    suporte nativo ◦ PHP: suporta Unicode, não nativamente ◦ Concatenar, atribuir (operadores básicos) ✔ ◦ Posição da ocorrência de uma string ❌ ◦ Tamanho de uma string ❌ ◦ Funções multibyte de strings (incompleto) ◦ Sistemas Operacionais, banco de dados
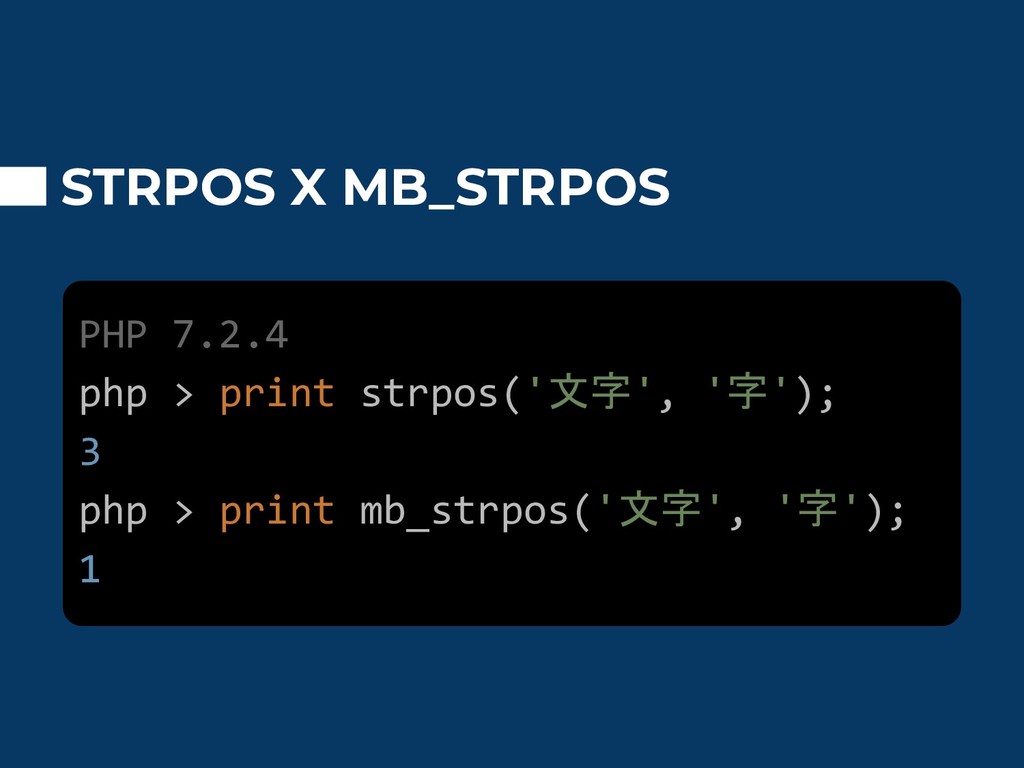
  28. STRPOS X MB_STRPOS PHP 7.2.4 php > print strpos('文字', '字');

    3 php > print mb_strpos('文字', '字'); 1
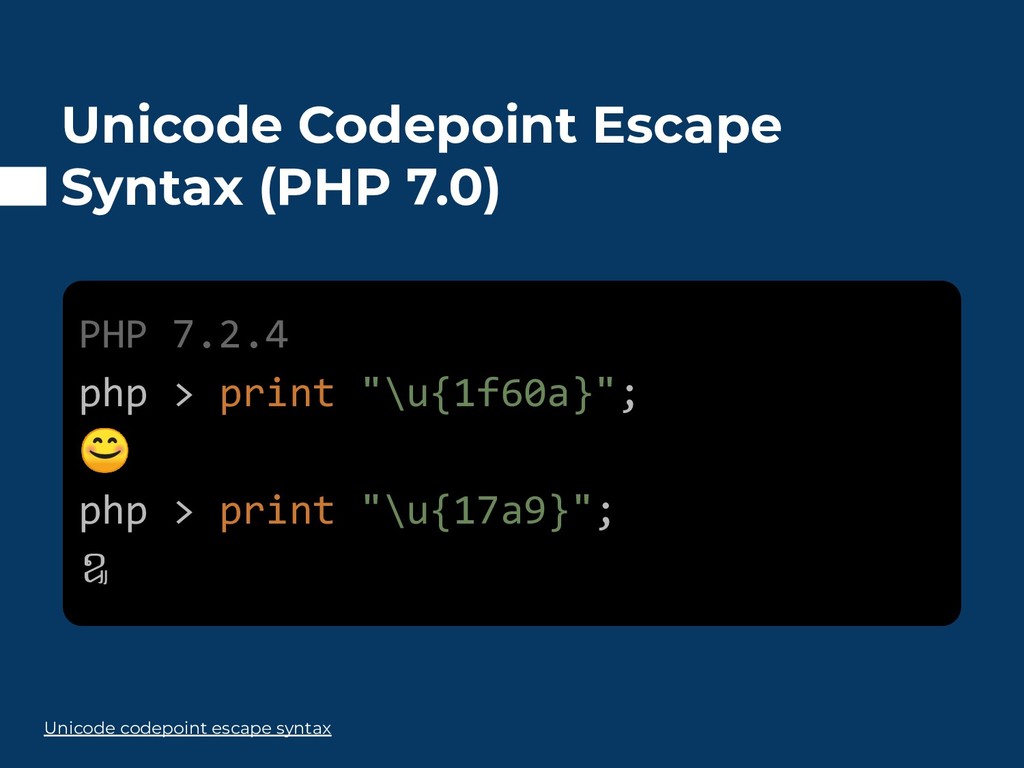
  29. Unicode Codepoint Escape Syntax (PHP 7.0) PHP 7.2.4 php >

    print "\u{1f60a}"; php > print "\u{17a9}"; ឩ Unicode codepoint escape syntax
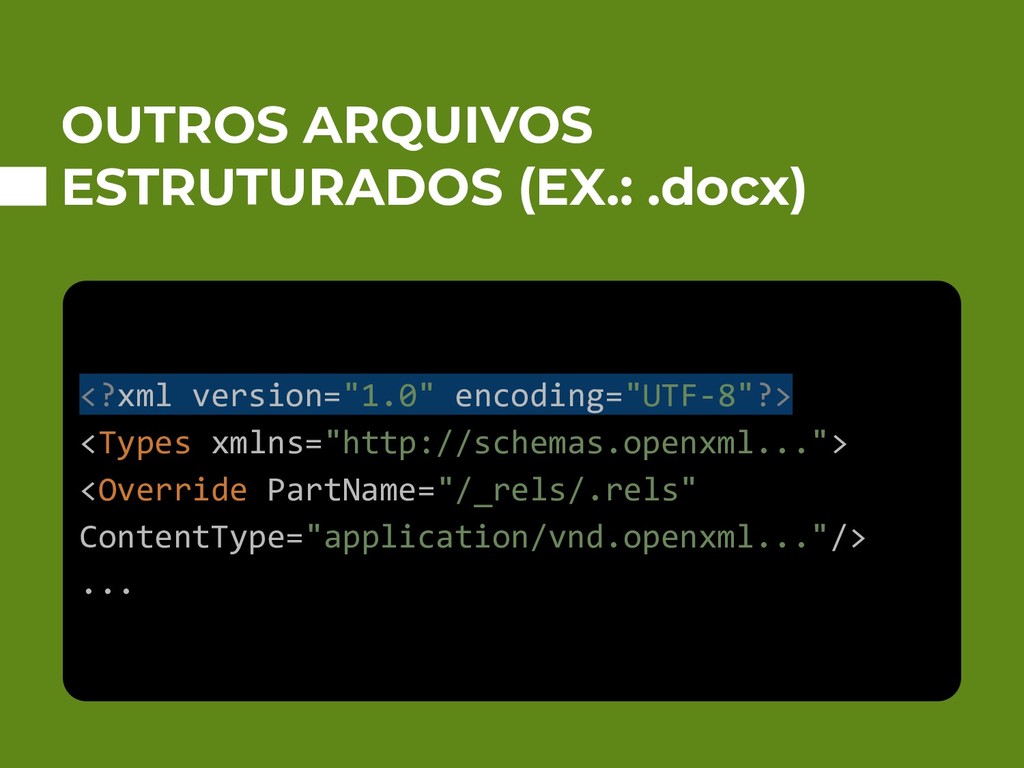
  30. OUTROS ARQUIVOS ESTRUTURADOS (EX.: .docx) <?xml version="1.0" encoding="UTF-8"?> <Types xmlns="http://schemas.openxml...">

    <Override PartName="/_rels/.rels" ContentType="application/vnd.openxml..."/> ...
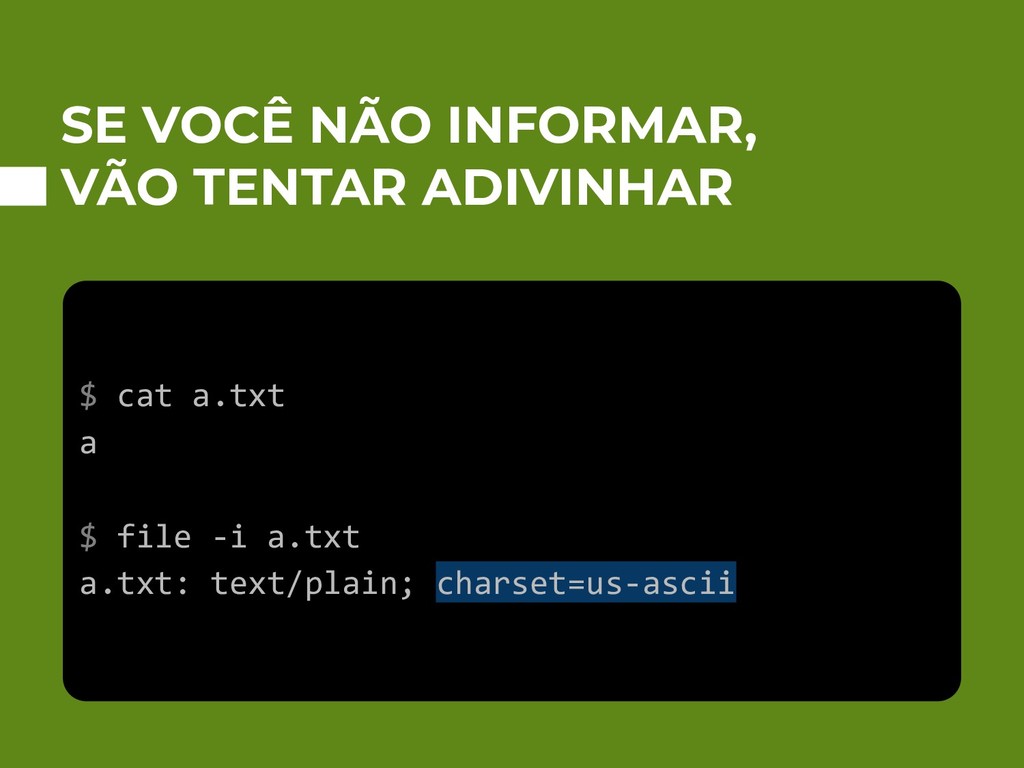
  31. SE VOCÊ NÃO INFORMAR, VÃO TENTAR ADIVINHAR $ cat a.txt

    a $ file -i a.txt a.txt: text/plain; charset=us-ascii
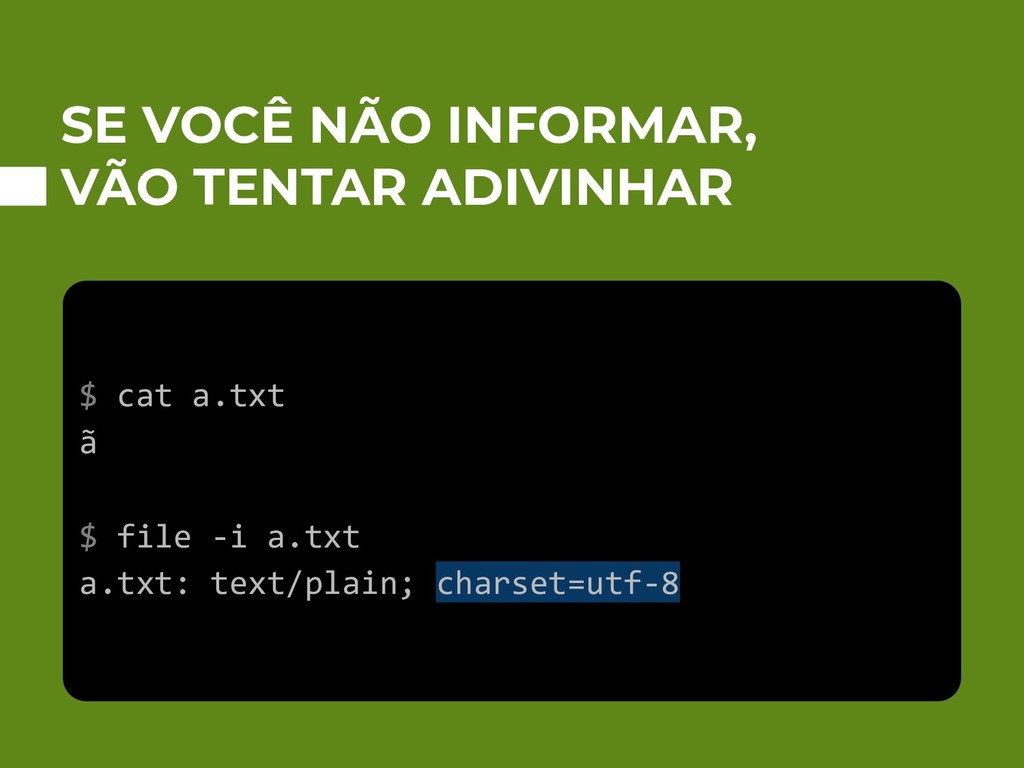
  32. SE VOCÊ NÃO INFORMAR, VÃO TENTAR ADIVINHAR $ cat a.txt

    ã $ file -i a.txt a.txt: text/plain; charset=utf-8
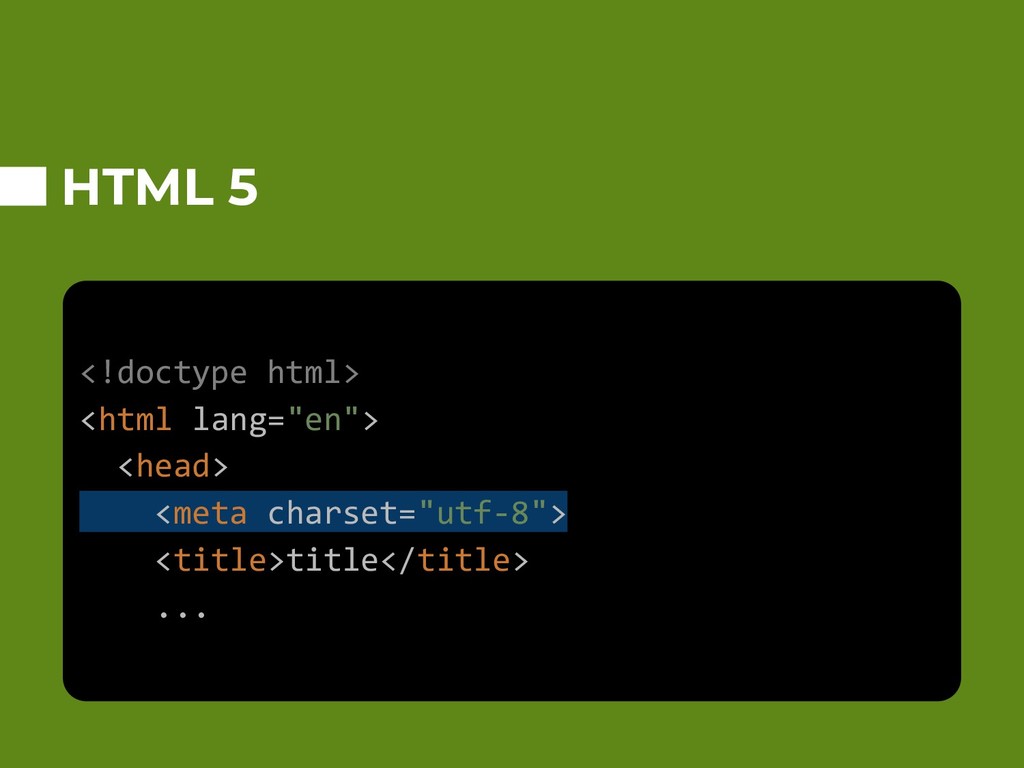
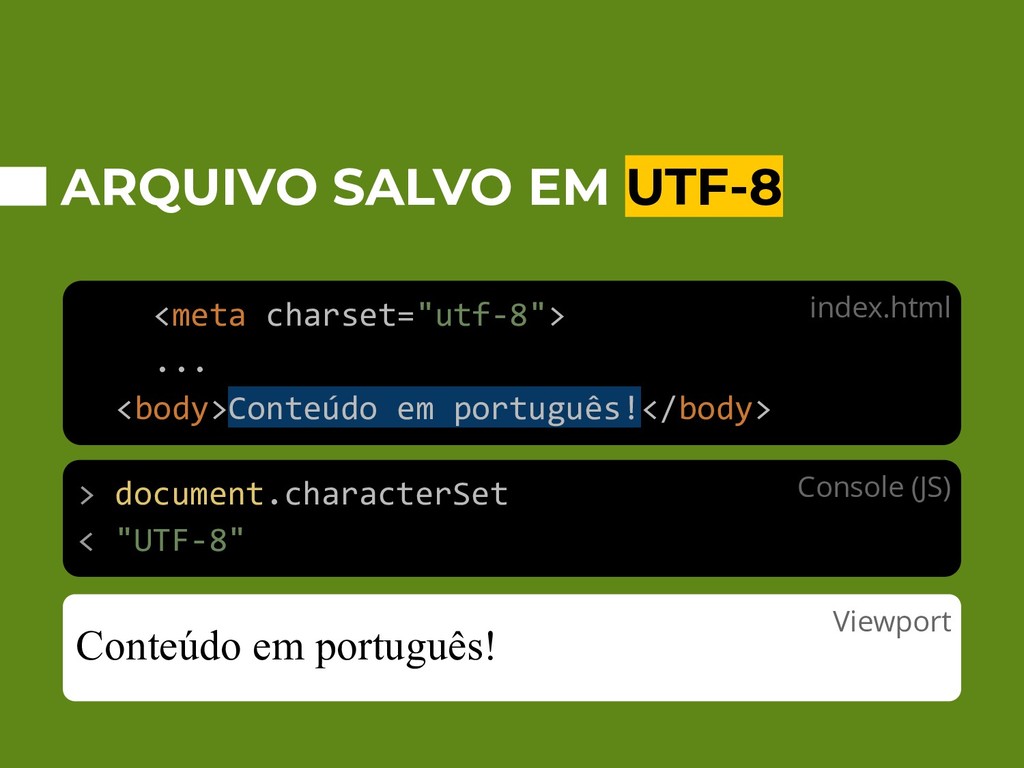
  33. ARQUIVO SALVO EM UTF-8 <meta charset="utf-8"> ... <body>Conteúdo em português!</body>

    Conteúdo em português! > document.characterSet < "UTF-8" index.html Console (JS) Viewport
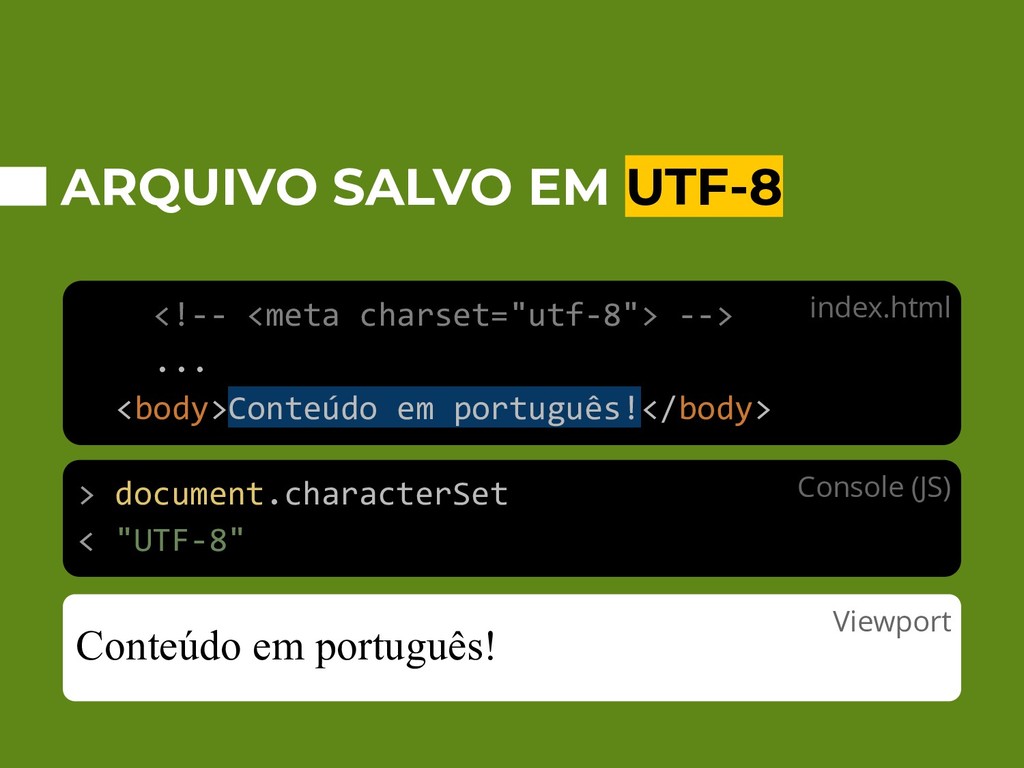
  34. ARQUIVO SALVO EM UTF-8 <!-- <meta charset="utf-8"> --> ... <body>Conteúdo

    em português!</body> Conteúdo em português! > document.characterSet < "UTF-8" index.html Console (JS) Viewport
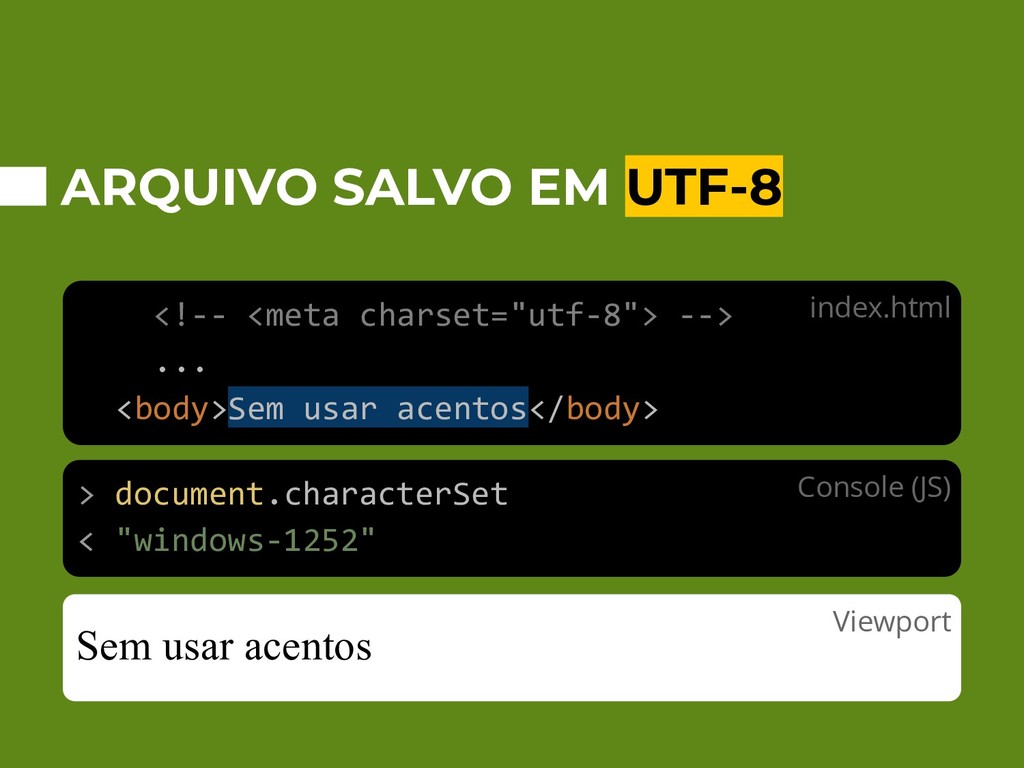
  35. ARQUIVO SALVO EM UTF-8 <!-- <meta charset="utf-8"> --> ... <body>Sem

    usar acentos</body> Sem usar acentos > document.characterSet < "windows-1252" index.html Console (JS) Viewport
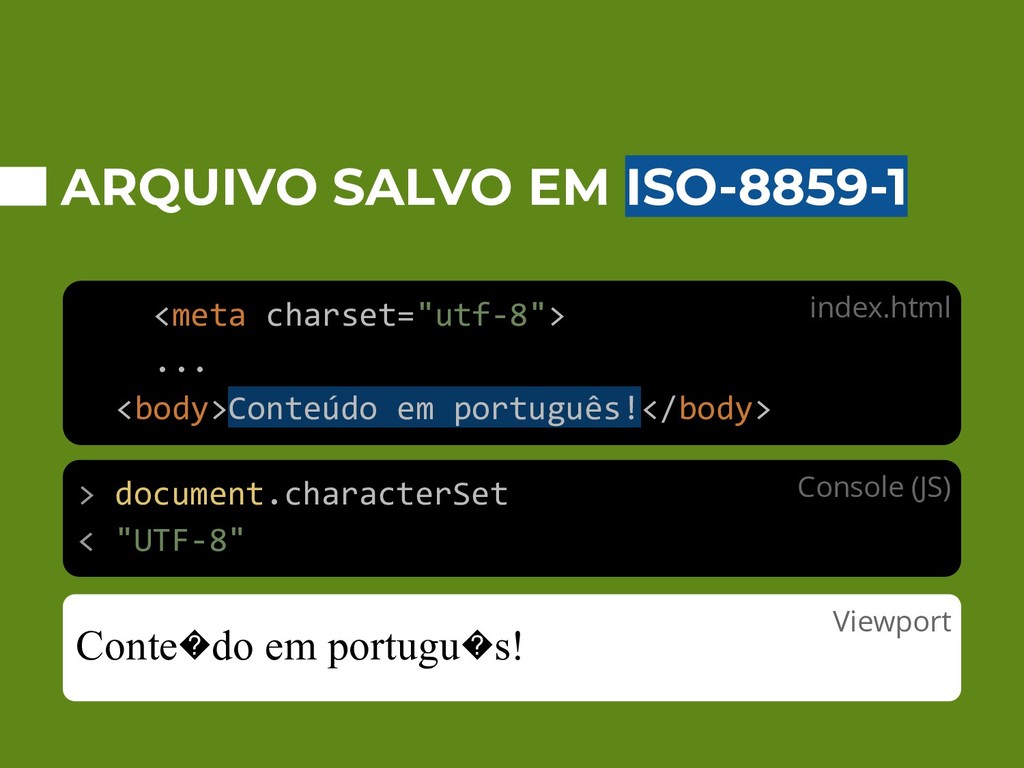
  36. ARQUIVO SALVO EM ISO-8859-1 <meta charset="utf-8"> ... <body>Conteúdo em português!</body>

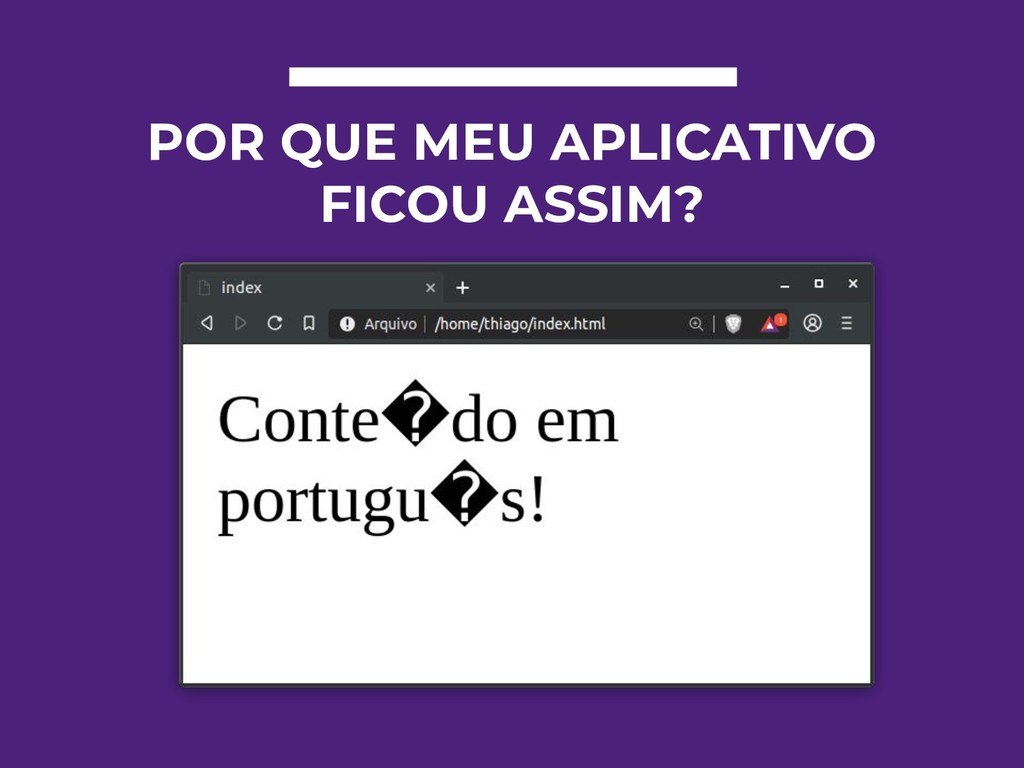
    Conte�do em portugu�s! > document.characterSet < "UTF-8" index.html Console (JS) Viewport
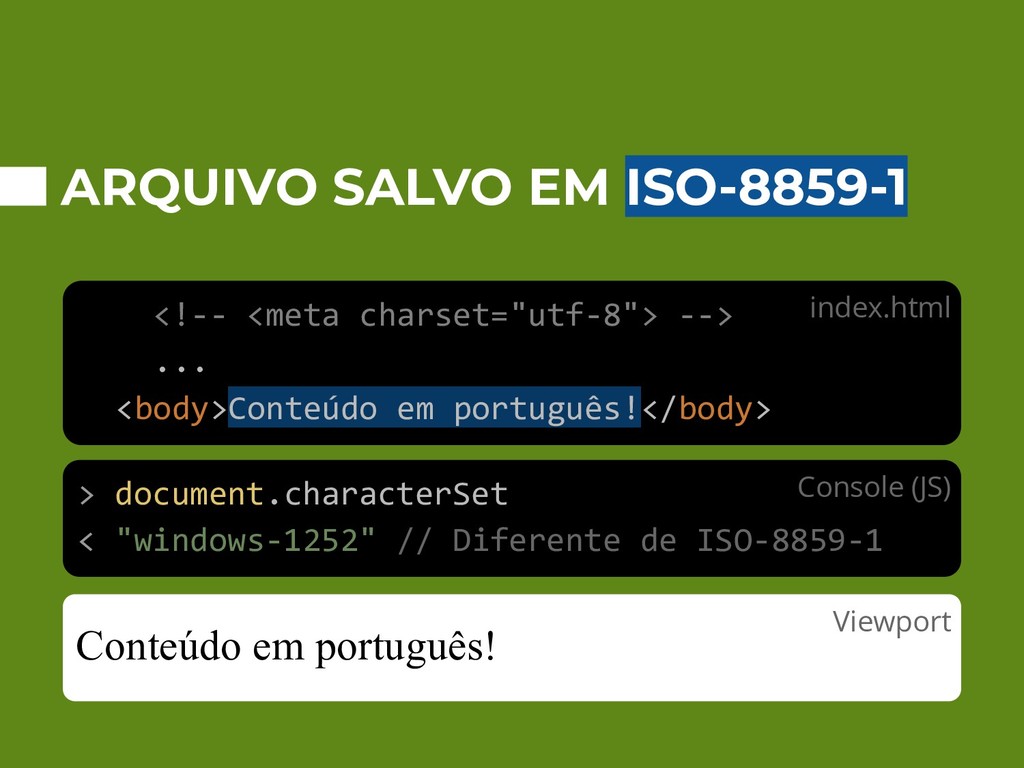
  37. ARQUIVO SALVO EM ISO-8859-1 <!-- <meta charset="utf-8"> --> ... <body>Conteúdo

    em português!</body> Conteúdo em português! > document.characterSet < "windows-1252" // Diferente de ISO-8859-1 index.html Console (JS) Viewport
  38. SEM DESCULPAS! ◦ Controle o character encoding do editor ◦

    Informe o character encoding no arquivo ◦ Use UTF-8 • Tem mais de 20 anos de amadurecimento • Padrão em linguagens e sistemas modernos • 94% dos top 1MM web sites usam (2019) ◦ Domine as ferramentas que você usa! Foto de Glenn Carstens-Peters em Unsplash
  39. “ “SÓ SENTIMOS FALTA DAQUILO QUE CONHECEMOS” ― Luciano Ramalho,

    em “Python Fluente” Foto de Andrew Neel em Unsplash
  40. REFERÊNCIA ◦ The Unicode Consortium ◦ Endianness ◦ Character Sets

    And Code Pages At The Push Of A Button ◦ Document.characterSet ◦ Entendendo Unicode e os Character Encodings ◦ What Every Programmer Absolutely, Positively Needs To Know About Encodings And Character Sets To Work With Text ◦ PHP não possui suporte nativo ao Unicode ◦ The Absolute Minimum Every Software Developer Absolutely, Positively Must Know About Unicode and Character Sets (No Excuses!) ◦ The Text Content-Type ◦ Experimentações e vivência :)

More Decks by Thiago Colares

Other Decks in Programming