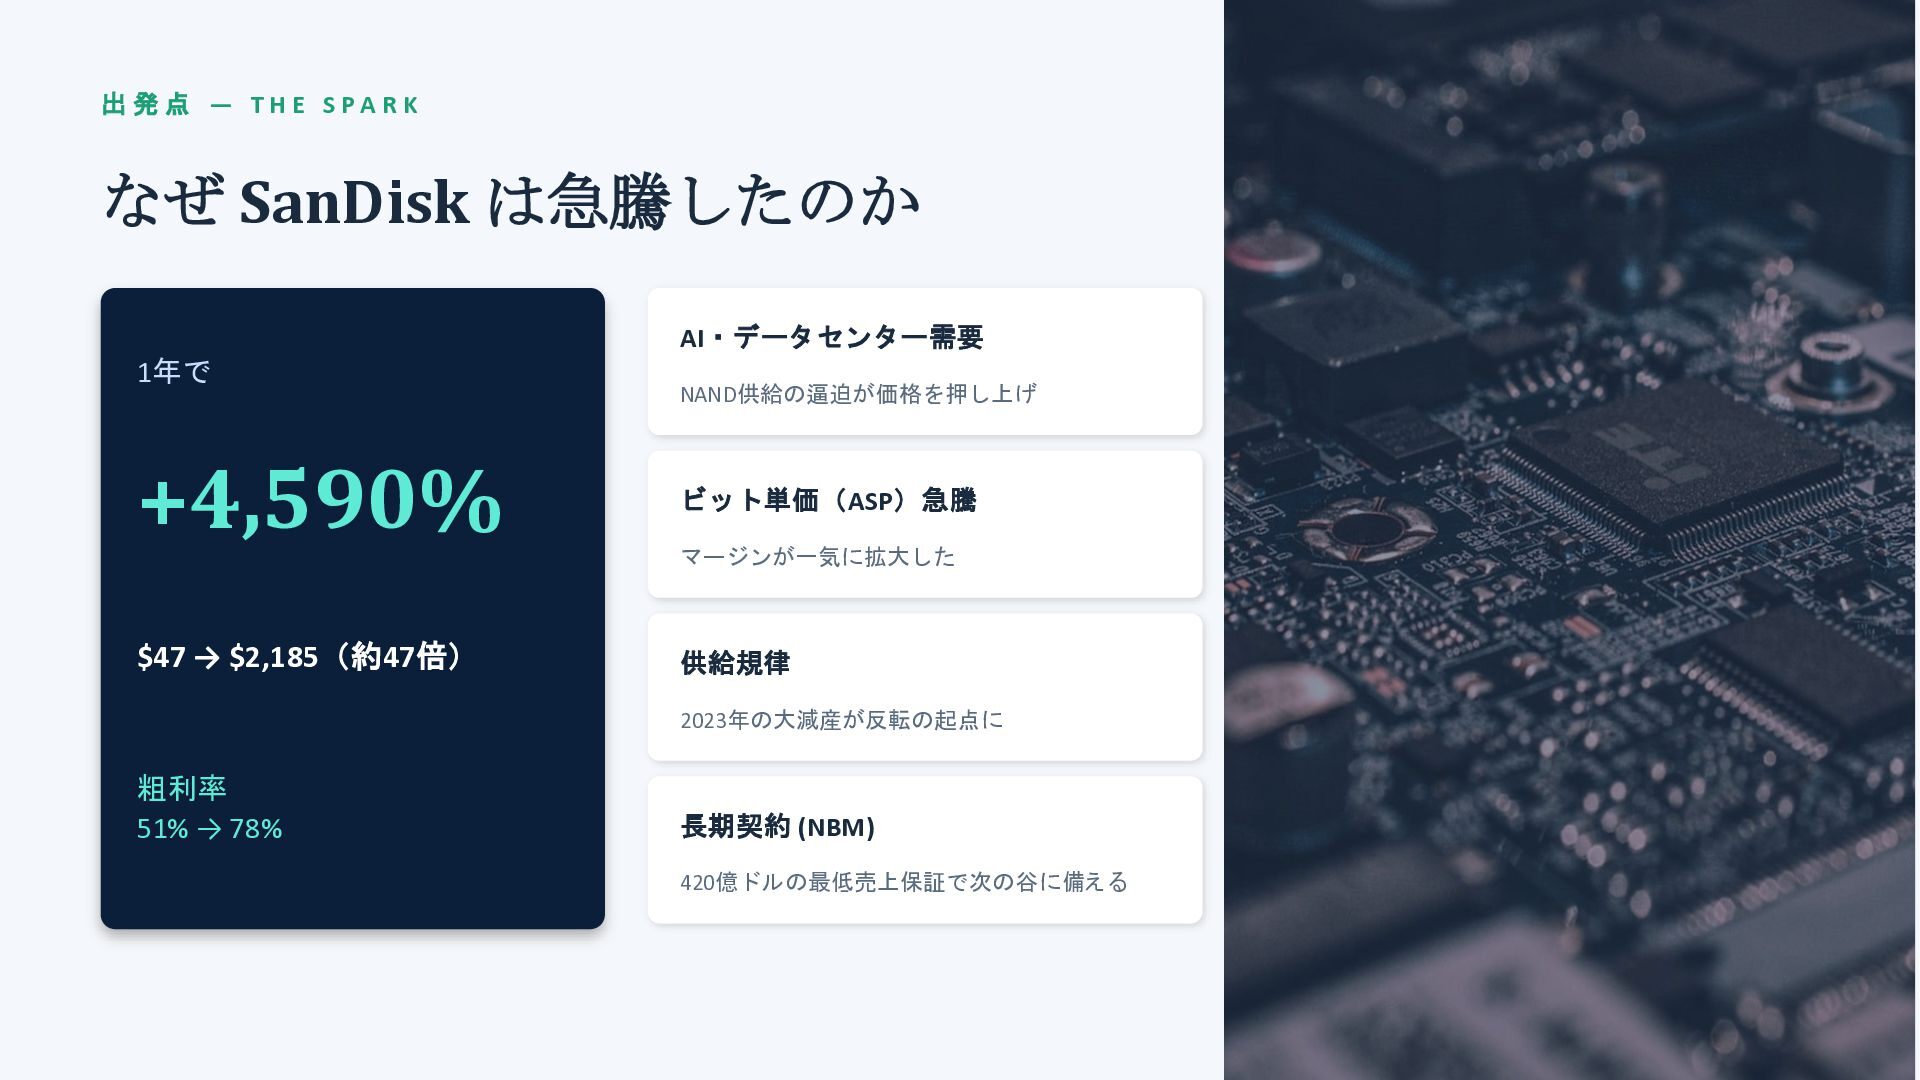
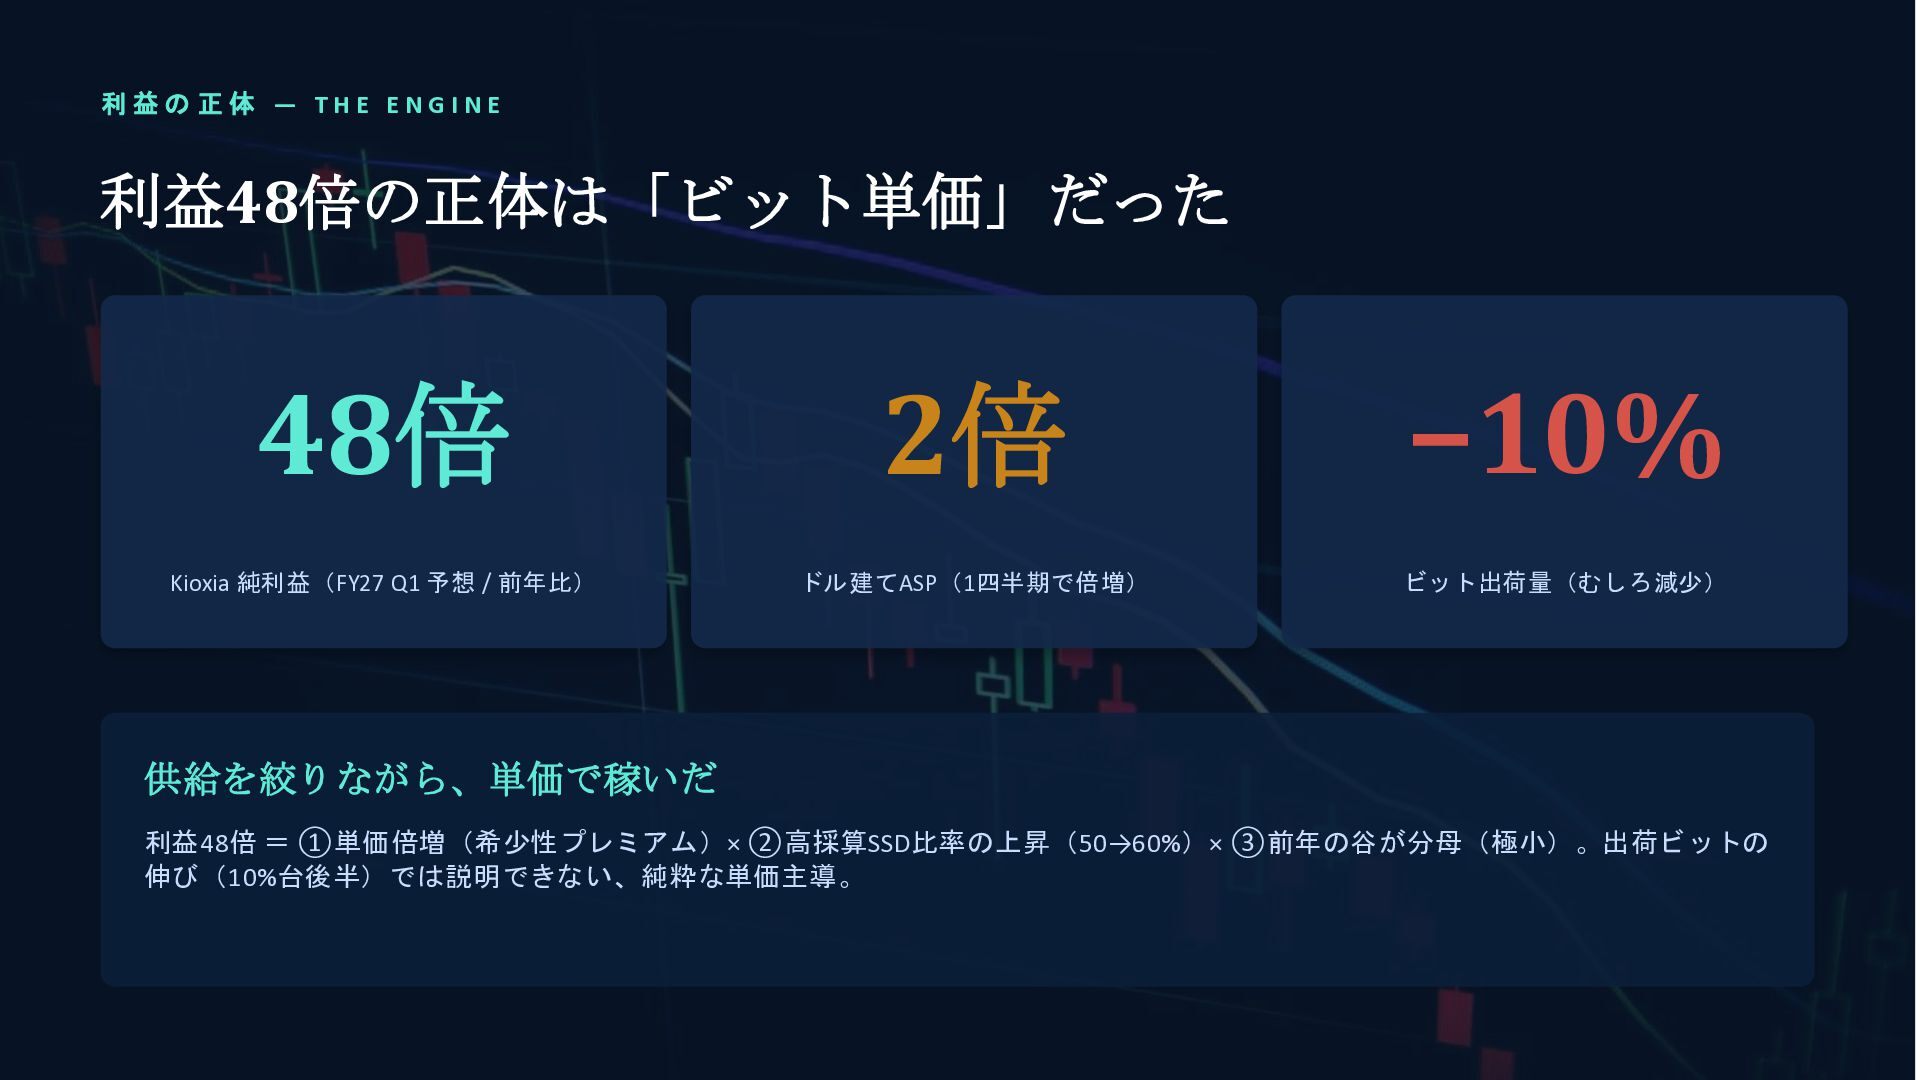
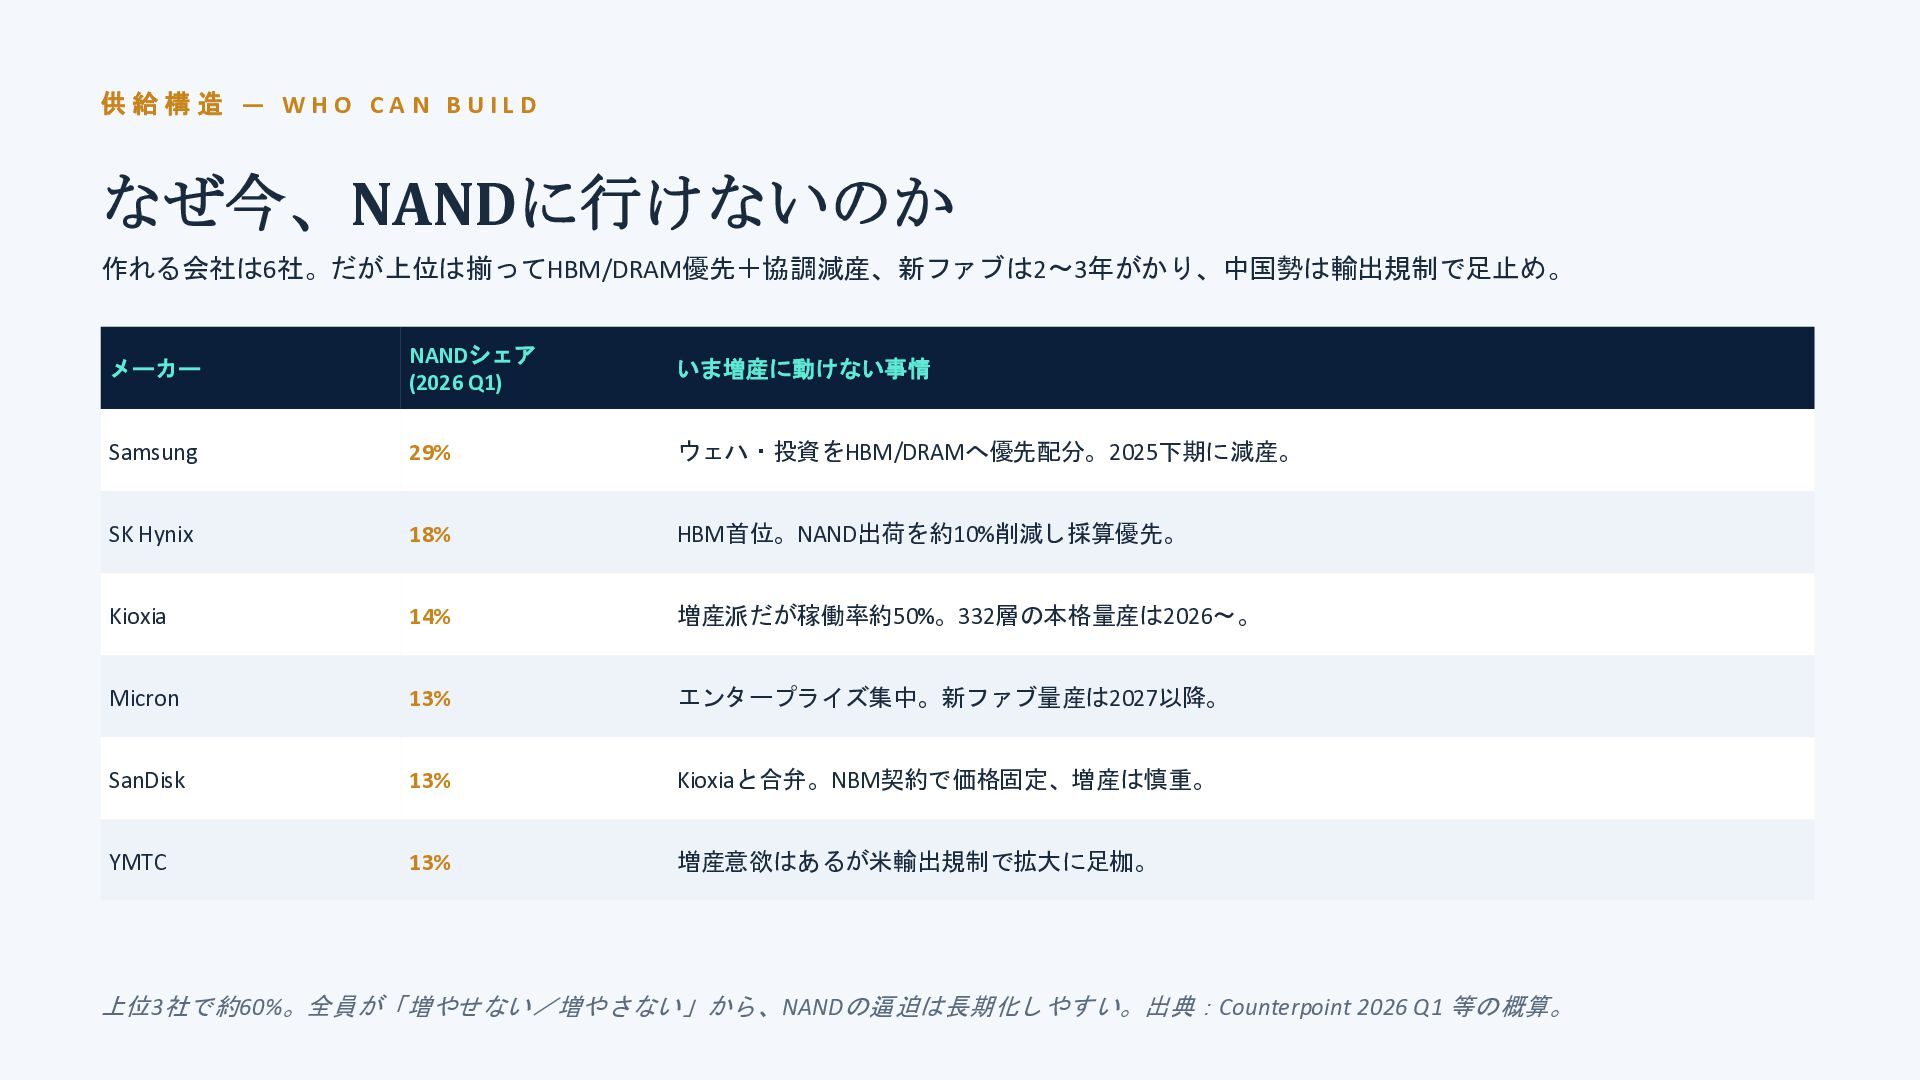
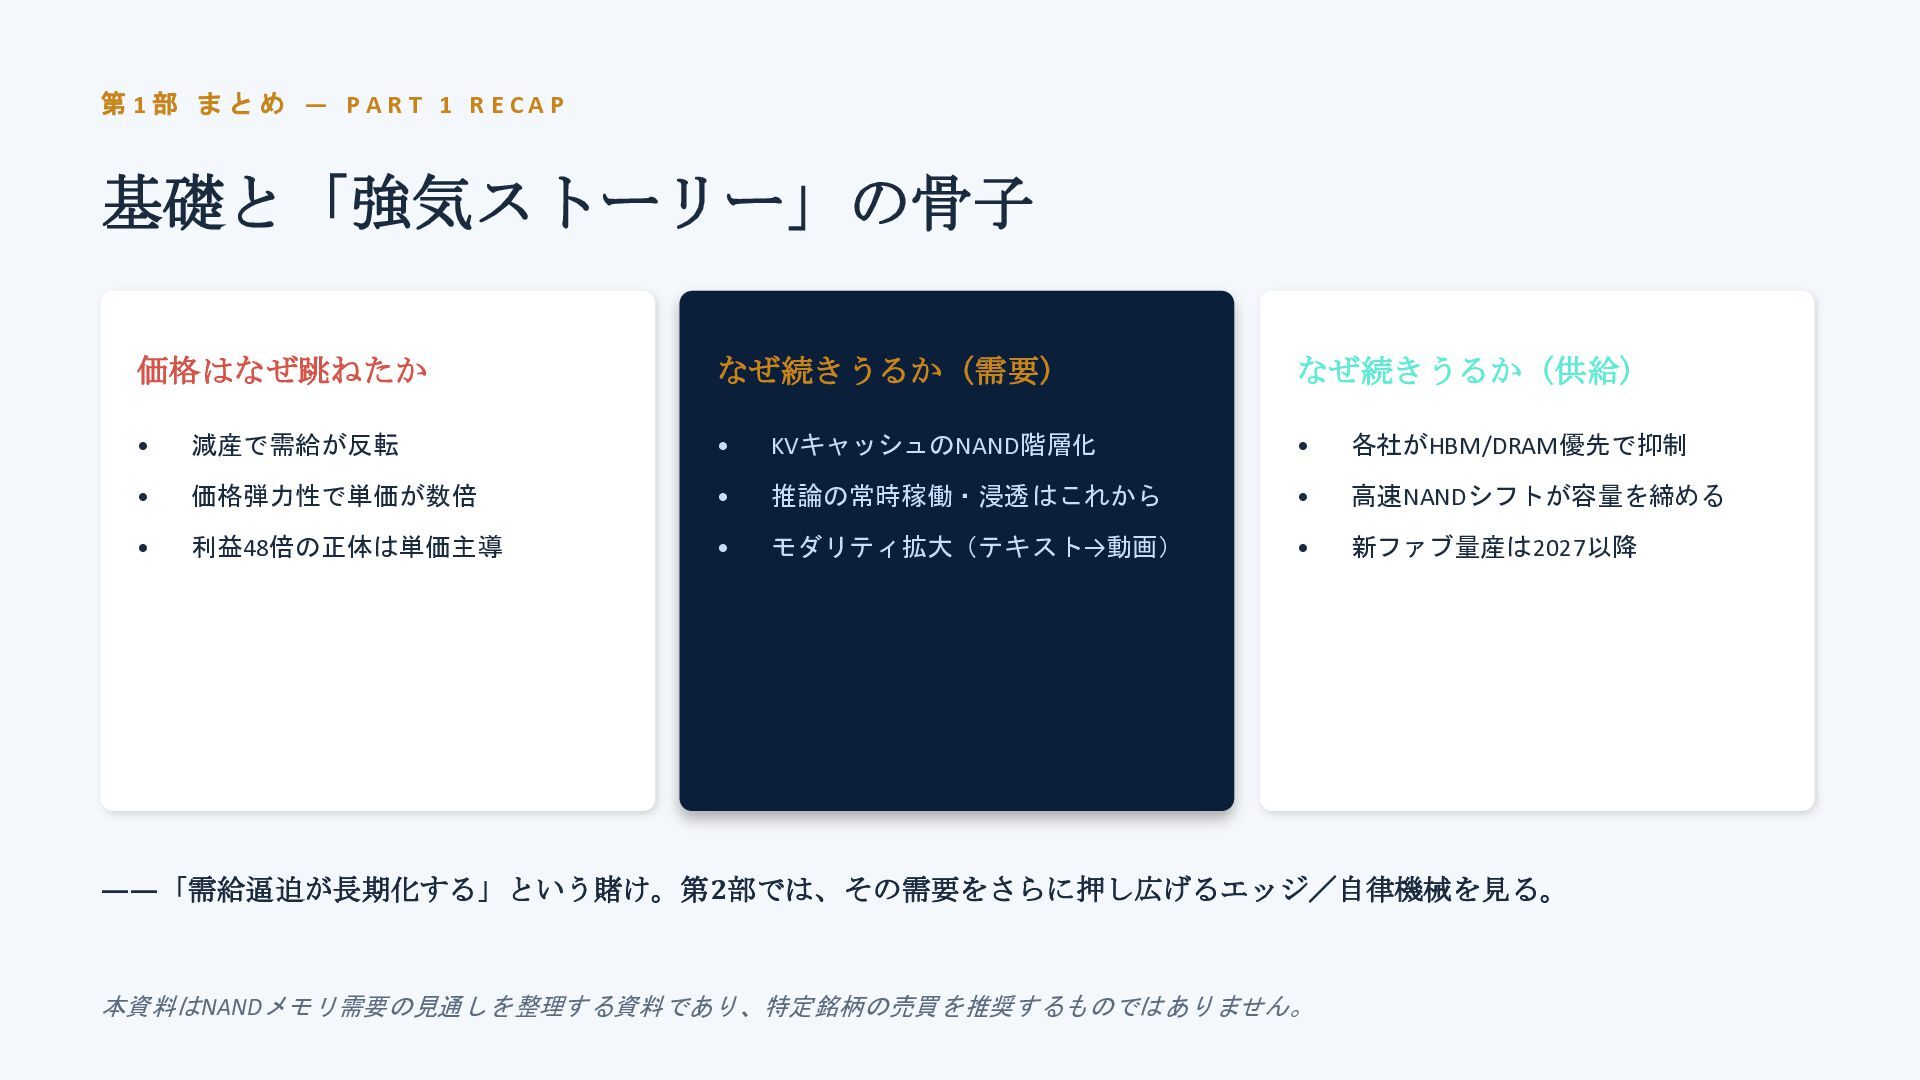
N G I N E 利益48倍の正体は「ビット単価」だった 48倍 Kioxia 純利益(FY27 Q1 予想 / 前年比) 2倍 ドル建てASP(1四半期で倍増) −10% ビット出荷量(むしろ減少) 供給を絞りながら、単価で稼いだ 利益48倍 = ①単価倍増(希少性プレミアム)× ②高採算SSD比率の上昇(50→60%)× ③前年の谷が分母(極小)。出荷ビットの 伸び(10%台後半)では説明できない、純粋な単価主導。
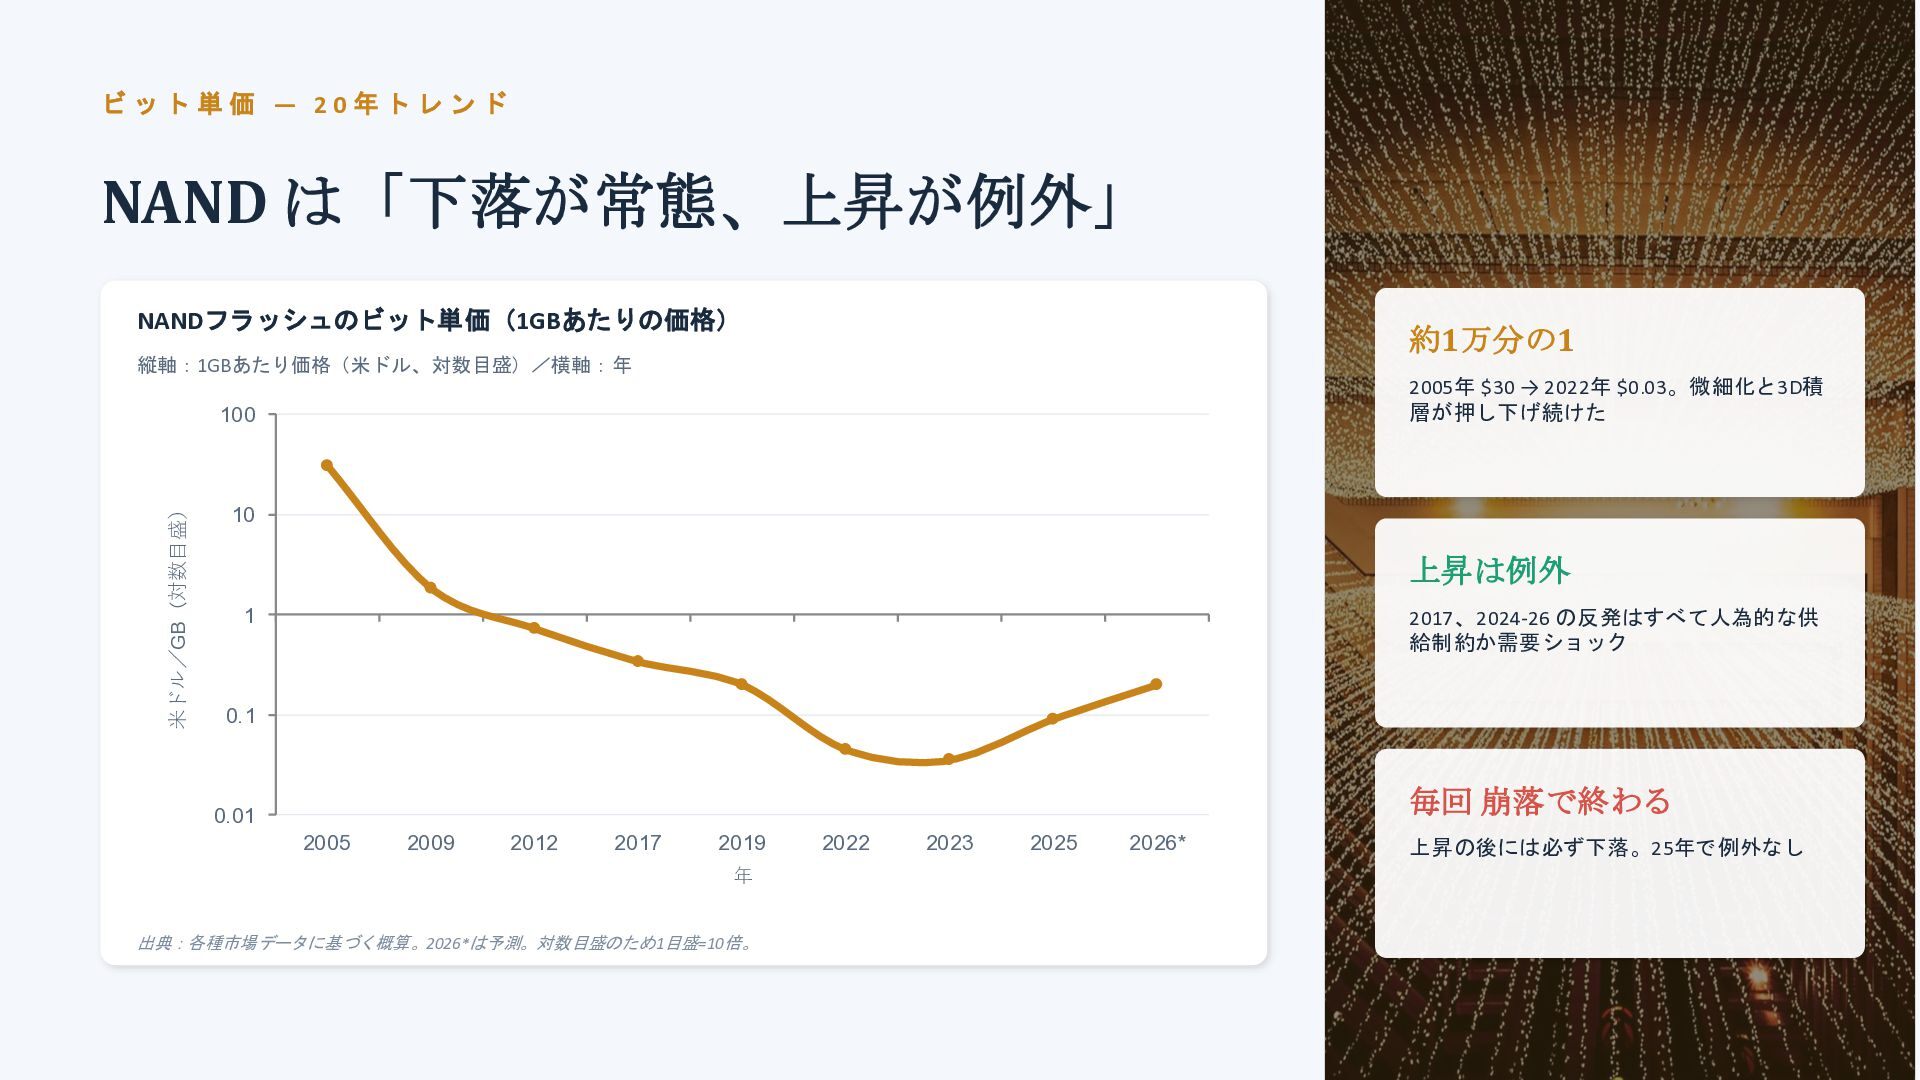
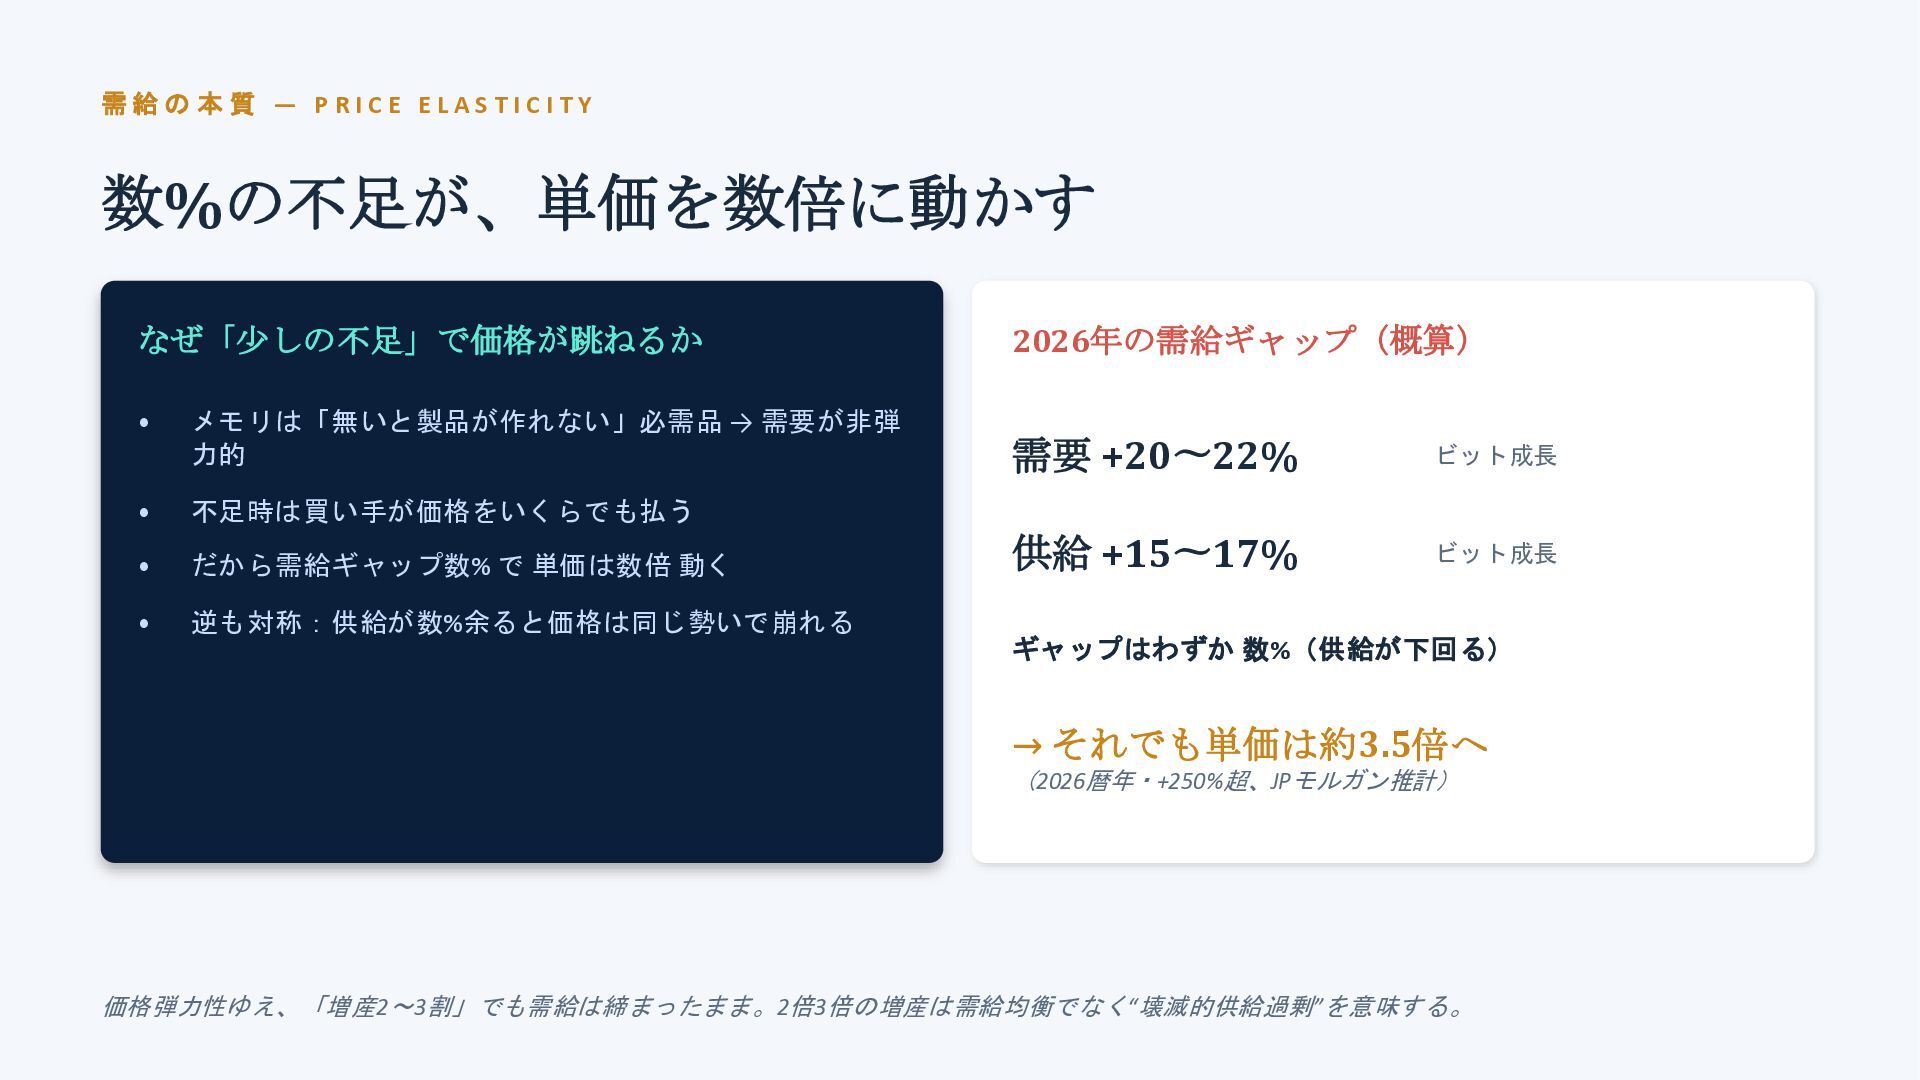
E E L A S T I C I T Y 数%の不足が、単価を数倍に動かす なぜ「少しの不足」で価格が跳ねるか • メモリは「無いと製品が作れない」必需品 → 需要が非弾 力的 • 不足時は買い手が価格をいくらでも払う • だから需給ギャップ数% で 単価は数倍 動く • 逆も対称:供給が数%余ると価格は同じ勢いで崩れる 2026年の需給ギャップ(概算) 需要 +20〜22% ビット成長 供給 +15〜17% ビット成長 ギャップはわずか 数%(供給が下回る) → それでも単価は約3.5倍へ (2026暦年・+250%超、JPモルガン推計) 価格弾力性ゆえ、「増産2〜3割」でも需給は締まったまま。2倍3倍の増産は需給均衡でなく“壊滅的供給過剰”を意味する。
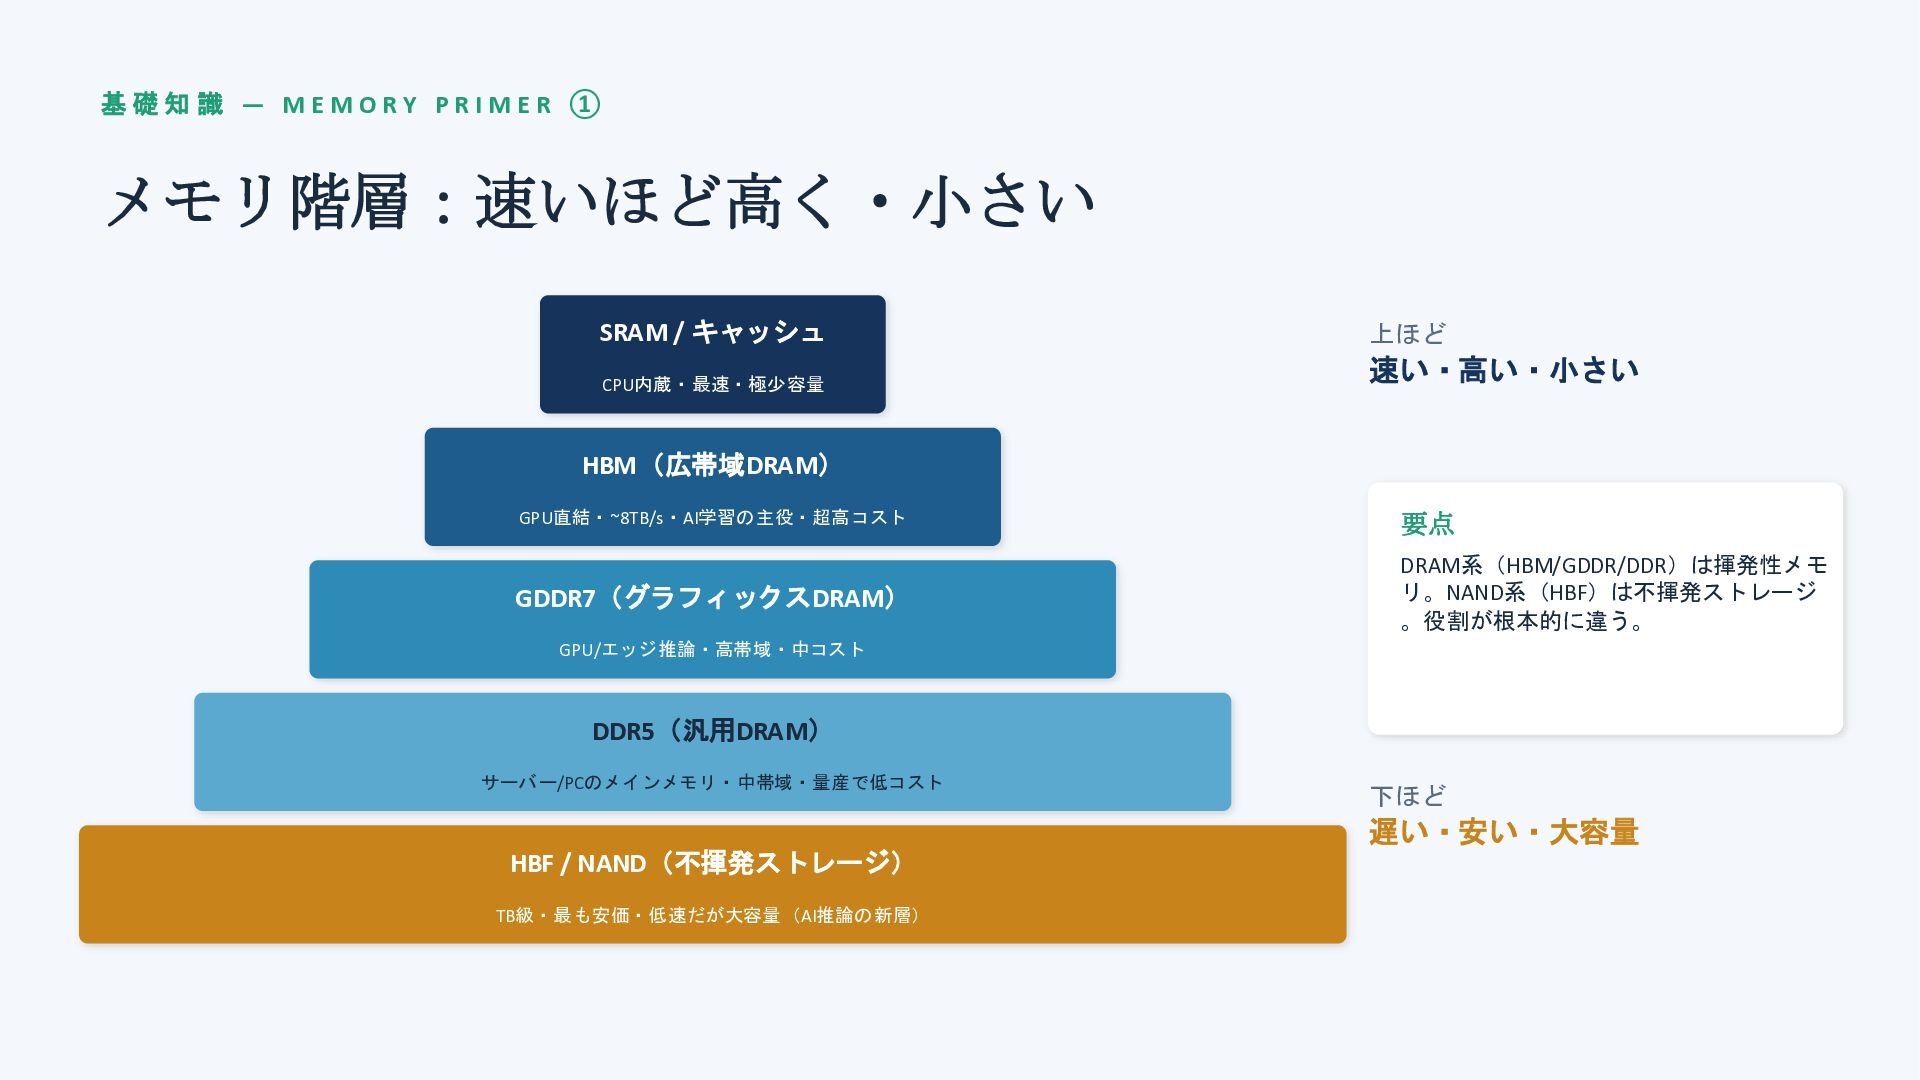
Y P R I M E R ① メモリ階層:速いほど高く・小さい SRAM / キャッシュ CPU内蔵・最速・極少容量 HBM(広帯域DRAM) GPU直結・~8TB/s・AI学習の主役・超高コスト GDDR7(グラフィックスDRAM) GPU/エッジ推論・高帯域・中コスト DDR5(汎用DRAM) サーバー/PCのメインメモリ・中帯域・量産で低コスト HBF / NAND(不揮発ストレージ) TB級・最も安価・低速だが大容量(AI推論の新層) 上ほど 速い・高い・小さい 下ほど 遅い・安い・大容量 要点 DRAM系(HBM/GDDR/DDR)は揮発性メモ リ。NAND系(HBF)は不揮発ストレージ 。役割が根本的に違う。
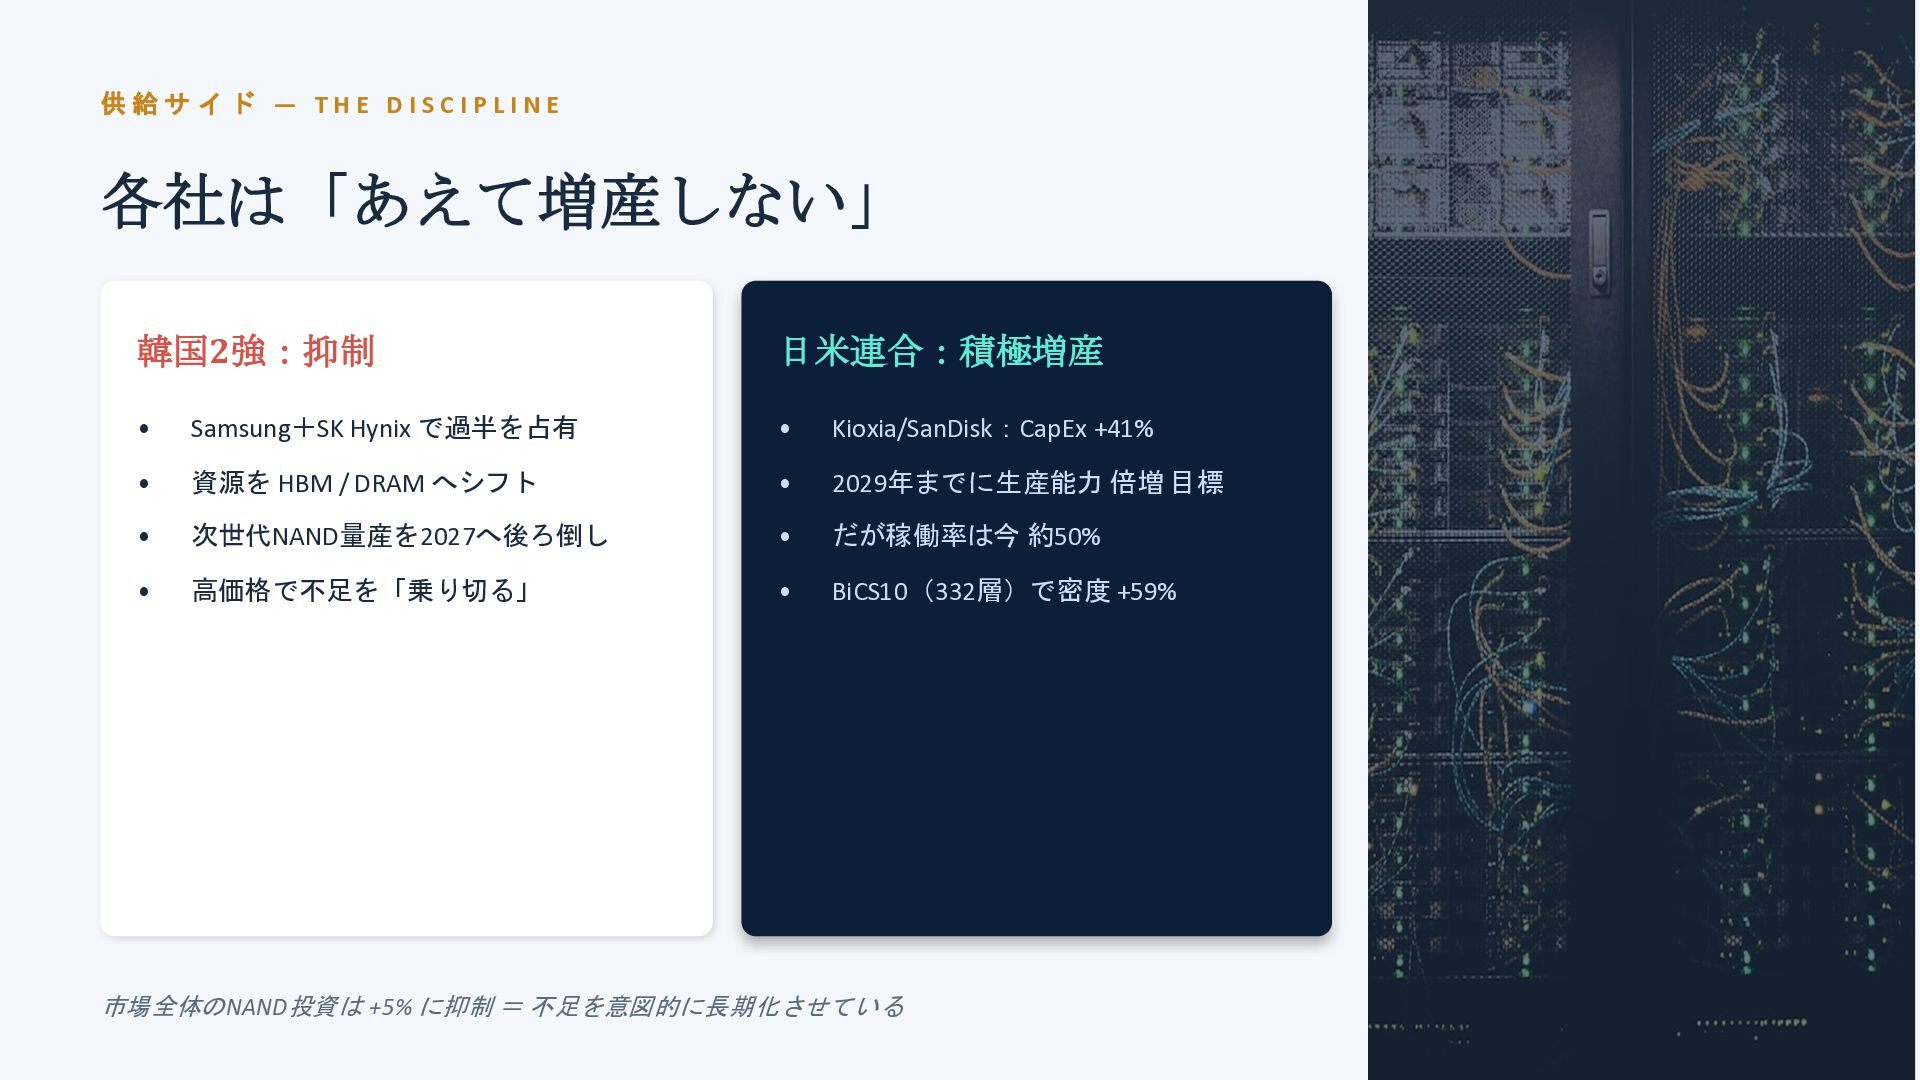
I S C I P L I N E 各社は「あえて増産しない」 韓国2強:抑制 • Samsung+SK Hynix で過半を占有 • 資源を HBM / DRAM へシフト • 次世代NAND量産を2027へ後ろ倒し • 高価格で不足を「乗り切る」 日米連合:積極増産 • Kioxia/SanDisk:CapEx +41% • 2029年までに生産能力 倍増 目標 • だが稼働率は今 約50% • BiCS10(332層)で密度 +59% 市場全体のNAND投資は +5% に抑制 = 不足を意図的に長期化させている
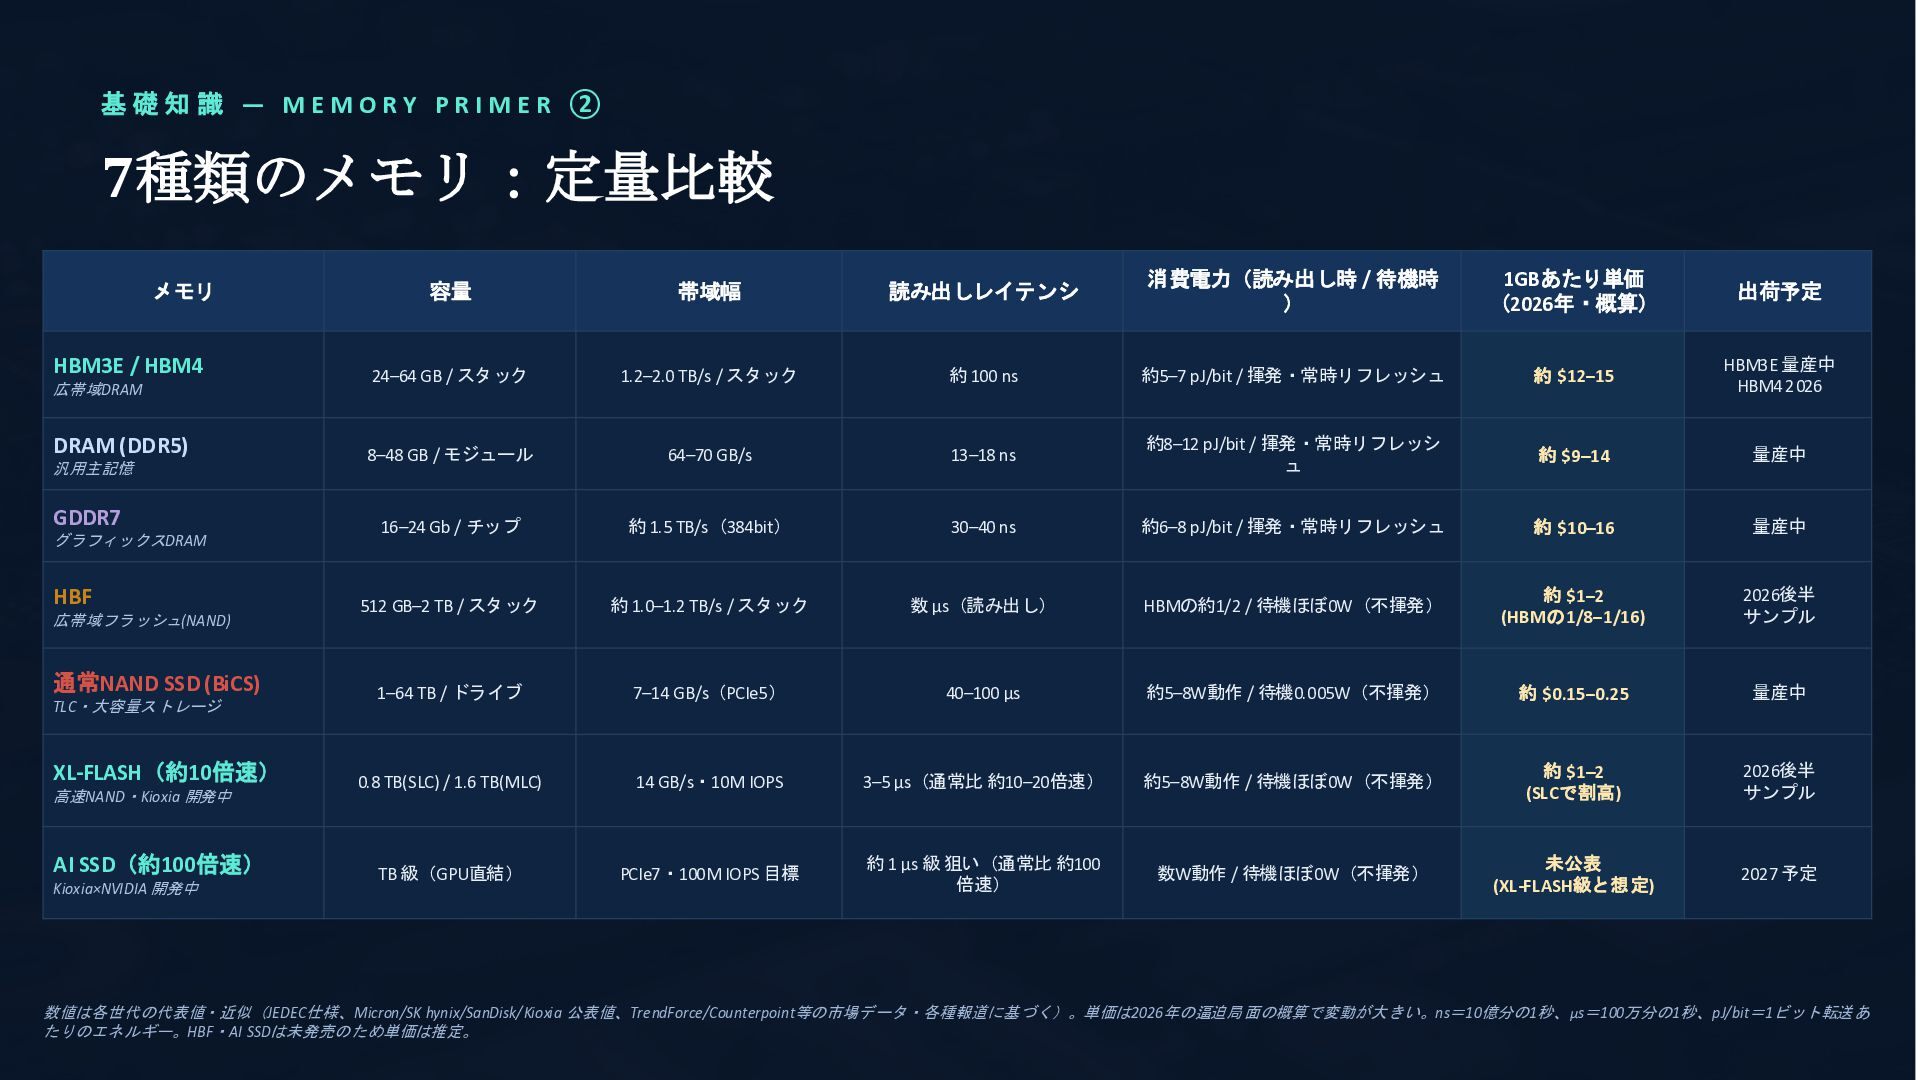
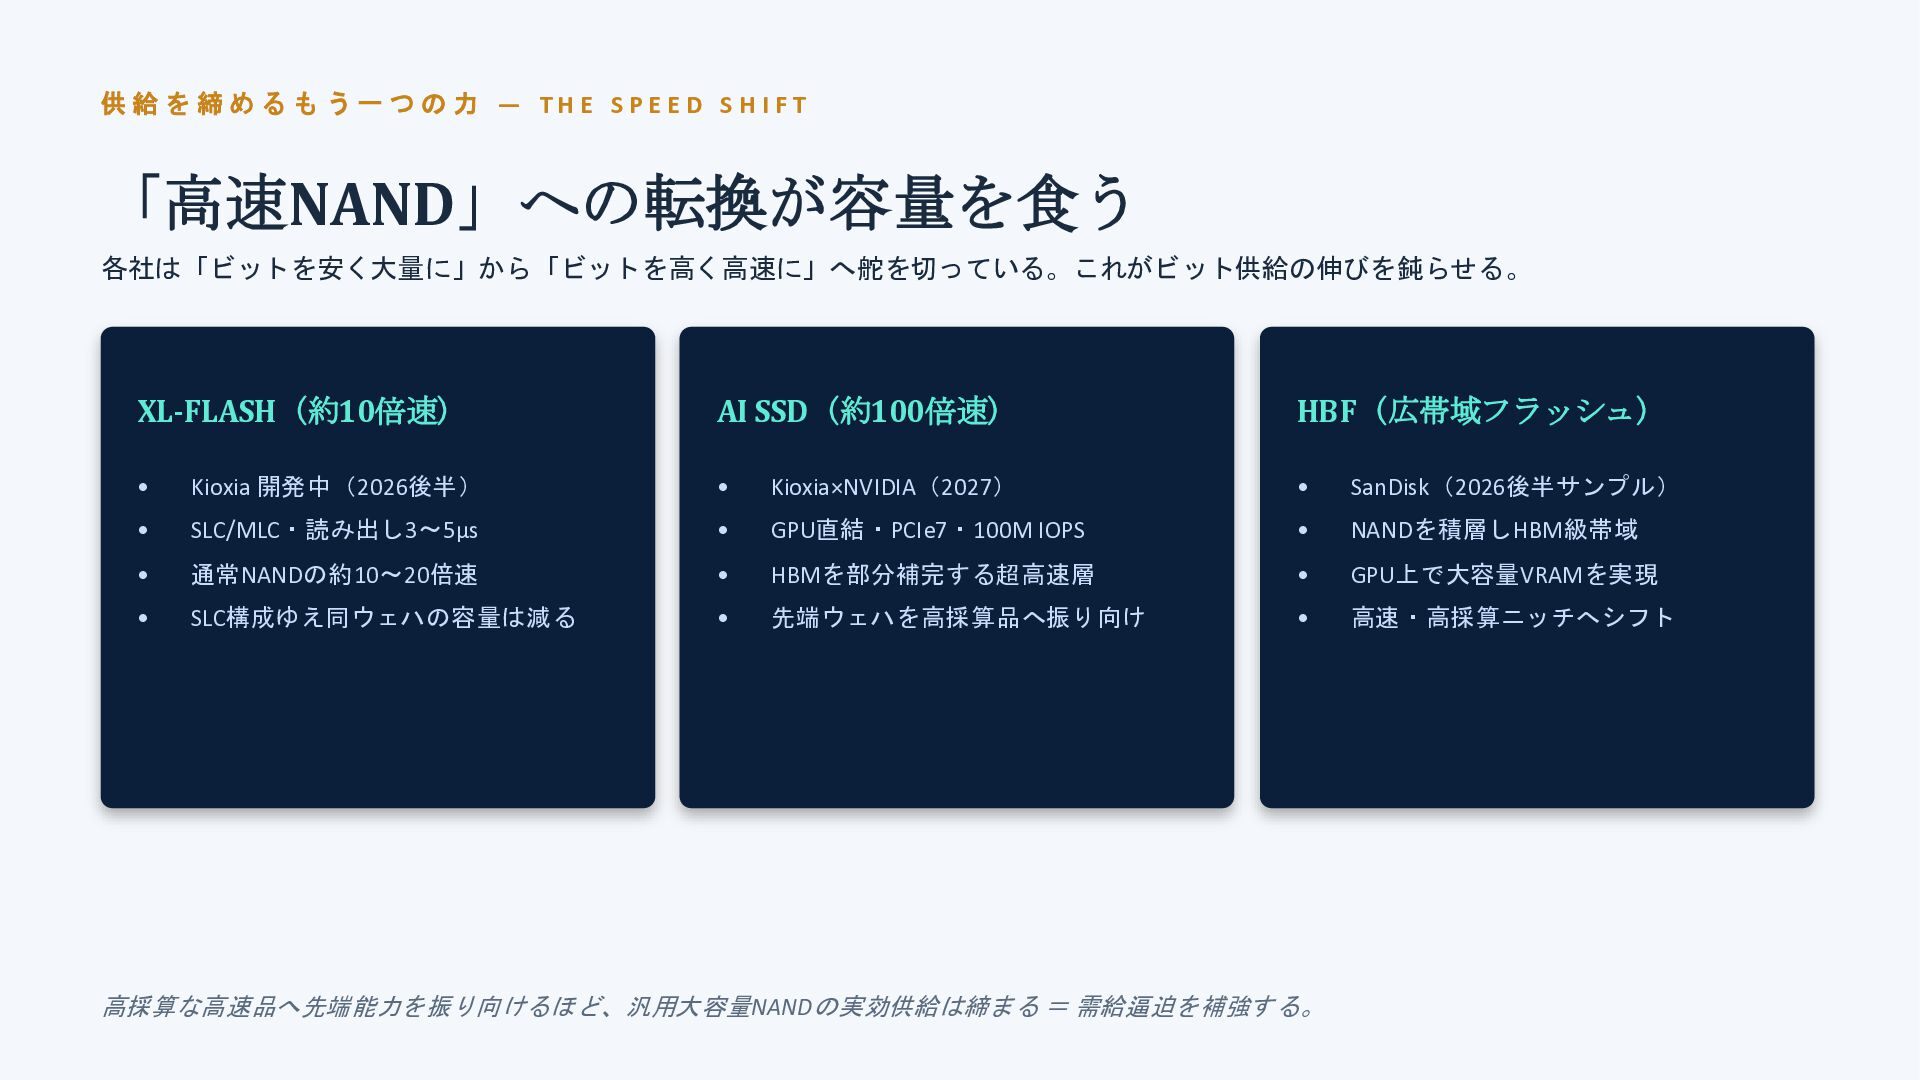
の 力 — T H E S P E E D S H I F T 「高速NAND」への転換が容量を食う 各社は「ビットを安く大量に」から「ビットを高く高速に」へ舵を切っている。これがビット供給の伸びを鈍らせる。 XL-FLASH(約10倍速) • Kioxia 開発中(2026後半) • SLC/MLC・読み出し3〜5μs • 通常NANDの約10〜20倍速 • SLC構成ゆえ同ウェハの容量は減る AI SSD(約100倍速) • Kioxia×NVIDIA(2027) • GPU直結・PCIe7・100M IOPS • HBMを部分補完する超高速層 • 先端ウェハを高採算品へ振り向け HBF(広帯域フラッシュ) • SanDisk(2026後半サンプル) • NANDを積層しHBM級帯域 • GPU上で大容量VRAMを実現 • 高速・高採算ニッチへシフト 高採算な高速品へ先端能力を振り向けるほど、汎用大容量NANDの実効供給は締まる = 需給逼迫を補強する。
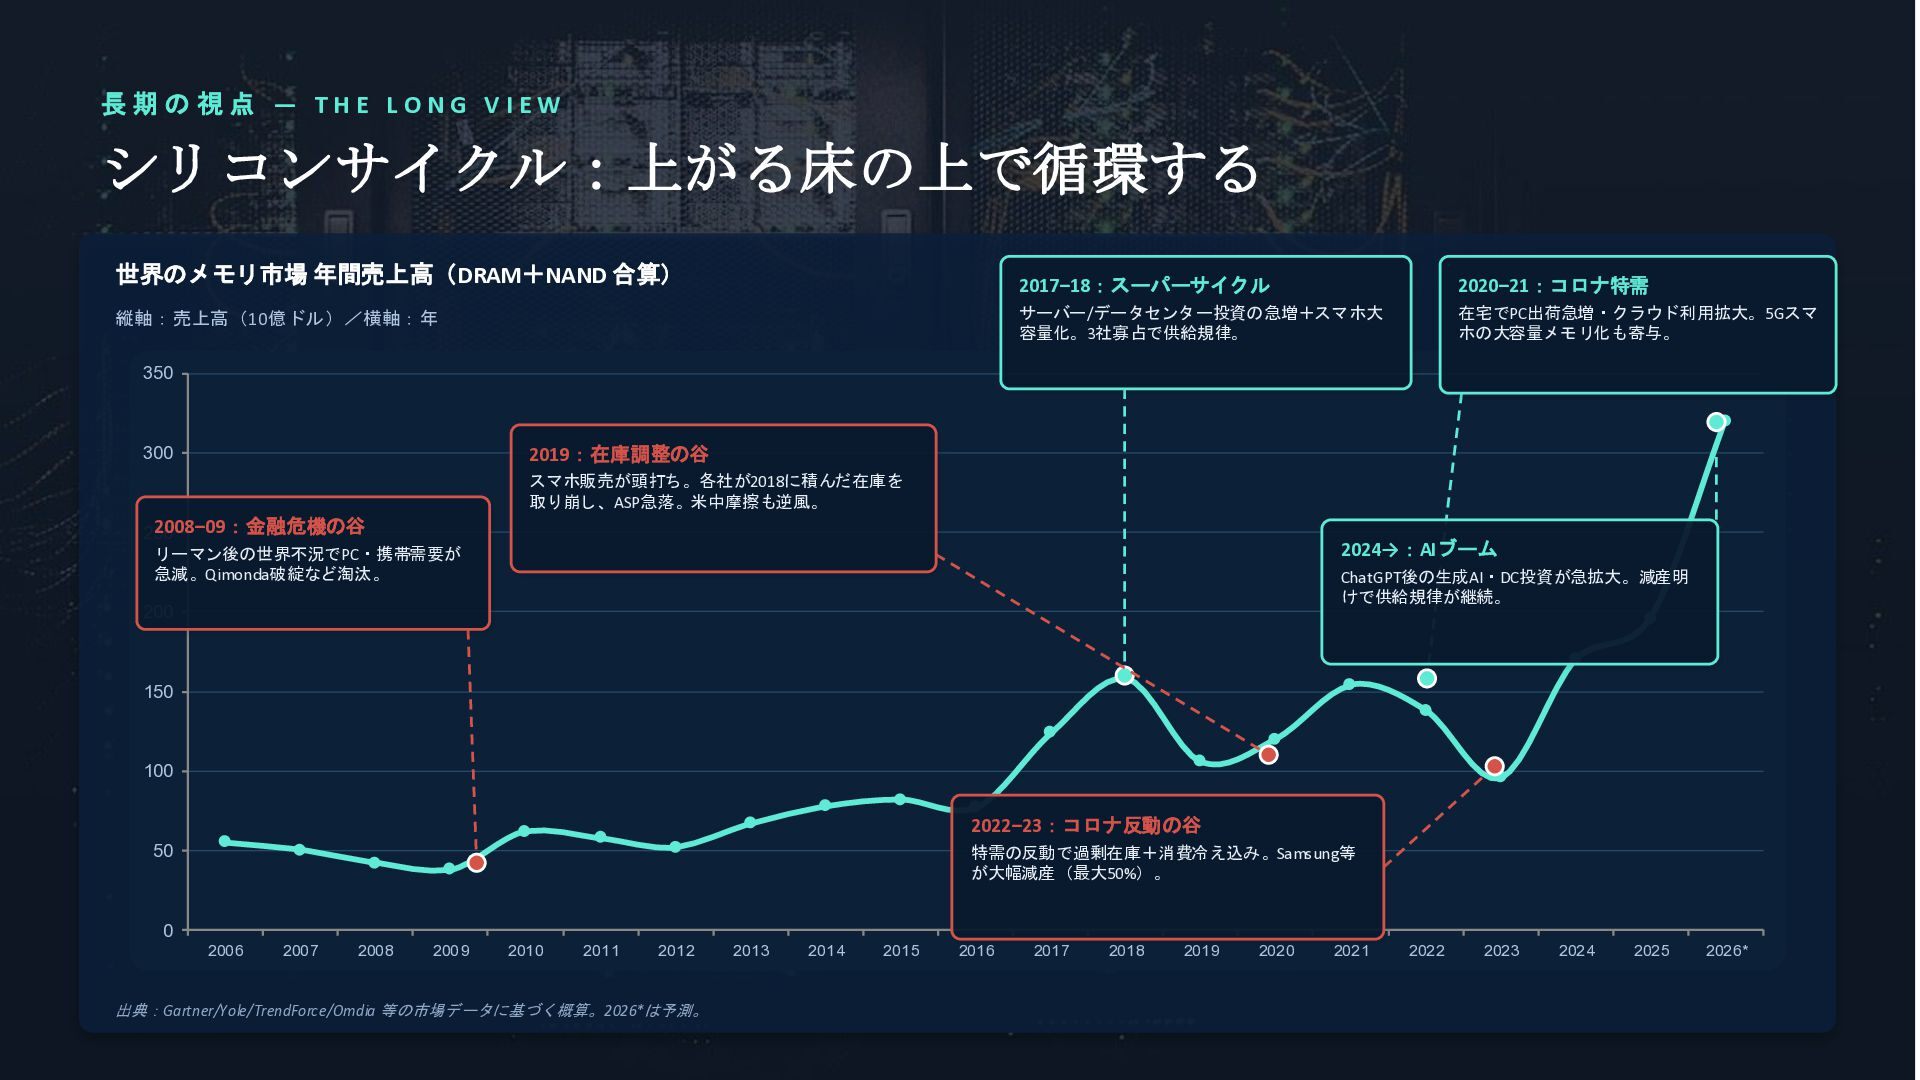
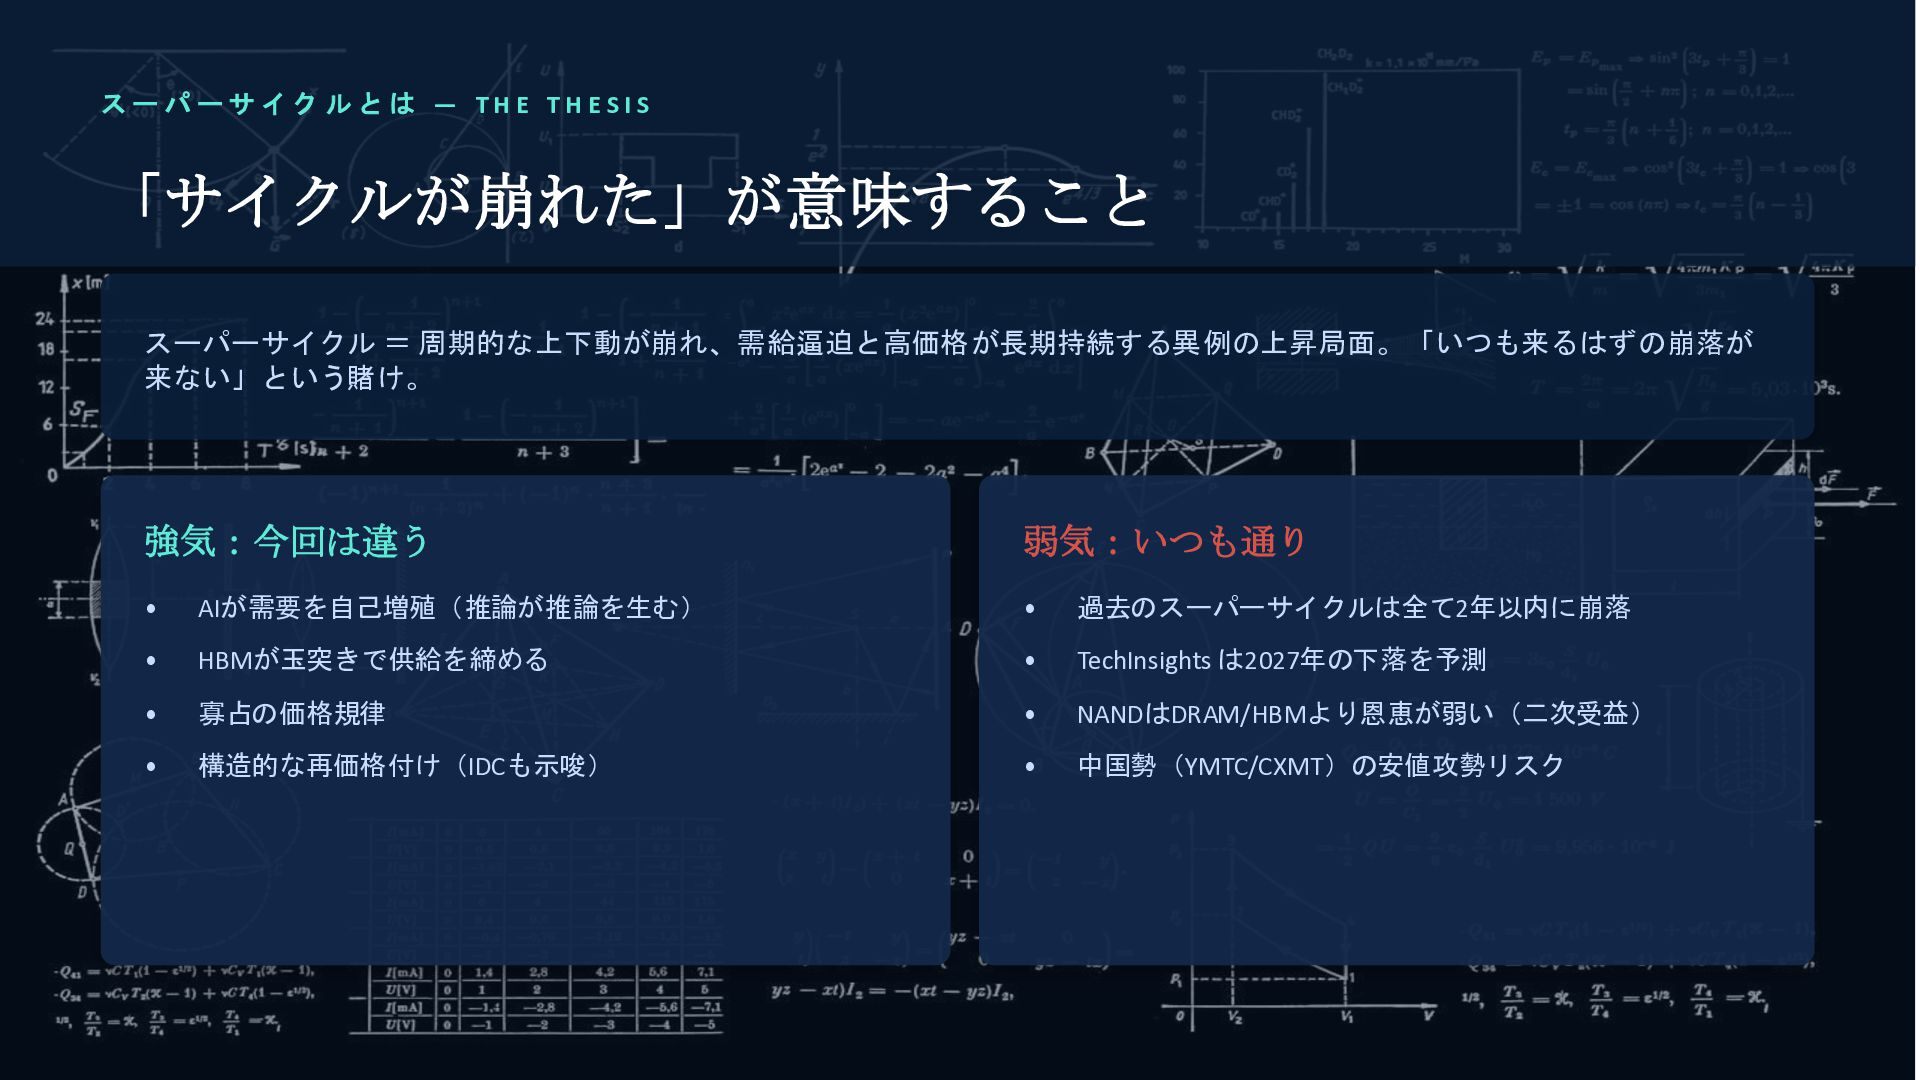
— T H E T H E S I S 「サイクルが崩れた」が意味すること スーパーサイクル = 周期的な上下動が崩れ、需給逼迫と高価格が長期持続する異例の上昇局面。「いつも来るはずの崩落が 来ない」という賭け。 強気:今回は違う • AIが需要を自己増殖(推論が推論を生む) • HBMが玉突きで供給を締める • 寡占の価格規律 • 構造的な再価格付け(IDCも示唆) 弱気:いつも通り • 過去のスーパーサイクルは全て2年以内に崩落 • TechInsights は2027年の下落を予測 • NANDはDRAM/HBMより恩恵が弱い(二次受益) • 中国勢(YMTC/CXMT)の安値攻勢リスク
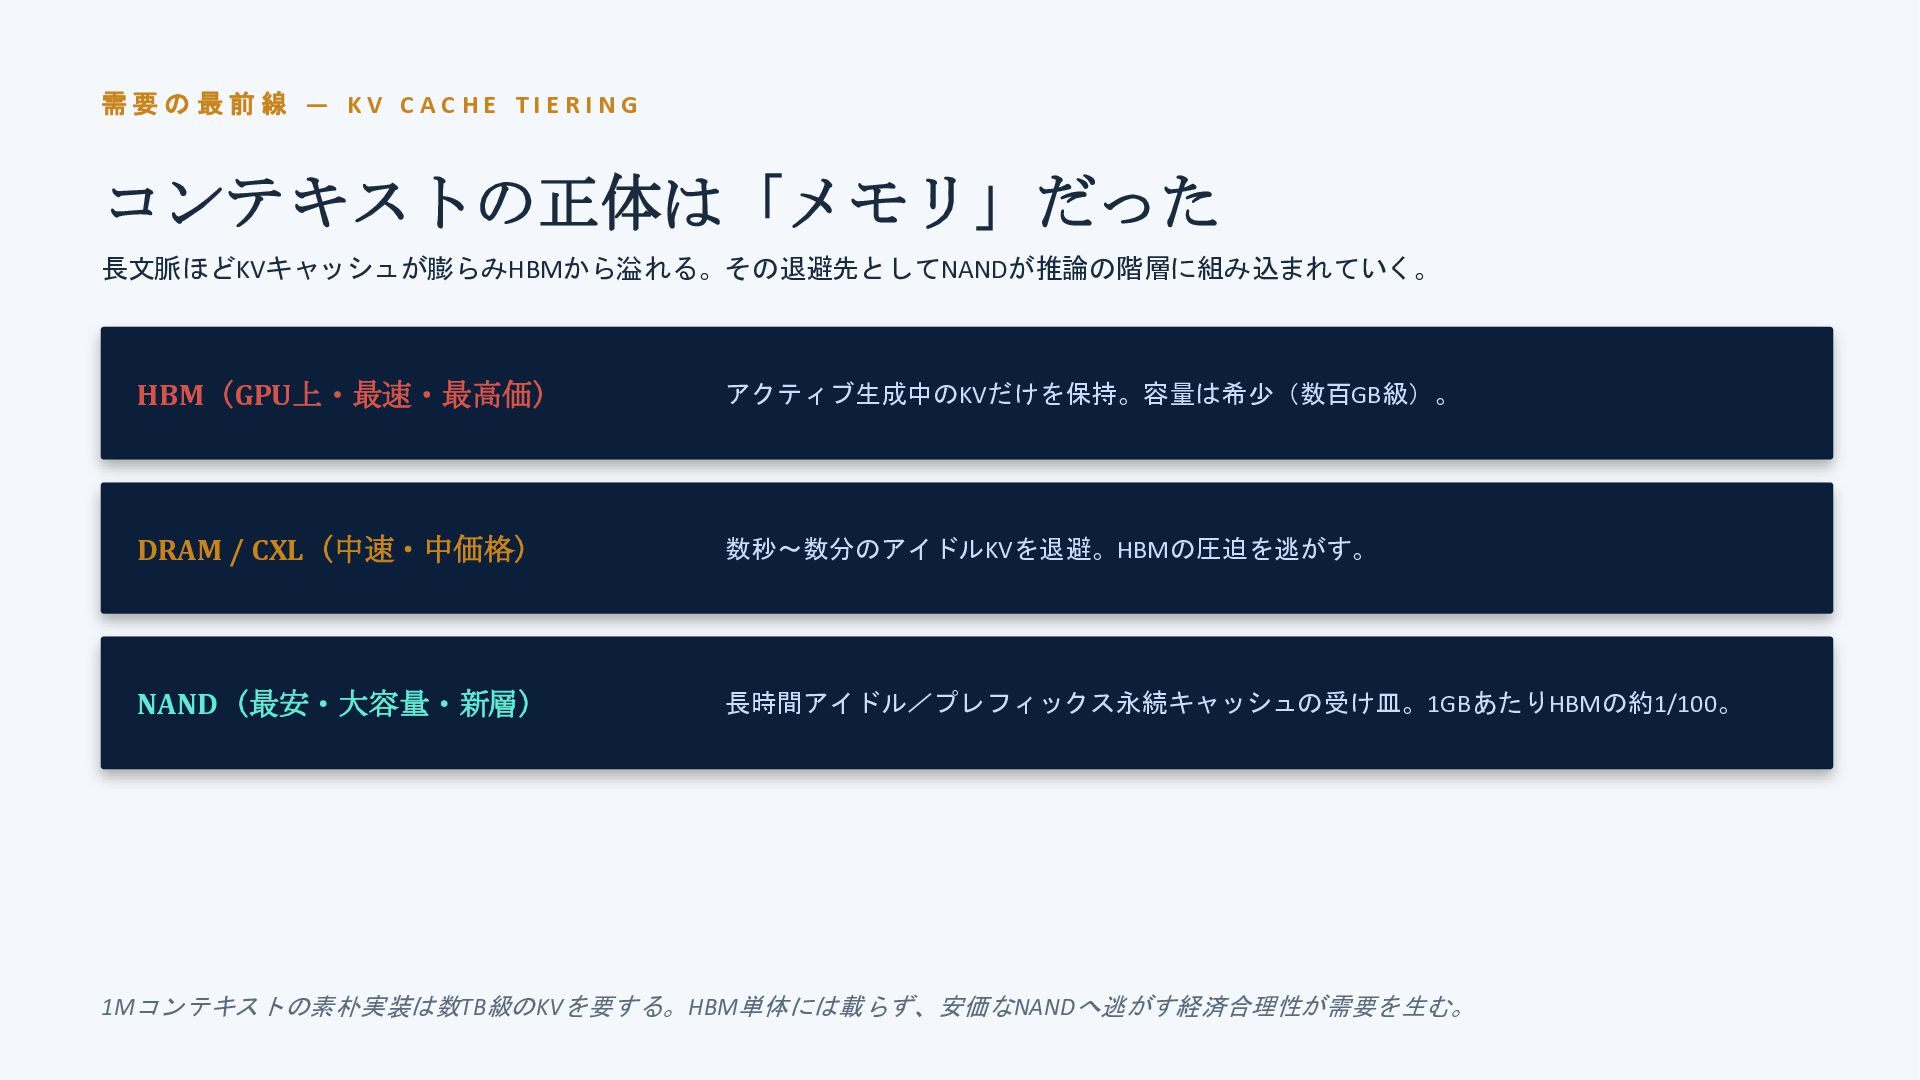
A C H E T I E R I N G コンテキストの正体は「メモリ」だった 長文脈ほどKVキャッシュが膨らみHBMから溢れる。その退避先としてNANDが推論の階層に組み込まれていく。 HBM(GPU上・最速・最高価) アクティブ生成中のKVだけを保持。容量は希少(数百GB級)。 DRAM / CXL(中速・中価格) 数秒〜数分のアイドルKVを退避。HBMの圧迫を逃がす。 NAND(最安・大容量・新層) 長時間アイドル/プレフィックス永続キャッシュの受け皿。1GBあたりHBMの約1/100。 1Mコンテキストの素朴実装は数TB級のKVを要する。HBM単体には載らず、安価なNANDへ逃がす経済合理性が需要を生む。
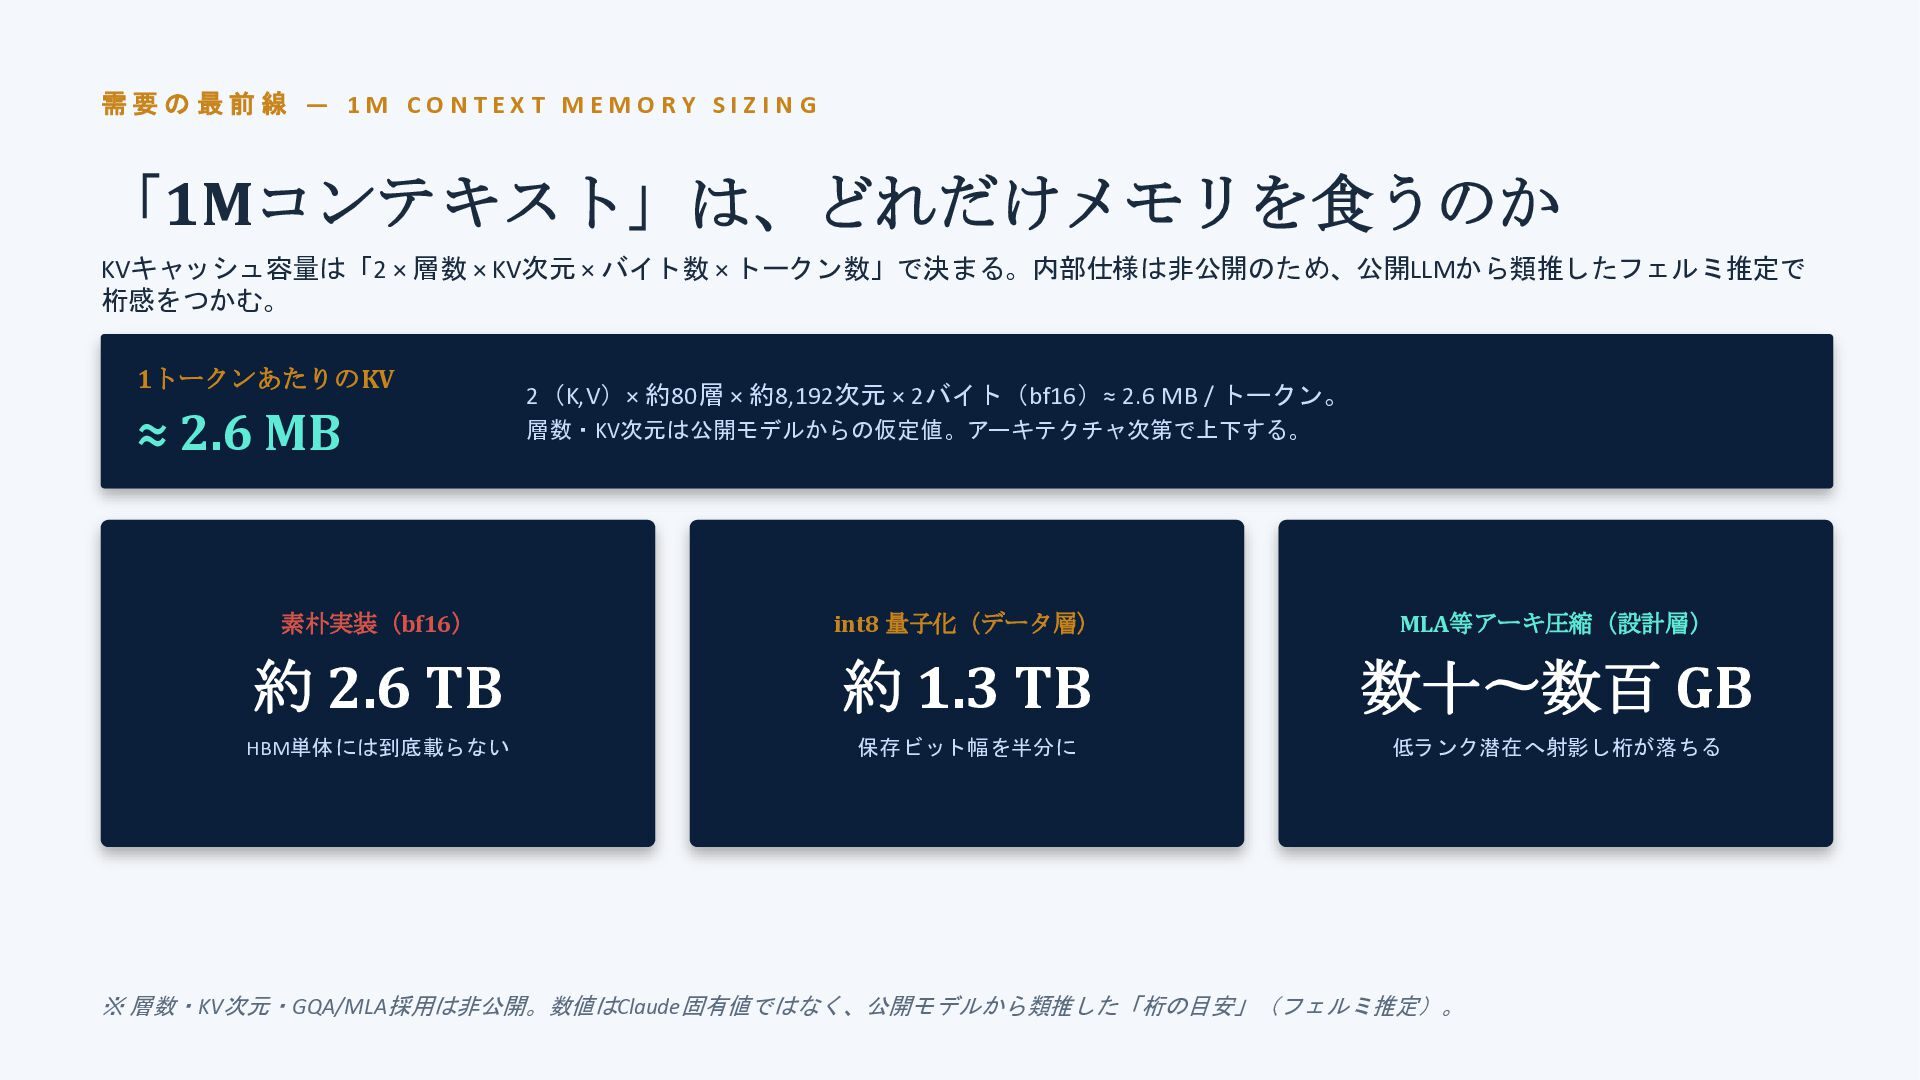
O N T E X T M E M O R Y S I Z I N G 「1Mコンテキスト」は、どれだけメモリを食うのか KVキャッシュ容量は「2 × 層数 × KV次元 × バイト数 × トークン数」で決まる。内部仕様は非公開のため、公開LLMから類推したフェルミ推定で 桁感をつかむ。 1トークンあたりのKV ≈ 2.6 MB 2(K,V)× 約80層 × 約8,192次元 × 2バイト(bf16)≈ 2.6 MB / トークン。 層数・KV次元は公開モデルからの仮定値。アーキテクチャ次第で上下する。 素朴実装(bf16) 約 2.6 TB HBM単体には到底載らない int8 量子化(データ層) 約 1.3 TB 保存ビット幅を半分に MLA等アーキ圧縮(設計層) 数十〜数百 GB 低ランク潜在へ射影し桁が落ちる ※ 層数・KV次元・GQA/MLA採用は非公開。数値はClaude固有値ではなく、公開モデルから類推した「桁の目安」(フェルミ推定)。
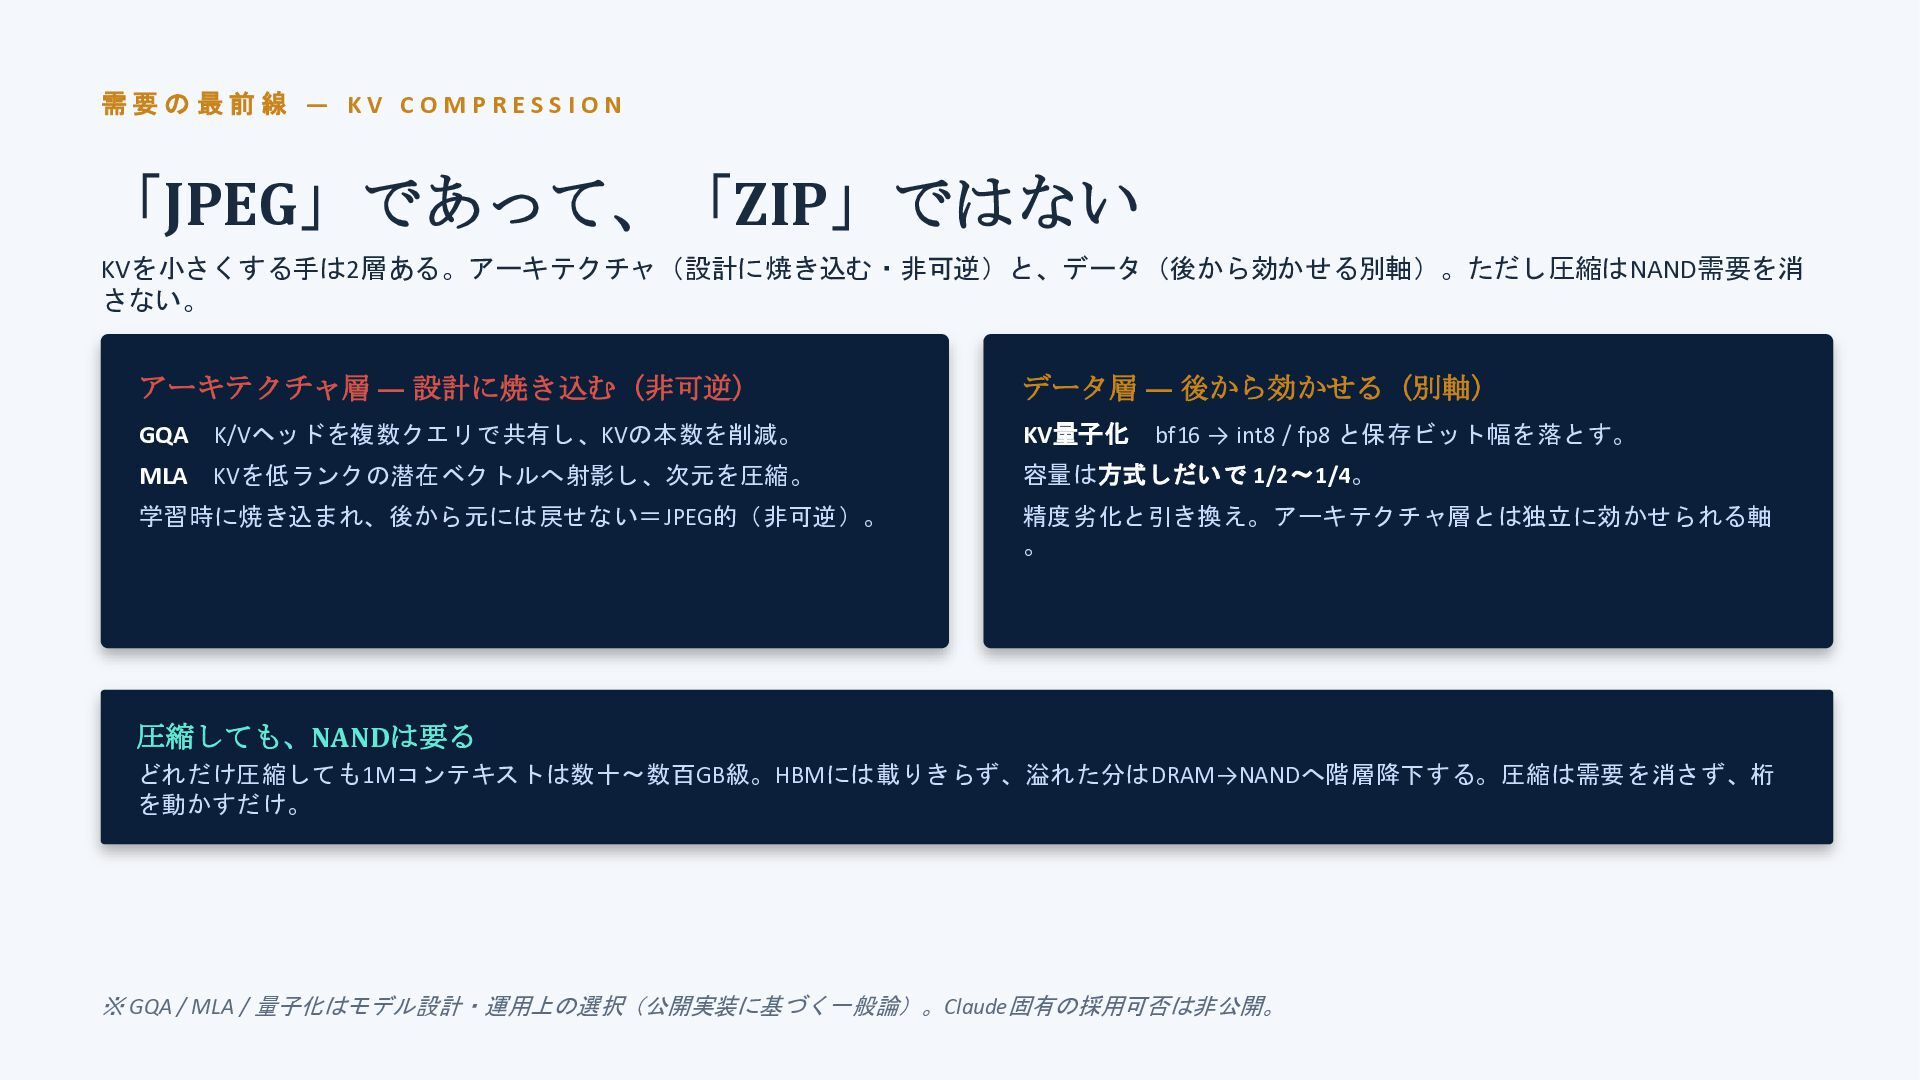
O M P R E S S I O N 「JPEG」であって、「ZIP」ではない KVを小さくする手は2層ある。アーキテクチャ(設計に焼き込む・非可逆)と、データ(後から効かせる別軸)。ただし圧縮はNAND需要を消 さない。 アーキテクチャ層 — 設計に焼き込む(非可逆) GQA K/Vヘッドを複数クエリで共有し、KVの本数を削減。 MLA KVを低ランクの潜在ベクトルへ射影し、次元を圧縮。 学習時に焼き込まれ、後から元には戻せない=JPEG的(非可逆)。 データ層 — 後から効かせる(別軸) KV量子化 bf16 → int8 / fp8 と保存ビット幅を落とす。 容量は方式しだいで 1/2〜1/4。 精度劣化と引き換え。アーキテクチャ層とは独立に効かせられる軸 。 圧縮しても、NANDは要る どれだけ圧縮しても1Mコンテキストは数十〜数百GB級。HBMには載りきらず、溢れた分はDRAM→NANDへ階層降下する。圧縮は需要を消さず、桁 を動かすだけ。 ※ GQA / MLA / 量子化はモデル設計・運用上の選択(公開実装に基づく一般論)。Claude固有の採用可否は非公開。
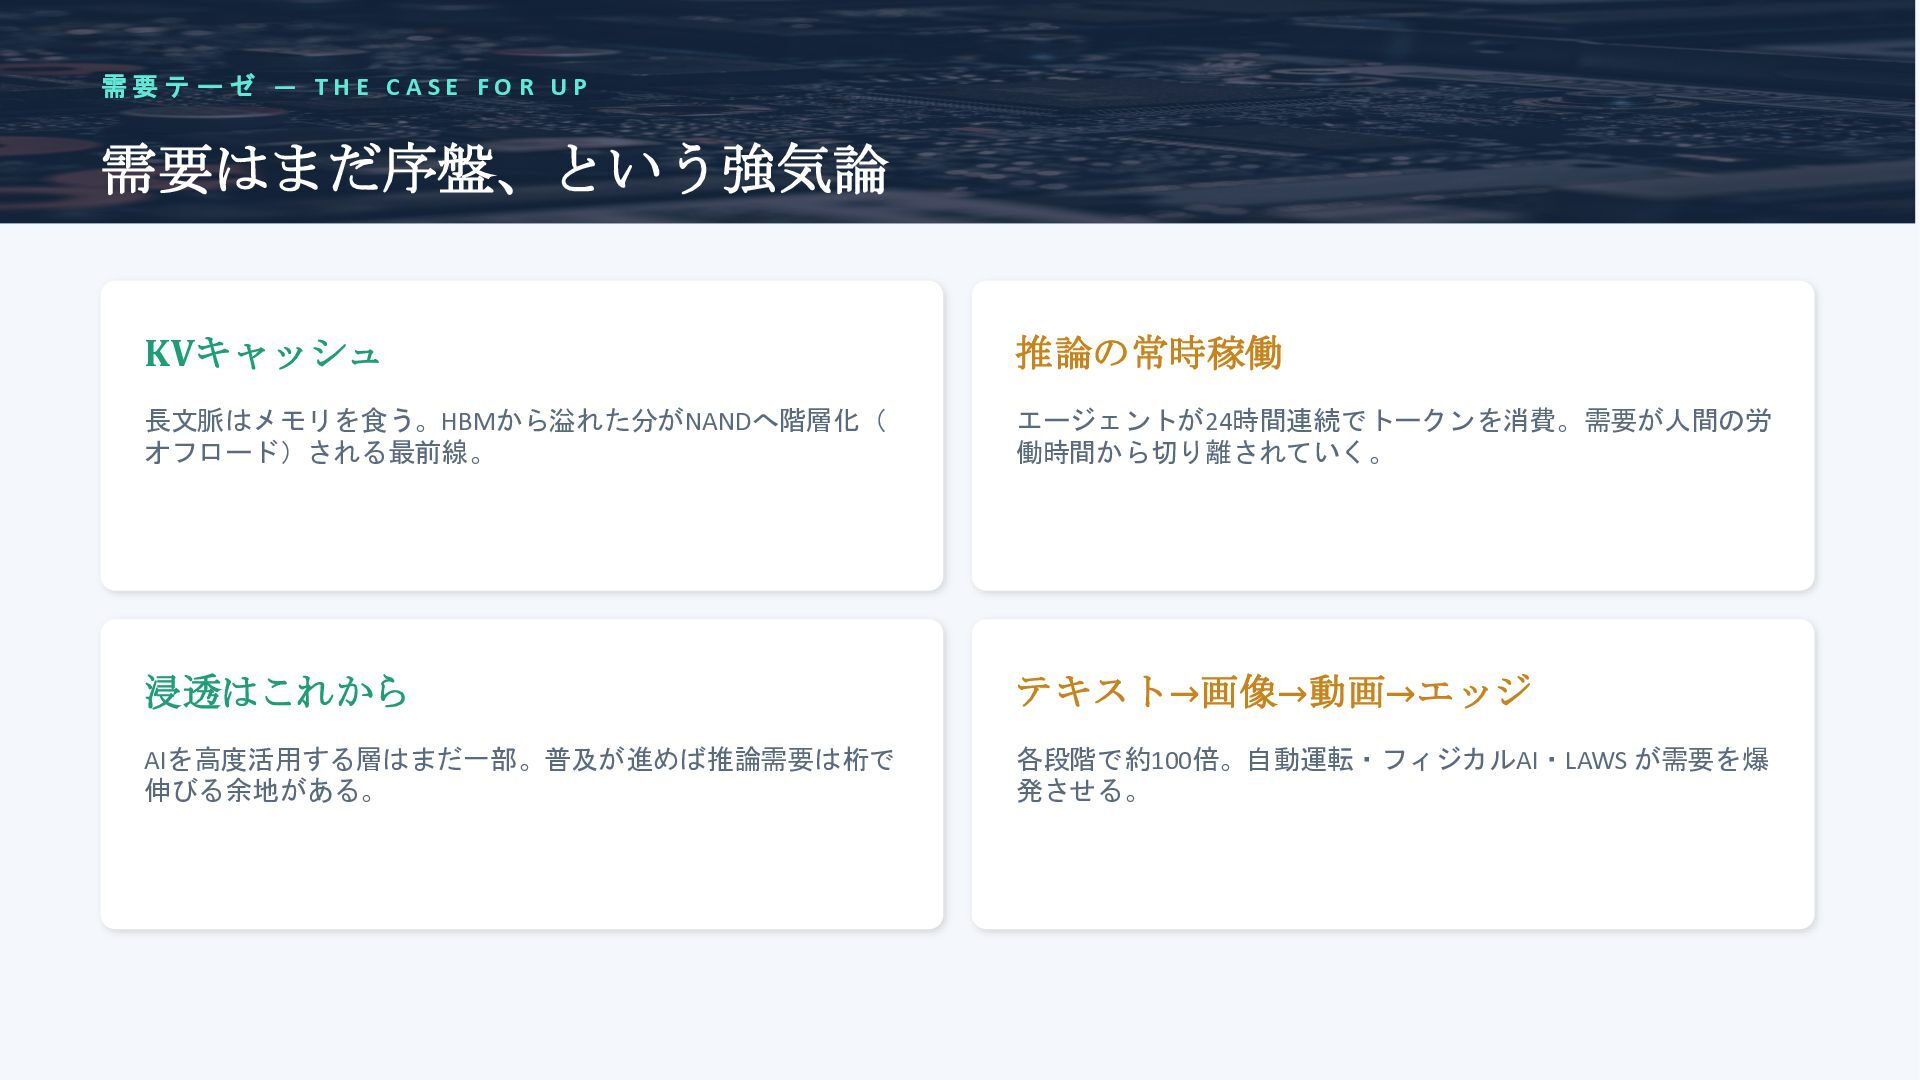
A S E F O R U P 需要はまだ序盤、という強気論 KVキャッシュ 長文脈はメモリを食う。HBMから溢れた分がNANDへ階層化( オフロード)される最前線。 推論の常時稼働 エージェントが24時間連続でトークンを消費。需要が人間の労 働時間から切り離されていく。 浸透はこれから AIを高度活用する層はまだ一部。普及が進めば推論需要は桁で 伸びる余地がある。 テキスト→画像→動画→エッジ 各段階で約100倍。自動運転・フィジカルAI・LAWS が需要を爆 発させる。


 topaz2
 pfn
 yut0naga1_fa
 ykanoh
 codmoninc
 taketakekaho
 shumei_ito
 sansantech
 hiracky16
 4o1sobblue
 glaforge
 grimoh
 willnet
 keavy
 addyosmani
 lauravandoore
 tmiket
 danielanewman
 csswizardry
 akashhashmi
 maggiecrowley
 asonas
 frankvandijk
 smashingmag