Share
Embed
Transcript
52 slides
-
⾃自⼰己紹介 l 海野 裕也 (@unnonouno) l Jubatusチームリーダー l 分散オンライン機械学習基盤 l
2011年年4⽉月からPFIにJOIN 専⾨門 l ⾃自然⾔言語処理理 l テキストマイニング -
宣伝 l 明後⽇日 5/18(⼟土)にTwitter研究会@フューチャーアー キテクトで発表します l 6/2(⽇日)にJubatus Casual Talks #1を開催します
l すでに定員に達してしまいましたが、増員あるカモ l 発表者、LTも募集中 3 -
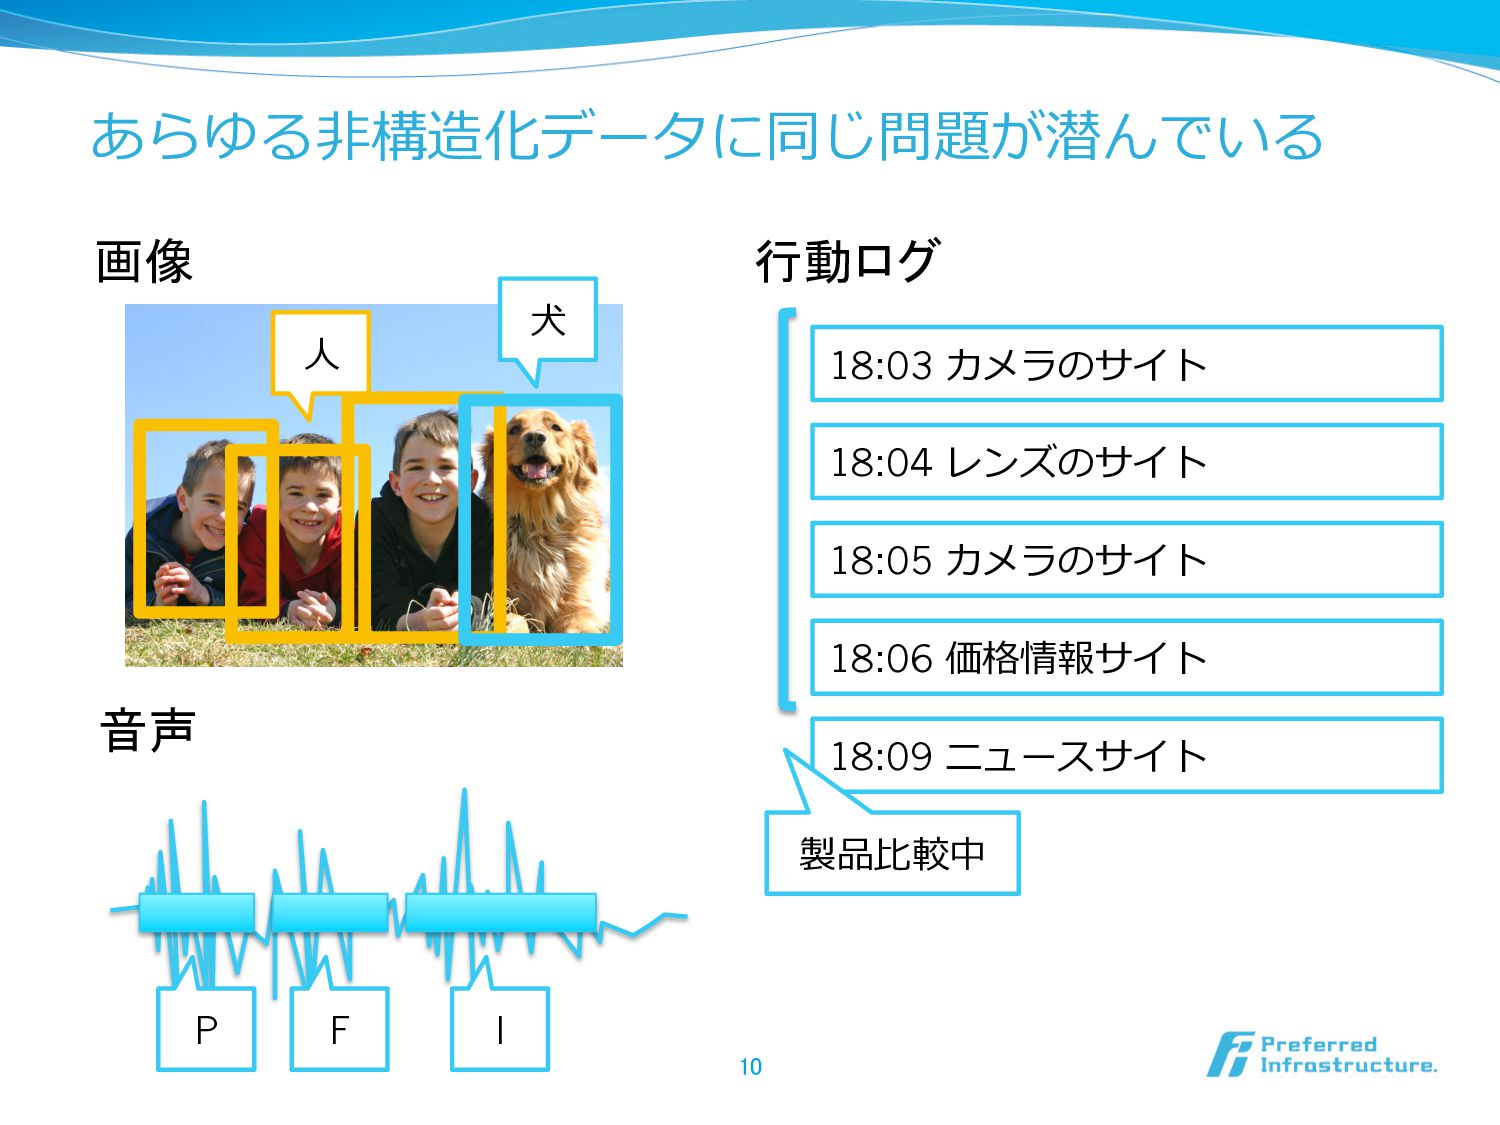
あらゆる⾮非構造化データに同じ問題が潜んでいる 10 画像 ⼈人 ⽝犬 音声 行動ログ P F I
18:03 カメラのサイト 18:04 レンズのサイト 18:05 カメラのサイト 18:06 価格情報サイト 18:09 ニュースサイト 製品⽐比較中 -
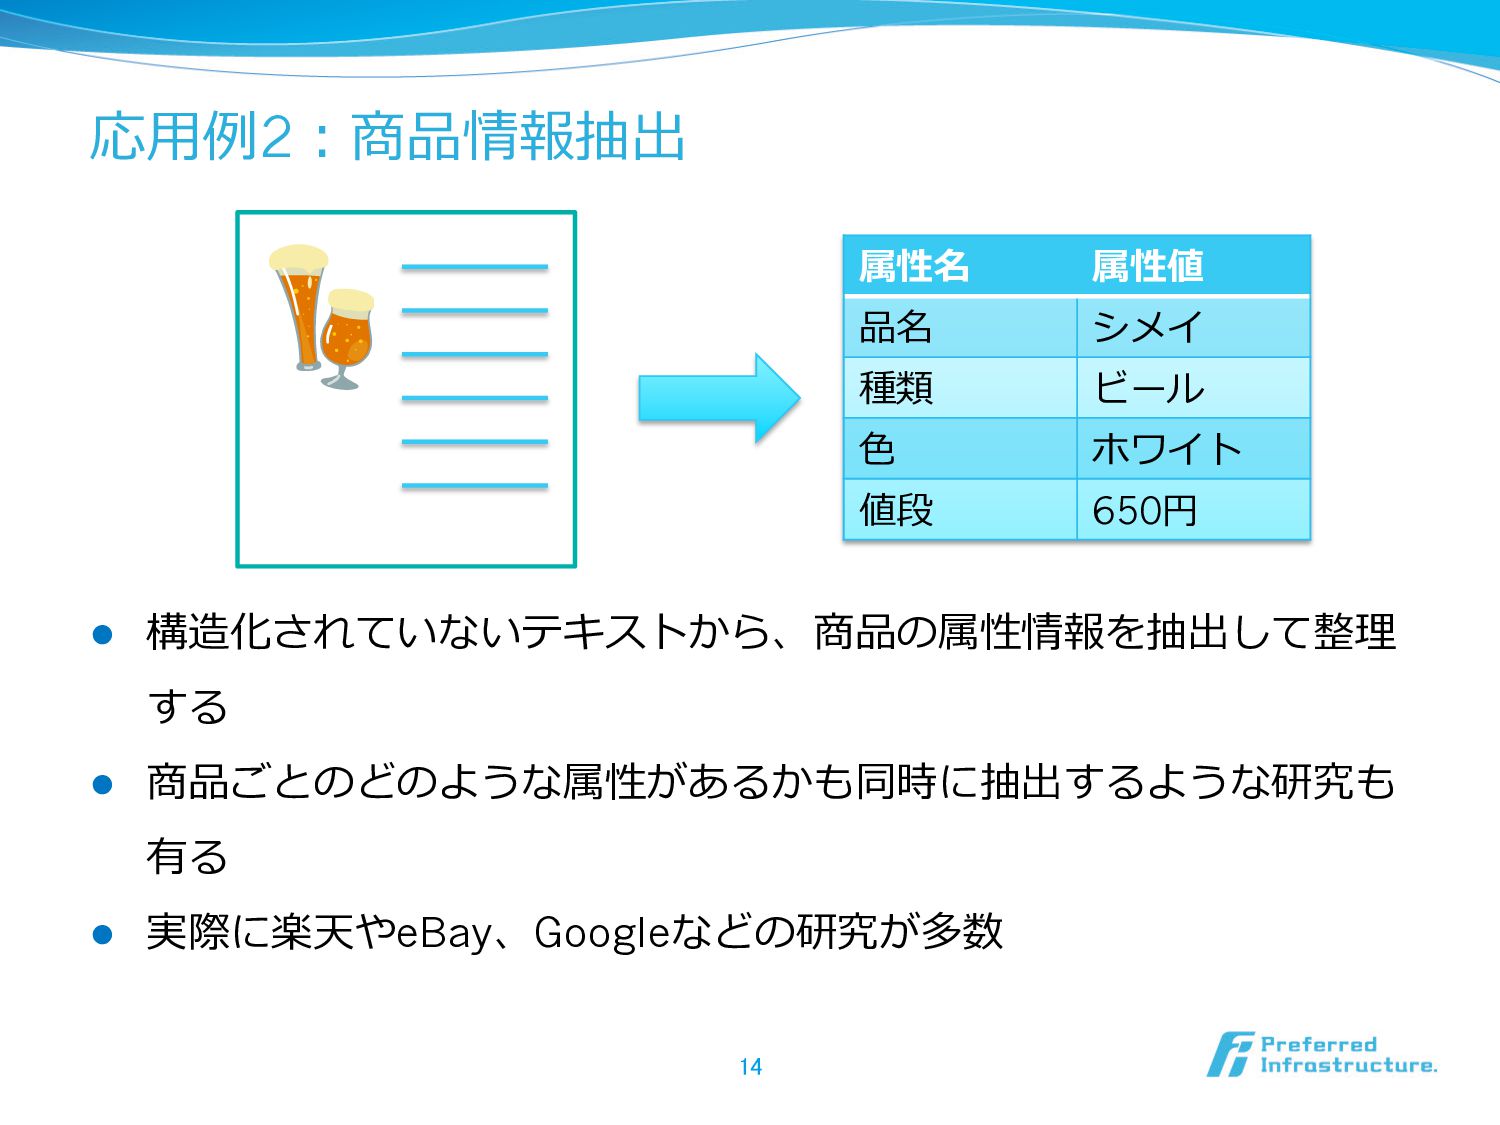
応⽤用例例2:商品情報抽出 l 構造化されていないテキストから、商品の属性情報を抽出して整理理 する l 商品ごとのどのような属性があるかも同時に抽出するような研究も 有る l 実際に楽天やeBay、Googleなどの研究が多数 14
属性名 属性値 品名 シメイ 種類 ビール ⾊色 ホワイト 値段 650円 -
整理理が出来ればできることが広がる l データ分析基盤とつなげる l テキストマイニング l 俗に「前処理理」と呼ばれる処理理は情報抽出に対応する l 情報検索索基盤とつなげる l
メタデータの抽出 l 抽出した情報をまとめあげる l オントロジーや辞書の⾃自動整理理 l 知⾒見見の発⾒見見 16 -
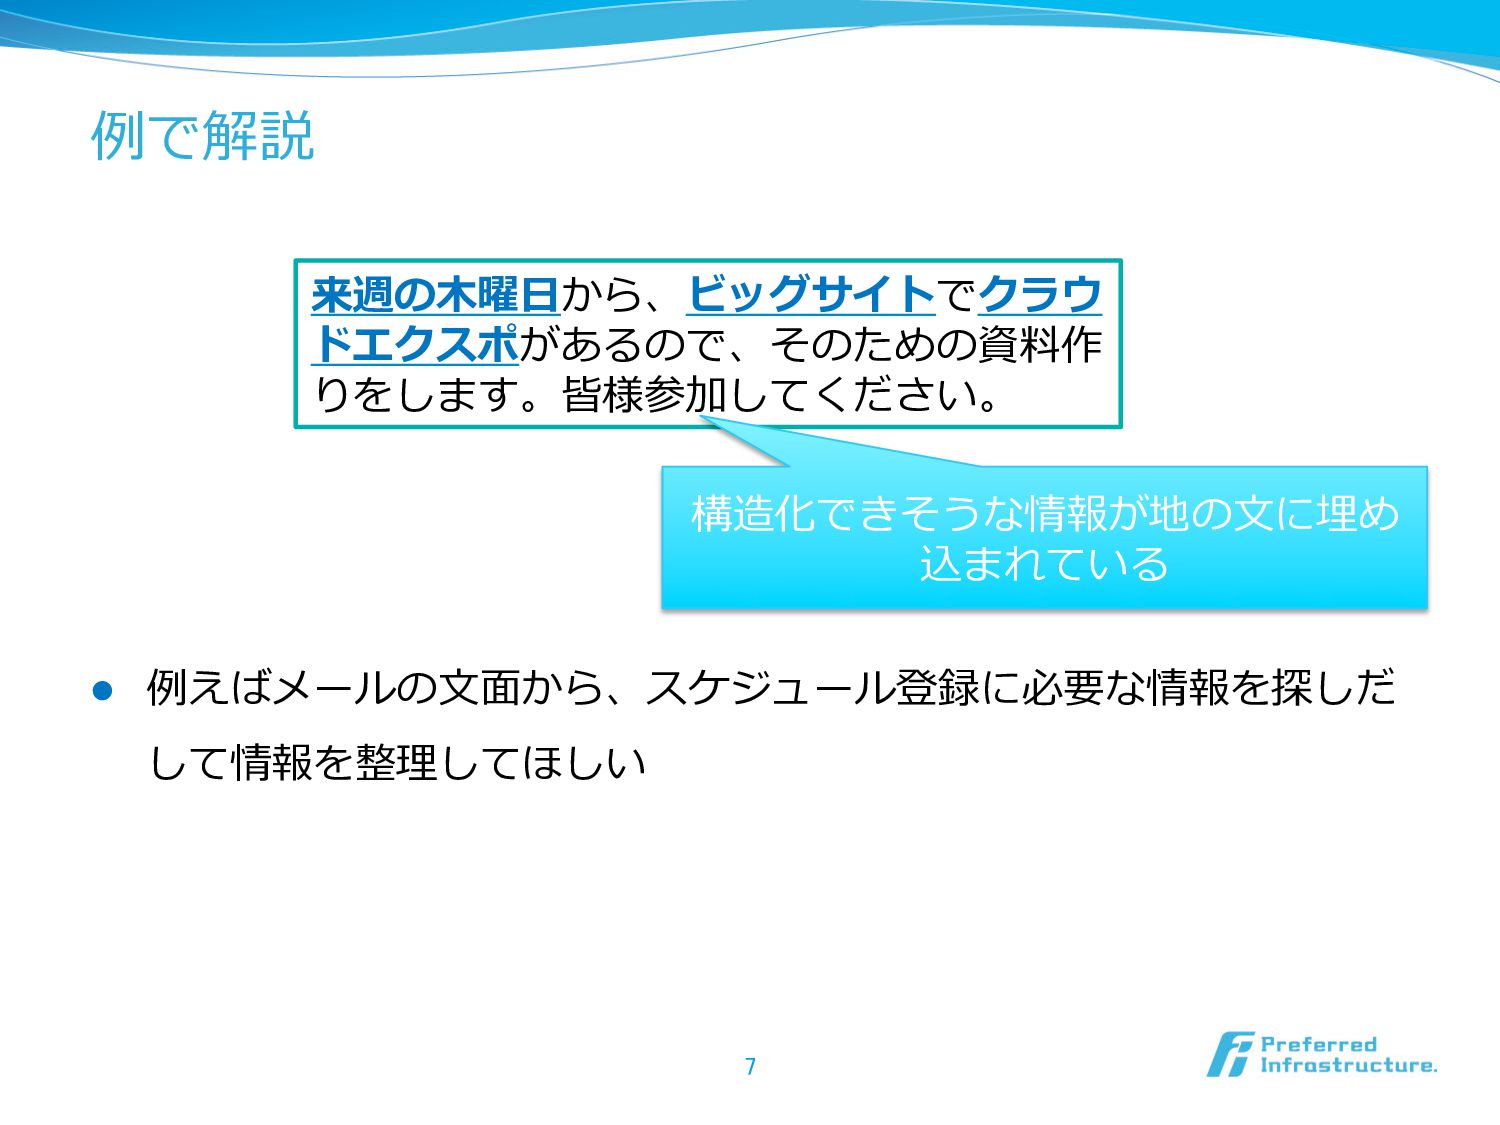
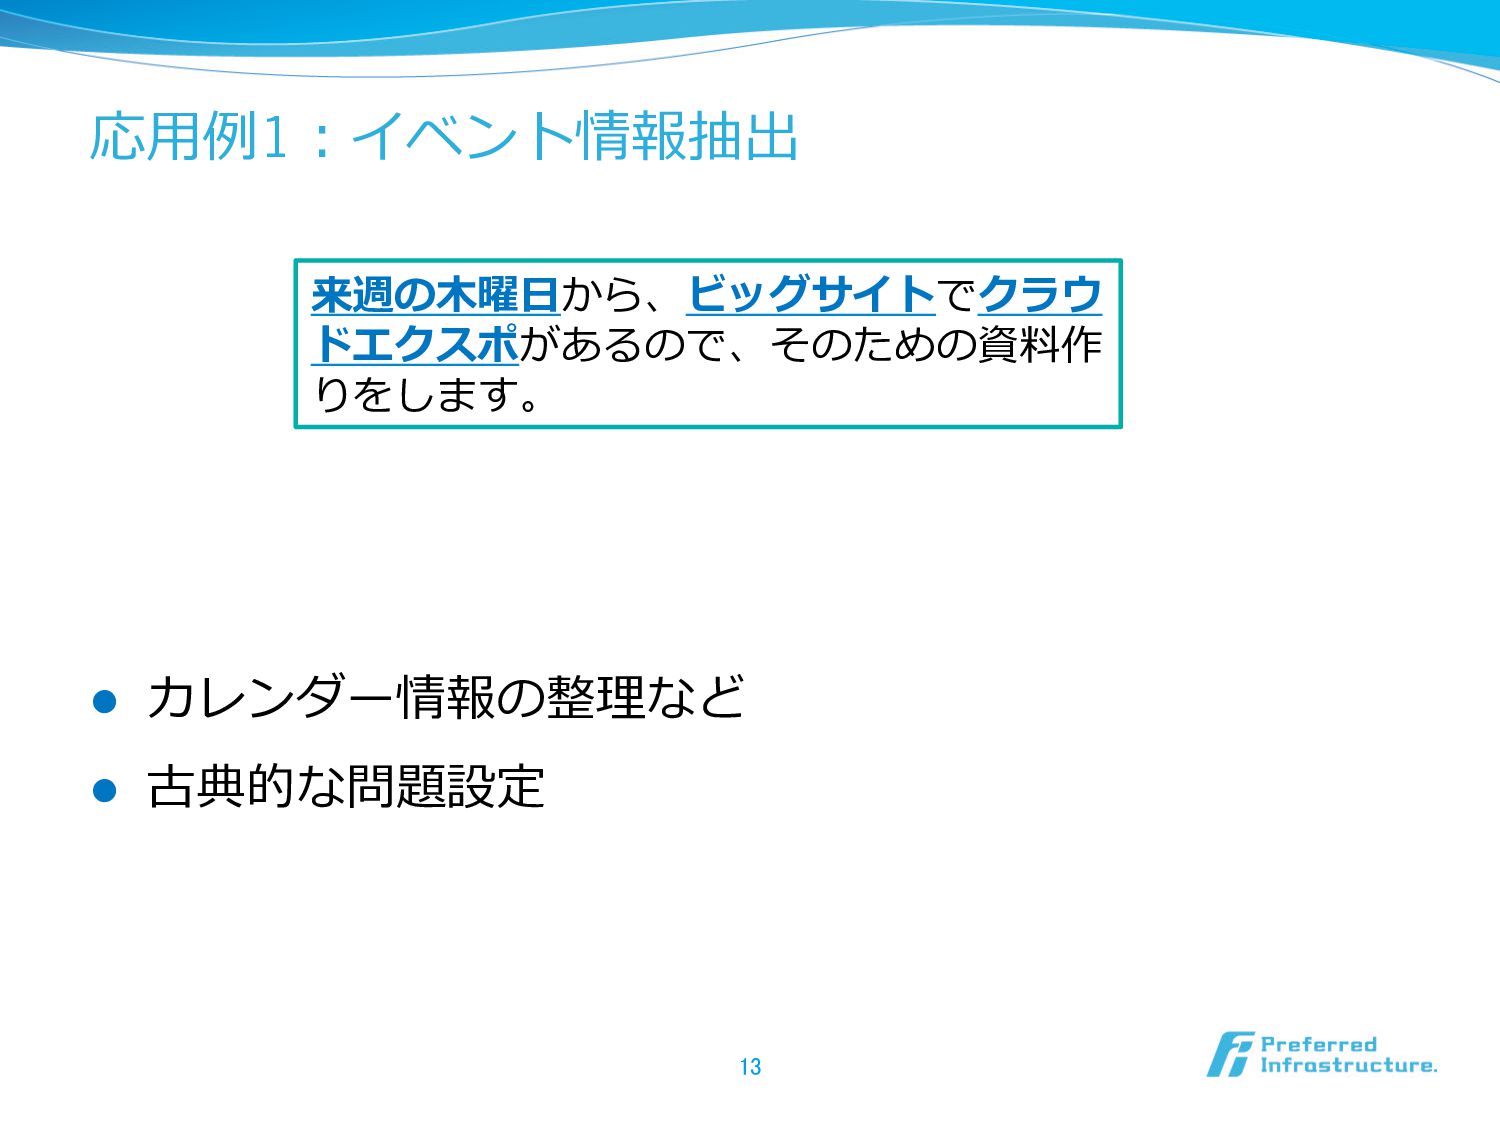
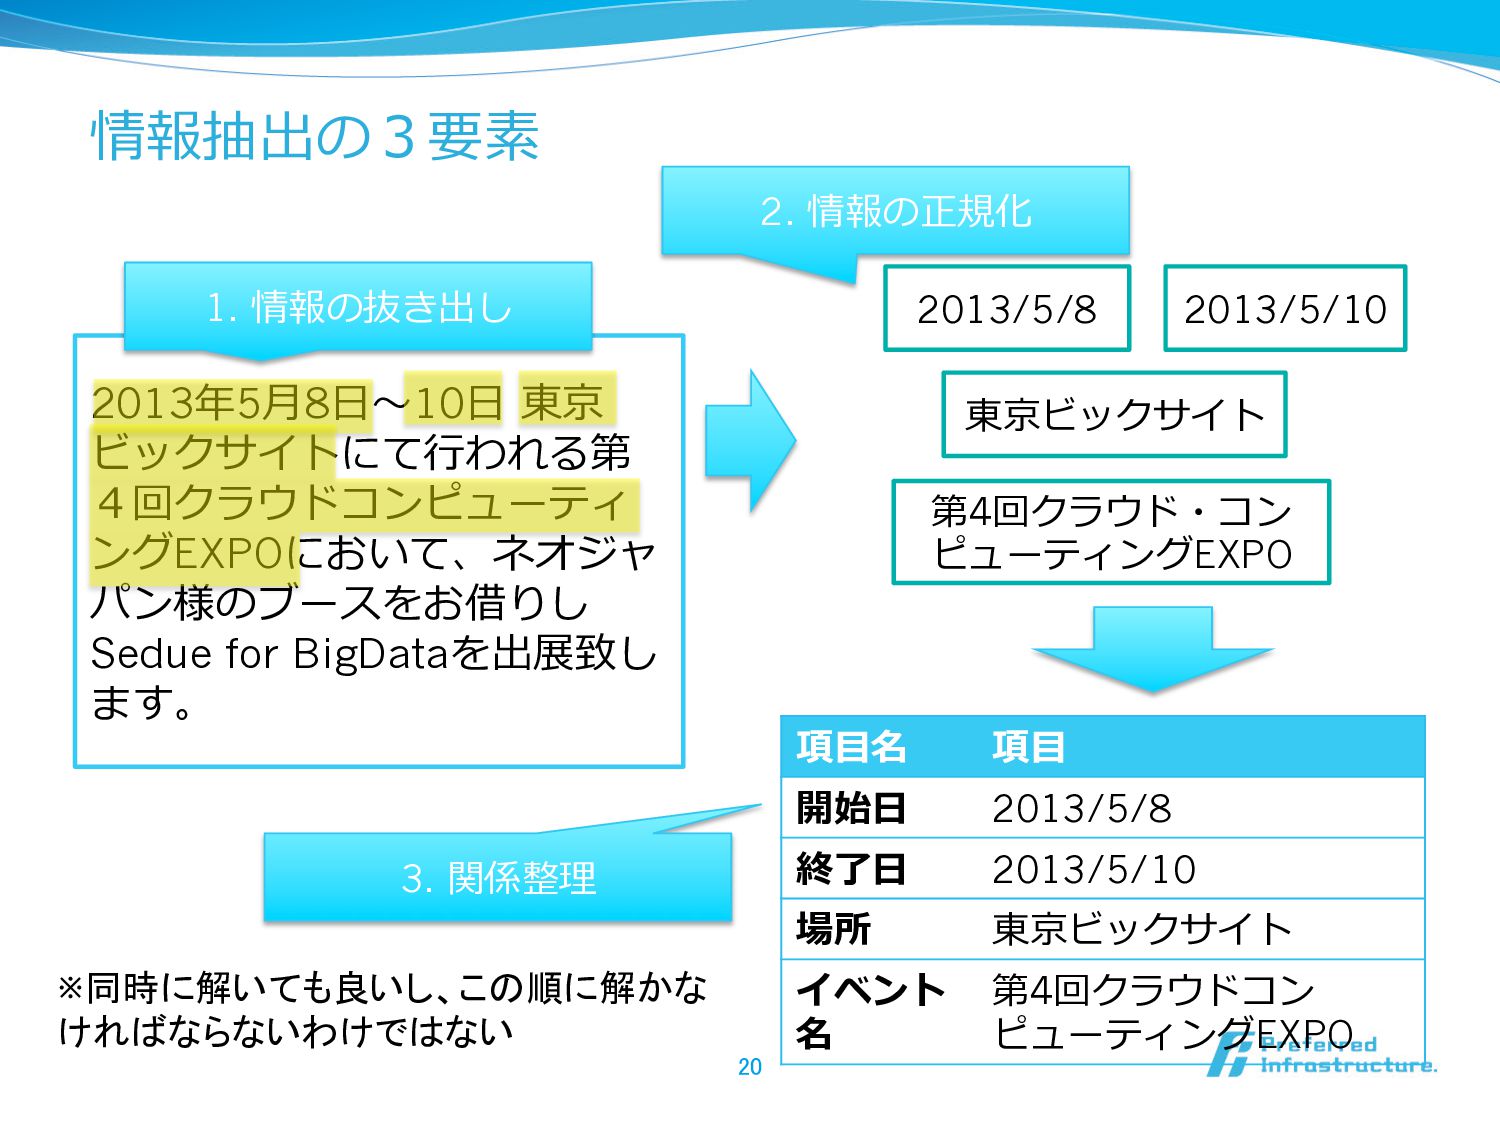
情報抽出の3要素 20 2013年年5⽉月8⽇日〜~10⽇日 東京 ビックサイトにて⾏行行われる第 4回クラウドコンピューティ ングEXPOにおいて、ネオジャ パン様のブースをお借りし Sedue for
BigDataを出展致し ます。 2013/5/8 2013/5/10 東京ビックサイト 第4回クラウド・コン ピューティングEXPO 項⽬目名 項⽬目 開始⽇日 2013/5/8 終了了⽇日 2013/5/10 場所 東京ビックサイト イベント 名 第4回クラウドコン ピューティングEXPO 1. 情報の抜き出し 2. 情報の正規化 3. 関係整理理 ※同時に解いても良いし、この順に解かな ければならないわけではない -
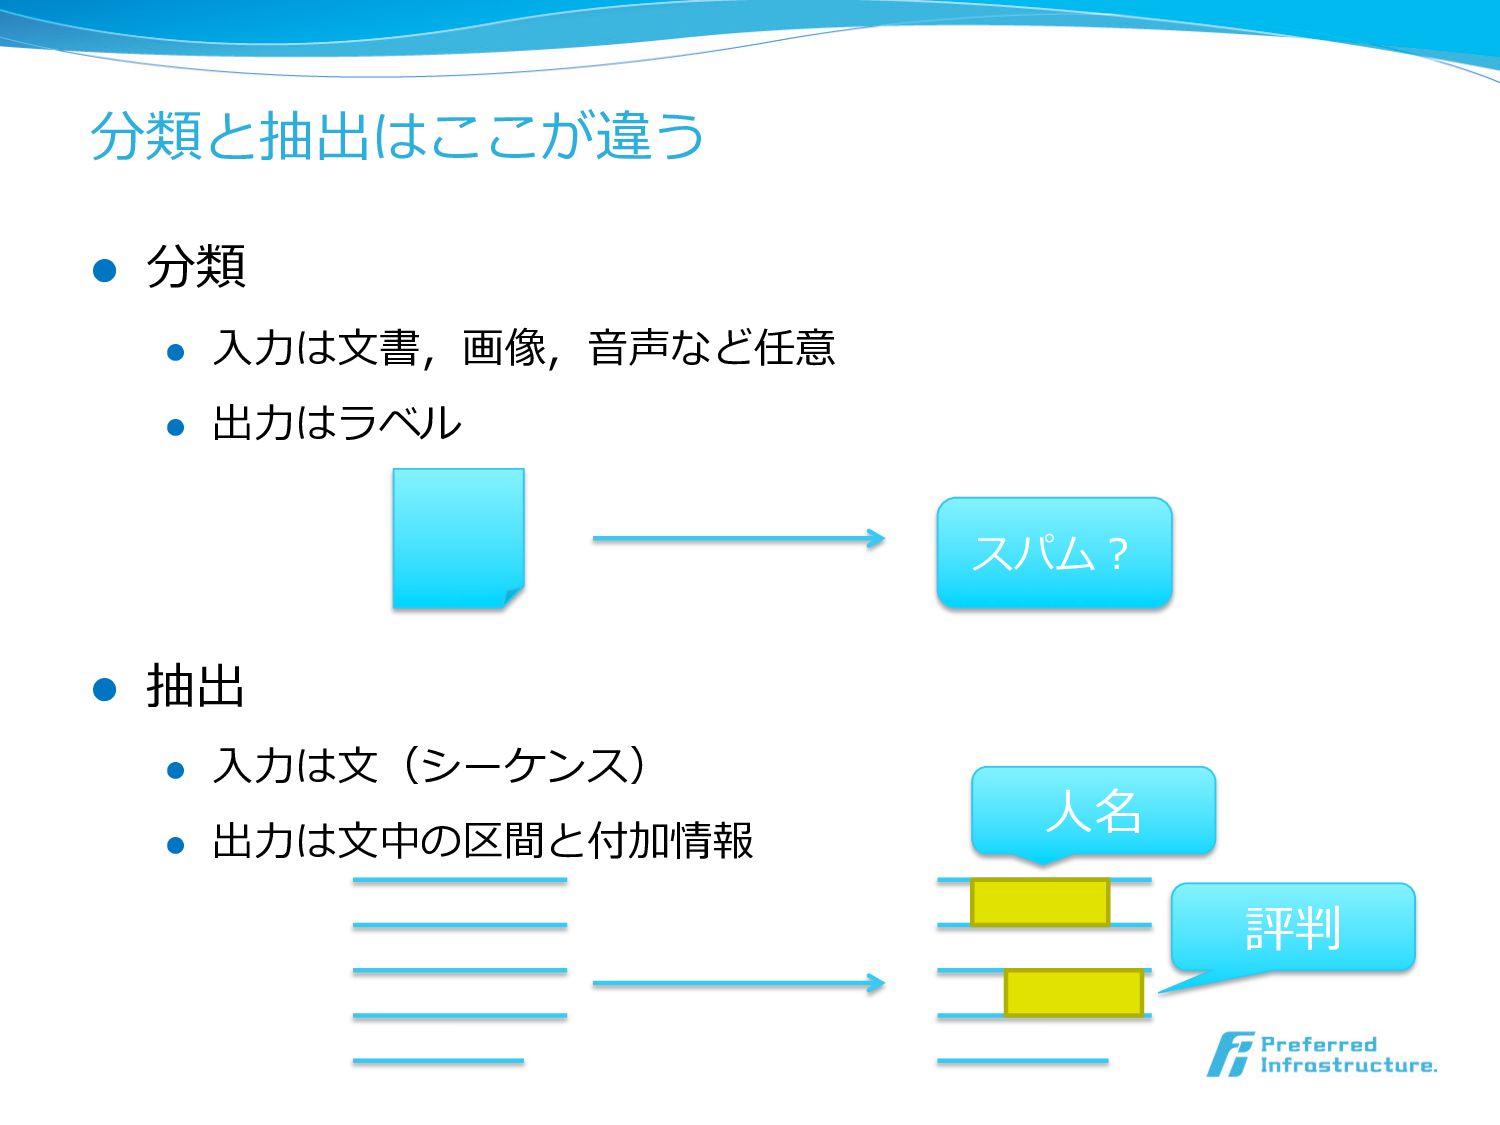
分類と抽出はここが違う l 分類 l ⼊入⼒力力は⽂文書,画像,⾳音声など任意 l 出⼒力力はラベル l 抽出 l
⼊入⼒力力は⽂文(シーケンス) l 出⼒力力は⽂文中の区間と付加情報 スパム? ⼈人名 評判 -
分類と抽出はここが同じ l ⽂文書の解析という意味では同じ l ⼊入⼒力力は⽂文書データ、出⼒力力は解析結果 l 結果だけ⾒見見れば同じように⾒見見える l 機械学習やルールを使うという意味では同じ l
ルールベースも機械学習も使う⽅方法はある l 問題設定としては、前者は分類問題、後者はシーケンシャルラ ベリングなどを応⽤用するのが⼀一般的 -
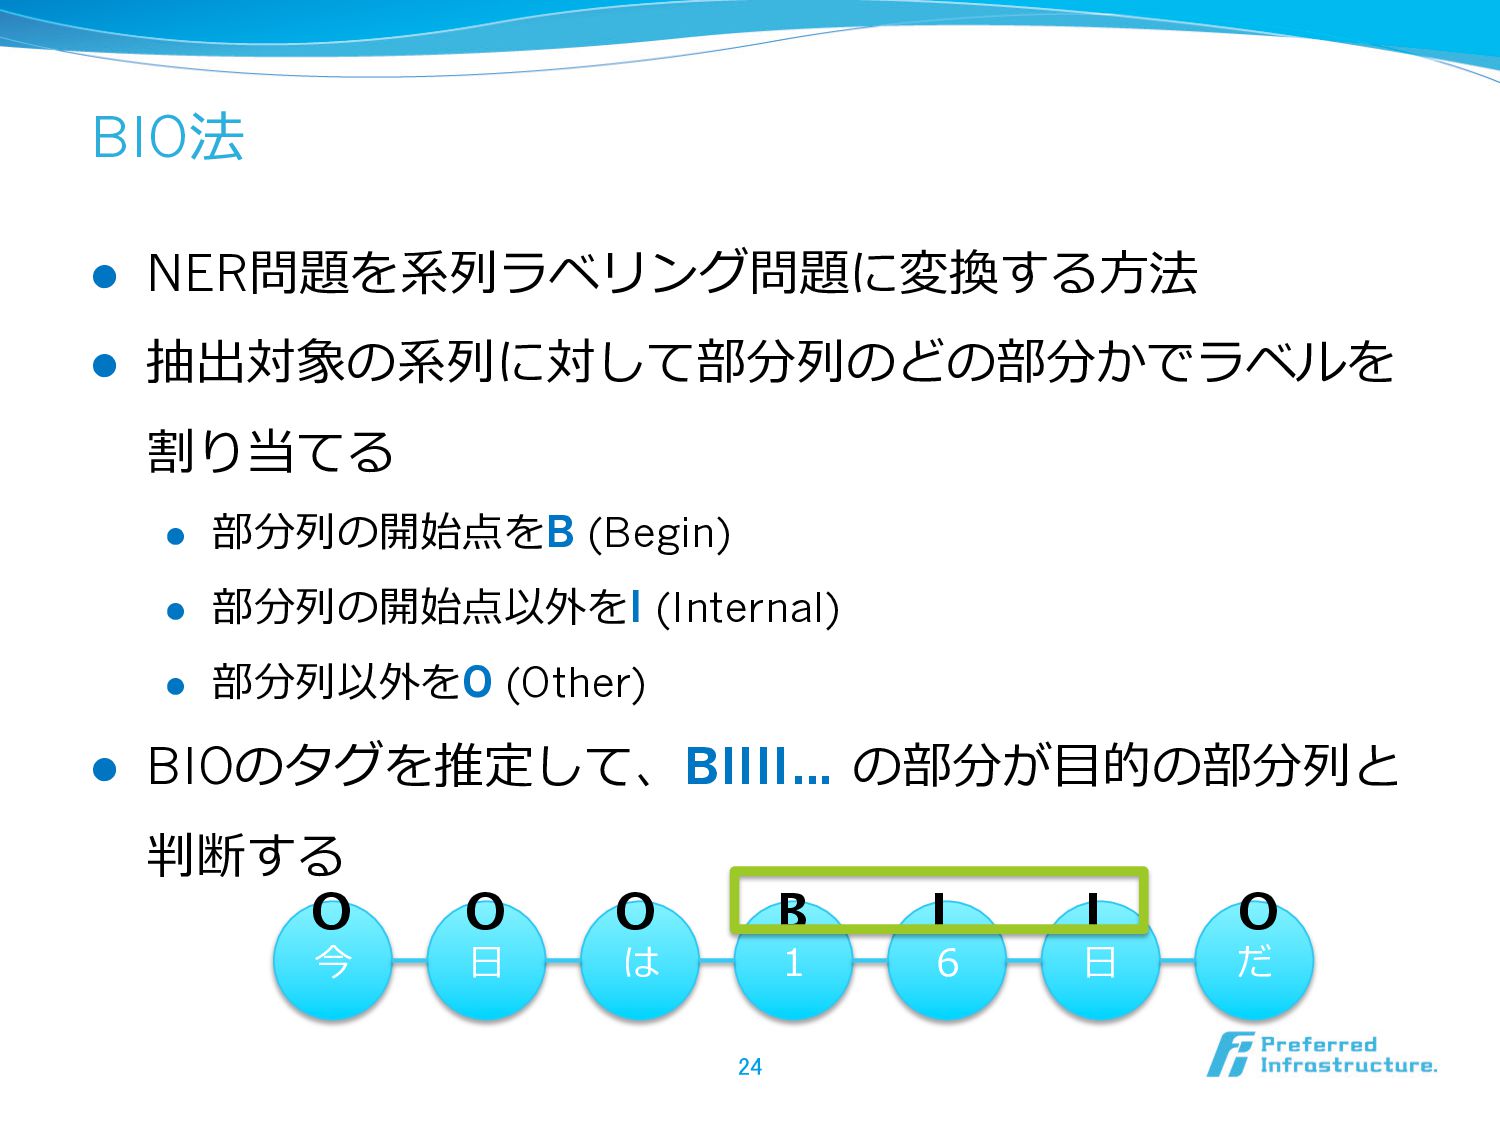
BIO法 l NER問題を系列列ラベリング問題に変換する⽅方法 l 抽出対象の系列列に対して部分列列のどの部分かでラベルを 割り当てる l 部分列列の開始点をB (Begin) l
部分列列の開始点以外をI (Internal) l 部分列列以外をO (Other) l BIOのタグを推定して、BIIII… の部分が⽬目的の部分列列と 判断する 24 今 ⽇日 は 1 6 ⽇日 だ B I I O O O O -
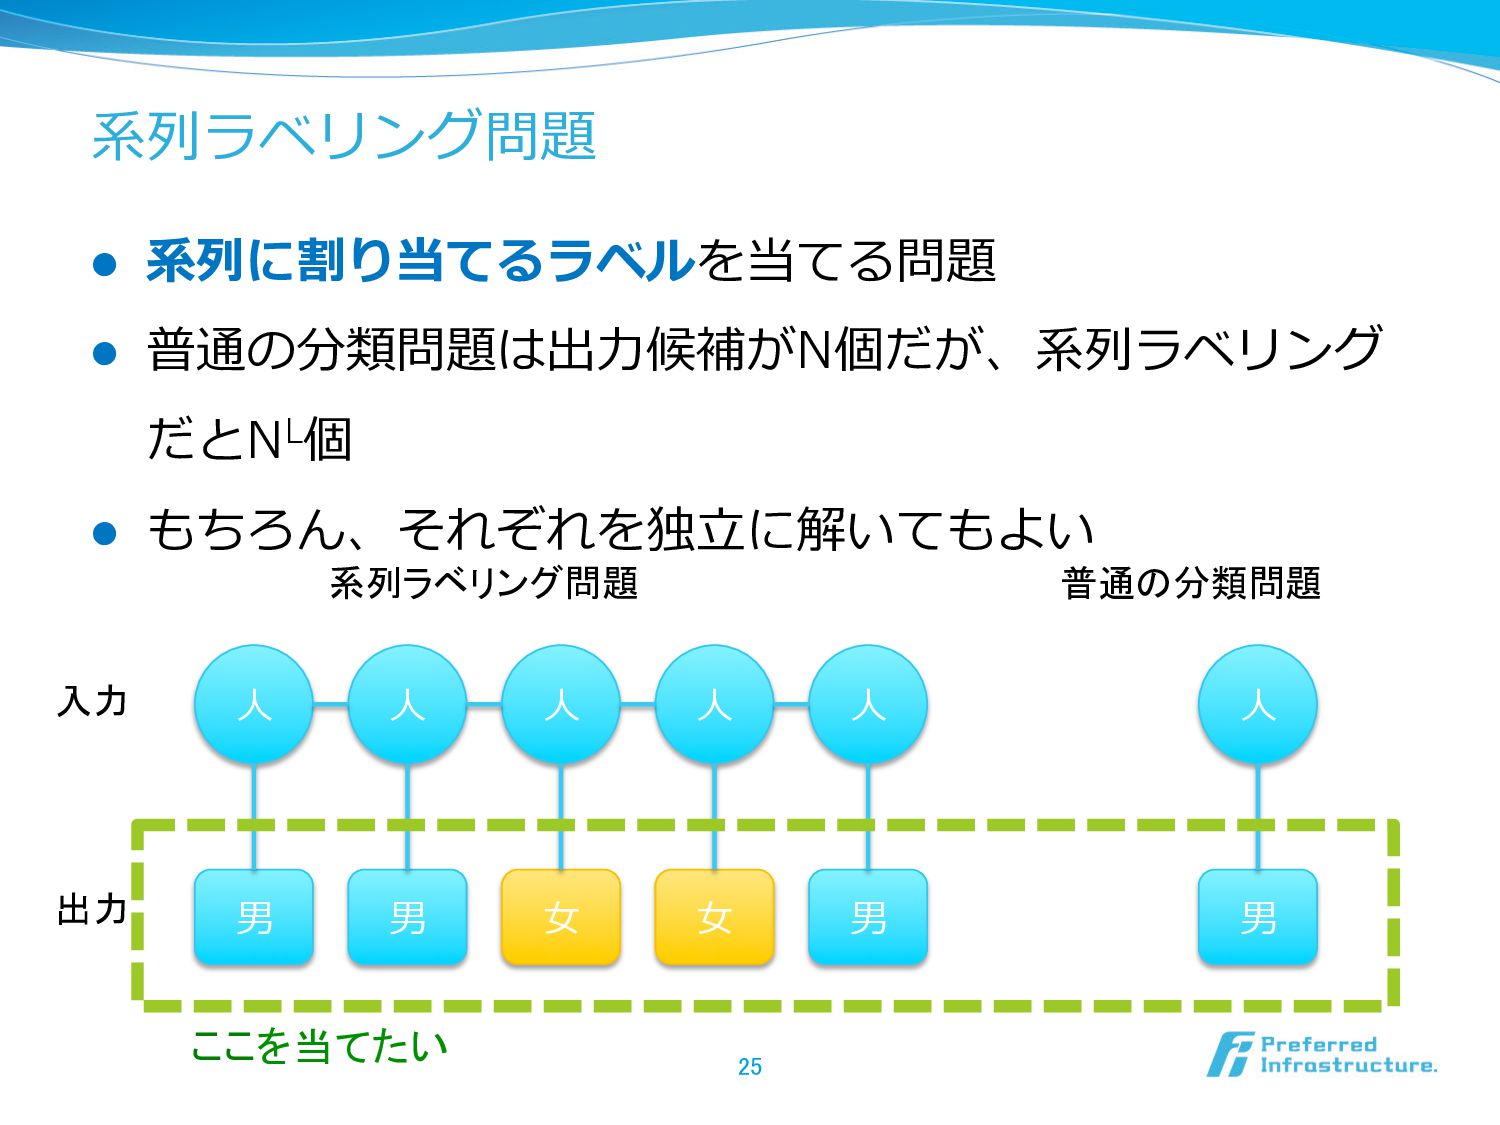
系列列ラベリング問題 l 系列列に割り当てるラベルを当てる問題 l 普通の分類問題は出⼒力力候補がN個だが、系列列ラベリング だとNL個 l もちろん、それぞれを独⽴立立に解いてもよい 25 ⼈人
⼈人 ⼈人 ⼈人 ⼈人 系列ラベリング問題 入力 普通の分類問題 ⼈人 出力 男 男 ⼥女女 ⼥女女 男 男 ここを当てたい -
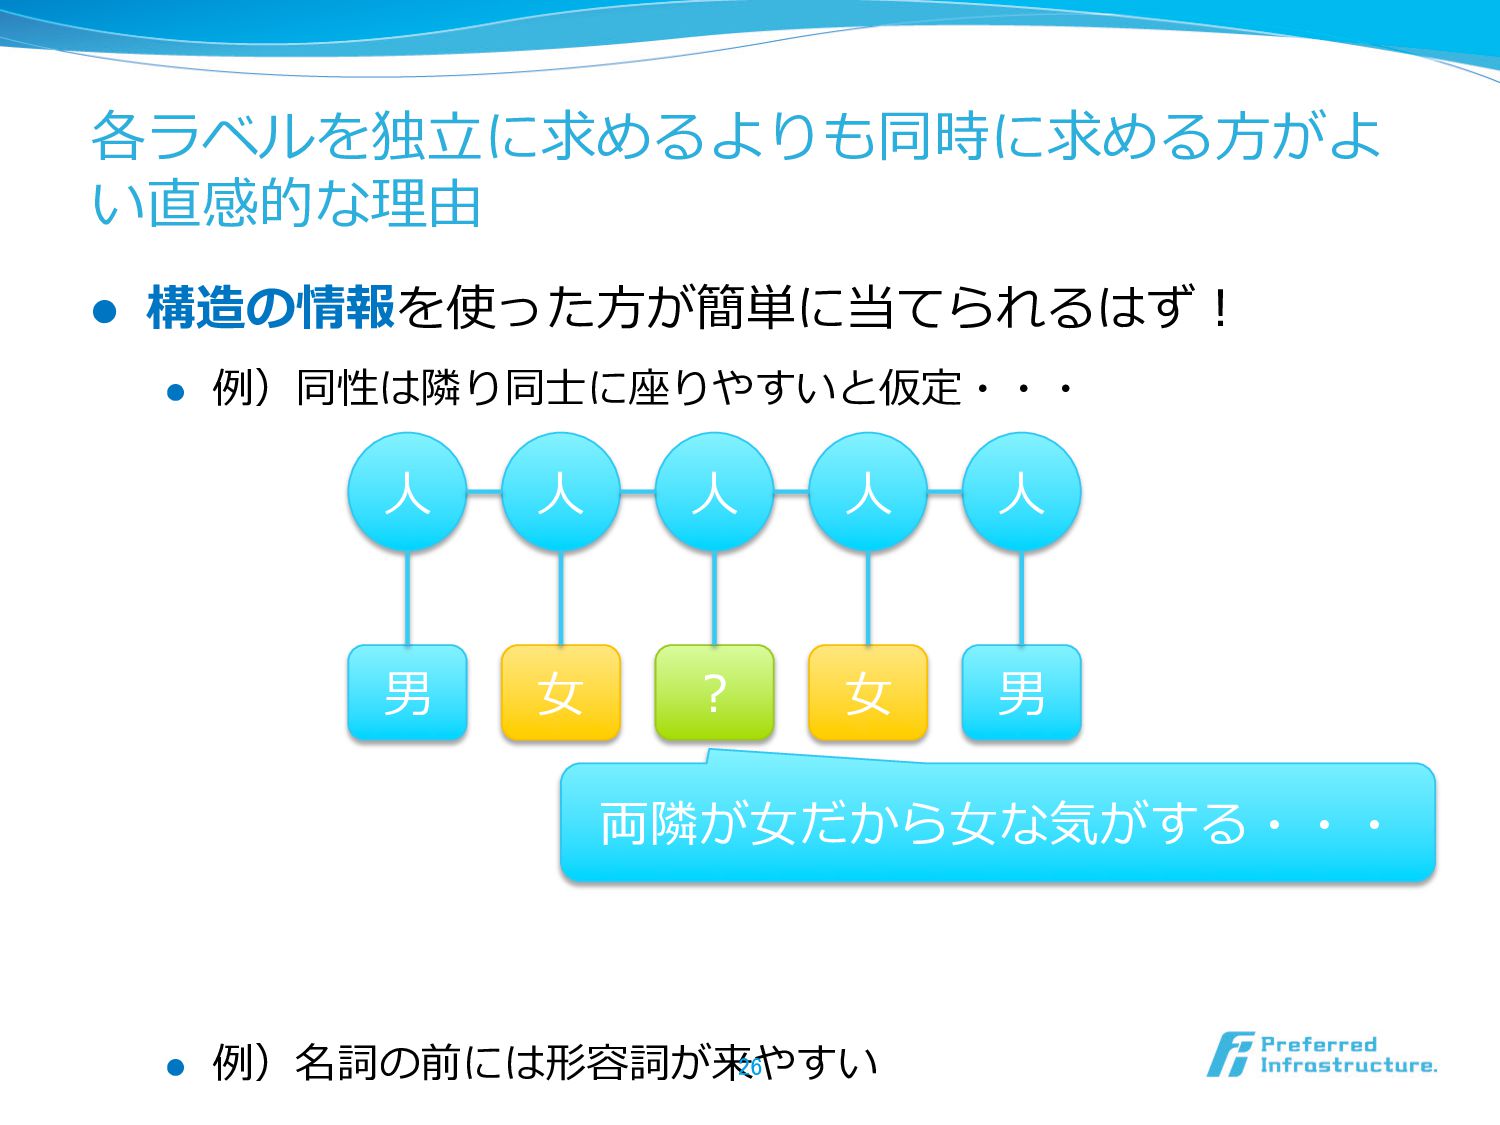
各ラベルを独⽴立立に求めるよりも同時に求める⽅方がよ い直感的な理理由 l 構造の情報を使った⽅方が簡単に当てられるはず! l 例例)同性は隣隣り同⼠士に座りやすいと仮定・・・ l 例例)名詞の前には形容詞が来やすい 26 ⼈人
⼈人 ⼈人 ⼈人 ⼈人 男 ⼥女女 ? ⼥女女 男 両隣隣が⼥女女だから⼥女女な気がする・・・ -
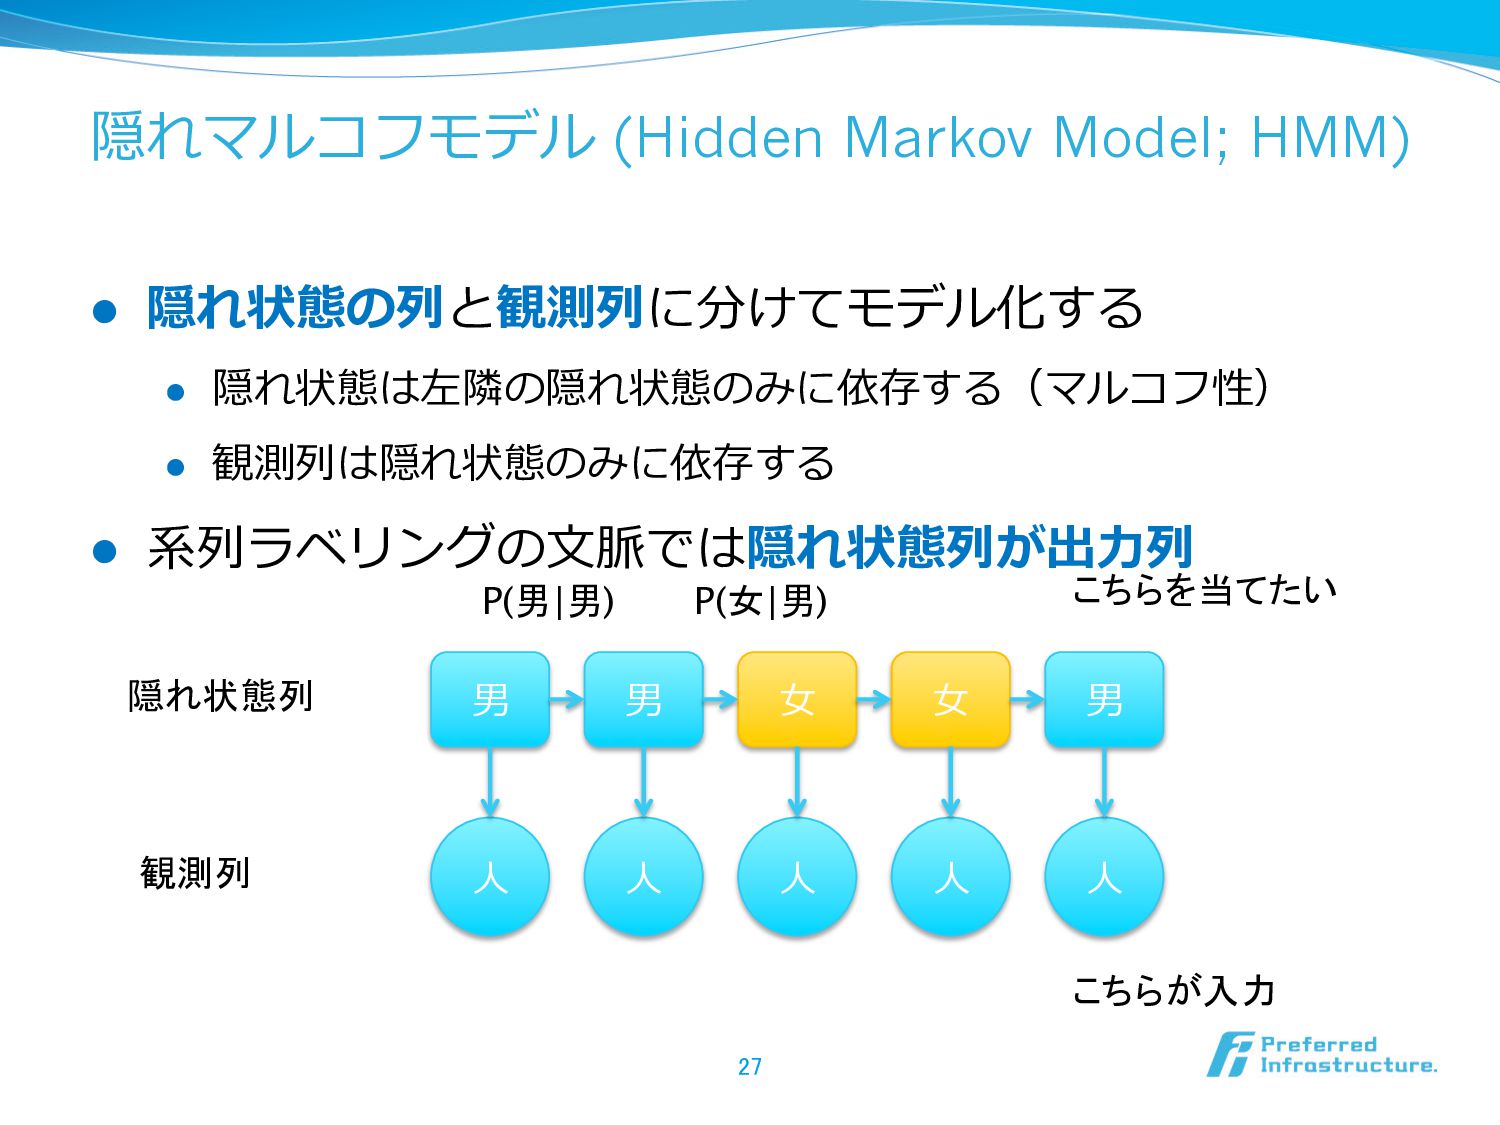
隠れマルコフモデル (Hidden Markov Model; HMM) l 隠れ状態の列列と観測列列に分けてモデル化する l 隠れ状態は左隣隣の隠れ状態のみに依存する(マルコフ性) l
観測列列は隠れ状態のみに依存する l 系列列ラベリングの⽂文脈では隠れ状態列列が出⼒力力列列 27 ⼈人 ⼈人 ⼈人 ⼈人 ⼈人 男 男 ⼥女女 ⼥女女 男 こちらを当てたい こちらが入力 隠れ状態列 観測列 P(男|男) P(女|男) -
条件付き確率率率場 (Conditional Random Field; CRF) [Lafferty2001] l ラベルの同時確率率率を直接モデル化する l P(y|x)
∝ exp(∑ i f(i)・w) l 特に⼊入⼒力力が系列列の時をlinear chain CRFと呼ぶ l ⾃自然⾔言語処理理の⽂文脈で出てくるとほとんどがこれのこと 28 ⼈人 ⼈人 ⼈人 ⼈人 ⼈人 男 男 ⼥女女 ⼥女女 男 隣接ラベルのみに特徴関数fi が設定されている -
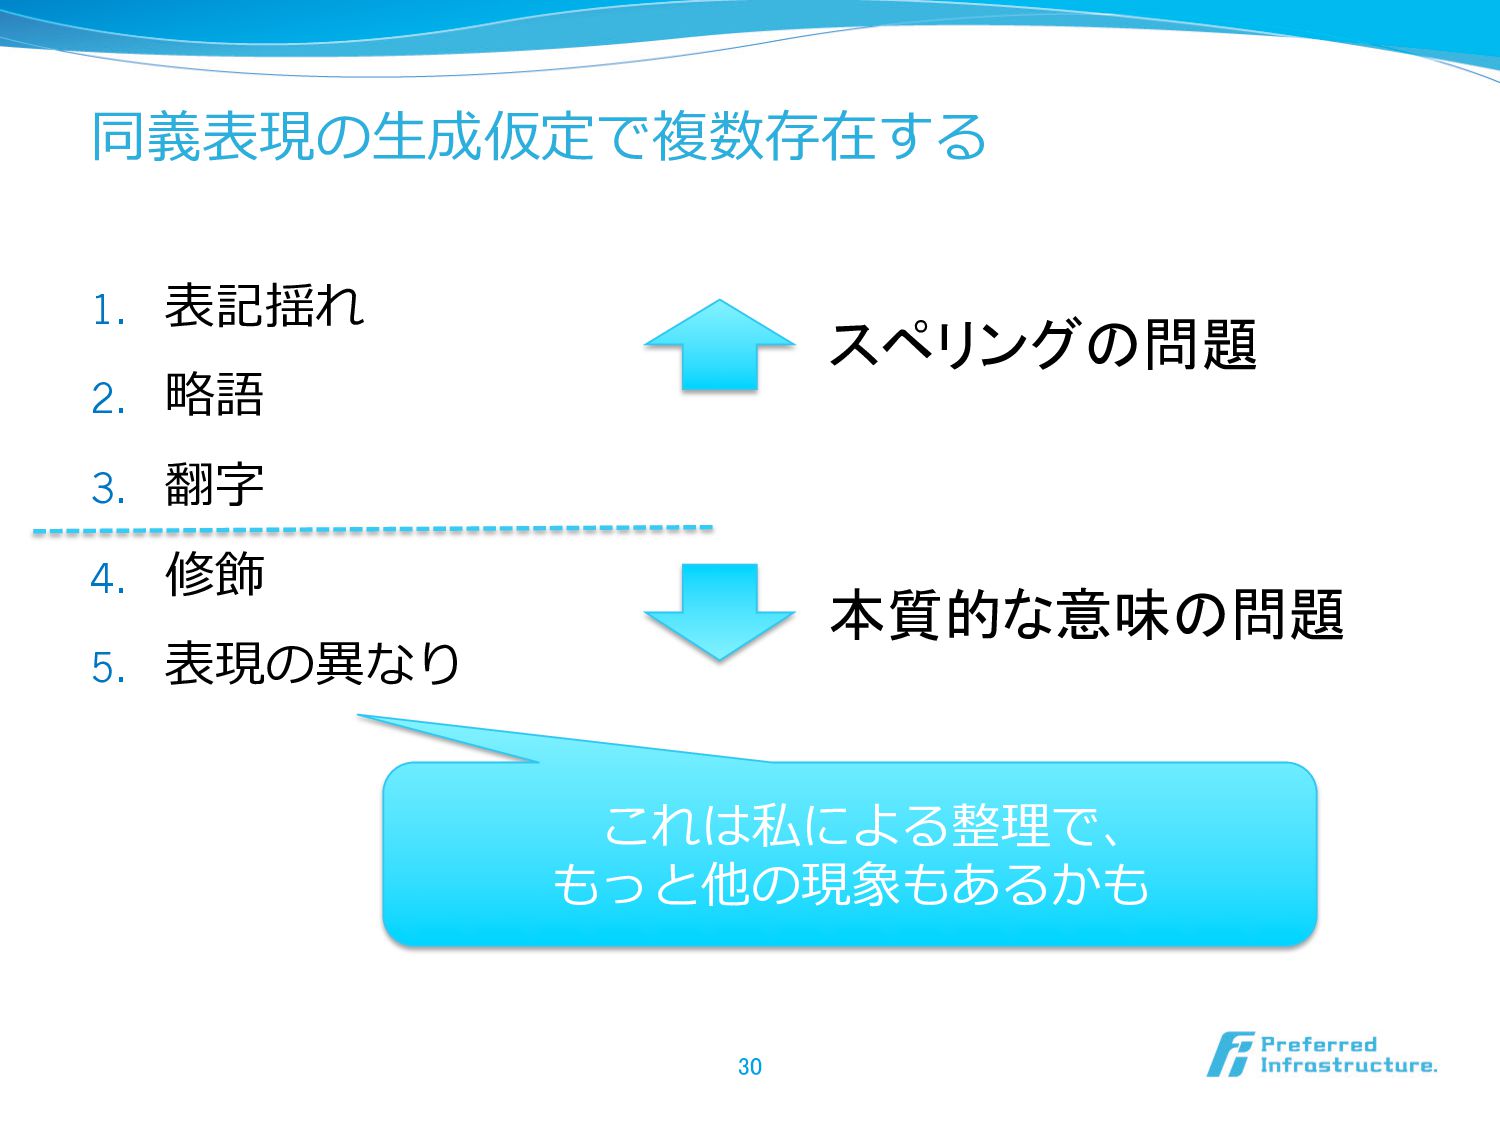
同義表現の⽣生成仮定で複数存在する 1. 表記揺れ 2. 略略語 3. 翻字 4. 修飾 5.
表現の異異なり 30 スペリングの問題 本質的な意味の問題 これは私による整理理で、 もっと他の現象もあるかも -
表記揺れ l 同⼀一⾔言語、同⼀一アルファベットでも、同じ発⾳音の単語の 表記に⾃自由度度がある l スペルミスもこれの⼀一種とみなしても良良さそう l 例例 l サーバ
vs サーバー l バイオリン vs ヴァイオリン l color vs colour 31 -
SimString [岡崎 10] l 閾値 t 以上の類似疎ベクトルを⾼高速に探索索するアルゴリズム l 疎ベクトルの類似度度が t
以上になるためには、t に応じた個数以上 の共通⾮非ゼロ要素がなければならない l この性質を使って候補を絞り込む 注意:⼀一般の類似ベクトル検索索に使おうとすると、閾値を設定できな い(ふうつうは上位N件)ため、うまく使えなさそう 32 $ simstring -u -d web1tja/unigrams.db -t 0.7 -s cosine スパゲッティー スパゲッティ スパゲッテー スパゲティー スパッティー … -
翻字 (Transliteration) l 例例 l 岩⽥田 vs Iwata l 中国語の翻字は意味としても通じるように作るのがオ
シャレらしい 33 ࣈʢ΄Μ͡ɺӳUSBOTMJUFSBUJPOʣͱɺݴޠֶʹ ͓͍ͯಛఆͷݴޠΛهͨ͠จࣈදهΛผͷจࣈʹΑ ΔදهʹҠ͢͜ͱΛ͍͏ɻࣈҹͷൃߦ͢Δ ࡍͳͲʹٕज़తͳಡऀͷศٓͷͨΊʹߦΘΕ Δɻ -
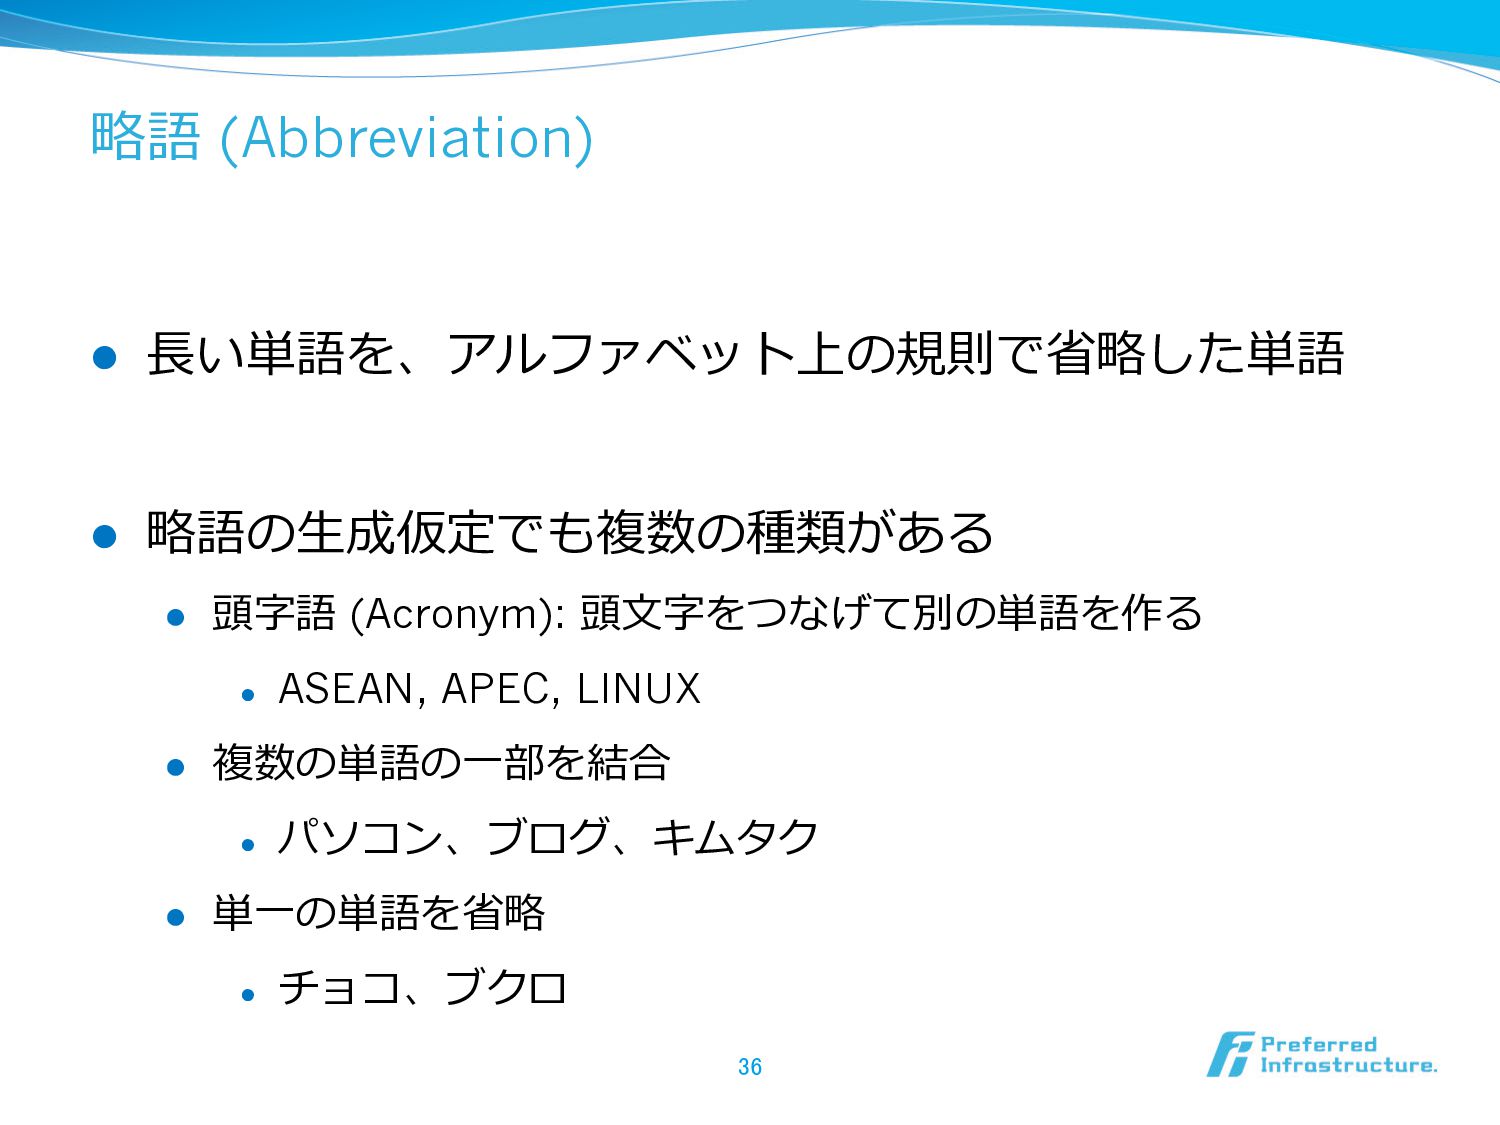
略略語 (Abbreviation) l ⻑⾧長い単語を、アルファベット上の規則で省省略略した単語 l 略略語の⽣生成仮定でも複数の種類がある l 頭字語 (Acronym): 頭⽂文字をつなげて別の単語を作る
l ASEAN, APEC, LINUX l 複数の単語の⼀一部を結合 l パソコン、ブログ、キムタク l 単⼀一の単語を省省略略 l チョコ、ブクロ 36 -
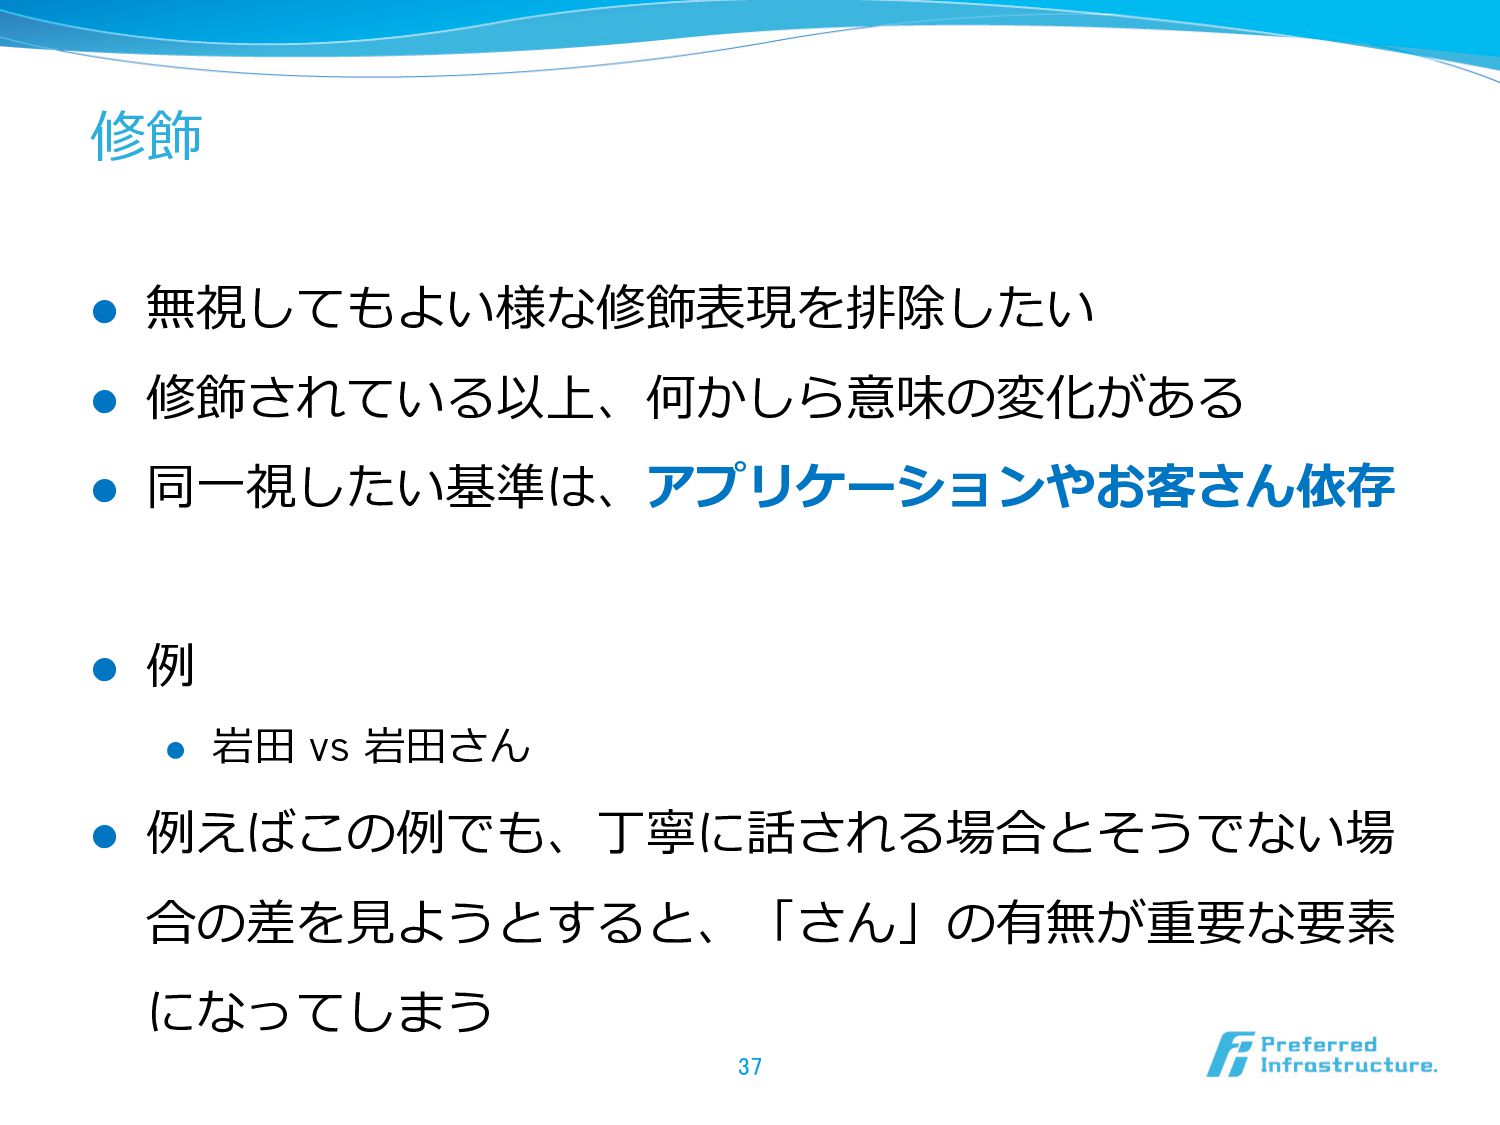
修飾 l 無視してもよい様な修飾表現を排除したい l 修飾されている以上、何かしら意味の変化がある l 同⼀一視したい基準は、アプリケーションやお客さん依存 l 例例 l
岩⽥田 vs 岩⽥田さん l 例例えばこの例例でも、丁寧に話される場合とそうでない場 合の差を⾒見見ようとすると、「さん」の有無が重要な要素 になってしまう 37 -
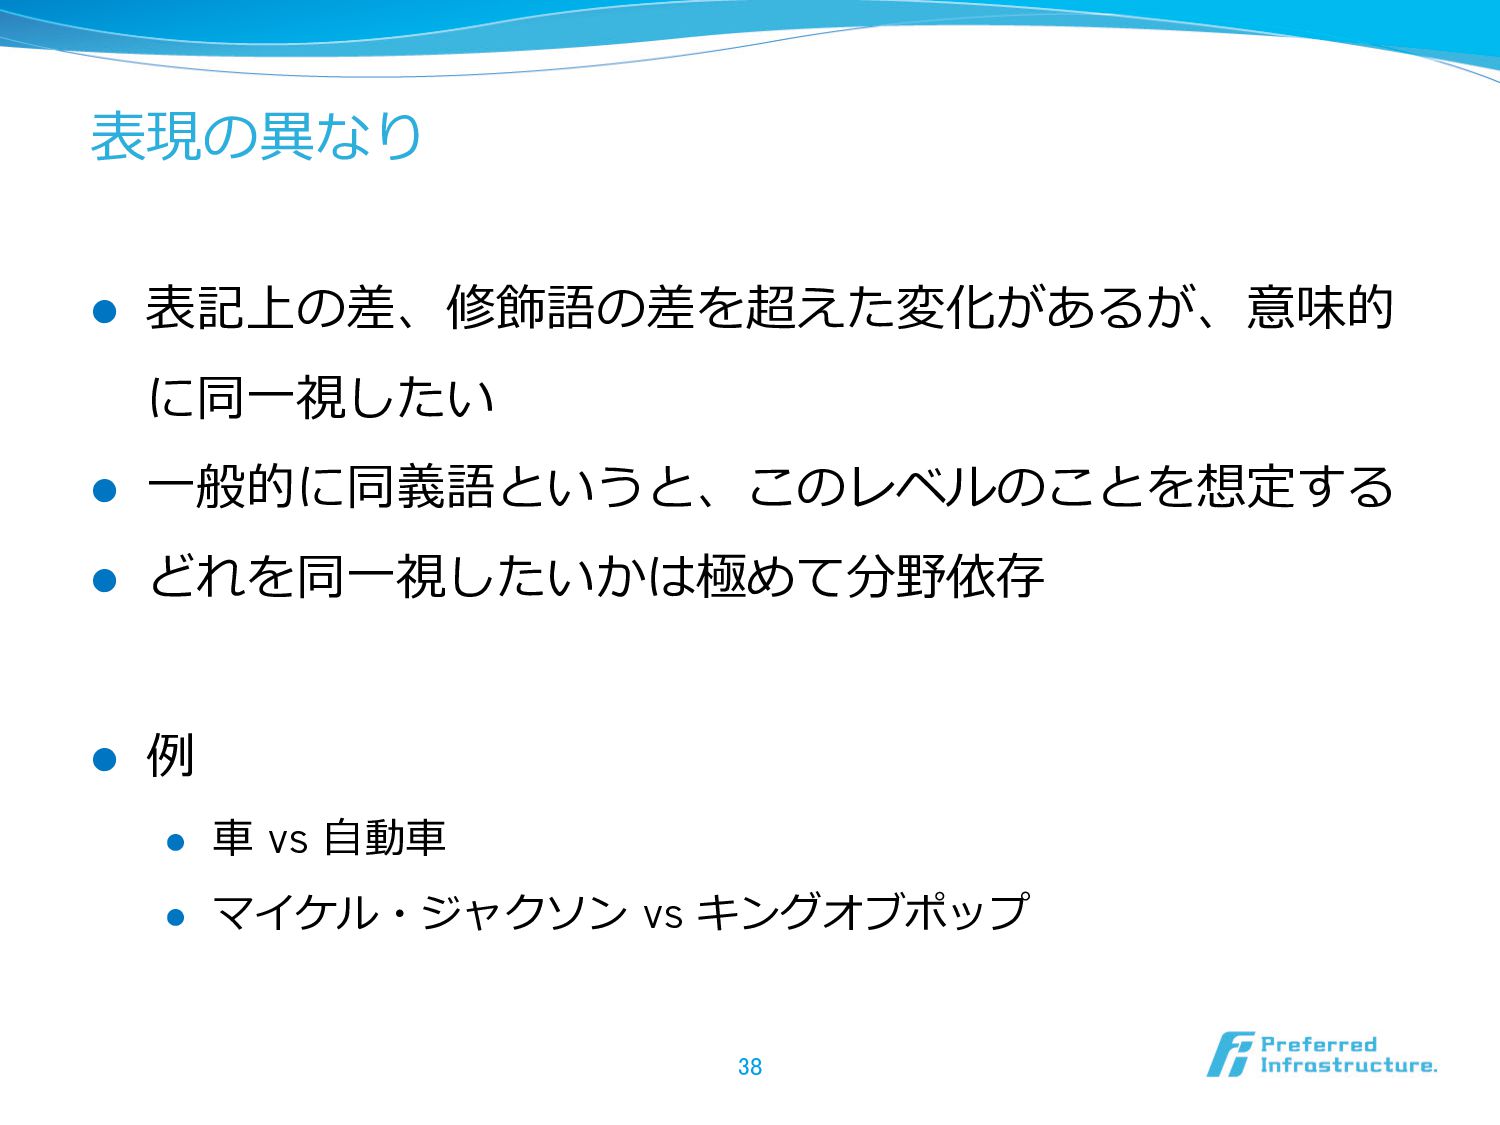
表現の異異なり l 表記上の差、修飾語の差を超えた変化があるが、意味的 に同⼀一視したい l ⼀一般的に同義語というと、このレベルのことを想定する l どれを同⼀一視したいかは極めて分野依存 l 例例
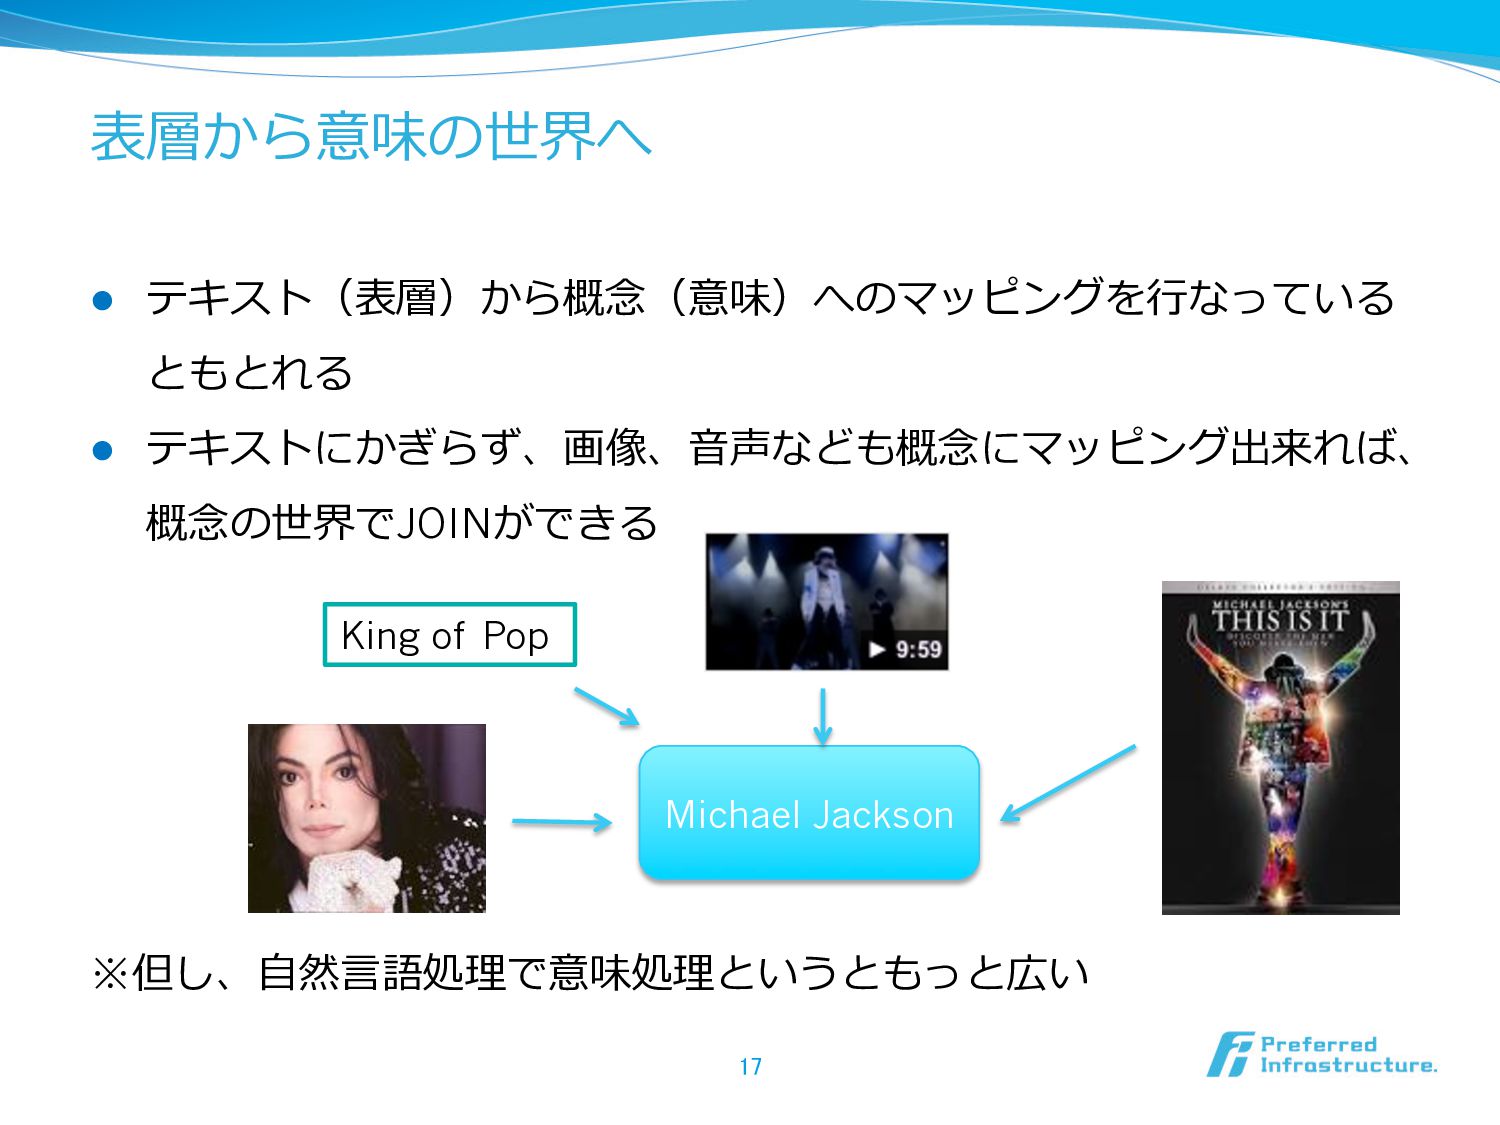
l ⾞車車 vs ⾃自動⾞車車 l マイケル・ジャクソン vs キングオブポップ 38 -
関係抽出の解き⽅方 l エンティティー間の関係の有無を分類問題として解く l シンプルな分類問題として解く l 構⽂文情報などをカーネルを使ってうまく特徴化する l もちろんルールで⾏行行う⽅方法や、ルールを機械学習的に発⾒見見する ような⽅方法もある
l 抽出されたエンティティーの間に書かれた情報が特に重 要になる l X is located in the Y 42 -
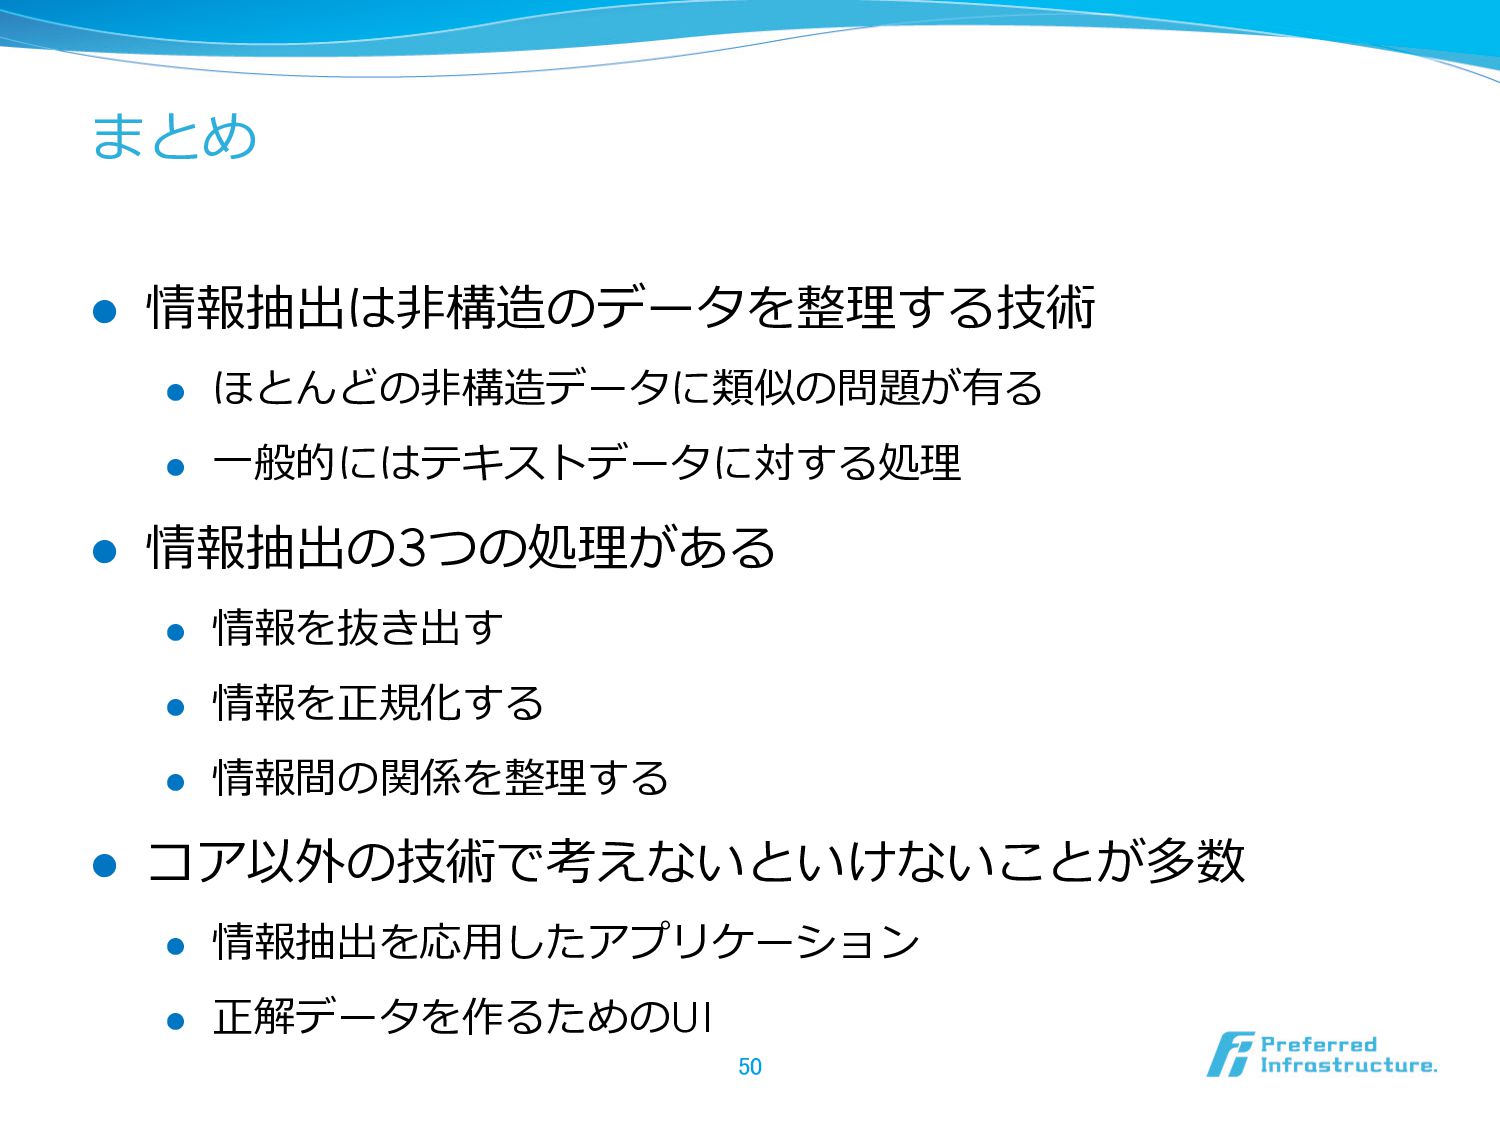
まとめ l 情報抽出は⾮非構造のデータを整理理する技術 l ほとんどの⾮非構造データに類似の問題が有る l ⼀一般的にはテキストデータに対する処理理 l 情報抽出の3つの処理理がある l
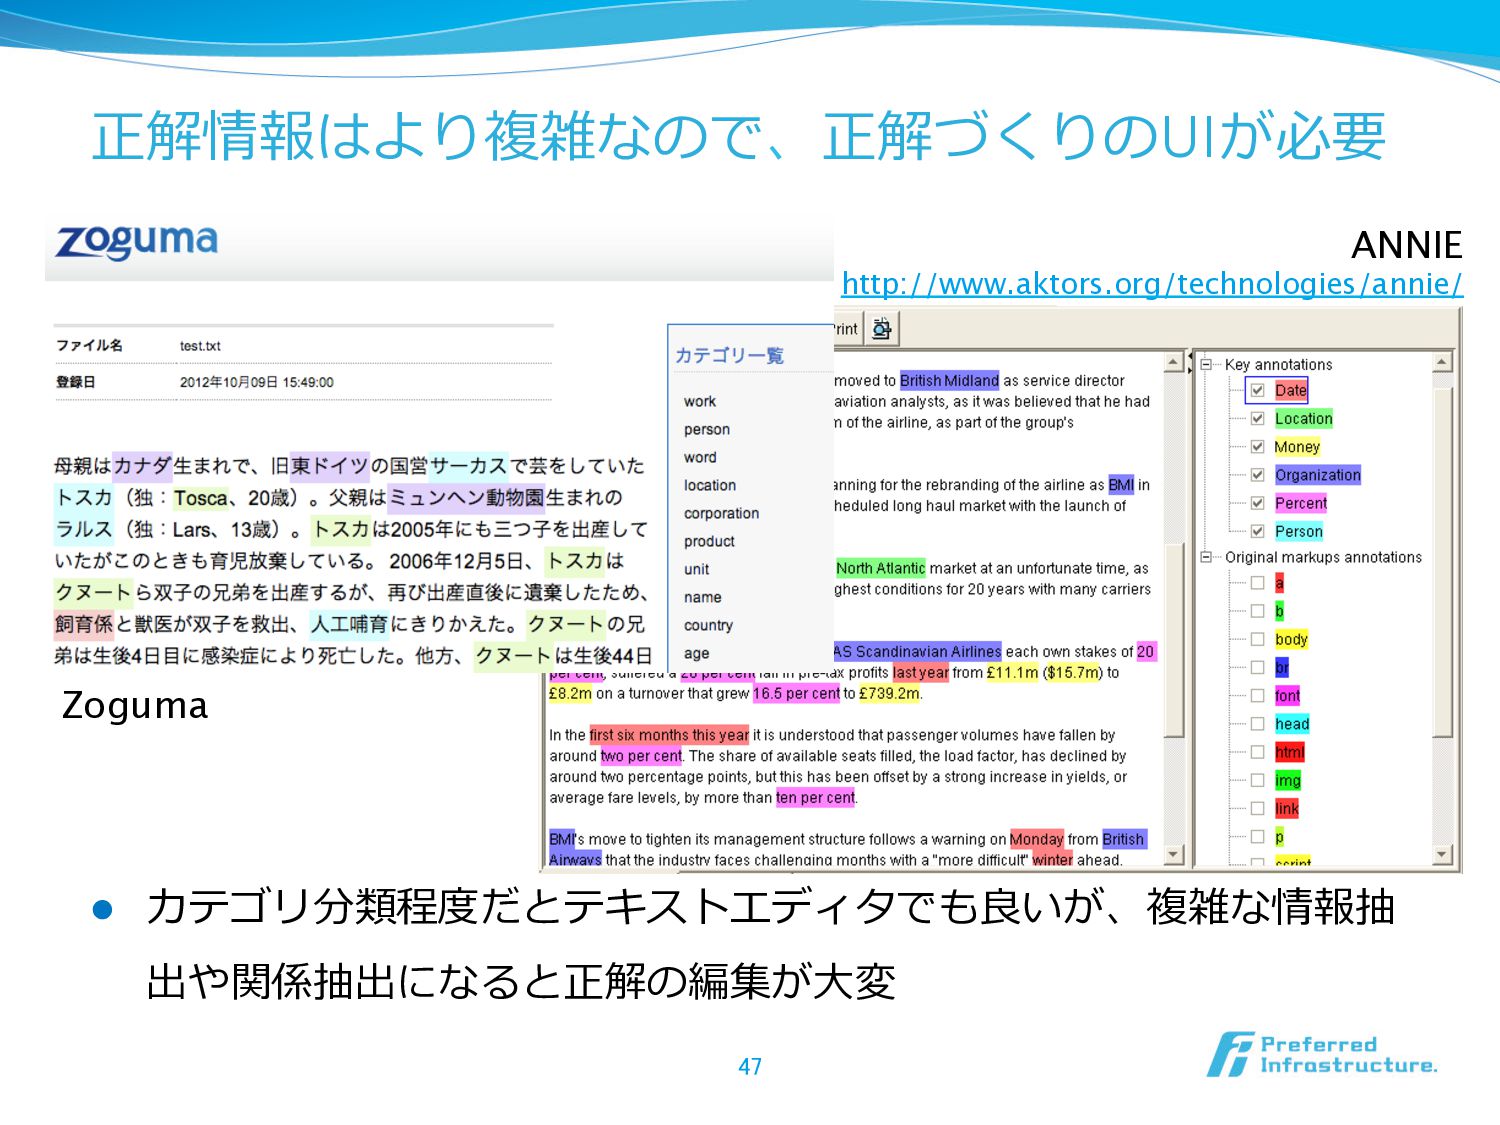
情報を抜き出す l 情報を正規化する l 情報間の関係を整理理する l コア以外の技術で考えないといけないことが多数 l 情報抽出を応⽤用したアプリケーション l 正解データを作るためのUI 50 -
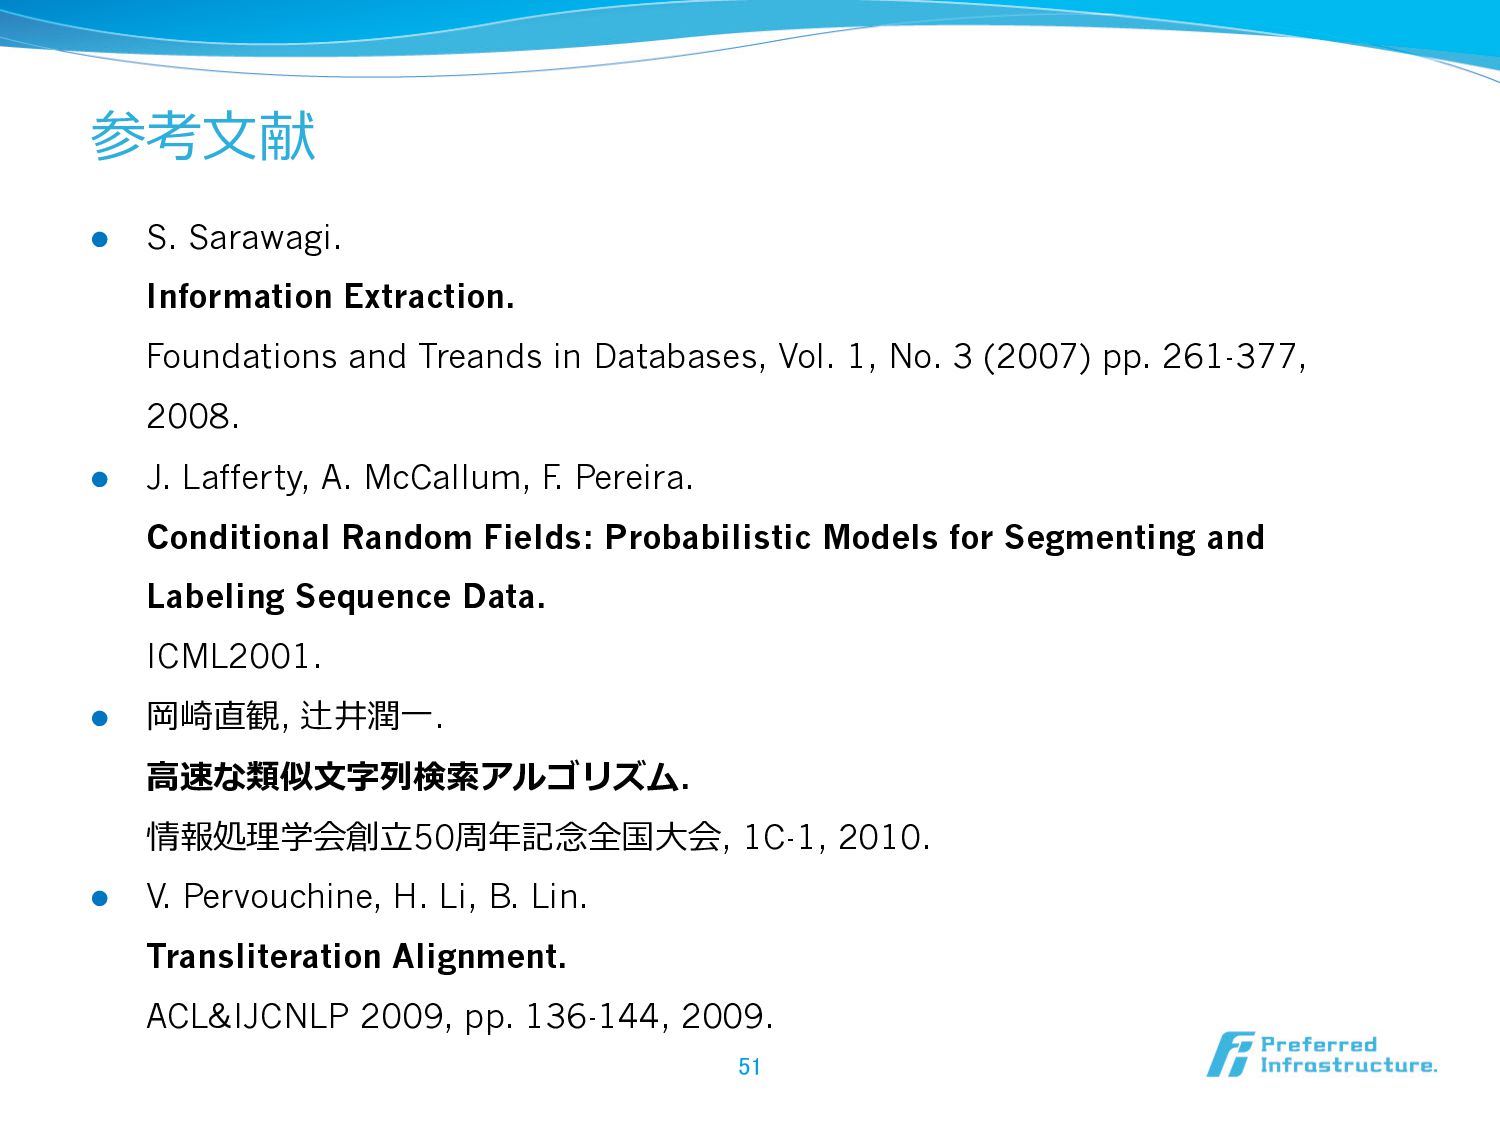
参考⽂文献 l S. Sarawagi. Information Extraction. Foundations and Treands in
Databases, Vol. 1, No. 3 (2007) pp. 261-377, 2008. l J. Lafferty, A. McCallum, F . Pereira. Conditional Random Fields: Probabilistic Models for Segmenting and Labeling Sequence Data. ICML2001. l 岡崎直観, 辻井潤⼀一. ⾼高速な類似⽂文字列列検索索アルゴリズム. 情報処理理学会創⽴立立50周年年記念念全国⼤大会, 1C-1, 2010. l V. Pervouchine, H. Li, B. Lin. Transliteration Alignment. ACL&IJCNLP 2009, pp. 136-144, 2009. 51