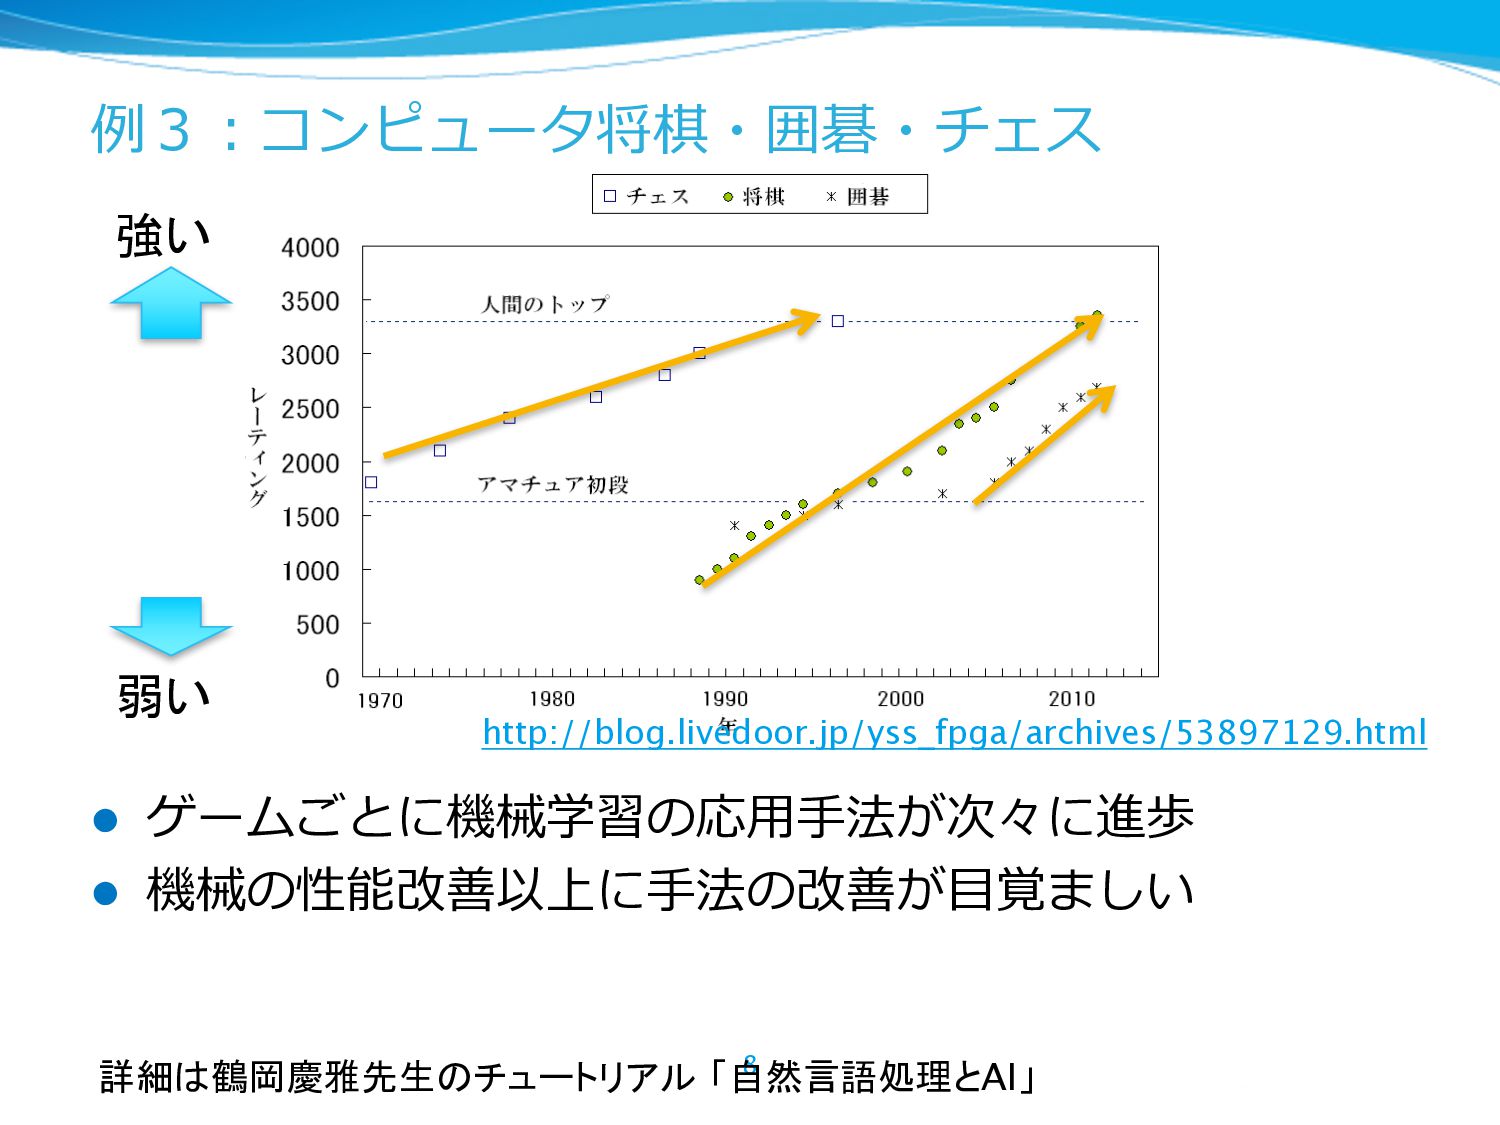
Share
Embed
Transcript
141 slides
-
⾃⼰紹介 海野 裕也 l -2008 東⼤情報理⼯修⼠,⾃然⾔語処理 l 2008-2011 ⽇本アイ・ビー・エム(株)東京基礎研 l
2011-2016 (株)プリファードインフラストラク チャー l 2016- (株)プリファードネットワークス l ⾃然⾔語処理、機械学習、テキストマイニング l ChainerなどのOSS開発 l 機械とのコミュニケーションの研究開発 NLP若⼿の会顧問(2016-) 「オンライン機械学習」(2015, 講談社) 「深層学習による⾃然⾔語処理」(2017, 講談社) 2 -
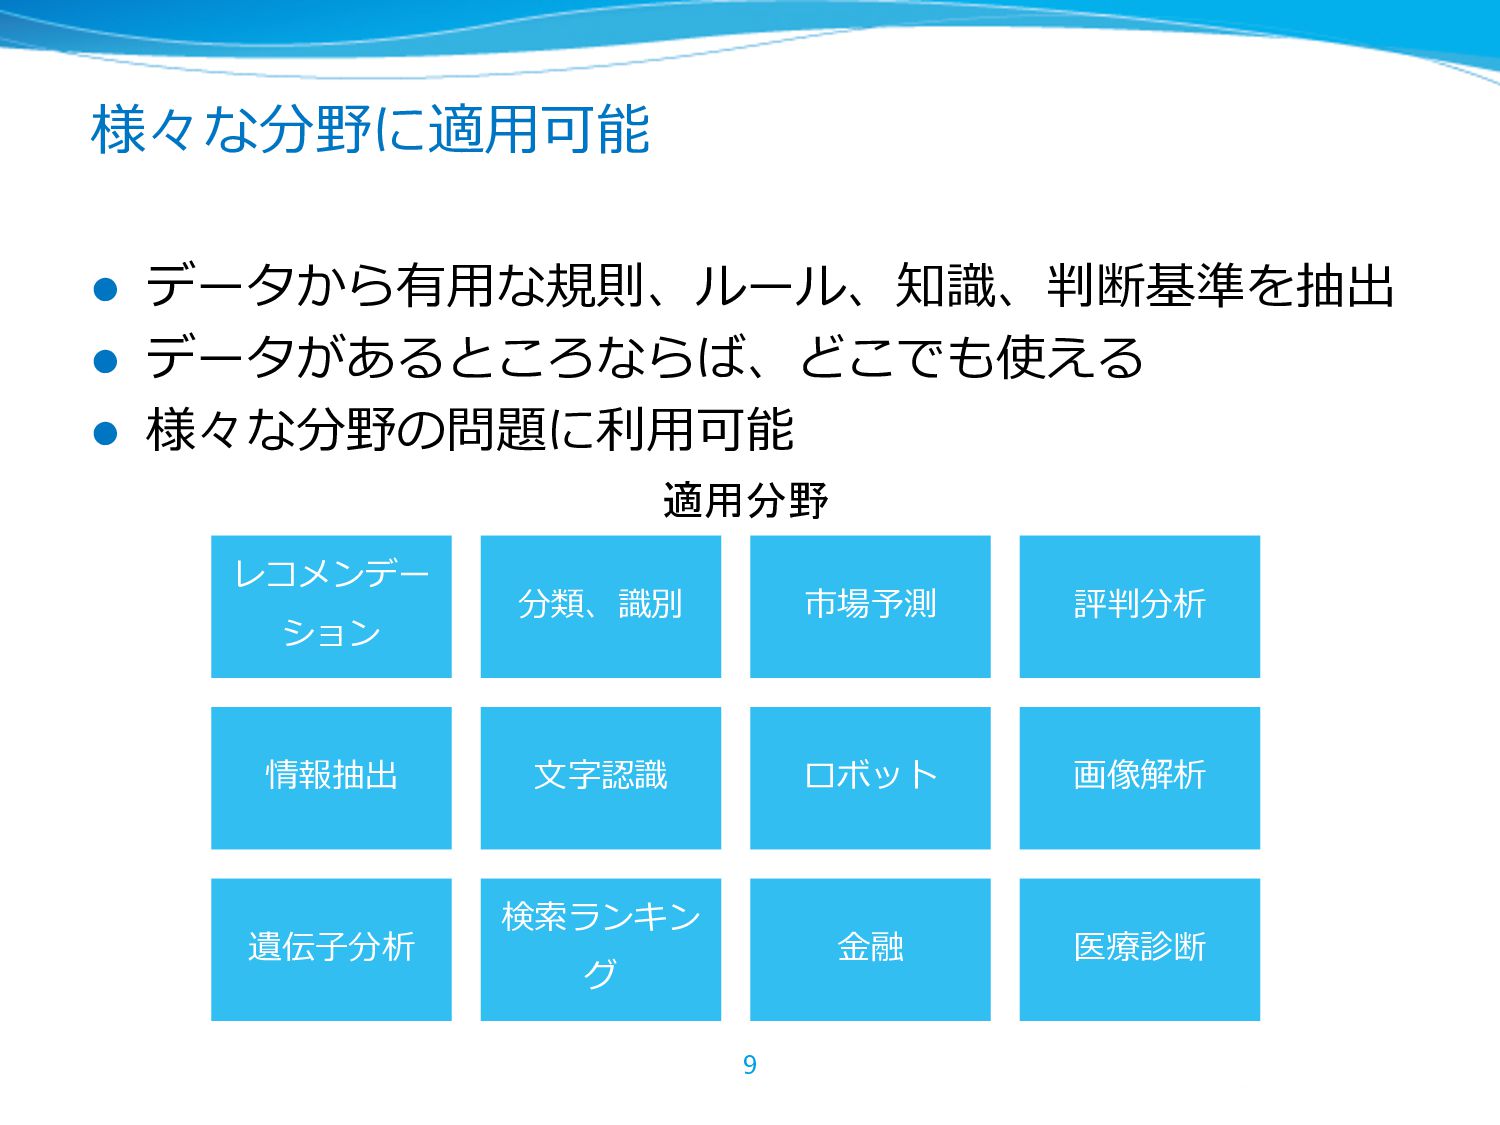
様々な分野に適⽤可能 l データから有⽤な規則、ルール、知識、判断基準を抽出 l データがあるところならば、どこでも使える l 様々な分野の問題に利⽤可能 9 レコメンデー ション
分類、識別 市場予測 評判分析 情報抽出 ⽂字認識 ロボット 画像解析 遺伝⼦分析 検索ランキン グ ⾦融 医療診断 適用分野 -
⼈に⽐べて機械学習のここがいい! l ⼤量 l ⼤量に処理できる l 機械を並べればいくらでもスケールする l ⾼速 l
⼈間の反応速度を超えることができる l ⾼精度 l 場合によっては⼈間を凌駕するようになってきた l ⼈と違って判断がブレない、疲れない 11 -
機械学習を活かすポイント 量と速度が圧倒的なポイント l 量 l ⼤量のデータが有って⼈⼿で処理できない l 情報源が多様すぎて⼈間では⼿に負えない l 速度
l ⼈間よりも圧倒的に⾼速に反応できる l 反応速度が重要な領域で価値が出る 12 いずれも⼀般的に機械が ⼈間より優っているポイント -
機械学習が失敗するパターン l できない精度を求める l サイコロの次の⽬を当てることはできない l 同じように、精度の限界がある l ⼈にとって簡単なタスクをやろうとする l
少ない情報から推論するのは⼈間が得意 l 逆に⼤量の情報から判断する必要がある時は機械が得意 l ボトルネックが別にある l アクションを取るのが⼈だったり、⼈が途中に介在する l 量と速度のメリットをいかに活かすか 13 -
「機械にやらせるなら、ルールを書けばいいんじゃ ないの?」 l 俗にルールベースと呼ばれる⽅法 l 最初は精度が悪いが頑張れば意外とどこまでも良くなる 14 「ゴルフ」 à スポーツ
「インテル」 à コンピュータ 「選挙」 à 政治 -
ルールに基づく判断の限界 l ⼈⼿で書いたルールはすぐ複雑、膨⼤になる l 1万⾏のperlスクリプト l どこを変えたらいいかわからない l 条件を追加したら何が起こるか・・・ l
複雑化したルールは引き継げなくなる 15 「ゴルフ」and「VW」 à ⾞ 「インテル」and「⻑友」 à サッカー 「選挙」and「AKB」 à 芸能 -
まとめ:機械学習 vs ⼈間 vs ルール 機械学習は速度、量、精度、メンテナンス性のバ ランスがとれている l ⼈間に⽐べて・・ l
量と速度に優る l 疲れない、ぶれない、スケールする l ルールに⽐べて l 精度に優る l メンテナンスできる、引き継げる、データの変化に 強い 22 -
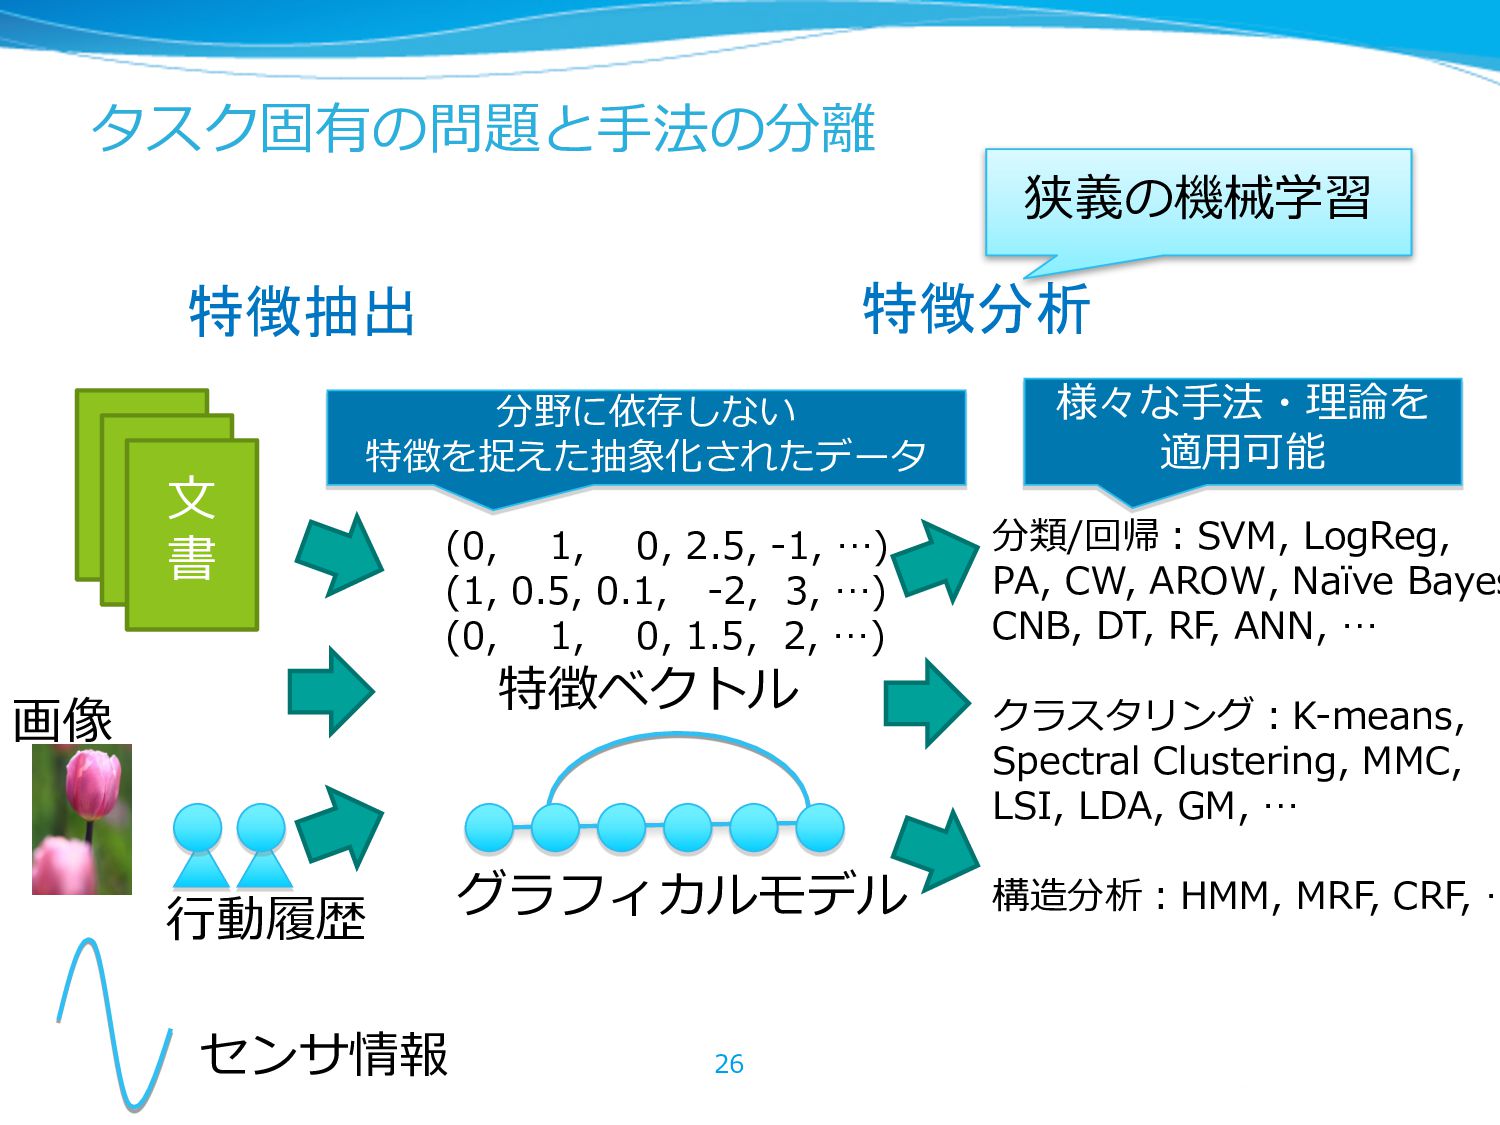
タスク固有の問題と⼿法の分離 26 ⽂ 書 (0, 1, 0, 2.5, -1, …)
(1, 0.5, 0.1, -2, 3, …) (0, 1, 0, 1.5, 2, …) 特徴ベクトル グラフィカルモデル 分類/回帰:SVM, LogReg, PA, CW, AROW, Naïve Bayes CNB, DT, RF, ANN, … クラスタリング:K-means, Spectral Clustering, MMC, LSI, LDA, GM, … 構造分析:HMM, MRF, CRF, … 画像 センサ情報 ⾏動履歴 分野に依存しない 特徴を捉えた抽象化されたデータ 様々な⼿法・理論を 適⽤可能 特徴抽出 特徴分析 狭義の機械学習 -
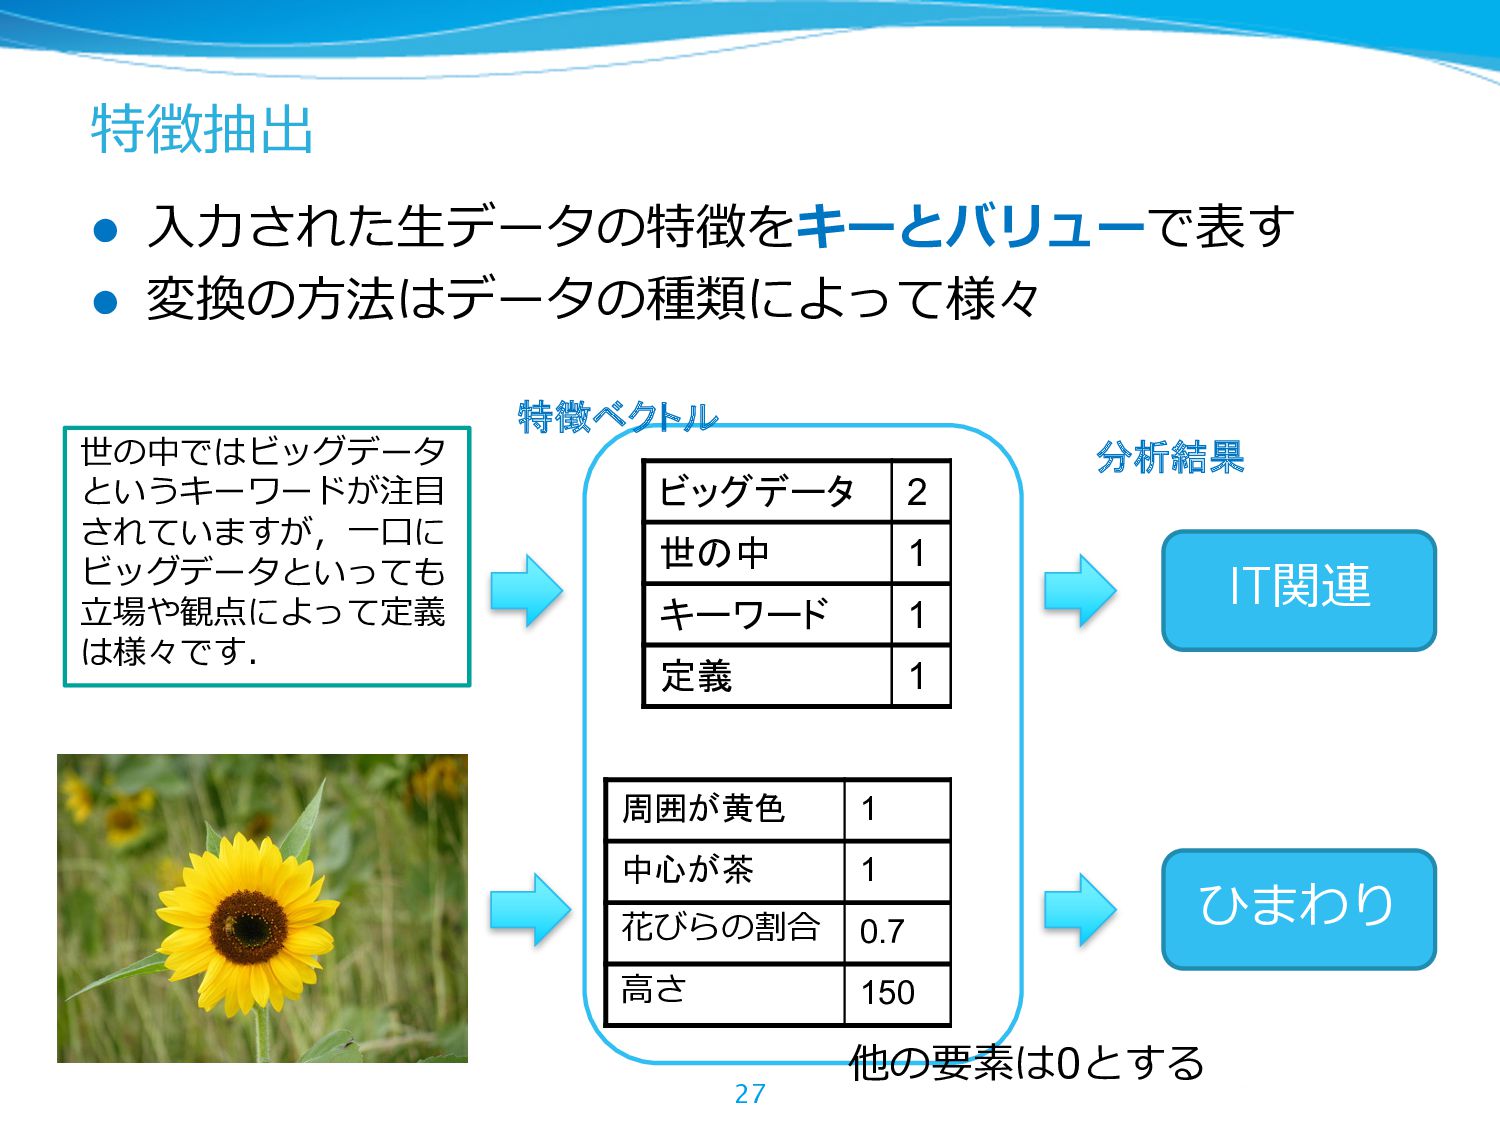
特徴抽出 l ⼊⼒された⽣データの特徴をキーとバリューで表す l 変換の⽅法はデータの種類によって様々 27 周囲が黄色 1 中心が茶 1
花びらの割合 0.7 ⾼さ 150 世の中ではビッグデータ というキーワードが注⽬ されていますが,⼀⼝に ビッグデータといっても ⽴場や観点によって定義 は様々です. 他の要素は0とする ビッグデータ 2 世の中 1 キーワード 1 定義 1 IT関連 ひまわり 特徴ベクトル 分析結果 -
機械学習の世界の分類 l 問題設定に基づく分類 l 教師あり学習 / 教師なし学習 / 半教師あり学習 /
強化学習 .. l 戦うドメインの違い l 特徴設計屋(各ドメイン毎に, NLP, Image, Bio, Music) l 学習アルゴリズム屋(SVM, xx Bayes, CW, …) l 理論屋(統計的学習理論、経験過程、Regret最⼩化) l 最適化実装屋 l 好みの違い l Bayesian / Frequentist / Connectionist / DeepLearning l [Non-|Semi-]Parametric 29 太字について話します -
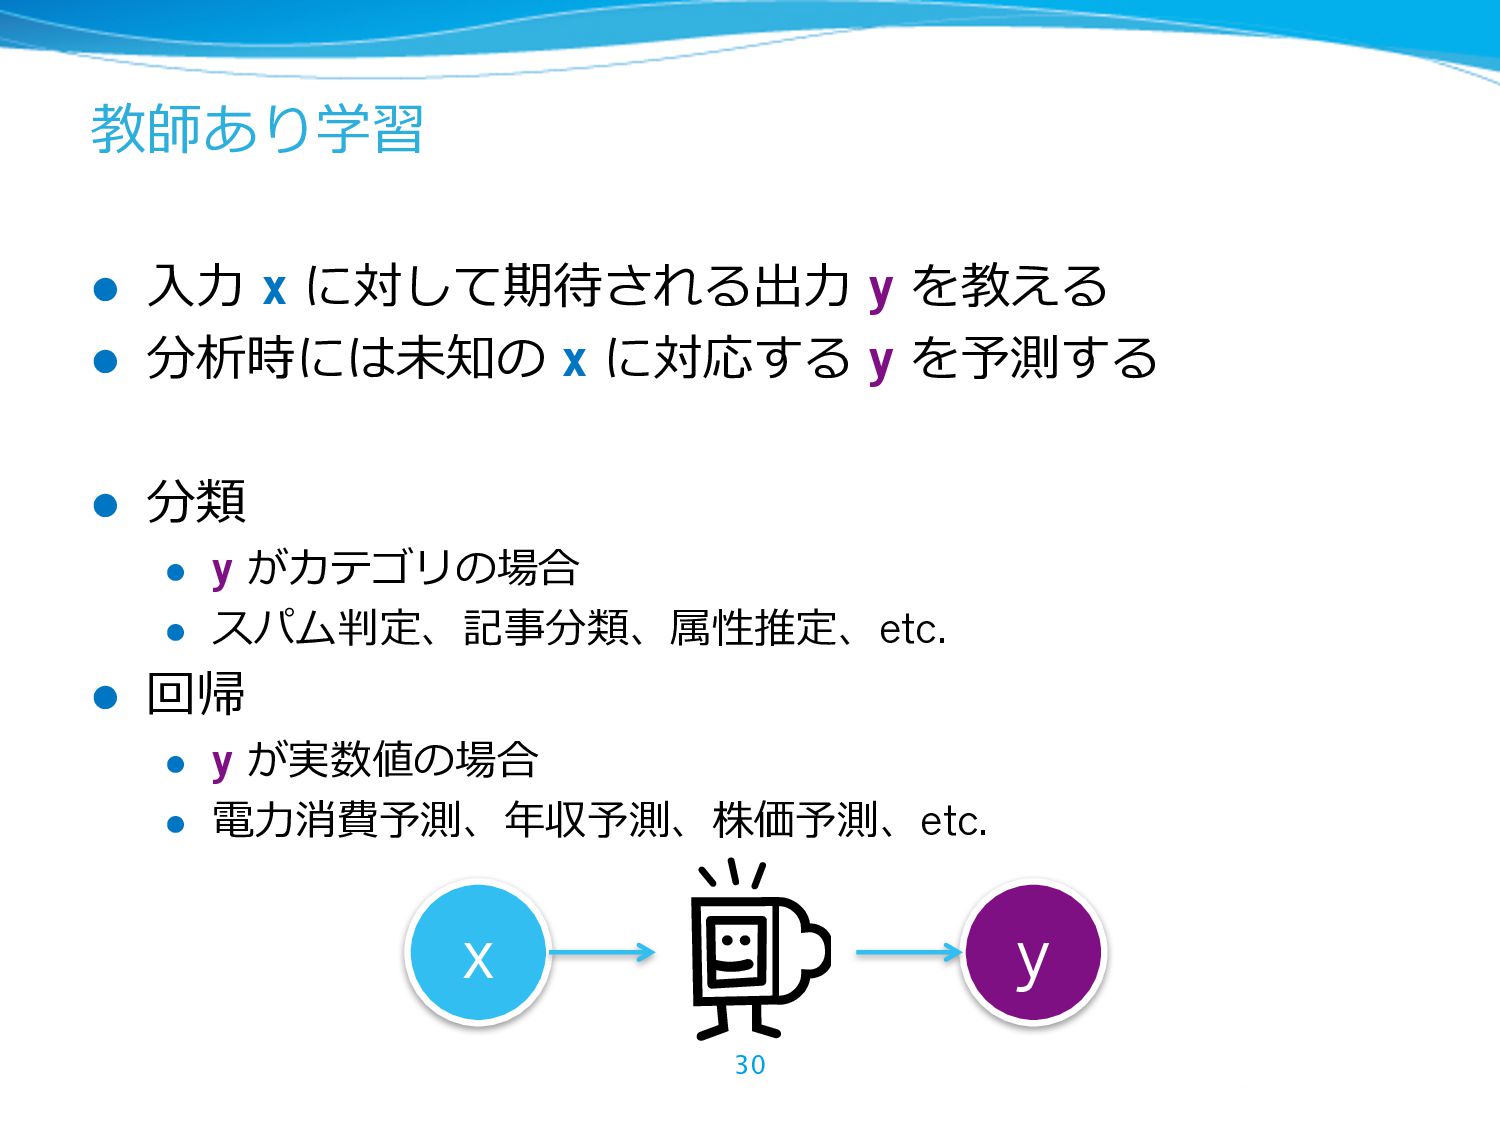
教師あり学習 l ⼊⼒ x に対して期待される出⼒ y を教える l 分析時には未知の x
に対応する y を予測する l 分類 l y がカテゴリの場合 l スパム判定、記事分類、属性推定、etc. l 回帰 l y が実数値の場合 l 電⼒消費予測、年収予測、株価予測、etc. 30 x y -
教師なし学習 l ⼊⼒ x をたくさん与えると、⼊⼒情報⾃体の性質に関し て何かしらの結果を返す l クラスタリング l 与えられたデータをまとめあげる
l 異常検知 l ⼊⼒データが異常かどうかを判定する 31 x -
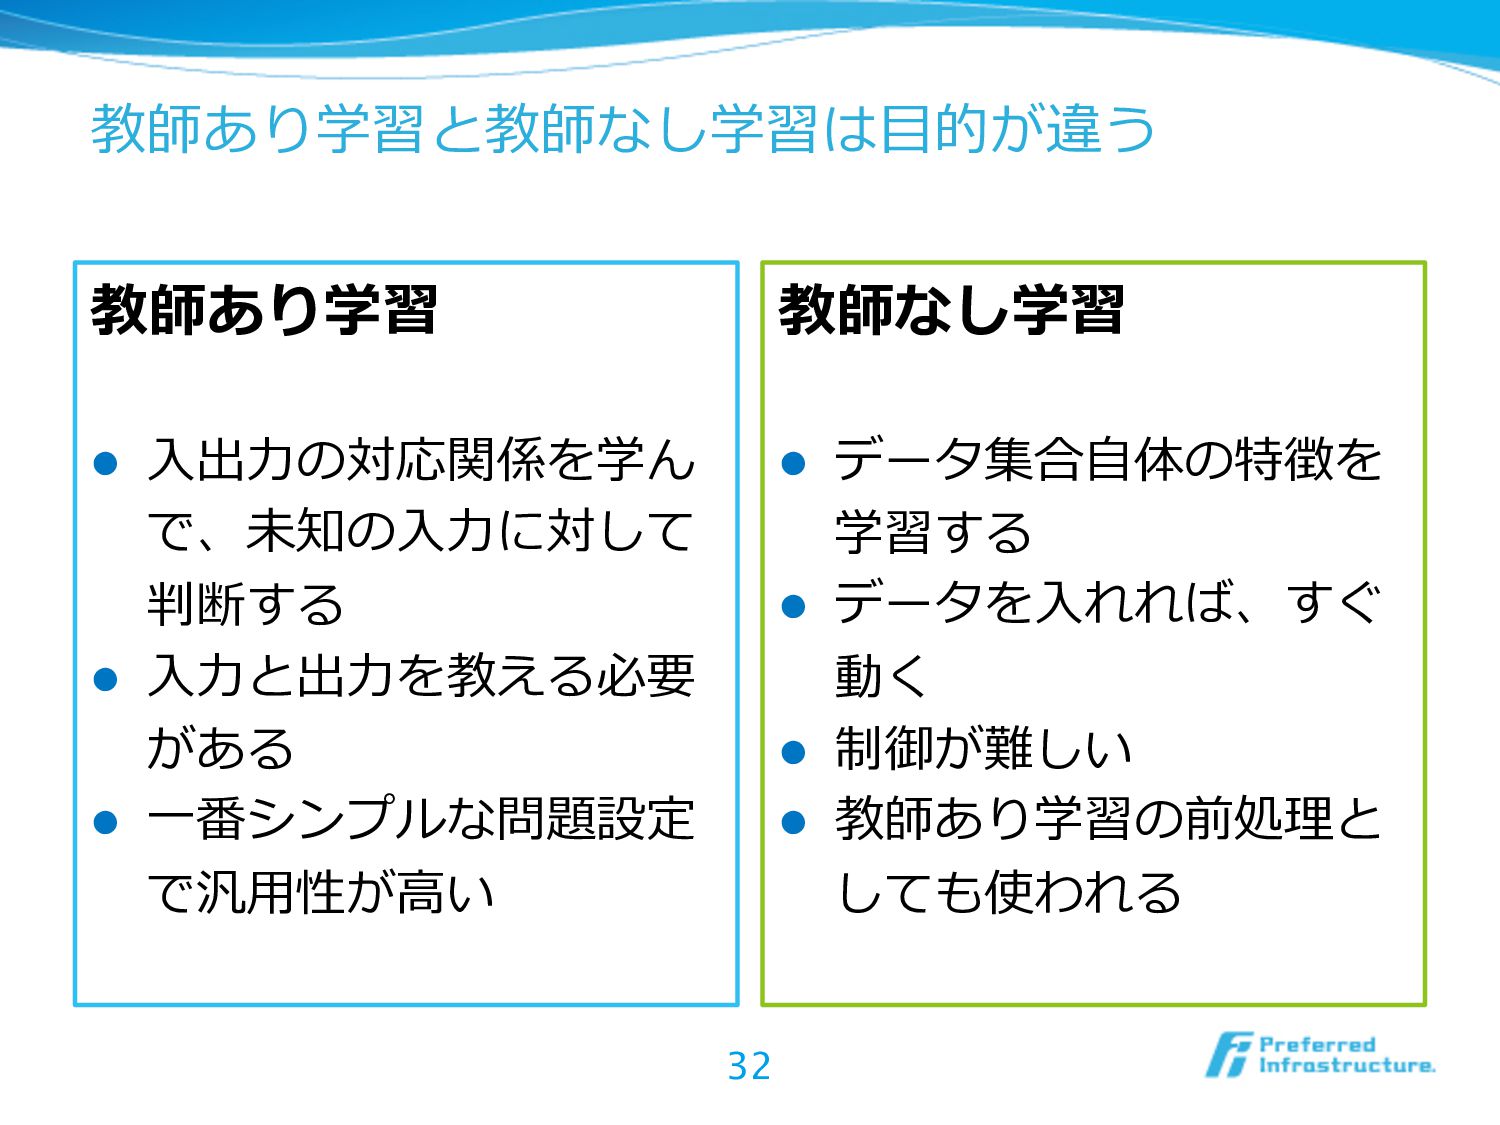
教師あり学習と教師なし学習は⽬的が違う 教師あり学習 l ⼊出⼒の対応関係を学ん で、未知の⼊⼒に対して 判断する l ⼊⼒と出⼒を教える必要 がある l
⼀番シンプルな問題設定 で汎⽤性が⾼い 教師なし学習 l データ集合⾃体の特徴を 学習する l データを⼊れれば、すぐ 動く l 制御が難しい l 教師あり学習の前処理と しても使われる 32 -
強化学習 l 事前にデータは与えられず、⼊⼒ x に対して⾏動を取る と初めて報酬 y が得られる l データの取得⾃体に試⾏錯誤が必要
l 多腕バンディット問題 l 未知の⾏動と、既知の⾏動の選択を⾏う 33 x y 行動 -
教師あり学習と強化学習は設定が違う 強化学習 l 教師データはない l 新規データの取得できる 環境がある l データがまだなく、デー タ取得まで⾃動化する場
合に向く 教師あり学習問題 l 教師データがある l 新規データの取得は不可 能 l 既知のラベル付きデータ が⼗分にある場合に向く 35 -
機械学習の仕組みを知る必要はあるのか? l 必ずしも必要ない l うまく機能していれば、中⾝を知る必要は特にない と思う l うまくいかないときが問題 l ⼿法⾃体を知っていると、限界がある程度わかる
l そのため、知っているとチューニングしやすい 36 -
その前に・・・ l ⼊⼒ x は全てベクトルだとします l 特徴抽出は終わっているということ l ベクトル以外の系列や⽣のデータを扱う⼿法もあり ますが、今回は対象外
l 直感的な2次元ベクトルの絵を出しますが、⼀般 的にはより⾼次元のベクトルとなるので直感と あわないことがあります 38 -
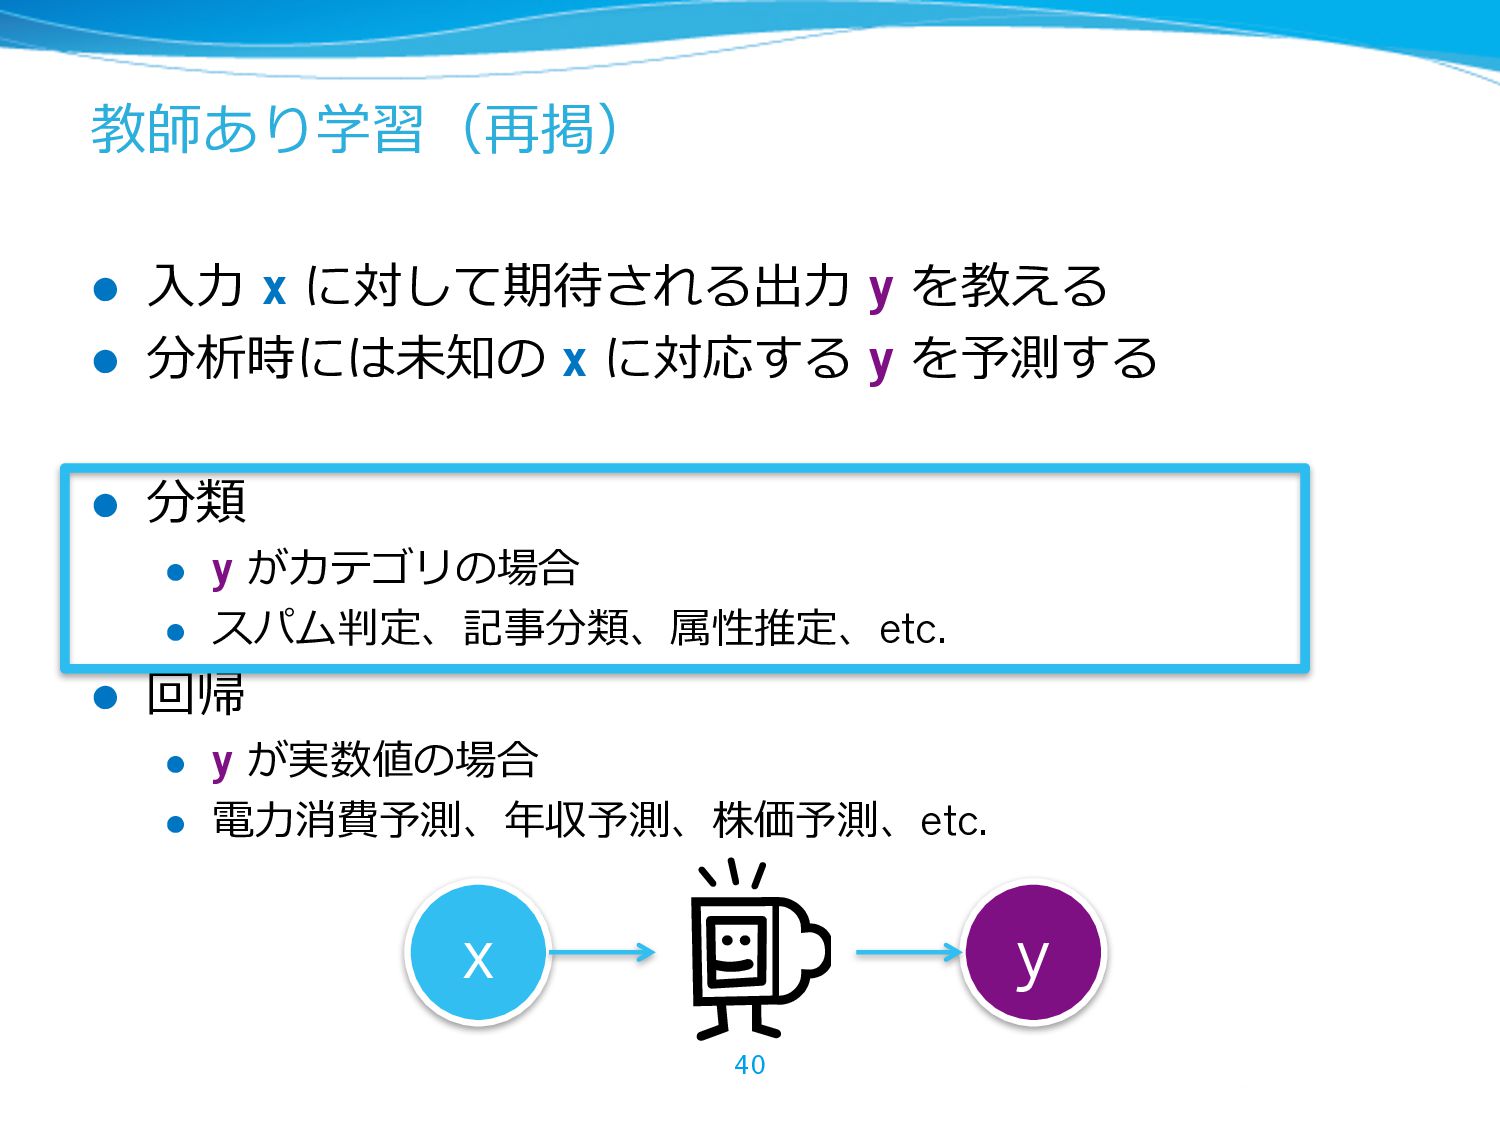
教師あり学習(再掲) l ⼊⼒ x に対して期待される出⼒ y を教える l 分析時には未知の x
に対応する y を予測する l 分類 l y がカテゴリの場合 l スパム判定、記事分類、属性推定、etc. l 回帰 l y が実数値の場合 l 電⼒消費予測、年収予測、株価予測、etc. 40 x y -
教師あり学習のユースケース例 ⾃動分類結果をシステムとつなぎあわせやすい l 重要情報のフィルタリング l コールセンターログを重要度やタイプ別に分類 l 分類結果から、深刻な問題を詳細に分析したり、問い合わせの トレンドを⾒ることができる l
顧客セグメントの予測 l 購買履歴などのログ情報から、顧客の詳細なセグメント(年代 性別のみならず、家族構成、趣味嗜好など)を予測 l 予測結果を、例えば広告やキャンペーン対象として利⽤する 41 -
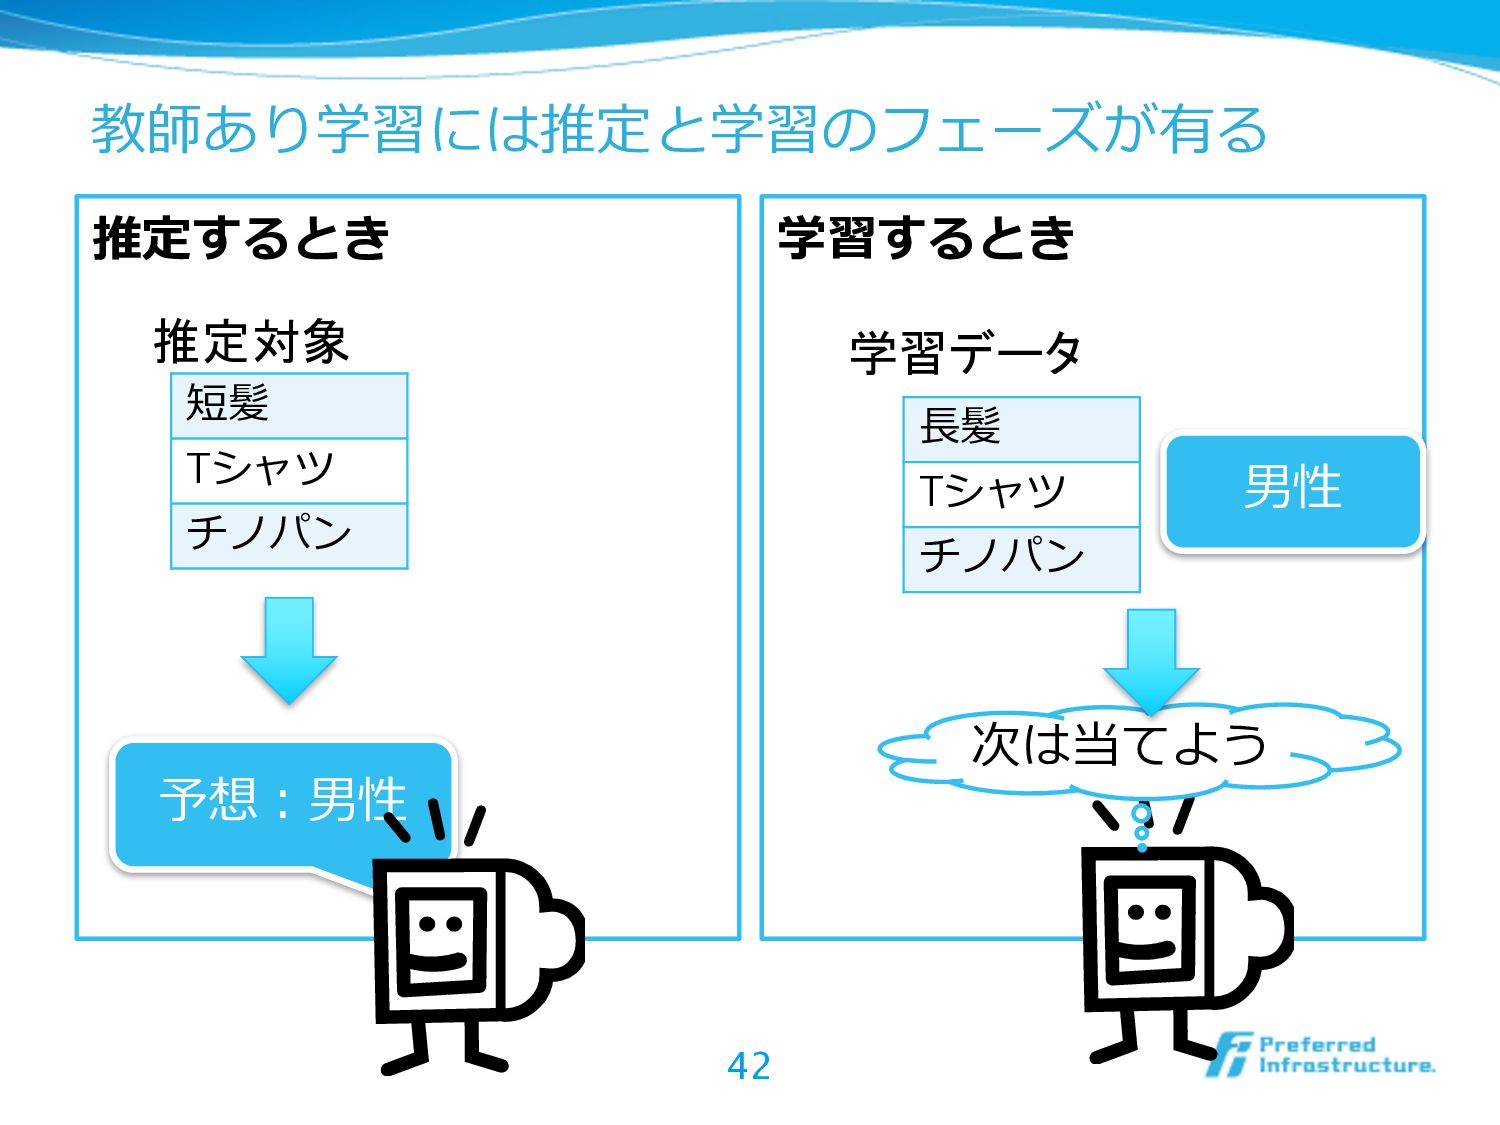
教師あり学習には推定と学習のフェーズが有る 推定するとき 学習するとき 42 短髪 Tシャツ チノパン 予想:男性 ⻑髪 Tシャツ
チノパン 学習データ 男性 次は当てよう 推定対象 -
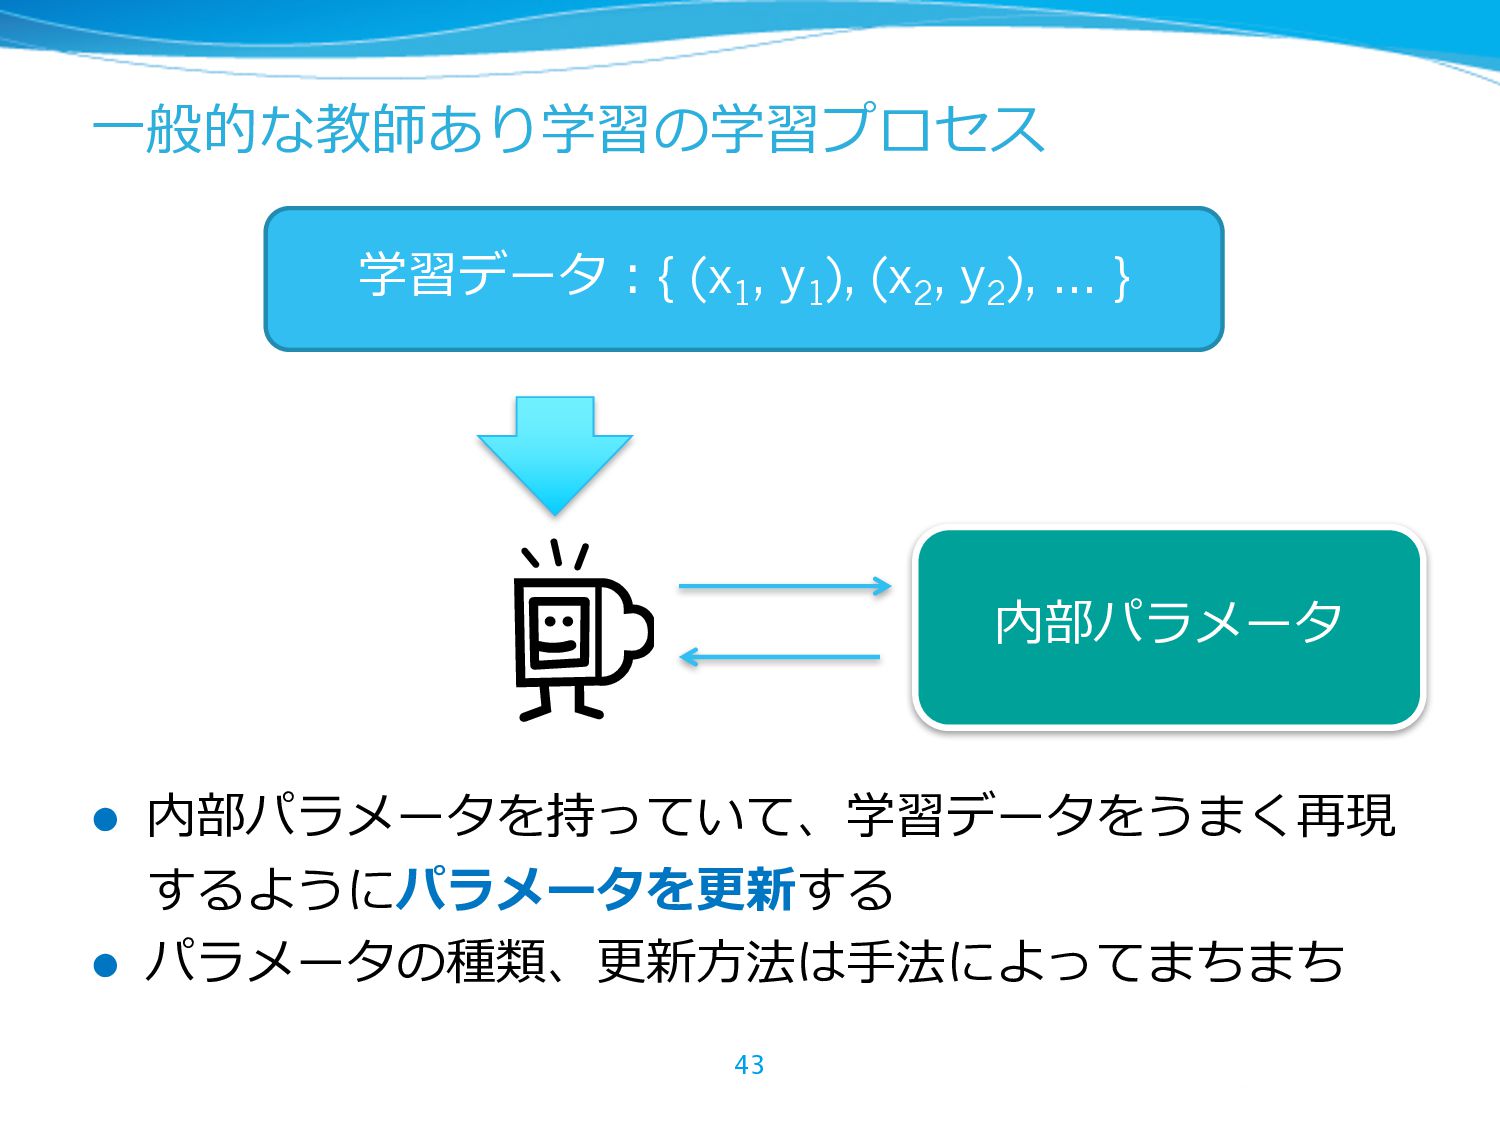
⼀般的な教師あり学習の学習プロセス l 内部パラメータを持っていて、学習データをうまく再現 するようにパラメータを更新する l パラメータの種類、更新⽅法は⼿法によってまちまち 43 学習データ:{ (x1 ,
y1 ), (x2 , y2 ), … } 内部パラメータ -
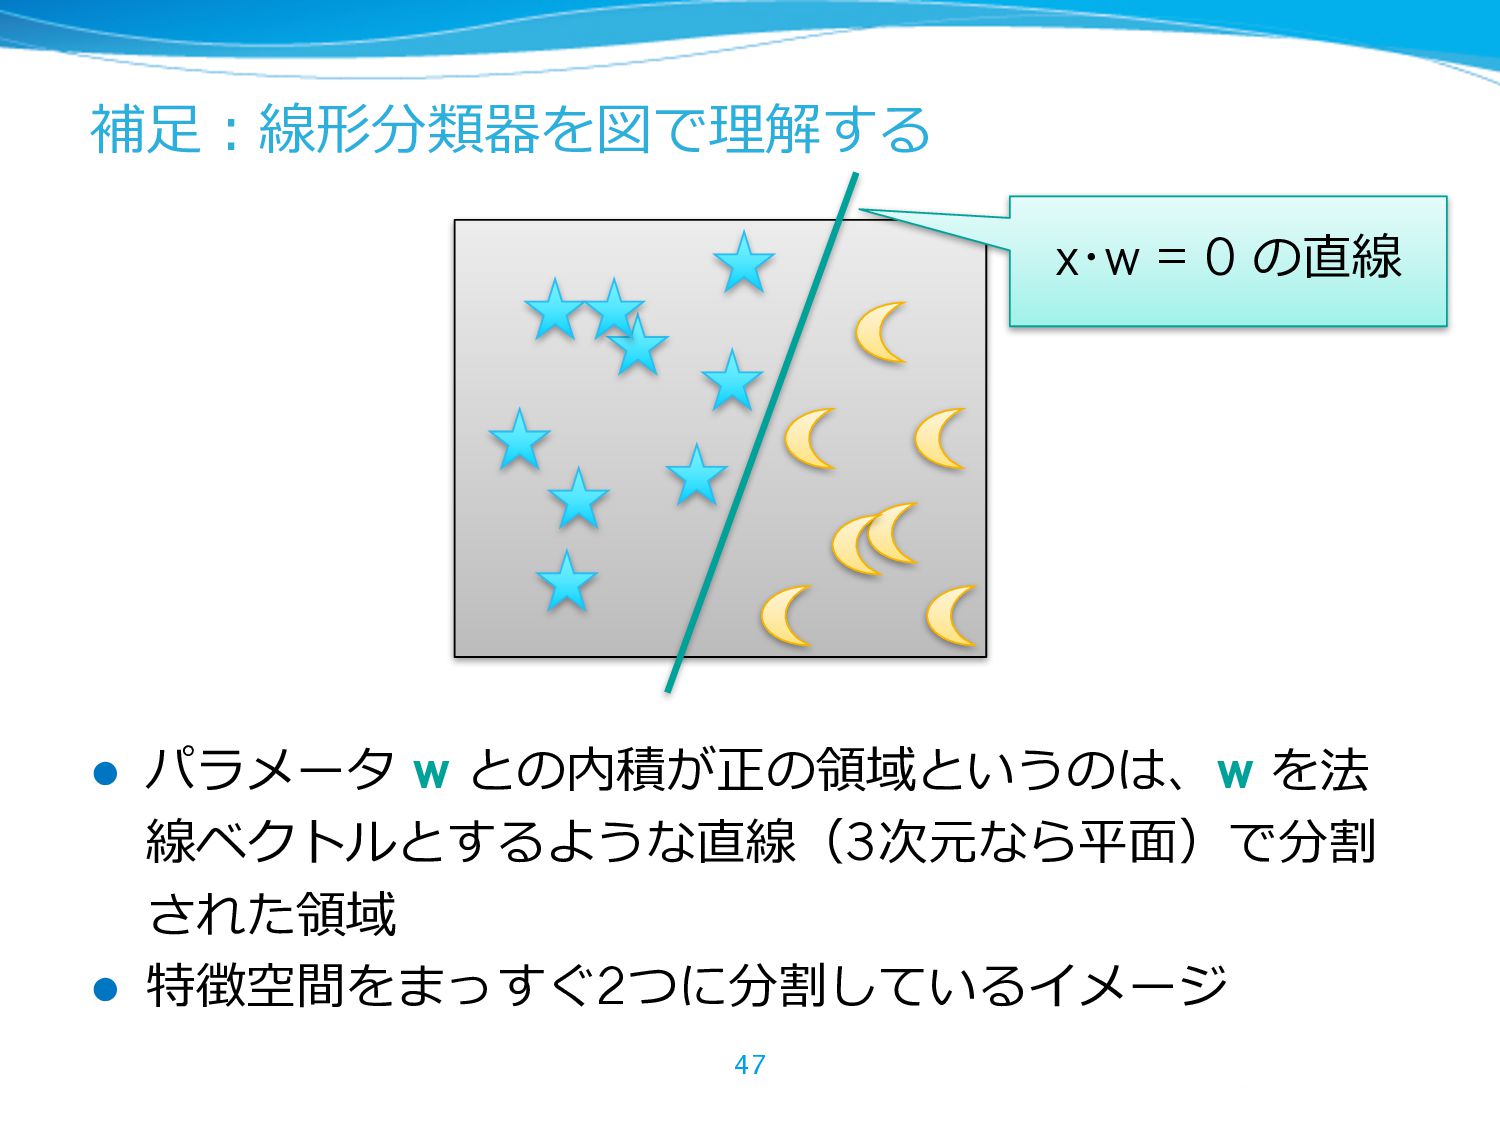
教師あり分類の種別 l 線形分類器 l 特徴ベクトルとパラメータの内積の⼤⼩で分類 l 決定⽊ l ツリー状の分類条件を獲得する l
ニューラルネットワーク l 内積と⾮線形関数の組合せを何度も⾏う l カーネル法(カーネル分類器) l 内積の代わりにカーネル関数を使う l アンサンブル学習 l 複数の分類器を組み合わせることで精度をあげる 44 これらは必ずしも 並列関係ではない -
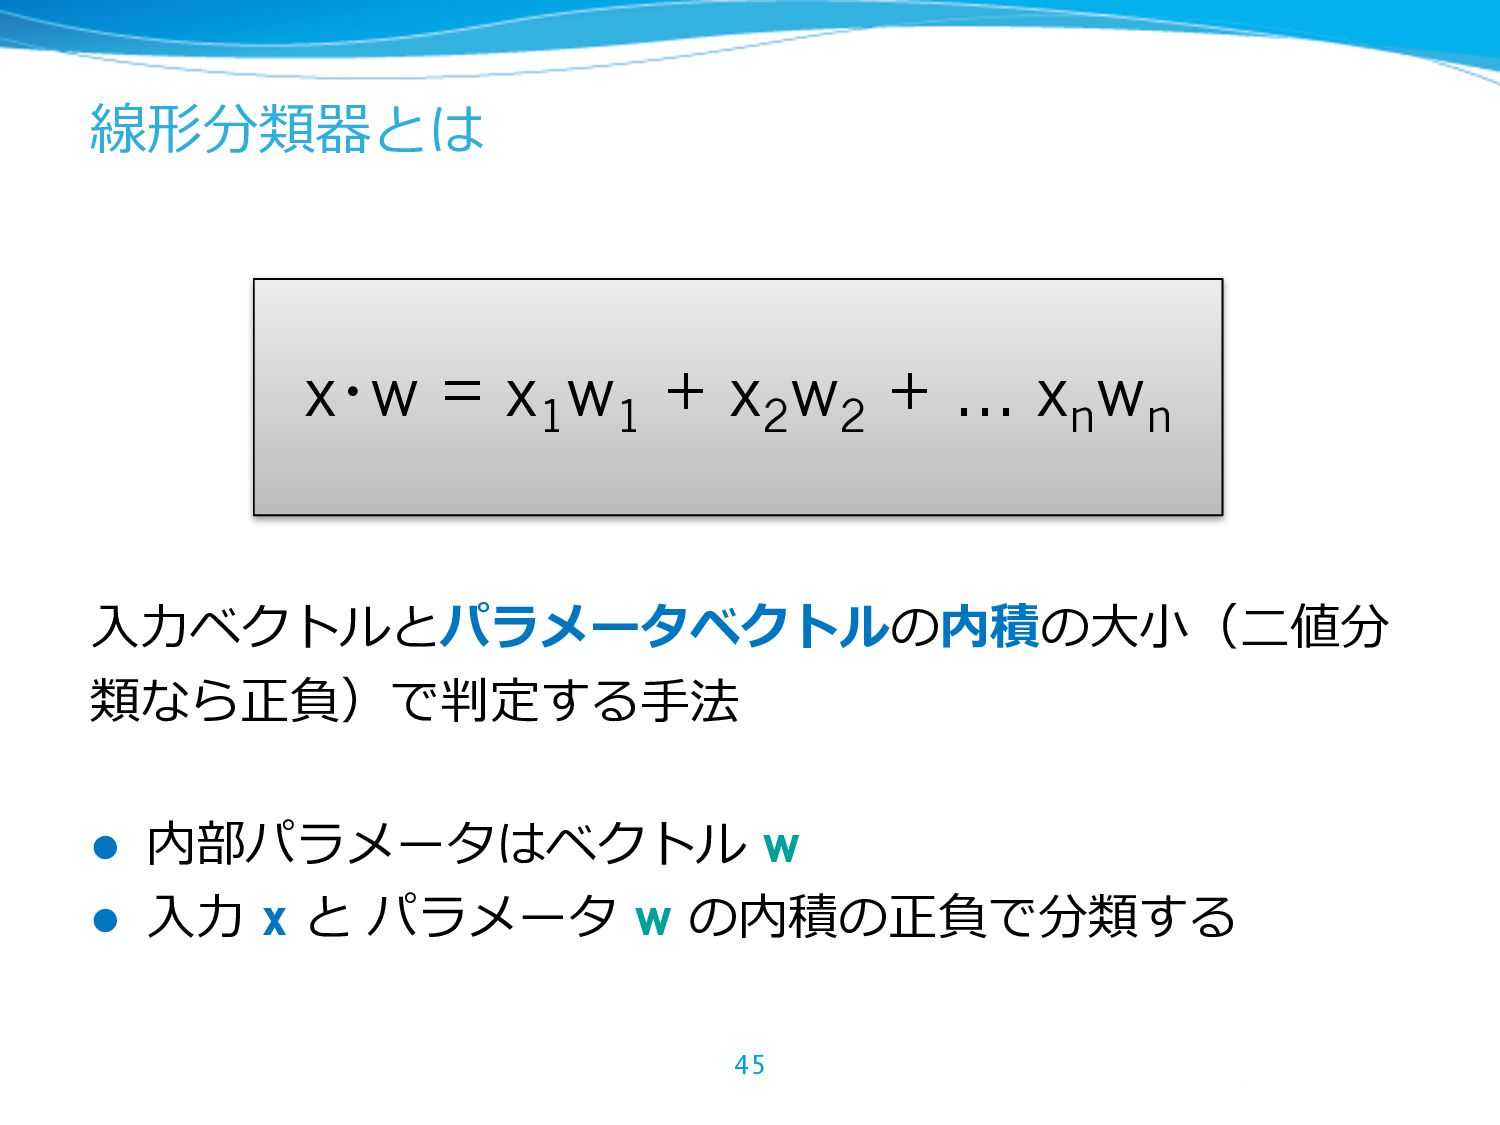
線形分類器とは ⼊⼒ベクトルとパラメータベクトルの内積の⼤⼩(⼆値分 類なら正負)で判定する⼿法 l 内部パラメータはベクトル w l ⼊⼒ x と
パラメータ w の内積の正負で分類する 45 x・w = x1 w1 + x2 w2 + … xn wn -
線形分類器は重み付き多数決 l 容姿の特徴から男性か⼥性か当てるとする l w は男性の特徴に正の重み、⼥性の特徴に負の重み l 判定対象の x に該当する重みの総和で予測が決定する
46 特徴 x ⻑髪 0 短髪 1 Tシャツ 1 ブラウス 0 ジーンズ 1 スカート 0 チノパン 0 w -3 +2 +1 -2 +2 -5 +3 +5 予想:男性 内部に表がある -
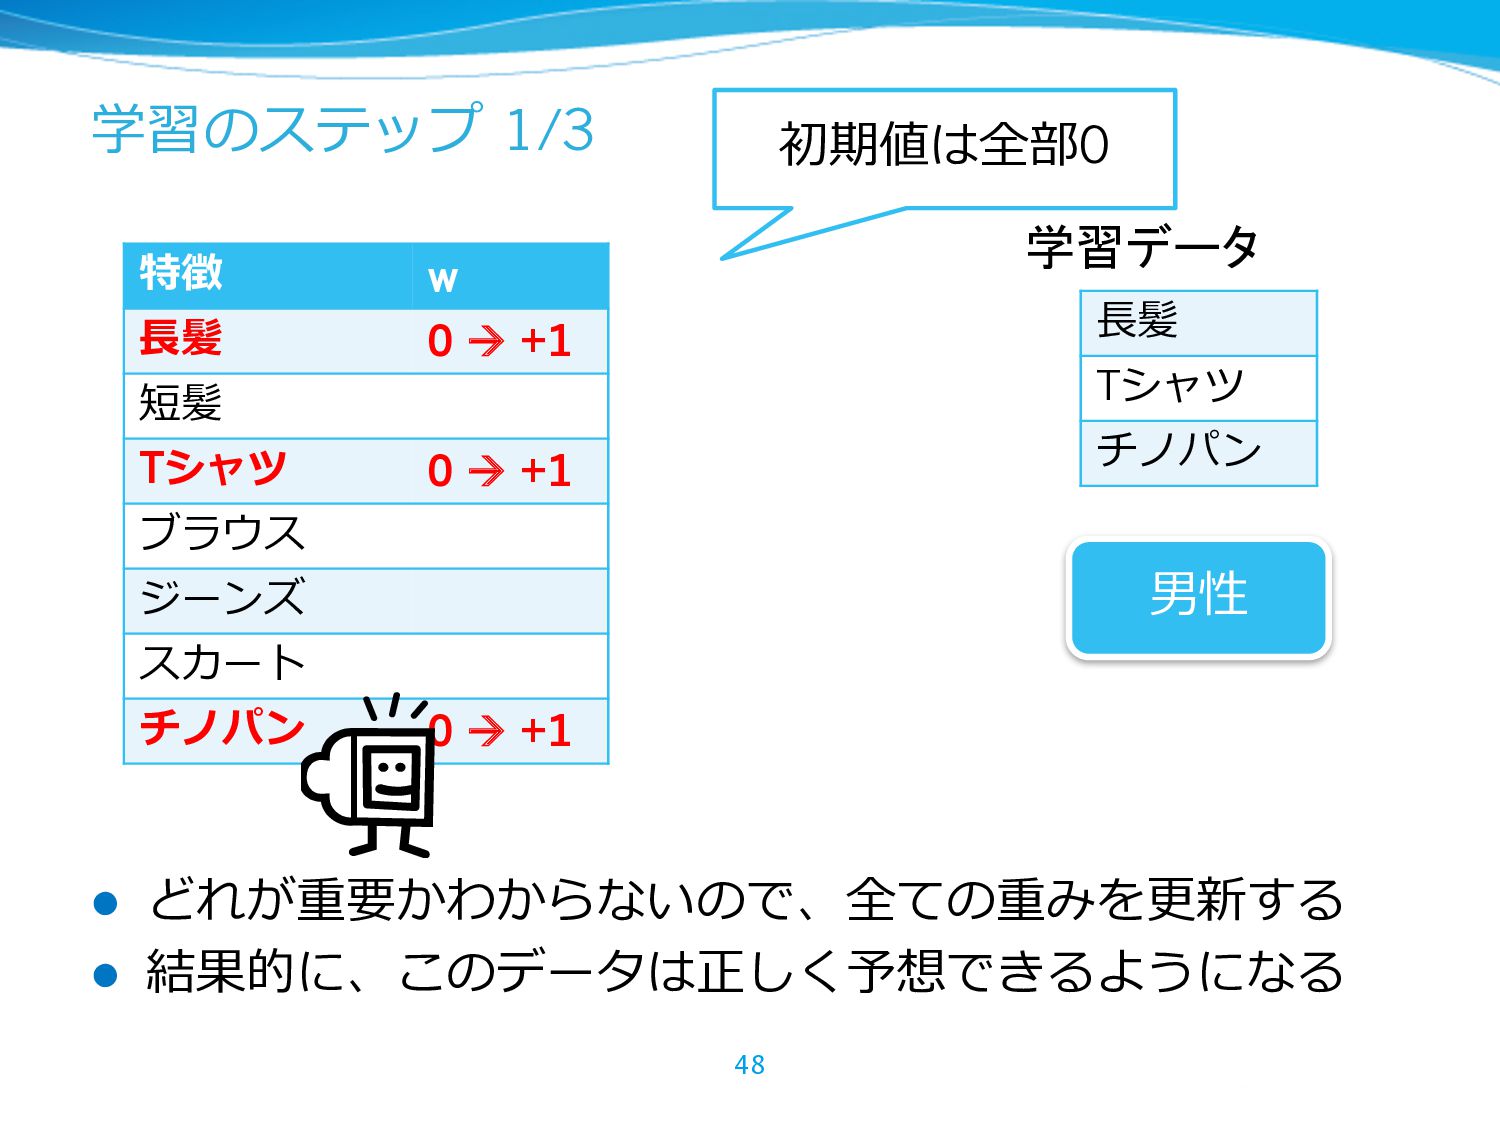
学習のステップ 1/3 l どれが重要かわからないので、全ての重みを更新する l 結果的に、このデータは正しく予想できるようになる 48 特徴 w ⻑髪
0 à +1 短髪 Tシャツ 0 à +1 ブラウス ジーンズ スカート チノパン 0 à +1 ⻑髪 Tシャツ チノパン 学習データ 男性 初期値は全部0 -
学習のステップ 2/4 l 間違えるたびに正しく分類できるように更新 49 特徴 w ⻑髪 +1 à
0 短髪 Tシャツ +1 ブラウス 0 à -1 ジーンズ スカート 0 à -1 チノパン +1 ⻑髪 ブラウス スカート 学習データ ⼥性 -
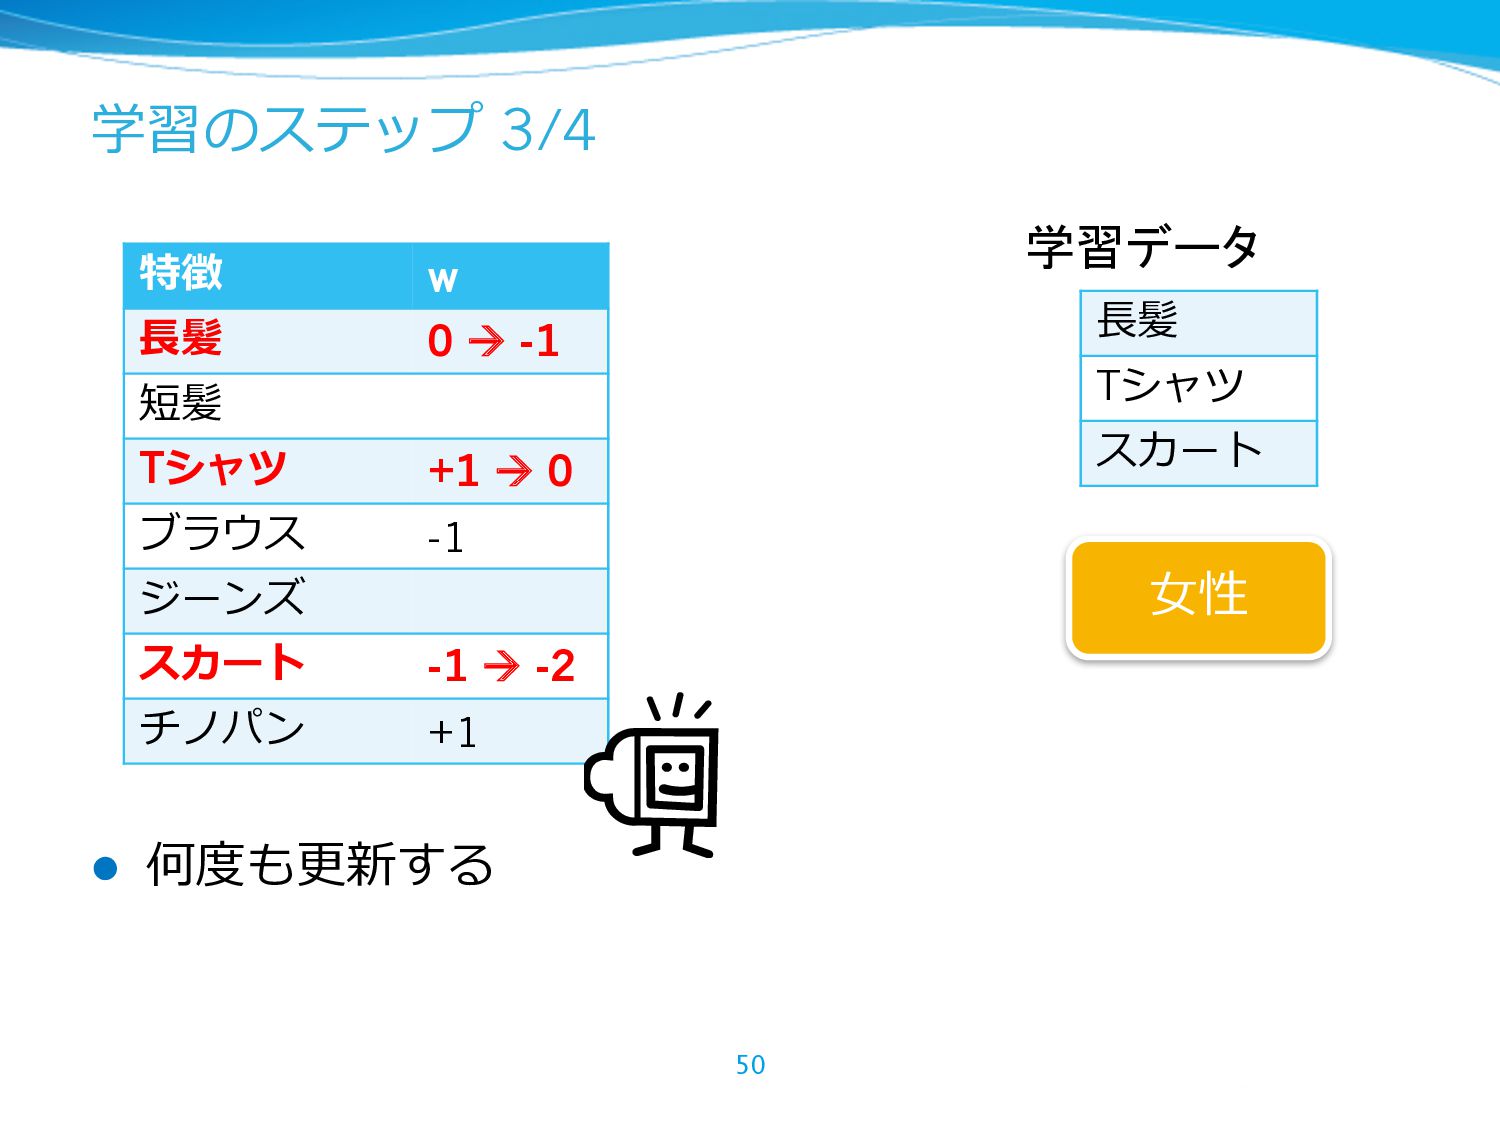
学習のステップ 3/4 l 何度も更新する 50 特徴 w ⻑髪 0 à
-1 短髪 Tシャツ +1 à 0 ブラウス -1 ジーンズ スカート -1 à -2 チノパン +1 ⻑髪 Tシャツ スカート 学習データ ⼥性 -
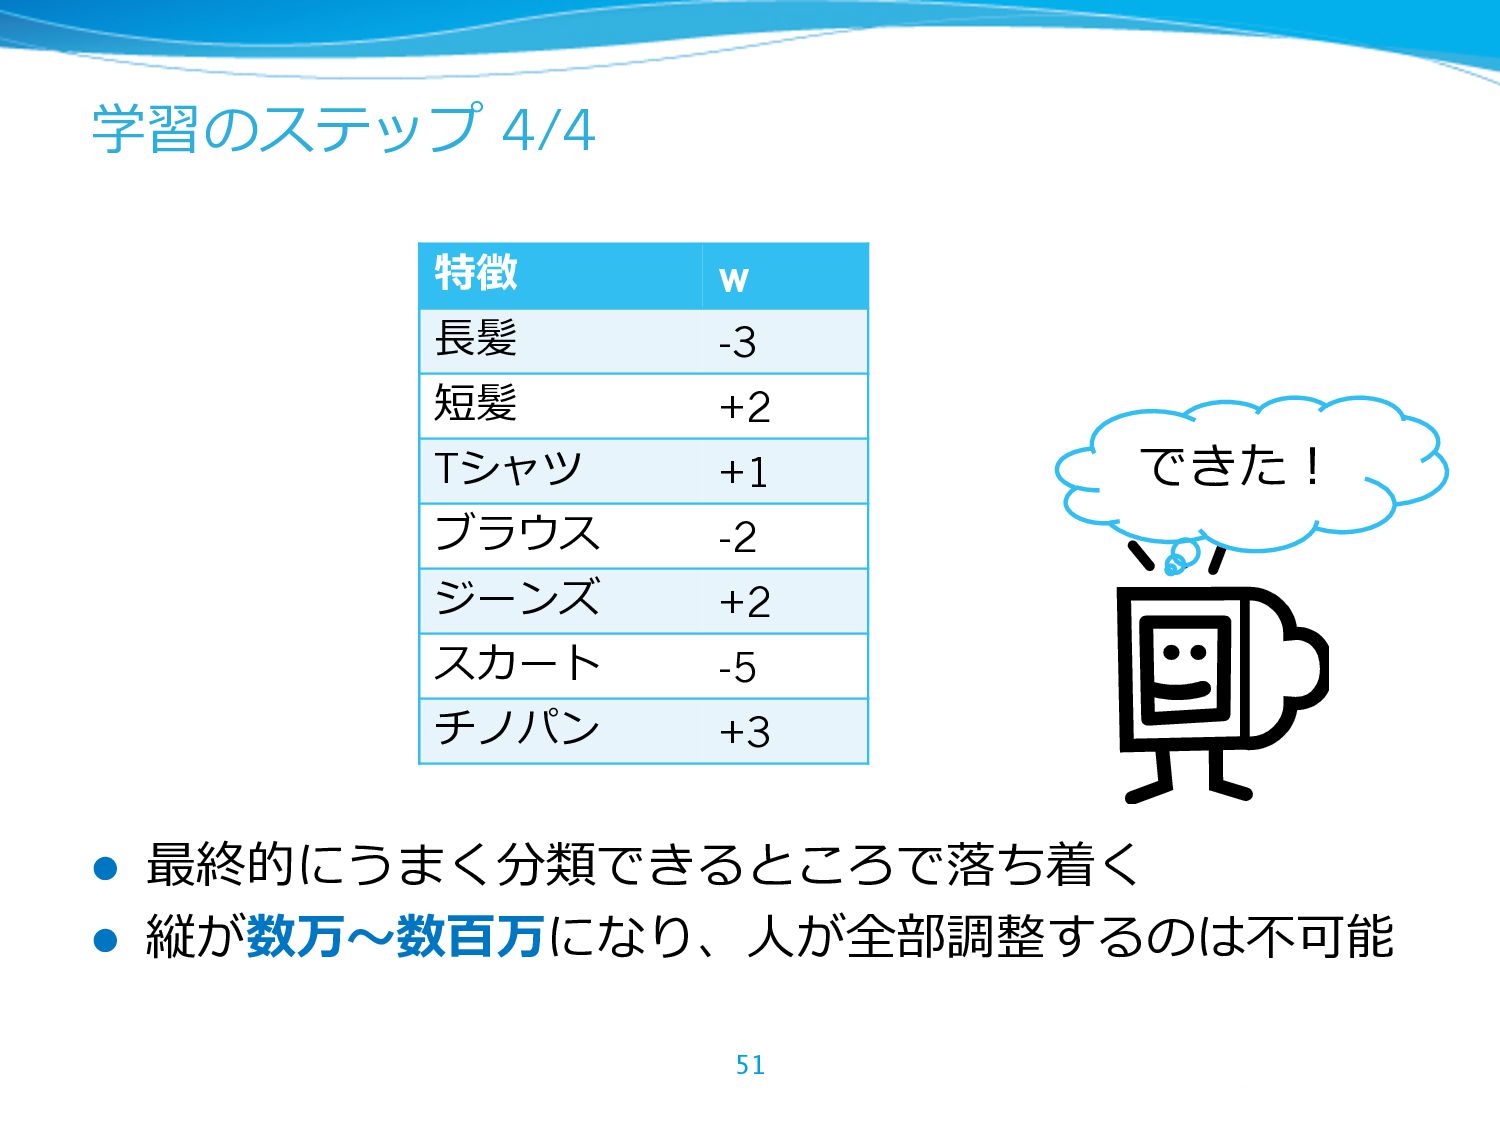
学習のステップ 4/4 l 最終的にうまく分類できるところで落ち着く l 縦が数万〜数百万になり、⼈が全部調整するのは不可能 51 特徴 w ⻑髪
-3 短髪 +2 Tシャツ +1 ブラウス -2 ジーンズ +2 スカート -5 チノパン +3 できた! -
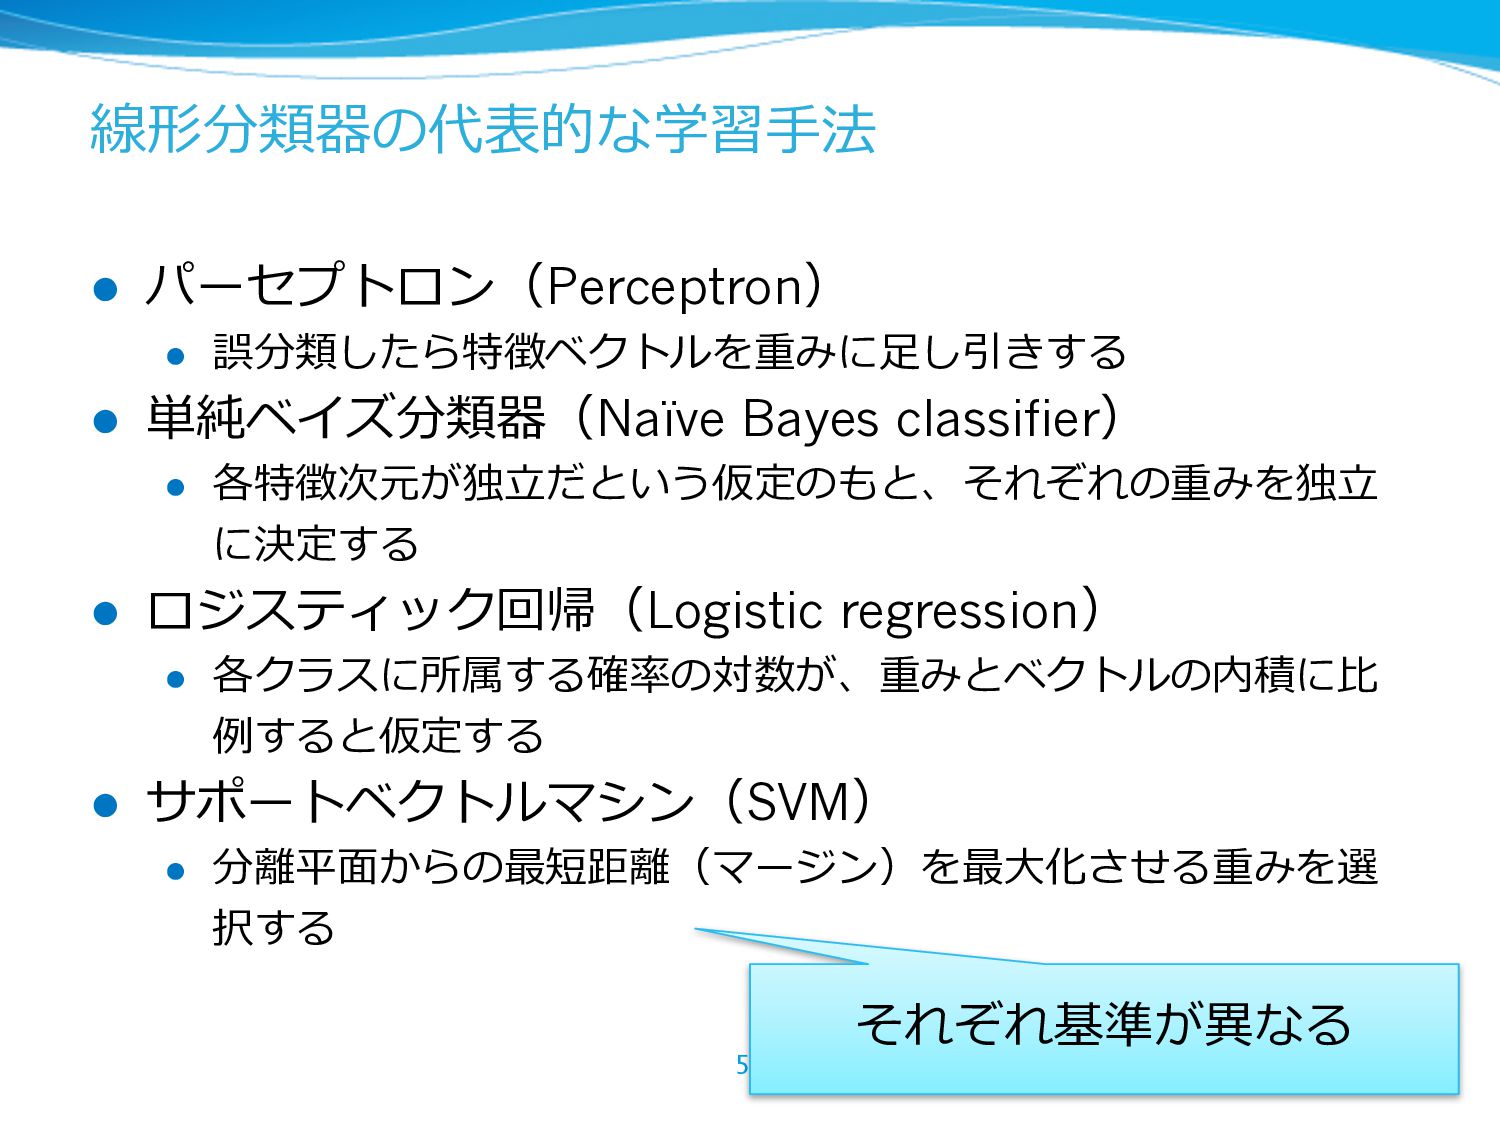
線形分類器の代表的な学習⼿法 l パーセプトロン(Perceptron) l 誤分類したら特徴ベクトルを重みに⾜し引きする l 単純ベイズ分類器(Naïve Bayes classifier) l
各特徴次元が独⽴だという仮定のもと、それぞれの重みを独⽴ に決定する l ロジスティック回帰(Logistic regression) l 各クラスに所属する確率の対数が、重みとベクトルの内積に⽐ 例すると仮定する l サポートベクトルマシン(SVM) l 分離平⾯からの最短距離(マージン)を最⼤化させる重みを選 択する 52 それぞれ基準が異なる -
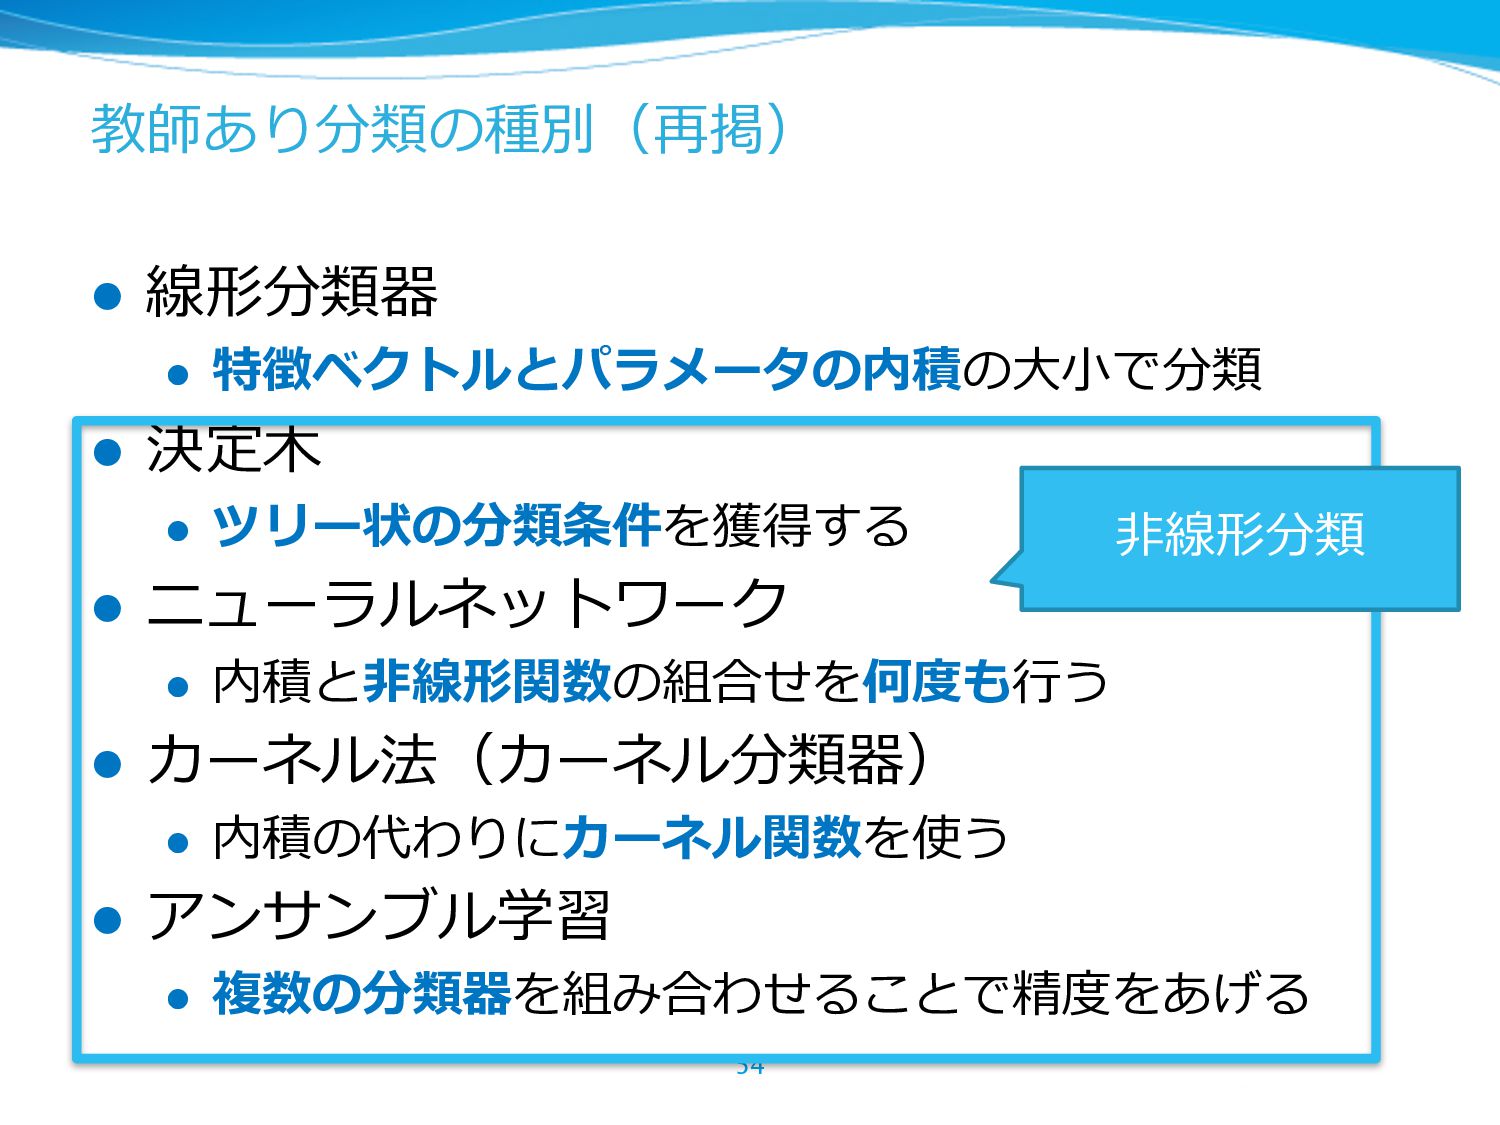
教師あり分類の種別(再掲) l 線形分類器 l 特徴ベクトルとパラメータの内積の⼤⼩で分類 l 決定⽊ l ツリー状の分類条件を獲得する l
ニューラルネットワーク l 内積と⾮線形関数の組合せを何度も⾏う l カーネル法(カーネル分類器) l 内積の代わりにカーネル関数を使う l アンサンブル学習 l 複数の分類器を組み合わせることで精度をあげる 54 ⾮線形分類 -
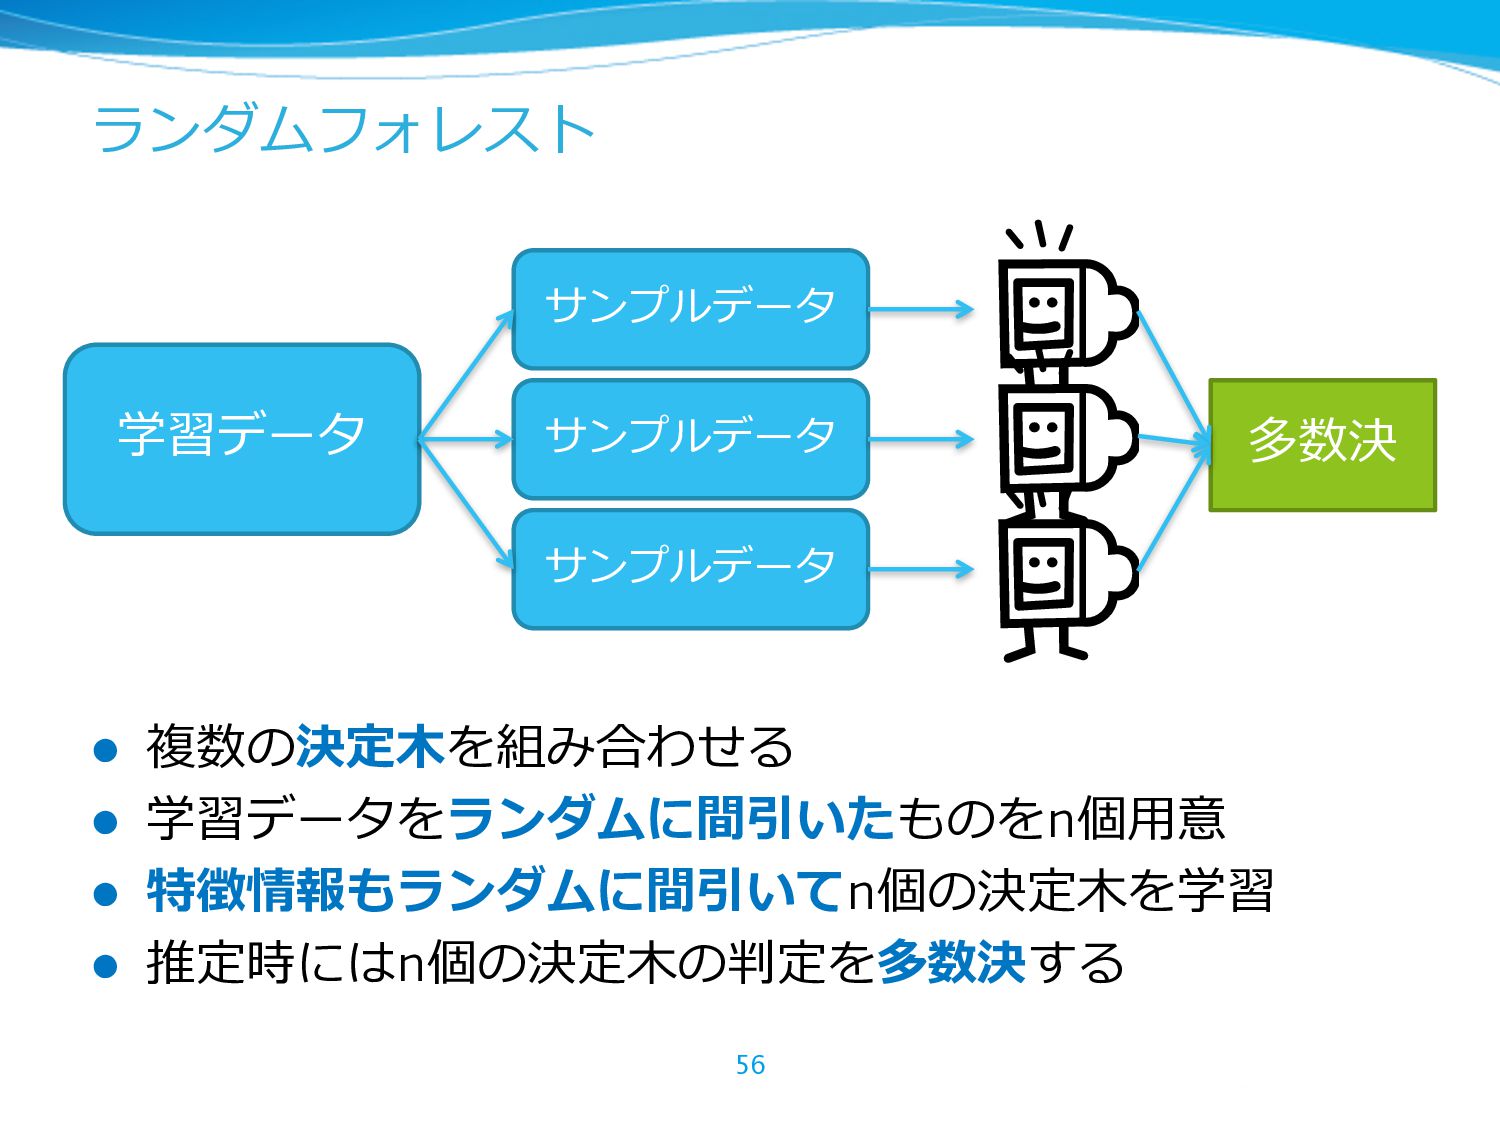
ランダムフォレスト l 複数の決定⽊を組み合わせる l 学習データをランダムに間引いたものをn個⽤意 l 特徴情報もランダムに間引いてn個の決定⽊を学習 l 推定時にはn個の決定⽊の判定を多数決する 56
学習データ サンプルデータ サンプルデータ サンプルデータ 多数決 -
複雑な⼿法と単純な⼿法のトレードオフ l 単純な⼿法 l 分類の根拠がわかりやすい l うまくいかない時に直すべき理由に気づきやすい l ⼀般的に分類速度、学習速度が速い l
実装が簡単なので、バグを埋め込みにくい l 例:線形分類器、決定⽊ l 複雑な⼿法 l ⼀般的に精度が⾼い l 例:アンサンブル学習、カーネル法、ニューラル ネット 57 -
教師あり学習まとめ l ⼊⼒と出⼒の対応関係を学習するのが教師あり 学習 l 学習には⼊⼒と出⼒のペア(教師データ)がた くさん必要 l 線形分類器は重み付き多数決のイメージ l
アンサンブル学習は、複数の学習器を組み合わ せる 58 -
教師なし学習(再掲) l ⼊⼒ x をたくさん与えると、⼊⼒情報⾃体の性質に関し て何かしらの結果を返す l クラスタリング l 与えられたデータをまとめあげる
l 異常検知 l ⼊⼒データが異常かどうかを判定する 60 x -
教師あり学習と教師なし学習は⽬的が違う 教師あり学習 l ⼊出⼒の対応関係を学ん で、未知の⼊⼒に対して 判断する l ⼊⼒と出⼒を教える必要 がある l
⼀番シンプルな問題設定 で汎⽤性が⾼い 教師なし学習 l データ集合⾃体の特徴を 学習する l データを⼊れれば、すぐ 動く l 制御が難しい l 教師あり学習の前処理と しても使われる 61 -
教師なし学習のユースケース例 発⾒的な利⽤ケースが多い l 顧客セグメントの⾃動分類 l 顧客の購買履歴や⾏動ログから、複数セグメントに分割する l 各セグメントの傾向から、施策の⽅針を選定する l 機械の異常状態の報告
l 機械の内部状態(センサーやログなどの)が、通常状態から著 しく乖離していることを発⾒ l 詳細な精密検査の候補に 62 -
クラスタリング l 与えられたデータをまとまり(クラスタ)に分 割する l データではなく類似の特徴をまとめるタイプも ある l 細かな設定の違いはある l
データは複数のクラスタに属するか属さないか l クラスタ数は固定か可変か l クラスタ間に関係(階層)はあるか、フラットか 63 -
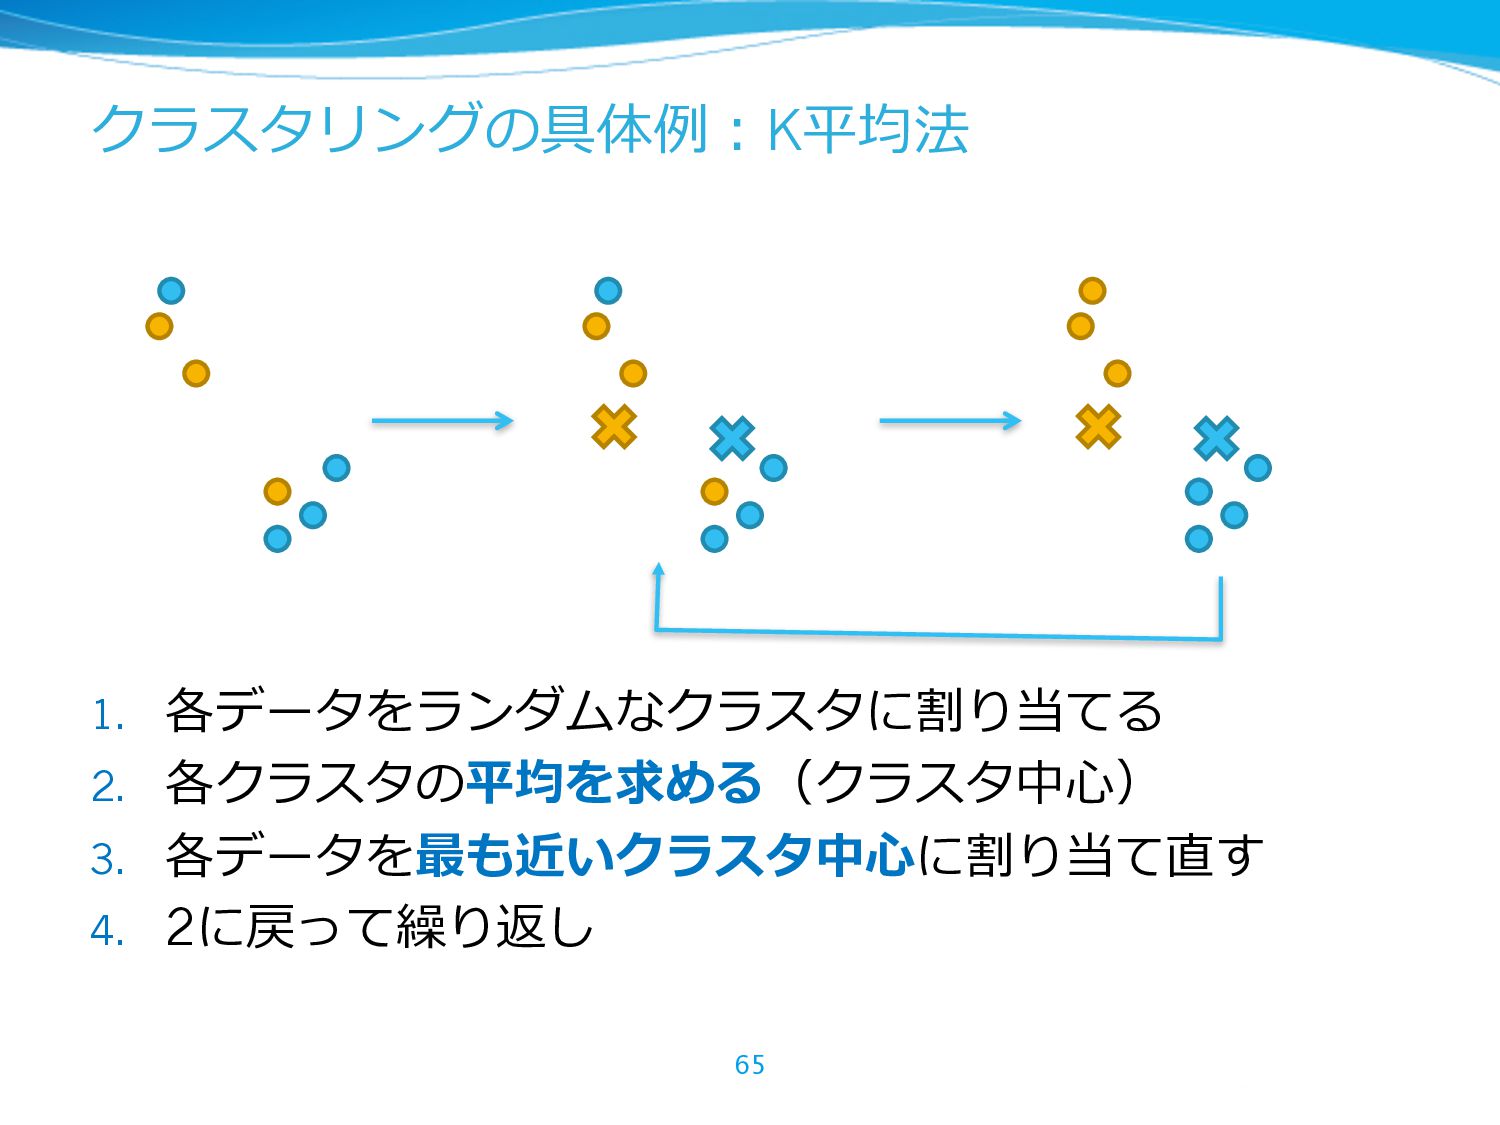
クラスタリングの代表的な⼿法 l K平均法(K-means) l 各クラスタに割り当てられたデータの平均(中⼼)の算出と、 ⼀番近いクラスタ中⼼への割り当てを交互に⾏う l 混合ガウスモデル(Gaussian Mixture Model)
l 複数の正規分布の重ね合わせからデータが⽣成されたと仮定し て、各データがどの正規分布から⽣成されたのかを推定する l LDA(Latent Dirichlet Allocation) l 各特徴がトピックにもとづいて⽣成されると仮定して、⽂書と 特徴のトピックを推定する l ⾏列分解 l データ・特徴⾏列を低次元⾏列の積で近似する 64 下2つは⼀般的にはクラスタリングと呼ばれない -
K平均法の特徴 l 最も基本的なクラスタリング⼿法 l 1ステップ毎に全データを⾛査する必要がある l ステップ数 x クラスタ数 x
データ数、位の時間がか かる l 全データがメモリ上にある必要がある 66 -
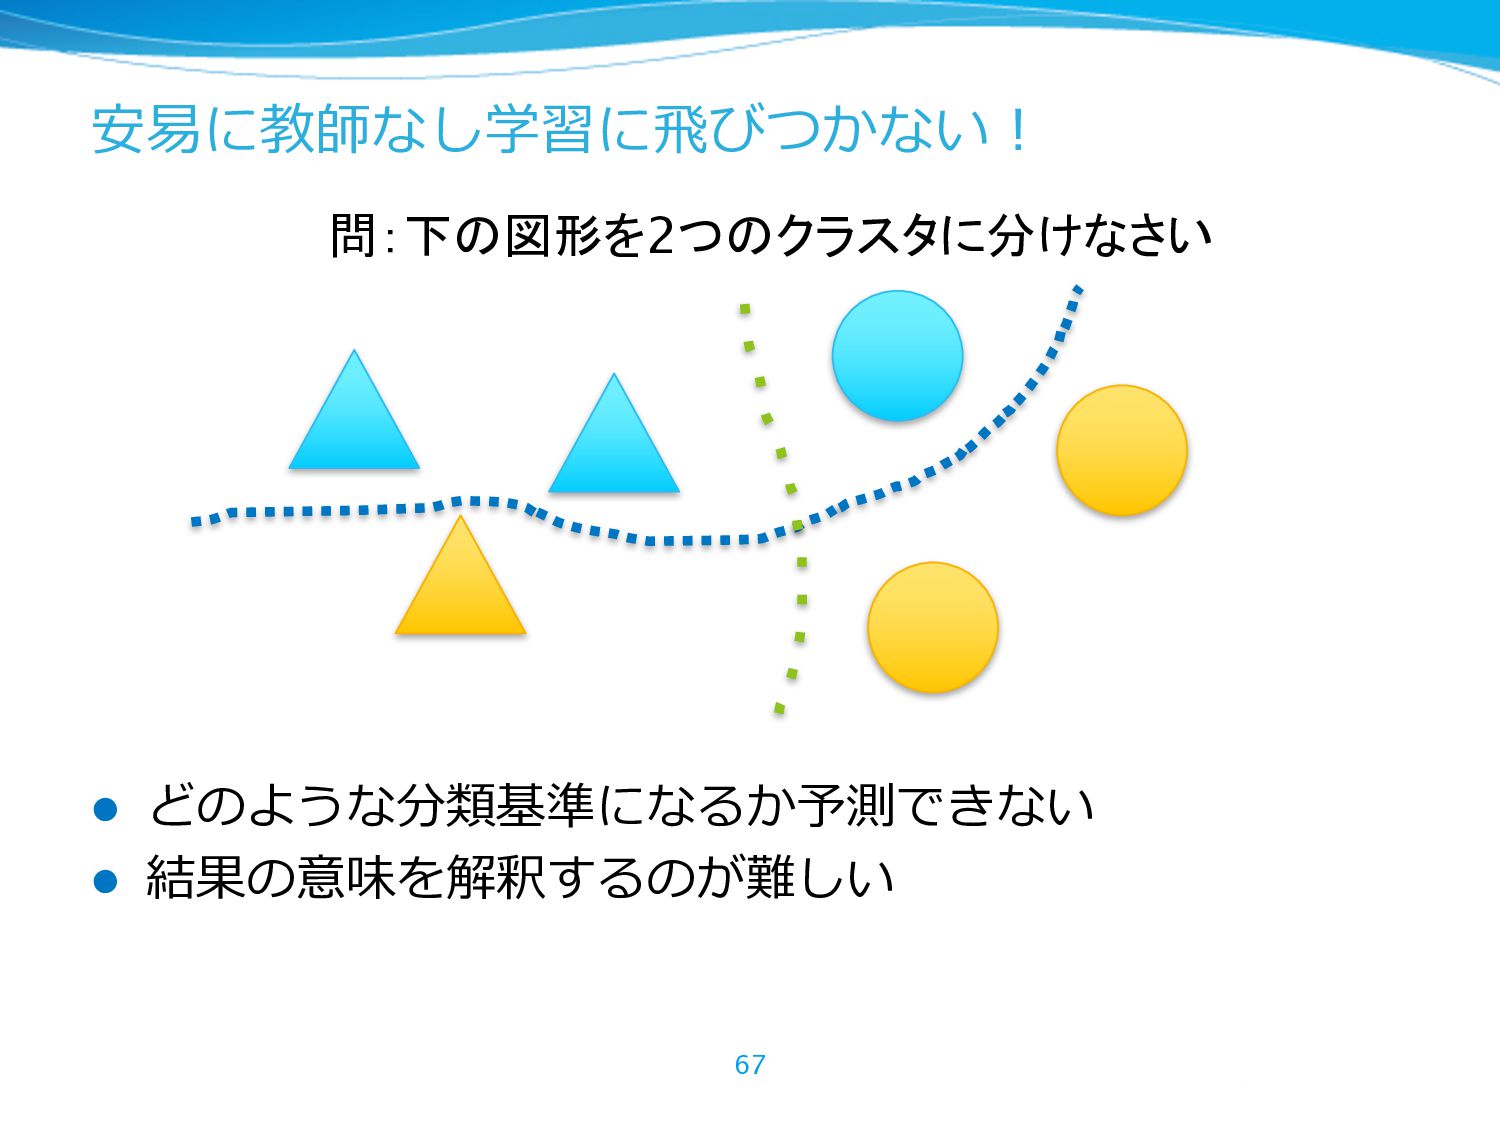
クラスタリングの本質的な難しさ l ⼿法の何処かに必ずまとめる基準があり、意図 通りの基準かどうかわからない l K平均法であれば、平均の求め⽅と近さの尺度 l GMMであれば、正規分布の仮定 l それぞれのクラスタの意味付けは分からない
l まずクラスタリングして、あとから意味付けを⼈⼿ で与えるようなアプローチはあり l ただし、必ずしも⼈間が意味付けできるクラスタが 出来る保証はない 68 -
クラスタリングはどうやって使うべき? l データ全体の傾向を確認するのに使う l クラスタリングの結果がうまく分割できているならば、特徴ベ クトルの設計はうまく出来ている l 半教師あり学習として使う l クラスタリングの結果(クラスタ番号)を特徴として、普通の
教師あり学習を⾏うことで精度が上がる l 教師データ不⼗分で、ラベルなしデータが沢⼭あるときに有効 l クラスタリング結果に対して⼈⼿で意味付けを⾏う l 対象データに対する分類基準がよく定まっていないのであれば、 先に分割してから基準を決める 69 -
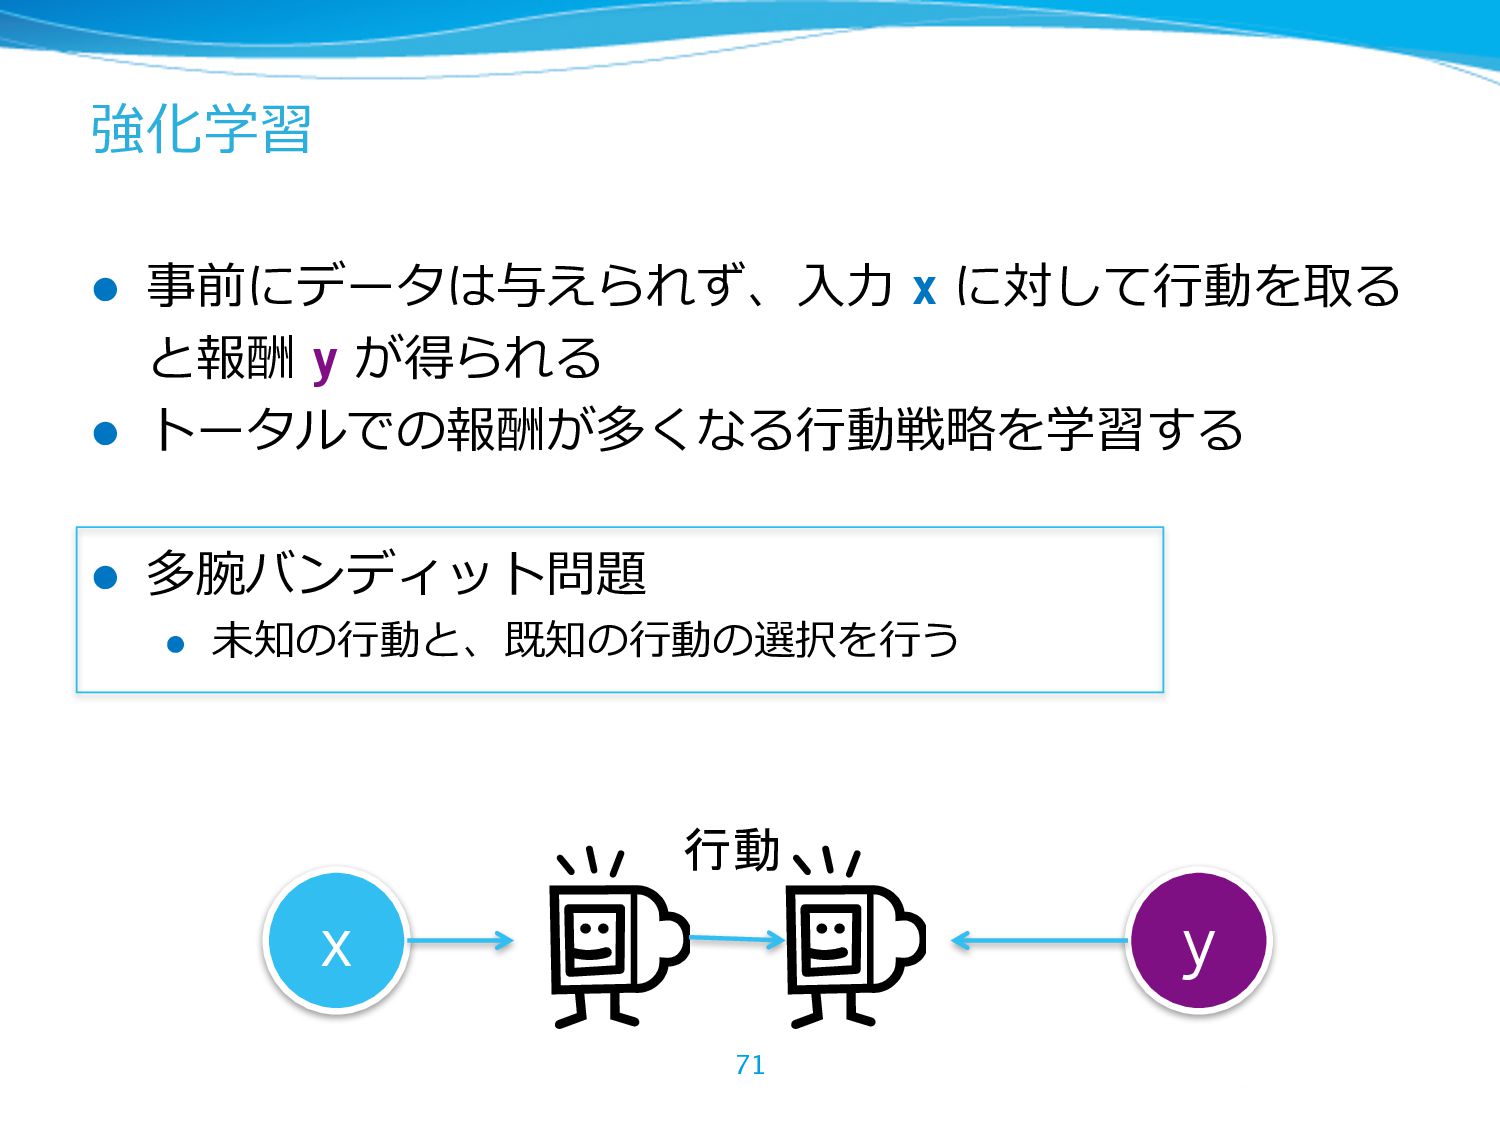
強化学習 l 事前にデータは与えられず、⼊⼒ x に対して⾏動を取る と報酬 y が得られる l トータルでの報酬が多くなる⾏動戦略を学習する
l 多腕バンディット問題 l 未知の⾏動と、既知の⾏動の選択を⾏う 71 x y 行動 -
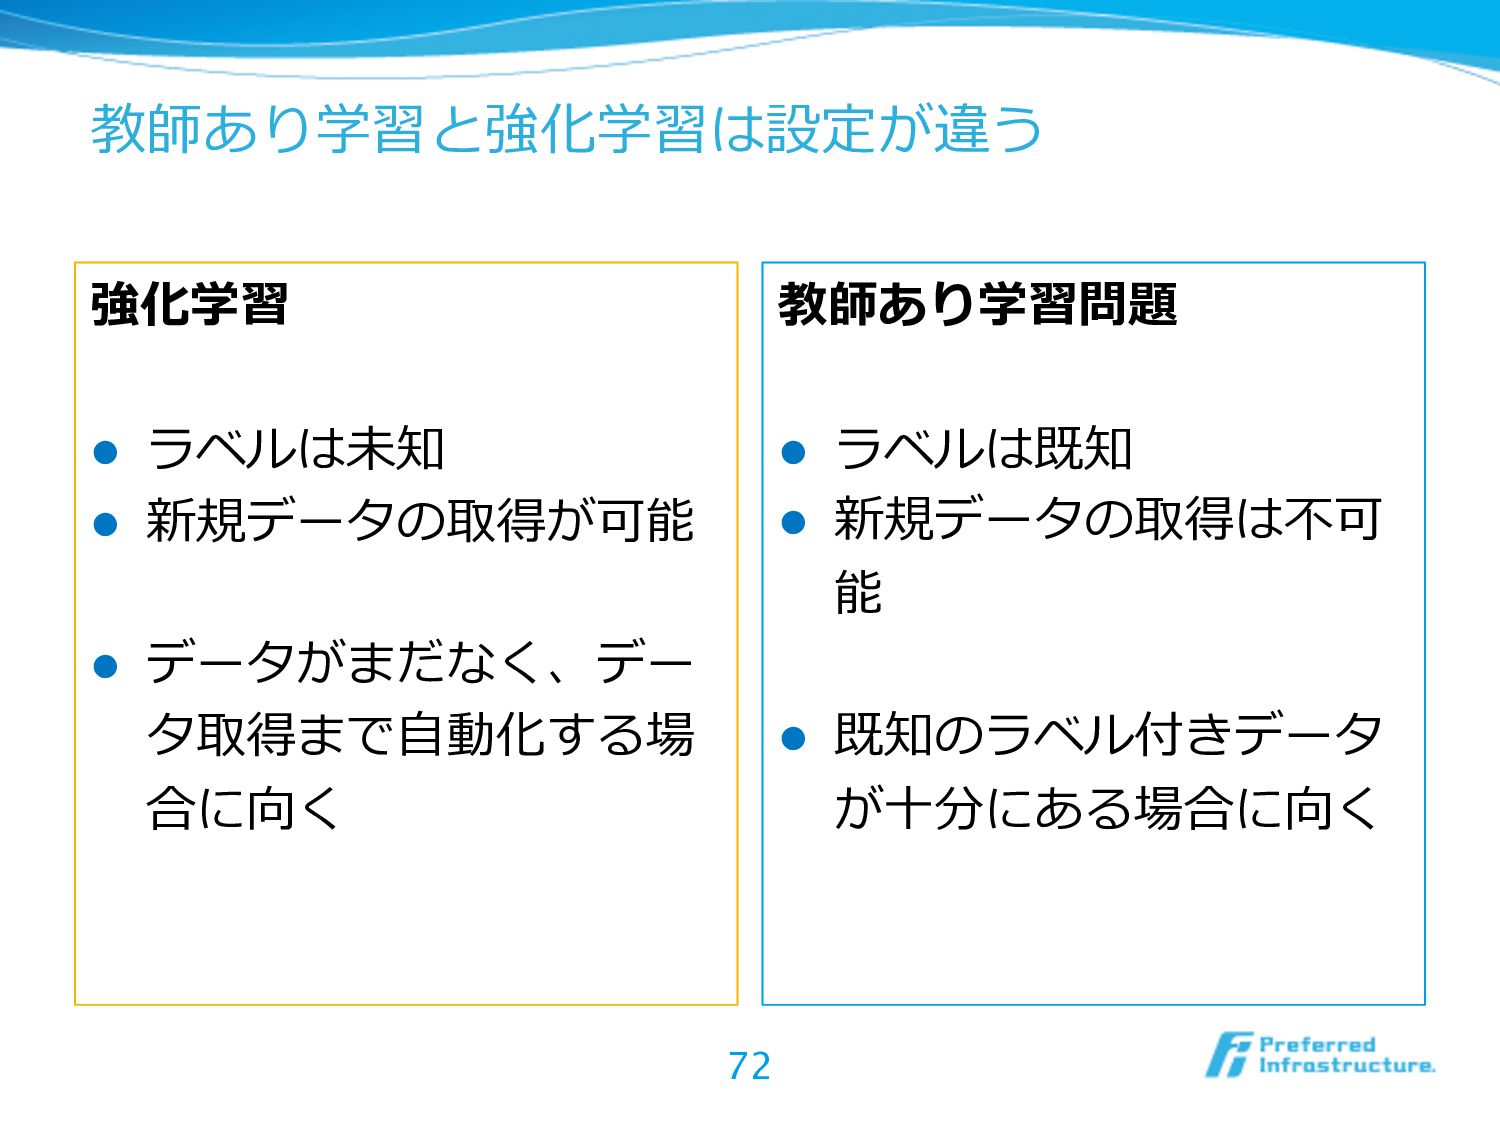
教師あり学習と強化学習は設定が違う 強化学習 l ラベルは未知 l 新規データの取得が可能 l データがまだなく、デー タ取得まで⾃動化する場 合に向く
教師あり学習問題 l ラベルは既知 l 新規データの取得は不可 能 l 既知のラベル付きデータ が⼗分にある場合に向く 72 -
強化学習のユースケース例 仮説の勝ち抜きを⾃動化させられる l 広告バナー選定を⾃動化 l 複数の広告候補があった時に、クリック率などの効 果の⾼そうな広告を⾃動的に選択しながら出し分け る l 検索結果画⾯の⾃動チューニング
l 複数の検索対象(動画や記事、商品など)があった ときに、どのコンテンツを優先的に出すかなどを⾃ 動選択する 73 -
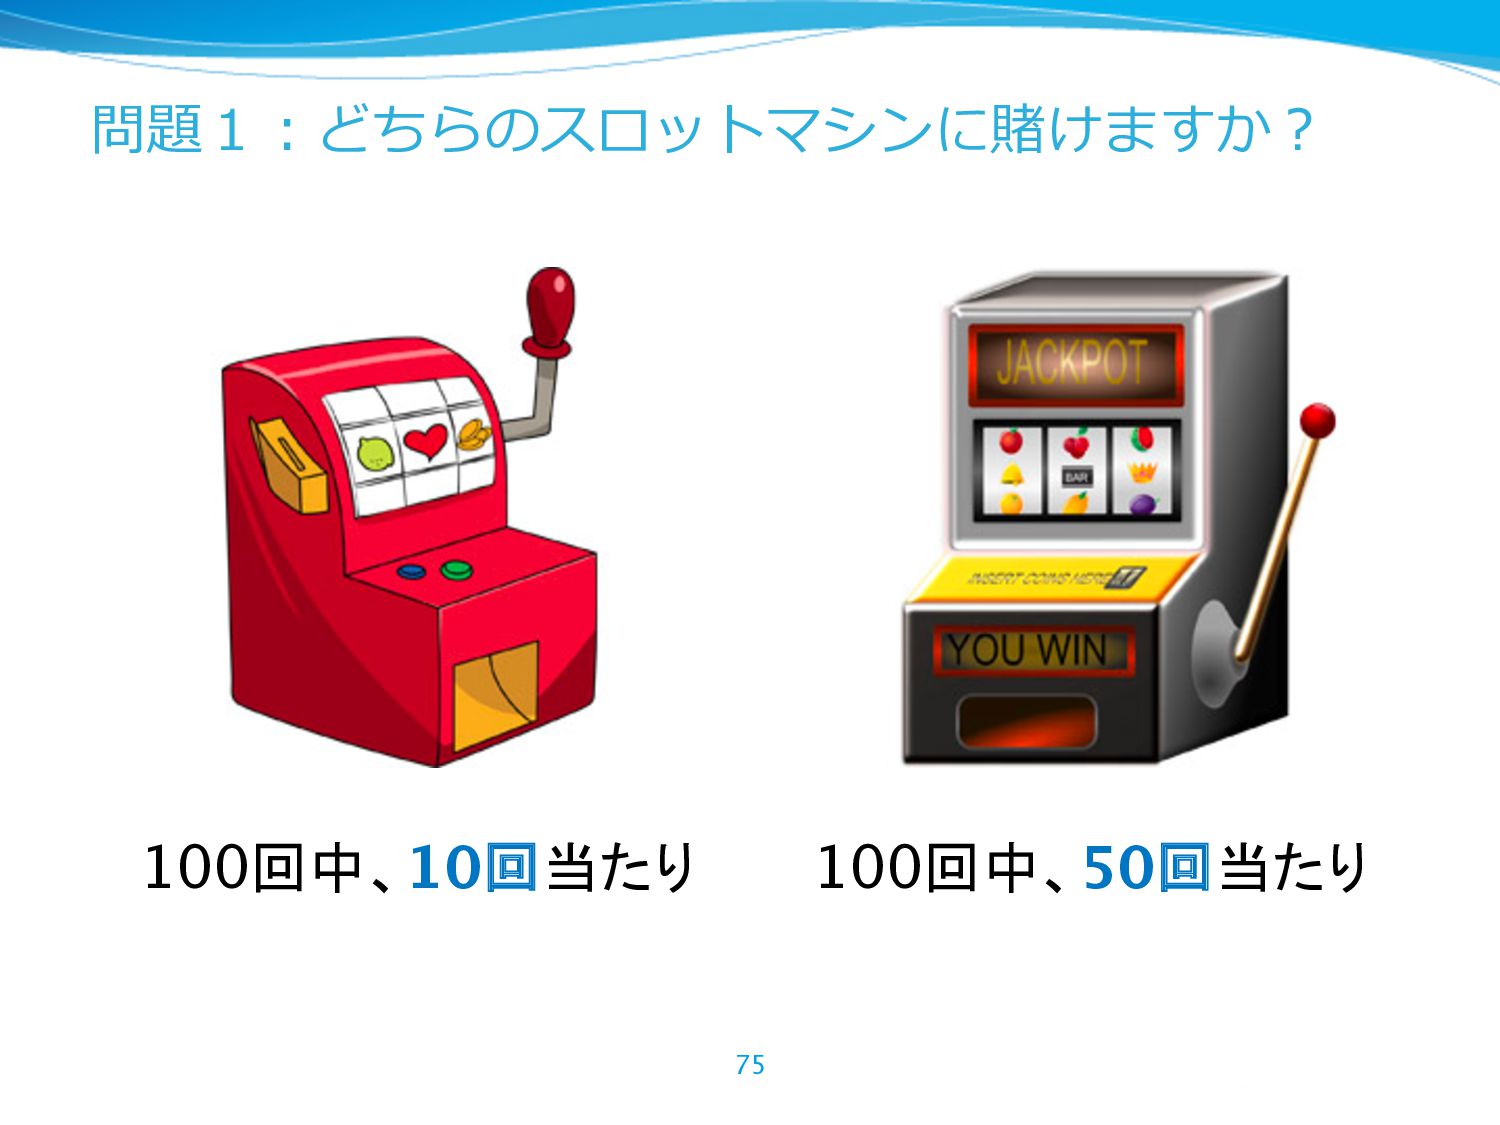
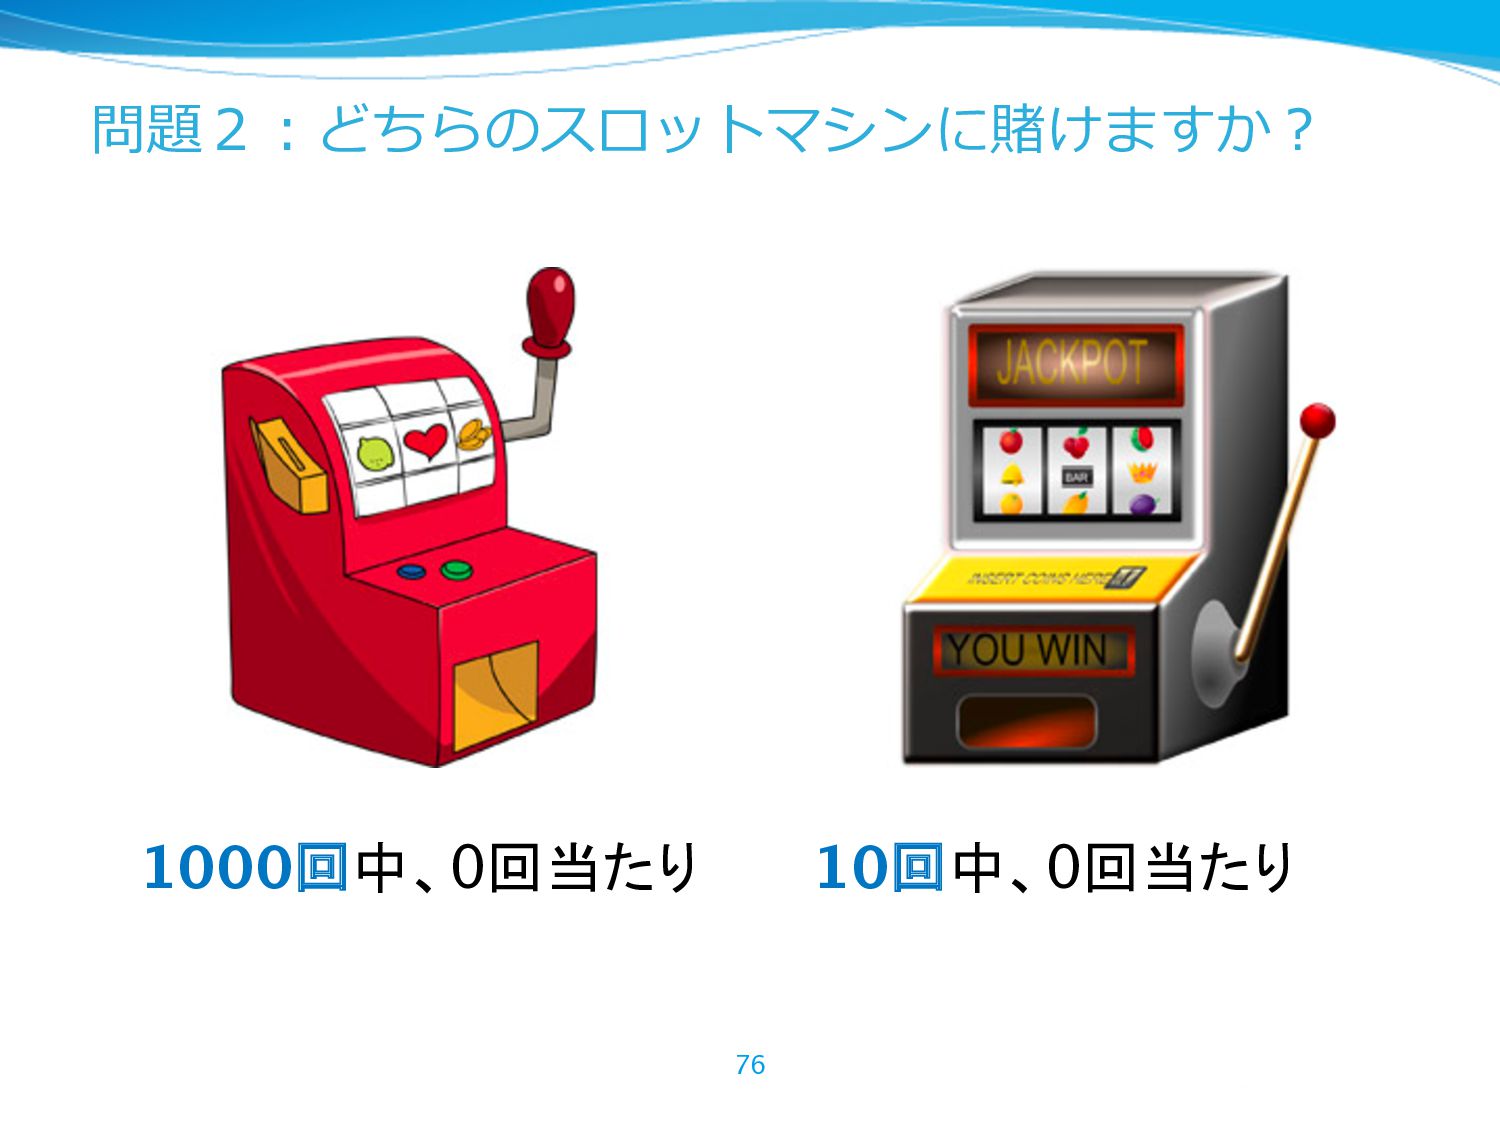
ε-Greedy法 最も単純な戦略 l εの確率で探索:ランダムに選択する l 1 – εの確率で活⽤:今までで⼀番成功確率の⾼ い選択肢を選ぶ 79
確率ε 確率 1 – ε 5/10 1/15 1/8 7/8 -
その他のバンディットアルゴリズム l UCB(Upper Confidence Bound) l 試した回数が少ないものほど優先的に探索するよう なスコアを利⽤する l Thompson
Sampling l 事後確率分布に従って、⾏動をサンプリングする 80 -
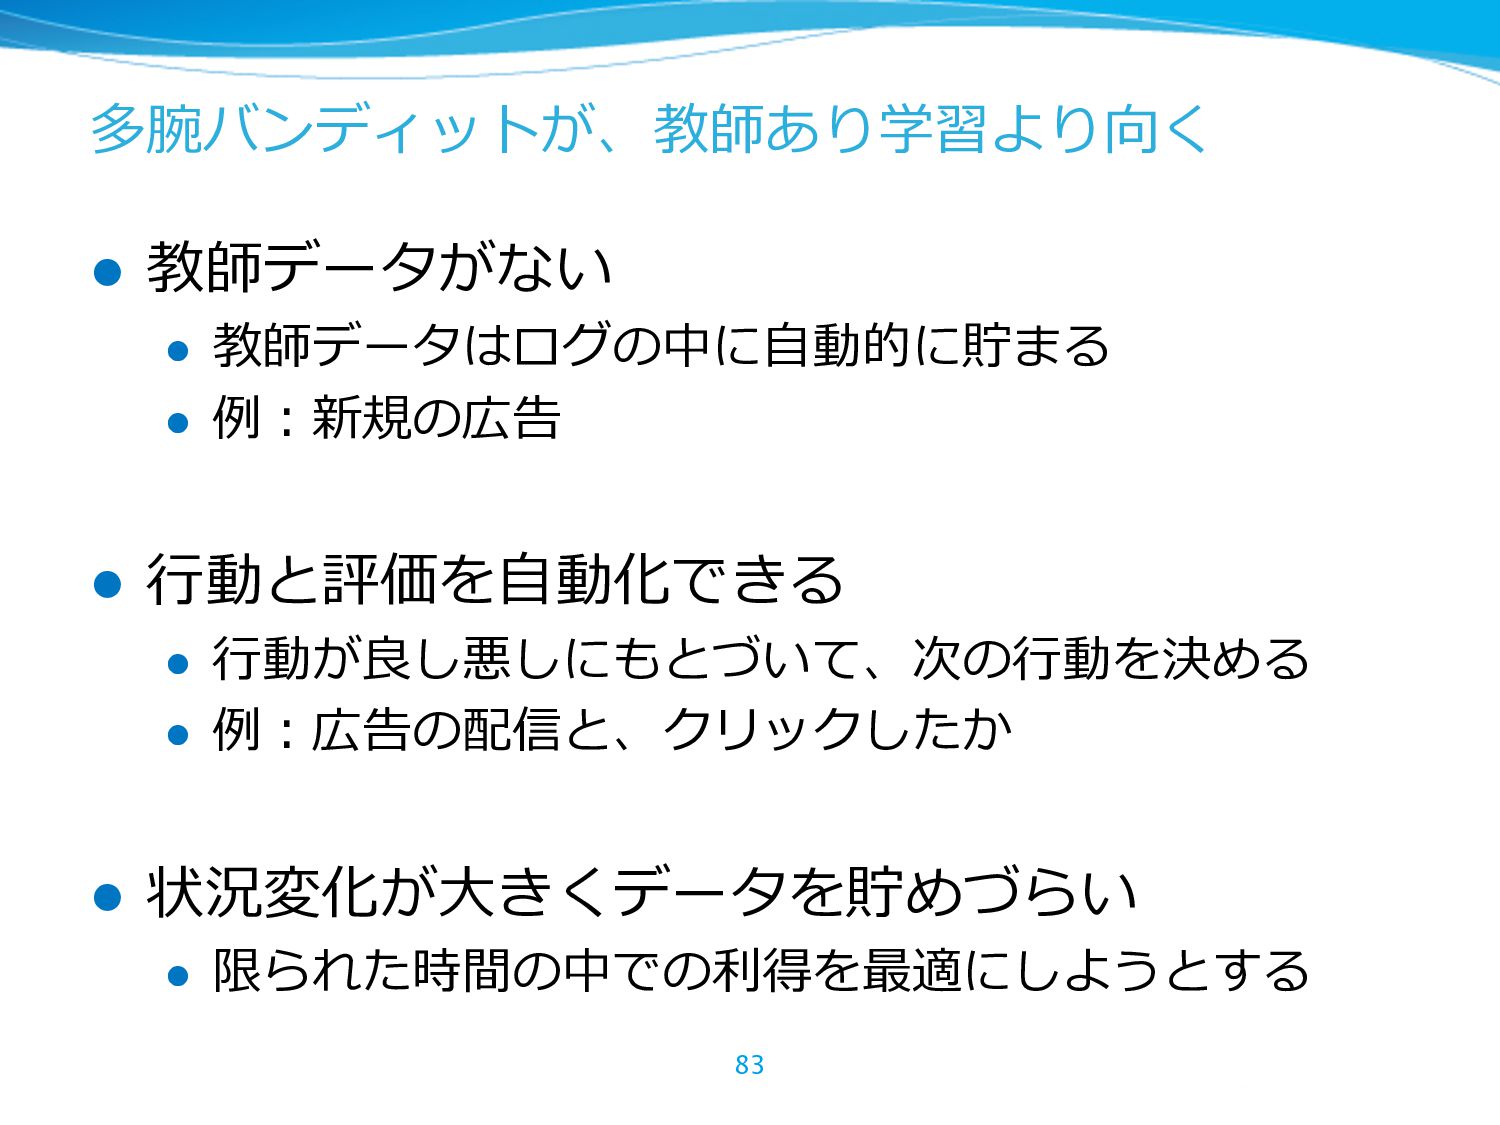
多腕バンディットが、教師あり学習より向く l 教師データがない l 教師データはログの中に⾃動的に貯まる l 例:新規の広告 l ⾏動と評価を⾃動化できる l
⾏動が良し悪しにもとづいて、次の⾏動を決める l 例:広告の配信と、クリックしたか l 状況変化が⼤きくデータを貯めづらい l 限られた時間の中での利得を最適にしようとする 83 -
教師あり学習のほうが、多腕バンディットより向く l すでに教師データが沢⼭ある l 教師あり学習の⽅がじっくり精度を確認できる l 教師データを作るコストが低い l きれいな教師データを作った⽅が効率は良い l
ログのデータはノイズが混ざりやすい l 実験的な⾏動を起こせない l 多腕バンディットは最初は⾏動を誤りやすい 84 -
代表的な深層学習の⼿法いくつか l Feed Forward Neural Network l 最も基本形の、いわゆるニューラルネットワーク l 重みとの内積と、⾮線形関数の組合せを繰り返す
l Convolutional Neural Network (CNN) l 特に画像解析で⼤成功して有名になった⼿法 l convolution層とpooling層を組み合わせる l Recurrent Neural Network (RNN) l ⾃然⾔語処理などシーケンスデータを扱う⼿法 l Long Short-Term Memory (LSTM)などの亜種が流⾏ している 88 -
流⾏の理由(?):ニューラルネットワークの抱え る⼤きな2つの問題が解消されたのでは? l 学習の遅さ l 計算効率の良い関数の採⽤、機械学習技術の進歩に よる効率の向上、マシンスペックの向上、GPUなど の新しい計算機の出現によって解消された l 過学習のしやすさ
l Dropoutという⼿法により、過学習を抑えられること が発⾒された l CNNやLSTMなど、対象の問題にあったネットワーク 構造の⼯夫がなされた 89 -
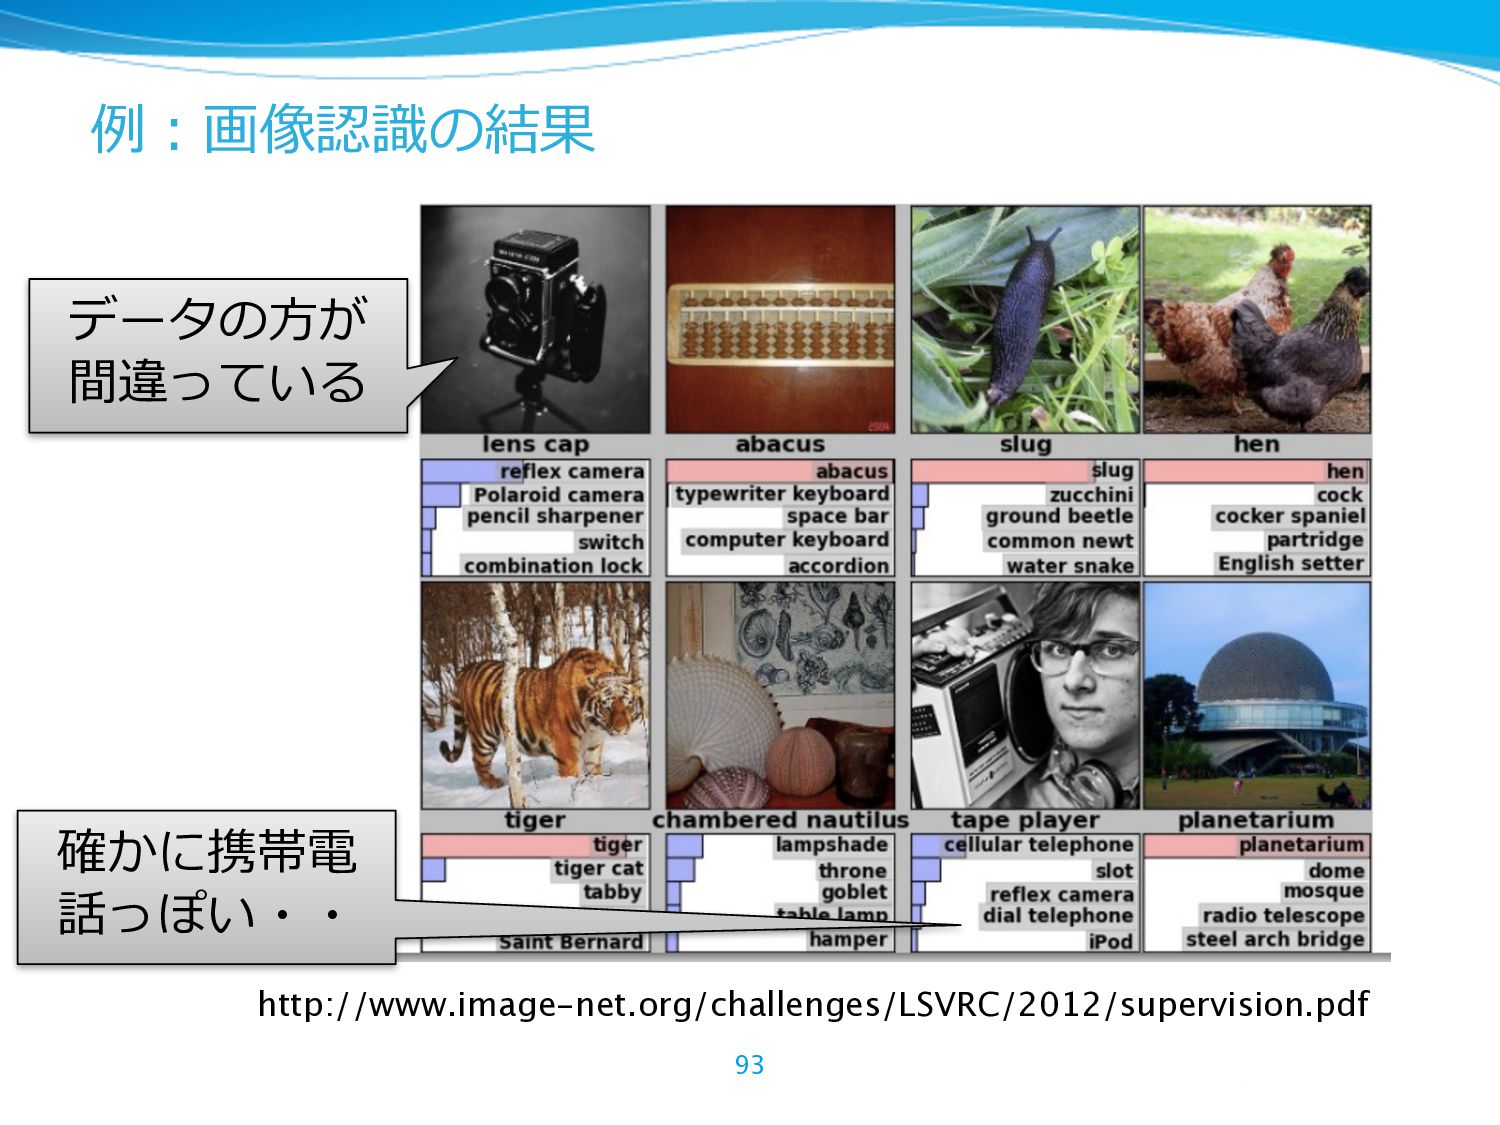
成果が顕著な領域 l ⾳声認識 l 認識精度が劇的に向上 l すでに多くの⾳声認識エンジンで利⽤されているのではと⾔わ れている l 画像認識
l 画像に映った物体の判定結果が劇的に向上 l エラー率が3年で25% à 7%に l ゲームプレイ l 昔のゲーム(インベーダーなど)を、ルールを教えずに画⾯と スコアだけで学習 l ⼀部のゲームで⼈間よりも強くなった 91 -
⼀番成功しているのはセンシング(認識)の部分 l 画像系 l 単⼀ではピクセルのRGBデータで、ほぼ意味が無い l 従来はエッジ検出なり、特徴点抽出なりの⼿法を組 み合わせるのが⼀般的だった l ⾳声系
l 単⼀では⾳圧のデータで、ほぼ意味が無い l 従来はスペクトラムや、ケプストラムの解析を⾏っ て特徴を抽出するのが⼀般的だった 94 -
より⾼次の機能はこれから l 意図やプランニング l 強化学習を応⽤した⼿法が成果を出し始めている l しかし、まだ汎⽤的に使えるわけではない l 意識や記憶 l
記憶のモデル化の研究はあるが、簡単なタスクしか とけていない l ⾔語や推論 l ⾔語処理では徐々に既存⼿法を追い抜いている領域 はあるが、劇的な変化という印象はない 95 -
深層学習は冷静に⾒る必要がある l うまく⾏っているところ切り出しても、⽣物の 知能としてみると原始的な機能 l ぶつからないように移動すること、⾳を聞いて反応 すること、ものを認識してつかむこと、いずれも昆 ⾍でもできること l ただし、これらの能⼒でもインパクトのある領
域はある l ⾃動運転、⾳声認識、ロボット制御になると、いず れも影響⼒は⼤きい l 知能=⼈間と考えると失敗する 96 -
深層学習を試すには? l すでに成果のでている結果を使うのが⼀番楽 l 画像認識なら、Caffeの学習済みモデルを利⽤できる l ⾃然⾔語処理なら、word2vecを使えば単語ベクトル の学習が簡単に⾏える l ⾃分で作るならツールキットを使うのが良い
l Caffe/torch/theano l Chainerというライブラリを作りました l いずれも仕組みを理解する必要がある 97 -
Chainer l Powerful(⾼速) l NVIDIA GPUに対応 l Flexible(柔軟) l ループや再帰のあるネットワークも簡単にかける
l Intuitive(直感的) l 通常のPythonコードがネットワーク定義になる 98 -
まとめ:機械学習の仕組み l ⼀⼝に機械学習といっても⾊々 l ⼊出⼒、設定、⽬標、好き嫌い、様々 l 機械学習3種類 l 教師あり学習:⼊出⼒関係を学習する l
教師なし学習:データの性質を学習する l 強化学習:試⾏錯誤による⾏動ポリシーの学習 l 深層学習はこれから? l ⽬⽴っているのは画像と⾳声 l ⾔語などの知能に関わる成果が期待される 99 -
機械学習で解くべき問題と、それ以外で解くべき問 題を切り分ける l 機械学習以外の⽅が適合する場合 l URLの検出など、ほぼ⾃明なルールが有る l スペル⾃動修正の代わりに、再⼊⼒させる l そのまま機械学習が適⽤できそうな場合
l 記事を⾃動で分類したい l 記事をユーザーに推薦したい l 少し⼯夫して機械学習の設定に落とす場合 l 好評か不評か判定する代わりに、好評・不評表現の辞書を機械 学習で作成する l 商品を買いそうか当てる代わりに、ユーザーの属性を機械学習 で当てて、狙った層に広告を出す 104 -
どの問題に落としこむべきか? l ⼿堅い問題の⽅が正直おすすめ l 教師あり分類の⽅がお薦め、正解情報はクラウド ソーシングを利⽤する⼿もある l 教師なしの場合でも、レコメンドなどの⼿堅い⼿法 が良い l
多腕バンディットは整備が必要 l 報酬(広告ならクリックされたか否か)の情報を、 学習エンジンに⼊⼒できるようにする必要がある 105 -
特徴量の設計 l 典型的な⽅法をまず試す l 数値の⼤⼩に意味があるならそのまま利⽤ l テキストなら出現する単語集号 l 男⼥などのカテゴリ情報なら0/1の変数 l
数値がIDなら、カテゴリ情報として扱う l データ整備に時間が掛かる l 空⽂字列、NULL、“なし” などが混在していること がある l 当てたい変数が紛れていることがある 107 -
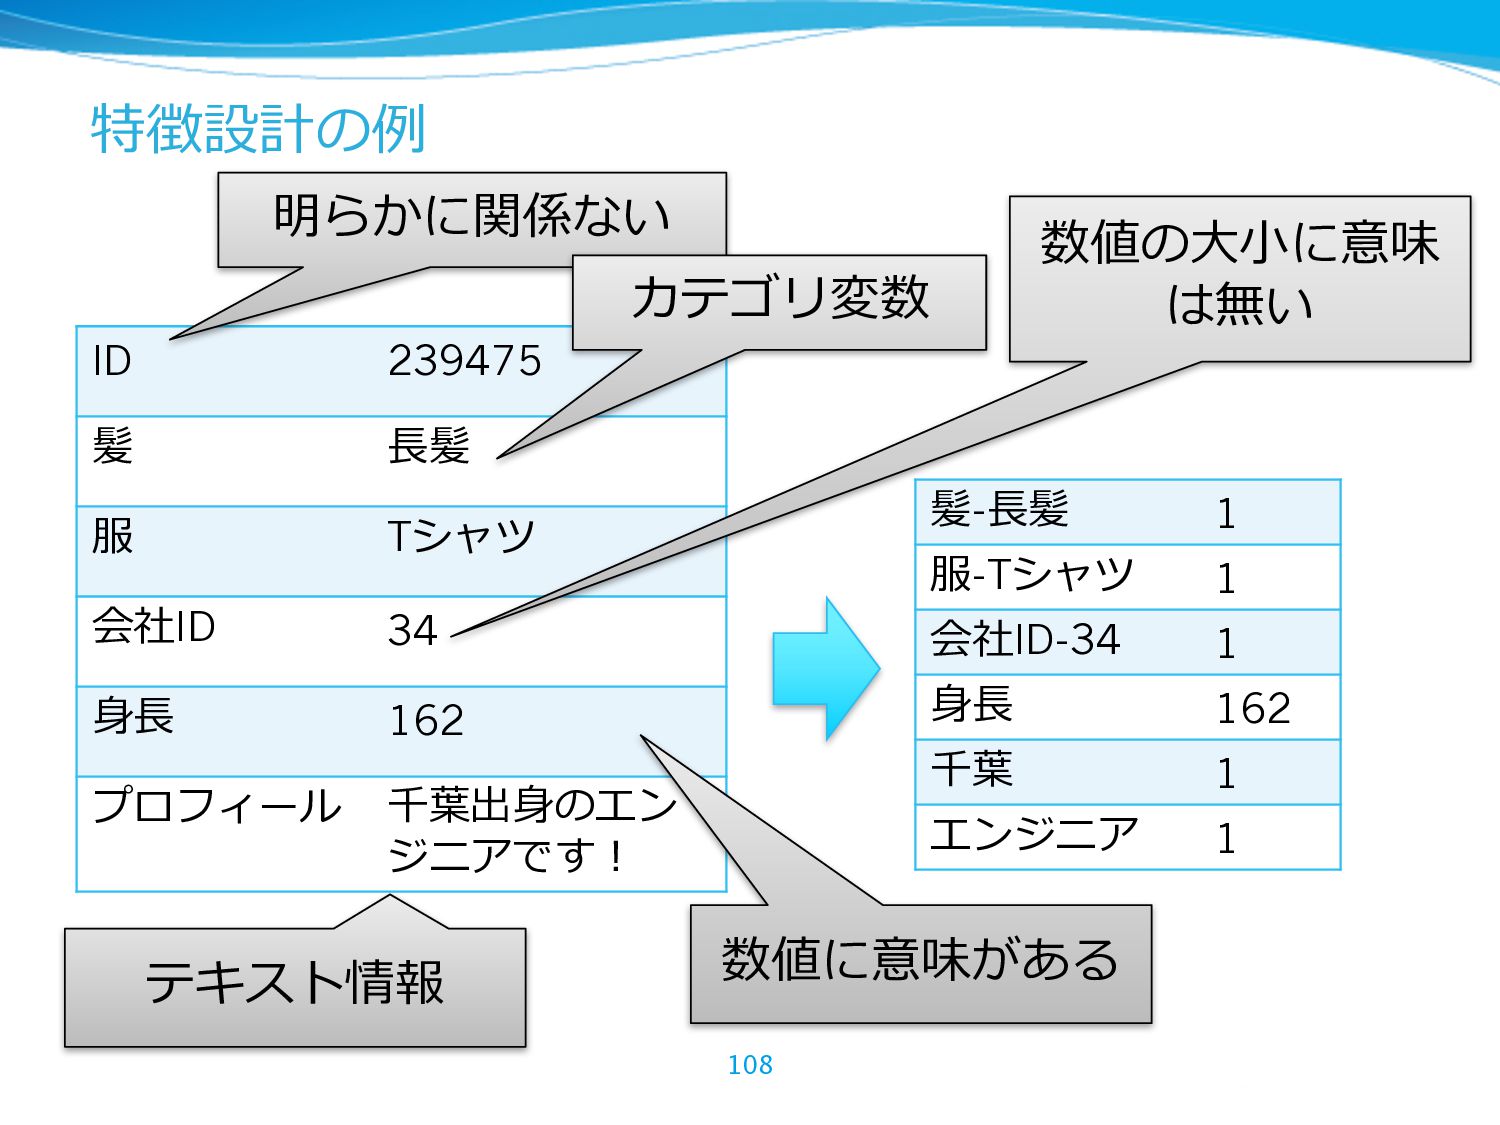
特徴設計の例 108 ID 239475 髪 ⻑髪 服 Tシャツ 会社ID 34
⾝⻑ 162 プロフィール 千葉出⾝のエン ジニアです! 髪-⻑髪 1 服-Tシャツ 1 会社ID-34 1 ⾝⻑ 162 千葉 1 エンジニア 1 明らかに関係ない カテゴリ変数 数値の⼤⼩に意味 は無い 数値に意味がある テキスト情報 -
特徴設計、ここに気をつける l 意味のない情報を使わない l ユーザーIDなど、予測に使えないと予め分かる情報は使わない l IDは数値とは違う l IDは整数になっているが、⼤⼩に意味は無い l
カテゴリ情報として使う l テキスト系データは扱いを特別に l テキストをカテゴリの⽤に扱うと、ほぼ全てのデータが別の意 味になってしまう l 意味のあるキーワードを抽出してカテゴリ変数として扱う l マルチメディアデータは特殊な処理が必要 109 -
データの特質から難易度のあたりをつける l おおよそできそう l 明らかに相関がありそうな変数がある l 例:記事の内容からカテゴリを当てる l できるかも l
隠れた相関があるかもしれない l 例:購買情報から家族構成を当てる l 絶対にできなさそう l ⼈間がじっくり⾒てもわからない l 例:何も買ってない⼈が次に買いそうなものを当て る 110 優先度⾼ -
データに対する誤解 l データさえあれば何でもわかるんですよね? l NO! データから分かることだけがわかります l データが沢⼭あれば確実にわかるんですよね? l NO!
単調増加でも、100%に達するとは限りません l ⼈間にわからないことがわかるんですよね? l NO! ⼀般的には⼈間のほうが⾼性能です 111 -
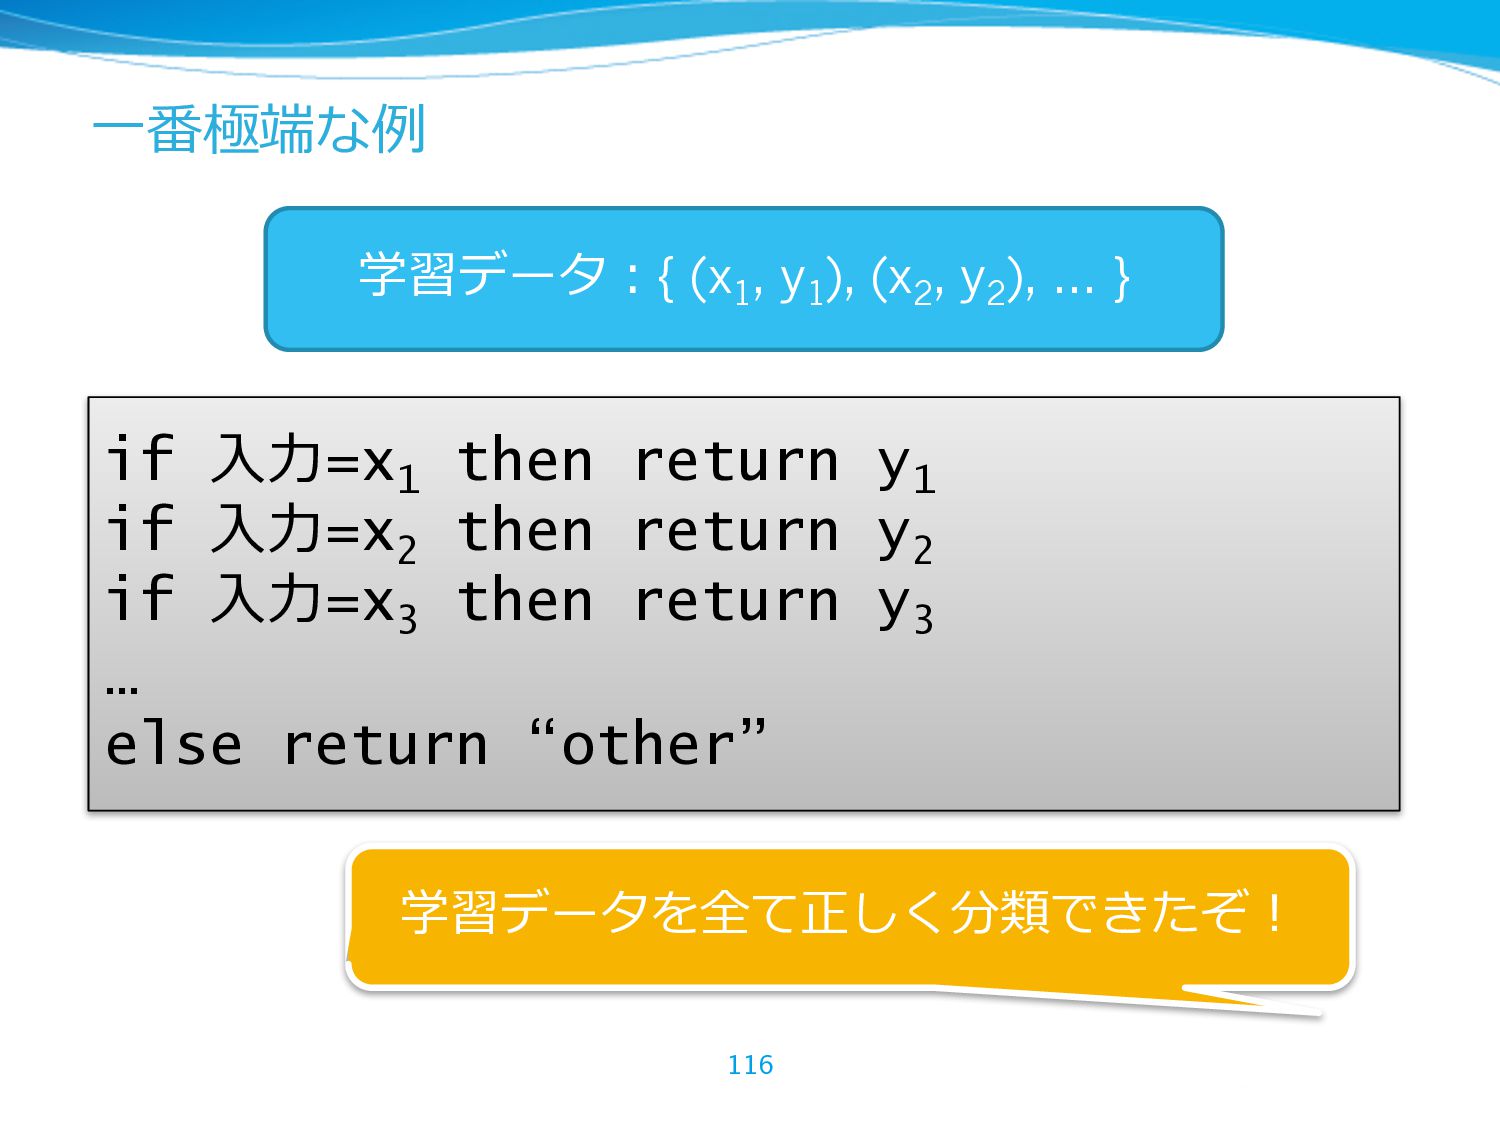
⼀番極端な例 116 if ⼊⼒=x1 then return y1 if ⼊⼒=x2 then
return y2 if ⼊⼒=x3 then return y3 … else return “other” 学習データを全て正しく分類できたぞ! 学習データ:{ (x1 , y1 ), (x2 , y2 ), … } -
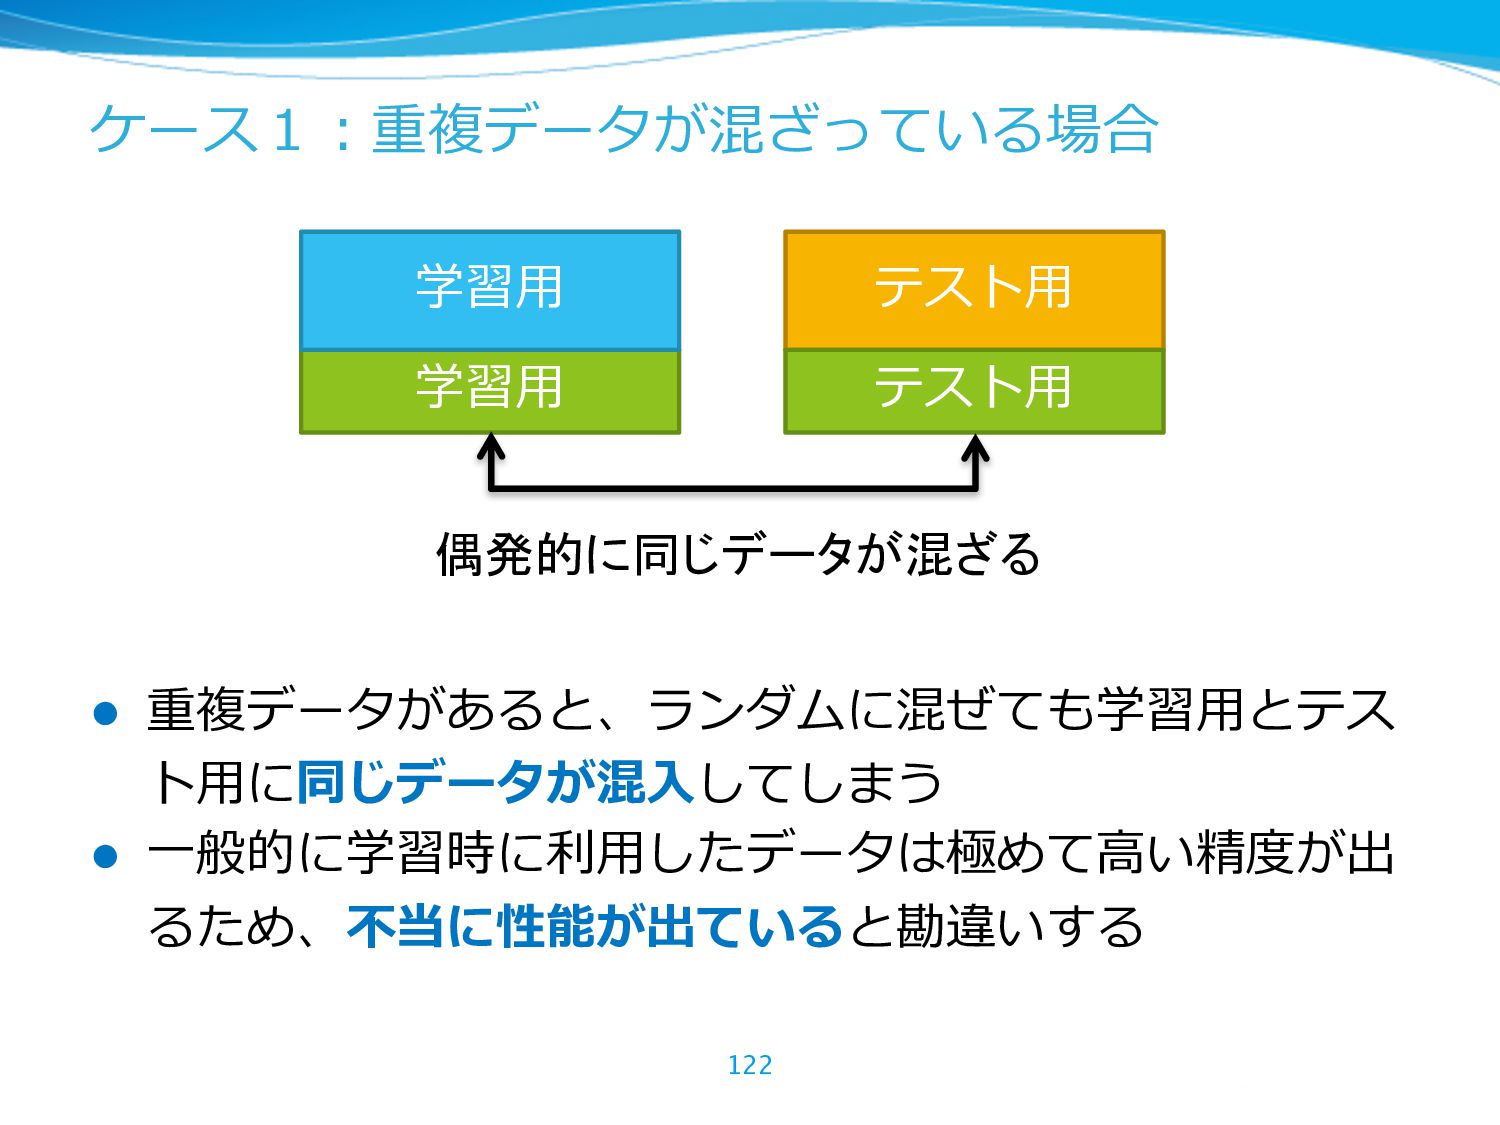
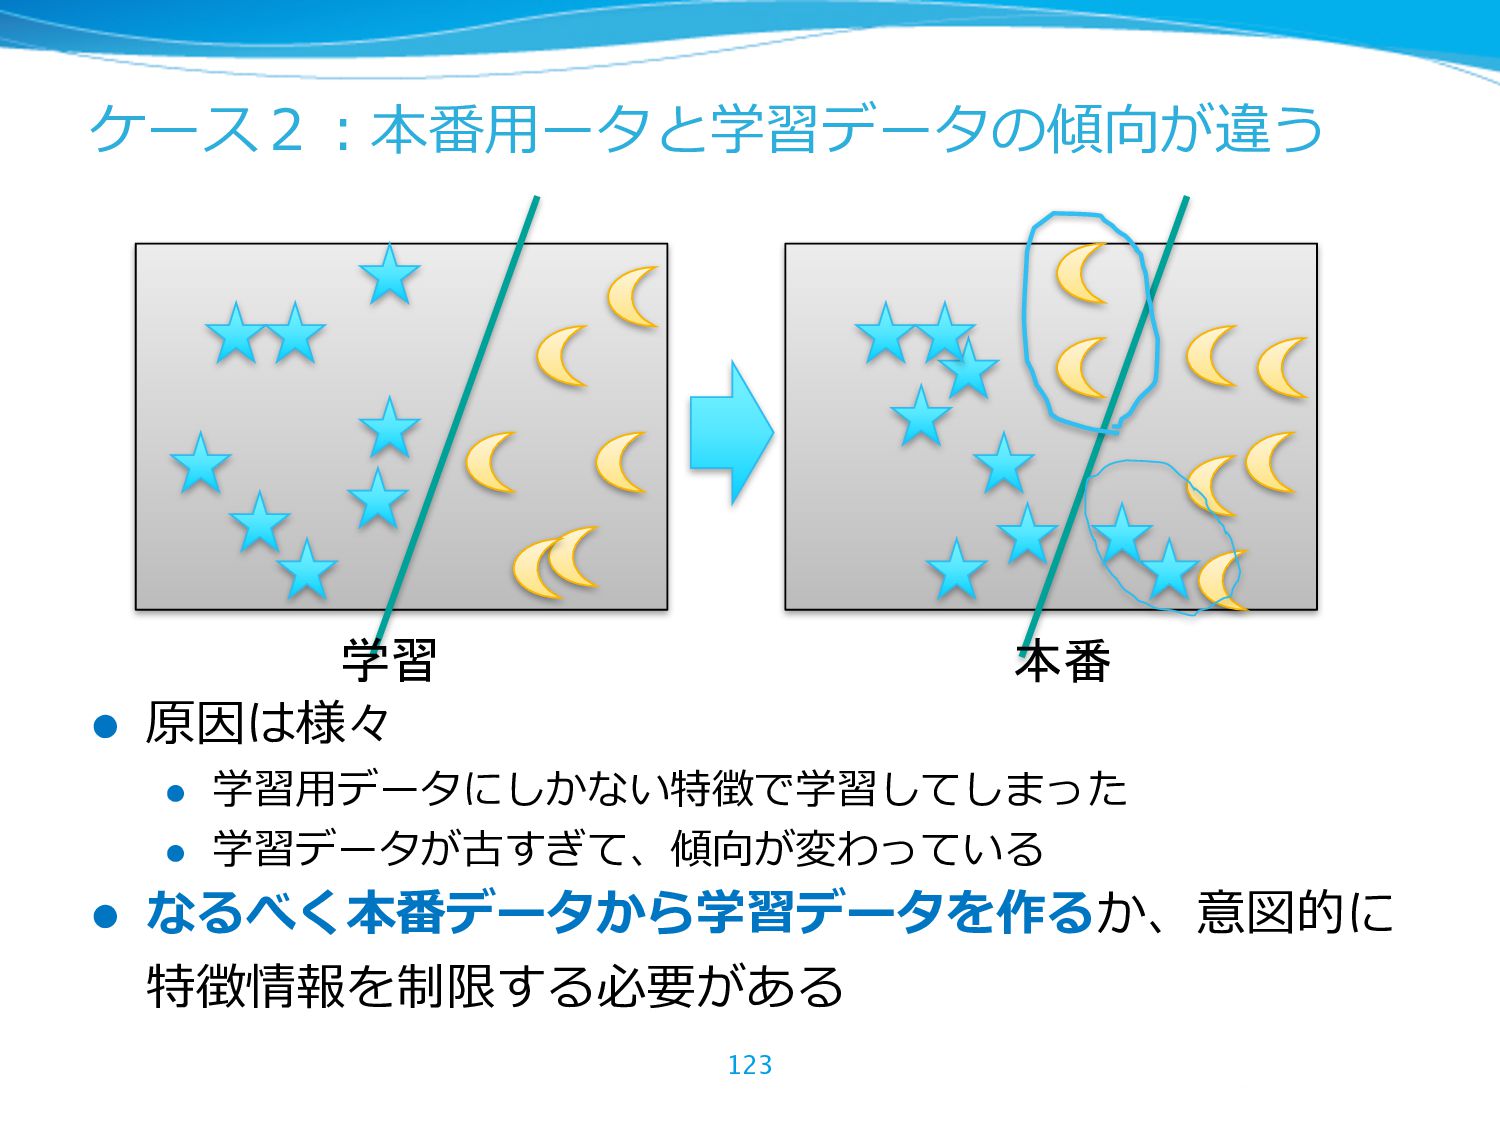
過学習とは l 既知データ(学習データ)に対する性能は、極めて⾼い l 未知データに対する性能が下がらなければ、学習データ に対する性能が⾼すぎても問題ない l ⼀般に、モデルの複雑さ(パラメータの数)に⽐べて、 学習データが少なすぎるときに起こる 117
学習データだけを過剰に正確に分類できる 反⾯、未知のデータに対する性能が下がっ てしまうこと -
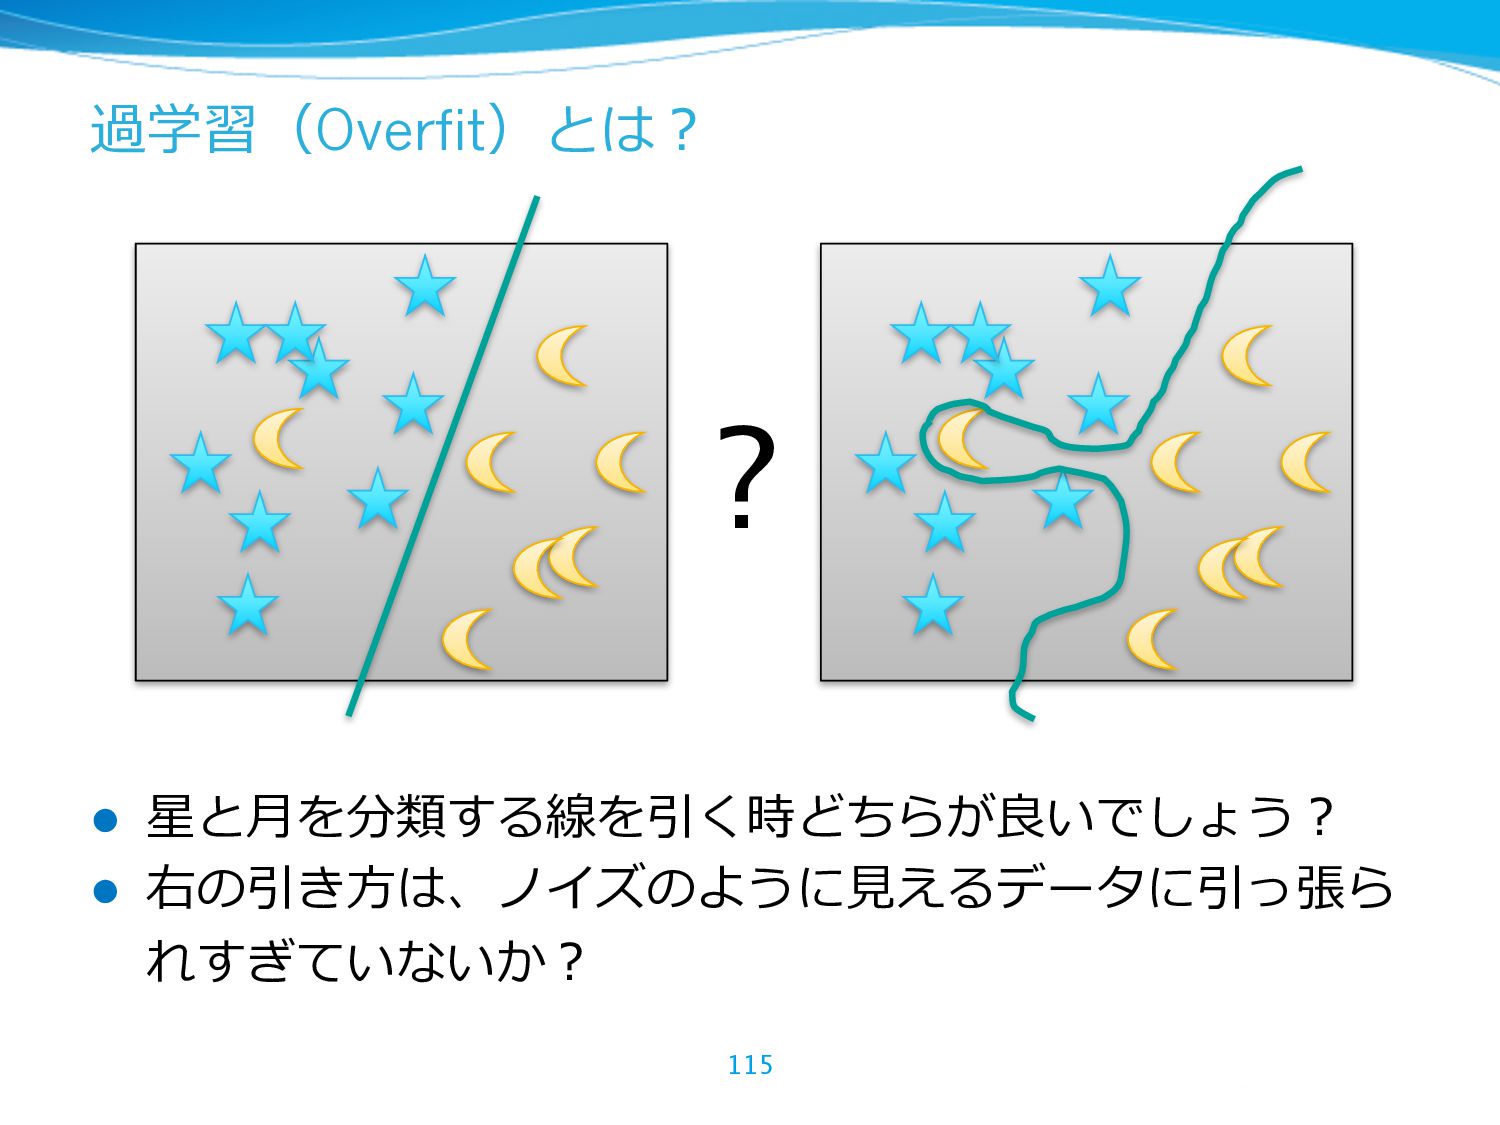
過学習を防ぐには? l データと特徴のバランスを正す l より多くのデータを⽤意するか、パラメータの数 (特徴の数)を意図的に制限する l バランスを図る尺度はある(⾚池情報基準など) l 正則化を⼊れる
l 正則化とはパラメータに対して制約を与えること l 過学習が起こっている場合、特定の特徴だけを過剰 に信⽤する(パラメータの値が巨⼤になる)ことが 多いため、⼤きくなり過ぎないように調整する 118 -
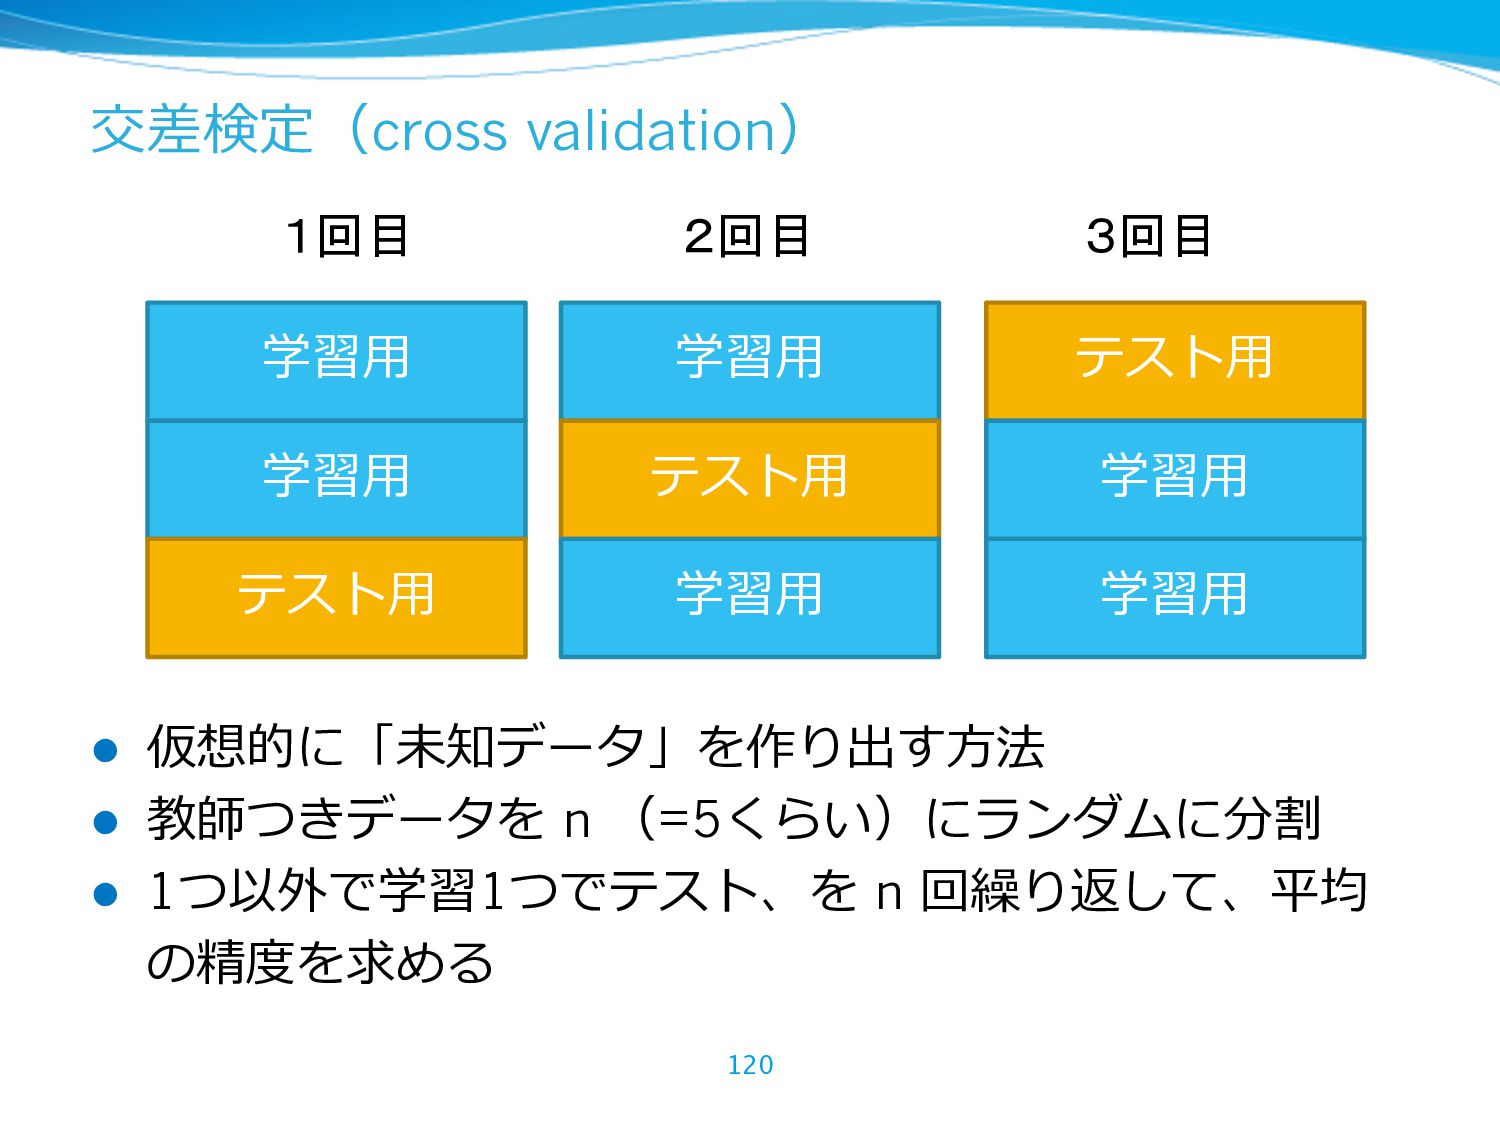
交差検定(cross validation) l 仮想的に「未知データ」を作り出す⽅法 l 教師つきデータを n (=5くらい)にランダムに分割 l 1つ以外で学習1つでテスト、を
n 回繰り返して、平均 の精度を求める 120 学習⽤ 学習⽤ テスト⽤ 学習⽤ テスト⽤ 学習⽤ テスト⽤ 学習⽤ 学習⽤ 1回目 2回目 3回目 -
最後は⼼の問題(?) l 想定外に性能が出ないことはよくある l 実験時に極めて⾼い性能が出たら、喜ぶ前に実 験設定を⾒なおして⽅がいい l 経験的には、⾼い性能が出た時はほとんど何かを間 違えている l
最終的には製品・サービス内で効果を計測する 気を抜かない 124 -
実験を⾏ったら・・・ l 精度が良いとき l おめでとうございます! l 精度が悪いとき l 頑張りましょう l
精度が良すぎるとき l 疑いましょう 125 -
精度が悪いとき l 簡単にできることから試す l 複数の学習⼿法を試す l ハイパーパラメータ(学習前に設定するパラメー タ)を変えてみる l 難しすぎる問題設定になっていないか確認する
l 正解データ内でも基準が曖昧だと、難しい l 不必要に難しい設定になっていないか再検討する l ⼿法を改善するのはそれから 126 -
難しすぎるケース:データに⼀貫性がない l データ作成時に⼀貫性がないと機械も迷う l 例:スポーツ選⼿の結婚記事は「芸能」? 「ス ポーツ」? l データ作成中に基準を決めて、⽂書等で共有する l
曖昧でも、データ上はどちらかになっているた め実験精度⾃体は落ちる l 実⽤上は問題ないかもしれない l 最終的には、個別の結果を⾒て判断を 127 -
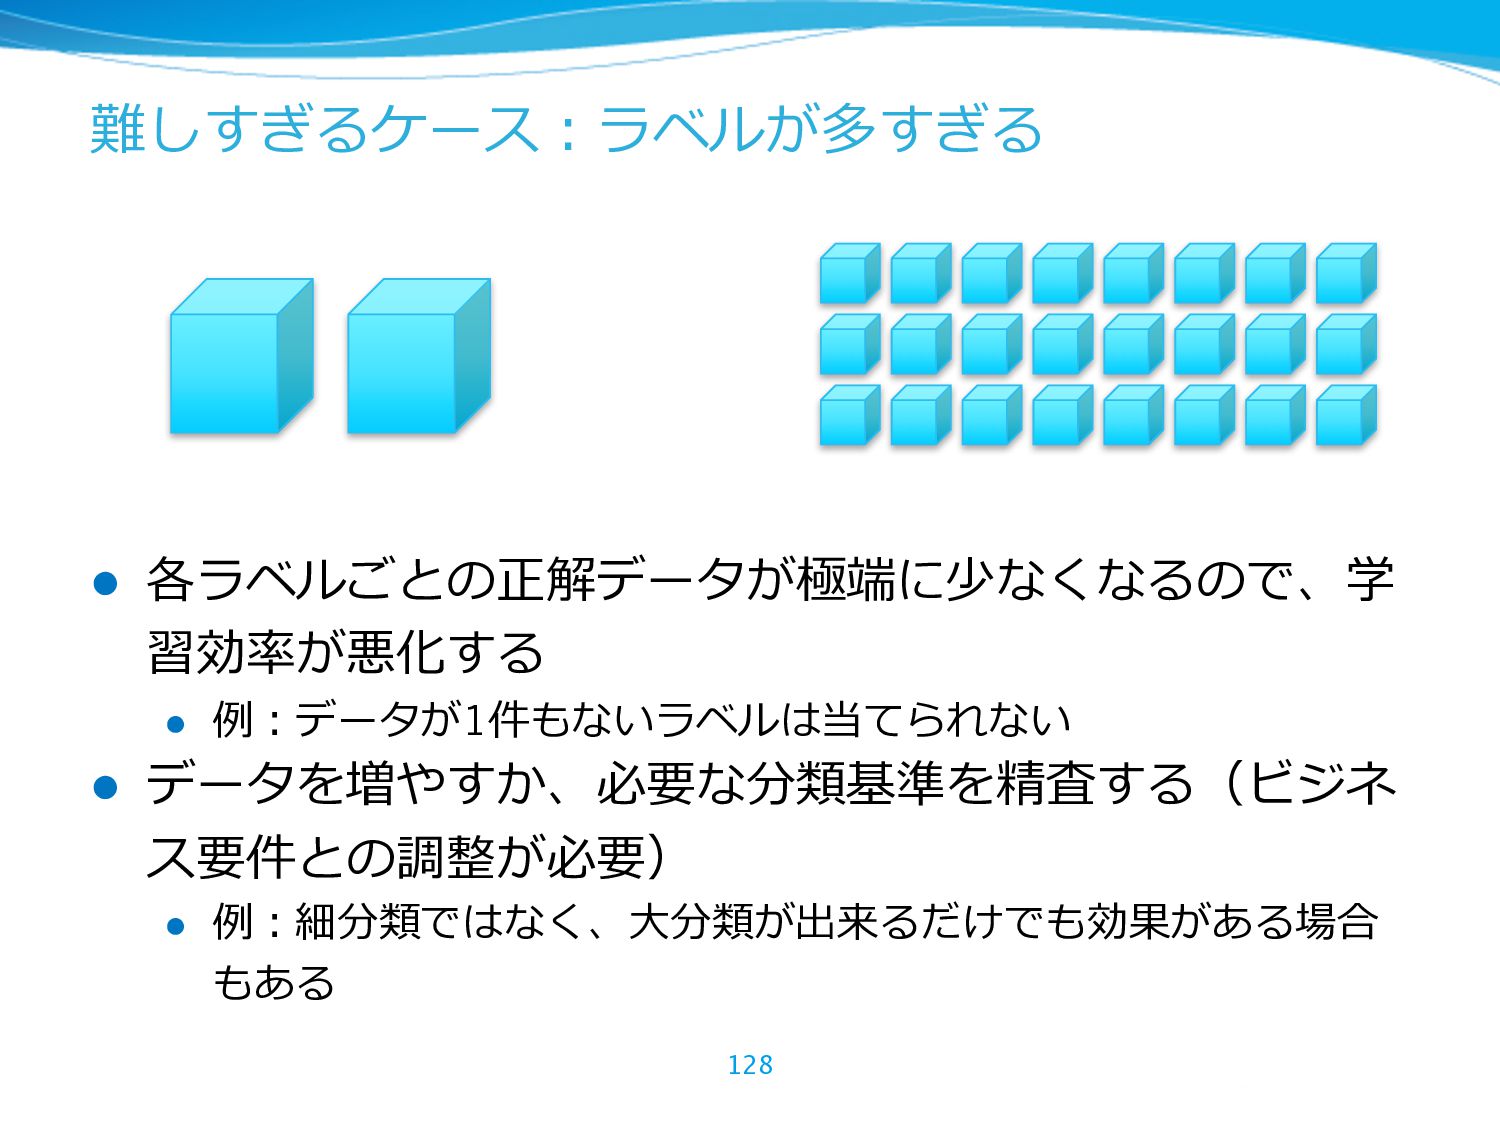
難しすぎるケース:ラベルが多すぎる l 各ラベルごとの正解データが極端に少なくなるので、学 習効率が悪化する l 例:データが1件もないラベルは当てられない l データを増やすか、必要な分類基準を精査する(ビジネ ス要件との調整が必要) l
例:細分類ではなく、⼤分類が出来るだけでも効果がある場合 もある 128 -
それでも精度が出ない l 要件を再検討 l 誤検知が問題なら、確信度の⾼い上位を利⽤する l 検知漏れが問題なら、確信度のしきい値を下げる l 間違い事例を精査 l
必要な特徴が取れていないことが多い l より⾼度な⽅法を検討 l ラベルなしデータを利⽤する(半教師あり学習) l 外部リソースを利⽤した特徴を利⽤する l 実装コスト、運⽤コスト、処理性能の劣化などの苦 労の割には性能向上は限定的 129 -
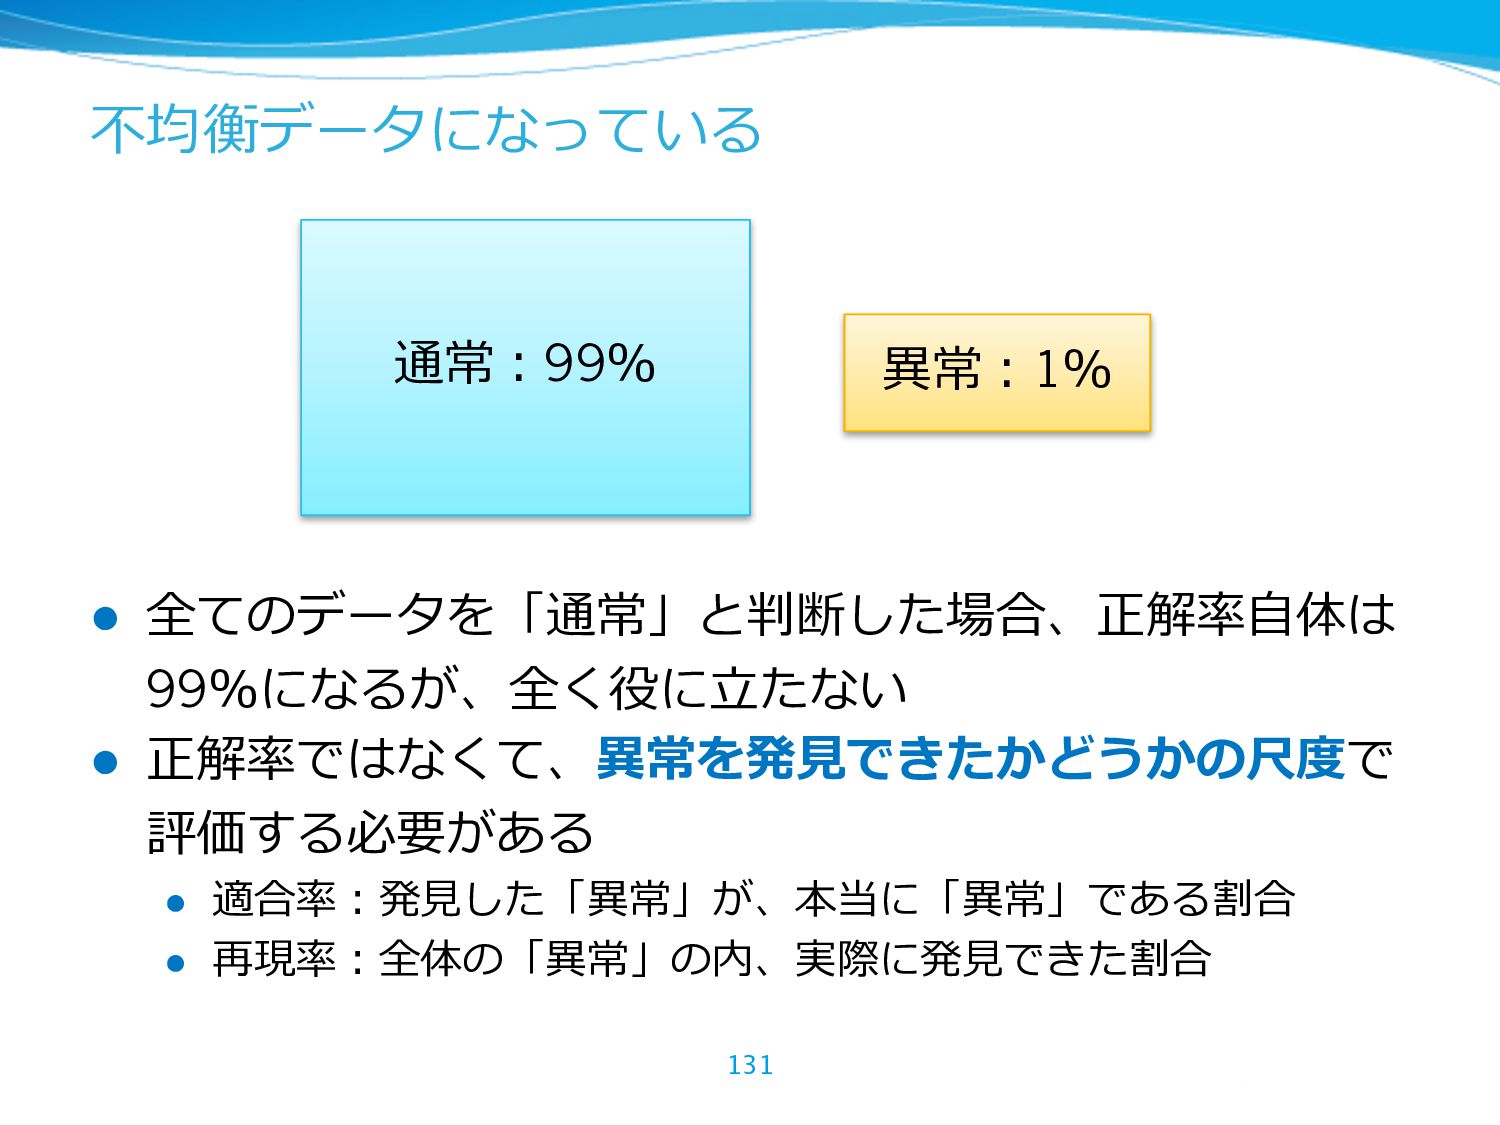
不均衡データになっている l 全てのデータを「通常」と判断した場合、正解率⾃体は 99%になるが、全く役に⽴たない l 正解率ではなくて、異常を発⾒できたかどうかの尺度で 評価する必要がある l 適合率:発⾒した「異常」が、本当に「異常」である割合 l
再現率:全体の「異常」の内、実際に発⾒できた割合 131 通常:99% 異常:1% -
実システムに組み込む l 実システム上で成果が出るかが⼀番⼤事 l 成果をどう設定するかはケースバイケース l クリック率が実際に向上するか? l データ整理に要する時間が短縮されたか? l
ユーザーの平均滞在時間が向上したか? l 効果を測定できる仕組みが必要 136 -
実データで試すと新たな問題が出てくる l 想定したデータとずれてくる l 例:スイカ=「野菜」が、ある⽇「交通」になった l システム全体として効果が出ない l 例:スパムと思って消したら、クリック率が下がっ た
l 対象がシステムに対抗してくる l 例:検索エンジン業者とSEO業者の攻防 137 -
まとめ l まず⽬標を明確に l ⽬標をうまく機械学習の問題に落とす l 機械学習の実験を繰り返す l 環境整備が⼤事 l
システムに組み込んで改善のループを回す 139 -
全体のおさらい l 機械学習はどこでも使える l データを利⽤して賢くなる⼿法全般 l データのある様々な領域で適⽤可能 l ⼿法は沢⼭ l
教師あり学習は⼊出⼒関係を学習 l 教師なし学習はデータの傾向を学習 l 強化学習は⾃動で試⾏錯誤する l 深層学習は多段のニューラルネット l 検証を繰り返す l 実験は交差検定で l システムに組み込んで効果をしっかり試す 140