Upgrade to Pro — share decks privately, control downloads, hide ads and more …

eSports Preparation Room — A-lite Prototype

Avatar for yosuku0 yosuku0
March 11, 2026

eSports Preparation Room — A-lite Prototype

An MCP-native AI analysis system for League of Legends teams.
Connects Riot API data and patch notes to an LLM, generating structured briefings for match preparation, post-match review, and self-analysis.

Avatar for yosuku0

yosuku0

March 11, 2026

More Decks by yosuku0

Other Decks in Technology

Transcript

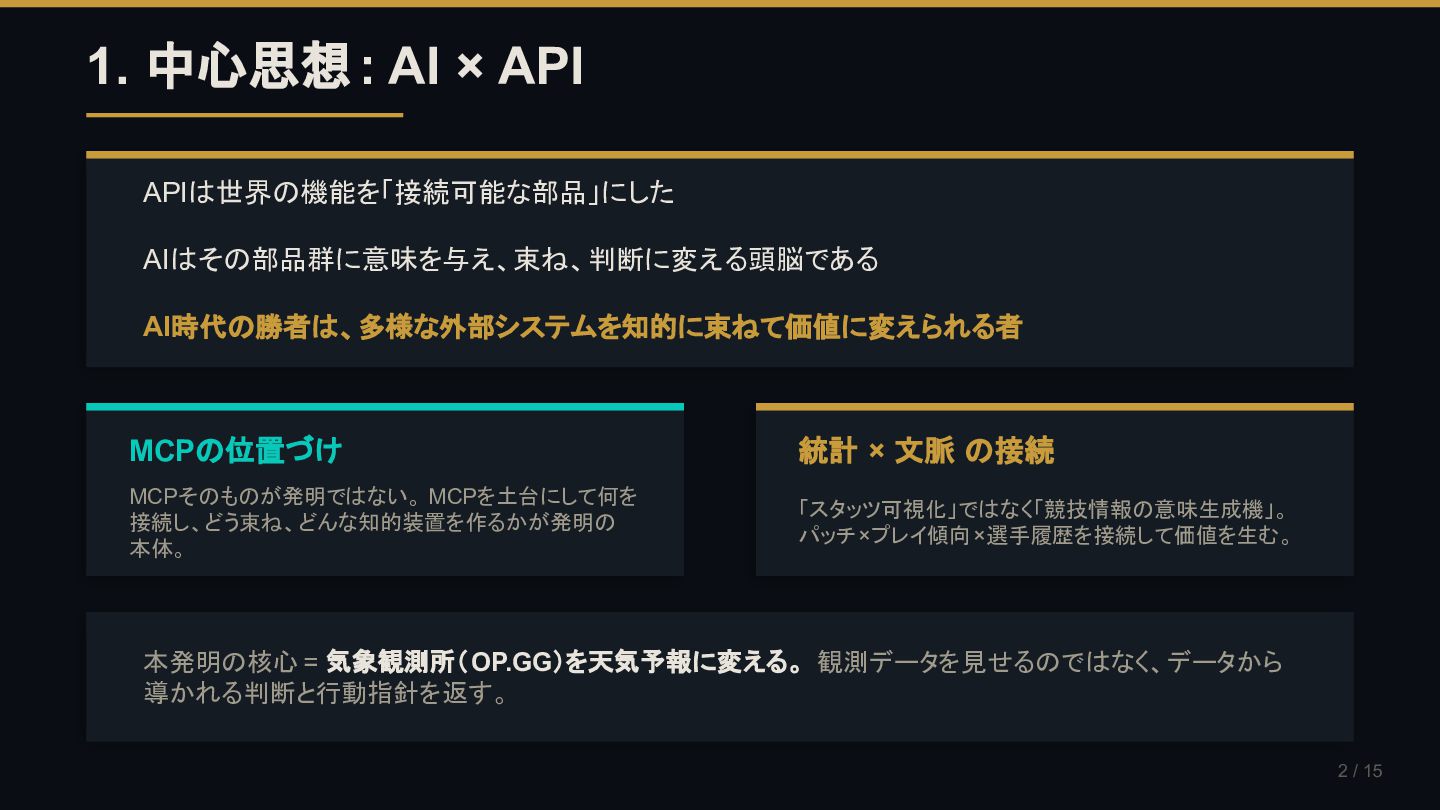
  1. 1. 中心思想: AI × API 2 / 15 APIは世界の機能を「接続可能な部品」にした AIはその部品群に意味を与え、束ね、判断に変える頭脳である

    AI時代の勝者は、多様な外部システムを知的に束ねて価値に変えられる者 MCPの位置づけ MCPそのものが発明ではない。 MCPを土台にして何を 接続し、どう束ね、どんな知的装置を作るかが発明の 本体。 統計 × 文脈 の接続 「スタッツ可視化」ではなく「競技情報の意味生成機」。 パッチ×プレイ傾向×選手履歴を接続して価値を生む。 本発明の核心 = 気象観測所(OP.GG)を天気予報に変える。 観測データを見せるのではなく、データから 導かれる判断と行動指針を返す。
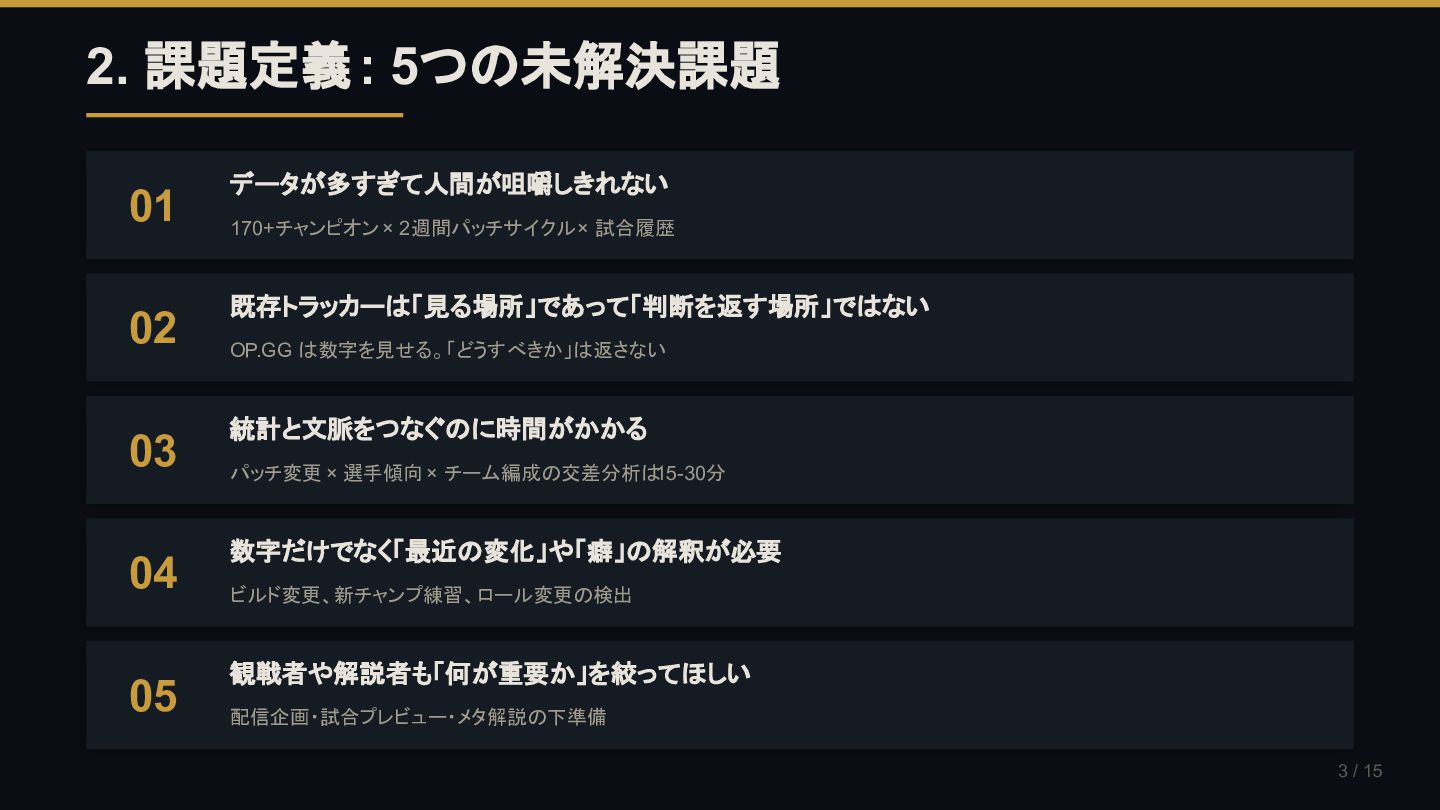
  2. 2. 課題定義: 5つの未解決課題 3 / 15 01 データが多すぎて人間が咀嚼しきれない 170+チャンピオン ×

    2週間パッチサイクル × 試合履歴 02 既存トラッカーは「見る場所」であって「判断を返す場所」ではない OP.GG は数字を見せる。「どうすべきか」は返さない 03 統計と文脈をつなぐのに時間がかかる パッチ変更 × 選手傾向 × チーム編成の交差分析は 15-30分 04 数字だけでなく「最近の変化」や「癖」の解釈が必要 ビルド変更、新チャンプ練習、ロール変更の検出 05 観戦者や解説者も「何が重要か」を絞ってほしい 配信企画・試合プレビュー・メタ解説の下準備
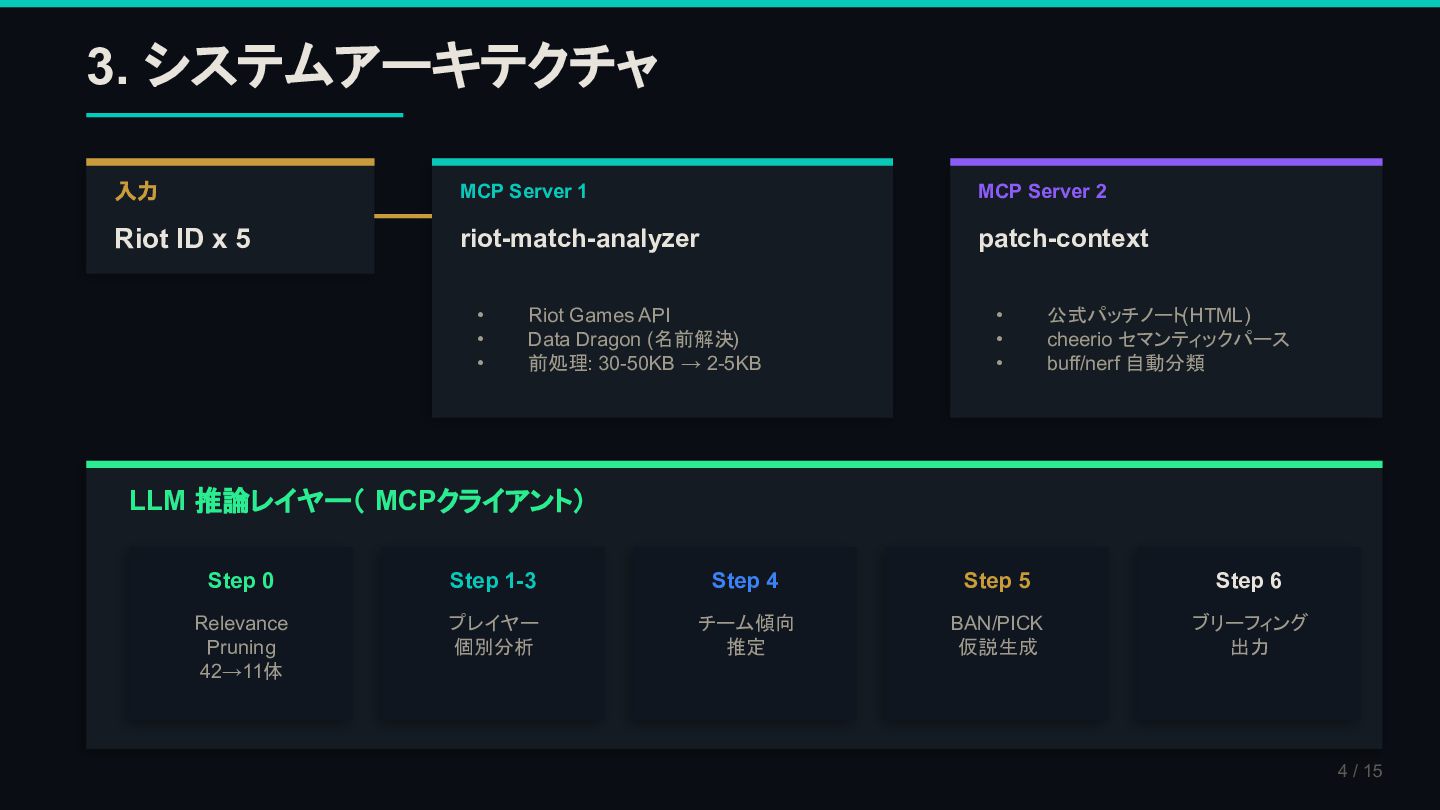
  3. 3. システムアーキテクチャ 4 / 15 入力 Riot ID x 5

    MCP Server 1 riot-match-analyzer • Riot Games API • Data Dragon (名前解決) • 前処理: 30-50KB → 2-5KB MCP Server 2 patch-context • 公式パッチノート(HTML) • cheerio セマンティックパース • buff/nerf 自動分類 LLM 推論レイヤー( MCPクライアント) Step 0 Relevance Pruning 42→11体 Step 1-3 プレイヤー 個別分析 Step 4 チーム傾向 推定 Step 5 BAN/PICK 仮説生成 Step 6 ブリーフィング 出力
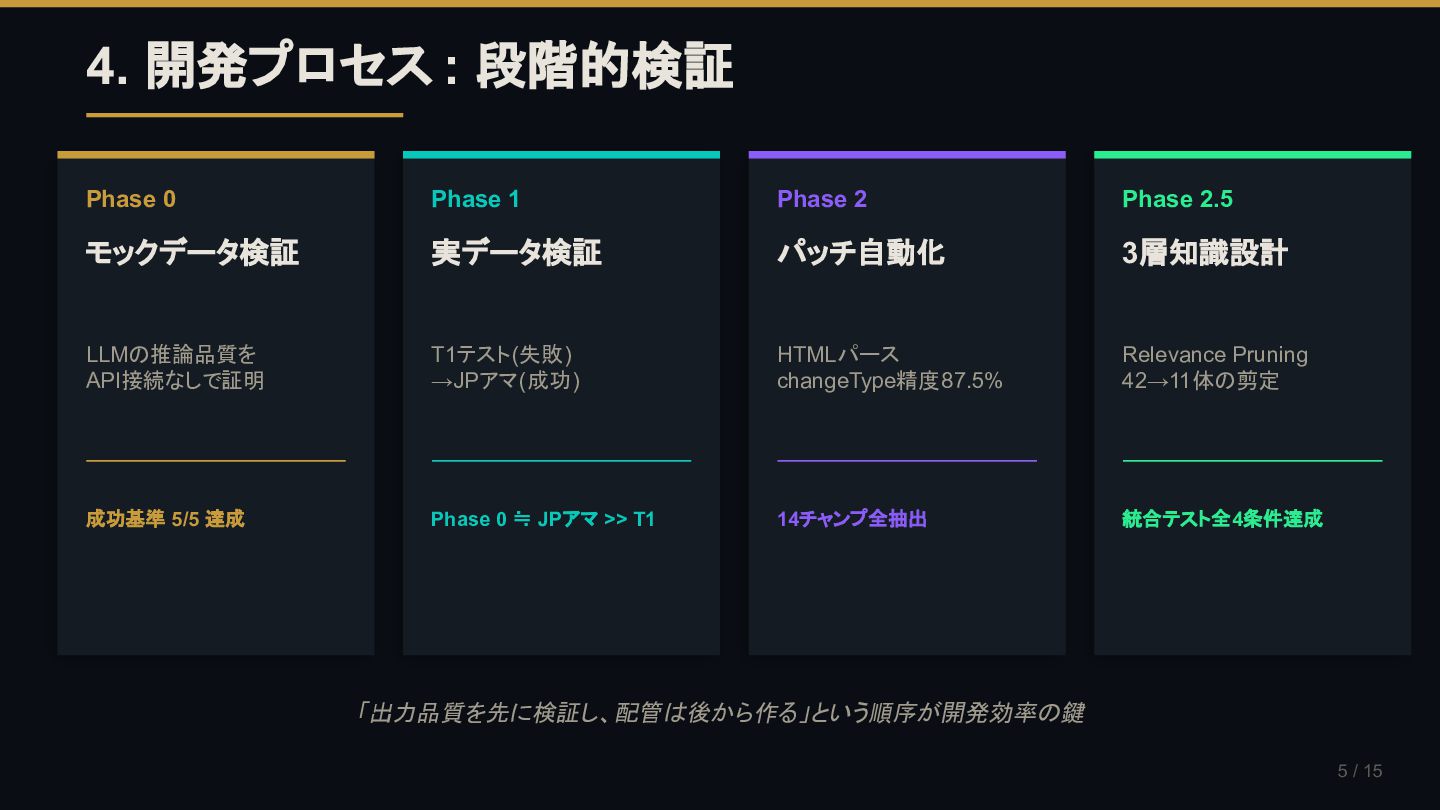
  4. 4. 開発プロセス : 段階的検証 5 / 15 Phase 0 モックデータ検証

    LLMの推論品質を API接続なしで証明 成功基準 5/5 達成 Phase 1 実データ検証 T1テスト(失敗) →JPアマ(成功) Phase 0 ≒ JPアマ >> T1 Phase 2 パッチ自動化 HTMLパース changeType精度87.5% 14チャンプ全抽出 Phase 2.5 3層知識設計 Relevance Pruning 42→11体の剪定 統合テスト全4条件達成 「出力品質を先に検証し、配管は後から作る」という順序が開発効率の鍵
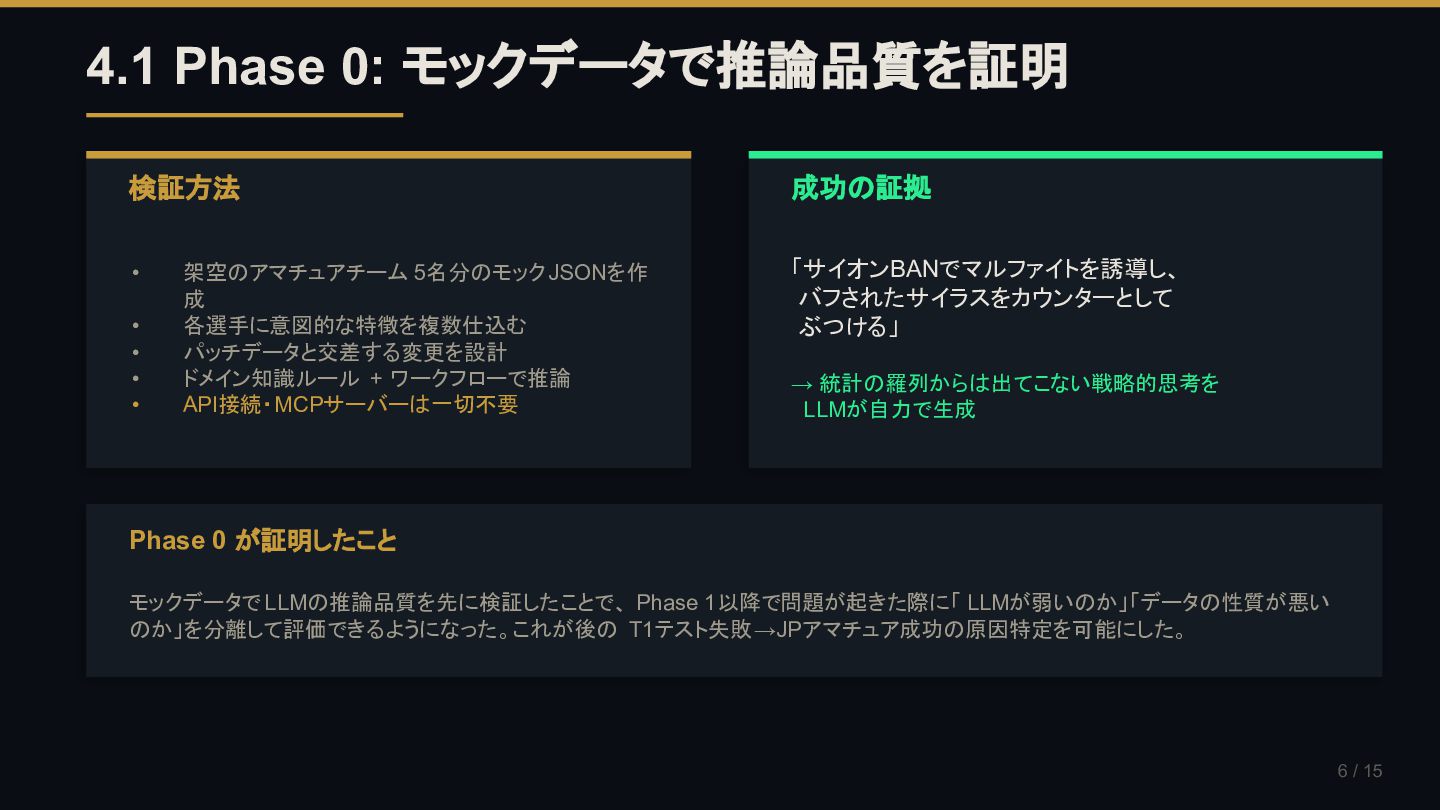
  5. 4.1 Phase 0: モックデータで推論品質を証明 6 / 15 検証方法 • 架空のアマチュアチーム

    5名分のモックJSONを作 成 • 各選手に意図的な特徴を複数仕込む • パッチデータと交差する変更を設計 • ドメイン知識ルール + ワークフローで推論 • API接続・MCPサーバーは一切不要 成功の証拠 「サイオンBANでマルファイトを誘導し、 バフされたサイラスをカウンターとして ぶつける」 → 統計の羅列からは出てこない戦略的思考を LLMが自力で生成 Phase 0 が証明したこと モックデータでLLMの推論品質を先に検証したことで、 Phase 1以降で問題が起きた際に「 LLMが弱いのか」「データの性質が悪い のか」を分離して評価できるようになった。これが後の T1テスト失敗→JPアマチュア成功の原因特定を可能にした。
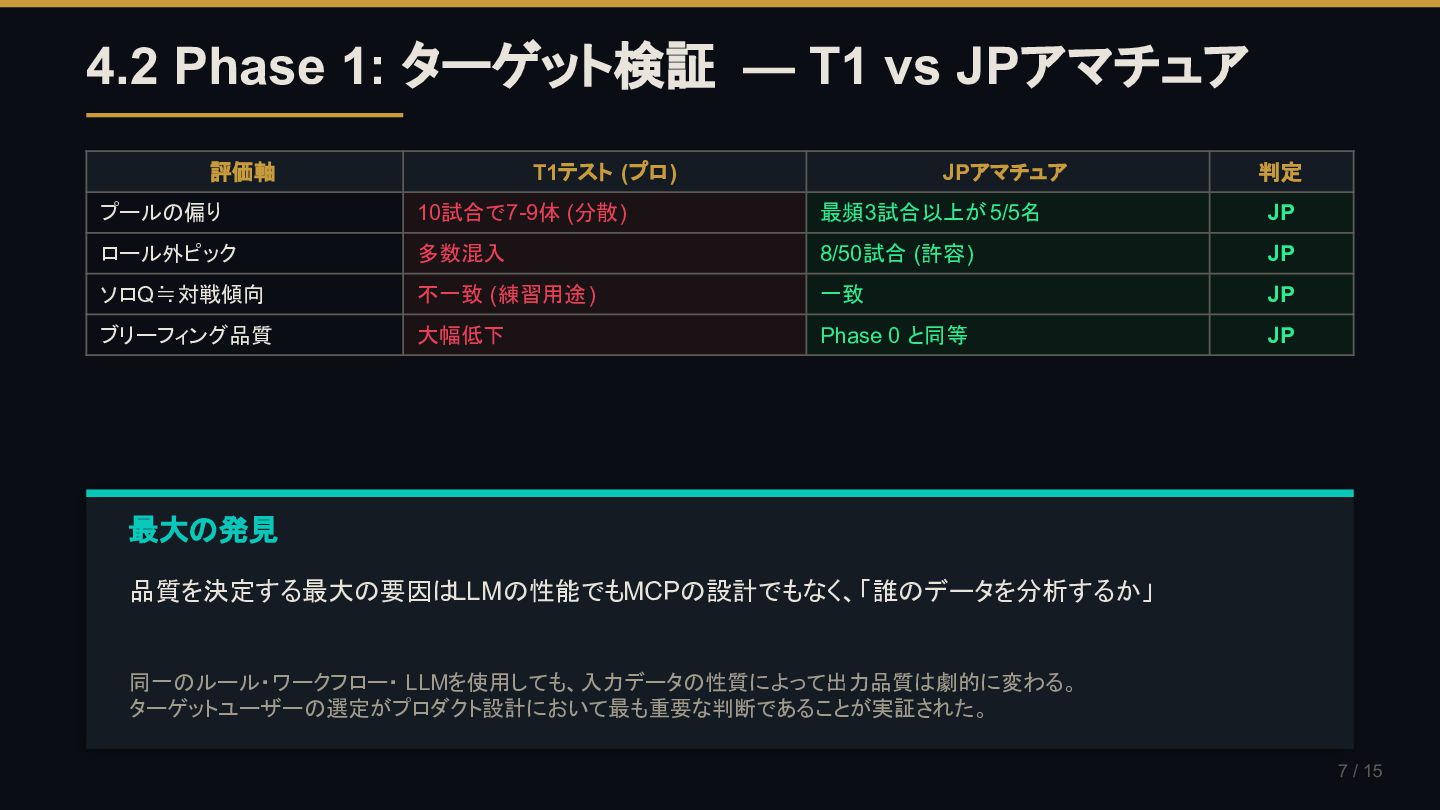
  6. 4.2 Phase 1: ターゲット検証 — T1 vs JPアマチュア 7 /

    15 評価軸 T1テスト (プロ) JPアマチュア 判定 プールの偏り 10試合で7-9体 (分散) 最頻3試合以上が5/5名 JP ロール外ピック 多数混入 8/50試合 (許容) JP ソロQ≒対戦傾向 不一致 (練習用途) 一致 JP ブリーフィング品質 大幅低下 Phase 0 と同等 JP 最大の発見 品質を決定する最大の要因は LLMの性能でもMCPの設計でもなく、「誰のデータを分析するか」 同一のルール・ワークフロー・ LLMを使用しても、入力データの性質によって出力品質は劇的に変わる。 ターゲットユーザーの選定がプロダクト設計において最も重要な判断であることが実証された。
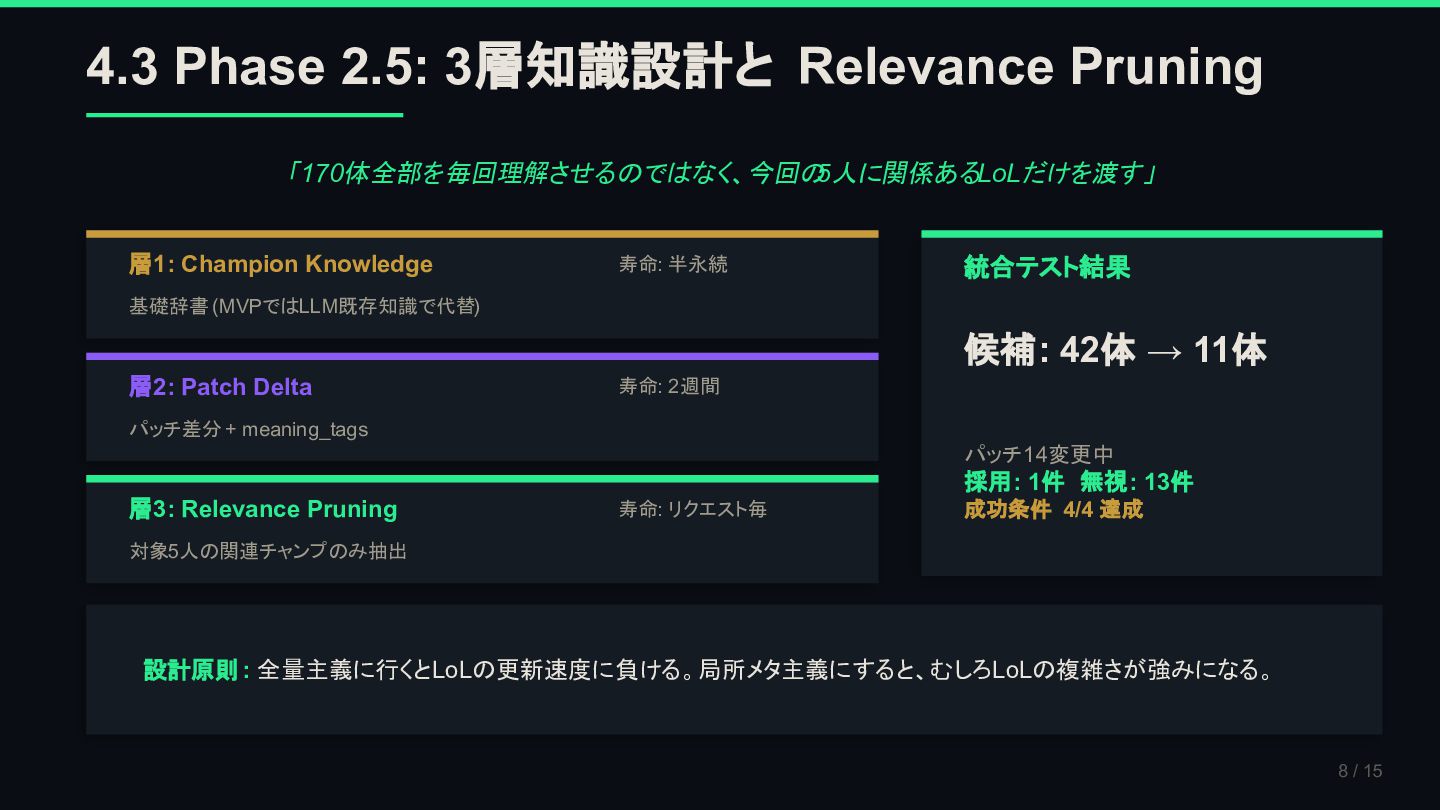
  7. 4.3 Phase 2.5: 3層知識設計と Relevance Pruning 8 / 15 「170体全部を毎回理解させるのではなく、今回の

    5人に関係あるLoLだけを渡す」 層1: Champion Knowledge 寿命: 半永続 基礎辞書 (MVPではLLM既存知識で代替) 層2: Patch Delta 寿命: 2週間 パッチ差分 + meaning_tags 層3: Relevance Pruning 寿命: リクエスト毎 対象5人の関連チャンプのみ抽出 統合テスト結果 候補: 42体 → 11体 パッチ14変更中 採用: 1件 無視: 13件 成功条件 4/4 達成 設計原則: 全量主義に行くとLoLの更新速度に負ける。局所メタ主義にすると、むしろLoLの複雑さが強みになる。
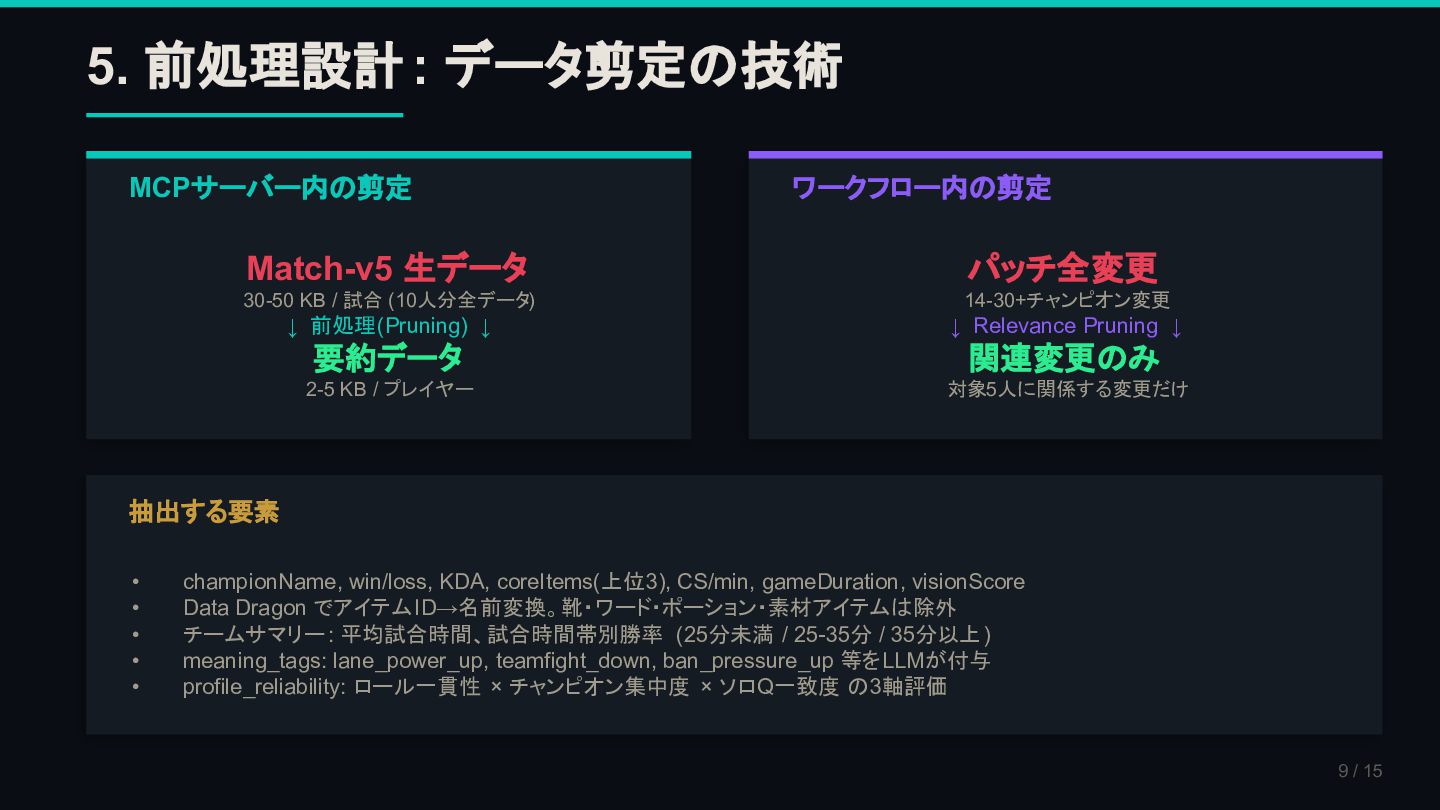
  8. 5. 前処理設計 : データ剪定の技術 9 / 15 MCPサーバー内の剪定 Match-v5 生データ

    30-50 KB / 試合 (10人分全データ) ↓ 前処理(Pruning) ↓ 要約データ 2-5 KB / プレイヤー ワークフロー内の剪定 パッチ全変更 14-30+チャンピオン変更 ↓ Relevance Pruning ↓ 関連変更のみ 対象5人に関係する変更だけ 抽出する要素 • championName, win/loss, KDA, coreItems(上位3), CS/min, gameDuration, visionScore • Data Dragon でアイテムID→名前変換。靴・ワード・ポーション・素材アイテムは除外 • チームサマリー: 平均試合時間、試合時間帯別勝率 (25分未満 / 25-35分 / 35分以上) • meaning_tags: lane_power_up, teamfight_down, ban_pressure_up 等をLLMが付与 • profile_reliability: ロール一貫性 × チャンピオン集中度 × ソロQ一致度 の3軸評価
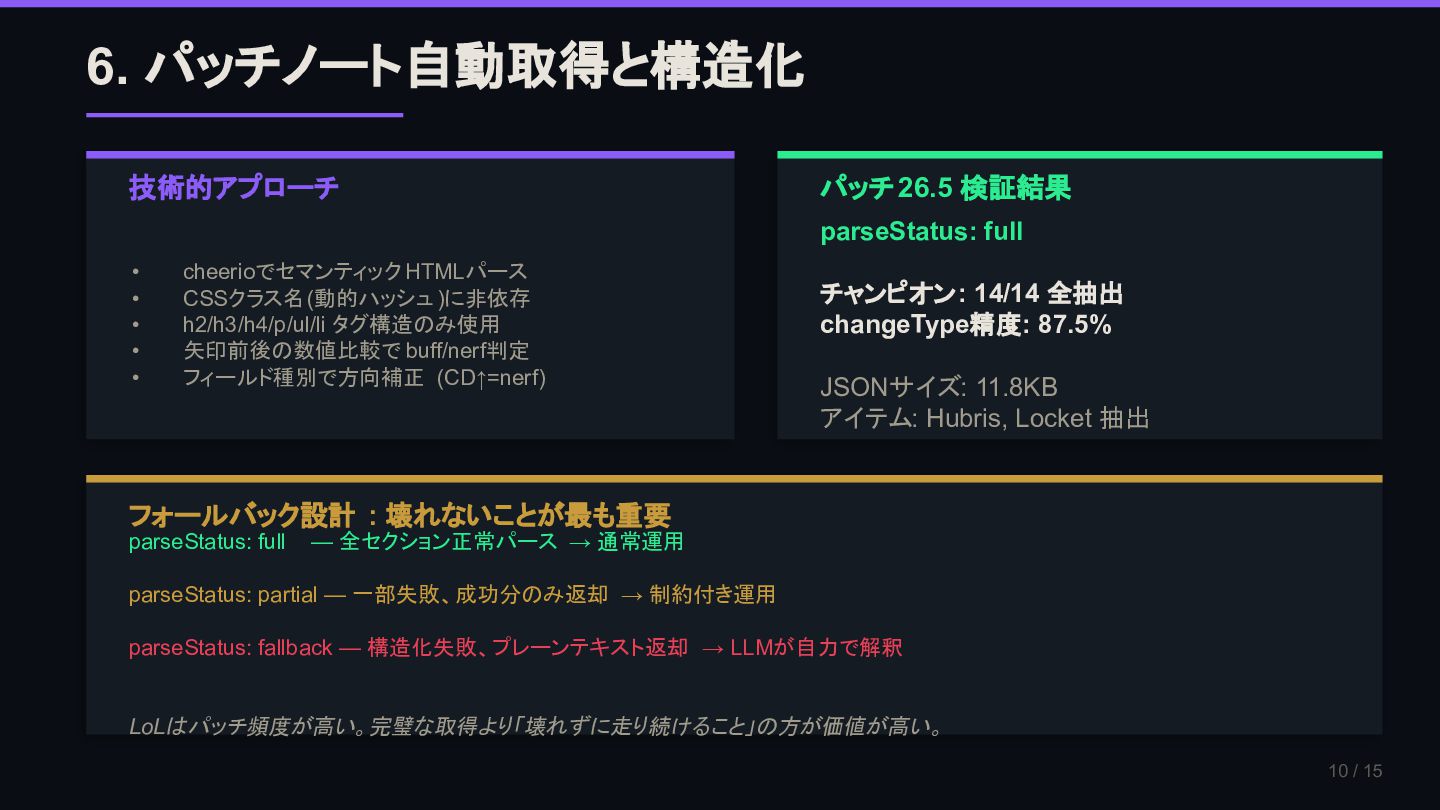
  9. 6. パッチノート自動取得と構造化 10 / 15 技術的アプローチ • cheerioでセマンティック HTMLパース •

    CSSクラス名(動的ハッシュ)に非依存 • h2/h3/h4/p/ul/li タグ構造のみ使用 • 矢印前後の数値比較で buff/nerf判定 • フィールド種別で方向補正 (CD↑=nerf) パッチ26.5 検証結果 parseStatus: full チャンピオン: 14/14 全抽出 changeType精度: 87.5% JSONサイズ: 11.8KB アイテム: Hubris, Locket 抽出 フォールバック設計 : 壊れないことが最も重要 parseStatus: full — 全セクション正常パース → 通常運用 parseStatus: partial — 一部失敗、成功分のみ返却 → 制約付き運用 parseStatus: fallback — 構造化失敗、プレーンテキスト返却 → LLMが自力で解釈 LoLはパッチ頻度が高い。完璧な取得より「壊れずに走り続けること」の方が価値が高い。
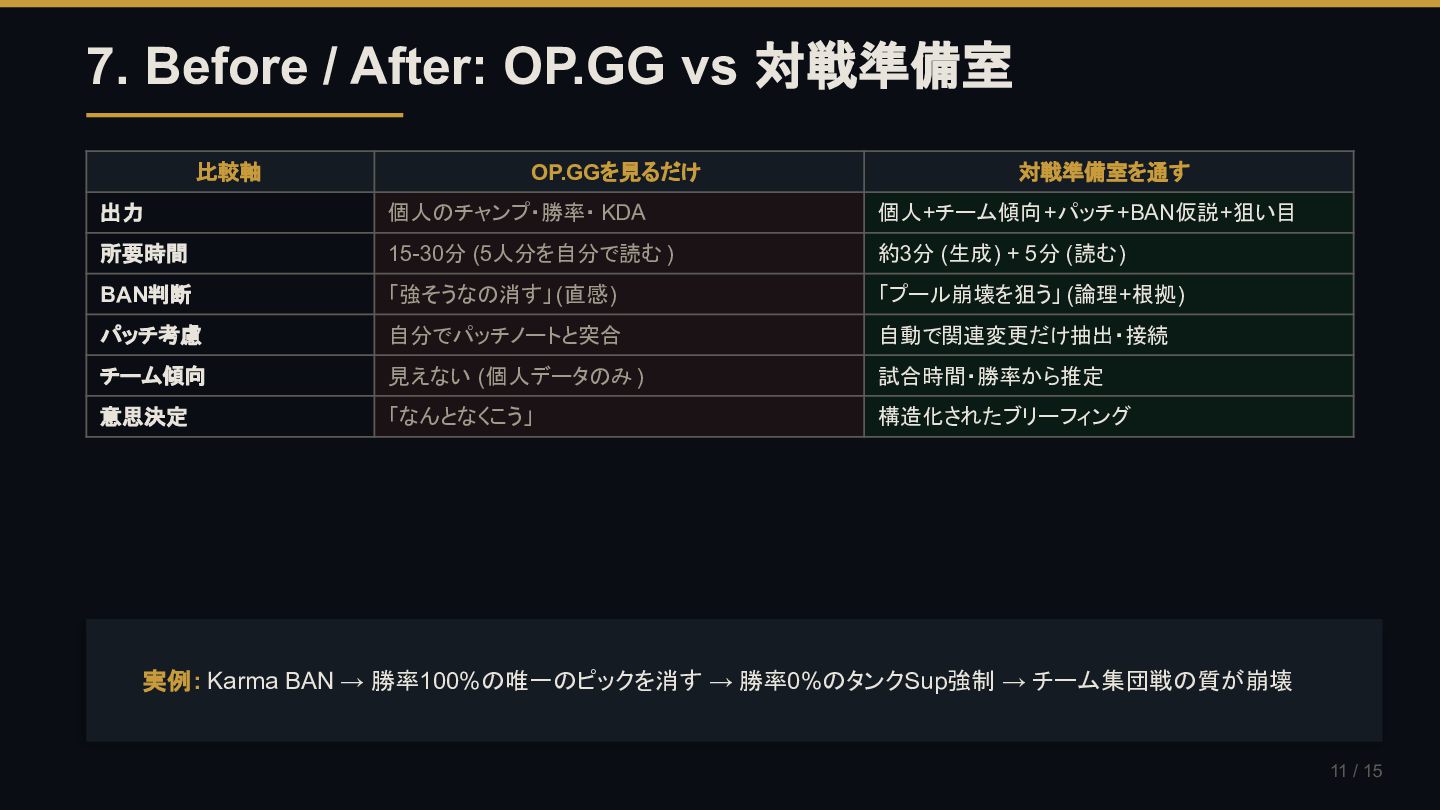
  10. 7. Before / After: OP.GG vs 対戦準備室 11 / 15

    比較軸 OP.GGを見るだけ 対戦準備室を通す 出力 個人のチャンプ・勝率・ KDA 個人+チーム傾向+パッチ+BAN仮説+狙い目 所要時間 15-30分 (5人分を自分で読む ) 約3分 (生成) + 5分 (読む) BAN判断 「強そうなの消す」 (直感) 「プール崩壊を狙う」 (論理+根拠) パッチ考慮 自分でパッチノートと突合 自動で関連変更だけ抽出・接続 チーム傾向 見えない (個人データのみ ) 試合時間・勝率から推定 意思決定 「なんとなくこう」 構造化されたブリーフィング 実例: Karma BAN → 勝率100%の唯一のピックを消す → 勝率0%のタンクSup強制 → チーム集団戦の質が崩壊
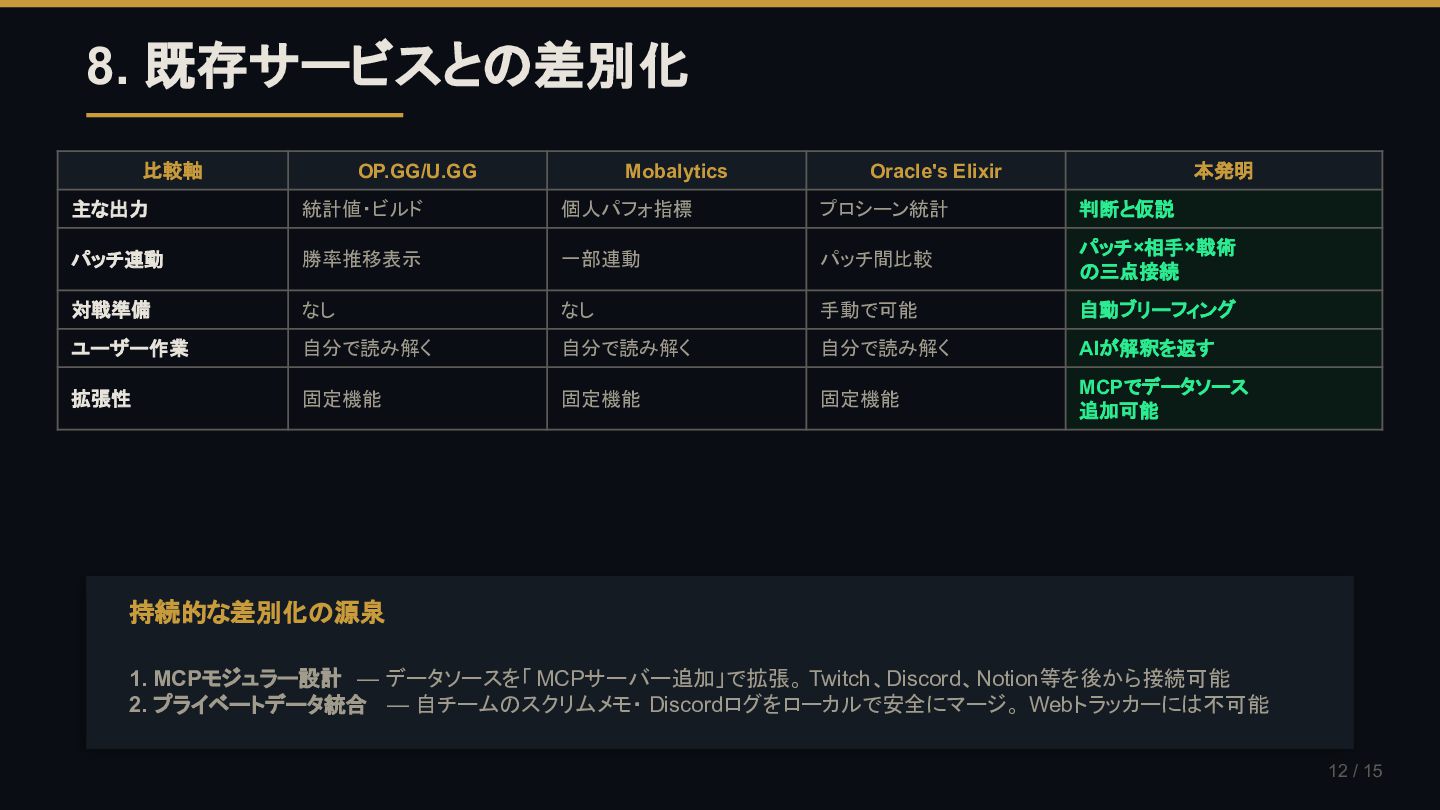
  11. 8. 既存サービスとの差別化 12 / 15 比較軸 OP.GG/U.GG Mobalytics Oracle's Elixir

    本発明 主な出力 統計値・ビルド 個人パフォ指標 プロシーン統計 判断と仮説 パッチ連動 勝率推移表示 一部連動 パッチ間比較 パッチ×相手×戦術 の三点接続 対戦準備 なし なし 手動で可能 自動ブリーフィング ユーザー作業 自分で読み解く 自分で読み解く 自分で読み解く AIが解釈を返す 拡張性 固定機能 固定機能 固定機能 MCPでデータソース 追加可能 持続的な差別化の源泉 1. MCPモジュラー設計 — データソースを「 MCPサーバー追加」で拡張。 Twitch、Discord、Notion等を後から接続可能 2. プライベートデータ統合 — 自チームのスクリムメモ・ Discordログをローカルで安全にマージ。 Webトラッカーには不可能
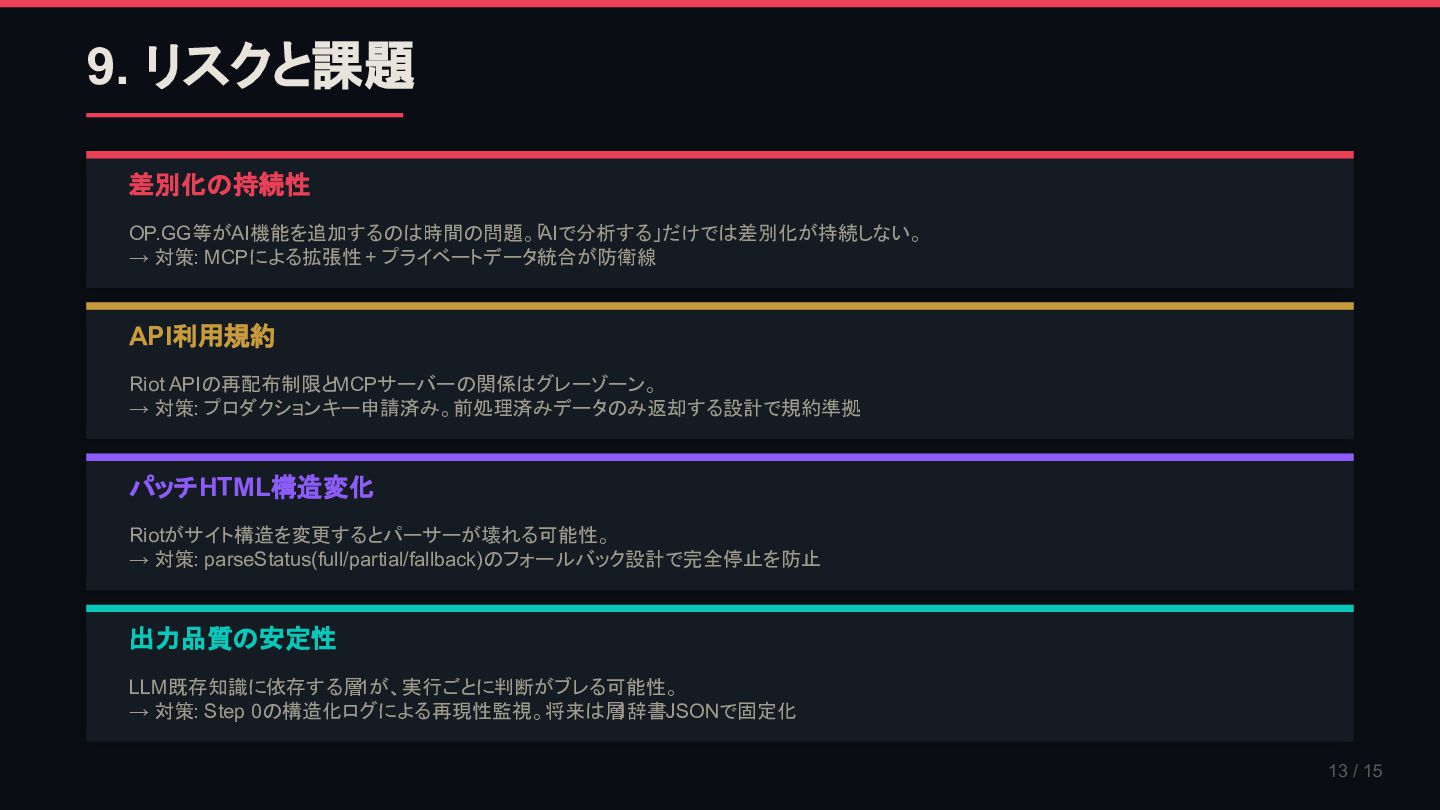
  12. 9. リスクと課題 13 / 15 差別化の持続性 OP.GG等がAI機能を追加するのは時間の問題。「 AIで分析する」だけでは差別化が持続しない。 → 対策:

    MCPによる拡張性 + プライベートデータ統合が防衛線 API利用規約 Riot APIの再配布制限とMCPサーバーの関係はグレーゾーン。 → 対策: プロダクションキー申請済み。前処理済みデータのみ返却する設計で規約準拠 パッチHTML構造変化 Riotがサイト構造を変更するとパーサーが壊れる可能性。 → 対策: parseStatus(full/partial/fallback)のフォールバック設計で完全停止を防止 出力品質の安定性 LLM既存知識に依存する層 1が、実行ごとに判断がブレる可能性。 → 対策: Step 0の構造化ログによる再現性監視。将来は層 1辞書JSONで固定化
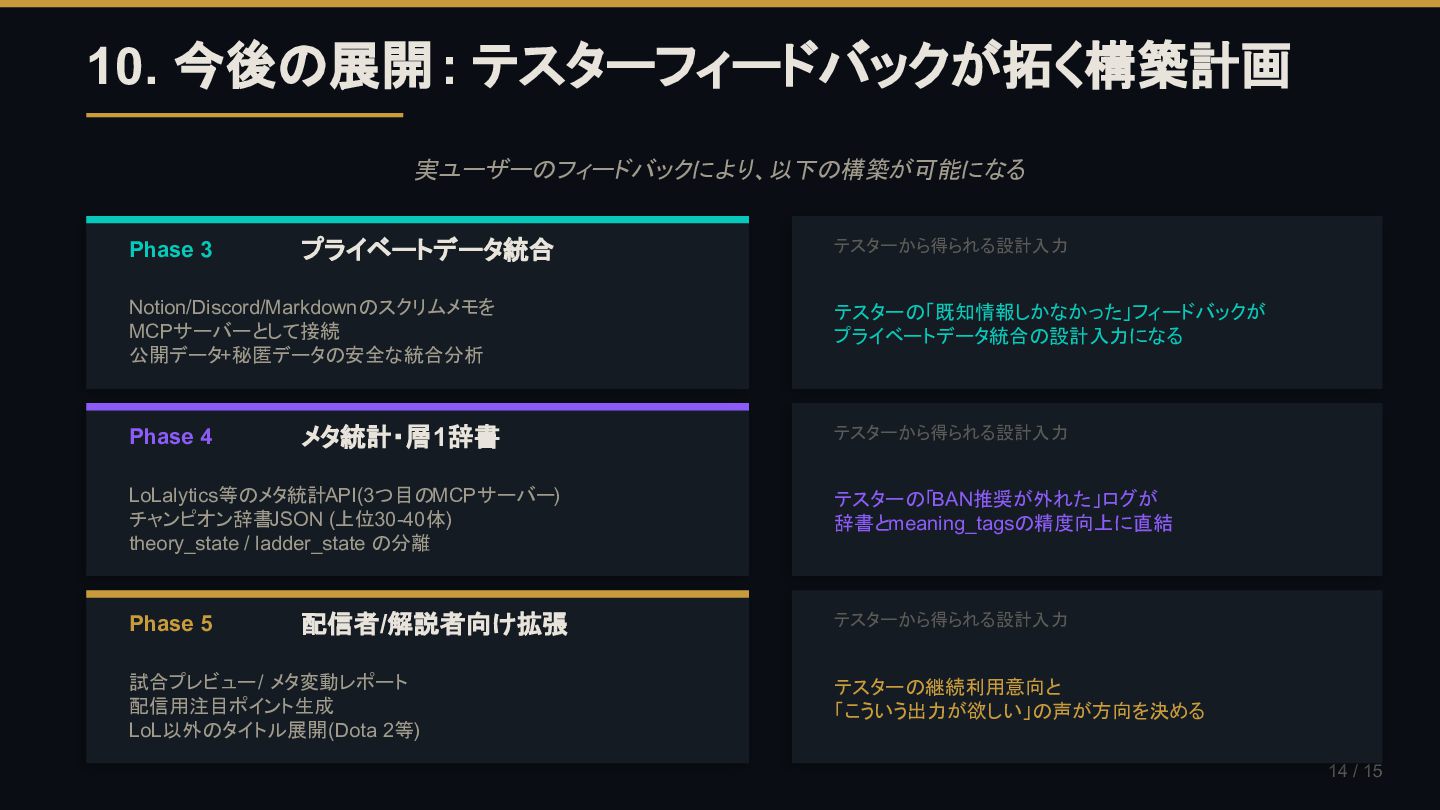
  13. 10. 今後の展開 : テスターフィードバックが拓く構築計画 14 / 15 実ユーザーのフィードバックにより、以下の構築が可能になる Phase 3

    プライベートデータ統合 Notion/Discord/Markdownのスクリムメモを MCPサーバーとして接続 公開データ+秘匿データの安全な統合分析 テスターから得られる設計入力 テスターの「既知情報しかなかった」フィードバックが プライベートデータ統合の設計入力になる Phase 4 メタ統計・層1辞書 LoLalytics等のメタ統計API(3つ目のMCPサーバー) チャンピオン辞書JSON (上位30-40体) theory_state / ladder_state の分離 テスターから得られる設計入力 テスターの「BAN推奨が外れた」ログが 辞書とmeaning_tagsの精度向上に直結 Phase 5 配信者/解説者向け拡張 試合プレビュー / メタ変動レポート 配信用注目ポイント生成 LoL以外のタイトル展開 (Dota 2等) テスターから得られる設計入力 テスターの継続利用意向と 「こういう出力が欲しい」の声が方向を決める
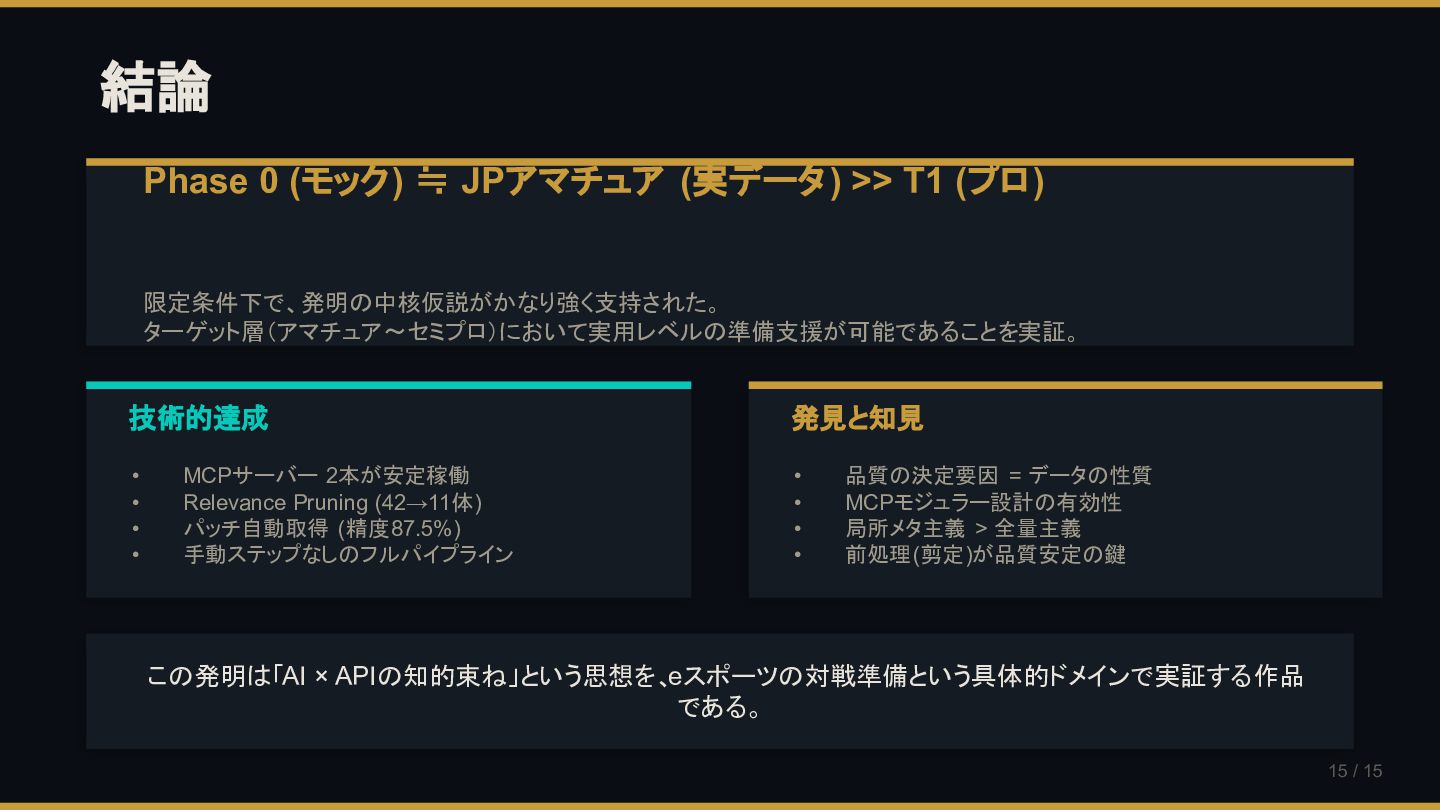
  14. 15 / 15 結論 Phase 0 (モック) ≒ JPアマチュア (実データ)

    >> T1 (プロ) 限定条件下で、発明の中核仮説がかなり強く支持された。 ターゲット層(アマチュア〜セミプロ)において実用レベルの準備支援が可能であることを実証。 技術的達成 • MCPサーバー 2本が安定稼働 • Relevance Pruning (42→11体) • パッチ自動取得 (精度87.5%) • 手動ステップなしのフルパイプライン 発見と知見 • 品質の決定要因 = データの性質 • MCPモジュラー設計の有効性 • 局所メタ主義 > 全量主義 • 前処理(剪定)が品質安定の鍵 この発明は「AI × APIの知的束ね」という思想を、 eスポーツの対戦準備という具体的ドメインで実証する作品 である。