Share
Embed

Transcript
47 slides
-
Rela%onal tri, Map/Reduce -‐ Hadoop mit RDBMS verbinden
von Marcus Ross Trainer / Developer / Freelancer @zahlenhelfer -
Fragen für diese Session • Ist es wirklich BIG
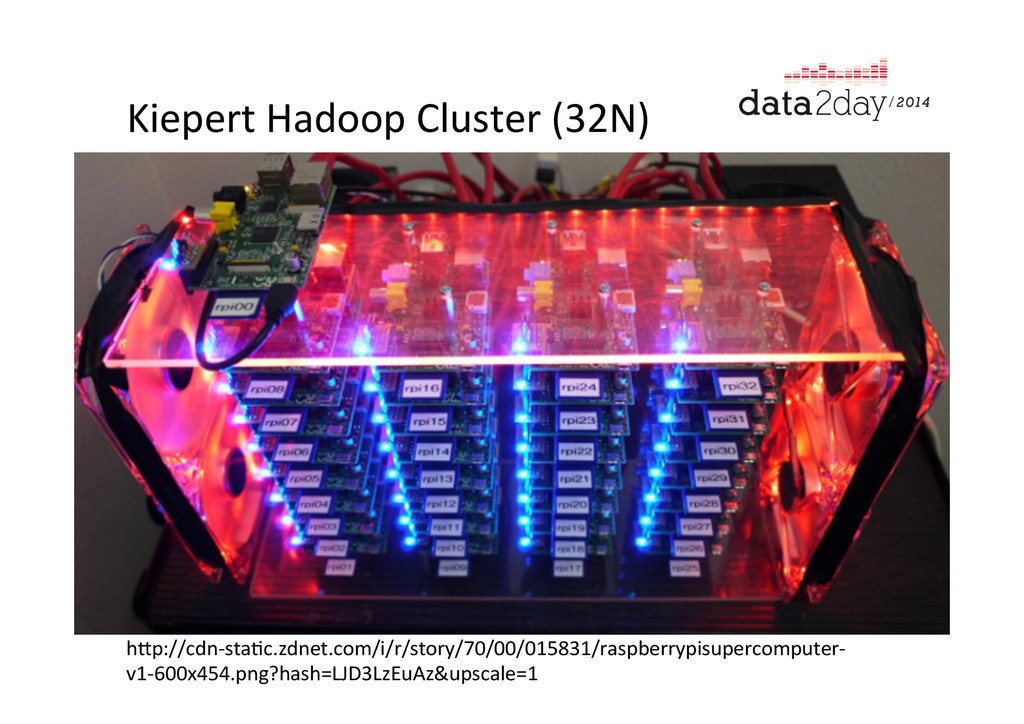
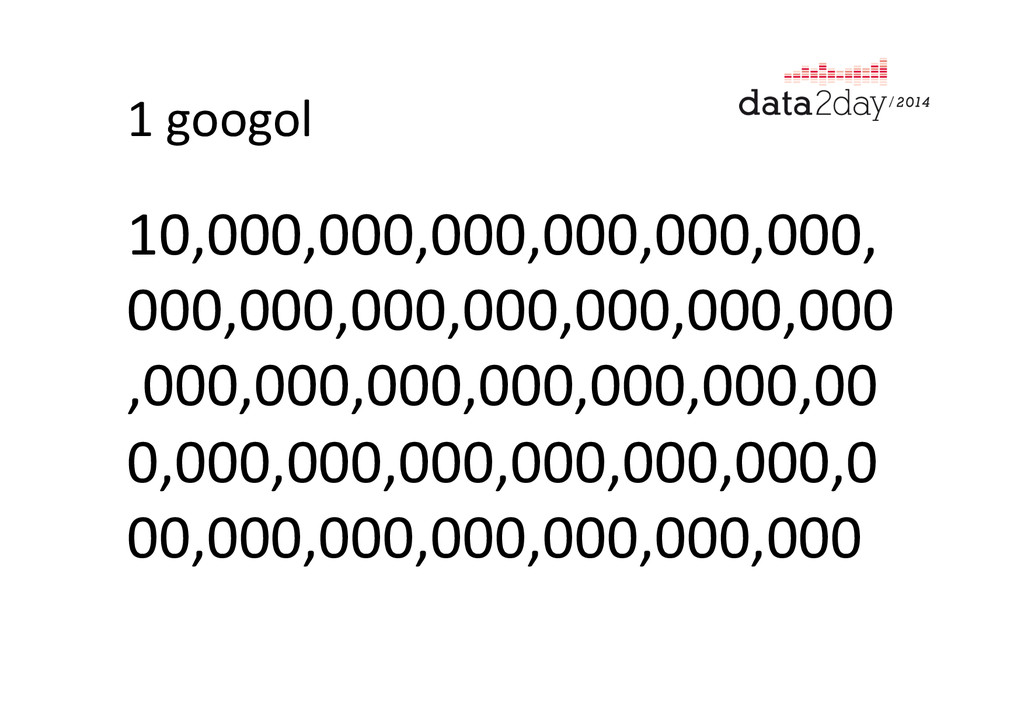
Data? – Ja, z.B. ein googol* Datensätze pro Tag • Muss es Hadoop sein? – Ja, da die Antwortzeit skalieren muss • Handelt es sich um Echtzeitdaten? – Nein, es werden Deltas zum Vortag impor%ert • Ist die Datenquelle ein RDBMS? – Ja, ein SQL Server wird angebunden *hUp://en.wikipedia.org/wiki/Googol -
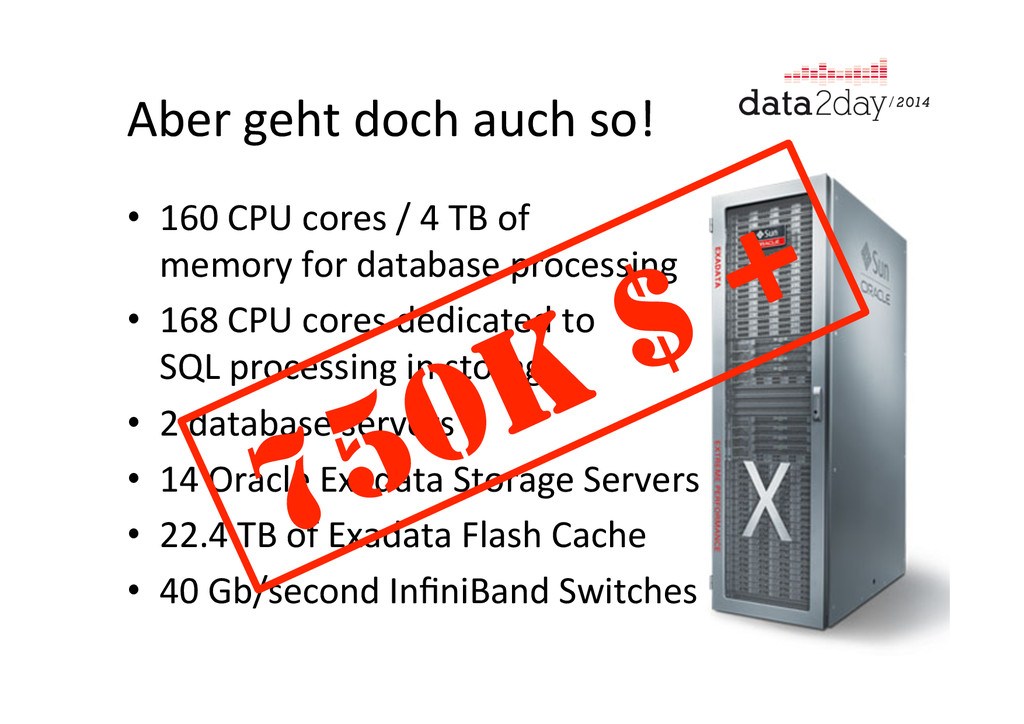
Aber geht doch auch so! • 160 CPU cores
/ 4 TB of memory for database processing • 168 CPU cores dedicated to SQL processing in storage • 2 database servers • 14 Oracle Exadata Storage Servers • 22.4 TB of Exadata Flash Cache • 40 Gb/second InfiniBand Switches -
Was ist ein googol? • Ein googol ist eine
große Zahl 1 mit 100 Nullen • Erfunden 1938 vom 9 jährigen Milton SiroUa – Neffe des Mathema%kers Edward Kasner – Kasner benö%gte einen Ausdruck für eine sehr große Zahl. – Der Ausdruck wurde 1940 im Buch Mathema'cs and the Imagina'on verwendet -
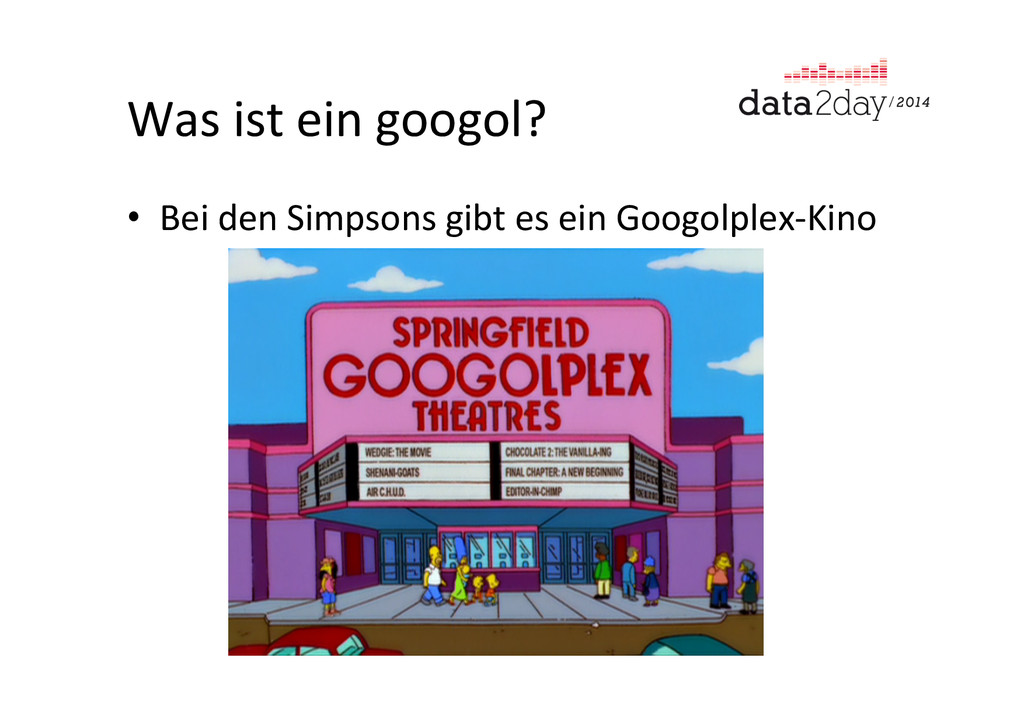
Was ist ein googol? • Bei den Simpsons gibt
es ein Googolplex-‐Kino -
Agenda • RDBMS tri, Hadoop -‐ Grundsätzliches •
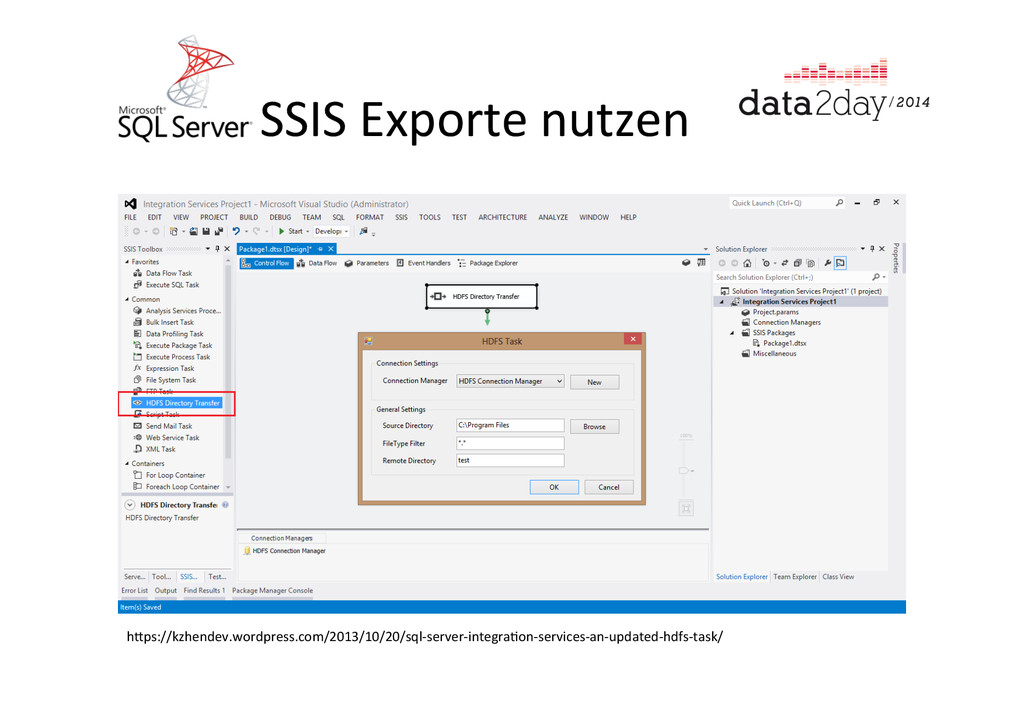
Auswahl an Möglichkeiten für die Aufgabe – Microsot SSIS-‐Pakete – Apache Hive Tables – Apache HBase – Apache Flume – Apache Sqoop • Hands-‐On Demo mit Sqoop/MySQL/Hive -
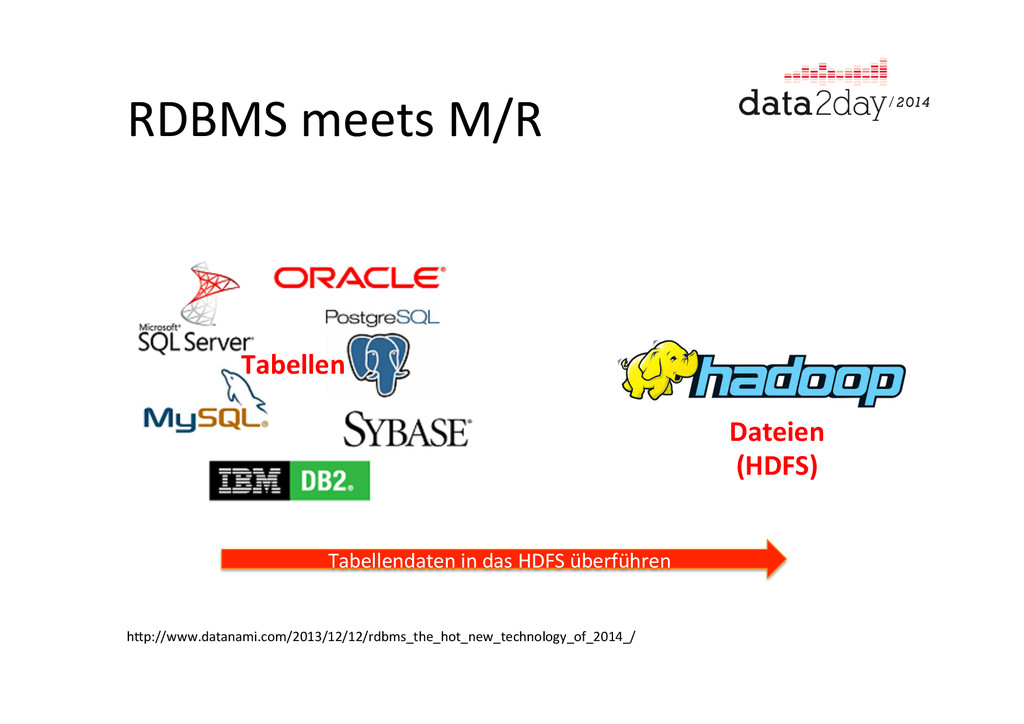
RDBMS meets M/R hUp://www.datanami.com/2013/12/12/rdbms_the_hot_new_technology_of_2014_/ Tabellen Dateien
(HDFS) Tabellendaten in das HDFS überführen -
Auswahl an Möglichkeiten für die Aufgabe •
Microsot SSIS-‐Pakete • Apache Hive Tables • Apache HBase • Apache Flume • Apache Sqoop(2) hUp://blogs.informa%ca.com/perspec%ves/2014/07/11/big-‐data-‐to-‐the-‐business-‐four-‐steps/#wid=PqWsf39GuXj -
Auswahl an Möglichkeiten für die Aufgabe •
Microsot SSIS-‐Pakete • Apache Hive Tables • Apache HBase • Apache Flume • Apache Sqoop -
Apache Hive
• Hive ist SELECT * FROM Hadoop • Entwickelt von Facebook, jetzt Apache • Ein SQL-‐basierte Abfragesprache (HiveQL) • Erweiterung durch map/reduce Code in Java möglich • Hat mit HCatalog und WebHCat einen Datenstore in Tabellenform • Daher auch als „Datawarehouse von Hadoop“ bekannt. -
Hive-‐Lösung • Export der Daten im CSV-‐Format vom RDBMS
• Import der Daten in eine Hive-‐Tabelle • Abfragen/Aggrega%on der Daten durch Hive • Export in ein CSV Format • Import der CSV in das RDBMS • Vorteil: einfacher Vorgang • Nachteil: dateibasierter Austausch der Daten -
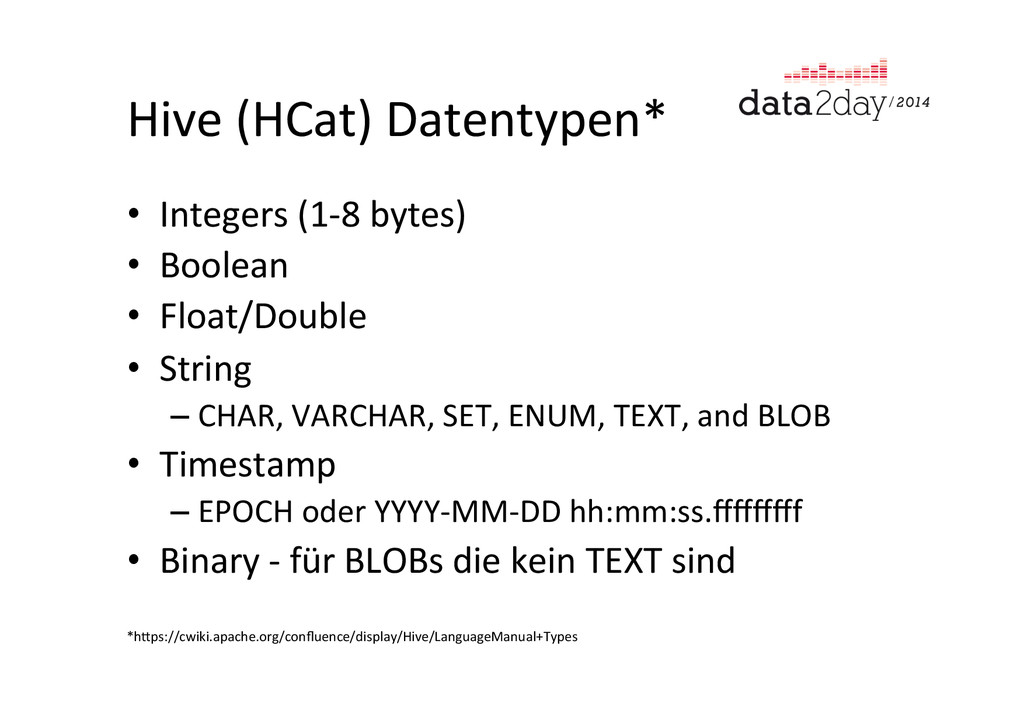
Hive (HCat) Datentypen* • Integers (1-‐8 bytes) •
Boolean • Float/Double • String – CHAR, VARCHAR, SET, ENUM, TEXT, and BLOB • Timestamp – EPOCH oder YYYY-‐MM-‐DD hh:mm:ss.fffffffff • Binary -‐ für BLOBs die kein TEXT sind *hUps://cwiki.apache.org/confluence/display/Hive/LanguageManual+Types -
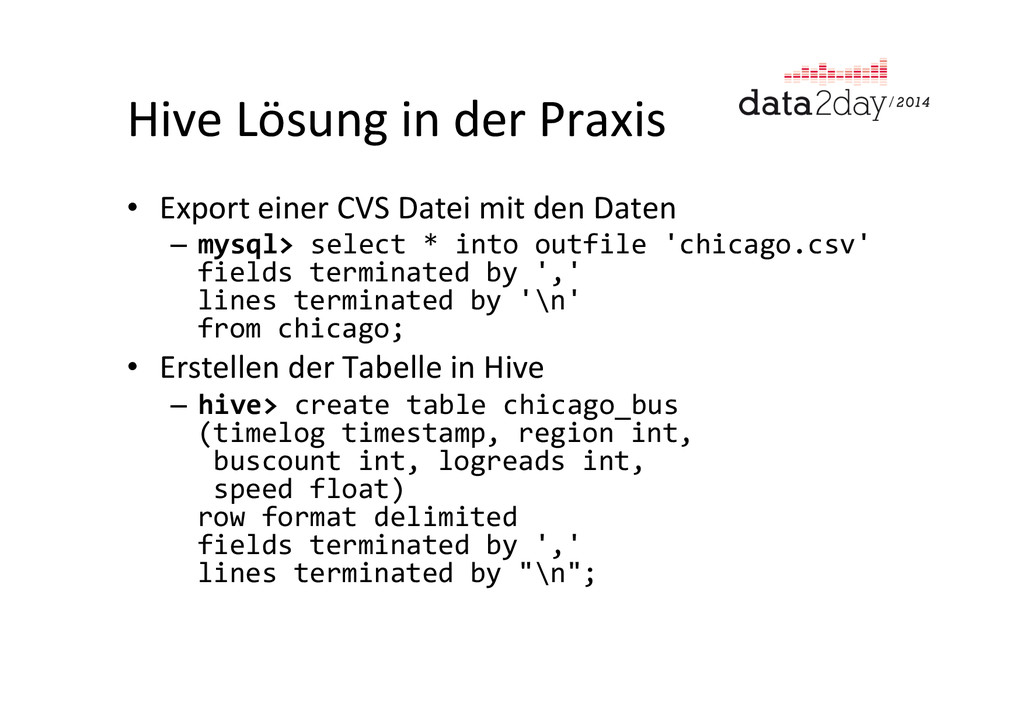
Hive Lösung in der Praxis • Export einer CVS
Datei mit den Daten – mysql> select * into outfile 'chicago.csv' fields terminated by ',' lines terminated by '\n' from chicago; • Erstellen der Tabelle in Hive – hive> create table chicago_bus (timelog timestamp, region int, buscount int, logreads int, speed float) row format delimited fields terminated by ',' lines terminated by "\n"; -
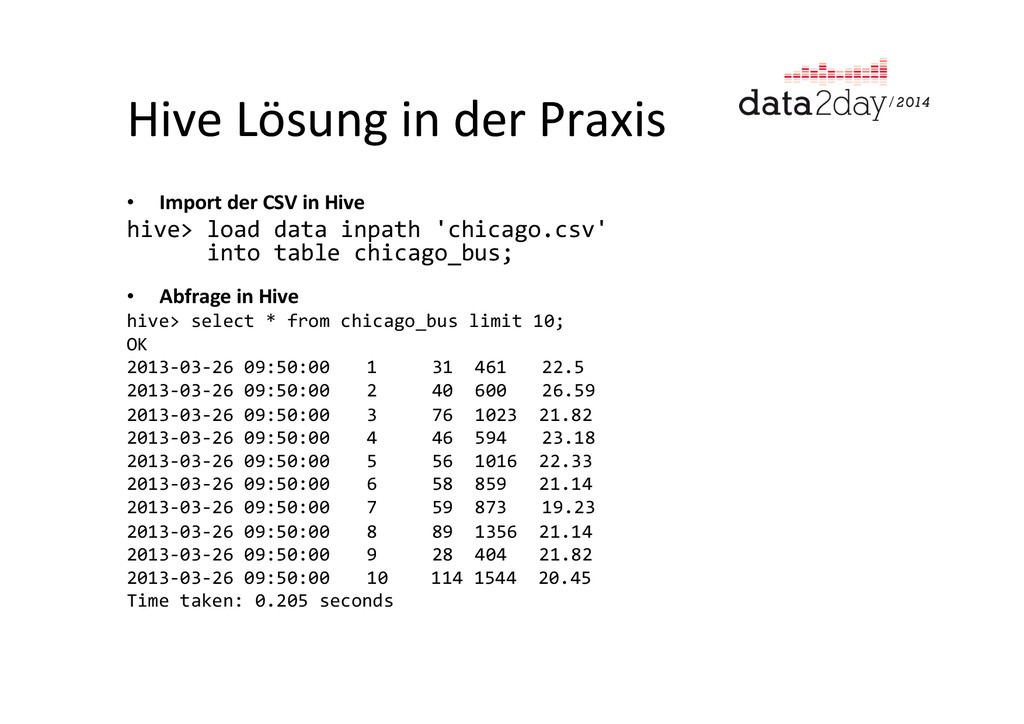
Hive Lösung in der Praxis • Import der CSV
in Hive hive> load data inpath 'chicago.csv' into table chicago_bus; • Abfrage in Hive hive> select * from chicago_bus limit 10; OK 2013-‐03-‐26 09:50:00 1 31 461 22.5 2013-‐03-‐26 09:50:00 2 40 600 26.59 2013-‐03-‐26 09:50:00 3 76 1023 21.82 2013-‐03-‐26 09:50:00 4 46 594 23.18 2013-‐03-‐26 09:50:00 5 56 1016 22.33 2013-‐03-‐26 09:50:00 6 58 859 21.14 2013-‐03-‐26 09:50:00 7 59 873 19.23 2013-‐03-‐26 09:50:00 8 89 1356 21.14 2013-‐03-‐26 09:50:00 9 28 404 21.82 2013-‐03-‐26 09:50:00 10 114 1544 20.45 Time taken: 0.205 seconds -
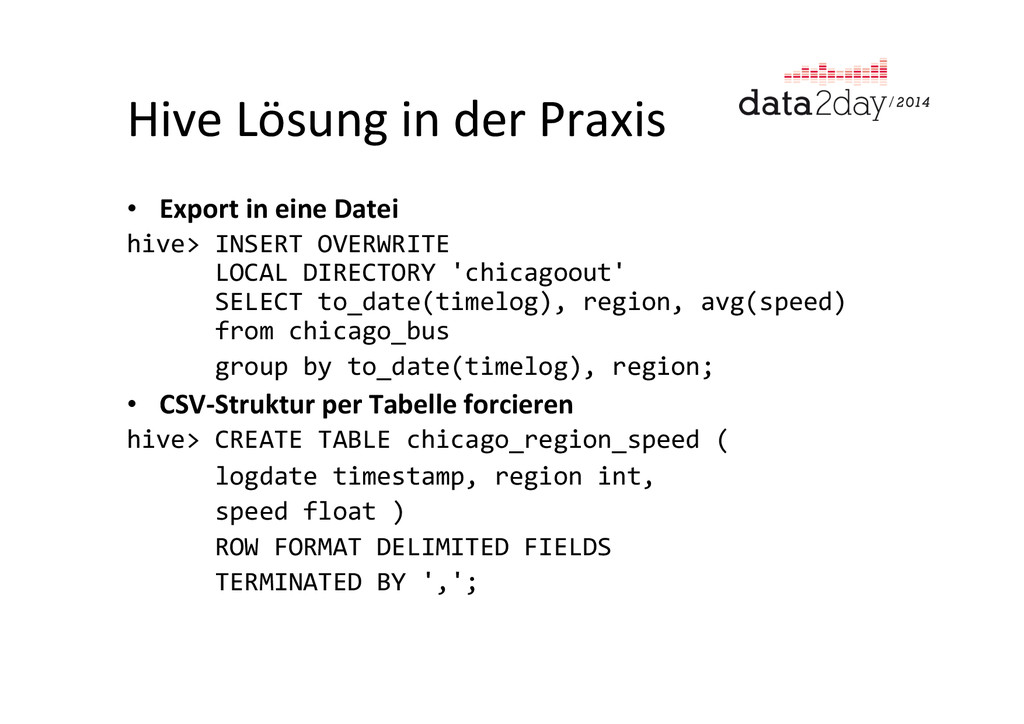
Hive Lösung in der Praxis • Export in eine
Datei hive> INSERT OVERWRITE LOCAL DIRECTORY 'chicagoout' SELECT to_date(timelog), region, avg(speed) from chicago_bus group by to_date(timelog), region; • CSV-‐Struktur per Tabelle forcieren hive> CREATE TABLE chicago_region_speed ( logdate timestamp, region int, speed float ) ROW FORMAT DELIMITED FIELDS TERMINATED BY ','; -
Auswahl an Möglichkeiten für die Aufgabe •
Microsot SSIS-‐Pakete • Apache Hive Tables • Apache HBase • Apache Flume • Apache Sqoop -
• Key / Value Store • Verteilte und versionierte
Datenbank • offene Implemen%erung von Google Bigtable • nutzbar für Billionen von Zeilen mit Millionen von Spalten • Betrieb im Cluster auf commodity Hardware • Abstrak%on des HDFS auf Bigtable -
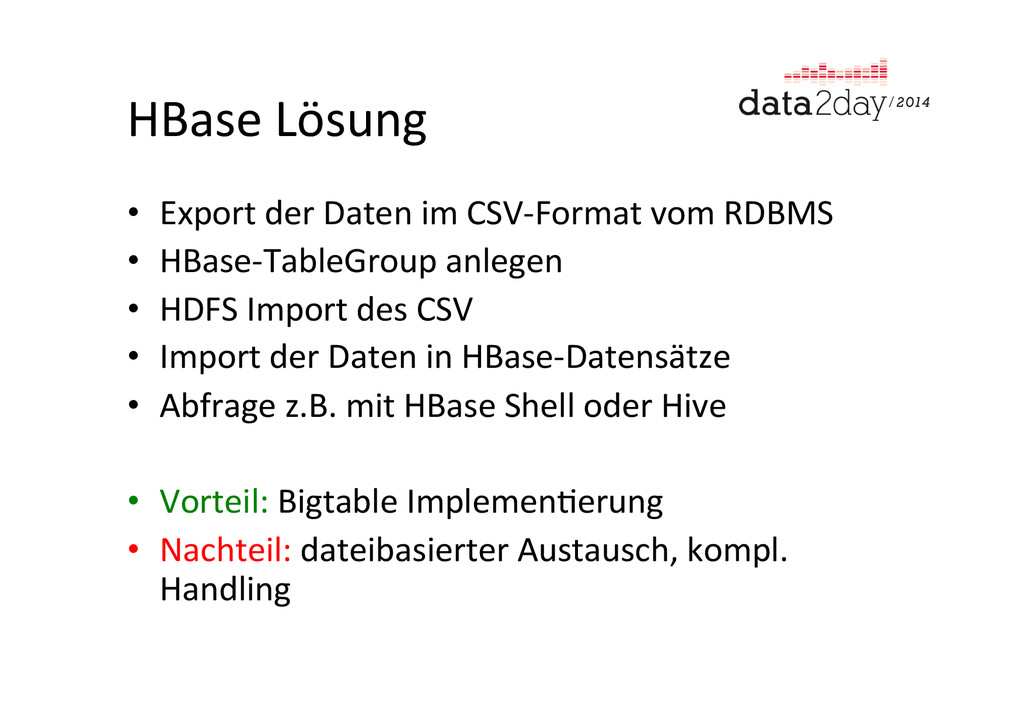
HBase Lösung • Export der Daten im CSV-‐Format vom
RDBMS • HBase-‐TableGroup anlegen • HDFS Import des CSV • Import der Daten in HBase-‐Datensätze • Abfrage z.B. mit HBase Shell oder Hive • Vorteil: Bigtable Implemen%erung • Nachteil: dateibasierter Austausch, kompl. Handling -
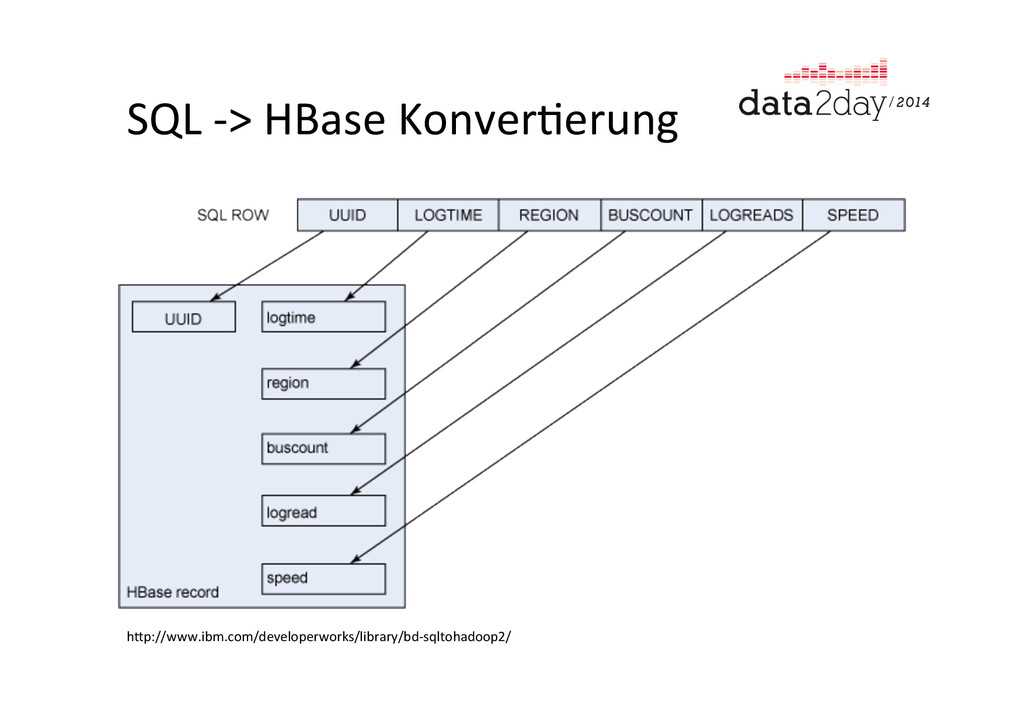
HBase Lösung in der Praxis • Export in MySQL:
mysql> select uuid(), timelogged, region, buscount, logreads, speed into outfile 'chicago.tsv' fields terminated by '\t' lines terminated by '\n' from chicago; -
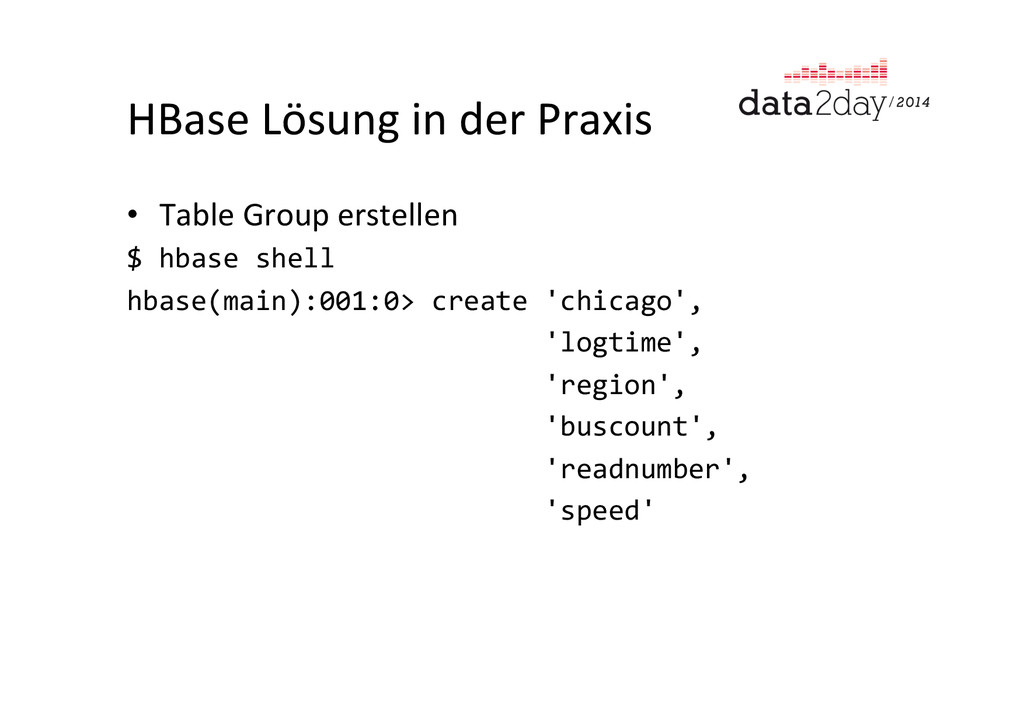
HBase Lösung in der Praxis • Table Group erstellen
$ hbase shell hbase(main):001:0> create 'chicago', 'logtime', 'region', 'buscount', 'readnumber', 'speed' -
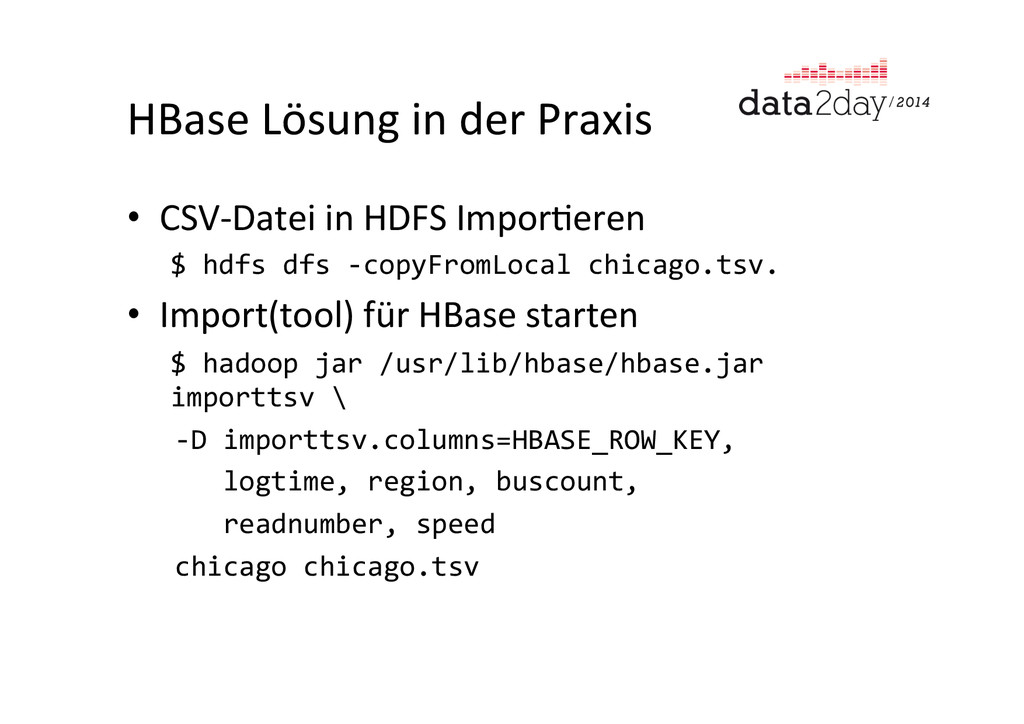
HBase Lösung in der Praxis • CSV-‐Datei in HDFS
Impor%eren $ hdfs dfs -‐copyFromLocal chicago.tsv. • Import(tool) für HBase starten $ hadoop jar /usr/lib/hbase/hbase.jar importtsv \ -‐D importtsv.columns=HBASE_ROW_KEY, logtime, region, buscount, readnumber, speed chicago chicago.tsv -
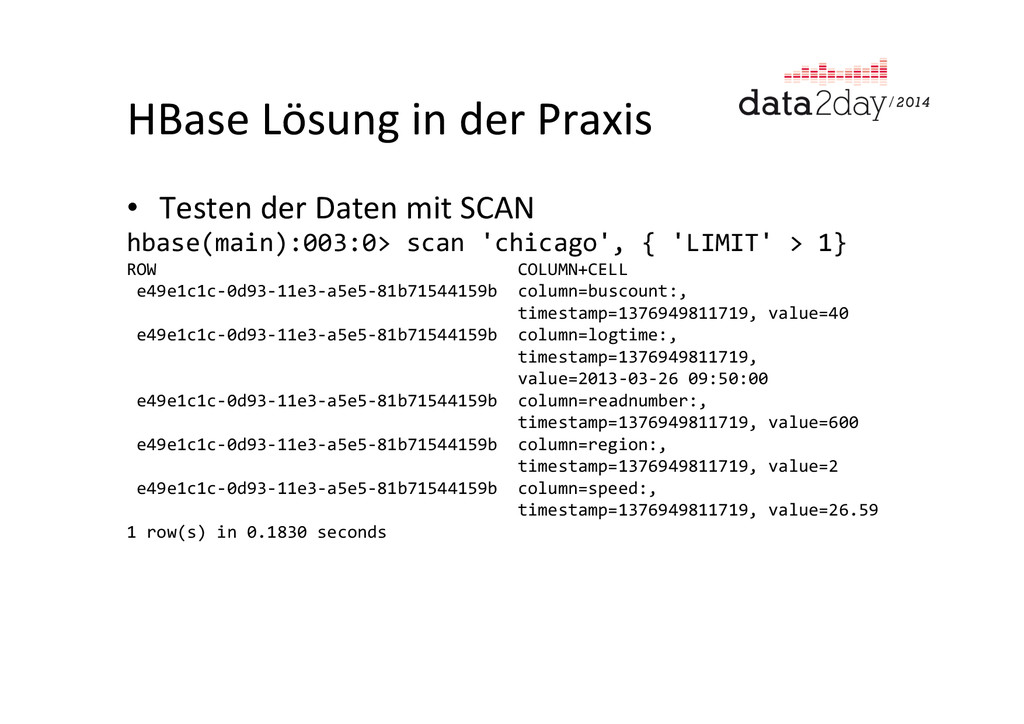
HBase Lösung in der Praxis • Testen der Daten
mit SCAN hbase(main):003:0> scan 'chicago', { 'LIMIT' > 1} ROW COLUMN+CELL e49e1c1c-‐0d93-‐11e3-‐a5e5-‐81b71544159b column=buscount:, timestamp=1376949811719, value=40 e49e1c1c-‐0d93-‐11e3-‐a5e5-‐81b71544159b column=logtime:, timestamp=1376949811719, value=2013-‐03-‐26 09:50:00 e49e1c1c-‐0d93-‐11e3-‐a5e5-‐81b71544159b column=readnumber:, timestamp=1376949811719, value=600 e49e1c1c-‐0d93-‐11e3-‐a5e5-‐81b71544159b column=region:, timestamp=1376949811719, value=2 e49e1c1c-‐0d93-‐11e3-‐a5e5-‐81b71544159b column=speed:, timestamp=1376949811719, value=26.59 1 row(s) in 0.1830 seconds -
Auswahl an Möglichkeiten für die Aufgabe •
Microsot SSIS-‐Pakete • Apache Hive Tables • Apache HBase • Apache Flume • Apache Sqoop -
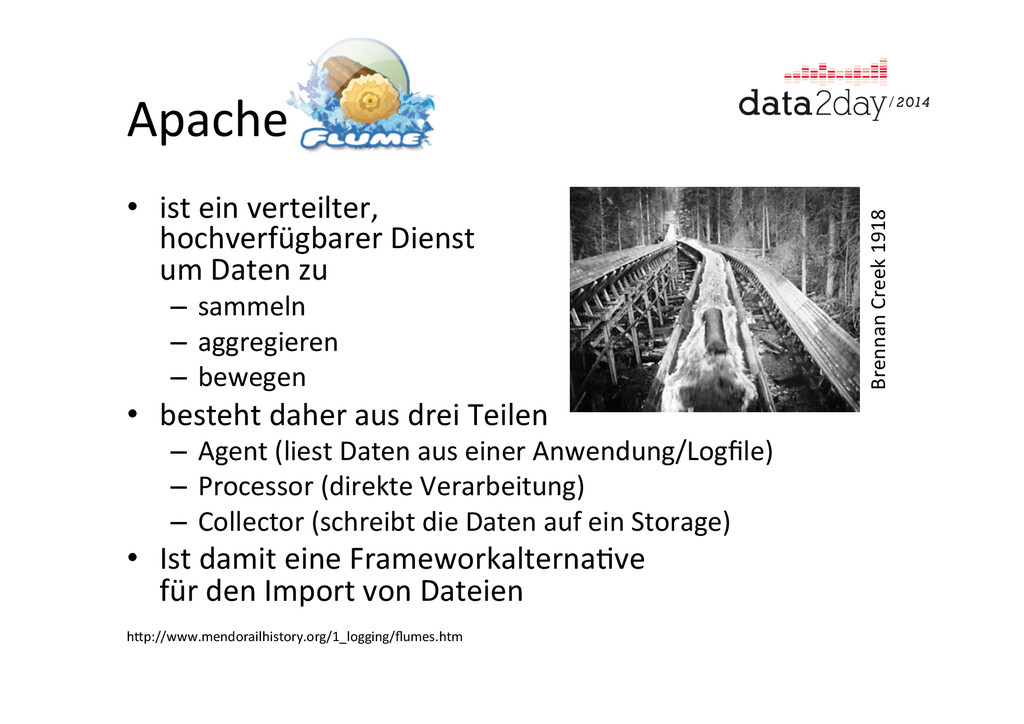
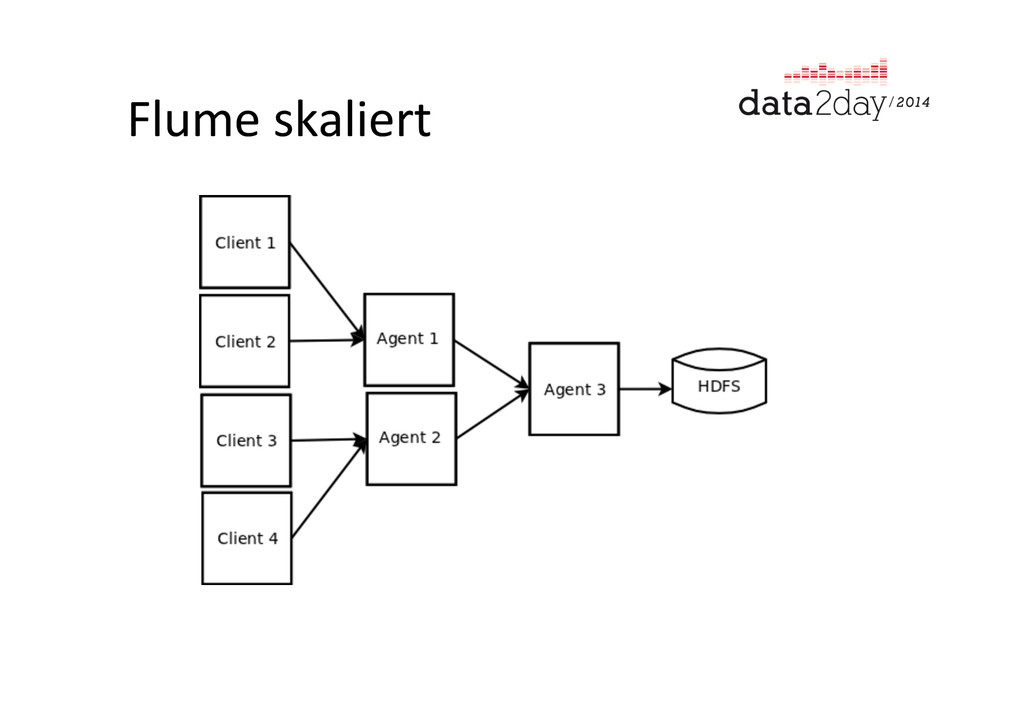
Apache • ist ein verteilter, hochverfügbarer Dienst
um Daten zu – sammeln – aggregieren – bewegen • besteht daher aus drei Teilen – Agent (liest Daten aus einer Anwendung/Logfile) – Processor (direkte Verarbeitung) – Collector (schreibt die Daten auf ein Storage) • Ist damit eine Frameworkalterna%ve für den Import von Dateien hUp://www.mendorailhistory.org/1_logging/flumes.htm Brennan Creek 1918 -
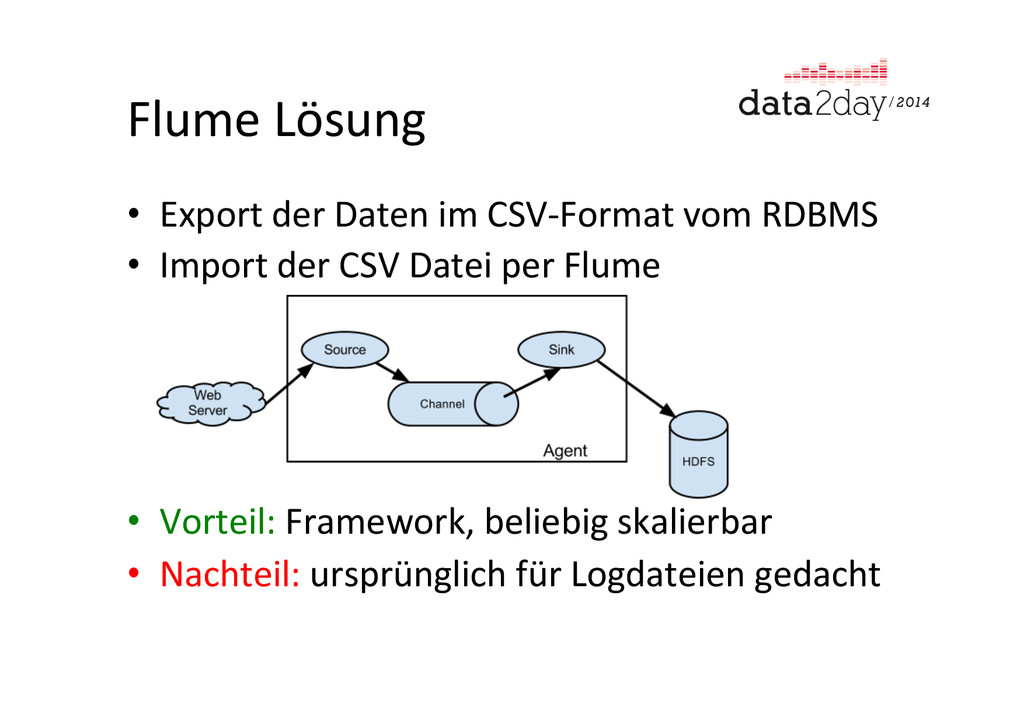
Flume Lösung • Export der Daten im CSV-‐Format vom
RDBMS • Import der CSV Datei per Flume • Vorteil: Framework, beliebig skalierbar • Nachteil: ursprünglich für Logdateien gedacht -
Flume Lösung in der Praxis • CSV-‐Datei in HDFS
Impor%eren $ bin/flume-‐ng agent -‐n $agent_name -‐c conf -‐f conf/flume-‐conf.properties.template -
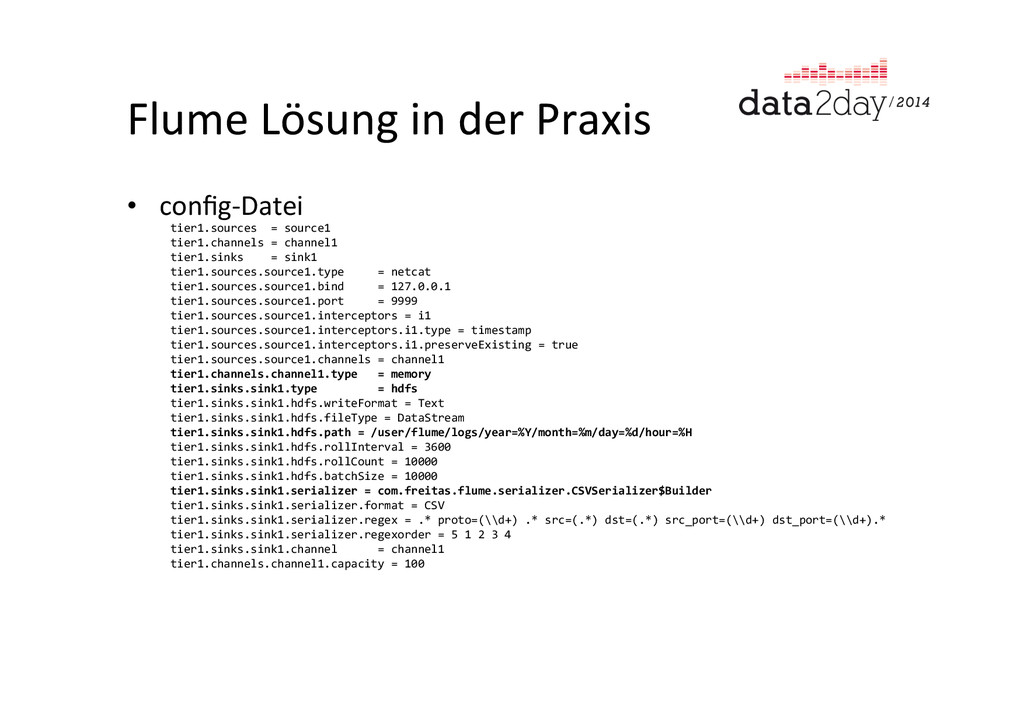
Flume Lösung in der Praxis • config-‐Datei tier1.sources
= source1 tier1.channels = channel1 tier1.sinks = sink1 tier1.sources.source1.type = netcat tier1.sources.source1.bind = 127.0.0.1 tier1.sources.source1.port = 9999 tier1.sources.source1.interceptors = i1 tier1.sources.source1.interceptors.i1.type = timestamp tier1.sources.source1.interceptors.i1.preserveExisting = true tier1.sources.source1.channels = channel1 tier1.channels.channel1.type = memory tier1.sinks.sink1.type = hdfs tier1.sinks.sink1.hdfs.writeFormat = Text tier1.sinks.sink1.hdfs.fileType = DataStream tier1.sinks.sink1.hdfs.path = /user/flume/logs/year=%Y/month=%m/day=%d/hour=%H tier1.sinks.sink1.hdfs.rollInterval = 3600 tier1.sinks.sink1.hdfs.rollCount = 10000 tier1.sinks.sink1.hdfs.batchSize = 10000 tier1.sinks.sink1.serializer = com.freitas.flume.serializer.CSVSerializer$Builder tier1.sinks.sink1.serializer.format = CSV tier1.sinks.sink1.serializer.regex = .* proto=(\\d+) .* src=(.*) dst=(.*) src_port=(\\d+) dst_port=(\\d+).* tier1.sinks.sink1.serializer.regexorder = 5 1 2 3 4 tier1.sinks.sink1.channel = channel1 tier1.channels.channel1.capacity = 100 -
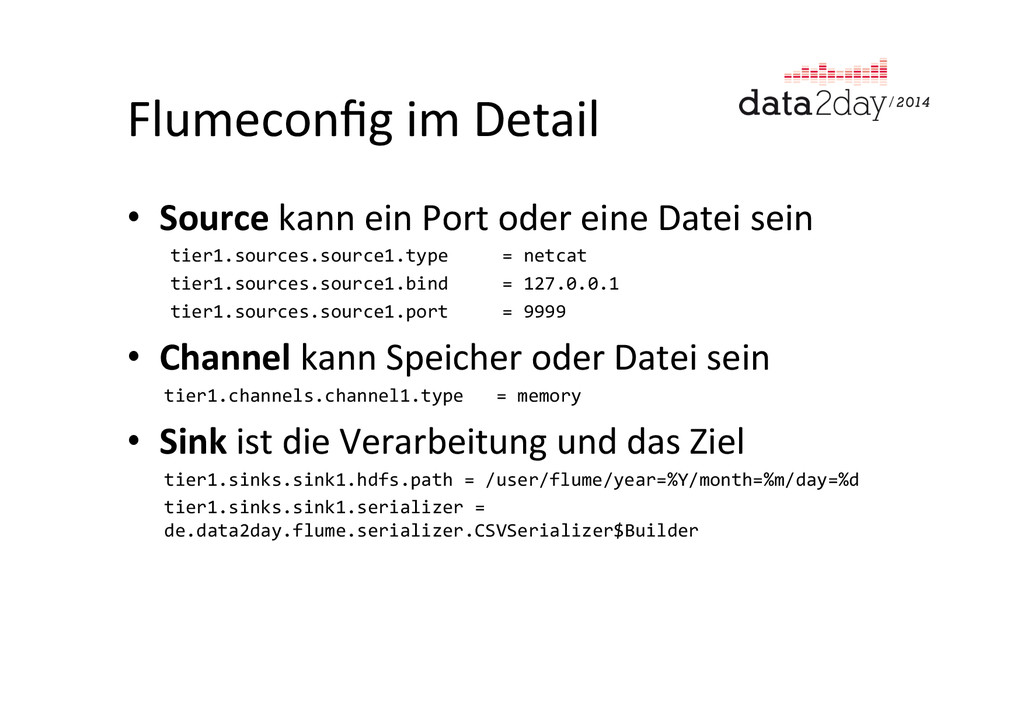
Flumeconfig im Detail • Source kann ein Port oder
eine Datei sein tier1.sources.source1.type = netcat tier1.sources.source1.bind = 127.0.0.1 tier1.sources.source1.port = 9999 • Channel kann Speicher oder Datei sein tier1.channels.channel1.type = memory • Sink ist die Verarbeitung und das Ziel tier1.sinks.sink1.hdfs.path = /user/flume/year=%Y/month=%m/day=%d tier1.sinks.sink1.serializer = de.data2day.flume.serializer.CSVSerializer$Builder -
Auswahl an Möglichkeiten für die Aufgabe •
Microsot SSIS-‐Pakete • Apache Hive Tables • Apache HBase • Apache Flume • Apache Sqoop -
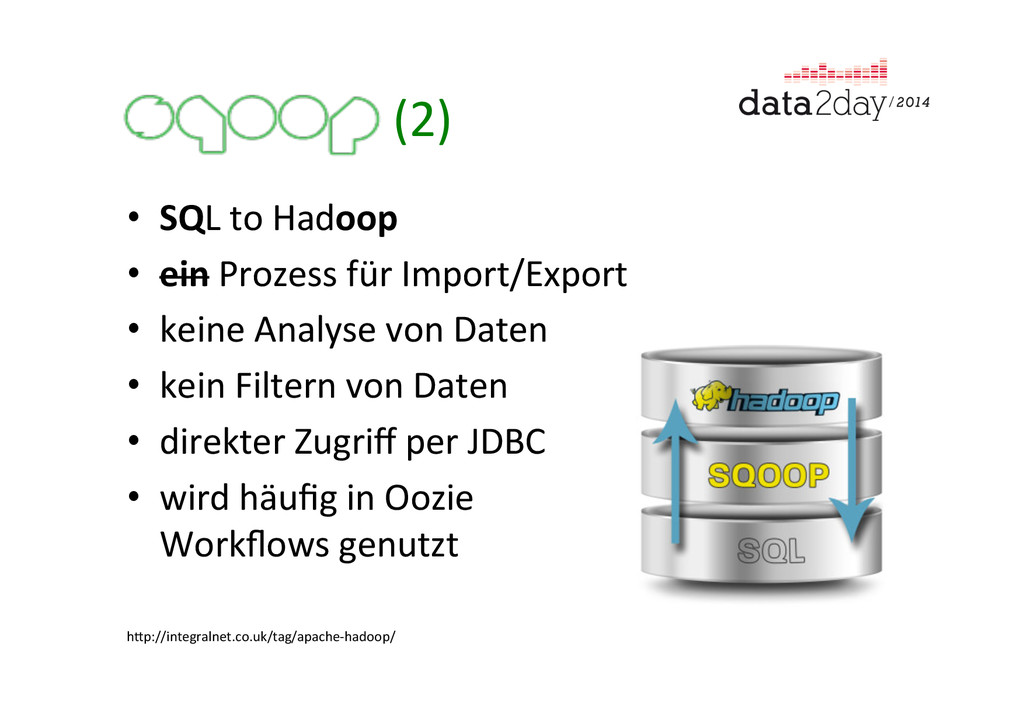
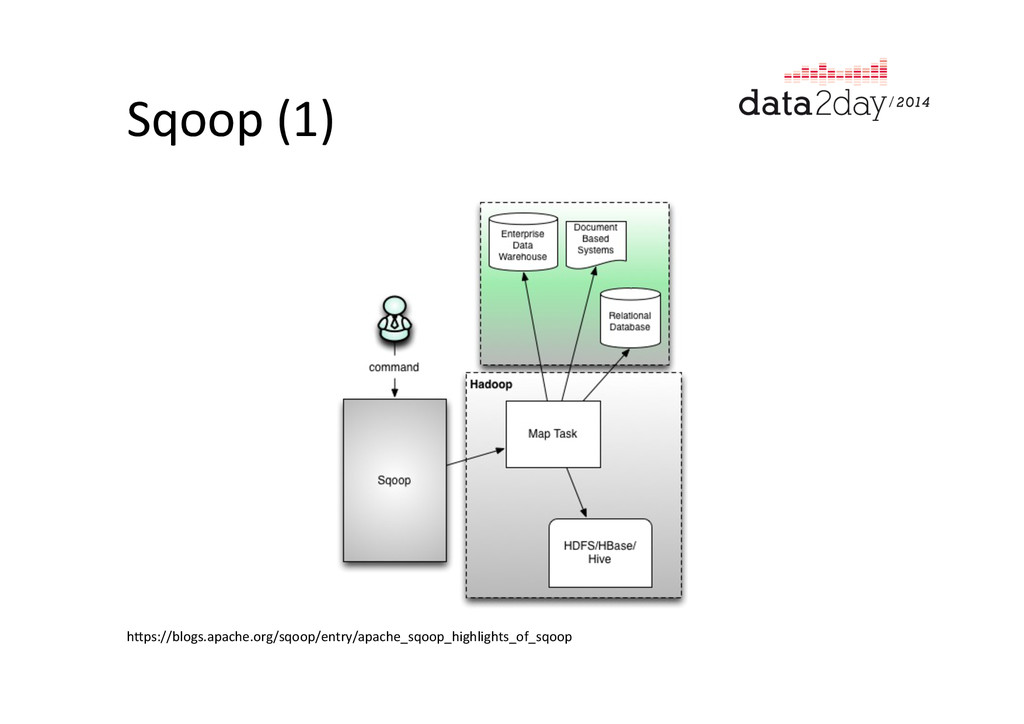
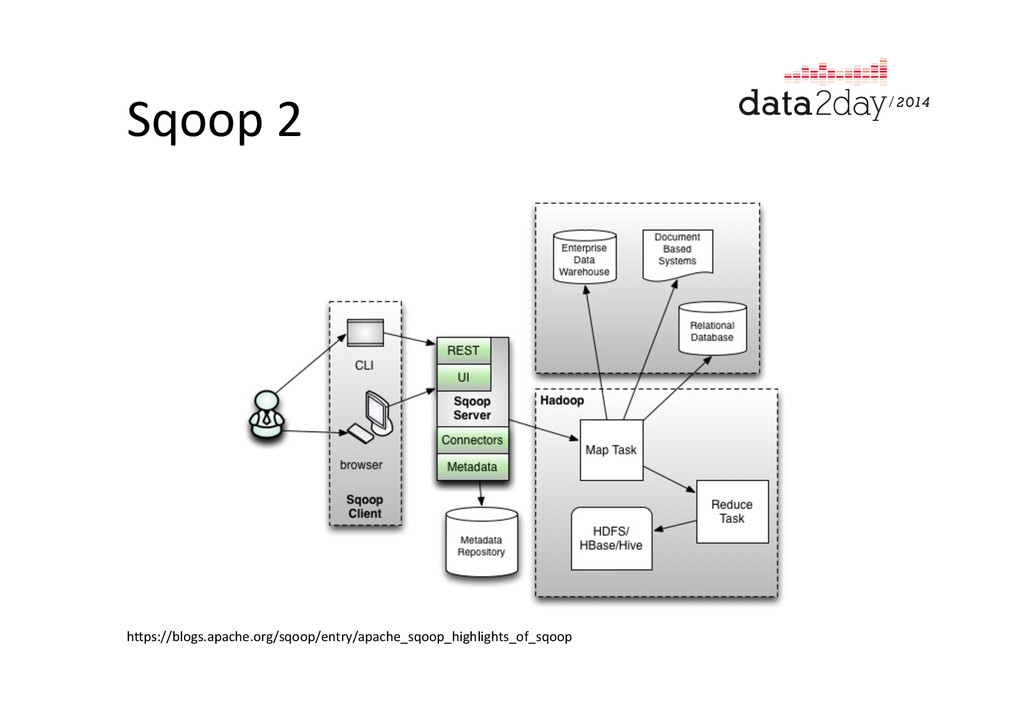
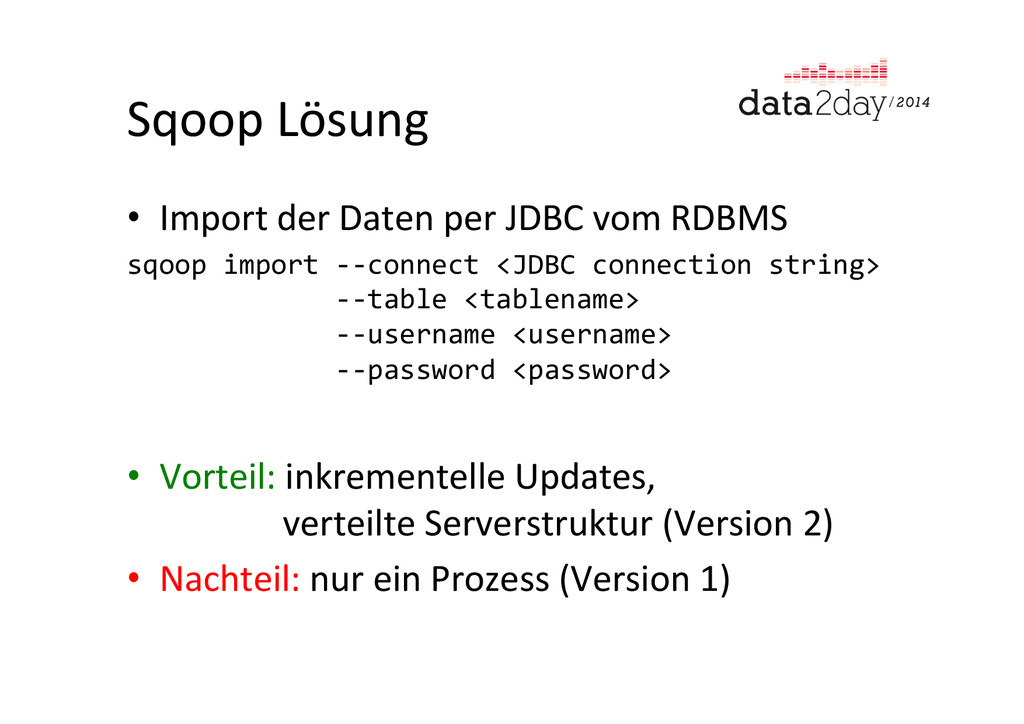
Sqoop Lösung • Import der Daten per JDBC vom
RDBMS sqoop import -‐-‐connect <JDBC connection string> -‐-‐table <tablename> -‐-‐username <username> -‐-‐password <password> • Vorteil: inkrementelle Updates, verteilte Serverstruktur (Version 2) • Nachteil: nur ein Prozess (Version 1) -
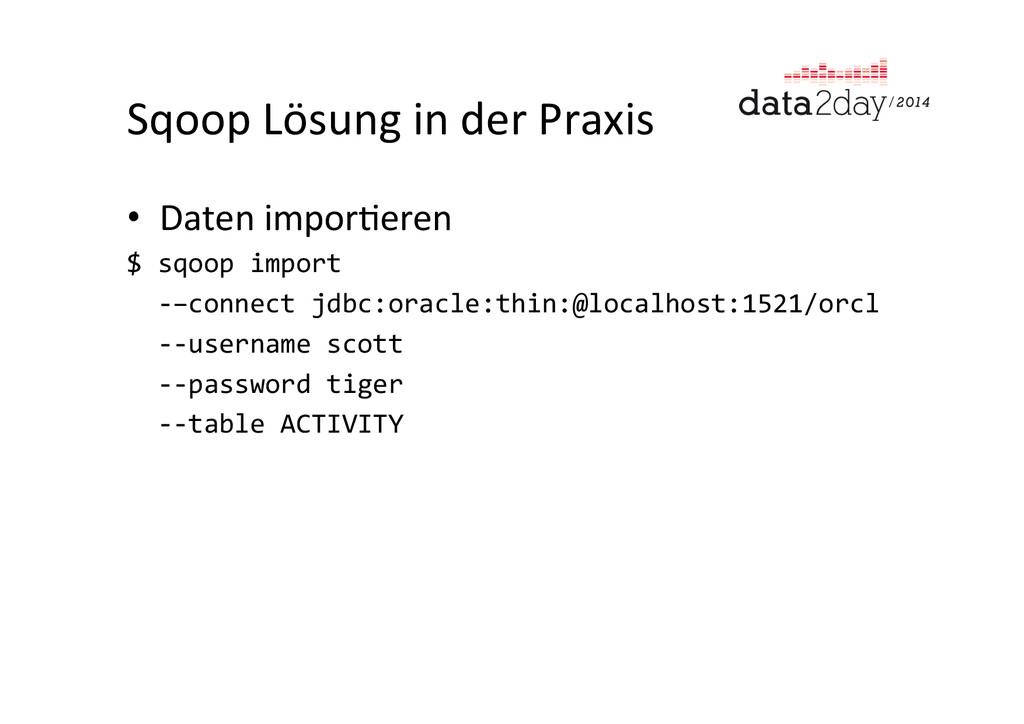
Sqoop Lösung in der Praxis • Daten impor%eren
$ sqoop import -‐–connect jdbc:oracle:thin:@localhost:1521/orcl -‐-‐username scott -‐-‐password tiger -‐-‐table ACTIVITY -
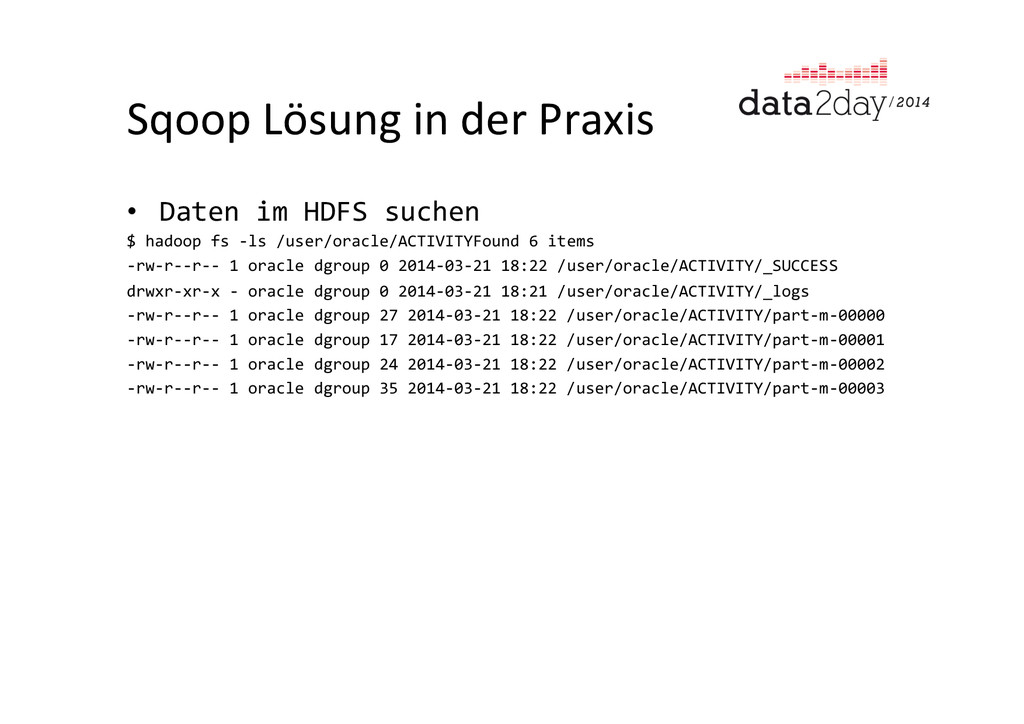
Sqoop Lösung in der Praxis • Daten im HDFS
suchen $ hadoop fs -‐ls /user/oracle/ACTIVITYFound 6 items -‐rw-‐r-‐-‐r-‐-‐ 1 oracle dgroup 0 2014-‐03-‐21 18:22 /user/oracle/ACTIVITY/_SUCCESS drwxr-‐xr-‐x -‐ oracle dgroup 0 2014-‐03-‐21 18:21 /user/oracle/ACTIVITY/_logs -‐rw-‐r-‐-‐r-‐-‐ 1 oracle dgroup 27 2014-‐03-‐21 18:22 /user/oracle/ACTIVITY/part-‐m-‐00000 -‐rw-‐r-‐-‐r-‐-‐ 1 oracle dgroup 17 2014-‐03-‐21 18:22 /user/oracle/ACTIVITY/part-‐m-‐00001 -‐rw-‐r-‐-‐r-‐-‐ 1 oracle dgroup 24 2014-‐03-‐21 18:22 /user/oracle/ACTIVITY/part-‐m-‐00002 -‐rw-‐r-‐-‐r-‐-‐ 1 oracle dgroup 35 2014-‐03-‐21 18:22 /user/oracle/ACTIVITY/part-‐m-‐00003 -
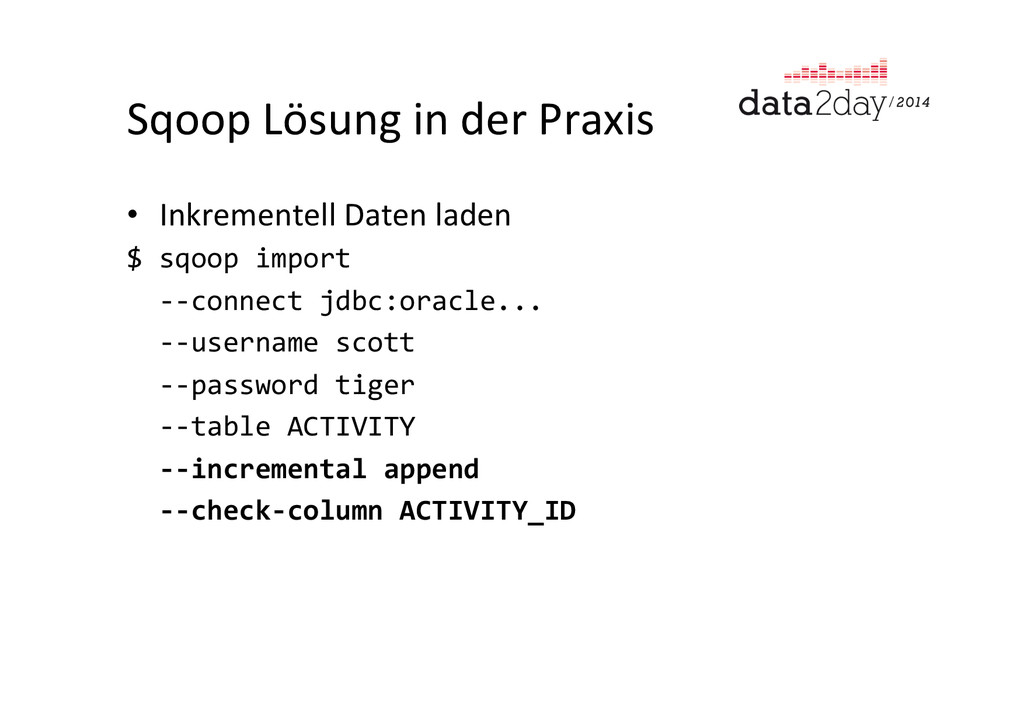
Sqoop Lösung in der Praxis • Inkrementell Daten laden
$ sqoop import -‐-‐connect jdbc:oracle... -‐-‐username scott -‐-‐password tiger -‐-‐table ACTIVITY -‐-‐incremental append -‐-‐check-‐column ACTIVITY_ID -
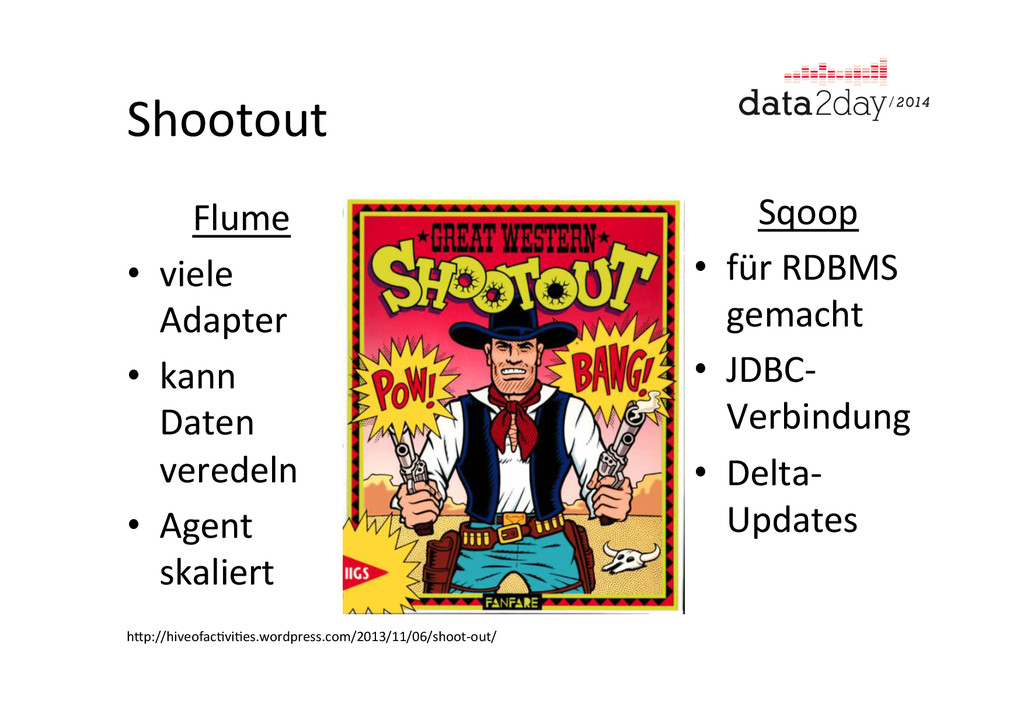
Shootout Flume • viele Adapter •
kann Daten veredeln • Agent skaliert Sqoop • für RDBMS gemacht • JDBC-‐ Verbindung • Delta-‐ Updates hUp://hiveofac%vi%es.wordpress.com/2013/11/06/shoot-‐out/ -
DANKE! Marcus Ross – Zahlenhelfer Consul%ng -‐ @zahlenhelfer
alle Folien auch auf www.speakerdeck.com/u/zahlenhelfer
 zahlenhelfer
 takuyay0ne
 sansantech
 inesmontani
 munakata
 kasada
 nejumi
 nicholsjasper
 csswizardry
 munenick
 wind111
 oidfj
 reverentgeek
 addyosmani
 ipullrank
 dougneiner
 mfonobong
 tammyeverts
 axbom
 sstephenson
 erikaheidi
 zakiyama
 philnash