Share
Embed

Transcript
60 slides
-
自己紹介 • 大阪大学博士課程 and 理研JRA • 修士課程卒業→制御エンジニア→理研 • 研究内容:細胞の自動培養、Deep Leaningによる細胞の識別
• 好きなこと:SF小説 落合幸治(おちあい こうじ) -
Agenda Arxiv sanity (http://www.arxiv-sanity.com/)で人 気だった論文を紹介。 2020/6/28にサーベイ 1. Top recent 「Last
month」の上位10個ずつ 2. Top hype 「Last month」の上位10個ずつ 3. 気になった論文一つ -
リンフォーマ:線形複雑性を持つ自己注意機構 Linformer: Self-Attention with Linear Complexity 大規模なトランスフォーマーモデルは、多くの自然言語処理アプリケーションにおいて最先端の結 果を達成するという点において、並外れた成功を示してきた。しかし、トランスの標準的な自己注 意メカニズムは、シーケンスの長さに対してO(n2)の時間と空間を使用するため、これらのモデルの 訓練と展開は、長いシーケンスに対して法外なコストがかかる可能性がある。本論文では、自己
注意メカニズムが低ランク行列で近似できることを示す。さらに、この発見を利用して、時間的にも 空間的にも、全体的な自己注意の複雑さをO(n2)からO(n)に低減する新しい自己注意メカニズムを 提案する。結果として得られた線形変圧器であるLinformerは、標準的な変圧器モデルと同等の性 能を持ちながら、より多くのメモリと時間効率を実現する。 Top Recent 2 Transformerの計算複雑性(計算時間)をO(n )からO(n)に減らした 2 -
ImageNetはもういいんじゃないかな? Are we done with ImageNet? 答えはイエスでありノーである。我々は、ImageNet分類ベンチマークの最近の進歩が意味のある 一般化を表し続けているのか、それともコミュニティがそのラベリング手順の特殊性に過剰に適合 し始めたのかに疑問を感じていた。そこで、ImageNetの検証セットの人間のアノテーションを収集 するための、より大幅にロバストな手順を開発した。これらの新しいラベルを用いて、最近提案され
たImageNet分類器の精度を再評価したところ、元のラベルで報告されているものよりも得られるも のは大幅に小さいことがわかった。さらに、元のImageNetラベルは、独立して収集されたセットの 最良の予測子ではなくなっており、ビジョンモデルの評価における有用性が終わりに近づいている ことを示しています。とはいえ、我々のアノテーション方法は、元のラベルの誤差を大幅に改善して おり、ImageNetは視覚認識の将来の研究のための強力なベンチマークとして強化されていること がわかりました。 Top Recent 3 最近のモデルがImageNet (image database) に過適合してないか検証 -
ImageNetはもういいんじゃないかな? Are we done with ImageNet? Top Recent 3 モデルの予測と元のImageNetラ
ベルを提示された場合、人間の アノテータは平均的にモデルの 予測を好むようになった(セク ション4)。とはいえ、人間の好み を完全に把握するには、まだか なりの進歩が必要である。 モデル予測の方が 好ましい ImageNet label の方が 好ましい -
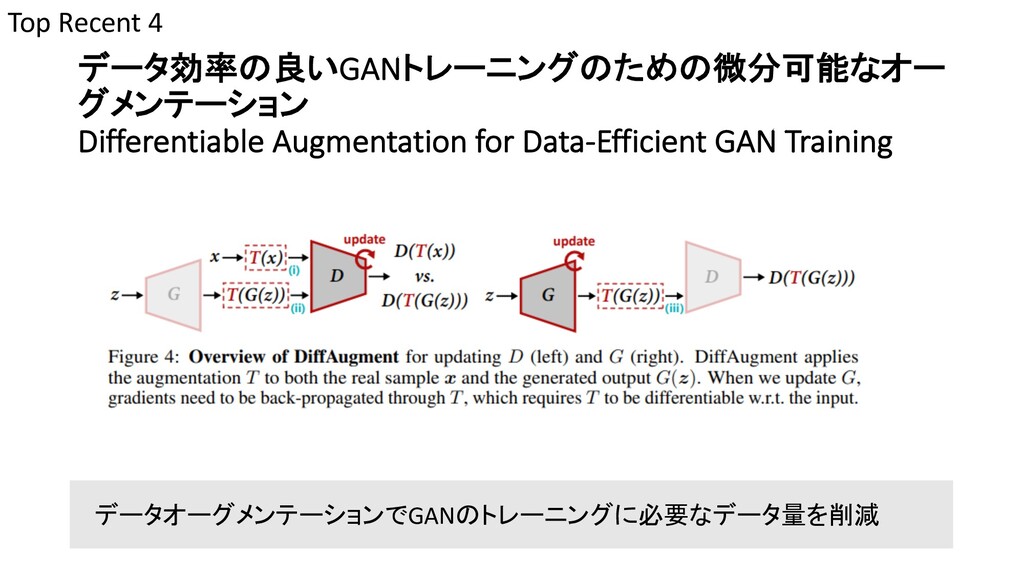
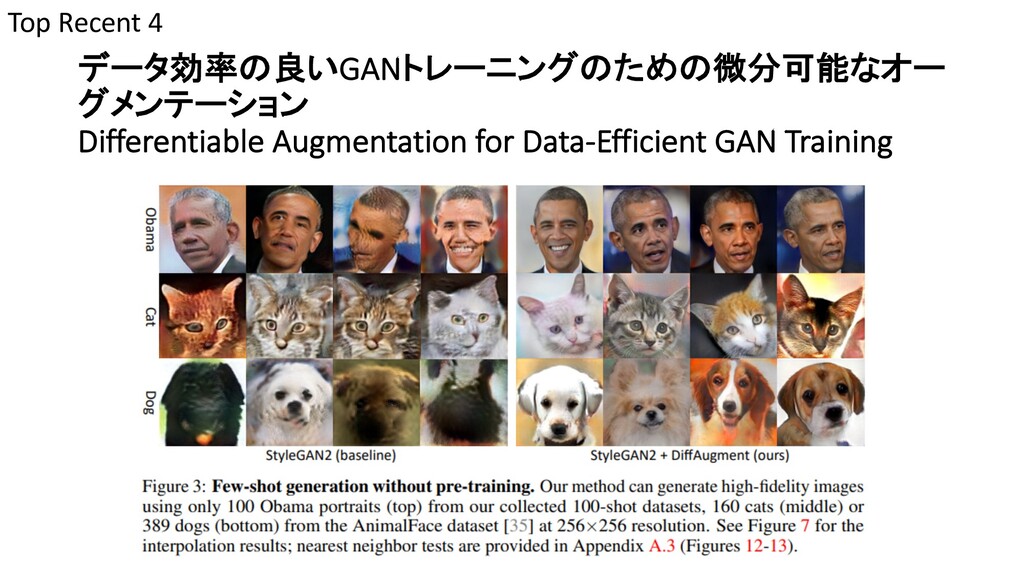
データ効率の良いGANトレーニングのための微分可能なオー グメンテーション Differentiable Augmentation for Data-Efficient GAN Training 生成的敵対者ネットワーク(GAN)の性能は、限られた量の訓練データを与えられたとき著しく低下 する。これは主に識別器が正確な訓練セットを記憶してしまうためである。この問題を解決するた
めに、我々は微分可能増強法(DiffAugment)を提案する。これは、実サンプルと偽サンプルの両方 に様々なタイプの微分可能増強を課すことでGANのデータ効率を改善する単純な手法である。こ れまでの手法では,学習データに直接オーグメンテーションを施すことで実画像の分布を操作して いたため,ほとんど効果がありませんでした.実験では,様々なGANアーキテクチャと損失関数を 用いて,無条件生成とクラス条件生成の両方において,我々の手法が一貫して向上していること が示されています.DiffAugmentを用いた実験では、ImageNet 128x128で6.80のFID、100.8のISを 達成しました。さらに,わずか20%の学習データで,CIFAR-10やCIFAR-100と同等の性能を得ること ができました.最後に、本手法は、既存の伝達学習アルゴリズムと同等の性能を持ちながら、事前 学習なしでわずか100枚の画像を用いて高忠実度の画像を生成することができます。コードは https://github.com/mit-han-lab/data-efficient-gans から入手可能です。 Top Recent 4 データオーグメンテーションでGANのトレーニングに必要なデータ量を削減 -
データ効率の良いGANトレーニングのための微分可能なオー グメンテーション Differentiable Augmentation for Data-Efficient GAN Training Top Recent
4 データオーグメンテーションでGANのトレーニングに必要なデータ量を削減 -
少サンプルBERT ファインチューニングの再検討 Revisiting Few-sample BERT Fine-tuning 我々は、BERT文脈表現の少数サンプルの微調整の問題を研究し、現在広く採用されている実践 における 3 つの部分最適選択を特定する。第一に、BERTADAM
オプティマイザーにおける勾配バ イアス補正の省略が、ファインチューニングの不安定性につながることを観察する。また、BERT ネットワークの一部がファインチューニングのための有害な出発点を提供し、これらの層を単に再 初期化するだけで学習が高速化され、性能が向上することを発見した。最後に、我々は訓練時間 の効果を研究し、一般的に使用されているレシピでは訓練に十分な時間が割り当てられていない ことが多いことを観察する。これらの知見を踏まえて、我々は、BERT を用いて少数サンプルのファ インチューニングを改善するために最近提案された方法を再検討し、その有効性を再評価する。 一般的に、我々の知見に基づいて微調整プロセスを修正した場合、それらの相対的な影響が減 少することが観察される。 Top Recent 5 BERTファインチューニングに関する新しいレシピ -
VirTex. テキストのアノテーションから視覚的な表現を学習する VirTex: Learning Visual Representations from Textual Annotations 多くのビジョンタスクに対する事実上のアプローチは、一般的にImageNet上の教師付き訓練によっ
て学習された事前訓練済みの視覚表現から開始することです。最近の手法では、膨大な量のラベ ル付けされていない画像に対応するために、教師なしの事前学習が模索されてきました。これに 対し,我々はより少ない画像から高品質な視覚表現を学習することを目指している.この目的のた めに、我々は教師付き予備訓練を再検討し、分類ベースの予備訓練に代わるデータ効率の良い 方法を模索する。我々は、意味的に密なキャプションを用いて視覚表現を学習する前学習アプ ローチであるVirTexを提案する。畳み込みネットワークをCOCOキャプション上でスクラッチから学習 し、画像分類、物体検出、インスタンスセグメンテーションなどの下流の認識タスクに適用する。す べてのタスクにおいて、VirTexは、使用する画像の数が10分の1にも満たないにもかかわらず、 ImageNetで学習したものと一致するか、またはそれ以上の特徴量を得ることができた。 Top Recent 6 ラベルではなくキャプションを使用すると少ないサンプルで表現学習ができる -
End-to-Endの敵対的テキスト・ツー・スピーチ End-to-End Adversarial Text-to-Speech 最近のテキスト音声合成パイプラインは、一般的に複数の処理段階があり、それぞれの処理段階 は他の段階とは独立して設計または学習されています。本研究では、正規化されたテキストや音 素からエンドツーエンドで音声を合成するための学習という挑戦的な課題に取り組み、文字や音 素の入力シーケンスを直接操作して生の音声出力を生成するモデルを生成する。提案するジェネ レータはフィードフォワード型であり、微分可能な単調補間スキームを用いて各入力トークンの持 続時間を予測することで、学習と推論の両方に効率的である。この生成器は、敵対的フィードバッ
クと予測損失を組み合わせて、生成された音声が総継続時間とメロスペクトログラムの点でほぼ 一致するように制約することで、高忠実度の音声を生成するように学習します。生成された音声の 時間的変動をモデルが捕捉できるようにするために、スペクトログラムベースの予測損失にソフト ダイナミックタイムワープを採用しました。結果として得られたモデルは、5点満点で4を超える平均 的な意見スコアを達成しており、これは多段階のトレーニングと追加の監視に依存する最先端の モデルに匹敵するものである。 Top Recent 7 音声合成をEnd-to-Endでやる -
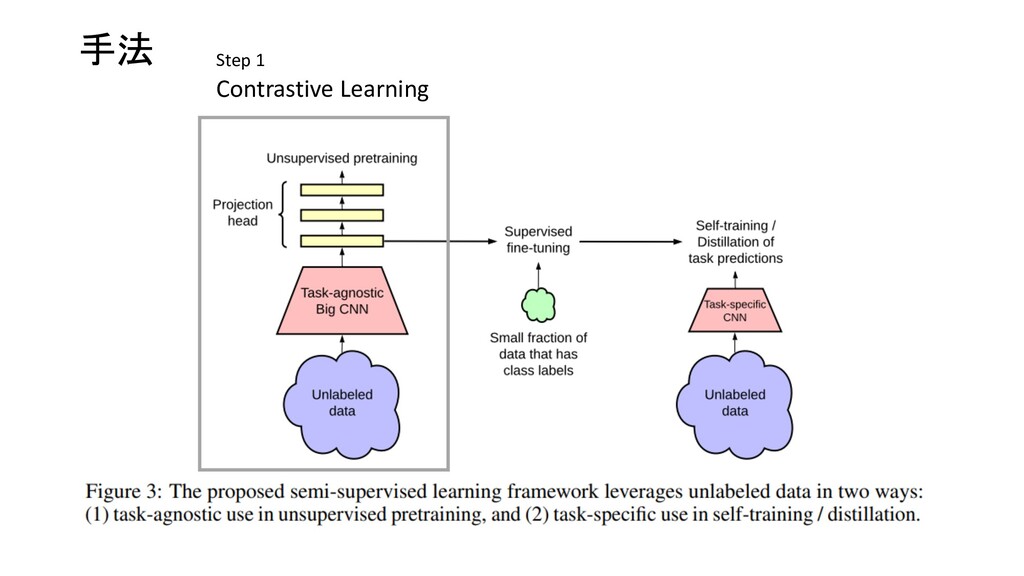
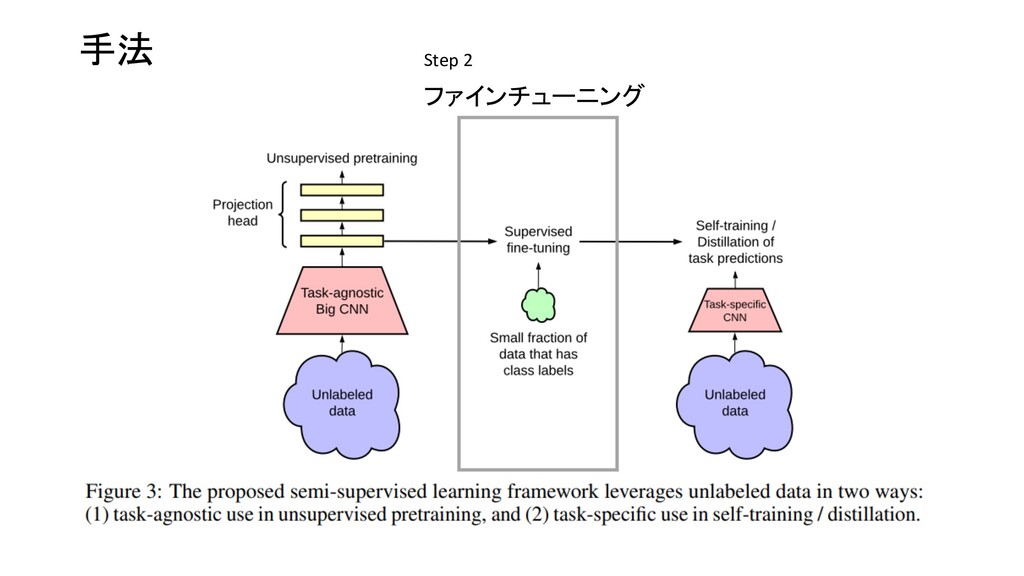
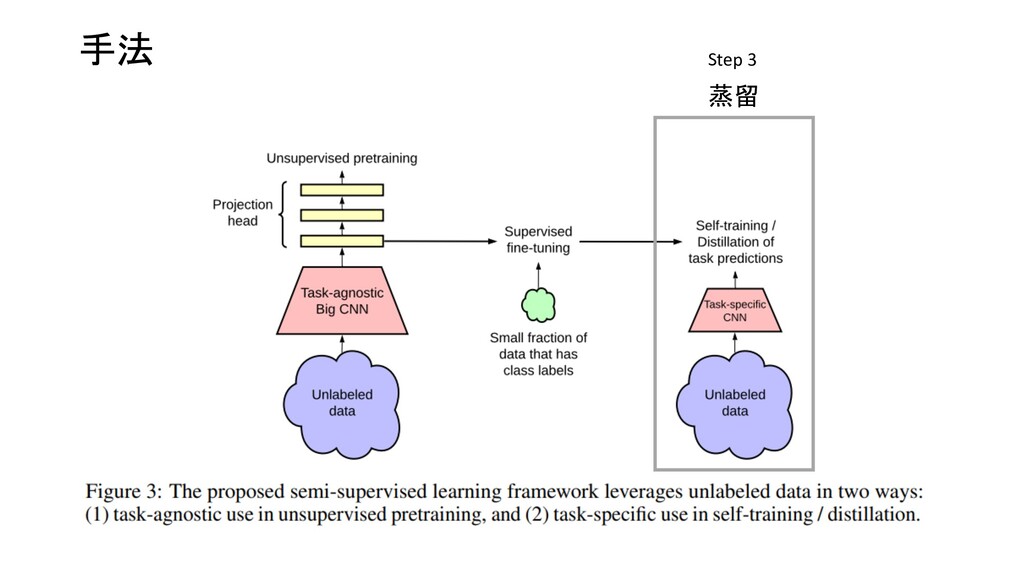
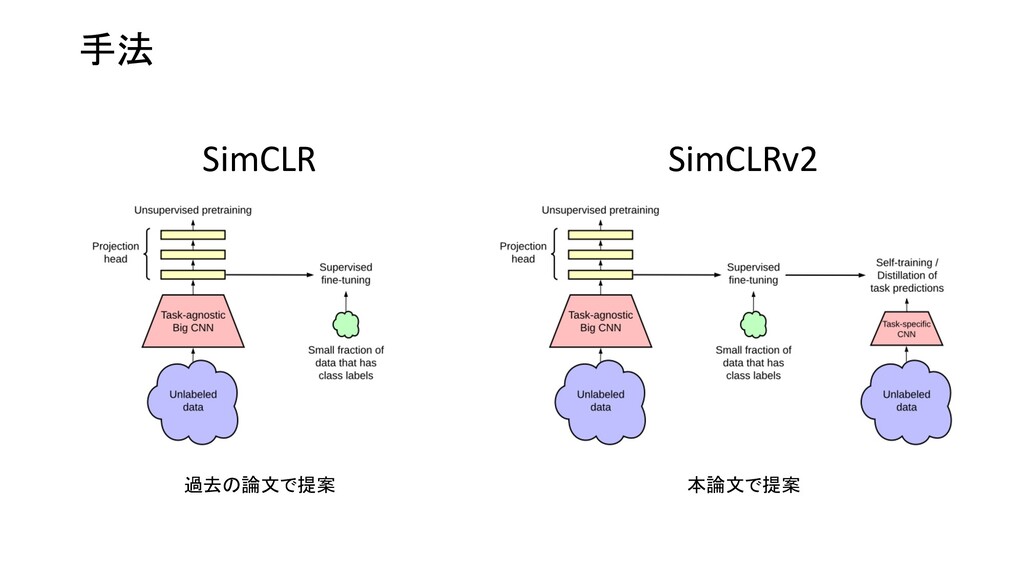
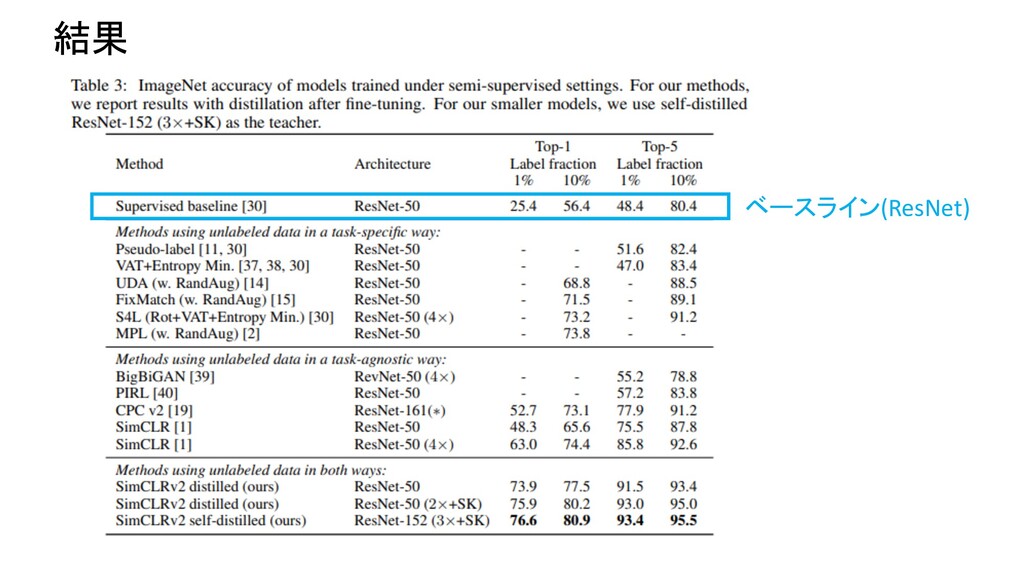
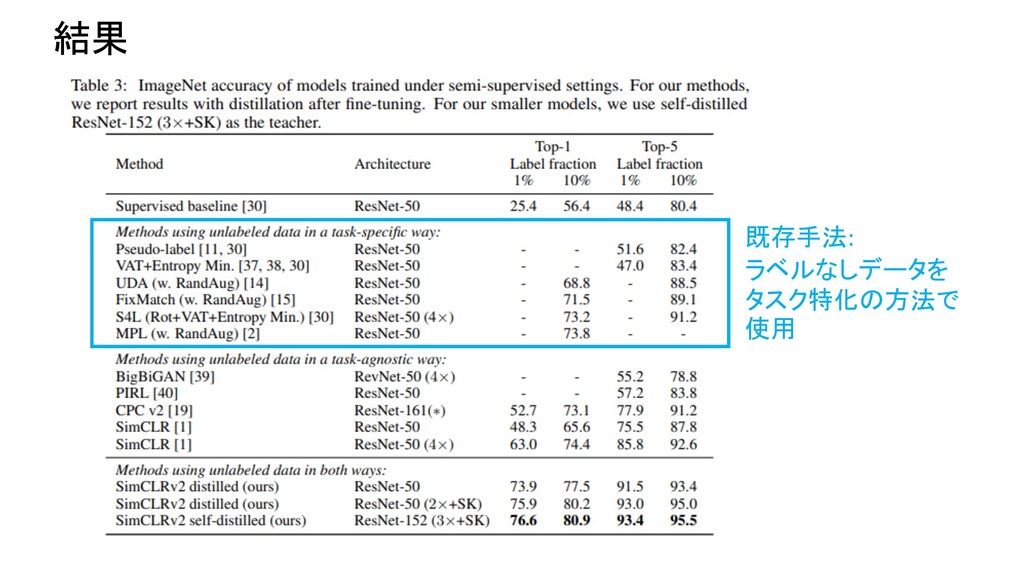
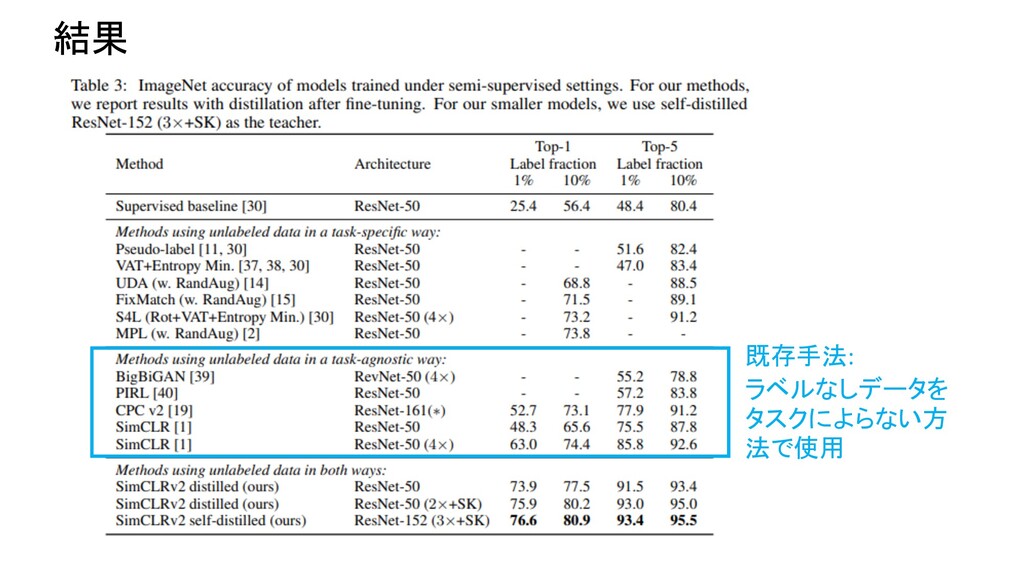
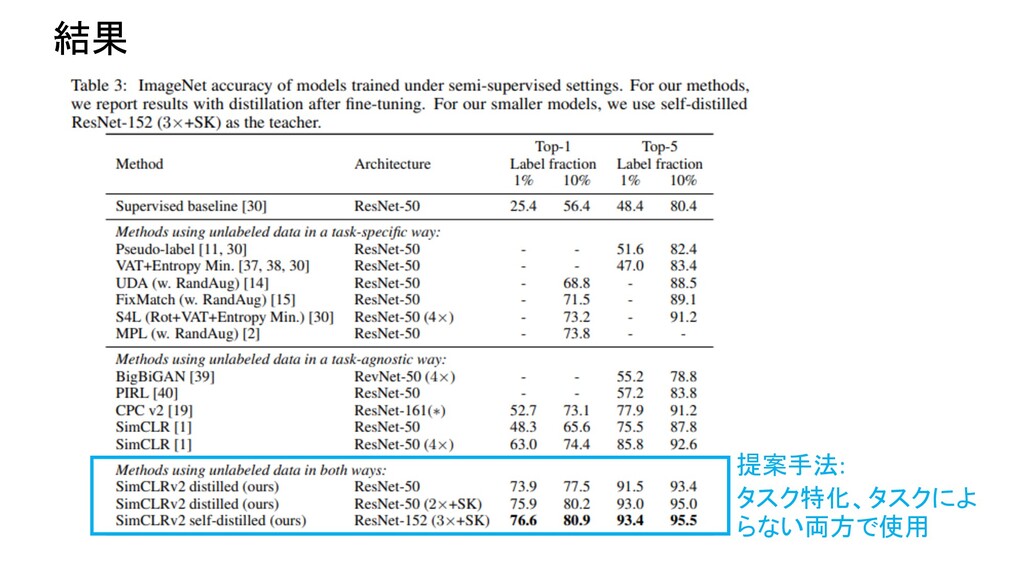
大きな自己学習モデルは強い半学習機 Big Self-Supervised Models are Strong Semi-Supervised Learners 大量のラベル付けされていないデータを最大限に活用しながら、ラベル付けされていない例から学習するた めのパラダイムの1つが、教師なし事前学習と教師付き微調整の組み合わせである。このパラダイムは、これ
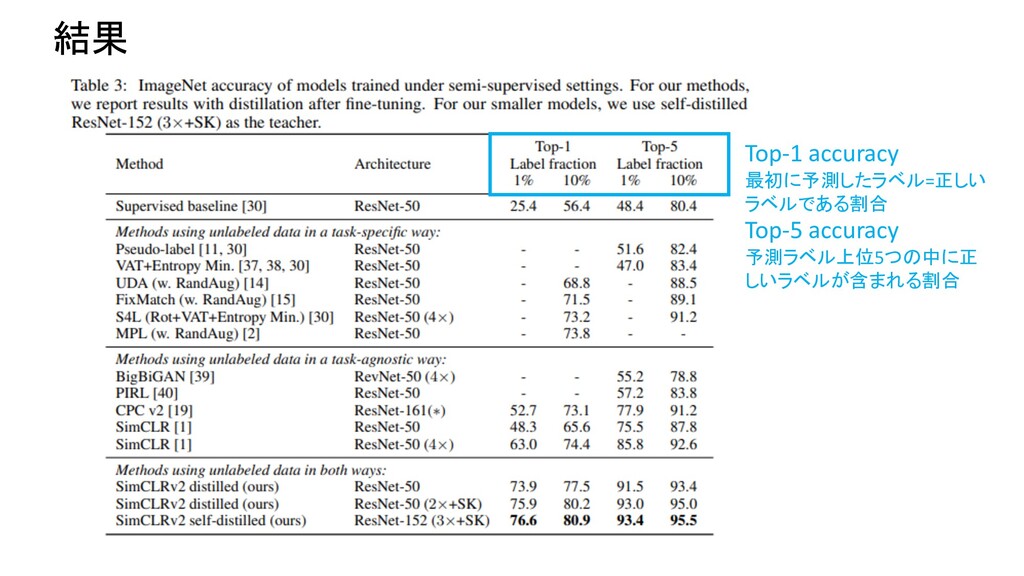
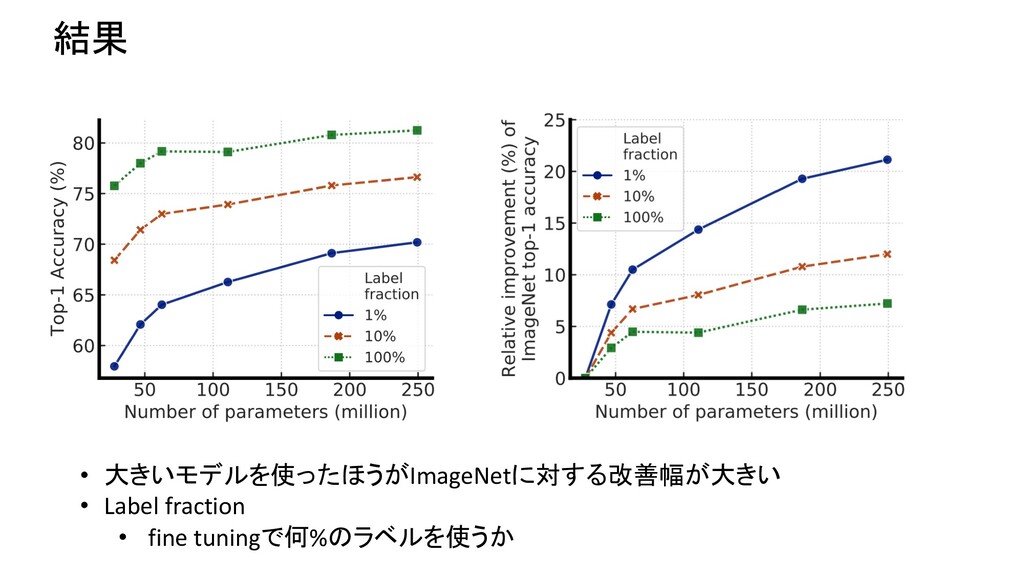
までのコンピュータビジョンのための半教師付き学習のほとんどのアプローチとは対照的に、ラベル付けされ ていないデータをタスクに依存しない方法で利用するが、 ImageNet上での半教師付き学習には驚くほど有効 であることを示す。我々のアプローチの重要な要素は、事前学習と微調整の際に大きな(深くて広い)ネット ワークを使用することである。ラベルが少ないほど、このアプローチ(ラベルの付いていないデータのタスクに 依存しない利用)はより大きなネットワークの恩恵を受けることがわかりました。微調整の後、大きなネット ワークは、ラベルの付いていない例をタスクに特化した方法で2回目に使用することで、さらに改良され分類 精度の損失を最小限に抑えて、はるかに小さなネットワークに蒸留することができます。提案された半教師付 き学習アルゴリズムは、3つのステップに要約することができます:SimCLRv2(SimCLRの改良版)を使用した大 規模なResNetモデルの教師なし事前学習、いくつかのラベル付き例での教師付き微調整、そしてタスク固有 の知識を洗練して伝達するためのラベルなし例を使用した蒸留です。この手法では、ResNet-50を用いて、わ ずか1%のラベル(クラスあたり13枚以下のラベル付き画像)で73.9%のImageNet top-1精度を達成し、ラベル 効率を従来の10倍に向上させました。10%のラベルを用いた場合,我々の手法を用いて学習したResNet-50 は77.5%のトップ1精度を達成し,すべてのラベルを用いた標準的な教師付き学習を凌駕する結果となった. Top Recent 8 ラベルの付なしデータで事前学習 Pick Up! -
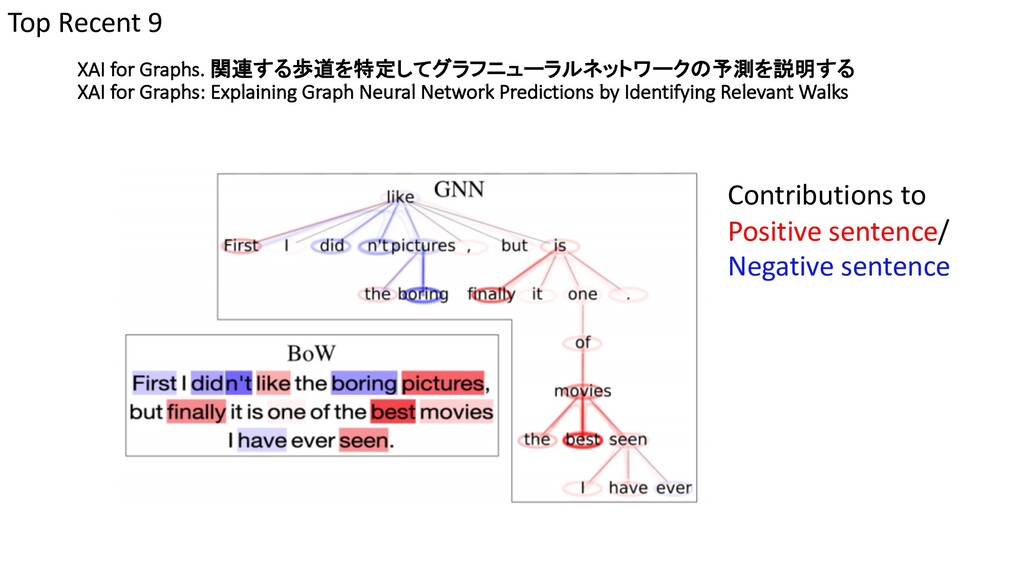
XAI for Graphs. 関連する歩道を特定してグラフニューラルネットワーク の予測を説明する XAI for Graphs: Explaining Graph
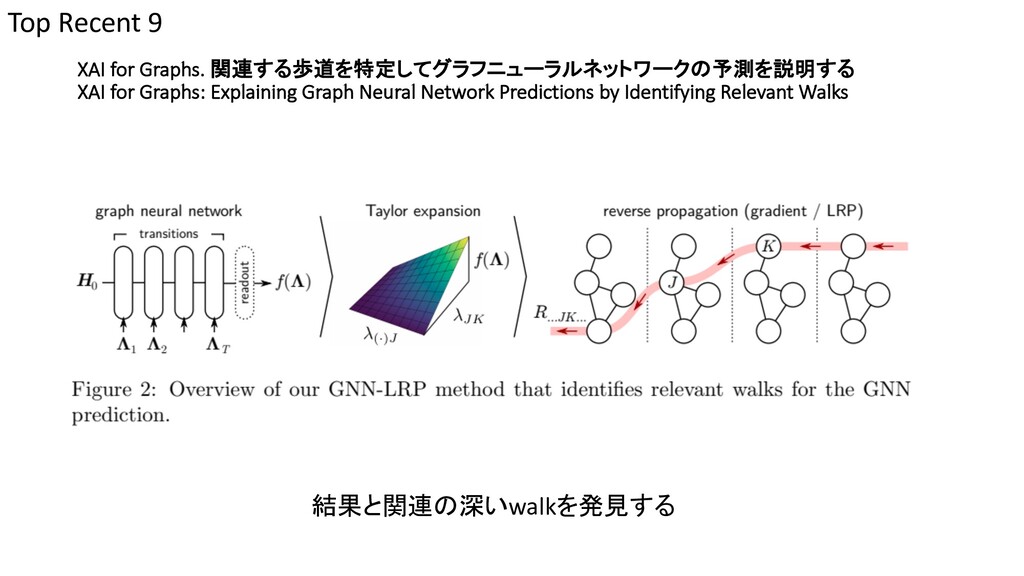
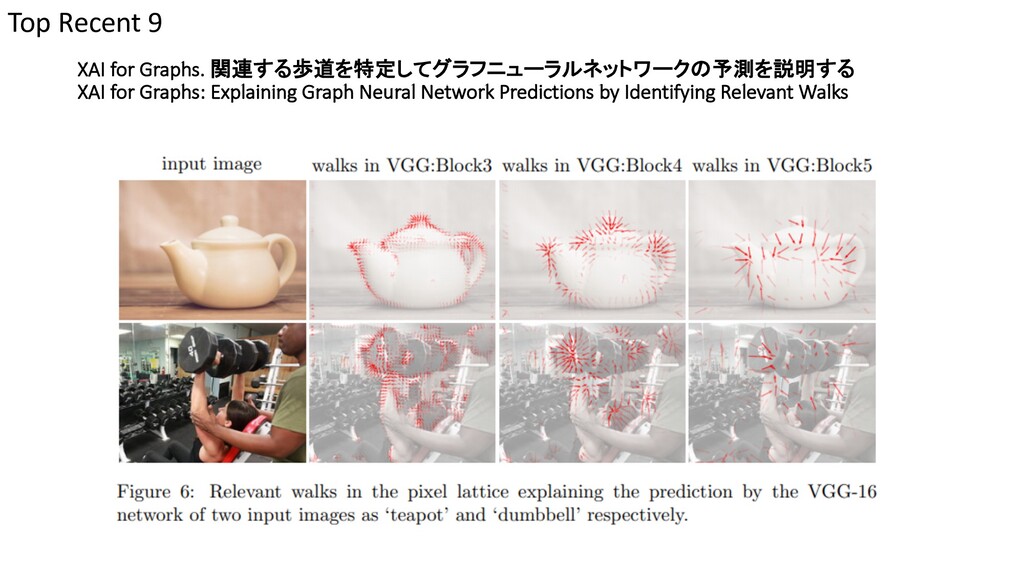
Neural Network Predictions by Identifying Relevant Walks グラフニューラルネットワーク(GNN)は、グラフ構造化データを予測するための一般的なアプロー チです。GNNは入力グラフをニューラルネットワーク構造に強く絡めるため、一般的な説明可能な AI(XAI)アプローチは適用できません。これまでのところ、GNNはユーザーにとってはブラックボック スのままであった。本論文では、GNNのための新しいXAIアプローチを提案することで貢献する。 我々のアプローチは高次テイラー展開に由来し、GNN予測の分解を入力グラフ上の関連する歩道 の集合として生成することができる。これらの高次テイラー展開は、GNNの最上層から第1層への 複数のバックプロパゲーションパスを用いて同等に(より簡単に)計算できることがわかる。この説 明は、勾配伝搬の標準方程式の代わりに層間関連性伝搬(LRP)を用いることで、さらにロバスト化 され、一般化することができます。我々が「GNN-LRP」と呼ぶ新しい手法は、スケールフリーグラフ、 文解析木、分子グラフ、画像を表すピクセル格子でテストされている。いずれの場合も、安定して 正確に動作し、興味深く新しいアプリケーションの知見を提供することができた。 Top Recent 9 グラフニューラルネットワークにおける説明可能AI -
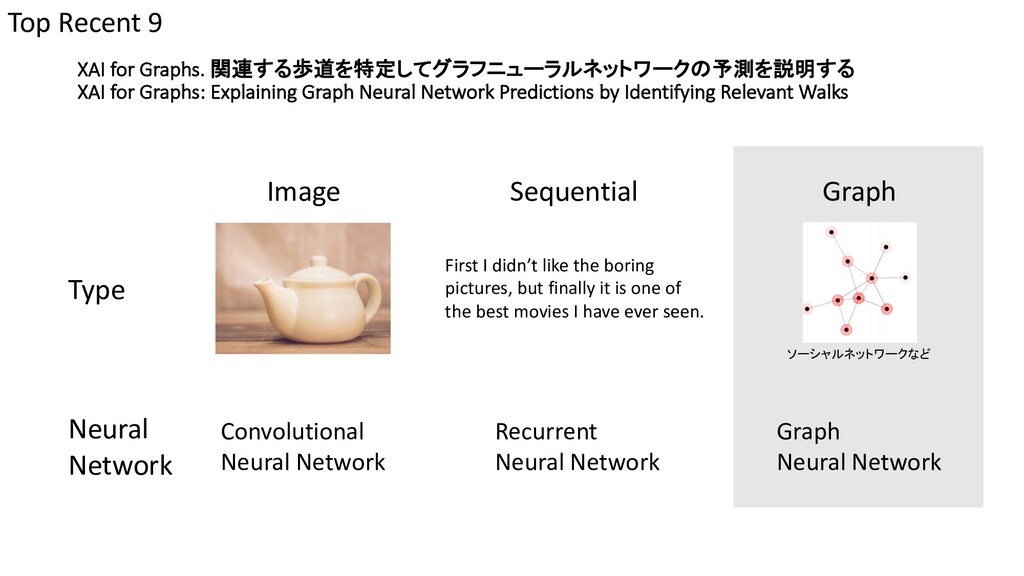
XAI for Graphs. 関連する歩道を特定してグラフニューラルネットワークの予測を説明する XAI for Graphs: Explaining Graph Neural
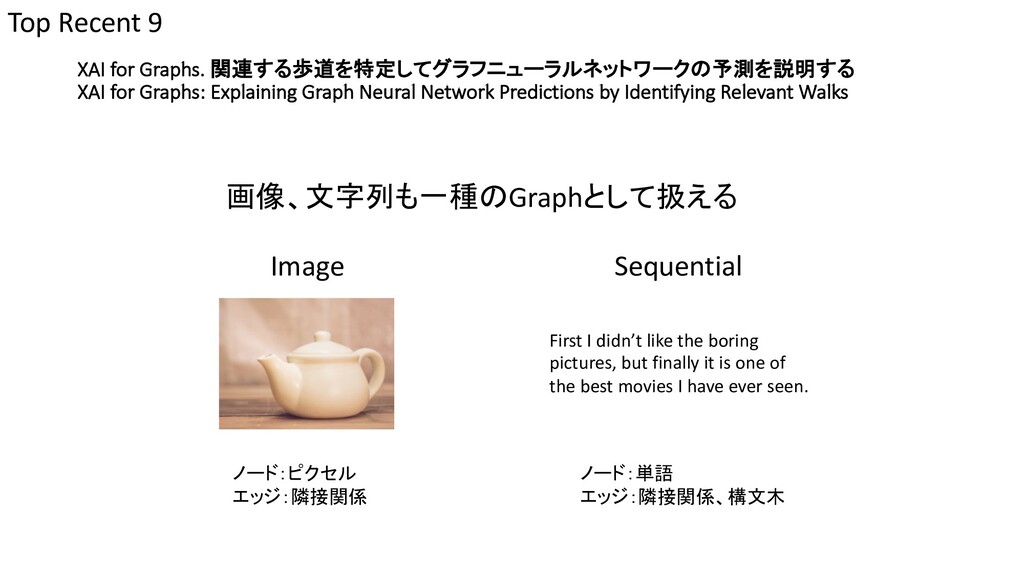
Network Predictions by Identifying Relevant Walks Top Recent 9 First I didn’t like the boring pictures, but finally it is one of the best movies I have ever seen. Image Sequential Graph Type ソーシャルネットワークなど Neural Network Convolutional Neural Network Recurrent Neural Network Graph Neural Network -
XAI for Graphs. 関連する歩道を特定してグラフニューラルネットワークの予測を説明する XAI for Graphs: Explaining Graph Neural
Network Predictions by Identifying Relevant Walks Top Recent 9 First I didn’t like the boring pictures, but finally it is one of the best movies I have ever seen. Image Sequential 画像、文字列も一種のGraphとして扱える ノード:ピクセル エッジ:隣接関係 ノード:単語 エッジ:隣接関係、構文木 -
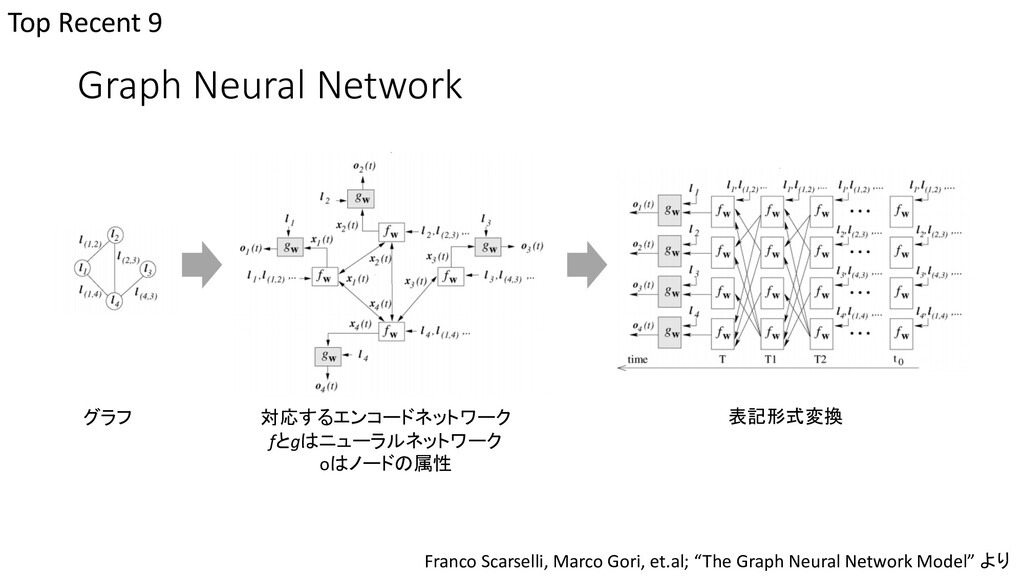
Graph Neural Network Top Recent 9 グラフ 対応するエンコードネットワーク fとgはニューラルネットワーク oはノードの属性
表記形式変換 Franco Scarselli, Marco Gori, et.al; “The Graph Neural Network Model” より -
XAI for Graphs. 関連する歩道を特定してグラフニューラルネットワークの予測を説明する XAI for Graphs: Explaining Graph Neural
Network Predictions by Identifying Relevant Walks Top Recent 9 結果と関連の深いwalkを発見する -
XAI for Graphs. 関連する歩道を特定してグラフニューラルネットワークの予測を説明する XAI for Graphs: Explaining Graph Neural
Network Predictions by Identifying Relevant Walks Top Recent 9 -
XAI for Graphs. 関連する歩道を特定してグラフニューラルネットワークの予測を説明する XAI for Graphs: Explaining Graph Neural
Network Predictions by Identifying Relevant Walks Top Recent 9 Contributions to Positive sentence/ Negative sentence -
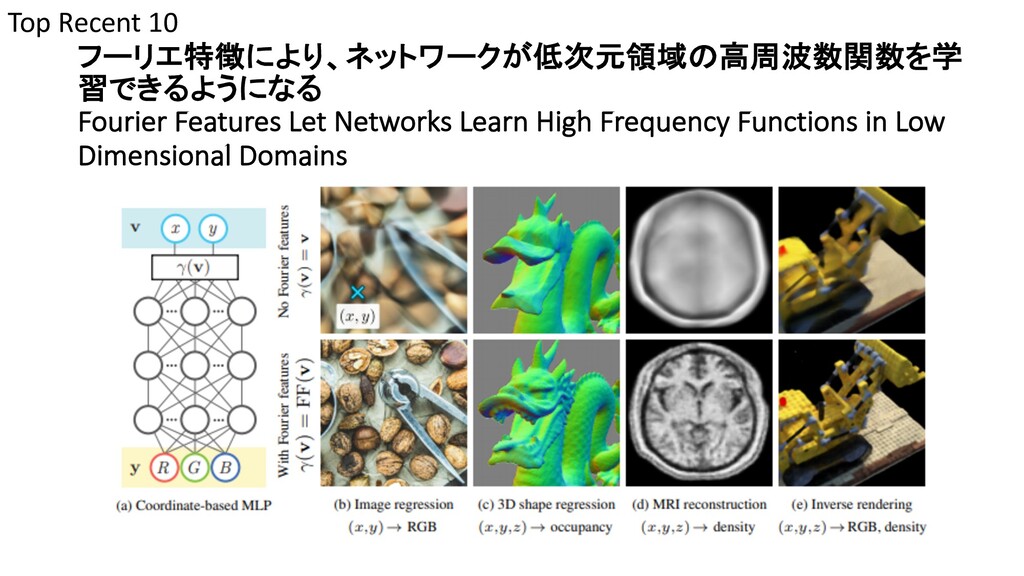
フーリエ特徴により、ネットワークが低次元領域の高周波数関数を学 習できるようになる Fourier Features Let Networks Learn High Frequency Functions
in Low Dimensional Domains 我々は、入力点を単純なフーリエ特徴写像に通すことで、多層パーセプトロン(MLP)が低次元の問 題領域で高周波数関数を学習できることを示した。これらの結果は、複雑な3次元物体やシーンを MLPで表現することで最先端の結果を得ようとしているコンピュータビジョンやグラフィックスの最近 の進歩に光を当てている。ニューラルタンジェントカーネル(NTK)文献のツールを用いて、標準的な MLPは理論的にも実際にも高周波数の学習に失敗することを示す。このスペクトルバイアスを克 服するために、我々はフーリエ特徴写像を用いて、有効なNTKを調整可能な帯域幅を持つ定常 カーネルに変換する。コンピュータビジョンやグラフィックスのコミュニティに関連する低次元回帰タ スクに対するMLPの性能を大幅に向上させる、問題固有のフーリエ特徴を選択するためのアプ ローチを提案する。 Top Recent 10 フーリエ特徴を利用してMLPに高周波数の特徴を学習させる -
フーリエ特徴により、ネットワークが低次元領域の高周波数関数を学 習できるようになる Fourier Features Let Networks Learn High Frequency Functions
in Low Dimensional Domains Top Recent 10 -
End-to-Endの敵対的テキスト・ツー・スピーチ End-to-End Adversarial Text-to-Speech 最近のテキスト音声合成パイプラインは、一般的に複数の処理段階があり、それぞれの処理段階 は他の段階とは独立して設計または学習されています。本研究では、正規化されたテキストや音 素からエンドツーエンドで音声を合成するための学習という挑戦的な課題に取り組み、文字や音 素の入力シーケンスを直接操作して生の音声出力を生成するモデルを生成する。提案するジェネ レータはフィードフォワード型であり、微分可能な単調補間スキームを用いて各入力トークンの持 続時間を予測することで、学習と推論の両方に効率的である。この生成器は、敵対的フィードバッ
クと予測損失を組み合わせて、生成された音声が総継続時間とメロスペクトログラムの点でほぼ 一致するように制約することで、高忠実度の音声を生成するように学習します。生成された音声の 時間的変動をモデルが捕捉できるようにするために、スペクトログラムベースの予測損失にソフト ダイナミックタイムワープを採用しました。結果として得られたモデルは、5点満点で4を超える平均 的な意見スコアを達成しており、これは多段階のトレーニングと追加の監視に依存する最先端の モデルに匹敵するものである。 Top Hype 1 音声合成をEnd-to-Endでやる 重複 -
ディープラーニングに基づくテキスト分類: 総合的なレビュー Deep Learning Based Text Classification: A Comprehensive Review
ディープラーニングベースのモデルは、感情分析、ニュース分類、質問回答、自然言語推論などの 様々なテキスト分類タスクにおいて、古典的な機械学習ベースのアプローチを凌駕している。本研 究では、近年開発されたテキスト分類のための150以上のディープラーニングベースモデルの詳 細なレビューを行い、それらの技術的貢献、類似点、および強みについて議論する。また、テキス ト分類に広く利用されている40以上の一般的なデータセットの概要を提供する。最後に、一般的な ベンチマークにおける異なるディープラーニングモデルの性能の定量的分析を行い、今後の研究 の方向性について議論します。 Top Hype 3 テキスト分類モデルのレビュー -
PULSE: 生成モデルの潜在空間探査による自己監視型アップサンプリ ング PULSE: Self-Supervised Photo Upsampling via Latent Space
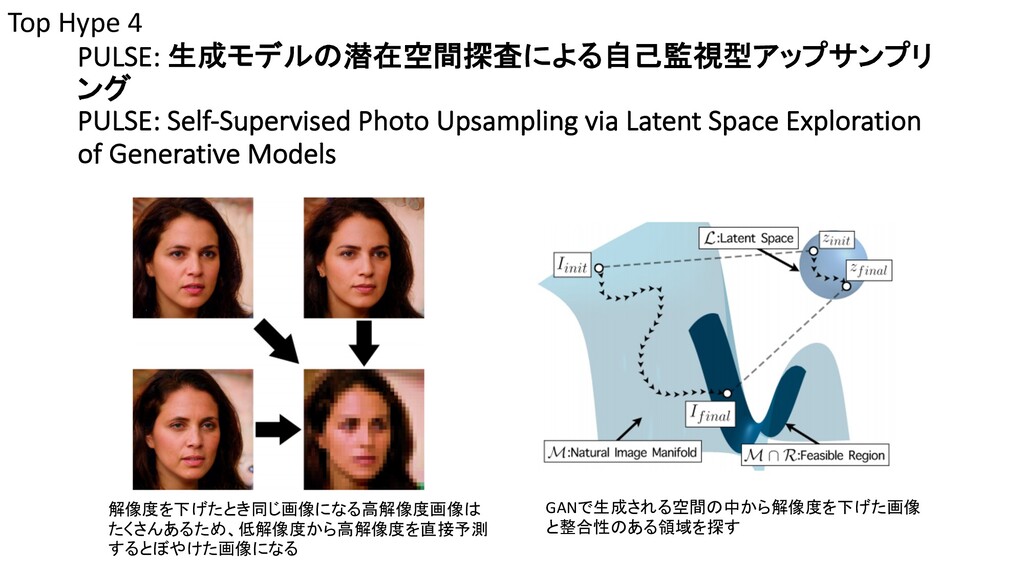
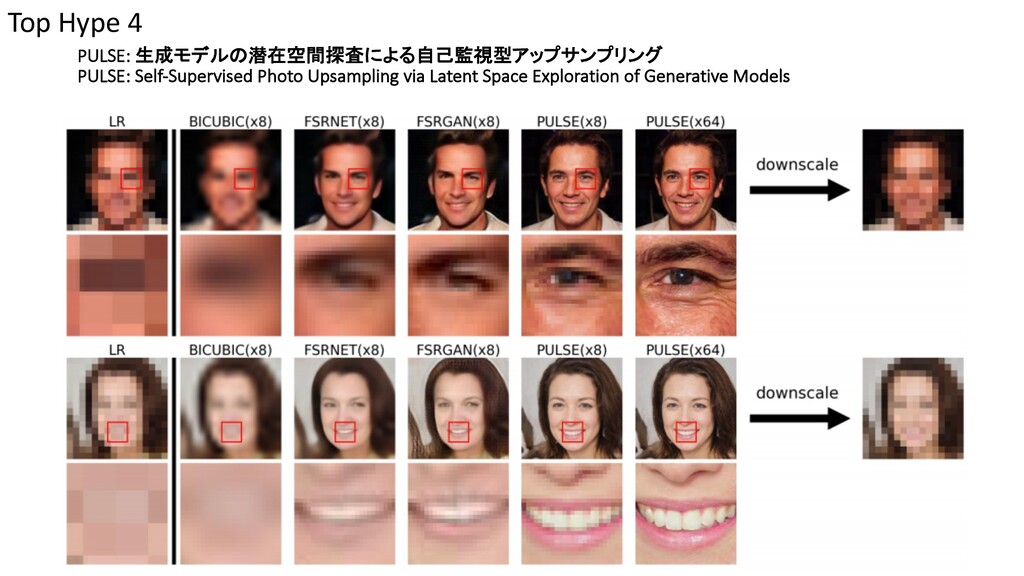
Exploration of Generative Models 単一画像超解像の主な目的は、対応する低解像度(LR)入力から高解像度(HR)画像を構築することである。こ れまでのアプローチでは、一般的に教師ありきで行われてきたが、トレーニングの目的は、通常、超解像(SR) 画像とHR画像の間のピクセル単位の平均距離を測定することであった。このようなメトリクスを最適化すると、 特に高分散(詳細)領域ではぼやけてしまうことが多い。本研究では、正確にダウンスケールする現実的なSR 画像を作成することに基づいて、超解像問題の代替的な定式化を提案する。この問題を解決する新しい超解 像アルゴリズム、PULSE (Photo Upsampling via Latent Space Exploration)を提案します。これは、これまでの手 法(教師付き学習のためにLR-HR画像ペアのデータベースを用いて学習する必要があった)とは異なり、学習 時に使用する特定の劣化演算子に制限されることなく、完全に自己監視下で行われます。PULSEは、LR画像 から始めてゆっくりと詳細を追加するのではなく、高解像度の自然画像の多様性を探索し、元のLR画像にダ ウンスケールする画像を探します。これは「ダウンスケーリングロス」によって形式化され、生成モデルの潜在 空間を探索する際の指針となります。高次元ガウシアンの特性を利用して、検索空間を制限し、現実的な出 力を保証します。これにより、PULSEは現実的でありながらダウンスケールを正確に行うことができる超解像画 像を生成します。私たちのアプローチが顔の超解像(顔の幻覚としても知られています)の領域で有効である ことを示す広範な実験結果を示しています。私たちの手法は、これまで可能だったよりも高い解像度とスケー ルファクタにおいて、知覚品質において最先端の手法を凌駕しています。 Top Hype 4 超解像度画像生成 -
PULSE: 生成モデルの潜在空間探査による自己監視型アップサンプリ ング PULSE: Self-Supervised Photo Upsampling via Latent Space
Exploration of Generative Models Top Hype 4 解像度を下げたとき同じ画像になる高解像度画像は たくさんあるため、低解像度から高解像度を直接予測 するとぼやけた画像になる GANで生成される空間の中から解像度を下げた画像 と整合性のある領域を探す -
PULSE: 生成モデルの潜在空間探査による自己監視型アップサンプリング PULSE: Self-Supervised Photo Upsampling via Latent Space Exploration
of Generative Models Top Hype 4 -
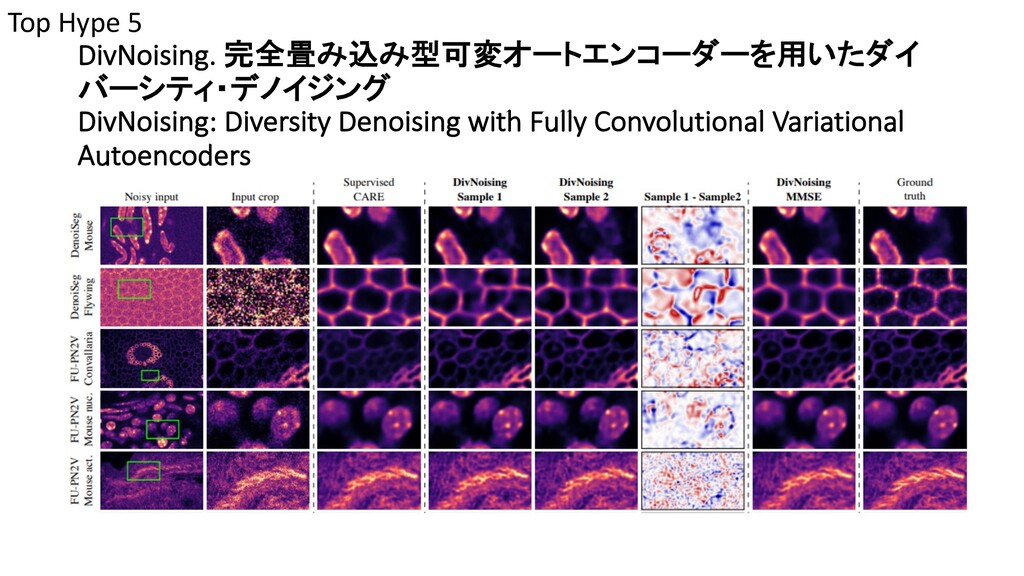
DivNoising. 完全畳み込み型可変オートエンコーダーを用いたダイ バーシティ・デノイジング DivNoising: Diversity Denoising with Fully Convolutional Variational
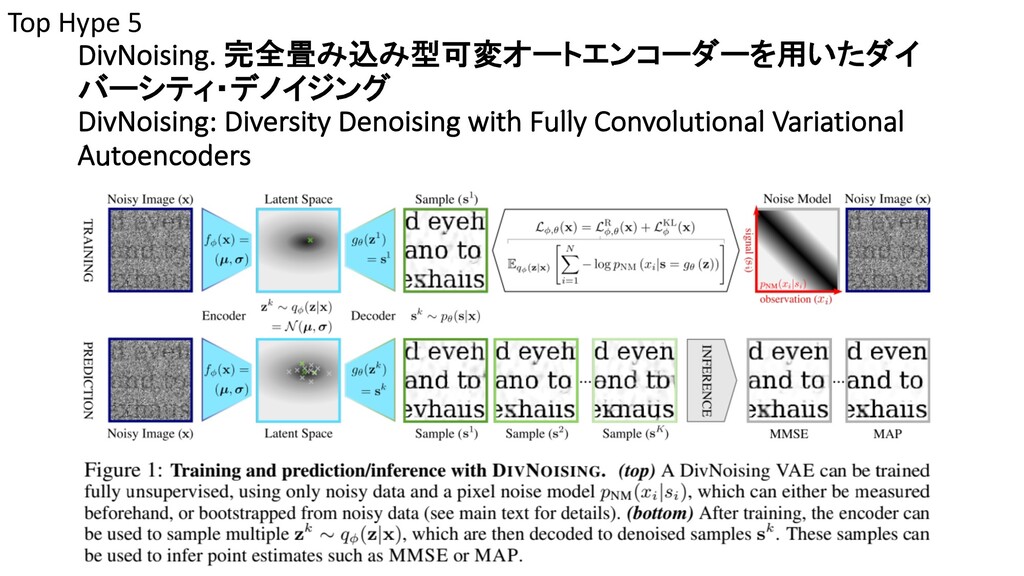
Autoencoders ディープラーニングに基づく手法は、事実上すべての画像復元タスクのための議論の余地のないリーダーと して浮上してきました。特に顕微鏡画像の領域では、取得したデータの解釈可能性を向上させるために、 様々なコンテンツを考慮した画像復元(CARE)アプローチが使用されています。しかし、破損した画像で復元で きるものには限界があり、復元された画像を予測する際には、どのような方法でも多くの可能性のあるクリー ンな信号の間で賢明な妥協をする必要があります。ここで、我々はDivNoisingを提案します。これは完全畳み 込みの変分法オートエンコーダーをベースとしたノイズ除去アプローチで、ノイズ除去された画像の分布全体 を予測することでこの問題を克服します。我々の手法は教師なしで、必要なのはノイズの多い画像と画像ノイ ズの記述のみであり、ノイズの多いデータから測定またはブートストラップすることができます。必要に応じて、 DivNoising予測のセットからコンセンサス予測を推論することができ、他の教師なし手法と競合する結果を得 ることができます。後処理からのDivNoisingサンプルは、多くの有用なアプリケーションを可能にします。本研 究では、(i) 光学的文字認識(OCR)アプリケーションが、曖昧なデータ上での多様な予測からどのように利益を 得ることができるかを議論し、(ii)多様なDivNoising予測を用いた場合にインスタンスセルのセグメンテーション がどのように性能を向上させるかを詳細に示す。 Top Hype 5 変分オートエンコーダを利用した画像復元(ノイズ除去) -
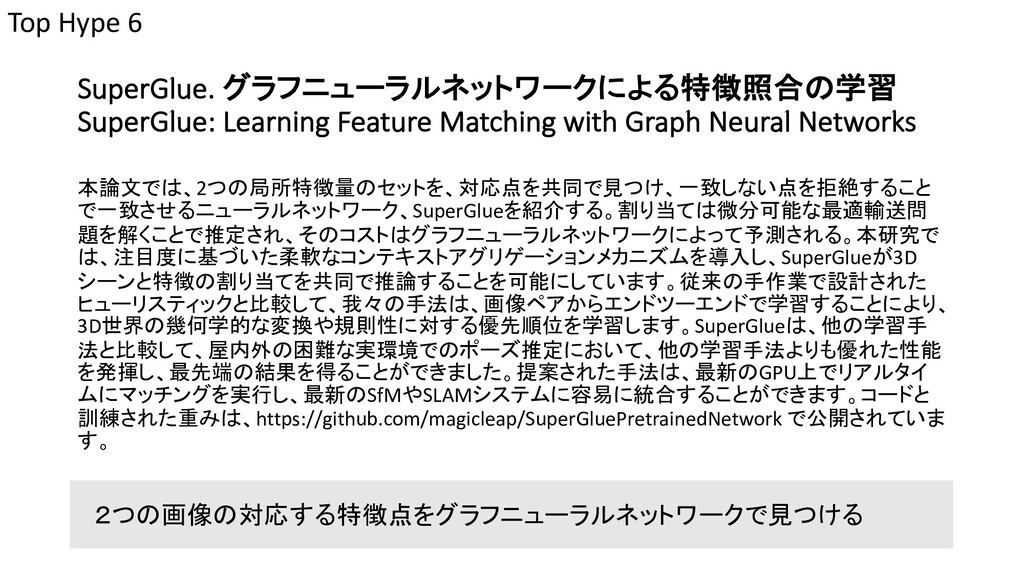
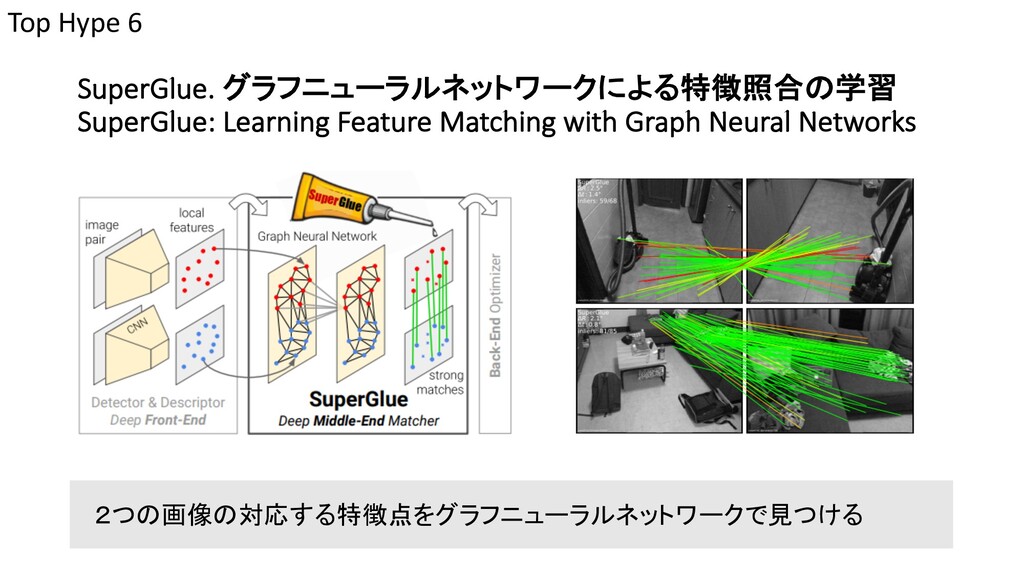
SuperGlue. グラフニューラルネットワークによる特徴照合の学習 SuperGlue: Learning Feature Matching with Graph Neural Networks
本論文では、2つの局所特徴量のセットを、対応点を共同で見つけ、一致しない点を拒絶すること で一致させるニューラルネットワーク、SuperGlueを紹介する。割り当ては微分可能な最適輸送問 題を解くことで推定され、そのコストはグラフニューラルネットワークによって予測される。本研究で は、注目度に基づいた柔軟なコンテキストアグリゲーションメカニズムを導入し、SuperGlueが3D シーンと特徴の割り当てを共同で推論することを可能にしています。従来の手作業で設計された ヒューリスティックと比較して、我々の手法は、画像ペアからエンドツーエンドで学習することにより、 3D世界の幾何学的な変換や規則性に対する優先順位を学習します。SuperGlueは、他の学習手 法と比較して、屋内外の困難な実環境でのポーズ推定において、他の学習手法よりも優れた性能 を発揮し、最先端の結果を得ることができました。提案された手法は、最新のGPU上でリアルタイ ムにマッチングを実行し、最新のSfMやSLAMシステムに容易に統合することができます。コードと 訓練された重みは、https://github.com/magicleap/SuperGluePretrainedNetwork で公開されていま す。 Top Hype 6 2つの画像の対応する特徴点をグラフニューラルネットワークで見つける -
SuperGlue. グラフニューラルネットワークによる特徴照合の学習 SuperGlue: Learning Feature Matching with Graph Neural Networks
Top Hype 6 2つの画像の対応する特徴点をグラフニューラルネットワークで見つける -
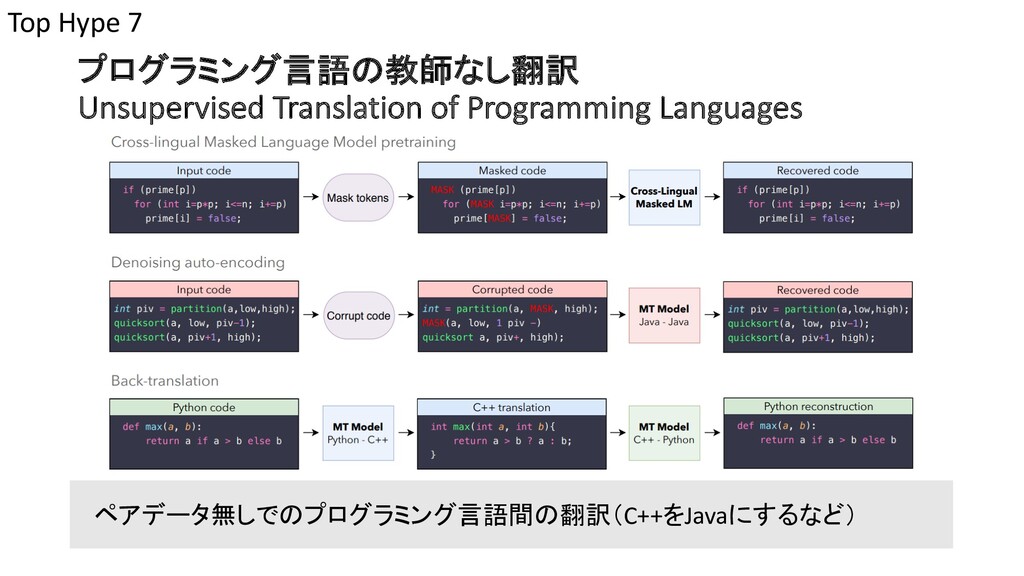
プログラミング言語の教師なし翻訳 Unsupervised Translation of Programming Languages トランスコンパイラは、ソース・ツー・ソース・トランスレータとも呼ばれ、高レベルのプログラミング言語(C++や Pythonなど)のソースコードを別の言語に変換するシステムです。トランスコンパイラは主に相互運用性のた めに使用され、時代遅れの言語(COBOL、Python 2など)で書かれたコードベースを最新の言語に移植するた
めに使用されます。一般的には、ソースコードの抽象構文ツリーに適用される、手作業で作られた書き換え ルールに依存します。残念なことに、結果として得られる翻訳は、しばしば可読性に欠け、ターゲット言語の規 則を尊重できず、適切に動作するためには手動での修正が必要となります。全体的な翻訳プロセスは時間が かかり、ソース言語とターゲット言語の両方の専門知識を必要とするため、コード翻訳プロジェクトは高額にな ります。ニューラルモデルは、自然言語翻訳の文脈ではルールベースのものよりもはるかに優れていますが、 この領域ではペアとなるデータが少ないため、トランスコンパイルへの応用は限られています。本論文では、 教師なし機械翻訳における最近のアプローチを活用して、完全教師なしニューラル・トランスコンパイラを訓練 することを提案する。我々は、オープンソースのGitHubプロジェクトのソースコードを用いて我々のモデルを訓 練し、C++、Java、Python間の関数を高精度に翻訳できることを示す。我々の手法は、単一言語のソースコード のみに依存しており、ソース言語やターゲット言語の専門知識を必要とせず、他のプログラミング言語にも容 易に一般化できる。また、852個の並列関数からなるテストセットを構築し、翻訳の正しさをチェックするための ユニットテストとともに公開しています。我々は、我々のモデルがルールベースの商用ベースラインを大幅に 上回ることを示している。 Top Hype 7 ペアデータ無しでのプログラミング言語間の翻訳(C++をJavaにするなど) -
ImageNetはもういいんじゃないかな? Are we done with ImageNet? 答えはイエスでありノーである。我々は、ImageNet分類ベンチマークの最近の進歩が意味のある 一般化を表し続けているのか、それともコミュニティがそのラベリング手順の特殊性に過剰に適合 し始めたのかに疑問を感じていた。そこで、ImageNetの検証セットの人間のアノテーションを収集 するための、より大幅にロバストな手順を開発した。これらの新しいラベルを用いて、最近提案され
たImageNet分類器の精度を再評価したところ、元のラベルで報告されているものよりも得られるも のは大幅に小さいことがわかった。さらに、元のImageNetラベルは、独立して収集されたセットの 最良の予測機ではなくなっており、ビジョンモデルの評価における有用性が終わりに近づいている ことを示しています。とはいえ、我々のアノテーション方法は、元のラベルの誤差を大幅に改善して おり、ImageNetは視覚認識の将来の研究のための強力なベンチマークとして強化されていること がわかりました。 Top Hype 8 新しいラベル付け方法の提案 重複 -
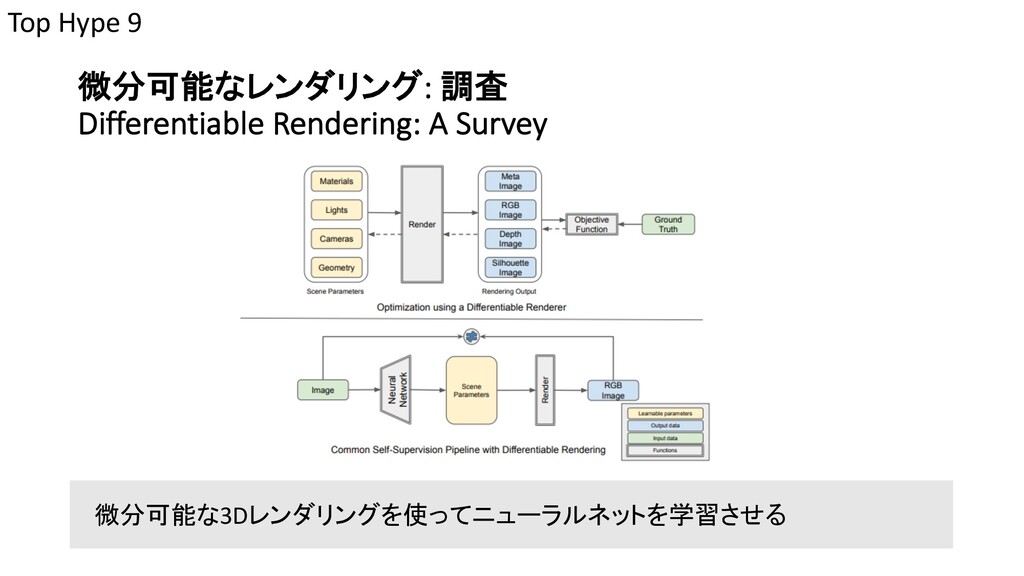
微分可能なレンダリング: 調査 Differentiable Rendering: A Survey ディープニューラルネットワーク(DNN)は、物体検出や画像のセグメンテーションなどのビジョン関 連のタスクにおいて顕著な性能向上を示している。しかし、その成功にもかかわらず、一般的には、 シーンの3次元情報を収集したり、簡単に注釈を付けたりすることができないため、画像を形成す る3次元オブジェクトの理解には欠けている。微分可能レンダリングは、3次元オブジェクトの勾配
を計算し、画像を介して伝播することを可能にする新しい分野である。また、様々なアプリケーショ ンでより高い成功率を可能にしながら、3Dデータの収集やアノテーションの要件を軽減することが できる。本論文では、既存の文献をレビューし、微分可能なレンダリングの現状とその応用、オー プンな研究課題について議論する。 Top Hype 9 微分可能な3Dレンダリングを使ってニューラルネットを学習させる -
Top Hype 10 End-to-Endの敵対的テキスト・ツー・スピーチ End-to-End Adversarial Text-to-Speech 最近のテキスト音声合成パイプラインは、一般的に複数の処理段階があり、それぞれの処理段階 は他の段階とは独立して設計または学習されています。本研究では、正規化されたテキストや音 素からエンドツーエンドで音声を合成するための学習という挑戦的な課題に取り組み、文字や音
素の入力シーケンスを直接操作して生の音声出力を生成するモデルを生成する。提案するジェネ レータはフィードフォワード型であり、微分可能な単調補間スキームを用いて各入力トークンの持 続時間を予測することで、学習と推論の両方に効率的である。この生成器は、敵対的フィードバッ クと予測損失を組み合わせて、生成された音声が総継続時間とメロスペクトログラムの点でほぼ 一致するように制約することで、高忠実度の音声を生成するように学習します。生成された音声の 時間的変動をモデルが捕捉できるようにするために、スペクトログラムベースの予測損失にソフト ダイナミックタイムワープを採用しました。結果として得られたモデルは、5点満点で4を超える平均 的な意見スコアを達成しており、これは多段階のトレーニングと追加の監視に依存する最先端の モデルに匹敵するものである。 音声合成をEnd-to-Endでやる 重複 -
気になった論文一つ 大きな自己学習モデルは強い半学習機 Big Self-Supervised Models are Strong Semi-Supervised Learners Ting
Chen, Simon Kornblith, Kevin Swersky, Mohammad Norouzi, Geoffrey Hinton Google Research, Brain Team -
気になった論文一つ 大きな自己学習モデルは強い半学習機 Big Self-Supervised Models are Strong Semi-Supervised Learners Ting
Chen, Simon Kornblith, Kevin Swersky, Mohammad Norouzi, Geoffrey Hinton Google Research, Brain Team -
問題提起 • 半教師あり学習 • ラベル付データ←少ない • ラベルなしデータ←いっぱい • ラベルなしデータを活用して少ないラベル付データから学習する •
自然言語処理の分野では • “ラベルなしデータで教師なし学習” + “ラベルありデータで教師あり学習” • 教師なし学習の際はタスクと無関係な学習を行う • 画像処理 • 教師付き学習の際に、正則化の一形態として、ラベル付けされていない データを直接利用する • 複数のモデルでラベルの一貫性を保つなど • “ラベルなしデータで教師なし学習” + “ラベルありデータで教師あり学習”という のをImageNetに適用した -
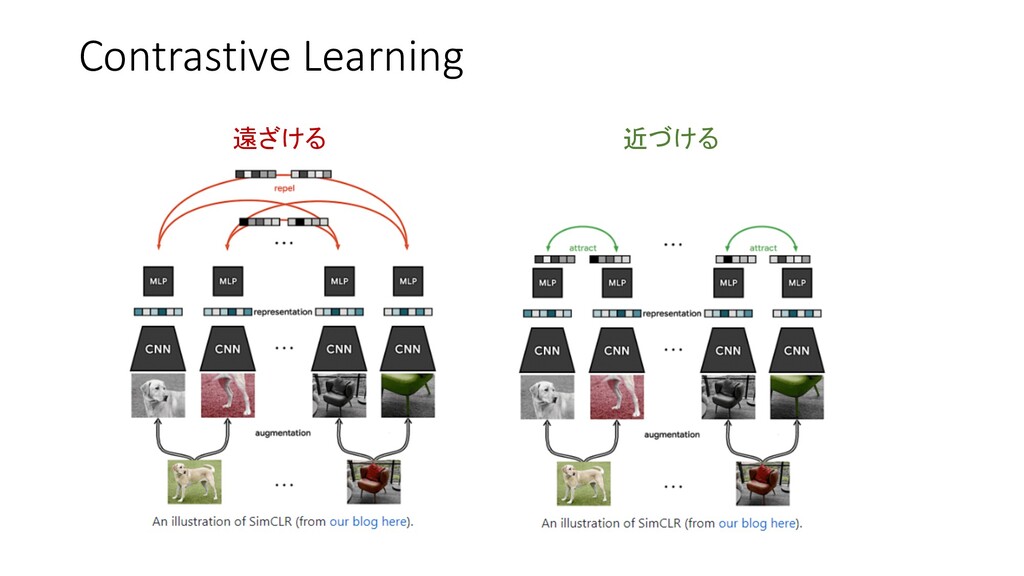
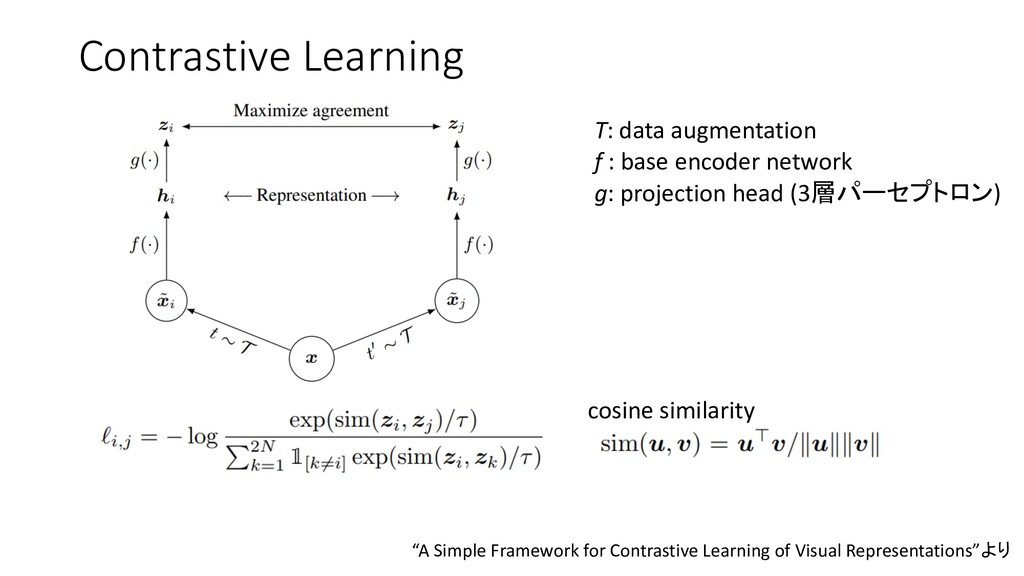
Contrastive Learning “A Simple Framework for Contrastive Learning of Visual
Representations”より T: data augmentation f : base encoder network g: projection head (3層パーセプトロン) cosine similarity -
コード GitHub - google-research/simclr: SimCLRv2 - Big Self- Supervised Models
are Strong Semi-Supervised Learners https://github.com/google-research/simclr
 ailaboocu
 konakalab
 trycycle
 institutdelelevage
 analokmaus
 xspa2012
 junkashihara
 tagtag
 masakiokuda
 varn
 afnizarnur
 inesmontani
 lara
 helmedeiros
 orderedlist
 palkan
 jcasabona
 samlambert
 csswizardry
 jacobtomlinson
 jeffersonlam