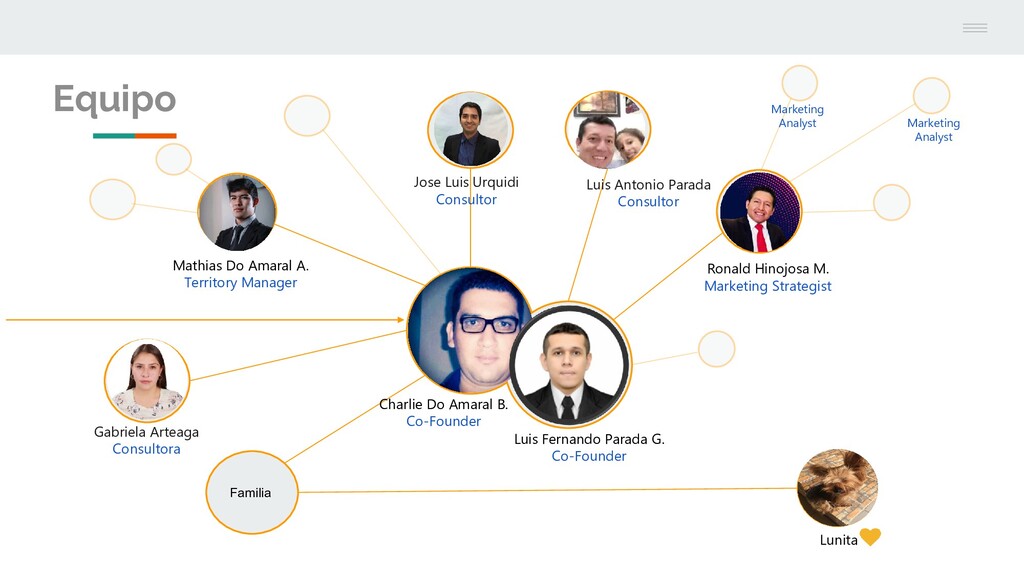
Parada G. Co-Founder Mathias Do Amaral A. Territory Manager Ronald Hinojosa M. Marketing Strategist Jose Luis Urquidi Consultor Gabriela Arteaga Consultora Marketing Analyst Marketing Analyst Luis Antonio Parada Consultor
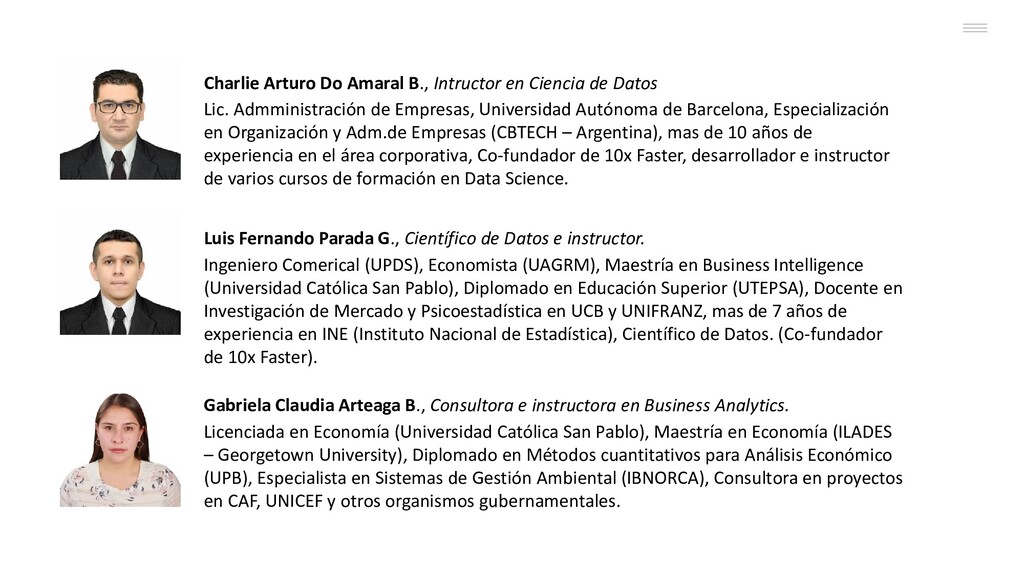
Lic. Admministración de Empresas, Universidad Autónoma de Barcelona, Especialización en Organización y Adm.de Empresas (CBTECH – Argentina), mas de 10 años de experiencia en el área corporativa, Co-fundador de 10x Faster, desarrollador e instructor de varios cursos de formación en Data Science. Luis Fernando Parada G., Científico de Datos e instructor. Ingeniero Comerical (UPDS), Economista (UAGRM), Maestría en Business Intelligence (Universidad Católica San Pablo), Diplomado en Educación Superior (UTEPSA), Docente en Investigación de Mercado y Psicoestadística en UCB y UNIFRANZ, mas de 7 años de experiencia en INE (Instituto Nacional de Estadística), Científico de Datos. (Co-fundador de 10x Faster). Gabriela Claudia Arteaga B., Consultora e instructora en Business Analytics. Licenciada en Economía (Universidad Católica San Pablo), Maestría en Economía (ILADES – Georgetown University), Diplomado en Métodos cuantitativos para Análisis Económico (UPB), Especialista en Sistemas de Gestión Ambiental (IBNORCA), Consultora en proyectos en CAF, UNICEF y otros organismos gubernamentales.
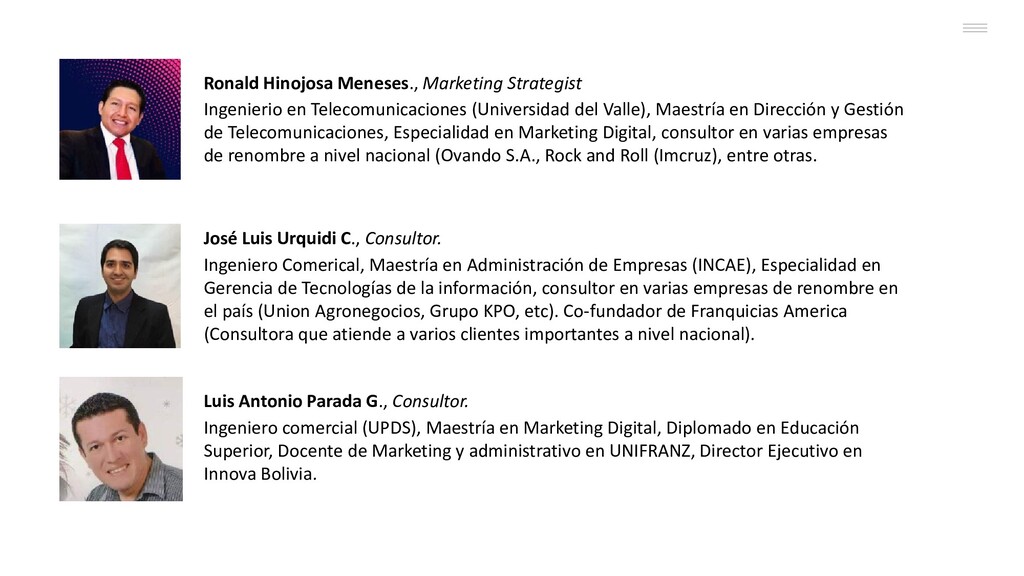
Valle), Maestría en Dirección y Gestión de Telecomunicaciones, Especialidad en Marketing Digital, consultor en varias empresas de renombre a nivel nacional (Ovando S.A., Rock and Roll (Imcruz), entre otras. José Luis Urquidi C., Consultor. Ingeniero Comerical, Maestría en Administración de Empresas (INCAE), Especialidad en Gerencia de Tecnologías de la información, consultor en varias empresas de renombre en el país (Union Agronegocios, Grupo KPO, etc). Co-fundador de Franquicias America (Consultora que atiende a varios clientes importantes a nivel nacional). Luis Antonio Parada G., Consultor. Ingeniero comercial (UPDS), Maestría en Marketing Digital, Diplomado en Educación Superior, Docente de Marketing y administrativo en UNIFRANZ, Director Ejecutivo en Innova Bolivia.
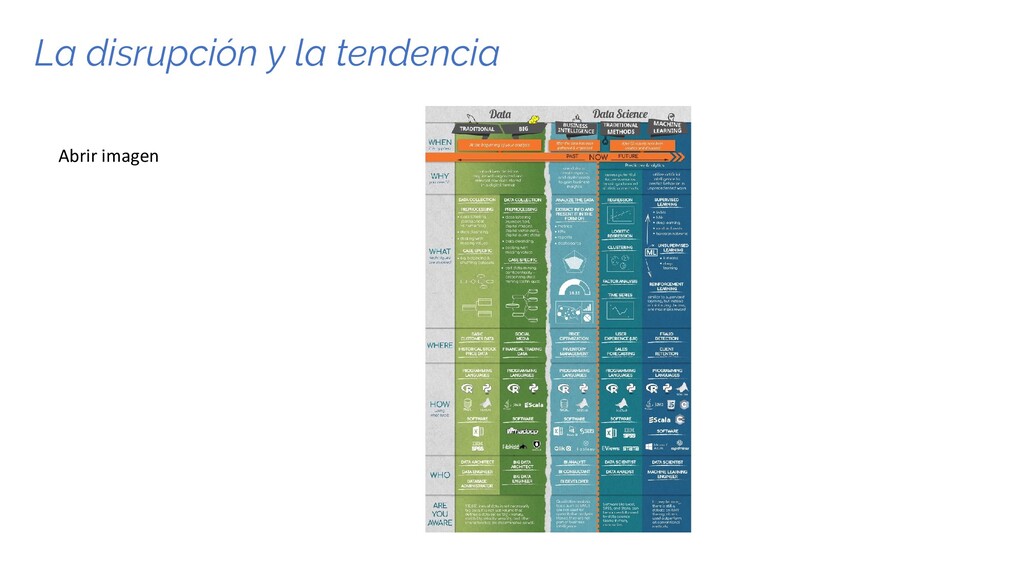
Disrupción y la tendencia 4. Las características más importantes • Extracción y manipulación de datos • Visualización e Storytelling • Paquetes • Reproducibilidad • Data Science 5. Propuesta de Valor
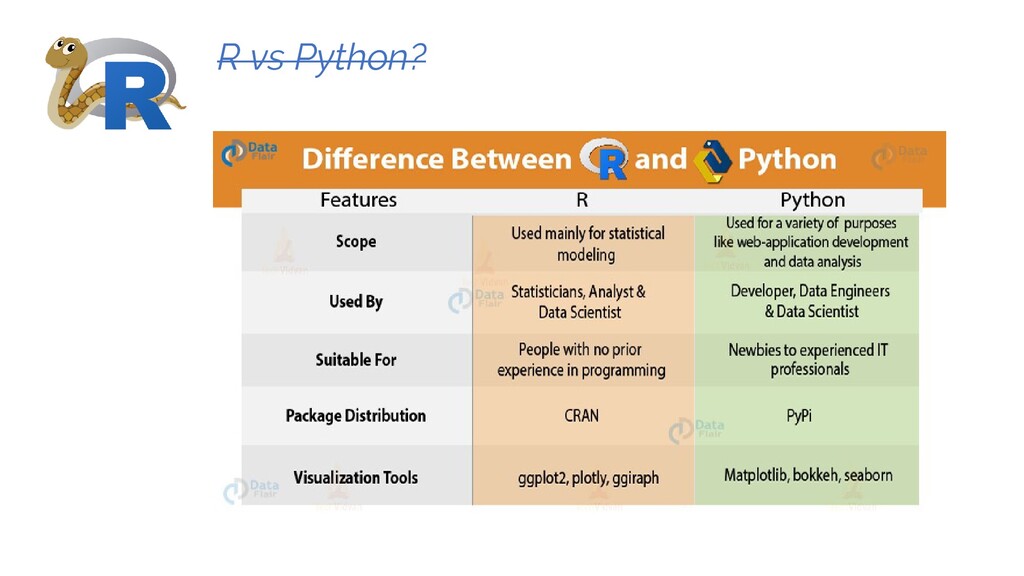
desarrollado por los neozelandeses Ross Ihaka y Robert Gentleman, en 1996, como un dialecto del lenguaje S, que había sido creado a principios de los años 90 del Siglo XX por los Laboratorios AT&T Bell. • R es un lenguaje de programación enfocado al análisis estadístico. Se trata de uno de los lenguajes de programación más utilizados en investigación científica, aunque también tiene aplicaciones al machine learning, minería de datos, investigación biomédica o matemáticas financieras.
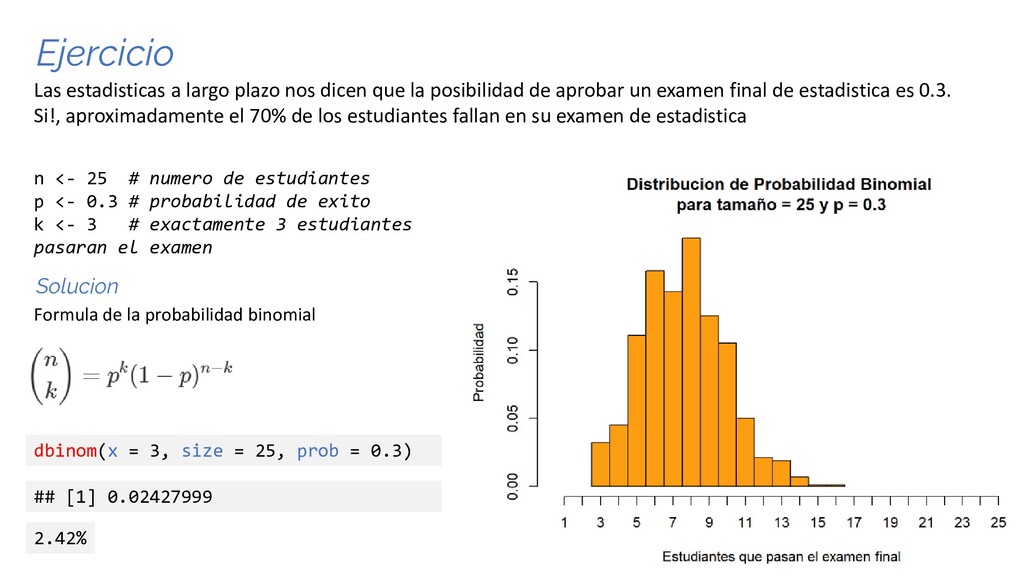
estadisticas a largo plazo nos dicen que la posibilidad de aprobar un examen final de estadistica es 0.3. Si!, aproximadamente el 70% de los estudiantes fallan en su examen de estadistica Ejercicio n <- 25 # numero de estudiantes p <- 0.3 # probabilidad de exito k <- 3 # exactamente 3 estudiantes pasaran el examen ## [1] 0.02427999 Solucion Formula de la probabilidad binomial 2.42%
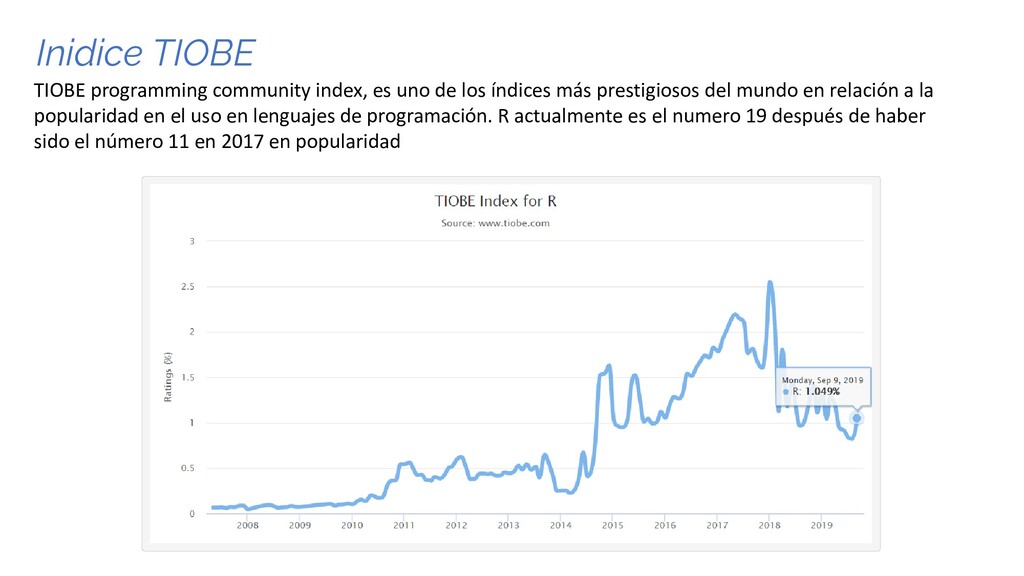
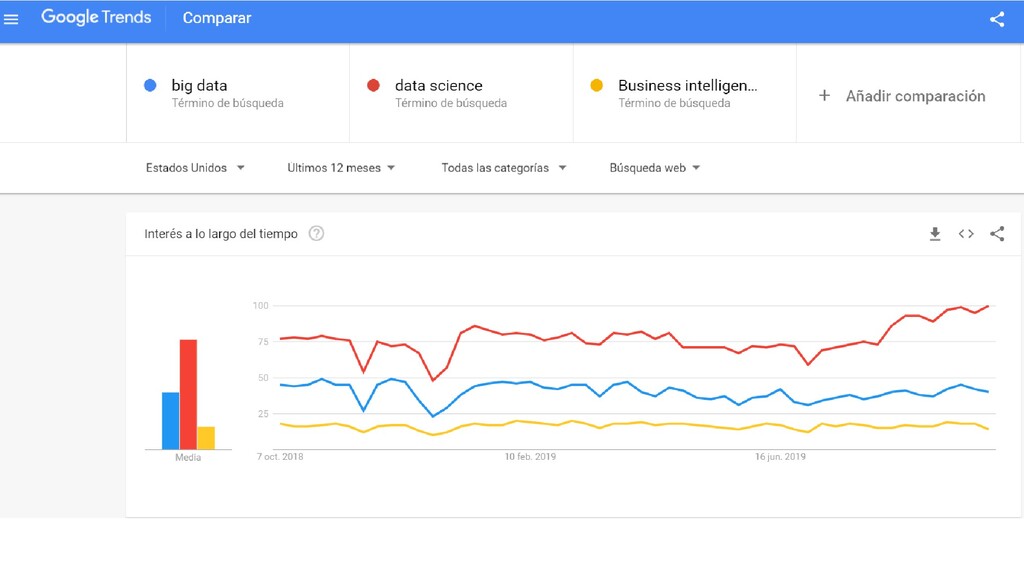
índices más prestigiosos del mundo en relación a la popularidad en el uso en lenguajes de programación. R actualmente es el numero 19 después de haber sido el número 11 en 2017 en popularidad
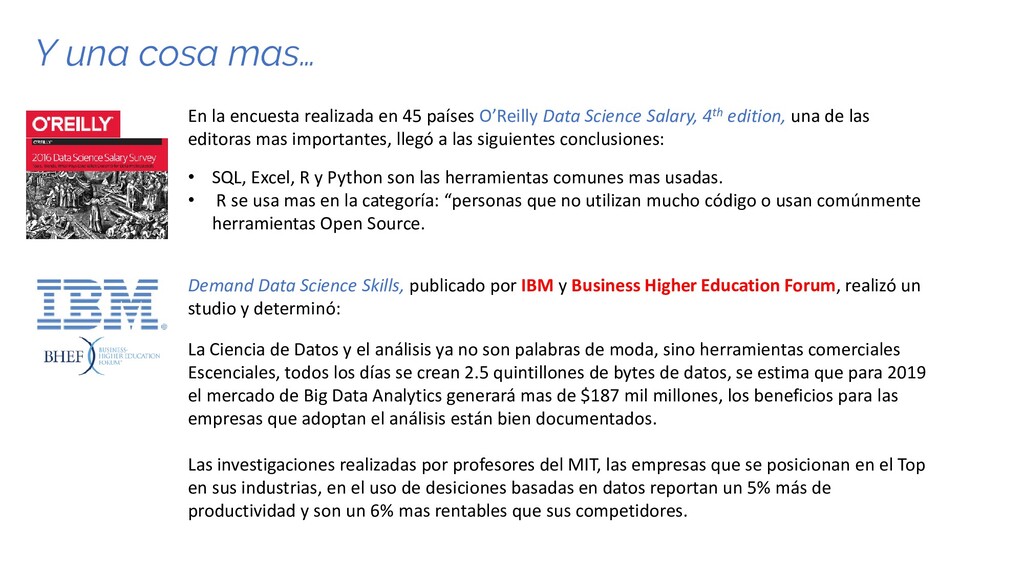
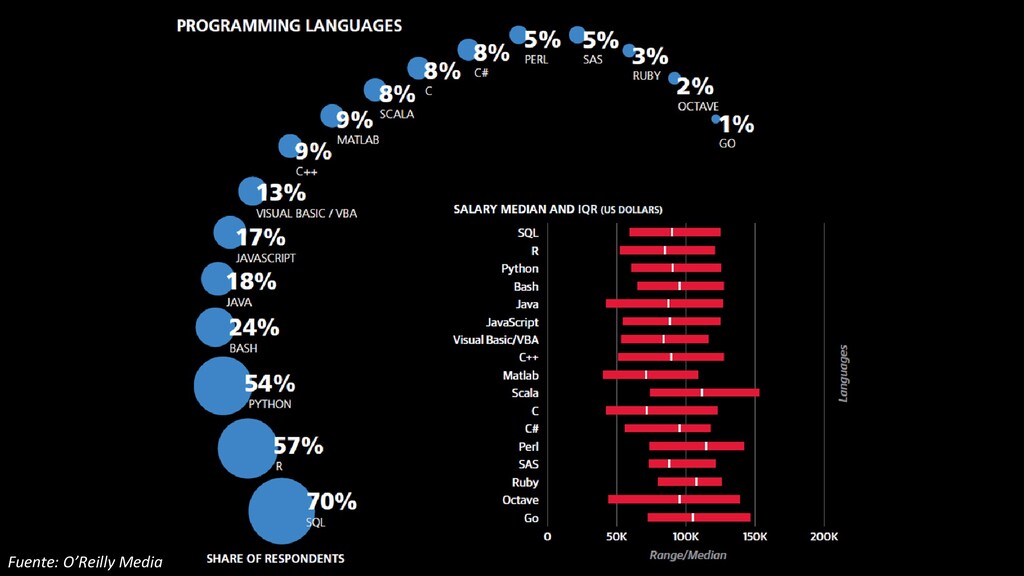
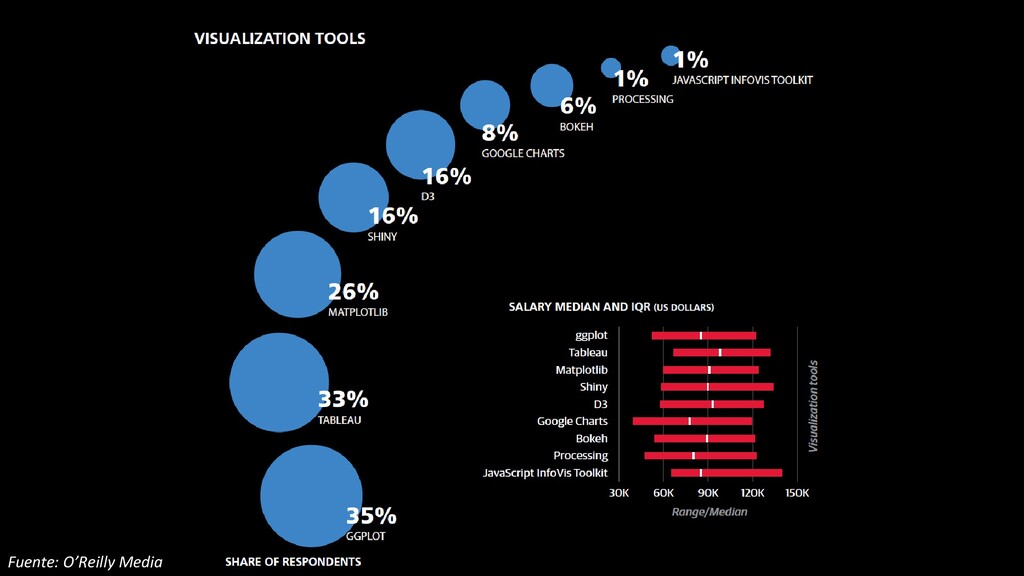
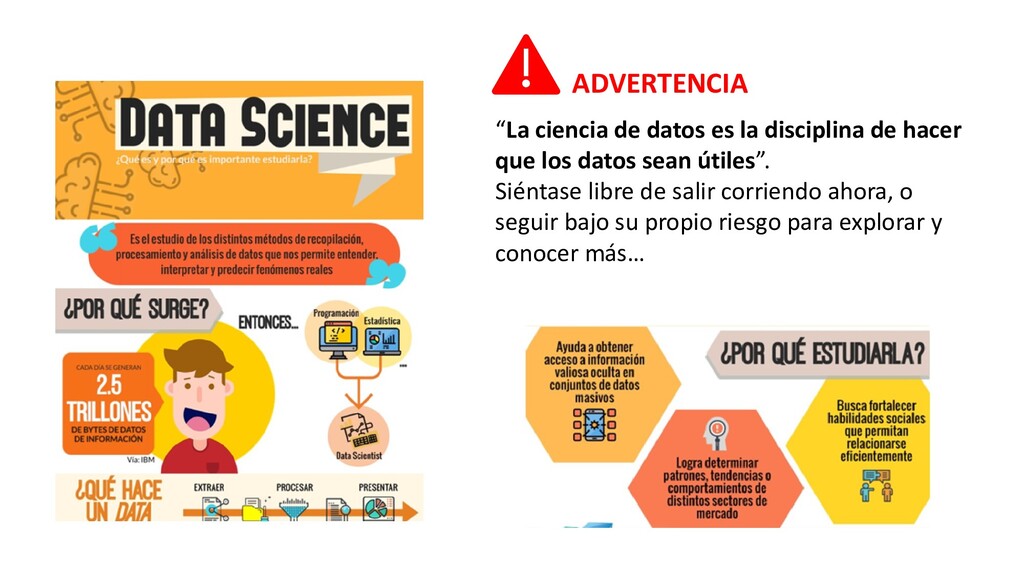
Salary, 4th edition, una de las editoras mas importantes, llegó a las siguientes conclusiones: • SQL, Excel, R y Python son las herramientas comunes mas usadas. • R se usa mas en la categoría: “personas que no utilizan mucho código o usan comúnmente herramientas Open Source. Y una cosa mas… Demand Data Science Skills, publicado por IBM y Business Higher Education Forum, realizó un studio y determinó: La Ciencia de Datos y el análisis ya no son palabras de moda, sino herramientas comerciales Escenciales, todos los días se crean 2.5 quintillones de bytes de datos, se estima que para 2019 el mercado de Big Data Analytics generará mas de $187 mil millones, los beneficios para las empresas que adoptan el análisis están bien documentados. Las investigaciones realizadas por profesores del MIT, las empresas que se posicionan en el Top en sus industrias, en el uso de desiciones basadas en datos reportan un 5% más de productividad y son un 6% mas rentables que sus competidores.
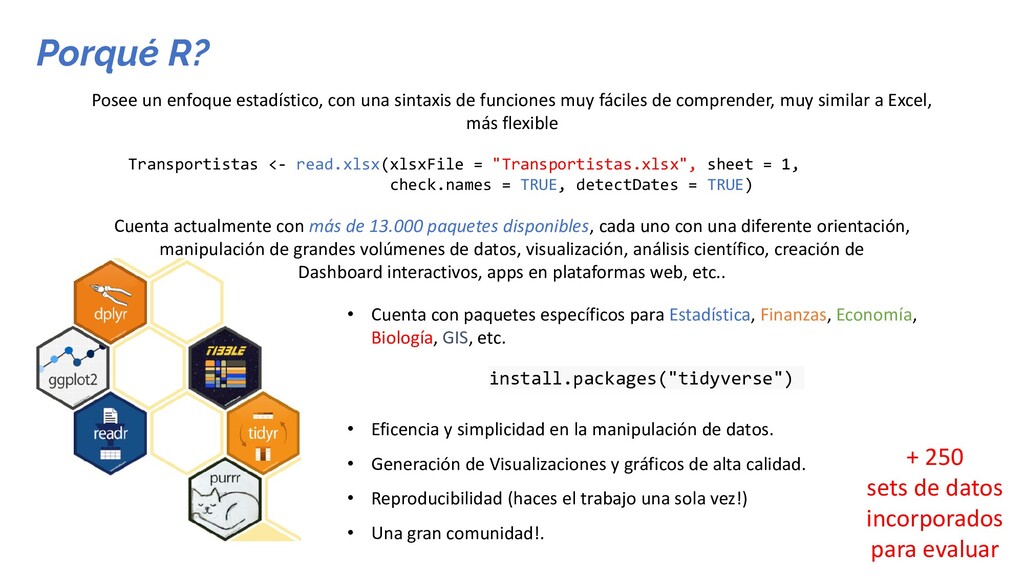
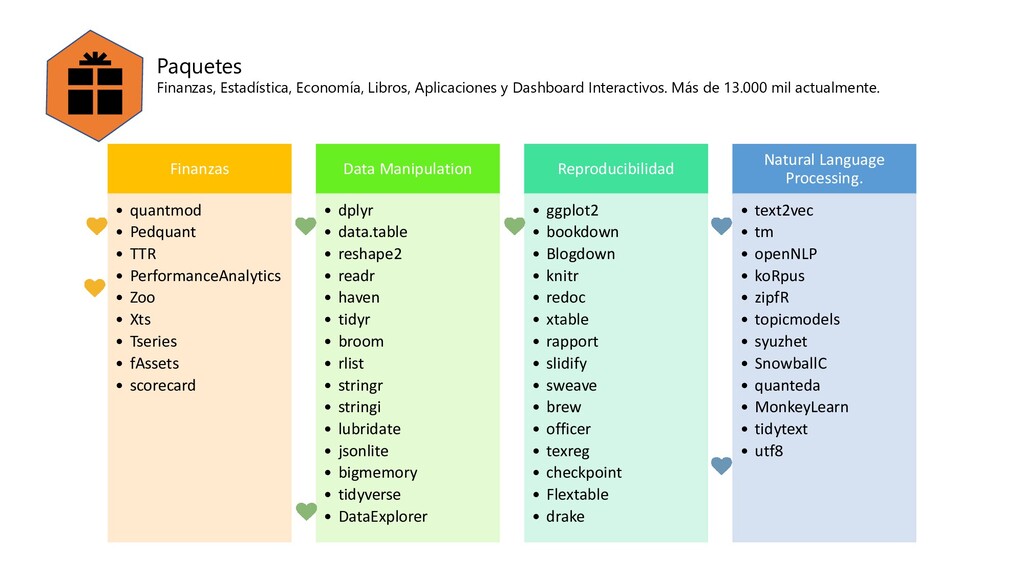
check.names = TRUE, detectDates = TRUE) Posee un enfoque estadístico, con una sintaxis de funciones muy fáciles de comprender, muy similar a Excel, más flexible Cuenta actualmente con más de 13.000 paquetes disponibles, cada uno con una diferente orientación, manipulación de grandes volúmenes de datos, visualización, análisis científico, creación de Dashboard interactivos, apps en plataformas web, etc.. • Cuenta con paquetes específicos para Estadística, Finanzas, Economía, Biología, GIS, etc. install.packages("tidyverse") • Eficencia y simplicidad en la manipulación de datos. • Generación de Visualizaciones y gráficos de alta calidad. • Reproducibilidad (haces el trabajo una sola vez!) • Una gran comunidad!. + 250 sets de datos incorporados para evaluar
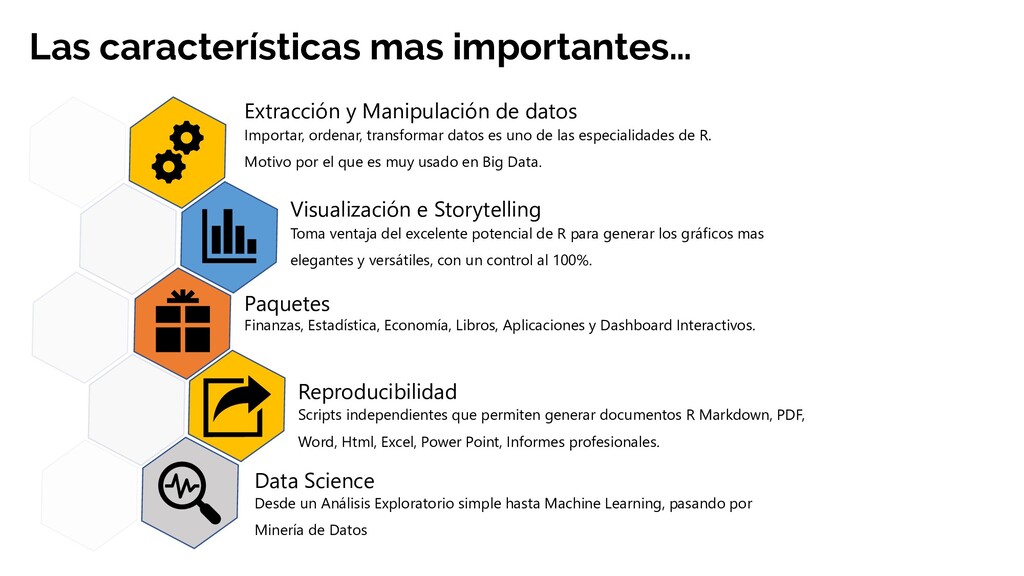
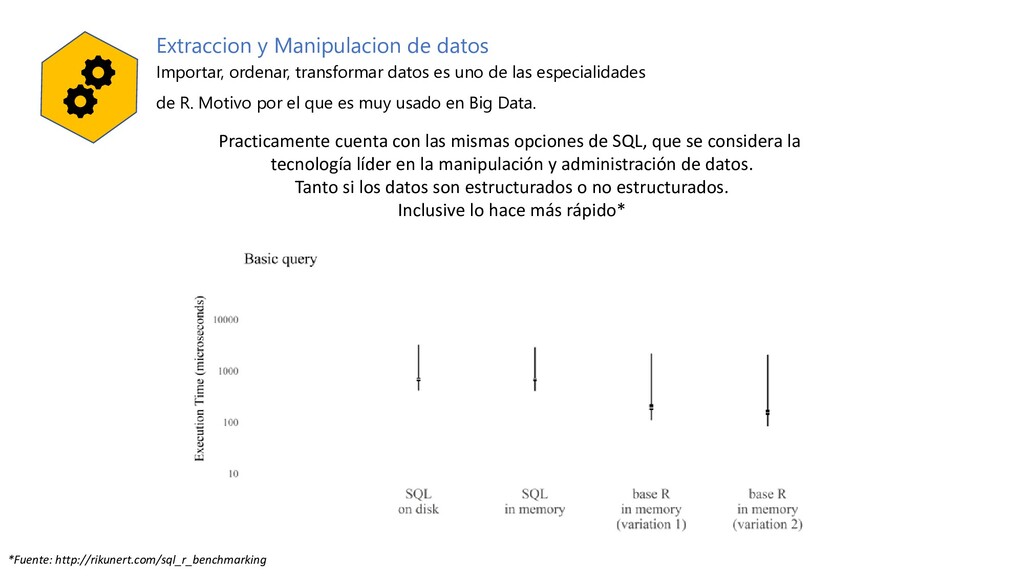
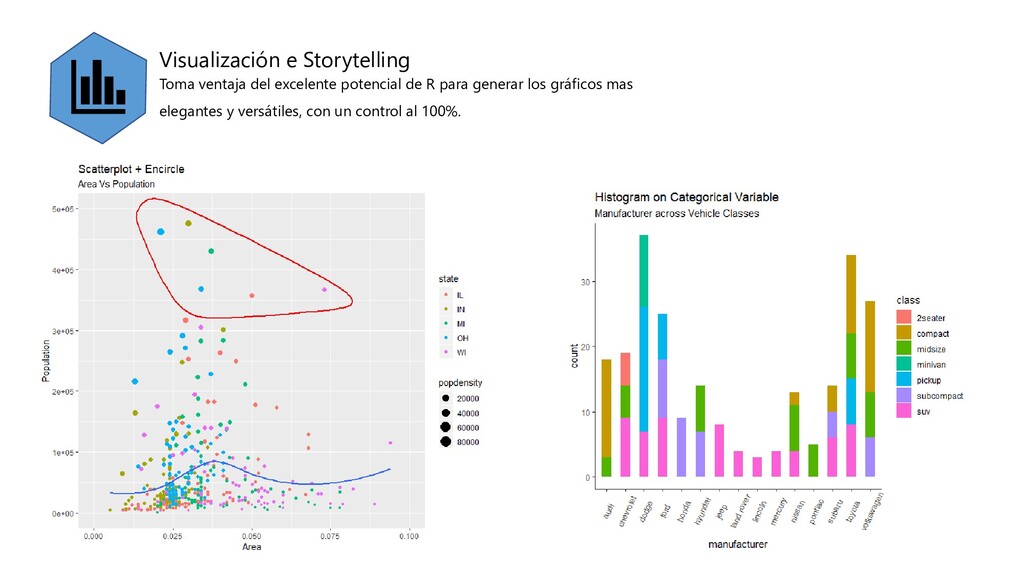
ordenar, transformar datos es uno de las especialidades de R. Motivo por el que es muy usado en Big Data. Paquetes Finanzas, Estadística, Economía, Libros, Aplicaciones y Dashboard Interactivos. Scripts independientes que permiten generar documentos R Markdown, PDF, Word, Html, Excel, Power Point, Informes profesionales. Reproducibilidad Visualización e Storytelling Toma ventaja del excelente potencial de R para generar los gráficos mas elegantes y versátiles, con un control al 100%. Data Science Desde un Análisis Exploratorio simple hasta Machine Learning, pasando por Minería de Datos
uno de las especialidades de R. Motivo por el que es muy usado en Big Data. Practicamente cuenta con las mismas opciones de SQL, que se considera la tecnología líder en la manipulación y administración de datos. Tanto si los datos son estructurados o no estructurados. Inclusive lo hace más rápido* *Fuente: http://rikunert.com/sql_r_benchmarking
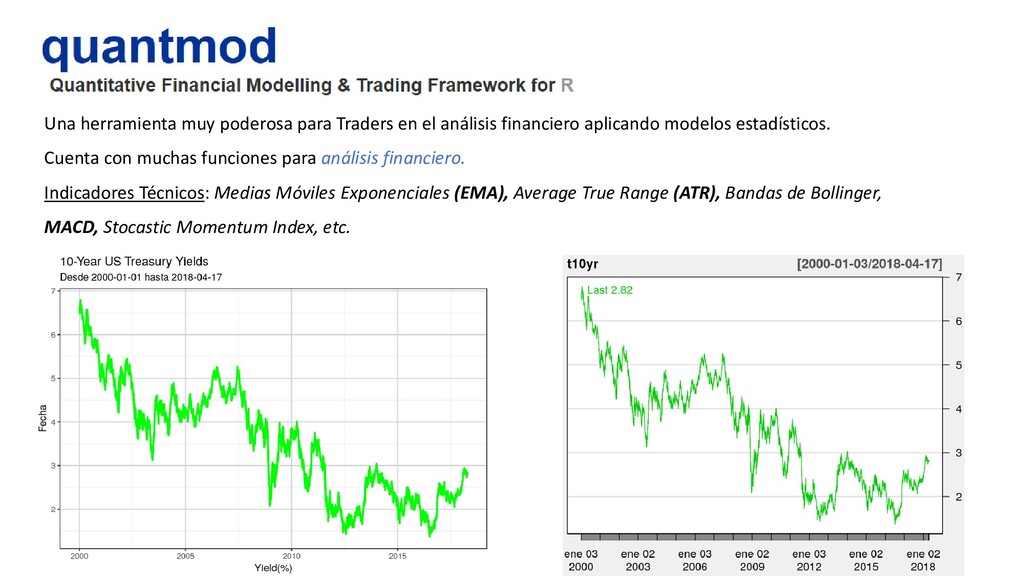
aplicando modelos estadísticos. Cuenta con muchas funciones para análisis financiero. Indicadores Técnicos: Medias Móviles Exponenciales (EMA), Average True Range (ATR), Bandas de Bollinger, MACD, Stocastic Momentum Index, etc.
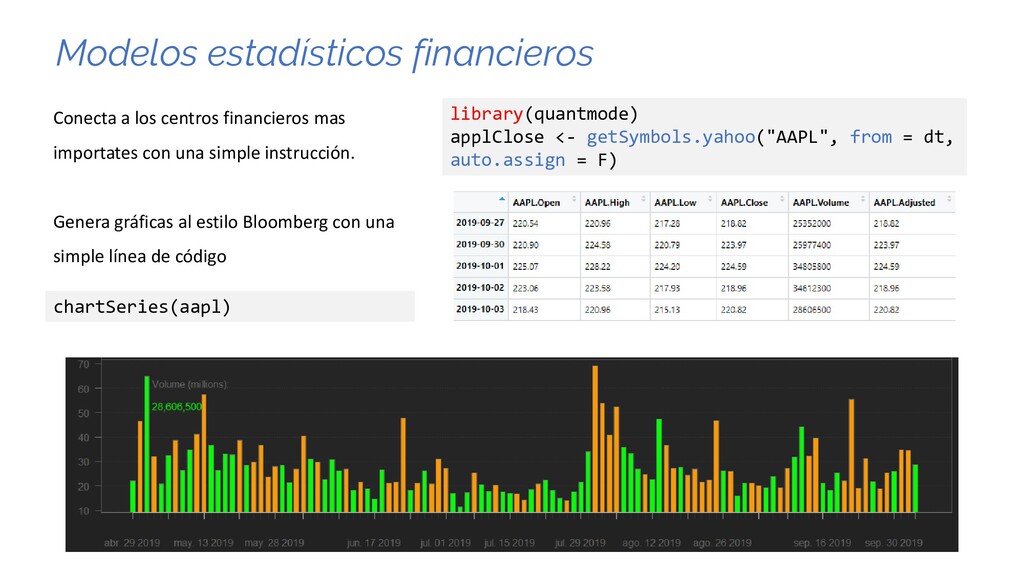
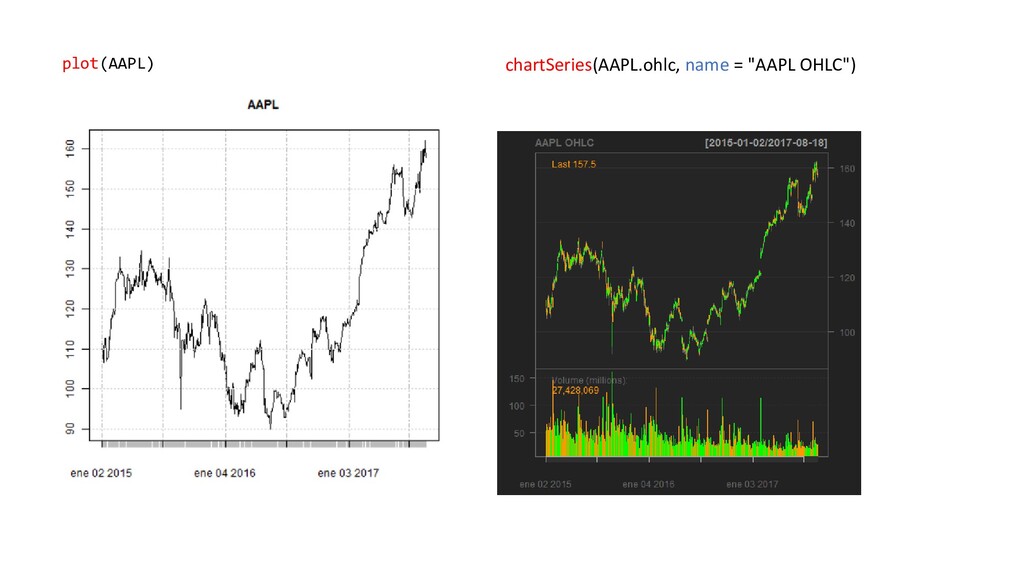
auto.assign = F) Conecta a los centros financieros mas importates con una simple instrucción. Genera gráficas al estilo Bloomberg con una simple línea de código chartSeries(aapl)
implementar modelos estadísticos financieros, también permite la extracción de datos financieros desde varias fuentes, Google Finance, Yahoo Finance, Federal Reserve Bank entre otras (mas de 11.000 mil series!). Tiene herramientas para realizar análisis técnico, cuenta con un motor para gráficos muy potente y muy fácil de usar al estilo Bloomberg o Reuters. ONTENER EL HISTORIAL DE PRECIOS DE LAS ACCIONES # Extracción de los datos de la acción de Apple, desde Google Finance AAPL <- getSymbols("AAPL", src="google", from = "2015-01-01", to = "2017-08-18", auto.assign = FALSE)
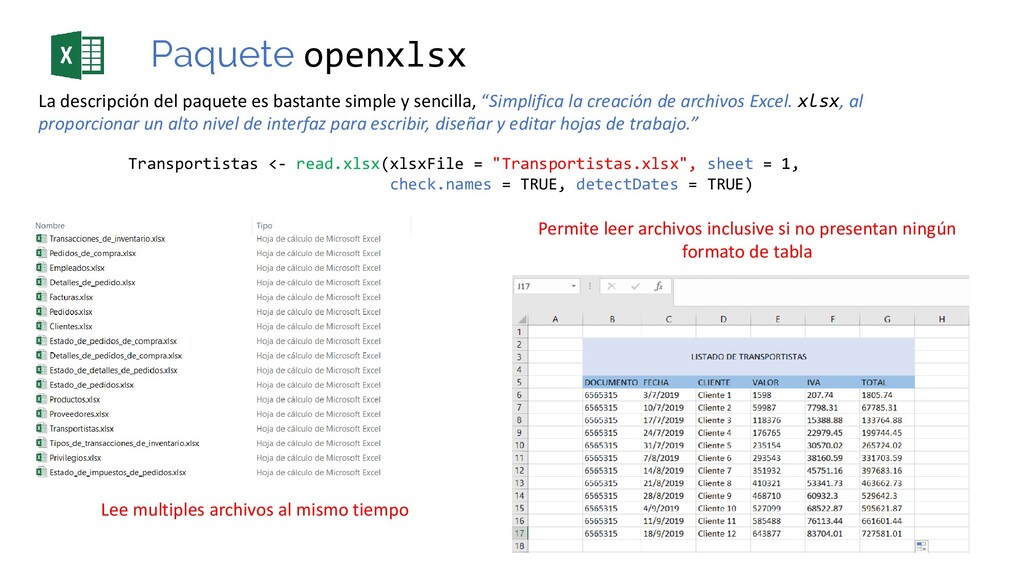
sencilla, “Simplifica la creación de archivos Excel. xlsx, al proporcionar un alto nivel de interfaz para escribir, diseñar y editar hojas de trabajo.” Transportistas <- read.xlsx(xlsxFile = "Transportistas.xlsx", sheet = 1, check.names = TRUE, detectDates = TRUE) Permite leer archivos inclusive si no presentan ningún formato de tabla Lee multiples archivos al mismo tiempo
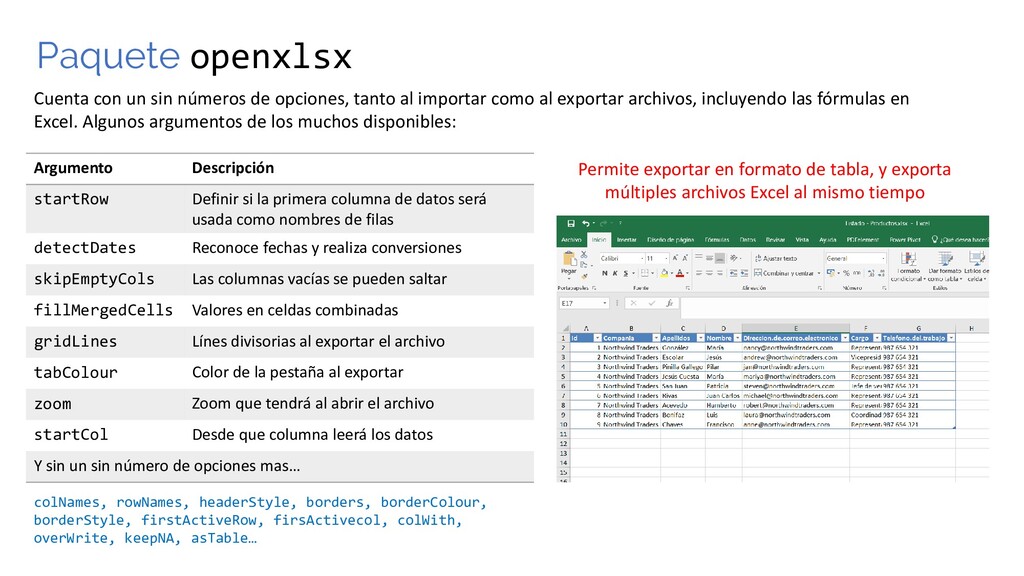
al importar como al exportar archivos, incluyendo las fórmulas en Excel. Algunos argumentos de los muchos disponibles: Argumento Descripción startRow Definir si la primera columna de datos será usada como nombres de filas detectDates Reconoce fechas y realiza conversiones skipEmptyCols Las columnas vacías se pueden saltar fillMergedCells Valores en celdas combinadas gridLines Línes divisorias al exportar el archivo tabColour Color de la pestaña al exportar zoom Zoom que tendrá al abrir el archivo startCol Desde que columna leerá los datos Y sin un sin número de opciones mas… Permite exportar en formato de tabla, y exporta múltiples archivos Excel al mismo tiempo colNames, rowNames, headerStyle, borders, borderColour, borderStyle, firstActiveRow, firsActivecol, colWith, overWrite, keepNA, asTable…
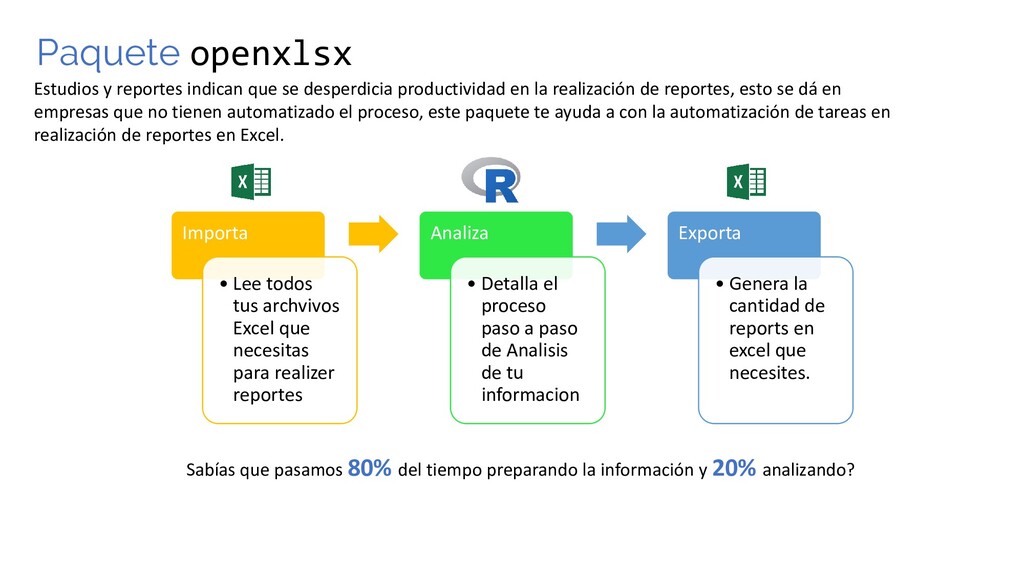
en la realización de reportes, esto se dá en empresas que no tienen automatizado el proceso, este paquete te ayuda a con la automatización de tareas en realización de reportes en Excel. Importa • Lee todos tus archvivos Excel que necesitas para realizer reportes Analiza • Detalla el proceso paso a paso de Analisis de tu informacion Exporta • Genera la cantidad de reports en excel que necesites. Sabías que pasamos 80% del tiempo preparando la información y 20% analizando?
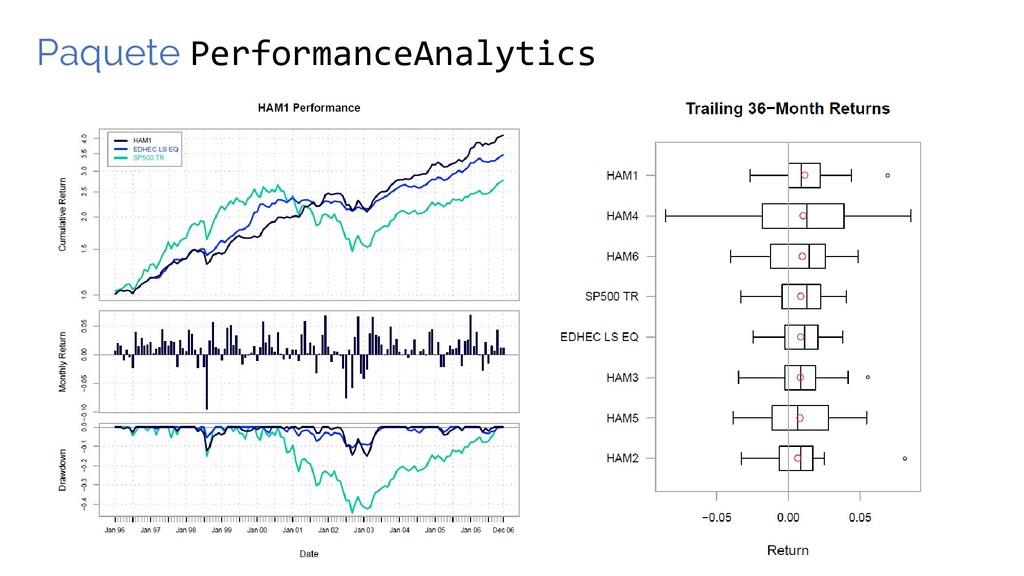
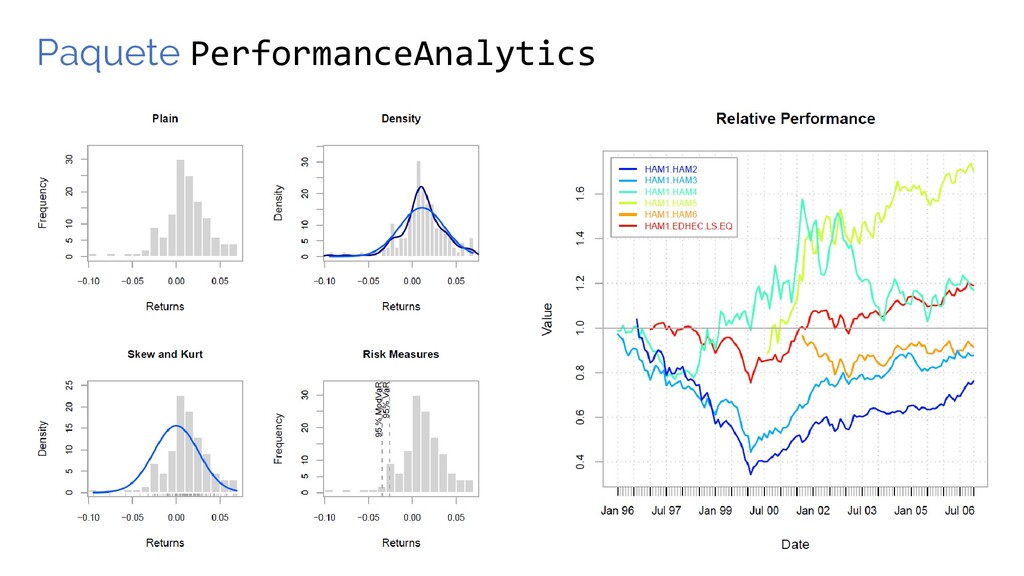
(con tratamiento separado de VaR, tablas de resúmenes de estadísticas relacionadas, cuadros gráficos y una variedad de funciones • Time Series Data • Performance Analysis • Style Analysis • Risk Analysis • Value at Risk – VaR • Moments and Co-moments • Robust Data Cleaning • Charts and Graphs
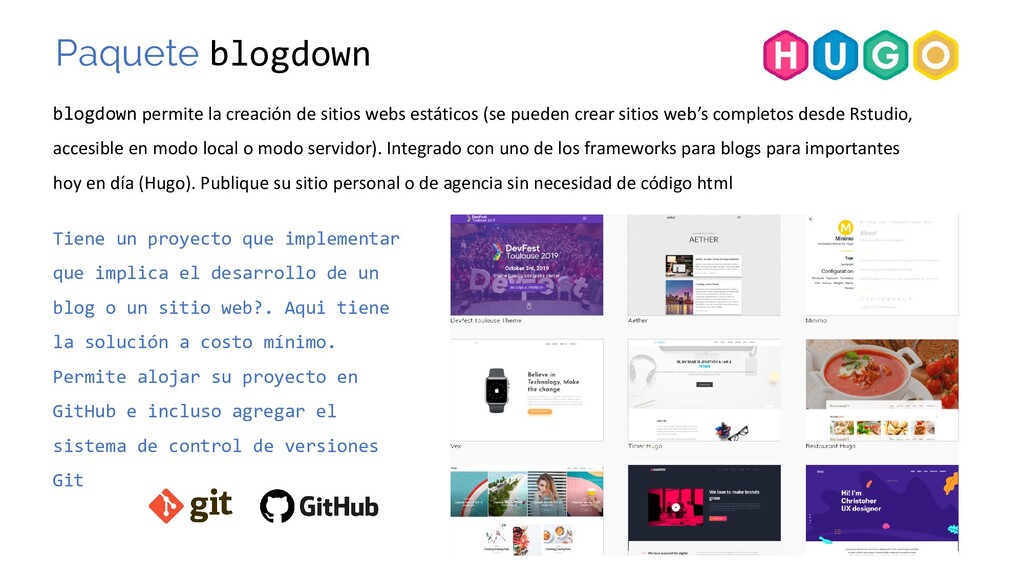
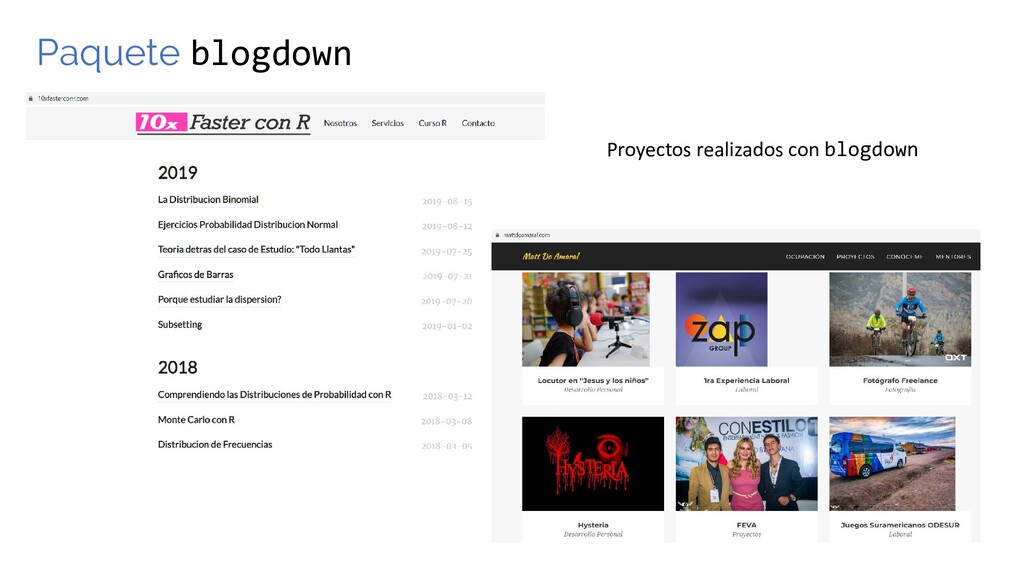
(se pueden crear sitios web’s completos desde Rstudio, accesible en modo local o modo servidor). Integrado con uno de los frameworks para blogs para importantes hoy en día (Hugo). Publique su sitio personal o de agencia sin necesidad de código html Tiene un proyecto que implementar que implica el desarrollo de un blog o un sitio web?. Aqui tiene la solución a costo mínimo. Permite alojar su proyecto en GitHub e incluso agregar el sistema de control de versiones Git
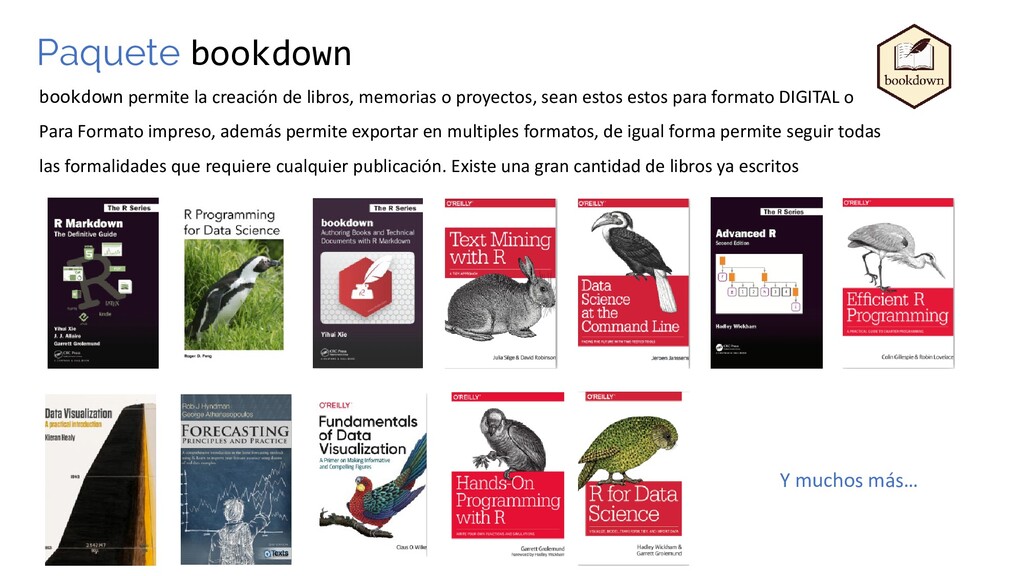
proyectos, sean estos estos para formato DIGITAL o Para Formato impreso, además permite exportar en multiples formatos, de igual forma permite seguir todas las formalidades que requiere cualquier publicación. Existe una gran cantidad de libros ya escritos Y muchos más…
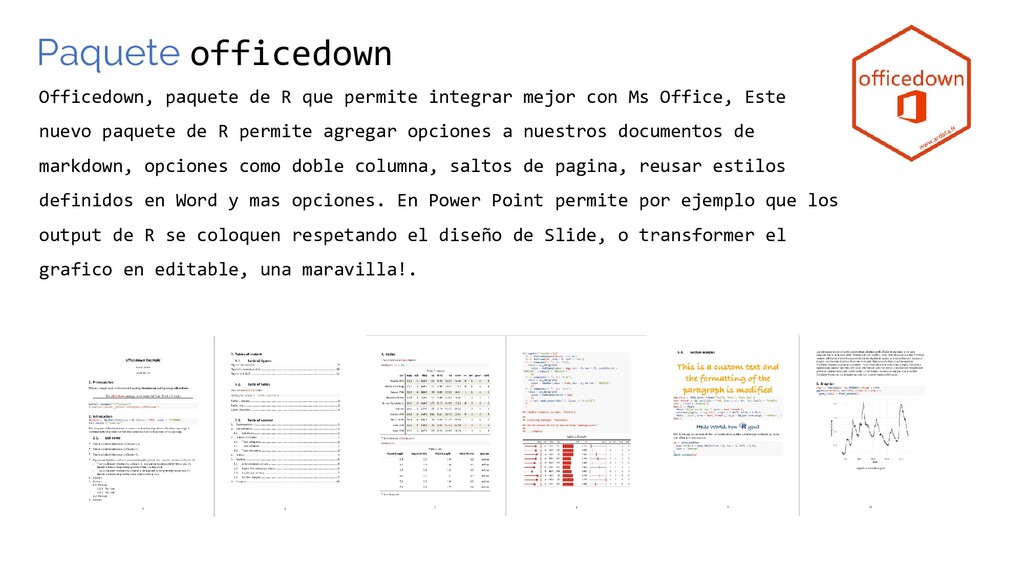
con Ms Office, Este nuevo paquete de R permite agregar opciones a nuestros documentos de markdown, opciones como doble columna, saltos de pagina, reusar estilos definidos en Word y mas opciones. En Power Point permite por ejemplo que los output de R se coloquen respetando el diseño de Slide, o transformer el grafico en editable, una maravilla!.
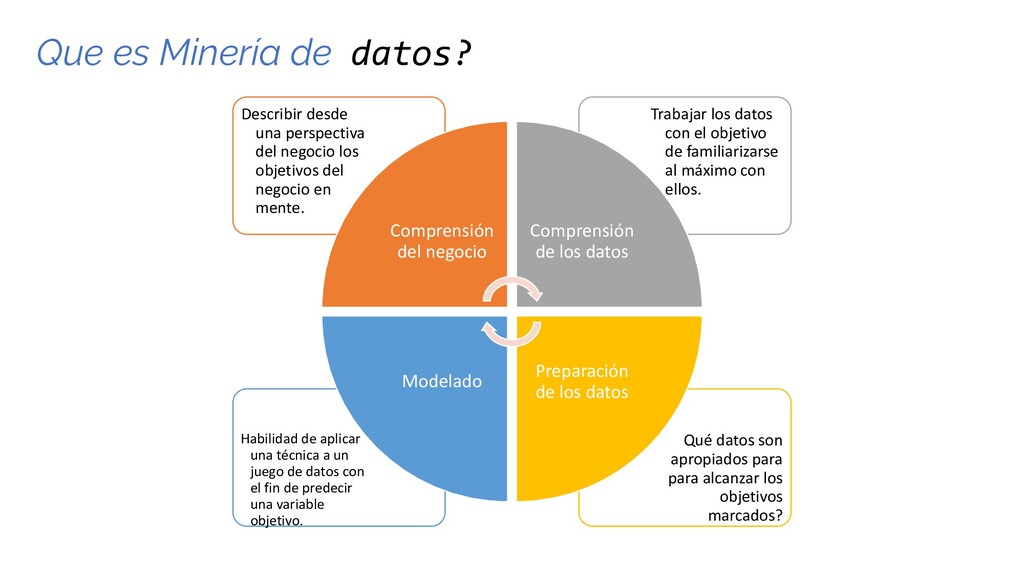
para alcanzar los objetivos marcados? Habilidad de aplicar una técnica a un juego de datos con el fin de predecir una variable objetivo. Trabajar los datos con el objetivo de familiarizarse al máximo con ellos. Describir desde una perspectiva del negocio los objetivos del negocio en mente. Comprensión del negocio Comprensión de los datos Preparación de los datos Modelado
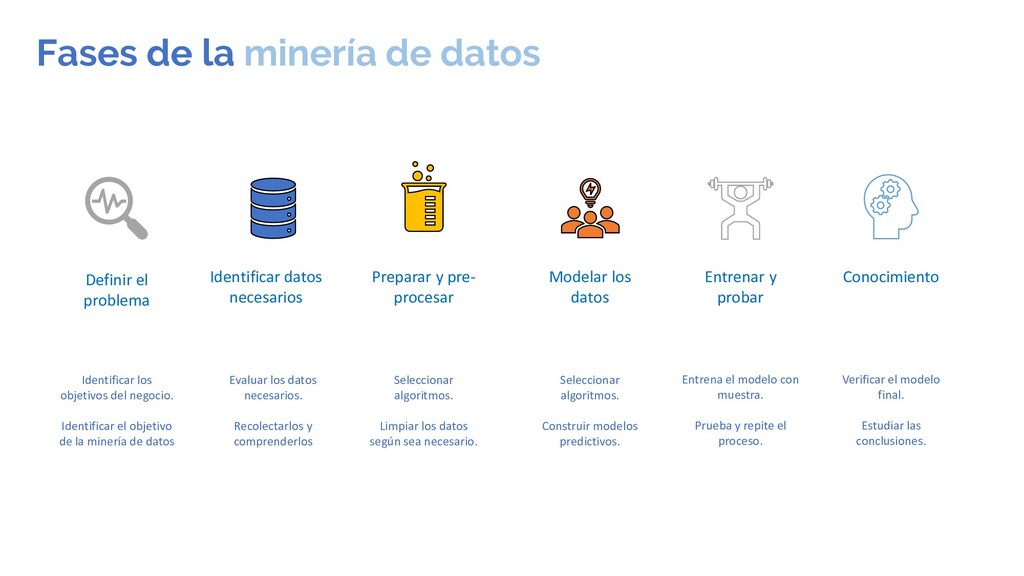
Modelar los datos Entrenar y probar Conocimiento Identificar los objetivos del negocio. Identificar el objetivo de la minería de datos Evaluar los datos necesarios. Recolectarlos y comprenderlos Seleccionar algoritmos. Limpiar los datos según sea necesario. Seleccionar algoritmos. Construir modelos predictivos. Entrena el modelo con muestra. Prueba y repite el proceso. Verificar el modelo final. Estudiar las conclusiones. Fases de la minería de datos
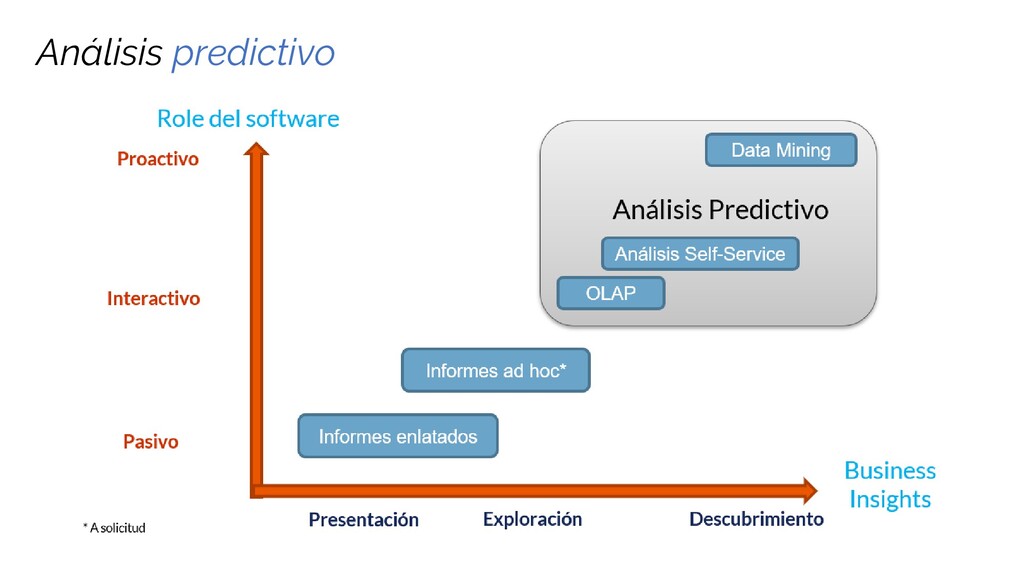
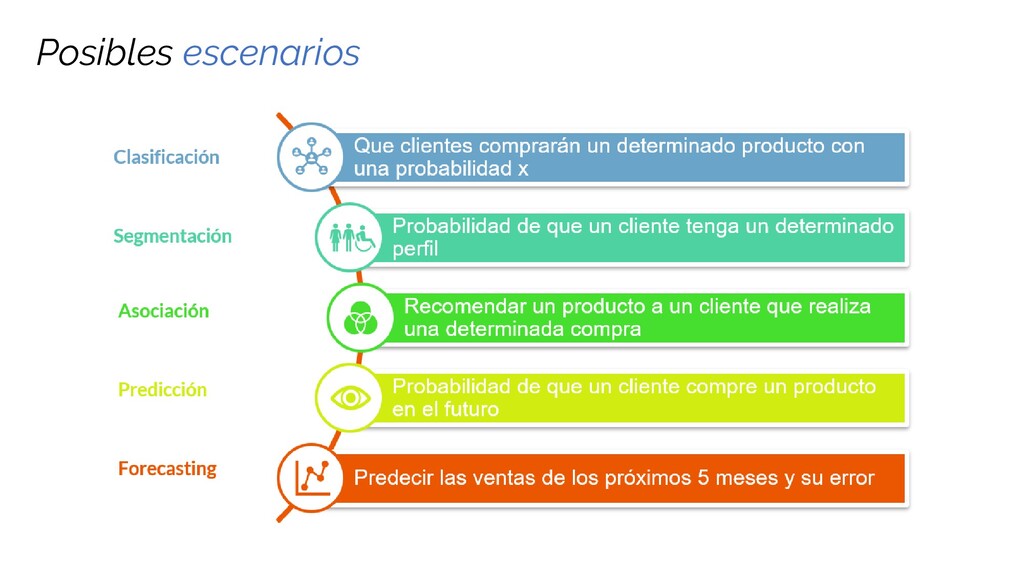
Data Mining • Extracción y análisis de información oculta y predecible de grandes bases de datos, mediante la identificación de modelos, patrones y relaciones. • Predecir los comportamientos y futuras compras de un cliente, realizando comparaciones con clientes del mismo perfil. • Qué productos tienden a venderse con otros? • A que grupo de clientes debo lanzar una campaña específica?.
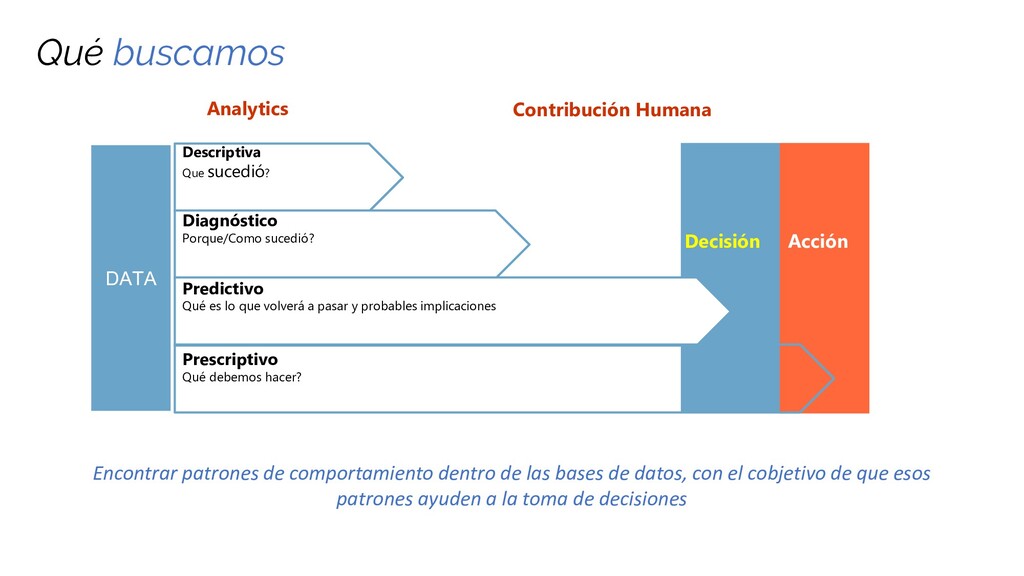
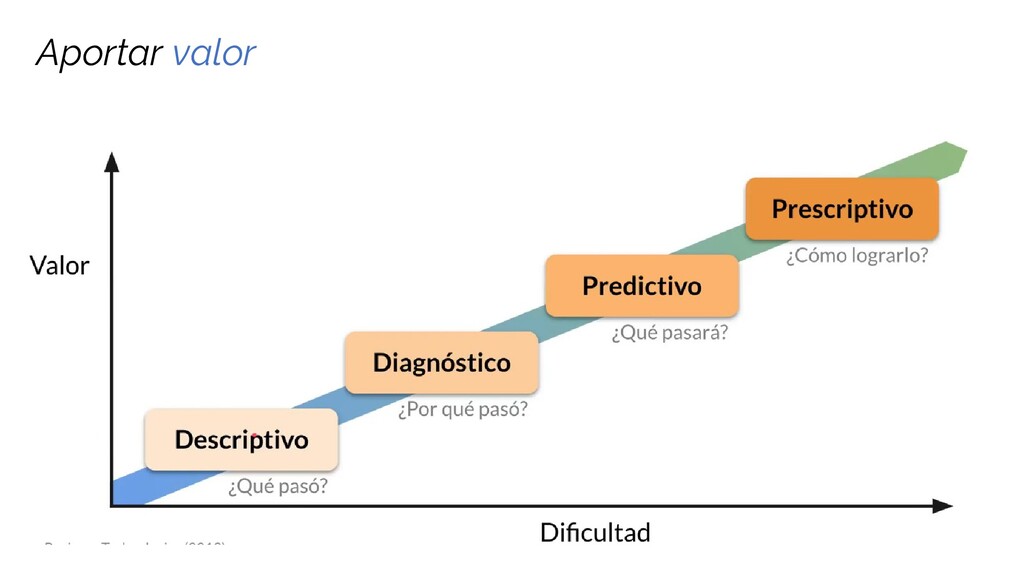
Qué es lo que volverá a pasar y probables implicaciones Contribución Humana Decisión Acción Prescriptivo Qué debemos hacer? Qué buscamos Encontrar patrones de comportamiento dentro de las bases de datos, con el cobjetivo de que esos patrones ayuden a la toma de decisiones
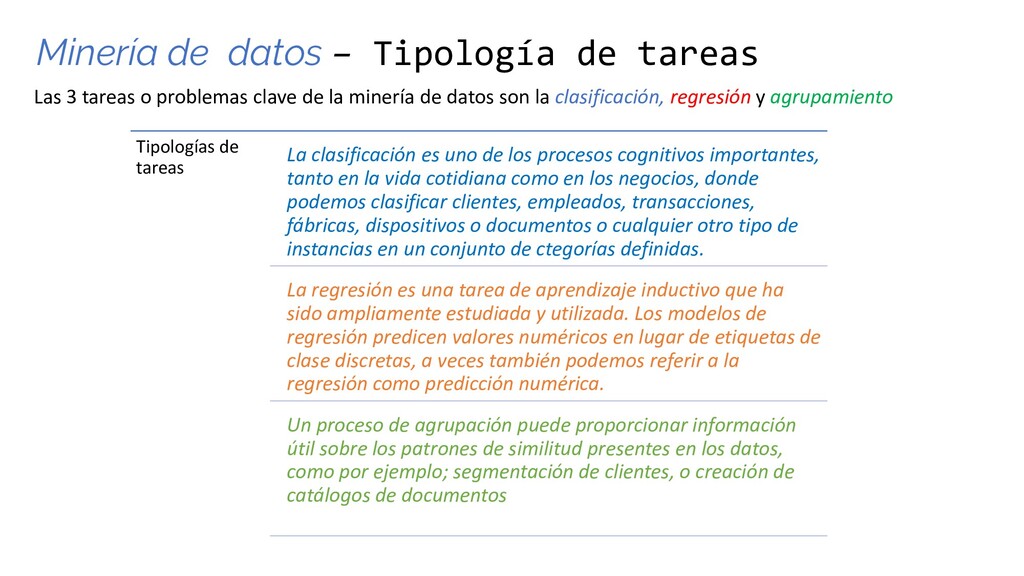
o problemas clave de la minería de datos son la clasificación, regresión y agrupamiento Tipologías de tareas La clasificación es uno de los procesos cognitivos importantes, tanto en la vida cotidiana como en los negocios, donde podemos clasificar clientes, empleados, transacciones, fábricas, dispositivos o documentos o cualquier otro tipo de instancias en un conjunto de ctegorías definidas. La regresión es una tarea de aprendizaje inductivo que ha sido ampliamente estudiada y utilizada. Los modelos de regresión predicen valores numéricos en lugar de etiquetas de clase discretas, a veces también podemos referir a la regresión como predicción numérica. Un proceso de agrupación puede proporcionar información útil sobre los patrones de similitud presentes en los datos, como por ejemplo; segmentación de clientes, o creación de catálogos de documentos
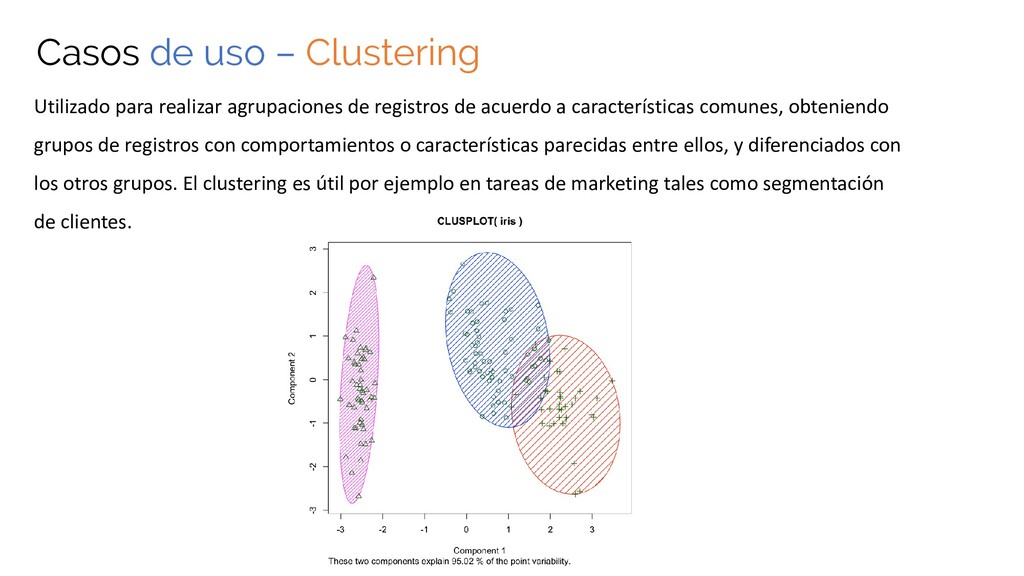
registros de acuerdo a características comunes, obteniendo grupos de registros con comportamientos o características parecidas entre ellos, y diferenciados con los otros grupos. El clustering es útil por ejemplo en tareas de marketing tales como segmentación de clientes.
Porque al tener información previa sobre nuestros posibles clientes, podemos definir acciones o estrategias que nos aproximen lo mas cerca posible a nuestros objetivos. Data Science es una cultura en la organización, no es una tecnología o un análisis. El saludar de forma personalizada, nos permitió conectar con nuestro publico. Sui hubiéramos disgregado por genero, por profesión...
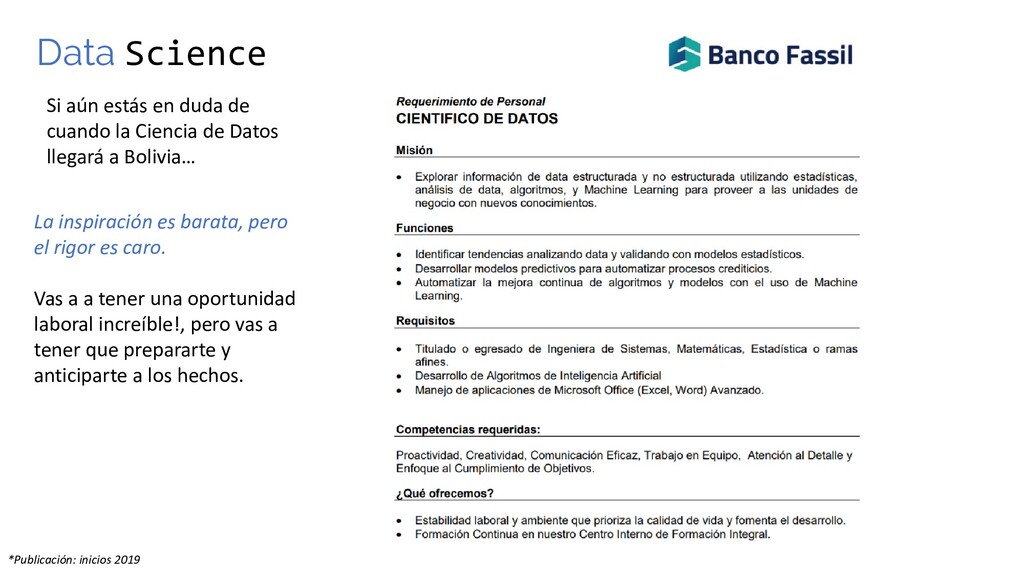
Ciencia de Datos llegará a Bolivia… *Publicación: inicios 2019 La inspiración es barata, pero el rigor es caro. Vas a a tener una oportunidad laboral increíble!, pero vas a tener que prepararte y anticiparte a los hechos.

 Your Podcast. Everywhere. Effortlessly.


 sasukefinanciallab
 synergymarketing
 noritaka88tax
 nakahara
 kamadamakoto
 uemura2024
 kaonavi
 tamosan01
 caddireat
 infcurion
 pokotyamu
 c0rp_mdm
 lemiorhan
 skoyamalab
 gurzu
 davidcarrasco
 geoffreycrofte
 gr2m
 marcduiker
 smashingmag
 inesmontani
 danielanewman
 katarinadahlin
 kevinliebholz