Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Reinforcement Learning Second edition - Notes o...
Search
Etsuji Nakai
November 30, 2019
Technology
230
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Reinforcement Learning Second edition - Notes on Chapter 5
Etsuji Nakai
November 30, 2019
More Decks by Etsuji Nakai
See All by Etsuji Nakai
強化学習「理論」入門
enakai00
5
4.3k
生成 AI の基礎 〜 サンプル実装で学ぶ基本原理
enakai00
7
4.8k
機械学習理論入門
enakai00
1
84
ディープラーニング入門
enakai00
0
51
ハミルトン・ヤコビ方程式の解の性質と物理的意味
enakai00
0
970
Agent Development Kit によるエージェント開発入門
enakai00
23
9.4k
GDG Tokyo 生成 AI 論文をわいわい読む会
enakai00
1
730
量子コンピューティングの開発課題と実用化へのロードマップ
enakai00
1
86
Lecture course on Microservices : Part 1
enakai00
1
3.9k
Other Decks in Technology
See All in Technology
日本語に強いオープンな大規模言語モデル「LLM-jp」
odashi
5
1.2k
Post AI時代のリファクタリング実践記 / Refactoring in the post AI era
kaminashi
1
320
AI × アーキテクト 第1・2章|生成AIの課題とアーキテクトの素養
daidaidai
1
230
ソフトウェア ファクトリー - 再現性のあるソフトウェアの工場づくり / Software factory
iktakahiro
7
5.3k
dbt Semantic Layerで進めるenechainのデータ民主化
akizhou
1
210
Metadata - Section 2: Simple Metadata & Meta Tags
mohab1
0
110
freeeにおける AI を用いた ブラウザ動作確認の自動化の取り組み
freee
PRO
0
130
「エーアイ」をバズワードにしないために RPA 導入経験と Kiro 上での Claude モデル利用経験から
kazzpapa3
0
110
Tofu-Controller lightning talk @ Containerday 2026
gionn
0
180
DBについての基礎説明(MySQL編) - コロプラ 2026年度 新卒研修
colopl
0
160
Gemini Intelligence 入門 ― AppFunctions と Gemini Nano
takuroabe
0
350
野蛮なアジャイル [サイボウズ発!]組織の常識を覆した反骨のスクラム実践記 / Barbaric Agile - Enterprise Agile Study Group
ama_ch
0
120
Featured
See All Featured
Code Reviewing Like a Champion
maltzj
529
40k
The Anti-SEO Checklist Checklist. Pubcon Cyber Week
ryanjones
0
270
Building AI with AI
inesmontani
PRO
1
1.3k
Leveraging LLMs for student feedback in introductory data science courses - posit::conf(2025)
minecr
1
450
[Rails World 2023 - Day 1 Closing Keynote] - The Magic of Rails
eileencodes
38
3.1k
Practical Tips for Bootstrapping Information Extraction Pipelines
honnibal
25
2.1k
Highjacked: Video Game Concept Design
rkendrick25
PRO
1
490
Evolving SEO for Evolving Search Engines
ryanjones
0
330
How to Ace a Technical Interview
jacobian
280
24k
10 Git Anti Patterns You Should be Aware of
lemiorhan
PRO
659
62k
More Than Pixels: Becoming A User Experience Designer
marktimemedia
3
570
Large-scale JavaScript Application Architecture
addyosmani
516
110k
Transcript
Reinforcement Learning Second edition - Notes on Chapter 5 Etsuji
Nakai (@enakai00)
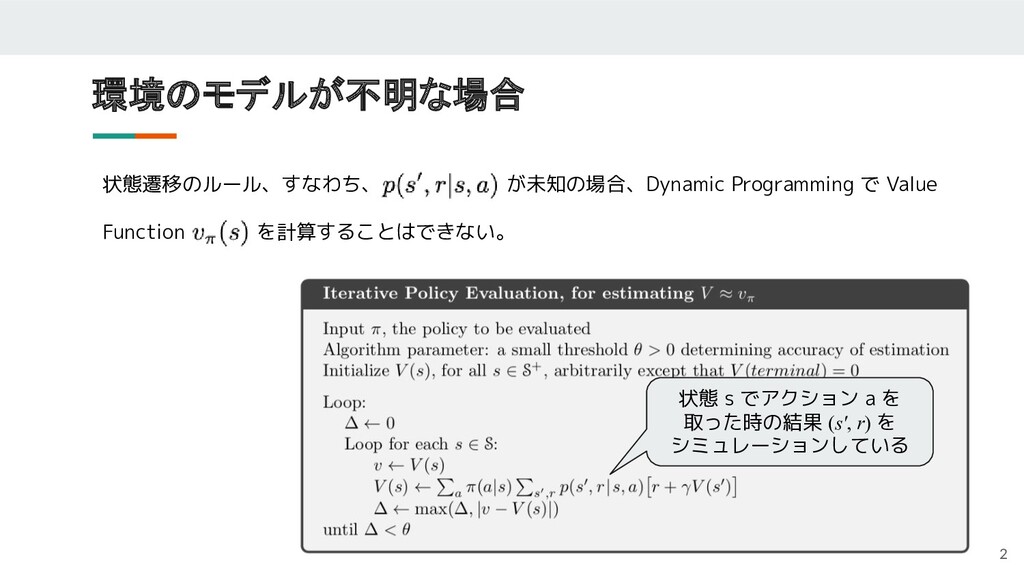
環境のモデルが不明な場合 2 状態遷移のルール、すなわち、 が未知の場合、Dynamic Programming で Value Function を計算することはできない。 状態
s でアクション a を 取った時の結果 (s', r) を シミュレーションしている
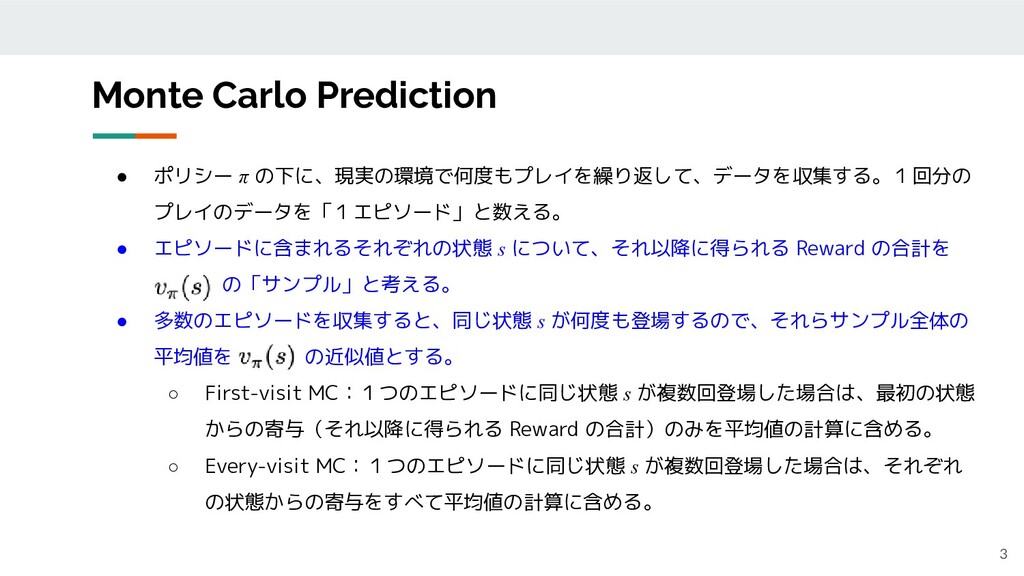
• ポリシー π の下に、現実の環境で何度もプレイを繰り返して、データを収集する。1回分の プレイのデータを「1エピソード」と数える。 • エピソードに含まれるそれぞれの状態 s について、それ以降に得られる Reward
の合計を の「サンプル」と考える。 • 多数のエピソードを収集すると、同じ状態 s が何度も登場するので、それらサンプル全体の 平均値を の近似値とする。 ◦ First-visit MC:1つのエピソードに同じ状態 s が複数回登場した場合は、最初の状態 からの寄与(それ以降に得られる Reward の合計)のみを平均値の計算に含める。 ◦ Every-visit MC:1つのエピソードに同じ状態 s が複数回登場した場合は、それぞれ の状態からの寄与をすべて平均値の計算に含める。 Monte Carlo Prediction 3
Monte Carlo Prediction 4 この条件を除くと Every-visit MC になる。
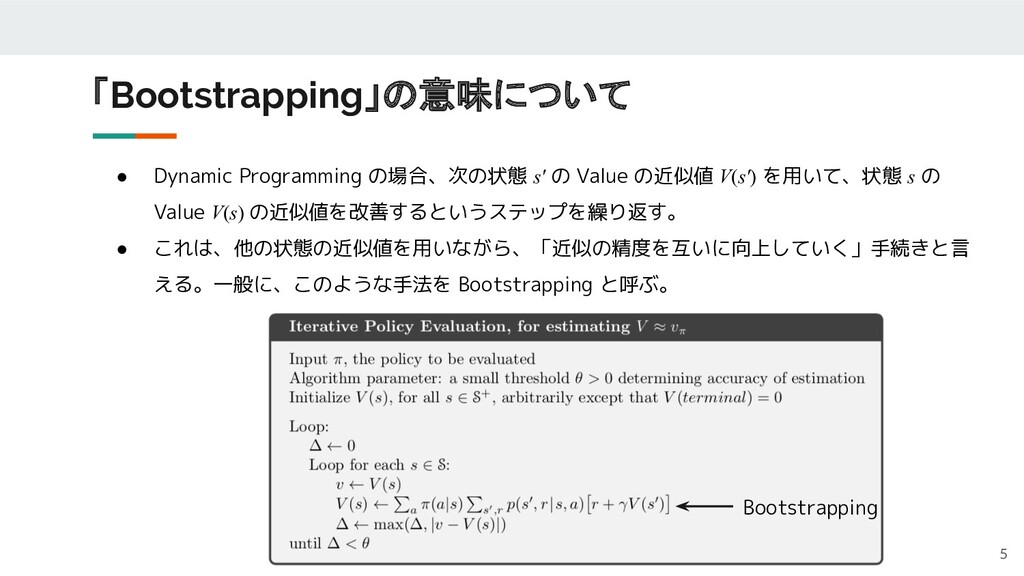
「Bootstrapping」の意味について 5 • Dynamic Programming の場合、次の状態 s' の Value の近似値
V(s') を用いて、状態 s の Value V(s) の近似値を改善するというステップを繰り返す。 • これは、他の状態の近似値を用いながら、「近似の精度を互いに向上していく」手続きと言 える。一般に、このような手法を Bootstrapping と呼ぶ。 Bootstrapping
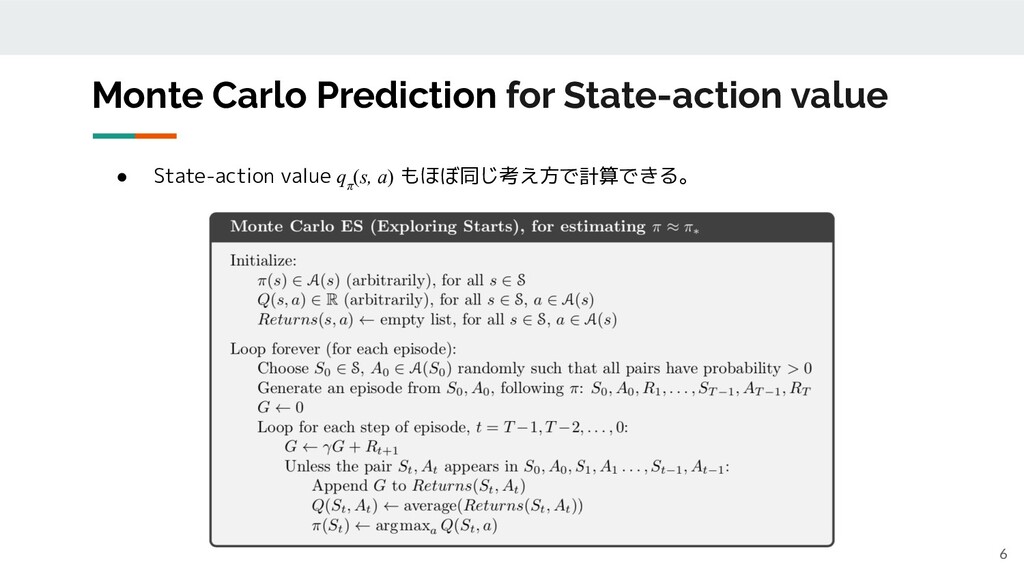
Monte Carlo Prediction for State-action value 6 • State-action value
q π (s, a) もほぼ同じ考え方で計算できる。
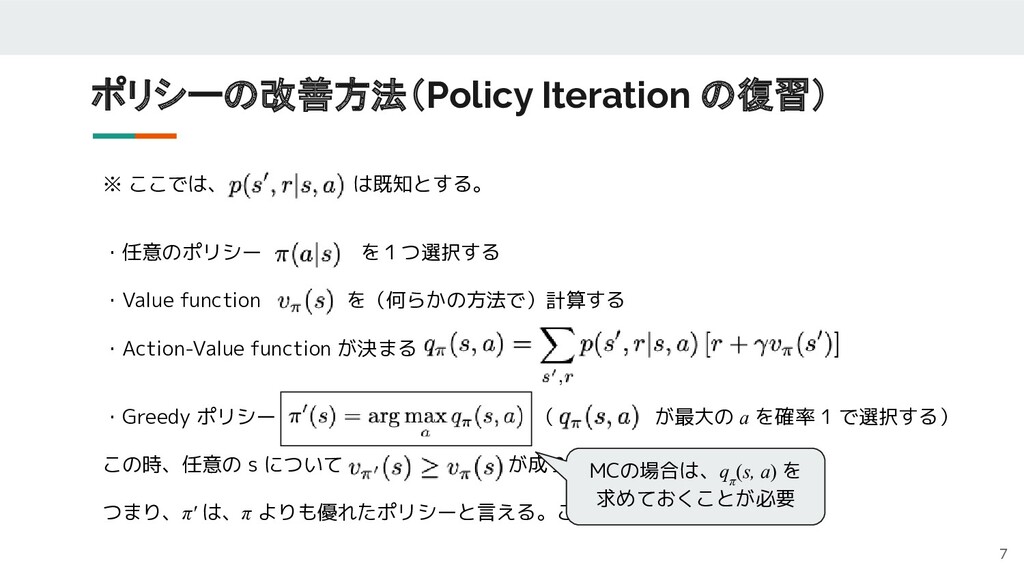
ポリシーの改善方法(Policy Iteration の復習) 7 ※ ここでは、 は既知とする。 ・任意のポリシー を1つ選択する ・Value function
を(何らかの方法で)計算する ・Action-Value function が決まる ・Greedy ポリシー ( が最大の a を確率 1 で選択する) この時、任意の s について が成り立つ。 つまり、π' は、π よりも優れたポリシーと言える。この改善処理を繰り返す。 MCの場合は、q π (s, a) を 求めておくことが必要
Monte Carlo Control(MC でのポリシー改善方法) 8 • 素朴に考えると、次の2つの方法が思いつく。 ◦ Policy Iteration:ポリシー
π の下に「十分な数のエピソード」をサンプリングして、 「十分に正確」と信じられる q π (s, a) を決定。その後、q π (s, a) に基づく Greedy Policy でポリシーを改善する。 ◦ Value Iteration:新しいエピソードを1つ追加して q(s, a) を更新した直後に、状態 s に対応するポリシーを q(s, a) に基づく Greedy Policy で改善する。 • 問題点:Greedy Policy を採用すると、その Policy では到達しない状態のサンプルが得られ なくなり、q(s, a) の近似精度がものすごく悪くなる。
Monte Carlo Control(MC でのポリシー改善方法) 9 • 改善案:Greedy Policy ではなく、ε-greedy policy
を採用する。 ◦ ほんとにこれでOK・・・・? • ポリシー改善の根本原理は、「 q π (s, a) に基づいた Greedy Policy は π よりも優れた Policy である」という基本定理。ε-greedy policy を採用すると、真にベストなポリシーに到達でき る保証がなくなる。 • これを解決するのが、次に説明する「Off-policy Prediction via Importance Sampling」の テクニック。
Off-policy prediction 10 • ポリシー b (behavior policy)の下に取集したエピソードを用いて、ポリシー π (target
plicy)に対する Action-value function q π (s, a) を計算するテクニック。 • あるエピソードに含まれる状態 s について、「それ以降の状態遷移全体がポリシー π の下に 得られる確率」の重みをかけて、Reward の平均値を計算する。 ◦ 「ポリシー b の下に得られる確率」=「ポリシー π の下に得られる確率」の時に、 ちょうど「重み ρ = 1」となるように設計 ⇨ Importance Sampling
Importance Sampling 11 • ポリシー π の下に状態遷移 が発生する確率 • ポリシー b
についても同様なので、確率の比率(平均値を計算する時の重み)は、
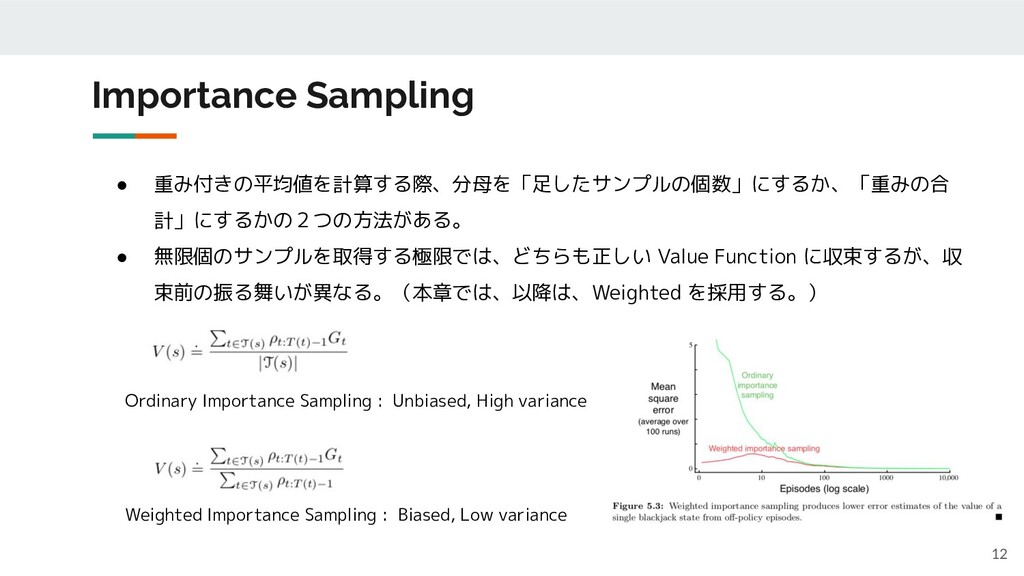
Importance Sampling 12 • 重み付きの平均値を計算する際、分母を「足したサンプルの個数」にするか、「重みの合 計」にするかの2つの方法がある。 • 無限個のサンプルを取得する極限では、どちらも正しい Value Function
に収束するが、収 束前の振る舞いが異なる。(本章では、以降は、Weighted を採用する。) Ordinary Importance Sampling : Unbiased, High variance Weighted Importance Sampling : Biased, Low variance
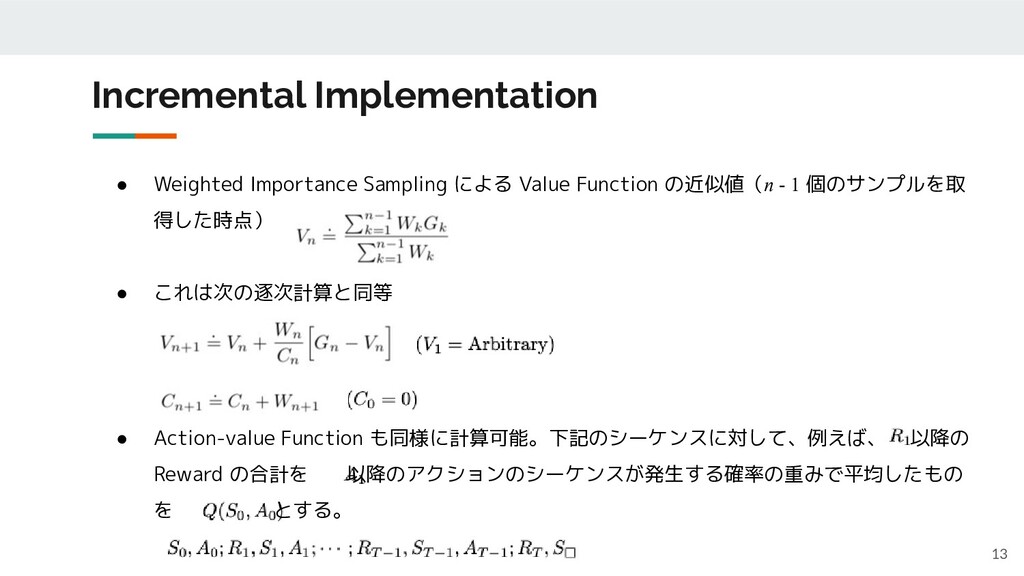
Incremental Implementation 13 • Weighted Importance Sampling による Value Function
の近似値(n - 1 個のサンプルを取 得した時点) • これは次の逐次計算と同等 • Action-value Function も同様に計算可能。下記のシーケンスに対して、例えば、 以降の Reward の合計を 以降のアクションのシーケンスが発生する確率の重みで平均したもの を とする。
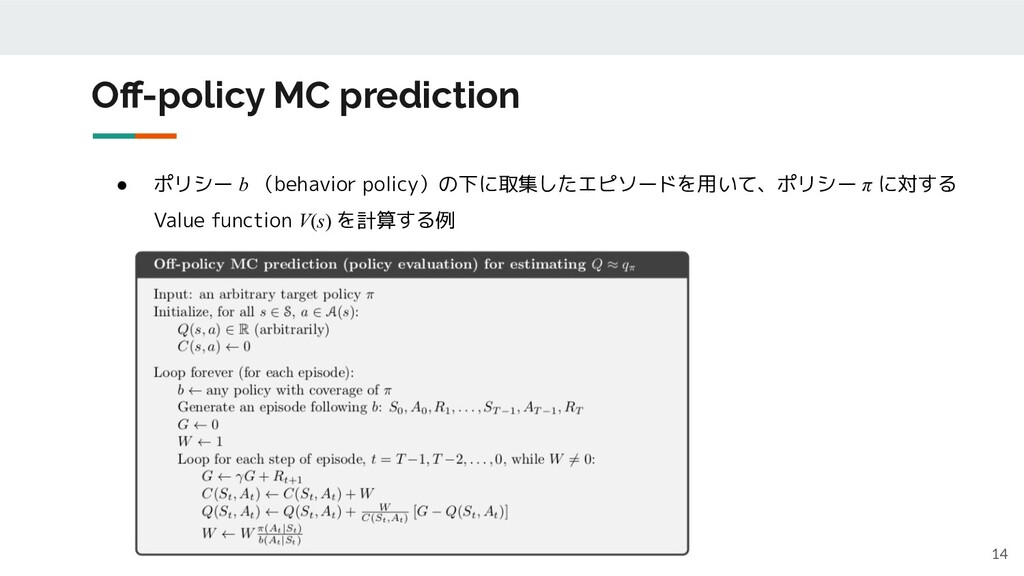
Off-policy MC prediction 14 • ポリシー b (behavior policy)の下に取集したエピソードを用いて、ポリシー π
に対する Value function V(s) を計算する例
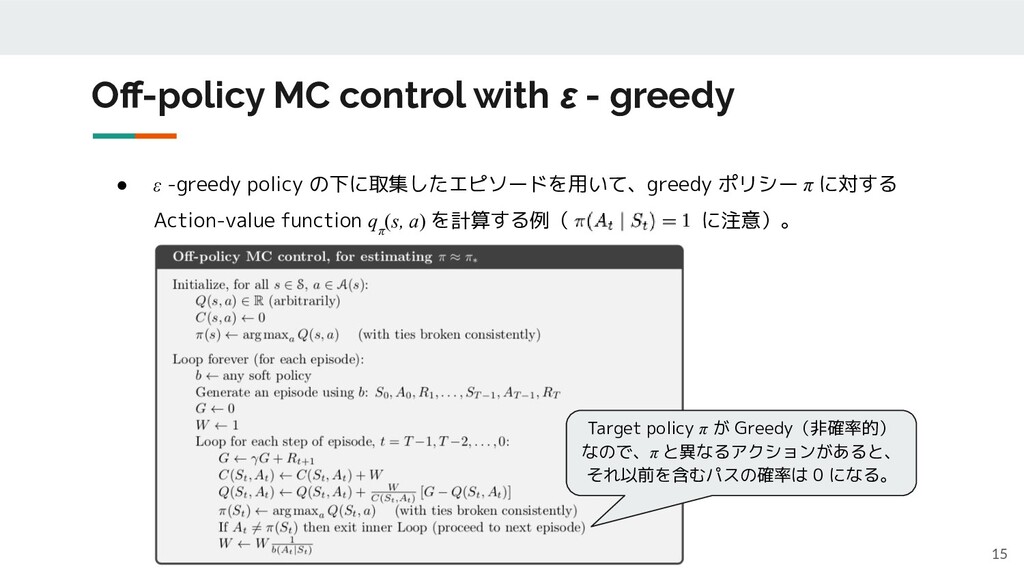
Off-policy MC control with ε - greedy 15 • ε
-greedy policy の下に取集したエピソードを用いて、greedy ポリシー π に対する Action-value function q π (s, a) を計算する例( に注意)。 Target policy π が Greedy(非確率的) なので、π と異なるアクションがあると、 それ以前を含むパスの確率は 0 になる。
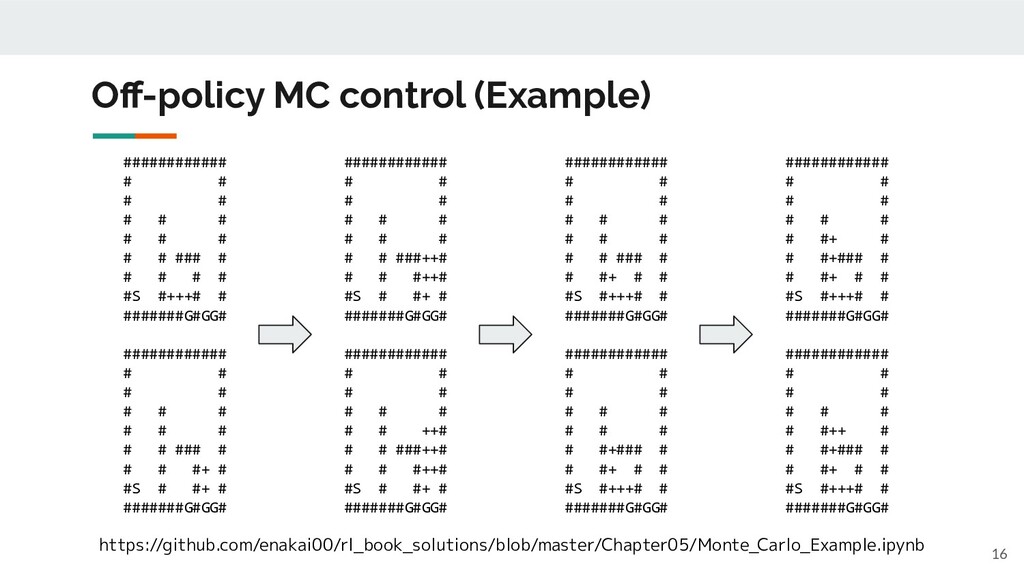
Off-policy MC control (Example) 16 https://github.com/enakai00/rl_book_solutions/blob/master/Chapter05/Monte_Carlo_Example.ipynb ############ # # #
# # # # # # # # # ### # # #+ # # #S #+++# # #######G#GG# ############ # # # # # # # # # # # #+### # # #+ # # #S #+++# # #######G#GG# ############ # # # # # # # # # # # # ### # # # # # #S #+++# # #######G#GG# ############ # # # # # # # # # # # # ### # # # #+ # #S # #+ # #######G#GG# ############ # # # # # # # # # # # # ###++# # # #++# #S # #+ # #######G#GG# ############ # # # # # # # # # ++# # # ###++# # # #++# #S # #+ # #######G#GG# ############ # # # # # # # # #+ # # #+### # # #+ # # #S #+++# # #######G#GG# ############ # # # # # # # # #++ # # #+### # # #+ # # #S #+++# # #######G#GG#
Off-policy MC control with ε - greedy の課題 17 •
ゴールから逆向きにエピソードをスキャンして、Value Function を更新していく。 • Target policy π が Greedy(非確率的)なので、π と異なるアクションがあると、それ以前 を含むパスの確率は 0 になり、そこでスキャンは打ち切られる。 • スタートからゴールまで Target policy にしたがって行動するエピソードがないと、スター ト付近の価値関数が学習できない。 ◦ つまり、長距離にわたる学習が困難 ⇨「Bootstrapping でない手法」の課題
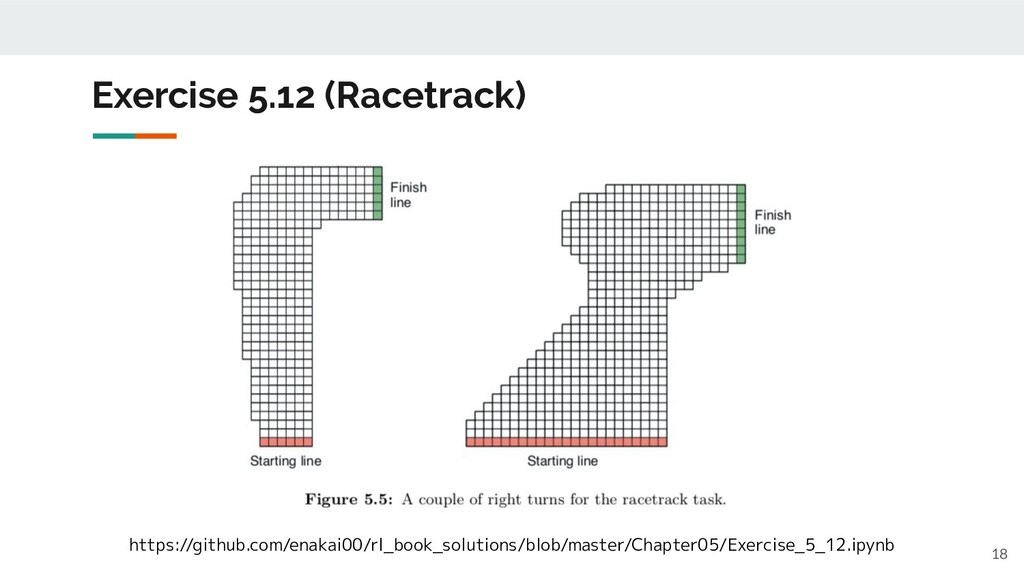
Exercise 5.12 (Racetrack) 18 https://github.com/enakai00/rl_book_solutions/blob/master/Chapter05/Exercise_5_12.ipynb


 enakai00
 odashi
 kaminashi
 daidaidai
 iktakahiro
 akizhou
 mohab1
 freee
 kazzpapa3
 gionn
 colopl
 takuroabe
 ama_ch
 maltzj
 ryanjones
 inesmontani
 minecr
 eileencodes
 honnibal
 rkendrick25
 jacobian
 lemiorhan
 marktimemedia
 addyosmani