Ramírez, Masayuki Asahara, Yuji Matsumoto International Joint Conference on Natural Language Processing (2008) Construcción de un tesauro japonés-español usando al inglés como pivote. 2
tareas de procesamiento de lenguaje natural. Falta de datos alineados es un obstáculo principal para obtener alto rendimiento en los sistemas PLN Construcción manual de recursos es costosa en tiempo y dinero. Se proponen métodos semiautomáticos o automáticos para construir estos recursos, como son diccionarios, tesauros y ontologías. 3
conceptos. En este caso la agrupacion se basa en relaciones semanticas. Para construir el tesauro multilingüe es necesario llevar a cabo estos pasos: Extraer tuplas de traducción de artículos de Wikipedia. Alinear los sentidos de las tuplas con aquellos de WordNet en inglés (desambiguación). Construir un tesauro de español-ingles-japonés con estas tuplas. 4
WordNet se realiza por medio de aplicar similitud de vector coseno entre textos de Wikipedia y WordNet. Para obtener POS se provee de la ayuda de WordNet. Wikipedia y WordNet contienen entradas polisémicas , se introduce método WSD para alinear estas entradas. Esta limitado únicamente a sustantivos, frase nominales y entidades nombradas. (Debido a que sólo se uso Wikipedia). 5
variedad de temas, alineados en distintos lenguajes. Tiene algunas características que lo hacen adecuado para la investigación como: Cada artículo tiene un título y un id. Páginas de redireccionamiento majean los sinónimos. Páginas de desambiguación son usadas cuando la palabra tiene distintos sentidos. Paginas de categoría contienen una lista de palabras que comparten la misma categoría semántica. 6
Agrupa los conceptos en synsets (conjunto de sinónimos) y cada concepto posee una glosa y una o más oraciones de ejemplo. Cada entrada ha sido clasificada en su categoría sintáctica como pronombres, verbos adjetivos, adverbios, etc. 7
se mapean a WordNet para determinar si una palabra tiene más de un sentido y se extraen los artículos ambiguos. Se usan dos métodos para desambiguar: Medir la similitud coseno entre el contenido de los artículos de Wikipedia y las glosas de WordNet Comparar la categoría de Wikipedia a la cual pertenece el articulo con la ontología de WordNet Finalmente se sustituye la palabra objetivo en japonés y español 8
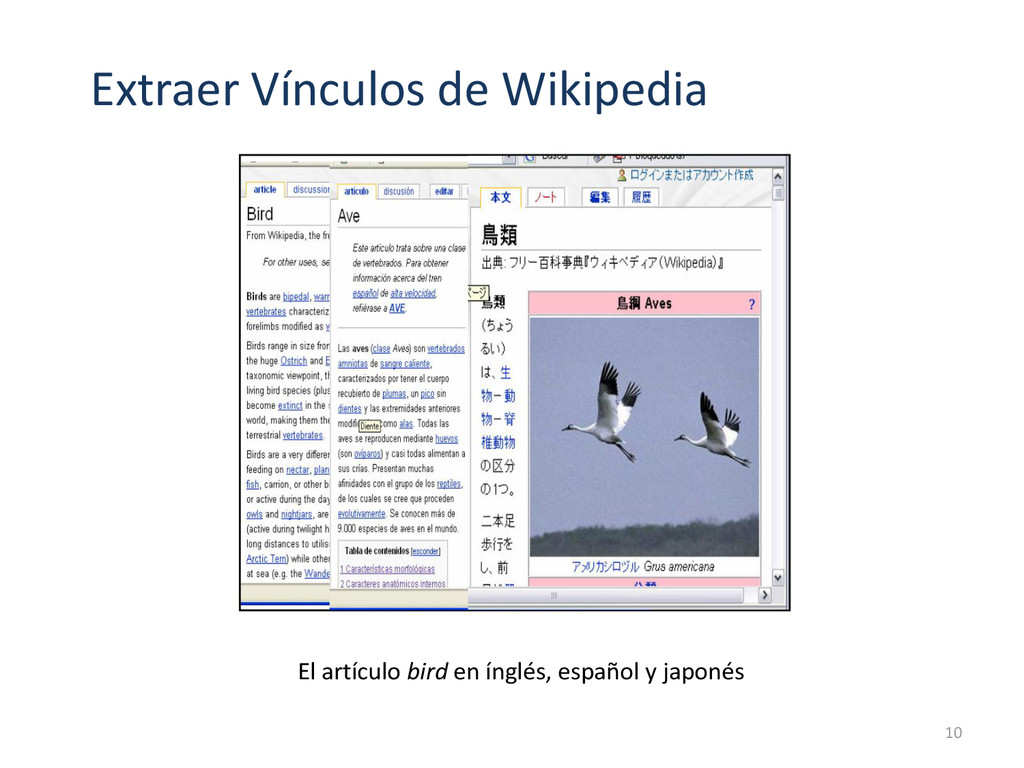
los artículos de Wikipedia Se extraen artículos de Wikipedia Se elimina la información irrelevante como imágenes menús y lenguaje especial de marcado como “()” y “"” Se verifica si el vínculo es un artículo redireccionado y extraer el articulo original Se remueven todas las palabras que no aportan información sobre un tópico en especifico como "él", "entre", etc. Se toman los artículos cuyo título corresponda a un sustantivo o entidad nombrada. Si el artículo se encuentra en más de un idioma se extraen sus títulos y se alinean con el título del artículo original. 9
glosa en WordNet contiene una asociación de pos y sentido. Por ejemplo: la entrada bark#n#1 es distinto a bark#v#1. Una vez extraído todos los vínculos y sus respectivas traducciones al español y japonés se buscan las palabras en ingles en WordNet si posee mas de un sentido es polisémica. Se usan dos métodos para desambiguar los artículos ambiguos: Desambiguación usando la similitud coseno Desambiguación usando el árbol de categoría de Wikipedia y el árbol de ontología de WordNet. 11
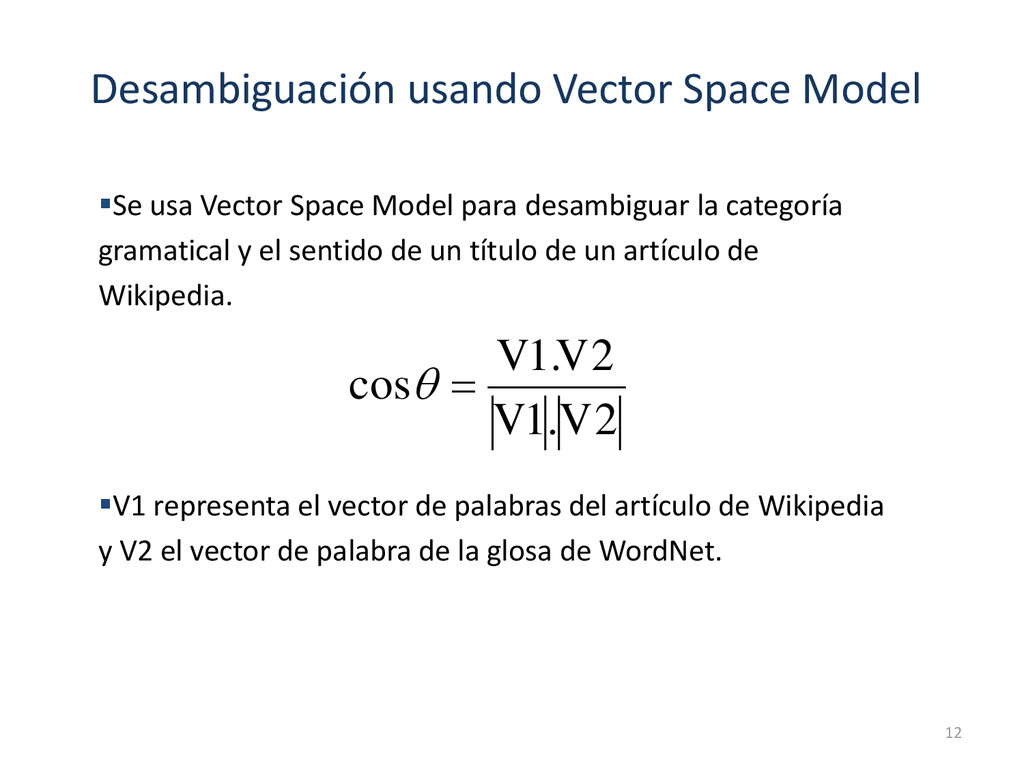
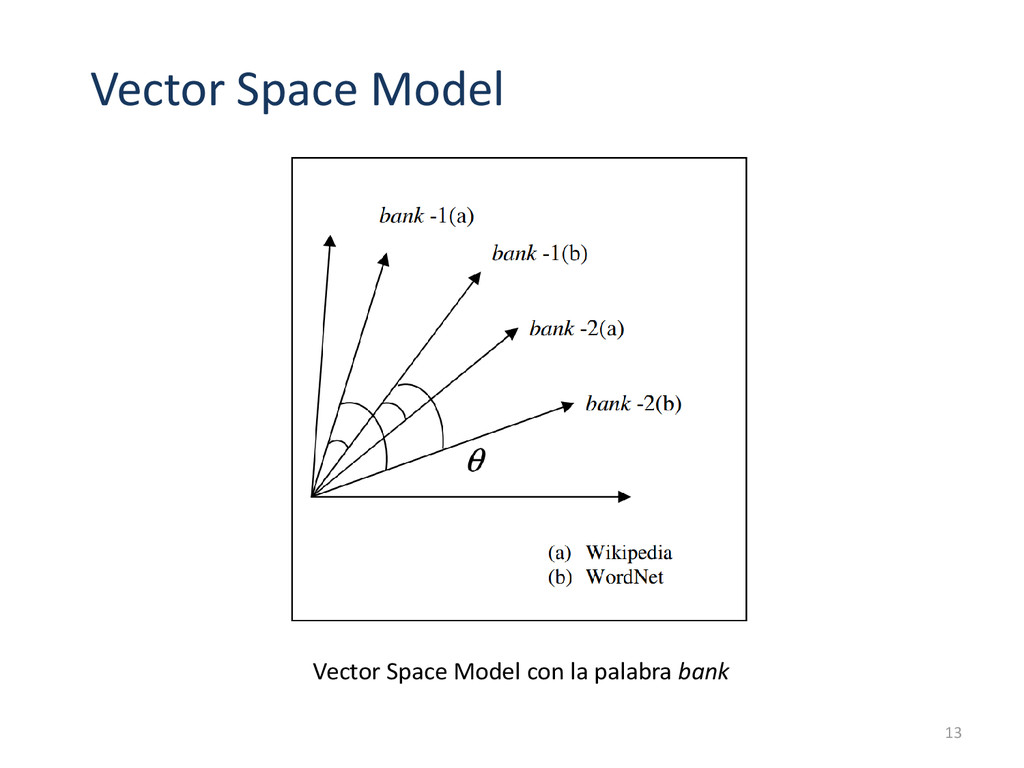
para desambiguar la categoría gramatical y el sentido de un título de un artículo de Wikipedia. V1 representa el vector de palabras del artículo de Wikipedia y V2 el vector de palabra de la glosa de WordNet. 12 2 . 1 2 . 1 cos V V V V
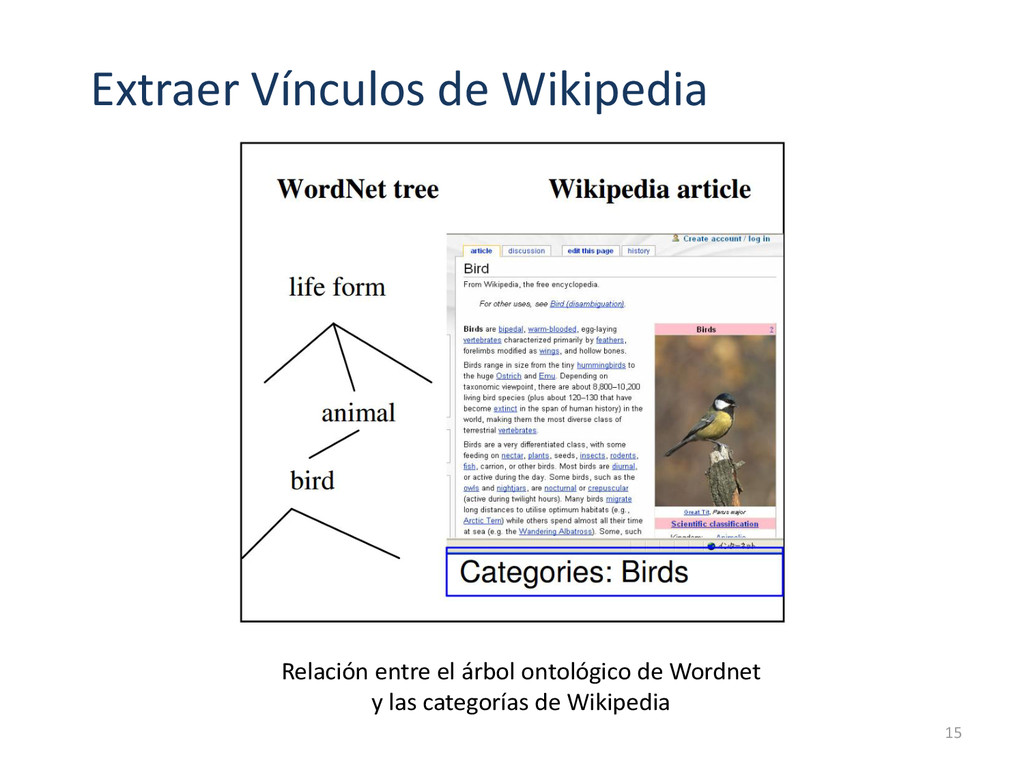
categorías de Wikipedia Se asume una superposición entre los hiperónimos e hipónimos de los artículos de Wikipedia y su sentido correcto de WordNet. A este método se la va a referir como MCAT (Map CATegories). Wikipedia posee en el fondo de cada página una caja conteniendo la categoría a la cual pertenece. 14
cada tupla de palabra y un POS para su información sintáctica Contiene el sentido de palabra obtenido en el proceso de desambiguación. Se extrae una pequeña definición de los artículos de Wikipedia, tiende a ser la primera oración del artículo de Wikipedia. Se usan patrones simples “X is/are Y”, “X es un(a) Y”, “X は/が Y であ る” 16
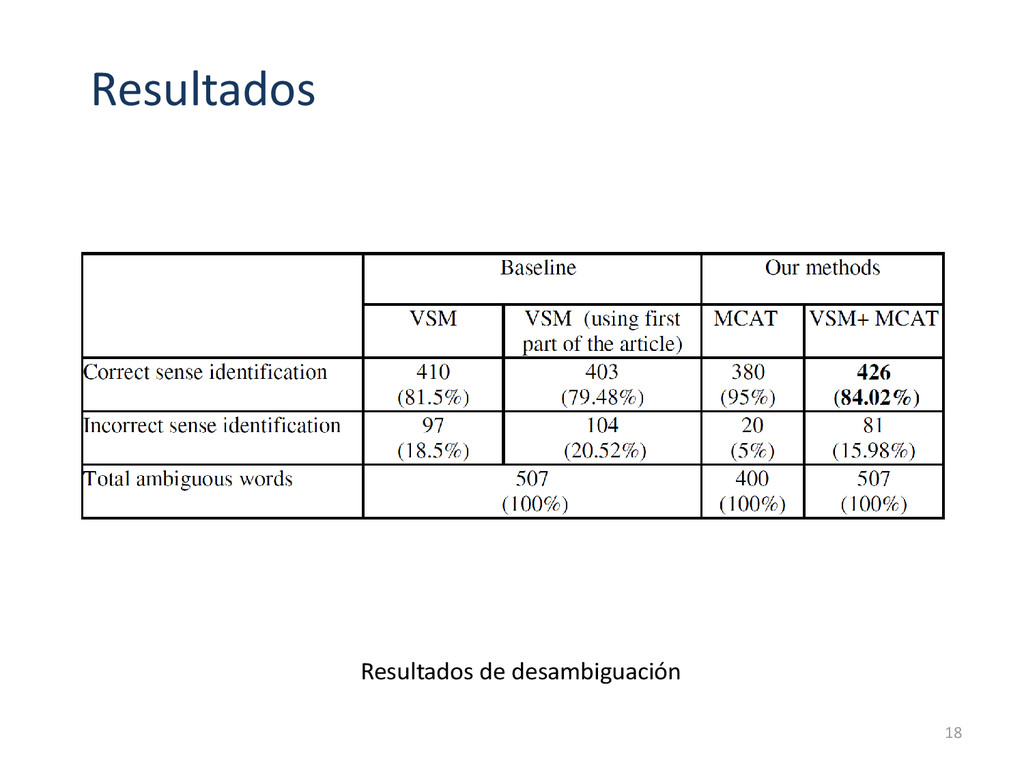
en español, ingles y japonés. Fueron extraídos en abril de 2006. La versión de WordNet utilizada es 2.1 Los datos de Wikipedia contienen un total de 377.621 artículos en japonés 2.749.310 en ingles y 194.708 en español. Se obtuvo un total de 25,379 palabras alineadas en los 3 idiomas. En WorNet hay 117,097 palabras y 141,274 sentidos. 78,247 tipos de palabras existen en WordNet, 14,614 corresponden a artículos polisémicos. El experimento se realizó usando 12,906 artículos de Wikipedia. Los resultados se muestran en la Tabla 1. 17
e inglés. Se usó la caracteristicas de Wikipedia para alinear en distintos idiomas. Se usaron dos métodos para desambiguar los artículos en ingles asignados a una palabra en WordNet. El segundo método mostró resultados compremetedores, sin embargo la cantidad de palabras que pueden ser desambiguadas es pequeña comparada con VSM. Se puede usar el método para obtener resultados en otros idiomas 19


 gamar
 gpeyre
 institutdelelevage
 dk999
 imai448
 rikkabotan7
 microbaseinc
 mikimhk
 signer
 satai
 s_mizuki_nlp
 wataruuuuu
 aemeredith
 tammyeverts
 destraynor
 portentint
 eitanlees
 colly
 tmiket
 jcasabona
 pwiseman
 jacobian
 pedronauck
 jlugia