Spanish Julio Javier Castillo Proceedings of the NAACL HLT 2010 Young Un enfoque de aprendizaje de máquina para reconocer la vinculación textual en español 2
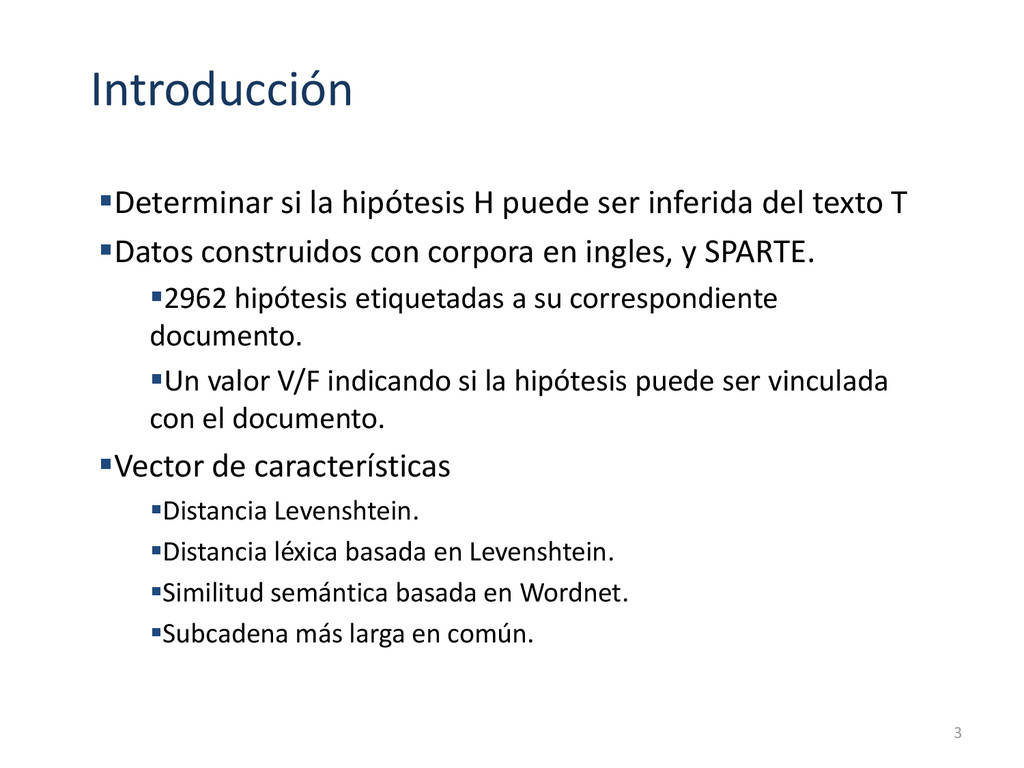
texto T Datos construidos con corpora en ingles, y SPARTE. 2962 hipótesis etiquetadas a su correspondiente documento. Un valor V/F indicando si la hipótesis puede ser vinculada con el documento. Vector de características Distancia Levenshtein. Distancia léxica basada en Levenshtein. Similitud semántica basada en Wordnet. Subcadena más larga en común. 3
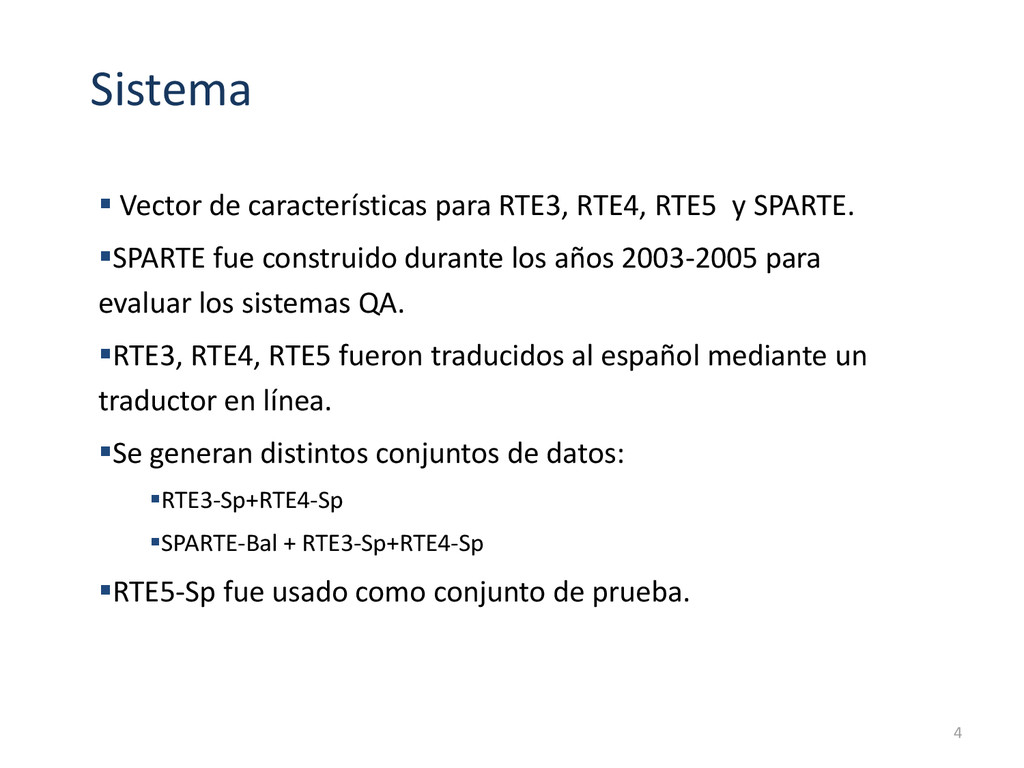
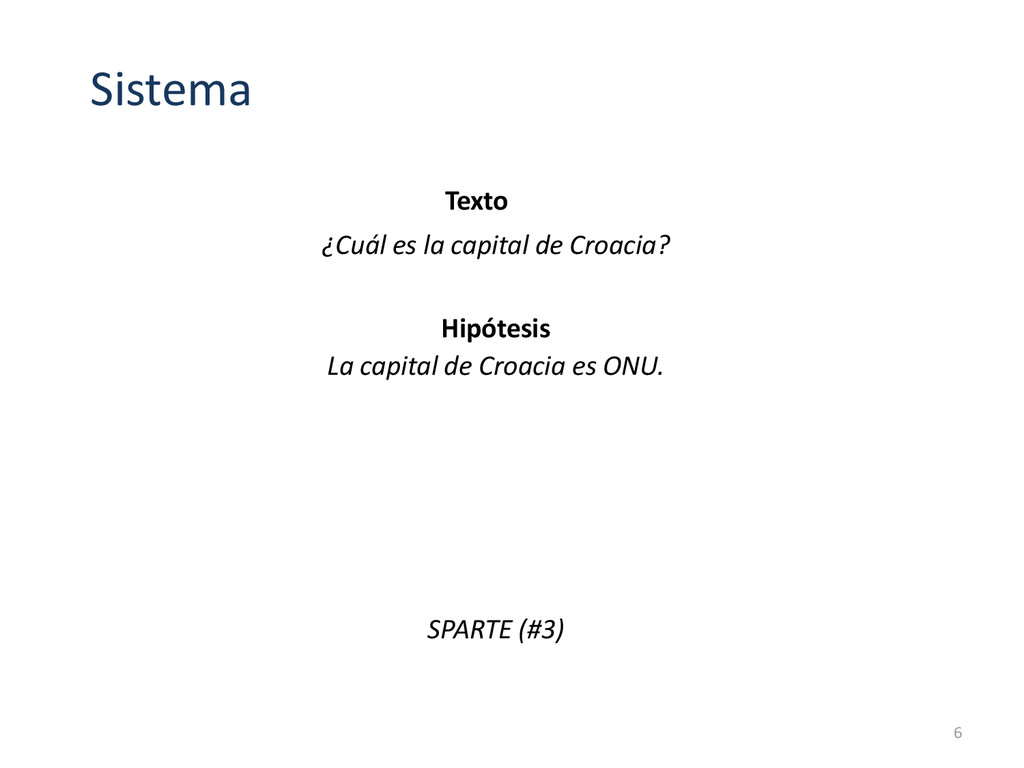
SPARTE. SPARTE fue construido durante los años 2003-2005 para evaluar los sistemas QA. RTE3, RTE4, RTE5 fueron traducidos al español mediante un traductor en línea. Se generan distintos conjuntos de datos: RTE3-Sp+RTE4-Sp SPARTE-Bal + RTE3-Sp+RTE4-Sp RTE5-Sp fue usado como conjunto de prueba. 4
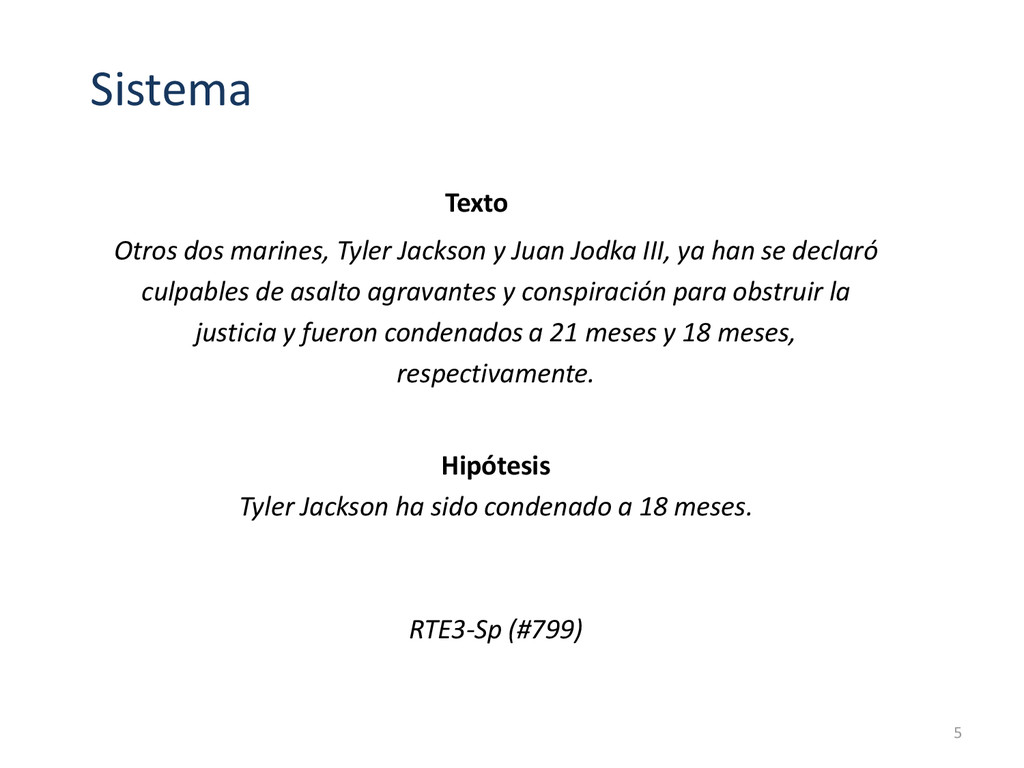
III, ya han se declaró culpables de asalto agravantes y conspiración para obstruir la justicia y fueron condenados a 21 meses y 18 meses, respectivamente. Hipótesis Tyler Jackson ha sido condenado a 18 meses. RTE3-Sp (#799) 5
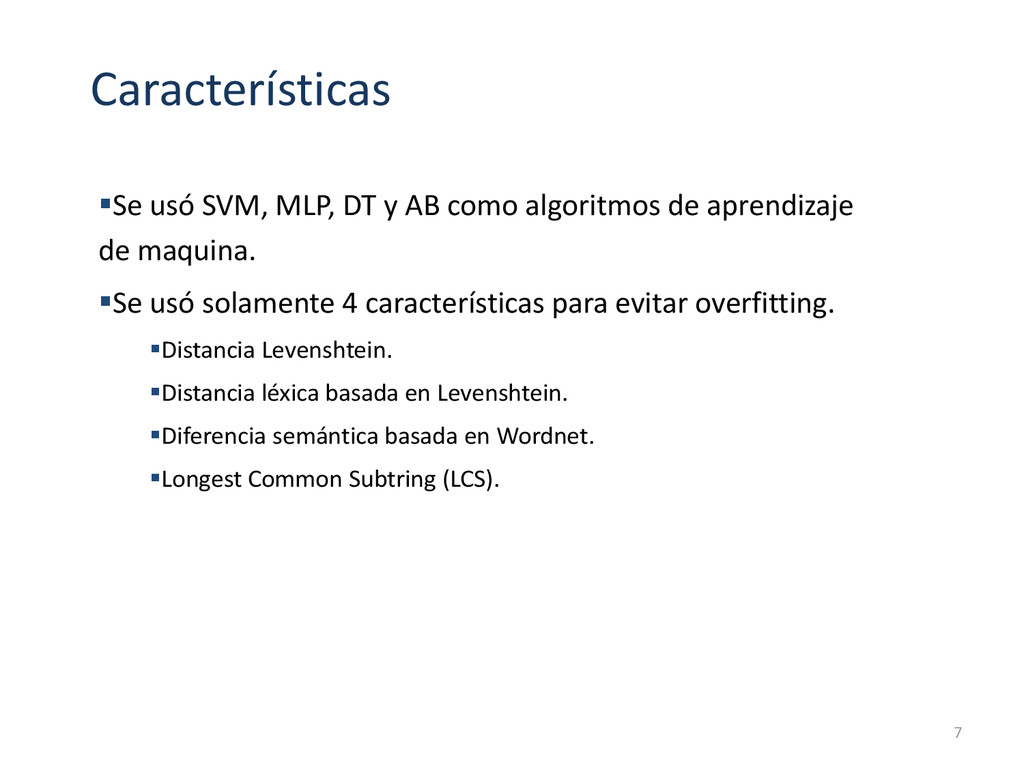
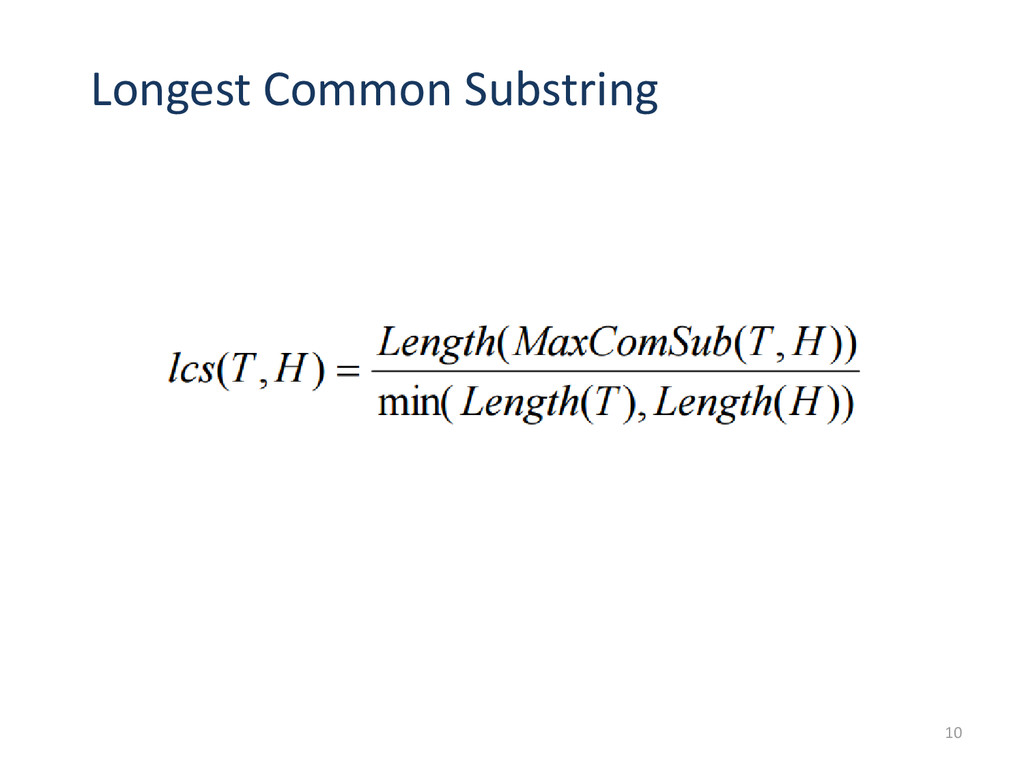
de aprendizaje de maquina. Se usó solamente 4 características para evitar overfitting. Distancia Levenshtein. Distancia léxica basada en Levenshtein. Diferencia semántica basada en Wordnet. Longest Common Subtring (LCS). 7
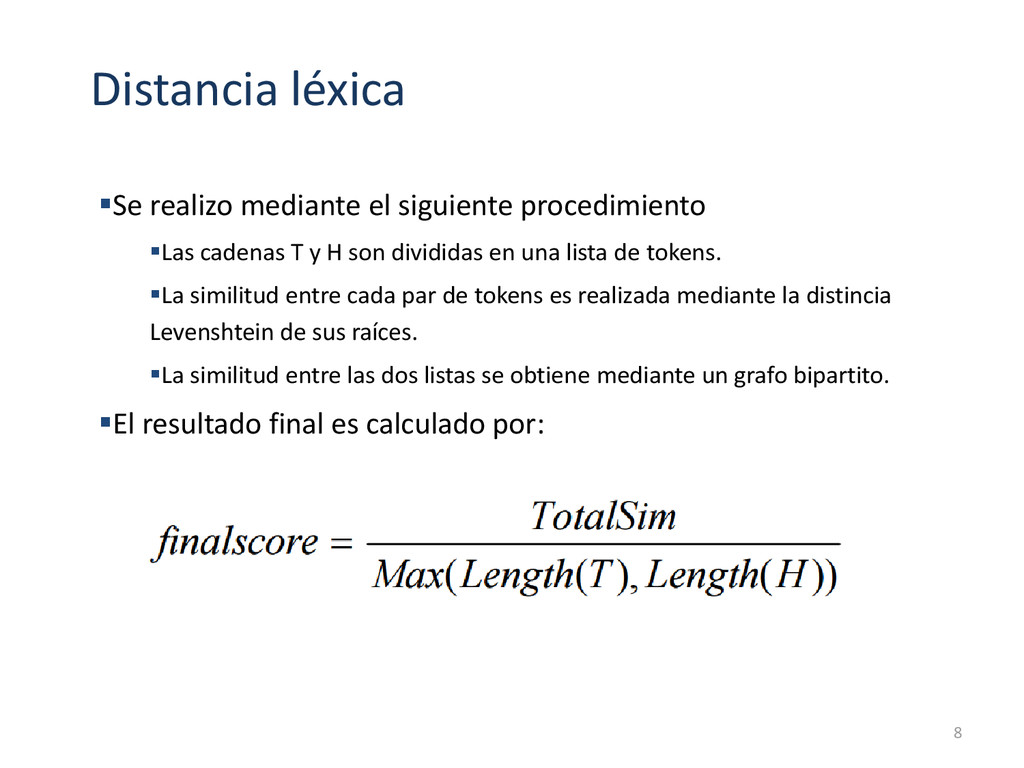
T y H son divididas en una lista de tokens. La similitud entre cada par de tokens es realizada mediante la distincia Levenshtein de sus raíces. La similitud entre las dos listas se obtiene mediante un grafo bipartito. El resultado final es calculado por: 8
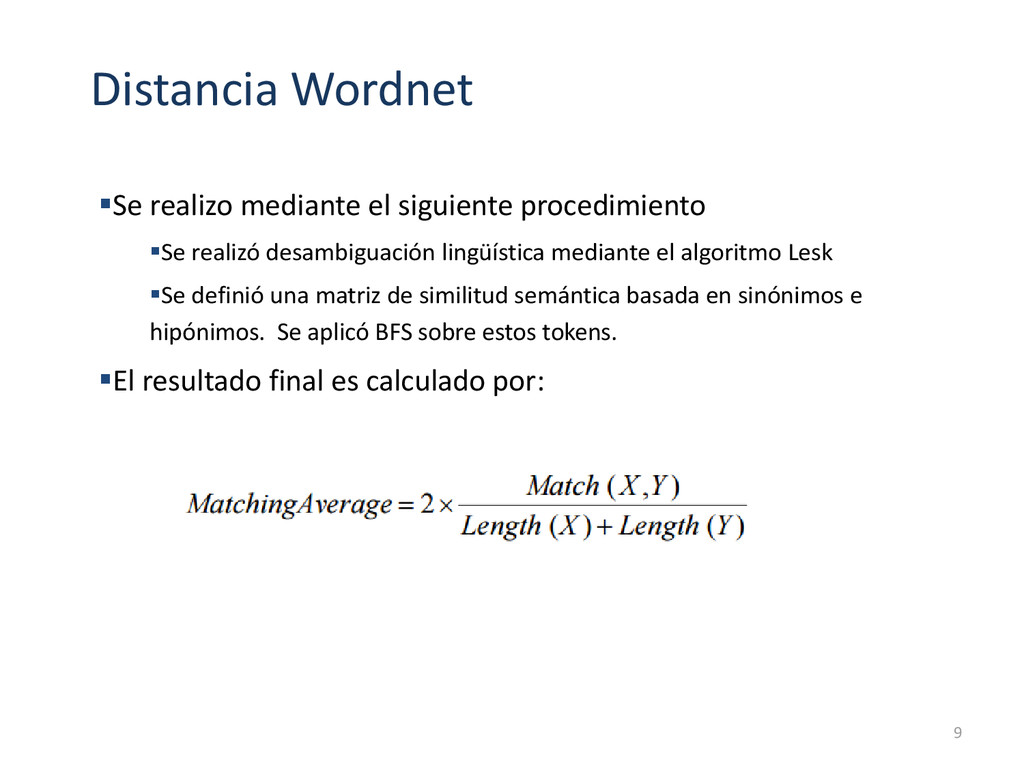
desambiguación lingüística mediante el algoritmo Lesk Se definió una matriz de similitud semántica basada en sinónimos e hipónimos. Se aplicó BFS sobre estos tokens. El resultado final es calculado por: 9
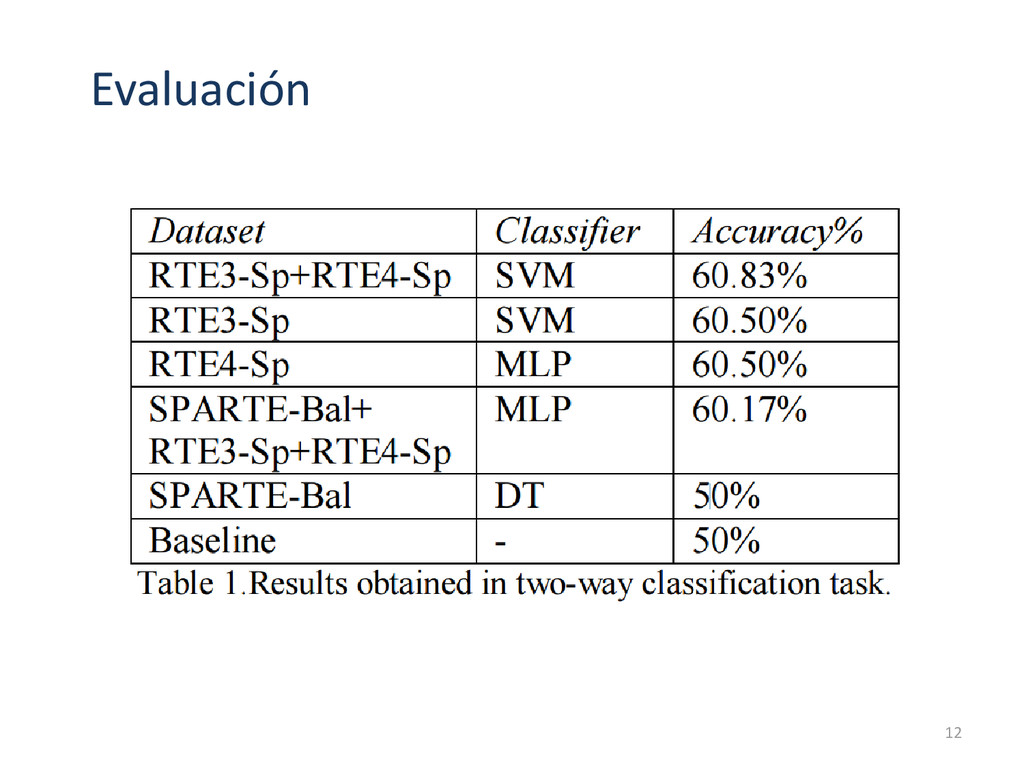
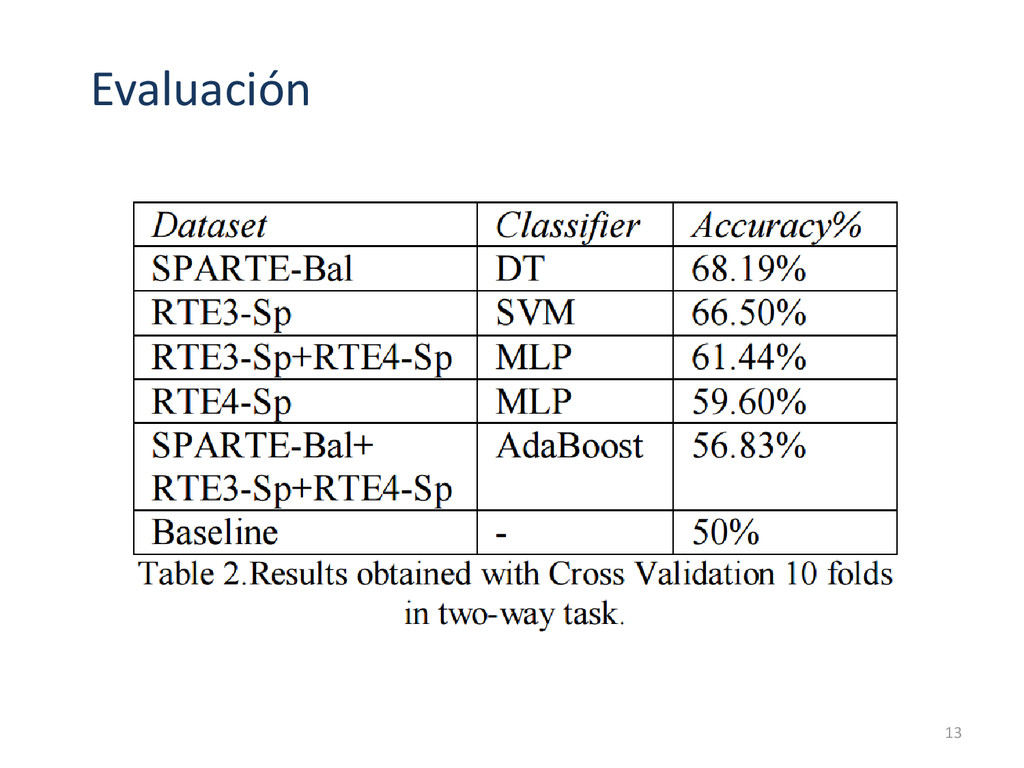
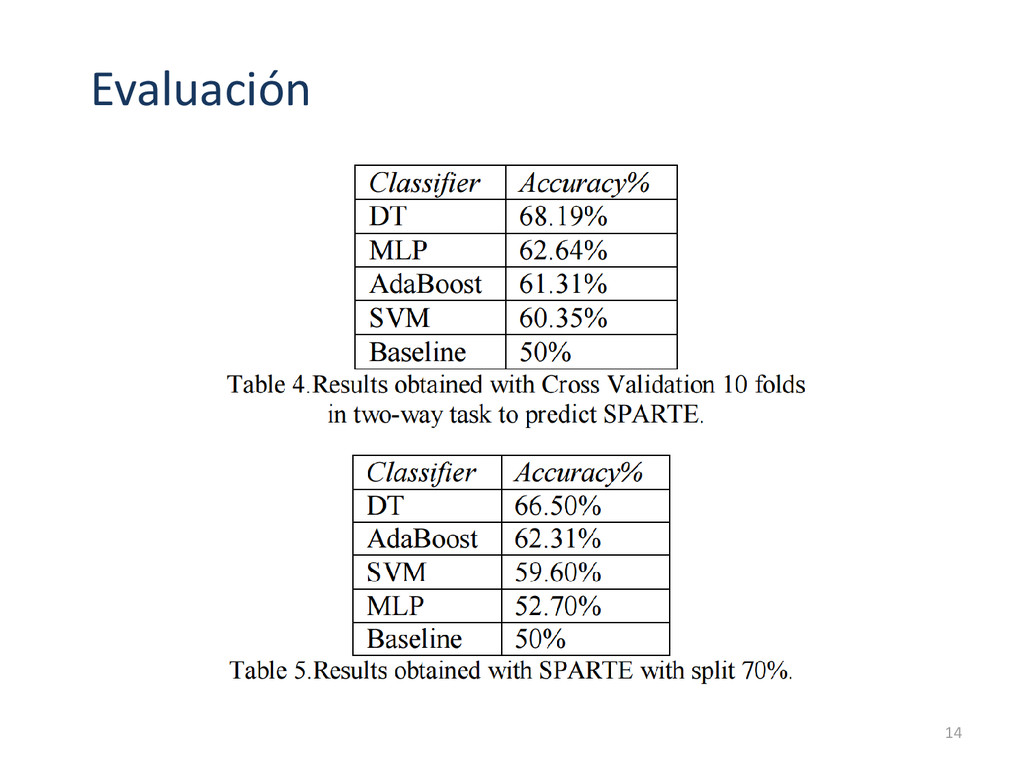
algunas posibles combinaciones: RTE3-Sp+RTE4-Sp SPARTE-Bal + RTE3-Sp+RTE4-Sp Se usaron 4 clasificadores distintos para cada conjunto de datos. Se muestra solo la precisión del mejor clasificador. Se muestran los resultados obtenidos para evaluar RTE5-Sp y un 10-cross fold validation para cada conjunto de datos. Posteriormente se muestran los resultados de los clasificadores con Sparte-Bal 11
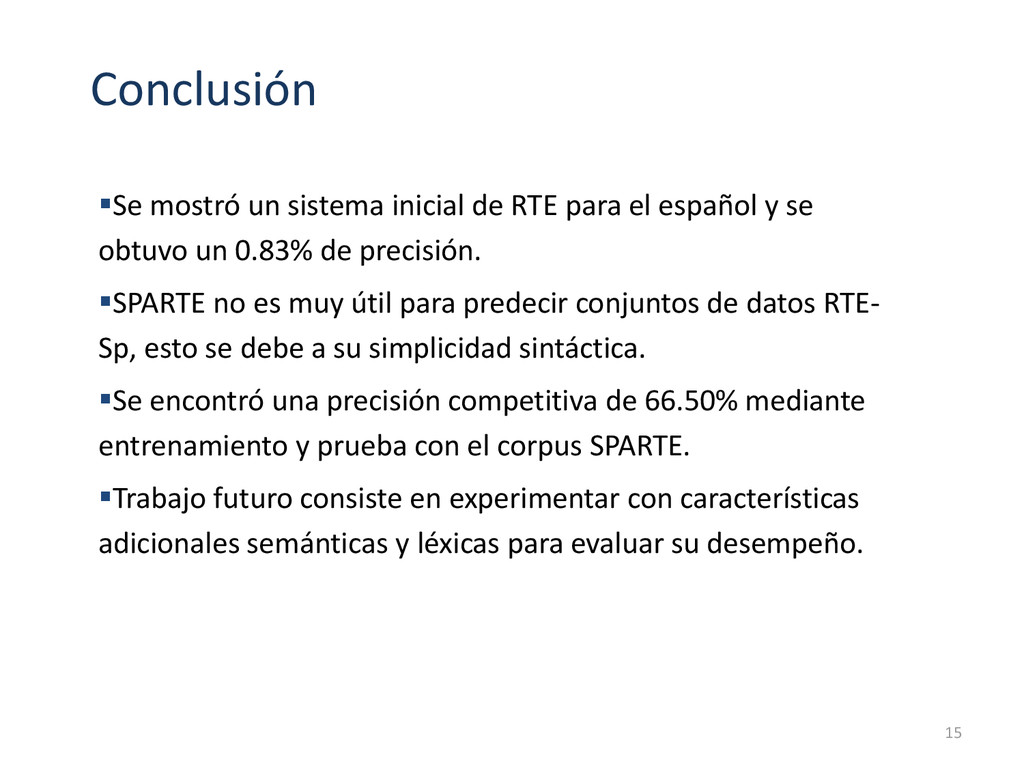
español y se obtuvo un 0.83% de precisión. SPARTE no es muy útil para predecir conjuntos de datos RTE- Sp, esto se debe a su simplicidad sintáctica. Se encontró una precisión competitiva de 66.50% mediante entrenamiento y prueba con el corpus SPARTE. Trabajo futuro consiste en experimentar con características adicionales semánticas y léxicas para evaluar su desempeño. 15

 Your Podcast. Everywhere. Effortlessly.


 gamar
 kobayashi31
 yukako_nakano
 institutdelelevage
 kohlerjohannes
 rikkabotan7
 junkashihara
 kogoro
 yumulab
 ept
 satai
 orderedlist
 morganepeng
 palkan
 zakiyama
 hannesfritz
 takai
 soudai
 kneath
 colly
 katiecoart
 reverentgeek
 bcantrill