Upgrade to Pro — share decks privately, control downloads, hide ads and more …

ポケカコンペ振り返り.pdf

Avatar for pao pao
October 15, 2026
330

 ポケカコンペ振り返り.pdf

"PTCG AI Battle Challenge コンペ振り返り会" で発表した資料です
https://matsuo-institute.connpass.com/event/404324/

背景画像はこちらを使わせていただいております。
https://github.com/klaudiosinani/hyper-pokemon

Avatar for pao

pao

October 15, 2026

Transcript

  1. 自己紹介 • • • • Pao @名古屋 Kaggle Grandmaster LLM開発

    (Post-training) 短期コンペ得意 ◦ ◦ Kaggledays WCS(?)優勝 atmaCup優勝x3 • 好きなポケモン ◦ ライチュウ、ラプラス、デカヌチャン等々
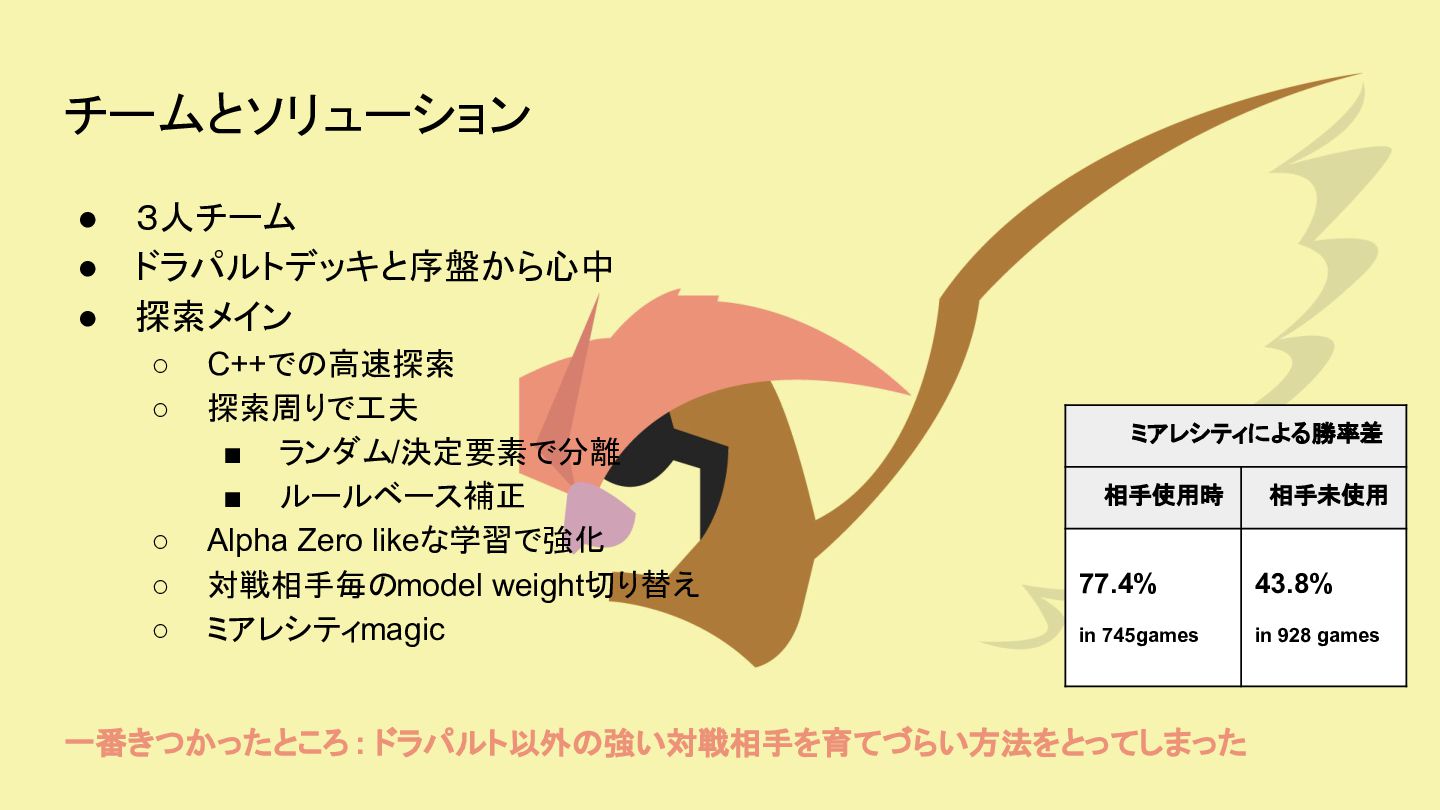
  2. チームとソリューション • • • 3人チーム ドラパルトデッキと序盤から心中 探索メイン ◦ ◦ ◦

    ◦ ◦ C++での高速探索 探索周りで工夫 ▪ ランダム/決定要素で分離 ▪ ルールベース補正 Alpha Zero likeな学習で強化 対戦相手毎のmodel weight切り替え ミアレシティmagic ミアレシティによる勝率差 相手使用時 相手未使用 77.4% 43.8% in 745games in 928 games 一番きつかったところ : ドラパルト以外の強い対戦相手を育てづらい方法をとってしまった
  3. Solutionから紐解く上位への道(多分) • • • • • • 強化学習(RL)を成功させる 大量の対戦数 効率的な学習・モデル/インプット構造

    複数のデッキを強く育てる 環境に応じたデッキ選定 …. 何故そこに至れなかったのか?
  4. 振り返り • 最初にRLを選択しなかったから駄目ではない ◦ ◦ • →舵切り判断のための実験が甘かった →シミュレーションコンペでのRLの特性理解 寝不足判断力での鈍り ◦

    ◦ ◦ →セルフコントロール不足 →1日くらい何もせずリフレッシュしたら判断変わっていたかも →長期コンペ苦手なのここかも? ってRLに舵切ってたからって勝てたわけじゃない。 その先の中で上位のエッセンスを考察すべき
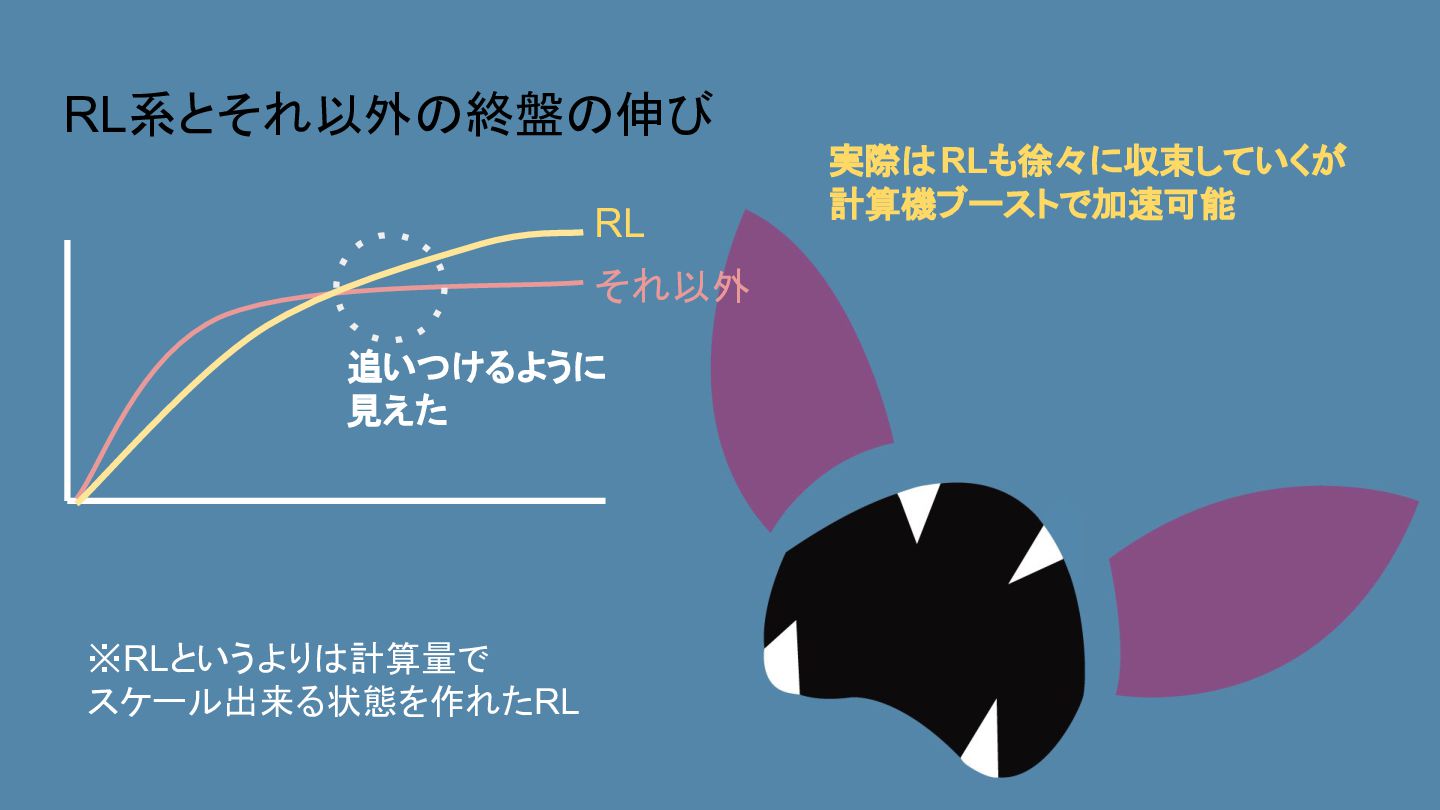
  5. 上位ソリューションからの考察1 • 全ては学習データの量の話に帰結する? ◦ ◦ • 高速化が大前提 ◦ ◦ •

    上位の学習データ量の中でも1位は明らかに大きい ▪ 1800億action ただ、計算資源で殴ればいいわけでもない Rolloutの高速化余地は多い C++ネイティブ実装、CUDA実装など 多くのテクニックは学習効率化につながる ◦ ◦ ◦ ◦ ◦ より直接的な盤面情報をモデルに入力 将来情報を入力 環境に応じてデッキを絞る Behavior Cloning (BC) →より少ない学習でも強く出来る
  6. 上位ソリューションからの考察2 • モデルサイズは数 M程度が十分ラインか ◦ ◦ ◦ • 1位2.24M, 2位2.4M

    parameters 大きくしすぎると学習量が減るトレードオフがある 計算資源が多いとより大きいモデルが強くなる可能性も? ▪ 2nd Round勢に期待 モデルのアーキテクチャ・入力による差はどれくらいある? ◦ ◦ ◦ ◦ ほとんどがTransformer採用だが、入力の仕方などは色々 ただ学習時間が長く、沢山の実験は上位でも出来てない気がする このあたりの差は正直よくわからない 逆に実験数少ない中で良いモデルを作る必要あり →モデルへの落とし込みは経験による差が出やすかった?
  7. 上位ソリューションからの考察3 • BC(Behavior Cloning)よりフルスクラッチか? ◦ ◦ • 上位はBCせずフルスクラッチが多い フルスクラッチのほうが環境に存在しない幅広いデッキを初期から育てられる? 幅広いデッキを汎用学習させる効果は?

    ◦ ◦ ◦ ◦ ◦ 1, 2, 3位どれも序盤は多量のデッキで汎用モデルを学習 汎用学習は、特定対面での強化には寄与しなかった(4th solution) 環境マイナーカードへの対応強化が主な効果? ▪ 例:ドータクン、ミアレシティ等 共通的に学ぶことで個別に学ぶより効率的な側面も? 最後に環境に応じたカード調整がしやすかった? ▪ 例:くさタイプ対策のファイヤー、イーユイなど
  8. 上位ソリューションからの考察4 • 環境に応じたデッキ選定 ◦ ◦ ◦ • 自分側のデッキ選定だけでなく対戦相手の想定も重要 対策が出来てないであろうヤドキングが最終的には急増 ⇔それを見越してヤドキングを育て対策できるか

    過去方策を入れるべきか? ◦ ◦ ◦ いくつかのソリューションでは一定比率は過去のcheckpointとの対戦も学習 ▪ 弱い相手や戦略が違う相手にも強くする 一方で、オンポリシーな学習に使えるデータは半減してしまう 学習データ量をとるのか、対戦相手の幅をとるのかどっちが有利だった?