Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
チャットボット奮闘記
Search
fuzyco
April 25, 2017
Technology
150
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
チャットボット奮闘記
RNNを用いてチャットボットを作った奮闘記です。
fuzyco
April 25, 2017
More Decks by fuzyco
See All by fuzyco
Functional Error&Retry Handling
hiroki6
2
660
Extensible Effects: beyond the Monad Transformers
hiroki6
1
900
High Performance Scala/high_performance_scala
hiroki6
4
4.5k
並行四方山話/tales_of_concurrency
hiroki6
0
150
Scalaでの並行・並列処理戦略/strategy-for-concurrency-and-parallel-by-scala
hiroki6
9
3.3k
Monad Error with Cats/monad-error-with-cats
hiroki6
0
680
scala_multi_thread.pdf
hiroki6
0
410
GAEを用いたBQ Load戦略/gae_bq_load_strategy
hiroki6
2
2k
Extensible Effects with Scala/eff-with-scala
hiroki6
0
1.1k
Other Decks in Technology
See All in Technology
Don't write the architecture only in the prompt.
neohsu
0
290
AIエージェント統制はAPIから——押さえるべき5つの要素
nagix
0
110
構造で守らせる データ・法務・セキュリティ・開発チームとつくる AI時代のデータガバナンスとデータ基盤のリアル
legalontechnologies
PRO
3
720
200人の配信コメント、 全部Jevが仕分けます 〜 マサカリガードを作ってみた 〜
katayamatg
1
500
[re:Invent2026事前勉強会(有志開催)]続きは、ラスベガスの廊下で / continue-in-the-vegas-hallway
sh_fk2
0
480
あなたのDartコードは丸見えかもしれない ~reFlutterで暴くFlutterアプリの中身と多層防御~
zozotech
PRO
0
740
Claude Codeから見る、エンジニアの世界の変容とその先
oikon48
8
5.1k
「作れる」と「リリースできる」の間にあったもの── PdMを外して見えた、PdMがやるべき仕事/Buildable ≠ Shippable: What Removing the PM Taught Me About the PM’s Job
yappli_developers
0
420
Jev の中身は50行で再現できる。でも本物との差はどこにあるのか
hisuzuya
0
280
Maestro MCPとClaude Code Skillsによる自律的なE2Eテスト支援
asmz
0
400
これだけは抑えておきたい!後悔しない re:Invent の過ごし方 / AWS re:Invent 2026 prestudy
kinunori
2
650
新米を「売り越さない」、Aurora DSQLで作る在庫ゼロ死守の限定ドロップEC
yama3133
0
140
Featured
See All Featured
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
960
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
The Illustrated Children's Guide to Kubernetes
chrisshort
51
53k
Google's AI Overviews - The New Search
badams
0
1.6k
Navigating Weather and Climate Data
rabernat
0
570
Exploring the relationship between traditional SERPs and Gen AI search
raygrieselhuber
PRO
4
4.4k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.2k
Practical Orchestrator
shlominoach
192
12k
Pawsitive SEO: Lessons from My Dog (and Many Mistakes) on Thriving as a Consultant in the Age of AI
davidcarrasco
0
290
Neural Spatial Audio Processing for Sound Field Analysis and Control
skoyamalab
0
600
SEO in 2025: How to Prepare for the Future of Search
ipullrank
3
3.9k
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
280
Transcript
チャットボット奮闘記 1
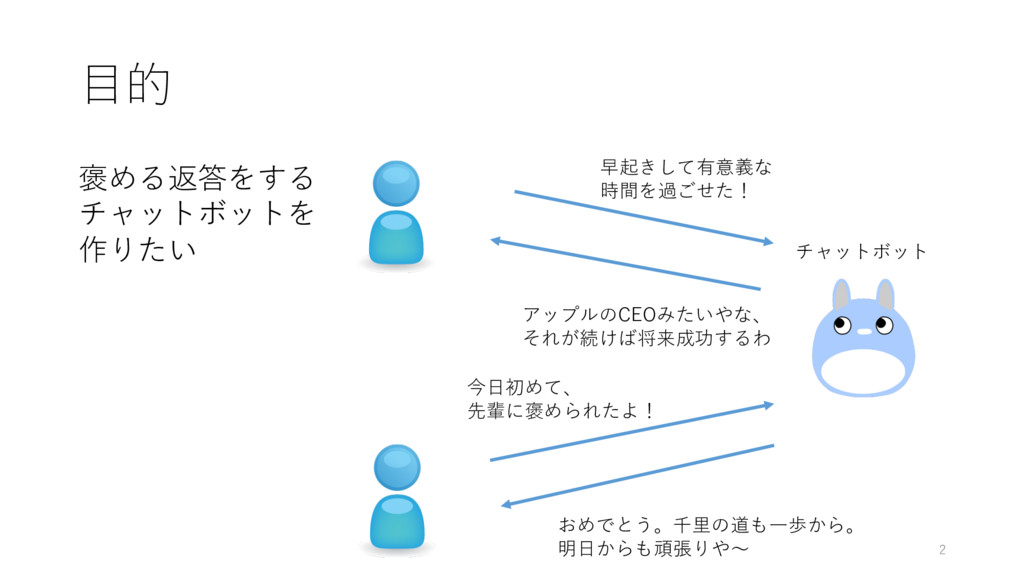
⽬的 2 早起きして有意義な 時間を過ごせた! アップルのCEOみたいやな、 それが続けば将来成功するわ 今⽇初めて、 先輩に褒められたよ! おめでとう。千⾥の道も⼀歩から。 明⽇からも頑張りや〜
褒める返答をする チャットボットを 作りたい チャットボット
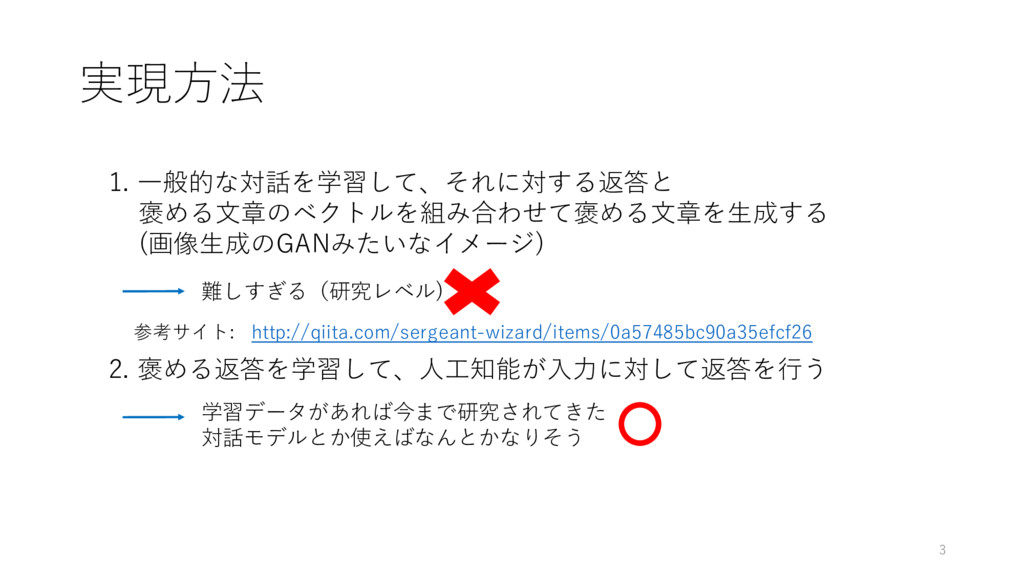
実現⽅法 3 2. 褒める返答を学習して、⼈⼯知能が⼊⼒に対して返答を⾏う 1. ⼀般的な対話を学習して、それに対する返答と 褒める⽂章のベクトルを組み合わせて褒める⽂章を⽣成する (画像⽣成のGANみたいなイメージ) 難しすぎる(研究レベル) 学習データがあれば今まで研究されてきた
対話モデルとか使えばなんとかなりそう 参考サイト: http://qiita.com/sergeant-wizard/items/0a57485bc90a35efcf26
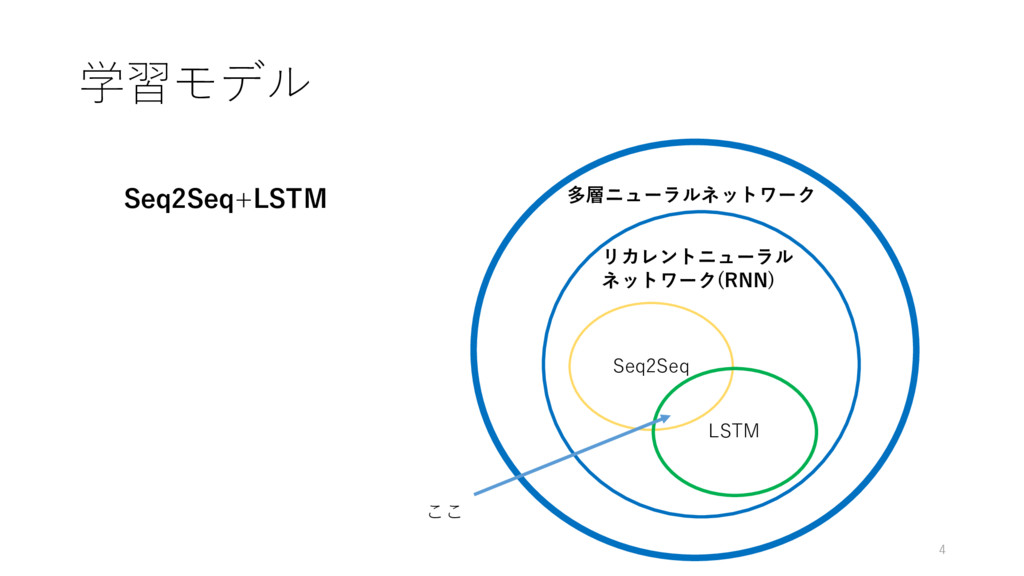
学習モデル 4 Seq2Seq 多層ニューラルネットワーク LSTM リカレントニューラル ネットワーク(RNN) ここ Seq2Seq+LSTM
RNNの例 語彙: [h, e, l, o] トレーニング⽂章: “hello” 1 0
0 0 0 1 0 0 0 0 1 0 0 0 0 1 “h” “e” “l” “l” ⼊⼒データ t 1 2 3 4 ⼊⼒層: X 5
RNNの例 語彙: [h, e, l, o] トレーニング⽂章: “hello” 1 0
0 0 0 1 0 0 0 0 1 0 0 0 0 1 0.3 -0.1 0.9 1.0 0.3 0.1 0.1 -0.5 -0.3 -0.3 0.9 0.7 “h” “e” “l” “l” ⼊⼒データ W W(in) zt = tanh(W(in)xt +Wzt−1) t 1 2 3 4 隠れ層: Z ⼊⼒層: X 6
RNNの例 語彙: [h, e, l, o] トレーニング⽂章: “hello” 出⼒層: Y
隠れ層: Z ⼊⼒層: X 1 0 0 0 0 1 0 0 0 0 1 0 0 0 0 1 0.3 -0.1 0.9 1.0 0.3 0.1 0.1 -0.5 -0.3 -0.3 0.9 0.7 1.0 2.2 -3.0 4.1 0.5 0.3 -1.0 1.2 0.1 0.5 1.9 -1.1 0.2 -1.5 -0.1 2.2 “h” “e” “l” “l” 教師データ “e” “l” “l” “o” ⼊⼒データ W(out) W W(in) 学習 t 1 2 3 4 7
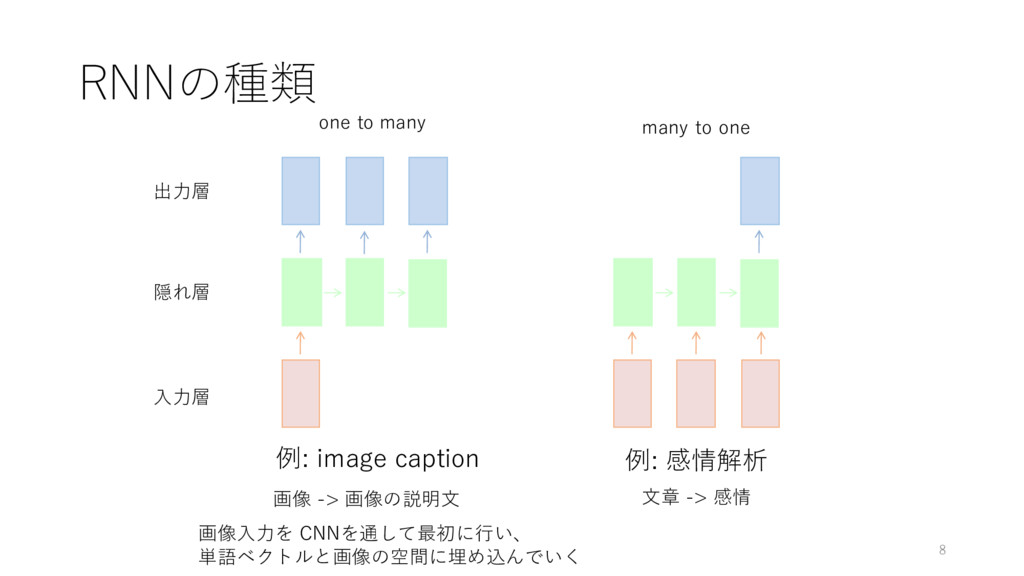
one to many many to one RNNの種類 例: image caption
出⼒層 隠れ層 ⼊⼒層 画像⼊⼒を CNNを通して最初に⾏い、 単語ベクトルと画像の空間に埋め込んでいく 例: 感情解析 ⽂章 -> 感情 画像 -> 画像の説明⽂ 8
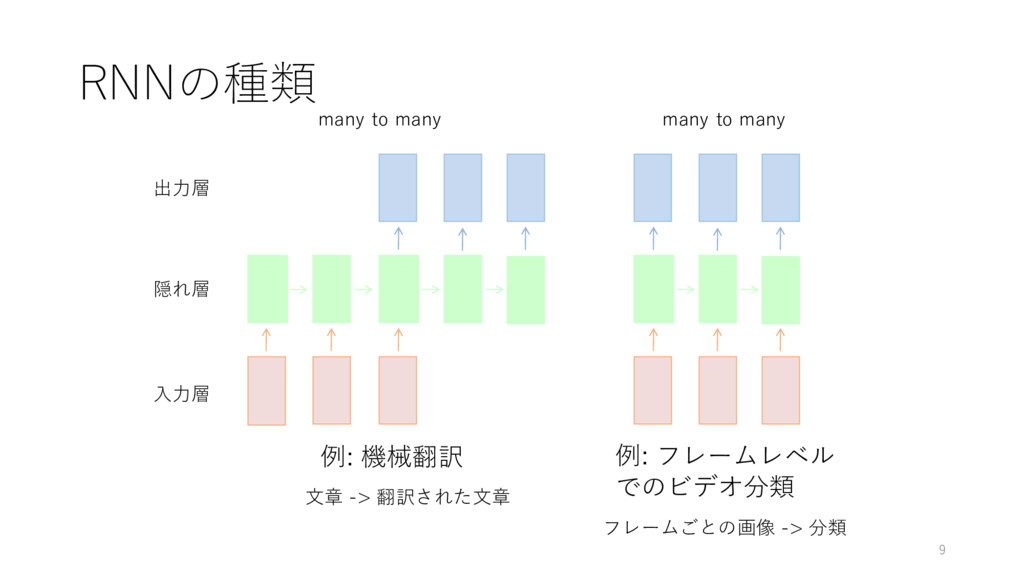
RNNの種類 many to many many to many 出⼒層 隠れ層 ⼊⼒層
例: 機械翻訳 ⽂章 -> 翻訳された⽂章 例: フレームレベル でのビデオ分類 フレームごとの画像 -> 分類 9
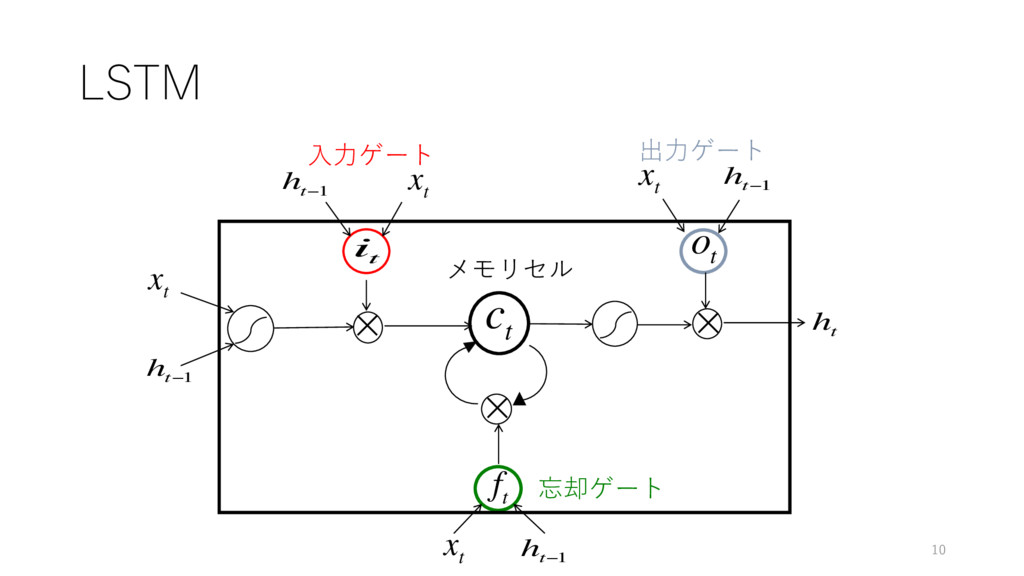
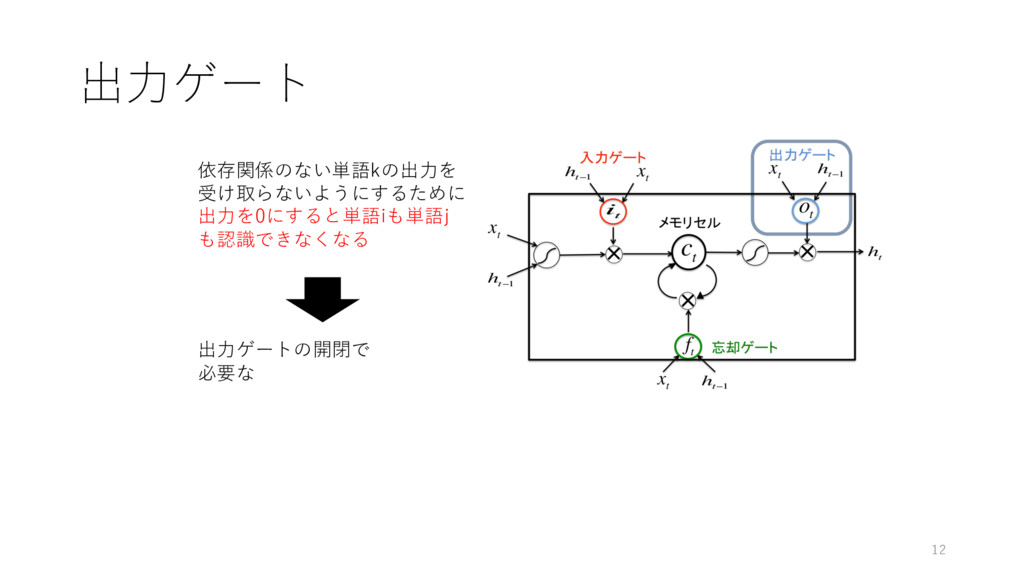
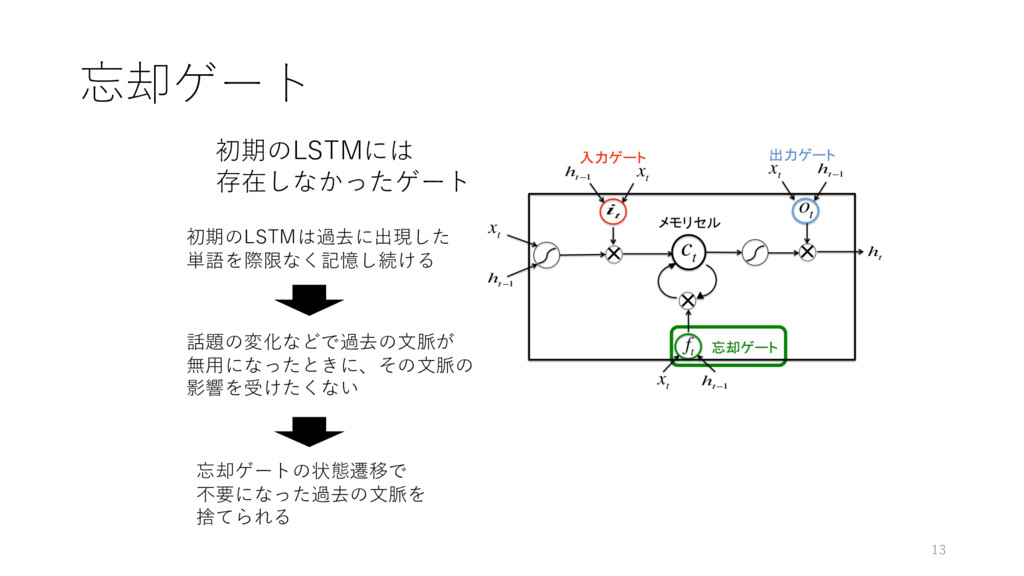
LSTM × × × i t o t c t
f t x t x t x t x t h t h t−1 h t−1 h t−1 h t−1 ⼊⼒ゲート 出⼒ゲート 忘却ゲート メモリセル 10
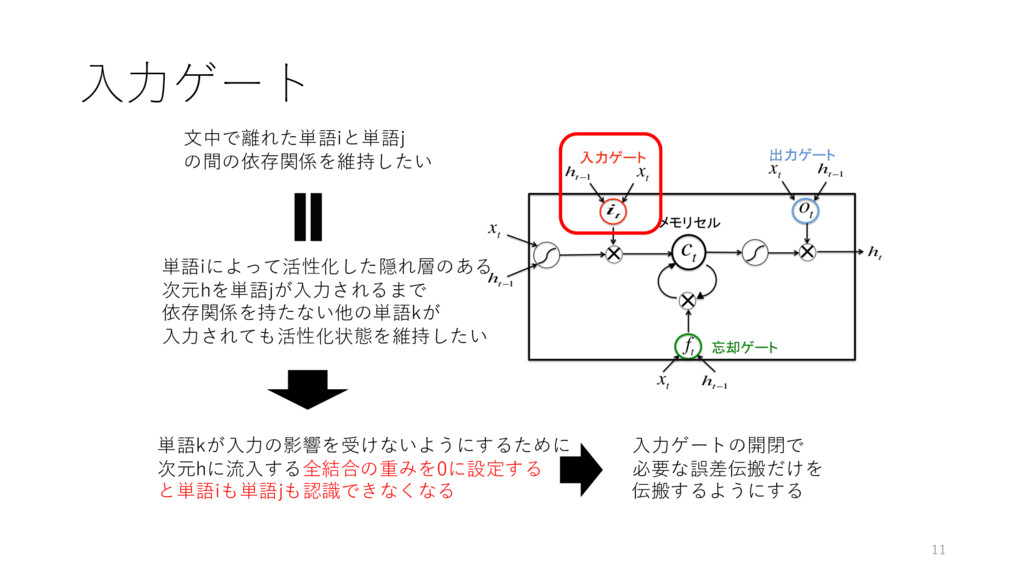
⼊⼒ゲート ⽂中で離れた単語iと単語j の間の依存関係を維持したい 単語iによって活性化した隠れ層のある 次元hを単語jが⼊⼒されるまで 依存関係を持たない他の単語kが ⼊⼒されても活性化状態を維持したい 単語kが⼊⼒の影響を受けないようにするために 次元hに流⼊する全結合の重みを0に設定する と単語iも単語jも認識できなくなる
⼊⼒ゲートの開閉で 必要な誤差伝搬だけを 伝搬するようにする 11
出⼒ゲート 依存関係のない単語kの出⼒を 受け取らないようにするために 出⼒を0にすると単語iも単語j も認識できなくなる 出⼒ゲートの開閉で 必要な 12
忘却ゲート 初期のLSTMには 存在しなかったゲート 話題の変化などで過去の⽂脈が 無⽤になったときに、その⽂脈の 影響を受けたくない 初期のLSTMは過去に出現した 単語を際限なく記憶し続ける 忘却ゲートの状態遷移で 不要になった過去の⽂脈を
捨てられる 13
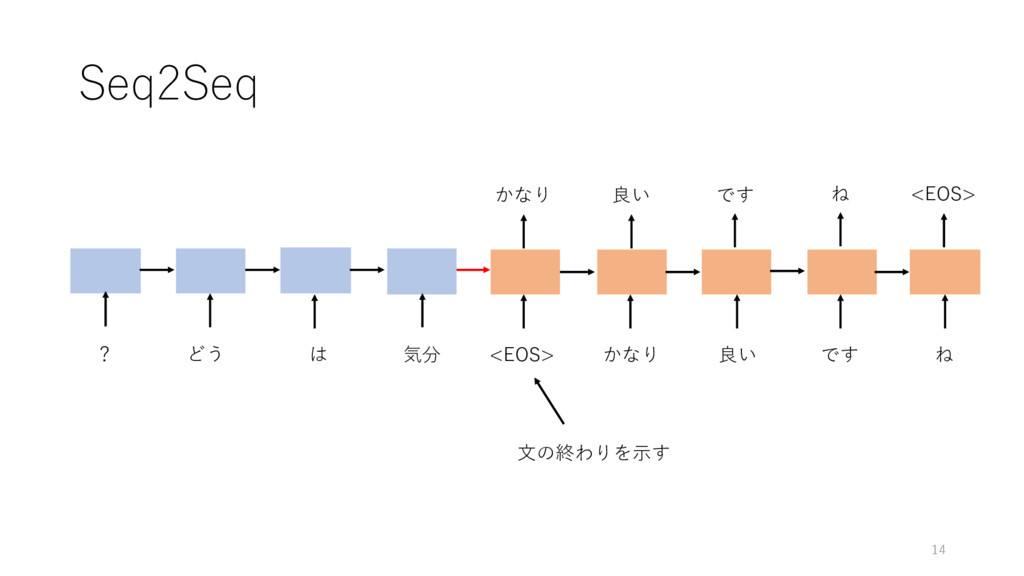
Seq2Seq ? どう は <EOS> かなり 良い です ね かなり
良い です ね <EOS> 14 気分 ⽂の終わりを⽰す
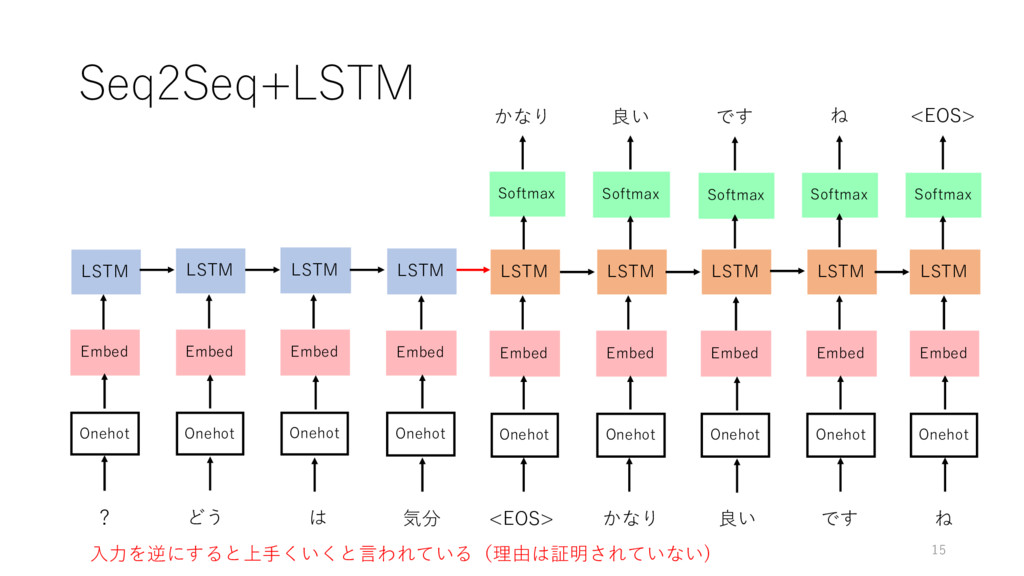
15 LSTM LSTM LSTM LSTM LSTM LSTM LSTM LSTM ?
どう は <EOS> かなり 良い です ね かなり 良い です ね <EOS> LSTM 気分 Embed Embed Embed Embed Embed Embed Embed Embed Embed Seq2Seq+LSTM Onehot Onehot Onehot Onehot Onehot Onehot Onehot Onehot Onehot Softmax Softmax Softmax Softmax Softmax ⼊⼒を逆にすると上⼿くいくと⾔われている(理由は証明されていない)
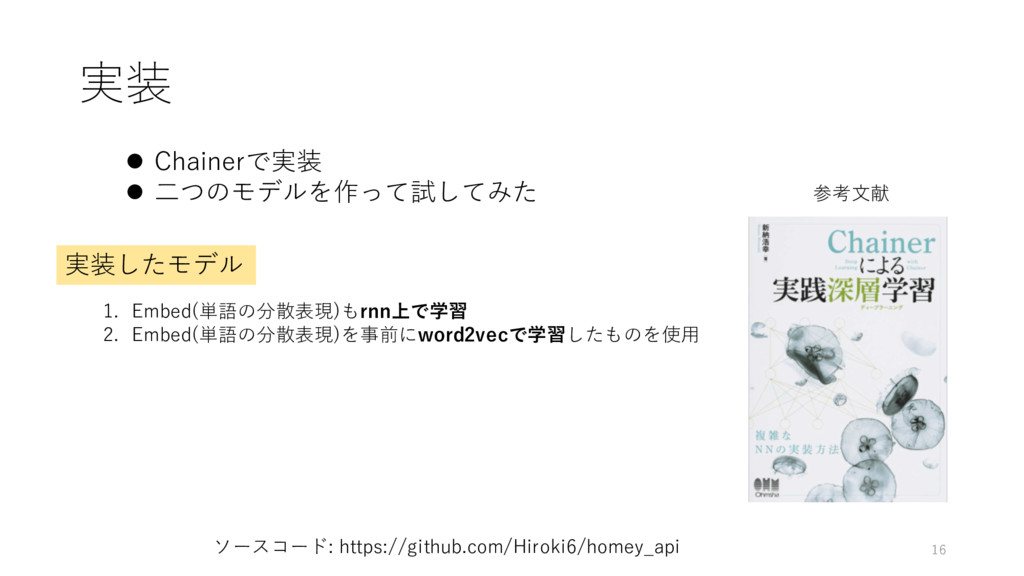
実装 16 l Chainerで実装 l ⼆つのモデルを作って試してみた 1. Embed(単語の分散表現)もrnn上で学習 2. Embed(単語の分散表現)を事前にword2vecで学習したものを使⽤
参考⽂献 ソースコード: https://github.com/Hiroki6/homey_api 実装したモデル
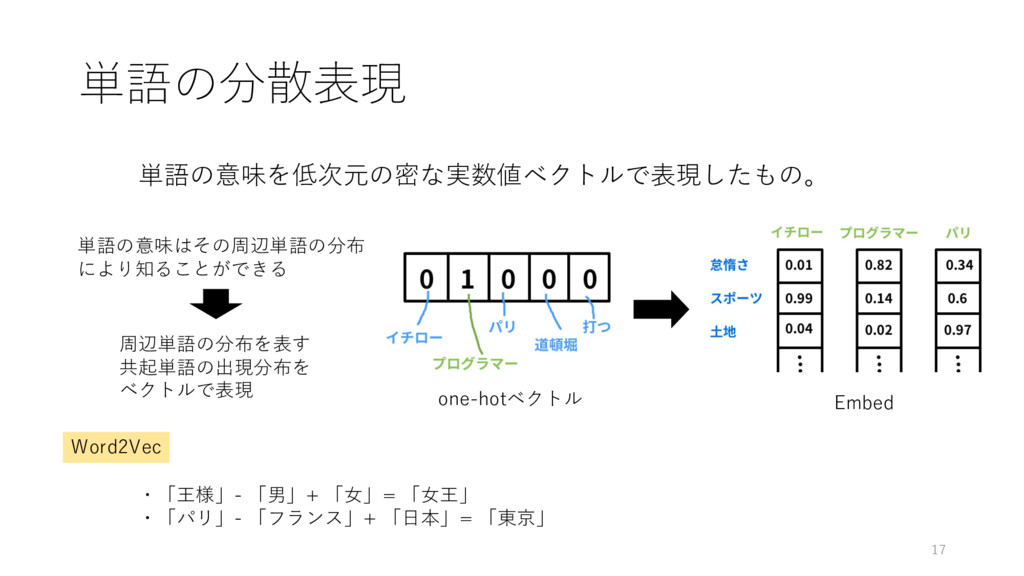
単語の分散表現 17 単語の意味を低次元の密な実数値ベクトルで表現したもの。 Word2Vec ・「王様」- 「男」+ 「⼥」= 「⼥王」 ・「パリ」- 「フランス」+
「⽇本」= 「東京」 one-hotベクトル Embed 単語の意味はその周辺単語の分布 により知ることができる 周辺単語の分布を表す 共起単語の出現分布を ベクトルで表現
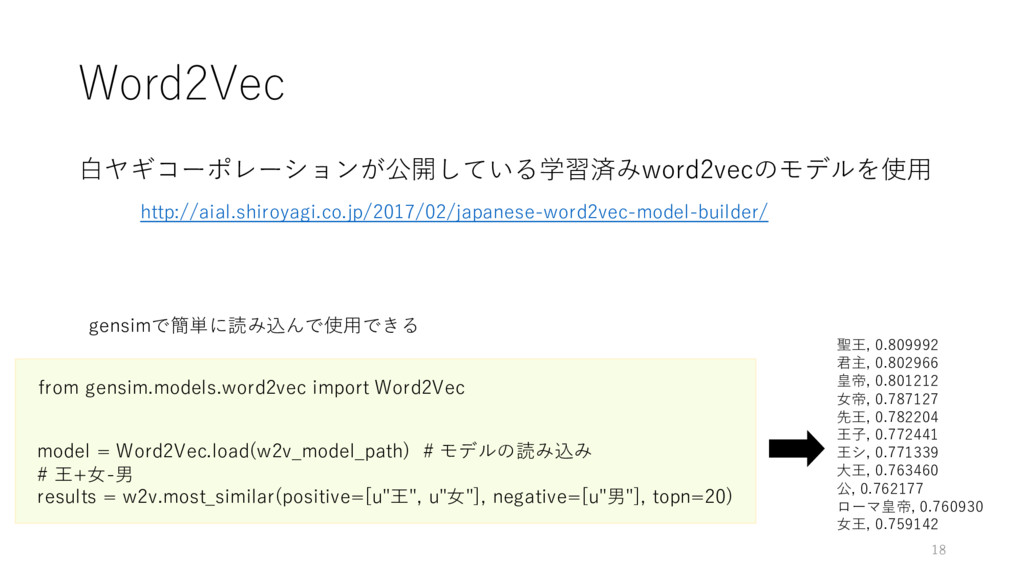
Word2Vec 18 from gensim.models.word2vec import Word2Vec model = Word2Vec.load(w2v_model_path) #
モデルの読み込み # 王+⼥-男 results = w2v.most_similar(positive=[u"王", u"⼥"], negative=[u"男"], topn=20) 聖王, 0.809992 君主, 0.802966 皇帝, 0.801212 ⼥帝, 0.787127 先王, 0.782204 王⼦, 0.772441 王シ, 0.771339 ⼤王, 0.763460 公, 0.762177 ローマ皇帝, 0.760930 ⼥王, 0.759142 ⽩ヤギコーポレーションが公開している学習済みword2vecのモデルを使⽤ http://aial.shiroyagi.co.jp/2017/02/japanese-word2vec-model-builder/ gensimで簡単に読み込んで使⽤できる
学習 19 chainerは簡単にgpu環境で動かせる関数を⽤意している import numpy as np from chainer import
cuda xp = cuda.cupy # npの代わりにxpを使⽤ cuda.get_device(0).use() # 使⽤するGPUを指定 model.to_gpu() # modelを学習するまえにgpu⽤に変換 Ø GPUを使⽤(Tesla) この3⾏を加えるだけ 環境 時間 褒める会話を多く含む11,000対話を100epoch学習 約1週間
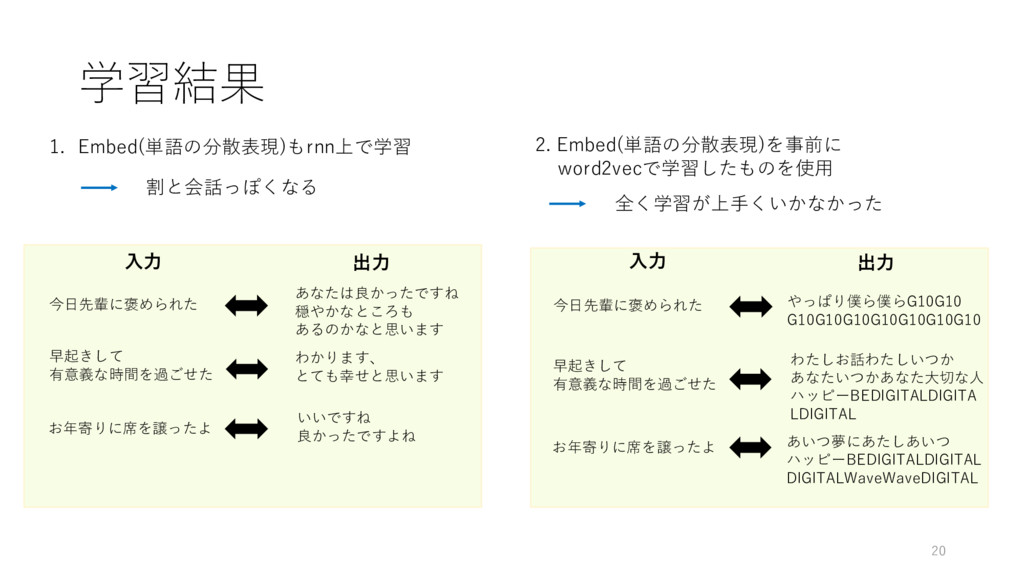
学習結果 20 1. Embed(単語の分散表現)もrnn上で学習 割と会話っぽくなる 全く学習が上⼿くいかなかった ⼊⼒ 出⼒ ⼊⼒ 出⼒
2. Embed(単語の分散表現)を事前に word2vecで学習したものを使⽤ 今⽇先輩に褒められた あなたは良かったですね 穏やかなところも あるのかなと思います やっぱり僕ら僕らG10G10 G10G10G10G10G10G10G10 今⽇先輩に褒められた わかります、 とても幸せと思います 早起きして 有意義な時間を過ごせた 早起きして 有意義な時間を過ごせた わたしお話わたしいつか あなたいつかあなた⼤切な⼈ ハッピーBEDIGITALDIGITA LDIGITAL いいですね 良かったですよね お年寄りに席を譲ったよ お年寄りに席を譲ったよ あいつ夢にあたしあいつ ハッピーBEDIGITALDIGITAL DIGITALWaveWaveDIGITAL
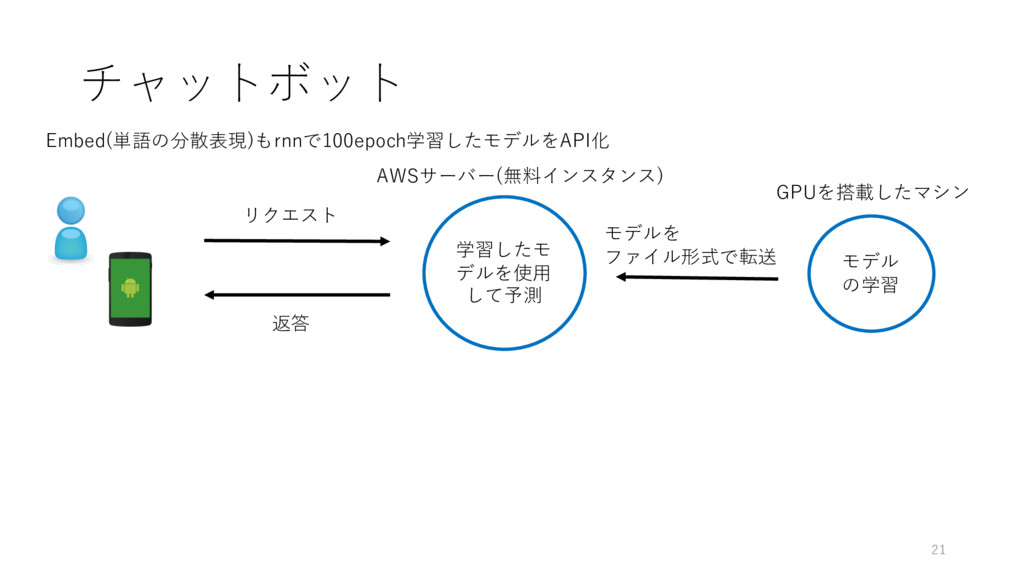
チャットボット 21 GPUを搭載したマシン モデル の学習 AWSサーバー(無料インスタンス) 学習したモ デルを使⽤ して予測 リクエスト
返答 モデルを ファイル形式で転送 Embed(単語の分散表現)もrnnで100epoch学習したモデルをAPI化
まとめ 22 l ディープラーニングはコストが⾼い l ⼤量の学習データ l 計算機(GPUなど) l 研究レベルと実⽤レベルは違う
l 研究だと⽂章っぽくなってても感動する l 実⽤だとちゃんとした⽂章が求められる l ディープラーニングは難しい l 細かいチューニング l パラメータが多い l 計算コスト l どの部分が有効かがわかりにくい


 hiroki6
 neohsu
 nagix
 legalontechnologies
 katayamatg
 sh_fk2
 zozotech
 oikon48
 yappli_developers
 hisuzuya
 asmz
 kinunori
 yama3133
 tammyeverts
 chrisshort
 badams
 rabernat
 raygrieselhuber
 reverentgeek
 shlominoach
 davidcarrasco
 skoyamalab
 ipullrank
 stuffmc